Kimi K3.1 Pro 开放权重跑评论分类:多少条才回本
K3.1 Pro 权重 1.56 TB,最低 8 卡 B300。按 1,130 条真实评论算:低推理档一次跑 13.2 万条以上,竞价租卡才比 API 省。
月之暗面在 2026 年 10 月 23 日上线 Kimi K3.1 Pro,11 月 4 日把权重放到 Hugging Face:2.8T 总参数、每个 token 激活 104B、上下文 1,048,576 个 token,权重文件 96 个分片合计 1,561.3 GB。拿它给应用商店评论打标签,自己租卡部署和直接调官方 API 哪个便宜、分界线在哪:2026 年 11 月 14 日 00:19 到 00:23(新加坡时间),我们用 EveryInfra 接口拉了 Duolingo 在 App Store 三个区、Google Play 两种语言、Trustpilot 和小红书的 1,130 条评论,再用 K3.1 Pro 模型仓库里自带的分词器逐条数 token。结果是:评论很短,中位数只有 7 到 77 个 token,给每条评论回一段标签 JSON 却要 33.8 个 token,模型费里约八成花在输出上;按公开的竞价租卡价和第三方实测吞吐,在低推理档(每批 20 条评论思考 200 个 token)下,一次跑 131,595 条以上,自部署才比标准 API 便宜,比 Batch 接口便宜要到 569,464 条;中、高推理档的这条线是 94,773 条和 60,767 条。本机没有 GPU,模型一侧的命令、提示词和脚本都是配置示例,模型的分类结果没有实测;实测的是数据接口、分词器,以及逐条读过原文的 51 条关键词命中。


Kimi K3.1 Pro 开放权重放出了什么:日期、许可证、参数和上下文
托管服务和权重是分两步放出的。Kimi 的技术博客写的是 2026 年 10 月 23 日在 kimi.ai、App 和开放平台上线 K3.1 Pro,同时上线速度快 2 到 3 倍的 K3.1 Pro Highspeed。权重仓库 moonshotai/Kimi-K3.1-Pro 按 Hugging Face 公开接口的记录是 11 月 2 日建、11 月 4 日公开、11 月 5 日最后一次提交(提交说明是更新 encoding_k3.py);我们在 11 月 14 日 00:15(新加坡时间)读取时,仓库有 112 个文件,其中 96 个 safetensors 分片合计 1,561.3 GB,累计下载 40,953 次、点赞 2,003 个。
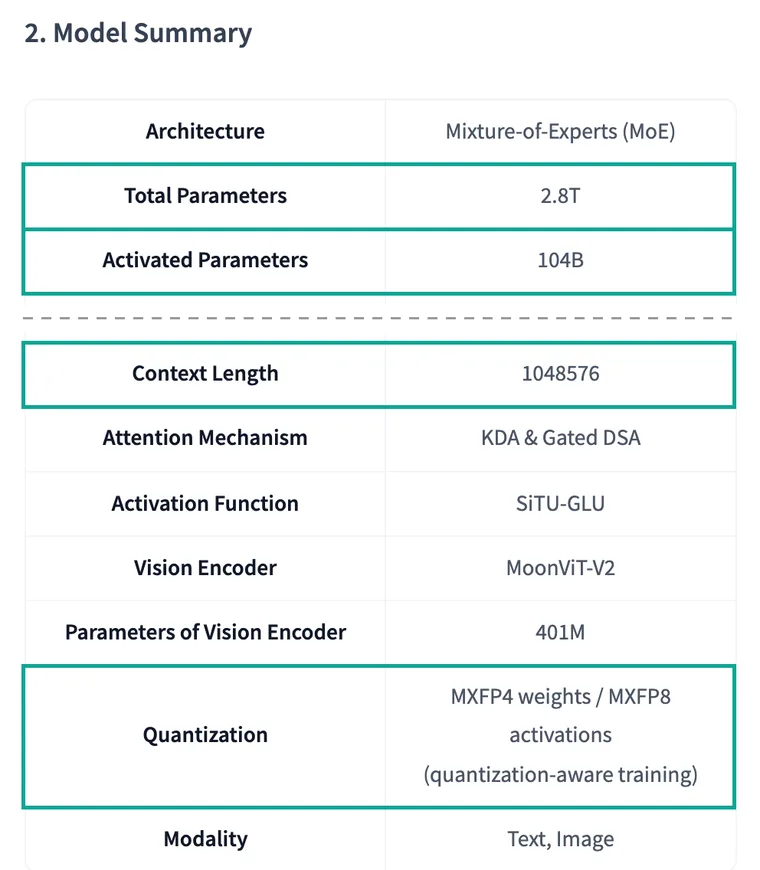
参数以模型卡和 config.json 为准:MoE 结构,总参数 2.8T,每个 token 激活 104B;93 层里 69 层是 Kimi Delta Attention,24 层是带门控的稀疏注意力;每层 896 个路由专家选 16 个,另有 2 个共享专家;词表 163,840;上下文 1,048,576 个 token;带一个 4.01 亿参数的 MoonViT-V2 视觉编码器,能读图。权重本身就是 MXFP4(激活用 MXFP8),训练时就按这个精度做了量化感知训练,所以官方仓库没有更大的 BF16 原版。MXFP4 这一类「微缩放」格式的定义见 OCP MX 规范的论文,NVIDIA 自家的 NVFP4 格式说明见它的开发者博客。
许可证文件叫 Kimi K3.1-Pro License(原文),主体照 MIT 协议,另加两条门槛:一是把模型做成对外的「模型即服务」生意、过去 12 个月收入超过 2,000 万美元的,要另签协议;二是月活超过 1 亿或月收入超过 2,000 万美元的产品,要在界面上显著标出「Kimi K3.1-Pro」。这两条门槛针对的是对外提供模型服务和超大产品;你的用途是否落在门槛内,以 LICENSE 原文和法务意见为准。
| 项目 | Kimi K3.1 Pro 的原文 | 出处 |
|---|---|---|
| 托管上线 | 2026-10-23,另有 K3.1 Pro Highspeed | Kimi 技术博客 |
| 权重公开 | 2026-11-04(仓库 11-02 建,11-05 最后提交) | Hugging Face 接口 |
| 参数 | 2.8T 总参数,104B 激活,93 层,896 专家选 16 加 2 个共享 | 模型卡、config.json |
| 上下文 | 1,048,576 token,文本加图片输入 | 模型卡 |
| 精度与大小 | MXFP4 权重 / MXFP8 激活,96 个分片 1,561.3 GB | 文件列表 |
| 许可证 | 类 MIT,加收入和月活两条门槛 | LICENSE |
| 推荐引擎 | vLLM、SGLang、TokenSpeed | 模型卡 |
| 最低 NVIDIA 配置 | 一组 TP8:一台 8 卡 B300 或两盘 GB300 | vLLM 使用说明 |
| 官方 API 价 | 每百万 token 输入 $2.00、输出 $10.00、缓存命中 $0.20 | Kimi 定价页 |
外部评测方面,Artificial Analysis 在发布后的测评里给 K3.1 Pro 的智能指数打了 55 分,排在第 4。托管入口也在变多:AWS 在 2026 年 11 月 10 日(美国太平洋时间)发文说 Bedrock 上可以调 K3.1 Pro。对评论分类,要看的是价格、吞吐和输出能不能稳定解析。
工具调用和结构化输出:XTML 标签、kimi_k3 解析器
K3.1 Pro 在模型这一层用自己的一套标签表示思考、回答和工具调用,编码规则写在仓库的 encoding_k3.py 里:<|open|>、<|close|>、<|sep|> 包住 think、response、tools、call、argument 这些段,一轮结束用 <|end_of_msg|>。自己部署时不用手写这些标签,vLLM 和 SGLang 都带了对应的解析器:vLLM 的 kimi_k3_tool_parser.py 和 kimi_k3_reasoning_parser.py,SGLang 的 kimik3_detector.py。启动时加 --tool-call-parser kimi_k3 --reasoning-parser kimi_k3 --enable-auto-tool-choice,返回就是 OpenAI 格式的 tool_calls 和单独的 reasoning_content。
有一处要留意:vLLM 通用的工具调用文档和 SGLang 的解析器列表,我们 11 月 14 日读的时候表里还只写到 Kimi K2 的 kimi_k2。照着通用文档配,会用错解析器,模型吐出的标签就原样留在正文里。K3.1 Pro 要以 vLLM 的模型使用说明和 SGLang 的 cookbook 为准。vLLM 这个解析器的提交记录显示,11 月 4 日刚合并过一次「流式工具调用改成增量扫描」的性能修改,版本太旧的镜像最好先升级。
官方 API 一侧的规则写在 K3.1 Pro 快速上手里,有四条和打标签直接相关。第一,模型一直会先思考,reasoning_effort 只能在 low、high、max 三档里选,默认 max(推理强度说明);分类用 low 就够,档位越高,输出里的思考 token 越多,钱也越多。第二,采样参数固定为 temperature 1.0、top_p 0.95,改了也不生效,所以同一条评论跑两次可能拿到不同标签。第三,结构化输出支持 response_format 的 json_schema,strict 设成 true 时按 schema 约束输出(结构化输出说明),解析时只读 content,不要去解析 reasoning_content。第四,多轮工具调用时,要把上一轮完整的 assistant 消息原样带回去,包括 reasoning_content 和 tool_calls,少了任何一样,下一轮可能报错或者答非所问。自部署时,vLLM 的结构化输出和推理输出文档讲的是同一套参数。
还有一个在 BL-67 里核过的点:Kimi 的三个托管接口都不接受远程 MCP 服务器。自部署的 vLLM 也一样,模型只负责发出调用,执行要靠你自己的代码。所以下文的工具定义,是给「让模型自己决定什么时候去拉评论」的交互式用法准备的;批量打标签时,先在模型外面把评论拉好再交给模型,更省钱:少走一轮请求,也少带一份工具定义。
kimi k3.1 pro local:本地到底要多大的机器
YouTube 上搜「kimi k3.1 pro open weights」,搜索结果里第 5 条视频(11 月 6 日发布)标题说 K3.1 把旗舰级模型「免费送了出来」,字幕里只说下载免费、只花电费,没有算过要什么硬件。它评论区里的抱怨就具体多了:有人说在家跑要上百万美元,对比三年订阅只要 $7,200;有人说要 2 TB 显存。Reddit 的 LocalLLaMA 版块讨论权重公开时,也有人算过用 4 台 512 GB 内存的 Mac Studio 拼起来约 $89,200。这些说法差得很远,我们按文件大小和官方文档核了一遍。
官方路线只有数据中心级的卡。vLLM 的使用说明把一组 8 卡张量并行写成 NVIDIA 上最简单的可用配置,也就是一台 8 卡 B300,或者两盘 GB300;AMD 是一台 8 卡 MI355X;Google TPU 是 16 颗 v7x 芯片。SGLang 的 cookbook 给的「均衡」配置里,B200 要 TP16(两台 8 卡),H200 要 TP16 加 EP16,H100 要 TP32 加 EP32,也就是四台 8 卡 H100。权重 1,561.3 GB 放进显存之后还要留 KV 缓存,vLLM 的说明里写,8 卡 B300 在 TP8、FP8 KV 下能放约 260 万个 token 的 KV 缓存。NVIDIA 在 11 月 11 日放出的 NVFP4 版面向 Blackwell,文件合计 1,605.2 GB,比官方版还大一点,换它不是为了省显存。
「本地」这条路在 11 月第二周有了进展。llama.cpp 在 11 月 6 日合并了 K3.1 Pro 文本模型的支持,提交说明里写测过 MXFP4 转换和一个 2 到 3 bit 的量化档;11 月 10 日又合并了视觉部分。社区随后在 Hugging Face 上传了 GGUF 量化版,我们 11 月 14 日 00:47(新加坡时间)用 Hugging Face 的模型搜索接口把几个下载量靠前的仓库文件大小加了一遍:最小的 IQ1_S 档约 580 到 593 GB,IQ2_XXS 约 710 GB,Q2_K 约 1,009 GB,MXFP4_MOE 约 1,509 GB。搜索结果里还有几个名字写着「12GB」的仓库,参数量摆在那里,这类仓库不要碰。Reddit 的 unsloth 版块有人问过什么时候出 K3.1 的量化,写稿时官方账号下还没有正式的 GGUF。
| 部署方式 | 文件大小 | 需要的机器 | 能不能跑评论分类 |
|---|---|---|---|
| 官方 MXFP4,vLLM / SGLang | 1,561.3 GB | 8 卡 B300、两盘 GB300、8 卡 MI355X 或 16 颗 TPU v7x | 能,官方路线,工具调用和结构化输出都有解析器 |
| NVIDIA NVFP4 | 1,605.2 GB | Blackwell 一组 TP8 | 能,面向 Blackwell 的推理内核 |
| 社区 GGUF IQ1_S | 约 580–593 GB | 内存加显存合计超过 600 GB 的多机 | 1-bit 档,质量和工具调用没有公开评测 |
| 社区 GGUF Q2_K | 约 1,009 GB | 两台以上 512 GB 内存的机器 | 同上,速度取决于内存带宽 |
| 官方 API / Batch | 不用下载 | 不需要 | 能,按 token 付费 |
对评论分类来说,显存的压力主要来自权重,KV 缓存几乎用不满。按我们的批次,一次请求的输入约 1,500 个 token,加上输出和思考也就两三千个,64 个并发同时在跑也不到 20 万个 token,离 8 卡 B300 在 TP8 下能放的约 260 万个 token 还远。Spheron 在同样配置下的实测记录是每张卡用掉 275,040 MiB 里的 248,210 MiB,其中 34.74 GiB 留给 KV 缓存,整机能放 2,151,492 个 token,比使用说明写的少一些,对评论分类仍然宽裕:低档一个请求约 2,344 个 token(输入 1,469、输出 875),64 个并发合计约 15 万个。所以评论分类用不上长上下文的那些并行方案,最简单的 TP8 就够;要提速,靠的是开足并发。官方 API 那边,K3.1 Pro Highspeed 的价格是标准版的两倍(每百万 token 输入 $4、输出 $20),批量打标签不赶时间,用标准版或 Batch 就行。
家用电脑和单台工作站都放不下 K3.1 Pro:最小的 1-bit 量化也比一台 512 GB 的 Mac Studio 大。能「自己部署」的,是租一台 8 卡 B300 这类云节点,或者公司本来就有这样的机房。下面的成本账也按租卡来算。
数据从哪里来:三家海外评论和一个中文平台
评论来自 EveryInfra 的四项能力:App Store 评论、Google Play 评论、Trustpilot 评论和小红书评论。请求都发到同一个地址 POST https://api.everyinfra.com/api/v1/social,用 platform 和 action 指定能力,Key 放在请求头里,接法见快速上手。我们选 Duolingo 做样本,因为它在中美墨三地的应用商店和 Trustpilot 都有大量公开评论,小红书上也有专门的避雷笔记,中外用户抱怨的东西可以放在一起比。
各平台官方也有读评论的接口,但只读你自己的应用:Apple 的 App Store Connect API 要开发者账号的密钥;Google Play 的 Reply to Reviews API 要服务账号授权,读取每小时限 200 次,而且只返回带文字的评论;Trustpilot 的 Business Units API 也是给商家看自家店铺的。要看竞品,或者把几个平台的公开评论放进同一张表,用按次付费的接口更方便。各能力的参数和单价以当天目录为准:App Store、Google Play、Trustpilot、小红书。
# 拉 Duolingo 中国区 App Store 最新 200 条评论;Key 只从环境变量读
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform": "app_store", "action": "reviews",
       "params": {"app_id": "570060128", "country": "cn", "sort": "newest", "limit": 200}}'
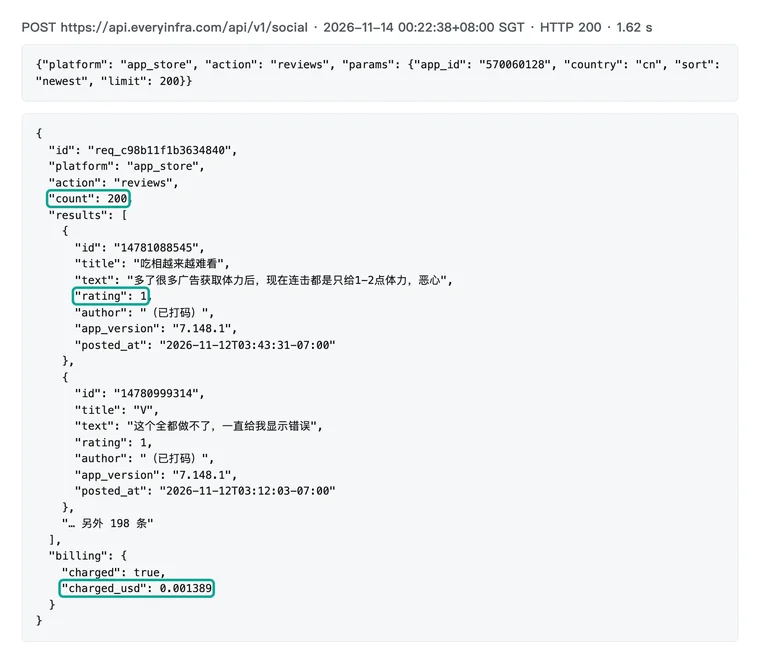
第一轮在 11 月 14 日 00:19 到 00:23(新加坡时间)跑完,下表 9 次调用合计扣费 $0.025002;Trustpilot 中途返回过 429,没扣费,重试后成功。App Store、Google Play、Trustpilot 每次调用的价格都是 $0.001389,本次 App Store 和 Google Play 每次返回 200 条,Trustpilot 返回 100 条;小红书评论每次 $0.005556,本次每页返回 15 条。
| 时刻(新加坡时间) | 能力 | 对象 | 条数 | 耗时 | 扣费 |
|---|---|---|---|---|---|
| 00:19 | app_store/reviews | 美区,最新 | 200 | 1.87 秒 | $0.001389 |
| 00:19 | google_play/reviews | 英文,最新 | 200 | 6.81 秒 | $0.001389 |
| 00:21 | xiaohongshu/search | 「多邻国」笔记搜索 | 一页 | 2.41 秒 | $0.005556 |
| 00:21 | xiaohongshu/comments | 一篇避雷笔记,按点赞排序,第 1 页 | 15 | 2.56 秒 | $0.005556 |
| 00:21 | trustpilot/reviews | duolingo.com,最新 | 100 | 18.67 秒 | $0.001389 |
| 00:22 | xiaohongshu/comments | 同一篇笔记,第 2 页 | 15 | 2.22 秒 | $0.005556 |
| 00:22 | app_store/reviews | 中国区,最新 | 200 | 1.62 秒 | $0.001389 |
| 00:22 | app_store/reviews | 墨西哥区,最新 | 200 | 1.58 秒 | $0.001389 |
| 00:23 | google_play/reviews | 西语,最新 | 200 | 9.30 秒 | $0.001389 |
每个应用商店区的评论速度差别很大,这决定了多久拉一次。我们用每批 200 条最新评论里最早和最晚的发布时间推算:Google Play 英文 200 条只覆盖 3.21 小时,折合每天约 1,493 条;Google Play 西语 12.14 小时,每天约 395 条;App Store 美区 17.88 小时,每天约 269 条;中国区 74.02 小时,每天约 65 条;墨西哥区 158.08 小时,每天约 30 条。Google Play 英文要每两三个小时拉一次才不漏,墨西哥区一天拉一次都绰绰有余。
四个平台的字段差别和入库表怎么设计
四个平台返回的字段不完全一样,入库前要先对齐。App Store 评论有 id、标题、正文、星级、作者、应用版本、「有帮助」次数和发布时间;Google Play 没有标题,星级字段叫 score,另有点赞数和应用版本;Trustpilot 多了评论语言、国家、是否经过验证和「体验发生时间」,标题常常是正文的前半句加省略号;小红书评论没有星级,有点赞数、回复数和所属笔记的 id。给模型的输入只需要 id、星级和正文三项,星级缺失时填空值,提示词里不用特别说明。应用版本字段可以和标签一起看,某个版本发布后 bug 类标签突然变多,往往比星级下降来得早。
一条评论有多少 token:用 K3.1 Pro 自带的分词器量
算模型费之前先要知道 token 数。按字数估 token 只是粗估,K3.1 Pro 的仓库里有它自己的分词器文件 tiktoken.model 和切词规则 tokenization_kimi.py,我们用 tiktoken(PyPI 包)加载这两样,对 1,130 条评论的「标题加正文」逐条计数。这一步不需要 GPU,跑一遍不到一秒。
Google Play 英文评论中位数只有 7 个 token,90% 分位 26 个;App Store 美区中位 27.5 个,90% 分位 86 个;中国区中位 15 个;墨西哥区中位 26 个;Trustpilot 最长,中位 77 个、90% 分位 179 个,因为它的用户多是来投诉的,写得长;小红书评论中位只有 10 个 token。英文平均每个 token 约 4.12 个字符,中文 App Store 评论每个 token 约 1.76 个字符,小红书评论约 1.54 个,中文同样字数要多花两倍多的 token。
| 来源 | 条数 | token 中位数 | 90% 分位 | 每 token 字符数 | 每千条取数费 |
|---|---|---|---|---|---|
| App Store 美区 | 200 | 27.5 | 86 | 4.12 | $0.0069 |
| App Store 中国区 | 200 | 15 | 40 | 1.76 | $0.0069 |
| App Store 墨西哥区 | 200 | 26 | 77 | 3.11 | $0.0069 |
| Google Play 英文 | 200 | 7 | 26 | — | $0.0069 |
| Google Play 西语 | 200 | 11.5 | 39 | — | $0.0069 |
| Trustpilot | 100 | 77 | 179 | — | $0.0139 |
| 小红书评论 | 30 | 10 | 24 | 1.54 | $0.3704 |
把评论装进请求后再算一遍。按每次 20 条一批、只放 id、星级和正文三项,用户消息平均每条评论 54.15 个 token;系统提示词 223 个、JSON schema 163 个,合计每次请求固定多出 386 个 token。模型回的标签 JSON,每条评论平均 33.76 个 token,比 Google Play 英文评论本身还长。所以模型费里输出占大头,和 BL-116 用 DeepSeek V4.1 Flash 真跑出来的结论方向一致。
分类提示词、结构化输出和工具定义
标签集按 Duolingo 评论里实际出现的问题定了 8 个:扣费(billing)、广告(ads)、付费压力(pressure,能量、宝石、连胜、排行榜和催你付费的弹窗)、内容质量(content)、AI 生成内容(ai)、故障(bug)、纯好评(praise)、其他(other)。每条评论给一个主标签、最多两个副标签、一个情绪值和一个「要不要人工回复」。提示词用英文写,因为输入里有英、西、中三种语言,标签名保持英文便于入库;输出不复述评论原文,省 token,也少一层泄露用户原话的风险。
You label app-store and community reviews for a product team.
For every review in the user message, return one object in "items", in the same order.
Use only these labels:
- billing: charges, renewals, refunds, free trials that turned into payments, subscription plans and their price
- ads: advertising inside the product
- pressure: energy, hearts, gems, streaks, leaderboards, upsell screens or notifications that push the user to pay or come back
- content: course or content quality, accuracy, missing languages or levels
- ai: features or content that the reviewer says is made by AI
- bug: crashes, freezes, login, sync, lost progress, performance
- praise: positive review with no specific problem
- other: anything else
Pick one primary label and up to two secondary labels.
sentiment: -1 negative, 0 mixed or neutral, 1 positive.
reply_needed: true only when the reviewer reports money lost, data lost, or a blocked account.
Copy the review id exactly. Do not translate or quote the review text.
输出格式用 response_format 的严格 JSON schema 约束。枚举把标签限定在 8 个以内,模型就没法自创「subscription_issue」这类新标签;additionalProperties: false 防止多出字段。官方 API 和 vLLM 都支持这一写法,见 Kimi 的结构化输出说明和 OpenAI 的函数调用文档。
{
  "type": "json_schema",
  "json_schema": {
    "name": "review_labels",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["items"],
      "properties": {
        "items": {
          "type": "array",
          "items": {
            "type": "object",
            "additionalProperties": false,
            "required": ["id", "primary", "secondary", "sentiment", "reply_needed"],
            "properties": {
              "id": {"type": "string"},
              "primary": {"type": "string", "enum": ["billing", "ads", "pressure", "content", "ai", "bug", "praise", "other"]},
              "secondary": {"type": "array", "maxItems": 2, "items": {"type": "string", "enum": ["billing", "ads", "pressure", "content", "ai", "bug", "praise", "other"]}},
              "sentiment": {"type": "integer", "enum": [-1, 0, 1]},
              "reply_needed": {"type": "boolean"}
            }
          }
        }
      }
    }
  }
}
如果你要的是交互式用法,比如在内部聊天工具里问「这周 Duolingo 美区差评都在说什么」,就给模型一个工具,让它自己决定去拉哪个平台、哪个区。工具定义按 OpenAI 函数格式写,limit 写成 integer 并给出上下限,source 用枚举,免得模型把整数写成字符串,或者编出一个不存在的平台名。这段定义按 K3.1 Pro 分词器计是 203 个 token,每一轮请求都会带上。
{
  "type": "function",
  "function": {
    "name": "fetch_reviews",
    "description": "Fetch the newest public reviews of one app or company from EveryInfra. Returns a JSON list with id, rating, text, posted_at. Billed per call by EveryInfra; failed or empty calls are not billed.",
    "parameters": {
      "type": "object",
      "additionalProperties": false,
      "required": ["source", "target"],
      "properties": {
        "source": {"type": "string", "enum": ["app_store", "google_play", "trustpilot"], "description": "Where the reviews come from."},
        "target": {"type": "string", "description": "App Store numeric id, Google Play package name, or company domain for Trustpilot."},
        "country": {"type": "string", "description": "Two-letter store country for app_store, for example us, cn, mx."},
        "language": {"type": "string", "description": "Two-letter review language for google_play and trustpilot."},
        "limit": {"type": "integer", "minimum": 1, "maximum": 200, "description": "Number of reviews."}
      }
    }
  }
}
批量打标签不用这个工具。每批 20 条评论如果改成让模型先发一次调用、你执行完再交回,同一批评论要多走一轮请求,多带 203 个 token 的工具定义,还要多一轮思考输出。模型在这一步做的判断(拉哪个平台、多少条)你在代码里早就定好了,交给模型只会多花钱、多出错。
关键词规则靠不住的地方:逐条读了 51 条命中
打标签之前先跑一遍关键词规则,花不了几分钱,可以拿来估规模。我们用一条覆盖中英西三种语言的扣费关键词规则(subscri、charg、refund、trial、扣、退款、续费、会员、试用、suscrip、cobr、reembols 等)跑了一遍:Google Play 英文 200 条里只命中 2 条(1.0%),西语 5 条,App Store 墨西哥区 7 条,美区 19 条,中国区 25 条;Trustpilot 100 条里命中 46 条,小红书那篇避雷笔记下的 30 条评论命中 15 条。Trustpilot 87% 是 1 到 2 星,那里本来就是去投诉的地方。
命中数不等于扣费投诉数。我们把美区、中国区和墨西哥区的 51 条命中逐条读了原文,再按下表四类归类,归类没有经过第二人复核。样本边界:这是三个区各自最新 200 条评论里的关键词命中,11 月 14 日拉取一次,美区 19 条、中国区 25 条、墨西哥区 7 条,评论编号存在原始记录里;下面的比例只说明这一批。美区 19 条里,只有 4 条在说扣费、退款或试用到期自动续费,例如一条写升级到 Max 之后每月多扣 $135;8 条说的是能量、宝石这些让人付费的设计,算付费压力;另外 7 条和扣费无关,「battery charge thing」指的是 App 里的能量条,「get the money」是用户攒钱想去法国。中国区 25 条里 14 条是扣费投诉,其中「738 元」出现了 3 次,另有 2 条写「七百多」「700 多」,都说试用期结束没收到提醒就被扣了年费;还有一条「经验宝也扣住不发」是故障,被「扣」字误抓。墨西哥区 7 条里没有一条是扣费投诉,「prueba Duolingo ya」是叫人试试看,其余 6 条在说价格贵或者能量收费。
| 区 | 关键词命中 | 读后判为扣费投诉 | 付费压力或嫌贵 | 无关或误抓 |
|---|---|---|---|---|
| App Store 美区 | 19 | 4 | 8 | 7 |
| App Store 中国区 | 25 | 14 | 4 | 7 |
| App Store 墨西哥区 | 7 | 0 | 6 | 1 |
在这 51 条里,关键词在美区的命中只有约 21%(4/19)是真扣费投诉,在中国区约 56%(14/25)。如果只靠关键词往客服推「扣费」工单,美区的客服会被大量误报淹没;中国区的扣费投诉又高度集中,同一个金额反复出现,用 reply_needed 单独拎出来更合适。模型打标签要解决的就是这种语义上的区分,它的准确率要拿你自己的人工样本去量:先人工标 200 条,模型跑两遍,看两遍之间、模型和人工之间各有多少条一致。K3.1 Pro 的 temperature 固定为 1.0,两遍不一致的比例是必须量的数。
这批数据还给出一个省钱的办法:只把 1 到 3 星的评论送去打标签。上面读出的 18 条扣费投诉(美区 4 条、中国区 14 条)全是 1 到 3 星,其中 17 条是 1 星。低星评论也更长:用 K3.1 Pro 分词器数,美区 1 到 3 星评论的 token 中位数是 54,4 到 5 星是 23;Google Play 西语分别是 43 和 11;中国区是 20.5 和 11。美区 200 条里 1 到 3 星有 50 条,占 25%,正文 token 却占 45.6%。按低档算,每批的思考 token、固定提示词和标签 JSON 跟着条数走,乘 25%;评论正文的输入费跟着 token 走,最多乘 45.6%;两项相加,美区每千条原始评论的模型费从 $0.5498 降到 $0.16 以下。代价是 4 到 5 星里的问题看不到了:美区 8 条付费压力类命中里有 2 条是 4 星和 5 星;西语 Google Play 还有一条 4 星评论在说免费试用一周后被扣费。这条过滤规则也只在这一批里验证过,换应用、换时间段要重新抽查。
| 来源 | 1 到 3 星条数 | 占条数 | 占正文 token | token 中位数(1–3 星) | token 中位数(4–5 星) |
|---|---|---|---|---|---|
| App Store 美区 | 50 / 200 | 25.0% | 45.6% | 54 | 23 |
| App Store 中国区 | 76 / 200 | 38.0% | 52.1% | 20.5 | 11 |
| App Store 墨西哥区 | 35 / 200 | 17.5% | 28.7% | 46 | 23 |
| Google Play 英文 | 25 / 200 | 12.5% | 14.6% | 11 | 7 |
| Google Play 西语 | 12 / 200 | 6.0% | 19.5% | 43 | 11 |
| Trustpilot | 96 / 100 | 96.0% | 98.5% | 77.5 | 21.5 |
表里的 token 按 K3.1 Pro 分词器数「标题加正文」。Google Play 西语的低星只占 6%,正文 token 却占近两成,按星级过滤在那里省得最多;Trustpilot 100 条里 96 条是 1 到 3 星,这一招在那里省不了钱。
中外对照:同一个应用,三个区和小红书在抱怨什么
同样是 Duolingo,三个区的低星评论说的事情差别很大。美区 200 条里 19.5% 是 1 到 2 星,抱怨集中在能量机制:每做一课要消耗能量,用完就得等、看广告或者付费,评论里反复出现「pay to win」「everything costs energy」,还有几条说课程越来越依赖 AI 生成、发音不准。中国区 200 条里 24.5% 是低星,最多的是试用期结束自动扣年费,金额写得很具体:738 元出现 3 次,另有 958 元、219 元,还有人说扣的是花呗。墨西哥区 200 条里低星只占 10.5%,几条 3 星评论在说宝石和能量收费、万圣节服装碎片总是重复,没有人写被错扣了钱。
小红书那篇「多邻国避雷」笔记下,我们按点赞排序取了两页 30 条评论,发布时间从 2025 年 9 月 27 日到 2026 年 6 月 11 日,比应用商店的评论老得多,适合定性看,不适合算比例。点赞最多的一条(86 个赞)只有一句:试用开完当场就要记得关。其余评论大致分成两半:一半在说自己也被扣了,金额有 588 元、798 元、「七百多」,有人说找苹果客服退回来了,有人说申请退款没有回音;另一半是在找人「拼会员」,家庭套餐还剩三四个位置,或者说在二手和电商平台上二三十元就能买到一年。后一类在 App Store 评论里一条都没有,我们的 8 个标签也装不下它,只能落到 other。
同一套标签用到中文社区,要按平台补一两个标签,比如「拼车和代充」,否则 other 会塞满,统计里看不出这一块。另一个差别是长度和语气,小红书评论中位只有 10 个 token,很多只有半句话加一个表情,单看一条很难判断情绪,提示词里可以把笔记标题和点赞数一起交给模型,作为上下文。Trustpilot 正好相反,100 条里 87% 是 1 到 2 星,70 条是 1 星,中位 77 个 token,退款和取消订阅的过程写得很细,适合用 reply_needed 挑出要客服跟进的条目。
批处理脚本:从取数到打标签
下面这个脚本分三步:用 EveryInfra 拉评论,按 id 去重后每 20 条一批组装请求,再交给一个 OpenAI 兼容地址打标签。取数部分我们真跑过;打标签部分是配置示例,BASE_URL 指向你自部署的 vLLM,或者指向 Kimi 的官方地址,代码不用改。并发用 Python 标准库的 concurrent.futures,校验 id 是否一一对上,是防止模型漏条、串条的最后一道检查。
import json, os, concurrent.futures as cf
import requests

EI = "https://api.everyinfra.com/api/v1/social"
EI_KEY = os.environ["EVERYINFRA_API_KEY"]
BASE_URL = os.environ.get("LLM_BASE_URL", "http://localhost:8000/v1")  # 自部署 vLLM;官方 API 换成 Kimi 的地址
LLM_KEY = os.environ.get("LLM_API_KEY", "EMPTY")
MODEL = os.environ.get("LLM_MODEL", "moonshotai/Kimi-K3.1-Pro")
SYSTEM = open("prompt_system.txt").read()
SCHEMA = json.load(open("schema.json"))

def fetch(platform, params):
    r = requests.post(EI, json={"platform": platform, "action": "reviews", "params": params},
                      headers={"Authorization": f"Bearer {EI_KEY}"}, timeout=120)
    r.raise_for_status()
    return r.json()["results"]

def label(batch):
    user = json.dumps([{"id": str(x["id"]), "stars": x.get("rating") or x.get("score"),
                        "text": ((x.get("title") or "") + " " + (x.get("text") or "")).strip()}
                       for x in batch], ensure_ascii=False, separators=(",", ":"))
    body = {"model": MODEL, "reasoning_effort": "low", "response_format": SCHEMA,
            "messages": [{"role": "system", "content": SYSTEM}, {"role": "user", "content": user}]}
    r = requests.post(f"{BASE_URL}/chat/completions", json=body,
                      headers={"Authorization": f"Bearer {LLM_KEY}"}, timeout=600)
    r.raise_for_status()
    items = json.loads(r.json()["choices"][0]["message"]["content"])["items"]  # 只解析 content
    want, got = [str(x["id"]) for x in batch], [i["id"] for i in items]
    if want != got:
        raise ValueError(f"id 对不上:缺 {set(want) - set(got)},多 {set(got) - set(want)}")
    return items

seen, rows = set(), []
for platform, params in [("app_store", {"app_id": "570060128", "country": "cn", "sort": "newest", "limit": 200}),
                         ("app_store", {"app_id": "570060128", "country": "us", "sort": "newest", "limit": 200}),
                         ("google_play", {"app_id": "com.duolingo", "language": "en", "sort": "newest", "limit": 200})]:
    for x in fetch(platform, params):
        key = (platform, str(x["id"]))
        if key not in seen:
            seen.add(key)
            rows.append(x)

batches = [rows[i:i + 20] for i in range(0, len(rows), 20)]
with cf.ThreadPoolExecutor(max_workers=16) as pool, open("labels.jsonl", "w") as out:
    for items in pool.map(label, batches):
        for it in items:
            out.write(json.dumps(it, ensure_ascii=False) + "\n")
自部署时的启动命令按 vLLM 使用说明的参数组合写,下面是一台 8 卡 B300 的配置示例。--max-num-seqs 256 来自 Spheron 11 月 8 日在同样机器上的测试记录,vLLM 默认的 1,024 个并发序列超过了 K3.1 Pro 线性注意力缓存在 B300 上的 603 个槽位,不改的话启动时就在图捕获阶段报错退出;实际参数以使用说明页面生成器给出的命令为准,镜像要用支持 K3.1 的版本。vLLM 和 SGLang 的源码分别在 vllm-project/vllm 和 sgl-project/sglang。
# 配置示例:一台 8 卡 B300,张量并行 8;工具调用和思考内容走 kimi_k3 解析器
vllm serve moonshotai/Kimi-K3.1-Pro \
  --tensor-parallel-size 8 \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --enable-auto-tool-choice \
  --max-num-seqs 256
不急着要结果的话,官方 API 还有一条更便宜的路:Batch 接口。把上面每一批的请求体写成一行 JSONL 上传,completion_window 填 24h,按批量定价是标准价的六成;缓存命中在 Batch 里只是尽力而为,我们算账时按不命中处理。写法和 OpenAI 的 Batch API 一样,每行带一个 custom_id,回来以后按它对上原始评论。账户的并发和速率上限见 Kimi 的限速说明。
两笔账:取数费和打标签费
第一笔是数据接口费,每千条价格按本次实际返回的条数算(单次扣费 ÷ 返回条数 × 1,000)。App Store、Google Play 每次 $0.001389、本次返回 200 条,折合每千条 $0.0069;Trustpilot 同价、本次返回 100 条,折合每千条 $0.0139;小红书评论每次 $0.005556、本次每页返回 15 条,折合每千条 $0.3704,约是 App Store 的 53 倍(0.3704 ÷ 0.006945),因为中文社区评论要按笔记一页一页地翻。失败和空结果不扣费。
第二笔是打标签的模型费。按 Kimi 的对话定价:输入每百万 token $2.00、输出 $10.00、缓存命中 $0.20(定价页写的是 2026 年 10 月 24 日核定的价格,我们 11 月 14 日读取)。每次请求固定的 386 个 token 提示词按缓存命中算,评论正文按输入价,标签 JSON 和思考内容按输出价。思考 token 数我们没法实测,按每批 20 条分别假设 200、800、2,000 个三档。
| 推理长度假设(每批 20 条) | 标准 API 每千条 | Batch 每千条 | 竞价租卡每千条(不含启动费) | AWS 容量块每千条 |
|---|---|---|---|---|
| 低:200 token | $0.5498 | $0.3507 | $0.2909 | $0.7574 |
| 中:800 token | $0.8498 | $0.5307 | $0.4903 | $1.2766 |
| 高:2,000 token | $1.4498 | $0.8907 | $0.8891 | $2.3150 |
低档下,标准 API 每千条 $0.5498,其中输入只占 20.4%,其余都是输出。所以省钱先从输出下手:把输出里的长 id 换成批内序号、字段名缩短成一两个字母,每条评论的标签 JSON 从 33.76 个 token 降到 22.15 个,低、中、高三档分别省 21.1%、13.7% 和 8.0%;推理长度越长,这一招省得越少。把这笔钱和取数费放在一起看,拉一千条 App Store 评论的 $0.0069,只有低档打标签费的 1.3%。
自部署多少条评论才回本
自部署的成本按租一台 8 卡 B300 算。吞吐用 Spheron 在 2026 年 11 月 8 日公开的实测:8 卡 B300 竞价实例、vLLM、64 个并发请求时,整台机器每秒输出 2,073.2 个 token,单个请求每秒 101.1 个;竞价价 $49.61/小时;从开机、下载 1,561.3 GB 权重到能接请求,这段准备时间按该测试的记录花了 $34.07 租金(那次是第二次启动)。按需租用以 AWS 为参照,EC2 容量块价目上 p6-b300.48xlarge(8 卡 B300)在多数区域是 $129.168/小时,折合每卡每小时 $16.146;容量块要提前预订固定时长,规则见 AWS 文档。长期包租以 FlexiCloud 公布的整机 $36/小时、最短一年为参照,一个月按 730 小时算是 $26,280。Akash 网络的B300 租价汇总给的中位价是每卡每小时 $8.31,整机约 $66.48,落在竞价和容量块之间。以上云价都在 2026 年 11 月 14 日读取。
用实测吞吐算,一台机器每小时能处理的评论数在低档约 170,545 条,中档约 101,183 条,高档约 55,797 条。算法是整机每秒输出 token 数乘 3,600,再除以每条评论摊到的输出 token:低档每条是标签 JSON 的 33.76 个,加上每批 200 个思考 token 摊到 20 条上的 10 个。竞价租卡每次启动都要先付 $34.07 的启动费,之后每千条的边际成本比标准 API 低(低档每千条 $49.61 ÷ 170,545 × 1,000 = $0.2909),于是存在一个分界线:启动费除以每条省下的钱,$34.07 ÷($0.5498 − $0.2909)× 1,000,低档下一次跑 131,595 条以上,竞价租卡比标准 API 便宜;中档 94,773 条;高档 60,767 条。和 Batch 比就难多了,低档要 569,464 条,中档 842,936 条,高档要 2,131 万条,因为高档下竞价每千条 $0.8891 和 Batch 的 $0.8907 几乎一样。AWS 容量块在三档下每千条都比标准 API 和 Batch 贵,按小时租按需的卡跑这种活不划算。
这条线没算预填充的差别。Spheron 的测试每个请求输入 1,000 个、输出 1,000 个 token;我们的一批在低档是输入约 1,469 个(386 个固定提示词加 20 条评论)、输出约 875 个(20 条标签 JSON 加 200 个思考 token),输入占比更高,同一台机器每秒吐出的输出 token 可能低于 2,073.2,分界线会往后推;vLLM 的前缀缓存能省掉固定的 386 个 token,把差距缩小一部分。
竞价价本身也在动。Spheron 那次测试的 2 小时 49 分里,竞价价从 $56.20/时变到 $46.71/时,$49.61 是平均实付价。准备时间折合约 41 分钟($34.07 ÷ $49.61/时),按这个时长和低档吞吐重算:竞价价 $46.71 时分界线约 11.6 万条,$56.20 时约 17.5 万条。跑到 131,595 条,机器本身只要跑约 46 分钟,准备时间和运行时间差不多长,一次的活越小,准备时间占的比重越大。那次测试的第一次启动用默认参数失败了,算上失败的那次,从第一次启动到能接请求用了 39 分 35 秒;竞价实例被回收后重来,这笔准备费要再付一次。
拿 Duolingo 的真实评论量对一下。上面五个应用商店区加起来每天约 2,252 条,攒够 131,595 条要 58 天左右;一个月约 67,560 条,按标准 API 低档算模型费约 $37,高档约 $98,取数费按每次 200 条约 $0.47。包一整年机器的话,每月 $26,280 的固定成本要每月处理约 4,780 万条(低档)才和标准 API 打平,是 Duolingo 这五个区月评论量的约 700 倍,而这台机器一个月最多也就处理 1.24 亿条。对绝大多数品牌,评论分类直接用 API 或 Batch 更省;自部署的理由在别处:数据不能出自己的机房、要微调、或者同一批卡本来就在跑别的活,评论分类只是顺带。
| 方式 | 每月固定成本 | 低档:每月多少条才比标准 API 省 | 低档:比 Batch 省 | 一台机器每月最多处理 |
|---|---|---|---|---|
| 竞价租卡,按需起停 | 无,每次启动 $34.07 | 每次 131,595 条以上 | 每次 569,464 条以上 | 按租用时长 |
| 包一年整机($36/时) | $26,280 | 4,780 万条 | 7,493 万条 | 1.24 亿条(低档) |
| AWS 容量块($129.168/时) | 按预订时长 | 达不到 | 达不到 | 按预订时长 |
这笔账有三处简化,你用自己的数重算时要注意。一是吞吐取自别人的测试,输入输出比和我们的评论批不同,方向见上一段;二是没算存储、出口流量和工程师时间;三是思考 token 只是假设。算账脚本是一份 Python,输入就是上面这些公开价和我们量出来的 token 数,改几个常数就能换成你的评论量和价格。
按每月评论量看账单
下面按低档推理长度、每月集中跑一次算,竞价租卡含一次 $34.07 的启动费,取数费按应用商店每次 200 条、$0.001389 算。每月 1 万条时,标准 API 约 $5.50,Batch 约 $3.51,租卡要 $36.98,光启动费就比 API 一个月的钱多;每月 10 万条时,API 约 $54.98,Batch 约 $35.07,租卡约 $63.16,仍然是 Batch 最便宜;每月 100 万条时,API 约 $549.80,Batch 约 $350.70,租卡约 $324.97,租卡第一次领先,机器要跑约 5.9 小时;每月 1,000 万条时,API 约 $5,498,Batch 约 $3,507,租卡约 $2,943,机器要跑约 58.6 小时。取数费在四档下分别是 $0.07、$0.69、$6.95 和 $69.45,始终只是模型费的零头。
| 每月评论量 | 取数费 | 标准 API | Batch | 竞价租卡(含一次启动) | 租卡运行时长 |
|---|---|---|---|---|---|
| 1 万 | $0.07 | $5.50 | $3.51 | $36.98 | 约 0.06 小时 |
| 10 万 | $0.69 | $54.98 | $35.07 | $63.16 | 约 0.6 小时 |
| 100 万 | $6.95 | $549.80 | $350.70 | $324.97 | 约 5.9 小时 |
| 1,000 万 | $69.45 | $5,498 | $3,507 | $2,943 | 约 58.6 小时 |
批大小也会改变这笔账。我们按每批 20 条算,是在几件事之间取的折中:每批固定的 386 个提示词 token 摊到 20 条上,每条约 19 个;批再大,摊得更薄,但一条输出里要对齐的 id 越多,模型漏条或串条的机会越大,出错时整批重跑的代价也越高。标准 API 下提示词按缓存价计,批大小对费用影响很小;Batch 下缓存只是尽力而为,按不命中算,批大一些能省一点输入费。自部署时影响吞吐的主要是并发数,Spheron 的测试在 64 个并发时拿到 2,073.2 个输出 token 每秒,单个请求只有 101.1 个,所以脚本里要开足并发,十几二十个线程同时发,机器才吃得满。64 个并发时,每个请求每秒只分到 34.2 个输出 token,首个 token 平均要等 1.6 秒;低档一批约 875 个输出 token,一批要约 26 秒才回来,所以脚本按批写结果,出错只重跑那一批。
增量拉取:按评论 ID 去重、按时间戳取增量
每天跑一次全量,同一条评论会被拉好几次、打好几次标签。增量拉取靠两样东西:评论 ID 和发布时间戳。下面用 Google Play 英文的三次真实返回举例,三次请求分别在 11 月 14 日 00:19、00:44、00:58(新加坡时间)发出。
第一次返回的 200 条里,最新一条的 posted_at 是 2026-11-12T15:48:41.180000+00:00,把它记成水位。第二次返回的 200 条里,发布时间晚于这个水位的有 36 条,最早一条是 15:52:15,最晚一条是 16:29:55;按 ID 和第一次比,新 ID 也正好是这 36 条,两种办法结果相同。第三次拿第二次的最新一条 16:29:55.686 当水位,晚于它的有 27 条,按 ID 比也是 27 条。第二次、第三次的返回分别还和上一次有 164 条、173 条重合,说明两次请求之间没有漏掉任何一条评论。
两样要一起用。时间戳适合在代码里快速切出「上次以后的」,但同一秒可能有两条评论,水位要用「大于等于」,再按 ID 去掉已有的;不同平台的时间戳写法不同,App Store 带 -07:00 这样的时区偏移,Google Play 是 UTC,比较前先统一换成 UTC,例如美区第一次返回里最新一条是 2026-11-12T04:31:43-07:00,换成 UTC 是 11:31:43。ID 是最后一道去重:键用「平台加 ID」,App Store 的 ID 是纯数字,Google Play 是 UUID,Trustpilot 是 24 位十六进制,三者不会撞,混在一张表里时带上平台名更稳。
轮询间隔按评论速度定,留一半余量。一次返回 200 条,覆盖的时长等于 200 除以每小时的评论数;间隔取覆盖时长的一半,某一段评论突然变多时,下一次返回里也还会有和上次重合的 ID。按前面量出的覆盖时长:Google Play 英文 3.21 小时,每 1.5 小时一次;App Store 美区 17.88 小时,每 8 小时一次;中国区 74 小时、墨西哥区 158 小时,每天一次就够。跑起来以后,盯住每次返回里和上次重合的条数:重合降到 0,说明间隔太长、中间可能漏了,要加密;重合一直在 190 条以上,可以把间隔放宽一些。三轮取数里,应用商店和 Trustpilot 的 11 次评论调用合计扣费 $0.015279。
模型只跑新 ID,旧评论的标签不重算。定时任务和会重试的调用走 REST,并在请求头里带上 Idempotency-Key,写法见讲 Idempotency-Key 的那篇。
上线前怎么验:人工样本、两遍一致率和思考 token
在你自己的部署或 API 上跑之前,先定好怎样才算可以上线,再看结果。我们建议的做法分三步,判据都来自模型以外。第一步,从目标平台各抽 200 条,由两个人分别人工标注,两人一致的条目当作参照答案,不一致的拿出来讨论标签定义。第二步,模型对同一批评论跑两遍,因为 K3.1 Pro 的采样参数固定、改不了 temperature,两遍主标签一致的比例就是它在这套提示词下的稳定度,低于你能接受的线,就要收紧标签定义或者给出少量例子。第三步,看返回里的 usage 字段,记下每批的输入、输出和思考 token,把真实数填回算账脚本,看分界线移到哪里。
验收标准可以写得很具体:主标签和人工参照答案一致的比例、reply_needed 漏掉的扣费投诉条数、两遍之间不一致的比例、每千条的实际费用,各定一个线,跑完逐项对。扣费类投诉漏掉的代价最大,可以单独要求 billing 的召回率;praise 和 other 分错的代价小,可以放宽。量召回率要先有足够多的扣费投诉:按这一批的比例,美区 200 条里只读出 4 条(2%),中国区 14 条(7%)。想在参照答案里凑够 30 条扣费投诉,美区要标约 1,500 条,中国区约 430 条;也可以先用关键词把候选挑出来多标一些,再另抽一批没命中的,看关键词漏掉了多少。中国区和小红书的样本要单独验,中文短评和表情多,和英文评论的表现不一定一样。
做不了或要注意的地方
第一,模型分类结果没有实测。本机没有 GPU,提示词、schema、启动命令和打标签脚本都是配置示例;准确率要你在自己的部署或 API 上,用人工标注样本去量。第二,思考 token 数是假设,K3.1 Pro 一直会先思考,reasoning_effort 设成 low 之后每批到底多少 token,跑几批就知道,把真实数填进算账脚本再看分界线。第三,吞吐和云价随时在变,竞价实例随时可能被回收,长任务要能断点续跑:按批写结果、按 id 跳过已完成的批。
第四,数据边界。评论来自平台公开展示的内容,我们的接口不登录、不碰私密内容;作者名和头像在入库前就可以丢掉,标签分析用不上。第五,许可证的两条门槛写在第一节,商用前对照原文核对自己的用途。第六,小红书评论按页取,每页 15 条,单价是应用商店评论的几十倍,中文社区的样本适合做定性对照,不适合当成全量统计的来源。
第七,版本要固定。权重仓库在 11 月 5 日还改过一次编码文件,解析器在 11 月 4 日改过一次流式扫描;自部署时用 vLLM 的 --revision 固定到你验过的那个提交,镜像也固定版本号,标签表里记下这两个值。以后模型仓库再更新,先在人工样本上重跑一遍,主标签一致率没有变差再切换,免得同一个月的统计里混进两套行为不同的模型。
延伸阅读:用 Kimi 托管 API 交叉核对微博评论和财报写于权重公开之前;DeepSeek V4.1 Flash 给评论清洗打标签真跑了托管 API、给出一万条评论的总账,可以和本篇的自部署账对照;腾讯 Hy4 的工具调用讲工具调用格式和参数类型。VS Code Copilot 每天给应用商店差评分类讲的是用云端自动化定时跑同类任务;平台总览见 App Store 接口、Google Play 接口、Trustpilot 接口和小红书接口。
常见问题
Kimi K3.1 Pro 的开放权重能商用吗?
来自 Reddit 的 LocalLLaMA 讨论帖「Kimi-K3.1-Pro is now open-weights」,评论里争论最多的是许可证。原文主体是 MIT,另加两条:做对外模型服务、过去 12 个月收入超过 2,000 万美元的要另签协议;月活超过 1 亿或月收入超过 2,000 万美元的产品要显著标出「Kimi K3.1-Pro」。某个用途是否碰到这两条,请以 LICENSE 原文 和你的法务意见为准。
用 vLLM 部署 kimi k3.1 pro 有没有现成的例子?
来自 Google 搜索联想「kimi k3.1 pro vllm example」。vLLM 的模型使用说明按硬件给出了参数组合和预设,11 月 4 日的 vLLM 博客写了首日支持的情况;工具调用记得用 kimi_k3 解析器,通用工具调用文档的表里还只有 kimi_k2。上面的启动命令和批处理脚本可以直接改着用,模型名和地址换成你的。
K3.1 Pro 会出 GGUF 吗?
来自 Reddit 的 unsloth 版块帖子「Any plans for kimi K3.1?」。写稿时 Hugging Face 上已有多个社区上传的 GGUF,IQ1_S 到 MXFP4_MOE 都有,大小从约 580 GB 到约 1,509 GB;llama.cpp 11 月 6 日合并了文本模型、11 月 10 日合并了视觉部分。官方账号下还没有正式 GGUF,名字带「12GB」的仓库和参数量对不上,不要下载。
参考资料
- Kimi K3.1 Pro 技术博客,Kimi,2026-10-23,https://www.kimi.ai/blog/kimi-k3-1-pro
- moonshotai/Kimi-K3.1-Pro 模型卡,Hugging Face,2026-11-05 最后提交,https://huggingface.co/moonshotai/Kimi-K3.1-Pro
- Kimi K3.1-Pro License,Hugging Face,https://huggingface.co/moonshotai/Kimi-K3.1-Pro/blob/main/LICENSE
- encoding_k3.py,Hugging Face,2026-11-05,https://huggingface.co/moonshotai/Kimi-K3.1-Pro/blob/main/encoding_k3.py
- Kimi K3.1 Pro 快速上手,Kimi 开放平台,https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- 对话模型定价,Kimi 开放平台,https://platform.kimi.ai/docs/pricing/chat
- Kimi K3.1 Pro 定价说明,Kimi,https://www.kimi.ai/resources/kimi-k3-1-pro-pricing
- Batch 定价,Kimi 开放平台,https://platform.kimi.ai/docs/pricing/batch
- 使用 Batch API,Kimi 开放平台,https://platform.kimi.ai/docs/guide/use-batch-api
- 结构化输出(response_format),Kimi 开放平台,https://platform.kimi.ai/docs/guide/response_format
- 推理强度(reasoning_effort),Kimi 开放平台,https://platform.kimi.ai/docs/guide/use-reasoning-effort
- 速率限制,Kimi 开放平台,https://platform.kimi.ai/docs/pricing/limits
- moonshotai/Kimi-K3.1-Pro 使用说明,vLLM Recipes,https://recipes.vllm.ai/moonshotai/Kimi-K3.1-Pro
- Kimi K3.1 Pro 首日支持,vLLM 博客,2026-11-04,https://vllm.ai/blog/2026-11-04-kimi-k31-pro
- Kimi-K3.1-Pro Cookbook,SGLang 文档,https://docs.sglang.io/cookbook/autoregressive/Moonshotai/Kimi-K3.1-Pro
- Tool Parser,SGLang 文档,https://docs.sglang.io/advanced_features/tool_parser.html
- Tool Calling,vLLM 文档,https://docs.vllm.ai/en/latest/features/tool_calling.html
- Structured Outputs,vLLM 文档,https://docs.vllm.ai/en/latest/features/structured_outputs.html
- Reasoning Outputs,vLLM 文档,https://docs.vllm.ai/en/latest/features/reasoning_outputs.html
- kimi_k3_tool_parser.py,vLLM,2026-11-04 提交,https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/kimi_k3_tool_parser.py
- kimi_k3_reasoning_parser.py,vLLM,https://github.com/vllm-project/vllm/blob/main/vllm/reasoning/kimi_k3_reasoning_parser.py
- kimik3_detector.py,SGLang,https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/function_call/kimik3_detector.py
- vllm-project/vllm,GitHub,https://github.com/vllm-project/vllm
- sgl-project/sglang,GitHub,https://github.com/sgl-project/sglang
- model: add Kimi-K3.1-Pro text model(#31779),llama.cpp,2026-11-06 合并,https://github.com/ggml-org/llama.cpp/pull/31779
- mtmd: add kimi K3.1 vision(#31980),llama.cpp,2026-11-10 合并,https://github.com/ggml-org/llama.cpp/pull/31980
- Hugging Face 模型搜索接口(Kimi-K3.1-Pro),2026-11-14 读取,https://huggingface.co/api/models?search=Kimi-K3.1-Pro
- nvidia/Kimi-K3.1-Pro-NVFP4,Hugging Face,2026-11-11,https://huggingface.co/nvidia/Kimi-K3.1-Pro-NVFP4
- Introducing NVFP4 for Efficient and Accurate Low-Precision Inference,NVIDIA 开发者博客,https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/
- Microscaling Data Formats for Deep Learning,arXiv,2023,https://arxiv.org/abs/2310.10537
- tiktoken,OpenAI,GitHub,https://github.com/openai/tiktoken
- tiktoken,PyPI,https://pypi.org/project/tiktoken/
- Kimi K3.1 vs DeepSeek V4.1 on B300,Spheron,2026-11-08,https://www.spheron.network/blog/kimi-k3-1-vs-deepseek-v4-1-b300/
- Amazon EC2 Capacity Blocks for ML 价格,AWS,2026-11-14 读取,https://aws.amazon.com/ec2/capacityblocks/pricing/
- Capacity Blocks for ML,AWS EC2 文档,https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-capacity-blocks.html
- GPU 价格,FlexiCloud,2026-11-14 读取,https://flexicloud.co/gpu
- B300 Rental Price 2026,Akash Network,https://akash.network/the-bid/b300-rental-price-2026-cost-per-hour/
- Kimi K3.1 Pro 发布测评,Artificial Analysis,https://artificialanalysis.ai/articles/kimi-k3-1-pro-launch-benchmarks
- Introducing Kimi K3.1 Pro on Amazon Bedrock,AWS 机器学习博客,2026-11-10,https://aws.amazon.com/blogs/machine-learning/introducing-kimi-k3-1-pro-on-amazon-bedrock/
- Kimi-K3.1-Pro is now open-weights,Reddit r/LocalLLaMA,https://www.reddit.com/r/LocalLLaMA/comments/1xnrhvb/kimik31pro_is_now_openweights/
- Any plans for kimi K3.1?,Reddit r/unsloth,https://www.reddit.com/r/unsloth/comments/1xq9wgo/any_plans_for_kimi_k31/
- 视频:Kimi K3.1 Just Gave Away Opus-Level AI for Free,YouTube,2026-11-06,https://www.youtube.com/watch?v=o7HxqdTm9Jo
- List all customer reviews for an app,Apple 开发者文档,https://developer.apple.com/documentation/appstoreconnectapi/get-v1-apps-_id_-customerreviews
- Reply to Reviews,Google Play 开发者文档,https://developers.google.com/android-publisher/reply-to-reviews
- Business Units API,Trustpilot 开发者文档,https://developers.trustpilot.com/business-units-api
- Function calling,OpenAI 平台文档,https://platform.openai.com/docs/guides/function-calling
- Batch API,OpenAI 平台文档,https://platform.openai.com/docs/guides/batch
- concurrent.futures,Python 文档,https://docs.python.org/3/library/concurrent.futures.html
- App Store 能力目录,EveryInfra,2026-11-14 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=app_store
- Google Play 能力目录,EveryInfra,2026-11-14 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=google_play
- Trustpilot 能力目录,EveryInfra,2026-11-14 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- 小红书能力目录,EveryInfra,2026-11-14 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- EveryInfra 社交数据接口,https://api.everyinfra.com/api/v1/social
引用编号 BL-144