








































Apify Google Search Scraperの代替を検証:オーガニック検索結果1,000ページあたりのコストを比較
検索結果1,000ページのコストは、Apify Freeで$4.50、Businessで$1.80です。当社のオーガニック結果のみのWeb検索は、実測で$0.694でした。People Also Askは含みません。
記事全文を読む当社独自のアクセス統計は常に有効です。Google Analyticsは、公開ページ(ログイン後のワークスペースは対象外)の利用状況を把握するためのもので、許可をいただいた場合のみ有効になります。詳しくは プライバシーポリシーをご覧ください。
データスクレイピングAPI、AI検索、CAPTCHAの解決を提供します。106のプラットフォームに対応した573のデータ機能をご利用いただけます。
対応プラットフォームからコンテンツ、コメント、商品データを収集します。各アイテムにはフィールドと出典が含まれます。
対応一覧に掲載されたWebサイトのCAPTCHAタイプを解決し、タイプに応じてトークン、座標、またはテキストを返します。失敗した試行は最終的に課金されません。
データ分析スキルを使って、収集した結果を商品比較、コンテンツのパフォーマンスレポート、タグ、レビューのインサイトに変換できます。
無料でダウンロードできます。お使いのAIツールとモデルでご利用ください。
スキル自体はデータを収集しません。EveryDataでのデータ収集は別途、リクエストごとに課金されます。
お使いのAIツールでSEOスキルを使い、検索最適化とAI検索での可視性(GEO)の向上に取り組めます。サイト診断、キーワード調査、コンテンツ最適化、技術監査、順位トラッキングの各項目を市場ごとに評価します。
無料でダウンロードできます。お使いのAIツールとモデルでご利用ください。
overviewresearchcontenttechnicalmonitoringcurl -fsSL https://raw.githubusercontent.com/everyinfra/seo-skills/main/install.sh | bashコントリビューター最初のコントリビューターになりましょう。
このスキルに貢献する金額を問わずチャージすると、AI APIを無料でご利用いただけます。
PromptBelow are TripAdvisor reviews of the British Museum, one JSON object per line. Merge reviews that make the same point into one item: write the point in one short sentence and count how many reviews make it. Output only a JSON array, no other text; each item has: text (the point), merged (how many reviews make this point).
| 要点 | レビュー |
|---|---|
| The Bayeux Tapestry is stunning, beautiful, and an amazing, well-worth-seeing historical exhibit. | 8 |
| The audio guide for the Bayeux Tapestry moves too fast and has a frustrating limit on how many times you can pause it. | 6 |
| Visitors in the Bayeux Tapestry exhibition are constantly rushed or urged to keep moving by staff, detracting from the experience. | 6 |
| Long queues and bottlenecks occur in the Bayeux Tapestry exhibition, especially later in the day. | 5 |
| The British Museum features an incredible, world-class, and massive collection across its halls. | 4 |
| Bathroom facilities are insufficient, poorly kept, or feature excessively long queues. | 3 |
ほか2件
PromptLabel each review below positive, negative or neutral, and give a topic of two to four words. Output only a JSON array, no other text; each item has: text (the review title), sentiment, keyword.
| レビュー | 感情 | トピック |
|---|---|---|
| What is the point of pre-booking? Terribly organised entry system | negative | entry system organization |
| Fantastic exhibition | positive | Bayeux Tapestry exhibition |
| Bayeux Tapestry | positive | Bayeux Tapestry experience |
| All day event | positive | exploring history halls |
| A wasted opportunity to experience something truly special | negative | disappointing audio guide |
| Bayeaux Tapestry | positive | viewing the tapestry |
ほか14件
PromptFrom each review below extract three fields: issue (entry queue, signage, staff, crowds, prices, none), pre_booked (yes, no, not said) and recommend (yes, no, not said). Output only a JSON array, no other text; each item has: text (the review title), issue, pre_booked, recommend.
| レビュー | 問題点 | 事前予約 | おすすめ |
|---|---|---|---|
| What is the point of pre-booking? Terribly organised entry system | entry queue | yes | no |
| Fantastic exhibition | none | yes | yes |
| Bayeux Tapestry | entry queue | yes | yes |
| All day event | none | not said | yes |
| A wasted opportunity to experience something truly special | entry queue | yes | no |
| Bayeaux Tapestry | entry queue | yes | yes |
ほか14件
EveryInfraのAI APIを使って、重複の削除、感情の分類、フィールドの抽出などのデータ整理を行いたいと考えています。API連携を支援するアシスタントとして、次の3つのステップで進めてください。

ステップ1:まだコードは書かないでください。以下の内容がすべて明確になるまで、1回につき1〜3個ずつ、何回かに分けて質問してください。
1. 整理したいデータの内容、取得元、保存先、行数。
2. 整理の方法(重複の削除、感情の分類、フィールドの抽出、またはその他)。フィールドの場合は、どのフィールドを対象とし、それぞれがどの値を取りうるか。
3. 結果の保存方法と保存先。
4. スクリプトの言語、実行環境、1回だけ実行するか定期的に実行するか。
回答があいまいだったり、以前の回答と矛盾したりする場合は、もう一度質問してください。私が「わからない」と答えた場合は、案を提示して確認を求めてください。

ステップ2:計画を説明し、承認を得てください。説明する内容は、モデルに渡すプロンプト、1リクエストあたりの行数、リクエストの総数、返されるJSONの形式です。データがまだ収集されていない場合は、https://everyinfra.com/agents.mdにあるEveryInfraのAIエージェント向けガイドを読み、データ収集も計画に含めてください。

ステップ3:私が承認してから初めてコードを書き、以下のAPIルールに従ってください。
- エンドポイント:OpenAI互換のChat Completions。公式のOpenAI SDKを使う場合はbase_urlをhttps://api.everyinfra.com/api/v1に設定し、使わない場合はPOST https://api.everyinfra.com/api/v1/chat/completionsを送信してください。
- モデル:デフォルトはgemini-3.6-flashで、より軽量なgemini-flash-liteも利用できます。GET https://api.everyinfra.com/api/v1/modelsで利用可能なモデルの一覧を取得できます(キー不要)。
- 認証:ヘッダー Authorization: Bearer <API key>。キーは環境変数EVERYINFRA_API_KEYから読み込み、コード、ログ、コミットには絶対に含めないでください。まだキーがない場合は、https://everyinfra.com/app#keysで作成するよう私に伝えてください。
- 費用:アカウントに一度でもチャージすれば(金額不問)、AI APIは無料で利用でき、残高から差し引かれることはありません。403でai_topup_requiredが返された場合は、そのアカウントではまだチャージが行われていないことを意味します。https://everyinfra.com/app#redeemでチャージするよう案内してください。
- レート制限はアカウントのチャージ累計額によって決まり、そのアカウントのすべてのキーの合計に適用されます(金額不問:1分あたり50リクエスト、同時実行数5; $100以上:1分あたり500リクエスト、同時実行数50; $500以上:1分あたり5,000リクエスト、同時実行数500)。処理中のリクエスト数は現在のティアの上限内に収めてください。
- 1件ごとにリクエストを送るのではなく、各リクエストに複数件をまとめてください。messages全体で45,000文字未満に収め、input_too_largeで422が返った場合はバッチを分割して再送してください。
- モデルへのプロンプトでは、すべてのフィールドとそれぞれが取りうる値を明示し、JSON配列のみを返してほかのテキストを含めないよう指示してください。パースできなかったバッチは1回だけ再送信し、それでも失敗した場合は、私が確認できるようログに記録してください。
- まず20件ほどで試し、結果が正しいことを私が確認してから全件を実行してください。
- 429または503が返された場合は、Retry-Afterで指定された時間だけ待ってから再試行してください。指定がない場合は、徐々に間隔を広げて再試行してください。
- AI APIは、EveryInfraで収集したデータを整理するためのものです。ほかの用途に使われた場合や、呼び出しが明らかに異常な場合は、そのアカウントのAI APIが一時停止されることがあります。アカウント自体、ほかのAPI、残高には影響しません。
| source | field | type | value |
|---|---|---|---|
| app_store | url | string | https:// |
| app_store | app_id | number | 1557175442 |
| app_store | name | string | Obsidian - Connected Notes |
| app_store | category | string | 仕事効率化 |
| app_store | price | number | 0 |
| app_store | rating_count | number | 2722 |
| app_store | rating | number | 4.5 |
| app_store | content_rating | string | 4+ |
| app_store | developer | string | Dynalist Inc. |
| app_store | version | string | 1.13.7 |
| app_store | min_os | string | iOS 15.6 |
url | string | https:// | |
username | string | nasa | |
is_verified | boolean | true | |
posts_count | number | 4931 | |
followers_display | string | 104M | |
following_count | number | 91 | |
name | string | NASA | |
bio | string | Making the seemingly impossible, possible. ✨ | |
website | string | https:// | |
| amazon | url | string | https:// |
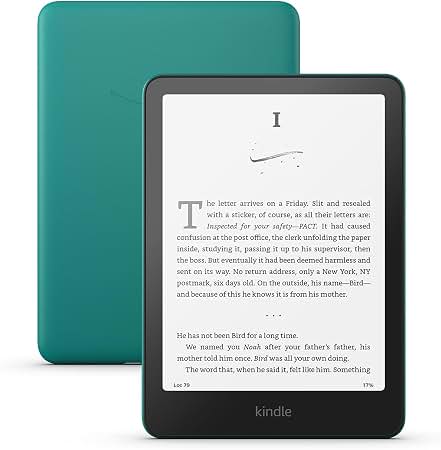
| amazon | asin | string | B0CFPHV9ZN |
| amazon | title | string | Kindle Paperwhite 16GB |
| amazon | price | null | — |
| amazon | color | string | Jade |
| amazon | brand | string | Amazon |
| amazon | display | string | 7-inch |
| amazon | storage | string | 16 GB |
| youtube | url | string | https:// |
| youtube | name | string | NASA |
| youtube | handle | string | @NASA |
| youtube | subscribers_display | string | 15.1M |
| youtube | videos_display | string | 6.1K |
| youtube | website | string | https:// |
| tiktok | url | string | https:// |
| tiktok | name | string | NASA |
| tiktok | username | string | nasa |
| tiktok | followers_display | string | 1.8M |
| tiktok | likes_display | string | 9.4M |
| tiktok | bio | string | Making the seemingly impossible, possible.✨ |
1つのAPIキーで、データ収集、Web検索、CAPTCHAの解決をすべて利用できます。以下の6つの活用例には、それぞれそのまま送信できるリクエストを用意しています。
MCP経由でEveryInfraをClaude、CursorなどのAIクライアントに接続するか、独自のエージェントからAPIを呼び出すことができます。エージェントはデータが必要になると自ら検索・取得し、構造化されたJSONを受け取ります。スクレイピングのコードを書く必要はありません。
例ClaudeがMCP経由でeveryinfra_call_apiを呼び出し、Redditでメカニカルキーボードに関する投稿を検索して、おすすめされているものをまとめます。
{
  "platform": "reddit",
  "action": "search",
  "params": {"keyword": "mechanical keyboard"}
}
titlecommunitylike_countcomment_counturlEverySearchはWebページ、ニュース、学術情報源を検索し、タイトル、リンク、スニペット、日付を返します。必要に応じてページの全文も取得できます。モデルはこれらの結果をもとに回答し、各結果から元の情報源をたどれます。
例EU AI法第50条の透明性義務に関する質問に答える前に、Webを検索してタイトル、リンク、スニペットをモデルに渡し、それらを引用した回答にします。
{
  "tool": "web",
  "params": {"q": "EU AI Act Article 50 transparency obligations", "num": 10}
}
titleurlsnippetpublishedレビュー、コメント、投稿本文をプラットフォームごとに大量に収集し、そのままクリーニングやラベル付けに回せる構造化されたJSONで取得できます。ほとんどのリストアクションは1回の呼び出しで多数の行を返し、課金は1回のみです。実行に失敗した場合や結果が空の場合は課金されません。
例Google PlayでWhatsAppの最新レビュー200件を取得します。各レビューには星評価が付いているため、そのまま感情ラベルとして使えます。
{
  "platform": "google_play",
  "action": "reviews",
  "params": {"app_id": "com.whatsapp", "sort": "newest", "limit": 200}
}
textscoreapp_versionposted_at商品リサーチ、価格追跡、競合分析などのツールでは、EveryInfraをデータレイヤーとして利用できます。1つのキーですべてのプラットフォームに対応し、呼び出しごとに課金されます。スクレイパー、プラットフォームのアカウント、プロキシを管理する必要はありません。
例価格トラッカーが1日1回Amazonの商品ページを読み取り、価格、評価、評価数、在庫の変化を記録します。
{
  "platform": "amazon",
  "action": "profile",
  "params": {"url": "https://www.amazon.com/dp/B09B8V1LZ3"}
}
priceratingrating_countin_stockseller_nameトレンド一覧、検索結果、コメントを定期的に取得し、AI APIでトピックの分類、感情スコアの算出、エンティティの抽出を行って、ソーシャルリスニングやコンテンツのダッシュボードに活用できます。AI APIは、チャージ済みのアカウントなら無料です。
例Xからオープンソースに関する最新の投稿を1時間ごとに取得し、AI APIで各投稿の感情とトピックをタグ付けして、トレンドレポートにまとめます。
{
  "platform": "twitter",
  "action": "search",
  "params": {"keyword": "open source"}
}
textlike_countview_countposted_at独自の定期ジョブ、ワークフロー、ブラウザ自動化スクリプトから同じAPIを呼び出せます。データを収集し、Webを検索し、CAPTCHAはEverySolveに任せられます。CAPTCHAの解決は成功時のみ課金されます。
例PlaywrightスクリプトがCloudflare Turnstileに遭遇すると、ページのURLとsitekeyをソルバーに送信してトークンを取得し、フォームに入力して処理を続行します。以下のリクエストでは、Cloudflare公式のデモページとテスト用sitekeyを使用しています。
{
  "type": "turnstile",
  "website_url": "https://demo.turnstile.workers.dev/",
  "website_key": "1x00000000000000000000AA"
}
tokenEveryInfraのAPIを使って、プラットフォームデータの収集、Web検索、CAPTCHAの解決を行いたいと考えています。API連携を支援するアシスタントとして、次の3つのステップで進めてください。
ステップ1:まだコードは書かないでください。次の点がすべて明確になるまで、1回に1〜3個ずつ、何回かに分けて質問してください。
1. やりたいことと、その結果の用途。
2. 対象のプラットフォームまたはWebサイト、対象がキーワード・リンク・アカウントのいずれか、およびその数。
3. 必要なフィールド、件数、期間。
4. 結果の保存方法と保存先。
5. スクリプトの言語、実行環境、1回だけ実行するか定期実行するか。
6. この作業にかけられる費用の上限。
回答があいまいだったり、以前の回答と矛盾したりする場合は、もう一度質問してください。私が「わからない」と答えた場合は、選択肢を提案して確認を求めてください。
ステップ2:https://everyinfra.com/agents.mdにあるEveryInfraのAIエージェント向けガイドを読み、カタログで機能、パラメータ、料金を確認してください(APIキーは不要です):
- プラットフォームデータ:GET https://api.everyinfra.com/api/v1/social/catalog?platform=<name>
- Web検索:GET https://api.everyinfra.com/api/v1/search/tools
- CAPTCHA:GET https://api.everyinfra.com/api/v1/captcha/types
そのうえで、承認を得るために計画を説明してください。使用する機能とリクエスト、おおよその呼び出し回数、カタログ価格に基づく概算費用、出力の形式を示してください。
ステップ3:私が承認してから、以下のAPIルールに従ってコードを書いてください。
- リクエスト:プラットフォームデータではPOST https://api.everyinfra.com/api/v1/socialにリクエストボディ{"platform", "action", "params"}を送信し、Web検索ではPOST https://api.everyinfra.com/api/v1/searchに{"tool", "params"}を送信し、CAPTCHAではPOST https://api.everyinfra.com/api/v1/captchaに{"type", ...other parameters}を送信します。パラメータ名と値はカタログの記載どおりに使用し、推測しないでください。
- 認証:ヘッダーAuthorization: Bearer <API key>。APIキーは環境変数EVERYINFRA_API_KEYから読み込み、コード、ログ、コミットには絶対に含めないでください。私がまだAPIキーを持っていない場合は、https://everyinfra.com/app#keysで作成するよう案内してください。
- まず1つの対象に対して小さい上限値で試し、レスポンスの形式を確認してから規模を拡大してください。複数の対象を指定した呼び出しは、対象ごとに課金されます。
- 時間のかかるプラットフォームデータのジョブや大規模なジョブでは、ボディに"mode": "async"を追加してください。APIは202とjob_idを返すので、statusがsucceededまたはfailedになるまでGET https://api.everyinfra.com/api/v1/jobs/{job_id}をポーリングしてください。202は成功ではありません。同期呼び出しでタイムアウトエラーが返された場合は、"mode": "async"を付けて同じリクエストを再送してください。
- プラットフォームデータの結果にnext_page_tokenが含まれている場合は、その値をpage_tokenとして渡し、他のパラメータは変えずに次のページを取得してください。1ページにつき1回の呼び出しです。
- 失敗または空の結果には最終的に課金されず、仮押さえされた金額は残高に戻ります。レスポンス内のbillingレシートを正として扱ってください。
- 422が返された場合は、エラーメッセージに示されたパラメータ名の候補と許可された値を使ってリクエストを修正してください。推測しないでください。
- 429または503が返された場合は、Retry-Afterで指定された時間だけ待ってから再試行してください。指定がない場合は、徐々に間隔を空けて再試行してください。
- ネットワークが切断された場合や結果が不明な場合は、request_id / job_idを保持し、まずそれを確認してください。自動で再送しないでください。
リモートMCPサーバーに接続できる場合は、https://api.everyinfra.com/mcp(ヘッダーAuthorization: Bearer <API key>)に接続し、そのツールを使って同じ作業を行うこともできます。課金とルールはAPIと同じです。各APIページにも専用のプロンプトがあります。例: TikTok検索
検索結果1,000ページのコストは、Apify Freeで$4.50、Businessで$1.80です。当社のオーガニック結果のみのWeb検索は、実測で$0.694でした。People Also Askは含みません。
記事全文を読む課金単位は機能ごとに異なります。呼び出す前に料金をご確認ください。
料金と対応タイプは、2026-09-26時点の各サービスの公式料金ページに基づいています。
| サービス | 課金単位 | 開始価格 | 公開最安価格 | 当社の優位点 |
|---|---|---|---|---|
EveryInfra(当社) | 1,000リクエストあたり | $0.6944 | $0.6944 | |
| 1,000リクエストあたり | $1.00 | $0.30 |
| |
| 1,000リクエストあたり | $25.00 | $1.96 |
| |
| 1,000リクエストあたり | $7.50 | $5.00 |
| |
| 1,000リクエストあたり | $7.00 | $7.00 |
| |
| 1,000リクエストあたり | $5.00 | $5.00 |
| |
| 1,000リクエストあたり | $5.00 | $1.00 |
| |
| 1,000リクエストあたり | $0.50 | $0.45 |
| |
| 1,000リクエストあたり | $7.60 | $1.20 |
| |
| 1,000リクエストあたり | $5.00 | $5.00 |
| |
| 1,000リクエストあたり | $5.00 | $5.00 |
| |
| 検索結果1,000ページあたり(1ページ10件) | $2.00 | $0.60 |
| |
| 1,000リクエストあたり | $4.00 | $1.00 |
| |
| 1,000リクエストあたり | $1.50 | $1.00 |
| |
| 検索結果1,000ページあたり(1ページ10件) | $1.00 | $0.50 |
| |
| 1,000リクエストあたり | $1.00 | $0.136 |
| |
| 1,000リクエストあたり | $2.00 | $0.90 |
|
| サービス | 課金単位 | 開始価格 | 公開最安価格 | 当社の優位点 |
|---|---|---|---|---|
EveryInfra(当社) | 検索結果1,000件あたり | $0.05556 | $0.05556 | |
| 検索結果1,000件あたり | $0.40–$5.00 | $0.30–$3.00 |
| |
| 検索結果1,000件あたり | $1.50 | $1.10 |
| |
| 1,000リクエストあたり | $1.00 | $0.50 |
| |
| 1,000ページあたり | $3.80 | $0.599 |
| |
| 1,000クレジットあたり | $0.49 | $0.083 |
| |
| 1,000リクエストあたり | $1.88 | $0.99 |
| |
| 1,000ユニットあたり | $2.22 | $0.93 |
| |
| 1,000クレジットあたり | $0.253 | $0.075 |
| |
| 1,000ページあたり | $1.15 | $0.25 |
| |
| 1,000ページあたり | $0.13 | $0.060 |
|
| サービス | reCAPTCHA v2 | reCAPTCHA v3 | Turnstile | hCaptcha | 画像CAPTCHA | 当社の優位点 |
|---|---|---|---|---|---|---|
EveryInfra(当社) | 掲載あり | 掲載あり | 掲載あり | 掲載あり | 掲載あり | |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載なし |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載あり | 掲載なし |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載なし | 掲載あり |
| |
| 掲載あり | 掲載あり | 掲載あり | 掲載あり | 掲載あり |
| |
| 掲載なし | 掲載なし | 掲載なし | 掲載なし | 掲載あり |
| |
| サブスクリプション制のクレジット。料金ページに種類別の価格は掲載されていません |
| |||||
サブスクリプション制のクレジット。料金ページに種類別の価格は掲載されていません
EveryInfraはAIアプリケーションのためのインフラプラットフォームです。1つのAPIキーで、データ収集(106プラットフォームにわたる573機能)、AI検索、CAPTCHAの解決、そしてチャージ後は無料で使えるOpenAI互換AI APIを利用できます。
マーケットプレイスを見る106プラットフォームに対応しています。Xiaohongshu(RedNote)、Douyin、WeChat公式アカウント、TikTok、Amazon、Taobao、LinkedIn、Google Mapsのレビューなど、コンテンツ・ソーシャル、コマース、レビュー、求人・ビジネス、Web検索の各分野をカバーしています。各プラットフォームには、パラメータとレスポンスフィールドを記載した専用のAPIページがあります。
カテゴリ別にすべてのプラットフォームを見る料金は機能ごとに設定されています。データ収集は1,000リクエストあたり$0.56からで、リクエストごとに課金されます(一部のリストアクションは一定行数ごとに課金され、その旨を料金の横に記載しています)。無効なリクエスト、失敗したリクエスト、空のリクエストには課金されません。CAPTCHAの解決は1,000回の解決成功あたり$0.14–$4.58で、成功時のみ課金されます。
料金の詳細を見るいいえ。プラットフォーム、機能、パラメータを送信するだけで、構造化されたJSONが返されます。スクレイパー、プラットフォームのアカウント、プロキシをご自身で管理する必要はありません。
はい。https://api.everyinfra.com/mcpのリモートMCPサーバーはお使いのAPIキーを使用するため、Claude、Cursor、ChatGPTなどのクライアントからすべての機能を直接呼び出せます。MCPを使わない場合は、REST APIを呼び出せます。
MCPを設定するまずは1つの機能から始めて、プロジェクトにインフラを組み込みましょう。
新規登録してAPIキーを作成したら、GitHubで両方のリポジトリにスターを付け、コンソールでトライアルクレジットを受け取ってください。トライアルクレジットの有効期間は、受け取りから24時間です。