Kimi K3.1 Pro con pesos abiertos: ¿cuándo conviene alojarlo para clasificar reseñas?
Los pesos de Kimi K3.1 Pro ocupan 1,56 TB y piden 8 GPU B300. Con 1130 reseñas y razonamiento bajo, alquilar GPU gana a la API desde 131.595 por lote.
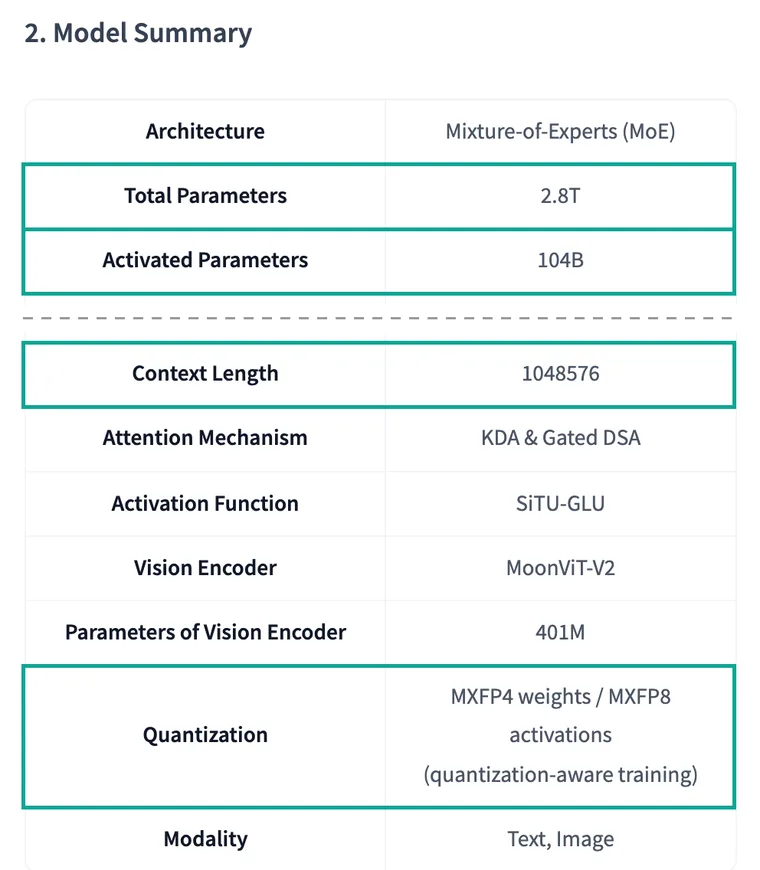
Moonshot AI lanzó Kimi K3.1 Pro el 2026-10-23 y publicó los pesos en Hugging Face el 2026-11-04. El modelo tiene 2,8 billones (2.8T) de parámetros en total y 104.000 millones (104B) activos por token. Su contexto llega a 1.048.576 tokens y los pesos ocupan 96 archivos con 1561,3 GB en total. Para etiquetar reseñas de apps comparamos dos caminos, alquilar GPU y alojar el modelo o llamar a la API oficial, y buscamos desde cuántas reseñas conviene el primero.
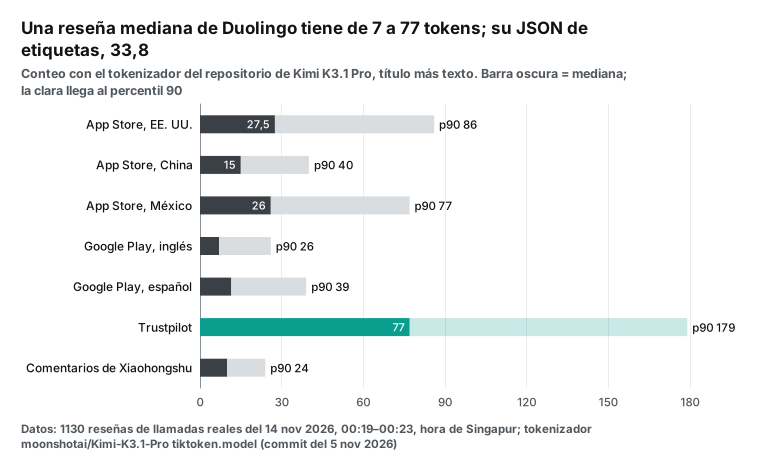
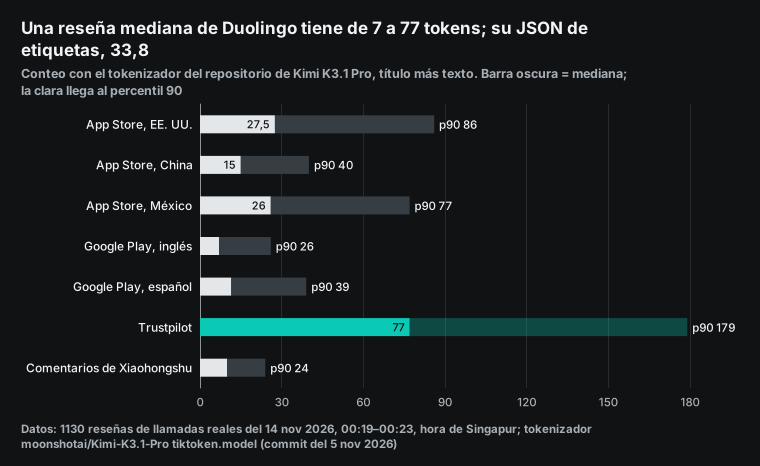
El 2026-11-14, entre las 00:19 y las 00:23 hora de Singapur, descargamos 1130 reseñas reales de Duolingo con la API de EveryInfra. Las fuentes fueron la App Store de México, Estados Unidos y China, Google Play en español e inglés, Trustpilot y Xiaohongshu. Luego contamos los tokens con el archivo de tokenizador que trae el propio repositorio de Kimi K3.1 Pro. Las reseñas son cortas: la mediana va de 7 a 77 tokens. En cambio, el JSON de etiquetas de cada reseña ocupa 33,8 tokens, así que cerca del 80 % del costo del modelo es salida.
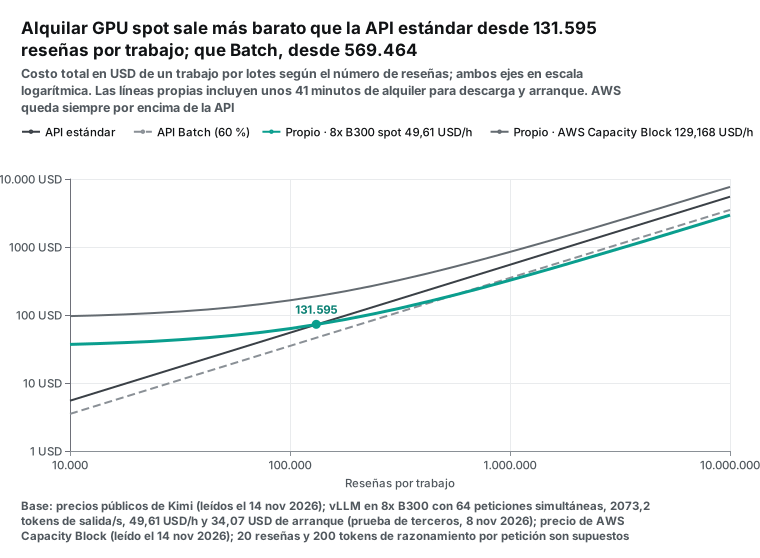
Con precios públicos de GPU spot y una prueba de rendimiento de un tercero, en el escenario de razonamiento bajo (200 tokens de razonamiento por lote de 20 reseñas), alojar el modelo gana a la API estándar solo por encima de 131.595 reseñas por lote. Para ganarle a la API Batch hacen falta 569.464 reseñas. En los escenarios medio y alto, la primera cifra baja a 94.773 y 60.767 reseñas. No tenemos GPU aquí: los comandos, el prompt y el script de etiquetado son ejemplos de configuración, y no medimos la precisión del modelo. Lo que sí medimos fueron las llamadas a la API de datos, el conteo de tokens y la lectura, una por una, del texto original de 56 coincidencias por palabras clave.


Qué trae la publicación de Kimi K3.1 Pro con pesos abiertos
El servicio alojado y los pesos llegaron en dos pasos. El blog técnico de Kimi da el 2026-10-23 como fecha de lanzamiento en kimi.ai, la app y la plataforma para desarrolladores. Ese mismo día salió K3.1 Pro Highspeed, de dos a tres veces más rápido. El repositorio de pesos es moonshotai/Kimi-K3.1-Pro. Según la API pública de Hugging Face, se creó el 2026-11-02, se hizo público el 2026-11-04 y su último commit es del 2026-11-05, con una actualización de encoding_k3.py.
Leímos el repositorio a las 00:15 hora de Singapur del 2026-11-14. Tenía 112 archivos y sus 96 archivos safetensors sumaban 1561,3 GB. Llevaba 40.953 descargas y 2003 «me gusta». Esas cifras cambian a diario, así que tómalas como una foto del momento.
La ficha del modelo y config.json describen la arquitectura. Es un modelo de mezcla de expertos (MoE) con 2,8 billones de parámetros en total y 104.000 millones activos por token. Tiene 93 capas: 69 usan Kimi Delta Attention y 24 usan atención dispersa con compuerta. Cada capa tiene 896 expertos y el enrutador elige 16; además, dos expertos compartidos trabajan con todos los tokens. El vocabulario tiene 163.840 entradas, y el modelo lee texto e imágenes con un codificador de visión MoonViT-V2 de 401 millones de parámetros.
Los pesos vienen en MXFP4, con activaciones en MXFP8. Moonshot entrenó el modelo con cuantización consciente a esa precisión, así que el repositorio oficial no incluye una copia BF16 más grande. Los formatos MX de «microescalado» vienen del artículo de OCP en arXiv. NVIDIA explica su propio formato NVFP4 en su blog para desarrolladores.
La licencia se llama Kimi K3.1-Pro License (texto completo). La base es la licencia MIT, con dos condiciones añadidas. Primera: un negocio de modelo como servicio con más de 20 millones de dólares de ingresos en los últimos 12 meses necesita un acuerdo aparte. Segunda: un producto con más de 100 millones de usuarios activos al mes, o 20 millones de dólares de ingresos mensuales, debe mostrar «Kimi K3.1-Pro» en un lugar visible.
Estos dos umbrales apuntan a servicios públicos de modelos y a productos muy grandes. Para saber si tu uso entra en ellos, guíate por el texto de LICENSE y por tu equipo legal.
| Dato | Valor en Kimi K3.1 Pro | Fuente |
|---|---|---|
| Lanzamiento alojado | 2026-10-23, junto con K3.1 Pro Highspeed | Blog técnico de Kimi |
| Pesos públicos | 2026-11-04 (repositorio creado el 11-02, último commit el 11-05) | API de Hugging Face |
| Parámetros | 2,8 billones en total, 104.000 millones activos, 93 capas, 16 de 896 expertos más 2 compartidos | Ficha del modelo, config.json |
| Contexto | 1.048.576 tokens, entrada de texto e imagen | Ficha del modelo |
| Precisión y tamaño | Pesos MXFP4, activaciones MXFP8, 96 archivos, 1561,3 GB | Lista de archivos |
| Licencia | Tipo MIT, con umbrales de ingresos y usuarios | LICENSE |
| Motores | vLLM, SGLang, TokenSpeed | Ficha del modelo |
| Configuración NVIDIA mínima | Un grupo TP8: un nodo 8x B300 o dos bandejas GB300 | Receta de vLLM |
| Precio de la API oficial | Por millón de tokens: 2,00 USD de entrada, 10,00 USD de salida, 0,20 USD con caché | Página de precios de Kimi |
Las evaluaciones externas son buenas. En su reseña del lanzamiento, Artificial Analysis le dio 55 puntos en su índice de inteligencia, en cuarto lugar. También hay más opciones alojadas: AWS publicó el 2026-11-10 (hora del Pacífico) una nota sobre K3.1 Pro en Amazon Bedrock. Para etiquetar reseñas, mira el precio, el rendimiento y que la salida tenga un formato estable.
Llamadas a herramientas y salida estructurada: etiquetas XTML y el parser kimi_k3
Por dentro, K3.1 Pro usa sus propias etiquetas para el razonamiento, la respuesta y las llamadas a herramientas. Las reglas están en encoding_k3.py, dentro del repositorio. Tokens como <|open|>, <|close|> y <|sep|> envuelven secciones llamadas think, response, tools, call y argument, y cada turno termina con <|end_of_msg|>. Si alojas el modelo, no tienes que escribir estas etiquetas a mano.
vLLM y SGLang traen parsers para este formato. En vLLM son kimi_k3_tool_parser.py y kimi_k3_reasoning_parser.py. En SGLang es kimik3_detector.py. Arranca el servidor con --tool-call-parser kimi_k3 --reasoning-parser kimi_k3 --enable-auto-tool-choice. La respuesta trae entonces tool_calls con el formato de OpenAI y un campo reasoning_content aparte.
Hay un detalle que puede costarte una tarde. El 2026-11-14, la guía general de llamadas a herramientas de vLLM todavía listaba solo kimi_k2 para los modelos Kimi, y la lista de parsers de SGLang también. Si sigues esas páginas generales, puedes elegir el parser equivocado y las etiquetas crudas quedan dentro del texto de la respuesta. Para K3.1 Pro, usa la receta de vLLM y el cookbook de SGLang.
El historial del parser de vLLM muestra un cambio del 2026-11-04 que revisa de forma incremental las llamadas a herramientas en streaming, para ganar velocidad. Si tu imagen de contenedor es más vieja, actualízala antes de probar las herramientas. Anota también la etiqueta de la imagen en tu registro de ejecución, para poder explicar después un cambio de comportamiento.
Las reglas de la API oficial están en la guía rápida de K3.1 Pro, y cuatro de ellas importan para etiquetar. Primera: el modelo siempre razona antes de responder. El campo reasoning_effort acepta low, high o max, y el valor por defecto es max (guía de esfuerzo de razonamiento). Para etiquetas basta con low, y cada nivel superior agrega tokens de salida y costo.
Segunda: los parámetros de muestreo están fijos en temperature 1.0 y top_p 0.95, y cambiarlos no tiene efecto. Por eso una misma reseña puede recibir otra etiqueta en una segunda pasada. Tercera: la salida estructurada admite response_format con un json_schema; con strict en true, la salida sigue el esquema (guía de salida estructurada). Lee solo content y deja fuera reasoning_content al analizar la respuesta.
Cuarta: en un ciclo de herramientas con varios turnos, devuelve el mensaje completo del asistente del turno anterior, con reasoning_content y tool_calls. Si falta una parte, el turno siguiente puede fallar o desviarse. Para un servidor propio, las páginas de vLLM sobre salidas estructuradas y salidas de razonamiento describen los mismos campos.
Revisamos un punto más en BL-67: ninguna de las tres API alojadas de Kimi acepta un servidor MCP remoto. Un servidor vLLM propio tampoco ejecuta herramientas; el modelo solo emite la llamada y tu código la ejecuta. Por eso la definición de herramienta de más abajo sirve para un uso interactivo, cuando el modelo decide cuándo traer reseñas. Para etiquetar por lotes, descarga primero las reseñas y luego pásalas al modelo; así sale más barato, porque te ahorras una ronda de solicitudes y una copia de la definición de herramienta.
Kimi K3.1 Pro local: qué tamaño de máquina hace falta
Buscamos «kimi k3.1 pro open weights» en YouTube. El quinto resultado es un video del 2026-11-06, y su título dice que K3.1 regaló una IA de primer nivel. La transcripción dice que la descarga es gratis y que solo pagas la luz, pero no calcula el hardware. Los comentarios son más concretos: un espectador escribió que montarlo en casa cuesta cerca de un millón de dólares, frente a 7200 dólares por tres años de un plan de pago. Otro escribió que necesita 2 TB de memoria de video.
En Reddit, un hilo de LocalLLaMA sobre la publicación de los pesos trae otra cuenta: alguien calculó cuatro Mac Studio de 512 GB cada una por unos 89.200 dólares. Las cifras están muy lejos entre sí, así que las comparamos con el tamaño de los archivos y con las guías oficiales.
La vía oficial usa solo GPU de centro de datos. La receta de vLLM da como configuración NVIDIA más simple un grupo de 8 GPU en paralelismo tensorial, es decir, un nodo 8x B300 o dos bandejas GB300. En AMD es un nodo 8x MI355X y en TPU de Google son 16 chips v7x. El cookbook de SGLang da configuraciones «equilibradas» para GPU más antiguas: B200 necesita TP16 (dos nodos de 8 GPU), H200 necesita TP16 con EP16 y H100 necesita TP32 con EP32, o sea, cuatro nodos de 8 GPU.
| Hardware | Disposición | Nodos de 8 GPU | Fuente |
|---|---|---|---|
| NVIDIA B300 | TP8 | 1 | Receta de vLLM |
| NVIDIA GB300 | TP8 en dos bandejas | 2 bandejas | Receta de vLLM |
| AMD MI355X | TP8 | 1 | Receta de vLLM |
| Google TPU v7x | TP32 en 16 chips | 4 hosts | Receta de vLLM |
| NVIDIA B200 | TP16 | 2 | Cookbook de SGLang |
| NVIDIA H200 | TP16 con EP16 | 2 | Cookbook de SGLang |
| NVIDIA H100 | TP32 con EP32 | 4 | Cookbook de SGLang |
Los 1561,3 GB de pesos deben caber en la memoria de las GPU y dejar espacio para la caché KV. Según la receta de vLLM, un nodo 8x B300 en TP8 con caché KV en FP8 guarda unos 2,6 millones de tokens. NVIDIA publicó el 2026-11-11 una versión NVFP4 para Blackwell. Sus archivos suman 1605,2 GB, un poco más que los pesos oficiales: NVFP4 sirve para los kernels de Blackwell, no para ahorrar memoria.
La vía «local» avanzó en la segunda semana de noviembre. El 2026-11-06, llama.cpp aceptó el soporte del modelo de texto de K3.1 Pro; el pull request dice que se probó una conversión MXFP4 y una cuantización de 2 a 3 bits. El 2026-11-10 aceptó la parte de visión. Después, usuarios de la comunidad subieron archivos GGUF a Hugging Face.
A las 00:47 hora de Singapur del 2026-11-14 consultamos la API de búsqueda de modelos de Hugging Face y sumamos el tamaño de los repositorios GGUF más descargados. La cuantización IQ1_S más pequeña pesa entre 580 y 593 GB. IQ2_XXS pesa unos 710 GB, Q2_K unos 1009 GB y MXFP4_MOE unos 1509 GB. Algunos repositorios dicen «12GB» en el nombre: ese tamaño no puede contener un modelo de 2,8 billones de parámetros, así que no los descargues.
En la comunidad de unsloth en Reddit alguien preguntó por las cuantizaciones de K3.1. Cuando escribimos esto, la cuenta oficial de Moonshot no tenía ningún GGUF. Todos los GGUF eran subidas de la comunidad sin pruebas de calidad publicadas.
| Opción | Tamaño | Máquina | ¿Sirve para etiquetar reseñas? |
|---|---|---|---|
| MXFP4 oficial con vLLM o SGLang | 1561,3 GB | 8x B300, dos bandejas GB300, 8x MI355X o 16 chips TPU v7x | Sí. Vía oficial, con parsers para herramientas y JSON |
| NVFP4 de NVIDIA | 1605,2 GB | Un grupo TP8 de Blackwell | Sí. Kernels para Blackwell |
| GGUF comunitario IQ1_S | Entre 580 y 593 GB | Varias máquinas con más de 600 GB de memoria en total | Cuantización de 1 bit, sin pruebas públicas de calidad ni de herramientas |
| GGUF comunitario Q2_K | Unos 1009 GB | Dos o más máquinas de 512 GB de memoria | Igual, y la velocidad depende del ancho de banda de memoria |
| API oficial o Batch | Sin descarga | Ninguna | Sí, con precio por token |
Para etiquetar, casi toda la memoria se va en los pesos y la caché KV queda casi vacía. En nuestros lotes, una solicitud tiene unos 1500 tokens de entrada; con la salida y el razonamiento llega a dos o tres mil. Incluso 64 solicitudes a la vez ocupan menos de 200.000 tokens de caché KV, muy lejos de los 2,6 millones que caben en 8x B300 con TP8. Así que TP8 simple alcanza, y la velocidad viene de subir la concurrencia. El registro de Spheron con la misma configuración muestra 248.210 de 275.040 MiB en uso por GPU; de eso, 34,74 GiB por GPU son caché KV, con espacio para 2.151.492 tokens en el nodo. Es menos que la cifra de la receta, pero sobra para etiquetar: en el escenario bajo, una solicitud tiene unos 2344 tokens (1469 de entrada y 875 de salida), y 64 solicitudes a la vez suman unos 150.000.
En la API, K3.1 Pro Highspeed cuesta el doble que el modelo estándar: 4 USD de entrada y 20 USD de salida por millón de tokens. Etiquetar por lotes no es urgente, así que usa el modelo estándar o la API Batch.
Una computadora de casa o una sola estación de trabajo no pueden con K3.1 Pro; incluso la cuantización más pequeña, de 1 bit, es más grande que una Mac Studio de 512 GB. Para alojarlo tú, alquilas un nodo en la nube como 8x B300, o tienes una sala de servidores parecida. El modelo de costos de más abajo usa nodos alquilados.
De dónde salen las reseñas: App Store de México y Google Play en español
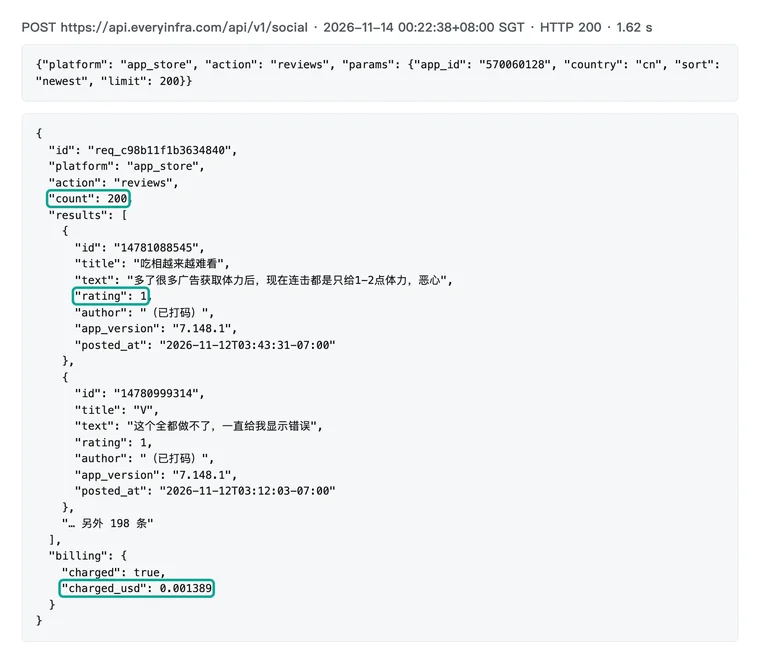
Para los datos usamos tres capacidades de EveryInfra: reseñas de App Store, reseñas de Google Play y reseñas de Trustpilot. Como contraste en chino, sumamos comentarios de Xiaohongshu. Todas las solicitudes van a POST https://api.everyinfra.com/api/v1/social; los campos platform y action eligen la capacidad, y la clave va en un encabezado. La guía de inicio rápido muestra la configuración.
Elegimos Duolingo porque tiene muchas reseñas públicas en las tiendas de México, Estados Unidos y China, y en Trustpilot. Además, muchas reseñas hablan del plan de pago y del sistema de «energía» de la app. Eso da casos claros para las etiquetas de cobros y de presión para pagar.
Cada tienda tiene una API oficial de reseñas, pero solo para tu propia app. La API de App Store Connect de Apple pide una clave de cuenta de desarrollador. La API Reply to Reviews de Google pide una cuenta de servicio, limita las lecturas a 200 por hora y solo devuelve reseñas con texto. La Business Units API de Trustpilot también es para empresas que administran su propio perfil.
Para comparar con la competencia, o para juntar en una tabla reseñas públicas de varias tiendas, una API de pago por llamada es más simple. Los parámetros y precios están en el catálogo del día para App Store, Google Play y Trustpilot. La plataforma china está en el catálogo de Xiaohongshu.
# Descarga las 200 reseñas más nuevas de Duolingo en la App Store de México. La clave sale de una variable de entorno.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform": "app_store", "action": "reviews",
       "params": {"app_id": "570060128", "country": "mx", "sort": "newest", "limit": 200}}'
La primera ronda corrió el 2026-11-14, de las 00:19 a las 00:23 hora de Singapur. Las nueve llamadas de esa ronda costaron 0,025002 USD en total. Trustpilot devolvió un error 429; esa llamada no se cobró y el reintento funcionó. Cada llamada a App Store, Google Play o Trustpilot cuesta 0,001389 USD. En esta ronda, cada llamada a App Store y Google Play devolvió 200 reseñas, y la de Trustpilot devolvió 100. Una llamada de comentarios de Xiaohongshu cuesta 0,005556 USD, y cada página devolvió 15 comentarios.
| Hora de Singapur | Capacidad | Objetivo | Filas | Tiempo | Cobro |
|---|---|---|---|---|---|
| 00:19 | app_store/reviews | Estados Unidos, más nuevas | 200 | 1,87 s | 0,001389 USD |
| 00:19 | google_play/reviews | Inglés, más nuevas | 200 | 6,81 s | 0,001389 USD |
| 00:21 | trustpilot/reviews | duolingo.com, más nuevas | 100 | 18,67 s | 0,001389 USD |
| 00:21 | xiaohongshu/comments | Una nota de advertencia sobre Duolingo, página 1 | 15 | 2,56 s | 0,005556 USD |
| 00:22 | app_store/reviews | China, más nuevas | 200 | 1,62 s | 0,001389 USD |
| 00:22 | app_store/reviews | México, más nuevas | 200 | 1,58 s | 0,001389 USD |
| 00:23 | google_play/reviews | Español, más nuevas | 200 | 9,30 s | 0,001389 USD |
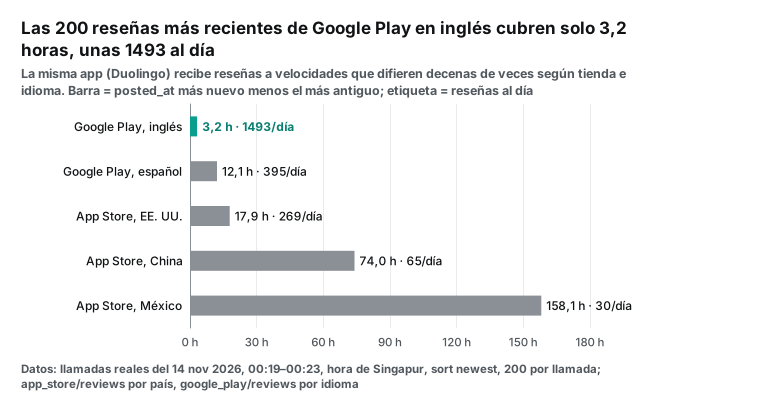
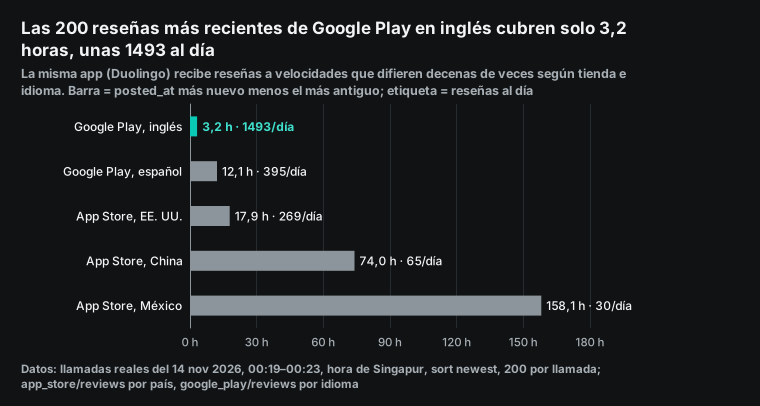
La velocidad de las reseñas cambia mucho según la tienda, y esa velocidad define cada cuánto descargar. Usamos la fecha más vieja y la más nueva de cada lote de 200 reseñas recientes. Google Play en español cubrió 12,14 horas, unas 395 reseñas por día. La App Store de México cubrió 158,08 horas, solo unas 30 por día. Como comparación, Google Play en inglés cubrió 3,21 horas (unas 1493 por día) y la App Store de Estados Unidos 17,88 horas (unas 269 por día).
Con estos números, la App Store de México aguanta una descarga diaria sin perder nada, incluso cada dos o tres días. Google Play en español pide una descarga cada seis horas, más o menos. Google Play en inglés necesita una cada dos o tres horas.
Campos de cada tienda y cómo guardar las etiquetas
Las tiendas devuelven campos un poco distintos, así que alinéalos antes de guardar. Las reseñas de App Store traen id, título, texto, calificación, autor, versión de la app, conteo de «útil» y fecha. Las de Google Play no tienen título; su calificación se llama score y suman «me gusta» y versión de la app. Trustpilot agrega idioma, país, una marca de verificación y la fecha de la experiencia, y su título suele ser la primera mitad del texto con puntos suspensivos.
El modelo solo necesita tres campos: el id, las estrellas y el texto. Si faltan las estrellas, manda un valor nulo; el prompt no necesita una regla especial para eso. El campo de versión de la app también ayuda: si las etiquetas de fallos suben tras una versión, eso suele verse antes que la caída de estrellas.
Cuántos tokens tiene una reseña: lo medimos con el tokenizador de K3.1 Pro
Para calcular el costo del modelo necesitas el conteo de tokens, y contar palabras da solo una aproximación. El repositorio de K3.1 Pro trae su propio archivo de tokenizador, tiktoken.model, y su regla de corte en tokenization_kimi.py. Cargamos ambos con tiktoken (el paquete en PyPI) y contamos el título más el texto de las 1130 reseñas. Este paso no necesita GPU y tarda menos de un segundo.
En Google Play en español, la mediana es de 11,5 tokens y el percentil 90 de 39. En la App Store de México, la mediana es de 26 tokens y el percentil 90 de 77, con unos 3,11 caracteres por token. Como referencia, el inglés de Estados Unidos rinde 4,12 caracteres por token y el chino de la App Store de China solo 1,76. Trustpilot tiene las reseñas más largas, con una mediana de 77 tokens, porque mucha gente llega allí a contar su queja completa.
| Fuente | Filas | Mediana de tokens | Percentil 90 | Caracteres por token | Costo de descarga por 1000 |
|---|---|---|---|---|---|
| App Store de México | 200 | 26 | 77 | 3,11 | 0,0069 USD |
| Google Play en español | 200 | 11,5 | 39 | — | 0,0069 USD |
| App Store de Estados Unidos | 200 | 27,5 | 86 | 4,12 | 0,0069 USD |
| Google Play en inglés | 200 | 7 | 26 | — | 0,0069 USD |
| App Store de China | 200 | 15 | 40 | 1,76 | 0,0069 USD |
| Trustpilot | 100 | 77 | 179 | — | 0,0139 USD |
| Comentarios de Xiaohongshu | 30 | 10 | 24 | 1,54 | 0,3704 USD |
Luego contamos los tokens dentro de una solicitud real, con lotes de 20 reseñas y solo id, estrellas y texto. El mensaje del usuario promedia 54,15 tokens por reseña. El prompt del sistema ocupa 223 tokens y el esquema JSON 163, así que cada solicitud carga 386 tokens fijos. El JSON de etiquetas promedia 33,76 tokens por reseña, más que una reseña típica de Google Play en español.
Así que la mayor parte del costo del modelo es salida. BL-116 corrió DeepSeek V4.1 Flash sobre reseñas reales y encontró el mismo patrón.
El prompt de etiquetado, el esquema JSON y la herramienta
Definimos ocho etiquetas a partir de los problemas que de verdad aparecen en las reseñas de Duolingo: billing (cobros), ads (anuncios), pressure (presión para pagar o volver), content (contenido), ai (contenido hecho con IA), bug (fallos), praise (elogio) y other (otro). «Pressure» cubre energía, vidas, gemas, rachas, ligas y pantallas que empujan a pagar. Cada reseña recibe una etiqueta principal, hasta dos secundarias, un valor de sentimiento y una marca de «necesita respuesta».
| Etiqueta | Qué cubre | Ejemplo de las reseñas en español |
|---|---|---|
| billing | Cobros, renovaciones, reembolsos, pruebas gratis que terminan en cobro | «acepté la prueba gratis y me descontaron todo el año» |
| ads | Anuncios dentro de la app | «Demasiados anuncios» |
| pressure | Energía, vidas, gemas, rachas, retos y pantallas que empujan a pagar | «te cobran tres de energía» en el ajedrez |
| content | Calidad de lecciones, personajes, idiomas o niveles | Un personaje que «no me gusta» |
| ai | Contenido que el autor considera hecho con IA | Ninguno en la muestra de México |
| bug | Fallos, cierres, acceso, progreso perdido, accesibilidad | «No es compatible con lector de pantalla» |
| praise | Reseña positiva sin un problema concreto | «Duolingo el mejor» |
| other | Todo lo demás | Sugerencias sin queja |
El prompt está en inglés porque la entrada mezcla inglés, español y chino, y porque las etiquetas en inglés son más fáciles de guardar. La salida no repite el texto de la reseña: ahorra tokens y deja las palabras de los usuarios fuera de la tabla de etiquetas.
You label app-store and community reviews for a product team.
For every review in the user message, return one object in "items", in the same order.
Use only these labels:
- billing: charges, renewals, refunds, free trials that turned into payments, subscription plans and their price
- ads: advertising inside the product
- pressure: energy, hearts, gems, streaks, leaderboards, upsell screens or notifications that push the user to pay or come back
- content: course or content quality, accuracy, missing languages or levels
- ai: features or content that the reviewer says is made by AI
- bug: crashes, freezes, login, sync, lost progress, performance
- praise: positive review with no specific problem
- other: anything else
Pick one primary label and up to two secondary labels.
sentiment: -1 negative, 0 mixed or neutral, 1 positive.
reply_needed: true only when the reviewer reports money lost, data lost, or a blocked account.
Copy the review id exactly. Do not translate or quote the review text.
Un esquema JSON estricto en response_format controla la salida. El enum deja al modelo dentro de las ocho etiquetas, así que no puede inventar una nueva como «subscription_issue». La opción additionalProperties: false bloquea campos extra. La API oficial y vLLM aceptan esta forma: mira la guía de salida estructurada de Kimi y la guía de llamadas a funciones de OpenAI.
{
  "type": "json_schema",
  "json_schema": {
    "name": "review_labels",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["items"],
      "properties": {
        "items": {
          "type": "array",
          "items": {
            "type": "object",
            "additionalProperties": false,
            "required": ["id", "primary", "secondary", "sentiment", "reply_needed"],
            "properties": {
              "id": {"type": "string"},
              "primary": {"type": "string", "enum": ["billing", "ads", "pressure", "content", "ai", "bug", "praise", "other"]},
              "secondary": {"type": "array", "maxItems": 2, "items": {"type": "string", "enum": ["billing", "ads", "pressure", "content", "ai", "bug", "praise", "other"]}},
              "sentiment": {"type": "integer", "enum": [-1, 0, 1]},
              "reply_needed": {"type": "boolean"}
            }
          }
        }
      }
    }
  }
}
Para un uso interactivo, dale una herramienta al modelo; por ejemplo, un bot interno que responde «¿qué dicen esta semana las reseñas negativas de Duolingo en México?». El modelo decide entonces qué tienda y qué país consultar. La definición usa el formato de funciones de OpenAI: limit es un entero con mínimo y máximo, y source es un enum. Esos límites evitan que el modelo mande un número como texto o invente una tienda. Con el tokenizador de K3.1 Pro, esta definición ocupa 203 tokens y viaja en cada solicitud del ciclo.
{
  "type": "function",
  "function": {
    "name": "fetch_reviews",
    "description": "Fetch the newest public reviews of one app or company from EveryInfra. Returns a JSON list with id, rating, text, posted_at. Billed per call by EveryInfra; failed or empty calls are not billed.",
    "parameters": {
      "type": "object",
      "additionalProperties": false,
      "required": ["source", "target"],
      "properties": {
        "source": {"type": "string", "enum": ["app_store", "google_play", "trustpilot"], "description": "Where the reviews come from."},
        "target": {"type": "string", "description": "App Store numeric id, Google Play package name, or company domain for Trustpilot."},
        "country": {"type": "string", "description": "Two-letter store country for app_store, for example us, cn, mx."},
        "language": {"type": "string", "description": "Two-letter review language for google_play and trustpilot."},
        "limit": {"type": "integer", "minimum": 1, "maximum": 200, "description": "Number of reviews."}
      }
    }
  }
}
El etiquetado por lotes no necesita esta herramienta. En un ciclo de herramientas, cada lote de 20 reseñas pide una vuelta más, carga los 203 tokens de la definición y suma otro paso de razonamiento. Tu código ya sabe qué tienda y cuántas reseñas descargar; si esa decisión la toma el modelo, pagas más y aparecen más errores.
Por qué las palabras clave fallan con los cobros: leímos cada coincidencia
Antes de correr el modelo, una regla de palabras clave casi no cuesta nada y da una primera estimación. Nuestra regla de cobros cubre palabras en español, inglés y chino, como suscrip, cobr, reembols, prueba, pago, precio, dinero, subscri, charg y refund. Google Play en español tuvo 5 coincidencias en 200 reseñas (2,5 %) y la App Store de México 7 (3,5 %). La App Store de Estados Unidos tuvo 19 (9,5 %) y Trustpilot 46 de 100.
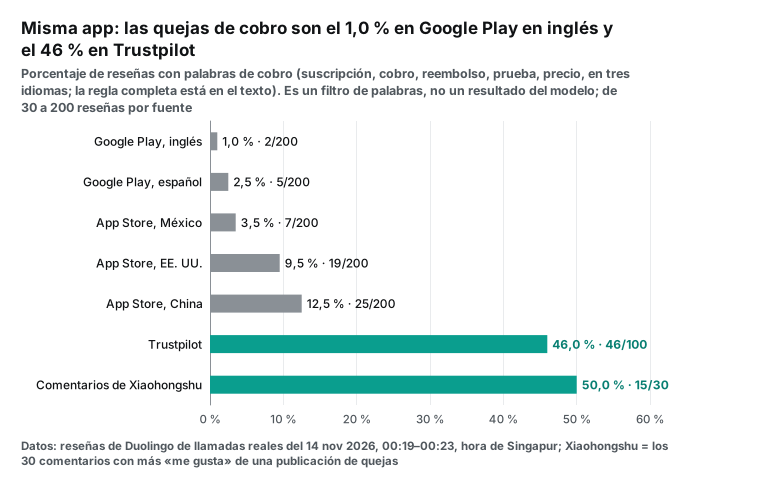
Una coincidencia no es una queja por cobros, así que leímos el texto original de cada caso y lo clasificamos en los grupos de la tabla. Nadie más revisó esta clasificación. La muestra tiene límites: son las coincidencias dentro de las 200 reseñas más nuevas de cada tienda, de una sola descarga del 2026-11-14, con 7 en México, 5 en Google Play en español, 19 en Estados Unidos y 25 en China, 56 en total. Los ids están en nuestros archivos de datos, y los porcentajes describen solo este lote. En la App Store de México, ninguna de las 7 coincidencias habla de un cobro indebido. Una es un elogio: «prueba Duolingo ya» invita a probar la app. Las otras 6 hablan de precio o de presión para pagar: gemas para recuperar un reto, el pago de Súper para ganar un traje de Halloween, o el deseo de que la app «no cobrara».
En Google Play en español, 2 de las 5 coincidencias son quejas claras por cobros. Una persona aceptó la prueba gratis y le descontaron el año completo sin autorización ni reembolso. Otra cuenta que la app invita a probar una semana gratis y al final cobra. Una tercera pagó 786,90 por un año con promoción, pero sigue sin energía y la app la empuja al plan familiar; la etiqueta principal es presión y la secundaria, cobros. Las 2 restantes hablan de energía en el ajedrez y de rachas perdidas.
| Tienda | Coincidencias | Cobros reales (tras leerlas) | Presión o precio | Otras |
|---|---|---|---|---|
| App Store de México | 7 | 0 | 6 | 1 |
| Google Play en español | 5 | 2 | 3 | 0 |
| App Store de Estados Unidos | 19 | 4 | 8 | 7 |
| App Store de China | 25 | 14 | 4 | 7 |
En estas 56 coincidencias, la regla en México no encontró ningún cobro real, y en Estados Unidos solo 4 de 19. Un equipo de soporte que envía todas las coincidencias como tickets de cobro recibiría sobre todo falsas alarmas. En la App Store de China, en cambio, 14 de 25 sí eran cobros, con montos que se repiten. Un modelo puede hacer esta separación por significado, pero su precisión la tienes que medir con tu propia muestra.
El método es este. Etiqueta 200 reseñas a mano y corre el modelo dos veces sobre ellas. Cuenta cuántas veces coinciden las dos pasadas del modelo y cuántas veces coincide el modelo con las etiquetas humanas. K3.1 Pro tiene temperature fija en 1.0, así que la coincidencia entre pasadas es un número que debes medir.
Este lote también muestra una forma de ahorrar: mandar al modelo solo las reseñas de 1 a 3 estrellas. Las 18 quejas por cobros que encontramos en Estados Unidos (4) y China (14) tienen de 1 a 3 estrellas, y 17 de ellas tienen una sola. En Google Play en español no pasa lo mismo: de sus 2 quejas por cobros, una tiene 1 estrella y la otra 4 («te dice que pruebes tu semana gratis pero al final te cobra»). Con el filtro, esa queja se escaparía.
Las reseñas bajas además son más largas. Con el tokenizador de K3.1 Pro, la mediana de Google Play en español es de 43 tokens con 1 a 3 estrellas y de 11 con 4 o 5. En la App Store de México es de 46 frente a 23. En Google Play en español, solo 12 de 200 reseñas (6 %) tienen de 1 a 3 estrellas, pero suman el 19,5 % de los tokens de texto.
En el escenario bajo, el razonamiento, el prompt fijo y el JSON de etiquetas siguen al número de reseñas, así que se multiplican por esa proporción. La entrada del texto sigue a los tokens y se multiplica, como mucho, por su proporción. En Estados Unidos (25 % de las reseñas y 45,6 % de los tokens), el costo por cada 1000 reseñas descargadas baja de 0,5498 USD a menos de 0,16 USD. En Google Play en español baja mucho más. Probamos esta regla solo en este lote: revísala de nuevo con otra app u otro periodo.
| Fuente | Reseñas de 1 a 3 estrellas | Parte de las reseñas | Parte de los tokens de texto | Mediana de tokens (1–3 estrellas) | Mediana de tokens (4–5 estrellas) |
|---|---|---|---|---|---|
| App Store de México | 35 / 200 | 17,5 % | 28,7 % | 46 | 23 |
| Google Play en español | 12 / 200 | 6,0 % | 19,5 % | 43 | 11 |
| App Store de Estados Unidos | 50 / 200 | 25,0 % | 45,6 % | 54 | 23 |
| App Store de China | 76 / 200 | 38,0 % | 52,1 % | 20,5 | 11 |
| Google Play en inglés | 25 / 200 | 12,5 % | 14,6 % | 11 | 7 |
| Trustpilot | 96 / 100 | 96,0 % | 98,5 % | 77,5 | 21,5 |
En Trustpilot, 96 de 100 reseñas tienen de 1 a 3 estrellas, así que ahí el filtro casi no ahorra nada.
De qué se quejan en México y en Google Play en español
Las reseñas de México hablan poco de dinero y mucho de las mecánicas del juego. De las 200 reseñas más nuevas, solo el 10,5 % tiene una o dos estrellas, y el 74 % tiene cinco. Leímos las 21 reseñas bajas una por una, sin una segunda revisión, y se repiten varios temas: piezas de rompecabezas repetidas, retos mensuales que subieron de 50 a 70, lecciones de ajedrez y rachas perdidas porque la app no cargó.
También hay al menos tres quejas por exceso de anuncios, una de ellas de alguien que paga y cancela su suscripción porque la app insiste con el plan familiar. Hay una más sobre notificaciones insistentes y otra sobre un personaje con una actitud «poco amigable».
Una de esas reseñas merece atención aparte: alguien escribe que, desde una actualización, varias funciones dejaron de ser compatibles con su lector de pantalla. En nuestro conjunto cae en bug, pero muchos equipos querrán una etiqueta propia de accesibilidad. Esa queja aparece una vez entre 200, y una regla por palabras clave de cobros nunca la encontraría.
Google Play en español es aún más positivo: 174 de 200 reseñas tienen cinco estrellas y solo 6 tienen una o dos (3 %). Las pocas quejas son las de cobros y energía descritas arriba. La App Store de Estados Unidos, en cambio, tiene un 19,5 % de reseñas bajas, sobre todo por el sistema de energía. Trustpilot llega al 87 %, porque la gente va allí a quejarse de reembolsos y cancelaciones.
| Tienda | Reseñas con 1 o 2 estrellas | Queja principal en la muestra |
|---|---|---|
| App Store de México | 10,5 % | Mecánicas de juego, anuncios y rachas |
| Google Play en español | 3 % | Pruebas gratis que terminan en cobro, energía |
| App Store de Estados Unidos | 19,5 % | Sistema de energía y muros de pago |
| Trustpilot | 87 % | Reembolsos, cobros tras la prueba y cancelación |
La conclusión práctica es que una sola tienda da una imagen parcial. Si solo miras Trustpilot, Duolingo parece tener un problema de cobros enorme; si solo miras Google Play en español, casi no hay quejas. Descarga las tiendas donde escriben tus usuarios y etiquétalas con el mismo prompt, para que las cifras se puedan comparar.
El script por lotes: de la descarga a las etiquetas
El script de abajo tiene tres pasos. Descarga reseñas de EveryInfra y quita duplicados por id, arma lotes de 20 y manda cada lote a un endpoint compatible con OpenAI para etiquetarlo. La parte de descarga la corrimos nosotros; la de etiquetado es un ejemplo de configuración. Apunta LLM_BASE_URL a tu servidor vLLM o a la API de Kimi, y el código no cambia.
El script usa concurrent.futures, de la biblioteca estándar de Python, para la concurrencia. También revisa que los ids de la respuesta coincidan con los del lote; esa revisión detecta una reseña que falta o que quedó cambiada de lugar.
import json, os, concurrent.futures as cf
import requests

EI = "https://api.everyinfra.com/api/v1/social"
EI_KEY = os.environ["EVERYINFRA_API_KEY"]
BASE_URL = os.environ.get("LLM_BASE_URL", "http://localhost:8000/v1")  # vLLM propio, o la URL de la API de Kimi
LLM_KEY = os.environ.get("LLM_API_KEY", "EMPTY")
MODEL = os.environ.get("LLM_MODEL", "moonshotai/Kimi-K3.1-Pro")
SYSTEM = open("prompt_system.txt").read()
SCHEMA = json.load(open("schema.json"))

def fetch(platform, params):
    r = requests.post(EI, json={"platform": platform, "action": "reviews", "params": params},
                      headers={"Authorization": f"Bearer {EI_KEY}"}, timeout=120)
    r.raise_for_status()
    return r.json()["results"]

def label(batch):
    user = json.dumps([{"id": str(x["id"]), "stars": x.get("rating") or x.get("score"),
                        "text": ((x.get("title") or "") + " " + (x.get("text") or "")).strip()}
                       for x in batch], ensure_ascii=False, separators=(",", ":"))
    body = {"model": MODEL, "reasoning_effort": "low", "response_format": SCHEMA,
            "messages": [{"role": "system", "content": SYSTEM}, {"role": "user", "content": user}]}
    r = requests.post(f"{BASE_URL}/chat/completions", json=body,
                      headers={"Authorization": f"Bearer {LLM_KEY}"}, timeout=600)
    r.raise_for_status()
    items = json.loads(r.json()["choices"][0]["message"]["content"])["items"]  # analiza solo content
    want, got = [str(x["id"]) for x in batch], [i["id"] for i in items]
    if want != got:
        raise ValueError(f"los ids no coinciden: faltan {set(want) - set(got)}, sobran {set(got) - set(want)}")
    return items

seen, rows = set(), []
for platform, params in [("app_store", {"app_id": "570060128", "country": "mx", "sort": "newest", "limit": 200}),
                         ("google_play", {"app_id": "com.duolingo", "language": "es", "sort": "newest", "limit": 200})]:
    for x in fetch(platform, params):
        key = (platform, str(x["id"]))
        if key not in seen:
            seen.add(key)
            rows.append(x)

batches = [rows[i:i + 20] for i in range(0, len(rows), 20)]
with cf.ThreadPoolExecutor(max_workers=16) as pool, open("labels.jsonl", "w") as out:
    for items in pool.map(label, batches):
        for it in items:
            out.write(json.dumps(it, ensure_ascii=False) + "\n")
Si alojas el modelo, el comando de arranque de abajo usa las opciones de la receta de vLLM; es un ejemplo de configuración para un nodo 8x B300. La opción --max-num-seqs 256 viene del registro de la prueba de Spheron del 2026-11-08: el valor por defecto de vLLM, 1024 secuencias, supera las 603 ranuras de la caché de atención lineal de K3.1 Pro en B300, y con él el servidor falla al arrancar, en la captura de grafos. Usa el comando que genera la página de la receta para tu hardware y una imagen con soporte para K3.1. El código fuente está en vllm-project/vllm y sgl-project/sglang.
# Ejemplo de configuración: un nodo 8x B300, paralelismo tensorial 8, parsers kimi_k3 para herramientas y razonamiento
vllm serve moonshotai/Kimi-K3.1-Pro \
  --tensor-parallel-size 8 \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3 \
  --enable-auto-tool-choice \
  --max-num-seqs 256
Si puedes esperar los resultados, la API oficial tiene un camino más barato: la API Batch. Escribe cada cuerpo de solicitud como una línea JSONL, sube el archivo y pon completion_window en 24h. La página de precios de Batch da el 60 % del precio estándar. Los aciertos de caché en Batch son solo de mejor esfuerzo, así que nuestro modelo de costos supone que no hay caché.
El formato es igual al de la API Batch de OpenAI: cada línea lleva un custom_id, que usas para unir las etiquetas con las reseñas. Los límites de concurrencia y de solicitudes de la cuenta están en la página de límites de Kimi.
Dos facturas: la descarga de datos y las etiquetas
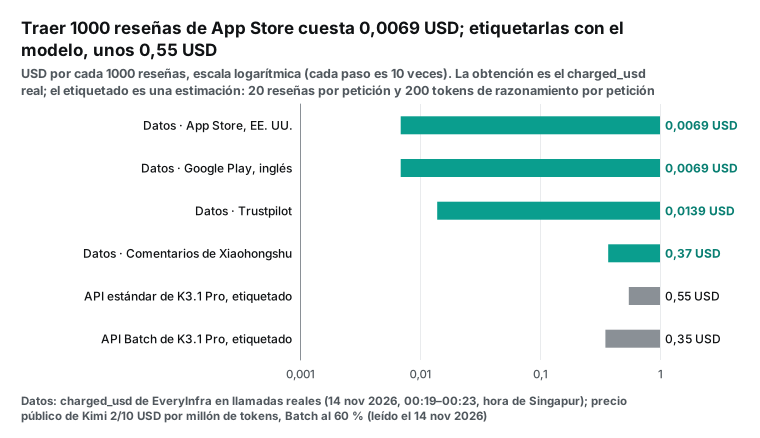
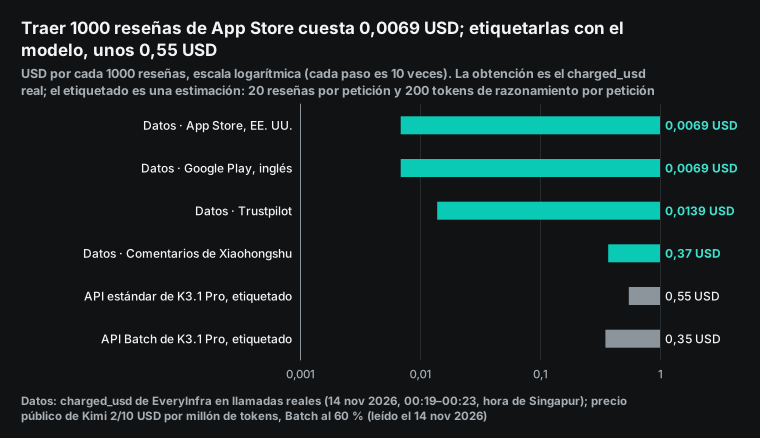
La primera factura es la API de datos. El costo por cada 1000 sale de las filas que devolvió cada llamada en esta ronda: cobro ÷ filas × 1000. Las llamadas a App Store y Google Play cuestan 0,001389 USD y devolvieron 200 reseñas, o sea, 0,0069 USD por cada 1000. La de Trustpilot tiene el mismo precio y devolvió 100, lo que da 0,0139 USD por cada 1000. Los comentarios de Xiaohongshu cuestan 0,005556 USD y cada página devolvió 15, o 0,3704 USD por cada 1000. Las llamadas fallidas y los resultados vacíos no se cobran.
La segunda factura es el modelo. La página de precios de chat de Kimi da estos precios por millón de tokens: 2,00 USD de entrada, 10,00 USD de salida y 0,20 USD para entrada en caché. La página dice que las tarifas se revisaron el 2026-10-24 y nosotros la leímos el 2026-11-14. Pusimos los 386 tokens fijos del prompt a precio de caché, el texto de las reseñas a precio de entrada, y el JSON de etiquetas más el razonamiento a precio de salida.
No podemos medir los tokens de razonamiento sin GPU ni una corrida de pago. Por eso usamos tres supuestos por lote de 20 reseñas: 200, 800 y 2000 tokens de razonamiento.
| Razonamiento por lote de 20 | API estándar por 1000 | Batch por 1000 | Nodo spot por 1000 (sin arranque) | AWS Capacity Block por 1000 |
|---|---|---|---|---|
| Bajo: 200 tokens | 0,5498 USD | 0,3507 USD | 0,2909 USD | 0,7574 USD |
| Medio: 800 tokens | 0,8498 USD | 0,5307 USD | 0,4903 USD | 1,2766 USD |
| Alto: 2000 tokens | 1,4498 USD | 0,8907 USD | 0,8891 USD | 2,3150 USD |
En el escenario bajo, la API estándar cuesta 0,5498 USD por cada 1000 reseñas, y la entrada es solo el 20,4 % de ese costo: el resto es salida. Así que recorta primero la salida. Cambia los ids largos por un índice corto dentro del lote y usa nombres de campo de una o dos letras. El JSON de etiquetas baja de 33,76 a 22,15 tokens por reseña, y el ahorro es del 21,1 %, 13,7 % y 8,0 % en los escenarios bajo, medio y alto.
Con más razonamiento, ese ahorro se achica. Compara también la etiqueta con la descarga: bajar 1000 reseñas de App Store por 0,0069 USD es apenas el 1,3 % del costo de etiquetarlas en el escenario bajo.
¿Desde cuántas reseñas conviene alojar el modelo?
Calculamos el costo de alojarlo con un nodo 8x B300 alquilado. El rendimiento sale de una prueba pública de Spheron del 2026-11-08. En un nodo spot 8x B300 con vLLM y 64 solicitudes simultáneas, el nodo produjo 2073,2 tokens de salida por segundo; una sola solicitud obtuvo 101,1. El precio spot fue de 49,61 USD por hora. La preparación, desde el arranque y la descarga de 1561,3 GB hasta la primera solicitud, costó 34,07 USD de alquiler; esa cifra es del segundo arranque de la prueba.
Para alquiler bajo demanda tomamos AWS. En la lista de precios de EC2 Capacity Blocks, p6-b300.48xlarge (8x B300) cuesta 129,168 USD por hora en la mayoría de las regiones, o 16,146 USD por GPU y hora. Los Capacity Blocks se reservan por un tiempo fijo y por adelantado, como explica la guía de AWS.
Para un contrato largo usamos el precio de FlexiCloud: 36 USD por hora por nodo completo, con un año como mínimo. Con 730 horas al mes, son 26.280 USD. El resumen de precios de B300 de Akash Network da una mediana de 8,31 USD por GPU y hora, unos 66,48 USD por nodo y hora, entre el precio spot y Capacity Blocks. Leímos todos los precios de nube el 2026-11-14.
Con ese rendimiento, un nodo etiqueta unas 170.545 reseñas por hora en el escenario bajo, unas 101.183 en el medio y unas 55.797 en el alto. La cuenta es: tokens de salida por segundo del nodo × 3600 ÷ tokens de salida por reseña. En el escenario bajo, cada reseña lleva los 33,76 tokens de su JSON más 10 de razonamiento (200 por lote de 20).
Cada arranque spot cuesta primero 34,07 USD. Después, el costo marginal por cada 1000 reseñas es menor que el de la API estándar: en el escenario bajo, 49,61 ÷ 170.545 × 1000 = 0,2909 USD. Así que existe un punto de equilibrio, que es el costo de arranque dividido entre lo que ahorras por reseña: 34,07 ÷ (0,5498 − 0,2909) × 1000.
En el escenario bajo, el nodo spot gana a la API estándar desde 131.595 reseñas por lote; en el medio, desde 94.773, y en el alto, desde 60.767. Ganarle a Batch es mucho más difícil: hacen falta 569.464 reseñas en el escenario bajo y 842.936 en el medio. En el alto se necesitan 21,3 millones, porque el nodo spot, con 0,8891 USD por cada 1000, casi iguala a Batch, con 0,8907. AWS Capacity Blocks cuesta más que la API y que Batch en los tres escenarios.
Esta cifra no incluye una diferencia en el prellenado. En la prueba de Spheron, cada solicitud tenía 1000 tokens de entrada y 1000 de salida. En el escenario bajo, uno de nuestros lotes tiene unos 1469 tokens de entrada (los 386 fijos del prompt más 20 reseñas) y unos 875 de salida (20 JSON de etiquetas más 200 de razonamiento). Nuestra proporción de entrada es mayor, así que el nodo puede dar menos de 2073,2 tokens de salida por segundo, y el punto de equilibrio sube. La caché de prefijos de vLLM puede saltarse los 386 tokens fijos y achicar esa diferencia.
El precio spot también se mueve. Durante las 2 horas y 49 minutos de la prueba de Spheron pasó de 56,20 a 46,71 USD por hora; los 49,61 USD son el promedio pagado. La preparación equivale a unos 41 minutos (34,07 ÷ 49,61 USD por hora). Con ese tiempo y el rendimiento del escenario bajo, el punto de equilibrio queda en unas 116.000 reseñas a 46,71 USD y en unas 175.000 a 56,20 USD.
Un lote de 131.595 reseñas necesita solo unos 46 minutos de nodo, así que la preparación y la corrida duran casi lo mismo, y cuanto más chico el trabajo, más pesa la preparación. En esa prueba, el primer arranque falló con las opciones por defecto; contando ese intento, desde el primer arranque hasta la primera respuesta pasaron 39 minutos y 35 segundos. Si el nodo spot se detiene y vuelves a empezar, pagas la preparación otra vez.
Comparemos con el volumen real de Duolingo. Las cinco tiendas de la muestra suman unas 2252 reseñas por día, así que juntar 131.595 reseñas lleva unos 58 días. En un mes llegan unas 67.560. Con la API estándar, el modelo cuesta unos 37 USD al mes en el escenario bajo y unos 98 USD en el alto. La descarga cuesta unos 0,47 USD, a 200 reseñas por llamada.
| Dato de Duolingo (cinco tiendas de la muestra) | Valor |
|---|---|
| Reseñas por día | Unas 2252 |
| Días para juntar 131.595 reseñas | Unos 58 |
| Reseñas por mes | Unas 67.560 |
| Modelo con API estándar, escenario bajo | Unos 37 USD al mes |
| Modelo con API estándar, escenario alto | Unos 98 USD al mes |
| Descarga de datos | Unos 0,47 USD al mes |
| Volumen para que un contrato anual iguale a la API | 47,8 millones al mes |
Un contrato de un año a 36 USD por hora cuesta 26.280 USD al mes, contando 730 horas. Para igualar a la API estándar tendrías que etiquetar unos 47,8 millones de reseñas al mes en el escenario bajo: cerca de 700 veces el volumen mensual de Duolingo en estas cinco tiendas. Un nodo etiqueta como máximo unos 124 millones de reseñas al mes en ese escenario. Para la mayoría de las marcas, la API o Batch salen más baratas.
Las buenas razones para alojar el modelo son otras: tus datos deben quedarse en tu propia sala de servidores, quieres ajustar el modelo con tus datos, o las GPU ya corren otro trabajo y las reseñas llenan el tiempo libre.
| Opción | Costo fijo al mes | Escenario bajo: gana a la API estándar desde | Escenario bajo: gana a Batch desde | Capacidad del nodo al mes |
|---|---|---|---|---|
| Nodo spot, encender y apagar | Ninguno, 34,07 USD por arranque | 131.595 reseñas por lote | 569.464 reseñas por lote | Según las horas alquiladas |
| Contrato de un año (36 USD por hora) | 26.280 USD | 47,8 millones de reseñas al mes | 74,9 millones de reseñas al mes | 124 millones (escenario bajo) |
| AWS Capacity Block (129,168 USD por hora) | Según las horas reservadas | Nunca | Nunca | Según las horas reservadas |
El modelo tiene tres simplificaciones. Primera: el rendimiento viene de la prueba de otro equipo, con otra proporción entre entrada y salida; el párrafo sobre el prellenado da la dirección de ese error. Segunda: no incluye almacenamiento, tráfico de salida ni horas de ingeniería. Tercera: los tokens de razonamiento son supuestos. Nuestro script de costos es un archivo corto de Python; cambia unas pocas constantes y usará tus volúmenes y tus precios.
La factura mensual con cuatro volúmenes
La tabla usa el escenario bajo y una corrida al mes. El nodo spot incluye un arranque de 34,07 USD, y la descarga usa llamadas a App Store de 200 reseñas a 0,001389 USD.
| Reseñas al mes | Descarga | API estándar | Batch | Nodo spot (un arranque) | Tiempo del nodo |
|---|---|---|---|---|---|
| 10.000 | 0,07 USD | 5,50 USD | 3,51 USD | 36,98 USD | Unas 0,06 horas |
| 100.000 | 0,69 USD | 54,98 USD | 35,07 USD | 63,16 USD | Unas 0,6 horas |
| 1.000.000 | 6,95 USD | 549,80 USD | 350,70 USD | 324,97 USD | Unas 5,9 horas |
| 10.000.000 | 69,45 USD | 5498 USD | 3507 USD | 2943 USD | Unas 58,6 horas |
Con 10.000 reseñas al mes, solo el arranque ya cuesta más que un mes de API. Con 100.000, Batch sigue siendo lo más barato. Con un millón, el nodo spot gana por primera vez, con unas 5,9 horas de uso. Con 10 millones, el nodo spot cuesta 2943 USD frente a 3507 USD de Batch. La descarga queda como una parte pequeña de la factura en todos los volúmenes.
El tamaño del lote también cambia la factura. Usamos 20 reseñas por lote como término medio: los 386 tokens fijos del prompt suman unos 19 tokens por reseña. Con lotes más grandes, el prompt se reparte más, pero cada respuesta debe alinear más ids y crece el riesgo de que falte una reseña o quede cambiada. Además, un lote fallido cuesta más al repetirlo.
Con la API estándar, el prompt va a precio de caché y el tamaño del lote casi no influye. Con Batch, la caché es de mejor esfuerzo, así que lotes más grandes ahorran un poco de entrada. En un nodo propio, lo que mueve el rendimiento es la concurrencia: la prueba de Spheron llegó a 2073,2 tokens de salida por segundo con 64 solicitudes simultáneas, pero una sola obtuvo 101,1. Lanza muchas solicitudes en paralelo para aprovechar el nodo completo. Con 64 solicitudes simultáneas, cada una recibió solo 34,2 tokens de salida por segundo y el primer token tardó 1,6 segundos de media. Un lote del escenario bajo tiene unos 875 tokens de salida, así que tarda unos 26 segundos. Escribe los resultados por lote, para que un fallo solo repita ese lote.
Descargas incrementales: quitar duplicados por id y cortar por fecha
Si descargas todo cada día, la misma reseña llega muchas veces y el modelo la etiqueta muchas veces. Una descarga incremental usa dos claves: el id de la reseña y su fecha de publicación. El ejemplo de abajo usa tres respuestas reales de Google Play en inglés, pedidas a las 00:19, 00:44 y 00:58 hora de Singapur del 2026-11-14.
En la primera respuesta, la reseña más nueva tiene el posted_at 2026-11-12T15:48:41.180000+00:00. Guárdalo como marca de agua. En la segunda respuesta, 36 reseñas son posteriores a esa marca: la más vieja es de las 15:52:15 y la más nueva de las 16:29:55. Si comparas por id con la primera respuesta, los ids nuevos son exactamente esos 36, así que los dos métodos dan lo mismo.
La tercera petición usa como marca 16:29:55.686, la reseña más nueva de la segunda. Hay 27 reseñas posteriores, y la comparación por id también da 27. La segunda y la tercera respuesta todavía comparten 164 y 173 reseñas con la anterior, así que entre una petición y otra no se perdió ninguna reseña.
Usa las dos claves juntas. La fecha sirve para cortar rápido «todo lo posterior a la última descarga», pero dos reseñas pueden caer en el mismo segundo: compara con «mayor o igual» y luego quita los ids que ya tienes. Además, cada tienda escribe la fecha a su manera. App Store trae un desfase como -07:00 y Google Play viene en UTC, así que pasa todo a UTC antes de comparar. Por ejemplo, la reseña más nueva de Estados Unidos en la primera respuesta es 2026-11-12T04:31:43-07:00, es decir, las 11:31:43 UTC.
El id es el último filtro. Usa «plataforma más id» como clave. Los ids de App Store son números, los de Google Play son UUID y los de Trustpilot tienen 24 caracteres hexadecimales; no chocan entre sí, pero el nombre de la plataforma hace más segura una tabla mixta.
Fija el intervalo según la velocidad de las reseñas, con un margen de la mitad. Una respuesta trae 200 reseñas, y el tiempo que cubre es 200 dividido entre las reseñas por hora. Descarga cada vez que pase la mitad de ese tiempo: así, aunque las reseñas suban de golpe, la siguiente respuesta todavía comparte algunos ids con la anterior.
| Tienda | Horas que cubren las 200 más nuevas | Reseñas por día | Intervalo sugerido |
|---|---|---|---|
| App Store de México | 158,08 | Unas 30 | Una vez al día |
| Google Play en español | 12,14 | Unas 395 | Cada 6 horas |
| App Store de Estados Unidos | 17,88 | Unas 269 | Cada 8 horas |
| Google Play en inglés | 3,21 | Unas 1493 | Cada 1,5 horas |
Cuando ya esté corriendo, vigila cuántos ids comparte cada respuesta con la anterior. Si esa coincidencia baja a 0, el intervalo es demasiado largo y puedes perder reseñas: descarga más seguido. Si se mantiene por encima de 190, puedes alargarlo. En las tres rondas, las 11 llamadas de reseñas a las tiendas y a Trustpilot costaron 0,015279 USD.
Manda al modelo solo los ids nuevos y no vuelvas a etiquetar reseñas viejas. Para tareas programadas y llamadas que se reintentan, usa la API REST con el encabezado Idempotency-Key; el artículo sobre el encabezado Idempotency-Key muestra cómo.
Cómo probar antes de salir a producción
Escribe tus criterios de aprobación antes de correr nada en tu servidor o en la API. Te sugerimos tres pasos, y cada uno usa una referencia externa al modelo. Primero, toma 200 reseñas de cada tienda y pide a dos personas que las etiqueten por separado. Usa como referencia las etiquetas en las que ambas coinciden, y discute las demás para afinar las definiciones.
Segundo, corre el modelo dos veces sobre el mismo lote. K3.1 Pro tiene el muestreo fijo y no puedes bajar la temperatura. El porcentaje de reseñas con la misma etiqueta principal en las dos pasadas muestra qué tan estable es el prompt. Si ese porcentaje es bajo, ajusta las definiciones o agrega algunos ejemplos. Tercero, lee el campo usage de cada respuesta, anota los tokens de entrada, salida y razonamiento por lote, y pon los números reales en el script de costos para ver dónde queda el punto de equilibrio.
| Revisión | Cómo medirla | Quién fija el límite |
|---|---|---|
| Coincidencia con la referencia humana | Etiqueta principal igual en la muestra de 200 | Responsable de producto o de soporte |
| Quejas de cobro sin marcar | Reseñas de cobro sin reply_needed | Responsable de soporte |
| Coincidencia entre pasadas | Misma etiqueta principal en dos corridas | Dueño de los datos |
| Costo real por cada 1000 reseñas | Tokens de usage por la lista de precios | Dueño del presupuesto |
Haz que los criterios sean concretos y revisa cada uno al terminar la corrida. Una queja de cobro que se escapa es lo más caro, así que puedes exigir un recall alto en billing. Confundir praise con other cuesta poco. Las muestras en español merecen su propia prueba: las reseñas son cortas, usan modismos locales («me descontaron», «está muy elevado el pago») y a veces mezclan inglés. Para medir el recall necesitas suficientes quejas por cobros en la referencia. En este lote encontramos 2 en 200 reseñas de Google Play en español (1 %) y ninguna en 200 de la App Store de México. Para tener 30 en la referencia, harían falta unas 3000 reseñas de Google Play en español. También puedes usar la regla de palabras clave para elegir más candidatas, y luego etiquetar aparte una muestra sin coincidencias para ver cuántas quejas se le escapan a la regla.
Límites y cosas a vigilar
Primero, no medimos las etiquetas del modelo, porque aquí no hay GPU. El prompt, el esquema, el comando de arranque y el script de etiquetado son ejemplos de configuración; mide la precisión en tu instalación con una muestra etiquetada por personas. Segundo, los tokens de razonamiento son supuestos. K3.1 Pro siempre razona primero: corre unos lotes con reasoning_effort en low y pon los conteos reales en el script de costos.
Tercero, el rendimiento y los precios de nube cambian seguido, y un nodo spot puede detenerse en cualquier momento. Los trabajos largos deben poder seguir desde el último lote guardado: escribe resultados por lote y salta los lotes cuyos ids ya están listos. Cuarto, los datos son públicos. Las reseñas salen de páginas públicas de las tiendas y nuestra API no inicia sesión ni lee contenido privado. Descarta nombres y avatares de autores antes de guardar.
Quinto, los dos umbrales de la licencia apuntan a servicios públicos de modelos y a productos muy grandes. Están descritos en la primera sección; antes de un uso comercial, compara tu caso con el texto original. Sexto, los comentarios de Xiaohongshu llegan en páginas de 15 y su precio por fila es unas 53 veces el de App Store; esa muestra sirve para comparar de forma cualitativa, no para un conteo completo.
Séptimo, fija las versiones. El repositorio de pesos cambió un archivo de codificación el 2026-11-05 y el parser de vLLM cambió su revisión en streaming el 2026-11-04. Usa la opción --revision de vLLM para fijar el commit que probaste, fija también la etiqueta de la imagen y guarda ambos valores en la tabla de etiquetas. Cuando el repositorio del modelo cambie, vuelve a correr la muestra humana antes de cambiar.
Para seguir leyendo: la API alojada de Kimi con comentarios de Weibo y resultados financieros salió antes de que se publicaran los pesos. DeepSeek V4.1 Flash para limpiar y etiquetar reseñas corrió una API alojada sobre 10.000 reseñas; su factura sirve para comparar con la de este artículo. Las llamadas a funciones de Tencent Hy4 explican formatos y tipos de parámetros. VS Code Copilot clasifica cada día las quejas de las tiendas de apps, un trabajo parecido con ejecución programada. Las páginas de plataforma son API de App Store, API de Google Play y API de Trustpilot.
Preguntas frecuentes
¿Puedo usar los pesos abiertos de Kimi K3.1 Pro en un producto comercial?
Sale del hilo de Reddit LocalLLaMA «Kimi-K3.1-Pro is now open-weights», donde la licencia fue el tema más discutido. La base es MIT con dos condiciones: un negocio de modelo como servicio con más de 20 millones de dólares de ingresos en 12 meses necesita un acuerdo aparte, y un producto con más de 100 millones de usuarios al mes o 20 millones de dólares de ingresos mensuales debe mostrar «Kimi K3.1-Pro». Para saber si un uso entra en estas condiciones, guíate por el archivo LICENSE y por tu equipo legal.
¿Hay un ejemplo de vLLM para Kimi K3.1 Pro?
Sale de la sugerencia de Google «kimi k3.1 pro vllm example». La receta de vLLM da opciones y preajustes por tipo de hardware, y la entrada del blog de vLLM del 2026-11-04 cuenta el soporte desde el primer día. Usa los parsers kimi_k3, porque la guía general de herramientas todavía lista solo kimi_k2. Puedes adaptar el comando de arranque y el script por lotes de este artículo: cambia el nombre del modelo y la URL del endpoint.
¿Habrá un GGUF de Kimi K3.1?
Sale del hilo de unsloth en Reddit «Any plans for kimi K3.1?». Cuando escribimos esto, Hugging Face tenía varias subidas GGUF de la comunidad, de IQ1_S a MXFP4_MOE, con tamaños de unos 580 GB a unos 1509 GB. llama.cpp aceptó el modelo de texto el 2026-11-06 y la parte de visión el 2026-11-10. La cuenta oficial todavía no tenía un GGUF. Los repositorios con «12GB» en el nombre no coinciden con el número de parámetros: no los descargues.
Referencias
- Blog técnico de Kimi K3.1 Pro, Kimi, 2026-10-23, https://www.kimi.ai/blog/kimi-k3-1-pro
- Ficha de moonshotai/Kimi-K3.1-Pro, Hugging Face, último commit 2026-11-05, https://huggingface.co/moonshotai/Kimi-K3.1-Pro
- Kimi K3.1-Pro License, Hugging Face, https://huggingface.co/moonshotai/Kimi-K3.1-Pro/blob/main/LICENSE
- encoding_k3.py, Hugging Face, 2026-11-05, https://huggingface.co/moonshotai/Kimi-K3.1-Pro/blob/main/encoding_k3.py
- Guía rápida de Kimi K3.1 Pro, plataforma de Kimi, https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Precios de modelos de chat, plataforma de Kimi, https://platform.kimi.ai/docs/pricing/chat
- Precios de Kimi K3.1 Pro, Kimi, https://www.kimi.ai/resources/kimi-k3-1-pro-pricing
- Precios de Batch, plataforma de Kimi, https://platform.kimi.ai/docs/pricing/batch
- Usar la API Batch, plataforma de Kimi, https://platform.kimi.ai/docs/guide/use-batch-api
- Salida estructurada (response_format), plataforma de Kimi, https://platform.kimi.ai/docs/guide/response_format
- Esfuerzo de razonamiento, plataforma de Kimi, https://platform.kimi.ai/docs/guide/use-reasoning-effort
- Límites de tasa, plataforma de Kimi, https://platform.kimi.ai/docs/pricing/limits
- Receta de moonshotai/Kimi-K3.1-Pro, vLLM Recipes, https://recipes.vllm.ai/moonshotai/Kimi-K3.1-Pro
- Soporte de Kimi K3.1 Pro desde el primer día, blog de vLLM, 2026-11-04, https://vllm.ai/blog/2026-11-04-kimi-k31-pro
- Cookbook de Kimi-K3.1-Pro, documentación de SGLang, https://docs.sglang.io/cookbook/autoregressive/Moonshotai/Kimi-K3.1-Pro
- Tool parser, documentación de SGLang, https://docs.sglang.io/advanced_features/tool_parser.html
- Tool calling, documentación de vLLM, https://docs.vllm.ai/en/latest/features/tool_calling.html
- Structured outputs, documentación de vLLM, https://docs.vllm.ai/en/latest/features/structured_outputs.html
- Reasoning outputs, documentación de vLLM, https://docs.vllm.ai/en/latest/features/reasoning_outputs.html
- kimi_k3_tool_parser.py, vLLM, commit del 2026-11-04, https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/kimi_k3_tool_parser.py
- kimi_k3_reasoning_parser.py, vLLM, https://github.com/vllm-project/vllm/blob/main/vllm/reasoning/kimi_k3_reasoning_parser.py
- kimik3_detector.py, SGLang, https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/function_call/kimik3_detector.py
- vllm-project/vllm, GitHub, https://github.com/vllm-project/vllm
- sgl-project/sglang, GitHub, https://github.com/sgl-project/sglang
- model: add Kimi-K3.1-Pro text model (#31779), llama.cpp, aceptado el 2026-11-06, https://github.com/ggml-org/llama.cpp/pull/31779
- mtmd: add kimi K3.1 vision (#31980), llama.cpp, aceptado el 2026-11-10, https://github.com/ggml-org/llama.cpp/pull/31980
- API de búsqueda de modelos de Hugging Face (Kimi-K3.1-Pro), leída el 2026-11-14, https://huggingface.co/api/models?search=Kimi-K3.1-Pro
- nvidia/Kimi-K3.1-Pro-NVFP4, Hugging Face, 2026-11-11, https://huggingface.co/nvidia/Kimi-K3.1-Pro-NVFP4
- Introducing NVFP4 for efficient low-precision inference, blog para desarrolladores de NVIDIA, https://developer.nvidia.com/blog/introducing-nvfp4-for-efficient-and-accurate-low-precision-inference/
- Microscaling Data Formats for Deep Learning, arXiv, 2023, https://arxiv.org/abs/2310.10537
- tiktoken, OpenAI, GitHub, https://github.com/openai/tiktoken
- tiktoken, PyPI, https://pypi.org/project/tiktoken/
- Kimi K3.1 vs DeepSeek V4.1 on B300, Spheron, 2026-11-08, https://www.spheron.network/blog/kimi-k3-1-vs-deepseek-v4-1-b300/
- Precios de Amazon EC2 Capacity Blocks for ML, AWS, leído el 2026-11-14, https://aws.amazon.com/ec2/capacityblocks/pricing/
- Capacity Blocks for ML, guía de AWS EC2, https://docs.aws.amazon.com/AWSEC2/latest/UserGuide/ec2-capacity-blocks.html
- Precios de GPU, FlexiCloud, leído el 2026-11-14, https://flexicloud.co/gpu
- B300 rental price 2026, Akash Network, https://akash.network/the-bid/b300-rental-price-2026-cost-per-hour/
- Kimi K3.1 Pro launch benchmarks, Artificial Analysis, https://artificialanalysis.ai/articles/kimi-k3-1-pro-launch-benchmarks
- Introducing Kimi K3.1 Pro on Amazon Bedrock, blog de aprendizaje automático de AWS, 2026-11-10, https://aws.amazon.com/blogs/machine-learning/introducing-kimi-k3-1-pro-on-amazon-bedrock/
- Kimi-K3.1-Pro is now open-weights, Reddit r/LocalLLaMA, https://www.reddit.com/r/LocalLLaMA/comments/1xnrhvb/kimik31pro_is_now_openweights/
- Any plans for kimi K3.1?, Reddit r/unsloth, https://www.reddit.com/r/unsloth/comments/1xq9wgo/any_plans_for_kimi_k31/
- Video: Kimi K3.1 Just Gave Away Opus-Level AI for Free, YouTube, 2026-11-06, https://www.youtube.com/watch?v=o7HxqdTm9Jo
- List all customer reviews for an app, documentación para desarrolladores de Apple, https://developer.apple.com/documentation/appstoreconnectapi/get-v1-apps-_id_-customerreviews
- Reply to Reviews, documentación para desarrolladores de Google Play, https://developers.google.com/android-publisher/reply-to-reviews
- Business Units API, documentación para desarrolladores de Trustpilot, https://developers.trustpilot.com/business-units-api
- Function calling, documentación de la plataforma de OpenAI, https://platform.openai.com/docs/guides/function-calling
- Batch API, documentación de la plataforma de OpenAI, https://platform.openai.com/docs/guides/batch
- concurrent.futures, documentación de Python, https://docs.python.org/3/library/concurrent.futures.html
- Catálogo de capacidades de App Store, EveryInfra, leído el 2026-11-14, https://api.everyinfra.com/api/v1/social/catalog?platform=app_store
- Catálogo de capacidades de Google Play, EveryInfra, leído el 2026-11-14, https://api.everyinfra.com/api/v1/social/catalog?platform=google_play
- Catálogo de capacidades de Trustpilot, EveryInfra, leído el 2026-11-14, https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- Catálogo de capacidades de Xiaohongshu, EveryInfra, leído el 2026-11-14, https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- API de datos sociales de EveryInfra, https://api.everyinfra.com/api/v1/social
Referencia BL-144