腾讯 Hy4 工具调用接微博热搜、B站和抖音:工具定义、参数类型和 token 账
Hy4 正式版权重未公开,自托管只能用 preview;3 个工具占 506 token,抖音 10 条原样 12,902 token,裁剪后剩 8.6%。
腾讯在 2026 年 11 月 4 日发布了 Hy4 正式版,但到 11 月 11 日凌晨我们查 Hugging Face 时,能下载的权重仍然只有 8 月 27 日上传的 Hy4 preview,所以「自己部署 Hy4 再接实时数据」今天能落地的是 preview,正式版只能经腾讯云和 OpenRouter 托管调用。我们没有运行 Hy4,模型一侧都写成配置示例;实测的是我们的数据接口,11 月 11 日三个时刻共真调 18 次。token 数则用 Hy4 preview 自带的对话模板和分词器在本机算出来:3 个工具定义占 506 个 token,一次抖音搜索的 10 条结果原样塞回去是 12,902 个 token,只留模型用得上的字段后是 1,110 个,只剩 8.6%。另一个更容易踩的坑在参数类型上:vLLM 的 Hy4 解析器只按工具定义里写的类型转换参数,limit 没写成 integer 时会以字符串 "10" 交给你的代码,我们的接口会回 422 并且不扣费,但你的循环就白跑了一轮。
这篇要回答的问题很具体:你已经有一台自己部署的开源模型,或者打算用 Hy4 这种权重开放的模型,因为数据不想出内网、想自己控成本或想微调;现在要让它回答「今天微博在热议什么、B 站和抖音上相关视频怎么样」这类问题。模型自己不知道今天的事,所以要给它一组工具,让它在需要时发出调用,由你的程序去取数,再把结果交回模型。下面每一步都标清楚哪些是我们真调、真算的,哪些是照官方文档写的配置示例。
先把名字和版本说清楚:tencent hy4 正式版、preview 和「开源」
写这篇之前我们先把版本对了一遍,因为网上的说法混在一起。腾讯 11 月 4 日的新闻稿写的是 Hy4 正式版发布,新增视觉理解和电脑操作,并说会在「coming days」公开模型权重和系统卡;同一天的混元研究页和中文版写法一致。我们在 2026 年 11 月 11 日 00:2x(新加坡时间)用 Hugging Face 的公开接口查了腾讯账号下名字带 Hy4 的模型,只有两个:tencent/Hy4-preview 和 tencent/Hy4-preview-FP8,都是 8 月 27 日创建、8 月 28 日最后更新;直接访问 tencent/Hy4 返回 404。2026 年 11 月 12 日 01:10(新加坡时间)发稿前我们又查了一次,结果相同:仍只有这两个 preview 仓库,模型接口查 tencent/Hy4 返回 401,这是仓库不存在或未公开时的回法。也就是说,「开源」今天只对 preview 成立。
preview 的基本信息以模型卡和 GitHub 仓库为准:MoE 结构,770B 总参数、每个 token 激活 49B,78 层,每层 256 个路由专家取前 8 个加 1 个共享专家,另带一个 10B 参数的 MTP 层用于投机解码;上下文 1M;许可证是 Apache 2.0。我们用 Hugging Face 的文件列表把权重大小加了一遍:BF16 版 131 个分片共 1,560.0 GB,FP8 版 130 个分片共 813.8 GB。官方给的部署命令都是 8 卡张量并行,这决定了后面算账时自托管的门槛。
正式版目前能用的入口是托管接口。我们在 11 月 11 日 00:16(新加坡时间)读了 OpenRouter 的模型列表接口:tencent/hy4 创建于 11 月 4 日,上下文 1,048,576,唯一的服务方是腾讯,量化标为 fp4,单次最多输出 65,536 个 token,支持的参数里有 tools。腾讯云开发者社区的发布文章写了国内价:输入每百万 token 6 元、输出 18 元、缓存命中 0.3 元,和 preview 相同,TokenHub 到 12 月 31 日打五折。
| 版本 | 发布日期 | 权重 | 怎么调用 | 工具调用 |
|---|---|---|---|---|
| Hy4 preview | 2026-08-27 上传,08-28 更新 | 已公开,Apache 2.0;BF16 1,560.0 GB,FP8 813.8 GB | 自己用 vLLM 或 SGLang 部署;托管也有 | 有,模板和解析器都公开 |
| Hy4 正式版 | 2026-11-04 | 写的是「近期」公开;11-11 查不到 | 腾讯云 TokenHub、OpenRouter、WorkBuddy 等 | 托管接口支持 tools |
| Hy4 Flash | 新闻稿写「即将发布」 | 未知 | 未上线 | 未知 |
这张表决定了本文的写法:协议细节、模板、分词器、解析器都来自 preview 的公开文件,可以在本机逐字核对;正式版的工具调用我们只能引用托管方的参数说明。正式版权重公开后,模板和解析器如果有变化,本文的 token 数需要重算,这一点写在文末的边界里。
为什么要给开源模型接实时社媒数据
开源模型的知识停在训练截止那天。Hy4 研究页提到它做了「时效检索、多源信息整合、事实一致性校验」方面的专项优化,并给出幻觉率下降的数字,但这些能力的前提是有人把新鲜的材料交给它。腾讯自家产品里,这部分由 WorkBuddy、元宝这些产品的搜索和连接器完成;你自己部署的模型没有这些,问它「今天微博热搜第一是什么」,它只能编,或者老实说不知道。
腾讯公布的幻觉率降幅在新闻稿和研究页里写法不一,而且都是内部评测,我们没有复现,引用时请带上出处。
工具调用解决的就是「把新鲜材料交给模型」这一步。模型不直接上网,它只输出一段结构化的请求,例如「调用 weibo_trending,limit=20」;你的程序收到后去调真正的数据接口,把结果作为一条 tool 消息塞回对话,模型再接着推理。这个分工的好处是取数这件事完全在你手里:调哪个接口、带什么鉴权、结果裁掉哪些字段、一分钟最多调几次,都由你的执行器决定,模型只负责判断什么时候要数据、要什么数据。
我们选微博热搜、B 站搜索和抖音搜索三个能力,是因为它们正好代表了三种常见的数据形状。微博热搜是一张短表,每行只有排名、标题、热度;B 站搜索返回视频列表,字段多但每条不长;抖音搜索返回的每条视频带作者资料、话题、音乐、多档码率的视频地址,一条就很长。三种形状对模型的上下文压力差别很大,后面的实测会看到差了一个数量级。三个平台的总览页分别在微博、B 站和抖音。
hy4 function calling 在协议层长什么样
大多数开发者接触 hy4 function calling 时看到的是 OpenAI 兼容接口:请求里带 tools 数组,响应里拿到 tool_calls,和 OpenAI 的函数调用指南写的一样。但模型本身输出的不是这个 JSON。我们下载了 preview 的 chat_template.jinja,它定义了模型实际看到和写出的文本:工具清单放在系统消息开头的 <tools></tools> 里,每个工具一行 JSON;模型发起调用时先写 <tool_calls:opensource>,每个调用写成 <tool_call:opensource>函数名,后面跟成对的 <arg_key> 和 <arg_value> 标签,最后再闭合。下面是我们用这个模板在本机渲染出来的一段,内容是第 1 轮的真实热搜返回(裁剪后):
<tool_calls:opensource><tool_call:opensource>weibo_trending<arg_key:opensource>limit</arg_key:opensource><arg_value:opensource>20</arg_value:opensource></tool_call:opensource></tool_calls:opensource><|hy_end:opensource|><|hy_start:opensource|>tool<|hy_middle:opensource|><tool_response:opensource>[{"rank":1,"title":"金鸡奖获奖名单","hot_value":1323824,"category":"电影"},{"rank":2,"title":"拼多多送货上门新规11月13日生效","hot_value":856784, ...这个格式有三个直接后果。第一,参数值在模型那一层全是文本,20 和 "20" 长得一样,要靠服务端的解析器按工具定义把它转回整数,所以工具定义里的类型不能省。第二,模板在把工具定义写进 prompt 时会删掉 strict 和 defer_loading 两个键(模板里 tool_to_json 宏的写法),我们渲染后的 prompt 里确实找不到 "strict",模型看不到你是否要求了严格模式;additionalProperties 则原样保留。第三,带工具的对话默认 preserved_thinking 为真,上一轮的思考内容会留在后续 prompt 里,推理模式默认是 high,可以用 reasoning_effort: "no_think" 关掉,这两点都会影响 token 用量。
把这段文本转回 tool_calls 的是推理框架。vLLM 的 Hy4 部署说明要求加 --tool-call-parser hy_v4 --reasoning-parser hy_v4 --enable-auto-tool-choice;SGLang 的说明用 --tool-call-parser auto。我们读了 vLLM 主干上的 hy_v4_tool_parser.py,它的 _parse_value 函数按工具定义里该参数的类型依次尝试布尔、整数、数字、JSON,最后才退回字符串。这个文件最近一次功能改动是 10 月 31 日合并的 PR #61542,修的是参数名里的空白被吃掉的问题;如果你的 vLLM 版本早于这次合并,参数名带空格的工具会出错。
# 配置示例(照 vLLM 官方 Hy4 部署说明,本机未运行):8 卡 FP8,打开工具调用
vllm serve tencent/Hy4-preview-FP8 \
  --tensor-parallel-size 8 \
  --speculative-config '{"num_speculative_tokens":3,"method":"mtp"}' \
  --attention-backend FLASHMLA_SPARSE \
  --tool-call-parser hy_v4 --reasoning-parser hy_v4 \
  --enable-auto-tool-choice \
  --tool-strict-level function \
  --served-model-name hy4-preview --port 8000
上面最后加的 --tool-strict-level function 不在腾讯的部署说明里,是 vLLM 在 9 月 18 日通过 PR #56268 加的服务端开关。这个 PR 的说明里给了一组很说明问题的数:作者统计了一个线上部署的 9,500 次请求,没有一次带 tool_choice,17,476 个工具定义里 strict 全是 false,因为常见的 SDK 和智能体框架默认就这么发;结果是服务端没法约束模型输出的调用格式,模型写坏了标签,解析器也救不回来。开关有三档:auto 是旧行为,只有标了 strict 的工具才受约束;function 约束调用的外壳和函数名;parameter 再把参数也按工具定义约束住。自托管时这个开关在你手里,托管接口上则取决于服务方。
官方评测里的工具调用分数
模型会不会在该调工具的时候调、参数写得对不对,我们本机没法测。能引用的是腾讯在 preview 模型卡附录里公布的分数。和工具调用最直接相关的两项是 MCP-Atlas(公开集)和 Toolathlon-Verified:Hy4 preview 分别是 83.7 和 74.1,上一代 Hy3 是 75.0 和 56.2。同一张表里,GLM 5.3 是 81.9 和 73.0,Kimi K3 是 84.2 和 76.5,Claude Opus 5 是 85.7 和 76.5;这些对手的分数在表里都带星号,表示是腾讯引用的其他来源。Toolathlon 的任务和评分方法见它的 GitHub 仓库;Hugging Face 上把这项分数登记成社区评测结果的方式见评测结果说明。
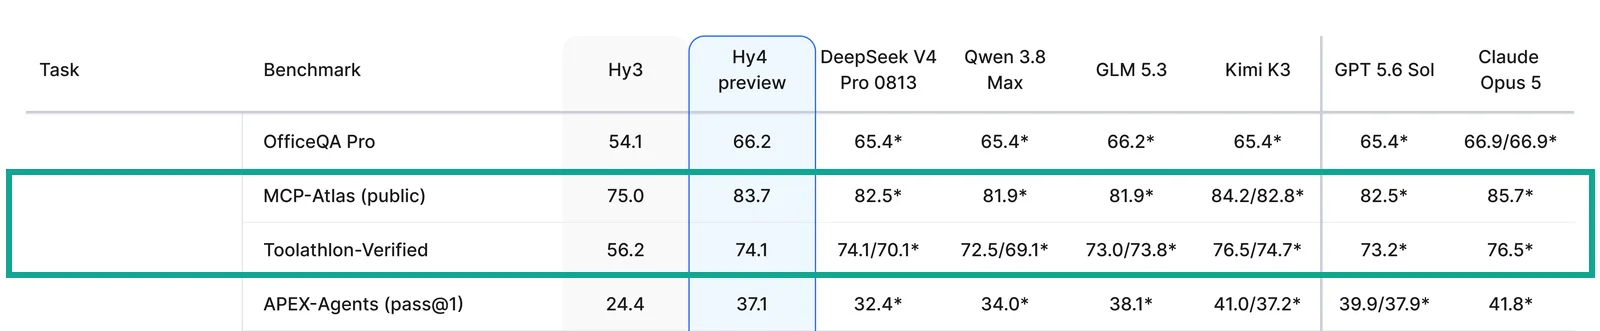
这组数说明两件事,也有两个边界。说明的是:从 Hy3 到 Hy4 preview,工具调用类评测提升明显,Toolathlon 涨了 17.9 分;在同代开源模型里它处在中间偏上,不是最高。边界一:这是 preview 的分数,正式版研究页给的总表我们没有找到这两项的单独数字,正式版的系统卡公布后才能对上。边界二:这些评测里的工具大多是通用的文件、网页、代码类工具,和「按关键词搜 B 站」这种具体接口不完全是一回事,所以下面我们不去猜模型会不会调错,而是把调错之后会发生什么测清楚。
工具定义怎么写:一个通用工具还是三个专用工具
接 EveryInfra 这类有几百项能力的数据接口,第一反应往往是只定义一个通用工具,参数是平台、能力名和一个 params 对象,让模型自己去填。我们把这种写法和「每个能力一个专用工具」都写了出来,用 preview 的模板渲染、分词器计数,比较它们各自往 prompt 里加了多少 token。对照组是同样的系统消息和用户问题、不带工具,共 71 个 token。
[
  {"type": "function", "function": {
    "name": "weibo_trending",
    "description": "Weibo hot search list right now: rank, title, hot_value, category, label.",
    "parameters": {"type": "object", "additionalProperties": false, "required": [],
      "properties": {"limit": {"type": "integer", "minimum": 1, "maximum": 200}}},
    "strict": true}},
  {"type": "function", "function": {
    "name": "bilibili_search",
    "description": "Search Bilibili videos by keyword. Returns title, url, posted_at, view/like/comment/danmaku counts.",
    "parameters": {"type": "object", "additionalProperties": false, "required": ["keyword"],
      "properties": {"keyword": {"type": "string"},
        "sort": {"type": "string", "enum": ["most_commented", "most_liked", "most_viewed", "newest", "relevance"]},
        "limit": {"type": "integer", "minimum": 1, "maximum": 50}}},
    "strict": true}},
  {"type": "function", "function": {
    "name": "douyin_search",
    "description": "Search Douyin videos by keyword. Returns text, url, posted_at, like/comment/share counts, author.",
    "parameters": {"type": "object", "additionalProperties": false, "required": ["keyword"],
      "properties": {"keyword": {"type": "string"},
        "publish_time": {"type": "string", "enum": ["half_year", "one_day", "one_week", "unlimited"]},
        "sort": {"type": "string", "enum": ["most_liked", "newest", "relevance"]},
        "limit": {"type": "integer", "minimum": 1, "maximum": 50}}},
    "strict": true}}
]上面三个专用工具的枚举值都是从我们的公开目录里原样取的,目录同时给出每个参数的中文说明、默认条数和上限。四种写法的结果如下表。
| 写法 | 工具数 | 工具定义 JSON 字节 | 加进 prompt 的 token |
|---|---|---|---|
1 个通用工具,params 是嵌套对象 | 1 | 525 | 256 |
| 3 个专用工具,扁平参数、短英文说明 | 3 | 1,415 | 506 |
| 3 个专用工具,照抄目录里的中文参数说明 | 3 | 3,237 | 939 |
| 10 个专用工具,扁平参数、短英文说明 | 10 | 3,675 | 1,090 |
通用工具最省 token,但它把难题推给了模型:模型得记住几百个平台和能力的名字,还得知道每个能力的参数名和允许值;写错时只能靠我们接口返回的 422 去改。更要紧的是上一节说的类型问题,params 是一个对象,模型在标签格式里会把它写成一段 JSON 文本,只有当工具定义里写明 "type": "object" 时,vLLM 的解析器才会把它解析回对象。专用工具多花两三百个 token,换来的是每个参数都有类型、枚举和上下限,解析器和服务端的约束都能起作用。照抄目录中文说明会让 token 数几乎翻倍,而多出来的大多是给人看的细节,例如分页令牌的有效期;模型做决定用不到这么多,我们的建议是说明写一句话,细节留在执行器里处理。
还要注意这部分开销是每一轮都付的:工具清单在系统消息里,模型每次被调用都要重新读一遍。一次「查热搜再搜两个平台」的任务至少三轮,工具定义就被计费三次。10 个工具时每轮 1,090 token,按 OpenRouter 的输入价 $0.417/百万 token 算,三轮约 $0.0014,单看不多,但如果你的智能体一天跑上千次,这笔钱会比你想的大。
参数类型:integer 不写清楚,"10" 就会变成字符串
这一节是本文最实用的发现,而且可以完全在模型以外核对。我们把 vLLM 解析器里负责转换参数值的几个函数原样抽出来,在本机喂给它同一段文本 10,只改工具定义里 limit 的写法,看它交给你的代码的是什么;然后把这两种结果真的发给我们的接口。
| 工具定义里 limit 的写法 | 解析器交出的值 | 发给 EveryInfra 的结果 |
|---|---|---|
{"type": "integer"} | 10(整数) | 正常返回 |
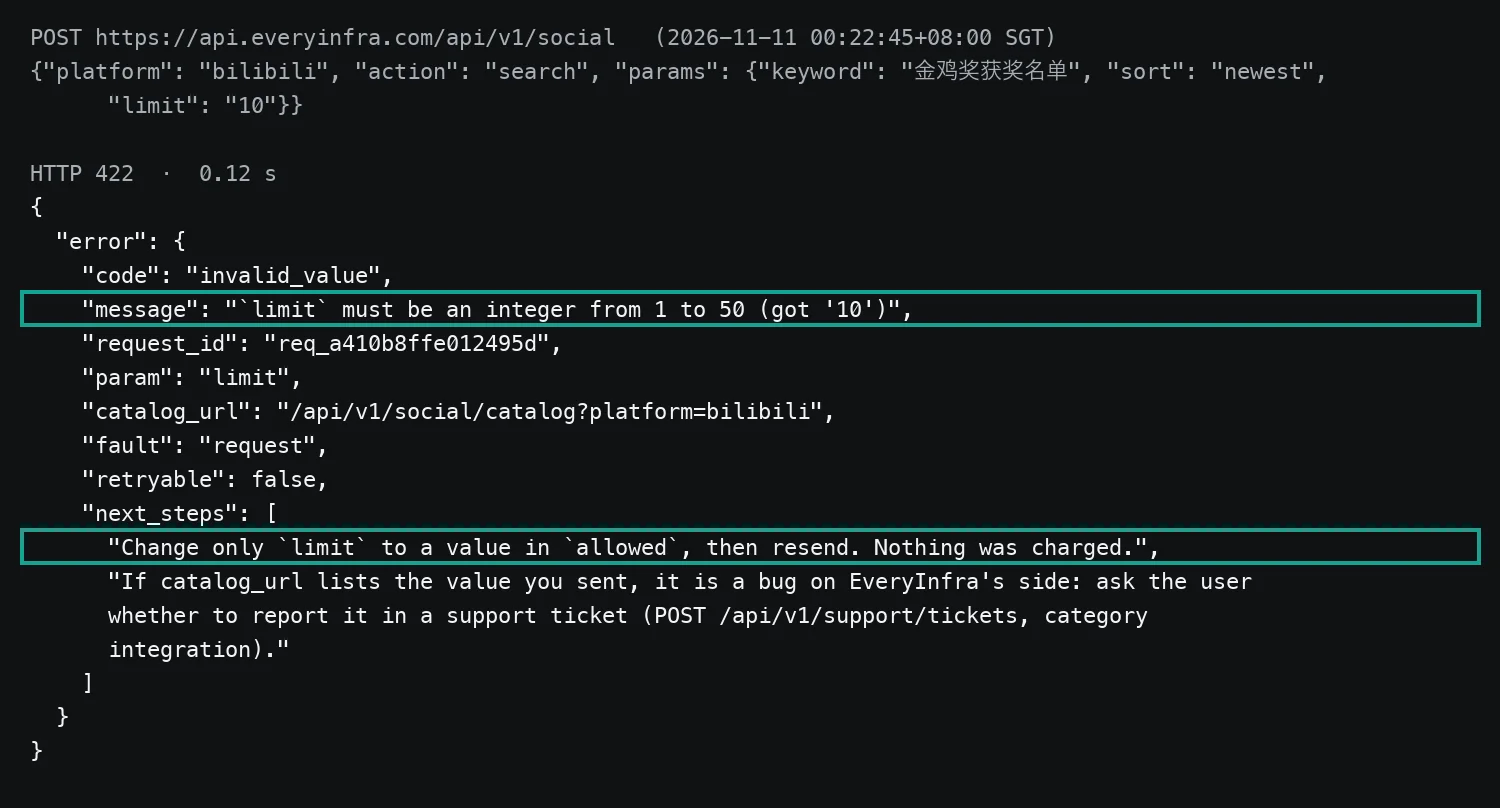
{"type": "string"} | "10"(字符串) | 422:limit must be an integer from 1 to 50 (got '10'),不扣费 |
| 不写 type | "10"(字符串) | 同上 |
| 工具定义里没有这个参数 | "10"(字符串) | 同上 |
通用工具里 params 写成 object | 对象 | 正常返回 |
通用工具里 params 不写 type | 一整段字符串 | 422:params: Input should be a valid dictionary,不扣费 |
表里两次 422 都是 2026 年 11 月 11 日 00:22(新加坡时间)真调的结果,响应原文如下图。我们的接口在参数错时会写明哪个参数、期望什么、你发了什么,并在 next_steps 里写「Nothing was charged」,这段文字是专门写给模型看的:把它原样作为 tool 消息交回去,大多数模型能自己改正再调一次。但这一来一回又多了一轮推理和一轮 prompt,Hy4 默认还开着深度思考,代价不是零。最省事的办法是在工具定义里把每个参数的类型写全,再在执行器里做一次转换:遇到 "10" 这种纯数字字符串,按工具定义转成整数再发。类型怎么写,照 JSON Schema 的 type 说明即可;OpenAI 的结构化输出文档对严格模式下哪些写法受支持列得更细,比如每个属性都要列进 required、additionalProperties 必须是 false,这些要求放到自托管的 Hy4 上同样是好习惯。
同一时段我们还故意把 B 站搜索的 sort 写成不存在的 hot(00:20 新加坡时间)。返回同样是 422,并给出全部允许值和两个最接近的候选 most_liked、most_viewed,同样不扣费。对智能体来说,这种「错了也告诉你怎么改」的返回比一句 Bad Request 有用得多;对你的账单来说,错误请求不扣钱,意味着让模型自己试错的成本只有模型那一侧的 token。
执行器这一侧的完整往返:手写的模型调用和我们的真实返回
下面从执行器这一侧把一次完整的往返串起来。用户问:「现在微博热搜第一是什么?去 B 站和抖音各找 10 条相关视频,告诉我哪边讨论更新鲜。」模型一侧是配置示例,我们没有运行 Hy4,模型发出的调用是按这个问题手写的;我们这一侧的三次调用都是 11 月 11 日凌晨真调的,返回的内容和计费都来自原始响应。


第一轮,模型读到问题和工具清单,发出 weibo_trending(limit=20)。我们的执行器把它翻译成对 EveryInfra 的请求,00:19:46(新加坡时间)发出,0.81 秒返回 20 条热搜,扣费 $0.000556。排在第一的是「金鸡奖获奖名单」,热度 1,323,824,分类是电影;第二是「拼多多送货上门新规11月13日生效」。第二轮,模型拿热搜第一条当关键词,同时发出 bilibili_search 和 douyin_search 两个调用,抖音那边加了 publish_time=one_day。B 站搜索 00:21:05 返回 10 条,用时 1.7 秒,扣费 $0.000556;抖音搜索 00:21:20 返回 10 条,用时 5.97 秒,扣费 $0.008333。测试用 Key 限速每分钟 10 次,连发时撞上两次 429,返回里写明 6 秒后重试、不扣费,后面「错误、限速和扣费」一节再细说。
# 执行器:把模型发出的 tool_calls 翻译成 EveryInfra 请求,裁字段后交回模型
# 模型一侧为配置示例(OpenAI 兼容客户端连自己部署的 vLLM);EveryInfra 一侧与本文真调一致
import json, os, requests
from openai import OpenAI

llm = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
EI = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
ROUTE = {"weibo_trending": ("weibo", "trending"),
         "bilibili_search": ("bilibili", "search"),
         "douyin_search": ("douyin", "search")}
KEEP = {"weibo_trending": ["rank", "title", "hot_value", "category"],
        "bilibili_search": ["title", "url", "posted_at", "view_count", "comment_count", "danmaku_count"],
        "douyin_search": ["text", "url", "posted_at", "like_count", "comment_count", "author_name"]}

def run_tool(name, args, schema):
    if name not in ROUTE:                       # 白名单:模型编出来的工具名不发
        return {"error": f"unknown tool {name}"}
    for k, v in list(args.items()):             # 按工具定义补救类型:"10" -> 10
        if schema.get(k, {}).get("type") == "integer" and isinstance(v, str) and v.isdigit():
            args[k] = int(v)
    platform, action = ROUTE[name]
    r = requests.post(EI, headers=HEAD, timeout=90,
                      json={"platform": platform, "action": action, "params": args})
    body = r.json()
    if r.status_code != 200:                    # 422 / 429 原样交回,模型能读懂 next_steps
        return body.get("error", body)
    rows = [{k: row.get(k) for k in KEEP[name] if row.get(k) is not None}
            for row in body.get("results", [])]
    for row in rows:
        if "text" in row:
            row["text"] = row["text"][:80]
    return {"count": len(rows), "results": rows, "charged_usd": body["billing"]["charged_usd"]}
模型拿到三条 tool 消息之后的回答,我们不替它写;能确定的是它会看到什么。B 站的 10 条是按综合排序取的,发布时间多在 2026 年 11 月 9 日到 11 月 10 日夜里,最早一条是 2026 年 10 月 19 日的提名争议视频,只有 1 条是在请求前 24 小时内发的,内容多是颁奖前的预测;抖音按最近 24 小时过滤,10 条全是 11 月 10 日晚上颁奖之后的发布,作者多是搜狐娱乐、厦门广电、1905电影网、央视文艺这类机构号,最新一条距请求只有 0.6 小时。所以对「哪边讨论更新鲜」这个问题,正确答案取决于你给 B 站传了什么排序,这正是工具定义里要把 sort 的枚举列清楚的原因。
没跑模型,token 是怎么量的
本文里所有 token 数都不是估算,而是用 Hy4 preview 自己的文件在本机算出来的,方法很简单,你也可以照做。第一步,从 Hugging Face 下载 chat_template.jinja 和 tokenizer.json 两个文件,前者 14,674 字节,后者约 9.4 MB,不需要下载任何权重。第二步,用 Jinja 的沙箱环境加载模板,补上 Transformers 渲染模板时提供的两个函数:raise_exception 和带 ensure_ascii 参数的 tojson(Transformers 的对话模板文档写了这套约定)。第三步,把系统消息、用户问题、工具清单、模型的调用和工具返回按 OpenAI 的消息格式喂给模板,得到模型真正读到的那段文本;再用 tokenizers 库加载分词器计数。
| 步骤 | 文件或工具 | 大小或版本 | 得到什么 |
|---|---|---|---|
| 1 | chat_template.jinja | 14,674 字节 | 工具清单、调用和工具返回在 prompt 里的原文 |
| 2 | tokenizer.json | 约 9.4 MB | 和模型一致的 token 计数 |
| 3 | Jinja 沙箱 + tojson + raise_exception | 用 uv 临时装 jinja2、tokenizers | 和 Transformers 一样的渲染结果 |
| 4 | OpenAI 格式的消息 | 第 1 轮的真实返回 | 每一轮 prompt 的大小,原样和裁剪后各一份 |
这样量出来的数有两个好处。一是它和推理框架实际送进模型的 prompt 一致,因为 vLLM 和 SGLang 用的就是同一个模板;二是它可以反复做对照实验,改一个字段、加一个工具,马上能看到 token 的变化,不用租 8 张卡。局限也要说清:分词器只告诉你输入有多少 token,模型会输出多少思考内容、调用写得有多长,这些只能真跑才知道;托管接口背后的模板如果和公开文件不同,账单上的 token 数也会不同。我们在 2026 年 11 月 11 日的测量里,不带工具的基准对话是 71 个 token,这个数可以拿来检查你自己的渲染是否和我们一致。
输出这一侧虽然量不了,结构上可以先想清楚。Hy4 默认打开深度思考,vLLM 启动时加了 --reasoning-parser hy_v4,它会把思考内容从正文里分出来,放进响应的单独字段(vLLM 的 Reasoning Outputs 文档写了这个字段怎么取);工具调用则由 --tool-call-parser 放进 tool_calls。两者都走 vLLM 的 OpenAI 兼容服务,所以你的执行器只需要读标准字段。要注意的是前面说过的 preserved_thinking:带工具时思考内容会留在下一轮 prompt 里,三轮对话的输入 token 会比我们上面量出的数更多,多多少取决于模型每轮想了多少。想压低这部分,可以在不需要推理的取数轮把 reasoning_effort 设成 no_think,到最后汇总时再打开。
工具结果要先裁字段
原样把接口返回塞给模型最省事,也最贵。我们把第 1 轮三次真调的返回分别用 Hy4 分词器计数,再按执行器里的裁剪规则只留模型做判断要用的字段,结果如下。
| 能力 | 条数 | 原样字节 | 原样 token | 裁剪后 token | 留下比例 |
|---|---|---|---|---|---|
weibo/trending | 20 | 7,276 | 3,287 | 545 | 16.6% |
bilibili/search | 10 | 8,949 | 3,227 | 842 | 26.1% |
douyin/search | 10 | 29,001 | 12,902 | 1,110 | 8.6% |
抖音那一项特别大,原因在字段:目录里 douyin/search 的 response_fields 有 55 个,除了正文、计数和作者,还有多档码率的视频地址、下载地址、封面和动图封面、音乐信息、话题 ID、作者头像和粉丝数等。这些对做数据分析很有用,对模型回答「哪边更新鲜」几乎没用,还会把真正有用的标题和时间淹没在一长串地址里。热搜返回本身不长,但每行带一个 URL 编码后的搜索链接,汉字被编码成 %E9%87%91 这样的形式,一个汉字变成九个字符,分词器也只能一段段切,所以 20 条原样就有 3,287 token。
把三轮对话完整渲染一遍,差距更直观:不裁字段时第三轮的 prompt 是 20,096 token,裁剪后是 3,177 token;三轮加起来分别是 24,565 和 4,904。Hy4 的上下文有 1M,装得下,但上下文越长,推理越慢、首个 token 越晚,按 token 计费的托管接口也越贵。裁剪规则要按任务定:做舆情摘要只要标题、时间和计数;要让模型引用原帖,就把链接留下;要分析评论情绪,就换成评论接口并留正文。我们的裁剪规则写在上面的执行器代码里,可以直接改。
三个时刻的实测:热搜在变,B 站和抖音跟得上吗
工具调用的价值在于「实时」,所以我们没有只跑一次就下结论。同一套流程在 2026-11-11 的三个时刻各跑一轮(新加坡时间 00:19、00:42、18:39):先取微博热搜前 20 条,再把第 1 条原样当关键词,交给 B 站搜索和抖音搜索。判断「新不新」的规则在跑之前就写好了:结果的发布时间距请求时刻不到 24 小时,算新。第 3 轮之后,我们又用第 1 轮的关键词「金鸡奖获奖名单」重搜了一次,用来区分「话题换了」和「搜索跟不上」这两种情况。每一次请求的原始返回我们都原样存档,下面的表格和图都从这些存档里直接统计,没有手工挑选或改动任何一条结果。
| 时刻(新加坡时间) | 热搜第 1 条(热度) | 前 20 条与第 1 轮重合 | B 站综合排序 24 小时内 | B 站最新排序 24 小时内 | 抖音最近 24 小时 | 本轮扣费 |
|---|---|---|---|---|---|---|
| 00:19 | 金鸡奖获奖名单(1,323,824) | 20 / 20 | 1 / 10 | 没跑 | 10 / 10 | $0.009445 |
| 00:42 | 金鸡奖获奖名单(1,035,614) | 17 / 20 | 1 / 10 | 5 / 10 | 10 / 10 | $0.010001 |
| 18:39 | 商场看中羽绒服网上便宜一千(1,105,701) | 0 / 20 | 2 / 10 | 0 / 10 | 6 / 6 | $0.010001 |
| 18:40,沿用第 1 轮关键词 | — | — | 没跑 | 8 / 10 | 10 / 10 | $0.008889 |
先看热搜本身。00:19 到 00:42 只隔 23 分钟,第 1 条没变,热度从 1,323,824 降到 1,035,614,前 20 条里有 17 条还在;到 18:39,前 20 条和第 1 轮一条都不重合,第 1 条换成了一条消费话题。这说明两件事:半小时以内重复取热搜,拿到的几乎是同一张表,执行器可以按 10 到 30 分钟缓存,省下的钱不多,但能少一轮工具调用;隔半天再看,就是另一张表,必须重新取。热搜接口每次 0.48 到 0.90 秒返回,是三个能力里最快的。
再看 B 站。综合排序三轮都以旧视频为主:00:19 那一轮,10 条里只有 1 条是 24 小时内发的,最旧的一条是 22 天前讨论提名的视频;18:39 那一轮,关键词换成羽绒服的话题,10 条里有 2 条是半小时内发的同名视频,但最旧的一条是将近 5 年前的探访视频。最新排序的表现分成两种。关键词是短的名词短语时,它有用:00:42 是 5/10,18:40 沿用「金鸡奖获奖名单」时是 8/10,最新一条 3.3 小时前发布。关键词是一整句话时,它会落空:18:39 用「商场看中羽绒服网上便宜一千」去搜,最新排序给出的 10 条里最新的也是 16 天前,内容只是同时含有「商场」和「羽绒服」的旧视频,而综合排序里那两条半小时内的同名视频,最新排序里一条都没有。我们不知道 B 站内部为什么这样排,只照实记下观察。
抖音的 publish_time=one_day 过滤四次都可靠:结果全部在 24 小时内,00:19 那一轮最新一条只有 0.6 小时。但 18:39 那一轮只回了 6 条,而不是 10 条,说明一个刚上榜的话题,24 小时内的视频本来就不多。这时仍按次扣 $0.008333:抖音搜索在目录里是按请求计价,不按条数;只有失败或空结果才不扣。抖音每次 5.9 到 8.3 秒返回,B 站 1.5 到 8.1 秒,执行器的超时至少要设 30 秒。
第 2 轮还有一个对模型很重要的发现:抖音 10 条结果里,「最佳男主角」的说法不一致。带认证标记的搜狐娱乐在北京时间 11-10 21:43 写的是梁家辉,和当晚微博热搜「梁家辉影史第二位三金影帝」一致;一个约 5 万粉丝、没有认证标记的个人号在 18:07 发帖,写成了另一位演员获奖,比搜狐娱乐那条早 3 个半小时。如果执行器把作者名和发布时间裁掉,模型只看正文,很可能把两种说法当成同等可信。所以我们在裁剪规则里保留了 author_name 和 posted_at;如果要做事实核对,可以再留 author_is_verified 和 author_follower_count,让模型按来源和时间判断,而不是按票数。
| 观察 | 对执行器和工具定义的要求 |
|---|---|
| 23 分钟内热搜前 20 条有 17 条不变,18 小时后 0 条不变 | 热搜缓存 10 到 30 分钟;跨半天的任务一定重取 |
| 热搜标题常是一整句话 | 在工具说明里让模型先把热搜缩成 2 到 4 个核心词再搜;或由执行器同时跑两种排序,按 posted_at 合并去重 |
| B 站综合排序多是旧视频 | 要「最新进展」时传 sort=newest,并在结果里保留 posted_at |
| 抖音 24 小时过滤可能不足 10 条,仍按次计费 | 不要为了凑条数连续重搜;条数少本身就是「话题刚起来」的信号 |
| 同一事件出现互相矛盾的帖子 | 裁剪时保留作者名和发布时间,必要时加认证状态和粉丝数 |
| 抖音 5.9–8.3 秒、B 站最长 8.1 秒 | 超时设 30 秒以上;两个搜索没有先后依赖时可以并发执行 |
三轮加上沿用关键词的重搜,一共 13 次成功调用,合计扣费 $0.038336;两次 429 和三次 422 都没有扣费。按这个节奏,一个每 30 分钟跑一轮的监控任务,一天 48 轮,取数费大约是 48 × $0.0100 ≈ $0.48;如果热搜按 30 分钟缓存、只在第 1 条变化时才去搜 B 站和抖音,费用还会更低。
执行器还要做的五件事
上面的执行器代码只有三十多行,生产里还要补几件事,每一件都对应我们实测里碰到的情况。第一是白名单。模型偶尔会编出一个工具清单里没有的名字,或者把参数名写错;执行器只认自己登记过的工具名,其他一律返回错误说明,不要把模型写的平台名和能力名直接拼进请求。这也是我们不建议用通用工具的另一个原因:通用工具等于把白名单交给了模型。
第二是类型补救。即使工具定义写全了类型,也难免有服务端没开严格模式、模型把整数写成带引号文本的时候。执行器按工具定义把纯数字字符串转成整数,把看起来像 JSON 的字符串转成对象,能省掉一轮 422 和一轮推理。vLLM 的 tool_strict_level.py 写明了三档约束的含义,它在服务端用 XGrammar 的结构化标签实现;打开 parameter 档后,参数会被按工具定义约束,执行器的补救就成了兜底。
第三是限速和重试。我们的接口在 429 时返回 retry_after,执行器按它等待;不要让模型看到 429,否则它可能换个参数再调,越调越超。本文用的测试 Key 限速每分钟 10 次。第四是裁剪,前面已经讲过,规则跟着任务走。第五是记账。每次返回里都有 charged_usd,执行器把它累加进这一轮对话的元数据,再和模型那一侧的 token 用量放在一起,你就能知道每个回答的真实成本。解析模型交出的参数时用标准库 json 即可;用 requests 或 OpenAI 的 Python 客户端都可以,我们的接口只要求 JSON 请求体和一个 Bearer 头。
| 要做的事 | 实测里看到的情况 | 写在执行器哪里 |
|---|---|---|
| 工具名白名单 | 通用工具让模型自己挑平台和能力 | ROUTE 字典 |
| 类型补救 | limit 是 "10" 时返回 422,不扣费 | 发请求前按工具定义转一遍 |
| 429 等待 | 测试 Key 连续两次 429,retry_after 6 秒 | 等待后原样重发 |
| 裁字段 | 抖音 10 条原样 12,902 token,裁剪后 1,110 | KEEP 字典 |
| 记账 | 每次 200 返回都带 charged_usd | run_tool 的返回值 |
上线前,在你自己的部署上回放一遍模型调用
本文没有运行 Hy4,所以「模型会不会调对」这件事,要由你在自己的部署上验证。办法不复杂:从真实业务里挑 20 到 30 个问题,覆盖三类情况,一类是需要调工具的,一类是闲聊或常识、不该调工具的,一类是要两个工具先后接力的。问题里至少放几条带错别字、口语化或中英混写的说法,因为真实用户就是这样问的,工具说明写得太窄时,这类问题最容易让模型不调工具或调错工具。每个问题在同样的采样参数下跑 3 次,把模型发出的 tool_calls 原样存下来,再用执行器里同一套规则逐条判。判对错的标准要在跑之前写好,不看到结果再改,否则很容易把「模型这次写成这样」当成「本来就该这样」。
| 检查项 | 怎么判对 | 不通过时先查什么 |
|---|---|---|
| 工具名合法 | 名字在执行器的 ROUTE 里 | 几个工具的说明是否太像、太长 |
| 参数合法 | 用 jsonschema 按工具定义的 parameters 校验 arguments | 类型是否写全,服务端是否开了 --tool-strict-level parameter |
| 不该调时不调 | 闲聊类问题的 tool_calls 为空 | 请求里的 tool_choice 是否被写成了 required |
| 两步任务接得上 | 第二轮的关键词来自第一轮的返回 | 上一轮的 tool 消息是否完整带进了下一轮 |
| 报错后能自己改 | 把我们接口的 422 原样交回,下一轮参数通过校验 | 执行器是否把 next_steps 裁掉了 |
回放的成本主要在你自己的 GPU 上。数据这一侧不必每次真调:把本文这类真实返回存成固定样本,在第二轮以后原样喂回模型,就能测模型读结果、接着调用的行为,而且每次输入一致,前后版本才好比较。要测端到端,再挑几条真调,一轮三次调用按本文目录价约 $0.0094。托管的正式版也可以用同一套问题回放,和 preview 在你的工具上逐项对比;在正式版权重公开之前,这是判断要不要换模型最直接的办法。
每次回放记下四个比例:工具名合法、参数通过校验、不该调时误调、422 之后一轮内改对。preview 和正式版之间、改工具说明前后,都拿这四个数比较;只看一两段对话的观感,很难判断一处改动是不是真的有用,也很难发现某一类问题在悄悄变多。
算账:模型费、取数费和自托管
先算一轮往返。取数这边按目录价:weibo/trending $0.000556、bilibili/search $0.000556、douyin/search $0.008333,三次合计 $0.009445,就是我们真调时响应里 charged_usd 的累加。模型这边,我们只能算输入:三轮对话的 prompt 合计,原样塞回是 24,565 token,裁剪后 4,904 token。按 OpenRouter 在 11 月 11 日 00:16(新加坡时间)列出的 Hy4 输入价 $0.417/百万 token,分别约 $0.0102 和 $0.0020;按腾讯新闻稿写的约 $0.90/百万 token,分别约 $0.0221 和 $0.0044。模型的输出(包括默认打开的深度思考)我们没有实测,没有算进去,这部分请用你自己的日志补上。
这张图最值得看的是中间那根:不裁字段时,光是模型读取数据的输入费就超过了取数本身的费用;裁剪之后,模型输入费降到取数费的五分之一左右。换句话说,在这类任务里,省钱的关键不在换一个更便宜的数据源,而在执行器里那十几行裁剪代码。把这个任务放大成每小时跑一次、一个月 30 天:取数费约 $6.80;模型输入费按 OpenRouter 价裁剪后约 $1.47,不裁约 $7.38。
| 项目 | 单价(读取时间) | 一轮 | 每小时一轮、30 天 |
|---|---|---|---|
| EveryInfra 取数(3 次调用) | 目录 price_usd(11-11 00:16 新加坡时间读取,2026-11-12 复核未变) | $0.009445 | $6.80 |
| Hy4 输入,裁剪后(OpenRouter) | $0.417/百万 token(11-11 00:16 新加坡时间) | $0.0020 | $1.47 |
| Hy4 输入,原样塞回(OpenRouter) | 同上 | $0.0102 | $7.38 |
| Hy4 输入,裁剪后(腾讯公布价) | 约 $0.90/百万 token(11-04 新闻稿) | $0.0044 | $3.18 |
| 自托管 8 张 H200(按需租用) | Runpod 每卡每小时 $5.29(11-11 读取) | — | $30,470 |
表中腾讯公布价是刊例价。腾讯云在 2026 年 11 月 10 日更新的模型价格说明写明,Hy4 推理费到 12 月 31 日按刊例价五折结算;折扣到期后托管价会翻倍,比较托管和自托管时要把这一点算进去。
自托管那一行要单独说。Hy4 preview 的 FP8 权重 813.8 GB,官方命令是 8 卡张量并行;NVIDIA 的 H200 每卡 141 GB 显存,8 卡共 1,128 GB,放下权重后剩下的才是 KV 缓存。按 Runpod 定价页上 H200 每卡每小时 $5.29 的按需价,8 卡一小时 $42.32,30 天约 $30,470。同样的钱在 OpenRouter 上能买约 730 亿个输入 token。对「每小时查一次热搜」这种量,自托管在成本上没有任何道理;它的价值在别处:数据不出你的机房、可以微调、可以用 --tool-strict-level 这类服务端开关自己控制输出格式、不受托管方限流。如果你本来就有空闲的 8 卡机器,那取数费就是这件事的主要现金成本,一个月几美元。
错误、限速和扣费
工具调用的循环里,错误是常态,所以要知道每种错误会不会扣钱、模型能不能自己处理。下表是本文实测遇到的全部错误,时间都是 11 月 11 日新加坡时间。
| 时间 | 情况 | HTTP | 返回里写了什么 | 扣费 |
|---|---|---|---|---|
| 00:19:54、00:19:57 | 测试 Key 超过每分钟 10 次 | 429 | rate_limited,retry_after 6 秒,Nothing was charged | 0 |
| 00:20:01 | sort 写成不存在的 hot | 422 | 全部允许值,did_you_mean 给出 most_liked、most_viewed | 0 |
| 00:22:45 | limit 是字符串 "10" | 422 | must be an integer from 1 to 50 (got '10') | 0 |
| 00:22:52 | params 整个是字符串 | 422 | params: Input should be a valid dictionary | 0 |
429 的处理放在执行器里,不要交给模型:按返回的 retry_after 等待后重发即可,模型不需要知道这件事。422 则应该交回模型,因为只有模型知道它本来想查什么。我们的错误返回里有 fault 字段,值是 request 表示请求本身有问题、改了再发,account 表示账户层面的限制;有 retryable 字段告诉你原样重试有没有意义。抖音搜索这类较慢的能力,目录写明同步请求有 85 秒的时间上限,超时可以在请求体里加 "mode": "async" 拿到任务号再轮询。整套接入方式和 Key 的申请见快速上手,价格见定价页。
做不了或要注意的地方
第一,模型行为没有实测。我们没有运行 Hy4,本文所有关于「模型会发出什么调用」的部分都是配置示例;模型会不会在该调的时候调、会不会编参数,只能参考腾讯公布的评测和你自己的回放。第二,token 数基于 preview 的模板和分词器。正式版权重公开后,如果模板改了,例如工具清单的写法或思考内容的保留规则变了,本文的 token 数要重算;托管接口背后用的模板我们看不到。第三,延迟没有写,因为本机没有跑模型;文中出现的秒数只是我们接口的响应时间。
第四,数据边界。热搜、视频搜索都是平台公开展示的内容,我们的接口不登录、不碰私密内容。微博、B 站、抖音各自有官方开放平台(微博开放平台、B 站开放平台、抖音开放平台),适合做自家账号的授权数据;跨账号看公开内容,是本文这种用法。第五,抖音搜索的单价比热搜和 B 站搜索高一个数量级,一轮的取数费里它占了 88%,如果预算紧,可以先用热搜和 B 站判断值不值得再查抖音。
延伸阅读
站内相关文章:GLM 5.3 在 Claude Code 里写知乎、微博采集脚本;Qwen-Agent 经远程 MCP 拿工具;DeepSeek V4.1 Flash 清洗、打标签一万条评论的总账;抖音 API Python 教程。模型前面已有支持 MCP 的客户端时,直接接远程 MCP 服务更省事。
常见问题
hy4 function calling example 在哪里能找到?
腾讯的模型卡和 GitHub 仓库只给了普通对话的示例,没有工具调用的完整例子;工具调用的格式要看 chat_template.jinja 和 vLLM 的工具调用文档。本文的工具定义 JSON 和执行器代码可以直接当例子用,请求格式和 OpenAI 的函数调用一样。
hy4 function calling error 一般是什么原因?
按我们读源码和真调的结果,最常见的有三类:没加 --enable-auto-tool-choice 和 --tool-call-parser hy_v4,模型的标签原样出现在回答正文里;工具定义没写参数类型,整数和对象被当成字符串交出来,下游接口报 422;vLLM 版本早于 10 月 31 日,参数名带空白时被改掉。第三类可以对照 PR #61542 判断。
tencent hy4 api 怎么调用,和自托管有什么区别?
托管调用有腾讯云 TokenHub(OpenAI 兼容地址,见腾讯云开发者社区的发布文章)和 OpenRouter,两者都支持 tools,用的是 Hy4 正式版;OpenRouter 的接入步骤见它的快速上手文档。自托管目前只能用 preview 权重,好处是模板、解析器和严格模式都在你手里,代价是 8 卡起步。
这么大的模型能在本地跑吗?
Hugging Face 上 Hy4-preview 的第 10 号讨论帖里,提问者说 Qwen 和 GLM 已经有 300B 以下、单机能跑的版本,Hy4 太大了。按我们算的权重大小,FP8 版 813.8 GB,至少要 8 张 141 GB 显存的卡;社区有人做了 GGUF 低比特量化(同一讨论区第 8、9 号帖,格式说明见 Hugging Face 的 GGUF 文档),但质量和工具调用的稳定性没有官方数据。如果只是想让模型能查热搜,托管接口加我们的数据接口是更现实的起点。
参考资料
- Tencent Launches Hy4, Joining the Ranks of the World's Leading Open-Source AI Models,腾讯,2026-11-04,https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Introducing Hy4,腾讯混元,2026-11-04,https://hy.tencent.ai/research/hy4
- Hy4 正式发布(中文研究页),腾讯混元,2026-11-04,https://hunyuan.tencent.com/research/hy4
- tencent/Hy4-preview 模型卡,Hugging Face,2026-08-28 更新,https://huggingface.co/tencent/Hy4-preview
- tencent/Hy4-preview-FP8,Hugging Face,2026-08-28 更新,https://huggingface.co/tencent/Hy4-preview-FP8
- Tencent-Hunyuan/Hy4-preview,GitHub,https://github.com/Tencent-Hunyuan/Hy4-preview
- Hy4-preview chat_template.jinja,Hugging Face,https://huggingface.co/tencent/Hy4-preview/blob/main/chat_template.jinja
- Hy4-preview,ModelScope,https://modelscope.cn/models/Tencent-Hunyuan/Hy4-preview
- tencent/Hy4-preview 使用说明,vLLM Recipes,https://recipes.vllm.ai/tencent/Hy4-preview
- Hy4-Preview Cookbook,SGLang,https://lmsysorg.mintlify.app/cookbook/autoregressive/Tencent/Hy4-Preview
- hy_v4_tool_parser.py,vLLM,2026-11-08 最近提交,https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/hy_v4_tool_parser.py
- [Bugfix][Tool Parser] Preserve whitespace in HYV4 argument names(#61542),vLLM,2026-10-31,https://github.com/vllm-project/vllm/pull/61542
- [Frontend] Add --tool-strict-level(#56268),vLLM,2026-09-18,https://github.com/vllm-project/vllm/pull/56268
- Tool Calling,vLLM 文档,https://docs.vllm.ai/en/latest/features/tool_calling.html
- Structured Outputs,vLLM 文档,https://docs.vllm.ai/en/latest/features/structured_outputs.html
- Tool Parser,SGLang 文档,https://docs.sglang.io/advanced_features/tool_parser.html
- Function calling,OpenAI 平台文档,https://platform.openai.com/docs/guides/function-calling
- Tool & Function Calling,OpenRouter 文档,https://openrouter.ai/docs/guides/features/tool-calling
- Models API(tencent/hy4 价格与参数),OpenRouter,2026-11-11 00:16 读取,https://openrouter.ai/api/v1/models
- Hy4 模型页,OpenRouter,https://openrouter.ai/tencent/hy4
- 腾讯混元 Hy4 正式版发布,腾讯云开发者社区,2026-11-04,https://developer.cloud.tencent.com/article/2776227
- Model pricing,腾讯云国际站,2026-11-10 更新,https://www.tencentcloud.com/document/product/1300/78937
- Hy4 Preview FAQ:Specifications, API, Pricing,腾讯云,2026-08-28,https://intl.cloud.tencent.com/techpedia/148044
- Chat templates,Hugging Face Transformers 文档,https://huggingface.co/docs/transformers/main/en/chat_templating
- Evaluation results,Hugging Face Hub 文档,https://huggingface.co/docs/hub/eval-results
- Toolathlon,HKUST NLP,GitHub,https://github.com/hkust-nlp/Toolathlon
- DeepSeek Sparse Attention 论文,arXiv 2512.02556,https://arxiv.org/abs/2512.02556
- IndexCache 论文,arXiv 2603.12201,https://arxiv.org/abs/2603.12201
- Apache License 2.0,Apache 软件基金会,https://www.apache.org/licenses/LICENSE-2.0
- AngelSlim,腾讯,GitHub,https://github.com/tencent/AngelSlim
- NVIDIA H200 Tensor Core GPU,NVIDIA,https://www.nvidia.com/en-us/data-center/h200/
- GPU Cloud Pricing,Runpod,2026-11-11 读取,https://www.runpod.io/pricing
- With Qwen and GLM now in sub 300B local machine level, this is a big model(讨论 #10),Hugging Face,2026-08-29,https://huggingface.co/tencent/Hy4-preview/discussions/10
- Tencent says its Hy4 joins 'top-tier' of open-source AI models,Nikkei Asia,2026-11-04,https://asia.nikkei.com/business/technology/artificial-intelligence/tencent-says-its-hy4-joins-top-tier-of-open-source-ai-models
- Tools(MCP 规范),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- openai-python,OpenAI,GitHub,https://github.com/openai/openai-python
- SGLang,GitHub,https://github.com/sgl-project/sglang
- 微博开放平台 API 文档,新浪微博,https://open.weibo.com/wiki/API
- 哔哩哔哩开放平台,哔哩哔哩,https://openhome.bilibili.com/
- 抖音开放平台,抖音,https://developer.open-douyin.com/
- EveryInfra 社媒数据目录,EveryInfra,2026-11-11 00:16 读取,https://api.everyinfra.com/api/v1/social/catalog
- Tencent Hy4 Tested for Free: Is It Actually Good?,YouTube,2026-11-04(新加坡时间 11-05 凌晨发布),https://www.youtube.com/watch?v=3YFnzpwNEvM
- Type(JSON Schema 参考),JSON Schema,https://json-schema.org/understanding-json-schema/reference/type
- tool_strict_level.py,vLLM,https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/tool_strict_level.py
- XGrammar 文档,https://xgrammar.mlc.ai/docs/
- Jinja,Pallets,GitHub,https://github.com/pallets/jinja
- Tokenizers 文档,Hugging Face,https://huggingface.co/docs/tokenizers/index
- Requests 文档,https://requests.readthedocs.io/en/latest/
- Reasoning Outputs,vLLM 文档,https://docs.vllm.ai/en/latest/features/reasoning_outputs.html
- OpenAI-Compatible Server,vLLM 文档,https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
- Structured outputs,OpenAI 平台文档,https://platform.openai.com/docs/guides/structured-outputs
- GGUF,Hugging Face Hub 文档,https://huggingface.co/docs/hub/gguf
- Quickstart,OpenRouter 文档,https://openrouter.ai/docs/quickstart
- json — JSON encoder and decoder,Python 文档,https://docs.python.org/3/library/json.html
- jsonschema 文档,Python,https://python-jsonschema.readthedocs.io/en/stable/
引用编号 BL-130