DeepSeek V4.1 Flash API 洗评论打标签:一万条的总账
907 条真调评论、真跑 DeepSeek V4.1 Flash:一万条总账 $0.36–0.92,模型费七到八成花在输出,短代码加空闲时段省七到八成。
用 DeepSeek V4.1 Flash 给一万条社媒评论打标签,模型费里 74% 到 83% 花在模型「写出来」的标签上,而不是读进去的评论;把输出从完整 JSON 改成短代码、再把任务挪到空闲时段跑,实测的模型费(中英文样本)能从高峰期的约 $0.34–0.50 降到 $0.07–0.14。这些数来自两次真调:2026 年 11 月 9 日 00:16–00:33(新加坡时间)用 EveryInfra 接口真调 38 次,拉回 907 条中英西三语评论和弹幕;03:21–03:30 再把其中 602 条清洗后的评论真送进 deepseek-v4.1-flash-1017,读返回的 usage 按 DeepSeek 官方定价换算。实测比按文档比例估的贵 20% 到 54%,中文读入的 token 比估算多七成。另外两个结论和直觉相反:先清洗、去重再送模型,三语合计只去掉 11.8% 的行,省钱效果有限;关键词规则能稳稳标出的只有 13.1% 到 34.2%,西语那 34.2% 里还藏着子串误配,不如全部交给模型。
这篇文章要回答的是一个很实际的问题:手上有一个公共卫生或农业食品话题,想把几个平台上的公众讨论拉下来,用一个便宜的模型批量清洗、去重、打标签,交给科普、风险沟通或者舆情团队用。一万条量级要花多少钱,钱花在哪一步,哪些做法真省钱、哪些只是看起来省钱。EveryInfra 一侧的每个数都来自真调的原始返回。DeepSeek 一侧,我们手上没有 DeepSeek 官方的 API Key,模型调用走的是一个 OpenAI 兼容的第三方转发接口,模型名填 deepseek-v4.1-flash-1017,每次返回的 model 字段都是这个名字;token 数取返回的 usage,费用按 DeepSeek 官方定价页换算,不是 DeepSeek 开出的真实账单。批大小那张表和西语短代码没有实测,仍是按文档比例估算,表上都标着;一万条是按样本外推。
这件活是什么:三个话题、三种语言、一万条评论
先把任务定死,因为后面所有的数都按这个任务算。我们挑了三个 2026 年 10 月到 11 月正在发生、公众讨论很多的话题,每种语言一个。中文是「熏硫白芷」:11 月 1 日央视《每周质量报告》播出调查后,青岛、成都两地立案,中国食品安全网转载的报道提到,市场监管总局今年发布的 21 期食品抽检不合格通报里有 19 期涉及白芷二氧化硫残留超标(中国食品安全网)。英文是美国华盛顿州奶牛 H5N1 疫情:美国农业部动植物卫生检验局 10 月 8 日确认华盛顿州首批两个奶牛场感染(USDA APHIS,2026-10-08),明尼苏达大学 CIDRAP 11 月 3 日报道 Yakima 县又有两人确诊、其中一人死亡(CIDRAP,2026-11-03)。西语是墨西哥的「gusano barrenador」(新大陆螺旋蝇)和随之而来的鳄梨谣言:泛美卫生组织 10 月 16 日发布人类蝇蛆病流行病学警报(OPS/OMS,2026-10-16),11 月 4 日墨西哥农业部长澄清鳄梨里的幼虫和牛身上的螺旋蝇不是一回事(The Food Tech,2026-11-04)。
选这三个话题有两个原因。第一,它们都是「事实和误解混在一起」的讨论:评论里有人在问怎么识别熏硫白芷,有人在骂商家,有人在传「生奶能防禽流感」,有人把鳄梨的蛀虫当成吃牛肉的蛆。给这样的评论打标签,规则很难写全,正好考验便宜模型的分辨能力。第二,三个话题落在三个不同的平台生态里:中文讨论集中在 B 站弹幕、抖音评论、知乎和微博,英文在 Reddit 和 YouTube,西语几乎全在 YouTube。一篇文章里能对照三种平台结构,算出来的数也就不只适用于一个平台。
输出要什么也先定好。每条评论最后要有三样东西:0 到 3 个话题标签(例如中文的「健康担忧」「监管与执法」「怎么识别」,英文的 raw_milk_pasteurization、distrust_conspiracy),一个立场或物种判断(西语多一个字段,专门区分评论说的是牛的螺旋蝇还是鳄梨的蛀虫),以及一个「需要核实」的布尔值,标出那些对病毒、标准、病例下了事实判断的评论,交给人工去核。标签表在动手前写进了提示词,后面不再改。
量级定在一万条。真调只拉几百条样本,一万条按样本里的「每次调用拿回多少条」「清洗后留下多少」「每条多少 token」等比例外推。这样做的好处是每一步的单价都是真的,坏处是放大以后会把样本的偏差一起放大,所以后面每个外推数都写明是外推,并且在「做不了或要注意的地方」一节里写清楚偏差可能往哪个方向走。
deepseek v4.1 flash api 是哪一版:版本、上下文和价格逐条核
写之前先核版本。DeepSeek 英文定价页在 2026 年 11 月 9 日 00:14(新加坡时间)读取时写的是:模型名填 deepseek-flash,当前对应的模型版本是 DeepSeek-V4.1-Flash-1017,上下文 1M,最大输出 384K,支持 JSON 输出和工具调用,思考模式默认开启(DeepSeek Models & Pricing)。中文定价页同日的内容一致。旧名字 deepseek-v4-flash 仍然接受,但请求会转给 V4.1-Flash-1017,按 Flash 价计费。所以标题里写 V4.1 Flash 是准的,不用改成别的版本。
这一版有两个发布日期,容易混。V4.1-Flash 第一次上线是 2026 年 9 月 10 日,DeepSeek 的发布说明写它是 552B 参数的混合专家模型,读入时激活 8B、写出时激活 16B,KV 缓存只要上一代四分之一的显存,新价格从 9 月 10 日 04:00 UTC 起生效(DeepSeek 发布说明,2026-09-10)。10 月 17 日发的 1017 是同一架构的新权重,发布说明的原话是跑分更高、完成任务更快、输出更短,权重同时放上 Hugging Face(DeepSeek 发布说明,2026-10-17)。DeepSeek 原文没有解释为什么不叫 V4.2。变更日志里 10 月 17 日这一条能对上(DeepSeek Change Log)。
| 项目 | deepseek-flash(V4.1-Flash-1017) | 出处 |
|---|---|---|
| 上下文 / 最大输出 | 1M / 384K | 定价页,2026-11-09 读 |
| 输入,缓存命中,每百万 token | 高峰 $0.006,空闲 $0.003 | 定价页 |
| 输入,缓存未命中,每百万 token | 高峰 $0.30,空闲 $0.15 | 定价页 |
| 输出,每百万 token | 高峰 $1.20,空闲 $0.60 | 定价页 |
| 高峰时段 | 周一到周五 01:00–04:00、06:00–10:00 UTC,中国法定节假日除外 | 定价页脚注 |
| 账户并发上限 | 2,500 | 限速页 |
| 思考模式 | 默认开启,默认强度 high | 思考模式页 |
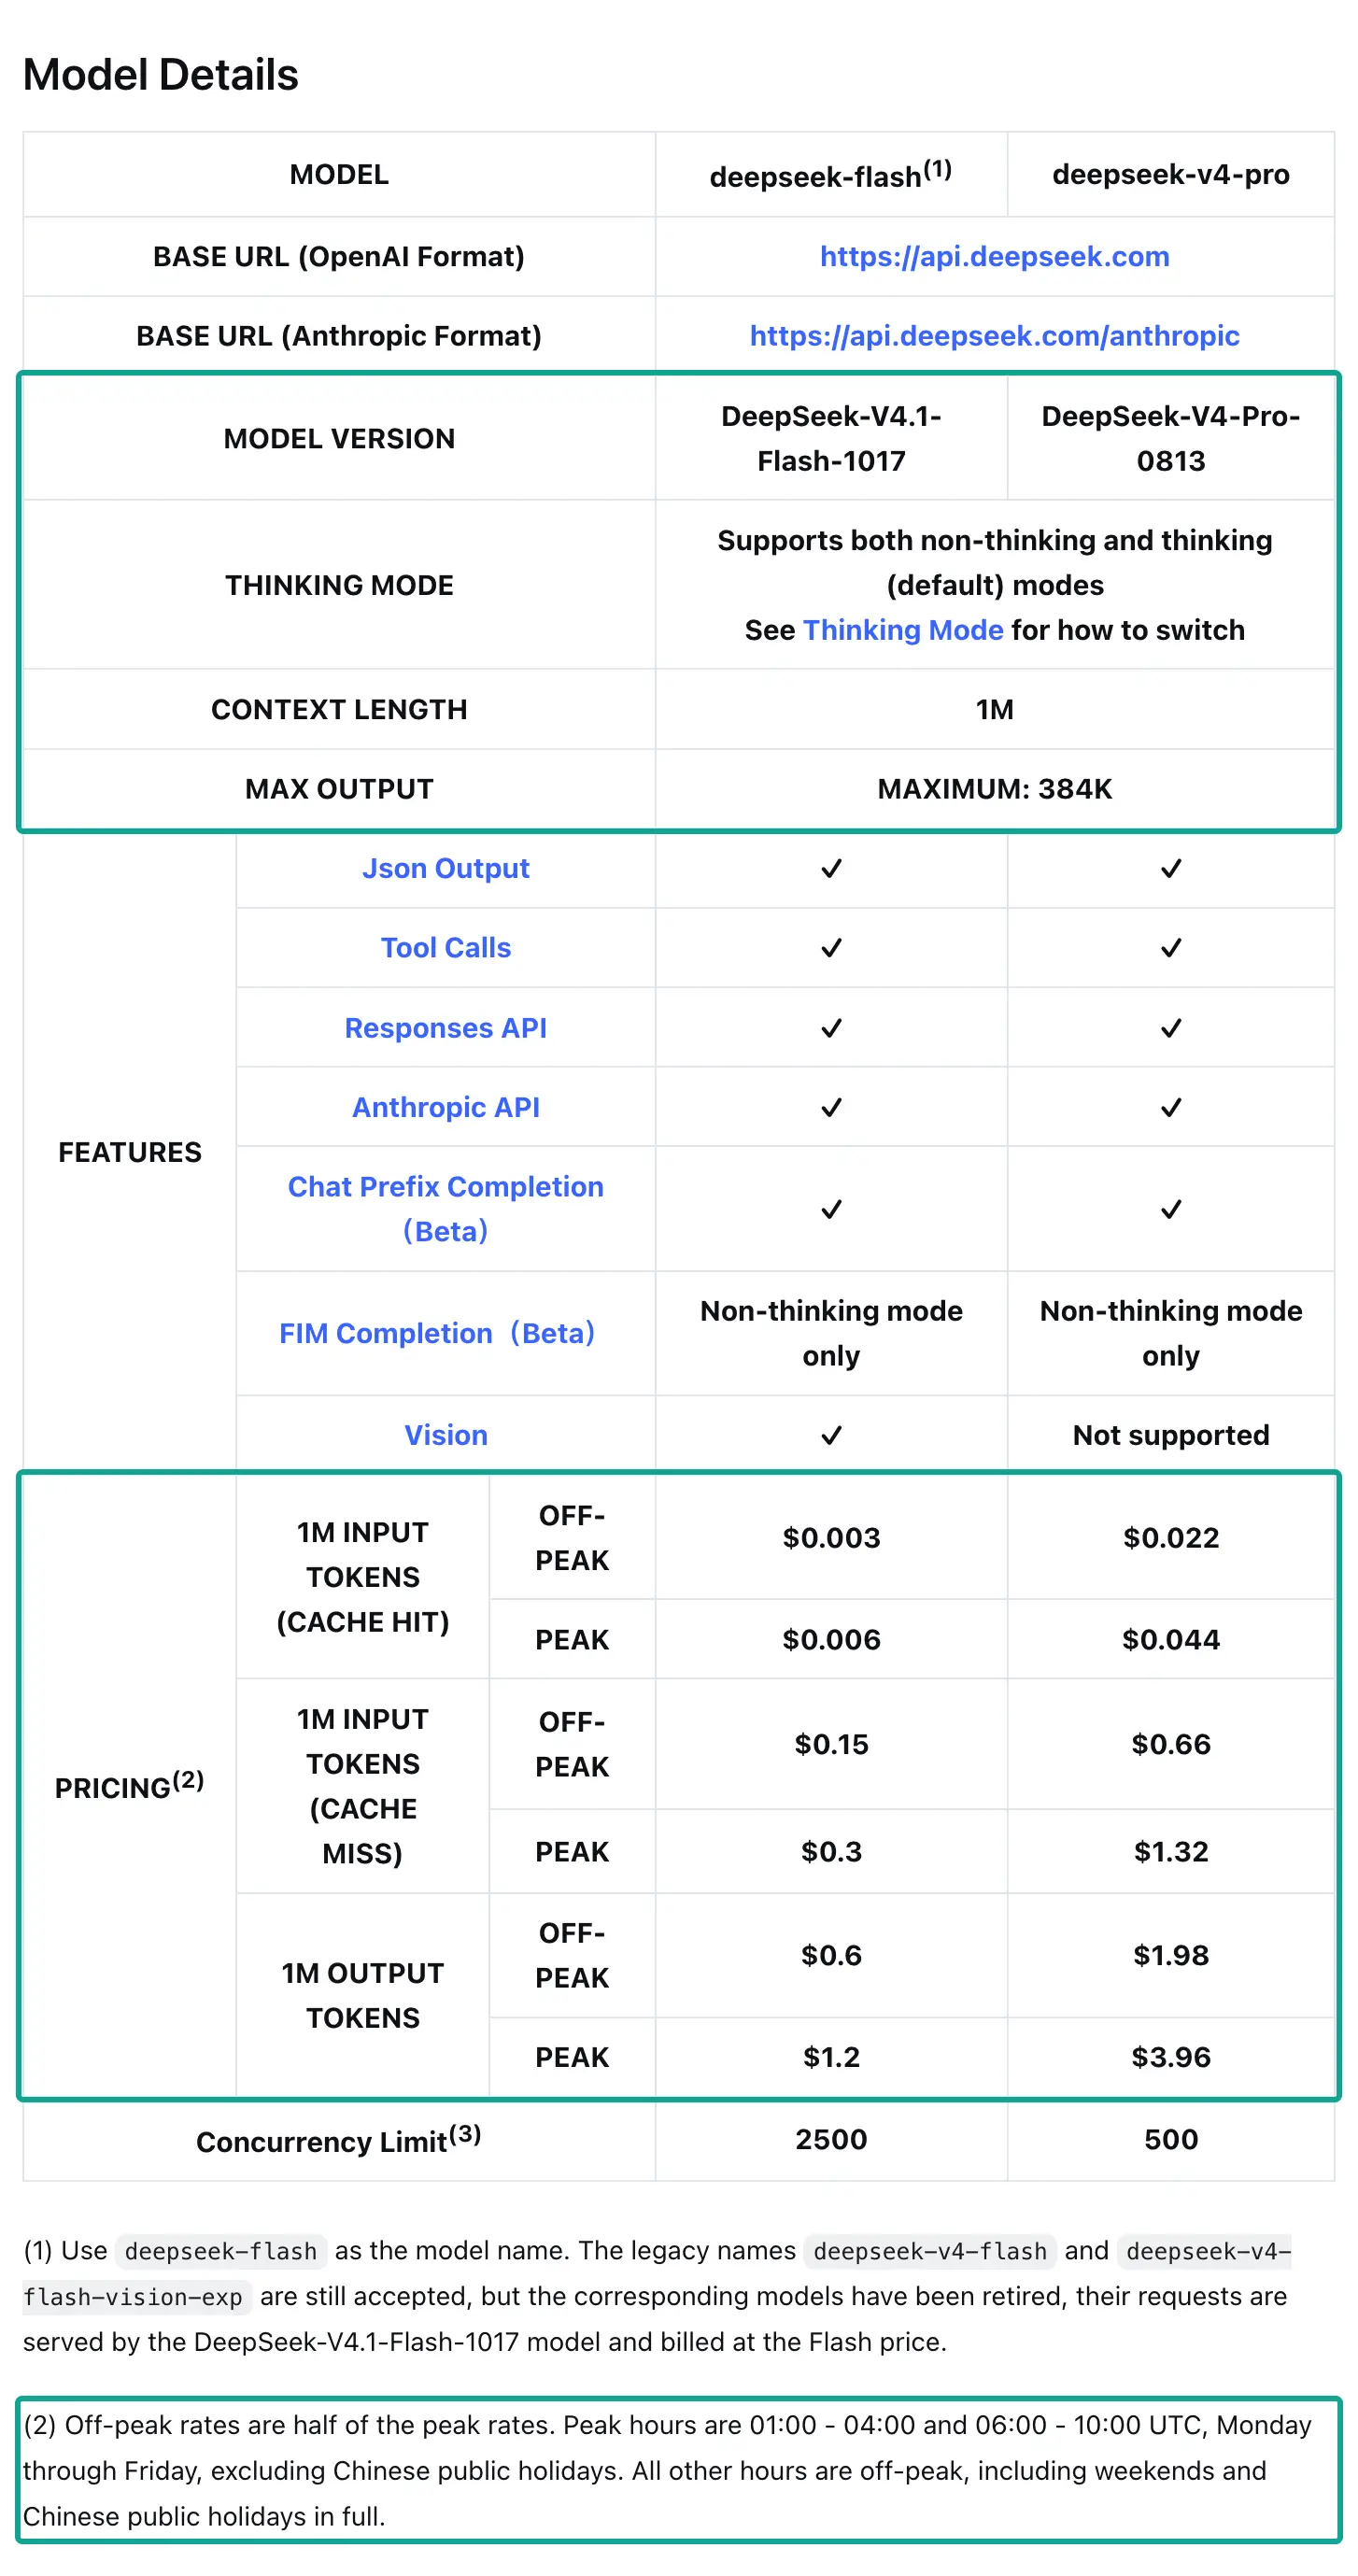
这张价格表里,对批量打标签影响最大的是两个比例。第一个是输出单价是未命中输入的 4 倍:高峰期写出一百万 token 要 $1.20,读入一百万 token 只要 $0.30。评论打标签这种活,每条评论读进去也许只有十几个到四十几个 token,写出来的 JSON 标签却有二十几个 token,输出的钱很容易超过输入。第二个是空闲价正好是高峰价的一半,这个「一半」目前写在定价页的计费规则里,不是活动价,但同一页也写明 DeepSeek 保留调价的权利(原文:Product prices may vary and DeepSeek reserves the right to adjust them);8 月 13 日 V4-Pro 发布时第一次引入峰谷价(DeepSeek 发布说明,2026-08-13),9 月 10 日 V4.1-Flash 发布时再次确认空闲价是高峰价的 50%。对能等几个小时的批处理来说,这等于白拿一半折扣,排程前读一眼当天的定价页即可。
和上一代比,便宜了多少?Hacker News 上有用户把三代 Flash 和 Pro 的空闲价并排列过:上一代 V4 Flash 0731 未命中输入 $0.22、输出 $0.66,V4.1 Flash 是 $0.15 和 $0.60(Hacker News 评论)。这个对比是用户贴的,我们在 11 月 9 日存了那条评论的快照;V4.1 Flash 的数和 DeepSeek 当前定价页对得上,上一代的数我们没有在官方页面找到存档,只作参考。
取数:38 次真调拿回 907 条评论和弹幕
EveryInfra 一侧的流程分两步:先用 youtube/search、reddit/search、bilibili/search、douyin/search、zhihu/search、weibo/search 找到讨论最集中的视频和帖子,再用 youtube/comments、reddit/comments、bilibili/comments、bilibili/danmaku、douyin/comments、zhihu/content_comments、weibo/comments 把评论拉下来。能力名、参数和单价都先从免费目录读(EveryInfra 目录,2026-11-09 00:14 读取),用到的 13 项能力在目录里都是 available: true,大多数单价是每次调用 $0.000556,weibo/search 是 $0.000806,douyin/search 是 $0.008333。抖音评论按每 20 条一个计费单位算,单位价同样是 $0.000556。
一次请求长这样,Key 只从环境变量读,不写进代码:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"bilibili","action":"danmaku",
       "params":{"url":"https://www.bilibili.com/video/BV1ZsJt6tE4z","limit":200}}'
下表是全部 38 次请求的汇总,时间都是新加坡时间。前 12 次是英文样本,中间穿插了几次故意的错误请求,最后是中文和西语。
| 时段(SGT) | 能力 | 次数 | 返回条数 | 扣费合计 | 备注 |
|---|---|---|---|---|---|
| 00:16:32–00:16:37 SGT | reddit/search、youtube/search | 2 | 9、20 | $0.001112 | 英文找帖子和视频 |
| 00:16:57 SGT | reddit/comments | 1 | 0 | $0 | 429,这把测试 Key 每分钟限 10 次,撞了限速 |
| 00:20:36–00:22:30 SGT | reddit/comments | 4 | 58、29、28、9 | $0.002224 | 华盛顿州奶牛和病例帖子 |
| 00:22:46–00:24:32 SGT | youtube/comments | 5 | 100、0、6、0、0 | $0.001112 | 3 次空结果自动退款 |
| 00:25:21–00:26:14 SGT | weibo/search、bilibili/search、zhihu/search | 4 | 16、20、20、20 | $0.002474 | 中文找视频和回答 |
| 00:26:23–00:27:23 SGT | youtube/search、reddit/search | 5 | 20、20、0、0、20 | $0.001668 | 2 次 Reddit 搜索空结果退款 |
| 00:27:39 SGT | youtube/comments | 1 | 0 | $0 | 422,故意把 sort 写成 top |
| 00:27:46–00:29:21 SGT | bilibili/comments、bilibili/danmaku、zhihu/content_comments、weibo/comments | 8 | 3、3、10、57、8、100、16、1 | $0.004448 | 中文评论和弹幕 |
| 00:29:29–00:30:49 SGT | youtube/comments | 4 | 100、100、100、39 | $0.002224 | 西语评论 |
| 00:31:22–00:32:55 SGT | douyin/search、douyin/comments | 4 | 10、49、60、31 | $0.012778 | 抖音按 20 条一个单位计费 |
合计 38 次请求,扣费 $0.028040。拉回的评论和弹幕是英文 230 条、中文 338 条、西语 339 条,共 907 条;另有 175 条搜索结果只用来挑帖子,不进打标签的样本。
这张图揭示了外推时最容易犯的错:按 limit 算调用次数。中文样本 11 次评论类调用平均只拿回 30.7 条,英文 6 次扣费调用平均 38.3 条,只有西语 4 次平均 84.8 条。中文偏低有接口自己的原因:目录里 bilibili/comments 的 default_limit 和 max_limit 都是 10,每次最多回 10 条,我们这三次也没传 limit;而且搜索结果里两个视频显示各有 98 条和 80 条评论,这次接口只回了 3 条和 3 条,第三个视频有 4,267 条评论,回了 10 条,正好是上限。微博那条显示有 3 条评论,回了 1 条;Reddit 的小帖子本身就只有 9 条。所以想在 B 站拉一万条,评论区要按每次 10 条算,弹幕(每次最多 200 条)才是大头。这件事我们已经记下来交给接口那边核对。
外推时还要把找帖子的搜索费算进去。样本里 12 次搜索扣了 $0.013587,占全部扣费 $0.028040 的 48%,其中 douyin/search 一次就是 $0.008333。按「样本实付 ÷ 样本条数 × 一万」算,一万条原始评论的取数费是中文 $0.5828、英文 $0.2176、西语 $0.0984;只算评论调用的话是 $0.2636、$0.1451、$0.0656,可以当下限。真实数通常落在两者之间:一个帖子的评论越多,搜索费摊到每条上就越少。中文贵还有一个原因是抖音按条数计费,每 20 条一个单位,评论多的视频单次扣费会到 $0.001667。
计费上有三处行为值得记下来,因为它们决定了「一万条」外推时要不要留余量。第一,空结果不扣钱:英文 YouTube 有三个视频关闭了评论或者评论是空的,返回 count: 0,账单里是 charged: false、reason: empty_result_refunded,自动退款。第二,抖音的单位制是按实际条数结账:第一次 douyin/comments 请求 limit: 150,预计 8 个单位,实际只回了 49 条,所以只收 3 个单位 $0.001667,剩下的单位当场退回。第三,参数错了直接被挡,不收钱。
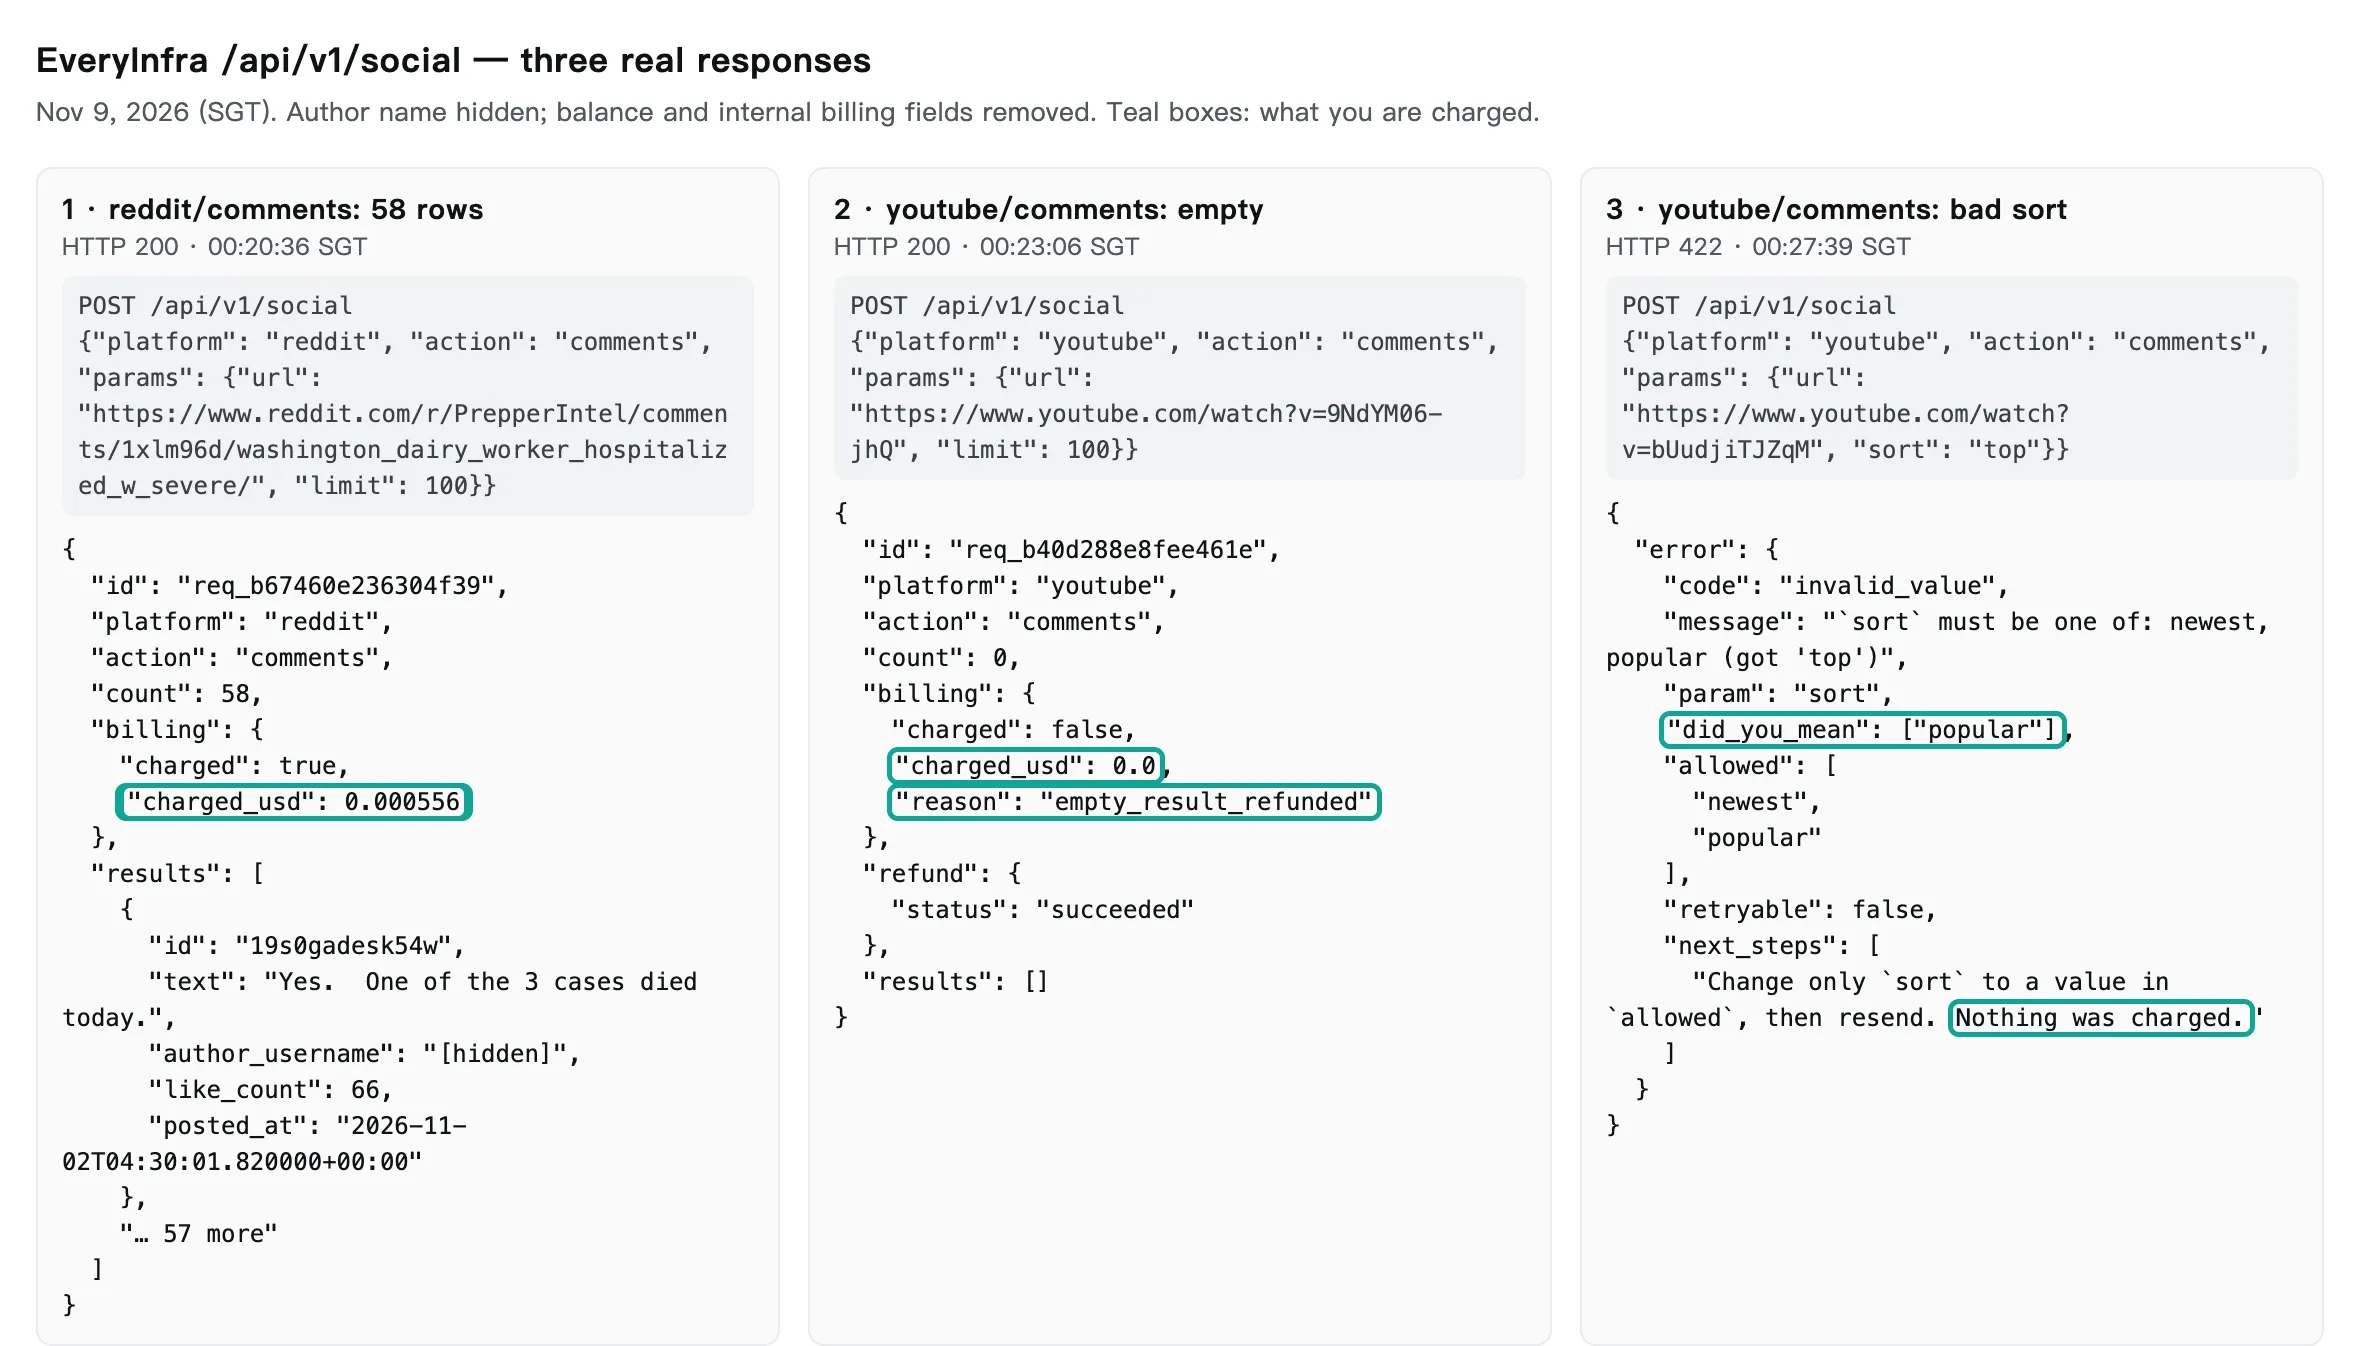
故意写错的那一次很能说明问题。我们把 youtube/comments 的 sort 写成了 top,返回 422,错误码 invalid_value,allowed 列出 newest 和 popular,did_you_mean 给的是 popular,next_steps 第一句就写着只改 sort 再重发、没有扣费。批处理脚本最怕的是参数被静默忽略、照常扣钱、结果却不是你要的排序;明确拒绝反而让脚本能自己修正。限速那一次也一样,429 的返回里写了 retry_after、limit: 10 和 retryable: true,我们的脚本按它退避重试,第二次在 00:20:36 成功。更多错误返回的处理方式可以看 API 错误怎么自愈,失败退款的对账方法见 失败退款对账。
清洗和去重:只去掉 11.8%,没到动手前定的门槛
拿到 907 条以后,第一步是不花模型钱的清洗。我们写了一个 Python 脚本,按顺序做七件事:先用 Unicode NFKC 把全角、半角和兼容字符统一(Python unicodedata 文档),去掉零宽字符,合并空白;再按规则丢掉垃圾行:只有链接的、带三个以上链接的推广、只有表情或标点的、「顶」「666」「笑死」这类无信息短句、英西少于 3 个词或中文少于 2 个汉字的;然后做精确去重,键是去掉链接、标点、空白和表情后的小写文本;最后做近似去重,中文按 3 个字一片、英西按 3 个词一片,两条评论的片段集合 Jaccard 相似度不低于 0.8 就算重复。
近似去重用的是最直白的两两比较,几百条样本一秒内跑完;一万条要比较约五千万对,换成 MinHash 加局部敏感哈希能降到线性规模,开源的 datasketch 库直接提供 MinHash LSH 索引(datasketch GitHub;datasketch PyPI)。
动手前我们定的门槛是:三语合计去掉的行不少于 15%,才在文中写「先洗再送模型能省钱」;否则就写「清洗主要为质量,不为省钱」。结果如下。
| 样本 | 原始条数 | 保留 | 去掉比例 | 主要去掉的原因 | token 变化(估算) |
|---|---|---|---|---|---|
| 中文:熏硫白芷 | 338 | 289 | 14.5% | 完全重复 37 条,几乎都是弹幕刷屏 | 约 4,165 → 3,003(-27.9%) |
| 英文:H5N1 奶牛 | 230 | 213 | 7.4% | 太短 12 条,例如「Phew...」 | 约 9,323 → 9,107(-2.3%) |
| 西语:gusano barrenador | 339 | 298 | 12.1% | 只有表情 21 条、太短 19 条 | 约 8,960 → 8,860(-1.1%) |
| 合计 | 907 | 800 | 11.8% | — | — |
三语合计去掉 107 条,占 11.8%,低于 15% 的门槛。按动手前写好的失败分支,这一节的结论是:清洗主要为了质量,不是为了省钱。英西两种语言去掉的多是很短的行,它们本来就没几个 token,去掉以后 token 只少了 2.3% 和 1.1%。真正的例外是中文弹幕:B 站第三个视频的 100 条弹幕里有 22 条被去掉,第一个视频的 57 条里去掉 23 条,主要是同一位偶像的两句应援口号被反复刷了 23 遍,每条都很长,于是中文样本去掉 14.5% 的行,却少了 27.9% 的 token。中文评论区(非弹幕)173 条里只去掉 4 条。这说明「清洗值不值」要按数据源分开看:弹幕和直播评论这种刷屏密集的源,清洗能省下四分之一以上的输入;普通评论区几乎省不了什么。
换成钱看更直观。按动笔时的估算成本模型(token 按文档比例算,实测会更高,但清洗前后的比例不受影响),一万条原始评论不清洗、直接送模型,高峰期完整 JSON 的模型费是中文 $0.2984、英文 $0.4442、西语 $0.3877;清洗以后是 $0.2502、$0.4176、$0.3495,分别省 16.2%、6.0%、9.9%。省下来的主要是输出:每条评论不管多短,模型都要为它写一个完整的标签对象,所以删掉一条「Phew...」省的是二十几个输出 token,而不是它本身那三个输入 token。从这个角度看,清洗的价值有一半其实来自「少写标签」。
清洗规则自己也会犯错,这一点必须写出来。中文样本里「NB」「007」被当成「只有表情或标点」丢掉了,因为脚本只数汉字,好在这两条本来也没什么信息;西语样本里两条俄语评论也被丢掉,理由相同;英文的「HMPV possibly?」(是不是人偏肺病毒?)只有两个词,被当成太短删掉,可它其实是一条值得核实的疑问。我们逐条看了全部 107 条被删的行,带有实际信息的误删有 6 条,约占 5.6%:除了「HMPV possibly?」,还有西语的「Bot flies」「Los torsalos」、那条俄语评论(意思是「这是马蝇幼虫,大蒜没用」)、「Falso.」和「puro monopolio」。有意思的是其中 3 条都在说另一种寄生蝇(马蝇、tórsalo),正好是物种混淆的线索。对公共卫生场景来说,宁可让模型多读几条短句,也不要把「这是不是另一种病」这样的问题删掉,所以如果你照搬这个脚本,建议把「太短」的门槛降到 2 个词,并且只对弹幕源开刷屏去重。
关键词规则能先打多少:13.1% 到 34.2%
清洗之后的第二个省钱念头是:能不能先用关键词规则把容易的评论标掉,只把难的交给模型。我们为每种语言写了六七个标签的关键词组,规则只命中一个标签的评论算「高置信」,可以直接用规则的结果;命中多个或一个都没命中的,交给模型。动手前定的门槛是高置信覆盖不低于 40%,才推荐「规则先打、模型补剩下」。
| 样本 | 保留条数 | 只命中一个 | 命中多个 | 一个都没命中 | 规则命中最多的标签 |
|---|---|---|---|---|---|
| 中文 | 289 | 38(13.1%) | 8(2.8%) | 243(84.1%) | 中药材与药食同源 11 条 |
| 英文 | 213 | 46(21.6%) | 7(3.3%) | 160(75.1%) | distrust_conspiracy 13 条 |
| 西语,规则原样 | 298 | 102(34.2%) | 53(17.8%) | 143(48.0%) | precio_y_exportacion 45 条 |
| 西语,修正「usa」误配后 | 298 | 92(30.9%) | 27(9.1%) | 179(60.1%) | ganado_y_moscas 38 条 |
三种语言都没到 40%,所以结论按失败分支写:全部交给模型更省事,规则只拿来当质检对照。中文最低,因为中文评论短而口语化:「因为没有枪毙」「注意安全!!」「食品安全必须严查」这样的句子,人一眼能看出是在说监管,但关键词组里没有「枪毙」,也没有「严查」,规则就一个都命不中。反过来也会误中:「昨天中午央视新闻报道了」因为含「闻」字,同时命中了「怎么识别」和「对媒体的看法」,规则分不出哪个对,只能整条交给模型。英文的问题是讽刺和暗示:「Wonder who has been doing "gain of function" research.」能被规则抓到,但「Hmmm and what country controls our media?」这种更隐晦的阴谋论说法就漏了。
西语覆盖最高,可准确率反而最可疑,而且我们在写这一节时才发现原因。「价格与出口」这个标签的关键词里有一个「usa」,本意是匹配「USA」(美国),可它没有加词边界,于是所有含「gusano」(虫)的评论都命中了它:「Cómo llegó a México ese maldito gusano」(这该死的虫是怎么来到墨西哥的)被标成了「价格与出口」。298 条里有 70 条含「gusano」。只把「usa」改成整词,高置信覆盖从 34.2% 降到 30.9%,「价格与出口」的高置信条数从 45 条降到 9 条,命中多个标签的从 53 条降到 27 条。这还没完:「precio」(价格)同样会命中「preciosa」(宝贵的),一句祷告「la sangre preciosa de nuestro señor」也被标成了价格。所以我们给所有关键词都加上词边界再跑一遍(重跑脚本和逐条结果都留了底):高置信覆盖 30.2%,「价格与出口」的高置信只剩 7 条,而我们逐条读了这 7 条,没有一条真在说价格或出口,它们只是提到了「carne」(肉,多半指虫吃的肉)或者「USA」。图里保留的是规则原样跑出的 34.2%,这些误配本身就是规则不可靠的最好证据:一个字符级的疏忽能把一个标签的计数放大 5 倍以上,而规则自己不会报错。加了词边界仍然低于 40%,结论不变。西语样本里最有价值的判断,恰恰是规则做不了的那一个:评论说的到底是牛身上的螺旋蝇,还是鳄梨核里的蛀虫,还是把两者搞混了。这个区分直接决定科普团队要回应哪一种误解,所以我们在西语提示词里专门加了一个 especie 字段。
规则也不是一无是处。它免费、可以解释、结果稳定,适合拿来做模型输出的对照:模型标了「监管与执法」而规则命中了「怎么识别」的那些评论,值得人工抽看。用两套独立的标注方法对照,是内容分析里常用的做法;2023 年苏黎世大学的研究用 2,382 条推文比较了 ChatGPT 和众包标注员,模型在五项任务中的四项准确率更高,每条标注成本不到 $0.003(Gilardi 等,arXiv 2303.15056)。这项研究支持用模型批量标注,但它也保留了人工抽检的环节,我们的规则对照就是一种便宜的抽检入口。
送进 Flash 的那一步:脚本和实测
下面这段脚本按 DeepSeek 官方文档写,用 OpenAI 的 Python SDK 把 base_url 指向 DeepSeek(openai-python GitHub;安装见 openai PyPI)。我们实测时把 base_url 和 Key 换成了转发接口的,模型名换成 deepseek-v4.1-flash-1017,其余参数不变;直接用 DeepSeek 官方 Key 的读者照下面写即可。
import json, os, time
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")
SYSTEM = open("prompt_zh.txt", encoding="utf-8").read()   # 标签表 + 一条示例,固定不变,放在最前面方便命中缓存

def label_batch(rows, retries=3):
    user = "\n".join(f"{i}|{r['text']}" for i, r in enumerate(rows, 1))
    for attempt in range(retries):
        resp = ds.chat.completions.create(
            model="deepseek-flash",
            messages=[{"role": "system", "content": SYSTEM},
                      {"role": "user", "content": user}],
            response_format={"type": "json_object"},
            max_tokens=len(rows) * 40 + 200,          # 给每条约 40 个输出 token,防止截断
            extra_body={"thinking": {"type": "disabled"}},  # 打标签不需要思维链
        )
        text = (resp.choices[0].message.content or "").strip()
        if text:                                       # JSON 模式可能返回只有空格的 content
            labels = json.loads(text)["labels"]
            if len(labels) == len(rows):
                return labels, resp.usage
        time.sleep(2 ** attempt)
    raise RuntimeError("blank or short JSON after retries")
这段代码里每一个选项都对应文档里的一条原文,下面逐个说为什么。
response_format={"type": "json_object"} 打开 JSON 输出。DeepSeek 的 JSON 输出文档写了四条注意事项:提示词里要出现「json」这个词并给出示例;max_tokens 要设够,否则 JSON 会在中间被截断;最重要的是第四条,如果模型的输出不能被识别为 JSON,接口会把非 JSON 的内容替换成空格,返回的 content 可能只有空格,看起来是空的,即使 finish_reason 是 stop,文档建议在代码里处理空白内容并重试(DeepSeek JSON Output)。所以上面的代码先去掉空白再判断,空了就退避重试,并且检查返回的条数是不是和输入一致。实测 7 次完整 JSON 请求里没有遇到空白返回,602 条评论全部按条数一一对上;但转发接口有两次在 46 秒和 107 秒时返回了一段纯文本的超时提示,usage 填的是整齐的 1,000,finish_reason 照样是 stop。只看状态码会把它当成功,正是 json.loads(Python json 文档)和条数校验把它拦了下来。
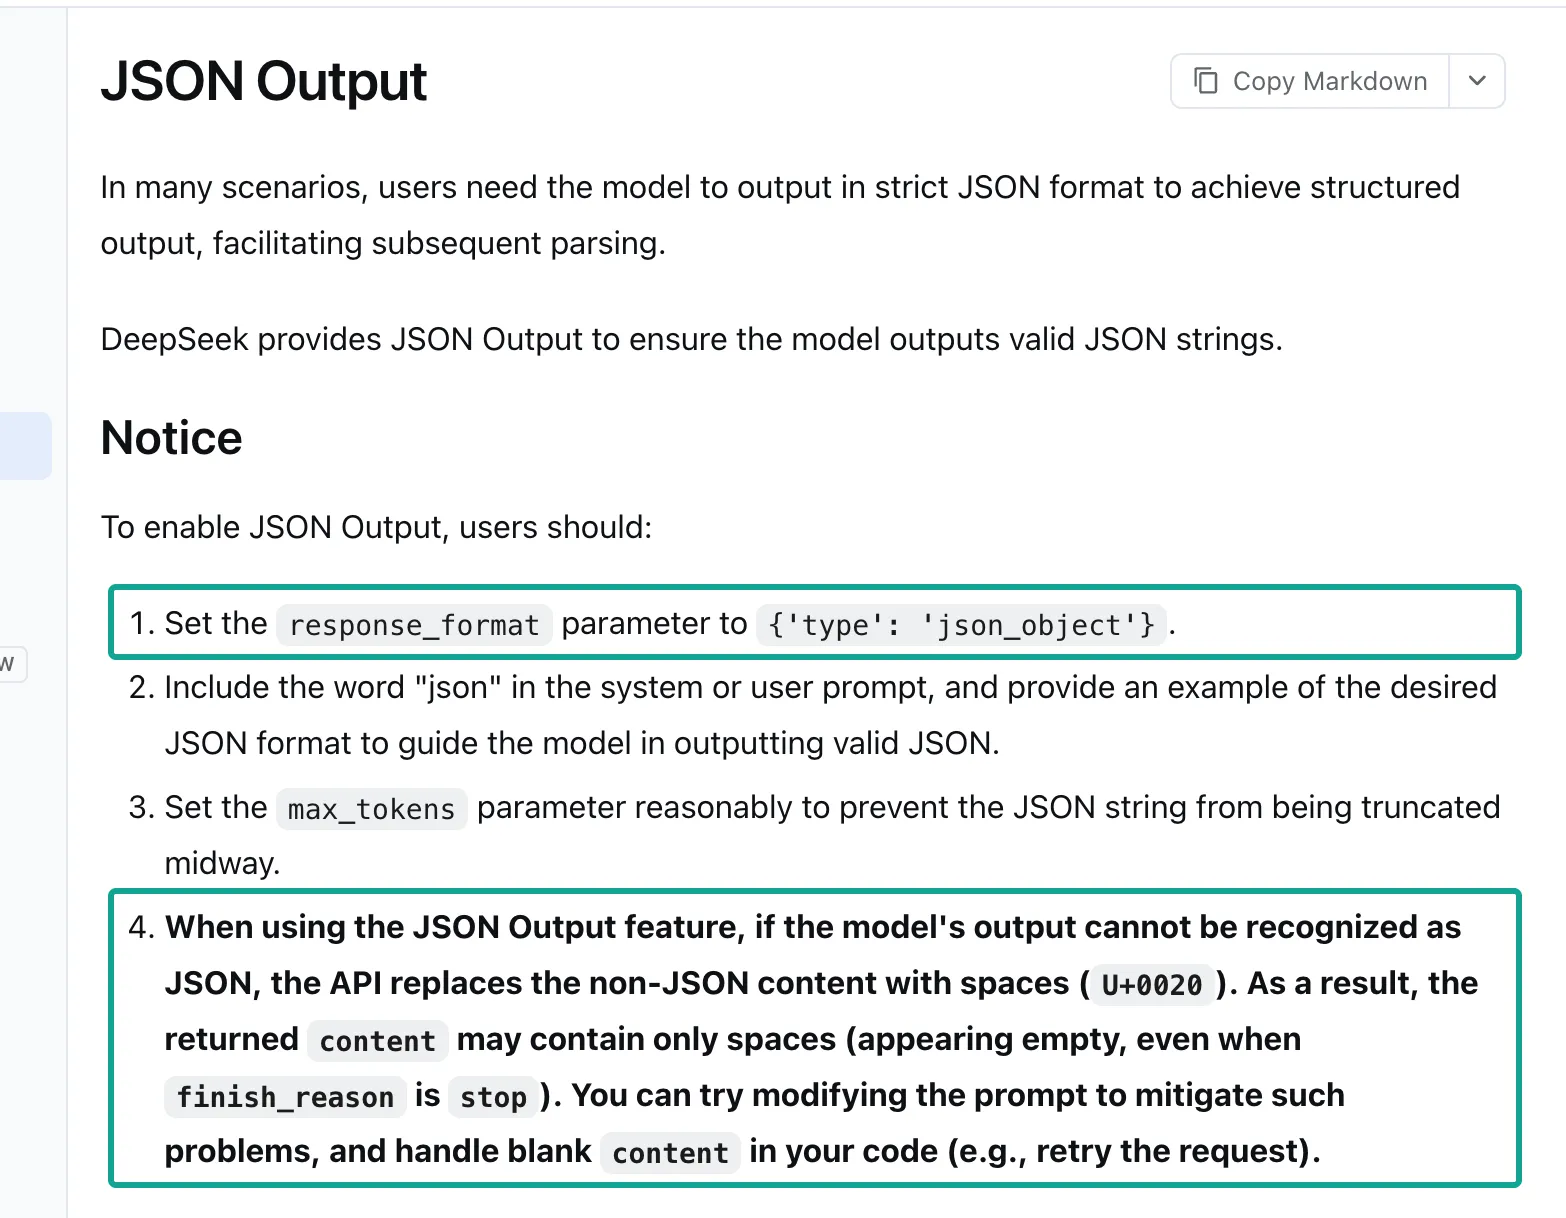
JSON 模式能保证返回的是合法 JSON 或者空白,但不能保证字段和条数是你要的,所以条数校验那一行不能省。如果要更强的结构约束,DeepSeek 的工具调用支持 strict 模式,需要把 base_url 换成 beta 地址,并给每个函数设 strict: true,模型输出会严格遵守函数的 JSON Schema(DeepSeek Tool Calls)。这个功能还在 Beta,我们没跑过,只作为备选。
extra_body={"thinking": {"type": "disabled"}} 关掉思考模式。DeepSeek 的思考模式文档写着,deepseek-flash 默认开启思考模式,默认强度是 high,模型会先输出一段思维链放在 reasoning_content 里,再给最终答案(DeepSeek Thinking Mode)。打标签这种短判断不需要长推理,而思维链本身也是模型写出来的内容:在 OpenAI 兼容格式的返回里它记在 completion_tokens_details.reasoning_tokens,OpenAI 文档写明这类 token 按输出计费(OpenAI Reasoning models)。r/DeepSeek 上 837 赞的 V4.1 Flash 发布帖里,最高赞(136 赞)的评论就是连写四行「Hmm」调侃它的思考过程(r/DeepSeek,2026-10)。我们每次请求都带了关掉思考的参数,可 9 次请求里仍有 4 次返回了思维链:completion_tokens_details.reasoning_tokens 分别是 4,041、4,046、6,137 和 8,010,而真正的标签只有几百到两千多个 token。这 4 次的费用因此是正常的 2 到 3 倍,9 次请求按空闲价换算共 $0.0300,其中 $0.0133(44%)花在这些不该有的思维链上。我们分不清这是转发接口没把参数传下去,还是模型这一侧的行为;能确定的是,批处理脚本必须逐次读 reasoning_tokens,不为 0 就记下来、必要时重发。
| 请求 | 发出时间(SGT) | 条数 | 秒 | prompt_tokens | completion_tokens | reasoning_tokens | 按空闲价换算 |
|---|---|---|---|---|---|---|---|
| 英文,第 1 批 | 03:21:27 | 100 | 97 | 4,804 | 3,290 | 0 | $0.002685 |
| 英文,第 2 批 | 03:23:04 | 100 | 77 | 4,371 | 3,424 | 0 | $0.002700 |
| 英文,第 3 批 | 03:25:34 | 13 | 45 | 946 | 4,436 | 4,046 | $0.002789 |
| 中文,第 1 批 | 03:25:34 | 100 | 44 | 2,058 | 6,564 | 4,041 | $0.004240 |
| 中文,第 2 批 | 03:26:18 | 100 | 60 | 1,966 | 8,779 | 6,137 | $0.005555 |
| 中文,第 3 批 | 03:27:18 | 89 | 79 | 2,571 | 2,721 | 0 | $0.002009 |
| 西语,第 1 批 | 03:27:26 | 100 | 86 | 4,570 | 3,961 | 0 | $0.002917 |
| 英文,短代码 | 03:29:30 | 100 | 72 | 4,810 | 1,297 | 0 | $0.001500 |
| 中文,短代码 | 03:29:30 | 100 | 56 | 2,063 | 8,860 | 8,010 | $0.005618 |
| 合计 | 03:21–03:30 | 802 | — | 28,159 | 43,332 | 22,234 | $0.030013 |
最后是并发和限速。DeepSeek 的限速页写着 deepseek-flash 每个账户并发上限 2,500,按账户算、不按 Key 算,超过就返回 429;请求发出后如果服务器 10 分钟还没开始推理就会断开连接,等待期间非流式请求会持续收到空行(DeepSeek Rate Limit & Isolation)。一万条评论按每批 100 条只有约 90 次请求,远到不了并发上限;我们实测每批 100 条要 44 到 97 秒才返回,所以并发发出比排队省时得多,真正的瓶颈在取数一侧:EveryInfra 的 Key 有每分钟请求数的限制,我们这把测试 Key 是每分钟 10 次,所以取数要排队,模型调用可以一次全发。DeepSeek 的错误码页列了 402 余额不足、429 限速、500 和 503 服务器问题(DeepSeek Error Codes),批处理脚本对 429、500、503 退避重试,对 402 直接停下来。
如果你更习惯在 AI 编程工具里完成整件事,也可以把 EveryInfra 的远程 MCP 接到工具里,让模型自己调取数能力,下面是一段配置示例(字段以你所用工具的文档为准):
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
不过对一万条量级的批处理,我们更推荐上面的直连脚本:取数和打标签都是确定的步骤,不需要模型在中间做决定,直连脚本的每一笔费用都能逐行对账。MCP 的接法见 远程 MCP 配置 和 MCP 服务器说明。
一次往返长什么样:我们回了什么,模型会收到什么
把上面两步串起来看一次完整往返。第一步,脚本向 EveryInfra 发 reddit/comments,参数是华盛顿州奶牛场工人住院那条帖子的链接,limit: 100。新加坡时间 00:20:36 返回 HTTP 200,count: 58,billing.charged_usd: 0.000556。目录里 reddit/comments 的 response_fields 列了 id、text、author_username、like_count、community、url、posted_at、platform 八个字段,可这 58 条和另外三次 Reddit 评论调用的返回里都没有 community,只有另外七个;要按版块分组的话,从帖子链接里取版块名更稳。这处目录和返回不一致,我们也记下来交给接口那边核对。第一条是「Yes. One of the 3 cases died today.」,66 个赞,发布时间 2026-11-02T04:30 UTC。我们只取 id 和 text 送去清洗,作者名在落盘时就隐去。
第二步,清洗后的评论按「行号|原文」拼成一个用户消息,和固定的系统提示词一起发给模型。英文系统提示词规定了 9 个标签、6 种立场和「需要核实」的判定条件,并给了一条输入输出示例。英文第一批 100 条在新加坡时间 03:21:27 发出,97 秒后返回,usage 是 prompt_tokens: 4804、completion_tokens: 3290、reasoning_tokens: 0。上面那条「Yes. One of the 3 cases died today.」得到的真实标签是 {"i":1,"tags":["spread_pandemic_risk"],"stance":"informative","needs_fact_check":true}:模型认为它在陈述病例事实,需要人工核实,这正是我们想要的。三语合计,英文 213 条里 70 条被标为需要核实,中文 289 条里 65 条,西语前 100 条里 40 条。按实测,英文每条评论分摊的读入约 47.5 个 token,写出的完整 JSON 标签约 33.4 个;中文每条读入约 22.8 个,标签约 27.3 个,标签反而比评论长。
这张图就是本文最重要的发现的来源,也是实测和估算差得最多的地方。动笔时我们只能按 DeepSeek 文档给的比例估:1 个英文字符约 0.3 个 token,1 个汉字约 0.6 个 token,实际以接口返回的 usage 为准(DeepSeek Token & Token Usage)。真跑以后,英文读入的 token 和估算几乎一样(实测是估算的 0.997 倍),西语多了 27%,中文多了 70%:评论里夹着的表情、全角标点和数字都比「每字 0.6」更费 token。写出的完整 JSON 标签三语都比估算长,中文 27.3 对 21.3,英文 33.4 对 26.4,西语 39.6 对 25.2。再乘上输出单价是输入 4 倍这个比例,高峰期完整 JSON 打标签,输出占模型费的 82.7%(中文)、73.8%(英文)、77.6%(西语)。估算时是 87.3%、70.3%、76.1%,结论「钱主要花在输出上」没有变,变的是总额。
deepseek v4.1 flash api pricing:一万条评论的总账
现在把取数费和模型费放在一起,按一万条原始评论外推。外推规则是:取数费 = 样本实付(含找帖子的搜索)÷ 样本条数 × 一万;送进模型的条数 = 一万 × 样本的清洗保留率;每条的输入、输出 token 用实测 usage 的均值(不含那几次多出来的思维链);价格取 DeepSeek 定价页和 EveryInfra 目录在 11 月 9 日读到的值。西语短代码没有实测,表里空着。外推只放大单价,不放大样本里没有的情况,例如样本里没有超长评论,那一万条里也不会有。
| 场景(一万条原始评论,外推) | 中文 | 英文 | 西语 |
|---|---|---|---|
| EveryInfra 取数(含搜索;只算评论调用的下限) | $0.5828($0.2636) | $0.2176($0.1451) | $0.0984($0.0656) |
| 送进模型的条数 | 8,550 | 9,261 | 8,791 |
| Flash 高峰 + 完整 JSON(实测 token) | $0.3386 | $0.5032 | $0.5383 |
| Flash 空闲 + 完整 JSON | $0.1693 | $0.2516 | $0.2691 |
| Flash 高峰 + 短代码(实测 token) | $0.1400 | $0.2781 | 未实测 |
| Flash 空闲 + 短代码 | $0.0700 | $0.1391 | 未实测 |
| 总账:最贵到最便宜 | $0.9214 → $0.6528 | $0.7208 → $0.3567 | $0.6367 → $0.3675 |
| 对照:动笔时按文档比例估的高峰完整 JSON | $0.2502 | $0.4176 | $0.3495 |
这张表里有三个读法。第一,总账很便宜:最贵的中文高峰完整 JSON,一万条从取数到打完标签是 $0.9214,每千条约 $0.09。作为参照,Gilardi 等人 2023 年估的 ChatGPT 每条标注成本不到 $0.003,按这个上限一万条是 $30;英文样本下 Flash 的实测模型费每条约 $0.000054,是那个上限的约五十分之一。当然两者的任务和模型都不同,这个对比只说明量级变了。
第二,取数费和模型费的大小关系随语言变。中文样本里取数费 $0.5828 是高峰期模型费 $0.3386 的 1.7 倍,因为中文评论短、模型便宜,而中文帖子的评论少、B 站评论每次最多 10 条,还有一次 $0.008333 的抖音搜索;西语样本相反,取数费只有 $0.0984,模型费是它的五倍多。所以「先优化哪一边」的答案取决于你的数据源:如果你拉的是评论很多的热门视频,模型费是大头;如果你拉的是很多条小帖子,取数费是大头,优化方向是挑帖子、少搜几次,而不是改提示词。
第三,模型那一侧真正的杠杆是输出格式和时段,不是批大小和缓存。同样 100 条评论,实测短代码把输出从 3,290 个 token 降到 1,297 个(英文),从 2,523 个降到 850 个(中文,不算思维链),高峰期模型费中文从 $0.3386 降到 $0.1400(-58.7%),英文从 $0.5032 降到 $0.2781(-44.7%)。省得比估算的六到七成少,因为短代码每行的行号、竖线和代码也要按字算 token。挪到空闲时段,再对半。两步叠加,模型费降到原来的约 21%(中文)到 28%(英文)。
批大小和缓存:几乎不影响账(按估算)
很多批处理教程会花很多篇幅讲「每批放多少条」和「怎么命中缓存」。按 DeepSeek 的缓存规则,前缀完全一致的部分才能命中,系统会在请求边界和检测到的公共前缀处持久化缓存单元,命中情况看 usage 里的 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens;缓存是尽力而为,不保证命中,不用了几小时到几天会被清掉(DeepSeek Context Caching)。我们的系统提示词固定放在最前面,第三次请求以后就有机会命中。下表是动笔时按文档比例做的估算,只用来看「批大小和缓存」的相对影响;实测的 9 次请求里,8 次的 cached_tokens 只有 0 到 102 个,连一个完整的系统提示词都没缓存上;唯一的例外是西语那批在转发接口超时后原样重发,984 个 token 命中了缓存。这和表里「缓存只省 1.7%」的判断方向一致:只有整段前缀重复时缓存才明显起作用。
| 每批条数 | 请求次数(英文) | 每次输出 token(英文) | 英文高峰,有缓存 | 英文高峰,无缓存 | 中文高峰,有缓存 | 西语高峰,有缓存 |
|---|---|---|---|---|---|---|
| 25 | 371 | 672 | $0.4220 | $0.4508 | $0.2541 | $0.3538 |
| 50 | 186 | 1,332 | $0.4190 | $0.4334 | $0.2515 | $0.3510 |
| 100 | 93 | 2,652 | $0.4176 | $0.4247 | $0.2502 | $0.3495 |
| 200 | 47 | 5,292 | $0.4168 | $0.4203 | $0.2495 | $0.3488 |
| 400 | 24 | 10,572 | $0.4165 | $0.4182 | $0.2492 | $0.3485 |
批大小从 25 条改到 400 条,英文高峰期的模型费只从 $0.4220 降到 $0.4165,差 1.3%;每批 100 条时有没有缓存只差 $0.0071,约 1.7%。原因很简单:批大小和缓存省的都是系统提示词的重复输入,而系统提示词只有两三百个 token,在一万条评论的总输入里占比很小。它们对输出这一大头完全没有影响。所以批大小应该按别的标准选:批越大,一次 JSON 出错要重试的条数越多;400 条一批时每次输出约 1 万个 token,离 384K 的上限很远,但一旦返回空白就要整批重跑。我们建议每批 50 到 100 条,失败重试的代价可控,请求次数也不多。
峰谷时段:同一批活晚几小时跑,模型费减半
DeepSeek 的高峰时段是周一到周五 UTC 01:00–04:00 和 06:00–10:00,中国法定节假日除外,其余时间(包括周末和中国法定节假日全天)都是空闲价,空闲价是高峰价的一半(DeepSeek 定价页)。我们看到有视频把它说成「亚洲工作时间以外」,这个说法不准:高峰时段换算到新加坡时间是上午 09:00–12:00 和下午 14:00–18:00,中午 12:00–14:00 本身就是空闲价。
| 地点(时区) | 高峰时段(周一到周五) | 建议的批处理窗口 |
|---|---|---|
| UTC | 01:00–04:00、06:00–10:00 | 10:00 以后到次日 01:00 |
| 新加坡、北京(UTC+8) | 09:00–12:00、14:00–18:00 | 18:00 以后,或中午 12:00–14:00 |
| 美国西海岸(11 月起 UTC-8) | 前一天 17:00–20:00、22:00–02:00 | 白天 02:00–17:00 |
| 墨西哥城(UTC-6) | 前一天 19:00–22:00、00:00–04:00 | 04:00–19:00 |
| 马德里(11 月起 UTC+1) | 02:00–05:00、07:00–11:00 | 11:00 以后 |
对中文团队来说,最自然的安排是傍晚下班前把当天拉好的评论排进队列,18:00 以后开跑;周末的活全部按空闲价。还要注意一个细节:脚注写的是「中国法定节假日除外」,春节、国庆这几天即使是工作日也按空闲价算。如果你的任务必须在白天出结果,例如上午开会前要看昨夜的舆情,那就让取数在夜里跑完,打标签也在夜里跑完,白天只看结果。打标签这种活几乎没有「必须在高峰期跑」的理由。
输出格式才是最大的杠杆:短代码和完整 JSON
既然输出占模型费的七到八成,最直接的省钱办法就是让模型少写。完整 JSON 每条要写键名、引号和完整的标签名;短代码把同样的信息压成一行竖线分隔的文本,例如中文写成「123|健,监|担|0」,表示第 123 条、标签是健康担忧和监管与执法、立场是担心、不需要核实,脚本再按对照表展开。我们真跑的短代码提示词就是这个格式,中英文各 100 行全部对上了正则,没有一行需要补发。
| 输出格式 | 中文每条输出 token(实测) | 英文(实测) | 西语 | 好处 | 代价 |
|---|---|---|---|---|---|
完整 JSON(json_object) | 27.3 | 33.4 | 39.6(实测) | 接口保证是合法 JSON,解析简单 | 输出贵,占模型费 74%–83% |
| 短代码(纯文本) | 8.5 | 13.0 | 未实测 | 输出少 61%–69%,100 行全部通过正则校验 | 不能用 JSON 模式,要自己校验格式 |
| 只回需要核实的行 | 视比例而定 | 视比例而定 | 视比例而定 | 输出最少 | 漏回的行分不清是「不需要」还是「漏了」 |
短代码的代价是放弃 JSON 模式的格式保证。我们的建议是两者结合:主流程用短代码,脚本按正则逐行校验(Python re 文档;关键词规则加词边界也用它的 \b),行数不对、代码不在对照表里的那一批,再用完整 JSON 模式重跑一次。按样本估计,重跑比例只要不超过一半,短代码方案就仍然比全部用 JSON 便宜。第三种「只回需要核实的行」看起来最省,但在批处理里很危险:模型少回了一行,你分不清它是判断为不需要核实,还是漏掉了,公共卫生场景里漏掉一条「生奶能防禽流感」的说法代价远高于省下的几分钱。
需要提醒的是,短代码和条数校验的关系:短代码每行都带行号,脚本可以精确找到缺了哪一条,只把缺的那几条补发一次,不用整批重跑。完整 JSON 模式下,如果返回是空白,你只能整批重跑。这也是为什么短代码在 400 条一批这种大批量下反而更稳。
三个话题各自看到了什么
数据接口和模型之外,样本本身也有值得写的观察,它们决定了标签表该怎么设计。
中文样本里,规则高置信命中的 38 条里有 11 条落在「中药材与药食同源」,例如「不止白芷,各种中药材,还有各种干货食材都应严查」(157 个赞)。模型给这 38 条打的标签里,34 条包含了规则那个标签,一致率最高。评论里很多人分不清白芷作为中药材和作为香辛料的两套二氧化硫标准,这正是「需要核实」字段要抓的东西,核对时以报道引用的原文为准(中国食品安全网)。弹幕的另一个特点是刷屏:两句和话题无关的应援口号被刷了 23 遍,这就是中文清洗收益最大的地方。
英文样本里,点赞最高的三条评论(324、221、153 赞)都被规则标成 distrust_conspiracy;规则高置信的 46 条里,模型的标签有 35 条与规则一致,不一致的多是规则只看到「lab」「gain of function」这类词,模型却判成在讲传播风险。needs_fact_check 要做的,是把这类说法和美国农业部动植物卫生检验局、美国疾控中心的原文对上(USDA APHIS,2026-11-04;CDC 现状页)。
西语样本里,加了词边界以后规则命中最多的是「牛与苍蝇」(38 条)。规则高置信的标签和模型一致的比例最低,前 100 条里的 38 条只有 15 条对得上,主要就是上面那些子串误配。规则命中多个标签的 27 条里,同时命中「牛」和「鳄梨」的只有 2 条;把两种虫混为一谈的评论,规则基本认不出来,而模型在前 100 条里把 14 条标成了 confunde_ambos(两者混淆),这就是我们加 especie 字段的理由。两件事的官方说法分别见美国农业部的螺旋蝇现状页和墨西哥农业部长 11 月 4 日的澄清报道(USDA APHIS 螺旋蝇现状;The Food Tech)。
做不了或要注意的地方
| 限制 | 影响 | 我们的处理 |
|---|---|---|
| 没有 DeepSeek 官方 Key,经第三方转发接口真跑 | token 是实测 usage,费用是按官方价换算,不是 DeepSeek 账单;转发接口可能影响思考模式开关和超时 | 每次的原始请求和返回都留底;超时返回和思维链 token 单独记账 |
| 只实测了 602 条、9 次请求 | 西语只跑了 100 条,西语短代码没跑;批大小表仍是估算 | 表里逐项标「实测」或「未实测」 |
| 一万条是外推 | 样本只有 907 条,热门帖和冷门帖的比例会改变每次调用的条数和搜索费的分摊 | 取数费给「含搜索」和「只算评论调用」两个数 |
| 思考模式默认开启,关了也可能漏 | 9 次里 4 次仍返回思维链,费用变成 2 到 3 倍 | 逐次读 reasoning_tokens |
| JSON 模式可能返回空白 | 看起来成功,其实没有标签 | 去空白、校验条数、退避重试 |
| 清洗规则会误删 | 「HMPV possibly?」这类短问题被删 | 英西太短门槛降到 2 个词,只对弹幕开刷屏去重 |
| 标签质量没有人工金标准 | 本文只给和规则的一致率,不给准确率 | 用关键词规则做对照,抽看两者不一致的评论 |
| 有的接口每次条数有上限 | B 站评论每次最多 10 条,小帖子每次只拿回 1 到 10 条 | 先用搜索挑评论多的帖子,B 站优先拉弹幕 |
这里面最大的一条是第一条。我们能确定的是 token 数和条数,确定不了的是 DeepSeek 官方接口会不会同样漏掉思考模式开关、超时会不会同样以纯文本返回。直接用官方 Key 的读者,第一批先跑 100 条,把 usage 和本文的实测表对一下,差得多就以你的为准。本文的核心结论是比例关系:输出比输入贵、短代码比 JSON 短、空闲比高峰便宜一半,这三条在实测里都成立,只是短代码省的比估算少。
还有一条不在表里但要说:本文只给数据方法,不评价任何一种说法的医学或法律对错。H5N1、螺旋蝇和二氧化硫残留的事实判断,请以文中链接的卫生和农业主管部门原文为准。
常见问题
deepseek v4.1 flash api key 在哪里拿?
在 DeepSeek 开放平台注册账户、充值后创建 API Key,模型名填 deepseek-flash。DeepSeek 的错误码页把 401 解释为 Key 错误、402 解释为余额不足,并分别链到创建 Key 和充值页面(DeepSeek Error Codes)。
deepseek v4.1 flash api free 有没有免费用法?
DeepSeek 官方 API 按 token 计费,定价页没有写免费额度;扣费时优先用赠送余额(DeepSeek 定价页)。YouTube 上播放量靠前的几个视频讲的是通过第三方平台的免费额度调用,这些渠道有每周限额,不适合一万条量级的批处理。
deepseek v4 1 flash 1017 api cost 和之前的版本比贵了还是便宜了?
按当前定价页,V4.1 Flash 空闲时段未命中输入 $0.15、输出 $0.60;Hacker News 用户贴出的上一代 V4 Flash 0731 空闲价是 $0.22 和 $0.66(Hacker News 评论)。上一代的价格我们没在官方页面找到存档,只作参考。
V4.1 Flash 打标签会不会胡编?
我们没有人工金标准,给不出准确率;能给的是两个对照:602 条里返回的标签条数全部和输入一致,没有多编或漏掉的行;规则高置信的评论里,模型标签和规则一致的比例是中文 34/38、英文 35/46、西语 15/38(西语低主要是规则自己误配)。建议的做法是用关键词规则做独立对照,并对 needs_fact_check 为真的评论全部人工核实。
关掉思考模式以后,账单里还会有思维链吗?
可能有。我们 9 次请求都带了 thinking: disabled,仍有 4 次返回了 4,041 到 8,010 个 reasoning_tokens,这几批的费用是正常的 2 到 3 倍。思考模式文档写了默认开启(DeepSeek Thinking Mode),r/DeepSeek 发布帖里最高赞的评论也在调侃它反复写「Hmm」(r/DeepSeek)。脚本里每次都读 usage.completion_tokens_details.reasoning_tokens,不为 0 就记账并考虑重发。
上手步骤
- 在 快速上手 拿到 EveryInfra API Key,先读免费目录确认能力和单价,价格总览见 定价。
- 按平台挑能力:英文用 YouTube 评论 和 Reddit 评论,中文用 B 站弹幕、抖音评论 和 知乎评论;平台总览见 YouTube 接口、Reddit 接口、B 站接口、抖音接口。
- 先拉 200 到 300 条样本,跑一遍清洗脚本,看你的数据源去掉多少行、每条多少 token。
- 把标签表写进系统提示词并固定不变,先用完整 JSON 模式跑一小批,确认标签表能用、读一遍
usage里的reasoning_tokens,再换短代码。 - 把整批任务排在空闲时段,脚本里处理空白返回、条数校验和 429 退避。
相关阅读
参考资料
- Models & Pricing,DeepSeek,2026-11-09 读取
- Change Log,DeepSeek,2026-10-17 条目
- DeepSeek-V4.1-Flash-1017 发布说明,DeepSeek,2026-10-17
- DeepSeek-V4.1-Flash 发布说明,DeepSeek,2026-09-10
- DeepSeek-V4-Pro GA 发布说明,DeepSeek,2026-08-13
- JSON Output,DeepSeek,2026-11-09 读取
- Thinking Mode,DeepSeek,2026-11-09 读取
- Context Caching,DeepSeek,2026-11-09 读取
- Rate Limit & Isolation,DeepSeek,2026-11-09 读取
- Token & Token Usage,DeepSeek,2026-11-09 读取
- Tool Calls,DeepSeek,2026-11-09 读取
- Error Codes,DeepSeek,2026-11-09 读取
- openai-python,OpenAI,GitHub,2026-11-09 读取
- Social API 目录,EveryInfra,2026-11-09 读取
- DeepSeek-V4.1-Flash-1017 just dropped,Reddit r/DeepSeek,2026-10
- V4.1 Flash、V4 Pro、V4 Flash 价格对比评论,Hacker News,2026-09
- A(H5) Bird Flu: Current Situation,美国疾控中心,2026-11-09 读取
- A(H5) Bird Flu Surveillance and Human Monitoring,美国疾控中心,2026-11-06
- USDA Confirms HPAI in Two Washington Dairy Herds,USDA APHIS,2026-10-08
- Update: Genetic Sequencing Results for Washington Dairy Herd,USDA APHIS,2026-11-04
- USDA Confirms HPAI in a Dairy Herd in Indiana,USDA APHIS,2026-11-02
- HPAI Confirmed Cases in Livestock,USDA APHIS,2026-11-09 读取
- Yakima County reports 2 more avian flu cases, 1 death,CIDRAP,2026-11-03
- HPAI (H5N1) in Cattle Producer Resources-in-cattle-producer-resources),华盛顿州农业厅,2026-11-09 读取
- Bird Flu (Avian Influenza),华盛顿州卫生厅,2026-11-09 读取
- Investigation of Avian Influenza A (H5N1) Virus in Dairy Cattle,美国食药局,2026-11-09 读取
- Influenza (avian and other zoonotic)),世卫组织,2026-01-21
- Avian influenza weekly update,世卫组织西太区,2026-10-30
- 关于发布 GB 2760-2024 等 47 项食品安全国家标准的公告,国家卫生健康委,2024-03-12
- 打着「无硫」旗号 熏硫白芷仍在偷偷售卖,中国食品安全网,2026-11
- 浔阳区市场监管局查获 1.5 吨问题熏硫白芷,九江市浔阳区政府网,2026-11-03
- Alerta Epidemiológica: Miasis por Cochliomyia hominivorax,泛美卫生组织,2026-10-16
- Brote de gusano barrenador del Nuevo Mundo,美国疾控中心,2026-10-29
- Current Status of New World Screwworm,USDA APHIS,2026-11-05
- USDA Confirms New World Screwworm Detection in Arizona,USDA APHIS,2026-10-28
- Boletín Informativo Avance GBG No. 11,SENASICA,2026-03-27
- ¿El gusano barrenador puede atacar frutas?,The Food Tech,2026-11-04
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks,Gilardi 等,arXiv,2023-03-27
- unicodedata,Python 文档,2026-11-09 读取
- datasketch,GitHub,2026-11-09 读取
- openai,PyPI,2026-11-09 读取
- datasketch,PyPI,2026-11-09 读取
- re,Python 文档,2026-11-09 读取
- json,Python 文档,2026-11-09 读取
- Reasoning models,OpenAI,2026-11-09 读取
引用编号 BL-116