Kimi K3.1 Pro 交叉核对微博舆情与三季报
用 Kimi K3.1 Pro 接微博和财报数据接口做交叉核对:评论时间分布、财报字段逐项对账、上下文容量估算,附 MCP 配置示例和每家公司的成本。
我们在 2026 年 11 月 2 日 00:17–00:23(新加坡时间)用 EveryInfra 接口拉了比亚迪三季报发布后的微博讨论和财务数据,再按 Kimi K3.1 Pro 能接的方式把它们放到一起核对,最先跳出来的不是情绪分数,而是评论的时间分布:一条博主解读帖下,我们拿到的 31 条评论点赞数全是 0,其中 11 条在同一个 18 秒里发出;另一条讨论同一份财报的长文下,36 条评论散落在两天多里,任意 20 秒内最多只有 1 条。第二个发现是讨论和原文关注的不是同一组数:三季报原文里变动最大的几项,存货比年初 +60.08%、应收账款 +52.61%、货币资金 −58.92%,原文都给了解释(例如存货增加主要是海外业务备货),但这几项在那 31 条评论里都没有出现。这不说明谁对谁错,只说明研究摘要不能只读评论区。这篇文章讲的就是这件活怎么搭:Kimi K3.1 Pro 负责长上下文里的对照和成文,EveryInfra 的 weibo/search、weibo/comments、yahoo_finance/financials 等能力负责把原始数据拿回来,中间哪一步该交给模型、哪一步必须由你的程序先做掉。
这篇文章只讲数据方法和工具接法,不评价任何一只股票值不值得买,也不给任何交易建议。文中出现的财务数字,都只是拿来演示「社交讨论说了什么、原始财报里有什么」这一步怎么核对,核对结果只写「讨论中出现或未出现」,不写好坏。本文由 EveryInfra 团队整理,统计全部用脚本完成,没有经过持牌证券分析师审阅;对任何一家公司的判断,请以公司公告和持牌机构的意见为准。Kimi 一侧的配置全部按 Moonshot 的官方文档原文写,我们本机没有 Kimi 的 Key,也没有真跑 Kimi,所以那部分一律标成「配置示例」;EveryInfra 一侧的每个数字都来自真实请求的原始返回。
这件活是什么:一页「舆情 + 财报」研究摘要
先把任务说具体,后面所有的配置和成本都按这个任务算。输入是一家上市公司和它最近一次财报的发布时间。我们要从公开数据里拿回四样东西:财报发布前后的微博讨论(关键词搜索和话题搜索)、讨论最多的几条微博下面的评论、这家公司最近几个季度的财务表、财报前后的日行情。输出是一页研究摘要,结构固定:社交讨论在说什么,财报原文里对应的数是什么,两边对不上的地方有哪些,哪些讨论看起来不像自然产生的,以及这页摘要自己的局限。
这件活适合交给一个长上下文、会调工具的模型,原因有三条。第一,原始材料杂:微博正文、评论、财务表、行情是四种完全不同的结构,人工对照要来回翻;模型可以一次读完再按固定格式写。第二,对照规则可以写清楚:比如「评论里提到的每一个财务说法,都要在财务表里找到对应字段,找不到就标出来」,这正是长上下文模型擅长的逐条比对。第三,最后的判断留给人:模型产出的是一页带出处的对照表,不是买卖结论。Moonshot 在 K3.1 Pro 的技术博客里说,这一代在「Financial Research」这项内部评测上比 K3 提高了 11.6 分,评测的内容是在证据和截止时间约束下写出「可审计」的研究(Kimi K3.1 Pro 技术博客)。「可审计」三个字正好是这件活的要求:摘要里的每一句话都要能回到原始数据。
我们选比亚迪做主例子,原因是时间点:比亚迪在 2026 年 10 月 29 日晚间披露三季报(巨潮资讯网 2026 年第三季度报告全文),到我们取数的 11 月 2 日凌晨,微博上的讨论还在持续,H 股已经交易了一天。特斯拉做对照,它在美东时间 2026 年 10 月 21 日盘后发布三季度更新(Tesla 向美国证监会提交的 8-K 附件 99.1),到取数时已经过去 11 天,正好能看出「什么时候取数」对结果的影响。
| 输入或输出 | 内容 | 用到的能力 | 目录单价 |
|---|---|---|---|
| 微博讨论 | 关键词搜索最多 50 条 | weibo/search | $0.000806 / 次 |
| 话题热度 | 话题的阅读数、讨论数 | weibo/topic_search | $0.000806 / 次 |
| 评论区 | 一条微博下最多 50 条评论 | weibo/comments | $0.000556 / 次 |
| 财务表 | 年度与季度利润表、资产负债表、现金流量表 | yahoo_finance/financials | $0.001389 / 次 |
| 行情 | 日 K 线,最长可回看多年 | yahoo_finance/history | $0.001389 / 次 |
| 分析师评级 | 评级分布与调高、调低记录 | yahoo_finance/analyst | $0.001389 / 次 |
| 输出 | 一页研究摘要(结构化 JSON + Markdown) | Kimi K3.1 Pro | 按 token 计费 |
表里的单价是我们在 2026 年 11 月 2 日 00:13(新加坡时间)从免费目录读到的 price_usd(微博能力目录、Yahoo Finance 能力目录)。各项能力的字段说明在 微博爬虫 API 和 Yahoo Finance 数据 API 两个平台页,单项见 微博关键词搜索、微博评论、微博话题搜索、财务指标、历史行情 和 分析师评级。
kimi k3.1 pro 是什么:版本、价格和这件活用得上的功能
派活时写的型号是 Kimi K3.1 Pro,我们先去 Moonshot 的原文里核对它是否存在、叫什么、怎么调。结论是存在,而且 API 里的模型 ID 和产品名不完全一样,配置时要分清。Kimi K3.1 Pro 在 2026 年 10 月 23 日发布,是 K3.1 系列的第一个模型,官方描述是「3T 级」参数、1M token 上下文,在编程、3D 生成、金融研究和其他智能体任务上有明显提升,同时发布一个推理速度快 2 到 3 倍的 Highspeed 版本,完整权重承诺在 11 月 4 日前开放(K3.1 Pro 快速上手文档;技术博客)。API 的模型 ID 是 kimi-k3.1-pro 和 kimi-k3.1-pro-highspeed;Kimi Code 里用的模型 ID 是 k3.1-pro,Kimi Code 的文档特别提醒,填错模型 ID 会退回到一个不带思考的旧模型(Kimi Code 模型配置)。
和这件活关系最大的几个参数,我们逐条列在下表,每一条都来自 2026 年 11 月 2 日读取的原文。
| 项目 | 原文写法 | 对这件活意味着什么 | 出处 |
|---|---|---|---|
| 上下文 | 1,048,576 token,按 token 统一计价,不按长度分档 | 几十家公司的原始数据能一次放进去 | 定价说明 |
| 价格 | 输入 $2.00、输出 $10.00、缓存写入 $2.00、缓存命中 $0.20(每百万 token) | 长输入便宜,思考和输出贵 | Kimi API 平台首页 |
| Highspeed | 输入 $4.00、输出 $20.00,缓存命中同为 $0.20 | 要快就付两倍 | Kimi API 平台首页 |
| 思考 | 一直开着,reasoning_effort 可选 low、high、max,默认 max | 默认最贵的一档,批量任务要手动调低 | 推理强度说明 |
| 输出上限 | max_completion_tokens 默认 131,072,最大 1,048,576 | 要给输出留出上下文 | 快速上手 |
| 固定参数 | temperature 1.0、top_p 0.95 等固定,请求里不要写 | 不能靠调温度让摘要更「稳」 | 快速上手 |
| 结构化输出 | json_schema 加 strict: true,只解析 message.content | 研究摘要可以强制成固定字段 | 结构化输出 |
| Batch | 标准价的 60%,有 completion_window | 每晚批量跑可以省四成 | Batch 定价 |
| 开通门槛 | 充值成功后解锁,最低 $1 | 先充值才能调旗舰模型 | 充值与限速 |
| 联网搜索 | 正在更新,近期不建议用于生产 | 外部数据不要指望模型自己搜 | 快速上手 |
最后一行值得多说一句。这件活需要的数据,模型本身拿不到,最省事的想法是开模型自带的联网搜索。但 Moonshot 在快速上手文档的「重要限制」里原话写的是联网搜索正在更新、近期不建议用于生产流程。即使搜索能用,网页搜索拿回来的是网页摘要,不是结构化的评论列表和财务表;要做逐条对照,还是得把原始数据作为工具结果交给模型。
另外,同一个幻觉率压力测试,技术博客写 K3.1 Pro 降到 8.3%,快速上手文档写 6.85%,两处都说明是故意挑难题的测试;厂商自己的数字也要回到原文核对,研究摘要更是如此。
能不能直接接远程 MCP:Kimi 的三个 API 都不收
EveryInfra 有一个远程 MCP 服务(地址 https://api.everyinfra.com/mcp,工具名以 everyinfra_ 开头),在 Claude、Cursor 这类客户端里可以直接填地址使用,接法见 MCP 接入说明 和 远程 MCP 接入验收。很多人会默认 Kimi API 也能在请求里挂一个远程 MCP 地址,我们逐个核对了 Kimi 的接口参考,答案是不能。
Kimi 的 Responses API 参考写得最清楚:tools 只支持四种类型,function、namespace、custom(只有 apply_patch)和 web_search,其他类型不支持;前三种在你这一侧执行,模型返回调用请求,你执行后把结果发回去(Responses API 参考)。Chat Completions 接口的工具调用是标准的函数调用(工具调用说明)。兼容 Anthropic 格式的 Messages 接口支持工具调用、思考和结构化输出,但参考文档里没有远程 MCP 服务器这个参数(Messages API 参考)。Playground 里有 MCP,但只能通过魔搭社区的 API Token 同步你在魔搭上托管的 MCP 服务(Playground 配置魔搭 MCP),这条路我们在 魔搭 MCP 广场接小红书、抖音数据 里写过。
| Kimi 的入口 | 能否直接填远程 MCP 地址 | 怎么接 EveryInfra | 适合谁 |
|---|---|---|---|
| Chat Completions API | 否,只有函数工具 | 定义一个函数工具,你的程序转发到 REST | 自己写程序、要批量跑 |
| Responses API | 否,四种工具类型里没有 MCP | 同上,或用 namespace 把多个函数归组 | 习惯 Responses 格式的项目 |
| Messages API(兼容 Anthropic) | 否 | 同上 | 已有 Anthropic SDK 代码的项目 |
| Playground | 只能同步魔搭托管的 MCP | 先把服务托管到魔搭,再同步 | 手动试验 |
| Kimi Code CLI | 能,mcp.json 写 url | 直接填地址,Key 用环境变量 | 开发者、终端里跑 |
| Kimi Work 桌面版 | 能,通过个人插件 | Plugin Builder 建插件时填 MCP 地址 | 不写代码的研究人员 |
| kimi.com 网页版 | 插件里支持 MCP 和 Skills | 用已上架或企业插件 | 普通对话 |
所以接法分两大类。写程序批量跑的,用 Kimi API 加函数工具,在你自己的程序里调 EveryInfra 的 REST 接口,顺便把数据预处理掉;不写程序的,用 Kimi Code CLI 或 Kimi Work,它们本身是 MCP 客户端,可以直接连远程 MCP。下面的流程图画的是第一种:模型只负责决定调什么,取数、去重、算指标都在模型外面。


配置示例一:Kimi API 加一个函数工具
这一节的代码是配置示例,按 Kimi 的快速上手文档和工具调用文档写成,我们没有用 Kimi 的 Key 跑过。EveryInfra 一侧的请求格式和返回结构来自本文的真调。思路是只给模型一个函数 everyinfra_social,参数就是 EveryInfra 的 platform、action、params 三段,用枚举把能用的能力限死。
# 配置示例:Kimi K3.1 Pro + EveryInfra 数据接口(Kimi 一侧未实测)
import json, os, requests
from openai import OpenAI

kimi = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")

TOOLS = [{
    "type": "function",
    "function": {
        "name": "everyinfra_social",
        "description": "拉公开社交与金融数据。微博用 search/topic_search/comments,"
                       "Yahoo Finance 用 financials/history/analyst,keyword 填带交易所后缀的代码,如 1211.HK。",
        "parameters": {
            "type": "object",
            "properties": {
                "platform": {"type": "string", "enum": ["weibo", "yahoo_finance"]},
                "action": {"type": "string",
                           "enum": ["search", "topic_search", "comments", "financials", "history", "analyst"]},
                "params": {"type": "object"}
            },
            "required": ["platform", "action", "params"]
        }
    }
}]

def call_everyinfra(args: dict) -> dict:
    r = requests.post("https://api.everyinfra.com/api/v1/social",
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
                      json=args, timeout=120)
    body = r.json()
    rows = body.get("results")
    # 预处理:财务表三个数组内容相同,只留一份;去掉头像链接等对研究没用的字段
    if isinstance(rows, list) and rows and "income" in rows[0]:
        rows[0].pop("balance_sheet", None); rows[0].pop("cash_flow", None)
    if isinstance(rows, list):
        for x in rows:
            x.pop("author_avatar_url", None)
    return {"status": r.status_code, "results": rows, "error": body.get("error"),
            "charged_usd": (body.get("billing") or {}).get("charged_usd")}

messages = [
    {"role": "system", "content": open("research_rules.md", encoding="utf-8").read()},
    {"role": "user", "content": "比亚迪 2026-10-29 晚发布三季报。按规则拉数据,写一页交叉研究摘要。"}
]
first = True
while True:
    resp = kimi.chat.completions.create(model="kimi-k3.1-pro", reasoning_effort="high",
                                        messages=messages, tools=TOOLS,
                                        tool_choice="required" if first else "auto")
    msg = resp.choices[0].message
    messages.append(msg)          # 文档要求:原样放回完整的 assistant 消息
    if not msg.tool_calls:
        break
    for tc in msg.tool_calls:
        result = call_everyinfra(json.loads(tc.function.arguments))
        messages.append({"role": "tool", "tool_call_id": tc.id,
                         "content": json.dumps(result, ensure_ascii=False)})
    first = False
print(msg.content)
几处取舍都有文档依据。第一轮用 tool_choice="required",是 Kimi 的工具调用最佳实践建议的写法,目的是防止模型不调工具、凭记忆回答;之后改回 auto,文档说改 tool_choice 不会让前缀缓存失效(K3 工具调用最佳实践;tool_choice 说明)。每一轮都把完整的 assistant 消息放回去,而不是只留 content,这是快速上手文档在多轮和工具调用里明确要求的,思考内容 reasoning_content 也在里面。reasoning_effort 写 high 而不是默认的 max,是因为这件活的推理难度主要在对照,不在数学证明,用户在 Reddit 上也报告过 K3.1 Pro 的 high 档能拿到 K3 在 max 档的结果(r/kimi 讨论帖);这只是个人反馈,正式跑之前应该用自己的样本比一次。
预处理放在 call_everyinfra 里,而不是交给模型,理由在后面的实测里有数:财务表三个数组内容完全一样,原样交回去会让模型多读 5 万多个字符。如果你的工具很多,Kimi 还有一个「动态加载工具」的写法:在一条不带 content 的 system 消息里放 tools,从这条消息往后工具才可见,服务端不会记住它,后续请求要原样带上(动态加载工具)。我们这件活只有一个工具,用不上;如果你要把 EveryInfra 的上百项能力都开放给模型,这个写法加一个 search_tools 检索函数,比一次声明全部工具省上下文。
配置示例二:Kimi Code CLI 直接连远程 MCP
不想自己写调度循环的,可以用 Kimi Code CLI。它本身是 MCP 客户端,支持 stdio、HTTP 和旧式 SSE 三种连接方式,HTTP 服务器在 mcp.json 里写一个 url 就行;用户级配置在 ~/.kimi-code/mcp.json,项目级在仓库的 .kimi-code/mcp.json,同名时项目级优先(Kimi Code MCP 文档)。下面是我们为这件活写的配置示例:
{
  "mcpServers": {
    "everyinfra": {
      "url": "https://api.everyinfra.com/mcp",
      "bearerTokenEnvVar": "EVERYINFRA_API_KEY",
      "enabledTools": ["everyinfra_call_api", "everyinfra_get_job", "everyinfra_list_capabilities"],
      "toolTimeoutMs": 120000
    }
  }
}
bearerTokenEnvVar 填的是环境变量的名字,不是 Key 本身,这样配置文件可以提交进仓库,Key 留在各人自己的环境里。enabledTools 是白名单:我们在 00:16(新加坡时间)不带 Key 读了一次 tools/list,返回 12 个工具、16,724 字节,除了取数据的 everyinfra_call_api,还有账户、充值链接、工单一类的工具,研究任务用不上,留着只会占上下文。toolTimeoutMs 设到 120 秒,是因为本文真调里 yahoo_finance/financials 一次用了 35.6 秒,单个 MCP 工具调用的超时最好留足。Kimi Code 里的 MCP 工具名格式是 mcp__<服务器>__<工具>,权限规则可以按这个名字放行,文档建议不要用 mcp__* 一次放行全部工具(同一页「Security」一节)。
Kimi Code 还有子 agent。内置三种:能读写文件的 coder、只读的 explore、只做规划的 plan;每个子 agent 有独立的上下文,只能看到主 agent 传给它的任务描述,最后只把结果交回主 agent,多个子 agent 可以并行(Agents and Sub-Agents 文档)。自定义子 agent 是一个 Markdown 文件,放在 .kimi-code/agents/,下面这个文件让每个子 agent 只处理一家公司、只能调 EveryInfra 一个工具:
---
name: company-evidence-worker
description: 拉一家上市公司的微博讨论、评论和财务数据,只交回一份压缩后的证据表。名单里每家公司用一个。
tools:
  - mcp__everyinfra__everyinfra_call_api
  - Write
---
你只处理任务里给你的一家公司。按顺序做:
1. weibo/search 搜「公司名 + 财报关键词」,limit 50;weibo/topic_search 搜同样的词。
2. 在搜索结果里按 comment_count 选前 2 条,分别调 weibo/comments,limit 50。
3. yahoo_finance/financials、history(period=3mo)、analyst,keyword 用带后缀的代码。
4. 把原始返回写进 evidence/<代码>/ 目录;财务表只留 income 一份。
5. 你的最后一条消息就是完整的交接:一张表,列出每条评论区的条数、点赞合计、
   最密 20 秒内的条数,以及财务表里季度营收、净利润、存货、应收账款、货币资金。
   不要写结论,不要给买卖意见。
最后一条规则是文档里专门提醒的:自定义子 agent 不带内置子 agent 的「最后一条消息就是全部交接」提示,所以要在正文里自己写明。主 agent 拿到每家公司的证据表以后,再在自己的上下文里做跨公司的对照和成文。文档同时提醒,每个子 agent 都单独消耗 token,简单任务没必要拆。我们的判断是:两三家公司直接在主 agent 里做,十家以上才值得拆。
配置示例三:Kimi Work 的个人插件和定时任务
研究员不一定写代码。Kimi Work 是 Moonshot 的桌面智能体,能读写本地文件、用浏览器扩展操作网页、定时跑任务,复杂任务可以开 Agent Swarm 拆给多个 agent 并行(Kimi Work 产品页)。K3.1 Pro 要求 Kimi Work 3.1.0 或更新的版本(技术博客 Availability 一节)。产品页还写了一句和这件活直接相关的话:Kimi Work 能从专业数据源取 A 股和港股的实时数据,不用复杂设置。也就是说,行情和财务这一半,Kimi Work 自带的金融插件已经能覆盖一部分;它缺的是微博评论这种社交原始数据。
接外部 MCP 的方式是个人插件。Kimi 的帮助中心写明,Kimi 插件可以包含 Skills、MCP、Agents、Hooks、Commands 和系统提示,网页版目前只支持插件里的 MCP 和 Skills,Kimi Work 和 Kimi Code 支持完整组合(插件说明)。在 Kimi Work 里调用内置的 Plugin Builder,用一句话描述需求,它会生成插件文件、校验、登记到「个人」标签;不能推断的信息,比如 MCP 服务器地址,会向你确认(如何创建个人插件)。它还能导入 MCP 官方注册表格式的 server.json,转成只含一个 MCP 服务的插件。
两条版本说明要注意。Kimi Work 3.2.21(2026 年 10 月 26 日)起,加载项目自带的 MCP 服务前会先问你;3.2.22(2026 年 10 月 29 日)把「定时任务」改名为「任务中心」,所有自动任务在一处管理(Kimi Work 版本说明)。定时任务可以每小时、每天或满足条件时触发,需要通宵跑的要在设置里打开「保持唤醒」(产品页 FAQ)。对这件活来说,定时任务比模型能力更关键,原因在后面特斯拉那一节:财报发布当天和发布后第 11 天取到的微博,是两批完全不同的数据。
一次真实往返:模型发出什么,接口回了什么
模型一侧,Kimi 返回的工具调用是标准格式:tool_calls 里每一项有 id、函数名和一个 JSON 字符串形式的参数。按上面的函数定义,Kimi 会发出类似下面这样的调用(这是格式示例,不是 Kimi 的真实输出):
{"id": "call_0", "type": "function",
 "function": {"name": "everyinfra_social",
              "arguments": "{\"platform\":\"weibo\",\"action\":\"comments\",\"params\":{\"url\":\"https://weibo.com/detail/<数字帖子ID>\",\"limit\":50}}"}}
你的程序把 arguments 原样发给 EveryInfra。下面是我们在 2026 年 11 月 2 日 00:17:51(新加坡时间)发出同一个请求时拿到的真实返回:HTTP 200,用时 16.6 秒,15,134 字节,count 为 31,billing.charged_usd 为 0.000556。每条评论有 id、text、like_count、author_id、author_name、author_avatar_url、post_id、post_url、posted_at、platform 十个字段,和目录里 weibo/comments 的 response_fields 逐个对得上。截图里只放了按时间排序后中间 18 秒的 11 条:
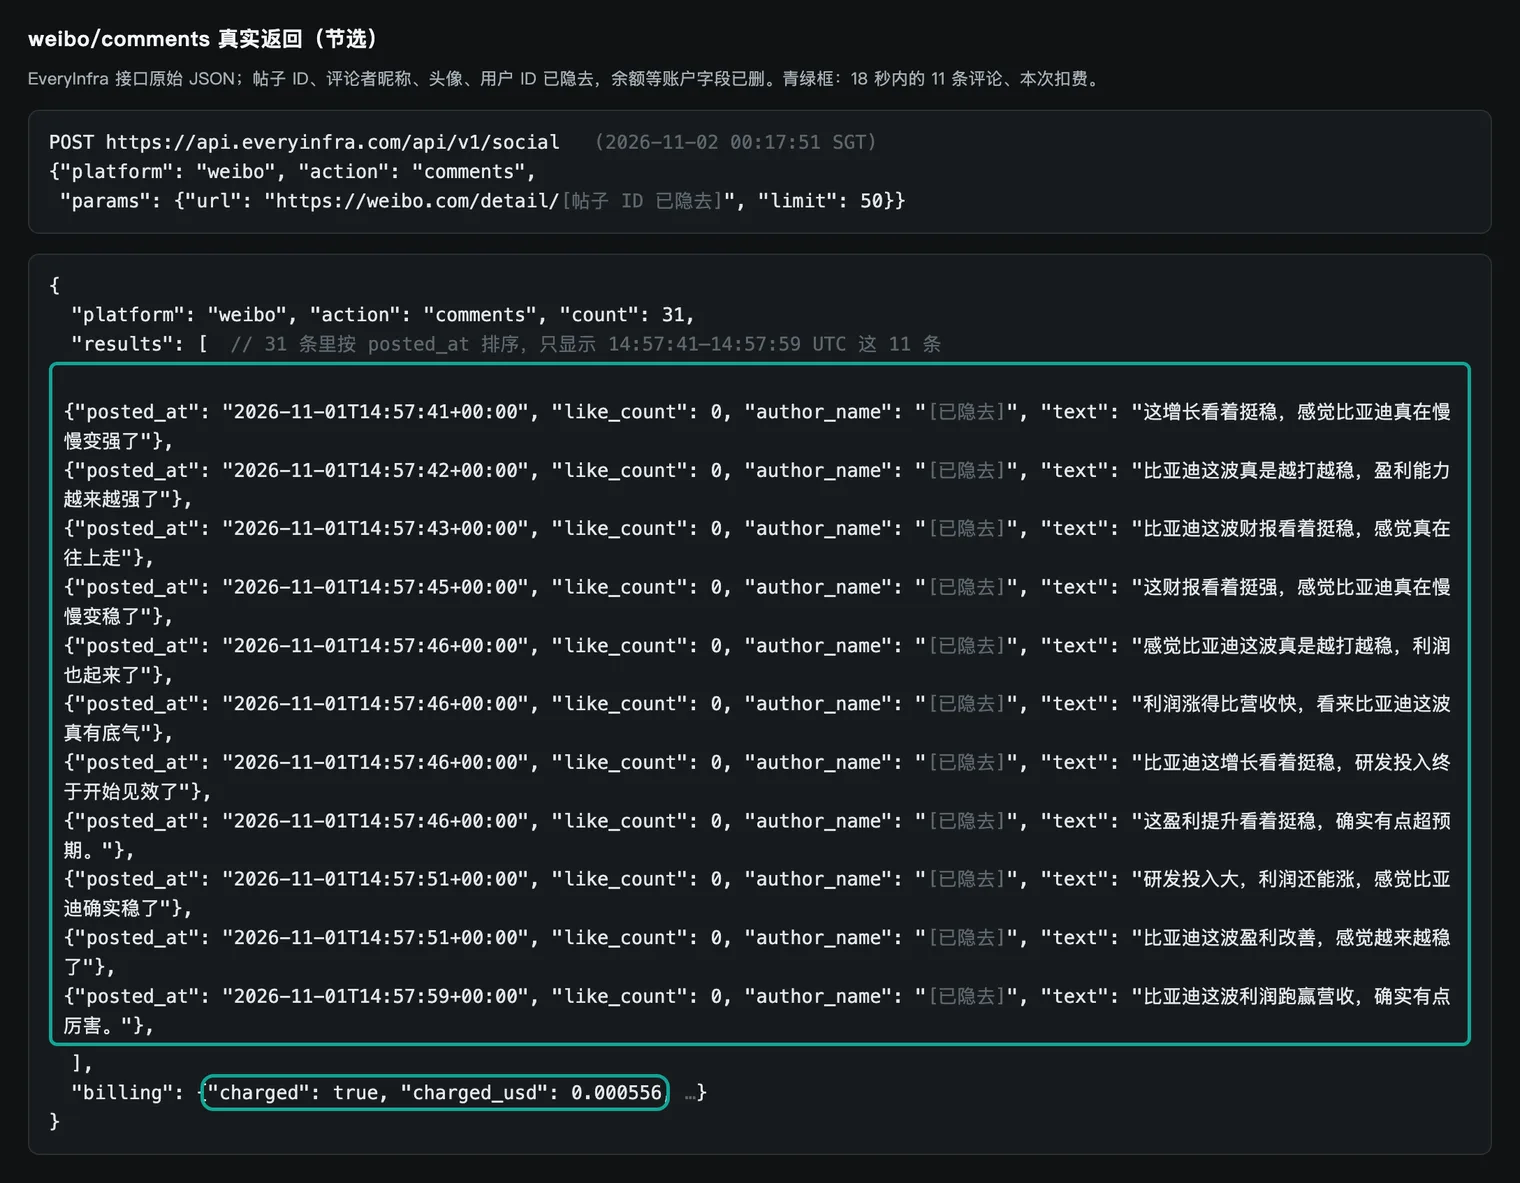
同一类请求也可以走 MCP。我们在 00:22:26(新加坡时间)用 MCP 的 tools/call 调 everyinfra_call_api,参数是另一条微博(帖子 B)的数字 ID,拿到 HTTP 200、21,757 字节,result.content[0].text 里是和 REST 完全相同结构的 JSON,count 36,扣费同样是 $0.000556。这次返回没有 structuredContent 字段,结构化数据就在文本里。Kimi Code 的文档说它会把 MCP 结果的文本和结构化部分都交给 agent(MCP 文档开头一段),所以在 Kimi Code 里两种写法读到的东西一样;在你自己的函数工具里,直接把 REST 的 JSON 交回去最省事。
还有一个格式上的细节会直接影响成功率。目录对 weibo/comments 的 url 参数写明:用 /detail/纯数字帖子ID 的链接,或直接填数字 ID;含字母的微博短码链接不能用。模型从搜索结果里拿帖子时,url 字段给的就是 /detail/ 加数字 ID 的格式,照抄即可;但如果让模型从网页上复制链接,很容易拿到短码。这条规则最好原样写进函数的 description,而不是指望模型自己读目录。
实测一:搜「比亚迪 三季报」拿到的 13 条,有多少在谈业绩
第一步是搜索。我们在 00:17:26(新加坡时间)调 weibo/search,关键词「比亚迪 三季报」,limit 写 30,返回 13 条,扣费 $0.000806。目录写明这个能力默认 20 条、最多 50 条;实际返回少于 limit 是常态,按次计费,不按条数,所以少了也不会多扣。13 条的发布时间从 10 月 19 日到 11 月 1 日,最新一条是 11 月 1 日 22:31(新加坡时间)。
动笔前我们写下了两条判定规则,不靠模型判:正文命中「财报、三季报、季报、净利、营收、利润、业绩、毛利、earnings」任一词算「谈业绩」;命中「4S、试驾、优惠、限时、到店、购车」任一词算「卖车广告」。结果 13 条里 10 条谈业绩,0 条卖车广告,另有 2 条正文里根本没有「比亚迪」,是两条华为智能汽车的官方微博,被搜索带了进来。这说明关键词搜索的噪声主要不是广告,而是相关品牌的热门帖;交给模型之前,至少要按公司名过滤一遍。
更值得看的是 13 条里的 6 条:它们都带同一个话题标签「#比亚迪三季报释放强劲增长信号#」,作者的粉丝数分别是 1、3、9、80、198、507,6 条加起来的评论、转发、点赞一共只有 1 个,发布时间集中在 11 月 1 日 20:49 到 22:26(新加坡时间)这 97 分钟里,正文大多是一句口号加一个短链接。我们随后在 00:21:26 用 weibo/topic_search 搜「比亚迪三季报」,这个话题的累计阅读数是 1.1 万、讨论数 66;另一个话题「比亚迪2026年三季报」阅读 2.6 万、讨论 58。也就是说,这个标签的声量很小,单看它不会影响什么结论;但如果把这 6 条和其他帖子一样计入「正面讨论条数」,正面占比就会被抬高将近一半。
| 13 条搜索结果 | 条数 | 判定方式 |
|---|---|---|
| 正文谈业绩 | 10 | 预先写定的关键词规则 |
| 卖车广告 | 0 | 预先写定的关键词规则 |
| 正文不含「比亚迪」 | 2 | 字符串匹配(两条华为智能汽车微博) |
| 带同一话题标签、作者粉丝都不超过 507 | 6 | 标签匹配加粉丝数 |
| 作者是认证用户 | 5 | 返回里的 author_verified |
这一步给 Kimi 的规则应该写成:先按公司名过滤,再把「同一标签、低粉丝、零互动、集中时段」的帖子单独成组,在摘要里报告这一组的条数和特征,但不并入情绪统计。注意我们没法判断这 6 条是不是有组织的推广,只能说它们的形态和普通讨论不一样。判断它们的性质需要账号历史、注册时间等更多信息,这超出了公开数据能证明的范围。
实测二:两条评论区的时间分布差别很大
搜索结果里互动最多的是一位认证数码博主的三季报解读,标着 49 条评论,我们把它叫帖子 A。00:17:51 调 weibo/comments 拿回 31 条(少于帖子标的 49 条,原因可能是部分评论被折叠、删除或不对外展示,我们没法从外部区分)。作为对照,我们在 00:22:26 通过 MCP 拿了另一条比亚迪长文(帖子 B,另一位认证博主 10 月 30 日发的,标 39 条评论)下的 36 条评论。两者都在谈比亚迪三季报和经营情况,但评论的时间分布和互动差别很大。我们不点名两位博主,也不在文中给出帖子链接:本节要演示的是一种量法,不是评价某个账号。
| 指标 | 帖子 A | 帖子 B | 怎么算的 |
|---|---|---|---|
| 返回的评论条数 | 31 | 36 | count |
| 点赞合计 | 0 | 43 | like_count 求和 |
| 点赞为 0 的条数 | 31 | 22 | 计数 |
| 第一条到最后一条的时间跨度 | 58.2 分钟 | 3,340.1 分钟(约 55.7 小时) | posted_at |
| 任意 20 秒内最多的条数 | 11 | 1 | 滑动窗口 |
| 提到「稳」或「研发」的条数 | 20 | 0 | 正则匹配 |
| 含负面词的条数 | 0 | 5 | 正则匹配(词表见下) |
| 平均字数 | 18.9 | 39.8 | 字符数 |
帖子 A 那 11 条评论的时间是 11 月 1 日 22:57:41 到 22:57:59(新加坡时间),内容是「这财报看着挺强,感觉比亚迪真在慢慢变稳了」「比亚迪这波真是越打越稳,盈利能力越来越强了」「利润涨得比营收快,看来比亚迪这波真有底气」这类句子,句式高度相似,都在复述博主正文的观点(「利润增速跑赢营收」「研发、高端、全球化」)。帖子 B 的评论就杂得多:有人补充员工宿舍和工资的对比,有人讨论车标和消费观念,有人嫌文章太长要「AI 总结」,也有直接骂的,点赞从 0 到 9 不等,时间散落在两天多里。
这里要老实交代两个方法上的弱点。「谈业绩」「卖车广告」两条规则是取数前写定的;「含负面词」用的词表(吹、憨、累、没耐心、错别字、骂、垃圾等)是我们读过帖子 B 的评论以后才定的,所以「0 对 5」只能当描述,不能当检验。同样,「提到『稳』或『研发』」这个词表也是读过帖子 A 的正文和评论以后才定的,「20 对 0」也只能当描述。真正站得住的是不依赖词表的三个数:点赞合计、时间密度、平均字数。这三个数都直接来自返回字段,任何人重跑都能得到同样的结果。
对 Kimi 来说,这一节决定了研究摘要的可信度。如果把两个评论区的 67 条评论直接丢给模型打情绪分,得到的大概是「压倒性正面」;如果先在程序里算出每个评论区的时间密度、点赞分布,把「时间高度集中、零互动」的评论单独标出来,再交给模型,摘要就会写「帖子 A 的评论区有 11 条在 18 秒内发出,点赞全为 0,单独列出,不并入情绪统计」。这一组是什么来历,摘要不下结论。前者是模型替你下结论,后者是模型帮你把证据写清楚。
实测三:财务数据和公司原文逐项对账
第二半是财务数据。00:18:38(新加坡时间)调 yahoo_finance/financials,代码 1211.HK,返回 78,732 字节,用时 35.6 秒,扣费 $0.001389。返回里有 income、balance_sheet、cash_flow 三个数组,各 5 条记录:2025 年的年度数据,加上 2025 年四季度到 2026 年三季度四个单季,币种 CNY,quarterly_income 为空。这三个数组的内容完全相同,每条记录都把利润表、资产负债表、现金流量表的字段合在一起(单季记录有 137 到 149 个字段),这一点下一节算上下文时会用到。
我们把接口返回和比亚迪在巨潮资讯网披露的三季报原文逐项对了一遍,结果如下。
| 项目 | 接口返回(1211.HK,2026-09-30) | 三季报原文 | 是否一致 |
|---|---|---|---|
| 三季度营业收入 | 221,488,251,000 | 221,488,251,000.00 元,同比 +13.59% | 一致 |
| 三季度归母净利润 | 10,019,570,000 | 10,019,570,000.00 元,同比 +28.08% | 一致 |
| 存货 | 221,577,509,000 | 221,577,509,000.00 元,比年初 +60.08% | 一致 |
| 应收账款 | 56,472,621,000 | 56,472,621,000.00 元,比年初 +52.61% | 一致 |
| 货币资金 | 30,988,011,000 | 30,988,011,000.00 元(年初 75,424,747,000.00) | 一致 |
| 前三季度研发费用 | 三个单季相加 36,277,138,000 | 36,277,138,000.00 元(上年同期 43,748,447,000.00) | 一致 |
六项全部对上,这对 Kimi 的研究流程很重要:财务数据这一半可以直接从接口拿,不用让模型去读 PDF 抽数。但对账也让我们看到接口数据没有的东西。三季报原文的「主要会计数据和财务指标发生变动的情况及原因」一节,对每个大幅变动都写了原因:存货增加「主要是海外汽车业务增长,备货增加所致」,资产减值损失增加 67.60%「主要是存货规模扩大相应计提的存货跌价损失增加所致」,合同负债增加 80.58%「主要是汽车业务预收款增加所致」。这些解释只在原文里,财务表接口不会给。一页像样的研究摘要,数从接口来,原因要从原文来,Kimi 的文件问答接口可以上传 PDF 抽取正文(文件问答说明),文件抽取接口目前免费,但抽出来的内容作为输入照常计费(定价说明 Billing Logic)。
特斯拉这边我们也对了一遍。00:20:40 调 yahoo_finance/financials,代码 TSLA,扣费 $0.001389。三季度营收 28,046、毛利 5,494、营业利润 718、净利润 787、自由现金流 1,531(百万美元),和 Tesla 提交给美国证监会的三季度更新(8-K 附件 99.1)里的财务摘要逐项一致。只有一处对不上:二季度自由现金流,接口返回 −1,099,Tesla 的财务摘要写的是 −1,092(经营现金流 4,697 减资本开支 5,789)。差 700 万美元,量不大,但说明「接口数据和原文一致」要逐项核,不能抽一两个数就默认全部对。
交叉对照:评论区说了什么,财报里有什么
把两半放在一起,交叉研究真正的产出才出来。帖子 A 的正文和评论,核心说法有三条:利润增速跑赢营收;研发投入大;越来越稳。我们把每一条说法对回三季报原文,再加上原文里变动最大、但评论区没有出现的几项,排成下表。最后一列只写「讨论中是否出现、能否对上」,不写评价。这张表就是我们希望 Kimi 最后写出来的样子,只是这里是我们按同样规则手工填的,不是 Kimi 的输出。
| 社交讨论里的说法 | 三季报原文里的对应数据 | 讨论中是否出现、能否对上 |
|---|---|---|
| 净利润增速跑赢营收 | 三季度营收 +13.59%,归母净利润 +28.08% | 出现;与单季数据一致 |
| 前三季度累计数 | 前三季度营收 +0.01%,归母净利润 −4.24% | 未出现 |
| 研发投入大 | 前三季度研发费用 362.77 亿元,上年同期 437.48 亿元(−17.08%) | 出现;绝对额一致,同比变动未被提及 |
| 越来越稳 | 财务表里没有直接对应「稳」的字段 | 出现;评价性说法,无法核对 |
| 存货、应收账款、货币资金 | 对比年初 +60.08%、+52.61%、−58.92%;原文把存货增加解释为海外汽车业务备货 | 未出现 |
| 资产减值损失 | 27.10 亿元,同比 +67.60%;原文解释为存货规模扩大、跌价计提增加 | 未出现 |
这张表要说清楚边界。它只回答「讨论里提到了什么、原文里有什么」,不回答这家公司经营得好不好,也不回答股价会怎么走。原文对每一项大幅变动都给了解释:存货增加对应海外汽车业务的备货,合同负债增加 80.58% 对应汽车业务预收款增加;如果只把变动幅度拎出来、不带原文解释,摘要本身就成了选择性呈现。所以我们给 Kimi 的规则是:凡是写进「未出现」一栏的数,必须同时附上原文对这个数的解释和页码,原文没有解释的写「原文未解释」。行情和分析师评级两个接口我们也调了,但它们和这一步核对无关,在本文里只计入数据包大小和成本,不进对照表。交叉研究的价值不在于预测,而在于把「讨论里没人说的数」连同原文的解释一起找出来,让读摘要的人自己决定要不要追问。
实测四:特斯拉,关键词搜索不等于财报窗口
特斯拉这组实测给出的最大教训是关于取数时间的。00:18:20(新加坡时间)调 weibo/search,关键词「特斯拉 财报」,返回 17 条,扣费 $0.000806。17 条里只有 6 条提到特斯拉,其中开头就在谈特斯拉财报的只有 3 条;发布时间是 10 月 19 日到 11 月 1 日,10 月 22 日之前的只有 1 条。其余是美股科技股下跌、谷歌和英特尔财报、比亚迪与特斯拉毛利对比之类的帖子。原因很简单:微博关键词搜索给的是最近的结果,而特斯拉在 10 月 21 日美东时间盘后发布财报,到我们取数时已经过了 11 天。
话题搜索给出了另一个角度。00:21:05 调 weibo/topic_search,关键词「特斯拉财报」,返回 20 个话题,每个都有累计阅读数和讨论数。按季度取阅读数最高的那个话题:2022 年三季度的「特斯拉发布2022年第三季度财报」阅读 6,982.8 万、讨论 1.3 万;到 2024 年三季度,最高的话题阅读 448.2 万。返回的 20 个话题里,没有一个是 2025 年或 2026 年的财报话题。这个结果不能直接解读为「中国网友不再关心特斯拉财报」,因为话题搜索的排序规则我们不知道,阅读数又是累计值,老话题天然占优;但它说明,靠话题搜索回看历史财报的热度,拿到的是一张被时间扭曲的图。
对照组是 Reddit。00:23:42 调 reddit/search,关键词「Tesla Q3 2026 earnings」,按相关度排序,返回 8 条,7 条发在 10 月 21 日到 22 日这两天,8 条合计 589 条评论,包括 r/TSLALounge 的财报讨论串和 r/teslamotors 关于 FSD 订阅数的帖子(Reddit 搜索能力)。同一个问题,Reddit 的相关度搜索能回到财报窗口,微博的关键词搜索只能看到最近。这就决定了这件活的正确做法:不是事后补搜,而是在财报发布当天、发布后 24 小时、发布后 72 小时各取一次,Kimi Work 的定时任务或者你自己的定时脚本负责触发,Kimi 只在最后一次取数后写摘要。「发布当天」的零点按财报实际发布时刻定:特斯拉是美东时间 10 月 21 日盘后,8-K 的提交日期和 CNBC 当天的报道都能印证(CNBC 2026 年 10 月 21 日报道)。
上下文怎么装:1M token 能放几家公司
K3.1 Pro 的 1M 上下文听起来什么都装得下,但我们先量了一家公司的数据包到底多大。比亚迪这一家,五次请求(微博搜索、评论、财务表、行情、评级)的 results 部分合计 119,869 个字符。其中财务表一项就占 82,350 个字符,而它的三个数组是同一份数据重复三次,只留一份是 27,418 个字符。去掉重复后整个数据包是 64,937 个字符,里面汉字只有 1,927 个,其余是英文字段名、数字和链接。
换算成 token 只能估算。Kimi 的主要概念文档写的是「普通英文文本 1 个 token 大约是 3 到 4 个英文字符」(主要概念),我们的数据包以英文字段和数字为主,按这个比例,64,937 个字符约合 16,234 到 21,646 个 token;就算把 1,927 个汉字按每个 2 个 token 计,上限也只到 2.4 万左右。要拿准数,用 Kimi 的 token 估算接口算一次(Token 估算接口)。按 1.6 万到 2.4 万 token 一家,1,048,576 的上下文先留出默认 131,072 的输出上限,剩下 917,504 个 token,能放 38 到 56 家公司。不去重的话,这个数要砍掉将近一半。
装得下不等于应该全装。我们的建议是两层:每家公司的原始数据先在程序或子 agent 里压成一张证据表(上面 Kimi Code 子 agent 文件的第 5 步),主模型只读证据表和需要引用的原文片段;只有在需要跨公司比对原始评论时,才把原始数据放进同一个上下文。另外,Kimi 的上下文缓存是自动的,默认 5 分钟,请求间隔超过 5 分钟的任务可以在 prompt_cache_options.ttl 里选 1h,避免过期后重复写入(上下文缓存)。研究规则、输出模板这类每次都一样的前缀放在最前面,缓存命中按 $0.20 每百万 token 计,是正常输入价的十分之一。
算一笔账:一家公司一次多少钱
EveryInfra 这一侧是确定的。一家公司跑一次,调 weibo/search 和 weibo/topic_search 各一次($0.000806 × 2),weibo/comments 一次($0.000556),yahoo_finance/financials、history、analyst 各一次($0.001389 × 3),合计 $0.006335。要看两条评论区就再加 $0.000556。价格按次,不按返回条数。
Kimi 这一侧只能估算,因为我们没有真跑。假设一家公司的输入是 24,000 个 token(取上一节估算的上限),输出加思考 8,000 个 token,按 2026 年 11 月 2 日读取的公开价(输入 $2.00、输出 $10.00 每百万 token),实时调用约 $0.048 加 $0.08;走 Batch 按标准价 60% 算,约 $0.0288 加 $0.048。
| 场景 | EveryInfra 接口费 | Kimi 输入(估) | Kimi 输出(估) | 合计 |
|---|---|---|---|---|
| 一家公司、实时调用 | $0.006335 | $0.048 | $0.080 | $0.134 |
| 一家公司、Batch | $0.006335 | $0.0288 | $0.048 | $0.083 |
| 20 家公司每周一次、4 周、实时 | $0.5068 | $3.84 | $6.40 | $10.75 |
| 20 家公司每周一次、4 周、Batch | $0.5068 | $2.30 | $3.84 | $6.65 |
这张账的结论是:实时调用时数据接口费约占总成本的 4.7%,走 Batch 时约占 7.6%(模型费打了六折,接口费不变),真正决定成本的是模型的输出和思考 token。所以省钱的顺序应该是先把 reasoning_effort 从默认的 max 降到 high 或 low,看摘要质量有没有变差;再把每家公司的输入压成证据表;最后才考虑 Batch。Batch 的限制是任务要在 completion_window 内完成,否则过期,缓存命中也只是尽力而为(Batch 使用说明)。财报季每天晚上集中跑一批,正好合适;财报当天需要尽快出稿的,还是用实时调用。更多价格见 EveryInfra 价格页。
失败、限速和不扣费:本文 21 次请求的账
本文一共发了 21 次请求,14 次成功扣费,合计 $0.014018;另外 7 次没有扣费。没扣费的 7 次正好覆盖了这件活在生产里会碰到的几种情况,每一种都值得写进给 Kimi 的规则里。
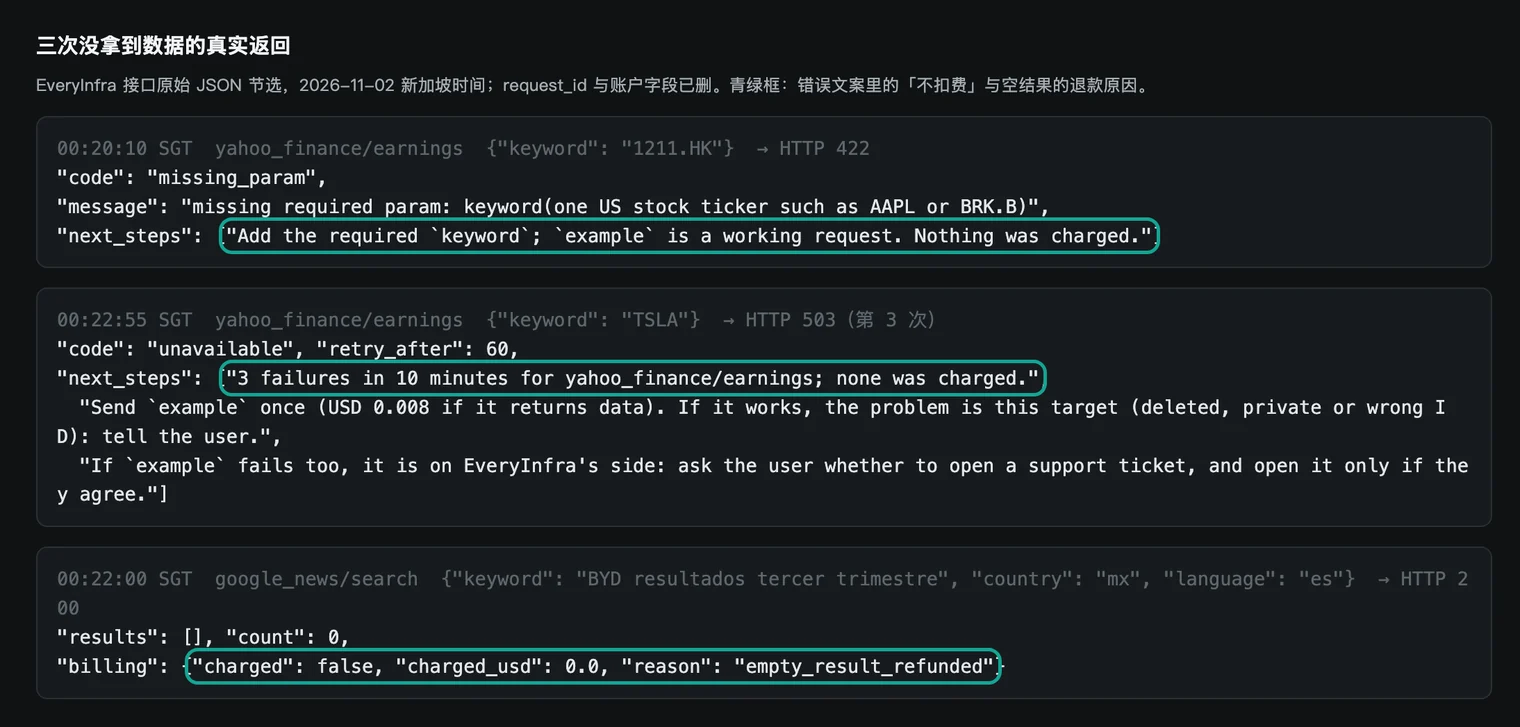
第一种是参数不合规。yahoo_finance/earnings 的目录说明写着只收美股代码,我们在 00:20:10(新加坡时间)故意传了港股代码 1211.HK,0.2 秒就回了 422,错误码 missing_param,文案说明需要一个美股代码,附了一个能用的示例请求,并写明「Nothing was charged」。这种文案是写给模型看的:Kimi 拿到这个工具结果,能自己改参数或换能力,而不是一直重试。第二种是服务端暂时不可用。00:20:32、00:21:30、00:22:55 三次调 yahoo_finance/earnings 查 TSLA 都回了 503,每次都写明不扣费、retry_after 60 秒;第三次的文案换了,建议先发一次示例请求判断问题在哪一边。我们照做,00:23:05 发了示例 AAPL,同样 503,说明是这项能力在那几分钟里整体不可用,不是 TSLA 这个代码的问题,我们没有开工单。财报的每股收益我们改用 Tesla 自己的三季度更新原文。
第三种是空结果。00:22:00 用西语关键词「BYD resultados tercer trimestre」搜墨西哥站新闻,返回 200 但 results 为空,billing.reason 是 empty_result_refunded,扣费 0;换成「BYD ganancias」后拿到 10 条。第四种是限速。几个任务共用一把 Key 同时跑时,可能撞上每分钟的请求上限,00:20:58 的一次话题搜索撞上 429,文案写着 2 秒后重试、不扣费,我们 00:21:05 重发成功。对一个并行跑多家公司的 Kimi Code 子 agent 来说,规则里要写清楚:遇到 429 按 retry_after 等待后重试一次,不要换参数重投;遇到 503 最多重试两次;遇到 422 先读 next_steps 再改参数。
| 时间(新加坡) | 能力 | 结果 | 扣费 | 给 Kimi 的处理规则 |
|---|---|---|---|---|
| 00:20:10 | yahoo_finance/earnings(1211.HK) | 422,只收美股代码 | $0 | 读 next_steps,换能力或改代码 |
| 00:20:32 / 00:21:30 / 00:22:55 | yahoo_finance/earnings(TSLA) | 503,服务暂时不可用 | $0 | 等 retry_after,最多两次,再发示例判断 |
| 00:20:58 | weibo/topic_search | 429,超出每分钟请求上限 | $0 | 等 retry_after 后原样重试一次 |
| 00:22:00 | google_news/search(西语) | 200,空结果,已退款 | $0 | 换关键词,不要当成「没有新闻」 |
| 00:23:05 | yahoo_finance/earnings(AAPL 示例) | 503 | $0 | 示例也失败,问题在服务端 |
失败不扣费、空结果自动退款的规则写在 快速上手 里,计费流水的核对方法见 失败退款对账。
研究摘要的输出模板:让 Kimi 只能按证据写
最后一步是让 Kimi 写摘要。K3.1 Pro 支持 json_schema 加 strict: true 约束最终的 message.content(快速上手 Structured output 一节),我们建议把摘要拆成固定字段,每条说法都必须带出处字段,模型写不出出处就不能写这条:
{
  "type": "json_schema",
  "json_schema": {
    "name": "cross_check_summary",
    "strict": true,
    "schema": {
      "type": "object",
      "additionalProperties": false,
      "required": ["company", "window", "claims", "unmentioned", "timing_clusters", "limits"],
      "properties": {
        "company": {"type": "string"},
        "window": {"type": "string"},
        "claims": {"type": "array", "items": {"type": "object", "additionalProperties": false,
          "required": ["social_claim", "social_source_ids", "filing_value", "filing_source", "verdict"],
          "properties": {
            "social_claim": {"type": "string"},
            "social_source_ids": {"type": "array", "items": {"type": "string"}},
            "filing_value": {"type": "string"},
            "filing_source": {"type": "string"},
            "verdict": {"type": "string", "enum": ["支持", "部分支持", "不支持", "无法核对"]}}}},
        "unmentioned": {"type": "array", "items": {"type": "string"}},
        "timing_clusters": {"type": "array", "items": {"type": "string"}},
        "limits": {"type": "array", "items": {"type": "string"}}
      }
    }
  }
}
social_source_ids 填微博或评论的 id,filing_source 填财务表字段名或原文页码,这样每一行都能回到原始数据。verdict 用枚举,不让模型自由发挥形容词;也不设任何「建议」或「评级」字段,从结构上排除买卖建议。timing_clusters 只记录时间高度集中、零互动这类可量的形态,不写对来历的猜测。limits 是必填项,要求模型写出这页摘要的局限,比如「微博搜索只覆盖最近两周」「评论区返回条数少于帖子标注」。上面交叉对照那张表,就是按这个模板手工填出来的样子。
不能当投资建议:给自己和读者划的线
这件活离「荐股」只有一步,所以边界要写在流程里,不能只写在免责声明里。中国证监会北京监管局 2026 年公布的一起处罚里,两名自媒体运营者因编造、传播某上市公司的虚假信息,分别被罚 20 万元和 25 万元,其中一人申辩说虚假内容是 AI 生成的,这条申辩没有被采纳;报道明确写道,生成式 AI 的使用者应当对生成内容承担必要的审核义务(证监会北京监管局转载《证券日报》报道)。2026 年 10 月 15 日,证监会江苏监管局转载的一篇报道梳理了微博、微信、抖音、小红书接连发布的财经内容治理公告,其中提到要求严禁预测个股涨跌、强化 AI 生成虚假财经内容的识别(证监会江苏监管局「媒体视点」)。
落到操作上,我们给自己定了四条线。一,摘要只写「说法和数据是否一致」,不写「值得买或卖」;二,所有数字必须带原始字段或原文出处,模型写不出出处的句子删掉;三,时间高度集中、零互动的评论单独成组,不计入情绪,也不猜测它们的来历;四,摘要只给内部研究用,要对外发布,先由人逐句核对原文。Moonshot 自己的技术博客也写明,它的事实错误率测试是故意挑难题的压力测试,不代表日常使用中的错误率。
做不了或要注意的地方
第一,Kimi 一侧我们没有实测。本文所有 Kimi API、Kimi Code、Kimi Work 的写法都来自 2026 年 11 月 2 日读取的官方文档,代码是配置示例;Moonshot 的文档在 K3.1 Pro 发布后更新很频繁,K2 系列已经从 2026 年 10 月 31 日起不再向新注册用户开放,并计划在 12 月底前全部下线(定价说明 K2 系列一节),照抄代码之前请再读一次原文。Token 数和 Kimi 的费用都是估算。
第二,微博数据有覆盖边界。关键词搜索返回的是最近的结果,limit 写 30 只拿到 13 条;评论接口拿到的条数少于帖子标注的评论数(31 对 49、36 对 39);话题阅读数是累计值,不能当成某一天的热度。要研究财报窗口,必须在窗口内取数。第三,yahoo_finance/earnings 只收美股代码,港股和 A 股的每股收益要从财务表或公告原文取;而且在我们取数的那几分钟里这项能力整体不可用,没有扣费。第四,财务接口的数据和原文对得上,但不含变动原因,原因只在公告原文里。第五,本文的「负面词」和「稳 / 研发」两个词表都是读过数据后定的,只能当描述。第六,所有评论者的昵称、用户 ID 和两条帖子的链接我们都在文中和截图里隐去了,做研究时同样不应该把普通用户的身份信息写进摘要。第七,本文只有一家公司、两条评论区,样本很小,只够演示方法,不够得出关于这家公司或这类讨论的任何一般结论;要做正式研究,至少要按同样的规则覆盖多家公司、多个财报季,并在取数前写下所有词表。
最近的变化
- 2026 年 10 月 23 日:Moonshot 发布 Kimi K3.1 Pro 和 Highspeed 版本,API 输入价 $2.00、输出价 $10.00 每百万 token,权重承诺 11 月 4 日前开放(Kimi API 平台首页;Simon Willison 当天的记录)。对读者:同样的长上下文研究任务,K3.1 Pro 比上一代 K3 的输入价便宜三分之一。
- 2026 年 10 月 26 日:Kimi Work 3.2.21 起,加载项目自带的 MCP 服务前要先确认;10 月 29 日的 3.2.22 把定时任务并入「任务中心」(Kimi Work 版本说明)。对读者:用 Kimi Work 定时取数的流程,第一次运行需要人在电脑前点一次确认。
- 2026 年 10 月 31 日起:K2 系列模型不再向新注册用户开放,计划 12 月底前全部下线(定价说明)。对读者:基于 K2 写的工具调用代码要迁到 K3 系列,注意 K3.1 Pro 的思考不能关闭。
常见问题
kimi k3.1 pro 的 context window 有多大?
API 文档写的是 1,048,576 个 token,不按上下文长度分档计价(定价说明)。注意输出也占上下文,max_completion_tokens 默认 131,072。按本文实测,一家公司去重后的「微博 + 财务」原始数据约 1.6 万到 2.4 万 token,留出默认输出空间后能放 38 到 56 家。(问题来自 Google 联想词「kimi k3.1 pro context window」。)
kimi k3.1 pro 的 api key 怎么拿,要先充值吗?
在 Kimi API 平台的控制台创建 Key;K3.1 Pro 是旗舰模型,充值成功后才能调用,最低充值 $1,累计充值金额决定账户等级和限速(快速上手 Access requirements;充值与限速)。API 按量计费,和 Kimi 会员、Kimi Code 的订阅是两套东西(产品对比)。(问题来自联想词「kimi k3.1 pro api key」。)
kimi k3.1 pro 价格是多少,和 k3 比贵还是便宜?
2026 年 11 月 2 日读取的公开价:K3.1 Pro 输入 $2.00、输出 $10.00、缓存命中 $0.20 每百万 token;上一代 K3 是输入 $3.00、输出 $15.00(Kimi API 平台首页)。Batch 按标准价 60% 计(Batch 定价)。按本文的估算,一家公司做一次交叉研究,实时约 $0.134,其中 EveryInfra 接口费 $0.006335。(问题来自联想词「kimi k3.1 pro pricing」和「kimi k3.1 pro vs k3」。)
kimi k3.1 pro 能直接接 MCP 吗?
Kimi 的 Chat Completions、Responses、Messages 三个 API 都不能在请求里挂远程 MCP,Responses API 的工具类型只有 function、namespace、custom 和 web_search 四种(Responses API 参考)。要用远程 MCP,走 Kimi Code CLI 的 mcp.json,或者 Kimi Work 的个人插件;Playground 只能同步魔搭托管的 MCP。(问题来自联想词「kimi k3.1 pro mcps」。)
kimi k3.1 pro 的金融数据从哪来?
模型本身不带实时数据。Kimi Work 内置了 Wind、恒生聚源、标普等金融数据库插件,能取 A 股和港股数据(Kimi Work 插件中心);社交平台的原始讨论和评论不在这些插件里,本文用 EveryInfra 的 weibo/* 和 yahoo_finance/* 补上。用 API 的话,数据都要通过工具调用交给模型。(问题来自联想词「kimi k3.1 pro 金融数据」。)
参考资料
- Kimi K3.1 Pro 快速上手,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Kimi K3.1 Pro Tech Blog,Moonshot AI,2026-10-23,https://www.kimi.com/blog/kimi-k3-1-pro
- Model Inference Pricing,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/pricing/chat
- Kimi API Platform 首页(模型价格),Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/
- BatchJob Pricing,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/pricing/batch
- Recharge and Rate Limiting,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/pricing/limits
- Responses API 参考,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/api/responses
- Messages API 参考,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/api/messages
- Use Kimi API for Tool Calls,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-kimi-api-to-complete-tool-calls
- Kimi K3 API Tool Calling Best Practices,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/kimi-k3-tool-calling-best-practice
- Tool Choice,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-tool-choice
- Dynamically Loaded Tools,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-dynamic-tool-loading
- Reasoning Effort,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-reasoning-effort
- Structured Output,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/response_format
- Context Caching,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/context-caching
- Using Batch API for Bulk Processing,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-batch-api
- Configure ModelScope MCP Server in Playground,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/configure-the-modelscope-mcp-server
- Use Kimi API for File-Based Q&A,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/use-kimi-api-for-file-based-qa
- Main Concepts,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/introduction
- Token 估算接口,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/api/estimate
- Compare with Other Kimi Products,Moonshot AI,2026-11-02 读取,https://platform.kimi.ai/docs/guide/product-plans
- Kimi Code:Model Context Protocol,Moonshot AI,2026-11-02 读取,https://www.kimi.com/code/docs/en/kimi-code-cli/customization/mcp.html
- Kimi Code:Agents and Sub-Agents,Moonshot AI,2026-11-02 读取,https://www.kimi.com/code/docs/en/kimi-code-cli/customization/agents.html
- Kimi Code:Model Configuration,Moonshot AI,2026-11-02 读取,https://www.kimi.com/code/docs/en/kimi-code/models.html
- Kimi Work 产品页,Moonshot AI,2026-11-02 读取,https://www.kimi.com/en/products/kimi-work
- Kimi Work Release Notes,Moonshot AI,2026-10-29 更新,https://www.kimi.com/en/help/kimi-work/release-notes
- What Are Kimi Plugins,Moonshot AI,2026-11-02 读取,https://www.kimi.com/en/help/plugins-and-skills/overview
- How to Create a Personal Plugin,Moonshot AI,2026-11-02 读取,https://www.kimi.com/en/help/plugins-and-skills/create
- Kimi Work Plugin Center,Moonshot AI,2026-11-02 读取,https://www.kimi.com/en/help/kimi-work/plugin-center
- 比亚迪股份有限公司 2026 年第三季度报告,比亚迪(巨潮资讯网),2026-10-30,https://static.cninfo.com.cn/finalpage/2026-10-30/1225641442.PDF
- Tesla Q3 2026 Update(8-K 附件 99.1),Tesla / 美国证监会 EDGAR,2026-10-21,https://www.sec.gov/Archives/edgar/data/1318605/000162828026066738/exhibit9914.htm
- EveryInfra 微博能力目录,EveryInfra,2026-11-02 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- EveryInfra Yahoo Finance 能力目录,EveryInfra,2026-11-02 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=yahoo_finance
- EveryInfra Google 新闻能力目录,EveryInfra,2026-11-02 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- EveryInfra Reddit 能力目录,EveryInfra,2026-11-02 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- 一篇「AI小作文」换来25万元罚单(转载《证券日报》),中国证监会北京监管局,2026-06-18,https://www.csrc.gov.cn/beijing/c105538/c7640109/content.shtml
- 媒体视点:多方共治净化财经生态,中国证监会江苏监管局,2026-10-15,https://www.csrc.gov.cn/jiangsu/c106440/c7664819/content.shtml
- Introducing Kimi K3.1 Pro,Simon Willison,2026-10-23,https://simonwillison.net/2026/Oct/23/kimi-k31-pro/
- Tesla beats on earnings and sales even as auto revenue declines,CNBC,2026-10-21,https://www.cnbc.com/2026/10/21/tesla-tsla-q3-2026-earnings-report.html
- How good is kimi K3.1 Pro?(讨论帖),Reddit r/kimi,2026-10,https://www.reddit.com/r/kimi/comments/1xdkngh/how_good_is_kimi_k31_pro/
- Model Context Protocol 规范,Model Context Protocol,2026-11-02 读取,https://modelcontextprotocol.io/specification/2025-06-18
引用编号 BL-67