Gemini Managed Agents 定时品牌监测:接 MCP 实测
Gemini Managed Agents 定时盯品牌:Reddit 最新 24 条只盖 8 小时,数据费每轮 $0.003,模型费是它的 3.5 倍起。
2026 年 11 月 14 日 00:18(新加坡时间),我们按 Gemini Managed Agents 文档里 mcp_server 工具的写法,向 EveryInfra 远程 MCP 发了一次 reddit/search,关键词 Anker、按最新排序:回来 24 条帖子,最早一条和最新一条只隔 8.04 小时。也就是说,一个每天只醒一次的品牌监测 agent,要么一次拉更多页,要么一天跑三次。这个 8.04 小时量的是 11 月 13 日 UTC 06:46 到 14:48 这一段;按这个速度,一天只跑一次会漏掉大部分新帖。同一轮里 trustpilot/reviews 取近 7 天评价,只有 9 条(3 条一星),google_news/search 取近一周新闻,20 条正好顶到单次上限。三项数据费合计每轮 $0.002973;按 Google 公布的单价和我们量到的返回体积估算,默认模型 Gemini 4 Hydrogen 读完这三份返回、写一份简报,模型费在 $0.041 到 $0.158 之间,是数据费的 14 到 53 倍。
EveryInfra 一侧都是真调:2026 年 11 月 14 日 00:18 到 00:51(新加坡时间),我们用一把 EveryInfra Key 对 https://api.everyinfra.com/mcp 做了握手、两次 tools/list 和 11 次 tools/call,分 00:18、00:34、00:50 三轮(其中 1 次是 youtube/search 试调,不进本文的方案),另对 REST 接口做了 1 次对照调用,原始返回逐条保存,文中每个数都能从返回里复算。Gemini 一侧,我们没有开通 Gemini API 的付费项目,也没有真的建 agent、建 Trigger:凡是 Gemini 的代码都标为「配置示例」,写法照 ai.google.dev 的原文,读取日期 2026-11-14。Gemini 的模型费是按公开价和我们量到的字节数算出来的估算,不是账单。
Gemini Managed Agents 是什么:2026 年的时间线
Gemini Managed Agents 是 Gemini API 里的托管 agent:一次 API 调用就在 Google 托管的 Linux 沙盒里起一个能推理、跑代码、管文件、上网的 agent。Gemini API 的发布说明把上线日期写在 2026 年 5 月 19 日,当天以公开预览推出 Managed Agents 和通用的 Antigravity agent(Gemini API 发布说明,2026-05-19);Google 博客的发布文写的是「一次调用就能起一个 agent,在隔离、用完即弃的 Linux 环境里推理、用工具、执行代码」(Google 博客:Build managed agents with the Gemini API)。目前 Agents 概览页仍标着「Public Preview」,提醒在敏感流程里先人工看过 agent 的动作和输出(Agents 概览:安全与最佳实践)。
落到 API 上,入口是 Interactions API。Interactions 文档写明它在 2026 年 6 月正式可用,是新项目的推荐接口,服务端可以保存对话状态,长任务用 background=true 在后台跑(Interactions API 概览)。
上线半年里,和本文相关的改动集中在最近两个月,按日期排出来是这样:
| 日期 | 改动 | 对品牌监测 agent 意味着什么 | 出处 |
|---|---|---|---|
| 2026-05-19 | Managed Agents 和 antigravity-preview-05-2026 公开预览 | 起点;当时默认模型是 Gemini 3.5 Flash | 发布说明 |
| 2026-09-17 | 发布 antigravity-preview-09-2026,旧版 10 月 5 日停用;内置文件工具改成 PascalCase 参数 | 只读 output_text 的代码改个 agent 名就行;自己解析工具调用的要重写 | 发布说明 |
| 2026-10-19 | 官方模板仓库把全部模板的 base agent 换成 09-2026 | 照模板起步的项目,模板本身已跟上新版本 | 模板仓库提交记录 |
| 2026-10-27 | Gemini API CLI(gemini-api)测试版,可以在命令行里跑托管 agent | 定时脚本、CI 里也能直接调 agent,不必写 SDK 代码 | 发布说明 |
| 2026-11-10 | Gemini 4 Carbon 正式版,11 月 30 日前输入 $2、输出 $10 | 可选的最强模型;定价页写明 12 月 1 日起输入 $4、输出 $20 | 发布说明、定价:Gemini 4 Carbon |
| 2026-11-12 | Gemini 4 Hydrogen 正式版,成为 Antigravity agent 的默认模型 | 不写 agent_config.model 的 agent,从这天起按 Hydrogen 计价 | 发布说明 |
最后一行和账单直接相关。Antigravity agent 文档写的是:antigravity-preview-09-2026 不传 agent_config 时默认用 gemini-4-hydrogen,可选的还有 Carbon、Argon、3.8 Flash、3.6 Flash 和 3.5 Flash-Lite(Antigravity agent:模型选择)。用 agents.create 存下来的命名 agent,模型在创建时就锁定,调用时不能再换(自建托管 agent:限制)。11 月 12 日以前建的、没写模型的 agent,账单单价在那天已经变了,要回头核一遍。Carbon 的价格要单独记一笔:定价页写明它不进免费档,输入 $2、输出 $10 只到 11 月 30 日,12 月 1 日起输入 $4、输出 $20(定价:Gemini 4 Carbon),输入单价是 Hydrogen 的 2.7 倍。给每天跑的品牌监测写死 Carbon,12 月起同样的 token 量,账单是 11 月的两倍。
品牌监测这件活拆成四步
我们要做的 agent 只干一件事:每天替品牌团队看一遍 Anker 在三个公开来源的新内容,挑出要人看的,写一份简报。Anker 是一个公开品牌,产品线横跨充电宝、耳机、家用储能,2025 年 6 月还因为充电宝电芯问题在美国召回过一百多万台(美国消费品安全委员会召回公告,2025-06-12),品牌团队有实际的理由每天盯一遍。我们从 reddit/search、youtube/search、trustpilot/reviews、google_news/search 四项里挑了三项:Reddit 看用户自发讨论,Trustpilot 看购买后的评价,Google 新闻看媒体和品牌自己发了什么。三项各自是 EveryInfra 的一个能力页:Reddit 搜索、Trustpilot 评价、Google 新闻搜索,平台总览在 Reddit 数据接口、Trustpilot 数据接口 和 Google 新闻数据接口。
四步的分工是这样定的。第一步醒来,由 Gemini 的 Triggers 按 cron 表达式和时区触发,每次执行复用同一个环境,所以上一轮写下的文件下一轮还在(Antigravity agent:Triggers)。第二步取数,agent 通过挂上的远程 MCP 调 EveryInfra 的 everyinfra_call_api,三个平台各一次。第三步去重,按帖子 id、评价 id 和新闻网址比对沙盒里的 seen_ids.json,只留新的;时间只用来排序,不用来判断新旧,因为 Reddit 帖子的 posted_at 和它出现在搜索里的时间不一定一致。第四步写简报,把当天新出现的一星评价、在讲真伪或故障的帖子、媒体报道分开列,写进 briefings/ 目录,同时把今天见过的 id 追加进 seen_ids.json。
这个结构直接借自 Google 官方模板仓库里的 News Curator:它也跑在 Trigger 上,扫 Google News、Hacker News 和 Medium,用持久环境里的 seen_items.json 保证同一篇不出现两次,用 curation_history.csv 记每轮的数量做趋势(News Curator 模板说明)。模板的说明文件把这件事写成一句话:Trigger 的持久环境既是记忆,也是个性化。它的三个来源都不需要账号和令牌,网络白名单只有三个域名。Reddit 帖子和 Trustpilot 评价不在那三个来源里,这就是要挂一个数据 MCP 的原因。
gemini managed agents api 挂远程 MCP:mcp_server、credential 和 allowed_tools
Antigravity agent 文档的「MCP servers」一节写了挂远程 MCP 的全部字段:type 固定是 mcp_server,name 必须是小写字母、数字、下划线或连字符,url 是服务器地址,headers 可以放鉴权头,allowed_tools 限定能调哪些工具,不写就全放开;传输只支持 Streamable HTTP(Antigravity agent:MCP servers)。同一页的限制一节又补了两条容易踩的:SSE 传输不支持;name 里有大写字母会报一个笼统的 400 Bad Request,错误信息里不会告诉你是名字的问题(Antigravity agent:限制)。
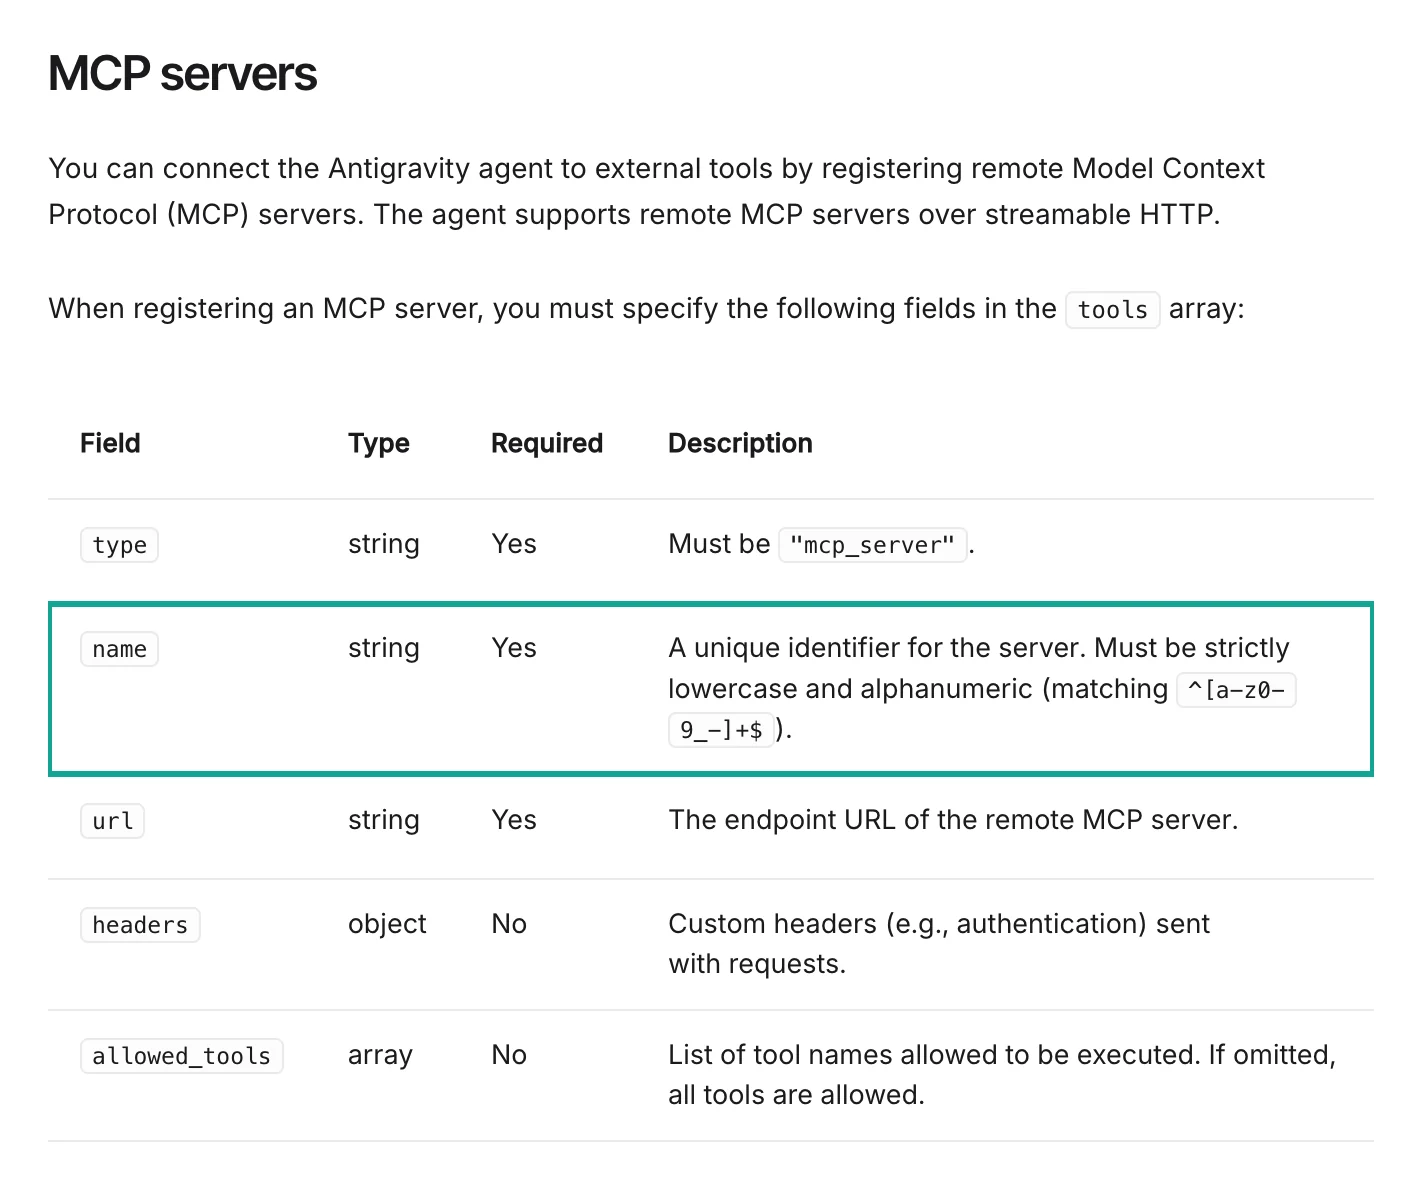
EveryInfra 的远程 MCP 地址是 https://api.everyinfra.com/mcp,用 Authorization: Bearer <你的 Key> 鉴权,正好落在这几条约束里面:它走 Streamable HTTP,我们 00:19:44 发 initialize 用了 0.145 秒,协商出的协议版本是 2025-06-18。密钥放在哪里,有两种写法。最省事的是把 Key 直接写进 headers,但这样 Key 会出现在每次请求体里,存在你自己的代码和日志里。文档推荐的是 Credentials:先用 POST /credentials 存一个 bearer_token 类型的凭据,之后在 mcp_server 里写 "credential": "<凭据 id>",出口代理在每次请求时把认证头加上,凭据的值只能写、不能读回,任何接口都不会返回它(Credentials:在 MCP 服务器上使用)。bearer_token 默认发 Authorization: Bearer <token>,header_name 和 prefix 可以改(Credentials:Bearer token),EveryInfra 用的就是默认格式,不用改。
下面是配置示例(Gemini 一侧未实际运行,照 2026-11-14 读取的文档写)。第一段存凭据,只做一次;第二段先手动跑一轮,确认 agent 能调到数据:
# 配置示例:Gemini 一侧未实际运行,写法照 ai.google.dev 2026-11-14 的文档
import os
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

# 1) 把 EveryInfra Key 存成只写凭据(值不会再从任何接口返回)
client.credentials.create(
    id="everyinfra-key",
    type="bearer_token",
    token=os.environ["EVERYINFRA_API_KEY"],   # 默认发 Authorization: Bearer <token>
)

# 2) 手动跑一轮:只放开 everyinfra_call_api 一个工具
interaction = client.interactions.create(
    agent="antigravity-preview-09-2026",
    agent_config={"type": "antigravity", "model": "gemini-3.5-flash-lite", "max_total_tokens": 120000},
    environment="remote",
    tools=[
        {"type": "code_execution"},
        {
            "type": "mcp_server",
            "name": "everyinfra",                  # 只能小写,大写会得到不说原因的 400
            "url": "https://api.everyinfra.com/mcp",
            "credential": "everyinfra-key",
            "allowed_tools": ["everyinfra_call_api"],
        },
    ],
    input=open("brand_brief_prompt.md").read(),
)
print(interaction.status, interaction.usage.total_tokens)
print(interaction.output_text)
我们 00:18 对 EveryInfra MCP 发 tools/list,回来 12 个工具,整个返回 16,250 字节;只算 everyinfra_call_api 一个工具的定义是 1,695 字节,加上 everyinfra_get_job 和 everyinfra_list_capabilities 三个是 3,309 字节。Gemini 文档的定价页写明,函数声明和工具的系统说明都按 token 计费(定价:Gemini 4 Hydrogen),按 Gemini 文档「约 4 个字符一个 token」的估法(Token 说明),全部 12 个工具约 4,063 个 token,只留一个约 424 个。agent 每走一步都要带着这些定义,一轮四步下来差 14,556 个 token。品牌监测用不上开工单、充值链接、验证码这些工具,只留 everyinfra_call_api 既省钱,也让模型少一个选错工具的机会。慢的能力要用 mode=async 时,再把 everyinfra_get_job 加回来,它读任务结果不收费。
12 个工具定义的大小差得不少,按 tools/list 返回里每个工具的 JSON 字节数排:
| 工具 | 定义大小(字节) | 品牌监测用不用 |
|---|---|---|
everyinfra_call_api | 1,695 | 用,三项数据都靠它取 |
everyinfra_list_capabilities | 816 | 可选,让 agent 自己查能力目录时才要 |
everyinfra_get_job | 798 | 可选,慢能力改用 mode=async 时才要 |
| 其余 9 个(开工单、搜索、验证码、账户、充值链接等) | 13,304 | 不用 |
最大的三个是开工单 2,958 字节、搜索 2,632 字节、验证码 1,808 字节,加起来比 everyinfra_call_api 大四倍多。12 个定义合计 16,613 字节,用不上的 9 个占了八成。allowed_tools 这一行不改提示、不换模型,就把每一步要带的工具定义砍掉九成。
max_total_tokens 是 Antigravity agent 的预算开关:输入、输出、思考 token 加起来到这个数就停,返回 status: "incomplete",缓存的 token 不算在内;文档说这是尽力而为,实际可能略超(Antigravity agent:预算控制)。无人值守的定时任务最好都设上,否则一次走偏的循环可以把一天的预算花完。AI Studio 的说明也提醒,一个提示可能引出没有上限的 token 消耗,要在提示里写清什么时候停(AI Studio 里的 agent:管理 token 消耗)。
还有一个文档没写清的地方:mcp_server 的请求是否也受沙盒 network.allowlist 约束。Agents 概览说沙盒默认出站不限,可以用白名单收紧(Agents 概览:网络访问);Credentials 页说 MCP 服务器和白名单用同一套 credential 字段和优先级规则。我们没有在 Gemini 一侧验证过两者的关系,所以下文的 Trigger 配置示例里收紧白名单时,把 api.everyinfra.com 也列了进去:不管 MCP 流量走不走白名单,这样写都不会被拦。
一次真实往返:tools/list 和 tools/call 回了什么
Gemini 的 mcp_server 工具在 agent 背后做的事,就是标准的 MCP 三步:initialize 握手、tools/list 拿工具定义、tools/call 调工具。MCP 规范里 Streamable HTTP 的写法是客户端对同一个地址发 HTTP POST,服务器回 JSON 或者 SSE 流(MCP 规范:Transports,2025-06-18 版)。我们用一个几十行的 Python 脚本照这个顺序对 EveryInfra 发请求,等于替 Gemini 的 agent 把它会发的请求先走一遍。下面是 00:18 那次 tools/call 的请求体,和 Gemini agent 调工具时会发的参数结构一致:
{
  "jsonrpc": "2.0",
  "id": 3,
  "method": "tools/call",
  "params": {
    "name": "everyinfra_call_api",
    "arguments": {
      "platform": "reddit",
      "action": "search",
      "params": {"keyword": "Anker", "sort": "newest"}
    }
  }
}
返回的 result.content[0].text 是一段 JSON 字符串,里面有 results 数组和 billing。reddit/search 的 billing.charged_usd 是 0.000792,和目录里这项的 price_usd 一致;返回里每条帖子带 id、url、title、text、community、like_count、comment_count、posted_at 等字段,和目录 response_fields 对得上。三项能力的参数我们都照目录写:reddit/search 的 sort 可选 newest,时间范围固定为最近一个月;trustpilot/reviews 的 company 要填官网域名,date 可选 last7days 等五档,单次最多 200 条;google_news/search 的 time_window 可选 hour、day、week、month、year,单次最多 20 条。
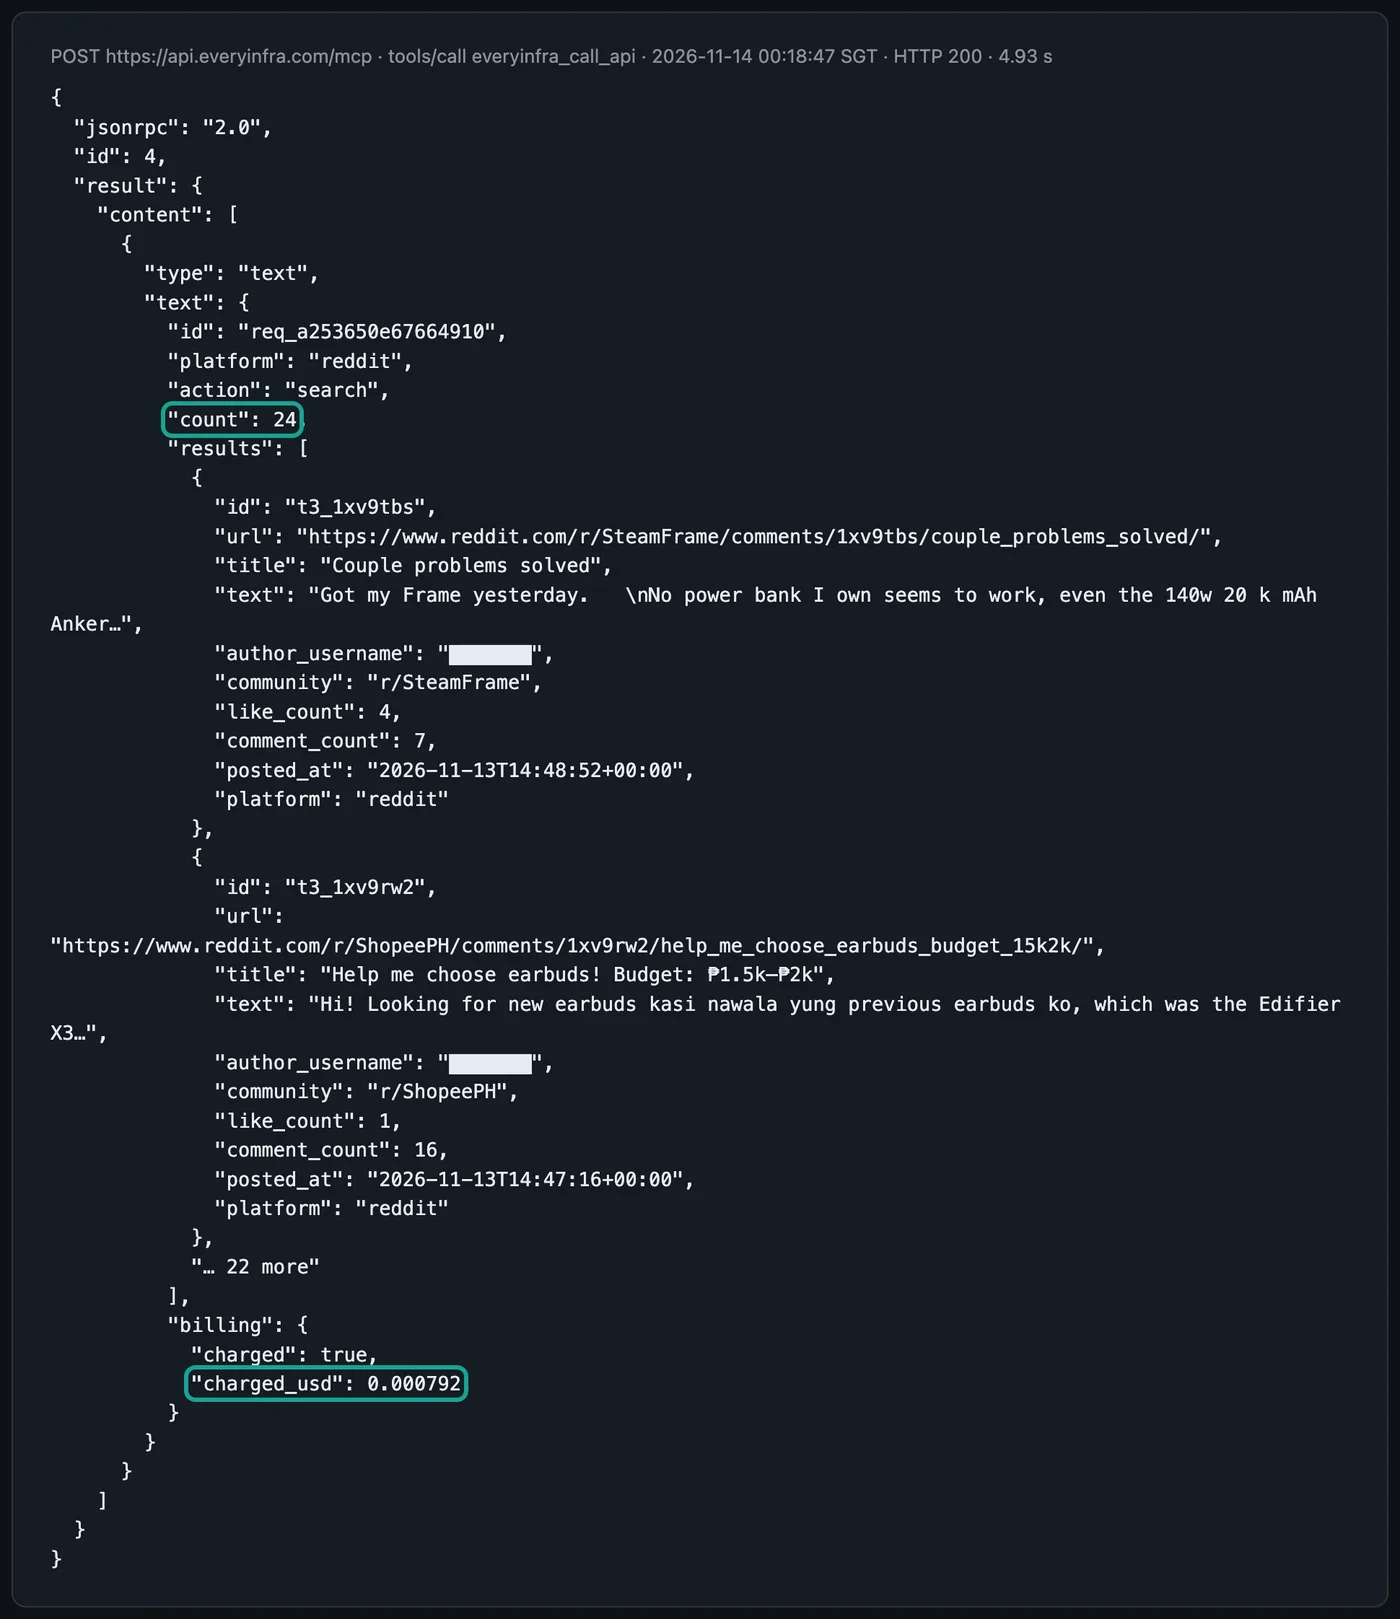
三轮下来,这三项一共成功调用 9 次,另有 1 次走 REST 接口的对照调用,逐次的用时和扣费如下,扣费合计 $0.009711。00:18:58 那次 trustpilot/reviews 返回了错误、没扣费,00:19:45 重发后成功,下表只列成功的调用:
| 轮次 | 发出时间(新加坡) | 能力 | 参数要点 | 返回条数 | 用时(秒) | 扣费(美元) |
|---|---|---|---|---|---|---|
| 第一轮 | 00:18:47 | reddit/search | newest | 24 | 4.9 | 0.000792 |
| 第一轮 | 00:19:06 | google_news/search | time_window week | 20 | 2.1 | 0.000792 |
| 第一轮 | 00:19:45 | trustpilot/reviews | last7days | 9 | 44.7 | 0.001389 |
| 第二轮 | 00:34:21 | reddit/search | newest | 24 | 5.9 | 0.000792 |
| 第二轮 | 00:34:35 | trustpilot/reviews | last7days | 9 | 41.3 | 0.001389 |
| 第二轮 | 00:35:24 | google_news/search | time_window day | 20 | 2.0 | 0.000792 |
| 第三轮 | 00:50:03 | reddit/search | newest | 24 | 5.4 | 0.000792 |
| 第三轮 | 00:50:16 | trustpilot/reviews | last7days | 10 | 48.0 | 0.001389 |
| 第三轮 | 00:51:12 | google_news/search | time_window day | 20 | 1.9 | 0.000792 |
| 第三轮 | 00:51:32 | google_news/search(REST) | time_window day | 20 | 2.9 | 0.000792 |
| 合计 | 0.009711 |
用时差别很大。google_news/search 三次都在 2 秒左右(1.9 到 2.1 秒),reddit/search 4.9 到 5.9 秒,trustpilot/reviews 三次都超过 40 秒(44.7、41.3、48.0 秒)。Gemini 的 Trigger 每次执行默认超时 600 秒(Antigravity agent:创建 Trigger),三项加起来一分钟左右,离超时还远;如果以后加到十几个品牌、每个品牌都调 Trustpilot,串行跑就要算一算,或者把 execution_timeout_seconds 调大。
错误返回不扣费,agent 重试即可;但简报的提示里要写一句:某个来源这轮没拿到数据,就在简报里写「本轮未取到」,不能写成「没有负面」。
三个来源一天各要跑几次
托管 agent 一天醒几次,取决于最快的那个来源。我们拿第一轮的返回算了每个来源单次能看到多长时间:
| 来源 | 参数 | 本次返回条数 | 最早一条(UTC) | 最新一条(UTC) | 覆盖小时数 | 每天至少调几次 |
|---|---|---|---|---|---|---|
reddit/search | Anker,newest | 24 | 11-13 06:46 | 11-13 14:48 | 8.04 | 3 |
trustpilot/reviews | anker.com,last7days | 9 | 11-07 19:28 | 11-11 11:38 | 88.18 | 1 |
google_news/search | Anker,week | 20 | 11-06 17:17 | 11-13 15:10 | 165.89 | 见下文 |
Reddit 这一行决定了节奏:最新 24 条只盖 8.04 小时,一天 24 小时就要至少 3 次,才能保证两次之间不漏。第二轮 00:34 再调,返回 24 条覆盖 9.47 小时;第三轮 00:50 覆盖 9.22 小时,最早一条挪到了 07:30。三轮里最新一条从 14:48 推到 16:23、再到 16:43(UTC),最早一条从 06:46 挪到 06:55、再到 07:30:窗口两头都在往前走,前面新进几条,后面就有几条被挤出去。三轮都在 8 到 10 小时之间,一天 3 次是下限。三轮都落在新加坡午夜后这 33 分钟里,量的是 UTC 早上到下午这一个时段;美国白天发帖更快,覆盖窗口会更短,我们只量了这一个时段。Trustpilot 正好相反,近 7 天只有 9 条,一天一次绰绰有余,两三天一次也不会漏。不漏之外还要看多快:第三轮抓到的那条一星评价,发出到出现在返回里只隔了 14 分钟,下一节细说。
所以 Trustpilot 每天调几次,要看品牌团队想多快回应差评。只求不漏,每天 09:00 那轮调一次,一天 $0.001389;想在差评发出后几个小时内就看到,就让它跟 Reddit 一样每 8 小时调一次,每天多花 2 × $0.001389 = $0.002778,30 天多 $0.083。agent 这条路的好处是 Reddit、新闻和评价放在同一份简报里,一星评价旁边就能看到同一型号在 Reddit 上有没有人遇到同样的问题。多花的这点数据费和模型费比可以忽略,要算的是另一头:每一轮都会让模型多读一份 Trustpilot 返回,约 11 KB,按 4 个字符一个 token 约 2,800 个 token,接法 A 下这部分每轮都要付。
第一轮那 9 条 Trustpilot 评价,我们也逐条读了正文。星级只分两头:3 条一星、6 条五星,没有中间分。按内容分,结果和星级不完全对应:
| 星级 | 条数 | 讲的是什么 | 所在国家 |
|---|---|---|---|
| 一星 | 1 | 官网下单 SOLIX C2000 和扩展电池,页面写有货,之后没按时发出 | 英国 |
| 一星 | 1 | 下单一个多月没收到货,客服一再承诺又一再延期 | 美国 |
| 一星 | 1 | PowerCore III Elite 26K 用 3 个月 USB-A 口坏了,因为是第三方卖家售出,Anker 不给换 | 法国 |
| 五星 | 3 | 客服和售后:耳机坏了第二天就寄新的、物流出问题客服协调解决 | 英国、荷兰、美国 |
| 五星 | 3 | 产品本身:耳机、充电产品耐用,其中一条正文是 Zolo 充电宝的完整产品名 | 英国、澳大利亚、美国 |
3 条一星里有 2 条讲的是下单和发货,只有 1 条讲产品故障;6 条五星里有 3 条夸的是客服换新。也就是说,这 9 条里有 5 条的主题是售后和物流,不是产品本身。品牌团队如果按星级把一星评价丢给产品经理,会有两条找错人;简报规则更适合先按主题分(产品故障、下单发货、售后处理),再看星级。第三轮新出现的那条一星(A2697 充电器坏了、换新还是退款各执一词)同样落在「售后处理」这一类。
Google 新闻那一行的问题在「顶到上限」。一周窗口回了 20 条,正好是单次上限,说明那一周 Anker 的新闻不止 20 条:测评、选购指南、黑色星期五折扣占了大半,来源里 BGR 一家就有 5 条,Anker 自己的博客 3 条。这 20 条的发布时间从 11 月 6 日铺到 11 月 13 日,落在最近一天里的只有 2 条(PCMag 和 SlashGear 各一条)。00:35 第二轮我们把窗口改成一天,同样回了 20 条,覆盖 21.53 小时,其中 18 条在一周窗口的返回里没有出现。也就是说,同一段时间里,一天窗口看到 20 条,一周窗口只看到 2 条:一周窗口的新闻顶到 20 条上限,会漏掉较早的报道,也会漏掉当天的大部分报道。两份列表的来源也几乎不重叠:一天窗口里 Tech Times 3 条,Kotaku、Trusted Reviews、9to5Toys 各 2 条,Anker 自己的博客一条都没有。
这说明新闻要用小窗口、勤调:每天按一天窗口调一次,当天的新闻被 20 条上限截掉的概率小得多;新闻多的品牌还可以按小时窗口调,或者把关键词拆细(Anker 加 eufy、Soundcore 分开查)。每多一次就多 $0.000792,一天按一天窗口调一次,一个月 $0.024。
关键词同名也会占掉名额。00:57 我们又按西班牙语查了两次一周窗口的新闻:country 设西班牙一次、设墨西哥一次,language 都是 es,每次 $0.000792。两次各回 20 条,同样顶到上限,两份列表有 15 条是同一批网址;每份里有 10 条是促销和降价,还有 3 条讲的是阿根廷经济政策里的「punto Anker」,和这个品牌毫无关系(Infobae,2026-11-12)。这类误命中在 AGENTS.md 里写一条按标题过滤的规则就能挡掉;两个市场一起盯时,去重也要跨查询按网址做,否则简报会把 15 条新闻报两遍。
后两轮新增多少:按 id 去重
00:34 的第二轮离第一轮 15 分钟,00:50 的第三轮又隔了 16 分钟,三项每轮都重调一次,按 id(新闻按网址)和前面所有轮次比:
| 轮次 | 来源 | 返回条数 | 新出现 | 前面见过 | 裁剪后新增(字节) | 原样返回(字节) |
|---|---|---|---|---|---|---|
| 第一轮 | 24 | 24 | 0 | 7,093 | 41,605 | |
| 第一轮 | Trustpilot | 9 | 9 | 0 | 2,173 | 11,253 |
| 第一轮 | Google 新闻 | 20 | 20 | 0 | 4,476 | 9,274 |
| 第二轮 | 24 | 1 | 23 | 214 | 40,699 | |
| 第二轮 | Trustpilot | 9 | 0 | 9 | 2 | 11,255 |
| 第二轮 | Google 新闻 | 20 | 18 | 2 | 5,021 | 10,253 |
| 第三轮 | 24 | 2 | 22 | 656 | 40,249 | |
| 第三轮 | Trustpilot | 10 | 1 | 9 | 251 | 13,123 |
| 第三轮 | Google 新闻 | 20 | 1 | 19 | 255 | 10,256 |
Reddit 15 分钟里只多了 1 条,还是一条噪声:r/AynThor 里有人问《GTA IV》怎么在掌机上跑得流畅,正文里提到的「Anker」和这个品牌无关。Trustpilot 0 条新增。新闻那一行的 18 条新增,主要是因为我们把窗口从一周换成了一天,返回的是另一批文章,不代表 15 分钟里冒出 18 篇新闻;这也提醒去重表要按来源和参数分开记,换了参数,「新增」的意义就变了。把三轮加起来看:一共返回 160 条(Reddit 72、Trustpilot 28、新闻 60),按 id 和网址去重后只有 76 条不同的内容(Reddit 27、Trustpilot 10、新闻 39),不到一半;其中新闻的 39 条里有 18 条是换窗口带来的,如果三轮参数都不变,重复的比例还要更高。接法 A 下模型三轮要读全部 160 条,重复的 84 条也照样占 token,这就是后文接法 B 要在模型之前先去重的原因。
第三轮新增 4 条,分属简报要处理的三种情况。Trustpilot 新出现一条一星评价,posted_at 是 2026-11-13 16:36(UTC),也就是新加坡时间 11 月 14 日 00:36,第二轮 00:34 时它还没发出,00:50 第三轮就拿到了:用户在土耳其,说自己的 Anker 140W 四口充电器(型号 A2697)用了 5 个半月就坏,授权维修点确认了硬件故障,之后在换新还是退款上和当地零售商、Anker 客服各执一词。这正是品牌团队要第一时间看到的一类,也是我们判据里写的「一星评价单列」。Reddit 新增 2 条,一条在 r/powerbanks 问哪种充电宝能长时间给 5V 灯带低电流供电,帖主提到自己那台 Anker 一万毫安充电宝的低电流模式休眠后会关掉,属于「顺带提到」里有产品反馈的那种;另一条是法语社区的黑五降价贴,属于促销类,合成一句即可。两条帖子发出到被抓到都不到 10 分钟。
去重为什么不用时间判断,后两轮各给了一个例子。第二轮:那条新帖的 posted_at 是 16:23(UTC),第一轮 00:18(新加坡时间)也就是 16:18 UTC 发请求时,它还没发出来。按时间判断这次不会出错,但 Reddit 搜索结果进入索引有延迟,一条 16:10 发的帖子完全可能 16:30 才出现在搜索里,只记「上次看到的最新时间」就会永远漏掉它。我们在 Claude Managed Agents 每晚巡检差评 那篇里,Google 地图评论就出现过这种「时间更早、第一次没出现」的条目。第三轮的新闻更直接:新增的那篇是一家媒体 11 月 12 日 17:13(UTC)发的 Anker 旅行充电器测评,比当轮列表里大多数文章都旧,前两轮却都没有出现,第三轮才排进前 20 条。只记「上次看到的最新时间」,这篇会被当成旧文丢掉。按 id 和网址比,就不用操心索引延迟和排序变动。
Reddit 24 条里有几条在讲 Anker
reddit/search 的关键词说明写得很细:只返回对得上关键词的帖子,标题、社区名或全帖里要出现这些词,只沾一个词的不返回(EveryInfra Reddit 搜索能力页)。Anker 是一个词,所以 24 条全部在标题或正文里提到了 Anker,其中以 Anker 为主题的只有 6 条。我们写稿时把第一轮 24 条逐条读了一遍,按帖子的主题分成四类:
| 类别 | 判法 | 条数 | 例子(社区) |
|---|---|---|---|
| Anker 是主角 | 提问、真伪、安装、二选一 | 6 | r/powerbanks 问 A1384 是不是正品;r/homeautomation 想把 Solarbank Max 接进 Home Assistant |
| 顺带提到 | 推荐、比较或别的问题里出现 | 8 | r/SteamFrame 说 140W 的 Anker 充电宝带不动头显;耳机选购帖里列了 Soundcore R60i |
| 促销和价格 | 降价、折扣清单 | 4 | r/priceglitch 的 SOLIX C300 降价;r/ClubicFR 的黑五降价 |
| 二手转卖 | 个人出售 | 6 | 一条阿拉伯语的充电宝转卖帖发在 4 个社区;一条 iPhone 转卖帖赠送 Anker 充电头 |
24 条来自 22 个社区,其中 5 条是跨社区重发的副本:耳机选购帖发了 2 次,阿拉伯语转卖帖发了 4 次,iPhone 转卖帖发了 2 次,去掉副本后是 19 个不同的帖子。标题里直接出现 Anker 或旗下品牌名(Soundcore、eufy、SOLIX、Nebula)的只有 6 条,4 条标题是阿拉伯语。品牌团队会点开看的,是「Anker 是主角」那 6 条里的真伪问题和接入问题,加上「顺带提到」里那条头显供电的抱怨:前者可能和假货有关,后者是一个具体的兼容性问题。
分类可以交给 agent:它能读帖子正文、按你写在 AGENTS.md 里的规则判类。上表是写稿时逐条判读的结果,规则就是「判法」那一列;换成 agent 判读时,先拿这 24 条对一遍,看它和上表差几条,再放手让它每天跑。阿拉伯语、菲律宾语、德语帖子要它先读懂,这几条要重点核。筛完之后,一份每天的简报大概是这样:Reddit 新帖里挑出 2~3 条要看的,Trustpilot 新出现的一二星评价逐条列出,新闻里只留和公司、产品安全、诉讼、召回有关的,促销类合成一句。
用 Triggers 定时:cron、时区和持久环境
Triggers 把 agent、环境、提示和时间表绑成一个持久资源,按 cron 自己触发;每次执行复用同一个环境,上一轮写的文件下一轮能看到。创建时必填 schedule(cron 表达式)、time_zone(IANA 时区名)和 interaction,可选 max_consecutive_failures(连续失败几次自动暂停,默认 5)和 execution_timeout_seconds(每次执行的超时,默认 600 秒);建好之后可以暂停、恢复、立刻跑一次,或者列出执行记录,每条记录带 interaction_id 和 environment_id(Antigravity agent:Triggers)。时区用 IANA 的名字,比如 Asia/Singapore,名字的来源是 IANA 维护的时区数据库(IANA 时区数据库)。
按上一节的覆盖窗口,Reddit 一天要跑 3 次,所以时间表写成每 8 小时一次。下面是配置示例(Gemini 一侧未实际运行):
# 配置示例:Gemini 一侧未实际运行,字段照 2026-11-14 的 Triggers 文档
trigger = client.triggers.create(
    schedule="0 1,9,17 * * *",          # 每天 01:00、09:00、17:00
    time_zone="Asia/Singapore",
    display_name="anker-brand-monitor",
    max_consecutive_failures=3,
    execution_timeout_seconds=900,      # Trustpilot 一次 40 多秒,留出余量
    interaction={
        "agent": "brand-monitor",       # 用 agents.create 存下的命名 agent,模型在创建时锁定
        "input": "按 AGENTS.md 跑一轮:Reddit 每轮都查;Trustpilot 和 Google 新闻只在 09:00 这轮查。"
                 "只报 seen_ids.json 里没有的条目,写 briefings/ 下当天的文件,最后更新 seen_ids.json。"
                 "某个来源没拿到数据时写明「本轮未取到」,不要写成没有负面。",
        "tools": [{"type": "mcp_server", "name": "everyinfra", "url": "https://api.everyinfra.com/mcp",
                   "credential": "everyinfra-key", "allowed_tools": ["everyinfra_call_api"]}],
        "environment": {"type": "remote", "network": {"allowlist": [{"domain": "api.everyinfra.com"}]}},
    },
)
print(trigger.id, trigger.next_run_time)
持久环境有两个时间要记住。环境闲置 15 分钟会自动快照并停下,下一次请求再恢复,会有一次冷启动;离线的环境保留 7 天,7 天里没人用就被自动删除,传过期的环境 id 会得到 404(环境:生命周期、环境:限制)。每天跑的 Trigger 不会碰到 7 天这条线;但如果你暂停了 Trigger 去度假,回来时 seen_ids.json 和历史简报可能已经没了,第一轮会把近期的内容全部当成新的再报一遍。重要的历史最好定期从环境里下载出来,文档给了列文件、下载单个文件、打包下载目录的接口(环境:管理文件)。
seen_ids.json 会一直变大。按第一轮的数,Reddit 一天 3 次、每次二十多条,加上 Trustpilot 和新闻,一天最多新增约 100 个 id,一年 3 万多个,存成 JSON 不过几百 KB。环境文档只给了从外面放进去的源文件的上限:内联文件单个 1 MB、合计 2 MB(环境:限制),没有写 agent 在沙盒里自己写的文件能有多大。按月归档、只留最近 90 天的 id,脚本读得更快,模型要看这份文件时也少花 token。
gemini managed agents pricing:每天跑一次要花多少
费用分三块:EveryInfra 的数据费、Gemini 的模型费、Gemini 的工具和沙盒费。数据费最好算,按 2026-11-14 00:17 读取的目录价,reddit/search 每次 $0.000792,trustpilot/reviews 每次 $0.001389,google_news/search 每次 $0.000792,真调的 charged_usd 和目录价逐次一致。返回错误和空结果的调用不扣费。
| 方案 | 每天调用 | 每天数据费 | 每 30 天数据费 |
|---|---|---|---|
| 三项各一次 | Reddit 1、Trustpilot 1、新闻 1 | $0.002973 | $0.089 |
| 本文推荐 | Reddit 3、Trustpilot 1、新闻 1 | $0.004557 | $0.137 |
| 三项每次都调 | Reddit 3、Trustpilot 3、新闻 3 | $0.008919 | $0.268 |
| 10 个品牌,本文推荐节奏 | 每个品牌同上 | $0.04557 | $1.367 |
Gemini 一侧,定价页「Pricing for agents」写的是:托管 agent 按底层模型的标准单价收 token 费,包括 agent 循环里的输入、输出和中间推理 token;预览期间环境算力(CPU、内存、沙盒执行)不收费(定价:Pricing for agents)。Agents 概览补了一句:一次交互可能触发多轮推理,通常消耗 10 万到 300 万 token(Agents 概览:定价)。Antigravity agent 页给了按任务类型的估算:调研和信息整理类一次 $0.30 到 $1.00,输入 10 万到 50 万 token、输出 1 万到 4 万;数据处理和分析类 $0.70 到 $3.25;输入 token 里通常有 50% 到 70% 命中缓存(Antigravity agent:估算费用)。
这些区间按任务类型给,我们按量到的字节数算一个下限。假设一轮走 4 步(计划并调 Reddit、调 Trustpilot、调新闻、写简报),每份返回在它之后的每一步都要再读一遍,工具定义每一步都要带上,按 4 个字符一个 token 换算,Hydrogen 和 Flash-Lite 的单价取 2026-11-14 的定价页(定价:Gemini 3.5 Flash-Lite)。harness 自己的系统提示、AGENTS.md、思考 token 都没算进去,所以实际账单只会比下表高:
| 模型 | 工具定义 | 缓存 | 输入 token | 一轮模型费(输出 2 千到 1 万 token) | 是数据费的几倍 |
|---|---|---|---|---|---|
| Gemini 4 Hydrogen(默认) | 全部 12 个 | 不算缓存 | 55,399 | $0.098~$0.158 | 33~53 |
| Gemini 4 Hydrogen | 只留 1 个 | 重读按缓存价 | 40,844 | $0.041~$0.101 | 14~34 |
| Gemini 3.8 Flash | 只留 1 个 | 重读按缓存价 | 40,844 | $0.021~$0.051 | 7~17 |
| Gemini 3.5 Flash-Lite | 只留 1 个 | 重读按缓存价 | 40,844 | $0.011~$0.031 | 3.5~10 |
数据费是小头:即使按最省的 Flash-Lite,模型费也是数据费的 3.5 倍以上;按默认的 Hydrogen、什么都不改,是 33 到 53 倍。所以省钱的顺序是先动模型这边:写明 agent_config.model,只留需要的工具,设 max_total_tokens,提示里写清做完什么就停。Hydrogen 的定价页另有 Batch 和 Flex 两档,输入输出都是标准价的一半(定价:Gemini 4 Hydrogen),但文档没有写托管 agent 能不能用这两档,我们不把它算进上表。
Gemini 自带的 Google 搜索也要单独算:Gemini 3 及以后的模型每月有 5,000 次免费搜索,之后每千次 $14,每个项目每天默认上限 1,500 次(定价:工具价格)。Antigravity agent 默认带 google_search,品牌监测不想让它自己去搜网页时,像上面的示例那样只列 code_execution 和 mcp_server,就把它关掉了。免费档的项目也能用 Antigravity agent,有免费的速率和用量额度(Antigravity agent:可用性与价格),先在免费档把提示调顺,再换到付费项目。
两种接法:返回进上下文,还是落进沙盒文件
上表的输入 token 大部分是三份原样返回:Reddit 那份 41,605 字节,约 10,401 个 token,一份就占了三份的三分之二。经 mcp_server 调工具,返回会整份进入模型的上下文,模型没法只看其中几个字段。托管 agent 还有另一条路:沙盒里能跑代码,环境的网络白名单可以给某个域名绑一个 credential,出口代理在请求发往这个域名时加上认证头(环境:网络配置)。于是可以让 agent 在沙盒里跑一个脚本,直接调 EveryInfra 的 REST 接口 POST /api/v1/social,把原样返回写进文件,脚本自己做去重和字段裁剪,只把新出现的条目、几个要用的字段打印出来给模型看。
| 接法 A:mcp_server 工具 | 接法 B:沙盒脚本调 REST | |
|---|---|---|
| 配置 | tools 里一个 mcp_server,带 credential | network.allowlist 里给 api.everyinfra.com 绑 credential,AGENTS.md 里放脚本 |
| 模型读到什么 | 整份返回(第一轮三份合计 62,132 字节) | 脚本打印的新增条目(第一轮 13,742 字节,第三轮 1,162 字节) |
| 去重在哪做 | 模型读完返回再比对文件,或者再调一次代码 | 脚本里按 id 比对,模型看不到旧条目 |
| 适合 | 先跑通、临时问一句、参数每次不同 | 每天固定跑、来源固定、量大 |
| 要注意 | 返回越大越贵;字段说明要靠工具描述 | 脚本出错时 agent 要能读懂报错;Key 只经凭据注入,不写进脚本 |
字节数是脚本从真调返回现算的:第一轮三份原样返回合计 62,132 字节,只留 Reddit 的 7 个字段(id、网址、标题、社区、时间、点赞、评论数)、Trustpilot 的 7 个字段、新闻的 4 个字段,标题截到 160 个字符,新增条目合计 13,742 字节,是原样的 22.1%。第二轮因为新闻换了窗口,新增 19 条,裁剪后 5,237 字节;第三轮参数不变,三项一共只新增 4 条,裁剪后的新增部分只有 1,162 字节,而原样返回仍是 63,628 字节,是它的 55 倍:接法 A 每轮都要为旧条目付钱,接法 B 只为新增付钱。按 Gemini 3.5 Flash-Lite 的输入价,第一轮裁剪后的 3,436 个 token 读一遍是 $0.00103,比接法 A 只读一遍原样返回的 $0.00466 少了约四分之三,后面每一步都不用再重读旧内容。
接法 B 的脚本骨架如下。EveryInfra 一侧的请求格式是真调过的,charged_usd 在返回的 billing 里;放进 Gemini 沙盒运行这一步没有实测,属于配置示例:
# fetch_new.py:放进 .agents/skills/brand-monitor/ 由 agent 调用(沙盒内运行为配置示例)
# Key 不写在这里:network.allowlist 给 api.everyinfra.com 绑了 credential,出口代理会加上认证头
import json, pathlib, urllib.request

SEEN = pathlib.Path(".agents/workspace/seen_ids.json")
seen = set(json.loads(SEEN.read_text())) if SEEN.exists() else set()
JOBS = [
    ("reddit", "search", {"keyword": "Anker", "sort": "newest"}, ["id", "url", "title", "community", "posted_at"]),
    ("trustpilot", "reviews", {"company": "anker.com", "date": "last7days", "sort": "newest", "limit": 20}, ["id", "url", "title", "rating", "posted_at"]),
    ("google_news", "search", {"keyword": "Anker", "time_window": "day"}, ["url", "title", "source", "published_at"]),
]
fresh, spent = [], 0.0
for platform, action, params, keep in JOBS:
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    req = urllib.request.Request("https://api.everyinfra.com/api/v1/social", data=body,
                                 headers={"Content-Type": "application/json"}, method="POST")
    data = json.loads(urllib.request.urlopen(req, timeout=120).read())
    spent += (data.get("billing") or {}).get("charged_usd", 0)
    for row in data.get("results") or []:
        key = f"{platform}:{row.get('id') or row.get('url')}"
        if key not in seen:
            seen.add(key)
            fresh.append({"src": platform, **{k: row.get(k) for k in keep}})
SEEN.write_text(json.dumps(sorted(seen)))
print(json.dumps({"new": fresh, "charged_usd": round(spent, 6)}, ensure_ascii=False))
接法 B 用的 REST 接口我们也真调了一次:00:51:32,参数和 20 秒前那次 MCP 新闻调用完全一样(Anker,一天窗口)。REST 回了 20 条,其中 19 条和 MCP 那次是同一批网址,1 条不同,排序也有先后差别;扣费同为 $0.000792,用时 2.94 秒。返回体积上,REST 直接回 JSON,9,156 字节;MCP 把同样的结果装进 JSON-RPC 的一个文本字段,加上外层和转义是 10,256 字节,多 12%。这点差别不是接法 B 省钱的原因,省钱靠的是脚本在模型看到之前就把旧条目和用不上的字段去掉了。两条路数据费一样,选哪条看你更在意配置省事,还是每轮的 token。
和另外三篇托管方案的分工
同题材我们写过三篇,平台不同:Claude 一侧的定时巡检看 Claude Managed Agents 每晚巡检差评;Google Cloud 企业平台的 MCP 接法看 Gemini Enterprise Agent Platform 接 MCP;Gemini 应用里的连接应用看 Gemini Connected Apps 怎么接数据工具。本文讲的是 ai.google.dev 上的 Gemini Developer API,拿一个 API Key 就能开始;Google 说给企业的托管 agent 同时在 Agent Platform 上以预览形式上线,那边走 Google Cloud 项目和它自己的定价页(Agent Platform 上的 Managed Agents API)。
换一个领域:消费品安全团队盯召回型号
同一个 agent 换个提示,就能给消费品安全的公共机构或者第三方检测机构用。以 Anker 为例,美国消费品安全委员会 2025 年 6 月 12 日公布召回一百多万台 PowerCore 10000 充电宝(型号 A1263),原因是电芯可能过热,补救方式是换新(CPSC 召回公告,2025-06-12);同年 9 月 18 日又有一次召回,补救方式是退款(CPSC 召回公告,2025-09-18)。Anker 官网有一个汇总所有召回的页面(Anker 产品召回页),2025 年 6 月起的全球自愿召回另列了 A1647、A1652、A1257、A1681、A1689 五个型号,要再核序列号才知道某一台在不在范围内(Anker 全球自愿召回说明)。召回公告发出以后,监管和检测人员关心的是:被召回的型号还有没有人在二手市场转卖,有没有新的过热、起火的描述。
做法只要改三处。关键词从品牌名换成召回型号(A1263、A1257 这类),Reddit 用 sort=newest 每天查;Trustpilot 用 stars=["1","2"] 只取低分评价;简报规则改成「出现转卖、过热、膨胀、起火、烧焦这类描述就单列」。第一轮的数据里正好有两个例子。一是那 6 条二手转卖帖:阿拉伯语那条卖的是没标型号的 2 万毫安 Anker 充电宝,我们没法判断是不是召回型号,这正是要人工跟进的一类。二是 Trustpilot 11 月 8 日一条五星评价,正文第一句写的是「Anker Zolo Power Bank (20K, 30W, Built-In USB-C Cable)」,这个名字和召回清单里 A1689 的产品名一字不差;评价本身在夸产品,不代表那台在召回范围内,但对检测人员来说,这就是「名字对上了、要核序列号」的那一类线索。agent 只负责把可能相关的公开帖子找出来、去重、排好,判断某个产品是否在召回范围内,要以 CPSC 公告和厂商的召回核验页为准,这一步不交给模型。
行业动向:最近 60 天和托管 agent 相关的变化
| 日期 | 变化 | 对读者意味着什么 | 出处 |
|---|---|---|---|
| 2026-10-30 | Computer Use 工具正式可用 | 对托管 agent 暂时无用:Antigravity agent 的限制里仍写着 computer_use 不支持 | 发布说明、限制 |
| 2026-11-10 | MCP 官方博客发布文件上传下载扩展的草案,配合 2026-07-28 版协议 | 以后「把一份大 CSV 拉进沙盒」可能有标准写法,现在还是实验 | MCP 博客,2026-11-10 |
| 2026-11-11 | Gemini Decision 1 和 Decisions API,做二分类、多分类和打分判断,不产生输出 token | 帖子分类这一步以后可以考虑单独交给它,托管 agent 只做调度和写简报 | 发布说明 |
MCP 协议本身也在变。2026-07-28 版规范在 7 月 28 日发布,官方博客说这是协议上线以来最大的一次修订,带来无状态的协议核心和按请求头路由(MCP 博客:2026-07-28 版规范、MCP 规范:Transports,2026-07-28 版)。我们 00:35 用 initialize 声明客户端支持 2026-07-28,EveryInfra 回的是 2025-11-25,按 MCP 的版本协商,客户端可以用这个版本继续;Gemini 一侧用哪个版本发起,文档没写,我们也没法从外面看到。
做不了的事和几条注意事项
第一,预览期。Agents 概览、Antigravity agent 页和自建 agent 页都写着预览,功能和请求格式可能变;命名 agent 还不支持版本和回滚,也不支持子 agent 嵌套(自建托管 agent:限制)。改 AGENTS.md 之后下一次调用就用新配置,没有「退回上一版」,自己用 Git 管好源文件。
第二,结构化输出。Antigravity agent 不支持结构化输出,temperature、max_output_tokens 这类生成参数会直接返回 400(Antigravity agent:限制)。简报要给下游系统读,就让 agent 在沙盒里写一个 JSON 文件,再用文件接口取,不要指望 output_text 的格式每次一样。
第三,函数调用只支持有状态的模式,要用 previous_interaction_id 接着上一轮(同一节限制)。本文的方案用的是 MCP 和代码执行,不涉及自定义函数;如果你想把「发 Slack」做成自定义函数,就要按这个限制写。
第四,数据这边的边界。reddit/search 的时间范围固定为最近一个月,Anker 这种讨论多的品牌要按每天 3 次的节奏跑;google_news/search 每次最多 20 条,要用小窗口;trustpilot/reviews 只认官网域名,不认公司名,Anker 要写 anker.com。三项都只读公开内容:Reddit 的私密社区、Trustpilot 上被隐藏的评价拿不到。个人用户名在简报里应当隐去,品牌和媒体名可以写。
第五,超时余量。trustpilot/reviews 三次都要 40 多秒,一轮三项串行一分钟左右;一个 Trigger 同时盯十几个品牌时,按品牌拆成几个 Trigger,或者把 execution_timeout_seconds 调大。调用返回错误时,错误以工具结果的形式回到模型手里,带 retry_after,不扣费,agent 照着重试即可。
第六,重试。Trigger 超时或者 agent 重试时,同一个调用可能发两次。定时任务和会重试的调用,走接法 B 的 REST 接口,并在请求头里带 Idempotency-Key;下游如果是发通知、开工单,也按同一个键做幂等,做法见 AI agent 重试和 Idempotency-Key。
常见问题
下面的问题取自 2026-11-14 读取的 Google 搜索联想词,每问后面注明来源词。
Gemini Managed Agents 怎么收费?
(联想词:gemini managed agents pricing)按底层模型的标准单价收 token 费,agent 循环里的输入、输出、推理 token 都算;Google 搜索这类工具按工具价另算;预览期间沙盒的 CPU、内存不收费(定价:Pricing for agents)。默认模型 Gemini 4 Hydrogen 输入每百万 token $1.50、输出 $7.50。我们这件品牌监测活按字节数估算,一轮模型费 $0.011 到 $0.158,取决于选哪个模型、挂几个工具;EveryInfra 的数据费另算,一轮三项 $0.002973。
Gemini API 的 Managed Agents 有哪些功能?
(联想词:gemini api managed agents features)默认带 code_execution、google_search、url_context 三个工具,指定 environment 后自动有文件工具;可以加自定义函数和远程 MCP 服务器;能后台运行、流式输出、按 cron 定时(Triggers)、存凭据(Credentials)、在沙盒里挂 Hooks 拦截代码执行和文件操作(Antigravity agent:支持的工具、Hooks)。上下文到约 13.5 万 token 时自动压缩,适合长时间、多轮的任务(Antigravity agent:能力)。
Gemini Managed Agents 能接哪些 MCP?
(联想词:gemini managed agents mcps)任何走 Streamable HTTP 的远程 MCP 服务器都能接,SSE 传输不支持,name 必须小写。鉴权可以写在 headers 里,也可以存成 credential 由出口代理注入;allowed_tools 限定能调的工具。EveryInfra 的 https://api.everyinfra.com/mcp 我们按这些约束真调过:握手 0.145 秒,tools/list 回 12 个工具。
Gemini Managed Agents 有哪些模板?
(联想词:google gemini gemini managed agents templates)官方模板仓库目前有数据分析、AI 电台、仓库维护、文档处理、新闻策展、SEO 审计等模板,另有客服和一个基础模板;新闻策展模板就是跑在 Trigger 上、用持久环境去重的那个,本文的结构借自它(模板仓库)。AI Studio 的 Agents 页签里也能直接选模板试跑(AI Studio 里的 agent)。
Antigravity agent 要什么 API key?
(联想词:antigravity agent api key)用普通的 Gemini API Key,请求头 x-goog-api-key,接口地址 generativelanguage.googleapis.com/v1beta/interactions;免费档和付费档的项目都能用,免费档有免费的速率和用量额度(Antigravity agent)。EveryInfra 的 Key 是另一把,存进 Gemini 的 Credentials,不要写进提示或 AGENTS.md。
上手步骤
- 在 EveryInfra 注册并拿一把 API Key,按 快速上手 用 curl 先调一次
reddit/search,确认返回和扣费。 - 看 远程 MCP 服务器说明,或者照 远程 MCP 接入教程 在本机的 MCP 客户端里先连一次
https://api.everyinfra.com/mcp,跑一遍tools/list。 - 在 Gemini 一侧把 Key 存成
bearer_token凭据,用本文的配置示例手动跑一轮interactions.create,看usage.total_tokens和output_text。 - 把规则写进
AGENTS.md,用agents.create存成命名 agent,写明模型,再建 Trigger。 - 价格和每项能力的单价在 价格页 和 数据市场。
参考资料
- Gemini API 发布说明,2026-05-19,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#05-19-2026
- Google 博客:Build managed agents with the Gemini API,Google,2026-11-14 读取,https://blog.google/innovation-and-ai/technology/developers-tools/managed-agents-gemini-api
- Agents 概览:安全与最佳实践,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agents#security-best-practices
- Interactions API 概览,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/interactions-overview
- Gemini API 发布说明,2026-09-17,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#09-17-2026
- 模板仓库提交记录,GitHub, google-gemini,2026-11-14 读取,https://github.com/google-gemini/gemini-managed-agents-templates/commits/main
- Gemini API 发布说明,2026-10-27,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#10-27-2026
- Gemini API 发布说明,2026-11-10,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#11-10-2026
- 定价:Gemini 4 Carbon,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/pricing#gemini-4-carbon
- Gemini API 发布说明,2026-11-12,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#11-12-2026
- Antigravity agent:模型选择,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#model-selection
- 自建托管 agent:限制,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/custom-agents#limitations
- 美国消费品安全委员会召回公告,2025-06-12,U.S. CPSC,2026-11-14 读取,https://www.cpsc.gov/Recalls/2025/More-than-One-Million-Anker-Power-Banks-Recalled-Due-to-Fire-and-Burn-Hazards-Manufactured-by-Anker-Innovations
- Antigravity agent:Triggers,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#triggers
- News Curator 模板说明,GitHub, google-gemini,2026-11-14 读取,https://github.com/google-gemini/gemini-managed-agents-templates/tree/main/news-curator
- Antigravity agent:MCP servers,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#mcp-servers
- Antigravity agent:限制,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#limitations
- Credentials:在 MCP 服务器上使用,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-credentials#mcp-servers
- Credentials:Bearer token,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-credentials#bearer-token
- 定价:Gemini 4 Hydrogen,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/pricing#gemini-4-hydrogen
- Token 说明,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/tokens
- Antigravity agent:预算控制,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#budget-controls
- AI Studio 里的 agent:管理 token 消耗,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/aistudio-agents#managing-token-consumption
- Agents 概览:网络访问,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agents#network-access
- MCP 规范:Transports,2025-06-18 版,Model Context Protocol,2026-11-14 读取,https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Infobae,2026-11-12,www.infobae.com,2026-11-14 读取,https://www.infobae.com/economia/2026/11/12/licitacion-clave-el-equipo-economico-se-entusiasma-por-el-regreso-del-punto-anker-y-espera-un-repunte-del-credito/
- IANA 时区数据库,IANA,2026-11-14 读取,https://www.iana.org/time-zones
- 环境:生命周期,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-environment#environment-lifecycle
- 环境:限制,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-environment#limitations
- 环境:管理文件,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-environment#download-files-from-the-environment
- 定价:Pricing for agents,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/pricing#pricing-for-agents
- Agents 概览:定价,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agents#pricing
- Antigravity agent:估算费用,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#availability-and-pricing
- 定价:Gemini 3.5 Flash-Lite,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/pricing#gemini-3.5-flash-lite
- 定价:工具价格,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/pricing#pricing-for-tools
- 环境:网络配置,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-environment#network-configuration
- Agent Platform 上的 Managed Agents API,Google Cloud,2026-11-14 读取,https://docs.cloud.google.com/gemini-enterprise-agent-platform/build/managed-agents
- CPSC 召回公告,2025-09-18,U.S. CPSC,2026-11-14 读取,https://www.cpsc.gov/Recalls/2025/Anker-Power-Banks-Recalled-Due-to-Fire-and-Burn-Hazards-Manufactured-by-Anker-Innovations-1
- Anker 产品召回页,Anker,2026-11-14 读取,https://www.anker.com/product-recalls
- Anker 全球自愿召回说明,Anker,2026-11-14 读取,https://www.anker.com/rc2506
- Gemini API 发布说明,2026-10-30,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#10-30-2026
- MCP 博客,2026-11-10,Model Context Protocol,2026-11-14 读取,https://blog.modelcontextprotocol.io/posts/exploring-file-uploads-and-downloads-in-mcp/
- Gemini API 发布说明,2026-11-11,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/changelog#11-11-2026
- MCP 博客:2026-07-28 版规范,Model Context Protocol,2026-11-14 读取,https://blog.modelcontextprotocol.io/posts/2026-07-28/
- MCP 规范:Transports,2026-07-28 版,Model Context Protocol,2026-11-14 读取,https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- Antigravity agent:支持的工具,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#supported-tools
- Hooks,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/agent-hooks
- Antigravity agent:能力,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent#capabilities
- 模板仓库,GitHub, google-gemini,2026-11-14 读取,https://github.com/google-gemini/gemini-managed-agents-templates
- AI Studio 里的 agent,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/aistudio-agents
- Antigravity agent,Google AI for Developers,2026-11-14 读取,https://ai.google.dev/gemini-api/docs/antigravity-agent
引用编号 BL-143