Liner Actions MCP:工具上千后怎么挑、花多少
Liner Actions MCP 用 4 个工具接 1,100 多个应用;574 项能力(540 项可用)收成 12 个工具、16,206 字节,附月费。
EveryInfra 的公开目录里有 106 个平台、574 项数据能力(其中 540 项可用),远程 MCP 把它们收成 12 个工具,我们在 2026 年 11 月 14 日 00:16(新加坡时间)读到的 tools/list 一共 16,206 字节。同样 574 项能力如果一项开一个工具,按目录字段拼出来的定义有 528,989 字节,约是现在的 33 倍。token 我们用 o200k 分词器估算(3,758 对 131,395),Claude 的实际计数会更高,所以由它算出的美元数都是下限:在 Sonnet 5.5 上不走缓存,574 个工具每轮光定义费至少约 $0.263,至少是一次 reddit/search 真调实扣 $0.000792 的约 330 倍。Liner Actions MCP 走的是同一条思路的极端版:4 个工具挡在 1,100 多个应用前面,模型先用英文搜动作,再执行。把写表、开工单这类动作交给它,读 Reddit、YouTube、Trustpilot 这类公开数据交给 EveryInfra:这次我们真调了 5 个计费接口,实扣合计 $0.004307。
11 月 4 日,r/mcp 上一条「MCP 工具多到几个以后 agent 会糊涂」的帖子拿到 21 条回复,答案五花八门:有人说过了 20 到 30 个错选就常见,有人说过了几百个才出问题,还有人说重叠的描述比数量更伤(r/mcp,2026-11-04)。一个 MCP 客户端挂进来的工具越多,模型每一轮要读的定义越多、要付的钱越多,选错一次的代价也各不相同。Liner 在 11 月发英文新闻稿的 Liner Actions MCP 代表「一个连接器管上千个应用的动作」;EveryInfra 的远程 MCP 代表「专门读公开平台数据」。Liner 一侧我们只读了文档、新闻稿和无登录时服务器的返回,没有登录 Liner 账号实跑,所以写表和开工单那一步全部标成「配置示例」;EveryInfra 一侧每个数都来自当晚的真实返回。本文和 Liner 没有任何合作关系。
liner actions mcp 是什么:4 个工具,后面 1,100 多个应用
Liner 是韩国的 AI 搜索公司。2026 年 9 月 29 日,韩国媒体报道它推出 Liner Actions MCP:AI agent 只连一次,就能用日历、Slack、Notion 等 1,100 多个外部服务(Digital Today,2026-09-29;VentureSquare,2026-09-29)。英文新闻稿在 11 月 3 日发出,标题里的数是「more than 1,100 verified apps」,正文说 Liner 把这些工具逐个调用过、确认能用,工具按需加载,系统不存用户数据,日志去标识化,Liner Actions MCP 和 Liner Actions API 目前免费,支持韩文和英文(VMblog 转载的新闻稿,2026-11-03)。11 月 11 日还有一篇分析稿把它和「每个应用单独接一个 MCP」做了对比(Efficiently Connected,2026-11-11)。按原文,首发是 9 月 29 日,英文新闻稿是 11 月 3 日。
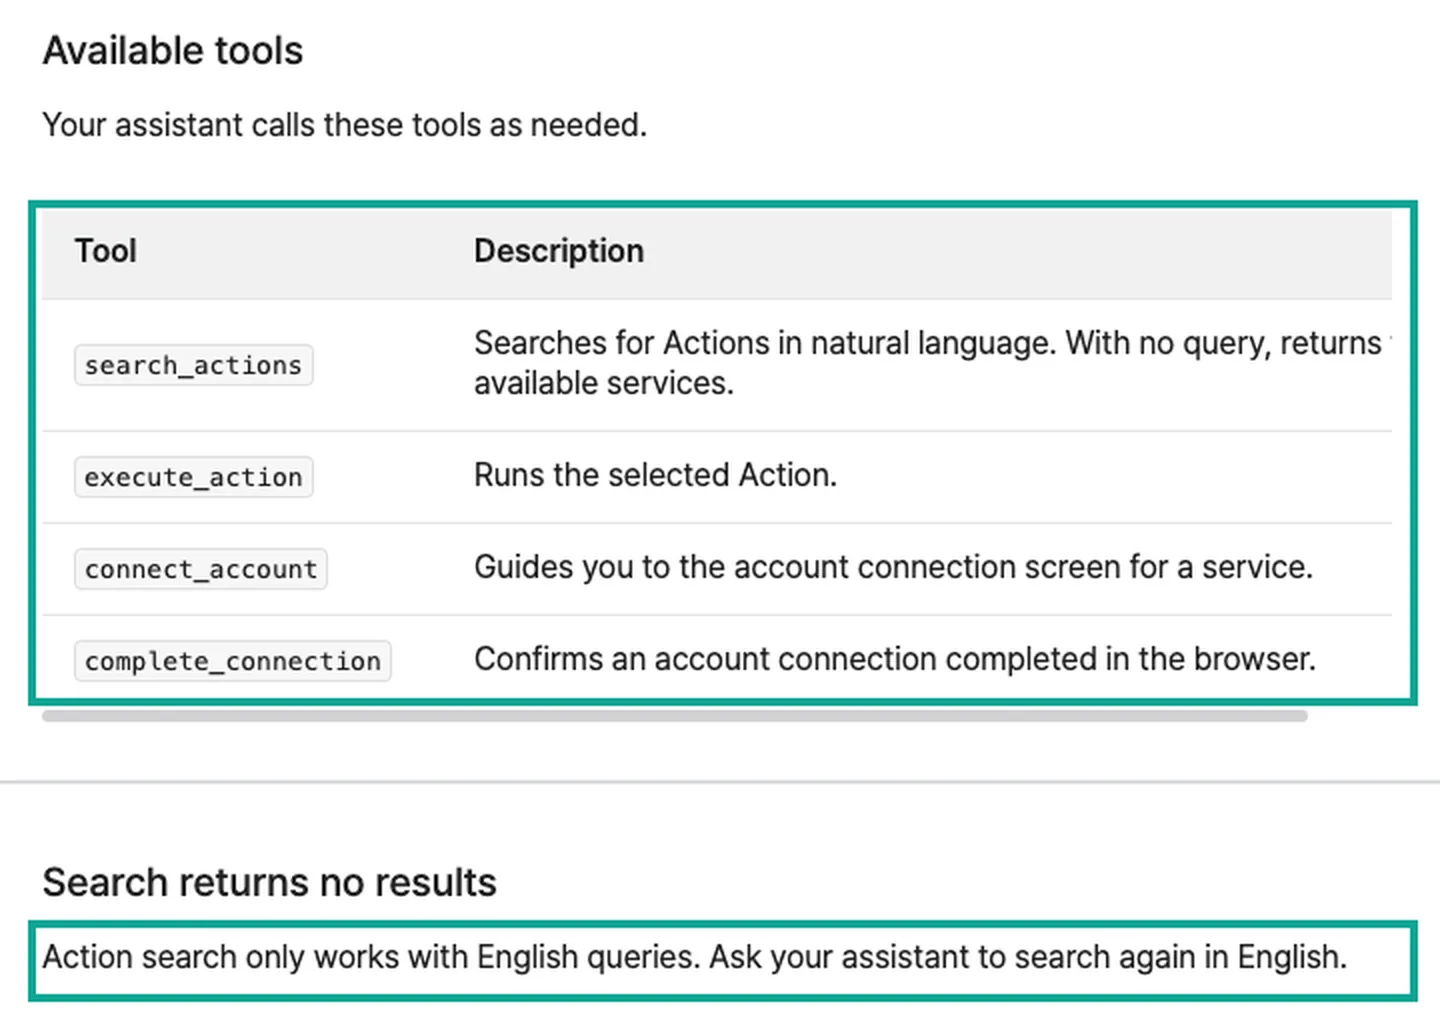
Liner 开发者文档里的 Actions MCP 页写得更具体(Liner Actions MCP 文档)。服务器只暴露 4 个工具:search_actions 用自然语言搜动作,不带查询时返回可用的服务清单;execute_action 执行选中的动作;connect_account 和 complete_connection 负责把你在某个应用里的账号连上。故障排查一节有三句话决定了它的用法:动作搜索只认英文查询;登录批准 30 天后过期,过期后请求会回 401;在浏览器里点完授权还不够,要让助手确认一次连接。我们在 00:15(新加坡时间)不带任何凭据向服务器发了一个请求,拿到的是 HTTP 401 和 {"error":"unauthorized"},响应头里的 resource_metadata 指向一份受保护资源元数据,写着授权服务器是 actions.liner.com、作用域只有 mcp。这正是 MCP 授权规范要求的发现方式(MCP 授权规范 2026-07-28;RFC 9728)。
接入方式按客户端分。Claude Code 用 claude mcp add 加一个 HTTP 服务器,作用域选 user,删掉时要带同一个 -s 值;Codex 用 codex mcp add liner-actions --url …,写进 ~/.codex/config.toml,然后 codex mcp login liner-actions 在浏览器里批准,再开一个新的 Codex 会话(运行中的会话不会重读配置)。ChatGPT 要先在「设置 › 安全与登录」打开开发者模式,再到 Plugins 里加 MCP 服务器、选 OAuth;文档写明这一入口对 Plus、Pro、Business、Enterprise、Edu 开放,但 Actions 的写操作只在 Business、Enterprise、Edu 套餐可用。OpenAI 自己的帮助文章也把「自定义 MCP 服务器」放在开发者模式下(OpenAI 帮助中心:在 ChatGPT 连接自定义 MCP 服务器;OpenAI 开发者文档:MCP)。
价格方面,新闻稿只说「目前免费」,没有写免费到什么时候、有没有调用上限。Liner 开发者定价页(2026-11-14 读取)列了 Tools API 每 1,000 次请求 $1、Agent API 每 1,000 次 $3,还写了 2026-11-10 起新开的账号买额度要加 5% 平台费,但没有 Actions 的条目(Liner 开发者定价)。所以本文的账单里,Liner 一侧按 $0 算,并在后面注明这一项要在用之前再核一次。
Liner 同时给了 MCP 和 API 两种接法,它的说明页把选择标准写得很清楚:你是把自己常用的 agent 接到自己的账号上,就用 MCP;你在做一个产品、要让每个用户连接自己的账号,就用 API,因为 API 允许你自己管理环境、用户和密钥,也能在没有浏览器的后台里跑。本文的场景是一个人或一个小团队在 Claude Code、ChatGPT 里用,所以选 MCP。换成 API 时,挑工具这件事就从 Liner 的服务器挪回到你自己的代码里:你从动作目录里排出候选,自己决定交给模型几个。
| 项目 | Liner 原文写的 | 出处与读取时间 |
|---|---|---|
| 名称 | Liner Actions MCP(另有 Liner Actions API) | 新闻稿 2026-11-03 |
| 发布 | 韩国 2026-09-29 首发报道;英文新闻稿 2026-11-03 | Digital Today、VMblog |
| 应用数 | 1,100 多个服务,逐个验证过 | 新闻稿;Actions MCP 文档 |
| 服务器 | actions.liner.com/api/v1/mcp,Streamable HTTP,OAuth 2.1 | 文档;00:15 新加坡时间无凭据请求回 401 |
| 暴露的工具 | 4 个:search_actions、execute_action、connect_account、complete_connection | Actions MCP 文档 |
| 怎么挑工具 | 先自然语言搜动作,只认英文;再执行 | Actions MCP 文档 |
| 登录有效期 | 批准 30 天后过期,回 401 后重登 | Actions MCP 文档 |
| ChatGPT | 开发者模式加服务器;写操作只限 Business、Enterprise、Edu | Liner 文档原文 |
| 价格 | MCP 与 API 目前免费;定价页未列 Actions | 新闻稿;定价页 2026-11-14 |
| 数据 | 不存用户数据,日志去标识化 | 新闻稿 |
它怎么挑工具:先搜、再给模型一份短名单
Liner 把「挑工具」拆成了两段。在 MCP 里,这件事交给 search_actions:模型用英文写一句「append a row to a Google Sheet」,服务器返回几条候选动作,模型再从里面挑一个执行。在给开发者的 Actions API 里,文档把同一件事写成了明确的步骤:按用户的请求给候选动作排序,只把一份小的短名单交给模型,原话是「Do not send the entire catalog」,也就是不要把整份目录发给模型(Liner Actions API:作为 LLM 工具使用)。同一页还写了三条和「选错」直接相关的规则:写入类和破坏性动作在第一次执行前要人确认;网络超时导致结果未知时不要自动重试,因为当前 API 没有公开的幂等键约定;返回 needs_connection 时不能当成动作没执行过,要先去对方应用里核对。快速上手页补了一条时间限制:needs_connection 返回的授权链接大约 15 分钟后失效,过期就重新调用 execute 拿一个新的(Liner Actions API 快速上手)。
这套做法和 Anthropic、OpenAI、微软在各自平台上推的「工具搜索」是一回事,只是位置不同。Anthropic 的 tool search 把工具标成 defer_loading,模型先调一个搜索工具(正则或 BM25 两种),每次拿回 3 到 5 个最相关的工具定义,单次请求最多可挂 10,000 个工具(Anthropic 工具搜索文档)。OpenAI 在 Responses API 里给 gpt-5.4 及以后的模型加了 tool_search,还建议用命名空间把工具分组,每组控制在 10 个函数以内(OpenAI 工具搜索指南)。微软 Foundry 的 Toolbox 给模型两个元工具 tool_search 和 call_tool,按 BM25 排序,默认返回 5 个、最多 10 个,文档建议工具超过 10 到 15 个时打开(Foundry Toolbox 概览;Foundry 工具搜索,2026-10-26)。区别在于:前三家是在客户端或模型平台一侧做搜索,你自己挂的每个 MCP 服务器照样把全部定义交上来;Liner 是在服务器一侧做,客户端看到的永远只有 4 个工具。
「只认英文」是这种服务器端搜索的一个代价。中文用户对 Claude 说「把这几条差评追加到表格里」,模型如果原样把中文丢给 search_actions,文档说的结果是搜不到;要么在提示里写明「搜索动作时一律用英文」,要么让模型先翻译再搜。Claude Code 文档对服务器作者也有一条类似的提醒:工具搜索按描述匹配时只读描述开头的一段,所以模型会用来搜的词要放在描述最前面(Claude Code MCP 文档)。
工具多了以后:模型选不准,多出来的定义每轮都要付钱
工具多带来两个问题,一个是准确率,一个是钱。准确率这边,公开数字都指向同一个方向。Anthropic 工具搜索文档写,Claude 的选择准确率在可用工具超过 30 到 50 个以后明显下降,并建议工具数达到 10 个或定义超过 10K token 时改用按需加载。Anthropic 在 2025 年 11 月 24 日的工程文章里给了两组测评:Opus 4 在开启工具搜索后从 49% 升到 74%,Opus 4.5 从 79.5% 升到 88.1%(Anthropic:高级工具使用)。学术界的结果类似:RAG-MCP 论文先用检索挑出候选工具再交给模型,选对率从 13.62% 升到 43.13%,提示词 token 少了一半以上(RAG-MCP,arXiv 2505.03275);LiveMCPBench 用 70 个服务、527 个工具测了 12 个模型,Claude-Sonnet-4 任务成功率 78.95%,多数模型只有 30% 到 50%,失败里约一半出在没检索到对的工具(LiveMCPBench,arXiv 2508.01780)。
论坛里的经验和这些数大致对得上,但更具体。11 月 4 日那条 r/mcp 帖子下,一位回答者说没有固定的数,错选通常在 20 到 30 个工具以后变多,描述互相重叠比数量本身更伤;另一位运行 9 到 10 个工具的人说,加了第二个读文件的工具那天,agent 就开始挑错。还有一位说他们的分界线是「几百个放在一张清单里」,模型开始按名字相似挑,不按要干的活挑,按领域分组、只加载用得上的那一组帮助最大。11 月 12 日有人拉了 50 个公开 MCP 服务器的 tools/list,发现 23 个服务器里至少三分之一的定义文字是同一段 schema 在每个工具上重复(r/mcp,2026-11-12)。
我们用 EveryInfra 的 reddit/search 搜「too many MCP tools」拿回 9 条帖子,用 youtube/search 搜同一个话题拿回 10 个视频。按发布周统计,19 条里有 16 条发在最近 7 周,11 月 9 日那一周最多,有 5 条。播放最多的一条视频是 10 月 6 日发的「Too many MCP tools? Anthropic found a solution.」,抓取时 37,239 次播放(YouTube),评论区里有人问「这个和缓存怎么配合」,有人说「挑哪个工具本身也是一次不确定的推理」,还有人说已经有现成的工具注册表在做同样的事。
Anthropic 的工具使用文档写得很直白:tools 参数里的名字、描述、schema 都算输入 token,开了工具还会自动加一段专门的系统提示(Claude 工具使用概览)。模型每一轮都要把这些定义重新读一遍,所以定义的成本是「每轮 × 轮数」。Anthropic 在那篇工程文章里举的例子是 5 个服务器、58 个工具,定义约 55,000 token;他们内部见过优化前 134,000 token 的情况;开了工具搜索以后整个会话的工具相关 token 降到约 8,700。拿本文的数对照:EveryInfra 12 个工具按 o200k 估约 3,758 token,不到 Anthropic 那个 58 个工具例子的十四分之一;按目录拼出的 574 个工具约 131,395 token,和他们见过的 134,000 token 是一个量级。
定义占多少上下文:EveryInfra 12 个工具 16,206 字节
EveryInfra 的远程 MCP 地址是 api.everyinfra.com/mcp。我们在 00:16(新加坡时间)带 Key 读了一次 tools/list,把每个工具的 JSON 按紧凑格式序列化,量字节数,再用 OpenAI 开源的 tiktoken 按 o200k 和 cl100k 两种分词器各数一遍(tiktoken)。结果是 16,206 字节、o200k 约 3,758 token、cl100k 约 3,728 token,平均每个工具约 313 token,约每 4.3 字节一个 token,和 tiktoken 文档说的「平均约 4 字节一个 token」一致。另外,握手时服务器还会发一段 3,993 字符(约 987 token)的使用说明;Claude Code 文档写,服务器说明和预先加载的工具描述各自只读前 4,096 个字符,v2.1.296 之前这个上限是 2,048,所以在旧版 Claude Code 里这段说明会被截掉后半段。说明和工具定义加起来是 20,218 字节、o200k 约 4,745 token,再加上 API 在带工具时自动附加的 286 token 系统提示,这是一个只挂 EveryInfra 的会话每轮固定要读的量。
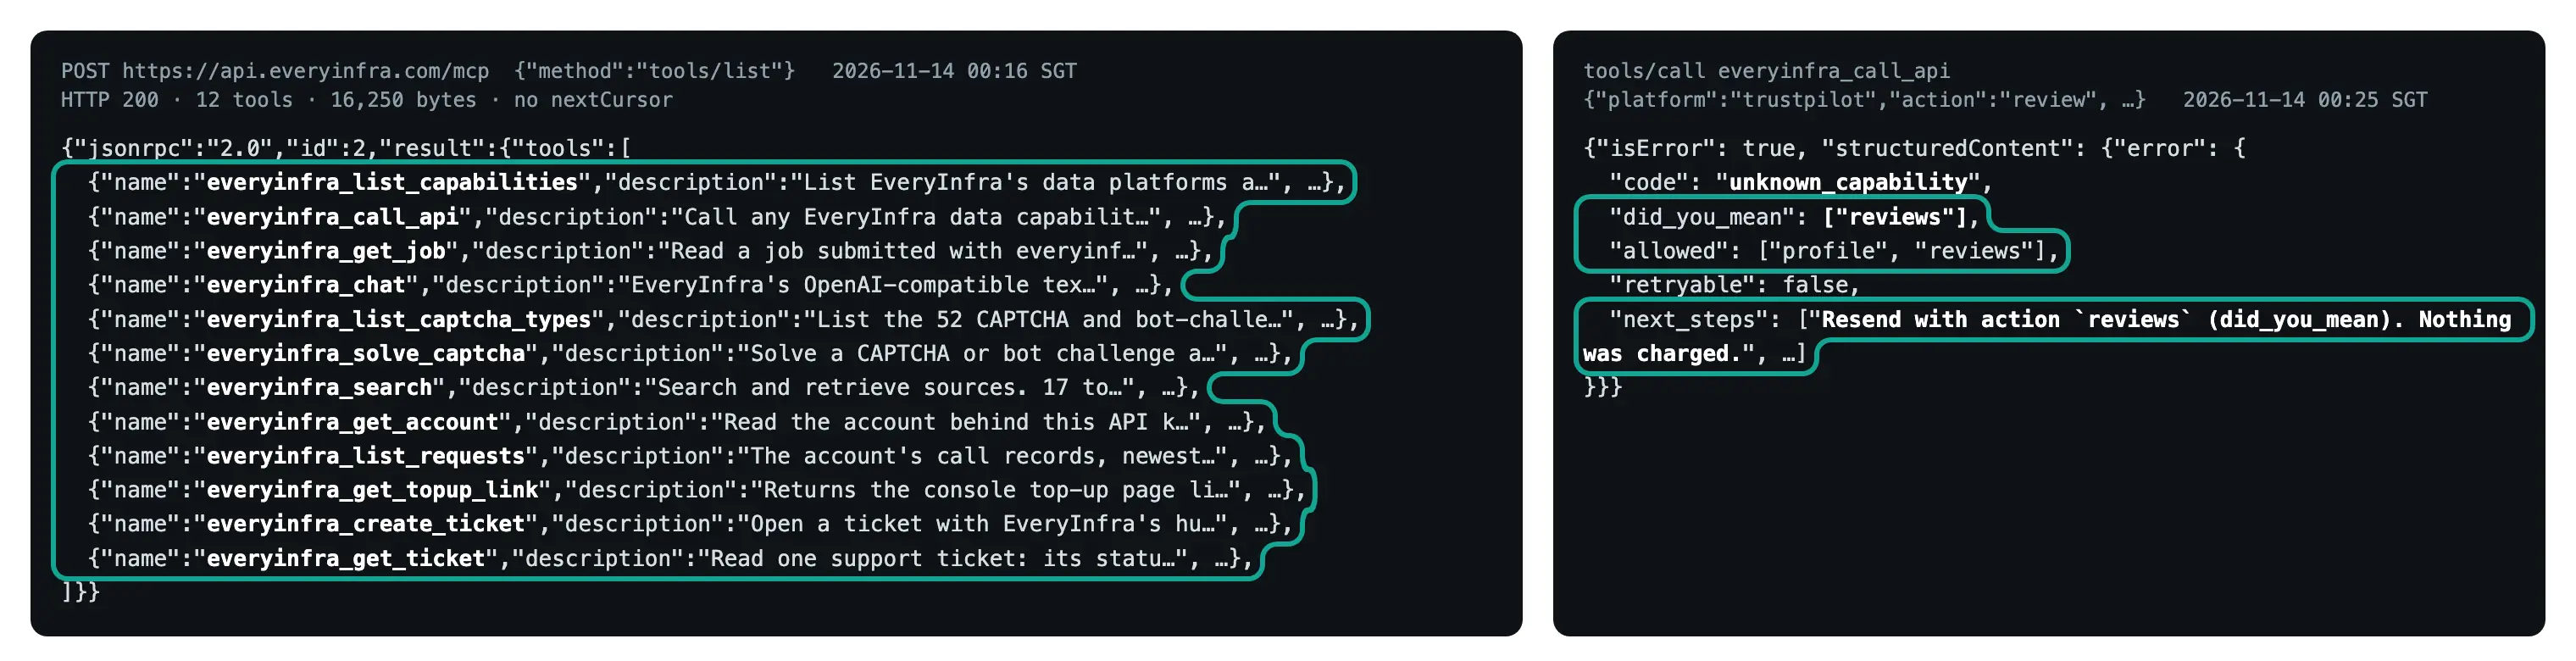
12 个工具里,和读数据直接相关的是四个:everyinfra_list_capabilities 查目录,everyinfra_call_api 调任意一项能力,everyinfra_get_job 取异步结果,everyinfra_search 做网页搜索。其余八个管账户、调用记录、充值链接、工单、验证码等。决定体积的主要是描述长度:最大的是开工单的工具,661 token,因为它要写明什么时候该开工单、要带哪些字段;最小的是取充值链接的工具,134 token。只读数据的那四个工具合计 5,825 字节、o200k 约 1,307 token,按字节占 12 个工具的 36%;客户端如果支持按工具启用,只开这四个,每轮固定要读的定义还能再少约三分之二。
| 工具 | 字节 | o200k token | 作用 |
|---|---|---|---|
| everyinfra_list_capabilities | 797 | 172 | 查目录:平台、能力、参数 |
| everyinfra_call_api | 1,657 | 392 | 调任意一项数据能力 |
| everyinfra_get_job | 777 | 170 | 取异步任务结果 |
| everyinfra_search | 2,594 | 573 | 网页、新闻等搜索 |
| everyinfra_get_account | 946 | 240 | 余额与账户状态 |
| everyinfra_list_requests | 1,204 | 270 | 查调用记录和退款 |
| everyinfra_get_topup_link | 578 | 134 | 生成充值链接 |
| everyinfra_create_ticket | 2,885 | 661 | 开工单 |
| everyinfra_get_ticket | 972 | 215 | 查工单 |
| 验证码相关 2 个 | 2,468 | 628 | 列类型、提交识别 |
| 其余 1 个 | 1,315 | 303 | 与本文无关 |
| 合计 12 个 | 16,206 | 3,758 | 00:16 新加坡时间读取 |
下面这段命令可以在你自己的机器上复现这些数,tools/list 本身不收费。tiktoken 的计数是估算,Claude 的分词器和它不同:Claude 定价页写,Claude 4.7 及以后的模型用的新分词器,同样的文本约多 30% token;只要请求里带了工具,API 还会再加一段工具使用系统提示,Sonnet 5.5 是 286 token(Claude 定价)。所以本文凡是由 o200k 估算算出的美元数,都是下限。要精确数,可以把同样的工具列表交给 count_tokens 接口(Claude token 计数文档)。
curl -s https://api.everyinfra.com/mcp \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Accept: application/json, text/event-stream' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}' > tools.json

uv run --with tiktoken python3 - <<'PY'
import json, tiktoken
tools = json.load(open("tools.json"))["result"]["tools"]
enc = tiktoken.get_encoding("o200k_base")
total_b = total_t = 0
for t in tools:
    s = json.dumps(t, ensure_ascii=False, separators=(",", ":"))
    b, n = len(s.encode()), len(enc.encode(s))
    total_b += b; total_t += n
    print(f"{t['name']:<34}{b:>7}{n:>6}")
print("total", len(tools), total_b, total_t)
PY
再做一个对照:如果 EveryInfra 不收工具,574 项能力每项开一个 MCP 工具,定义有多大。我们用公开目录 api.everyinfra.com/api/v1/social/catalog 里每项能力的名字、说明和参数(含参数说明、枚举值、默认值)拼出 574 个工具定义,一共 528,989 字节、o200k 约 131,395 token;每个工具的中位数是 185 token,90% 分位 374,最大的一个 1,281。只留工具名和参数类型、去掉全部说明的最省写法,也有 109,086 字节、约 24,811 token。这两个数都是我们按目录拼出来的假想定义,不是哪个真实服务器的返回,但足够说明量级:同一份能力,一项一个工具按字节比收成 12 个大约 33 倍(o200k 估算约 35 倍);最省的写法按字节也大约 6.7 倍,而且模型拿到的说明少了,更容易挑错。
两个细节说明估算的不确定性有多大。第一,分词器换一个,数就会变:12 个真实工具用 cl100k 数是 3,728,和 o200k 的 3,758 几乎一样;574 个假想工具用 cl100k 数是 146,004,比 o200k 多 11%,因为它们带了大量参数说明和枚举值。Claude 用的是第三种分词器,所以本文只把字节数当硬数,token 和美元都当估算。第二,按组装载也不是一定省:目录里能力最多的 10 个平台合计 185 项,占 574 项的 32%,其中抖音一个平台就有 38 项、TikTok 24 项、X 21 项。按每个工具中位数 185 token 粗估,单开抖音这一组约 7,000 token,已经比 EveryInfra 现在 12 个工具的全量大。分组能把 574 个工具拆小,但组的大小不均,大平台那一组照样要靠描述写得短、参数做成枚举来控制。
每轮要花多少钱:定义费可能比取数费还贵
把 token 换成钱,用 Claude 定价页 2026-11-14 读到的单价(Claude 定价):Sonnet 5.5 输入每百万 token $2,缓存命中 $0.10;Opus 5.5 输入 $4,缓存命中 $0.20;Haiku 5.5 在提示不超过 10 万 token 时输入 $0.10、缓存命中 $0.01,超过 10 万 token 按 $0.50 和 $0.05 算(单价存档于同日读取的定价页)。下面的 token 都按 o200k 估算,Claude 实际计数更高,所以每个美元数都是下限。EveryInfra 实际的 12 个工具在 Sonnet 5.5 上不走缓存每轮至少约 $0.0075,命中缓存至少约 $0.00038;假想的 574 个工具不走缓存每轮至少约 $0.263,命中缓存至少约 $0.013。作为对照,00:18 那次 reddit/search 真调实扣 $0.000792。也就是说,工具一项一个、又没有缓存时,模型每读一轮工具定义,花的钱至少够调约 330 次 reddit/search。
换模型时差距按单价等比放大或缩小。Opus 5.5 的输入单价是 Sonnet 5.5 的两倍,假想的 574 个工具不走缓存每轮至少约 $0.526;Haiku 5.5 便宜得多,但 131,395 token 超过了它 10 万 token 的计价线,单价从 $0.10 跳到 $0.50,每轮至少约 $0.066,仍至少是一次取数的 80 多倍;只留名字和参数类型的最省写法约 24,811 token,留在 10 万以内档,每轮至少约 $0.0025。EveryInfra 实际的 12 个工具在 Haiku 5.5 上不走缓存每轮约 $0.00038,命中缓存约 $0.00004(同样是下限),比任何一次数据调用都便宜。
缓存能省掉大部分,但有条件。Anthropic 的提示缓存按前缀匹配,工具定义放在最前面,只要工具列表一个字节都不变,后面每轮都按缓存价算(Claude 工具使用与提示缓存)。MCP 规范 2026-07-28 版在工具一节也写了,服务器返回 tools/list 时应保持确定的顺序,以提高提示缓存命中(MCP 规范:工具)。工具搜索把新发现的工具追加在已缓存前缀的后面,不打乱前缀,这也是 10 月 18 日那条讲工具搜索的视频里反复强调的一点(YouTube,2026-10-18)。视频作者给模型挂了 4 个 MCP 服务器、只让它存一个文件,结果大部分输入都是工具定义;开工具搜索后输入少了三分之一以上,但在只有几个小工具的配置里反而多花了钱,因为多了一轮搜索。规范本身也在按固定节奏演进:11 月 11 日 MCP 博客公布了新的发版节奏,下一版规范定在 2027-03-30(MCP 博客,2026-11-11;SEP-3398);同一天 Google 开源博客也谈到工具膨胀和渐进披露(Google 开源博客,2026-11-11)。
四档做法:从全部给模型,到一个 mcp tool router
把公开文档里的阈值排一排,大致是四档。工具不到 10 个、定义总量小的时候,一次全部给模型最省事,缓存命中后每轮成本很低。从 10 个工具或 10K token 起,Anthropic 建议开工具搜索;Claude Code 已经默认打开,只在会话开始时加载工具名和服务器说明,ENABLE_TOOL_SEARCH=auto 则是定义总量不到上下文 10% 时照旧全部加载、超过才延迟(Claude Code MCP 文档;Agent SDK 工具搜索)。几十到几百个工具时,服务器作者自己就该分组或收工具:GitHub 的 MCP 服务器提供 --toolsets,README 的原意是只打开需要的那几组能帮模型挑工具、也能缩小上下文(GitHub MCP Server);EveryInfra 则把 574 项能力收进一个 everyinfra_call_api,能力名作为参数,模型先查目录再调。上千个工具时,就只剩「搜索 + 执行」这一种形态:Liner 用 4 个工具管 1,100 多个应用;Uber 在 10 月 1 日的工程博客里写,他们内部的 MCP 网关面对 5,000 多个工具,让 agent 按需发现(Uber 工程博客,2026-10-01)。
「mcp tool router」这个词在搜索联想里出现,指的就是第三、四档:一层夹在模型和成百上千个工具之间的路由,负责把请求分到对的工具。做法有好几种。Composio 的 Tool Router 是托管服务,代 agent 搜索、鉴权、执行(Composio 文档);Zapier MCP 给 agent 的也是发现类工具,按它的用量文档,每次工具调用记 2 个 task,失败的调用不计,免费档每月 100 个 task,付费的 Professional 档从每月 $19.99 起(Zapier MCP 用量文档;Zapier 定价,2026-11-14 读取);学术上,JSPLIT 按类目层级先挑工具组(JSPLIT,arXiv 2510.14537),Dynamic ReAct 在调用过程中动态加载工具,报告最多少加载一半(Dynamic ReAct,arXiv 2509.20386)。Anthropic 的 Messages API 也可以直接连远程 MCP 服务器,并对每个工具设 enabled 和 defer_loading,相当于在请求里自己写一个简单的路由(Claude MCP connector)。
能力作参数的代价是:模型不能从工具名直接看出 EveryInfra 有哪 574 项能力,要么先调一次 everyinfra_list_capabilities 查目录,要么靠服务器说明和自己的记忆猜一个能力名。查目录多一轮对话,猜错就会碰到前面那种 unknown_capability。目录查询免费;写错能力名不扣费,返回允许值和最接近的候选。它和 Liner 的 search_actions 是同一类设计,只是 EveryInfra 的目录是固定的公开清单,模型可以按平台和能力名精确取,Liner 的目录要靠自然语言搜。
| 做法 | 谁在用 | 客户端看到几个工具 | 挑工具的方式 | 公开价格(读取日期) |
|---|---|---|---|---|
| 服务器端搜索 + 执行 | Liner Actions MCP | 4 个 | 英文自然语言搜动作 | 目前免费,未列价(2026-11-14) |
| 发现类工具 | Zapier MCP | 少数几个 | 搜能力、补参数、执行 | 每次成功调用 2 个 task;免费档 100 个/月(2026-11-14) |
| 托管路由 | Composio Tool Router | 少数几个 | 托管搜索与鉴权 | 见其定价页 |
| 平台工具搜索 | Anthropic、OpenAI、Foundry | 按需 3–10 个 | 正则或 BM25 | 按模型 token 计费 |
| 按组装载 | GitHub MCP toolsets | 打开的那几组 | 人工选组 | 免费开源 |
| 能力作参数 | EveryInfra MCP | 12 个 | 查目录后填能力名 | 按每次调用的 price_usd |
一个动作连接器配一个数据 MCP:两条道各管一半
把两个服务器挂进同一个客户端,分工很自然:动作类的事情交给 Liner,比如往 Google Sheets 追加一行、在 Linear 或 Jira 开一张工单、发一条 Slack;读公开平台的数据交给 EveryInfra,比如 Reddit 上的讨论、YouTube 评论、Trustpilot 评价。这样分的理由有三条。第一,两边加起来只有 16 个工具:EveryInfra 这边 16,206 字节(o200k 约 3,758 token),Liner 那边只有 4 个,模型每轮要读的定义量很小,Claude Code 默认的工具搜索也只在用到时才加载。第二,两边的失败方式不同:读数据失败了重来一次没有副作用,而且 EveryInfra 失败不扣费;写操作失败或结果未知时不能随便重来,Liner 的文档也是这么要求的。第三,数据这一侧要能按次计费、能看到每次扣了多少,EveryInfra 每个响应都带 charged_usd,调用记录可以用 everyinfra_list_requests 查。
下面是在 Claude Code 里同时加两个服务器的配置。EveryInfra 一侧我们用同样的地址和 Key 做过真调;Liner 一侧按它文档里的步骤写,我们没有用 Liner 账号跑过,属于配置示例。EveryInfra 的 Key 从快速开始拿,客户端的其他接法在 MCP 服务器页。
# 数据:EveryInfra 远程 MCP(真调用过)
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# 动作:Liner Actions MCP(配置示例,按 Liner 文档)
claude mcp add --transport http -s user liner-actions https://actions.liner.com/api/v1/mcp
# 第一次调用时浏览器会打开 Liner 的登录与批准页;30 天后需要重新批准
# 删除时带同一个作用域:claude mcp remove liner-actions -s user

# Codex 的写法(配置示例)
codex mcp add liner-actions --url https://actions.liner.com/api/v1/mcp
codex mcp login liner-actions
真调:一次用户反馈汇总的七个接口
为什么选这几项能力:Reddit 的讨论帖能看到用户自己描述的问题和解决办法,评论区常有更细的经验;YouTube 的教程视频播放量能反映一个话题有多少人在学,评论区是看的人卡在哪;Trustpilot 是付费用户写评价最集中的地方之一,一星和两星的评价多半和钱、客服有关。三者合起来,一边是使用中的问题,一边是付费中的不满,正好是产品团队每周想看的那张表。这次用到的五项能力,每次调用的价格都在 $0.0014 以内,失败和空结果不扣费。
我们拿一件具体的活来测:替一款 SaaS 产品收集最近的用户反馈,先读公开讨论,再把整理好的结果写进表格。数据这一半用 EveryInfra MCP 真调,时间是 2026-11-14 00:18 到 00:36(新加坡时间),每次都经 everyinfra_call_api 走 MCP 的 tools/call。话题选「MCP 工具太多」本身,因为它正好是本文要的材料;产品评价选 Notion 的 Trustpilot 页面,因为它是公开页、评价多、语言杂。
| 时间(新加坡) | 能力 | 参数要点 | 返回 | 实扣 |
|---|---|---|---|---|
| 00:16 | tools/list | 列出工具 | 12 个工具,16,206 字节 | 免费 |
| 00:18 | reddit/search | too many MCP tools | 9 条帖子 | $0.000792 |
| 00:20 | reddit/comments | r/mcp 帖子 1xnmicj | 16 条评论 | $0.000792 |
| 00:21 | youtube/search | MCP tool search | 10 个视频 | $0.000778 |
| 00:25 | youtube/comments | 视频 g87DYmwbzuo | 17 条评论 | $0.000556 |
| 00:25 | trustpilot / review(故意写错) | action 写成单数 | unknown_capability,did_you_mean reviews | $0 |
| 00:34–00:35 | trustpilot/reviews 异步 | notion.com,近 30 天 | 0 条 | 按空结果退回,$0 |
| 00:36 | trustpilot/reviews 异步 | notion.so,1–2 星,近 3 个月 | 16 条,52 秒 | $0.001389 |
最后实扣 5 次,合计 $0.004307;写错能力名的那次和返回 0 条的那次都没有扣费。
写错能力名的代价很小:模型把 reviews 写成 review,服务器在 1 秒内回 unknown_capability,结构化错误里带 allowed: ["profile","reviews"] 和 did_you_mean: ["reviews"],下一步提示写着重发 reviews、没有扣费,模型下一轮就能改对。这条返回只有 470 字节、约 119 token(o200k),按 Sonnet 5.5 输入价读一遍至少约 $0.00024,约是一次 reddit/search 实扣的十分之三,加上多出的一轮定义读取,写错一次的总代价仍在一分钱的零头里。Trustpilot 那两次异步请求的条件不同:notion.com、近 30 天,返回 0 条;notion.so、1–2 星、近 3 个月,返回 16 条。Notion 在 Trustpilot 上的主页地址是 notion.so(Trustpilot:Notion)。Trustpilot 评价这类要现抓的能力,我们用 "mode":"async" 提交,拿到 job_id 后用 everyinfra_get_job 轮询,这次 52 秒拿回结果。
{"jsonrpc":"2.0","id":17,"method":"tools/call","params":{
  "name":"everyinfra_call_api",
  "arguments":{"platform":"trustpilot","action":"reviews","mode":"async",
    "params":{"company":"notion.so","stars":["1","2"],"date":"last3months"}}}}
16 条评价发在 2026-08-23 到 2026-11-13 之间,13 条一星、3 条两星,来自 11 个国家。我们按标题和正文前两句人工判读,每条只定一个主类:计费、订阅和试用 7 条,客服 4 条,产品与 AI 功能变化 4 条,数据隐私 1 条。样本只有这 16 条,只能说明这三个月里 1–2 星评价在抱怨什么,不代表 Notion 全部用户。在这 16 条里,计费类 7 条全是一星;3 条两星里 2 条是客服、1 条是产品太杂。按月份看,9 月 7 条最多,11 月前两周已有 4 条;按国家看,英国 4 条,立陶宛和美国各 2 条,其余 8 个国家各 1 条。对产品团队来说,这几个切面比总条数更有用:一星集中在钱,两星集中在服务和上手。这张表就是第二步要写进表格或工单的内容;我们没有记录任何评价人的名字。
| 类别 | 条数 | 典型说法(转述) |
|---|---|---|
| 计费、订阅、试用 | 7 | 试用中途被取消;额度用完要另买;退款被拒 |
| 客服 | 4 | 商业版工单没人回;AI 额度被扣后不恢复 |
| 产品与 AI 功能 | 4 | 页面打不开;功能太杂;AI 功能无法关闭 |
| 数据隐私 | 1 | 数据被发给第三方模型,条款写在小字里 |
如果把这件活换成你自己的产品,只要换关键词、帖子编号、视频编号和 Trustpilot 域名。能力的参数和价格见 reddit/search、reddit/comments、youtube/search、youtube/comments 和 trustpilot/reviews;平台总览在 Reddit、YouTube、Trustpilot。
结果也占上下文:只留需要的字段
定义之外,工具的返回也进上下文,而且只进一次,但体积常常比定义大。我们把四次取数的原始返回文本按 o200k 数了一遍:reddit/search 9 条约 5,622 token,youtube/search 10 条约 5,696,reddit/comments 16 条约 3,636,youtube/comments 17 条约 1,625,合计约 16,579;Trustpilot 16 条另有约 6,027。只保留链接、标题、正文、时间和点赞(Trustpilot 换成评分)五个字段,四次合计降到约 11,157,少了 33%;Trustpilot 降到约 3,210。Claude Code 在单次 MCP 输出超过 10,000 token 时给警告,默认上限 25,000 token,可以用 MAX_MCP_OUTPUT_TOKENS 调;文字结果超过 50,000 字符时直接存成文件,只给模型一个路径(Claude Code MCP 文档)。所以在一次反馈汇总里,单次调用的 limit 定在 20 到 50 之间比较稳,既不会触发警告,也给模型留出了合并结果的空间。
把返回体积和取数价格放在一起看,差距更明显。下表按本次实际返回的条数算:每千条价格 = 实扣 ÷ 返回条数 × 1,000;读入费 = 返回的 o200k token × Sonnet 5.5 输入单价 $2 / 百万 token,只算第一次读入,所以同样是下限。五次合计,原样返回约 22,606 token,第一次读入至少约 $0.0452,是实扣 $0.004307 的 10.5 倍;只留五个字段后约 14,367 token、至少约 $0.0287,仍是 6.7 倍。差别最大的是两类搜索:reddit/search 每条帖子约 624 token,读一遍的钱是取数费的 14.2 倍;youtube/comments 每条评论只有约 95 token,只留字段后降到 1.9 倍。换句话说,在工具已经收紧以后,一次汇总里最大的一笔通常是模型读返回的钱,而不是数据接口的钱;limit 和字段筛选直接决定这笔账。
| 能力 | 本次返回 | 实扣 | 每千条 | 每条约 token | 读入费 ÷ 实扣(原样 / 只留字段) |
|---|---|---|---|---|---|
reddit/search | 9 条 | $0.000792 | $0.088 | 624 | 14.2 / 11.8 |
reddit/comments | 16 条 | $0.000792 | $0.050 | 227 | 9.2 / 7.1 |
youtube/search | 10 条 | $0.000778 | $0.078 | 569 | 14.6 / 8.0 |
youtube/comments | 17 条 | $0.000556 | $0.033 | 95 | 5.8 / 1.9 |
trustpilot/reviews | 16 条 | $0.001389 | $0.087 | 376 | 8.7 / 4.6 |
| 五次合计 | 68 条 | $0.004307 | — | — | 10.5 / 6.7 |
让模型挑得准:工具描述怎么写
工具数定下来以后,挑得准不准主要看描述。几份材料给出的写法可以合成一套检查。第一,模型会拿来搜的词放在描述最前面:Claude Code 文档说,工具搜索按描述匹配时只读较短上限以内的那一段,预先加载的工具和服务器说明各自只读前 4,096 个字符。第二,写清楚「什么时候用、什么时候别用」:11 月 4 日那条帖子的发帖人把每个工具描述改成「use this when… not for…」的句式,回答者认为方向对,因为相似描述之间的混淆比数量更常见。第三,去掉重复的 schema 文字:11 月 12 日那份 50 个服务器的统计里,有 23 个服务器至少三分之一的定义是同一段话的重复,这部分 token 每轮都在付钱,对挑工具没有帮助。第四,让错误信息能把模型带回正路:EveryInfra 在能力名写错时返回允许值和最接近的候选。
还有一条容易漏:模型得先「想到」去搜工具。11 月 4 日那条帖子下,一条 11 月 5 日的回复指出,模型不会为每件事都去搜工具,要在 AGENTS.md 一类的项目说明里写明「处理某类事情时先搜工具」;同帖另一位建议拿一组固定的提示词,在直接给全部工具和开工具搜索两种配置下各跑一遍,分别记下「没搜到」和「搜到了但调错」,因为检索可能在模型挑工具之前就已经失败。这和 LiveMCPBench 的发现一致:失败里约一半出在检索。动作类连接器还要多一条:Liner 只认英文查询,提示里要写明搜动作时用英文。
第二步写表或开工单(配置示例)
数据整理好以后,第二步交给动作道。下面这段是给 Claude 的提示和它预期会发出的调用,全部按 Liner 文档写成,我们没有登录 Liner 账号实跑,属于配置示例。提示里要写三件事:搜动作时用英文;写操作执行前先把要写的内容给人看;执行结果不明时不要重试,先去表格里核对。
你挂着两个 MCP:everyinfra(读公开数据)和 liner-actions(执行动作)。
1. 用 everyinfra_call_api 拉 trustpilot/reviews(company=notion.so,stars=["1","2"],date=last3months,mode=async),
   再用 everyinfra_get_job 取结果;只保留 url、title、text、posted_at、rating。
2. 按「计费 / 客服 / 产品 / 隐私」分类,每条一行。
3. 调 liner-actions 的 search_actions,查询词用英文:"append rows to a google sheet"。
4. 把将要写入的行数和前三行给我看,等我确认后再调 execute_action。
5. 如果 execute_action 超时或结果不明,不要重试;先读一次表格,确认有没有写进去。{"name":"execute_action","arguments":{
"action":"<search_actions 返回的 Google Sheets 追加行动作>",
"input":{"spreadsheet":"Notion 用户反馈 2026-11","rows":[
["2026-11-13","1","计费、订阅、试用","https://www.trustpilot.com/reviews/…"],
["2026-11-12","1","计费、订阅、试用","https://www.trustpilot.com/reviews/…"]]}}}这里有两点要提前想好。第一,Liner 的 execute_action 第一次碰到没连过的应用,会返回需要连接账号,模型要调 connect_account,你在浏览器里登录 Google,再回到对话让模型调 complete_connection 确认;Liner Actions API 文档写的授权链接约 15 分钟有效。第二,「重试」在两条道上的意义不同。EveryInfra 一侧失败不扣费;定时跑的汇总和会自动重试的调用,走 REST 并带 Idempotency-Key,同一个键重发只按一次请求处理,做法见幂等键那篇。Liner 一侧往表格追加一行,如果超时后自动重发,就可能写两行;Liner Actions API 文档写明目前没有公开的幂等键约定,只能靠写前确认和写后核对。
选错工具要付什么代价
把这次实测和文档里的规则合在一起,选错大致分三种,代价差别很大。读数据的那几种,代价是多一轮对话和几秒钟;写数据的那几种,代价可能是表格里多一行、工单多开一张,或者一封发错的消息。
| 选错的方式 | 本次实测或文档依据 | 直接花费 | 隐藏代价 |
|---|---|---|---|
| 能力名写错 | review 回 unknown_capability + did_you_mean,00:25 | $0,约 119 token 返回 | 多一轮,定义再读一遍 |
| 动作搜不到 | Liner 文档:只认英文查询 | 未公开 | 模型可能改用别的工具硬做 |
| 写动作挑错或重复执行 | Liner 文档:写前确认,结果未知不重试 | 未公开 | 写错表、重复工单,要人工清理 |
这张表里,第一行的代价我们量到了,后两行只能按文档推断。读数据一侧的错误有一个共同点:服务器能判断请求本身有没有问题,失败不扣费,所以模型多试一次只多花时间。写数据一侧的错误没有这个保护,动作一旦执行,外部系统的状态就变了,模型和连接器都不一定知道变成了什么样。Liner 文档要求写前确认、结果不明时先核对再决定要不要重来,原因就在这里。落到提示上,就是把「读」和「写」分给两个服务器之后,再给写的那一边加一道人工确认。
算一笔账:一次汇总和一个月
本次实跑 5 个计费接口,实扣 $0.004307,与目录价一致。下面按目录价推算一次完整汇总:两类评论各读两个帖子或视频,数据这一半是 7 次调用(reddit/search 1 次、reddit/comments 2 次、youtube/search 1 次、youtube/comments 2 次、trustpilot/reviews 1 次),按目录 price_usd 合计 $0.005655。模型这一半按 8 轮对话算(7 次工具调用加最后一轮回答),每轮都要读工具定义,token 按 o200k 估算、美元数是下限:EveryInfra 的 12 个工具在 Sonnet 5.5 上第一轮不走缓存 $0.0075、后面 7 轮命中缓存,合计至少约 $0.0101;如果同样的能力做成 574 个工具,合计至少约 $0.355。每天给 5 个产品各跑一次,一个月 150 次:数据费约 $0.85,12 个工具的定义费至少约 $1.52,574 个工具的定义费至少约 $53.2。这还没算工具返回和模型输出的 token,那部分两种做法一样多。首轮还有一个被低估的地方:要让后面 7 轮命中缓存,首轮得先写缓存,定价页写的 5 分钟缓存写入是输入价的 1.25 倍,Sonnet 5.5 是每百万 token $2.50,12 个工具的首轮因此至少约 $0.0094,而上面按 $2 算的是 $0.0075,所以表里的定义费又多了一层偏低。
| 项目 | 每次汇总 | 每月(5 个产品 × 30 天) | 依据 |
|---|---|---|---|
| EveryInfra 数据费(7 次调用,推算) | $0.005655 | $0.85 | 目录 price_usd;本次实跑 5 次实扣与目录价一致 |
| 12 个工具定义 · Sonnet 5.5(下限) | $0.0101 | $1.52 | o200k 估 3,758 token,首轮不缓存,其余命中 |
| 574 个工具定义 · Sonnet 5.5(下限) | $0.355 | $53.2 | o200k 估 131,395 token,同上 |
| 12 个工具定义 · Opus 5.5(下限) | $0.0203 | $3.04 | 单价翻倍 |
| 12 个工具定义 · Haiku 5.5(下限) | $0.00064 | $0.10 | 10 万 token 以内档 |
| Liner Actions MCP | $0 | $0 | 新闻稿称目前免费,用前再核 |
如果每周给 20 个产品各跑一次,数据费一个月约 $0.48(20 × 30/7 周 × $0.005655)。这些数里最容易变的是模型单价和 Liner 的价格,EveryInfra 的 price_usd 以发布当天的目录为准,价格页和目录一致。
用同一套数量一量你自己的配置
先对每个挂进来的 MCP 服务器跑一次 tools/list,用前面那段脚本数出字节和 token,把总数和 10K token、上下文 10% 这两条线比一比;超过了,就打开工具搜索,或者回头找服务器作者问有没有分组开关。再拿五到十条你每天真会说的请求,固定下来,在三种配置下各跑一遍:全部工具直接给、开工具搜索、只挂当前任务要用的那一两个服务器。每次记四个数:第一轮输入 token、工具调用次数、调错或没搜到的次数、最后结果对不对。最后按定价页的单价把 token 换成钱,和数据接口的账单放在一起看。
我们这次的结果给了一个参照:只挂 EveryInfra 一个服务器时,工具定义 16,206 字节(o200k 约 3,758 token);实测五次数据调用的返回原样约 22,606 token、只留五个字段约 14,367 token,按七次方案推算约 2.8 万和 1.8 万。返回的体积是定义的好几倍,所以在工具已经收得很紧的情况下,下一步该省的是返回,limit 和字段筛选比再砍工具更有效。反过来,如果你挂的是一个一项一个工具的服务器,定义每轮十几万 token,那就先处理定义,返回的那点体积可以放到后面。
做不了的、要注意的
Liner 一侧我们没有实跑,所以几件事只能按文档写:search_actions 一次返回几个候选、候选怎么排序、写操作失败时的错误格式,这些文档都没给出完整示例。新闻稿说「目前免费」,没有说免费期多长,开发者定价页也没列 Actions,正式用之前要再看一次。中文查询搜不到动作这一点要写进提示,否则模型可能在搜不到时改用别的工具硬做。ChatGPT 的 Plus、Pro 用户能把服务器加进来,但写操作要 Business 以上套餐,个人用户做第二步会卡住。
EveryInfra 一侧也有边界。Trustpilot 评价这类要现抓的能力,我们用异步模式提交再轮询。目录 574 项里有 34 项标着暂不可用,本文用的五项都是可用状态。本文的 token 都是 o200k 估算,Claude 的实际计数会更高,由它算出的美元数是下限,算钱前用 count_tokens 接口核一次。最后,工具少不等于一定选得准:EveryInfra 把能力放进参数,模型选错能力名的概率并没有消失,只是代价变成了一次不扣费的报错加一轮重发。
数据的去向也要想清楚。EveryInfra 返回的是公开页面上的内容,里面可能带评价人的名字和头像链接;写进团队表格或工单之前,最好像本文这样只留链接、时间、评分、正文和分类,把人名去掉。Liner 的新闻稿说它不存用户数据、日志去标识化,但表格和工单本身存在你的 Google、Linear 或 Jira 账号里,谁能看到这张表,要按你们自己的权限来定。
「每天重复的活走固定名单、长尾交给路由」的分流规则见 Monid 那篇,两个 MCP 合表见 Airbyte MCP 那篇,让子代理分担返回体积见 Claude Code 子代理那篇。
常见问题
mcp tool search claude code 怎么开、怎么关?
Claude Code 默认开启,MCP 工具延迟加载;ENABLE_TOOL_SEARCH=false 关闭,auto 表示定义不到上下文 10% 时照旧全部加载,auto:5 可改成 5%(Claude Code MCP 文档)。问题来自联想词「mcp tool search claude code」。
mcp tool router 是什么,和工具搜索有什么区别?
工具搜索是模型平台或客户端的功能,模型先搜再用;mcp tool router 一般指夹在模型和多个工具或服务器之间的一层,负责搜索、鉴权、执行,Liner Actions MCP、Composio Tool Router、Zapier MCP 都属于这一类。区别在于路由层自己维护工具目录,客户端只看到几个固定工具。问题来自派活关键词「mcp tool router」和联想词「mcp server too many tools」。
liner actions mcp 要钱吗?
Liner 11 月 3 日的英文新闻稿说 Liner Actions MCP 和 API 目前免费;开发者定价页 2026-11-14 没有列 Actions 的价格,只列了 Tools API 和 Agent API,正式用之前要再看一次定价页。ChatGPT 里的写操作另外要求 Business、Enterprise 或 Edu 套餐(Liner Actions MCP 文档)。问题来自派活关键词「liner actions mcp」,该词的联想词没有结果。
只有一两个 agent,上 MCP 是不是太重?
r/mcp 上 11 月 9 日有人这样问。工具少、定义小的时候,直接写几个函数交给模型更省;要跨客户端复用、要让 Claude Code、ChatGPT、Codex 共用同一套数据能力时,远程 MCP 的价值才出来。EveryInfra 的 REST 接口和 MCP 用同一个 Key、同一套价格,两种接法可以并存。问题来自 r/mcp,2026-11-09。
参考资料
- Liner Actions MCP,Liner 开发者文档,2026-11-14 读取,https://liner.com/developers/docs/actions-mcp
- Liner Developers 文档首页,2026-11-14 读取,https://liner.com/developers/docs
- Actions API Quick Start,Liner 开发者文档,2026-11-14 读取,https://liner.com/developers/docs/actions-api-quick-start
- Use Actions as LLM tools,Liner 开发者文档,2026-11-14 读取,https://liner.com/developers/docs/actions-api-guides-llm-tools
- Pricing,Liner 开发者文档,2026-11-14 读取,https://liner.com/developers/docs/pricing
- Liner Launches Actions MCP,VMblog 转载新闻稿,2026-11-03,https://vmblog.com/news/liner-launches-actions-mcp-connecting-ai-agents-to-more-than-1100-verified-apps-through-a-single-integration/
- Liner launches Liner Actions MCP,Digital Today,2026-09-29,https://www.digitaltoday.co.kr/en/view/108354/liner-launches-liner-actions-mcp-to-connect-1-100-apps-to-ai-agents
- Liner: Use 1100 Apps Once Connected to AI Agent,VentureSquare,2026-09-29,https://www.venturesquare.net/en/1116726/
- Liner Actions MCP: One Integration for 1,100 AI Agent Apps,Efficiently Connected,2026-11-11,https://www.efficientlyconnected.com/liner-actions-mcp-agent-integration/
- Tool search tool,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Pricing,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/about-claude/pricing
- Tool use with prompt caching,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-use-with-prompt-caching
- Tool use with Claude,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Token counting,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/build-with-claude/token-counting
- MCP connector,Claude 文档,2026-11-14 读取,https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- Connect Claude Code to tools via MCP,Claude Code 文档,2026-11-14 读取,https://code.claude.com/docs/en/mcp
- Tool search,Claude Agent SDK 文档,2026-11-14 读取,https://code.claude.com/docs/en/agent-sdk/tool-search
- Introducing advanced tool use,Anthropic,2025-11-24,https://www.anthropic.com/research/advanced-tool-use
- Tool search,OpenAI API 文档,2026-11-14 读取,https://developers.openai.com/api/docs/guides/tools-tool-search
- Model Context Protocol,OpenAI 开发者文档,2026-11-14 读取,https://developers.openai.com/codex/mcp
- Connecting custom MCP servers in ChatGPT,OpenAI 帮助中心,2026-11-14 读取,https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- Toolbox overview,Microsoft Foundry 文档,2026-11-14 读取,https://learn.microsoft.com/en-us/azure/foundry/agents/concepts/toolbox-overview
- Tool search,Microsoft Foundry 文档,2026-10-26,https://learn.microsoft.com/en-us/azure/foundry/agents/how-to/tools/tool-search
- Tools,MCP 规范 2026-07-28,https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- Authorization,MCP 规范 2026-07-28,https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- SEP-3398 Release cycle updates,MCP,https://modelcontextprotocol.io/seps/3398-release-cycle-updates
- MCP release cycle,MCP 博客,2026-11-11,https://blog.modelcontextprotocol.io/posts/mcp-release-cycle/
- RFC 9728 OAuth 2.0 Protected Resource Metadata,IETF,https://datatracker.ietf.org/doc/html/rfc9728
- github-mcp-server README,GitHub,2026-11-14 读取,https://github.com/github/github-mcp-server
- tiktoken README,GitHub,2026-11-14 读取,https://github.com/openai/tiktoken
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection,arXiv 2505.03275,https://arxiv.org/abs/2505.03275
- JSPLIT,arXiv 2510.14537,https://arxiv.org/abs/2510.14537
- LiveMCPBench,arXiv 2508.01780,https://arxiv.org/abs/2508.01780
- Dynamic ReAct,arXiv 2509.20386,https://arxiv.org/abs/2509.20386
- Zapier MCP usage,Zapier 文档,2026-11-14 读取,https://docs.zapier.com/mcp/overview/usage
- Zapier pricing,2026-11-14 读取,https://zapier.com/pricing
- Composio 文档,2026-11-14 读取,https://docs.composio.dev/docs
- Designing an MCP gateway,Uber 工程博客,2026-10-01,https://www.uber.com/us/en/blog/designing-mcp-gateway/
- Scaling AI agents with open standards,Google 开源博客,2026-11-11,https://opensource.googleblog.com/2026/11/scaling-ai-agents-open-standards-mcp-aaif.html
- How many MCP tools is too many before your agent gets confused?,r/mcp,2026-11-04,https://www.reddit.com/r/mcp/comments/1xnmicj/how_many_mcp_tools_is_too_many_before_your_agent/
- A lot of heavy MCP tool lists are the same schema block repeated,r/mcp,2026-11-12,https://www.reddit.com/r/mcp/comments/1xujtxy/a_lot_of_heavy_mcp_tool_lists_are_the_same_schema/
- Is using MCP too much if you've only got one or two agents?,r/mcp,2026-11-09,https://www.reddit.com/r/mcp/comments/1xrw28k/is_using_mcp_too_much_if_youve_only_got_one_or/
- Too many MCP tools? Anthropic found a solution.,YouTube,2026-10-06,https://www.youtube.com/watch?v=g87DYmwbzuo
- Why do MCP Tools Eat Your Context?,YouTube,2026-10-18,https://www.youtube.com/watch?v=4QuXrXoMVtM
- Notion reviews,Trustpilot,2026-11-14 读取,https://www.trustpilot.com/review/notion.so
- EveryInfra 数据能力目录,2026-11-14 00:16 新加坡时间读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra 远程 MCP 服务器,2026-11-14 00:16 新加坡时间读取,https://api.everyinfra.com/mcp
引用编号 BL-145