API 幂等键实测:AI agent 重试工具怎样不多扣费
同一 Key 重发 3 次只扣 1 次,改参数回 409,不带 Key 同步重发扣 2 次;附 20 次真调和两家 agent 框架的重试设置。
我们在 2026 年 11 月 9 日 00:17–00:22(新加坡时间)对 EveryInfra 数据接口真调了 20 次(另有 6 次被限速挡回,不扣费),专门测 AI agent 最常见的几种重发:带同一个 Idempotency-Key 原样重发 3 次,账户请求记录里只有 1 笔扣费($0.000556);同一个 Key 改了参数,接口回 409 idempotency_conflict,不执行、不扣费;第一次还在跑时重发,接口回 409 idempotency_in_progress 和 Retry-After: 5,等第一次跑完再发,0.13 秒拿回原结果。反过来,不带 Key 把同一个同步请求发两次,就是两笔扣费,而且两次返回的内容还不一样(第一次 1 条、第二次 2 条)。再拿耗时算:OpenAI Agents SDK 的 MCP 读超时默认 5 秒,而测试账户 30 天的成功调用里至少 22.1% 超过 5 秒,在一批偏慢的 10 小时样本(314 次)里是 66.6%。也就是说,一个不带 Key、超时就盲发的 agent,会让五分之一到三分之二的成功请求再付一次钱;Python 用户装官方 SDK 就自动带 Key,这笔钱可以直接省掉。
这篇文章要回答的问题很窄:AI agent 会重试工具调用,原因可能是超时、断线,也可能是模型自己觉得第一次没成功又调一次。agent 调 EveryInfra 的数据接口时,怎样做到不重复扣费、不重复处理?下面每个数都来自写稿当天的真调原始返回、测试账户的请求记录,或者官方文档原文。Claude Code 和 OpenAI Agents SDK 一侧我们只读了官方文档和更新日志,没有在本机跑这两个客户端,所以凡是那一侧的配置都写成「配置示例」。
先看结论:19 次真调,9 种情况各回了什么
先把全部真调摆在一张表里,后面每一节再拆开讲。所有请求都打到 POST https://api.everyinfra.com/api/v1/social,能力是 reddit/search 和 twitter/search,目录单价都是每次 $0.000556(目录原文)。「实际扣费」一列不看响应里写了什么,而是用测试账户的请求记录(GET /portal/api/logs)逐个 request_id 核对:只有记录里 charged=true 的那一行才算一笔钱。这样做是因为回放响应里的 billing 是第一次的原样,charged: true 和 charged_usd: 0.000556 都还在,只看响应很容易误以为又扣了一次。
| 情况 | 新加坡时间 | 发了几次 | 返回 | 实际扣费 |
|---|---|---|---|---|
| 同一个 Key 原样重发(含调换参数顺序) | 00:17:18–00:17:37 | 3 | 200、200 回放、200 回放 | 1 次 $0.000556 |
| 同一个 Key 改参数(limit 10 改成 5) | 00:17:44 | 1 | 409 idempotency_conflict | 0 |
| 第一次还在跑时重发 | 00:18:02–00:18:28 | 3 | 200(23.4 秒)、409 进行中、200 回放 | 1 次 $0.000556 |
| 422 参数错误后用同一个 Key 改对再发 | 00:19:47–00:20:02 | 2 | 422、200 | 1 次 $0.000556 |
| 空结果后用同一个 Key 重发 | 00:20:15–00:20:26 | 2 | 200 count 0、200 回放 count 0 | 0 |
| 不带 Key 同步重发 | 00:19:02–00:19:14 | 2 | 200(1 条)、200(2 条) | 2 次 $0.001112 |
| 不带 Key 异步重发(5 分钟内) | 00:19:31–00:19:40 | 2 | 202、202 回放 | 1 次 $0.000556 |
| MCP 同步重发(没有 Key 参数) | 00:20:40–00:21:52 | 2 | 200、200 | 2 次 $0.001112 |
| MCP 异步重发(5 分钟内) | 00:21:06–00:22:11 | 2 | 200 job、200 回放 | 1 次 $0.000556 |
表里 19 次请求,9 笔扣费,合计 $0.005。另有两类请求不在表里:00:17:11 一次 Key 格式校验(422,不扣费,见后文),以及被每分钟 10 次限速挡回的 6 次(REST 4 次 429,MCP 2 次 rate_limited),它们都不扣费。多出来的两笔钱,全部出在「没带 Key 的同步重发」上:一次走 REST,一次走 MCP。这是全文最重要的一个观察:只要带了 Key,或者走异步,重发再多次也只付一次;最贵的错误是同步调用、不带 Key、超时就再发。
ai agent tool call retry 从哪来:超时、断线、模型自己再调
在讲接口规则之前,先把 agent 为什么会重发拆清楚,因为三种来源要用不同的办法挡。第一种是客户端超时。agent 框架给每次工具调用设了一个等待上限,到点没等到响应就当失败处理。问题在于超时只说明「我没等到」,不说明「对方没做」。这条请求很可能已经到了服务端,正在跑,跑完照样扣费。MCP 规范在取消一节里写得很直白:取消通知可能在请求处理完、甚至响应已经发出之后才到,双方都必须能处理这种先后错位(MCP 规范 2026-07-28 版 Cancellation)。
第二种是连接中途断开。Claude Code 的错误手册专门有一条「MCP server connection closed before the tool call was answered」:连接在服务端回答之前断了,Claude Code 判断不了工具到底跑没跑,原文提醒「重复调用可能会重复工具的动作」,所以它只在服务端把工具标成可以安全重复时,才自己再发一次(Claude Code 错误参考)。这条规则是 2026 年 10 月 21 日的 2.1.307 版加上的,更新日志原话是修复了连接中途关闭时 HTTP MCP 工具调用被发两次的问题,现在只重试只读或幂等的工具(Claude Code 更新日志,GitHub 上的同一份 CHANGELOG)。换句话说,在这个版本之前,客户端自己就可能把一次付费调用发两遍。
第三种最难防:模型自己再调一次。工具返回了一个模型看不懂的结果、一个超时错误文本,或者干脆什么都没回,模型会觉得「刚才没成功」,于是用同样或者稍微改过的参数再调一次。Reddit 上 r/LangChain 一个讨论帖里,有人提到工具出错却没给模型可读的反馈时,模型会卡在原地反复重试,另一位开发者说他的 agent 拿不到预期形状的结果就会一直敲同一个工具(讨论帖);r/LLMDevs 上 2026 年 10 月 28 日的一个帖子更直接,标题就是 agent 整晚都在重试一个失败的工具调用,第二天早上看账单才发现(原帖)。这一类重发,框架层面的重试开关管不到,只能靠接口本身认出「这是同一件事」。


这三种来源的共同点是:客户端在重发的那一刻,都不知道第一次的结果。幂等键要解决的正是这个「不知道」:客户端给一次逻辑上的请求起一个名字,不管发多少遍都用这个名字,服务端看到同一个名字就只做一次,并且把第一次的结果交回去。Stripe 的文档把这件事讲成「出现连接错误时可以安全地重复请求,不会创建第二个对象」(Stripe Idempotent requests);IETF 正在推进的 Idempotency-Key 请求头草案,2026 年 10 月 22 日刚更新到第 08 版,目标就是把这个头标准化,让 POST 这类本来不幂等的方法也能容错(draft-ietf-httpapi-idempotency-key-header-08)。草案对两种重发分别建议了状态码:第一次还没处理完就重发,回 409;同一个 Key 配了不同的请求体,回 422。EveryInfra 的进行中也是 409,和草案一致;参数不同时用的是 409 加 idempotency_conflict 错误码,不是 422,所以写客户端时要按错误码分辨,不能只看状态码。按 RFC 9110 的定义,GET、PUT、DELETE 是幂等的,POST 不是,而几乎所有数据接口的查询都是 POST。
api idempotency key 在 EveryInfra 怎么用:规则原文和返回码
EveryInfra 的规则写在面向开发者和 AI 的完整说明里(llms-full.txt 的 Retries and idempotency 一节),OpenAPI 文档里也有同样的头和错误码(openapi.json),站内的 文档页 是同一套。我们先把三处逐条比了一遍,说法一致,然后再用真调验证每一条。归纳下来是这几条:POST /api/v1/social 接受 Idempotency-Key 请求头,取值是 1 到 255 个可见 ASCII 字符,不能有空格;一个逻辑请求用一个新 Key;同步调用 24 小时内用同一个 Key 原样重发,拿回第一次成功的响应,billing 不变,不再执行也不再扣费,响应体里多一个 replayed: true,响应头多一个 Idempotent-Replayed: true。
| 你发出的 | 接口返回 | 扣不扣费 | 下一步该做什么 |
|---|---|---|---|
| 新 Key,第一次 | 正常 200 或 202 | 成功且有数据才扣 | 保存 Key 和 request_id |
| 同一个 Key、同样参数,24 小时内 | 200,replayed true,响应头 Idempotent-Replayed | 不再扣 | 直接用结果 |
| 同一个 Key、参数不同 | 409 idempotency_conflict,retryable false | 不扣 | 新请求换新 Key |
| 同一个 Key,第一次还在跑 | 409 idempotency_in_progress,Retry-After | 不扣 | 按秒数等,再原样发 |
| Key 格式不对(有空格或超 255) | 422 invalid_idempotency_key | 不扣 | 改 Key 格式 |
| 第一次失败(参数错、余额不足、限速、失败已退款) | 原错误码 | 不扣 | Key 已释放,下次会真跑 |
| 504 response_timeout 或 502 response_interrupted | 外层网关返回,request_id 以 cf- 开头 | 可能已扣 | 用同一个 Key 再发 |
| 503 refund_outcome_unknown 或 submission_outcome_unknown | 结果还在确认 | 未知 | 不要再发,留着 request_id 稍后查 |
最后两行特别值得 agent 开发者注意。文档写明,接口没在 100 秒内回答时,外层会回 504 response_timeout,并直接建议「它可能还会完成,所以用同一个 Idempotency-Key 再发」;连接被切断时回 502 response_interrupted,建议也一样。而 503 refund_outcome_unknown 和 503 submission_outcome_unknown 恰恰相反,意思是扣费或提交的结果还在确认,文档要求不要再发,留着请求编号或 job_id 过一会儿再查。一个只会「出错就重试」的 agent,在这两种 503 上会做错事;一个会读 retryable 字段的 agent 不会。每个错误体都带 fault、retryable、retry_after 和 next_steps,这是专门写给模型读的。
下面是一次带 Key 的最小请求。Key 用什么格式由你定,我们测试时用的是「前缀 + 运行编号 + 场景名」,生产里建议用 UUID:RFC 9562 定义的 UUIDv7 带时间戳、按时间排序,存进数据库做索引比随机的 UUIDv4 友好;Stripe 也建议用 V4 UUID 或足够随机的字符串,并提醒不要把邮箱这类个人信息放进 Key。
# 一个逻辑请求一个 Key;超时、断线后重发时 Key 和请求体都不变
KEY="agent-run42-step7-$(uuidgen)"
curl -sS https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $KEY" \
  -d '{"platform":"reddit","action":"search","params":{"keyword":"idempotency key","limit":10}}' \
  -D - | grep -i -E "^(HTTP|idempotent-replayed|retry-after|x-request-id)"
实测一:同一个 Key 原样重发,3 次只扣 1 次
00:17:18(新加坡时间)我们发出第一次请求:reddit/search,关键词「idempotency key」,limit 10,带 Key。4.4 秒后返回 200,count 3,id 是 req_876177aa43924339,billing.charged_usd 是 0.000556。三条结果里最新的一条发于 2026 年 11 月 3 日(新加坡时间),标题叫「Idempotency keys look simple. 5 cases that break a naive implementation」,内容和本文正好是一个题目。00:17:30 用同一个 Key、同一个请求体再发,0.116 秒回来,HTTP 200,响应头 Idempotent-Replayed: true,响应体 replayed: true,id 还是 req_876177aa43924339,三条结果一字不差。00:17:37 第三次,我们故意把 JSON 里的字段顺序全部调换(先写 params 再写 action 和 platform,params 里先写 limit 再写 keyword),0.142 秒回放,结果相同。
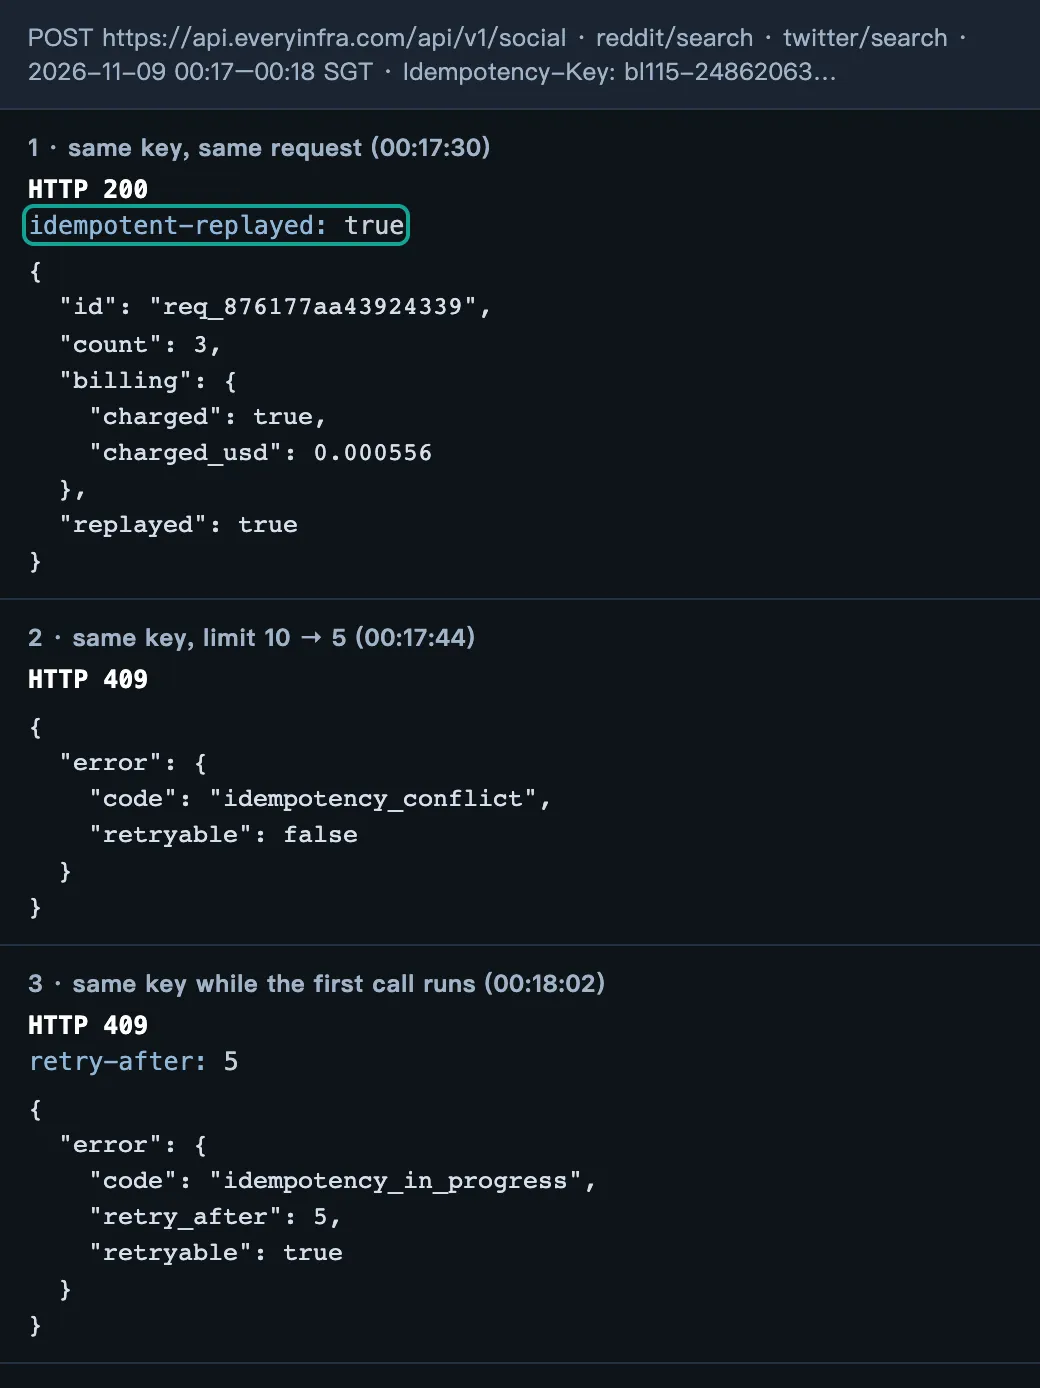
这三次里有两个细节,文档没写,但对写客户端的人很重要。第一,回放响应的 X-Request-Id 响应头是新的(第二次是 req_cce7840d402b4dc1),而响应体里的 id 是第一次的。所以如果你的日志按响应头记请求编号,会看到三个不同的编号;如果按响应体的 id 记,就是同一个。对账时应该以响应体 id 为准,响应头的编号只用来追查这一次网络往返。第二,回放响应的 billing 完全照抄第一次,连 balance_after_usd 都是第一次扣完后的余额。如果客户端拿每次响应的 charged_usd 累加成本,带 Key 重发三次就会算成三倍。正确的做法是看到 replayed: true 就不累加,或者干脆以 GET /portal/api/logs 的记录为准。我们核对了请求记录:这三次在记录里只有一行 req_876177aa43924339,charged=true,金额 $0.000556。
参数顺序调换也能回放,说明接口比较的是请求的内容,而不是原始字节。这对 agent 很重要:模型重新生成一次工具调用参数时,JSON 字段的顺序经常会变,如果服务端按字节比较,同一个意图会被当成「同 Key 不同参数」,直接 409。Stripe 的说法是幂等层会比较新请求和原请求的参数,不一样就报错,防止误用(Stripe 原文);我们实测下来,EveryInfra 在「不一样」的判断上不把字段顺序算进去。
实测二:同一个 Key 改了参数,回 409 不执行
00:17:44 用同一个 Key,只把 limit 从 10 改成 5,0.146 秒回 409 idempotency_conflict。错误信息原文是这个 Key 在最近 24 小时里已经用于另一个请求(platform、action 或 params 不同),新请求要用新 Key;retryable 是 false,next_steps 里写着 Nothing was charged。账户记录里这次没有扣费行。
这个设计看起来严格,其实是在保护 agent。设想一个场景:模型第一次调 reddit/search 时 limit 写了 10,超时了;重试时模型「顺手」把 limit 改成 5。如果接口把第二次也当成「同一件事」回放第一次的结果,agent 会拿到 10 条却以为是 5 条;如果接口把它当成新请求执行,Key 就失去了意义。直接拒绝是最安全的:它告诉客户端「你现在发的已经不是原来那件事了」。Square 的文档也是同一个做法:同一个 Key 改了请求内容就报错,并注明各接口的行为可能不同(Square Idempotency)。实际写 agent 时,这条规则带来一个硬要求:Key 必须由框架或工具封装层在调用前生成并固定,而不是交给模型每次重新写。r/LangChain 上一个 2026 年的讨论里,有人把这个说得很准:Key 要在调用发出之前生成并存好,每次重试都复用它(讨论帖)。
实测三:第一次还在跑时重发,拿到 409 和 Retry-After
这是 agent 场景里最常见、也最容易出事的情况:客户端 5 秒就放弃了,服务端还要跑 20 多秒。我们挑了一个慢一点的能力 twitter/search(关键词同上,limit 20),第一次请求发出后 2.5 秒用同一个 Key 再发。第一轮两个请求都撞上了这把测试 Key 每分钟 10 次的限速(00:17:55 和 00:17:57 两次 429,分别要求等 5 秒和 3 秒,这两次不扣费,也不占用 Key),等过限速后,00:18:02 两个请求几乎同时发出:第一次跑了 23.4 秒,返回 200、count 20、扣费 $0.000556;重发的那次只用了 0.107 秒就回来了,状态码 409,错误码 idempotency_in_progress,响应头 Retry-After: 5,retryable true,max_retries 3,原文是「使用这个 Key 的第一次请求还在跑,5 秒后再原样发一次就能拿到它的结果」。00:18:28 第一次跑完后再发,0.131 秒回放,拿到同一个 id 和 20 条结果。
这一节的结论有两层。第一层是钱:三次请求,一笔扣费,在跑时的那次重发既没有启动第二次搜索,也没有扣费。第二层是行为:409 进行中是一个「请稍等」,不是「失败」。通用重试库对 409 的处理并不一致:OpenAI Python SDK 的 README 写明连接错误、408、409、429 和 500 以上默认重试 2 次,409 在名单里;AWS SDK 的重试说明 按错误类别判断,只重试瞬时错误(如网络超时)和限速错误,409 不属于这两类。前一种在 idempotency_conflict 上也会白白重发两次,后一种在 idempotency_in_progress 上会直接放弃。所以给 agent 写工具封装时,不要依赖库的默认行为:把 idempotency_in_progress 单独拿出来,读 Retry-After,按秒数等,再用同一个 Key、同一个请求体原样发;把 idempotency_conflict 明确列为不重试。错误体里的 max_retries: 3 也给了一个上限参考,等三轮还没完,就该改走异步查任务了。
失败和空结果不扣费:422 之后 Key 被释放
文档的总原则是「只有调用成功并且返回了数据才扣费,失败、空结果和被拒绝的请求都免费」。我们用两组请求验证这句话,并顺便看 Key 在失败之后的状态。00:19:47 带 Key 发一个错误参数:reddit/search 的 sort 写成 bestest。0.113 秒回 422 invalid_value,错误体里有 param: sort、allowed 列出 6 个合法值(controversial、newest、popular、relevance、rising、top),还有 catalog_url 指向目录。这种结构化错误就是给模型改参数用的。00:20:02 用同一个 Key 把 sort 改成 top 再发:如果 Key 还被第一次占着,这次应该回 409 conflict;实际是 200、真跑了一次、扣了 $0.000556。这验证了文档那句「第一次没成功,Key 就释放,下一次真跑」。
空结果那组更有意思。00:20:15 带 Key 搜一个不可能有结果的关键词,4.3 秒后返回 200、count 0、charged: false、charged_usd: 0,billing.reason 是 empty_result_refunded,另有一个 refund.status: succeeded。00:20:26 用同一个 Key 重发,0.12 秒回放,依然是 0 条、0 元。也就是说,空结果算「成功完成」,Key 不会被释放;24 小时内同一个 Key 再发只会拿到同一个空结果。对 agent 来说这意味着:如果你真想在几分钟后重新搜一遍(比如等新帖出现),要换一个新 Key,不然拿到的永远是缓存的空结果。另外,我们在写稿前先测了 Key 本身的格式校验:00:17:11 发了一个带空格的 Key,回 422 invalid_idempotency_key,原文要求 1 到 255 个可见 ASCII 字符、不能有空格,同样不扣费。
把测试账户近 30 天的统计拿出来看,这条规则的分量更清楚。2026 年 10 月 10 日到 11 月 8 日(UTC),这个账户一共 8,201 次调用,成功 7,449 次,空结果 245 次(2.99%),失败 752 次(9.17%),失败里 668 次是服务端原因、61 次是限速、8 次是请求本身的问题,其余 15 次没有分类(GET /portal/api/quality?days=30)。这约 12% 的空结果和失败都没有扣费。所以对 agent 来说,「失败了重试」本身几乎不花钱;真正花钱的是另一种重试:第一次其实成功了、而且已经扣费,只是客户端没等到。
不带 Key 会怎样:同步扣两次,异步 5 分钟内合并
00:19:02 和 00:19:14,我们不带 Key 发了两次一模一样的同步请求(reddit/search,关键词「agent retry duplicate charge」,limit 5)。结果是两个不同的 id(req_00b3776d1bb5491c 和 req_a744369a248d4463),两笔扣费,各 $0.000556。更要看的是内容:第一次返回 1 条(一个 10 月 26 日的帖子),第二次返回 2 条,而且是完全不同的两个帖子(一个 10 月 28 日、一个 10 月 13 日)。同一个查询 12 秒之内结果就变了,原因是社交平台的搜索本身就不稳定:排序、索引更新、个性化都会让结果漂移。这说明不带 Key 的重发不只是多花钱,还会让 agent 拿到两份互相矛盾的数据。如果 agent 把两次结果都写进下游表,就是重复处理;如果只保留后一次,前一次扣的钱就白花了。带 Key 回放的价值正在这里:它给的是「第一次的那份」,同一件事只有一个答案。
异步提交的规则不一样。00:19:31 不带 Key 发一个 "mode": "async" 的请求,1.8 秒回 202、status: running、给了 job_id 和 poll_url;00:19:40 同样不带 Key 再发一次,0.148 秒回 202,replayed: true,job_id 和第一次相同,响应体的 id 是新的(req_4832d1bbe32943e8)。账户记录里只有第一次那一行扣费。文档写的是:没有 Key 时,同一个 5 分钟窗口里一模一样的异步提交会按同样的方式合并。轮询 GET /api/v1/jobs/{job_id} 不收费,也不占每分钟的限额;我们 00:20 左右轮询这个任务,状态已经是 succeeded,billing_state 为 charged、refund_state 为 not_applicable。
这给出了一条很实用的规则:如果你的 agent 框架没办法加请求头(有些托管平台的 HTTP 工具只让你填 URL 和请求体),或者你走的是 MCP,把慢能力改成异步提交,就自动获得 5 分钟的去重窗口。代价是多一步轮询,好处是连超时都不太会发生,因为异步提交本身在 2 秒内就返回。
MCP 一侧:everyinfra_call_api 没有幂等参数,怎么办
很多 agent 不直接调 REST,而是通过远程 MCP 连 https://api.everyinfra.com/mcp。00:14(新加坡时间)我们读了这个端点的 tools/list 原文:一共 12 个工具,取数据的主工具 everyinfra_call_api 的输入参数只有 platform、action、params、mode 四个,没有幂等键;而开工单的 everyinfra_create_ticket 是有 idempotency_key 参数的。工具注解上,everyinfra_call_api 是 readOnlyHint: false、destructiveHint: true、openWorldHint: true,没有声明 idempotentHint。
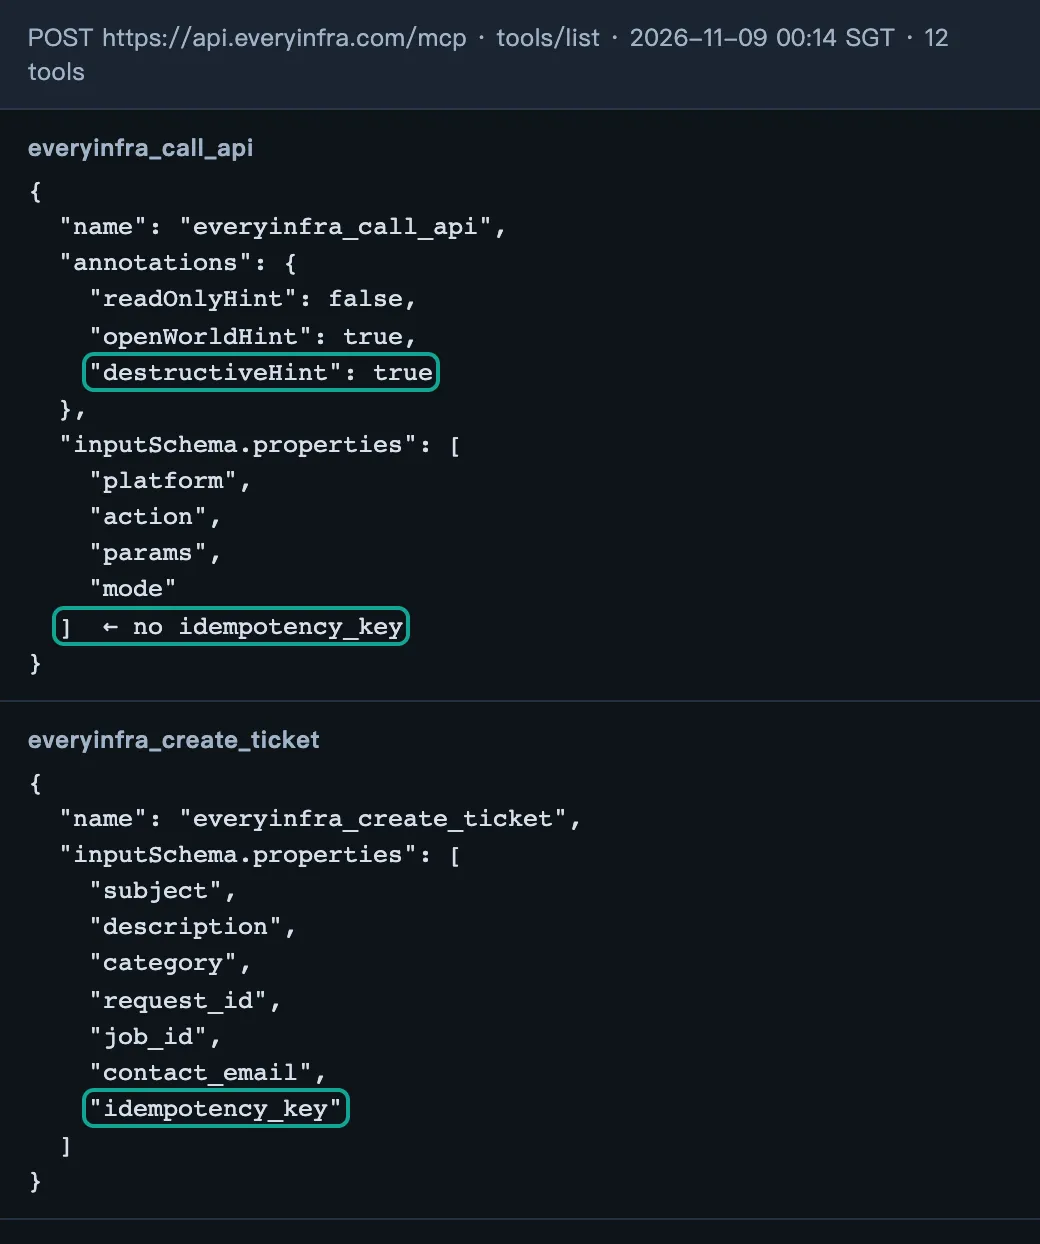
按 MCP 规范,idempotentHint 的意思是「用同样的参数反复调用,对环境没有额外影响」,默认值是 false,而且只在 readOnlyHint 为 false 时才有意义(MCP 2026-07-28 schema)。规范同时强调这些注解只是提示,客户端不应该根据不可信服务端的注解做决定。Claude Code 的 MCP 文档里有一节专门讲「把可以安全调用两次的工具标出来」:只有标了 idempotentHint 或 readOnlyHint 为 true 的工具,连接断开时 Claude Code 才会在新连接上自己重发一次(Claude Code MCP 文档)。所以对 everyinfra_call_api,Claude Code 不会在断线时自动替你重发,这其实是对的:同步调用在 MCP 上没有 Key,自动重发就会多扣一次。
我们把这件事真调了一遍。00:20:40 通过 MCP 同步调 reddit/search(关键词「mcp tool retry」,limit 5),5.1 秒返回 5 条,扣 $0.000556;00:21:52 原样再调一次(中间 00:20:52 那次被限速挡回),4.0 秒返回,又扣 $0.000556,两个 id 不同。异步那组:00:20:59 第一次被限速挡回,00:21:06 带 mode: async 再调,返回 job_id;00:22:11 原样再调,返回同一个 job_id、replayed: true,账户记录里只有一笔。和 REST 的结论完全对得上:MCP 上的同步重发会重复扣费,异步提交在 5 分钟内合并。
| 走法 | 能不能带 Key | 同样请求 24 小时内重发 | 实测扣费 | 适合谁 |
|---|---|---|---|---|
| REST 同步,带 Idempotency-Key | 能 | 回放,不再扣 | 3 次扣 1 次 | 自己写工具封装的 agent |
| REST 同步,不带 Key | — | 再跑一次 | 2 次扣 2 次 | 不建议用于会重试的场景 |
| REST 异步,带或不带 Key | 能 | 5 分钟内合并(带 Key 按 Key) | 2 次扣 1 次 | 慢能力、托管平台 HTTP 工具 |
| MCP 同步 everyinfra_call_api | 不能 | 再跑一次 | 2 次扣 2 次 | 快能力、客户端超时够长 |
| MCP 异步 everyinfra_call_api + everyinfra_get_job | 不能,但自动合并 | 5 分钟内合并 | 2 次扣 1 次 | 超时短的 MCP 客户端 |
所以在 MCP 上,我们给的建议是:对中位耗时超过几秒的能力,让 agent 默认传 mode: async,再用 everyinfra_get_job 取结果;把这条写进系统提示或工具说明,比指望模型自己判断可靠。对于这一点我们也记了一条改进建议给产品:给 everyinfra_call_api 加一个和 everyinfra_create_ticket 一样的 idempotency_key 参数,并在加上之后声明 idempotentHint,这样 Claude Code 断线重发也能用上。在它上线之前,上面那张表就是现在的真实情况。站内另一篇 MCP 2026 规范与生产接入 讲了规范里其他和生产有关的条款,可以对照看。
Claude Code 的重试设置:哪些会重发,哪些不会
Claude Code 的环境变量里,大部分重试设置只管它调模型接口的请求,不会让你的 MCP 工具被多调一次;和本文有关的只有一条:CLAUDE_CODE_DISABLE_NONSTREAMING_FALLBACK 的说明提到,在某些代理或网关后面,流式失败后的非流式兜底可能导致工具被重复执行,可以用这个开关关掉(环境变量文档)。
工具调用本身,Claude Code 设了三道时间线。一是墙钟上限:服务器配置里的 timeout 字段(毫秒)或者 MCP_TOOL_TIMEOUT 环境变量,不设的话默认约 28 小时。二是单次请求计时器:对 HTTP、SSE 和 claude.ai 连接器,覆盖到服务端返回第一个字节为止,取 60 秒、该服务器的工具超时、MCP_TIMEOUT 三者中最大的那个,所以默认至少 60 秒,设得比 60 秒小也不会更短。三是空闲超时:网络类服务器 5 分钟没有任何响应或进度通知就中止,可以用 CLAUDE_CODE_MCP_TOOL_IDLE_TIMEOUT 改(Claude Code MCP 文档的时间限制一节)。另外,主会话里跑过 2 分钟的工具调用会被移到后台,不会卡住会话。
把这些规则和我们的耗时数据放在一起看:Claude Code 默认的 60 秒单次计时器,覆盖了测试账户最近 314 次同步成功调用里的 98.4%(只有 5 次超过 60 秒,1.6%)。再加上断线时它只自动重发标了幂等的工具,Claude Code 默认配置下因为客户端超时导致的重复扣费其实很少。剩下的风险主要来自模型自己再调,这一层只能靠前面说的异步提交或者自己写带 Key 的封装。下面是一个配置示例(我们没有在本机跑 Claude Code,字段名都来自官方文档):
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 120000
    }
  }
}
这里的 timeout 设成 120 秒,是为了比 EveryInfra 同步调用的 85 秒上限再多留一点:文档写明同步调用超过 85 秒会回 503 timeout,并建议改小 limit 或者改走异步,这种失败不扣费。把客户端超时设得比服务端上限长,客户端就总能等到一个明确的答案(成功或者 503),而不是在服务端还在跑时自己先放弃。最近几个版本里,Claude Code 还在 11 月 4 日的 2.1.318 修了重试过工具调用之后会话重启会丢掉被中断那一轮的问题,在 11 月 6 日的 2.1.319 加了 MCP 任务在终端里自动转后台(更新日志)。这些改动都在往「工具调用的结果不能丢、不能重复」这个方向走。
OpenAI Agents SDK 的重试设置:5 秒默认读超时
OpenAI Agents SDK(Python 版)连 MCP 服务器用 MCPServerStreamableHttp 这类类。它的文档写明:client_session_timeout_seconds 控制 MCP 客户端会话的读超时,在 MCPServerStdio、MCPServerSse 和 MCPServerStreamableHttp 上默认都是 5 秒;max_retry_attempts 和 retry_backoff_seconds_base 会给 list_tools() 和 call_tool() 加上自动重试;retry_backoff_seconds_max 默认不设上限(Agents SDK MCP 文档)。文档里的示例把 max_retry_attempts 设成 3。
5 秒这个默认值对数据接口来说太短了。我们测试账户最近 314 次同步成功调用的中位耗时是 7.8 秒,209 次(66.6%)超过 5 秒。也就是说,用 Agents SDK 的默认设置连 EveryInfra 的 MCP,三次成功调用里大约有两次会在客户端这边先「超时」,而服务端照样跑完、照样扣费。如果再打开 max_retry_attempts,SDK 会在超时后把同一个工具调用再发一遍;MCP 同步调用没有 Key,每发一次就是一笔新的扣费。即使不打开自动重试,同一页文档写着 MCP 工具调用失败时默认返回一段模型能读的错误文本(failure_error_function 不设就用默认格式,设成 None 才改为抛异常),模型看到「超时」很可能自己再调一次。超时是不是也走这条路、模型具体看到哪几个字,文档没写,我们也没测。Agents SDK 在模型请求那一层倒是很谨慎:重试要显式打开,已经开始流式输出或带本地副作用的请求默认不重放(Agents SDK Models 文档);但对远程 MCP 工具的读超时,默认值仍然是 5 秒。
下面是一个配置示例(同样没在本机跑,参数名来自上面的文档原文):把读超时放到 90 秒,比 85 秒的服务端同步上限略长(官方 Python SDK 直连 REST 时默认等 300 秒,MCP 客户端至少要等过 85 秒);不打开 max_retry_attempts,让重试只发生在我们自己能控制 Key 的地方。
from agents import Agent, Runner
from agents.mcp import MCPServerStreamableHttp
import os

async def main():
    async with MCPServerStreamableHttp(
        name="everyinfra",
        params={
            "url": "https://api.everyinfra.com/mcp",
            "headers": {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"},
        },
        client_session_timeout_seconds=90,   # 默认 5 秒,比本文测到的中位耗时 7.8 秒还短
        # max_retry_attempts 不设:MCP 同步调用没有幂等键,自动重发会再扣一次
        cache_tools_list=True,
    ) as server:
        agent = Agent(
            name="researcher",
            instructions="调用 everyinfra_call_api 时,慢能力一律传 mode=async,再用 everyinfra_get_job 取结果。",
            mcp_servers=[server],
        )
        result = await Runner.run(agent, "搜 Reddit 上最近讨论 idempotency key 的帖子")
print(result.final_output)| 设置项 | Claude Code(MCP 工具) | OpenAI Agents SDK(MCPServerStreamableHttp) | 对 EveryInfra 的建议 |
|---|---|---|---|
| 每次工具调用等多久 | 单次请求计时器至少 60 秒;墙钟默认约 28 小时 | client_session_timeout_seconds 默认 5 秒 | 设到 90–120 秒,比 85 秒同步上限长 |
| 空闲多久中止 | 网络类服务器 5 分钟 | 由读超时决定 | 长任务走异步 |
| 断线或超时后自动重发 | 只重发标了 idempotentHint 或 readOnlyHint 的工具,1 次 | 设了 max_retry_attempts 才重发 call_tool | 不对 everyinfra_call_api 开自动重发 |
| 出错后模型看到什么 | 断线时一条错误文本,提醒先核对是否已执行 | 默认一段错误文本(failure_error_function) | 系统提示里写明先查记录再重试 |
我们的接口到底多慢:314 次同步调用的耗时分布
前面反复用到「66.6% 超过 5 秒」,这里把数据来源说清楚。我们取了测试账户在 2026 年 11 月 8 日 14:06 到 11 月 9 日 00:22(新加坡时间)之间的请求记录(GET /portal/api/logs,两批各 200 条,按 request_id 去重后 330 次),只留 HTTP 200 的同步调用,一共 314 次。latency_ms 是服务端记录的耗时。中位数 7.8 秒,p90 20.6 秒,p95 30.3 秒,最长 85.0 秒(正好碰到同步上限)。超过 5 秒的 209 次(66.6%),超过 10 秒的 83 次(26.4%),超过 30 秒的 19 次(6.0%),超过 60 秒的 5 次(1.6%),超过 85 秒的 1 次(0.3%)。这 314 次里有 8 次是本文自己的测试调用(最长 23.3 秒);把它们剔掉,剩下 306 次里超过 5 秒的占 67.6%,比 66.6% 还略高,所以结论不是我们自己的测试撑起来的。
这批请求的能力组成偏慢,要说清楚边界。按能力分,样本 10 次以上的能力里,twitter/comments(71 次)、threads/comments(41 次)、youtube/transcript(19 次)、threads/search(14 次)、youtube/search(10 次)全部超过 5 秒;xiaohongshu/comments(71 次)中位数只有 2.0 秒,超过 5 秒的只有 5.6%,reddit/search(13 次)是 15.4%,xiaohongshu/search(11 次)是 18.2%。所以「66.6%」是这个账户这十个小时的组合,换一组能力会不一样。为了给一个更稳的下限,我们又看了 30 天的质量统计:有耗时数据的 95 项能力里,67 项的成功调用中位耗时超过 5 秒,按「中位数以上至少一半超过 5 秒」推,30 天 7,449 次成功调用里至少 22.1% 超过 5 秒;p95 超过 60 秒的能力有 19 项,按同样方法推,至少 0.48% 超过 60 秒。
这张图能帮你判断哪些能力该默认走异步。30 天调用最多的 12 项里,twitter/search 中位 22.7 秒、p95 57.4 秒,threads/search 中位 11.7 秒,youtube/search 中位 9.8 秒,这三项在 5 秒超时下几乎每次都会被客户端放弃。另一类要注意的是中位数很快、p95 很慢的能力,比如 twitter/comments 中位 1.9 秒、p95 19.1 秒,threads/comments 中位 1.9 秒、p95 30.9 秒:平时很快,偶尔一次慢到十几二十秒,正好是 agent 最容易「以为失败了」的时候。另外 search/web 中位 1.7 秒、p95 3.2 秒,在 5 秒超时下基本不会出事。
算一笔账:不带 Key、每天重试率 X% 的 agent 多花多少
不带 Key 的 agent 会多花多少,取决于每天有百分之几(记作 X)的调用被重发,而 X 又取决于客户端超时 T。X 不能拍,我们用上面的耗时分布来定:假设客户端超时设成 T 秒,超时后不带 Key 盲发一次,那么 X 就是耗时超过 T 的成功调用占比,每一次这样的重发都会多扣一笔。我们只算「每次超时盲发 1 次」,而实际上重发的那次也可能再超时、再重发,所以下面的数是下限。单价用 $0.000556,这是 reddit/search 等 116 项能力的目录价;当天目录里 571 项可用能力的中位单价是 $0.001389,最低 $0.000556,最高 $0.28。
| 客户端超时 T | X(耗时超过 T 的占比) | 每天 1 万次、单价 $0.000556,每月多付 | 每天 1 万次、中位单价 $0.001389,每月多付 |
|---|---|---|---|
| 5 秒(Agents SDK 的 MCP 默认) | 66.6%(30 天下限 22.1%) | $111.02(下限约 $36.8) | $277.36(下限约 $92) |
| 10 秒 | 26.4% | $44.09 | 约 $110 |
| 30 秒 | 6.0% | $10.09 | 约 $25 |
| 60 秒(Claude Code 单次请求默认) | 1.6% | $2.65 | 约 $6.6 |
| 85 秒(EveryInfra 同步上限) | 0.3% | $0.53 | 约 $1.3 |
| 带 Idempotency-Key(任何 T) | 不重复扣 | $0.00 | $0.00 |
算法是:每月多付 = 每天调用数 × X × 单价 × 30。以第一行为例:10,000 × 0.6656 × $0.000556 × 30 = $111.02。中位单价那一列 5 秒那格是 10,000 × 0.6656 × $0.001389 × 30 = $277.36,其余几格按同样算法取整写成「约」。另一个角度是用测试账户真实花的钱来验算:那 314 次同步成功调用里扣了费的 291 次,合计 $0.6588;其中耗时超过 5 秒的 187 次,合计 $0.2150,占 32.6%。也就是说,如果这批调用来自一个 5 秒超时、不带 Key、超时就盲发一次的 agent,这十个小时的接口费会从 $0.66 涨到至少 $0.87,多出将近三分之一(按金额算低于按次数算的 66.6%,是因为慢的能力里单价低的居多)。
这笔账有三个边界。第一,耗时分布来自一个测试账户十个小时的真实调用,能力组合偏慢;换成以 xiaohongshu/comments、search/web 这类快能力为主的 agent,5 秒那一行会小很多,30 天下限是 22.1%,对应每月至少约 $36.8。第二,我们假设超时后一定重发,而且只发一次;实际 agent 可能不重发(直接告诉用户失败),也可能连发好几次,Reddit 上那个「整晚重试」的帖子就是后一种。第三,钱只是一半的成本:不带 Key 重发拿到的是一份新数据,像前面 12 秒内结果从 1 条变 2 条那样,下游要额外做去重。带 Key 这一行的 $0 不依赖任何假设,因为回放不执行、不扣费。
回调按 X-EveryInfra-Event-Id 去重
重复处理不只发生在 agent 调接口这一侧,也发生在接口通知你这一侧。EveryInfra 的回调(控制台里的 Settings → Webhooks)有两种事件:balance.low(余额降到你设的美元阈值以下,每次跨线发一次)和 job.finished(异步任务成功或失败,而且在扣费或退款落定之后才发)。每次投递是一个 POST,请求体是 {"id", "type", "created_at", "data"};job.finished 带 job_id、request_id、status、result_count、billing_state、refund_state 和 result_url,不带结果行,结果要用提交任务的那把 Key 去 GET /api/v1/jobs/{job_id} 取。
文档对投递的承诺是「至少一次」:你返回任何 2xx 就算送达,否则在 30 秒、2 分钟、10 分钟、30 分钟、2 小时、6 小时后重投,一共 7 次。所以同一个事件完全可能到你这里两次:比如你的服务处理完了,但回 200 之前超时了。文档的要求是按 X-EveryInfra-Event-Id 去重,同时校验签名:X-EveryInfra-Signature: v1=<hex> 等于用签名密钥对「X-EveryInfra-Timestamp 加一个点再加原始请求体」做 HMAC-SHA256,时间戳偏差超过 5 分钟的拒收。Stripe 的回调文档给的是同一个办法:记录处理过的事件编号,已记录的不再处理(Stripe webhooks);微软的重试模式文档也专门提醒,处理重投消息的一方要做成幂等消费者(Azure Retry pattern)。
import hashlib, hmac, json, time

def handle_everyinfra_webhook(headers, raw_body: bytes, secret: bytes, db):
    ts = headers["X-EveryInfra-Timestamp"]
    sig = headers["X-EveryInfra-Signature"].removeprefix("v1=")
    want = hmac.new(secret, ts.encode() + b"." + raw_body, hashlib.sha256).hexdigest()
    if not hmac.compare_digest(sig, want) or abs(time.time() - int(ts)) > 300:
        return 400
    event_id = headers["X-EveryInfra-Event-Id"]
    # 唯一索引保证同一个事件只处理一次;重投时插入失败,直接回 200
    if not db.insert_if_absent("webhook_events", event_id):
        return 200
    event = json.loads(raw_body)
    if event["type"] == "job.finished":
        db.enqueue_fetch(event["data"]["job_id"])   # 结果用 GET /api/v1/jobs/{job_id} 取
    return 200
这里有一个和 agent 相关的细节:去重要用「先占位、再处理」,而不是「先查、再处理」。r/LangChain 那个讨论里有人指出,如果两次投递几乎同时到,两边都先查、都查不到、都去处理,去重就失效了,Key 必须是一把锁,而不只是一个标签(讨论帖)。用数据库唯一索引插入,插入成功的那一方处理,失败的那一方直接回 200,就把这个窗口关上了。Python 用户也可以直接用 SDK 里的 from everyinfra.webhooks import verify_signature 做签名校验。
一个能直接用的工具封装:Key 在调用前生成,重试时不换
Python 用户最简单的做法是直接用官方 SDK:pip install everyinfra(0.3.0,Python 3.9 起,零依赖)。它的 README 写明 data() 每次调用都自动带 Idempotency-Key,同步、异步都是:断线后 SDK 重发,同步调用拿回第一次的响应,异步拿回同一个任务,都不会再扣一次;要跨进程重试同一个逻辑请求,就自己传一个稳定的 Key(PyPI 上的 everyinfra)。README 还专门提醒默认超时 300 秒,别随手调小:客户端超时短于服务端还在算的时间,就会出现「已经扣了费、结果没拿到」这种最坏的情况,和本文测到的完全是一回事。
import os
from everyinfra import EveryInfra

ei = EveryInfra(os.environ["EVERYINFRA_API_KEY"])
posts = ei.data("reddit", "search", keyword="idempotency key", limit=10,
                idempotency_key="run42-step7")   # 进程崩溃重启后同一步仍用同一个 Key
不用 Python SDK 的场景(JS 写的 agent、托管平台的 HTTP 工具、想自己掌控重试的框架),就照同样的规则自己写。把前面所有的规则合在一起,工具封装只需要做好四件事:在调用之前生成 Key 并固定下来;超时、断线、504、502 就用同一个 Key 重发;409 进行中按 Retry-After 等;409 冲突、4xx 和两种「结果未知」的 503 就停,不重发。下面这段 Python 只用标准库,可以对照着改成任何语言。
import json, os, time, uuid, urllib.error, urllib.request

API = "https://api.everyinfra.com/api/v1/social"
STOP = {"idempotency_conflict", "refund_outcome_unknown", "submission_outcome_unknown"}

def call_social(body: dict, key=None, timeout: float = 90, attempts: int = 4):
    key = key or f"agent-{uuid.uuid4()}"          # 一个逻辑请求一个 Key,存进任务状态
    for i in range(attempts):
        req = urllib.request.Request(API, data=json.dumps(body).encode(), method="POST", headers={
            "Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"],
            "Content-Type": "application/json",
            "Idempotency-Key": key,
        })
        try:
            with urllib.request.urlopen(req, timeout=timeout) as r:
                data = json.load(r)
                data["_cost_usd"] = 0 if data.get("replayed") else data["billing"]["charged_usd"]
                return data
        except urllib.error.HTTPError as e:
            try:
                err = (json.load(e) or {}).get("error", {})
            except ValueError:                        # 外层网关回的 HTML 等非 JSON 错误体
                err = {"retryable": e.code in (502, 504)}
            if err.get("code") in STOP or not err.get("retryable"):
                raise RuntimeError(f"{e.code} {err.get('code')}: {err.get('message')} key={key}")
            time.sleep(float(e.headers.get("Retry-After") or err.get("retry_after") or 2 ** i))
        except (TimeoutError, urllib.error.URLError):
            time.sleep(2 ** i)                        # 结果未知:同一个 Key 再发
raise RuntimeError(f"gave up after {attempts} tries, Idempotency-Key={key}")几处取舍解释一下。_cost_usd 在回放时记 0,避免前面说的「回放 billing 被重复累加」。判断要不要重试,优先看错误体的 retryable,而不是自己维护一张状态码表:EveryInfra 的 429、409 进行中、可重试的服务端错误都标了 retryable: true,409 冲突、422、401、402、403 都是 false。等待时长优先读 Retry-After 响应头,这也是通用做法,OpenAI 的错误码文档对 429 的建议就是有这个头时照它等(OpenAI Error codes)。超时默认 90 秒,比 85 秒的同步上限略长(官方 SDK 用 300 秒,更稳);错误体不是 JSON 时(比如外层网关返回的页面),只有 502、504 按可重试处理。最后,Key 由调用方传入时,应该来自 agent 的运行编号加步骤编号(比如 run42-step7),这样即使整个 agent 进程崩溃重启,同一步重新执行时也会用同一个 Key,24 小时内拿回原结果,不会再付一次。这正是 r/LangChain 讨论里有人建议的「用运行和步骤编号派生 Key」。LangGraph 的文档也是这个思路:节点在中断或重试后会从头再跑一遍,之前做过的副作用会再做一次,所以建议用幂等键、upsert 或先读后写来保证重跑安全(LangGraph Graph API)。站内 Claude Code 子代理拉 TikTok 品牌号 那篇讲过 429 的退避写法,和这里的 Retry-After 处理是同一套;OpenAI Agents SDK 搭评论监控 agent 那篇可以直接套上这个封装。
别家的 idempotent api retry 规则:几家对照
把 EveryInfra 的规则放到行业里看,可以帮你判断哪些行为是通例、哪些要单独适配。我们只列各家文档里写明的事实,读取时间都是 2026 年 11 月 9 日。
| 服务 | 请求头或字段 | Key 长度 | 保留多久 | 同 Key 不同参数 |
|---|---|---|---|---|
| EveryInfra 数据接口 | Idempotency-Key | 1–255 个可见 ASCII 字符 | 24 小时(异步无 Key 合并 5 分钟) | 409 idempotency_conflict |
| Stripe API v1 | Idempotency-Key | 最多 255 字符 | 至少 24 小时后可清理 | 报错 |
| Square | idempotency_key 字段 | 页面未写 | 页面未写 | 报错(各接口可能不同) |
| AWS EC2 | ClientToken | 最多 64 个 ASCII 字符 | 页面未写 | 报错 |
| Google AIP-155 | request_id 字段 | UUID | 由各 API 定 | 由各 API 定 |
| IETF 草案 08 版 | Idempotency-Key | 由服务端定 | 由服务端公布 | 建议 422(进行中建议 409) |
出处依次是:Stripe、Square Idempotency、AWS EC2 幂等说明(client token 是最多 64 个 ASCII 字符、区分大小写的字符串)、Google AIP-155(给请求消息加一个 UUID 的 request_id 字段,主要用途就是幂等)和 IETF 草案。写「页面未写」的格子,是原文在我们读到的那一页没给出具体数字,我们不替它补。另外两家支付接口的请求头名字不同:Adyen 用 idempotency-key、最多 64 个字符,PayPal 用 PayPal-Request-Id,同一个编号返回上一次请求的最新状态。错误体的格式也各家不同:IETF 草案的示例用 RFC 9457 的 application/problem+json,EveryInfra 回的是普通 JSON,字段是 code、message、fault、retryable、next_steps,多出来的 retryable 正好能直接驱动重试判断。
对照下来,EveryInfra 和 Stripe 的规则最接近:同一个请求头名字、同样 255 的长度上限、同样 24 小时、同样「同名不同参数报错」。有一处不同:Stripe API v1 在端点开始执行后就保存第一次的状态码和响应体,重试同一个 Key 会连 500 错误一起原样返回;EveryInfra 只保存成功的结果,失败(包括已退款的服务端失败)会释放 Key,下一次真跑。对数据接口来说,后一种更合理:一次失败的搜索不该在 24 小时里一直回放失败。亚马逊在《Making retries safe with idempotent APIs》里还讲过回放该返回什么:只回一个「资源已存在」的错误虽然没有副作用,但调用方仍然不知道是不是自己那次创建的,所以更好的做法是在一段时间内对同一个请求编号返回语义相同的响应(Amazon Builders' Library)。EveryInfra 回放完整的第一次响应,就是这一种。
做不了或要注意的地方
Key 只防「同一件事做两遍」,不防「做了一件过时的事」。r/AI_Agents 上有人把这一点说得很清楚:幂等键能挡住重复动作,但挡不住一个已经过时的动作执行一次而且执行错了(讨论帖)。对数据接口来说,就是 24 小时内同一个 Key 永远回放第一次的数据。想要新数据,就要换新 Key;agent 的任务状态里要分清「这是重试」和「这是新的一次查询」。
MCP 同步调用目前没有幂等参数,这是写稿当天的真实情况:要么走异步,要么在 MCP 客户端前面自己包一层 REST。回放只认 24 小时,过了 24 小时同一个 Key 会被当成新请求;异步不带 Key 的合并窗口只有 5 分钟。限速 429 不占 Key、不扣费,但会让你的重试节奏乱掉:我们这次测试就有 6 次被限速(REST 4 次 429、MCP 2 次),测试 Key 被单独限到每分钟 10 次(账户默认 60 次)。另外,按 Key 的花费上限(spend_limit_usd,到了回 403 key_spend_limit_reached)是在服务端挡钱,比在 agent 进程里算预算可靠,Reddit 那个整晚重试的帖子底下也有人建议把每日预算放到 API Key 上,理由是按单次运行计的上限会在任务重启时清零(原帖)。
最后是关于我们测不到的部分。服务端在客户端断开之后会不会中止任务、会不会退款,文档没有承诺,只写了「没带 Key 的同步调用丢了连接,可能已经跑完并扣了费」,所以本文的算账一律按「照样扣费」算。Claude Code 和 Agents SDK 的行为我们只读了文档和更新日志,没在本机验证;如果你在自己的环境里测到不一样的结果,以实测为准。
最近的变化
- 2026-11-06 / 11-04:Claude Code 2.1.319 支持把 MCP 任务转到后台,2.1.318 修了重试过工具调用后会话重启丢掉中断那一轮的问题(更新日志)。
- 2026-10-22:IETF Idempotency-Key 草案更新到第 08 版,有效期到 2027-04-25(datatracker)。
- 2026-10-21:Claude Code 2.1.307 起只在断线时自动重发标了只读或幂等的 MCP 工具。同期 OpenAI Agents SDK 的预览版 v0.24.0-alpha.7 让应用保存的会话报告「不确定是否生效」的调用、交给应用核对,不自动重放(发布页,写稿时为 GitHub 上最新一版)。
常见问题
怎么生成 idempotency key?
用 UUID 就行:Stripe 建议 V4 UUID 或足够随机的字符串,RFC 9562 定义的 UUIDv7 带时间顺序,存库更友好。关键不是格式,而是时机:Key 要在第一次调用之前生成,存进 agent 的任务状态,每次重试复用。EveryInfra 要求 1 到 255 个可见 ASCII 字符、不能有空格,否则回 422 invalid_idempotency_key。不要把邮箱、用户名这类个人信息放进 Key。
idempotent api retry 时,超时到底该设多长?
带 Key 的前提下,超时短只会多几次回放,不会多扣钱,所以超时主要影响体验。不带 Key 时超时就是钱:每天 1 万次、5 秒超时,按 30 天数据每月至少多付约 $37,偏慢的样本里是 $111.02;60 秒降到 $2.65。对 EveryInfra,MCP 客户端的超时设到 90–120 秒(比 85 秒同步上限长),官方 Python SDK 默认 300 秒不要调小,慢能力直接走异步。HTTPX 这类常用 HTTP 库默认 5 秒无响应就超时(HTTPX Timeouts),用它写工具时要显式放宽。
ai agent tool call retry 会不会被重复扣费?
这也是 r/LangChain 讨论帖《How do you catch an AI agent repeating an action after a timeout?》的问题(讨论帖)。看你怎么发。本文实测:REST 带同一个 Key 重发 3 次扣 1 次;不带 Key 的同步重发 2 次扣 2 次;异步提交 5 分钟内重发只扣 1 次;MCP 同步重发扣 2 次。失败和空结果无论重发几次都不扣。注意回放响应里的 billing 是第一次的原样,charged: true 还在,但不代表又扣了一次,认 replayed: true 就不要累加成本。
回放时能拿回原来的结果,还是只给一个「重复」的错误?
r/LangChain 讨论帖里有人提醒,很多号称去重的接口只回一个重复错误,agent 仍然不知道第一次的结果,应该先测清楚(讨论帖)。EveryInfra 是前者:同步调用成功后,同一个 Key 24 小时内回放完整的第一次响应(我们实测 3 条结果一字不差,0.116 秒返回);第一次还在跑时回 409 和 Retry-After,等过之后再发就拿到结果。
回调会不会重复到达?
会,Stripe 回调文档的「Handle duplicate events」一节讲的就是这件事。EveryInfra 的回调是至少一次投递,没收到 2xx 就在 30 秒到 6 小时之间重投,最多 7 次。按 X-EveryInfra-Event-Id 去重,用数据库唯一索引「先占位再处理」,并校验签名和 5 分钟时间窗。
上手步骤
第一步,在控制台建一把 API Key,把它放进环境变量 EVERYINFRA_API_KEY,不要写进代码和 Key 本身之外的任何日志。第二步,读免费目录 GET /api/v1/social/catalog,找到要用的能力、参数和 price_usd,比如 Reddit 数据接口 和 X(Twitter)数据接口 各有搜索、评论等能力。第三步,照本文的 curl 带一个 Idempotency-Key 发第一次请求,再原样发一次,确认响应头出现 Idempotent-Replayed: true。第四步,Python 直接 pip install everyinfra 用 ei.data(...)(自动带 Key),其他语言把上面的 call_social 照着改成你 agent 框架里的工具,或者在 MCP 客户端里把读超时放到 90 秒以上、慢能力传 mode: async。完整的快速上手在 文档,按次计费的价格在 价格页,能力清单在 数据市场。
参考资料
- EveryInfra 完整开发者说明(Retries and idempotency、Errors、Webhooks 各节),EveryInfra,读取于 2026-11-09,https://api.everyinfra.com/llms-full.txt
- EveryInfra OpenAPI 文档,EveryInfra,读取于 2026-11-09,https://api.everyinfra.com/openapi.json
- EveryInfra 数据能力目录,EveryInfra,读取于 2026-11-09,https://api.everyinfra.com/api/v1/social/catalog
- everyinfra 0.3.0(官方 Python SDK,README:自动带 Idempotency-Key、默认超时 300 秒),PyPI,读取于 2026-11-09,https://pypi.org/project/everyinfra/
- EveryInfra MCP 端点 tools/list,EveryInfra,读取于 2026-11-09,https://api.everyinfra.com/mcp
- Connect Claude Code to tools via MCP,Anthropic,读取于 2026-11-09,https://code.claude.com/docs/en/mcp
- Claude Code environment variables,Anthropic,读取于 2026-11-09,https://code.claude.com/docs/en/env-vars
- Claude Code error reference,Anthropic,读取于 2026-11-09,https://code.claude.com/docs/en/errors
- Claude Code changelog(2.1.307、2.1.318、2.1.319),Anthropic,2026-10-21 至 2026-11-06,https://code.claude.com/docs/en/changelog
- Claude Code CHANGELOG.md,Anthropic(GitHub),读取于 2026-11-09,https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Model context protocol (MCP),OpenAI Agents SDK 文档,读取于 2026-11-09,https://openai.github.io/openai-agents-python/mcp/
- Models(Runner-managed retries、Model-call timeouts),OpenAI Agents SDK 文档,读取于 2026-11-09,https://openai.github.io/openai-agents-python/models/
- openai-agents-python Releases(v0.24.0-alpha.7),OpenAI(GitHub),读取于 2026-11-09,https://github.com/openai/openai-agents-python/releases
- openai-agents,PyPI,读取于 2026-11-09,https://pypi.org/project/openai-agents/
- MCP Specification 2026-07-28: Tools,Model Context Protocol,读取于 2026-11-09,https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- MCP Specification 2026-07-28: Schema(ToolAnnotations),Model Context Protocol,读取于 2026-11-09,https://modelcontextprotocol.io/specification/2026-07-28/schema
- MCP Specification 2026-07-28: Cancellation,Model Context Protocol,读取于 2026-11-09,https://modelcontextprotocol.io/specification/2026-07-28/basic/patterns/cancellation
- The Idempotency-Key HTTP Header Field(draft-08),IETF HTTPAPI 工作组,2026-10-22,https://datatracker.ietf.org/doc/draft-ietf-httpapi-idempotency-key-header/
- RFC 9110 HTTP Semantics(Idempotent Methods),IETF,2022-06,https://www.rfc-editor.org/rfc/rfc9110#name-idempotent-methods
- RFC 9457 Problem Details for HTTP APIs,IETF,2023-07,https://www.rfc-editor.org/info/rfc9457/
- RFC 9562 Universally Unique IDentifiers (UUIDs),IETF,2024-05,https://www.rfc-editor.org/info/rfc9562/
- Idempotent requests,Stripe,读取于 2026-11-09,https://docs.stripe.com/api/idempotent_requests
- Receive Stripe events in your webhook endpoint,Stripe,读取于 2026-11-09,https://docs.stripe.com/webhooks
- API idempotency,Adyen,读取于 2026-11-09,https://docs.adyen.com/development-resources/api-idempotency
- Idempotency,PayPal Developer,读取于 2026-11-09,https://developer.paypal.com/api/rest/reference/idempotency
- Idempotency,Square Developer,读取于 2026-11-09,https://developer.squareup.com/docs/build-basics/common-api-patterns/idempotency
- Ensuring idempotency in Amazon EC2 API requests,AWS,读取于 2026-11-09,https://docs.aws.amazon.com/ec2/latest/devguide/ec2-api-idempotency.html
- Retry behavior,AWS SDKs and Tools,读取于 2026-11-09,https://docs.aws.amazon.com/sdkref/latest/guide/feature-retry-behavior.html
- Making retries safe with idempotent APIs,Amazon Builders' Library,读取于 2026-11-09,https://aws.amazon.com/builders-library/making-retries-safe-with-idempotent-apis/
- Retry pattern,Microsoft Azure Architecture Center,读取于 2026-11-09,https://learn.microsoft.com/en-us/azure/architecture/patterns/retry
- Retry strategy,Google Cloud Storage,读取于 2026-11-09,https://docs.cloud.google.com/storage/docs/retry-strategy
- AIP-155 Request identification,Google,读取于 2026-11-09,https://google.aip.dev/155
- Timeouts,HTTPX,读取于 2026-11-09,https://www.python-httpx.org/advanced/timeouts/
- What is a Temporal Retry Policy?,Temporal,读取于 2026-11-09,https://docs.temporal.io/encyclopedia/retry-policies
- Graph API overview(RetryPolicy),LangChain,读取于 2026-11-09,https://docs.langchain.com/oss/python/langgraph/graph-api
- openai-python README(Retries),OpenAI(GitHub),读取于 2026-11-09,https://github.com/openai/openai-python
- Error codes,OpenAI API,读取于 2026-11-09,https://developers.openai.com/api/docs/guides/error-codes
- How do you catch an AI agent repeating an action after a timeout?,Reddit r/LangChain,读取于 2026-11-09,https://www.reddit.com/r/LangChain/comments/1xcbih6/how_do_you_catch_an_ai_agent_repeating_an_action/
- Has anyone dealt with duplicate tool calls when agents retry the tool calls?,Reddit r/LangChain,读取于 2026-11-09,https://www.reddit.com/r/LangChain/comments/1pal3x4/has_anyone_dealt_with_duplicate_tool_calls_when/
- My agent spent the whole night retrying one failed tool call,Reddit r/LLMDevs,2026-10-28,https://www.reddit.com/r/LLMDevs/comments/1xhlg75/my_agent_spent_the_whole_night_retrying_one/
- Your agent's retry logic dies when the agent does,Reddit r/AI_Agents,读取于 2026-11-09,https://www.reddit.com/r/AI_Agents/comments/1v9vjp2/your_agents_retry_logic_dies_when_the_agent_does/
引用编号 BL-115