OpenAI Agents API per il monitoraggio delle recensioni: un report settimanale sulle recensioni con poche stelle da cinque siti
Un agente settimanale per il monitoraggio delle recensioni sull'OpenAI Agents API: 21 chiamate reali su cinque siti di recensioni, $0,0069 a settimana per brand in costi dei dati, configurazione e limiti.
Il 1° novembre 2026, dalle 00:47 alle 15:45 ora di Singapore (SGT), abbiamo chiamato gli endpoint delle recensioni di EveryInfra per Notion e ClickUp. Alle 19:22–19:23 SGT abbiamo fatto 4 nuovi test. I siti erano Trustpilot, G2, Capterra, App Store e Google Play. Un controllo settimanale per un brand richiede cinque chiamate e costa $0,006945 in costi dei dati. La parte difficile è la copertura, non il prezzo. Su Google Play le 200 recensioni più recenti di Notion risalgono a soli 22 giorni fa, mentre 20 recensioni di Notion con poche stelle su Trustpilot risalgono fino a giugno.
La cifra più alta è la fattura del modello. La nostra tariffa sui dati è per chiamata, quindi 200 righe costano quanto 20. Ma ogni riga in più entra nel contesto del modello.
Con i limiti che consigliamo, una settimana di recensioni di Notion pesa circa 421 KB grezzi, cioè circa 105k token. Nella prima esecuzione erano 652 KB, per via del codice di pagina che descriviamo più avanti. Ai prezzi di listino di OpenAI del 1° novembre 2026, quella settimana costa da circa $0,03 a $2,9 in token del modello. Il modello più economico e quello più costoso differiscono di 100 volte nel prezzo di listino, quindi è la scelta del modello a determinare la fattura.
Dalle chiamate reali sono emerse anche due trappole. Capterra non ordina le recensioni per data. Nella prima esecuzione del 1° novembre, alcune recensioni di Capterra avevano un campo pros di circa 100.000 caratteri di codice di pagina. Quella sera il gateway ha rimosso il codice di pagina e ha impostato un limite di 5.000 caratteri per campo. Il nostro nuovo test delle 19:23 SGT ha restituito le stesse 86 recensioni, e il campo più lungo aveva 1.154 caratteri.
OpenAI ha aperto l'Agents API in beta pubblica il 10 settembre 2026. Può far girare un agente che si attiva ogni lunedì, manda un subagent su ciascun sito di recensioni e scrive un breve report sulle recensioni con poche stelle? Ogni nome di campo, valore predefinito e limite di OpenAI citato qui viene dalla documentazione di OpenAI, che abbiamo scaricato e verificato il 1° novembre 2026. Non abbiamo eseguito l'agente su un account OpenAI, quindi la parte OpenAI è un esempio di configurazione. Ogni numero di EveryInfra viene dalle risposte grezze di chiamate reali, comprese quelle non riuscite.
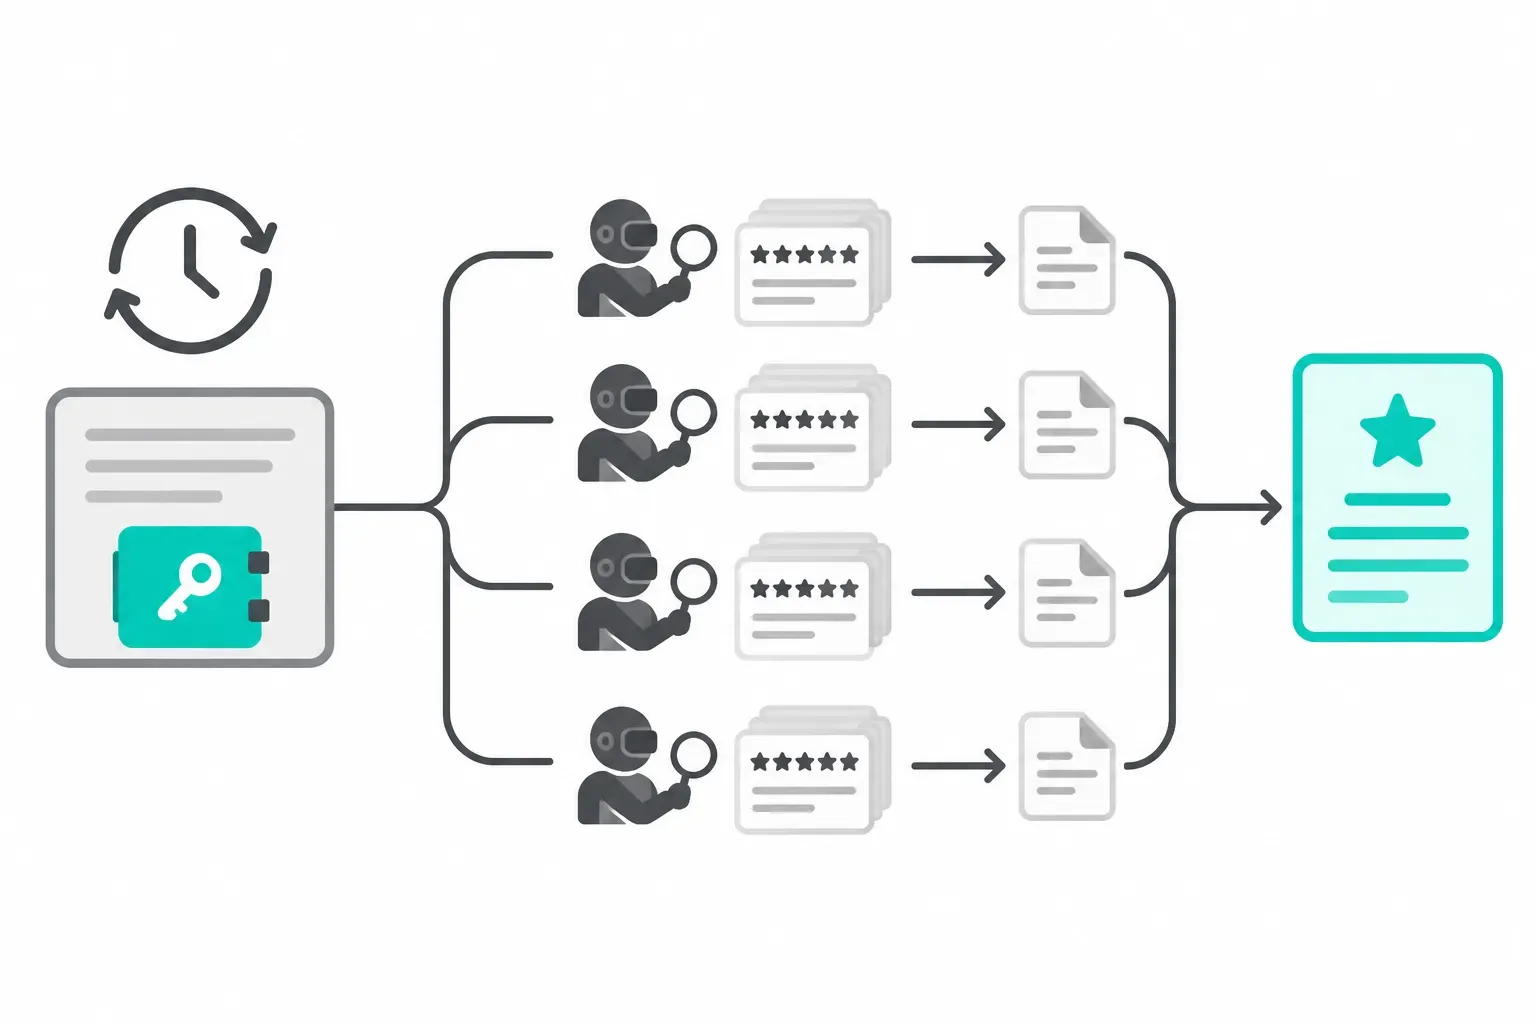
Il compito: un report settimanale sulle recensioni con poche stelle da cinque siti
Prima definiamo il compito, perché tutti i numeri che seguono dipendono da questo. L'input è un elenco di brand. Per ogni brand memorizzi un identificatore per sito. Trustpilot richiede il dominio dell'azienda, per esempio notion.so. G2 richiede l'URL o lo slug delle recensioni, e Capterra l'URL della pagina prodotto. App Store richiede l'ID numerico dell'app, e Google Play il nome del pacchetto.
L'output è un report settimanale. Ogni brand ha una sezione con le recensioni nuove e quelle con poche stelle per sito, più i principali temi delle lamentele. Il report elenca anche i problemi nuovi rispetto alla settimana precedente, con i link alle recensioni originali per il team di supporto.
Perché questi cinque siti? Coprono due pubblici diversi. Trustpilot, G2 e Capterra sono i siti che gli acquirenti consultano prima di comprare un software, quindi chi legge spesso è chi prende le decisioni. App Store e Google Play raccolgono il feedback degli utenti attuali, quindi le lamentele sono specifiche e spesso riportano un numero di versione.
Il nostro precedente blueprint per il monitoraggio della reputazione su più piattaforme spiega come registrare la copertura prima di giudicare un trend negativo. Il nostro test su 30 aziende con Exa, G2 e Trustpilot mostra un confronto una tantum tra concorrenti. Questo articolo trasforma il controllo in un agente che gira ogni settimana senza l'intervento di una persona. Usa anche dati reali per verificare se basta un'esecuzione a settimana.
Il compito corrisponde a quattro funzionalità dell'Agents API. I cinque siti sono indipendenti tra loro, quindi ognuno può andare a un subagent che restituisce solo un riepilogo. La pianificazione si adatta alle automation, che aprono sessioni secondo un'espressione cron in un fuso orario specifico. La chiave API va in un vault, così resta fuori dalle istruzioni. La fonte dei dati è un server MCP remoto, che l'Agents API può raggiungere dal lato OpenAI senza sandbox.
openai agents api a confronto con l'Agents SDK
OpenAI ha rilasciato l'Agents API in beta pubblica il 10 settembre 2026. Il post di lancio dice che una sola chiamata API con un compito, un modello, degli strumenti e un ambiente crea un agente di produzione. L'agente usa lo stesso harness di Codex (post di lancio di OpenAI; changelog). L'harness è il ciclo che chiama il modello, esegue gli strumenti e gestisce il contesto. La pagina di panoramica divide il prodotto in quattro concetti: Agent, Environment, Session ed Events and items (panoramica dell'Agents API). Il post di lancio dice anche che l'Agents API non ha costi aggiuntivi: paghi i token e gli strumenti che l'agente usa (post di lancio di OpenAI).
Il nome si confonde facilmente con l'Agents SDK. L'SDK è un framework open source di orchestrazione che OpenAI ha rilasciato l'11 marzo 2025, e il suo ciclo dell'agente gira dentro la tua applicazione (changelog; openai-agents-python su GitHub). La guida «Agents» di OpenAI contiene una tabella di confronto. La tabella qui sotto segue quella pagina (Agents guide: compare agent runtime options).
| Voce | Agents API | Agents SDK | Responses API |
|---|---|---|---|
| Da usare per | Attività lunghe in cui OpenAI gestisce l'agente e salva i progressi | Agenti con strumenti e flussi di lavoro personalizzati nella tua app | Chiamate dirette al modello, o un agente costruito da zero |
| Dove gira l'agente | OpenAI esegue un harness Codex gestito | L'SDK gira dentro la tua applicazione | La tua applicazione, con orchestrazione hosted facoltativa |
| Impegno di integrazione | Bassa | Media | Alta |
| Stato tra un'attività e l'altra | Configurazione della sessione, turni ed elementi salvati | Il tuo storage e le sessioni dell'SDK, o lo stato delle conversazioni della Responses API | Cronologia manuale, concatenamento delle risposte o Conversations |
| Esecuzione degli strumenti | Strumenti collegati al servizio, handler di funzioni nell'app, sandbox facoltativa | Strumenti e integrazioni nella tua applicazione | Strumenti hosted e strumenti eseguiti dalla tua app |
Per il monitoraggio delle recensioni la tabella ha un significato semplice. Se non vuoi gestire un processo di lunga durata per il ciclo dell'agente, l'archiviazione delle sessioni e i nuovi tentativi, l'Agents API fa questo lavoro per te. Il prezzo da pagare è che lo stato dell'agente risiede presso OpenAI, e il prodotto è ancora in beta. Se la tua azienda ha bisogno che i dati restino nella tua regione, l'SDK è la scelta più sicura. La pagina di panoramica dice che l'Agents API supporta solo la residenza dei dati negli Stati Uniti e non supporta la Zero Data Retention (ZDR), nemmeno con una sandbox self-hosted (panoramica dell'Agents API).


Passo 1: aggiungi EveryInfra come connessione MCP
Nell'Agents API, un server MCP è una voce di agent.tools con type: "mcp". La connessione può partire da due punti. Con connection_origin: "service", il valore predefinito, è OpenAI a connettersi al server, quindi il server deve essere raggiungibile da internet. Questa modalità funziona con o senza ambiente. Con connection_origin: "environment", la connessione parte dalla sandbox della sessione, per i server su una rete privata (documentazione sulle connessioni MCP).
L'endpoint MCP di EveryInfra è pubblico all'indirizzo https://api.everyinfra.com/mcp, quindi l'origine predefinita service è quella giusta, e l'ambiente della sessione può essere none. La pagina sull'architettura dice che senza ambiente l'agente può comunque chiamare strumenti MCP remoti. Perde solo Bash, i file del workspace e gli MCP dell'executor (architettura dell'Agents API). Questo conta per il costo: senza sandbox non c'è il costo del container.
Ecco la voce dello strumento come esempio di configurazione. Abbiamo verificato ogni campo sulla documentazione.
allowed_tools contiene solo everyinfra_call_api e everyinfra_get_job. Il secondo strumento legge il risultato di una chiamata asincrona (vedi Test 3). Con required: true, il turno fallisce quando il server non riesce ad avviarsi. È quello che vogliamo, perché altrimenti l'agente potrebbe scrivere un report senza dati. La documentazione dice che per impostazione predefinita l'inizializzazione MCP è facoltativa (documentazione sulle connessioni MCP).
{
  "type": "mcp",
  "server_label": "everyinfra",
  "transport": { "type": "http", "server_url": "https://api.everyinfra.com/mcp" },
  "connection_origin": "service",
  "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
  "required": true
}
Perché solo due strumenti? Alle 15:45 SGT del 1° novembre 2026 abbiamo inviato tools/list al server MCP di EveryInfra. Ha restituito 12 strumenti, con descrizioni JSON per un totale di 16.669 byte. Le descrizioni di everyinfra_call_api e everyinfra_get_job insieme occupano 2.505 byte. A circa 4 caratteri per token per il testo inglese, sono circa 4.167 token contro circa 626 token (OpenAI Help Center: tokens).
Le descrizioni degli strumenti entrano nel contesto a ogni turno, e ognuno dei cinque subagent ne porta una copia. La differenza è di circa 18k token per esecuzione. L'elenco degli strumenti cambia anche quando il servizio aggiunge o rimuove strumenti, e una lettura precedente nello stesso giorno aveva dato un numero diverso. Una allow list mantiene fisso questo costo. La documentazione definisce allowed_tools come il modo per limitare gli strumenti che l'agente può scoprire e chiamare (documentazione sulle connessioni MCP).
| Elenco degli strumenti | Strumenti | JSON delle descrizioni (byte) | Token stimati (÷4) | Cinque subagent |
|---|---|---|---|---|
Senza allowed_tools | 12 | 16,669 | 4,167 | circa 20.835 |
Solo everyinfra_call_api e everyinfra_get_job | 2 | 2,505 | 626 | circa 3.130 |
Secondo il post di lancio, l'Agents API ha anche il tool search, che carica le definizioni degli strumenti solo quando l'agente ne ha bisogno (post di lancio di OpenAI; documentazione sul tool search). È utile quando l'elenco degli strumenti è lungo e il compito è aperto. Qui il compito richiede due strumenti, quindi una allow list è più semplice e rende il costo più prevedibile.
Passo 2: tieni la chiave in un vault, non nelle istruzioni
La connessione MCP richiede una chiave EveryInfra. La documentazione indica tre posti per le credenziali. Per una singola sessione, metti il valore in transport.authorization o transport.headers. L'Agents API cifra questi valori e li esclude dalla sessione restituita.
Per riutilizzarla, salva la credenziale in un vault e collega il vault con vault_ids. Per i server stdio, usa le variabili d'ambiente, ma in quel caso il codice nella sandbox può leggerne il valore (documentazione sulle connessioni MCP: Add authentication). Un job settimanale rientra nel secondo caso.
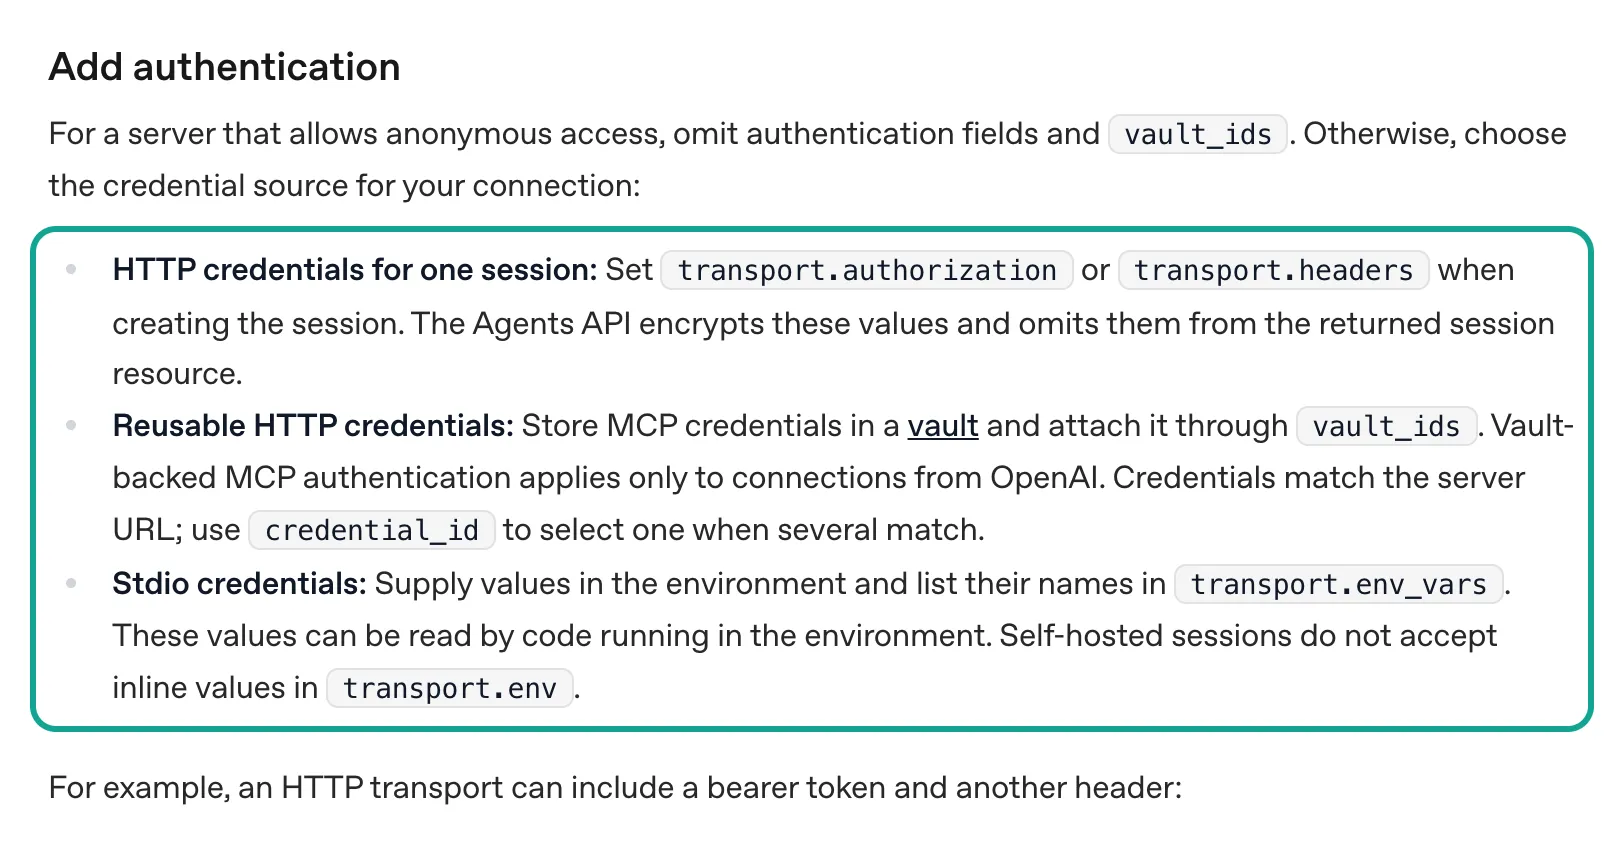
La pagina Vaults mostra le chiamate. Prima, client.beta.agents.vaults.create crea un vault. Poi vaults.credentials.create aggiunge una credenziale con auth.type: "static_bearer", l'URL MCP in mcp_server_url e la chiave in token. Il valore di mcp_server_url lega la credenziale a quel server (documentazione sui vault). Quando leggi un vault o una credenziale, l'API non restituisce il segreto. Per gestire i vault, la chiave della tua applicazione deve avere i permessi api.vaults.read e api.vaults.write (documentazione sui vault; documentazione sulla sicurezza della sandbox).
Due regole della documentazione sfuggono facilmente. Primo, le credenziali MCP del vault valgono solo per le connessioni che partono da OpenAI. Una connessione con connection_origin: "environment" non le usa. Secondo, eliminare una credenziale non revoca il token originale e non ferma una sessione in esecuzione (documentazione sui vault: rotate or remove credentials). Per revocare una chiave EveryInfra, disattivala dalla console di EveryInfra.
Passo 3: un subagent per sito, e l'agente principale si limita a unire i risultati
Nell'Agents API la modalità multi-agente si attiva con un solo interruttore. Imposta agent.multi_agent.enabled: true quando crei la sessione. L'harness dà quindi all'agente gli strumenti per creare subagent, inviare loro messaggi, attenderli e interromperli, senza che tu debba dichiarare questi strumenti (documentazione multi-agente). max_concurrent_subagents limita quanti subagent girano contemporaneamente. Il valore predefinito è 6, escluso l'agente principale, e il nostro compito ha 5 siti, quindi il valore predefinito basta.
La stessa pagina contiene tre regole importanti per questo compito. I subagent ereditano gli strumenti MCP configurati, le relative credenziali e gli strumenti consentiti. I subagent non supportano i function tool. I subagent condividono il file system solo quando la sessione ha un ambiente (documentazione multi-agente).
La prima regola significa che la chiave del vault arriva a ogni subagent senza configurazioni aggiuntive. La seconda significa che un subagent non può scrivere nel tuo database tramite una funzione. È l'agente principale a dover restituire i risultati, e la tua applicazione li salva.
La documentazione dice anche quando suddividere il lavoro. Le attività indipendenti vanno ai subagent. Le attività brevi e i passaggi dipendenti restano all'agente principale (documentazione multi-agente: when to use subagents). I cinque siti di recensioni sono indipendenti.
Il confronto con la settimana precedente e il riepilogo finale richiedono tutti e cinque i risultati, quindi restano all'agente principale. La pagina sulle automation ha una sezione proprio su questo schema. Per un obiettivo di lunga durata, l'agente principale mantiene l'obiettivo e la pianificazione, affida ogni attività pianificata a un subagent e conserva un risultato breve. Così l'output dettagliato degli strumenti di ogni controllo resta fuori dal contesto principale (documentazione sulle scheduled automations: keep repeated work out of the main context).
Queste sono le istruzioni dell'agente principale che usiamo nell'esempio. Ogni riga corrisponde a un test reale descritto più avanti nell'articolo.
You run a weekly review check for the brands listed in the input.
Delegate each platform (trustpilot, g2, capterra, app_store, google_play) to its own subagent.
Each subagent calls everyinfra_call_api once per brand with the parameters given below,
uses mode=async when limit is 100 or more (read the rows with everyinfra_get_job),
keeps only reviews posted in the last 7 days (filter by posted_at yourself),
cuts every text field to 2,000 characters, and returns JSON:
{platform, brand, new_reviews, low_star, themes:[{name,count,example_url}], new_issue_vs_last_week}.
Do not return raw reviews. The main agent merges the five results into one report.
If a call returns an error with retryable=true, wait retry_after seconds and retry at most twice.
Never invent reviews. If a platform failed, say so in the report.
L'input di ogni esecuzione contiene i parametri per sito. Questa tabella mostra i valori per Notion. Ogni scelta deriva da un test descritto più avanti nell'articolo. Imposta limit in modo che una chiamata copra almeno due settimane. Non usare il massimo su tutti i siti. Il Test 1 e il Test 4 spiegano perché.
| Subagent | Parametri per brand | Criterio per le poche stelle | Motivo |
|---|---|---|---|
| Trustpilot | company: "notion.so", stars: ["1","2"], sort: "recency", limit: 20, senza date | Tutte le righe, perché la chiamata chiede 1–2 stelle | 20 righe risalgono a 129 giorni fa, circa 1 recensione con poche stelle a settimana, quindi leggi tutte le 20 righe e filtra per posted_at; per sort usa un valore del catalogo (Test 3) |
| G2 | url, sort: "newest", limit: 100, mode: "async" | rating pari o inferiore a 2,5; salta la riga record_type: summary | Nessun filtro per stelle; ClickUp riceve circa 47 recensioni a settimana (Test 1); una chiamata sincrona ha richiesto 50 secondi |
| Capterra | company impostato sull'URL del prodotto, limit: 100, mode: "async" | rating pari o inferiore a 2 | Nessun ordinamento; prendi tutte le righe e confronta id con la settimana precedente (Test 1) |
| App Store | app_id: "1232780281", country: "us", sort: "newest", limit: 50 | rating pari o inferiore a 2; conta per app_version | 50 righe coprono 39 giorni; le lamentele seguono i rilasci (Test 2) |
| Google Play | app_id: "notion.id", sort: "newest", language: "en", limit: 200 | score pari o inferiore a 2 | 40 righe coprivano solo 4,2 giorni, 200 righe ne coprivano 22 (Test 1) |
Attenzione ai nomi dei campi. Google Play restituisce il valore delle stelle in score, mentre gli altri quattro siti usano rating.
Passo 4: un'automation apre una nuova sessione ogni lunedì
Le pianificazioni sono una risorsa separata, POST /v1/agents/automations. Con type: "periodic" imposti expression (una stringa cron standard a cinque campi) e timezone (un nome IANA come America/New_York). Con type: "once" imposti run_at in secondi Unix. Esistono due tipi di target.
new_session apre una nuova sessione a ogni esecuzione e richiede un agente o un agent_id salvato, un ambiente e target.input. existing_session invia un promemoria a una sessione già esistente, per i lavori che richiedono risultati precedenti (documentazione «Scheduled automations»). Il riferimento API mostra che un target new_session accetta vault_ids e che il suo ambiente può essere none (riferimento «Create automation»). I nomi dei fusi orari provengono dal database IANA (IANA Time Zone Database) e i cinque campi cron seguono il crontab Unix (crontab(5)).
Ecco l'esempio di configurazione completo in Python. L'SDK aggiunge l'header OpenAI-Beta: agents=v1 per te; con curl devi aggiungerlo tu («Agents API quickstart»). Qui usiamo una pianificazione sul fuso orario di New York perché la maggior parte del traffico di recensioni per questi due brand è in inglese.
import os
from openai import OpenAI

client = OpenAI()  # app key needs api.agents.read / api.agents.write / api.responses.write / api.vaults.write
MCP_URL = "https://api.everyinfra.com/mcp"

vault = client.beta.agents.vaults.create(name="review-check")
client.beta.agents.vaults.credentials.create(
    vault.id,
    name="EveryInfra read-only key",
    auth={"type": "static_bearer", "mcp_server_url": MCP_URL, "token": os.environ["EVERYINFRA_API_KEY"]},
)

agent = client.beta.agents.create(
    model="gpt-6.1-terra",
    instructions=open("weekly_review_instructions.txt").read(),
    tools=[{
        "type": "mcp", "server_label": "everyinfra",
        "transport": {"type": "http", "server_url": MCP_URL},
        "connection_origin": "service",
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"], "required": True,
    }],
    multi_agent={"enabled": True, "max_concurrent_subagents": 5},
)

automation = client.beta.agents.automations.create(
    type="periodic",
    name="Weekly review check",
    expression="0 9 * * MON",
    timezone="America/New_York",
    target={
        "type": "new_session",
        "agent_id": agent.id,
        "environment": {"type": "none"},
        "vault_ids": [vault.id],
        "input": [{"role": "user", "content": [{"type": "input_text",
                   "text": "Brands: ClickUp (clickup.com; g2 clickup; capterra https://www.capterra.com/p/158833/ClickUp/; "
                           "app_store 1535098836; google_play co.mangotechnologies.clickup). Write this week's report."}]}],
    },
)
print(automation.id)
Alcuni dettagli della documentazione cambiano il significato di "pianificato". Una nuova automazione ha lo stato active, ma non viene eseguita subito: la prima esecuzione avviene al successivo orario corrispondente. Le esecuzioni ricorrenti ricevono un piccolo ritardo casuale per distribuire il carico.
Se la sessione target è occupata, l'attività resta in attesa. Ogni esecuzione crea un'invocazione, e un'invocazione con status: completed indica solo che la consegna è riuscita, non che l'agente abbia finito. Per il risultato, controlla agent.session.turn.completed o turn.failed negli eventi della sessione (documentazione «Scheduled automations»; documentazione «Sessions»).
La tua applicazione può leggere il report dallo stream di eventi o da un webhook. Il webhook agent.session.idle indica che la sessione può ricevere nuovo input. Anche questo non significa che l'ultimo turno sia andato a buon fine (documentazione «Webhooks»). Per fare una prova prima di lunedì, invia un POST /v1/agents/automations/{id}/invocations vuoto. Un'esecuzione manuale non modifica la pianificazione salvata (documentazione «Scheduled automations», sezione «try a run»).
Quale target conviene, new_session o existing_session? Una nuova sessione parte ogni settimana con un contesto pulito, quindi il costo è facile da prevedere. L'agente non ricorda la settimana precedente, perciò la tua applicazione deve inserire il riepilogo della settimana scorsa in target.input. Una sessione esistente conserva i risultati precedenti, e l'Agents API compatta il contesto più vecchio quando la sessione si avvicina al limite (post di lancio di OpenAI; documentazione «Compaction»). Noi preferiamo una nuova sessione con nell'input il riepilogo della settimana scorsa, che occupa solo mille o duemila token.
Un vero round trip MCP: cosa invia il subagente e cosa riceve in risposta
Ciò che un subagente invia a EveryInfra è una singola tools/call MCP. Alle 00:47:47 SGT del 1° novembre 2026 abbiamo inviato questa chiamata a https://api.everyinfra.com/mcp con la nostra chiave di test. È la chiamata che farebbe il subagente di Trustpilot: le recensioni recenti da 1 e 2 stelle per notion.so. L'oggetto arguments è l'input di everyinfra_call_api: la piattaforma, la funzionalità e i suoi parametri.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api","arguments":{"platform":"trustpilot","action":"reviews","params":{"company":"notion.so","stars":["1","2"],"date":"last30days","sort":"recency","limit":20}}}}La risposta è un blocco di testo interpretabile come JSON. count vale 14. Ogni riga in results contiene title, text, rating, posted_at, verification_level, country e altro, e i campi corrispondono all'elenco response_fields di trustpilot/reviews nel catalogo. billing.charged è true e charged_usd è 0.001389, cioè il prezzo di catalogo (catalogo: trustpilot). La prima recensione ha il titolo "I find everything in Notion a bit too chaotic" ed è stata pubblicata il 20 ottobre 2026. Per confronto abbiamo aperto la pagina pubblica di Notion su Trustpilot: la stessa recensione, con la stessa data, è lì (Trustpilot: Notion).
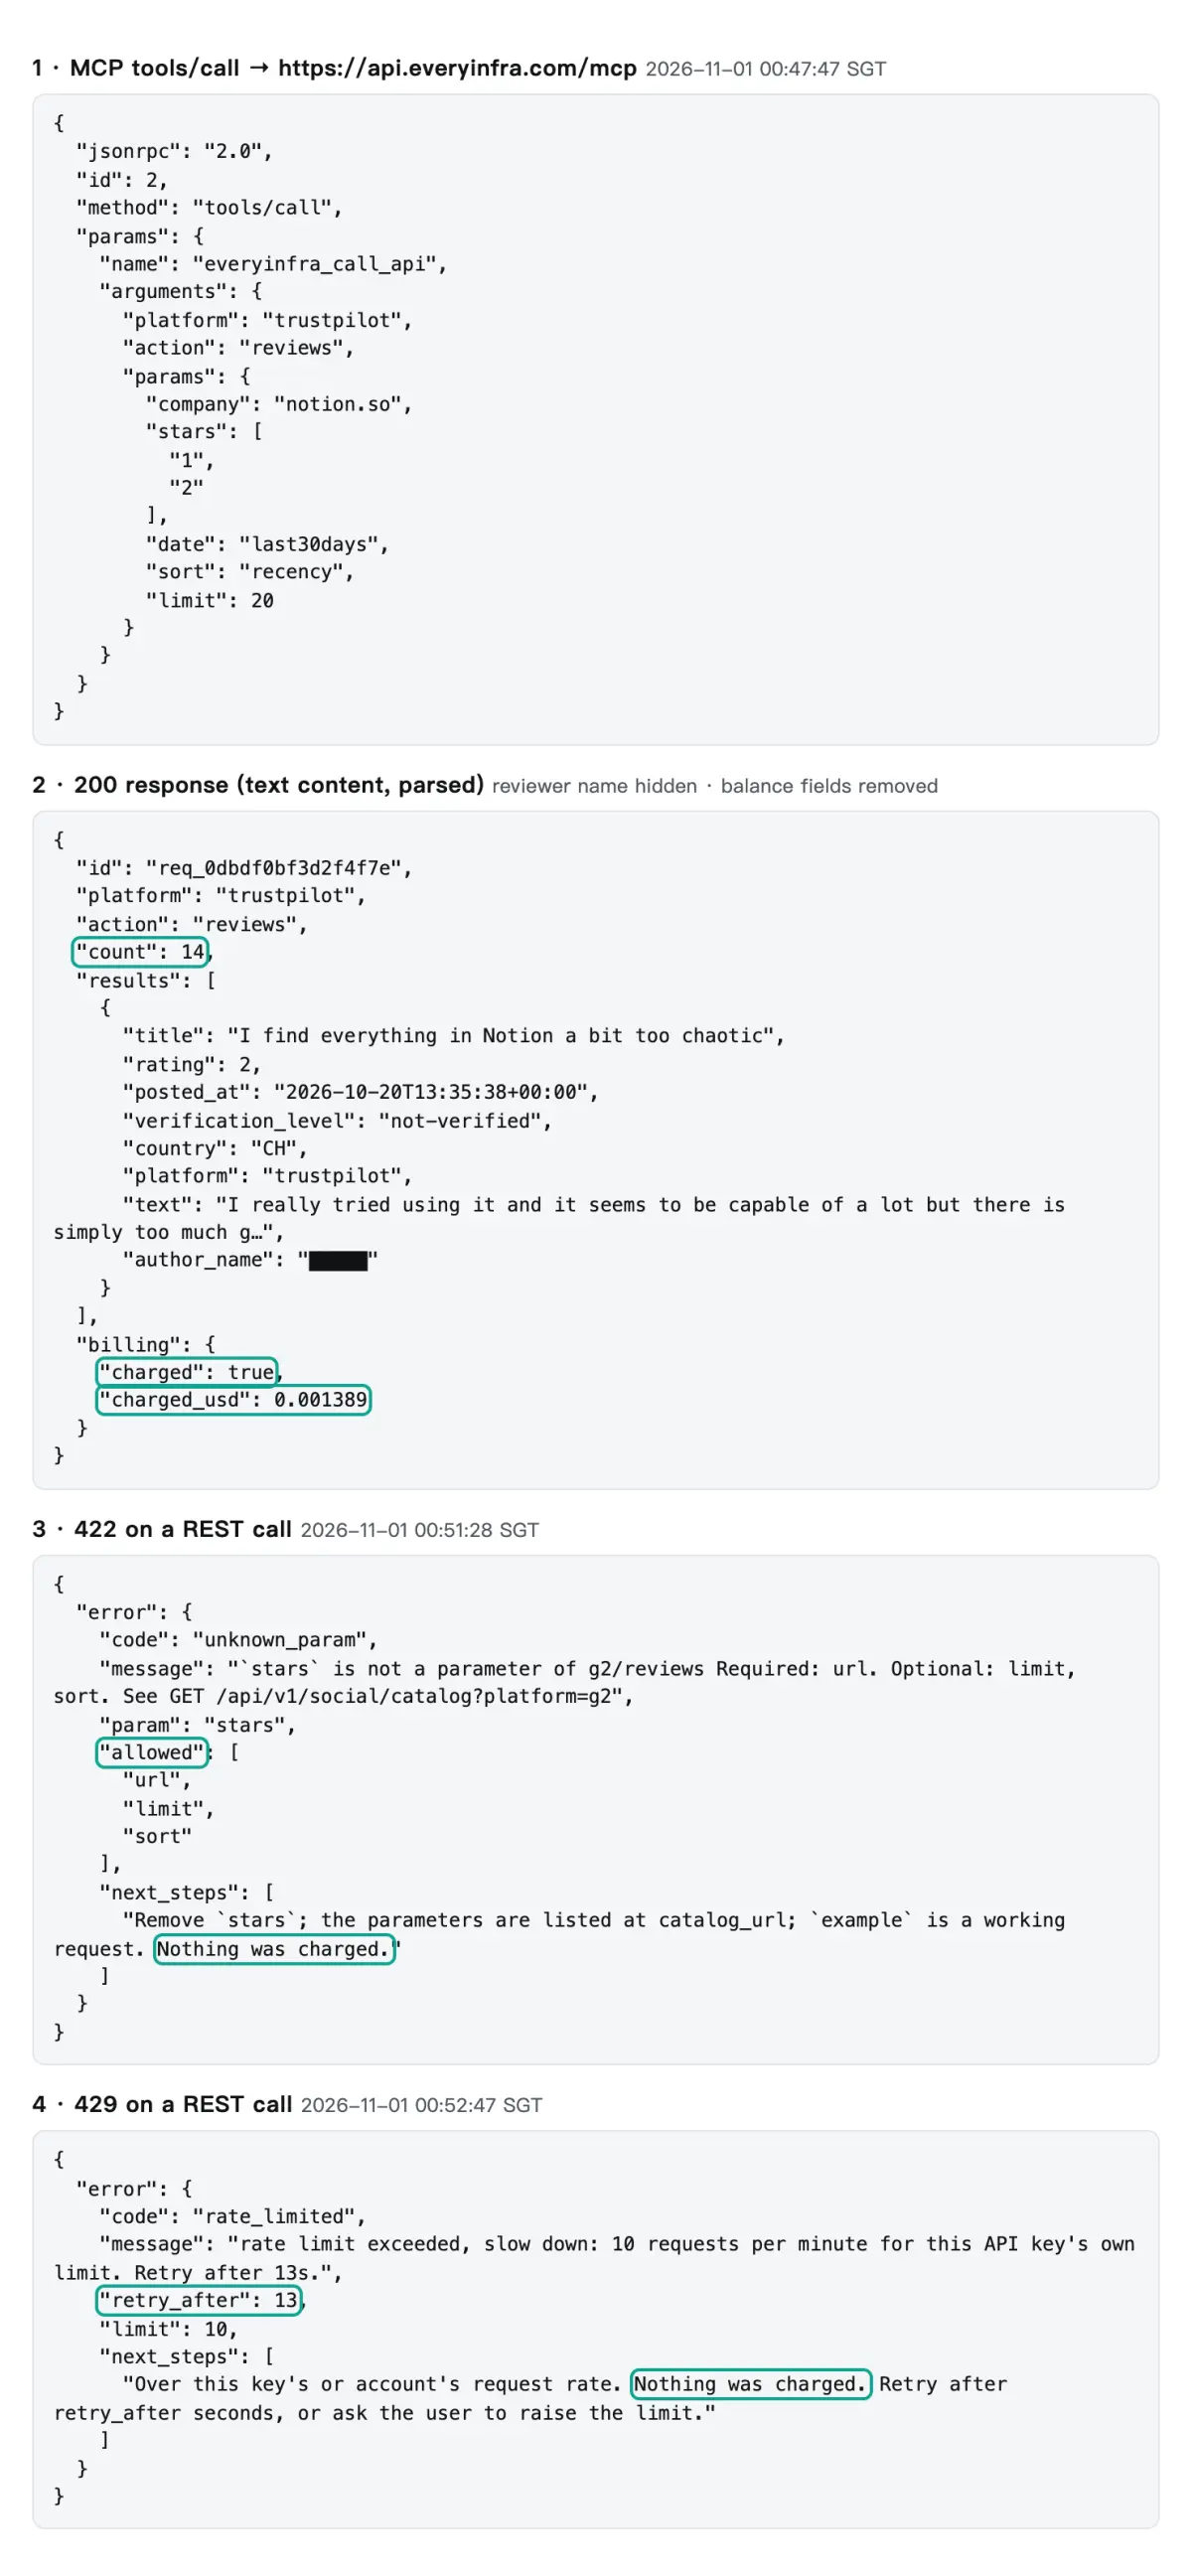
Lo stesso screenshot mostra due errori che un subagente incontrerà nelle esecuzioni reali. Alle 00:51:28 SGT abbiamo inviato di proposito stars a g2/reviews, anche se quella funzionalità non lo supporta. L'API ha restituito 422 con error.code impostato su unknown_param. L'elenco allowed indicava url, limit e sort, e next_steps diceva di rimuovere stars e che non era stato addebitato nulla.
Alle 00:52:47 e alle 00:53:46 SGT due chiamate hanno restituito 429. In quel momento diversi job di test usavano la stessa chiave di test e ne condividevano il limite di 10 richieste al minuto. Il primo 429 aveva retry_after impostato a 13 secondi, e il nostro nuovo tentativo 37 secondi dopo è riuscito. Il nuovo tentativo dopo il secondo 429 è arrivato 15 secondi dopo ed è riuscito anch'esso. Nessuno dei due 429 è stato addebitato.
Ogni errore indica al modello quale parametro cambiare e quanto attendere, così un subagente può correggersi da solo. La regola per i nuovi tentativi nelle nostre istruzioni usa questo formato.
Un altro errore richiede una nota attenta, e ne abbiamo trovato la causa solo con un test di controllo. Alle 00:51:16 SGT, sort: "newest" su trustpilot/reviews ha restituito un 503 con retryable: true, retry_after: 20 e nessun addebito. L'errore diceva che questa funzionalità era fallita 3 volte in 10 minuti. Tutte e 3 quelle chiamate fallite (due provenivano da altri test in corso nello stesso momento) avevano un valore non presente nel catalogo. Negli stessi minuti, le chiamate con valori presenti nel catalogo funzionavano.
Per verificare la causa abbiamo inviato gli stessi parametri due volte, alle 15:39:46 e alle 15:40:07 SGT. L'unica differenza era sort: prima newest, poi recency, il valore presente nel catalogo. Entrambe le chiamate hanno restituito 200 con un addebito di $0,001389 ciascuna, ma le righe erano diverse.
La chiamata con recency ha restituito le stesse 20 righe della chiamata delle 00:54, tutte in inglese e ciascuna con un campo source. La chiamata con newest ne aveva in comune solo 14. Le altre 6 righe erano in tedesco, francese e olandese, e nessuna riga aveva source o verification_level. La nota sui campi nel catalogo dice che questi campi possono mancare quando i risultati provengono da una fonte di riserva.
| `sort` | Orario (SGT) | Risposta | Righe | Lingue | Campo `source` | Addebitato |
|---|---|---|---|---|---|---|
newest (non in catalogo) | 00:51:16 | 503 | — | — | — | No |
newest (non in catalogo) | 15:39:46 | 200 | 20, solo 14 in comune con recency | 14 en, 3 de, 2 fr, 1 nl | Nessuna riga | $0.001389 |
recency | 15:40:07 | 200 | 20, le stesse delle 00:54 | 20 en | Tutte le 20 righe | $0.001389 |
newest (dopo la correzione serale) | 19:23:05 | 200 | 20, le stesse di recency | 20 en | Tutte le 20 righe | $0.001389 |
recency (dopo la correzione serale) | 19:22:49 | 200 | 20, le stesse delle 00:54 | 20 en | Tutte le 20 righe | $0.001389 |
Quindi il controllo dei parametri non blocca newest. La fonte principale fallisce con quel valore, e il risultato dipende dalla fonte di riserva in quel momento. Alle 00:51 anche la fonte di riserva è fallita e abbiamo ricevuto un 503. Alle 15:39 ha funzionato e abbiamo ricevuto un 200 con dati diversi e un addebito normale.
È peggio di un errore, perché un subagente non può accorgersi del problema.
Questi erano i risultati delle prime ore e del pomeriggio del 1° novembre. Quella sera il gateway ha modificato sort: ora accetta newest (equivalente a recency), recency e relevance. Gli altri valori ricevono un 422 prima di qualsiasi addebito, con i valori ammessi e un suggerimento del tipo "forse intendevi". Il nostro nuovo test delle 19:22–19:23 SGT è nella tabella alla fine del Test 3.
Ma cambiare sito spesso significa cambiare nome del parametro. Per questo le istruzioni fissano comunque i parametri per ogni sito e non lasciano che il modello tiri a indovinare. retry_after gestisce gli errori temporanei.
Test 1: basta un'esecuzione a settimana? Dipende da quanto indietro arriva una singola chiamata
"Controlla una volta a settimana" sembra ovvio, ma presuppone una cosa: una chiamata per sito deve coprire tutti i 7 giorni. Se un sito riceve 60 nuove recensioni a settimana e ne leggi 20, il report vede solo il weekend. Per questo, prima di qualsiasi configurazione, abbiamo misurato quanti giorni copre una chiamata su ciascun sito.
Per Notion e ClickUp abbiamo chiamato platform/reviews una volta su ciascuno dei cinque siti. Abbiamo registrato la data di pubblicazione più recente e quella meno recente, e se le righe arrivavano a partire dalla più recente. Abbiamo anche contato le righe dal 25 ottobre al 1° novembre 2026 (UTC). Per i due brand sono servite 12 chiamate live tra le 00:48 e le 14:38 SGT del 1° novembre 2026.
| Sito · brand | Righe richieste | Righe restituite | Meno recente | Più recente | Prima le più recenti | Ultimi 7 giorni | Valutazione bassa |
|---|---|---|---|---|---|---|---|
| Trustpilot · Notion (solo 1–2 stelle) | 20 | 20 | 2026-06-13 | 2026-10-20 | Sì | 0 | 0 |
| Trustpilot · ClickUp (solo 1–2 stelle) | 20 | 20 | 2026-05-16 | 2026-10-29 | Sì | 2 | 2 |
| G2 · Notion | 20 | 19 recensioni + 1 riepilogo | 2022-11-28 | 2026-10-29 | In gran parte, con 3 righe vecchie in mezzo | 12 | 0 |
| G2 · ClickUp | 20 | 19 recensioni + 1 riepilogo | 2026-10-28 | 2026-10-31 | Sì | 19 | 0 |
| Capterra · Notion | 20 | 19 | 2025-12-11 | 2026-10-09 | No | 0 | 0 |
| Capterra · ClickUp | 20 | 17 | 2025-11-05 | 2026-10-21 | No | 0 | 0 |
| App Store · Notion | 50 | 50 | 2026-09-20 | 2026-10-29 | Sì | 9 | 6 |
| App Store · ClickUp | 50 | 50 | 2026-03-30 | 2026-10-29 | Sì | 2 | 2 |
| Google Play · Notion | 200 | 200 | 2026-10-08 | 2026-10-30 | Sì | 52 | 15 |
| Google Play · ClickUp | 200 | 200 | 2026-03-04 | 2026-10-31 | Sì | 5 | 1 |
Contano soprattutto i due estremi. Su G2, tutte le 19 recensioni di ClickUp cadono tra il 28 e il 31 ottobre, in tre giorni. A quel ritmo ClickUp riceve circa 47 recensioni G2 a settimana, quindi 20 righe mostrano solo gli ultimi due o tre giorni.
Su Google Play abbiamo chiesto all'inizio 40 recensioni di Notion, che coprivano solo 4,2 giorni. Con 200 righe, il massimo per quella funzionalità, la chiamata copriva 22 giorni. All'estremo opposto, le recensioni di Notion con valutazione bassa su Trustpilot sono rare: venti di queste risalgono fino al 13 giugno, circa una a settimana.
Quindi la stessa pianificazione settimanale richiede il limit massimo su alcuni siti e solo 20 righe su altri. Gli endpoint per le recensioni di EveryInfra addebitano per chiamata. La chiamata Google Play da 200 righe aveva charged_usd pari a 0.001389, come quella da 40 righe.
Ma il massimo su ogni sito non è la scelta migliore. Durante la revisione abbiamo fatto un altro giro per Notion con il max_limit del catalogo su ogni sito (Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200). Le 500 righe dell'App Store risalivano fino al 14 febbraio 2026, e le righe Trustpilot con valutazione bassa fino ad aprile 2024. È molto più di quanto serva a un report settimanale, e ogni riga in più finisce nel contesto del modello (i numeri sono nel Test 4).
La nostra regola: imposta limit in modo che una chiamata copra almeno due settimane. Per Notion significa Trustpilot 20, G2 100, Capterra 100, App Store 50 e Google Play 200. Il subagente poi filtra per posted_at sugli ultimi 7 giorni. I tuoi brand hanno volumi diversi, quindi misura prima una chiamata per sito, come nella tabella qui sopra.
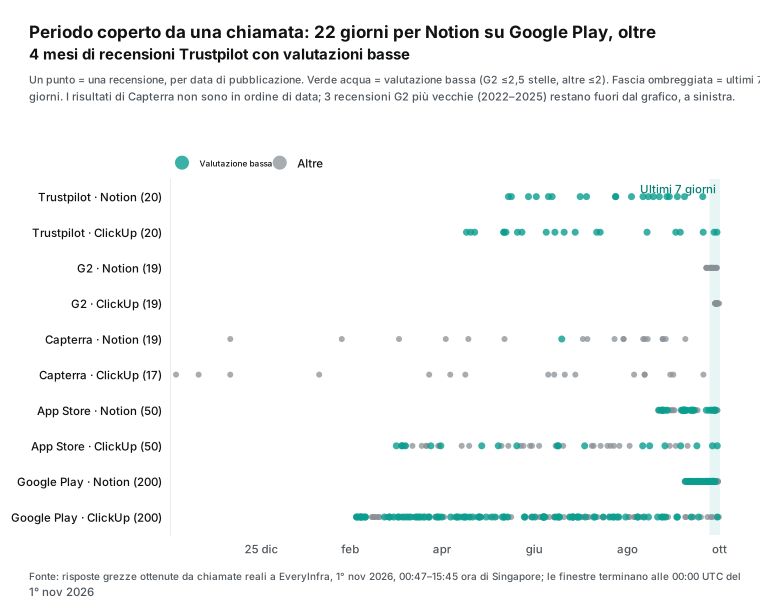
Il grafico mostra un terzo caso. Le due righe di Capterra sono distribuite su un anno intero, e l'ordine dei risultati non ha alcun legame con il tempo. capterra/reviews ha un solo parametro obbligatorio, company, e nessun parametro di ordinamento. Le 19 recensioni di Notion vanno dall'11 dicembre 2025 al 9 ottobre 2026 in ordine sparso, e solo 1 rientra negli ultimi 30 giorni. Le 17 recensioni di ClickUp hanno lo stesso andamento.
Per il report, "prendi le N più recenti" non funziona su Capterra. Chiedi ogni volta 100 righe e confronta id e posted_at con il risultato della settimana scorsa. Le recensioni su Capterra sono poche, 1 in 30 giorni per ciascun brand, quindi un'esecuzione settimanale basta.
Anche G2 ha una piccola trappola. La prima riga della risposta per Notion non è una recensione: è una riga con record_type: summary che contiene la valutazione complessiva di 4,6, un totale di 13.962 recensioni e i principali pro e contro. Le 19 recensioni successive sono in gran parte ordinate dalla più recente, ma in mezzo ci sono tre recensioni del periodo 2022–2025.
Un subagente che usasse la data meno recente come "copertura" penserebbe che la chiamata sia risalita di quattro anni. La regola "filtra tu per posted_at" gestisce questo caso. La riga di riepilogo è comunque utile: il report può citare la valutazione complessiva G2 della settimana senza una chiamata g2/profile separata.
Test 2: dove si trovano le recensioni con valutazione bassa
Misurata la copertura, possiamo confrontare dove si trovano le recensioni con valutazione bassa. Abbiamo contato quelle degli ultimi 30 giorni visibili con una chiamata per sito (G2 fino a 2,5 stelle, gli altri fino a 2). Notion ne ha 67 in totale: 22 sull'App Store, 42 su Google Play, 3 su Trustpilot e 0 su G2 e Capterra. Quindi 64 su 67, il 95,5%, sono nei due app store. ClickUp ne ha 14 in totale, distribuite in modo più uniforme: 5 su Trustpilot, 4 sull'App Store, 5 su Google Play e 0 su G2 e Capterra.
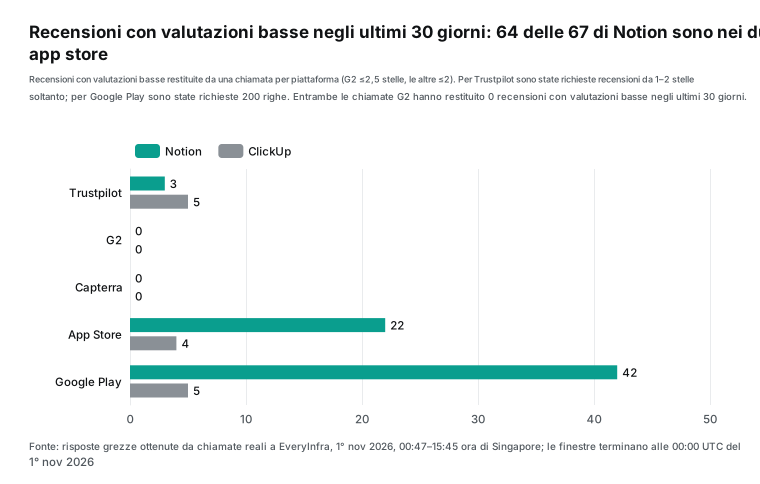
Questa distribuzione offre due lezioni per il report. Primo, i siti di recensioni B2B hanno poche recensioni con valutazione bassa. Nessuno dei due brand ha avuto una recensione G2 con valutazione bassa in 30 giorni in una chiamata da 20 righe. Durante la revisione, una chiamata da 100 righe per Notion ha restituito 50 recensioni: 41 degli ultimi 30 giorni, e solo 1 di queste con valutazione bassa. È coerente con la valutazione di riepilogo G2 di 4,6. Un team che monitora solo G2 e Capterra potrebbe pensare che vada tutto bene.
Secondo, le lamentele negli app store sono numerose e specifiche, e la maggior parte riporta un numero di versione. Ogni riga dell'App Store ha un campo app_version. Delle 22 recensioni di Notion con valutazione bassa in 30 giorni, 8 riguardano la versione 1.7.345, più di qualsiasi altra versione. Un subagente che conta per versione può scrivere "le recensioni con valutazione bassa si concentrano dopo la 1.7.345", un'indicazione su cui un team di engineering può agire.
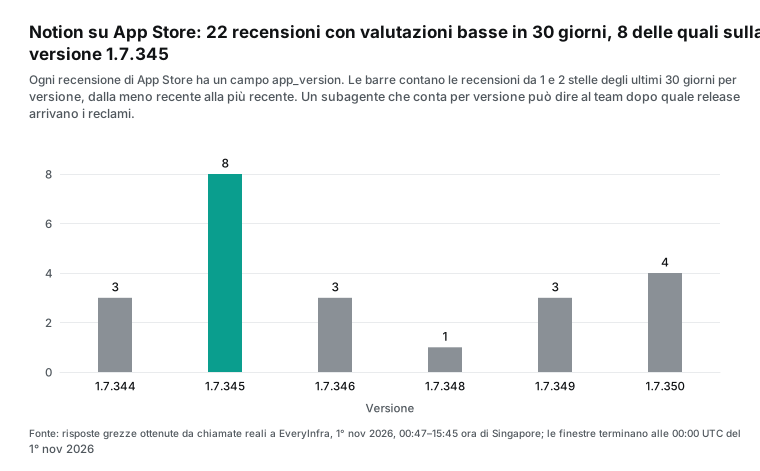
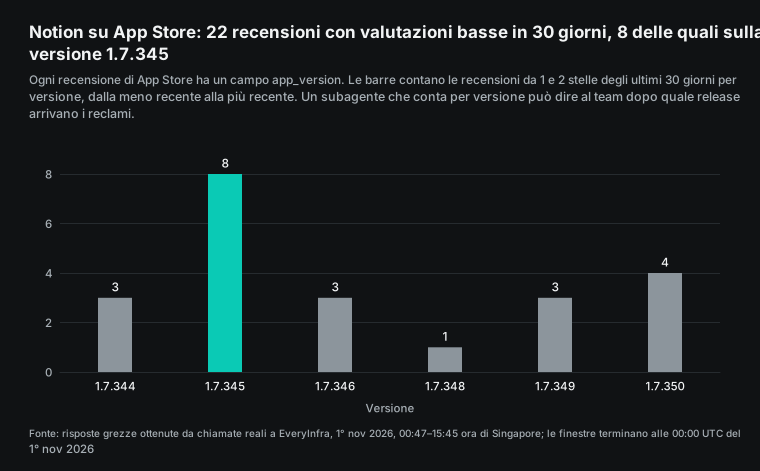
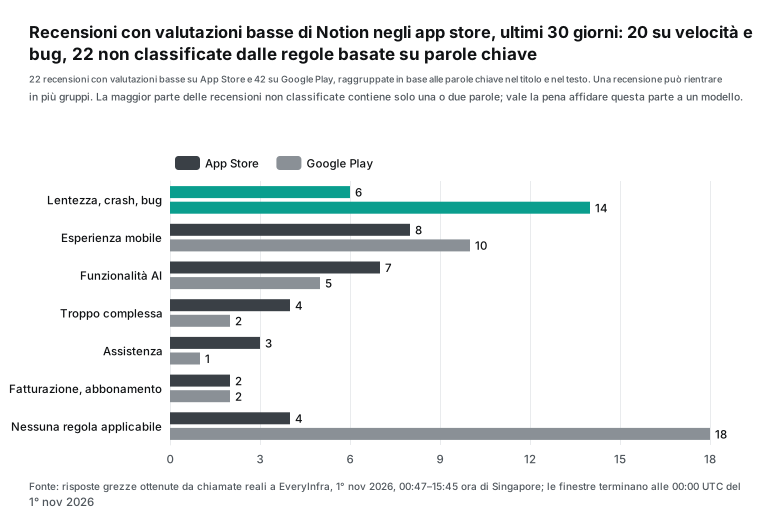
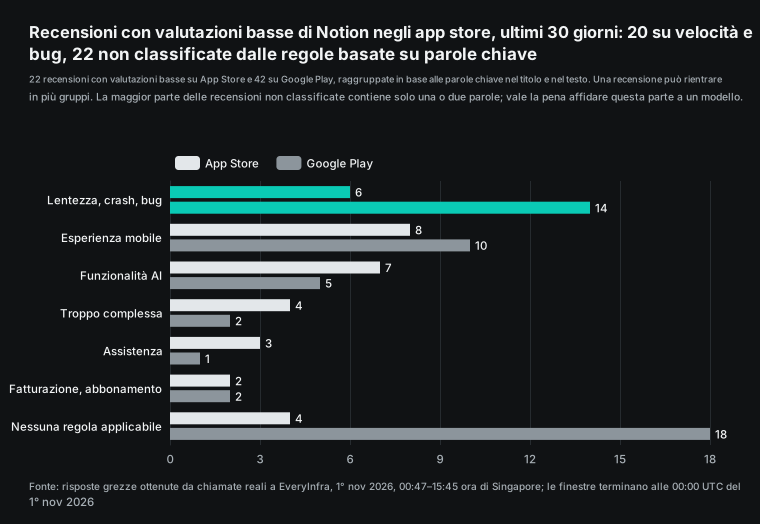
Abbiamo anche raggruppato queste recensioni con regole basate su parole chiave. Le regole sono nel nostro script di riconteggio. Per esempio, "slow", "crash" o "bug" nel titolo o nel testo assegnano una recensione al gruppo velocità e bug. Una recensione può rientrare in più gruppi.
Delle 64 recensioni di Notion con valutazione bassa nei due app store, 20 riguardano velocità e bug, 18 l'esperienza mobile e 12 le funzionalità AI. Le regole non sono riuscite a classificarne 22, e 18 di queste sono su Google Play. Si tratta per lo più di recensioni di una o due parole.
È in quest'ultimo gruppo che un modello giustifica il suo costo. Le regole gestiscono le lamentele lunghe e chiare, ma falliscono su "bad", "worst update" o sul sarcasmo. Quindi il modello del subagente dovrebbe spendere la maggior parte dei token sulle recensioni che le regole non riescono a classificare, non su una seconda lettura di tutte le recensioni.
Un segnale emerge solo guardando più brand insieme, ma il campione è molto piccolo. Negli ultimi 30 giorni, 2 recensioni di Notion e 1 di ClickUp sull'App Store citano l'"iPhone Duo". Una recensione di Notion da 2 stelle del 26 ottobre dice che le aree touch smettono di funzionare, il testo scompare quando viene selezionato e l'app va in crash su iPhone Duo. Una recensione di ClickUp da 1 stella del 29 ottobre ha il titolo "No iPhone Duo support". L'iPhone Duo è il primo iPhone pieghevole di Apple ed è arrivato in vendita negli Apple Store il 23 ottobre (Apple Newsroom). Nelle prime settimane di un nuovo dispositivo, i problemi di supporto delle app sono comuni.
Quindi tre recensioni non dimostrano un problema per cui uno dei due team debba pianificare interventi. Una buona riga di report è "supporto per il nuovo dispositivo, da monitorare: verificare la settimana prossima se il numero cresce". La lezione utile riguarda i ruoli. In un singolo brand è una lamentela; guardando più brand si vede che punta a un unico dispositivo. L'agente principale vede tutti i riepiloghi dei subagenti, quindi questo passaggio tra brand spetta all'agente principale.
Com'è il report settimanale, con i dati reali di questa settimana
È più facile giudicare l'output quando lo vedi. La tabella qui sotto usa la settimana dal 25 ottobre al 1° novembre 2026 (UTC). Per ogni sito e brand mostra le nuove recensioni visibili con una chiamata e quante avevano una valutazione bassa. Tutti i valori provengono dalle risposte grezze di chiamate live. Questa è la forma dei dati che i subagenti restituiscono all'agente principale.
| Sito | Notion nuove / valutazione bassa | ClickUp nuove / valutazione bassa | Cosa dovrebbe dire il report |
|---|---|---|---|
| Trustpilot | 0 / 0 | 2 / 2 | Due recensioni di ClickUp da 1 stella: una sul chatbot dell'assistenza, una sul preavviso di 30 giorni per le modifiche a licenze e fatturazione. Inoltrale entrambe ad assistenza e fatturazione. |
| G2 | 12 / 0 | 19 / 0 | Nessuna recensione con valutazione bassa per nessuno dei due brand. ClickUp ne riceve circa 47 a settimana, quindi imposta limit a 100. |
| Capterra | 0 / 0 | 0 / 0 | Nessuna nuova recensione questa settimana. I risultati non sono ordinati, quindi confronta i valori di id con la settimana scorsa. |
| App Store | 9 / 6 | 2 / 2 | Le lamentele su Notion si concentrano sulla versione 1.7.345. Tre recensioni dei due brand citano l'iPhone Duo; da ricontrollare la settimana prossima. |
| Google Play | 52 / 15 | 5 / 1 | La principale fonte di lamentele su Notion. Invia al modello le 22 recensioni brevi. |
L'agente principale riceve cinque righe brevi come queste, più la valutazione complessiva di ciascun brand. La riga di riepilogo di G2 fornisce una valutazione, e una chiamata trustpilot/profile restituisce per Notion un TrustScore di 2,2 basato su 442 recensioni.
L'agente principale prende poi tre decisioni. Quale riga è cresciuta molto rispetto alla settimana scorsa? Qualche problema si ripete tra siti o brand? Quali recensioni originali meritano un link nel report? Tutte e tre richiedono tutti e cinque i risultati, quindi restano all'agente principale. Leggere centinaia di recensioni e contarle per versione e parola chiave è un lavoro meccanico, quindi va ai subagenti.
Ti consigliamo di far restituire all'agente principale un JSON fisso e di lasciare alla tua applicazione il compito di trasformarlo in un'email o in un messaggio di chat. Le sessioni accettano uno schema di output in agent.text.format.schema, e input e schema insieme devono restare sotto i 4 MiB (documentazione «Sessions»). Con uno schema fisso, il report ha la stessa forma ogni settimana e il confronto settimana su settimana è semplice.
Test 3: un parametro sbagliato cambia il risultato
Le sezioni precedenti hanno accennato ad alcuni problemi con i parametri. Questa tabella li raccoglie insieme agli altri casi che abbiamo osservato. Ogni riga è una chiamata live. L'ultima colonna è la regola da inserire nelle istruzioni del subagente.
| Cosa è successo | Ora (SGT, 1° nov 2026) | Risposta | Addebitato | Soluzione |
|---|---|---|---|---|
Trustpilot con date: "last30days" ha restituito più di 30 giorni | 00:47 | 14 righe dal 31 luglio al 20 ottobre, solo 3 entro 30 giorni. Dopo la correzione serale, il nuovo test delle 19:22 ha restituito 3 righe, tutte entro 30 giorni. | Sì, $0,001389 | Dopo la correzione il preset funziona. Per il report settimanale, filtra comunque per posted_at. |
G2 con un stars non supportato | 00:51 | 422 unknown_param, ammessi: url, limit, sort | No | G2 non ha un filtro per stelle. Filtra tu per rating. |
| Diversi job di test condividevano una chiave e ne hanno esaurito le 10 richieste al minuto | 00:52, 00:53 | 429, primo retry_after di 13 secondi; entrambi i nuovi tentativi sono riusciti | No | Attendi retry_after. |
Trustpilot con sort: "newest", un valore non presente nel catalogo | 00:51, 15:39 | Prima un 503. Poi un 200 da una fonte di riserva, con 6 righe non in inglese e senza campo source. Dopo la correzione serale, newest equivale a recency. | 503 no; 200 sì, $0,001389 | Usa i valori del catalogo. Dopo la correzione, un valore errato riceve un 422. |
| Trustpilot, 200 righe, chiamata sincrona | 15:40 | Timeout dopo 85 secondi, 503, con il consiglio di usare mode: "async" | No | Usa la modalità asincrona per un limit elevato e leggi le righe con everyinfra_get_job. La chiamata asincrona ha restituito 131 righe. |
Ricerca su Capterra per nome Notion | 00:49 | 20 righe, 3 senza data né link, provenienti da un add-on di esportazione per Google Sheets | Sì, $0,001389 | Usa l'URL della pagina prodotto /p/186596/Notion/. |
| Ricerca su Capterra per URL del prodotto | 00:50 | 19 righe, non ordinate, un campo pros di 98.725 caratteri. Dopo la correzione serale, ogni campo ha al massimo 5.000 caratteri. | Sì, $0,001389 | Mantieni un limite su ogni campo di testo, per esempio 2.000 caratteri. |
| La prima riga di G2 è un riepilogo | 00:48 | record_type: summary, valutazione 4,6, 13.962 recensioni | Sì, $0,001389 | Gestisci il riepilogo a parte. Non contarlo come recensione. |
La riga di Trustpilot merita un esame più attento. Il catalogo descrive date come un preset temporale, dove last30days indica gli ultimi 30 giorni. L'abbiamo inviato con solo 1 e 2 stelle e abbiamo ricevuto 14 righe dal 31 luglio al 20 ottobre, di cui solo 3 entro 30 giorni. La stessa richiesta senza date ha restituito 20 righe fino al 13 giugno, e le sue prime 14 righe erano proprio quelle 14.
Quindi nell'esecuzione delle prime ore del 1° novembre la chiamata con il preset si è fermata a circa tre mesi prima, non a 30 giorni. Un report che contasse le righe avrebbe indicato 14 recensioni con valutazione bassa in 30 giorni, quando il numero reale era 3.
Quella sera il gateway ha modificato i preset in modo che taglino per data di pubblicazione: 7, 30, 92, 183 e 366 giorni indietro. Un preset errato ora riceve un 422 prima di qualsiasi addebito. Il nostro nuovo test delle 19:22 SGT ha restituito 3 righe dal 3 al 20 ottobre, cioè le 3 righe che nell'esecuzione delle prime ore rientravano nei 30 giorni. Ora puoi quindi usare last30days come filtro per data. Per il report settimanale continuiamo comunque a leggere tutte le 20 righe e a filtrare per posted_at, perché il subagente confronta le nuove recensioni con quelle più vecchie.
La ricerca per nome su Capterra mostra un principio generale. I siti di recensioni elencano molti prodotti con nomi uguali o simili, quindi una ricerca per nome può includere un altro prodotto. La nota del catalogo per company consiglia di inviare, quando possibile, il link del prodotto per evitarlo. Con l'URL del prodotto, tutte le 19 righe erano recensioni di Notion. Il tuo elenco di brand dovrebbe memorizzare per ogni sito un link o un ID, non un nome. Decidilo quando progetti l'input.
La tabella qui sotto riassume i nostri nuovi test dopo la correzione serale del 1° novembre (19:22–19:23 SGT), con gli stessi parametri usati durante il giorno:
| Voce | Esecuzione delle prime ore o del pomeriggio, 1° novembre | Nuovo test serale | Addebitato |
|---|---|---|---|
Trustpilot sort: "newest" | 503 alle 00:51; 200 alle 15:39, ma 6 righe non in inglese e nessun source | 200, le stesse righe di recency e delle 00:54, tutte in inglese | $0.001389 |
Trustpilot date: "last30days" | 14 righe, solo 3 entro 30 giorni | 3 righe, tutte entro 30 giorni | $0.001389 |
URL del prodotto su Capterra, limit: 100 | 86 righe, 375.315 byte, campo più lungo 103.138 caratteri | Le stesse 86 righe, 144.341 byte, campo più lungo 1.154 caratteri | $0.001389 |
| Giro settimanale consigliato (Notion) | 651.907 byte, circa 163k token | 420.933 byte, circa 105k token | — |
Test 4: il costo del modello dipende dalle dimensioni di una settimana di recensioni grezze
I modelli addebitano per token, quindi ti serve la dimensione di una settimana di recensioni grezze. Ogni riga restituita da una chiamata entra nel contesto del subagente come output dello strumento, quindi limit determina quanto legge il modello. Abbiamo misurato tre configurazioni per Notion, ognuna su risposte reali, più un nuovo test serale di Capterra. Per il testo in inglese i token sono stimati a circa 4 caratteri per token (OpenAI Help Center: tokens).
| Configurazione (Notion, una chiamata per sito) | `limit` per sito | Grezzo | Token (circa) | Campi di testo tagliati a 2.000 caratteri | Token (circa) |
|---|---|---|---|---|---|
| Primo giro (00:47–00:57) | Trustpilot 20 (con last30days), G2 20, Capterra 20, App Store 50, Google Play 200 | 359.497 byte | 89,874 | 246.387 byte | 61,597 |
| Consigliata | Trustpilot 20, G2 100, Capterra 100, App Store 50, Google Play 200 | 651.907 byte | 162,977 | 422.892 byte | 105,723 |
| Consigliata, con il nuovo test serale di Capterra (19:23) | Come sopra | 420.933 byte | 105,233 | 420.732 byte | 105,183 |
max_limit ovunque | Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200 | 1.021.087 byte | 255,272 | 786.452 byte | 196,613 |
Per la configurazione consigliata, G2 e Capterra provengono da due nuove chiamate alle 15:42 e alle 15:43 SGT. G2 ha richiesto 100 righe e ha restituito 50 recensioni più 1 riga di riepilogo. Capterra ne ha richieste 100 e ne ha restituite 86. Le altre tre chiamate provengono dal primo giro, con gli stessi parametri. Il giro con max_limit vale circa 197k token dopo il taglio, 1,86 volte la configurazione consigliata. La maggior parte dell'eccedenza è dovuta a 450 righe in più dell'App Store e 111 righe in più di Trustpilot, quasi tutte molto più vecchie di una settimana.
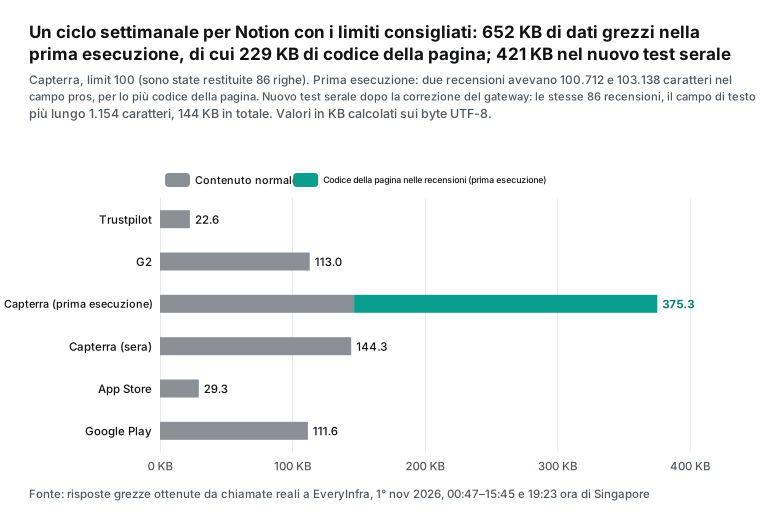
Nell'esecuzione delle prime ore del 1° novembre, più di un terzo dei 652 KB proveniva da due recensioni. Nel primo giro, la risposta Capterra da 20 righe pesava 148.915 byte, e una sola recensione al suo interno 114.983 byte. Il suo campo pros aveva 98.725 caratteri: inizia con un normale commento dell'utente e poi prosegue con un lungo blocco di dati di script della pagina. La risposta da 100 righe conteneva due recensioni di questo tipo, con campi pros di 100.712 e 103.138 caratteri. La risposta Capterra di ClickUp ne conteneva una, con 103.556 caratteri.
Il parser aveva preso i dati della pagina insieme alla recensione.
Con ogni campo di testo tagliato a 2.000 caratteri, la risposta Capterra da 100 righe è scesa da 375.315 a 146.501 byte. Il giro settimanale consigliato è sceso da circa 163k a circa 106k token. Senza il taglio, un subagente leggeva il 54% in più.
Quella sera il gateway ha corretto il parser: ora rimuove il codice della pagina da pros, cons e text, e ogni campo ha al massimo 5.000 caratteri. Il nostro nuovo test delle 19:23 SGT ha restituito le stesse 86 recensioni in 144.341 byte, poco meno dei 146.501 byte dopo il taglio delle prime ore (vedi la tabella alla fine del Test 3). Il giro settimanale consigliato vale ora circa 105k token, con una differenza di appena lo 0,5% rispetto al valore delle prime ore dopo il taglio. Quindi la stima del costo del modello qui sotto non cambia.
Limitare i campi di testo prima di passare i dati a un modello resta una buona abitudine. Non costa nulla e ti protegge se in futuro un altro sito avrà lo stesso problema.
È qui che i subagenti ripagano. Senza di loro, l'agente principale legge da solo tutti i 106k token. Con cinque subagenti, ognuno legge solo il proprio sito (Capterra, il più grande, vale circa 37k token dopo il taglio), e l'agente principale riceve un riepilogo JSON di qualche centinaio di token per sito. La documentazione delle automazioni dice lo stesso: delega ogni attività pianificata a un subagente, così l'output dettagliato degli strumenti resta fuori dal contesto principale (documentazione «Scheduled automations»). Il nostro test dei subagenti di Claude Code con account TikTok di brand ha rilevato un rapporto di circa 100 a 1 tra dati grezzi e riepiloghi.
Il conto: prezzi dell'OpenAI Agents API e costo dei dati
Partiamo dai dati. Gli endpoint per le recensioni di EveryInfra addebitano per chiamata, e il numero di righe non cambia il prezzo. Tutte e cinque le funzionalità hanno un price_usd di 0.001389 (catalogo; pagina dei prezzi). Un brand, con cinque chiamate a settimana, costa $0,006945 a settimana e $0,3611 all'anno. Dieci brand, il tuo più nove concorrenti, costano $3,61 all'anno.
Questi numeri non sono stime. Per questo articolo abbiamo fatto 21 chiamate addebitate, 6 delle quali durante la revisione. Ognuna ha restituito charged_usd pari a 0.001389, per un totale di $0,029169. Le 6 chiamate fallite (tre 503, un 422 e due 429) non sono state addebitate. Dopo la correzione serale abbiamo fatto 4 nuovi test (3 su Trustpilot, 1 su Capterra), ciascuno con un addebito di $0,001389, per un totale di $0,005556.
Passiamo al lato OpenAI. La pagina di panoramica dice che i modelli vengono fatturati alle rispettive tariffe API, gli strumenti alle tariffe standard e le sandbox ospitate alle tariffe dei container («Agents API overview»: pricing). La nostra configurazione non usa sandbox (environment: none) né ricerca web, quindi restano solo i token del modello. Questi sono i prezzi di listino standard per milione di token, rilevati il 1° novembre 2026 («OpenAI API pricing»):
| Modello | Input | Input in cache | Scrittura in cache da 30 minuti | Output |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6.1-sol | $2.00 | $0.10 | $2.50 | $10.00 |
| gpt-6.1-terra | $1.00 | $0.05 | $1.25 | $5.00 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
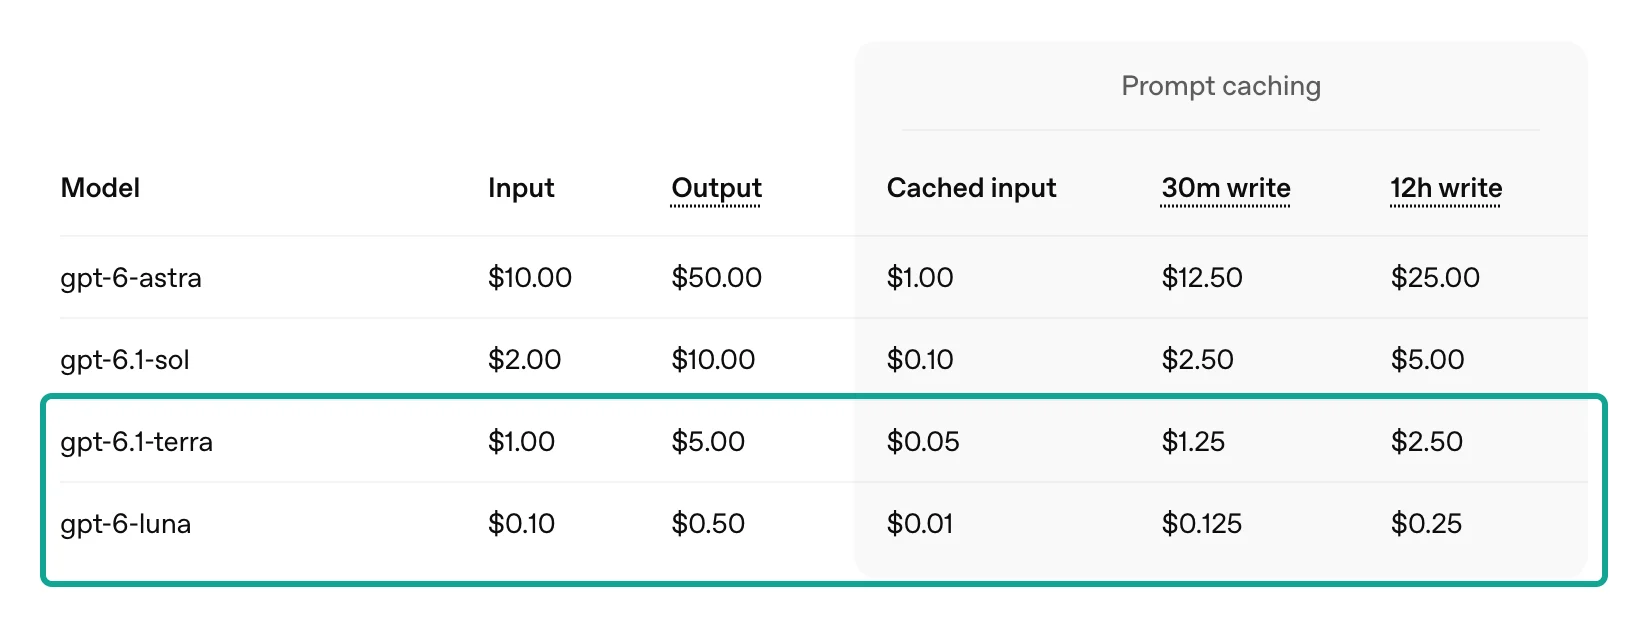
Ecco il metodo, così puoi usare i tuoi numeri. L'input ha tre componenti. Una settimana di recensioni con i limiti consigliati vale circa 105.723 token dopo il taglio. Ciascuno dei 5 subagenti aggiunge circa 8.000 token per istruzioni, descrizione dello strumento e contesto. L'agente principale aggiunge circa 20.000 token.
Calcoliamo la prima lettura alla tariffa di scrittura in cache da 30 minuti. Per GPT-5.6 e successivi, una scrittura in cache da 30 minuti costa 1,25 volte il prezzo dell'input, quindi questa scelta porta a una stima per eccesso (documentazione «Prompt caching»).
Un subagente chiama il modello più di una volta per turno. Per questo aggiungiamo altre due letture delle recensioni e dell'overhead alla tariffa in cache. L'output è di 1.500 token per subagente e 3.000 per l'agente principale.
Solo la dimensione delle recensioni è misurata. Gli altri input sono ipotesi, quindi arrotondiamo a due cifre significative. La stima è di circa $0,029 con gpt-6-luna, circa $0,27 con gpt-6.1-terra, circa $0,55 con gpt-6.1-sol e circa $2,9 con gpt-6-astra. Lo scarto di 100 volte tra i modelli è solo il rapporto tra i prezzi di listino: il prezzo di input di astra, $10,00, è 100 volte quello di luna, per qualsiasi attività.
| Un brand, una settimana | Importo | Un anno (×52) | Base |
|---|---|---|---|
| Chiamate dati EveryInfra (5) | $0.006945 | $0.3611 | Addebitato nel nostro test |
| Modello, gpt-6-luna | circa $0,029 | circa $1,5 | Stima dai prezzi di listino |
| Modello, gpt-6.1-terra | circa $0,27 | circa $14 | Stima dai prezzi di listino |
| Modello, gpt-6.1-sol | circa $0,55 | circa $29 | Stima dai prezzi di listino |
| Modello, gpt-6-astra | circa $2,9 | circa $150 | Stima dai prezzi di listino |
Quale ipotesi conta di più? Questa tabella varia l'overhead e il numero di riletture, con tre livelli ciascuno. Usa gpt-6.1-terra, i limiti consigliati e le altre ipotesi descritte sopra.
| Overhead per subagente | 1 rilettura | 2 riletture | 4 riletture |
|---|---|---|---|
| 4.000 token | $0.24 | $0.25 | $0.26 |
| 8.000 token | $0.27 | $0.27 | $0.29 |
| 16.000 token | $0.32 | $0.33 | $0.35 |
Tutti e nove i risultati sono compresi tra $0,24 e $0,35. Le riletture non cambiano quasi nulla, perché il prezzo in cache è il 5% del prezzo di input. L'overhead incide un po' di più. A fare davvero la differenza è il volume delle recensioni. Con le stesse ipotesi, max_limit ovunque costa circa $0,40, mentre il primo giro ridotto costa circa $0,21. Quindi imposta prima limit e il taglio del testo, e solo dopo scegli il modello.
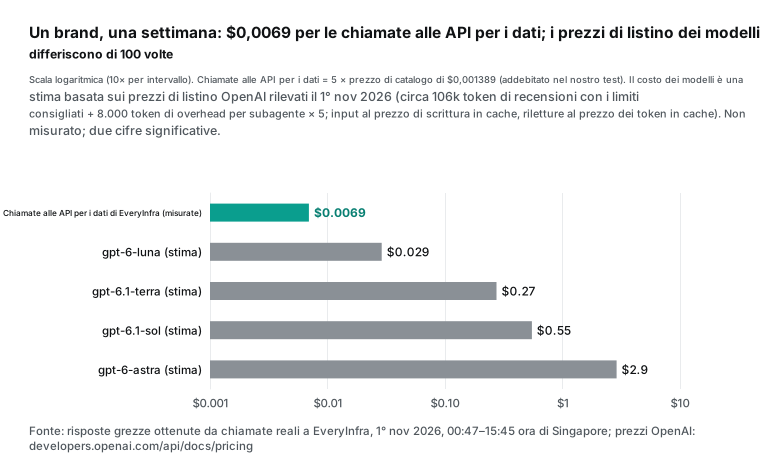
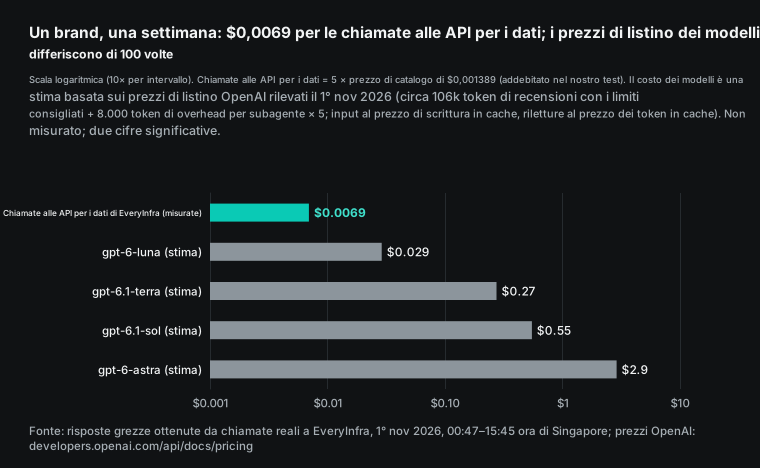
La tabella mostra un rapporto. La tariffa per i dati è una piccola parte del totale e la variabile principale è la scelta del modello. La creazione di un report sulle recensioni a poche stelle richiede la lettura di molte recensioni e decisioni semplici. Per questo eseguiremmo i subagenti su gpt-6-luna o gpt-6.1-terra. Usa un modello più potente per l'agente principale solo se il riepilogo lo richiede.
Una sessione può modificare model, reasoning.effort e service_tier in un secondo momento. Non può invece modificare tools, instructions o multi_agent (documentazione sulla configurazione). Quindi pianifica la combinazione di modelli quando crei l'agente.
Vale la pena segnalare due dettagli sulla fatturazione. Primo, il campo usage dell'Agents API è best-effort. Può essere null, può cambiare in seguito e non è una fattura. Inoltre non conta separatamente i token di scrittura in cache, quindi sui modelli con un prezzo per la scrittura in cache usage da solo non basta a calcolare il costo esatto del modello (documentazione su Observability).
Secondo, se in seguito aggiungi una sandbox ospitata, i container hanno prezzi di listino (4 GB a $0,12 ogni 20 minuti, con addebito al minuto e un minimo di 5 minuti dal 2 giugno 2026). Dal 9 ottobre 2026 le sandbox ospitate vengono addebitate solo durante i turni attivi, non per il tempo di inattività tra un turno e l'altro (prezzi dell'API di OpenAI; changelog). La nostra configurazione non usa sandbox, quindi questo costo è zero.
Limiti della beta pubblica da verificare prima di andare in produzione
L'Agents API è in beta pubblica. Le richieste devono includere l'header OpenAI-Beta: agents=v1 e gli SDK di OpenAI usano il namespace beta.agents (guida rapida). Il post di lancio afferma che OpenAI modificherà rapidamente il prodotto durante la beta, in vista della disponibilità generale (post di lancio di OpenAI). Questa tabella elenca solo i limiti indicati nella documentazione, e ognuno incide sul monitoraggio delle recensioni.
| Limite | Cosa dice la documentazione | Effetto sul monitoraggio delle recensioni | Fonte |
|---|---|---|---|
| Residenza e conservazione dei dati | Solo residenza dei dati negli Stati Uniti. Niente Zero Data Retention, nemmeno con una sandbox self-hosted. | Le recensioni pubbliche comportano un rischio basso. Se il report include anche ticket di assistenza, verifica prima la conformità. | Panoramica, i tuoi dati |
| Le pianificazioni non sono esatte | Le esecuzioni ricorrenti ricevono un piccolo ritardo casuale. Se la sessione di destinazione è occupata, l'attività resta in attesa. | Il report arriva qualche minuto dopo le 9:00. Non collegarlo a un passaggio che richiede tempi esatti. | Automazioni |
| Consegnato non significa completato | Un'invocazione con completed indica solo che la consegna è riuscita. | Usa turn.completed o turn.failed e imposta un avviso in caso di errore. | Automazioni, webhook |
| I vault vengono usati solo per le connessioni lato OpenAI | Le connessioni HTTP avviate dall'ambiente non usano le credenziali del vault. | Il server MCP di EveryInfra è pubblico, quindi l'origine predefinita service va bene. | Connessioni MCP |
| Nessun function tool nei subagenti | I subagenti ereditano i tool MCP e le credenziali, ma non possono usare i function tool. | Solo l'agente principale restituisce i dati. La tua app li salva. | Multi-agente |
| L'utilizzo non è una fattura | Best-effort, può essere null, può cambiare, nessun conteggio delle scritture in cache. | Per i costi usa la fattura, non usage. | Osservabilità |
| Limiti di dimensione | Istruzioni più configurazione dei tool sotto i 4 MiB. Ogni input sotto i 4 MiB. | Per elenchi lunghi di brand, invia il riepilogo della settimana precedente, non tutti i dati della settimana precedente. | Configurazione, sessioni |
| Errore di avvio MCP | Con required: true, un avvio non riuscito fa fallire il turno con mcp_server_startup_failed (424). | È proprio ciò che vogliamo: niente dati, niente report. | Errori |
Cosa non può fare questa configurazione e cosa tenere d'occhio
Primo, questa configurazione legge le recensioni pubbliche ma non risponde. Le risposte su App Store e Google Play passano dalle console per sviluppatori di Apple e Google (Apple, «Ratings, reviews and responses»; Guida di Google Play Console, «Ratings and reviews»). Le risposte della nostra API includono reply_text per Google Play e Trustpilot e vendor_response per Capterra. Così il report può segnalare quali recensioni hanno già una risposta, ma a scriverla resta comunque una persona.
Secondo, non usare questa configurazione per manipolare le recensioni. La norma definitiva della Federal Trade Commission statunitense dell'agosto 2024 vieta le recensioni false e i compensi condizionati a recensioni positive o negative. La norma cita espressamente le recensioni false generate dall'AI (comunicato stampa della FTC, 2024-08-14). Un report sulle recensioni a poche stelle serve a individuare presto i problemi, non a modificare le recensioni.
Terzo, imposta per ogni sito la soglia delle recensioni a poche stelle. G2 usa le mezze stelle, quindi consideriamo basse le valutazioni pari o inferiori a 2,5. Negli altri siti consideriamo basse le valutazioni pari o inferiori a 2. Nessuno dei due brand ha ricevuto recensioni G2 a poche stelle in 30 giorni. Se vale lo stesso per il tuo prodotto, alza la soglia di G2 a 3 stelle. Altrimenti la riga di G2 indica sempre 0 e chi legge smette di guardarla.
Quarto, fai applicare prima al subagente delle regole basate su parole chiave. Invia al modello solo le recensioni che le regole non riescono a classificare, come le 22 del Test 2. Il programmatic tool calling è pensato proprio per questo: filtra i risultati nel codice e riporta nel contesto solo la parte rilevante (post di lancio di OpenAI; documentazione sul programmatic tool calling).
Modifiche recenti
Durante la beta l'Agents API cambia ogni poche settimane. Queste sono le modifiche che riguardano questa configurazione, dalla meno recente alla più recente.
| Data | Modifica | Cosa significa per questa configurazione |
|---|---|---|
| 10 settembre 2026 | Beta pubblica con sandbox ospitate, subagenti e compattazione del contesto, senza costi di piattaforma (changelog; annuncio sul forum) | Meno codice dell'agente da mantenere, quindi una prima versione si realizza in fretta |
| 9 ottobre 2026 | Le sandbox ospitate vengono addebitate solo durante i turni attivi e possono essere preriscaldate (changelog) | Un monitor che esegue script non paga più il tempo di inattività |
| 16 ottobre 2026 | Modalità Ultrafast; le sandbox ospitate includono l'Artifact SDK per fogli di calcolo e documenti (changelog) | Il report può essere un file in formato foglio di calcolo, ma serve una sandbox |
| 20 ottobre 2026 | Prompt caching di 12 ore, con scritture a 2,5 volte il prezzo di input (changelog; documentazione sul prompt caching) | Le esecuzioni settimanali sono distanziate da molto più di 12 ore, quindi la cache aiuta solo all'interno di una singola esecuzione |
| 26 ottobre 2026 | Rilascio di GPT-6.1 Terra (changelog) | Un livello di prezzo tra luna e sol; la stima settimanale di $0,2154 si basa su questo modello |
| 28 ottobre 2026 | Gli abbonati a ChatGPT Pro e Business idonei possono richiedere fino a $500 al mese in crediti API (changelog) | Un piccolo team potrebbe coprire con quei crediti il costo del modello per questo monitor |
| 30 novembre 2026 | Dismissione prevista di Agent Builder, annunciata il 3 giugno 2026 (deprecazioni) | Sposta i vecchi flussi sull'Agents API o sull'Agents SDK prima di quella data. Sul forum per sviluppatori, lo staff di OpenAI ha anche consigliato a un utente di usare i vault dell'Agents API per i flussi con rotazione delle credenziali (forum per sviluppatori di OpenAI) |
FAQ
Come funzionano i prezzi dell'OpenAI Agents API e c'è un costo di piattaforma?
Non c'è un costo di piattaforma separato. Il post di lancio di OpenAI dice che l'Agents API non prevede costi aggiuntivi e che si pagano i token e i tool usati dagli agenti. La pagina di panoramica dice che i modelli vengono addebitati alle tariffe del modello scelto, i tool alle tariffe standard e le sandbox ospitate alle tariffe dei container.
Senza sandbox, la nostra stima del costo del modello per un brand a settimana va da circa $0,029 (gpt-6-luna) a circa $2,9 (gpt-6-astra). Le chiamate dati aggiungono $0,006945. (Origine della domanda: suggerimenti di Google «openai agents api pricing» e «openai agents api cost». Fonti: post di lancio, panoramica, prezzi.)
OpenAI Agents API o SDK: quale conviene usare?
Usa l'Agents API se vuoi che sia OpenAI a eseguire il loop, conservare le sessioni ed eseguire le pianificazioni. Usa l'Agents SDK se l'agente deve girare nella tua applicazione con il tuo storage. Nel confronto di OpenAI, l'impegno di integrazione è «Low» per l'Agents API e «Medium» per l'SDK. I team che hanno bisogno di Zero Data Retention per ora devono usare l'SDK. (Origine della domanda: suggerimento di Google «openai agents api vs sdk». Fonti: guida agli agenti, panoramica.)
Il client MCP dell'OpenAI Agents SDK può collegarsi allo stesso server EveryInfra?
Sì. Secondo la documentazione MCP dell'SDK, Streamable HTTP è supportato. Usa https://api.everyinfra.com/mcp con la tua chiave: il nome del tool e i parametri sono gli stessi di questo articolo. La differenza è che la pianificazione, i nuovi tentativi e l'archiviazione delle credenziali li scrivi tu. (Origine della domanda: suggerimenti di Google «openai agents sdk mcp» e «openai agents sdk mcp server». Fonti: documentazione MCP dell'Agents SDK, specifica dei transport MCP.)
Di quali permessi ha bisogno una chiave API per l'OpenAI Agents API?
La guida rapida indica api.agents.read e api.agents.write per le sessioni e api.responses.write per l'inferenza del modello. Per gestire i vault, aggiungi api.vaults.read e api.vaults.write. Tieni questa chiave OpenAI sul tuo server, fuori dalle istruzioni dell'agente e fuori da qualsiasi sandbox. (Origine della domanda: suggerimento di Google «openai agents api key». Fonti: guida rapida, sicurezza della sandbox.)
La funzionalità computer use dell'OpenAI Agents API può leggere direttamente i siti di recensioni?
L'Agents API ha introdotto la funzionalità computer use il 29 settembre 2026. Un agente può lavorare in un browser ospitato da OpenAI, mentre la tua applicazione gestisce le approvazioni e l'accesso. Però sfogliare le recensioni pagina per pagina in un browser richiede una sandbox, impiega più tempo e usa molti più token.
Inoltre le pagine di Trustpilot, G2 e Capterra bloccano l'accesso tramite script: nel nostro test, semplici richieste curl a tutti e tre i siti hanno restituito 403. Per ottenere recensioni strutturate, un'API per i dati è più stabile e costa meno. (Origine della domanda: suggerimento di Google «openai agents api computer use». Fonte: changelog.)
È sicuro dare una chiave API a un agente AI?
Nel thread di r/artificial sul lancio, un commento dice «Auguri ad affidare password e segreti all'AI». Nell'architettura di OpenAI, un vault non restituisce il segreto quando lo leggi. OpenAI aggiunge l'autenticazione MCP al momento della connessione, quindi il codice dell'agente non vede la chiave.
La pagina sulla sicurezza della sandbox dice anche che i valori nelle variabili d'ambiente sono leggibili dal codice dell'agente. Quindi metti la chiave in un vault, non in env, e dai a questo agente una chiave dedicata. (Origine della domanda: thread su r/artificial. Fonti: Vaults, sicurezza della sandbox.)
Per iniziare
- Registrati su EveryInfra, ottieni una chiave API e segui la guida rapida per effettuare una sola chiamata al catalogo gratuito. Verifica che
trustpilot/reviews,g2/reviews,capterra/reviews,app_store/reviewsegoogle_play/reviewsmostrinoavailable: true. Parametri e campi sono descritti nelle pagine delle funzionalità: Recensioni Trustpilot, Recensioni G2, Recensioni Capterra, Recensioni App Store, Recensioni Google Play. - Trova e salva in un'unica tabella il link o l'ID di ogni brand su ciascun sito. Le panoramiche dei siti sono nelle pagine API Trustpilot, API G2, API Capterra, API App Store e API Google Play.
- Prima di usare l'Agents API, effettua una chiamata REST a ciascun sito per il tuo brand. Misura quanti giorni copre una chiamata e imposta
limitcome nel Test 1. - Sul lato OpenAI, crea il vault, l'agente e l'automazione partendo dall'esempio del Passaggio 4. Avvia un'invocazione manuale e leggi il report e gli eventi della sessione.
- Dopo due settimane, confronta il costo del modello con la fattura. Passa i subagenti a un modello più economico se la qualità resta la stessa.
Per trasformare i dati delle recensioni in un prodotto per i clienti, leggi come i dati delle recensioni diventano un prodotto a pagamento. Per un lavoro simile con le attività pianificate di ChatGPT, vedi le attività pianificate di ChatGPT come radar della domanda. Tutte le funzionalità e i prezzi sono nel mercato dei dati.
Riferimenti
- «Agents API overview», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/overview
- «Agents API quickstart», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/quickstart
- «Agents API architecture», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/architecture
- «Configuring agents», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/configuration
- «Sessions», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions
- «Scheduled automations», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions/automations
- «Webhooks», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions/webhooks
- «Multi-agent», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/multi-agent
- «Vaults», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/tools/vaults
- «MCP connections», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- «OpenAI-hosted sandboxes», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/environments/openai-hosted
- «Sandbox security», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/environments/security
- «Errors and recovery», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/errors
- «Observability and usage», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/observability
- «API pricing», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/pricing
- «Changelog» (voci dal 2025-03-11 al 2026-10-30), documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/changelog
- «Deprecations» (Agent Builder), documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/deprecations
- «Agents» (confronto tra le opzioni di runtime per agenti), documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/agents
- «Your data», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/your-data
- «Prompt caching», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/prompt-caching
- «Tool search», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/tools-tool-search
- «Programmatic tool calling», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/tools-programmatic-tool-calling
- «Compaction», documentazione per sviluppatori di OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/docs/guides/compaction
- «Create automation» (riferimento API), OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/reference/resources/beta/subresources/agents/subresources/automations/methods/create
- «Agents» (riferimento API), OpenAI, consultato il 2026-11-01, https://developers.openai.com/api/reference/resources/beta/subresources/agents
- «Introducing the Agents API», OpenAI, 2026-09-10, https://openai.com/index/introducing-the-agents-api/
- «Introducing the Agents API and hosted sandboxes», forum per sviluppatori di OpenAI, 2026-09-10, https://community.openai.com/t/introducing-the-agents-api-and-hosted-sandboxes/1396481
- «Agent Builder MCP Secrets API», forum per sviluppatori di OpenAI, consultato il 2026-11-01, https://community.openai.com/t/agent-builder-mcp-secrets-api/1368113
- «OpenAI launches Agents API public beta built on Codex harness», Reddit r/artificial, consultato il 2026-11-01, https://www.reddit.com/r/artificial/comments/1wctpbu/openai_launches_agents_api_public_beta_built_on/
- openai/openai-agents-python, GitHub, consultato il 2026-11-01, https://github.com/openai/openai-agents-python
- «Model context protocol» (documentazione dell'Agents SDK), OpenAI, consultato il 2026-11-01, https://openai.github.io/openai-agents-python/mcp/
- «MCP specification: Transports» (2025-06-18), Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- «RFC 6750: OAuth 2.0 Bearer Token Usage», IETF, 2012-10, https://datatracker.ietf.org/doc/html/rfc6750
- «Time Zone Database», IANA, consultato il 2026-11-01, https://www.iana.org/time-zones
- «crontab(5)», Linux man-pages, consultato il 2026-11-01, https://man7.org/linux/man-pages/man5/crontab.5.html
- «Ratings, reviews, and responses», Apple Developer, consultato il 2026-11-01, https://developer.apple.com/app-store/ratings-and-reviews/
- «View & analyze your app's ratings & reviews», Guida di Google Play Console, consultato il 2026-11-01, https://support.google.com/googleplay/android-developer/answer/138230
- «Understanding and counting tokens», Centro assistenza OpenAI, consultato il 2026-11-01, https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- «Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials», Federal Trade Commission degli Stati Uniti, 2024-08-14, https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- «Notion Reviews», Trustpilot, consultato il 2026-11-01, https://www.trustpilot.com/review/notion.so
- «Notion Reviews», G2, consultato il 2026-11-01, https://www.g2.com/products/notion/reviews
- «Notion», Capterra, consultato il 2026-11-01, https://www.capterra.com/p/186596/Notion/
- Pagina dell'app Notion, App Store, consultata il 2026-11-01, https://apps.apple.com/us/app/notion-notes-tasks-ai/id1232780281
- Pagina dell'app Notion, Google Play, consultata il 2026-11-01, https://play.google.com/store/apps/details?id=notion.id
- Catalogo dati EveryInfra (trustpilot), EveryInfra, consultato il 2026-11-01, https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- Catalogo dati EveryInfra (completo), EveryInfra, consultato il 2026-11-01, https://api.everyinfra.com/api/v1/social/catalog
- «ClickUp», Capterra, consultato il 2026-11-01, https://www.capterra.com/p/158833/ClickUp/
- Pagina dell'app ClickUp, Google Play, consultata il 2026-11-01, https://play.google.com/store/apps/details?id=co.mangotechnologies.clickup
- «iPhone Duo arrives at Apple Store locations worldwide», Apple Newsroom, 2026-10, https://www.apple.com/newsroom/2026/10/iphone-duo-arrives-at-apple-store-locations-worldwide/
Riferimenti BL-59