OpenAI Agents API로 리뷰 모니터링하기: 리뷰 사이트 5곳에서 주간 저평점 리포트 만들기
OpenAI Agents API로 만든 주간 리뷰 모니터링 에이전트: 리뷰 사이트 5곳에서 실제 호출 21회, 브랜드당 주 $0.0069의 데이터 비용, 설정과 한계를 정리했습니다.
2026년 11월 1일 싱가포르 시간(SGT) 00:47부터 15:45까지 Notion과 ClickUp을 대상으로 EveryInfra 리뷰 엔드포인트를 호출했습니다. 19:22–19:23 SGT에는 재테스트를 4회 진행했습니다. 대상 사이트는 Trustpilot, G2, Capterra, App Store, Google Play입니다. 브랜드 하나를 매주 확인하려면 호출 5회가 필요하고 데이터 요금은 $0.006945입니다. 어려운 점은 가격보다 수집 범위입니다. Google Play에서 Notion의 최신 리뷰 200개는 22일 전까지만 거슬러 올라가지만, Trustpilot의 Notion 저평점 리뷰 20개는 6월까지 거슬러 올라갑니다.
비용의 대부분은 모델 요금입니다. 저희 데이터 요금은 호출당 과금이므로 200행이든 20행이든 비용이 같습니다. 하지만 행이 늘어나는 만큼 모델 컨텍스트에 들어가는 양도 늘어납니다.
권장 한도를 적용하면 Notion 리뷰 1주 분량은 원본 약 421KB, 약 105k 토큰입니다. 초기 실행에서는 아래에서 설명할 페이지 코드 때문에 652KB였습니다. 2026년 11월 1일 OpenAI 정가 기준으로 이 1주 분량의 모델 토큰 비용은 약 $0.03~$2.9입니다. 가장 저렴한 모델과 가장 비싼 모델의 정가가 100배 차이 나므로 모델 선택이 비용을 좌우합니다.
실제 호출에서 함정 두 가지도 드러났습니다. Capterra는 리뷰를 날짜순으로 정렬하지 않습니다. 11월 1일 초기 실행에서는 일부 Capterra 리뷰의 pros 필드에 약 100,000자의 페이지 코드가 들어 있었습니다. 그날 저녁 게이트웨이가 페이지 코드를 제거하고 필드당 5,000자 제한을 두었습니다. 19:23 SGT 재테스트에서는 같은 리뷰 86개가 반환되었고, 가장 긴 필드는 1,154자였습니다.
OpenAI는 2026년 9월 10일 Agents API를 퍼블릭 베타로 공개했습니다. 매주 월요일 실행되어 리뷰 사이트마다 서브에이전트를 하나씩 보내고 짧은 저평점 리포트를 쓰는 에이전트를 이 API로 운영할 수 있을까요? 이 글에 나오는 OpenAI 필드 이름, 기본값, 한도는 모두 2026년 11월 1일에 내려받아 확인한 OpenAI 문서에서 가져왔습니다. OpenAI 계정에서 에이전트를 실행하지는 않았으므로 OpenAI 부분은 설정 예시입니다. EveryInfra 수치는 모두 실제 호출의 원본 응답에서 가져왔으며, 실패한 호출도 포함합니다.
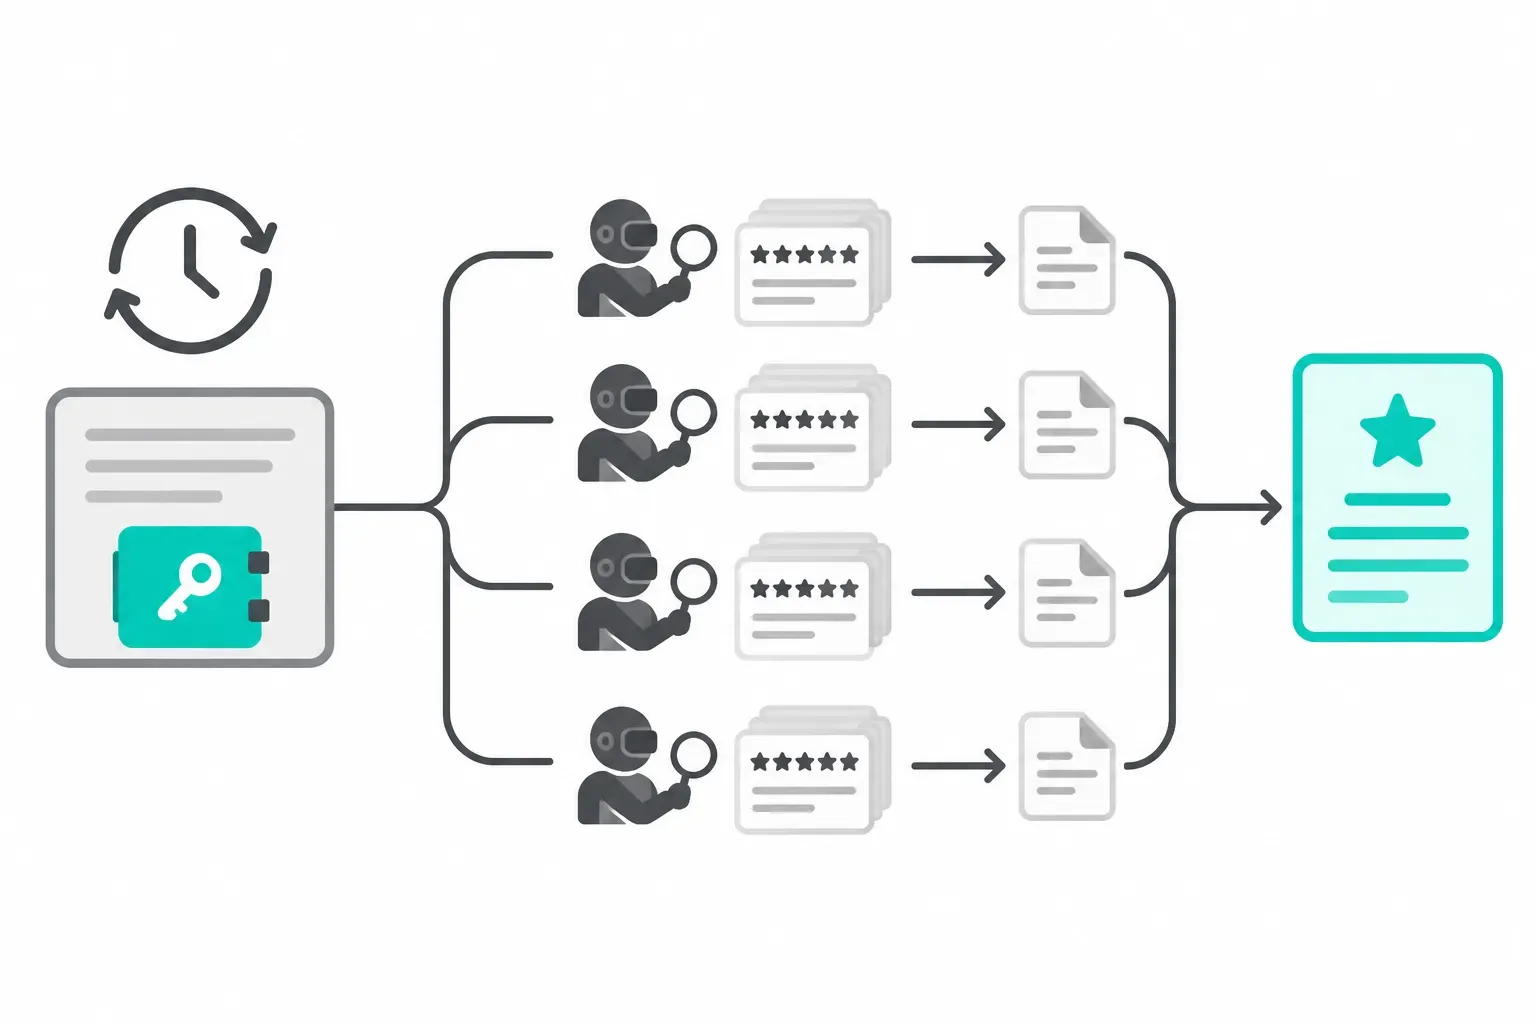
작업 정의: 리뷰 사이트 5곳의 주간 저평점 리포트
아래의 모든 수치가 작업 정의에 따라 달라지므로 작업부터 정의합니다. 입력은 브랜드 목록입니다. 브랜드마다 사이트별 식별자를 하나씩 저장합니다. Trustpilot은 회사 도메인(예: notion.so)을 받습니다. G2는 리뷰 URL 또는 슬러그를, Capterra는 제품 페이지 URL을 받습니다. App Store는 숫자로 된 앱 ID를, Google Play는 패키지 이름을 받습니다.
출력은 주간 리포트 하나입니다. 브랜드마다 섹션이 하나씩 있으며, 사이트별 신규 리뷰와 저평점 리뷰, 주요 불만 주제를 담습니다. 지난주 이후 새로 생긴 이슈도 나열하고, 지원팀이 볼 수 있도록 원본 리뷰 링크를 붙입니다.
왜 이 5개 사이트일까요? 서로 다른 두 독자층을 다루기 때문입니다. Trustpilot, G2, Capterra는 구매자가 소프트웨어를 사기 전에 읽는 곳이라 독자가 의사 결정권자인 경우가 많습니다. App Store와 Google Play에는 현재 사용자의 피드백이 모이므로 불만이 구체적이고 버전 번호가 함께 적힌 경우가 많습니다.
앞서 소개한 멀티 플랫폼 평판 모니터링 블루프린트에서는 부정적인 추세를 판단하기 전에 수집 범위를 기록하는 방법을 설명했습니다. Exa, G2, Trustpilot으로 30개 기업을 테스트한 글은 일회성 경쟁사 비교 사례입니다. 이 글은 그 점검을 사람 없이 매주 실행되는 에이전트로 바꿉니다. 또한 실제 데이터로 주 1회 실행이 충분한지 검증합니다.
이 작업은 Agents API의 네 가지 기능과 잘 맞습니다. 5개 사이트는 서로 의존하지 않으므로 각각 요약만 반환하는 서브에이전트에 맡길 수 있습니다. 일정은 지정한 시간대 기준 cron 표현식으로 세션을 여는 자동화(automations)에 맞습니다. API 키는 볼트에 넣어 지침에서 분리할 수 있습니다. 데이터 소스는 원격 MCP 서버이며, Agents API는 샌드박스 없이 OpenAI 쪽에서 여기에 접속할 수 있습니다.
OpenAI Agents API는 Agents SDK와 무엇이 다른가
OpenAI는 2026년 9월 10일 Agents API를 퍼블릭 베타로 출시했습니다. 발표 글에 따르면 작업, 모델, 도구, 환경을 담은 API 호출 한 번으로 프로덕션 에이전트를 만들 수 있습니다. 에이전트는 Codex와 같은 하네스에서 실행됩니다(OpenAI 발표 글; 변경 내역). 하네스는 모델을 호출하고, 도구를 실행하고, 컨텍스트를 관리하는 루프입니다. 개요 페이지는 이 제품을 Agent, Environment, Session, Events and items의 네 가지 개념으로 나눕니다(Agents API 개요). 발표 글은 Agents API에 별도 요금이 없으며, 에이전트가 사용한 토큰과 도구 비용만 낸다고도 밝힙니다(OpenAI 발표 글).
이름 때문에 Agents SDK와 헷갈리기 쉽습니다. SDK는 OpenAI가 2025년 3월 11일 공개한 오픈 소스 오케스트레이션 프레임워크로, 에이전트 루프가 사용자의 애플리케이션 안에서 실행됩니다(변경 내역; GitHub의 openai-agents-python). OpenAI의 "Agents" 가이드에 비교표가 있으며, 아래 표는 그 페이지를 따릅니다(Agents 가이드: 에이전트 런타임 옵션 비교).
| 항목 | Agents API | Agents SDK | Responses API |
|---|---|---|---|
| 용도 | OpenAI가 에이전트를 관리하고 진행 상황을 저장하는 장시간 작업 | 앱 안에서 커스텀 도구와 워크플로를 쓰는 에이전트 | 모델 직접 호출 또는 처음부터 직접 만드는 에이전트 |
| 에이전트 실행 위치 | OpenAI가 관리형 Codex 하네스를 실행 | SDK가 애플리케이션 안에서 실행 | 애플리케이션(호스팅 오케스트레이션 선택 가능) |
| 통합 난이도 | 낮음 | 중간 | 높음 |
| 작업 간 상태 | 저장된 세션 설정, 턴, 항목 | 자체 스토리지와 SDK 세션, 또는 Responses 대화 상태 | 수동 히스토리 관리, 응답 체이닝 또는 Conversations |
| 도구 실행 | 서비스 연결 도구, 앱 함수 핸들러, 선택적 샌드박스 | 애플리케이션 안의 도구와 통합 | 호스팅 도구와 앱에서 실행하는 도구 |
리뷰 모니터링 관점에서 이 표의 의미는 간단합니다. 에이전트 루프, 세션 저장, 재시도를 위해 장기 실행 프로세스를 직접 운영하고 싶지 않다면 Agents API가 그 일을 대신합니다. 대신 에이전트 상태가 OpenAI에 저장되며, 제품은 아직 베타입니다. 회사 정책상 데이터를 자체 리전에 두어야 한다면 SDK가 더 안전한 선택입니다. 개요 페이지에 따르면 Agents API는 미국 데이터 레지던시만 지원하며, 자체 호스팅 샌드박스를 쓰더라도 Zero Data Retention(ZDR)은 지원하지 않습니다(Agents API 개요).


1단계: EveryInfra를 MCP 연결로 추가하기
Agents API에서 MCP 서버는 agent.tools에 들어가는 type: "mcp" 항목 하나입니다. 연결은 두 곳에서 시작할 수 있습니다. 기본값인 connection_origin: "service"에서는 OpenAI가 서버에 접속하므로 서버가 공용 인터넷에 있어야 합니다. 이 모드는 환경이 있든 없든 동작합니다. connection_origin: "environment"에서는 세션 샌드박스 안에서 연결이 시작되며, 사설 네트워크에 있는 서버에 사용합니다(MCP 연결 문서).
EveryInfra MCP 엔드포인트는 https://api.everyinfra.com/mcp로 공개되어 있으므로 기본값인 service 연결을 쓰면 되고, 세션 환경은 none으로 둘 수 있습니다. 아키텍처 페이지에 따르면 환경이 없어도 에이전트는 원격 MCP 도구를 호출할 수 있습니다. Bash, 워크스페이스 파일, executor MCP만 쓸 수 없습니다(Agents API 아키텍처). 이 점은 비용에 영향을 줍니다. 샌드박스가 없으면 컨테이너 요금도 들지 않습니다.
다음은 설정 예시로 작성한 도구 항목입니다. 각 필드는 문서와 대조해 확인했습니다.
allowed_tools에는 everyinfra_call_api와 everyinfra_get_job만 넣습니다. 두 번째 도구는 비동기 호출의 결과를 읽습니다(테스트 3 참고). required: true로 설정하면 서버가 시작되지 않을 때 턴이 실패합니다. 그렇지 않으면 에이전트가 데이터 없이 리포트를 쓸 수 있으므로 이 동작이 필요합니다. 문서에 따르면 MCP 초기화는 기본적으로 선택 사항입니다(MCP 연결 문서).
{
  "type": "mcp",
  "server_label": "everyinfra",
  "transport": { "type": "http", "server_url": "https://api.everyinfra.com/mcp" },
  "connection_origin": "service",
  "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
  "required": true
}
왜 도구를 두 개만 쓸까요? 2026년 11월 1일 15:45 SGT에 EveryInfra MCP 서버로 tools/list를 보냈습니다. 도구 12개가 반환되었고, JSON 설명을 합치면 16,669바이트였습니다. everyinfra_call_api와 everyinfra_get_job의 설명은 합쳐서 2,505바이트입니다. 영어 텍스트는 토큰당 약 4자이므로 약 4,167토큰 대 약 626토큰입니다(OpenAI 도움말 센터: 토큰).
도구 설명은 턴마다 컨텍스트에 들어가며, 서브에이전트 5개에도 각각 사본이 들어갑니다. 그 차이는 실행 한 번에 약 18k 토큰입니다. 서비스에 도구가 추가되거나 제거되면 도구 목록도 바뀌며, 같은 날 앞서 조회했을 때는 도구 개수가 달랐습니다. 허용 목록을 쓰면 이 비용이 고정됩니다. 문서는 allowed_tools를 에이전트가 찾고 호출할 수 있는 도구를 제한하는 방법으로 정의합니다(MCP 연결 문서).
| 도구 목록 | 도구 수 | 설명 JSON(바이트) | 토큰 환산(÷4) | 서브에이전트 5개 |
|---|---|---|---|---|
allowed_tools 없음 | 12 | 16,669 | 4,167 | 약 20,835 |
everyinfra_call_api와 everyinfra_get_job만 | 2 | 2,505 | 626 | 약 3,130 |
발표 글에 따르면 Agents API에는 에이전트가 필요할 때만 도구 정의를 불러오는 도구 검색 기능도 있습니다(OpenAI 발표 글; 도구 검색 문서). 도구 목록이 크고 작업 범위가 정해지지 않았을 때 유용합니다. 이 작업에는 도구가 두 개만 필요하므로 허용 목록이 더 간단하고 비용을 예측하기도 쉽습니다.
2단계: 키는 지침이 아닌 볼트에 보관하기
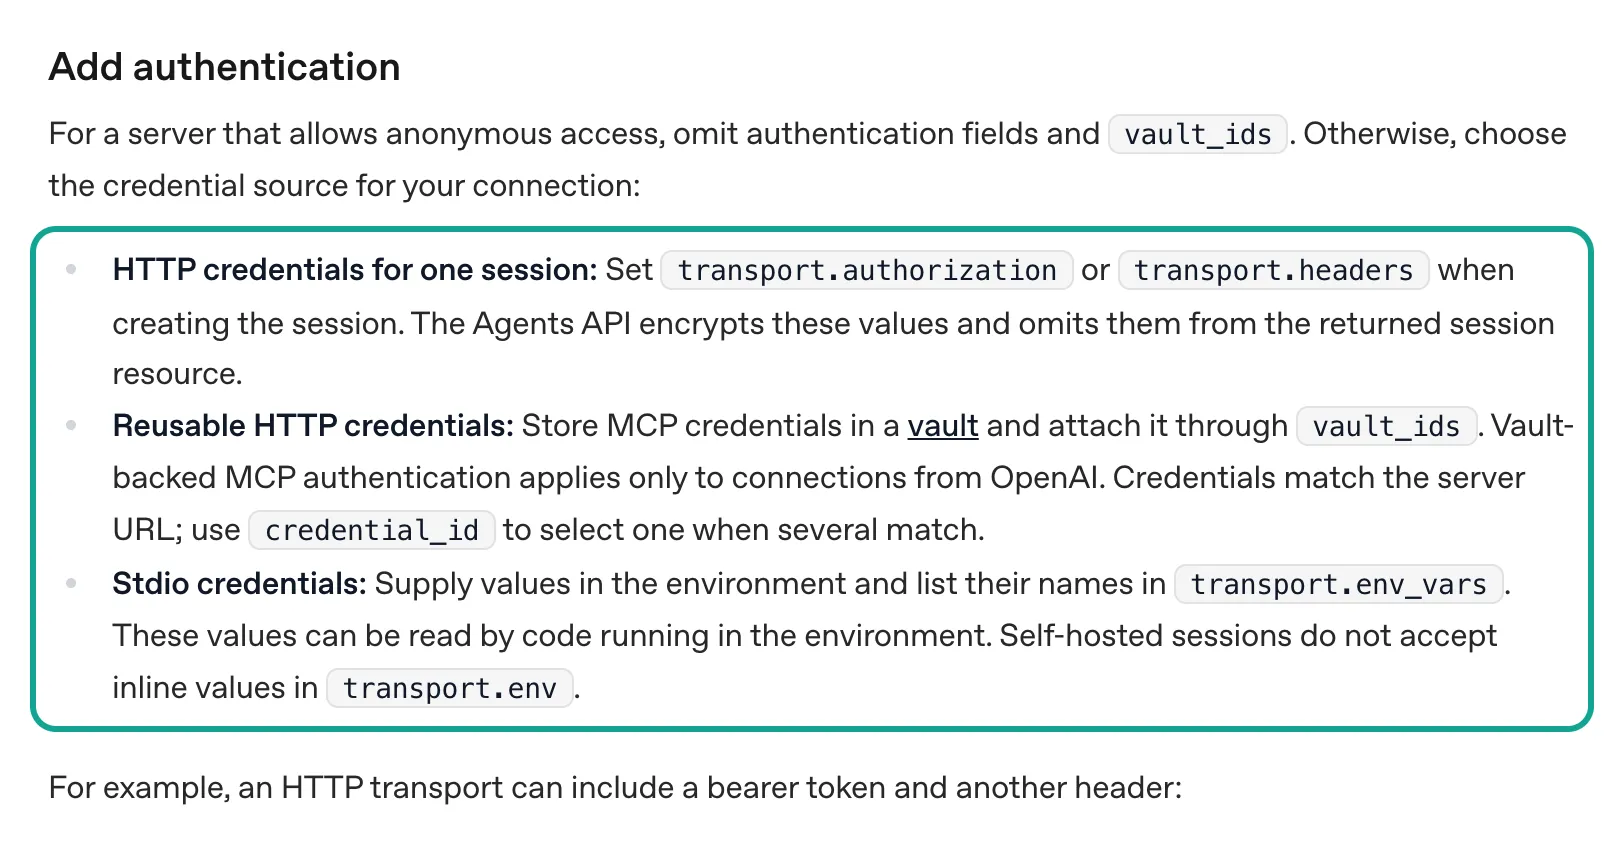
MCP 연결에는 EveryInfra 키가 필요합니다. 문서는 자격 증명을 둘 수 있는 곳으로 세 가지를 제시합니다. 세션 하나에만 쓴다면 값을 transport.authorization 또는 transport.headers에 넣습니다. Agents API는 이 값을 암호화하고 반환되는 세션에서는 제외합니다.
재사용하려면 자격 증명을 볼트에 저장하고 vault_ids로 볼트를 연결합니다. stdio 서버에는 환경 변수를 쓰지만, 이 경우 샌드박스 안의 코드가 값을 읽을 수 있습니다(MCP 연결 문서: Add authentication). 주간 작업은 두 번째 경우에 해당합니다.
Vaults 페이지에 호출 방법이 나와 있습니다. 먼저 client.beta.agents.vaults.create로 볼트를 만듭니다. 그다음 vaults.credentials.create로 자격 증명을 추가하면서 auth.type: "static_bearer"를 지정하고, mcp_server_url에 MCP URL을, token에 키를 넣습니다. mcp_server_url 값은 자격 증명을 해당 서버에 연결합니다(Vaults 문서). 볼트나 자격 증명을 조회해도 API는 비밀 값을 반환하지 않습니다. 볼트를 관리하려면 애플리케이션 키에 api.vaults.read와 api.vaults.write 권한이 필요합니다(Vaults 문서; 샌드박스 보안 문서).
문서에서 놓치기 쉬운 규칙이 두 가지 있습니다. 첫째, 볼트의 MCP 자격 증명은 OpenAI에서 시작하는 연결에만 적용됩니다. connection_origin: "environment" 연결에는 적용되지 않습니다. 둘째, 자격 증명을 삭제해도 원래 토큰은 폐기되지 않으며 실행 중인 세션도 멈추지 않습니다(Vaults 문서: 자격 증명 교체 또는 삭제). EveryInfra 키를 폐기하려면 EveryInfra 콘솔에서 비활성화하세요.
3단계: 사이트마다 서브에이전트를 하나씩 두고 메인 에이전트에는 병합만 맡기기
Agents API에서 멀티 에이전트 모드는 설정 하나로 켭니다. 세션을 만들 때 agent.multi_agent.enabled: true를 설정하세요. 그러면 하네스가 서브에이전트를 생성하고, 메시지를 보내고, 기다리고, 중단하는 도구를 에이전트에 제공하며, 이 도구들은 따로 선언하지 않아도 됩니다(멀티 에이전트 문서). max_concurrent_subagents는 동시에 실행되는 서브에이전트 수를 제한합니다. 기본값은 메인 에이전트를 제외하고 6이며, 이 작업의 사이트는 5개이므로 기본값으로 충분합니다.
같은 페이지에 이 작업과 관련된 규칙이 세 가지 있습니다. 서브에이전트는 설정된 MCP 도구와 그 자격 증명, 허용된 도구를 상속합니다. 서브에이전트는 함수 도구를 지원하지 않습니다. 서브에이전트는 세션에 환경이 있을 때만 파일 시스템을 공유합니다(멀티 에이전트 문서).
첫 번째 규칙에 따라 볼트 키는 별도 설정 없이 모든 서브에이전트에 전달됩니다. 두 번째 규칙에 따라 서브에이전트는 함수를 통해 데이터베이스에 쓸 수 없습니다. 메인 에이전트가 결과를 반환하고, 애플리케이션이 이를 저장해야 합니다.
문서는 작업을 언제 나눌지도 설명합니다. 독립적인 작업은 서브에이전트에 맡기고, 짧은 작업과 서로 의존하는 단계는 메인 에이전트가 맡습니다(멀티 에이전트 문서: 서브에이전트를 쓸 때). 리뷰 사이트 5곳은 서로 독립적입니다.
지난주와의 비교와 최종 요약에는 5개 결과가 모두 필요하므로 메인 에이전트가 맡습니다. 자동화 페이지에는 바로 이 패턴을 다룬 섹션이 있습니다. 장기 목표의 경우 메인 에이전트는 목표와 일정을 유지하면서 예약된 작업을 각각 서브에이전트에 맡기고 짧은 결과만 보관합니다. 그러면 각 점검의 상세한 도구 출력이 메인 컨텍스트에 들어오지 않습니다(예약 자동화 문서: 반복 작업을 메인 컨텍스트 밖에 두기).
다음은 예시에 쓴 메인 에이전트 지침입니다. 각 줄은 이 글 뒷부분의 실제 테스트와 연결됩니다.
You run a weekly review check for the brands listed in the input.
Delegate each platform (trustpilot, g2, capterra, app_store, google_play) to its own subagent.
Each subagent calls everyinfra_call_api once per brand with the parameters given below,
uses mode=async when limit is 100 or more (read the rows with everyinfra_get_job),
keeps only reviews posted in the last 7 days (filter by posted_at yourself),
cuts every text field to 2,000 characters, and returns JSON:
{platform, brand, new_reviews, low_star, themes:[{name,count,example_url}], new_issue_vs_last_week}.
Do not return raw reviews. The main agent merges the five results into one report.
If a call returns an error with retryable=true, wait retry_after seconds and retry at most twice.
Never invent reviews. If a platform failed, say so in the report.
실행마다 입력에 사이트별 파라미터를 담습니다. 아래 표는 Notion에 쓴 값입니다. 각 값은 이 글 뒷부분의 테스트 결과를 바탕으로 정했습니다. 호출 한 번이 최소 2주를 커버하도록 limit을 설정하세요. 모든 사이트에 최댓값을 쓰지는 마세요. 그 이유는 테스트 1과 테스트 4에서 확인할 수 있습니다.
| 서브에이전트 | 브랜드별 파라미터 | 저평점 기준 | 이유 |
|---|---|---|---|
| Trustpilot | company: "notion.so", stars: ["1","2"], sort: "recency", limit: 20, date 없음 | 1~2점만 요청하므로 모든 행 | 20행이 129일 전까지 거슬러 올라가며 저평점 리뷰는 주 1개 정도이므로, 20행을 모두 읽고 posted_at으로 필터링. sort에는 카탈로그 값 사용(테스트 3) |
| G2 | url, sort: "newest", limit: 100, mode: "async" | rating 2.5 이하, record_type: summary 행은 제외 | 별점 필터 없음. ClickUp은 주당 리뷰 약 47개(테스트 1). 동기 호출은 50초 소요 |
| Capterra | company에 제품 URL 지정, limit: 100, mode: "async" | rating 2 이하 | 정렬 순서 없음. 모든 행을 가져와 id를 지난주와 비교(테스트 1) |
| App Store | app_id: "1232780281", country: "us", sort: "newest", limit: 50 | rating 2 이하, app_version별로 집계 | 50행이 39일을 커버하며, 불만은 릴리스 이후에 나타남(테스트 2) |
| Google Play | app_id: "notion.id", sort: "newest", language: "en", limit: 200 | score 2 이하 | 40행은 4.2일만 커버하고 200행은 22일을 커버(테스트 1) |
필드 이름에 주의하세요. Google Play는 별점을 score로 반환하고, 나머지 4개 사이트는 rating을 씁니다.
4단계: 자동화로 매주 월요일 새 세션 열기
스케줄은 별도 리소스인 POST /v1/agents/automations에서 관리합니다. type: "periodic"이면 expression(표준 5필드 cron 문자열)과 timezone(America/New_York 같은 IANA 이름)을 지정합니다. type: "once"이면 run_at에 초 단위 Unix 타임스탬프를 지정합니다. 대상 유형은 두 가지입니다.
new_session은 실행할 때마다 새 세션을 열며, 에이전트 또는 저장된 agent_id, 환경, target.input이 필요합니다. existing_session은 이미 있는 세션에 리마인더를 보내며, 이전 결과가 필요한 작업에 사용합니다(Scheduled automations docs). API 레퍼런스를 보면 new_session 대상은 vault_ids를 받을 수 있고 환경을 none으로 둘 수 있습니다(Create automation reference). 시간대 이름은 IANA 데이터베이스를 따르며(IANA Time Zone Database), cron의 5개 필드는 Unix crontab 규칙을 따릅니다(crontab(5)).
다음은 Python으로 작성한 전체 설정 예시입니다. SDK는 OpenAI-Beta: agents=v1 헤더를 자동으로 추가합니다. curl을 쓴다면 직접 추가해야 합니다(Agents API quickstart). 두 브랜드의 리뷰 트래픽은 대부분 영어이므로 여기서는 뉴욕 시간 기준으로 스케줄을 잡았습니다.
import os
from openai import OpenAI

client = OpenAI()  # app key needs api.agents.read / api.agents.write / api.responses.write / api.vaults.write
MCP_URL = "https://api.everyinfra.com/mcp"

vault = client.beta.agents.vaults.create(name="review-check")
client.beta.agents.vaults.credentials.create(
    vault.id,
    name="EveryInfra read-only key",
    auth={"type": "static_bearer", "mcp_server_url": MCP_URL, "token": os.environ["EVERYINFRA_API_KEY"]},
)

agent = client.beta.agents.create(
    model="gpt-6.1-terra",
    instructions=open("weekly_review_instructions.txt").read(),
    tools=[{
        "type": "mcp", "server_label": "everyinfra",
        "transport": {"type": "http", "server_url": MCP_URL},
        "connection_origin": "service",
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"], "required": True,
    }],
    multi_agent={"enabled": True, "max_concurrent_subagents": 5},
)

automation = client.beta.agents.automations.create(
    type="periodic",
    name="Weekly review check",
    expression="0 9 * * MON",
    timezone="America/New_York",
    target={
        "type": "new_session",
        "agent_id": agent.id,
        "environment": {"type": "none"},
        "vault_ids": [vault.id],
        "input": [{"role": "user", "content": [{"type": "input_text",
                   "text": "Brands: ClickUp (clickup.com; g2 clickup; capterra https://www.capterra.com/p/158833/ClickUp/; "
                           "app_store 1535098836; google_play co.mangotechnologies.clickup). Write this week's report."}]}],
    },
)
print(automation.id)
문서의 몇 가지 세부 사항을 보면 '예약 실행'의 의미가 달라집니다. 새 자동화는 상태가 active이지만 바로 실행되지는 않습니다. 첫 실행은 조건에 맞는 다음 시각에 이뤄집니다. 반복 실행에는 부하를 분산하기 위해 약간의 무작위 지연이 붙습니다.
대상 세션이 사용 중이면 작업은 대기합니다. 실행할 때마다 invocation이 하나 생성되며, status: completed인 invocation은 전달에 성공했다는 뜻일 뿐입니다. 에이전트가 작업을 마쳤다는 뜻은 아닙니다. 결과를 확인하려면 세션 이벤트에서 agent.session.turn.completed 또는 turn.failed를 확인하십시오(Scheduled automations docs; Sessions docs).
애플리케이션은 이벤트 스트림이나 웹훅으로 보고서를 받을 수 있습니다. agent.session.idle 웹훅은 세션이 새 입력을 받을 수 있다는 뜻입니다. 이 역시 마지막 턴이 성공했다는 뜻은 아닙니다(Webhooks docs). 월요일 전에 테스트하려면 빈 POST /v1/agents/automations/{id}/invocations 요청을 보내십시오. 수동 실행은 저장된 스케줄을 바꾸지 않습니다(Scheduled automations docs: try a run).
new_session과 existing_session 중 어느 쪽이 나을까요? 새 세션은 매주 이전 기록이 없는 컨텍스트로 시작하므로 비용을 예측하기 쉽습니다. 에이전트는 지난주 내용을 기억하지 못하므로 애플리케이션이 지난주 요약을 target.input에 넣어야 합니다. 기존 세션은 이전 결과를 유지하며, 세션이 한도에 가까워지면 Agents API가 오래된 컨텍스트를 압축합니다(OpenAI launch post; compaction docs). 저희는 1,000~2,000 토큰에 불과한 지난주 요약을 입력에 넣어 새 세션을 사용하는 방식을 선호합니다.
실제 MCP 왕복 한 번: 서브에이전트가 보내는 요청과 돌아오는 응답
서브에이전트가 EveryInfra로 보내는 것은 MCP tools/call 하나입니다. 2026년 11월 1일 00:47:47 SGT에 테스트 키로 이 호출을 https://api.everyinfra.com/mcp에 보냈습니다. Trustpilot 서브에이전트가 보낼 바로 그 호출로, notion.so의 최근 별점 1점·2점 리뷰를 요청합니다. arguments 객체는 everyinfra_call_api의 입력이며 플랫폼, 기능, 해당 파라미터로 구성됩니다.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api","arguments":{"platform":"trustpilot","action":"reviews","params":{"company":"notion.so","stars":["1","2"],"date":"last30days","sort":"recency","limit":20}}}}응답은 JSON으로 파싱되는 텍스트 블록입니다. count는 14입니다. results의 각 행에는 title, text, rating, posted_at, verification_level, country 등이 있으며, 이들 필드는 카탈로그에 나온 trustpilot/reviews의 response_fields 목록과 일치합니다. billing.charged는 true이고 charged_usd는 0.001389로, 카탈로그 가격과 같습니다(카탈로그: trustpilot). 첫 리뷰의 제목은 "I find everything in Notion a bit too chaotic"이며 2026년 10월 20일에 게시됐습니다. 비교를 위해 Trustpilot의 공개 Notion 페이지를 열어 보니 같은 날짜의 같은 리뷰가 있었습니다(Trustpilot: Notion).
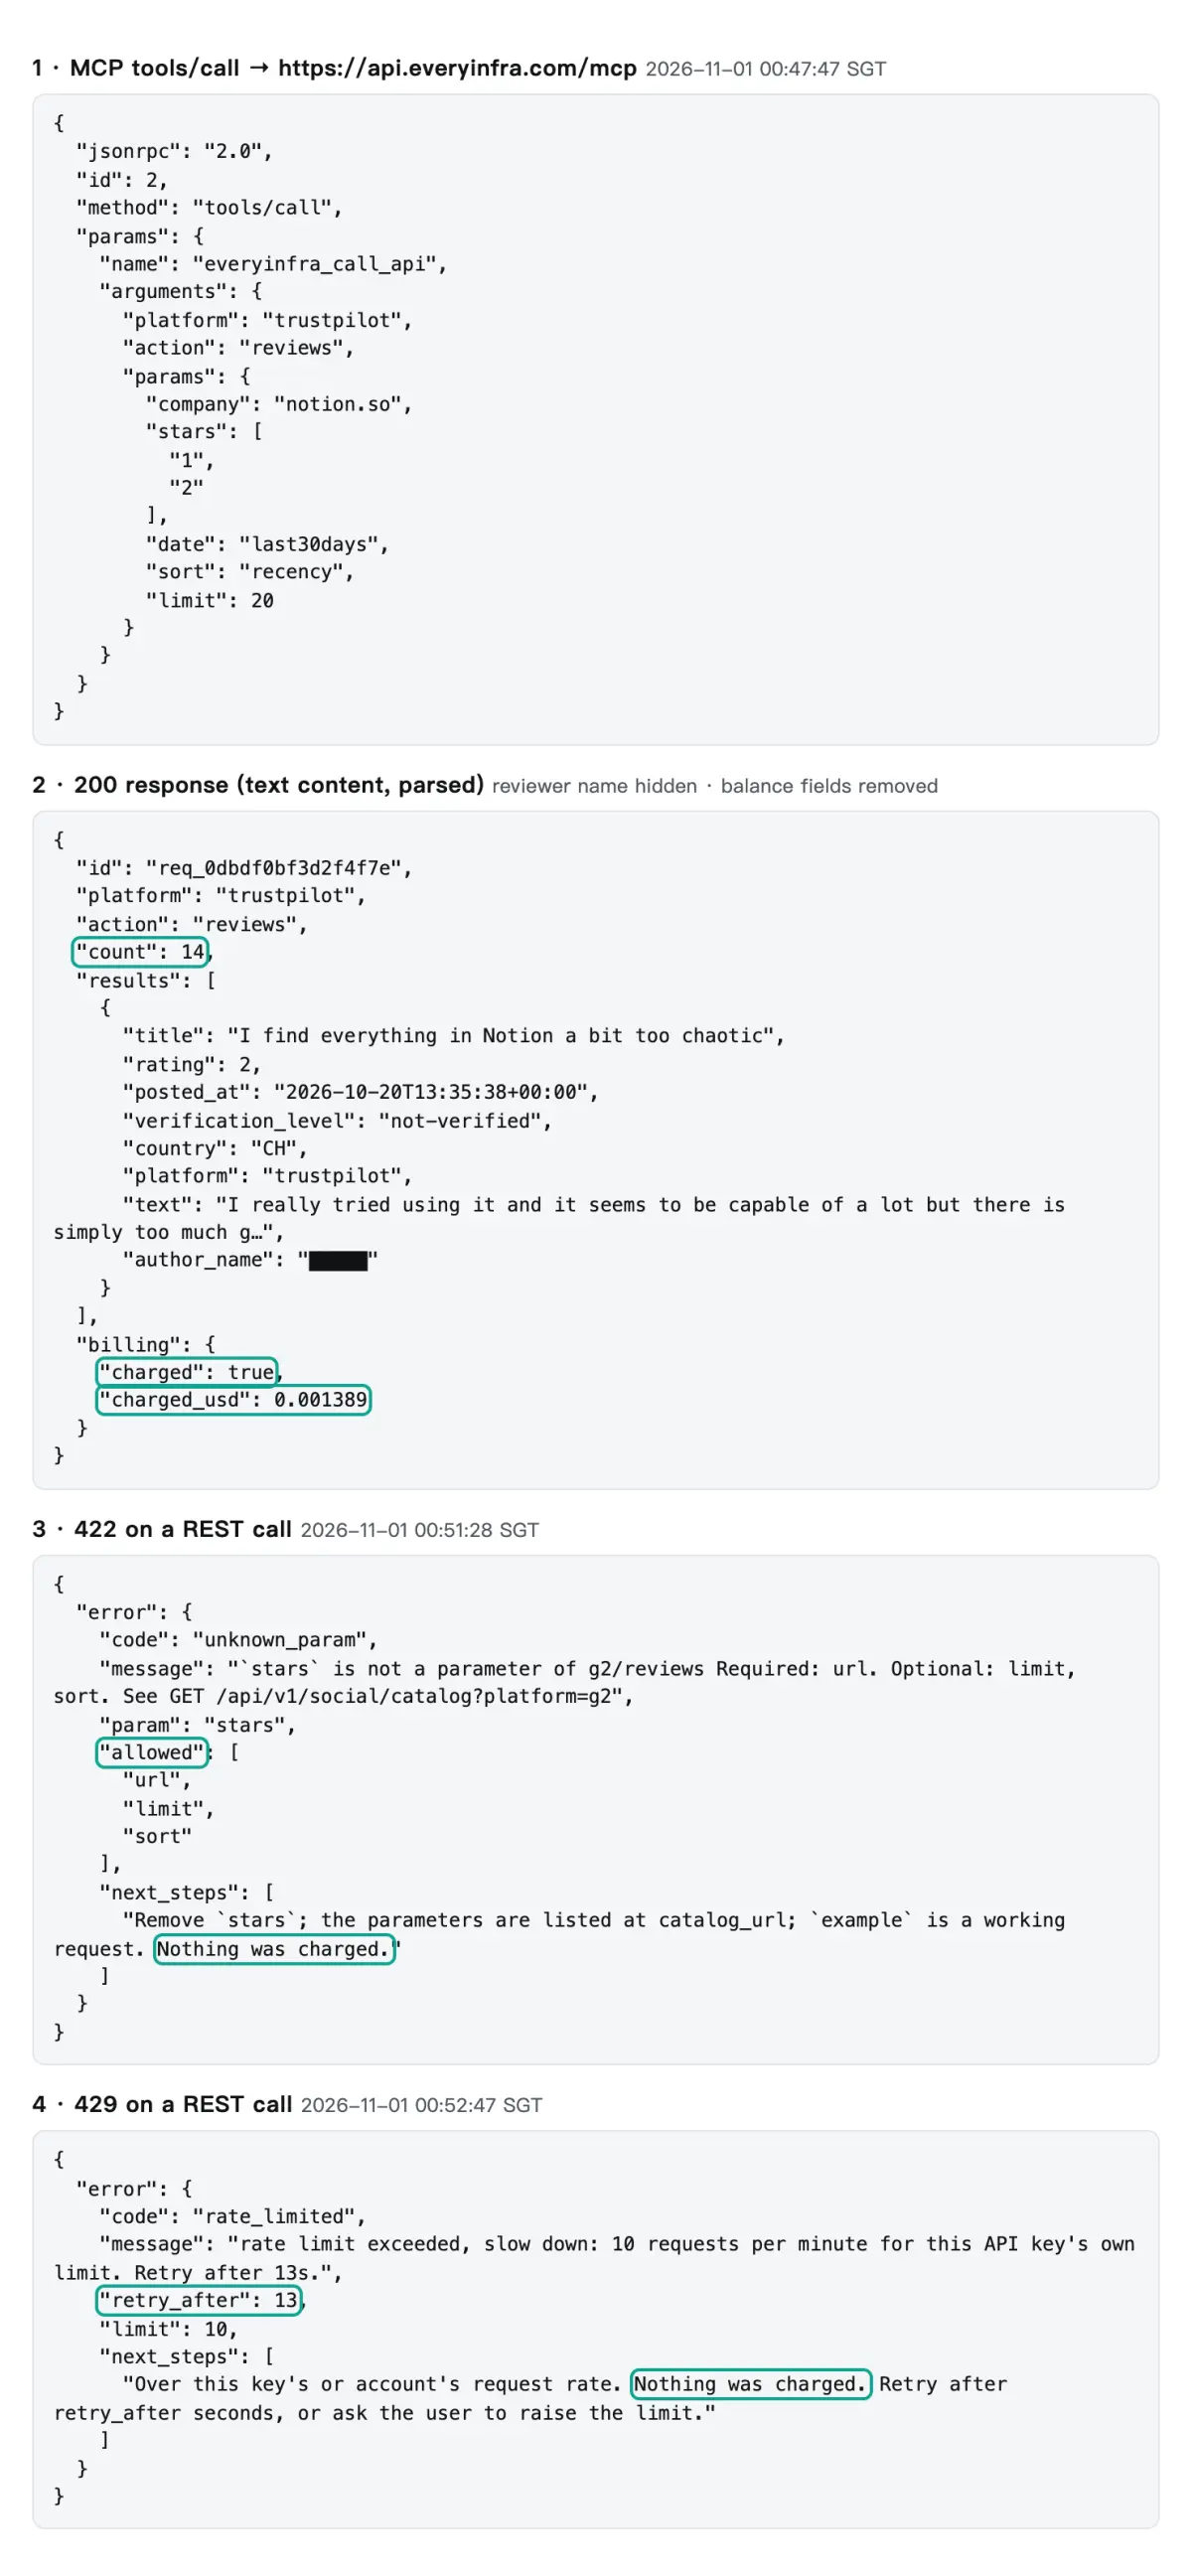
같은 스크린샷에는 서브에이전트가 실제 실행에서 마주칠 실패 두 가지도 담겨 있습니다. 00:51:28 SGT에 g2/reviews가 지원하지 않는 stars를 일부러 보냈습니다. API는 error.code가 unknown_param인 422를 반환했습니다. allowed 목록에는 url, limit, sort가 있었고, next_steps에는 stars를 제거하라는 안내와 과금되지 않았다는 내용이 있었습니다.
00:52:47과 00:53:46 SGT에 호출 두 건이 429를 반환했습니다. 당시 여러 테스트 작업이 같은 테스트 키를 쓰면서 분당 10회 요청 한도를 나눠 쓰고 있었습니다. 첫 429의 retry_after는 13초였고, 37초 뒤에 한 재시도는 성공했습니다. 두 번째 429 이후의 재시도는 15초 뒤에 했고 역시 성공했습니다. 두 429 모두 과금되지 않았습니다.
각 오류가 어떤 파라미터를 바꿔야 하는지, 얼마나 기다려야 하는지 모델에 알려 주므로 서브에이전트가 스스로 수정할 수 있습니다. 지침에 넣은 재시도 규칙도 이 형식을 활용합니다.
실패 하나는 더 주의 깊게 짚어야 하며, 그 원인은 대조 테스트에서야 찾았습니다. 00:51:16 SGT에 trustpilot/reviews에 sort: "newest"를 보내자 retryable: true, retry_after: 20과 함께 503이 반환됐고 과금은 없었습니다. 오류 메시지에는 이 기능이 10분 동안 3번 실패했다고 나와 있었습니다. 실패한 3건(2건은 같은 시각 다른 테스트에서 보낸 호출)은 모두 카탈로그에 없는 값을 쓰고 있었습니다. 같은 시간대에 카탈로그에 있는 값으로 보낸 호출은 정상적으로 처리됐습니다.
원인을 확인하기 위해 15:39:46과 15:40:07 SGT에 같은 파라미터로 두 번 호출했습니다. 바꾼 것은 sort뿐으로, 처음에는 newest, 다음에는 카탈로그에 있는 값인 recency를 썼습니다. 두 호출 모두 200을 반환했고 $0.001389가 과금됐지만, 반환된 행은 서로 달랐습니다.
recency 호출은 00:54 호출과 같은 20개 행을 반환했으며, 모두 영어였고 각 행에 source 필드가 있었습니다. newest 호출은 그중 14개 행만 겹쳤습니다. 나머지 6개 행은 독일어, 프랑스어, 네덜란드어였고, source나 verification_level이 있는 행은 하나도 없었습니다. 카탈로그의 필드 설명에 따르면 결과가 백업 소스에서 올 때는 이 필드가 없을 수 있습니다.
| `sort` | 시각(SGT) | 응답 | 행 | 언어 | `source` 필드 | 과금액 |
|---|---|---|---|---|---|---|
newest(카탈로그에 없음) | 00:51:16 | 503 | — | — | — | 아니요 |
newest(카탈로그에 없음) | 15:39:46 | 200 | 20개, recency와 겹치는 행은 14개뿐 | 영어 14, 독일어 3, 프랑스어 2, 네덜란드어 1 | 있는 행 없음 | $0.001389 |
recency | 15:40:07 | 200 | 20개, 00:54와 동일 | 영어 20 | 20개 행 모두 | $0.001389 |
newest(저녁 수정 이후) | 19:23:05 | 200 | 20개, recency와 동일 | 영어 20 | 20개 행 모두 | $0.001389 |
recency(저녁 수정 이후) | 19:22:49 | 200 | 20개, 00:54와 동일 | 영어 20 | 20개 행 모두 | $0.001389 |
즉, 파라미터 검사는 newest를 막지 않습니다. 메인 소스는 이 값에서 실패하고, 결과는 그 시점의 백업 소스 상태에 따라 달라집니다. 00:51에는 백업 소스도 실패해 503이 반환됐습니다. 15:39에는 백업 소스가 동작해 다른 데이터가 담긴 200이 반환됐고 정상적으로 과금됐습니다.
서브에이전트가 문제를 알아챌 수 없으므로 오류보다 더 나쁜 상황입니다.
여기까지가 11월 1일 새벽과 오후의 결과입니다. 그날 저녁 게이트웨이가 sort 처리 방식을 변경했습니다. 이제 newest(recency와 동일), recency, relevance를 허용합니다. 그 밖의 값을 보내면 게이트웨이는 과금 전에 422를 반환하며, 응답에는 허용 값 목록과 입력값에 가까운 허용 값을 제안하는 힌트가 포함됩니다. 19:22–19:23 SGT에 진행한 재테스트 결과는 테스트 3 마지막 표에 있습니다.
하지만 사이트가 바뀌면 파라미터 이름도 바뀌는 경우가 많습니다. 그래서 지침에서는 여전히 사이트별로 파라미터를 고정하고 모델이 추측하지 못하게 합니다. 일시적인 실패는 retry_after로 처리합니다.
테스트 1: 주 1회 실행으로 충분할까? 호출 한 번으로 얼마나 이전 데이터까지 가져오느냐에 달렸다
'주 1회 확인'은 당연해 보이지만 전제가 하나 있습니다. 사이트별 호출 한 번으로 7일 전체를 커버해야 한다는 것입니다. 일주일에 새 리뷰가 60개 달리는 사이트에서 20개만 읽으면 보고서는 주말 분량만 보게 됩니다. 그래서 설정에 앞서 각 사이트에서 호출 한 번이 며칠을 커버하는지 측정했습니다.
Notion과 ClickUp에 대해 다섯 사이트에서 각각 platform/reviews를 한 번씩 호출했습니다. 가장 최근 게시일과 가장 오래된 게시일, 그리고 행이 최신순으로 오는지를 기록했습니다. 2026년 10월 25일부터 11월 1일(UTC)까지의 행 수도 셌습니다. 두 브랜드에 대해 2026년 11월 1일 00:48부터 14:38 SGT까지 실제 호출 12건을 보냈습니다.
| 사이트 · 브랜드 | 요청 행 수 | 반환된 행 | 가장 오래된 날짜 | 가장 최근 날짜 | 최신순 | 최근 7일 | 저평점 |
|---|---|---|---|---|---|---|---|
| Trustpilot · Notion(별점 1–2점만) | 20 | 20 | 2026-06-13 | 2026-10-20 | 예 | 0 | 0 |
| Trustpilot · ClickUp(별점 1–2점만) | 20 | 20 | 2026-05-16 | 2026-10-29 | 예 | 2 | 2 |
| G2 · Notion | 20 | 리뷰 19개 + 요약 1개 | 2022-11-28 | 2026-10-29 | 대체로 최신순, 오래된 행 3개 섞임 | 12 | 0 |
| G2 · ClickUp | 20 | 리뷰 19개 + 요약 1개 | 2026-10-28 | 2026-10-31 | 예 | 19 | 0 |
| Capterra · Notion | 20 | 19 | 2025-12-11 | 2026-10-09 | 아니요 | 0 | 0 |
| Capterra · ClickUp | 20 | 17 | 2025-11-05 | 2026-10-21 | 아니요 | 0 | 0 |
| App Store · Notion | 50 | 50 | 2026-09-20 | 2026-10-29 | 예 | 9 | 6 |
| App Store · ClickUp | 50 | 50 | 2026-03-30 | 2026-10-29 | 예 | 2 | 2 |
| Google Play · Notion | 200 | 200 | 2026-10-08 | 2026-10-30 | 예 | 52 | 15 |
| Google Play · ClickUp | 200 | 200 | 2026-03-04 | 2026-10-31 | 예 | 5 | 1 |
양 극단이 가장 중요합니다. G2에서는 ClickUp 리뷰 19개가 모두 10월 28일부터 31일까지 사흘 사이에 몰려 있습니다. 이 속도라면 ClickUp은 G2에서 주당 약 47개의 리뷰를 받으므로, 20개 행으로는 최근 2~3일만 볼 수 있습니다.
Google Play에서는 처음에 Notion 리뷰 40개를 요청했는데 4.2일치밖에 되지 않았습니다. 해당 기능의 최댓값인 200개 행을 요청하자 22일치를 커버했습니다. 반면 Trustpilot에서는 Notion 저평점 리뷰가 드뭅니다. 20개를 가져오면 6월 13일까지 거슬러 올라가며, 대략 일주일에 1개꼴입니다.
따라서 같은 주간 스케줄이라도 어떤 사이트는 limit 최댓값이 필요하고, 어떤 사이트는 20개 행이면 충분합니다. EveryInfra 리뷰 엔드포인트는 호출 단위로 과금됩니다. 200개 행을 받은 Google Play 호출의 charged_usd는 40개 행 호출과 같은 0.001389였습니다.
그렇다고 모든 사이트에서 최댓값을 쓰는 것이 최선은 아닙니다. 글을 수정하는 과정에서 모든 사이트에 카탈로그의 max_limit(Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200)을 적용해 Notion 리뷰 수집을 한 차례 더 진행했습니다. App Store에서 가져온 500개 행은 2026년 2월 14일까지, Trustpilot의 저평점 행은 2024년 4월까지 거슬러 올라갔습니다. 이는 주간 보고서에 필요한 양을 훨씬 넘으며, 추가된 행은 모두 모델 컨텍스트에 들어갑니다(수치는 테스트 4 참고).
저희 규칙은 호출 한 번이 최소 2주를 커버하도록 limit을 설정하는 것입니다. Notion의 경우 Trustpilot 20, G2 100, Capterra 100, App Store 50, Google Play 200입니다. 그런 다음 서브에이전트가 posted_at으로 최근 7일을 필터링합니다. 브랜드마다 리뷰량이 다르므로 위 표처럼 먼저 사이트별로 한 번씩 호출해 측정하세요.
차트에는 세 번째 경우도 나타납니다. Capterra 두 행은 1년 전체에 퍼져 있고, 결과 순서는 시간과 아무 관련이 없습니다. capterra/reviews에는 필수 파라미터 company 하나만 있고 정렬 파라미터는 없습니다. Notion 리뷰 19개는 2025년 12월 11일부터 2026년 10월 9일까지 뒤섞인 순서로 나오며, 최근 30일 안의 리뷰는 1개뿐입니다. ClickUp 리뷰 17개도 마찬가지입니다.
보고서 관점에서 Capterra에서는 '최신 N개 가져오기'가 통하지 않습니다. 매번 100개 행을 요청하고 id와 posted_at을 지난주 결과와 비교하세요. Capterra 리뷰는 브랜드별로 30일에 1개꼴로 적으므로 주 1회 실행이면 충분합니다.
G2에도 작은 함정이 있습니다. Notion 응답의 첫 행은 리뷰가 아닙니다. record_type: summary인 행으로, 전체 평점 4.6, 총 리뷰 수 13,962개, 주요 장단점이 담겨 있습니다. 이어지는 리뷰 19개는 대체로 최신순이지만, 2022~2025년 리뷰 3개가 중간에 끼어 있습니다.
가장 오래된 날짜를 '커버 범위'로 삼는 서브에이전트는 이 호출이 4년 전까지 거슬러 올라갔다고 판단할 것입니다. 'posted_at으로 직접 필터링' 규칙이 이 문제를 해결합니다. 그래도 요약 행은 쓸모가 있습니다. 별도의 g2/profile 호출 없이 이번 주 G2 전체 평점을 보고서에 인용할 수 있습니다.
테스트 2: 저평점 리뷰는 어디에 몰려 있나
커버 범위를 측정했으니 저평점 리뷰가 어디에 있는지 비교할 수 있습니다. 사이트별 호출 한 번으로 볼 수 있는 최근 30일 저평점 리뷰(G2는 별점 2.5 이하, 나머지는 2 이하)를 셌습니다. Notion은 총 67개로, App Store 22개, Google Play 42개, Trustpilot 3개, G2와 Capterra 0개입니다. 즉 67개 중 64개(95.5%)가 두 앱 스토어에 있습니다. ClickUp은 총 14개로 더 고르게 분포합니다. Trustpilot 5개, App Store 4개, Google Play 5개, G2와 Capterra 0개입니다.
이 분포에서 보고서에 필요한 교훈 두 가지를 얻을 수 있습니다. 첫째, B2B 리뷰 사이트에는 저평점 리뷰가 적습니다. 20개 행 호출에서는 두 브랜드 모두 30일 동안 G2 저평점 리뷰가 없었습니다. 글을 수정하는 동안 Notion에 대해 100개 행으로 호출하자 리뷰 50개가 반환됐습니다. 그중 41개가 최근 30일 리뷰였고, 저평점은 1개뿐이었습니다. G2 요약 평점 4.6과도 맞아떨어집니다. G2와 Capterra만 보는 팀이라면 아무 문제가 없다고 생각할 수 있습니다.
둘째, 앱 스토어 불만은 많고 구체적이며 대부분 버전 번호가 붙어 있습니다. App Store의 모든 행에는 app_version 필드가 있습니다. 30일간 Notion 저평점 리뷰 22개 중 8개가 버전 1.7.345에서 나왔으며, 다른 어떤 버전보다 많습니다. 버전별로 집계하는 서브에이전트는 '저평점 리뷰가 1.7.345 이후 몰려 있음'이라고 쓸 수 있고, 엔지니어링 팀은 이를 바로 조치로 옮길 수 있습니다.
이 저평점 리뷰는 키워드 규칙으로도 분류했습니다. 규칙은 재집계 스크립트에 들어 있습니다. 예를 들어 제목이나 본문에 "slow", "crash", "bug"가 있으면 해당 리뷰는 속도·버그 그룹에 들어갑니다. 리뷰 하나가 여러 그룹에 속할 수 있습니다.
두 앱 스토어의 Notion 저평점 리뷰 64개 중 20개는 속도와 버그, 18개는 모바일 사용 경험, 12개는 AI 기능에 관한 것입니다. 규칙으로 분류하지 못한 리뷰는 22개이며, 그중 18개가 Google Play 리뷰입니다. 대부분 한두 단어짜리 리뷰입니다.
모델이 제값을 하는 곳이 바로 이 마지막 그룹입니다. 규칙은 길고 명확한 불만은 잘 처리합니다. 하지만 "bad", "worst update" 같은 표현이나 비꼬는 말에는 실패합니다. 따라서 서브에이전트 모델은 모든 리뷰를 다시 읽는 데 토큰을 쓰기보다 규칙이 분류하지 못한 리뷰에 토큰 대부분을 써야 합니다.
브랜드를 가로질러 봐야만 드러나는 신호도 있지만, 표본은 매우 작습니다. 최근 30일 동안 Notion App Store 리뷰 2개와 ClickUp App Store 리뷰 1개가 'iPhone Duo'를 언급합니다. 10월 26일에 올라온 Notion 별점 2점 리뷰는 iPhone Duo에서 터치 영역이 작동하지 않고, 텍스트를 선택하면 사라지며, 앱이 충돌한다고 말합니다. 10월 29일에 올라온 ClickUp 별점 1점 리뷰의 제목은 "No iPhone Duo support"입니다. iPhone Duo는 Apple의 첫 폴더블 iPhone으로, 10월 23일 Apple Store에서 판매를 시작했습니다(Apple Newsroom). 새 기기가 나온 뒤 처음 몇 주 동안은 앱 지원 문제가 흔합니다.
따라서 리뷰 3개만으로 어느 팀이든 대응을 계획해야 할 문제라고 단정할 수는 없습니다. 보고서에는 '신규 기기 지원, 지켜볼 것, 다음 주에 건수가 늘었는지 확인' 정도로 쓰면 좋습니다. 유용한 교훈은 역할 분담에 있습니다. 한 브랜드 안에서는 불만 하나일 뿐입니다. 브랜드를 가로질러 보면 그것이 하나의 기기를 가리킨다는 것을 알 수 있습니다. 메인 에이전트는 모든 서브에이전트의 요약을 보므로, 이런 브랜드 간 분석은 메인 에이전트가 맡아야 합니다.
주간 보고서는 어떤 모습일까: 이번 주 실제 데이터로 살펴보기
결과물은 직접 봐야 판단하기 쉽습니다. 아래 표는 2026년 10월 25일부터 11월 1일(UTC)까지의 한 주를 기준으로 합니다. 사이트와 브랜드별로 호출 한 번으로 볼 수 있었던 새 리뷰 수와 그중 저평점 리뷰 수를 보여 줍니다. 모든 값은 실제 호출의 원본 응답에서 가져왔습니다. 서브에이전트가 메인 에이전트에 돌려주는 데이터가 바로 이런 형태입니다.
| 사이트 | Notion 신규 / 저평점 | ClickUp 신규 / 저평점 | 보고서에 담을 내용 |
|---|---|---|---|
| Trustpilot | 0 / 0 | 2 / 2 | ClickUp 별점 1점 리뷰 2개로, 하나는 고객 지원 챗봇, 다른 하나는 사용자 시트·결제 변경 시 30일 전 통지에 관한 내용입니다. 두 리뷰 모두 고객 지원팀과 결제팀에 전달하세요. |
| G2 | 12 / 0 | 19 / 0 | 두 브랜드 모두 저평점 리뷰가 없습니다. ClickUp은 주당 약 47개가 달리므로 limit을 100으로 설정하세요. |
| Capterra | 0 / 0 | 0 / 0 | 이번 주 새 리뷰는 없습니다. 결과가 정렬되지 않으므로 id 값을 지난주와 비교하세요. |
| App Store | 9 / 6 | 2 / 2 | Notion 불만은 버전 1.7.345에 몰려 있습니다. 두 브랜드를 합쳐 리뷰 3개가 iPhone Duo를 언급하므로 다음 주에 다시 확인하세요. |
| Google Play | 52 / 15 | 5 / 1 | Notion 불만이 가장 많이 나오는 곳입니다. 짧은 리뷰 22개는 모델에 넘기세요. |
메인 에이전트는 이런 짧은 행 5개와 브랜드별 전체 평점을 받습니다. G2 요약 행에서 평점 하나를 얻고, trustpilot/profile 호출로 리뷰 442개 기준 Notion의 TrustScore 2.2를 얻습니다.
그다음 메인 에이전트는 세 가지를 판단합니다. 어느 행이 지난주보다 크게 늘었는가? 여러 사이트나 브랜드에서 반복되는 문제가 있는가? 보고서에 링크할 만한 원본 리뷰는 무엇인가? 세 가지 모두 다섯 가지 결과를 전부 확인해야 하므로 메인 에이전트가 처리합니다. 리뷰 수백 개를 읽고 버전과 키워드별로 집계하는 일은 단순 반복 작업이므로 서브에이전트에 맡깁니다.
메인 에이전트는 고정된 JSON을 반환하고, 애플리케이션이 이를 이메일이나 채팅 메시지로 바꾸는 방식을 권합니다. 세션은 agent.text.format.schema로 출력 스키마를 받으며, 입력과 스키마를 합쳐 4 MiB 미만이어야 합니다(Sessions docs). 스키마를 고정하면 보고서가 매주 같은 형태가 되어 주간 비교가 간단해집니다.
테스트 3: 파라미터 하나만 틀려도 결과가 달라진다
앞에서 몇 가지 파라미터 문제를 언급했습니다. 이 표는 그 문제들과 저희가 겪은 다른 사례를 한데 모았습니다. 각 행은 실제 호출입니다. 마지막 열은 서브에이전트 지침에 넣을 규칙입니다.
| 발생 상황 | 시간(SGT, 2026년 11월 1일) | 응답 | 과금액 | 해결 방법 |
|---|---|---|---|---|
date: "last30days"를 지정한 Trustpilot 호출에서 30일보다 오래된 결과 반환 | 00:47 | 7월 31일부터 10월 20일까지 14개 행이 반환됐고, 30일 이내는 3개뿐이었습니다. 저녁 수정 이후 19:22 재테스트에서는 3개 행이 반환됐으며 모두 30일 이내였습니다. | 예, $0.001389 | 수정 이후에는 프리셋이 정상 동작합니다. 그래도 주간 보고서에서는 posted_at으로 필터링하세요. |
G2에 지원되지 않는 stars 파라미터 지정 | 00:51 | 422 unknown_param, 허용: url, limit, sort | 아니요 | G2에는 별점 필터가 없습니다. rating으로 직접 필터링하세요. |
| 여러 테스트 작업이 키 하나를 공유해 분당 10회 요청을 모두 사용 | 00:52, 00:53 | 429, 첫 retry_after는 13초, 두 재시도 모두 성공 | 아니요 | retry_after만큼 기다리세요. |
Trustpilot에 카탈로그에 없는 sort: "newest" 지정 | 00:51, 15:39 | 처음에는 503이 반환됐습니다. 이후 백업 소스에서 200이 반환됐으며, 영어가 아닌 행 6개가 섞여 있고 source 필드가 없었습니다. 저녁 수정 이후 newest는 recency와 동일합니다. | 503 아니요, 200 예($0.001389) | 카탈로그 값을 쓰세요. 수정 이후에는 잘못된 값에 422가 반환됩니다. |
| Trustpilot, 200개 행, 동기 호출 | 15:40 | 85초 후 타임아웃, 503, mode: "async" 사용 권장 안내 | 아니요 | limit이 크면 비동기로 호출하고 everyinfra_get_job으로 행을 읽으세요. 비동기 호출은 131개 행을 반환했습니다. |
이름 Notion으로 Capterra 조회 | 00:49 | Google Sheets 내보내기 애드온 리뷰 20개 행, 그중 3개는 날짜 또는 링크 없음 | 예, $0.001389 | 제품 페이지 URL /p/186596/Notion/을 쓰세요. |
| 제품 URL로 Capterra 조회 | 00:50 | 19개 행, 정렬되지 않음, 98,725자에 달하는 pros 필드 1개. 저녁 수정 이후에는 모든 필드가 5,000자 이하입니다. | 예, $0.001389 | 텍스트 필드마다 상한을 두세요(예: 2,000자). |
| G2 첫 행이 요약 | 00:48 | record_type: summary, 평점 4.6, 리뷰 13,962개 | 예, $0.001389 | 요약은 따로 처리하세요. 리뷰로 세지 마세요. |
Trustpilot 행은 좀 더 자세히 볼 필요가 있습니다. 카탈로그는 date를 기간 프리셋으로 설명하며, last30days는 최근 30일을 뜻합니다. 별점 1점·2점만 지정해 이 값을 보냈더니 7월 31일부터 10월 20일까지 14개 행이 반환됐고, 30일 이내는 3개뿐이었습니다. date 없이 같은 요청을 보내자 6월 13일까지 거슬러 올라가는 20개 행이 반환됐으며, 처음 14개 행은 앞의 14개 행과 같았습니다.
즉 11월 1일 새벽 실행에서 프리셋 호출은 30일이 아니라 약 3개월 전에서 멈췄습니다. 행 수만 세는 보고서라면 실제로는 3개인데 30일간 저평점 리뷰가 14개라고 썼을 것입니다.
그날 저녁 게이트웨이는 프리셋이 게시일을 기준으로 각각 최근 7일, 30일, 92일, 183일, 366일 범위만 반환하도록 변경했습니다. 이제 잘못된 프리셋은 과금 전에 422를 반환합니다. 19:22 SGT 재테스트에서는 10월 3일부터 10월 20일까지 3개 행이 반환됐습니다. 새벽 실행에서 30일 이내였던 바로 그 3개 행입니다. 따라서 이제 last30days를 날짜 필터로 쓸 수 있습니다. 그래도 주간 보고서에서는 서브에이전트가 새 리뷰를 이전 리뷰와 비교하므로, 20개 행을 모두 읽고 posted_at으로 필터링합니다.
Capterra 이름 조회 사례에서 일반적인 교훈을 얻을 수 있습니다. 리뷰 사이트에는 이름이 같거나 비슷한 제품이 많아서, 이름으로 조회하면 다른 제품이 섞일 수 있습니다. 카탈로그의 company 설명도 이를 피하려면 가능한 한 제품 링크를 보내라고 안내합니다. 제품 URL로 조회하자 19개 행이 모두 Notion 리뷰였습니다. 브랜드 목록에는 이름이 아니라 사이트별 링크나 ID를 저장해야 합니다. 입력을 설계할 때 이 점을 정해 두세요.
아래 표는 11월 1일 저녁 수정 이후(19:22–19:23 SGT) 낮과 같은 파라미터로 진행한 재테스트 결과를 정리한 것입니다.
| 항목 | 11월 1일 새벽 또는 오후 실행 | 저녁 재테스트 | 과금액 |
|---|---|---|---|
Trustpilot sort: "newest" | 00:51에 503, 15:39에 200이지만 영어가 아닌 행 6개, source 없음 | 200, recency 및 00:54 호출과 같은 행, 모두 영어 | $0.001389 |
Trustpilot date: "last30days" | 14개 행, 30일 이내는 3개뿐 | 3개 행, 모두 30일 이내 | $0.001389 |
Capterra 제품 URL, limit: 100 | 86개 행, 375,315바이트, 가장 긴 필드 103,138자 | 같은 86개 행, 144,341바이트, 가장 긴 필드 1,154자 | $0.001389 |
| 권장 주간 실행(Notion) | 651,907바이트, 약 163k 토큰 | 420,933바이트, 약 105k 토큰 | — |
테스트 4: 일주일치 원본 리뷰의 크기가 모델 비용을 결정한다
모델은 토큰 단위로 과금하므로 일주일치 원본 리뷰의 크기를 알아야 합니다. 호출이 반환하는 각 행은 도구 출력으로 서브에이전트 컨텍스트에 들어갑니다. 따라서 limit이 모델이 읽는 양을 결정합니다. Notion에 대해 세 가지 설정을 각각 실제 응답으로 측정했고, 저녁에 Capterra 재테스트를 한 번 진행했습니다. 토큰 수는 영어 텍스트 기준 토큰당 약 4자로 계산했습니다(OpenAI Help Center: tokens).
| 설정(Notion, 사이트별 호출 1회) | 사이트별 `limit` | 원본 | 대략적인 토큰 수 | 텍스트 필드를 2,000자로 자른 경우 | 대략적인 토큰 수 |
|---|---|---|---|---|---|
| 1회차(00:47–00:57) | Trustpilot 20(last30days 적용), G2 20, Capterra 20, App Store 50, Google Play 200 | 359,497바이트 | 89,874 | 246,387바이트 | 61,597 |
| 권장 | Trustpilot 20, G2 100, Capterra 100, App Store 50, Google Play 200 | 651,907바이트 | 162,977 | 422,892바이트 | 105,723 |
| 권장, 저녁 Capterra 재테스트 반영(19:23) | 위와 같음 | 420,933바이트 | 105,233 | 420,732바이트 | 105,183 |
모든 사이트에 max_limit | Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200 | 1,021,087바이트 | 255,272 | 786,452바이트 | 196,613 |
권장 설정의 G2와 Capterra 값은 15:42와 15:43 SGT에 새로 보낸 호출 두 건의 결과입니다. G2는 100개 행을 요청해 리뷰 50개와 요약 행 1개를 반환했습니다. Capterra는 100개를 요청해 86개를 반환했습니다. 나머지 세 호출은 같은 파라미터로 보낸 1회차 결과입니다. max_limit 회차는 자른 뒤 약 197k 토큰으로, 권장 설정의 1.86배입니다. 늘어난 양의 대부분은 App Store 행 450개와 Trustpilot 행 111개이며, 거의 모두 일주일보다 훨씬 오래된 리뷰입니다.
11월 1일 새벽 실행에서 652 KB의 3분의 1 이상이 리뷰 2개에서 나왔습니다. 1회차에서 20개 행짜리 Capterra 응답은 148,915바이트였고, 그중 리뷰 하나가 114,983바이트였습니다. 이 리뷰의 pros 필드는 98,725자였습니다. 평범한 사용자 의견으로 시작하다가 페이지의 긴 스크립트 데이터 블록이 이어집니다. 100개 행 응답에는 이런 리뷰가 2개 있었고, pros 필드는 각각 100,712자와 103,138자였습니다. ClickUp Capterra 응답에는 103,556자짜리 리뷰가 1개 있었습니다.
파서가 리뷰와 함께 페이지 데이터까지 가져온 것입니다.
모든 텍스트 필드를 2,000자로 자르자 100개 행 Capterra 응답은 375,315바이트에서 146,501바이트로 줄었습니다. 권장 주간 실행은 약 163k 토큰에서 약 106k 토큰으로 줄었습니다. 자르지 않으면 서브에이전트가 54% 더 많은 분량을 읽는 셈입니다.
그날 저녁 게이트웨이에서 파서가 수정됐습니다. 이제 pros, cons, text에서 페이지 코드를 제거하며, 각 필드는 5,000자 이하입니다. 19:23 SGT 재테스트에서는 같은 리뷰 86개가 144,341바이트로 반환됐으며, 새벽에 자른 뒤의 146,501바이트보다 약간 작습니다(테스트 3 마지막 표 참고). 권장 주간 실행은 이제 약 105k 토큰으로, 새벽에 자른 뒤의 수치와 0.5%밖에 차이 나지 않습니다. 따라서 아래 모델 비용 추정은 달라지지 않습니다.
데이터를 모델에 넘기기 전에 텍스트 필드에 상한을 두는 것은 여전히 좋은 습관입니다. 비용이 들지 않으며, 나중에 다른 사이트에서 같은 문제가 생겨도 대비할 수 있습니다.
서브에이전트가 효과를 발휘하는 지점이 바로 여기입니다. 서브에이전트가 없으면 메인 에이전트가 106k 토큰을 모두 직접 읽어야 합니다. 서브에이전트 5개를 쓰면 각자 자기 사이트만 읽고(가장 큰 Capterra가 자른 뒤 약 37k 토큰), 메인 에이전트는 사이트당 수백 토큰 분량의 JSON 요약을 받습니다. 자동화 문서도 예약 작업을 각각 서브에이전트에 위임하면 상세한 도구 출력이 메인 컨텍스트 밖에 머문다고 안내합니다(Scheduled automations docs). TikTok 브랜드 계정으로 진행한 Claude Code 서브에이전트 테스트에서는 원본 데이터와 요약의 크기가 약 100배 차이 났습니다.
청구 금액: OpenAI Agents API 요금과 데이터 비용
데이터 쪽부터 보겠습니다. EveryInfra 리뷰 엔드포인트는 호출 단위로 과금되며, 행 수는 가격에 영향을 주지 않습니다. 다섯 기능 모두 price_usd가 0.001389입니다(카탈로그; 요금 페이지). 브랜드 하나에 주 5회 호출하면 주당 $0.006945, 연간 $0.3611입니다. 자사와 경쟁사 9곳을 합친 브랜드 10개는 연간 $3.61입니다.
이 수치는 추정치가 아닙니다. 이 글을 쓰면서 과금된 호출은 21건이며, 그중 6건은 글을 고치는 과정에서 보냈습니다. 각 호출의 charged_usd는 0.001389로, 합계 $0.029169입니다. 실패한 호출 6건(503 3건, 422 1건, 429 2건)은 과금되지 않았습니다. 저녁 수정 이후에는 재테스트 4건(Trustpilot 3건, Capterra 1건)을 진행했습니다. 각각 $0.001389가 과금돼 합계 $0.005556입니다.
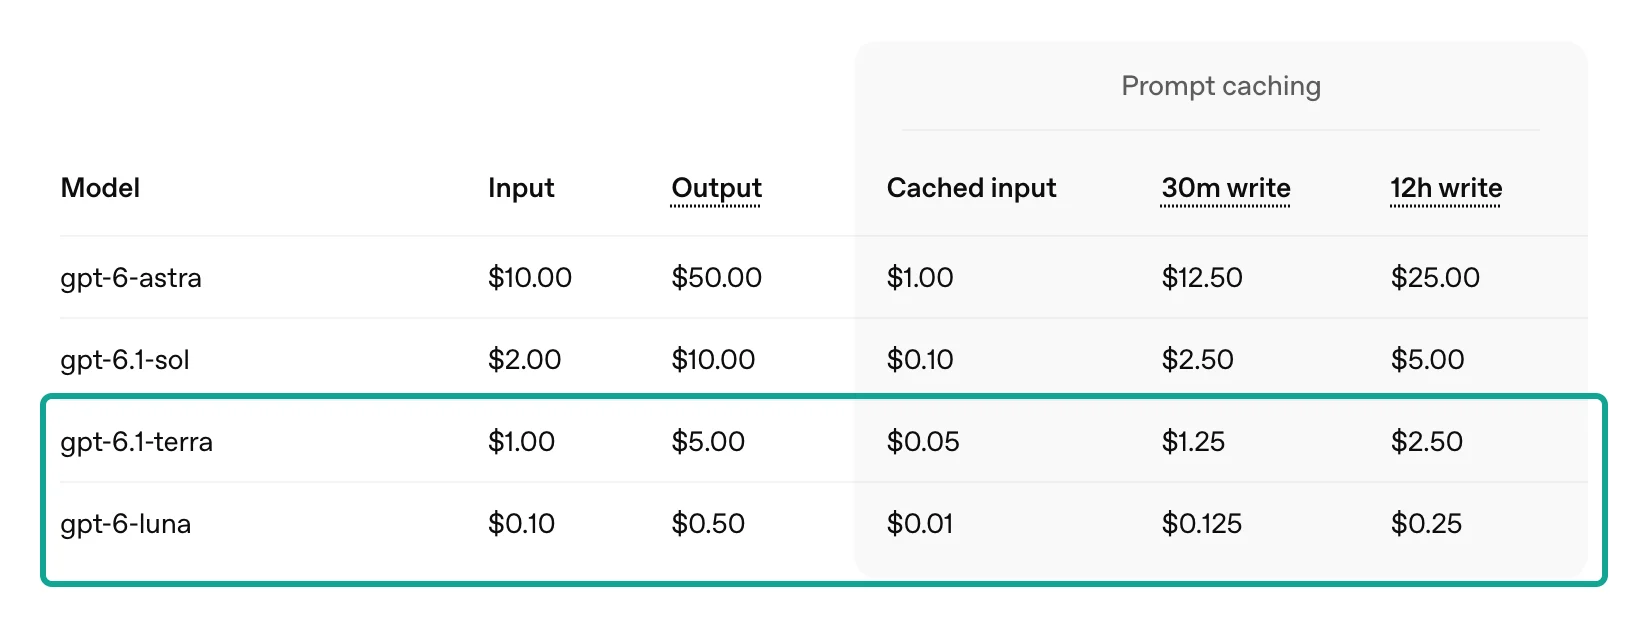
이제 OpenAI 쪽입니다. 개요 페이지에 따르면 모델은 API 요금, 도구는 표준 요금, 호스팅 샌드박스는 컨테이너 요금으로 청구됩니다(Agents API overview: pricing). 저희 구성은 샌드박스(environment: none)와 웹 검색을 쓰지 않으므로 모델 토큰 비용만 남습니다. 다음은 2026년 11월 1일에 확인한 100만 토큰당 표준 정가입니다(OpenAI API pricing).
| 모델 | 입력 | 캐시된 입력 | 30분 캐시 쓰기 | 출력 |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6.1-sol | $2.00 | $0.10 | $2.50 | $10.00 |
| gpt-6.1-terra | $1.00 | $0.05 | $1.25 | $5.00 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
직접 수치를 넣어 계산할 수 있도록 방법을 설명합니다. 입력은 세 부분으로 나뉩니다. 권장 제한값을 적용해 잘라낸 일주일치 리뷰는 약 105,723 토큰입니다. 서브에이전트 5개에는 각각 지침, 도구 설명, 컨텍스트로 약 8,000 토큰이 추가됩니다. 메인 에이전트에는 약 20,000 토큰이 추가됩니다.
첫 읽기는 30분 캐시 쓰기 요금으로 계산했습니다. GPT-5.6 이후 모델에서 30분 캐시 쓰기는 입력 가격의 1.25배이므로, 이 가정은 다소 높게 잡은 편입니다(Prompt caching docs).
서브에이전트는 한 턴에 모델을 여러 번 호출합니다. 그래서 리뷰와 오버헤드를 캐시 요금으로 두 번 더 읽는다고 보고 비용에 더했습니다. 출력은 서브에이전트당 1,500 토큰, 메인 에이전트 3,000 토큰입니다.
실측한 것은 리뷰 크기뿐입니다. 나머지 입력은 가정이므로 유효숫자 두 자리로 반올림했습니다. 추정 비용은 gpt-6-luna 약 $0.029, gpt-6.1-terra 약 $0.27, gpt-6.1-sol 약 $0.55, gpt-6-astra 약 $2.9입니다. 모델 간 100배 차이는 정가 비율일 뿐입니다. astra의 입력 가격 $10.00은 어떤 작업이든 luna 가격의 100배입니다.
| 브랜드 1개, 1주 | 금액 | 1년(×52) | 근거 |
|---|---|---|---|
| EveryInfra 데이터 호출(5건) | $0.006945 | $0.3611 | 테스트에서 실제 과금된 금액 |
| 모델, gpt-6-luna | 약 $0.029 | 약 $1.5 | 정가 기준 추정 |
| 모델, gpt-6.1-terra | 약 $0.27 | 약 $14 | 정가 기준 추정 |
| 모델, gpt-6.1-sol | 약 $0.55 | 약 $29 | 정가 기준 추정 |
| 모델, gpt-6-astra | 약 $2.9 | 약 $150 | 정가 기준 추정 |
어떤 가정이 결과에 가장 큰 영향을 줄까요? 아래 표는 오버헤드와 재읽기 횟수를 각각 세 단계로 바꿔 본 결과입니다. 모델은 gpt-6.1-terra를 사용했고, 권장 한도와 나머지 가정은 앞과 같습니다.
| 서브에이전트당 오버헤드 | 재읽기 1회 | 재읽기 2회 | 재읽기 4회 |
|---|---|---|---|
| 4,000토큰 | $0.24 | $0.25 | $0.26 |
| 8,000토큰 | $0.27 | $0.27 | $0.29 |
| 16,000토큰 | $0.32 | $0.33 | $0.35 |
9개 결과는 모두 $0.24~$0.35 사이입니다. 캐시 가격이 입력 가격의 5%이므로 재읽기는 결과를 거의 바꾸지 않습니다. 오버헤드는 조금 더 영향을 줍니다. 큰 차이를 만드는 것은 검토할 리뷰의 양입니다. 같은 가정에서 모든 곳에 max_limit을 쓰면 약 $0.40이고, 첫 라운드의 검토량을 작게 잡으면 약 $0.21입니다. 따라서 먼저 limit과 텍스트 자르기 기준을 정한 다음 모델을 고르세요.
표가 보여 주는 것은 비율입니다. 데이터 요금은 전체에서 작은 부분이고, 핵심 변수는 모델 선택입니다. 저평점 리포트는 많이 읽고 단순한 판단을 내립니다. 그래서 저희라면 서브에이전트에 gpt-6-luna 또는 gpt-6.1-terra를 쓰겠습니다. 메인 에이전트에는 요약에 꼭 필요한 경우에만 더 강력한 모델을 쓰세요.
세션에서는 나중에 model, reasoning.effort, service_tier를 변경할 수 있습니다. tools, instructions, multi_agent는 변경할 수 없습니다(구성 문서). 따라서 모델 조합은 에이전트를 만들 때 미리 계획하세요.
과금과 관련해 짚어 둘 점이 두 가지 있습니다. 첫째, Agents API의 usage 필드는 best-effort로 제공됩니다. null일 수 있고 나중에 바뀔 수 있으며 청구서가 아닙니다. 또한 캐시 쓰기 토큰 수를 따로 집계하지 않으므로, 캐시 쓰기 가격이 있는 모델에서는 usage만으로 정확한 모델 비용을 계산할 수 없습니다(관측성 문서).
둘째, 나중에 호스팅 샌드박스를 추가하면 컨테이너에 정가가 적용됩니다(4 GB 기준 20분당 $0.12, 2026년 6월 2일부터 분 단위 과금, 최소 5분). 2026년 10월 9일부터 호스팅 샌드박스는 턴 사이의 유휴 시간이 아니라 활성 턴 동안에만 과금됩니다(OpenAI API 요금; 변경 내역). 저희 구성에는 샌드박스가 없으므로 이 비용은 0입니다.
배포 전에 확인해야 할 퍼블릭 베타 제한 사항
Agents API는 퍼블릭 베타입니다. 요청에는 OpenAI-Beta: agents=v1 헤더가 필요하며, OpenAI SDK는 beta.agents 네임스페이스를 사용합니다(빠른 시작). 출시 게시물에 따르면 OpenAI는 정식 출시를 향해 베타 기간 동안 제품을 빠르게 변경할 예정입니다(OpenAI 출시 게시물). 이 표에는 문서에 명시된 제한만 담았으며, 모두 리뷰 모니터링에 영향을 줍니다.
| 한계 | 문서 내용 | 리뷰 모니터링에 미치는 영향 | 출처 |
|---|---|---|---|
| 데이터 레지던시 및 보존 | 미국 데이터 레지던시만 지원합니다. 자체 호스팅 샌드박스를 사용해도 Zero Data Retention은 지원되지 않습니다. | 공개 리뷰는 위험이 낮습니다. 리포트에 지원 티켓을 섞는다면 먼저 컴플라이언스를 확인하세요. | 개요, 사용자 데이터 |
| 스케줄이 정확하지 않음 | 반복 실행에는 약간의 무작위 지연이 붙습니다. 대상 세션이 사용 중이면 작업이 대기합니다. | 리포트는 9:00이 몇 분 지난 뒤 도착합니다. 정확한 시각이 필요한 단계와 연결하지 마세요. | 자동화 |
| 전달은 완료가 아님 | completed 상태의 호출(invocation)은 전달에 성공했다는 의미일 뿐입니다. | turn.completed 또는 turn.failed를 사용하고, 실패 시 알림을 보내세요. | 자동화, 웹훅 |
| 볼트는 OpenAI 측 연결에만 사용됨 | 환경(environment)에서 시작되는 HTTP 연결은 볼트 자격 증명을 사용하지 않습니다. | EveryInfra MCP 서버는 공개되어 있으므로 기본 service 오리진이 적합합니다. | MCP 연결 |
| 서브에이전트에서는 함수 도구 사용 불가 | 서브에이전트는 MCP 도구와 자격 증명을 상속하지만 함수 도구는 사용할 수 없습니다. | 데이터는 메인 에이전트만 반환합니다. 저장은 애플리케이션에서 합니다. | 멀티 에이전트 |
| 사용량은 청구서가 아님 | best-effort로 제공되며, null일 수 있고 나중에 바뀔 수 있으며 캐시 쓰기 토큰 수를 집계하지 않습니다. | 비용은 usage가 아니라 청구서로 확인하세요. | 관측성 |
| 크기 제한 | 지침과 도구 구성의 합계가 4 MiB 미만이어야 합니다. 각 입력도 4 MiB 미만이어야 합니다. | 브랜드 목록이 길면 지난주 전체 데이터가 아니라 지난주 요약을 보내세요. | 구성, 세션 |
| MCP 시작 실패 | required: true이면 시작에 실패할 때 mcp_server_startup_failed(424)로 턴이 실패합니다. | 의도한 동작입니다. 데이터가 없으면 리포트도 없습니다. | 오류 |
이 구성으로 할 수 없는 일과 주의할 점
첫째, 이 구성은 공개 리뷰를 읽기만 하며 답글을 달지는 않습니다. App Store와 Google Play 답글은 Apple과 Google 개발자 콘솔에서 작성합니다(Apple: 평점, 리뷰 및 답변; Google Play Console 고객센터: 평점 및 리뷰). 저희 응답에는 Google Play와 Trustpilot의 reply_text, Capterra의 vendor_response가 포함됩니다. 따라서 리포트에서 어떤 리뷰에 답글이 있는지 표시할 수는 있지만, 답글은 여전히 사람이 작성해야 합니다.
둘째, 이 구성을 리뷰 조작에 사용하지 마세요. 2024년 8월 미국 연방거래위원회(FTC)의 최종 규칙은 가짜 리뷰와, 긍정 또는 부정 리뷰를 조건으로 하는 보상을 금지합니다. 이 규칙은 AI가 생성한 가짜 리뷰를 명시하고 있습니다(FTC 보도자료, 2024-08-14). 저평점 리포트는 문제를 조기에 발견하기 위한 것이지, 리뷰를 바꾸기 위한 것이 아닙니다.
셋째, 저평점 기준은 사이트별로 정하세요. G2는 0.5점 단위 별점을 사용하므로 저희는 2.5 이하를 저평점으로 집계했습니다. 나머지 사이트는 2 이하입니다. 두 브랜드 모두 30일 동안 G2 저평점 리뷰가 없었습니다. 여러분의 제품도 마찬가지라면 G2 기준을 3점으로 올리세요. 그렇지 않으면 G2 항목은 항상 0으로 표시되고, 독자는 더 이상 그 줄을 보지 않게 됩니다.
넷째, 서브에이전트가 먼저 키워드 규칙을 적용하게 하세요. 테스트 2의 22건처럼 규칙으로 분류할 수 없는 리뷰만 모델로 보내세요. 프로그래매틱 도구 호출(programmatic tool calling)이 바로 이런 용도로 만들어졌습니다. 코드에서 결과를 필터링하고 관련된 부분만 컨텍스트로 다시 가져옵니다(OpenAI 출시 게시물; 프로그래매틱 도구 호출 문서).
최근 변경 사항
베타 기간 동안 Agents API는 몇 주마다 바뀝니다. 아래는 이 구성에 영향을 주는 변경 사항이며, 최신 항목이 맨 아래에 있습니다.
| 날짜 | 변경 사항 | 이 구성에 미치는 영향 |
|---|---|---|
| 2026년 9월 10일 | 호스팅 샌드박스, 서브에이전트, 컨텍스트 압축을 갖춘 퍼블릭 베타 출시, 플랫폼 수수료 없음(변경 내역; 포럼 공지) | 유지보수할 에이전트 코드가 줄어 첫 버전을 빠르게 만들 수 있음 |
| 2026년 10월 9일 | 호스팅 샌드박스가 활성 턴 동안에만 과금되며 사전 워밍 가능(변경 내역) | 스크립트를 실행하는 모니터가 더 이상 유휴 시간 비용을 내지 않음 |
| 2026년 10월 16일 | Ultrafast 모드 추가, 호스팅 샌드박스에 스프레드시트·문서용 Artifact SDK 포함(변경 내역) | 리포트를 스프레드시트 파일로 만들 수 있지만 샌드박스가 필요함 |
| 2026년 10월 20일 | 12시간 프롬프트 캐싱, 쓰기 가격은 입력 가격의 2.5배(변경 내역; 프롬프트 캐싱 문서) | 주간 실행 간격이 12시간보다 훨씬 길어 캐싱은 한 번의 실행 안에서만 효과가 있음 |
| 2026년 10월 26일 | GPT-6.1 Terra 출시(변경 내역) | luna와 sol 사이의 가격대이며, 주간 추정치 $0.2154는 이 모델 기준 |
| 2026년 10월 28일 | 자격을 갖춘 ChatGPT Pro 및 Business 구독자는 매월 최대 $500의 API 크레딧을 받을 수 있음(변경 내역) | 소규모 팀이라면 이 크레딧으로 모니터의 모델 비용을 충당할 수도 있음 |
| 2026년 11월 30일 | 2026년 6월 3일에 발표된 Agent Builder 종료 예정일(지원 중단) | 이 날짜 전에 기존 플로를 Agents API 또는 Agents SDK로 옮기세요. 개발자 포럼에서 OpenAI 직원은 한 사용자에게 자격 증명을 교체하는 플로에는 Agents API 볼트를 사용하라고 안내하기도 했습니다(OpenAI 개발자 포럼) |
FAQ
OpenAI Agents API 요금은 어떻게 책정되며, 플랫폼 수수료가 있나요?
별도의 플랫폼 수수료는 없습니다. OpenAI 출시 게시물에 따르면 Agents API에는 추가 요금이 없으며, 에이전트가 사용하는 토큰과 도구에 대해서만 비용을 냅니다. 개요 페이지에 따르면 모델은 선택한 모델의 요금으로, 도구는 표준 요금으로, 호스팅 샌드박스는 컨테이너 요금으로 과금됩니다.
샌드박스 없이 브랜드 1개를 주 1회 처리할 때 모델 비용 추정치는 약 $0.029(gpt-6-luna)에서 약 $2.9(gpt-6-astra)입니다. 여기에 데이터 호출 비용 $0.006945가 추가됩니다. (질문 출처: Google 추천 검색어 “openai agents api pricing”, “openai agents api cost”. 근거: 출시 게시물, 개요, 요금.)
OpenAI Agents API와 SDK, 어느 쪽을 사용해야 할까요?
OpenAI가 루프를 실행하고 세션을 유지하며 스케줄을 실행하게 하려면 Agents API를 사용하세요. 에이전트를 자체 애플리케이션과 자체 스토리지에서 실행해야 한다면 Agents SDK를 사용하세요. OpenAI 비교표에서 통합 난이도는 Agents API가 “Low”, SDK가 “Medium”입니다. Zero Data Retention이 필요한 팀은 당분간 SDK를 사용해야 합니다. (질문 출처: Google 추천 검색어 “openai agents api vs sdk”. 근거: Agents 가이드, 개요.)
OpenAI Agents SDK의 MCP 클라이언트로 동일한 EveryInfra 서버에 연결할 수 있나요?
네. SDK MCP 문서에 따르면 Streamable HTTP를 지원합니다. https://api.everyinfra.com/mcp를 API 키와 함께 사용하면 되며, 도구 이름과 파라미터는 이 글과 같습니다. 차이점은 스케줄링, 재시도, 자격 증명 저장을 직접 구현해야 한다는 것입니다. (질문 출처: Google 추천 검색어 “openai agents sdk mcp”, “openai agents sdk mcp server”. 근거: Agents SDK MCP 문서, MCP 전송 사양.)
OpenAI Agents API 키에는 어떤 권한이 필요한가요?
빠른 시작 문서에는 세션용 api.agents.read, api.agents.write와 모델 추론용 api.responses.write가 나와 있습니다. 볼트를 관리하려면 api.vaults.read와 api.vaults.write를 추가하세요. 이 OpenAI 키는 서버에만 두고, 에이전트 지침이나 샌드박스에는 넣지 마세요. (질문 출처: Google 추천 검색어 “openai agents api key”. 근거: 빠른 시작, 샌드박스 보안.)
OpenAI Agents API의 computer use 기능으로 리뷰 사이트를 직접 읽을 수 있나요?
Agents API는 2026년 9월 29일에 computer use를 추가했습니다. 에이전트는 OpenAI가 호스팅하는 브라우저에서 작업할 수 있고, 승인과 로그인은 애플리케이션이 처리합니다. 하지만 브라우저에서 리뷰 페이지를 넘기려면 샌드박스가 필요하고, 시간이 더 오래 걸리며, 토큰도 훨씬 많이 사용합니다.
Trustpilot, G2, Capterra 페이지는 스크립트 접근도 차단합니다. 저희 테스트에서 세 사이트 모두 일반 curl 요청에 403을 반환했습니다. 구조화된 리뷰가 필요하다면 데이터 API가 더 안정적이고 비용도 적게 듭니다. (질문 출처: Google 추천 검색어 “openai agents api computer use”. 근거: 변경 내역.)
AI 에이전트에게 API 키를 맡겨도 안전한가요?
출시 소식을 다룬 r/artificial 스레드에는 “AI에게 비밀번호와 시크릿을 맡긴다니, 행운을 빕니다”라는 댓글이 있습니다. OpenAI 설계에서 볼트는 조회해도 시크릿을 반환하지 않습니다. OpenAI가 연결 시점에 MCP 인증을 추가하므로 에이전트 코드는 키를 볼 수 없습니다.
샌드박스 보안 페이지에는 환경 변수 값을 에이전트 코드가 읽을 수 있다는 내용도 있습니다. 따라서 키는 env가 아닌 볼트에 넣고, 이 에이전트에는 별도의 키를 발급하세요. (질문 출처: r/artificial 스레드. 근거: 볼트, 샌드박스 보안.)
시작하기
- EveryInfra에 회원가입하고 API 키를 발급받은 뒤 빠른 시작에 따라 무료 카탈로그를 한 번 호출하세요.
trustpilot/reviews,g2/reviews,capterra/reviews,app_store/reviews,google_play/reviews가available: true로 표시되는지 확인하세요. 파라미터와 필드는 각 기능 페이지에서 확인할 수 있습니다: Trustpilot 리뷰, G2 리뷰, Capterra 리뷰, App Store 리뷰, Google Play 리뷰. - 각 사이트에서 브랜드별 링크나 ID를 찾아 하나의 표에 저장하세요. 사이트별 개요는 Trustpilot API, G2 API, Capterra API, App Store API, Google Play API 페이지에 있습니다.
- Agents API를 사용하기 전에 브랜드별로 각 사이트를 REST로 한 번씩 호출하세요. 호출 1회가 며칠 분량을 커버하는지 측정하고, 테스트 1처럼
limit을 설정하세요. - OpenAI 측에서는 4단계 예제에 따라 볼트, 에이전트, 자동화를 만드세요. 수동 호출을 한 번 실행하고 리포트와 세션 이벤트를 확인하세요.
- 2주 후 모델 비용을 청구서와 비교하세요. 품질이 그대로라면 서브에이전트를 더 저렴한 모델로 옮기세요.
리뷰 데이터를 고객용 제품으로 만들려면 리뷰 데이터를 유료 제품으로 만드는 방법을 읽어 보세요. ChatGPT 예약 작업으로 비슷한 작업을 하려면 ChatGPT 예약 작업을 수요 레이더로 활용하기를 참고하세요. 모든 기능과 가격은 데이터 마켓에서 확인할 수 있습니다.
참고 자료
- “Agents API overview”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/overview
- “Agents API quickstart”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/quickstart
- “Agents API architecture”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/architecture
- “Configuring agents”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/configuration
- “Sessions”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/sessions
- “Scheduled automations”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/sessions/automations
- “Webhooks”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/sessions/webhooks
- “Multi-agent”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/multi-agent
- “Vaults”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/tools/vaults
- “MCP connections”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- “OpenAI-hosted sandboxes”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/environments/openai-hosted
- “Sandbox security”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/environments/security
- “Errors and recovery”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/errors
- “Observability and usage”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents-api/observability
- “API pricing”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/pricing
- “Changelog”(2025-03-11~2026-10-30 항목), OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/changelog
- “Deprecations”(Agent Builder), OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/deprecations
- “Agents”(에이전트 런타임 옵션 비교), OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/agents
- “Your data”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/your-data
- “Prompt caching”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/prompt-caching
- “Tool search”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/tools-tool-search
- “Programmatic tool calling”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/tools-programmatic-tool-calling
- “Compaction”, OpenAI 개발자 문서, 2026-11-01 열람, https://developers.openai.com/api/docs/guides/compaction
- “Create automation”(API 레퍼런스), OpenAI, 2026-11-01 열람, https://developers.openai.com/api/reference/resources/beta/subresources/agents/subresources/automations/methods/create
- “Agents”(API 레퍼런스), OpenAI, 2026-11-01 열람, https://developers.openai.com/api/reference/resources/beta/subresources/agents
- “Introducing the Agents API”, OpenAI, 2026-09-10, https://openai.com/index/introducing-the-agents-api/
- “Introducing the Agents API and hosted sandboxes”, OpenAI 개발자 포럼, 2026-09-10, https://community.openai.com/t/introducing-the-agents-api-and-hosted-sandboxes/1396481
- “Agent Builder MCP Secrets API”, OpenAI 개발자 포럼, 2026-11-01 열람, https://community.openai.com/t/agent-builder-mcp-secrets-api/1368113
- “OpenAI launches Agents API public beta built on Codex harness”, Reddit r/artificial, 2026-11-01 열람, https://www.reddit.com/r/artificial/comments/1wctpbu/openai_launches_agents_api_public_beta_built_on/
- “openai/openai-agents-python”, GitHub, 2026-11-01 열람, https://github.com/openai/openai-agents-python
- “Model context protocol”(Agents SDK 문서), OpenAI, 2026-11-01 열람, https://openai.github.io/openai-agents-python/mcp/
- “MCP specification: Transports”(2025-06-18), Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- “RFC 6750: OAuth 2.0 Bearer Token Usage”, IETF, 2012-10, https://datatracker.ietf.org/doc/html/rfc6750
- “Time Zone Database”, IANA, 2026-11-01 열람, https://www.iana.org/time-zones
- “crontab(5)”, Linux man-pages, 2026-11-01 열람, https://man7.org/linux/man-pages/man5/crontab.5.html
- “Ratings, reviews, and responses”, Apple Developer, 2026-11-01 열람, https://developer.apple.com/app-store/ratings-and-reviews/
- “View & analyze your app's ratings & reviews”, Google Play Console 고객센터, 2026-11-01 열람, https://support.google.com/googleplay/android-developer/answer/138230
- “Understanding and counting tokens”, OpenAI 고객센터, 2026-11-01 열람, https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- “Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials”, 미국 연방거래위원회, 2024-08-14, https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- “Notion Reviews”, Trustpilot, 2026-11-01 열람, https://www.trustpilot.com/review/notion.so
- “Notion Reviews”, G2, 2026-11-01 열람, https://www.g2.com/products/notion/reviews
- “Notion”, Capterra, 2026-11-01 열람, https://www.capterra.com/p/186596/Notion/
- Notion 앱 페이지, App Store, 2026-11-01 열람, https://apps.apple.com/us/app/notion-notes-tasks-ai/id1232780281
- Notion 앱 페이지, Google Play, 2026-11-01 열람, https://play.google.com/store/apps/details?id=notion.id
- EveryInfra 데이터 카탈로그(trustpilot), EveryInfra, 2026-11-01 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- EveryInfra 데이터 카탈로그(전체), EveryInfra, 2026-11-01 열람, https://api.everyinfra.com/api/v1/social/catalog
- “ClickUp”, Capterra, 2026-11-01 열람, https://www.capterra.com/p/158833/ClickUp/
- ClickUp 앱 페이지, Google Play, 2026-11-01 열람, https://play.google.com/store/apps/details?id=co.mangotechnologies.clickup
- “iPhone Duo arrives at Apple Store locations worldwide”, Apple Newsroom, 2026-10, https://www.apple.com/newsroom/2026/10/iphone-duo-arrives-at-apple-store-locations-worldwide/
참고 BL-59