OpenAI Agents APIでレビューを監視する:5つのレビューサイトから低評価の週次レポートを作る
OpenAI Agents APIで構築する週次レビュー監視エージェント。5つのレビューサイトに対して実際に21回呼び出し、データコストは1ブランドあたり週$0.0069です。設定と制限も解説します。
2026年11月1日のシンガポール時間(SGT)00:47から15:45にかけて、NotionとClickUpを対象にEveryInfraのレビューエンドポイントを呼び出しました。19:22〜19:23 SGTには再テストを4回実施しました。対象サイトはTrustpilot、G2、Capterra、App Store、Google Playです。1ブランドの週次チェックに必要な呼び出しは5回で、データ料金は$0.006945です。難しいのは価格ではなくカバレッジです。Google PlayではNotionの最新レビュー200件が22日前までしかさかのぼれませんが、TrustpilotではNotionの低評価レビュー20件が6月までさかのぼります。
大きいのはモデルの料金です。当社のデータ料金は呼び出しごとなので、200件でも20件でも費用は同じです。ただし、増やした件数はすべてモデルのコンテキストに入ります。
推奨の上限設定では、Notionのレビュー1週間分は生データで約421 KB、トークン換算で約105kです。初期の実行では、後述するページコードが原因で652 KBありました。2026年11月1日時点のOpenAIの定価で計算すると、この1週間分のモデルトークン費用は約$0.03〜$2.9です。最も安いモデルと最も高いモデルでは定価に100倍の差があるため、請求額はモデルの選択で決まります。
実際の呼び出しからは、注意すべき点がさらに2つ見つかりました。まず、Capterraはレビューを日付順に並べ替えません。また、11月1日の初期の実行では、一部のCapterraレビューのprosフィールドに約100,000文字のページコードが含まれていました。同日夜、ゲートウェイ側でページコードを除去し、フィールドごとに5,000文字の上限を設けました。19:23 SGTの再テストでは同じ86件のレビューが返され、最長のフィールドは1,154文字でした。
OpenAIは2026年9月10日にAgents APIをパブリックベータとして公開しました。毎週月曜日に起動し、レビューサイトごとにサブエージェントを1つずつ割り当て、低評価レビューの短いレポートを作成するエージェントを動かせるでしょうか。本記事に登場するOpenAIのフィールド名、デフォルト値、制限はすべてOpenAIのドキュメントに基づいており、2026年11月1日にダウンロードして確認したものです。OpenAIアカウント上でエージェントは実行していないため、OpenAIに関する部分は設定例です。EveryInfraに関する数値はすべて、失敗した呼び出しを含む、実際の呼び出しの生レスポンスから取得しています。
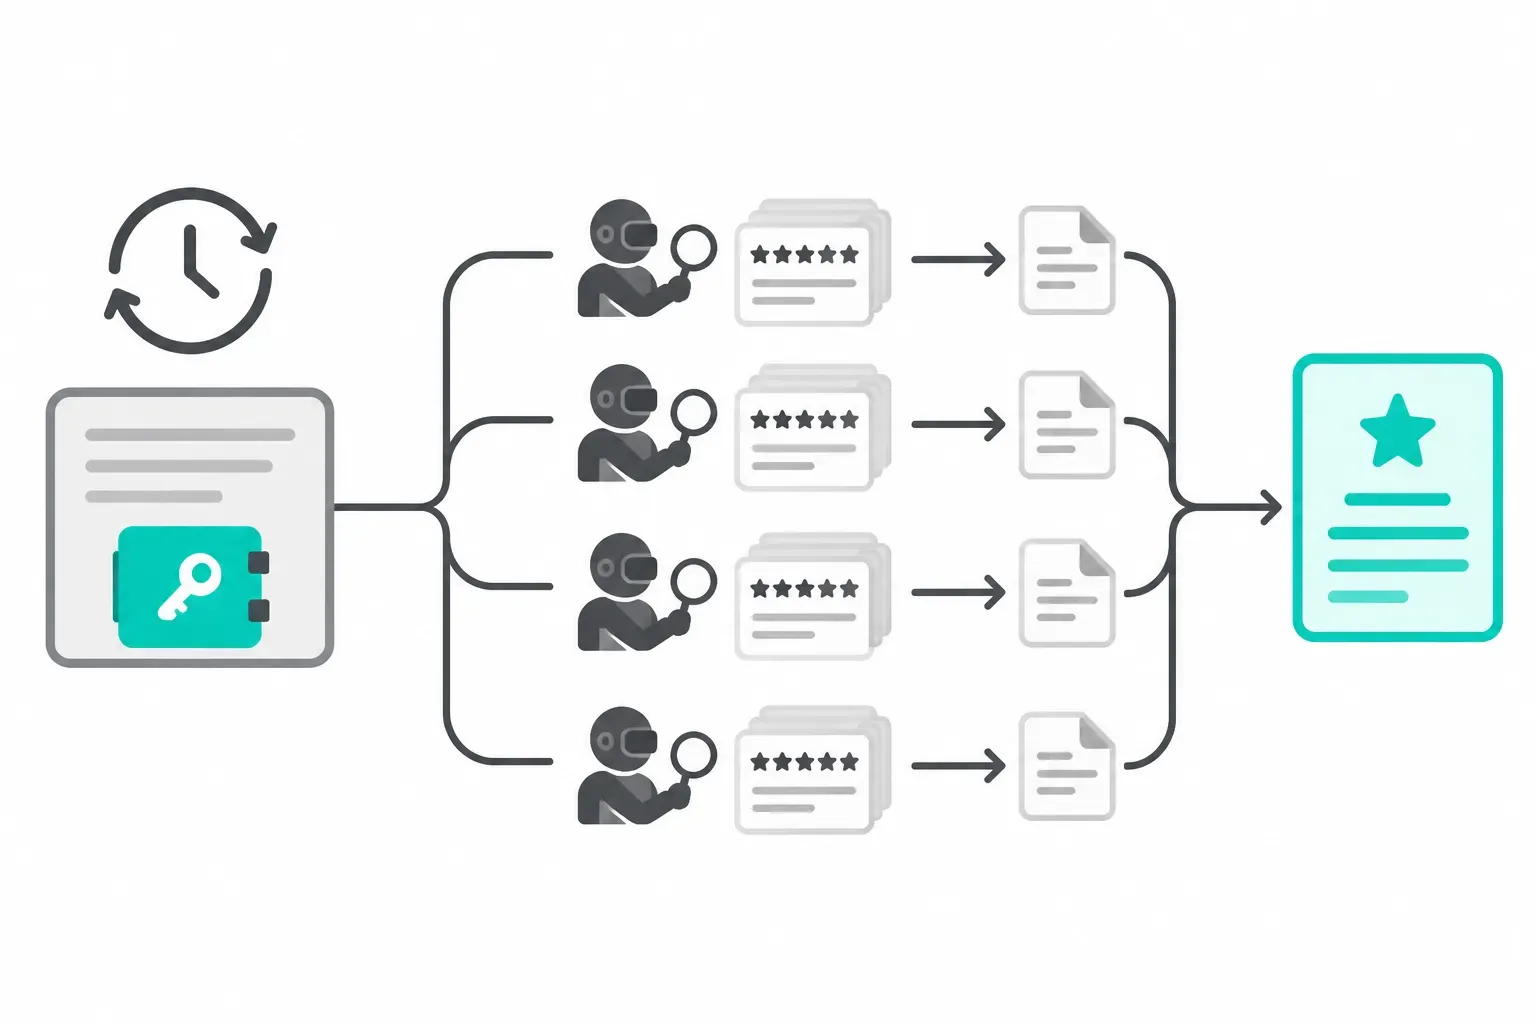
タスク:5つのレビューサイトを対象とした低評価レビューの週次レポート
以下の数値はすべてこのタスクを前提にしているため、まずタスクを定義します。入力はブランドのリストです。ブランドごとに各サイトの識別子を1つずつ保存します。Trustpilotには会社のドメイン(例:notion.so)を指定します。G2にはレビューURLまたはスラッグを、Capterraには製品ページのURLを指定します。App Storeには数値のアプリIDを、Google Playにはパッケージ名を指定します。
出力は週1回のレポートです。ブランドごとに1つのセクションを設け、サイトごとの新着レビューと低評価レビュー、主な不満のテーマをまとめます。また、先週から新たに発生した問題を、サポート担当者向けに元のレビューへのリンク付きで一覧にします。
なぜこの5つのサイトなのでしょうか。これらは異なる2つの読者層をカバーしています。Trustpilot、G2、Capterraは購入者がソフトウェアを購入する前にレビューを読む場所で、読者の多くは意思決定者です。App StoreとGoogle Playには現在のユーザーからのフィードバックが集まるため、不満の内容が具体的で、バージョン番号が含まれていることもよくあります。
以前のマルチプラットフォームの評判モニタリングのブループリントでは、ネガティブな傾向を判断する前にカバレッジを記録する方法を解説しました。Exa、G2、Trustpilotを使った30社のテストでは、1回限りの競合比較を紹介しています。本記事では、このチェックを人手を介さず毎週実行するエージェントに落とし込みます。あわせて、週1回の実行で十分かどうかを実データで検証します。
このタスクは、Agents APIの4つの機能に適しています。5つのサイトは互いに依存しないため、サイトごとにサブエージェントを割り当て、要約だけを返させることができます。スケジュールにはオートメーションが適しており、指定したタイムゾーンのcron式に従ってセッションを開始できます。APIキーはボールトに保管できるため、指示文に含めずに済みます。データソースはリモートMCPサーバーで、Agents APIはOpenAI側からサンドボックスなしで接続できます。
OpenAI Agents APIとAgents SDKの比較
OpenAIは2026年9月10日、Agents APIをパブリックベータとしてリリースしました。発表記事によると、タスク、モデル、ツール、環境を指定した1回のAPI呼び出しで、本番環境向けのエージェントを作成できます。エージェントはCodexと同じハーネスで動作します(OpenAIの発表記事、変更履歴)。ハーネスとは、モデルを呼び出し、ツールを実行し、コンテキストを管理するループのことです。概要ページでは、製品をAgent、Environment、Session、Events and itemsの4つの概念に分けています(Agents APIの概要)。発表記事には、Agents API自体に追加料金はなく、エージェントが使用したトークンとツールの分だけ支払うことも明記されています(OpenAIの発表記事)。
この名前はAgents SDKと混同しがちです。SDKはOpenAIが2025年3月11日にリリースしたオープンソースのオーケストレーションフレームワークで、エージェントループは自分のアプリケーション内で動作します(変更履歴、GitHubのopenai-agents-python)。OpenAIの「Agents」ガイドには比較表があり、下の表はそのページに沿っています(Agentsガイド:エージェントランタイムの選択肢の比較)。
| 項目 | Agents API | Agents SDK | Responses API |
|---|---|---|---|
| 用途 | OpenAIがエージェントを管理し、進捗を保存する長時間タスク | アプリ内の独自ツールやワークフローを使うエージェント | モデルの直接呼び出し、またはゼロから構築するエージェント |
| エージェントの実行場所 | OpenAIがマネージドのCodexハーネスを実行 | アプリケーション内でSDKが動作 | 自分のアプリケーション(ホスト型オーケストレーションも選択可) |
| 統合の手間 | 低 | 中 | 高 |
| タスク間の状態 | 保存されたセッション設定、ターン、アイテム | 自前のストレージとSDKセッション、またはResponsesの会話状態 | 手動の履歴管理、レスポンスのチェーン、またはConversations |
| ツールの実行 | サービス接続型ツール、アプリの関数ハンドラー、任意のサンドボックス | アプリケーション内のツールと連携機能 | ホスト型ツールと、アプリが実行するツール |
レビューモニタリングにとって、この表の意味はシンプルです。エージェントループ、セッションの保存、リトライのために常駐プロセスを運用したくなければ、その作業はAgents APIが引き受けます。その代わり、エージェントの状態はOpenAI側に置かれ、製品もまだベータ版です。データを自社のリージョン内に留める必要がある場合は、SDKのほうが安全な選択です。概要ページによると、Agents APIがサポートするデータレジデンシーは米国のみで、セルフホストのサンドボックスを使う場合でもZero Data Retention(ZDR)には対応していません(Agents APIの概要)。


ステップ1:EveryInfraをMCP接続として追加
Agents APIでは、MCPサーバーはagent.tools内でtype: "mcp"を指定した1つのエントリです。接続の起点は2つあります。デフォルトのconnection_origin: "service"では、OpenAIがサーバーに接続するため、サーバーはパブリックなインターネット上にある必要があります。このモードは環境の有無にかかわらず動作します。connection_origin: "environment"では、接続はセッションのサンドボックス内から開始されるため、プライベートネットワーク上のサーバーに使えます(MCP接続のドキュメント)。
EveryInfraのMCPエンドポイントはhttps://api.everyinfra.com/mcpで公開されているため、デフォルトのservice起点で問題なく、セッションの環境はnoneにできます。アーキテクチャのページによると、環境がなくてもエージェントはリモートMCPツールを呼び出せます。使えなくなるのはBash、ワークスペースのファイル、executor MCPだけです(Agents APIのアーキテクチャ)。これはコストに影響します。サンドボックスがなければ、コンテナ料金はかかりません。
以下に、ツールエントリの設定例を示します。各フィールドはドキュメントと照合済みです。
allowed_toolsにはeveryinfra_call_apiとeveryinfra_get_jobだけを指定しています。2つ目のツールは非同期呼び出しの結果を取得します(テスト3を参照)。required: trueを指定すると、サーバーを起動できない場合にそのターンは失敗します。これは意図どおりの動作です。そうしないと、エージェントがデータのないままレポートを書いてしまうおそれがあるためです。ドキュメントによると、MCPの初期化はデフォルトでは任意です(MCP接続のドキュメント)。
{
  "type": "mcp",
  "server_label": "everyinfra",
  "transport": { "type": "http", "server_url": "https://api.everyinfra.com/mcp" },
  "connection_origin": "service",
  "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
  "required": true
}なぜツールを2つだけにするのでしょうか。2026年11月1日15:45(SGT)に、EveryInfraのMCPサーバーへtools/listを送信しました。返ってきたツールは12個で、JSON形式の説明は合計16,669バイトでした。everyinfra_call_apiとeveryinfra_get_jobの説明は合わせて2,505バイトです。英語のテキストは1トークンあたり約4文字なので、12個すべてでは約4,167トークン、2つだけなら約626トークンになります(OpenAIヘルプセンター:トークン)。
ツールの説明はターンごとにコンテキストに入り、5つのサブエージェントがそれぞれそのコピーを持ちます。その差は1回の実行あたり約18kトークンです。また、ツール一覧はサービス側でツールが追加・削除されると変わります。同じ日の早い時間に取得したときは、ツールの数が異なっていました。許可リストを使えば、このコストを一定に保てます。ドキュメントでは、allowed_toolsはエージェントが検出・呼び出しできるツールを制限する手段として定義されています(MCP接続のドキュメント)。
| ツール一覧 | ツール | 説明のJSON(バイト) | おおよそのトークン数(÷4) | サブエージェント5つ |
|---|---|---|---|---|
allowed_toolsなし | 12 | 16,669 | 4,167 | 約20,835 |
everyinfra_call_apiとeveryinfra_get_jobのみ | 2 | 2,505 | 626 | 約3,130 |
ローンチ記事によると、Agents APIにはツール検索もあり、エージェントが必要とするときだけツール定義を読み込みます(OpenAIのローンチ記事、ツール検索のドキュメント)。これは、ツール一覧が大きく、タスクの範囲が決まっていない場合に役立ちます。今回のタスクに必要なツールは2つなので、許可リストのほうがシンプルで、コストも予測しやすくなります。
ステップ2:キーを指示に含めずVaultに保管
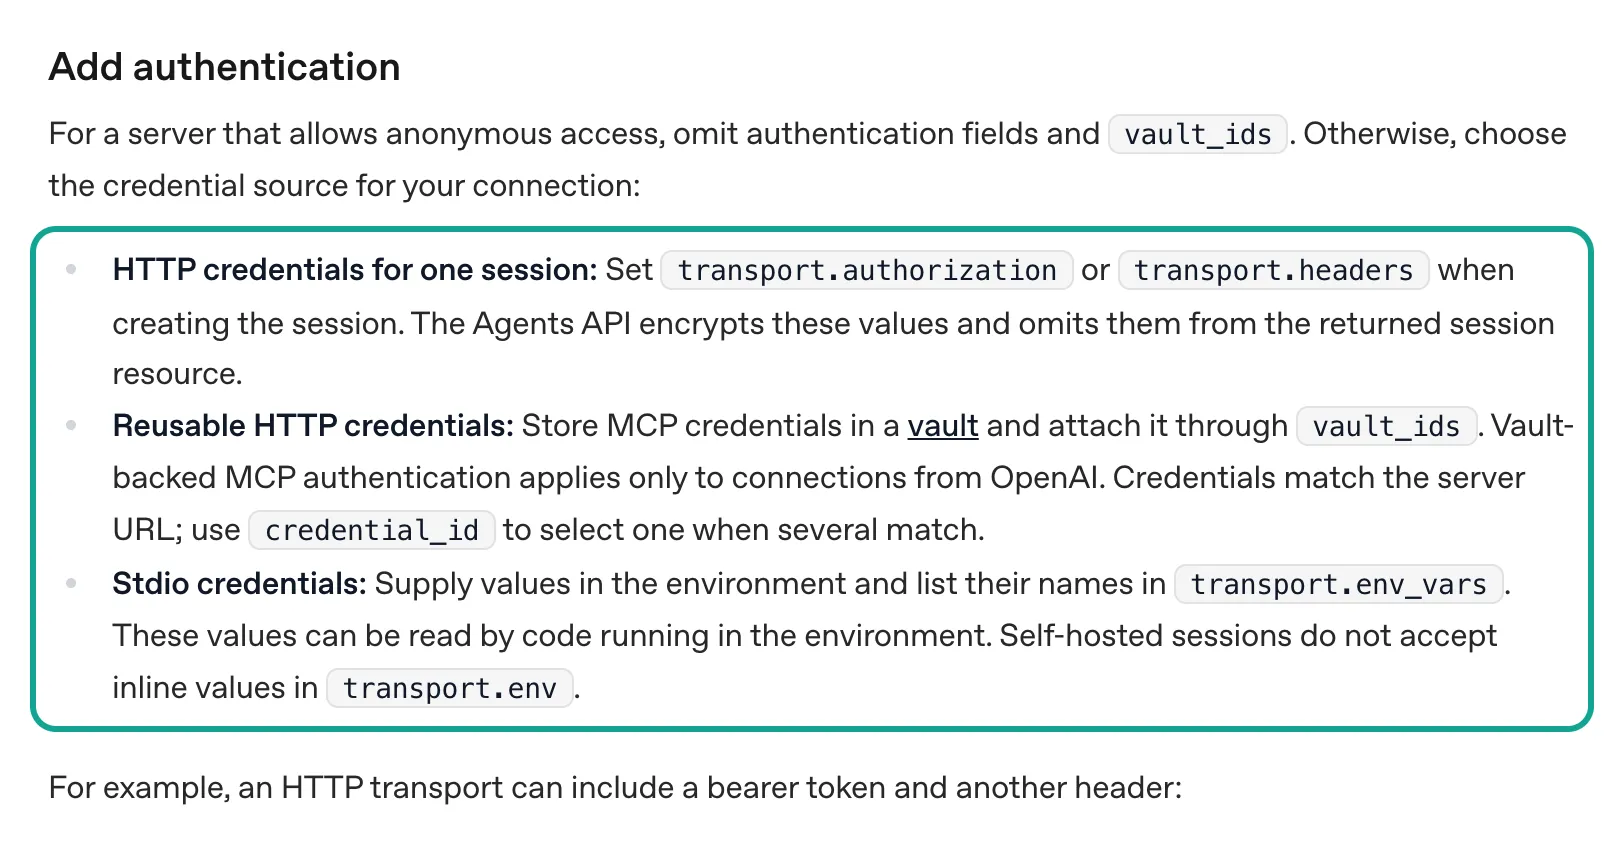
MCP接続にはEveryInfraのキーが必要です。ドキュメントでは、認証情報の置き場所が3つ示されています。1つのセッションだけで使う場合は、transport.authorizationまたはtransport.headersに値を設定します。Agents APIはこれらの値を暗号化し、返されるセッションには含めません。
再利用する場合は、認証情報をVaultに保存し、vault_idsでそのVaultをアタッチします。stdioサーバーでは環境変数を使いますが、その場合はサンドボックス内のコードから値を読み取れてしまいます(MCP接続のドキュメント:認証の追加)。毎週のジョブは2つ目のケースに当たります。
Vaultsページに呼び出し方法が示されています。まずclient.beta.agents.vaults.createでVaultを作成します。次にvaults.credentials.createで認証情報を追加します。このときauth.type: "static_bearer"を指定し、mcp_server_urlにMCPのURL、tokenにキーを設定します。mcp_server_urlの値によって、その認証情報はそのサーバーに紐付けられます(Vaultsのドキュメント)。Vaultや認証情報を読み取っても、APIはシークレットを返しません。Vaultを管理するには、アプリケーションのキーにapi.vaults.readとapi.vaults.writeの権限が必要です(Vaultsのドキュメント、サンドボックスのセキュリティに関するドキュメント)。
ドキュメントには見落としやすいルールが2つあります。第1に、vaultのMCP認証情報は、OpenAI側から開始する接続にのみ適用されます。connection_origin: "environment"の接続では使われません。第2に、認証情報を削除しても元のトークンは失効せず、実行中のセッションも止まりません(Vaults docs: rotate or remove credentials)。EveryInfraのAPIキーを失効させるには、EveryInfraのコンソールで無効にしてください。
ステップ3:サイトごとに1つのサブエージェントを使用し、メインエージェントは結果の統合のみ
Agents APIでは、マルチエージェントモードは1つの設定で有効にできます。セッションの作成時にagent.multi_agent.enabled: trueを設定してください。するとハーネスが、サブエージェントの作成、メッセージ送信、待機、中断を行うツールをエージェントに提供します。これらのツールを宣言する必要はありません(マルチエージェントのドキュメント)。max_concurrent_subagentsは、同時に実行できるサブエージェントの数を制限します。デフォルトはメインエージェントを除いて6です。今回のジョブの対象サイトは5つなので、デフォルトのままで足ります。
同じページには、このジョブに関係するルールが3つあります。サブエージェントは、設定されたMCPツール、その認証情報、許可されたツールを継承します。サブエージェントは関数ツールをサポートしません。サブエージェントがファイルシステムを共有するのは、セッションに環境がある場合だけです(マルチエージェントのドキュメント)。
1つ目のルールにより、Vaultのキーは追加の設定なしですべてのサブエージェントに渡ります。2つ目のルールにより、サブエージェントは関数を通じてデータベースに書き込むことができません。メインエージェントが結果を返し、それをアプリケーション側で保存する必要があります。
ドキュメントには、作業を分割すべき場面も書かれています。独立したタスクはサブエージェントに任せ、短いタスクや前の結果に依存する手順はメインエージェントに残します(マルチエージェントのドキュメント:サブエージェントを使う場面)。5つのレビューサイトは互いに独立しています。
先週との比較と最終的なまとめには5つすべての結果が必要なので、メインエージェントが担当します。オートメーションのページには、まさにこのパターンを扱ったセクションがあります。長期にわたる目標では、メインエージェントが目標とスケジュールを保持し、スケジュールされた各タスクをサブエージェントに渡して、短い結果だけを保持します。そうすれば、各チェックで得た詳細なツール出力がメインのコンテキストに入りません(スケジュール実行のドキュメント:繰り返しの作業をメインのコンテキストから切り離す)。
以下は、この例で使用しているメインエージェントへの指示です。各行は、この記事の後半で行う実際のテストに対応しています。
You run a weekly review check for the brands listed in the input.
Delegate each platform (trustpilot, g2, capterra, app_store, google_play) to its own subagent.
Each subagent calls everyinfra_call_api once per brand with the parameters given below,
uses mode=async when limit is 100 or more (read the rows with everyinfra_get_job),
keeps only reviews posted in the last 7 days (filter by posted_at yourself),
cuts every text field to 2,000 characters, and returns JSON:
{platform, brand, new_reviews, low_star, themes:[{name,count,example_url}], new_issue_vs_last_week}.
Do not return raw reviews. The main agent merges the five results into one report.
If a call returns an error with retryable=true, wait retry_after seconds and retry at most twice.
Never invent reviews. If a platform failed, say so in the report.各実行への入力には、サイトごとのパラメータが含まれます。次の表はNotionの場合の値です。それぞれの設定は、この記事の後半のテストに基づいています。limitは、1回の呼び出しで少なくとも2週間分をカバーできる値に設定してください。すべてのサイトで一律に最大値を使うのは避けてください。その理由はテスト1とテスト4で示します。
| サブエージェント | ブランドごとのパラメータ | 低評価の判定条件 | 理由 |
|---|---|---|---|
| Trustpilot | company: "notion.so"、stars: ["1","2"]、sort: "recency"、limit: 20、dateなし | すべての行(星1〜2のみを取得しているため) | 20件で129日前までさかのぼり、低評価レビューは週に約1件。20件すべてを読み、posted_atで絞り込む。sortにはカタログの値を使う(テスト3) |
| G2 | url、sort: "newest"、limit: 100、mode: "async" | ratingが2.5以下。record_type: summaryの行はスキップ | 星による絞り込みなし。ClickUpのレビューは週に約47件(テスト1)。同期呼び出しでは50秒かかった |
| Capterra | companyに製品URLを指定、limit: 100、mode: "async" | ratingが2以下 | 並べ替えの指定なし。すべての行を取得し、idを先週分と比較(テスト1) |
| App Store | app_id: "1232780281"、country: "us"、sort: "newest"、limit: 50 | ratingが2以下。app_versionごとに集計 | 50件で39日分。不満はリリース後に集中(テスト2) |
| Google Play | app_id: "notion.id"、sort: "newest"、language: "en"、limit: 200 | scoreが2以下 | 40件では4.2日分、200件では22日分(テスト1) |
フィールド名に注意してください。Google Playは星の値をscoreで返し、ほかの4サイトはratingを使います。
ステップ4:オートメーションで毎週月曜日に新しいセッションを開く
スケジュールは、別のリソースであるPOST /v1/agents/automationsで管理します。type: "periodic"の場合は、expression(標準的な5フィールドのcron文字列)とtimezone(America/New_YorkなどのIANA名)を設定します。type: "once"の場合は、run_atにUnix秒で日時を設定します。ターゲットの種類は2つあります。
new_sessionは実行のたびに新しいセッションを開きます。エージェントまたは保存済みのagent_id、環境、target.inputが必要です。existing_sessionは既存のセッションにリマインダーを送るもので、以前の調査結果を必要とする作業に使います(Scheduled automations docs)。APIリファレンスによると、new_sessionターゲットはvault_idsを受け付け、その環境にはnoneも指定できます(Create automation reference)。タイムゾーン名はIANAデータベース(IANA Time Zone Database)に基づき、5つのcronフィールドはUnixのcrontab(crontab(5))に従います。
以下はPythonでの設定例の全体です。SDKはOpenAI-Beta: agents=v1ヘッダーを自動で付加します。curlの場合は自分で付ける必要があります(Agents API quickstart)。この2ブランドのレビューは大半が英語のため、ここではニューヨーク時間のスケジュールを使っています。
import os
from openai import OpenAI

client = OpenAI()  # app key needs api.agents.read / api.agents.write / api.responses.write / api.vaults.write
MCP_URL = "https://api.everyinfra.com/mcp"

vault = client.beta.agents.vaults.create(name="review-check")
client.beta.agents.vaults.credentials.create(
    vault.id,
    name="EveryInfra read-only key",
    auth={"type": "static_bearer", "mcp_server_url": MCP_URL, "token": os.environ["EVERYINFRA_API_KEY"]},
)

agent = client.beta.agents.create(
    model="gpt-6.1-terra",
    instructions=open("weekly_review_instructions.txt").read(),
    tools=[{
        "type": "mcp", "server_label": "everyinfra",
        "transport": {"type": "http", "server_url": MCP_URL},
        "connection_origin": "service",
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"], "required": True,
    }],
    multi_agent={"enabled": True, "max_concurrent_subagents": 5},
)

automation = client.beta.agents.automations.create(
    type="periodic",
    name="Weekly review check",
    expression="0 9 * * MON",
    timezone="America/New_York",
    target={
        "type": "new_session",
        "agent_id": agent.id,
        "environment": {"type": "none"},
        "vault_ids": [vault.id],
        "input": [{"role": "user", "content": [{"type": "input_text",
                   "text": "Brands: ClickUp (clickup.com; g2 clickup; capterra https://www.capterra.com/p/158833/ClickUp/; "
                           "app_store 1535098836; google_play co.mangotechnologies.clickup). Write this week's report."}]}],
    },
)
print(automation.id)ドキュメントには、「スケジュール実行」の意味を左右する細かな点がいくつかあります。新しいオートメーションのステータスはactiveになりますが、すぐには実行されません。最初の実行は次に条件が一致する時刻です。定期実行では、負荷を分散するためにわずかなランダムな遅延が入ります。
対象のセッションが処理中の場合、タスクは待機します。実行のたびに呼び出しが作成されますが、そのstatus: completedは配信が成功したことを示すだけです。エージェントの処理が完了したことを意味するわけではありません。結果を知るには、セッションイベントのagent.session.turn.completedまたはturn.failedを監視してください(Scheduled automations docs、Sessions docs)。
アプリケーションは、イベントストリームまたはWebhookからレポートを読み取れます。agent.session.idle Webhookは、セッションが新しい入力を受け付けられる状態であることを示します。これも直前のターンが成功したことを意味するわけではありません(Webhooks docs)。月曜日を待たずにテストするには、空のPOST /v1/agents/automations/{id}/invocationsを送信します。手動実行で保存済みのスケジュールが変わることはありません(Scheduled automations docs: try a run)。
ターゲットはnew_sessionとexisting_sessionのどちらがよいでしょうか。新しいセッションは毎週クリーンなコンテキストで始まるため、コストを予測しやすくなります。エージェントは前週の内容を覚えていないので、アプリケーション側で前週のサマリーをtarget.inputに入れる必要があります。既存のセッションは以前の調査結果を保持し、セッションが上限に近づくとAgents APIが古いコンテキストを圧縮します(OpenAI launch post、compaction docs)。私たちは、前週のサマリー(わずか1,000〜2,000トークン程度)を入力に含める新しいセッションを選んでいます。
実際のMCPラウンドトリップ1回分:サブエージェントが送る内容と返ってくる内容
サブエージェントがEveryInfraに送るのは、1回のMCP tools/callです。2026年11月1日00:47:47(SGT)に、テスト用キーでこの呼び出しをhttps://api.everyinfra.com/mcpに送信しました。これはTrustpilotサブエージェントが行う呼び出しと同じもので、notion.soの最近の星1つと星2つのレビューを取得します。argumentsオブジェクトはeveryinfra_call_apiの入力で、プラットフォーム、機能、そのパラメータを指定します。
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api","arguments":{"platform":"trustpilot","action":"reviews","params":{"company":"notion.so","stars":["1","2"],"date":"last30days","sort":"recency","limit":20}}}}レスポンスはJSONとしてパースできるテキストブロックです。countは14です。resultsの各行にはtitle、text、rating、posted_at、verification_level、countryなどがあり、これらのフィールドはカタログにあるtrustpilot/reviewsのresponse_fieldsリストと一致します。billing.chargedはtrue、charged_usdは0.001389で、カタログの価格どおりです(catalog: trustpilot)。最初のレビューのタイトルは「I find everything in Notion a bit too chaotic」で、投稿日は2026年10月20日です。比較のためTrustpilotの公開Notionページを開いたところ、同じ日付の同じレビューが掲載されていました(Trustpilot: Notion)。
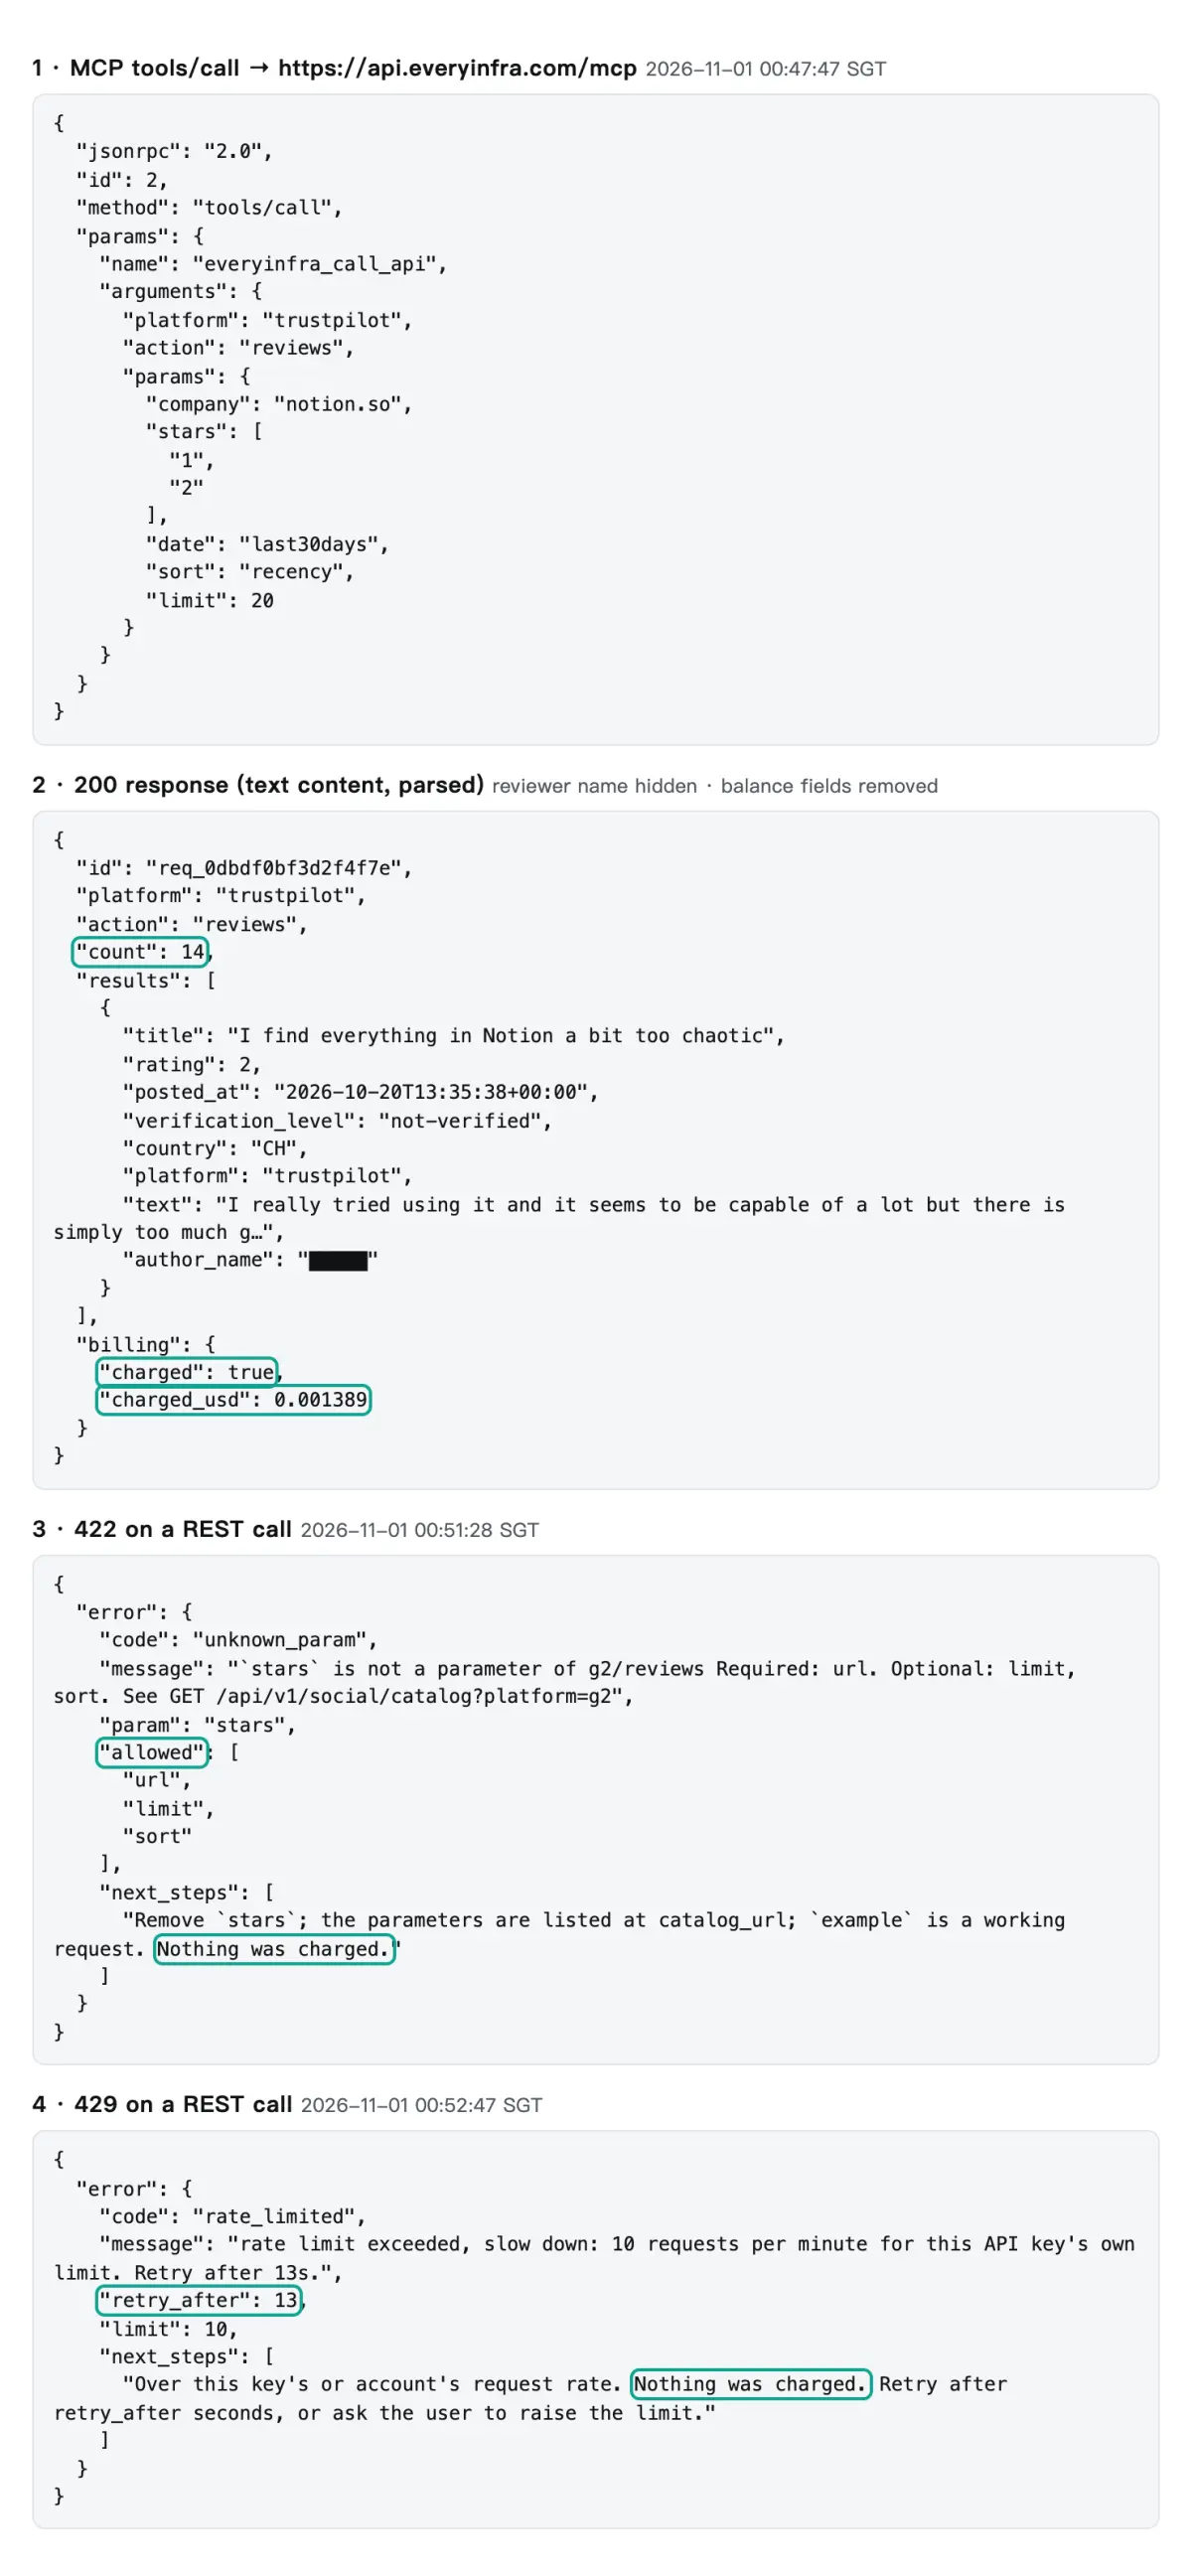
同じスクリーンショットには、サブエージェントが実運用で遭遇する2つの失敗も写っています。00:51:28(SGT)には、g2/reviewsがサポートしていないことを承知のうえで、あえてstarsを送信しました。APIは422を返し、error.codeはunknown_paramでした。allowedリストにはurl、limit、sortが挙げられ、next_stepsにはstarsを削除するよう記載され、課金されていないことも示されていました。
00:52:47と00:53:46(SGT)には、2件の呼び出しが429を返しました。このとき複数のテストジョブが同じテスト用キーを使っており、1分あたり10リクエストの上限を共有していました。1回目の429ではretry_afterが13秒で、37秒後のリトライは成功しました。2回目の429のあとのリトライは15秒後で、これも成功しました。どちらの429も課金されていません。
各エラーは、どのパラメータを変更すべきか、どれだけ待つべきかをモデルに伝えるため、サブエージェントは自力で修正できます。インストラクション内のリトライルールはこの形式を前提にしています。
もう1つの失敗は注意が必要で、原因は対照テストで初めて判明しました。00:51:16(SGT)、trustpilot/reviewsにsort: "newest"を指定すると、retryable: true、retry_after: 20の503が返り、課金はありませんでした。エラーには、この機能が10分間に3回失敗したと書かれていました。その3件の失敗した呼び出し(うち2件は同時に実行していた別のテストによるもの)は、いずれもカタログに記載のない値を指定していました。同じ時間帯でも、記載のある値を使った呼び出しは成功していました。
原因を確かめるため、15:39:46と15:40:07(SGT)に同じパラメータで2回送信しました。変えたのはsortだけで、1回目はnewest、2回目はカタログに記載のあるrecencyです。どちらも200を返し、$0.001389が課金されましたが、返された行は異なっていました。
recencyの呼び出しは00:54の呼び出しと同じ20件を返し、すべて英語で、それぞれにsourceフィールドがありました。newestの呼び出しと共通していたのは14件だけでした。残りの6件はドイツ語、フランス語、オランダ語で、どれにもsourceやverification_levelがありませんでした。カタログのフィールドの注記には、バックアップソースから結果を取得した場合、これらのフィールドが欠けることがあると書かれています。
| `sort` | 時刻(SGT) | レスポンス | 件数 | 言語 | `source`フィールド | 課金額 |
|---|---|---|---|---|---|---|
newest(記載なし) | 00:51:16 | 503 | — | — | — | 不要 |
newest(記載なし) | 15:39:46 | 200 | 20(recencyと共通は14のみ) | 英語14件、ドイツ語3件、フランス語2件、オランダ語1件 | どの行にもなし | $0.001389 |
recency | 15:40:07 | 200 | 20(00:54と同じ) | 英語20件 | 20件すべて | $0.001389 |
newest(夕方の修正後) | 19:23:05 | 200 | 20(recencyと同じ) | 英語20件 | 20件すべて | $0.001389 |
recency(夕方の修正後) | 19:22:49 | 200 | 20(00:54と同じ) | 英語20件 | 20件すべて | $0.001389 |
つまり、パラメータチェックではnewestは弾かれません。メインソースがこの値で失敗し、結果はその時点のバックアップソースの状態に左右されます。00:51にはバックアップも失敗して503が返りました。15:39にはバックアップが動作し、異なるデータの200が返り、通常どおり課金されました。
サブエージェントが問題に気づけないため、これはエラーよりも厄介です。
以上が11月1日の早朝と午後の結果です。その日の夕方、ゲートウェイのsortの扱いが変更されました。現在はnewest(recencyと同じ)、recency、relevanceを受け付けます。それ以外の値には、課金前に422が返り、許可される値と入力値の修正候補が示されます。19:22〜19:23(SGT)の再テスト結果は、テスト3の最後の表にあります。
ただし、サイトが変わればパラメータ名も変わることがよくあります。そのため、インストラクションでは引き続きサイトごとにパラメータを固定し、モデルに推測させないようにしています。一時的な失敗にはretry_afterで対応します。
テスト1:週1回の実行で十分か? 1回の呼び出しでどこまで遡れるかによる
「週に1回チェックする」は当たり前に聞こえますが、前提があります。サイトごとに1回の呼び出しで7日間すべてをカバーできなければなりません。あるサイトに週60件の新しいレビューが付くのに20件しか読まなければ、レポートには週末の分しか反映されません。そこで設定に入る前に、各サイトで1回の呼び出しが何日分をカバーするかを計測しました。
NotionとClickUpについて、5つのサイトそれぞれでplatform/reviewsを1回ずつ呼び出しました。最新と最古の投稿日、および行が新しい順に並んでいるかを記録しました。また、2026年10月25日から11月1日(UTC)までの行数も数えました。2つのブランドについて、2026年11月1日00:48〜14:38(SGT)の間にAPIを計12回実際に呼び出しました。
| サイト・ブランド | 要求行数 | 返却行数 | 最古 | 最新 | 新しい順 | 直近7日間 | 低評価 |
|---|---|---|---|---|---|---|---|
| Trustpilot・Notion(星1〜2のみ) | 20 | 20 | 2026-06-13 | 2026-10-20 | 可能 | 0 | 0 |
| Trustpilot · ClickUp(星1〜2のみ) | 20 | 20 | 2026-05-16 | 2026-10-29 | 可能 | 2 | 2 |
| G2 · Notion | 20 | レビュー19件+サマリー1件 | 2022-11-28 | 2026-10-29 | おおむね(古い行が3件混在) | 12 | 0 |
| G2 · ClickUp | 20 | レビュー19件+サマリー1件 | 2026-10-28 | 2026-10-31 | 可能 | 19 | 0 |
| Capterra · Notion | 20 | 19 | 2025-12-11 | 2026-10-09 | 不要 | 0 | 0 |
| Capterra · ClickUp | 20 | 17 | 2025-11-05 | 2026-10-21 | 不要 | 0 | 0 |
| App Store · Notion | 50 | 50 | 2026-09-20 | 2026-10-29 | 可能 | 9 | 6 |
| App Store · ClickUp | 50 | 50 | 2026-03-30 | 2026-10-29 | 可能 | 2 | 2 |
| Google Play · Notion | 200 | 200 | 2026-10-08 | 2026-10-30 | 可能 | 52 | 15 |
| Google Play · ClickUp | 200 | 200 | 2026-03-04 | 2026-10-31 | 可能 | 5 | 1 |
最も重要なのは両極端のケースです。G2では、ClickUpのレビュー19件がすべて10月28日〜31日の3日間に収まっています。このペースではClickUpにはG2で週に約47件のレビューが付くため、20件では直近2〜3日分しか見えません。
Google Playでは、まずNotionのレビューを40件取得しましたが、4.2日分しかカバーできませんでした。その機能の上限である200件にすると、22日分をカバーできました。反対に、TrustpilotのNotionの低評価レビューは少なく、20件で6月13日までさかのぼります。週に約1件のペースです。
つまり、同じ週次スケジュールでも、サイトによってlimitを上限にする必要がある場合と、20件で足りる場合があります。EveryInfraのレビューのエンドポイントは呼び出しごとに課金します。200件を返したGoogle Playの呼び出しのcharged_usdは0.001389で、40件の呼び出しと同じでした。
ただし、すべてのサイトで上限にするのが最善とは限りません。改訂の際、すべてのサイトでカタログのmax_limit(Trustpilot 200、G2 100、Capterra 100、App Store 500、Google Play 200)を指定して、Notionをもう1回分取得しました。App Storeの500件は2026年2月14日まで、Trustpilotの低評価レビューは2024年4月までさかのぼりました。週次レポートに必要な範囲をはるかに超えており、増やした件数はすべてモデルのコンテキストに入ります(数値はテスト4を参照)。
私たちのルールは、1回の呼び出しで少なくとも2週間分をカバーできるようにlimitを設定することです。Notionの場合、Trustpilot 20、G2 100、Capterra 100、App Store 50、Google Play 200です。そのうえでサブエージェントがposted_atで直近7日間に絞り込みます。ブランドごとにレビュー数は異なるため、上の表のように、まずサイトごとに1回呼び出して測定してください。
チャートには3つ目のケースも表れています。Capterraの2行は丸1年に散らばっており、結果の順序と時間には関連がありません。capterra/reviewsの必須パラメータはcompanyの1つだけで、並べ替えのパラメータはありません。Notionのレビュー19件は2025年12月11日から2026年10月9日まで順不同で並び、直近30日間のものは1件だけです。ClickUpの17件も同様です。
レポートでは、Capterraについて「最新のN件を取る」方法は使えません。毎回100件を取得し、idとposted_atを先週の結果と比較してください。Capterraのレビューは少なく、各ブランドとも30日間で1件なので、週1回の実行で十分です。
G2にも小さな落とし穴があります。Notionのレスポンスの最初の行はレビューではありません。record_type: summaryの行で、総合評価4.6、レビュー総数13,962件、主な長所と短所が含まれています。続く19件のレビューはおおむね新しい順ですが、2022年から2025年のレビュー3件が間に挟まっています。
最古の日付を「カバー範囲」とみなすサブエージェントは、呼び出しが4年前までさかのぼったと判断してしまいます。「posted_atで自分で絞り込む」ルールがこれに対処します。とはいえ、サマリー行は役に立ちます。レポートでは、別途g2/profileを呼び出さなくても、今週のG2総合評価を引用できます。
テスト2:低評価レビューはどこにあるか
カバー範囲を測定できたので、低評価レビューがどこにあるかを比較できます。各サイトで1回の呼び出しで見えた直近30日間の低評価レビュー(G2は星2.5以下、その他は星2以下)を数えました。Notionは合計67件で、App Storeが22件、Google Playが42件、Trustpilotが3件、G2とCapterraは0件です。つまり67件中64件、95.5%が2つのアプリストアに集中しています。ClickUpは合計14件で、分布はより平坦です。Trustpilotが5件、App Storeが4件、Google Playが5件、G2とCapterraは0件です。
このばらつきから、レポートについて2つの教訓が得られます。第1に、B2Bのレビューサイトには低評価レビューが少ないことです。20件の呼び出しでは、どちらのブランドにも30日以内のG2の低評価レビューはありませんでした。改訂の際にNotionで100件の呼び出しを行うと50件が返り、そのうち41件が直近30日間のもので、低評価はその中の1件だけでした。これはG2のサマリー評価4.6と一致します。G2とCapterraだけを見ているチームは、問題がないと思い込むおそれがあります。
2つ目は、アプリストアの不満は数が多く具体的で、ほとんどにバージョン番号が含まれていることです。App Storeの各行にはapp_versionフィールドがあります。30日間のNotionの低評価レビュー22件のうち、8件がバージョン1.7.345のもので、他のどのバージョンよりも多くなっています。バージョンごとに集計するサブエージェントなら「低評価レビューは1.7.345以降に集中している」と書けるため、エンジニアリングチームが対応に動けます。
これらの低評価レビューは、キーワードルールでグループ分けもしました。ルールは再集計スクリプトに記載しています。たとえば、タイトルか本文に「slow」「crash」「bug」が含まれるレビューは、速度・バグのグループに入ります。1件のレビューが複数のグループに入ることもあります。
2つのアプリストアにあるNotionの低評価レビュー64件のうち、20件が速度とバグ、18件がモバイル体験、12件がAI機能に関するものでした。22件はルールで分類できず、そのうち18件がGoogle Playのものです。ほとんどが1〜2語だけのレビューでした。
この最後のグループこそ、モデルがコストに見合う働きをする場面です。ルールは長くて明確な不満には対応できますが、「bad」や「worst update」、皮肉には対応できません。そのため、サブエージェントのモデルはすべてのレビューを読み直すのではなく、ルールで分類できないレビューにトークンの大半を使うべきです。
ブランドを横断して見たときにだけ現れるシグナルもありますが、サンプルはごく少数です。直近30日間で、NotionのApp Storeレビュー2件とClickUpのApp Storeレビュー1件が「iPhone Duo」に言及しています。10月26日のNotionの星2レビューには、タップ領域が反応しなくなる、選択したテキストが消える、iPhone Duoでアプリがクラッシュすると書かれています。10月29日のClickUpの星1レビューのタイトルは「No iPhone Duo support」です。iPhone DuoはApple初の折りたたみ式iPhoneで、10月23日にApple Storeで発売されました(Apple Newsroom)。新しいデバイスの発売から数週間は、アプリの対応に関する問題がよく起こります。
したがって、3件のレビューだけでは、どちらかのチームが対策を計画すべき問題だとは言えません。レポートには「新デバイスへの対応。要注視。来週件数が増えていないか確認」と書くのが適切です。役立つ教訓は役割分担に関するものです。1つのブランドの中では1件の不満にすぎません。ブランドを横断すると、それが1つのデバイスを指していることがわかります。メインエージェントはすべてのサブエージェントの要約を見られるため、このブランド横断のステップはメインエージェントが担うべきです。
今週の実データで見る週次レポートのイメージ
出力は実際に見たほうが判断しやすくなります。下の表は、2026年10月25日から11月1日(UTC)までの週を対象にしています。サイトとブランドごとに、1回の呼び出しで取得できた新着レビュー数と、そのうち低評価だった件数を示しています。値はすべて実際の呼び出しで得た生のレスポンスから取得したものです。これが、サブエージェントがメインエージェントに返すデータの形式です。
| サイト | Notionの新着/低評価 | ClickUpの新着/低評価 | レポートに記載すべき内容 |
|---|---|---|---|
| Trustpilot | 0 / 0 | 2 / 2 | ClickUpの星1レビューが2件あります。1件はサポートチャットボットについて、もう1件はシート数と請求の変更に30日前までの通知が必要な点についてです。どちらもサポート担当と請求担当に送ります。 |
| G2 | 12 / 0 | 19 / 0 | どちらのブランドにも低評価レビューはありません。ClickUpは週に約47件のレビューがつくため、limitを100に設定します。 |
| Capterra | 0 / 0 | 0 / 0 | 今週の新しいレビューはありません。結果は並べ替えられていないため、idの値を先週と比較します。 |
| App Store | 9 / 6 | 2 / 2 | Notionへの不満はバージョン1.7.345に集中しています。両ブランドで3件のレビューがiPhone Duoに言及しているため、来週も確認します。 |
| Google Play | 52 / 15 | 5 / 1 | Notionへの不満が最も多く集まるサイトです。22件の短いレビューをモデルに渡します。 |
メインのエージェントが受け取るのは、このような短い5行と、各ブランドの総合評価です。G2のサマリー行から評価が1つ得られ、trustpilot/profileの呼び出しでは、NotionのTrustScoreが442件のレビューに基づく2.2と返ります。
続いて、メインエージェントは3つの判断を行います。先週から大きく増えた行はどれか。サイトやブランドをまたいで繰り返し出ている問題はあるか。レポートにリンクを載せるべき元のレビューはどれか。3つとも5つの結果すべてが必要なため、メインエージェントに残します。数百件のレビューを読み、バージョンやキーワードごとに件数を数えるのは機械的な作業なので、サブエージェントに任せます。
メインエージェントは固定形式のJSONを返し、それをアプリケーション側でメールやチャットメッセージに変換する構成をおすすめします。Sessionsではagent.text.format.schemaで出力スキーマを指定でき、入力とスキーマの合計は4 MiB未満に収める必要があります(Sessionsのドキュメント)。スキーマを固定すれば毎週同じ形式のレポートになり、前週との比較も簡単です。
テスト3:パラメータを1つ間違えるだけで結果が変わる
これまでのセクションでも、パラメータに関する問題をいくつか取り上げました。この表では、それらと私たちが遭遇したほかのケースをまとめています。各行は実際の呼び出しです。最後の列は、サブエージェントの指示に盛り込むルールです。
| 出来事 | 時刻(SGT、2026年11月1日) | レスポンス | 課金額 | 対処法 |
|---|---|---|---|---|
Trustpilotでdate: "last30days"を指定したところ、30日より前のデータも返された | 00:47 | 7月31日〜10月20日の14件で、30日以内は3件のみ。夜の修正後、19:22の再テストでは3件が返り、すべて30日以内。 | あり、$0.001389 | 修正後はプリセットが正しく機能します。ただし週次レポートでは、引き続きposted_atで絞り込みます。 |
G2で未対応のstarsを指定 | 00:51 | 422 unknown_param、使用可能:url、limit、sort | 不要 | G2には星の数による絞り込みがありません。ratingで自分で絞り込みます。 |
| 複数のテストジョブが1つのキーを共有し、その上限である毎分10リクエストを使い切った | 00:52, 00:53 | 429、最初のretry_afterは13秒。2回のリトライはどちらも成功 | 不要 | retry_afterの時間だけ待ちます。 |
Trustpilotで、カタログに記載のない値sort: "newest"を指定 | 00:51, 15:39 | 最初は503。次にバックアップソースから200が返り、英語以外の6件を含み、sourceフィールドなし。夜の修正後、newestはrecencyと同じ。 | 503はなし、200はあり($0.001389) | カタログに記載された値を使います。修正後は、誤った値を指定すると422が返されます。 |
| Trustpilot、200件、同期呼び出し | 15:40 | 85秒後にタイムアウトし503。mode: "async"の使用を勧めるメッセージ付き | 不要 | 大きなlimitには非同期を使い、everyinfra_get_jobで結果を読み取る。非同期の呼び出しでは131件が返った。 |
名前NotionによるCapterraの検索 | 00:49 | 20件、うち3件は日付とリンクがなく、Google Sheetsのエクスポート用アドオンのもの | あり、$0.001389 | 製品ページのURL/p/186596/Notion/を使います。 |
| 製品URLによるCapterraの検索 | 00:50 | 19件、並び順なし、prosフィールドが98,725文字のものが1件。夜の修正後、各フィールドは5,000文字以下。 | あり、$0.001389 | 各テキストフィールドには上限を設けておきます(例:2,000文字)。 |
| G2の先頭行はサマリー | 00:48 | record_type: summary、評価4.6、レビュー13,962件 | あり、$0.001389 | サマリーは別に扱い、レビューとしてカウントしないようにします。 |
Trustpilotの行はよく見る必要があります。カタログではdateを期間のプリセットとして説明しており、last30daysは直近30日間を意味します。星1と星2だけを指定してこれを送ると、7月31日から10月20日までの14件が返り、30日以内のものは3件だけでした。dateなしで同じリクエストを送ると6月13日までの20件が返り、その先頭14件は先ほどの14件と同じでした。
そのため、11月1日の初回実行では、プリセットを指定した呼び出しで、30日前ではなく約3か月前まで遡ったデータが返されました。行数だけを数えるレポートでは、30日以内の低評価レビューは実際には3件しかないのに、14件と報告することになります。
同日夜、ゲートウェイ側でプリセットが投稿日で絞り込む方式に変更されました。対象は7、30、92、183、366日前までです。誤ったプリセットには課金前に422が返るようになりました。19:22 SGTの再テストでは、10月3日から10月20日までの3件が返りました。これは早朝の実行で30日以内に入っていた3件と同じです。これでlast30daysを日付フィルターとして使えるようになりました。ただし週次レポートでは、サブエージェントが新しいレビューと過去のレビューを比較するため、引き続き20件すべてを読み込み、posted_atで絞り込んでいます。
Capterraの名前検索の結果は、一般的な教訓を示しています。レビューサイトには同名や類似名の製品が多数掲載されているため、名前で検索すると別の製品が混ざることがあります。カタログのcompanyの注記にも、これを避けるため可能な限り製品リンクを送るよう書かれています。製品URLを指定すると、19件すべてがNotionのレビューでした。ブランドリストには、サイトごとに名前ではなくリンクかIDを保存してください。これは入力を設計する段階で決めておきましょう。
次の表は、11月1日の夜の修正後(19:22~19:23 SGT)に、日中と同じパラメータで行った再テストの結果をまとめたものです。
| 項目 | 11月1日未明または午後の実行 | 夜の再テスト | 課金額 |
|---|---|---|---|
Trustpilot sort: "newest" | 00:51に503、15:39に200。ただし6件が英語以外で、sourceなし | 200。recency指定時および00:54の実行時と同じ行で、すべて英語 | $0.001389 |
Trustpilot date: "last30days" | 14件、30日以内は3件のみ | 3件、すべて30日以内 | $0.001389 |
Capterraの製品URL、limit: 100 | 86件、375,315バイト、最長フィールド103,138文字 | 同じ86件、144,341バイト、最長フィールド1,154文字 | $0.001389 |
| 推奨の週次実行(Notion) | 651,907バイト、約163kトークン | 420,933バイト、約105kトークン | — |
テスト4:1週間分の生レビューのサイズがモデルコストを決める
モデルはトークン単位で課金されるため、1週間分の生レビューのサイズを把握する必要があります。呼び出しが返す各行は、ツール出力としてサブエージェントのコンテキストに入ります。つまり、limitによってモデルが読み込む量が決まります。Notionについて3つの設定をそれぞれ実際のレスポンスから計測し、Capterraは夜に1回再テストしました。トークン数は、英語テキストで1トークンあたり約4文字として算出しています(OpenAI Help Center: tokens)。
| 設定(Notion、サイトごとに1回呼び出し) | サイトごとの`limit` | 生データ | トークン数(概算) | テキストフィールドを2,000文字に切り詰め | トークン数(概算) |
|---|---|---|---|---|---|
| 初回実行(00:47~00:57) | Trustpilot 20(last30days指定)、G2 20、Capterra 20、App Store 50、Google Play 200 | 359,497バイト | 89,874 | 246,387バイト | 61,597 |
| 推奨 | Trustpilot 20、G2 100、Capterra 100、App Store 50、Google Play 200 | 651,907バイト | 162,977 | 422,892バイト | 105,723 |
| 推奨(19:23に行ったCapterra再テストを反映) | 同上 | 420,933バイト | 105,233 | 420,732バイト | 105,183 |
全サイトでmax_limit | Trustpilot 200、G2 100、Capterra 100、App Store 500、Google Play 200 | 1,021,087バイト | 255,272 | 786,452バイト | 196,613 |
推奨設定のG2とCapterraは、15:42と15:43 SGTに新たに実行した2回の呼び出しの結果です。G2は100件を指定し、レビュー50件とサマリー1件が返りました。Capterraは100件を指定し、86件が返りました。残り3回の呼び出しは1回目のラウンドのもので、パラメータは同じです。max_limitのラウンドは切り詰め後で約197kトークンとなり、推奨設定の1.86倍です。増加分の大半はApp Storeの450件とTrustpilotの111件で、ほぼすべてが1週間よりはるかに古いものです。
11月1日の早朝の実行では、652 KBの3分の1以上が2件のレビューに由来していました。1回目のラウンドでは、20件のCapterraレスポンスが148,915バイトで、そのうち1件のレビューが114,983バイトありました。そのprosフィールドは98,725文字です。冒頭は通常のユーザーコメントですが、その後にページのスクリプトデータが長々と続いています。100件のレスポンスにはこうしたレビューが2件あり、prosフィールドはそれぞれ100,712文字と103,138文字でした。ClickUpのCapterraレスポンスにも1件あり、103,556文字でした。
パーサーがレビューと一緒にページデータまで取り込んでいたのです。
すべてのテキストフィールドを2,000文字で切り詰めると、100件のCapterraレスポンスは375,315バイトから146,501バイトに減りました。推奨の週次ラウンドは約163kトークンから約106kトークンに減っています。切り詰めなしでは、サブエージェントの読み込み量が54%多くなっていました。
その日の夕方、ゲートウェイ側でパーサーが修正されました。pros、cons、textからページコードが除去され、各フィールドは5,000文字以下になりました。19:23(SGT)に行った再テストでは、同じ86件のレビューが144,341バイトで返り、初回の切り詰め後の146,501バイトよりわずかに小さくなりました(テスト3の末尾の表を参照)。推奨設定での週次ラウンドは現在約105kトークンで、切り詰め後の初回の数値との差はわずか0.5%です。したがって、以下のモデルコストの見積もりは変わりません。
モデルにデータを渡す前にテキストフィールドへ上限を設けるのは、今でも良い習慣です。コストはかからず、今後ほかのサイトで同じ問題が起きた場合にも備えられます。
ここでサブエージェントが効いてきます。サブエージェントがなければ、メインエージェントが106kトークンすべてを自分で読み込みます。5つのサブエージェントを使えば、それぞれが担当サイトだけを読み込み(最大のCapterraでも切り詰め後約37kトークン)、メインエージェントはサイトごとに数百トークンのJSONサマリーを受け取るだけです。自動化に関するドキュメントにも同じことが書かれています。スケジュールされた各タスクをサブエージェントに委任すれば、詳細なツール出力はメインコンテキストに入りません(Scheduled automations docs)。TikTokのブランドアカウントを使ったClaude Codeサブエージェントのテストでは、生データとサマリーのサイズに約100倍の差がありました。
請求額:OpenAI Agents APIの料金とデータ料金
まずはデータ側です。EveryInfraのレビューエンドポイントは呼び出しごとに課金され、行数によって料金は変わりません。5つの機能はすべてprice_usdが0.001389です(カタログ、料金ページ)。1ブランドで週5回呼び出すと、週$0.006945、年$0.3611です。自社と競合9社の計10ブランドなら年$3.61です。
これらの数値は見積もりではありません。この記事では課金対象の呼び出しを21回行い、そのうち6回は改訂中のものです。いずれもcharged_usdは0.001389で、合計$0.029169でした。失敗した6回の呼び出し(503が3回、422が1回、429が2回)は課金されていません。夕方の修正後には再テストを4回(Trustpilotで3回、Capterraで1回)行いました。各回$0.001389が課金され、合計$0.005556でした。
次はOpenAI側です。概要ページによると、モデルはAPI料金、ツールは標準料金、ホスト型サンドボックスはコンテナ料金で課金されます(Agents API overview: pricing)。今回の構成ではサンドボックスを使わず(environment: none)、Web検索も使わないため、残るのはモデルのトークンのみです。以下は2026年11月1日時点の、100万トークンあたりの標準定価です(OpenAI API pricing):
| モデル | 入力 | キャッシュ済み入力 | 30分キャッシュ書き込み | 出力 |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6.1-sol | $2.00 | $0.10 | $2.50 | $10.00 |
| gpt-6.1-terra | $1.00 | $0.05 | $1.25 | $5.00 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
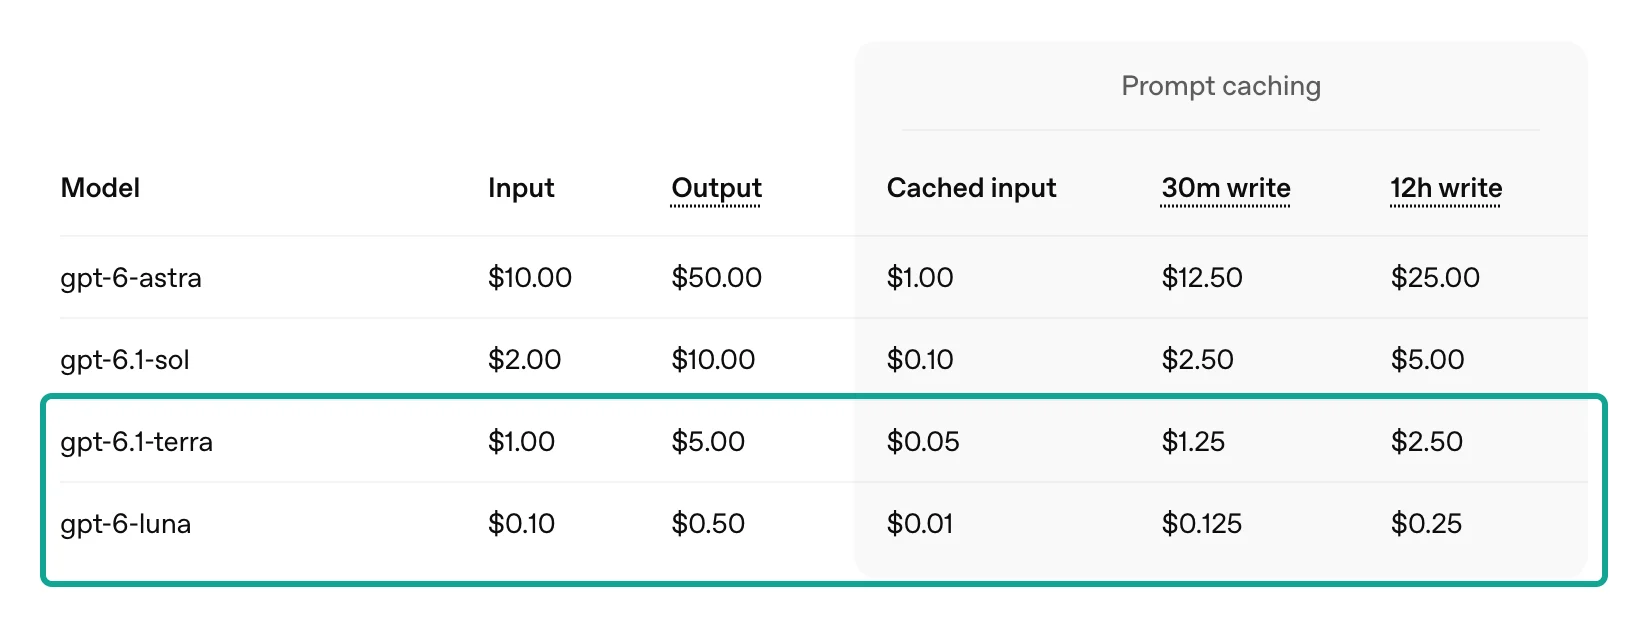
ご自身の数値で計算できるよう、方法を示します。入力は3つの部分から成ります。推奨上限で1週間分のレビューを取得すると、切り詰め後で約105,723トークンです。5つのサブエージェントはそれぞれ、指示、ツールの説明、コンテキストとして約8,000トークンを追加します。メインエージェントは約20,000トークンを追加します。
最初の読み込みは、30分キャッシュ書き込みの料金で計算しています。GPT-5.6以降では、30分キャッシュ書き込みの料金は入力料金の1.25倍なので、これは高めの見積もりになります(Prompt caching docs)。
サブエージェントは1ターンの中でモデルを複数回呼び出します。そこで、レビューとオーバーヘッドの読み込みをさらに2回分、キャッシュ入力の料金で加算します。出力はサブエージェント1つあたり1,500トークン、メインエージェントは3,000トークンです。
実測しているのはレビューのサイズのみです。そのほかの入力は仮定のため、有効数字2桁に丸めています。見積もりは、gpt-6-lunaで約$0.029、gpt-6.1-terraで約$0.27、gpt-6.1-solで約$0.55、gpt-6-astraで約$2.9です。モデル間の100倍の差は、単に定価の比率によるものです。astraの入力料金$10.00は、タスクを問わずlunaの100倍です。
| 1ブランド、1週間 | 金額 | 1年間(×52) | 算出根拠 |
|---|---|---|---|
| EveryInfraのAPI呼び出し(5回) | $0.006945 | $0.3611 | テストでの実際の課金額 |
| モデル:gpt-6-luna | 約$0.029 | 約$1.5 | 定価からの試算 |
| モデル:gpt-6.1-terra | 約$0.27 | 約$14 | 定価からの試算 |
| モデル:gpt-6.1-sol | 約$0.55 | 約$29 | 定価からの試算 |
| モデル:gpt-6-astra | 約$2.9 | 約$150 | 定価からの試算 |
どの前提が最も影響するでしょうか。この表では、オーバーヘッドと再読み込みの回数をそれぞれ3段階で変えています。gpt-6.1-terra、推奨の上限、その他の前提は上記と同じです。
| サブエージェントあたりのオーバーヘッド | 再読み込み1回 | 再読み込み2回 | 再読み込み4回 |
|---|---|---|---|
| 4,000トークン | $0.24 | $0.25 | $0.26 |
| 8,000トークン | $0.27 | $0.27 | $0.29 |
| 16,000トークン | $0.32 | $0.33 | $0.35 |
9つの結果はすべて$0.24〜$0.35の範囲に収まります。キャッシュ価格は入力価格の5%なので、再読み込みの回数はほとんど影響しません。オーバーヘッドはもう少し影響します。大きな差を生むのはレビューの量です。同じ前提で、すべてをmax_limitにすると約$0.40、最初のラウンドを小さくすると約$0.21になります。そのため、まずlimitとテキストの切り詰めを設定し、そのうえでモデルを選んでください。
この表が示しているのは比率です。データ料金は全体のごく一部で、主な変数はモデルの選択です。低評価レビューのレポートは読み込む量が多い一方、判断は単純です。そのため、私たちならサブエージェントにはgpt-6-lunaかgpt-6.1-terraを使います。メインエージェントにより強力なモデルを使うのは、要約にそれが必要な場合だけにしてください。
セッションではmodel、reasoning.effort、service_tierを後から変更できますが、tools、instructions、multi_agentは変更できません(設定のドキュメント)。そのため、モデルの組み合わせはエージェントの作成時に決めておいてください。
課金について2点補足します。1つ目に、Agents APIのusageフィールドはベストエフォートです。nullになることも、後から変わることもあり、請求額ではありません。また、キャッシュ書き込みトークンを個別にカウントしないため、キャッシュ書き込み料金があるモデルでは、usageだけでは正確なモデルコストを算出できません(オブザーバビリティのドキュメント)。
第2に、後からホスト型サンドボックスを追加する場合、コンテナには定価があります(4 GBで20分あたり$0.12。2026年6月2日以降は分単位課金で、最低5分)。2026年10月9日以降、ホスト型サンドボックスはアクティブなターン中のみ課金され、ターン間のアイドル時間は課金されません(OpenAI API pricing、変更履歴)。今回の構成にはサンドボックスがないため、このコストはゼロです。
リリース前に確認すべきパブリックベータの制限
Agents APIはパブリックベータです。リクエストにはOpenAI-Beta: agents=v1ヘッダーが必要で、OpenAI SDKではbeta.agents名前空間を使います(クイックスタート)。ローンチ記事によると、OpenAIは一般提供に向けてベータ期間中に製品をすばやく変更していくとのことです(OpenAIのローンチ記事)。次の表にはドキュメントに明記された制限のみを挙げており、いずれもレビュー監視に影響します。
| 制約 | ドキュメントの記載 | レビュー監視への影響 | 出典 |
|---|---|---|---|
| データレジデンシーとデータ保持 | データレジデンシーは米国のみです。Zero Data Retentionには対応しておらず、セルフホスト型サンドボックスを使う場合も同様です。 | 公開レビューであればリスクは低めです。レポートにサポートチケットを含める場合は、先にコンプライアンスを確認してください。 | 概要、データの取り扱い |
| スケジュールは厳密ではない | 定期実行にはわずかなランダム遅延が加わります。対象のセッションがビジー状態だと、タスクは待機します。 | レポートは9:00の数分後に届きます。厳密なタイミングが必要な処理にはつながないでください。 | オートメーション |
| 配信済みは完了ではない | 呼び出しがcompletedでも、配信に成功したことを示すだけです。 | turn.completedまたはturn.failedを使い、失敗時にはアラートを出してください。 | オートメーション、Webhook |
| VaultはOpenAI側の接続専用 | 環境(environment)オリジンのHTTP接続では、Vaultの認証情報は使われません。 | EveryInfraのMCPサーバーは公開されているため、デフォルトのserviceオリジンで問題ありません。 | MCP接続 |
| サブエージェントでは関数ツールを使えない | サブエージェントはMCPツールと認証情報を継承しますが、関数ツールは使えません。 | データを返すのはメインエージェントだけです。保存はアプリ側で行います。 | マルチエージェント |
| 使用量は請求額ではない | ベストエフォートで、nullになる場合や値が変わる場合があり、キャッシュ書き込みトークン数は含まれません。 | コストはusageではなく請求書で確認してください。 | オブザーバビリティ |
| サイズ制限 | 指示とツール設定の合計は4 MiB未満、各入力も4 MiB未満です。 | ブランドリストが長い場合は、先週の全データではなく先週のサマリーを送信してください。 | 設定、セッション |
| MCPの起動失敗 | required: trueの場合、起動に失敗するとそのターンはmcp_server_startup_failed(424)で失敗します。 | これは意図どおりの動作です。データがなければレポートも作成しません。 | エラー |
この構成でできないことと注意点
1つ目に、この構成は公開レビューを読み取るだけで、返信はしません。App StoreとGoogle Playの返信は、AppleとGoogleのデベロッパーコンソールから行います(Apple:評価、レビュー、および返信、Google Play Consoleヘルプ:評価とレビュー)。EveryInfraのレスポンスには、Google PlayとTrustpilotではreply_text、Capterraではvendor_responseが含まれます。そのため、レポートでどのレビューに返信済みかは示せますが、返信を書くのは人です。
第2に、この構成をレビューの操作に使わないでください。米連邦取引委員会(FTC)が2024年8月に出した最終規則は、偽レビューと、肯定的または否定的なレビューを条件とする報酬を禁止しています。この規則はAIが生成した偽レビューにも明示的に言及しています(FTCプレスリリース、2024-08-14)。低評価レポートは問題を早期に把握するためのもので、レビューを変えるためのものではありません。
3つ目に、低評価のしきい値はサイトごとに設定してください。G2は0.5刻みの評価を使うため、2.5以下を低評価としています。ほかのサイトは2以下です。どちらのブランドも、30日間でG2の低評価レビューはありませんでした。自社製品も同様であれば、G2のしきい値を3つ星に上げてください。そうしないとG2の行は常に0となり、読み手が見なくなります。
4つ目に、まずサブエージェントにキーワードルールを適用させてください。テスト2の22件のように、ルールで分類できないレビューだけをモデルに送ります。プログラマティックなツール呼び出しはこの用途のための機能で、結果をコードで絞り込み、関連する部分だけをコンテキストに戻します(OpenAIのリリース記事、プログラマティックなツール呼び出しのドキュメント)。
最近の変更点
Agents APIはベータ期間中、数週間ごとに変更されます。この構成に影響する変更を古い順に示します。
| 日付 | 変更内容 | この構成への影響 |
|---|---|---|
| 2026年9月10日 | ホステッドサンドボックス、サブエージェント、コンテキスト圧縮を備えたパブリックベータを公開。プラットフォーム利用料なし(変更履歴、フォーラムでの告知) | 保守するエージェントのコードが減り、最初のバージョンをすばやく構築できます |
| 2026年10月9日 | ホステッドサンドボックスはアクティブなターンの間のみ課金され、事前ウォームアップも可能に(変更履歴) | スクリプトを実行するモニターでも、アイドル時間の料金がかからなくなります |
| 2026年10月16日 | Ultrafastモードを追加。ホステッドサンドボックスにスプレッドシートとドキュメント用のArtifact SDKを同梱(変更履歴) | レポートはスプレッドシート形式のファイルにできますが、その場合はサンドボックスが必要です |
| 2026年10月20日 | 12時間のプロンプトキャッシュを導入。書き込みは入力料金の2.5倍(変更履歴、プロンプトキャッシュのドキュメント) | 週次実行の間隔は12時間を大きく超えるため、キャッシュが効くのは1回の実行内だけです |
| 2026年10月26日 | GPT-6.1 Terraをリリース(変更履歴) | lunaとsolの中間の価格帯です。週あたり$0.2154という見積もりでは、このモデルを使用しています |
| 2026年10月28日 | 対象のChatGPT ProおよびBusinessの契約者は、月最大$500分のAPIクレジットを受け取れるように(変更履歴) | 小規模なチームなら、このモニターのモデル費用をそのクレジットでまかなえる可能性があります |
| 2026年11月30日 | Agent Builderの提供終了予定日。2026年6月3日に告知(非推奨) | この日までに既存のフローをAgents APIまたはAgents SDKに移行してください。また、開発者フォーラムでOpenAIのスタッフが、認証情報をローテーションするフローにはAgents APIのVaultを使うようユーザーに案内しています(OpenAI開発者フォーラム) |
FAQ
OpenAI Agents APIの料金体系は?プラットフォーム利用料はかかりますか?
プラットフォーム利用料は別途かかりません。OpenAIのリリース記事では、Agents APIに追加料金はなく、エージェントが使用するトークンとツールの料金を支払うと説明されています。概要ページによると、モデルは選択したモデルの料金、ツールは標準料金、ホステッドサンドボックスはコンテナ料金で課金されます。
サンドボックスを使わない場合、1ブランドあたりの週次モデル費用は、約$0.029(gpt-6-luna)から約$2.9(gpt-6-astra)と見積もられます。データAPIの呼び出しには$0.006945が加わります。(質問の出典:Googleのサジェスト「openai agents api pricing」「openai agents api cost」。根拠:リリース記事、概要、料金)
OpenAI Agents APIとSDK、どちらを使うべきですか?
ループの実行、セッションの保持、スケジュール実行をOpenAIに任せるならAgents APIを使います。自社アプリケーション内で独自のストレージを使ってエージェントを動かす必要があるなら、Agents SDKを使います。OpenAIの比較では、統合の手間はAgents APIが「低」、SDKが「中」です。Zero Data Retentionが必要なチームは、現時点ではSDKを使う必要があります。(質問の出典:Googleのサジェスト「openai agents api vs sdk」。根拠:Agentsガイド、概要)
OpenAI Agents SDKのMCPクライアントから同じEveryInfraサーバーに接続できますか?
はい。SDKのMCPドキュメントはStreamable HTTPに対応しています。https://api.everyinfra.com/mcpをご自身のキーとともに使えば、ツール名とパラメータはこの記事と同じです。違いは、スケジュール、リトライ、認証情報の保管を自分で実装する点です。(質問の出典:Googleのサジェスト「openai agents sdk mcp」「openai agents sdk mcp server」。根拠:Agents SDKのMCPドキュメント、MCPトランスポート仕様)
OpenAI Agents APIキーにはどの権限が必要ですか?
クイックスタートでは、セッション用にapi.agents.readとapi.agents.write、モデル推論用にapi.responses.writeが挙げられています。Vaultを管理するには、api.vaults.readとapi.vaults.writeを追加します。このOpenAI APIキーはサーバー上に置き、エージェントの指示やサンドボックスには含めないでください。(質問の出典:Googleのサジェスト「openai agents api key」。根拠:クイックスタート、サンドボックスのセキュリティ)
OpenAI Agents APIのcomputer useでレビューサイトを直接読み取れますか?
Agents APIは2026年9月29日にcomputer useに対応しました。エージェントはOpenAIがホストするブラウザで操作でき、承認とサインインはアプリケーション側で処理します。ただし、ブラウザでレビューをページ送りするにはサンドボックスが必要で、時間がかかり、トークンも大幅に多く消費します。
また、Trustpilot、G2、Capterraのページはスクリプトによるアクセスをブロックします。テストでは、3サイトすべてで単純なcurlリクエストが403を返しました。レビューを構造化データとして取得するなら、データAPIのほうが安定していて低コストです。(質問の出典:Googleのサジェスト「openai agents api computer use」。根拠:変更履歴)
AIエージェントにAPIキーを渡しても安全ですか?
リリースに関するr/artificialのスレッドには、「Good luck trusting AI with passwords and secrets」(AIにパスワードやシークレットを預けるなんて、うまくいくといいですね)というコメントがあります。OpenAIの設計では、Vaultを読み取ってもシークレットは返されません。OpenAIが接続時にMCPの認証情報を付与するため、エージェントのコードからキーは見えません。
サンドボックスのセキュリティページには、環境変数の値はエージェントのコードから読み取れるとも書かれています。そのため、キーはenvではなくVaultに保存し、このエージェントには専用のキーを発行してください。(質問の出典:r/artificialのスレッド。根拠:Vault、サンドボックスのセキュリティ)
始め方
- EveryInfraに新規登録してAPIキーを取得し、クイックスタートに従って無料のカタログを1回呼び出してください。
trustpilot/reviews、g2/reviews、capterra/reviews、app_store/reviews、google_play/reviewsがavailable: trueになっていることを確認してください。パラメータとフィールドは、Trustpilotレビュー、G2レビュー、Capterraレビュー、App Storeレビュー、Google Playレビューの各機能ページに記載されています。 - 各サイトでブランドごとのリンクまたはIDを調べ、1つの表にまとめます。各サイトの概要はTrustpilot API、G2 API、Capterra API、App Store API、Google Play APIの各ページにあります。
- Agents APIを使う前に、自社ブランドについて、各サイトにRESTで1回ずつリクエストを送ります。1回の呼び出しで何日分をカバーできるかを測り、テスト1と同じように
limitを設定します。 - OpenAI側で、ステップ4の例に沿ってVault、エージェント、オートメーションを作成します。手動で1回実行し、レポートとセッションイベントを確認します。
- 2週間後に、モデルのコストを請求書と突き合わせます。品質が変わらなければ、サブエージェントを低コストのモデルに切り替えます。
レビューデータを顧客向けの製品にするには、レビューデータを有料製品にする方法をお読みください。ChatGPTのスケジュールタスクで同様の処理を行う例は、ChatGPTのスケジュールタスクを需要レーダーとして使うをご覧ください。すべての機能と料金はデータマーケットで確認できます。
参考文献
- Agents API概要、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/overview
- Agents APIクイックスタート、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/quickstart
- Agents APIアーキテクチャ、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/architecture
- エージェントの設定、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/configuration
- セッション、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/sessions
- スケジュール設定されたオートメーション、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/sessions/automations
- Webhook、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/sessions/webhooks
- マルチエージェント、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/multi-agent
- Vault、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/tools/vaults
- MCP接続、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- OpenAIホスト型サンドボックス、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/environments/openai-hosted
- サンドボックスのセキュリティ、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/environments/security
- エラーと復旧、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/errors
- オブザーバビリティと使用量、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents-api/observability
- API料金、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/pricing
- Changelog(2025-03-11〜2026-10-30のエントリ)、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/changelog
- Deprecations(Agent Builder)、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/deprecations
- Agents(エージェントのランタイムオプションを比較)、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/agents
- Your data、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/your-data
- Prompt caching、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/prompt-caching
- Tool search、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/tools-tool-search
- Programmatic tool calling、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/tools-programmatic-tool-calling
- Compaction、OpenAI開発者ドキュメント、2026-11-01閲覧、https://developers.openai.com/api/docs/guides/compaction
- Create automation(APIリファレンス)、OpenAI、2026-11-01閲覧、https://developers.openai.com/api/reference/resources/beta/subresources/agents/subresources/automations/methods/create
- Agents(APIリファレンス)、OpenAI、2026-11-01閲覧、https://developers.openai.com/api/reference/resources/beta/subresources/agents
- Introducing the Agents API、OpenAI、2026-09-10、https://openai.com/index/introducing-the-agents-api/
- Introducing the Agents API and hosted sandboxes、OpenAI開発者フォーラム、2026-09-10、https://community.openai.com/t/introducing-the-agents-api-and-hosted-sandboxes/1396481
- Agent Builder MCP Secrets API、OpenAI開発者フォーラム、2026-11-01閲覧、https://community.openai.com/t/agent-builder-mcp-secrets-api/1368113
- OpenAI launches Agents API public beta built on Codex harness、Reddit r/artificial、2026-11-01閲覧、https://www.reddit.com/r/artificial/comments/1wctpbu/openai_launches_agents_api_public_beta_built_on/
- openai/openai-agents-python、GitHub、2026-11-01閲覧、https://github.com/openai/openai-agents-python
- Model context protocol(Agents SDKドキュメント)、OpenAI、2026-11-01閲覧、https://openai.github.io/openai-agents-python/mcp/
- MCP仕様:Transports(2025-06-18)、Model Context Protocol、https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- RFC 6750: OAuth 2.0 Bearer Token Usage、IETF、2012-10、https://datatracker.ietf.org/doc/html/rfc6750
- Time Zone Database、IANA、2026-11-01閲覧、https://www.iana.org/time-zones
- crontab(5)、Linux man-pages、2026-11-01閲覧、https://man7.org/linux/man-pages/man5/crontab.5.html
- 評価、レビュー、および返信、Apple Developer、2026-11-01閲覧、https://developer.apple.com/app-store/ratings-and-reviews/
- アプリの評価とレビューを表示、分析する、Google Play Consoleヘルプ、2026-11-01閲覧、https://support.google.com/googleplay/android-developer/answer/138230
- トークンの理解とカウント、OpenAIヘルプセンター、2026-11-01閲覧、https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials、米国連邦取引委員会(FTC)、2024-08-14、https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- Notion Reviews、Trustpilot、2026-11-01閲覧、https://www.trustpilot.com/review/notion.so
- Notion Reviews、G2、2026-11-01閲覧、https://www.g2.com/products/notion/reviews
- Notion、Capterra、2026-11-01閲覧、https://www.capterra.com/p/186596/Notion/
- Notionのアプリページ、App Store、2026-11-01閲覧、https://apps.apple.com/us/app/notion-notes-tasks-ai/id1232780281
- Notionのアプリページ、Google Play、2026-11-01閲覧、https://play.google.com/store/apps/details?id=notion.id
- EveryInfraデータカタログ(trustpilot)、EveryInfra、2026-11-01閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- EveryInfraデータカタログ(全体)、EveryInfra、2026-11-01閲覧、https://api.everyinfra.com/api/v1/social/catalog
- ClickUp、Capterra、2026-11-01閲覧、https://www.capterra.com/p/158833/ClickUp/
- ClickUpのアプリページ、Google Play、2026-11-01閲覧、https://play.google.com/store/apps/details?id=co.mangotechnologies.clickup
- iPhone Duoが世界各地のApple Storeに登場、Apple Newsroom、2026-10、https://www.apple.com/newsroom/2026/10/iphone-duo-arrives-at-apple-store-locations-worldwide/
参考資料 BL-59