openai agents api para vigilar reseñas: un informe semanal de reseñas negativas en cinco sitios
Un agente semanal de reseñas con la openai agents api: 21 llamadas reales en cinco sitios, 0,0069 USD por marca y semana en datos, configuración y límites.
El 1 de noviembre de 2026, entre las 00:47 y las 15:45 hora de Singapur (SGT), consultamos las reseñas de Notion y ClickUp con la API de EveryInfra, y esa noche repetimos 4 llamadas entre las 19:22 y las 19:23. Los sitios fueron Trustpilot, G2, Capterra, App Store y Google Play. Revisar una marca durante una semana exige cinco llamadas y cuesta 0,006945 USD en datos. El precio no es el problema. El problema es la cobertura: en Google Play, las 200 reseñas más recientes de Notion solo llegan 22 días atrás, mientras que 20 reseñas negativas de Notion en Trustpilot llegan hasta junio.
La cifra grande es la del modelo. Nuestro cobro es por llamada, así que 200 filas cuestan lo mismo que 20; pero cada fila de más entra en el contexto del modelo. Con los límites que recomendamos, una semana de reseñas de Notion pesa unos 421 KB en bruto, unos 105 mil tokens; de madrugada pesaba 652 KB por el código de página que explicamos más abajo. Con los precios públicos de OpenAI del 1 de noviembre de 2026, esa semana cuesta entre unos 0,03 y 2,9 USD en tokens, según el modelo. El modelo más caro y el más barato difieren 100 veces en precio de lista, así que la elección del modelo marca la factura.
Las llamadas reales destaparon además dos trampas. Capterra no ordena las reseñas por fecha. Y en la prueba de la madrugada del 1 de noviembre, algunas reseñas de Capterra traían un campo pros de unos 100.000 caracteres con código de la página. Esa misma noche la pasarela quitó ese código y limitó cada campo a 5000 caracteres; al repetir la prueba a las 19:23 volvieron las mismas 86 reseñas, y el campo más largo tenía 1154 caracteres.
La pregunta es concreta: ¿sirve la Agents API, en beta pública desde el 10 de septiembre de 2026, para un agente que despierte cada lunes, mande un subagente a cada sitio y escriba un informe de reseñas negativas? Los campos, valores por defecto y límites de OpenAI salen de su documentación, revisada el 1 de noviembre de 2026. No ejecutamos el agente en una cuenta de OpenAI: esa parte es un ejemplo de configuración. Las cifras de EveryInfra salen de respuestas reales.
El trabajo: un informe semanal de reseñas negativas en cinco sitios
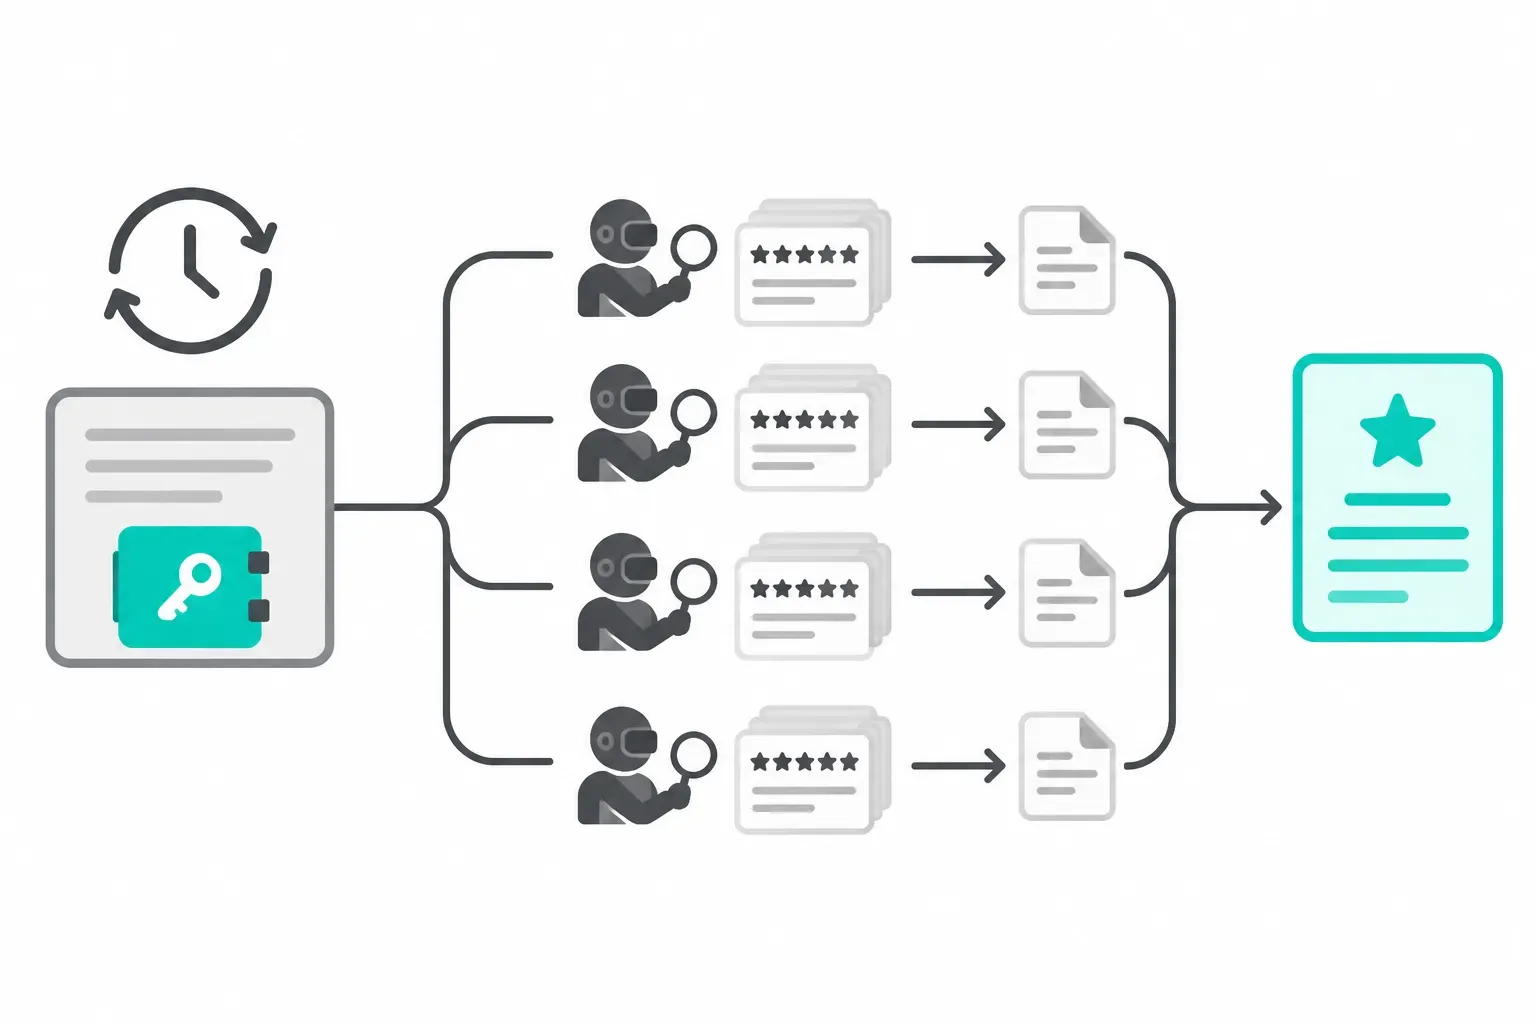
La entrada es una lista de marcas, con un identificador por sitio. Trustpilot usa el dominio de la empresa, por ejemplo notion.so. G2 usa la URL o el slug de reseñas y Capterra la URL de la página del producto. App Store usa el ID numérico de la app y Google Play el nombre del paquete.
La salida es un informe por semana. Cada marca tiene una sección con las reseñas nuevas y negativas por sitio y los temas de queja principales. También señala los problemas que no estaban la semana anterior, con enlaces a las reseñas originales para que soporte pueda responder.
Estos cinco sitios cubren dos públicos. En Trustpilot, G2 y Capterra leen los compradores antes de contratar software. App Store y Google Play recogen a quienes ya usan el producto, con quejas concretas que suelen traer número de versión.
Nuestro plan de monitoreo de reputación en varias plataformas explica cómo registrar la cobertura antes de juzgar una tendencia negativa. Nuestra prueba con 30 empresas en Exa, G2 y Trustpilot muestra una comparación puntual entre competidores. Aquí damos un paso más: la revisión se convierte en un agente que corre cada semana sin que nadie lo lance, y medimos con datos reales si una pasada semanal alcanza.
El trabajo encaja con cuatro piezas de la Agents API: subagentes para cinco sitios independientes, automations para la programación cron, un vault para la clave y una conexión a un servidor MCP remoto desde el lado de OpenAI, sin sandbox.
openai agents api frente al Agents SDK
OpenAI lanzó la Agents API en beta pública el 10 de septiembre de 2026. Según el anuncio, una sola llamada con una tarea, un modelo, herramientas y un entorno crea un agente listo para producción, que corre sobre el mismo harness que Codex (anuncio de OpenAI; changelog). El harness es el bucle que llama al modelo, ejecuta herramientas y gestiona el contexto.
La página de introducción divide el producto en cuatro conceptos: Agent, Environment, Session y Events and items (introducción a la Agents API). El anuncio aclara además que la Agents API no cobra una tarifa aparte: se pagan los tokens y las herramientas que usa el agente (anuncio de OpenAI).
El nombre se confunde fácilmente con el Agents SDK. El SDK es un framework de orquestación de código abierto que OpenAI publicó el 11 de marzo de 2025, y su bucle de agente corre dentro de tu propia aplicación (changelog; openai-agents-python en GitHub). La guía «Agents» de OpenAI trae una tabla comparativa; la nuestra la sigue de cerca (guía Agents: comparar opciones de ejecución).
| Aspecto | Agents API | Agents SDK | Responses API |
|---|---|---|---|
| Para qué | Tareas largas en las que OpenAI gestiona el agente y guarda el progreso | Agentes con herramientas y flujos propios dentro de tu app | Llamadas directas al modelo o un agente hecho desde cero |
| Dónde corre el agente | OpenAI ejecuta un harness de Codex gestionado | El SDK corre dentro de tu aplicación | Tu aplicación, con orquestación alojada opcional |
| Esfuerzo de integración | Bajo | Medio | Alto |
| Estado entre tareas | Configuración de sesión, turnos e ítems guardados | Tu almacenamiento y sesiones del SDK, o estado de conversación de Responses | Historial manual, encadenado de respuestas o Conversations |
| Ejecución de herramientas | Herramientas conectadas al servicio, handlers de funciones, sandbox opcional | Herramientas e integraciones en tu aplicación | Herramientas alojadas y herramientas que ejecuta tu app |
Para vigilar reseñas: si no quieres mantener un proceso propio para el bucle, las sesiones y los reintentos, la Agents API lo hace. A cambio, el estado del agente vive en OpenAI y el producto sigue en beta.
Si tu empresa necesita que los datos se queden en su región, el SDK es la opción más segura. La página de introducción dice que la Agents API solo admite residencia de datos en Estados Unidos y no admite Zero Data Retention (ZDR), ni siquiera con un sandbox propio (introducción a la Agents API).


Paso 1: conectar EveryInfra como conexión MCP
En la Agents API, un servidor MCP es una entrada de agent.tools con type: "mcp". La conexión puede salir de dos lugares. Con connection_origin: "service", que es el valor por defecto, OpenAI se conecta al servidor, así que este debe estar en internet. Ese modo funciona con o sin entorno. Con connection_origin: "environment", la conexión sale desde el sandbox de la sesión, pensado para servidores en una red privada (documentación de conexiones MCP).
El endpoint MCP de EveryInfra es público, https://api.everyinfra.com/mcp, así que el origen service es el correcto y el entorno de la sesión puede ser none. La página de arquitectura dice que, sin entorno, el agente sigue pudiendo llamar herramientas MCP remotas; solo pierde Bash, los archivos del espacio de trabajo y los MCP del ejecutor (arquitectura de la Agents API). Eso importa para el costo: sin sandbox no hay cargo por contenedor.
Esta es la entrada de herramienta como ejemplo de configuración, con cada campo cotejado con la documentación. allowed_tools solo incluye everyinfra_call_api y everyinfra_get_job; la segunda lee el resultado de una llamada asíncrona (ver la prueba 3). Con required: true, el turno falla si el servidor no arranca, y eso es lo que queremos: si no, el agente podría escribir un informe sin datos. La documentación indica que la inicialización MCP es opcional por defecto (documentación de conexiones MCP).
{
  "type": "mcp",
  "server_label": "everyinfra",
  "transport": { "type": "http", "server_url": "https://api.everyinfra.com/mcp" },
  "connection_origin": "service",
  "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
  "required": true
}
¿Por qué solo dos herramientas? A las 15:45 hora de Singapur del 1 de noviembre de 2026 enviamos tools/list al servidor MCP de EveryInfra. Devolvió 12 herramientas cuyas descripciones JSON suman 16.669 bytes; las de everyinfra_call_api y everyinfra_get_job juntas ocupan 2505 bytes. Con la regla práctica del centro de ayuda de OpenAI, unos 4 caracteres por token en inglés, son unos 4167 tokens frente a unos 626 (centro de ayuda de OpenAI: tokens).
Las descripciones de herramientas entran en el contexto en cada turno, y cada uno de los cinco subagentes carga su copia. La diferencia ronda los 18 mil tokens por ejecución. Además, la lista cambia cuando el servicio añade o quita herramientas: una lectura anterior del mismo día dio otra cifra. Una lista permitida deja este costo fijo. La documentación define allowed_tools justamente como la forma de limitar qué herramientas puede descubrir y llamar el agente (documentación de conexiones MCP).
| Lista de herramientas | Herramientas | JSON de descripciones (bytes) | Tokens aprox. (÷4) | Cinco subagentes |
|---|---|---|---|---|
Sin allowed_tools | 12 | 16.669 | 4167 | unos 20.835 |
Solo everyinfra_call_api y everyinfra_get_job | 2 | 2505 | 626 | unos 3130 |
El anuncio menciona también tool search, que carga las definiciones de herramientas solo cuando el agente las necesita (anuncio de OpenAI; documentación de tool search). Aquí bastan dos herramientas, así que una lista permitida es más simple y predecible.
Paso 2: la clave va en un vault, no en las instrucciones
La conexión MCP necesita una clave de EveryInfra. La documentación ofrece tres lugares para las credenciales. Para una sola sesión, el valor va en transport.authorization o transport.headers; la Agents API lo cifra y no lo devuelve en la sesión. Para reutilizarla, la credencial se guarda en un vault y el vault se adjunta con vault_ids. Para servidores stdio se usan variables de entorno, pero entonces el código del sandbox puede leer el valor (conexiones MCP: Add authentication). Un trabajo semanal es el segundo caso.
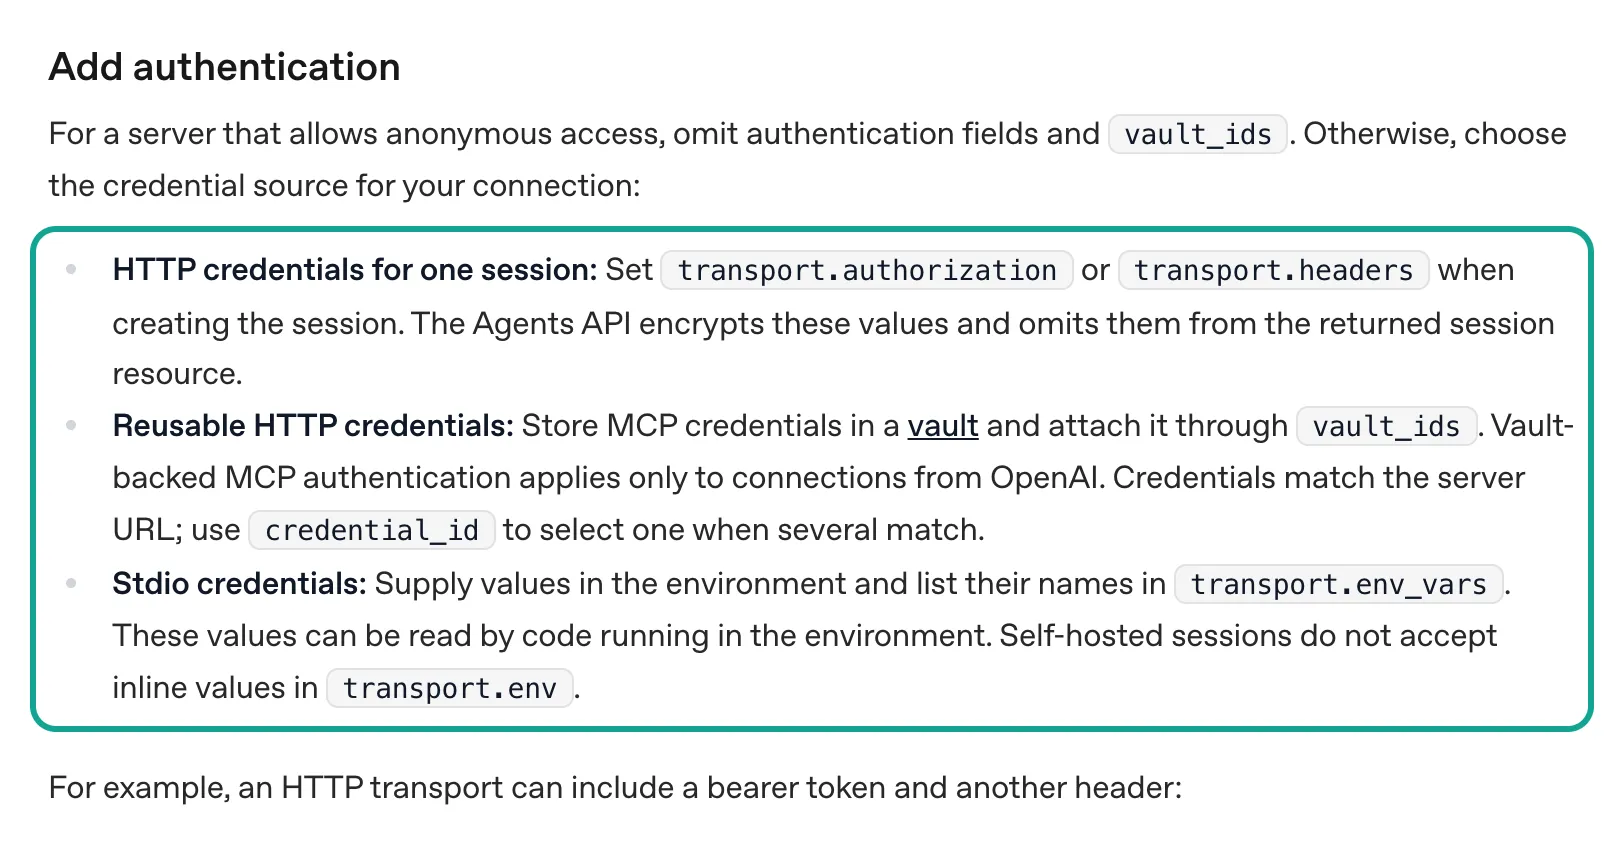
La página de Vaults muestra las llamadas. Primero, client.beta.agents.vaults.create crea el vault. Después, vaults.credentials.create agrega una credencial con auth.type: "static_bearer", la URL del MCP en mcp_server_url y la clave en token. El valor de mcp_server_url ata la credencial a ese servidor (documentación de Vaults). Al leer un vault o una credencial, la API no devuelve el secreto. Para gestionar vaults, la clave de tu aplicación necesita los permisos api.vaults.read y api.vaults.write (Vaults; seguridad del sandbox).
Hay dos reglas fáciles de pasar por alto. La primera: las credenciales MCP del vault solo valen para conexiones que salen de OpenAI; una conexión con connection_origin: "environment" no las usa. La segunda: borrar una credencial no revoca el token original ni detiene una sesión en curso (Vaults: rotar o quitar credenciales). Para revocar una clave de EveryInfra hay que desactivarla en la consola de EveryInfra.
Paso 3: un subagente por sitio, y el agente principal solo combina
En la Agents API, el modo multiagente es un interruptor: agent.multi_agent.enabled: true al crear la sesión. El harness le da entonces al agente herramientas para crear subagentes, enviarles mensajes, esperarlos e interrumpirlos, sin que tengas que declararlas (documentación de multiagente). max_concurrent_subagents limita cuántos corren a la vez. El valor por defecto es 6, sin contar al agente principal, y nuestro trabajo tiene 5 sitios, así que alcanza.
Tres reglas de la misma página importan aquí. Los subagentes heredan las herramientas MCP configuradas, sus credenciales y sus herramientas permitidas. Los subagentes no admiten function tools. Y solo comparten sistema de archivos cuando la sesión tiene entorno (multiagente). La primera regla significa que la clave del vault llega a todos los subagentes sin configuración extra. La segunda, que un subagente no puede escribir en tu base de datos mediante una función: el agente principal devuelve los resultados y tu aplicación los guarda.
La documentación también dice cuándo dividir el trabajo: las tareas independientes van a subagentes, y las tareas cortas o dependientes se quedan en el agente principal (multiagente: cuándo usar subagentes). Los cinco sitios son independientes. La comparación con la semana anterior y el resumen final necesitan los cinco resultados, así que se quedan en el agente principal.
La página de automations dedica una sección a este patrón exacto. En un objetivo de larga duración, el agente principal conserva el objetivo y la programación, delega cada tarea programada a un subagente y guarda un resultado breve. Así, la salida detallada de cada revisión no entra en el contexto principal (automations: mantener el trabajo repetido fuera del contexto principal).
Estas son las instrucciones del agente principal en el ejemplo. Las dejamos en inglés, como en la documentación; cada línea responde a una prueba real que verás más abajo.
You run a weekly review check for the brands listed in the input.
Delegate each platform (trustpilot, g2, capterra, app_store, google_play) to its own subagent.
Each subagent calls everyinfra_call_api once per brand with the parameters given below,
uses mode=async when limit is 100 or more (read the rows with everyinfra_get_job),
keeps only reviews posted in the last 7 days (filter by posted_at yourself),
cuts every text field to 2,000 characters, and returns JSON:
{platform, brand, new_reviews, low_star, themes:[{name,count,example_url}], new_issue_vs_last_week}.
Do not return raw reviews. The main agent merges the five results into one report.
If a call returns an error with retryable=true, wait retry_after seconds and retry at most twice.
Never invent reviews. If a platform failed, say so in the report.
Los parámetros indicados a continuación viajan en la entrada de cada ejecución. La tabla muestra los valores para Notion; cada decisión sale de una prueba posterior.
| Subagente | Parámetros por marca | Qué cuenta como negativa | Motivo |
|---|---|---|---|
| Trustpilot | company: "notion.so", stars: ["1","2"], sort: "recency", limit: 20, sin date | Todas las filas, porque la llamada ya pide 1–2 estrellas | 20 filas llegan 129 días atrás, con cerca de 1 reseña negativa por semana, así que conviene leer las 20 y filtrar por posted_at; sort con un valor del catálogo (prueba 3) |
| G2 | url, sort: "newest", limit: 100, mode: "async" | rating de 2,5 o menos; se salta la fila record_type: summary | No hay filtro por estrellas; ClickUp recibe unas 47 reseñas por semana (prueba 1); en modo síncrono tardó 50 segundos |
| Capterra | company con la URL del producto, limit: 100, mode: "async" | rating de 2 o menos | No hay orden por fecha; se piden todas las filas y se compara id con la semana anterior (prueba 1) |
| App Store | app_id: "1232780281", country: "us", sort: "newest", limit: 50 | rating de 2 o menos; se cuenta por app_version | 50 filas cubren 39 días; las quejas siguen a las versiones (prueba 2) |
| Google Play | app_id: "notion.id", sort: "newest", language: "en", limit: 200 | score de 2 o menos | 40 filas solo cubrían 4,2 días; 200 cubrieron 22 (prueba 1) |
Ojo con los nombres de campo: Google Play devuelve las estrellas en score y los otros cuatro sitios en rating. El limit de cada sitio se fija para que una llamada cubra al menos dos semanas, no siempre el máximo; las pruebas 1 y 4 explican por qué.
Paso 4: una automation abre una sesión nueva cada lunes
Las programaciones viven en un recurso aparte, POST /v1/agents/automations. Con type: "periodic" se define expression (una cadena cron estándar de cinco campos) y timezone (un nombre IANA como America/Mexico_City). Con type: "once" se define run_at en segundos Unix. Hay dos tipos de destino. new_session abre una sesión limpia en cada ejecución y necesita un agente o un agent_id guardado, un entorno y target.input. existing_session le envía un recordatorio a una sesión que ya existe, para trabajos que necesitan hallazgos anteriores (documentación de automations).
La referencia de la API muestra que un destino new_session acepta vault_ids y que su entorno puede ser none (referencia de create automation). Los nombres de zona horaria salen de la base de datos de IANA (IANA Time Zone Database) y los cinco campos cron siguen el crontab de Unix (crontab(5)).
Este es el ejemplo completo en Python. El SDK agrega por ti la cabecera OpenAI-Beta: agents=v1; con curl hay que añadirla a mano (quickstart de la Agents API). Para este artículo usamos la hora de Ciudad de México, pensando en un equipo de soporte en Latinoamérica.
import os
from openai import OpenAI

client = OpenAI()  # app key needs api.agents.read / api.agents.write / api.responses.write / api.vaults.write
MCP_URL = "https://api.everyinfra.com/mcp"

vault = client.beta.agents.vaults.create(name="review-check")
client.beta.agents.vaults.credentials.create(
    vault.id,
    name="EveryInfra read-only key",
    auth={"type": "static_bearer", "mcp_server_url": MCP_URL, "token": os.environ["EVERYINFRA_API_KEY"]},
)

agent = client.beta.agents.create(
    model="gpt-6.1-terra",
    instructions=open("weekly_review_instructions.txt").read(),
    tools=[{
        "type": "mcp", "server_label": "everyinfra",
        "transport": {"type": "http", "server_url": MCP_URL},
        "connection_origin": "service",
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"], "required": True,
    }],
    multi_agent={"enabled": True, "max_concurrent_subagents": 5},
)

automation = client.beta.agents.automations.create(
    type="periodic",
    name="Weekly review check",
    expression="0 9 * * MON",
    timezone="America/Mexico_City",
    target={
        "type": "new_session",
        "agent_id": agent.id,
        "environment": {"type": "none"},
        "vault_ids": [vault.id],
        "input": [{"role": "user", "content": [{"type": "input_text",
                   "text": "Brands: ClickUp (clickup.com; g2 clickup; capterra https://www.capterra.com/p/158833/ClickUp/; "
                           "app_store 1535098836; google_play co.mangotechnologies.clickup). Write this week's report."}]}],
    },
)
print(automation.id)
Una automation nueva queda active, pero la primera ejecución llega en la siguiente hora que coincida. Las ejecuciones recurrentes reciben un pequeño retraso aleatorio, y si la sesión de destino está ocupada, la tarea espera.
Cada ejecución crea una invocation, y una invocation con status: completed solo indica que la entrega funcionó, no que el agente terminó. Para saber el resultado hay que esperar agent.session.turn.completed o turn.failed en los eventos de la sesión (automations; sesiones).
Tu aplicación puede leer el informe del flujo de eventos o de un webhook. El webhook agent.session.idle indica que la sesión acepta nueva entrada, pero tampoco garantiza que el último turno saliera bien (documentación de webhooks). Para probar antes del lunes, basta un POST /v1/agents/automations/{id}/invocations vacío; una ejecución manual no cambia la programación guardada (automations: probar una ejecución).
¿Qué destino conviene, new_session o existing_session? Una sesión nueva empieza cada semana con el contexto limpio, y el costo es fácil de prever. Pero no recuerda la semana anterior, así que tu aplicación debe poner el resumen previo en target.input. Una sesión existente conserva los hallazgos anteriores, y la Agents API compacta el contexto viejo cuando la sesión se acerca a su límite (anuncio de OpenAI; documentación de compaction). Preferimos sesión nueva con el resumen de la semana anterior en la entrada, que ocupa solo uno o dos mil tokens.
Un ida y vuelta MCP real: qué envía el subagente y qué recibe
Lo que un subagente envía a EveryInfra es un tools/call de MCP. A las 00:47:47 hora de Singapur del 1 de noviembre de 2026 enviamos esta llamada a https://api.everyinfra.com/mcp con nuestra clave de prueba. Es la llamada que haría el subagente de Trustpilot: reseñas recientes de 1 y 2 estrellas de notion.so. El objeto arguments es la entrada de everyinfra_call_api: plataforma, capacidad y parámetros.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api","arguments":{"platform":"trustpilot","action":"reviews","params":{"company":"notion.so","stars":["1","2"],"date":"last30days","sort":"recency","limit":20}}}}La respuesta es un bloque de texto que se parsea como JSON. count vale 14. Cada fila de results trae title, text, rating, posted_at, verification_level, country y más, y los campos coinciden con la lista response_fields de trustpilot/reviews en el catálogo. billing.charged es true y charged_usd vale 0.001389, el precio del catálogo (catálogo: trustpilot).
La primera reseña se titula «I find everything in Notion a bit too chaotic» y se publicó el 20 de octubre de 2026. Abrimos la página pública de Notion en Trustpilot para comparar, y la misma reseña está ahí con la misma fecha (Trustpilot: Notion).
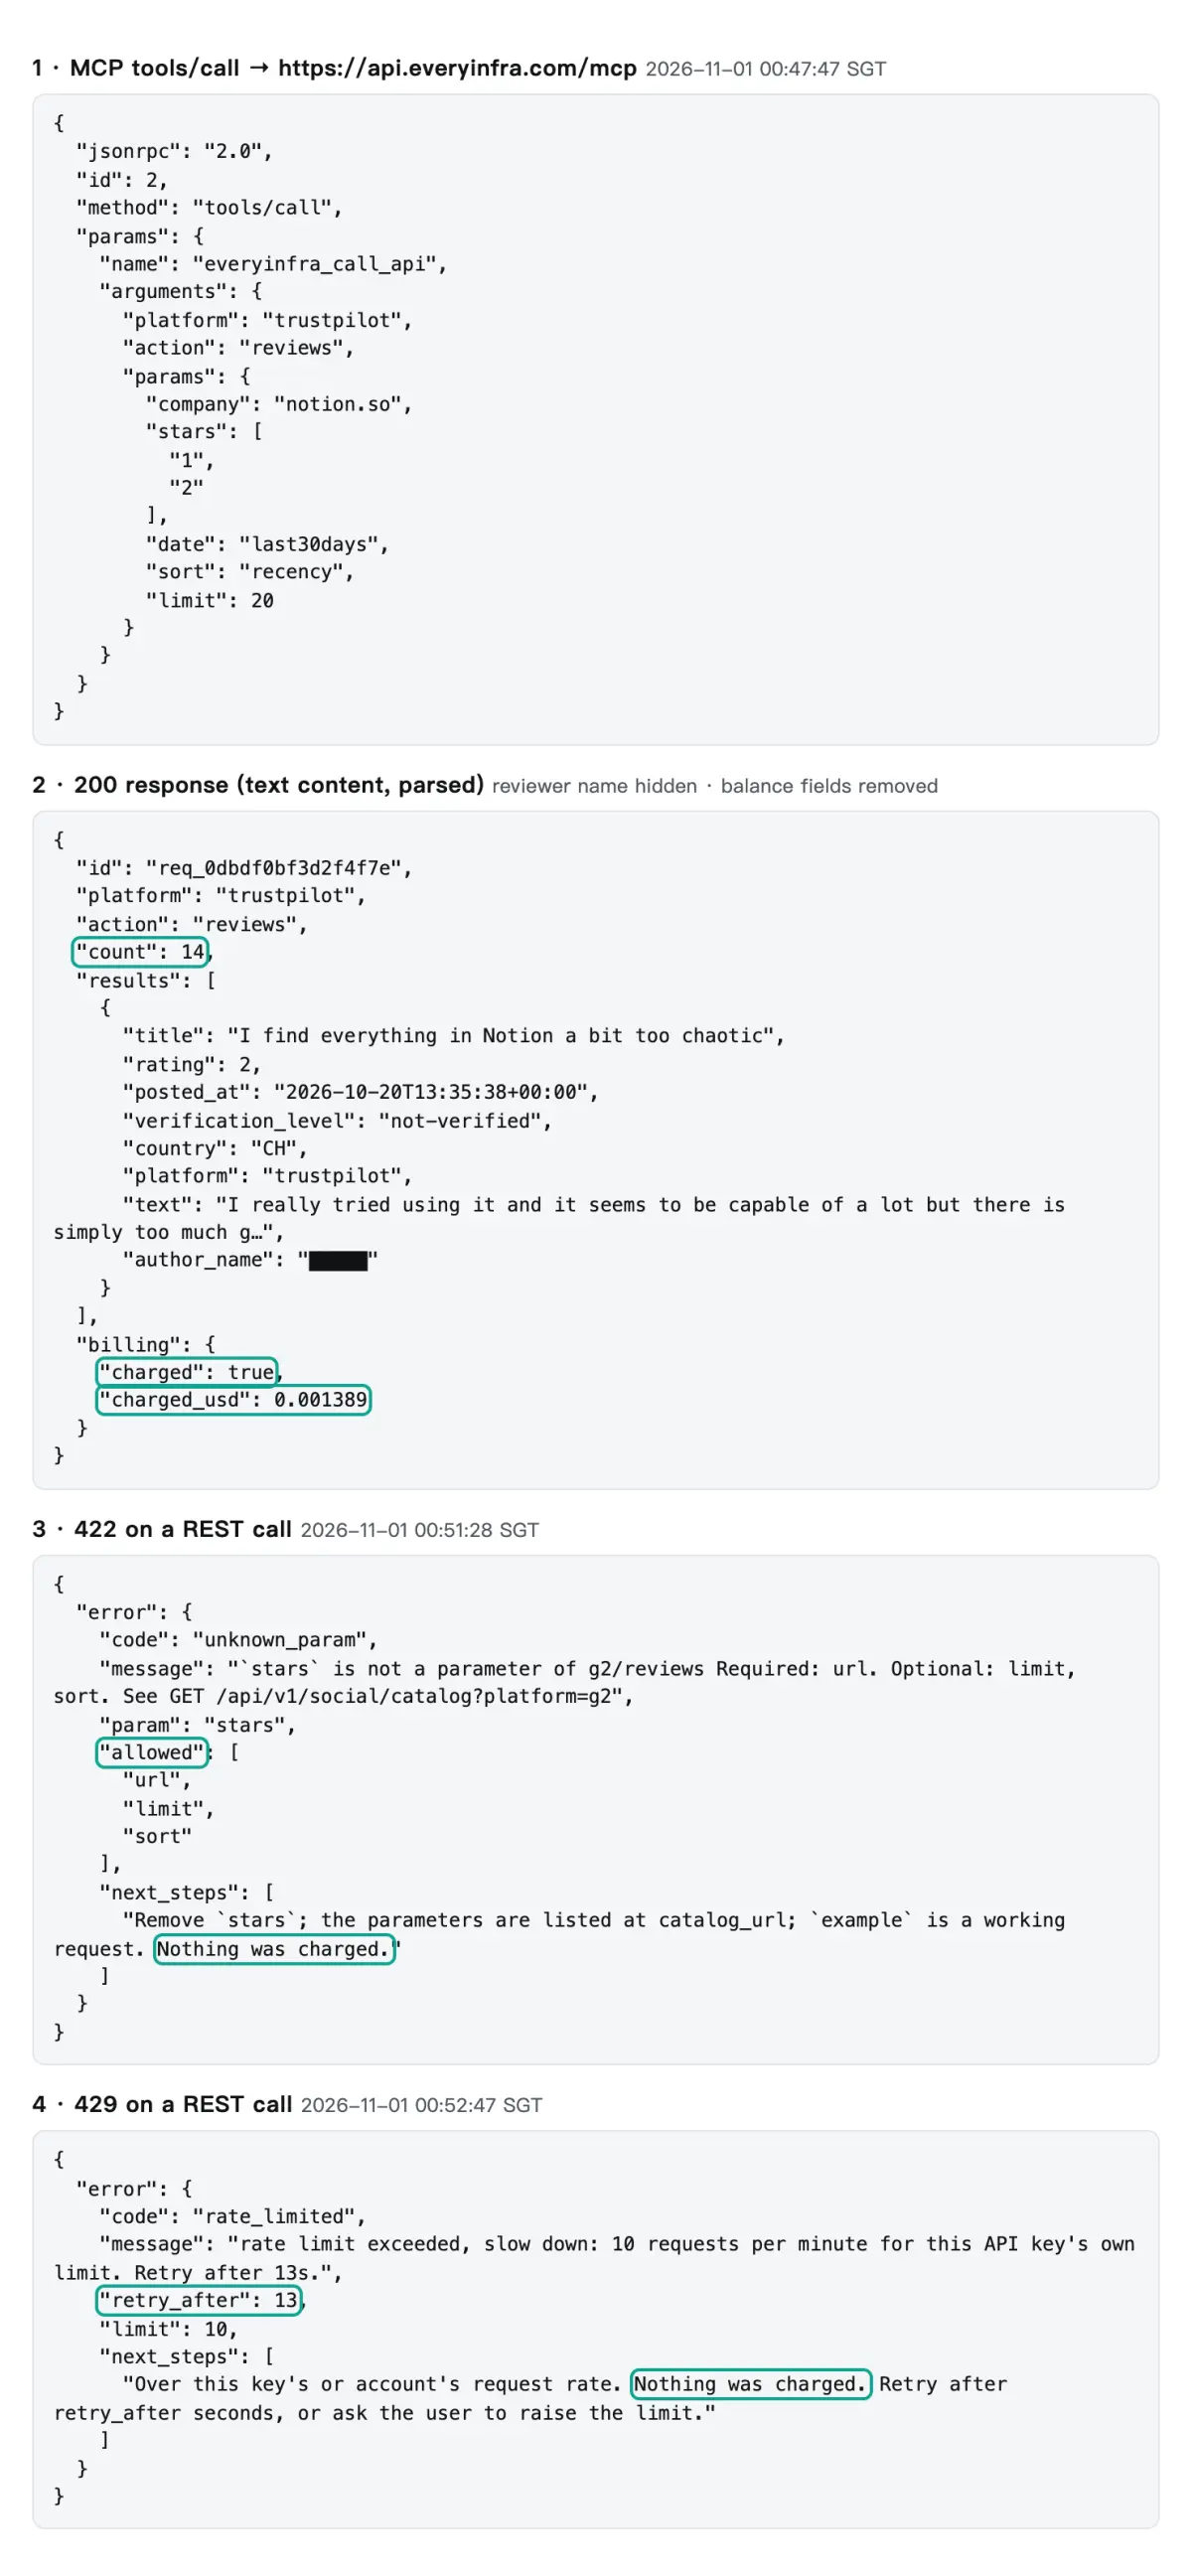
La misma captura muestra dos fallos que un subagente encontrará en la práctica. A las 00:51:28 hora de Singapur enviamos a propósito stars a g2/reviews, que no lo admite. La API respondió 422 con error.code igual a unknown_param; la lista allowed nombraba url, limit y sort, y next_steps decía que había que quitar stars y que no se cobró nada. A las 00:52:47 y a las 00:53:46, dos llamadas devolvieron 429: en esos minutos varias pruebas usaban la misma clave de prueba y compartían su límite de 10 peticiones por minuto. El primer 429 traía retry_after de 13 segundos y el reintento, 37 segundos después, funcionó; tras el segundo reintentamos a los 15 segundos, también con éxito. Ninguno se cobró. Cada error dice qué cambiar y cuánto esperar, así que el subagente puede corregirse solo.
Un fallo más merece una nota cuidadosa, y su causa solo quedó clara con una prueba de control. A las 00:51:16 hora de Singapur, sort: "newest" en trustpilot/reviews devolvió un 503 con retryable: true, retry_after: 20 y sin cobro, y el error decía que esa capacidad había fallado 3 veces en 10 minutos. Los 3 fallos (dos venían de otras pruebas a la misma hora) llevaban un valor que el catálogo no lista, mientras que las llamadas con valores válidos de esos minutos funcionaron.
Para confirmar la causa repetimos los mismos parámetros dos veces, a las 15:39:46 y a las 15:40:07, cambiando solo sort: primero newest y luego recency, el valor que indica el catálogo. Las dos respondieron 200 y se cobraron 0,001389 USD, pero con filas distintas. La de recency devolvió las mismas 20 filas que la llamada de las 00:54, todas en inglés y con el campo source. La de newest solo compartía 14 filas con ella; las otras 6 estaban en alemán, francés y neerlandés, y ninguna fila traía source ni verification_level. La nota de campos del catálogo dice que esos campos pueden faltar cuando los resultados vienen de una fuente de respaldo.
| `sort` | Hora (SGT) | Respuesta | Filas | Idiomas | Campo `source` | Cobro |
|---|---|---|---|---|---|---|
newest (no listado) | 00:51:16 | 503 | — | — | — | No |
newest (no listado) | 15:39:46 | 200 | 20, solo 14 en común con recency | 14 en, 3 de, 2 fr, 1 nl | Ninguna fila | 0,001389 USD |
recency | 15:40:07 | 200 | 20, las mismas que a las 00:54 | 20 en | Las 20 filas | 0,001389 USD |
newest (tras el arreglo de la noche) | 19:23:05 | 200 | 20, las mismas que con recency | 20 en | Las 20 filas | 0,001389 USD |
recency (tras el arreglo de la noche) | 19:22:49 | 200 | 20, las mismas que a las 00:54 | 20 en | Las 20 filas | 0,001389 USD |
Es decir, la validación de parámetros no frena newest: la fuente principal falla con ese valor y el resultado depende de la fuente de respaldo en ese momento. A las 00:51 también falló y llegó un 503; a las 15:39 funcionó y llegó un 200 con otros datos y cobro normal. Eso es peor que un error, porque el subagente no lo nota. Esa misma noche la pasarela cambió sort: ahora acepta newest (igual que recency), recency y relevance, y otro valor recibe un 422 antes de cobrar. La prueba de las 19:22–19:23 está en la tabla al final de la prueba 3. Aun así, cambiar de sitio suele significar cambiar el nombre de un parámetro, y por eso las instrucciones fijan los parámetros por sitio y no dejan que el modelo adivine, y retry_after se encarga de los fallos pasajeros.
Prueba 1: ¿alcanza con una pasada semanal? Depende de cuánto retrocede una llamada
Una pasada semanal supone que una llamada por sitio cubre los 7 días. Si un sitio recibe 60 reseñas a la semana y lees 20, el informe solo ve el fin de semana. Por eso medimos primero cuántos días cubre una llamada en cada sitio.
Para Notion y ClickUp llamamos platform/reviews una vez en cada uno de los cinco sitios. Registramos la fecha de publicación más nueva y más vieja, si las filas venían de la más reciente a la más antigua y cuántas caían entre el 25 de octubre y el 1 de noviembre de 2026 (UTC). Las dos marcas sumaron 12 llamadas reales entre las 00:48 y las 14:38 hora de Singapur del 1 de noviembre de 2026.
| Sitio · marca | Filas pedidas | Filas devueltas | Más vieja | Más nueva | Más recientes primero | Últimos 7 días | Negativas |
|---|---|---|---|---|---|---|---|
| Trustpilot · Notion (solo 1–2 estrellas) | 20 | 20 | 2026-06-13 | 2026-10-20 | Sí | 0 | 0 |
| Trustpilot · ClickUp (solo 1–2 estrellas) | 20 | 20 | 2026-05-16 | 2026-10-29 | Sí | 2 | 2 |
| G2 · Notion | 20 | 19 reseñas + 1 resumen | 2022-11-28 | 2026-10-29 | Casi, con 3 filas viejas intercaladas | 12 | 0 |
| G2 · ClickUp | 20 | 19 reseñas + 1 resumen | 2026-10-28 | 2026-10-31 | Sí | 19 | 0 |
| Capterra · Notion | 20 | 19 | 2025-12-11 | 2026-10-09 | No | 0 | 0 |
| Capterra · ClickUp | 20 | 17 | 2025-11-05 | 2026-10-21 | No | 0 | 0 |
| App Store · Notion | 50 | 50 | 2026-09-20 | 2026-10-29 | Sí | 9 | 6 |
| App Store · ClickUp | 50 | 50 | 2026-03-30 | 2026-10-29 | Sí | 2 | 2 |
| Google Play · Notion | 200 | 200 | 2026-10-08 | 2026-10-30 | Sí | 52 | 15 |
| Google Play · ClickUp | 200 | 200 | 2026-03-04 | 2026-10-31 | Sí | 5 | 1 |
Los dos extremos son los que importan. En G2, las 19 reseñas de ClickUp caen entre el 28 y el 31 de octubre, tres días. A ese ritmo, ClickUp recibe unas 47 reseñas por semana en G2, y 20 filas solo muestran los últimos dos o tres días. En Google Play pedimos primero 40 reseñas de Notion y cubrieron apenas 4,2 días; con 200 filas, el máximo de esa capacidad, la llamada cubrió 22 días. En el otro extremo, las reseñas negativas de Notion en Trustpilot son escasas: 20 llegan hasta el 13 de junio, más o menos una por semana.
Así que la misma programación semanal necesita el limit máximo en unos sitios y solo 20 filas en otros. Las reseñas de EveryInfra se cobran por llamada: la de 200 filas en Google Play tuvo charged_usd de 0.001389, igual que la de 40. Pero pedir el máximo en todos los sitios no es lo más conveniente. Durante la revisión hicimos otra ronda de Notion con el max_limit del catálogo en cada sitio (Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200). Las 500 filas de App Store llegaron hasta el 14 de febrero de 2026 y las reseñas negativas de Trustpilot, hasta abril de 2024: mucho más de lo que necesita un informe semanal, y cada fila de más entra en el contexto del modelo (la prueba 4 hace la cuenta).
Nuestra regla: fija limit para que una llamada cubra al menos dos semanas. Para Notion son Trustpilot 20, G2 100, Capterra 100, App Store 50 y Google Play 200, y el subagente filtra por posted_at los últimos 7 días. Tus marcas tendrán otros volúmenes, así que mide primero una llamada por sitio, como en la tabla de arriba.
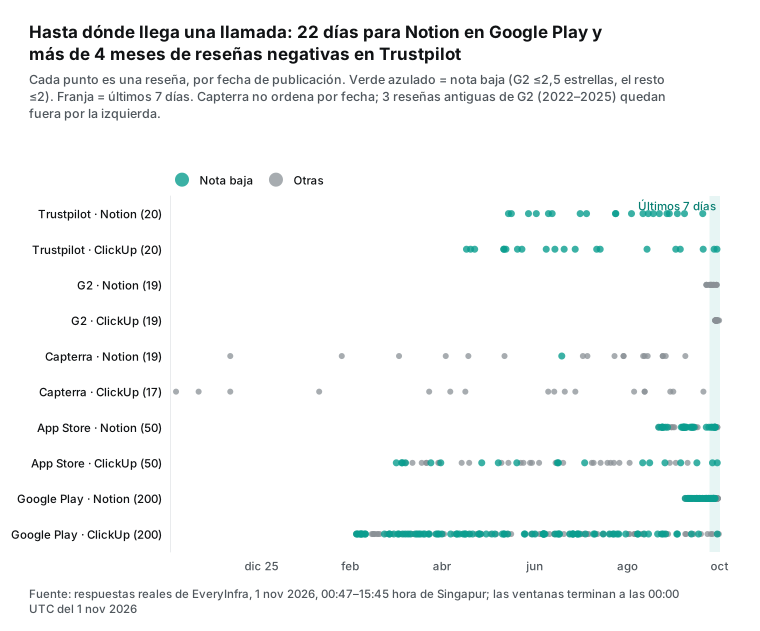
El gráfico muestra un tercer caso. Las dos filas de Capterra se reparten por todo un año, y el orden de los resultados no tiene relación con el tiempo. capterra/reviews tiene un único parámetro obligatorio, company, y ningún parámetro de orden. Las 19 reseñas de Notion van del 11 de diciembre de 2025 al 9 de octubre de 2026 en orden mezclado, y solo 1 cae en los últimos 30 días. Las 17 de ClickUp se ven igual.
Para el informe, «tomar las N más nuevas» no funciona en Capterra. Hay que pedir 100 filas cada vez y comparar id y posted_at con el resultado de la semana anterior. Las reseñas de Capterra son pocas, una en 30 días por marca, así que la pasada semanal alcanza.
G2 también tiene su trampa. La primera fila de la respuesta de Notion no es una reseña: es una fila con record_type: summary que trae la nota global de 4,6, un total de 13.962 reseñas y los pros y contras más citados. Las 19 reseñas siguientes van casi siempre de la más nueva a la más vieja, pero hay tres de 2022 a 2025 intercaladas. Un subagente que tome la fecha más vieja como «cobertura» creería que la llamada retrocedió cuatro años. La regla de filtrar por posted_at resuelve esto. La fila de resumen, eso sí, es útil: el informe puede citar la nota global de G2 de la semana sin una llamada aparte a g2/profile.
Prueba 2: dónde están las reseñas negativas
Contamos las reseñas negativas de los últimos 30 días que una llamada por sitio podía ver (G2 con 2,5 estrellas o menos, el resto con 2 o menos). Notion suma 67: 22 en App Store, 42 en Google Play, 3 en Trustpilot y 0 en G2 y Capterra. Es decir, 64 de 67, el 95,5 %, están en las dos tiendas de apps. ClickUp suma 14 con un reparto más plano: 5 en Trustpilot, 4 en App Store, 5 en Google Play y 0 en G2 y Capterra.
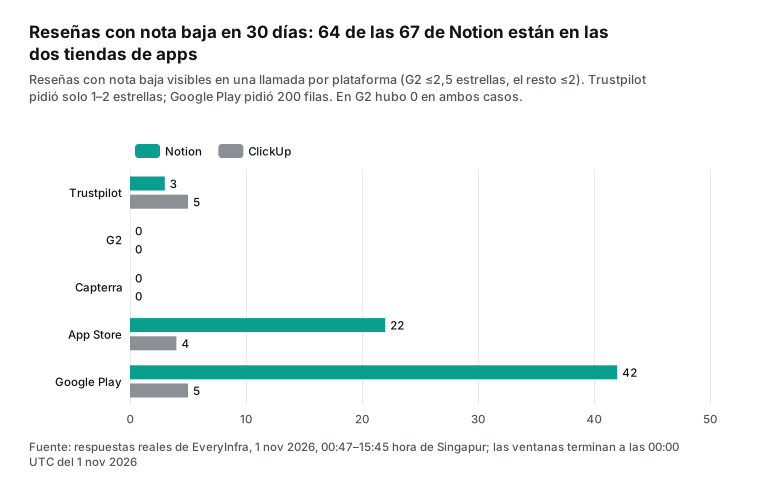
Este reparto deja dos lecciones para el informe. Primera: los sitios B2B tienen pocas reseñas negativas. En una llamada de 20 filas, ninguna marca tuvo una reseña negativa en G2 en 30 días; durante la revisión, una llamada de 100 filas para Notion devolvió 50 reseñas, 41 de los últimos 30 días y solo 1 negativa. Eso encaja con la nota global de 4,6. Quien solo mire G2 y Capterra creerá que todo va bien.
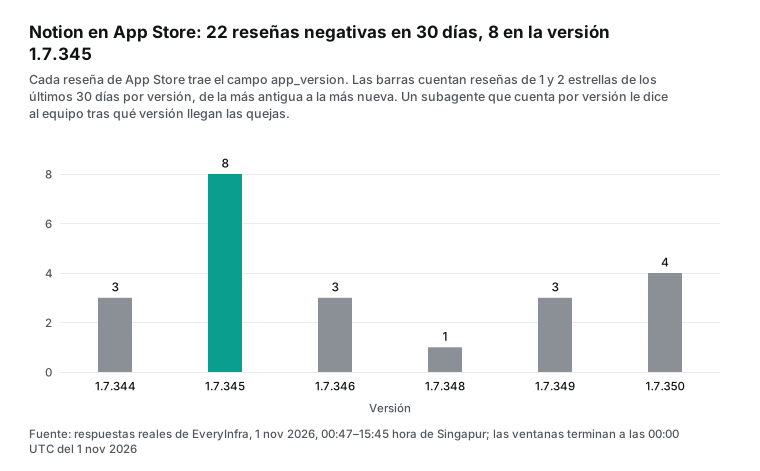
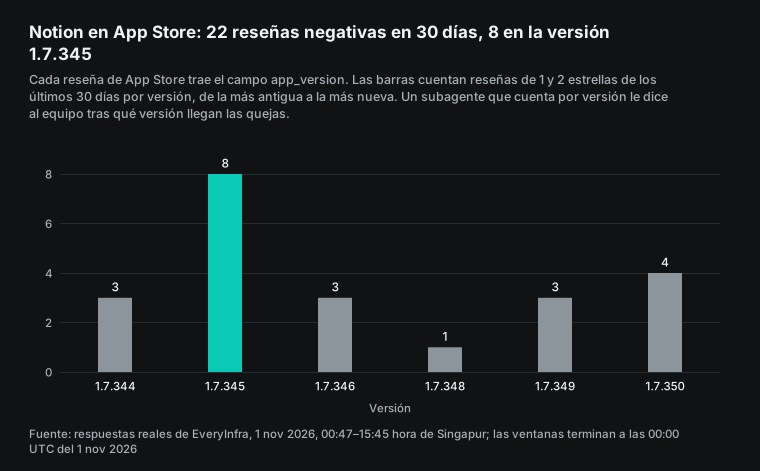
Segunda: las quejas en las tiendas de apps son muchas y concretas, y casi todas traen versión. Cada fila de App Store tiene el campo app_version. De las 22 reseñas negativas de Notion en 30 días, 8 son de la versión 1.7.345, más que cualquier otra. Un subagente que cuente por versión puede escribir «las reseñas negativas se concentran tras la 1.7.345», y un equipo de ingeniería puede actuar con eso.
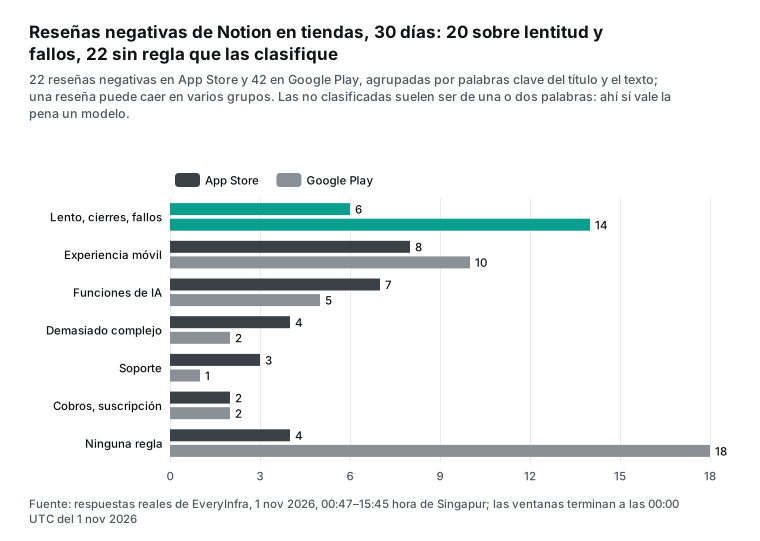
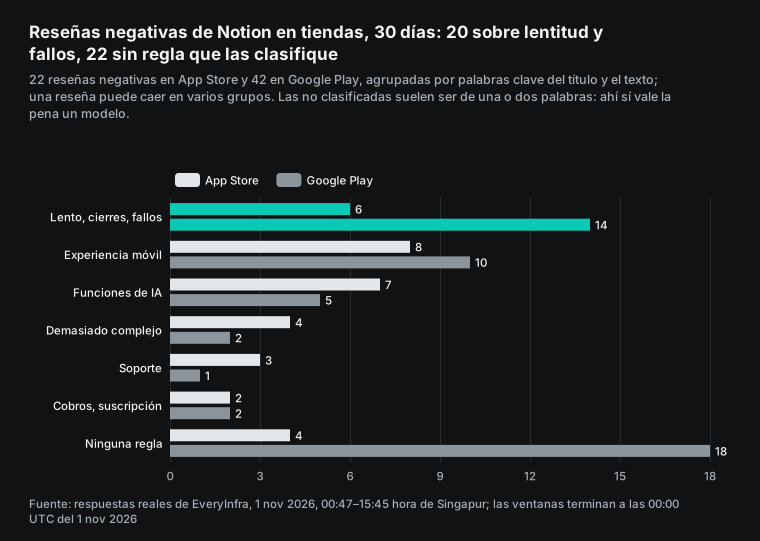
También agrupamos estas reseñas negativas con reglas de palabras clave, que están en nuestro script de recuento. Por ejemplo, «slow», «crash» o «bug» en el título o el texto ponen una reseña en el grupo de lentitud y fallos, y una reseña puede caer en más de un grupo. De las 64 reseñas negativas de Notion en las dos tiendas, 20 hablan de lentitud y fallos, 18 de la experiencia móvil y 12 de las funciones de IA. Las reglas no pudieron clasificar 22, y 18 de ellas son de Google Play; casi todas tienen una o dos palabras.
Ese último grupo es donde el modelo se gana su costo. Las reglas resuelven las quejas largas y claras, pero fallan con «bad», «worst update» o la ironía. Así que el modelo del subagente debería gastar la mayor parte de sus tokens en las reseñas que las reglas no clasifican, no en releer todas.
Hay una señal que solo aparece al mirar varias marcas, aunque la muestra es muy pequeña. En los últimos 30 días, 2 reseñas de Notion y 1 de ClickUp en App Store mencionan el «iPhone Duo». Una reseña de 2 estrellas de Notion del 26 de octubre dice que los toques dejan de responder, que el texto desaparece al seleccionarlo y que la app se cierra en iPhone Duo. Una de 1 estrella de ClickUp del 29 de octubre se titula «No iPhone Duo support». El iPhone Duo es el primer iPhone plegable de Apple y salió a la venta en las Apple Store el 23 de octubre (Apple Newsroom); en las primeras semanas de un dispositivo nuevo, los problemas de compatibilidad de las apps son habituales.
Por eso tres reseñas no bastan para decir que alguna de las dos marcas tenga un problema que planificar. Lo sensato en el informe es «compatibilidad con un dispositivo nuevo: vigilar y ver la semana próxima si crece». Lo que sí muestra es el reparto de tareas: en una marca es una queja suelta; al juntar marcas se ve que apunta al mismo dispositivo. Como el agente principal ve todos los resúmenes, este cruce le toca a él.
Cómo se ve el informe semanal con los datos reales de esta semana
La tabla usa la semana del 25 de octubre al 1 de noviembre de 2026 (UTC) y muestra, por sitio y marca, las reseñas nuevas que una llamada podía ver y cuántas eran negativas. Todo sale de respuestas reales.
| Sitio | Notion nuevas / negativas | ClickUp nuevas / negativas | Qué debería decir el informe |
|---|---|---|---|
| Trustpilot | 0 / 0 | 2 / 2 | Dos reseñas de 1 estrella de ClickUp: una sobre el chatbot de soporte y otra sobre el aviso de 30 días para cambiar asientos y facturación. Ambas van a soporte y facturación. |
| G2 | 12 / 0 | 19 / 0 | Ninguna negativa en las dos marcas. ClickUp recibe unas 47 por semana, así que limit debe ser 100. |
| Capterra | 0 / 0 | 0 / 0 | Ninguna nueva esta semana. Los resultados no vienen ordenados: hay que comparar id con la semana anterior. |
| App Store | 9 / 6 | 2 / 2 | Las quejas de Notion se concentran en la versión 1.7.345. Entre las dos marcas, 3 reseñas mencionan el iPhone Duo; revisar la semana próxima. |
| Google Play | 52 / 15 | 5 / 1 | La mayor fuente de quejas de Notion. Las 22 reseñas cortas van al modelo. |
El agente principal recibe cinco filas breves como estas, más la nota global de cada marca. La fila de resumen de G2 da una nota, y una llamada a trustpilot/profile le da a Notion un TrustScore de 2,2 con 442 reseñas.
Luego el agente principal decide qué fila creció respecto de la semana anterior, qué problema se repite entre sitios o marcas y qué reseñas merecen enlace. Eso necesita los cinco resultados; leer y contar cientos de reseñas es trabajo mecánico para los subagentes.
Recomendamos que el agente principal devuelva un JSON fijo y que tu aplicación lo convierta en correo o mensaje de chat. Las sesiones aceptan un esquema de salida en agent.text.format.schema, y la entrada más el esquema deben quedar por debajo de 4 MiB (documentación de sesiones). Así el informe tiene la misma forma cada semana.
Prueba 3: un parámetro mal puesto cambia el resultado
Esta tabla reúne los problemas de parámetros que vimos. Cada fila es una llamada real, y la última columna es la regla para el subagente.
| Qué pasó | Hora (SGT, 1 nov 2026) | Respuesta | Cobro | Solución |
|---|---|---|---|---|
Trustpilot con date: "last30days" devolvió más de 30 días | 00:47 | 14 filas del 31 de julio al 20 de octubre, solo 3 dentro de 30 días | Sí, 0,001389 USD | Tras el arreglo, el preajuste funciona; el informe filtra igual por posted_at. |
G2 con un stars no admitido | 00:51 | 422 unknown_param, permitidos: url, limit, sort | No | G2 no filtra por estrellas. Filtrar por rating. |
| Varias pruebas compartían una clave y agotaron sus 10 peticiones por minuto | 00:52, 00:53 | 429, el primero con retry_after de 13 segundos; los dos reintentos funcionaron | No | Esperar retry_after. |
Trustpilot con sort: "newest", valor que el catálogo no lista | 00:51, 15:39 | Primero 503; después 200 desde una fuente de respaldo, con 6 filas en otros idiomas y sin campo source | 503 no; 200 sí, 0,001389 USD | Usar valores del catálogo; tras el arreglo, un valor erróneo recibe un 422. |
| Trustpilot, 200 filas en modo síncrono | 15:40 | Tiempo agotado a los 85 segundos, 503, con el consejo de usar mode: "async" | No | Para un limit grande, modo asíncrono y leer las filas con everyinfra_get_job; la llamada asíncrona devolvió 131 filas. |
Capterra buscado por el nombre Notion | 00:49 | 20 filas, 3 sin fecha ni enlace, de un complemento para exportar a Google Sheets | Sí, 0,001389 USD | Usar la URL del producto /p/186596/Notion/. |
| Capterra buscado por URL del producto | 00:50 | 19 filas, sin orden, un campo pros de 98.725 caracteres | Sí, 0,001389 USD | Mantener un tope por campo de texto, por ejemplo 2000 caracteres. |
| La primera fila de G2 es un resumen | 00:48 | record_type: summary, nota 4,6, 13.962 reseñas | Sí, 0,001389 USD | Tratar el resumen aparte; no contarlo como reseña. |
La fila de Trustpilot merece una mirada más atenta. El catálogo describe date como un preajuste de tiempo, donde last30days significa los últimos 30 días. Lo enviamos pidiendo solo 1 y 2 estrellas y recibimos 14 filas del 31 de julio al 20 de octubre, de las que solo 3 caían dentro de 30 días. La misma petición sin date devolvió 20 filas hasta el 13 de junio, y sus primeras 14 eran exactamente las mismas 14.
Es decir, en la prueba de la madrugada del 1 de noviembre la llamada con preajuste se detuvo unos tres meses atrás, no 30 días, y un informe que contara filas habría dicho 14 reseñas negativas en 30 días cuando en realidad eran 3. Esa noche la pasarela pasó a cortar los preajustes por fecha de publicación, y la prueba de las 19:22 devolvió solo las 3 filas de los últimos 30 días. Aun así, el informe semanal lee las 20 filas y filtra por posted_at, porque el subagente compara con reseñas anteriores.
La búsqueda por nombre en Capterra mezcló otro producto con nombre parecido. La nota del catálogo para company pide enviar el enlace del producto, y con la URL las 19 filas eran de Notion. Tu lista de marcas debe guardar un enlace o ID por sitio, no un nombre.
La tabla resume las pruebas que repetimos tras el arreglo de la noche del 1 nov (19:22–19:23, hora de Singapur), con los mismos parámetros que durante el día:
| Caso | Madrugada o tarde del 1 nov | Prueba de la noche | Cobro |
|---|---|---|---|
Trustpilot sort: "newest" | 503 a las 00:51; 200 a las 15:39, pero 6 filas en otros idiomas y sin source | 200, las mismas filas que con recency y que a las 00:54, todas en inglés | 0,001389 USD |
Trustpilot date: "last30days" | 14 filas, solo 3 dentro de 30 días | 3 filas, todas dentro de 30 días | 0,001389 USD |
Capterra con URL de producto, limit: 100 | 86 filas, 375.315 bytes, campo más largo de 103.138 caracteres | Las mismas 86 filas, 144.341 bytes, campo más largo de 1154 caracteres | 0,001389 USD |
| Ronda semanal recomendada (Notion) | 651.907 bytes, unos 163 mil tokens | 420.933 bytes, unos 105 mil tokens | — |
Prueba 4: el tamaño de una semana de reseñas fija el costo del modelo
Los modelos cobran por token, así que hace falta saber cuánto pesa una semana de reseñas en bruto. Cada fila que devuelve una llamada entra en el contexto del subagente como salida de la herramienta, de modo que limit decide cuánto lee el modelo. Medimos tres configuraciones para Notion, todas con respuestas reales, y repetimos Capterra esa noche; los tokens salen de unos 4 caracteres por token para texto en inglés (centro de ayuda de OpenAI: tokens).
| Configuración (Notion, una llamada por sitio) | `limit` por sitio | En bruto | Tokens aprox. | Textos recortados a 2000 caracteres | Tokens aprox. |
|---|---|---|---|---|---|
| Primera ronda (00:47–00:57) | Trustpilot 20 (con last30days), G2 20, Capterra 20, App Store 50, Google Play 200 | 359.497 bytes | 89.874 | 246.387 bytes | 61.597 |
| Recomendada | Trustpilot 20, G2 100, Capterra 100, App Store 50, Google Play 200 | 651.907 bytes | 162.977 | 422.892 bytes | 105.723 |
| Recomendada, con la nueva prueba de Capterra de la noche (19:23) | Igual | 420.933 bytes | 105.233 | 420.732 bytes | 105.183 |
max_limit en todo | Trustpilot 200, G2 100, Capterra 100, App Store 500, Google Play 200 | 1.021.087 bytes | 255.272 | 786.452 bytes | 196.613 |
En la configuración recomendada, G2 y Capterra salen de dos llamadas nuevas de las 15:42 y las 15:43: G2 pidió 100 filas y devolvió 50 reseñas más 1 fila de resumen; Capterra pidió 100 y devolvió 86. Las otras tres son de la primera ronda, con los mismos parámetros. La ronda con max_limit ronda los 197 mil tokens tras el recorte, 1,86 veces la recomendada; casi todo lo que sobra son 450 filas más de App Store y 111 más de Trustpilot, muy anteriores a la última semana.
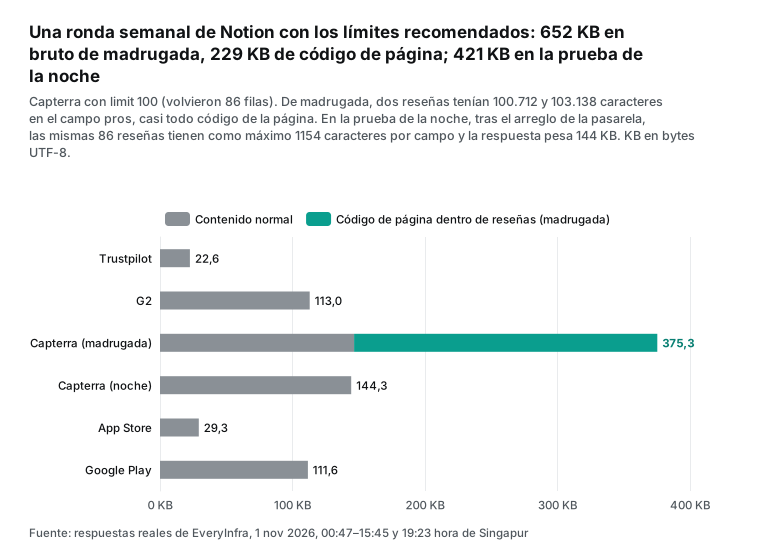
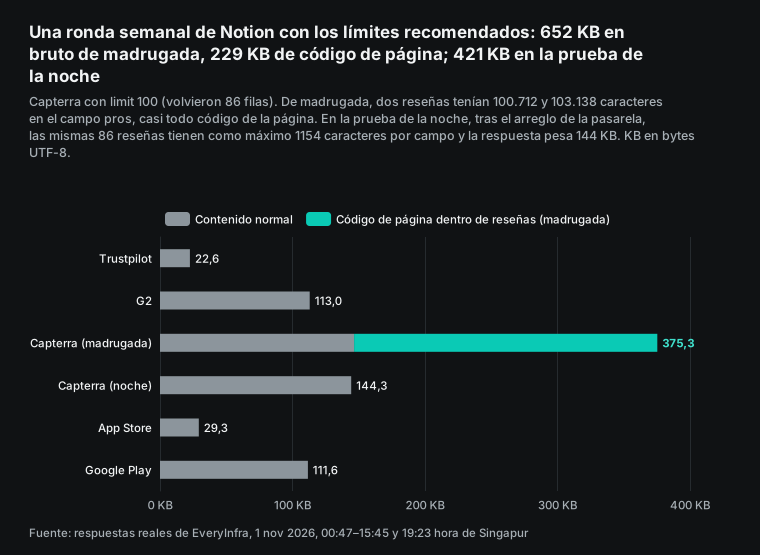
En la prueba de la madrugada del 1 de noviembre, más de un tercio de esos 652 KB venía de dos reseñas. En la primera ronda, la respuesta de Capterra de 20 filas pesó 148.915 bytes, y una reseña dentro de ella, 114.983. Su campo pros tenía 98.725 caracteres: empieza con un comentario normal y sigue con un bloque largo de datos de script de la página. La respuesta de 100 filas traía dos reseñas así, con campos pros de 100.712 y 103.138 caracteres, y la de Capterra de ClickUp, una de 103.556.
El parser se llevó datos de la página junto con la reseña. Con cada campo cortado a 2000 caracteres, la respuesta de Capterra de 100 filas bajaba de 375.315 a 146.501 bytes, y la ronda semanal recomendada pasaba de unos 163 mil a unos 106 mil tokens: sin recorte, el subagente leía un 54 % más. Esa noche la pasarela lo corrigió: quita ese código de pros, cons y text, con un máximo de 5000 caracteres por campo. La prueba de las 19:23 devolvió las mismas 86 reseñas en 144.341 bytes, algo menos que los 146.501 bytes tras el recorte de la madrugada (tabla al final de la prueba 3). La ronda semanal recomendada queda en unos 105 mil tokens, solo un 0,5 % por debajo de la cifra recortada, así que la estimación del costo del modelo no cambia. Un tope por campo sigue siendo un buen hábito: no cuesta nada y protege si otro sitio falla igual.
Aquí es donde los subagentes rinden. Sin ellos, el agente principal lee los 106 mil tokens por su cuenta. Con cinco subagentes, cada uno lee solo su sitio (Capterra, el más grande, ronda los 37 mil tokens tras el recorte) y el agente principal recibe un resumen JSON de unos cientos de tokens por sitio. En nuestra prueba de subagentes de Claude Code con cuentas de marca en TikTok, datos en bruto y resúmenes quedaron unas 100 veces separados.
La cuenta: precios de la openai agents api y el costo de los datos
Primero, los datos. Las reseñas de EveryInfra se cobran por llamada, y la cantidad de filas no cambia el precio. Las cinco capacidades tienen un price_usd de 0.001389 (catálogo; página de precios). Una marca con cinco llamadas por semana cuesta 0,006945 USD por semana y 0,3611 USD al año. Diez marcas, la tuya y nueve competidoras, cuestan 3,61 USD al año.
Estas cifras no son estimaciones. Este artículo hizo 21 llamadas cobradas, 6 de ellas durante la revisión, cada una con charged_usd de 0.001389, en total 0,029169 USD. Las 6 llamadas fallidas (tres 503, un 422 y dos 429) no se cobraron. Tras el arreglo de la noche repetimos 4 llamadas (3 en Trustpilot y 1 en Capterra), a 0,001389 USD cada una, 0,005556 USD en total.
Ahora, OpenAI. La página de introducción dice que los modelos se cobran a su tarifa de API, las herramientas a tarifa estándar y los sandboxes alojados a tarifa de contenedor (introducción a la Agents API: precios). Nuestra configuración no usa sandbox (environment: none) ni búsqueda web, así que solo quedan los tokens del modelo. Estos son los precios estándar por millón de tokens, leídos el 1 de noviembre de 2026 (precios de la API de OpenAI):
| Modelo | Entrada | Entrada en caché | Escritura en caché 30 min | Salida |
|---|---|---|---|---|
| gpt-6-astra | 10,00 USD | 1,00 USD | 12,50 USD | 50,00 USD |
| gpt-6.1-sol | 2,00 USD | 0,10 USD | 2,50 USD | 10,00 USD |
| gpt-6.1-terra | 1,00 USD | 0,05 USD | 1,25 USD | 5,00 USD |
| gpt-6-luna | 0,10 USD | 0,01 USD | 0,125 USD | 0,50 USD |
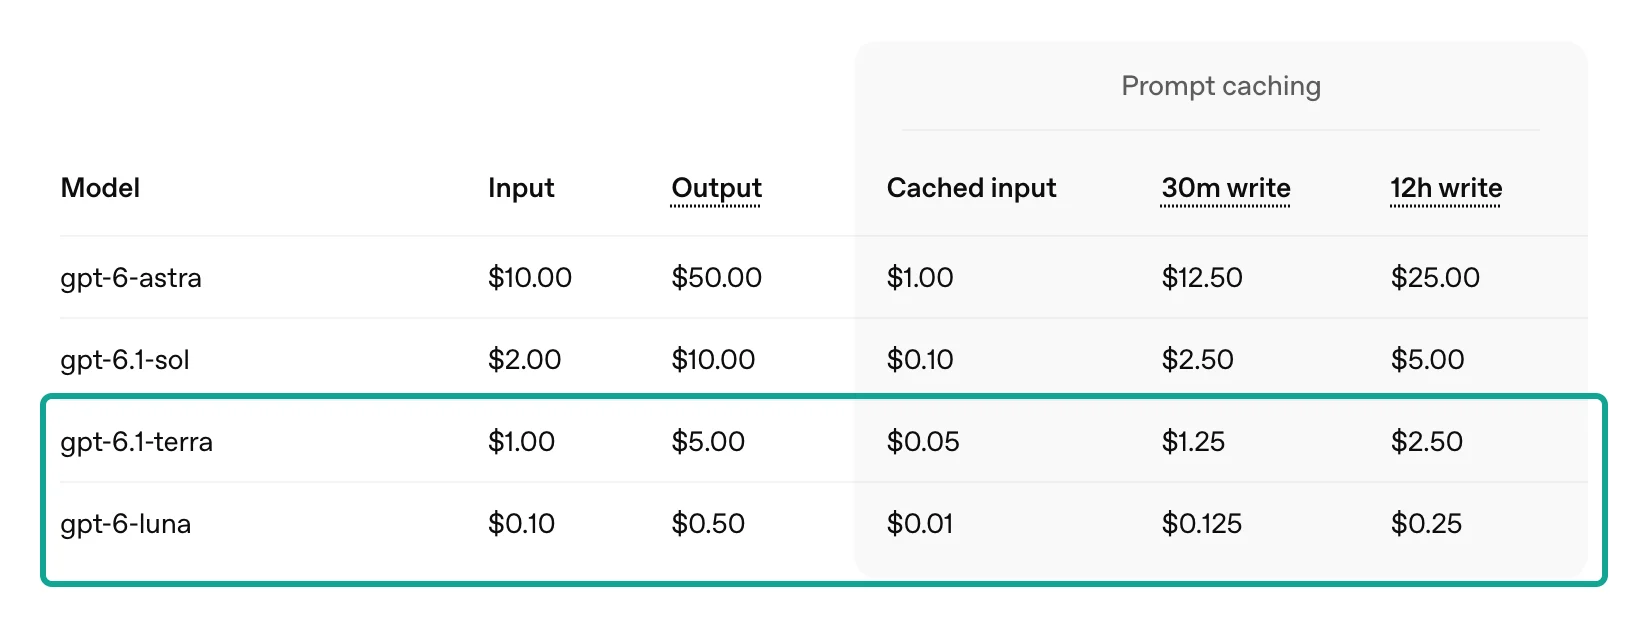
El método, para que uses tus cifras: la entrada tiene tres partes: una semana de reseñas con los límites recomendados, unos 105.723 tokens tras el recorte; unos 8000 tokens fijos por cada uno de los 5 subagentes (instrucciones, descripción de la herramienta y contexto); y unos 20.000 tokens del agente principal. La primera lectura la calculamos a la tarifa de escritura en caché de 30 minutos, que para GPT-5.6 y posteriores, familia GPT-6 incluida, es 1,25 veces el precio de entrada, así que la cifra queda del lado alto (documentación de prompt caching).
Un subagente llama al modelo más de una vez por turno, así que sumamos dos lecturas más de las reseñas y del costo fijo a tarifa de caché. La salida es de 1500 tokens por subagente y 3000 para el agente principal. Solo el tamaño de las reseñas está medido; lo demás son supuestos, así que damos dos cifras significativas: unos 0,029 USD con gpt-6-luna, 0,27 USD con gpt-6.1-terra, 0,55 USD con gpt-6.1-sol y 2,9 USD con gpt-6-astra. La distancia de 100 veces entre modelos es solo la razón entre precios de lista (la entrada de astra, 10,00 USD, es 100 veces la de luna) y valdría para cualquier tarea.
| Una marca, una semana | Monto | Un año (×52) | Base |
|---|---|---|---|
| Llamadas de datos de EveryInfra (5) | 0,006945 USD | 0,3611 USD | Cobrado en nuestra prueba |
| Modelo, gpt-6-luna | unos 0,029 USD | unos 1,5 USD | Estimación con precios públicos |
| Modelo, gpt-6.1-terra | unos 0,27 USD | unos 14 USD | Estimación con precios públicos |
| Modelo, gpt-6.1-sol | unos 0,55 USD | unos 29 USD | Estimación con precios públicos |
| Modelo, gpt-6-astra | unos 2,9 USD | unos 150 USD | Estimación con precios públicos |
¿Qué supuesto pesa más? Esta tabla cambia el costo fijo y el número de relecturas, tres valores cada uno, con gpt-6.1-terra, los límites recomendados y el resto de supuestos igual:
| Costo fijo por subagente | 1 relectura | 2 relecturas | 4 relecturas |
|---|---|---|---|
| 4000 tokens | 0,24 USD | 0,25 USD | 0,26 USD |
| 8000 tokens | 0,27 USD | 0,27 USD | 0,29 USD |
| 16.000 tokens | 0,32 USD | 0,33 USD | 0,35 USD |
Las nueve combinaciones quedan entre 0,24 y 0,35 USD. Las relecturas casi no cambian nada, porque el precio en caché es el 5 % del de entrada; el costo fijo pesa algo más. Lo que de verdad mueve la cifra es el tamaño de las reseñas: con los mismos supuestos, max_limit en todo sale por unos 0,40 USD y la primera ronda pequeña, por unos 0,21 USD. Así que primero se fijan limit y el recorte, y después se elige el modelo.
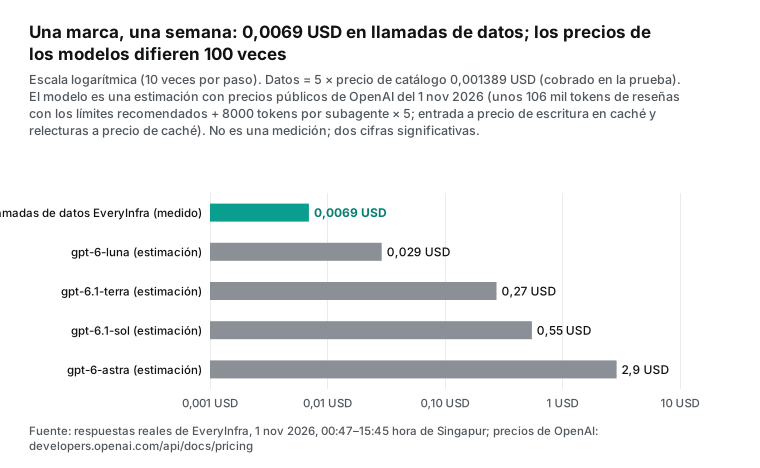
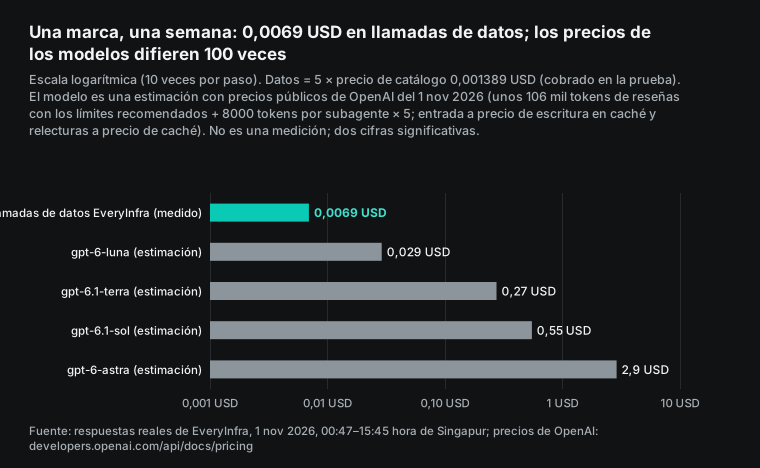
La tabla deja ver una proporción: el costo de los datos es una parte pequeña del total, y la elección de modelo es la variable principal. Un informe de reseñas negativas lee mucho y decide cosas simples. Por eso pondríamos los subagentes en gpt-6-luna o gpt-6.1-terra, y un modelo más potente en el agente principal solo si el resumen lo pide.
Una sesión puede cambiar después model, reasoning.effort y service_tier, pero no tools, instructions ni multi_agent (documentación de configuración). Conviene decidir la mezcla de modelos al crear el agente.
Dos detalles de facturación. Primero, el campo usage de la Agents API es best-effort: puede venir nulo, puede cambiar después y no es una factura. Tampoco separa los tokens de escritura en caché, así que en modelos con precio de escritura, usage por sí solo no da el costo exacto (documentación de observabilidad).
Segundo, si más adelante agregas un sandbox alojado, los contenedores tienen precio público: 4 GB a 0,12 USD cada 20 minutos, por minuto y con un mínimo de 5 minutos desde el 2 de junio de 2026. Desde el 9 de octubre de 2026, los sandboxes alojados solo cobran durante los turnos activos (precios de la API de OpenAI; changelog). Nuestra configuración no tiene sandbox, así que ese costo es cero.
Límites de la beta pública que hay que revisar antes de lanzar
La Agents API es una beta pública. Las peticiones necesitan la cabecera OpenAI-Beta: agents=v1 y los SDK usan el espacio de nombres beta.agents (quickstart). El anuncio avisa que OpenAI cambiará el producto rápido durante la beta, camino a la disponibilidad general (anuncio de OpenAI). La tabla solo recoge límites escritos en la documentación que afectan a este caso.
| Límite | Qué dice la documentación | Efecto en la vigilancia de reseñas | Fuente |
|---|---|---|---|
| Residencia y retención de datos | Solo residencia en Estados Unidos. Sin Zero Data Retention, tampoco con sandbox propio. | Las reseñas públicas son de bajo riesgo. Si el informe mezcla tickets de soporte, revisa cumplimiento antes. | Introducción, tus datos |
| La programación no es exacta | Las ejecuciones recurrentes tienen un pequeño retraso aleatorio; una sesión ocupada hace esperar la tarea. | El informe llega unos minutos después de las 9:00. No lo encadenes a un paso que exija hora exacta. | Automations |
| Entregado no es terminado | Una invocación con completed solo indica que la entrega funcionó. | Usa turn.completed o turn.failed y alerta si falla. | Automations, webhooks |
| Los vaults solo sirven a conexiones desde OpenAI | Las conexiones HTTP con origen environment no usan credenciales del vault. | El MCP de EveryInfra es público, así que el origen service por defecto encaja. | Conexiones MCP |
| Sin function tools en subagentes | Heredan herramientas MCP y credenciales, pero no usan function tools. | Solo el agente principal devuelve datos; tu app los guarda. | Multiagente |
usage no es una factura | Best-effort, puede ser nulo o cambiar, sin conteo de escritura en caché. | Para el costo, usa la factura. | Observabilidad |
| Límites de tamaño | Instrucciones más configuración de herramientas por debajo de 4 MiB; cada entrada también. | Con listas largas de marcas, envía el resumen de la semana anterior, no los datos completos. | Configuración, sesiones |
| Fallo de arranque del MCP | Con required: true, un arranque fallido hace fallar el turno con mcp_server_startup_failed (424). | Es lo que queremos: sin datos, no hay informe. | Errores |
Qué no hace esta configuración y qué vigilar
Primero, esta configuración lee reseñas públicas, no las responde. Las respuestas en App Store y Google Play se escriben desde las consolas de Apple y Google (Apple: valoraciones, reseñas y respuestas; ayuda de Google Play Console). Nuestras respuestas incluyen reply_text en Google Play y Trustpilot y vendor_response en Capterra, así que el informe puede marcar qué reseñas ya tienen respuesta; la respuesta la sigue escribiendo una persona.
Segundo, esto no sirve para manipular reseñas. La regla final de la Comisión Federal de Comercio de Estados Unidos de agosto de 2024 prohíbe las reseñas falsas y los incentivos condicionados a una reseña positiva o negativa, y menciona expresamente las reseñas falsas generadas con IA (nota de prensa de la FTC, 2024-08-14).
Tercero, fija el umbral por sitio. G2 usa medias estrellas, así que contamos como negativa 2,5 o menos; en los demás, 2 o menos. Ninguna marca tuvo reseñas negativas en G2 en 30 días. Si tu producto se parece, sube el umbral de G2 a 3 estrellas, o esa línea siempre dirá 0.
Cuarto, deja que el subagente aplique primero las reglas de palabras clave y mande al modelo solo lo que las reglas no clasifican, como las 22 de la prueba 2. El programmatic tool calling de la Agents API está pensado para esto: filtra resultados en código y devuelve al contexto solo la parte relevante (anuncio de OpenAI; documentación de programmatic tool calling).
Cambios recientes
La Agents API cambia cada pocas semanas durante la beta. Estos son los cambios que afectan a esta configuración, del más antiguo al más reciente.
| Fecha | Cambio | Qué significa aquí |
|---|---|---|
| 2026-09-10 | Beta pública con sandboxes alojados, subagentes y compactación de contexto, sin tarifa de plataforma (changelog; anuncio en el foro) | Menos código de agente que mantener; una primera versión sale rápido |
| 2026-10-09 | Los sandboxes alojados solo cobran durante turnos activos y se pueden precalentar (changelog) | Un monitor que ejecuta scripts ya no paga tiempo ocioso |
| 2026-10-16 | Modo Ultrafast; los sandboxes alojados incluyen el Artifact SDK para hojas de cálculo y documentos (changelog) | El informe puede ser una hoja de cálculo, pero eso exige sandbox |
| 2026-10-20 | Prompt caching de 12 horas, con escritura a 2,5 veces el precio de entrada (changelog; prompt caching) | Entre pasadas semanales hay mucho más de 12 horas; la caché solo ayuda dentro de una ejecución |
| 2026-10-26 | Lanzamiento de GPT-6.1 Terra (changelog) | Un precio intermedio entre luna y sol; la estimación semanal de 0,2154 USD lo usa |
| 2026-10-28 | Los suscriptores elegibles de ChatGPT Pro y Business pueden obtener hasta 500 USD al mes en créditos de API (changelog) | Un equipo pequeño podría cubrir con esos créditos el costo del modelo |
| 2026-11-30 | Cierre previsto de Agent Builder, anunciado el 3 de junio de 2026 (deprecations) | Mueve los flujos viejos a la Agents API o al Agents SDK antes de esa fecha; en el foro de desarrolladores, el personal de OpenAI recomendó los vaults de la Agents API para flujos que rotan credenciales (foro de desarrolladores de OpenAI) |
Preguntas frecuentes
¿La openai agents api es gratis?
No hay tarifa de plataforma, pero no es gratis. El anuncio de OpenAI dice que la Agents API no tiene cargos adicionales y que se pagan los tokens y las herramientas que usa el agente; los sandboxes alojados se cobran a tarifa de contenedor. Sin sandbox, nuestra estimación del modelo para una marca y una semana va de unos 0,029 USD (gpt-6-luna) a unos 2,9 USD (gpt-6-astra), más 0,006945 USD de datos. (Origen de la pregunta: sugerencia de Google «openai agents api en español gratis». Base: anuncio, introducción, precios.)
openai agents api o Agents SDK: ¿cuál conviene?
La Agents API, si quieres que OpenAI ejecute el bucle del agente, guarde las sesiones y lo despierte según una programación. El Agents SDK, si el agente debe correr dentro de tu aplicación con tu propio almacenamiento. En la comparación de OpenAI, el esfuerzo de integración es «bajo» para la Agents API y «medio» para el SDK. Y si necesitas Zero Data Retention, por ahora toca el SDK. (Origen: sugerencia de Google «openai agents api vs sdk». Base: guía Agents, introducción.)
¿El cliente MCP del Agents SDK puede conectarse al mismo servidor de EveryInfra?
Sí. La documentación MCP del SDK admite Streamable HTTP. Usa https://api.everyinfra.com/mcp con tu clave; el nombre de la herramienta y los parámetros son los mismos de este artículo. La programación, los reintentos y las credenciales corren por tu cuenta. (Origen: sugerencias de Google «openai agents sdk mcp» y «openai agents sdk mcp server». Base: MCP en el Agents SDK, especificación de transportes MCP.)
¿Qué permisos necesita la clave de la openai agents api?
El quickstart pide api.agents.read y api.agents.write para las sesiones y api.responses.write para la inferencia del modelo. Para gestionar vaults, suma api.vaults.read y api.vaults.write. Esa clave se queda en tu servidor, fuera de las instrucciones y de cualquier sandbox. (Origen: sugerencia de Google «openai agents api key». Base: quickstart, seguridad del sandbox.)
¿Puede el computer use de la openai agents api leer directamente los sitios de reseñas?
La Agents API sumó computer use el 29 de septiembre de 2026, así que un agente puede trabajar en un navegador alojado por OpenAI mientras tu aplicación gestiona aprobaciones e inicio de sesión. Pero paginar reseñas en un navegador exige sandbox y gasta muchos más tokens. Además, las páginas de Trustpilot, G2 y Capterra bloquean el acceso automatizado: en nuestra prueba, una petición curl simple a las tres devolvió 403. Para reseñas estructuradas, una API de datos es más estable y más barata. (Origen: sugerencia de Google «openai agents api computer use». Base: changelog.)
¿Es seguro darle una clave de API a un agente de IA?
En el hilo de r/artificial sobre el lanzamiento, un comentario dice «Good luck trusting AI with passwords and secrets». En el diseño de OpenAI, un vault no devuelve el secreto al leerlo, y OpenAI añade la autenticación MCP al conectar, así que el código del agente no ve la clave. La página de seguridad del sandbox advierte además que los valores en variables de entorno sí son legibles por el código del agente. Por eso la clave va en un vault, no en env, y este agente debería tener una clave propia. (Origen: hilo de r/artificial. Base: Vaults, seguridad del sandbox.)
Cómo empezar
- Crea una cuenta en EveryInfra, obtén una clave y sigue el inicio rápido para llamar una vez al catálogo gratuito. Comprueba que
trustpilot/reviews,g2/reviews,capterra/reviews,app_store/reviewsygoogle_play/reviewsmuestranavailable: true. Los parámetros y campos están en las páginas de cada capacidad: reseñas de Trustpilot, reseñas de G2, reseñas de Capterra, reseñas de App Store, reseñas de Google Play. - Busca el enlace o ID de cada marca en cada sitio y guárdalos en una tabla. Las páginas generales son API de Trustpilot, API de G2, API de Capterra, API de App Store y API de Google Play.
- Antes de tocar la Agents API, llama una vez por REST a cada sitio con tu marca. Mide cuántos días cubre una llamada y fija
limitcomo en la prueba 1. - En OpenAI, crea el vault, el agente y la automation con el ejemplo del paso 4. Lanza una invocation manual y lee el informe y los eventos de la sesión.
- Tras dos semanas, compara el costo del modelo con tu factura. Si la calidad se mantiene, pasa los subagentes a un modelo más barato.
Para convertir datos de reseñas en un producto para clientes, lee cómo los datos de reseñas se vuelven un producto de pago. Para un trabajo parecido con tareas programadas de ChatGPT, mira las tareas programadas de ChatGPT como radar de demanda. Todas las capacidades y precios están en el mercado de datos.
Referencias
- Agents API overview, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/overview
- Agents API quickstart, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/quickstart
- Agents API architecture, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/architecture
- Configuring agents, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/configuration
- Sessions, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions
- Scheduled automations, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions/automations
- Webhooks, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/sessions/webhooks
- Multi-agent, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/multi-agent
- Vaults, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/tools/vaults
- MCP connections, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- OpenAI-hosted sandboxes, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/environments/openai-hosted
- Sandbox security, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/environments/security
- Errors and recovery, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/errors
- Observability and usage, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents-api/observability
- API pricing, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/pricing
- Changelog (entradas del 2025-03-11 al 2026-10-30), documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/changelog
- Deprecations (Agent Builder), documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/deprecations
- Agents (comparar opciones de ejecución), documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/agents
- Your data, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/your-data
- Prompt caching, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/prompt-caching
- Tool search, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/tools-tool-search
- Programmatic tool calling, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/tools-programmatic-tool-calling
- Compaction, documentación para desarrolladores de OpenAI, leído 2026-11-01, https://developers.openai.com/api/docs/guides/compaction
- Create automation (referencia de la API), OpenAI, leído 2026-11-01, https://developers.openai.com/api/reference/resources/beta/subresources/agents/subresources/automations/methods/create
- Agents (referencia de la API), OpenAI, leído 2026-11-01, https://developers.openai.com/api/reference/resources/beta/subresources/agents
- Introducing the Agents API, OpenAI, 2026-09-10, https://openai.com/index/introducing-the-agents-api/
- Introducing the Agents API and hosted sandboxes, foro de desarrolladores de OpenAI, 2026-09-10, https://community.openai.com/t/introducing-the-agents-api-and-hosted-sandboxes/1396481
- Agent Builder MCP Secrets API, foro de desarrolladores de OpenAI, leído 2026-11-01, https://community.openai.com/t/agent-builder-mcp-secrets-api/1368113
- OpenAI launches Agents API public beta built on Codex harness, Reddit r/artificial, leído 2026-11-01, https://www.reddit.com/r/artificial/comments/1wctpbu/openai_launches_agents_api_public_beta_built_on/
- openai/openai-agents-python, GitHub, leído 2026-11-01, https://github.com/openai/openai-agents-python
- Model context protocol (documentación del Agents SDK), OpenAI, leído 2026-11-01, https://openai.github.io/openai-agents-python/mcp/
- MCP specification: Transports (2025-06-18), Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- RFC 6750: OAuth 2.0 Bearer Token Usage, IETF, 2012-10, https://datatracker.ietf.org/doc/html/rfc6750
- Time Zone Database, IANA, leído 2026-11-01, https://www.iana.org/time-zones
- crontab(5), Linux man-pages, leído 2026-11-01, https://man7.org/linux/man-pages/man5/crontab.5.html
- Ratings, reviews, and responses, Apple Developer, leído 2026-11-01, https://developer.apple.com/app-store/ratings-and-reviews/
- View & analyze your app's ratings & reviews, Ayuda de Google Play Console, leído 2026-11-01, https://support.google.com/googleplay/android-developer/answer/138230
- Understanding and counting tokens, Centro de ayuda de OpenAI, leído 2026-11-01, https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials, Comisión Federal de Comercio de EE. UU., 2024-08-14, https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- Notion Reviews, Trustpilot, leído 2026-11-01, https://www.trustpilot.com/review/notion.so
- Notion Reviews, G2, leído 2026-11-01, https://www.g2.com/products/notion/reviews
- Notion, Capterra, leído 2026-11-01, https://www.capterra.com/p/186596/Notion/
- Página de la app Notion, App Store, leído 2026-11-01, https://apps.apple.com/us/app/notion-notes-tasks-ai/id1232780281
- Página de la app Notion, Google Play, leído 2026-11-01, https://play.google.com/store/apps/details?id=notion.id
- Catálogo de datos de EveryInfra (trustpilot), EveryInfra, leído 2026-11-01, https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- Catálogo de datos de EveryInfra (completo), EveryInfra, leído 2026-11-01, https://api.everyinfra.com/api/v1/social/catalog
- ClickUp, Capterra, leído 2026-11-01, https://www.capterra.com/p/158833/ClickUp/
- Página de la app ClickUp, Google Play, leído 2026-11-01, https://play.google.com/store/apps/details?id=co.mangotechnologies.clickup
- iPhone Duo arrives at Apple Store locations worldwide, Apple Newsroom, 2026-10, https://www.apple.com/newsroom/2026/10/iphone-duo-arrives-at-apple-store-locations-worldwide/
Referencia BL-59