Subagent di Claude Code: worker Haiku per analizzare gli account TikTok
Un account brand su TikTok vale circa 9.700 token di dati grezzi. Un subagent Haiku 5.5 restituisce un riepilogo di 95 token. 98 chiamate reali, gestione dei 429 e costo per 50 account.
Il 26 ottobre 2026, dalle 17:25 alle 17:48 SGT, abbiamo raccolto 18 account brand di TikTok tramite l'API di EveryInfra. Per ogni account abbiamo preso il profilo, i 10 video più recenti e i commenti di un video. I risultati grezzi erano in media di 38.794 byte per account, cioè circa 9.700 token secondo il rapporto indicato nella pagina dei prezzi di Anthropic (10 kB corrispondono a circa 2.500 token). Il riepilogo dello stesso account è di circa 382 byte, ovvero 95 token. Questo divario di circa 100x è ciò che i subagent di Claude Code fanno risparmiare nel contesto principale.
C'è un secondo risultato che è facile trascurare. Abbiamo limitato la nostra chiave di test a 10 richieste al minuto (il valore predefinito dell'account è 60). Sei worker in parallelo hanno ricevuto 20 errori di limite di frequenza delle richieste (429) su 56 richieste. Quattro worker con un limite lato client hanno ottenuto oltre il 50% di risultati in più al minuto.
Questo articolo risponde a una domanda pratica. Hai un elenco di qualche decina di account brand su TikTok: concorrenti, possibili partner o i tuoi account regionali. Vuoi che Claude Code raccolga profili, video recenti e commenti, e poi costruisca una tabella comparativa. Come dividi il lavoro tra i subagent? Quale modello e quali strumenti assegni a ciascun subagent? Quali chiamate ai dati fa, quanto costa e cosa succede quando il limite di frequenza delle richieste dell'API lo blocca?
Le impostazioni di Claude Code in questo articolo vengono dalla documentazione ufficiale e dal changelog. Non abbiamo eseguito il subagent sulla nostra macchina, quindi quella parte è indicata come esempio di configurazione. Ogni numero di EveryInfra proviene dalle risposte grezze di chiamate reali.
Il lavoro: 50 account brand, una tabella comparativa
Definiamo prima il lavoro, perché tutti i numeri che seguono dipendono da questo. L'input è un elenco di username TikTok. Per ogni account vogliamo tre cose. La prima è il profilo (follower, numero di video, stato di verifica).
La seconda sono i 10 video più recenti (visualizzazioni, like, commenti, orario di pubblicazione). La terza sono fino a 50 commenti sul video più commentato tra quei 10. L'output è una riga di tabella per account. Le colonne sono follower, visualizzazioni mediane dei video recenti, tasso di engagement, post a settimana e numero di commenti campionati, più una breve nota.
Questo job ha tre caratteristiche che corrispondono a ciò per cui esistono i subagent. Primo, gli account non dipendono l'uno dall'altro. Per estrarre i dati di Nike non serve il risultato di Adidas, quindi il lavoro può girare in parallelo. Secondo, il job legge molto più di quanto conserva. Ogni account restituisce decine di kilobyte, ma la tabella ne conserva una sola riga. Terzo, i passaggi sono fissi e le decisioni semplici, quindi può eseguirli un modello piccolo ed economico.
La documentazione di Claude Code descrive i subagent negli stessi termini. Consiglia di usarne uno quando un'attività secondaria inonderebbe la conversazione principale. Può trattarsi di risultati di ricerca, log o contenuti di file che non rileggerai. Il subagent svolge quel lavoro nel proprio contesto e restituisce solo il riepilogo (documentazione dei subagent di Claude Code).
Abbiamo testato 24 username in tre gruppi. Il gruppo dell'abbigliamento sportivo statunitense contava 8 account: Nike, Adidas, Gymshark, lululemon, Under Armour, New Balance, PUMA e HOKA. Il gruppo dei brand con sede in Cina comprendeva SHEIN, Temu, DJI, OnePlus ed EcoFlow. Comprendeva anche tre username che abbiamo dedotto dai nomi dei brand Anker, Insta360 e Xiaomi.
Il gruppo in lingua spagnola comprendeva Zara, Bershka, Real Madrid, Telcel e Pull&Bear, più tre username dedotti per Mercado Libre, OXXO e Bimbo. Tutte e sei le ipotesi erano sbagliate, e la sezione sugli errori spiega perché conta. I restanti 18 account di brand verificati sono la base di tutti i dati su dimensioni, costi e velocità riportati sotto, scalati a 50 dove lo indichiamo.


Conviene davvero suddividere? Cosa dice la guida di Anthropic del 22 ottobre
Prima della configurazione, guarda il consiglio opposto. Il 22 ottobre 2026 Anthropic ha pubblicato una lunga guida intitolata «When to fold subagents into your main agent loop» (guida di Anthropic). La guida sostiene che la maggior parte degli agenti dovrebbe usare meno subagent. L'impostazione predefinita dovrebbe essere un solo modello, una sola finestra di contesto e un solo loop di tool aperto. Le procedure di dominio vanno nelle Skill, mentre le ricerche puntuali e i limiti rigidi vanno nei tool. Un riepilogo su Reddit riporta che il loop singolo di un cliente era circa 2 volte più veloce della sua configurazione multi-agente.
Il single-agent-loop-kit che accompagna la guida è cauto su questa affermazione. Il suo README dice che il kit non dà per scontato che un loop singolo vinca sempre. Misura ogni modifica sulla stessa eval, prima e dopo. Lo stesso README elenca anche buoni motivi per mantenere un subagent: la ricerca in parallelo su contesti nuovi, la verifica indipendente e il lavoro che legge molto più di quanto serva poi all'agente principale.
Estrarre 50 account TikTok rientra nell'ultimo caso. Ogni account porta circa 9.700 token, e alla sessione principale serve una sola riga da 95 token. The Decoder riporta le tre condizioni di Anthropic per mantenere i subagent: una perdita di qualità misurabile dovuta alla crescita del contesto, attività parallele con contesti separati o difficoltà nella scelta dei tool. Il nostro job soddisfa le prime due.
| Motivo per mantenere un subagent (kit di Anthropic) | Vale qui? | Dati di questo articolo |
|---|---|---|
| Ricerca in parallelo su contesti nuovi | Sì | Gli account non dipendono l'uno dall'altro |
| Lavoro che legge molto più di quanto serva all'agente principale | Sì | Circa 9.700 token letti contro 95 restituiti per account |
| Verifica indipendente | In parte | Un worker nuovo può rieseguire un account per un controllo |
| Difficoltà con troppi tool | Sì, senza un filtro | 25 tool MCP contro 2 consentiti |
La nostra decisione è suddividere, ma su un solo livello e solo per il passaggio «estrai e comprimi». La tabella, la scelta degli account da esaminare più da vicino e la decisione di fare un altro giro restano nella sessione principale. Queste decisioni richiedono tutti gli account insieme. Non è lo schema «un subagent per team» da cui la guida mette in guardia. I nostri worker non hanno un ruolo: ognuno ha una sequenza fissa di passaggi e un solo account.
Subagent di Claude Code: il file, il campo model e l'allowlist dei tool
Un subagent di Claude Code è un file Markdown. Inizia con metadati YAML (la documentazione li chiama frontmatter) e il corpo diventa il system prompt del subagent. I subagent di progetto vanno in .claude/agents/ e puoi farne il commit per condividerli con il team. I subagent utente vanno in ~/.claude/agents/.
La documentazione dice che solo name e description sono obbligatori. I nomi dei campi usano il camelCase, e Claude Code ignora un campo scritto male senza segnalare errori (riferimento del frontmatter). Ecco il nostro esempio di configurazione per questo job. I paragrafi successivi spiegano ogni scelta.
---
name: tiktok-account-worker
description: Pull one TikTok account (profile, newest videos, comments on one video) and return a one-line JSON summary. Use one per account in the list.
model: claude-haiku-5-5
effort: low
tools: mcp__everyinfra__everyinfra_call_api, mcp__everyinfra__everyinfra_get_job
mcpServers:
  - everyinfra:
      type: http
      url: https://api.everyinfra.com/mcp
      headers:
        Authorization: "Bearer ${EVERYINFRA_API_KEY}"
maxTurns: 8
omitClaudeMd: true
---

Work on the one TikTok username in your task. Do these steps in order:
1. Call everyinfra_call_api with platform=tiktok, action=profile, params={username}.
   If is_verified is false and follower_count < 1000, stop and return {"username":..., "flag":"lookalike"}.
2. Call action=user_videos with params={username, limit:10}. Leave out is_pinned=true videos from medians and rates.
3. Take the video with the highest comment_count from step 2. Call action=comments with params={url, limit:50}.
4. On a 429, wait retry_after seconds and retry once. Do not change the parameters.
5. Output one JSON line only: username, verified, followers, median_views, engagement_pct,
   posts_per_week, comments_fetched, and one note of 25 words or less. Do not output raw data.
La riga model usa l'ID completo del modello invece dell'alias haiku. La prossima sezione spiega perché. La riga tools è un'allowlist. Secondo la documentazione, un subagent con un elenco tools può usare solo quei tool. Un subagent senza elenco eredita tutti i tool della conversazione principale (tool disponibili).
Il server MCP remoto di EveryInfra restituisce 25 tool in tools/list. Due servono a ottenere i dati: everyinfra_call_api e everyinfra_get_job. Gli altri gestiscono account, chiavi, ticket di assistenza e webhook. Un tool come everyinfra_key_delete non ha posto in un job batch che un modello piccolo esegue 50 volte. L'allowlist conserva due tool ed elimina il rischio alla radice.
La riga mcpServers è quella che fa risparmiare più contesto. La documentazione dice che un server MCP inline in un subagent si connette quando il subagent si avvia e si disconnette quando termina. Quindi definisci il server inline, non in .mcp.json. Così il testo dei suoi tool resta fuori dal contesto principale (limitare i server MCP a un subagent).
Abbiamo misurato la risposta tools/list di EveryInfra: 30.682 byte, circa 7.670 token. La risposta initialize aggiunge 3.924 caratteri di istruzioni del server. I due tool consentiti occupano 2.505 byte, circa 626 token. La documentazione indica anche una regola di fiducia: Claude Code carica un server MCP inline da un file .claude/agents/ di progetto solo dopo che hai dato fiducia a quella cartella. Le versioni precedenti alla v2.1.238 non effettuavano questo controllo.
omitClaudeMd: true avvia il subagent senza i file CLAUDE.md utente, di progetto e locali. Per impostazione predefinita, un subagent carica ogni livello di CLAUDE.md caricato dalla conversazione principale (cosa viene caricato all'avvio). A un worker che fa tre chiamate API la maggior parte di quelle regole non serve, e ciascuno dei 50 worker caricherebbe la propria copia. Questo campo richiede Claude Code v2.1.271 o successiva. maxTurns: 8 imposta un limite di turni. Al raggiungimento del limite, Claude Code segna l'output come parziale e la sessione principale può riprendere il worker (v2.1.246 e successive).
La chiave usa l'espansione delle variabili d'ambiente. La documentazione MCP di Claude Code dice che .mcp.json e le voci MCP dei subagent supportano ${VAR}. Un team può condividere un solo file e ogni persona può usare una chiave personale. Alcuni nomi di credenziali, però, si espandono sempre in un valore vuoto in url e headers di un server remoto.
Tra questi ci sono ANTHROPIC_API_KEY, le credenziali dei cloud provider e NPM_TOKEN (documentazione MCP, variabili d'ambiente). Questa regola impedisce a un file di progetto di inviare le tue credenziali a un server indicato nel file stesso. Usa un nome di variabile tuo, ad esempio EVERYINFRA_API_KEY.
Puoi anche tenere il server fuori dal file del subagent. Aggiungilo al progetto con un solo comando, poi usa il suo nome in mcpServers:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"
C'è un'altra impostazione che può bloccare il job. In tools/list, everyinfra_call_api ha readOnlyHint: false e destructiveHint: true, perché ogni chiamata costa denaro. La documentazione spiega cosa succede quando un subagent in background ha bisogno di un permesso per una chiamata a un tool: Claude Code mostra la richiesta nella sessione principale e indica il nome del subagent (foreground e background).
Cinquanta worker possono voler dire cinquanta richieste di permesso. Prima di iniziare, consenti mcp__everyinfra__everyinfra_call_api in permissions.allow nelle impostazioni (documentazione dei permessi). Consenti solo quel tool.
La tabella seguente elenca ogni campo, la sua funzione e la fonte ufficiale con la versione richiesta.
| Campo | Valore in questo esempio | Cosa fa | Fonte (versione) |
|---|---|---|---|
model | claude-haiku-5-5 | Imposta il modello del subagent. Funzionano anche alias come haiku e inherit | Documentazione dei subagent, «Choose a model» |
tools | Solo due tool MCP | Allowlist; senza, il subagent eredita tutti i tool | Documentazione dei subagent, «Available tools» |
mcpServers | Server EveryInfra inline | Le descrizioni dei tool vengono caricate solo nel subagent | Documentazione dei subagent; controllo di fiducia dalla v2.1.238 |
effort | low | Livello di effort per questo subagent | Documentazione dei subagent, «Choose an effort level» |
maxTurns | 8 | Limite di turni; output segnato come parziale al raggiungimento del limite | Segnalazione di output parziale dalla v2.1.246 |
omitClaudeMd | true | Salta i file CLAUDE.md | v2.1.271 e successive |
Scelta del modello per i subagent di Claude Code: quattro passaggi e la trappola dell'alias haiku
Il modello su cui gira un subagent è la parte di questo job più sensibile ai costi. È anche una delle domande più frequenti: tra i suggerimenti di Google compaiono «claude code subagents model selection», «claude code subagent model default» e «claude_code_subagent_model force». La documentazione indica un ordine in quattro passaggi.
Primo, il parametro model che la sessione principale passa quando avvia il subagent. Secondo, il campo model nel file del subagent, dove inherit indica il modello principale. Terzo, la variabile d'ambiente CLAUDE_CODE_SUBAGENT_MODEL. Quarto, il modello della conversazione principale (Choose a model).
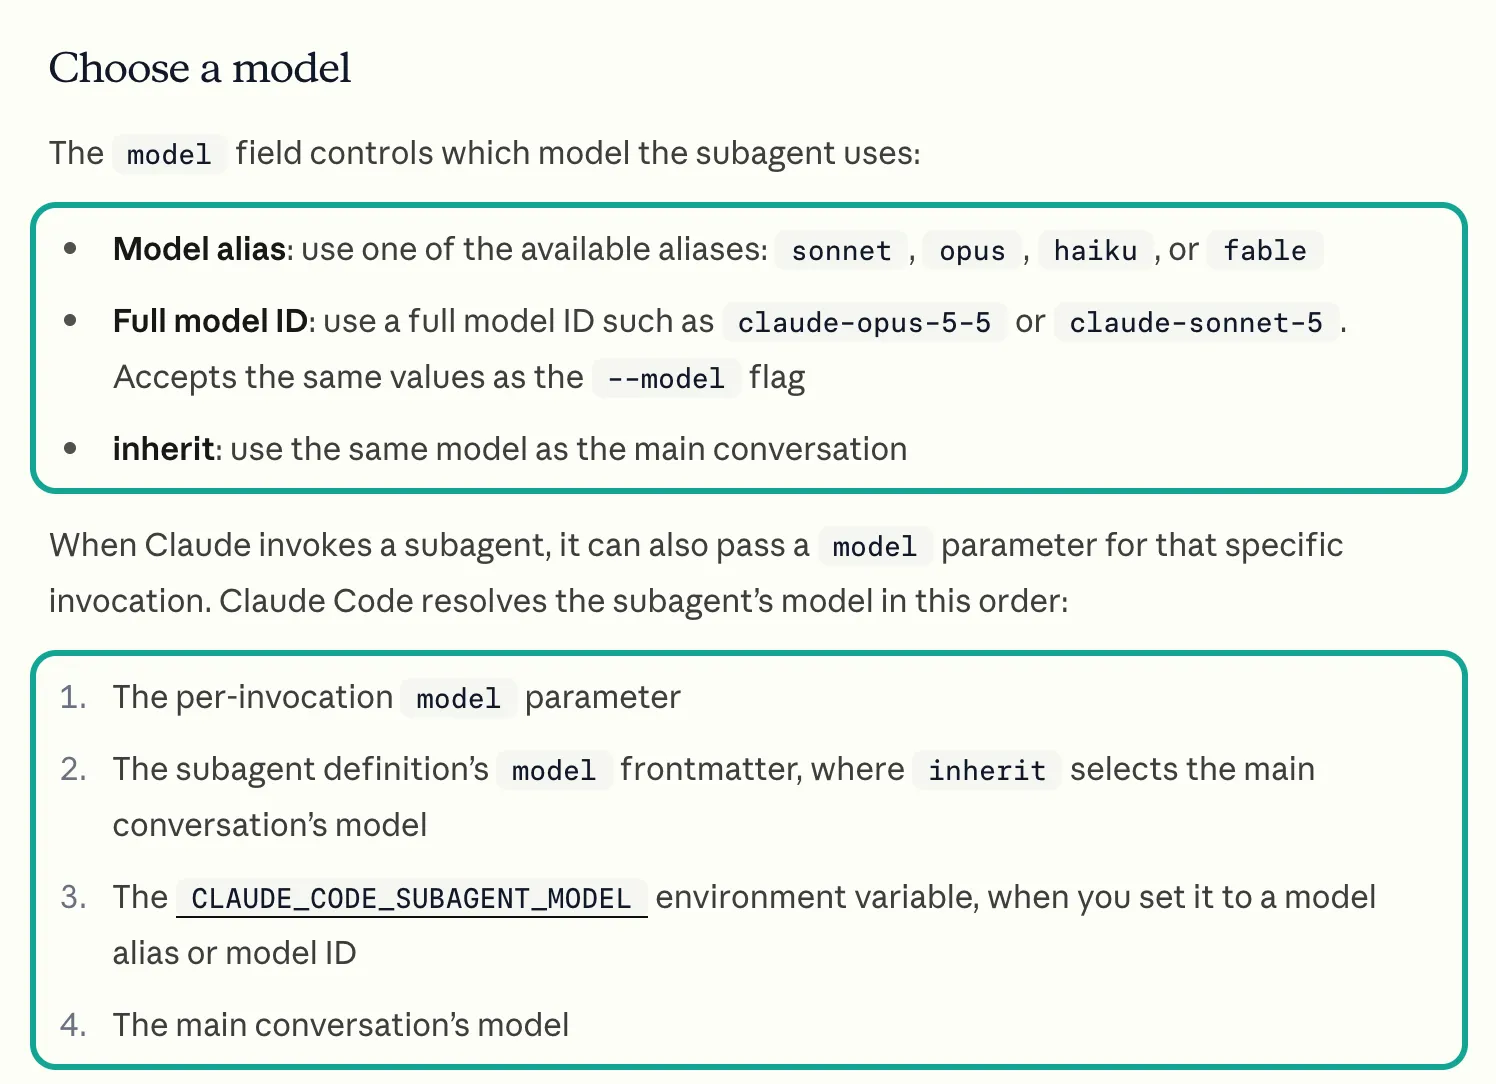
Questo ordine ha due conseguenze. Primo, un subagent senza campo model eredita il modello principale. Se la tua sessione principale usa Opus 5.5, anche un piccolo worker di dati viene fatturato alle tariffe di Opus. Un post su Reddit con 736 upvote lanciava lo stesso avvertimento: il subagent integrato Explore non gira più sempre su Haiku, ma segue la sessione principale (thread su r/ClaudeCode).
Secondo, la variabile d'ambiente viene dopo il file, quindi è solo un valore predefinito. Per imporre un modello a tutti i subagent, la documentazione dice di impostare anche CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1. Con questo flag, Claude Code ignora il campo model nei file dei subagent. Un vecchio post della community mette la variabile al primo posto (thread su r/claude). Quell'ordine non corrisponde alla documentazione attuale, quindi segui la documentazione.
Usiamo l'ID completo invece di haiku perché l'alias punta a modelli diversi a seconda del provider. La documentazione sulla configurazione dei modelli di Claude Code contiene una tabella. Sulla Anthropic API, haiku indica Haiku 5.5. Su Claude Platform on AWS, Amazon Bedrock, Google Cloud e Microsoft Foundry, haiku indica ancora Haiku 4.5 (documentazione sulla configurazione dei modelli). Il prezzo di listino di Haiku 4.5 è $1 per milione di token di input e $5 per milione di token di output, 10 volte il prezzo di Haiku 5.5 (tabella prezzi della pagina di lancio di Haiku 5.5).
Lo stesso file di subagent su Bedrock può costare dieci volte di più, senza che compaia alcun errore. Secondo il changelog di Claude Code, Haiku 5.5 è diventato il modello Haiku predefinito sull'API di Anthropic nella v2.1.293, il 2026-10-07 (changelog di Claude Code).
| Provider | L'alias `haiku` punta a | Input / output per milione di token | Cosa fare |
|---|---|---|---|
| Anthropic API | Haiku 5.5 | $0,10 / $0,50 (prompt fino a 100k) | Alias o ID completo |
| Claude Platform on AWS | Haiku 4.5 | $1 / $5 | Usa l'ID completo |
| Amazon Bedrock e Google Cloud | Haiku 4.5 | Prezzi del cloud provider | Usa l'ID del modello del provider |
| Microsoft Foundry | Haiku 4.5 | Prezzi di Azure | Usa l'ID completo |
Perché Haiku 5.5 e non Sonnet? La pagina di lancio del 7 ottobre 2026 indica l'uso previsto: attività ad alto volume e sensibili ai costi, come riepiloghi, compattazione, query su database e classificazione. Dice che il modello si abbina bene a Opus 5.5 e Sonnet 5.5 come subagent. La stessa pagina dice che Sonnet 5.5 e Opus 5.5 restano migliori per il coding agentico complesso, mentre Haiku 5.5 dà il meglio in attività dal perimetro ristretto (pagina di lancio di Haiku 5.5).
Il nostro worker fa tre cose: chiama l'API in sequenza, sceglie il video con più commenti e calcola alcune mediane. Uno script può verificare ogni output. È un'attività ristretta.
I report della community concordano. Un utente ha eseguito Haiku 5.5 su 7 attività piccole e delimitate e ha ottenuto 140 risultati accettati su 140, come con Opus 5.5. Lo stesso utente avvertiva che «un file più un controllo va bene», mentre il lavoro senza confini precisi tende a deragliare (thread su r/ClaudeAI).
Haiku 5.5 cambia anche alcuni comportamenti dell'API. La guida alla migrazione dice che Haiku 5.5 non accetta temperature, top_p o top_k. Un valore thinking con budget_tokens restituisce un errore 400, quindi usa {"type": "adaptive"}. Il prefill dell'assistente non è supportato (guida alla migrazione a Haiku 5.5). Claude Code gestisce questi parametri al posto tuo. Se costruisci i worker con l'Agent SDK o con l'API, verificali.
Le tre chiamate a EveryInfra di ogni worker
Tutte e tre le funzionalità vengono dal catalogo di EveryInfra (GET /api/v1/social/catalog, gratuito, senza chiave). Lo abbiamo letto e salvato il 26 ottobre 2026 alle 17:22 SGT. Tutte e tre rientrano nella fascia TikTok con un price_usd di 0.000556, cioè $0,000556 per chiamata. Una chiamata costa uguale indipendentemente dal numero di righe che restituisce.
user_videos restituisce fino a 50 righe per chiamata e comments fino a 200 (catalogo TikTok). Le pagine delle funzionalità sono tiktok/profile, tiktok/user_videos e tiktok/comments. La panoramica della piattaforma è l'API per i dati di TikTok.
| Funzionalità | Parametro obbligatorio | Uso in questo articolo | Prezzo per chiamata | Campi usati (corrispondono ai response_fields del catalogo) |
|---|---|---|---|---|
tiktok/profile | username | 1 chiamata per account | $0.000556 | username, display_name, follower_count, video_count, like_count e is_verified |
tiktok/user_videos | username | limit: 10 | $0.000556 | url, view_count, like_count, comment_count, posted_at e is_pinned |
tiktok/comments | url | limit: 50 | $0.000556 | id, like_count, reply_count, is_reply e posted_at |
tiktok/search | keyword | content_type: profile per trovare lo username corretto | $0,000556 per account restituito | author_username, author_is_verified e author_follower_count |
L'ultima riga richiede una nota. Nel catalogo, tiktok/search ha un campo rows_per_unit_when. Il campo indica che, con content_type impostato su profile, ogni riga restituita conta come un'unità. Lo abbiamo usato con limit: 5 per trovare gli username corretti di tre brand, e ogni chiamata è costata $0,002778, cioè 5 × $0,000556. Una ricerca di video costa un'unità per chiamata, mentre una ricerca di account costa un'unità per account. È una differenza facile da trascurare in un budget.
Ecco il primo passaggio del worker via REST. La chiave arriva solo da una variabile d'ambiente. Il campo billing.charged_usd nella risposta mostra l'addebito reale della chiamata.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"user_videos","params":{"username":"nike","limit":10}}'
Due dettagli dei campi cambiano la tabella. Primo, user_videos ordina dal più recente, ma i video fissati (is_pinned: true) vengono per primi. Sette account su 18 avevano video fissati tra i 10 più recenti, e SHEIN, DJI e Gymshark ne avevano 3 ciascuno. I video fissati possono risalire a mesi prima. Senza il filtro, gli «ultimi 10 video» di SHEIN coprono 294 giorni e la frequenza di pubblicazione risulta sbagliata.
Secondo, usa il numero di commenti restituiti dalla chiamata, non il comment_count del video. Il video di New Balance mostrava 29 commenti e la chiamata ne ha restituiti 27. Il video di Telcel ne mostrava 10 e la chiamata ne ha restituiti 5. Il catalogo dice anche che ogni commento di primo livello include al massimo due risposte, e il thread completo non è garantito.
Un vero round trip MCP: cosa invia il modello e cosa torna indietro
Un subagent che chiama l'API tramite MCP usa il trasporto Streamable HTTP della specifica MCP. L'ordine è initialize, poi notifications/initialized, poi tools/list, poi tools/call (trasporti MCP 2025-06-18, ciclo di vita).
Lo abbiamo fatto a mano alle 17:30 SGT del 26 ottobre 2026. initialize ha restituito 200 con la versione di protocollo 2025-06-18. La risposta non aveva l'header Mcp-Session-Id, quindi questo server non richiede un ID di sessione. notifications/initialized ha restituito 202 con corpo vuoto, come indica la nostra guida alla configurazione del server MCP remoto. tools/list ha restituito 25 tool.
Alle 17:45:05 SGT abbiamo inviato una tools/call a everyinfra_call_api per i commenti di un video di Nike con limit: 200. È la stessa chiamata che un worker Haiku invia da Claude Code. L'API ha risposto 200 dopo 92,6 secondi. La risposta HTTP completa era di 61.653 byte. Il suo campo content[0].text conteneva 54.819 caratteri con 177 commenti e billing.charged_usd: 0.000556.
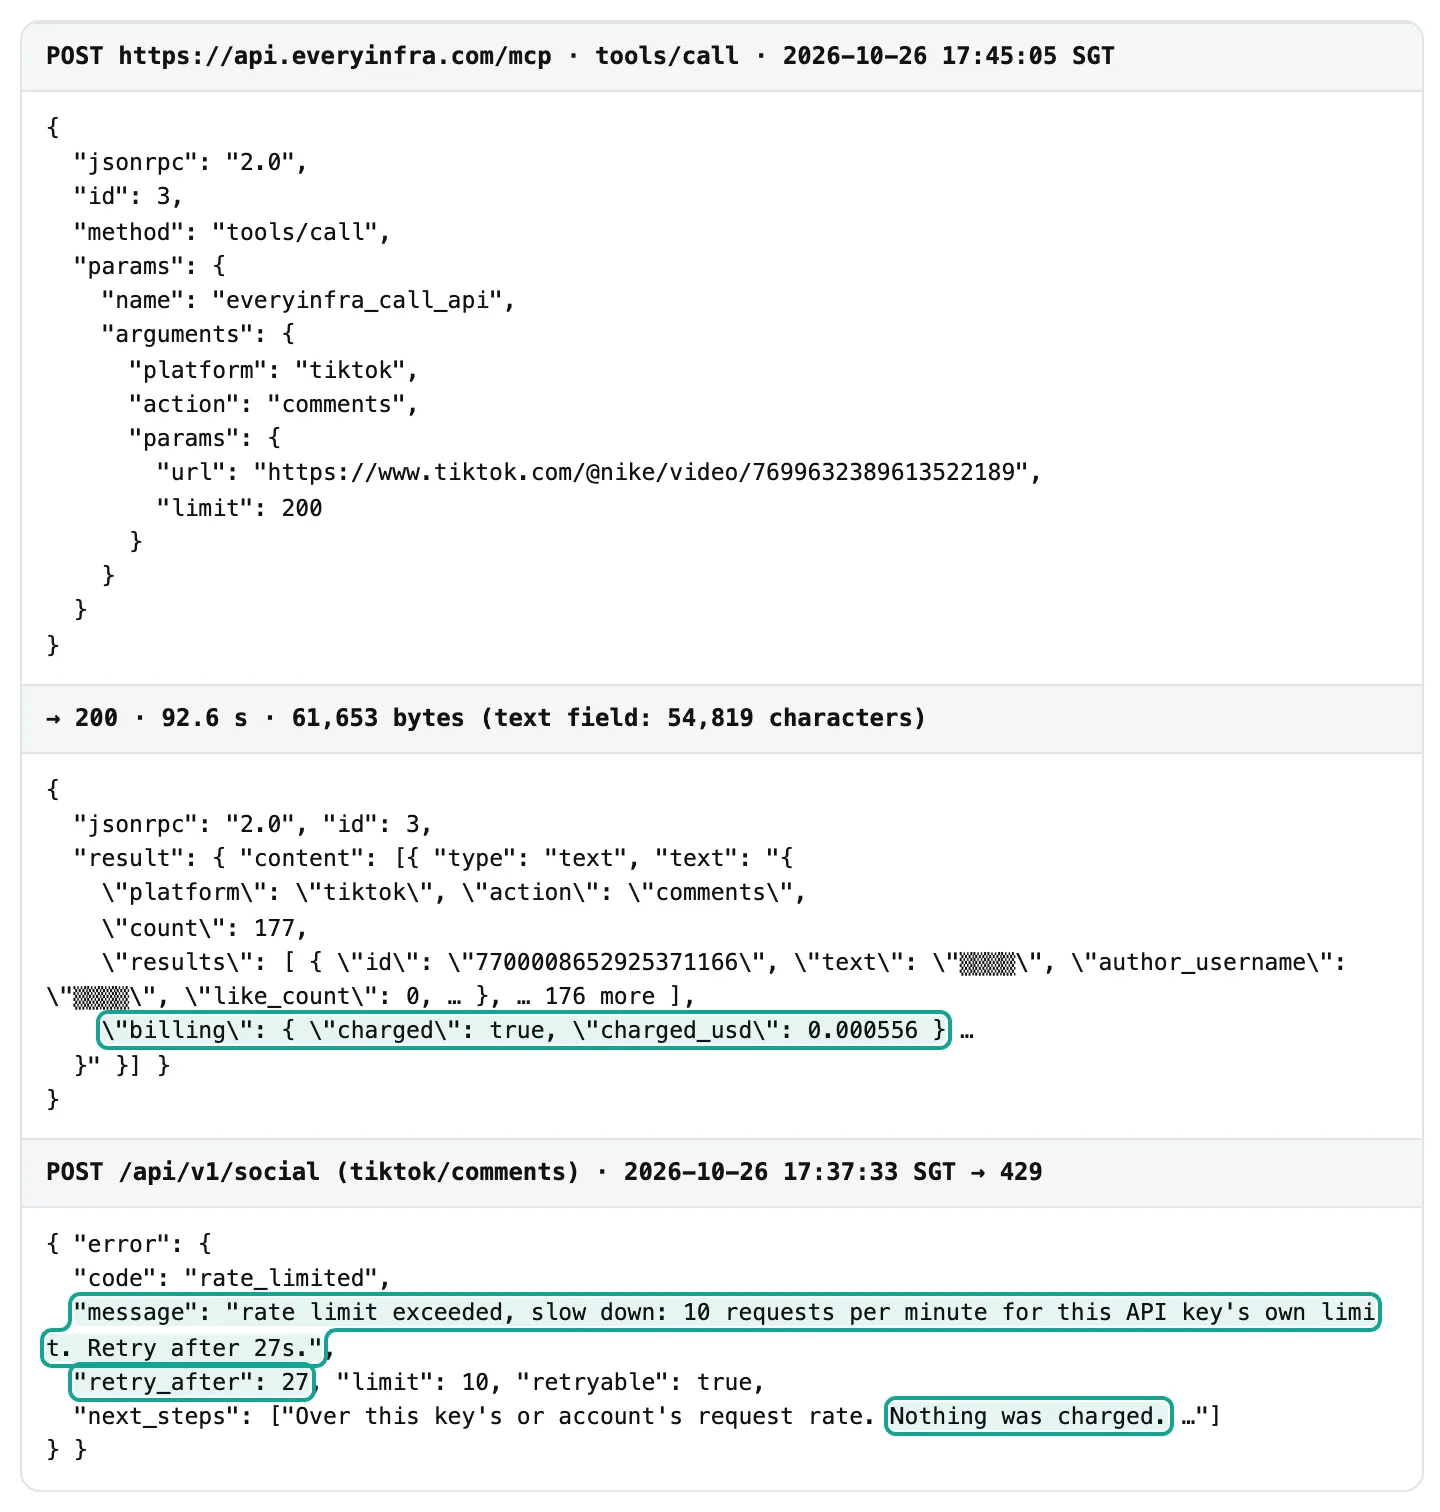
Confronta i 54.819 caratteri con tre limiti di Claude Code. La documentazione MCP dice che Claude Code mostra un avviso quando l'output di un tool MCP supera i 10.000 token. Il limite predefinito è 25.000 token e puoi alzarlo con MAX_MCP_OUTPUT_TOKENS. Inoltre, alcuni tool non hanno l'annotazione anthropic/maxResultSizeChars. Per questi tool, Claude Code salva su file un risultato testuale riuscito oltre i 50.000 caratteri. La conversazione conserva solo un riferimento al file (limiti di output MCP).
| Limite di Claude Code per i risultati MCP | Valore nella documentazione | Il nostro risultato misurato | Lo supera? |
|---|---|---|---|
| Avviso | 10.000 token | 200 commenti: circa 13.865 token | Sì |
Limite di output predefinito (MAX_MCP_OUTPUT_TOKENS) | 25.000 token | 200 commenti: circa 13.865 token | No |
Salvataggio su file (senza anthropic/maxResultSizeChars) | 50.000 caratteri | 200 commenti: 54.819 caratteri | Sì |
| Salva su file | 50.000 caratteri | 50 commenti: al massimo 24.749 caratteri | No |
| Salva su file | 50.000 caratteri | 10 video: al massimo 29.156 caratteri | No |
Abbiamo controllato la risposta tools/list: i tool di EveryInfra non hanno questa annotazione. Quindi una sola chiamata da 200 commenti supera la soglia di avviso di 10.000 token (circa 13.865 token a 4 byte per token) e Claude Code salva il risultato su disco. Il worker deve poi fare una chiamata Read su quel file, che aggiunge un turno e altro contesto.
La soluzione è semplice: usa limit: 50 per i commenti. Le nostre 18 risposte con 50 commenti avevano in media 14.106 caratteri di JSON, e la più lunga 24.749. Sono tutte sotto i 50.000. La risposta più lunga da 10 video aveva 29.156 caratteri, anch'essa sotto la soglia.
Se ti servono 200 commenti, usa mode: "async", prendi il job_id e leggilo con everyinfra_get_job. La descrizione del tool dice che leggere un job è gratuito e non conta ai fini del limite al minuto. Il modello non vede questa riga. Serve solo un passaggio in più dopo il salvataggio.
Test uno: quanto pesano i dati grezzi di un account?
Il grafico qui sotto mostra la dimensione dei risultati delle tre chiamate per ciascuno dei 18 account di brand. Contiamo solo i byte UTF-8 del campo results ed escludiamo i campi di fatturazione e saldo. La media è di 38.794 byte per account e la mediana di 39.983. Il più piccolo è Pull&Bear con 25.426 byte, perché il suo video aveva solo 2 commenti.
Il più grande è DJI con 53.324 byte. Il profilo è piccolo, 740 byte in media. I 10 video sono la parte più grande, con 24.514 byte. I commenti pesano in media 13.540 byte.
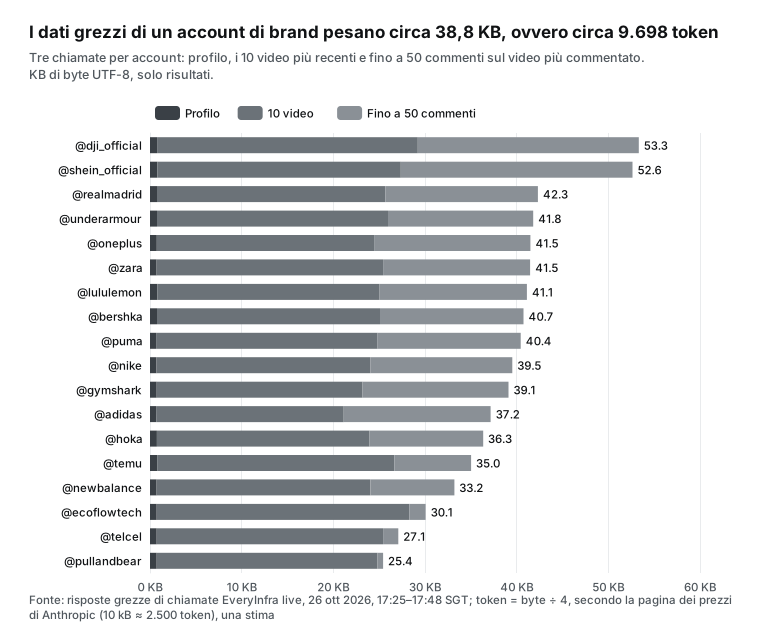
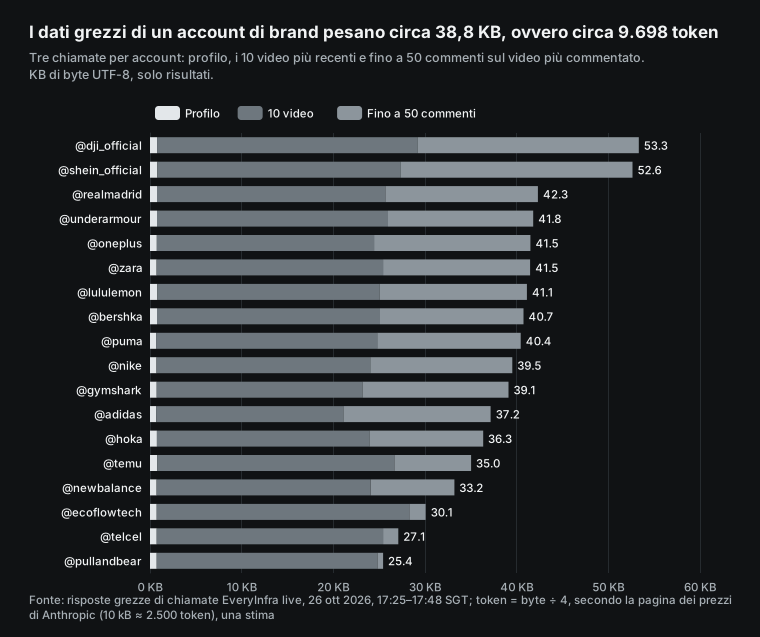
| Parte di un account | Byte medi | Token stimati (÷ 4) | Con il nuovo tokenizer (× 1,3) |
|---|---|---|---|
| Profilo | 740 | 185 | 240 |
| 10 video più recenti | 24,514 | 6,128 | 7,967 |
| Fino a 50 commenti | 13,540 | 3,385 | 4,400 |
| Totale | 38,794 | 9,698 | 12,608 |
| Riepilogo restituito dal worker | 382 | 95 | 124 |
Perché i video pesano così tanto? Un record video contiene un URL dell'immagine di copertina, un URL dell'avatar e un URL della musica. Ogni URL ha parametri CDN firmati di tre o quattrocento caratteri. Abbiamo rimosso tutti i campi che finiscono in _url, mantenendo però il campo url del video. La dimensione media è scesa a 25.175 byte, quindi i campi URL rappresentano il 35,1% dei byte. A una tabella di confronto non ne serve nessuno.
Per questo il worker restituisce un riepilogo e non «i dati ripuliti». Anche senza URL, la sessione principale riceverebbe 25 KB per account. Con il nostro formato di riepilogo, riceve 382 byte.
Per il rapporto tra byte e token usiamo un esempio della pagina dei prezzi di Anthropic. Una pagina web media da 10 kB corrisponde a circa 2.500 token, cioè 4 byte per token (prezzi di Anthropic, web fetch). La stessa pagina dice che Claude 4.7 e i modelli successivi usano un nuovo tokenizer che produce circa il 30% di token in più per lo stesso testo. Per questo tutti i numeri di token qui sono stime, e riportiamo sia «4 byte per token» sia «30% in più». Per conteggi esatti usa l'endpoint di conteggio dei token. La documentazione dice che è gratuito e limitato solo dalle richieste al minuto (documentazione sul conteggio dei token).
Perché il risparmio di contesto è reale: i calcoli sui subagent Haiku di Claude Code, su tre livelli
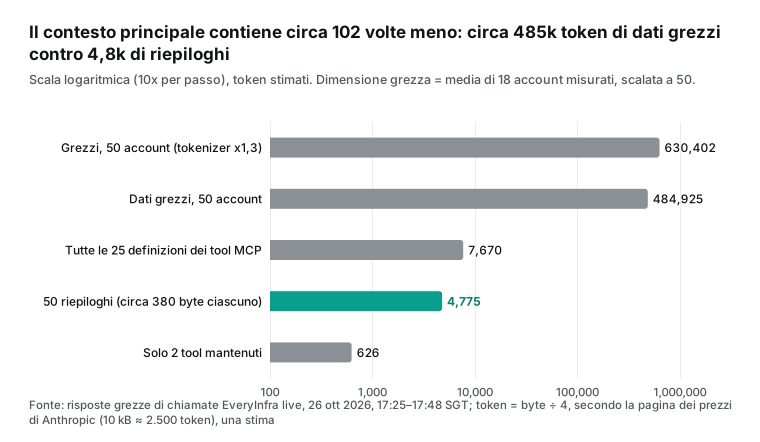
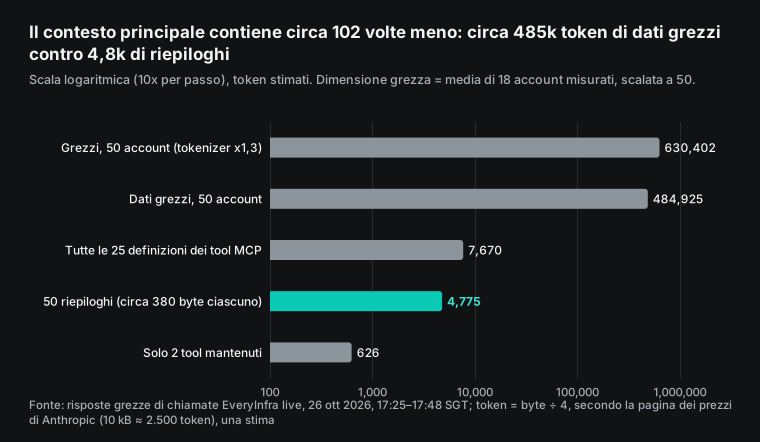
Nota la dimensione di un account, possiamo calcolare quanto fanno risparmiare i subagent. Il primo livello è il contesto principale. Su 50 account, i risultati grezzi occupano circa 1,94 milioni di byte, cioè circa 485.000 token (circa 630.000 con il nuovo tokenizer). Questa quantità corrisponde a una quota compresa tra la metà e i due terzi del contesto da 1 milione di token di Opus 5.5. Sotto forma di riepiloghi, i 50 account occupano circa 4.800 token, circa 102 volte meno.
Le descrizioni di tutti i 25 tool di EveryInfra occupano altri 7.670 token circa. Con una voce mcpServers inline e un'allowlist si scende a 626 token, e solo all'interno del worker.
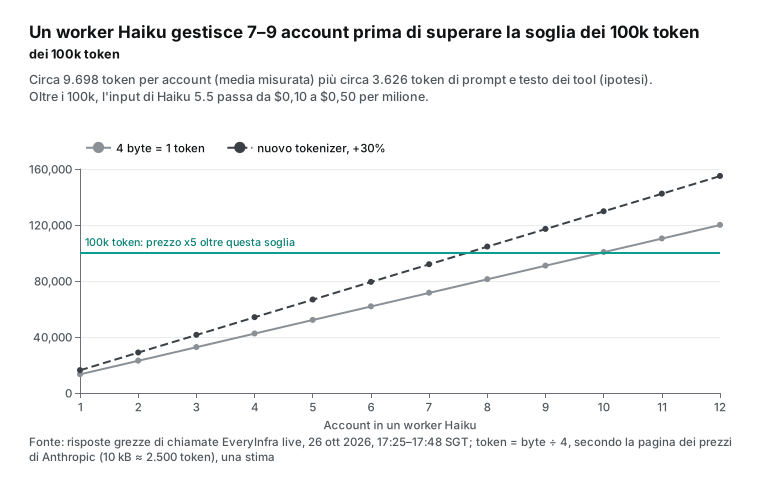
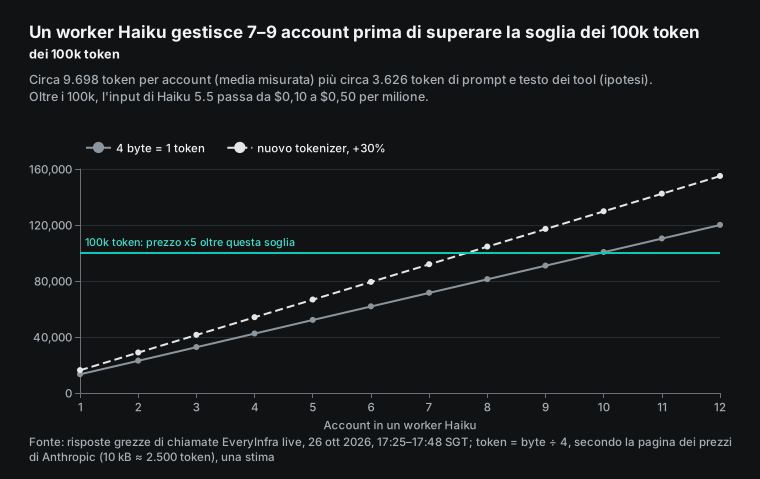
Il secondo livello è il contesto di ogni worker, e ha una soglia di prezzo che molti non notano. La pagina dei prezzi di Anthropic dice che il prezzo di Haiku 5.5 dipende dalla lunghezza del prompt. Alcune richieste hanno un prompt oltre i 100.000 token, letture e scritture della cache incluse. Queste richieste pagano $0,50 per milione di token di input invece di $0,10. L'output passa da $0,50 a $2,50 per milione. L'intera richiesta paga il prezzo più alto (prezzi per contesti lunghi).
Ogni account in più aggiunge circa 9.700 token a un worker. A questi si sommano circa 3.600 token di prompt e testo dei tool. I 626 token di testo dei tool sono misurati, mentre i 3.000 token di prompt e testo dell'attività sono una nostra ipotesi. Con questi numeri, un worker può elaborare 9 account senza superare la soglia. Con l'aumento del 30% dovuto al tokenizer, può elaborarne 7. Oltre questa soglia, ogni richiesta costa 5 volte di più.
Il terzo livello è il denaro. La documentazione sui costi di Claude Code spiega perché le sessioni lunghe diventano costose. Claude Code invia l'intera conversazione a ogni richiesta. Ogni uso di un tool invia un'altra richiesta con i risultati del tool.
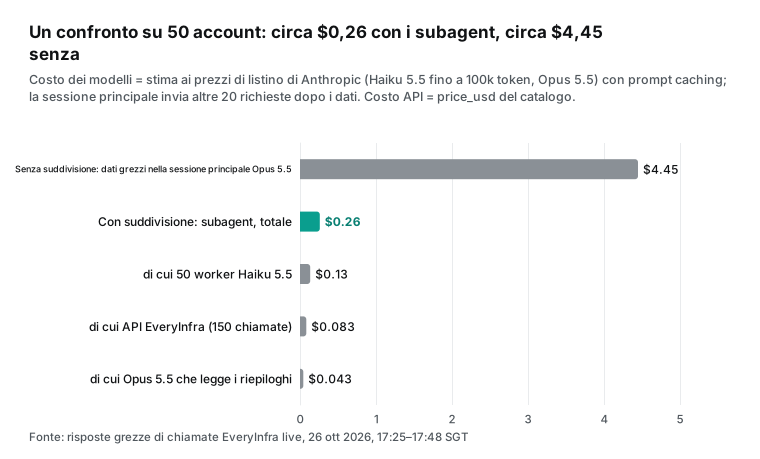
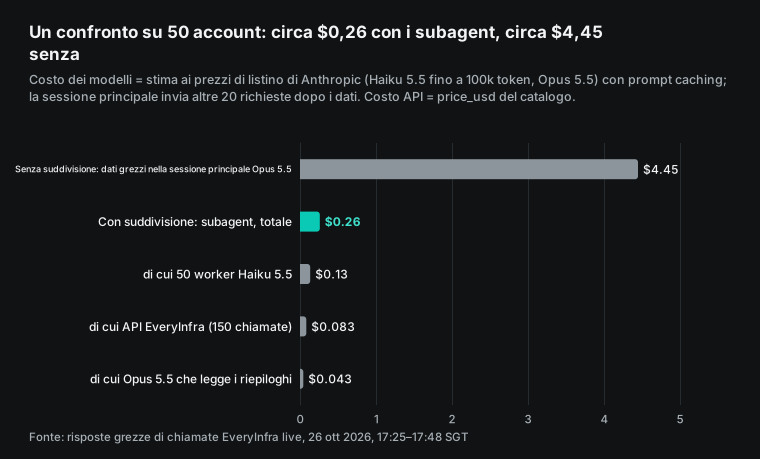
Con il prompt caching, la cronologia viene riletta alla tariffa della cache (documentazione sui costi di Claude Code). Quindi i dati grezzi nella sessione principale costano a ogni richiesta successiva, non una volta sola. Ecco la nostra stima a prezzi di listino, con le ipotesi sotto la tabella:
| Configurazione | Voci principali | Costo stimato per 50 account |
|---|---|---|
| Subagent | 50 worker Haiku 5.5 circa $0,134, API di EveryInfra $0,0834, sessione principale Opus 5.5 che legge i riepiloghi circa $0,043 | Circa $0,26 |
| Nessuna suddivisione, dati grezzi nella sessione principale | API di EveryInfra $0,0834, la sessione principale Opus 5.5 contiene circa 485.000 token e li rilegge in 20 richieste successive, circa $4,36 | Circa $4,45 |
Le ipotesi: ogni worker invia 4 richieste (3 chiamate a tool e 1 risposta finale) con circa 400 token di output ciascuna. Usiamo i prezzi di listino di Haiku 5.5 per milione di token: $0,10 input, $0,125 scrittura in cache, $0,01 lettura dalla cache e $0,50 output, con una cache di 5 minuti. Per la sessione principale usiamo i prezzi di listino di Opus 5.5 per milione di token: $4 input, $5 scrittura in cache (1,25x), $0,20 lettura dalla cache. Dopo l'arrivo dei dati, la sessione principale invia altre 20 richieste.
I prezzi di Opus 5.5 vengono dalla panoramica dei modelli di Anthropic. Il prezzo di lettura dalla cache viene dalla sezione sul prompt caching della pagina dei prezzi. Se usi un piano Pro o Max, Claude Code non addebita questi importi, ma consuma i limiti del tuo piano. Il rapporto resta lo stesso: i dati grezzi nella sessione principale consumano i tuoi limiti più di dieci volte più in fretta. La documentazione sui costi dice anche che le richieste dei subagent contano negli stessi limiti di utilizzo (documentazione sui costi).
Questa stima ha dei limiti. Esclude la pianificazione e la scrittura della tabella nella sessione principale, che costano più o meno lo stesso nelle due configurazioni. Le 20 richieste successive sono un'ipotesi. Una sessione più lunga rende più costosa la riga «nessuna suddivisione».
Claude Code inoltre compatta la sessione principale quando il contesto si riempie. La compattazione è a sua volta una richiesta di grandi dimensioni, e non l'abbiamo contata. Infine, 485.000 token sono quasi metà del contesto da 1 milione di token di Haiku 5.5. Anche una sessione principale su Haiku supererebbe la soglia di prezzo dei 100.000 token.
Test due: quanti worker in parallelo?
I subagent possono girare in parallelo, ma è l'API a dettare il ritmo. La nostra chiave di test consente 10 richieste al minuto e oltre questa soglia restituisce 429. Abbiamo impostato noi questo limite su questa singola chiave, e il 429 riporta reason: key_limit. Il valore predefinito dell'account è 60 richieste al minuto, condivise da tutte le chiavi. Con $50, $150 e $750 di ricariche totali sale a 180, 600 e 1.800 (pagina dei prezzi). Ricalcola il numero di worker qui sotto con il tuo limite. Con circa 25 secondi per chiamata, 60 richieste al minuto tengono occupati circa 25 worker, più del limite predefinito di Claude Code di 20 subagent simultanei. Abbiamo eseguito tre round e misurato i tempi reali.
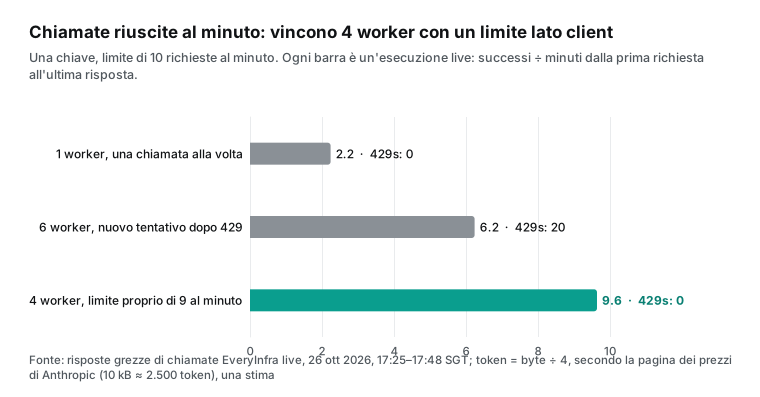
Il primo round è durato dalle 17:25 alle 17:37 SGT. Un worker ha estratto 24 profili in sequenza e ha ottenuto 24 risposte in 10,72 minuti, 2,24 al minuto. Il tempo mediano per chiamata è stato di 18,2 secondi. Nessuna chiamata ha ricevuto un 429, ma la maggior parte del tempo è andata nell'attesa delle risposte.
Il secondo round è durato dalle 17:37 alle 17:43 SGT. Sei worker hanno estratto video e commenti di 18 account, due chiamate ciascuno. Quando riceveva un 429, ogni worker attendeva per la durata indicata da retry_after e riprovava. Delle 56 richieste, 36 sono riuscite e 20 hanno ricevuto 429. Il round è durato 5,77 minuti, 6,24 successi al minuto.
Il terzo round è durato dalle 17:46 alle 17:48 SGT. Quattro worker condividevano un unico limitatore lato client che consente di avviare al massimo 9 richieste in ogni finestra di un minuto allineata all'orologio. Hanno estratto i video popolari (sort: popular) di 12 account. Tutte le 12 chiamate sono riuscite senza alcun 429. Il round è durato 1,25 minuti, 9,64 successi al minuto.
| Round | Orario (SGT) | Worker e regola | Richieste | Successi | 429s | Successi al minuto | Tempo mediano per chiamata |
|---|---|---|---|---|---|---|---|
| 1 | 17:25–17:37 | 1 worker, in sequenza | 24 | 24 | 0 | 2.24 | 18.2 s |
| 2 | 17:37–17:43 | 6 worker, nuovo tentativo dopo il 429 | 56 | 36 | 20 | 6.24 | 26.1 s |
| 3 | 17:46–17:48 | 4 worker, limite di 9 al minuto | 12 | 12 | 0 | 9.64 | 19.6 s |
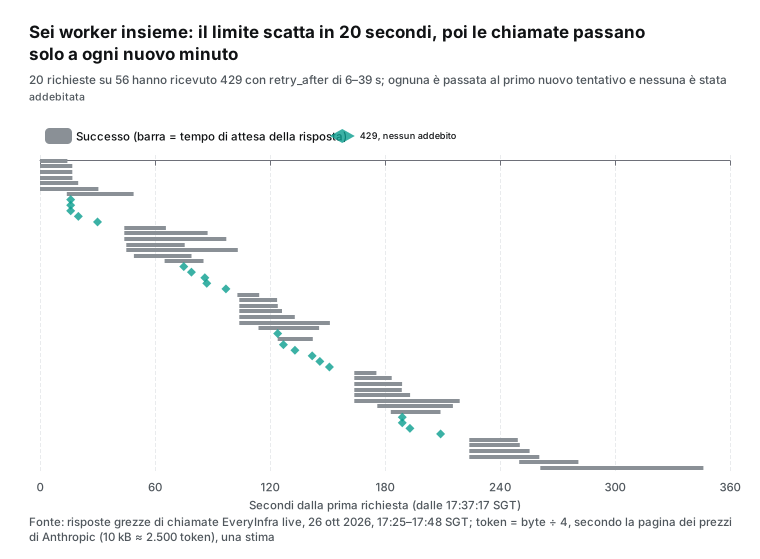
La timeline del secondo round mostra perché i 429 hanno rallentato l'esecuzione. Ogni riga è una richiesta. Una barra grigia rappresenta l'attesa di una risposta, mentre un rombo verde acqua rappresenta un 429. I sei worker hanno esaurito la quota dell'intero minuto nei primi 16 secondi e tutte le richieste successive sono fallite. Ogni worker la cui richiesta era fallita ha atteso l'inizio del minuto successivo; poi hanno riprovato tutti insieme.
I valori di retry_after andavano da 6 a 39 secondi e indicavano tutti l'inizio del minuto successivo. Questo mostra che, per questa chiave, il conteggio si azzera allo scoccare di ogni minuto. Il risultato è una raffica di richieste all'inizio di ogni minuto, seguita da una lunga pausa inattiva.
Da qui puoi calcolare un tetto semplice. Il numero utile di worker in parallelo è circa il limite al minuto moltiplicato per il tempo medio di chiamata in secondi, diviso 60. Il tempo medio di tutte le chiamate riuscite nei tre round è stato di 25,1 secondi, quindi 10 × 25,1 ÷ 60 ≈ 4,2. Con meno di 4 worker, parte della quota resta inutilizzata. Con più di 4, i worker in più producono solo 429.
Con questi calcoli, 150 chiamate per 50 account richiedono almeno 15 minuti con una chiave da 10 richieste al minuto, oppure 2,5 minuti con il valore predefinito dell'account di 60. In sequenza servono circa 63 minuti. Per impostazione predefinita, Claude Code consente 20 subagent contemporaneamente. Il 21° subagent avviato restituisce «Concurrent subagent limit reached» e CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS modifica il limite (limite di subagent simultanei). Il valore predefinito di 20 è molto superiore a 4, quindi chiedi esplicitamente alla sessione principale di eseguire al massimo 4 worker alla volta.
Questi round sono piccoli. Il terzo aveva solo 12 chiamate e una sola funzionalità, e i tempi delle chiamate cambiano con l'ora e con l'account. Non copiare 4,2 così com'è. Ricalcolalo con il tuo limite e il tuo tempo medio di chiamata. GET /api/v1/account (MCP: everyinfra_account) mostra il limite al minuto. La documentazione dell'API dice che questa chiamata è gratuita e non conta ai fini del limite.
Come gestire il 429: la risposta reale e uno schema di backoff
Ecco un 429 reale. Alle 17:37:33 SGT la richiesta di commenti del worker Nike è fallita. Il corpo conteneva code: rate_limited, retry_after: 27, limit: 10, retryable: true e max_retries: 3. Il campo next_steps diceva «Nothing was charged.» Abbiamo controllato tutti e 20 questi errori.
Nessuna richiesta è stata addebitata e ciascuna è andata a buon fine al primo nuovo tentativo dopo l'attesa. Lo standard HTTP definisce il codice 429 come indicazione di un numero eccessivo di richieste in un determinato intervallo di tempo. La risposta può includere Retry-After per indicare al client quanto attendere (RFC 6585, sezione 4; RFC 9110, Retry-After).
Gestiscilo su tre livelli. Livello uno: evita di raggiungere il limite. Nella sessione principale limita quanti worker girano contemporaneamente e aggiungi un unico limitatore condiviso a livello di chiamata. Per questo il terzo round non ha avuto 429.
Livello due: quando raggiungi il limite, aspetta. Attendi esattamente retry_after e aggiungi un piccolo ritardo casuale. Così un gruppo di worker non riprova nello stesso secondo.
Un articolo di AWS lo spiega bene. Il carico può causare gli errori. Se poi tutti i client riprovano nello stesso momento, i nuovi tentativi peggiorano il carico. Perciò aggiungi un ritardo casuale per distribuire le richieste nel tempo (Amazon Builders' Library).
Livello tre: non reinviare una chiamata già addebitata. Le risposte 429, 422 e 401 arrivano prima di qualsiasi addebito, quindi un nuovo tentativo è sicuro. Non reinviare una chiamata che ha già restituito 200 solo perché il worker ne ha perso traccia. Le nostre guide sugli errori API con auto-correzione e sui controlli dei rimborsi mostrano come verificare tramite l'ID della richiesta.
Questo è il nucleo del limitatore del terzo round. Usa il thread pool della libreria standard di Python (documentazione di concurrent.futures). In Claude Code puoi dire alla sessione principale di pianificare i worker con la stessa regola. Puoi anche mettere questa logica in uno script che i worker richiamano.
import threading, time, random
lock = threading.Lock(); state = {"minute": None, "n": 0}
def acquire(per_min=9):            # at most per_min starts per clock minute
    while True:
        with lock:
            m = int(time.time() // 60)
            if state["minute"] != m:
                state["minute"], state["n"] = m, 0
            if state["n"] < per_min:
                state["n"] += 1
                return
        time.sleep(0.5)
def on_429(err):                    # err is the error object of the response
    time.sleep(err["retry_after"] + random.uniform(0.5, 2.0))
Il limite è 9 e non 10. Così resta uno slot al minuto per altre chiamate della sessione principale, come un controllo del saldo o una lettura del catalogo.
Errori e addebiti: 422, risultati vuoti e username sbagliati
Oltre ai 429, nella stessa ora abbiamo provocato o incontrato diversi errori. Ognuno influisce su un job batch in modo diverso. Ogni riga della tabella seguente corrisponde a una risposta reale.
| Caso | Orario (SGT) | HTTP e risposta | Addebito | Cosa deve fare il worker |
|---|---|---|---|---|
Parametro scritto male usernme | 17:43:20 | 422, missing_param, «usernme is not a parameter here», con un esempio funzionante | $0 | Correggi il parametro e reinvia la richiesta |
| Nessuna chiave | 17:43:20 | 401, missing_key | $0 | Fermati e segnala un problema di configurazione |
| Troppo veloce | 17:37:33 e altri 19 | 429, retry_after 6–39 s | $0 | Attendi e fai un nuovo tentativo |
| Il nome utente non esiste | 17:33:34, 17:34:49 | 200, risultato vuoto, reason: empty_result_refunded | $0 (addebitato e poi rimborsato) | Segna «non trovato» e non riprovare |
| Il nome utente esiste, ma non appartiene al brand | 17:31:16 e altri 3 | 200, non verificato, 4–222 follower | $0,000556 come di consueto | Segna «possibile sosia» e lascia decidere la sessione principale |
La risposta 422 è scritta perché la legga un modello. Dice che manca username, che qui usernme non è un parametro, e fornisce una richiesta di esempio funzionante. Un modello piccolo come Haiku riesce a correggere la chiamata partendo da quel testo. I due risultati vuoti (i nomi che avevamo ipotizzato per Mercado Libre e OXXO) hanno restituito 200 con charged_usd pari a 0 e il motivo empty_result_refunded. Non sono costati nulla.
L'ultima riga è la più importante. I quattro nomi utente che abbiamo dedotto dai nomi dei brand (uno ciascuno per Anker, Insta360, Xiaomi e Bimbo) esistono tutti, ma sono normali account personali. Nessuno è verificato. Hanno 4, 121, 222 e 14 follower e da 0 a 8 video. L'API ha restituito correttamente i loro dati, quindi le chiamate sono state addebitate.
L'API non può intercettare questo tipo di errore. Deve farlo il worker. Da qui nasce il passo 1 dell'esempio: fermati e segnala ogni account non verificato con meno di 1.000 follower.
Puoi trovare il nome utente giusto con tiktok/search cercando per account. Abbiamo eseguito tre ricerche tra le 17:43 e le 17:44 SGT e trovato gli account verificati insta360_official (2,4 milioni di follower), xiaomi.official (8,3 milioni) e ankercharging (803.600), a $0,002778 ciascuna. La provenienza della tua lista determina se la tabella è corretta fin dall'inizio.
Il conto: costi API in base al numero di account
La parte EveryInfra è facile da calcolare. Dipende solo dal numero di chiamate, non da quante righe vengono restituite né da quale modello esegue il worker.
| Dimensione | Chiamate | Costo API con `price_usd` $0,000556 | Tempo minimo a 10 al minuto |
|---|---|---|---|
| 1 account | 3 | $0.001668 | 18 secondi |
| 50 account | 150 | $0.0834 | 15 minuti |
| 50 account, ogni settimana, per un mese | circa 650 | circa $0,361 | 15 minuti per esecuzione |
| 500 account | 1,500 | $0.834 | 150 minuti |
Questa tabella presuppone che la lista sia corretta. Se prima ti serve tiktok/search per trovare un nome utente, aggiungi circa $0,002778 per account (limit: 5). L'intero test ha usato 98 richieste: 97 via REST e 1 tools/call MCP, più 3 messaggi di handshake MCP gratuiti. Sono state addebitate 74 richieste, per un totale di $0,04781.
Le 24 chiamate non addebitate erano 20 errori (429), 2 risultati vuoti, 1 errore 422 e 1 errore 401. Ciascuna corrisponde al blocco billing o al corpo di errore della sua risposta. Per la configurazione, la guida rapida mostra i tre passaggi REST e la pagina del server MCP contiene le impostazioni dei client.
Scegliere il formato del riepilogo: quell'unica riga decide cosa può fare la sessione principale
Decidere cosa deve restituire il worker è il passaggio che merita più attenzione. La nostra regola si articola in due parti. Il riepilogo contiene solo i numeri che servono alla sessione principale per decidere. Uno script può calcolare ciascun numero dalla risposta grezza. Questo offre due vantaggi.
Primo, la sessione principale può fare controlli a campione. Sceglie un account qualsiasi, chiede a un nuovo worker di rieseguirlo e confronta i numeri. Non deve fidarsi della «comprensione» di nessun worker. Secondo, la dimensione resta sotto controllo. Il nostro formato ha 15 campi. I 18 riepiloghi pesano in media 382 byte di JSON e il più lungo, Real Madrid, arriva solo a 398 byte, perché i suoi numeri hanno più cifre.
Non lasciare che i worker restituiscano «tutto ciò che sembra importante». I riepiloghi in formato libero hanno lunghezze variabili. Alcuni worker restituiscono mezza pagina, altri ricopiano il testo dei commenti. Il contesto principale torna a crescere. Due worker possono anche valutare «importante» in modo diverso, e allora le righe non sono compatibili con un'unica tabella.
Fai particolare attenzione ai commenti. Il testo dei commenti contiene nomi utente e affermazioni personali di utenti comuni e, se arriva alla sessione principale, può finire nel report finale. Il nostro formato restituisce solo il numero di commenti e quanti hanno risposte. Per analisi del sentiment o dei temi, classifica all'interno del worker e restituisci solo il conteggio per ogni classe.
L'istruzione per la sessione principale può stare in tre frasi. Assegna ogni nome utente della lista a tiktok-account-worker, al massimo 4 alla volta. Quando sono tornati tutti, unisci i riepiloghi in un'unica tabella e indica gli account segnalati come sosia. Per i primi 3 e gli ultimi 3 account per visualizzazioni mediane ed engagement, scrivi una frase di spiegazione ciascuno.
Le prime due frasi riguardano la pianificazione. Solo la terza richiede il giudizio di un modello grande. Secondo la guida di Anthropic, questo tipo di lavoro va nel loop principale.
Cosa riceve la sessione principale: la tabella dell'abbigliamento sportivo USA
Ecco la tabella che la sessione principale costruisce dai riepiloghi dei worker per il gruppo dell'abbigliamento sportivo USA. Per rendere la dimensione riproducibile, uno script ha calcolato questi riepiloghi dalle risposte grezze con le stesse regole dell'esempio del worker. Non li ha scritti Haiku. Una nota scritta da Haiku aggiungerebbe qualche decina di byte a ogni riepilogo. Le visualizzazioni mediane e il tasso di engagement (la mediana dei like divisi per le visualizzazioni) escludono i video fissati.
| Account | Follower | Visualizzazioni mediane, video recenti | Engagement | Post a settimana | Commenti campionati |
|---|---|---|---|---|---|
| Nike | 9.3M | 24,250 | 3.82% | 11.9 | 50 |
| Adidas | 12.3M | 142,200 | 2.72% | 4.2 | 50 |
| Gymshark | 6.7M | 50,900 | 14.07% | 4.6 | 50 |
| lululemon | 1.5M | 34,900 | 1.08% | 3.0 | 50 |
| Under Armour | 1.0M | 28,600 | 5.20% | 4.8 | 50 |
| New Balance | 1.0M | 24,900 | 1.19% | 1.3 | 27 |
| PUMA | 6.2M | 15,450 | 6.68% | 4.8 | 50 |
| HOKA | 268,300 | 7,912 | 0.99% | 1.2 | 28 |
Questa tabella mostra perché il giudizio resta nella sessione principale. Nike pubblica di più (11,9 post a settimana), ma le sue visualizzazioni mediane sono inferiori a quelle di Adidas, che pubblica 4,2 post a settimana. Gymshark ha la metà dei follower di Adidas ma un tasso di engagement del 14,07%, più di cinque volte superiore. Inoltre, tra i suoi 10 video più recenti, Gymshark aveva 3 video fissati di luglio. Senza il filtro sui video fissati, i suoi tassi mescolerebbero post vecchi e nuovi.
Questi confronti richiedono tutte le righe insieme e un po' di buon senso. È un lavoro per il modello grande della sessione principale, non per ogni singolo worker. Fuori da questo gruppo, Real Madrid mostra un'altra trappola. I suoi «466 post a settimana» non sono un errore. Tutti i suoi 10 video più recenti sono usciti lo stesso giorno, il 2026-10-25, e un tasso giornaliero trasforma questo dato in un numero settimanale enorme.
Lo stesso worker su altre piattaforme: Instagram e YouTube
Se la tua lista contiene anche account di brand su Instagram e YouTube, il worker mantiene la sua struttura. Cambia tre cose: il nome della piattaforma, il nome dell'azione e il nome del parametro. La tabella qui sotto proviene dallo stesso catalogo (consultato il 26 ottobre 2026 alle 17:22 SGT). Non abbiamo effettuato chiamate reali su queste due piattaforme, quindi la tabella riporta solo i prezzi e i parametri del catalogo. Misura tu stesso una volta la dimensione dei risultati. Le pagine di presentazione delle piattaforme sono l'API per i dati di Instagram e l'API per i dati di YouTube.
| Piattaforma | Profilo | Post recenti | Commenti | Prezzo per chiamata | Nota |
|---|---|---|---|---|---|
| TikTok (misurato qui) | profile, parametro username | user_videos, fino a 50 | comments, fino a 200 | $0.000556 | I video fissati compaiono per primi |
profile, parametro username | user_posts, fino a 200 | comments, fino a 100 | $0.000556 | reels al momento non è disponibile | |
| YouTube | profile, il parametro è l'url del canale | user_posts, url del canale, fino a 50 | comments, fino a 100 | $0.000556 | Gli Shorts usano un'azione shorts separata |
Queste tre funzionalità hanno lo stesso prezzo su tutte e tre le piattaforme. Quindi tre chiamate per account costano $0,001668 e 50 account costano $0,0834 su ciascuna piattaforma. I parametri sono diversi. Il profilo e l'elenco video di YouTube richiedono l'URL del canale, non un nome utente, quindi il passo 1 del worker deve prima ottenere l'URL.
Anche le dimensioni dei risultati sono diverse. I record dei post di Instagram, come quelli dei video di TikTok, contengono molti URL di immagini. Visto quanto osservato su TikTok, misura prima i dati grezzi di un account. Poi scegli quanti account assegnare a ogni worker e quanti commenti chiedere per chiamata. Magari hai già usato MCP per queste piattaforme in un altro editor. Il nostro articolo precedente sui dati di TikTok, Instagram e Amazon in Cursor riporta tempi di chiamata misurati che ti aiutano a dimensionare il numero di worker.
Limiti e aspetti da tenere d'occhio
Primo, i termini delle piattaforme. I Termini di servizio di TikTok per gli USA limitano la raccolta automatizzata dei dati. Non è consentito fare scraping o crawling né esportare o estrarre dati della piattaforma con un sistema automatizzato. L'eccezione è un'approvazione scritta di TikTok USDS Joint Venture (TikTok Terms of Service).
I ricercatori accademici e delle organizzazioni non profit possono richiedere l'accesso ai Research Tools di TikTok, e l'approvazione richiede di solito circa 4 settimane (TikTok Research Tools, codebook). Valuta tu, per la tua area geografica e il tuo caso d'uso, se il tuo utilizzo è appropriato. Questo articolo tratta solo il metodo per ottenere i dati.
Un punto correlato crea confusione. Il 5 ottobre 2026 TikTok ha annunciato che l'MCP di TikTok for Business è ora un connettore su Claude e su altre piattaforme di AI (TikTok newsroom). Quell'MCP lavora sul tuo account pubblicitario: campagne, creatività e risultati (blog di TikTok for Business). Non legge i profili pubblici e i commenti di altri brand.
Secondo, i commenti non sono completi. comments restituisce al massimo due risposte per ogni commento di primo livello, e il conteggio può essere inferiore al numero mostrato dal video. In 5 delle nostre 18 chiamate sono tornati meno di 50 commenti, perché quei video ne avevano pochi. Per l'analisi del sentiment, includi la dimensione del campione nel riepilogo.
Terzo, avere più subagent non è sempre meglio. Oltre al limite dell'API, Claude Code ha i propri limiti. Per impostazione predefinita i subagent possono annidarsi fino a tre livelli, e CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH modifica questo valore. La dimensione del contesto di un worker dipende dal modello del worker, non dal modello principale (documentazione sui subagent).
Per una lista di migliaia di account, la documentazione rimanda ai dynamic workflows. In questo caso Claude scrive uno script JavaScript che pianifica gli agenti. Il valore predefinito è fino a 16 agenti contemporaneamente, e CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS lo porta fino a 256 (documentazione sui dynamic workflows). La quota API al minuto non aumenta per questo.
Quarto, cosa non abbiamo testato. Non abbiamo eseguito questo subagent in Claude Code. Non abbiamo dati misurati sulla qualità dei riepiloghi di Haiku 5.5. Non abbiamo misurato nemmeno quanto rispetti la regola is_pinned, né il tempo reale di 50 worker. I dati su dimensione, addebiti, errori 429 e velocità sono misurati.
I costi dei modelli sono stime basate sui prezzi di listino. Prima di farci affidamento, prova con 10 account. Controlla il modello di ogni subagent in /tasks. Poi controlla la quota dei subagent in /usage.
Modifiche recenti
2026-10-07: Anthropic ha rilasciato Claude Haiku 5.5. Costa $0,10 per milione di token di input e $0,50 per milione di token di output per prompt fino a 100.000 token. Anthropic ha indicato il lavoro dei subagent come uno degli usi principali (pagina di lancio). Lo stesso giorno, Claude Code v2.1.293 lo ha reso il modello Haiku predefinito sull'API di Anthropic (changelog). Cosa significa per te: un worker per i dati ora costa circa un decimo di quanto costava il mese scorso. Verifica però quale modello indica haiku sul tuo provider.
2026-10-16: con Claude Code v2.1.302, l'app desktop e VS Code eseguono sempre in background i subagent della conversazione principale, come già fa il terminale. I fork subagent sono diventati inoltre il default in claude -p, nell'Agent SDK, nell'app desktop e in VS Code (changelog). Cosa significa per te: i worker in background inviano le richieste di autorizzazione alla sessione principale, quindi consenti in anticipo l'unico tool di cui hanno bisogno.
2026-10-19 e 2026-10-21: la v2.1.304 ha migliorato la velocità quando molti subagent sono in esecuzione contemporaneamente. Ha anche risolto un problema per cui i subagent dimenticavano il lavoro recente dopo un rapido messaggio di follow-up. La v2.1.307 ha indicato a ogni fork subagent di un gruppo quale avvio gli apparteneva, riducendo la frequenza con cui i fork avviavano il lavoro degli altri (changelog). Cosa significa per te: i worker paralleli sono più stabili di un mese fa. Questo articolo usa subagent normali, non fork.
2026-10-22: Anthropic ha pubblicato «When to fold subagents into your main agent loop». La guida consiglia alla maggior parte degli agenti di usare meno subagent. Vanno mantenuti solo in caso di crescita misurabile del contesto, di contesto parallelo usa e getta o di troppi tool (guida, kit). Cosa significa per te: prima di suddividere, verifica che il tuo lavoro legga molto, conservi poco e abbia parti indipendenti. Altrimenti, tienilo nella sessione principale con le Skill.
2026-10-05: all'Advertising Week New York, TikTok ha annunciato che il suo MCP per gli annunci è un connettore su Claude, Kimi, Perplexity e altre piattaforme (TikTok newsroom). Cosa significa per te: usalo per gestire i tuoi annunci. Per vedere come si comportano pubblicamente gli account di altri brand, ti serve comunque un'API per i dati pubblici.
FAQ
I subagent di Claude Code possono usare un modello diverso?
Sì. Imposta model nel file del subagent. Accetta un alias (sonnet, opus, haiku, fable), un ID completo come claude-haiku-5-5 oppure inherit. L'ordine di priorità è: il parametro al momento dello spawn, poi il campo model, poi CLAUDE_CODE_SUBAGENT_MODEL, infine il modello principale. (Fonte della domanda: suggerimenti di Google «claude code subagents different model» e «claude code subagents model selection»; risposta: documentazione sui subagent)
Quale modello usa per impostazione predefinita un subagent di Claude Code?
Senza un campo model, l'ordine indicato sopra arriva al modello principale, quindi il subagent lo eredita. Anche il subagent integrato Explore non usa più sempre Haiku. Per assegnare lo stesso modello a tutti i subagent, imposta sia CLAUDE_CODE_SUBAGENT_MODEL sia CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1. (Fonte della domanda: suggerimenti «claude code subagent model default» e «claude_code_subagent_model force»; risposta: documentazione sui subagent, thread su r/ClaudeCode)
**Perché il mio subagent Haiku di Claude Code costa ancora tanto con model: haiku?**
Ci sono due cause comuni. Su Bedrock, Google Cloud, Foundry o Claude Platform su AWS, l'alias haiku indica Haiku 4.5, che costa 10 volte Haiku 5.5. Oppure è impostato CLAUDE_CODE_SUBAGENT_MODEL_FORCE e Claude Code ignora il campo model. /tasks mostra il modello reale di ogni subagent. (Fonte della domanda: suggerimenti «claude code subagent model=haiku» e «claude code use haiku for subagents»; risposta: documentazione sulla configurazione dei modelli, documentazione sui subagent)
Qual è la differenza tra i subagent e gli agent team di Claude Code?
Un subagent restituisce il risultato all'agente principale e i subagent non comunicano tra loro. I membri di un agent team condividono un elenco di attività e possono scambiarsi messaggi. Questo li rende adatti ai lavori che richiedono confronto e coordinamento. Secondo la documentazione, gli agent team sono sperimentali, disattivati per impostazione predefinita e consumano molti più token. Per un batch di account indipendenti bastano i subagent. (Fonte della domanda: suggerimento «claude code subagents vs agent teams»; risposta: documentazione sugli agent team)
Quanti subagent può eseguire contemporaneamente Claude Code?
Per impostazione predefinita, Claude Code ne esegue 20 contemporaneamente. Il 21° restituisce «Concurrent subagent limit reached». Dalla v2.1.217 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS modifica questo valore, e il numero totale in una sessione non ha limiti. Per i worker che chiamano un'API esterna, il vero limite è la quota dell'API. Con le 10 richieste al minuto della nostra chiave di test e circa 25 secondi per chiamata, più di 4 worker producono solo errori 429. Con il valore predefinito dell'account di 60 al minuto, il numero è circa 25. (Fonte della domanda: suggerimento «claude code run subagents in parallel»; risposta: documentazione sui subagent, limite di esecuzioni simultanee e il nostro test)
Cosa fa Claude Code con un risultato molto grande di un tool MCP?
Mostra un avviso sopra i 10.000 token, e il limite predefinito è di 25.000 token (si modifica con MAX_MCP_OUTPUT_TOKENS). Per un tool senza anthropic/maxResultSizeChars, un risultato riuscito oltre i 50.000 caratteri viene salvato in un file. Il nostro risultato TikTok con 200 commenti aveva 54.819 caratteri, quindi verrebbe salvato. Il risultato più lungo con 50 commenti aveva 24.749 caratteri, quindi no. (Fonte della domanda: il nostro test; risposta: documentazione MCP, limiti di output)
Riferimenti
- «Create custom subagents», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/sub-agents
- «Connect Claude Code to tools via MCP», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/mcp
- «Claude Code changelog» (da v2.1.293 a v2.1.310), Anthropic, dal 2026-10-07 al 2026-10-23, https://code.claude.com/docs/en/changelog
- «Manage costs effectively», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/costs
- «Model configuration», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/model-config
- «Environment variables», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/env-vars
- «Agent teams», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/agent-teams
- «Orchestrate subagents at scale with dynamic workflows», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/workflows
- «Explore the context window», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/context-window
- «Permissions», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/permissions
- «Settings», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/settings
- «Run Claude Code programmatically», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/headless
- «Skills», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/skills
- «Prompt caching», documentazione di Claude Code, Anthropic, consultato il 2026-10-26, https://code.claude.com/docs/en/prompt-caching
- CHANGELOG.md, anthropics/claude-code, GitHub, consultato il 2026-10-26, https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- «Introducing Claude Haiku 5.5», Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5
- «Claude Haiku 5.5 System Card», Anthropic, 2026-10-07, https://www.anthropic.com/claude-haiku-5-5-system-card
- «Pricing», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/about-claude/pricing
- «Models overview», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/about-claude/models/overview
- «Migrating to Claude Haiku 5.5», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- «Prompt caching», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- «Token counting», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/build-with-claude/token-counting
- «Rate limits», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/api/rate-limits
- «Release notes», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/release-notes/overview
- «Tool search tool», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- «Tool use overview», documentazione di Claude Platform, Anthropic, consultato il 2026-10-26, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- «Claude pricing (Pro, Max, Team)», Anthropic, consultato il 2026-10-26, https://claude.com/pricing
- «Building agents: When to fold subagents into your main agent loop», Anthropic, 2026-10-22, https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- single-agent-loop-kit, anthropics, GitHub, consultato il 2026-10-26, https://github.com/anthropics/single-agent-loop-kit
- «Transports (2025-06-18)», specifica del Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- «Tools (2025-06-18)», specifica del Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- «Lifecycle (2025-06-18)», specifica del Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- «RFC 6585: Additional HTTP Status Codes» (429), IETF, aprile 2012, https://www.rfc-editor.org/rfc/rfc6585
- «RFC 9110: HTTP Semantics» (Retry-After), IETF, giugno 2022, https://www.rfc-editor.org/rfc/rfc9110
- «Timeouts, retries, and backoff with jitter», Amazon Builders' Library, 2019-12-05, https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- «concurrent.futures», documentazione di Python, consultato il 2026-10-26, https://docs.python.org/3/library/concurrent.futures.html
- «TikTok Research Tools: Access and Eligibility», TikTok for Developers, consultato il 2026-10-26, https://developers.tiktok.com/products/research-api/
- «Research API Codebook», TikTok for Developers, consultato il 2026-10-26, https://developers.tiktok.com/doc/research-api-codebook
- «TikTok Unveils AI-Powered Updates for Advertisers», TikTok Newsroom, 2026-10-05, https://newsroom.tiktok.com/tiktok-unveils-ai-powered-updates-for-advertisers-driving-discovery-action-and-measurable-business-outcomes?lang=en
- «Evolving TikTok for Business MCP», blog di TikTok for Business, 2026-06-30, https://ads.tiktok.com/business/en-US/blog/tiktok-agentic-hub-ai-agents-skills-mcp
- «TikTok Terms of Service (US)», TikTok, consultato il 2026-10-26, https://www.tiktok.com/legal/page/us/terms-of-service/en
- «EveryInfra data catalog», EveryInfra, consultato il 2026-10-26 alle 17:22 SGT, https://api.everyinfra.com/api/v1/social/catalog
- «EveryInfra TikTok catalog», EveryInfra, consultato il 2026-10-26, https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- «Haiku 5.5 is 40x cheaper than Opus 5.5. Your Explore subagent is probably still running on Opus», Reddit r/ClaudeCode, 2026-10-08, https://www.reddit.com/r/ClaudeCode/comments/1x0kzbh/haiku_55_is_40x_cheaper_than_opus_55_your_explore/
- «PSA: Claude Code subagents inherit your session model now», Reddit r/claude, consultato il 2026-10-26, https://www.reddit.com/r/claude/comments/1v7iqqy/psa_claude_code_subagents_inherit_your_session/
- «How much more effective is using Opus 5.5 with Haiku subagents», Reddit r/ClaudeAI, consultato il 2026-10-26, https://www.reddit.com/r/ClaudeAI/comments/1x1buac/how_much_more_effectivebetter_is_using_opus_55/
- «Anthropic's new guide (Oct 22) argues most agents should have fewer subagents», Reddit r/ClaudeAI, 2026-10-24, https://www.reddit.com/r/ClaudeAI/comments/1xdwquj/anthropics_new_guide_oct_22_argues_most_agents/
- «Anthropic says one AI agent beats many subagents», The Decoder, 2026-10-25, https://the-decoder.com/anthropic-says-one-ai-agent-beats-many-subagents-now-that-models-can-handle-complexity-alone/
Riferimenti BL-53