openai agents api 口碑巡检:五平台差评周报
用 openai agents api 每周巡检五个评论平台的差评:21 次真调,一个品牌每周接口费 $0.0069,附配置、模型费估算和限制。
我们在 2026 年 11 月 1 日 00:47–15:45(新加坡时间)对 Notion 和 ClickUp 两个品牌(当晚 19:22–19:23 又复测了 4 次),在 Trustpilot、G2、Capterra、App Store、Google Play 五个评论平台调用了 EveryInfra 的评论能力,结论是:每周巡检一个品牌只要 5 次调用、$0.006945 的接口费,但「一次调用能往回看多远」在平台之间差了一个数量级,Google Play 上 Notion 的 200 条最新评论只覆盖 22 天,而 Trustpilot 的 20 条 1–2 星评论能一直回溯到 6 月。接口按次计费,取多少条都是一个价,可每多取一行,模型就要多读一行:按我们推荐的配方,Notion 一周原样返回约 42 万字节、约 10.5 万 token(凌晨实测是约 65 万字节,多出来的是下面说的网页代码)。真正决定账单的是模型:同一份一周的评论,交给 OpenAI Agents API 上不同的模型处理,按 2026-11-01 的公开价估算,从约 $0.03 到约 $2.9;最贵和最便宜的两档模型单价本身就差 100 倍,所以选哪个模型比怎么写指令更影响账单。另外两个容易踩的坑也是实测出来的:Capterra 的评论不按时间排序;11 月 1 日凌晨实测时,Capterra 的返回里有评论的 pros 字段长达 10 万个字符,混进了网页代码;当晚网关已经去掉这些代码,单个字段最多 5,000 字,我们 19:23 复测同样 86 条评论,最长的字段只有 1,154 个字符。
这篇要回答的问题是:用 OpenAI 9 月 10 日开放公开测试的 Agents API,能不能「一次调用」就建好一个口碑巡检代理——每周一早上自己醒来,分平台去拉新评论,几个子代理各管一个平台做归类,主代理汇总出一份差评周报。OpenAI 一侧的每个字段名、默认值和限制,都来自 developers.openai.com 的官方文档原文,我们在 2026 年 11 月 1 日下载并逐条核对过;因为没有在 OpenAI 账号上实跑,这部分一律写成「配置示例」。EveryInfra 一侧每个数字都来自真调的原始返回,失败和扣费也照实写。
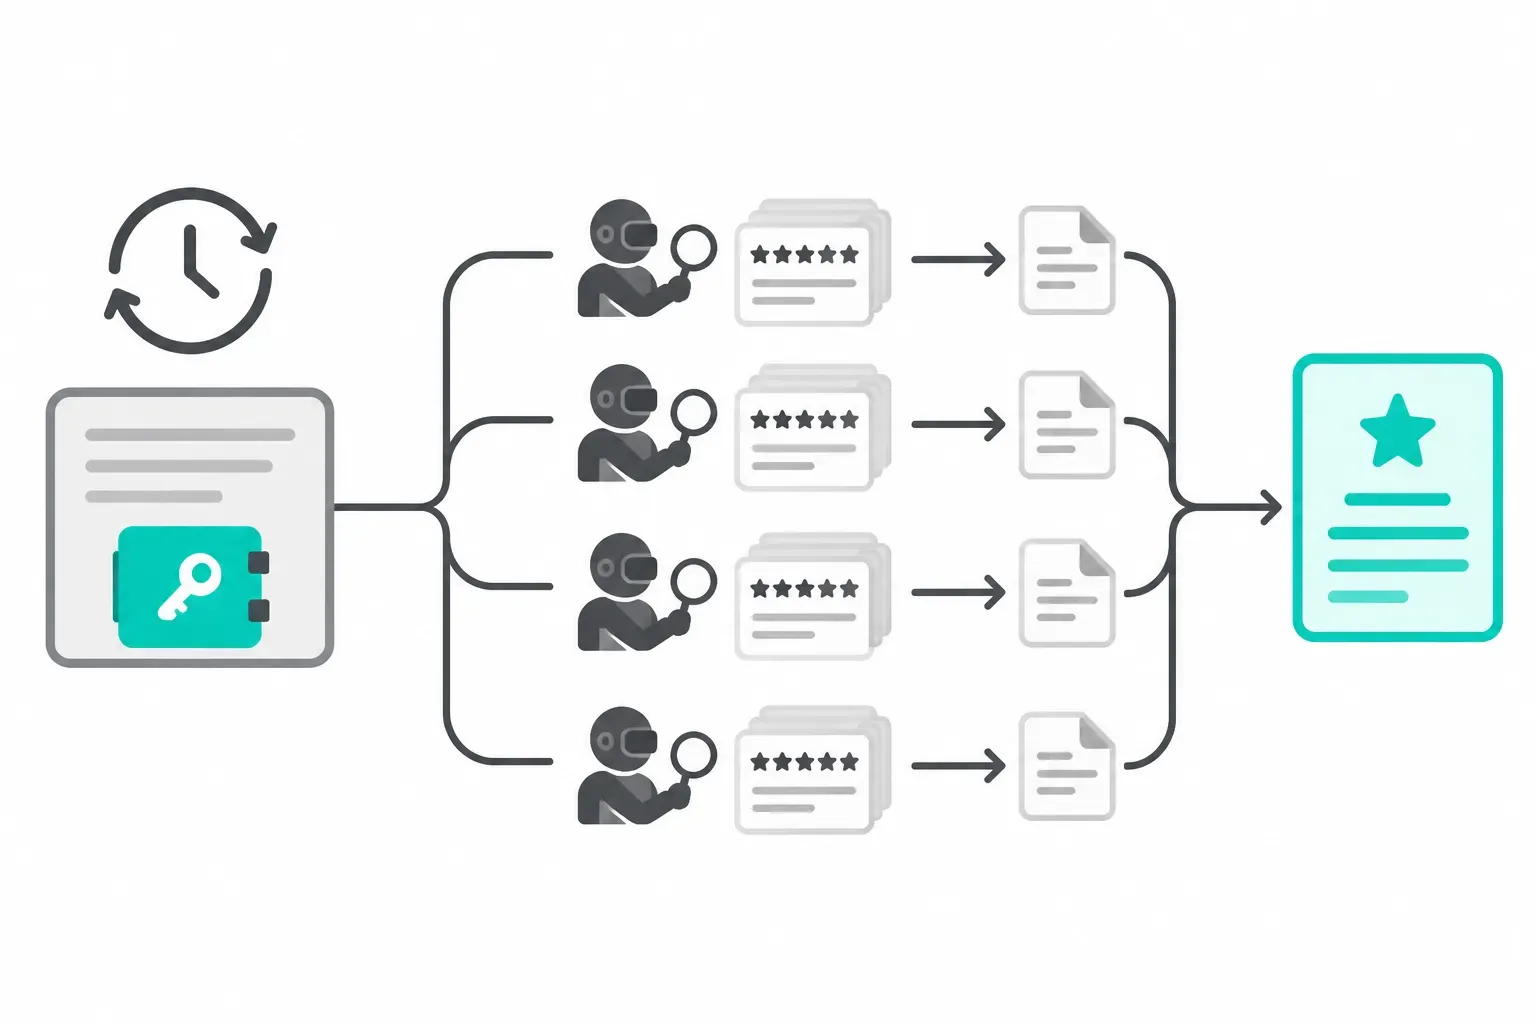
这件活是什么:每周一份差评周报,覆盖五个评论平台
先把任务定清楚,后面所有的数都按这个任务算。输入是一份品牌清单,每个品牌给出它在五个平台上的标识:Trustpilot 用官网域名(例如 notion.so),G2 用产品评论页链接或短名,Capterra 用产品页链接,App Store 用数字 ID,Google Play 用包名。输出是一份周报,每个品牌一节,写这一周各平台新增了多少条低分评论、集中在哪几类问题、有没有和上周不一样的新问题,并附上原文链接,方便运营同事直接去回复。
为什么选这五个平台?它们正好覆盖两类读者:Trustpilot、G2、Capterra 是买软件之前会去看的评测站,读者多是决策者;App Store 和 Google Play 是已经在用的人留下的反馈,问题更具体,常常带着版本号。我们站内的多平台口碑监控蓝图讲过先记录采集范围、再判断负面变化的思路,用 Exa 找竞品、查 G2 和 Trustpilot 口碑的 30 家实测讲过一次性的竞品对比。本篇往前走一步:把它做成一个每周自己运行、不用人盯的代理,并且用真调数据回答「每周跑一次够不够」。
这件活和 Agents API 的几个功能刚好对得上。第一,五个平台互不依赖,适合交给子代理并行,每个子代理在自己的上下文里读几十 KB 的评论,只把摘要交回主代理。第二,需要定时:Agents API 的 automations 可以按 cron 表达式和时区定时开会话。第三,需要一把访问数据接口的 Key,而 Key 不应该写进代理的指令里:Agents API 的 vault 专门放 MCP 的凭据。第四,数据接口本身是一个远程 MCP 服务,Agents API 可以从 OpenAI 一侧直接连上去,不需要沙箱,也不需要你的服务器转发每一次调用。下面按这四件事逐一展开。
openai agents api 是什么,和 Agents SDK 有什么区别
OpenAI 在 2026 年 9 月 10 日把 Agents API 作为公开测试推出,官方发布文的说法是:用一次 API 调用、写明任务、模型、工具和运行环境,就能建一个生产可用的代理,背后跑的是和 Codex 同一套「harness」,也就是负责调模型、调工具、管上下文的那层循环(OpenAI 发布文;更新日志 2026-09-10)。文档首页把它拆成四个概念:Agent(模型、指令、工具和 MCP 服务)、Environment(可选的沙箱)、Session(代理的一次持久实例)和 Events/Items(输入和产出)(Agents API 概览)。发布文还写明,使用 Agents API 本身不另收费,只按代理用掉的 token 和工具计费(OpenAI 发布文)。
名字最容易和它混的是 Agents SDK。SDK 是 2025 年 3 月 11 日发布的开源编排框架,代理循环跑在你自己的程序里(更新日志 2025-03-11;openai-agents-python 仓库)。OpenAI 在「Agents」总览页给了一张三列对比表,下面按原文整理,第一列和第二列就是本篇关心的区别(Agents 总览:Compare agent runtime options):
| 对比项 | Agents API | Agents SDK | Responses API |
|---|---|---|---|
| 适合做什么 | 长时间运行、由 OpenAI 管理代理并保存进度的任务 | 在自己的应用里用自定义工具和流程搭代理 | 直接调模型,或从零搭代理 |
| 代理在哪里跑 | OpenAI 运行托管的 Codex harness | SDK 跑在你的应用里 | 你的应用,可选托管编排 |
| 集成工作量 | 低 | 中 | 高 |
| 任务之间的状态 | 保存的会话配置、回合和条目 | 你自己的存储和 SDK 会话,或 Responses 的会话状态 | 手动管理历史、链式响应或 Conversations |
| 工具在哪执行 | 服务端连的工具、应用里的函数处理器、可选沙箱 | 应用里配置的工具和集成 | 托管工具和你的应用运行的工具 |
对口碑巡检来说,这张表的意思很直接:如果你不想自己养一个常驻进程去跑代理循环、存会话、处理重试,Agents API 把这些都接过去了;代价是代理的状态存在 OpenAI 那边,而且现在还在公开测试,后面「公开 beta 的限制」一节会逐条列出。如果你的公司要求数据留在自己的机房,或者需要零数据保留,那就该用 SDK 自己跑,这一点在 Agents API 概览页写得很清楚:目前只支持美国的数据驻留,不支持零数据保留(ZDR),用自托管沙箱也不会让它符合 ZDR(Agents API 概览)。


第一步:把 EveryInfra 接成一个 MCP connection
Agents API 里,MCP 服务是写在 agent.tools 里的一项,type 为 mcp。连接可以从两个地方发起:connection_origin: "service"(默认值)表示由 OpenAI 的服务去连,服务器必须能从公网访问,而且这种连接不需要会话有运行环境;connection_origin: "environment" 表示从会话的沙箱里去连,适合内网服务(MCP connections 文档)。EveryInfra 的 MCP 地址是公网的 https://api.everyinfra.com/mcp,所以用默认的 service 即可,会话的 environment 可以设成 none。架构页写明,没有运行环境时,代理仍然可以直接调用远程 MCP 工具,只是没有 Bash、文件和从沙箱发起的 MCP(Agents API 架构)。这一点对成本很重要:不开沙箱,就不会有容器费。
下面是这一项的配置示例。字段名逐个对照过文档原文;allowed_tools 只放了 everyinfra_call_api 和 everyinfra_get_job 两个工具(后者用来读异步任务的结果,原因见「实测三」),required: true 表示服务器初始化失败时直接让这一回合失败,而不是让代理在没有数据的情况下硬写一份周报(文档原话:初始化默认是可选的)(MCP connections 文档)。
{
  "type": "mcp",
  "server_label": "everyinfra",
  "transport": { "type": "http", "server_url": "https://api.everyinfra.com/mcp" },
  "connection_origin": "service",
  "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"],
  "required": true
}
为什么只放两个工具?我们在 2026 年 11 月 1 日 15:45(新加坡时间)调了一次 EveryInfra MCP 的 tools/list,一共返回 12 个工具,全部工具说明的 JSON 有 16,669 字节;只保留 everyinfra_call_api 和 everyinfra_get_job 的话是 2,505 字节。按 OpenAI 帮助中心「英文约 4 个字符合 1 个 token」的粗略换算,前者约 4,167 token,后者约 626 token(OpenAI 帮助中心:token 估算)。工具说明每一回合都会进上下文,五个子代理各带一份,差别就是每次巡检多读约 1.8 万 token。工具清单本身也会随服务更新而增减,同一天早些时候读到的数目就和这次不同;白名单让这部分开销不跟着变。文档里 allowed_tools 的定义正好是「限制代理能发现和调用的工具」(MCP connections 文档)。另外,按 OpenAI 发布文,Agents API 有 tool search,会按需加载工具定义(OpenAI 发布文;Tool search 文档),但在工具清单这么明确的任务里,直接白名单更省事,也更好预估成本。
| 工具清单 | 工具数 | 说明 JSON 字节 | 约合 token(÷4) | 五个子代理各带一份 |
|---|---|---|---|---|
不设 allowed_tools | 12 | 16,669 | 4,167 | 约 20,835 |
只放 everyinfra_call_api 和 everyinfra_get_job | 2 | 2,505 | 626 | 约 3,130 |
第二步:用 vault 放 Key,而不是写进指令
MCP 连接要带 EveryInfra 的 Key。文档给了三种放法:只用于一个会话的,写在 transport.authorization 或 transport.headers 里,Agents API 会加密,并且不在返回的会话对象里出现;要反复用的,存进 vault,再用 vault_ids 挂到会话上;stdio 的服务则通过环境变量,这时沙箱里运行的代码能读到这些值(MCP connections 文档:Add authentication)。每周自动跑的任务属于第二种。
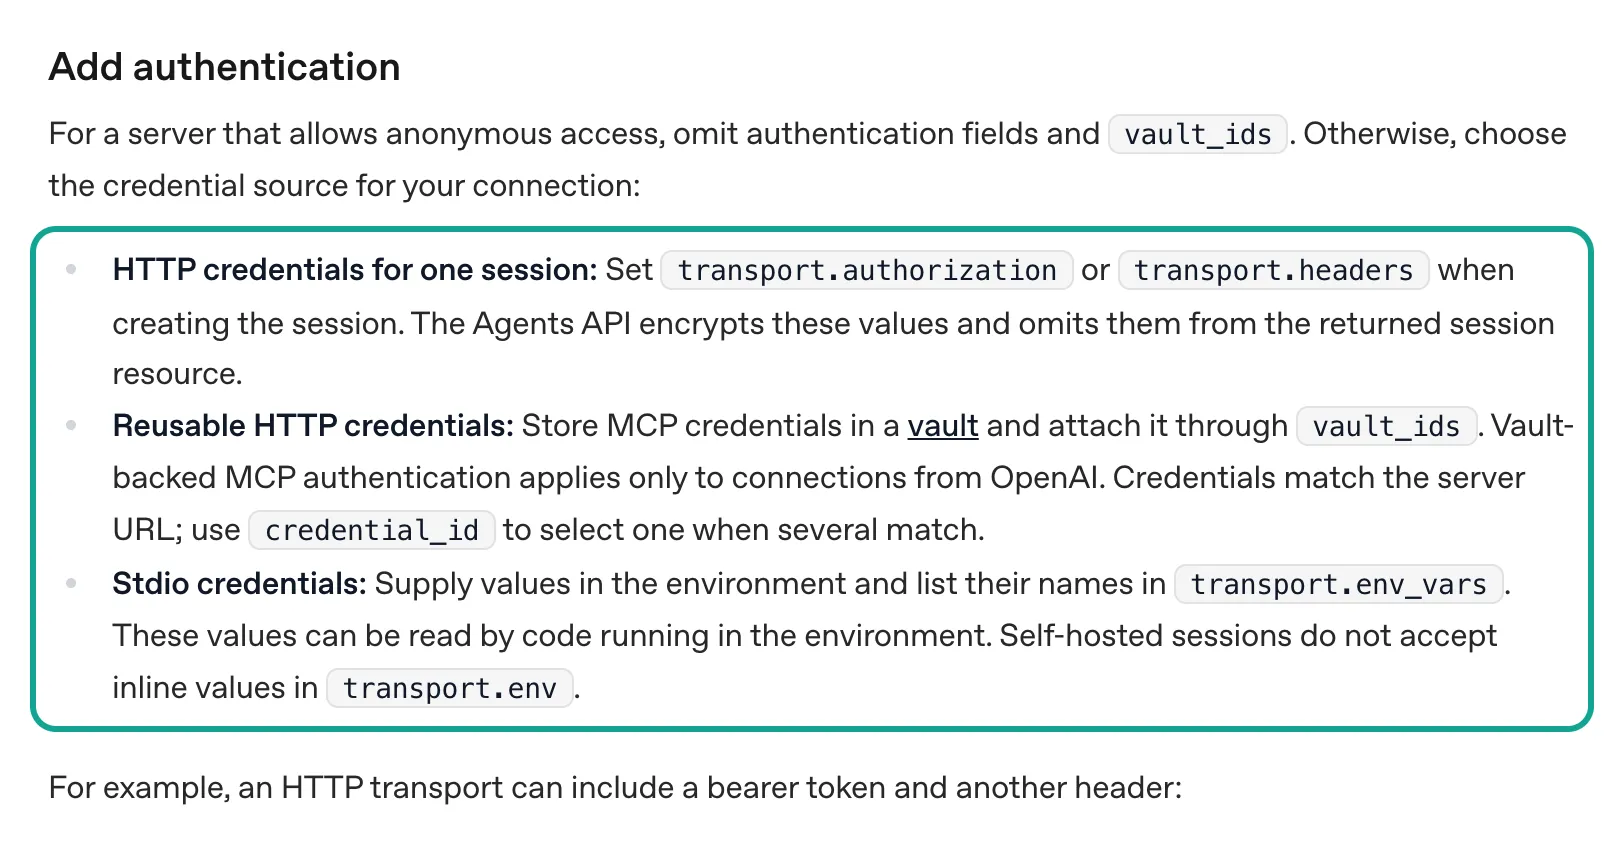
vault 的用法在 Vaults 页:先 client.beta.agents.vaults.create 建一个 vault,再用 vaults.credentials.create 往里放一条凭据,auth.type 选 static_bearer,mcp_server_url 写 MCP 地址,token 写 Key;mcp_server_url 把这条凭据绑定到这个服务器上(Vaults 文档)。读取 vault 或凭据时不会返回密钥原文;应用的 Key 要有 api.vaults.read 和 api.vaults.write 两个权限才能管 vault(Vaults 文档;沙箱安全文档)。有两点要特别记住。第一,vault 里的 MCP 凭据只用于从 OpenAI 发起的连接,用 connection_origin: "environment" 的连接不会用它。第二,删除凭据不会去吊销原来的 Key,也不会停掉正在跑的会话,换 Key 要你自己在 EveryInfra 控制台操作(Vaults 文档:Rotate or remove credentials)。
第三步:主代理只做汇总,五个子代理各管一个平台
多代理在 Agents API 里是一个开关:创建会话时设 agent.multi_agent.enabled: true,harness 会自动给代理加上创建、发消息、等待和中断子代理的工具,不需要你自己声明(Multi-agent 文档)。max_concurrent_subagents 限制同时运行的子代理数,默认 6 个,不含主代理。我们的任务正好 5 个平台,默认值够用。文档还写了三条对本任务很关键的规则:子代理继承会话里配置好的 MCP 工具、它们的凭据和 allowed_tools;子代理不支持 function tools;只有在环境里时,子代理才共用文件系统(Multi-agent 文档)。第一条意味着 vault 里的那把 Key 子代理也能用,不用每个子代理单独配;第二条意味着如果你想让子代理把结果写进你自己的数据库,不能靠函数工具,只能由主代理统一交回,再由你的应用去存。
文档对什么时候拆子代理也有一句很实在的话:独立的任务拆出去,短任务和互相依赖的步骤留在主代理(Multi-agent 文档:When to use subagents)。五个平台的评论互不依赖,正好符合;而「和上周比、写总结」依赖全部结果,留给主代理。automations 文档里还有一段专门讲这件事:对长期目标,让主代理只保留目标和计划,每次定时任务交给一个子代理去做,只留一个简短结果,这样重复检查的详细工具输出不会堆进主会话的上下文(Scheduled automations 文档:Keep repeated work out of the main context)。
主代理的指令我们这样写(配置示例,英文是因为模型对英文指令的遵循更稳定,你可以换成中文):
You run a weekly review check for the brands listed in the input.
Delegate each platform (trustpilot, g2, capterra, app_store, google_play) to its own subagent.
Each subagent calls everyinfra_call_api once per brand with the parameters given below,
uses mode=async when limit is 100 or more (read the rows with everyinfra_get_job),
keeps only reviews posted in the last 7 days (filter by posted_at yourself),
cuts every text field to 2,000 characters, and returns JSON:
{platform, brand, new_reviews, low_star, themes:[{name,count,example_url}], new_issue_vs_last_week}.
Do not return raw reviews. The main agent merges the five results into one report.
If a call returns an error with retryable=true, wait retry_after seconds and retry at most twice.
Never invent reviews. If a platform failed, say so in the report.
指令里说的「下面给出的参数」,放在每次运行的输入里。下表是 Notion 的取值,每一项都来自后文的某个实测。limit 按「一次调用至少覆盖两周」来定,不是一律开到上限,原因见实测一和实测四。
| 子代理 | 每个品牌的参数 | 怎么算低分 | 原因 |
|---|---|---|---|
| Trustpilot | company: "notion.so"、stars: ["1","2"]、sort: "recency"、limit: 20,不传 date | 全部算,因为请求时只要 1–2 星 | 20 条回溯 129 天,一周平均约 1 条差评,取满 20 条再按 posted_at 过滤更稳;sort 用目录列出的值(实测三) |
| G2 | url、sort: "newest"、limit: 100、mode: "async" | rating ≤ 2.5;跳过 record_type: summary 那一行 | 没有星级过滤;ClickUp 每周约 47 条新评论(实测一);同步调用要 50 秒 |
| Capterra | company 填产品页 URL、limit: 100、mode: "async" | rating ≤ 2 | 不按时间排序,要取满再和上周比 id(实测一) |
| App Store | app_id: "1232780281"、country: "us"、sort: "newest"、limit: 50 | rating ≤ 2;按 app_version 计数 | 50 条覆盖 39 天;差评跟着版本走(实测二) |
| Google Play | app_id: "notion.id"、sort: "newest"、language: "en"、limit: 200 | score ≤ 2 | 40 条只覆盖 4.2 天,200 条覆盖 22 天(实测一) |
注意字段名:Google Play 的星级在 score 里,其余四个平台都叫 rating。
第四步:用 automations 每周一早上开一个新会话
定时任务在 automations 页。它是一个单独的资源 POST /v1/agents/automations:type: "periodic" 时写 expression(标准五段 cron)和 timezone(IANA 时区名,例如 Asia/Singapore);type: "once" 时写 run_at(Unix 秒)。目标有两种:new_session 每次开一个新会话,需要 agent(或保存过的 agent_id,二选一)、environment 和 target.input;existing_session 把一段提醒发给已有的会话,适合需要沿用之前发现的任务(Scheduled automations 文档)。API 参考写明 new_session 目标可以带 vault_ids,environment 可以是 none(Create automation 参考)。时区的写法遵循 IANA 时区库(IANA Time Zone Database),cron 的五段写法和 Unix crontab 一致(crontab(5))。
把前面三步合在一起,完整的配置示例如下(Python SDK;OpenAI-Beta: agents=v1 头由 SDK 自动加上,用 curl 时要自己写)(Agents API 快速上手):
import os
from openai import OpenAI

client = OpenAI()  # 应用 Key 需要 api.agents.read / api.agents.write / api.responses.write / api.vaults.write
MCP_URL = "https://api.everyinfra.com/mcp"

vault = client.beta.agents.vaults.create(name="review-check")
client.beta.agents.vaults.credentials.create(
    vault.id,
    name="EveryInfra read-only key",
    auth={"type": "static_bearer", "mcp_server_url": MCP_URL, "token": os.environ["EVERYINFRA_API_KEY"]},
)

agent = client.beta.agents.create(
    model="gpt-6.1-terra",
    instructions=open("weekly_review_instructions.txt").read(),
    tools=[{
        "type": "mcp", "server_label": "everyinfra",
        "transport": {"type": "http", "server_url": MCP_URL},
        "connection_origin": "service",
        "allowed_tools": ["everyinfra_call_api", "everyinfra_get_job"], "required": True,
    }],
    multi_agent={"enabled": True, "max_concurrent_subagents": 5},
)

automation = client.beta.agents.automations.create(
    type="periodic",
    name="Weekly review check",
    expression="0 9 * * MON",
    timezone="Asia/Singapore",
    target={
        "type": "new_session",
        "agent_id": agent.id,
        "environment": {"type": "none"},
        "vault_ids": [vault.id],
        "input": [{"role": "user", "content": [{"type": "input_text",
                   "text": "Brands: Notion (notion.so; g2 notion; capterra https://www.capterra.com/p/186596/Notion/; "
                           "app_store 1232780281; google_play notion.id). Write this week's report."}]}],
    },
)
print(automation.id)
这里有几处文档原文里的细节会影响你对「定时」的预期。创建后状态是 active,但不会立刻跑,第一次在下一个匹配时刻;循环任务会被加一个小的随机延迟来分散负载;目标会话忙的话任务会排队;每次运行生成一个 invocation,它的 status 变成 completed 只表示「任务投递成功」,不表示代理已经做完,要看会话事件里的 agent.session.turn.completed 或 turn.failed(Scheduled automations 文档;Sessions 文档)。周报写好以后,你的应用可以开着事件流读,也可以订阅 webhook:agent.session.idle 表示会话空闲、可以接新输入,但它同样不等于上一回合成功(Webhooks 文档)。想先试一次,不用等到周一:对 automation 发一个空的 POST /v1/agents/automations/{id}/invocations,手动触发不会改动计划(Scheduled automations 文档:Try a run)。
new_session 和 existing_session 怎么选?new_session 每周一个干净的会话,上下文从零开始,成本可预估;缺点是代理不记得上周写了什么,「和上周比」要靠你的应用把上周的摘要放进 target.input。existing_session 正好相反,同一个会话一直往下走,主代理记得以前的发现,文档里的订餐厅例子就是这么用的;Agents API 会在会话接近上下文上限时自动压缩早先的内容(OpenAI 发布文;Compaction 文档)。我们倾向 new_session 加「上周摘要放进输入」,因为差评周报的「上周」只需要一两千 token 的摘要,没必要让会话无限变长。
一次真实的 MCP 往返:模型发出什么,接口回了什么
子代理真正发给 EveryInfra 的,是一次 MCP tools/call。我们在 2026 年 11 月 1 日 00:47:47(新加坡时间)用同一把测试 Key 直接对 https://api.everyinfra.com/mcp 发了这一次调用,模拟 Trustpilot 子代理会做的事:查 notion.so 最近的 1–2 星评论。请求体的 arguments 就是 everyinfra_call_api 的入参:平台、能力和参数。
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api","arguments":{"platform":"trustpilot","action":"reviews","params":{"company":"notion.so","stars":["1","2"],"date":"last30days","sort":"recency","limit":20}}}}返回的是一段文本内容,解析出来是标准的 JSON:count 为 14,results 里每条评论有 title、text、rating、posted_at、verification_level、country 等字段,和目录里 trustpilot/reviews 的 response_fields 一一对得上;billing.charged 为 true,charged_usd 为 0.001389,也就是目录价(目录:trustpilot)。第一条评论标题是「I find everything in Notion a bit too chaotic」,发布于 2026-10-20;我们另外打开 Trustpilot 上 Notion 的公开页面核对,同一条评论、同一天,确实在那里(Trustpilot:Notion)。
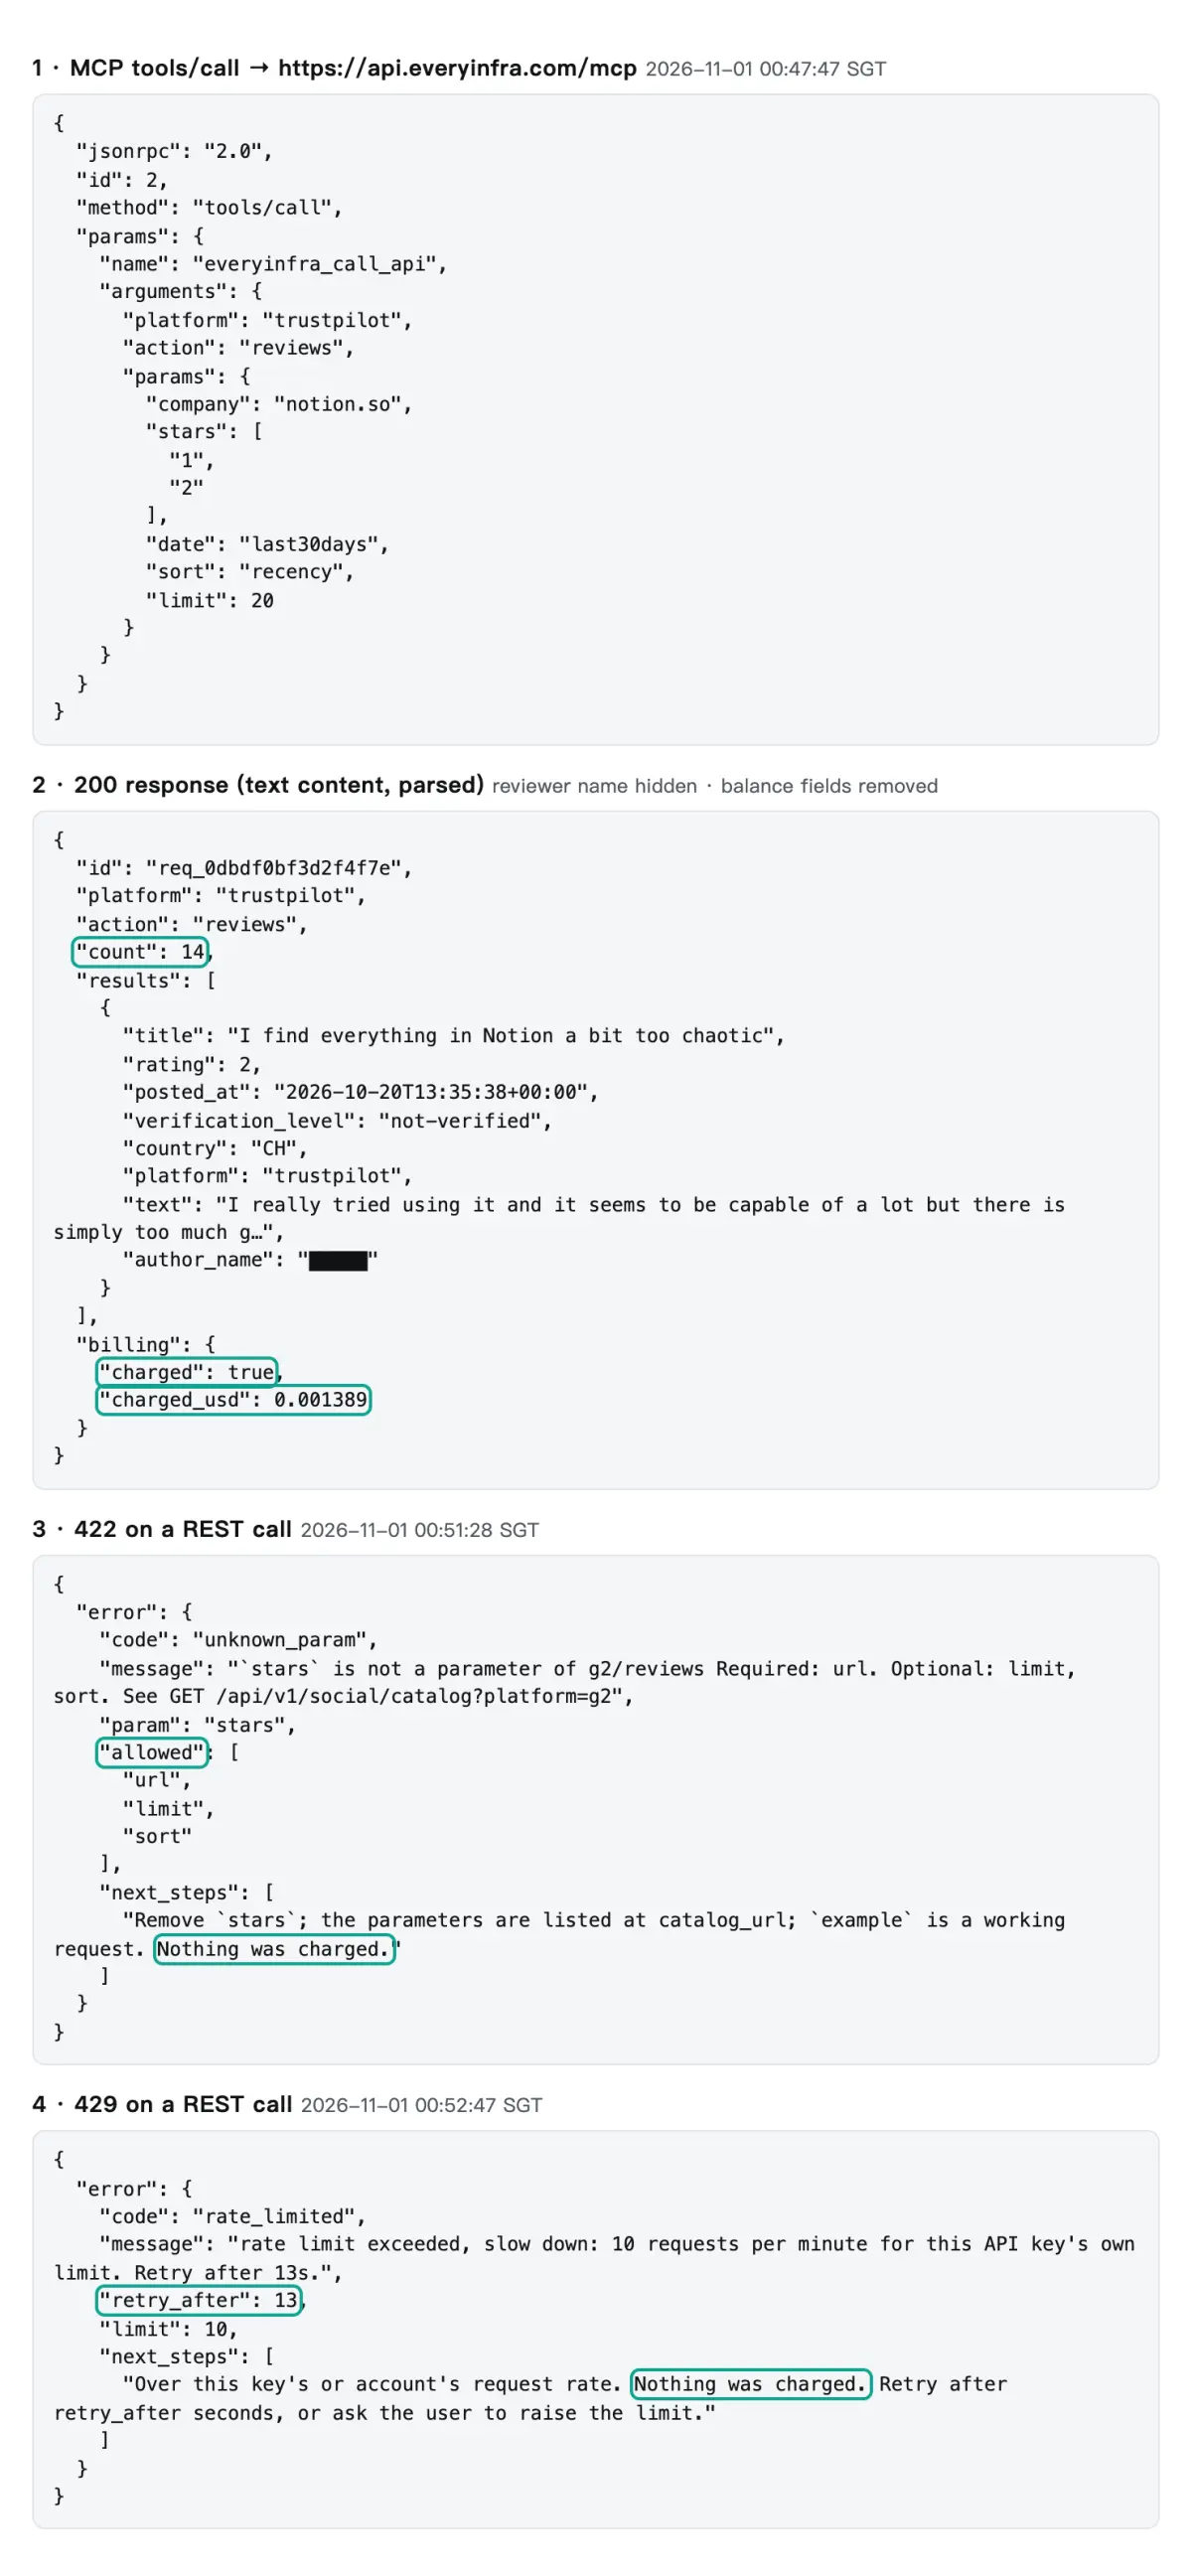
同一张截图里还有两次失败,都是子代理在真实运行时会碰到的。00:51:28(新加坡时间)我们故意给 g2/reviews 传了它不支持的 stars 参数,接口回 422,error.code 是 unknown_param,allowed 列出 url、limit、sort 三个合法参数,next_steps 写着「去掉 stars……Nothing was charged」。00:52:47 和 00:53:46 有两次调用回了 429:那几分钟同时有好几个测试任务在用同一把测试 Key,共用每分钟 10 次的额度。第一次 retry_after 为 13 秒,我们 37 秒后重试成功;第二次 15 秒后重试成功;两次都写明没有扣费。这两种返回对代理很友好:错误里直接告诉模型该改哪个参数、等几秒,子代理不需要人工介入就能自己改正。我们在指令里写「retryable 为 true 时按 retry_after 等,最多重试两次」,就是照着这个格式写的。
还有一种失败要单独说,它的原因是改稿时补做对照才弄清的。00:51:16(新加坡时间)我们给 trustpilot/reviews 传了 sort: "newest",回的是 503,retryable 为 true,retry_after 20 秒,提示 10 分钟内这项能力已经失败了 3 次、都没有扣费。这 3 次失败(另外两次是同一时段其他测试发出的)带的都是目录里没有列出的取值,而同一时段带合法取值的调用都成功了。为了确认因果,我们在 15:39:46 和 15:40:07 用同一组参数各调了一次,只把 sort 从 newest 换成目录写明的 recency。两次都回 200、都扣了 $0.001389,但内容不一样。带 recency 的那次,20 条和 00:54 那次逐条相同,全是英文评论,每条都有 source 字段;带 newest 的那次,20 条里只有 14 条和前者重合,另外 6 条是德语、法语和荷兰语评论,而且所有行都没有 source 和 verification_level 字段。目录的字段说明写明,主来源不可用时结果来自备用来源,这几个字段会缺失。也就是说,newest 没有在参数校验这一步被拦下,而是让主来源失败,结果取决于备用来源当时能不能用:00:51 那次备用来源也没成,回了 503;15:39 那次成了,回了 200,数据却和你要的不一样,而且照常扣费。这比直接报错更麻烦,因为子代理看不出来。以上是 11 月 1 日凌晨和下午的实测;当晚网关已经改了:sort 收 newest(等于 recency)、recency、relevance 三个值,别的值在扣费前回 422,带允许值和 did-you-mean。我们 19:22–19:23(新加坡时间)用同一组参数复测,newest 和 recency 返回的 20 条逐条相同,也和 00:54 那次相同,全是英文评论、每条都有 source,各扣 $0.001389;即便如此,「换平台就换参数名」仍是子代理最容易犯的错,所以指令里我们把每个平台的参数写死,不让模型自己猜;临时失败则交给 retry_after 去等。
| `sort` 取值 | 时间(新加坡) | 返回 | 条数 | 语言 | `source` 字段 | 扣费 |
|---|---|---|---|---|---|---|
newest(目录未列出) | 00:51:16 | 503 | — | — | — | 否 |
newest(目录未列出) | 15:39:46 | 200 | 20,只有 14 条和 recency 重合 | 英 14、德 3、法 2、荷 1 | 全部没有 | $0.001389 |
recency | 15:40:07 | 200 | 20,和 00:54 那次逐条相同 | 英 20 | 20 条都有 | $0.001389 |
newest(当晚修复后) | 19:23:05 | 200 | 20,和 recency 逐条相同 | 英 20 | 20 条都有 | $0.001389 |
recency(当晚修复后) | 19:22:49 | 200 | 20,和 00:54 那次逐条相同 | 英 20 | 20 条都有 | $0.001389 |
实测一:每周跑一次够不够,要看一次调用能往回看多远
「每周巡检一次」听起来理所当然,但它隐含一个前提:每个平台一次调用拿回来的评论,要能覆盖完整的 7 天。如果一个平台一周新增 60 条评论,而一次只取 20 条,那周报就只看到了周末那几天。所以在写任何配置之前,我们先量了每个平台一次调用实际能往回覆盖多少天。方法是:对 Notion 和 ClickUp 两个品牌,在五个平台各调一次 平台/reviews,看返回里最新和最旧一条的发布时间、是否按时间倒序,以及统计窗口内(2026-10-25 至 2026-11-01,UTC)有几条。两个品牌一共 12 次真调,从 2026-11-01 00:48 到 14:38(新加坡时间)。
| 平台 · 品牌 | 请求的条数 | 实际返回 | 最旧一条 | 最新一条 | 按时间倒序 | 近 7 天 | 其中低分 |
|---|---|---|---|---|---|---|---|
| Trustpilot · Notion(只要 1–2 星) | 20 | 20 | 2026-06-13 | 2026-10-20 | 是 | 0 | 0 |
| Trustpilot · ClickUp(只要 1–2 星) | 20 | 20 | 2026-05-16 | 2026-10-29 | 是 | 2 | 2 |
| G2 · Notion | 20 | 19 条评论 + 1 条汇总 | 2022-11-28 | 2026-10-29 | 大体是,混了 3 条旧的 | 12 | 0 |
| G2 · ClickUp | 20 | 19 条评论 + 1 条汇总 | 2026-10-28 | 2026-10-31 | 是 | 19 | 0 |
| Capterra · Notion | 20 | 19 | 2025-12-11 | 2026-10-09 | 否 | 0 | 0 |
| Capterra · ClickUp | 20 | 17 | 2025-11-05 | 2026-10-21 | 否 | 0 | 0 |
| App Store · Notion | 50 | 50 | 2026-09-20 | 2026-10-29 | 是 | 9 | 6 |
| App Store · ClickUp | 50 | 50 | 2026-03-30 | 2026-10-29 | 是 | 2 | 2 |
| Google Play · Notion | 200 | 200 | 2026-10-08 | 2026-10-30 | 是 | 52 | 15 |
| Google Play · ClickUp | 200 | 200 | 2026-03-04 | 2026-10-31 | 是 | 5 | 1 |
这张表里最要紧的是两个极端。G2 上 ClickUp 的 19 条评论全部集中在 10 月 28 日到 31 日这 3 天里,按这个密度推算一周约 47 条,取 20 条只够看到最近两三天;Google Play 上 Notion 我们先取了 40 条,只覆盖 4.2 天,改成取 200 条(这项能力的上限)才覆盖到 22 天。另一端,Trustpilot 上 Notion 的 1–2 星评论很稀,20 条一路回溯到 6 月 13 日,一周平均约 1 条。也就是说,同样「每周一次」,有的平台要把 limit 开到上限,有的平台 20 条绰绰有余。EveryInfra 的评论能力按次计费:Google Play 那次取 200 条,charged_usd 仍然是 0.001389,和取 40 条那次一模一样。但这不等于「每个平台都取到上限」最划算。改稿时我们按目录的 max_limit(Trustpilot 200、G2 100、Capterra 100、App Store 500、Google Play 200)对 Notion 再跑了一轮:App Store 的 500 条一路回溯到 2026 年 2 月 14 日,Trustpilot 的 1–2 星评论回到 2024 年 4 月,远远超过一份周报需要的范围,而这些多出来的行都要进模型的上下文(实测四算了这笔账)。所以我们的推荐是:每个平台按「一次调用至少覆盖两周」定 limit,Notion 就是 Trustpilot 20、G2 100、Capterra 100、App Store 50、Google Play 200,再由子代理按 posted_at 自己过滤出最近 7 天。你的品牌评论量不同,先照这张表的方法量一次再定。
图上能直接看到第三种情况:Capterra 的两行点散落在一整年里,而且返回的顺序和时间无关。capterra/reviews 在目录里只有一个必填参数 company,没有排序参数;Notion 的 19 条从 2025-12-11 到 2026-10-09 打乱排列,近 30 天只有 1 条;ClickUp 的 17 条也是同样的情况。对周报来说,这意味着 Capterra 不能靠「取最新的 N 条」来判断这周有没有新评论,只能每次取满 100 条,按 posted_at 和 id 跟上周的结果做差集。好消息是 Capterra 的评论本身就少,两个品牌近 30 天都只有 1 条,一周一次完全跟得上。
G2 也有一个小坑。Notion 那次返回的第一行不是评论,而是一条 record_type 为 summary 的汇总记录:总评分 4.6、累计 13,962 条评论、最常被提到的优点和缺点;后面 19 条评论大体按时间倒序,但中间夹了 3 条 2022 到 2025 年的旧评论。如果子代理拿「最旧一条的日期」来判断覆盖范围,就会误以为这次调用回溯了 4 年。指令里「自己按 posted_at 过滤」这一句,就是为这种情况写的。汇总记录倒是很有用:周报里可以直接引用这一周的总评分,不用另调一次 g2/profile。
实测二:差评在哪里,五个平台不是平均分布的
覆盖范围量清楚以后,才能比较「差评在哪」。我们把每个平台一次调用能看到的近 30 天低分评论数(G2 按不高于 2.5 星,其余按不高于 2 星)放在一起:Notion 一共 67 条,其中 App Store 22 条、Google Play 42 条,两个应用商店合起来 64 条,占 95.5%;Trustpilot 3 条;G2 和 Capterra 都是 0 条。ClickUp 一共 14 条,分布更平均:Trustpilot 5 条、App Store 4 条、Google Play 5 条,G2 和 Capterra 同样是 0 条。
这个分布对周报的设计有两层含义。第一,B2B 评测站上的差评很少,G2 上两个品牌各取 20 条时,近 30 天一条低分都没有;改稿时对 Notion 取 100 条(实回 50 条评论),近 30 天的 41 条里也只有 1 条低分。这和 G2 在汇总记录里给出的 4.6 分是一致的;如果只盯 G2 和 Capterra,你会以为一切正常。第二,应用商店的差评又多又具体,而且大多带版本号。App Store 返回的每条评论都有 app_version 字段,Notion 近 30 天 22 条低分里,有 8 条来自 1.7.345 这一个版本,是所有版本里最多的。一个子代理只要按版本数一下,就能在周报里写出「1.7.345 之后差评集中」这种可以直接转给研发的句子。
我们又用一组关键词规则给这些低分评论分了类(规则写在复算脚本里,标题和正文里出现「slow、crash、bug……」就归到卡顿与故障,以此类推,一条可以归多类)。Notion 两个应用商店的 64 条低分评论里,卡顿、崩溃和故障类 20 条,手机端体验类 18 条,AI 功能类 12 条;关键词规则完全分不出来的有 22 条,其中 Google Play 占 18 条,多是一两个词的短评。这一部分恰恰是值得交给模型读的:规则能处理写得清楚的长评论,处理不了「bad」「worst update」这种短评和反讽。换句话说,子代理的模型费,应该主要花在规则分不出来的那部分上,而不是把每一条都重新读一遍。
还有一个只有跨品牌才看得到的信号,但样本很小,只能当作线索。App Store 近 30 天的评论里,提到「iPhone Duo」的 Notion 有 2 条、ClickUp 有 1 条:Notion 一条 10 月 26 日的 2 星评论说 iPhone Duo 版触控失灵、选中文字时文字消失、频繁闪退;ClickUp 一条 10 月 29 日的 1 星评论标题就是「No iPhone Duo support」。iPhone Duo 是苹果第一款折叠屏 iPhone,10 月 23 日才在 Apple Store 开售(Apple Newsroom),新设备上市头几周,各家应用出适配问题并不少见。所以这 3 条还不足以说明哪一家有值得排期的问题,周报里合适的写法是「新设备适配,值得留意,下周看是否增加」。它真正说明的是分工:单看一个品牌只是一条差评,放在一起才看得出指向同一个设备;主代理能看到所有子代理的摘要,这种跨品牌的归纳应该留在主代理那一层。
周报长什么样:用这一周的真实数据拼一份
把上面两节的数放回周报的格式里,读者更容易判断这份东西有没有用。下面这张表就是 2026-10-25 到 2026-11-01(UTC)这一周,两个品牌在五个平台上「一次调用能看到的新评论数 / 其中低分数」,全部来自真调的原始返回,是子代理交回主代理的那部分数据的样子。
| 平台 | Notion 本周新增 / 低分 | ClickUp 本周新增 / 低分 | 周报里该写什么 |
|---|---|---|---|
| Trustpilot | 0 / 0 | 2 / 2 | ClickUp 两条 1 星:一条说客服的 AI 机器人,一条说减席位和改账单要提前 30 天,都该转给客服和订阅团队 |
| G2 | 12 / 0 | 19 / 0 | 两家都没有低分;ClickUp 一周约 47 条,limit 要开到 100 |
| Capterra | 0 / 0 | 0 / 0 | 一周都没有新评论,返回不按时间排序,靠 id 做差集 |
| App Store | 9 / 6 | 2 / 2 | Notion 低分集中在 1.7.345 版本;两家共 3 条提到 iPhone Duo,下周再看 |
| Google Play | 52 / 15 | 5 / 1 | Notion 低分最多的一处,22 条短评要交给模型读 |
主代理拿到的就是这样五行、每行一两句话的摘要,加上每个品牌的总评分(G2 的汇总记录、Trustpilot 的 trustpilot/profile 返回里,Notion 的 TrustScore 是 2.2、累计 442 条评论)。它要做的判断只有三件:哪一行比上周明显变多、有没有跨平台或跨品牌重复出现的问题、哪几条原文值得附上链接。这三件事都依赖全部五个平台的结果,所以留在主代理;而读几百条原文、按版本和关键词计数这些机械活,交给子代理。我们建议主代理最后输出一份固定结构的 JSON,再由你的应用渲染成邮件或聊天消息:Agents API 的会话支持通过 agent.text.format.schema 指定输出结构,输入和输出结构合计不超过 4 MiB(Sessions 文档)。这样周报的格式每周一致,下游也好做对比。
实测三:参数写错一个,结果就不一样
前面两节已经零散提到了几个参数问题,这里把它们和其余实测到的情况放进一张表,每一行都是真调的结果。表里的「怎么改」就是写进子代理指令里的规则。
| 现象 | 真调时间(新加坡时间) | 实际返回 | 扣费 | 怎么改 |
|---|---|---|---|---|
Trustpilot 传 date: "last30days",结果不只 30 天 | 2026-11-01 00:47 | 14 条,2026-07-31 到 2026-10-20,只有 3 条在 30 天内;当晚修复后 19:22 复测回 3 条,全在 30 天内 | 是,$0.001389 | 当晚起可以用预设;周报仍取满后按 posted_at 自己过滤 |
G2 传了不支持的 stars | 2026-11-01 00:51 | 422,unknown_param,列出允许的 url、limit、sort | 否 | G2 没有星级筛选,按 rating 自己筛 |
| 多个测试任务共用一把 Key,每分钟 10 次的额度用完 | 2026-11-01 00:52、00:53 | 429,第一次 retry_after 13 秒;两次重试都成功 | 否 | 按 retry_after 等 |
Trustpilot 传目录没列的 sort: "newest" | 2026-11-01 00:51、15:39 | 第一次 503;第二次 200,但来自备用来源,混进 6 条非英文评论,缺 source 字段;当晚修复后 newest 等于 recency | 503 否;200 是,$0.001389 | 用目录列出的取值,写错的值当晚起回 422 |
| Trustpilot 同步取 200 条 | 2026-11-01 15:40 | 85 秒后超时,回 503,提示改用 mode: "async" | 否 | 大 limit 用异步提交,再用 everyinfra_get_job 读结果;异步那次回了 131 条 |
Capterra 用产品名 Notion 查 | 2026-11-01 00:49 | 20 行,其中 3 行没有日期和链接,标题是另一个导出到 Google Sheets 的插件 | 是,$0.001389 | 用产品页链接 /p/186596/Notion/ 查 |
| Capterra 用产品页链接查 | 2026-11-01 00:50 | 19 条,不按时间排序,有 1 条 pros 字段 98,725 字符;当晚修复后单字段最多 5,000 字 | 是,$0.001389 | 仍给每个文本字段设上限,例如 2,000 字符 |
| G2 第一行是汇总记录 | 2026-11-01 00:48 | record_type: summary,总评分 4.6、13,962 条 | 是,$0.001389 | 汇总单独处理,不算进评论数 |
Trustpilot 那一行值得多说一句。目录对 date 的说明是「时间预设:last30days 最近 30 天……留空不限」,我们传了 last30days 并只要 1–2 星,返回的 14 条却从 7 月 31 日一直到 10 月 20 日,真正在 30 天内的只有 3 条。同样的条件不带 date 再调一次,返回 20 条,最旧的到 6 月 13 日,前 14 条和带 date 的那次逐条相同;也就是说,11 月 1 日凌晨实测时,带预设的那次只是截在了 7 月 31 日,离调用当天约 3 个月,而不是 30 天;如果直接把返回条数当成「近 30 天差评数」写进周报,报出来的是 14 条,实际只有 3 条,多了 3.7 倍。当晚网关已经改成按发布日期截止:五个预设分别往前推 7、30、92、183、366 天,写错的预设在扣费前回 422。我们 19:22(新加坡时间)用同样的参数复测,回了 3 条,发布时间从 10 月 3 日到 10 月 20 日,正好是凌晨那 14 条里落在 30 天内的 3 条,扣 $0.001389。所以现在可以把 last30days 当日期过滤器用;周报仍建议取满 20 条、按 posted_at 自己过滤,因为子代理还要拿更早的差评做对比。
Capterra 按名字查的那一行也说明了一个通用道理:评论平台上同名、近名的产品很多,用名字查有时会混进别家的评论。目录里对 company 的说明也写了「优先提供产品链接以减少同名误匹配」。换成产品页链接之后,19 条全部是 Notion 本身的评论。周报的品牌清单里,每个平台都应该存「链接或 ID」而不是名字,这一点在一开始设计输入格式的时候就要定下来。
下表汇总 11 月 1 日晚网关修复后的复测(19:22–19:23,新加坡时间),参数和白天相同:
| 项目 | 11 月 1 日凌晨或下午 | 当晚复测 | 扣费 |
|---|---|---|---|
Trustpilot sort: "newest" | 00:51 回 503;15:39 回 200,但 6 条非英文、缺 source | 200,和 recency、和 00:54 那次逐条相同,全英文 | $0.001389 |
Trustpilot date: "last30days" | 14 条,只有 3 条在 30 天内 | 3 条,全在 30 天内 | $0.001389 |
Capterra 产品页链接,limit: 100 | 86 条,375,315 字节,最长字段 103,138 字符 | 同样 86 条,144,341 字节,最长字段 1,154 字符 | $0.001389 |
| 推荐配方一周(Notion) | 651,907 字节,约 16.3 万 token | 420,933 字节,约 10.5 万 token | — |
实测四:一周的原始评论有多大,决定了模型费
模型费按 token 算,所以要先知道一周的原始评论有多大。子代理每调用一次,返回的每一行都会作为工具输出进它的上下文,所以 limit 开多大,直接决定模型要读多少。我们用 Notion 量了三种配方,每一种都是真调的原始返回(当晚又按推荐配方复测了一次 Capterra),token 按 OpenAI 帮助中心「英文约 4 个字符合 1 个 token」粗算(OpenAI 帮助中心:token 估算)。
| 配方(Notion,五个平台各一次) | 各平台 `limit` | 原样返回 | 约合 token | 文本字段截到 2,000 字符后 | 约合 token |
|---|---|---|---|---|---|
| 第一轮实测(00:47–00:57) | Trustpilot 20(带 last30days)、G2 20、Capterra 20、App Store 50、Google Play 200 | 359,497 字节 | 89,874 | 246,387 字节 | 61,597 |
| 推荐配方 | Trustpilot 20、G2 100、Capterra 100、App Store 50、Google Play 200 | 651,907 字节 | 162,977 | 422,892 字节 | 105,723 |
| 推荐配方,Capterra 换成当晚复测(19:23) | 同上 | 420,933 字节 | 105,233 | 420,732 字节 | 105,183 |
全部取 max_limit | Trustpilot 200、G2 100、Capterra 100、App Store 500、Google Play 200 | 1,021,087 字节 | 255,272 | 786,452 字节 | 196,613 |
推荐配方里,G2 和 Capterra 用的是 15:42–15:43 新跑的两次(G2 要 100 条,实回 50 条评论加 1 条汇总;Capterra 要 100 条,实回 86 条),其余三次沿用第一轮的原始返回,参数相同。全部取上限的那一轮,截断后约 19.7 万 token,是推荐配方的 1.86 倍,多出来的主要是 App Store 多取的 450 条和 Trustpilot 多取的 111 条,几乎都早已超出一周的范围。
11 月 1 日凌晨实测的 652 KB 里,有三分之一以上来自两条评论。第一轮 Capterra 取 20 条时,返回 148,915 字节,其中一条评论单独就有 114,983 字节,它的 pros 字段长达 98,725 个字符:开头是一段正常的用户评价,后面接着一大段网页里的脚本数据。改稿时取 100 条,这样的评论有两条,pros 字段分别是 100,712 和 103,138 个字符;ClickUp 那次 Capterra 返回也有一条,103,556 个字符。这是解析时把页面里的数据也带了进来。按每个文本字段最多 2,000 字符截断后,Capterra 那次 100 条的返回从 375,315 字节降到 146,501 字节;推荐配方一周的总量从约 16.3 万 token 降到约 10.6 万 token,也就是说,当时不截断要多读 54%。当晚网关已经修好:pros、cons、text 里混进的页面代码去掉了,单个字段最多 5,000 字。我们 19:23(新加坡时间)用同样的产品页链接和 limit: 100 复测,回来的还是那 86 条评论,最长的文本字段 1,154 个字符,整个返回 144,341 字节,比凌晨截断后的 146,501 字节还小一点,扣 $0.001389。推荐配方一周因此降到约 42 万字节、约 10.5 万 token,和凌晨截断后的数只差 0.5%,所以下文的模型费估算不用改。在把数据交给模型之前给文本字段设一个上限,仍然值得保留:它不花钱,还能防住以后别的平台出同样的问题。
子代理的设计在这里就体现出价值了。如果不拆子代理,主代理要把这 10 万多 token 全部读进自己的上下文;拆成 5 个子代理后,每个子代理只读自己那一份(最大的 Capterra 截断后约 3.7 万 token),交回主代理的只是一段几百 token 的 JSON 摘要。Agents API 的 automations 文档把这个好处说得很直白:把每次定时任务交给子代理,详细的工具输出就不会堆进主会话的上下文(Scheduled automations 文档)。我们之前在 Claude Code 子代理并行拉 TikTok 品牌号一文里实测过同样的思路,原始数据和摘要差了约 100 倍;这里换成评论数据,结论是一样的。
算账:openai agents api pricing 和我们的接口费
先算我们这一半。EveryInfra 的评论能力按调用次数计费,和返回多少条无关,五个平台的 price_usd 都是 0.001389(目录;价格页)。一个品牌每周五次,就是 $0.006945;一年 52 周是 $0.3611;同时盯 10 个品牌(自家加竞品),一年 $3.61。这些不是估算:本篇一共 21 次扣费的调用(含改稿时补的 6 次),每次返回的 charged_usd 都是 0.001389,合计 $0.029169;另外 6 次失败(3 次 503、1 次 422、2 次 429)都没有扣费。当晚网关修复后,我们又复测了 4 次(Trustpilot 3 次、Capterra 1 次),各扣 $0.001389,合计 $0.005556。
再算 OpenAI 那一半。Agents API 概览页写明:模型用量按所选模型的 API 价格计费,OpenAI 工具按标准价,OpenAI 托管沙箱按标准容器价(Agents API 概览:Pricing)。我们的方案不开沙箱(environment: none),也不用 web search,所以只剩模型 token。2026 年 11 月 1 日读取的标准档公开价如下(每百万 token)(OpenAI 价格页):
| 模型 | 输入 | 缓存输入 | 30 分钟缓存写入 | 输出 |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $12.50 | $50.00 |
| gpt-6.1-sol | $2.00 | $0.10 | $2.50 | $10.00 |
| gpt-6.1-terra | $1.00 | $0.05 | $1.25 | $5.00 |
| gpt-6-luna | $0.10 | $0.01 | $0.125 | $0.50 |
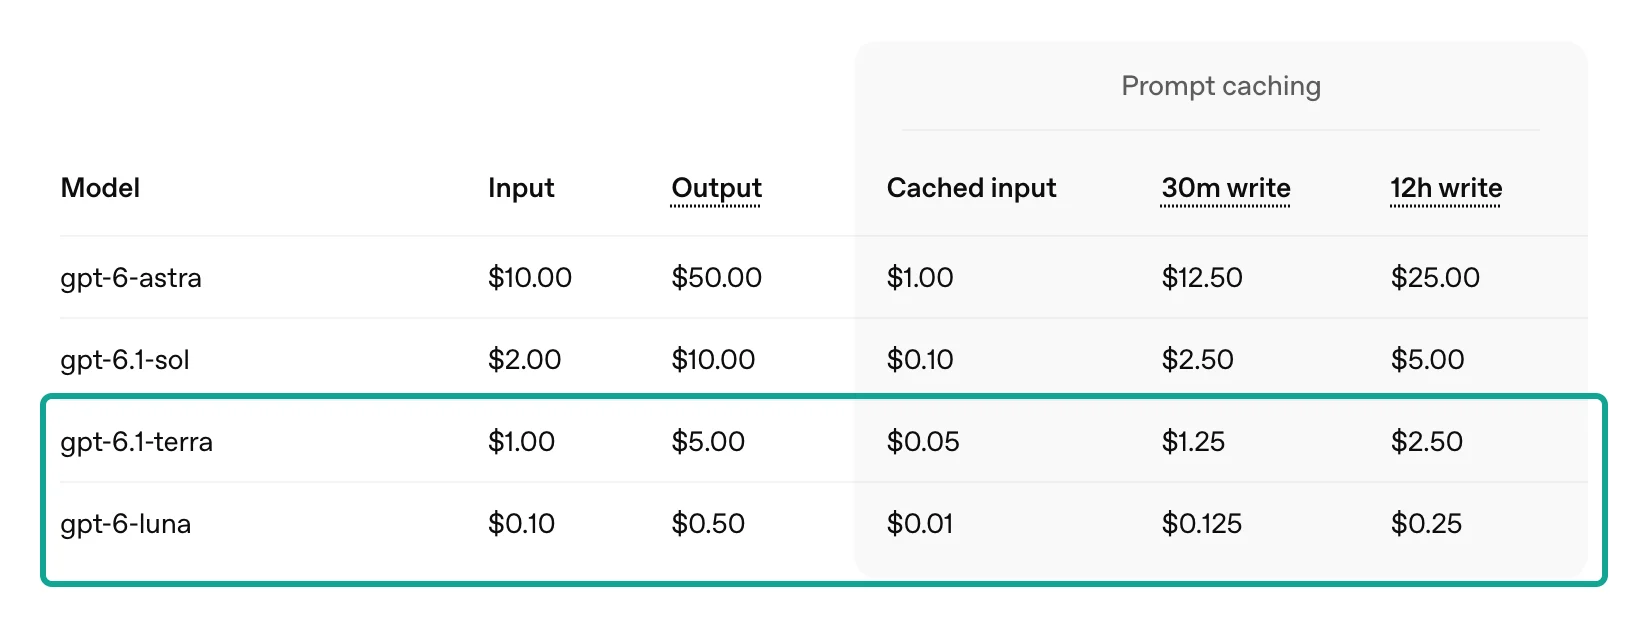
估算方法写在这里,方便你换成自己的数。输入有三块:推荐配方一周的评论(截断后约 105,723 token)、5 个子代理各约 8,000 token 的固定开销(指令、工具说明、推理时的中间内容)、主代理约 20,000 token。这些第一次读时按 30 分钟缓存写入价计(prompt caching 文档写明 GPT-5.6 及以后的模型,30 分钟缓存写入是普通输入价的 1.25 倍,这样算偏保守)(Prompt caching 文档);子代理在一个回合里会多次调模型,我们假设评论和开销被按缓存价再读两遍;输出按每个子代理 1,500 token、主代理 3,000 token 计。除了评论体积是实测的,其余几项都是假设,所以下面的金额只取两位有效数字:gpt-6-luna 约 $0.029,gpt-6.1-terra 约 $0.27,gpt-6.1-sol 约 $0.55,gpt-6-astra 约 $2.9。四个模型之间差约 100 倍,这只是单价之比(astra 的输入价 $10.00 是 luna 的 100 倍),换成任何任务都一样,并不是这件活特有的结论。
| 每周、一个品牌 | 金额 | 一年(×52) | 来源 |
|---|---|---|---|
| EveryInfra 数据调用(5 次) | $0.006945 | $0.3611 | 实测扣费 |
| 模型费,gpt-6-luna | 约 $0.029 | 约 $1.5 | 按公开价估算 |
| 模型费,gpt-6.1-terra | 约 $0.27 | 约 $14 | 按公开价估算 |
| 模型费,gpt-6.1-sol | 约 $0.55 | 约 $29 | 按公开价估算 |
| 模型费,gpt-6-astra | 约 $2.9 | 约 $150 | 按公开价估算 |
哪项假设影响最大?下表把固定开销和重读次数各换三档重算(gpt-6.1-terra,推荐配方,其余假设不变):
| 每个子代理的固定开销 | 重读 1 遍 | 重读 2 遍 | 重读 4 遍 |
|---|---|---|---|
| 4,000 token | $0.24 | $0.25 | $0.26 |
| 8,000 token | $0.27 | $0.27 | $0.29 |
| 16,000 token | $0.32 | $0.33 | $0.35 |
九种组合都在 $0.24 到 $0.35 之间。重读次数几乎不影响结果,因为缓存价只有输入价的 5%;固定开销影响稍大。真正拉开差距的是评论本身的体积:同样的假设下,全部取 max_limit 约 $0.40,第一轮的小配方约 $0.21。所以控制模型费的第一步是定好 limit 和截断,第二步才是选模型。
这张表最想说明的是比例:数据费只占总成本的零头,选哪个模型才是主要的变量。对差评周报这种「读很多、判断简单」的任务,我们会让子代理用便宜的模型(gpt-6-luna 或 gpt-6.1-terra)做归类,主代理视需要用好一点的模型写总结。Agents API 支持在同一个会话里更新 model、reasoning.effort 和 service_tier,但不能中途改 tools、instructions 和 multi_agent(配置文档),所以模型组合要在建 agent 的时候就想好。
最后提醒两点计费上的细节。第一,Agents API 返回的 usage 是「尽力而为」的:可能为 null、可能事后变化,不是最终账单;而且它不单独列出缓存写入的 token 数,所以在有缓存写入价的模型上,光看 usage 算不出准确的模型费(Observability 文档)。第二,如果你改用托管沙箱,容器按公开价计费(4 GB 每 20 分钟 $0.12,2026 年 6 月 2 日起按分钟计、每次最少 5 分钟),而托管沙箱自 2026-10-09 起只在活跃回合计费,回合之间的空闲不再收钱(OpenAI 价格页;更新日志 2026-10-09)。本方案用不到沙箱,这笔是 0。
公开 beta 的限制:上线前要逐条确认
Agents API 目前是公开测试,请求要带 OpenAI-Beta: agents=v1 头,官方 SDK 用 beta.agents 命名空间(快速上手)。OpenAI 在发布文里说会在测试期根据反馈快速迭代、走向正式版(OpenAI 发布文),所以接口细节还会变。下面这张表只列文档原文里写明的限制,每条都和口碑巡检有关。
| 限制 | 原文怎么说 | 对口碑巡检的影响 | 出处 |
|---|---|---|---|
| 数据驻留和保留 | 目前只支持美国的数据驻留,不支持零数据保留;用自托管沙箱也不会变成 ZDR 可用 | 评论是公开数据,问题不大;但如果周报里会混进客户工单等内部数据,要先过合规 | 概览、数据控制 |
| 定时不是准点 | 循环任务会加小的随机延迟;目标会话忙就排队 | 周报会在 9 点后几分钟到,别把它接到要求准点的流程上 | Automations |
| 投递完成不等于做完 | invocation 的 completed 只表示投递成功 | 要以 turn.completed 或 turn.failed 判断成败,失败时要告警 | Automations、Webhooks |
| vault 只给 OpenAI 发起的连接用 | 从环境发起的 HTTP 连接不使用 vault 凭据 | EveryInfra MCP 是公网服务,用默认 service 正好合适 | MCP connections |
| 子代理不支持 function tools | 子代理继承 MCP 工具和凭据,但不能用函数工具 | 想写库只能由主代理交回、你的应用去存 | Multi-agent |
| usage 不是账单 | best-effort,可为 null,会变;不单列缓存写入 | 成本要以账单为准,别用 usage 做精确对账 | Observability |
| 配置和输入大小 | 指令加工具配置不超过 4 MiB;单次输入不超过 4 MiB | 品牌清单很长时,别把上周全量结果塞进输入,只放摘要 | 配置、Sessions |
| MCP 起不来 | 设了 required: true 时初始化失败会让回合失败,错误码 mcp_server_startup_failed(424) | 这是我们想要的:没数据就不写周报 | 错误与恢复 |
做不了或要注意的地方
第一,这套方案只读公开评论,不替你回复。五个平台里,App Store 和 Google Play 的开发者回复要走苹果和谷歌自己的开发者后台(Apple:评分、评论和回复;Google Play 管理中心:查看和分析评分与评论)。我们的返回里有 reply_text 字段(Google Play、Trustpilot)和 vendor_response(Capterra),周报可以顺手标出「已回复 / 未回复」,但真正回复要人去后台点。
第二,不要用这套东西去「处理」差评。美国联邦贸易委员会 2024 年 8 月发布的消费者评论规则,明确禁止买卖虚假评论、禁止以特定好评或差评为条件提供报酬,并点名 AI 生成的假评论(FTC 新闻稿,2024-08-14)。差评周报的用处是让产品和客服更早看到问题,而不是去影响评论本身。
第三,评分门槛要按平台设。G2 用半星制,我们按不高于 2.5 星算低分;其余按不高于 2 星。G2 上两个品牌近 30 天都没有低分评论,如果你的产品也是这样,可以把 G2 的门槛放宽到 3 星,否则 G2 那一栏永远是 0,周报的读者会慢慢不看它。
第四,关键词规则和模型各有分工。实测二里规则分不出来的 22 条短评,是模型最该读的部分;而写得清楚的长评论,规则已经能分对大多数。如果你只想要一个最便宜的版本,可以让子代理先用规则分一遍,只把分不出来的交给模型;Agents API 的 programmatic tool calling 也是为「在代码里过滤、合并结果,只把相关的带回上下文」设计的(OpenAI 发布文;Programmatic tool calling 文档)。
最近的变化
- 2026-09-10:Agents API 开放公开测试,带托管沙箱、子代理、上下文压缩,不另收平台费(更新日志;OpenAI 开发者论坛公告)。对读者意味着:自己维护代理循环的必要性变小了,可以先用它做原型。
- 2026-10-09:托管沙箱改成只在活跃回合计费,并支持预热(更新日志)。对读者意味着:需要跑脚本的巡检,空闲等待不再花钱。
- 2026-10-16:Agents API 加了 Ultrafast 模式,托管沙箱内置 Artifact SDK,能直接生成表格和文档(更新日志)。对读者意味着:周报可以直接出成表格文件,不过这需要开沙箱。
- 2026-10-20:API 支持 12 小时提示缓存,写入价是输入价的 2.5 倍(更新日志;Prompt caching 文档)。对读者意味着:每周跑一次的任务间隔远超 12 小时,缓存帮不上跨周的忙,只在一次运行内部有用。
- 2026-10-26:GPT-6.1 Terra 发布(更新日志)。对读者意味着:子代理多了一个价格在 luna 和 sol 之间的选择,本文估算里的 $0.2154/周就是它。
- 2026-10-28:符合条件的 ChatGPT Pro 和 Business 订阅用户每月最多可以领 $500 的 API 额度(更新日志)。对读者意味着:小团队跑这套巡检的模型费,很可能被这笔额度覆盖。
- 2026-11-30:Agent Builder 计划关停,OpenAI 在 2026 年 6 月 3 日宣布了这次弃用(弃用页)。对读者意味着:老流程要在这之前迁到 Agents API 或 Agents SDK;开发者论坛上有人问 Agent Builder 里的 MCP Key 能不能用程序更新,OpenAI 员工也建议需要自动轮换凭据的流程改用 Agents API 的 vault(OpenAI 开发者论坛)。
常见问题
openai agents api pricing 怎么算,有没有平台费?
没有单独的平台费。OpenAI 发布文写的是「使用 Agents API 不收额外费用,只付代理用掉的 token 和工具」;概览页写明模型按所选模型的 API 价、工具按标准价、托管沙箱按标准容器价计费。本文的方案不开沙箱,一个品牌一周的模型费按公开价估算约 $0.029(gpt-6-luna)到约 $2.9(gpt-6-astra)之间,数据调用另付 $0.006945。(问题来源:Google 联想词「openai agents api pricing」「openai agents api cost」;依据:OpenAI 发布文、概览、价格页)
openai agents api vs sdk,该选哪个?
要 OpenAI 帮你跑代理循环、保存会话、定时唤醒,选 Agents API;要代理跑在自己的程序里、数据和状态都在自己手里,选 Agents SDK。官方对比表里,Agents API 的集成工作量是「低」,SDK 是「中」。要零数据保留的团队目前只能选 SDK,因为 Agents API 不支持 ZDR。(问题来源:Google 联想词「openai agents api vs sdk」;依据:Agents 总览、概览)
openai agents sdk mcp 能接同一个 EveryInfra 服务吗?
能。SDK 的 MCP 文档支持 Streamable HTTP,把 https://api.everyinfra.com/mcp 和 Key 填进去即可,工具名和参数与本文一样。区别在于定时、重试和凭据保存要你自己写。(问题来源:Google 联想词「openai agents sdk mcp」「openai agents sdk mcp server」;依据:Agents SDK MCP 文档、MCP 传输规范)
openai agents api key 要开哪些权限?
快速上手页写的是:应用 Key 要有 api.agents.read、api.agents.write(会话操作)和 api.responses.write(模型推理);要管理 vault,再加 api.vaults.read、api.vaults.write。这把 OpenAI Key 留在你的服务器上,不要放进代理的指令或沙箱。(问题来源:Google 联想词「openai agents api key」;依据:快速上手、沙箱安全)
openai agents api computer use 能不能直接去评论网站上读?
Agents API 在 2026-09-29 加了 computer use,代理可以在 OpenAI 托管的浏览器里操作网站,网站访问审批和登录由你的应用处理。但用浏览器一页页翻评论,要开沙箱、耗时长、token 也多得多,而且 Trustpilot、G2、Capterra 的页面对脚本访问有防护(我们用 curl 直接打开这三个页面都是 403)。读结构化评论,用数据接口更稳也更便宜。(问题来源:Google 联想词「openai agents api computer use」;依据:更新日志 2026-09-29)
把 Key 交给 AI 代理,安全吗?
r/artificial 讨论 Agents API 发布的帖子里,就有人留言「Good luck trusting AI with passwords and secrets」。按 OpenAI 文档的设计,vault 里的密钥读取时不返回原文,MCP 认证由 OpenAI 服务在连接时加上,代理生成的代码碰不到;但沙箱安全页也写明,放进环境变量的值能被代理生成的代码读到。所以 Key 要进 vault,不要进 env,再给巡检单独开一把只读用途的 Key。(问题来源:r/artificial 讨论帖;依据:Vaults、沙箱安全)
上手步骤
- 在 EveryInfra 注册并拿到 API Key,照快速上手用 curl 调一次免费的目录接口,确认五项评论能力
trustpilot/reviews、g2/reviews、capterra/reviews、app_store/reviews、google_play/reviews都是available: true。各能力的参数和返回字段见能力页:Trustpilot 评论、G2 评论、Capterra 评论、App Store 评论、Google Play 评论。 - 为每个品牌在五个平台上找好链接或 ID,存成一张表。平台层面的说明在 Trustpilot API、G2 API、Capterra API、App Store API、Google Play API 几页。
- 先不上 Agents API,用 REST 对你的品牌各调一次,量一下每个平台一次能覆盖几天,照「实测一」的表格定好
limit。 - 在 OpenAI 一侧照「第四步」的配置示例建 vault、agent 和 automation,用手动 invocation 先跑一次,看周报和会话事件。
- 跑满两周后,对照账单检查模型费,按需要把子代理换成更便宜的模型。
如果你还想把评论数据做成对外的产品,可以接着读评论数据如何做成付费产品;想换成 ChatGPT 的定时任务做类似的事,可以看 ChatGPT 定时任务做需求雷达。全部能力和价格在数据市场。
参考资料
- Agents API overview,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/overview
- Agents API quickstart,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/quickstart
- Agents API architecture,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/architecture
- Configuring agents,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/configuration
- Sessions,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/sessions
- Scheduled automations,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/sessions/automations
- Webhooks,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/sessions/webhooks
- Manage sessions,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/sessions/manage
- Events and items,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/sessions/events
- Multi-agent,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/multi-agent
- Vaults,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/tools/vaults
- MCP connections,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/tools/mcp
- OpenAI-hosted sandboxes,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/environments/openai-hosted
- Sandbox security,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/environments/security
- Self-hosted sandboxes,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/environments/self-hosted
- Errors and recovery,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/errors
- Observability and usage,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/observability
- Tracing,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents-api/tracing
- API pricing,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/pricing
- Changelog(2025-03-11 至 2026-10-30 条目),OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/changelog
- Deprecations(Agent Builder),OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/deprecations
- Agents(Compare agent runtime options),OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/agents
- Your data(数据控制),OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/your-data
- Prompt caching,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/prompt-caching
- MCP servers(Responses API),OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/tools-connectors-mcp
- Tool search,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/tools-tool-search
- Programmatic tool calling,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/tools-programmatic-tool-calling
- Compaction,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/compaction
- Rate limits,OpenAI 开发者文档,2026-11-01 读取,https://developers.openai.com/api/docs/guides/rate-limits
- Create automation(API 参考),OpenAI,2026-11-01 读取,https://developers.openai.com/api/reference/resources/beta/subresources/agents/subresources/automations/methods/create
- Agents(API 参考),OpenAI,2026-11-01 读取,https://developers.openai.com/api/reference/resources/beta/subresources/agents
- Introducing the Agents API,OpenAI,2026-09-10,https://openai.com/index/introducing-the-agents-api/
- Introducing the Agents API and hosted sandboxes,OpenAI 开发者论坛,2026-09-10,https://community.openai.com/t/introducing-the-agents-api-and-hosted-sandboxes/1396481
- Agent Builder MCP Secrets API,OpenAI 开发者论坛,2026-11-01 读取,https://community.openai.com/t/agent-builder-mcp-secrets-api/1368113
- OpenAI launches Agents API public beta built on Codex harness,Reddit r/artificial,2026-11-01 读取,https://www.reddit.com/r/artificial/comments/1wctpbu/openai_launches_agents_api_public_beta_built_on/
- openai/codex 仓库,GitHub,2026-11-01 读取,https://github.com/openai/codex
- openai/openai-agents-python 仓库,GitHub,2026-11-01 读取,https://github.com/openai/openai-agents-python
- Model context protocol(Agents SDK 文档),OpenAI,2026-11-01 读取,https://openai.github.io/openai-agents-python/mcp/
- openai-agents(PyPI),2026-11-01 读取,https://pypi.org/project/openai-agents/
- MCP 规范:Transports(2025-06-18),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- MCP 规范:Tools(2025-06-18),Model Context Protocol,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- RFC 6750:OAuth 2.0 Bearer Token Usage,IETF,2012-10,https://datatracker.ietf.org/doc/html/rfc6750
- RFC 3339:Date and Time on the Internet: Timestamps,IETF,2002-07,https://datatracker.ietf.org/doc/html/rfc3339
- Time Zone Database,IANA,2026-11-01 读取,https://www.iana.org/time-zones
- crontab(5),Linux man-pages,2026-11-01 读取,https://man7.org/linux/man-pages/man5/crontab.5.html
- Ratings, reviews, and responses,Apple Developer,2026-11-01 读取,https://developer.apple.com/app-store/ratings-and-reviews/
- View & analyze your app's ratings & reviews,Google Play 管理中心帮助,2026-11-01 读取,https://support.google.com/googleplay/android-developer/answer/138230
- Understanding and counting tokens,OpenAI 帮助中心,2026-11-01 读取,https://help.openai.com/en/articles/4936856-what-are-tokens-and-how-to-count-them
- Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials,美国联邦贸易委员会,2024-08-14,https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- Notion Reviews,Trustpilot,2026-11-01 读取,https://www.trustpilot.com/review/notion.so
- Notion Reviews,G2,2026-11-01 读取,https://www.g2.com/products/notion/reviews
- Notion,Capterra,2026-11-01 读取,https://www.capterra.com/p/186596/Notion/
- Notion 应用页,App Store,2026-11-01 读取,https://apps.apple.com/us/app/notion-notes-tasks-ai/id1232780281
- Notion 应用页,Google Play,2026-11-01 读取,https://play.google.com/store/apps/details?id=notion.id
- EveryInfra 数据能力目录(trustpilot),EveryInfra,2026-11-01 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot
- EveryInfra 数据能力目录(全部),EveryInfra,2026-11-01 读取,https://api.everyinfra.com/api/v1/social/catalog
- iPhone Duo arrives at Apple Store locations worldwide,Apple Newsroom,2026-10,https://www.apple.com/newsroom/2026/10/iphone-duo-arrives-at-apple-store-locations-worldwide/
引用编号 BL-59