Liner Actions MCP y el mcp tool router: cómo elige un agente entre miles de herramientas
Liner Actions MCP pone 4 herramientas delante de 1100 apps. Medimos 574 capacidades (540 activas) en 12 herramientas MCP: 16 206 bytes. Costes y ejemplos.
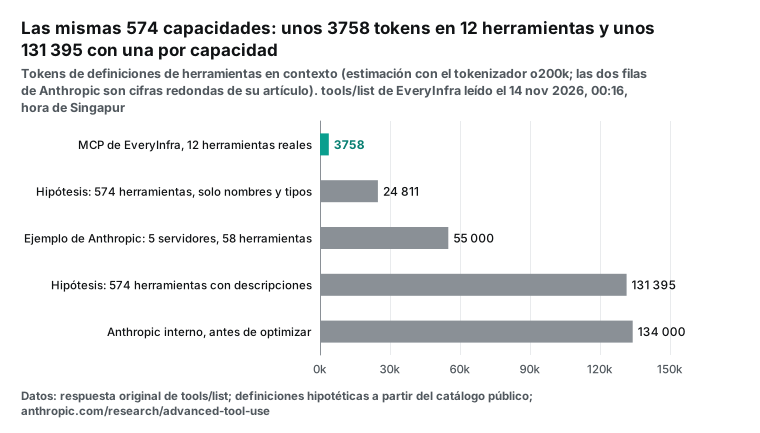
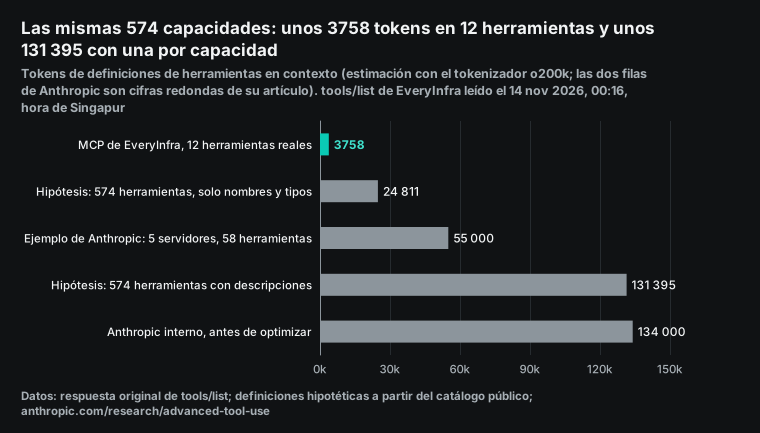
El catálogo público de EveryInfra tiene 106 plataformas y 574 capacidades de datos, 540 de ellas disponibles, y nuestro servidor MCP remoto las agrupa en 12 herramientas. El 14 de noviembre de 2026, a las 00:16 hora de Singapur, la respuesta de tools/list ocupaba 16 206 bytes. Si cada capacidad fuera una herramienta, la lista que construimos con el mismo catálogo ocuparía 528 989 bytes, unas 33 veces más.
Los tokens los estimamos con el tokenizador o200k (3758 frente a 131 395). Claude cuenta más tokens que eso, así que cualquier importe en dólares que salga de esta estimación es un mínimo. En Sonnet 5.5 y sin caché, la lista de 574 herramientas cuesta como mínimo unos 0,263 USD por turno. Una llamada real a reddit/search costó 0,000792 USD, así que un solo turno de definiciones equivale al menos a unas 330 llamadas de datos. Liner Actions MCP lleva la misma idea al extremo: enseña 4 herramientas al modelo y guarda más de 1100 aplicaciones detrás. Si le das a Liner las acciones (una fila en una hoja, un ticket) y a EveryInfra los datos públicos de Reddit, YouTube y Trustpilot. En nuestra prueba, las cinco llamadas de datos cobradas sumaron 0,004307 USD.
A principios de mes, un hilo de r/mcp preguntó cuántas herramientas MCP aguanta un agente antes de confundirse (r/mcp, 2026-11-04). Recibió 21 respuestas muy distintas. Una persona veía elecciones erróneas a partir de 20 o 30 herramientas, otra solo por encima de unos cientos, y una tercera decía que las descripciones parecidas hacen más daño que la cantidad.
Cuantas más herramientas conectas, más definiciones lee el modelo en cada turno, más pagas y distinto es el precio de cada error de elección. Liner Actions MCP representa el conector de acciones para más de mil aplicaciones, y el servidor MCP remoto de EveryInfra representa la lectura de datos de plataformas públicas.
Del lado de Liner leímos la documentación y la nota de prensa, y enviamos una petición sin credenciales para ver la respuesta. No iniciamos sesión con una cuenta de Liner, así que todo paso que escribe en una hoja o abre un ticket aparece como ejemplo de configuración. Del lado de EveryInfra, cada cifra sale de respuestas reales de esa noche. EveryInfra no tiene ninguna relación comercial con Liner.
Qué es liner actions mcp: 4 herramientas delante de más de 1100 apps
Liner es una empresa coreana de búsqueda con IA. El 29 de septiembre de 2026, la prensa coreana informó del lanzamiento de Liner Actions MCP (Digital Today, 2026-09-29; VentureSquare). La idea es sencilla: conectas un agente de IA una sola vez y puede usar calendarios, Slack, Notion y más de 1100 servicios.
La nota de prensa en inglés salió el 3 de noviembre de 2026 (nota de prensa en VMblog, 2026-11-03). El titular habla de «more than 1,100 verified apps». Según el texto, Liner llamó a cada herramienta para comprobar que funciona, las herramientas se cargan bajo demanda, no guarda datos de usuarios y sus registros están desidentificados. El MCP y la API de Liner Actions son gratis por ahora y funcionan en coreano e inglés.
Un análisis del 11 de noviembre de 2026 lo comparó con la opción de tener un servidor MCP por aplicación (Efficiently Connected, 2026-11-11). El primer lanzamiento fue el 29 de septiembre, y la nota en inglés, el 3 de noviembre.
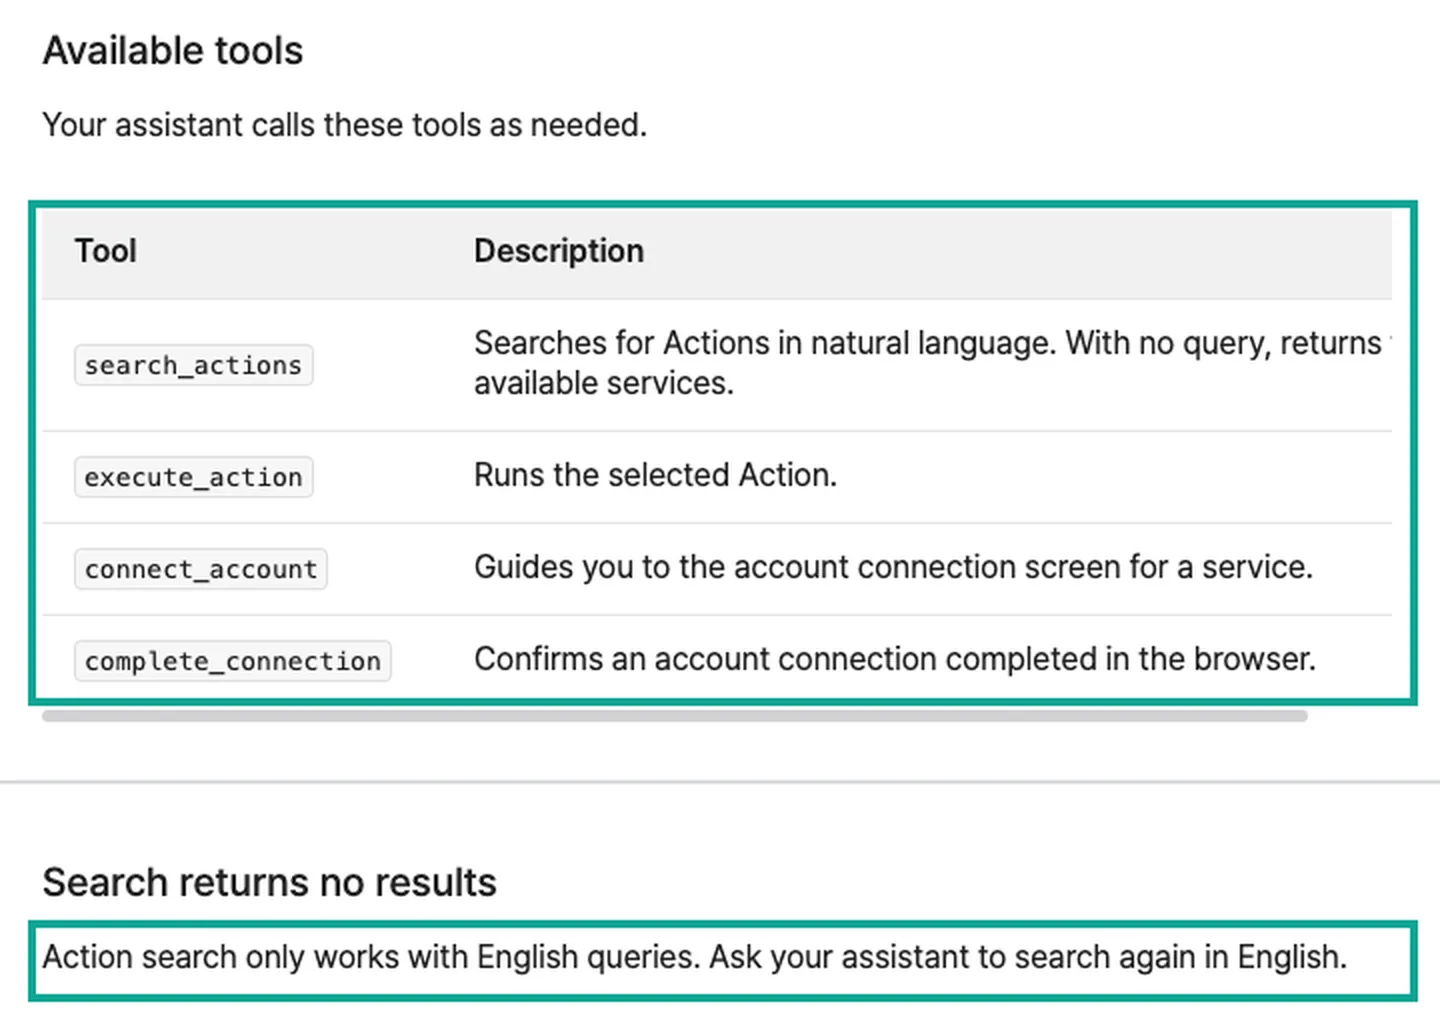
La página de Actions MCP en la documentación para desarrolladores da más detalle (documentación de Liner Actions MCP). El servidor muestra cuatro herramientas. search_actions busca acciones con lenguaje natural y, sin consulta, lista los servicios disponibles. execute_action ejecuta la acción elegida. connect_account y complete_connection enlazan tu cuenta de una aplicación concreta.
La sección de problemas frecuentes tiene tres reglas que marcan el uso. La búsqueda de acciones solo funciona con consultas en inglés. La aprobación del inicio de sesión caduca a los 30 días y después las peticiones devuelven 401. Terminar el inicio de sesión en el navegador no basta, porque el asistente también tiene que confirmar la conexión.
A las 00:15 hora de Singapur enviamos una petición al servidor sin credenciales. Devolvió HTTP 401 y {"error":"unauthorized"}. El valor resource_metadata de la cabecera apuntaba a un documento de metadatos del recurso protegido, que nombra a actions.liner.com como servidor de autorización con un único alcance, mcp. Es el mecanismo de descubrimiento que pide la especificación de autorización de MCP (autorización MCP, 2026-07-28; RFC 9728).
La instalación depende del cliente. En Claude Code se añade un servidor HTTP con claude mcp add en el ámbito de usuario, y para quitarlo hay que pasar el mismo valor de -s. En Codex se ejecuta codex mcp add liner-actions --url …, que escribe en ~/.codex/config.toml, y después codex mcp login liner-actions para aprobar en el navegador. Luego hay que abrir una sesión nueva de Codex, porque la sesión en curso no vuelve a leer la configuración.
En ChatGPT se activa el modo desarrollador en Ajustes › Seguridad e inicio de sesión, se añade el servidor MCP en Plugins y se elige OAuth. Según Liner, esto está abierto a los planes Plus, Pro, Business, Enterprise y Edu, pero las acciones de escritura solo funcionan en Business, Enterprise y Edu. La ayuda de OpenAI también coloca los servidores MCP propios dentro del modo desarrollador (Ayuda de OpenAI: servidores MCP propios en ChatGPT; documentación de OpenAI sobre MCP).
Sobre el precio, la nota solo dice «gratis por ahora», sin fecha de fin ni límite de llamadas. La página de precios para desarrolladores de Liner lista la Tools API a 1 USD por cada 1000 peticiones y la Agent API a 3 USD por cada 1000. También añade una comisión del 5 % sobre los créditos para cuentas creadas desde el 10 de noviembre de 2026. No tiene ninguna fila para Actions. En nuestras tablas de costes Liner vale 0 USD, con una nota para volver a comprobarlo antes de depender de él.
Liner ofrece un servidor MCP y una API, y su documentación explica cuándo usar cada uno. El MCP sirve para conectar tu propio agente a tus propias cuentas. La API sirve para construir un producto en el que cada usuario conecta sus cuentas, porque permite gestionar entornos, usuarios y claves, y funciona en servidores sin navegador. Nuestro caso es una persona o un equipo pequeño en Claude Code o ChatGPT, así que usamos el MCP.
| Dato | Lo que dice Liner | Fuente y fecha de lectura |
|---|---|---|
| Nombre | Liner Actions MCP (y Liner Actions API) | Nota de prensa, 2026-11-03 |
| Lanzamiento | Corea 2026-09-29; nota en inglés 2026-11-03 | Digital Today, VMblog |
| Aplicaciones | Más de 1100 servicios, probados uno a uno | Nota de prensa; documentación |
| Servidor | actions.liner.com/api/v1/mcp, Streamable HTTP, OAuth 2.1 | Documentación; 401 sin credenciales a las 00:15 SGT |
| Herramientas visibles | 4: search_actions, execute_action, connect_account, complete_connection | Documentación MCP |
| Cómo elige | Busca acciones con lenguaje natural, solo en inglés, y ejecuta una | Documentación MCP |
| Duración del acceso | La aprobación caduca a los 30 días, luego 401 | Documentación MCP |
| ChatGPT | Modo desarrollador; escrituras solo en Business, Enterprise, Edu | Documentación de Liner |
| Precio | MCP y API gratis por ahora; sin fila de Actions | Nota; página de precios leída el 2026-11-14 |
| Datos | No guarda datos de usuario; registros desidentificados | Nota de prensa |
Cómo elige herramientas: primero busca, luego una lista corta
Liner divide la elección en dos pasos. En el servidor MCP, search_actions hace el primero: el modelo escribe una consulta como «append a row to a Google Sheet», el servidor devuelve unas pocas acciones candidatas y el modelo elige una para ejecutarla.
La documentación de la API de Actions describe el mismo flujo con pasos explícitos (Liner Actions API: usar Actions como herramientas de un LLM). Ordenas las acciones candidatas según la petición y pasas al modelo solo una lista corta. El texto lo dice sin rodeos: «Do not send the entire catalog», es decir, no envíes el catálogo completo.
La misma página tiene tres reglas sobre llamadas erróneas o dudosas. Las acciones de escritura y destructivas necesitan la confirmación de la persona antes de la primera ejecución. Si un tiempo de espera deja el resultado en duda, no reintentes de forma automática, porque la API no publica una clave de idempotencia. Una respuesta needs_connection no prueba que la acción no se ejecutara, así que conviene revisar la aplicación. La guía rápida añade que el enlace de autorización de needs_connection caduca a los 15 minutos aproximadamente (guía rápida de Liner Actions API).
Es el mismo patrón que la búsqueda de herramientas de Anthropic, OpenAI y Microsoft; solo cambia dónde ocurre. Anthropic marca las herramientas con defer_loading y el modelo llama a una herramienta de búsqueda con regex o BM25. Cada búsqueda devuelve las 3 a 5 definiciones más relevantes, y una petición admite hasta 10 000 herramientas (búsqueda de herramientas de Anthropic).
OpenAI añadió tool_search a la Responses API para gpt-5.4 y modelos posteriores, y su guía recomienda agrupar herramientas en espacios de nombres de menos de 10 funciones (guía de búsqueda de herramientas de OpenAI). Microsoft Foundry Toolbox da al modelo dos metaherramientas, tool_search y call_tool, ordenadas con BM25. Devuelve 5 por defecto y 10 como máximo (Foundry Toolbox), y la documentación la recomienda a partir de 10 a 15 herramientas (Foundry, 2026-10-26).
La diferencia es esta. En esos tres casos la búsqueda ocurre en el cliente o en la plataforma del modelo, y cada servidor MCP que añades sigue enviando todas sus definiciones. En Liner la búsqueda ocurre en el servidor, y el cliente ve siempre las mismas 4 herramientas.
Buscar solo en inglés es un coste de esa búsqueda en el servidor. Si un usuario pide a Claude en español que añada unas reseñas a una hoja y el modelo pasa ese texto tal cual a search_actions, la documentación dice que la búsqueda no encuentra nada. Hay que indicar en el prompt que las acciones se buscan en inglés. La documentación de Claude Code da un consejo parecido a quien escribe servidores: la búsqueda de herramientas lee solo el principio de cada descripción, así que las palabras clave van primero.
Más herramientas: menos acierto y más gasto en cada turno
Tener muchas herramientas trae dos problemas: la precisión y el dinero. En precisión, las cifras públicas apuntan en la misma dirección.
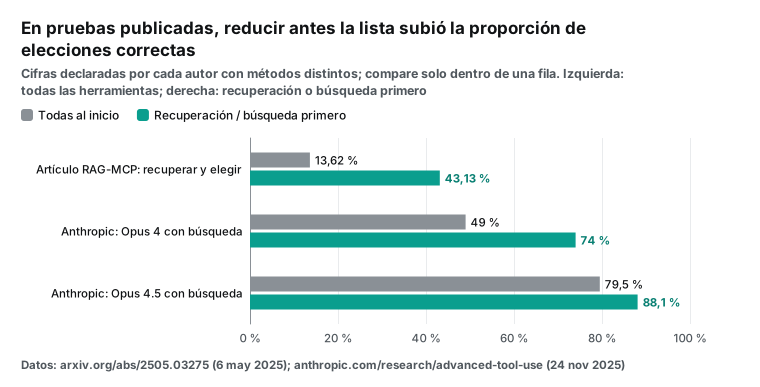
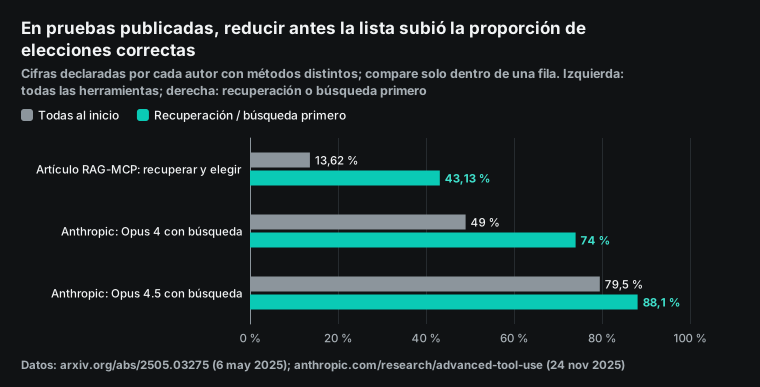
La documentación de búsqueda de herramientas de Anthropic dice que la precisión de Claude al elegir baja a partir de 30 a 50 herramientas, y recomienda la carga bajo demanda desde 10 herramientas o 10K tokens de definiciones. El artículo de ingeniería de Anthropic del 24 de noviembre de 2025 dio dos resultados (Anthropic: uso avanzado de herramientas). Opus 4 pasó del 49 % al 74 % con búsqueda de herramientas, y Opus 4.5, del 79,5 % al 88,1 %.
Los artículos académicos muestran mejoras parecidas. RAG-MCP recupera primero las herramientas candidatas, y los aciertos subieron del 13,62 % al 43,13 % con menos de la mitad de tokens en el prompt (RAG-MCP, arXiv 2505.03275). LiveMCPBench probó 12 modelos con 70 servidores y 527 herramientas (LiveMCPBench, arXiv 2508.01780). Claude-Sonnet-4 completó el 78,95 % de las tareas y la mayoría de los modelos se quedó entre el 30 % y el 50 %; cerca de la mitad de los fallos vino de no encontrar la herramienta correcta.
| Fuente | Prueba | Antes | Después |
|---|---|---|---|
| RAG-MCP (arXiv 2505.03275) | Recuperar herramientas candidatas primero | 13,62 % de aciertos | 43,13 % de aciertos |
| Anthropic, artículo de ingeniería | Opus 4 con búsqueda | 49 % | 74 % |
| Anthropic, artículo de ingeniería | Opus 4.5 con búsqueda | 79,5 % | 88,1 % |
| LiveMCPBench (arXiv 2508.01780) | 70 servidores, 527 herramientas, 12 modelos | La mayoría 30–50 % | Claude-Sonnet-4 78,95 % |
Los foros coinciden con estas cifras y añaden detalle. En el hilo de r/mcp del 4 de noviembre, una respuesta decía que no hay un número fijo, pero que los errores se vuelven frecuentes a partir de 20 o 30 herramientas, y que las descripciones parecidas pesan más que la cantidad. Otra persona usa 9 o 10 herramientas por servidor sin problema; el día que añadió una segunda herramienta para leer archivos, el agente empezó a elegir la equivocada.
Una tercera respuesta situaba el límite en «unos cientos en una sola lista». A partir de ahí, el modelo elegía por parecido del nombre y no por la tarea. Agrupar las herramientas por área y cargar solo el grupo necesario ayudó más que reducir el número.
Otros hilos aportan datos. El 12 de noviembre de 2026, alguien descargó tools/list de 50 servidores MCP públicos: en 23 de ellos, al menos un tercio del texto era el mismo bloque de esquema repetido en cada herramienta (r/mcp, 2026-11-12).
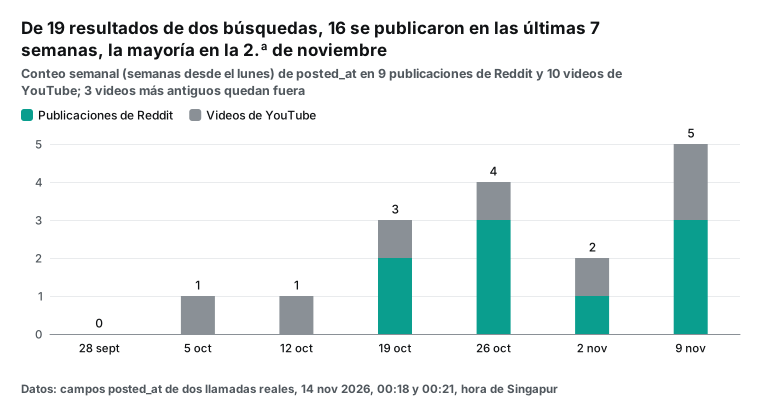
Con reddit/search de EveryInfra y la consulta «too many MCP tools» obtuvimos 9 publicaciones. Con youtube/search sobre el mismo tema obtuvimos 10 videos. De esos 19 resultados, 16 se publicaron en las últimas 7 semanas, y la semana del 9 de noviembre fue la de más actividad, con 5.
El video más visto se publicó el 6 de octubre de 2026 con el título «Too many MCP tools? Anthropic found a solution.» y tenía 37 239 visualizaciones al leerlo (YouTube). En los comentarios, alguien preguntaba cómo encaja la búsqueda de herramientas con la caché, otra persona decía que elegir la herramienta también es un paso incierto del modelo, y otra recordaba que ya existen registros de herramientas que hacen lo mismo.
La documentación de Anthropic sobre uso de herramientas dice que los nombres, descripciones y esquemas del parámetro tools cuentan como tokens de entrada, y que la API añade además un prompt de sistema especial (uso de herramientas en Claude). El modelo vuelve a leer esas definiciones en cada turno, de modo que su coste es el precio por turno multiplicado por el número de turnos.
El artículo de Anthropic ponía como ejemplo 5 servidores y 58 herramientas, unos 55 000 tokens de definiciones. Internamente habían visto 134 000 tokens antes de optimizar. Con búsqueda de herramientas, los tokens de herramientas de toda una sesión bajaron a unos 8700. Comparado con nuestras cifras: las 12 herramientas de EveryInfra rondan los 3758 tokens o200k, menos de una catorceava parte del ejemplo de 58 herramientas de Anthropic, y las 574 herramientas hipotéticas, unos 131 395, están en la misma escala que los 134 000 tokens que vio Anthropic.
Cuánto contexto ocupan las definiciones: 12 herramientas, 16 206 bytes
El servidor MCP remoto de EveryInfra está en api.everyinfra.com/mcp.
Leímos tools/list una vez con nuestra clave a las 00:16 hora de Singapur. Escribimos el JSON de cada herramienta en formato compacto, medimos los bytes y contamos tokens con tiktoken en dos codificaciones (tiktoken). Resultado: 16 206 bytes, unos 3758 tokens con o200k y 3728 con cl100k. Son unos 313 tokens por herramienta, un token cada 4,3 bytes, cerca de la regla de «unos 4 bytes por token» del README de tiktoken.
Durante el saludo inicial el servidor envía además unas instrucciones de uso de 3993 caracteres, unos 987 tokens. La documentación de Claude Code dice que solo lee los primeros 4096 caracteres de las instrucciones del servidor y de cada descripción que se carga al inicio. Antes de la versión 2.1.296 el límite era 2048, así que las versiones antiguas cortarían nuestras instrucciones por la mitad.
Instrucciones y definiciones suman 20 218 bytes, unos 4745 tokens o200k. Cuando la petición lleva herramientas, la API añade además un prompt de sistema de uso de herramientas de 286 tokens en Sonnet 5.5. Eso es lo que lee en cada turno una sesión que solo tiene conectado EveryInfra.
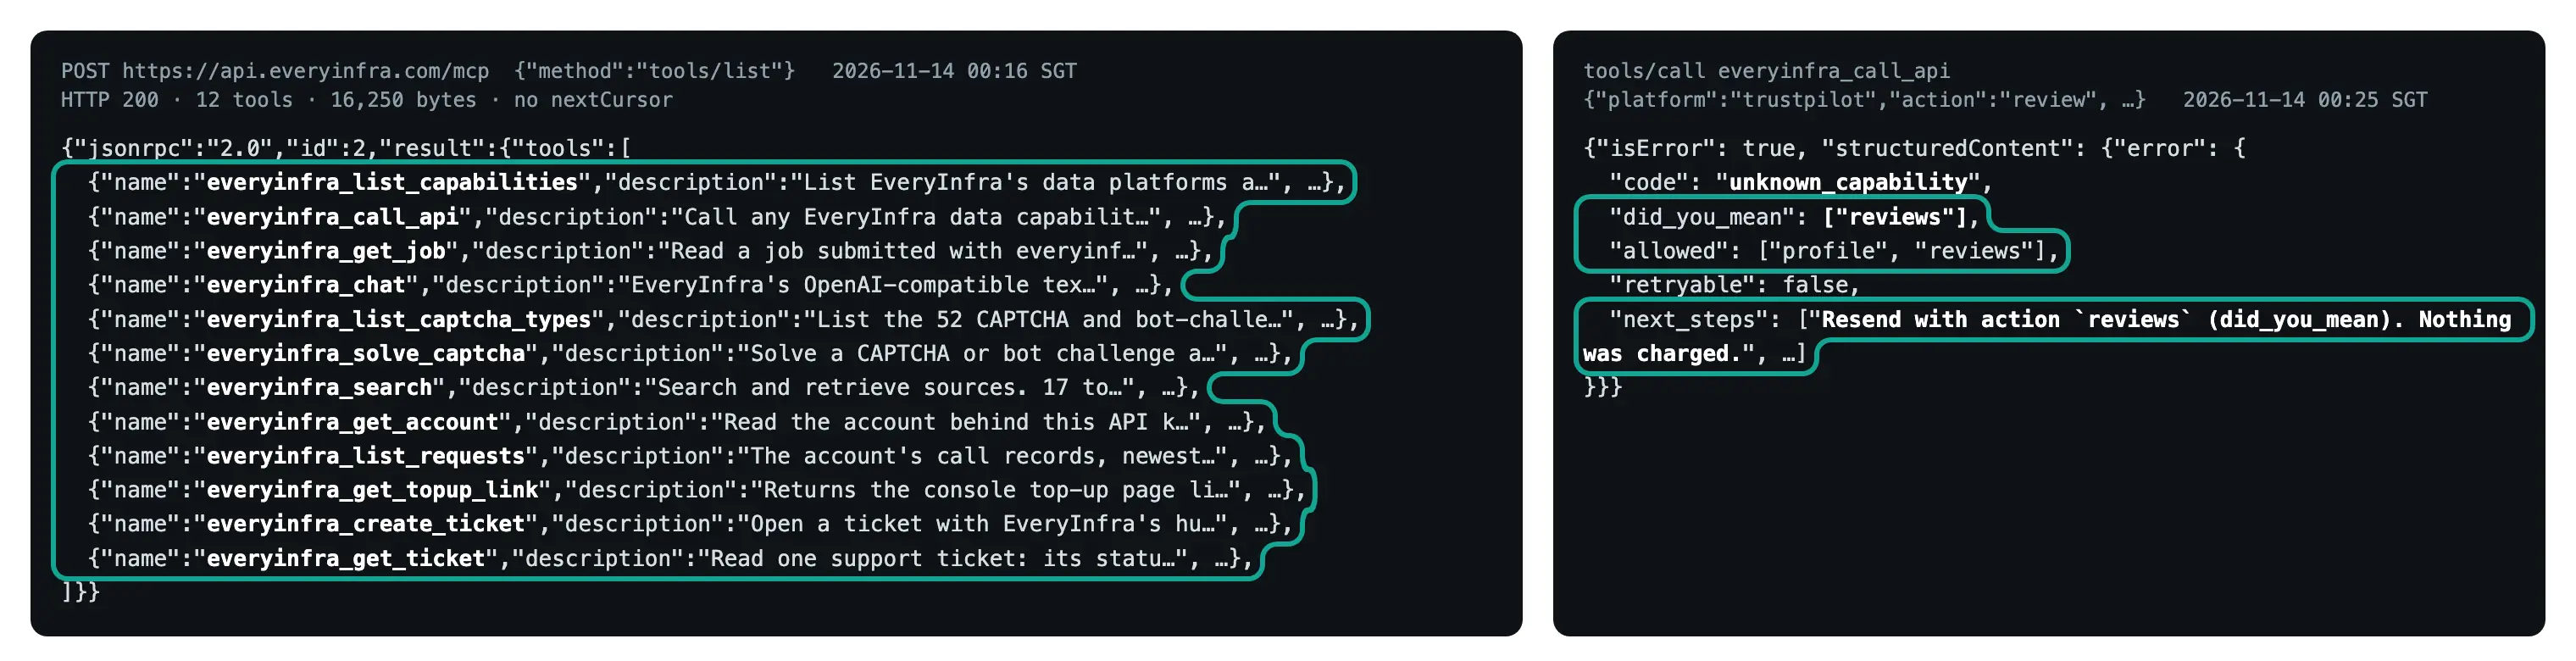
Cuatro de las 12 herramientas leen datos directamente: everyinfra_list_capabilities consulta el catálogo, everyinfra_call_api llama a cualquier capacidad, everyinfra_get_job recoge resultados asíncronos y everyinfra_search hace búsquedas web. Las otras ocho gestionan la cuenta, el historial de llamadas, los enlaces de recarga, los tickets de soporte y los captchas.
El tamaño depende sobre todo de la descripción. La herramienta de tickets es la más grande, 661 tokens, porque explica cuándo abrir un ticket y qué campos enviar. La del enlace de recarga es la más pequeña, 134 tokens. Las cuatro herramientas de datos suman 5825 bytes, unos 1307 tokens o200k: el 36 % de las 12 en bytes. Si tu cliente permite activar herramientas una a una, deja solo esas cuatro y la carga fija por turno baja unos dos tercios.
| Herramienta | Bytes | Tokens o200k | Para qué sirve |
|---|---|---|---|
| everyinfra_list_capabilities | 797 | 172 | Consultar el catálogo |
| everyinfra_call_api | 1657 | 392 | Llamar a cualquier capacidad |
| everyinfra_get_job | 777 | 170 | Recoger trabajos asíncronos |
| everyinfra_search | 2594 | 573 | Búsqueda web y de noticias |
| everyinfra_get_account | 946 | 240 | Saldo y estado de la cuenta |
| everyinfra_list_requests | 1204 | 270 | Historial y reembolsos |
| everyinfra_get_topup_link | 578 | 134 | Enlace de recarga |
| everyinfra_create_ticket | 2885 | 661 | Abrir un ticket |
| everyinfra_get_ticket | 972 | 215 | Leer un ticket |
| 2 herramientas de captcha | 2468 | 628 | Listar tipos, enviar tarea |
| 1 herramienta más | 1315 | 303 | No se usa aquí |
| Total, 12 herramientas | 16 206 | 3758 | Leído a las 00:16 hora de Singapur |
Puedes repetir estas cifras en tu máquina con el script siguiente; llamar a tools/list no tiene coste. El recuento de tiktoken es una estimación y el tokenizador de Claude es distinto. La página de precios de Claude dice que el tokenizador de Claude 4.7 y modelos posteriores produce un 30 % más de tokens para el mismo texto, y que, cuando la petición lleva herramientas, la API añade un prompt de sistema de 286 tokens en Sonnet 5.5 (precios de Claude). Por eso todos los importes de este artículo calculados con o200k son mínimos. Para un número exacto, envía la misma lista al endpoint count_tokens (conteo de tokens de Claude).
curl -s https://api.everyinfra.com/mcp \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Accept: application/json, text/event-stream' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/list"}' > tools.json

uv run --with tiktoken python3 - <<'PY'
import json, tiktoken
tools = json.load(open("tools.json"))["result"]["tools"]
enc = tiktoken.get_encoding("o200k_base")
total_b = total_t = 0
for t in tools:
    s = json.dumps(t, ensure_ascii=False, separators=(",", ":"))
    b, n = len(s.encode()), len(enc.encode(s))
    total_b += b; total_t += n
    print(f"{t['name']:<34}{b:>7}{n:>6}")
print("total", len(tools), total_b, total_t)
PY
Ahora la comparación con un servidor que tuviera una herramienta MCP por capacidad. Tomamos del catálogo público (api.everyinfra.com/api/v1/social/catalog) el nombre, la descripción y los parámetros de cada capacidad, con sus descripciones, valores permitidos y valores por defecto. Las 574 definiciones sumaron 528 989 bytes, unos 131 395 tokens o200k.
La herramienta mediana tenía 185 tokens, el percentil 90 llegaba a 374 y la mayor a 1281. La forma más austera, solo con nombres y tipos de parámetros, sigue pidiendo 109 086 bytes, unos 24 811 tokens. Las dos listas son hipotéticas y las construimos nosotros; no son la respuesta de un servidor real. Sirven para ver la escala: en bytes, una herramienta por capacidad es unas 33 veces más grande que nuestras 12 (unas 35 veces en tokens o200k), y la forma austera sigue siendo unas 6,7 veces más grande en bytes, con menos texto para que el modelo acierte.
Dos detalles muestran cuánta incertidumbre tiene la estimación. Primero, cambiar de tokenizador cambia la cifra. En nuestras 12 herramientas reales, cl100k da 3728 y o200k 3758, casi lo mismo; en las 574 hipotéticas, cl100k da 146 004, un 11 % más que o200k, porque llevan muchas descripciones de parámetros y valores permitidos. Claude usa un tercer tokenizador, así que tomamos los bytes como dato firme y los tokens y los dólares como estimaciones.
Segundo, agrupar no siempre ahorra tanto. Las 10 plataformas con más capacidades reúnen 185 de las 574, el 32 %: Douyin tiene 38, TikTok 24 y X 21. Con la mediana de 185 tokens por herramienta, solo el grupo de Douyin rondaría los 7000 tokens, más que las 12 herramientas actuales de EveryInfra juntas. Los grupos reducen la lista, pero no son iguales, y el grupo de una plataforma grande sigue necesitando descripciones cortas y parámetros con valores cerrados.
Coste por turno: las definiciones pueden costar más que los datos
Para pasar de tokens a dinero usamos la página de precios de Claude leída el 14 de noviembre de 2026 (precios de Claude). Sonnet 5.5 cuesta 2 USD por millón de tokens de entrada y 0,10 USD con acierto de caché. Opus 5.5 cuesta 4 USD y 0,20 USD. Haiku 5.5 cuesta 0,10 USD de entrada y 0,01 USD con caché hasta 100 000 tokens por prompt; por encima, 0,50 USD y 0,05 USD. Guardamos una copia de la página ese mismo día.
Los tokens que siguen son estimaciones o200k; Claude cuenta más, así que cada importe es un mínimo. En Sonnet 5.5, nuestras 12 herramientas reales cuestan al menos unos 0,0075 USD por turno sin caché y al menos unos 0,00038 USD con caché. Las 574 herramientas hipotéticas cuestan al menos unos 0,263 USD por turno sin caché y al menos unos 0,013 USD con caché. Como referencia, la llamada real a reddit/search de las 00:18 costó 0,000792 USD. Con una herramienta por capacidad y sin caché, cada turno de definiciones cuesta al menos lo mismo que unas 330 llamadas a reddit/search.
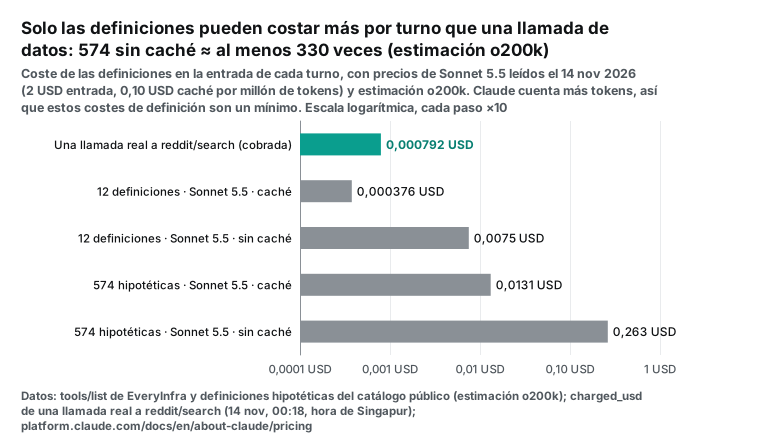
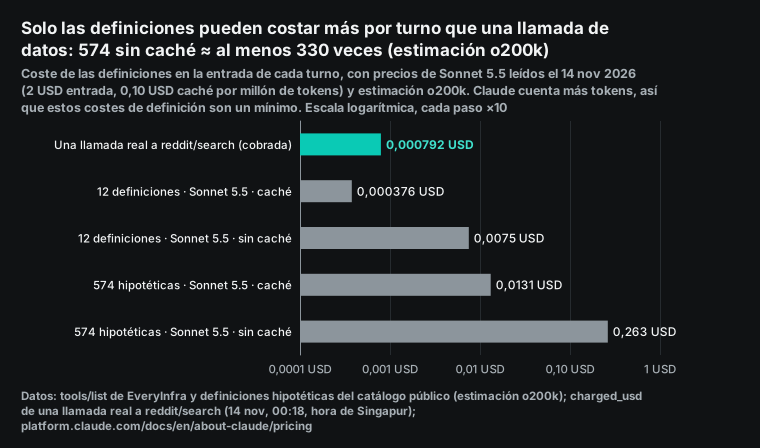
Cambiar de modelo mueve la diferencia en proporción al precio. La entrada de Opus 5.5 cuesta el doble que la de Sonnet 5.5, así que las 574 herramientas hipotéticas costarían al menos unos 0,526 USD por turno sin caché. Haiku 5.5 es mucho más barato, pero 131 395 tokens superan su línea de 100 000 y el precio de entrada sube de 0,10 a 0,50 USD: al menos unos 0,066 USD por turno, como mínimo lo de 80 llamadas de datos. La forma más austera, unos 24 811 tokens, se queda por debajo de esa línea y cuesta al menos unos 0,0025 USD por turno.
Nuestras 12 herramientas en Haiku 5.5 cuestan unos 0,00004 USD por turno con caché, también como mínimo.
La caché de prompts elimina casi todo ese coste, pero tiene condiciones. La caché de Anthropic compara el prefijo, y las definiciones van al principio; si la lista de herramientas no cambia ni un byte, cada turno siguiente paga el precio de caché (uso de herramientas con caché de prompts).
La especificación MCP 2026-07-28 pide que los servidores devuelvan tools/list en un orden estable para mejorar los aciertos de caché (especificación MCP: herramientas). La búsqueda de herramientas añade las nuevas detrás del prefijo en caché, sin alterarlo. Un video del 18 de octubre de 2026 insistía en esto (YouTube, 2026-10-18). Su autor conectó 4 servidores MCP y pidió al modelo guardar un archivo: casi toda la entrada eran definiciones. La búsqueda redujo la entrada en más de un tercio, pero con pocas herramientas pequeñas salió más cara por el turno extra de búsqueda.
La propia especificación cambia ya con un calendario fijo. El 11 de noviembre de 2026, el blog de MCP anunció un nuevo ciclo de versiones, con la siguiente especificación fijada para el 2027-03-30 (SEP-3398). Ese mismo día, el blog de código abierto de Google habló del exceso de herramientas y de mostrarlas de forma progresiva.
Cuatro niveles, de todas las herramientas a un mcp tool router
Los umbrales públicos se ordenan en cuatro niveles. Con menos de 10 herramientas y definiciones pequeñas, lo más simple es enviarlas todas; con caché, cada turno cuesta muy poco.
A partir de 10 herramientas o 10K tokens, Anthropic recomienda la búsqueda de herramientas. Claude Code la activa por defecto y al empezar una sesión solo carga los nombres de herramientas y las instrucciones de los servidores (MCP en Claude Code; búsqueda en el Agent SDK).
| Valor de ENABLE_TOOL_SEARCH | Qué hace Claude Code |
|---|---|
| Sin definir | Todas las herramientas MCP diferidas y cargadas bajo demanda |
| true | Igual que sin definir |
| auto | Carga todo al inicio mientras las definiciones ocupan menos del 10 % del contexto |
| auto:N | Igual que auto, con N % como línea |
| false | Carga todas las herramientas MCP al inicio |
Entre decenas y cientos de herramientas, quien escribe el servidor debería agruparlas. El servidor MCP de GitHub tiene la opción --toolsets, y su README explica que activar solo los grupos necesarios ayuda al modelo a elegir y reduce el contexto (GitHub MCP Server). EveryInfra coloca sus 574 capacidades detrás de everyinfra_call_api, con el nombre de la capacidad como parámetro; el modelo consulta el catálogo y después llama.
Con miles de herramientas solo queda una forma: buscar y ejecutar. Liner muestra 4 herramientas para más de 1100 aplicaciones. El blog de ingeniería de Uber del 1 de octubre de 2026 describe una pasarela MCP interna con más de 5000 herramientas que los agentes encuentran bajo demanda.
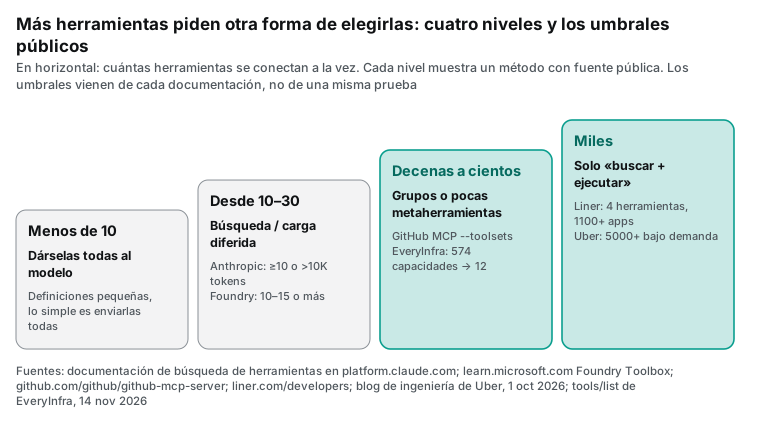
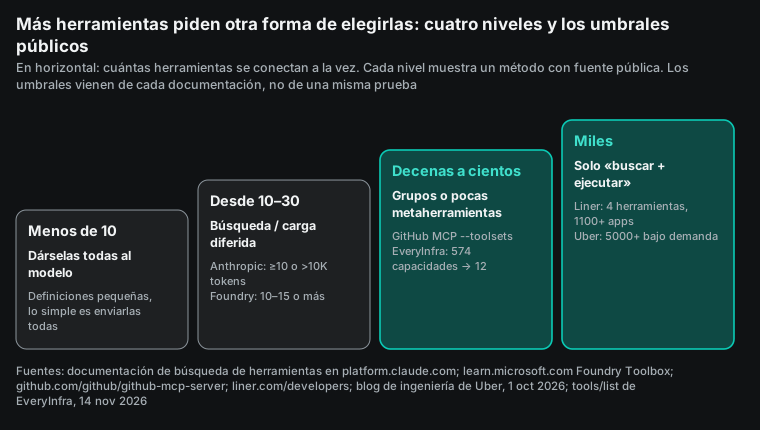
«mcp tool router» aparece en las sugerencias de búsqueda y se refiere a los niveles tres y cuatro: una capa entre el modelo y cientos o miles de herramientas que envía cada petición a la herramienta correcta. Hay varias formas de construirla.
Composio Tool Router es un servicio alojado que busca, inicia sesión y ejecuta herramientas por el agente (documentación de Composio). Zapier MCP también da al agente herramientas de descubrimiento; según su documentación de uso, cada llamada cuenta como 2 tareas y las llamadas fallidas no cuentan (uso de Zapier MCP). El plan gratuito tiene 100 tareas al mes y el plan Professional empieza en 19,99 USD al mes (precios de Zapier, leídos el 2026-11-14).
En investigación, JSPLIT elige primero grupos de herramientas a partir de una taxonomía (JSPLIT, arXiv 2510.14537), y Dynamic ReAct carga herramientas durante la ejecución con hasta un 50 % menos de carga (Dynamic ReAct, arXiv 2509.20386). La Messages API de Anthropic también puede conectarse a servidores MCP remotos y fijar enabled y defer_loading por herramienta, lo que equivale a un pequeño enrutador dentro de la petición (conector MCP de Claude).
El coste de poner la capacidad como parámetro es este: el modelo no ve las 574 capacidades en los nombres de las herramientas: tiene que llamar antes a everyinfra_list_capabilities o adivinar un nombre a partir de las instrucciones. Consultar el catálogo añade un turno, y adivinar mal devuelve unknown_capability. El catálogo es gratis, y un nombre erróneo no se cobra y devuelve los valores permitidos y el más parecido.
| Enfoque | Quién lo usa | Herramientas que ve el cliente | Cómo elige | Precio público (fecha) |
|---|---|---|---|---|
| Búsqueda en el servidor + ejecutar | Liner Actions MCP | 4 | Búsqueda en inglés | Gratis por ahora, sin precio (2026-11-14) |
| Herramientas de descubrimiento | Zapier MCP | Unas pocas | Buscar, completar, ejecutar | 2 tareas por llamada correcta; plan gratuito, 100 al mes (2026-11-14) |
| Enrutador alojado | Composio Tool Router | Unas pocas | Búsqueda e inicio de sesión alojados | Ver su página de precios |
| Búsqueda en la plataforma | Anthropic, OpenAI, Foundry | 3–10 bajo demanda | Regex o BM25 | Precio por token del modelo |
| Grupos | GitHub MCP | Los grupos activados | Eliges tú | Gratis, código abierto |
| Capacidad como parámetro | MCP de EveryInfra | 12 | Catálogo y luego nombre | price_usd por llamada |
Un conector de acciones y un servidor MCP de datos
Con los dos servidores en un mismo cliente, el reparto sale solo. Liner se encarga de las acciones: una fila nueva en Google Sheets, un ticket en Linear o Jira, un mensaje de Slack. EveryInfra lee datos de plataformas públicas: hilos de Reddit, comentarios de YouTube, reseñas de Trustpilot. Hay tres motivos para este reparto.
Primero, entre los dos suman solo 16 herramientas: EveryInfra ocupa 16 206 bytes (unos 3758 tokens o200k) y Liner muestra 4 herramientas, y la búsqueda de Claude Code solo las carga cuando hacen falta. Segundo, cada lado falla de forma distinta. Una lectura fallida no deja efectos y se puede repetir, y EveryInfra no cobra los fallos; una escritura fallida o dudosa es otra cosa, y la documentación de Liner pide no reintentarla a ciegas. Tercero, las llamadas de datos deben tener un precio claro por llamada: cada respuesta de EveryInfra trae charged_usd y everyinfra_list_requests muestra el historial con los reembolsos.
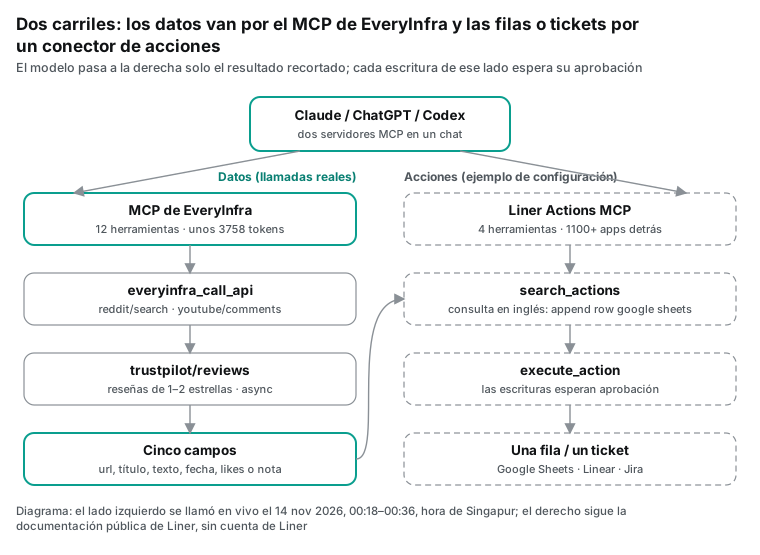
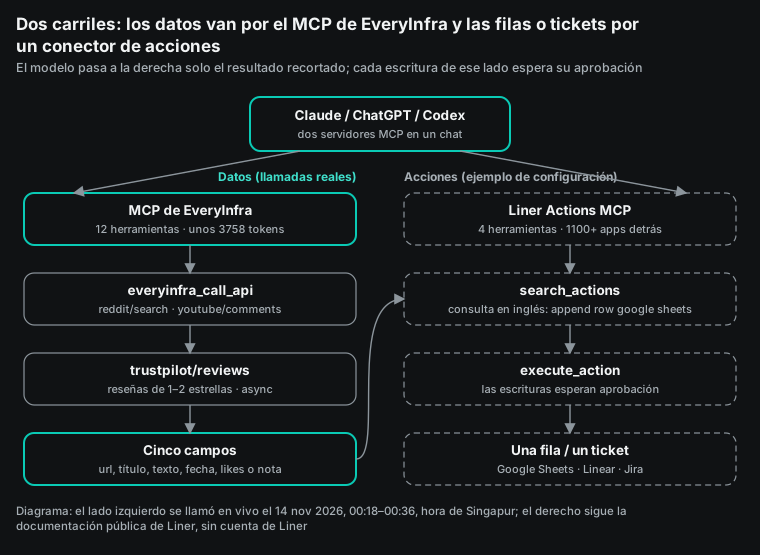
Esta es la configuración de los dos servidores en Claude Code. Con EveryInfra hicimos llamadas reales con esta URL y clave. La parte de Liner sigue su documentación y no la ejecutamos con una cuenta de Liner, así que es un ejemplo de configuración. La clave de EveryInfra se obtiene en la guía rápida, y la página del servidor MCP muestra otros clientes.
# Datos: MCP remoto de EveryInfra (llamado en vivo)
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# Acciones: Liner Actions MCP (ejemplo de configuración, según la documentación de Liner)
claude mcp add --transport http -s user liner-actions https://actions.liner.com/api/v1/mcp
# La primera llamada abre el inicio de sesión de Liner en el navegador. Hay que aprobar de nuevo a los 30 días.
# Para quitarlo, usa el mismo ámbito: claude mcp remove liner-actions -s user

# Codex (ejemplo de configuración)
codex mcp add liner-actions --url https://actions.liner.com/api/v1/mcp
codex mcp login liner-actions
Llamadas reales: siete peticiones para una revisión de opiniones
Probamos un trabajo concreto: reunir opiniones recientes sobre un producto SaaS a partir de fuentes públicas y después escribir el resultado en una hoja. La parte de datos se hizo con llamadas reales al MCP de EveryInfra entre las 00:18 y las 00:36 hora de Singapur del 14 de noviembre de 2026, cada una como tools/call a everyinfra_call_api.
El tema fue «too many MCP tools», porque es justo el asunto de este artículo. Para las reseñas de producto elegimos la página de Notion en Trustpilot: es pública, tiene muchas reseñas y llegan en muchos idiomas.
¿Por qué estas fuentes? Los hilos de Reddit muestran los problemas que describen los usuarios y las soluciones que encontraron. Los tutoriales de YouTube indican cuánta gente aprende un tema, y sus comentarios, dónde se atasca. Trustpilot reúne muchas reseñas de clientes que pagan, y las de una y dos estrellas suelen tratar de dinero y soporte. Las cinco capacidades usadas cuestan 0,0014 USD o menos por llamada, y los fallos y los resultados vacíos no se cobran.
| Hora (Singapur) | Capacidad | Parámetros clave | Resultado | Cobro |
|---|---|---|---|---|
| 00:16 | tools/list | Listar herramientas | 12 herramientas, 16 206 bytes | Gratis |
| 00:18 | reddit/search | too many MCP tools | 9 publicaciones | 0,000792 USD |
| 00:20 | reddit/comments | Publicación 1xnmicj de r/mcp | 16 comentarios | 0,000792 USD |
| 00:21 | youtube/search | MCP tool search | 10 videos | 0,000778 USD |
| 00:25 | youtube/comments | Video g87DYmwbzuo | 17 comentarios | 0,000556 USD |
| 00:25 | trustpilot / review (mal escrito a propósito) | Acción en singular | unknown_capability, did_you_mean reviews | 0 USD |
| 00:34–00:35 | trustpilot/reviews asíncrono | notion.com, últimos 30 días | 0 filas | Vacío reembolsado, 0 USD |
| 00:36 | trustpilot/reviews asíncrono | notion.so, 1–2 estrellas, 3 meses | 16 reseñas, 52 segundos | 0,001389 USD |
Se cobraron cinco llamadas, 0,004307 USD en total; la llamada con el nombre mal escrito y la que devolvió 0 filas no se cobraron.
Un nombre de capacidad erróneo sale barato. Enviamos review en lugar de reviews y en menos de un segundo el servidor devolvió unknown_capability. El error estructurado incluía allowed: ["profile","reviews"] y did_you_mean: ["reviews"], y el siguiente paso decía que se reenviara con reviews y que no se había cobrado nada. Esa respuesta ocupaba solo 470 bytes, unos 119 tokens o200k, y el modelo puede corregir la llamada en el turno siguiente. Leerla en Sonnet 5.5 cuesta al menos unos 0,00024 USD, unas tres décimas de una llamada a reddit/search; incluso con un turno más de definiciones en caché, un nombre mal escrito cuesta una fracción de céntimo.
Las dos peticiones asíncronas a Trustpilot tenían condiciones distintas. Con notion.com y los últimos 30 días, el resultado traía 0 filas; con notion.so, 1–2 estrellas y los últimos 3 meses, traía 16 reseñas. La dirección de la página de Notion en Trustpilot es notion.so (Trustpilot: Notion).
Para capacidades que leen una página en vivo, como las reseñas de Trustpilot, enviamos "mode":"async", recibimos un job_id y consultamos con everyinfra_get_job. Este trabajo volvió en 52 segundos.
{"jsonrpc":"2.0","id":17,"method":"tools/call","params":{
  "name":"everyinfra_call_api",
  "arguments":{"platform":"trustpilot","action":"reviews","mode":"async",
    "params":{"company":"notion.so","stars":["1","2"],"date":"last3months"}}}}
Las 16 reseñas se publicaron entre el 23 de agosto y el 13 de noviembre de 2026: 13 de una estrella y 3 de dos, desde 11 países. Leímos el título y las dos primeras frases de cada una y le asignamos una sola categoría principal. Facturación, planes y pruebas: 7. Soporte: 4. Producto y cambios de IA: 4. Privacidad de datos: 1. Esta tabla es lo que el segundo paso escribe en una hoja o un ticket, sin ningún nombre de autor.
La muestra son solo estas 16 reseñas: dice de qué se quejaban las reseñas de 1 y 2 estrellas en estos tres meses, no lo que piensan todos los usuarios de Notion. Las 7 de facturación tenían una estrella. De las 3 de dos estrellas, 2 hablaban de soporte y 1 de un producto con demasiadas cosas. Por meses, septiembre tuvo más, 7, y las dos primeras semanas de noviembre ya sumaban 4. Por países, Reino Unido tuvo 4, Lituania y Estados Unidos 2 cada uno, y otros 8 países 1 cada uno. Para un equipo de producto, estos cortes dicen más que el total: una estrella es dinero; dos estrellas, soporte y primeros pasos.
| Categoría | Reseñas | Idea típica (parafraseada) |
|---|---|---|
| Facturación, planes, pruebas | 7 | Prueba cancelada antes de tiempo; hay que comprar más créditos; reembolso denegado |
| Soporte | 4 | Sin respuesta en un plan de empresa; asignación de IA sin restaurar |
| Producto y funciones de IA | 4 | Páginas que no cargan; demasiadas cosas; la IA no se puede desactivar |
| Privacidad de datos | 1 | Datos enviados a un modelo de terceros, en letra pequeña |
Para hacer este trabajo con tu producto, cambia las palabras clave, los identificadores de publicaciones y videos y el dominio de Trustpilot. Los parámetros y precios están en reddit/search, reddit/comments, youtube/search, youtube/comments y trustpilot/reviews. Las páginas de plataforma son Reddit, YouTube y Trustpilot.
Los resultados también ocupan contexto: quédate con los campos útiles
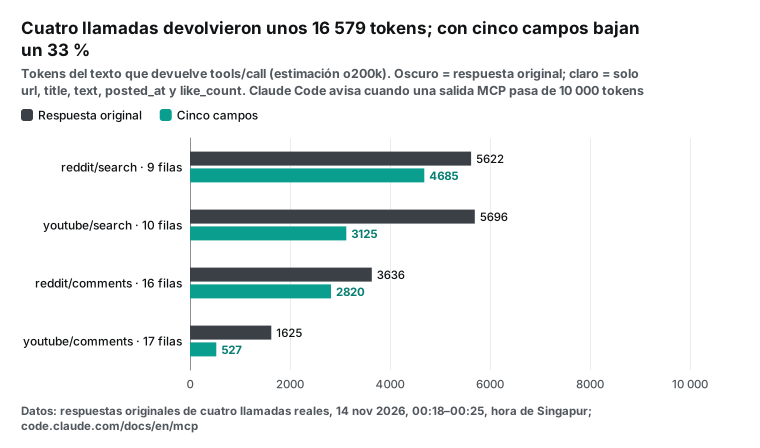
Los resultados de las herramientas también entran en el contexto. Entran una sola vez, pero suelen ser más grandes que las definiciones. Contamos con o200k el texto original de cuatro llamadas: reddit/search con 9 filas usó unos 5622 tokens y youtube/search con 10 filas unos 5696; reddit/comments con 16 filas, unos 3636, y youtube/comments con 17 filas, unos 1625. En total, unos 16 579, y las 16 reseñas de Trustpilot sumaron otros 6027.
Nos quedamos con cinco campos: enlace, título, texto, fecha y likes (o nota en Trustpilot). Las cuatro llamadas bajaron a unos 11 157 tokens, un 33 % menos, y Trustpilot a unos 3210. Claude Code avisa cuando una salida MCP pasa de 10 000 tokens y la limita a 25 000 por defecto; el límite se cambia con MAX_MCP_OUTPUT_TOKENS. Los textos de más de 50 000 caracteres se guardan en un archivo y el modelo solo recibe la ruta (MCP en Claude Code). Para una revisión de opiniones, un limit de 20 a 50 por llamada queda por debajo del aviso y deja sitio para unir resultados.
| Llamada | Filas | Tokens originales | Cinco campos | Reducción |
|---|---|---|---|---|
reddit/search | 9 | 5622 | 4685 | 17 % |
youtube/search | 10 | 5696 | 3125 | 45 % |
reddit/comments | 16 | 3636 | 2820 | 22 % |
youtube/comments | 17 | 1625 | 527 | 68 % |
trustpilot/reviews | 16 | 6027 | 3210 | 47 % |
Si se pone el tamaño del resultado junto al precio de los datos, la diferencia se ve mejor. La tabla usa las filas que devolvió cada llamada. Precio por 1000 filas = importe cobrado ÷ filas devueltas × 1000. Coste de lectura = tokens o200k del resultado × 2 USD por millón de tokens de entrada en Sonnet 5.5; contamos solo la primera lectura, así que también es un mínimo.
En las cinco llamadas, los resultados originales sumaban unos 22 606 tokens: leerlos por primera vez cuesta al menos unos 0,0452 USD, 10,5 veces los 0,004307 USD cobrados. Con cinco campos quedaban unos 14 367 tokens y al menos unos 0,0287 USD, todavía 6,7 veces. Las búsquedas muestran la mayor diferencia: cada publicación de reddit/search ocupa unos 624 tokens y leerla cuesta 14,2 veces la tarifa de datos, mientras que un comentario de youtube/comments ocupa unos 95 tokens y, con cinco campos, la proporción baja a 1,9. Con una lista de herramientas ya corta, el gasto mayor de una revisión suele ser que el modelo lea los resultados, no la API de datos, y limit y los filtros de campos deciden esa cuenta.
| Capacidad | Filas devueltas | Cobrado | Por 1000 filas | Tokens por fila | Lectura ÷ cobro (original / cinco campos) |
|---|---|---|---|---|---|
reddit/search | 9 | 0,000792 USD | 0,088 USD | 624 | 14,2 / 11,8 |
reddit/comments | 16 | 0,000792 USD | 0,050 USD | 227 | 9,2 / 7,1 |
youtube/search | 10 | 0,000778 USD | 0,078 USD | 569 | 14,6 / 8,0 |
youtube/comments | 17 | 0,000556 USD | 0,033 USD | 95 | 5,8 / 1,9 |
trustpilot/reviews | 16 | 0,001389 USD | 0,087 USD | 376 | 8,7 / 4,6 |
| Cinco llamadas | 68 | 0,004307 USD | — | — | 10,5 / 6,7 |
Ayudar al modelo a acertar: cómo escribir las descripciones
Con el número de herramientas fijado, las descripciones deciden cuántas veces acierta el modelo. Varias fuentes se resumen en una lista corta.
| Comprobación | Por qué | Fuente |
|---|---|---|
| Palabras de búsqueda al principio | La búsqueda solo lee la primera parte | Documentación MCP de Claude Code |
| «Úsala cuando… no para…» | Las descripciones parecidas causan más errores que la cantidad | r/mcp, 2026-11-04 |
| Sin bloques de esquema repetidos | El texto repetido se paga en cada turno | r/mcp, 2026-11-12 |
| Errores con valores permitidos y el más parecido | El modelo corrige en el turno siguiente | Prueba real de EveryInfra, 00:25 |
| Consultas de acciones en inglés para Liner | La búsqueda solo funciona en inglés | Documentación de Liner Actions MCP |
Primero, las palabras que el modelo usará para buscar van al principio: según la documentación de Claude Code, la búsqueda lee solo la parte dentro del límite corto, y las instrucciones y descripciones cargadas al inicio solo se leen hasta 4096 caracteres. Segundo, hay que decir cuándo usar la herramienta y cuándo no. En el hilo del 4 de noviembre, quien lo abrió reescribió cada descripción con la forma «use this when… not for…», y las respuestas le dieron la razón.
Tercero, conviene quitar el texto de esquema repetido: en el estudio de 50 servidores, 23 repetían el mismo bloque en al menos un tercio de sus definiciones, y esos tokens se pagan en cada turno sin ayudar a elegir. Cuarto, los errores deben devolver al modelo al buen camino. EveryInfra devuelve los valores permitidos y el más parecido cuando el nombre de capacidad está mal.
Hay un punto fácil de pasar por alto: el modelo tiene que pensar en buscar una herramienta. Una respuesta del 5 de noviembre en el mismo hilo decía que el modelo no busca herramientas para cada tarea, y que hace falta una línea en AGENTS.md o en un archivo parecido del tipo «para este tipo de tarea, busca herramientas primero».
Otra respuesta proponía un conjunto fijo de prompts, ejecutado una vez con todas las herramientas y otra con búsqueda, anotando por separado las búsquedas fallidas y las llamadas erróneas, porque la recuperación puede fallar antes de que el modelo elija nada. Coincide con LiveMCPBench, donde cerca de la mitad de los fallos venía de la recuperación. Para un conector de acciones hay que añadir una línea más: Liner necesita consultas en inglés.
Segundo paso: escribir en una hoja o abrir un ticket (ejemplo de configuración)
Con los datos listos, entra el carril de acciones. Abajo están un prompt para Claude y la llamada que esperamos que envíe. Los escribimos a partir de la documentación de Liner y no los ejecutamos con una cuenta de Liner, así que es un ejemplo de configuración. El prompt tiene que decir tres cosas: buscar las acciones en inglés, enseñar el contenido a una persona antes de escribir, y no reintentar si el resultado no está claro, sino leer antes la hoja.
Tienes dos servidores MCP: everyinfra (lee datos públicos) y liner-actions (ejecuta acciones).
1. Llama a everyinfra_call_api para trustpilot/reviews (company=notion.so, stars=["1","2"],
   date=last3months, mode=async). Recoge el resultado con everyinfra_get_job.
   Quédate solo con url, title, text, posted_at, rating.
2. Clasifica cada reseña en facturación / soporte / producto / privacidad. Una fila por reseña.
3. Llama a search_actions de liner-actions con una consulta en inglés: "append rows to a google sheet".
4. Enséñame el número de filas y las tres primeras. Espera mi visto bueno antes de execute_action.
5. Si execute_action agota el tiempo o el resultado no está claro, no reintentes. Lee antes la hoja.{"name":"execute_action","arguments":{
"action":"<acción de Google Sheets para añadir filas devuelta por search_actions>",
"input":{"spreadsheet":"Opiniones de Notion 2026-11","rows":[
["2026-11-13","1","Facturación, planes, pruebas","https://www.trustpilot.com/reviews/…"],
["2026-11-12","1","Facturación, planes, pruebas","https://www.trustpilot.com/reviews/…"]]}}}Hay dos cosas que prever. La primera vez que execute_action encuentra una aplicación sin conectar, pide una conexión: el modelo llama a connect_account, inicias sesión en Google en el navegador y después el modelo llama a complete_connection. Según la documentación de la API de Liner Actions, el enlace dura unos 15 minutos.
Además, reintentar significa cosas distintas en cada carril. En EveryInfra los fallos son gratis; para revisiones programadas y llamadas que se reintentan solas, usa la API REST con la cabecera Idempotency-Key, y un reenvío con la misma clave cuenta como una sola petición. Cómo hacerlo está en el artículo sobre claves de idempotencia. En Liner, un reenvío automático tras un tiempo agotado puede añadir la misma fila dos veces; la documentación de la API de Liner Actions dice que aún no hay un contrato público de claves de idempotencia, así que queda confirmar antes y leer después.
Lo que cuesta elegir mal
Juntamos nuestras pruebas reales con las reglas de la documentación. Los errores de elección se dividen en tres tipos con costes muy distintos: en lectura, un error cuesta un turno más y unos segundos; en escritura, puede costar una fila de más, un ticket duplicado o un mensaje en el sitio equivocado.
| Error | Prueba real o regla | Coste directo | Coste oculto |
|---|---|---|---|
| Nombre de capacidad erróneo | review devolvió unknown_capability + did_you_mean, 00:25 | 0 USD, respuesta de unos 119 tokens | Un turno más; se releen las definiciones |
| La búsqueda de acciones no encuentra nada | Liner: solo consultas en inglés | No publicado | El modelo puede forzar otra herramienta |
| Acción de escritura errónea o repetida | Liner: confirmar antes, no reintentar sin saber | No publicado | Hoja equivocada, ticket duplicado, limpieza a mano |
La primera fila la medimos; las dos últimas salen solo de la documentación. Los errores de lectura tienen algo en común: el servidor sabe si la petición está mal y los fallos no se cobran, así que otro intento solo cuesta tiempo.
Los errores de escritura no tienen esa protección. Cuando una acción se ejecuta, el estado del otro sistema cambia, y ni el modelo ni el conector tienen por qué saber cuál es el nuevo estado. Por eso la documentación de Liner pide confirmar antes y comprobar antes de cualquier reintento.
Las cuentas: una revisión y un mes
Nuestra ejecución real hizo 5 llamadas cobradas por 0,004307 USD, igual que los precios del catálogo. Lo que sigue es una estimación con precios de catálogo para una revisión completa en la que cada capacidad de comentarios lee dos publicaciones o videos. Esa revisión hace 7 llamadas de datos: una a reddit/search, dos a reddit/comments, una a youtube/search, dos a youtube/comments y una a trustpilot/reviews. Con el price_usd del catálogo, el total es 0,005655 USD.
| Llamada de la revisión | Veces | Precio por llamada | Subtotal |
|---|---|---|---|
reddit/search | 1 | 0,000792 USD | 0,000792 USD |
reddit/comments | 2 | 0,000792 USD | 0,001584 USD |
youtube/search | 1 | 0,000778 USD | 0,000778 USD |
youtube/comments | 2 | 0,000556 USD | 0,001112 USD |
trustpilot/reviews | 1 | 0,001389 USD | 0,001389 USD |
| Total | 7 | 0,005655 USD |
Para el modelo contamos 8 turnos: 7 llamadas a herramientas y una respuesta final, y en cada turno se leen las definiciones. Los tokens son estimaciones o200k, así que los importes son mínimos. Con nuestras 12 herramientas en Sonnet 5.5, el primer turno sin caché cuesta 0,0075 USD y los 7 siguientes usan la caché, al menos unos 0,0101 USD en total. Las mismas capacidades como 574 herramientas costarían al menos unos 0,355 USD.
Con una revisión al día para 5 productos salen 150 revisiones al mes. Las tarifas de datos suman unos 0,85 USD. Las definiciones cuestan al menos unos 1,52 USD con 12 herramientas y al menos unos 53,2 USD con 574. Estas cifras no incluyen los tokens de resultados ni la salida del modelo, que son iguales en los dos casos.
El primer turno también se queda corto: para que los 7 siguientes acierten en caché, el primero tiene que escribirla, y la página de precios pone la escritura de caché de 5 minutos a 1,25 veces el precio de entrada, 2,50 USD por millón en Sonnet 5.5. Así, el primer turno de 12 herramientas cuesta al menos unos 0,0094 USD, no los 0,0075 USD que usamos.
| Concepto | Por revisión | Al mes (5 productos × 30 días) | Base |
|---|---|---|---|
| Datos de EveryInfra (7 llamadas, estimación) | 0,005655 USD | 0,85 USD | price_usd del catálogo; las 5 llamadas reales cobraron el precio de catálogo |
| 12 definiciones · Sonnet 5.5 (mínimo) | 0,0101 USD | 1,52 USD | Unos 3758 tokens o200k, primer turno sin caché |
| 574 definiciones · Sonnet 5.5 (mínimo) | 0,355 USD | 53,2 USD | Unos 131 395 tokens o200k, misma regla |
| 12 definiciones · Opus 5.5 (mínimo) | 0,0203 USD | 3,04 USD | El doble de precio de entrada |
| 12 definiciones · Haiku 5.5 (mínimo) | 0,00064 USD | 0,10 USD | Por debajo de 100 000 tokens |
| Liner Actions MCP | 0 USD | 0 USD | Gratis por ahora según la nota; revisar antes |
Con una revisión semanal para 20 productos, los datos cuestan unos 0,48 USD al mes (20 × 30/7 semanas × 0,005655 USD). Lo que más puede cambiar son los precios de los modelos y el de Liner. El price_usd de EveryInfra sigue el catálogo del día de la llamada, y la página de precios coincide con el catálogo.
Mide tu propia configuración con las mismas cifras
Primero, ejecuta tools/list en cada servidor MCP que uses, cuenta bytes y tokens con el script anterior y compara el total con 10K tokens y con el 10 % de tu ventana de contexto. Si superas alguna de las dos líneas, activa la búsqueda de herramientas o pide grupos a quien mantiene el servidor.
Después, elige entre cinco y diez peticiones que haces de verdad cada día y ejecútalas en tres configuraciones: todas las herramientas al inicio, búsqueda activada y solo los servidores que pide la tarea. En cada ejecución anota cuatro números: tokens de entrada del primer turno, llamadas a herramientas, llamadas erróneas o fallidas, y si el resultado fue correcto. Luego convierte los tokens en dinero con la página de precios y ponlo junto a la factura de datos.
Nuestra prueba sirve de referencia. Solo con el servidor de EveryInfra, las definiciones ocupaban 16 206 bytes, unos 3758 tokens o200k. Los resultados originales de nuestras cinco llamadas reales sumaban unos 22 606 tokens, y unos 14 367 con cinco campos; para la revisión de siete llamadas estimamos unos 27 900 y 17 700. Los resultados eran varias veces más grandes que las definiciones.
Así que, si la lista de herramientas ya es corta, lo siguiente es recortar resultados con limit y filtros de campos. Si tu servidor tiene una herramienta por capacidad y más de cien mil tokens de definiciones, arregla primero las definiciones.
Límites y precauciones
No ejecutamos la parte de Liner, así que algunos puntos solo salen de la documentación. No hay un ejemplo completo de cuántas candidatas devuelve search_actions, cómo las ordena ni cómo es una escritura fallida. La nota dice «gratis por ahora» sin fecha de fin y la página de precios no tiene fila de Actions, así que conviene revisarlo antes de depender de ello.
Escribe la regla del inglés en tu prompt; si no, cuando la búsqueda no encuentre nada, el modelo puede forzar otra herramienta. Los usuarios de ChatGPT Plus y Pro pueden añadir el servidor, pero las escrituras piden Business o superior, así que quien trabaja solo se quedará en el segundo paso.
EveryInfra también tiene límites. Para capacidades que leen una página en vivo, como las reseñas de Trustpilot, enviamos en modo asíncrono y luego consultamos. En el catálogo, 34 de las 574 capacidades figuran como no disponibles, pero las cinco de este artículo estaban disponibles.
Todos los tokens de este artículo son estimaciones o200k; los recuentos reales de Claude son más altos, así que los importes que salen de ellos son mínimos. Compruébalos con count_tokens antes de presupuestar. Una lista corta tampoco evita todos los errores: con EveryInfra se puede seguir escribiendo mal un nombre de capacidad, solo que cuesta un error sin cobro y un turno más.
Piensa también adónde van los datos. EveryInfra devuelve contenido de páginas públicas que puede incluir nombres y avatares de autores. Antes de escribir filas en una hoja de equipo, quédate con enlace, fecha, nota, texto y categoría, y quita los nombres. Liner dice que no guarda datos de usuarios y que desidentifica los registros, pero la hoja o el ticket viven en tu cuenta de Google, Linear o Jira, y tus propias reglas de acceso deciden quién los ve.
La regla de mandar los trabajos diarios a una lista fija y la cola larga a un enrutador está en el artículo sobre Monid; dos servidores MCP que cruzan reseñas con datos del almacén, en el artículo sobre Airbyte MCP; y cómo llevar resultados grandes a subagentes, en el artículo sobre subagentes de Claude Code.
Preguntas frecuentes
¿Cómo activo o desactivo la búsqueda de herramientas MCP en Claude Code?
Viene activada y las herramientas MCP se cargan bajo demanda. ENABLE_TOOL_SEARCH=false la desactiva. auto carga todo al inicio mientras las definiciones ocupan menos del 10 % del contexto, y auto:5 pone la línea en el 5 % (MCP en Claude Code). Origen: la sugerencia de Google «mcp tool search claude code».
¿Qué es un mcp tool router y en qué se diferencia de la búsqueda de herramientas?
La búsqueda de herramientas es una función de la plataforma del modelo o del cliente: el modelo busca y luego llama. Un mcp tool router es una capa entre el modelo y muchas herramientas o servidores que busca, inicia sesión y ejecuta; Liner Actions MCP, Composio Tool Router y Zapier MCP están en este grupo. El enrutador mantiene su propio catálogo y el cliente solo ve unas pocas herramientas fijas. Origen: la palabra clave «mcp tool router» y la sugerencia de Google «mcp server too many tools».
¿Es gratis liner actions mcp?
La nota de prensa en inglés del 3 de noviembre de 2026 dice que Liner Actions MCP y la API son gratis por ahora. La página de precios para desarrolladores, leída el 14 de noviembre de 2026, lista la Tools API y la Agent API, pero no Actions; conviene revisarla de nuevo antes de usar Actions. En ChatGPT, las escrituras piden además un plan Business, Enterprise o Edu (documentación de Liner Actions MCP). Origen: la palabra clave «liner actions mcp», que no tenía sugerencias de Google.
¿Es demasiado MCP si solo tengo uno o dos agentes?
Alguien lo preguntó en r/mcp el 9 de noviembre de 2026. Con pocas herramientas y definiciones pequeñas, unas funciones simples salen más baratas. El MCP remoto compensa cuando Claude Code, ChatGPT y Codex tienen que compartir las mismas herramientas de datos. La API REST y el MCP de EveryInfra usan la misma clave y los mismos precios, así que puedes usar los dos. Origen: r/mcp, 2026-11-09.
Referencias
- Liner Actions MCP, documentación para desarrolladores de Liner, leída el 2026-11-14, https://liner.com/developers/docs/actions-mcp
- Portada de la documentación de Liner Developers, leída el 2026-11-14, https://liner.com/developers/docs
- Actions API Quick Start, documentación de Liner, leída el 2026-11-14, https://liner.com/developers/docs/actions-api-quick-start
- Use Actions as LLM tools, documentación de Liner, leída el 2026-11-14, https://liner.com/developers/docs/actions-api-guides-llm-tools
- Pricing, documentación de Liner, leída el 2026-11-14, https://liner.com/developers/docs/pricing
- Liner Launches Actions MCP, nota de prensa en VMblog, 2026-11-03, https://vmblog.com/news/liner-launches-actions-mcp-connecting-ai-agents-to-more-than-1100-verified-apps-through-a-single-integration/
- Liner launches Liner Actions MCP, Digital Today, 2026-09-29, https://www.digitaltoday.co.kr/en/view/108354/liner-launches-liner-actions-mcp-to-connect-1-100-apps-to-ai-agents
- Liner: Use 1100 Apps Once Connected to AI Agent, VentureSquare, 2026-09-29, https://www.venturesquare.net/en/1116726/
- Liner Actions MCP: One Integration for 1,100 AI Agent Apps, Efficiently Connected, 2026-11-11, https://www.efficientlyconnected.com/liner-actions-mcp-agent-integration/
- Tool search tool, documentación de Claude, leída el 2026-11-14, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Pricing, documentación de Claude, leída el 2026-11-14, https://platform.claude.com/docs/en/about-claude/pricing
- Tool use with prompt caching, documentación de Claude, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-use-with-prompt-caching
- Tool use with Claude, documentación de Claude, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Token counting, documentación de Claude, https://platform.claude.com/docs/en/build-with-claude/token-counting
- MCP connector, documentación de Claude, https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- Connect Claude Code to tools via MCP, documentación de Claude Code, leída el 2026-11-14, https://code.claude.com/docs/en/mcp
- Tool search, documentación del Claude Agent SDK, https://code.claude.com/docs/en/agent-sdk/tool-search
- Introducing advanced tool use, Anthropic, 2025-11-24, https://www.anthropic.com/research/advanced-tool-use
- Tool search, documentación de la API de OpenAI, https://developers.openai.com/api/docs/guides/tools-tool-search
- Model Context Protocol, documentación para desarrolladores de OpenAI, https://developers.openai.com/codex/mcp
- Connecting custom MCP servers in ChatGPT, centro de ayuda de OpenAI, https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt
- Toolbox overview, documentación de Microsoft Foundry, https://learn.microsoft.com/en-us/azure/foundry/agents/concepts/toolbox-overview
- Tool search, documentación de Microsoft Foundry, 2026-10-26, https://learn.microsoft.com/en-us/azure/foundry/agents/how-to/tools/tool-search
- Tools, especificación MCP 2026-07-28, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- Authorization, especificación MCP 2026-07-28, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- SEP-3398 Release cycle updates, MCP, https://modelcontextprotocol.io/seps/3398-release-cycle-updates
- MCP release cycle, blog de MCP, 2026-11-11, https://blog.modelcontextprotocol.io/posts/mcp-release-cycle/
- RFC 9728 OAuth 2.0 Protected Resource Metadata, IETF, https://datatracker.ietf.org/doc/html/rfc9728
- README de github-mcp-server, GitHub, https://github.com/github/github-mcp-server
- README de tiktoken, GitHub, https://github.com/openai/tiktoken
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection, arXiv 2505.03275, https://arxiv.org/abs/2505.03275
- JSPLIT, arXiv 2510.14537, https://arxiv.org/abs/2510.14537
- LiveMCPBench, arXiv 2508.01780, https://arxiv.org/abs/2508.01780
- Dynamic ReAct, arXiv 2509.20386, https://arxiv.org/abs/2509.20386
- Zapier MCP usage, documentación de Zapier, leída el 2026-11-14, https://docs.zapier.com/mcp/overview/usage
- Precios de Zapier, leídos el 2026-11-14, https://zapier.com/pricing
- Documentación de Composio, leída el 2026-11-14, https://docs.composio.dev/docs
- Designing an MCP gateway, blog de ingeniería de Uber, 2026-10-01, https://www.uber.com/us/en/blog/designing-mcp-gateway/
- Scaling AI agents with open standards, blog de código abierto de Google, 2026-11-11, https://opensource.googleblog.com/2026/11/scaling-ai-agents-open-standards-mcp-aaif.html
- How many MCP tools is too many before your agent gets confused?, r/mcp, 2026-11-04, https://www.reddit.com/r/mcp/comments/1xnmicj/how_many_mcp_tools_is_too_many_before_your_agent/
- A lot of heavy MCP tool lists are the same schema block repeated, r/mcp, 2026-11-12, https://www.reddit.com/r/mcp/comments/1xujtxy/a_lot_of_heavy_mcp_tool_lists_are_the_same_schema/
- Is using MCP too much if you've only got one or two agents?, r/mcp, 2026-11-09, https://www.reddit.com/r/mcp/comments/1xrw28k/is_using_mcp_too_much_if_youve_only_got_one_or/
- Too many MCP tools? Anthropic found a solution., YouTube, 2026-10-06, https://www.youtube.com/watch?v=g87DYmwbzuo
- Why do MCP Tools Eat Your Context?, YouTube, 2026-10-18, https://www.youtube.com/watch?v=4QuXrXoMVtM
- Reseñas de Notion, Trustpilot, leídas el 2026-11-14, https://www.trustpilot.com/review/notion.so
- Catálogo de capacidades de datos de EveryInfra, leído el 2026-11-14 a las 00:16 hora de Singapur, https://api.everyinfra.com/api/v1/social/catalog
- Servidor MCP remoto de EveryInfra, leído el 2026-11-14 a las 00:16 hora de Singapur, https://api.everyinfra.com/mcp
Referencia BL-145