Claude Code subagents:Haiku 子代理并行拉 TikTok 品牌号
TikTok 品牌号原始数据约 9,700 token,Haiku 5.5 子代理只回 95 token 摘要;附 98 次真调和 50 个账号的账。
我们在 2026 年 10 月 26 日 17:25–17:48(新加坡时间)用 EveryInfra 接口拉了 18 个 TikTok 品牌号的主页、最新 10 条视频和一条视频的评论,每个账号原样返回平均 38,794 字节,按 Anthropic 定价页「10 kB 约 2,500 token」的比例约合 9,700 token;同样的信息压成一份摘要只有约 382 字节、95 token,差 100 倍左右。所以用 Claude Code 子代理做这件活,真正省下来的是主会话的上下文:50 个账号的原始数据约 48.5 万 token,摘要只有约 4,800 token。另一个实测结论更容易被忽略:这把测试 Key 被我们单独限到每分钟 10 次请求(账户默认是 60 次),6 个工人一起跑时 56 次请求里有 20 次 429,4 个工人加客户端限速反而每分钟多拿到 50% 以上的结果。
这篇文章要回答的问题很具体:手上有一份几十个 TikTok 品牌号的名单(竞品、合作候选、自家各国分号),想用 Claude Code 一次拉回主页、近期视频和评论,再出一张对比表。怎么拆给子代理,每个子代理配什么模型、给哪些工具,调哪几项数据能力,花多少钱,被限速了怎么办。Claude Code 一侧的设置全部来自官方文档和更新日志的原文,我们没有在本机跑子代理,所以那部分写成「配置示例」;EveryInfra 一侧的每个数字都来自真调的原始返回。
这件活是什么:50 个品牌号,一张对比表
先把任务说清楚,因为后面所有的数都按这个任务算。输入是一份 TikTok 用户名清单。对每个账号,我们要三样东西:主页信息(粉丝数、作品数、是否认证),最新的 10 条视频(播放、点赞、评论数、发布时间),以及这 10 条里评论最多的那一条视频下的评论(最多 50 条)。输出是一张表,每个账号一行,列是粉丝数、最近 10 条的播放中位数、互动率、发帖频率、被抽到的评论条数,外加一两句观察。
这件活有三个特点,正好对上子代理的用途。第一,账号之间互不依赖,拉 Nike 不需要知道 Adidas 的结果,可以并行。第二,读得多、留得少:每个账号的原始返回有几十 KB,但对比表里每个账号只占一行。第三,步骤固定,判断简单:调三次接口、挑一条视频、算几个数,不需要大模型做复杂推理,便宜的小模型就够。Claude Code 官方文档对子代理的定义也是这三点,原话的意思是:当一项支线任务会用你以后不再看的搜索结果、日志或文件内容塞满主对话时,就用子代理,它在自己的上下文里做完,只把摘要交回来(Claude Code 子代理文档)。
我们实际测的是 24 个用户名,分三组:美国运动品牌 8 个(Nike、Adidas、Gymshark、lululemon、Under Armour、New Balance、PUMA、HOKA),中国出海品牌 8 个(SHEIN、Temu、DJI、OnePlus、EcoFlow,加上按品牌名猜的 Anker、Insta360、小米三个用户名),西语市场品牌 8 个(Zara、Bershka、Real Madrid、Telcel、Pull&Bear,加上按品牌名猜的 Mercado Libre、OXXO、Bimbo 三个用户名)。猜的那几个后来证明是错的,这本身就是一个值得写的发现,放在后面的「边界」一节。最后 18 个是认证的品牌号,后面所有的体积、成本、吞吐的数都按这 18 个算,再按比例放大到 50 个。


先回答该不该拆:Anthropic 10 月 22 日那篇指南怎么说
在讲怎么配之前,要先面对一个反方向的意见。Anthropic 在 2026 年 10 月 22 日发了一篇面向智能体开发者的长文《When to fold subagents into your main agent loop》,主张大多数智能体应该减少子代理,默认用一个模型、一个上下文、一个开放的工具循环,把领域流程放进 Skills,把查询和硬限制放进工具(Anthropic 原文;据 Reddit 讨论帖转述,文中一家客户的单循环比多智能体快约 2 倍)。配套的 single-agent-loop-kit 在 README 里写得更直接:这套工具不假设单循环永远更好,它先量,每次改动前后用同一套评测打分。
同一份 README 也写了什么时候应该保留子代理:在新的上下文里并行做研究、独立核验,或者一件活读进来的东西远多于主智能体事后需要的东西。拉 50 个 TikTok 账号正好是最后这一种:每个账号读进来约 9,700 token,主会话需要的只是约 95 token 的一行。按 The Decoder 的报道转述,Anthropic 给的保留条件是:单个智能体的上下文出现可测量的质量下降、多个任务需要用各自的上下文并行、或者单个智能体在工具选择上吃力。我们这件活满足前两条。
| Anthropic 工具包写的保留理由 | 本文的活是否满足 | 本文的数据 |
|---|---|---|
| 在新的上下文里并行做研究 | 是 | 账号之间互不依赖 |
| 读进来的远多于主智能体事后需要的 | 是 | 每个账号读约 9,700 token,交回约 95 token |
| 独立核验 | 部分 | 可以让新工人重跑一个账号做抽查 |
| 工具太多导致选择吃力 | 不过滤时是 | MCP 共 25 个工具,白名单只留 2 个 |
所以我们的判断是:这件活该拆,但只拆一层,只拆「拉数据、压摘要」这一段。对比表的结论、哪些账号值得深看、要不要再拉一轮,这些判断留在主会话里做,因为它们需要同时看到全部账号。这和 Anthropic 那篇文章反对的「按组织架构拆出一堆角色子代理」不是一回事:我们拆出去的工人没有角色,只有一份固定的工作说明和一个账号。
claude code subagents 的定义文件:model 字段、工具白名单和 MCP
Claude Code 的子代理是一个 Markdown 文件:开头是 YAML 格式的元数据(官方叫 frontmatter),后面的正文就是这个子代理的系统提示。项目级的放在 .claude/agents/,可以提交进版本库给团队共用;用户级的放在 ~/.claude/agents/。官方文档写明只有 name 和 description 两个字段是必填的,字段名用驼峰写法,写错了不会报错而是被静默忽略(子代理文档 Frontmatter 一节)。下面是我们为这件活写的配置示例,每一行的取舍在后面解释。
---
name: tiktok-account-worker
description: 拉一个 TikTok 账号的主页、最新视频和一条视频的评论,只返回一行 JSON 摘要。名单里每个账号用一个。
model: claude-haiku-5-5
effort: low
tools: mcp__everyinfra__everyinfra_call_api, mcp__everyinfra__everyinfra_get_job
mcpServers:
  - everyinfra:
      type: http
      url: https://api.everyinfra.com/mcp
      headers:
        Authorization: "Bearer ${EVERYINFRA_API_KEY}"
maxTurns: 8
omitClaudeMd: true
---

你只处理任务里给你的一个 TikTok 用户名。按顺序做:
1. 调 everyinfra_call_api:platform=tiktok, action=profile, params={username}。
   如果 is_verified 为 false 且 follower_count < 1000,停下,返回 {"username":..., "flag":"lookalike"}。
2. 调 action=user_videos, params={username, limit:10}。算播放中位数和互动率时去掉 is_pinned=true 的视频。
3. 在第 2 步的视频里挑 comment_count 最大的一条,调 action=comments, params={url, limit:50}。
4. 遇到 429:按返回里的 retry_after 秒数等待后重试一次;不要换参数重投。
5. 最后只输出一行 JSON:username, verified, followers, median_views, engagement_pct,
   posts_per_week, comments_fetched,以及不超过 40 字的一句观察。不要输出原始数据。
model 这一行我们写了完整的模型 ID,而不是别名 haiku,理由在下一节。tools 是白名单:官方文档说明,写了 tools 的子代理只能用列出来的工具,没写就继承主对话可用的全部工具(可用工具一节)。EveryInfra 的远程 MCP 在 tools/list 里一共返回 25 个工具,除了取数据的 everyinfra_call_api 和读异步任务的 everyinfra_get_job,还有账户、Key 管理、工单、Webhook 一类的工具,其中 everyinfra_key_delete 这样的工具不该交给一个批量跑的小模型。白名单只留 2 个,等于从源头上去掉误操作的可能。
mcpServers 是这份配置里最省上下文的一行。官方文档写道,在子代理里内联定义的 MCP 服务器只在这个子代理启动时连接、结束时断开,如果想让一个 MCP 服务器完全不进主对话、不让它的工具说明占用主对话的上下文,就把它定义在这里,而不是写进 .mcp.json(限定 MCP 服务器一节)。我们实测 EveryInfra 的 tools/list 响应是 30,682 字节,约 7,670 token;initialize 返回的使用说明另有 3,924 个字符。只留 2 个工具时,这两个工具的定义是 2,505 字节,约 626 token。注意文档同时写了一条信任规则:项目 .claude/agents/ 里的内联 MCP 服务器,要在你信任这个文件夹以后才会加载,v2.1.238 之前不检查。
omitClaudeMd: true 让子代理启动时不加载用户、项目和本地的 CLAUDE.md。默认情况下子代理会加载主对话加载的每一层 CLAUDE.md(启动时加载什么),对一个只按固定步骤调三次接口的工人,这些规则大多用不上,却要在 50 个工人里各占一份。这个字段要求 Claude Code v2.1.271 或更新。maxTurns: 8 给工人设一个回合上限,达到上限时 Claude Code 会把输出标成「部分完成」,主会话可以恢复它接着做(v2.1.246 起)。
Key 的写法用了环境变量展开。Claude Code 的 MCP 文档说明,.mcp.json 和子代理里的 MCP 配置支持 ${VAR} 写法,团队可以共用一份配置而各自放自己的 Key;但它对一组凭据变量名做了特殊处理:ANTHROPIC_API_KEY、云服务商凭据、NPM_TOKEN 这类名字在远程服务器的 url 和 headers 里一律读成空值,防止项目配置把你的凭据发给它指定的服务器(MCP 文档环境变量一节)。所以变量要起自己的名字,比如 EVERYINFRA_API_KEY。不想把 MCP 写进子代理文件的,也可以用一行命令加到项目里,再在子代理的 mcpServers 里按名字引用:
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
--scope project --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"还有一处容易卡住:everyinfra_call_api 在 tools/list 里的标注是 readOnlyHint: false、destructiveHint: true,因为它会扣费。官方文档写明,后台子代理遇到需要权限的工具调用时,会把确认提示放到主会话里,并写明是哪个子代理在问(前台与后台一节)。50 个工人就可能弹 50 次确认。要提前在 settings 的 permissions.allow 里放行 mcp__everyinfra__everyinfra_call_api(权限文档),并且只放行这一个工具。
下表把这份配置里每个字段的作用、对应的官方依据和版本要求列在一起。
| 字段 | 本文的写法 | 作用 | 官方依据(版本) |
|---|---|---|---|
model | claude-haiku-5-5 | 指定子代理的模型;也可写 haiku 等别名或 inherit | 子代理文档「Choose a model」 |
tools | 只列 2 个 MCP 工具 | 白名单;没写就继承全部工具 | 子代理文档「Available tools」 |
mcpServers | 内联 EveryInfra | 工具说明只进子代理,不进主对话 | 子代理文档;内联服务器信任检查 v2.1.238 起 |
effort | low | 子代理自己的思考强度 | 子代理文档「Choose an effort level」 |
maxTurns | 8 | 回合上限,超了标为部分完成 | 部分完成标记 v2.1.246 起 |
omitClaudeMd | true | 不加载 CLAUDE.md | v2.1.271 起 |
claude code subagents model selection:四级顺序和 haiku 别名的坑
子代理到底跑在哪个模型上,是这件活成本最敏感的一项,也是社区里问得最多的问题之一(Google 联想词里有「claude code subagents model selection」「claude code subagent model default」「claude_code_subagent_model force」)。官方文档给了一个四级的解析顺序:先看主会话调用子代理时传的 model 参数;再看子代理定义文件里的 model 字段,写 inherit 就用主会话的模型;再看环境变量 CLAUDE_CODE_SUBAGENT_MODEL;最后才是主会话自己的模型(子代理文档 Choose a model)。
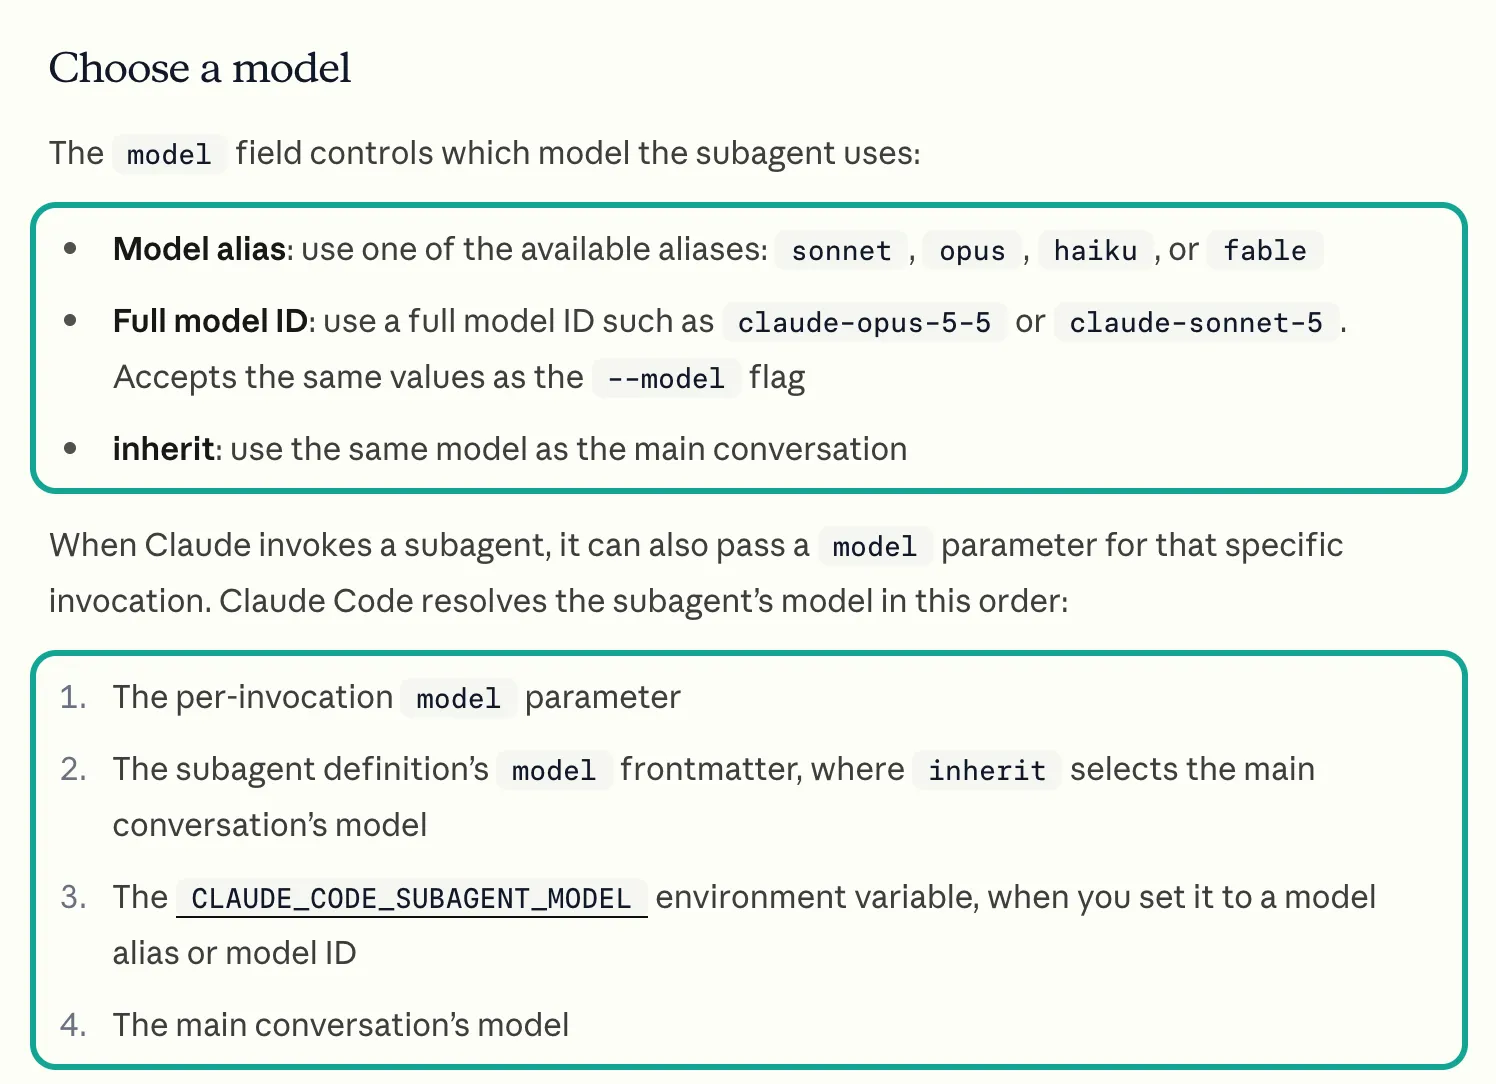
这个顺序有两个推论。第一,没写 model 的子代理会继承主会话的模型。如果主会话跑的是 Opus 5.5,一个看起来很轻的取数工人也会按 Opus 计费。Reddit 上一条 736 赞的帖子提醒过同一件事:内置的 Explore 子代理已经不再固定跑 Haiku,会跟着主会话走(r/ClaudeCode 讨论)。第二,环境变量排在定义文件后面,只是一个默认值。要把所有子代理都压到同一个模型上,文档说要同时设 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1,这时定义文件里的 model 会被忽略。社区里一篇更早的帖子把环境变量写成第一优先(r/claude 讨论),和今天的文档顺序不一致,以文档为准。
我们在配置示例里写完整 ID 而不写 haiku,是因为别名在不同的接入方式下指向不同的模型。Claude Code 的模型配置文档列了一张表:在 Anthropic API 上,haiku 指 Haiku 5.5;在 Claude Platform on AWS、Amazon Bedrock、Google Cloud 和 Microsoft Foundry 上,haiku 仍然指 Haiku 4.5(模型配置文档)。Haiku 4.5 的公开价是每百万输入 token $1、输出 $5,是 Haiku 5.5 的 10 倍(Haiku 5.5 发布页的价格表)。同一份子代理文件拿到 Bedrock 上跑,账单会差一个数量级,而且没有任何报错。Claude Code 的更新日志也写明,Haiku 5.5 是从 2026-10-07 的 v2.1.293 起才成为 Anthropic API 上的默认 Haiku 模型(Claude Code 更新日志)。
| 接入方式 | `haiku` 别名指向 | 输入 / 输出(每百万 token) | 建议 |
|---|---|---|---|
| Anthropic API | Haiku 5.5 | $0.10 / $0.50(10 万 token 以内) | 写别名或完整 ID 都行 |
| Claude Platform on AWS | Haiku 4.5 | $1 / $5 | 写完整 ID |
| Amazon Bedrock、Google Cloud | Haiku 4.5 | 按云平台价格 | 写云平台的模型 ID |
| Microsoft Foundry | Haiku 4.5 | 按 Azure 价格 | 写完整 ID |
为什么是 Haiku 5.5,而不是 Sonnet。Anthropic 在 2026-10-07 的发布页里直接写了它的定位:适合大批量、对成本敏感的任务,例如摘要、压缩、数据库查询和分类,「和 Opus 5.5、Sonnet 5.5 搭配当子代理很合适」;同一页也写明,复杂的编程智能体任务仍然是 Sonnet 5.5 和 Opus 5.5 更好,Haiku 5.5 最适合范围清楚的窄任务(Haiku 5.5 发布页)。我们的工人只做三件事:按顺序调接口、挑出评论最多的视频、算几个中位数,结果可以机械核对,这正是那篇文章说的窄任务。社区的经验也类似:有人在 7 个有边界的小任务上跑 Haiku 5.5,140 次全部通过,和 Opus 5.5 一样,但他也提醒「一个文件加一项检查没问题,开放的一大块活就会跑偏」(r/ClaudeAI 讨论)。
Haiku 5.5 还有几处和旧版不同的接口行为,写工人时要避开。迁移指南写明:Haiku 5.5 不接受 temperature、top_p、top_k;thinking 写成带 budget_tokens 的旧格式会返回 400,要改成 {"type": "adaptive"};以助手回合结尾让模型续写的预填写法也不再支持(Haiku 5.5 迁移指南)。在 Claude Code 里这些参数由客户端处理,一般碰不到;自己用 Agent SDK 或 API 写工人时就要注意。
每个子代理调哪三项能力,字段对得上吗
工人调的三项能力都来自 EveryInfra 目录(GET /api/v1/social/catalog,免费、不需要 Key),我们在 2026-10-26 17:22 新加坡时间读了一次并存档。三项都在 TikTok 这一档,price_usd 都是 0.000556,即每次调用 $0.000556;一次返回多少行都只算一次,user_videos 每次最多 50 条、comments 每次最多 200 条(TikTok 目录)。能力页分别是 tiktok/profile、tiktok/user_videos 和 tiktok/comments,平台总览在 TikTok 数据接口。
| 能力 | 必填参数 | 本文用法 | 每次价格 | 本文用到的返回字段(与目录 response_fields 一致) |
|---|---|---|---|---|
tiktok/profile | username | 每个账号 1 次 | $0.000556 | username、display_name、follower_count、video_count、like_count、is_verified |
tiktok/user_videos | username | limit: 10 | $0.000556 | url、view_count、like_count、comment_count、posted_at、is_pinned |
tiktok/comments | url | limit: 50 | $0.000556 | id、like_count、reply_count、is_reply、posted_at |
tiktok/search | keyword | content_type: profile,找正确的用户名 | 每返回 1 个账号 $0.000556 | author_username、author_is_verified、author_follower_count |
最后一行要单独说明。tiktok/search 在目录里有一个 rows_per_unit_when 字段,写的是 content_type 为 profile 时按 1 行计 1 次。我们用它找三个品牌的正确用户名,limit: 5,每次扣了 $0.002778,正好是 5 × $0.000556。按视频搜索时一次只算一次,按账号搜索时按返回的账号数算,这一点在估预算时容易漏。
下面是工人第一步的 REST 写法。Key 只从环境变量读,不写进文件;返回里的 billing.charged_usd 是这次实际扣的钱。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"tiktok","action":"user_videos","params":{"username":"nike","limit":10}}'有两个字段细节直接影响对比表的正确性。第一,user_videos 默认按最新排序,但置顶视频(is_pinned: true)会排在最前面。18 个账号里有 7 个在最新 10 条里带置顶视频,SHEIN、DJI、Gymshark 各 3 条,这些置顶视频可能是几个月前发的。如果不排除,SHEIN 的「最近 10 条」时间跨度会被算成 294 天,发帖频率就错了。第二,评论数以返回为准,不以视频上的 comment_count 为准:New Balance 那条视频标着 29 条评论,返回 27 条;Telcel 标 10 条,返回 5 条。目录对 comments 的说明也写了每条顶层评论最多附带两条回复,不保证完整的对话树。
一次真实的 MCP 往返:模型发出什么,接口回了什么
子代理通过 MCP 调接口时,走的是 MCP 规范里的 Streamable HTTP 传输:先 initialize,再发 notifications/initialized,再 tools/list,然后 tools/call(MCP 2025-06-18 传输规范、生命周期规范)。我们在 2026-10-26 17:30 新加坡时间手动走了一遍:initialize 返回 200,协议版本 2025-06-18,响应头里没有 Mcp-Session-Id,说明这个服务器不要求会话 ID;notifications/initialized 返回 202、空响应体,和我们接入说明写的一致;tools/list 返回 25 个工具。
17:45:05 我们用 tools/call 调了一次 everyinfra_call_api,参数是 Nike 一条视频的评论、limit: 200。这就是一个 Haiku 工人在 Claude Code 里会发出的那一次调用。接口用了 92.6 秒返回 200,整个 HTTP 响应 61,653 字节,其中 content[0].text 这个文本字段有 54,819 个字符,里面是 177 条评论和 billing.charged_usd: 0.000556。
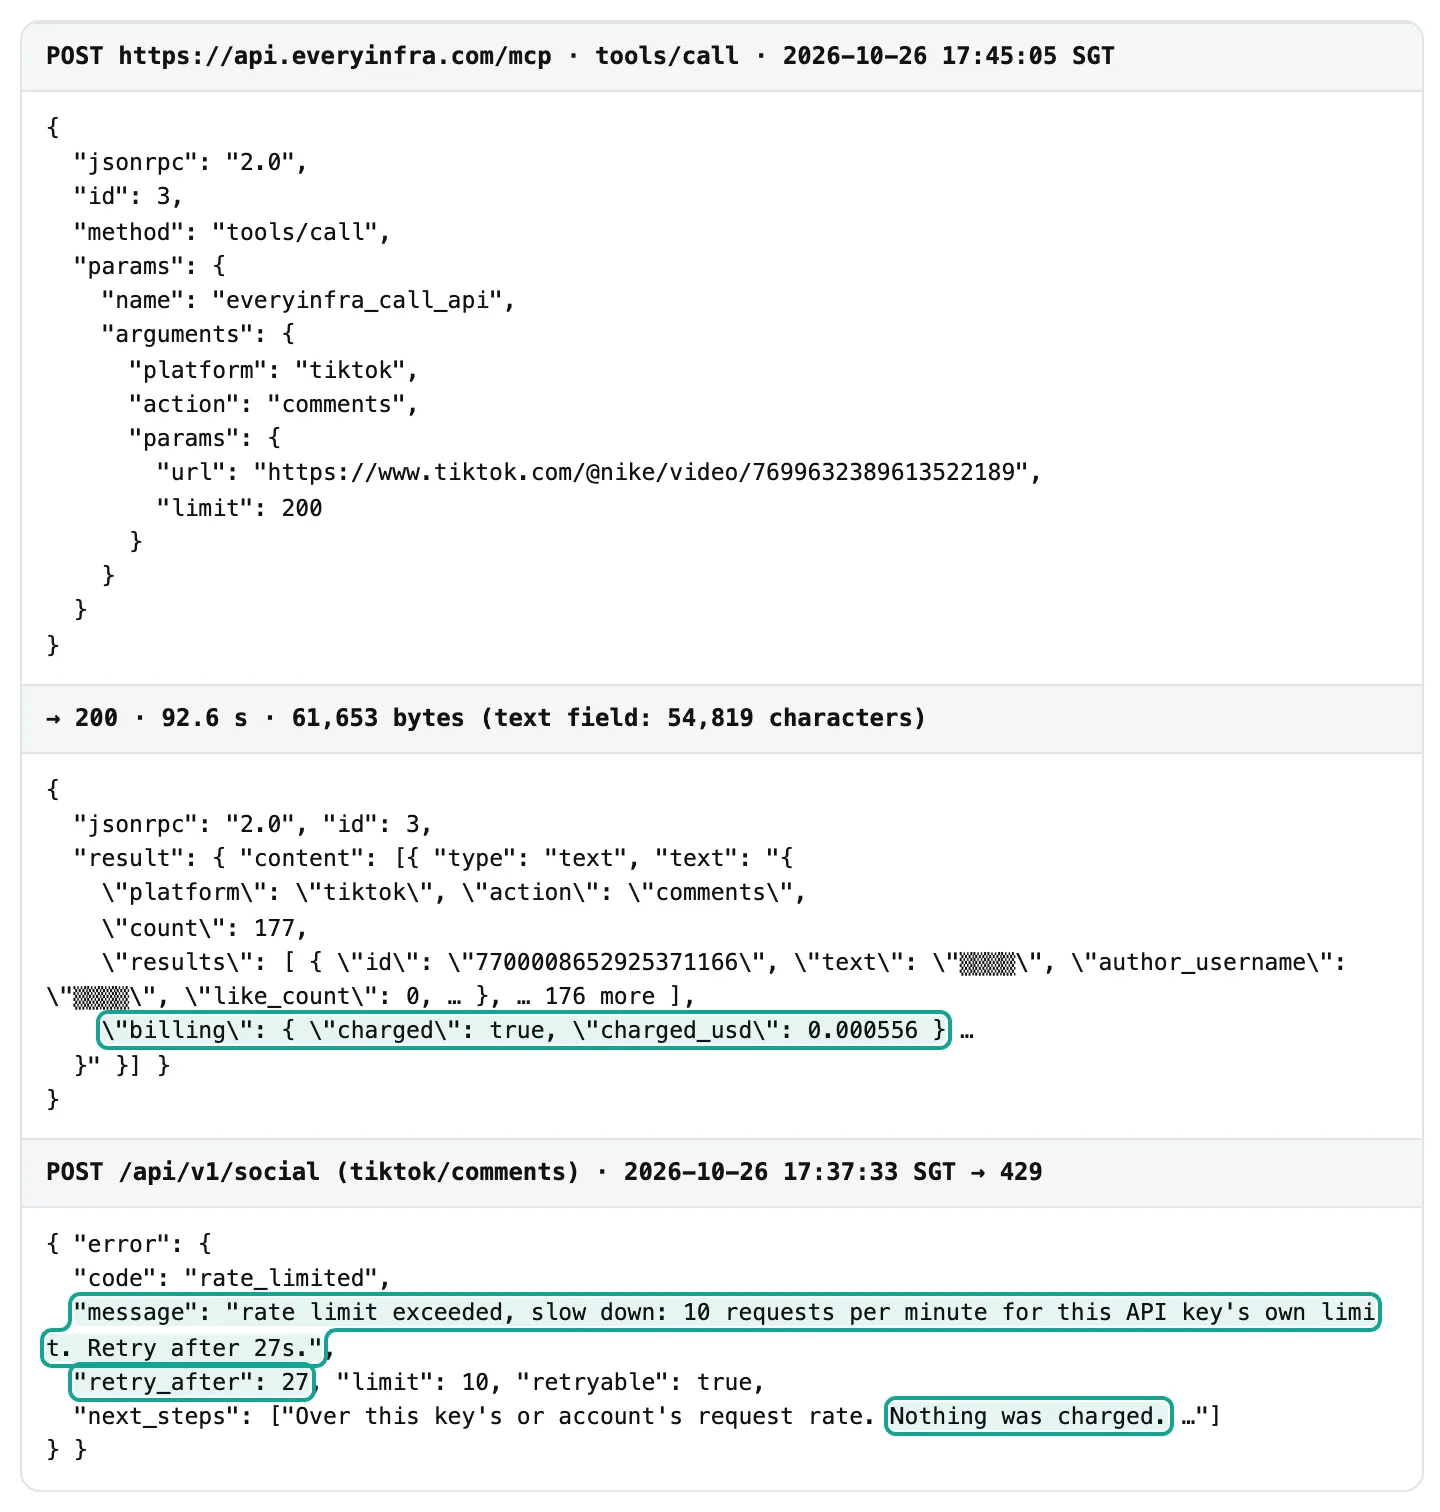
54,819 这个数要和 Claude Code 的三条阈值放在一起看。官方 MCP 文档写明:任何 MCP 工具输出超过 10,000 token 时显示警告;默认上限是 25,000 token,可以用 MAX_MCP_OUTPUT_TOKENS 调高;另外,对没有声明 anthropic/maxResultSizeChars 的工具,成功的纯文本结果只要超过 50,000 个字符,就会被存成文件,对话里只留一个文件引用(MCP 输出上限一节)。
| Claude Code 对 MCP 结果的阈值 | 文档写的数 | 我们实测的返回 | 是否越线 |
|---|---|---|---|
| 警告 | 10,000 token | 200 条评论:约 13,865 token | 是 |
默认上限(MAX_MCP_OUTPUT_TOKENS) | 25,000 token | 200 条评论:约 13,865 token | 否 |
存成文件(未声明 anthropic/maxResultSizeChars) | 50,000 字符 | 200 条评论:54,819 字符 | 是 |
| 存成文件 | 50,000 字符 | 50 条评论:最长 24,749 字符 | 否 |
| 存成文件 | 50,000 字符 | 10 条视频:最长 29,156 字符 | 否 |
我们核对了 tools/list 的原文,EveryInfra 的工具没有这个标注。也就是说,一次 200 条评论的调用在 Claude Code 里会越过 1 万 token 的警告线(按 4 字节 1 token 约 13,865 token),并且整段结果会落盘。工人要再用 Read 去读这个文件,多一个回合,也多一份上下文。
对策很简单:工人取评论时用 limit: 50。我们 18 次 50 条评论的返回,整段 JSON 平均 14,106 个字符、最长 24,749 个字符,都在 5 万字符以内;10 条视频的返回最长 29,156 个字符,也在线内。真的需要 200 条评论时,交给 mode: "async",拿到 job_id 后用 everyinfra_get_job 读,工具说明写明读取任务免费、不计入每分钟限额。这一点也说明了为什么要看原始返回的体积:模型看不到这条线,它只会在结果被落盘以后多做一步。
实测一:一个账号的原始返回到底有多大
下图是 18 个品牌号各自三次调用的返回体积,只算 results 部分的 UTF-8 字节,不算计费和余额字段。平均每个账号 38,794 字节,中位数 39,983 字节,最小的 Pull&Bear 25,426 字节(那条视频只有 2 条评论),最大的 DJI 53,324 字节。三部分里,主页只有平均 740 字节;10 条视频平均 24,514 字节,是大头;评论平均 13,540 字节。
| 一个账号的组成 | 平均字节 | 估计 token(÷4) | 按新分词器(×1.3) |
|---|---|---|---|
| 主页 | 740 | 185 | 240 |
| 最新 10 条视频 | 24,514 | 6,128 | 7,967 |
| 最多 50 条评论 | 13,540 | 3,385 | 4,400 |
| 合计 | 38,794 | 9,698 | 12,608 |
| 工人交回的摘要 | 382 | 95 | 124 |
视频为什么这么大?打开一条视频记录就知道:封面图、头像、背景音乐都是带签名参数的 CDN 链接,单个链接就有三四百个字符。我们把所有以 _url 结尾的字段(保留视频本身的 url)去掉再量,平均每个账号剩 25,175 字节,链接字段占了 35.1%。对一张对比表来说,这些链接一个都用不上。这也是让工人「只输出摘要」而不是「把数据整理一下交回来」的原因:哪怕只是删掉链接再交回,主会话还是要收 25 KB;按我们的摘要格式交回,是 382 字节。
字节换成 token 的比例,我们用的是 Anthropic 定价页给的例子:平均一个 10 kB 的网页约 2,500 token,也就是 4 字节约 1 token(Anthropic 定价页 Web fetch 一节)。同一页还写明,Claude 4.7 及之后的模型用了新的分词器,同样的文本会多出约 30% 的 token。所以本文所有 token 数都是估计值,给的是「4 字节 1 token」和「再多 30%」两个数。要精确计数,可以用官方的 token 计数接口,文档写明它免费,只受每分钟请求数限制(Token 计数文档)。
上下文为什么能省:claude code haiku subagent 的账要算三层
有了单个账号的体积,就可以算子代理到底省了什么。第一层是主会话的上下文。50 个账号的原始返回按均值放大是约 194 万字节、约 48.5 万 token(按新分词器约 63 万 token),接近 Opus 5.5 百万 token 上下文的一半到三分之二。换成摘要,50 份一共约 4,800 token,差约 102 倍。EveryInfra 全部 25 个工具的说明还要再占约 7,670 token,这部分用内联 mcpServers 加白名单可以压到 626 token,而且只出现在工人的上下文里。
第二层是每个工人自己的上下文,这里有一条容易被忽略的计价线。Anthropic 定价页写明,Haiku 5.5 按单次请求的提示长度定价:提示(含缓存读写)超过 10 万 token 的请求,输入价从每百万 $0.10 变成 $0.50,输出从 $0.50 变成 $2.50,并且这次请求整笔按高价算(定价页 Long context pricing)。一个工人每多装一个账号,上下文就多约 9,700 token。再加上约 3,600 token 的提示和工具说明(工具说明 626 token 是实测,提示和任务说明的 3,000 token 是我们的假设),一个工人最多装 9 个账号;按新分词器多 30% 算,最多 7 个。超过这个数,后面每次请求的单价都乘以 5。
第三层是钱。Claude Code 的成本文档解释了长会话为什么越来越贵:每次请求都会把整段对话发一遍,每用一次工具就再发一次带着工具结果的请求;有提示缓存时,历史部分按缓存价重读(Claude Code 成本文档)。所以原始数据进了主会话,代价不是一次,而是之后的每一次请求。我们按公开价做了一个估算(假设写在表下):
| 做法 | 主要构成 | 估算费用(50 个账号) |
|---|---|---|
| 拆成子代理 | 50 个 Haiku 5.5 工人约 $0.134 + EveryInfra 接口费 $0.0834 + Opus 5.5 主会话读摘要约 $0.043 | 约 $0.26 |
| 不拆,原始数据进主会话 | EveryInfra 接口费 $0.0834 + Opus 5.5 主会话装约 48.5 万 token 并在之后 20 次请求里重读约 $4.36 | 约 $4.45 |
估算的假设:每个工人 4 次请求(3 次工具调用加 1 次收尾),每次输出约 400 token,按 Haiku 5.5 的公开价(输入 $0.10、缓存写 $0.125、缓存读 $0.01、输出 $0.50,每百万 token)和 5 分钟缓存计;主会话按 Opus 5.5 的公开价(输入 $4,缓存写按 1.25 倍即 $5,缓存读 $0.20,每百万 token),读完数据后再发 20 次请求。Opus 5.5 的价格来自 Anthropic 模型总览,缓存读价来自定价页的提示缓存一节。如果你用的是 Pro 或 Max 订阅,Claude Code 不按这个价格扣钱,而是扣用量额度;比例关系一样,原始数据进主会话会让额度消耗快十几倍。官方成本文档也提醒,子代理的请求同样计入用量额度(成本文档)。
这个估算的边界要说清楚。它没有算主会话自己的规划和写表的输出,这部分两种做法差不多;20 次后续请求是假设,你的会话越长,不拆的那一行越贵;Claude Code 在主会话上下文到一定比例时会自动压缩,压缩本身也是一次大请求,我们没有计入。另外,48.5 万 token 已经接近 Haiku 5.5 的 100 万上下文上限一半,如果主会话用的是 Haiku,那一行还会越过 10 万 token 的计价线。
实测二:并行几个工人最合适
子代理能并行,接口不一定能。这把测试 Key 的限额是每分钟 10 次请求,超出时返回 429。这个 10 次是我们给这把 Key 单独设的上限,429 返回里的 reason 是 key_limit;账户默认是每分钟 60 次、所有 Key 共用,充值累计满 $50、$150、$750 分别升到 180、600、1,800 次(价格页)。下面按 10 次算出的工人数,要换成你自己的限额重算:同样单次约 25 秒,每分钟 60 次大约能喂满 25 个工人,已经超过 Claude Code 默认同时 20 个子代理的上限。我们用同一组账号跑了三轮,每轮都按真实耗时计:
第一轮在 17:25–17:37 新加坡时间,1 个工人串行拉 24 个账号的主页,10.72 分钟拿到 24 次返回,每分钟 2.24 次,单次耗时中位数 18.2 秒。没有一次 429,但大部分时间在等接口返回。
第二轮在 17:37–17:43 新加坡时间,6 个工人同时跑 18 个账号的视频和评论(每个账号 2 次调用),遇到 429 就按 retry_after 等待后重试。56 次请求里 36 次成功、20 次 429,5.77 分钟完成,每分钟 6.24 次成功。
第三轮在 17:46–17:48 新加坡时间,4 个工人共用一个客户端限速器,每个自然分钟最多发起 9 次请求,拉 12 个账号的热门视频(sort: popular)。12 次全部成功,0 次 429,1.25 分钟完成,每分钟 9.64 次成功。
| 轮次 | 时间(SGT) | 工人数和规则 | 请求 | 成功 | 429 | 每分钟成功 | 单次耗时中位数 |
|---|---|---|---|---|---|---|---|
| 1 | 17:25–17:37 | 1 个工人串行 | 24 | 24 | 0 | 2.24 | 18.2 秒 |
| 2 | 17:37–17:43 | 6 个工人,撞了再等 | 56 | 36 | 20 | 6.24 | 26.1 秒 |
| 3 | 17:46–17:48 | 4 个工人,每分钟限 9 次 | 12 | 12 | 0 | 9.64 | 19.6 秒 |
第二轮的时间线说明了 429 为什么拖慢了整体。图里每一行是一次请求,灰色横条是等待返回的时长,青绿菱形是 429。6 个工人在头 16 秒内就把这一分钟的额度用完了,之后的请求全部被拒;被拒的工人按 retry_after 等到下一个整分钟,又一起冲上去。我们从返回的 retry_after 看,它在 6 到 39 秒之间变化,指向的都是下一个自然分钟的开头,说明这把 Key 的计数是按自然分钟清零的。结果就是每分钟开头挤一波、后面一大段空着。
由此可以算出一个简单的上限。并行工人数的上限约等于每分钟限额乘以单次平均耗时(秒)再除以 60:我们三轮所有成功请求的平均耗时是 25.1 秒,10 × 25.1 ÷ 60 ≈ 4.2。少于 4 个工人,额度用不满;多于 4 个,多出来的工人只是在制造 429。按这个算法,50 个账号、每个 3 次调用共 150 次,每分钟 10 次的 Key 最快也要 15 分钟(按账户默认每分钟 60 次是 2.5 分钟);串行要约 63 分钟。Claude Code 自己默认允许同时运行 20 个子代理,超过时 Agent 工具返回「Concurrent subagent limit reached」,可以用 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS 调整(并发上限一节)。20 这个默认值远大于 4,所以要你自己在主会话的指令里写明「每次最多同时启动 4 个工人」。
这三轮的样本不大:第三轮只有 12 次、只有一种能力,耗时也会随时段和账号变化。所以 4.2 这个数不要直接照抄,要用你自己账户的限额和你测到的平均耗时重算。每分钟限额可以用 GET /api/v1/account(MCP 里是 everyinfra_account)查,接口说明写明这个查询免费、不计入每分钟限额。
429 怎么处理:真实返回和退避写法
先看真实的 429 长什么样。17:37:33 新加坡时间,Nike 那个工人的评论请求被拒,返回体里有 code: rate_limited、retry_after: 27、limit: 10、retryable: true、max_retries: 3,next_steps 里写着「Nothing was charged」。20 次 429 我们逐条核对过:都没有扣费,都在按 retry_after 等待后的第一次重试里成功。HTTP 规范对 429 的定义是用户在给定时间内发了太多请求,响应可以带上 Retry-After 告诉客户端等多久(RFC 6585 第 4 节、RFC 9110 Retry-After)。
工人端的处理分三层。第一层是不撞:在主会话里限制同时运行的工人数,再在调用层面加一个共享的限速器,这是第三轮 0 次 429 的原因。第二层是撞了就等:严格按 retry_after 等,再加一点随机抖动,避免一批工人在同一秒一起重试。AWS 架构文章把这个问题讲得很透:如果错误是负载造成的,所有客户端同时重试,重试本身就会让情况更糟,所以要加随机的等待时间把请求打散(AWS Builders' Library)。第三层是不重投扣费的调用:429、422、401 都发生在扣费之前,可以放心重试;但已经返回 200 的请求不要因为工人自己的问题重复发,我们的错误自愈说明和失败退款核对写了怎么用请求号核对。
下面是第三轮用的限速器的核心部分,用 Python 标准库的线程池实现(concurrent.futures 文档)。在 Claude Code 里,你可以让主会话按同样的规则调度工人,或者把这段逻辑放进一个工人能调用的脚本里。
import threading, time, random
lock = threading.Lock(); state = {"minute": None, "n": 0}
def acquire(per_min=9):            # 每个自然分钟最多发起 per_min 次
    while True:
        with lock:
            m = int(time.time() // 60)
            if state["minute"] != m:
                state["minute"], state["n"] = m, 0
            if state["n"] < per_min:
                state["n"] += 1
                return
        time.sleep(0.5)
def on_429(err):                    # err 是返回体里的 error 对象
    time.sleep(err["retry_after"] + random.uniform(0.5, 2.0))
限速器设成每分钟 9 次而不是 10 次,是给主会话里偶尔发生的其他调用(比如查余额、读目录)留一格。
失败和扣费:422、空结果、猜错的用户名
除了 429,我们还在同一个下午故意制造或者碰到了几种失败,它们对批量任务的影响各不相同。下表的每一行都对应一次真实返回。
| 情况 | 时间(SGT) | HTTP / 返回 | 扣费 | 对工人的意思 |
|---|---|---|---|---|
参数拼错 usernme | 17:43:20 | 422,missing_param,提示「usernme is not a parameter here」并给出可用示例 | $0 | 按提示改参数后重发 |
| 没带 Key | 17:43:20 | 401,missing_key | $0 | 配置问题,停下报告 |
| 超速 | 17:37:33 等 20 次 | 429,retry_after 6–39 秒 | $0 | 等待后重试 |
| 用户名不存在 | 17:33:34、17:34:49 | 200,空结果,reason: empty_result_refunded | $0(先扣后退) | 标记「找不到」,不重试 |
| 用户名存在但不是品牌 | 17:31:16 等 4 次 | 200,未认证,粉丝 4–222 | 照常扣 $0.000556 | 标记「疑似冒名」,交主会话决定 |
422 的返回是写给模型看的:它不只说缺了 username,还明确说 usernme 不是这里的参数,并附了一条能直接用的示例请求,Haiku 这类小模型照着改就能自愈。空结果的两次(我们猜的 Mercado Libre 和 OXXO 用户名)返回 200,但 charged_usd 是 0,reason 写明 empty_result_refunded,没有花钱。
最后一行最要紧。按品牌名猜的 4 个用户名(Anker、Insta360、小米、Bimbo 各一个)都真实存在,但都是普通个人账号:未认证,粉丝分别只有 4、121、222、14,作品 0 到 8 条。接口正确地返回了这些账号的数据,所以照常扣费。这种错误接口不会替你发现,只能由工人自己判断,这就是配置示例里第 1 步那条规则的来源:未认证且粉丝不到 1,000 的账号,停下并标记。正确的用户名可以用 tiktok/search 按账号搜:我们在 17:43–17:44 搜了三次,找到认证的 insta360_official(240 万粉丝)、xiaomi.official(830 万粉丝)和 ankercharging(80.36 万粉丝),每次 $0.002778。名单从哪里来,决定了这张对比表一开始就对不对。
算一笔账:按账号数算接口费
EveryInfra 这一侧的钱最好算,因为它只和调用次数有关,和返回多少行、跑在哪个模型上都无关。
| 规模 | 调用次数 | 接口费(按 `price_usd` $0.000556) | 按每分钟 10 次的最短用时 |
|---|---|---|---|
| 1 个账号 | 3 | $0.001668 | 18 秒 |
| 50 个账号 | 150 | $0.0834 | 15 分钟 |
| 50 个账号,每周一次,一个月 | 约 650 | 约 $0.361 | 每次 15 分钟 |
| 500 个账号 | 1,500 | $0.834 | 150 分钟 |
这张表假设名单是对的。如果名单里有一部分要先用 tiktok/search 找用户名,每个账号再加约 $0.002778(limit: 5)。本文这次实测总共发了 98 次请求(REST 97 次、MCP tools/call 1 次;另有 MCP 握手 3 次,不扣费),扣费 74 次,合计 $0.04781。没扣费的 24 次是 20 次 429、2 次空结果、1 次 422 和 1 次 401,每一笔都能在返回的 billing 或错误体里对上。想看接入方式的,快速上手有 REST 的三步,MCP 服务器页有各家客户端的配置。
汇总成对比表:主会话收到的是什么
下面是 18 个工人按配置示例里的摘要格式交回、由主会话合成的对比表。为了让体积可以复算,这里的摘要是用脚本按同样的规则从原始返回算出来的,不是 Haiku 实际写的;Haiku 写出来的那一句观察会让每份摘要多几十个字节。播放中位数和互动率(点赞 ÷ 播放的中位数)都排除了置顶视频。
| 账号 | 粉丝 | 最近视频播放中位数 | 互动率 | 每周发帖 | 抽到的评论 |
|---|---|---|---|---|---|
| Nike | 930 万 | 24,250 | 3.82% | 11.9 | 50 |
| Adidas | 1,230 万 | 142,200 | 2.72% | 4.2 | 50 |
| Gymshark | 670 万 | 50,900 | 14.07% | 4.6 | 50 |
| SHEIN | 1,160 万 | 12,400 | 2.50% | 14.0 | 50 |
| Temu | 430 万 | 20,250 | 1.47% | 15.7 | 25 |
| DJI | 440 万 | 14,400 | 4.53% | 21.0 | 50 |
| OnePlus | 35.64 万 | 49,300 | 2.20% | 0.7 | 50 |
| Zara | 1,490 万 | 2,250,000 | 1.11% | 2.9 | 50 |
| Real Madrid | 7,860 万 | 4,050,000 | 20.61% | 466.0 | 50 |
这张表本身就说明了为什么判断要留在主会话。Real Madrid 的「每周发帖 466」不是数据错了,而是它最新 10 条视频都在 2026-10-25 同一天发出,按天数换算就会出现这种数;Zara 的播放中位数 225 万远高于粉丝更多的 Adidas,互动率却只有 1.11%。这些都需要同时看到全部账号、再结合常识去解释,适合交给主会话的大模型,而不是让每个工人各自下结论。中国出海品牌那一组里,DJI 每周发 21 条、互动率 4.53%,SHEIN 和 Temu 发得勤但互动率在 1.5%–2.5%,这类对比只有放在一张表里才看得出来。
摘要格式怎么定:交回来的那一行决定主会话能做什么
工人交回什么,是这套做法里最值得花时间的一步。我们的规则是:摘要只放主会话做判断要用的数,并且每个数都能从原始返回里机械地算出来。这样有两个好处。一是主会话可以抽查:任选一个账号,让一个新的工人重跑一遍,对一下数是否一致,不需要信任任何一个工人的「理解」。二是摘要的体积可控:我们的格式里有 15 个字段,18 份摘要的 JSON 平均 382 字节,最长的 Real Madrid 也只有 398 字节,因为它的数都比别人大一位。
反过来,要避免让工人交回「它觉得重要的内容」。这种开放式的总结长度不稳定,有的工人会交回半页话,有的会把几条评论原文抄回来,主会话的上下文又被撑大了;而且两个工人对「重要」的理解不一样,表就拼不起来。评论这一项尤其要小心:评论正文里有普通用户的用户名和个人表述,交回主会话以后很可能被原样写进最终报告。我们的格式里评论只交回条数和带回复的条数,要做情绪或主题分析,就在工人里分好类,只交回每一类的数量。
在主会话里给出的指令可以写成三句话:把名单里每个用户名交给 tiktok-account-worker,同一时间最多 4 个;全部回来以后,把摘要合成一张表,标出 flag 为 lookalike 的账号;对播放中位数和互动率排前 3 和后 3 的账号各写一句解释。前两句是机械的调度,第三句才是需要大模型判断的部分,也正是 Anthropic 那篇指南说应该留在主循环里的那类工作。
同一个工人换平台:Instagram 和 YouTube 要改哪几处
名单里如果还有品牌的 Instagram 和 YouTube 账号,工人的结构不用变,只要换三处:平台名、动作名和参数名。下表来自同一份目录(2026-10-26 17:22 新加坡时间读取),这两个平台我们这次没有真调,表里只有目录里写明的价格和参数,返回体积要你自己量一次。平台总览见 Instagram 数据接口 和 YouTube 数据接口。
| 平台 | 主页 | 近期内容 | 评论 | 每次价格 | 要注意 |
|---|---|---|---|---|---|
| TikTok(本文实测) | profile,参数 username | user_videos,最多 50 条 | comments,最多 200 条 | $0.000556 | 置顶视频排在最前 |
profile,参数 username | user_posts,最多 200 条 | comments,最多 100 条 | $0.000556 | reels 目前暂不可用 | |
| YouTube | profile,参数是频道 url | user_posts,参数是频道 url,最多 50 条 | comments,最多 100 条 | $0.000556 | 短视频用单独的 shorts |
三个平台的这三项能力价格一样,所以一个账号三次调用的接口费都是 $0.001668,50 个账号都是 $0.0834。差别在参数:YouTube 的主页和视频列表要的是频道链接,不是用户名,工人的第 1 步要改成先拿链接。差别还在返回体积:Instagram 的帖子记录和 TikTok 的视频记录一样带着很多图片链接,按本文的经验,先量一个账号的原始返回,再决定每个工人装几个账号、评论取多少条,比照搬 TikTok 的数更稳。如果你已经在别的编辑器里用 MCP 拉过这几个平台,我们之前写过的 Cursor 里调用 TikTok、Instagram、Amazon 数据有各平台的实测耗时,可以拿来估算工人数。
做不了或要注意的地方
第一,平台条款。TikTok 美国版的服务条款写明,未经 TikTok USDS Joint Venture 书面批准,不得用自动化系统从平台抓取、爬取、导出或以其他方式提取数据(TikTok 服务条款)。学术和非营利机构可以申请 TikTok 的研究接口,审批通常要 4 周左右(TikTok Research Tools、数据字典)。你的用途是否合适,要按你所在地区和用途自己判断,本文只写数据方法。另一个容易混淆的是 TikTok 在 2026-10-05 宣布、已在 Claude 等平台作为连接器上线的 TikTok for Business MCP(TikTok 新闻室),它管的是你自己广告账户里的投放、素材和效果(TikTok for Business 博客),不是读取别的品牌号的公开主页和评论。
第二,评论不完整。comments 每条顶层评论最多带两条回复,返回条数可能少于视频上显示的评论数,本文 18 次里有 5 次少于请求的 50 条,都是视频本身评论不多。要做评论情绪分析,样本量要在摘要里写明。
第三,子代理不是越多越好。除了接口限额,Claude Code 的子代理也有自己的限制:默认最多嵌套 3 层,可以用 CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH 调;工人的上下文大小由工人自己的模型决定,不是主会话的(子代理文档)。如果名单上千个账号,官方文档建议看动态工作流:由 Claude 写一段 JavaScript 来调度,默认最多同时 16 个智能体,可以用 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS 调到 256(动态工作流文档)。但接口那边每分钟的额度不会因此变多。
第四,我们没测的。本文没有在 Claude Code 里实际运行这个子代理,Haiku 5.5 写出的摘要质量、它对 is_pinned 规则的遵守程度、50 个工人的真实总耗时,都没有实测数据。体积、扣费、429、吞吐这几组数是实测,模型费用是按公开价的估算。如果你要正式用,先拿 10 个账号跑一遍,看 /tasks 里每个子代理实际用的模型(文档写明那里会显示),再对一下 /usage 里子代理的占比。
最近的变化
2026-10-07:Anthropic 发布 Claude Haiku 5.5,输入每百万 token $0.10、输出 $0.50(10 万 token 以内),官方点名适合当子代理(发布页);同一天 Claude Code v2.1.293 把它设为 Anthropic API 上的默认 Haiku(更新日志)。对读者的意思:同样的取数工人,模型费比一个月前低一个数量级,但要确认你的接入方式下 haiku 指的是哪个模型。
2026-10-16:Claude Code v2.1.302 把桌面应用和 VS Code 里主对话启动的子代理改为一律在后台运行,和终端一致;fork 子代理在 claude -p、Agent SDK、桌面应用和 VS Code 里也默认打开(更新日志)。对读者的意思:工人在后台跑时,它们的权限确认会集中弹到主会话,提前放行唯一需要的工具。
2026-10-19 和 2026-10-21:v2.1.304 改进了大量子代理同时运行时的响应速度,并修复了子代理在结束后马上被追问时会忘记最近工作的问题;v2.1.307 让同时启动的多个 fork 子代理各自知道自己是哪一个,减少互相抢活(更新日志)。对读者的意思:并行工人这条路比一个月前稳,但本文用的是普通子代理,不是 fork。
2026-10-22:Anthropic 发布《When to fold subagents into your main agent loop》,建议多数智能体减少子代理,只在上下文膨胀可测、需要并行的一次性上下文、或工具太多时保留(原文、配套工具)。对读者的意思:拆之前先确认你的活是不是「读得多、留得少、互不依赖」,不是的话用 Skills 留在主会话里更好。
2026-10-05:TikTok 在纽约广告周宣布 TikTok for Business MCP 已作为连接器接入 Claude、Kimi、Perplexity 等平台(TikTok 新闻室)。对读者的意思:管理自己的广告用它;看别的品牌号的公开表现,仍然需要公开数据接口。
常见问题
claude code subagents 能指定不同的模型吗?
能。在子代理定义文件里写 model,可以是 sonnet、opus、haiku、fable 这些别名,也可以是完整 ID 如 claude-haiku-5-5,或者 inherit。解析顺序是:调用时传的参数 → 定义文件的 model → CLAUDE_CODE_SUBAGENT_MODEL → 主会话模型。(问题来源:Google 联想词「claude code subagents different model」「claude code subagents model selection」;答案依据:子代理文档)
claude code subagent 默认用什么模型?
没写 model 时,按上面的顺序最后落到主会话的模型,也就是继承。内置的 Explore 子代理也不再固定跑 Haiku,默认跟着主会话的模型走;只有主会话是 Fable 时,在订阅和 Anthropic API 上改跑 opus 别名指向的模型。想全部压到一个模型,要同时设 CLAUDE_CODE_SUBAGENT_MODEL 和 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1。(问题来源:联想词「claude code subagent model default」「claude_code_subagent_model force」;依据:子代理文档、r/ClaudeCode 讨论)
**claude code haiku subagent 写了 model: haiku 为什么还是很贵?**
两个常见原因。一是你在 Bedrock、Google Cloud、Foundry 或 Claude Platform on AWS 上,haiku 别名指的是 Haiku 4.5,价格是 Haiku 5.5 的 10 倍;二是设了 CLAUDE_CODE_SUBAGENT_MODEL_FORCE,定义文件里的 model 被忽略。在 /tasks 里能看到每个子代理实际跑的模型。(问题来源:联想词「claude code subagent model=haiku」「claude code use haiku for subagents」;依据:模型配置文档、子代理文档)
claude code subagents 和 agent teams 有什么区别?
子代理做完把结果交回主代理,彼此不通信;agent teams 的队友共用一份任务清单、可以直接互相发消息,适合需要相互挑战和协调的活。官方文档写明 agent teams 是实验功能、默认关闭,token 消耗明显更高。拉一批账号这种互不依赖的活用子代理就够。(问题来源:联想词「claude code subagents vs agent teams」;依据:Agent teams 文档)
Claude Code 能同时跑多少个子代理?
默认同时运行 20 个,第 21 个会返回「Concurrent subagent limit reached」,可以用 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS 改,要求 v2.1.217 或更新;会话里启动的总数不限。但对调外部接口的工人,真正的上限是接口限额:按本文测试 Key 的每分钟 10 次、单次约 25 秒,超过 4 个工人就只剩 429;账户默认每分钟 60 次时约 25 个。(问题来源:联想词「claude code run subagents in parallel」;依据:子代理文档并发上限一节、本文实测)
MCP 工具返回太大,Claude Code 会怎么处理?
超过 1 万 token 显示警告,默认上限 2.5 万 token(MAX_MCP_OUTPUT_TOKENS 可调),没有声明 anthropic/maxResultSizeChars 的工具,成功结果超过 5 万字符会存成文件。我们实测 200 条 TikTok 评论的返回是 54,819 字符,会被落盘;50 条最长 24,749 字符,不会。(问题来源:本文实测;依据:MCP 文档输出上限一节)
参考资料
- Create custom subagents,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/sub-agents
- Connect Claude Code to tools via MCP,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/mcp
- Claude Code changelog(v2.1.293–v2.1.310),Anthropic,2026-10-07 至 2026-10-23,https://code.claude.com/docs/en/changelog
- Manage costs effectively,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/costs
- Model configuration,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/model-config
- Environment variables,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/env-vars
- Agent teams,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/agent-teams
- Orchestrate subagents at scale with dynamic workflows,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/workflows
- Explore the context window,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/context-window
- Permissions,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/permissions
- Settings,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/settings
- Run Claude Code programmatically,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/headless
- Skills,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/skills
- Prompt caching,Claude Code 文档,Anthropic,2026-10-26 读取,https://code.claude.com/docs/en/prompt-caching
- CHANGELOG.md,anthropics/claude-code,GitHub,2026-10-26 读取,https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing Claude Haiku 5.5,Anthropic,2026-10-07,https://www.anthropic.com/claude-haiku-5-5
- Claude Haiku 5.5 System Card,Anthropic,2026-10-07,https://www.anthropic.com/claude-haiku-5-5-system-card
- Pricing,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/about-claude/pricing
- Models overview,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/about-claude/models/overview
- Migrating to Claude Haiku 5.5,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/models/haiku-5-5/migration-guide
- Prompt caching,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Token counting,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/build-with-claude/token-counting
- Rate limits,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/api/rate-limits
- Release notes,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/release-notes/overview
- Tool search tool,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Tool use overview,Claude Platform 文档,Anthropic,2026-10-26 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- Claude pricing(Pro、Max、Team),Anthropic,2026-10-26 读取,https://claude.com/pricing
- Building agents: When to fold subagents into your main agent loop,Anthropic,2026-10-22,https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- single-agent-loop-kit,anthropics,GitHub,2026-10-26 读取,https://github.com/anthropics/single-agent-loop-kit
- Transports(2025-06-18),Model Context Protocol 规范,https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
- Tools(2025-06-18),Model Context Protocol 规范,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Lifecycle(2025-06-18),Model Context Protocol 规范,https://modelcontextprotocol.io/specification/2025-06-18/basic/lifecycle
- RFC 6585: Additional HTTP Status Codes(429),IETF,2012-04,https://www.rfc-editor.org/rfc/rfc6585
- RFC 9110: HTTP Semantics(Retry-After),IETF,2022-06,https://www.rfc-editor.org/rfc/rfc9110
- Timeouts, retries, and backoff with jitter,Amazon Builders' Library,2019-12-05,https://aws.amazon.com/builders-library/timeouts-retries-and-backoff-with-jitter/
- concurrent.futures,Python 文档,2026-10-26 读取,https://docs.python.org/3/library/concurrent.futures.html
- TikTok Research Tools: Access and Eligibility,TikTok for Developers,2026-10-26 读取,https://developers.tiktok.com/products/research-api/
- Research API Codebook,TikTok for Developers,2026-10-26 读取,https://developers.tiktok.com/doc/research-api-codebook
- TikTok Unveils AI-Powered Updates for Advertisers,TikTok 新闻室,2026-10-05,https://newsroom.tiktok.com/tiktok-unveils-ai-powered-updates-for-advertisers-driving-discovery-action-and-measurable-business-outcomes?lang=en
- Evolving TikTok for Business MCP,TikTok for Business 博客,2026-06-30,https://ads.tiktok.com/business/en-US/blog/tiktok-agentic-hub-ai-agents-skills-mcp
- TikTok Terms of Service(US),TikTok,2026-10-26 读取,https://www.tiktok.com/legal/page/us/terms-of-service/en
- EveryInfra 数据目录,EveryInfra,2026-10-26 17:22 SGT 读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra TikTok 目录,EveryInfra,2026-10-26 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=tiktok
- Haiku 5.5 is 40x cheaper than Opus 5.5. Your Explore subagent is probably still running on Opus,Reddit r/ClaudeCode,2026-10-08,https://www.reddit.com/r/ClaudeCode/comments/1x0kzbh/haiku_55_is_40x_cheaper_than_opus_55_your_explore/
- PSA: Claude Code subagents inherit your session model now,Reddit r/claude,2026-10-26 读取,https://www.reddit.com/r/claude/comments/1v7iqqy/psa_claude_code_subagents_inherit_your_session/
- How much more effective is using Opus 5.5 with Haiku subagents,Reddit r/ClaudeAI,2026-10-26 读取,https://www.reddit.com/r/ClaudeAI/comments/1x1buac/how_much_more_effectivebetter_is_using_opus_55/
- Anthropic's new guide (Oct 22) argues most agents should have fewer subagents,Reddit r/ClaudeAI,2026-10-24,https://www.reddit.com/r/ClaudeAI/comments/1xdwquj/anthropics_new_guide_oct_22_argues_most_agents/
- Anthropic says one AI agent beats many subagents,The Decoder,2026-10-25,https://the-decoder.com/anthropic-says-one-ai-agent-beats-many-subagents-now-that-models-can-handle-complexity-alone/
引用编号 BL-53