TikTok trends API:官方、免费和按次付费三条路
TikTok 官方没有趋势榜接口。我们分三个时刻调用话题和音乐榜:音乐榜按期整体换,两天里 Viral 50 有 46 首变动;话题视频总量每小时都在涨。
想要一个能定时调用、返回「现在什么在火」的 TikTok 接口,官方目前给不了。2026-11-14 我们把 TikTok 开发者网站上的 9 个产品逐个核对了一遍,没有一个直接给热门话题榜或热门歌曲榜:Research API 只开放给学术和非营利机构,数据还慢 48 小时到 10 天;Display API 只读授权用户自己的视频;Commercial Content API 只有欧洲的广告;Creative Center 有热门榜,但它是网页。免费的开源脚本要装无头浏览器、带 cookie,GitHub 上星标最多的那个库最近一次发版停在 2026-04-01。
剩下的一条路是按次付费的接口。我们用 EveryInfra 的 6 项 TikTok 能力,在 2026-11-14 凌晨分三个时刻对同一批话题、同两张音乐榜各取一次,再和我们 11 月 11、12 日为另一篇文章拉的音乐榜快照(Viral 50 四次、Top 50 三次)连起来看。看到的是平台本身的数据在变,而且变法不一样。音乐榜是一期一期整体换的:同一天三轮名次一处没动,往前对照 11-12 00:13 那一期,Viral 50 有 12 首新进榜、34 首换了名次,合计 46 首。话题的视频总量每次快照都在涨:El Buen Fin 第一天,#buenfin 每小时新增 1,071 和 1,222 条视频,#thanksgiving 是 408 和 344 条。本篇的 TikTok 数字来自 31 次调用的原始返回,合计花费 $0.0215,拿回 876 行;按能力算,每千行成本在 $0.0161 到 $0.0463 之间。
TikTok trends API 有没有官方的:四个入口逐个看
我们在 2026-11-14 把 TikTok for Developers 网站页脚列出的产品逐个打开,一共 9 项:Share Kit、Login Kit、Content Posting API、Research API、Display API、Embed Videos、Data Portability API、Green Screen Kit、Commercial Content API(TikTok for Developers 产品列表,页脚原文)。这 9 项里没有一项叫「趋势」或「热门榜」,名字里带数据读取的只有 Research API、Display API 和 Commercial Content API 三个。广告主后台里那个按国家看热门话题、热门歌曲的 Creative Center 是网页,不在这份产品列表里。以下原文都是 2026-11-14 打开读的。
Research API 是三个接口里离「趋势」最近的一个。产品页第一句写明,美国、欧洲、加拿大和巴西的合格研究者可以申请研究 TikTok 公开内容和账号数据(Research Tools 产品页)。申请条件写得很细:要么是美国、欧洲经济区、英国、加拿大或瑞士的学术机构,要么是欧盟境内的非营利或独立研究机构;巴西只开放给研究未成年人网络安全的学术和非营利机构;申请人要独立于商业利益、公开经费来源、通过伦理审查。Research API 常见问题第 6 条更直接:创作者、广告主和商业用户不能申请。审批时间在产品页写的是「通常 4 周内回复」。
拿到资格以后,Research API 也不直接给「本周热门话题」。它的视频查询接口像一条 SQL 的 WHERE 子句,可以按 hashtag_name、music_id、region_code、keyword、create_date 等字段过滤(Research API 入门指南),每次最多返回 100 条,end_date 和 start_date 之间不能超过 30 天(Query Videos 接口说明,页面写最后更新于 2026-09-01)。要知道某个话题在不在涨,得自己按天切窗口去数视频数。额度是每天 1,000 次请求、最多 10 万条记录,UTC 零点重置。时效上,同一份常见问题写明,新视频最多要 48 小时才进入检索,播放数和粉丝数这类统计最多要 10 天才更新。研究一个月前的话题很合适,盯「今天下午哪个话题起来了」就慢了两天。
Display API 解决的是另一件事。它有 /v2/user/info/、/v2/video/list/、/v2/video/query/ 三个接口,用途是在你自己的网站或 App 里展示「授权给你的那个 TikTok 用户」的资料和视频(Display API 概览,2026-08-04 更新)。调用之前要通过 Login Kit 拿到用户授权,申请 user.info.basic 和 video.list 两个权限(Display API 入门,2026-08-19 更新),video/list 每页最多 20 条(List Videos 接口说明)。它只能读授权账号自己发的视频,别人的视频和全站话题都读不到,所以跟趋势无关。
Commercial Content API 读的是广告。产品页写明这是广告透明度接口,可查广告、广告主和定向信息,广告数据在投放期间和最后一次展示后一年内可查,申请后 1 到 2 周答复(Commercial Content API 产品页)。覆盖范围只有欧洲:支持的国家页列了欧盟 27 国、挪威、冰岛、列支敦士登、英国和瑞士(Supported Countries,2026-09-01 更新)。每次能拿几条,文档前后不一致:入门指南的表里写默认 10、最多 50,Query Ads 接口说明写默认 10、最多也是 10。拿它看「哪些品牌在欧洲投什么广告」可以,看自然流量里的热门话题和歌不行。
Creative Center 是唯一明面上展示「热门话题、热门歌曲、热门创作者」的官方页面,但它是网页。我们在 2026-11-14 用 curl 请求旧地址 ads.tiktok.com/business/creativecenter/inspiration/popular/hashtag/pc/en,服务器回 301,跳到新地址 ads.tiktok.com/creative/creativeCenter/trends,页面标题已经换成「TikTok One Creative Suite」。前面那份产品列表里没有 Creative Center,开发者文档里也找不到它的接口说明。看一眼可以,要把它接进自己的程序、每小时存一次快照,没有官方给的路。
| 官方入口 | 能不能拿到趋势 | 谁能申请 | 一次 / 一天能拿多少 | 时效 | 原文更新日期 |
|---|---|---|---|---|---|
| Research API | 没有榜单;可按话题、音乐 ID 过滤后自己数 | 美、欧、英、加、瑞学术机构,欧盟非营利机构,巴西特定研究;商业用户不行 | 每次 ≤100 条,每天 1,000 次、10 万条 | 新视频最多 48 小时入库,统计最多 10 天更新 | 2026-09-01 |
| Display API | 不能 | 任何开发者,但要用户逐个授权 | 每页 ≤20 条,只读授权账号自己的视频 | 实时 | 2026-08-19 |
| Commercial Content API | 只有广告,不含自然流量 | 任何国家的研究者和专业人士,审批 1–2 周 | 每次 10 条(另一页写 50) | 广告最后展示后一年内可查 | 2026-09-01 |
| Creative Center | 网页上有热门话题、歌曲、创作者 | 打开网页就能看 | 没有公开接口 | 网页按周期刷新 | 2026-11-14 实测 301 |
免费的开源脚本卡在哪
上面四个官方入口都不收钱,卡在资格、时效或者没有接口。剩下的免费路线是开源脚本:GitHub 上有不少非官方的 TikTok Python 库,代码不要钱,要付出的是维护。我们看了 GitHub 上 tiktok-api 话题页星标最多的那个非官方 Python 库,2026-11-14 读到的状态是:6,748 个星标、150 个未关闭的 issue,最近一个正式版本 v7.3.3 发布于 2026-04-01,最近一次提交在 2026-08-24。2026 年新开的 issue 里有一条标题是「user-level 查询返回 200 但响应体为空」(issue #1311,2026-07-18 提出,至今未关闭)。HTTP 200 加空结果时,只看状态码的监控不会报警,表里却一行新数据都没有。这个库要装无头浏览器、要 cookie,最近一个正式版本停在 2026-04-01。
我们用 YouTube 数据接口搜了「tiktok trends api python」,在前 10 条结果里挑了三条讲 TikTok Python 抓取的视频(第 1、7、9 条)读字幕(这一步另用了 4 次调用、$0.0024,不算在下文的 TikTok 数字里),里面的步骤和抱怨很一致。库作者本人的教程第一步是 pip install,第二步是 python -m playwright install,装一个无头浏览器;另一条 2021 年的「用 Python 做 TikTok 趋势看板」教程要先从浏览器里复制一个 cookie 才能跑,作者还在视频里说,每次运行拿到的结果都不一样,10 条结果按日期一过滤剩 5 条,再跑一次剩 3 条。2026-08-28 上传的一条短视频说:官方接口审批慢,脚本直接读页面,页面结构一改就坏;它的结论是,商业用途还是官方接口更稳。
还有一条和规则有关的边界。TikTok 美国服务条款写明,未经 TikTok USDS Joint Venture 书面同意,不得用任何自动化系统或软件抓取、爬取、导出或提取平台上的任何数据或内容(TikTok 美国服务条款,2026-07-15 更新)。这里只写条款原文,不构成法律意见,具体用途请咨询律师。
按次付费怎么取:六项能力分工
第三条路是按次付费的接口:不登录 TikTok、不装浏览器、不申请资格,一次 HTTP 请求拿回结构化的 JSON。我们在 2026-11-14 00:13(新加坡时间)读了 EveryInfra 的免费目录,TikTok 平台可用的能力有 22 项,跟「趋势」直接相关的是下面六项,分工各不相同:
tiktok/hashtag_search 按关键词找话题,每个话题给出视频数和播放数,用来回答「这个词下面有哪些话题、各有多大」;tiktok/hashtag 给定一个话题名,返回这个话题下的视频,每次最多 30 条,用来看「这个话题里现在在发什么」;tiktok/music_chart 一次给整张 Top 50 或 Viral 50 音乐榜;tiktok/music_search 按歌名或歌手找 TikTok 音乐库里的歌;tiktok/sound_videos 顺着一首歌的 ID 拉用了这首歌的视频;tiktok/search 是普通的视频关键词搜索,用来按 ID 跟踪单条视频的播放。六项能力按调用计费,目录价是每次 $0.000556 或 $0.000806,失败的调用不扣钱。
成本按实际扣费和实际行数算,不按目录价反推。三轮加上补充调用,这六项能力一共调了 31 次,每次返回里的 billing.charged_usd 都等于目录价,合计 $0.0215,拿回 876 行。算法是「这项能力所有调用的扣费合计 ÷ 这些调用返回的行数合计 × 1000」:最便宜的是 music_chart,6 次共 300 行、扣 $0.004836,每千行 $0.0161;最贵的是 sound_videos,3 次共 36 行、扣 $0.001668,每千行 $0.0463。同样的单价,一次能拿回多少行决定了每千行的成本。
| 能力 | 返回什么 | 每次条数(目录) | 本次实测(调用次数、返回行数合计) | 每次价格 | 每千行 |
|---|---|---|---|---|---|
hashtag_search | 话题名、视频数、播放数 | 每页 20(翻页) | 9 次、180 行 | $0.000806 | $0.0403 |
hashtag | 话题页上的视频 | 最多 30(默认 10) | 7 次、210 行 | $0.000556 | $0.0185 |
music_chart | 整张 Top 50 或 Viral 50 | 固定 50 | 6 次、300 行 | $0.000806 | $0.0161 |
music_search | 音乐库里的歌 | 每页 20(翻页) | 2 次、40 行 | $0.000806 | $0.0403 |
sound_videos | 用了某首歌的视频 | 每页 ≤20(翻页) | 3 次、36 行 | $0.000556 | $0.0463 |
search | 关键词视频搜索 | 按 limit(默认 10) | 4 次、110 行 | $0.000556 | $0.0202 |
这张表只算接口费。要看 TikTok 各类接口的整体价格对比,见 TikTok API pricing;要抓评论,见抓 TikTok 评论的三种方法。
一行趋势数据里有什么:字段对照
字段决定你能算什么。下面按目录里的 response_fields 列出和趋势分析有关的字段,三类数据各取最常用的几个。话题行和视频行是两种东西:hashtag_search 回的是话题本身(名字、视频数、播放数),hashtag 和 search 回的是视频(每条视频的播放、点赞、发布时间、用了哪首歌);音乐榜回的是歌(名次、被多少条视频用过、发行日期)。
| 数据 | 字段 | 意思 | 用来算什么 |
|---|---|---|---|
| 话题(hashtag_search) | hashtag_name、video_count、view_count | 话题名(不带 #)、视频数、累计播放 | 两次快照之差 = 每小时新增视频和播放 |
| 话题(hashtag_search) | next_page_token | 翻页令牌,24 小时有效 | 拿第 21 个以后的相近话题 |
| 视频(hashtag、search、sound_videos) | id、posted_at、view_count、like_count、collect_count | 视频 ID、发布时间、播放、点赞、收藏 | 按 ID 对齐两次快照,算单条视频的增速 |
| 视频 | hashtags、music | 视频带的话题列表;背景音乐的 id、title、is_original | 话题共现、热门音乐 |
| 视频 | is_ad、has_shop_product | 是否广告、是否挂了 TikTok Shop 商品 | 把广告和带货视频单独统计 |
| 音乐榜(music_chart) | rank、use_count、released_at、is_commercial | 名次、用过这首歌的视频数、发行日期、是否商用曲库 | 名次变化、使用量增量、能不能给品牌视频用 |
is_commercial 对品牌团队有用:这首歌在不在 TikTok 商用曲库里,决定了企业号能不能拿来做投放素材。music.is_original 用来剔除「原声」:上面那条 2021 年的看板教程专门花了一段时间把「original sound」从热门音乐里过滤掉,用这个字段一行就够了。
分页、条数和「短页不代表到底」
六项能力的分页方式不一样,写批处理脚本之前要分清。hashtag_search、music_search 和 sound_videos 用 page_token 翻页:把上一次响应里的 next_page_token 原样传回,就拿到下一页,令牌 24 小时有效,每一页单独计一次费。这三项不认 limit 参数,每页条数由平台决定:话题和歌每页最多 20 个,sound_videos 每页最多 20 条、常见 12 到 13 条。目录里专门写了一句:短页不代表到底,没有 next_page_token 才是最后一页。我们 00:16 那次 sound_videos 只回了 12 条,但带着翻页令牌,响应里的 has_more 也是 true。
hashtag 和 search 用 limit 控制条数(hashtag 最多 30 条,两者默认都是 10),一次调用计一次费,limit 调高时单价不变。music_chart 不用翻页,一次就是整张 50 首的榜。
同一个话题、同一张榜,三个时刻各取一次
我们在 2026-11-14 凌晨分三轮调了同样的能力、同样的参数:00:15、01:16 和 02:17(新加坡时间),相邻两轮间隔一小时左右。每一轮都包括两张音乐榜、#thanksgiving 和 #buenfin 两个话题的 hashtag_search 与 hashtag、「thanksgiving recipes」的 search,以及 Gangster Bxtch 这首歌的 sound_videos。第二、三轮另加了一个跨领域的话题「flu shot」。判断「变了没有」的标准是动手前写下的:榜单有 1 首进出或 3 首以上名次变化才算变;单条视频的增速只用两次都出现的视频算中位数,少于 5 条不下结论;话题总量差值为 0 就写「没涨」。
音乐榜:几个小时一动不动,两天换了一期
先看音乐榜。11 月 11、12 日我们为另一篇文章拉过这两张榜:Viral 50 四次(11-11 00:20、01:35、02:45 和 11-12 00:13,新加坡时间),Top 50 三次(11-11 00:20、02:45 和 11-12 00:13),原始返回和本篇的调用一起存档。这几次快照之间,两张榜的 50 首歌一首没进、一首没出,名次也一处没动。到 11 月 14 日 00:15 再拉,Viral 50 新进了 12 首,留下来的 38 首里 34 首换了名次,只有 4 首没变;Top 50 新进了 17 首,留下来的 33 首里 31 首换了名次,只有 2 首没变。同一天我们又在 01:16 和 02:17 各拉了一次,两张榜和 00:15 那次一模一样:没有一首进出,名次一处没动,只有使用量在涨(Viral 50 两段里分别有 43 首和 40 首的 use_count 变大)。
这说明两张榜是一期一期整体换的,不是每小时滚动。同一期之内,名次不动,使用量照样在涨:Housewife 从 11-11 00:20 到 11-12 00:13 一直排 Viral 50 第 28,用过它的视频却从 609,101 条涨到 622,586 条,23.9 小时多了 13,485 条,平均每小时 564 条;Gangster Bxtch 一直排第 3,同一段里从 5,086 涨到 5,472。我们没有找到 TikTok 关于更新周期的公开原文,所以只写观察:在我们看到的这几天里,11 月 12 日 00:13 到 11 月 14 日 00:15 之间换过一期,同一期之内名次不动。对盯榜的人来说,每小时拉一次音乐榜没有意义,每天一次足够,每小时都在变的是 use_count。
换期时变的不只是尾部。下表是 11-14 这一期 Viral 50 的前 10 名,对照 11-12 那一期的名次,再列出 11-14 三轮的 use_count:前 10 名里只有 Beauty School Dropout 还在第 4 名,其余 9 首都换了位置,第 9 名 nothing 是从第 29 名升上来的。
| 11-14 名次 | 歌曲 | 11-12 00:13 名次 | 11-14 00:15 使用量 | 01:16 | 02:17 | 2.04 小时增量 |
|---|---|---|---|---|---|---|
| 1 | Gangster Bxtch | 3 | 6,534 | 6,638 | 6,747 | +213 |
| 2 | Stolen From Each Other | 6 | 19,160 | 19,223 | 19,292 | +132 |
| 3 | Rechazame | 5 | 134,562 | 134,598 | 134,625 | +63 |
| 4 | Beauty School Dropout | 4 | 20,865 | 20,869 | 20,887 | +22 |
| 5 | Time (2011 Remastered Version) | 2 | 163,650 | 163,661 | 163,693 | +43 |
| 6 | Acting Like You Kanye | 8 | 1,844 | 1,850 | 1,849 | +5 |
| 7 | wonder wander | 13 | 5,557 | 5,566 | 5,566 | +9 |
| 8 | Bounce it | 7 | 425,559 | 425,613 | 425,707 | +148 |
| 9 | nothing | 29 | 91,400 | 91,470 | 91,500 | +100 |
| 10 | Don't You Worry 'Bout A Thing | 14 | 26,644 | 26,648 | 26,655 | +11 |
Top 50 的换期更彻底:前 10 名里 Stolen From Each Other 守住第 1,第 2 名 Gangster Bxtch 是这一期新进榜的,11-12 排第 2 的 Housewife 降到第 7,排第 15 的 Last Christmas 升到第 6。下表同样对照两期名次,并列出 11-14 三轮的 use_count。
| 11-14 名次 | 歌曲 | 11-12 00:13 名次 | 11-14 00:15 使用量 | 01:16 | 02:18 | 2.04 小时增量 |
|---|---|---|---|---|---|---|
| 1 | Stolen From Each Other | 1 | 19,161 | 19,223 | 19,292 | +131 |
| 2 | Gangster Bxtch | 新进榜 | 6,534 | 6,638 | 6,747 | +213 |
| 3 | nothing | 7 | 91,400 | 91,470 | 91,501 | +101 |
| 4 | the feeling | 8 | 18,178 | 18,190 | 18,204 | +26 |
| 5 | Coming Up Roses | 4 | 235,590 | 235,674 | 235,752 | +162 |
| 6 | Last Christmas | 15 | 672,119 | 672,131 | 672,142 | +23 |
| 7 | Housewife | 2 | 648,964 | 649,540 | 650,083 | +1,119 |
| 8 | Beauty School Dropout | 12 | 20,865 | 20,869 | 20,887 | +22 |
| 9 | All I Want For Christmas Is You | 9 | 16,297,134 | 16,297,542 | 16,297,960 | +826 |
| 10 | Rechazame | 5 | 134,562 | 134,598 | 134,625 | +63 |
两张表里涨得最多的 Housewife 和 All I Want For Christmas Is You 名次都不靠前,Housewife 在 Top 50 还从第 2 降到第 7。节日歌(Last Christmas、All I Want For Christmas Is You)在 11 月中旬已经回到前 10。
掉出 Viral 50 的 12 首里,包括 11-12 排第 1 的 Ramalama (Bang Bang)、第 11 的 Sky 和第 12 的 What Hurts The Most。新进榜的也不一定是新歌:Viral 50 新进的 12 首里,11 首带发行日期,其中只有 2 首是 2026 年发行的,最早的是 2004 年;Top 50 新进的 17 首里,14 首带发行日期,2026 年发行的 4 首,最早的是 1990 年。两张榜新进的 25 首带日期的歌里,19 首是 2026 年以前发行的:换期时被重新用起来的多是老歌,选歌时不能拿发行日期当热度。
| 歌曲 | 11-11 00:20 名次 / 使用量 | 11-12 00:13 | 11-14 00:15 | 两天的使用量变化 |
|---|---|---|---|---|
| Gangster Bxtch | Viral 第 3 / 5,086 | 第 3 / 5,472 | 第 1 / 6,534 | +1,062(+19.4%) |
| Ramalama (Bang Bang) | Viral 第 1 / 857,779 | 第 1 / 858,204 | 掉出两张榜 | 01:19 用 music_search 查到 859,203,+999(+0.12%);02:20 再查是 859,178 |
| Rechazame | Viral 第 5 / 133,119 | 第 5 / 133,485 | 第 3 / 134,562 | +1,077(+0.81%) |
| Housewife | Viral 第 28 / 609,101 | 第 28 / 622,586 | 第 33 / 648,960 | +26,374(+4.24%) |
榜单不动,使用量在动。同一天第一轮到第三轮的 2.04 小时里,两张榜上 77 首歌中有 67 首的 use_count 变大,涨得最多的是 Dame Hombro,每小时多 681 条视频(0.15%);也有 8 首变小,视频被删或设为私密时,用过这首歌的视频数会回落;掉榜的 Ramalama 在 01:19 到 02:20 之间也少了 25 条。单次的小幅下降不要当成趋势反转。
名次和使用量不是一回事。Gangster Bxtch 只有六千多条视频在用,两天涨了 19%,升到 Viral 50 第 1;Ramalama 有 85 万多条视频,两天里还多了 999 条,却掉出了两张榜;Housewife 两天多了 2.6 万条视频,Viral 50 名次反而从第 28 降到第 33。在这几首歌上,Viral 50 的名次和 use_count 的相对涨幅更接近,和存量对不上;TikTok 没有公开排名算法,这里只写观察。选歌时要把名次和 use_count 的增量放在一起看。这也和我们 11 月 11 日那篇 Instagram Edits 热门音频的观察一致:一天之内榜单不动,使用量在动。
话题总量:每次快照都在涨,大促话题涨得最快
和音乐榜相反,hashtag_search 给的话题总量每次都在变。下表是两个主话题三轮的原始读数(时间是每次调用的新加坡时间,两个关键词各调一次,所以时刻差几分钟):
| 话题 | 调用时间 | `video_count` | `view_count` | 比上一次:每小时新增视频 | 每小时新增播放 |
|---|---|---|---|---|---|
| #thanksgiving | 00:15:50 | 5,020,838 | 62,909,924,865 | — | — |
| #thanksgiving | 01:17:03 | 5,021,254 | 62,912,371,953 | 408 | 约 240 万 |
| #thanksgiving | 02:18:20 | 5,021,605 | 62,914,954,253 | 344 | 约 253 万 |
| #buenfin | 00:20:02 | 247,285 | 4,283,898,061 | — | — |
| #buenfin | 01:17:59 | 248,319 | 4,286,340,121 | 1,071 | 约 253 万 |
| #buenfin | 02:19:16 | 249,567 | 4,289,165,871 | 1,222 | 约 277 万 |
两个话题每一段的增量都不是零,可以直接拿差值算增速。算法是「两次 video_count 之差 ÷ 两次调用相隔的小时数」,例如 #buenfin 第一段是 (248,319 − 247,285) ÷ 0.966 小时 ≈ 1,071 条。下图是同一个请求在 00:20 和 02:19 两次返回的节选,只改了取数时刻,#buenfin 的 video_count 从 247,285 变成 249,567。
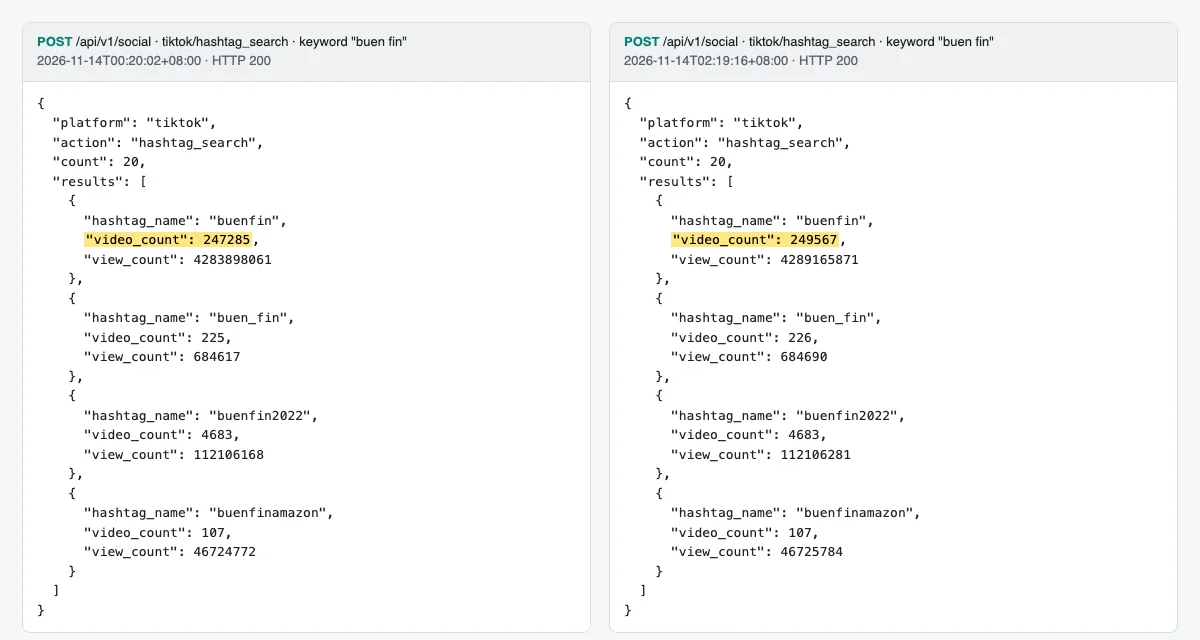
播放的增量和视频的增量要分开看。#thanksgiving 每小时新增的视频不到 #buenfin 的一半,每小时新增的播放却和 #buenfin 差不多(约 240 万、253 万对约 253 万、277 万)。按「每小时新增播放 ÷ 每小时新增视频」算,#thanksgiving 每多一条新视频对应约 5,900 和 7,400 次新增播放,#buenfin 只有约 2,400 和 2,300 次。话题级的播放增量里有很大一部分来自存量老视频被继续观看,所以它不能代替新增视频数去判断「现在有多少人在发」。
比较两个话题时,倍数要写明是哪一种。按每小时新增的绝对条数,#buenfin 两段分别是 #thanksgiving 的 2.6 倍(1,071 ÷ 408)和 3.6 倍(1,222 ÷ 344),两段差得不少,所以只能说「约 3 倍」。按占存量的比例(每小时新增 ÷ 上一次的 video_count),#buenfin 是 0.433% 和 0.492%,#thanksgiving 是 0.0081% 和 0.0068%,比值是 53 倍和 72 倍;这个倍数大,主要是因为分母差了 20 倍:#thanksgiving 的五百万条视频大多是往年发的,#buenfin 的存量只有二十多万。我们取数的时候,墨西哥城正是 11 月 13 日上午到中午,El Buen Fin 第一天。
占存量的比例更适合在同一组相近话题里找「小而快」的那个。「buen fin」第一页上,#ofertasbuenfin 只有 2,214 条视频,两段每小时新增 22.8 和 18.6 条,占存量 1.03% 和 0.83%;#promocionesbuenfin 只有 793 条,两段每小时新增 5.2 和 14.7 条,占存量 0.65% 和 1.84%。
| 话题 | 00:20 视频数 | 01:17 | 02:19 | 每小时新增视频(两段) | 每小时占存量 |
|---|---|---|---|---|---|
| #buenfin | 247,285 | 248,319 | 249,567 | 1,071 / 1,222 | 0.433% / 0.492% |
| #ofertasbuenfin | 2,214 | 2,236 | 2,255 | 22.8 / 18.6 | 1.03% / 0.83% |
| #promocionesbuenfin | 793 | 798 | 813 | 5.2 / 14.7 | 0.65% / 1.84% |
按绝对数它们只有 #buenfin 的零头,按比例却比 #buenfin 的 0.43% 到 0.49% 还高。品牌和编辑部常常更关心这一类:话题还小,但涨得快,跟进得早就有机会。脚本里可以同时排两张名单:每小时新增条数前十、占存量比例前十,两张都看。
同一页上带年份的旧话题(#buenfin2020 到 #buenfin2023)和小众变体(#thanksgivinggame、带表情符号的 #thanksgiving🦃)两个小时里一条新视频都没有,但它们的播放还在涨:#thanksgivinggame 每小时多约 438 次,#buenfin2023 多约 436 次。也就是说,视频数冻住的话题,老视频还在被人看。做趋势时,这类话题的「新增视频」是 0,不能当作在起来;它们的播放增量只说明存量还有人刷到。
话题页上的 30 条视频:大促话题一小时换掉一大半
tiktok/hashtag 每次给 30 条话题页上的视频。El Buen Fin 第一天,#buenfin 的话题页换得很快:相邻两轮只有 6 条和 12 条相同,第一轮的 30 条到第三轮还在的只有 3 条。换进来的是当天新发的视频:30 条里一天内发布的,三轮分别是 14、24、24 条,中位发布时间从 1.6 天降到 0.7 天、0.5 天。同一页的播放中位数跟着从 10.9 万降到 1.7 万、4,646,换进来的多是刚发、还没攒起播放的视频。这些视频大多用原声:30 条里 music.is_original 为 true 的三轮分别是 24、21、23 条;带广告标记(is_ad)的是 3、2、2 条;挂了 TikTok Shop 商品(has_shop_product)的只有第一轮 1 条。只看这几个字段,大促第一天的话题页上,直接挂商品的视频很少;想统计带货视频,要另外按商品关键词去搜,不能只看话题页。对照组变化小得多:「thanksgiving recipes」的 search 20 条里,相邻两轮有 13 条和 14 条相同,中位发布时间一直在 3.6 到 3.7 天;Gangster Bxtch 的 sound_videos 三轮返回的 12 条完全一样。
| 返回的视频 | 00:15 中位发布天数 | 01:16 | 02:17 | 一天内发布的(三轮) |
|---|---|---|---|---|
#buenfin · hashtag | 1.6 | 0.7 | 0.5 | 14、24、24(共 30 条) |
「thanksgiving recipes」· search | 3.6 | 3.6 | 3.7 | 3、5、3(共 20 条) |
Gangster Bxtch · sound_videos | 10.8 | 10.8 | 10.9 | 0、0、0(共 12 条) |
这对用法有三个直接影响。第一,话题页是「现在有人在发什么」的窗口,适合每隔几小时看一次新面孔,不适合当成固定样本去追踪同一批视频的增长;要追踪,就把第一次拿到的视频 ID 存下来,之后用 search 或单条视频接口按 ID 去取。第二,sound_videos 三轮返回的 12 条视频完全相同,说明一首歌的视频列表在几个小时里是稳定的;想看「新用这首歌的视频」,要翻到后面几页,而不是重复拉第一页。第三,每次记一下返回视频的发布时间中位数,它本身就是一个热度信号:#buenfin 两个小时里从 1.6 天降到 0.5 天,说明当天新发的视频正在挤进话题页。
单条视频:全部在涨,发得越早涨得越慢
单条视频的增速用 search 的返回算。「thanksgiving recipes」的 20 条结果里,第一、二轮都出现的有 13 条,13 条播放在涨,中位每小时多 1,803 次(每小时涨 0.53%);第二、三轮都出现的有 14 条,14 条在涨,中位每小时多 2,807 次(0.62%)。两段都超过 5 条,按动笔前的标准可以下结论:这些视频在几个小时里都在持续涨。
按每小时涨幅看:发布不到 2 天的 4 个点,每小时涨幅中位 10.76%;2 到 7 天的 20 个点,中位 0.56%;7 天以上的 3 个点,中位 0.06%。发布时长和涨幅的秩相关系数(Spearman)是 -0.83,样本只有 27 个点,但方向很明确。可以这样用:同一个话题下,发布不到一天、每小时涨幅还在几个百分点的视频,就是这个话题「现在」的代表作,值得人工点开看;发布一周以上、每小时只涨零点几个百分点的,是存量里的老视频,看它们的播放总量只能说明过去。
怎么判断一个话题正在起来:三条读数规则
有了每小时的快照,下一步是决定「什么样的变化算起来了」。下面三条都拿这次的读数演示一遍。
第一,看增量,不看存量。#thanksgiving 有五百多万条视频,#buenfin 有二十多万条,拿这两个数比大小没有意义,前者是一个每年都会回来的节日话题,存量里大部分是往年的视频。要比的是两次快照之间新增的视频数,再除以间隔的小时数,得到「每小时新增视频数」:#buenfin 是 1,071 和 1,222 条,#thanksgiving 是 408 和 344 条。这个数才反映「现在有多少人在发」。
第二,至少两个信号同向,才算起来。可用的信号有三个:hashtag_search 的每小时新增视频数、话题页上一天内发布的视频占比(hashtag 返回的 posted_at)、search 返回的单条视频播放中位增速。拿 #buenfin 走一遍:每小时新增视频从 1,071 涨到 1,222,占存量的比例从 0.433% 涨到 0.492%;话题页 30 条里一天内发布的从 14 条涨到 24 条。两个信号同时往上,这个话题可以标记为「正在起来」。反过来,只有一个信号动的时候先不标记:话题总量在涨、话题页上却都是几天前的视频,可能只是老视频补打了标签;search 里几条新视频的播放涨得快、话题总量却不动,可能是这几条视频在推荐流里走红,话题本身还没有扩散。
第三,门槛要高过平稳话题自己的波动。#thanksgiving 是一个平稳的节日话题,相邻两段每小时新增 408 和 344 条,差了 16%;#flushot 两次快照之间只多了 5 条。也就是说,一个平稳话题在相邻两小时之间涨跌一两成是常态,提醒门槛至少要高过这个幅度。具体倍数没法从三轮数据里定,先按自己的话题跑几天,看出它平时的波动范围再定。
每项数据多久拉一次:按实测定频率
把上面的实测换成调度表,每项数据按它真实的变化速度去拉。月费按 30 天、一个话题或一张榜算。
| 数据 | 能力 | 实测怎么变 | 建议频率 | 每月接口费 |
|---|---|---|---|---|
| 音乐榜名次 | music_chart | 同一期之内 0 变化,两天内换过一期 | 每天 1 次 | 2 张榜 $0.0484 |
| 歌曲使用量 | music_chart(同一次返回) | 每小时都在涨,也会回落 | 跟榜单一起拉;关注的歌用 music_search 每天补一次 | 每首 $0.0242 |
| 话题总量 | hashtag_search | 每次快照都在涨,旧话题不涨 | 每小时 1 次 | $0.5803 |
| 话题页视频 | hashtag | #buenfin 相邻两轮只留下 6 和 12 条,换进来的是当天新视频 | 大促期间每小时,平时每 3–6 小时 | $0.0667–$0.4003 |
| 单条视频播放 | search | 两次都出现的视频全部在涨 | 每小时 1 次 | $0.4003 |
| 某首歌的视频 | sound_videos | 三轮第一页完全相同 | 每天 1 次,往后翻页找新视频 | $0.0167 起 |
照这张表,一个话题(总量和单条视频每小时、话题页每 3 小时)加两张榜每天一次,一个月的接口费是 $1.16。算法是每天 hashtag_search 和 search 各 24 次、hashtag 8 次、两张榜各 1 次:(24 × $0.000806 + 24 × $0.000556 + 8 × $0.000556 + 2 × $0.000806) × 30 天 ≈ $1.1624。十个话题照此办理是 $11.19,比每小时把三项话题能力和两张榜都拉一遍的 $14.97 少四分之一。
用 Python 每小时存一次话题和音乐榜快照
上面几组数都出自同一个脚本。它做四件事:拉两张音乐榜、按关键词搜话题、拉一个话题下的 30 条视频、再用普通搜索拿单条视频的播放数;结果写进本地 SQLite,每跑一次就和上一次比,打印名次变化、话题每小时新增视频数、视频集合的重合度和单条视频的播放增速。用到的只有 requests 和 Python 自带的 sqlite3,Key 从环境变量读,不写进代码。每两次调用之间默认等 7 秒,碰到 429 会按响应里的 retry_after 等一下再试。脚本放进定时任务、会自动重试,所以每次调用都带一个 Idempotency-Key 请求头,重试时沿用同一个值,同一次请求不会扣两次(做法见给 API 调用加 Idempotency-Key)。
"""Take one snapshot of TikTok trend signals and compare it with the previous one.

Usage:
    export EVERYINFRA_API_KEY=...            # your key, never hard-code it
    python3 tiktok_trends.py --hashtag thanksgiving --keyword "thanksgiving recipes"

Each run stores rows in trends.sqlite and prints what changed since the last run.
"""
import argparse, json, os, sqlite3, statistics, time, uuid, datetime as dt
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
SGT = dt.timezone(dt.timedelta(hours=8))


def call(platform, action, params, raw_dir=None, tag=""):
    """One POST. Retries on 429 with the same Idempotency-Key; follows poll_url if the job is still running."""
    body = {"platform": platform, "action": action, "params": params}
    headers = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}",
               "Idempotency-Key": str(uuid.uuid4())}  # one key per logical call, reused on retry
    for _ in range(3):
        r = requests.post(API, json=body, headers=headers, timeout=120)
        if r.status_code != 429:
            break
        time.sleep(int(r.json().get("error", {}).get("retry_after", 60)) + 1)
    data = r.json()
    while data.get("status") == "running" and data.get("poll_url"):
        time.sleep(5)
        data = requests.get(data["poll_url"], headers=headers, timeout=60).json()
    if raw_dir:
        Path(raw_dir).mkdir(parents=True, exist_ok=True)
        stamp = dt.datetime.now(SGT).isoformat(timespec="seconds")
        out = {"requested_at_sgt": stamp, "http_status": r.status_code, "request": body, "response": data}
        Path(raw_dir, f"{tag}{action}.json").write_text(json.dumps(out, ensure_ascii=False, indent=1))
    if r.status_code != 200:
        raise RuntimeError(f"{platform}/{action}: HTTP {r.status_code} {data.get('error')}")
    return data


def snapshot(args):
    now = dt.datetime.now(SGT).isoformat(timespec="seconds")
    raw, tag = args.raw_dir, args.tag
    rows = []
    for chart in ("viral50", "top50"):
        res = call("tiktok", "music_chart", {"chart": chart}, raw, f"{tag}{chart}-")
        for x in res["results"]:
            rows.append((now, f"chart:{chart}", x["id"], x.get("title"), x.get("rank"), x.get("use_count"), None))
        time.sleep(args.pause)
    res = call("tiktok", "hashtag_search", {"keyword": args.hashtag}, raw, tag)
    for x in res["results"]:
        rows.append((now, "tag_total", x["hashtag_id"], x["hashtag_name"], None, x.get("video_count"), x.get("view_count")))
    time.sleep(args.pause)
    res = call("tiktok", "hashtag", {"hashtag": args.hashtag, "limit": 30}, raw, tag)
    for i, x in enumerate(res["results"], 1):
        rows.append((now, f"tag_videos:{args.hashtag}", x["id"], x.get("posted_at"), i, x.get("like_count"), x.get("view_count")))
    time.sleep(args.pause)
    # per-video view growth is measured on search results, matched by video ID
    res = call("tiktok", "search", {"keyword": args.keyword, "limit": 20}, raw, tag)
    for i, x in enumerate(res["results"], 1):
        rows.append((now, "search_videos", x["id"], x.get("posted_at"), i, x.get("like_count"), x.get("view_count")))
    return now, rows


def compare(db, now):
    prev = db.execute("SELECT MAX(taken_at) FROM rows WHERE taken_at < ?", (now,)).fetchone()[0]
    if not prev:
        print("first snapshot stored; run again later to see changes")
        return
    hours = (dt.datetime.fromisoformat(now) - dt.datetime.fromisoformat(prev)).total_seconds() / 3600
    print(f"comparing {prev} -> {now} ({hours:.2f} h)")
    q = """SELECT a.kind, a.name, a.rank, b.rank, a.n1, b.n1, a.n2, b.n2 FROM rows a JOIN rows b
           ON a.kind = b.kind AND a.item_id = b.item_id WHERE a.taken_at = ? AND b.taken_at = ?"""
    pairs = list(db.execute(q, (prev, now)))
    for chart in ("chart:viral50", "chart:top50"):
        rows = [p for p in pairs if p[0] == chart]
        moved = sum(1 for p in rows if p[2] != p[3])
        new = db.execute("SELECT COUNT(*) FROM rows WHERE kind=? AND taken_at=?", (chart, now)).fetchone()[0] - len(rows)
        print(f"{chart}: {new} new songs, {moved} rank changes")
        top = sorted(rows, key=lambda p: (p[5] or 0) - (p[4] or 0), reverse=True)[:3]
        for _, name, r0, r1, n0, n1, _, _ in top:
            print(f"  #{r1} {name[:30]:30} uses {n0}->{n1} ({((n1 or 0) - (n0 or 0)) / hours:+.0f}/h)")
    for kind, name, r0, r1, n0, n1, v0, v1 in pairs:
        if kind == "tag_total" and n0 and n1 is not None and n1 != n0 and n0 >= 1000:
            print(f"#{name:27} videos {n0}->{n1} ({(n1 - n0) / hours:+.0f}/h)")
    grow = [(v1 - v0) / hours for kind, _, _, _, _, _, v0, v1 in db.execute(q, (prev, now))
            if kind == "search_videos" and v0 and v1 is not None]
    if grow:
        print(f"search videos seen twice: {len(grow)}, median views/h {statistics.median(grow):+.0f}")
    for (kind,) in db.execute("SELECT DISTINCT kind FROM rows WHERE kind LIKE 'tag_videos:%' OR kind = 'search_videos' ORDER BY kind DESC").fetchall():
        a = {i for (i,) in db.execute("SELECT item_id FROM rows WHERE kind=? AND taken_at=?", (kind, prev))}
        b = {i for (i,) in db.execute("SELECT item_id FROM rows WHERE kind=? AND taken_at=?", (kind, now))}
        if a and b:
            print(f"{kind}: {len(a & b)} of {len(b)} videos also in previous run (Jaccard {len(a & b) / len(a | b):.2f})")


def main():
    p = argparse.ArgumentParser()
    p.add_argument("--hashtag", default="thanksgiving")
    p.add_argument("--keyword", default="thanksgiving recipes")
    p.add_argument("--db", default="trends.sqlite")
    p.add_argument("--raw-dir")
    p.add_argument("--tag", default="")
    p.add_argument("--pause", type=float, default=7.0, help="seconds between calls")
    args = p.parse_args()
    db = sqlite3.connect(args.db)
    db.execute("CREATE TABLE IF NOT EXISTS rows (taken_at, kind, item_id, name, rank, n1, n2)")
    now, rows = snapshot(args)
    db.executemany("INSERT INTO rows VALUES (?,?,?,?,?,?,?)", rows)
    db.commit()
    compare(db, now)


if __name__ == "__main__":
    main()
把它放进 cron 或任何定时任务,每小时跑一次(0 * * * * cd ~/tt && python3 tiktok_trends.py --hashtag thanksgiving)。下面是 02:17(新加坡时间)那一次运行打印的前几行,和上一次运行相比:
comparing 2026-11-14T01:16:39+08:00 -> 2026-11-14T02:17:55+08:00 (1.02 h)
chart:viral50: 0 new songs, 0 rank changes
  #32 Friday                         uses 155939->156532 (+581/h)
  #33 Housewife                      uses 649539->650076 (+526/h)
  #37 All I Want For Christmas Is Yo uses 16297542->16297959 (+408/h)
chart:top50: 0 new songs, 0 rank changes
  #32 Dame Hombro                    uses 448501->449241 (+725/h)
  #7 Housewife                      uses 649540->650083 (+532/h)
  #9 All I Want For Christmas Is Yo uses 16297542->16297960 (+409/h)
#thanksgiving                videos 5021254->5021605 (+344/h)
search videos seen twice: 14, median views/h +2807
tag_videos:thanksgiving: 0 of 30 videos also in previous run (Jaccard 0.00)
search_videos: 14 of 20 videos also in previous run (Jaccard 0.54)
脚本只做存和比,判断交给人或者 agent。有三处可以按需要改:话题和关键词换成你盯的领域;music_chart 两张榜如果用不上就删掉,每次省 $0.001612;想要更长的视频列表,把 search 的 limit 调高,单价不变。
一次真实往返:请求和返回长什么样
每次调用都是同一个地址 POST https://api.everyinfra.com/api/v1/social,请求体只有三项:platform、action、params。下面是第一轮 00:15:32(新加坡时间)那次 Viral 50 的真实返回节选,results 只留第 1 行,封面和音频链接删掉了,计费只留两项:
{
  "id": "req_be98682e5b1b451b",
  "platform": "tiktok",
  "action": "music_chart",
  "count": 50,
  "results": [
    {
      "rank": 1,
      "id": "7698515848231372806",
      "url": "https://www.tiktok.com/music/Gangster-Bxtch-7698515848231372806",
      "title": "Gangster Bxtch",
      "author_name": "Additup",
      "language": "English",
      "duration_seconds": 55,
      "use_count": 6534,
      "is_commercial": true
    }
  ],
  "billing": { "charged": true, "charged_usd": 0.000806 }
}返回体的顶层字段是固定的几项:platform 和 action 回显你调的能力,count 是这一页的行数,results 是数据行,billing.charged_usd 是这次实际扣的美元,billing.charged 说明这次有没有扣费。翻页能力还会带 next_page_token 和 pagination.has_more;我们 00:15 那次 hashtag_search 的 pagination 是 {"page": 1, "has_more": true}。每个返回里都有一句 async_hint,提示可以在请求体里加 "mode": "async",先拿到 job_id,再到 GET /api/v1/jobs/{job_id} 取结果;定时任务不想让一个连接一直挂着时可以用这种方式。
每千条成本和三种月用量
按次付费的账单只取决于调用次数。下面按 2026-11-14 目录价算三种用法的月接口费:六项能力里 hashtag_search 和 music_chart 每次 $0.000806,hashtag 和 search 每次 $0.000556;一个话题每次快照调三次(hashtag_search、hashtag、search),两张音乐榜每次快照各调一次。
| 用法 | 每月调用次数 | 每月返回行数 | 每月接口费 |
|---|---|---|---|
| 小:1 个话题 + 2 张音乐榜,每天 1 次 | 150 | 约 5,100 | $0.1059 |
| 中:10 个话题 + 2 张音乐榜,每小时 1 次 | 23,040 | 约 576,000 | $14.97 |
| 大:100 个话题 + 2 张音乐榜,每小时 1 次 | 217,440 | 约 5,112,000 | $139.26 |
算法写成代码就是下面几行,换成你自己的话题数和频率即可:
PRICE = {"hashtag_search": 0.000806, "music_chart": 0.000806, "hashtag": 0.000556, "search": 0.000556}
def monthly(topics, runs_per_day, charts=2, days=30):
    per_run = topics * (PRICE["hashtag_search"] + PRICE["hashtag"] + PRICE["search"]) + charts * PRICE["music_chart"]
    return round(per_run * runs_per_day * days, 4)
print(monthly(1, 1), monthly(10, 24), monthly(100, 24))   # 0.1059 14.97 139.26
省钱的办法是按变化速度分频率:话题总量用 hashtag_search 每小时记一次,hashtag 的视频列表平时降到每 3 到 6 小时一次,只有 #buenfin 这种大促话题(相邻两轮 30 条只留下 6 和 12 条)才值得每小时拉;音乐榜每天一次。按调度表的频率,十个话题加两张榜一个月是 $11.19,比全部每小时拉的 $14.97 少四分之一。
接进 AI 工具:远程 MCP 配置
同样的六项能力也可以让 AI 助手直接调。EveryInfra 的远程 MCP 地址是 https://api.everyinfra.com/mcp,用 Bearer 令牌鉴权。我们在 2026-11-14 00:3x(新加坡时间)对它发了一次 tools/list,返回 12 个工具,查数据用的是 everyinfra_list_capabilities(免费,列出平台、能力、参数和价格)、everyinfra_call_api(调任意一项能力)和 everyinfra_get_job(读异步任务结果)。支持远程 MCP 的客户端(Claude Code、Cursor 等)里加一段配置就能用,下面是配置示例,Key 换成你自己的:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
接好以后可以直接用自然语言下任务,例如「每天早上 9 点拉一次 TikTok Viral 50,和昨天比,列出使用量涨得最快的 5 首歌,排除原声」。模型会先调 everyinfra_list_capabilities 看 tiktok 平台有哪些能力,再用 everyinfra_call_api 传 platform: tiktok、action: music_chart、params: {"chart": "viral50"}。和上面的 Python 脚本相比,MCP 适合临时问一句、让模型顺手写结论;要每小时稳定存快照、做长期对比,还是脚本加数据库更稳,因为模型每次调用的参数和比较方法不一定一样。定时任务和会自动重试的调用走 REST,并在请求头带 Idempotency-Key,重试时用同一个值(见给 API 调用加 Idempotency-Key)。完整的接入步骤见 MCP 接入页。
跨领域:新闻编辑部和公共卫生传播团队怎么盯话题热度
盯 TikTok 话题的不只有品牌和带货团队。皮尤研究中心 2026-10-19 发布的数据显示,五分之一的美国成年人经常在 TikTok 上看新闻,这个比例在 2020 年只有 3%;路透研究所 2026 年数字新闻报告写到,全球 48 个市场平均有 20% 的受访者用 TikTok 获取新闻,是增长最快的视频平台。对编辑部来说,一个话题在 TikTok 上起来,往往比在搜索引擎上早;对公共卫生部门来说,一种说法在短视频里传开,辟谣和科普就要跟上。
方法和上面的脚本一样,只是话题换了。我们在第二、三轮顺手试了一个公共卫生话题:用 hashtag_search 搜「flu shot」,最大的话题 #flushot 在 01:19 有 16,198 条视频,1.03 小时后是 16,203 条(+5),播放多了 13,206 次。
| 话题 | 01:19 视频数 | 02:20 视频数 | 01:19 播放 | 02:20 播放 | 1.03 小时变化 |
|---|---|---|---|---|---|
| #flushot | 16,198 | 16,203 | 172,627,176 | 172,640,382 | 视频 +5,播放 +13,206 |
| #flushots | 1,501 | 1,501 | 16,607,565 | 16,608,052 | 视频 +0,播放 +487 |
| #flushotseason | 394 | 394 | 4,387,517 | 4,387,572 | 视频 +0,播放 +55 |
同一页上第二大的 #flushots 有 1,501 条视频,这一小时里一条新视频都没有,播放却多了 487 次;#flushotseason 有 394 条,播放多了 55 次。也就是说,公共卫生话题里能看出「有人在发新内容」的只有主话题,变体话题的播放增量只是老视频还有人看。和 #buenfin 每小时上千条相比,#flushot 是一个平静的话题,正好可以当基线:哪天它每小时新增几十上百条,就值得去看发生了什么。编辑部可以每小时记一次几个突发话题的视频数,新增视频数连续几个小时翻倍就提醒值班编辑去看;公共卫生团队可以把流感、疫苗、某种药物的话题放进同一个列表,看哪个说法的视频数在涨,再去读视频本身判断内容。世界卫生组织 2025 年发布的社交聆听伦理指南给了几条底线:只用公开数据、尽量用汇总数而不是盯具体的人、结论要回到人工核实。脚本只存视频 ID、发布时间和计数,不存作者名;需要读视频内容时,再按 ID 单独去看。本节只写数据方法,不提供任何医疗建议。
什么时候官方入口更合适
按次付费的接口解决的是「现在就要、每小时都要、不想等审批」。三种情况官方入口更合适:要完整历史样本的合格学术研究,用 Research API(按日期窗口、地区、话题组合查询,每天 10 万条,免费);研究欧洲的广告,用 Commercial Content API(有广告主、投放时间、触达和定向信息);在自己的产品里展示某位创作者授权的视频,用 Display API,这是 TikTok 为这个用途提供的官方方式。反过来,按次付费的接口没有 Research API 那种按地区、按日期窗口的全量检索,hashtag 每次只给 30 条话题页上的视频,不是这个话题的全部视频;它也没有广告的定向和触达数据。
接进生产前要注意的两点
第一,hashtag_search 返回的是名字相近的话题,排序不按大小。我们搜「thanksgiving」,第一页 20 个话题里,主话题 #thanksgiving 有 5,020,838 条视频,但带表情符号的变体(例如 thanksgiving 后面加一个爱心)只有 4 到 2,349 条,混在同一页里。用之前先按 video_count 排序或设个下限。搜「buen fin」的第一页也一样:
| 「buen fin」第一页的位置 | 话题 | 00:20 视频数 | 02:19 视频数 | 两小时变化 |
|---|---|---|---|---|
| 1 | #buenfin | 247,285 | 249,567 | +2,282 |
| 2 | #buen_fin | 225 | 226 | +1 |
| 9 | #promocionesbuenfin | 793 | 813 | +20 |
| 18 | #ofertasbuenfin | 2,214 | 2,255 | +41 |
| 5 | #buenfin2023 | 8,214 | 8,214 | +0 |
| 3 | #buenfin2022 | 4,683 | 4,683 | +0 |
| 7 | #buenfin2020 | 3,053 | 3,053 | +0 |
| 6 | #buenfin2021 | 2,032 | 2,032 | +0 |
同一页 20 个话题,两个小时里只有上表前 4 个的视频数在变,其余 16 个一条没涨,包括带年份的 #buenfin2020 到 #buenfin2023。把这些冻住的话题从监控名单里去掉,名单会短很多;要保留的话,只记它们的播放增量,不当成「在起来」的话题。
第二,没有按国家筛选的话题榜。六项能力里的音乐榜和话题都是平台给的那一份,没有国家参数,返回里也不写是哪个地区的榜单。我们从歌名看,榜上英语歌占多数,也有西语歌(例如 Prince Royce 的 Rechazame 在两张榜上都排前 10),但这只是观察,不能当成「这是美国榜」的证据。要看某个国家,就挑当地语言的关键词和话题,比如墨西哥的 #buenfin。
最近的变化
| 日期 | 变化和对你的影响 |
|---|---|
| 2026-11-14 | Creative Center 旧的热门话题地址 301 跳到 ads.tiktok.com/creative/creativeCenter/trends,页面标题改为 TikTok One Creative Suite(我们当天用 curl 核对)。意味着按旧地址写的书签、文档和网页解析脚本都要改。 |
| 2026-11-13 | 墨西哥 El Buen Fin 2026 开始,按项目规则从 11 月 13 日持续到 17 日,由 Profeco 等机构协调。意味着墨西哥的购物类话题在这五天里会被活动整体推高,和平常的一周不能直接比。 |
| 2026-11-12 | TikTok 宣布 LIVE Fest 2026 的应用内比赛从 2026-11-09 开始,持续到 12 月底。意味着这段时间直播相关话题的视频数会被活动推高,看增速时要把活动因素考虑进去。 |
| 2026-11-05 | TikTok Shop 德国站公布 Black Friday 活动从 11 月 11 日跑到 12 月 16 日,其中 11 月 23 日到 30 日是高峰周;同一篇写到 9 月 16 日到 10 月 15 日 #blackfriday 的帖子数比前 30 天多约 630%。意味着购物类话题在 11 月下旬的增速不能和 10 月直接比。 |
| 2026-11-05 | TikTok 更新了 Get Client Access Token 文档:Research API 和 Commercial Content API 用的客户端令牌有效期 2 小时(7,200 秒),接口不返回刷新令牌。意味着跑得久的任务每 2 小时要重新取一次令牌。 |
| 2026-10-19 | 皮尤研究中心发布,20% 的美国成年人经常在 TikTok 上看新闻,30 岁以下是 39%。意味着新闻编辑部盯 TikTok 话题的理由更充分了。 |
| 2026-10-13 | TikTok Shop 美国站公布 Black Friday 和 Cyber Monday 活动从 11 月 11 日到 30 日,并写到 9 月 #holidayshopping 内容环比增长 263%。意味着 #thanksgiving 这类节日话题在感恩节(美国联邦假日表上 2026 年是 11 月 26 日)前会持续升温。 |
常见问题
下面几问来自 Google 联想词(2026-11-14 用联想词工具读取,原词写在每问后面)。
TikTok 有官方的趋势 API 吗?Research API 和 Creative Center 能用吗?
TikTok for Developers 列了 9 个产品,能读数据的 Research API、Display API 和 Commercial Content API 都没有「热门话题榜」或「热门歌曲榜」接口(联想词「does tiktok have an api」)。Research API 免费,但只给美国、欧洲、加拿大、瑞士等地的学术机构和欧盟非营利机构,商业用户不能申请,额度是每天 1,000 次请求、10 万条记录(联想词「tiktok research api free」「tiktok research api rate limit」)。Creative Center 有热门榜,但它是网页,开发者文档里没有它的接口说明,我们 2026-11-14 核对时旧地址已经 301 跳到新的 Creative Suite 页面(联想词「tiktok creative center api」)。
怎么用 API 拿 TikTok 热门话题?
官方没有直接给榜单。可行的做法是挑一组关键词,用 tiktok/hashtag_search 定时记录每个话题的 video_count 和 view_count,两次之差就是每小时新增量;再用 tiktok/hashtag 看话题里正在发什么(联想词「tiktok api trending hashtags」)。
怎么用 API 拿 TikTok 热门音乐?
tiktok/music_chart 一次给整张 Top 50 或 Viral 50,每行带名次、use_count(用过这首歌的视频数)和发行日期;看中某首歌,再用 tiktok/sound_videos 拉用了这首歌的视频(联想词「tiktok trending sounds api」「tiktok trending songs api」)。
调用失败扣钱吗?
不扣。失败和空结果都不扣费:每次返回的 billing.charged 会写明这次有没有扣,没扣时 charged_usd 是 0(见文档的计费一节)。我们这次 31 次调用全部成功返回,每次的 billing.charged_usd 都和目录单价一致。
TikTok 热门歌曲榜多久更新一次?
我们没有找到 TikTok 关于更新周期的公开原文,只能给实测:2026-11-11 00:20 到 2026-11-12 00:13 之间,Viral 50 四次、Top 50 三次快照一处没变;2026-11-12 00:13 到 2026-11-14 00:15 之间换了一期,Viral 50 有 46 首、Top 50 有 48 首进出或换了名次;2026-11-14 当天三轮又一处没变。按这个节奏,榜单每天拉一次就够,每小时变的是 use_count(联想词「how often does tiktok update trending songs」)。
能按国家拿 TikTok 热门话题吗?
官方的 Creative Center 网页可以按国家筛热门话题,但没有接口;Research API 的视频查询有 region_code 过滤,只对合格研究者开放。本篇用到的六项按次付费能力里,音乐榜和话题数据都没有国家参数,返回里也不写地区。要看某个国家的热度,可行的做法是挑当地语言的关键词和话题(比如墨西哥的 #buenfin),用 hashtag_search 定时记总量(联想词「tiktok trending hashtags by country」)。
上手:从试用台到每小时一次的快照
- 在 EveryInfra 控制台注册并拿到 API Key,按快速上手页的步骤把 Key 放进环境变量
EVERYINFRA_API_KEY。 - 免费读目录:
curl https://api.everyinfra.com/api/v1/social/catalog,找到platform为tiktok的几行,看available、price_usd和参数说明;也可以在 TikTok 平台页和各能力页(例如music_chart)里直接试。 - 先手动调一次:
curl -X POST https://api.everyinfra.com/api/v1/social -H "Authorization: Bearer $EVERYINFRA_API_KEY" -H "Content-Type: application/json" -d '{"platform":"tiktok","action":"music_chart","params":{"chart":"viral50"}}',确认能拿到 50 行。 - 把上面的 Python 脚本存成
tiktok_trends.py,pip install requests后跑两次,间隔一小时,看第二次打印的变化。 - 放进定时任务每小时跑一次;想让 AI 助手直接查,按上面的配置接远程 MCP。价格和计费规则见价格页,同类数据的其他接法可以在数据市场里找。
参考资料
- Research Tools,TikTok for Developers,2026-11-14 读取。
- Research API FAQ,TikTok for Developers,2026-11-14 读取。
- Research API: Getting Started,TikTok for Developers,2026-11-14 读取。
- Research API Reference: Query Videos,TikTok for Developers,2026-09-01,2026-11-14 读取。
- Research API Reference: Query User Info,TikTok for Developers,2026-09-01,2026-11-14 读取。
- Research API Reference: Query Video Comments,TikTok for Developers,2026-09-01,2026-11-14 读取。
- Research API Codebook,TikTok for Developers,2026-09-10,2026-11-14 读取。
- Vetted Researcher Data Access,TikTok for Developers,2026-11-14 读取。
- Display API Overview,TikTok for Developers,2026-08-04,2026-11-14 读取。
- Display API: Get Started,TikTok for Developers,2026-08-19,2026-11-14 读取。
- API Reference: List Videos,TikTok for Developers,2026-11-14 读取。
- Rate Limits,TikTok for Developers,2026-08-04,2026-11-14 读取。
- Scopes Overview,TikTok for Developers,2026-11-14 读取。
- Login Kit Overview,TikTok for Developers,2026-08-19,2026-11-14 读取。
- Get Client Access Token,TikTok for Developers,2026-11-05,2026-11-14 读取。
- Commercial Content API,TikTok for Developers,2026-11-14 读取。
- Commercial Content API: Getting Started,TikTok for Developers,2026-11-14 读取。
- Commercial Content API Reference: Query Ads,TikTok for Developers,2026-11-14 读取。
- Commercial Content API Reference: Query Advertisers,TikTok for Developers,2026-09-01,2026-11-14 读取。
- Commercial Content API: Supported Countries,TikTok for Developers,2026-09-01,2026-11-14 读取。
- Data Portability API,TikTok for Developers,2026-11-14 读取。
- Data Portability API: Get Started,TikTok for Developers,2026-09-10,2026-11-14 读取。
- Changelog,TikTok for Developers,2026-08-25,2026-11-14 读取。
- TikTok One Creative Suite: Trends,TikTok for Business,2026-11-14 读取。
- Terms of Service (US),TikTok USDS Joint Venture,2026-07-15,2026-11-14 读取。
- Terms of Service (global),TikTok,2026-11-14 读取。
- Commercial Music Library,TikTok Help Center,2026-11-14 读取。
- What's shaping the holiday season on TikTok Shop,TikTok Newsroom,2026-10-13,2026-11-14 读取。
- Black Friday 2026 bei TikTok Shop,TikTok Newsroom,2026-11-05,2026-11-14 读取。
- Veterans Day 2026: honoring #VeteransofTikTok,TikTok Newsroom,2026-11-04,2026-11-14 读取。
- TikTok LIVE Fest 2026,TikTok Newsroom,2026-11-12,2026-11-14 读取。
- Social data catalog,EveryInfra,2026-11-14 读取。
- tiktok-api topic,GitHub,2026-11-14 读取。
- TikTok-Api releases,GitHub,2026-04-01,2026-11-14 读取。
- Issue #1311: 200 empty body response for user-level queries,GitHub,2026-07-18,2026-11-14 读取。
- TikTokApi 7.3.3,PyPI,2026-04-01,2026-11-14 读取。
- sqlite3: DB-API 2.0 interface for SQLite databases,Python documentation,2026-11-14 读取。
- Requests: HTTP for Humans,Requests documentation,2026-11-14 读取。
- Model Context Protocol: Transports,Model Context Protocol,2025-06-18,2026-11-14 读取。
- Regulation (EU) 2022/2065 (Digital Services Act),EUR-Lex,2022-10-19,2026-11-14 读取。
- Delegated act on data access under the Digital Services Act,European Commission,2025-07-02,2026-11-14 读取。
- New measures unlock access to data from largest online platforms,European Commission,2025-10-29,2026-11-14 读取。
- Social listening in infodemic management for public health emergencies: guidance on ethical considerations,World Health Organization,2025-04-08,2026-11-14 读取。
- Infodemic,World Health Organization,2026-11-14 读取。
- Federal Holidays,U.S. Office of Personnel Management,2026-11-14 读取。
- El Buen Fin,Profeco,2026-11-14 读取。
- El Buen Fin 2026,Portal oficial de El Buen Fin,2026-11-14 读取。
- 1 in 5 Americans regularly get news on TikTok,Pew Research Center,2026-10-19,2026-11-14 读取。
- Digital News Report 2026: Executive summary,Reuters Institute,2026-06-16,2026-11-14 读取。
引用编号 BL-149