数据接口和工具路由:EveryInfra 与 Monid 分工
同一个小红书请求跑 6 次,前 3 名出现 16 篇不同笔记,每次扣费都是 $0.005556。智能体每天的活走数据接口,名单外的长尾交给 Monid。
2026 年 11 月 3 日 16:33 到 16:45(新加坡时间),我们用同一个请求在 EveryInfra 的 xiaohongshu/search 上搜「抹茶拿铁」、按「点赞最多(most_liked)」排序,前后跑了 6 次:每次都回了 20 条笔记、扣了 $0.005556,字段名都落在目录写好的那一组里,但 6 次的前 3 名一共 18 个位置,出现了 16 篇不同的笔记;其中两次有单独计时,分别用了 3.9 秒和 4.3 秒。这说明每天的任务能固定下来的是请求的样子、字段名、单价和错误格式,结果本身会动,所以要连排序和调用时刻一起存。
正因为这几样能固定,天天重复的平台数据适合交给专门的数据接口;偶尔才用一次、事先不知道会用的工具,交给 Monid 这样的工具路由。Monid 在 2026 年 11 月 3 日的首页写着 2,800+ 个工具;按 Monid 10 月 29 日给我们的材料,discover 和 inspect 免费,run 按工具卡上的价从一个余额里扣。
这篇文章的底稿来自 Monid 团队给我们的一份草稿,论点我们保留了:智能体的工具调用分两种,一种天天重复,一种临时才发现,两种不该用同一种方式接。我们改了一处,又加了一组自己的真调。改的那一处是分流规则里的「每天」名单:草稿的示例只写了小红书、抖音、TikTok 三个平台,我们按 EveryInfra 当天的目录把 106 个平台按类别列全了,名单之外的长尾才走 Monid。加的那组真调是上面说的「抹茶拿铁」,以及笔记详情、评论、抖音搜索和两次故意写错的请求。Monid 一侧的数字,我们只引用他们 2026 年 10 月 29 日在自己那边跑的结果和他们官网上带日期的事实,不替他们重测收费的调用。
智能体的工具调用分两种:每天重复的和临时发现的
Monid 的底稿开头建议先做一件事:把智能体上周的工具调用全部拉出来,按「同一个调用重复了几次」排序。按他们的说法,重复的那部分是一张短名单:你跟踪的那几个平台、你要存的那几列字段、你定好的那个时间表,同一个请求一天跑好几次。不重复的那部分是一条很长的尾巴,比如用户临时问某个场馆当天的天气,问一个你平时不跟踪的平台上某个创作者的粉丝数,问某家公司最近一轮融资,或者要抓一个普通请求打不开的页面。尾巴上的每一种都可能来自不同的公司,有各自的 Key、字段和注册流程,一年也就调几次。
这两段要的东西正好相反。重复的那段,最值钱的是「不变」:字段名不变,智能体的代码和下游的表才能一直对得上;单价不变,财务才能提前算账;错误的格式不变,重试逻辑才能写一次用很久。Anthropic 在《Writing effective tools for agents》里把工具定义成确定性系统和非确定性智能体之间的约定,并建议给工具起清楚的名字、按功能分好边界、返回对智能体有用的上下文。长尾那段,最值钱的是「广」:智能体事先不知道会用到哪个工具,不应该为每一个都提前配置一遍,而是在需要时找到它、看清价格、调一次就走。
错误的做法是用同一种方式对待两段。把长尾一家一家接进来,智能体上线第一周都在收集 API Key;把每天的活也交给一个通用路由,等于放弃了让每天的活便宜好维护的那份固定字段。更具体的代价在模型这一侧:工具挂得越多,模型越容易挑错。RAG-MCP 论文在 MCP 压力测试里报告,先用检索挑出相关工具再交给模型,工具选择准确率从 13.62% 提到 43.13%,提示词长度降了一半以上;早一些的 ToolLLM 和 Gorilla 也都在讲同一件事:API 一多,模型生成正确参数和挑对接口都变难。一位同时跑 58 个 MCP 服务、680 多个工具的开发者在 Reddit 的 r/mcp 版写,过了 30 到 60 个工具,模型挑工具的能力就明显变差,他的办法是延迟加载工具说明,加上给每个专门的智能体只配 10 到 20 个工具。
| 维度 | 每天重复的调用 | 临时发现的调用 |
|---|---|---|
| 频率 | 每天、每小时,同一个请求反复跑 | 一年几次,事先不知道 |
| 智能体事先知道吗 | 知道:平台、字段、排序都定好了 | 不知道:用户问到才需要 |
| 最看重什么 | 字段名不变、单价不变、错误格式不变 | 覆盖面广、不用提前注册、按次付费 |
| 本文的例子 | 小红书「抹茶拿铁」日报:xiaohongshu/search、xiaohongshu/comments | 按域名取一家公司的 Logo;搜一个名单外平台上的帖子 |
| 走哪 | 专门的数据接口:EveryInfra | 工具路由:Monid(discover、inspect、run) |
所以合理的形状是一根直连的管子接每天的活,一个路由接其余的。这不是二选一:两个服务都按 MCP 协议提供,可以同时挂在同一个智能体客户端里,再给智能体一条分流规则。后面几节先说清 Monid 是什么、EveryInfra 的「每天」名单有多长,再看真调。
Monid 是什么:三个动作,一个余额
Monid 把自己描述为智能体工具界的 OpenRouter。这句话说的是产品形态,不是合作关系:OpenRouter 把很多模型放到一个 Key 和一个余额后面,按 OpenRouter 文档的说法,它用一个接口地址给出几百个模型,并自动处理备用路线;按 Monid 10 月 29 日给我们的材料,Monid 做的是同样的事,只是往上挪了一层,管的是智能体选好模型以后要调用的那些工具。Monid 的定位页(2026 年 11 月 3 日读取)把这个对照写成一句:OpenRouter 是一个 Key、所有模型、按 token 付费,Monid 是一个技能、所有工具、按次付费。这里只借这个比喻说明产品形态,不表示两家公司之间有任何关系。
我们在 2026 年 11 月 3 日读 Monid 首页,上面写着 2,800+ 个工具,新账户送 $1 的免费额度;他们 10 月 29 日给我们的材料里,这两个数也一样。按他们 10 月 29 日的材料,目录覆盖网页搜索、抓取、人员和公司信息补全、社交平台数据(包括中文平台)、地图和点评、电商、金融以及生成类媒体。计费的原话是:从一个余额里按次扣,不用订阅;discover 和 inspect 免费,run 按工具卡上标的价收费。
按 Monid 10 月 29 日的材料,用法是三个动作。discover 是对整个目录的免费语义搜索:智能体用一句话描述要做什么,拿回一组排好序的接口,每个接口带价格和状态。inspect 也免费,返回一个接口的入参说明、价格和文档。run 是唯一收费的一步,按 inspect 显示的价从预付余额里扣。接入方式有 MCP、Skill 文件、命令行、REST API。MCP 一种写在 Monid 的 MCP 接入说明里(Monid MCP 接入指南,2026-11-03 读):服务地址是 https://mcp.monid.ai/v1,用 OAuth 登录,页面上分别写了 Claude Code、Codex 等客户端的接法。技能文件在 monid.ai/SKILL.md,按 Monid 的材料,给智能体一句 set up 加这个地址,它就能自己学会三个动作;机器可读的总览在 monid.ai/llms.txt。
| 动作 | 收不收费 | 返回什么(按 Monid 2026-10-29 的材料) |
|---|---|---|
| discover | 免费 | 按匹配程度排好的接口列表,带价格和状态 |
| inspect | 免费 | 一个接口的入参说明、价格、文档 |
| run | 按工具卡上的价扣 | 结果和一个可以再取的 run id |


EveryInfra 的「每天」名单:106 个平台、569 项能力
分流规则的第一句是「名单里的平台走 EveryInfra」,所以名单的长度决定了规则好不好用。Monid 草稿里的示例规则只写了 xiaohongshu, douyin, tiktok 三个平台;读者照抄的话,Amazon 的评论、Google 地图的点评、LinkedIn 的职位、Reddit 的帖子这些在 EveryInfra 目录里有固定字段和固定单价的任务,也会被规则送进名单外的那一支。所以这一节把名单列全。
数据来自 EveryInfra 的免费目录 GET /api/v1/social/catalog,2026 年 11 月 3 日 16:32(新加坡时间)读取。目录里一共 106 个平台、573 项能力,其中 569 项是可用状态;另外 4 项标着 available=false(g2/compare、jd/reviews、temu/search、wechat_oa/wechat_index),这几项当天不要放进每天的名单。类别按 /market 页面用的同一套规则分:内容与社交、点评口碑、电商商品、招聘商业、搜索网页与行情。下表是全部 106 个平台,按每个平台的可用能力数从多到少排。
| 类别 | 平台数 | 可用能力 | 平台(按能力数从多到少) |
|---|---|---|---|
| 内容与社交 | 49 | 373 | 抖音、TikTok、X (Twitter)、Instagram、小红书、Facebook、知乎、快手、微信公众号、微博、GitHub、B站、Reddit、YouTube、Pinterest、Substack、Threads、Spotify、Dailymotion、Quora、Rumble、SoundCloud、Telegram、今日头条、Twitch、Bluesky、Mastodon、Truth Social、微信视频号、DeviantArt、Discord、豆瓣、Gab、Lemmy、Naver、Odysee、Patreon、Product Hunt、Snapchat、Tumblr、优酷、Dribbble、爱奇艺、Medium、网易云音乐、Behance、Flickr、VK、Eventbrite |
| 点评口碑 | 15 | 65 | Google Play、App Store、G2、谷歌地图点评、TripAdvisor、Zillow、Airbnb、Booking、Expedia、Yelp、Realtor、Clutch、Nextdoor、Upwork、Crexi |
| 电商商品 | 13 | 53 | Amazon、速卖通、京东、eBay、Etsy、淘宝、Shopee、Walmart、1688、闲鱼、得物、Temu、Google 购物 |
| 搜索网页与行情 | 17 | 40 | Yahoo Finance、加密行情、公司数据、Polymarket、Yandex、SimilarWeb、加密新闻、Kalshi、SERP 搜索结果、Bing 搜索、Bing 地图、DuckDuckGo 搜索、DuckDuckGo 地图、Apple 地图、Google 新闻、Google 趋势、Google 广告透明度中心 |
| 招聘商业 | 12 | 38 | LinkedIn、Glassdoor、Indeed、Xing、Capterra、Trustpilot、Naukri、ThomasNet、StepStone、SEEK、Dice、Craigslist |
两点要说明。第一,名单是一个会变的东西:目录每天都可能加平台、加能力,也可能把某一项暂时标成不可用,所以规则里的名单最好不要手写,而是开工时让智能体先调一次免费的 everyinfra_list_capabilities 工具或者目录接口,拿当天的列表填进去。第二,名单按平台列还不够细:同一个平台上,有的能力每天能跑,有的只在特定参数下有结果。小红书一个平台就有 17 项可用能力(搜索、笔记详情、评论、评论回复、用户主页、用户笔记、用户搜索、话题、热榜、商品搜索、商品详情、评价、粉丝列表、笔记发布地点、多链接评论批量采集、视频详情、蒲公英内容广场榜),单价除了蒲公英内容广场榜是每次 $0.016,其余都是每次 $0.005556。按能力写名单,智能体在规则里就能直接看到「这一项多少钱、要哪些参数」,详细说明在小红书数据接口页和小红书搜索能力页。
分流规则改一处:名单写全,名单外才走 Monid
有了名单,规则可以写得很短。我们照 Monid 草稿的结构改写了一版,只改了平台那一行,并加了一条「拿不准就先问 EveryInfra,回 unknown_capability 再走 Monid」的兜底。规则是给智能体读的文字,放在系统提示词或者项目说明文件里都可以。
每天的固定任务,只要平台在下面的名单里,就调 everyinfra_call_api:
关键词用该平台自己的语言;任务里写「这周」「今天」就按时间排序;
每次调用都把 platform、action、params、调用时刻和 charged_usd 记下来。
名单以外的平台、一次性的查询、不是数据的工具,走 Monid:
先 discover,再 inspect(两步都免费),确认价格在预算内再 run,
run 按 inspect 显示的价收费;把每次的价格和 run id 记下来。
如果拿不准平台在不在名单里,先调 EveryInfra;
返回 400 且 error.code 是 unknown_capability(不扣费)时,再走 Monid。
名单(EveryInfra 目录,2026-11-03 读取,开工时用 everyinfra_list_capabilities 刷新):
airbnb, alibaba1688, aliexpress, amazon, app_store, apple_maps, behance,
bilibili, bing, bing_maps, bluesky, booking, capterra, clutch, company_data,
craigslist, crexi, crypto_market, crypto_news, dailymotion, deviantart,
dewu, dice, discord, douban, douyin, dribbble, duckduckgo, duckduckgo_maps,
ebay, etsy, eventbrite, expedia, facebook, flickr, g2, gab, github,
glassdoor, google_ads_transparency, google_maps_reviews, google_news,
google_play, google_shopping, google_trends, indeed, instagram, iqiyi, jd,
kalshi, kuaishou, lemmy, linkedin, mastodon, medium, naukri, naver,
netease_music, nextdoor, odysee, patreon, pinterest, polymarket,
producthunt, quora, realtor, reddit, rumble, seek, shopee, similarweb,
snapchat, soundcloud, spotify, stepstone, substack, taobao, telegram, temu,
thomasnet, threads, tiktok, toutiao, tripadvisor, trustpilot, truth_social,
tumblr, twitch, twitter, upwork, vk, walmart, web, wechat_channels,
wechat_oa, weibo, xianyu, xiaohongshu, xing, yahoo_finance, yandex, yelp,
youku, youtube, zhihu, zillow
那条兜底是我们这次真调验证过的。16:41:00(新加坡时间)我们故意请求了一个不在名单里的平台 lemon8,EveryInfra 在 0.24 秒内回了 HTTP 400,error.code 是 unknown_capability,allowed 字段里列出全部 106 个平台名,next_steps 的第一句写明没有扣费。16:40:52 我们又故意给小红书搜索传了一个不存在的排序值 hot(这正是 Monid 草稿里第二家接口用的排序名),接口在 0.11 秒内回了 HTTP 422,did_you_mean 给出 most_liked,allowed 列出 5 个合法值,同样不扣费。这两种错误的区别对分流很重要:400 unknown_capability 是「这件事不归我」,智能体应该转去 Monid;422 invalid_value 是「这件事归我,但你参数写错了」,智能体应该按 allowed 改一个参数再发,而不是转走。
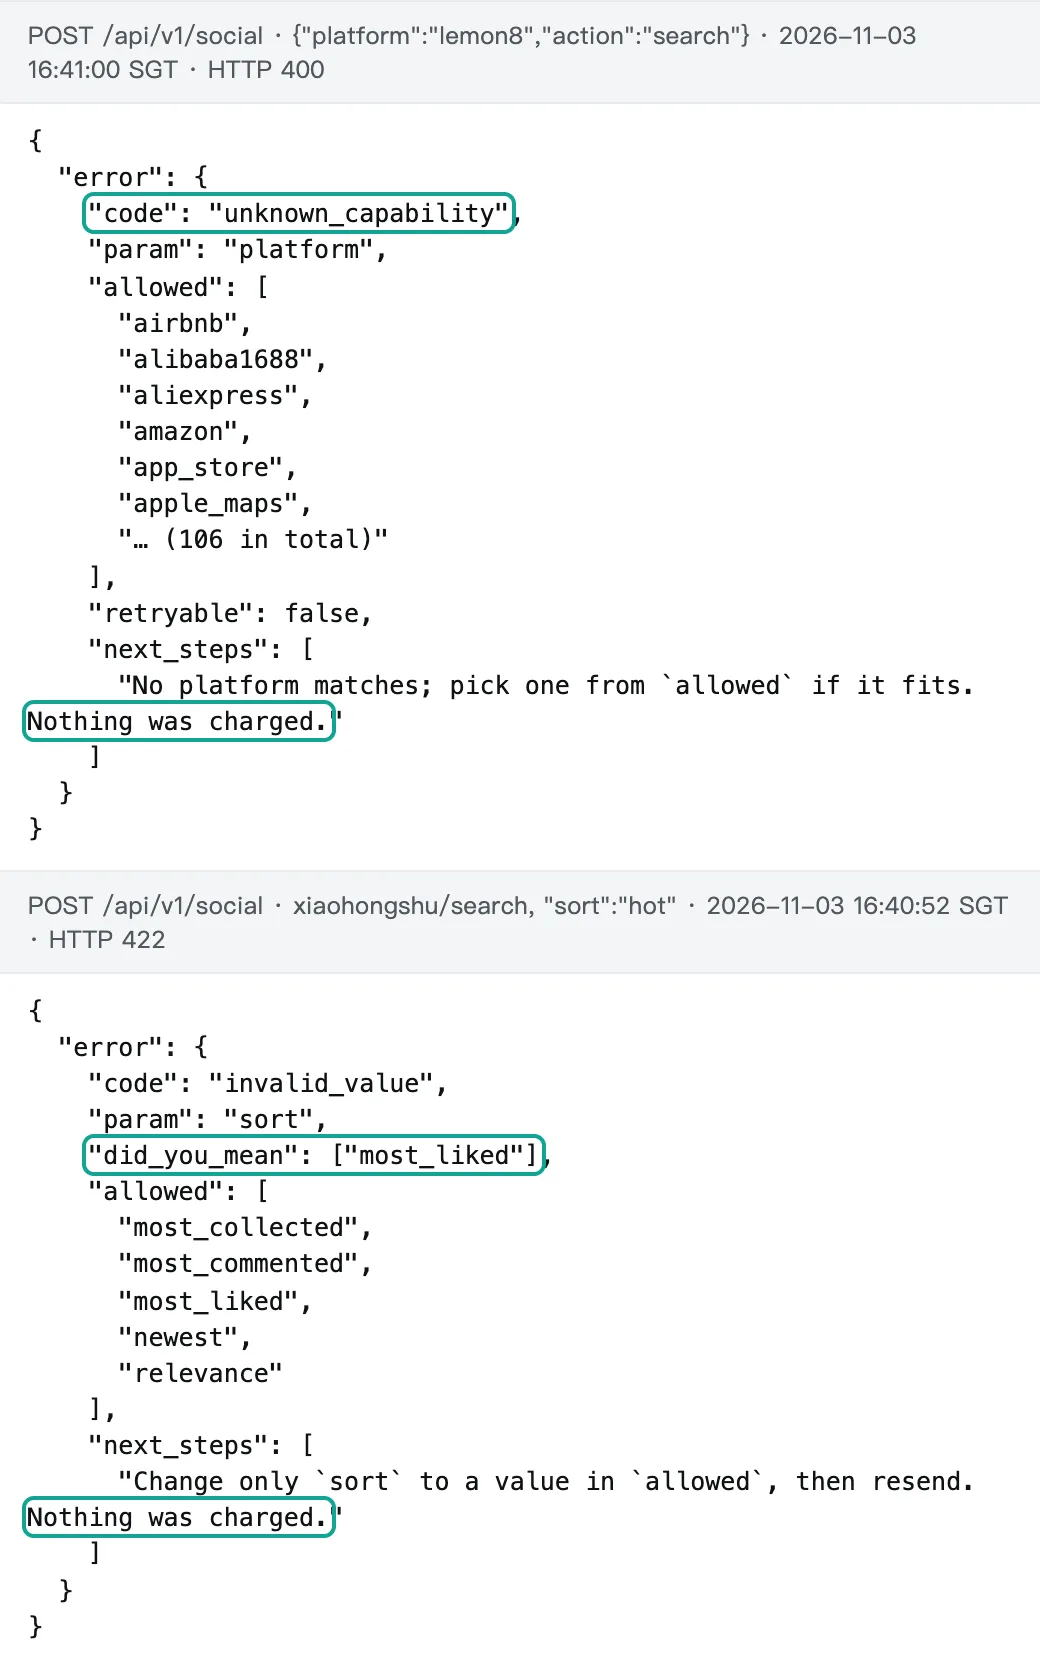
这条兜底的价值在于它让规则可以「宁可先问」:名单就算过时了一天,智能体先调 EveryInfra 的代价也只是一次零扣费、零点几秒的往返,拿到 unknown_capability 再按规则转走。每天的平台则不宜先送进名单外那一支:按 Monid 10 月 29 日材料自己的说法,同一个平台的两家接口排序的叫法不同、返回的字段名也不同,所以任务一旦每天重复,就要固定一家接口、一种排序、一套字段(原话见下文「真调一」末尾)。同样的思路也写在我们的接入文档里和 Monid 一起用的那一节,以及合作伙伴页面上的 Monid 介绍。
两个 MCP 服务挂进一个客户端
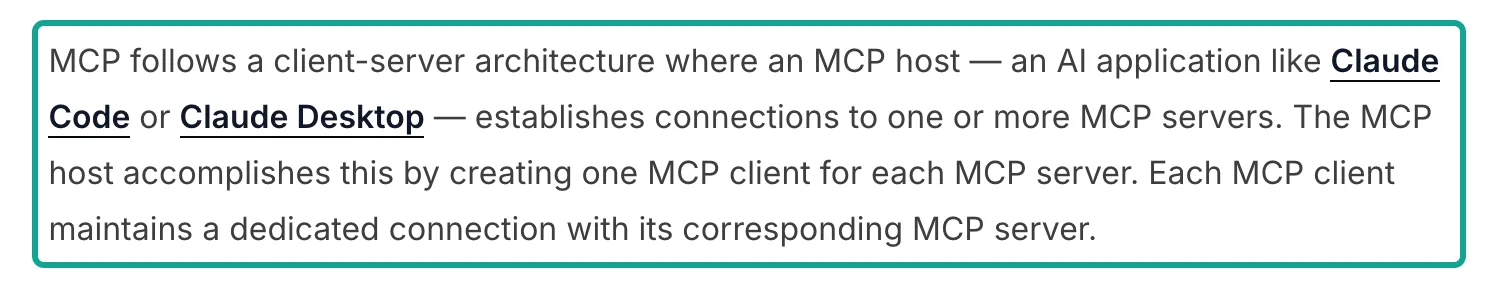
两个服务能同时用,靠的是 MCP 本身的结构。按 MCP 官方架构说明,宿主程序(Claude Code、Claude Desktop、Cursor、VS Code 或者你自己写的程序)会为每一个 MCP 服务器各建一个客户端,各自保持一条专用连接;连上以后,宿主把所有服务器的工具列表合在一起交给模型,模型每次调用时自己挑。也就是说,EveryInfra 和 Monid 挂在同一个宿主里,彼此看不到对方,也不需要知道对方存在,分工全靠模型读到的工具说明和你写的那条分流规则。协议层面的消息格式是 JSON-RPC 2.0,远程服务走 Streamable HTTP 传输,工具的列出和调用按规范里 tools 一节来。
在 Claude Code 里,两条命令就够了。EveryInfra 用 API Key 鉴权,Key 放在环境变量里,通过 --header 传进去;按 Monid MCP 接入指南(2026-11-03 读),Monid 的远程服务走 OAuth,加完以后在 Claude Code 里输入 /mcp,选中 monid,按提示完成授权。--scope user 让两个服务对你所有项目都可用,Claude Code 的 MCP 文档里还有 local 和 project 两种范围,project 范围会写进项目根目录的 .mcp.json,适合团队共用。第一次接 MCP 的读者可以先看 Claude Code 的 MCP 快速上手,再看我们的 MCP 服务说明页。
# EveryInfra:API Key 鉴权,Key 只放在环境变量里
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Monid:远程 MCP,OAuth 登录(加完在 Claude Code 里输入 /mcp,选 monid 完成授权)
claude mcp add --transport http monid https://mcp.monid.ai/v1 --scope user
如果你的客户端读的是一个 mcpServers 配置文件,写法是下面这样。有一处容易踩:Claude Code 的项目文件 .mcp.json 里,远程服务要写 "type": "http",只写 url 会在加载时报配置错误;Cursor 的写法和它基本一样;VS Code 的顶层键是 servers 而不是 mcpServers;Gemini CLI 用 httpUrl 表示 Streamable HTTP 地址;Codex 用 TOML。下面的表把五个常见客户端的差别列在一起,每一行都来自各家 2026 年 11 月 3 日的官方文档。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    },
    "monid": { "type": "http", "url": "https://mcp.monid.ai/v1" }
  }
}| 客户端 | 配置放在哪 | 远程服务怎么写 | Key 或登录怎么给 | 官方说明 |
|---|---|---|---|---|
| Claude Code | claude mcp add 命令,或项目里的 .mcp.json | "type": "http" 加 url | --header 或 headers;OAuth 服务用 /mcp 登录 | Claude Code MCP 文档 |
| Cursor | 项目 .cursor/mcp.json 或全局 ~/.cursor/mcp.json | mcpServers 下写 url | headers;支持 OAuth | Cursor MCP 文档 |
| Codex | ~/.codex/config.toml,或受信任项目的 .codex/config.toml | [mcp_servers.名字] 下写 url | bearer_token_env_var 填环境变量名;OAuth 用 codex mcp login | Codex MCP 文档 |
| VS Code | 工作区 .vscode/mcp.json | 顶层键 servers,"type": "http" | headers,或输入框变量;支持 OAuth | VS Code MCP 文档 |
| Gemini CLI | settings.json 的 mcpServers | httpUrl | headers;可用 includeTools 只放行部分工具 | Gemini CLI MCP 文档 |
两个服务都挂上以后,模型每一轮对话都会看到两边的工具说明,这是有成本的。我们在 16:42:41(新加坡时间)对 EveryInfra 的 MCP 服务发了一次 tools/list:一共 12 个工具,包括 everyinfra_list_capabilities(读目录)、everyinfra_call_api(调任何一项数据能力)、everyinfra_get_job(取异步任务结果)和搜索、验证码、AI 对话、账户、工单相关的工具,整个返回体 16,247 字节,按常用的每 4 个字节约 1 个 token 粗算,约 4,060 个 token。这个数字不大,原因是我们没有把 569 项能力各做成一个工具,而是用一个通用的 everyinfra_call_api 加一个免费的目录工具,模型要什么就先查目录。Anthropic 在《Introducing advanced tool use》里给过一个对照:50 多个 MCP 工具的说明一次全部加载,大约要 72K token,用工具搜索按需加载以后只剩一小部分。
宿主这一侧也在帮忙。按 Claude Code 的环境变量说明,工具搜索默认开启(ENABLE_TOOL_SEARCH),MCP 工具说明不会一次全部塞进上下文;单次工具输出超过 10,000 token 会出警告,默认上限 25,000 token(MAX_MCP_OUTPUT_TOKENS 可调)。这跟数据接口有直接关系:我们这次 5 页各 20 条的小红书搜索,原始返回在 35,538 到 51,999 字节之间,里面有图片地址、头像地址和翻页令牌这些对分析没用的长字符串。所以每天的任务最好让智能体在拿到结果后只留下要存的那几列,或者直接用 HTTP 接口在脚本里跑,结果写进文件,不经过模型的上下文。Anthropic 的《Code execution with MCP》讲的就是这种做法:让模型写代码去调工具,中间结果留在执行环境里,只把结论带回对话。
真调一:抹茶拿铁,三种排序和两种语言
下面是这篇文章的主要实测。所有请求都从新加坡发出,走 EveryInfra 的 HTTP 接口 POST /api/v1/social,平台 xiaohongshu,能力 search,关键词「抹茶拿铁」,只改排序、页码、时间范围和关键词语言。耗时是客户端测到的总时间,含网络往返;价格取每次返回里 billing.charged_usd 的值。前三行由我们的编辑同事在 16:33 先跑,后面几行是写这篇文章时跑的;两组用的是同一把测试 Key、同一个接口。
| 时刻(新加坡时间) | 排序 / 条件 | 页 | 条数 | 耗时 | 扣费 | 点赞中位数 | 30 天内的笔记 |
|---|---|---|---|---|---|---|---|
| 11-03 16:33:22 | most_liked | 1 | 20 | 3.91 秒 | $0.005556 | 1,427.5 | 0 |
| 11-03 16:33:26 | newest | 1 | 20 | 3.42 秒 | $0.005556 | 0 | 20 |
| 11-03 16:33:29 | most_liked,关键词改成 matcha latte | 1 | 20 | 3.52 秒 | $0.005556 | 1,011 | 1 |
| 11-03 16:40:40 | most_liked(重跑) | 1 | 20 | 4.26 秒 | $0.005556 | 1,513.5 | 2 |
| 11-03 16:41:08 | most_liked,用上一页的 page_token | 2 | 20 | 2.34 秒 | $0.005556 | 194.5 | 1 |
| 11-03 16:41:18 | most_liked + last_30_days | 1 | 1 | 9.45 秒 | $0.005556 | 1,857 | 1 |
请求本身很短。下面是 16:40:40 那一次的写法,返回体只保留了第一条笔记和计费字段;完整字段说明在小红书搜索能力页,第一次用的读者可以从接入文档的快速开始拿 Key。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search",
"params":{"keyword":"抹茶拿铁","sort":"most_liked"}}'{
"platform": "xiaohongshu", "action": "search", "count": 20,
"pagination": { "page": 1, "has_more": true },
"next_page_token": "pt1.…",
"results": [
{ "id": "69a509f400000000220335a9", "title": "这一杯乃星巴克真神",
"like_count": 16056, "collect_count": 2657, "comment_count": 6223,
"share_count": 3261, "posted_at": "2026-03-02T04:15:14+00:00",
"is_video": false, "is_cooperation_note": true }
],
"billing": { "charged": true, "charged_usd": 0.005556 }
}先看排序。最多赞和最新是两个完全不同的问题:16:33 的最多赞第 1 页点赞中位数 1,427.5、收藏中位数 747.5,20 条里没有一条是 30 天内发的,最老的一条发于 2025 年 5 月 28 日,按年龄分是 0 条在 30 天内、12 条在 30 到 179 天、5 条在 180 到 364 天、3 条超过一年;最新第 1 页的 20 条全部发在 11 月 2 日和 3 日,点赞中位数是 0。两页之间没有一条重合。如果智能体把这两页都存成「抹茶拿铁 前 20」,下游的人就没法分辨哪一页回答的是「什么最受欢迎」,哪一页回答的是「今天有人在说什么」。
再看关键词语言。英文词 matcha latte 按最多赞排,点赞中位数 1,011,20 条里 11 条是视频(中文词那页是 9 条),最老的一条发于 2023 年 3 月 18 日,超过一年的有 5 条;和中文词 16:33 那页有 4 条重合。这说明同一个话题,用中文词和英文词搜到的是两批有交集、但不一样的笔记;英文词这页里发布超过一年的有 5 条,中文词那页是 3 条。分流规则里写「关键词用该平台自己的语言」,就是为了不让智能体默认拿英文去搜中文平台。
第 2 页和时间范围也值得一看。用第 1 页返回的 next_page_token 翻到第 2 页,20 条和第 1 页没有重合,点赞中位数掉到 194.5,耗时 2.34 秒,是这次最快的一次;每翻一页算一次调用,单价不变。加上 date_range=last_30_days 以后,这一页只回来 1 条:10 月 9 日发的一篇,1,857 赞,耗时 9.45 秒,是这次最慢的一次。目录里对这个参数写得很直白:近 30 天这种窄范围,一页可能不足 20 条,想要满页就配 sort=newest;一条都没有的页不收费。这次回了 1 条,所以照常扣了 $0.005556。如果你的每天任务是「近 30 天最受欢迎的抹茶拿铁笔记」,更稳的写法是每天按最新排序翻几页、存下来,自己按点赞排,而不是每天请求一次「近 30 天 + 最多赞」。
九次同步调用的耗时中位数是 3.6 秒,最快 2.34 秒,最慢 9.45 秒。对每天跑一次的任务,这个速度足够;对要在一轮对话里连调十几次的智能体,可以在请求里加 "mode": "async",接口立刻返回一个任务编号,再用 everyinfra_get_job 或 GET /api/v1/jobs/{job_id} 取结果。返回体里的 async_hint 字段每次都会提醒这一点。
最后把 Monid 10 月 29 日在他们那边跑的结果放在旁边。他们用同一个关键词,在 Monid 的小红书工具页上选了 Monid 目录里两家不同的小红书笔记搜索接口,各跑了一次,又用英文词跑了一次。按他们的材料,当天那个工具页一共列了 49 个接口。下表的条数、耗时和结果全部照搬 Monid 给我们的材料,时间是美国太平洋时间;我们没有重跑这三次,也不拿它和我们的结果比高低:日期不同、排序参数不同,两边回答的不是同一个问题。
| 日期(Monid 在他们那边跑) | 接口 | 输入 | 条数 | 耗时 | 结果 |
|---|---|---|---|---|---|
| 2026-10-29 20:34 | 第一家的小红书笔记搜索 | 抹茶拿铁,最多赞,第 1 页 | 20 | 3.2 秒 | 点赞中位数 2,132,收藏中位数 1,571;没有一条在 30 天内,最老的超过三年半 |
| 2026-10-29 20:34 | 第二家的小红书笔记搜索 | 抹茶拿铁,排序 hot | 20 | 3.2 秒 | 点赞中位数 97;20 条里 5 条在 30 天内 |
| 2026-10-29 20:35 | 第一家的小红书笔记搜索 | matcha latte,最多赞 | 20 | 2.9 秒 | 点赞中位数 2,961,一半是视频 |
Monid 从这组结果里得出的结论,和我们的观察是同一个方向:排序方式必须跟着数据一起存。他们 10 月 29 日材料里的原话是(我们的中文译文):「同一个关键词、同一天、两家接口,回答的是两个不同的问题。把两页都记成『前 20』的智能体,就丢掉了唯一能让它们可比的东西。」同一份材料接着写到,两家接口给排序起的名字不同,返回的字段名也不同,所以一旦这件事变成每天的序列,智能体就需要一家接口、一种排序、一套字段,这时调用就该从路由搬到直连的那条线上。Monid 那边的完整做法见他们的小红书数据获取指南。
真调二:同一个请求跑 6 次,前 3 名出现 16 篇不同的笔记
这一节是这次实测里最出乎意料的结果。从 16:33 到 16:45(新加坡时间),完全相同的请求 {"keyword": "抹茶拿铁", "sort": "most_liked"}、第 1 页,一共跑了 6 次:16:33:22 一次;16:36 我们的编辑同事第一次试跑后面那段示例脚本,一次;16:40:40 一次;16:45 编辑同事又用示例脚本按中英西三个语言版本各跑了一次。示例脚本只打印前 3 条,所以 6 次能逐条对比的是前 3 名。6 次的前 3 名一共 18 个位置,出现了 16 篇不同的笔记:16,056 赞那篇在 16:33 和 16:40 都排第一,20,972 赞那篇在 16:36 排第三、在 16:45 的第一次排第一,其余 14 篇各只出现一次。把 6 次的前 3 名两两比较,一共 15 对,其中 13 对一篇都不重合,2 对各重合 1 篇。16:33 和 16:40 两次的完整 20 条,重合的只有 7 条。
先说清楚请求的是什么。目录里这个排序值写作「点赞最多(most_liked)」,EveryInfra 返回的是小红书搜索在那一刻按这个排序给出的第 1 页,不是把所有抹茶拿铁笔记拿来按点赞数全量排一遍的结果,所以第 1 页里不保证有全平台点赞最多的那几篇。6 次的原始返回正好说明了这一点:16:33 和 16:40 两页的第 1 名都是 16,056 赞,可 16:36 那次的第 1 名有 53,316 赞,16:45 三次的第 1 名分别是 20,972、22,440、21,468 赞,这几篇都不在 16:33 和 16:40 两次的完整 20 条里。16:45 那三次是在同一分钟里跑的,前 3 名也互不重合,可见几分钟、甚至一分钟之内,平台给出的第 1 页就会换一批。接口这一侧的东西则每次都一样:每次都是 HTTP 200,每次都回了 20 条,每次都扣了 $0.005556,字段名每次都落在目录 response_fields 列出的那一组里(有一两个字段只在有值时出现,比如笔记带了地点才有 poi_id)。
这件事对「每天的任务」有三条直接的影响。第一,固定的东西要分清:请求的样子、字段名、单价、错误格式是可以固定、也应该固定的;结果集合本身不可能固定,任何声称「每天同一个请求返回同样的前 20」的方案都不可信。第二,存数据时要把请求条件和时刻一起存:排序方式、页码、关键词、调用时刻,缺一个,过一周你就说不清这批数据回答的是什么问题。第三,想要稳定的榜单,就别依赖一次请求的前几名:每天多翻几页、按笔记 id 去重合并成一张自己的表,再按自己定义的规则(比如点赞数)排序,结果才是你能复现的。
拿这次的数据试一下第三条。16:33 和 16:40 两次的第 1 页各 20 条,按笔记 id 去重合并以后是 33 篇不同的笔记,比任何一次单独的第 1 页都多出 13 篇;再按点赞数自己排,16,056 赞那篇排第一,这个结果下次合并时还能算出来,不取决于平台下一分钟给出哪一页。每天存一行时,建议至少留下面这几列,示例值取自 16:40:40 那次返回的第 1 条。
| 列 | 从哪来 | 示例值(2026-11-03 16:40:40 新加坡时间) | 为什么要存 |
|---|---|---|---|
| 调用时刻 | 自己记 | 2026-11-03 16:40:40 | 同一个请求隔几分钟结果就不同,没有时刻就无法复现 |
| 关键词、排序、页码 | 请求参数 | 抹茶拿铁、most_liked、1 | 「点赞最多」和「最新」回答的是两个问题,要能分开 |
| 名次 | 结果里的顺序 | 1 | 看同一篇笔记在不同时刻的位置变化 |
| 笔记 id | id | 69a509f400000000220335a9 | 多次、多页合并时按它去重 |
| 互动数 | like_count、collect_count、comment_count | 16,056、2,657、6,223 | 自己定义排序规则时用 |
| 发布时间 | posted_at | 2026-03-02 | 区分「最近在说的」和「一直很热的」 |
| 是否合作笔记 | is_cooperation_note | true | 推广内容单独统计 |
| 扣费 | billing.charged_usd | 0.005556 | 月底对账 |
合并要多花多少钱,也能提前算出来。16:41 那次翻到的第 2 页和第 1 页一条都不重合,所以一个关键词每天跑第 1、2 页就能拿到 40 篇不同的笔记;如果上午、下午各跑一轮再合并,一个关键词一天是 4 次调用,按每次 $0.005556 算,一天约 $0.022,30 天约 $0.67。和「每天请求一次、直接拿前 20 当榜单」相比,多出来的钱买到的是一张能复现、能对比的表:哪篇笔记哪天进了前 40、点赞涨了多少,下周都还查得到。后面「算一笔账」一节按同样的单价,算了几种更常见的组合,包括多关键词、翻页、加评论和加抖音;每一种的花费都能在开工前写进预算表,不用等月底看账单才知道。
| 每天跑同一个请求时 | 这次实测里是否不变 | 依据(2026-11-03 新加坡时间) | 对你的存储和规则意味着什么 |
|---|---|---|---|
| 请求的样子(平台、能力、参数名) | 不变 | 9 次调用都是同一个 platform + action + params 结构 | 规则和脚本写一次就能一直用 |
| 字段名 | 不变 | 16:33 和 16:40 两次完整返回的字段都在目录列出的 30 个字段里 | 下游表结构可以提前建好 |
| 单价 | 不变 | 小红书 10 次搜索、1 次笔记详情、1 次评论,每次都扣 $0.005556 | 月账可以提前算 |
| 错误格式 | 不变 | 400 和 422 都带 code、allowed、next_steps | 重试和转向逻辑写一次 |
| 前 20 条是哪些笔记 | 会变 | 16:33 和 16:40 两次只重合 7/20 | 存的时候带上排序和时刻,按 id 去重合并 |
| 前 3 名 | 会变 | 6 次的 18 个位置里有 16 篇不同的笔记;两两比较的 15 对里 13 对不重合 | 稳定的榜单要靠自己多页合并后排序 |
真调三:笔记详情、评论和抖音
每天的任务很少只停在搜索。拿到一批笔记以后,通常还要看头部几篇的详情和评论,有时还要在另一个平台上用同一个词再搜一次。下面三次调用都在 16:41 到 16:42 之间(新加坡时间)完成,用的还是同一个接口、同一种请求形状,只换了 platform 和 action。
| 时刻(新加坡时间) | 能力 | 输入 | 条数 | 耗时 | 扣费 | 值得注意的字段 |
|---|---|---|---|---|---|---|
| 11-03 16:41:50 | xiaohongshu/note | 16,056 赞那篇的链接 | 1 | 2.55 秒 | $0.005556 | ip_location 为福建,is_cooperation_note 为 true,9 个标签 |
| 11-03 16:42:00 | xiaohongshu/comments | 同一篇,按最多赞排 | 15 | 3.60 秒 | $0.005556 | 最高一条 1,213 赞;15 条下面共有 650 条回复;has_more 为 true |
| 11-03 16:41:36 | douyin/search | 抹茶拿铁,最多赞 | 10 | 6.18 秒 | $0.008333 | 点赞中位数 6,179.5,最高一条 1,178,986 |
笔记详情给出了搜索结果里没有的几样东西:发布地的 ip_location、完整的标签列表 tags 和话题 topics,以及是否挂了商品的 has_goods。这次排在第一的那篇是一篇合作笔记(is_cooperation_note 为 true),推的是一个玫瑰风味的咖啡系列,正文介绍了三款,其中一款就是「玫瑰20抹茶拿铁」,还写了一句「抹茶佬完全会心水」;但标题里没有「抹茶」两个字,9 个标签里也没有,抹茶拿铁只是这个系列里的一款。这提醒做每天监测的人两件事:判断一篇笔记和关键词相不相关,要看正文,不能只看标题和标签;合作笔记最好单独统计,相关性按正文判断,不然一两篇推广就能把整周的平均点赞拉高。这些字段的完整说明在笔记详情能力页。
评论这一次回了 15 条一级评论,点赞从 1,213 到 3,每条带 sub_comment_count,15 条加起来下面挂着 650 条回复;返回的 has_more 为 true,用 next_page_token 能继续翻。这一页的 ip_location 全部为空,说明评论的属地不是每次都有,下游统计不要假设它一定存在。评论的字段里还有一个 author_is_ai_agent,这一页 15 条都是 false。想按评论做情绪或卖点分析的读者,可以看评论能力页,以及我们之前写的《用 Claude Code 动态工作流批量看小红书评论》。
抖音搜索一页是 10 条,单价每次 $0.008333,也就是每千次 $8.33,比小红书的每千次 $5.56 高一些,这是目录里两项能力各自的标价。10 条的点赞中位数是 6,179.5,最高一条超过 117 万,发布时间从 2025 年 2 月到 2026 年 9 月都有。字段名和小红书不完全一样:抖音多了 author_follower_count、music、hashtags 和 is_pinned,但 like_count、comment_count、share_count、posted_at 这些共有的字段名是一致的,跨平台合并时只需要处理各自多出来的几列。抖音数据接口页和抖音搜索能力页列了全部字段;TikTok 的对应能力在 TikTok 数据接口页。
示例脚本:每天的活和一次性的活写在一起
下面这段 Python 是两个服务一起用的最小示例,用 Requests 写成。前半段是每天的活:EveryInfra 的 xiaohongshu/search,一个固定的请求形状,打印前 3 条和这次的扣费。后半段是一次性的活:按域名取一家公司的 Logo,这不是每天要跑的平台数据,所以走 Monid,先 discover、再 inspect,价格在预算内才 run。两把 Key 都从环境变量读,脚本里没有任何 Key 的值。
import os

import requests

EVERYINFRA_API_KEY = os.environ["EVERYINFRA_API_KEY"]
MONID_API_KEY = os.environ["MONID_API_KEY"]
MONID = "https://api.monid.ai/v1"
MONID_HEADERS = {"Authorization": f"Bearer {MONID_API_KEY}"}
MAX_PRICE_USD = 0.01  # do not run a Monid tool that costs more than this per call

# 1. The daily job: EveryInfra xiaohongshu/search, one fixed request shape
resp = requests.post(
    "https://api.everyinfra.com/api/v1/social",
    headers={"Authorization": f"Bearer {EVERYINFRA_API_KEY}"},
    json={"platform": "xiaohongshu", "action": "search",
          "params": {"keyword": "抹茶拿铁", "sort": "most_liked"}},
    timeout=120,
)
resp.raise_for_status()
body = resp.json()
for note in body["results"][:3]:
    print(note["like_count"], note["collect_count"], note["posted_at"][:10], note["url"])
print("EveryInfra:", len(body["results"]), "notes, charged (USD):", body["billing"]["charged_usd"])

# 2. A one-off lookup that is not a daily platform: discover, inspect, run on Monid
found = requests.post(f"{MONID}/discover", headers=MONID_HEADERS, timeout=60,
                      json={"query": "company logo image URL from a domain", "limit": 3}).json()["results"]
# discover adds ranking and price fields to each result; inspect and run take only the fields that name the tool
SHOWN_ONLY = ("providerName", "description", "price", "score", "scoreBreakdown", "tags", "metrics", "hints")
tool = {key: value for key, value in found[0].items() if key not in SHOWN_ONLY}
detail = requests.post(f"{MONID}/inspect", headers=MONID_HEADERS, timeout=60, json=tool).json()
price = detail["price"]["amount"]["value"]
print("Monid tool:", detail["endpoint"], "price (USD):", price)
if price <= MAX_PRICE_USD:
    run = requests.post(f"{MONID}/run", headers=MONID_HEADERS, timeout=120,
                        json={**tool, "input": {"pathParams": {"company": "starbucks.com"}}}).json()
    print("Monid run:", run.get("runId"), run.get("status"), run.get("output"))
我们的编辑同事在 2026 年 11 月 3 日 16:36(新加坡时间)先试跑了一次这段脚本,16:45 又按三个语言版本各跑了一次,每次整段耗时 6.4 到 7.7 秒。EveryInfra 那一半每次回 20 条、扣 $0.005556,打印出来的前 3 名就是上一节点阵图里 16:36 和 16:45 那几行。
Monid 那一半,四次 discover 到的第一个结果都是一个按域名取公司 Logo 的接口;inspect 显示这个接口当时的单价是 $0,所以脚本照常 run 了,run 的状态是 COMPLETED,返回了一个 Logo 图片地址。脚本里的 MAX_PRICE_USD 是一条很朴素的护栏:discover 和 inspect 都免费,智能体可以先看价格,超过预算的工具就不 run,把决定交回给人。
Monid 自己 10 月 29 日的材料也提醒过一点(我们的中文转述):discover 是一个排序,不是保证;用「小红书笔记搜索」这样的能力短语去搜,排得会比较准,一句夹着专有名词的长口语,可能把和任务无关的接口排到前面,所以 run 之前先看排在前面的几个结果,这一步免费。分流规则里「先 discover、再 inspect、确认价格在预算内再 run」这几步,就是照这个意思写的。
算一笔账:每天的固定任务一个月多少钱
固定字段和固定单价最直接的好处是可以提前算账。下面按目录 2026 年 11 月 3 日的标价算一个小红书「抹茶拿铁」类监测任务的月账,每个月按 30 天,假设每次都扣费(实际上失败和一条都没有的页不扣,所以这是上限)。小红书除蒲公英内容广场榜以外的 16 项能力每次 $0.005556,抖音搜索每次 $0.008333,完整价目在价格页。
| 方案 | 每天的调用 | 每天花费 | 30 天花费 |
|---|---|---|---|
| A:3 个关键词,各看第 1 页 | 3 次 xiaohongshu/search | $0.0167 | $0.50 |
| B:3 个关键词,各翻 2 页 | 6 次 xiaohongshu/search | $0.0333 | $1.00 |
| C:B 再加每天前 5 篇的评论 | 6 次搜索 + 5 次 xiaohongshu/comments | $0.0611 | $1.83 |
| D:C 再加抖音同 3 个词 | 上面 11 次 + 3 次 douyin/search | $0.0861 | $2.58 |
这几行数字本身不大,重要的是它们是可以提前写进预算表的:请求不变、单价不变,月底的账就不会因为这个月模型挑了另一个接口而变。长尾那一侧的账是另一种算法:每次 run 前 inspect 一下价格,按次记账,月底按实际发生的汇总。两种账放在一起看,每天的部分是固定的一行,长尾的部分是一串明细,财务和工程都容易对。本文列出的扣费调用一共 13 次、合计 $0.075005:写稿时我们自己跑的 6 次 $0.036113,编辑同事跑的 7 次(16:33 三次、16:36 一次、16:45 三次)$0.038892。
边界:这套分工管什么,不管什么
分流规则解决的是「调用该去哪」,不解决「数据该不该拿」。小红书的用户服务协议和隐私政策对平台内容和用户信息的使用都有约定;在中国境内处理个人信息,还要符合《个人信息保护法》和 2025 年 1 月 1 日起施行的《网络数据安全管理条例》。落到每天的任务上,最实用的做法是只存分析要用的列:笔记 id、标题、互动数、发布时间、排序条件和调用时刻通常就够了,作者昵称、头像、评论人的主页这些个人信息,不需要就别存,需要时也要有明确的用途和保存期限。
规则本身也有边界。第一,名单会过期:目录每天都可能变,规则里写死的 106 个平台过几周就可能不准,所以要么开工时刷新,要么依赖 unknown_capability 那条兜底。第二,限流照常存在:EveryInfra 每把 Key 有每分钟的请求上限,超了会回 429,按 RFC 6585 的语义等一会再试,不要让智能体在 429 上原地重试。第三,鉴权方式不同:EveryInfra 用 API Key;按 Monid MCP 接入指南(2026-11-03 读),Monid 的远程 MCP 用 OAuth 登录,远程 MCP 服务的授权流程由 MCP 规范的授权一节定义。团队共用配置时,Key 一律放环境变量,不要写进提交到仓库的 .mcp.json。
最后一条边界和模型有关。工具接得再好,模型照样可能挑错、拼错参数。MCP-Universe 用真实 MCP 服务器测试模型,最好的 GPT-5 成功率也只有 43.72%;MCP-Bench 用 28 个服务器、250 个工具搭了一套更接近真实工作的任务,把跨工具、多步骤的调用单独拿出来评测。所以本文的规则写得很「笨」:名单明确列出、错误码明确区分、价格先看再付,尽量让模型少做需要猜的判断。我们在《Claude 严格工具调用和数据接口》里也讲过另一个办法:用严格的参数结构让模型拼不出非法参数。
最近的变化
工具调用这件事这两个月变化很快。下面几条都在 2026 年 7 月以后,前面是日期和事实,后面一列写它对「每天走数据接口、长尾走路由」这套分工意味着什么。
| 日期 | 发生了什么 | 对读者意味着什么 |
|---|---|---|
| 2026-07-28 | MCP 发布新版规范:核心改为无状态,请求带 Mcp-Method 和 Mcp-Name 头,tools/list 加了缓存提示并要求顺序确定,授权部分补了 RFC 9207 和客户端元数据文档 | 两个远程服务挂在一起更省连接;工具列表可缓存,模型每轮读到的工具说明更稳定 |
| 2026-10-06 | The Hacker News 发文分析了 15,465 个公开的 MCP 服务器 | 可挂的服务越来越多,「挑哪几个常驻」比「能不能接」更重要 |
| 2026-10-16 | Semafor 报道一家对标 OpenRouter 的模型路由公司 TrustedRouter 完成种子轮 | 「一个 Key 管很多后端」的路由形态在模型层持续被看好,工具层的同类产品值得跟进 |
| 2026-10-19 | 小红书开放平台公告下线类目预测接口 | 官方开放平台继续聚焦店铺和电商,公开内容数据仍要靠别的方式取 |
| 2026-10-21 | Bloomberg 介绍它推动的 Skills over MCP 提案(SEP-2640);同一天 Stripe 发布面向智能体的 Treasury,经 MCP 使用 | 技能文件和 MCP 正在合流,挑服务时可以顺带看它有没有技能文件这类接入方式 |
| 2026-10-22 | Anthropic 发文讨论何时把子代理并回主循环 | 少量轻量数据工具放主循环通常更快更准,两个服务挂在一个智能体里是合理默认 |
| 2026-10-30 | MCP 官方博客宣布 Ruby SDK 进入 Tier 1 | 更多语言能稳定地写 MCP 客户端,自己的宿主程序也能同时挂两个服务 |
常见问题
小红书有官方的笔记搜索 API 吗?
截至 2026 年 11 月 3 日,小红书开放平台主要面向店铺和电商 ERP 类应用,提供订单、商品、售后这类接口,2026 年 10 月 19 日还发公告下线了一个类目预测接口;公开笔记的搜索、详情和评论不在开放范围里。EveryInfra 的 xiaohongshu/search 每次 $0.005556,详见小红书数据接口页。
平台不在 EveryInfra 的名单里,调用会扣钱吗?
不会。平台不在名单里回 HTTP 400 unknown_capability,参数写错回 HTTP 422 并给出 did_you_mean,两种都不扣费,实测见上文「分流规则改一处」一节(2026-11-03 16:40–16:41 新加坡时间)。
一个智能体挂多少个工具合适?
没有硬性的数。RAG-MCP 报告工具多了以后先检索再选,选择准确率从 13.62% 提到 43.13%;r/mcp 上那位挂了 680 多个工具的开发者的经验是过了 30 到 60 个就明显变差。子代理和主循环怎么分,见《用 Claude Code 子代理批量看 TikTok 账号》。
参考资料
- EveryInfra 数据能力目录
GET /api/v1/social/catalog,EveryInfra,2026-11-03 16:32 新加坡时间读取。 - Architecture overview,Model Context Protocol 官方文档,2026-11-03 读取。
- MCP 2026-07-28 版规范发布说明,MCP 官方博客,2026-07-28。
- Specification: Tools,MCP 规范 2026-07-28 版。
- Specification: Authorization,MCP 规范 2026-07-28 版。
- Specification: Transports,MCP 规范 2026-07-28 版。
- MCP Ruby SDK 进入 Tier 1,MCP 官方博客,2026-10-30。
- MCP Registry,MCP 官方注册表,2026-11-03 读取。
- JSON-RPC 2.0 Specification,JSON-RPC 工作组。
- Connect Claude Code to tools via MCP,Claude Code 官方文档,2026-11-03 读取。
- MCP quickstart,Claude Code 官方文档,2026-11-03 读取。
- Environment variables,Claude Code 官方文档,2026-11-03 读取。
- Model Context Protocol,Cursor 官方文档,2026-11-03 读取。
- Model Context Protocol,OpenAI Codex 官方文档,2026-11-03 读取。
- Use MCP servers in VS Code,VS Code 官方文档,2026-11-03 读取。
- MCP servers with Gemini CLI,Gemini CLI 官方文档,2026-11-03 读取。
- Connectors and MCP servers,OpenAI 平台文档,2026-11-03 读取。
- Quickstart,OpenRouter 官方文档,2026-11-03 读取。
- FAQ,OpenRouter 官方文档,2026-11-03 读取。
- Writing effective tools for agents,Anthropic Engineering。
- Introducing advanced tool use,Anthropic Engineering。
- Code execution with MCP,Anthropic Engineering。
- Building agents: When to fold subagents into your main agent loop,Anthropic,2026-10-22。
- RAG-MCP: Mitigating Prompt Bloat in LLM Tool Selection via Retrieval-Augmented Generation,arXiv:2505.03275。
- ToolLLM: Facilitating Large Language Models to Master 16000+ Real-world APIs,arXiv:2307.16789。
- Gorilla: Large Language Model Connected with Massive APIs,arXiv:2305.15334。
- MCP-Universe: Benchmarking Large Language Models with Real-World Model Context Protocol Servers,arXiv:2508.14704。
- MCP-Bench: Benchmarking Tool-Using LLM Agents with Complex Real-World Tasks via MCP Servers,arXiv:2508.20453。
- RFC 9110: HTTP Semantics,IETF。
- RFC 6585: Additional HTTP Status Codes,IETF。
- RFC 9457: Problem Details for HTTP APIs,IETF。
- RFC 9728: OAuth 2.0 Protected Resource Metadata,IETF。
- RFC 8707: Resource Indicators for OAuth 2.0,IETF。
- RFC 9207: OAuth 2.0 Authorization Server Issuer Identification,IETF。
- The OAuth 2.1 Authorization Framework(草案 13),IETF。
- Skills over MCP: How Bloomberg helped standardize agent skills at scale,Bloomberg,2026-10-21。
- Treasury for agents,Stripe Newsroom,2026-10-21。
- 对 15,465 个公开 MCP 服务器的分析,The Hacker News,2026-10-06。
- 关于 Pi 智能体、MCP 与代码模式的报道,The New Stack。
- MCP Server and SI Agent Government Hackathon,美国总务管理局,2026 年 9–11 月。
- OpenRouter 竞争者完成种子轮的报道,Semafor,2026-10-16。
- 58 个 MCP 服务器、680 多个工具的使用经验帖,Reddit r/mcp。
- Requests: Quickstart,Requests 官方文档。
- 小红书用户服务协议,小红书,2026-11-03 读取。
- 小红书隐私政策,小红书,2026-11-03 读取。
- 小红书开放平台,小红书,2026-11-03 读取(含 2026-10-19 公告)。
- 中华人民共和国个人信息保护法,国家互联网信息办公室。
- 网络数据安全管理条例,国务院,2024 年 9 月公布,2025-01-01 起施行。
- 小红书 AI 相关报道,虎嗅,2026-10-16。
- Monid 首页,2026-11-03 读取(「Live · 2800+ tools」「Start with $1 in free credit」),见正文链接。
- Monid:The OpenRouter for agent tools,定位页,2026-11-03 读取,见正文链接。
- Monid:MCP quickstart,接入文档,2026-11-03 读取,见正文链接。
- Monid:小红书工具页,2026-10-29 列出 49 个接口,见正文链接。
- Monid:How to get Xiaohongshu (RedNote) data through an API,指南,2026-11-03 读取,见正文链接。
引用编号 BL-78