Threads API 实测:官方能读什么,公开回复怎么拿
官方 Threads API 没过审只能搜自己的帖子,帖子里也没有点赞数。我们用 Python 在三个时刻真调搜索、详情、回复和主页,附脚本和每千行成本。
Meta 官方的 Threads API 主要是给账号管理自己内容用的:没过审的应用调关键词搜索只会搜到自己的帖子,读别人的主页和帖子要先拿到高级权限,官方帖子对象里也没有点赞数和回复数字段。我们在 2026 年 11 月 13 日 22:31、23:00 和 11 月 14 日 00:24(新加坡时间)三个时刻,用 Python 按次调用 EveryInfra 的 Threads 能力,把「搜索 → 帖子 → 回复 → 作者主页」这条链各跑了一遍。第三轮的完整脚本一次 4 次调用花 $0.002446,返回 82 行,折合每 1,000 行 $0.0298。搜「threads api」返回的 50 条帖子里,没有一条在讲 Threads API;隔半小时再搜一次,50 条里一条都不重复,所以要多次搜索、去重,再按正文过滤。
三条路对照表:官方 Threads API、自己写 threads scraper、第三方数据接口
想用程序读 Threads 上的公开帖子和回复,2026 年 11 月能走的路有三条。EveryInfra 的价格来自 11 月 13 日的公开目录,扣费以真调响应里的 charged_usd 为准。
| 路 | 能读什么(官方文档、开源仓库或真调里确认过的) | 前提 | 钱 | 要注意的地方 |
|---|---|---|---|---|
| 官方 Threads API | 自己账号的帖子、回复、insights;过审后可按关键词搜公开帖子、按用户名读粉丝 ≥100 的公开账号 | Meta 开发者应用、OAuth 用户令牌;读别人要高级权限,企业应用要先转 Tech Provider | 不按次收费,24 小时 4,800 × 曝光数次调用 | 没过审时关键词搜索只搜自己;帖子对象没有点赞数和回复数字段 |
| 自己写爬虫(threads scraper) | 网页上公开显示的内容 | 自己维护请求、解析和出口 IP | 代码免费,代理和维护时间另算 | 改版就要改代码 |
| 第三方数据接口(本文用 EveryInfra) | 公开帖子搜索、账号帖子、单帖详情、公开回复、主页、发现账号 | 一个 API Key;不登录任何 Threads 账号 | 搜索每次 $0.000778,其余每次 $0.000556;失败和空结果不扣 | 只返回公开可见的内容 |
| 三条路都适用 | Threads 使用条款第 3(a)(iv) 项、Meta 服务条款第 3.2 条对自动化收集的限制,以及 robots.txt 对未列名爬虫的 Disallow: / | 使用前自己核对条款和所在地法规 | — | 原文见下文「Meta 条款」一节 |
管理自己的品牌账号、发帖、看自己帖子的浏览数,只有官方 API 能做。读别人的公开帖子和回复,官方路要先过权限审核;第三方数据接口要一个 Key,同样受上表最后一行那几份文件约束。
Threads API 能读什么:官方文档逐条核对
Meta 给 Threads API 的总述写得很直白:这套接口用来让人「代表某个人在 Threads 上发帖」,并且把这些帖子「只展示给发帖的那个人」(Threads API overview,2025-12-22 更新)。读的能力是围着「自己的账号」搭起来的:GET /me/threads 拿自己的帖子,GET /{media-id}/replies 读自己帖子下的回复,insights 看自己的数据。2026 年 11 月 13 日我们把文档目录里和「读」有关的页面逐页打开过一遍,结果如下。
| 想读的东西 | 官方端点 | 需要的权限 | 不申请高级权限时能读到什么 | 次数上限 |
|---|---|---|---|---|
| 自己账号的帖子 | GET /{user-id}/threads | threads_basic | 只能读授权给你的那个账号 | 按应用调用量算:24 小时内 4,800 × 曝光数 |
| 某个公开账号的帖子 | GET /profile_posts?username= | threads_basic + threads_profile_discovery | 只能查 Meta 的部分官方账号,文档举的例子是 @meta、@threads、@instagram、@facebook | 每个用户 24 小时 1,000 次;只返回粉丝 ≥100 的公开账号 |
| 某个公开账号的主页 | GET /profile_lookup?username= | 同上 | 同上 | 同上 |
| 按关键词或话题搜帖子 | GET /keyword_search | threads_basic + threads_keyword_search | 只在你自己发过的帖子里搜 | 每个用户 24 小时 2,200 次,跨应用合计 |
| 单条帖子 | GET /{media-id} | threads_basic | 只能读 Threads 测试员发的帖子 | 同第一行 |
| 帖子下的回复 | GET /{media-id}/replies、/conversation | threads_basic + threads_read_replies | 管理的是你自己帖子的回复 | 同第一行 |
| 别人 @ 你的帖子 | GET /{user-id}/mentions | threads_manage_mentions | 只返回测试员发的 | 同第一行 |
| 热门话题和话题下的帖子 | GET /trending_topics、/{trend-id}/posts | 应用访问令牌 + Trending Topics 功能 | 只能列话题,读帖子要高级权限;只有美国和日本 | 话题最多每小时变一次 |
表里的出处依次是:Retrieve user posts(2026-04-14 更新)、Threads profiles、Keyword and topic tag search(2026-01-21 更新)、Retrieve media replies and conversations、Mentions、Trending topics。调用量公式在 overview 页:「Calls within 24 hours = 4800 * Number of Impressions」,曝光数低于 10 按 10 算,所以一个新账号的应用每天至少有 48,000 次调用额度;读别人的内容要先过权限审核。
从这张表能读出一个规律:每一种「读别人」的能力,官方都另设了一个权限,而且不申请高级权限(Advanced Access)时,这个权限只对你自己、你的测试员或者 Meta 的几个官方账号生效。按 Access Levels(2026-06-30 更新)的写法,标准权限只能向「在应用上有角色的人」申请,高级权限要先过 Business Verification,有的还要单独过 App Review。所以「threads api 能不能读别人的帖子」这个问题,答案取决于你的应用有没有拿到这几个权限的高级权限,文档本身没有给出「个人开发者读公开帖子」的通道。
permalink 字段在帖子含版权内容或被标记侵权时会被省略,owner 字段只在你自己的顶层帖子上出现。公开账号的帖子列表和主页查询都写了「只返回粉丝不少于 100 的公开账号」,这个门槛是 2025 年 11 月 20 日从 1,000 降到 100 的(Threads Changelog)。粉丝不到 100 的小账号,官方这条路读不到。
Threads API keyword search:过审之前只能搜到自己
联想词里有「threads api keyword search」和「threads api search」(2026-11-13 读取)。文档原文是:「If your app has not been approved for the threads_keyword_search permission, the search is performed only on posts owned by the authenticated user. After approval, public posts are searchable.」也就是说,没过审的应用调 /keyword_search,返回的只会是你自己账号发过的帖子。
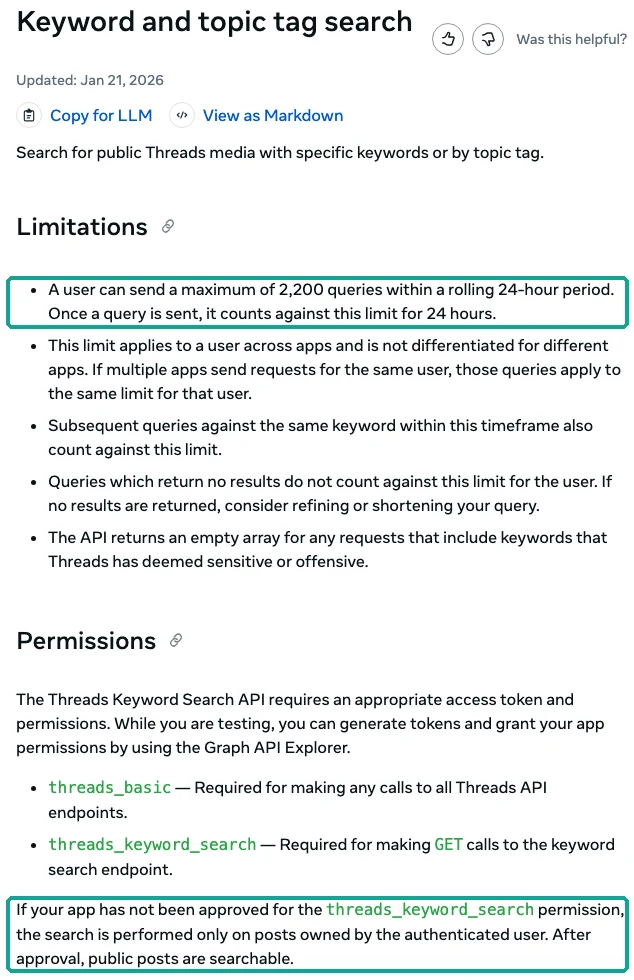
Meta 开发者社区里能找到几个开发者把这件事测出来的原帖。一位开发者在 Threads keyword_search returns only my own posts 里写,他用 q=tarot、search_type=RECENT、limit=100 调了一次,HTTP 200,返回的 100 条全部来自他自己的账号。另一个帖子 How can a self-use Threads app get public keyword search approval 记录了 2026 年 10 月 21 日 00:38(日本时间)的 6 次搜索,关键词是三个日文常见词,全部返回空数组;同一份令牌读自己的主页、自己的帖子都正常,控制台上 threads_keyword_search 的状态是「Ready for testing」,不是「已通过审核」。还有一个帖子 returns the same post and repeats the same pagination cursor 说,带着返回的 after 游标翻页,拿到的还是同一条自己的帖子和同一个游标。
想把它从「只搜自己」变成「搜公开帖子」,要走 App Review。几个原帖都提到同一个卡点:点「Add to App Review」时,控制台要求先把企业转成 Tech Provider,并提示这个选择不能撤回(first-party brand app 的提问、内部业务应用的提问)。Meta 的 Tech Providers 文档把 Tech Provider 定义为「为了给其他企业提供服务、需要访问其他企业数据的企业」,并把 threads_basic、threads_keyword_search、threads_read_replies 等 7 个 Threads 权限都列进了「不是 Tech Provider 就不能授予」的名单。只服务自己品牌的团队,要么转成 Tech Provider,要么只让有应用角色的人使用。我们读到的这几个原帖,截至 11 月 13 日都没有 Meta 员工给出另一条路。
过了审以后,限额是每个用户 24 小时 2,200 次查询,同一个关键词重复查也算次数,返回空结果的查询不算;被 Threads 判定为敏感或冒犯的关键词一律返回空数组。参数方面,search_type 有 TOP 和 RECENT 两种排序,search_mode=TAG 按话题标签搜,media_type 可以只要文字、图片或视频,since、until 最早只能到 1688540400(2023 年 7 月 5 日,Threads 上线前后),limit 默认 25、最多 100,2026 年 1 月 20 日起还能用 author_username 只看某个账号。返回字段里不会有 owner。
一条 Threads 帖子里有哪些字段:官方和按次付费接口对照
官方 Threads API 的帖子对象里没有点赞数、回复数、浏览数这类字段。Retrieve user posts 页列出的 27 个媒体字段(含默认返回的 id),从 id、text、timestamp 到 poll_attachment、ghost_post_status,没有一个是计数;关键词搜索页给的示例请求也只要了 id,text,media_type,permalink,timestamp,username,has_replies,is_quote_post,is_reply。计数在另一个端点 /{threads-media-id}/insights 里,而 Insights 文档第一句就写明它读的是「users' own Threads posts and profiles」,也就是授权给你的那个账号自己的帖子,要 threads_manage_insights 权限。
这意味着即使应用拿到了关键词搜索和主页发现的高级权限,用官方 API 搜出来的别人的帖子,也没法按点赞数或回复数排序,只能看到正文、时间和有没有回复(has_replies)。官方唯一能看到别人热度的地方是 profile_lookup:它给出某个公开账号过去 7 天所有帖子加起来的点赞、引用、转发、浏览总数,是账号级的合计,不是单帖数据(Threads profiles)。
| 想要的信息 | 官方 Threads API | EveryInfra 的 Threads 能力(目录里的 response_fields) |
|---|---|---|
| 帖子 ID、正文、发布时间、链接 | id、text、timestamp、permalink(含版权内容时省略) | id、text、posted_at、url |
| 作者 | username;owner 只在你自己的顶层帖子上有 | author_username、author_name、author_id、author_is_verified |
| 别人帖子的点赞、回复数 | 没有字段;insights 只读自己的帖子 | like_count、comment_count(search、user_posts、post_detail) |
| 浏览、转发、引用、分享 | 只在自己帖子的 insights 里 | view_count、repost_count、quote_count、share_count(目录里 user_posts 和 post_detail 都列了) |
| 回复的树结构 | has_replies、root_post、replied_to、is_reply、hide_status | reply_to、author_name;目录没有写明能否带出嵌套回复,本次没有单独实测 |
| 话题、提及、链接 | topic_tag、link_attachment_url | hashtags、mentions、links |
| 账号主页 | profile_lookup:粉丝数和过去 7 天的互动总数 | threads/profile:follower_count、bio、is_private、external_url |
| 付费合作标记 | 文档未列 | is_paid_partnership(post_detail) |
右栏字段取自 2026-11-13 21:30(新加坡时间)读取的 EveryInfra 公开目录,每个能力都有自己的 response_fields 列表,表里只列出现过的字段名。两边都有的是 ID、正文、时间、作者;差别集中在计数和回复结构上。官方的回复结构字段更完整(能分清直接回复和嵌套回复、能看隐藏状态),按次付费接口的优势是能读别人帖子的计数。要按回复数给别人的帖子排序,只能用带计数字段的接口。
Threads API 更新日志:89 条里读取类 20 条,每加一项都配了新权限
为了判断官方 API 的读取能力会不会很快放开,我们把 Threads Changelog 截至 2026 年 11 月 13 日的全部 89 条记录(最早一条是 2024 年 4 月 8 日,早于 2024 年 6 月 18 日向所有开发者开放)逐条分了类:读取和发现(搜索、主页、回复读取、读取端点的新字段)、发帖和回复、洞察和 webhook、广告、令牌和其他。分类规则是每个日期下的每一条算一条,按标题和第一句人工判断。
| 类别 | 条数 | 第一条 | 最近一条 | 最近 12 个月(2025-11-13 到 2026-11-13) |
|---|---|---|---|---|
| 发帖(发帖、回复、引用、转发、帖子格式) | 31 | 2024-05-02 | 2026-03-25 | 9 |
| 读取(检索、搜索、提及、主页、读回复、读取端点新增字段) | 20 | 2024-04-18 | 2026-03-03 | 4 |
| 其他(令牌、域名、文档、调试) | 16 | 2024-04-08 | 2026-08-18 | 2 |
| 洞察和 webhook | 14 | 2024-04-26 | 2026-01-30 | 2 |
| Threads 广告 | 8 | 2025-08-15 | 2026-04-21 | 4 |
| 合计 | 89 | — | — | 21 |
读取类的 20 条里,影响最大的是 2024 年 12 月 9 日加的关键词搜索和提及列表、2025 年 7 月 14 日加的按用户名读主页和帖子(同一天还加了话题标签搜索和时间过滤)、2025 年 11 月 20 日把主页发现的粉丝门槛从 1,000 降到 100,以及 2026 年 1 月 20 日关键词搜索加的 author_username。最后一条读取类条目是 2026 年 3 月 3 日,内容是 oEmbed 嵌入接口不再需要访问令牌;2026 年 8 月 18 日之后,更新日志没有任何新条目,到 11 月 13 日已经快三个月。
读取类排第二,少于发帖类的 31 条,多于洞察类的 14 条和广告类的 8 条;读取别人内容的能力在加,但每一项都配了新的权限和审核。最近一条读取类更新是 2026 年 3 月 3 日,此后 8 个月没有新的读取能力。回复审批一条归在发帖类。
threads api python 实测:一条链,三个时刻
我们在三个时刻调了 EveryInfra 的 Threads 能力(新加坡时间):第一轮 11 月 13 日 22:31 到 22:46,第二轮 23:00 到 23:07,第三轮 11 月 14 日 00:24 到 00:31。每一轮都走同一条链:用 threads/search 搜关键词「threads api」,取回复最多的帖子,用 threads/post_detail 读详情,用 threads/comments 读回复,用 threads/profile 读作者主页。为了看同一条帖子在不同时刻的变化,每一轮还固定读两条新闻帖的详情:一条是纽约时报(@nytimes)11 月 12 日关于微软服务中断的帖子,一条是 BBC 中文(@bbcchinese)11 月 11 日关于一名英国公务员身兼五职的帖子。
下面是完整脚本,只依赖 requests,Key 从环境变量读。它在 11 月 14 日 00:29:59 到 00:31:14 真跑过一次,输出贴在代码后面。
"""Threads 公开数据一条链:关键词搜索 → 帖子详情 → 回复 → 作者主页。
用法:EVERYINFRA_API_KEY=... python3 threads_chain.py "关键词" [输出目录]
只依赖 requests;Key 只从环境变量读。"""
import csv, json, os, sys, time
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
S = requests.Session()
S.headers.update({"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
spent = 0.0


def call(action, **params):
    """调 threads/<action>,最多试三次;429 等 60 秒,可重试的 503 按 retry_after 等。"""
    global spent
    for _ in range(3):
        r = S.post(API, json={"platform": "threads", "action": action, "params": params}, timeout=180)
        body = r.json()
        if r.status_code == 429:
            time.sleep(60); continue
        if r.status_code == 503 and body.get("error", {}).get("retryable"):
            time.sleep(min(body["error"].get("retry_after", 60), 300)); continue
        break
    spent += (body.get("billing") or {}).get("charged_usd") or 0
    if r.status_code != 200:
        raise RuntimeError(f"threads/{action} {r.status_code}: {body.get('error', {}).get('message')}")
    return body


def full_link(post):
    """帖子完整链接 https://www.threads.com/@用户名/post/短码,读详情用。"""
    code = post["url"].rstrip("/").split("/")[-1]
    return f"https://www.threads.com/@{post['author_username']}/post/{code}"


def main(keyword, out="."):
    posts = call("search", keyword=keyword, limit=50)["results"]
    print(f"search: {len(posts)} 条")
    top = max(posts, key=lambda p: p.get("comment_count") or 0)   # 回复最多的那条
    detail = call("post_detail", url=full_link(top))["results"]
    detail = detail[0] if isinstance(detail, list) else detail
    replies = call("comments", url=top["url"])["results"]   # 短链原样传
    author = call("profile", username=top["author_username"])["results"]
    author = author[0] if isinstance(author, list) else author
    print(f"post_detail: like={detail.get('like_count')} reply={detail.get('comment_count')}")
    print(f"comments: {len(replies)} 条;profile: follower_count={author.get('follower_count')}")
    with open(os.path.join(out, "posts.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["id", "url", "posted_at", "like_count", "comment_count", "author_username", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(posts)
    with open(os.path.join(out, "replies.csv"), "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, ["id", "posted_at", "like_count", "comment_count", "reply_to", "author_name", "text"], extrasaction="ignore")
        w.writeheader(); w.writerows(replies)
    rows = len(posts) + 1 + len(replies) + 1
    print(f"合计 {rows} 行,花费 ${spent:.6f},每 1,000 行 ${spent / rows * 1000:.4f}")


if __name__ == "__main__":
main(sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else ".")search: 50 条
post_detail: like=10298 reply=797
comments: 30 条;profile: follower_count=112
合计 82 行,花费 $0.002446,每 1,000 行 $0.0298这次运行搜出 50 条帖子,回复最多的一条在详情接口里是 797 条回复、10,298 个赞;回复接口本次返回 30 条,每条都带 reply_to 和 author_name;作者主页显示这个账号有 112 个粉丝。四次调用一共扣 $0.002446(搜索 $0.000778,另外三次各 $0.000556),按 82 行算每 1,000 行 $0.0298。
同一条帖子在一分半钟后的英文版脚本里又被选中(00:31:25 开始):search 那一行从 10,298 个赞、797 条回复变成 10,311 个赞、799 条回复,详情接口给出 10,315 个赞、799 条回复,几个数在同一次运行里也会差几个赞。热门帖子的计数一直在动,存数据时要把读取时间和计数存在同一行。这条帖子的作者只有 112 个粉丝;前一晚 23:05 那次脚本选中的帖子(1,838 条回复)作者只有 7 个粉丝。按回复数选出来的「最热」帖子,两次都来自粉丝很少的账号;只看这两个样本,粉丝少的账号也会出现单帖几百上千条回复,按粉丝数筛账号会漏掉这类帖子。这一轮 50 条搜索结果里,26 条的回复数是 0,回复数前三是 797、763、173。
| 轮次(新加坡时间) | search 返回 | 和之前搜索相同的帖子 | 纽约时报那条:点赞 / 回复数 | BBC 中文那条:点赞 / 回复数 | 本轮扣费 |
|---|---|---|---|---|---|
| 第一轮 11-13 22:31–22:46 | 50 条 | 22:31:06 和 22:31:40 两次之间 47 条 | 216 / 18 | 864 / 35 | $0.009340 |
| 第二轮 11-13 23:00–23:07(不含 23:05 那次脚本) | 50 条 | 0 条(和 22:31 那两次比) | 215 / 19 | 864 / 35 | $0.007116 |
| 第三轮 11-14 00:24–00:31(搜索、两条新闻帖、脚本) | 44 条 | 0 条(和 11-13 的五次搜索比) | 216 / 19 | 864 / 35 | $0.005448 |
两条新闻帖在三个时刻的计数几乎没动:纽约时报那条的回复数从 18 涨到 19,点赞在 215 和 216 之间;BBC 中文那条三次都是 864 赞、35 条回复。这两条帖子发出一两天后,计数在两个小时里基本没动。第三轮按下面的推荐做法读了这两条帖子的回复,本次分别返回 17 条和 28 条:纽约时报那条的 17 条都是直接回复帖子的,BBC 中文那条的 28 条里 22 条直接回复帖子、6 条回的是别的回复者。这一轮四次新闻帖调用每次 6.7 到 25.2 秒,详情两次都在 8 秒以内,回复两次都在 20 秒以上。
第一,读回复和读详情的链接写法。推荐做法是:读回复时把 search 返回的帖子链接(https://threads.com/t/<短码>)原样传给 threads/comments;读单帖详情时用完整帖子链接 https://www.threads.com/@用户名/post/<短码>,目录对 post_detail 参数的说明就是这种写法。脚本里的 full_link() 用 author_username 和短码拼出完整链接,只给详情用。11 月 14 日 00:24 到 00:27 我们按这个做法读了三个机构账号各一条帖子的回复:纽约时报 11 月 11 日一条、BBC 中文 11 月 12 日一条、CNN en Español 11 月 13 日一条,本次分别返回 30、30、9 条,每条带 reply_to(被回复的账号名)和 author_name。reply_to 能看出回复的层级:纽约时报那条的 30 条里 28 条回的是 @nytimes,另外 2 条回的是别的回复者;BBC 中文那条的 30 条里 25 条回的是 @bbcchinese,5 条回的是别的回复者。所以返回结果里既有直接回复,也有一部分回复下面的回复,做统计时可以按 reply_to 是否等于帖子作者把两类分开。
| 帖子(11-14 新加坡时间读取) | 本次返回 | `reply_to` 是帖子作者 | `reply_to` 是别的回复者 |
|---|---|---|---|
| 纽约时报 11 月 11 日那条(00:24) | 30 | 28 | 2 |
| BBC 中文 11 月 12 日那条(00:25) | 30 | 25 | 5 |
| CNN en Español 11 月 13 日那条(00:27) | 9 | 9 | 0 |
| 纽约时报 11 月 12 日那条(00:28,第三轮) | 17 | 17 | 0 |
| BBC 中文 11 月 11 日那条(00:29,第三轮) | 28 | 22 | 6 |
第二,没有翻页游标,同一个关键词每次搜到的帖子变化很大。threads/search 只有 keyword 一个参数,limit 最多 50,目录也写明 search 不支持按日期筛选。我们在 22:31:06 和 22:31:40 连搜两次,47 条相同;23:00 那次和 22:31 那两次一条都不重合;23:05 脚本那次和 23:00 那次有 11 条相同;11 月 14 日 00:24 那次的 44 条,和前一晚五次搜索一条都不重合。重合多少和两次搜索的间隔有关:11 月 14 日 00:29:59 和 00:31:25 两次相隔一分半钟,50 条里 43 条相同;00:24 和 00:29 相隔约 6 分钟,28 条相同;00:24 和 00:31 相隔约 7 分钟,21 条相同;前一晚 23:00 和 23:05 相隔 5 分钟,11 条相同;相隔一小时以上的任意两次,重合都是 0 条。
| 两次搜索(新加坡时间) | 间隔 | 相同的帖子 |
|---|---|---|
| 11-13 22:31:06 和 22:31:40 | 34 秒 | 47 条 |
| 11-14 00:29:59 和 00:31:25 | 一分半钟 | 43 条 |
| 11-14 00:24:07 和 00:29:59 | 约 6 分钟 | 28 条 |
| 11-14 00:24:07 和 00:31:25 | 约 7 分钟 | 21 条 |
| 11-13 23:00:13 和 23:05:32 | 约 5 分钟 | 11 条 |
| 相隔一小时以上的任意两次 | 一小时以上 | 0 条 |
也就是说,几分钟内连搜拿到的大多是同一批帖子,想拿到更多帖子,办法是隔一段时间(本次的数据是一小时左右)重复搜,再按 id 去重合并。我们 8 次搜索(含一次加引号的对照)累计拿到 224 条不同的帖子,搜索部分一共扣 $0.006224,每 1,000 条不同帖子约 $0.0278($0.006224 ÷ 224 × 1,000)。
第三,关键词是按词匹配的,不是按词组。下图是我们对 22:31 那次 50 条结果逐条人工判断的结果:14 条在讲软件或编程接口,9 条只是正文里的链接带了 api 或 threads(比如 api.whatsapp.com、?api=1),12 条里的 api 是别的语言里的词(马来语和印尼语里 api 是「火」,kereta api 是火车),15 条正文里根本找不到这两个词。讲 Threads API 的一条都没有,回复最多的那条(1,696 条回复)正文里也没有这两个词。我们又在 23:07 用加了英文引号的 "threads api" 搜了一次,返回 39 条,同样没有一条含这个词组。人工判断只做了这 50 条;其余搜索结果只用下面的正文规则过滤过。
拿到结果后要在自己这边再过滤一遍。下面这段代码把多次运行的 CSV 合并去重,再要求正文同时含两个条件。我们拿 11 月 13 日 22:31、23:00、23:05 和 11 月 14 日 00:24、00:29、00:31 六次的结果真跑了一遍:6 个文件去重后 210 条,同时含 threads 和大写 API 的 0 条。
"""把每次运行的 posts.csv 合并去重,再按正文过滤。用法:python3 merge_filter.py runs/posts_*.csv"""
import csv, re, sys

MUST = [re.compile(r"\bthreads?\b", re.I), re.compile(r"\bAPI\b")]   # 两个条件都要满足;按你的话题改

seen, kept = {}, []
for path in sys.argv[1:]:
    with open(path, encoding="utf-8") as f:
        for row in csv.DictReader(f):
            seen.setdefault(row["id"], row)          # 同一个帖子只留第一次出现的那行
for row in seen.values():
    if all(rx.search(row["text"] or "") for rx in MUST):
        kept.append(row)
print(f"{len(sys.argv) - 1} 个文件,去重后 {len(seen)} 条,正文同时含 threads 和 API 的 {len(kept)} 条")
换成更有区分度的词(产品名、活动名、话题标签),或者从账号出发,用 threads/user_posts 读你关心的那些账号,噪音会少很多。
每 1,000 行多少钱,每次调用多久
成本按本文全部成功的调用计算:11 月 13 日 22:31 到 11 月 14 日 00:31 一共 60 次,扣费合计 $0.032356。每 1,000 行的算法是「扣费合计 ÷ 返回行数 × 1,000」,返回行数按接口实际返回的条数数,单行能力(详情、主页)每次记 1 行。
| 能力 | 成功调用次数 | 返回行数 | 扣费合计 | 每 1,000 行 |
|---|---|---|---|---|
| threads/search(每次最多 50 条) | 8 | 383 | $0.006224 | $0.0163 |
| threads/user_posts(每次最多 50 条) | 12 | 230 | $0.003892 | $0.0169 |
| threads/comments(每个帖子一次) | 17 | 329 | $0.009452 | $0.0287 |
| threads/post_detail(每个链接 1 行) | 17 | 17 | $0.009452 | $0.5560 |
| threads/profile(每个账号 1 行) | 6 | 6 | $0.003336 | $0.5560 |
| 完整脚本:搜索 + 详情 + 回复 + 主页 | 3 × 4 | 228 | $0.007338 | $0.0322 |
threads/search 和 threads/user_posts 每次最多 50 行,每 1,000 行不到 2 美分;threads/comments 按 17 次一共 329 行算,每 1,000 行约 3 美分;post_detail 和 profile 每次只有 1 行,每 1,000 行 $0.556。所以设计流程时,能从列表接口拿到的字段(点赞数、回复数、发布时间)就不要再逐条调详情。完整脚本三次运行一共 228 行、扣 $0.007338,每 1,000 行 $0.0322。按我们自己的假设算一笔账:如果每小时跑一次这个脚本、盯一个关键词,一天 24 次 × $0.002446 = $0.0587,30 天约 $1.76;每次多读一个账号的帖子列表加 $0.000556,30 天多 $0.40。实际花费以每次响应里的 charged_usd 为准;要把单价换成你自己的量,用上表最后一列乘以你预计每月拿到的行数再除以 1,000 即可。
耗时只统计记录了单次耗时的 48 次成功调用(三次完整脚本只记了整体起止时间):search 17.9 到 26.6 秒,中位数 20.1 秒;post_detail 6.4 到 27.4 秒,中位数 9.0 秒;comments 6.4 到 88.0 秒,中位数 13.7 秒;profile 19.2 到 57.7 秒,中位数 21.9 秒;user_posts 27.2 到 78.2 秒,中位数 38.1 秒。这些都是同步调用,脚本里把超时设成 180 秒是够的;要一次查很多账号,可以在请求体里加 "mode": "async" 拿到任务号再轮询,接口的提示里写了这个用法。
脚本的 call() 函数区分两种错误:429 是你自己的 Key 超了速率,等 60 秒再试;接口返回 503 时响应里 charged_usd 是 0,retryable 为 true,并给出建议等待秒数 retry_after,按这个秒数等待后重试即可成功,不要把它当成「没有数据」写进结果。最多试三次,都失败才抛异常;定时任务可以把失败的关键词记下来,下一轮再补。
回复是一棵树:官方的 replies 和 conversation
Threads 的回复可以层层嵌套,官方用两个端点处理这棵树。GET /{media-id}/replies 只返回第一层回复,每条带一个 has_replies 字段,告诉你下面还有没有更深的回复,要继续往下就再调一次;GET /{media-id}/conversation 把所有层级的回复摊平成一个列表,按时间正序或倒序(reverse 参数,默认倒序)。文档还特别注明 conversation 只用在有回复的顶层帖子上(Retrieve media replies and conversations)。
官方文档对这两个端点还写了三条限制:username 和 permalink 只对公开账号和你自己的账号返回;is_verified 和 profile_picture_url 只在直接回复上有(2025 年 12 月 16 日加的字段);hide_status 有 NOT_HUSHED、UNHUSHED、HIDDEN、COVERED、BLOCKED、RESTRICTED 六个值,做统计时要先按这个字段过滤。读回复要 threads_read_replies 权限,它也在 Tech Provider 名单里(Retrieve and manage replies)。EveryInfra 的 threads/comments 不需要这些权限,每次 $0.000556,返回公开回复和 reply_to;目录没有写明返回顺序。
2026 年 2 月 13 日起,发帖人还能打开「回复审批」:新回复要等作者批准才公开,未批准的回复用 GET /{media-id}/pending_replies 读,状态是 pending 或 ignored(Reply management)。这对外部统计有影响:开了审批的帖子,公开能看到的回复只是作者批过的那一部分,回复数字段和你能读到的回复条数之间会有差距。
Meta 条款、robots.txt 和数据边界
用程序读 Threads 的公开数据之前,先读三份 Meta 的文件。以下转述的是 2026 年 11 月 13 日和 14 日读到的原文,自己写爬虫和使用第三方数据接口(包括 EveryInfra)同样适用。本文不是法律意见;使用前请自己核对 Meta 条款和所在地法规。
第一份是 Threads Terms of Use。第 3(a) 条列了不能做的事,其中第 (iv) 项写的是:不得使用机器人、蜘蛛程序、爬虫、抓取工具或其他自动化的设备、程序、软件或查询,去拦截、「挖掘」、抓取、提取或以其他方式访问 Threads 服务,以「监视、提取、复制或收集」其中的信息或数据,也不得用人工方式做同样的事。同一条开头还写明,不得促成或允许第三方做这些事。
第二份是 Threads 网站的 robots.txt。我们 11 月 13 日 21:37(新加坡时间)存下的版本共 389 行,开头四行注释写着:未经 Threads 书面许可,禁止用自动化手段收集 Threads 上的数据,被列出的爬虫要遵守 Meta 的 Automated Data Collection Terms。文件末尾对所有未列名的爬虫写的是 User-agent: * 加 Disallow: /。
第三份是 Meta Terms of Service。第 3.2 条第 3 项写的是:未经 Meta 事先许可,不得用自动化方式访问或收集 Meta 产品的数据,也不得试图访问你无权访问的数据,「无论这种自动化访问或收集是否在登录 Facebook 账号的状态下进行」。页面顶部同时写着,新版服务条款将在 2027 年 1 月 20 日生效。
EveryInfra 的 Threads 能力只返回公开可见的内容,不登录任何账号,不碰私信、私密账号和仅好友可见的帖子。threads/profile 返回的 is_private 字段可以用来判断账号是否私密。2026 年 10 月 29 日 Threads 在爱尔兰、意大利和日本测试「Threads Friends」,可以把帖子只发给最多 50 个好友(Social Media Today,2026-10-29、Engadget),这类帖子同样不在公开数据之内。
| 内容 | 官方 API(有高级权限) | EveryInfra Threads 能力 |
|---|---|---|
| 公开账号的帖子和回复 | 能,要过 App Review;按用户名查主页要求粉丝 100 以上 | 能 |
| 私密账号的帖子 | 只能读自己的账号 | 不能 |
| 只给好友看的帖子(「Threads Friends」测试) | 我们读到的文档里没有提到 | 不能 |
| 私信 | 我们读到的文档里没有对应的读取端点 | 不能 |
| 等待审批的回复 | 只有帖子作者能读(pending_replies) | 不能 |
| 洞察:浏览数、粉丝画像 | 只能读自己和授权账号的帖子 | 不能;user_posts 对公开帖子返回 view_count |
新闻和公共服务场景里处理这类数据,常见做法有四条:只存分析需要的字段(帖子 ID、时间、正文、互动数),不存头像和个人主页链接;把普通用户的用户名哈希化或删掉,机构账号可以保留名称;设定保存期限,到期删除;对外发布时只给统计结果,不贴普通用户的原话截图。若你的分析涉及欧盟或英国居民,先读一遍当地数据保护机构的指引。
什么时候官方 Threads API 或 Meta 自己的研究工具更合适
有三种情况,走官方路比用第三方数据接口更合适。
第一种,你要管理的是自己的账号或客户授权给你的账号。发帖、回复、隐藏回复、回复审批、看 insights(浏览、点赞、回复、转发、引用、粉丝数和粉丝画像),这些都只有官方 API 能做。第三方数据接口只读公开数据,不能发帖,也拿不到 insights 里的浏览数和粉丝画像。官方接口本身不按次收费,额度按「4,800 × 曝光数」算,曝光数 1 万的账号每天是 4,800 万次。
第二种,你是高校或非营利研究机构的研究者。Meta 的 Meta Content Library 网页工具收录了 Threads 上粉丝不少于 100 的公开账号的帖子,支持关键词趋势图、按发布者列表过滤,申请由法国的 Secure Data Access Center(CASD)独立审核,在 Meta Secure Research Environment 里使用不收费。限制是:只有学术或非营利机构能申请,数据要在受控环境里分析,Content Library API 目前列出的端点里没有 Threads(网页工具有)。这条路的数据来源有文档,申请经过 CASD 审核,适合需要可追溯、可复现、经过伦理审查的研究。
第三种,你只关心美国或日本的热门话题。/trending_topics 用应用访问令牌就能列出话题标题,基础权限即可,话题每小时最多变一次;读话题下的帖子要高级权限。文档还写明不得转移或修改这些热门数据。
其余情况,例如不经账号授权读任意公开账号的帖子、按关键词搜别人发的帖子、读别人帖子下的回复,在官方体系里都要先拿到高级权限。各路线的适用场景如下:
| 你要做的事 | 更合适的路线 | 主要原因 |
|---|---|---|
| 在自己的账号上发帖、回复、隐藏或审批回复 | 官方 API | 只有官方 API 能写入 |
| 自己账号的浏览数和粉丝画像 | 官方 API 的洞察 | 洞察只读授权过的账号 |
| 过了伦理审查的学术研究 | Meta Content Library | 来源有文档,在受控环境里分析 |
| 美国或日本的热门话题标题 | 官方 /trending_topics | 基础权限就能拿到标题 |
| 别人账号的公开帖子和回复 | 第三方数据接口 | 不需要 Meta 开发者应用;同样受上文三份文件约束 |
跨领域用法:给公共机构和新闻账号的回复做情绪统计
对一条通告或一篇报道下面的公开回复做情绪统计,可以按四步走,每一步都对应上文的一个能力。
第一步,选帖子。用 threads/user_posts 拉机构账号最近的帖子(每次最多 50 条),按 comment_count 排序,挑出回复数够多的几条。回复数太少的帖子,情绪分数的波动很大。第二步,拉回复。对每条帖子调 threads/comments,拿到回复正文、时间、点赞数和 reply_to。第三步,清洗。去掉机构账号自己的回复(按 author_username 过滤),去掉只有表情或链接的回复,按语言分组。第四步,打分。英文回复可以先用 VADER 这类基于词典和规则的情绪模型打一个 -1 到 1 的分数(Hutto 和 Gilbert,ICWSM 2014),它不需要训练数据,对短文本和社交媒体的写法做过专门调整;其他语言要换对应语言的模型,或者用大模型按固定提示词分成正面、负面、中性三类。
我们拿三个新闻账号试了第一步。11 月 13 日 23:03 到 23:05(新加坡时间),用 threads/user_posts 各取最近 50 条帖子,按回复数分档:纽约时报 50 条里回复在 20 条以上的有 9 条,中位数 5 条,最多 68 条;BBC 中文 20 条以上的 5 条,中位数 1 条,最多 186 条;CNN en Español 50 条里 46 条没有回复,最多的一条 10 条。也就是说,同样是新闻账号,能拿来算情绪的帖子数量差别很大,西语账号几乎没有可算的样本。这三次调用一共扣 $0.001668。
| 账号(新加坡时间) | 帖子数 | 0 条回复 | 1–4 条 | 5–19 条 | 20 条以上 | 中位数 | 最多 | 回复合计 |
|---|---|---|---|---|---|---|---|---|
| 纽约时报(23:03) | 50 | 5 | 20 | 16 | 9 | 5 | 68 | 561 |
| BBC 中文(23:03) | 50 | 16 | 19 | 10 | 5 | 1 | 186 | 529 |
| CNN en Español(23:04) | 50 | 46 | 3 | 1 | 0 | 0 | 10 | 14 |
我们又拿纽约时报两条帖子试了第二到第四步。11 月 14 日 00:24 和 00:28(新加坡时间),按上文的推荐做法用 threads/comments 读回复,11 月 11 日那条本次返回 30 条,11 月 12 日那条本次返回 17 条;去掉空文本和 @nytimes 自己的回复后剩 28 条和 15 条,用 vaderSentiment 3.3.2 打分,compound 不低于 0.05 记正面、不高于 -0.05 记负面、其余记中性。结果是 28 条里正面 14、中性 7、负面 7,平均分 0.131;15 条里正面 7、中性 5、负面 3,平均分 0.149。这两组样本都只有十几到二十几条,人工抽查本次没有做,所以只能当作流程演示,不能拿来说读者对这两篇报道的态度。两组的平均分只差 0.018,在十几条的样本里,多一两条负面回复就能把这个差距抹掉,所以比较两条帖子时,至少要先把每条帖子的回复样本扩到同一量级,再看差距是否稳定。打分用的是 vaderSentiment 的默认词典,没有改任何参数。
点赞数在回复之间分布很不均匀,这一点会直接影响加权方式。2026 年 11 月 11 日那条纽约时报帖子本次返回的 30 条回复一共 1,053 个赞,点赞最多的一条占 901 个,其余 29 条的中位数是 1 个赞;2026 年 11 月 12 日那条 BBC 中文帖子本次返回的 30 条回复一共 4,424 个赞,最多的一条 1,896 个,中位数 2.5 个。如果按点赞数给情绪分数加权,结果基本由排第一的那一两条回复决定;不加权时,每条回复算一票,又会把只有 0 个赞的回复和几百个赞的回复同等看待。比较稳妥的做法是两种都算,在报告里同时给出。
中文回复要另选模型。BBC 中文那条帖子 00:25 本次返回的 30 条回复里,25 条含汉字,其中 14 条含繁体字常用字(們、這、說、會等),1 条正文为空,平均每条 17 个字符;00:29 第三轮读的另一条 BBC 中文帖子本次返回 28 条,22 条含汉字,5 条正文为空。回复短、繁简混用、空文本比例不低,直接套英文词典模型不可行,要用支持中文的模型,或者用大模型按固定提示词分三类,再人工抽查。CNN en Español 那条本次返回的 9 条回复全是西语,平均每条 27 个字符,同样要换西语模型。按语言分组这一步要放在打分之前做,各组分开报告,不要把不同语言的分数直接平均。
这套方法有五个数据上的限制,写报告时每一条都要交代。
五个限制分别是覆盖率、排序偏差、回复审批和隐藏、谁在回复、模型误差。谁在回复这一条有一个外部数字可以参考:路透研究所《2026 数字新闻报告》在 48 个市场的平均数据里,社交媒体和视频平台第一次超过新闻机构自己的网站和应用,成为最常用的线上新闻入口(54% 对 51%)(Reuters Institute Digital News Report 2026,2026-06-16),但在一条帖子下面留言的人只是看新闻的人里的一部分。讽刺、反问和行业术语是情绪模型最容易判错的地方,正式发布前要人工抽查。
五个限制和报告里该写什么:
| 限制 | 会怎样影响结果 | 报告里写什么 |
|---|---|---|
| 覆盖率 | 一次回复调用不一定返回全部回复 | 「拿到 N 条里的 M 条」 |
| 排序偏差 | 只拿到某一段回复,早期或热门回复可能不在里面 | 拿回的是哪一段、什么时候拿的 |
| 回复审批和隐藏 | 公开结果里只有作者批过、没隐藏的回复,结果偏正面 | 帖子是否开了审批,隐藏回复不在样本里 |
| 谁在回复 | 回复的人不代表公众,也不代表不用 Threads 的人 | 结论只限「在 Threads 上回复的人」 |
| 模型误差 | 讽刺、反问、行业术语最容易判错 | 人工抽查的条数和一致率 |
抽样上的更多问题,可以接着读我们的《社媒数据做研究样本:同一查询重搜两次,一半结果变了》和《社交平台健康风险监测》两篇。把这五条写清楚以后,这类分析适合回答的是「同一个账号的不同帖子之间,哪类话题的回复更负面」这种相对比较,不适合回答「公众对这个机构满不满意」这种绝对判断。
上手:从一次调用到每天自动跑
同样从一个账号出发读 Instagram 的帖子和评论,可以接着读《Python 抓 Instagram 帖子和评论:三条路实测》。
第一步,注册并创建一个 API Key,在接口市场里找到 Threads 的几项能力和单价,按文档的快速开始用 curl 调一次 threads/search,确认 Key 能用。第二步,把本文的 Python 脚本存下来,把 Key 放进环境变量 EVERYINFRA_API_KEY,运行一次,看 posts.csv 和 replies.csv 里的字段是不是你要的。第三步,要每天跑的话,用 cron 或你自己的调度工具定时执行,按日期写到不同文件,后面再做去重和合并。每个 Threads 能力的参数、示例和返回字段在各自的文档页里:搜索、主页、账号帖子、单帖详情、回复、发现账号,总览在 Threads 爬虫 API。
如果你用 Claude、Cursor 这类能接 MCP 的 AI 工具,也可以不写代码:把 https://api.everyinfra.com/mcp 加成远程 MCP 服务器,带上同一把 Key,工具列表里会出现 everyinfra_call_api,直接用自然语言让 AI 去搜 Threads 帖子、读回复,配置方法见 MCP 接入页。同一套接口也能读 Instagram 和 Reddit 等平台的公开数据,价格统一列在 价格页。
行业动向:最近 30 天和 Threads 数据有关的四件事
2026 年 11 月 10 日,Threads 上线高级搜索筛选。 官方账号 @threads 发帖说,搜索栏右侧新增筛选菜单,可以按日期范围、社区、帖子类型过滤,还能只看完全匹配的结果(@threads 原帖,Social Media Today 同日报道)。对读者意味着:App 里的人工搜索能按日期缩小范围了,而开发者用的 /keyword_search 早在 2025 年 7 月 14 日就有 since、until 参数,两边的筛选项并不一一对应,App 里能筛的「社区」在 API 文档里没有对应参数。
2026 年 10 月 30 日,Meta 新版商业条款生效。 新条款允许 Meta 用自动化程序抓取与企业账号相关的网站,用于广告和商业产品;新闻机构普遍有 Meta 企业账号,用来管理 Facebook 主页、Threads 账号和 Instagram 账号,英国新闻媒体协会等组织公开表示反对(Nieman Lab,2026-10,条款预览原文)。对读者意味着:新闻机构既可能是 Threads 数据分析的对象,也是这份商业条款的签约一方,分析自家账号数据前可以先查一下自己签的是哪一版条款。
2026 年 10 月 29 日,Threads 测试「Threads Friends」。 用户可以把帖子只发给最多 50 个好友,先在爱尔兰、意大利和日本测试(Social Media Today)。对读者意味着:Threads 上「不公开」的内容类型多了一种,做舆情统计时,好友可见的帖子和私密账号的帖子一样不在样本里,样本的代表性要在报告里写明。
2026 年 10 月 21 日,Meta 公布第三季度财报。 新闻稿写明 Meta 旗下应用 9 月平均每日活跃人数 36.4 亿,同比增长 3%(Meta Reports Third Quarter 2026 Results);扎克伯格在当天的电话会上说 Threads 的月活已经超过 X,但没有给出具体数字(电话会文字稿的原话是 Threads「has now overtaken X in monthly actives」,见 Q3 2026 财报电话会文字稿;Music Ally 在 2026 年 10 月 22 日报道了这句话,见 Music Ally),Meta 上一次公布的 Threads 数字是 2026 年 6 月 16 日的 5 亿月活(据 Yahoo Finance 转载的 24/7 Wall St. 报道)。对读者意味着:Threads 的公开讨论量还在涨,但官方没有可核对的用户数,Threads 没有公开的用户数,样本无法加权到全体网民。
常见问题
Threads API 免费吗,有没有 threads api pricing?
问题来自联想词「threads api free」「threads api pricing」(2026-11-13 读取)。Meta 的 Threads API 不按调用次数收费,文档里没有价目表,限制体现在调用量(24 小时内 4,800 × 曝光数)和权限上:读别人的公开数据要过 App Review 和 Tech Provider,这一步不花钱但要花时间,也不保证能过。按次付费接口相反:不需要审核,按调用付钱。EveryInfra 的 Threads 能力在 2026-11-13 的公开目录里,threads/search 每次 $0.000778,其余 6 项每次 $0.000556,失败和空结果不扣钱。
Threads API key 或 token 怎么拿?
问题来自联想词「threads api key」「threads api token」。官方 API 没有一把通用的 key,用的是 OAuth 用户访问令牌:先在 Meta 开发者后台建一个选了「Threads use case」的应用,用户在授权窗口同意权限后拿到授权码,换成 1 小时有效的短期令牌,再换成 60 天有效的长期令牌,到期前可以刷新(Get started)。公开账号授予的权限 90 天有效,刷新长期令牌时会顺延;私密账号的授权过期后要重新授权。热门话题用的是另一种「应用访问令牌」。
为什么 Threads API keyword search 只搜到自己的帖子?
问题来自 Meta 开发者社区的原帖(3633404910150925、1476322604349910)。因为应用还没通过 threads_keyword_search 的审核。文档原话是没过审时「搜索只在已认证用户自己的帖子上进行」。控制台显示「Ready for testing」不等于过审;过审要走 App Review,企业应用还会被要求先转成 Tech Provider。
Threads API 能读别人帖子下面的回复吗?
问题来自 Stack Overflow 的提问「Does Meta Threads API Allow Reading Timeline Posts and Liking Others' Posts?」,截至 11 月 13 日 0 个回答。按文档,回复管理 API 是用来「读取和管理用户自己帖子的回复」的;读单条帖子在没有 threads_basic 高级权限时只能读测试员的帖子。读别人帖子下的公开回复,官方路要先拿到这些权限的高级权限;按次付费接口用帖子链接直接读,例如 threads/comments。
有免费的 threads scraper 吗,GitHub 上的能用吗?
问题来自联想词「threads scraper free」「threads scraper github」。GitHub 上较早出现的非官方 Threads 客户端 junhoyeo/threads-api 在 README 里写着:2023 年 9 月 8 日起,因为收到 Meta 的通知,项目停止开发并归档,作者说使用或分发这段代码可能违反 Meta 的服务条款。无论自己写爬虫还是用第三方数据接口,上文那三份条款都适用;自己写爬虫另有改版带来的维护成本。
threads api python 有官方 SDK 吗?
问题来自联想词「threads api python」「threads api example」。Meta 提供的是一个 Node.js 写的开源示例应用 fbsamples/threads_api 和一份 Postman 集合,文档里没有官方 Python SDK;示例应用的 README 还提醒,Threads 应用的回调地址不支持 localhost,本地测试要在 hosts 文件里映射一个域名。YouTube 上「threads api python」排第一的视频(2025-01-28 发布,约 19 分钟)讲的也是官方 API 的应用创建和令牌配置。用 Python 调官方 API 就是用 requests 发 HTTP GET,调按次付费接口则是发一个 POST,本文的脚本只依赖 requests。
参考资料
- Threads API overview,Meta for Developers,2025-12-22,<https://developers.facebook.com/documentation/threads/overview>
- Get started (Threads API),Meta for Developers,<https://developers.facebook.com/documentation/threads/get-started>
- Retrieve user posts,Meta for Developers,2026-04-14,<https://developers.facebook.com/documentation/threads/retrieve-and-discover-posts/retrieve-posts>
- Threads profiles,Meta for Developers,<https://developers.facebook.com/documentation/threads/threads-profiles>
- Keyword and topic tag search,Meta for Developers,2026-01-21,<https://developers.facebook.com/documentation/threads/keyword-search>
- Retrieve media replies and conversations,Meta for Developers,<https://developers.facebook.com/documentation/threads/retrieve-and-manage-replies/replies-and-conversations>
- Retrieve and manage replies,Meta for Developers,<https://developers.facebook.com/documentation/threads/retrieve-and-manage-replies>
- Reply management,Meta for Developers,<https://developers.facebook.com/documentation/threads/reply-management>
- Mentions,Meta for Developers,<https://developers.facebook.com/documentation/threads/threads-mentions>
- Trending topics,Meta for Developers,<https://developers.facebook.com/documentation/threads/trending-topics>
- Threads Insights API,Meta for Developers,<https://developers.facebook.com/documentation/threads/insights>
- Embed a Threads post (oEmbed),Meta for Developers,<https://developers.facebook.com/documentation/threads/tools-and-resources/embed-a-threads-post>
- Threads Changelog,Meta for Developers,2026-08-18,<https://developers.facebook.com/documentation/threads/changelog>
- Access Levels,Meta for Developers,2026-06-30,<https://developers.facebook.com/documentation/development/graph-api/overview/access-levels>
- Tech Providers,Meta for Developers,<https://developers.facebook.com/docs/development/release/tech-providers/>
- The Threads API is finally here,Meta for Developers blog,2024-06-18,<https://developers.facebook.com/blog/post/2024/06/18/the-threads-api-is-finally-here/>
- Threads keyword_search returns only my own posts,Meta Developer Community,<https://developers.facebook.com/community/threads/3633404910150925/>
- How can a self-use Threads app get public keyword search approval,Meta Developer Community,2026-10-21,<https://developers.facebook.com/community/threads/2883329558707631/>
- keyword_search returns the same post and repeats the same pagination cursor,Meta Developer Community,<https://developers.facebook.com/community/threads/1476322604349910/>
- Threads App Review for a first-party brand app,Meta Developer Community,<https://developers.facebook.com/community/threads/1094128013493014/>
- Threads App Review for an internal business app,Meta Developer Community,<https://developers.facebook.com/community/threads/2580213639125398/>
- Does Meta Threads API Allow Reading Timeline Posts and Liking Others' Posts?,Stack Overflow,<https://stackoverflow.com/questions/79455370/does-meta-threads-api-allow-reading-timeline-posts-and-liking-others-posts>
- fbsamples/threads_api (sample app),GitHub,<https://github.com/fbsamples/threads_api>
- Threads API Postman collection,Meta on Postman,<https://www.postman.com/meta/threads/overview>
- junhoyeo/threads-api (archived),GitHub,2023-09-08,<https://github.com/junhoyeo/threads-api>
- Threads Terms of Use,Instagram Help Center,<https://help.instagram.com/769983657850450>
- threads.com robots.txt,Threads,2026-11-13,<https://www.threads.com/robots.txt>
- Automated Data Collection Terms,Meta,<https://www.facebook.com/legal/automated_data_collection_terms>
- Meta Terms of Service,Meta,<https://www.facebook.com/terms/>
- Commercial Terms (preview),Meta,<https://www.facebook.com/legal/commercial_terms_preview>
- Meta Content Library,Meta Transparency Center,<https://transparency.meta.com/researchtools/meta-content-library/>
- Meta Content Library and API documentation,Meta for Developers,<https://developers.facebook.com/docs/content-library-and-api/>
- Centre d'accès sécurisé aux données (CASD),CASD,<https://www.casd.eu/en/>
- Meta Reports Third Quarter 2026 Results,Meta Investor Relations,2026-10-21,<https://investor.atmeta.com/investor-news/press-release-details/2026/Meta-Reports-Third-Quarter-2026-Results/default.aspx>
- Meta's Threads Now Has More Monthly Users Than X,24/7 Wall St. on Yahoo Finance,2026-06-16,<https://finance.yahoo.com/media-advertising/articles/meta-threads-now-more-monthly-161328077.html>
- @threads post on advanced search filters,Threads,2026-11-10,<https://www.threads.com/@threads/post/DfkgGO8Jedq>
- Threads adds advanced search filters,Social Media Today,2026-11-10,<https://www.socialmediatoday.com/news/threads-adds-advanced-search-filters/874339/>
- Threads tests smaller group sharing option,Social Media Today,2026-10-29,<https://www.socialmediatoday.com/news/threads-tests-smaller-group-sharing-option/873271/>
- Meta Is Testing 'Threads Friends' For Sharing Posts With Smaller Groups,Engadget,2026-10-29,<https://www.engadget.com/2301804/meta-is-testing-threads-friends-for-sharing-posts-with-smaller-groups/>
- Third Quarter 2026 Results Conference Call (transcript),Meta Investor Relations,2026-10-21,<https://s21.q4cdn.com/399680738/files/content_files/META-Q3-2026-Earnings-Call-Transcript.pdf>
- Meta says Threads now has more monthly active users than X,Music Ally,2026-10-22,<https://musically.com/2026/10/22/meta-says-threads-now-has-more-monthly-active-users-than-x/>
- Legal experts warn Meta's new terms still grant broad scraping permissions,Nieman Lab,2026-10,<https://www.niemanlab.org/2026/10/legal-experts-warn-metas-new-terms-still-grant-broad-scraping-permissions-despite-language-changes/>
- Digital News Report 2026: executive summary,Reuters Institute,2026-06-16,<https://reutersinstitute.politics.ox.ac.uk/digital-news-report/2026/dnr-executive-summary>
- VADER: A Parsimonious Rule-based Model for Sentiment Analysis of Social Media Text (Hutto & Gilbert, ICWSM 2014),AAAI / ICWSM,2014,<https://doi.org/10.1609/icwsm.v8i1.14550>
- cjhutto/vaderSentiment,GitHub,<https://github.com/cjhutto/vaderSentiment>
- Requests: HTTP for Humans,Python Software Foundation / Requests docs,<https://requests.readthedocs.io/en/latest/>
- EveryInfra public catalog (Threads capabilities),EveryInfra,2026-11-13,<https://api.everyinfra.com/api/v1/social/catalog>
以上链接都在 2026-11-13(新加坡时间)打开核对过;带日期的是页面写明的更新或发布日期。
引用编号 BL-142