Claude Managed Agents 每晚巡检门店差评
Claude Managed Agents 定时部署每晚读三个平台新评论挑出差评:Google 100 条约盖 4 天,每店每晚接口费 $0.0056。
我们在 2026 年 11 月 4 日(新加坡时间)用 EveryInfra 接口真调了纽约 Katz's Delicatessen 和法拉盛海底捞在 Google 地图、Yelp、Tripadvisor 上的评论,最影响设计的发现是:三个平台的「最新 N 条」覆盖的时间差得很远,Google 100 条不到 4 天,Tripadvisor 50 条近 4 个月,Yelp 第一页还不按时间排;一小时后重读,Google 又冒出一条显示时间早于第一轮调用、第一轮却没读到的评论,所以每晚的任务要按评论 id 判新、记住上次看到哪里,不能只取最新 N 条、只看发布时间。钱的方面,接口费很小,一家店一晚 4 次调用不到 1 美分,大头在 Anthropic 一侧的模型 token:用 Sonnet 5.5 时我们估算模型费是接口费的十几倍,所以要让沙盒里的脚本先把原始返回筛成 1–2 星,再交给模型。
这篇文章回答一个具体的问题:一家连锁餐厅的运营负责人,想每天早上 7 点前收到一份晨报,列出昨晚以来 Google 地图、Yelp、Tripadvisor 上新出现的 1–2 星评论,每条写清楚是菜品、服务、排队还是价格的问题,哪些还没有回复。我们用 Claude Managed Agents 的定时部署(scheduled deployments)来跑:每晚由 Anthropic 云端按 cron 开一个新会话,会话里的 agent 经 HTTP 或远程 MCP 调 EveryInfra 的三个评论接口,挑出新差评、归类、写晨报,跑完发 webhook。EveryInfra 一侧我们做了 26 次真调,其中 20 次扣费,合计 $0.02778;Anthropic 一侧我们没有部署,每条事实都链到 platform.claude.com 的文档或更新日志原文,读取日期是 2026 年 11 月 4 日。
这件活是什么:每天早上一份三平台新差评晨报
我们选了两家店做样本。第一家是纽约下东区的 Katz's Delicatessen,在 Google 地图上评分 4.5、56,460 条评论,在 Tripadvisor 上评分 4.2、18,710 条评论,客流大、游客多,正好用来测「一晚会进来多少条新评论」。第二家是纽约法拉盛的海底捞,Google 评分 4.8、8,792 条,Yelp 评分 4.8、2,643 条,代表评分高、差评少的门店。这两家都只是公开样本,我们和它们没有任何关系,晨报示例只用来说明方法。
为什么要每晚跑,而不是每周跑一次?按 Katz 在 Google 上的真实返回,最新 100 条评论从第一条到最后一条只隔了 3.97 天,折合每天约 24.7 条;最新 50 条只隔 1.80 天,最近 24 小时就进来 29 条。差评的处理窗口通常以天计:客人刚写完差评的那一两天,店家回复、补偿、内部复盘的效果最好。每周跑一次,Google 一侧要翻 4 页才能读完一周,周报出来时最早那条差评已经放了六七天。每晚跑,读最新 50 条就能盖住昨晚以来的全部新评论,还留出一晚的余量。
| 平台 | 用的能力 | 每次读多少 | 排序 | 每次价格 |
|---|---|---|---|---|
| Google 地图 | google_maps_reviews/reviews | 最多 100 条,我们用 50 条 | sort=newest 按时间倒序,可加 since 日期下界 | $0.001389 |
| Yelp | yelp/reviews | 每页 10 条,用 page_token 翻页 | 平台默认顺序,不按时间 | $0.001389 |
| Tripadvisor | tripadvisor/reviews | 最多 50 条 | 没有排序参数,实测按时间倒序 | $0.001389 |
| 三个平台找店 | google_maps_reviews/search、yelp/search、tripadvisor/search | 第一次配置时各 1 次 | — | $0.001389 |
表里的价格来自 2026 年 11 月 4 日 00:13(新加坡时间)读取的免费目录 https://api.everyinfra.com/api/v1/social/catalog,三个评论能力都是 available,每次 100 credits,即 $0.001389。找店的三次调用只在第一次配置时用:把店名换成各平台的店铺网址,之后每晚直接用网址读评论。
claude managed agents 是什么:四个对象,加一个定时部署
Claude Managed Agents 是 Anthropic 在 Claude Platform 上提供的一组托管 API:你定义 agent 用什么模型、什么提示词、什么工具,Anthropic 在自己的云端替你跑 agent 循环、开沙盒容器、执行工具调用、保存会话记录。它在 2026 年 4 月 8 日以公开 beta 上线,所有请求都要带 anthropic-beta: managed-agents-2026-04-01 请求头(概览、更新日志)。按概览页的说法,核心是四个概念:agent、environment、session 和 vault;定时部署(deployment)是 2026 年 6 月 9 日加上的第五个对象,用来按计划自动开会话(Anthropic 博客)。
| 对象 | 管什么 | 这个巡检里怎么配 | 文档 |
|---|---|---|---|
| agent | 模型、系统提示词、工具、MCP 服务器、权限策略,带版本号 | Sonnet 5.5;只开 bash 和读写文件,关掉 web_fetch、web_search;如走 MCP,只放行 everyinfra_call_api | Define your agent |
| environment | 沙盒容器怎么建、能连哪些主机 | limited 网络,allowed_hosts 只写 api.everyinfra.com | Cloud environment setup |
| vault | 存凭据,会话运行时注入 | 一条 environment_variable 凭据 EVERYINFRA_API_KEY,只对 api.everyinfra.com 的请求头替换 | Authenticate with vaults |
| session | 一次运行:一个新容器加一段对话记录 | 由定时部署每晚自动创建,不手动建 | Start a session |
| deployment | 按 cron 和时区自动开会话,带每次预算 | 30 6 * * *、America/New_York,每次预算 50 美分 | Scheduled deployments |
这五个对象里最容易被忽略的是 environment 每次都是新的。会话文档写明,每个会话都会拿到一个全新的容器,上一次运行写进沙盒的文件不会留到下一次(Start a session)。这对差评巡检很要紧:「昨晚已经看过哪些评论」这件事,不能存在沙盒的某个文件里,要么存在 memory store(另一个 beta,挂载在 /mnt/memory/ 下,Using agent memory),要么由你自己的服务器在收到 webhook 后保存,第二天通过初始消息或文件再交回给 agent。
定时部署:cron、时区、抖动、每次预算和不补跑
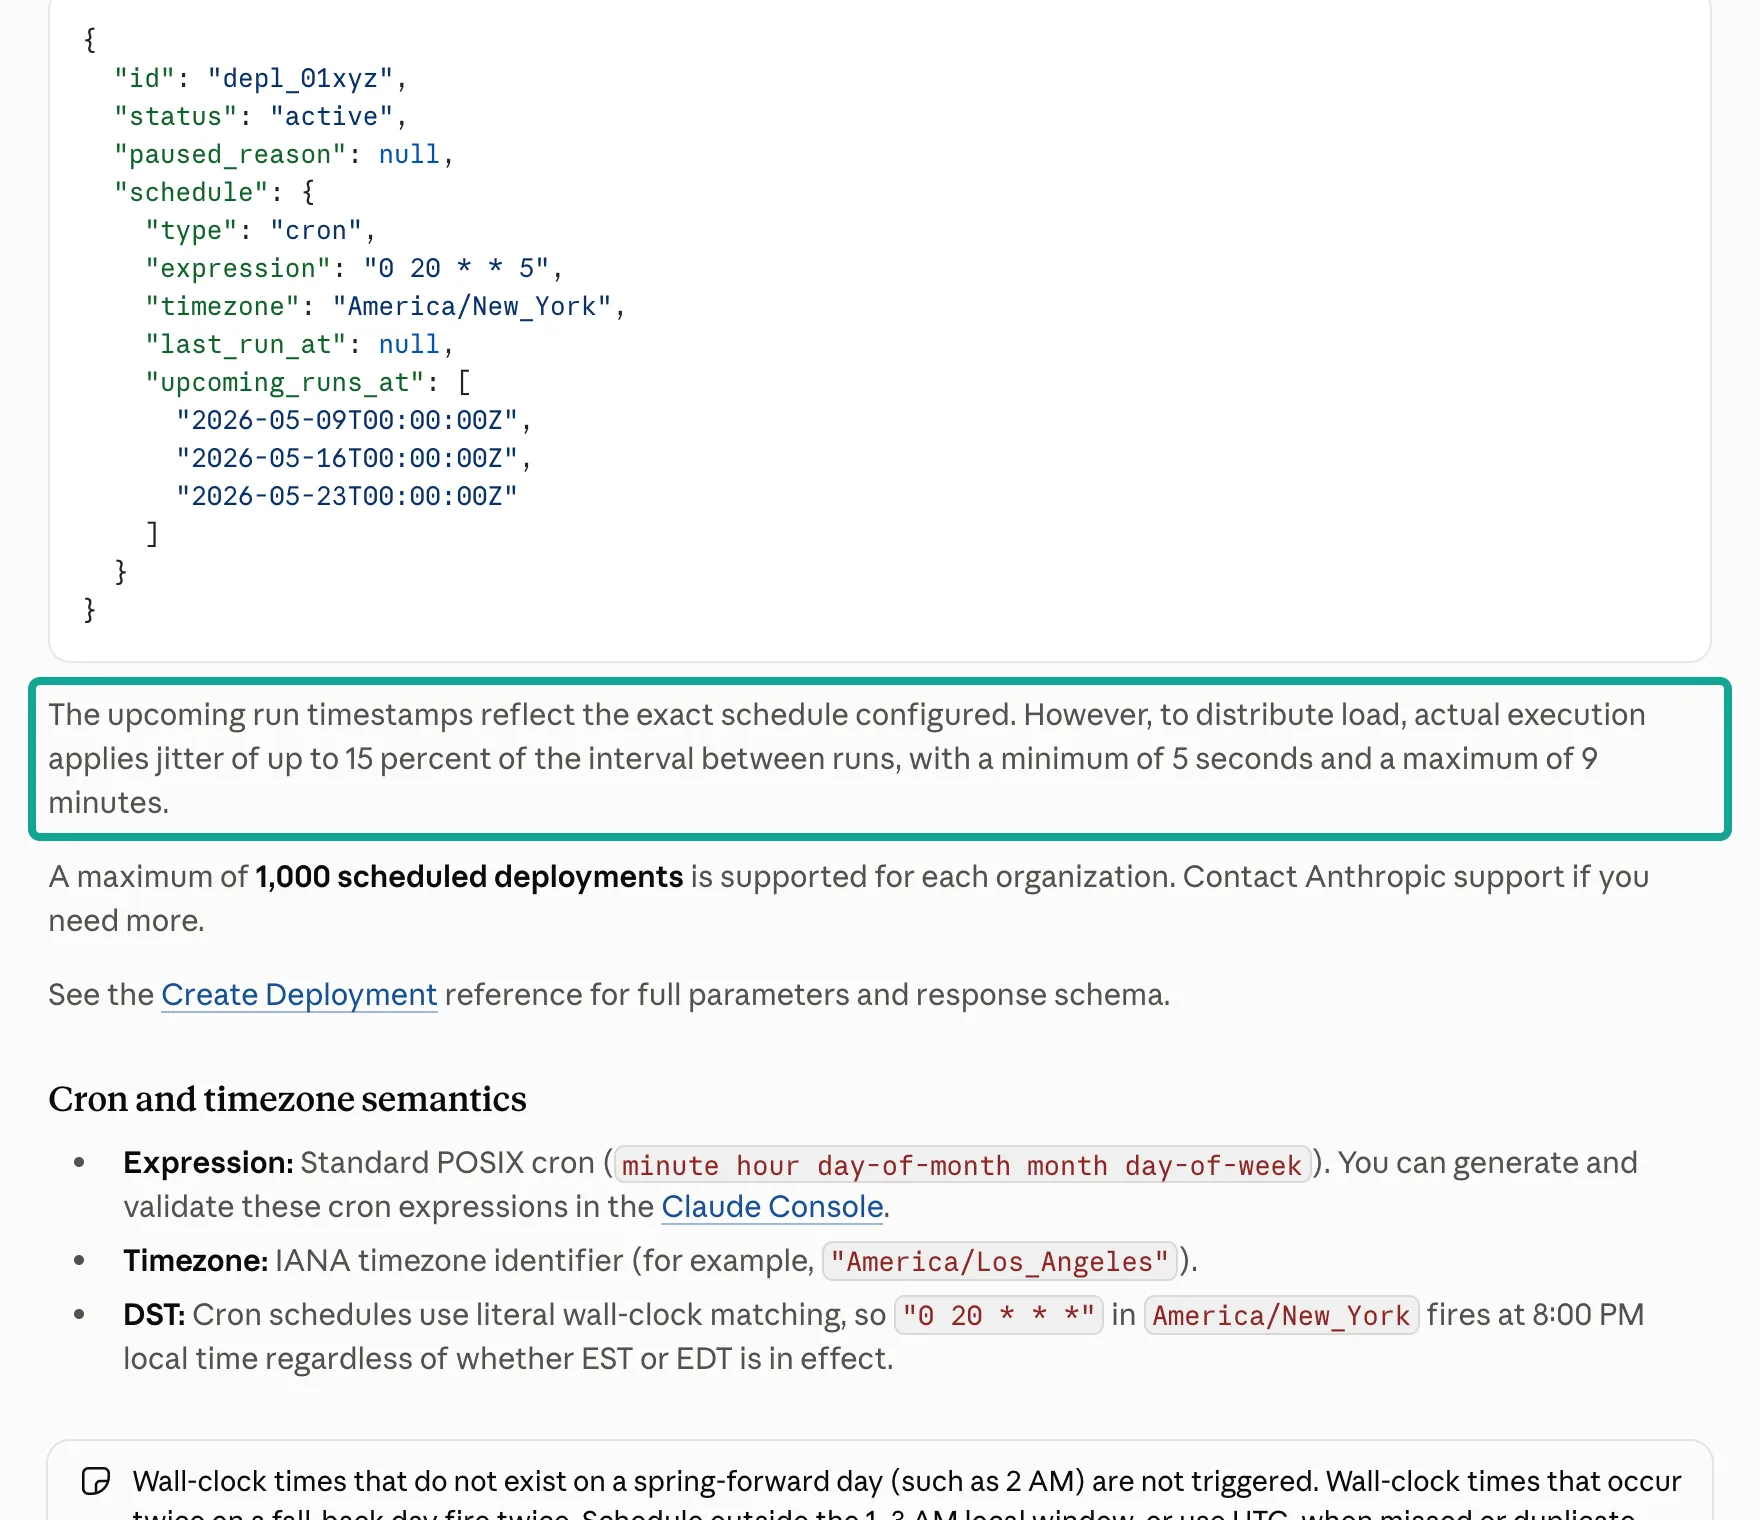
定时部署用 POST /v1/deployments 创建,必填的是 agent、environment、一条或几条初始事件(通常是一条 user.message),以及 schedule:type 固定为 cron,expression 是标准的 5 段 POSIX cron 表达式,精确到分钟,timezone 是 IANA 时区名,例如 America/New_York(Scheduled deployments;cron 字段的含义见 POSIX crontab,时区名来自 IANA 时区数据库,最新版本 2026f 发布于 2026-10-27)。创建成功后,返回体里的 schedule.upcoming_runs_at 会列出接下来几次的触发时刻,用来确认表达式没写错。
文档里有一句话直接影响晨报的截止时间:触发时刻是精确的,但实际执行会加最多为运行间隔 15% 的抖动,最少 5 秒,最多 9 分钟。我们把这条规则画成下图:每 5 分钟一次的部署最多晚 45 秒,每小时一次的最多晚 9 分钟,每天一次的也最多晚 9 分钟。所以如果晨报必须在早上 7 点前到,cron 定在 6:30 就留出了 9 分钟抖动加二十分钟运行的余量。
夏令时是第二个坑。文档说 cron 按「墙上时间」字面匹配:0 20 * * * 配 America/New_York,不管是冬令时还是夏令时都在当地晚上 8 点触发;春季拨快那天不存在的时刻(比如凌晨 2 点)不会触发,秋季拨回那天重复出现的时刻会触发两次。文档建议避开当地凌晨 1 点到 3 点,或者改用 UTC。美国 2026 年的夏令时在 11 月 1 日结束,所以本周起 30 6 * * * 在纽约对应 UTC 11:30、新加坡时间 19:30;夏令时期间则是 UTC 10:30。如果晨报给的是新加坡总部看,时区写 Asia/Singapore 就不用管这件事,因为新加坡不实行夏令时。
第三件事是预算。部署可以带一个可选的 budget,形状和会话预算一样:{"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}},金额是以美分为单位、不带小数点的字符串,"50" 就是 50 美分(Session budgets)。部署会把这个上限复制到每个新会话上,所以它限的是每一次运行,不是一个月的累计:文档里的例子写得很直白,带 "2000" 上限的部署,每次运行都可以花到约 20 美元。预算按公开列表价实时累计模型 token、网页搜索(每 1,000 次 $10)和会话运行时(每小时 $0.08),在两次模型请求之间检查,超了就以 budget_reached 暂停。它不包括你在 EveryInfra 一侧的接口费,那部分由调用次数决定,每家店每晚固定 4 次。
第四件事是失败和停用。暂停一个部署后,计划触发全部停止,正在跑的会话继续跑完;恢复以后从下一次计划时刻开始,错过的触发不补跑(文档原文是 Missed triggers are not backfilled)。每次触发都会留下一条 deployment run 记录,可以用 GET /v1/deployment_runs?deployment_id=…&has_error=true 查失败的那几次;常见的错误类型有 environment_archived_error、agent_archived_error,以及会话创建被限流时的 session_rate_limited_error,后者也只记录、不自动重试。一个组织最多 1,000 个定时部署。这意味着晨报任务要自己处理「昨晚没跑」:下一晚读评论时,不能只读最近 24 小时,而要从上次成功运行时记下的最后一条评论 id 往回读。
Key 放在哪:vault 的两种凭据
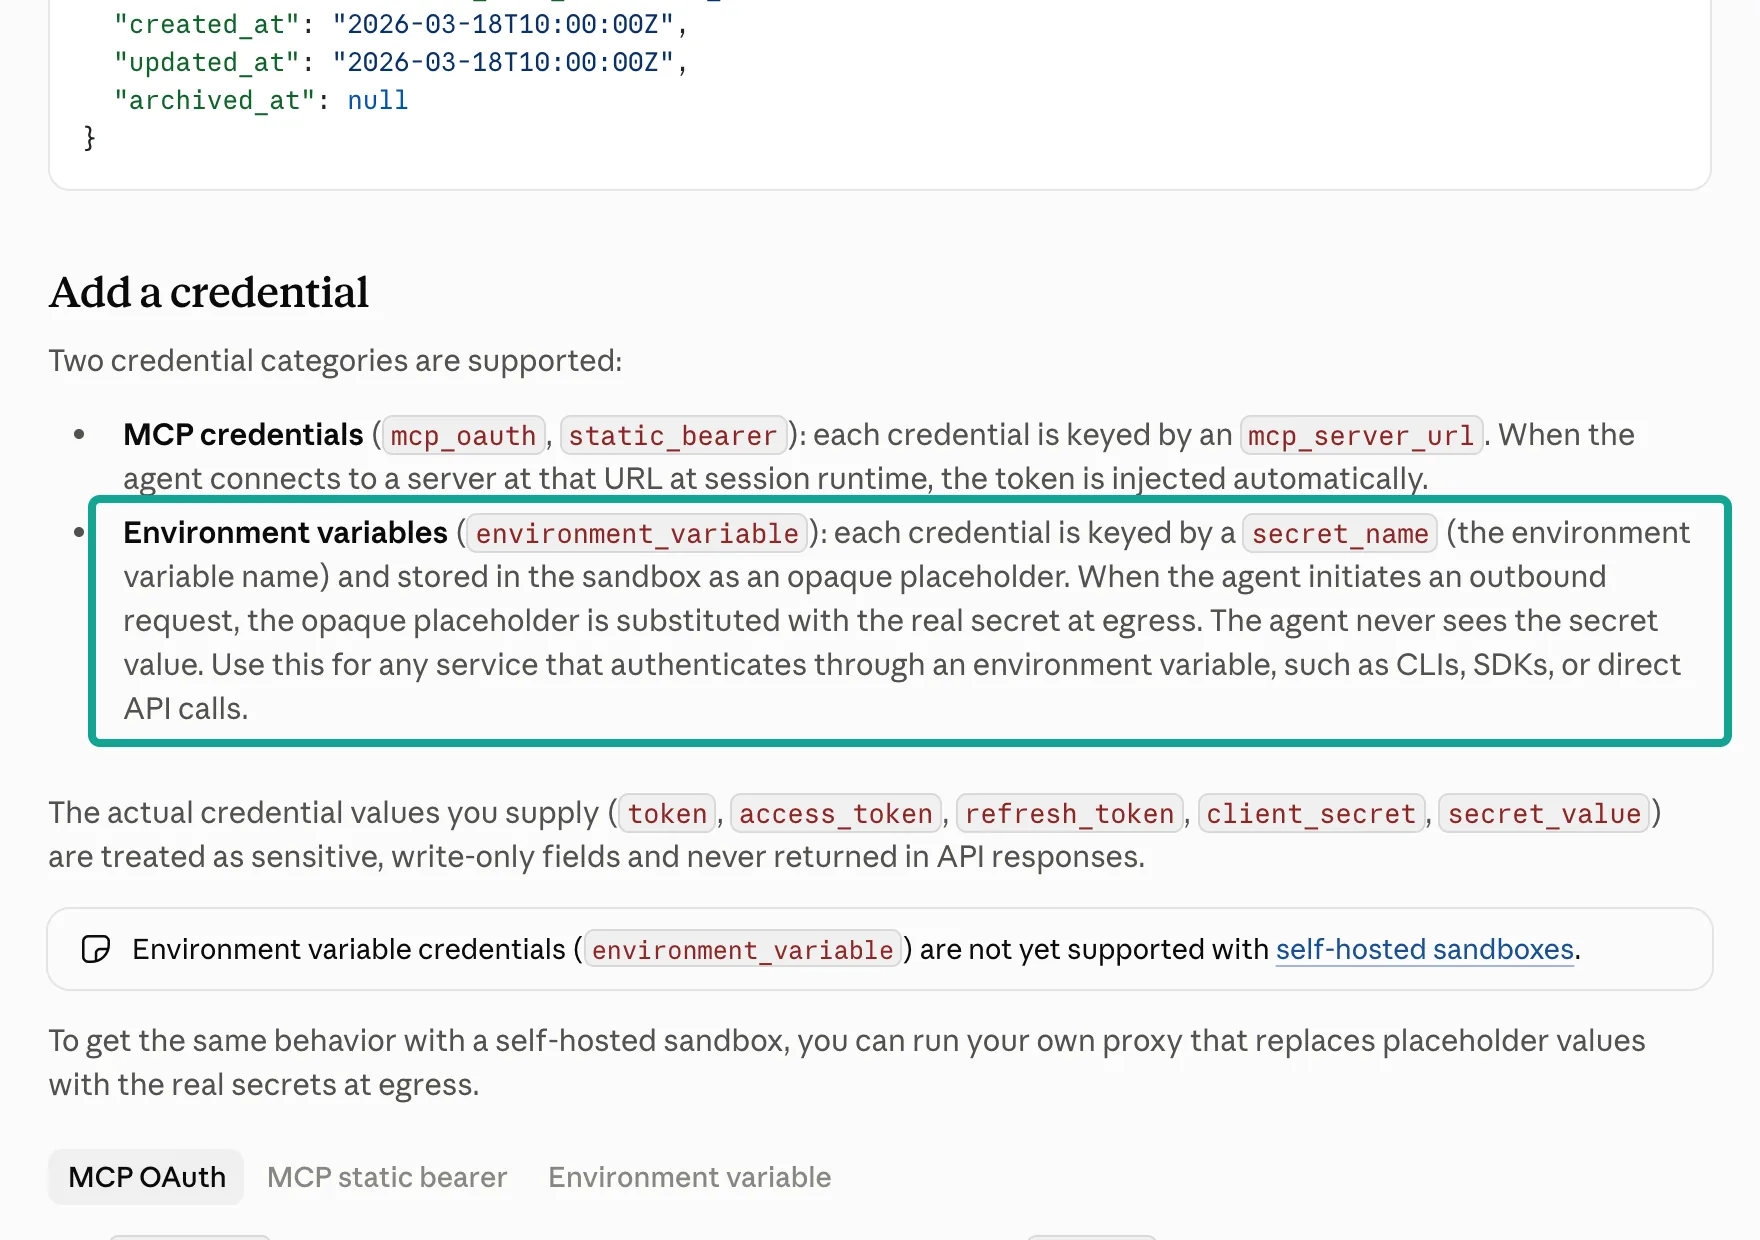
EveryInfra 的 Key 要么交给 MCP 连接用,要么交给沙盒里的 curl 用,两种用法对应 vault 的两类凭据(Authenticate with vaults)。MCP 凭据有 mcp_oauth 和 static_bearer 两种,按 mcp_server_url 匹配:会话连接到那个网址的 MCP 服务器时,自动把令牌带上。环境变量凭据 environment_variable 按 secret_name 匹配,在沙盒里只放一个不透明的占位值;agent 发出外部请求时,才在出网边界把占位值换成真值,而且只对 networking.allowed_hosts 里列出的主机替换,injection_location 还可以限定只替换请求头。
我们推荐差评巡检用环境变量凭据,理由有三条。第一,Key 的去向被收得很窄:凭据的 allowed_hosts 只写 api.everyinfra.com,就算模型被评论里的一段恶意文字诱导去请求别的网址,带出去的也只是占位值。第二,凭据上的 allowed_hosts 只决定「哪些请求会替换 Key」,不决定「哪些请求能发出去」,后者由 environment 的 networking 管,所以两处都写 api.everyinfra.com,等于网络和 Key 各加一道锁。第三,走 HTTP 时原始返回可以先落进沙盒文件,用 jq 筛过再给模型看,这一点后面算账时会看到它省下多少 token。环境变量凭据也有限制:它暂不支持自托管沙盒;一个 vault 最多 20 条凭据;凭据在创建时不做校验,要等会话运行时才知道对不对。
最后这条限制,我们在 EveryInfra 一侧真调过一次。00:22(新加坡时间)我们故意不带 Key 调远程 MCP 的 tools/call:HTTP 状态是 200,返回体里 isError 为真,文字说明未授权、Nothing was charged,没有扣费。也就是说,vault 里的 Key 写错或过期,夜间会话不会在连接 MCP 时就失败,而是在第一次调用工具时拿到一条错误结果。agent 的提示词里要写明:看到未授权错误就停下,在晨报里写「Key 无效」,而不是换着参数重试。
为什么不用 web_fetch 直接读评论页
Managed Agents 的内置工具里有 web_fetch,看起来最省事:把三个店铺网址写进提示词,让 agent 每晚自己去读页面。我们按文档和三个网站的 robots.txt 逐条核对,结论是这条路在无人值守的夜间任务里走不通,原因列在下表。
| 路径 | 能不能每晚读到新评论 | 依据 |
|---|---|---|
web_fetch 读店铺页 | 不稳定。2026-10-07 起只抓会话里已出现过的网址,写在系统提示词或 MCP 返回里的网址不算;不执行 JavaScript;遵守 robots.txt | 更新日志 2026-10-07、Web fetch tool |
| Yelp 网页 | Yelp 的 robots.txt 对 Claude-User 只放行 /article,其余路径 Disallow: /(2026-11-04 读取) | yelp.com/robots.txt、Anthropic 抓取说明 |
| Google Places API | 每个地点最多返回 5 条评论,按相关度排序 | Place Details |
| Google Business Profile API | 只能读你自己管理的地点,要 OAuth 授权 | Review data |
| Yelp Fusion API | 每家店最多 3 条评论摘录,按 Yelp 默认顺序 | Yelp Fusion reviews |
| Tripadvisor Content API | 每个地点最多 5 条最新评论 | Location reviews |
| EveryInfra 三个评论接口 | Google 每次最多 100 条、可按最新排序;Yelp 每页 10 条可翻页;Tripadvisor 每次最多 50 条 | 目录 |
web_fetch 的第一条限制最容易被忽略。2026 年 10 月 7 日的更新说,为降低数据外泄风险,web_fetch 只抓已经在会话里出现过的网址,例如用户消息里的网址、web_search 结果里的网址;只出现在 Claude 自己的输出、系统提示词、附件或 bash、MCP 工具输出里的网址,调用会返回 url_not_in_prior_context。同一天的另一条更新又说,limited 网络下 environment 的 allowed_hosts 也约束 web_fetch 和 web_search(Restrict web search and web fetch domains)。10 月 20 日起,组织管理员还可以在 Console 的 Capabilities 页整体关掉 web fetch,关掉后 Managed Agents 会话里的 web_fetch 一律返回错误。三条叠在一起,一个每晚自动跑、提示词里写死网址的任务,读不读得到页面要看太多条件。
更根本的是页面本身。Google 地图的评论列表要执行 JavaScript 才会加载,web_fetch 文档明确写着不支持 JavaScript 动态渲染的网站;Yelp 的店铺页对 Claude-User 不开放;Tripadvisor 的 robots.txt 对 ClaudeBot 整站 Disallow: /,Claude-User 不在单列名单里,落在通用规则下。几家平台的官方 API 则各有上限:Google Places 5 条、Yelp Fusion 3 条摘录、Tripadvisor Content API 5 条,对一晚就进 25 条评论的 Katz 来说远远不够。所以这个任务的工具层只留一条路:经 HTTP 或远程 MCP 调评论接口,拿结构化的 JSON。
远程 MCP 还是 HTTP:两条路,两种代价
第一条路是远程 MCP。EveryInfra 的 MCP 服务器地址是 https://api.everyinfra.com/mcp,用 Streamable HTTP 传输(MCP 传输规范),tools/list 返回 12 个工具,其中真正花钱的是 everyinfra_call_api(说明见 MCP 服务器页)。在 agent 上声明一个 type: url 的 MCP 服务器,再加一个 mcp_toolset,凭据用 vault 里按网址匹配的 static_bearer(MCP connector)。这条路配置最少,但有两个坑。其一,权限策略文档写明,agent 自带工具集默认 always_allow,MCP 工具集默认 always_ask(Permission policies):会话在调用 MCP 工具前会暂停等你批准,夜里没人批,会话就一直停着。要在工具集上写 default_config.enabled: false 关掉全部工具,再对 everyinfra_call_api 单独写 always_allow。everyinfra_call_api 的工具注解是 readOnlyHint: false、destructiveHint: true,因为它会扣费,所以用 auto 策略时也可能被要求确认(MCP 工具注解的定义见 MCP 工具规范)。
其二是返回体大小。MCP 连接器文档说,工具输出超过 100,000 个字符(约 25,000 token)时,会自动写进沙盒里的文件,模型只收到截断的预览。我们实测 Katz 在 Google 上最新 100 条评论的返回体是 105,266 个字符,刚好越过这条线;第二轮经 MCP 读最新 50 条的真实返回是 53,364 个字符,Tripadvisor 50 条 54,739 个字符,Yelp 一页 10 条一万字符上下。下图把每次真调的返回体大小和这条线放在一起。
第二条路是 HTTP 加环境变量凭据。agent 用自带的 bash 工具执行 curl,请求头写 Authorization: Bearer $EVERYINFRA_API_KEY,沙盒里这个变量只是占位值,出网时被替换;返回的 JSON 直接存成沙盒文件,再用 jq 只把 1–2 星、且不在上次 id 名单里的评论读出来交给模型。这样模型看到的是十几条筛过的评论,而不是一晚 12 万多个字符的原始数据。代价是提示词要写清楚脚本步骤,environment 要允许包管理器装 jq(或者在 environment 里预装)。我们推荐第二条路,MCP 留作手动排查时用:手动开一个会话,让 agent 用 everyinfra_list_requests 查某次调用的状态和扣费,这个工具不收费。
配置示例:environment、agent、vault、deployment
下面四份配置按 platform.claude.com 文档的字段写成,都是配置示例,没有在我们的组织里实际创建。文档里的 ant 命令行工具可以用 ant apply 把带 YAML 头的 Markdown 文件创建成对象,并把 id 记进 claude-lock.json(Define your agent)。先是 environment:
# 配置示例:environment(按 Cloud environment setup 文档字段,未在本机实测)
name: review-patrol-env
config:
  type: cloud
  networking:
    type: limited
    allowed_hosts:
      - api.everyinfra.com
    allow_package_managers: true   # 用来装 jq;预装后可以关掉
    allow_mcp_servers: false
然后是 agent。系统提示词里写死三件事:只调四个接口、按 id 判新、看到未授权就停。
---
# 配置示例:agent.md(按 Define your agent、Tools、Permission policies 文档字段,未在本机实测)
name: Nightly review patrol
model: claude-sonnet-5-5
tools:
  - type: agent_toolset_20260401
    configs:
      - name: web_fetch
        enabled: false
      - name: web_search
        enabled: false
---
你每晚为门店清单里的每家店读新评论,只用 bash 执行 curl 调 https://api.everyinfra.com/api/v1/social。
每家店 4 次:google_maps_reviews/reviews(sort=newest,limit=50),yelp/reviews 第 1、2 页,tripadvisor/reviews。
把每次返回存到 /tmp/<店>-<平台>.json,用 jq 去掉 /mnt/memory/review-patrol/seen.json 里已有的评论 id,只读 1–2 星。
每条差评归到一类或几类:菜品、服务、排队与座位、价格与名气、环境、线上订单;非英文先译成中文。
返回里出现 unauthorized 就停止,晨报第一行写「EveryInfra Key 无效」,不要重试。
最后把本次看到的全部评论 id 写回 /mnt/memory/review-patrol/seen.json,晨报写到 /mnt/session/outputs/report.md。
vault 凭据只有一条,secret_value 在你自己的机器上从环境变量读,不写进文件:
# 配置示例:在 vault 里加一条环境变量凭据(按 Authenticate with vaults 文档字段,未在本机实测)
curl --fail-with-body -sS "https://api.anthropic.com/v1/vaults/$VAULT_ID/credentials" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "anthropic-beta: managed-agents-2026-04-01" \
  -H "content-type: application/json" \
  -d "$(jq -n --arg v "$EVERYINFRA_API_KEY" '{
        auth: {
          type: "environment_variable",
          secret_name: "EVERYINFRA_API_KEY",
          secret_value: $v,
          networking: {type: "limited", allowed_hosts: ["api.everyinfra.com"]},
          injection_location: {header: true}
        },
        display_name: "EveryInfra key for nightly review patrol"
      }')"
最后是定时部署。文档说部署接受和创建会话相同的配置:必填 agent 和 environment,可选文件、memory store 和 vault;门店清单放在初始消息里,预算 50 美分一次:amount 以美分为单位,"50" 是 0.50 美元,不是 50 美元。memory store 按显示名挂载在 /mnt/memory/ 下,名为 review-patrol 的存储就是 /mnt/memory/review-patrol/。
{
  "name": "Nightly review patrol (NYC)",
  "agent": "agent_01...",
  "environment_id": "env_01...",
  "vault_ids": ["vlt_01..."],
  "resources": [
    {"type": "memory_store", "memory_store_id": "memstore_01...", "access": "read_write",
     "instructions": "seen.json 是上次运行看到的评论 id,按平台分组。"}
  ],
  "initial_events": [
    {
      "type": "user.message",
      "content": [{"type": "text", "text": "门店清单:Katz's Delicatessen(Google、Yelp、Tripadvisor 网址见附件 stores.json);Haidilao Hot Pot Flushing。读昨晚以来的新评论,出晨报。"}]
    }
  ],
  "schedule": {"type": "cron", "expression": "30 6 * * *", "timezone": "America/New_York"},
  "budget": {"type": "limit", "max_list_cost": {"amount": "50", "currency": "USD"}}
}
运行结果怎么拿到?webhook 只推「瘦」载荷:事件类型、id 和时间,不带完整对象,你收到后再用 GET 去取(Subscribe to webhooks)。订阅 session.status_idled 和 deployment_run.failed 两种就够了。要注意 session.status_idled 的意思是「agent 停下来等输入」,跑完和卡在审批上都会发它;收到后要用 GET 取会话,看最近一次 session.status_idle 事件里的 stop_reason.type,再决定去取晨报还是去告警(Session event stream)。deployment_run.failed 说明这一晚连会话都没建起来;你手动调 run 接口触发的运行不发 deployment_run 事件,测试时别等它。同一事件最多投递 3 次,间隔 5 到 120 秒、带抖动的指数退避,最后一次也失败就丢弃,不会排队补发,所以你的服务器要按 event.id 去重,并且每天早上再用 deployment runs 列表对一遍账。签名密钥以 whsec_ 开头,请求头是 webhook-id、webhook-timestamp 和 webhook-signature,格式和 Standard Webhooks 一致。
| `stop_reason.type` | 什么意思 | 收到 webhook 后你的服务器做什么 |
|---|---|---|
end_turn | agent 做完了这一轮 | 用 Files API 取 /mnt/session/outputs/report.md,推给值班经理 |
requires_action | 有工具调用在等批准,比如 MCP 工具还是 always_ask | 发告警,改 agent 的权限策略;不要在半夜自动批准 |
budget_reached | 这次运行的列表价花到了预算 | 发告警,查是不是 agent 在循环重试;第二天再调预算 |
一次真实往返:模型发出什么,接口回了什么
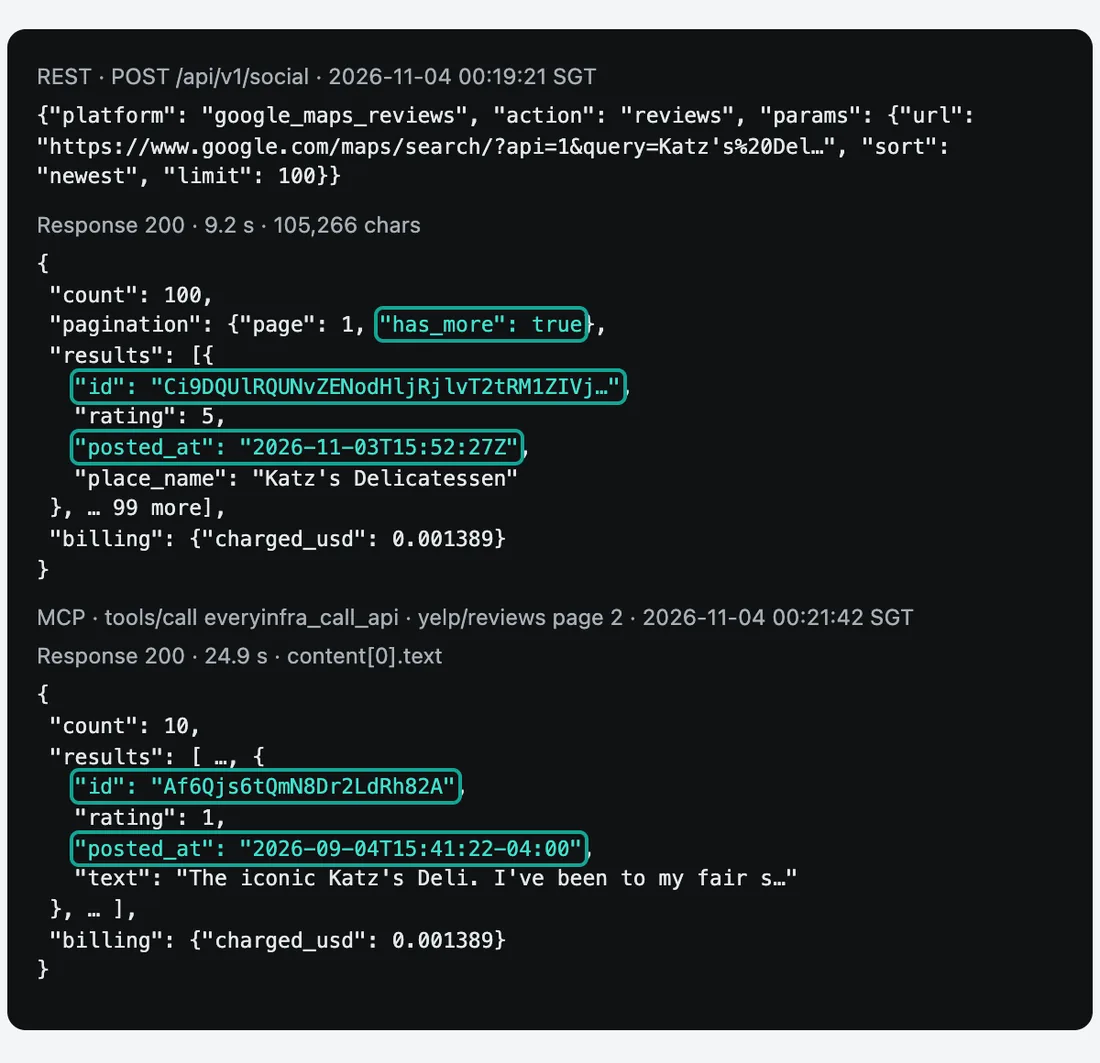
Anthropic 一侧我们没有部署,但 agent 经 MCP 发给 EveryInfra 的请求,和它自己用 curl 发的请求在接口一侧是一样的。下面是 00:21:42(新加坡时间)经远程 MCP tools/call 读 Katz 在 Yelp 上第 2 页评论的真实请求,page_token 来自第一页返回里的 next_page_token,这里截短了:
{"jsonrpc": "2.0", "id": 7, "method": "tools/call",
 "params": {"name": "everyinfra_call_api",
  "arguments": {"platform": "yelp", "action": "reviews",
   "params": {"url": "https://www.yelp.com/biz/katzs-delicatessen-new-york",
              "page_token": "pt1.4EnA2jhN8mJn…"}}}}
返回 HTTP 200,耗时 24.9 秒,content[0].text 里是 9,675 个字符的 JSON,10 条评论,按 $0.001389 扣费。每条评论有 id、rating、posted_at、text 等字段;我们关心的是 id,因为后面判断「新」全靠它。下面这张表是 Katz 三个平台第一轮(T1)的全部真调。
| 新加坡时间 | 能力 | 方式 | 条数 | 耗时 | 返回体字符 | 扣费 |
|---|---|---|---|---|---|---|
| 00:18:04 | google_maps_reviews/search | REST | 3 | 72.5 秒 | 3,915 | $0.001389 |
| 00:19:21 | google_maps_reviews/reviews,newest,100 条 | REST | 100 | 9.2 秒 | 105,266 | $0.001389 |
| 00:19:46 | yelp/reviews 第 1 页 | REST | 10 | 24.6 秒 | 11,825 | $0.001389 |
| 00:20:22 | tripadvisor/search | REST | 1 | 15.2 秒 | 1,741 | $0.001389 |
| 00:20:43 | tripadvisor/reviews | REST | 50 | 11.1 秒 | 54,739 | $0.001389 |
| 00:21:02 | yelp/reviews,网址带 sort_by=date_desc | REST | 10 | 27.4 秒 | 11,825 | $0.001389 |
| 00:21:42 | yelp/reviews 第 2 页 | MCP | 10 | 24.9 秒 | 9,675 | $0.001389 |
00:17:32 的第一次调用拿到了 429(我们用的测试 Key 每分钟限 10 次),没有扣费,等了半分钟重试成功。之后为了海底捞和墨西哥城的 Contramar 又做了 13 次调用,其中 4 次搜索结果为空,接口按 empty_result_refunded 自动退回,第一轮合计扣费 15 次、$0.020835;加上 01:20 的第二轮 5 次,全部 20 次扣费合计 $0.02778。Google 地点搜索在美国以外的两家店(马德里 Botín、墨西哥城 Contramar)都返回空结果并退款,我们改用 Google 地图搜索网址直接调 google_maps_reviews/reviews,拿到了 Contramar 的 50 条评论。
实测一:「最新 N 条」在三个平台各盖多少天
每晚读多少条才够,取决于这一页覆盖多长时间。我们按每次返回列表里第一条和最后一条的 posted_at 相减,得到下图。Google 有两条被编辑过的旧评论(日期是 10 月 23 日和 8 月 10 日)排在列表中间,Google 帮助中心说评论被编辑后显示的是编辑日期(Google 商家资料帮助),我们没有把这两条算进覆盖时长。
同样是「最新 50 条」,在 Katz 的 Google 上不到两天,在 Contramar 的 Tripadvisor 上超过一年。差别来自两件事:一是店本身的评论量,二是平台的评论语言。Tripadvisor 的两次返回全部是英文:Katz 的 50 条全是英文;Contramar 我们用的是墨西哥站 tripadvisor.com.mx 的网址,返回的 50 条也全是英文,时间跨度 2025-09-02 到 2026-10-21。也就是说,这个接口读到的是 Tripadvisor 的英文评论,西班牙语评论不在里面;对以本地客人为主的店,Tripadvisor 一侧每晚基本不会有新评论,但读一次只要 $0.001389,留着也不亏。
Yelp 是另一种情况。Katz 的 Yelp 第一页 10 条,日期从 9 月 20 日到 11 月 2 日,顺序是乱的;Yelp 支持页面说默认排序会综合时间、投票和评论质量等因素,所以较旧的评论可能排在较新的前面,登录用户才能选「Newest First」(Yelp 支持中心)。我们在网址后面加 sort_by=date_desc 再调一次,返回的 10 条 id 和第一次完全一样,这个网址参数没有效果。第 2 页的 10 条里有一条 11 月 1 日的评论,还有 5 条比第一页最旧的那条更新。所以 Yelp 每晚至少读两页,且只能靠 id 判新,不能靠「第一页最上面那条」。
实测二:差评在哪个平台,讲的是什么
下图是每次返回里各星级的占比。Katz 的 Google 最新 100 条里 1–2 星有 10 条,占 10%;Tripadvisor 50 条里 10 条,占 20%;Yelp 两页 20 条里只有 1 条 1 星。海底捞 Google 50 条里 49 条是 5 星、1 条 3 星,没有差评;Yelp 第一页 10 条都是 4–5 星。Contramar 的 Google 50 条里 1 星、2 星各 1 条。
我们逐条读了 Katz 在 Google 和 Tripadvisor 上各 10 条 1–2 星原文,人工打了标签,一条可以有几个标签。Google 的 10 条里,讲菜品(肉干、面包散)的 6 条,讲「名气大、不值这个价」的 7 条,讲服务态度的 3 条,讲座位拥挤或环境的 2 条,讲排队的 1 条。Tripadvisor 的 10 条里,菜品 7 条、价格与名气 6 条、服务 5 条、排队与座位 3 条,另有 2 条讲的是网上订购和邮寄,和堂食无关。这个区分对晨报有用:网上订单的投诉应该转给电商团队,不该算进门店服务。
另外两个发现直接决定提示词怎么写。第一,Google 那 10 条差评里有 6 条不是英文:意大利语 2 条、德语 2 条、土耳其语 1 条、西班牙语 1 条,接口参数 lang 控制的是界面语言,不会把评论翻译过来,所以 agent 要先翻译再归类。第二,Google 最新 100 条里有 10 条带店家回复,回复时间全部落在 11 月 2 日 UTC 21:10 到 21:32 这 22 分钟里,10 条里 9 条回的是 5 星,只有 1 条是 1 星差评(讲有人插队),那条差评发出约 35 小时后才得到回复。也就是说,这家店是定期集中回复,而且优先回好评;晨报加一列「是否已回复」,就能把没人管的差评顶到最前面。
实测三:两次快照之间怎么判「新」
第一轮(T1)在 00:19–00:21(新加坡时间),第二轮(T2)在 01:20–01:21,相隔约一小时,正好模拟「上一晚」和「这一晚」两次运行。T2 我们先经远程 MCP 读 Katz 在 Google 上最新 50 条,再用 REST 加 since=2026-11-03 读一次,Yelp 第一页和 Tripadvisor 各读一次,合计 4 次、$0.005556,另用 1 次 yelp/search 给西语版找 Contramar 的 Yelp 店铺页。判新的规则只有一条:评论 id 不在上一次见过的集合里,就是新的。
| 平台 | T1 读到 | T2 读到 | T2 里上次没见过的 id | 其中 1–2 星 |
|---|---|---|---|---|
| Google 最新 50 条(MCP) | 100 条 | 50 条,53,364 个字符 | 3 条,全是 5 星 | 0 |
Google since=2026-11-03(REST) | — | 17 条,21,588 个字符,没有下一页 | 3 条(另 14 条 T1 已读过) | 0 |
| Yelp 第 1 页 | 10 条 | 10 条,id 和顺序与 T1 完全一样 | 0 | 0 |
| Tripadvisor | 50 条 | 50 条 | 0 | 0 |
最有用的是 Google 那 3 条新评论的发布时间:17:15、16:49 和 14:54(UTC)。前两条晚于 T1 的调用时刻(UTC 16:19),是正常的新评论;第三条 14:54 却比 T1 调用早了 1 小时 25 分,比 T1 返回里最新的那条(15:52)还早,T1 的 100 条里却没有它。也就是说,评论在 Google 上出现的时刻可能晚于它显示的发布时间。如果晨报的规则写成「只看 posted_at 晚于上次最新一条的评论」,这条就会被永远跳过;按 id 比对才能接住它。同一批里,T1 和 T2 都出现的评论,posted_at、星级和店家回复都没有变化。
since 参数的表现也值得写进提示词。它是日期,不是时刻:since=2026-11-03 返回了 UTC 11 月 3 日当天的全部 17 条,其中 14 条 T1 已经读过,所以它不能代替 id 去重;但它把返回体从 53,364 个字符降到 21,588 个字符,少了约 60%,对走 MCP 的做法尤其划算。我们的建议是:since 写上一次成功运行日期的前一天,sort=newest,再按 id 去重;limit 仍写 50,作为 since 写错时的兜底。Yelp 和 Tripadvisor 在这一小时里都没有新评论,Yelp 第一页的 10 个 id 连顺序都没变,所以第一页不变并不说明第二页也没变,两页都要读。这一晚的晨报只有一行:「过去一小时三个平台新增 3 条评论,都是 5 星,没有新差评。」
memory store 里存什么,也由这次对比决定。每个平台存最近见过的评论 id 集合就够了,Google 存最近 400 个(接口一次最多翻到 400 条)、Yelp 和 Tripadvisor 各存最近 100 个,再加一个「上次成功运行的日期」。不要只存「最新一条的时间」,原因就是上面那条 14:54 的评论。
晨报长什么样
归类规则要写死在提示词里,而且要给每一类一句定义和几个判断线索,否则同一条差评今天归「服务」、明天归「排队」,月底就没法比。我们按 Katz 和 Contramar 的 28 条差评原文(Katz 21 条、Contramar 7 条)整理出下面六类,每一类的线索都来自原文里反复出现的说法。一条差评可以同时属于几类;agent 拿不准时宁可多给一个标签,也不要硬选一个。
| 类别 | 一句定义 | 原文里常见的线索 | 晨报里转给谁 |
|---|---|---|---|
| 菜品 | 吃到的东西本身有问题 | 干、咸、油、没味道、不新鲜、面包散 | 厨房负责人 |
| 服务 | 员工的态度或做法 | 粗鲁、不理人、摔袋子、擅自加小费 | 店长 |
| 排队与座位 | 等位、分桌、座位安排 | 排很久、插队、只给吧台、桌距太近 | 前厅经理 |
| 价格与名气 | 觉得不值这个价,或名气大于实际 | 太贵、被吹大了、网红店、不值得专程 | 市场与定价 |
| 环境 | 店内环境和设施 | 拥挤、桌距近、邻桌抽电子烟 | 店长 |
| 线上订单 | 网上下单、邮寄、外卖 | 寄了一周才到、网上买的调料有问题 | 电商团队 |
下面是用 T1 返回里 Katz 在 Google 上 10 条 1–2 星拼出的晨报样例,评论原文的大意由我们翻译和压缩,日期是 UTC。真实晨报里每一行还应该带评论链接,方便值班经理点开回复。
| 发布时间 | 星级 | 原文语言 | 大意 | 归类 | 已回复 |
|---|---|---|---|---|---|
| 11-03 02:40 | 1 | 意大利语 | 饮料和配菜窗口的员工态度粗鲁,打包时把袋子摔给客人 | 服务 | 否 |
| 11-01 17:59 | 1 | 英语 | 这几年菜越来越差,今天的熏牛肉三明治又油又没味 | 菜品、价格与名气 | 否 |
| 11-01 10:08 | 1 | 英语 | 有人插队,厨师却让自己继续排 | 排队与座位 | 是 |
| 10-31 15:07 | 1 | 土耳其语 | 名气被吹大了,不值得打车专程来 | 价格与名气 | 否 |
| 10-31 12:55 | 2 | 西班牙语 | 切肉的店员态度差,让人很不舒服 | 服务 | 否 |
| 10-31 08:34 | 2 | 意大利语 | 肉像白煮的、很干,面包差,价格很高 | 菜品、价格与名气、环境 | 否 |
| 10-31 02:53 | 2 | 德语 | 菜很失望,只有环境像美国老店;看不懂这份名气,价格和期待都对不上 | 菜品、价格与名气 | 否 |
| 10-31 02:51 | 1 | 德语 | 肉出乎意料地干、没调味,配不上这份名气,不值这个钱 | 菜品、价格与名气 | 否 |
| 10-30 23:33 | 1 | 英语 | 31 美元的熏牛肉三明治很干,筋多到切不开 | 菜品、价格与名气 | 否 |
| 10-30 16:33 | 2 | 英语 | 主要在投诉一位不负责他们这桌的服务员态度粗鲁,冤枉他们私自挪了邻桌;另说名不副实、菜一般、桌距太近 | 服务、菜品、环境、价格与名气 | 否 |
晨报的第一段应该是汇总,而不是逐条罗列:昨晚以来新增几条 1–2 星,分别在哪个平台,最多的原因是什么,有几条还没回复。按上表,汇总可以写成:「过去 4 天 Google 新增 10 条 1–2 星,『名不副实、不值这个价』7 条,菜品 6 条;6 条是外语评论;9 条未回复,其中 3 条讲员工态度,建议今天先回这 3 条。」评论里出现的人名、员工名不要写进晨报正文,只保留链接。Contramar 的 Google 评论正文里还夹着 <br> 这样的换行标签(30 条有文字的评论里有 6 条),写晨报前要先清掉。
门店多了怎么拆:一个部署管几家店
两家店放进一个会话没有问题,二十家、两百家就要想清楚怎么拆。第一种拆法是一个部署管全部门店:一个 cron、一个会话、一份晨报,配置最少;缺点是一个会话的上下文会随店数变长,模型费近似按店数线性增长,而且只要中途有一家店的接口报错、agent 停下来,后面的店就都没读。第二种拆法是每个城市或每个区域一个部署:纽约一个、洛杉矶一个,各用各的时区,晨报按区域经理分发;一个区域出错不影响别的区域。文档写明一个组织最多 1,000 个定时部署,按区域拆远远用不完。
拆的时候还要注意两件事。其一是错开触发时刻。多个部署如果都写 30 6 * * *,它们会在同一分钟前后挤着打 EveryInfra 接口;我们这把测试 Key 每分钟 10 次,第一次调用就碰到了 429。生产 Key 的次数按你的套餐算,但把 cron 写成 30 6、33 6、36 6 这样错开几分钟,几乎没有代价。其二是预算按区域算。部署的预算是每次运行的上限,所以 10 家店的区域和 50 家店的区域应该各写各的数,不要用一个统一的大数。按前面的估算,Sonnet 5.5 走 HTTP 加筛选,一家店一晚最多约 $0.0855;10 家店的区域写 "300",50 家店的区域写 "1300",都留出了约三倍的余量。
claude managed agents pricing:每晚接口费和 Anthropic 一侧的账
账分两边算。EveryInfra 一侧最简单:每家店每晚 4 次调用,按 $0.001389 一次是 $0.005556;一个月 30 晚 $0.1667;10 家店 $1.6668,50 家店 $8.334。没有月费,空结果自动退款,找店的 3 次搜索只在第一次配置时花(价格见定价页)。
Anthropic 一侧,按 2026 年 11 月 4 日读取的定价页,Managed Agents 按两项计费:token 按所用模型的列表价,会话运行时每小时 $0.08,只在会话处于 running 状态时按毫秒计,idle 等待时不计;会话里的网页搜索每 1,000 次 $10;Batch API 的折扣不适用(Pricing)。同一页上的列表价是:Opus 5.5 输入每百万 token $4、输出 $20;Sonnet 5.5 输入 $2、输出 $10;Haiku 5.5(提示词不超过 10 万 token 时)输入 $0.10、输出 $0.50。
token 用多少,我们没有实测,只能估算,假设写在这里,方便你换成自己的数。一家店一晚的原始返回是 129,603 个字符(Google 50 条用第二轮的真实返回、Yelp 两页、Tripadvisor 50 条)。术语表说旧模型约 3.5 个英文字符折 1 个 token、4.7 及以后的模型同样文字多约 30% 的 token(Glossary),我们按每 token 2.69 个字符算,原始返回约 48,138 个 token。agent 循环里上下文会被重复读取,读几遍我们测不到,所以给两档:1 倍(每份返回只进上下文一次)是下限,3 倍是偏高的上限;两档都另加 15,000 个 token 的系统提示词和工具说明、3,000 个输出 token,不计提示词缓存的折扣(缓存命中会更便宜,所以这是偏高的估计)。走 MCP、让原始返回全部进上下文,一晚约 63,138~159,414 个输入 token;走 HTTP、用 jq 只把 1–2 星交给模型,一晚约 17,854~23,564 个输入 token,按 3 倍那档算少了约 85%。字符折 token 的系数也是估算,用 Anthropic 的 token 计数接口对自己的返回体数一次会更准。运行时按实测的 4 次工具耗时 69.8 秒加 60 秒模型时间算,一晚 $0.00288。
| 一家店 | 每晚(重复读 1 倍~3 倍) | 每月(30 晚,3 倍) |
|---|---|---|
| EveryInfra 接口费(4 次,目录价) | $0.005556 | $0.1667 |
| 会话运行时(估算 129.8 秒) | $0.00288 | $0.0864 |
| Haiku 5.5,HTTP 加筛选 | $0.0033~$0.0039 | $0.117 |
| Haiku 5.5,MCP 全量进上下文 | $0.0078~$0.0174 | $0.522 |
| Sonnet 5.5,HTTP 加筛选 | $0.0657~$0.0771 | $2.313 |
| Sonnet 5.5,MCP 全量进上下文 | $0.1563~$0.3488 | $10.464 |
| Opus 5.5,HTTP 加筛选 | $0.1314~$0.1543 | $4.629 |
结论很直接:接口费是确定的小数,真正决定成本的是模型和「让多少原始数据进上下文」。用 Sonnet 5.5 走 HTTP 加筛选,一家店一晚合计约 $0.074~$0.086,接口费只占 6.5%~7.5%;同样的模型走 MCP 全量,一晚约 $0.165~$0.357,是前者的 2.2~4.2 倍。归因和翻译这种活,Haiku 5.5 多半够用,一家店一个月不到 $0.40。部署的每次预算可以按「店数 × 单店估算 × 3」来定:10 家店用 Sonnet 走 HTTP,估算一晚约 $0.86,预算写 "300"(3 美元)就能挡住失控的循环,又不会误伤正常运行。有网友在 Reddit 上说自己试了三次 Managed Agents 就花了约 6 美元 API 费(Reddit 讨论),这正是预算要从第一天就设上的原因。
claude managed agents vs agent sdk,以及 Claude Code、Cowork 定时任务
Anthropic 现在至少有四种方式让 Claude 定时干活,选哪种取决于谁来跑循环、谁来付钱、Key 放在哪。Agent SDK 是一个库,把 Claude Code 的 agent 循环搬进你自己的进程,你自己找机器、自己排程(Agent SDK 概览、托管说明);Managed Agents 是 Anthropic 托管的循环加沙盒;Claude Code 的定时任务(routines)和 Cowork 的定时任务则是订阅产品里的功能,按订阅用量算。
| Managed Agents 定时部署 | Agent SDK | Claude Code 定时任务 | Cowork 定时任务 | |
|---|---|---|---|---|
| 谁跑循环 | Anthropic 云端 | 你的服务器或容器 | Anthropic 云端 | Anthropic 云端 |
| 怎么排程 | cron + IANA 时区,抖动最多 9 分钟 | 你自己的 cron 或任务队列 | cron,最短间隔 1 小时 | 在应用里选频率 |
| 计费 | API 按 token + 每小时 $0.08 | API 按 token | 订阅用量 | 订阅用量 |
| 适合 | 多门店、要预算上限和 webhook 的生产任务 | 已有服务器、要完全控制 | 开发者自己看的摘要 | 个人每周报表 |
| 出处 | Scheduled deployments、Pricing | Agent SDK 概览、托管说明 | Routines | Cowork 帮助中心 |
我们之前写过另外两篇:一篇用 Claude Code 定时任务每晚读 Reddit 帖子出痛点摘要,实测一页 100 帖只盖 18.7 小时(Claude Code 定时任务读 Reddit);一篇用 Cowork 定时任务每周一出竞品价格评论表(Cowork 定时任务竞品价格表)。三篇放在一起看:给自己看、一周一次的,用 Cowork 最省事;开发者自己用、跑在仓库旁边的,用 Claude Code;给几十家门店、每晚都跑、要有预算上限、失败要告警、结果要推回自己系统的,用 Managed Agents 的定时部署。Claude Code 定时任务文档写明最短间隔是 1 小时、按订阅用量计(Routines);Cowork 定时任务在云端跑,电脑睡着也照常运行(Cowork 帮助中心)。只想把 Google 地图评论导出成表,不需要 agent,可以看Google 地图评论怎么批量抓。
出问题时先查哪一层
夜间任务出错时,晨报里往往只有一句「没拿到数据」。下面这张表把三层可能的毛病放在一起:Anthropic 的部署和会话、vault 与网络、EveryInfra 的接口。左边是你会看到的症状,右边是先去查的地方。表里 EveryInfra 一侧的几行,我们在 11 月 4 日的真调里都遇到过;Anthropic 一侧的几行来自文档对各种错误和状态的说明。
| 症状 | 通常是哪一层 | 先查哪里 | 怎么办 |
|---|---|---|---|
| 早上没有晨报,也没有 webhook | 部署没建起会话,或 webhook 3 次投递都失败被丢弃 | GET /v1/deployment_runs?has_error=true | 手动调 POST /v1/deployments/{id}/run 补一次 |
| 会话一直停着,晨报文件不出现 | MCP 工具集默认 always_ask | 会话最后一个 idle 事件的 stop_reason | 对 everyinfra_call_api 设 always_allow |
| 工具结果写着未授权、Nothing was charged | vault 里的 Key 错了,或凭据的 allowed_hosts 没写对 | vault 凭据的 secret_name 和 networking | 改凭据,不要让 agent 重试 |
curl 拿到 403,正文里写着主机名 | environment 的 allowed_hosts 没放行 | environment 的 networking | 把 api.everyinfra.com 加进去 |
| 模型只看到一段截断的预览 | MCP 工具输出超过 10 万字符 | 那次调用的 limit | 改成 50 条,或改走 HTTP 加 jq |
| 接口返回 429 | 一把 Key 的每分钟次数用完 | 返回里的 retry_after | 等够秒数再调,429 不扣费 |
| 搜索返回空结果,并且自动退款 | 地点搜索没找到这家店 | 返回里的 reason | 改用 Google 地图搜索网址直接读评论 |
这张表背后有一个原则:每一层的错误都要在晨报里写出来,而不是让 agent 自己想办法绕过去。agent 很擅长「换个参数再试一次」,但对一个每晚花钱、无人值守的任务来说,绕过去往往意味着读错了店、读了两遍,或者把一个早该修的配置问题拖了一个月。所以提示词里要写明:遇到未授权、403、预算暂停这三类,直接停下写原因;只有 429 可以等待后重试一次。
做不了或要注意的地方
第一,Anthropic 一侧我们没有实测。定时部署、vault 替换、权限策略、webhook,全部是按 platform.claude.com 文档写的配置示例,读取日期 2026 年 11 月 4 日;Managed Agents 仍是 beta,字段可能变。vault_ids、resources 这些字段的写法按会话文档和 memory 文档的示例写成,创建前请用你所用 SDK 版本的 deployments 接口参考再核一次。第二,Tripadvisor 一侧只读到英文评论,西语、中文等其他语言的评论不在返回里。第三,Google 地点搜索对美国以外的店我们两次都拿到空结果(已退款),改用地图搜索网址直接读评论才成功;配置新店时先手动核对一次店铺网址。第四,Yelp 的第一页不按时间排,网址里的排序参数无效,只能多读一页、按 id 判新。
第五,评论文字是不可信的输入。memory 文档专门提醒,写进 memory store 的内容可能带有提示词注入;评论正文同理,有人可能在差评里写「忽略之前的指令」。用 HTTP 加 jq 的做法,让评论只作为数据进上下文,再加上 environment 只放行 api.everyinfra.com、vault 只对这一个主机替换 Key,即使模型被诱导,Key 也出不去。第六,晨报只用于改进自己的门店。美国联邦贸易委员会 2024 年的规则禁止买卖假评论、按特定好评或差评给报酬、压制负面评论等做法(FTC 新闻稿)。差评值得每晚看,但正确的反应是回复和改进,不是去影响评论本身。这里只讲数据方法,不构成法律意见。
最近的变化
过去一个月里,和这个任务直接相关的更新有这几条,都来自 Claude Platform 更新日志。2026-10-07:web_fetch 只抓会话里已出现过的网址;limited 网络的 allowed_hosts 同时约束 web_fetch 和 web_search。2026-10-09:Managed Agents 可以用动态工作流(dynamic workflows)一次跑多个 agent;门店多到几百家时可以考虑,本文没有实测。2026-10-14:定时部署在 Claude Platform on AWS 上也能用。2026-10-20:组织管理员可以在 Console 关掉 web fetch 或限定域名,Managed Agents 会话跟随这一设置。2026-10-29:用量与成本分析 API 上线 beta,可以按模型、工作区、API Key 拆分 token 和费用,适合每月核对巡检任务花了多少。
常见问题
claude managed agents 和 Claude Code 定时任务有什么区别?
问题来自搜索联想词「claude managed agents vs claude code」「claude managed agents vs routines」和 Reddit 上的原帖「What is the point of Managed Agents」(Reddit 讨论)。两者都在 Anthropic 云端跑,区别在计费和控制面:Claude Code 定时任务按订阅用量计,最短间隔 1 小时(Routines);Managed Agents 定时部署按 API token 加每小时 $0.08 计,可以精确到分钟,每次运行有硬预算上限,结果用 webhook 推给你的系统(Scheduled deployments)。给团队或客户跑的生产任务选后者。
claude managed agents pricing 怎么算,一晚大概多少钱?
问题来自联想词「claude managed agents pricing」和「claude managed agents cost」。两项:模型 token 按列表价,会话运行时每小时 $0.08,只在 running 状态计(Pricing,2026-11-04 读取)。按本文的估算,一家店一晚用 Sonnet 5.5 走 HTTP 加筛选约 $0.077 模型费、$0.0029 运行时,加 EveryInfra 接口费 $0.0056,合计约 $0.0855(按偏高的 3 倍那档估算)。
claude managed agents vs agent sdk,该选哪个?
问题来自联想词「claude managed agents vs agent sdk」。Agent SDK 是一个库,循环跑在你自己的进程里,你负责机器、排程、密钥和日志(Agent SDK 概览);Managed Agents 把循环、沙盒、定时、凭据替换和会话记录都托管了。已经有服务器和任务队列、需要完全控制运行环境的,用 SDK;不想维护调度器、要 webhook 和每次预算的,用 Managed Agents。
Managed Agents 能不能用 web_fetch 直接读 Google 地图或 Yelp 的评论?
问题来自搜索联想词「claude managed agents web」。不稳定:web_fetch 不执行 JavaScript,2026-10-07 起只抓会话里出现过的网址(更新日志),而 Yelp 的 robots.txt 对 Claude-User 只放行 /article(yelp.com/robots.txt)。用结构化的评论接口更可靠。
定时部署错过了一次运行会怎样?
问题来自联想词「claude managed agents schedule」。暂停期间错过的触发不补跑,会话创建被限流时那次只记一条 session_rate_limited_error、不重试(Scheduled deployments)。所以下一晚要从上次成功运行记下的最后一条评论 id 往回读,而不是只读最近 24 小时;Google 一侧用 limit=50 约能盖住两天,Katz 这样的店漏一晚还能补上。
vault 里的 Key 模型能看到吗?
问题来自联想词「claude managed agents vault」「claude managed agents credential vault」。看不到。环境变量凭据在沙盒里只存占位值,出网时才替换成真值,只对 allowed_hosts 里的主机替换(Authenticate with vaults)。Anthropic 的博客也写明,agent 从头到尾看不到你的 Key(Anthropic 博客)。
上手步骤
- 在 EveryInfra 注册并取得 API Key,按快速开始用
google_maps_reviews/search、yelp/search、tripadvisor/search各找一次店,记下三个店铺网址。 - 在本机用 curl 先调一次
google_maps_reviews/reviews、yelp/reviews、tripadvisor/reviews,看清字段和返回体大小;想走 MCP 的,按 MCP 服务器页接入。 - 在 Claude Console 建 environment(
limited网络,只放行api.everyinfra.com)、vault(一条EVERYINFRA_API_KEY环境变量凭据)和 agent(关掉web_fetch、web_search)。 - 先手动开一个会话跑一遍,或者对部署调
POST /v1/deployments/{id}/run,确认晨报格式和花费;再建定时部署,cron30 6 * * *,带每次预算,订阅session.status_idled和deployment_run.failed。 - 想先看 Google 地图评论接口能读到什么,可以看Google 地图评论平台页、Yelp 平台页和Tripadvisor 平台页;每周汇总多个评论平台的做法见openai agents api 口碑巡检。
参考资料
- Claude Managed Agents overview,Anthropic 文档,2026-11-04 读取。
- Scheduled deployments,Anthropic 文档,2026-11-04 读取。
- Authenticate with vaults,Anthropic 文档,2026-11-04 读取。
- Cloud environment setup,Anthropic 文档,2026-11-04 读取。
- Tools,Anthropic 文档,2026-11-04 读取。
- MCP connector,Anthropic 文档,2026-11-04 读取。
- Permission policies,Anthropic 文档,2026-11-04 读取。
- Session budgets,Anthropic 文档,2026-11-04 读取。
- Subscribe to webhooks,Anthropic 文档,2026-11-04 读取。
- Reference,Anthropic 文档,2026-11-04 读取。
- Using agent memory,Anthropic 文档,2026-11-04 读取。
- Restrict web search and web fetch domains,Anthropic 文档,2026-11-04 读取。
- Web fetch tool,Anthropic 文档,2026-11-04 读取。
- Pricing,Anthropic 文档,2026-11-04 读取。
- Claude Platform release notes,Anthropic 更新日志,2026-11-04 读取。
- Define your agent,Anthropic 文档,2026-11-04 读取。
- Start a session,Anthropic 文档,2026-11-04 读取。
- Session event stream,Anthropic 文档,2026-11-04 读取。
- Glossary,Anthropic 文档,2026-11-04 读取。
- Agent SDK overview,Claude Code 文档,2026-11-04 读取。
- Hosting the Agent SDK,Claude Code 文档,2026-11-04 读取。
- Routines,Claude Code 文档,2026-11-04 读取。
- Schedule recurring tasks in Claude Cowork,Claude 帮助中心,2026-11-04 读取。
- Does Anthropic crawl data from the web,Claude 帮助中心,2026-11-04 读取。
- New in Claude Managed Agents: run agents on a schedule,Anthropic 博客,2026-11-04 读取。
- Claude Managed Agents: get to production 10x faster,Anthropic 博客,2026-11-04 读取。
- MCP Transports,Model Context Protocol 规范,2026-11-04 读取。
- MCP Tools,Model Context Protocol 规范,2026-11-04 读取。
- Place Details (New),Google 开发者文档,2026-11-04 读取。
- Work with review data,Google Business Profile 文档,2026-11-04 读取。
- Read and reply to reviews,Google 商家资料帮助,2026-11-04 读取。
- Business Reviews,Yelp Fusion 文档,2026-11-04 读取。
- How is the order of reviews determined?,Yelp 支持中心,2026-11-04 读取。
- yelp.com/robots.txt,Yelp,2026-11-04 读取。
- Location Reviews,Tripadvisor Content API 文档,2026-11-04 读取。
- tripadvisor.com/robots.txt,Tripadvisor,2026-11-04 读取。
- crontab,The Open Group Base Specifications Issue 8,2026-11-04 读取。
- Time Zones,IANA,2026-11-04 读取。
- Standard Webhooks,Standard Webhooks,2026-11-04 读取。
- FTC final rule banning fake reviews,美国联邦贸易委员会,2024-08-14 发布,2026-11-04 读取。
- What is the point of Managed Agents?,Reddit r/ClaudeAI,2026-11-04 读取。
- EveryInfra 接口目录,EveryInfra,2026-11-04 00:13 新加坡时间读取。
引用编号 BL-79