Gemini Connected Apps:数据工具怎么接
Gemini Connected Apps 预览已开放。拿真实数据 MCP 对照 Google 的 12 条要求实测:鉴权卡在哪、工具怎么写、调用多少钱。
这篇文章写给做数据工具的开发者:你手上已经有一个远程 MCP 服务器,能把社交平台和电商的数据交给 AI,现在想知道 Google 在 2026 年 10 月 28 日开放预览的 Connected Apps Platform 能不能、该不该接。先说清楚测了什么、没测什么。Google 一侧的 Connected Console 注册、开发者模式里建自定义应用、审核和发布,我们都没有执行:Connected Console 目前只对美国开发者开放预览,申请要填表排队,本文里凡是 Google 一侧的步骤和配置,都标成「配置示例」,内容照 developers.google.com 和 support.google.com 的原文写。EveryInfra 一侧的每个数都来自 2026 年 11 月 11 日 00:17 到 00:35(新加坡时间)对 https://api.everyinfra.com/mcp 的真实调用:握手、列工具、8 次数据调用、几次故意出错的请求,以及按 Google 文档的发现顺序去探 OAuth 元数据。EveryInfra 没有在 Gemini 或 Google 搜索里上架,也没有提交审核,本文不代表 Google 对任何一方的认可。
结论先放前面。把 Google 文档里能逐条核对的 12 条要求拿来对照,EveryInfra 的通用入口 /mcp 符合 6 条,带 OAuth 的 /mcp/all 符合 5 条,另有 3 条部分符合。挡路的不是传输协议,也不是版本号,而是两件更根本的事:Gemini 的连接方式里没有地方填 API key 请求头,只能走 OAuth;Google 的上架政策不允许「一个工具分发到很多能力」的通用写法,而这恰恰是大多数数据 MCP 的写法。第三件事是返回体积:11 月 11 日一次 youtube/search 原样返回 20 条视频,正文 39,732 字节;只留回答问题要用的 6 个字段,是 5,062 字节,只剩 12.7%。返回越大,模型读它花的钱越多,正文按 token 估算了这笔账。
Gemini Connected Apps Platform 是什么:10 月 28 日的预览
2026 年 10 月 28 日,Google 在开发者博客上宣布 Connected Apps Platform,定位是让开发者「做一次,接到 Gemini 应用和搜索两个地方」(Google 博客,2026-10-28)。在这之前,Gemini 里的第三方连接应用要和 Google 一对一合作才能做出来;按 9to5Google 当天的报道,Gemini 应用里这类应用当时已经超过 50 个,包括 Adobe、Dropbox、Instacart、OpenTable、Ticketmaster,Calm 会在几周内加入(9to5Google,2026-10-28)。新平台把这个过程改成自助:开发者准备一个云端托管的 MCP 服务器,或者在 Android 应用里用 AppFunctions 做本机 MCP,然后在新的 Google Connected Console 里注册、测试、提交审核,并且可以自己选上线到搜索、Gemini 应用还是两边都上。
产品主页把两条接入路径写得很清楚:远程 MCP 服务器用于把工具和经过授权的数据接到 Google 的产品里,还可以用 MCP Apps 做交互界面;Android MCP 是客户端路径,用 Jetpack AppFunctions 库让应用把功能交给 Gemini 这样的助手,在手机本地执行(Connected Apps Platform 主页)。Android 文档补了一个限制:AppFunctions 需要 Android 16 以上,和 Gemini 的集成截至 2026 年 5 月还是给受信测试者的私有预览(AppFunctions 概览)。做数据工具的团队通常没有自己的 Android 应用,本文只讨论远程 MCP 这条路。
「谁能用」是第一个要核对的点。在 10 月 29 日发布的开发者讲解视频里,Google 的工程师在第 6 分钟说明预览只对美国开发者开放,接着又说开发者模式现在对美国所有用户可用(Android Developers 频道视频,2026-10-29)。用户这边也一样窄:Gemini 帮助中心写明,自己连自定义 MCP 应用要年满 18 岁、在美国、用个人 Google 账号(不能是工作或学校账号)、打开「保留活动记录」,界面只有英文,而且只能在网页版里建立连接(Gemini 帮助:自定义应用)。搜索一侧的帮助页也说,搜索 AI 模式里的连接应用目前只在美国、只用英文(Google 搜索帮助:连接应用)。如果你的用户主要不在美国,这一段已经决定了短期内的收益上限。
最近 60 天的变化:从连接应用到开发者平台
Connected Apps Platform 不是一夜冒出来的。把最近两个月 Google 自己公布的变化排一下,可以看出它是一步步从「Google 挑合作方」走到「开发者自己申请」的。
| 日期 | 变化 | 对数据工具开发者意味着什么 | 出处 |
|---|---|---|---|
| 2026-09-23 | 新一批连接应用进入 Gemini:Airtable、Linear、monday.com、Adobe、Webflow、Experian、Peloton 等 | 第三方应用在 Gemini 里用 @ 提及的用法已经成形,但名单还是 Google 选的 | Google 博客 |
| 2026-10-13 | Gemini 改版,加入「Customize」页面集中管理连接应用,可连的应用超过 40 个,大多只在美国英文环境 | 用户开始有一个固定位置找应用,入口变清楚了 | Gemini 发布说明 |
| 2026-10-27 至 10-30 | developers.google.com 上线 MCP 开发者指南、服务器优化、OAuth、开发者模式、Connected Console 的整套文档 | 要求第一次写成文字,可以逐条对照自己的服务器 | MCP 开发者指南、前置条件,2026-10-30 更新 |
| 2026-10-28 | Connected Apps Platform 开放预览,一个 MCP 服务器同时接 Gemini 和搜索 | 自助注册,但要过审核,只对美国开发者 | Google 博客 |
| 2026-10-29 | Google 开发者讲解视频:从 FastMCP 写服务器、部署到 Cloud Run、开发者模式测试到 Console 提交 | 整个流程第一次被完整演示,也说清了只对美国开放 | 视频 |
| 2026-11-02 | Connected Apps 政策更新,「集成完整性」一节禁止动态发现工具和通用分发工具 | 大多数数据 MCP 的「一个工具调所有能力」写法不合规 | Connected Apps 政策 |
| 2026-11-10 | Gemini API 发布 Gemini 4 Carbon 正式版,11 月 30 日前输入每百万 token $2、输出 $10 | 在 Gemini API 里自己接 MCP 的路线,模型选择和价格又多了一档 | Gemini API 发布说明 |
Gemini Connected Apps Platform API:三条接法各管什么
「把数据工具接进 Gemini」其实有三条完全不同的路,适用的人、鉴权方式和审核要求都不一样。很多讨论把它们混在一起,结果在开发者模式里折腾半天,才发现自己要的其实是 Gemini API。
第一条是 Connected Apps Platform 本身:你的应用出现在 Gemini 应用和搜索 AI 模式的应用列表里,所有符合条件的用户都能用 @ 提到它。要走 Connected Console 注册、通过审核才能发布,鉴权只能是不鉴权、机器对机器的 OAuth 客户端凭据,或者用户授权的 OAuth 授权码流程(Console 操作步骤,2026-10-28 更新)。第二条是开发者模式里的自定义应用:在 gemini.google.com/devmode 里填一个 MCP 服务器网址就能连,只有你自己的账号能用,不需要审核,但同样只能选 OAuth 或者不鉴权(开发者模式使用说明,2026-10-28 更新)。第三条是 Gemini API 的 Interactions 接口:在请求的 tools 里写一个 mcp_server,可以带任意 HTTP 请求头,用 allowed_tools 限定能调哪些工具,只支持 Streamable HTTP(Gemini API 函数调用文档)。Gemini CLI 的 settings.json 也属于这一类,httpUrl 加 headers 就能带 API key(Gemini CLI MCP 配置)。
| 接法 | 谁能用 | 能带 API key 请求头吗 | 要审核吗 | 地区和账号限制 | 适合谁 |
|---|---|---|---|---|---|
| Connected Apps Platform 上架 | 所有符合条件的 Gemini 和搜索用户 | 不能,只有不鉴权或 OAuth | 要,Console 第 9 步提交 | 预览只对美国开发者;用户侧美国、英文 | 有自己用户账号体系、想被普通用户发现的服务 |
| 开发者模式自定义应用 | 只有建应用的那个账号 | 不能,只有不鉴权或 OAuth | 不要 | 18 岁以上、美国、个人账号、网页版建立连接 | 上架前自测;个人自用 |
Gemini API 的 mcp_server | 你自己的程序和 agent | 能,headers 任意填 | 不要 | 按 Gemini API 的可用地区 | 做数据分析、监测、报表的团队 |
| Gemini CLI | 你自己的终端 | 能,headers 任意填 | 不要 | 按 Gemini CLI 的可用范围 | 开发者日常查数、写脚本 |
| Gemini Enterprise | 企业里的员工 | 不能直接填,要经 ADK 和 Agent Gateway 转 | 企业管理员批准 | 按企业版合同 | 公司统一管理工具 |
如果你看的是企业版,我们之前写过一篇 Gemini Enterprise 接 MCP 做品牌口碑监测,那里的结论是企业版的 MCP 连接同样只认 OAuth 或不鉴权,要带 API key 得在中间放一层 ADK agent。如果你想要的是「让 Gemini 定期整理一份热帖摘要」,那是 Gemini skills 的用法,见 Gemini skills 取代 Gems:每周热帖摘要实测。如果你要的是一份带引用的长报告,Deep Research API 也能挂 MCP,见 Gemini Deep Research API 接 MCP 拿社交数据。本文只回答一个问题:Connected Apps Platform 和开发者模式这两条面向 Gemini 应用的路,数据工具要准备什么、会卡在哪。
申请条件和审核:Connected Console 的九步
Connected Console 的操作文档把上架拆成 9 步,每一步要准备的东西不一样。我们没有 Console 账号,下面的表是照文档原文整理的「配置示例」,没有实际走过。
| 步骤 | 做什么 | 要准备的东西 | 对数据工具的难点 |
|---|---|---|---|
| 1 | 建应用、选类别 | 类别选定后不能改 | 「数据查询」不是现成类别,要从现有类别里挑最接近的 |
| 2 | 填应用信息 | 名称、30 词以内的一句话描述、512×512 图标(不超过 1 MB)、至少 3 项能力、至少 3 条示例提问 | 示例提问至少 2 条要以 @应用名开头,至少 1 条自然提到应用名 |
| 3 | 填 MCP 服务器地址、验证域名 | 公网 HTTPS 地址;在 /.well-known/google-connected-apps 放验证文件,必须直接回 200、不能跳转 | 验证文件要放在 MCP 服务器所在的域名上 |
| 4 | 选鉴权方式 | 不鉴权;或机器对机器(Client ID 加可选 Secret);或用户授权(预先登记、CIMD 或 DCR) | 没有 API key 请求头这个选项 |
| 5 | 准备测试账号 | 审核员用的种子账号,关掉两步验证 | 数据服务通常要给审核员预充值 |
| 6 | 同步工具快照 | 发布的版本会冻结;文档建议每个版本用一个新地址 | 工具描述改一个字也要重新同步 |
| 7 | 设可用范围 | 国家、语言、产品;每个工具单独开关;位置等上下文信号;用户确认 | 写操作和扣费工具要设确认 |
| 8 | 加测试者 | 测试者必须是 @gmail.com 账号,生效要等最多 10 分钟 | 团队成员要有个人 Gmail |
| 9 | 提交审核 | 审核通过后状态变成可发布 | 审核时间文档没写 |
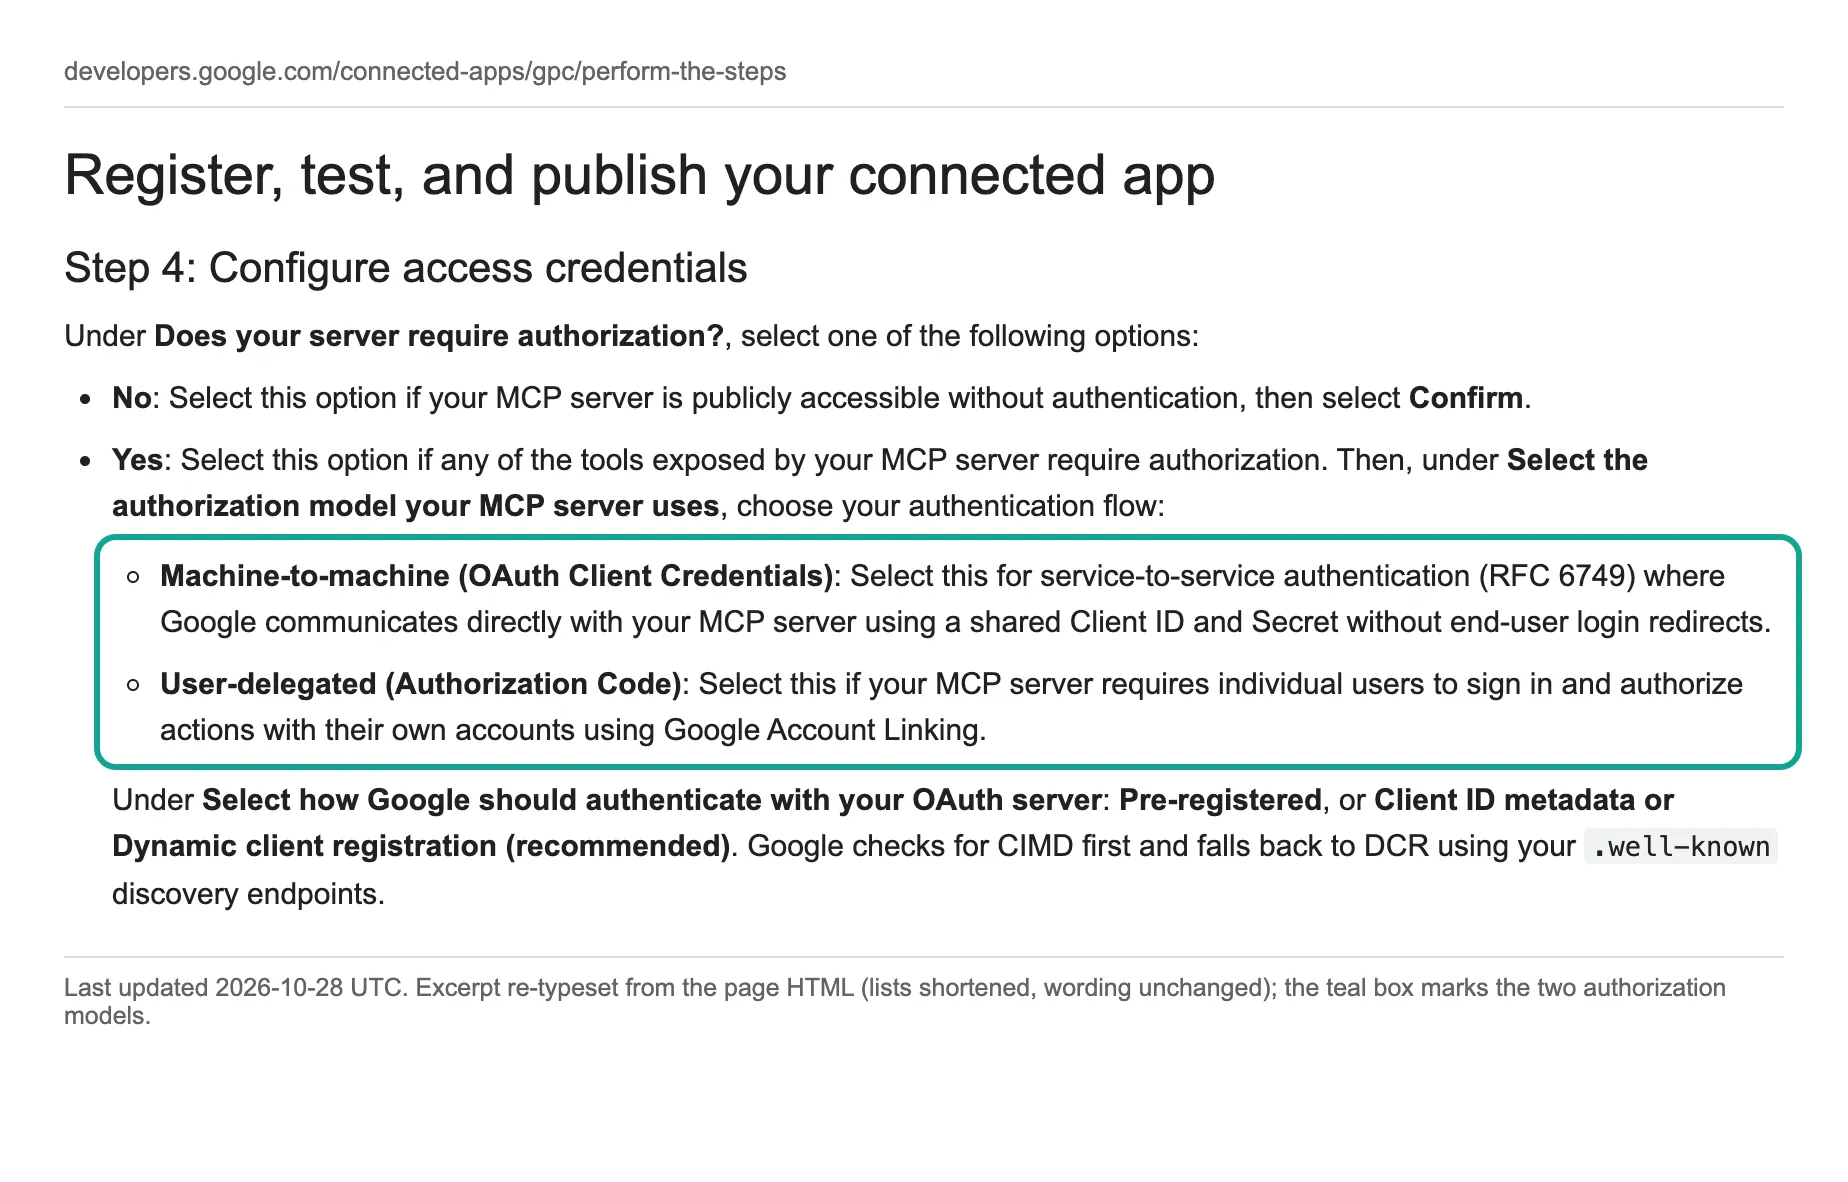
前置条件页还有几条容易漏掉的硬要求(前置条件,2026-10-30 更新)。一是每个连接应用只能有一个全球统一的 MCP 地址,不支持按数据中心分开的网址,按国家分的域名只能在只面向那个国家上线时用。二是如果你的服务器按来源 IP 做了限制,要放行 Google 列出的 7 个网段,并建议定期从 Google 公布的 用户触发型 agent IP 列表 刷新。三是 Console 的服务条款要由组织的所有者或管理员先接受,其他成员才能继续。四是要有公开的服务条款和隐私政策网址。MCP 请求流程页还写了一条:Google 发出的每个 JSON-RPC 请求都带 User-Agent: Google(MCP 请求流程,2026-10-27 更新),如果你的网关按 UA 拦爬虫,要先确认不会把它挡掉。
我们在 00:17(新加坡时间)用 User-Agent: Google 探了一遍 EveryInfra 的几个地址:/mcp 的握手和列工具都正常回 200,GET /mcp 回 405 并在 Allow 头里写明只收 POST,这正是 Google 服务器优化文档说「可以接受」的行为(服务器优化,2026-10-27 更新);/.well-known/google-connected-apps 回 404,因为我们没有申请,也就没有验证文件。下面是一条可以照抄的自查命令,属于配置示例,把域名换成你自己的:
# 配置示例:上架前自查(把 api.example.com 换成你的 MCP 域名)
curl -s -o /dev/null -w "%{http_code} %{redirect_url}\n" \
  https://api.example.com/.well-known/google-connected-apps      # 要求:200,且没有跳转
curl -s -o /dev/null -w "%{http_code}\n" -X GET https://api.example.com/mcp   # 405 可以接受
curl -s https://api.example.com/mcp -A "Google" \
  -H "Content-Type: application/json" -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-11-25","capabilities":{},"clientInfo":{"name":"self-check","version":"0"}}}'
鉴权:Gemini 能用哪几种方式进你的服务器
鉴权是数据工具接 Gemini 最先撞上的墙。EveryInfra 的 /mcp 和大多数数据服务一样,只认请求头里的 API key:客户在控制台建一把 key,填进 Claude Desktop、Cursor 或自己程序的配置里,每次请求带上。可是 Google 给的三种鉴权方式里没有这一种。开发者模式的使用说明也是一样,认证一栏只有「动态客户端注册」和「手动客户端注册」两种 OAuth 选项(开发者模式使用说明)。所以对一个只认 API key 的数据 MCP,Gemini 应用这条路在第一步就走不通,这和服务器写得好不好无关。
那换成 OAuth 呢?EveryInfra 另有一组入口:/mcp/all 和按平台分的 /mcp/youtube 等,可以用 OAuth 登录。我们在同一分钟里按 MCP 授权规范的发现顺序走了一遍,看 Gemini 理论上会看到什么(MCP 授权规范 2025-11-25)。不带凭据请求 /mcp/all,00:17:48(新加坡时间)回 401,WWW-Authenticate 头里带着受保护资源元数据的地址和需要的权限范围,这符合 RFC 9728 第 5.1 节(RFC 9728):
HTTP/1.1 401 Unauthorized
www-authenticate: Bearer resource_metadata="https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all",
  scope="data:call search:call captcha:call ai:call account:read offline_access"

GET https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all   -> 200,authorization_servers: https://auth.everyinfra.com/oidc
GET https://auth.everyinfra.com/oidc/.well-known/oauth-authorization-server     -> 200
  code_challenge_methods_supported: ["S256"]          # PKCE,符合
  client_id_metadata_document_supported: true        # CIMD,符合
  registration_endpoint: (没有这个字段)
前三步都过了:401 带资源元数据地址、资源元数据回 200、授权服务器元数据(RFC 8414)回 200,PKCE 用 S256(RFC 7636)。卡在第四步「注册客户端」。Google 的 OAuth 实现指南把必需字段列成 authorization_endpoint、token_endpoint、response_types_supported(含 code)和 registration_endpoint,并且专门说了一句:即使服务器支持 Client ID 元数据文档(CIMD),Gemini 应用目前仍然要求一个独立的注册端点(OAuth 实现指南,2026-09-14 更新)。注册端点就是 RFC 7591 的动态客户端注册(RFC 7591)。EveryInfra 的授权服务器支持 CIMD(CIMD 草案),但没有开放动态注册,按这份指南,Gemini 应用会在这里停下。
这里有一个 Google 两份文档说法不一致的地方,值得写出来。更新日期更晚的 Console 操作步骤(2026-10-28)说,用户授权模式下推荐 CIMD 或 DCR,Google 会先查 CIMD、再查 DCR(Console 操作步骤)。而 9 月 14 日更新的 OAuth 指南说 Gemini 应用必须有注册端点。社区的实际经验偏向后者:10 月 19 日 r/mcp 一个讨论 Gemini 自定义连接器的帖子里,有人说 Gemini 还不支持 CIMD,只能手动填 Client ID(r/mcp 讨论)。我们的判断是:正式上架走 Console 时 CIMD 可能可用,开发者模式自测时按 OAuth 指南准备注册端点更稳。两条都没法在美国以外实测,要等美国的开发者验证。
就算元数据全齐了,还有一道门:登录本身对谁开放。EveryInfra 的 OAuth 登录目前只对几家已登记的 AI 客户端开放(按 CIMD 地址认),Google 的回调地址不在名单里。Google 的 OAuth 指南列出了 Gemini 用的回调地址形式,是 oauth-redirect.googleusercontent.com 下的几个路径,另有沙盒和测试用的变体,并要求账号关联保持长期有效、不要轮换刷新令牌(OAuth 实现指南、Google 账号关联)。所以对一个数据服务来说,「支持 OAuth」要做的事是一串:开动态注册或者确认 CIMD 被接受、把 Google 的回调地址加进允许名单、给机器调用和用户调用分开发令牌、刷新令牌不轮换。这不是一个周末能做完的活。
社区里卡在这一步的人不少。Google AI 开发者论坛 10 月 2 日一个帖子说,自定义应用的 OAuth 走到回调就停了,Gemini 从来没有去调令牌端点,同一个服务器在 Claude 和 ChatGPT 里都正常(Google AI 开发者论坛)。10 月 22 日 r/GeminiAI 有人问自定义连接器的回调地址到底填什么(r/GeminiAI)。另一个 r/GeminiAI 的帖子里,有人反映服务器用 2026-07-28 协议版本握手时,Gemini 报「这个网址看起来不是有效的 MCP 服务器」(r/GeminiAI)。最后这条和 Google 的文档对得上:服务器优化页写明支持的 MCP 版本到 2025-11-25 为止(服务器优化)。我们在 00:27(新加坡时间)主动要 2026-07-28 版本,EveryInfra 回的是 2025-11-25,这种「客户端要新版本、服务器回自己支持的版本」的协商是 MCP 规范允许的(MCP 规范 2026-07-28),所以版本这一条不挡路。
我们按标题把 11 月 11 日 reddit/search 拿到的 14 条帖子人工归了一下类,8 条在讲把 MCP 接进 Gemini,话题集中在自定义连接器的 OAuth 走不通、Gemini 网页版和 Antigravity 怎么接、同一个服务器怎么同时给 Claude、ChatGPT 和 Gemini 用。10 月 17 日 r/modelcontextprotocol 一位做股票数据 MCP 的开发者写了经验:给 Claude 和 ChatGPT 用 OAuth 加动态客户端注册,给其他客户端用 Bearer 请求头,接 Gemini 时走的是 Gemini CLI 的扩展安装,而不是 Gemini 应用(r/modelcontextprotocol)。
工具描述:对照 Google 的 12 条要求
过了鉴权,审核员和 Gemini 模型看到的就是你的工具清单。Google 在质量页、服务器优化页和政策页里对工具写了很多具体要求,我们挑出能直接拿服务器返回核对的 12 条,对照 EveryInfra 三个入口的真实 tools/list 和 initialize 返回,逐条判定。判定是作者一个人做的,判据和证据文件都写在数据文件里:2 表示符合,1 表示部分符合,0 表示不符合。
| Google 的要求 | 出处 | `/mcp` | `/mcp/youtube` | `/mcp/all` | 证据 |
|---|---|---|---|---|---|
| Streamable HTTP,一个网址收 POST | 服务器优化 | 符合 | 符合 | 符合 | 三个入口 POST 都回 200,GET 回 405 |
| 握手版本不高于 2025-11-25 | 服务器优化 | 符合 | 符合 | 符合 | 都回 2025-11-25 |
initialize 带 server instructions | 排错页 | 符合 | 符合 | 符合 | 3,993 / 2,092 / 3,973 个字符 |
| 每个工具都写 annotations | 服务器优化 | 符合 | 符合 | 符合 | 12/12、3/3 |
| 只读查数工具不标 destructive | 服务器优化、讲解视频 | 不符合 | 不符合 | 不符合 | everyinfra_call_api 标 destructiveHint=true |
| 不用通用分发和动态发现工具 | 政策「集成完整性」 | 不符合 | 不符合 | 不符合 | 一个工具按 platform 和 action 分发 |
| 固定取值的参数写 enum | 服务器优化 | 不符合 | 不符合 | 不符合 | platform、action 是自由字符串 |
| 工具数不到「几十个」 | 服务器优化 | 符合 | 符合 | 部分符合 | 12 / 3 / 24 个 |
| 结果是 TextContent 里的 JSON | 服务器优化 | 符合 | 符合 | 符合 | 成功结果都在 content[0].text |
| 限速等终止错误用 JSON-RPC 错误码 | 服务器优化 | 不符合 | 不符合 | 不符合 | 限速回 200 加 isError |
| 时间字段写明格式 | 服务器优化 | 部分符合 | 部分符合 | 部分符合 | 搜索是 ISO 时间,评论是「11 days ago」 |
| 鉴权方式在 Google 的选项里 | Console 第 4 步 | 不符合 | 不符合 | 部分符合 | 见上一节 |
做得对的几条先说。Google 的排错页把「initialize 里没有 instructions」列为会出警告的问题(排错页,2026-10-27 更新),服务器优化页建议用 instructions 告诉模型什么时候用哪个工具、怎么组合。EveryInfra 的 /mcp 在握手时给了 3,993 个字符的说明,包括「需求不清时先问平台、关键词、数量、时效和预算,先小量跑一次再放大」这类引导,按 4 个字符约 1 个 token 估算约 998 个 token(Gemini API token 说明)。结果放在 TextContent 的 JSON 里,也正是 Google 现在要的格式:服务器优化页明说 structuredContent 暂不支持,要把 JSON 序列化进文本内容。
不符合的几条里,有两条是写法问题,改起来不难。一是 enum:everyinfra_call_api 的 platform 和 action 是自由字符串,Google 建议固定取值都写成 enum,让模型少猜。EveryInfra 的做法是猜错了再纠正:00:24(新加坡时间)我们故意把 search 拼成 serch,返回是 isError,错误码 unknown_capability,带「你是不是想要 search」和可用动作列表,并写明没有扣费。这对模型自我修正很友好,但多了一轮往返。按平台分的入口 /mcp/youtube 只有一个平台,action 只有 8 个取值,完全可以写成 enum。二是时间格式:youtube/search 返回 ISO 时间,youtube/comments 返回「11 days ago」这种相对时间,模型要换算才能比较,Google 建议在字段说明里写清格式。
另外两条是设计问题,改动要大得多,下一节单独讲。
政策:通用分发工具和确认弹窗
Connected Apps 政策 11 月 2 日的版本里有一节「集成完整性」,大意是:上架的应用不能暴露动态发现函数(比如 list_tools、get_schema),也不能暴露通用的运行时分发器(比如 execute_command、invoke_dynamic_tool);工具定义要在注册时就固定下来,审核看到什么,上线就是什么(Connected Apps 政策,2026-11-02 更新)。同一份政策还要求数据最少化,不能索要对话历史。
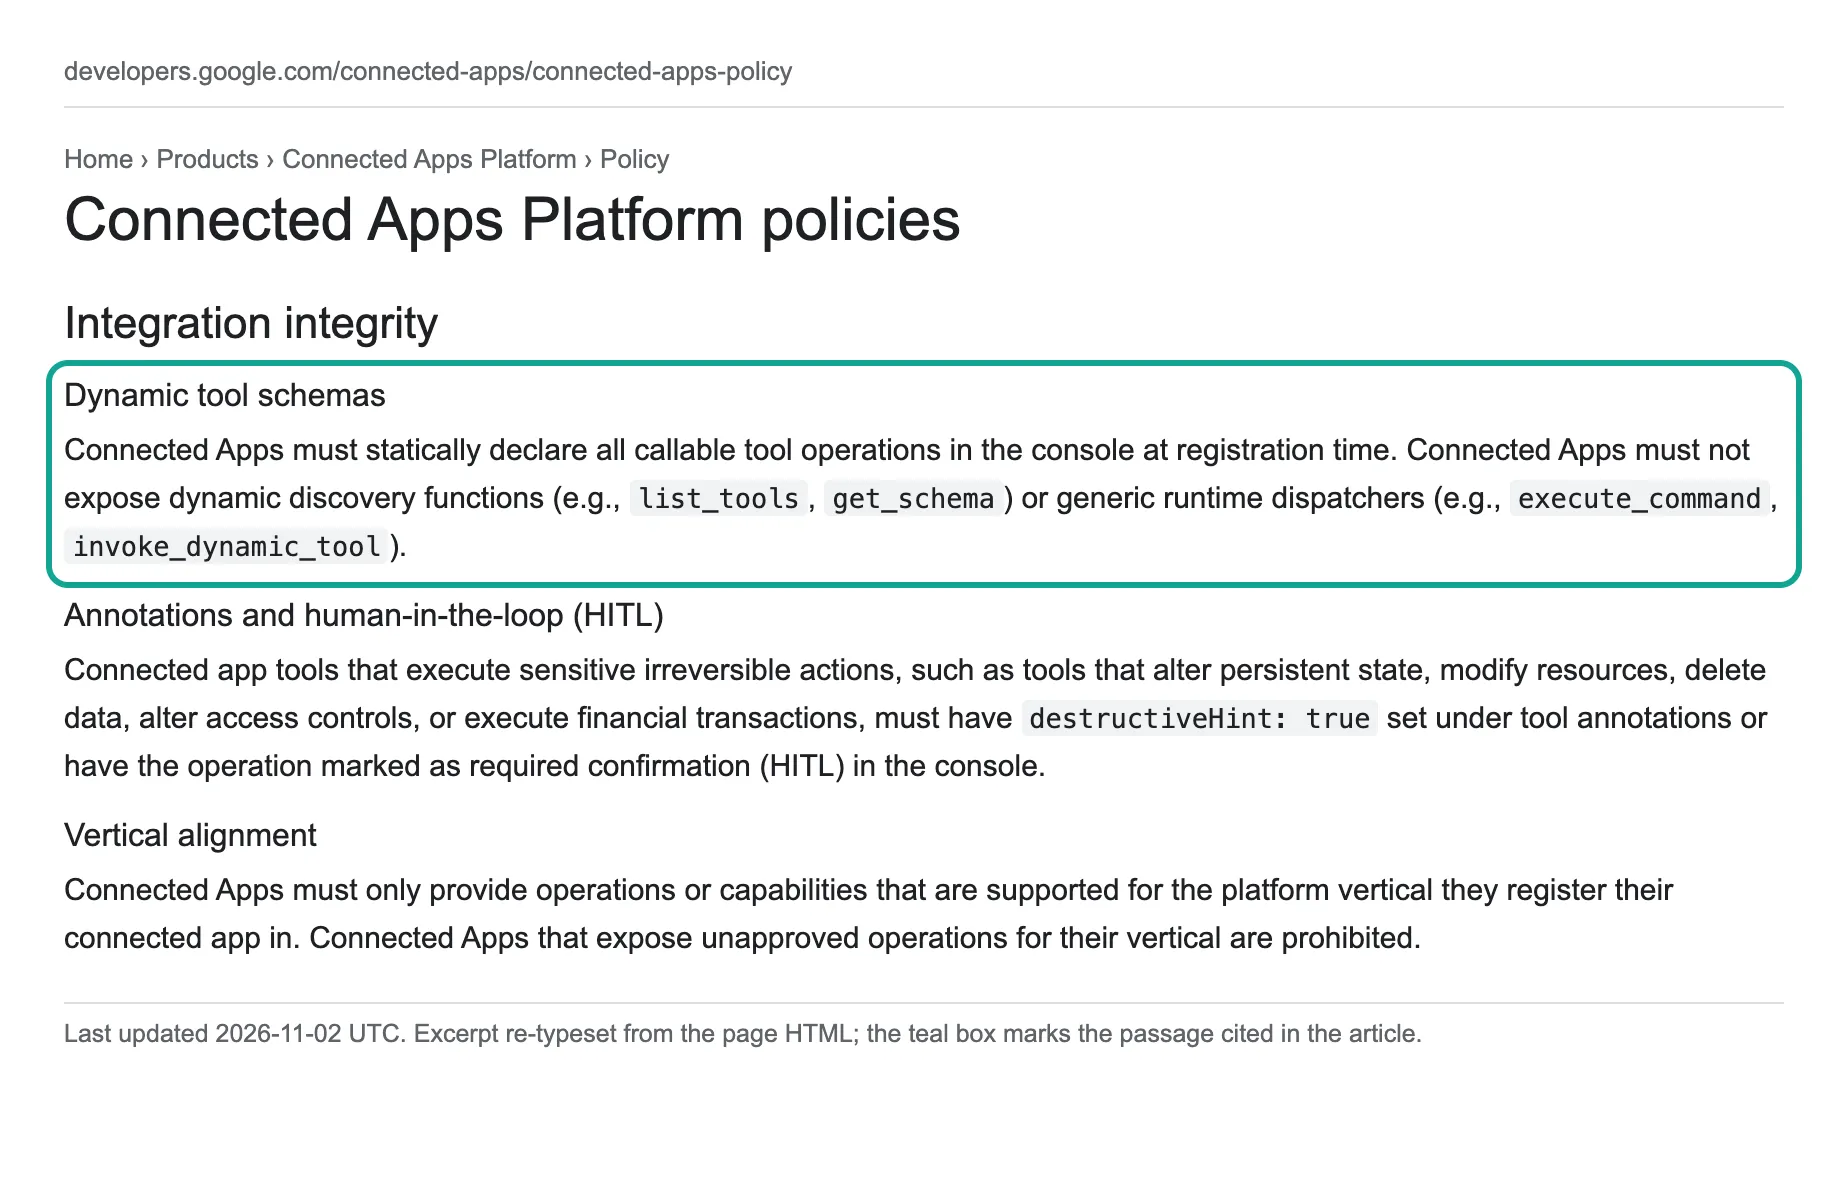
这条对数据 MCP 的影响很直接。EveryInfra 有 106 个平台、573 项能力(00:17 新加坡时间读取的目录,其中 538 项可用),如果每项能力做一个工具,工具清单会有几百个,Google 服务器优化页明说「几十个工具」就会被标出来;所以 EveryInfra 和大多数多平台数据服务一样,用一个 everyinfra_call_api 按 platform 加 action 分发,再用一个免费的 everyinfra_list_capabilities 让模型先查能力。下面是 00:17 拿到的 tools/list 里这个工具的定义(节选):
{
  "name": "everyinfra_call_api",
  "title": "Call a data capability",
  "annotations": { "readOnlyHint": false, "openWorldHint": true, "destructiveHint": true },
  "description": "Call any EveryInfra data capability and get structured JSON. ... Check platform/action, required params and max_limit or page_size with everyinfra_list_capabilities first. ...",
  "inputSchema": {
    "type": "object",
    "required": ["platform", "action"],
    "properties": {
      "platform": { "type": "string", "description": "e.g. xiaohongshu / twitter / tiktok / web" },
      "action":   { "type": "string", "description": "e.g. search / profile / user_posts / post" },
      "params":   { "type": "object" },
      "mode":     { "type": "string", "enum": ["sync", "async"], "default": "sync" }
    }
  }
}
在 Claude、ChatGPT 和 Cursor 里,这种写法工作得很好:模型先查目录,再按目录里的参数调用。但按 Google 的政策,它同时踩了「通用分发」和「动态发现」两条。要上架,就得把工具拆成固定的、按任务命名的几个,比如 search_youtube_videos、search_reddit_posts、get_reddit_comments,每个工具的参数写死、取值写 enum。Google 服务器优化页给的命名建议也是「动词_名词」、一个工具做一件事、参数扁平。按平台分的入口 /mcp/youtube 是往这个方向走的一步:它只有 3 个工具,清单只有 4,020 字节,但里面仍然是 call_api 加 list_capabilities 的组合,没有拆成按任务命名。
第二个设计问题是确认弹窗。Google 的服务器优化页写明,同时标了 destructiveHint 和 openWorldHint 的工具会触发用户确认;没写 readOnlyHint 的工具一律当成有破坏性。讲解视频第 7 分 52 秒说得更直白:确认的强度跟风险走,不会每次调工具都弹窗,查东西这种操作应该没有阻力(讲解视频)。Gemini 帮助中心也说,写操作 Gemini 会要求用户手动确认(Gemini 帮助:自定义应用)。EveryInfra 的 12 个工具里有 7 个只读(列能力、查任务、查账户、查工单、取充值链接、列验证码类型、列请求记录),但真正查数据的 everyinfra_call_api 标的是 destructiveHint=true。原因是它会从钱包里扣钱,按 MCP 规范,改变外部状态就该这样标(MCP 规范:工具)。结果是:在 Gemini 里,每查一次数据都可能弹一次确认。
这是一个真实的两难。标成只读,用户体验顺,但对一个按次扣费的工具不诚实;标成会改变状态,诚实,但每次弹窗。Google 视频里的原话是要「诚实地标」。我们的建议是把扣钱这件事从工具语义里拿出来:用户在 OAuth 授权时就同意一个每月预算,查数工具在预算内按只读标,超预算时返回错误而不是继续扣,这样标只读就是诚实的。这需要服务端有按授权会话的预算控制,EveryInfra 目前没有。
一次真实往返:tools/list 和 tools/call 返回了什么
下面是 Gemini 理论上会发给 MCP 服务器的那类请求,我们用 EveryInfra 的 API key 在本机发出,请求头里同样带 User-Agent: Google。第一次数据调用在 00:18:30(新加坡时间),查 YouTube 上关于 Gemini Connected Apps 的视频:
curl -s https://api.everyinfra.com/mcp -A "Google" \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" -H "Accept: application/json, text/event-stream" \
  -H "MCP-Protocol-Version: 2025-11-25" \
  -d '{"jsonrpc":"2.0","id":10,"method":"tools/call","params":{"name":"everyinfra_call_api",
       "arguments":{"platform":"youtube","action":"search","params":{"keyword":"Gemini Connected Apps Platform","sort":"relevance","limit":20}}}}'
# 返回(节选):HTTP 200,8.36 秒,41,840 字节
# {"jsonrpc":"2.0","id":10,"result":{"content":[{"type":"text","text":"{\"platform\":\"youtube\",\"action\":\"search\",
#   \"results\":[{...}, {...}, {\"title\":\"Extend your app to Gemini and Search with the Connected Apps Platform\",
#   \"posted_at\":\"2026-10-29T19:55:04+00:00\",\"view_count\":1265, ...}, ... 共 20 条],
#   \"billing\":{\"charged\":true,\"charged_usd\":0.000556, ...}}"}]}}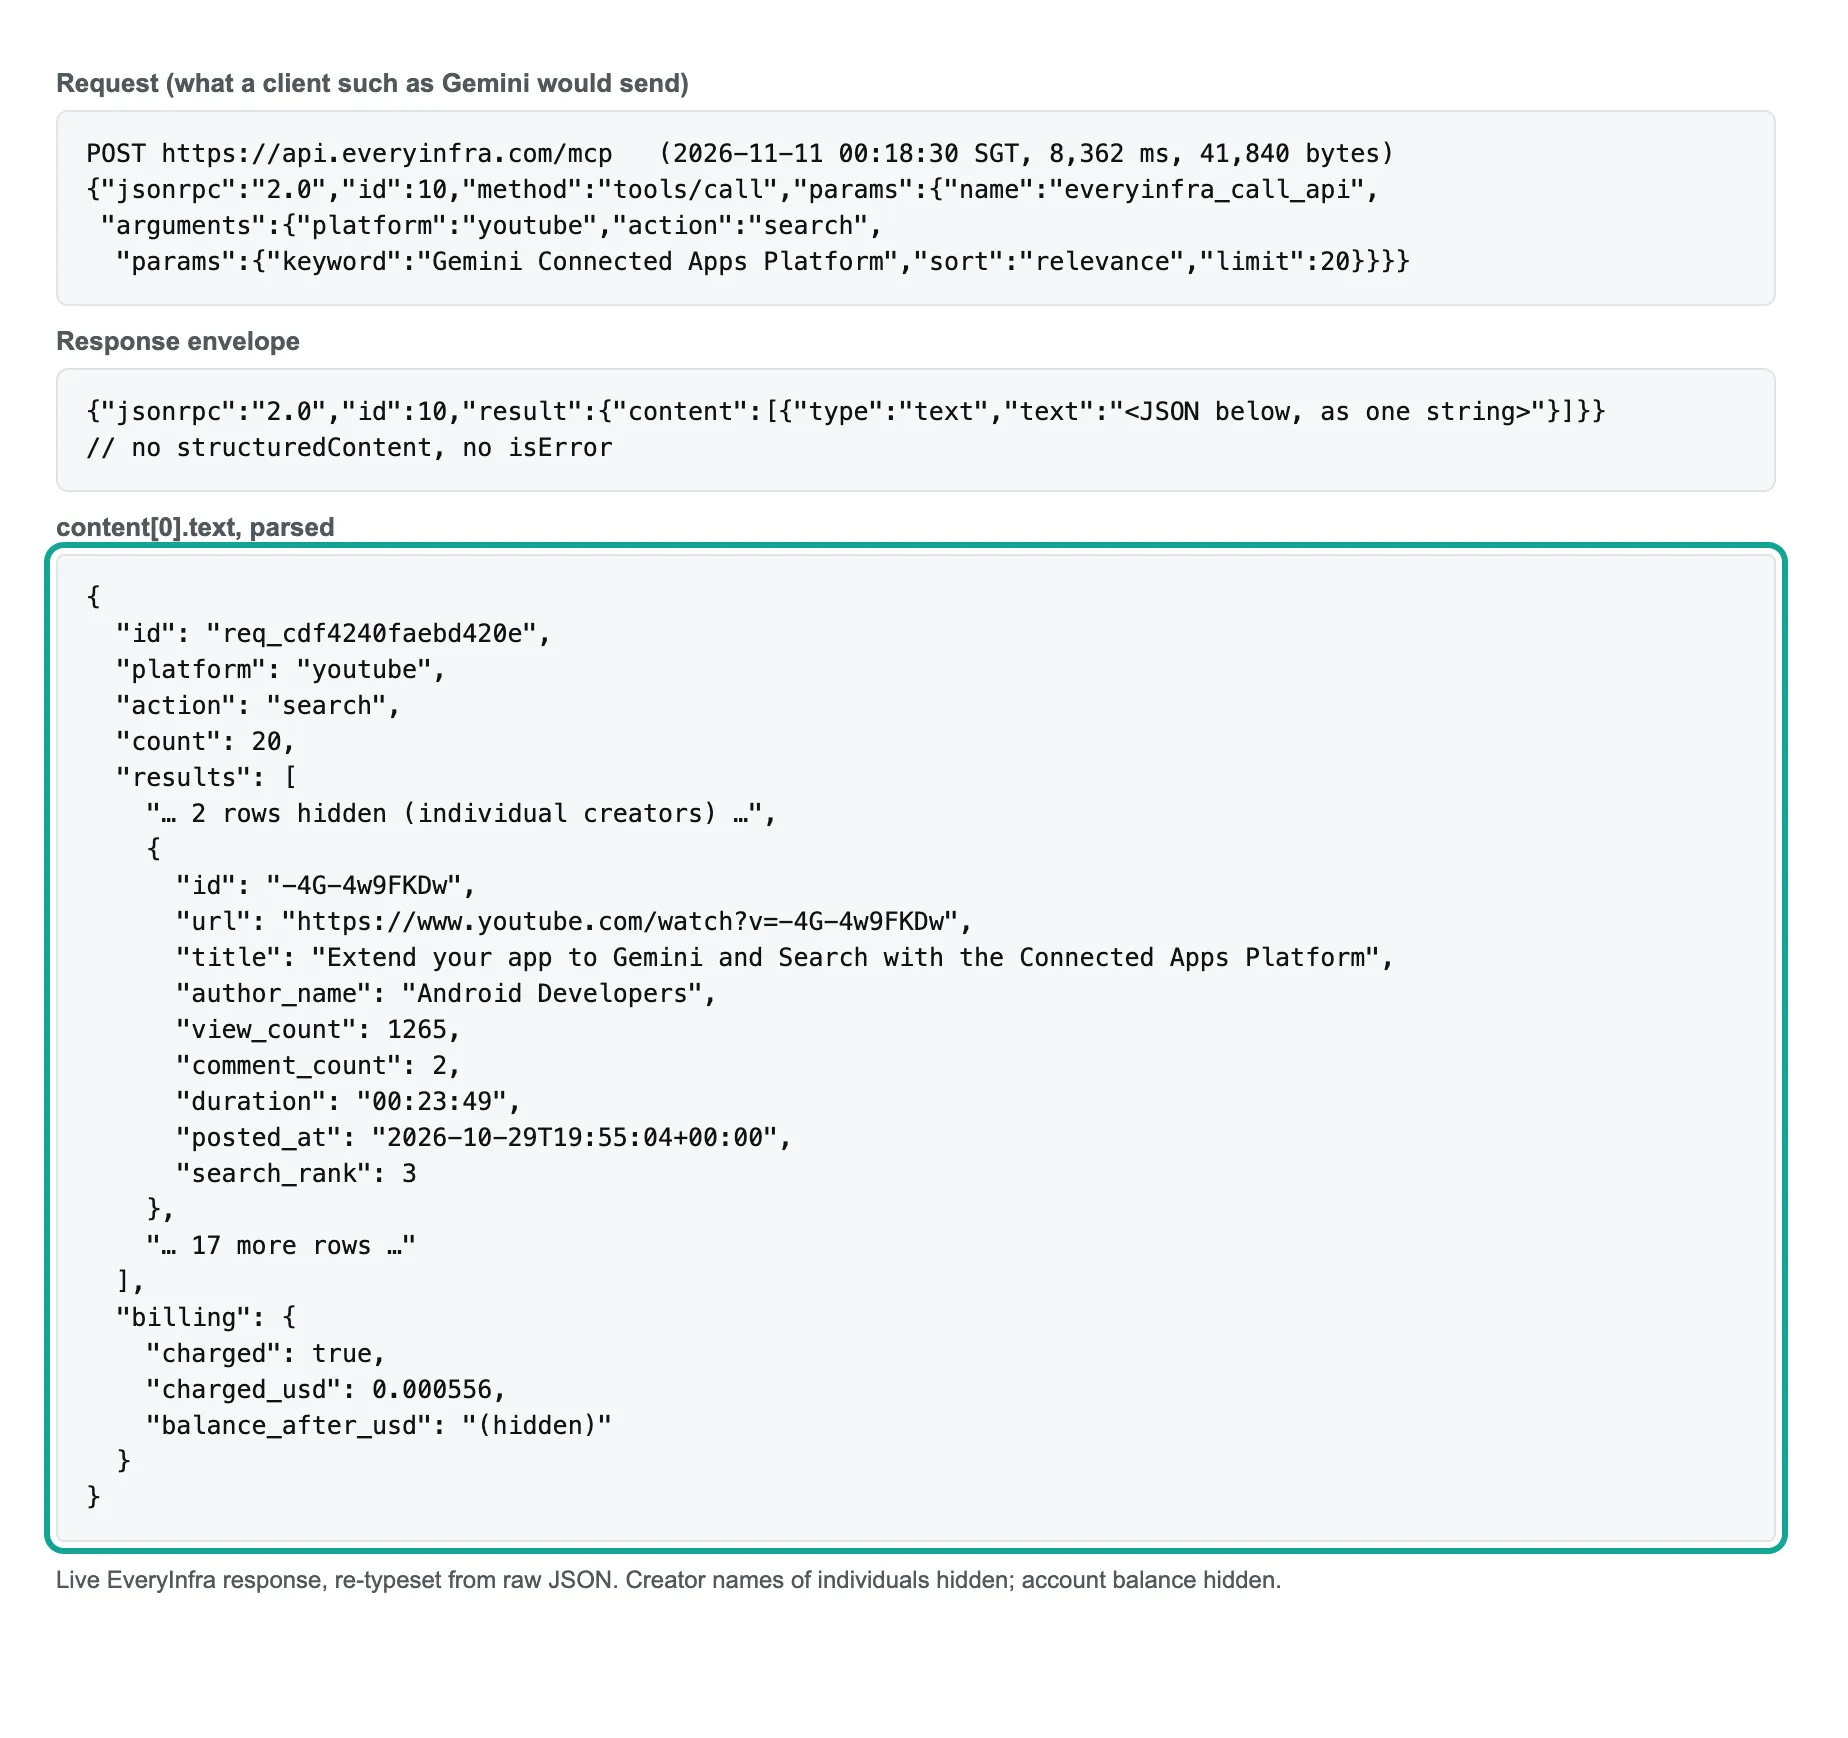
返回的结构正好是 Google 要的:结果是 content[0].text 里的一段 JSON,没有 structuredContent。每条视频带 22 个字段,包括标题、链接、频道、发布时间、播放量、时长、缩略图和描述片段,和 YouTube 视频搜索接口页 列的返回字段一一对应。全部 8 次数据调用列在下面,都发往同一个地址,除了一次字幕走 REST 接口做对照:
| 时间(新加坡时间) | 经 | 能力 | 结果 | 耗时 | 扣费 |
|---|---|---|---|---|---|
| 00:18:30 | MCP | youtube/search | 20 条视频 | 8.36 秒 | $0.000556 |
| 00:18:52 | MCP | reddit/search | 14 条帖子 | 5.14 秒 | $0.000556 |
| 00:19:08 | MCP | reddit/comments(r/mcp 帖) | 5 条评论 | 11.60 秒 | $0.000556 |
| 00:19:20 | MCP | reddit/comments(r/GoogleGemini 帖) | 4 条评论 | 9.68 秒 | $0.000556 |
| 00:19:30 | MCP | reddit/comments(没有评论的帖子) | 0 条 | 55.66 秒 | $0 |
| 00:22:38 | REST | youtube/transcript(讲解视频) | 454 段字幕 | 6.09 秒 | $0.000556 |
| 00:24:28 | MCP | youtube/comments(讲解视频) | 2 条评论 | 13.66 秒 | $0.000556 |
| 00:35:03 | MCP | reddit/search 按最新排序 | 1 条帖子 | 4.30 秒 | $0.000556 |
耗时中位数 9.0 秒。最慢的一次值得注意:一条没有评论的 Reddit 帖子,等了 55.7 秒才返回 0 条,没有扣费。对 Gemini 来说这意味着两件事。一是 MCP 客户端的超时要够长,Gemini CLI 默认 10 分钟没问题(Gemini CLI MCP 配置),但 Gemini 应用的超时文档没有写,我们没法测。二是空结果不扣费这条规则,让模型「多试一个帖子」的代价只是时间。按次计费的数据工具,关键词和排序方式要先小量试。
出错时的返回也要看,因为 Google 对错误有自己的要求。00:21:27(新加坡时间)我们撞上了这把 key 每分钟 10 次的限速:同一秒里,REST 接口回 HTTP 429,MCP 接口回 HTTP 200 加 isError: true,错误码 rate_limited,retry_after 33 秒,写明没有扣费。00:24:42 不带 key 调工具,同样是 HTTP 200 加 isError,错误码 unauthorized。MCP 规范允许把工具执行错误放进结果里让模型看到并自我修正;但 Google 的服务器优化页对「终止性」错误另有要求:限速、要重新授权这类模型自己修不好的错误,应该用 JSON-RPC 错误码返回,限速用 -32300(USER_RATE_LIMITED)。EveryInfra 现在的做法对 Claude 和 Cursor 很友好,模型会照 retry_after 等一会儿再试;在 Gemini 里,按文档它会被当成一次普通的工具失败。
返回体积:模型读的比数据贵
这一节是本文最出乎意料的发现。按次计费的数据工具,开发者通常只盯着数据费;但在 Gemini 这类场景里,返回的 JSON 会整个塞进模型的上下文,模型读它也要钱。
youtube/search 那次返回的文本有 39,732 字节,其中 20 条结果占 38,825 字节,每条 22 个字段。真正回答「最近有哪些讲 Connected Apps 的视频」需要的只有 6 个:标题、链接、频道、发布时间、播放量、评论数。只留这 6 个字段,体积降到 5,062 字节,是原来的 12.7%。reddit/search 那次 14 条帖子 25,212 字节,留标题、链接、社区、时间、点赞和评论数,降到 4,274 字节,是 17.0%。Google 服务器优化页对这个问题也有明确建议:先在服务器端汇总,不要把原始数据整个倒给模型。
换成钱更直观。按 Gemini API 文档「一个 token 约 4 个字符」的估算(token 说明),youtube/search 原样返回约 9,933 个 token;按 Gemini 3.8 Flash 付费档 2026 年 12 月 31 日前每百万输入 token $0.75 的价格(Gemini API 定价),模型读一遍约 $0.00745,是这次数据费 $0.000556 的 13.4 倍。只留 6 个字段后约 1,266 个 token、$0.00095,是数据费的 1.7 倍。reddit/search 从 8.5 倍降到 1.4 倍。这几个倍数都是对 11 月 11 日那次实际扣费算的;11 月 12 日重读目录,youtube/search 已调成每次 $0.000778、reddit/search 调成 $0.000792,按新价算,youtube/search 是 9.6 倍降到 1.2 倍,reddit/search 是 6.0 倍降到 1.0 倍。注意这只是模型读一遍工具结果的输入费,没算提示词、对话历史和输出;2027 年 1 月 1 日起 Gemini 3.8 Flash 输入价涨到每百万 $1.50,倍数还要翻一番。
| 能力 | 结果条数 | 原样字节 | 原样估算 token | 模型输入费(估算) | 只留 6 字段 token | 只留 6 字段输入费 | 数据费 |
|---|---|---|---|---|---|---|---|
youtube/search | 20 | 39,732 | 9,933 | $0.00745(13.4 倍) | 1,266 | $0.00095(1.7 倍) | $0.000556 |
reddit/search | 14 | 25,212 | 6,303 | $0.004727(8.5 倍) | 1,068 | $0.000801(1.4 倍) | $0.000556 |
在 Gemini 应用里,模型费用是 Google 付的,用户不直接看到;但 Google 服务器优化页把「返回太大」列为影响质量的问题,返回越大,模型越容易在长上下文里丢细节、答得越慢,审核和排序都可能吃亏。在 Gemini API 里自己接 MCP,这笔钱就是你自己付。所以无论走哪条路,数据工具都该给一个「只要这几个字段」的参数,或者干脆提供按任务裁好的工具。
工具清单本身也占上下文
模型在调用任何工具之前,先要读完整个工具清单。这部分每轮对话都要付。
00:17 和 00:27(新加坡时间)三次 tools/list 的结果:通用入口 /mcp 12 个工具、16,250 字节,约 4,063 个 token;按平台分的 /mcp/youtube 3 个工具、4,020 字节,约 1,005 个 token;/mcp/all 用 key 连时 24 个工具、32,921 字节,约 8,230 个 token。最长的单个工具定义是建工单的 2,958 字节,其次是搜索的 2,640 字节。对一个只想让 Gemini 查 YouTube 的用户来说,连 /mcp/youtube 比连 /mcp 每轮少读约 3,000 个 token。Gemini API 的 allowed_tools 和 Gemini CLI 的 includeTools 能在客户端过滤工具,但工具清单通常还是会先完整读一次;在服务器端按场景拆入口,效果更确定。这和上一节的结论是同一个方向:给 Gemini 的工具,越窄越好。
数据工具现在能做的:用 Gemini API 和 Gemini CLI 接
如果你的目标是让自己的团队或客户的 agent 在 Gemini 模型上用你的数据,而不是让普通用户在 Gemini 应用里发现你,那今天就能接,不需要审核,也不受美国限制。下面两段都是配置示例,按 Google 文档的字段写,我们没有用 Gemini API key 实际跑过。
Gemini API 的 Interactions 接口支持远程 MCP。文档写明只支持 Streamable HTTP,服务器名不能带短横线,headers 会随每个请求发给 MCP 服务器,allowed_tools 限定能调哪些工具(Gemini API 函数调用文档)。把只读的列能力工具和查数工具放进白名单,其他工具(建工单、取充值链接等)不让模型碰:
# 配置示例:Gemini API Interactions 接 EveryInfra 远程 MCP(未实际运行)
import os
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Find this week's Reddit posts about Gemini custom MCP apps and list the main problems people report.",
    tools=[{
        "type": "mcp_server",
        "name": "everyinfra_youtube_reddit",          # 文档要求不用短横线
        "url": "https://api.everyinfra.com/mcp",
        "headers": {"Authorization": "Bearer " + os.environ["EVERYINFRA_API_KEY"]},
        "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"],
    }],
)
Gemini CLI 在 settings.json 的 mcpServers 里配置,httpUrl 走 Streamable HTTP,headers 可以带请求头,includeTools 是工具白名单,timeout 默认 600,000 毫秒,trust 设成 true 会跳过所有确认,所以对会扣费的工具建议保持 false(Gemini CLI MCP 配置)。同一份文档提醒不要把密钥硬写进配置文件;下面用占位符表示,实际使用时按文档的环境变量写法替换:
{
  "mcpServers": {
    "everyinfraYoutube": {
      "httpUrl": "https://api.everyinfra.com/mcp/youtube",
      "headers": { "Authorization": "Bearer <你的 EveryInfra API key>" },
      "includeTools": ["everyinfra_list_capabilities", "everyinfra_call_api"],
      "timeout": 120000,
      "trust": false
    }
  }
}
这两条路有两个共同的好处。一是 API key 能直接用,不需要为 Google 单独做 OAuth。二是工具白名单在你手里,可以只放查数工具,确认弹窗也由你的程序决定。代价是:没有 Gemini 应用里的分发,普通用户不会在 @ 列表里看到你。数据工具的使用者大多是开发者、分析师和自己搭 agent 的团队,对他们来说这条路已经够用。这里各平台的参数和返回字段可以在 YouTube 数据接口 和 Reddit 数据接口 两页查到,评论和字幕见 Reddit 评论接口页、YouTube 评论接口页 和 YouTube 字幕接口页。
想上架 Connected Apps 要先改什么
如果你的服务本来就有用户账号,用户在你这里有自己的数据(订单、项目、收藏、监测任务),上架 Connected Apps 是值得的。Google 的质量页把「用户登录后体验更好」列为好应用的第一个特征,同时说明连接应用不是数据源的替代品,也不是给「通用的、无需登录就能拿到的信息」用的(质量页,2026-10-28 更新)。这一句对公开数据工具影响很大:如果你的工具只是「搜 YouTube 上的公开视频」,审核员很可能会问用户为什么要登录你的应用来做这件事。反过来,如果工具做的是「看我自己设的品牌监测任务这周抓到了什么」「把我收藏的竞品帖子按情绪分组」,就是用户自己的数据,正好对口。
政策和平台条款也要提前对照。Connected Apps 政策不允许转包或重新包装不属于你的第三方 API;各平台自己的条款,比如 YouTube API 服务的开发者政策(YouTube 开发者政策)和 Reddit 的数据 API 条款(Reddit 数据 API 条款),对数据怎么展示、怎么存储都有自己的要求。上架前要能讲清楚你的工具在原始数据之上做了什么:汇总、去重、打分、长期存储、按用户的任务组织。只有这部分是你自己的。
按本文前面的对照,一个数据 MCP 要上架,最少要改这几件事:开 OAuth 的动态客户端注册,并把 Google 的回调地址加进允许名单;把通用分发工具拆成按任务命名、参数写死的几个工具,取值写 enum;查数工具按只读标,扣费由授权时的预算控制;限速和要重新授权改用 JSON-RPC 错误码;返回只给模型需要的字段;时间统一成 ISO 格式;在 /.well-known/google-connected-apps 放验证文件。Google 的界面指南还要求 MCP Apps 的界面符合 WCAG AA 对比度、最小字号 13pt(界面指南,2026-10-28 更新),如果你打算做交互卡片,也要提前按这个做。开发阶段可以先用 MCP Inspector 本地调试(MCP Inspector),再按讲解视频的做法部署到 Cloud Run 这类公网 HTTPS 服务上测(Cloud Run 部署文档)。
这几件事里,工具拆分最容易低估,拿 /mcp/youtube 举个例子。它现在有 3 个工具:免费的 everyinfra_list_capabilities、只读的 everyinfra_get_job,以及真正查数的 everyinfra_call_api,后者的 platform 永远是 youtube,action 和 params 都是自由填写。按 Google 的写法,应该把常用的几项能力各自做成一个工具:search_youtube_videos 只收关键词、排序和条数,排序写成 enum;get_youtube_comments 只收视频链接和条数;get_youtube_transcript 只收视频链接。每个工具的说明里写清楚返回哪些字段、时间是什么格式、什么情况会回空结果。这样做之后,list_capabilities 这个「先查目录」的工具就可以不放进上架版本,模型也不用先读一遍目录再决定怎么调。代价是能力一多,工具数很快会逼近 Google 说的「几十个」,所以上架版本只能挑最常用的几项,其余能力留在 Claude、Cursor 这些客户端用的通用入口里。
错误码的改法相对简单。现在限速时,MCP 接口回 HTTP 200,结果里 isError: true,正文写着错误码、要等多少秒、没有扣费;Google 要的是把这类模型自己修不好的错误放到 JSON-RPC 的 error 对象里,code 写 -32300,等待时间和是否扣费可以放进 error.data。参数写错、能力名拼错这类模型能自己改的错误,继续放在结果里返回更好,因为模型能读到「你是不是想要 search」这类提示,下一次就调对了。两类错误分开处理,对 Claude、Cursor 和 Gemini 都不会变差。
预算控制是改动最大的一项,也最值得先想清楚。用户在 OAuth 授权页上就看到「这个应用每月最多花多少」,同意后授权会话带着这个上限;查数工具每次调用前先核剩余额度,够就照常查、照常扣,不够就直接返回终止性错误,并在错误说明里告诉用户去哪里调高上限。这样查数工具在额度内的行为就是「读数据、不改别的东西」,按只读标才说得过去,Gemini 也就不会每次都弹确认。
Google 的垂直场景页列了一批它想要的应用类型,比如音乐、内容创作、生鲜(配合通用电商协议)、房产等,每一类都写了期望的用户旅程(垂直场景,2026-10-28 更新)。数据分析和社媒监测不在现有列表里。这不等于不能上,但意味着类别要从现有的里面选,审核员对「这类应用该做什么」没有现成的参照。
每月花多少钱:一个小例子
假设一个团队用 Gemini API 加 EveryInfra 远程 MCP,每天让 agent 做一份「Gemini 开发者动态」:搜一次 YouTube、搜一次 Reddit、读 3 个热帖的评论、读 1 个视频的评论,每天 6 次数据调用。按 2026 年 11 月 12 日重读的目录价格,youtube/search 每次 $0.000778,reddit/search 和 reddit/comments 每次 $0.000792,youtube/comments 每次 $0.000556,一个月 30 天 180 次,数据费约 $0.1351(11 月 11 日实测时这 4 种能力都是每次 $0.000556,同样用量是 $0.1001)。价格以 定价页 为准。
| 项目 | 每天 | 每月(30 天) | 说明 |
|---|---|---|---|
| EveryInfra 数据费 | $0.000778 + 4 × $0.000792 + $0.000556 | 约 $0.1351 | youtube/search、reddit/search、reddit/comments 3 次、youtube/comments |
| 模型读两次搜索的原样返回(估算) | $0.00745 + $0.004727 | 约 $0.3653 | Gemini 3.8 Flash 输入价,只算工具结果 |
| 模型读两次搜索的 6 字段返回(估算) | $0.00095 + $0.000801 | 约 $0.0525 | 同上 |
工具清单(/mcp,估算) | 约 4,063 token × 每轮 | 按轮数算 | 换成 /mcp/youtube 每轮约 1,005 token |
这张表说明的是比例,不是总账:只看两次搜索,模型读原样返回一个月约 $0.3653,是全月数据费的 2.7 倍;裁成 6 个字段后约 $0.0525,比数据费还低。空结果不扣费这一条在实际运行中也有用:本文 8 次调用里有 1 次是空结果,没有扣费。11 月 11 日实测这 8 次数据调用合计扣费 $0.003892。
做不了或要注意的地方
第一,Gemini 应用里的超时、确认弹窗的具体样子、审核要多久,文档都没写。讲解视频说确认会按风险调整,但没有给出判断规则。第二,Google 的回调地址、IP 网段、支持的 MCP 版本都可能在预览期变化,上架前要按页面底部的更新日期重新核对。第三,token 数是按 4 个字符约 1 个 token 估的,实际分词会有出入,模型费用只看比例。第四,本文 EveryInfra 一侧的耗时和返回体积都是 11 月 11 日那一轮真调的结果,价格按 11 月 12 日重读的目录写;接入前按接口页和目录重新核对一遍。
常见问题
Gemini Connected Apps Platform 要钱吗?
Google 的博客、产品主页和 Console 文档都没有提到注册或上架费用,也没有说按调用收费(产品主页)。你自己的服务器、托管和数据成本照常由你承担。如果改走 Gemini API 自己接 MCP,模型调用按 Gemini API 定价 付费。
不在美国能用 Connected Apps Platform 吗?
目前不能。讲解视频说预览只对美国开发者开放;用户侧的自定义应用要求在美国,搜索 AI 模式里的连接应用也只在美国英文环境(Gemini 帮助、搜索帮助)。不在美国的团队可以先走 Gemini API 或 Gemini CLI。
有没有 Gemini Connected Apps Platform API?
没有单独的一套 API。Connected Apps Platform 的接口就是 MCP:你提供一个远程 MCP 服务器,Gemini 和搜索作为 MCP 客户端来调你(MCP 开发者指南)。注册、测试、提交在 Connected Console 网页里做,文档没有提到管理用的 API。想在程序里用 Gemini 调 MCP,是 Gemini API 的 mcp_server 工具,属于另一条路。
我的 MCP 服务器在 Claude 里能用,为什么 Gemini 连不上?
最常见的三个原因:协议版本高于 2025-11-25;OAuth 元数据缺 registration_endpoint,或者没有把 Google 的回调地址加进允许名单;服务器只认 API key 请求头。可以先对照 Google 的排错页,它列了 405、缺少受保护资源元数据、缺授权服务器元数据、注册失败等常见报错(排错页)。
只认 API key 的服务器,能先放进开发者模式里试吗?
不能直接试。开发者模式的认证一栏只有不鉴权和两种 OAuth 注册方式,没有地方填请求头(开发者模式使用说明)。如果只是想看 Gemini 怎么读你的工具清单、会不会弹确认,可以单独起一个不鉴权的测试地址,里面只放不扣费、不碰用户数据的工具,比如列能力和查文档;测完就关掉,不要让这个地址长期在公网上。真正要扣费的查数工具,还是要等 OAuth 和预算控制做好以后,再放进开发者模式里测。开发者模式只有建应用的那个账号能用,而且账号要满足美国、18 岁以上、个人账号这些条件,不在美国的团队目前只能在 Gemini API 和 Gemini CLI 里先把工具本身调顺。
上手:先在自己的程序里跑通
- 在 EveryInfra 控制台建一把 API key,按 快速开始 用 curl 发一次
tools/list和一次tools/call,确认返回里有billing。各客户端的远程 MCP 配置见 MCP 服务器页。 - 选一个窄的入口,比如只用 YouTube 就连
/mcp/youtube,工具清单从约 4,063 个 token 降到约 1,005 个。 - 在 Gemini API 的
mcp_server或 Gemini CLI 的mcpServers里配置,用allowed_tools或includeTools只放查数工具。 - 先用一个关键词、小的
limit跑一次,看返回大小,在提示词里要求模型只读需要的字段。 - 如果你有自己的用户账号体系、打算上架 Connected Apps,按上文「要先改什么」一节逐条改,再在开发者模式里自测。
YouTube 和 Reddit 的搜索参数见 YouTube 视频搜索接口页 和 Reddit 帖子搜索接口页。在其他云平台上做同样的事,可以对照 Bedrock AgentCore Gateway 接 MCP 的返回格式与账单 和 用 Airbyte MCP 搭社交数据 agent。
参考资料
Google 一侧的页面都在 2026 年 11 月 11 日(新加坡时间)读取;括号里是页面自己写的发布或更新日期,没有写的不标。EveryInfra 一侧的数字来自同一天的真调原始返回。
- Google 博客:Connected Apps Platform: bring your apps to Gemini and Search(2026-10-28) <https://blog.google/innovation-and-ai/technology/developers-tools/connected-apps-one-place>
- Google for Developers:Connected Apps Platform 产品主页 <https://developers.google.com/connected-apps>
- Google for Developers:Connected Apps Platform MCP server developer guide(2026-10-27 更新) <https://developers.google.com/connected-apps/mcp>
- Google for Developers:MCP request flow(2026-10-27 更新) <https://developers.google.com/connected-apps/mcp/mcp-flow>
- Google for Developers:Quality guidelines for connected apps(2026-10-28 更新) <https://developers.google.com/connected-apps/mcp/quality>
- Google for Developers:MCP server optimization(2026-10-27 更新) <https://developers.google.com/connected-apps/mcp/server-optimization>
- Google for Developers:MCP Apps UI guidelines(2026-10-28 更新) <https://developers.google.com/connected-apps/mcp/guidelines>
- Google for Developers:Vertical user journeys(2026-10-28 更新) <https://developers.google.com/connected-apps/mcp/vertical-journeys>
- Google for Developers:OAuth 2.1 implementation guide(2026-09-14 更新) <https://developers.google.com/connected-apps/mcp/oauth>
- Google for Developers:Developer Mode(2026-10-28 更新) <https://developers.google.com/connected-apps/mcp/dev-mode>
- Google for Developers:Use Developer Mode(2026-10-28 更新) <https://developers.google.com/connected-apps/mcp/dev-mode/usage>
- Google for Developers:Google Connected Console 概览 <https://developers.google.com/connected-apps/gpc>
- Google for Developers:Prerequisites for using connected apps(2026-10-30 更新) <https://developers.google.com/connected-apps/gpc/prerequisites>
- Google for Developers:Perform the steps in Google Connected Console(2026-10-28 更新) <https://developers.google.com/connected-apps/gpc/perform-the-steps>
- Google for Developers:Troubleshooting(2026-10-27 更新) <https://developers.google.com/connected-apps/gpc/troubleshooting>
- Google for Developers:Connected apps policy(2026-11-02 更新) <https://developers.google.com/connected-apps/connected-apps-policy>
- Gemini 帮助中心:Connect custom apps to Gemini <https://support.google.com/gemini/answer/17209137?hl=en>
- Gemini 帮助中心:Use & manage Connected Apps in Gemini <https://support.google.com/gemini/answer/13695044?hl=en>
- Gemini 帮助中心:Check the availability & requirements of Connected Apps <https://support.google.com/gemini/table/17434654>
- Google 搜索帮助:Use & manage Connected Apps in Search <https://support.google.com/websearch/answer/17265703>
- Gemini 应用发布说明(2026.10.13 条目) <https://gemini.google/release-notes/>
- Google 博客:New connected apps roll out to Gemini(2026-09-23) <https://blog.google/innovation-and-ai/products/gemini-app/new-connected-apps-gemini>
- Android Developers 频道:Extend your app to Gemini and Search with the Connected Apps Platform(2026-10-29) <https://www.youtube.com/watch?v=-4G-4w9FKDw>
- 9to5Google:Google adding more Connected Apps to Gemini and Search(2026-10-28) <https://9to5google.com/2026/10/28/gemini-google-connected-apps-platform>
- Model Context Protocol:Specification 2025-11-25 <https://modelcontextprotocol.io/specification/2025-11-25>
- Model Context Protocol:Authorization(2025-11-25) <https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization>
- Model Context Protocol:Tools(2025-11-25) <https://modelcontextprotocol.io/specification/2025-11-25/server/tools>
- Model Context Protocol:Specification 2026-07-28 <https://modelcontextprotocol.io/specification/2026-07-28>
- IETF RFC 9728:OAuth 2.0 Protected Resource Metadata <https://www.rfc-editor.org/rfc/rfc9728>
- IETF RFC 8414:OAuth 2.0 Authorization Server Metadata <https://www.rfc-editor.org/rfc/rfc8414>
- IETF RFC 7591:OAuth 2.0 Dynamic Client Registration Protocol <https://www.rfc-editor.org/rfc/rfc7591>
- IETF RFC 7636:Proof Key for Code Exchange <https://www.rfc-editor.org/rfc/rfc7636>
- IETF 草案:OAuth Client ID Metadata Document <https://datatracker.ietf.org/doc/draft-ietf-oauth-client-id-metadata-document/>
- GitHub:modelcontextprotocol/inspector <https://github.com/modelcontextprotocol/inspector>
- Gemini API 文档:Function calling(Remote MCP 一节) <https://ai.google.dev/gemini-api/docs/function-calling>
- Gemini API 发布说明(2026-11-10 条目) <https://ai.google.dev/gemini-api/docs/changelog>
- Gemini API 定价 <https://ai.google.dev/gemini-api/docs/pricing>
- Gemini API 文档:Understand and count tokens <https://ai.google.dev/gemini-api/docs/tokens>
- Gemini CLI 文档:MCP servers with the Gemini CLI <https://geminicli.com/docs/tools/mcp-server/>
- Android Developers:Overview of AppFunctions <https://developer.android.com/ai/appfunctions>
- Google Identity:OAuth-based Account Linking <https://developers.google.com/identity/account-linking/oauth-linking>
- Google Cloud 文档:Deploying to Cloud Run <https://cloud.google.com/run/docs/deploying>
- Google:User-triggered agents IP ranges(JSON) <https://developers.google.com/static/crawling/ipranges/user-triggered-agents.json>
- YouTube API Services:Developer Policies <https://developers.google.com/youtube/terms/developer-policies>
- Reddit:Data API Terms <https://redditinc.com/policies/data-api-terms>
- Google AI 开发者论坛:Gemini app custom apps MCP OAuth never exchanges the code(2026-10-02) <https://discuss.ai.google.dev/t/gemini-app-spark-custom-apps-mcp-oauth-never-exchanges-the-code-cannot-complete-request-on-oauth-redirect-googleusercontent-com/186405>
- Reddit r/mcp:custom connectors - gemini(2026-10-19) <https://www.reddit.com/r/mcp/comments/1xaba94/custom_connectors_gemini/>
- Reddit r/GeminiAI:Gemini now supports general MCP servers <https://www.reddit.com/r/GeminiAI/comments/1wwe3u1/gemini_now_supports_general_mcp_servers/>
- Reddit r/GeminiAI:Gemini App adding custom Connectors(2026-10-22) <https://www.reddit.com/r/GeminiAI/comments/1xcbzub/gemini_app_adding_custom_connectors/>
- Reddit r/modelcontextprotocol:How I got one stock market data MCP server into Claude, ChatGPT, Cursor, Codex and Gemini CLI(2026-10-17) <https://www.reddit.com/r/modelcontextprotocol/comments/1x8lxcq/how_i_got_one_stock_market_data_mcp_server_into/>
- Reddit r/GoogleGemini:MCP with Gemini(2026-10-28) <https://www.reddit.com/r/GoogleGemini/comments/1xhword/mcp_with_gemini/>
- EveryInfra:远程 MCP 接口(2026-11-11 真调) <https://api.everyinfra.com/mcp>
- EveryInfra:/mcp/all 受保护资源元数据(2026-11-11 读取) <https://api.everyinfra.com/.well-known/oauth-protected-resource/mcp/all>
- EveryInfra:授权服务器元数据(2026-11-11 读取) <https://auth.everyinfra.com/oidc/.well-known/oauth-authorization-server>
- EveryInfra:数据能力目录(2026-11-11、2026-11-12 读取) <https://api.everyinfra.com/api/v1/social/catalog>
引用编号 BL-129