DeepSeek Search API più i dati interni alle app social cinesi
DeepSeek Search API costa $0,75 per 1.000 chiamate e non restituisce like né commenti. Aggiungi i dati di Xiaohongshu, Zhihu e Weibo: 8 chiamate reali costano $0,014.
Il 17 ottobre 2026 DeepSeek ha aperto a tutti gli utenti dell'API due nuovi endpoint, Search e Fetch. Ognuno costa $0,75 per 1.000 richieste andate a buon fine. Un risultato di Search contiene un titolo, un URL, due riassunti, il testo della pagina, il nome del sito, una data e due punteggi. Non contiene like, commenti né salvataggi (guida a Search e Fetch di DeepSeek).
Abbiamo eseguito xiaohongshu/search, zhihu/search e weibo/search di EveryInfra su un unico argomento, «robot aspirapolvere», tra le 00:15 e le 00:19 SGT del 3 novembre. Tutte le 98 righe avevano numero di like, numero di commenti e data di pubblicazione. Su Xiaohongshu, 12 righe su 33 avevano anche un flag per i contenuti di brand a pagamento. Un team di brand che chiede «di cosa si lamentano gli acquirenti cinesi» ha bisogno proprio di questi campi, e i risultati web non li hanno.
Il costo dipende da un fattore preciso. Una pagina di ricerca di Xiaohongshu costa $0,005556, cioè 7,4 volte una chiamata a DeepSeek Search. Con i limiti di chiamate di questo articolo, il costo dei dati per 1.000 domande scende da $20,89 a $4,53.
Questo articolo è per i team fuori dalla Cina che vendono in Cina o competono con brand cinesi. Esempi tipici sono un brand europeo di elettrodomestici, un produttore statunitense di robot aspirapolvere o un'agenzia che monitora le conversazioni dei consumatori cinesi per un cliente. Vuoi un piccolo assistente che risponda a una domanda sul prodotto citando le fonti. DeepSeek ora ha un proprio endpoint di ricerca web, quindi la parte sul web aperto è semplice. Questo articolo mostra cosa fa quell'endpoint, cosa non restituisce e come aggiungere dati dall'interno di tre app cinesi. Mostra anche quanto costa ogni chiamata.
Ogni informazione su DeepSeek viene da api-docs.deepseek.com, consultato il 3 novembre 2026. Non abbiamo una chiave API di DeepSeek. Quindi la parte DeepSeek della configurazione è un esempio, non un test. Ogni numero di EveryInfra viene dalla risposta grezza di una chiamata reale.
In un articolo precedente, DeepSeek V4 con Claude Code per la pulizia dei commenti, abbiamo usato DeepSeek come modello in Claude Code e misurato il costo della pulizia dei commenti. Conteneva solo una breve sezione su Search e Fetch. Questo articolo parte dall'endpoint Search e si chiede come dividere il lavoro con i dati interni alle piattaforme.
Cosa fa l'API di ricerca web di DeepSeek, secondo la documentazione consultata il 3 novembre
Prima di dividere il lavoro ti serve un quadro chiaro del lato DeepSeek. La guida a Search e Fetch definisce entrambi gli endpoint «raw JSON APIs». Usano la stessa chiave API dei modelli di chat, con Authorization: Bearer. Search accetta una query e restituisce risultati web strutturati dal motore di ricerca di DeepSeek.
Fetch accetta un URL e restituisce il corpo della pagina in Markdown. Nessuno dei due endpoint passa da un modello, quindi nessuno dei due è fatturato a token. Abbiamo verificato ogni riga della tabella qui sotto con il riferimento dell'API Search e il riferimento dell'API Fetch.
| Voce | Ricerca | Fetch |
|---|---|---|
| Endpoint (sull'host api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| Campi della richiesta | query (da 1 a 128 caratteri, con site:, lang:, after:, before: e altro), count (da 1 a 50, predefinito 10), ori_question, localization (un indirizzo IP), need_content | url (fino a 8.192 caratteri, http o https, senza nome utente né password) |
| Risposta | un array results; ogni risultato ha 10 campi: rerank_score, title, url, snippet, summary, content, site_name, site_icon, date, authority | title, content (Markdown) |
| Prezzo | $0,75 per 1.000 richieste andate a buon fine; count non cambia il prezzo | same |
| Non addebitato | errori, array results vuoto, timeout | errori, nessun contenuto della pagina, timeout |
| Limite di frequenza delle richieste | 100 richieste al secondo per account | 25 richieste al secondo per account, più un limite per dominio di destinazione |
Per gli sviluppatori contano tre dettagli. Primo, summary è un riassunto lungo scritto per un modello, di solito da 600 a 800 caratteri. snippet è un riassunto breve per un'interfaccia utente, da 100 a 200 caratteri. Dieci risultati con i riassunti completi aggiungono al contesto da 6.000 a 8.000 caratteri per ogni ricerca.
Secondo, date è la data di pubblicazione della pagina, in UTC, ed è null quando è sconosciuta. authority è un voto da 0 a 4, con -1 per sconosciuto. rerank_score è un punteggio di pertinenza da 0 a 3, e la guida considera buono un risultato da 1,5 in su.
Terzo, Search passa query al servizio di ricerca così com'è. Quindi puoi scrivere site:xiaohongshu.com in una query. Ma il numero di risultati dipende da quante pagine di quel sito sono nell'indice di DeepSeek. Inoltre, l'indice conserva ogni pagina com'era al momento della scansione. La sezione «Ora dello snapshot e ora della chiamata» più avanti spiega perché questo conta per i contenuti delle app.
La guida spiega con chiarezza anche gli errori. Il formato corrisponde a quello degli errori di OpenAI, e il campo param è sempre null. Per gli errori 408, 429 e 5xx puoi fare un nuovo tentativo dopo un'attesa. Un 402 significa che il saldo è insufficiente.
Per gli altri errori 4xx non fare nuovi tentativi senza modificare la richiesta. EveryInfra funziona in modo simile. Un valore errato restituisce un 422 che indica il campo sbagliato ed elenca i valori ammessi. La sezione «Un round trip reale» mostra un esempio concreto.
Prezzi della DeepSeek Search API: cosa è diventato a pagamento dal 1° novembre
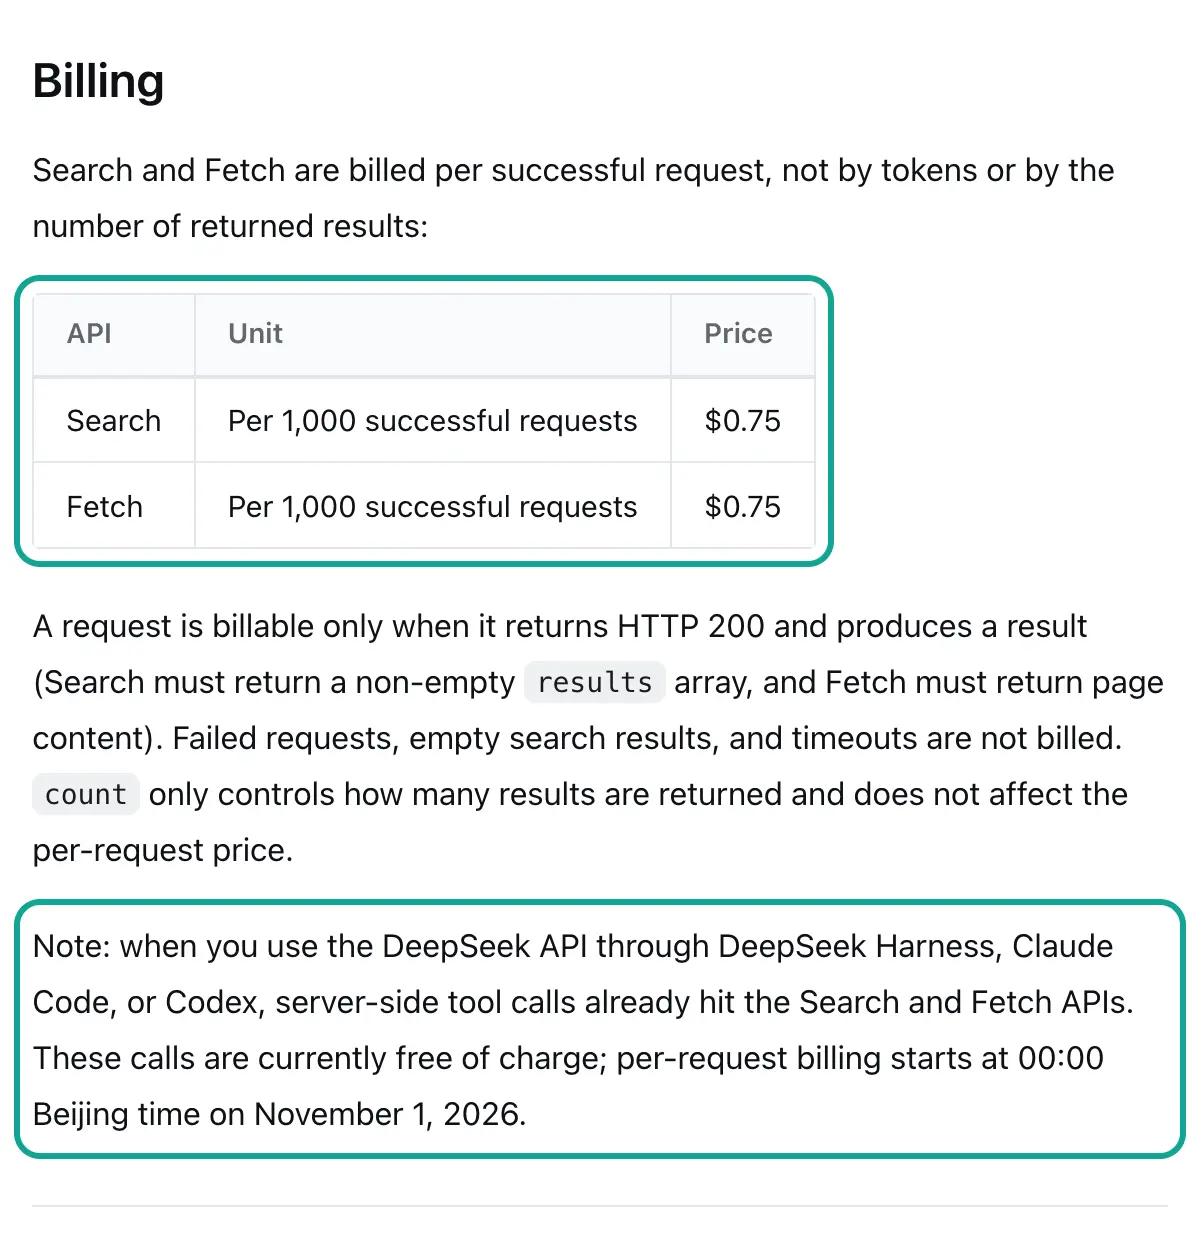
Il prezzo in sé è semplice. Sulla pagina dei prezzi in inglese Search e Fetch costano $0,75 per 1.000 richieste andate a buon fine. La pagina cinese indica 5 yuan per la stessa unità. count cambia solo il numero di risultati, non il prezzo. Quindi una richiesta da 50 risultati costa quanto una da 10. Per 1.000 risultati, sono $0,015 con count=50 e $0,075 con count=10.
Una frase della nota di rilascio del 17 ottobre passa facilmente inosservata. Quando usano l'API di DeepSeek, Claude Code, Codex e DeepSeek Harness chiamano già Search e Fetch tramite tool lato server. Queste chiamate erano gratuite, e la fatturazione per richiesta parte alle 16:00 UTC del 31 ottobre 2026, cioè alle 00:00 del 1° novembre a Pechino e anche a Singapore.
Il 3 novembre, la pagina dei prezzi e la guida riportavano ancora la dicitura «currently free of charge» accanto a quella data. La data è passata, quindi queste chiamate ora rientrano nel periodo a pagamento. Se il tuo team usa DeepSeek dentro Claude Code (guida di DeepSeek per Claude Code), ogni ricerca web ora aggiunge $0,75 per 1.000 al costo dei token.
Conviene guardare anche i prezzi dei modelli, perché i risultati di ricerca finiscono in un modello. Sulla stessa pagina dei prezzi, deepseek-flash ora punta a DeepSeek-V4.1-Flash-1017. Nelle ore di punta, l'input con cache miss costa $0,30 per milione di token e l'output $1,20. Fuori dalle ore di punta i prezzi sono dimezzati.
Le ore di punta vanno dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC nei giorni feriali. Per un team a Londra corrispondono alle prime ore del mattino e alla tarda mattinata. Per un team a New York cadono di notte. La lunghezza del contesto è di 1M di token, ed entrambi i modelli supportano le chiamate ai tool e l'output JSON.
| Voce | Unità | USD (pagina in inglese) | Consultato il |
|---|---|---|---|
| Search | per 1.000 richieste andate a buon fine | $0.75 | 2026-11-03 |
| Fetch | per 1.000 richieste andate a buon fine | $0.75 | 2026-11-03 |
| Input di deepseek-flash (cache miss, ore di punta) | per 1M di token | $0.30 | 2026-11-03 |
| Output di deepseek-flash (ore di punta) | per 1M di token | $1.20 | 2026-11-03 |
EveryInfra zhihu/search | per 1.000 richieste andate a buon fine | $0.556 | 2026-11-03 |
EveryInfra weibo/search | per 1.000 richieste andate a buon fine | $0.806 | 2026-11-03 |
EveryInfra xiaohongshu/search | per 1.000 richieste andate a buon fine | $5.556 | 2026-11-03 |
I tre prezzi di EveryInfra vengono dal campo price_usd del catalogo gratuito. La regola è la stessa di DeepSeek: errori e risultati vuoti sono gratuiti.
Risultati web della DeepSeek Search API e dati interni alle piattaforme: i campi a confronto
Il modo migliore per vedere la differenza è mettere i campi uno accanto all'altro. Un risultato di DeepSeek Search ha 10 campi. Servono a trovare una pagina, dare un riassunto a un modello e mostrare un risultato a un utente. I risultati di una ricerca dentro un'app rispondono a un'altra domanda: come hanno reagito le persone su quest'app a questo post? Anche loro hanno un titolo, un testo, un link e una data di pubblicazione.
In più hanno like, commenti, salvataggi e condivisioni, oltre a flag sull'autore e sui contenuti. La colonna di sinistra qui sotto segue la documentazione di DeepSeek. Le altre tre colonne mostrano i campi presenti nelle nostre risposte reali del 3 novembre.
| Domanda | DeepSeek Search (campi documentati) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| Cosa dice il post? | title, summary, content | title, text (circa 60 caratteri) | title, text | text |
| Dove posso aprirlo? | url | url (con un token di accesso) | url | url |
| Quando è stato pubblicato? | date (può essere null) | posted_at, updated_at | posted_at | posted_at |
| Quanti like e salvataggi ha? | none | like_count, collect_count | like_count, collect_count | like_count |
| Quanto è attiva la discussione? | none | comment_count, share_count | comment_count | comment_count, repost_count |
| Chi l'ha detto? | site_name, authority | author_name, author_id | author_name, author_follower_count, testo del badge | author_follower_count, author_verified, motivo della verifica |
| È un contenuto di brand a pagamento? | none | is_cooperation_note, is_goods_note | none | nessuno (usa il motivo della verifica) |
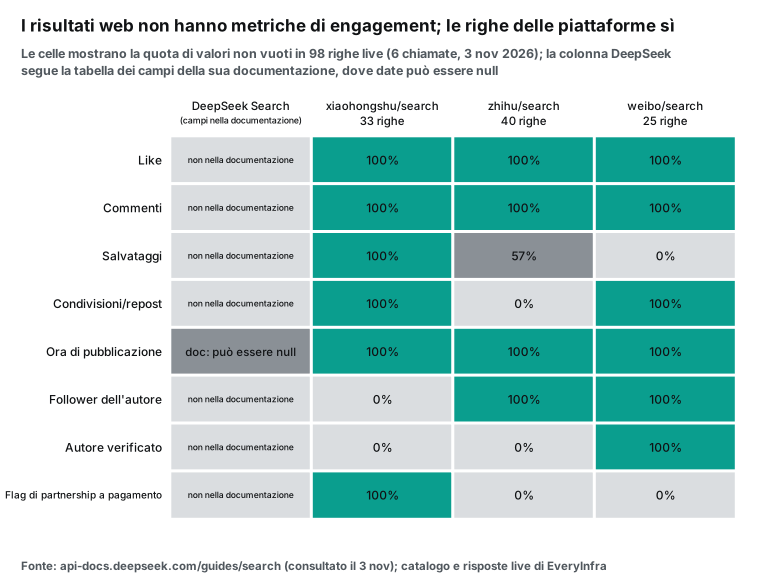
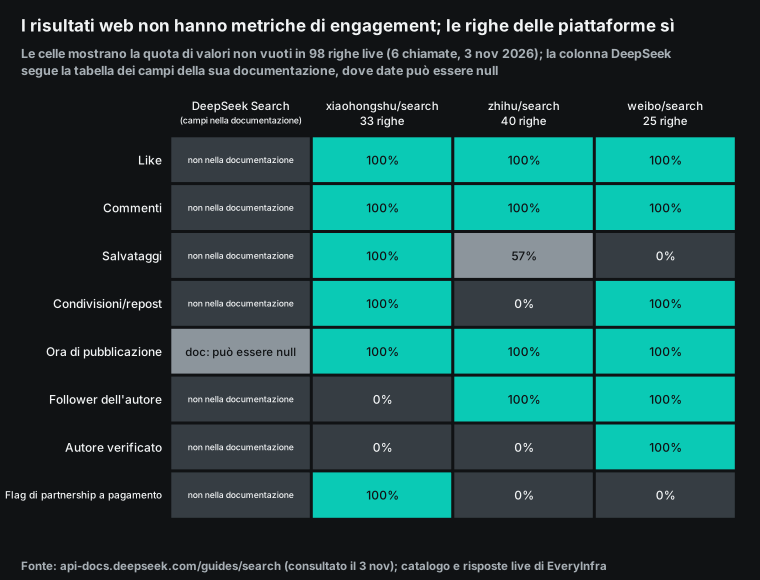
Questo grafico ha due limiti. Primo, «non nella documentazione» non significa che DeepSeek non possa mai vedere questi numeri. Il suo campo content è il corpo della pagina. Se il corpo di una pagina dice «12.000 like», un modello può leggere quel testo.
Ma è testo di una pagina, non un campo che puoi ordinare o sommare. Ed è anche un valore del momento della scansione. Secondo, uno 0% in una colonna delle app ha due cause. Alcuni campi non sono nel catalogo per quella funzionalità, come le condivisioni per la ricerca di Zhihu.
Altri campi sono nel catalogo ma questa volta non sono tornati. Il catalogo elenca author_is_verified per la ricerca di Xiaohongshu, ma nessuna delle nostre 33 righe lo conteneva. Quindi scrivi il codice basandoti sui response_fields del catalogo e gestisci i campi mancanti in qualsiasi riga.
Ora dello snapshot e ora della chiamata: i numeri di una stessa nota cambiano
C'è anche una differenza di tempo. Una ricerca web restituisce pagine dal suo indice, quindi ogni pagina è com'era al momento della scansione. La documentazione di DeepSeek elenca 10 campi per i risultati. Uno è date, la data di pubblicazione. Nessun campo indica l'ora della scansione, quindi non puoi sapere il giorno dello snapshot.
Una ricerca dentro l'app fornisce i valori al momento della chiamata. Like, commenti e salvataggi sono i conteggi attuali. Xiaohongshu restituisce anche updated_at, che il catalogo definisce come l'ora dell'ultima modifica della nota.
Per gli argomenti di prodotto questa differenza pesa molto. Abbiamo esaminato le 20 note di Xiaohongshu sulle lamentele, ordinate per numero di like. Per 13 di esse, l'ultima modifica era avvenuta più di 30 giorni dopo la pubblicazione. Per 5, più di un anno dopo. Una nota aveva una modifica 1.154 giorni dopo la data di pubblicazione.
| Intervallo tra pubblicazione e ultima modifica | Note (su 20) |
|---|---|
| Meno di 30 giorni | 7 |
| Da 30 a 365 giorni | 8 |
| Più di 365 giorni | 5 |
Gli autori tornano spesso su una nota. Correggono il testo, aggiungono un aggiornamento o cambiano il nome del modello. Se uno snapshot web è precedente alla modifica, il modello legge la versione vecchia. La nota sul sacchetto per la polvere nello screenshot qui sotto aveva 992 like e 571 commenti. Al momento della nostra chiamata aveva solo una settimana circa. Se le persone continuano a mettere like e a commentarla, uno snapshot più vecchio mostra conteggi più bassi.
Weibo è ancora più aggiornato. Tutti i 25 post delle nostre due ricerche erano dei 4 giorni precedenti la chiamata. Per una domanda come «c'è un nuovo problema di assistenza post-vendita questa settimana?», la risposta è in quei post.
Puoi quindi dividere il lavoro in base al tempo. Usa la ricerca web per i contenuti che cambiano lentamente: pagine delle specifiche dei brand, recensioni della stampa, manuali e comunicati stampa. Per queste pagine basta una scansione ogni poche settimane. Usa la ricerca interna all'app per i contenuti che cambiano in fretta: per esempio le lamentele dell'ultima settimana, i problemi post-vendita in crescita e le note con conteggi che continuano a salire. La ricerca interna offre anche ordinamenti che solo l'app può applicare: più recenti, più like e più commenti.
Vale anche il contrario. Una ricerca dentro un'app non può sostituire una ricerca web. Siti dei brand, pagine delle specifiche, recensioni della stampa e forum esterni a queste app non ci sono. Per un brand occidentale, il lato web copre anche fonti in lingua inglese ed europee, come la recensione di una rivista tedesca. I due tipi di dati si dividono il lavoro. Nessuno dei due sostituisce l'altro.
I criteri che abbiamo scritto prima del test
Abbiamo scritto questi criteri prima delle chiamate reali, così da non poterli cambiare dopo aver visto i risultati. Sono loro a stabilire se ogni conclusione che segue regge.
| Criterio | Superato | Non superato |
|---|---|---|
| I dati interni alle piattaforme aggiungono campi che mancano nei risultati web? | like, commenti e data di pubblicazione presenti in almeno il 90% delle righe su tutte e tre le app | sotto il 90% su almeno un'app |
| Tutte e tre le app rispondono entro 85 secondi, senza passare a un job asincrono? | tutte e 6 le chiamate restituiscono 200 | un timeout o un 503 |
| Un modello riesce a correggere da solo un valore errato? | il 422 indica il campo ed elenca i valori ammessi, e non viene addebitato nulla | un errore generico o un addebito |
| Possiamo controllare il costo di Xiaohongshu? | un piano porta il costo dei dati sotto i $5 per 1.000 domande | l'unico modo per controllarlo è fare meno domande |
| Le righe possono finire direttamente nella risposta come «voce degli acquirenti»? | al massimo il 20% delle righe richiede un filtro | più del 20% su ogni app (qui ci aspettavamo un esito negativo) |
Ecco il risultato in anticipo. I primi quattro criteri sono soddisfatti. Il quinto non lo è su nessuna delle tre app, quindi una sezione successiva spiega i filtri.
Il flusso: una domanda sul prodotto, due canali di dati


Il flusso ha quattro passaggi, e il secondo è quello chiave. Il modello DeepSeek non esegue alcuna funzione. Restituisce tool_calls, che dicono «chiama questa funzione con questi argomenti». Le chiamate reali a DeepSeek Search e a EveryInfra le fa il tuo codice.
La guida alle tool call di DeepSeek dice lo stesso: la funzione la fornisce l'utente e il modello non la esegue. Il vantaggio è che entrambe le chiavi API restano sul tuo server e il modello non le vede mai. Il costo è che il loop lo scrivi tu. Le sezioni successive riportano un esempio di configurazione completo.
Nel primo passaggio l'utente fa una domanda. Nel secondo il modello legge la domanda e le descrizioni delle quattro funzioni. Decide cosa cercare e può inviare quattro chiamate insieme: una ricerca web e tre ricerche nelle app. Nel terzo il tuo codice chiama entrambi gli endpoint. Restituisce il JSON grezzo, o una versione ridotta, in un messaggio role: tool con il tool_call_id corrispondente.
Nel quarto passaggio il modello legge tutti i risultati e scrive la risposta. Il system prompt gli chiede di aggiungere dopo ogni affermazione l'URL della fonte, il numero di like e la data di pubblicazione. Una domanda successiva, come «cosa dice la gente del marchio A rispetto al marchio B», avvia un nuovo giro di chiamate. Il loop si ferma quando il modello non restituisce tool_calls.
In questo flusso ogni canale di dati ha un compito preciso. La ricerca web trova siti dei marchi, pagine delle specifiche, recensioni dei media e notizie. Risponde a «cosa fa questo modello e cosa dice il marchio?». I dati delle piattaforme trovano cosa dicono gli utenti reali su Xiaohongshu, Zhihu e Weibo. Rispondono a «come lo valutano gli acquirenti e quali problemi tornano più spesso?». Con entrambi i tipi di fonti nella risposta, chi legge vede affiancate le affermazioni del marchio e le segnalazioni degli acquirenti. Dove le due cose non coincidono, spesso trovi la conclusione più utile.
Definizioni dei tool: quattro funzioni in JSON completo (esempio di configurazione)
Ecco le quattro funzioni per il modello DeepSeek. Per le tre funzioni delle app, ogni nome di parametro, valore enum e descrizione proviene dai campi param_meanings e allowed_values del catalogo EveryInfra. La funzione di ricerca web segue il riferimento della DeepSeek Search API. Usiamo la modalità strict. La guida alle tool call di DeepSeek indica che la modalità strict richiede il base URL beta (api.deepseek.com/beta con prefisso https). Ogni proprietà di ciascun oggetto deve comparire in required e additionalProperties deve essere false.
Quindi un parametro facoltativo non si può semplicemente omettere. Lo gestiamo in due modi. Per un enum con valore predefinito, inseriamo il valore predefinito nell'enum e lasciamo che sia il modello a sceglierlo. Ad esempio relevance per sort e any_time per date_range. Per una stringa senza valore predefinito, come un token di pagina, usiamo anyOf con null.
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword in Chinese, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]
Perché mettere il prezzo nella descrizione? Perché il modello legge description. Scrivi «una pagina = USD 0,005556» nella funzione Xiaohongshu. Poi scrivi «al massimo una pagina Xiaohongshu per domanda, prova prima Zhihu e Weibo» nel system prompt.
Così il modello ha informazioni sui costi quando sceglie una funzione. Non è un limite rigido. Il limite rigido va nel codice del loop, come mostra la sezione successiva.
C'è un altro dettaglio importante per un team fuori dalla Cina. La keyword per le tre funzioni delle app deve essere in cinese, perché i post sono in cinese. La descrizione lo specifica. Un modello come deepseek-flash scrive buone keyword in cinese a partire da una domanda in inglese, quindi i tuoi utenti possono fare domande in inglese. Abbiamo verificato con uno script gli enum qui sopra rispetto al catalogo del 3 novembre.
| Parametro della funzione | `allowed_values` del catalogo | Enum nella definizione del tool | Corrispondenza |
|---|---|---|---|
xiaohongshu_search.sort | 5 valori: relevance, newest, most_liked, most_commented, most_collected | gli stessi 5 | yes |
xiaohongshu_search.date_range | 6: da any_time a last_1_year | gli stessi 6 | yes |
xiaohongshu_search.content_type | 3: all, image, video | gli stessi 3 | yes |
zhihu_search.content_type | 4 valori: all, answer, article, video | gli stessi 4 | yes |
zhihu_search.sort | 3 valori: general, upvote_count_descending, time_descending | gli stessi 3 | yes |
web_search.count | Documentazione DeepSeek: da 1 a 50 | minimo 1, massimo 50 | yes |
Perché questa tabella è importante? Un enum errato riceve un 422 da EveryInfra e non viene addebitato nulla. Ma il modello ha bisogno di un giro in più per correggerlo. Con gli enum corretti nella definizione risparmi un round trip e i relativi token.
Il catalogo è consultabile gratuitamente in qualsiasi momento, ad esempio la voce del catalogo Xiaohongshu. Quando una funzionalità cambia, puoi rigenerare le definizioni. Anche la pagina della funzionalità di ricerca Xiaohongshu spiega i campi.
La voce del catalogo Zhihu e la voce del catalogo Weibo elencano parametri e campi per le altre due. La ricerca di Weibo ha un solo parametro, keyword, quindi la sua funzione è la più breve. Un modello non la sbaglia quasi mai.
Il codice del loop: tool_calls di DeepSeek in Python (esempio di configurazione)
Il codice Python qui sotto usa l'SDK Python di OpenAI, dal pacchetto openai su PyPI. La chat API di DeepSeek usa il formato OpenAI, e la guida al function calling di OpenAI descrive la stessa struttura dei tools. Entrambi gli endpoint dei dati usano requests con un timeout di 90 secondi, perché EveryInfra ha un budget di 85 secondi per una chiamata sincrona. Prima di restituire i risultati al modello, teniamo 12 campi. ensure_ascii=False lascia i caratteri cinesi così come sono (documentazione json di Python). I caratteri con escape userebbero diverse volte più token.
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # at most 1 Xiaohongshu page per question

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # a 422 has param, allowed, did_you_mean: give it to the model
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "Answer in English. After each claim, give the source url, like count and post date. "
                                          "Search Zhihu and Weibo first; use Xiaohongshu only when needed. Keywords for the apps in Chinese."},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # keeps reasoning_content; required when tools are present
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
            msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})
Due punti seguono la documentazione di DeepSeek. Primo, la modalità thinking è attiva per impostazione predefinita. La guida alla modalità thinking dice che una richiesta con tools deve rimandare il reasoning_content di ogni turno precedente. Altrimenti l'API restituisce un 400.
È quello che fa la riga msgs.append(m). Secondo, la modalità strict funziona solo sul base URL beta. Sull'URL normale il campo strict non ha effetto e a volte un modello può omettere un argomento. In quel caso EveryInfra restituisce un 422 e il modello aggiunge l'argomento al giro successivo.
Il controllo del budget sta nel loop, non nel prompt. Un prompt può solo chiedere al modello di risparmiare. Il codice può garantire che una domanda non spenda mai più di un importo fisso. Per un team di brand che esegue centinaia di domande al giorno, questa differenza si vede sulla fattura mensile.
Un round trip reale: cosa invia il modello e cosa torna indietro
Non abbiamo eseguito il lato del modello, perché non abbiamo una chiave DeepSeek. Prendi la domanda «Acquisto un robot aspirapolvere per l'11.11: di cosa si lamentano di più gli acquirenti?». In base alle definizioni dei tool, un modello potrebbe inviare una chiamata Xiaohongshu con una keyword in cinese per «lamentele robot aspirapolvere». Gli altri argomenti sono sort impostato su most_liked, date_range su any_time, content_type su all e page_token su null. Il loop scarta il valore null e invia a EveryInfra la richiesta qui sotto. Questa chiamata è reale.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'
La richiesta delle 00:17:22 SGT del 3 novembre 2026 ha restituito 200 con 20 righe. Il corpo era di 36.627 byte e billing.charged_usd era 0.005556. Nello stesso minuto abbiamo rinviato di proposito la chiamata con sort impostato su hot. Ha restituito un 422 con code impostato su invalid_value e did_you_mean su most_liked.
Il campo allowed elencava i 5 valori validi. Il primo elemento di next_steps diceva: «Cambia solo sort con un valore presente in allowed, poi invia di nuovo. Non è stato addebitato nulla.» Un modello che riceve questo messaggio role: tool cambia solo sort al giro successivo. Non serve alcun intervento umano.
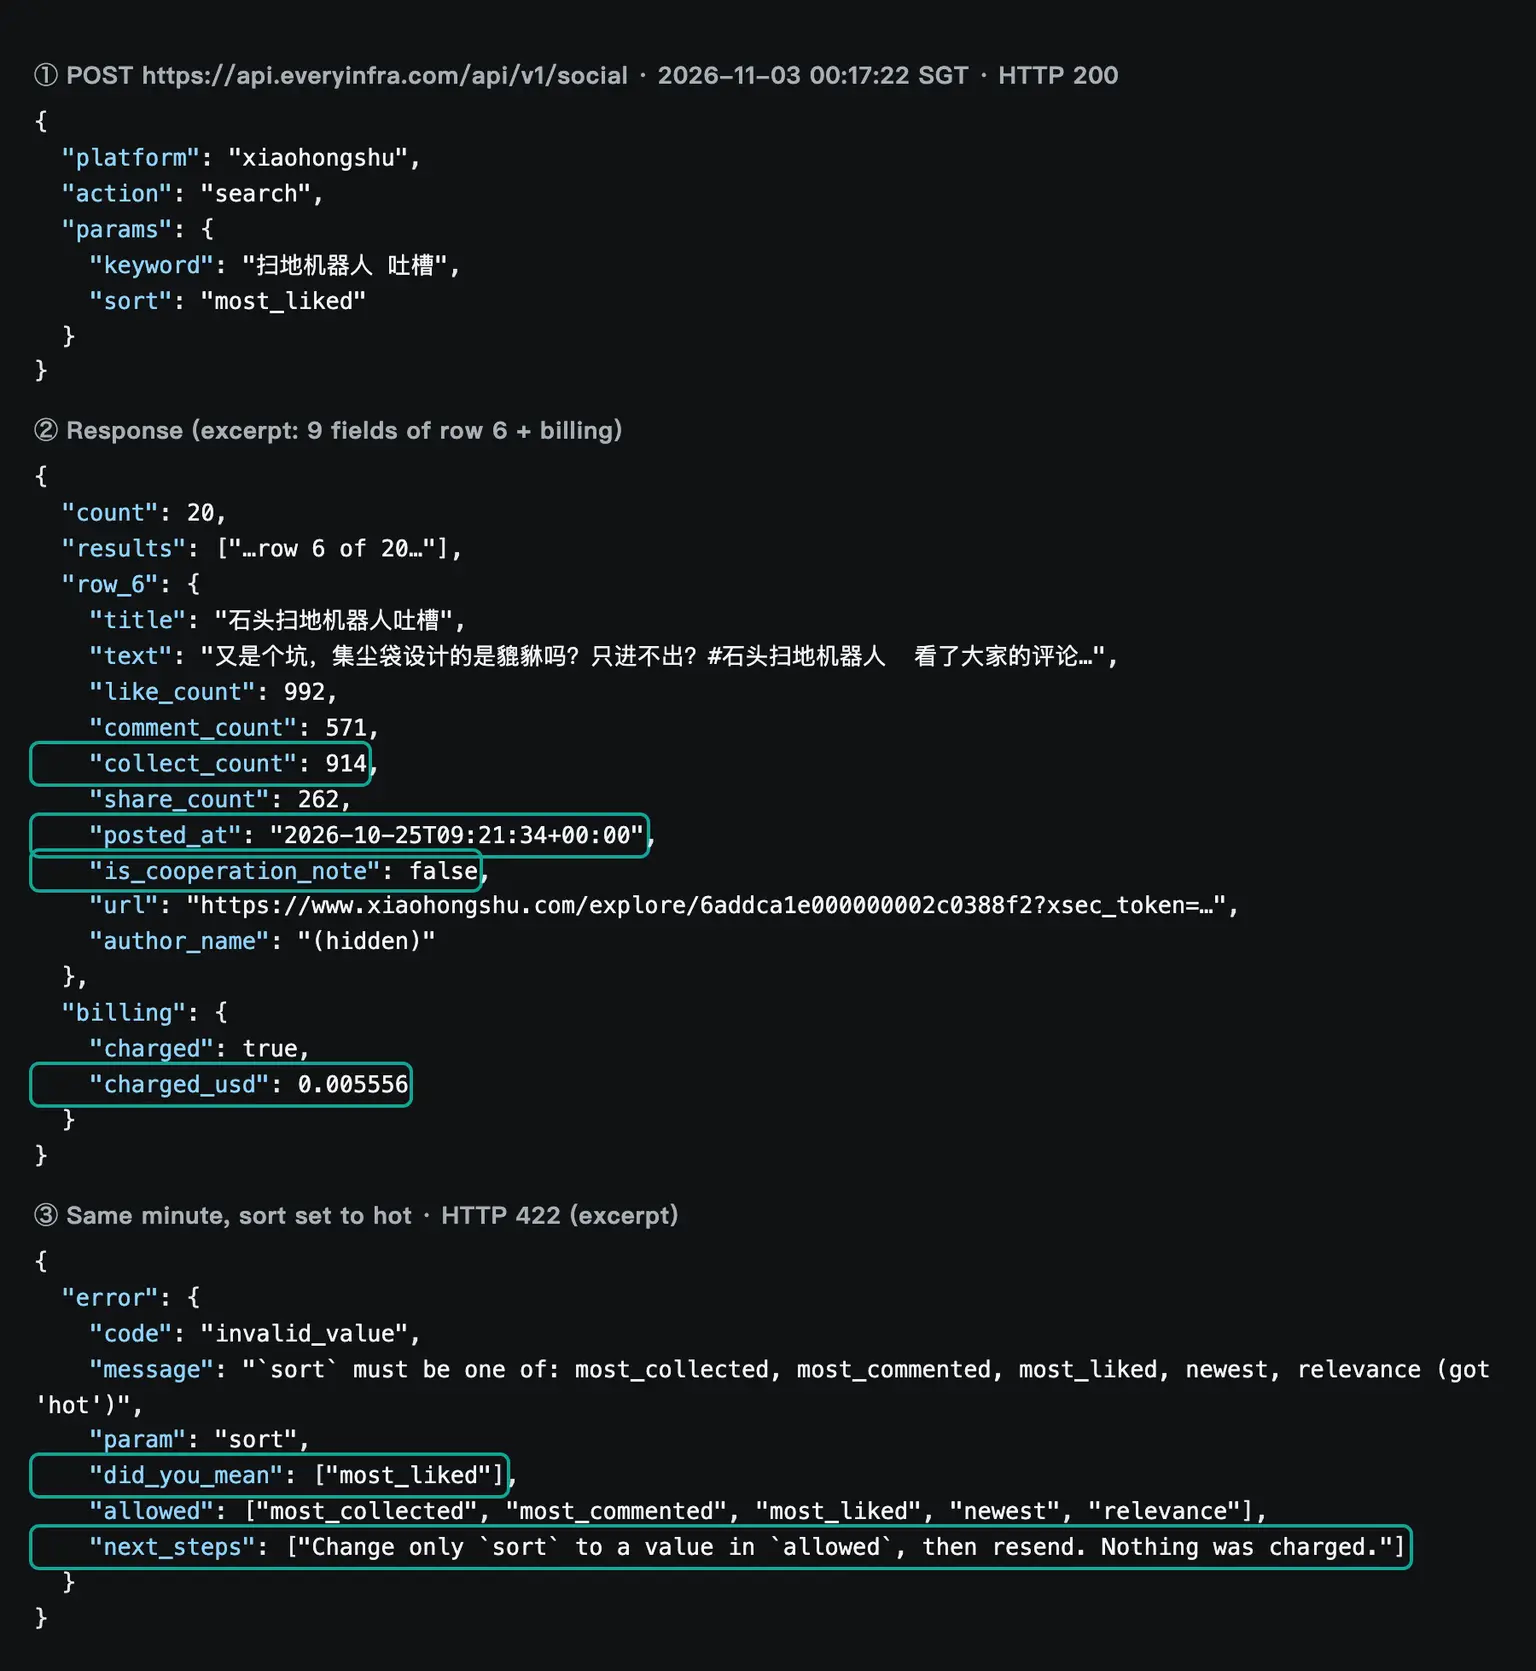
La riga 6 nello screenshot è una nota del 25 ottobre. Il titolo dice che è una lamentela su un marchio di robot aspirapolvere. Il testo dice che il sacchetto della polvere «fa solo entrare e mai uscire», il che rimanda al costo dei sacchetti di ricambio. Ha 992 like, 571 commenti e 914 salvataggi.
Il numero di commenti supera la metà dei like, quindi la nota ha avviato una vera discussione. È il segnale che cerchi per le «lamentele principali». In un risultato di ricerca web, un modello vede al massimo il titolo e un riassunto di questa nota.
Per vedere su cosa discutono i commenti, puoi chiamare xiaohongshu/note con l'url di questa riga per avere il testo completo. È possibile anche una chiamata per i commenti. Anche ognuna di queste chiamate costa $0,005556, quindi vale la stessa logica di budget.
Test 1: cosa ha restituito ciascuna app
Tra le 00:15 e le 00:19 SGT abbiamo fatto 8 chiamate sul tema «robot aspirapolvere». Sei erano due per app. Una era per il confronto con Reddit più avanti, e una aveva di proposito un valore errato. Tutte le chiamate hanno risposto in modo sincrono e nessuna ha richiesto un job asincrono.
| SGT | Funzionalità | Parametri | Righe | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | consigli robot aspirapolvere, solo risposte | 20 | $0.000556 |
| 00:16:17 | weibo/search | robot aspirapolvere | 13 | $0.000806 |
| 00:16:32 | xiaohongshu/search | robot aspirapolvere, più commenti, ultimi 30 giorni | 13 | $0.005556 |
| 00:17:22 | xiaohongshu/search | sort impostato su hot | 422 | $0 |
| 00:17:22 | xiaohongshu/search | lamentele robot aspirapolvere, più like | 20 | $0.005556 |
| 00:18:26 | zhihu/search | difetti robot aspirapolvere, più voti positivi | 20 | $0.000556 |
| 00:18:31 | weibo/search | assistenza post-vendita robot aspirapolvere | 12 | $0.000806 |
| 00:18:53 | reddit/search | robot aspirapolvere, top | 5 | $0.000556 |
| Totale | 103 righe | $0.014392 |
Le tre app cinesi hanno restituito contenuti molto diversi. La ricerca Xiaohongshu sulle lamentele, ordinata per numero di like, ha restituito 20 note. La maggior parte dei titoli parla di uso reale e di cose da evitare. Trattano il design del sacchetto della polvere, un robot caduto in una buca dopo che la zona vietata non ha funzionato, problemi con il riconoscimento degli animali domestici e «un elettrodomestico che è una tassa sugli ingenui». Otto delle 20 hanno il flag di contenuto a pagamento, e sono recensioni di marchi e guide all'acquisto.
Una riga è importante in particolare per i marchi occidentali. Una nota del 16 dicembre 2025 ha un titolo che invita a non comprare un robot aspirapolvere Dyson. Ha 1.444 like e 53 commenti. Il testo dice che il prodotto non è male, ma che il rapporto qualità-prezzo è troppo basso. Un marchio occidentale che vende in Cina può trovare questo tipo di nota solo dentro l'app.
La tabella qui sotto mostra cinque righe di quella ricerca, con il nostro riassunto tradotto di ogni titolo. Mostrano cosa aggiungono i campi di engagement: vedi subito quale lamentela ha avviato più discussione.
| Pubblicata | Titolo, riassunto in italiano | Like | Commenti | Flag a pagamento |
|---|---|---|---|---|
| 2026-10-16 | Un incidente temuto è successo comunque con un robot pensato per gli animali domestici | 3,710 | 183 | false |
| 2023-09-17 | Il robot ha ignorato la zona vietata per un mese, poi è caduto in una buca | 3,445 | 1,937 | false |
| 2025-12-16 | Non comprare il robot aspirapolvere Dyson | 1,444 | 53 | false |
| 2026-10-25 | Lamentela sul design del sacchetto della polvere di un marchio | 992 | 571 | false |
| 2026-07-06 | Un elettrodomestico che è una tassa sugli ingenui | 553 | 973 | false |
La ricerca Zhihu sui consigli ha restituito 20 risposte, per lo più guide all'acquisto ed elenchi di modelli. Le ricerche Weibo hanno restituito 25 post, tutti della settimana precedente al 2 novembre. Erano i più eterogenei. Alcuni utenti chiedevano consigli. Un utente ha scritto che un apparecchio si era rotto dopo due anni e che il marchio non aveva pezzi di ricambio. C'erano anche post di campagne dei marchi e post di guide agli acquisti.
Ogni tipo di contenuto ha il suo uso. Per difetti specifici segnalati più volte, Xiaohongshu ordinato per like o commenti è la fonte più mirata. Per analisi esperte su cosa comprare, le risposte lunghe di Zhihu sono le più ricche di informazioni. Per i nuovi problemi di assistenza di questa settimana, Weibo è la più aggiornata. Un assistente che usa solo la ricerca web farà fatica a ottenere tutti e tre i punti di vista. E non otterrà nemmeno i conteggi di engagement che mostrano quale post è rappresentativo.
La chiamata a Reddit offre un contrasto utile per un team anglofono. I primi 5 risultati per «robot vacuum» sono stati pubblicati tra il 7 e il 22 ottobre. Provenivano da community umoristiche e fuori tema. In cima c'erano un video in r/TikTokCringe con 6.551 like e un «garage per robot aspirapolvere» in r/homeassistant con 3.076 like. Il terzo era un robot aspirapolvere travestito da personaggio dei cartoni animati in r/futurama, con 2.998 like. Nessuno era una lamentela di un acquirente.
| Pubblicata | Community | Titolo | Like | Commenti |
|---|---|---|---|---|
| 2026-10-20 | r/TikTokCringe | Robot aspirapolvere giapponese all'avanguardia | 6,551 | 107 |
| 2026-10-16 | r/homeassistant | Garage per robot aspirapolvere | 3,076 | 176 |
| 2026-10-14 | r/futurama | Il mio robot aspirapolvere travestito da Scruffy il bidello e Wash Bucket | 2,998 | 76 |
| 2026-10-07 | r/Perfectfit | Come il mio robot aspirapolvere si infila sotto il mobile della TV | 1,773 | 16 |
| 2026-10-22 | r/BORUpdates | AITAH for refusing to share with my cousin-in-law? (fuori tema) | 1,102 | 222 |
Quindi «top» su qualsiasi app mostra ciò che è popolare, non ciò che è utile. Anche sulle app occidentali la scelta dell'ordinamento e della keyword conta. La pagina della funzionalità di ricerca Reddit elenca le opzioni.
Test 2: ordinando per voti positivi, 0 righe Zhihu su 20 erano recenti
«Recente» è il punto dove le domande sui prodotti sbagliano più spesso. I robot aspirapolvere cambiano più volte all'anno, e una guida all'acquisto di due anni fa potrebbe non essere più valida. Abbiamo usato posted_at per contare, per ogni chiamata, le righe degli ultimi 30 giorni, cioè successive al 4 ottobre 2026. Le sei ricerche nelle app erano molto diverse.
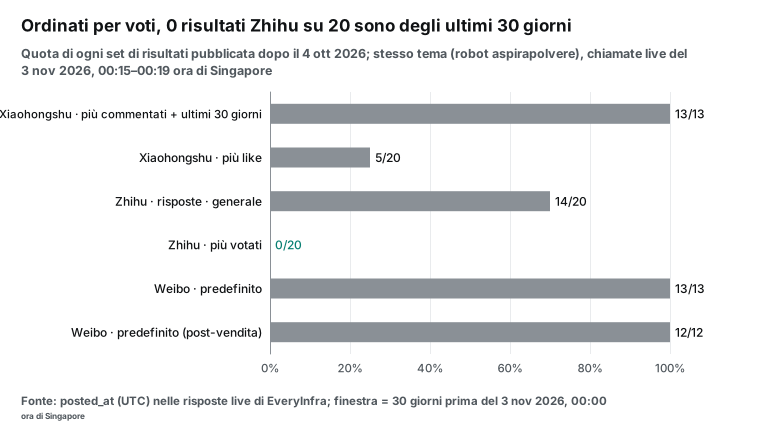
Il caso estremo è la ricerca Zhihu ordinata per più voti positivi. Delle 20 righe, 18 sono state pubblicate prima del 2026, e la più vecchia è del 2015. I titoli colpiscono ancora di più. Nove titoli su 20 citano il 2026.
Otto di questi nove sono stati pubblicati prima del 2026. Il più vecchio è del 12 aprile 2018, ma il titolo promette una guida all'acquisto 2026. Sono risposte evergreen i cui autori aggiornano il testo e l'anno ogni anno. Il contenuto può essere nuovo, ma un lettore o un modello che guarda solo il titolo penserà che sia di quest'anno.
Il date di un risultato web può intercettare questo caso? Dipende da quale data mostrava la pagina al momento del crawling. La documentazione di DeepSeek dice solo che date è null quando è sconosciuta. I dati delle piattaforme forniscono l'ora di pubblicazione registrata dall'app stessa. Puoi confrontarla direttamente con il titolo.
La soluzione è semplice. Per le domande sul «recente», usa date_range=last_30_days con sort=most_commented su Xiaohongshu e sort=time_descending su Zhihu. Weibo restituisce i post recenti per impostazione predefinita. Per le domande sulla «reputazione a lungo termine», ordina per like e chiedi al modello di indicare l'anno di pubblicazione di ogni fonte.
C'è anche un dettaglio sui costi. La chiamata Xiaohongshu con last_30_days ha restituito solo 13 righe. Il catalogo indica che questo filtro può restituire meno di 20 righe per pagina, e una pagina con risultati viene addebitata come una pagina. Quindi il prezzo per 1.000 risultati di quella chiamata è stato di $0,427, il 54% in più rispetto ai $0,278 di una pagina completa.
Test 3: le righe da filtrare prima
Ci aspettavamo che il quinto criterio non fosse soddisfatto, ed è andata così. Ogni app ha un tipo di riga che dà un'immagine sbagliata della «voce degli acquirenti» se la usi così com'è.
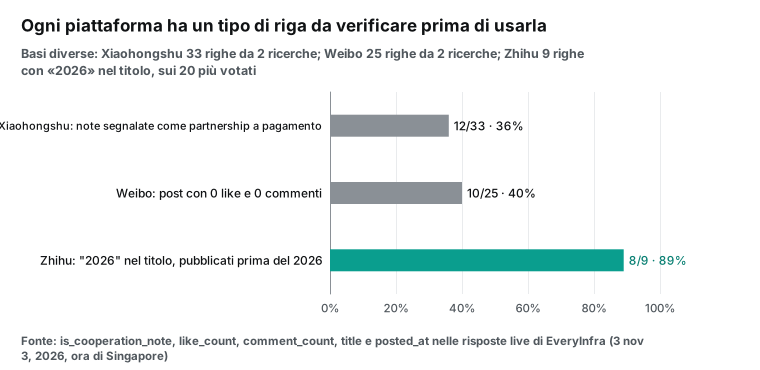
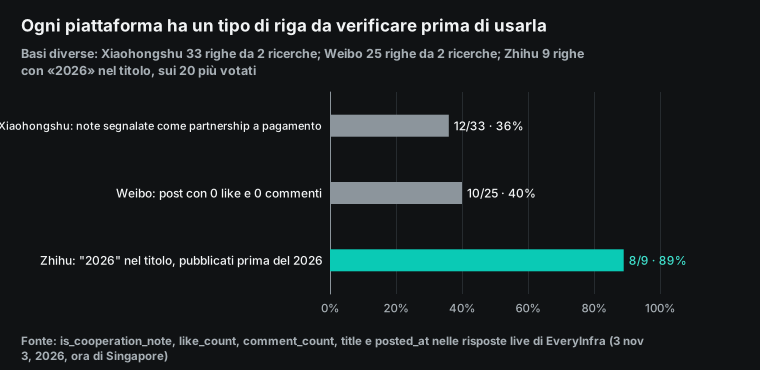
Su Xiaohongshu, is_cooperation_note è il campo più diretto. Era true per 12 righe su 33. La chiamata per più commenti negli ultimi 30 giorni ne aveva 4 su 13. La chiamata per le lamentele ordinate per like ne aveva 8 su 20. Una nota a pagamento non è sempre falsa.
Ma per «di cosa si lamentano gli acquirenti», mostra il messaggio che un marchio vuole farti vedere. Quindi metti queste righe in un gruppo a parte, o segnalale nella risposta. Solo i dati delle piattaforme hanno questo campo. I risultati web non hanno un campo equivalente.
La ricerca Xiaohongshu per più commenti negli ultimi 30 giorni aveva un secondo tipo di rumore. Le prime righe erano un meme su un robot smarrito con 14.963 like, un video di fitness e una clip di un videogioco horror. Sono post popolari che usano l'hashtag, non segnalazioni di acquirenti. Quindi, quando cerchi i problemi degli acquirenti, usa una keyword con un punto critico, come «lamentele» o «difetti».
Su Weibo il problema è il rumore. Delle 25 righe, 10 non avevano né like né commenti. Nove provenivano da account verificati e 8 da account con 100.000 follower o più. Tra questi c'erano post di campagne dei marchi e post di guide agli acquisti.
Un avviso di livestream di un marchio aveva 2.435 like e 421 commenti. Questi post hanno un engagement alto ma non sono lamentele degli acquirenti. Puoi individuarli con author_verified_reason e i link ai prodotti nel testo.
I post utili vengono spesso da account con decine o centinaia di follower. Citano un marchio e un difetto. Un post del 2 novembre racconta che un robot aspirapolvere comprato a marzo 2024 si è rotto dopo circa due anni. L'assistenza ha detto al proprietario che il modello era fuori produzione e senza ricambi, e ha offerto solo una permuta da 200 yuan.
Quel post aveva 0 like e 1 commento. È comunque un segnale reale sull'assistenza post-vendita. Quindi un filtro non può semplicemente scartare le righe con poco engagement.
Dopo il filtro, ordina le righe. Su tutte e tre le app, poche righe concentrano la maggior parte dell'engagement.
La chiamata Xiaohongshu per più commenti negli ultimi 30 giorni aveva 13 note con 124.557 like in totale, e le prime 3 ne avevano il 49%. La chiamata per le lamentele aveva 20 note con 23.938 like, e le prime 3 ne avevano il 48%. La chiamata Zhihu per i consigli aveva 20 risposte con soli 1.151 voti positivi. Le prime 3 ne avevano il 75% e la mediana era 11. La chiamata Weibo sull'assistenza post-vendita aveva 12 post con 2.290 like. Un post ne aveva 2.288, e gli altri 11 post ne avevano 2 in totale.
| Chiamata | Righe | Totale like o voti positivi | Quota delle prime 3 righe |
|---|---|---|---|
xiaohongshu/search, più commenti, ultimi 30 giorni | 13 | 124,557 | 49% |
xiaohongshu/search, lamentele, più like | 20 | 23,938 | 48% |
zhihu/search, consigli, solo risposte | 20 | 1,151 | 75% |
weibo/search, post-vendita | 12 | 2,290 | 100% |
Se invii 20 righe al modello nell'ordine in cui le restituisce l'app, l'«opinione prevalente» può venire da due o tre righe popolari. Un metodo migliore è ordinare le righe per engagement nel codice del loop e rimuovere i duplicati per author_id. Poi invia i conteggi insieme a ogni riga. Così il modello può dire al lettore «questa nota ha 992 like» o «questo post ha 0 like ma riporta fatti specifici».
Python lo fa senza librerie aggiuntive. Ordina con sorted() e una funzione key su like_count (guida all'ordinamento di Python). Tieni gli autori già usati in un set. Questo passaggio non richiede chiamate aggiuntive.
Come appare la risposta: un esempio di formato costruito con righe reali
Non abbiamo eseguito il modello, quindi non abbiamo una risposta scritta da DeepSeek. Ma puoi comunque vedere il formato. Abbiamo scritto a mano l'inizio di una risposta partendo dalle righe reali qui sopra. È un esempio di formato, non un output del modello. Ogni numero corrisponde a una risposta grezza. I link contengono token di accesso, quindi scriviamo «link omesso».
Il primo gruppo di lamentele riguarda il sacchetto della polvere e i ricambi. Una nota Xiaohongshu del 25 ottobre dice che il sacchetto della polvere di un marchio «fa solo entrare e mai uscire», con 992 like, 571 commenti e 914 salvataggi (link omesso; non è contenuto a pagamento). Il secondo gruppo riguarda l'assistenza post-vendita. Il 2 novembre un utente Weibo con 124 follower ha scritto che un apparecchio comprato a marzo 2024 si è rotto dopo due anni. Il marchio ha detto che il modello era fuori produzione e ha offerto solo una permuta da 200 yuan (link omesso; 0 like, 1 commento). Su Zhihu, la maggior parte delle guide all'acquisto più votate è stata pubblicata tra il 2018 e il 2022, anche se i titoli dicono 2026. Verifica l'anno di pubblicazione prima di farci affidamento.
Ogni affermazione dell'esempio riporta app, data, conteggi di engagement e flag di contenuto a pagamento. Un system prompt può chiedere al modello questo formato.
Mentre scrivevamo l'esempio abbiamo notato anche un altro dettaglio. Due autori avevano ciascuno 3 delle 20 righe Zhihu. Le 3 risposte di un autore iniziano quasi con le stesse parole, hanno 0 voti positivi ciascuna e rimandano allo stesso articolo. L'altro autore ha scritto 3 risposte in due giorni, e tutte e tre consigliano modelli dello stesso marchio. Se le conti come 20 voci indipendenti, sopravvaluti quel marchio.
Quindi rimuovi i duplicati per author_id prima che le righe tornino al modello. Tieni solo la riga con più engagement per ogni autore. Tutte e tre le app restituiscono questo campo. Il codice richiede poche righe ed è più affidabile di un prompt che chiede al modello di «fare attenzione agli autori ripetuti».
Test 4: quanti token risparmi prima di arrivare al modello
Il passaggio più economico di questo flusso è rimuovere campi prima che i risultati tornino al modello. Abbiamo stimato i token di tre ricerche in due forme: la risposta grezza e solo i 13 campi che contano. Abbiamo usato i rapporti della guida all'uso dei token di DeepSeek: circa 0,3 token per carattere inglese e 0,6 token per carattere cinese. Sono stime. Il conteggio reale si trova nel campo usage di ogni risposta.
| Ricerca | Caratteri grezzi | Token grezzi (stima) | Caratteri con 13 campi | Token dopo (stima) |
|---|---|---|---|---|
xiaohongshu/search lamentele, più like | 33,905 | 10,549 | 7,302 | 2,542 |
zhihu/search difetti, più voti positivi | 15,459 | 5,696 | 7,356 | 3,162 |
weibo/search post-vendita | 10,786 | 3,624 | 3,873 | 1,458 |
| Totale | 60,150 | 19,869 | 18,531 | 7,162 |
La forma ridotta è più piccola del 64%. Xiaohongshu è quella che risparmia di più, perché le sue righe grezze contengono elenchi di immagini, avatar, link ai video, larghezze e altezze. Niente di questo serve a una risposta. Al prezzo di input di picco di deepseek-flash, $0,30 per milione di token, 19.869 token costano $0,0060 e 7.162 token costano $0,0021. Per una singola chiamata la differenza è piccola.
In un loop di tool call, però, i risultati precedenti vengono rinviati a ogni nuova richiesta. Con più giri, la differenza cresce. DeepSeek ha una cache del contesto, e l'input con cache hit costa $0,006 per milione di token in orario di picco secondo la pagina dei prezzi in inglese. Quindi il costo reale della parte rinviata è molto più basso, ma solo quando c'è un cache hit.
La guida al context caching di DeepSeek dice che una richiesta ottiene un cache hit solo quando il suo prefisso corrisponde completamente a un'unità di prefisso memorizzata. La chat API è stateless, quindi ogni giro deve rinviare tutti i messaggi precedenti (guida alle conversazioni multi-turno). Da qui derivano due regole per il codice del loop.
Primo, non modificare né riordinare i risultati dei tool nei giri successivi, e tieni il system prompt e le definizioni dei tool all'inizio e invariati. Secondo, rimuovi i campi, ordina e rimuovi i duplicati prima di inviare i risultati la prima volta. Così, dal secondo giro in poi, la parte precedente viene addebitata al prezzo della cache. Solo il nuovo giro viene addebitato al prezzo di cache miss.
In ogni caso, un contesto più piccolo aiuta anche il modello a concentrarsi, come suggerisce la ricerca citata nella sezione «Novità recenti».
Costi: DeepSeek Search API a $0,75 per 1.000, Xiaohongshu a $0,005556 per chiamata
Mettendo i prezzi a confronto, il risultato è chiaro. La ricerca web costa poco. Zhihu e Weibo costano più o meno quanto la ricerca web. Xiaohongshu costa circa dieci volte di più.
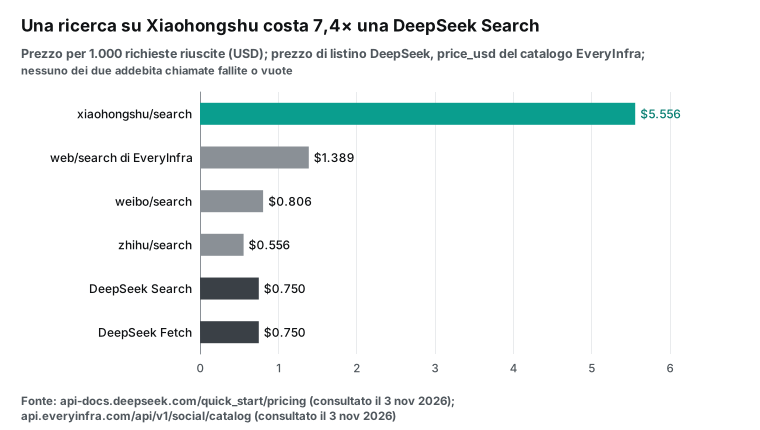
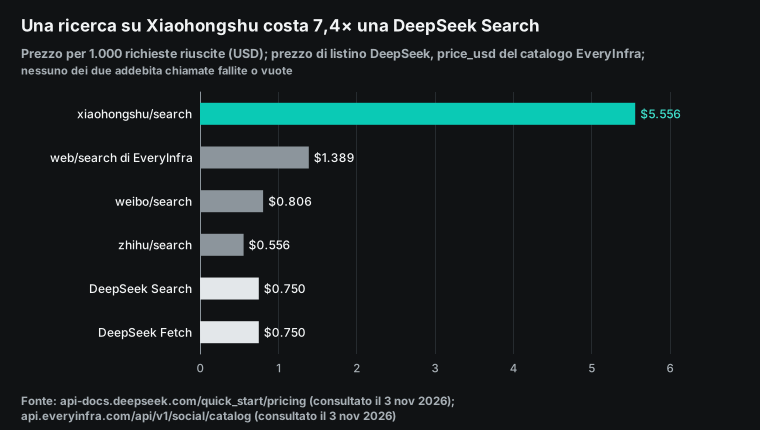
Una cosa va detta chiaramente. Per la sola ricerca web generica, DeepSeek Search a $0,75 per 1.000 costa meno del web/search di EveryInfra a $1,389 per 1.000. Restituisce anche fino a 50 risultati per chiamata. Quindi in questo flusso DeepSeek dovrebbe gestire la ricerca web ed EveryInfra solo i dati delle piattaforme. Per 1.000 risultati, il divario è ancora maggiore.
DeepSeek costa $0,015 con count=50. Zhihu costa $0,028 per 1.000 risultati, Weibo da $0,062 a $0,067 e Xiaohongshu da $0,278 a $0,427. Ma questi due tipi di risultati non si possono confrontare in base al numero di righe. Un risultato web e un post di un'app con i conteggi di engagement rispondono a domande diverse.
| Chiamate per domanda | Prezzo unitario | Chiamate | Subtotale |
|---|---|---|---|
| DeepSeek Search | $0.00075 | 2 | $0.0015 |
xiaohongshu/search | $0.005556 | 1 | $0.005556 |
zhihu/search | $0.000556 | 1 | $0.000556 |
weibo/search | $0.000806 | 1 | $0.000806 |
| Costo dei dati (piano B) | 5 | $0.008418 | |
| Costo del modello (stima, orario di picco, circa 16.000 token di input e 1.500 token di output) | circa $0,0066 |
La stima del modello ha un ampio margine. L'input conta 7.162 token di dati delle app ridotti e circa 8.400 token di riassunti web da due ricerche, con 10 risultati ciascuna. L'output conta 1.500 token. La stima non include il contesto rinviato né i cache hit. Il costo dei dati è esatto, perché è il prezzo del catalogo moltiplicato per il numero di chiamate. Una domanda costa circa 1,5 centesimi di dollaro in totale, e il solo Xiaohongshu rappresenta il 66% del costo dei dati.
Come limitare le chiamate a Xiaohongshu: tre piani
A $0,005556 per pagina, Xiaohongshu è il costo da gestire. L'obiettivo non è usare meno Xiaohongshu. L'obiettivo è usarlo solo quando aggiunge qualcosa. Abbiamo definito tre piani. Ogni piano prevede due ricerche DeepSeek per domanda.
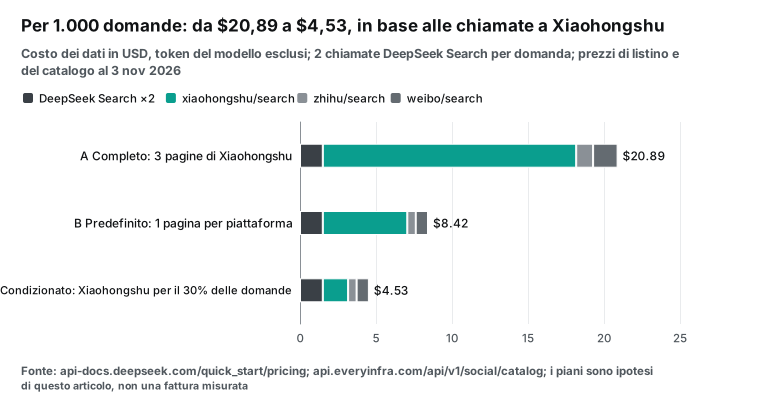
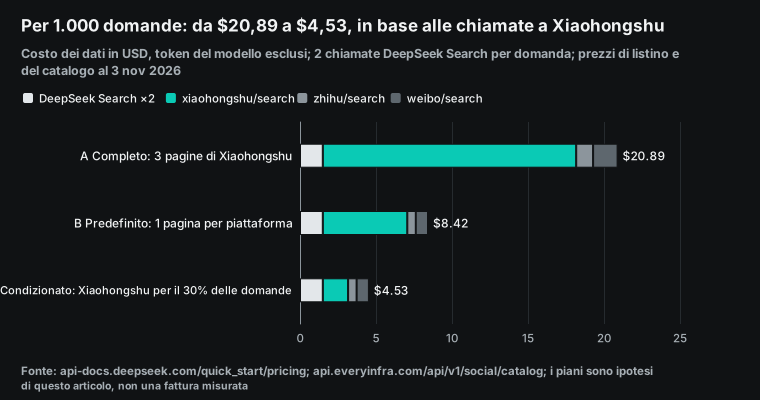
| Piano | Xiaohongshu | Zhihu | Per domanda | Per 1.000 domande | Quota Xiaohongshu | |
|---|---|---|---|---|---|---|
| A, completo | 3 pagine | 2 chiamate | 2 chiamate | $0.0209 | $20.89 | 80% |
| B, predefinito | 1 pagina | 1 chiamata | 1 chiamata | $0.0084 | $8.42 | 66% |
| C, su richiesta | 1 pagina per il 30% delle domande | 1 chiamata | 1 chiamata | $0.0045 | $4.53 | 37% |
Il 30% del piano C l'abbiamo scelto noi. Non è un tasso misurato. Ci sono tre modi per decidere quando serve Xiaohongshu, dal più semplice al più difficile. Primo, usa la categoria di prodotto.
Interroga Xiaohongshu per bellezza, cura della persona, prima infanzia, casa e piccoli elettrodomestici, dove le discussioni su Xiaohongshu sono fitte. Saltalo per ricambi o prodotti industriali. Secondo, prova prima le app economiche. Se Zhihu e Weibo restituiscono già abbastanza righe recenti che citano modelli specifici, salta Xiaohongshu.
Terzo, lascia decidere il modello, ma imposta un limite nel loop, come BUDGET nel codice qui sopra. Quando il modello chiede una seconda pagina, restituisci «budget raggiunto». Inoltre, non usare last_30_days quando vuoi una pagina completa. Il Test 2 ha mostrato che può restituire 13 righe e costare comunque una pagina. Per le domande sulle «ultime novità», sort=newest restituisce una pagina completa. La nota del catalogo su date_range dà lo stesso consiglio.
Un'altra strada: DeepSeek Harness con un server MCP remoto (esempio di configurazione)
Forse non vuoi scrivere un loop tuo. Se usi DeepSeek Harness, l'agente open source di DeepSeek (guida rapida), puoi saltare le definizioni dei tool. Collega invece il server MCP remoto di EveryInfra. Il README del client MCP di Harness usa una voce per ogni server MCP. Un server remoto usa il transport streamable-http e può inviare header. I suoi tool appaiono al modello come mcp__<serverName>__<tool>, e il timeout predefinito per chiamata è di 60 secondi.
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
    toolCallTimeoutMs: 90000
Portiamo toolCallTimeoutMs da 60 a 90 secondi per lo stesso motivo del timeout di requests visto sopra. Il server MCP di EveryInfra segue la specifica MCP 2026-07-28 e il suo transport Streamable HTTP. Una chiamata tools/list senza chiave del 3 novembre ha mostrato 12 tool. Per i dati delle app, il tool è everyinfra_call_api, con platform, action e params. La pagina del server MCP spiega l'autenticazione.
La sezione sull'autorizzazione della specifica MCP rende l'autorizzazione facoltativa. Quando un server usa un transport basato su HTTP, dovrebbe seguire quella sezione. EveryInfra accetta una chiave API in un header della richiesta, quindi alla voce di Harness servono solo gli headers, senza accesso dal browser.
Harness ha una sua ricerca web. Il pacchetto dsh-tool-web aggiunge web_search e web_fetch. Per impostazione predefinita restituisce fino a 8 fonti, invia fino a 4 query e taglia ogni riassunto a 800 caratteri. Il README dice che il back end di ricerca DeepSeek non compare nell'elenco dei tool quando il modello corrente non ha credenziali. Con questa configurazione, una sessione Harness usa DeepSeek per la ricerca web e MCP per i dati delle app. La divisione è la stessa della versione con le funzioni, ma il loop lo gestisce Harness.
Come scegliere tra le due? La strada MCP non richiede codice, e il modello vede da solo le nuove funzionalità nel catalogo. Però il modello vede un solo tool generico, everyinfra_call_api, e deve prima leggere il catalogo per conoscere i parametri. Questo aggiunge uno o due giri. La strada delle funzioni richiede che tu mantenga le definizioni.
In cambio, ogni descrizione, enum e prezzo è fisso, il modello sceglie meglio e il tuo codice può imporre un budget. Per un flusso di prodotto fisso, usa le funzioni. Per un assistente aperto per il tuo team, usa MCP. Il nostro articolo su Claude strict tool use con un'API per i dati mette a confronto lo stesso compromesso.
Cosa non funziona e a cosa fare attenzione
Primo, non abbiamo chiamato l'endpoint DeepSeek Search. Quindi non abbiamo un dato misurato su quante note Xiaohongshu trova una ricerca DeepSeek per «robot aspirapolvere». Tutto ciò che riguarda DeepSeek qui proviene dalla sua documentazione. Non abbiamo misurato quanto contenuto delle app ci sia nell'indice di DeepSeek, né quanto spesso venga aggiornato. La sezione «Ora dello snapshot e ora della chiamata» riguarda solo il lato delle app.
Secondo, il testo della ricerca Xiaohongshu è un estratto di circa 60 caratteri. Per il testo completo serve una chiamata al dettaglio della nota a $0,005556. Anche i commenti sono addebitati a parte. Terzo, tutte e tre le app restituiscono solo contenuti pubblici. Messaggi privati, post riservati ai follower e post eliminati non sono disponibili. Per i contenuti a pagamento di Zhihu, ottieni solo un riassunto.
La paginazione ha due dettagli che possono metterti in difficoltà nel codice del loop. Una pagina di ricerca Xiaohongshu ha sempre 20 righe e limit non ha effetto. Per avere più righe, usa il next_page_token dell'ultima pagina. Quel token è valido solo per 24 ore. Se salvi una conversazione e la riprendi il giorno dopo, il vecchio token non funziona.
La ricerca riparte dalla pagina 1 e paghi di nuovo. Zhihu restituisce 20 righe per impostazione predefinita e fino a 100. Weibo ne restituisce 20 per impostazione predefinita e fino a 50. Per queste due, un numero di righe maggiore costa meno della paginazione, perché il prezzo è per chiamata.
Quarto, ci sono due aspetti di conformità. Il primo: i dati delle app contengono nomi e profili di utenti privati. Cita solo contenuti e link. Non raccogliere né mostrare i dati personali di un utente privato. Un paper su arXiv del 22 ottobre (Social-HUMINT) studia il rischio di usare gli LLM per dedurre tratti personali da dati social pubblici.
Per gli argomenti di prodotto, resta a livello di tema. Il secondo: un assistente che serve il pubblico nella Cina continentale rientra nelle misure provvisorie cinesi per i servizi di AI generativa. Le misure per l'etichettatura dei contenuti generati dall'AI si applicano dal 1° settembre 2025. Questo non è un parere legale. Chiedi al tuo team legale quali sono i tuoi obblighi.
Quinto, i limiti di frequenza delle richieste sono diversi. Un account EveryInfra ha per impostazione predefinita 60 chiamate al minuto. La nostra chiave di test aveva un limite speciale di 10 al minuto. DeepSeek Search ne consente 100 al secondo. Con traffico elevato, aggiungi nel loop una coda per il lato EveryInfra.
Modifiche recenti
17 ottobre 2026: DeepSeek ha aperto Search e Fetch. Lo stesso giorno il modello è passato a DeepSeek-V4.1-Flash-1017. I pesi sono su Hugging Face. Per te significa che una sola chiave DeepSeek ora copre anche la ricerca web. Non serve un servizio di ricerca separato.
1° novembre 2026, 00:00 ora di Pechino: la ricerca lato server nei client è diventata a pagamento. Usi DeepSeek tramite Claude Code, Codex o Harness? Allora i costi di ricerca ora compaiono nella tua fattura mensile. Controlla la pagina di utilizzo nella console DeepSeek.
13 ottobre 2026: un paper sugli agenti AI per lo shopping è arrivato alla versione 5. Questo paper su arXiv (Does Rank Still Matter?) ha studiato 7.000 sessioni. Gli agenti AI guardavano più risultati delle persone, ma i risultati nelle posizioni centrali erano quelli con meno probabilità di essere visti.
Per te significa che più righe non sono sempre meglio. Ordina le righe per engagement o per data prima che arrivino al modello. È più affidabile di 50 righe non ordinate. I dati di engagement del Test 3 indicano lo stesso passaggio.
Intorno al 25 ottobre 2026: è cambiata la documentazione del client MCP di DeepSeek Harness. Harness supporta la versione MCP 2026-07-28 (README del client MCP). I server remoti usano Streamable HTTP (README dei pacchetti MCP). Per te significa che puoi aggiungere i dati delle app a un agente DeepSeek senza codice.
FAQ
La DeepSeek API supporta la ricerca web?
La chat API non cerca sul web da sola. Hai due possibilità. Primo, chiami tu l'endpoint Search (POST /v1/tools/search) e passi i risultati al modello come risultati dei tool. Secondo, usi un client come DeepSeek Harness, Claude Code o Codex.
Questi chiamano Search e Fetch tramite tool lato server, addebitati per richiesta dal 1° novembre 2026. (Fonte della domanda: suggerimento di ricerca «does deepseek api support web search». Base: guida a Search e Fetch di DeepSeek.)
Quanto costa la DeepSeek Search API e c'è un piano gratuito?
Costa $0,75 per 1.000 richieste riuscite. Le richieste fallite, vuote e scadute per timeout sono gratuite, e count non cambia il prezzo. Non abbiamo trovato una quota di ricerca gratuita separata né nella pagina dei prezzi né nella guida. Sia il saldo omaggio sia il saldo ricaricato coprono l'utilizzo, e il saldo omaggio viene usato per primo. (Fonte della domanda: suggerimenti di ricerca «deepseek search api pricing» e «deepseek search api free tier». Base: pagina dei prezzi di DeepSeek.)
La chiave della DeepSeek Search API è la stessa del modello?
Sì. La guida dice che Search e Fetch usano la stessa autenticazione Bearer della DeepSeek API. Le chiavi si creano sulla piattaforma DeepSeek. I limiti di frequenza delle richieste si applicano per account, non per chiave. (Fonte della domanda: suggerimento di ricerca «deepseek search api key». Base: guida a Search e Fetch di DeepSeek e pagina dei limiti di frequenza.)
DeepSeek Search e Fetch API: qual è la differenza e quando usare Fetch?
Search restituisce più risultati per una query. Fetch restituisce una pagina completa in Markdown a partire da un URL. Search può già restituire il testo delle pagine con need_content. Quindi usa Fetch quando hai già un link e ti serve il testo completo, ad esempio il link al sito di un marchio trovato nei dati delle app.
Fetch dipende dalla policy di accesso del sito di destinazione. Quando non ottiene contenuti, restituisce un 404 e non paghi nulla. (Fonte della domanda: suggerimento di ricerca «deepseek search fetch api». Base: riferimento della Fetch API.)
DeepSeek Harness e ricerca: Harness può usare un altro provider di ricerca?
Sì. Harness aggiunge la ricerca web come plugin. Il tool web_search viene dal plugin dsh-tool-web, e puoi sostituirne il back end con un altro plugin di ricerca. I dati delle app si collegano tramite il client MCP come server remoto. (Fonte della domanda: suggerimento di ricerca «deepseek harness search provider». Base: README di dsh-tool-web e il repository di Harness.)
Il function calling della DeepSeek API supporta la modalità strict?
Sì. Usa il base URL beta (api.deepseek.com/beta con prefisso https) e imposta strict: true su ogni funzione. Elenca ogni proprietà in required e imposta additionalProperties su false. minLength, maxLength, minItems e maxItems non sono supportati.
La modalità strict funziona sia in modalità thinking sia in modalità non-thinking. (Fonte della domanda: suggerimento di ricerca «deepseek api function calling». Base: guida alle tool call di DeepSeek.)
Come iniziare
Primo, crea una chiave API dalla guida rapida di EveryInfra. Leggi il catalogo gratuitamente e controlla parametri e prezzi di xiaohongshu/search, zhihu/search e weibo/search. Le panoramiche delle piattaforme sono l'API per i dati di Xiaohongshu, l'API per i dati di Zhihu e l'API per i dati di Weibo. Tutti i prezzi sono nella pagina dei prezzi.
Secondo, copia da questo articolo le quattro definizioni dei tool e il codice del loop. Inserisci le tue due chiavi e prova una domanda dall'inizio alla fine. Terzo, scegli dalla sezione sui costi il piano adatto al tuo volume di domande e imposta il limite in BUDGET. Due articoli mostrano la stessa idea con altri strumenti. Uno è workflow dinamici di Claude Code per i commenti di Xiaohongshu. L'altro è Gemini Deep Research con un server MCP remoto. Per i dati dei commenti, i commenti di Weibo funzionano come i commenti di Xiaohongshu.
Riferimenti
- «Search & Fetch», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/guides/search
- «Search API reference», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/api/search
- «Fetch API reference», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/api/fetch
- «Models & Pricing», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/quick_start/pricing
- «DeepSeek-V4.1-Flash-1017 release note», DeepSeek, 2026-10-17, https://api-docs.deepseek.com/news/news261017
- «Tool Calls», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/guides/tool_calls
- «Thinking Mode», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/guides/thinking_mode
- «Rate Limit & Isolation», DeepSeek API Docs, consultato il 2026-11-03, https://api-docs.deepseek.com/quick_start/rate_limit
- «Token & Token Usage», documentazione delle API di DeepSeek, consultato il 2026-11-03, https://api-docs.deepseek.com/quick_start/token_usage
- «Integrate with Claude Code», documentazione delle API di DeepSeek, consultato il 2026-11-03, https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- Pagina «API keys», DeepSeek Platform, consultata il 2026-11-03, https://platform.deepseek.com/api_keys
- Model card di DeepSeek-V4.1-Flash-1017, Hugging Face, consultata il 2026-11-03, https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Repository di DeepSeek Harness, GitHub, consultato il 2026-11-03, https://github.com/deepseek-ai/deepseek-harness
- «Quick start» di DeepSeek Harness, consultato il 2026-11-03, https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- README di dsh-tool-web, GitHub, consultato il 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- README di dsh-mcp-client, GitHub, consultato il 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- README dei pacchetti MCP di Harness, GitHub, consultato il 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python, GitHub, consultato il 2026-11-03, https://github.com/openai/openai-python
- openai, PyPI, consultato il 2026-11-03, https://pypi.org/project/openai/
- «Function calling», documentazione per sviluppatori di OpenAI, consultato il 2026-11-03, https://platform.openai.com/docs/guides/function-calling
- «Advanced Usage» (timeout), documentazione di Requests, consultato il 2026-11-03, https://requests.readthedocs.io/en/latest/user/advanced/
- «json, JSON encoder and decoder», documentazione di Python, consultato il 2026-11-03, https://docs.python.org/3/library/json.html
- «MCP Specification 2026-07-28», Model Context Protocol, consultato il 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28
- «Transports», MCP 2026-07-28, consultato il 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- «Tools», MCP 2026-07-28, consultato il 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- «Authorization», MCP 2026-07-28, consultato il 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- «Weibo open platform API list», consultato il 2026-11-03, https://open.weibo.com/wiki/API
- «Network Data Security Management Regulations», Governo cinese, 2024-09-30, https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- «Interim Measures for the Management of Generative AI Services», Cyberspace Administration of China, 2023-07-13, https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- «Measures for Labeling AI-Generated Synthetic Content», Cyberspace Administration of China e altri, 2025-03-14, https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- «Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf», arXiv:2608.22697v5, 2026-10-13, https://arxiv.org/abs/2608.22697
- «Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure», arXiv:2610.31573, 2026-10-22, https://arxiv.org/abs/2610.31573
- Catalogo dei dati EveryInfra, consultato alle 00:13 SGT del 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog
- Catalogo Xiaohongshu di EveryInfra, consultato il 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- Catalogo Zhihu di EveryInfra, consultato il 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- Catalogo Weibo di EveryInfra, consultato il 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- «Context Caching», documentazione delle API di DeepSeek, consultato il 2026-11-03, https://api-docs.deepseek.com/guides/kv_cache
- «Multi-round Conversation», documentazione delle API di DeepSeek, consultato il 2026-11-03, https://api-docs.deepseek.com/guides/multi_round_chat
- «Sorting Techniques», documentazione di Python, consultato il 2026-11-03, https://docs.python.org/3/howto/sorting.html
- «Built-in Types: set», documentazione di Python, consultato il 2026-11-03, https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset
Riferimenti BL-73