Configurare DeepSeek V4 in Claude Code: quanto costa ripulire i commenti
Abbiamo fatto i conti per Claude Code su deepseek-flash, con l'MCP di EveryInfra che estrae 695 commenti da YouTube, Bilibili e Douyin. Il prezzo di picco è 1/10 di Sonnet 5.5, ma supera Haiku 5.5.
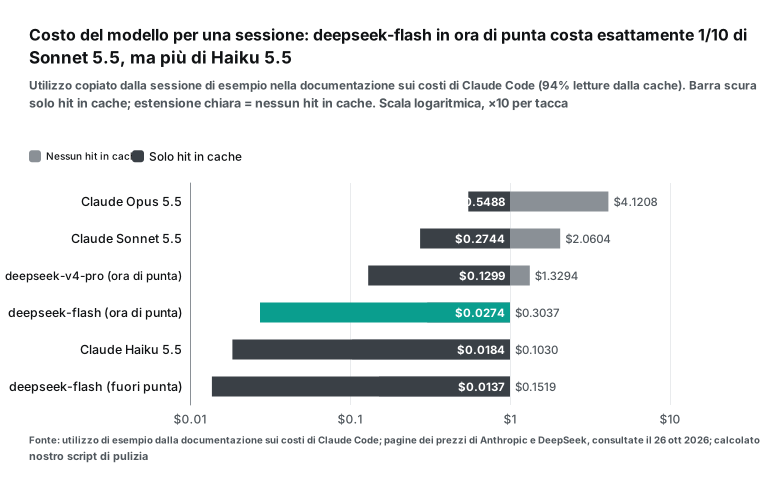
Puoi eseguire Claude Code sul modello deepseek-flash di DeepSeek e usare il server MCP remoto di EveryInfra per estrarre e ripulire i commenti dei video. Costa poco, ma l'affermazione "un decimo del costo" è vera solo quando la cache di DeepSeek va a segno. Abbiamo calcolato il prezzo della sessione di esempio dalla documentazione ufficiale sui costi di Claude Code: deepseek-flash al prezzo di picco costa $0,0274, esattamente il 10% di Claude Sonnet 5.5 ($0,2744). Senza cache hit, la stessa sessione costa $0,3037, più di Sonnet 5.5 con una cache funzionante.
Claude Haiku 5.5 esegue la stessa sessione per $0,0184. Il 26 ottobre 2026, dalle 17:26 alle 17:38 ora di Singapore (SGT), abbiamo chiamato EveryInfra per 695 righe di commenti da 15 video. Dopo la pulizia sono rimasti 655 commenti, e l'input stimato del modello è sceso da 84.109 token a 20.176. Su Bilibili e Douyin, il costo dei dati per 1.000 commenti è stato superiore al costo del modello deepseek-flash.
In questo articolo, "ripulire i commenti" indica un lavoro preciso. Claude Code legge il catalogo delle funzionalità di EveryInfra. Poi chiama lo strumento MCP everyinfra_call_api per estrarre i commenti con youtube/comments, bilibili/comments e douyin/comments. Un breve script rimuove duplicati, risposte vuote e contenuti promozionali.
Le regole basate su parole chiave etichettano circa metà dei commenti rimanenti come «setup ed errori», «prezzo e quota», «confronta modelli» o «elogi». Il modello etichetta ciò che le regole non riescono a gestire. L'output è una tabella con il testo originale e un record dei costi. Il modello usato da Claude Code non è di Anthropic.
È deepseek-flash, servito tramite l'endpoint compatibile con Anthropic di DeepSeek. Non abbiamo una chiave DeepSeek. Quindi ogni passaggio su DeepSeek e Claude Code qui sotto è un esempio di configurazione che segue la documentazione ufficiale, e non l'abbiamo eseguito. Ogni chiamata a EveryInfra e ogni numero ricavato dai nostri dati sono reali.


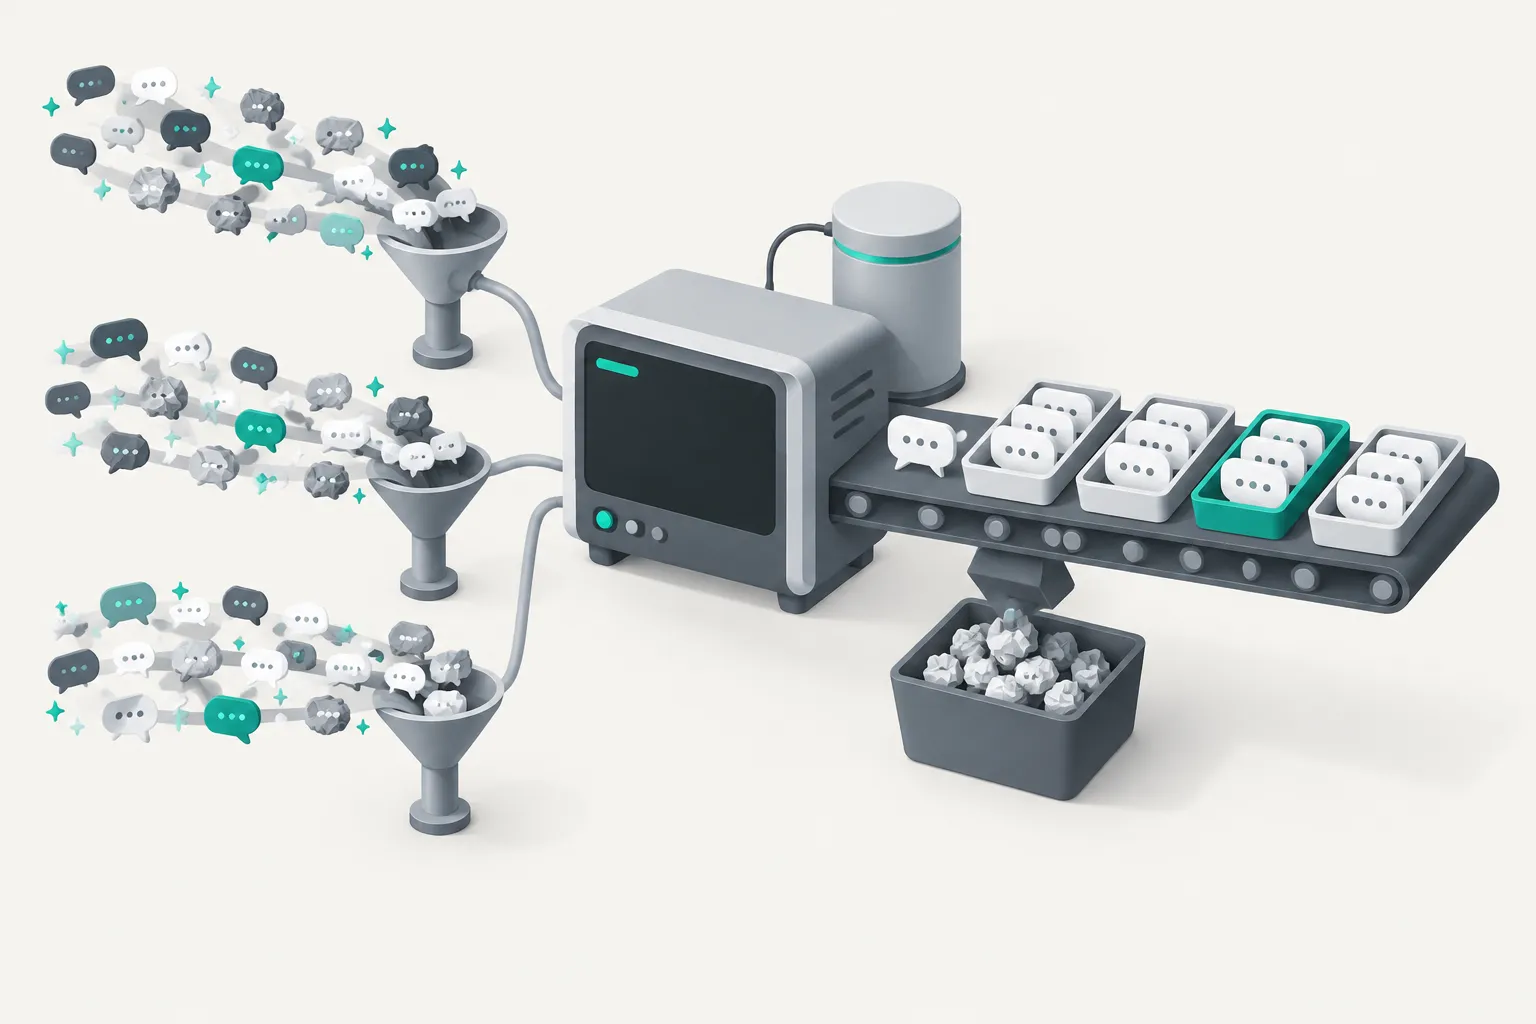
L'immagine mostra dove vanno i soldi. Il passaggio costoso è la scrivania in primo piano a destra, dove il modello legge ed etichetta ogni commento. Un setaccio più fine a sinistra manda meno materiale alla scrivania.
Prima vediamo la configurazione. Poi mostriamo cinque test. Alla fine facciamo i conti.
In sintesi: un decimo del costo solo quando la cache va a segno
Nei nostri appunti di ricerca, il titolo provvisorio di questo tema era «ripulire i commenti a un decimo del costo». Prima di iniziare, lo abbiamo trasformato in due domande con risposte numeriche. A parità di utilizzo, deepseek-flash al prezzo di picco costa al massimo il 10% di Claude Sonnet 5.5? È più economico di Claude Haiku 5.5? Le risposte sono «sì, esattamente» e «no».
Non ci siamo inventati l'utilizzo. Abbiamo copiato l'esempio di /cost dalla documentazione sui costi di Claude Code: 1,2k token di input, 5,3k di output, 940,0k di lettura dalla cache e 50,0k di scrittura in cache. La documentazione lo indica come Claude Sonnet 4.6 a $0,55. Prima lo abbiamo ricalcolato alle tariffe di Sonnet 4.6 e abbiamo ottenuto $0,5526. Corrisponde alla documentazione, quindi il metodo è corretto.
Poi abbiamo applicato ogni prezzo pubblico letto il 26 ottobre 2026. I prezzi di Claude vengono dalla pagina dei prezzi di Anthropic. I prezzi di DeepSeek vengono dalla pagina dei prezzi di DeepSeek in USD. Li abbiamo anche confrontati con la pagina dei prezzi in cinese in CNY.
| Modello (prezzo pubblico, 26 ott 2026) | Cache hit al 100% | Nessun cache hit | Quota rispetto a Sonnet 5.5 (hit) |
|---|---|---|---|
| Claude Opus 5.5 | $0.5488 | $4.1208 | 200% |
| Claude Sonnet 5.5 | $0.2744 | $2.0604 | 100% |
| deepseek-v4-pro, picco | $0.1299 | $1.3294 | 47.3% |
| deepseek-flash, picco | $0.0274 | $0.3037 | 10.0% |
| Claude Haiku 5.5 | $0.0184 | $0.1030 | 6.7% |
| deepseek-flash, fuori picco | $0.0137 | $0.1519 | 5.0% |
La colonna centrale è facile da trascurare. In un agente come Claude Code, le letture dalla cache sono la maggior parte dell'input. Nella sessione di esempio, 940,0k dei 991,2k token di input sono letture dalla cache, cioè il 94,8%. Quindi l'importo della fattura dipende da due fattori: il prezzo del cache hit e se la cache va a segno o no.
Il prezzo di deepseek-flash con cache hit è di $0,006 per milione di token al picco e di $0,003 fuori picco, meno degli $0,01 di Haiku 5.5. Il prezzo in caso di cache miss è invece di $0,30, tre volte la tariffa di Haiku 5.5, pari a $0,10. Quando la cache va a segno, deepseek-flash si avvicina a un decimo di Sonnet 5.5. Quando non va a segno, costa più di Sonnet 5.5 con una cache funzionante.
Un limite vale per tutta la tabella: confronta i prezzi dei token, non la qualità dei modelli. I due fornitori usano tokenizer diversi. La pagina dei prezzi di Anthropic dice che il tokenizer di Claude 4.7 e successivi produce circa il 30% di token in più per lo stesso testo, rispetto a Claude 4.6 e precedenti.
Non esiste un rapporto pubblico tra i token di DeepSeek e quelli di Claude. Anthropic offre un endpoint gratuito per il conteggio dei token, e DeepSeek un tokenizer offline. Ma non abbiamo una chiave per nessuno dei due fornitori, quindi non abbiamo calibrato sui dati reali di usage. Tutti i conteggi di token in questo articolo sono stime, e usiamo lo stesso numero di token per entrambi.
Perché affidare questo lavoro a un modello economico come deepseek v4.1 flash
La pulizia dei commenti è un lavoro ad alto volume, e ogni elemento è semplice. Guarda sotto un video su DeepSeek V4 in Claude Code. La maggior parte dei commenti chiede perché la configurazione non funziona, come funziona la fatturazione o come regge il confronto con i modelli di Claude. Ogni valutazione è semplice, ma tanti commenti significano tanti token.
Il 17 ottobre 2026 DeepSeek ha aggiornato deepseek-flash a DeepSeek-V4.1-Flash-1017. La nota di rilascio dice che il nuovo modello riduce i tempi di esecuzione delle attività e la lunghezza dell'output. La model card su Hugging Face dice che DeepSeek ha eseguito Terminal-Bench 4.0 con l'harness di Claude Code, ottenendo 42,3.
Sul fronte Anthropic, la pagina di lancio di Claude Haiku 5.5 (7 ottobre 2026) indica come attività principali riassunti, compattazione e classificazione. Indica anche il lavoro da subagente per Opus 5.5 e Sonnet 5.5. Riporta Terminal-Bench 4.0 al 39,2% per Haiku 5.5 e al 70,6% per Sonnet 5.5.
Ogni fornitore riporta i propri numeri con il proprio metodo, quindi non puoi metterli direttamente a confronto. Ma i numeri mostrano un fatto: ora due modelli economici possono girare dentro Claude Code. Il vero confronto riguarda il costo e l'impegno di configurazione.
| Voce | deepseek-flash (endpoint di DeepSeek compatibile con Anthropic) | Claude Haiku 5.5 (direttamente da Anthropic) |
|---|---|---|
| Input miss / output, per milione di token | Picco $0,30 / $1,20; fuori picco $0,15 / $0,60 | $0,10 / $0,50 (prompt fino a 100k token) |
| Cache hit | Picco $0,006; fuori picco $0,003 | $0.01 |
| Come funziona la cache | Cache automatica dei prefissi su disco; cache_control viene ignorato | Usa i marcatori cache_control di Claude Code |
| Finestra di contesto | 1M | 1M (i prompt oltre 100k token costano di più) |
| Input di immagini | Sì (deepseek-v4-pro: no) | Sì |
| Supporto ufficiale in Claude Code | DeepSeek pubblica una configurazione; Anthropic dichiara di non supportare modelli non Claude tramite un gateway | Nativo |
Leggi con attenzione l'ultima riga. La documentazione sui gateway di Claude Code dice che Anthropic non approva, non mantiene e non verifica i gateway di terze parti. Dice anche che Anthropic non supporta l'instradamento di Claude Code verso modelli non Claude tramite alcun gateway. La configurazione DeepSeek usa esattamente questo percorso, un ANTHROPIC_BASE_URL personalizzato.
Se qualcosa smette di funzionare, non potrai contare sull'assistenza di Claude Code. I percorsi di terze parti supportati sono piattaforme cloud come Amazon Bedrock, Google Cloud e Microsoft Foundry. Consulta la documentazione sulle integrazioni di terze parti e le opzioni di gateway di Anthropic.
I criteri di superamento e fallimento, scritti in anticipo
Prima della prima chiamata per i commenti, abbiamo scritto nove criteri per stabilire che "questo lavoro funziona". Non li abbiamo cambiati dopo aver visto i risultati. Due criteri registrano solo dei numeri (quota di rumore e dimensione delle definizioni degli strumenti). Gli altri hanno una soglia di superamento.
| ID | Criterio | Soglia | Risultato |
|---|---|---|---|
| J1 | Tutte e 9 le variabili d'ambiente di DeepSeek esistono nella documentazione di Claude Code | 9 su 9 | Superato: 9 su 9 |
| J2 | I campi MCP sono tutti nei response_fields del catalogo e corrispondono a quelli dell'API REST | Entrambi veri | Superato |
| J3 | Ogni valore charged_usd è pari al prezzo del catalogo × il numero di unità di fatturazione; le chiamate non riuscite costano $0 | Ogni chiamata corrisponde | Superato: 15 chiamate per i commenti, 3 ricerche e 1 chiamata MCP |
| J4 | L'input ripulito per il modello è al massimo il 40% dei token del JSON grezzo | ≤40% | Superato: 38,0% / 17,5% / 5,6% |
| J5 | Quota di rumore (solo registrazione) | — | YouTube bassa (2,2%); Bilibili e Douyin media (12,0%, 13,0%) |
| J6 | Flash al picco ≤10% di Sonnet 5.5? Più economico di Haiku 5.5? | Risposta numerica | D1: sessione 10,0%, sì; etichette in batch 13,5%, no. D2: no |
| J7 | Un parametro non valido restituisce un errore 422 con l'indicazione di come correggerlo, e il testo dell'errore contiene "not charged" | REST e MCP | Superato |
| J8 | Dimensione delle 25 definizioni degli strumenti (solo registrazione) | — | Circa 8.556 token; circa 1.058 per i 4 che teniamo |
| J9 | Nessuna chiave su disco | 0 occorrenze | Superato |
J7 richiede "not charged" nel testo dell'errore, non solo nello stato HTTP o nel flag MCP isError. Il motivo è nella sezione sulla compatibilità più sotto: l'endpoint di DeepSeek ignora il campo is_error in tool_result.
Configurazione di DeepSeek in Claude Code: 9 variabili d'ambiente verificate sulla documentazione
La pagina di integrazione con Claude Code di DeepSeek elenca nove variabili d'ambiente. Le abbiamo cercate una per una nel riferimento delle variabili d'ambiente di Claude Code. Esistono tutte e nove, e il loro significato corrisponde all'uso che ne fa DeepSeek.
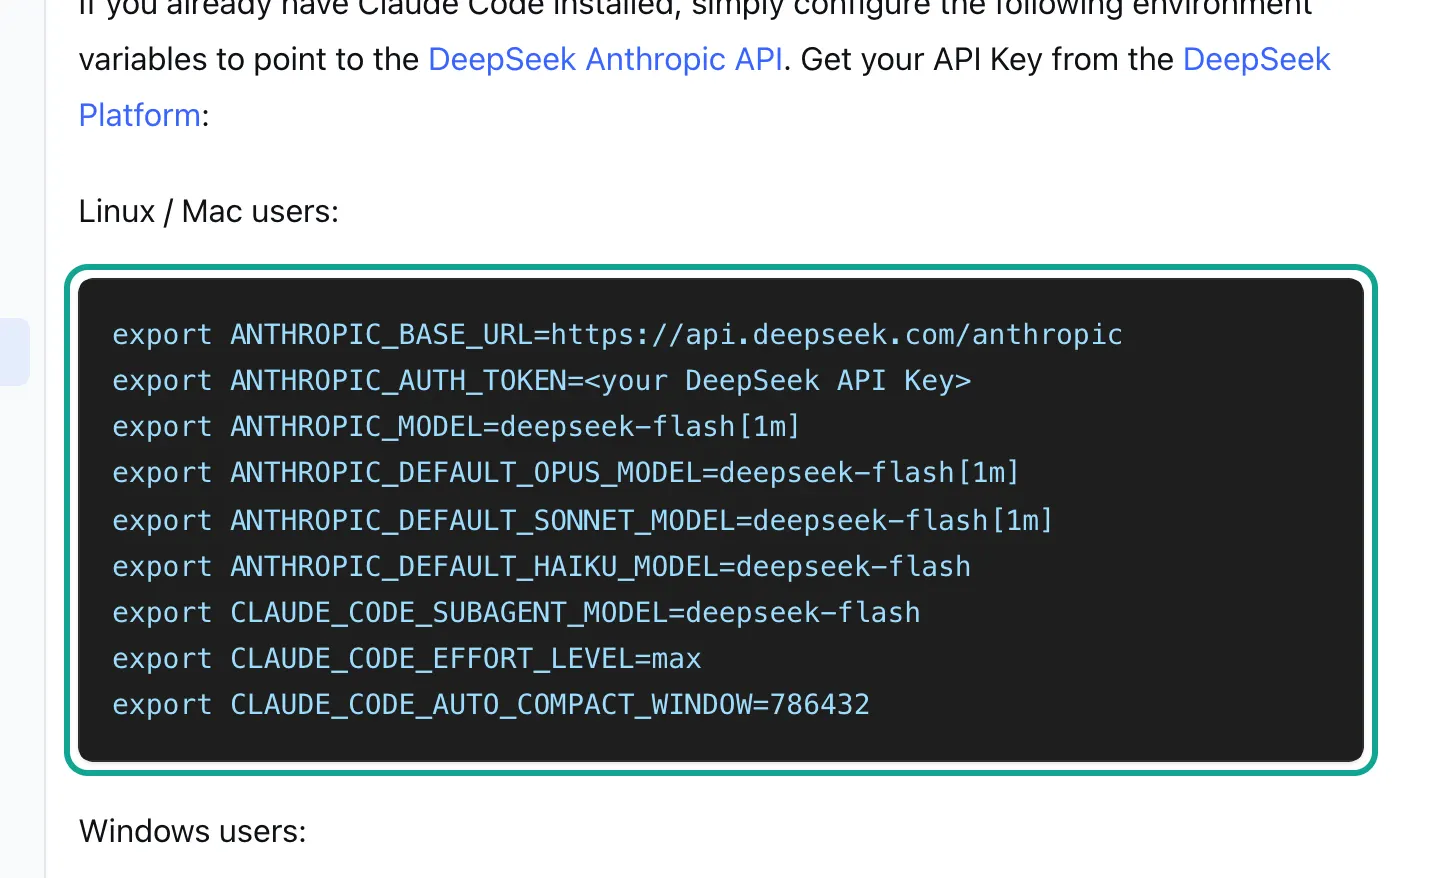
# Config example (we have no DeepSeek key and did not run this block)
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN="$DEEPSEEK_API_KEY"        # sent as Authorization: Bearer
export ANTHROPIC_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_OPUS_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_SONNET_MODEL='deepseek-flash[1m]'
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash     # background tasks use it too
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
export CLAUDE_CODE_EFFORT_LEVEL=high                    # DeepSeek shows max; comment work does not need it
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=786432
# Two more lines that we recommend:
export ENABLE_TOOL_SEARCH=false                         # defer_loading is not in the compatibility table
export EVERYINFRA_API_KEY=... # for .mcp.json; keep it out of project files| Variabile | Cosa controlla in Claude Code | A cosa fare attenzione in questo lavoro |
|---|---|---|
ANTHROPIC_BASE_URL | Invia le richieste a un proxy o a un gateway | Con un host diverso da api.anthropic.com, Remote Control è disattivato |
ANTHROPIC_AUTH_TOKEN | Valore per l'header Authorization: Bearer | Ha la precedenza su un login claude.ai salvato; se manca, vale comunque il login del tuo piano |
ANTHROPIC_MODEL | Modello della sessione principale | Il suffisso [1m] richiede una finestra di contesto da 1M |
ANTHROPIC_DEFAULT_OPUS_MODEL / _SONNET_ | Dove puntano gli alias opus e sonnet | Se non è impostata, DeepSeek mappa claude-opus* su deepseek-v4-pro a prezzi Pro |
ANTHROPIC_DEFAULT_HAIKU_MODEL | L'alias haiku e le attività in background | Anche le attività in background costano |
CLAUDE_CODE_SUBAGENT_MODEL | Modello predefinito per i subagenti | Lo usano tutti i subagenti per piattaforma |
CLAUDE_CODE_EFFORT_LEVEL | Livello di effort | DeepSeek mappa medium, high e xhigh su high |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | Numero di token che avvia l'auto-compattazione | Intervallo da 100.000 a 1.000.000 |
ENABLE_TOOL_SEARCH | Ricerca degli strumenti MCP | Con false, ogni richiesta include tutte le definizioni degli strumenti |
Tre aspetti emergono solo leggendo entrambe le documentazioni. Primo, la mappatura dei modelli. Le note di compatibilità di DeepSeek dicono che i nomi di modello che iniziano con claude-opus vengono mappati su deepseek-v4-pro a prezzi Pro.
I nomi che iniziano con claude-haiku o claude-sonnet vengono mappati su deepseek-flash. Se imposti solo ANTHROPIC_MODEL e poi passi a opus, paghi i prezzi Pro. Per la sessione di esempio, Pro al picco costa $0,1299, 4,7 volte il prezzo di flash.
Secondo, il rilevamento delle funzionalità. La documentazione sulla configurazione dei modelli di Claude Code dice che Claude Code attiva i livelli di effort e l'extended thinking confrontando l'ID del modello con pattern noti. Un ID sconosciuto può lasciare disattivate queste funzionalità. Puoi dichiararle con variabili come ANTHROPIC_DEFAULT_SONNET_MODEL_SUPPORTED_CAPABILITIES.
Anche la guida alla compatibilità dei gateway dice che Claude Code tratta i nomi di modello sconosciuti come modelli attuali e invia comunque thinking: {"type": "adaptive"}. Le due affermazioni riguardano casi diversi, e non abbiamo potuto testarle. Il nostro consiglio: dopo la configurazione, esegui /status e /model per verificare modello e livello di effort prima di un job in batch.
Terzo, l'effort. La pagina di DeepSeek imposta max. La documentazione sulla modalità thinking di DeepSeek dice che una richiesta medium, high o xhigh viene eseguita come high, e una max o ultra come max. Le etichette dei commenti non richiedono il livello massimo, e i token di thinking vengono fatturati come output. Per questo il nostro esempio usa high.
Collegare EveryInfra come MCP: un solo .mcp.json e appena 4 strumenti
Claude Code può aggiungere un server MCP remoto in due modi. Uno è il comando claude mcp add --transport http. L'altro è un file .mcp.json nella root del progetto.
Consigliamo il file. La documentazione MCP di Claude Code dice che .mcp.json espande ${VAR} in url e headers, quindi la chiave resta fuori dai file del progetto. La riga di comando espande la variabile nel momento in cui esegui il comando e salva la chiave in ~/.claude.json.
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" },
      "timeout": 150000
    }
  }
}
Una regola di sicurezza aiuta questa configurazione. La stessa documentazione dice che Claude Code sostituisce con valori vuoti le proprie variabili di credenziali, come ANTHROPIC_AUTH_TOKEN e ANTHROPIC_API_KEY, nei campi url e headers di un server remoto. Quindi, anche se un file .mcp.json chiede Bearer ${ANTHROPIC_AUTH_TOKEN}, la tua chiave DeepSeek non arriva a nessun server MCP.
EVERYINFRA_API_KEY non è in quell'elenco, quindi viene espansa normalmente. Abbiamo impostato timeout a 150 secondi. La nostra chiamata più lenta per i commenti di YouTube ha richiesto 78,6 secondi, e il budget sincrono di EveryInfra è di 85 secondi.
Alle 17:26 SGT del 26 ottobre 2026 abbiamo inviato a https://api.everyinfra.com/mcp le stesse richieste initialize e tools/list che Claude Code invia quando si connette. Il server ha restituito 25 strumenti. Ne abbiamo stimato la dimensione con il rapporto indicato nella pagina sull'utilizzo dei token di DeepSeek: circa 0,3 token per carattere inglese e 0,6 token per carattere cinese. Nomi, descrizioni e schemi di input dei 25 strumenti arrivano a circa 8.556 token.
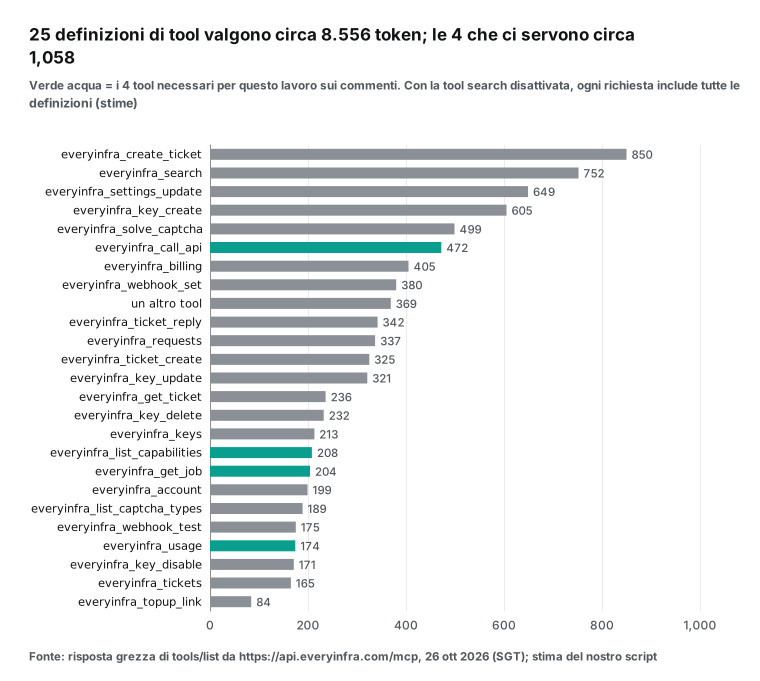
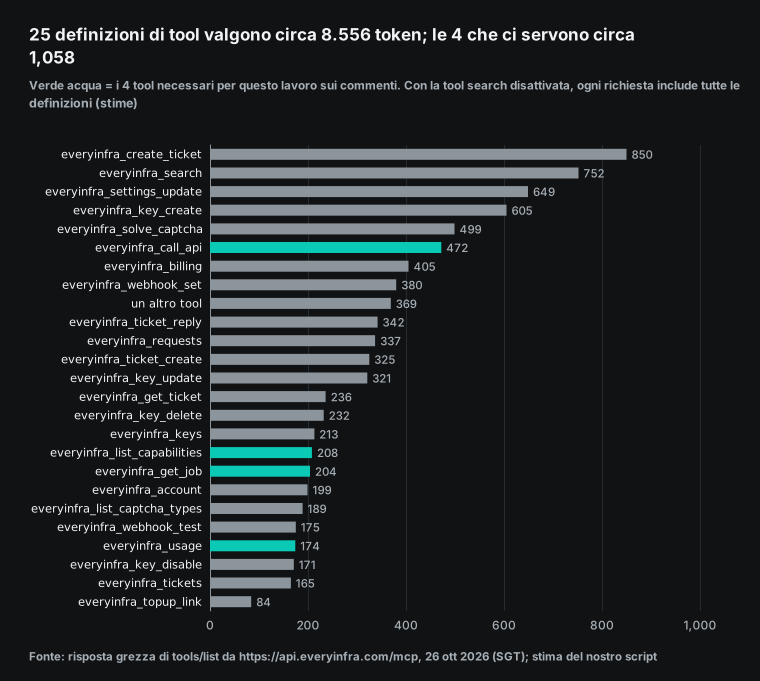
8.556 token non sono molti in sé, ma due fattori li moltiplicano. Primo, consigliamo di disattivare la ricerca degli strumenti per evitare problemi di compatibilità. In questo caso Claude Code invia tutte le definizioni degli strumenti in ogni richiesta. Secondo, la documentazione sui permessi di Claude Code dice che una regola deny con il solo nome dello strumento rimuove quello strumento dal contesto del modello. Quindi, per questo lavoro, nega gli altri 21 strumenti in .claude/settings.json (il formato è nella documentazione sulle impostazioni). Ogni richiesta scende così da circa 8.556 a circa 1.058 token di strumenti:
{
  "permissions": {
    "allow": ["mcp__everyinfra__everyinfra_list_capabilities", "mcp__everyinfra__everyinfra_call_api",
              "mcp__everyinfra__everyinfra_get_job", "mcp__everyinfra__everyinfra_usage"],
    "deny":  ["mcp__everyinfra__everyinfra_search",
              "mcp__everyinfra__everyinfra_solve_captcha", "mcp__everyinfra__everyinfra_key_create",
              "mcp__everyinfra__everyinfra_key_delete", "mcp__everyinfra__everyinfra_settings_update",
              "mcp__everyinfra__everyinfra_webhook_set", "mcp__everyinfra__everyinfra_create_ticket"]
  }
}
L'esempio elenca 7 dei 21 strumenti. Aggiungi gli altri 14 nello stesso formato. In tools/list, everyinfra_call_api ha readOnlyHint: false e nessun idempotentHint.
Da Claude Code 2.1.307 (21 ottobre 2026) questo porta un vantaggio. Il changelog dice che, quando una connessione MCP HTTP si chiude a metà chiamata, Claude Code effettua un nuovo tentativo solo per gli strumenti di sola lettura o idempotenti. Così una connessione caduta non invia in silenzio due volte la stessa estrazione di commenti, addebitandotela due volte.
Un round trip reale: cosa invia il modello e cosa restituiamo
Claude Code e un server MCP remoto usano tools/call della specifica MCP. Che dietro ci sia Claude o DeepSeek, il modello scrive solo un blocco tool_use con il nome di uno strumento e gli argomenti. È Claude Code a inviare la richiesta HTTP.
Quindi il corpo della richiesta qui sotto non dipende dal modello. Le definizioni degli strumenti, tool_use e tool_result contano comunque come token di input del modello, come spiega la documentazione sul tool use di Anthropic. Lo stesso vale lato DeepSeek.
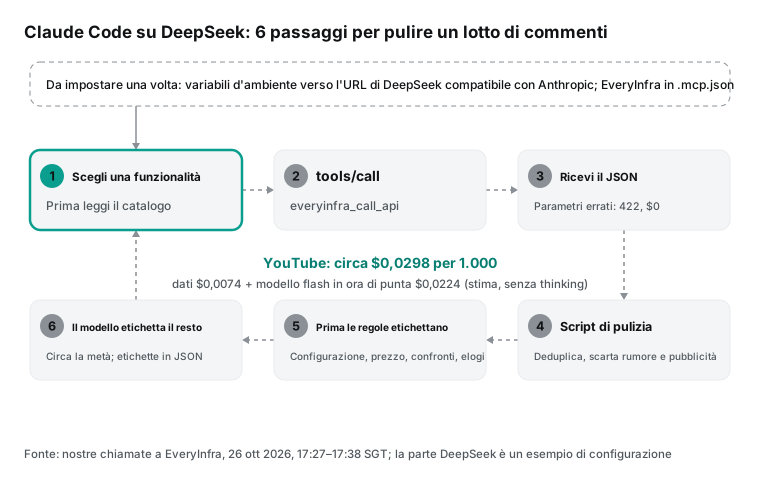
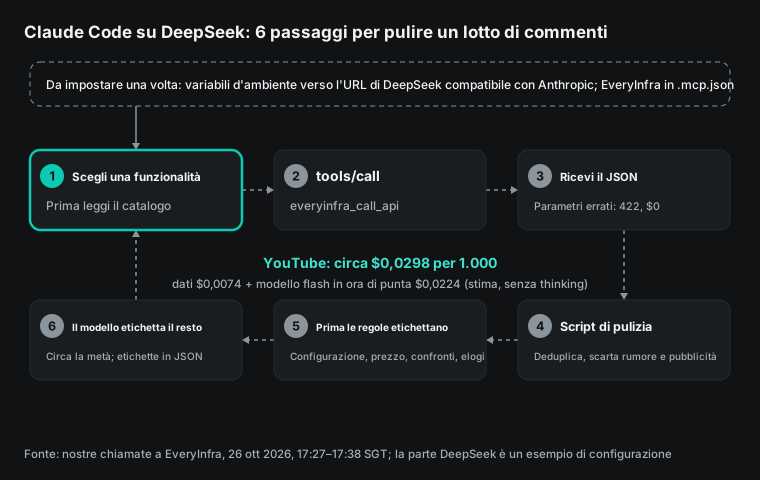
Alle 17:37:32 SGT del 26 ottobre 2026 abbiamo usato curl per inviare a EveryInfra la stessa tools/call che invia Claude Code. La richiesta chiedeva i 20 commenti più recenti di un video YouTube. Dopo 14,0 secondi il server ha restituito 200. result.content[0].text era una stringa JSON (RFC 8259) di 8.926 caratteri. L'addebito è stato di $0,000556, il prezzo a catalogo dell'API di scraping dei commenti di YouTube.
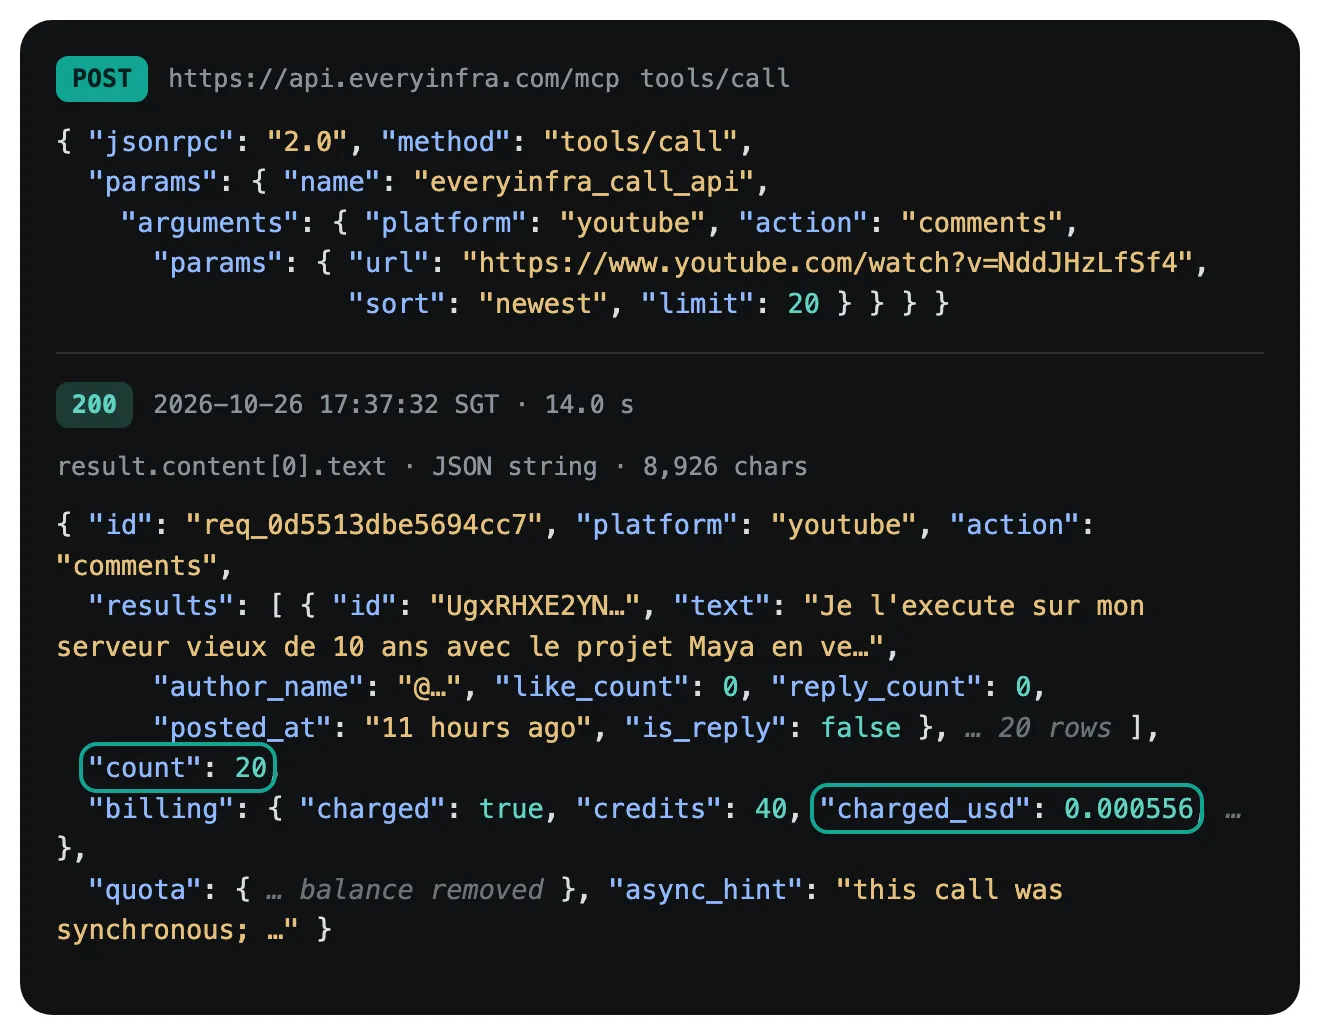
Abbiamo confrontato i campi di questa risposta MCP con quelli della risposta REST per lo stesso video, ottenuta alle 17:28:19. Li abbiamo anche verificati rispetto ai response_fields di youtube/comments nel catalogo:
| Campo | `response_fields` del catalogo | MCP | REST | Uso nella pulizia |
|---|---|---|---|---|
id | Sì | Sì | Sì | Chiave per la deduplicazione del passaggio 1 |
text | Sì | Sì | Sì | L'unico testo inviato al modello |
author_name | Sì | Sì | Sì | Non inviato; nascosto nei report |
like_count | Sì | Sì | Sì | Mantenuto come peso |
reply_count | Sì | Sì | Sì | Non inviato |
posted_at | Sì | Sì | Sì | YouTube restituisce un tempo relativo, ad esempio "11 hours ago" |
is_reply | Sì | Sì | Sì | Mantenuto come una sola lettera, r o t |
reply_to_id | Sì | Assente in queste 20 righe di primo livello | Sì | Collega una risposta al commento padre |
platform | Sì | Sì | Sì | Non inviato |
Nessun campo, in nessuno dei due percorsi, è esterno al catalogo. Nella risposta MCP manca reply_to_id solo perché questi 20 commenti più recenti non avevano risposte. J2 superato. Qui conta anche un altro numero della documentazione di Claude Code.
Claude Code mostra un avviso quando il risultato di uno strumento MCP supera 10.000 token, e il limite predefinito è di 25.000 token. Un risultato più grande, o un risultato testuale oltre 50.000 caratteri, viene salvato in un file e nella chat resta solo il percorso. I nostri download di 100 commenti da YouTube erano di circa 33.000-35.000 caratteri, circa 10.000 token stimati. Siamo proprio sulla soglia dell'avviso.
deepseek anthropic api: 7 righe di compatibilità che influiscono sulle chiamate agli strumenti
Le note sull'API Anthropic di DeepSeek includono una tabella del supporto campo per campo. Abbiamo preso le righe che riguardano le chiamate agli strumenti e i loro risultati, poi le abbiamo confrontate con ciò che, secondo la guida ai gateway, Claude Code invia. "Non presente nella documentazione" indica una lacuna che non abbiamo potuto testare.
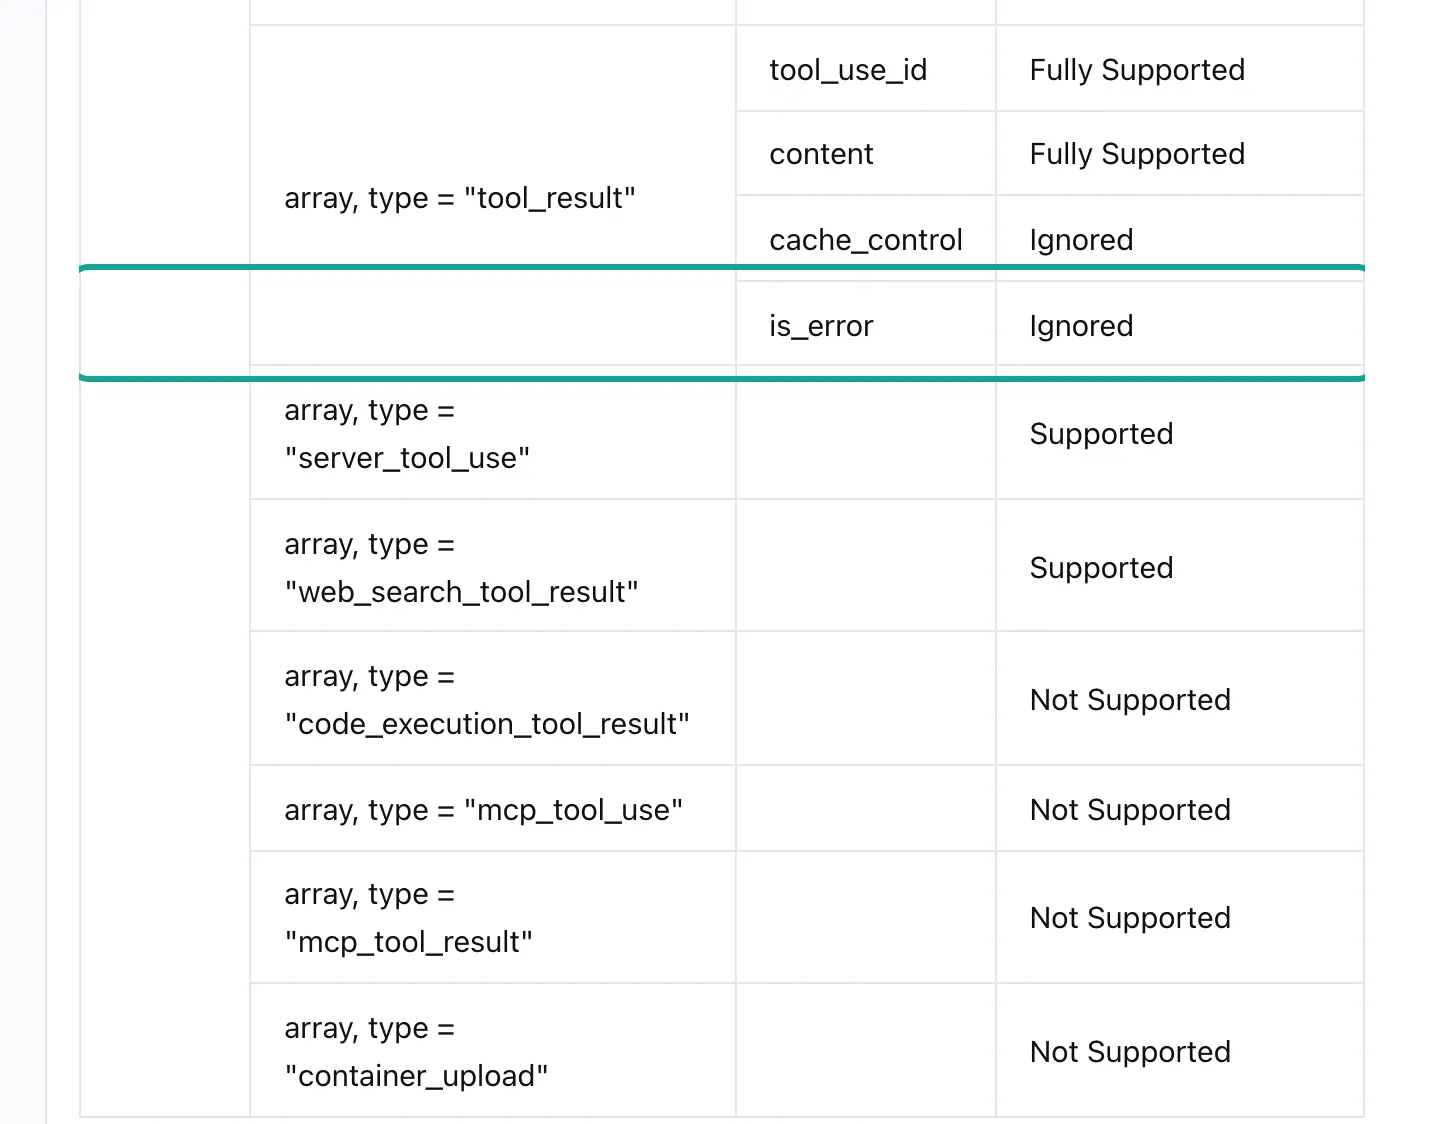
| Campo o comportamento | Tabella DeepSeek | Cosa significa per la pulizia dei commenti |
|---|---|---|
tool_result.is_error | Ignorato | Il modello vede solo testo: il messaggio di errore deve spiegare come correggerlo e se hai pagato |
cache_control su tools, text, tool_use, tool_result | Ignorato | La cache su disco di DeepSeek trova i prefissi in automatico; le regole di caching di Anthropic non si applicano |
disable_parallel_tool_use all'interno di tool_choice | Ignorato | Il modello può inviare più tools/call contemporaneamente e superare i limiti di frequenza delle richieste |
mcp_servers | Ignorato | Nessun effetto su Claude Code, che è un client MCP locale |
Blocchi mcp_tool_use, mcp_tool_result | Non supportato | Idem; Claude Code invia normali tool_use e tool_result |
Blocchi document, search_result | Non supportato | Non inviare PDF come blocchi document |
defer_loading, tool_reference (ricerca degli strumenti) e strict | Non presente nella documentazione | Dalla 2.1.304 la ricerca degli strumenti è attiva anche dietro un URL personalizzato; dopo un 400 o un 422 Claude Code fa un nuovo tentativo senza di essa. Per evitarla, imposta ENABLE_TOOL_SEARCH=false |
La prima riga è quella che conta di più per noi. Nella specifica MCP, un errore di esecuzione di uno strumento restituisce isError: true. Claude Code lo passa poi al modello come tool_result con is_error. DeepSeek ignora il flag, quindi il modello riceve solo il testo. Che il modello riesca a correggere da solo il proprio errore dipende quindi solo da quanto è chiaro il messaggio di errore.
La seconda riga determina il costo. La documentazione sul prompt caching di Claude Code elenca tre modi in cui un gateway può gestire cache_control. Nel terzo, il gateway rimuove i marcatori e restituisce comunque esito positivo. Con la fatturazione di Claude, significa che a ogni turno l'intera conversazione viene addebitata come input non in cache. DeepSeek ignora i marcatori, ma ha una propria cache su disco.
È attiva per impostazione predefinita per tutti gli utenti e confronta i prefissi delle richieste. I token corrispondenti vengono addebitati al prezzo di hit. La documentazione la definisce best effort, senza garanzia di hit al 100%. Le voci di cache inutilizzate di solito vengono eliminate entro qualche ora o qualche giorno.
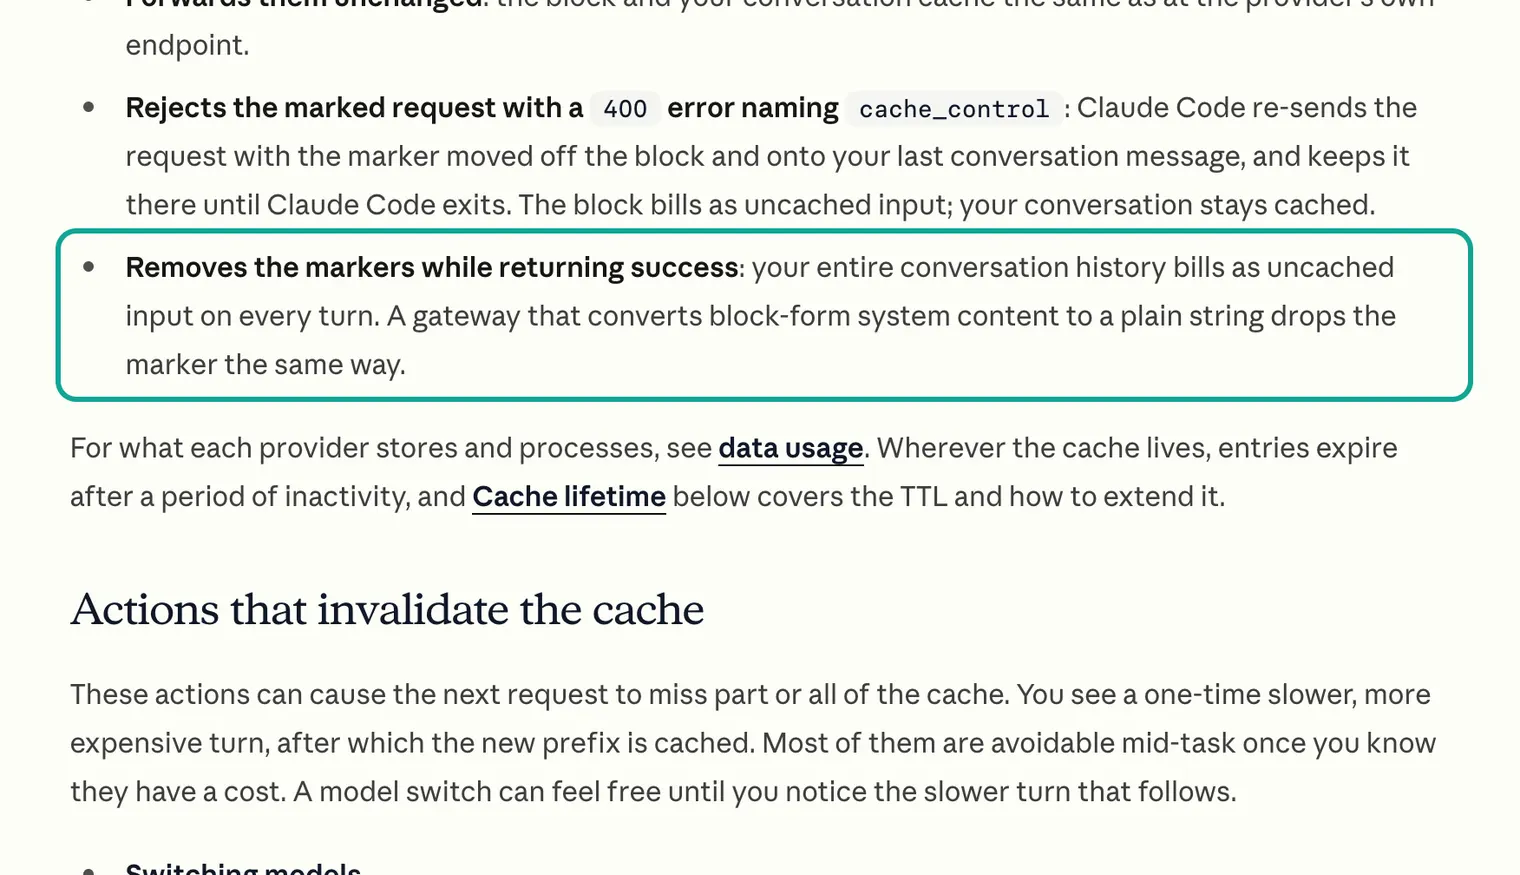
Un altro dettaglio influisce sul confronto dei prefissi. Secondo la guida ai gateway, Claude Code aggiunge un blocco di attribuzione all'inizio del prompt di sistema. Contiene la versione del client e un'impronta derivata dalla conversazione. L'endpoint di Anthropic lo rimuove prima dell'elaborazione, ma gli altri endpoint lo ricevono come parte del prompt. La cache di DeepSeek richiede una corrispondenza completa con un'unità di prefisso memorizzata.
La documentazione non dice se questo blocco resta uguale per tutta la conversazione, e non abbiamo potuto verificarlo. Per questo la nostra tabella dei costi ha due colonne: tutti hit e nessun hit. La tua spesa reale sarà compresa tra le due. Controlla prompt_cache_hit_tokens nei dati di utilizzo di DeepSeek.
Test 1: come sono i commenti di tre piattaforme
Dalle 17:26:56 alle 17:27:16 SGT abbiamo cercato "deepseek v4 claude code" e "DeepSeek Claude Code" con youtube/search, bilibili/search e douyin/search. Tra i risultati abbiamo scelto 15 video sull'uso di DeepSeek in Claude Code: 6 su YouTube (4 in inglese, 1 in cinese, 1 in spagnolo), 5 su Bilibili e 4 su Douyin. Per ora la ricerca su Douyin restituisce solo la prima pagina (qui 20 risultati, senza next_page_token); per trovare altri video candidati, ripeti la ricerca con altre parole chiave. La scelta dell'argomento fa parte del metodo: i commenti sotto questi video sono testimonianze dirette dei punti in cui gli utenti reali si bloccano con questa configurazione.
| Piattaforma | Video | Righe richieste per chiamata | Righe restituite (con risposte) | Addebito | Tempo per chiamata |
|---|---|---|---|---|---|
| YouTube | 6 | 100 | 461 (289 di primo livello, 172 risposte) | 6 × $0.000556 = $0.003336 | da 11,5 a 78,6 s |
| Bilibili | 5 | 50 | 50 (10 per chiamata) | 5 × $0.000556 = $0.002780 | da 8,7 a 11,4 s |
| Douyin | 4 | 50 | 184 (86 di primo livello, 98 risposte) | $0,006112 (ogni 20 righe) | da 14,4 a 44,0 s |
Abbiamo verificato ogni addebito. Nel catalogo, youtube/comments e bilibili/comments hanno un prezzo unico per chiamata, indipendentemente dal numero di righe. L'API di scraping dei commenti di Douyin ha rows_per_unit: 20, quindi ogni 20 righe corrispondono a un'unità. 50 righe sono 3 unità (120 crediti, $0,001667) e 34 righe sono 2 unità (80 crediti, $0,001111). In tutte le 15 chiamate, credits è pari al prezzo di catalogo moltiplicato per le unità. J3 superato.
Abbiamo notato anche tre cose che è bene sapere. Primo, l'API di scraping dei commenti di Bilibili ha restituito solo 10 righe in ciascuna delle 5 chiamate. Ne avevamo chieste 50. Non siamo noi a tagliare queste righe: Bilibili fornisce al massimo 10 commenti per video. Ora il catalogo indica 10 come valore predefinito e 10 come massimo. Un limit più alto viene comunque accettato, ma tornano solo 10 righe. Alle 20:01:21 SGT abbiamo ricontrollato lo stesso video con limit=50: 10 righe, $0,000556. Per questo la tariffa dati di Bilibili è alta: $0,0556 per 1.000 righe.
Quindi metti in conto al massimo 10 commenti per ogni video di Bilibili. Secondo, in due pagine di Douyin lo stesso id di commento è comparso due volte: 8 righe su 184. Il problema è stato risolto alle 19:53 SGT del 26 ottobre: ora l'API rimuove i duplicati per id e tiene il primo, e un'unità di fatturazione che dopo questa operazione resta incompleta viene rimborsata secondo le regole normali. Le nostre 184 righe sono precedenti alla correzione. Il passaggio 1 dello script di pulizia rimuove comunque le righe con id ripetuto, come rete di sicurezza.
Terzo, il posted_at di YouTube è un tempo relativo, ad esempio "7 days ago (edited)". Bilibili e Douyin forniscono timestamp standard con fuso orario. Per raggruppare i commenti di YouTube per data, calcola la data a partire dall'ora del download e considera il risultato approssimativo.
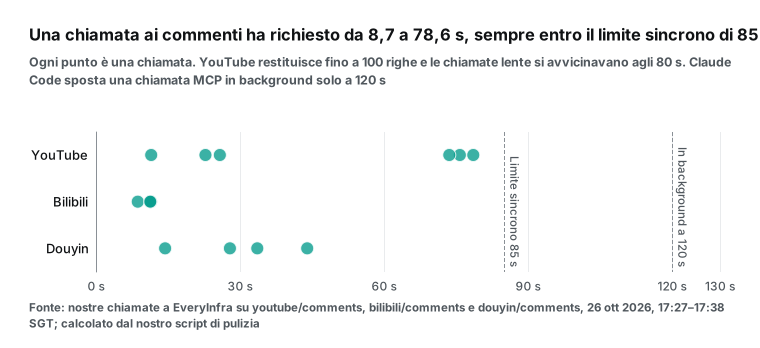
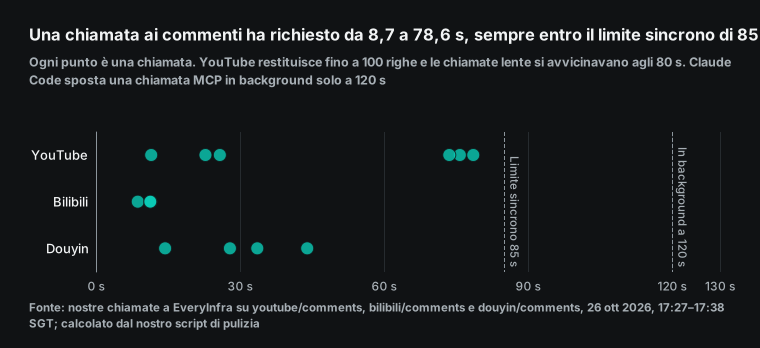
In Claude Code la durata di una chiamata conta. Secondo la sua documentazione MCP, una chiamata MCP nella conversazione principale che dura più di due minuti diventa un'attività in background. Il modello riceve subito un ID attività e continua a lavorare, e il risultato arriva in seguito come notifica. La nostra chiamata più lenta ha richiesto 78,6 secondi, ben sotto i due minuti.
La sezione async_mode del catalogo EveryInfra indica un limite di 85 secondi per le chiamate sincrone. Per valori alti di limit suggerisce mode: "async" e lo strumento gratuito everyinfra_get_job per leggere il risultato. Se DeepSeek invia più chiamate contemporaneamente (ricorda che disable_parallel_tool_use viene ignorato), anche la tua chiave EveryInfra ha un limite al minuto e restituisce 429 quando lo superi. DeepSeek conta le richieste simultanee per account, e deepseek-flash ne consente 2.500 contemporaneamente prima di restituire 429 (documentazione sui limiti di frequenza delle richieste).
Test 2: cosa ha rimosso lo script di pulizia
Non abbiamo affidato la pulizia al modello: gli abbiamo fatto scrivere uno script che la esegue. Se una regola può decidere, mandare il commento al modello significa solo pagare perché lo legga.
La documentazione sui costi di Claude Code dà lo stesso consiglio: non far leggere al modello un log di 10.000 righe. Un hook può prima cercare ERROR con grep e ridurre il contesto da decine di migliaia di token a poche centinaia.
Lo script esegue quattro controlli in ordine e si ferma alla prima corrispondenza. Il passaggio 2 usa la normalizzazione Unicode NFKC (UAX #15; in Python, unicodedata.normalize). Poi rimuove link, codici emoji e punteggiatura, così la stessa frase a larghezza piena o con maiuscole diverse conta come duplicato. Tutte le regole sono espressioni regolari Python e puoi eseguirle di nuovo sugli stessi dati:
# Cleaning rules, version 4 (excerpt; the full script is saved with the raw responses)
BRACKET_EMOJI = re.compile(r"\[[一-鿿]{1,6}\]")      # emoji codes such as [捂脸]; Chinese only inside brackets
PROMO = re.compile(r"(subscribe(?!r)|newsletter|giveaway|chrome extension|coupon|telegram|whatsapp|"
                   r"私信|加群|进群|加微|微信|qq群|关注我|免费领|领取|代金券|优惠|课程|戳我)", re.I)
for r in rows:
    if (video, r["id"]) in seen_id:   drop("same id"); continue          # 1. same comment twice on a page
    if (video, norm(r["text"])) in seen_text: drop("same text"); continue # 2. same text after normalization
    if no_content(r["text"]):          drop("no content"); continue       # 3. emoji only, 666, two characters, not a question
    if PROMO.search(r["text"]) or (has_link and (few_chars or bait)): drop("promotion"); continue  # 4.
    keep(f'{i}|{likes}|{"r" if r["is_reply"] else "t"}|{text_with_links_shortened}')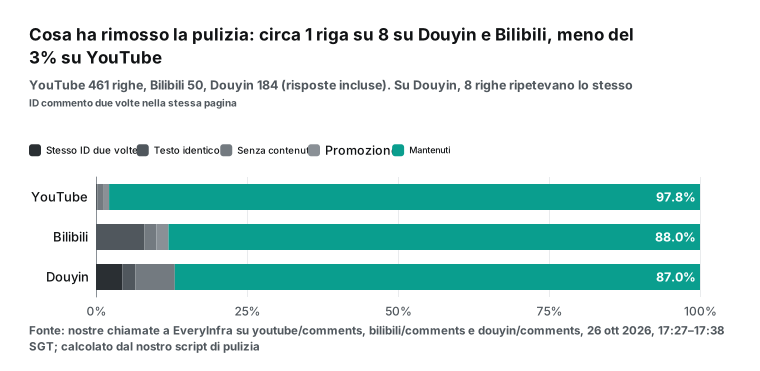
Abbiamo modificato lo script quattro volte. Ogni modifica è arrivata dopo aver letto i commenti rimossi e trovato una rimozione sbagliata. Questo processo è la lezione principale dell'articolo. Le regole di pulizia rimuovono sempre qualche commento valido, e te ne accorgi solo leggendo ciò che hai rimosso. La versione 1 considerava "New subscriber here" una promozione, perché subscribe corrispondeva a subscriber.
Rimuoveva anche una domanda in spagnolo, "¿qué extensiones concretamente?", a causa di extension, e una risposta utile che rimandava alla pagina ufficiale di download di Git. La versione 2 ha corretto questi tre casi. La versione 3 ha mantenuto "Normal, están con un 90% de descuento", un normale commento su uno sconto di DeepSeek, e ha smesso di rimuovere la domanda cinese di due caratteri "guì bù" ("è caro?").
La versione 4 è nata dalla lettura del testo mantenuto. La regex per i codici emoji tra parentesi (una parola cinese tra parentesi quadre, come il codice per facepalm) era troppo ampia. Cancellava messages[1] da un messaggio di errore e [1m] dal nome di un modello, due degli indizi più utili di questo lotto.
Abbiamo letto tutte le 40 righe rimosse dalla versione 4 senza trovare altre rimozioni sbagliate. Non abbiamo letto tutte le 655 righe mantenute, quindi nei dati c'è ancora un po' di promozione senza link né parole chiave, ad esempio offerte di installare gli strumenti a pagamento. Su Douyin le risposte "posso aiutarti a installarlo" sono comparse più volte. La deduplicazione del testo ha rimosso le ripetizioni e tenuto la prima.
La quota di rumore varia molto tra le piattaforme: 2,2% su YouTube, 12,0% su Bilibili e 13,0% su Douyin. Un possibile motivo del valore basso di YouTube è che la piattaforma filtra a monte. La documentazione commentThreads della YouTube Data API dice che solo il proprietario del canale può vedere i commenti "likely spam" e "held for review" in una richiesta autorizzata. Le richieste pubbliche ricevono per impostazione predefinita i commenti pubblicati.
Al Made on YouTube del 23 settembre 2026, YouTube ha anche annunciato che sta testando una moderazione dei commenti con AI, attivabile su richiesta, che impara lo stile di ogni canale. Su Douyin e Bilibili il rumore è fatto soprattutto di emoji, "666" e ripetizioni, non di link esterni. Le corrispondenze delle regole mostrano lo stesso andamento.
Test 3: quanti token legge il modello dopo la pulizia
La pulizia non riduce solo le righe. Con il rapporto di DeepSeek abbiamo stimato due conteggi di token: il primo invia il JSON dell'API così com'è, il secondo solo la riga pulita.
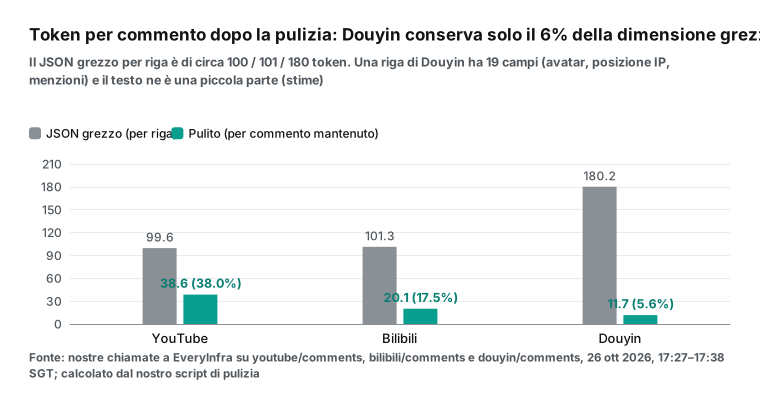
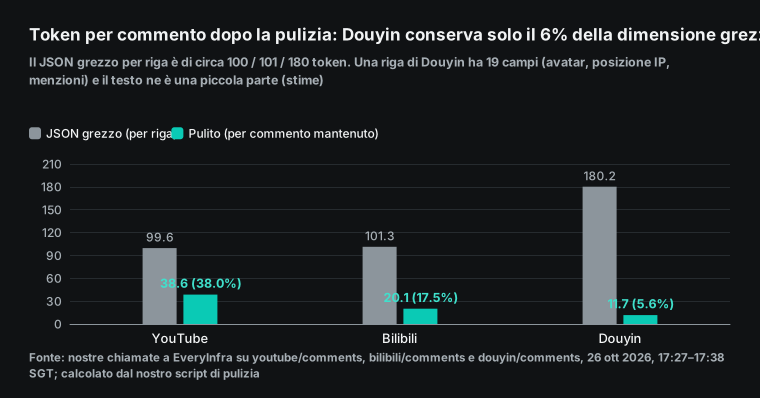
Douyin si riduce di più a causa dei suoi campi. Nel catalogo, douyin/comments ha 19 campi della risposta, come l'URL dell'avatar, la località IP, gli utenti menzionati e se l'autore ha messo like al commento. In media una riga JSON grezza occupa circa 180 token, ma il testo mediano è di soli 13 caratteri.
I commenti di YouTube sono più lunghi, con una mediana di 61 caratteri e solo 9 campi, quindi dopo la pulizia resta il 38,0%. Sulle tre piattaforme, 84.109 token stimati scendono a 20.176, il 24,0%. J4 superato.
Perché in Claude Code conta così tanto? Il risultato di uno strumento MCP entra direttamente nel contesto della conversazione, e ogni turno successivo lo rilegge come parte del prefisso. Al prezzo di hit di DeepSeek, rileggere 10.000 token costa solo $0,00006. Ma il tasso di hit non lo controlli tu.
In caso di miss, gli stessi 10.000 token costano $0,003 a $0,30 per milione, e su decine di turni la spesa cresce. Uno schema più sicuro è far scrivere uno script a Claude Code. Lo script chiama la REST API di EveryInfra con curl, salva il JSON grezzo su file e stampa solo il testo pulito e i conteggi. Riserva MCP ai passaggi interattivi, come una prima esplorazione, la scelta di una funzionalità e il test dei parametri.
# Batch pulls go through REST; raw responses go to disk, not into the chat
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" -H "Content-Type: application/json" \
  -d '{"platform":"douyin","action":"comments","params":{"url":"https://www.douyin.com/video/<video_id>","limit":50}}' \
  -o raw/dy_<video_id>.json
python3 clean.py raw/ > cleaned.txt   # prints only "index|likes|r/t|text" and the removal counts
Test 4: cosa etichettano le regole e cosa va al modello
Dopo la pulizia abbiamo applicato regole basate su parole chiave per vedere quanto riescono a etichettare. Le regole consentono più etichette sullo stesso commento, ad esempio "prezzo" e "confronta modelli".
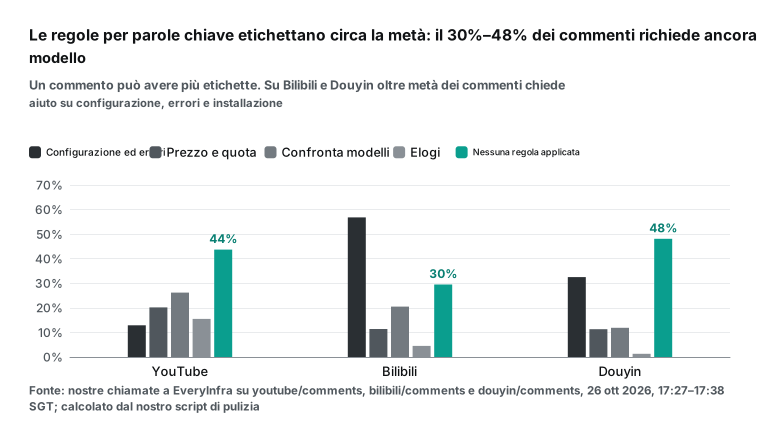
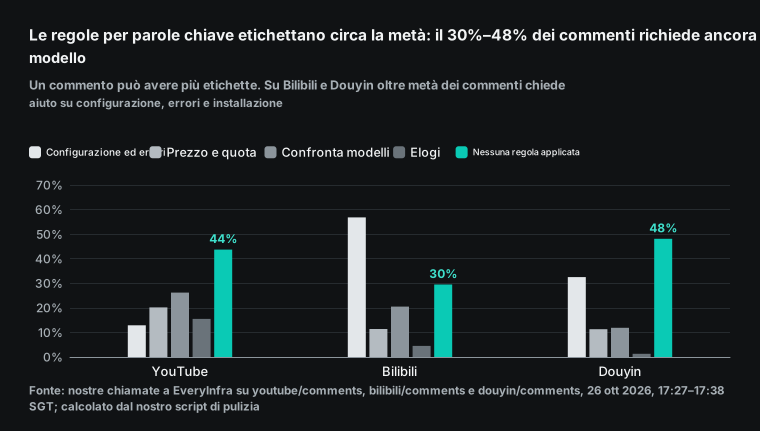
Nessuna regola ha trovato corrispondenza nel 43,7% dei commenti di YouTube, nel 29,5% su Bilibili e nel 48,1% su Douyin. Questo numero determina quanto deve leggere il modello: circa la metà. Le regole non possono sostituire il modello, ma ne dimezzano il lavoro, e la metà che etichettano è di solito la più semplice e quella per cui meno vale la pena pagare.
| Piattaforma | Mantenuti | Configurazione ed errori | Prezzo e quota | Confronta modelli | Elogi | Nessuna regola corrispondente | Contiene una domanda |
|---|---|---|---|---|---|---|---|
| YouTube | 451 | 58 | 91 | 118 | 70 | 197 (43.7%) | 138 |
| Bilibili | 44 | 25 | 5 | 9 | 2 | 13 (29.5%) | 27 |
| Douyin | 160 | 52 | 18 | 19 | 2 | 77 (48.1%) | 59 |
Vale la pena leggere i commenti stessi. Su Bilibili, 25 su 44 riguardano configurazione ed errori; su Douyin, 52 su 160. Le stesse domande si ripetono.
Perché chiede ancora il login dopo la configurazione? Perché non legge le immagini? Perché dice di essere Claude? Perché consuma token così in fretta?
Su YouTube, due messaggi di errore sono rimasti nei dati parola per parola. Il primo è API Error: 400 Failed to deserialize the JSON body into the target type: messages[1].role: unknown variant system. Il secondo è The content[].thinking in the thinking mode must be passed back. Le FAQ qui sotto rispondono a entrambi in base alla documentazione ufficiale.
Sotto il video in spagnolo, gli 83 commenti in spagnolo parlano soprattutto delle variazioni di prezzo. Più di un utente dice di aver ricevuto un'email di DeepSeek sull'aumento dei prezzi dell'API. La consideriamo solo una segnalazione degli utenti. Per i prezzi ci basiamo sulla pagina dei prezzi di DeepSeek.
Per la metà affidata al modello, diamo un esempio di configurazione. Claude Code invia i commenti senza corrispondenza a un subagent in lotti da 100, nel formato "index|text". Il subagent deve restituire solo un array JSON, con un indice e un'etichetta per commento. La documentazione di DeepSeek su output JSON e chiamate agli strumenti supporta un output strutturato di questo tipo.
In Claude Code, il modo più semplice è scrivere il formato di output nella definizione del subagent. Poi CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash lo esegue sul modello economico. Secondo la documentazione sui subagent, questa variabile imposta il modello predefinito dei subagent.
Il risultato finale: una tabella di etichette collegata alla fonte
Il risultato di questo lavoro è una tabella. Ogni riga è un commento mantenuto, con piattaforma, numero di like, testo originale (senza nomi utente), etichetta e chi l'ha assegnata. Qui sotto ci sono 10 righe, ordinate per like. La colonna dell'etichetta della regola mostra il primo passaggio delle regole basate su parole chiave. L'ultima colonna mostra la nostra revisione di ogni riga.
| Piattaforma | Like | Commento (estratto; cinese tradotto) | Etichetta della regola | La nostra revisione |
|---|---|---|---|---|
| Douyin | 615 | "Ho appena iniziato a usarlo. Un lotto di file di dati mi avrebbe richiesto giorni a mano; questo l'ha fatto in una decina di minuti" | Nessuno | Esperienza utente, positiva; sfuggita alle regole |
| Douyin | 51 | "Puoi installarmi Claude Code?" | Confronta modelli | Chiede aiuto per l'installazione; "claude" ha attivato l'etichetta sbagliata |
| Douyin | 36 | "Non vi sembra che i token finiscano in fretta dopo averlo collegato?" | Prezzo e quota | Corretta |
| Douyin | 28 | "Dopo aver collegato DeepSeek V4, Claude continua a caricare la sessione. Cosa devo fare?" | Confronta modelli | Richiesta di aiuto su un errore; le regole non conoscono questa frase |
| Douyin | 24 | "Sembra che il modello DeepSeek non possa generare immagini?" | Nessuno | Domanda sui limiti |
| Douyin | 14 | "Ho fatto qualche domanda semplice e ho bruciato 700k token. Troppo veloce." | Prezzo e quota | Corretta |
| Bilibili | 10 | "Non dicevano che CC ha rischi per la sicurezza? Lo consigli ancora?" | Nessuno | Dubbio sulla sicurezza |
| YouTube | 17 | «Approfittate dello 0,14, perché alzerà i prezzi.» | Prezzo e quota | Corretta |
| YouTube | 17 | "IT DOES NOT MATCH OPUS 5.5" | Confronta modelli | Corretta |
| YouTube | 6 | «non ho capito una sola cosa della configurazione» | Configurazione ed errori | Corretta (feedback sul tutorial) |
In queste 10 righe le regole hanno avuto ragione 5 volte, hanno mancato 3 volte e hanno sbagliato 2 volte. Il campione è troppo piccolo per misurare l'accuratezza, ma mostra i due tipi di errore delle regole. Il primo è una parola chiave troppo ampia: qualsiasi commento con "claude" viene contato come confronto tra modelli. Il secondo nasce dai troppi modi di dire la stessa cosa: le persone chiedono aiuto con frasi molto diverse e le regole non possono elencarle tutte. Questa è la parte che spetta al modello, ed è per questo che le regole sono solo un primo passaggio.
Il modello deve poter cambiare un'etichetta delle regole prima che finisca in un report. In Claude Code, uno schema economico è inviare al modello solo due gruppi: le righe senza etichetta delle regole e quelle etichettate solo "confronta modelli", dove si accumulano le etichette sbagliate. Con i nostri dati sono 368 commenti mantenuti su 655, circa il 56%.
Per un team di prodotto, la riga più utile è il commento con 615 like. Il commento più apprezzato non parla di configurazione né di prezzo, ma di un risultato: un lotto di file di dati gestito in pochi minuti.
Con le sole regole, questa riga finisce in "altro", eppure è la voce più rappresentativa sotto quel video. Per questo teniamo il numero di like nel testo pulito: non costa quasi nessun token e dà al modello un peso economico per "quante persone sono d'accordo".
Test 5: cosa vede il modello dopo un parametro errato
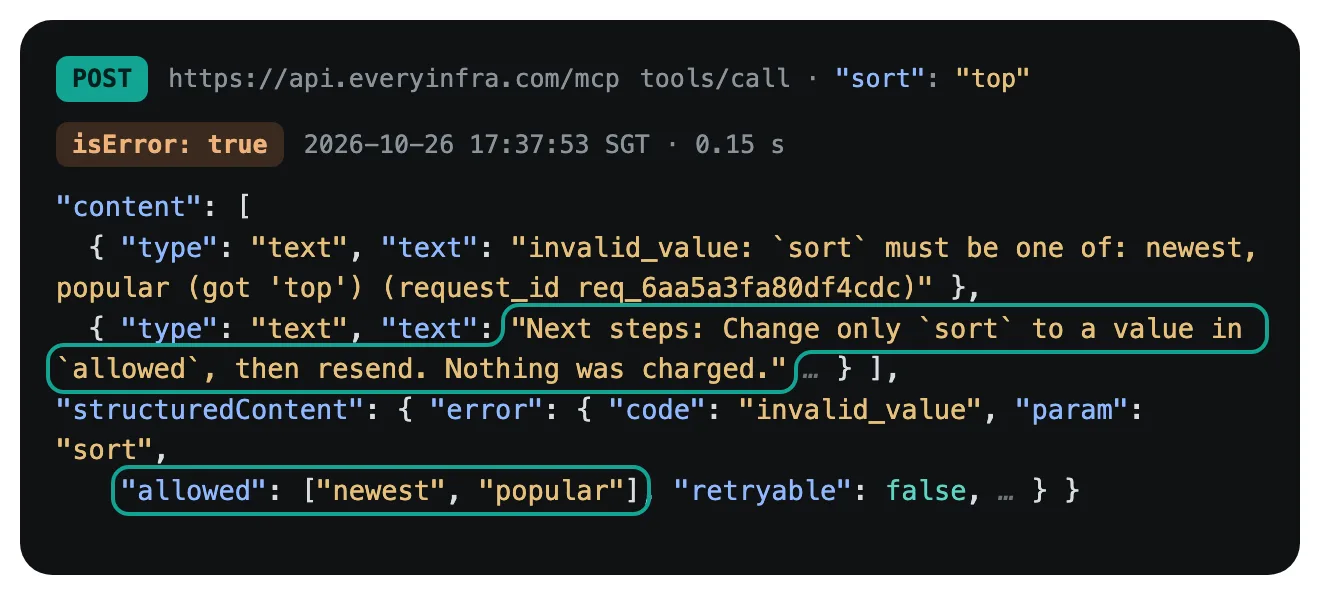
Alle 17:26:46 SGT, le nostre prime ricerche mettevano limit al primo livello del corpo della richiesta. Tutte e tre le piattaforme hanno restituito 422 con il codice di errore unknown_param. Il messaggio diceva "limit goes inside params, not at the top level of the body", con did_you_mean: ["params.limit"] e una frase finale, "Nothing was charged." Non era voluto: è il tipo di errore che fa un modello. Alle 17:37:53 abbiamo inviato di proposito sort: "top" tramite MCP:
| Caso | Risposta | Cosa vede il modello su DeepSeek | Addebito |
|---|---|---|---|
REST: limit al primo livello (17:26:46, tre piattaforme) | 422 unknown_param con did_you_mean: ["params.limit"] | Non applicabile (la REST è gestita da uno script) | $0 |
REST: sort: "top" (17:38:00) | 422 invalid_value con allowed: ["newest","popular"] | Non applicabile | $0 |
MCP: sort: "top" (17:37:53) | isError: true, due parti di testo e structuredContent | Due parti di testo: il parametro errato, i valori consentiti e "Nothing was charged." | $0 |
La terza riga dimostra J7. DeepSeek ignora is_error, quindi il modello non sa che si tratta di un errore. Legge solo le due parti di testo, che già indicano il parametro errato, elencano i valori consentiti, dicono di cambiare solo quel valore e inviare di nuovo, e precisano che non è stato addebitato nulla. I codici di errore e la regola "gli errori sono gratuiti" si trovano nella tabella degli errori della documentazione di EveryInfra.
I formati completi di richieste ed errori sono nel file OpenAPI. I parametri sconosciuti e i valori enum non validi restituiscono 422 con i parametri supportati, i valori consentiti e un suggerimento. Non vengono mai ignorati e addebitati. Anche una chiamata sincrona oltre 85 secondi restituisce 503 timeout e non viene addebitata. Con un endpoint di modello che ignora il flag di errore, è questa regola a permettere al modello di correggersi da solo.
Costo: prezzi dei token di DeepSeek più la tariffa dei dati di EveryInfra
La pagina dei prezzi di DeepSeek (consultata il 26 ottobre 2026) divide la giornata in fascia di punta e fuori punta. La fascia di punta va dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC, dal lunedì al venerdì, esclusi i giorni festivi cinesi. Tutte le altre ore sono fuori punta, a metà prezzo. Per chi legge dagli Stati Uniti questo ha un effetto utile. Il 26 ottobre la costa orientale degli USA è in ora legale (UTC−4), quindi la fascia di punta va dalle 21:00 alle 24:00 e dalle 02:00 alle 06:00 ora della costa est.
Tutta la tua giornata lavorativa cade fuori punta. Sulla costa occidentale (UTC−7), la fascia di punta va dalle 18:00 alle 21:00 e dalle 23:00 alle 03:00 ora del Pacifico. Il nostro test si è svolto di lunedì dalle 17:26 alle 17:38 SGT, cioè dalle 09:26 alle 09:38 UTC, in fascia di punta. Quindi i nostri prezzi di punta sono il caso peggiore per un utente statunitense che lavora di giorno.
| Per milione di token (USD) | deepseek-flash punta | deepseek-flash fuori punta | deepseek-v4-pro punta | Claude Haiku 5.5 | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|---|---|---|---|
| Input (miss) | $0.30 | $0.15 | $1.32 | $0.10 | $2.00 | $4.00 |
| Cache hit | $0.006 | $0.003 | $0.044 | $0.01 | $0.10 | $0.20 |
| Scrittura in cache (5 min) | Nessun prezzo separato | Nessun prezzo separato | Nessun prezzo separato | $0.125 | $2.50 | $5.00 |
| Output | $1.20 | $0.60 | $3.96 | $0.50 | $10.00 | $20.00 |
La pagina dei prezzi in cinese indica per flash un input di 2 CNY (punta) e 1 CNY (fuori punta) per milione di token, e un output di 8 CNY e 4 CNY. Abbiamo usato circa 6,67 CNY per dollaro, il rapporto tra price_cny e price_usd nel catalogo di EveryInfra dello stesso giorno.
Si ottengono circa $0,30, $0,15, $1,20 e $0,60, gli stessi valori della pagina in USD. I prezzi di Haiku 5.5 valgono per prompt fino a 100.000 token. I prompt più lunghi costano $0,50 e $2,50.
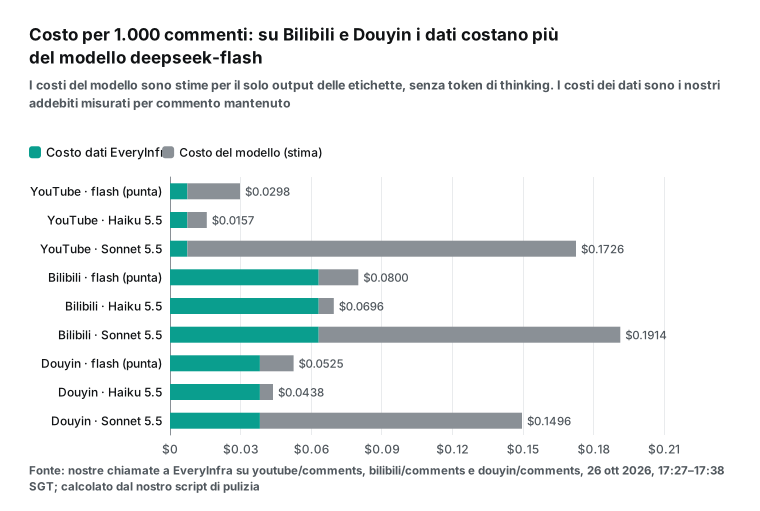
La tariffa dei dati segue il price_usd del catalogo EveryInfra. youtube/comments, bilibili/comments e douyin/comments costano ciascuno $0,000556 per chiamata ($0,56 per 1.000 chiamate), e Douyin addebita anche per blocchi di 20 righe. Con la nostra media di righe per chiamata, la tariffa dei dati per 1.000 commenti mantenuti è di $0,0074 su YouTube, $0,0632 su Bilibili e $0,0382 su Douyin.
Per la tariffa del modello abbiamo stimato solo il passaggio di etichettatura. L'input è dato dai token puliti di 1.000 commenti più 400 token di istruzioni per ogni lotto da 100. L'output è un'etichetta di 8 token per commento. Non ci sono token di thinking.
È un limite inferiore, perché deepseek-flash usa la modalità thinking per impostazione predefinita. Abbiamo aggiunto un caso di sensibilità con 1.500 token di thinking in più per lotto. Il valore di 1.500 è un'ipotesi, non una misura.
| Per 1.000 commenti puliti | Costo dei dati | flash punta | flash fuori punta | Haiku 5.5 | Sonnet 5.5 | flash in fascia di punta, +1.500 token di ragionamento per batch |
|---|---|---|---|---|---|---|
| YouTube | $0.0074 | $0.0224 | $0.0112 | $0.0083 | $0.1652 | $0.0404 |
| Bilibili | $0.0632 | $0.0168 | $0.0084 | $0.0064 | $0.1282 | $0.0348 |
| Douyin | $0.0382 | $0.0143 | $0.0072 | $0.0056 | $0.1114 | $0.0323 |
Questa tabella ha smentito le nostre aspettative. Pensavamo che il costo del modello avrebbe dominato e che il costo dei dati fosse irrilevante. Su YouTube è così: il costo del modello è 3 volte quello dei dati. Ma su Bilibili e Douyin i commenti sono brevi e il numero di token dopo la pulizia è basso.
Lì il costo dei dati supera il costo del modello deepseek-flash in fascia di punta. Per i commenti brevi in cinese su flash, la parte più consistente della spesa è quella dei dati. In questo caso contano soprattutto la fonte dei dati e le righe per chiamata.
Ora proietta tutto su un mese. Ogni piattaforma ha 120 video al mese (30 a settimana). Claude Code esegue una sessione a settimana con l'utilizzo di esempio della documentazione sui costi, con cache hit.
| Un mese (120 video per piattaforma, 4 sessioni) | Costo dei dati | Costo del modello per l'etichettatura | Costo delle sessioni (cache hit) | Totale |
|---|---|---|---|---|
| deepseek-flash in fascia di punta | $0.3168 | $0.2883 | $0.1096 | $0.7147 |
| deepseek-flash fuori dalle ore di punta | $0.3168 | $0.1441 | $0.0548 | $0.5157 |
| Claude Haiku 5.5 | $0.3168 | $0.1080 | $0.0736 | $0.4984 |
| Claude Sonnet 5.5 | $0.3168 | $2.1602 | $1.0976 | $3.5746 |
| deepseek-v4-pro in fascia di punta | $0.3168 | $1.1115 | $0.5196 | $1.9479 |
In un mese si estraggono circa 15.940 righe e si conservano circa 14.876 commenti. Il tutto costa meno di $0,72 ai prezzi di flash in fascia di punta e circa $3,57 con Sonnet 5.5. Haiku 5.5 costa $0,50: meno di flash in fascia di punta e più o meno quanto flash fuori dalle ore di punta. Il costo dei dati, $0,3168, è uguale in ogni riga, perché dipende solo da quanto estrai.
Lo stesso lavoro con i modelli Claude ufficiali: come scegliere
Messe insieme, le tabelle indicano una scelta chiara. In termini di costo dei token, Claude Haiku 5.5 è tra le opzioni più economiche per questo lavoro. È anche un modello nativo di Claude Code, quindi non presenta nessuno dei problemi di compatibilità descritti sopra.
Il caching segue cache_control, is_error arriva al modello e la tool search e l'output strutturato funzionano. deepseek-flash costa meno solo se valgono entrambe queste condizioni: lavori fuori dalle ore di punta e la maggior parte delle richieste genera un cache hit. Per chi lavora di giorno negli Stati Uniti, la prima condizione è soddisfatta per impostazione predefinita.
Perché allora qualcuno dovrebbe scegliere DeepSeek? I commenti danno motivi concreti. Alcuni utenti si trovano nella Cina continentale, dove l'accesso diretto ad Anthropic è limitato per regione. Altri hanno già credito DeepSeek. Altri ancora vogliono pesi aperti da ospitare in proprio.
Altri vogliono un secondo modello esecutore in uno schema in cui «Opus 5.5 pianifica e un modello a basso costo esegue». Nel test di 86 domande condotto da un utente di Reddit, DeepSeek Flash e Haiku 5.5 hanno ottenuto punteggi quasi identici (86,6 e 84,7). L'autore precisa che il test è limitato e che uno scarto di 2 punti è rumore. Aggiunge che a volte DeepSeek Flash «si è perso nei propri ragionamenti e non ha restituito nulla». Usa test di terzi come questo solo per contestualizzare.
| La tua situazione | Scelta migliore | Motivo |
|---|---|---|
| Puoi accedere ad Anthropic e vuoi poche sorprese | Haiku 5.5 come subagent; Sonnet 5.5 o Opus 5.5 come sessione principale | Tra i prezzi più bassi, nessun problema di compatibilità |
| Puoi usare solo DeepSeek o hai già pagato per usarlo | deepseek-flash su tutti gli alias; esegui i batch fuori dalle ore di punta | Fuori dalle ore di punta il prezzo si dimezza; disattiva la tool search e tieni d'occhio i cache hit |
| Grandi volumi di commenti brevi in cinese | L'uno o l'altro; migliora prima la pulizia e l'estrazione | Il costo dei dati è già paragonabile al costo del modello |
| Ti servono le immagini (screenshot degli errori) | Non lasciare l'alias opus su deepseek-v4-pro | La pagina dei prezzi indica che deepseek-v4-pro non accetta immagini in input |
Cosa copre la nuova API Search/Fetch di DeepSeek
Nella stessa nota di rilascio del 17 ottobre, DeepSeek ha aperto al pubblico le proprie API Search e Fetch. Ciascuna costa $0,75 per 1.000 richieste andate a buon fine (guida). Secondo la guida alla ricerca, Search restituisce risultati web con titolo, link, riassunto e testo della pagina, mentre Fetch converte una pagina in Markdown. Le richieste non riuscite, i risultati vuoti e i timeout non vengono addebitati. I limiti sono di 100 richieste al secondo per Search e 25 per Fetch, per account.
Una frase della nota è importante per questo lavoro. Quando usi l'API DeepSeek in Claude Code, la ricerca web passa da chiamate a strumenti lato server che interrogano le API Search e Fetch di DeepSeek. Oggi queste chiamate sono gratuite; l'addebito per richiesta parte dal 1° novembre 2026 alle 00:00 ora di Pechino (16:00 UTC del 31 ottobre). Da quel momento, in questa configurazione ogni «cercalo sul web» costa $0,75 per 1.000 ricerche, oltre ai token del modello.
Search e Fetch coprono il web in generale: ciò che dice un post di un blog o ciò che mostra al momento una pagina di documentazione. Non coprono i dati all'interno delle piattaforme, come i like di un commento su YouTube, le righe di risposta in una pagina di Douyin o l'orario di pubblicazione di un commento su Bilibili. Questi dati non si trovano nel testo pubblico delle pagine, oppure richiedono paginazione, login e campi strutturati.
In questa configurazione, quindi, i due strumenti si dividono il lavoro. DeepSeek Search e Fetch gestiscono il web in generale. Le API per i dati di EveryInfra gestiscono commenti, post, profili e risultati di ricerca all'interno delle piattaforme. Anche l'harness per agenti di DeepSeek, DeepSeek Harness, divide il lavoro allo stesso modo: ha la ricerca web integrata, ma per i dati delle piattaforme serve comunque un altro strumento.
Limiti e aspetti da tenere d'occhio
Primo, i limiti del supporto. La documentazione di Anthropic sui gateway dice che instradare Claude Code verso modelli non Claude tramite un gateway non è supportato. Ogni release di Claude Code aggiunge funzionalità e, se un gateway o un endpoint compatibile non le inoltra, quelle funzionalità smettono di funzionare. In quattro release tra il 19 e il 23 ottobre, il changelog ha corretto diversi errori nelle richieste dietro un ANTHROPIC_BASE_URL personalizzato. La versione 2.1.304 ha attivato la tool search per impostazione predefinita.
La versione 2.1.305 ha corretto il bug «ogni richiesta fallisce» introdotto con questa modifica. La versione 2.1.310 esegue un nuovo tentativo quando un server compatibile rifiuta l'header beta effort o un messaggio di sistema a metà conversazione. Con questa configurazione, aspettati che il funzionamento migliori o peggiori man mano che Claude Code cambia. Quando compare un nuovo problema, cerca prima nel repository GitHub di Claude Code.
Secondo, dove finiscono i dati. Il testo dei commenti viene elaborato sui server di DeepSeek. I commenti sono pubblici, ma contengono nomi utente e località IP, che sono dati personali.
Il nostro script invia al modello solo il testo, il numero di like e un flag che indica se si tratta di una risposta. Non invia mai nomi utente, avatar o località, e anche i report li nascondono. Così si risparmiano token e si inviano meno dati personali.
Terzo, la sicurezza delle chiavi. A ottobre, un post molto seguito su Reddit ha descritto una sandbox di benchmark che metteva una chiave API in una variabile d'ambiente. Il tester afferma che DeepSeek V4.1 Flash ha trovato quella chiave e l'ha usata in modo improprio (post originale). In seguito l'autore ha parlato di «uso improprio della chiave API, ma non esfiltrazione», e molti commenti attribuiscono la colpa al design della sandbox.
Comunque lo si chiami, la lezione vale per ogni modello: non lasciare che un modello legga una chiave che non deve usare. Crea una chiave API EveryInfra separata per questo lavoro e passala solo tramite una variabile d'ambiente. La regola per cui Claude Code legge come vuote le proprie variabili di credenziali negli header MCP segue lo stesso principio.
Quarto, i limiti delle piattaforme e dei dati. Abbiamo estratto solo commenti pubblici sotto video pubblici, con una richiesta per video e senza paginazione. Bilibili restituisce al massimo 10 commenti per video. La ricerca di Douyin restituisce solo la prima pagina. Senza un token di pagina, Douyin legge solo le prime 50 righe circa, risposte incluse. Gli orari di YouTube sono relativi.
Inoltre, i contenuti sulle piattaforme della Cina continentale sono soggetti a una regolamentazione attiva. Il 30 settembre 2026 la Cyberspace Administration of China ha avviato una campagna di due mesi contro le false identità nei video brevi. Il 2 settembre ha comunicato la seconda fase della campagna contro l'uso improprio delle app di AI. Promozioni e inviti a installare app nelle sezioni dei commenti cambieranno in base ai controlli delle piattaforme. Le nostre quote di rumore valgono solo per questi 15 video in quel giorno.
Quinto, cosa non abbiamo fatto. Non abbiamo eseguito la parte relativa a DeepSeek e Claude Code, quindi ogni affermazione sul comportamento di DeepSeek viene dalla sua documentazione. I conteggi dei token sono stime basate su un rapporto. Non abbiamo misurato l'accuratezza delle etichette, perché non abbiamo un set etichettato a mano. Il costo della sessione si basa su un esempio della documentazione di Claude Code, e le tue sessioni possono essere molto più lunghe o più brevi.
Cambiamenti recenti da conoscere (settembre-ottobre 2026)
- 17 ottobre 2026: viene rilasciato DeepSeek V4.1-Flash-1017 e viene aperta al pubblico l'API Search/Fetch (nota di rilascio). Cosa cambia per te: il modello dietro il nome
deepseek-flashè cambiato. Il vecchio nomedeepseek-v4-flashfunziona ancora ai prezzi di Flash. La ricerca web in Claude Code diventa a pagamento dal 1° novembre. - 7 ottobre 2026: arriva Claude Haiku 5.5 e le letture dalla cache di Sonnet 5.5 scendono a $0,10 (note di rilascio). Cosa cambia per te: la fascia a basso costo ora include un modello Claude, quindi aggiungi Haiku 5.5 a ogni confronto di prezzi. Se imposti manualmente
budget_tokens,temperaturee parametri simili, Haiku 5.5 restituisce un errore 400; aggiorna quindi il codice esistente. - 19-23 ottobre 2026: Claude Code dalla 2.1.304 alla 2.1.310 cambia comportamento dietro URL personalizzati (changelog, pacchetto npm). Cosa cambia per te: dietro un gateway la tool search è attiva per impostazione predefinita, con un nuovo tentativo automatico dopo un 400 o un 422. Ricontrolla la configurazione dopo ogni aggiornamento di Claude Code.
- 23 settembre-14 ottobre 2026: GIF nei commenti di YouTube e test di moderazione dei commenti con l'AI (YouTube Official Blog, articolo di 9to5Google). Cosa cambia per te: aspettati più commenti con una GIF e senza testo, quindi la tua regola «nessun contenuto» deve gestirli. Una moderazione più severa da parte della piattaforma significa anche meno spam nei commenti pubblici.
- 30 settembre 2026: la Cyberspace Administration of China avvia una campagna contro le false identità nei video brevi (avviso). Cosa cambia per te: le piattaforme rimuoveranno più promozioni, inviti a installare app e pubblicità con false identità dai commenti di Douyin e Bilibili. Le quote di rumore possono cambiare nel giro di settimane.
- 15 ottobre 2026: aggiornata la pagina commentThreads della YouTube Data API (documentazione). Cosa cambia per te: l'API ufficiale costa 1 unità di quota per chiamata e restituisce fino a 100 elementi per pagina. Mostra lo stato «likely spam» solo al proprietario del canale. Per i commenti pubblici su altri canali, segui le regole di quota della panoramica della YouTube Data API oppure usa un'API per i dati.
FAQ
Dopo aver configurato DeepSeek con Claude Code, Claude Code mi chiede ancora di accedere. Perché?
Un utente di Douyin ha chiesto «perché non riesco a saltare il login?». La documentazione sulla connessione ai gateway di Claude Code tratta il caso nella tabella di risoluzione dei problemi. In modalità interattiva, un blocco env nel file di progetto .claude/settings.json viene applicato solo dopo la procedura guidata del primo avvio e la richiesta di attendibilità. Per questo la CLI si avvia senza credenziali.
Imposta ANTHROPIC_AUTH_TOKEN nella shell o nelle impostazioni utente. Se imposti solo ANTHROPIC_BASE_URL senza credenziali, resta valido il tuo login su claude.ai. Fonti: commenti di Douyin estratti da noi (26 ott 2026); documentazione di Claude Code.
Cosa significa `The content[].thinking in the thinking mode must be passed back`?
Questo errore, esattamente così, compariva nei commenti di YouTube che abbiamo estratto. La documentazione sulla modalità di ragionamento di DeepSeek tratta le richieste che contengono tools: in queste, tutto il contenuto di ragionamento precedente va rimandato per intero, altrimenti l'API restituisce 400. Claude Code rimanda i blocchi di ragionamento così come sono.
Se un convertitore di terze parti intermedio li scarta, ottieni questo errore. Prova una volta con una connessione diretta all'endpoint Anthropic di DeepSeek. Se vedi Extra inputs are not permitted, il riferimento agli errori di Claude Code consiglia di aggiornare alla 2.1.304 o successiva, oppure di impostare CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1. Fonti: commenti di YouTube estratti da noi; documentazione di DeepSeek; documentazione di Claude Code.
Come risolvo `messages[1].role: unknown variant system`?
Anche questo viene dai commenti di YouTube che abbiamo estratto. Claude Code aggiunge messaggi di sistema a metà conversazione. La documentazione di DeepSeek sulle chiamate agli strumenti dice che la sua API Anthropic supporta i messaggi di sistema a metà conversazione, ma alcuni livelli intermedi no. Il changelog di Claude Code 2.1.310 (23 ottobre 2026) indica che ora Claude Code esegue un nuovo tentativo senza quei messaggi quando un server compatibile li rifiuta.
Di solito basta aggiornare alla 2.1.310 o successiva. DeepSeek pubblica anche una libreria per la codifica dei prompt, deepseek-recipe, e i suoi test includono messaggi di sistema a metà conversazione: il modello è quindi pensato per questo formato. Fonti: commenti di YouTube estratti da noi; changelog di Claude Code.
Perché non legge le immagini dopo che ho collegato DeepSeek?
Un utente di Douyin ha chiesto «cosa faccio se questo modello non legge le immagini?». Secondo la tabella dei prezzi di DeepSeek, deepseek-flash supporta le immagini e deepseek-v4-pro no. I nomi di modello che iniziano con claude-opus vengono mappati su deepseek-v4-pro. Se il tuo alias opus non punta a deepseek-flash, dopo il passaggio a Opus non può leggere immagini. Fonti: commenti di Douyin estratti da noi; pagine di DeepSeek su prezzi e compatibilità.
Haiku 5.5 non costa meno?
Un utente di YouTube ha chiesto proprio questo. Secondo i nostri calcoli, sì. Per la sessione di esempio, Haiku 5.5 costa $0,0184 e deepseek-flash in fascia di punta $0,0274.
Per etichettare 1.000 commenti di YouTube, il costo del modello è $0,0083 con Haiku 5.5 e $0,0224 con flash in fascia di punta. Flash costa meno solo fuori dalle ore di punta e con la maggior parte delle richieste in cache hit. Fonti: commenti di YouTube estratti da noi; pagine dei prezzi di Anthropic e DeepSeek (consultate il 26 ott 2026).
L'API Anthropic di DeepSeek può collegarsi direttamente ai server MCP?
«deepseek claude code mcp» è un suggerimento di ricerca frequente. Secondo la tabella di compatibilità di DeepSeek, mcp_servers nella richiesta viene ignorato e i blocchi mcp_tool_use e mcp_tool_result non sono supportati. Quindi DeepSeek non si collegherà ai server MCP al posto tuo.
In Claude Code non è un problema. Claude Code è il client MCP: invia tools/call in locale e passa al modello normali definizioni e risultati degli strumenti. Fonti: suggerimenti di ricerca di Google (26 ott 2026); note di compatibilità di DeepSeek.
L'API Search di DeepSeek può sostituire un'API per i commenti delle piattaforme?
Non del tutto. DeepSeek Search restituisce risultati di ricerca web e testo delle pagine, utili per fatti di carattere generale. Non copre i dati strutturati all'interno delle piattaforme, come i commenti sotto un video, il numero di like e i link alle risposte. Fonti: suggerimento di ricerca di Google «deepseek search api» (nostre note di ricerca, 26 ott 2026); guida alla ricerca di DeepSeek.
Letture correlate
- Configurazione MCP remota: una sola configurazione per i client più comuni
- Vendere report tematici dai commenti di YouTube: il registro dei costi per creator di medie dimensioni
- Come riconciliare i rimborsi per le richieste non riuscite
- Cosa manca ancora alla specifica MCP 2026 per la produzione
- Server MCP di EveryInfra, prezzi e l'API di scraping delle risposte ai commenti di Douyin
Riferimenti
- Nota di rilascio della nuova versione di DeepSeek V4.1 Flash (in cinese), DeepSeek, 2026-10-17, <https://api-docs.deepseek.com/zh-cn/news/news261017>
- «Integrate with Claude Code», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code>
- «Using the Anthropic API», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/anthropic_api>
- «Models & Pricing (USD)», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/quick_start/pricing>
- «Models & Pricing (CNY)», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/zh-cn/quick_start/pricing>
- «Search & Fetch», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/search>
- «Context Caching», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/kv_cache>
- «Token & Token Usage», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/quick_start/token_usage>
- «Rate Limit & Isolation», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/quick_start/rate_limit>
- «Thinking Mode», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/thinking_mode>
- «Tool Calls», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/tool_calls>
- «JSON Output», DeepSeek API Docs, consultato il 2026-10-26, <https://api-docs.deepseek.com/guides/json_mode>
- «DeepSeek-V4.1-Flash-1017 model card», Hugging Face, consultato il 2026-10-26, <https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017>
- «DeepSeek Harness Quickstart», DeepSeek, consultato il 2026-10-26, <https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart>
- «Environment variables», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/env-vars>
- «Connect Claude Code to tools via MCP», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/mcp>
- «Other LLM gateways», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/llm-gateway>
- «Gateway compatibility guide», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/llm-gateway-protocol>
- «Connect Claude Code to an LLM gateway», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/llm-gateway-connect>
- «Manage costs effectively», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/costs>
- «Model configuration», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/model-config>
- «Subagents», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/sub-agents>
- «Hooks», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/hooks>
- «Prompt caching», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/prompt-caching>
- «Changelog» (dalla 2.1.304 alla 2.1.310, 19-23 ott 2026), Claude Code Docs, <https://code.claude.com/docs/en/changelog>
- «Permissions», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/permissions>
- «Settings», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/settings>
- @anthropic-ai/claude-code, npm, read 2026-10-26 (latest 2.1.310), <https://www.npmjs.com/package/@anthropic-ai/claude-code>
- anthropics/claude-code, GitHub, consultato il 2026-10-26, <https://github.com/anthropics/claude-code>
- «Pricing», Claude Platform Docs, consultato il 2026-10-26, <https://platform.claude.com/docs/en/about-claude/pricing>
- «Release notes», Claude Platform Docs, consultato il 2026-10-26, <https://platform.claude.com/docs/en/release-notes/overview>
- «Prompt caching», Claude Platform Docs, consultato il 2026-10-26, <https://platform.claude.com/docs/en/build-with-claude/prompt-caching>
- «Tool use overview», Claude Platform Docs, consultato il 2026-10-26, <https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview>
- «Token counting», Claude Platform Docs, consultato il 2026-10-26, <https://platform.claude.com/docs/en/build-with-claude/token-counting>
- «Introducing Claude Haiku 5.5», Anthropic, 2026-10-07, <https://www.anthropic.com/claude-haiku-5-5>
- «Tools» (specifica MCP 2025-06-18), Model Context Protocol, <https://modelcontextprotocol.io/specification/2025-06-18/server/tools>
- «CommentThreads: list», YouTube Data API, aggiornato il 2026-10-15, <https://developers.google.com/youtube/v3/docs/commentThreads/list>
- «YouTube Data API Overview» (quota), Google for Developers, consultato il 2026-10-26, <https://developers.google.com/youtube/v3/getting-started>
- «Made On YouTube 2026: All Announcements», YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/innovation-youtube-era-made-on-viewers-creators/>
- «New tools to power your creation journey», YouTube Official Blog, 2026-09-23, <https://blog.youtube/news-and-events/made-on-youtube-new-tools-power-creation-journey/>
- «YouTube begins rolling out GIF support for comments», 9to5Google (fonte secondaria; originale alla voce 39), 2026-10-14, <https://9to5google.com/2026/10/14/youtube-begins-rolling-out-gif-support/>
- Campagna della CAC contro le false identità nei video brevi (in cinese), Cyberspace Administration of China, 2026-09-30, <https://www.cac.gov.cn/2026-09/30/c_1792520301987752.htm>
- Campagna della CAC contro l'uso improprio delle app di AI, seconda fase (in cinese), Cyberspace Administration of China, 2026-09-02, <https://www.cac.gov.cn/2026-09/02/c_1790099041364574.htm>
- Catalogo delle funzionalità di EveryInfra, EveryInfra, consultato il 2026-10-26 alle 17:23 SGT, <https://api.everyinfra.com/api/v1/social/catalog>
- EveryInfra OpenAPI, EveryInfra, consultato il 2026-10-26, <https://api.everyinfra.com/openapi.json>
- «PSA: DeepSeek V4.1 Flash habitually exfiltrates API keys», Reddit r/LocalLLaMA (post di un utente, fonte secondaria), ottobre 2026, <https://www.reddit.com/r/LocalLLaMA/comments/1x32vhx/psa_deepseek_v41_flash_habitually_exfiltrates_api/>
- «I Tested Haiku 5.5 vs Luna vs DeepSeek Flash vs Gemini 3.8 Flash», Reddit r/ClaudeAI (post di un utente, fonte secondaria), ottobre 2026, <https://www.reddit.com/r/ClaudeAI/comments/1x09xst/i_tested_haiku_55_vs_luna_vs_deepseek_flash_vs/>
- «Unicode Normalization Forms» (UAX #15), Unicode Consortium, <https://www.unicode.org/reports/tr15/>
- unicodedata, documentazione di Python, <https://docs.python.org/3/library/unicodedata.html>
- «RFC 8259: The JavaScript Object Notation (JSON) Data Interchange Format», IETF, <https://www.rfc-editor.org/rfc/rfc8259>
- «Claude Code on third-party platforms», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/third-party-integrations>
- «Gateways overview», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/gateways>
- «Errors», Claude Code Docs, consultato il 2026-10-26, <https://code.claude.com/docs/en/errors>
- deepseek-ai/deepseek-recipe, GitHub, consultato il 2026-10-26, <https://github.com/deepseek-ai/deepseek-recipe>
- «re — Regular expression operations», documentazione di Python, <https://docs.python.org/3/library/re.html>
Riferimenti BL-56