DeepSeek Search API и данные непосредственно из китайских соцсетей
DeepSeek Search API стоит $0.75 за 1 000 вызовов и не возвращает лайки и комментарии. Добавьте данные Xiaohongshu, Zhihu и Weibo: 8 реальных вызовов обходятся в $0.014.
17 октября 2026 года DeepSeek открыла всем пользователям API два новых эндпоинта: Search и Fetch. Каждый стоит $0.75 за 1 000 успешных запросов. Результат Search содержит заголовок, URL, два саммари, текст страницы, название сайта, дату и две оценки. Лайков, комментариев и сохранений в нём нет (руководство DeepSeek по Search и Fetch).
Мы запустили в EveryInfra xiaohongshu/search, zhihu/search и weibo/search по одной теме, «робот-пылесос», 3 ноября с 00:15 до 00:19 SGT. Во всех 98 записях были число лайков, число комментариев и время публикации. На Xiaohongshu 12 из 33 записей к тому же содержали признак платного контента бренда. Команде бренда, которая спрашивает «на что жалуются китайские покупатели», нужны именно эти поля, а в результатах веб-поиска их нет.
Стоимость определяет один явный фактор. Одна страница поиска Xiaohongshu стоит $0.005556, это в 7.4 раза дороже одного вызова DeepSeek Search. С лимитами вызовов из этой статьи стоимость данных на 1 000 вопросов снижается с $20.89 до $4.53.
Эта статья предназначена для команд за пределами Китая, которые продают на китайском рынке или конкурируют с китайскими брендами. Типичные примеры: европейский бренд бытовой техники, американский производитель роботов-пылесосов или агентство, которое отслеживает для клиента обсуждения среди китайских потребителей. Вам нужен небольшой ассистент, который отвечает на вопросы о продукте со ссылками на источники. У DeepSeek теперь есть собственный эндпоинт веб-поиска, так что с открытым вебом всё просто. В статье показано, что делает этот эндпоинт, чего он не возвращает и как добавить данные непосредственно из трёх китайских приложений. Кроме того, указана стоимость каждого вызова.
Все факты о DeepSeek в статье взяты с api-docs.deepseek.com по состоянию на 3 ноября 2026 г. У нас нет API-ключа DeepSeek, поэтому настройка на стороне DeepSeek — это пример конфигурации, а не тест. Все цифры EveryInfra взяты из необработанных ответов реальных вызовов.
Ранее мы опубликовали статью «DeepSeek V4 и Claude Code для очистки комментариев». В ней DeepSeek использовалась как модель в Claude Code, и мы измеряли стоимость очистки комментариев. Эндпоинтам Search и Fetch там был посвящён лишь один короткий раздел. Эта статья начинается с самого эндпоинта Search и разбирает, как распределить задачи между ним и источниками данных внутри платформ.
Что умеет API веб-поиска DeepSeek: по документации на 3 ноября
Прежде чем распределять работу, нужно чётко понимать возможности DeepSeek. Руководство по Search и Fetch называет оба эндпоинта «raw JSON APIs». Они используют тот же API-ключ, что и чат-модели, с заголовком Authorization: Bearer. Search принимает один запрос и возвращает структурированные результаты из собственной поисковой системы DeepSeek.
Fetch принимает один URL и возвращает содержимое страницы в формате Markdown. Ни один из эндпоинтов не обращается к модели, поэтому их использование не тарифицируется по токенам. Каждую строку таблицы ниже мы сверили со справочником Search API и справочником Fetch API.
| Пункт | Поисковый запрос | Fetch |
|---|---|---|
| Эндпоинт (хост api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| Поля запроса | query (от 1 до 128 символов, поддерживает site:, lang:, after:, before: и другие операторы), count (от 1 до 50, по умолчанию 10), ori_question, localization (IP-адрес), need_content | url (до 8 192 символов, http или https, без имени пользователя и пароля) |
| Реагирование | массив results; у каждого результата 10 полей: rerank_score, title, url, snippet, summary, content, site_name, site_icon, date, authority | title, content (Markdown) |
| Цена | $0.75 за 1 000 успешных запросов; count не влияет на цену | same |
| Плата не списывается | сбои, пустой массив results, тайм-ауты | сбои, отсутствие содержимого страницы, тайм-ауты |
| Лимит запросов | 100 запросов в секунду на аккаунт | 25 запросов в секунду на аккаунт плюс лимит на каждый целевой домен |
Для разработчиков важны три детали. Во-первых, summary содержит длинное саммари для модели, обычно от 600 до 800 символов. snippet содержит короткое описание для пользовательского интерфейса, от 100 до 200 символов. Десять результатов с полными саммари добавляют в контекст от 6 000 до 8 000 символов на каждый поиск.
Во-вторых, date — время публикации страницы в UTC; если оно неизвестно, значение равно null. authority — оценка от 0 до 4, где -1 означает «неизвестно». rerank_score — оценка релевантности от 0 до 3; хорошим результатом руководство считает 1,5 и выше.
В-третьих, Search передаёт query поисковому сервису как есть. Поэтому в запросе можно написать site:xiaohongshu.com. Но число результатов зависит от того, сколько страниц этого сайта есть в индексе DeepSeek. Кроме того, индекс хранит каждую страницу в том виде, в каком она была при обходе. Почему это важно для контента приложений, показано ниже в разделе «Время снимка и время вызова».
Ошибки руководство тоже описывает понятно. Формат совпадает с форматом ошибок OpenAI, а поле param всегда равно null. После паузы можно повторить запрос при ошибках 408, 429 и 5xx. Код 402 означает, что на балансе недостаточно средств.
При других ошибках 4xx не следует повторять запрос, не изменив его. EveryInfra работает похожим образом. Если передать недопустимое значение, EveryInfra возвращает ошибку 422, в которой указаны поле с ошибкой и допустимые значения. Реальный пример приведён в разделе «Один реальный цикл запроса и ответа».
Цены на DeepSeek Search API: что стало платным 1 ноября
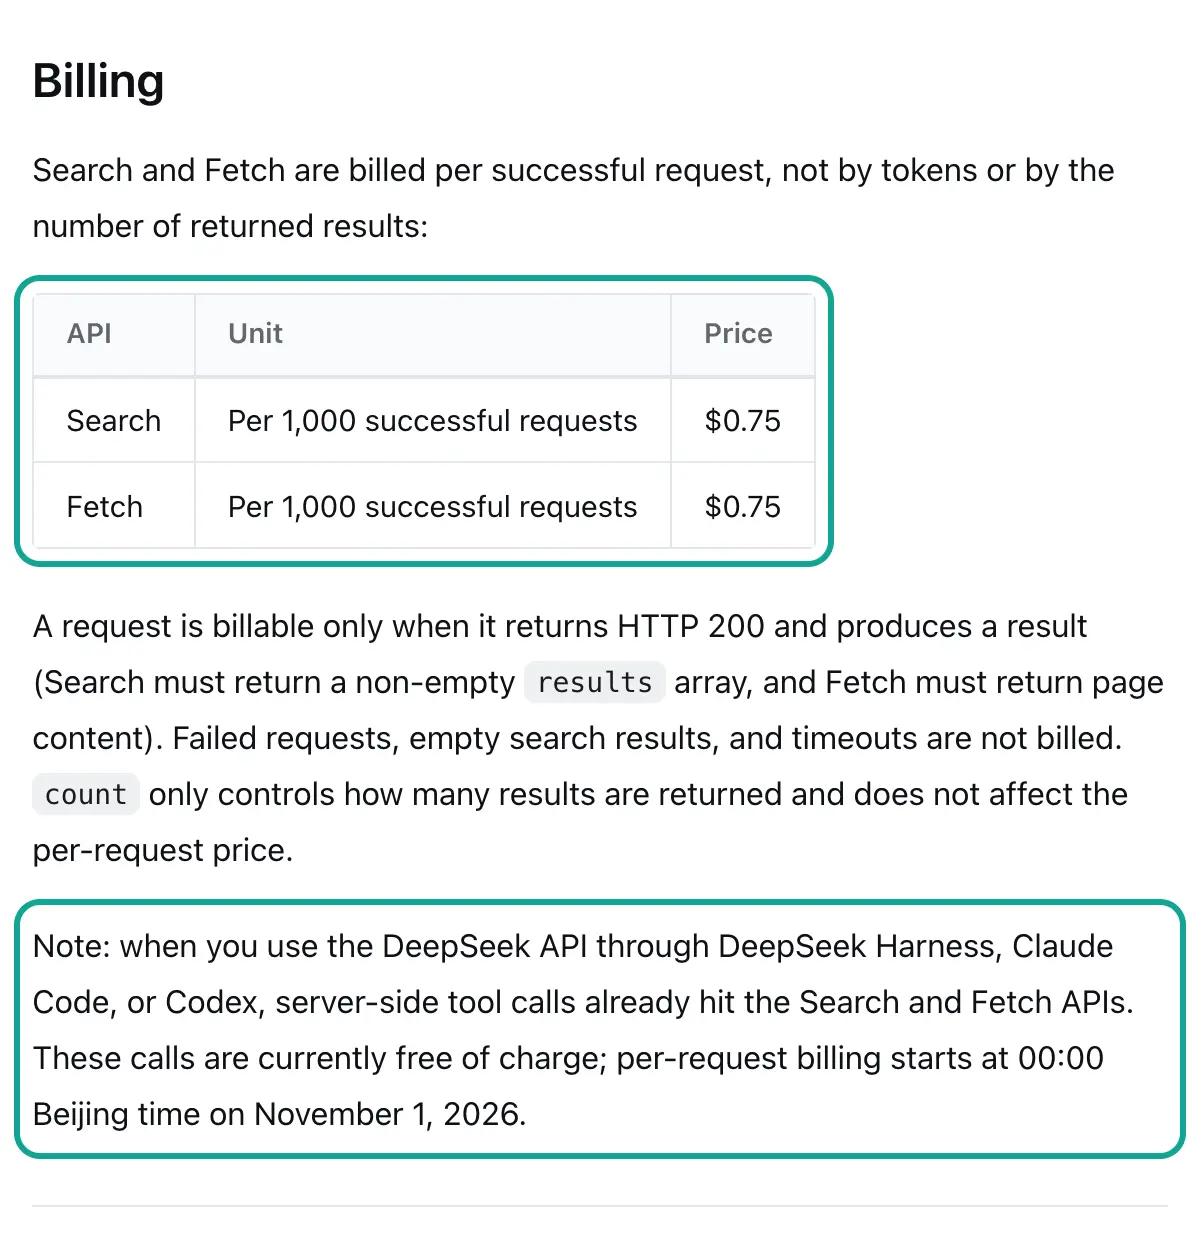
Сама цена устроена просто. На англоязычной странице тарифов Search и Fetch стоят $0.75 за 1 000 успешных запросов. На китайской странице за ту же единицу указано 5 юаней. count меняет только количество результатов, но не цену. Поэтому один запрос на 50 результатов стоит столько же, сколько один запрос на 10 результатов. В пересчёте на 1 000 результатов это $0.015 при count=50 и $0.075 при count=10.
Одно предложение в примечании к выпуску от 17 октября легко пропустить. Claude Code, Codex и DeepSeek Harness при работе с DeepSeek API уже вызывают Search и Fetch через серверные инструменты. Эти вызовы были бесплатными, а оплата за каждый запрос начинается в 16:00 UTC 31 октября 2026 г. Это 00:00 1 ноября и в Пекине, и в Сингапуре.
3 ноября страница тарифов и руководство всё ещё указывали рядом с этой датой формулировку «currently free of charge». Дата прошла, так что эти вызовы уже оплачиваются. Если ваша команда использует DeepSeek внутри Claude Code (руководство DeepSeek по Claude Code), каждый веб-поиск теперь добавляет к стоимости токенов $0.75 за 1 000.
Стоит посмотреть и на цены моделей, потому что результаты поиска попадают в модель. На той же странице тарифов deepseek-flash теперь указывает на DeepSeek-V4.1-Flash-1017. В пиковые часы входные токены при промахе кеша стоят $0,30 за миллион, выходные — $1,20. Вне пиковых часов цены вдвое ниже.
Пиковые часы: с 01:00 до 04:00 и с 06:00 до 10:00 UTC по будням. Для команды в Лондоне это раннее и позднее утро. Для команды в Нью-Йорке пиковые часы приходятся на ночь. Размер контекстного окна — 1 млн токенов, обе модели поддерживают вызовы инструментов и вывод в JSON.
| Пункт | Единица | USD (английская страница) | Подробнее |
|---|---|---|---|
| Search | за 1 000 успешных запросов | $0.75 | 2026-11-03 |
| Fetch | за 1 000 успешных запросов | $0.75 | 2026-11-03 |
| Вход deepseek-flash (промах кеша, пиковые часы) | за 1 млн токенов | $0.30 | 2026-11-03 |
| Выход deepseek-flash (пиковые часы) | за 1 млн токенов | $1.20 | 2026-11-03 |
EveryInfra zhihu/search | за 1 000 успешных запросов | $0.556 | 2026-11-03 |
EveryInfra weibo/search | за 1 000 успешных запросов | $0.806 | 2026-11-03 |
EveryInfra xiaohongshu/search | за 1 000 успешных запросов | $5.556 | 2026-11-03 |
Три цены EveryInfra взяты из поля price_usd бесплатного каталога. Правило то же, что у DeepSeek: сбои и пустые результаты бесплатны.
Веб-результаты DeepSeek Search API и данные внутри платформ: сравнительная таблица полей
Разницу лучше всего видно, если поставить поля рядом. У результата DeepSeek Search 10 полей. Они помогают найти страницу, дать модели выжимку и показать результат пользователю. Результаты поиска внутри приложения отвечают на другой вопрос: как пользователи этого приложения отреагировали на пост? В них тоже есть заголовок, текст, ссылка и время публикации.
Кроме того, в них есть лайки, комментарии, сохранения и репосты, а также признаки автора и контента. Левый столбец ниже составлен по документации DeepSeek. Остальные три столбца показывают поля, которые присутствовали в наших реальных ответах 3 ноября.
| Вопрос | DeepSeek Search (поля из документации) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| О чём пост? | title, summary, content | title, text (около 60 символов) | title, text | text |
| Где его открыть? | url | url (с токеном доступа) | url | url |
| Когда это было опубликовано? | date (может быть null) | posted_at, updated_at | posted_at | posted_at |
| Сколько человек поставили лайк или сохранили публикацию? | none | like_count, collect_count | like_count, collect_count | like_count |
| Насколько активно идёт обсуждение? | none | comment_count, share_count | comment_count | comment_count, repost_count |
| Кто автор? | site_name, authority | author_name, author_id | author_name, author_follower_count, текст значка | author_follower_count, author_verified, причина верификации |
| Это платный брендовый контент? | none | is_cooperation_note, is_goods_note | none | нет (используйте причину верификации) |
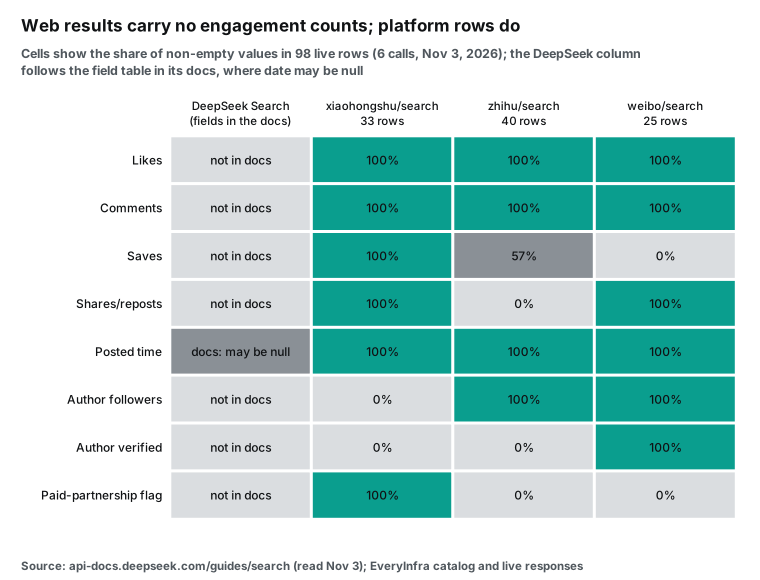
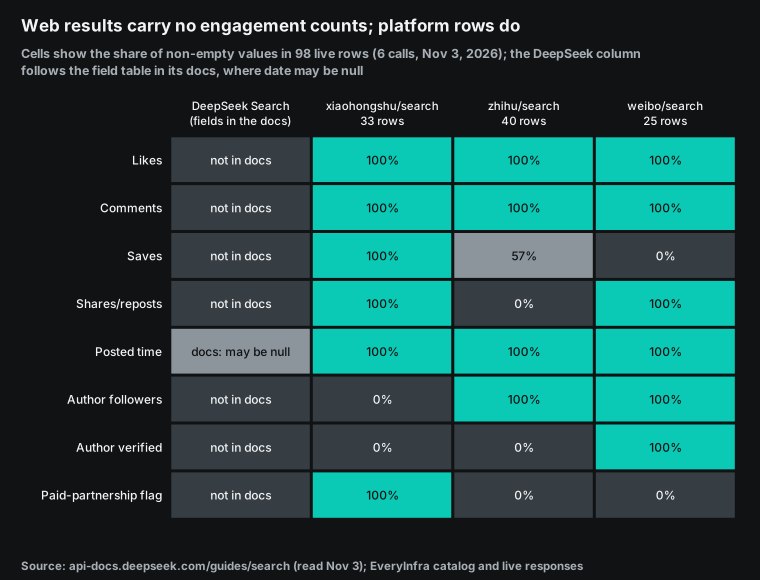
У этой диаграммы есть два ограничения. Во-первых, «нет в документации» не означает, что DeepSeek никогда не сможет увидеть эти числа. Поле content содержит текст страницы. Если в нём написано «12 000 лайков», модель может прочитать этот текст.
Но это текст со страницы, а не поле, по которому можно сортировать или значения которого можно суммировать. Кроме того, это значение зафиксировано на момент обхода. Во-вторых, показатель 0% в столбце приложения может объясняться двумя причинами. Некоторые поля отсутствуют в каталоге для соответствующей возможности, например поле отправок в поиске Zhihu.
Другие поля в каталоге есть, но в этот раз не вернулись. Каталог указывает author_is_verified для поиска Xiaohongshu, но ни в одной из наших 33 записей его не было. Поэтому пишите код по response_fields из каталога и допускайте отсутствие полей в любой записи.
Время снимка и время вызова: цифры одной заметки меняются
Есть и разница во времени. Веб-поиск возвращает страницы из своего индекса, то есть в том виде, в котором они были на момент обхода. В документации DeepSeek перечислено 10 полей результата. Одно из них — date, время публикации. Поля со временем обхода нет, поэтому узнать день снимка нельзя.
Поиск внутри приложения возвращает значения на момент вашего вызова. Лайки, комментарии и сохранения — это текущие счётчики. Xiaohongshu также возвращает updated_at. Каталог описывает его как время последней правки заметки.
Для товарных тем эта разница велика. Мы взяли 20 заметок с жалобами в Xiaohongshu, отсортированных по числу лайков. У 13 из них последнее редактирование было позже чем через 30 дней после публикации. У 5 из них прошло больше года. Одну заметку отредактировали через 1 154 дня после даты публикации.
| Интервал от публикации до последней правки | Заметки (из 20) |
|---|---|
| Меньше 30 дней | 7 |
| От 30 до 365 дней | 8 |
| Больше 365 дней | 5 |
Авторы часто возвращаются к заметкам. Они правят текст, добавляют продолжение или меняют название модели. Если веб-снимок сделан до правки, модель читает старую версию. У заметки о пылесборнике на скриншоте ниже было 992 лайка и 571 комментарий. На момент нашего вызова ей было всего около недели. Если её до сих пор лайкают и комментируют, более старый снимок покажет меньшие цифры.
Weibo ещё актуальнее. Все 25 постов в двух наших поисках были опубликованы за 4 дня до вызова. На вопрос вроде «не появилась ли на этой неделе новая проблема с сервисом» ответ находится именно в этих постах.
Поэтому работу можно разделить по времени. Используйте веб-поиск для контента, который меняется медленно: страниц с характеристиками на сайтах брендов, обзоров в СМИ, инструкций и пресс-релизов. Для таких страниц достаточно обхода раз в несколько недель. Поиск внутри приложений используйте для быстро меняющегося контента. Это жалобы за последнюю неделю, нарастающие проблемы с сервисным обслуживанием и заметки, счётчики которых ещё растут. Кроме того, поиск внутри приложения даёт сортировки, доступные только самому приложению: по новизне, по числу лайков и по числу комментариев.
Верно и обратное. Поиск внутри приложения не заменит веб-поиск. В нём нет сайтов брендов, страниц с характеристиками, обзоров в СМИ и форумов за пределами этих приложений. Для западного бренда веб-поиск также охватывает англоязычные и европейские источники, например обзор в немецком журнале. Эти два вида данных решают разные задачи и дополняют друг друга. Ни один из них не заменяет другой.
Критерии, которые мы записали до теста
Мы записали эти критерии до реальных вызовов, чтобы не менять их, увидев результаты. Они определяют, подтверждается ли каждый вывод ниже.
| Критерий | Критерий прохождения | Критерий не выполнен |
|---|---|---|
| Добавляют ли данные изнутри платформ поля, которых нет в веб-результатах? | лайки, комментарии и время публикации есть минимум в 90% записей во всех трёх приложениях | меньше 90% хотя бы в одном приложении |
| Отвечают ли все три приложения в пределах 85 секунд без перехода в асинхронную задачу? | все 6 вызовов возвращают 200 | тайм-аут или 503 |
| Может ли модель сама исправить неверное значение? | ошибка 422 указывает поле и перечисляет допустимые значения, при этом ничего не списывается | невнятная ошибка или списание |
| Можно ли контролировать стоимость данных Xiaohongshu? | один тариф снижает стоимость данных до уровня ниже $5 за 1 000 вопросов | единственный способ — задавать меньше вопросов |
| Можно ли вставлять записи прямо в ответ как «голос покупателя»? | фильтрация требуется максимум для 20% записей | больше 20% хотя бы в одном приложении (здесь мы ожидали провал) |
Забегая вперёд: первые четыре критерия выполнены. Пятый не выполнен ни для одного из трёх приложений, поэтому фильтрам посвящён отдельный раздел ниже.
Схема: один вопрос о продукте, два маршрута данных


В схеме четыре шага, и ключевой из них второй. Модель DeepSeek не выполняет никаких функций. Она возвращает tool_calls, то есть указания «вызови эту функцию с такими аргументами». Реальные вызовы DeepSeek Search и EveryInfra делает ваш код.
Руководство DeepSeek по вызовам инструментов говорит то же самое: функцию предоставляет пользователь, а модель её не выполняет. Плюс в том, что оба API-ключа остаются на вашем сервере и модель их никогда не видит. Минус в том, что цикл вы пишете сами. Полный пример конфигурации приведён в следующих разделах.
На первом шаге пользователь задаёт вопрос. На втором модель читает вопрос и описания четырёх функций. Она решает, что искать, и может отправить сразу четыре вызова: один веб-поиск и три поиска в приложениях. На третьем шаге ваш код вызывает оба эндпоинта. Он возвращает необработанный JSON или его сокращённую версию в сообщении role: tool с соответствующим tool_call_id.
На четвёртом шаге модель читает все результаты и пишет ответ. Системный промпт велит ей после каждого утверждения указывать URL источника, число лайков и дату публикации. Уточняющий вопрос, например «что говорят о бренде A по сравнению с брендом B», запускает новый раунд вызовов. Цикл завершается, когда модель не возвращает tool_calls.
В этой схеме у каждого маршрута данных своя задача. Веб-поиск находит сайты брендов, страницы с характеристиками, обзоры в СМИ и новости. Он отвечает на вопрос «что умеет эта модель и что говорит бренд?». Данные изнутри платформ показывают, что говорят реальные пользователи Xiaohongshu, Zhihu и Weibo. Они отвечают на вопрос «как покупатели оценивают продукт и какие проблемы всплывают снова и снова?». Когда в ответе есть оба вида источников, читатель видит заявления бренда и отзывы покупателей рядом. Там, где они расходятся, часто и находится самый полезный вывод.
Определения инструментов: четыре функции в полном JSON (пример конфигурации)
Ниже приведены четыре функции для модели DeepSeek. Для трёх функций приложений все названия параметров, значения enum и описания взяты из полей param_meanings и allowed_values каталога EveryInfra. Функция веб-поиска соответствует справочнику DeepSeek Search API. Мы используем режим strict. Руководство DeepSeek по вызовам инструментов указывает, что для режима strict нужен базовый URL бета-версии (api.deepseek.com/beta с префиксом https). Каждое свойство каждого объекта должно быть в required, а additionalProperties должно быть false.
Поэтому необязательный параметр нельзя просто опустить. Мы решаем это двумя способами. Для enum со значением по умолчанию мы включаем это значение в enum и даём модели его выбрать. Например, relevance для sort и any_time для date_range. Для строки без значения по умолчанию, например токена страницы, мы используем anyOf с null.
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword in Chinese, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]
Зачем указывать цену в описании? Потому что модель читает description. Напишите в функции Xiaohongshu «one page = USD 0.005556». Затем напишите в системном промпте «at most one Xiaohongshu page per question, try Zhihu and Weibo first».
Теперь при выборе функции модель учитывает информацию о стоимости. Это не жёсткое ограничение. Жёсткое ограничение должно быть задано в коде цикла, показанном в следующем разделе.
Для команды за пределами Китая важна ещё одна деталь. Ключевое слово для трёх функций приложений должно быть на китайском, потому что посты написаны на китайском. Это сказано в описании. Модель вроде deepseek-flash хорошо составляет китайские ключевые слова по английскому вопросу, так что пользователи могут спрашивать на английском. Мы сверили приведённые выше значения enum с версией каталога от 3 ноября с помощью скрипта.
| Параметр функции | `allowed_values` в каталоге | Enum в определении инструмента | Совпадает |
|---|---|---|---|
xiaohongshu_search.sort | 5: relevance, newest, most_liked, most_commented, most_collected | те же 5 | yes |
xiaohongshu_search.date_range | 6: от any_time до last_1_year | те же 6 | yes |
xiaohongshu_search.content_type | 3: all, image, video | те же 3 | yes |
zhihu_search.content_type | 4: all, answer, article, video | те же 4 | yes |
zhihu_search.sort | 3: general, upvote_count_descending, time_descending | те же 3 | yes |
web_search.count | Документация DeepSeek: от 1 до 50 | минимум 1, максимум 50 | yes |
Почему эта таблица важна? На неверное значение enum EveryInfra возвращает 422, и ничего не списывается. Но модели нужен ещё один раунд, чтобы исправить ошибку. Если указать в определении корректные значения enum, вы сэкономите один цикл обмена с моделью и токены, которые он потребовал бы.
Каталог доступен для бесплатного просмотра в любое время — например, можно открыть запись каталога для Xiaohongshu. Когда возможность меняется, определения можно сгенерировать заново. Поля также описаны на странице возможности поиска Xiaohongshu.
Параметры и поля двух других приложений перечислены в записи каталога для Zhihu и записи каталога для Weibo. У поиска Weibo всего один параметр, keyword, поэтому его функция самая короткая. Модель почти никогда в ней не ошибается.
Код цикла: обработка tool_calls DeepSeek на Python (пример конфигурации)
Приведённый ниже код на Python использует Python SDK OpenAI из пакета openai на PyPI. Чат-API DeepSeek использует формат OpenAI, а руководство OpenAI по вызову функций описывает ту же структуру инструментов. Оба эндпоинта данных вызываются через requests с тайм-аутом 90 секунд, потому что у EveryInfra на синхронный вызов отводится 85 секунд. Перед возвратом результатов модели мы оставляем 12 полей. ensure_ascii=False сохраняет китайские иероглифы как есть (документация Python по json). Экранирование символов увеличило бы расход токенов в несколько раз.
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # at most 1 Xiaohongshu page per question

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # a 422 has param, allowed, did_you_mean: give it to the model
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "Answer in English. After each claim, give the source url, like count and post date. "
                                          "Search Zhihu and Weibo first; use Xiaohongshu only when needed. Keywords for the apps in Chinese."},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # keeps reasoning_content; required when tools are present
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
            msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})
Два момента следуют из документации DeepSeek. Во-первых, режим рассуждений включён по умолчанию. Руководство по режиму рассуждений говорит, что запрос с tools должен передавать обратно reasoning_content всех предыдущих ходов. Иначе API возвращает 400.
Это обеспечивает строка msgs.append(m). Во-вторых, режим strict работает только с базовым URL бета-версии. При использовании обычного URL поле strict ни на что не влияет, и модель иногда может пропустить аргумент. Тогда EveryInfra возвращает 422, и модель добавляет аргумент в следующем раунде.
Проверка бюджета находится в цикле, а не в промпте. Промпт может лишь попросить модель экономить. Код же позволяет гарантировать, что расходы на один вопрос не превысят заданную сумму. Для команды бренда, которая задаёт сотни вопросов в день, эта разница отражается в ежемесячном счёте.
Один реальный цикл: что отправляет модель и что приходит в ответ
Мы не запускали часть с моделью, потому что у нас нет ключа DeepSeek. Возьмём вопрос «Покупаю робот-пылесос на 11.11: на что покупатели жалуются чаще всего?». С учётом определений инструментов модель могла бы отправить вызов Xiaohongshu с китайским ключевым словом для запроса «жалобы на работу роботов-пылесосов». Остальные аргументы: sort со значением most_liked, date_range со значением any_time, content_type со значением all и page_token со значением null. Цикл исключает параметр со значением null и отправляет в EveryInfra приведённый ниже запрос. Это реальный вызов.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'
Запрос в 00:17:22 SGT 3 ноября 2026 г. вернул 200 и 20 записей. Тело ответа занимало 36 627 байт, а billing.charged_usd было равно 0.005556. В ту же минуту мы намеренно повторили вызов с sort со значением hot. Он вернул 422 с code со значением invalid_value и did_you_mean со значением most_liked.
Поле allowed перечисляло 5 допустимых значений. Первый пункт next_steps гласил: «Change only sort to a value in allowed, then resend. Nothing was charged.» Модель, получив такое сообщение role: tool, в следующем раунде меняет только sort. Вмешательство человека не требуется.
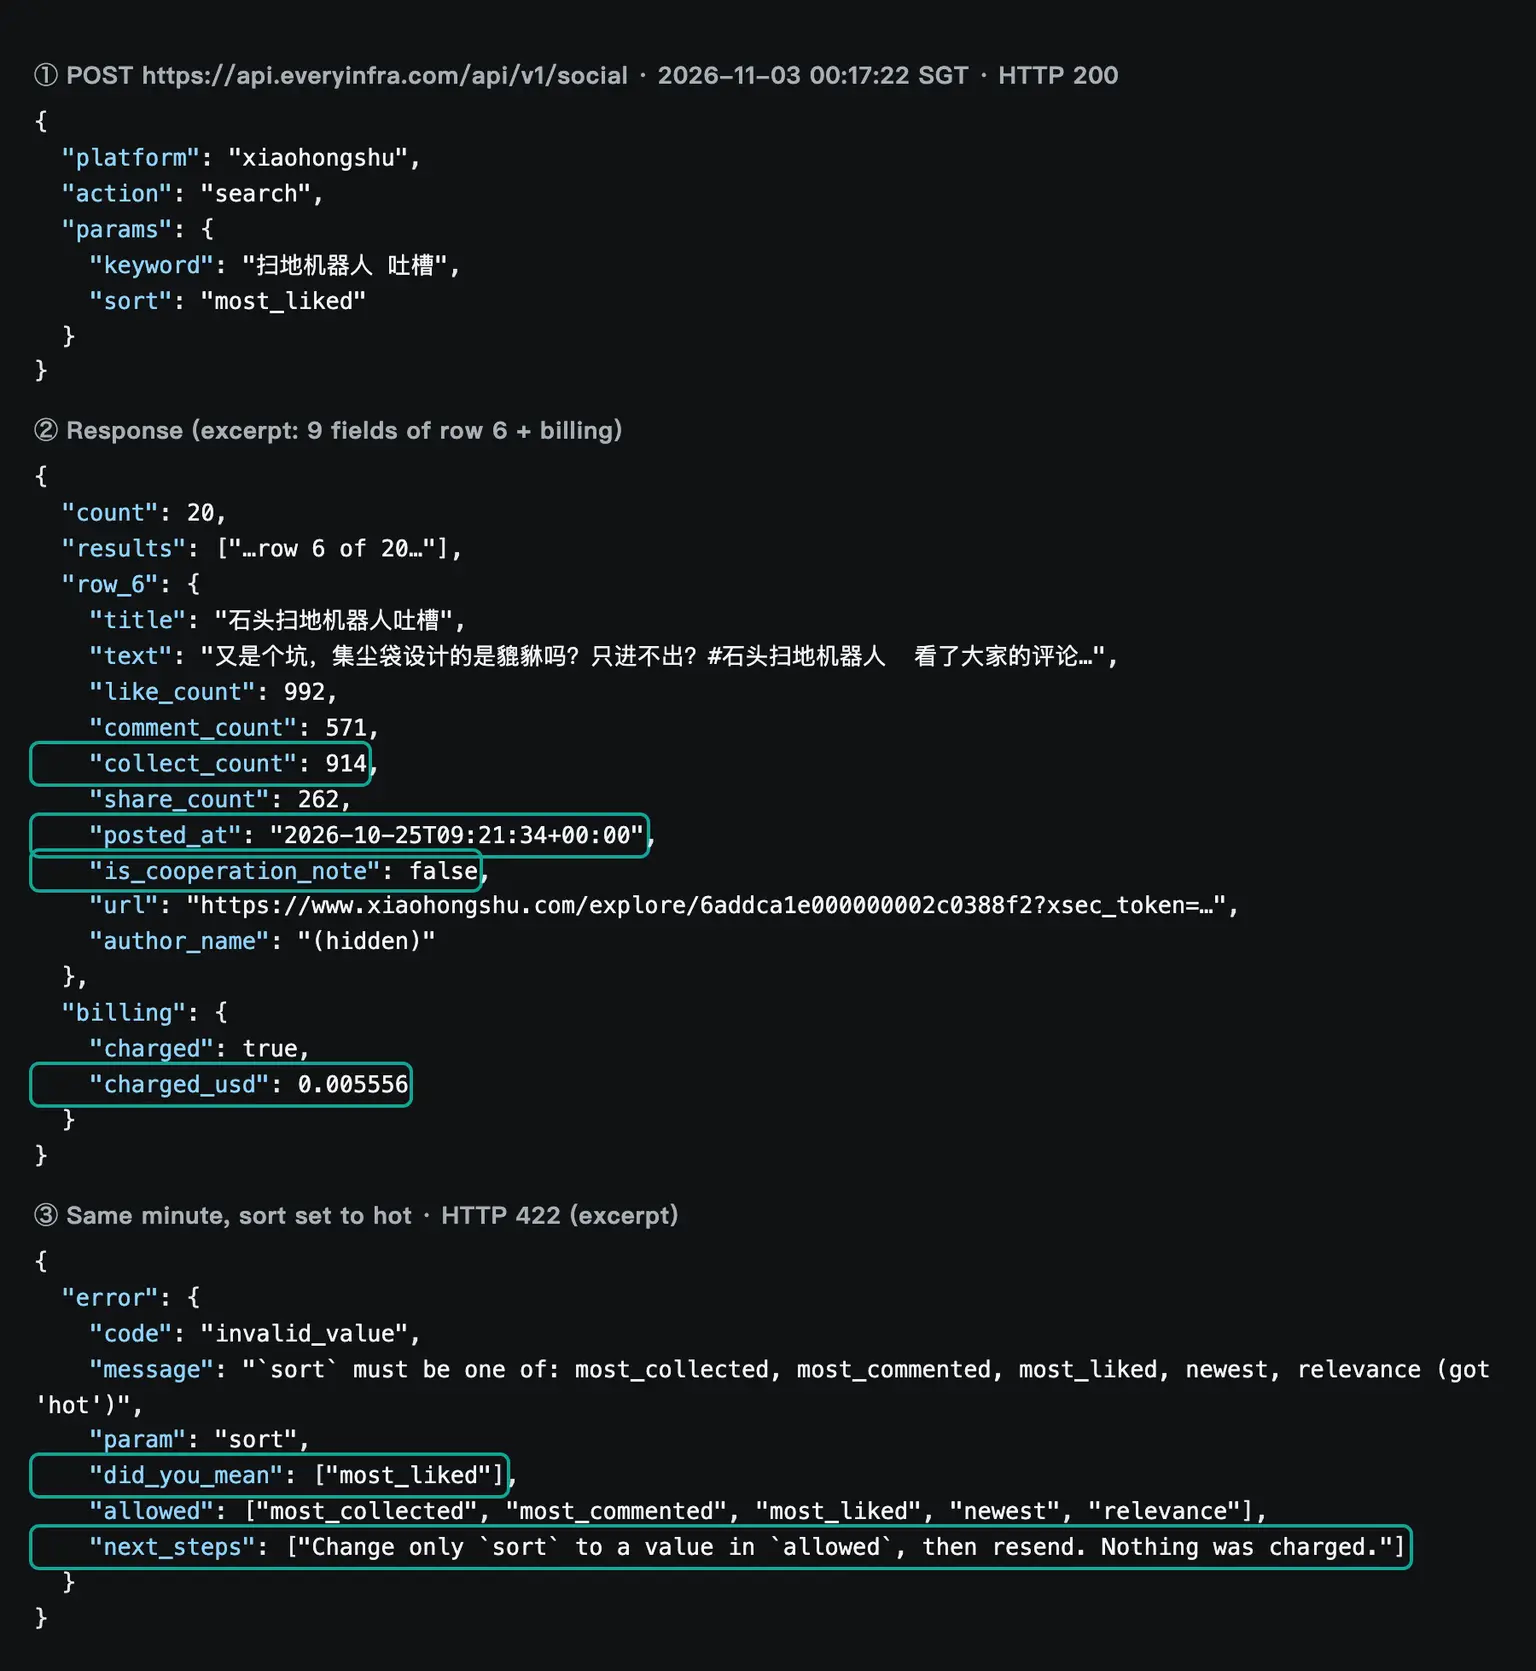
Запись 6 на скриншоте — заметка от 25 октября. Судя по заголовку, это жалоба на один бренд роботов-пылесосов. В тексте конструкцию мешка для пыли описывают словами «только принимает и ничего не отдаёт», что указывает на стоимость сменных мешков. У заметки 992 лайка, 571 комментарий и 914 сохранений.
Комментариев больше половины от числа лайков, значит, заметка вызвала настоящее обсуждение. Именно такой сигнал нужен для вопроса о главных жалобах. В результате веб-поиска модель увидит у этой заметки в лучшем случае заголовок и выжимку.
Чтобы узнать, о чём спорят в комментариях, можно вызвать xiaohongshu/note с url этой записи и получить полный текст. Можно также запросить комментарии. Каждый такой вызов тоже стоит $0,005556, так что действует та же логика бюджета.
Тест 1: что вернуло каждое приложение
С 00:15 до 00:19 SGT мы сделали 8 вызовов по теме «робот-пылесос». Шесть вызовов — по два на приложение. Ещё один понадобился для сравнения с Reddit ниже, а в одном мы намеренно указали неверное значение. Все вызовы отработали синхронно, асинхронные задачи не понадобились.
| SGT | Возможность | Параметры | Записи | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | советы по выбору робота-пылесоса, только ответы | 20 | $0.000556 |
| 00:16:17 | weibo/search | робот-пылесос | 13 | $0.000806 |
| 00:16:32 | xiaohongshu/search | робот-пылесос, больше всего комментариев, последние 30 дней | 13 | $0.005556 |
| 00:17:22 | xiaohongshu/search | sort со значением hot | 422 | $0 |
| 00:17:22 | xiaohongshu/search | жалобы на роботы-пылесосы, больше всего лайков | 20 | $0.005556 |
| 00:18:26 | zhihu/search | недостатки роботов-пылесосов, больше всего голосов «за» | 20 | $0.000556 |
| 00:18:31 | weibo/search | послепродажное обслуживание роботов-пылесосов | 12 | $0.000806 |
| 00:18:53 | reddit/search | робот-пылесос, сортировка top | 5 | $0.000556 |
| Итого | 103 записи | $0.014392 |
Три китайских приложения выдали очень разный контент. Поиск жалоб на Xiaohongshu с сортировкой по лайкам вернул 20 заметок. Большинство заголовков — о реальном использовании и о том, чего стоит избегать. В них рассказывается о конструкции мешка для пыли, о роботе, который упал в яму, когда не сработала запретная зона, о проблемах с распознаванием питомцев и о приборе, который называют «налогом на наивных». Восемь из 20 заметок помечены как платный контент: это обзоры брендов и гайды по выбору.
Одна запись особенно важна для западных брендов. Заголовок заметки от 16 декабря 2025 года призывает не покупать робот-пылесос Dyson. У неё 1 444 лайка и 53 комментария. В тексте говорится, что сам продукт неплох, но не оправдывает свою цену. Западный бренд, который продаёт в Китае, может найти такую заметку только внутри приложения.
В таблице ниже пять записей из этого поиска с нашим кратким пересказом каждого заголовка на русском. Они показывают, что дают поля вовлечённости: сразу видно, какая жалоба вызвала больше всего обсуждений.
| Опубликован | Заголовок (краткий пересказ) | Лайки | Комментарии | Метка платного контента |
|---|---|---|---|---|
| 2026-10-16 | Робот «для владельцев питомцев» всё-таки устроил то, чего боялись | 3,710 | 183 | false |
| 2023-09-17 | Месяц робот игнорировал запретную зону, а потом упал в яму | 3,445 | 1,937 | false |
| 2025-12-16 | Не покупайте робот-пылесос Dyson | 1,444 | 53 | false |
| 2026-10-25 | Жалоба на конструкцию пылесборника одного бренда | 992 | 571 | false |
| 2026-07-06 | Техника, которая стала налогом на наивность | 553 | 973 | false |
Поиск рекомендаций на Zhihu вернул 20 ответов, в основном гайды по выбору и подборки моделей. Поиски на Weibo вернули 25 постов, все были опубликованы в течение недели перед 2 ноября. Они оказались самыми разнородными. Одни пользователи просили совета. Один написал, что пылесос сломался через два года, а у бренда нет запчастей. Были и рекламные посты брендов, и посты с подборками товаров.
У каждого типа контента своя польза. Для конкретных дефектов, на которые жалуются снова и снова, точнее всего Xiaohongshu с сортировкой по лайкам или комментариям. Для экспертного разбора, что купить, больше всего информации дают развёрнутые ответы на Zhihu. Для новых проблем с послепродажным обслуживанием за эту неделю актуальнее всего Weibo. Ассистенту, который использует только веб-поиск, будет трудно охватить все три точки зрения. Он также не получит счётчики вовлечённости, которые показывают, насколько типичен пост.
Вызов Reddit даёт полезный контраст для англоязычной команды. Топ-5 результатов по запросу «robot vacuum» опубликованы с 7 по 22 октября. Они пришли из юмористических и оффтоп-сообществ. В первую тройку вошли видеопост в r/TikTokCringe с 6 551 лайком и «гараж для робота-пылесоса» в r/homeassistant с 3 076 лайками. Третьим стал робот-пылесос в костюме мультяшного персонажа в r/futurama с 2 998 лайками. Ни один из них не был жалобой покупателя.
| Опубликован | Сообщество | Заголовок | Лайки | Комментарии |
|---|---|---|---|---|
| 2026-10-20 | r/TikTokCringe | Японский робот-пылесос последнего поколения | 6,551 | 107 |
| 2026-10-16 | r/homeassistant | Гараж для робота-пылесоса | 3,076 | 176 |
| 2026-10-14 | r/futurama | Мой робот-пылесос в образе уборщика Скраффи и его ведра | 2,998 | 76 |
| 2026-10-07 | r/Perfectfit | Как мой робот-пылесос идеально помещается под тумбу для телевизора | 1,773 | 16 |
| 2026-10-22 | r/BORUpdates | AITAH, раз я отказался делиться с родственником супруга? (не по теме) | 1,102 | 222 |
Так что «топ» в любом приложении показывает популярное, а не полезное. Выбор сортировки и ключевых слов важен и в западных приложениях. Доступные варианты перечислены на странице возможности поиска по Reddit.
Тест 2: при сортировке по голосам свежих записей Zhihu — 0 из 20
Чаще всего вопросы о товарах спотыкаются о «новизну». Роботы-пылесосы обновляются несколько раз в год, и гайд по выбору двухлетней давности может уже не работать. По posted_at мы посчитали для каждого вызова записи за последние 30 дней, то есть после 4 октября 2026 года. Результаты шести поисков в приложениях сильно различались.
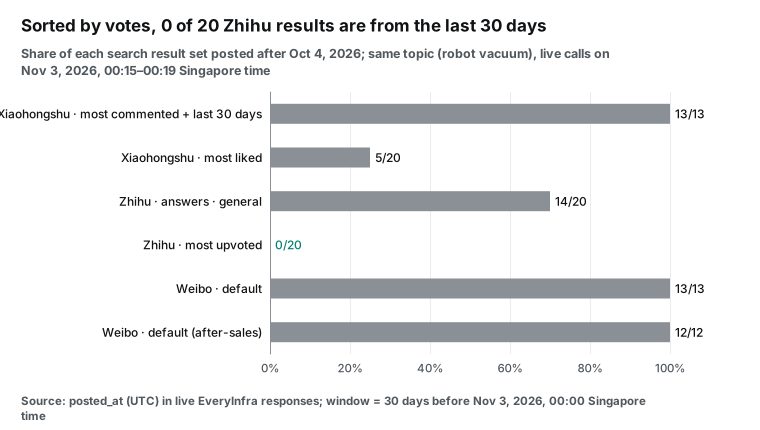
Крайний случай — поиск на Zhihu с сортировкой по числу голосов. Из 20 записей 18 опубликованы до 2026 года, самая старая — в 2015-м. Заголовки ещё показательнее: в 9 из 20 упоминается 2026 год.
Восемь из этих девяти опубликованы до 2026 года. Самый старый ответ опубликован 12 апреля 2018 года, но его заголовок обещает гайд по выбору на 2026 год. Это «вечнозелёные» ответы: авторы каждый год обновляют текст и год. Текст может быть свежим, но читатель или модель, которые смотрят только на заголовок, решат, что ответ написан в этом году.
Поймает ли такой случай поле date у веб-результата? Зависит от того, какую дату показывала страница в момент обхода. В документации DeepSeek сказано лишь, что date равно null, если дата неизвестна. Данные изнутри платформы дают время публикации, которое записывает само приложение. Его можно сразу сравнить с заголовком.
Решение простое. Для вопросов о свежих данных используйте на Xiaohongshu date_range=last_30_days с sort=most_commented, а на Zhihu — sort=time_descending. Weibo по умолчанию возвращает свежие посты. Для вопросов о «долгосрочной репутации» сортируйте по лайкам и просите модель указывать год публикации каждого источника.
Есть и нюанс со стоимостью. Вызов Xiaohongshu с last_30_days вернул всего 13 записей. В каталоге сказано, что с этим фильтром на странице может оказаться меньше 20 записей, а страница с результатами оплачивается как одна страница. Поэтому цена за 1 000 результатов для этого вызова составила $0.427, что на 54% больше, чем $0.278 за полную страницу.
Тест 3: какие записи отфильтровать в первую очередь
Мы ожидали, что результаты не пройдут проверку по пятому критерию, и так и вышло. В каждом приложении есть тип записей, которые искажают картину «голоса покупателя», если использовать их как есть.
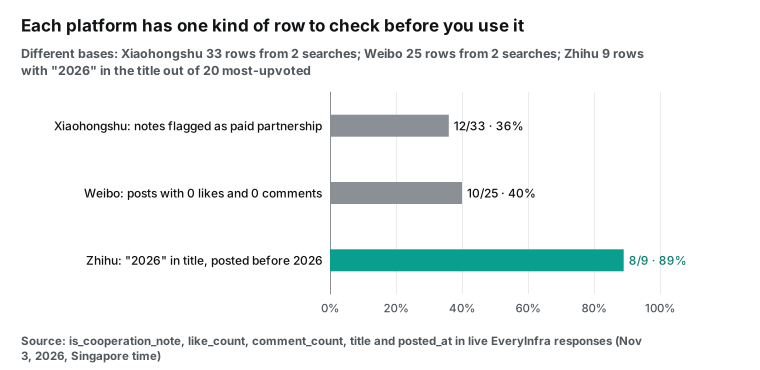
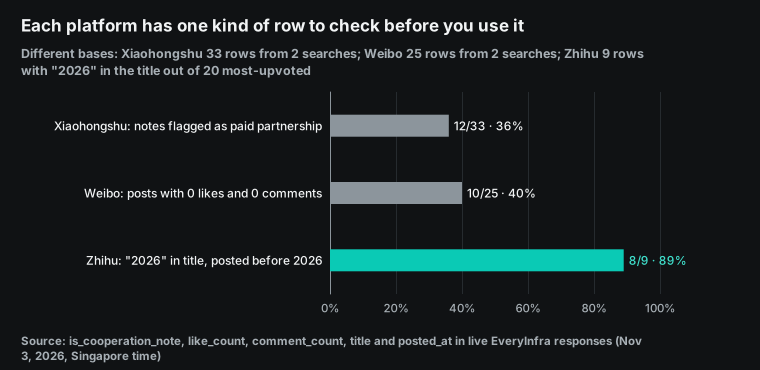
На Xiaohongshu самое прямое поле — is_cooperation_note. Оно было true у 12 из 33 записей. В вызове по числу комментариев за последние 30 дней — у 4 из 13. В вызове по жалобам с сортировкой по лайкам — у 8 из 20. Платная заметка не обязательно содержит недостоверную информацию.
Но в ответе на вопрос «на что жалуются покупатели» такая заметка передаёт сообщение, которое бренд хочет вам показать. Поэтому выделяйте такие записи в отдельную группу или помечайте их в ответе. Это поле есть только в данных изнутри платформы. У веб-результатов аналогичного поля нет.
В поиске Xiaohongshu по числу комментариев за последние 30 дней нашёлся и второй тип шума. Верхние записи — мем о потерявшемся роботе с 14 963 лайками, фитнес-видео и клип из хоррор-игры. Это популярные посты с хештегом, а не отзывы покупателей. Поэтому, если вам нужны проблемы покупателей, используйте ключевое слово, обозначающее проблему, например «жалобы» или «минусы».
На Weibo проблема — шум. У 10 из 25 записей не было ни лайков, ни комментариев. Девять из них опубликованы верифицированными аккаунтами, 8 — аккаунтами со 100 000 подписчиков и больше. Среди них были рекламные посты брендов и посты с подборками товаров.
У одного анонса брендового прямого эфира было 2 435 лайков и 421 комментарий. У таких постов высокая вовлечённость, но это не жалобы покупателей. Их можно отличить по author_verified_reason и ссылкам на товары в тексте.
Полезные посты часто публикуют пользователи с десятками или сотнями подписчиков. В них названы бренд и дефект. В посте от 2 ноября говорится, что робот-пылесос, купленный в марте 2024 года, сломался примерно через два года. Сервисная служба сообщила владельцу, что модель снята с производства и запчастей нет, и предложила только сдать пылесос по программе trade-in за 200 юаней.
У этого поста 0 лайков и 1 комментарий. И всё же это реальный сигнал о проблемах с сервисом. Поэтому фильтр не может просто отбрасывать записи с низкой вовлечённостью.
После фильтрации отсортируйте записи. Во всех трёх приложениях основная часть вовлечённости приходится на несколько записей.
Вызов Xiaohongshu по самым комментируемым заметкам за последние 30 дней вернул 13 заметок, у которых в сумме 124 557 лайков, и на первые 3 пришлось 49%. Вызов по жалобам вернул 20 заметок с 23 938 лайками, на первые 3 пришлось 48%. Вызов Zhihu по рекомендациям вернул 20 ответов, у которых всего 1 151 голос «за». На первые 3 пришлось 75%, а медиана составила 11. Вызов Weibo по постпродажному обслуживанию вернул 12 постов с 2 290 лайками. На один пост пришлось 2 288 из них, а у остальных 11 постов было всего 2.
| Вызов | Записи | Всего лайков или голосов | Доля топ-3 записей |
|---|---|---|---|
xiaohongshu/search, больше всего комментариев, последние 30 дней | 13 | 124,557 | 49% |
xiaohongshu/search, жалобы, больше всего лайков | 20 | 23,938 | 48% |
zhihu/search, рекомендации, только ответы | 20 | 1,151 | 75% |
weibo/search, послепродажное обслуживание | 12 | 2,290 | 100% |
Если отправить модели 20 записей в том порядке, в каком их вернуло приложение, «мнение большинства» может сложиться из двух-трёх популярных записей. Лучше отсортировать записи по вовлечённости в коде цикла и удалить дубликаты по author_id. Затем передавайте счётчики вместе с каждой записью. Тогда модель сможет сказать читателю: «у этой заметки 992 лайка» или «у этого поста 0 лайков, но в нём конкретные факты».
Python справится с этим без дополнительных библиотек. Сортируйте через sorted() с функцией key по like_count (руководство по сортировке в Python). Уже использованных авторов храните в множестве. Этот шаг не требует дополнительных вызовов.
Как выглядит ответ: образец формата на основе реальных записей
Мы не запускали модель, поэтому ответа, написанного DeepSeek, у нас нет. Но формат всё равно можно показать. Мы вручную написали начало ответа по реальным записям выше. Это образец формата, а не вывод модели. Все числа соответствуют исходным ответам. Ссылки содержат токены доступа, поэтому вместо них мы пишем «ссылка скрыта».
Первая группа жалоб касается пылесборника и запчастей. В заметке на Xiaohongshu от 25 октября говорится, что пылесборник одного бренда «только всасывает и ничего не выпускает»; у неё 992 лайка, 571 комментарий и 914 сохранений (ссылка скрыта; не является платным контентом). Вторая группа касается послепродажного обслуживания. 2 ноября пользователь Weibo со 124 подписчиками написал, что пылесос, купленный в марте 2024 года, сломался через два года. Бренд ответил, что модель снята с производства, и предложил только сдать пылесос по программе trade-in за 200 юаней (ссылка скрыта; 0 лайков, 1 комментарий). На Zhihu большинство гайдов по выбору с наибольшим числом голосов опубликованы в 2018–2022 годах, хотя в заголовках указан 2026 год. Прежде чем на них полагаться, проверьте год публикации.
У каждого утверждения в образце указаны приложение, дата, счётчики вовлечённости и метка платного контента. Такой формат можно запросить у модели в системном промпте.
Пока мы готовили этот пример, мы заметили ещё одну деталь. Двум авторам принадлежат по 3 из 20 записей Zhihu. 3 ответа первого автора начинаются почти одинаково, у каждого 0 голосов «за», и все ведут на одну и ту же статью. Второй автор написал 3 ответа за два дня, и все три рекомендуют модели одного бренда. Если считать эти 20 записей независимыми мнениями, вы переоцените этот бренд.
Поэтому удаляйте дубликаты по author_id до того, как записи вернутся к модели. Для каждого автора оставляйте только запись с наибольшей вовлечённостью. Это поле возвращают все три приложения. Код занимает несколько строк и надёжнее промпта с просьбой к модели «следить за повторяющимися авторами».
Тест 4: сколько токенов можно сэкономить до передачи модели
Самый дешёвый шаг в этом процессе — удалить лишние поля до того, как результаты вернутся к модели. Мы оценили число токенов для трёх поисков в двух вариантах: необработанный ответ и только 13 нужных полей. Мы использовали коэффициенты из руководства DeepSeek по токенам: около 0,3 токена на английский символ и 0,6 токена на китайский. Это оценки. Точное число указано в поле usage каждого ответа.
| Поисковый запрос | Символов в исходном виде | Токенов в исходном виде (оценка) | Символов с 13 полями | Токенов после (оценка) |
|---|---|---|---|---|
xiaohongshu/search жалобы, больше всего лайков | 33,905 | 10,549 | 7,302 | 2,542 |
zhihu/search минусы, больше всего голосов | 15,459 | 5,696 | 7,356 | 3,162 |
weibo/search послепродажное обслуживание | 10,786 | 3,624 | 3,873 | 1,458 |
| Итого | 60,150 | 19,869 | 18,531 | 7,162 |
Сокращённая форма меньше на 64%. Больше всего экономия на Xiaohongshu: в его сырых записях есть списки изображений, аватары, ссылки на видео, ширина и высота. Для ответа всё это бесполезно. По пиковой цене входных токенов deepseek-flash в $0.30 за миллион токенов 19 869 токенов стоят $0.0060, а 7 162 токена стоят $0.0021. Для одного вызова разница невелика.
Но в цикле вызовов инструментов предыдущие результаты отправляются заново с каждым новым запросом. Чем больше раундов, тем больше разница. У DeepSeek есть контекстный кеш: по англоязычной странице тарифов входные токены, попавшие в кеш, стоят $0.006 за миллион в пиковое время. Поэтому реальная стоимость повторно отправляемой части намного ниже, но только при попадании в кеш.
Согласно руководству DeepSeek по контекстному кешированию, запрос попадает в кеш, только если его префикс полностью совпадает с сохранённой единицей префикса. Chat API не хранит состояние, поэтому в каждом раунде нужно заново отправлять все предыдущие сообщения (руководство по многораундовому диалогу). Отсюда два правила для кода цикла.
Во-первых, не редактируйте и не переставляйте результаты инструментов в последующих раундах, а системный промпт и определения инструментов держите в начале без изменений. Во-вторых, удаляйте поля, сортируйте и убирайте дубликаты до первой отправки результатов. Тогда со второго раунда предыдущая часть тарифицируется по цене кеша, а по цене промаха — только новый раунд.
И всё же меньший контекст помогает модели сосредоточиться, на что указывает исследование из раздела «Последние изменения».
Стоимость: DeepSeek Search API по $0.75 за 1 000, Xiaohongshu по $0.005556 за вызов
Если сравнить цены, картина ясна. Веб-поиск дешёвый. Zhihu и Weibo стоят примерно как веб-поиск. Xiaohongshu — примерно в десять раз дороже.
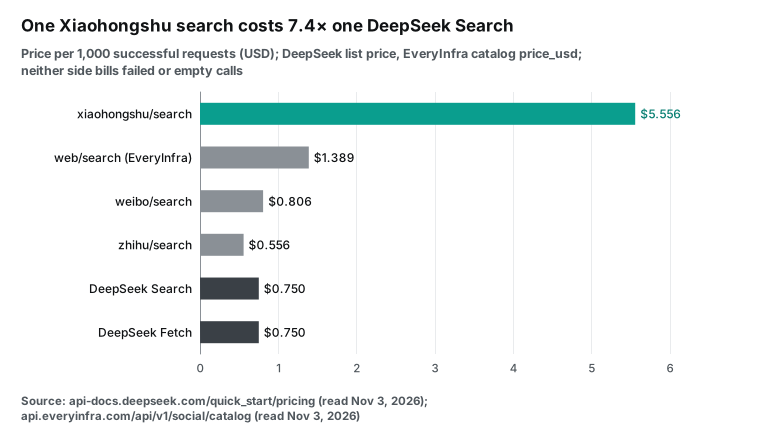
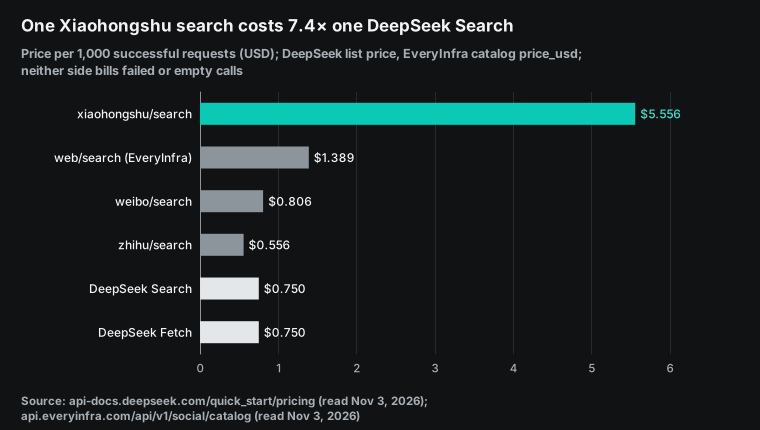
Скажем прямо об одном. Для обычного веб-поиска DeepSeek Search за $0.75 за 1 000 дешевле собственного web/search от EveryInfra за $1.389 за 1 000. К тому же он возвращает до 50 результатов за вызов. Поэтому в этой схеме веб-поиском должен заниматься DeepSeek, а EveryInfra только данными внутри платформ. В пересчёте на 1 000 результатов разрыв ещё больше.
DeepSeek при count=50 стоит $0.015. Zhihu стоит $0.028 за 1 000 результатов, Weibo от $0.062 до $0.067, Xiaohongshu от $0.278 до $0.427. Но сравнивать эти два вида результатов по числу записей нельзя. Веб-результат и пост из приложения со счётчиками вовлечённости отвечают на разные вопросы.
| Вызовов на вопрос | Цена за единицу | Вызовы | Промежуточный итог |
|---|---|---|---|
| DeepSeek Search | $0.00075 | 2 | $0.0015 |
xiaohongshu/search | $0.005556 | 1 | $0.005556 |
zhihu/search | $0.000556 | 1 | $0.000556 |
weibo/search | $0.000806 | 1 | $0.000806 |
| Стоимость данных (план B) | 5 | $0.008418 | |
| Стоимость модели (оценка, пиковый тариф, около 16 000 входных и 1 500 выходных токенов) | около $0.0066 |
У оценки стоимости модели большая погрешность. На входе учтены 7 162 токена сокращённых данных из приложений и около 8 400 токенов веб-сводок из двух поисков по 10 результатов в каждом. На выходе учтено 1 500 токенов. Оценка не учитывает повторно отправленный контекст и попадания в кэш. Стоимость данных точная, потому что это цена из каталога, умноженная на число вызовов. В сумме один вопрос стоит около 1.5 цента США, и на один только Xiaohongshu приходится 66% стоимости данных.
Как ограничить вызовы Xiaohongshu: три плана
При цене $0.005556 за страницу именно расходы на Xiaohongshu нужно контролировать. Цель не в том, чтобы реже использовать Xiaohongshu, а в том, чтобы обращаться к нему только тогда, когда он даёт дополнительные данные. Мы составили три плана. В каждом — по два поиска DeepSeek на вопрос.
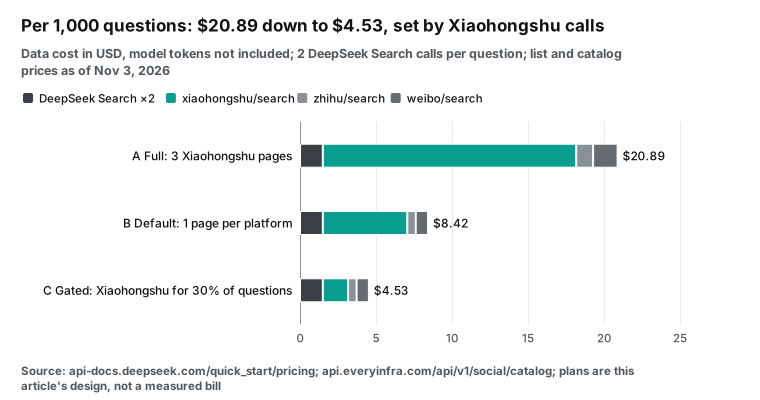
| План | Xiaohongshu | Zhihu | На вопрос | На 1 000 вопросов | Доля Xiaohongshu | |
|---|---|---|---|---|---|---|
| A, полный | 3 страницы | 2 вызова | 2 вызова | $0.0209 | $20.89 | 80% |
| B, по умолчанию | 1 страница | 1 вызов | 1 вызов | $0.0084 | $8.42 | 66% |
| C, по запросу | 1 страница для 30% вопросов | 1 вызов | 1 вызов | $0.0045 | $4.53 | 37% |
30% в плане C мы выбрали сами, это не измеренный показатель. Решить, когда нужен Xiaohongshu, можно тремя способами — от простого к сложному. Первый — по категории товара.
Запрашивайте Xiaohongshu для косметики, средств ухода, детских товаров, товаров для дома и мелкой бытовой техники — там обсуждений на Xiaohongshu много. Для запчастей и промышленных товаров его можно пропустить. Второй способ — сначала опросить дешёвые приложения. Если Zhihu и Weibo уже вернули достаточно свежих записей с конкретными моделями, Xiaohongshu не вызывайте.
Третий — доверить решение модели, но задать лимит в цикле, как BUDGET в коде выше. Когда модель запрашивает вторую страницу, возвращайте «бюджет исчерпан». Кроме того, не используйте last_30_days, если нужна полная страница. Тест 2 показал, что так можно получить 13 записей и всё равно заплатить за целую страницу. Для запросов о самых свежих данных sort=newest возвращает полную страницу. Тот же совет дан в примечании к date_range в каталоге.
Другой путь: DeepSeek Harness с удалённым MCP-сервером (пример конфигурации)
Возможно, вы не пишете собственный цикл. Если вы используете DeepSeek Harness, агента DeepSeek с открытым исходным кодом (Быстрый старт), определения инструментов можно не писать. Вместо этого подключите удалённый MCP-сервер EveryInfra. В README MCP-клиента Harness для каждого MCP-сервера используется отдельная запись. Удалённый сервер использует транспорт streamable-http, а клиент может передавать ему заголовки. Его инструменты видны модели как mcp__<serverName>__<tool>, а тайм-аут на вызов по умолчанию — 60 секунд.
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
    toolCallTimeoutMs: 90000
Мы увеличиваем toolCallTimeoutMs с 60 до 90 секунд по той же причине, что и тайм-аут requests выше. MCP-сервер EveryInfra соответствует спецификации MCP 2026-07-28 и её транспорту Streamable HTTP. Вызов tools/list без ключа 3 ноября показал 12 инструментов. Для данных приложений служит инструмент everyinfra_call_api с платформой, действием и параметрами. Аутентификация описана на странице MCP-сервера.
Согласно разделу об авторизации в спецификации MCP, авторизация необязательна. Если сервер использует транспорт на основе HTTP, ему следует придерживаться этого раздела. EveryInfra принимает API-ключ в заголовке запроса, поэтому для записи в Harness нужны только headers, без входа через браузер.
В Harness есть собственный веб-поиск. Пакет dsh-tool-web добавляет web_search и web_fetch. По умолчанию он возвращает до 8 источников, отправляет до 4 запросов и обрезает каждую сводку до 800 символов. В его README сказано, что поисковый бэкенд DeepSeek не появляется в списке инструментов, если у текущей модели нет учётных данных. В такой конфигурации одна сессия Harness использует DeepSeek для веб-поиска и MCP для данных приложений. Разделение то же, что и в варианте с функциями, но цикл выполняет Harness.
Как выбрать между этими двумя вариантами? Вариант с MCP не требует кода, и модель сама обнаруживает новые возможности в каталоге. Однако модель видит только один общий инструмент, everyinfra_call_api, и должна сначала прочитать каталог, чтобы узнать параметры. Это добавляет одну-две итерации обмена. При использовании функций вам придётся поддерживать их определения.
Взамен каждое описание, enum и цена зафиксированы, модель выбирает точнее, а ваш код может контролировать бюджет. Для одного фиксированного продуктового сценария используйте функции. Для открытого ассистента для команды — MCP. Тот же компромисс разобран в нашей статье о строгом вызове инструментов в Claude с API данных.
Что не работает и за чем следить
Во-первых, мы не вызывали эндпоинт DeepSeek Search. Поэтому у нас нет измеренных данных о том, сколько заметок Xiaohongshu находит поиск DeepSeek по запросу «robot vacuum». Всё, что здесь сказано о DeepSeek, взято из документации. Мы не измеряли объём контента приложений в индексе DeepSeek и частоту его обновления. Раздел «Время снимка и время вызова» касается только данных приложений.
Во-вторых, текст в поиске Xiaohongshu — это фрагмент длиной около 60 символов. Чтобы получить полный текст, нужно вызвать эндпоинт с подробными данными о заметке за $0.005556. Комментарии тоже оплачиваются отдельно. В-третьих, все три приложения возвращают только публичный контент. Личные сообщения, посты только для подписчиков и удалённые посты недоступны. Для платного контента Zhihu доступна только сводка.
У пагинации есть две особенности, на которых легко споткнуться в коде цикла. Страница поиска Xiaohongshu всегда содержит 20 записей, и limit ни на что не влияет. Чтобы получить больше записей, используйте next_page_token с последней страницы. Этот токен действует только 24 часа. Если вы сохраните диалог и продолжите на следующий день, старый токен не сработает.
Поиск снова начинается со страницы 1, и вы платите ещё раз. Zhihu по умолчанию возвращает 20 записей, максимум 100. Weibo по умолчанию возвращает 20, максимум 50. Для этих двух платформ запросить больше записей выгоднее, чем листать страницы, потому что оплата идёт за каждый вызов.
В-четвёртых, нужно учесть два требования. Первое: данные приложений содержат имена и профили частных лиц. Цитируйте только контент и ссылки. Не собирайте и не показывайте личные данные частных лиц. В статье на arXiv от 22 октября (Social-HUMINT) изучается риск использования LLM для определения личных характеристик по публичным данным соцсетей.
Анализируя товары, работайте на уровне темы, а не отдельных пользователей. Второе требование: ассистент, доступный широкой публике в материковом Китае, подпадает под китайские временные меры по управлению сервисами генеративного ИИ. Меры по маркировке контента, созданного ИИ действуют с 1 сентября 2025 года. Это не юридическая консультация. Уточните свои обязанности у юристов.
В-пятых, лимиты запросов различаются. У аккаунта EveryInfra по умолчанию 60 вызовов в минуту. У нашего тестового ключа был особый лимит — 10 в минуту. DeepSeek Search допускает 100 в секунду. При высокой нагрузке добавьте в цикл очередь для вызовов EveryInfra.
Последние изменения
17 октября 2026 года: DeepSeek открыл доступ к Search и Fetch. В тот же день модель обновилась до DeepSeek-V4.1-Flash-1017. Веса опубликованы на Hugging Face. Для вас это значит, что одного ключа DeepSeek теперь хватает и для веб-поиска. Отдельный поисковый сервис не нужен.
1 ноября 2026 года, 00:00 по пекинскому времени: серверный поиск в клиентах стал платным. Используете DeepSeek через Claude Code, Codex или Harness? Тогда плата за поиск теперь включается в ваш ежемесячный счёт. Проверьте страницу использования в консоли DeepSeek.
13 октября 2026 года: статья об ИИ-агентах для покупок вышла в версии 5. В этой статье на arXiv («Does Rank Still Matter?») изучено 7 000 сессий. ИИ-агенты просматривали больше результатов, чем люди, но результаты на средних позициях реже всего попадали в поле зрения.
Для вас это значит, что больше записей — не всегда лучше. Сортируйте записи по вовлечённости или времени перед передачей модели. Это надёжнее, чем 50 несортированных записей. Данные о вовлечённости из Теста 3 указывают на тот же шаг.
Около 25 октября 2026 года: обновилась документация MCP-клиента DeepSeek Harness. Harness поддерживает MCP версии 2026-07-28 (README MCP-клиента). Удалённые серверы используют Streamable HTTP (README пакетов MCP). Для вас это значит, что данные приложений можно подключить к агенту DeepSeek без кода.
FAQ
Поддерживает ли DeepSeek API веб-поиск?
Chat API сам в интернете не ищет. Есть два способа. Первый — самостоятельно вызывать эндпоинт Search (POST /v1/tools/search) и передавать результаты модели как результаты инструментов. Второй — использовать клиент вроде DeepSeek Harness, Claude Code или Codex.
Они вызывают Search и Fetch через серверные инструменты, и с 1 ноября 2026 года действует оплата за каждый запрос. (Источник вопроса: поисковая подсказка «does deepseek api support web search». Основание: руководство DeepSeek по Search и Fetch.)
Сколько стоит API DeepSeek Search и есть ли бесплатный тариф?
Цена составляет $0.75 за 1 000 успешных запросов. Неудачные, пустые и завершившиеся по тайм-ауту запросы бесплатны, а count не влияет на цену. Отдельной бесплатной квоты на поиск мы не нашли ни на странице цен, ни в руководстве. Использование оплачивается как с начисленного, так и с пополненного баланса, причём начисленный баланс расходуется первым. (Источник вопроса: поисковые подсказки «deepseek search api pricing» и «deepseek search api free tier». Основание: страница цен DeepSeek.)
Ключ API DeepSeek Search — тот же, что и ключ для модели?
Да. В руководстве сказано, что Search и Fetch используют ту же Bearer-аутентификацию, что и DeepSeek API. Ключи создаются на платформе DeepSeek. Лимиты запросов действуют на аккаунт, а не на ключ. (Источник вопроса: поисковая подсказка «deepseek search api key». Основание: руководство DeepSeek по Search и Fetch и страница о лимитах запросов.)
API DeepSeek Search и Fetch: в чём разница и когда использовать Fetch?
Search возвращает несколько результатов по запросу. Fetch возвращает одну полную страницу в Markdown по URL. Search и сам умеет возвращать текст страницы с need_content. Поэтому Fetch нужен, когда ссылка уже есть и требуется полный текст, например ссылка на сайт бренда из данных приложения.
Работа Fetch зависит от политики доступа целевого сайта. Если получить контент не удалось, он возвращает 404, и вы ничего не платите. (Источник вопроса: поисковая подсказка «deepseek search fetch api». Основание: справочник по Fetch API.)
DeepSeek Harness и поисковый API: может ли Harness работать с другим поисковым провайдером?
Да. Harness подключает веб-поиск как плагин. Инструмент web_search предоставляет плагин dsh-tool-web, и его бэкенд можно заменить другим поисковым плагином. Данные приложений подключаются через MCP-клиент, настроенный на удалённый сервер. (Источник вопроса: поисковая подсказка «deepseek harness search provider». Основание: README dsh-tool-web и репозиторий Harness.)
Поддерживает ли вызов функций в API DeepSeek строгий режим?
Да. Используйте бета-адрес (api.deepseek.com/beta с префиксом https) и задайте strict: true для каждой функции. Перечислите все свойства в required и установите additionalProperties в false. minLength, maxLength, minItems и maxItems не поддерживаются.
Строгий режим работает как в режиме размышления, так и без него. (Источник вопроса: поисковая подсказка «deepseek api function calling». Основание: руководство DeepSeek по вызовам инструментов.)
С чего начать
Сначала создайте API-ключ по инструкции из раздела Быстрый старт EveryInfra. Бесплатно изучите каталог и проверьте параметры и цены xiaohongshu/search, zhihu/search и weibo/search. Обзоры платформ: API данных Xiaohongshu, API данных Zhihu и API данных Weibo. Все цены — на странице тарифов.
Затем скопируйте из этой статьи четыре определения инструментов и код цикла. Подставьте оба ключа и прогоните один вопрос от начала до конца. Наконец, выберите в разделе о стоимости план под ваш объём вопросов и задайте лимит в BUDGET. Ту же идею с другими инструментами показывают две статьи. Первая — динамические рабочие процессы в Claude Code для комментариев Xiaohongshu. Вторая — Gemini Deep Research с удалённым MCP-сервером. Если нужны данные комментариев, комментарии Weibo работают так же, как комментарии Xiaohongshu.
Источники
- «Search & Fetch», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/guides/search
- «Search API reference», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/api/search
- «Fetch API reference», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/api/fetch
- «Models & Pricing», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/quick_start/pricing
- «DeepSeek-V4.1-Flash-1017 release note», DeepSeek, 2026-10-17, https://api-docs.deepseek.com/news/news261017
- «Tool Calls», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/guides/tool_calls
- «Thinking Mode», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/guides/thinking_mode
- «Rate Limit & Isolation», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/quick_start/rate_limit
- «Token & Token Usage», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/quick_start/token_usage
- «Integrate with Claude Code», DeepSeek API Docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- «API keys», DeepSeek Platform, дата обращения: 2026-11-03, https://platform.deepseek.com/api_keys
- «DeepSeek-V4.1-Flash-1017 model card», Hugging Face, дата обращения: 2026-11-03, https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Репозиторий DeepSeek Harness, GitHub, дата обращения: 2026-11-03, https://github.com/deepseek-ai/deepseek-harness
- «Быстрый старт DeepSeek Harness», дата обращения: 2026-11-03, https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- «dsh-tool-web README», GitHub, дата обращения: 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- «dsh-mcp-client README», GitHub, дата обращения: 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- «Harness MCP packages README», GitHub, дата обращения: 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python, GitHub, дата обращения: 2026-11-03, https://github.com/openai/openai-python
- openai, PyPI, дата обращения: 2026-11-03, https://pypi.org/project/openai/
- «Function calling», OpenAI developer docs, дата обращения: 2026-11-03, https://platform.openai.com/docs/guides/function-calling
- «Advanced Usage» (тайм-ауты), документация Requests, дата обращения: 2026-11-03, https://requests.readthedocs.io/en/latest/user/advanced/
- «json — JSON encoder and decoder», документация Python, дата обращения: 2026-11-03, https://docs.python.org/3/library/json.html
- «MCP Specification 2026-07-28», Model Context Protocol, дата обращения: 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28
- «Transports», MCP 2026-07-28, дата обращения: 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- «Tools», MCP 2026-07-28, дата обращения: 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- «Authorization», MCP 2026-07-28, дата обращения: 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- «Weibo open platform API list», дата обращения: 2026-11-03, https://open.weibo.com/wiki/API
- «Network Data Security Management Regulations», Правительство КНР, 2024-09-30, https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- «Interim Measures for the Management of Generative AI Services», Администрация киберпространства Китая, 2023-07-13, https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- «Measures for Labeling AI-Generated Synthetic Content», Администрация киберпространства Китая и другие ведомства, 2025-03-14, https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- «Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf», arXiv:2608.22697v5, 2026-10-13, https://arxiv.org/abs/2608.22697
- «Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure», arXiv:2610.31573, 2026-10-22, https://arxiv.org/abs/2610.31573
- Каталог данных EveryInfra, дата обращения: 2026-11-03, 00:13 SGT, https://api.everyinfra.com/api/v1/social/catalog
- Каталог EveryInfra для Xiaohongshu, дата обращения: 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- Каталог EveryInfra для Zhihu, дата обращения: 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- Каталог EveryInfra для Weibo, дата обращения: 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- «Context Caching», DeepSeek API docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/guides/kv_cache
- «Multi-round Conversation», DeepSeek API docs, дата обращения: 2026-11-03, https://api-docs.deepseek.com/guides/multi_round_chat
- «Sorting Techniques», документация Python, дата обращения: 2026-11-03, https://docs.python.org/3/howto/sorting.html
- «Built-in Types: set», документация Python, дата обращения: 2026-11-03, https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset
Справка BL-73