Workflow dinamici di Claude Code per i commenti di Xiaohongshu: test dell'API ed esempio di script
I workflow dinamici di Claude Code classificano i commenti di Xiaohongshu in parallelo. Il nostro test: 4 pagine su 8 avevano 10 righe, un post era rumore al 96%, 500 commenti sono costati 0,222 $.
Il 2 novembre 2026, dalle 00:14 alle 00:22 ora di Singapore (SGT), abbiamo effettuato 10 chiamate addebitate all'API di EveryInfra. Hanno restituito 100 commenti di primo livello da 6 post di Xiaohongshu (RedNote) sui robot aspirapolvere, per un totale di 0,066671 $. In un post, 24 commenti su 25 dicevano solo «entrare nel gruppo», «ci sto» o «entrare» in cinese. Il catalogo indica che xiaohongshu/comments restituisce 15 righe per pagina, ma 4 delle nostre 8 pagine ne hanno restituite 10.
Questo cambia il budget di un workflow dinamico di Claude Code. Con la dimensione di pagina del catalogo, 500 commenti richiedono 34 chiamate e costano 0,189 $. Con la nostra media misurata di 12,5 righe per pagina, ne richiedono 40 e costano 0,222 $. Se scarti anche il 25% di rumore e vuoi comunque 500 commenti utili, servono 54 chiamate e 0,300 $.
Un quarto risultato conta per le riesecuzioni. Abbiamo inviato la stessa richiesta tre volte e in 6 minuti la prima pagina è cambiata di 7 commenti. Ognuna delle tre chiamate è stata addebitata.
Questo articolo risponde a una domanda pratica. Hai una parola chiave di prodotto e vuoi che Claude Code scriva un programma parallelo. Il programma estrae i commenti di Xiaohongshu, li suddivide in quattro gruppi (esigenza, lamentela, prezzo, elogio) e scrive una tabella di riepilogo. Quale funzionalità usi, com'è fatto lo script e come colleghi i dati?
Quante chiamate servono per 500 commenti, e cosa si rompe con i limiti di frequenza delle richieste e i nuovi tentativi? Ogni informazione su Claude Code qui sotto viene dalla pagina dei workflow di Claude Code o dal changelog. Non abbiamo eseguito un workflow sulla nostra macchina, quindi le parti su Claude Code sono esempi di configurazione. Ogni numero di EveryInfra viene da una risposta grezza dell'API.
Il compito: 500 commenti di Xiaohongshu, quattro gruppi, una tabella
Definiamo prima il compito, perché ogni numero successivo dipende da questo. L'input è una sola parola chiave. Abbiamo usato la parola cinese per «robot aspirapolvere», perché la categoria ha molti thread del tipo «quale dovrei comprare» e «si è rotto» intorno ai saldi dell'11 novembre. L'output è una tabella. Mostra il numero e la quota di ciascun gruppo e tre commenti di esempio per gruppo. Mostra anche il costo dell'API e il tasso di concordanza di un controllo a campione.
Il lavoro si svolge in tre fasi. xiaohongshu/search trova i post. xiaohongshu/comments e xiaohongshu/sub_comments estraggono commenti e risposte. Poi un modello etichetta ogni commento. Lo script definisce i quattro gruppi.
Un'esigenza chiede quale modello comprare o chiede un link. Una lamentela segnala un problema con un prodotto o un servizio. Un commento sul prezzo parla di costi, copie più economiche o di dove comprare. Un elogio viene da chi usa il prodotto e lo consiglia. Tutti gli altri commenti vanno in «altro».
Perché usare un programma parallelo per questo compito? Soddisfa tre condizioni. Primo, i post sono indipendenti: il post A non ha bisogno del risultato del post B. Secondo, l'input è molto più grande dell'output. Un commento restituisce circa 1.445 byte di JSON, ma il suo testo occupa circa 95 byte. Terzo, la regola di etichettatura è fissa, quindi può occuparsene un modello piccolo.
Il 22 ottobre 2026 Anthropic ha pubblicato una guida che invita la maggior parte di chi costruisce agenti a usare meno subagenti (articolo di Anthropic). La stessa guida conserva i subagenti per un solo caso: più attività in parallelo che richiedono contesti nuovi e separati. La classificazione dei commenti è proprio quel caso.
Abbiamo estratto 6 post. Prima abbiamo cercato con sort=most_commented e ottenuto 20 post. Poi abbiamo scelto 6 post con argomenti diversi. La tabella qui sotto li mostra con un riassunto in italiano dei titoli. Dieci dei 20 risultati di ricerca avevano is_cooperation_note impostato su true. Su Xiaohongshu sono post sponsorizzati che passano dalla piattaforma Pugongying.
Quella piattaforma esamina un post sponsorizzato prima della pubblicazione. Il brand deve accettarlo o rifiutarlo entro 72 ore (centro assistenza di Pugongying, pagina datata 2026-10-22; home di Pugongying). Nessuno dei nostri 6 post era sponsorizzato. Tienilo presente quando leggi i numeri sugli elogi.
| Post (nostro codice) | Titolo, riassunto in italiano | Commenti mostrati nella ricerca | Commenti di primo livello estratti |
|---|---|---|---|
| A | «Non comprare ancora un robot aspirapolvere, guarda prima il test del Singles' Day» | 2,069 | 25 (2 pagine) |
| B | Un thread di lamentele su un aspirapolvere Roborock | 570 | 30 (2 pagine) |
| C | «Guida all'acquisto dei robot aspirapolvere 2026» | 377 | 10 |
| D | Un breve video comico su un aspirapolvere «potente» | 3,278 | 10 |
| E | «Un elettrodomestico spreca-soldi: l'inutile robot aspirapolvere» | 973 | 15 |
| F | Chi compra per la prima volta chiede consiglio | 487 | 10 |
Cosa sono i workflow dinamici di Claude Code, con le parole della documentazione
La documentazione di Claude Code definisce un workflow dinamico come uno script JavaScript che orchestra molti subagenti contemporaneamente. Claude scrive lo script per il tuo compito. Un runtime lo esegue in background mentre la tua sessione resta reattiva (pagina dei workflow). La funzionalità è arrivata per la prima volta nella v2.1.154 il 28 maggio 2026. Il changelog dice che Claude «orchestra il lavoro su decine o centinaia di agenti in background» e che /workflows mostra le tue esecuzioni (changelog).
L'articolo di lancio ora indica che i workflow dinamici sono disponibili per tutti. Elenca la CLI, l'app Desktop e l'estensione per VS Code. Elenca i piani Pro, Max, Ultra, Team ed Enterprise, oltre a Claude API, Amazon Bedrock, Vertex AI e Microsoft Foundry (articolo di lancio di Anthropic).
La documentazione mostra uno script salvato. Inizia con export const meta = { name, description }. Il corpo è JavaScript semplice con await di primo livello. agent() avvia un subagente.
pipeline() esegue una catena per ogni elemento di una lista. parallel() esegue un insieme di attività contemporaneamente e attende che finiscano tutte. phase() raggruppa gli agenti successivi sotto un titolo, log() stampa una riga e args contiene l'input (pagina dei workflow, «What the saved script looks like»).
Quando passi uno schema ad agent(), il subagente restituisce un oggetto conforme a quel JSON Schema. Se l'output non supera la validazione per cinque volte, la chiamata fallisce. MAX_STRUCTURED_OUTPUT_RETRIES modifica questo numero (stessa pagina). È esattamente ciò che serve alla fase di etichettatura. Ogni agente di etichettatura restituisce un array di oggetti {id, label}, e lo script li conta direttamente.
Ci sono quattro modi per avviare un workflow (pagina dei workflow, «Have Claude write a workflow»; pagina dei comandi).
| Come lo avvii | Chi decide di usare un workflow | Nota |
|---|---|---|
Scrivi la parola chiave ultracode nel prompt | Tu, per questo prompt | Solo in un prompt che scrivi tu |
| Chiedi «un workflow» con parole tue | Tu, per questo prompt | Claude scrive lo script per questo compito |
Esegui /effort ultracode o claude --effort ultracode | Claude, per ogni compito | Il flag imposta anche l'effort su xhigh |
Esegui un comando di workflow salvato, come /deep-research | Tu | Riutilizza un'esecuzione che ha funzionato |
La parola chiave funziona solo in un prompt scritto da una persona. Non funziona in un prompt passato con -p (documentazione headless). Non funziona nemmeno nel prompt di un'attività pianificata, in un webhook o in un commento di una pull request. Quindi, per un report settimanale sui commenti, salva prima un'esecuzione riuscita come comando. Poi richiama quel comando dall'attività pianificata.
| Subagenti | Skill | Agent teams | Workflow | |
|---|---|---|---|---|
| Cos'è | Un worker avviato da Claude | Istruzioni che Claude segue | Un agente principale con sessioni paritarie | Uno script eseguito dal runtime |
| Chi decide il passo successivo | Claude, turno per turno | Claude, in base al prompt | L'agente principale | Lo script |
| Dove stanno i risultati | Il contesto di Claude | Il contesto di Claude | Un elenco di attività condiviso | Variabili dello script |
| Cosa puoi ripetere | La definizione del worker | Le istruzioni | La definizione del team | L'orchestrazione |
| Scale | Poche attività per turno | Come i subagenti | Pochi peer di lunga durata | Da decine a centinaia di agenti |
| Dopo un'interruzione | Il turno riparte | Il turno riparte | I compagni di team continuano a lavorare | Riprendibile nella stessa sessione |
La tabella segue il confronto della sezione «When to use a workflow» della pagina dei workflow. Qui conta soprattutto la terza riga. Con i subagenti, ogni riepilogo di post finisce nella conversazione principale. Con un workflow, i 100 commenti, le etichette e i risultati del controllo a campione restano nelle variabili dello script.
La conversazione riceve solo la tabella finale. Gli Agent teams sono ancora sperimentali e richiedono CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 (documentazione degli Agent teams), quindi qui non li usiamo.
Workflow dinamici e subagenti a confronto: il piano sta nel codice, non nella chat
La vera differenza non è il parallelismo, ma chi gestisce il piano. Con i subagenti, a ogni turno è Claude a decidere quale avviare dopo. Ogni risultato deve tornare nel suo contesto prima che possa decidere. Secondo la documentazione dei subagenti, con 20 subagenti in esecuzione la chiamata Agent successiva fallisce con un errore che dice a Claude di non fare un nuovo tentativo. CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS modifica questo numero (documentazione dei subagenti, «Concurrent subagent limit»).
Con un workflow, cicli, rami e numero di nuovi tentativi sono fissati nello script. Claude non decide di nuovo per ogni post, quindi i primi risultati non possono cambiare il modo in cui vengono gestiti i post successivi. Per l'etichettatura è una proprietà utile. Ogni post riceve lo stesso prompt e lo stesso schema, quindi puoi confrontare i risultati tra un post e l'altro.
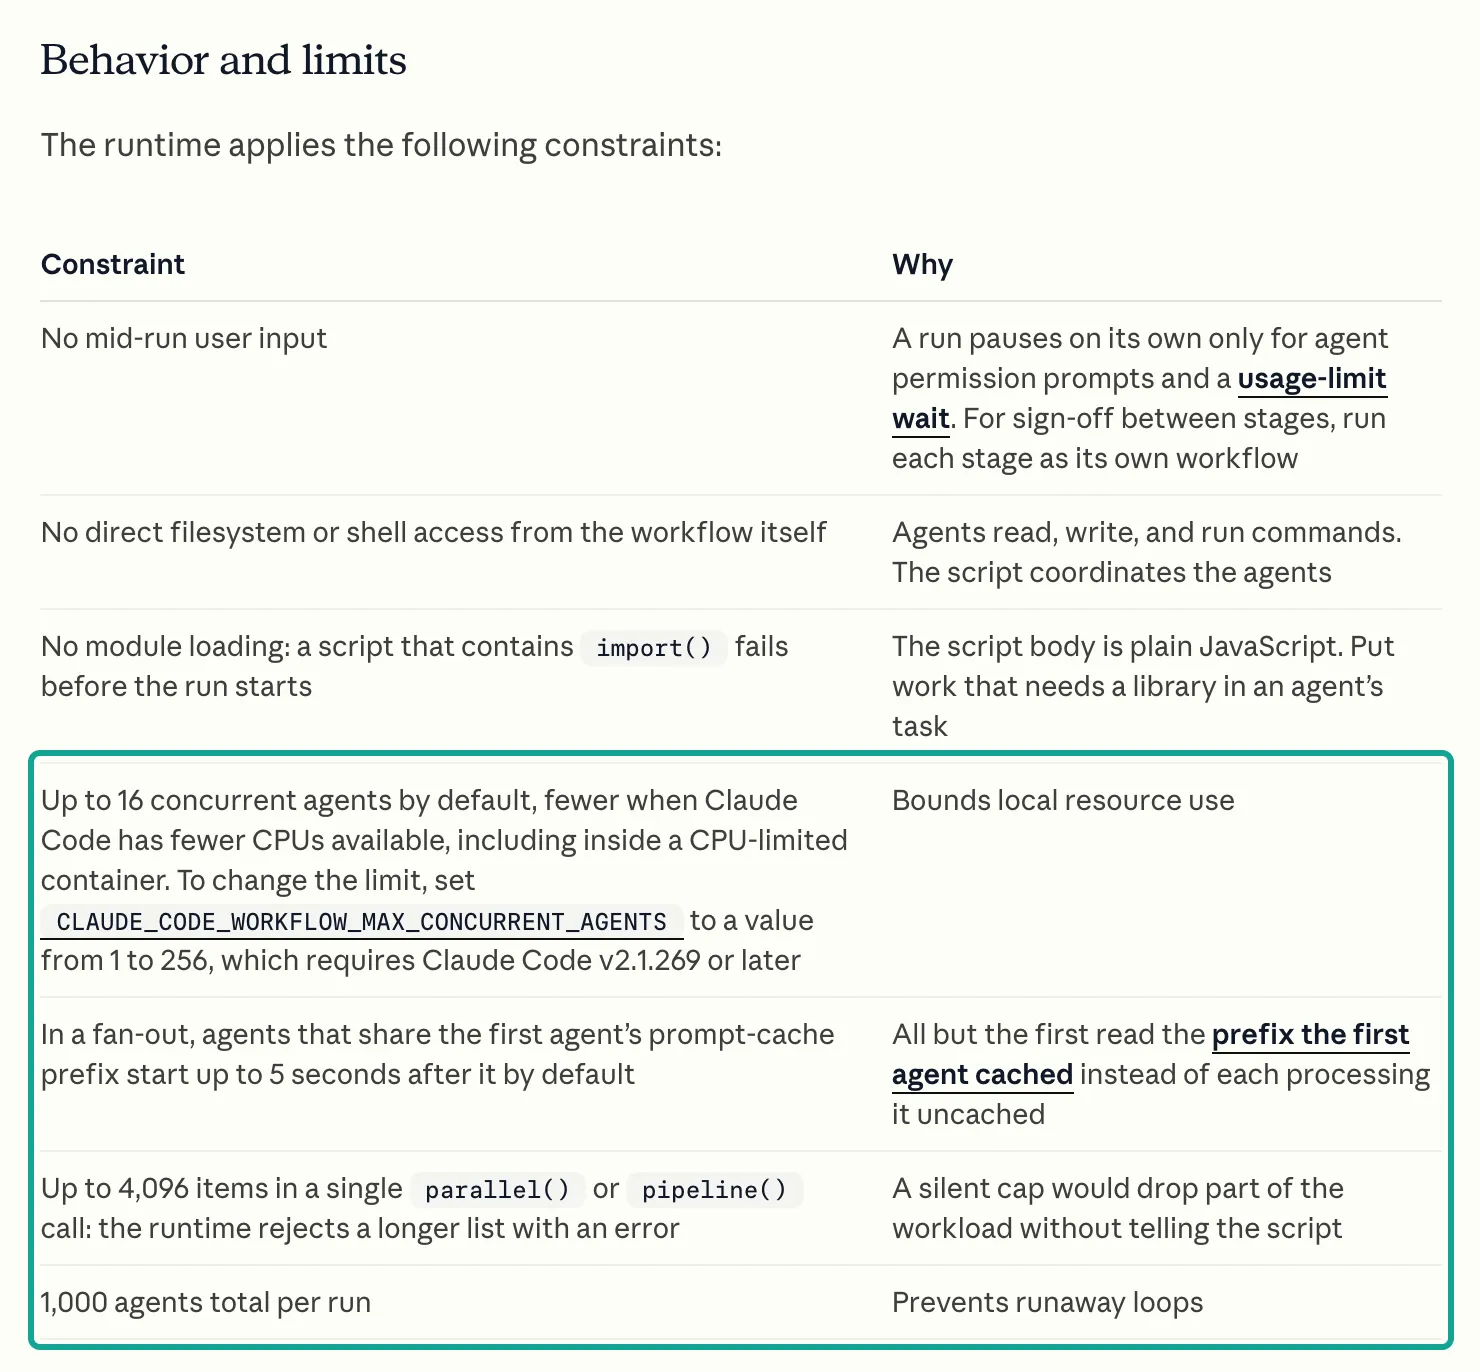
Il runtime ha limiti rigidi. Lo screenshot qui sotto è tratto dalla documentazione di Claude Code. Il riquadro verde acqua evidenzia i tre limiti più rilevanti in questo caso. Per impostazione predefinita vengono eseguiti fino a 16 agenti contemporaneamente, e meno sulle macchine con meno CPU.
CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS imposta un valore da 1 a 256, a partire dalla v2.1.269. Una singola chiamata parallel() o pipeline() accetta fino a 4.096 elementi e rifiuta un elenco più lungo con un errore. Un'esecuzione avvia al massimo 1.000 agenti.
Contano anche altri tre limiti. Un'esecuzione non può chiederti input a metà. Lo script non può leggere file né eseguire comandi shell da solo. Uno script che contiene import() fallisce prima di partire.
La regola per cui lo script non può accedere a file o comandi determina il modo in cui arrivano i dati. Lo script non può chiamare fetch o curl, quindi sono gli agenti a dover chiamare EveryInfra. Un agente può usare gli strumenti MCP connessi alla sessione. Può anche eseguire Bash, se i tuoi permessi lo consentono.
Il riferimento incluso per la creazione dei workflow aggiunge un altro dato. Gli agenti dei workflow possono accedere a tutti gli strumenti MCP connessi alla sessione, ma i server che richiedono un accesso interattivo possono mancare nelle esecuzioni headless. Quel riferimento è la skill /workflow-authoring, che richiede la v2.1.248 o successiva (pagina dei workflow, «Edit a saved script»; documentazione delle skill). Il server MCP remoto di EveryInfra usa una chiave in un header della richiesta, non un accesso interattivo, quindi funziona anche nelle esecuzioni headless.
Un'altra regola riguarda il tempo. All'interno dello script, Date.now(), Math.random() e new Date() senza argomenti generano un errore. Un'esecuzione ripresa deve ripetere le stesse chiamate agent(), e timestamp o valori casuali lo impedirebbero (pagina dei workflow). Se ti serve una data, passala tramite args. Per i «commenti delle ultime 24 ore», usa invece il filtro dell'API: xiaohongshu/search accetta date_range=last_24_hours.
Versioni e opzioni: quale comportamento arriva con quale release
I workflow dinamici sono cambiati molto tra maggio e novembre 2026. Molti tutorial descrivono il comportamento precedente. La tabella riporta solo le voci rilevanti per questo lavoro. Versioni e date provengono dal changelog di Claude Code, che replica il CHANGELOG.md su GitHub. Le righe contrassegnate con «docs» provengono dalle note di versione nella pagina dei workflow.
| Versione | Data | Modifica | Effetto sulla classificazione dei commenti |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | Arrivano i workflow dinamici e /workflows | Punto di partenza |
| 2.1.157 | 2026-05-29 | Un'impostazione disattiva l'avvio tramite parola chiave | Scrivere «workflow» non avvia più un'esecuzione per errore |
| 2.1.269 | docs | CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS | Limita a 2 o 3 gli agenti che chiamano l'API |
| 2.1.271 | docs | Le esecuzioni si mettono in pausa al raggiungimento di un limite di utilizzo; su Pro la dimensione predefinita è small | Le esecuzioni lunghe non falliscono a metà |
| 2.1.296 | 2026-10-09 | CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL | Una sola variabile porta tutti gli agenti su Haiku |
| 2.1.299 | 2026-10-14 | /usage mostra avvisi sui workflow | Puoi vedere dove sono finiti i token |
| 2.1.301 | 2026-10-15 | Correzione: gli agenti saltavano un passaggio e l'esecuzione risultava comunque riuscita | Un passaggio di etichettatura saltato non sembra più un successo |
| 2.1.305 | 2026-10-20 | Correzione: la ripresa rieseguiva gli agenti pipeline() e parallel() già completati | Con la ripresa non paghi più due volte i commenti |
| 2.1.311 | 2026-10-26 | Correzione: i subagenti non vedevano i server MCP connessi in ritardo | Una connessione MCP remota lenta non nasconde più gli strumenti |
| 2.1.316 | 2026-10-31 | CLAUDE_CODE_SUBAGENT_EFFORT | Imposta un effort basso per tutti gli agenti di etichettatura in un colpo solo |
Le righe 2.1.269 e 2.1.271 provengono dalle sezioni «Behavior and limits», «When a run hits your usage limit» e «Set a size guideline» della pagina dei workflow. La linea guida sulla dimensione ha quattro valori. unrestricted indica nessuna linea guida, small meno di 5 agenti, medium meno di 10 e large meno di 50. Claude considera il valore un consiglio, non un tetto. Il limite rigido resta di 1.000 agenti. Puoi anche impostare workflowSizeGuideline in qualsiasi file di impostazioni (riferimento delle impostazioni).
Per 500 commenti basta medium. Ti servono 1 agente di ricerca, alcuni agenti di fetch, altrettanti agenti di etichettatura, 1 agente per i controlli a campione e 1 agente per il report. Una sezione successiva mostra come una chiamata batch riduce gli agenti di fetch a 1 o 2.
Ci sono due modi per attivare ultracode, con effetti diversi. In una sessione, dalla v2.1.284 /effort ultracode attiva solo ultracode senza modificare il livello di effort. /effort ultracode off lo disattiva.
Prima della v2.1.284, /effort ultracode impostava la sessione su effort xhigh e /effort ultracode off falliva con Invalid argument. Il flag di avvio claude --effort ultracode (v2.1.203 o successiva) funziona in modo diverso: attiva ultracode e imposta anche l'effort su xhigh (documentazione sulla configurazione del modello; pagina dei workflow). Con ultracode attivo, l'avviso «Large workflow» non compare e il limite di subagenti simultanei non viene applicato. Per i lavori che chiamano un'API a pagamento, ti consigliamo di lasciare ultracode disattivato. Chiedi invece un workflow in un unico prompt, così vedi il piano prima che venga eseguito.
Collega i dati: MCP remoto o POST /api/v1/social
Un workflow può usare l'API per i dati in due modi. Un agente può chiamare EveryInfra come server MCP remoto oppure eseguire curl su POST https://api.everyinfra.com/api/v1/social. Secondo la documentazione MCP di Claude Code, un server HTTP remoto si aggiunge con claude mcp add --transport http <name> <url>. Per l'autenticazione Bearer, aggiungi --header (documentazione MCP).
Il nostro server MCP remoto usa il trasporto Streamable HTTP definito nella specifica MCP (specifica MCP 2025-11-25, transports). Nella specifica, una chiamata a uno strumento è una richiesta tools/call e il risultato si trova in un array content (specifica MCP 2025-11-25, tools). La nostra chiamata tools/list ha restituito 12 strumenti. Qui ne contano tre: everyinfra_list_capabilities, everyinfra_call_api e everyinfra_get_job.
# Configuration example. Keep the key in an environment variable, never in a file.
export EVERYINFRA_API_KEY="<your key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# Fewer approval prompts: add these to permissions.allow in .claude/settings.json
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# Keep at most 3 agents running, so a 10-per-minute key is not saturated
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3
Le righe dei permessi hanno tre origini. In claude -p e nell'Agent SDK, Claude Code non mostra mai la richiesta di approvazione del workflow. Per consentire l'avvio di un'esecuzione, aggiungi Workflow alle tue regole allow. Per un singolo workflow salvato, aggiungi Workflow(<name>) (pagina dei workflow, «Approve the plan before it runs»).
L'articolo di lancio suggerisce la modalità auto per i workflow. In modalità auto, un classificatore esamina ogni chiamata (documentazione sulle modalità di autorizzazione). Anche un hook PreToolUse può restituire allow per la chiamata (documentazione sugli hook).
Le regole allow per MCP hanno la forma mcp__<server>__<tool>. Un glob è valido solo dopo il nome del server, come in mcp__everyinfra__* (documentazione sui permessi). I subagenti di un workflow usano le tue regole dei permessi. La documentazione suggerisce di consentire gli strumenti necessari agli agenti prima di un'esecuzione lunga, così che non si fermi in attesa di approvazioni.
Quale metodo usare? Per un'etichettatura in sola lettura con un numero noto di chiamate, noi usiamo MCP. La tabella mette a confronto i due metodi. La riga sulla sandbox proviene dalla documentazione sul sandboxing, che parte senza domini di rete consentiti.
| Domanda | MCP remoto | curl su `POST /api/v1/social` |
|---|---|---|
| L'agente ha bisogno di Bash? | No | Sì, più una regola di rete nella sandbox |
| L'agente conosce fatturazione e paginazione? | Sì, dalla descrizione dello strumento | Solo dal tuo prompt |
Campi di errore come retry_after e did_you_mean | Nel risultato dello strumento | Nel corpo della risposta |
| JSON grezzo su disco per un audit | No | Sì, l'agente scrive il file |
| Ideale per | Etichettatura con un numero di chiamate noto | Job che devono conservare ogni file grezzo |
Con curl, l'agente di recupero scrive ogni file grezzo e restituisce allo script solo {id, text, like_count}.
Prima di iniziare, tieni presente un limite di dimensione. Claude Code mostra un avviso quando l'output di uno strumento MCP supera 10.000 token e, per impostazione predefinita, lo limita a 25.000 token. MAX_MCP_OUTPUT_TOKENS modifica il limite. Un risultato testuale riuscito più lungo di 50.000 caratteri viene salvato in un file (documentazione MCP, “MCP output limits and warnings”).
Una pagina di 15 commenti via MCP pesava 16.892 byte. Una pagina di ricerca con 20 post pesava 34.991 byte. Entrambe restano sotto la soglia.
Una chiamata comments_batch per 3 post pesava 42.991 byte. Con questo rapporto, 20 post danno circa 280.000 byte. Quel risultato finirà in un file, e l'agente dovrà leggerlo in un secondo passaggio. Il risultato non cambia: si aggiunge solo un passaggio. Per mantenere il risultato nel contesto dell'agente, richiedi 3 o 4 post per chiamata.
Un round trip reale: cosa invia l'agente e cosa restituisce l'API
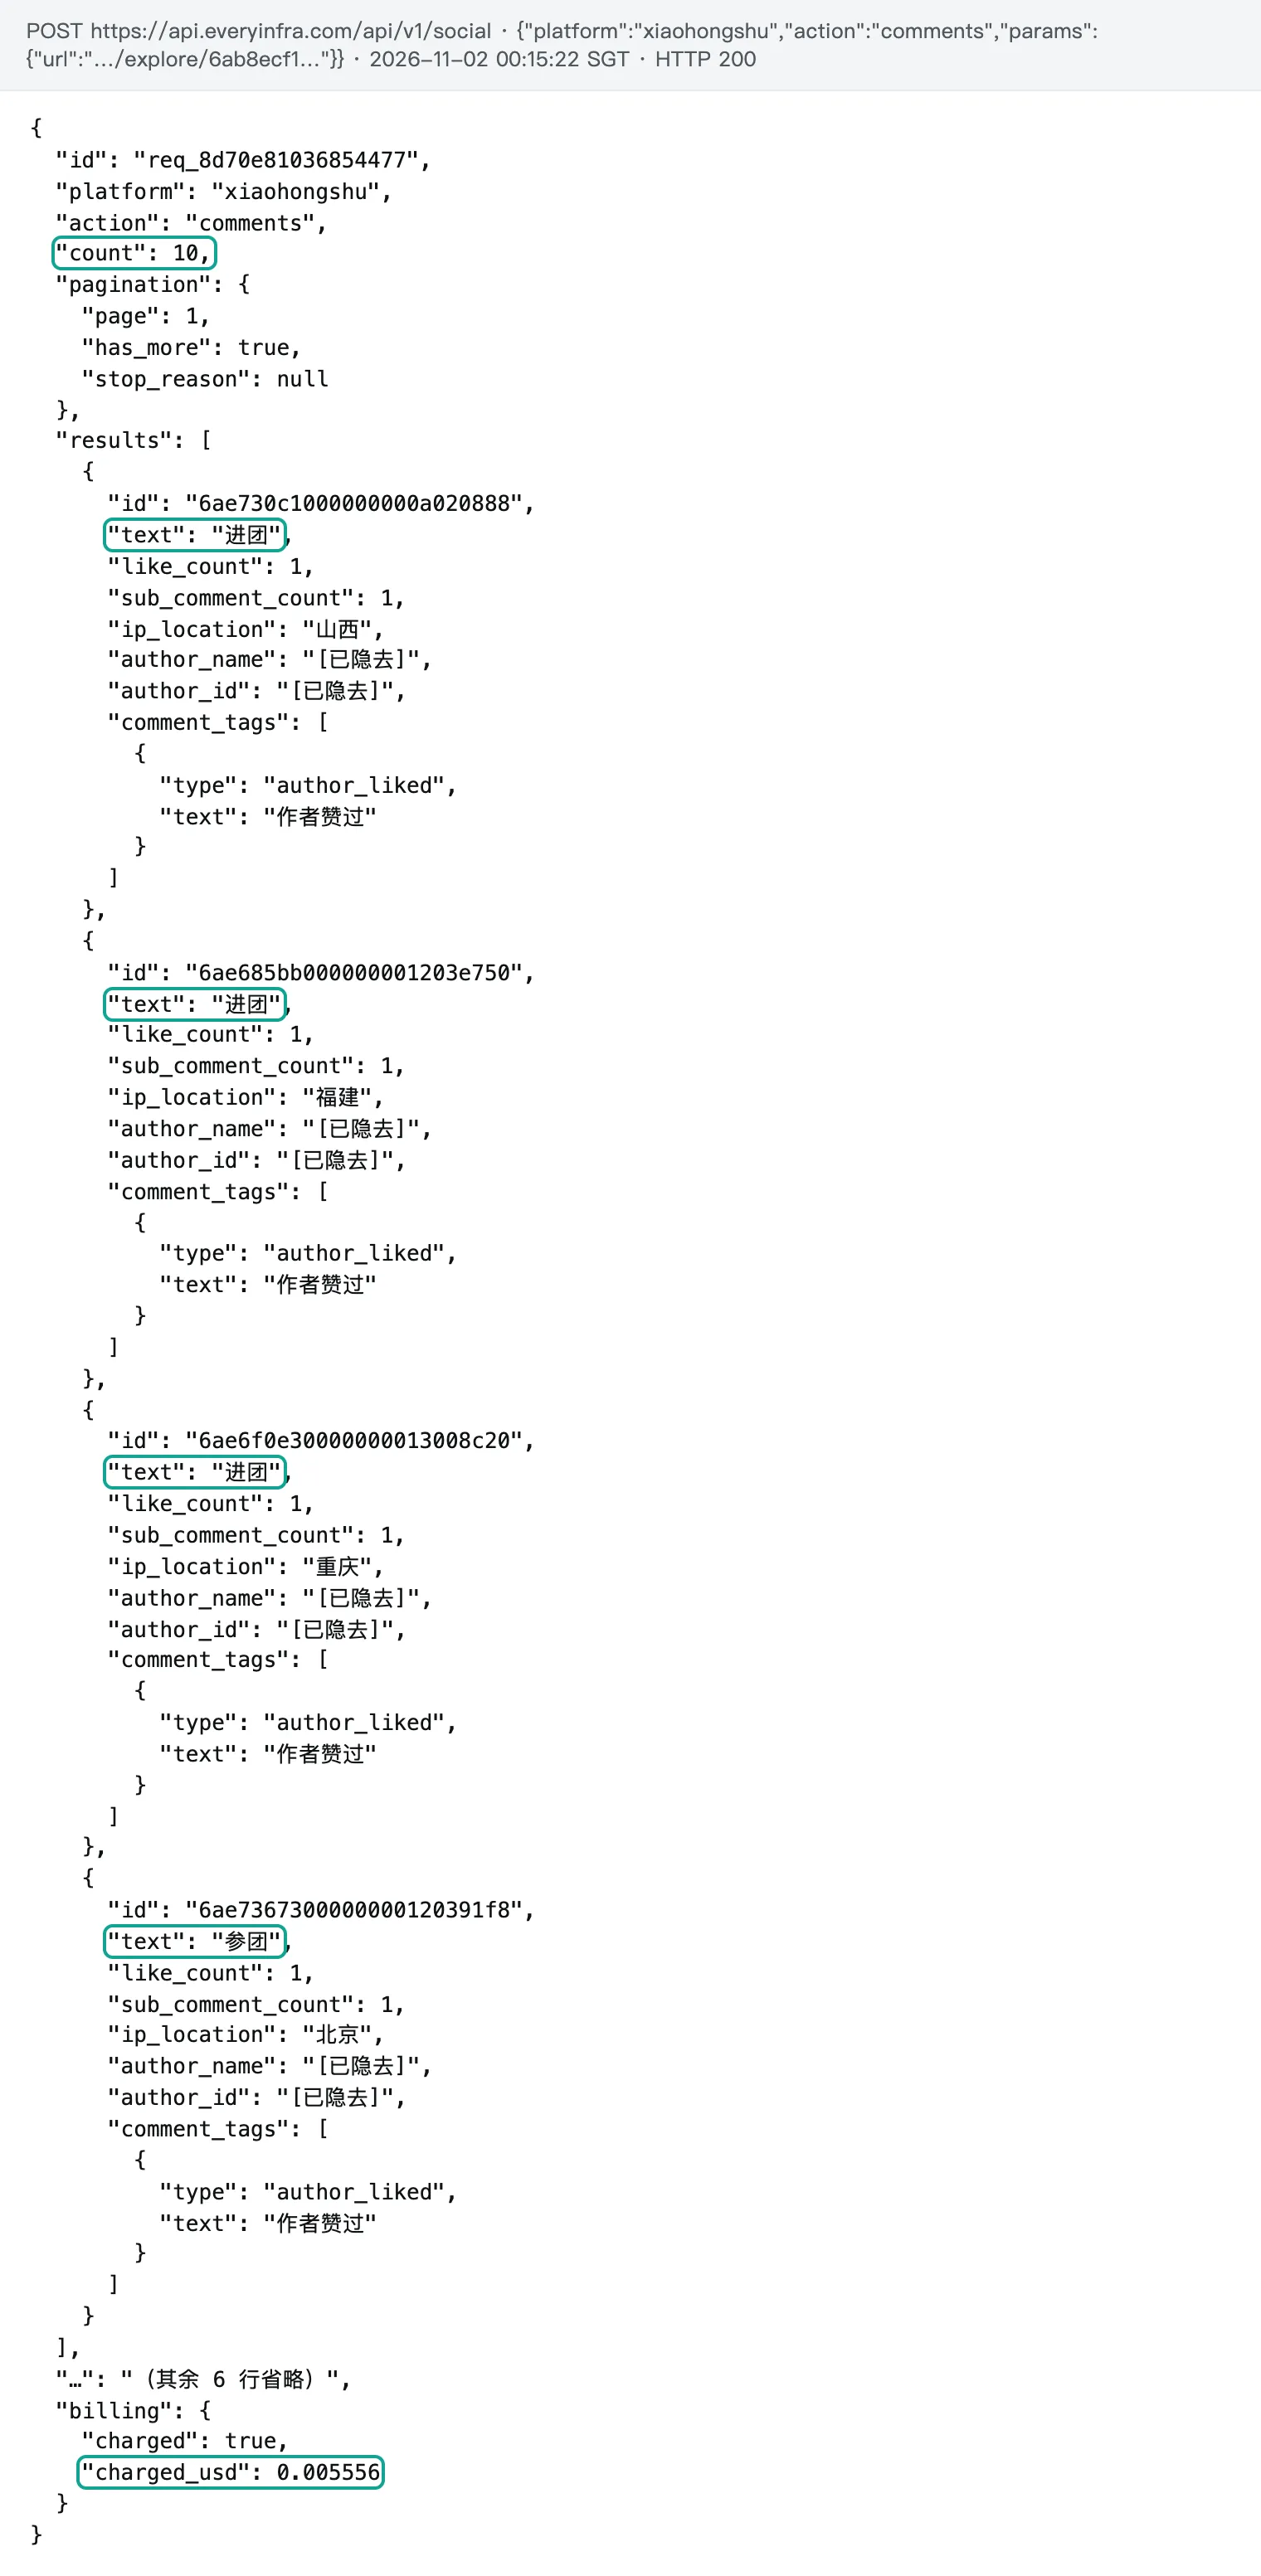
Alle 00:17:55 SGT del 2 novembre 2026 abbiamo inviato via MCP la richiesta tools/call qui sotto. È la stessa richiesta JSON-RPC che un agente di Claude Code invia quando chiama mcp__everyinfra__everyinfra_call_api. L'obiettivo era il post F, quello di chi compra per la prima volta, ordinato per like. Il risultato si trova in result.content[0].text come testo JSON. Mostriamo il primo commento, il campo di fatturazione e nient'altro. Abbiamo rimosso la query string dall'URL del post e nascosto nomi e ID degli autori.
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[{"id":"693ab483000000001702fef1","text":"(Chinese) How is the DJI one? I hear its obstacle avoidance is strong",
   "like_count":3,"author_name":"[hidden]","author_id":"[hidden]","sub_comment_count":0}],
 "billing":{"charged":true,"charged_usd":0.005556}}
Otto di questi 10 commenti esprimono esigenze chiare. Quasi tutti indicano la superficie, il budget, gli animali domestici e il tipo di pavimento. Un esempio, tradotto: “140 metri quadrati, tappeti, niente animali, piastrelle ovunque, tanti capelli, budget 3.000 yuan, quale prendo?” Questo tipo di commento è utile ai team di prodotto e di assistenza. È anche ben strutturato, quindi un modello può estrarre budget, superficie e animali come campi.
I campi restituiti corrispondono ai 20 response_fields di xiaohongshu/comments nel catalogo. La tabella mostra quali conserva l'agente di recupero.
| Campo | Contenuto | Da conservare per l'etichettatura? |
|---|---|---|
id, text, like_count | ID, testo e like del commento | Sì |
sub_comment_count | Numero di risposte | Sì, per scegliere i thread da cui prendere le risposte |
comment_tags | “Piace all'autore”, “in evidenza”, risposte ai sondaggi | Facoltativo, aiuta il filtro del rumore |
posted_at, ip_location | Ora e regione IP | Solo per report su orari o regioni |
author_name, author_id, immagine del profilo | Chi l'ha scritto | No, e non inserirli nei report |
note_url, next_page_token, sub_comments | Paginazione e prima risposta | Solo all'interno dell'agente di recupero |
Lo scheletro dello script: scoperta, recupero, filtro, etichettatura, controllo, report (esempio)
Abbiamo scritto lo scheletro qui sotto partendo dall'API degli script descritta nella documentazione. Non l'abbiamo eseguito, quindi consideralo un esempio di configurazione. Contiene cinque chiamate phase() ma sei tappe. Il filtro non è un agente: è una regex nello script e non consuma token.
Ogni scelta di design deriva da una misurazione presentata in questo articolo. Gli agenti di recupero restituiscono solo id, text e like_count, senza i dati dell'autore e altri 30 campi. Gli agenti di etichettatura usano uno schema con cinque etichette fisse. Il controllo a campione usa un modello diverso per rietichettare il 10% dei commenti, senza vedere le prime etichette.


export const meta = {
  name: 'xhs-comment-triage',
  description: 'Pull Xiaohongshu comments for a keyword, drop noise, label need/complaint/price/praise, write a table',
  whenToUse: 'You have a product keyword and want to know what the comment sections ask and complain about',
  phases: [
    { title: 'Discover', detail: '1 agent searches posts' },
    { title: 'Fetch', detail: '1 agent per post pulls 2 pages' },
    { title: 'Classify', detail: '1 agent per post labels comments' },
    { title: 'Verify', detail: 'another model relabels 10%' },
    { title: 'Report', detail: '1 agent writes the table' },
  ],
}

const KEYWORD = (args && args.keyword) || 'robot vacuum (Chinese keyword)'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['need', 'complaint', 'price', 'praise', 'other']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/   // "join the group" replies, empty text, emoji only

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Discover')
const found = await agent(
  `Use ${TOOL} with platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}. ` +
  `Follow next_page_token until you have ${NOTE_COUNT} posts. Keep each url exactly as returned, with xsec_token.`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'search' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `Use ${TOOL} for xiaohongshu/comments with params={url:"${note.url}"}, then fetch page 2 with next_page_token. ` +
    `On 429, wait error.retry_after seconds and retry, at most 3 times. On 422, do not retry; report it. ` +
    `Keep only id, text and like_count. Sum billing.charged_usd into charged_usd.`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Fetch', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `Label each Xiaohongshu comment as one of ${LABELS.join(', ')}. need = asks which model to buy or for a link; ` +
    `complaint = a product or service problem; price = cost, cheaper copies or where to buy; ` +
    `praise = the writer uses it and recommends it; other = jokes or off-topic.\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Classify', label: 'classify' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`Fetched ${ok.length}/${found.notes.length} posts; filter dropped ${ok.reduce((s, r) => s + r.dropped, 0)} comments`)

phase('Verify')
const second = await agent(
  `Label these comments on your own. Labels: ${LABELS.join(', ')}.\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'relabel-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Report')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `Write a Markdown table with count and share per label and 3 example comments per label, translated to English. ` +
  `End with API cost $${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)} and spot-check agreement ${agree}/${sample.length}.\n` +
  JSON.stringify({ counts, examples: all.slice(0, 150) }),
  { model: 'sonnet', effort: 'low', label: 'report' })
Alcune parti di questo scheletro sono facili da sbagliare, e la documentazione le tratta tutte. meta deve essere la prima istruzione e un semplice oggetto letterale. Se contiene una variabile, una chiamata di funzione o uno spread, /<name> scompare dall'autocompletamento (pagina sui workflow, “Edit a saved script”). I titoli in phases devono corrispondere esattamente agli argomenti di phase(), altrimenti la vista di avanzamento mostra un gruppo in più.
Quando un agente all'interno di pipeline() fallisce, il suo slot diventa null, quindi lo script chiama filter(Boolean). Quando fallisce un agente di cui fai direttamente await, l'intera esecuzione termina (“When an agent stalls and restarts”, stessa pagina). Le fasi di recupero ed etichettatura usano haiku. Il controllo e il report usano sonnet.
Claude Code sceglie il modello per gli agenti dei workflow con lo stesso ordine usato per i subagent. Un modello indicato nello script è il modello della singola chiamata. Se non è indicato alcun modello, l'agente usa quello della sessione (pagina sui workflow, “Cost”; la documentazione sui subagent elenca gli alias sonnet, opus, haiku e fable).
Perché il filtro sta nello script e non in un modello? Lo script è JavaScript puro, quindi una regex, un filtro e un conteggio non consumano token. Il filtro rimuove le risposte “entro nel gruppo”, i testi vuoti e i commenti fatti solo di emoji. Nessuno di questi casi richiede comprensione.
La sezione successiva mostra che erano 25 dei nostri 100 commenti. Anche il riferimento per la scrittura incluso nel pacchetto dice che un workflow deve registrare con log() ciò che scarta quando limita la copertura. Senza quella riga, chi legge presume una copertura completa. La riga log() dello scheletro svolge proprio questo compito.
Test 1: il catalogo indica 15 righe per pagina; 4 pagine su 8 ne avevano 10
Per xiaohongshu/comments, il catalogo indica page_size 15 e limit_ignored true. Quindi la dimensione della pagina è fissa e un valore di limit non ha effetto. xiaohongshu/sub_comments ne ha 10, xiaohongshu/search 20 e comments_batch 15 per post. Prima dei test abbiamo annotato l'ipotesi “ogni pagina ha 15 righe”. I dati l'hanno smentita.
Alle 00:15:22 SGT la prima pagina del post A aveva 10 righe, e la seconda, alle 00:15:49, ne aveva 15. Alle 00:17:38 una chiamata comments_batch per 3 post ha restituito 10 righe per C, 10 per D e 15 per E. Alle 00:17:55 il post F via MCP ne ha restituite 10. La media delle 8 pagine è 12,5 righe.
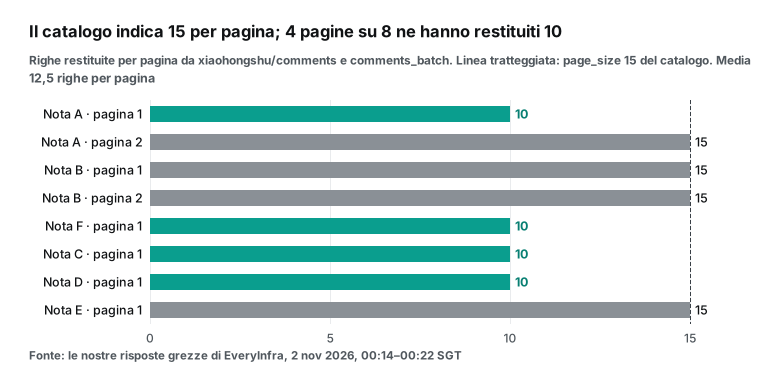
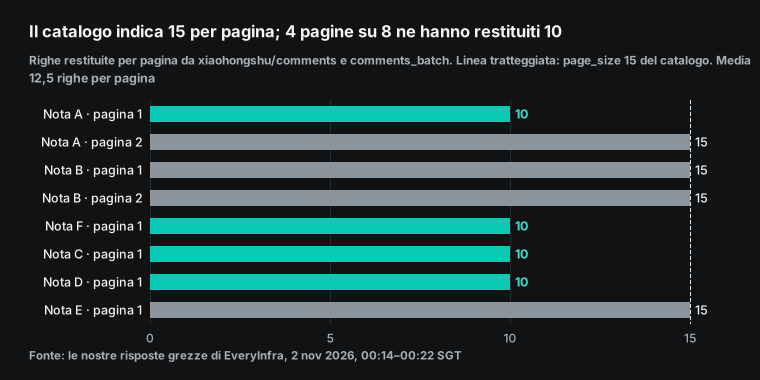
Una pagina corta non significa che i commenti siano finiti. Per i post A e F, pagination.has_more era true sulla pagina corta. Per i post C e D nel risultato batch, ogni riga aveva un next_page_token. La pagina 2 del post A è tornata a 15 righe. La nostra ipotesi è che la piattaforma tratti diversamente la prima pagina, per esempio per i commenti in evidenza o con sondaggio. Non abbiamo altre prove, quindi riportiamo solo ciò che abbiamo visto.
La conseguenza pratica riguarda la regola di arresto. Con una dimensione di pagina variabile, “numero obiettivo diviso 15” non dà il numero di chiamate. La regola di arresto corretta è “ho abbastanza righe” oppure “has_more è false”, non “ho recuperato N pagine”.
Le risposte si comportano allo stesso modo. Un commento del post B aveva sub_comment_count 52. Alle 00:17:17 SGT abbiamo chiamato xiaohongshu/sub_comments per quel commento. La pagina 1 ha restituito 5 righe, non 10, e 2 avevano il testo vuoto, probabilmente immagini o sticker.
Quindi le risposte costano di più per riga utile. Una pagina di commenti principali ha dato in media 12,5 righe per 0,005556 $, mentre questa pagina di risposte ha dato 3 righe con testo. Per l'etichettatura ti consigliamo di saltare le risposte per impostazione predefinita. Recuperale solo per un commento che il modello classifica come reclamo e che ha molte risposte.
| Funzionalità | page_size nel catalogo | Righe per pagina osservate | Prezzo per chiamata | Costo per riga utile |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20 (1 pagina) | $0.005556 | circa 0,00028 $ per post |
xiaohongshu/comments | 15 | da 10 a 15, media 12,5 (8 pagine) | $0.005556 | circa 0,00044 $ per commento |
xiaohongshu/comments_batch | 15 per post | da 10 a 15 per post (3 post) | 0,005556 $ per post | uguale a quello di un singolo post |
xiaohongshu/sub_comments | 10 | 5, di cui 2 senza testo (1 pagina) | $0.005556 | circa 0,0019 $ per risposta |
Test 2: cosa rimuove un filtro a regole e cosa non può fare
La nostra terza ipotesi era “i commenti possono andare direttamente al modello”. La soglia di superamento era meno del 30% di rumore su ogni post. Il post A l'ha mancata di molto. Dei suoi 25 commenti su due pagine, 24 dicevano solo “entro nel gruppo” (17), “ci sto” (6) o “entro” (1) in cinese. Lo screenshot mostra che la maggior parte ha il tag “piace all'autore” e alcuni hanno un tag di risposta a un sondaggio. Ognuno ha sub_comment_count 1.
La nostra interpretazione è che l'autore abbia organizzato un acquisto di gruppo nei commenti e che gli utenti abbiano risposto per essere aggiunti. Questi commenti non dicono nulla su ciò che gli utenti vogliono, ma riempiono pagine addebitate. Tra gli altri 5 post, solo il post D aveva 1 riga di rumore, un commento vuoto.
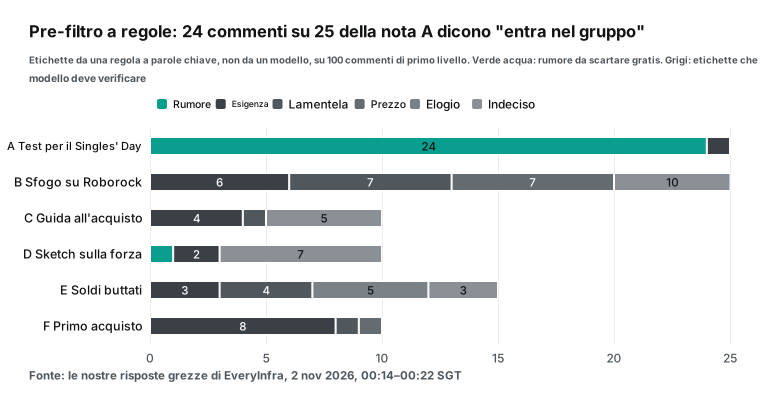
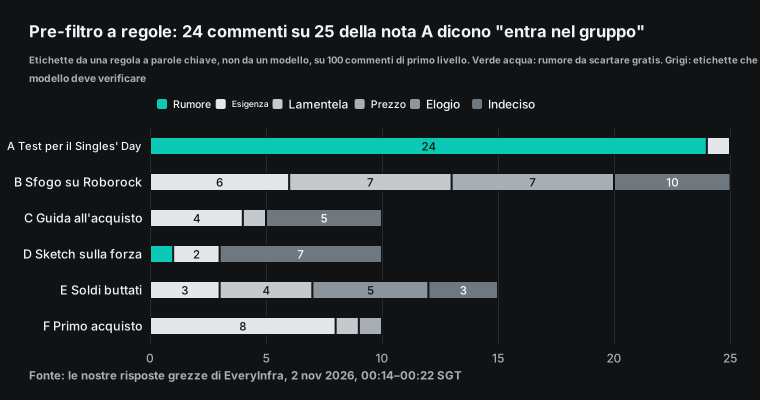
Per vedere cosa può fare una sola regex, abbiamo scritto come baseline un classificatore a regole basato su parole chiave. Prima la regola marca il rumore: testo composto solo da “entro nel gruppo”, solo da emoji, o vuoto. Poi cerca parole di reclamo (puzza, reso, soldi buttati, si aggroviglia), poi parole di esigenza (consigliate, quale, punti interrogativi), poi parole di prezzo (prezzo, yuan, alternativa economica, budget), infine parole di elogio (funziona bene, pulito, fa risparmiare tempo). Un commento che non corrisponde a nulla è “incerto”.
Questo non è un risultato del modello. Mostra quali parti può gestire una regola e quali richiedono un modello. Su 100 commenti, la regola ha dato rumore 25, esigenza 24, reclamo 13, prezzo 8, elogio 5 e incerto 25.
| La regola ha classificato bene | La regola ha sbagliato o non ha saputo decidere |
|---|---|
| Tutte le 25 risposte “entro nel gruppo” corrispondevano esattamente e sono state rimosse | “Quindi il fantasma si è nascosto in casa nostra per quattro giorni...?” è una battuta, ma il punto interrogativo l'ha resa un'esigenza |
| “3 yuan l'uno, dura un mese” è finito in prezzo | “Il mio Xiaomi economico non aggroviglia i capelli” è un elogio, ma la parola “aggroviglia” l'ha reso un reclamo |
| “140 metri quadrati... budget 3.000, quale prendo?” è finito in esigenza | “Solo leggendo i commenti ho scoperto che il sacchetto della polvere è monouso” è una nuova informazione, quindi è rimasto incerto |
| “Lo scarico della base puzza, come lo risolvo?” è finito in reclamo | “Stai 30 minuti accanto alla lavatrice?” è una domanda retorica, ma è finita in esigenza |
La tabella spiega perché lo script ha due fasi. La regola rimuove solo il rumore. Il rumore è sempre uguale, e uno scarto sbagliato non costa quasi nulla. Le quattro intenzioni passano a un modello, perché un punto interrogativo può indicare una richiesta, una domanda retorica o una battuta.
Il post C ha “guida all'acquisto” nel titolo e il post D ha “robot aspirapolvere” nel titolo. Ma nelle loro sezioni commenti si parla soprattutto della trama comica del creator e di fitness. Almeno sette di quelle righe sono battute che sia una regola sia un modello dovrebbero classificare come “altro”. Se scegli i post solo dal titolo, sovrastimi i commenti utili. Ti consigliamo quindi di passare all'agente di scoperta anche is_cooperation_note, il numero di commenti e il titolo. Così può scartare subito i post chiaramente comici.
La ricerca sull'etichettatura di testi con i modelli aiuta a impostare il controllo a campione. Uno studio ha rilevato che le etichette zero-shot superano i crowd worker nella maggior parte dei compiti (arXiv 2303.15056). Un altro ha rilevato grandi differenze tra modelli e compiti (arXiv 2311.05769), e un articolo metodologico indica una validazione rigorosa come passaggio obbligatorio (Sociologica, 2024). Per questo lavoro, ciò si traduce in tre regole. Non saltare il controllo a campione. Usa un modello diverso che non veda le prime etichette. Fissa in anticipo una soglia, per esempio l'80% di concordanza. Se l'esecuzione resta sotto, modifica le definizioni delle etichette e rietichetta l'intero batch.
Test 3: la stessa pagina richiesta tre volte ha dato 7 commenti nuovi, e ogni chiamata è stata addebitata
Questo test risponde a una domanda sui workflow: cosa succede quando un agente fallisce e viene rieseguito? Abbiamo recuperato la prima pagina del post B alle 00:15:33 SGT. Abbiamo inviato di nuovo lo stesso corpo della richiesta alle 00:21:35 e alle 00:21:55. La seconda risposta aveva in comune con la prima solo 8 commenti su 15.
La terza ne aveva 13 in comune con la prima e 10 con la seconda. In totale, le tre chiamate hanno restituito 22 commenti distinti. Ogni chiamata è costata 0,005556 $, e la richiesta identica non l'ha resa gratuita.
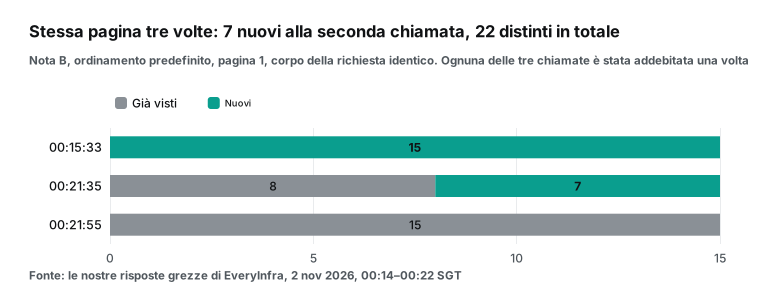
Quindi l'ordinamento predefinito non è stabile. Cambia nel tempo e con il ranking della piattaforma. In un workflow, questo si somma alle regole di ripresa. La documentazione è chiara: alla ripresa, gli agenti completati restituiscono i risultati salvati.
Ma il primo agente il cui prompt è cambiato viene rieseguito, e con lui tutti gli agenti successivi. Un agente fallito viene rieseguito, insieme a tutti gli agenti che lo script avvia dopo di lui, anche quelli completati. La documentazione fa un esempio: uno script avvia A, B, C e D, e B fallisce. Alla ripresa, A arriva dalla cache, mentre B, C e D vengono rieseguiti (pagina sui workflow, “Which agents run again”).
La v2.1.305 del 20 ottobre 2026 ha corretto un problema collegato. Prima di quella correzione, alla ripresa uno script non modificato poteva rieseguire gli agenti completati in pipeline() e parallel() (changelog 2.1.305).
Metti insieme i due fatti. Quando un agente di recupero viene rieseguito, chiama di nuovo l'API e paghi di nuovo. I commenti restituiti possono essere diversi, quindi le etichette già prodotte dagli agenti successivi potrebbero non corrispondere. Ti consigliamo tre regole al di fuori dello scheletro.
Primo, separa recupero ed etichettatura in due workflow. Il primo workflow si limita a recuperare i dati e scrivere i file. Quando i dati sembrano corretti, il secondo workflow legge i file e li etichetta. Così un errore nell'esecuzione di etichettatura non tocca mai l'API.
Secondo, recupera con sort=newest o sort=most_liked, molto più stabili dell'ordinamento predefinito. Non cambiare l'ordinamento durante la paginazione, perché secondo il catalogo un vecchio next_page_token smette di funzionare. Terzo, deduplica le etichette per id del commento prima di contarle, perché lo stesso commento può comparire in due recuperi.
Gli stalli causano un altro tipo di riesecuzione. Se un agente non produce output abbastanza a lungo, riparte dallo stesso prompt, fino a cinque volte. I file che ha già modificato restano modificati, e i suoi token restano nel totale dell'esecuzione (pagina sui workflow, “When an agent stalls and restarts”). Il tempo passato ad attendere le proprie chiamate agli strumenti non conta, quindi una chiamata API da 2,5 secondi non provoca uno stallo.
Un errore diverso si verifica quando uno stream di risposta resta in silenzio. Un watchdog di inattività dello streaming lo interrompe, e CLAUDE_STREAM_IDLE_TIMEOUT_MS imposta quel timeout (documentazione sulla configurazione di rete). Se un agente attende a lungo dopo un 429 senza produrre output, può essere considerato in stallo e ripartire. A quel punto ripete chiamate che hai già pagato.
Il nostro 429 chiedeva un'attesa di 1 secondo, quindi il rischio era basso. Su una chiave condivisa molto usata, le attese si allungano. In quel caso, assegna agli agenti di recupero un proprio stallMs, per esempio agent(prompt, { stallMs: 600000 }).
Limiti di frequenza in parallelo: 16 agenti contro una chiave da 10 richieste al minuto
Per impostazione predefinita, un workflow esegue 16 agenti alla volta. La nostra chiave ha un limite proprio di 10 richieste al minuto, e altri programmi la usavano nello stesso momento. Abbiamo fatto una chiamata circa ogni 10 secondi, che dovrebbe stare ben sotto il limite. Ma l'header x-ratelimit-remaining-requests indicava 5, 5, 2 e 0.
Alle 00:15:59 SGT una chiamata ha restituito 429. Dopo, l'header indicava 8, 3, 6, 5 e 1. Ecco come appare una chiave condivisa. Non puoi vedere quando la usano gli altri, quindi puoi solo leggere l'header e i 429. Se una chiave la usa solo il tuo programma, il conteggio residuo dovrebbe scendere a ogni tua chiamata, senza salire e scendere. Questi salti dipendono dalla chiave condivisa, e su una chiave tutta tua non li vedrai.
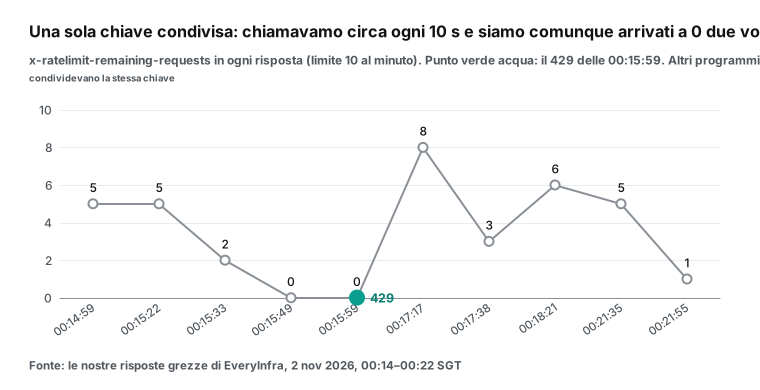
Un agente può leggere direttamente il corpo del 429. Il testo era "rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.". Il corpo conteneva anche retry_after: 1, retryable: true, max_retries: 3 e la frase “Nothing was charged”. Per sicurezza abbiamo atteso più di 60 secondi e alle 00:17:17 abbiamo ricevuto un 200.
Il 429 non è costato nulla e non rientra nel nostro totale addebitato. Il prompt di recupero nello scheletro usa la stessa regola: in caso di 429, attendi error.retry_after secondi e riprova, al massimo 3 volte. Anche l'API di Anthropic restituisce 429 con un header retry-after quando vai troppo veloce (documentazione di Anthropic sui limiti di frequenza). Una sola regola nel prompt copre entrambi i casi.
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
  "next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}
I nuovi tentativi sono una difesa passiva. Ce ne sono due attive. La prima è ridurre le richieste simultanee: imposta CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS a 2 o 3.
Un agente di recupero che scarica due pagine richiede circa 5 secondi di tempo API più il proprio tempo di ragionamento. Con 3 agenti, la frequenza delle richieste si avvicina a 10 al minuto, e i nuovi tentativi coprono il resto. Questa variabile vale per l'intera esecuzione, quindi rallenta anche gli agenti di etichettatura. Se conta il tempo totale, separa recupero ed etichettatura in due workflow e non limitare l'esecuzione di etichettatura.
La seconda difesa attiva è la chiamata batch. xiaohongshu/comments_batch accetta fino a 20 post per richiesta e addebita per post. Alle 00:17:38 SGT abbiamo recuperato 3 post in una sola richiesta. Ha restituito 35 commenti ed è costata 0,016667 $, cioè 0,005556 $ per post, come xiaohongshu/comments. La richiesta ha impiegato 3,28 secondi, mentre una chiamata per un singolo post ne richiedeva circa 2,4.
| Prime pagine di 40 post | Richieste | Minuti minimi a 10 al minuto | Costo API |
|---|---|---|---|
Una chiamata xiaohongshu/comments per post | 40 | 4 | $0.22224 |
xiaohongshu/comments_batch, 20 post per chiamata | 2 | 1 | $0.22224 |
La chiamata batch cambia il numero di richieste, non il costo. Per una chiave condivisa e un workflow, il vero collo di bottiglia è il numero di richieste. 40 richieste su una chiave da 10 al minuto richiedono almeno 4 minuti. 2 richieste finiscono in pochi secondi. Uno scheletro migliore usa quindi 1 o 2 agenti per chiamare comments_batch su tutte le prime pagine dopo la scoperta. Poi prosegue con la paginazione solo sui post con molti commenti.
Ogni riga di un risultato batch ha un next_page_token, quindi puoi proseguire con xiaohongshu/comments. Il catalogo contiene un'avvertenza: quando alcuni post falliscono, controlla partial e missed nella risposta. Non trattare un post mancante come un post senza commenti. Inserisci questa frase nel prompt di recupero.
È disponibile anche la modalità asincrona. Secondo il catalogo, qualsiasi funzionalità accetta "mode":"async" nel corpo. Ricevi subito un 202 e un job_id, poi interroghi GET /api/v1/jobs/{job_id}. Alle 00:18:21 SGT abbiamo usato la modalità asincrona per la pagina 2 del post B. Il 202 mostrava già lo stato succeeded.
Alle 00:18:30 il polling ha restituito 15 righe. Il polling è gratuito e non rientra nel limite al minuto, come indica la descrizione dello strumento everyinfra_get_job. I commenti arrivano in 2-3 secondi, quindi non serve la modalità asincrona. Ma se lo stesso workflow chiama anche funzionalità lente, la modalità asincrona con polling evita che gli agenti restino in attesa su richieste aperte.
Errori, nuovi tentativi e fatturazione: cosa può farti pagare due volte
La tabella affianca le nostre osservazioni al comportamento dei workflow. La colonna “Comportamento del workflow” proviene dalla pagina sui workflow. La colonna “Fatturazione API” proviene dalle nostre risposte grezze.
| Evento | Comportamento del workflow | Fatturazione API | Difesa nello script |
|---|---|---|---|
| 429 per limite di frequenza delle richieste | Lo gestisce l'agente | Non addebitato (“Nothing was charged”) | Nuovo tentativo dopo retry_after, al massimo 3 volte |
422 per valore non valido, come sort=hottest | Lo gestisce l'agente | Non addebitato | Non riprovare; riporta il messaggio |
| L'agente va in stallo | Riparte dallo stesso prompt, fino a 5 volte | Le chiamate riuscite vengono rieseguite e addebitate di nuovo | Imposta stallMs sugli agenti di recupero |
| Ripresa dopo un agente fallito | Quell'agente e tutti i successivi vengono rieseguiti | I recuperi rieseguiti vengono addebitati di nuovo | Separa recupero ed etichettatura in due workflow |
| Stessa richiesta entro 6 minuti | Non applicabile | Addebitata ogni volta, e il contenuto cambia | Deduplica per id del commento |
| L'output delle etichette non rispetta lo schema | Riprova e fallisce dopo cinque tentativi | Nessuna chiamata API | Mantieni lo schema piccolo |
| Limite di utilizzo dell'abbonamento | Si mette in pausa fino al reset, dalla v2.1.271, se le condizioni sono soddisfatte | Nessuna chiamata API | Prova prima su un piccolo campione |
Per la riga sul limite di utilizzo, anche la sessione stessa può attendere un reset (documentazione sulla modalità interattiva). Il test del 422 è stato eseguito alle 00:16:07 SGT, con sort impostato di proposito su hottest. La risposta diceva `"sort must be one of: default, most_liked, newest (got 'hottest')". Riportava anche l'elenco allowed e did_you_mean: ["most_liked"]`, e indicava che non era stato addebitato nulla.
Questo tipo di errore si presta bene a un workflow. Un agente di recupero può leggerlo, cambiare un valore e proseguire senza farti domande. Nel nostro articolo sullo strict tool use abbiamo mostrato che le definizioni strict degli strumenti bloccano i valori enum non validi lato modello. In un workflow, una soluzione più semplice è fissare il valore di sort nel prompt di recupero.
Il conto: quante chiamate servono e quanto costano 500 commenti
Per questo lavoro l'API ha un unico prezzo unitario. Abbiamo letto il catalogo alle 00:14 SGT del 2 novembre 2026. xiaohongshu/search, xiaohongshu/comments, xiaohongshu/sub_comments e xiaohongshu/comments_batch costano ciascuno 0,005556 $ per chiamata (per post nel caso del batch). Le chiamate fallite e i risultati vuoti sono gratuiti. Per una funzionalità paginata, il numero di chiamate è l'obiettivo di righe diviso le righe per pagina, arrotondato per eccesso.
I tre metodi qui sotto contano solo le pagine di commenti. La ricerca restituisce 20 post per pagina. 500 commenti richiedono di solito da 20 a 40 post, il che aggiunge 1 o 2 chiamate, da 0,0056 $ a 0,0111 $.
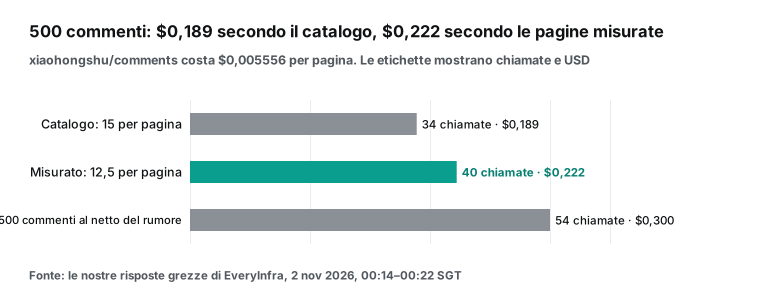
| Metodo | Righe per pagina | Chiamate | Costo API |
|---|---|---|---|
| Valore del catalogo | 15 | 34 | $0.188904 |
| La nostra media misurata | 12.5 | 40 | $0.22224 |
| 500 commenti utili dopo il 25% di rumore | 12.5 | 54 (scaricandone prima 667) | $0.300024 |
| Spesa per questo articolo: 10 richieste addebitate, 12 unità addebitate | n/a | 10 | $0.066671 |
La tabella seguente elenca ogni richiesta di questo test, in ora SGT del 2 novembre 2026. Il 429, il 422 e il polling del job erano gratuiti.
| Orario (SGT) | Richiesta | HTTP | Righe | Addebitate |
|---|---|---|---|---|
| 00:14:59 | xiaohongshu/search | 200 | 20 post | $0.005556 |
| 00:15:22 | xiaohongshu/comments, post A pagina 1 | 200 | 10 | $0.005556 |
| 00:15:33 | xiaohongshu/comments, post B pagina 1 | 200 | 15 | $0.005556 |
| 00:15:49 | xiaohongshu/comments, post A pagina 2 | 200 | 15 | $0.005556 |
| 00:15:59 | xiaohongshu/sub_comments, articolo B | 429 | 0 | $0 |
| 00:16:07 | xiaohongshu/comments con sort=hottest | 422 | 0 | $0 |
| 00:17:17 | xiaohongshu/sub_comments, articolo B | 200 | 5 | $0.005556 |
| 00:17:38 | xiaohongshu/comments_batch, post C, D, E | 200 | 35 | $0.016667 |
| 00:17:55 | MCP everyinfra_call_api, articolo F | 200 | 10 | $0.005556 |
| 00:18:21 | xiaohongshu/comments asincrono, post B pagina 2 | 202 | 15 al polling | $0.005556 |
| 00:21:35 | xiaohongshu/comments, di nuovo post B pagina 1 | 200 | 15 | $0.005556 |
| 00:21:55 | xiaohongshu/comments, di nuovo post B pagina 1 | 200 | 15 | $0.005556 |
Il terzo metodo richiede cautela. La quota di rumore del 25% viene dai nostri 6 post, e quasi tutta dal post A. Con un'altra parola chiave, la quota può essere 0 o molto più alta. Esegui quindi prima il workflow su 3-5 post.
Leggi il conteggio del filtro nella riga log(), poi decidi quanti post scaricare. La documentazione dà lo stesso consiglio sui costi: esegui prima un piccolo campione, controlla i token di ogni agente in /workflows e, se necessario, interrompi l'esecuzione (pagina sui workflow, “Cost”).
Non abbiamo misurato il lato Claude, quindi riportiamo solo i dati che puoi verificare. La pagina dei prezzi di Anthropic, consultata il 2 novembre 2026, indica questi prezzi per milione di token. Haiku 5.5 costa 0,10 $ in input e 0,50 $ in output per prompt fino a 100.000 token. Sonnet 5.5 costa 2 $ e 10 $. Opus 5.5 costa 4 $ e 20 $.
Solo come testo, 500 commenti valgono circa 12.000 token secondo la regola empirica della pagina (10 kB corrispondono a circa 2.500 token). L'input di Haiku per quel testo costa meno di 0,002 $. La maggior parte del costo sta altrove. Ogni agente porta con sé un system prompt, le definizioni degli strumenti e il proprio ragionamento, e quella dimensione dipende dalla tua versione e dai tuoi strumenti MCP. Non l'abbiamo misurata, quindi controlla i tuoi numeri in /workflows.
Con un abbonamento, l'uso dei workflow conta per i limiti del piano. La documentazione sui costi dice che ogni subagent e ogni agente di workflow invia le proprie richieste. Nel thread di lancio su Reddit, un utente ha scritto che un solo prompt ha consumato 700.000 token e il 36% dell'utilizzo di un piano Max. Un altro ha detto che il primo tentativo ha consumato 1,2 milioni di token (thread di lancio su Reddit). Sono segnalazioni di utenti che non possiamo verificare, ma mostrano comunque perché è importante un primo test ridotto.
Contesto e token: perché la fase di recupero deve snellire i dati
Un commento restituisce in media circa 1.445 byte di JSON, mentre il solo testo occupa circa 95 byte, cioè circa 15 volte meno. Il JSON grezzo contiene, tra 20 campi, il nome dell'autore, l'URL dell'avatar, la regione IP, i tag, la prima risposta e un URL del post con xsec_token. Quasi nessuno serve all'etichettatura.
Secondo il rapporto approssimativo della pagina dei prezzi, un commento grezzo vale circa 361 token e il suo testo circa 24 token. In pratica il testo cinese segue un rapporto diverso. Per numeri esatti, usa l'endpoint di conteggio dei token con il tuo modello.
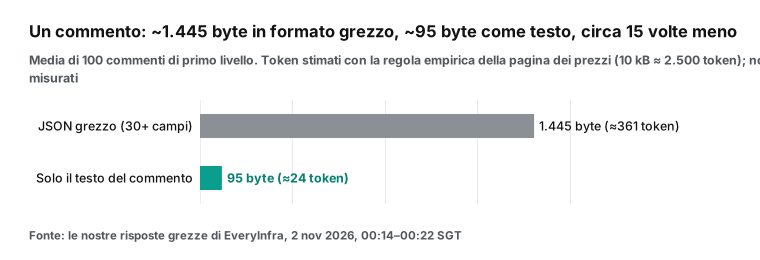
Questa differenza conta in due punti. Il primo è l'input degli agenti di etichettatura. Se gli agenti di recupero restituiscono JSON grezzo, ogni agente di etichettatura legge da 10.000 a 30.000 token di JSON per post. Se restituiscono il testo, ne legge poche centinaia.
Il secondo è il prompt caching. Secondo la documentazione, gli agenti di una stessa esecuzione con lo stesso modello, livello di effort, tipo di agente, strumenti, schema di output e directory di lavoro condividono un prefisso. Un agente successivo può leggere la cache di quello precedente. Per impostazione predefinita, gli agenti dei workflow mantengono la cache per 5 minuti.
subagentPromptCacheTtl impostato a 1h la mantiene per un'ora, con un prezzo di scrittura più alto (pagina sui workflow, “Prompt caching in a fan-out”; documentazione sul prompt caching). Nello scheletro, tutti gli agenti di recupero usano lo stesso modello haiku, effort low e schema COMMENTS, quindi possono condividere quel prefisso. Se assegni un modello diverso a ogni post, perdi la cache condivisa.
La fase di etichettatura: schema, definizioni delle etichette e concordanza
Lo schema di etichettatura ha due campi: id e label, con label limitato a cinque valori. Meno campi significano meno errori e meno nuovi tentativi per lo schema. Se ti servono anche budget, superficie e animali domestici, aggiungi una fase di estrazione separata ed eseguila solo sui commenti che il modello ha etichettato come esigenza. Non aggiungere molti campi facoltativi allo schema di etichettatura.
L'API di Anthropic vincola l'output con un json_schema in output_config.format (documentazione sugli structured outputs). L'opzione schema dei workflow fa lo stesso all'interno di Claude Code. Il valore restituito è già un oggetto, quindi lo script non deve fare il parsing del testo.
Scrivi ogni definizione di etichetta in modo che una persona possa applicarla. Tutti e quattro gli errori della nostra baseline a regole derivavano da definizioni vaghe. Una domanda retorica e una battuta sembravano esigenze. Un confronto (“il mio modello economico non aggroviglia i capelli”) sembrava un reclamo. Per questo lo scheletro definisce cosa significa ogni etichetta, non quali parole contiene. Gli esempi sono commenti tradotti dai nostri 6 post.
| Etichetta | Definizione | Esempio dai nostri dati |
|---|---|---|
| need | Chiede quale modello comprare o chiede un link | “140 metri quadrati, piastrelle, tanti capelli, budget 3.000, quale prendo?” |
| complaint | Segnala un problema del prodotto o del servizio | “Lo scarico della base puzza, come lo risolvo?” |
| price | Parla di costi, alternative economiche o di dove comprare | “3 yuan l'uno, dura un mese” |
| praise | Chi scrive usa il prodotto e lo consiglia | “Il mio Xiaomi economico non aggroviglia i capelli” |
| other | Battute, commenti sulla trama, fuori tema | “Quindi il fantasma si è nascosto in casa nostra per quattro giorni...?” |
E un commento che è sia un'esigenza sia un commento sul prezzo, come “budget 3.000, quale prendo?”? Etichettiamo in base a ciò che vuole chi scrive, quindi questo è un'esigenza. Se al tuo team interessano di più le fasce di prezzo, metti il prezzo prima dell'esigenza e indica quest'ordine nel prompt.
Il controllo a campione riprende la revisione avversariale descritta nella documentazione dei workflow, in cui agenti indipendenti contestano a vicenda i propri risultati prima che l'esecuzione li riporti (pagina sui workflow, “When to use a workflow”). L'etichettatura non è una caccia ai bug, quindi il nostro agente di controllo non cerca di confutare le prime etichette. Rietichetta il campione senza vederle. Poi lo script calcola il tasso di concordanza. Un modello diverso (Sonnet nello scheletro) riduce la probabilità che entrambi gli agenti commettano lo stesso errore.
La concordanza è solo un limite inferiore. Se entrambi i modelli classificano una battuta come esigenza, la concordanza è alta ma l'etichetta è sbagliata. Per una nuova parola chiave, quindi, alla prima esecuzione leggi tu stesso 20 commenti del campione. Aggiungi alle definizioni delle etichette i disaccordi e gli errori evidenti. Poi rietichetta l'intero batch.
Limiti e avvertenze
La tabella elenca sette limiti e cosa fare per ciascuno. Le prime due righe provengono dalla pagina sui workflow, “Behavior and limits”.
| Limite | Effetto | Cosa fare |
|---|---|---|
| Lo script non può accedere alla rete | Ogni chiamata API avviene dentro un agente, che può fare una chiamata in più | Restituisci calls e charged_usd tramite lo schema e controlla il totale |
| Un'esecuzione non può chiederti input | Nessuna revisione tra recupero ed etichettatura | Un workflow per fase |
| Un'esecuzione si interrompe quando esci | Gli agenti in esecuzione ripartono da capo al rilancio | Rilancia dai risultati salvati |
Gli URL per i commenti richiedono xsec_token | Un URL “ripulito” non funziona | Mantieni l'URL esattamente come restituito |
| Solo commenti pubblici | Mancano i commenti nascosti o compressi | Aspettati meno opinioni negative |
| Le nostre etichette sono una baseline a regole | I conteggi non sono output del modello | Esegui il controllo a campione sui tuoi dati |
| Le versioni sono diverse | Molti tutorial descrivono il comportamento precedente | Esegui claude --version; questo articolo usa la 2.1.316 |
Un'esecuzione non prosegue da sola dopo che hai mandato la sessione in background o ne sei uscito. Claude deve rilanciarla dai risultati salvati, e gli agenti ancora in esecuzione ripartono da capo e consumano di nuovo token (documentazione su agent view).
Il catalogo richiede l'URL completo per i commenti, preso da un risultato di ricerca recente e con la sua query string. I token di pagina durano 24 ore, quindi una ripresa il giorno dopo deve ricominciare da zero. I numeri sui 500 commenti derivano dal prezzo unitario e dalle dimensioni di pagina misurate: non abbiamo scaricato 500 commenti. Questo articolo si basa sulla documentazione consultata il 2 novembre 2026.
I dati dei commenti includono regioni IP e nomi visualizzati. Nel report inserisci solo etichette, conteggi e citazioni senza nomi. Prima di inviare o pubblicare citazioni dei commenti, verifica che il tuo utilizzo rispetti la legge locale e i termini della piattaforma. Questo articolo descrive un metodo di gestione dei dati e non costituisce consulenza legale.
FAQ
claude code workflows vs agent teams: quale conviene per smistare i commenti?
Gli agent teams sono formati da un agente principale, alcune sessioni peer di lunga durata e un elenco di attività condiviso. Sono sperimentali e richiedono un flag (documentazione degli agent teams). Un workflow è uno script che avvia decine o centinaia di agenti di breve durata. Per centinaia di commenti indipendenti è più adatto un workflow. Per pochi post che vuoi guidare turno per turno sono più adatti i normali subagent, come nel nostro articolo sui subagent di Claude Code. (Origine della domanda: il suggerimento di completamento automatico «claude code workflows vs agent teams».)
Workflow o Skill in Claude Code: mi servono entrambi?
Una Skill è un insieme di istruzioni che Claude segue nella conversazione. Un workflow è uno script eseguito da un runtime (pagina dei workflow). I due strumenti funzionano insieme. Metti le definizioni delle etichette in una Skill e lascia che gli agenti del workflow la carichino. Così le definizioni restano in un solo posto. (Origine della domanda: il suggerimento «claude code workflows vs skills».)
Quanti token usa una singola esecuzione di un workflow dinamico di Claude Code?
La documentazione non indica un numero fisso. Spiega che un'esecuzione può usare molti più token rispetto allo stesso lavoro svolto in una conversazione. Suggerisce di partire da una piccola porzione del lavoro e di controllare /workflows (pagina dei workflow, «Cost»). Alcuni utenti di Reddit hanno segnalato un consumo compreso tra 700.000 e 1,2 milioni di token per un solo prompt (Reddit). Il costo API di questo lavoro è a parte: circa $0,222 per 500 commenti. (Origine della domanda: il suggerimento «claude code workflows cost», che ha dieci varianti, come «cost per token» e «cost reddit».)
Cos'è ultracode e conviene attivarlo?
Ultracode è un'opzione di Claude Code. Quando è attiva, Claude decide per ogni attività non banale se scrivere un workflow. Non è un livello di effort.
In una sessione, /effort ultracode (v2.1.284 o successive) attiva solo l'opzione e mantiene il livello di effort. Solo il flag di avvio claude --effort ultracode imposta anche l'effort su xhigh (documentazione sulla configurazione del modello). Con l'opzione attiva, l'avviso «Large workflow» non compare. Per i lavori che chiamano un'API a pagamento, ti consigliamo di lasciarla disattivata e di chiedere un workflow in un solo prompt. (Origine della domanda: i suggerimenti «ultracode claude» e «ultracode claude reddit».)
Come faccio a fermare un workflow per una revisione umana?
La documentazione risponde che un'esecuzione non può chiedere input, quindi un'approvazione richiede workflow separati (pagina dei workflow, «Behavior and limits»). Puoi anche selezionare un'esecuzione in /workflows e premere x per fermarla; gli agenti già completati conservano i loro risultati. Una discussione su Hacker News ha sollevato lo stesso problema: la parte difficile è inserire il giudizio umano nelle esecuzioni lunghe (Hacker News, 2026-05-28). (Origine della domanda: un utente nel thread di lancio su Reddit ha chiesto quali segnali fermano i subagent prima che proseguano lungo un ramo sbagliato.)
Come iniziare
- Ottieni una chiave dalla guida rapida di EveryInfra, poi consulta il catalogo gratuito per
xiaohongshu/searchexiaohongshu/comments. - Aggiungi il server MCP remoto a Claude Code con il comando qui sopra. Vedi la configurazione del server MCP remoto e la pagina del server MCP.
- Chiedi a Claude Code un workflow che segua lo schema su 5 post. Leggi il piano, poi seleziona «Yes, run it».
- Dopo l'esecuzione, controlla i token in
/workflowse confronta il costo API con la pagina dei prezzi. Salva un'esecuzione riuscita come comando cons.
Lo stesso schema funziona su altre piattaforme se cambi i nomi delle funzionalità. Vedi l'API per i dati di Xiaohongshu, con commenti, risposte e commenti in batch. Per altre piattaforme cinesi, vedi l'API per i dati di Douyin e l'API per i dati di Weibo. Per ripulire i commenti prima dell'etichettatura, leggi DeepSeek V4 in Claude Code per la pulizia dei commenti.
Riferimenti
- «Orchestrate subagents at scale with dynamic workflows». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/workflows
- «Claude Code changelog». Anthropic. Ultima voce 2.1.316, 2026-10-31. https://code.claude.com/docs/en/changelog
- CHANGELOG.md. anthropics/claude-code su GitHub. Consultato il 2026-11-02. https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- «Introducing dynamic workflows». Anthropic. 2026-05-28. https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- «Claude Code Adds Dynamic Workflows for Parallel Agent Coordination». InfoQ. Giugno 2026. https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- «Building agents: When to fold subagents into your main agent loop». Anthropic. 2026-10-22. https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- «Create custom subagents». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/sub-agents
- «Run agents in parallel». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/agents
- «Agent teams». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/agent-teams
- «Skills». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/skills
- «Settings reference». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/settings-reference
- «Model configuration». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/model-config
- «Environment variables». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/env-vars
- «Agent SDK reference», TypeScript. Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/agent-sdk/typescript
- «Connect Claude Code to tools via MCP». Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/mcp
- «Manage costs». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/costs
- «Configure permissions». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/permissions
- «Permission modes». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/permission-modes
- «Prompt caching in Claude Code». Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/prompt-caching
- «Run Claude Code programmatically». Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/headless
- «Hooks reference». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/hooks
- «Sandboxing». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/sandboxing
- «Plugin manifest reference». Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/plugins/manifest-reference
- «Agent view». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/agent-view
- «Claude Code on the web». Anthropic. Consultato il 2026-11-02. https://code.claude.com/docs/en/claude-code-on-the-web
- «Remote Control». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/remote-control
- «Interactive mode». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/interactive-mode
- «Network configuration». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/network-config
- «Scheduled tasks». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/scheduled-tasks
- «Commands». Anthropic, documentazione di Claude Code. Consultato il 2026-11-02. https://code.claude.com/docs/en/commands
- «Pricing». Anthropic, documentazione della piattaforma Claude. Consultato il 2026-11-02. https://platform.claude.com/docs/en/about-claude/pricing
- «Structured outputs». Anthropic, documentazione della piattaforma Claude. Consultato il 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- «Rate limits». Anthropic, documentazione della piattaforma Claude. Consultato il 2026-11-02. https://platform.claude.com/docs/en/api/rate-limits
- «Token counting». Anthropic, documentazione della piattaforma Claude. Consultato il 2026-11-02. https://platform.claude.com/docs/en/build-with-claude/token-counting
- «Transports», specifica 2025-11-25. Model Context Protocol. Consultato il 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- «Tools», specifica 2025-11-25. Model Context Protocol. Consultato il 2026-11-02. https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- «Xiaohongshu capability catalog». EveryInfra. Consultato il 2026-11-02 alle 00:14 SGT. https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- «Content review rules». Centro assistenza di Xiaohongshu Pugongying. Pagina datata 2026-10-22. https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- Home page di Pugongying. Xiaohongshu. Consultato il 2026-11-02. https://pgy.xiaohongshu.com/
- «ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks». Gilardi, Alizadeh, Kubli. arXiv 2303.15056, v2 2023-07-19. https://arxiv.org/abs/2303.15056
- «Are Chatbots Reliable Text Annotators? Sometimes». Kristensen-McLachlan e altri. arXiv 2311.05769, v2 2025-02-25. https://arxiv.org/abs/2311.05769
- «Best Practices for Text Annotation with Large Language Models». Petter Törnberg. Sociologica, 2024. https://sociologica.unibo.it/article/view/19461
- «Introducing dynamic workflows in Claude Code», thread di discussione. r/ClaudeAI. Maggio 2026. https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- «Dynamic Workflows in Claude Code», discussione. Hacker News. 2026-05-28. https://news.ycombinator.com/item?id=48311705
Riferimenti BL-64