DeepSeek Search APIに中国のSNSアプリ内のデータを組み合わせる
DeepSeek Search APIは1,000回の呼び出しあたり$0.75で、いいね数やコメント数は返しません。Xiaohongshu、Zhihu、Weiboのデータを追加すると、8回の実際の呼び出しで$0.014でした。
DeepSeekは2026年10月17日、SearchとFetchという2つの新しいエンドポイントをすべてのAPIユーザーに公開しました。料金はいずれも成功した1,000リクエストあたり$0.75です。Searchの結果には、タイトル、URL、2つの要約、ページ本文、サイト名、日付、2つのスコアが含まれます。いいね、コメント、保存の情報は含まれません(DeepSeek Search and Fetchガイド)。
11月3日00:15〜00:19(SGT)に、EveryInfraのxiaohongshu/search、zhihu/search、weibo/searchを1つのトピック「ロボット掃除機」で実行しました。98件すべてに、いいね数、コメント数、投稿時刻がありました。Xiaohongshuでは、33件中12件に、ブランドの有料コンテンツであることを示すフラグも付いていました。「中国の購入者は何に不満を持っているか」を問うブランドチームに必要なのはまさにこれらのフィールドで、Web検索の結果にはありません。
コストを左右する要因は明確です。Xiaohongshuの検索1ページは$0.005556で、DeepSeek Searchの呼び出し1回の7.4倍です。この記事の呼び出し上限を適用すると、質問1,000件あたりのデータコストは$20.89から$4.53に下がります。
この記事は、中国国外から中国市場向けに製品を販売するチームや、中国ブランドと競合するチームを対象としています。たとえば、ヨーロッパの家電ブランド、米国のロボット掃除機メーカー、クライアントのために中国の消費者の声を追跡する代理店などです。製品に関する質問に出典付きで答える小さなアシスタントが欲しいとします。DeepSeekには独自のWeb検索エンドポイントがあるため、オープンWebの部分は簡単です。この記事では、そのエンドポイントで何ができて何が返らないか、そして3つの中国アプリ内のデータをどう追加するかを説明します。各呼び出しの費用も示します。
この記事に記載したDeepSeekに関する事実はすべて、2026年11月3日に確認したapi-docs.deepseek.comに基づいています。私たちはDeepSeekのAPIキーを持っていません。そのため、DeepSeek側の設定は構成例であり、テスト結果ではありません。EveryInfraの数値はすべて、実際のAPI呼び出しで得た生のレスポンスから取得したものです。
以前の記事DeepSeek V4とClaude Codeによるコメントのクリーニングでは、Claude CodeのモデルとしてDeepSeekを使い、コメントのクリーニングにかかるコストを測定しました。SearchとFetchについては短いセクションが1つあるだけでした。この記事ではSearchエンドポイント自体から出発し、プラットフォーム内データとどう役割を分担すべきかを考えます。
DeepSeekのWeb検索APIでできること(11月3日時点のドキュメントより)
役割を分担する前に、DeepSeek側を正確に把握しておく必要があります。Search and Fetchガイドでは、両エンドポイントを「raw JSON API」と呼んでいます。どちらもチャットモデルと同じAPIキーを使い、Authorization: Bearer形式で指定します。Searchは1つのクエリを受け取り、DeepSeek独自の検索エンジンから構造化されたWeb検索結果を返します。
Fetchは1つのURLを受け取り、ページ本文をMarkdownで返します。どちらのエンドポイントもモデルを経由しないため、トークン単位では課金されません。下の表の各行は、Search APIリファレンスとFetch APIリファレンスと照合して確認しました。
| 項目 | 検索 | Fetch |
|---|---|---|
| エンドポイント(ホスト:api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| リクエストフィールド | query(1〜128文字。site:、lang:、after:、before:などに対応)、count(1〜50、デフォルトは10)、ori_question、localization(IPアドレス)、need_content | url(最大8,192文字、httpまたはhttps、ユーザー名とパスワードは不可) |
| レスポンス | results配列。各結果には、rerank_score、title、url、snippet、summary、content、site_name、site_icon、date、authorityの10個のフィールドがあります | title、content(Markdown) |
| 料金 | 成功した1,000リクエストあたり$0.75。countは料金に影響しません | same |
| 課金対象外 | 失敗、空のresults配列、タイムアウト | 失敗、ページコンテンツなし、タイムアウト |
| レート制限 | 1アカウントあたり毎秒100リクエスト | 1アカウントあたり毎秒25リクエスト(対象ドメインごとの制限もあり) |
開発者にとって重要な点が3つあります。1つ目に、summaryはモデル向けに書かれた長い要約で、通常600〜800文字です。snippetはユーザーインターフェース向けの短い要約で、100〜200文字です。要約全文を含む結果が10件あると、検索1回ごとにコンテキストが6,000〜8,000文字増えます。
第2に、dateはページの公開日時(UTC)で、不明な場合はnullです。authorityは0〜4の評価で、不明な場合は-1です。rerank_scoreは0〜3の関連度スコアで、ガイドでは1.5以上を良い結果としています。
3つ目に、Searchはqueryをそのまま検索サービスに渡します。そのため、クエリにsite:xiaohongshu.comと書くこともできます。ただし、ヒット数はDeepSeekのインデックスにそのサイトのページがどれだけ含まれているかで決まります。また、インデックスには各ページがクロール時点の状態で保存されています。これがアプリのコンテンツにとってなぜ重要なのかは、後述の「スナップショットの時刻と呼び出しの時刻」のセクションで説明します。
ガイドではエラーについても明確に説明しています。形式はOpenAIのエラー形式と同じで、paramフィールドは常にnullです。408、429、5xxのエラーは、時間をおいてリトライできます。402は残高不足を意味します。
それ以外の4xxエラーは、リクエストを変更せずにリトライすべきではありません。EveryInfraも同様の仕組みです。誤った値を送ると422が返り、該当するフィールド名と許可される値の一覧が示されます。実例は「実際の1往復」のセクションで紹介します。
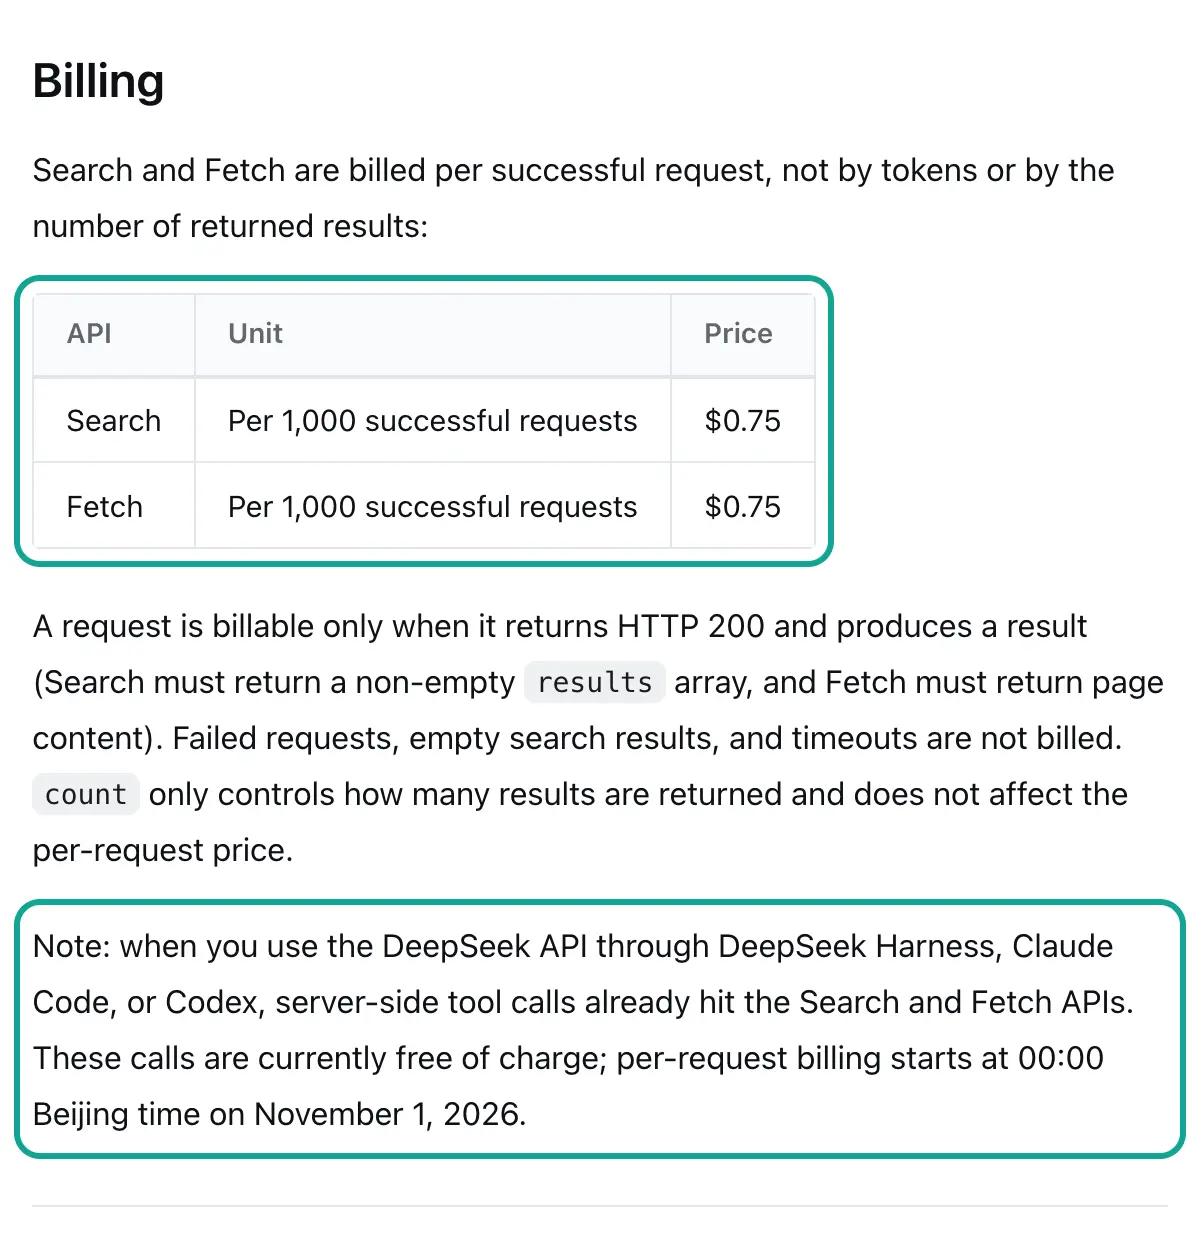
DeepSeek Search APIの料金:11月1日から有料になったもの
料金体系自体はシンプルです。英語版の料金ページでは、SearchとFetchは成功した1,000リクエストあたり$0.75です。中国語版のページでは、同じ単位で5元と記載されています。countで変わるのは結果の件数だけで、料金は変わりません。つまり、50件の結果を返す1リクエストも、10件の結果を返す1リクエストも同じ料金です。結果1,000件あたりに換算すると、count=50では$0.015、count=10では$0.075になります。
10月17日のリリースノートには、見落としやすい一文があります。Claude Code、Codex、DeepSeek HarnessはDeepSeek APIを使う際、すでにサーバーサイドツール経由でSearchとFetchを呼び出しています。これらの呼び出しはこれまで無料でしたが、2026年10月31日16:00(UTC)からリクエストごとに課金されます。これは北京時間でもシンガポール時間でも11月1日00:00にあたります。
11月3日の時点でも、料金ページとガイドにはこの日付の横に「現在は無料」という文言が残っていました。日付はすでに過ぎているため、これらの呼び出しは現在、課金対象の期間に入っています。チームでClaude Code内からDeepSeekを使っている場合(DeepSeekのClaude Codeガイド)、Web検索1,000回あたり$0.75がトークン料金に上乗せされます。
検索結果はモデルに入力されるため、モデルの料金も確認しておきましょう。同じ料金ページでは、deepseek-flashは現在DeepSeek-V4.1-Flash-1017を指しています。ピーク時間帯の料金は、キャッシュミス時の入力が100万トークンあたり$0.30、出力が$1.20です。オフピーク時はその半額です。
平日のピーク時間帯はUTCの01:00から04:00と06:00から10:00です。ロンドンのチームにとっては早朝と午前の遅い時間帯にあたります。ニューヨークのチームでは、ピーク時間帯は夜間になります。コンテキスト長は1Mトークンで、どちらのモデルもツール呼び出しとJSON出力に対応しています。
| 項目 | 単位 | USD(英語版ページ) | 確認日 |
|---|---|---|---|
| Search | 成功した1,000リクエストあたり | $0.75 | 2026-11-03 |
| Fetch | 成功した1,000リクエストあたり | $0.75 | 2026-11-03 |
| deepseek-flash入力(キャッシュミス、ピーク時) | 1Mトークンあたり | $0.30 | 2026-11-03 |
| deepseek-flash出力(ピーク時) | 1Mトークンあたり | $1.20 | 2026-11-03 |
EveryInfra zhihu/search | 成功した1,000リクエストあたり | $0.556 | 2026-11-03 |
EveryInfra weibo/search | 成功した1,000リクエストあたり | $0.806 | 2026-11-03 |
EveryInfra xiaohongshu/search | 成功した1,000リクエストあたり | $5.556 | 2026-11-03 |
EveryInfraの3つの料金は、無料カタログのprice_usdフィールドから取得しています。課金ルールはDeepSeekと同じで、失敗した場合や結果が空の場合は無料です。
DeepSeek Search APIのWeb検索結果とプラットフォーム内データの比較:フィールド一覧表
違いを確かめるには、フィールドを並べて比べるのが一番です。DeepSeek Searchの結果には10個のフィールドがあります。これらはページを探す、モデルに要約を渡す、ユーザーに結果を表示する、といった用途に役立ちます。一方、アプリ内検索の結果は別の問いに答えるためのものです。その問いとは「このアプリのユーザーはこの投稿にどう反応したか」です。アプリ内検索の結果にも、タイトル、本文、リンク、投稿日時があります。
さらに、いいね、コメント、保存、シェアの数に加えて、投稿者やコンテンツに関するフラグもあります。下の表の左列はDeepSeekのドキュメントに基づいています。残りの3列は、11月3日に当社が実際に取得したレスポンスに含まれていたフィールドです。
| 質問 | DeepSeek Search(ドキュメント記載のフィールド) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| 投稿の内容は? | title、summary、content | title、text(約60文字) | title、text | text |
| どこで開けるか? | url | url(アクセストークン付き) | url | url |
| 投稿日時は? | date(nullの場合あり) | posted_at、updated_at | posted_at | posted_at |
| いいねや保存をした人数は? | none | like_count、collect_count | like_count、collect_count | like_count |
| 議論はどれだけ活発か? | none | comment_count、share_count | comment_count | comment_count、repost_count |
| 誰の発言か? | site_name、authority | author_name、author_id | author_name、author_follower_count、バッジテキスト | author_follower_count、author_verified、認証理由 |
| 有償のブランドコンテンツか? | none | is_cooperation_note、is_goods_note | none | なし(認証理由を使用) |
この図には限界が2つあります。まず、「ドキュメントに記載なし」は、DeepSeekがこれらの数値をまったく参照できないという意味ではありません。contentフィールドはページ本文です。ページ本文に「12,000件のいいね」と書かれていれば、モデルはそのテキストを読み取れます。
ただし、それはページ上のテキストであり、並べ替えたり合計したりできるフィールドではありません。また、クロール時点の値です。第2に、アプリの列の0%には2つの原因があります。1つは、Zhihu検索のシェアのように、その機能のカタログにフィールドがない場合です。
もう1つは、カタログにはあるのに今回は返ってこなかったフィールドです。カタログではXiaohongshu検索にauthor_is_verifiedが記載されていますが、33件のどれにもありませんでした。そのため、コードはカタログのresponse_fieldsに合わせて書き、各件でフィールドが欠落する可能性を考慮してください。
スナップショット時刻と呼び出し時刻:同じノートでも数値が変わる
時間の違いもあります。Web検索はインデックスからページを返すため、各ページはクロール時点の状態です。DeepSeekのドキュメントには10個の結果フィールドが記載されており、そのひとつが公開日時を示すdateです。クロール日時を示すフィールドはないため、スナップショットがいつのものかはわかりません。
アプリ内検索では、呼び出し時点の値が得られます。いいね、コメント、保存は現在の件数です。Xiaohongshuはupdated_atも返します。カタログではこれをノートの最終編集日時としています。
製品に関するトピックでは、この違いが大きく表れます。不満に関するXiaohongshuのノートを、いいねの多い順に20件調べました。そのうち13件では、投稿から最終編集までの期間が30日を超えていました。5件では、その期間が1年を超えていました。投稿日の1,154日後に編集されたノートもありました。
| 投稿から最終編集までの期間 | ノート数(20件中) |
|---|---|
| 30日未満 | 7 |
| 30〜365日 | 8 |
| 365日超 | 5 |
投稿者はノートを後から見直すことがよくあります。本文を修正したり、追記したり、機種名を変えたりします。Webスナップショットが編集前のものなら、モデルは古い版を読むことになります。下のスクリーンショットにあるダストバッグのノートには、992件のいいねと571件のコメントがありました。呼び出し時点で、投稿からわずか1週間ほどでした。まだいいねやコメントが増えているなら、古いスナップショットではそれより少ない件数になります。
Weiboはさらにリアルタイム性が高く、2回の検索で得た25件の投稿は、すべて呼び出し前の4日間のものでした。「今週新たなアフターサービスの問題が出ていないか」といった質問の答えは、こうした投稿の中にあります。
そのため、時間軸で役割を分けられます。変化の遅いコンテンツにはWeb検索を使います。ブランドの仕様ページ、メディアのレビュー、取扱説明書、プレスリリースなどです。こうしたページは数週間ごとのクロールで十分です。変化の速いコンテンツにはアプリ内検索を使います。たとえば直近1週間の不満、広がりつつあるアフターサービスの問題、件数がまだ伸びているノートなどです。アプリ内検索では、アプリ側でしか適用できない並び順(新着順、いいね数順、コメント数順)も使えます。
逆もまた同様です。アプリ内検索はWeb検索の代わりにはなりません。ブランドサイト、仕様ページ、メディアのレビュー、これらのアプリ外のフォーラムは含まれないからです。欧米ブランドの場合、Web側はドイツの雑誌のレビューなど、英語や欧州の情報源もカバーします。2種類のデータは役割を分担しており、どちらも他方の代わりにはなりません。
テスト前に定めた判定基準
結果を見てから変更できないよう、これらの基準は実際の呼び出しの前に書きました。以下の各結論が成り立つかどうかは、これらの基準で判断します。
| 基準 | 合格 | 不合格 |
|---|---|---|
| プラットフォーム内データは、Web検索結果にないフィールドを補えるか | 3つのアプリすべてで、いいね数、コメント数、投稿日時が90%以上の行に含まれる | いずれかのアプリで90%未満 |
| 3つのアプリすべてが、非同期ジョブに切り替わらずに85秒以内に応答するか | 6回の呼び出しすべてが200を返す | タイムアウトまたは503 |
| モデルは誤った値を自力で修正できるか | 422がフィールド名と許可される値を示し、課金は発生しない | 曖昧なエラー、または課金が発生する |
| Xiaohongshuのコストを制御できるか | いずれかのプランでデータコストを1,000質問あたり$5未満に抑えられる | 質問数を減らす以外に制御手段がない |
| 行をそのまま「購入者の声」として回答に使えるか | フィルターが必要な行が20%以下 | いずれかのアプリで20%超(ここは不合格を予想していました) |
先に結果をお伝えします。最初の4つの基準は合格です。5つ目は3つのアプリすべてで不合格だったため、後のセクションでフィルターについて説明します。
フロー:商品に関する1つの質問、2つのデータルート


フローは4つのステップで構成され、要となるのはステップ2です。DeepSeekモデル自体は関数を実行しません。「この引数でこの関数を呼び出す」という内容のtool_callsを返します。DeepSeek SearchとEveryInfraへの実際の呼び出しは、あなたのコードが行います。
DeepSeekのツール呼び出しガイドにも同じことが書かれています。関数はユーザーが用意し、モデルはそれを実行しません。利点は、両方のAPIキーがサーバー上にとどまり、モデルの目に触れないことです。その代わり、ループは自分で書く必要があります。以降のセクションで完全な設定例を紹介します。
ステップ1では、ユーザーが質問します。ステップ2では、モデルが質問と4つの関数の説明を読みます。何を検索するかを決め、Web検索1件とアプリ内検索3件の計4件の呼び出しを一度に送ることもできます。ステップ3では、コードが両方のエンドポイントを呼び出します。そして生のJSON、またはそれを絞り込んだものを、対応するtool_call_idを付けたrole: toolメッセージで返します。
ステップ4では、モデルがすべての結果を読んで回答を書きます。システムプロンプトでは、各主張の後に出典URL、いいね数、投稿日を付けるよう指示しています。「ブランドAとブランドBの評判の違いは?」のような追加の質問があると、新たな呼び出しのラウンドが始まります。モデルがtool_callsを返さなくなった時点でループは終了します。
このフローでは、各データルートの役割が明確です。Web検索は、ブランドサイト、仕様ページ、メディアのレビュー、ニュースを見つけます。「この機種で何ができ、ブランドは何と言っているか」に答えるものです。プラットフォーム内データは、Xiaohongshu、Zhihu、Weiboで実際のユーザーが何と言っているかを見つけます。「購入者はどう評価し、どんな問題が繰り返し起きているか」に答えるものです。回答に両方の情報源があれば、読み手はブランドの主張と購入者の報告を並べて見られます。両者が食い違う箇所に、最も有用な結論が見つかることがよくあります。
ツール定義:4つの関数を含む完全なJSON(設定例)
以下はDeepSeekモデル用の4つの関数です。3つのアプリ用関数では、パラメータ名、enum値、説明はすべてEveryInfraカタログのparam_meaningsとallowed_valuesフィールドから取っています。Web検索関数はDeepSeek Search APIのリファレンスに沿っています。strictモードを使います。DeepSeekのツール呼び出しガイドによると、strictモードにはベータ版のベースURL(https接頭辞付きのapi.deepseek.com/beta)が必要です。各オブジェクトのすべてのプロパティをrequiredに含め、additionalPropertiesをfalseにする必要があります。
そのため、任意のパラメータを単純に省略することはできません。これには2つの方法で対処します。デフォルト値があるenumでは、デフォルト値をenumに含め、モデルに選ばせます。たとえばsortのrelevanceや、date_rangeのany_timeです。ページトークンのようにデフォルト値のない文字列には、nullとのanyOfを使います。
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword in Chinese, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]なぜ説明に価格を入れるのでしょうか。モデルはdescriptionを読むからです。Xiaohongshuの関数には「1ページ = USD 0.005556」と書きます。そのうえでシステムプロンプトに「Xiaohongshuは1質問あたり最大1ページまで。まずZhihuとWeiboを試す」と書きます。
これで、モデルは関数を選ぶ際にコスト情報を参照できます。ただし、これは厳密な上限ではありません。厳密な上限はループのコードに組み込むべきもので、次のセクションで示します。
中国以外のチームにとって重要な点がもうひとつあります。投稿は中国語なので、3つのアプリ用関数のキーワードは中国語にする必要があります。説明にもそう記載しています。deepseek-flashのようなモデルは英語の質問から適切な中国語キーワードを作れるため、ユーザーは英語で質問できます。上記のenumは、スクリプトを使って11月3日時点のカタログと照合しました。
| 関数パラメータ | カタログの`allowed_values` | ツール定義のenum | 一致 |
|---|---|---|---|
xiaohongshu_search.sort | 5:relevance、newest、most_liked、most_commented、most_collected | 同じ5個 | yes |
xiaohongshu_search.date_range | 6:any_timeからlast_1_yearまで | 同じ6個 | yes |
xiaohongshu_search.content_type | 3:all、image、video | 同じ3個 | yes |
zhihu_search.content_type | 4:all、answer、article、video | 同じ4個 | yes |
zhihu_search.sort | 3:general、upvote_count_descending、time_descending | 同じ3個 | yes |
web_search.count | DeepSeekのドキュメント:1〜50 | 最小1、最大50 | yes |
この表が重要なのはなぜでしょうか。enumの値を誤るとEveryInfraは422を返し、課金は発生しません。ただし、モデルが修正するためにもう1往復が必要になります。定義に正しいenumを含めておけば、その1往復と消費するトークンを節約できます。
カタログはいつでも無料で参照できます。たとえばXiaohongshuのカタログエントリがあります。機能が変更されたら、定義を再生成できます。各フィールドについてはXiaohongshu検索機能のページでも説明しています。
残りの2つについては、ZhihuのカタログエントリとWeiboのカタログエントリにパラメータとフィールドが記載されています。Weiboの検索はパラメータがkeywordの1つだけなので、関数定義も最も短くなります。モデルが誤ることはほとんどありません。
ループのコード:PythonでのDeepSeek tool_calls(設定例)
以下のPythonコードは、PyPIのopenaiパッケージで提供されているOpenAIのPython SDKを使用しています。DeepSeekのチャットAPIはOpenAI形式を採用しており、OpenAIのfunction callingガイドにも同じtools構造が説明されています。2つのデータエンドポイントへのリクエストにはrequestsを使い、タイムアウトを90秒に設定しています。EveryInfraの同期呼び出しの上限が85秒であるためです。結果をモデルに返す前に、12個のフィールドに絞り込みます。ensure_ascii=Falseを指定すると、中国語の文字がそのまま保持されます(Pythonのjsonドキュメント)。文字がエスケープされると、トークン数が数倍に増えてしまいます。
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # at most 1 Xiaohongshu page per question

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # a 422 has param, allowed, did_you_mean: give it to the model
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "Answer in English. After each claim, give the source url, like count and post date. "
                                          "Search Zhihu and Weibo first; use Xiaohongshu only when needed. Keywords for the apps in Chinese."},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # keeps reasoning_content; required when tools are present
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})DeepSeekのドキュメントに従うべき点が2つあります。1つ目は、思考モードがデフォルトで有効になっていることです。思考モードのガイドによると、toolsを含むリクエストでは、それまでのすべてのターンのreasoning_contentを送り返す必要があります。送り返さない場合、APIは400を返します。
msgs.append(m)の行がその処理です。第2に、strictモードはベータ版のベースURLでしか機能しません。通常のURLではstrictフィールドに効果はなく、モデルが引数を省略することがあります。その場合、EveryInfraは422を返し、モデルは次のラウンドで引数を追加します。
予算チェックはプロンプトではなく、ループ内で行います。プロンプトでできるのは、コストを抑えるようモデルに頼むことだけです。コードなら、1つの質問に対する支出が一定額を超えないことを保証できます。1日に数百件の質問を処理するブランドチームでは、この差が毎月の請求額に表れます。
実際の1往復:モデルが送るものと返ってくるもの
DeepSeekのキーがないため、モデル側は実行していません。「11.11にロボット掃除機を買うなら、購入者がいちばん不満に思っている点は?」という質問を例にします。ツール定義に基づき、モデルは「ロボット掃除機 不満」を意味する中国語キーワードでXiaohongshuの呼び出しを送ると考えられます。そのほかの引数は、sortがmost_liked、date_rangeがany_time、content_typeがall、page_tokenがnullです。ループはnullの値を除外し、以下のリクエストをEveryInfraに送信します。この呼び出しは実際に行ったものです。
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'2026年11月3日00:17:22(SGT)のリクエストは200を返し、20件を取得しました。ボディは36,627バイトで、billing.charged_usdは0.005556でした。同じ1分以内に、わざとsortをhotにして同じ呼び出しを再送しました。返ってきたのは422で、codeはinvalid_value、did_you_meanはmost_likedでした。
allowedフィールドには有効な5つの値が列挙されていました。next_stepsの最初の項目は「sortだけをallowed内の値に変更して再送信してください。課金は発生していません。」というものでした。このrole: toolメッセージを受け取ったモデルは、次のラウンドでsortだけを変更します。人が介入する必要はありません。
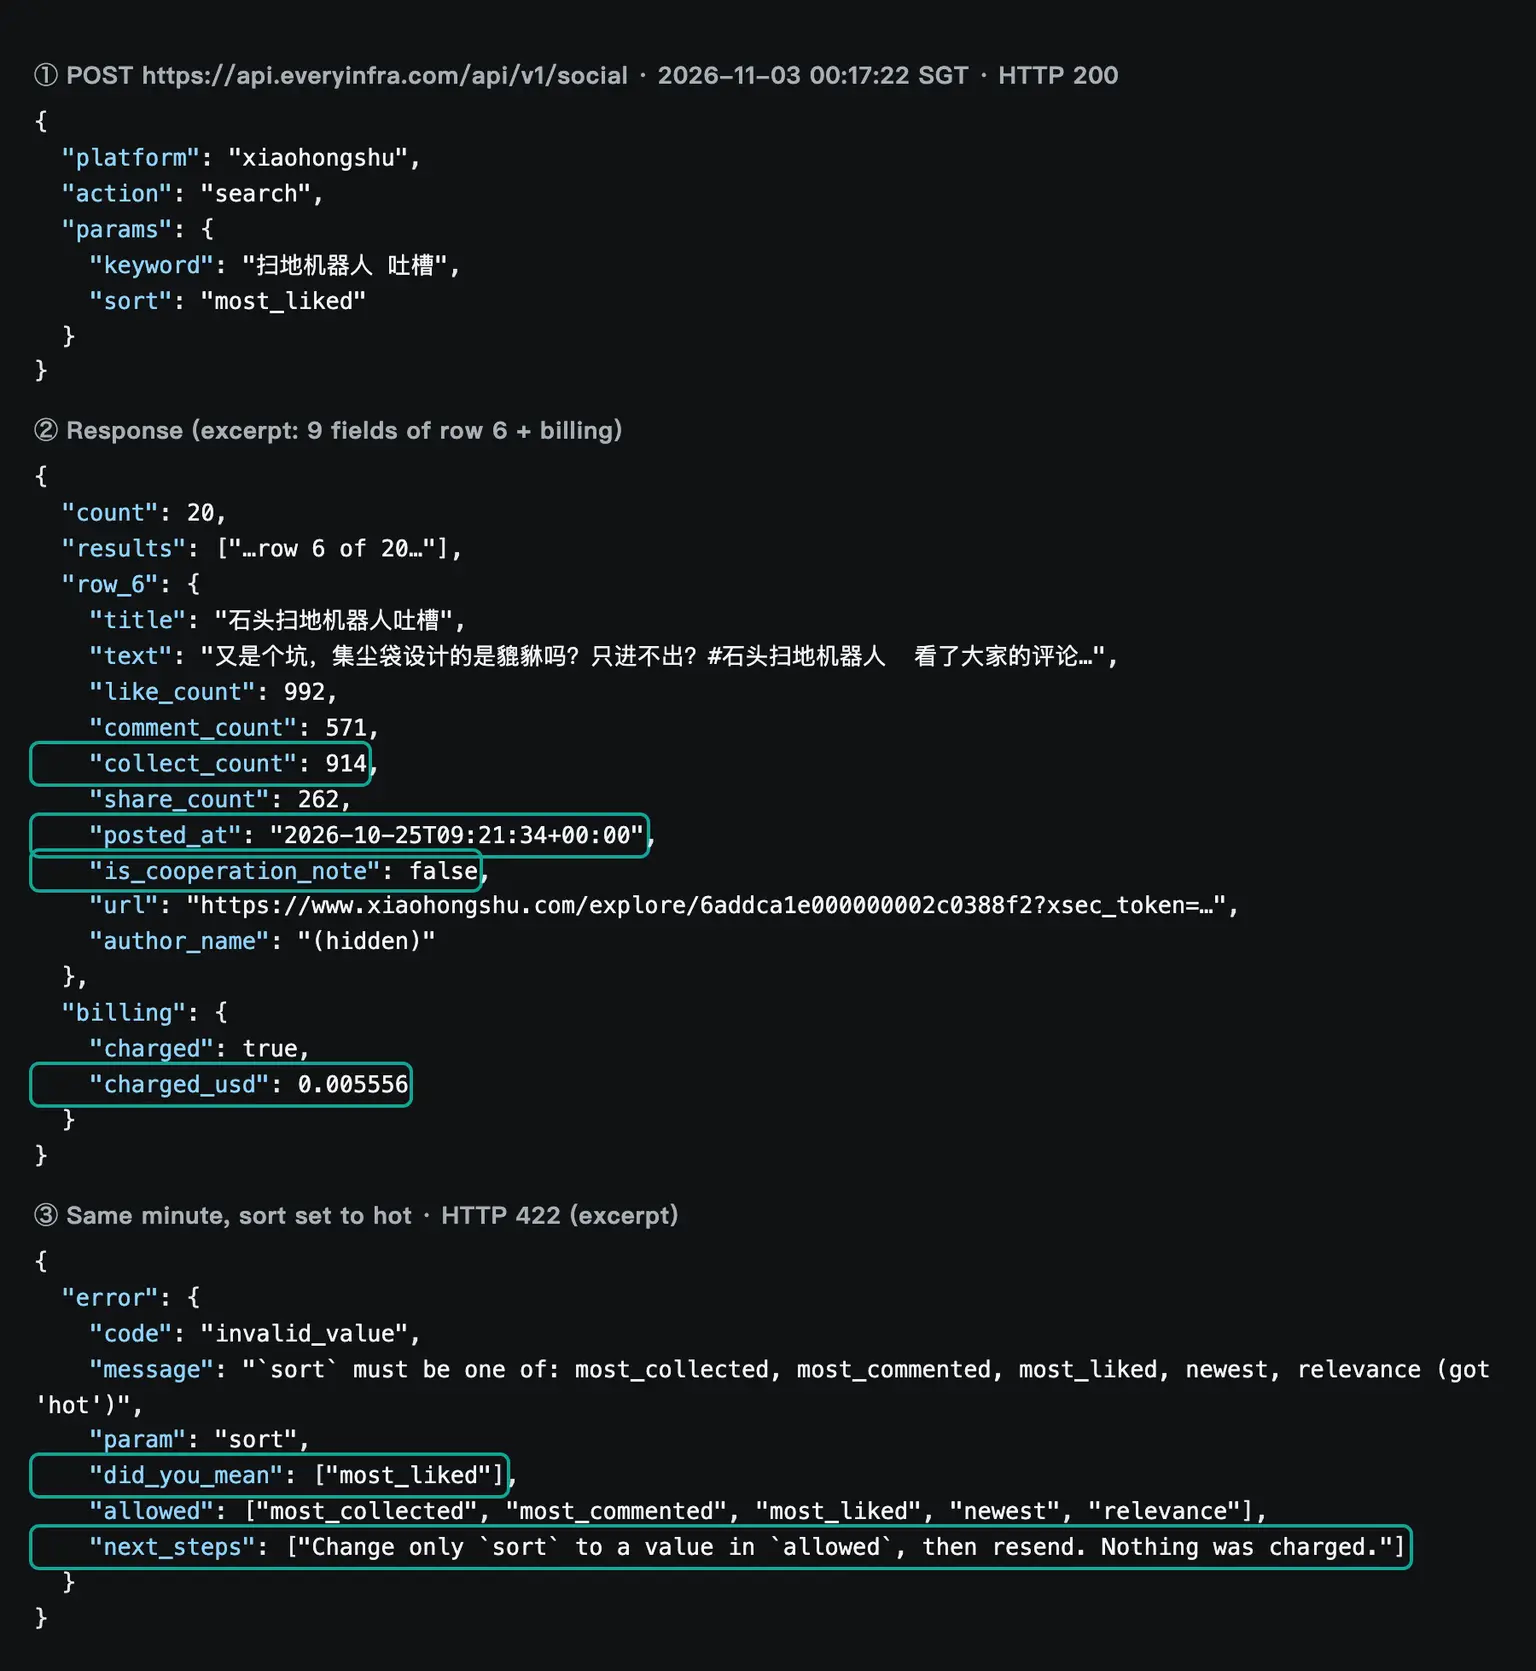
スクリーンショットの6行目は、10月25日に投稿されたノートです。タイトルから、あるロボット掃除機ブランドへの不満を述べたものだとわかります。本文ではダストバッグの設計を「入るばかりで出ていかない」と表現しており、交換用バッグのコストを指摘しています。いいねは992件、コメントは571件、保存は914件です。
コメント数がいいね数の半分を超えているので、このノートは実際に議論を呼んだことがわかります。「主な不満点」を探すときに求めるのは、まさにこうしたシグナルです。Web検索の結果では、モデルが目にできるのはこのノートのタイトルと要約程度です。
コメントで何が議論されているかを知りたい場合は、この行のurlを指定して xiaohongshu/note を呼び出すと全文を取得できます。コメントを取得する呼び出しも可能です。いずれも1回あたり$0.005556かかるため、同じ予算ロジックが適用されます。
テスト1:各アプリが返した内容
00:15から00:19(SGT)の間に、「ロボット掃除機」をテーマに8回の呼び出しを行いました。そのうち6回は各アプリ2回ずつです。残りは、後述するRedditとの比較用が1回、意図的に誤った値を指定したものが1回です。すべての呼び出しが同期的に応答し、非同期ジョブを必要としたものはありませんでした。
| SGT | 機能 | パラメータ | 件数 | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | ロボット掃除機 おすすめ、回答のみ | 20 | $0.000556 |
| 00:16:17 | weibo/search | ロボット掃除機 | 13 | $0.000806 |
| 00:16:32 | xiaohongshu/search | ロボット掃除機、コメント数順、過去30日 | 13 | $0.005556 |
| 00:17:22 | xiaohongshu/search | sortをhotに設定 | 422 | $0 |
| 00:17:22 | xiaohongshu/search | ロボット掃除機 不満、いいね数順 | 20 | $0.005556 |
| 00:18:26 | zhihu/search | ロボット掃除機 デメリット、賛同数順 | 20 | $0.000556 |
| 00:18:31 | weibo/search | ロボット掃除機 アフターサービス | 12 | $0.000806 |
| 00:18:53 | reddit/search | ロボット掃除機、top | 5 | $0.000556 |
| 合計 | 103件 | $0.014392 |
中国の3つのアプリでは、得られる内容が大きく異なりました。Xiaohongshuで不満をいいね数順に検索すると、20件のノートが返されました。タイトルの大半は、実際の使用感や避けるべき点に関するものです。ダストバッグの設計、進入禁止エリアが機能せず穴に落ちたロボット、ペット検知の問題、「情弱税のような家電」などが挙げられています。20件中8件にはタイアップコンテンツのフラグが付いており、ブランドのレビューや購入ガイドです。
欧米ブランドにとって特に重要な行が1つあります。2025年12月16日のノートで、タイトルはDysonのロボット掃除機を買わないよう呼びかけています。いいねは1,444件、コメントは53件です。本文では、製品自体は悪くないものの、コストパフォーマンスが低すぎると述べています。中国で販売する欧米ブランドがこうしたノートを見つけられるのは、アプリの中だけです。
以下の表は、その検索から5件を選び、各タイトルを英語で要約したものです。エンゲージメントのフィールドで何がわかるかがよく表れており、どの不満が最も議論を呼んだかが一目でわかります。
| 投稿日 | タイトル(要約) | いいね | コメント | 広告フラグ |
|---|---|---|---|---|
| 2026-10-16 | ペット対応ロボットで、恐れていた事故がやはり起きた | 3,710 | 183 | false |
| 2023-09-17 | ロボットが1か月間進入禁止エリアを無視し、最後は穴に落ちた | 3,445 | 1,937 | false |
| 2025-12-16 | ダイソンのロボット掃除機は買うな | 1,444 | 53 | false |
| 2026-10-25 | あるブランドのダストバッグの設計への不満 | 992 | 571 | false |
| 2026-07-06 | 情弱税のような家電 | 553 | 973 | false |
Zhihuでおすすめを検索すると20件の回答が返り、大半は購入ガイドや機種リストでした。Weiboの検索では25件の投稿が返り、すべて11月2日までの1週間に投稿されたものでした。内容は最も雑多でした。アドバイスを求めるユーザーもいれば、2年で本体が故障したのにブランドに交換部品がなかったと書くユーザーもいました。ブランドのキャンペーン投稿やショッピングガイドの投稿も含まれていました。
コンテンツの種類ごとに適した用途があります。繰り返し指摘されている具体的な欠陥を調べるには、Xiaohongshuをいいね順またはコメント順で検索すると、最も的を絞った結果が得られます。購入すべき製品について専門的な分析を得るには、Zhihuの長文回答が最も多くの情報を含んでいます。今週新たに発生したアフターサービスの問題を調べるには、Weiboが最もタイムリーです。Web検索しか使わないアシスタントでは、この3つの視点をすべて得るのは難しいでしょう。また、どの投稿が典型的かを示すエンゲージメント数も得られません。
英語圏のチームにとっては、Redditの呼び出しが参考になる対比です。「robot vacuum」の上位5件は10月7日から10月22日の間に投稿されたもので、ユーモア系や本題とは関係のないコミュニティからのものでした。上位3件は、r/TikTokCringeの動画投稿(いいね6,551)、r/homeassistantの「ロボット掃除機ガレージ」(いいね3,076)、r/futuramaのアニメキャラクターに扮したロボット掃除機(いいね2,998)でした。購入者の不満は1件もありませんでした。
| 投稿日 | コミュニティ | タイトル | いいね | コメント |
|---|---|---|---|---|
| 2026-10-20 | r/TikTokCringe | 最先端の日本製ロボット掃除機 | 6,551 | 107 |
| 2026-10-16 | r/homeassistant | ロボット掃除機のガレージ | 3,076 | 176 |
| 2026-10-14 | r/futurama | うちのロボット掃除機を用務員スクラッフィーとウォッシュバケツにしてみた | 2,998 | 76 |
| 2026-10-07 | r/Perfectfit | うちのロボット掃除機がテレビ台の下にぴったり収まる様子 | 1,773 | 16 |
| 2026-10-22 | r/BORUpdates | AITAH:義理のいとこと共有するのを断った私は悪い?(話題外) | 1,102 | 222 |
つまり、どのアプリでも「トップ」が示すのは人気のある投稿であり、役に立つ投稿ではありません。欧米のアプリでも、並べ替えとキーワードの選び方が重要です。選択肢はRedditの検索機能ページに掲載しています。
テスト2:賛同数順では、Zhihuの20件中、最近の投稿は0件
製品に関する質問で最も間違いが起きやすいのは「新しさ」です。ロボット掃除機は年に何度も新モデルが出るため、2年前の購入ガイドはもう当てはまらないかもしれません。そこでposted_atを使い、呼び出しごとに直近30日間(2026年10月4日以降)の件数を数えました。6つのアプリ検索の結果は大きく異なりました。
極端な例は、賛同数順で並べたZhihuの検索です。20件のうち18件は2026年より前の投稿で、最も古いものは2015年のものでした。タイトルはさらに目を引きます。20件中9件のタイトルに2026年と書かれています。
この9件のうち8件は2026年より前に投稿されたものです。最も古いものは2018年4月12日の投稿ですが、タイトルでは2026年版の購入ガイドをうたっています。これらは、作者が毎年本文と年を更新する定番回答です。本文は新しいかもしれませんが、タイトルだけを見た読者やモデルは今年の投稿だと思い込むでしょう。
Web検索結果のdateでこのケースを見抜けるでしょうか。それは、クロール時にページがどの日付を表示していたかによります。DeepSeekのドキュメントには、不明な場合dateはnullになるとしか書かれていません。プラットフォーム内のデータなら、アプリ自体が記録した投稿時刻が得られるため、タイトルと直接比較できます。
対策は簡単です。「最近」についての質問では、Xiaohongshuでdate_range=last_30_daysとsort=most_commentedを、Zhihuでsort=time_descendingを使います。Weiboはデフォルトで最近の投稿を返します。「長期的な評判」についての質問ではいいね順に並べ、各ソースの投稿年を示すようモデルに指示します。
コスト面の注意点もあります。last_30_daysを指定したXiaohongshuの呼び出しでは、13件しか返りませんでした。カタログによると、このフィルターでは1ページあたり20件未満になることがあり、結果のあるページは1ページとして課金されます。そのため、この呼び出しの1,000件あたりの料金は$0.427となり、20件そろったページの$0.278より54%高くなりました。
テスト3:最初にフィルタリングすべき行
5つ目の基準は満たせないと予想していましたが、そのとおりでした。どのアプリにも、そのまま使うと「購入者の声」を見誤らせる種類の行が1つあります。
Xiaohongshuでは、is_cooperation_noteが最も直接的なフィールドです。33件中12件でtrueでした。直近30日間のコメント数順の呼び出しでは13件中4件、いいね順の不満の呼び出しでは20件中8件でした。広告投稿だからといって、内容が虚偽とは限りません。
しかし「購入者は何に不満を持っているか」を知りたい場合、こうしたノートが示すのはブランドが見せたいメッセージです。そのため、これらの行は別のグループに分けるか、回答の中で明示してください。このフィールドがあるのはプラットフォーム内データだけで、Web検索結果には対応するフィールドがありません。
直近30日間のコメント数順で検索したXiaohongshuの結果には、別の種類のノイズもありました。上位には、迷子のロボットのミーム(いいね14,963)、フィットネス動画、ホラーゲームのクリップが並びました。これらはハッシュタグを使った人気投稿であり、購入者による報告ではありません。購入者が抱えている問題を知りたいときは、「不満」や「デメリット」など、問題点を表すキーワードを使ってください。
Weiboでは、ノイズが問題になります。25件のうち10件は、いいねもコメントも0件でした。この10件のうち、9件は認証済みアカウント、8件はフォロワー100,000人以上のアカウントによる投稿でした。その中には、ブランドのキャンペーン投稿やショッピングガイドの投稿も含まれていました。
あるブランドのライブ配信の告知は、いいね2,435、コメント421を集めていました。こうした投稿はエンゲージメントが高いものの、購入者の不満ではありません。author_verified_reasonと本文中の商品リンクで見分けられます。
役に立つ投稿は、フォロワーが数十人から数百人のアカウントによるものが多く、ブランド名と欠陥を具体的に挙げています。11月2日の投稿には、2024年3月に購入したロボット掃除機が約2年で故障したと書かれていました。アフターサービスからは、そのモデルは生産終了で部品がないと伝えられ、200元相当の下取りしか提示されなかったそうです。
この投稿はいいね0、コメント1でしたが、それでも実際のアフターサービスに関するシグナルです。そのため、エンゲージメントの低い行を単純に除外するフィルターは使えません。
フィルタリングの後は、行を並べ替えます。3つのアプリのいずれでも、少数の行がエンゲージメントの大半を占めています。
直近30日間のコメント数順で検索したXiaohongshuの呼び出しでは、13件のノートのいいね数が合計124,557で、上位3件が49%を占めました。「不満」を検索した呼び出しでは、20件のノートのいいね数が合計23,938で、上位3件が48%を占めました。「おすすめ」を検索したZhihuの呼び出しでは、20件の回答の賛同数が合計わずか1,151で、上位3件が75%を占め、中央値は11でした。Weiboのアフターサービス検索では、12件の投稿のいいね数が合計2,290で、そのうち1件が2,288、残り11件が合計2でした。
| 呼び出し | 件数 | いいね・賛同の合計 | 上位3件の割合 |
|---|---|---|---|
xiaohongshu/search、コメント数順、直近30日間 | 13 | 124,557 | 49% |
xiaohongshu/search、不満、いいね順 | 20 | 23,938 | 48% |
zhihu/search、おすすめ、回答のみ | 20 | 1,151 | 75% |
weibo/search、アフターサービス | 12 | 2,290 | 100% |
アプリが返した順のまま20件のデータをモデルに渡すと、「多数派の意見」が、エンゲージメントの多い2、3件の投稿だけに基づくものになりかねません。より良い方法は、ループのコードでデータをエンゲージメント順に並べ替え、author_idで重複を除くことです。そのうえで、各データにエンゲージメント数を添えて渡します。こうすれば、モデルは読者に「このノートには992件のいいねがあります」や「この投稿のいいねは0件ですが、具体的な事実が書かれています」と伝えられます。
Pythonなら追加のライブラリなしで実現できます。like_countを対象にしたkey関数を指定してsorted()で並べ替えます(Pythonのソートガイド)。すでに採用した投稿者はsetに保持します。このステップで追加の呼び出しは発生しません。
回答のイメージ:実際の行から作成したフォーマット例
今回はモデルを実行していないため、DeepSeekが書いた回答はありません。それでもフォーマットは確認できます。上記の実際の行をもとに、回答の冒頭部分を手作業で書きました。これはフォーマット例であり、モデルの出力ではありません。各数値は生のレスポンスと一致しています。リンクにはアクセストークンが含まれるため、「リンク省略」と記載しています。
不満はまず、ダストバッグと交換部品に集中しています。10月25日に投稿されたXiaohongshuのノートには、あるブランドのダストバッグが「吸い込むだけで一切出てこない」とあり、いいね992件、コメント571件、保存914件を集めています(リンク省略、有料コンテンツではありません)。2つ目はアフターサービスです。11月2日、フォロワー124人のWeiboユーザーが、2024年3月に購入した製品が2年で故障したと投稿しました。ブランド側はそのモデルが生産終了になったとして、200元の下取りしか提示しませんでした(リンク省略、いいね0件、コメント1件)。Zhihuでは、賛同数上位の購入ガイドのほとんどが2018年から2022年に投稿されたものですが、タイトルには2026年と書かれています。参考にする前に投稿年を確認してください。
サンプル内の各主張には、アプリ、日付、エンゲージメント数、有料コンテンツかどうかのフラグが付いています。この形式は、システムプロンプトでモデルに指定できます。
サンプルを書いている途中で、もう1つ気づいたことがあります。Zhihuの20件のうち、2人の投稿者がそれぞれ3件を占めていました。一方の投稿者の3件の回答は書き出しがほぼ同じで、賛同数はいずれも0、同じ記事にリンクしています。もう一方の投稿者は2日間で3件の回答を書き、3件とも1つのブランドのモデルを勧めていました。これらを20人の独立した声として数えると、そのブランドを過大評価してしまいます。
そこで、結果をモデルに戻す前にauthor_idで重複を除いてください。投稿者ごとに、エンゲージメントが最も多い1件だけを残します。このフィールドは3つのアプリすべてで返ります。コードは数行で済み、「同じ投稿者の繰り返しに注意して」とモデルに頼むプロンプトより確実です。
テスト4:モデルに渡す前にどれだけトークンを削減できるか
このフローで最もコストのかからない手順は、結果をモデルに戻す前にフィールドを削ることです。3つの検索について、生のレスポンスと、必要な13フィールドだけに絞った形式の2通りでトークン数を見積もりました。比率はDeepSeekのトークン使用量ガイドに従い、英語は1文字あたり約0.3トークン、中国語は1文字あたり約0.6トークンとしています。これらは推定値です。実際のトークン数は、各レスポンスのusageフィールドで確認できます。
| 検索 | 生の文字数 | 生のトークン数(推定) | 13フィールドでの文字数 | 削減後のトークン数(推定) |
|---|---|---|---|---|
xiaohongshu/search不満、いいねの多い順 | 33,905 | 10,549 | 7,302 | 2,542 |
zhihu/searchデメリット、賛同数の多い順 | 15,459 | 5,696 | 7,356 | 3,162 |
weibo/searchアフターサービス | 10,786 | 3,624 | 3,873 | 1,458 |
| 合計 | 60,150 | 19,869 | 18,531 | 7,162 |
削減後の形式は64%小さくなります。最も削減幅が大きいのはXiaohongshuです。生の行に画像リスト、アバター、動画リンク、幅と高さが含まれているためです。これらはどれも回答の役に立ちません。deepseek-flashのピーク時入力価格(100万トークンあたり$0.30)で計算すると、19,869トークンは$0.0060、7,162トークンは$0.0021です。1回の呼び出しだけなら、その差はわずかです。
ただし、ツール呼び出しのループでは、新しいリクエストのたびにそれまでの結果も再送されます。ラウンドが増えるほど、差は大きくなります。DeepSeekにはコンテキストキャッシュがあり、英語版の料金ページによると、キャッシュにヒットした入力はピーク時で100万トークンあたり$0.006です。そのため、再送部分の実際のコストはずっと低くなります。ただし、これはキャッシュにヒットした場合に限られます。
DeepSeekのコンテキストキャッシュガイドによると、リクエストがキャッシュにヒットするのは、そのプレフィックスが保存済みのプレフィックス単位と完全に一致する場合だけです。チャットAPIはステートレスなので、各ラウンドでそれまでのメッセージをすべて送り直す必要があります(マルチラウンド会話ガイド)。ここから、ループのコードについて2つのルールが導かれます。
1つ目は、後のラウンドでツールの結果を編集したり並べ替えたりしないことです。システムプロンプトとツール定義は先頭に置き、変更しないでください。2つ目は、結果を初めて送る前に、フィールドの削減、並べ替え、重複の除去を済ませておくことです。そうすれば、2ラウンド目以降はそれまでの部分がキャッシュ価格で課金され、キャッシュミス価格で課金されるのは新しいラウンドの分だけになります。
それでも、「最近の変更」セクションで紹介した研究が示すように、コンテキストを小さくすると、モデルが要点に集中しやすくなるという利点もあります。
コスト:DeepSeek Search APIは1,000リクエストあたり$0.75、Xiaohongshuは1回あたり$0.005556
価格を並べてみると、結果ははっきりしています。Web検索は安価です。ZhihuとWeiboはWeb検索とほぼ同じ価格です。Xiaohongshuは約10倍の価格です。
はっきりお伝えしておきたいことがあります。一般的なWeb検索だけなら、1,000リクエストあたり$0.75のDeepSeek Searchのほうが、1,000リクエストあたり$1.389のEveryInfraのweb/searchより安価です。さらにDeepSeek Searchは、1回の呼び出しで最大50件の結果を返します。そのため、このフローではWeb検索をDeepSeekに任せ、EveryInfraにはプラットフォーム固有のデータだけを扱わせるべきです。結果1,000件あたりで比べると、差はさらに広がります。
結果1,000件あたりで見ると、DeepSeekはcount=50の場合で$0.015です。Zhihuは$0.028、Weiboは$0.062〜$0.067、Xiaohongshuは$0.278〜$0.427です。ただし、この2種類の結果は行数では比較できません。Web検索の結果と、エンゲージメント数付きのアプリの投稿とでは、答えられる問いが異なるためです。
| 1問あたりの呼び出し回数 | 単価 | 呼び出し回数 | 小計 |
|---|---|---|---|
| DeepSeek Search | $0.00075 | 2 | $0.0015 |
xiaohongshu/search | $0.005556 | 1 | $0.005556 |
zhihu/search | $0.000556 | 1 | $0.000556 |
weibo/search | $0.000806 | 1 | $0.000806 |
| データコスト(プランB) | 5 | $0.008418 | |
| モデルコスト(推定、ピーク時、入力約16,000トークン、出力約1,500トークン) | 約$0.0066 |
モデルコストの推定値には大きな誤差があり得ます。入力には、削減後のアプリデータ7,162トークンと、2回の検索(各10件)から得たWeb要約約8,400トークンを含めています。出力は1,500トークンで計算しています。この推定には、再送されるコンテキストやキャッシュヒットは含まれていません。データコストはカタログ価格に呼び出し回数を掛けたものなので、正確な値です。1問あたりの費用は合計で約1.5米セントで、Xiaohongshuだけでデータコストの66%を占めます。
Xiaohongshuの呼び出しを抑える3つのプラン
このフローで管理すべきなのは、1ページあたり$0.005556かかるXiaohongshuのコストです。目的はXiaohongshuの利用を減らすことではありません。価値がある場合にだけ使うことです。そこで3つのプランを設定しました。どのプランでも、1問につきDeepSeekの検索を2回行います。
| 方式 | Xiaohongshu | Zhihu | 1問あたり | 1,000問あたり | Xiaohongshuの割合 | |
|---|---|---|---|---|---|---|
| A(フル) | 3ページ | 2回 | 2回 | $0.0209 | $20.89 | 80% |
| B(デフォルト) | 1ページ | 1回 | 1回 | $0.0084 | $8.42 | 66% |
| C(オンデマンド) | 質問の30%で1ページ | 1回 | 1回 | $0.0045 | $4.53 | 37% |
プランCの30%は私たちが設定した値で、実測値ではありません。Xiaohongshuが必要かどうかを判断する方法は、簡単なものから順に3つあります。1つ目は、製品カテゴリで判断する方法です。
Xiaohongshuで話題の多い美容、パーソナルケア、ベビー用品、家庭用品、小型家電ではXiaohongshuを検索し、部品や工業製品では省きます。2つ目は、安価なアプリから先に試す方法です。ZhihuとWeiboだけで、具体的なモデル名を挙げた最近の結果が十分に得られれば、Xiaohongshuは省きます。
第3に、判断はモデルに任せつつ、上のコードのBUDGETのようにループに上限を設けます。モデルが2ページ目を求めたら「予算上限に達しました」と返します。また、上限件数まで1ページ分を取得したいときはlast_30_daysを使わないでください。テスト2では、13件しか返らなくても1ページ分の料金がかかりました。「最新」を問う質問では、sort=newestを使うと上限件数まで返ります。date_rangeに関するカタログの注記も同じことを勧めています。
別の方法:リモートMCPサーバーを使うDeepSeek Harness(設定例)
ループを自分で書かない場合もあるでしょう。DeepSeekのオープンソースエージェントであるDeepSeek Harness(クイックスタート)を使うなら、ツール定義は不要です。代わりにEveryInfraのリモートMCPサーバーに接続します。HarnessのMCPクライアントのREADMEでは、MCPサーバーごとに1つのエントリを使います。リモートサーバーはstreamable-httpトランスポートを使い、ヘッダーを送信できます。そのツールはモデルからはmcp__<serverName>__<tool>として見え、1回の呼び出しあたりのデフォルトのタイムアウトは60秒です。
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
toolCallTimeoutMs: 90000上記のrequestsのタイムアウトと同じ理由で、toolCallTimeoutMsを60秒から90秒に引き上げます。EveryInfraのMCPサーバーはMCP 2026-07-28仕様とそのStreamable HTTPトランスポートに準拠しています。11月3日にキーなしでtools/listを呼び出したところ、12個のツールが表示されました。アプリデータ用のツールはeveryinfra_call_apiで、プラットフォーム、アクション、パラメータを指定します。認証についてはMCPサーバーのページで説明しています。
MCP仕様の認可セクションでは、認可は任意とされています。HTTPベースのトランスポートを使うサーバーは、このセクションに従うべきとされています。EveryInfraはリクエストヘッダーでAPIキーを受け取るため、Harnessのエントリに必要なのはheadersだけで、ブラウザでのサインインは不要です。
Harnessには独自のWeb検索があります。dsh-tool-webパッケージはweb_searchとweb_fetchを追加します。デフォルトでは最大8件のソースを返し、最大4件のクエリを送信し、各要約を800文字に切り詰めます。READMEによると、現在のモデルに認証情報がない場合、DeepSeekの検索バックエンドはツール一覧に表示されません。この構成では、1つのHarnessセッションでWeb検索にDeepSeekを、アプリデータにMCPを使います。役割分担は関数版と同じですが、ループはHarnessが実行します。
2つの方法はどう選べばよいでしょうか。MCPの方法はコードが不要で、カタログに追加された新しい機能もモデルが自分で把握します。ただし、モデルから見えるのは汎用ツールeveryinfra_call_apiの1つだけで、パラメータを知るにはまずカタログを読む必要があります。そのぶんやり取りが1〜2回増えます。関数の方法では、定義を自分で保守する必要があります。
その代わり、説明、enum、価格がそれぞれ固定されるため、モデルがより適切に選択でき、コード側で予算上限を適用できます。決まった単一のプロダクトフローには関数を、チーム向けの汎用アシスタントにはMCPを使ってください。同じトレードオフは、データAPIを使ったClaudeのstrict tool useの記事でも比較しています。
うまくいかない点と注意点
1つ目に、DeepSeek Searchのエンドポイントは呼び出していません。そのため、DeepSeekで「robot vacuum」を検索したときにXiaohongshuのノートが何件見つかるかの実測値はありません。本記事のDeepSeekに関する記述はすべてDeepSeekのドキュメントに基づいています。DeepSeekのインデックスにアプリのコンテンツがどれだけ含まれているか、どのくらいの頻度で更新されているかは測定していません。「スナップショット時点と呼び出し時点」のセクションで扱っているのはアプリ側のみです。
第2に、Xiaohongshuの検索結果のテキストは約60文字の抜粋です。全文を取得するには、$0.005556のノート詳細の呼び出しが必要です。コメントも別途課金されます。第3に、3つのアプリが返すのは公開コンテンツだけです。プライベートメッセージ、フォロワー限定の投稿、削除済みの投稿は取得できません。Zhihuの有料コンテンツは概要のみ取得できます。
ページングには、ループのコードでつまずきやすい点が2つあります。Xiaohongshuの検索ページは常に20件で、limitは効きません。それ以上の件数が必要なら、前のページのnext_page_tokenを使います。このトークンの有効期限は24時間だけです。会話を保存して翌日に続けると、古いトークンは使えません。
検索は1ページ目からやり直しになり、再び料金がかかります。Zhihuはデフォルトで20件、最大100件を返します。Weiboはデフォルトで20件、最大50件です。この2つは呼び出しごとの料金なので、ページングするより1回の件数を増やしたほうが安くなります。
4つ目に、コンプライアンス上の注意点が2つあります。1点目として、アプリのデータには個人ユーザーの名前やプロフィールが含まれます。引用するのはコンテンツとリンクだけにしてください。個人ユーザーの個人情報を収集したり表示したりしないでください。10月22日のarXiv論文(Social-HUMINT)は、公開されたソーシャルデータからLLMで個人の特性を推測するリスクを研究しています。
製品に関する話題では、トピック単位の扱いにとどめてください。2点目として、中国本土で一般向けにサービスを提供するアシスタントは、中国の生成AIサービス管理暫定弁法の対象になります。AI生成コンテンツの表示に関する弁法は2025年9月1日から適用されています。本記事は法的助言ではありません。自社の義務については法務チームに確認してください。
5つ目に、レート制限が異なります。EveryInfraのアカウントはデフォルトで1分あたり60回です。テスト用のキーには1分あたり10回という特別な制限が設定されていました。DeepSeek Searchは1秒あたり100回まで可能です。トラフィックが多い場合は、ループ内にEveryInfra側のキューを追加してください。
最近の変更点
2026年10月17日:DeepSeekがSearchとFetchを公開。同日、モデルがDeepSeek-V4.1-Flash-1017に更新されました。重みはHugging Faceで公開されています。これにより、1つのDeepSeekキーでWeb検索まで利用できるようになりました。別の検索サービスは不要です。
2026年11月1日0:00(北京時間):クライアントでのサーバーサイド検索が有料に。Claude Code、Codex、Harness経由でDeepSeekを使っていますか。その場合、検索料金が月々の請求に含まれるようになりました。DeepSeekコンソールの使用量ページを確認してください。
2026年10月13日:AIショッピングエージェントに関する論文がバージョン5に。このarXiv論文(Does Rank Still Matter?)は7,000セッションを調査しました。AIエージェントは人間より多くの結果を閲覧しましたが、中間の順位にある結果は最も見られにくいことがわかりました。
つまり、件数は多いほどよいとは限りません。モデルに渡す前に、エンゲージメントか時刻で並べ替えてください。並べ替えていない50件より確実です。テスト3のエンゲージメントデータも、同じ手順の必要性を示しています。
2026年10月25日ごろ:DeepSeek HarnessのMCPクライアントドキュメントの変更。HarnessはMCPバージョン2026-07-28に対応しています(MCPクライアントのREADME)。リモートサーバーはStreamable HTTPを使います(MCPパッケージのREADME)。これにより、コードを書かずにDeepSeekエージェントにアプリデータを追加できます。
FAQ
DeepSeek APIはWeb検索に対応していますか?
チャットAPI自体はWeb検索を行いません。方法は2つあります。1つは、Searchエンドポイント(POST /v1/tools/search)を自分で呼び出し、その結果をツールの結果としてモデルに渡す方法です。もう1つは、DeepSeek Harness、Claude Code、Codexなどのクライアントを使う方法です。
これらのクライアントはサーバーサイドのツールを通じてSearchとFetchを呼び出し、2026年11月1日からはリクエストごとに課金されています。(質問の出典:検索候補「does deepseek api support web search」。根拠:DeepSeekのSearchとFetchのガイド。)
DeepSeek Search APIの料金は?無料枠はありますか?
成功した1,000リクエストあたり$0.75です。失敗したリクエスト、結果が空のリクエスト、タイムアウトしたリクエストは無料で、countを変えても料金は変わりません。料金ページとガイドには、検索専用の無料枠は見当たりませんでした。付与された残高とチャージした残高のどちらも利用料金に充てられ、付与された残高が先に使われます。(質問の出典:検索候補「deepseek search api pricing」と「deepseek search api free tier」。根拠:DeepSeekの料金ページ。)
DeepSeek Search APIのAPIキーはモデル用のAPIキーと同じですか?
はい。ガイドによると、SearchとFetchはDeepSeek APIと同じBearer認証を使います。APIキーはDeepSeekプラットフォームで作成します。レート制限はAPIキー単位ではなくアカウント単位で適用されます。(質問の出典:検索候補「deepseek search api key」。根拠:DeepSeekのSearchとFetchのガイドとレート制限のページ。)
DeepSeek Search Fetch API:SearchとFetchの違いは?Fetchはいつ使えばよいですか?
Searchはクエリに対して複数の結果を返します。FetchはURLを指定すると、1ページ全体をMarkdownで返します。Searchでもneed_contentを使えばページ本文を取得できます。そのためFetchは、アプリデータから得たブランドサイトのリンクのように、すでにリンクがあって全文が必要な場合に使います。
Fetchの結果は対象サイトのアクセスポリシーに左右されます。コンテンツを取得できなかった場合は404を返し、料金はかかりません。(質問の出典:検索候補「deepseek search fetch api」。根拠:Fetch APIリファレンス。)
DeepSeek Harnessの検索API:Harnessで別の検索プロバイダーを使えますか?
はい。HarnessはWeb検索をプラグインとして追加します。web_searchツールはdsh-tool-webプラグインが提供しており、そのバックエンドは別の検索プラグインに切り替えられます。アプリデータは、リモートサーバーとしてMCPクライアント経由で接続します。(質問の出典:検索候補「deepseek harness search provider」。根拠:dsh-tool-web READMEおよびHarnessリポジトリ。)
DeepSeek APIのFunction Callingはstrictモードに対応していますか?
はい。ベータ版のベースURL(api.deepseek.com/betaの先頭にhttpsを付けたもの)を使い、すべての関数でstrict: trueを設定します。すべてのプロパティをrequiredに列挙し、additionalPropertiesをfalseにします。minLength、maxLength、minItems、maxItemsには対応していません。
strictモードは思考モードと非思考モードのどちらでも使えます。(質問の出典:検索候補「deepseek api function calling」。根拠:DeepSeekツール呼び出しガイド。)
始め方
まず、EveryInfraのクイックスタートでAPIキーを作成します。カタログは無料で閲覧できるので、xiaohongshu/search、zhihu/search、weibo/searchのパラメータと料金を確認してください。各プラットフォームの概要については、XiaohongshuデータAPI、ZhihuデータAPI、WeiboデータAPIをご覧ください。すべての料金は料金ページに掲載しています。
次に、この記事の4つのツール定義とループのコードをコピーします。2つのキーを設定し、1件の質問について一連の処理を最初から最後まで実行してみてください。最後に、コストのセクションから質問数に合ったプランを選び、BUDGETに上限を設定します。同じ考え方を別のツールで実践した記事が2つあります。1つはXiaohongshuのコメントを扱うClaude Codeの動的ワークフロー、もう1つはリモートMCPサーバーを使ったGemini Deep Researchです。コメントデータについては、WeiboのコメントもXiaohongshuのコメントと同じ方法で扱えます。
参考文献
- Search & Fetch、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/guides/search
- Search APIリファレンス、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/api/search
- Fetch APIリファレンス、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/api/fetch
- Models & Pricing、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek-V4.1-Flash-1017リリースノート、DeepSeek、2026-10-17、https://api-docs.deepseek.com/news/news261017
- Tool Calls、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/guides/tool_calls
- Thinking Mode、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/guides/thinking_mode
- Rate Limit & Isolation、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/quick_start/rate_limit
- Token & Token Usage、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/quick_start/token_usage
- Integrate with Claude Code、DeepSeek API Docs、2026-11-03閲覧、https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- APIキーページ、DeepSeek Platform、2026-11-03閲覧、https://platform.deepseek.com/api_keys
- DeepSeek-V4.1-Flash-1017モデルカード、Hugging Face、2026-11-03閲覧、https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- DeepSeek Harnessリポジトリ、GitHub、2026-11-03閲覧、https://github.com/deepseek-ai/deepseek-harness
- DeepSeek Harnessクイックスタート、2026-11-03閲覧、https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- dsh-tool-web README、GitHub、2026-11-03閲覧、https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- dsh-mcp-client README、GitHub、2026-11-03閲覧、https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- Harness MCPパッケージのREADME、GitHub、2026-11-03閲覧、https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python、GitHub、2026-11-03閲覧、https://github.com/openai/openai-python
- openai、PyPI、2026-11-03閲覧、https://pypi.org/project/openai/
- Function calling、OpenAI developer docs、2026-11-03閲覧、https://platform.openai.com/docs/guides/function-calling
- Advanced Usage(タイムアウト)、Requests docs、2026-11-03閲覧、https://requests.readthedocs.io/en/latest/user/advanced/
- json, JSON encoder and decoder、Python docs、2026-11-03閲覧、https://docs.python.org/3/library/json.html
- MCP Specification 2026-07-28、Model Context Protocol、2026-11-03閲覧、https://modelcontextprotocol.io/specification/2026-07-28
- Transports、MCP 2026-07-28、2026-11-03閲覧、https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- Tools、MCP 2026-07-28、2026-11-03閲覧、https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- Authorization、MCP 2026-07-28、2026-11-03閲覧、https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- WeiboオープンプラットフォームAPI一覧、2026-11-03閲覧、https://open.weibo.com/wiki/API
- ネットワークデータセキュリティ管理条例、中国政府、2024-09-30、https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- 生成AIサービス管理暫定弁法、中国国家インターネット情報弁公室、2023-07-13、https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- AI生成合成コンテンツ表示弁法、中国国家インターネット情報弁公室ほか、2025-03-14、https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf、arXiv:2608.22697v5、2026-10-13、https://arxiv.org/abs/2608.22697
- Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure、arXiv:2610.31573、2026-10-22、https://arxiv.org/abs/2610.31573
- EveryInfraデータカタログ、2026-11-03 00:13 SGT閲覧、https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra Xiaohongshuカタログ、2026-11-03閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- EveryInfra Zhihuカタログ、2026-11-03閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- EveryInfra Weiboカタログ、2026-11-03閲覧、https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- Context Caching、DeepSeek API docs、2026-11-03閲覧、https://api-docs.deepseek.com/guides/kv_cache
- Multi-round Conversation、DeepSeek API docs、2026-11-03閲覧、https://api-docs.deepseek.com/guides/multi_round_chat
- Sorting Techniques、Python docs、2026-11-03閲覧、https://docs.python.org/3/howto/sorting.html
- Built-in Types: set、Python docs、2026-11-03閲覧、https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset
参考資料 BL-73