DeepSeek Search API y datos de dentro de las apps chinas
DeepSeek Search API cuesta 0,75 USD por 1000 llamadas y no trae likes ni comentarios. Cómo sumar Xiaohongshu, Zhihu y Weibo: 9 llamadas reales, 0,015 USD.
El 2026-10-17 DeepSeek abrió dos endpoints nuevos, Search y Fetch, a todos los usuarios de su API. Cada uno cuesta 0,75 USD por cada 1000 peticiones correctas. Un resultado de Search trae título, URL, dos resúmenes, el texto de la página, el nombre del sitio, una fecha y dos puntuaciones, pero no trae likes, comentarios ni guardados (guía de Search y Fetch de DeepSeek). Entre las 00:15 y las 00:19, hora de Singapur, del 2026-11-03 lanzamos xiaohongshu/search, zhihu/search y weibo/search de EveryInfra sobre un mismo tema: el robot aspirador. Las 98 filas devueltas traían número de likes, número de comentarios y fecha de publicación, todas sin excepción. En Xiaohongshu, además, 12 de 33 filas llevaban la marca de contenido pagado por una marca.
Son justo los campos que necesita un equipo que quiere saber qué critican los compradores chinos, y los resultados web no los tienen. El coste depende de una sola cosa. Una página de búsqueda en Xiaohongshu cuesta 0,005556 USD, es decir, 7,4 veces una llamada a DeepSeek Search. Con los límites que proponemos aquí, el coste de datos por cada 1000 preguntas baja de 20,89 USD a 4,53 USD.
Este artículo es para equipos de España y de Latinoamérica que venden o distribuyen aparatos de marcas chinas, como robots aspiradores, o que compiten con ellas. Piensa en un distribuidor de Madrid, en una tienda online de México o en una agencia de Bogotá que sigue la conversación de consumo en China para un cliente. Muchos de esos modelos se venden antes en China, así que lo que allí se critica hoy puede anticipar las preguntas que te harán tus clientes. Quieres un asistente pequeño que responda una pregunta de producto con fuentes. DeepSeek ya tiene su propio endpoint de búsqueda web, así que la parte de la web abierta es sencilla. Aquí verás qué hace ese endpoint, qué no devuelve y cómo sumar datos de dentro de tres apps chinas, con el coste de cada llamada.
Todo lo que decimos de DeepSeek sale de api-docs.deepseek.com, leído el 2026-11-03. No tenemos clave de la API de DeepSeek, así que la parte de DeepSeek es un ejemplo de configuración, no una prueba. Cada cifra de EveryInfra sale de la respuesta original de una llamada real. En un artículo anterior, DeepSeek V4 con Claude Code para limpiar comentarios, usamos DeepSeek como modelo dentro de Claude Code y medimos el coste de limpiar comentarios. Aquel texto solo dedicaba una sección corta a Search y Fetch. Este parte del propio endpoint de búsqueda y se pregunta cómo debe repartirse el trabajo con los datos de dentro de cada app.
Qué hace DeepSeek Search API, según la documentación leída el 2026-11-03
Antes de repartir el trabajo conviene tener claro el lado de DeepSeek. La guía de Search y Fetch llama a los dos endpoints «APIs de JSON en bruto». Usan la misma clave que los modelos de chat, con Authorization: Bearer. Search recibe una consulta y devuelve resultados web estructurados del buscador propio de DeepSeek. Fetch recibe una URL y devuelve el cuerpo de la página en Markdown. Ninguno pasa por un modelo, así que ninguno se cobra por tokens. Comprobamos cada fila de la tabla con la referencia de Search y la referencia de Fetch.
| Elemento | Search | Fetch |
|---|---|---|
| Endpoint (dominio api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| Campos de la petición | query (de 1 a 128 caracteres, admite site:, lang:, after:, before: y más), count (de 1 a 50, 10 por defecto), ori_question, localization (una IP), need_content | url (hasta 8192 caracteres, http o https, sin usuario ni contraseña) |
| Respuesta | una lista results; cada resultado tiene 10 campos: rerank_score, title, url, snippet, summary, content, site_name, site_icon, date, authority | title, content (Markdown) |
| Precio | 0,75 USD por 1000 peticiones correctas; count no cambia el precio | igual |
| No se cobra | fallos, results vacío, tiempo agotado | fallos, página sin contenido, tiempo agotado |
| Límite | 100 peticiones por segundo y cuenta | 25 peticiones por segundo y cuenta, más un límite por dominio de destino |
Hay tres detalles que importan. El primero: summary es un resumen largo pensado para un modelo, normalmente de 600 a 800 caracteres, mientras que snippet es uno corto para la interfaz, de 100 a 200 caracteres. Diez resultados con su resumen completo añaden entre 6000 y 8000 caracteres al contexto en cada búsqueda. El segundo: date es la fecha de publicación de la página, en UTC, y vale null cuando se desconoce. authority es un grado de 0 a 4, con -1 para «desconocido», y rerank_score es una puntuación de relevancia de 0 a 3; la guía considera bueno un resultado con 1,5 o más.
El tercero: Search pasa query tal cual al servicio de búsqueda. Puedes escribir site:xiaohongshu.com en una consulta, pero el número de resultados depende de cuántas páginas de ese sitio haya en el índice de DeepSeek. Además, el índice guarda cada página tal como estaba al rastrearla; la sección «Momento de la copia y momento de la llamada» explica por qué esto importa con el contenido de las apps.
La guía también explica bien los errores. El formato es el mismo que el de OpenAI, y el campo param siempre vale null. Los errores 408, 429 y 5xx se pueden reintentar tras una espera. Un 402 indica que el saldo no alcanza. Los demás 4xx no conviene reintentarlos sin cambiar la petición. EveryInfra funciona de forma parecida: un valor incorrecto devuelve un 422 que nombra el campo y enumera los valores permitidos. La sección «Un viaje de ida y vuelta real» muestra un ejemplo.
Precio de DeepSeek Search API: qué empezó a cobrarse el 1 de noviembre
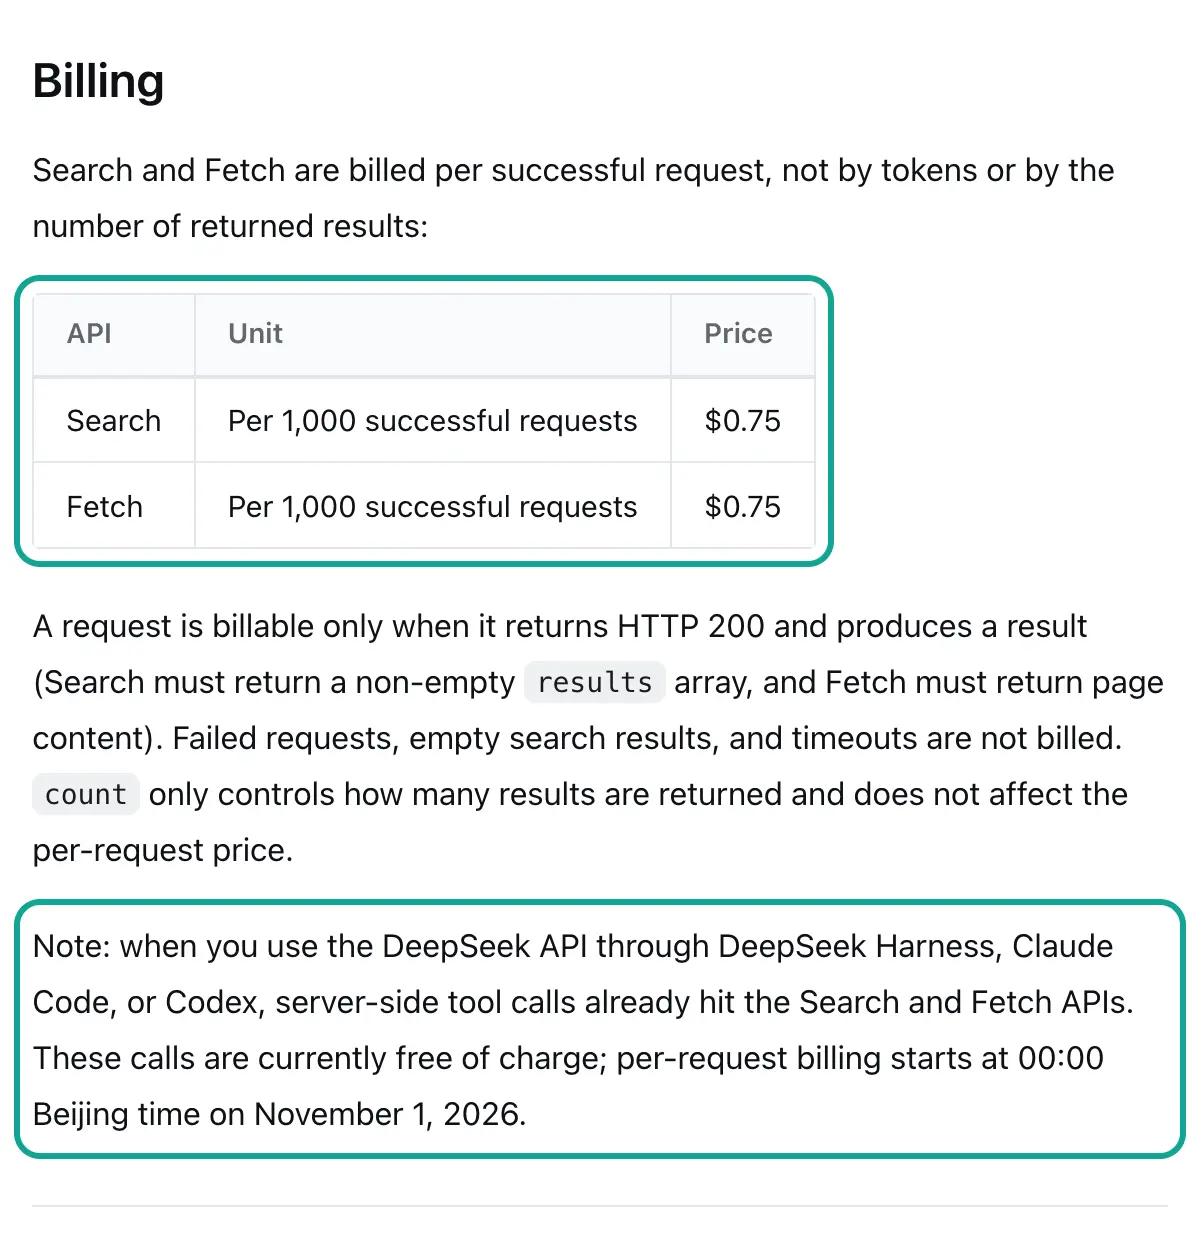
El precio en sí es sencillo. Search y Fetch cuestan 0,75 USD por 1000 peticiones correctas según la página de precios en inglés; la página en chino da 5 yuanes por la misma unidad. count solo cambia cuántos resultados recibes, no el precio. Una petición de 50 resultados cuesta lo mismo que una de 10. Por cada 1000 resultados, eso son 0,015 USD con count=50 y 0,075 USD con count=10.
Hay una frase de la nota de la versión del 2026-10-17 que se pasa por alto con facilidad. Claude Code, Codex y DeepSeek Harness ya llaman a Search y Fetch mediante herramientas del servidor cuando usan la API de DeepSeek. Esas llamadas eran gratis, y el cobro por petición empieza a las 16:00 UTC del 31 de octubre de 2026. Eso son las 00:00 del 1 de noviembre en Pekín, las 17:00 del 31 de octubre en Madrid y las 10:00 del 31 de octubre en Ciudad de México.
El 2026-11-03, la página de precios y la guía seguían diciendo «currently free of charge» junto a esa fecha. La fecha ya pasó, así que estas llamadas están en el periodo de cobro. Si tu equipo usa DeepSeek dentro de Claude Code (guía de DeepSeek para Claude Code), cada consulta web suma ahora 0,75 USD por 1000 al coste de tokens.
También hay que mirar el precio del modelo, porque los resultados acaban dentro de él. En la misma página, deepseek-flash apunta ahora a DeepSeek-V4.1-Flash-1017. En horas punta, la entrada sin caché cuesta 0,30 USD por millón de tokens y la salida 1,20 USD. Fuera de esas horas, la mitad. Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables: en Madrid caen de madrugada y por la mañana, y en Ciudad de México de noche. El contexto es de 1M tokens, y los dos modelos admiten llamadas a herramientas y salida JSON.
| Concepto | Unidad | USD (página en inglés) | Leído el |
|---|---|---|---|
| Search | por 1000 peticiones correctas | 0,75 USD | 2026-11-03 |
| Fetch | por 1000 peticiones correctas | 0,75 USD | 2026-11-03 |
| Entrada de deepseek-flash (sin caché, hora punta) | por 1M tokens | 0,30 USD | 2026-11-03 |
| Salida de deepseek-flash (hora punta) | por 1M tokens | 1,20 USD | 2026-11-03 |
zhihu/search de EveryInfra | por 1000 peticiones correctas | 0,556 USD | 2026-11-03 |
weibo/search de EveryInfra | por 1000 peticiones correctas | 0,806 USD | 2026-11-03 |
xiaohongshu/search de EveryInfra | por 1000 peticiones correctas | 5,556 USD | 2026-11-03 |
Los tres precios de EveryInfra salen del campo price_usd del catálogo gratuito. La regla es la misma que en DeepSeek: los fallos y los resultados vacíos no se cobran.
Resultados web frente a datos de dentro de la app con DeepSeek Search API: tabla de campos
La forma más clara de ver la diferencia es poner los campos uno al lado del otro. Los 10 campos de un resultado de DeepSeek Search sirven para encontrar una página, dar un resumen al modelo y mostrar el resultado a una persona. Los resultados de una búsqueda dentro de una app responden a otra pregunta: ¿cómo reaccionó la gente de esa app a esta publicación? También tienen título, texto, enlace y fecha. Además traen likes, comentarios, guardados y compartidos, y datos del autor y del contenido. La columna izquierda sigue la documentación de DeepSeek; las otras tres muestran los campos que aparecieron en nuestras respuestas reales del 2026-11-03.
| Pregunta | DeepSeek Search (campos documentados) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| ¿Qué dice la publicación? | title, summary, content | title, text (unos 60 caracteres) | title, text | text |
| ¿Dónde la abro? | url | url (con un token de acceso) | url | url |
| ¿Cuándo se publicó? | date (puede ser null) | posted_at, updated_at | posted_at | posted_at |
| ¿A cuánta gente le gustó o la guardó? | ninguno | like_count, collect_count | like_count, collect_count | like_count |
| ¿Cuánto se habla de ella? | ninguno | comment_count, share_count | comment_count | comment_count, repost_count |
| ¿Quién lo dice? | site_name, authority | author_name, author_id | author_name, author_follower_count, texto de la insignia | author_follower_count, author_verified, motivo de la verificación |
| ¿Es contenido pagado por una marca? | ninguno | is_cooperation_note, is_goods_note | ninguno | ninguno (mira el motivo de la verificación) |
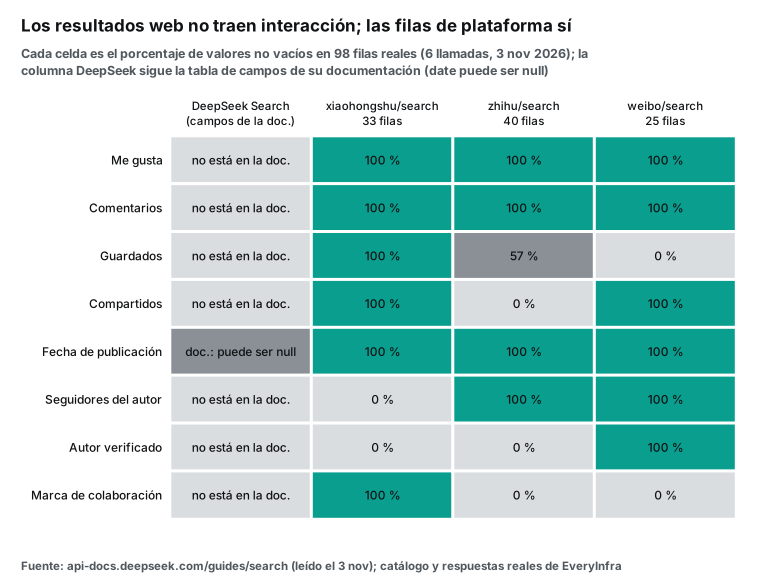
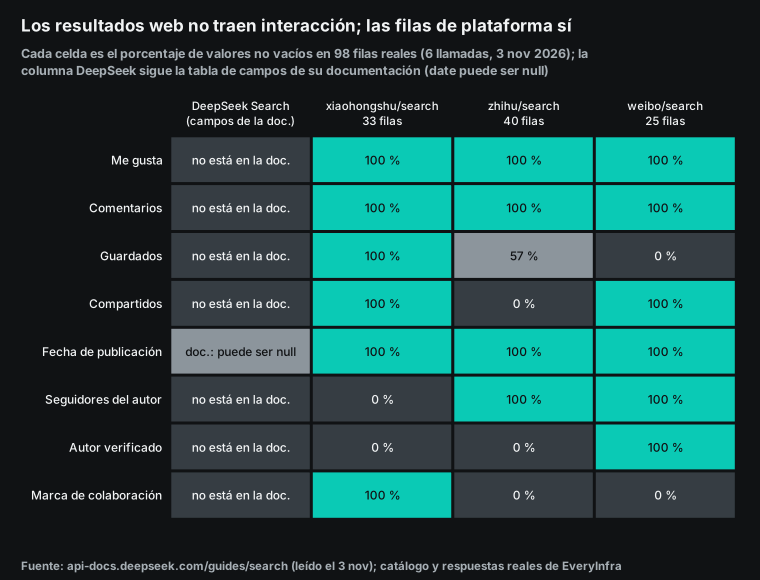
El gráfico tiene dos límites. Primero, «no documentado» no significa que DeepSeek nunca vea esas cifras. Su campo content es el cuerpo de la página, y si el texto dice «12 000 likes», el modelo puede leerlo. Pero es texto de una página, no un campo que puedas ordenar o sumar, y refleja el momento en que se rastreó.
Segundo, un 0 % en una columna de app tiene dos causas posibles. Algunos campos no están en el catálogo de esa capacidad, como los compartidos en la búsqueda de Zhihu. Otros están en el catálogo pero no llegaron esta vez: el catálogo incluye author_is_verified para la búsqueda de Xiaohongshu, y ninguna de nuestras 33 filas lo traía. Por eso conviene programar contra el campo response_fields del catálogo y aceptar campos ausentes en cualquier fila.
Momento de la copia y momento de la llamada: las cifras de una misma nota cambian
Además de los campos, hay una diferencia de tiempo. Una búsqueda web devuelve páginas de su índice, es decir, cada página tal como estaba cuando se rastreó. La documentación de DeepSeek enumera 10 campos por resultado; uno es date, la fecha de publicación, pero ninguno indica la fecha de rastreo, así que no sabes de qué día es la copia. Una búsqueda dentro de la app da los valores del momento de tu llamada: likes, comentarios y guardados son los de ese instante. Xiaohongshu devuelve además updated_at, que el catálogo describe como la hora de la última edición de la nota.
En temas de producto la diferencia no es pequeña. Miramos las 20 notas de Xiaohongshu de la búsqueda de quejas ordenada por más likes. En 13 de ellas, la última edición llegó más de 30 días después de la publicación; en 5, más de un año después. Una nota se editó 1154 días después de publicarse.
| Tiempo entre publicación y última edición | Notas (de 20) |
|---|---|
| Menos de 30 días | 7 |
| De 30 a 365 días | 8 |
| Más de 365 días | 5 |
Los autores vuelven a sus notas: corrigen el texto, añaden una actualización o cambian el nombre del modelo. Si la copia web es anterior a la edición, el modelo lee la versión vieja. La nota de la bolsa de polvo de la captura de más abajo tenía 992 likes y 571 comentarios y, en el momento de nuestra llamada, solo una semana de vida; mientras la gente siga reaccionando, una copia de hace unos días mostrará cifras más bajas. Weibo es aún más inmediato: las 25 publicaciones de nuestras dos búsquedas eran de los 4 días anteriores a la llamada.
Por eso puedes repartir el trabajo según el tiempo. La búsqueda web sirve para lo que cambia despacio: fichas técnicas de la marca, reseñas de prensa, manuales y notas de prensa, que no pierden valor si se rastrean cada pocas semanas. La búsqueda dentro de la app sirve para lo que cambia rápido: quejas de la última semana, problemas de posventa que crecen y notas cuyas cifras siguen subiendo. También da órdenes que solo la app puede aplicar: más reciente, más likes y más comentarios.
Lo contrario también es cierto. Una búsqueda dentro de una app no sustituye a una búsqueda web: no contiene webs de marca, fichas técnicas, reseñas de prensa ni foros de fuera de esas apps. Para un equipo hispanohablante, la parte web cubre también las fuentes en español, como una prueba en una revista de consumo o una tienda que publica opiniones. Los dos tipos de datos se reparten el trabajo; ninguno sustituye al otro.
Los criterios que escribimos antes de la prueba
Escribimos estos criterios antes de las llamadas reales para no poder cambiarlos al ver los resultados. De ellos depende que cada conclusión de este artículo se sostenga.
| Criterio | Aprueba | Suspende |
|---|---|---|
| ¿Aportan los datos de dentro de la app campos que no tienen los resultados web? | likes, comentarios y fecha en al menos el 90 % de las filas de las tres apps | menos del 90 % en alguna app |
| ¿Responden las tres apps en menos de 85 segundos, sin pasar a una tarea asíncrona? | las 6 llamadas devuelven 200 | un tiempo agotado o un 503 |
| ¿Puede un modelo corregir solo un valor incorrecto? | el 422 nombra el campo, enumera los valores permitidos y no cobra nada | un error vago, o un cobro |
| ¿Podemos controlar el coste de Xiaohongshu? | un plan deja el coste de datos por debajo de 5 USD por 1000 preguntas | la única forma es hacer menos preguntas |
| ¿Pueden las filas ir tal cual a la respuesta como «voz del comprador»? | como mucho el 20 % de las filas necesita filtro | más del 20 % en alguna app (esperábamos suspender aquí) |
Adelantamos el resultado: los cuatro primeros criterios aprueban y el quinto suspende en las tres apps. Por eso una sección posterior explica los filtros.
El flujo: una pregunta de producto y dos caminos de datos


El flujo tiene cuatro pasos, y el segundo es la clave. El modelo de DeepSeek no ejecuta ninguna función. Devuelve tool_calls, que vienen a decir «llama a esta función con estos argumentos», y es tu código el que llama de verdad a DeepSeek Search y a EveryInfra. La guía de llamadas a herramientas de DeepSeek lo dice así: la función la aporta el usuario y el modelo no la ejecuta. La ventaja es que las dos claves se quedan en tu servidor y el modelo nunca las ve. El precio es que el bucle lo escribes tú; las secciones siguientes traen un ejemplo de configuración completo.
En el primer paso, el usuario pregunta. En el segundo, el modelo lee la pregunta y la descripción de las cuatro funciones, decide qué buscar y puede lanzar cuatro llamadas a la vez: una búsqueda web y tres búsquedas en apps. En el tercero, tu código llama a los dos endpoints y devuelve el JSON original, o una versión reducida, en un mensaje role: tool con el tool_call_id que corresponde.
En el cuarto, el modelo lee todos los resultados y escribe la respuesta. El mensaje de sistema le pide que añada después de cada afirmación la URL de la fuente, el número de likes y la fecha de publicación. Una pregunta de seguimiento, como «¿qué se dice de la marca A frente a la marca B?», abre otra ronda de llamadas. El bucle termina cuando el modelo ya no devuelve tool_calls.
En este flujo, cada camino tiene su tarea. La búsqueda web encuentra webs de marca, fichas técnicas, reseñas de prensa y noticias, y responde a «¿qué hace este modelo y qué dice la marca?». Los datos de dentro de la app encuentran lo que dicen los usuarios reales en Xiaohongshu, Zhihu y Weibo, y responden a «¿cómo lo valoran los compradores y qué problemas se repiten?». Con las dos fuentes en la respuesta, el lector ve juntas las promesas de la marca y la experiencia de los compradores. Donde no coinciden suele estar la conclusión más útil.
Definición de herramientas: cuatro funciones en JSON completo (ejemplo de configuración)
Abajo están las cuatro funciones para el modelo de DeepSeek. En las tres funciones de apps, cada nombre de parámetro, cada valor de enum y cada descripción salen de los campos param_meanings y allowed_values del catálogo de EveryInfra. La función de búsqueda web sigue la referencia de DeepSeek Search. Usamos el modo strict. La guía de llamadas a herramientas indica que ese modo necesita la URL base beta (api.deepseek.com/beta, con el prefijo https). Cada propiedad de cada objeto debe estar en required, y additionalProperties debe valer false.
Eso significa que un parámetro opcional no se puede omitir sin más. Lo resolvemos de dos maneras. Si un enum tiene valor por defecto, metemos ese valor en el enum y dejamos que el modelo lo elija: relevance para sort y any_time para date_range. Si una cadena no tiene valor por defecto, como el token de página, usamos anyOf con null.
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword in Chinese, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]
¿Por qué poner el precio en la descripción? Porque el modelo lee description. Si en la función de Xiaohongshu pone «una página = 0,005556 USD» y el mensaje de sistema dice «como mucho una página de Xiaohongshu por pregunta, prueba antes Zhihu y Weibo», el modelo tiene información de coste cuando elige función. No es un límite duro; el límite duro va en el código del bucle, que verás en la sección siguiente.
Hay otro detalle importante para un equipo fuera de China. La palabra clave de las tres funciones de apps debe ir en chino, porque las publicaciones están en chino, y la descripción lo indica. Un modelo como deepseek-flash escribe buenas palabras clave en chino a partir de una pregunta en español, así que tus usuarios pueden preguntar en su idioma. Comprobamos con un script los enums de arriba contra el catálogo del 2026-11-03.
| Parámetro de la función | `allowed_values` del catálogo | Enum en la definición | Coincide |
|---|---|---|---|
xiaohongshu_search.sort | 5: relevance, newest, most_liked, most_commented, most_collected | los mismos 5 | sí |
xiaohongshu_search.date_range | 6: de any_time a last_1_year | los mismos 6 | sí |
xiaohongshu_search.content_type | 3: all, image, video | los mismos 3 | sí |
zhihu_search.content_type | 4: all, answer, article, video | los mismos 4 | sí |
zhihu_search.sort | 3: general, upvote_count_descending, time_descending | los mismos 3 | sí |
web_search.count | documentación de DeepSeek: de 1 a 50 | minimum 1, maximum 50 | sí |
¿Por qué importa esta tabla? Un enum incorrecto recibe un 422 de EveryInfra y no se cobra nada, pero el modelo necesita una ronda más para corregirlo. Con los enums bien puestos desde el principio te ahorras un viaje de ida y vuelta y sus tokens. El catálogo se puede leer gratis en cualquier momento, por ejemplo la entrada de Xiaohongshu. Cuando cambia una capacidad, vuelves a generar las definiciones. La página de la capacidad de búsqueda de Xiaohongshu también explica los campos.
La entrada de Zhihu y la entrada de Weibo del catálogo enumeran los parámetros y campos de las otras dos. La búsqueda de Weibo tiene un único parámetro, keyword, así que su función es la más corta y un modelo casi nunca la escribe mal.
El código del bucle: tool_calls de DeepSeek en Python (ejemplo de configuración)
El código de abajo usa el SDK de Python de OpenAI, del paquete openai en PyPI. La API de chat de DeepSeek usa el formato de OpenAI, y la guía de llamadas a funciones de OpenAI describe la misma estructura de tools. Los dos endpoints de datos se llaman con requests y un tiempo límite de 90 segundos, porque EveryInfra reserva 85 segundos para una llamada síncrona. Antes de devolver los resultados al modelo nos quedamos con 12 campos. ensure_ascii=False guarda los caracteres chinos tal cual (documentación de json en Python); escapados ocuparían varias veces más tokens.
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # como mucho 1 página de Xiaohongshu por pregunta

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # un 422 trae param, allowed y did_you_mean: se lo pasamos al modelo
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "Responde en español. Tras cada afirmación da la url de la fuente, los likes y la fecha. "
                                          "Busca primero en Zhihu y Weibo; usa Xiaohongshu solo si hace falta. Palabras clave de las apps en chino."},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # conserva reasoning_content; obligatorio cuando hay tools
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
            msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})
Dos puntos siguen la documentación de DeepSeek. El primero: el modo de razonamiento viene activado por defecto. La guía del modo de razonamiento dice que una petición con tools debe reenviar el reasoning_content de todos los turnos anteriores; si no lo hace, la API responde con un 400. La línea msgs.append(m) se encarga de eso. El segundo: el modo strict solo funciona con la URL base beta. Con la URL normal, el campo strict no tiene efecto y el modelo puede dejarse algún argumento; EveryInfra devolverá entonces un 422 y el modelo lo añadirá en la siguiente ronda.
El control de presupuesto está en el bucle, no en el mensaje de sistema. Un mensaje de sistema solo puede pedir al modelo que ahorre. El código puede garantizar que una pregunta nunca gaste más de una cantidad fija. Para un equipo que lanza cientos de preguntas al día, esa diferencia se nota en la factura del mes.
Un viaje de ida y vuelta real: qué envía el modelo y qué vuelve
No ejecutamos el lado del modelo porque no tenemos clave de DeepSeek. Toma la pregunta «Voy a comprar un robot aspirador en el 11.11: ¿qué critican más los compradores?». Con las definiciones de arriba, un modelo podría enviar una llamada a Xiaohongshu con una palabra clave en chino que significa «quejas sobre robots aspiradores». Los demás argumentos serían sort igual a most_liked, date_range igual a any_time, content_type igual a all y page_token igual a null. El bucle quita el null y envía a EveryInfra la petición de abajo. Esta llamada es real.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'
La petición de las 00:17:22, hora de Singapur, del 2026-11-03 devolvió 200 con 20 filas. El cuerpo pesaba 36 627 bytes y billing.charged_usd valía 0.005556. En el mismo minuto repetimos la llamada con sort igual a hot a propósito. Volvió un 422 con code igual a invalid_value y did_you_mean igual a most_liked. El campo allowed enumeraba los 5 valores válidos, y el primer elemento de next_steps decía, en inglés, que se cambiara solo sort a un valor de allowed y se reenviara, y que no se había cobrado nada. Un modelo que recibe ese mensaje role: tool cambia solo sort en la siguiente ronda, sin que intervenga nadie.
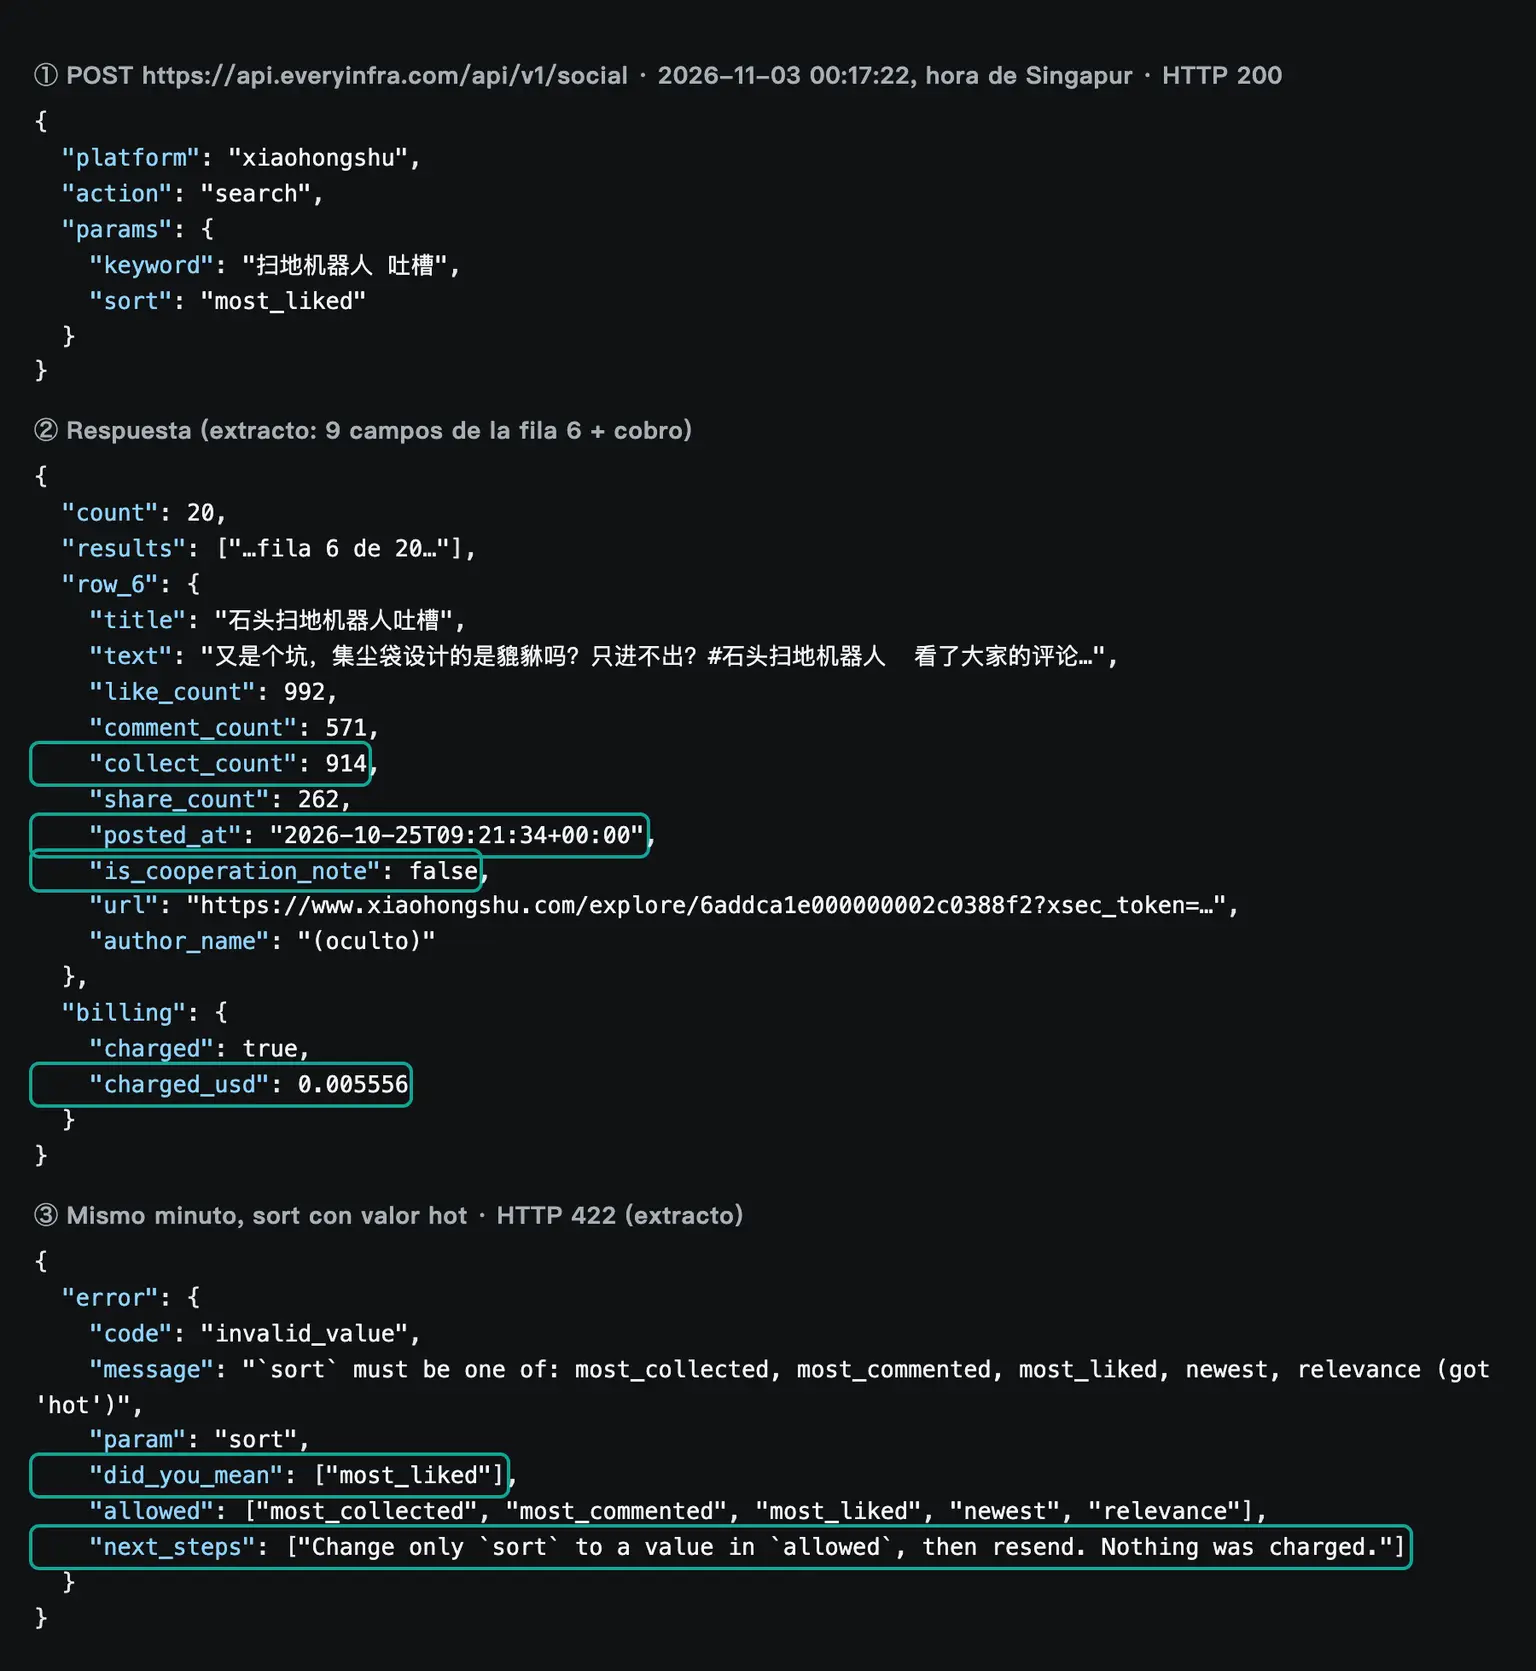
La fila 6 de la captura es una nota del 2026-10-25. Su título dice que es una queja sobre una marca de robots aspiradores. El texto dice que la bolsa de polvo «solo traga y nunca suelta», en alusión al coste de las bolsas de recambio. Tiene 992 likes, 571 comentarios y 914 guardados. Los comentarios superan la mitad de los likes, así que la nota abrió una discusión de verdad; es la señal que buscas cuando preguntas por las quejas principales. En un resultado de búsqueda web, el modelo vería como mucho el título y un resumen de esta nota.
Para ver de qué se discute en los comentarios, puedes llamar a xiaohongshu/note con la url de esta fila y obtener el texto completo. También existe una llamada de comentarios. Cada una cuesta igualmente 0,005556 USD, así que se aplica la misma lógica de presupuesto.
Prueba 1: qué devolvió cada app
Entre las 00:15 y las 00:19, hora de Singapur, hicimos 9 llamadas sobre el tema «robot aspirador». Seis fueron dos por app. Otras dos sirvieron de comparación con plataformas occidentales, Reddit y YouTube en español, y una llevaba un valor incorrecto a propósito. Todas respondieron de forma síncrona y ninguna necesitó una tarea asíncrona.
| Hora de Singapur | Capacidad | Parámetros | Filas | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | recomendación de robot aspirador, solo respuestas | 20 | 0,000556 USD |
| 00:16:17 | weibo/search | robot aspirador | 13 | 0,000806 USD |
| 00:16:32 | xiaohongshu/search | robot aspirador, más comentarios, últimos 30 días | 13 | 0,005556 USD |
| 00:17:22 | xiaohongshu/search | sort igual a hot | 422 | 0 USD |
| 00:17:22 | xiaohongshu/search | quejas sobre robot aspirador, más likes | 20 | 0,005556 USD |
| 00:18:26 | zhihu/search | defectos del robot aspirador, más votos | 20 | 0,000556 USD |
| 00:18:31 | weibo/search | posventa del robot aspirador | 12 | 0,000806 USD |
| 00:18:53 | reddit/search | robot vacuum, top | 5 | 0,000556 USD |
| 00:18:59 | youtube/search | aspiradora robot opiniones 2026 | 10 | 0,000556 USD |
| Total | 113 filas | 0,014948 USD |
Las tres apps chinas devolvieron contenidos muy distintos. La búsqueda de quejas en Xiaohongshu, ordenada por más likes, trajo 20 notas. Casi todos los títulos hablan del uso real y de qué evitar: el diseño de la bolsa de polvo, un robot que cayó por un desnivel porque falló su zona prohibida, problemas al reconocer mascotas y «un electrodoméstico que es un impuesto para ingenuos». Ocho de las 20 llevan la marca de contenido pagado; son pruebas y guías de compra encargadas por marcas.
La tabla de abajo muestra cinco filas de esa búsqueda, con nuestro resumen en español de cada título. Se ve enseguida lo que añaden los campos de interacción: qué queja generó más conversación.
| Publicada | Título, resumido en español | Likes | Comentarios | Contenido pagado |
|---|---|---|---|---|
| 2026-10-16 | Pasó el accidente que temía con un robot «apto para mascotas» | 3710 | 183 | false |
| 2023-09-17 | El robot ignoró su zona prohibida un mes y luego cayó por un desnivel | 3445 | 1937 | false |
| 2025-12-16 | No compres el robot aspirador de Dyson | 1444 | 53 | false |
| 2026-10-25 | Queja sobre el diseño de la bolsa de polvo de una marca | 992 | 571 | false |
| 2026-07-06 | Un electrodoméstico que es un impuesto para ingenuos | 553 | 973 | false |
La búsqueda de recomendaciones en Zhihu devolvió 20 respuestas, sobre todo guías de compra y listas de modelos. Las búsquedas de Weibo devolvieron 25 publicaciones, todas de la semana anterior al 2026-11-02, y fueron las más variadas. Había usuarios que pedían consejo y uno que contaba que su robot se averió a los dos años y que la marca ya no tenía piezas. También había publicaciones de campañas de marca y de guías de compra.
Cada tipo de contenido tiene su uso. Para defectos concretos que la gente repite una y otra vez, lo más concentrado es Xiaohongshu ordenado por likes o por comentarios. Para análisis expertos sobre qué comprar, las respuestas largas de Zhihu traen más información. Para problemas de posventa nuevos de esta semana, Weibo es lo más actual. Un asistente que solo use búsqueda web difícilmente tendrá las tres miradas, y tampoco tendrá las cifras de interacción que dicen qué publicación es representativa.
Prueba 2: en YouTube en español, 0 de 10 vídeos eran del último mes
Para un equipo hispanohablante, la comparación más útil es su propio mercado. Buscamos «aspiradora robot opiniones 2026» en YouTube a las 00:18, hora de Singapur. Los 10 primeros vídeos por relevancia van de 511 a 1 001 262 visualizaciones, y ninguno se publicó en los últimos 30 días; el más reciente es del 2026-08-08. Ocho títulos dicen «2026», y uno de ellos es de un vídeo publicado el 2024-08-25. Dos títulos nombran marcas concretas, Roborock y Xiaomi.
| Publicado | Título | Visualizaciones | Likes | Comentarios |
|---|---|---|---|---|
| 2026-06-01 | Los Mejores Robots Aspiradores CALIDAD PRECIO del 2026! | 62 320 | 450 | 13 |
| 2026-04-27 | NO COMPRES un ROBOT ASPIRADOR en 2026 sin ver ESTO, Roborock Qrevo S Pro | 28 739 | 338 | 29 |
| 2026-03-08 | NO COMPRES un robot aspirador de Xiaomi en 2026 sin ver esto | 55 612 | 474 | 18 |
| 2024-08-25 | En 2026... ¿Ya MERECE la pena un ROBOT ASPIRADORA que FRIEGA? | 323 709 | 4529 | 283 |
| 2023-12-22 | ¿Vale la pena un robot aspiradora trapeadora? | 1 001 262 | 19 848 | 762 |
La conclusión es doble. Por un lado, el patrón de «título con el año actual sobre un contenido más antiguo» no es solo chino; aparece también en tu mercado. Por otro, en esta muestra la conversación en español está dominada por guías de compra genéricas, mientras que en Xiaohongshu una queja concreta ya acumula cientos de comentarios. Una muestra de 10 vídeos no prueba un retraso entre mercados, pero sí indica que las quejas concretas se encuentran antes en las apps chinas. Seguirlas te ayuda a preparar respuestas de atención al cliente o a ajustar la ficha del producto. La página de la capacidad de búsqueda de YouTube y la de Reddit explican los parámetros; en Reddit, los 5 primeros resultados de «robot vacuum» del 2026-10-07 al 2026-10-22 eran humor y temas sin relación con quejas de compradores.
| Publicado | Comunidad | Título | Likes | Comentarios |
|---|---|---|---|---|
| 2026-10-20 | r/TikTokCringe | State of the art Japanese robot vacuum | 6551 | 107 |
| 2026-10-16 | r/homeassistant | Robot vacuum garage | 3076 | 176 |
| 2026-10-14 | r/futurama | My robot vacuum as Scruffy the Janitor and Wash Bucket | 2998 | 76 |
| 2026-10-07 | r/Perfectfit | The way my robot vacuum fits under the TV rack | 1773 | 16 |
| 2026-10-22 | r/BORUpdates | AITAH for refusing to share with my cousin-in-law? (sin relación) | 1102 | 222 |
Prueba 3: ordenado por votos, 0 de 20 respuestas de Zhihu eran recientes
«Nuevo» es donde más fallan las preguntas de producto. Los robots aspiradores cambian varias veces al año, y una guía de compra de hace dos años puede no servir ya. Con posted_at contamos, en cada llamada, las filas de los últimos 30 días, es decir, posteriores al 2026-10-04. Las seis búsquedas en apps chinas fueron muy distintas.
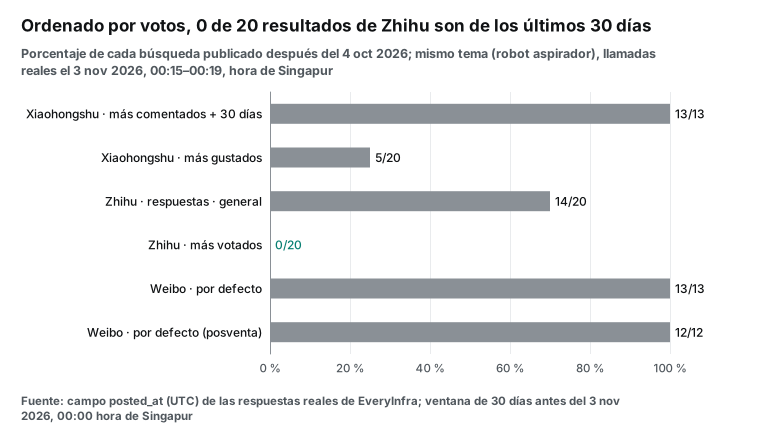
El caso extremo es la búsqueda de Zhihu ordenada por más votos. De 20 filas, 18 se publicaron antes de 2026 y la más antigua es de 2015. Los títulos llaman todavía más la atención: 9 de los 20 mencionan 2026, y 8 de esos 9 se publicaron antes de 2026. La más antigua se publicó el 2018-04-12, pero su título promete una guía de compra de 2026. Son respuestas perennes cuyos autores actualizan el texto y el año cada temporada. El cuerpo puede ser nuevo, pero un lector o un modelo que solo mire el título creerá que es de este año.
| Posición en la búsqueda | Publicada | Votos | Comentarios |
|---|---|---|---|
| 1 | 2022-05-30 | 7349 | 2751 |
| 4 | 2020-10-22 | 3654 | 1783 |
| 5 | 2019-03-13 | 2284 | 596 |
| 6 | 2020-05-11 | 2282 | 1340 |
| 8 | 2022-03-24 | 2157 | 41 |
| 9 | 2019-03-15 | 1832 | 227 |
| 10 | 2018-04-12 | 1609 | 6 |
| 11 | 2021-04-26 | 1370 | 84 |
| 20 | 2026-09-30 | 503 | 34 |
La tabla recoge las 9 respuestas cuyo título menciona 2026. Solo la de la posición 20 se publicó de verdad en 2026, y es la que menos votos tiene: ordenar por votos favorece justo a las respuestas antiguas.
¿Puede detectar esto el campo date de un resultado web? Depende de qué fecha mostraba la página cuando se rastreó; la documentación de DeepSeek solo dice que date vale null cuando se desconoce. Los datos de dentro de la app dan la fecha que registra la propia app, y puedes compararla directamente con el título.
La solución es sencilla. Para preguntas sobre lo «reciente», usa date_range=last_30_days con sort=most_commented en Xiaohongshu y sort=time_descending en Zhihu; Weibo devuelve publicaciones recientes por defecto. Para preguntas sobre «reputación a largo plazo», ordena por likes y pide al modelo que indique el año de cada fuente.
Hay también un detalle de coste. La llamada de Xiaohongshu con last_30_days devolvió solo 13 filas. El catálogo avisa de que ese filtro puede traer menos de 20 filas por página, y una página con resultados se cobra como página entera. Por eso, el precio por cada 1000 resultados de esa llamada fue de 0,427 USD, un 54 % más que los 0,278 USD de una página llena.
Prueba 4: filas que conviene filtrar antes
Esperábamos que el quinto criterio suspendiera, y suspendió. Cada app tiene un tipo de fila que da una imagen falsa de la «voz del comprador» si la usas tal cual.
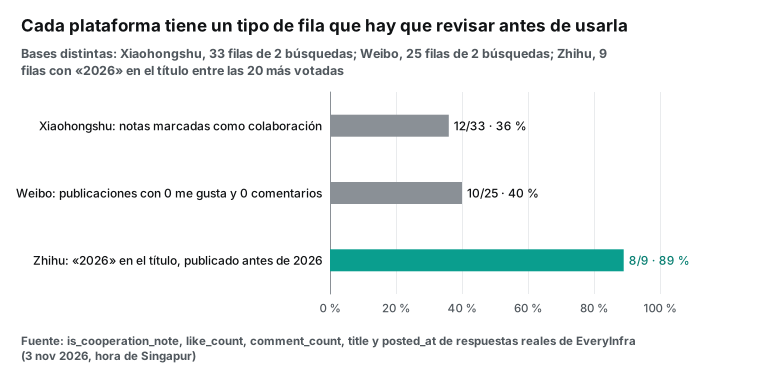
En Xiaohongshu, is_cooperation_note es el campo más directo. Valía true en 12 de 33 filas. La llamada de más comentarios en los últimos 30 días tenía 4 de 13. La de quejas ordenadas por likes tenía 8 de 20. Una nota pagada no es necesariamente falsa. Pero ante la pregunta «¿de qué se quejan los compradores?», muestra el mensaje que la marca quiere que veas, así que conviene agruparlas aparte o marcarlas en la respuesta. Solo los datos de dentro de la app tienen este campo; los resultados web no tienen nada equivalente.
La búsqueda de Xiaohongshu por más comentarios en los últimos 30 días tenía otro tipo de ruido. Sus primeras filas eran un meme sobre un robot perdido con 14 963 likes, un vídeo de ejercicio y un clip de un juego de terror. Son publicaciones populares que usan la etiqueta, no experiencias de compradores. Si buscas problemas reales, usa una palabra clave con el problema, como «quejas» o «defectos».
| Weibo, 25 filas de dos búsquedas | Filas | Porcentaje |
|---|---|---|
| Publicadas entre el 2026-10-29 y el 2026-11-02 (UTC) | 25 | 100 % |
| Sin likes ni comentarios | 10 | 40 % |
| De cuentas verificadas | 9 | 36 % |
| De cuentas con 100 000 seguidores o más | 8 | 32 % |
En Weibo, el problema es el ruido. De 25 filas, 10 no tenían ni likes ni comentarios. Nueve venían de cuentas verificadas y 8 de cuentas con 100 000 seguidores o más. Entre ellas había campañas de marca y guías de compra; un aviso de directo de una marca tenía 2435 likes y 421 comentarios. Tienen mucha interacción, pero no son quejas de compradores. Puedes localizarlas con author_verified_reason y con los enlaces de producto del texto.
Las publicaciones útiles suelen venir de cuentas con decenas o cientos de seguidores que nombran una marca y un defecto. Una del 2026-11-02 cuenta que un robot comprado en marzo de 2024 se averió a los dos años. El servicio posventa le dijo al dueño que el modelo estaba descatalogado y sin piezas, y solo le ofreció un descuento de 200 yuanes por entregar el viejo. Esa publicación tenía 0 likes y 1 comentario, y aun así es una señal real de posventa. Por eso un filtro no puede descartar sin más las filas con poca interacción.
Después de filtrar, ordena. En las tres apps, unas pocas filas concentran casi toda la interacción. La llamada de Xiaohongshu con más comentarios de los últimos 30 días trajo 13 notas con 124 557 likes en total, y las 3 primeras sumaban el 49 %. La de quejas trajo 20 notas con 23 938 likes, y las 3 primeras sumaban el 48 %. La de recomendaciones de Zhihu trajo 20 respuestas con solo 1151 votos: las 3 primeras sumaban el 75 % y la mediana era 11. La de posventa de Weibo trajo 12 publicaciones con 2290 likes; una sola tenía 2288 y las otras 11 sumaban 2.
| Llamada | Filas | Likes o votos en total | Parte de las 3 primeras filas |
|---|---|---|---|
xiaohongshu/search, más comentarios, últimos 30 días | 13 | 124 557 | 49 % |
xiaohongshu/search, quejas, más likes | 20 | 23 938 | 48 % |
zhihu/search, recomendaciones, solo respuestas | 20 | 1151 | 75 % |
weibo/search, posventa | 12 | 2290 | 100 % |
Si pasas las 20 filas al modelo en el orden en que llegan, la «opinión mayoritaria» puede salir de dos o tres filas populares. Es mejor ordenar por interacción en el código del bucle, quitar duplicados por author_id y enviar las cifras con cada fila, para que el modelo diga al lector si cita «una nota con 992 likes» o «una publicación con 0 likes pero con datos concretos». En Python basta con sorted() y una función key sobre like_count (guía de ordenación de Python), más un conjunto con los autores ya usados. No cuesta ninguna llamada más.
Cómo queda la respuesta: un ejemplo de formato hecho con filas reales
No ejecutamos el modelo, así que no tenemos una respuesta escrita por DeepSeek. Pero se puede ver el formato. Escribimos a mano el comienzo de una respuesta con las filas reales de arriba. Es un ejemplo de formato, no una salida del modelo, y cada cifra coincide con una respuesta original. Los enlaces llevan tokens de acceso, así que ponemos «enlace omitido».
El primer grupo de quejas trata de la bolsa de polvo y los recambios. Una nota de Xiaohongshu del 2026-10-25 dice que la bolsa de una marca «solo traga y nunca suelta», con 992 likes, 571 comentarios y 914 guardados (enlace omitido; no es contenido pagado). El segundo grupo trata del posventa. El 2026-11-02, un usuario de Weibo con 124 seguidores contó que su robot, comprado en marzo de 2024, se averió a los dos años; la marca dijo que el modelo estaba descatalogado y solo ofreció 200 yuanes por el viejo (enlace omitido; 0 likes, 1 comentario). En Zhihu, la mayoría de las guías de compra con más votos se publicaron entre 2018 y 2022, aunque sus títulos digan 2026: comprueba el año antes de fiarte.
El ejemplo aplica tres reglas que un mensaje de sistema puede pedir. Primera: cada afirmación lleva su app, su fecha y sus cifras de interacción, así que el lector puede juzgar su peso. Una nota con 992 likes y una publicación de Weibo con 0 likes no pesan igual, pero la de Weibo es una experiencia concreta de posventa y no conviene descartarla porque nadie le diera like. Segunda: la marca de contenido pagado va entre paréntesis, así que el lector sabe que la nota no es publicidad. Tercera: la frase de Zhihu no cita ninguna respuesta; avisa del año de publicación, porque la prueba 3 mostró que las respuestas de Zhihu ordenadas por votos son casi todas antiguas.
Al escribir el ejemplo encontramos otro detalle. Dos autores tenían cada uno 3 de las 20 filas de Zhihu. Las 3 respuestas de uno empiezan casi con las mismas palabras, tienen 0 votos y llevan al mismo artículo. El otro escribió 3 respuestas en dos días y las tres recomiendan modelos de una misma marca. Si las cuentas como 20 voces independientes, sobrevaloras esa marca.
Así que elimina duplicados por author_id antes de devolver las filas al modelo y quédate con la fila de más interacción de cada autor. Las tres apps devuelven ese campo. Son unas pocas líneas de código, y es más fiable que pedir al modelo en el mensaje de sistema que «vigile los autores repetidos».
Prueba 5: cuántos tokens te ahorras antes del modelo
El paso más barato de este flujo es quitar campos antes de devolver los resultados al modelo. Estimamos los tokens de tres búsquedas de dos formas: la respuesta original y solo los 13 campos que importan. Usamos las proporciones de la guía de uso de tokens de DeepSeek: unos 0,3 tokens por carácter inglés y 0,6 por carácter chino. Son estimaciones; la cifra real está en el campo usage de cada respuesta.
| Búsqueda | Caracteres originales | Tokens originales (est.) | Caracteres con 13 campos | Tokens después (est.) |
|---|---|---|---|---|
xiaohongshu/search quejas, más likes | 33 905 | 10 549 | 7302 | 2542 |
zhihu/search defectos, más votos | 15 459 | 5696 | 7356 | 3162 |
weibo/search posventa | 10 786 | 3624 | 3873 | 1458 |
| Total | 60 150 | 19 869 | 18 531 | 7162 |
La forma reducida ocupa un 64 % menos. Xiaohongshu es donde más se ahorra, porque sus filas originales traen listas de imágenes, avatares, enlaces de vídeo, anchos y altos, y nada de eso ayuda a responder. Al precio de entrada de deepseek-flash en hora punta, 0,30 USD por millón de tokens, 19 869 tokens cuestan 0,0060 USD y 7162 tokens cuestan 0,0021 USD. En una sola llamada, la diferencia es pequeña.
En un bucle de llamadas a herramientas, en cambio, los resultados anteriores se reenvían con cada petición nueva, y con más rondas la diferencia crece. DeepSeek tiene caché de contexto, y la entrada que acierta en caché cuesta 0,006 USD por millón de tokens en hora punta según la página en inglés, así que el coste real de lo reenviado es mucho menor, pero solo si acierta en caché.
Según la guía de caché de contexto de DeepSeek, una petición acierta solo cuando su prefijo coincide por completo con una unidad de prefijo ya guardada. La API de chat no guarda estado, así que cada ronda reenvía todos los mensajes anteriores (guía de conversación de varias rondas). En el código del bucle eso se traduce en dos reglas. Primera: no edites ni reordenes los resultados de herramientas en rondas posteriores, y deja el prompt de sistema y las definiciones de herramientas al principio y sin cambios. Segunda: quita campos, ordena y elimina duplicados antes de devolver los resultados por primera vez. Así, desde la segunda ronda, la parte anterior se cobra a precio de caché y solo la ronda nueva se cobra sin caché.
Aun así, un contexto más pequeño ayuda al modelo a centrarse, como sugiere el estudio citado en «Cambios recientes».
Coste: DeepSeek Search API a 0,75 USD por 1000 y Xiaohongshu a 0,005556 USD por llamada
Con los precios uno al lado del otro, el resultado es claro. La búsqueda web es barata; Zhihu y Weibo cuestan más o menos lo mismo; Xiaohongshu cuesta unas diez veces más.
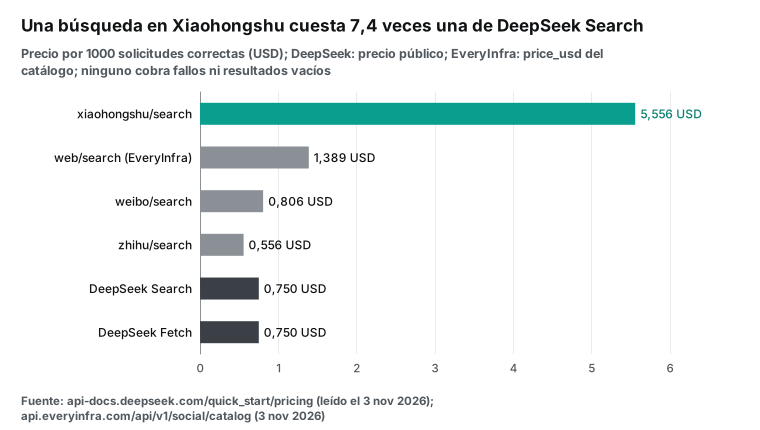
Hay algo que conviene decir con claridad. Si solo necesitas búsqueda web general, DeepSeek Search, a 0,75 USD por 1000, es más barato que el propio web/search de EveryInfra, a 1,389 USD por 1000, y además devuelve hasta 50 resultados por llamada. Por eso, en este flujo la búsqueda web debe hacerla DeepSeek y EveryInfra solo debe encargarse de los datos de dentro de las apps.
Por cada 1000 resultados, la diferencia es mayor: DeepSeek cuesta 0,015 USD con count=50, Zhihu 0,028 USD, Weibo entre 0,062 y 0,067 USD, y Xiaohongshu entre 0,278 y 0,427 USD. Pero estos dos tipos de resultados no se pueden comparar por número de filas, porque un resultado web y una publicación con cifras de interacción responden a preguntas distintas.
| Llamadas por pregunta | Precio unitario | Llamadas | Subtotal |
|---|---|---|---|
| DeepSeek Search | 0,00075 USD | 2 | 0,0015 USD |
xiaohongshu/search | 0,005556 USD | 1 | 0,005556 USD |
zhihu/search | 0,000556 USD | 1 | 0,000556 USD |
weibo/search | 0,000806 USD | 1 | 0,000806 USD |
| Coste de datos (plan B) | 5 | 0,008418 USD | |
| Coste del modelo (estimación, hora punta, unos 16 000 tokens de entrada y 1500 de salida) | unos 0,0066 USD |
La estimación del modelo tiene mucho margen. La entrada suma 7162 tokens de datos de apps reducidos y unos 8400 tokens de resúmenes web de dos búsquedas de 10 resultados cada una; la salida, 1500 tokens. No incluye el contexto reenviado ni los aciertos de caché. El coste de datos, en cambio, es exacto: precio del catálogo por número de llamadas. Una pregunta cuesta en total alrededor de 1,5 céntimos de dólar, y solo Xiaohongshu supone el 66 % del coste de datos.
Cómo limitar las llamadas a Xiaohongshu: tres planes
A 0,005556 USD por página, Xiaohongshu es el coste que hay que gestionar. El objetivo no es usarlo menos, sino usarlo solo cuando aporta. Planteamos tres planes; todos incluyen dos búsquedas de DeepSeek por pregunta.
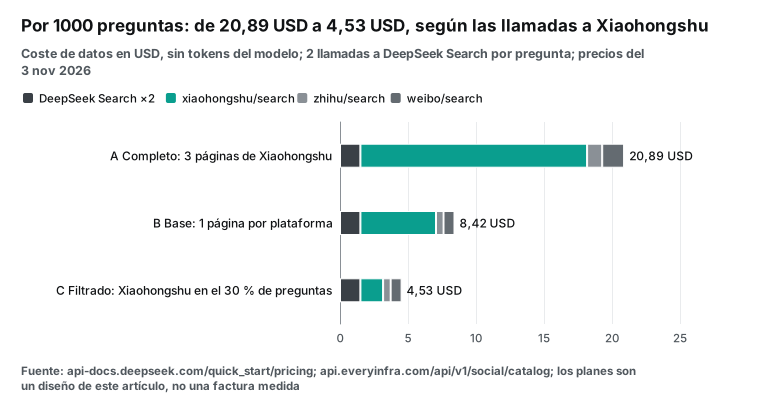
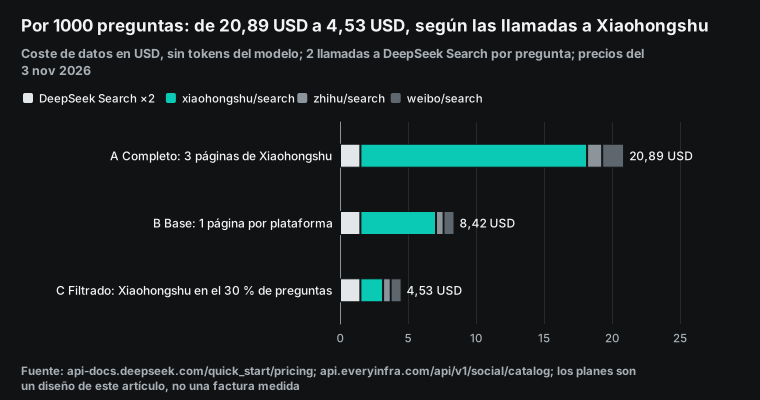
| Plan | Xiaohongshu | Zhihu | Por pregunta | Por 1000 preguntas | Peso de Xiaohongshu | |
|---|---|---|---|---|---|---|
| A, completo | 3 páginas | 2 llamadas | 2 llamadas | 0,0209 USD | 20,89 USD | 80 % |
| B, por defecto | 1 página | 1 llamada | 1 llamada | 0,0084 USD | 8,42 USD | 66 % |
| C, bajo demanda | 1 página en el 30 % de las preguntas | 1 llamada | 1 llamada | 0,0045 USD | 4,53 USD | 37 % |
El 30 % del plan C lo elegimos nosotros; no es una tasa medida. Hay tres formas de decidir cuándo hace falta Xiaohongshu, de más fácil a más difícil. La primera es por categoría de producto: consulta Xiaohongshu en belleza, cuidado personal, bebé, hogar y pequeño electrodoméstico, donde se concentra la conversación, y sáltalo en recambios o productos industriales. La segunda es probar antes las apps baratas: si Zhihu y Weibo ya traen suficientes filas recientes que nombran modelos concretos, no consultes Xiaohongshu.
La tercera es dejar que decida el modelo, pero con un límite en el bucle, como BUDGET en el código de arriba: cuando el modelo pida una segunda página, devuelve «presupuesto agotado». Además, no uses last_30_days si quieres una página llena. La prueba 3 mostró que puede devolver 13 filas y cobrarse como página entera. Para preguntas sobre lo «último», sort=newest devuelve una página llena; la nota del catálogo sobre date_range da el mismo consejo.
Otra vía: DeepSeek Harness con un servidor MCP remoto (ejemplo de configuración)
Quizá no escribes tu propio bucle. Si usas DeepSeek Harness, el agente de código abierto de DeepSeek (inicio rápido), puedes saltarte las definiciones de herramientas y conectar el servidor MCP remoto de EveryInfra. El README del cliente MCP de Harness usa una entrada por servidor. Un servidor remoto usa el transporte streamable-http y puede enviar cabeceras. Sus herramientas le llegan al modelo como mcp__<serverName>__<tool>, y el tiempo límite por defecto de cada llamada es de 60 segundos.
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
    toolCallTimeoutMs: 90000
Subimos toolCallTimeoutMs de 60 a 90 segundos por la misma razón que el tiempo límite de requests. El servidor MCP de EveryInfra sigue la especificación MCP 2026-07-28 y su transporte Streamable HTTP. Una llamada tools/list sin clave el 2026-11-03 mostró 12 herramientas. Para datos de apps, la herramienta es everyinfra_call_api, con platform, action y params. La página del servidor MCP explica la autenticación.
La sección de autorización de la especificación MCP la define como opcional, y un servidor con transporte HTTP debería seguir esa sección. EveryInfra recibe la clave en una cabecera de la petición, así que la entrada de Harness solo necesita headers, sin inicio de sesión en el navegador.
Harness tiene su propia búsqueda web. El paquete dsh-tool-web añade web_search y web_fetch. Por defecto devuelve hasta 8 fuentes, lanza hasta 4 consultas y recorta cada resumen a 800 caracteres. Su README dice que el motor de búsqueda de DeepSeek no aparece en la lista de herramientas si el modelo actual no tiene credenciales. Con esta configuración, una misma sesión de Harness usa DeepSeek para la búsqueda web y MCP para los datos de apps. El reparto es el mismo que en la versión con funciones, pero el bucle lo lleva Harness.
¿Cuál elegir? La vía MCP no necesita código, y el modelo descubre por sí solo las capacidades nuevas del catálogo. Pero el modelo ve una herramienta general, everyinfra_call_api, y tiene que leer antes el catálogo para conocer los parámetros, lo que añade una o dos rondas. La vía con funciones te obliga a mantener las definiciones; a cambio, cada descripción, enum y precio queda fijo, el modelo elige mejor y tu código puede imponer un presupuesto. Para un flujo de producto fijo, usa funciones. Para un asistente abierto para tu equipo, usa MCP. Nuestro artículo sobre el uso estricto de herramientas de Claude con una API de datos compara el mismo dilema.
Lo que no funciona y lo que hay que vigilar
Primero, no llamamos al endpoint de DeepSeek Search. No tenemos, por tanto, una cifra medida de cuántas notas de Xiaohongshu encuentra una búsqueda de DeepSeek sobre robots aspiradores. Todo lo que decimos de DeepSeek sale de su documentación. No medimos cuánto contenido de estas apps hay en el índice de DeepSeek ni cada cuánto se actualiza; la sección «Momento de la copia y momento de la llamada» solo describe el lado de las apps.
Segundo, el texto de la búsqueda de Xiaohongshu es un extracto de unos 60 caracteres. Para el texto completo hace falta una llamada de detalle de nota, a 0,005556 USD, y los comentarios también se cobran aparte. Tercero, las tres apps solo devuelven contenido público: no hay mensajes privados, publicaciones solo para seguidores ni publicaciones borradas. En el contenido de pago de Zhihu solo llega un resumen.
La paginación tiene dos detalles que pueden pillarte en el bucle. Una página de búsqueda de Xiaohongshu siempre trae 20 filas, y limit no tiene efecto. Para más filas, usa el next_page_token de la página anterior, que solo vale 24 horas. Si guardas una conversación y la retomas al día siguiente, el token viejo falla, la búsqueda empieza otra vez desde la página 1 y vuelves a pagar. Zhihu devuelve 20 filas por defecto y hasta 100; Weibo, 20 por defecto y hasta 50. En estas dos, pedir más filas sale más barato que paginar, porque se cobra por llamada.
Cuarto, hay dos puntos de cumplimiento normativo. Los datos de las apps contienen nombres y perfiles de particulares: cita solo contenido y enlaces, y no reúnas ni muestres datos personales de un particular. Un artículo de arXiv del 2026-10-22 (Social-HUMINT) estudia el riesgo de usar modelos de lenguaje para deducir rasgos personales a partir de datos sociales públicos; con temas de producto, quédate en el nivel del tema. Además, un asistente que atiende al público en China continental está sujeto a las medidas provisionales sobre servicios de IA generativa, y las medidas de etiquetado de contenido generado por IA se aplican desde el 2025-09-01. Esto no es asesoramiento jurídico; consulta a tu equipo legal sobre tus obligaciones.
Quinto, los límites de frecuencia son distintos. Una cuenta de EveryInfra tiene 60 llamadas por minuto por defecto, y nuestra clave de prueba tenía un límite especial de 10 por minuto. DeepSeek Search admite 100 por segundo. Con mucho tráfico, añade una cola para el lado de EveryInfra en tu bucle.
Cambios recientes
2026-10-17: DeepSeek abrió Search y Fetch. Ese mismo día el modelo pasó a DeepSeek-V4.1-Flash-1017, cuyos pesos están en Hugging Face. Para ti significa que una sola clave de DeepSeek cubre ahora la búsqueda web, sin un servicio de búsqueda aparte.
2026-11-01, 00:00 hora de Pekín: se empezó a cobrar la búsqueda en el servidor de los clientes. ¿Usas DeepSeek mediante Claude Code, Codex o Harness? Entonces las búsquedas ya aparecen en tu factura mensual. Revisa la página de uso de la consola de DeepSeek.
2026-10-13: un estudio sobre agentes de IA que compran llegó a su versión 5. Este artículo de arXiv (Does Rank Still Matter?) analizó 7000 sesiones. Los agentes de IA miraban más resultados que las personas, pero los de las posiciones intermedias eran los que menos se veían. Para ti significa que más filas no siempre es mejor: ordena las filas por interacción o por fecha antes de pasarlas al modelo, en vez de enviar 50 sin ordenar. Los datos de concentración de la prueba 4 apuntan al mismo paso.
Hacia el 2026-10-25: cambió la documentación del cliente MCP de DeepSeek Harness. Harness admite la versión 2026-07-28 de MCP (README del cliente MCP), y los servidores remotos usan Streamable HTTP (README de los paquetes MCP). Para ti significa que puedes añadir datos de apps a un agente de DeepSeek sin escribir código.
Preguntas frecuentes
¿La API de DeepSeek permite buscar en la web?
La API de chat no busca en la web por sí sola. Tienes dos caminos. Uno: llamar tú al endpoint de Search (POST /v1/tools/search) y pasar los resultados al modelo como resultados de herramienta. Otro: usar un cliente como DeepSeek Harness, Claude Code o Codex, que llaman a Search y Fetch desde el servidor y se cobran por petición desde el 2026-11-01. (Origen de la pregunta: sugerencias de búsqueda sobre si la API de DeepSeek permite buscar en internet. Base: guía de Search y Fetch de DeepSeek.)
¿Cuál es el precio de DeepSeek Search API y tiene nivel gratuito?
Cuesta 0,75 USD por 1000 peticiones correctas. Las peticiones fallidas, vacías o con tiempo agotado no se cobran, y count no cambia el precio. No vimos una cuota gratuita específica de búsqueda en la página de precios ni en la guía. El saldo regalado y el saldo recargado pagan el uso, y el regalado se gasta primero. (Origen de la pregunta: sugerencias «deepseek search api pricing» y «deepseek search api free». Base: página de precios de DeepSeek.)
¿La clave de DeepSeek Search API es la misma que la del modelo?
Sí. La guía dice que Search y Fetch usan la misma autenticación Bearer que la API de DeepSeek. Las claves se crean en la plataforma de DeepSeek. Los límites de frecuencia se aplican por cuenta, no por clave. (Origen de la pregunta: sugerencia «deepseek api key». Base: guía de Search y Fetch y página de límites.)
DeepSeek Search Fetch API: ¿qué diferencia hay entre Search y Fetch, y cuándo usar Fetch?
Search devuelve varios resultados para una consulta; Fetch devuelve una página completa en Markdown para una URL. Search ya puede devolver el texto de la página con need_content, así que Fetch sirve sobre todo cuando ya tienes un enlace y necesitas el texto entero, por ejemplo la web de una marca que salió en los datos de una app. Fetch depende de la política de acceso del sitio de destino; si no consigue contenido devuelve un 404 y no pagas nada. (Origen de la pregunta: sugerencia «deepseek search fetch api». Base: referencia de Fetch.)
¿Dónde está la documentación de DeepSeek Harness para cambiar el motor de búsqueda?
Harness añade la búsqueda web como un complemento. La herramienta web_search viene del complemento dsh-tool-web, y su motor se puede cambiar por otro complemento de búsqueda. Los datos de apps se conectan mediante el cliente MCP como un servidor remoto. (Origen de la pregunta: sugerencias «deepseek api docs» y «deepseek harness search provider». Base: README de dsh-tool-web y el repositorio de Harness.)
¿Las llamadas a funciones de DeepSeek admiten el modo strict?
Sí. Usa la URL base beta (api.deepseek.com/beta, con el prefijo https) y pon strict: true en cada función. Incluye todas las propiedades en required y pon additionalProperties en false. No se admiten minLength, maxLength, minItems ni maxItems. El modo strict funciona con y sin razonamiento. (Origen de la pregunta: sugerencia «deepseek api function calling». Base: guía de llamadas a herramientas de DeepSeek.)
Cómo empezar
Primero, crea una clave en el inicio rápido de EveryInfra. Lee gratis el catálogo y revisa los parámetros y precios de xiaohongshu/search, zhihu/search y weibo/search. Las páginas de cada plataforma son la API de datos de Xiaohongshu, la API de datos de Zhihu y la API de datos de Weibo, y todos los precios están en la página de precios.
Segundo, copia las cuatro definiciones de herramientas y el código del bucle de este artículo, pon tus dos claves y lanza una pregunta de principio a fin. Tercero, elige en la sección de coste el plan que encaje con tu volumen de preguntas y fija el límite en BUDGET. Dos artículos muestran la misma idea con otras herramientas: flujos dinámicos de Claude Code para comentarios de Xiaohongshu y Gemini Deep Research con un servidor MCP remoto. Para datos de comentarios, los comentarios de Weibo funcionan igual que los de Xiaohongshu.
Referencias
- Search & Fetch, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/guides/search
- Referencia de Search, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/api/search
- Referencia de Fetch, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/api/fetch
- Models & Pricing, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/quick_start/pricing
- Nota de la versión DeepSeek-V4.1-Flash-1017, DeepSeek, 2026-10-17, https://api-docs.deepseek.com/news/news261017
- Tool Calls, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/guides/tool_calls
- Thinking Mode, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/guides/thinking_mode
- Rate Limit & Isolation, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/quick_start/rate_limit
- Token & Token Usage, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/quick_start/token_usage
- Integrate with Claude Code, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- Página de claves de API, plataforma de DeepSeek, leído el 2026-11-03, https://platform.deepseek.com/api_keys
- Ficha del modelo DeepSeek-V4.1-Flash-1017, Hugging Face, leído el 2026-11-03, https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- Repositorio de DeepSeek Harness, GitHub, leído el 2026-11-03, https://github.com/deepseek-ai/deepseek-harness
- Inicio rápido de DeepSeek Harness, leído el 2026-11-03, https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- README de dsh-tool-web, GitHub, leído el 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- README de dsh-mcp-client, GitHub, leído el 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- README de los paquetes MCP de Harness, GitHub, leído el 2026-11-03, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python, GitHub, leído el 2026-11-03, https://github.com/openai/openai-python
- openai, PyPI, leído el 2026-11-03, https://pypi.org/project/openai/
- Function calling, documentación para desarrolladores de OpenAI, leído el 2026-11-03, https://platform.openai.com/docs/guides/function-calling
- Advanced Usage (timeouts), documentación de Requests, leído el 2026-11-03, https://requests.readthedocs.io/en/latest/user/advanced/
- json, codificador y decodificador JSON, documentación de Python, leído el 2026-11-03, https://docs.python.org/3/library/json.html
- Especificación MCP 2026-07-28, Model Context Protocol, leído el 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28
- Transports, MCP 2026-07-28, leído el 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- Tools, MCP 2026-07-28, leído el 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- Authorization, MCP 2026-07-28, leído el 2026-11-03, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- Lista de API de la plataforma abierta de Weibo, leído el 2026-11-03, https://open.weibo.com/wiki/API
- Reglamento de gestión de la seguridad de los datos en red, Gobierno de China, 2024-09-30, https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- Medidas provisionales para la gestión de servicios de IA generativa, Administración del Ciberespacio de China, 2023-07-13, https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- Medidas de etiquetado de contenido sintético generado por IA, Administración del Ciberespacio de China y otros, 2025-03-14, https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf, arXiv:2608.22697v5, 2026-10-13, https://arxiv.org/abs/2608.22697
- Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure, arXiv:2610.31573, 2026-10-22, https://arxiv.org/abs/2610.31573
- Catálogo de datos de EveryInfra, leído a las 00:13, hora de Singapur, del 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog
- Catálogo de Xiaohongshu de EveryInfra, leído el 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- Catálogo de Zhihu de EveryInfra, leído el 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- Catálogo de Weibo de EveryInfra, leído el 2026-11-03, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- Context Caching, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/guides/kv_cache
- Multi-round Conversation, documentación de la API de DeepSeek, leído el 2026-11-03, https://api-docs.deepseek.com/guides/multi_round_chat
- Sorting Techniques, documentación de Python, leído el 2026-11-03, https://docs.python.org/3/howto/sorting.html
- Built-in Types: set, documentación de Python, leído el 2026-11-03, https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset
Referencia BL-73