Strict tool use di Claude con un'API per i dati: due livelli che mantengono valide le chiamate
Opus 5.5 rifiuta il tool_choice forzato. Abbiniamo tool strict ed errori 422 che spiegano come correggere: 29 chiamate reali, parametri errati respinti in 0,17 s, senza addebito.
Claude Opus 5.5, Sonnet 5.5 e Fable 5.1 restituiscono un errore 400 quando tool_choice è any o tool. Il codice che forzava una chiamata a un tool per ottenere un JSON dalla struttura fissa smette di funzionare su questi modelli. Anthropic consiglia di mantenere tool_choice: auto e aggiungere strict: true, oppure di spostare lo schema negli structured outputs. Il 1° novembre 2026 abbiamo scritto tool strict per le recensioni di Trustpilot, App Store e Amazon a partire dal catalogo EveryInfra. Poi abbiamo inviato 29 richieste reali alla nostra API. Dieci erano chiamate di controllo aggiunte nel pomeriggio.
In serata abbiamo inviato altre 12 richieste per ripetere il test.
Le richieste con un nome di parametro o un valore enum errato hanno ricevuto un 422 in 0,11-0,23 secondi. Ogni 422 riportava i valori ammessi e il passaggio successivo, e nessuna di queste richieste è stata addebitata. Nella prima versione del catalogo, due parametri non avevano valori ammessi. In un test di controllo del pomeriggio, i valori errati per questi parametri non hanno generato errori. L'API ha restituito 200, ha addebitato la tariffa normale e ha restituito senza avvisi un insieme diverso di recensioni. Nulla nella risposta segnalava al modello che qualcosa non andava.
In serata il gateway ha aggiunto i valori ammessi per questi due parametri. Ora un valore errato genera un errore 422 prima di qualsiasi addebito, come ha confermato il test ripetuto alle 19:18 SGT.
Questo articolo risponde a una domanda pratica. Hai un'app Claude che chiama un'API esterna per i dati. In passato forzavi il modello a chiamare il tuo tool, così ogni richiesta aveva la stessa forma. Su un modello nuovo, quella riga ora fallisce. Come la modifichi perché il modello continui a chiamare l'API in modo affidabile e restituisca un JSON che puoi salvare?
Ogni affermazione su Claude viene dalla documentazione di Anthropic, e per ciascuna mettiamo il link. Sulla nostra macchina di test non abbiamo una chiave API di Anthropic. Quindi il codice Claude di questo articolo è un esempio di configurazione, non il risultato di un test. Ogni numero su EveryInfra viene dalle risposte grezze di chiamate reali del 1° novembre 2026.
Cosa è cambiato: tre nuovi modelli rifiutano il tool_choice forzato, quindi lo strict tool use di Claude è ora la scelta predefinita
La modifica è semplice, e ogni scelta di design successiva in questo articolo dipende da essa. Le note di rilascio dell'API di Anthropic del 1° settembre 2026 dicono che Fable 5.1 e Mythos 5.1 non supportano i tipi any e tool di tool_choice. Queste richieste restituiscono un errore 400, mentre auto e none continuano a funzionare come prima (note di rilascio dell'API). Le note consigliano lo strict tool use o gli structured outputs per ottenere input dei tool conformi allo schema. Il 22 settembre, la voce su Opus 5.5 dice che si verifica lo stesso errore 400 «come su Claude Fable 5.1». Il 28 settembre, la voce su Sonnet 5.5 lo elenca tra i cinque modi in cui il codice scritto per Sonnet 5 può smettere di funzionare.
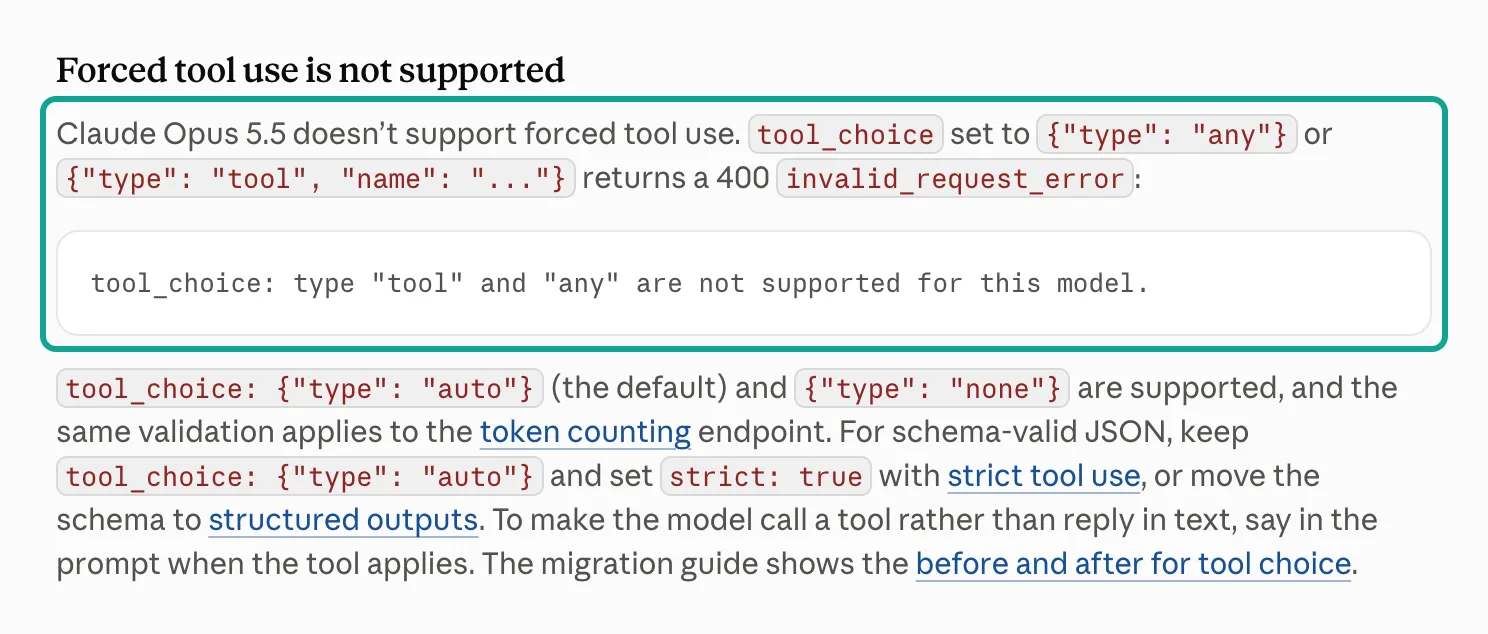
Ogni modello ha una pagina «What's new» con una sezione intitolata «Forced tool use is not supported». Tutte e tre le pagine riportano lo stesso testo di errore, che citiamo qui sotto. Puoi leggerlo nelle pagine di Opus 5.5, Sonnet 5.5 e Fable 5.1. Il testo è tool_choice: type "tool" and "any" are not supported for this model. Lo stesso controllo vale anche per l'endpoint di conteggio dei token. Quindi non puoi usare il conteggio dei token per testare una chiamata forzata prima di inviarla.
Perché Anthropic ha eliminato le chiamate forzate? La pagina di Fable 5.1 spiega il motivo. Su questi modelli il thinking è sempre attivo e una chiamata forzata a un tool lo salta. Il modello allora scrive il suo ragionamento negli argomenti del tool e la qualità degli argomenti cala. È un aspetto importante se la tua app chiama un'API per i dati.
Nel vecchio design forzavi la chiamata per ottenere una forma stabile. Ora la forma stabile viene dalla grammatica strict e la decisione di chiamare il tool torna al modello. Il tuo prompt deve specificare quando usare il tool. La pagina di Fable 5.1 aggiunge che il modello segue in modo affidabile le istruzioni esplicite sui tool, per esempio «Usa il tool get_weather per rispondere».
| Modello | Data di rilascio | Valori di `tool_choice`: any / tool | Alternativa indicata da Anthropic | Prezzo standard, input / output per MTok |
|---|---|---|---|---|
| Fable 5.1 | 1° settembre 2026 | Errore 400 | auto + strict, oppure structured outputs | $10 / $50 |
| Opus 5.5 | 22 settembre 2026 | Errore 400 | auto + strict, oppure structured outputs | $4 / $20 |
| Sonnet 5.5 | 28 settembre 2026 | Errore 400 | auto + strict, oppure structured outputs | $2 / $10 |
| Haiku 5.5 | 7 ottobre 2026 | Non indicato nelle note di rilascio | — | $0.10 / $0.50 |
Le date e i prezzi provengono dalle note di rilascio e dalla pagina dei prezzi, consultate il 1° novembre 2026. La pagina dei prezzi mostra anche che questa modifica non è temporanea. La sua tabella dei token di system prompt per il tool use ha due colonne, una per auto, none e una per any, tool. Per Opus 5.5 solo la prima colonna ha un valore: 286 token.
Per Opus 5 entrambe le colonne hanno un valore, 286 e 406 token. Le note di rilascio di Haiku 5.5 elencano altre breaking change, come i budget manuali per il thinking, i parametri di campionamento e il prefill. Non citano il tool use forzato, quindi non facciamo affermazioni su Haiku 5.5. Usiamo comunque i tool strict anche lì, così lo stesso codice gira su tutti e quattro i modelli.
Lo strict tool use non è una novità e non riguarda solo i nuovi modelli. Due pagine dicono che la funzionalità è disponibile su tutti i modelli ed è idonea alla HIPAA readiness (strict tool use, structured outputs). Quello che è cambiato è il suo ruolo: prima era un passaggio di sicurezza facoltativo, ora è la strada principale.
La checklist di migrazione di Opus 5.5 dice di sostituire any e tool con auto più strict tool use o structured outputs. Dice anche di controllare prima ogni input_schema, perché strict accetta solo un sottoinsieme di JSON Schema (guida alla migrazione a Opus 5.5). Gran parte del lavoro di migrazione riguarda gli schemi, non il codice delle chiamate.
Strict tool use e structured outputs di Claude: cosa controlla ciascuno
I due nomi si somigliano, ma controllano parti diverse della risposta. Lo strict tool use aggiunge "strict": true alla definizione di un tool. Controlla l'input di ogni blocco tool_use. L'API usa il campionamento vincolato da una grammatica, quindi l'input corrisponde sempre all'input_schema e il nome del tool è sempre valido.
L'esempio di Anthropic è un sistema di prenotazione che richiede passengers: int. Senza la modalità strict, il modello può inviare "two" o "2". Con la modalità strict invia sempre 2.
Gli structured outputs di Claude corrispondono al campo output_config.format di una richiesta. Controllano il testo finale della risposta, che diventa un JSON conforme al tuo schema. In un flusso con un'API per i dati servono entrambi. I tool strict mantengono corretti i parametri che vanno a POST /api/v1/social. Gli structured outputs trasformano le recensioni restituite in campi fissi, come argomento, gravità e una breve citazione. Le due funzionalità usano la stessa pipeline di grammatica, quindi condividono gli stessi limiti.
La sezione «JSON Schema limitations» della pagina sugli structured outputs elenca questi limiti. Supportati: tutti i tipi di base, enum, const, anyOf, $ref interni, dieci formati di stringa e pattern regex semplici. Non supportati: schemi ricorsivi, limiti numerici come minimum e maximum, limiti di lunghezza delle stringhe e minItems diverso da 0 o 1. Ogni oggetto deve impostare additionalProperties: false. Se usi una funzionalità non supportata, l'API restituisce un errore 400 con i dettagli.
| Voce | Strict tool use | Output strutturati (`output_config.format`) |
|---|---|---|
| Cosa controlla | Argomenti dei tool nei blocchi tool_use | Il testo finale della risposta |
| Come attivarlo | Aggiungi "strict": true a un tool | Aggiungi un JSON Schema in output_config.format |
| Ruolo in questo articolo | Parametri corretti per EveryInfra | Campi fissi per ogni recensione |
| Limiti condivisi per richiesta | 20 tool strict, 24 parametri facoltativi, 16 parametri con tipi union | Stessi limiti, conteggiati insieme |
| Non supportato | Intervalli numerici, lunghezza delle stringhe, ricorsione | Stesse limitazioni; inoltre, gli structured outputs non possono essere usati insieme alle citazioni |
| Prima richiesta | Ritardo aggiuntivo durante la compilazione della grammatica; la cache dura 24 ore | Come sopra |
L'espressione «per richiesta» è la trappola più comune. La pagina sugli structured outputs fa un esempio: quattro tool strict con sei parametri facoltativi ciascuno raggiungono già il limite di 24, anche se nessun tool, preso da solo, sembra complesso. Oltre ai limiti espliciti, ci sono limiti interni sulla dimensione della grammatica compilata. Se li superi, l'API restituisce «Schema is too complex for compilation». L'ultimo limite di sicurezza è un timeout di compilazione di 180 secondi.
Anthropic suggerisce quattro passaggi, in quest'ordine: segna come strict solo i tool critici, rendi obbligatori i parametri, appiattisci gli oggetti annidati e suddividi il lavoro tra più richieste o subagenti.


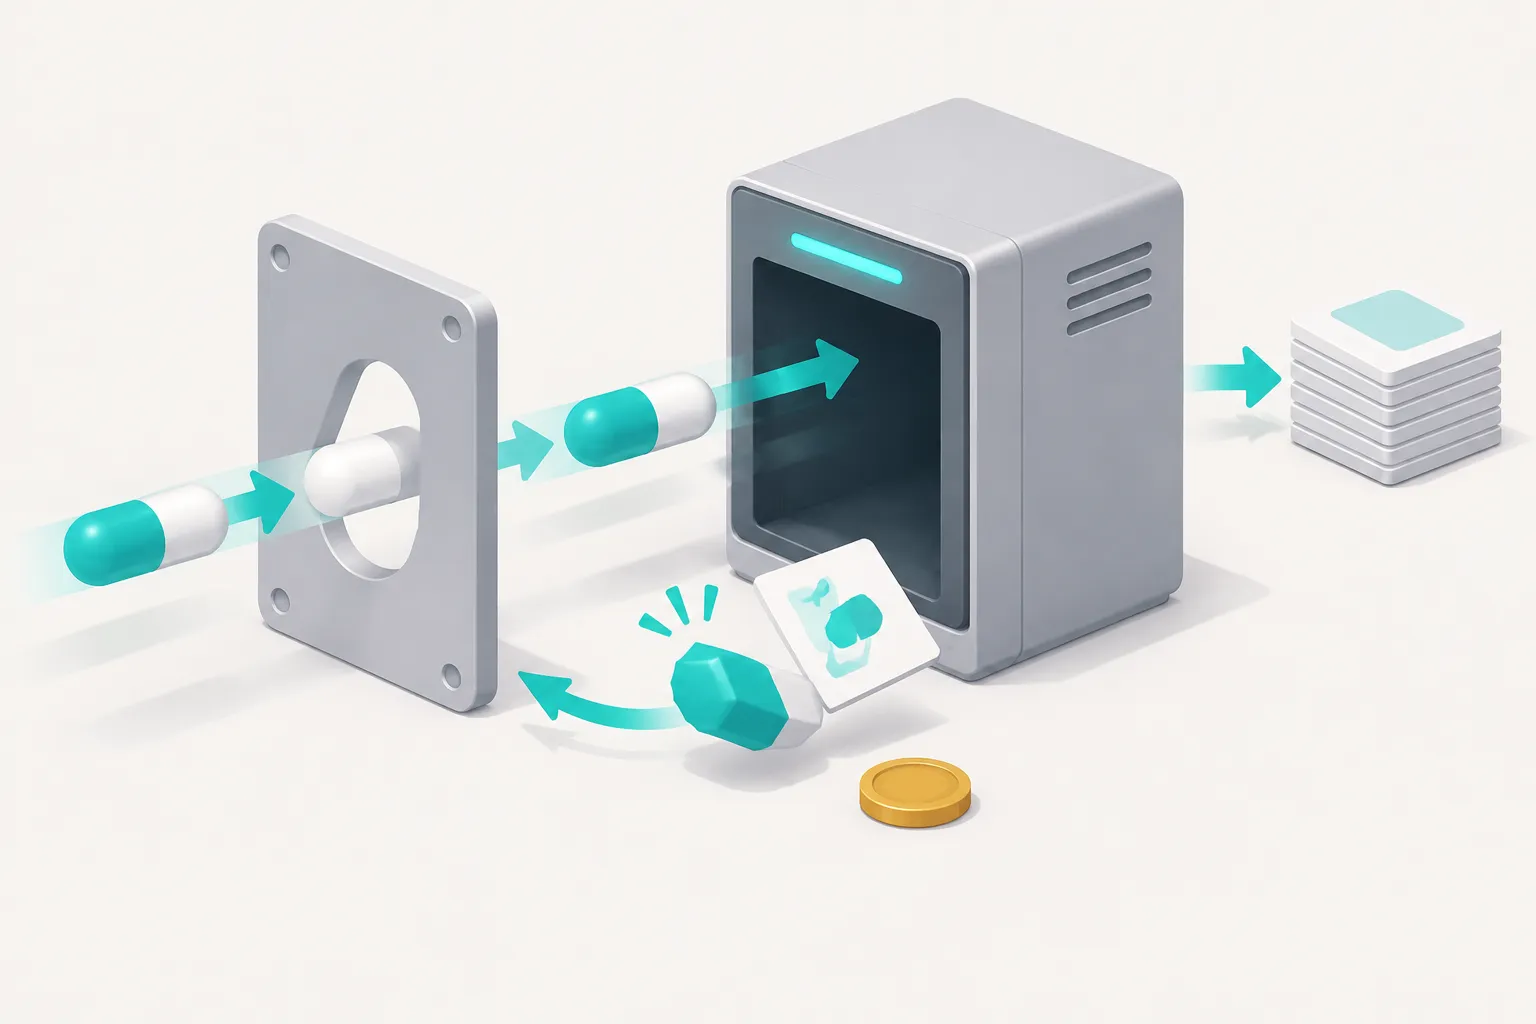
Il diagramma mostra l'idea principale di questo articolo. Il primo livello è sul lato di Claude. La modalità strict garantisce che tipi, campi obbligatori e valori enum corrispondano al tuo schema. Il modello non può inviare un campo come max_results se il tuo schema non lo prevede. Il secondo livello è sul lato di EveryInfra.
Alcune regole non stanno in uno schema, per esempio «questo link è una pagina prodotto?» o «come chiama questa piattaforma questo ordinamento?». La nostra API controlla questi valori rispetto al catalogo. Quando un valore è errato, restituisce un 422 con i valori ammessi e la corrispondenza più vicina. Il modello modifica un campo e invia di nuovo la richiesta.
Livello uno: come costruire tool strict per POST /api/v1/social a partire dal catalogo
L'endpoint del catalogo EveryInfra, GET /api/v1/social/catalog, è gratuito e non richiede una chiave API (catalogo grezzo). Per ogni funzionalità indica i parametri obbligatori e facoltativi, una descrizione di ciascun parametro, i valori ammessi (allowed_values), i campi restituiti e il prezzo. L'abbiamo letto il 1° novembre 2026 alle 00:46 SGT. Elencava 426 funzionalità su 91 piattaforme. Di queste, 402 funzionalità su 89 piattaforme erano disponibili quel giorno.
Le funzionalità disponibili contano 809 descrizioni di parametri. Di queste, 155 elencano i valori ammessi, 143 hanno il formato uri e 38 il formato date. Questi tre gruppi corrispondono direttamente a enum, format: uri e format: date in uno schema strict. Al netto delle sovrapposizioni, 336 parametri su 809 (41,5%) si traducono in un vincolo che la modalità strict può garantire.
Solo 155 (circa il 19%) possono diventare un enum. Gli altri sono testo libero o numeri. Per questi, il controllo deve essere affidato alla descrizione e al secondo livello.
Ecco le definizioni dei tool per tre funzionalità dedicate alle recensioni, scritte a partire dal catalogo. È un esempio di configurazione: non lo abbiamo eseguito su Claude.
[
  {
    "name": "trustpilot_reviews",
    "description": "Get recent Trustpilot reviews of one company through EveryInfra (platform trustpilot, action reviews). Call it whenever the user names a company and asks what customers say. company is the company's website domain, for example temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Website domain such as temu.com, or a trustpilot.com/review/<domain> link"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Star ratings to keep; [] keeps all"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = no date filter"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "1 to 200; use 20 unless the user asks for more"}
      },
      "required": ["company", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Get App Store reviews of one iOS app through EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Numeric App Store id, for example 6473753684"},
        "country": {"type": "string", "pattern": "^[a-z]{2}$"},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "1 to 500; use 30 unless the user asks for more"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Get the featured customer reviews shown on one Amazon product page (platform amazon, action reviews). Usually about a dozen reviews per product.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.[a-z.]{2,6}/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.com", "amazon.co.uk", "amazon.de", "amazon.fr", "amazon.it", "amazon.es", "amazon.ca", "amazon.com.au", "amazon.in", "amazon.co.jp", "amazon.sg"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]
I limiti visti sopra hanno imposto quattro scelte di design. Primo, ogni parametro è obbligatorio. Il catalogo assegna a trustpilot/reviews sei parametri facoltativi, più limit, quindi sette in totale. Se li copiassimo come facoltativi, occuperebbero quasi un terzo dei 24 slot.
Anthropic suggerisce un approccio diverso: quando un parametro ha sempre un default ragionevole, rendilo obbligatorio e lascia che sia il modello a inserire il default. Per questo abbiamo aggiunto un valore any a date e consentito un array vuoto per stars. Il nostro codice rimuove any e [] prima di inviare la richiesta, perché il catalogo dice che un valore vuoto significa nessun filtro. In serata abbiamo inviato date: any all'API come test e abbiamo ricevuto un 422 in 0,11 secondi. Quindi non saltare questo passaggio.
Secondo, l'intervallo di limit è nella descrizione, non in minimum o maximum, perché i limiti numerici non sono supportati. I valori oltre il massimo sono gestiti dall'API. Sei funzionalità del catalogo indicano «capped» per questo caso, quindi l'API applica il massimo. Terzo, una regex semplice limita il link Amazon alle pagine prodotto. La nota del catalogo per amazon/reviews dice che la home page di uno store non funziona.
Abbiamo testato un link a uno store con questo schema usando un validatore JSON Schema locale, e la regex lo ha rifiutato.
Quarto, il catalogo che abbiamo letto nelle prime ore del 1° novembre non indicava allowed_values per date e sort su trustpilot/reviews. Abbiamo copiato i valori dal testo del catalogo. La prossima sezione spiega perché era importante. In serata il catalogo ha aggiunto questi valori, quindi abbiamo aggiunto last7days qui sopra. Per domain abbiamo usato gli 11 siti elencati dal catalogo alle 22:14 SGT. amazon.com.mx non è tra questi, perché ora quel sito restituisce un errore 422 prima di qualsiasi addebito. I dettagli sono nella sezione sui limiti.
L'intera definizione usa solo enum, required, additionalProperties: false, pattern semplici e format. La maggior parte dei sistemi di decodifica vincolata li supporta. Gli intervalli numerici e le lunghezze hanno un supporto diverso a seconda del sistema, come mostra il test JSONSchemaBench su sei framework. Per questo li lasciamo al 422. Così le stesse definizioni dei tool possono passare a un altro provider di modelli con piccole modifiche ai nomi, e il secondo livello non cambia.
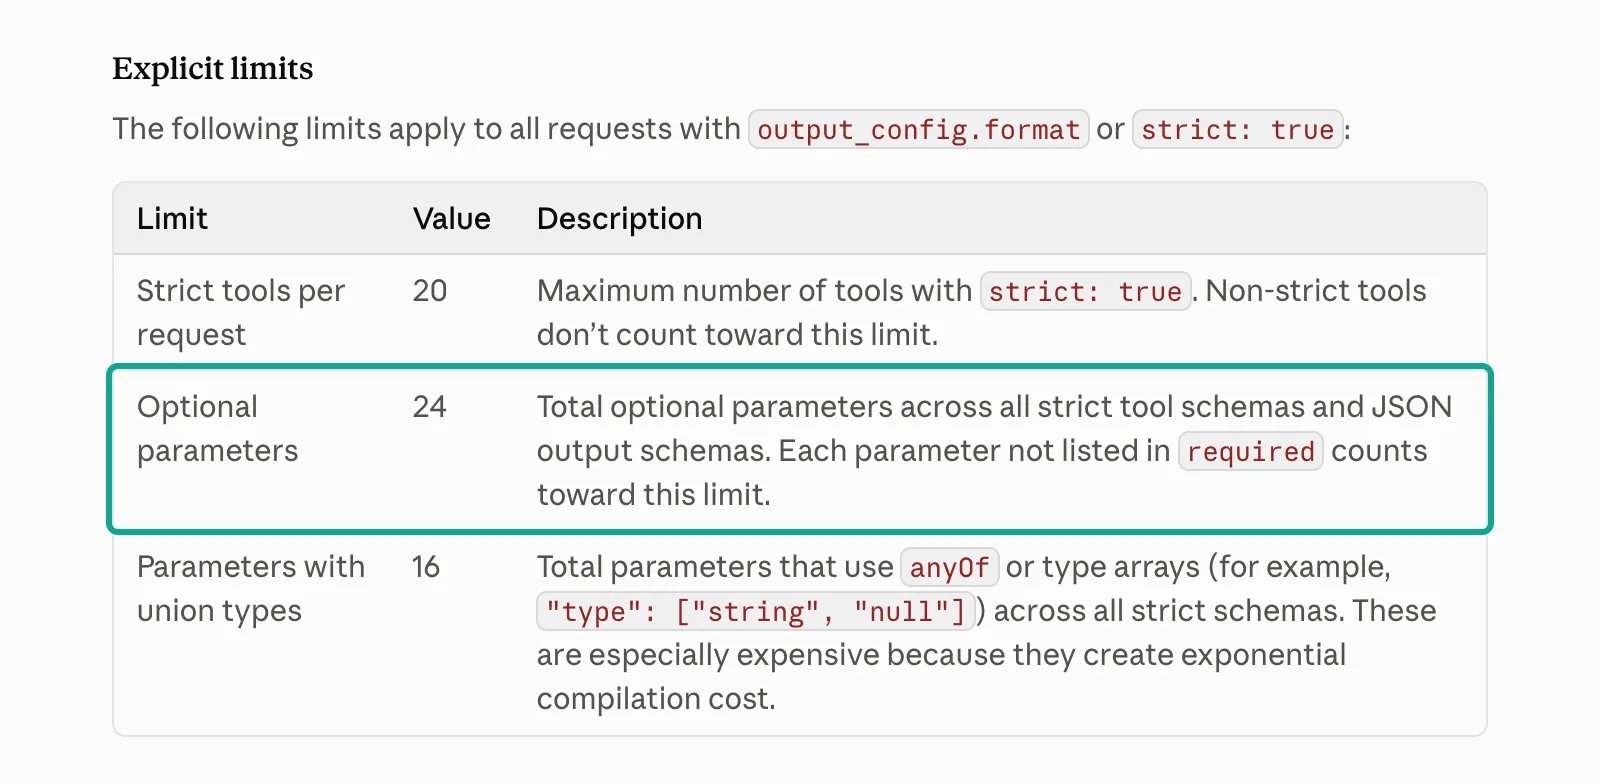
Quante funzionalità del catalogo rientrano in questo budget? Abbiamo contato i parametri facoltativi di tutte le 402 funzionalità disponibili. Per le funzionalità che restituiscono un elenco abbiamo contato anche limit. La mediana è 1 e il massimo è 9. Nessuna funzionalità supera 24. 100 funzionalità non hanno parametri facoltativi e 139 ne hanno uno, quindi 239 funzionalità (59,5%) ne hanno zero o uno.
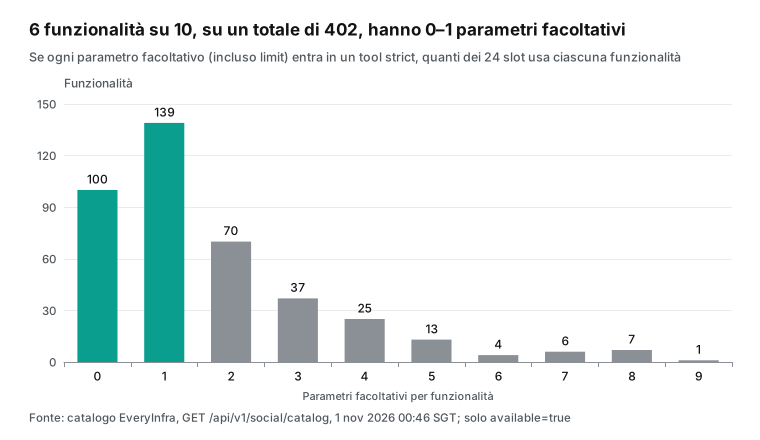
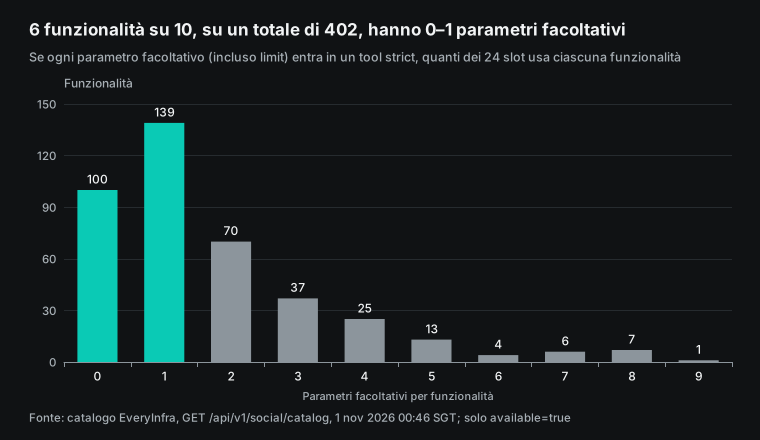
Questa distribuzione ci dice due cose. La buona notizia: se rendi obbligatorio ogni parametro, 20 funzionalità qualsiasi rientrano in una richiesta senza usare slot facoltativi. La cattiva notizia: non puoi trasformare tutte le 402 funzionalità in tool strict in un'unica richiesta. I loro parametri facoltativi sono 686 in totale. Con 24 per richiesta, servono almeno 29 gruppi.
Il nostro raggruppamento greedy ha usato 30 gruppi. Il solo limite di 20 tool strict per richiesta richiede almeno 21 gruppi. L'approccio giusto è quindi scegliere i tool in base al compito. Per un monitor delle recensioni, otto funzionalità di recensioni insieme usano esattamente 23 slot facoltativi.
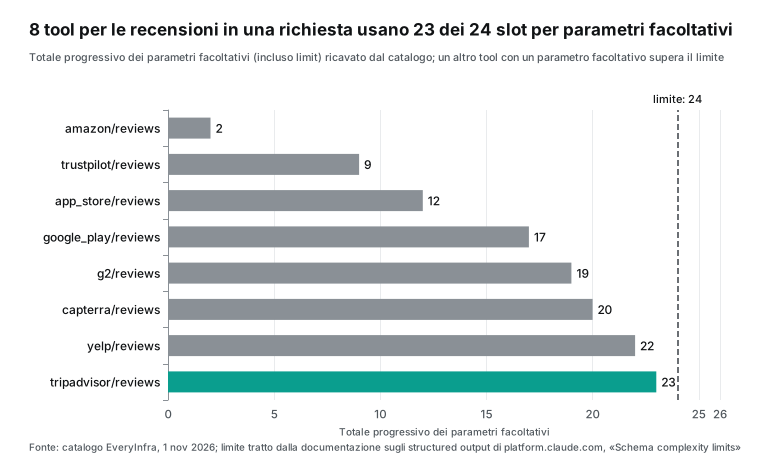
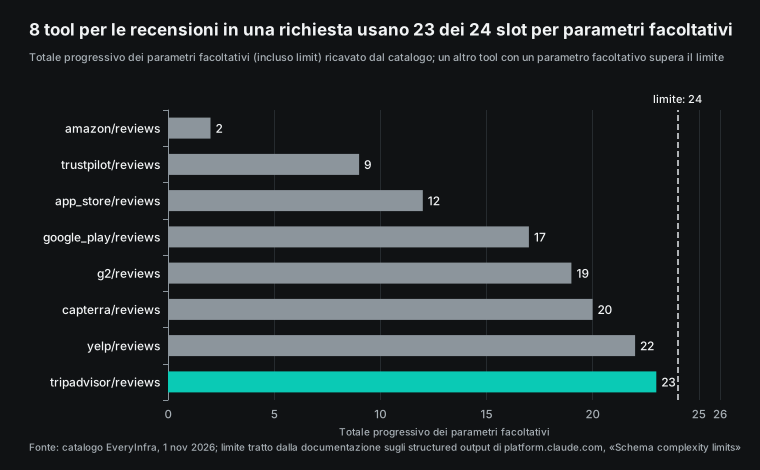
23 è uno sotto il limite di 24. Aggiungi uno schema di structured output con un campo facoltativo e la richiesta fallisce. Per questo Anthropic consiglia di rendere obbligatori i parametri dove possibile. I nostri tre tool di esempio hanno solo parametri obbligatori, quindi usano zero slot facoltativi. Così il budget resta disponibile per lo schema di output.
C'è anche un controesempio utile. Il server MCP remoto di EveryInfra ha un tool generico, everyinfra_call_api. Il suo campo params è un oggetto aperto, perché il tool deve accettare tutte le 426 funzionalità. Per un tool normale va bene.
Ma la modalità strict richiede additionalProperties: false su ogni oggetto, quindi questo schema non può essere strict. Quando abbiamo riletto l'elenco dei tool MCP alle 15:41 SGT del 1° novembre 2026, conteneva 12 tool e pesava 16.247 byte. Il campo params di everyinfra_call_api era ancora un oggetto aperto. Se vuoi la garanzia della modalità strict, scrivi tool specifici per il compito come quelli sopra. Tieni il tool generico per l'esplorazione.
Trasforma automaticamente il catalogo in schemi e ricostruiscili ogni giorno
Tre tool puoi scriverli a mano. Con trenta tool farai errori, e in più il catalogo cambia. Un approccio più sicuro è un piccolo script. Legge il catalogo gratuito una volta al giorno, costruisce i tool strict secondo regole fisse e confronta il risultato con quello del giorno prima.
Usiamo sei regole, e ognuna deriva da un limite descritto sopra. Il nostro codice rimuove i valori «non impostato» prima di ogni chiamata.
| Campo del catalogo | Schema strict | Motivo |
|---|---|---|
required_params | Copia in required | I campi obbligatori non usano slot facoltativi |
optional_params | Anche in required, con un valore «non impostato» come any o [] | Lascia libero il budget di 24 slot |
allowed_values | enum, copiato esattamente, con le stesse maiuscole e minuscole | La modalità strict garantisce i valori enum |
format: uri o date | Stesso format | La modalità strict accetta dieci formati di stringa |
default_limit, max_limit | integer, con l'intervallo nella descrizione | minimum e maximum non sono supportati |
| Ogni oggetto | additionalProperties: false | La modalità strict lo richiede |
Due casi richiedono l'intervento di una persona. Il primo è un parametro che elenca i propri valori solo nel testo, senza allowed_values. I parametri date e sort di trustpilot/reviews ne sono un esempio. Lo script non può trovare questi valori. Una persona deve copiarli in un enum, oppure aspettare che il catalogo li aggiunga. Il catalogo ha aggiunto questi due la sera del 1° novembre.
Teniamo un elenco di questi parametri e lo mostriamo a ogni ricostruzione.
Il secondo caso è un enum molto grande. Il giorno del nostro test, 8 enum avevano più di 100 valori e il più grande ne aveva 183. Un enum grande rende più grande la grammatica compilata. Anthropic dice che questi limiti interni non corrispondono a un numero preciso. Per questi parametri omettiamo l'enum, elenchiamo i valori più comuni nella descrizione e lasciamo il controllo al 422. Il 422 restituisce comunque l'elenco completo allowed.
Una ricostruzione giornaliera ti dice anche quando pagherai una nuova compilazione. La pagina sugli structured outputs dice che le grammatiche compilate restano in cache per 24 ore dall'ultimo utilizzo. Una modifica alla struttura dello schema svuota la cache. Quando usi insieme structured outputs e tool, la svuota anche una modifica all'insieme dei tool. Una modifica solo a name o description invece no. Lo script deve quindi distinguere due tipi di modifica.
Se è cambiato solo il testo, sostituiscilo senza costi. Se sono cambiati parametri, valori o campi obbligatori, la richiesta successiva sarà più lenta. In un batch questo ritardo non conta. In una chat live, invia una richiesta di riscaldamento in un momento di traffico basso. Anche un batch trae vantaggio da questa regola: migliaia di richieste condividono un unico insieme di tool e un unico schema di output, quindi la grammatica viene compilata una sola volta.
Secondo livello: il 422 permette al modello di correggere da solo la propria chiamata
Il primo livello blocca gli errori di forma. Non blocca gli errori di valore. Un modello può scegliere un valore sbagliato che lo schema consente comunque. Per esempio, può inviare most_recent come ordinamento per App Store, che è il nome usato su un'altra piattaforma. Oppure la tua app potrebbe non usare affatto la modalità strict e chiamare il tool generico. In questi casi il secondo livello deve fallire subito, non addebitare nulla e spiegare come correggere.
La pagina di Anthropic sulle chiamate ai tool dice due cose che valgono anche qui (handle tool calls). Primo, metti l'errore in un tool_result con is_error: true. Il modello farà allora un nuovo tentativo con le correzioni, di solito 2 o 3 volte prima di scusarsi con l'utente. Secondo, scrivi messaggi di errore che spieghino il problema. Non scrivere solo «failed». Indica cosa è andato storto e cosa dovrebbe provare Claude come passo successivo.
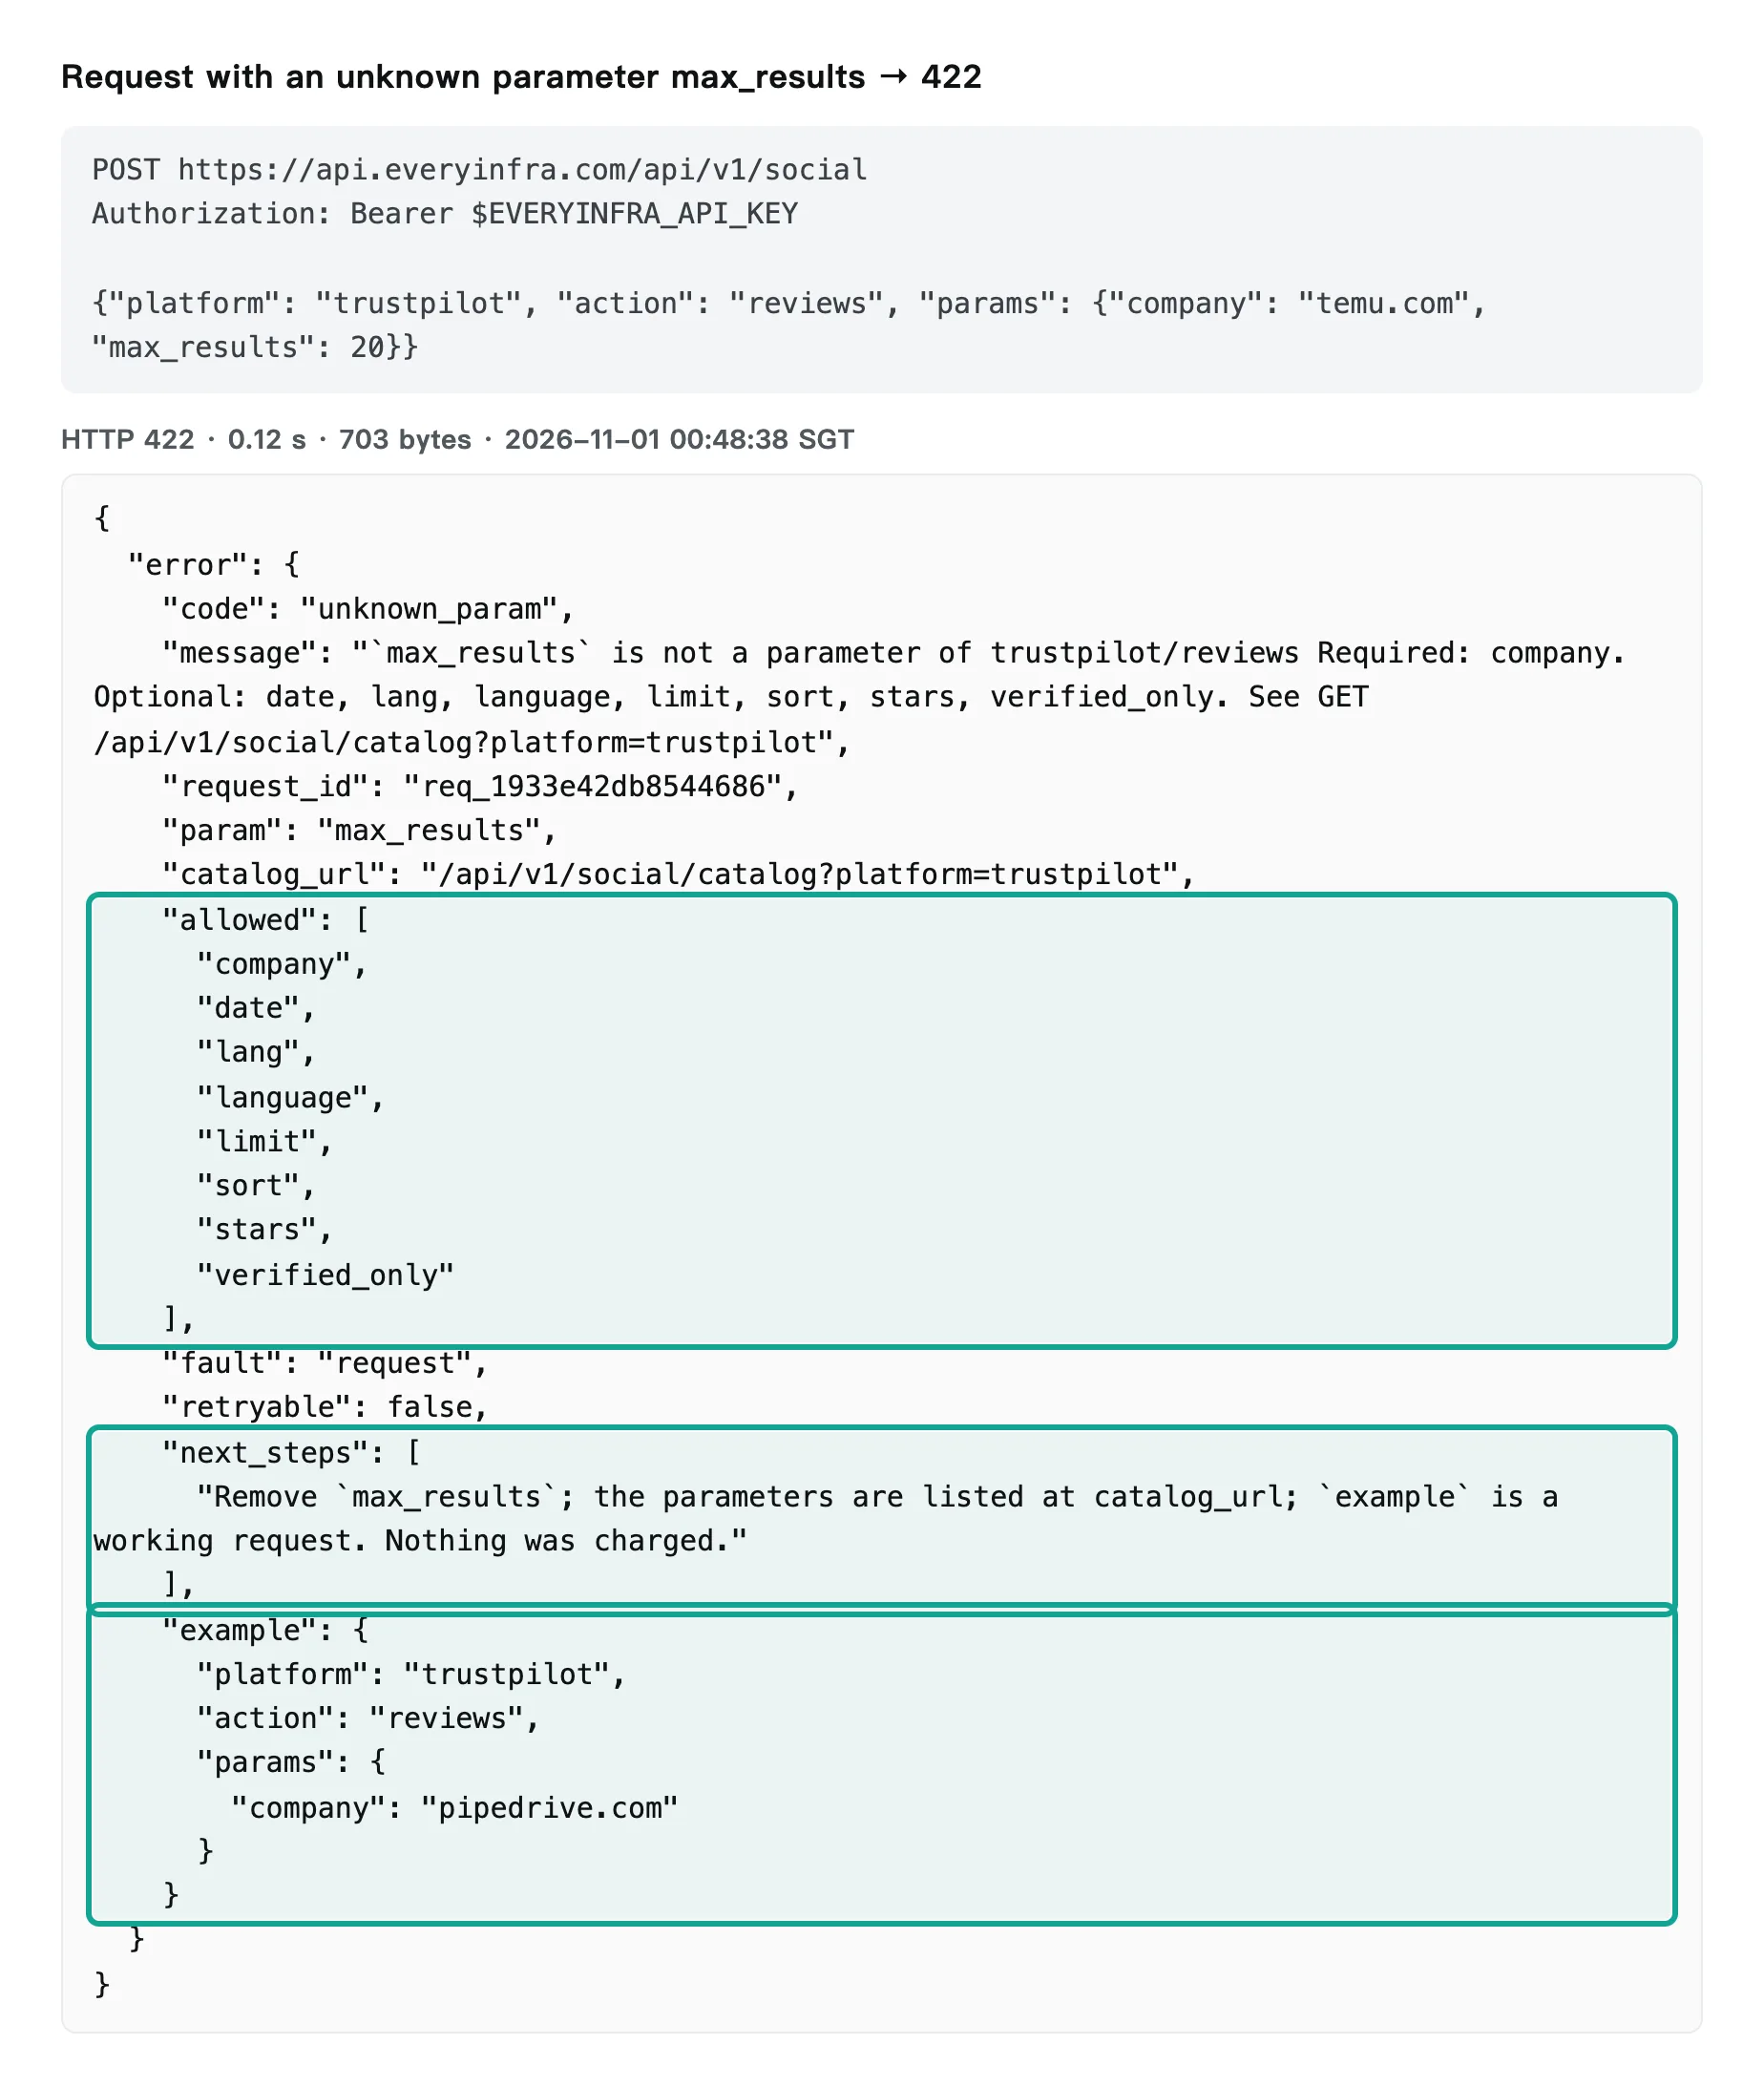
Il 1° novembre 2026, tra le 00:48 e le 00:49 SGT, abbiamo inviato di proposito sette richieste errate. Alle 00:57 SGT ne abbiamo inviata un'altra tramite MCP. Ecco la risposta grezza per un parametro sconosciuto. La richiesta contiene un max_results in più.
L'API ha restituito un 422 in 0,12 secondi. Il campo allowed elenca tutti e otto i nomi di parametro validi. Il campo example fornisce una richiesta funzionante. Il campo next_steps dice di rimuovere max_results e che non è stato addebitato nulla.
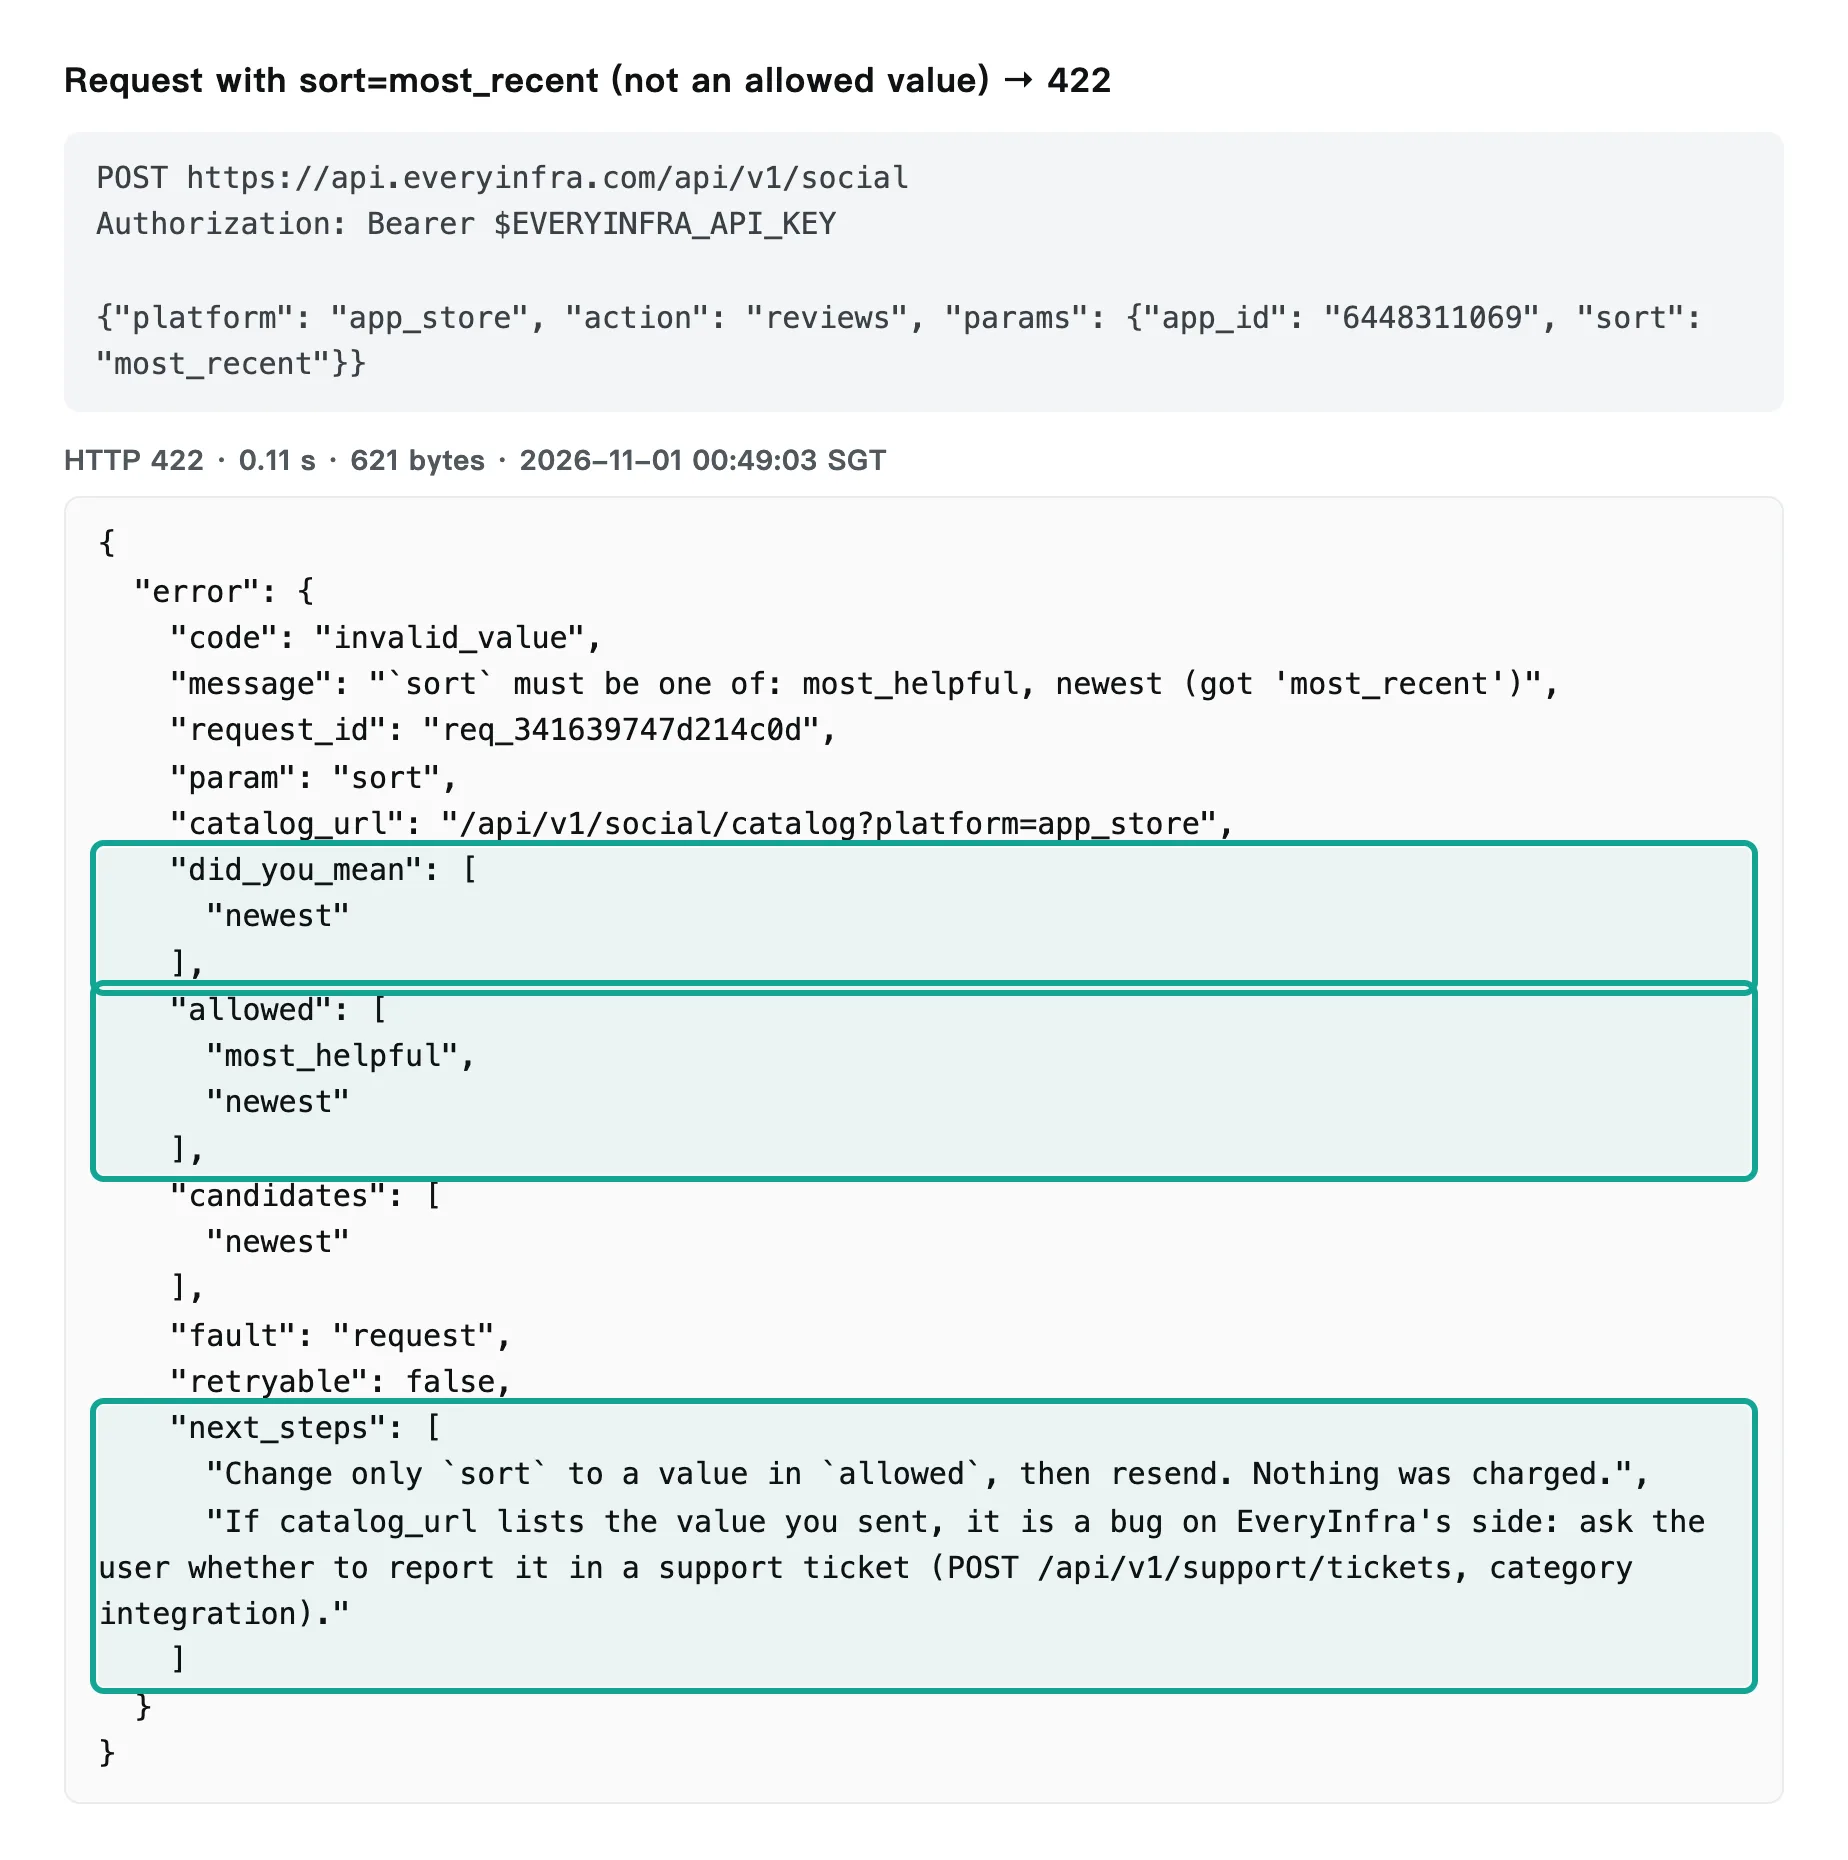
Un valore enum sbagliato è il caso più tipico. Alle 00:49 SGT abbiamo inviato sort: most_recent a app_store/reviews. L'API ha restituito un 422 in 0,11 secondi. Il campo did_you_mean era ["newest"] e allowed era ["most_helpful", "newest"]. La prima riga di next_steps dice di cambiare solo sort con un valore presente in allowed e inviare di nuovo, e che non è stato addebitato nulla.
Anche la seconda riga è utile. Dice cosa fare se il catalogo elenca il valore che hai inviato. In quel caso il bug è dal lato di EveryInfra, e il modello dovrebbe chiedere all'utente se aprire un ticket di supporto. Questa riga è pensata per il modello. Distingue «il mio input era sbagliato» da «il servizio ha un problema». Così il modello non scambia un proprio errore per un disservizio e non riprova con lo stesso valore.
La tabella seguente mostra gli otto casi di errore, le due chiamate di controllo del pomeriggio e cinque nuovi test serali dopo la correzione. L'ultima colonna deriva da un controllo locale. Abbiamo validato ogni input rispetto alle definizioni dei tool riportate sopra. Abbiamo usato un validatore JSON Schema per il Draft 2020-12 validation vocabulary.
| Orario (SGT) | Cosa abbiamo rotto | Risposta | Tempo | Addebito | Suggerimenti di correzione nella risposta | La modalità strict lo blocca prima? |
|---|---|---|---|---|---|---|
| 00:48:37 | Nessuna chiave | 401 missing_key | 0.12 s | 0 | Dice di inviare una chiave | Non pertinente |
| 00:48:38 | max_results in più | 422 unknown_param | 0.12 s | 0 | Elenco dei parametri, richiesta di esempio | Sì |
| 00:48:42 | company digitato come compnay | 422 missing_param | 0.23 s | 0 | Indica il refuso, esempio | Sì |
| 00:48:42 | date: last7days | 503 | 1.69 s | 0 (rimborsato) | Solo «riprova più tardi» | Sì, all'epoca; dopo la correzione serale è un valore valido |
| 00:48:44 | sort: newest | 503 | 1.91 s | 0 (rimborsato) | Solo «riprova più tardi» | Sì, all'epoca; dopo la correzione serale è un valore valido |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0.11 s | 0 | did_you_mean, allowed | Sì |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0.20 s | 0 | did_you_mean, allowed | Sì |
| 00:57:45 | G2 sort: most_recent tramite MCP | isError: true | — | 0 | Gli stessi, in structuredContent | Non applicabile |
| 15:39:38 | sort: newest (controllo) | 200, 20 righe | 14.3 s | $0.001389 | Nessuno; recensioni diverse | Sì, all'epoca; dopo la correzione serale è un valore valido |
| 15:39:38 | date: last7days (controllo) | 200, 20 righe | 14.4 s | $0.001389 | Nessuno; recensioni diverse | Sì, all'epoca; dopo la correzione serale è un valore valido |
| 19:18:39 | sort: newst (dopo la correzione) | 422 invalid_value | 0.21 s | 0 | did_you_mean (newest), allowed | Sì |
| 19:18:46 | date: last_week (dopo la correzione) | 422 invalid_value | 0.12 s | 0 | did_you_mean (last7days), allowed | Sì |
| 19:18:53 | date: any (dopo la correzione) | 422 invalid_value | 0.11 s | 0 | allowed | No; lo schema lo consente e il codice lo rimuove |
| 19:19:01 | language: eng (dopo la correzione) | 422 missing_param | 0.19 s | 0 | Chiede un codice di due lettere | Non presente nella nostra definizione |
| 19:19:23 | sort: newest (dopo la correzione, ora valido) | 200, 20 righe | 14.1 s | $0.001389 | Stesse righe di recency | Non necessario |
Le quattro righe diurne di trustpilot/reviews vanno esaminate con attenzione. Nel catalogo iniziale, i parametri date e sort di questa funzionalità hanno solo una descrizione testuale, senza allowed_values. Quindi l'API non può verificarli come enum all'ingresso. Alle 00:48 SGT ogni valore sbagliato ha ricevuto un 503 dopo 1,7-1,9 secondi. Non ci è stato addebitato nulla e next_steps diceva solo di riprovare dopo retry_after secondi.
Ma non possiamo attribuire quei due errori 503 ai valori. Negli stessi minuti, un altro nostro test ha chiamato trustpilot/profile senza questi parametri e ha ricevuto anch'esso un 503. In quel momento era quindi instabile la piattaforma stessa.
Abbiamo quindi eseguito un test di controllo nel pomeriggio. Alle 15:39:38 SGT abbiamo inviato quattro chiamate nello stesso minuto, tutte per temu.com. Ogni chiamata cambiava un solo parametro. Abbiamo confrontato sort: newest con il valore valido sort: recency, e date: last7days con il valore valido date: last30days. Alle 15:40 SGT abbiamo aggiunto una chiamata di riferimento senza parametri facoltativi e una ripetizione di newest. Tutte e sei le chiamate hanno restituito 200 con 20 righe e ognuna è costata $0,001389.
I risultati si dividono in due gruppi netti. I due valori validi e la chiamata di riferimento hanno restituito le stesse 20 recensioni. Erano tutte in inglese, e verification_level e source avevano un valore. I due valori non elencati e la ripetizione hanno restituito un altro insieme di 20 recensioni. Di queste, 13 erano in inglese, 3 in francese, 2 in spagnolo e 2 in italiano. In tutte e 20 quei due campi erano vuoti.
Quindi, durante il giorno del 1° novembre, un valore sbagliato non riceveva né un 422 né un 503. L'API lo accettava, addebitava la tariffa normale e cambiava il risultato senza segnalarlo.
Per un modello è peggio di un 503. Il modello vede un successo, quindi non fa un nuovo tentativo e non avvisa l'utente. Le recensioni in lingue miste finiscono direttamente nella tua pipeline. Il testo del catalogo per sort in effetti dice di usare recency e non il valore newest di altre piattaforme. Ma lo nota solo chi legge il testo. Il controllo dell'API non lo ha rilevato.
Questi sono i risultati diurni. Quella sera il gateway ha cambiato queste regole:
| Parametro | Durante il giorno del 1° novembre | Dopo la correzione serale |
|---|---|---|
sort | Nessun valore elencato; newest veniva accettato e addebitato, con recensioni diverse | newest (equivale a recency), recency, relevance |
date | Nessun valore elencato; last7days veniva accettato e addebitato, con recensioni diverse | Cinque preset che filtrano per data di pubblicazione: 7, 30, 92, 183 e 366 giorni indietro |
language, lang | Il testo forniva solo esempi | Solo codici di due lettere; senza lingua, solo recensioni in inglese |
| Valori non presenti nell'elenco | Potevano essere accettati e addebitati | Un 422 prima di qualsiasi addebito, con i valori consentiti e un suggerimento did-you-mean |
Le ultime cinque righe della tabella degli errori sono il nostro nuovo test con la stessa azienda. I valori sbagliati hanno ricevuto un 422 con un suggerimento e nessun addebito. Quattro chiamate hanno restituito 200 a $0,001389 ciascuna: sort: newest, sort: recency, date: last7days e una chiamata di riferimento. Tutte e quattro hanno restituito le stesse 20 recensioni in inglese, con verification_level e source in ogni riga. La recensione più vecchia aveva meno di un giorno, quindi last7days e l'assenza di date devono dare lo stesso risultato.
Questo mostra anche perché il primo livello è necessario. Il nostro schema strict elenca date e sort come enum, quindi questi errori non possono uscire da Claude. Dopo la correzione serale, anche un 422 blocca questi due errori. Ma altri parametri possono ancora elencare i propri valori solo nel testo, quindi lo schema del tuo client resta il primo controllo.
Il lato MCP usa la stessa suddivisione. La specifica MCP, sezione sui tool colloca gli errori di validazione dell'input insieme agli errori di esecuzione dei tool. Vanno nel risultato con isError: true e il client li passa al modello perché possa correggersi. La nostra chiamata MCP delle 00:57 SGT ha restituito esattamente questo. La nostra guida agli errori delle API tratta ogni codice di errore, e la guida alla verifica dei rimborsi mostra come riconciliare i rimborsi.
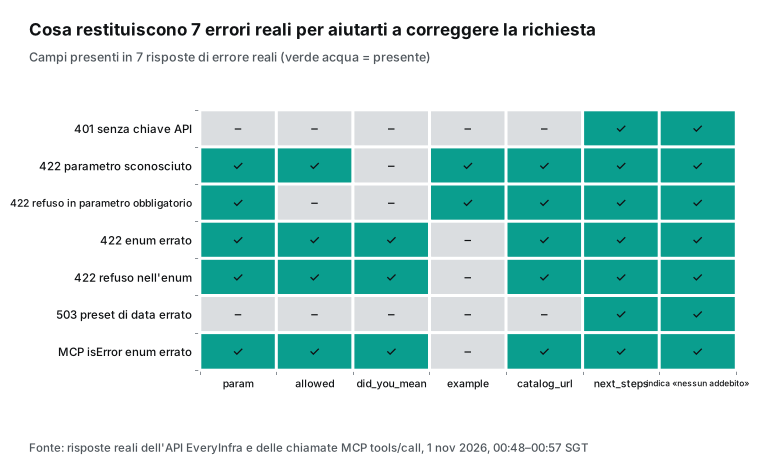
Un'altra scoperta viene da una piccola nota nella documentazione di Anthropic. Gli structured outputs non garantiscono maiuscole e minuscole dei valori enum di tipo stringa. Il modello può restituire un valore che differisce dal tuo schema solo per le maiuscole, senza alcun errore. La nota dice che questo vale anche per l'uso strict dei tool (structured outputs, «Invalid outputs»). Quindi, anche con la modalità strict, newest può diventare Newest. Alle 14:33 SGT abbiamo testato app_store/reviews con sort: Newest.
L'API non ha restituito un errore. Ha restituito 200 con 30 recensioni ordinate dalla più recente e ha addebitato $0,001389.
Una sola chiamata non basta per stabilire una regola, quindi dalle 15:39 alle 15:41 SGT abbiamo testato altre due piattaforme. Su g2/reviews, sort: Newest e sort: newest hanno restituito gli stessi 21 record. Su google_play/reviews, sort: Top_Rated ha restituito 40 recensioni, tutte a cinque stelle. Una chiamata con sort: Newest nello stesso minuto ha restituito un mix da una a cinque stelle, quindi il valore con la maiuscola ha avuto effetto. Queste quattro chiamate sono costate $0,001389 ciascuna.
Quindi, sulle tre funzionalità che abbiamo testato, una differenza tra maiuscole e minuscole conta come lo stesso valore. Non abbiamo testato gli altri enum del catalogo. Il metodo sicuro è convertire in minuscolo i valori enum nel tuo codice prima di inviarli. Quella sola riga costa molto meno di una chiamata sbagliata. Vale anche l'altro consiglio di Anthropic: non definire due valori enum che differiscono solo per le maiuscole.
Anche l'uso parallelo dei tool influisce su entrambi i livelli. È attivo per impostazione predefinita. Il modello può quindi inviare più blocchi tool_use in un turno, per esempio Trustpilot e App Store insieme. La pagina parallel tool use indica due regole di formato. Tutti i risultati dei tool del turno vanno in un unico messaggio utente e nessun testo precede i risultati. Il tuo codice deve quindi gestire un 422 e un 200 nello stesso turno.
Contrassegna il risultato 422 con is_error: true e restituisci normalmente il risultato 200. Il modello invia di nuovo solo la chiamata non riuscita. Se la tua chiave ha un limite di frequenza delle richieste basso, o vuoi log semplici, aggiungi disable_parallel_tool_use: true all'interno dell'oggetto tool_choice. In modalità auto il modello chiama allora al massimo un tool per risposta. Questa impostazione non è un parametro di primo livello della richiesta.
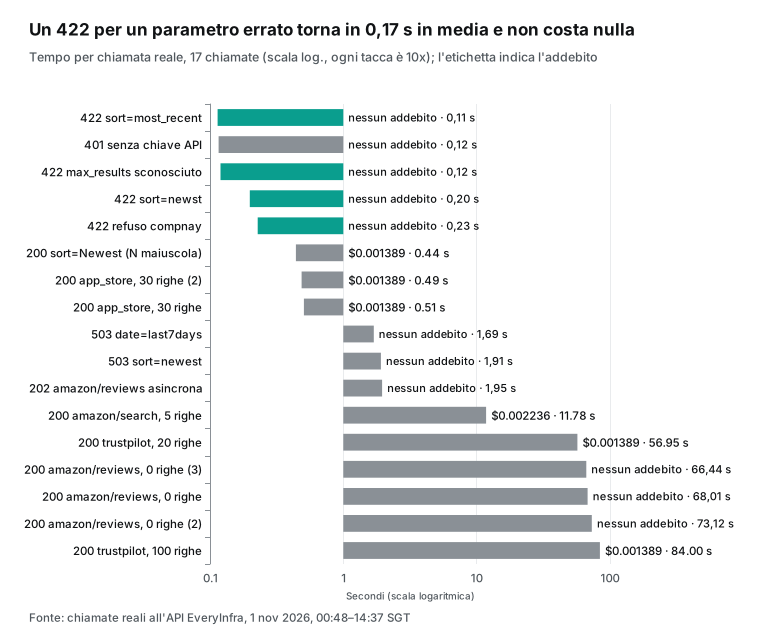
Il grafico mostra lo stesso fatto da un altro punto di vista. Un nuovo tentativo dopo un 422 costa $0 e circa 0,17 secondi lato API, cioè la media delle quattro chiamate 422. Il costo sta nel turno aggiuntivo del modello.
Usa questa formula per un turno aggiuntivo: costo della rielaborazione = (token di contesto + token dell'errore) × prezzo di input + token della correzione × prezzo di output. Usiamo circa 240 token per il corpo dell'errore e circa 120 token di output per la correzione. La lunghezza del contesto determina la maggior parte del costo, quindi la tabella mostra tre dimensioni. I prezzi provengono dalla pagina dei prezzi, consultata il 1° novembre 2026. Il numero tra parentesi è il costo espresso in chiamate di recensioni a $0,001389 ciascuna.
| Contesto | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1.000 token | $0.00018 (0.1) | $0.0037 (2.6) | $0.0074 (5.3) | $0.0184 (13) |
| 5.000 token | $0.00058 (0.4) | $0.0117 (8.4) | $0.0234 (17) | $0.0584 (42) |
| 20.000 token | $0.0021 (1.5) | $0.0417 (30) | $0.0834 (60) | $0.2084 (150) |
Un'app con tre definizioni di tool e qualche turno ha spesso un contesto di 20.000 token. In quel caso un errore su Opus 5.5 costa circa 60 chiamate di dati. Con il prompt caching, la parte di contesto usa il prezzo di lettura dalla cache. Quel prezzo è il 10% del prezzo di input su Haiku 5.5, il 5% su Opus 5.5 e Sonnet 5.5 e il 2,5% su Fable 5.1. A 20.000 token su Opus 5.5, un turno aggiuntivo scende così da $0,0834 a circa $0,0074.
Inserisci la tua lunghezza di contesto nella formula per ottenere il tuo rapporto. La tendenza è la stessa a ogni dimensione: un contesto più lungo rende più costoso un nuovo tentativo. Questa è la ragione economica del primo livello. La modalità strict blocca il nuovo tentativo più comune prima che inizi.
Un round trip completo: cosa invia il modello e cosa riceve
Il codice seguente unisce i due livelli in un ciclo minimo. Segue la documentazione di Anthropic. È un esempio di configurazione e non abbiamo eseguito la parte di Claude. Le richieste e le risposte di EveryInfra sono risultati reali del 1° novembre 2026.
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # reads ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # the three strict tools above
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # "any" and [] mean no filter
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=90)
    body = r.json()
    if r.status_code == 422:                    # value error: pass it to the model as is
        return json.dumps(body["error"]), True
    if r.status_code >= 400:
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}), False

messages = [{"role": "user", "content": "Use the trustpilot_reviews tool to get 20 one- and two-star reviews of temu.com from the last 30 days, then group them by topic."}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
    messages.append({"role": "user", "content": results})
Alcuni dettagli rendono stabile questo ciclo. Il codice imposta tool_choice su auto. È il valore predefinito, ma il valore esplicito dice al prossimo sviluppatore che non si usano chiamate forzate. Il messaggio dell'utente nomina il tool.
Questa è l'alternativa alla chiamata forzata indicata nella documentazione di Opus 5.5 e Fable 5.1. Il codice mette il corpo dell'errore 422 nel tool_result così com'è, con is_error: true. Non sostituirlo con «parametro errato», perché allowed e did_you_mean sono le parti che il modello può usare.
In caso di successo, il codice restituisce al modello solo cinque campi: id, valutazione, titolo, testo e ora di pubblicazione.
L'abbiamo misurato sulle risposte reali di quel giorno. I results di 20 recensioni Trustpilot contavano 31.046 caratteri. Con solo i cinque campi ne contavano 13.040, cioè il 58% in meno. Per 30 recensioni App Store la dimensione è passata da 13.012 a 7.726 caratteri, cioè il 41% in meno. Se il modello legge meno, ogni turno costa meno. Usiamo la dimensione ridotta nei calcoli sui batch qui sotto.
Ecco il round trip reale di questo ciclo alle 00:49 SGT del 1° novembre 2026. La modalità strict fa inviare al modello parametri come {"company": "temu.com", "stars": ["1", "2"], "date": "last30days", "sort": "recency", "limit": 20}. Il nostro codice li invia a trustpilot/reviews. L'API ha restituito 200 dopo 56,9 secondi con 20 recensioni: 19 a una stella e 1 a due stelle, pubblicate tra il 30 ottobre 2026 e il 31 ottobre 2026.
Per paese, 10 provenivano dal Regno Unito e 3 dagli Stati Uniti, e 16 avevano una risposta dell'azienda. L'addebito è stato di $0,001389, pari al price_usd del catalogo. Se il modello avesse scelto "sort": "newest", la modalità strict avrebbe bloccato quella chiamata. Senza modalità strict, l'API non avrebbe rifiutato il valore. Come nel test di controllo descritto sopra, avrebbe addebitato la tariffa normale e restituito un insieme di recensioni in lingue miste.
Cosa vedrà lo structured output? Non abbiamo eseguito Claude, quindi non riportiamo output del modello. Abbiamo invece applicato semplici regole per parole chiave alle 100 recensioni Trustpilot della chiamata delle 14:37 SGT. Su 100 recensioni, 40 menzionano un rimborso e 20 un reso.
35 menzionano la consegna, 33 la qualità o un danno, 35 il servizio clienti e 14 un account. 16 recensioni non corrispondono a nessuna regola. La lunghezza mediana del testo è di 432 caratteri e la recensione più lunga ne ha 3.371.
Questi numeri aiutano in due modi. Primo, una recensione corrisponde spesso a più di un argomento. Se il tuo schema consente un solo topic, il modello deve scegliere, quindi metti la regola nella descrizione, per esempio «preferisci l'argomento che riguarda il denaro». Secondo, la recensione più lunga corrisponde a circa 1.350 token.
Quando pianifichi 25 recensioni per richiesta, basati sulla distribuzione delle lunghezze, non sulla media. Altrimenti alcune richieste possono raggiungere il tuo max_tokens. Queste recensioni sono state pubblicate dal 27 ottobre 2026 al 1° novembre 2026, quindi descrivono solo quei giorni.
Il secondo passaggio chiede al modello di inserire ogni recensione in campi fissi con gli structured outputs di Claude. Anche questo schema è un esempio di configurazione:
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "At most 20 words copied from the review"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}
Questo schema ha zero parametri facoltativi, quindi rientra nella stessa richiesta dei tre tool strict. Il campo quote indica «al massimo 20 parole» nella descrizione invece di usare maxLength, perché i limiti di lunghezza non sono supportati. Restano due eccezioni documentate. Se il modello rifiuta, la risposta ha stop_reason: "refusal" e l'output potrebbe non rispettare lo schema.
Se l'output raggiunge max_tokens, la risposta ha stop_reason: "max_tokens" e l'output potrebbe essere incompleto. Controlla quindi stop_reason prima di salvare qualsiasi cosa. Inoltre, un campo che chiede un «ragionamento passo passo» può causare un rifiuto reasoning_extraction. La pagina refusals and fallback suggerisce di chiedere invece una breve spiegazione.
I team che sviluppano app per gli Stati Uniti partiranno spesso dalle recensioni App Store. Alle 00:54 SGT abbiamo letto le 30 recensioni statunitensi più recenti dell'app Claude (app_store/reviews, app_id 6473753684). 24 provenivano dalla versione 1.261026.20 e 6 dalla versione 1.261028.19. Le recensioni sono state pubblicate tra il 28 ottobre 2026 e il 30 ottobre 2026. La tabella mette questi campioni accanto ai campioni Trustpilot.
| Campione | Orario (SGT) | Righe | 1 o 2 stelle | 5 stelle | Addebito |
|---|---|---|---|---|---|
trustpilot/reviews, temu.com, stelle 1–2, limit 20 | 00:49 | 20 | 20 | 0 | $0.001389 |
trustpilot/reviews, temu.com, stelle 1–2, limit 100 | 14:37 | 100 | 100 | 0 | $0.001389 |
app_store/reviews, app Claude, USA, più recenti | 00:54 | 30 | 10 | 16 | $0.001389 |
app_store/reviews, app ChatGPT, USA, più recenti | 00:54 | 30 | 5 | 21 | $0.001389 |
Questi conteggi non hanno valore statistico. Mostrano un fatto pratico. Lo stesso schema vede quasi solo recensioni negative su Trustpilot, perché abbiamo filtrato per una e due stelle. Su App Store vede un mix.
La distribuzione di un campo come severity cambia con la fonte, quindi imposta i livelli di allerta per fonte. La pagina per sviluppatori di Apple dice che la valutazione complessiva è per storefront e può essere azzerata con una nuova versione. Le recensioni scritte restano (Apple, ratings and reviews). Le recensioni per versione sono quindi più utili del punteggio totale.
Batch: quanto costano 1.000 recensioni con Message Batches
Quando un round trip funziona, il costo sta nel volume. La Message Batches API elabora le richieste in modo asincrono e tutto l'utilizzo costa il 50% dei prezzi standard. Un batch può contenere fino a 100.000 richieste o 256 MB. La maggior parte dei batch termina entro un'ora. Le richieste che non terminano entro 24 ore scadono e non vengono addebitate.
I risultati restano disponibili per 29 giorni (batch processing). La pagina sugli structured outputs dice che la funzione è compatibile con i batch, con lo stesso sconto del 50%. Ogni richiesta in un batch è una richiesta Messages completa. I tool strict e output_config.format vanno quindi inseriti così come sono (create a Message Batch).
Sul lato dei dati, la prima domanda è quante righe ottenere per chiamata. Il catalogo assegna a trustpilot/reviews un valore predefinito di 20 e un massimo di 200, a $0,001389 per chiamata. Non ha un campo di prezzo per riga. Alle 14:37 SGT abbiamo inviato limit: 100.
Abbiamo ricevuto 100 recensioni e l'addebito è rimasto di $0,001389, come per 20 righe. Di queste 100 recensioni, 95 erano a una stella e 5 a due stelle. 44 provenivano dal Regno Unito e 21 dagli Stati Uniti.
Il prezzo di un limit elevato è il tempo. La chiamata sincrona ha impiegato 84,0 secondi, e il catalogo indica un budget sincrono di 85 secondi. È molto vicino al limite. Per scaricare grandi quantità di recensioni, usa quindi un limit elevato e aggiungi "mode": "async" al corpo della richiesta. Poi interroga periodicamente GET /api/v1/jobs/{job_id}. Non restare in attesa di una chiamata sincrona.
| Per 1.000 recensioni | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| Costo del modello, standard | $0.0577 | $1.1537 | $2.3073 | $5.7683 |
| Costo del modello, Message Batches | $0.0288 | $0.5768 | $1.1537 | $2.8842 |
| Costo dei dati, limit=100 (10 chiamate) | $0.0139 | $0.0139 | $0.0139 | $0.0139 |
| Totale, batch + limit=100 | $0.0427 | $0.5907 | $1.1676 | $2.8981 |
Ecco come abbiamo stimato il costo del modello, così puoi usare i tuoi numeri. La pagina models overview dice che 1M di token corrisponde a circa 2,5M di caratteri Unicode, quindi usiamo 0,4 token per carattere.
| Dato della stima | Valore | Da dove viene |
|---|---|---|
| Recensioni per richiesta | 25, quindi 40 richieste | Una nostra scelta |
| Caratteri per recensione ridotta | Circa 440 | Risposte reali di Trustpilot e App Store |
| Istruzioni e schema per richiesta | Circa 1.424 caratteri | Il nostro prompt e lo schema di output |
| Caratteri per elemento di output | Circa 189 | Un elemento di output di esempio |
| Token totali | Circa 198.832 in input, 75.600 in output | Caratteri × 0,4 |
Non abbiamo contato i token di thinking, il prompt di sistema per l'uso dei tool (286 token su Opus 5.5) né il prompt di formato aggiunto dagli structured outputs. I numeri sono quindi un limite inferiore. Con il valore predefinito limit=20, il costo dei dati per 1.000 recensioni è di 50 chiamate e $0,0694, cinque volte il costo con limit=100.
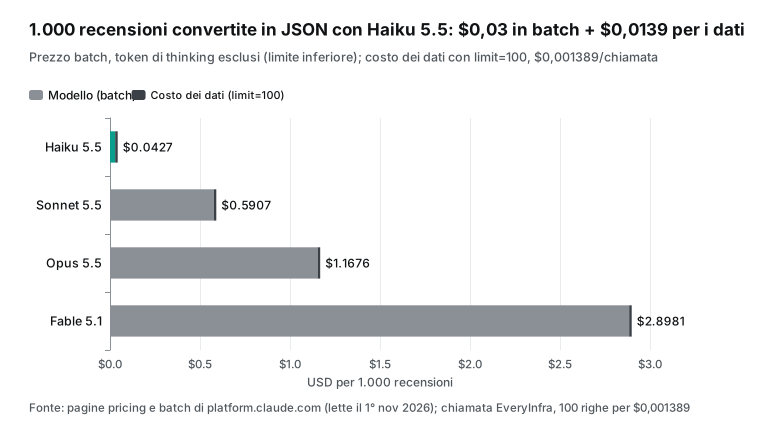
Il risultato è chiaro. Raggruppare le recensioni richiede molta lettura e decisioni semplici, quindi affidalo a Haiku 5.5. In questo caso il costo del modello e il costo dei dati sono simili, per un totale di circa $0,04 per 1.000 recensioni. Opus 5.5 costa 27 volte di più e Fable 5.1 68 volte di più. Haiku 5.5 ha una soglia di prezzo da tenere d'occhio.
Oltre i 100.000 token di prompt, il prezzo diventa $0,50 / $2,50, o $0,25 / $1,25 in un batch. Con 25 recensioni brevi per richiesta resti molto al di sotto di quella soglia. Se ti serve un giudizio più fine, per esempio «consegna lenta» rispetto a «il venditore ha rifiutato un reso», esegui prima Haiku su tutto. Poi invia a Opus 5.5 solo gli elementi con severity: high.
Ora applica tutto questo a un monitor giornaliero. Prendi le recensioni Trustpilot a una e due stelle di 50 aziende, più le nuove recensioni App Store di 50 app. Sono 100 chiamate API al giorno: $0,1389 al giorno e $4,17 per 30 giorni. Il monitor legge fino a circa 2.500 recensioni al giorno.
Per 30 giorni, il raggruppamento costa circa $2,16 su Haiku 5.5 in batch, $43,26 su Sonnet 5.5 e $86,53 su Opus 5.5. Batch e prompt caching possono funzionare insieme, e i prompt di sistema e le definizioni dei tool in cache costano meno. Ma il tasso di cache hit in un batch dipende dall'ordine delle richieste. Non l'abbiamo testato, quindi non è incluso in questi numeri.
Cosa non funziona e a cosa fare attenzione
Prima di tutto, una nostra lacuna. amazon/reviews non ha restituito recensioni in quattro tentativi il 1° novembre 2026. Due chiamate sincrone alle 00:50 e alle 00:51 SGT hanno atteso circa 68 e 73 secondi. Un job asincrono alle 00:53 SGT si è concluso con 0 righe.
Un'altra chiamata sincrona alle 14:34 SGT, con domain impostato, ha atteso 66 secondi e ha restituito anch'essa 0 righe. Nessuna delle quattro chiamate è costata nulla. I risultati vuoti vengono rimborsati per regola, e il job asincrono è stato addebitato e poi rimborsato.
Quella sera il gateway ha cambiato due casi Amazon. Li abbiamo testati di nuovo dalle 19:19 alle 19:24 SGT:
| Richiesta | Durante il giorno | Nuovo test serale | Addebito |
|---|---|---|---|
| Sito USA, sincrona | 200, 0 righe, 66–73 s | 503 access_blocked in 24,6 s; next_steps dice che un nuovo tentativo immediato non servirà | 0 |
| Sito USA, asincrona | Job completato, 0 righe | 202 con una trattenuta di $0,001389; il job è fallito con access_blocked | 0 (rimborsato) |
amazon.co.jp | Non testato | 19:19: 422 missing_param, messaggio «missing domain». 22:14: 200 in 35,3 s con 5 recensioni, tutte di acquirenti di altri paesi (3 Stati Uniti, 2 Germania) | 0 alle 19:19; $0,001389 alle 22:14 |
amazon.com.mx | Non testato | 19:19: 422 missing_param. 22:14: 422 invalid_value in 0,09 s, con l'elenco degli 11 siti supportati | 0 |
Alle 19:19 il messaggio di errore non diceva che questi due siti non erano supportati. Alle 22:14 il catalogo indicava domain come enum di 11 siti: amazon.com, co.uk, de, fr, it, es, ca, com.au, in, co.jp e sg. Ora il sito messicano viene bloccato prima di qualsiasi addebito e l'errore elenca gli 11 valori. La definizione del tool qui sopra usa lo stesso elenco. Il sito giapponese ora restituisce recensioni, ma non sempre di acquirenti in Giappone. Per tenere solo le recensioni dal Giappone, filtra sul campo country.
Il catalogo dice già che questa funzionalità recupera solo le recensioni in evidenza nella pagina prodotto, di solito una decina per prodotto. Quel giorno non ha recuperato nemmeno quelle. Per questo il tool Amazon di questo articolo è solo un esempio di configurazione. I nostri test reali hanno usato trustpilot/reviews e app_store/reviews, che quel giorno funzionavano.
Nello stesso momento amazon/search funzionava: alle 00:51 SGT una ricerca di «anker power bank 10000mah» ha restituito 5 prodotti in 11,8 secondi per $0,002236. Prima di aggiungere le recensioni Amazon a un batch, controlla il catalogo. Poi fai una piccola chiamata di prova quel giorno stesso.
Poi ci sono i limiti documentati da Anthropic. I tool strict sono idonei per HIPAA, ma l'API memorizza nella cache gli schemi compilati separatamente dal contenuto dei messaggi, senza la stessa protezione («Strict tool use», sezione «Data retention»). Quindi non inserire un elenco di clienti in un enum. La guida alla migrazione di Fable 5.1 tratta il caso CMEK («Fable 5.1 migration guide»).
| Limite | Cosa significa per un'API per i dati | Fonte |
|---|---|---|
| Nessun dato sanitario negli schemi | Nessuna PHI nei nomi delle proprietà, in enum, const o pattern | «Strict tool use», sezione «Data retention» |
| Organizzazioni con CMEK | Niente structured outputs né strict: true sui modelli Fable; usa solo l'istruzione | «Fable 5.1 migration guide» |
| Citazioni | Non funziona con gli structured outputs: restituisce un errore 400 | «Structured outputs», sezione «Feature compatibility» |
| Cambio di formato | Un nuovo output_config.format invalida la cache del prompt | «Structured outputs», sezione «Token costs» |
Il limite sulle citazioni richiede un'altra nota. Per dati strutturati con una fonte per ogni valore, usa il metodo specifico descritto nella documentazione «Citations».
Infine, anche il secondo livello ha dei limiti. Un 422 può bloccare solo gli errori definiti dal catalogo: parametri sconosciuti, parametri obbligatori mancanti ed enum con valori elencati.
Non può bloccare errori su regole che il catalogo riporta solo come testo. Durante il giorno del 1° novembre, date e sort su trustpilot/reviews ne erano un esempio. In quel momento i valori errati per questi due parametri non producevano nemmeno un errore. Costavano la tariffa normale e cambiavano il risultato. La correzione della sera ha aggiunto i valori ammessi per entrambi, quindi ora restituiscono un 422.
Il 422 non può nemmeno intercettare condizioni verificabili solo in fase di esecuzione, come la risposta alla domanda «questa azienda ha una pagina Trustpilot?».
Quindi usa entrambi i livelli. Metti nello schema strict tutte le regole possibili. Lascia il resto al 422. Per gli enum copiati dal testo del catalogo, controlla anche nel codice la lingua e i campi chiave di ogni risposta.
Risoluzione dei problemi: sette sintomi e le relative soluzioni
In produzione, i problemi di solito nascono nei casi limite. Uno schema smette improvvisamente di compilarsi. In un turno, il modello non chiama un tool. Alcuni elementi di un batch non corrispondono. La tabella seguente elenca sette sintomi tratti dalla documentazione e dalle nostre chiamate reali.
Per prima cosa, controlla chi ha restituito il codice di stato. Un 400 arriva da Anthropic e indica che la richiesta o lo schema non sono corretti, quindi modifica il codice. Un 422 o un 503 proviene da EveryInfra e indica che la struttura è corretta, ma che un valore non è valido o l'esecuzione non è riuscita, quindi segui next_steps. Questo singolo controllo fa risparmiare gran parte del tempo di debug, perché i due formati di errore sono diversi e nei log è facile confonderli.
| Sintomo | Chi lo restituisce | Causa | Soluzione |
|---|---|---|---|
| 400, tool_choice non supportato | Anthropic | any o tool su un modello nuovo | Usa auto e indica il nome del tool nel messaggio dell'utente |
| 400, schema troppo complesso | Anthropic | Più di 24 parametri facoltativi o una grammatica troppo grande | Rendi obbligatori i parametri; sostituisci gli enum di grandi dimensioni con testo e affida la validazione al 422 |
| Il modello risponde con del testo, senza chiamare il tool | Anthropic | Istruzione poco chiara | Indica il tool e la condizione che lo attiva; controlla stop_reason e richiedi la chiamata |
422 invalid_value | EveryInfra | Valore non presente in allowed_values del catalogo | Modifica un campo alla volta secondo did_you_mean; nessun addebito |
| 503 ripetuto | EveryInfra | La piattaforma è instabile; lo hanno ricevuto anche le nostre chiamate senza valori sospetti. Con reason: access_blocked, la pagina di destinazione richiede un login o ha accesso limitato | Attendi retry_after; dopo errori ripetuti, serve un controllo manuale; per access_blocked, cambia destinazione |
| 200, ma la lingua o i campi sembrano sbagliati | EveryInfra | Un valore non elencato nel testo del catalogo è stato accettato e ha cambiato il risultato. È il caso di date e sort su trustpilot/reviews prima della correzione serale | Bloccalo con un enum lato client; controlla il testo del catalogo |
| 200 con 0 righe | EveryInfra | Quel giorno la pagina di destinazione non aveva dati | Rimborso già effettuato; cambia destinazione o funzionalità |
Le ultime tre righe vengono dai nostri test, le prime quattro dalla documentazione di Anthropic. Gestisci la sesta riga nel codice, perché altri parametri possono avere lo stesso problema. Scrivi nello schema ogni enum copiato dal testo del catalogo. Dopo ogni risposta, confronta la distribuzione delle lingue e i campi chiave con un riferimento. Se non corrispondono, segnala la chiamata per un controllo manuale. Nel nostro test di controllo, 7 delle 20 recensioni ottenute con i valori sbagliati non erano in inglese. Due campi erano vuoti in tutte e 20. Un controllo semplice lo rileva subito.
Modifiche recenti rilevanti per questa configurazione
| Data | Modifica | Cosa significa per te |
|---|---|---|
| 22 settembre 2026 | Lancio di Opus 5.5; il thinking non si può disattivare; il tool_choice forzato restituisce 400 | Rimuovi le chiamate forzate prima di passare da Opus 5; usa auto più strict |
| 28 settembre 2026 | Lancio di Sonnet 5.5; anche questo modello rifiuta il tool_choice forzato | Tornare a Sonnet non evita la modifica |
| 7 ottobre 2026 | Lancio di Haiku 5.5; contesto da 1M; prezzo dei batch $0,05 / $0,25 | Il costo del modello per il raggruppamento in blocco ora è vicino alla tariffa dei dati |
| 15 ottobre 2026 | L'API Models indica il supporto al thinking between_tools; la fast mode di Opus 5.5 esce dalla research preview | Verifica le funzionalità del modello nel codice, non dal model ID |
| 21 ottobre 2026 | Versione API 2026-10-21 e nuovi SDK (Python 2.0.0 e altri) | Quando aggiorni l'SDK, cerca campi obsoleti come output_format |
| 22 ottobre 2026 | Claude tramite Google Cloud, gestito da Anthropic | Un'altra via di fatturazione per i job batch; l'uso di strict non cambia |
| 28 ottobre 2026 | Il limite di dimensione delle richieste Messages passa da 32 MB a 128 MB | In una richiesta entrano più recensioni, ma il costo dipende dai token |
| 29 ottobre 2026 | Usage and Cost Analytics API in beta, con raggruppamento per modello, workspace e chiave API | Suddividi il costo del modello per attività e confrontalo con la tariffa dei dati |
| 30 ottobre 2026 | La fast mode di Opus 4.8 sarà rimossa il 30 novembre 2026 | Pianifica la migrazione se usi quel modello per l'estrazione in produzione |
Queste voci provengono dalle «API release notes», aggiornate il 30 ottobre 2026, e dalla guida alla migrazione della versione API. La voce più importante per questo articolo è il lancio di Haiku 5.5 il 7 ottobre 2026. Prima, il raggruppamento in blocco su Haiku 4.5 in batch costava $0,50 / $2,50, dieci volte di più, e il costo del modello superava di gran lunga la tariffa dei dati. Ora i due costi sono simili, quindi il prezzo dell'API per i dati diventa un fattore concreto.
Un'altra voce è del 22 settembre 2026: un messaggio di sistema a metà conversazione può contenere una definizione completa di tool, in beta. Permette di aggiungere un tool strict a sessione in corso senza invalidare la cache del prompt. Anthropic lo indica come una delle alternative alle chiamate forzate.
Domande frequenti
Posso ancora forzare l'uso dei tool in Claude?
Questa domanda nasce dal suggerimento di ricerca «claude force tool use». Non è possibile su Fable 5.1, Mythos 5.1, Opus 5.5 o Sonnet 5.5. Un tool_choice impostato su any o tool restituisce un 400, e l'endpoint di conteggio dei token applica lo stesso controllo. auto e none funzionano ancora. Mantieni auto, aggiungi strict: true ai tool e indica nel messaggio dell'utente quando usare ciascun tool. Se un tool deve essere eseguito nel turno corrente, la guida alla migrazione di Fable 5.1 suggerisce un messaggio di sistema a metà conversazione.
Cosa fare se con claude tool_choice impostato su auto il modello non chiama il tool?
Questa domanda nasce dal suggerimento «claude tool_choice». Anthropic afferma che Fable 5.1 segue in modo affidabile le istruzioni esplicite sui tool. Quindi, primo: rendi chiara l'istruzione, indicando il tool e la condizione che lo attiva. Secondo: controlla stop_reason nel tuo loop.
Se il modello ha risposto con del testo e ti servono i dati, aggiungi un messaggio dell'utente che richieda la chiamata. Terzo: scrivi una description chiara per il tool. La pagina «Define tools» definisce le descrizioni dettagliate «di gran lunga il fattore più importante per le prestazioni dei tool».
Gli structured outputs di Claude funzionano su Bedrock?
Questa domanda nasce dal suggerimento «claude structured outputs bedrock». La tabella di disponibilità della pagina sullo strict tool use elenca Amazon Bedrock, inclusa InvokeModel, e Google Cloud. La pagina sugli structured outputs indica «tutte le piattaforme supportate» e «tutti i modelli». I modelli Fable richiedono la conservazione dei dati per 30 giorni e non rientrano nella zero data retention. Controlla la pagina sulla conservazione dei dati prima di usarli.
Come si usano gli structured outputs di Claude con Pydantic?
Questa domanda nasce dal suggerimento «claude structured output pydantic». La pagina sugli structured outputs consiglia di passare un modello Pydantic a client.messages.parse(). L'SDK trasforma lo schema e sposta nelle descrizioni i vincoli non supportati, come minimum e maxLength. Poi verifica la risposta rispetto allo schema originale con tutti i vincoli.
Per EveryInfra, scrivi gli allowed_values del catalogo come Literal[...], che diventa un enum. Scrivi l'intervallo di limit con Field(ge=1, le=200): l'SDK lo verifica in locale. Nel catalogo, sei funzionalità indicano che i valori oltre il massimo vengono limitati al valore massimo.
Conviene usare l'API Structured Outputs di Claude e i tool strict nella stessa richiesta?
Questa domanda nasce dal suggerimento «claude structured outputs api». Sì, puoi farlo. La sezione «Feature compatibility» della pagina sugli structured outputs dice che entrambi possono funzionare nella stessa richiesta. Condividono i limiti di 20 tool strict, 24 parametri facoltativi e 16 parametri di tipo union, quindi rendi completamente obbligatorio anche lo schema di output.
Come iniziare
- Leggi il catalogo.
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilotè gratuito e non richiede una chiave. Fornisce parametri, valori ammessi e prezzi. - Scrivi tool strict seguendo le sei regole viste sopra. Rendi obbligatori i parametri, scrivi
allowed_valuescomeenume metti gli intervalli nelle descrizioni. - Ottieni una chiave nella guida rapida. Invia una richiesta con un enum sbagliato e verifica di ricevere un 422 con
did_you_mean. - Per i lavori in blocco, usa un
limitalto e"mode": "async". Lato Claude, usa Message Batches.
Pagine delle piattaforme: API di scraping per Trustpilot, API di scraping per App Store e API di scraping per Amazon. Pagine delle funzionalità: recensioni Trustpilot, recensioni App Store e recensioni Amazon. Altre pagine sulle recensioni: recensioni G2 e recensioni Google Play. Per collegare il server MCP remoto in Claude senza scrivere codice, leggi configurazione del server MCP remoto.
Per i dati delle recensioni come prodotto, leggi i dati delle recensioni come prodotto a pagamento. Leggi anche un solo SKILL.md per quattro strumenti AI. Per raccogliere dati in parallelo con i subagenti, leggi subagenti di Claude Code per gli account brand di TikTok. Confronta i prezzi delle funzionalità nel marketplace dei dati.
Riferimenti
- «What's new in Claude Opus 5.5» (sezione «Forced tool use is not supported»), Anthropic, 22 settembre 2026, https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- «What's new in Claude Fable 5.1», Anthropic, 1° settembre 2026, https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- «What's new in Claude Sonnet 5.5», Anthropic, 28 settembre 2026, https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- «Claude Opus 5.5 migration guide», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- «Claude Fable 5.1 migration guide», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- «Claude Sonnet 5.5 migration guide», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- «API release notes», Anthropic, aggiornato il 30 ottobre 2026, https://platform.claude.com/docs/en/release-notes/overview
- «Strict tool use», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- «Structured outputs», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- «Define tools», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- «Handle tool calls», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- «Tool use overview», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- «How tool use works», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- «Troubleshooting tool use», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- «Parallel tool use», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- «Tool runner», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- «Tool search tool», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- «Programmatic tool calling», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- «Batch processing», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/batch-processing
- «Create a Message Batch» (riferimento API), Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/api/messages/batches/create
- «Pricing», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/about-claude/pricing
- «Prompt caching», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- «Token counting», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/token-counting
- «Rate limits», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/api/rate-limits
- «Errors», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/api/errors
- «Models overview», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/models/overview
- «Claude Haiku 5.5 overview», Anthropic, 7 ottobre 2026, https://platform.claude.com/docs/en/models/haiku-5-5/overview
- «Claude Opus 5.5 overview», Anthropic, 22 settembre 2026, https://platform.claude.com/docs/en/models/opus-5-5/overview
- «Claude Mythos 5.1 overview», Anthropic, 1° settembre 2026, https://platform.claude.com/docs/en/models/mythos-5-1/overview
- «Effort», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/effort
- «Streaming», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/streaming
- «Refusals and fallback», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- «Citations», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/build-with-claude/citations
- «MCP connector», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- «Remote MCP servers», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- «Migrating to API version 2026-10-21», Anthropic, 21 ottobre 2026, https://platform.claude.com/docs/en/api/migration-2026-10-21
- «API and data retention», Anthropic, consultato il 1° novembre 2026, https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- «Model Context Protocol specification 2025-11-25: Tools», MCP, https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- «JSON Schema Validation», draft 2020-12, JSON Schema, https://json-schema.org/draft/2020-12/json-schema-validation
- «JSONSchemaBench», Geng et al., arXiv 2501.10868, 2025, https://arxiv.org/abs/2501.10868
- «Ratings, reviews, and responses», Apple Developer, consultato il 1° novembre 2026, https://developer.apple.com/app-store/ratings-and-reviews/
- «EveryInfra data catalog» (GET /api/v1/social/catalog), EveryInfra, consultato il 1° novembre 2026 alle 00:46 SGT, https://api.everyinfra.com/api/v1/social/catalog
Riferimenti BL-60