Gemini Deep Research API con un server MCP remoto: dati social che puoi verificare
La Gemini Deep Research API accetta server MCP remoti ma non funzioni personalizzate. 7 chiamate live per dati social costano 0,0046 $. Configurazione, prezzi e verifica delle citazioni.
In breve: sì. La Gemini Deep Research API oggi può chiamare un server MCP remoto. Non accetta dichiarazioni di funzioni personalizzate e non supporta l'output strutturato. Tutti e tre i fatti sono nella sezione «Limitations» della pagina di Google su Deep Research (documentazione di Deep Research, aggiornata il 2026-10-13). Puoi quindi indirizzarla al server MCP remoto di EveryInfra all'indirizzo https://api.everyinfra.com/mcp.
Il 2026-11-02, tra le 00:16 e le 00:20 SGT, abbiamo anche fatto 7 chiamate live alla nostra API per dati social e notizie. Hanno restituito 131 righe e sono costate in totale 0,0046 $. I dati mostrano che, per avere citazioni verificabili, il punto debole non è il modello ma i dati stessi. Le date delle notizie in inglese erano in ritardo da 0 a 1 giorno e tutte e 10 le date delle notizie in spagnolo erano vuote. Nessuno dei 50 commenti di YouTube aveva un link, mentre tutti e 35 i commenti di Reddit avevano un permalink.
Questo articolo risponde a una domanda pratica. Vuoi che Gemini Deep Research scriva un report su un tema pubblico. Vuoi anche che ogni affermazione sui social media contenuta nel report rimandi a una riga che il lettore può aprire. Come fornisci all'agente dati social strutturati perché tutto questo funzioni?
Come tema di test abbiamo scelto gli incendi delle batterie delle e-bike a New York. Un incendio in un appartamento del Bronx il 2026-10-28 ha ucciso un ragazzo e, in seguito, altre tre persone. Nel giro di pochi giorni ha generato notizie in inglese e spagnolo, thread su Reddit e video su YouTube: un buon banco di prova per quattro tipi di fonte.
Ogni fatto su Google in questo articolo proviene da pagine di ai.google.dev, dalla documentazione di Google Cloud o dal blog di Google. Non abbiamo una chiave API Gemini e non abbiamo eseguito Deep Research. Tutto il codice Gemini qui sotto è un esempio di configurazione, non il risultato di un test. Ogni numero di EveryInfra proviene dalle risposte grezze delle nostre chiamate live.
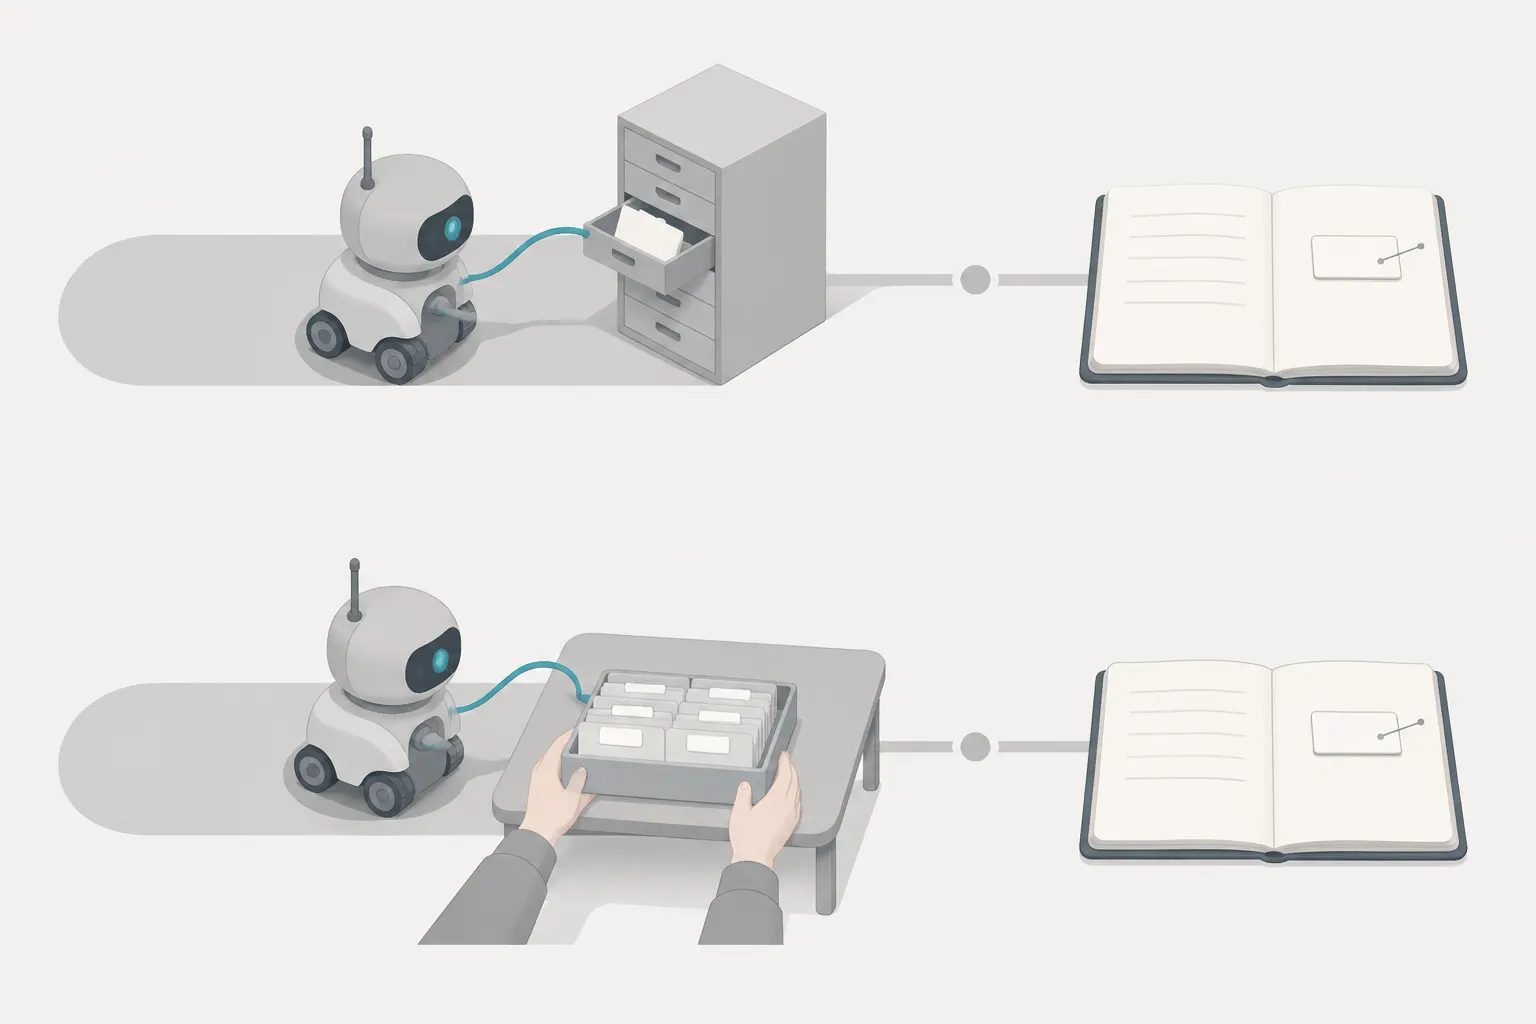
La Gemini Deep Research API può collegarsi a un server MCP remoto?
Sì. La pagina di Deep Research elenca cinque tipi di strumenti. Tre sono attivi per impostazione predefinita: google_search, url_context e code_execution. Gli altri due vanno aggiunti: mcp_server e file_search (documentazione di Deep Research, «Supported tools»). Questa funzionalità è stata rilasciata il 2026-04-21 insieme ai nuovi agenti Deep Research. La voce del changelog cita pianificazione collaborativa, visualizzazione, integrazione con server MCP e File Search (changelog della Gemini API).
Lo strumento mcp_server ha cinque campi. type è obbligatorio e deve valere "mcp_server". name è un nome visualizzato e url è l'URL completo dell'endpoint MCP. headers contiene gli header HTTP inviati con ogni richiesta, e la documentazione cita come esempio un token di autenticazione. allowed_tools limita gli strumenti di quel server che l'agente può chiamare.
Le funzioni personalizzate sono un'altra storia. La prima limitazione nella stessa pagina dice che al momento non puoi fornire a Deep Research strumenti di Function Calling personalizzati, e aggiunge che puoi invece usare server MCP remoti. La seconda limitazione è che l'output strutturato non è supportato. La terza è un tempo massimo di ricerca di 60 minuti, e la maggior parte delle attività dovrebbe concludersi entro 20 minuti.
Altre due frasi nelle pagine di Google possono confondere. Il post sul blog di Google dedicato a Deep Research Max dice che Deep Research «supporta definizioni arbitrarie di strumenti» (blog di Google, 2026-04-21). Letta insieme alla documentazione, la frase indica strumenti esposti tramite MCP, non dichiarazioni di funzioni nella richiesta. Anche la panoramica della Interactions API dice che Gemini 3 non supporta ancora MCP remoto (panoramica della Interactions API, aggiornata il 2026-10-15). Quella nota riguarda i modelli chiamati con il parametro model. Deep Research è un agente chiamato con il parametro agent, quindi la nota non si applica.
| Domanda | Risposta nella documentazione di Google | Fonte e data |
|---|---|---|
| Server MCP remoto? | Sì, tipo di strumento mcp_server con headers e allowed_tools | Documentazione di Deep Research, 2026-10-13 |
| Funzioni personalizzate? | No, al momento no | Stessa pagina, sezione Limitations |
| Output in JSON strutturato? | No | Stessa pagina, sezione Limitations |
| Tempo massimo di esecuzione? | 60 minuti; la maggior parte delle esecuzioni termina entro 20 minuti | Stessa pagina, sezione Limitations |
| Modalità background obbligatoria? | Sì, background=true con store=true | Stessa pagina, documentazione sul background |
| Limiti di contesto e di output | 1.048.576 token di input e 65.536 di output | Pagina del modello, 2026-10-29 |
| Nomi degli agenti | deep-research-preview-04-2026 e deep-research-max-preview-04-2026 | Pagina del modello, changelog |
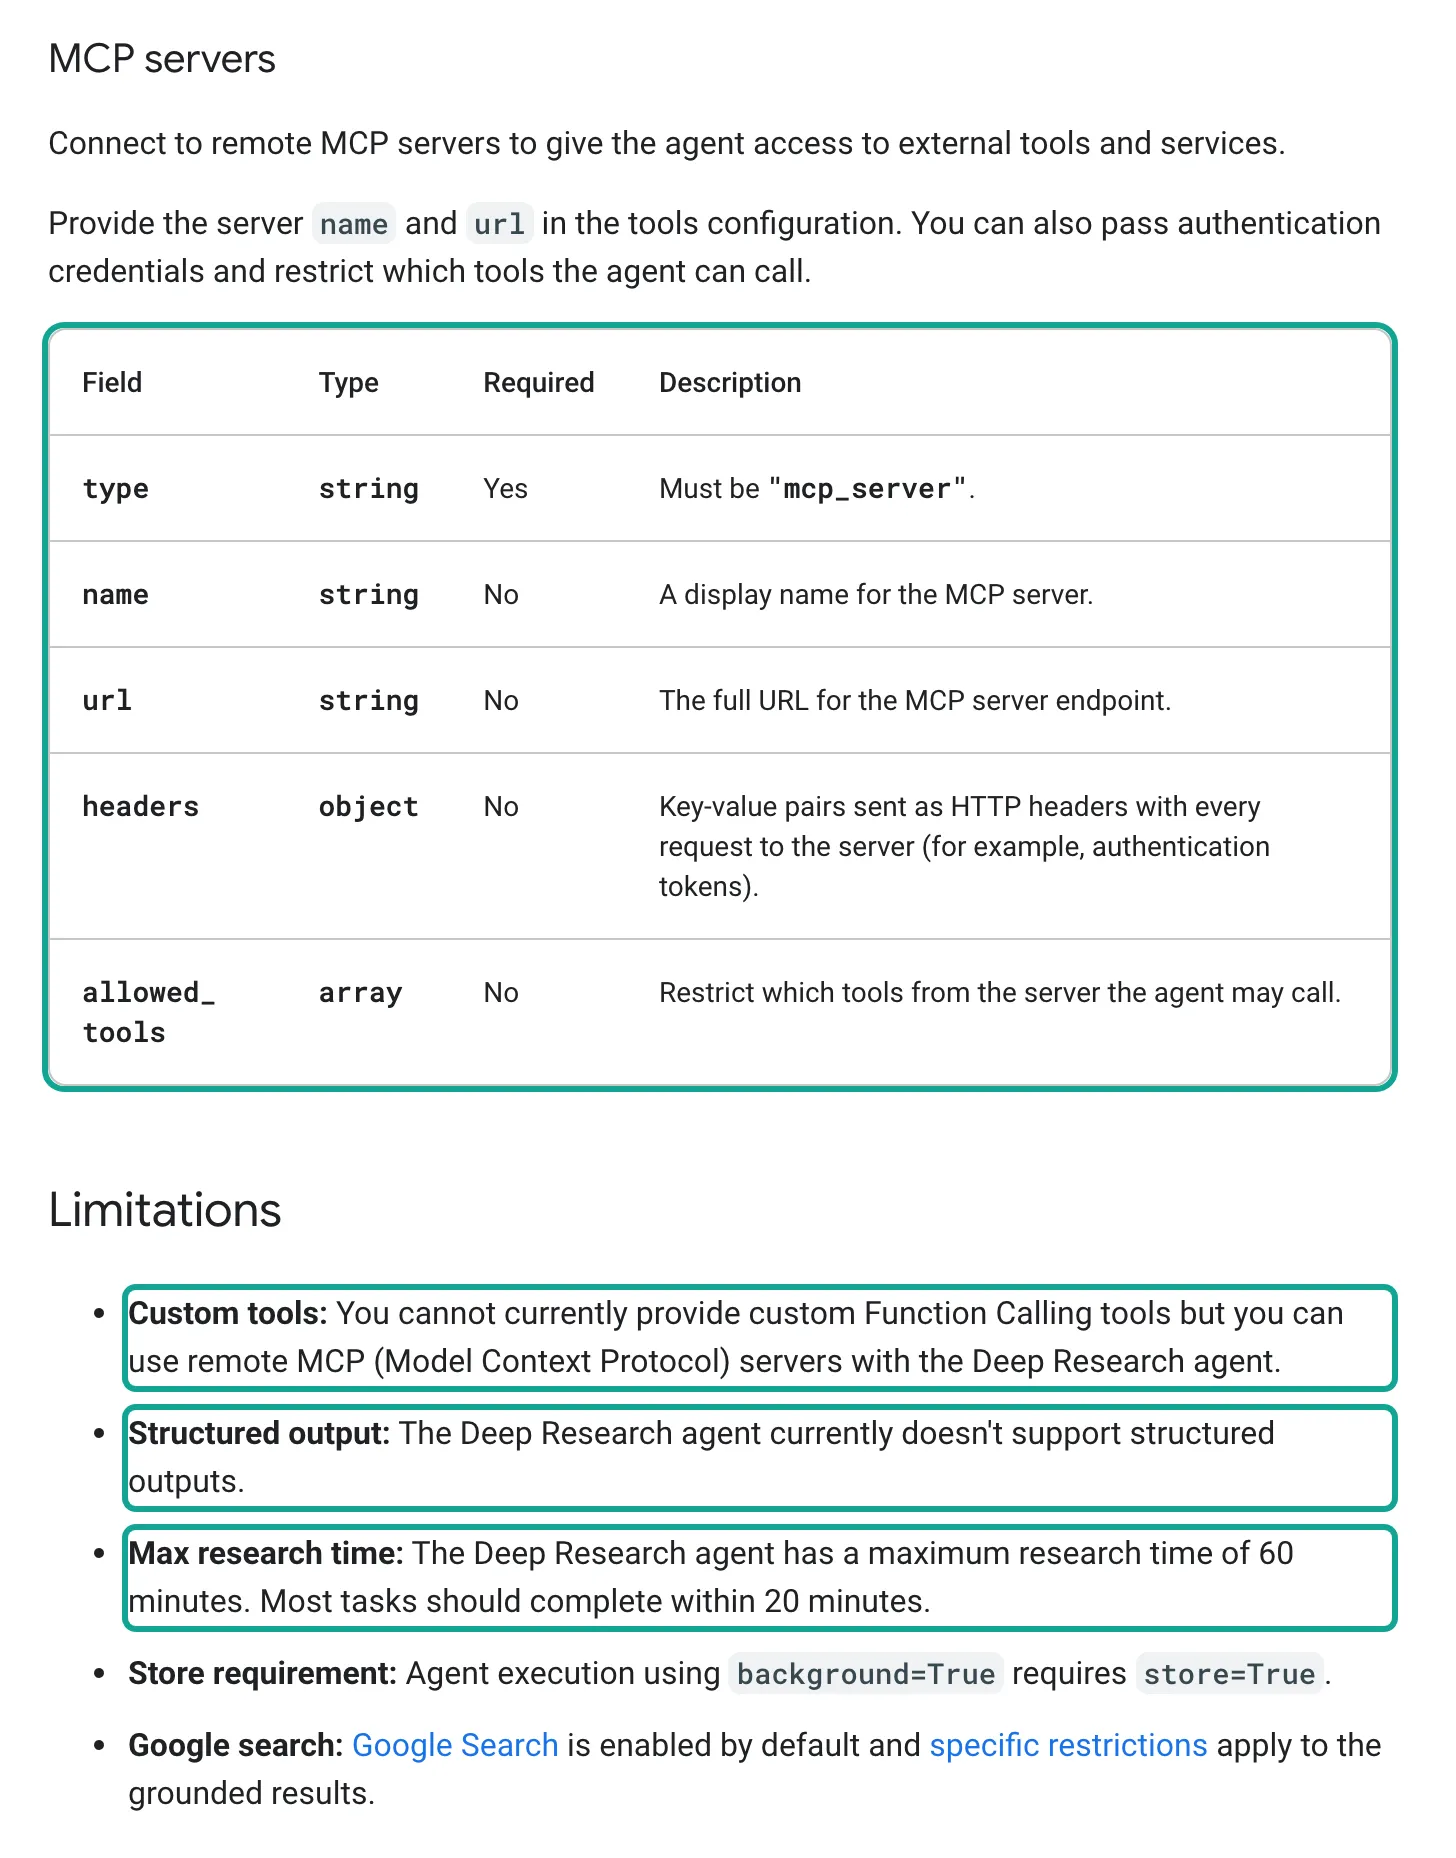
Quindi entrambi i percorsi del nostro piano funzionano, ma cambia l'ordine. Nel percorso A inserisci il nostro URL MCP in tools. Durante l'esecuzione è poi l'agente a decidere da solo quando cercare su Reddit o recuperare notizie. Nel percorso B il tuo programma chiama prima POST /api/v1/social, trasforma i risultati in una tabella e la passa all'agente come input o come documenti di File Search.
Il percorso B non è obbligatorio, ma è il più sicuro per avere citazioni verificabili. Il motivo sta nei dati, non in Gemini.
Come funziona la chiamata alla Gemini Deep Research API: modalità background, polling e streaming
Deep Research funziona solo tramite la Interactions API, non con il vecchio metodo generateContent. La Interactions API è stata lanciata il 2025-12-11 ed è diventata disponibile a livello generale a giugno 2026. Oggi Google la definisce l'interfaccia predefinita per i nuovi progetti (panoramica della Interactions API).
Una chiamata a Deep Research si differenzia da una normale chiamata al modello per tre aspetti. Usi il parametro agent, non model. Devi impostare background=true, e l'API restituisce subito un oggetto parziale con un id. Poi fai polling con quell'id oppure apri uno stream.
Il blocco qui sotto segue l'esempio REST della documentazione. È un esempio di configurazione che non abbiamo eseguito.
# Configuration example: start Deep Research with the EveryInfra remote MCP server (not run by us)
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "Content-Type: application/json" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -d '{
    "agent": "deep-research-preview-04-2026",
    "input": "Research how e-bike battery fires in New York City were discussed in news, Reddit and YouTube in October 2026. For every claim about social media, quote the row id and url from the EveryInfra tool result. If a date is approximate, say so.",
    "tools": [
      {"type": "google_search"},
      {"type": "url_context"},
      {"type": "mcp_server",
       "name": "EveryInfra",
       "url": "https://api.everyinfra.com/mcp",
       "headers": {"Authorization": "Bearer '"$EVERYINFRA_API_KEY"'"},
       "allowed_tools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]}
    ],
    "agent_config": {"type": "deep-research", "thinking_summaries": "auto"},
    "background": true
  }'

# Poll (replace INTERACTION_ID with the id from the first response)
curl "https://generativelanguage.googleapis.com/v1beta/interactions/INTERACTION_ID" \
  -H "x-goog-api-key: $GEMINI_API_KEY"
Un'interazione in background ha cinque stati: in_progress, requires_action, completed, failed e cancelled (documentazione sull'esecuzione in background). background=true richiede store=true, e store=false in modalità background restituisce un errore 400. Le interazioni salvate restano disponibili per 55 giorni nel livello a pagamento e per 1 giorno in quello gratuito. I progetti a pagamento possono portare questo periodo a 7, 14 o 28 giorni in AI Studio. Per i dati questo conta: la tua chiave EveryInfra in headers non compare nell'interazione, ma ogni riga di dati social recuperata dall'agente viene salvata come step.
Lo streaming richiede sia stream=true sia background=true. Per vedere i riepiloghi del ragionamento durante l'esecuzione, imposta anche agent_config.thinking_summaries su "auto". L'esempio della documentazione gestisce la caduta della connessione: salva l'interaction_id e l'ultimo event_id e, dopo una caduta, chiama GET /interactions/{id}?stream=true&last_event_id=... per riprendere. La documentazione indica un timeout di 600 secondi tra le cause delle cadute, quindi in un'esecuzione lunga questa logica di riconnessione non è facoltativa.
| Campo di `agent_config` | Predefinito | Cosa fa | Perché conta qui |
|---|---|---|---|
type | Obbligatorio, "deep-research" | Identifica una chiamata a Deep Research | — |
thinking_summaries | "none" | "auto" mostra gli step nello stream | Vedi quando l'agente chiama MCP |
visualization | "auto" | Consente i grafici, ma li disegna solo se il prompt lo chiede | Chiedi i grafici nel prompt |
collaborative_planning | false | Restituisce prima un piano; modificalo con previous_interaction_id, poi imposta false nell'ultimo turno. Una risposta come «va bene» senza cambiare l'opzione non produce alcun report (Philipp Schmid, 2026-04-29) | Limita le funzionalità già in fase di pianificazione |
Prezzi della Gemini Deep Research API: da 1 a 3 $ per attività, da 3 a 7 $ per Max
Google non assegna a Deep Research un prezzo proprio. Paghi separatamente l'inferenza del modello e l'uso degli strumenti (pagina dei prezzi, «Pricing for agents», aggiornata il 2026-10-30). Tutta l'inferenza è addebitata alle tariffe standard di Gemini, inclusi i token intermedi del loop dell'agente. Gli strumenti sono addebitati con tariffe proprie. I risultati di Google Search non contano come token, mentre i contenuti di URL Context e File Search sì.
La pagina di Deep Research fornisce una stima dei costi (documentazione di Deep Research, «Estimated costs»). Un'attività standard con un'analisi di media complessità usa circa 80 ricerche e 250.000 token di input, di cui dal 50% al 70% in cache. Usa inoltre circa 60.000 token di output, per un totale di circa 1-3 $. Un'attività Max per un'analisi competitiva approfondita usa fino a circa 160 ricerche, 900.000 token di input e 80.000 token di output, con una stima di circa 3-7 $.
La pagina dei prezzi elenca anche le tariffe di Google Search. I modelli Gemini 3 e successivi condividono 5.000 ricerche gratuite al mese. Oltre quella soglia le ricerche costano 14 $ per 1.000, e ogni progetto ha un limite predefinito di 1.500 ricerche al giorno. La documentazione non dice se le ricerche all'interno di Deep Research siano addebitate a questa tariffa o rientrino nel limite giornaliero. Se rientrano, il limite consente circa 18 report al giorno da 80 ricerche ciascuno. Non abbiamo eseguito Deep Research, quindi controlla il campo usage nella tua fattura.
I limiti di spesa sono facili da trascurare. La pagina sui limiti di frequenza delle richieste dice che la Gemini API limita anche la spesa in una finestra mobile di 10 minuti. Il limite è di 10 $ nel Tier 1, 50 $ nel Tier 2 e 200 $ nel Tier 3. Un progetto che lo supera riceve 429 RESOURCE_EXHAUSTED (limiti di frequenza delle richieste, aggiornati il 2026-10-28). A 3 $ per attività, un progetto Tier 1 può raggiungere il limite con tre o quattro attività in 10 minuti.
Anche il livello a pagamento richiede un passaggio iniziale. La pagina sulla fatturazione dice che per passare dal livello gratuito a quello a pagamento devi collegare un account di fatturazione. I nuovi account ricevono per impostazione predefinita il piano prepagato, con una ricarica minima di 5 $ (documentazione sulla fatturazione). Le richieste falliscono quando il saldo prepagato si esaurisce. Per un progetto che genera report pianificati, mantieni un saldo sufficiente o attiva le ricariche automatiche.
I team con molti report possono valutare Google Cloud. La pagina di Deep Research per Google Cloud descrive un'opzione service_tier="deferred" quando stream=false, che sposta le attività in background nelle ore di minor carico a metà prezzo (documentazione di Deep Research su Google Cloud).
| Voce di costo | Prezzo (consultato il 2026-11-02) | Uso in un'attività Deep Research |
|---|---|---|
| Inferenza del modello | Tariffe standard di Gemini, inclusi i token intermedi | Circa 250k in input, 60k in output (Max 900k, 80k) |
| Google Search | 5.000 gratuite al mese, poi 14 $ per 1.000, limite di 1.500 al giorno | Circa 80 ricerche (Max circa 160) |
| URL Context | Contenuti addebitati come token di input | Dipende dalle pagine lette |
| File Search | Indicizzazione a 0,15 $ per 1M di token di embedding; archiviazione ed embedding delle query gratuiti | Solo se carichi file |
| Esecuzione del codice | Codice e risultati addebitati come token | Quando l'agente fa calcoli o grafici |
| Dati social di EveryInfra | price_usd del catalogo per chiamata; nessun addebito per errori o risultati vuoti | 23 chiamate per un report, circa 0,0135 $ |
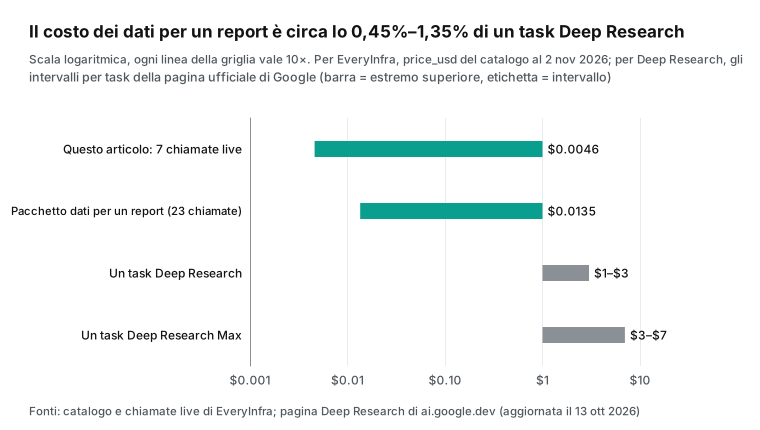
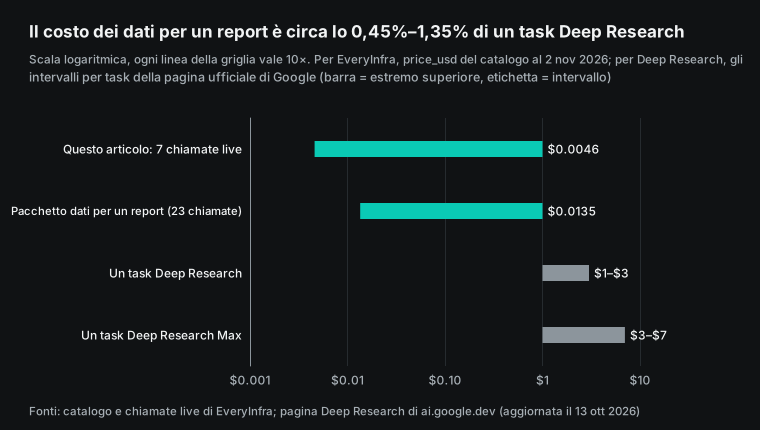
La parte della fattura dovuta ai dati social è minima. Ai prezzi di catalogo del 2026-11-02, google_news/search costa 0,000792 $ per chiamata. reddit/search, reddit/comments, youtube/search e youtube/comments costano 0,000556 $ per chiamata. Ogni chiamata ha un prezzo unico, indipendentemente dal numero di righe. Supponi che un report usi 3 ricerche di notizie, 3 ricerche su Reddit, i commenti di 10 thread di Reddit, 2 ricerche su YouTube e i commenti di 5 video. Sono 23 chiamate per 0,0135 $, cioè dallo 0,45% all'1,35% di una sola attività Deep Research.
Il costo del report dipende quindi da Deep Research, non dalle chiamate per i dati. L'aspetto a cui devi prestare attenzione è la verificabilità dei dati.
| Funzionalità | Prezzo di catalogo per chiamata | Chiamate in un report | Subtotale |
|---|---|---|---|
google_news/search | $0.000792 | 3 (inglese, spagnolo, cinese) | $0.002376 |
reddit/search | $0.000556 | 3 | $0.001668 |
reddit/comments | $0.000556 | 10 | $0.005560 |
youtube/search | $0.000556 | 2 | $0.001112 |
youtube/comments | $0.000556 | 5 | $0.002780 |
| Totale | — | 23 | $0.013496 |
Quanto ci vuole: minuti per Deep Research, 77 secondi per le nostre 7 chiamate
Le esecuzioni di Deep Research durano diversi minuti. Nella tabella comparativa della documentazione, la latenza delle normali chiamate ai modelli è espressa in secondi, mentre quella di Deep Research è espressa in minuti, con esecuzione asincrona e in background. Il limite è di 60 minuti e la maggior parte delle attività termina entro 20 minuti.
Il 2026-03-05 un utente del forum che sviluppa ricerche di compliance ha scritto che un'esecuzione del vecchio agente aveva richiesto circa 7 minuti. Le esecuzioni successive con prompt simili sono rimaste in in_progress. Lo stream mostrava quattro o cinque step di ragionamento, poi la connessione cadeva senza errori (thread del forum per sviluppatori). Il tuo codice di polling ha bisogno di un proprio timeout per in_progress, non solo di handler per completed e failed.
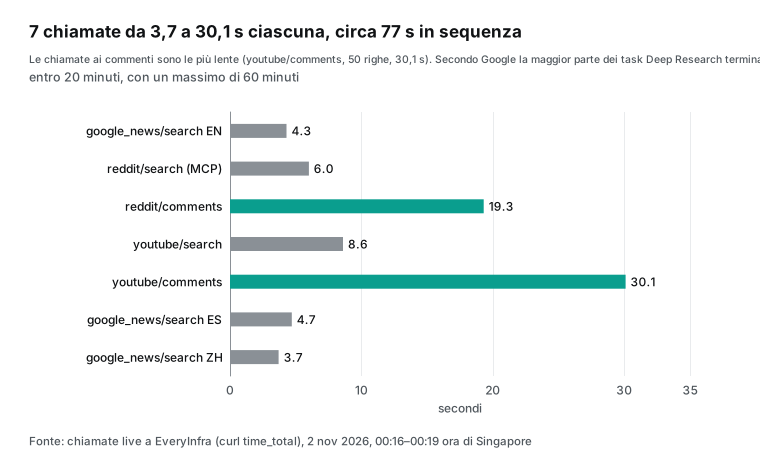
Le nostre 7 chiamate in sequenza hanno richiesto circa 77 secondi. I commenti sono stati i più lenti: 30,1 secondi per 50 commenti di YouTube e 19,3 secondi per 35 commenti di Reddit. Ogni ricerca di notizie ha richiesto da 3,7 a 4,7 secondi. Nel percorso A l'agente attende ogni chiamata, e una dozzina di chiamate per i commenti aggiunge qualche minuto a un'esecuzione che già dura parecchi minuti.
Le richieste lente, come quelle dei commenti, non dovrebbero tenere l'agente in attesa. La descrizione dello strumento everyinfra_call_api dice all'agente cosa fare: per attività lente o un limit elevato, indica di passare mode=async. L'agente riceve subito un job_id e legge il risultato con everyinfra_get_job, che è gratuito.
Ognuna delle nostre 7 risposte sincrone conteneva anche un async_hint che rimanda alla modalità asincrona, così l'agente può leggerlo. Nel percorso B il tuo programma può eseguire le chiamate in parallelo: qualche decina di chiamate si completa in uno o due minuti, e poi passi tutto a Deep Research in una volta sola.
Formato delle citazioni: url_citation, file_citation e offset in byte
Deep Research non inserisce note a piè di pagina nel testo del report, ma allega le citazioni all'array annotations dello step di output. Il riferimento della Interactions API elenca diversi tipi di annotazione (riferimento API, aggiornato il 2026-10-28), e qui ne contano due. url_citation ha quattro campi: url, title, start_index ed end_index. file_citation ha document_uri, file_name, source, custom_metadata, page_number e media_id, più gli stessi due campi di indice.
Il riferimento dice che gli indici contano byte e che end_index è esclusivo. Questo conta per qualsiasi report che contenga testo non ASCII. In UTF-8 una virgoletta tipografica occupa 3 byte e una lettera spagnola accentata 2. Se tagli la stringa Python con questi indici, ogni citazione dopo il primo carattere speciale risulta spostata. Codifica prima il testo in byte, poi taglia. Il codice qui sotto usa i nomi dei campi del riferimento ed è un esempio di configurazione.
# Configuration example: map Deep Research citations back to text spans (field names from the Interactions API reference)
def cited_spans(interaction):
    out = []
    for step in interaction["steps"]:
        if step.get("type") != "model_output":
            continue
        for block in step.get("content", []):
            if block.get("type") != "text":
                continue
            raw = block["text"].encode("utf-8")          # indexes count bytes
            for a in block.get("annotations", []):
                span = raw[a["start_index"]:a["end_index"]].decode("utf-8", "replace")
                meta = {m["key"]: m.get("string_value", m.get("numeric_value"))
                        for m in a.get("custom_metadata", [])}
                out.append({"type": a["type"], "text": span,
                            "url": a.get("url") or meta.get("source_url"),
                            "row_id": meta.get("row_id")})
    return out
Le chiamate e i risultati MCP compaiono come altri due tipi di step. mcp_server_tool_call ha name, server_name, arguments e id. mcp_server_tool_result ha call_id e result, e call_id lo collega alla chiamata. Il riferimento non dice se i risultati MCP producano voci url_citation. Quindi, nel percorso A, non dare per scontato che una frase su un thread di Reddit riporti l'URL del thread come citazione.
Un metodo più sicuro è chiedere all'agente di scrivere nella frase l'id e l'url della riga. Dopo l'esecuzione, verifica ciascuno con gli step mcp_server_tool_result salvati. Nel percorso B con File Search, il campo custom_metadata che aggiungi a ogni documento viene restituito in file_citation (documentazione di File Search, «Citations», aggiornata il 2026-10-13). È l'unico modo documentato per riportare i tuoi id di riga all'interno di una citazione.
| Da dove proviene il testo citato | Tipo di annotazione | Cosa viene restituito | Come verificare |
|---|---|---|---|
| Pagine lette da Google Search o URL Context | url_citation | URL, titolo, intervallo di byte | Apri l'URL e confronta la frase |
| I tuoi documenti in File Search | file_citation | Nome del file, custom_metadata, intervallo di byte | Usa l'id di riga nei metadati per trovare la riga grezza |
| Righe restituite da un server MCP remoto | Non documentato | mcp_server_tool_result completo negli step | Chiedi id e url nel testo, poi confronta |
Percorso A: fornisci alla Gemini Deep Research API il server MCP di EveryInfra
Il percorso A è il blocco mcp_server nell'esempio curl qui sopra. Tre campi meritano un'occhiata più da vicino. url è https://api.everyinfra.com/mcp, un endpoint HTTPS pubblico conforme alla specifica MCP datata 2026-07-28. Quella versione ha eliminato l'handshake initialize: ogni richiesta porta con sé la propria versione del protocollo, e in Streamable HTTP ogni messaggio viene inviato con una singola richiesta POST (changelog di MCP, trasporti).
headers contiene Authorization: Bearer <your EveryInfra key>. Il nostro endpoint accetta questa forma, e l'esempio nella documentazione di Google ha la stessa struttura. La specifica MCP rende l'autenticazione facoltativa, e i token OAuth 2.1 vanno nello stesso header (autorizzazione MCP). La specifica completa è nell'indice di MCP 2026-07-28, con sezioni per server, client e trasporti.
allowed_tools richiede la massima attenzione. Il 2026-11-02 alle 00:15 SGT abbiamo chiamato tools/list senza chiave, e ha restituito 12 strumenti in 16.247 byte.
Solo 3 servono per la ricerca. everyinfra_list_capabilities elenca piattaforme e funzionalità, everyinfra_call_api chiama qualsiasi funzionalità di dati ed everyinfra_get_job recupera i risultati asincroni. Gli altri 9 sono uno strumento di ricerca web e strumenti per la gestione dell'account, di cui un'attività di ricerca non ha bisogno.
Un agente di ricerca che lavora senza supervisione non trae alcun vantaggio da quei 9 strumenti. Innanzitutto, le definizioni degli strumenti consumano contesto: le 12 definizioni occupano circa 16.610 byte, mentre i 3 strumenti di ricerca ne occupano 3.309, circa l'80% in meno. Inoltre, everyinfra_call_api ha destructiveHint impostato su true perché costa denaro. Le azioni sull'account non dovrebbero partire da un'attività in background che nessuno controlla.
La sezione della specifica MCP sugli strumenti aggiunge un avvertimento: i client devono considerare non attendibili le annotazioni degli strumenti, a meno che non provengano da server attendibili (specifica degli strumenti MCP). Quindi non aspettarti che Deep Research proceda con più cautela perché vede destructiveHint. Il controllo su cui puoi contare è la allow list che scrivi in allowed_tools.
| Strumento | Dimensione della definizione (byte) | Da usare per la ricerca? | Motivo |
|---|---|---|---|
everyinfra_list_capabilities | 816 | Sì | Gratuito; consulta prima nomi e parametri |
everyinfra_call_api | 1,695 | Sì | Recupera i dati; addebitato per chiamata, nessun addebito in caso di errore |
everyinfra_get_job | 798 | Sì | Gratuito; recupera i risultati asincroni |
everyinfra_search | 2,632 | No | La ricerca web è già coperta da Google Search |


Il prompt deve funzionare insieme agli strumenti. La sezione sulle best practice della pagina di Deep Research suggerisce di dire all'agente cosa fare quando mancano dati, per esempio dichiarare che un numero è sconosciuto invece di stimarlo.
Per i dati social il prompt dovrebbe dire almeno tre cose. Primo, ogni affermazione su una piattaforma social riporta l'id e l'url della riga. Secondo, per le date non esatte l'agente scrive «circa». Terzo, l'agente chiama everyinfra_list_capabilities prima di ogni nuova funzionalità e non tira a indovinare i parametri.
La terza regola ha un motivo. EveryInfra restituisce un 422 per parametri sconosciuti e valori non validi. L'errore elenca i valori consentiti e un suggerimento, e non viene addebitato nulla. Un agente che legge l'errore può correggere da solo la chiamata, e nella prossima sezione trovi un esempio reale. Per approfondire la gestione degli errori, vedi errori API e autocorrezione. Per configurare MCP in altri client, vedi configurazione di MCP remoto e la pagina del server MCP.
Un round trip reale: cosa invia l'agente e cosa torna indietro
Non abbiamo eseguito Deep Research. Ma la specifica MCP fissa il formato della richiesta che un client invia a un server. Si tratta di una chiamata JSON-RPC tools/call che specifica il name dello strumento e gli arguments. Abbiamo inviato lo stesso formato JSON-RPC al nostro endpoint MCP con una chiave di test.
Questo mostra solo il lato server: cosa riceve il server e cosa restituisce. Non abbiamo testato il lato Deep Research. Non sappiamo quale strumento sceglie né come compila gli argomenti, e non sappiamo nemmeno come legge le righe o se le trasforma in citazioni. Per scoprirlo, esegui tu stesso un'attività e leggi mcp_server_tool_call e mcp_server_tool_result.
Il 2026-11-02 alle 00:16:51 SGT abbiamo chiamato everyinfra_call_api con platform=reddit e action=search. La query era e-bike battery fire, con sort=relevance e limit=10. La risposta è arrivata in 6,0 secondi con stato 200 e un count di 6.
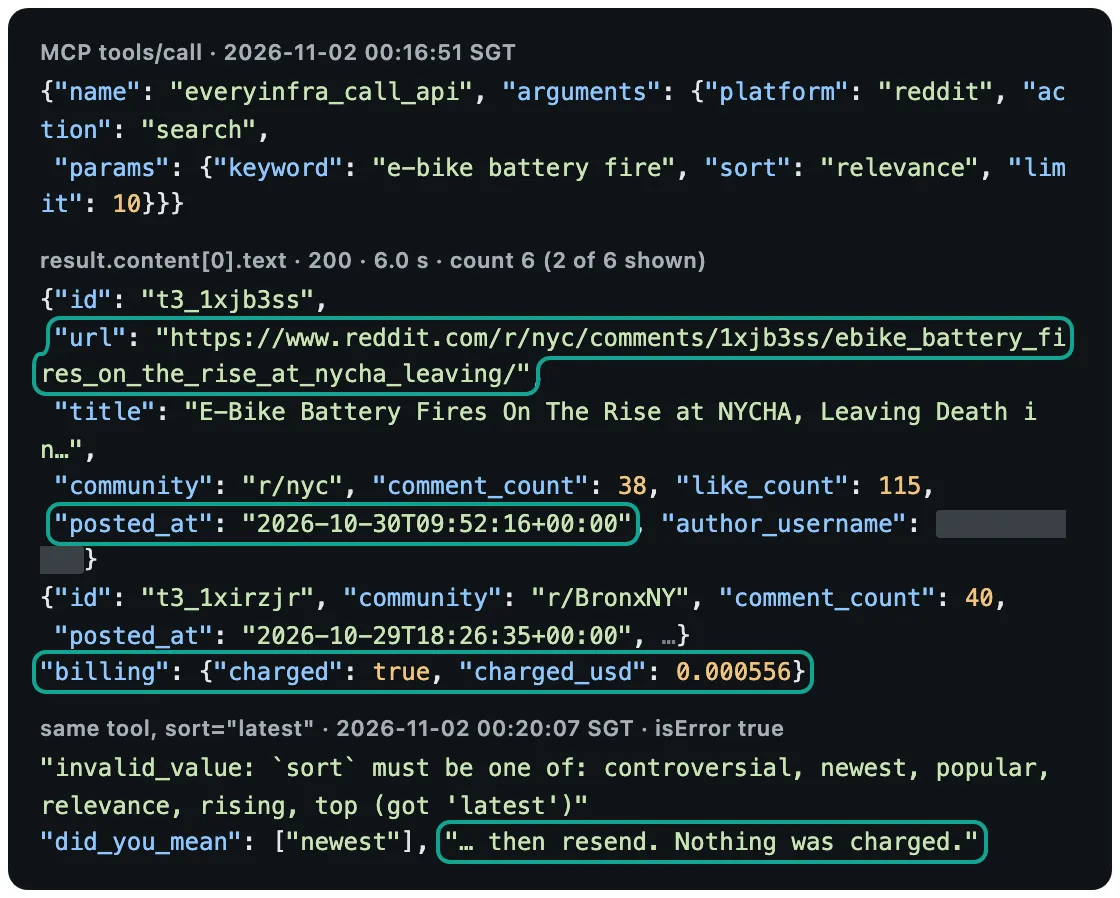
Queste 6 righe mostrano tre cose. Primo, il limit era 10 ma sono tornati solo 6 thread, perché questa funzionalità restituisce solo i thread che corrispondono alla query. Il catalogo elenca tre tipi di corrispondenza: le parole compaiono nel titolo o nel nome della community, oppure in tutto il thread, oppure una accanto all'altra nel testo. L'intervallo di tempo è fisso sull'ultimo mese.
Secondo, i 6 thread provenivano da 5 community: r/nyc, r/BronxNY, r/ebikes, r/interesting e r/MTB, con 1.293 commenti in totale. Un solo thread di r/interesting su quanto sia difficile spegnere gli incendi al litio ne aveva 1.137. Un agente che legge solo i titoli può scivolare verso un thread così popolare e allontanarsi dall'incendio del Bronx.
Terzo, ogni riga ha un url e un posted_at preciso al secondo. Tutte le verifiche più avanti in questo articolo dipendono da questi due campi. I dettagli dei campi sono nella pagina della funzionalità di ricerca su Reddit.
Nello stesso minuto abbiamo fatto due chiamate gratuite. Alle 00:20:00 SGT, everyinfra_list_capabilities per Reddit ha risposto in 0,28 secondi.
Alle 00:20:07 SGT abbiamo impostato di proposito sort su latest. La risposta è arrivata in 0,19 secondi con isError: true e il messaggio «sort must be one of: controversial, newest, popular, relevance, rising, top (got 'latest')». did_you_mean era newest, e il messaggio terminava con «Nothing was charged». Per un agente senza supervisione, questo messaggio significa che può correggere la chiamata e fare un nuovo tentativo, invece di registrare una chiamata fallita come «nessuna discussione su Reddit».
Percorso B: recupera prima i dati social strutturati, poi passali alla Gemini Deep Research API
Il percorso B toglie la raccolta dei dati dalle mani dell'agente e la affida al tuo programma. Tra le 00:16 e le 00:19 SGT abbiamo fatto 7 chiamate a pagamento per un report, che coprivano notizie in tre lingue, thread e commenti di Reddit, video e commenti di YouTube. La tabella qui sotto elenca ogni chiamata, e charged_usd è il valore del campo billing.
| Tempo | Funzionalità | Parametri principali | Righe | Addebitato | Tempo impiegato |
|---|---|---|---|---|---|
| 00:16:32 SGT | google_news/search | e-bike battery fire, us / en, ultimo mese | 10 | $0.000792 | 4.3 s |
| 00:16:51 SGT | reddit/search (tramite MCP) | incendio batteria e-bike, pertinenza | 6 | $0.000556 | 6.0 s |
| 00:17:23 SGT | reddit/comments | Un thread di r/nyc, limit 50 | 35 | $0.000556 | 19.3 s |
| 00:18:02 SGT | youtube/search | incendio batteria e-bike, pertinenza | 10 | $0.000556 | 8.6 s |
| 00:18:29 SGT | youtube/comments | Un video dell'FDNY, popular, limit 50 | 50 | $0.000556 | 30.1 s |
| 00:19:16 SGT | google_news/search | «incendio batería bicicleta eléctrica» (incendio della batteria di una bici elettrica), mx / es | 10 | $0.000792 | 4.7 s |
| 00:19:36 SGT | google_news/search | Query in cinese sugli incendi delle batterie delle e-bike, hk / zh | 10 | $0.000792 | 3.7 s |
| Totale | 5 funzionalità | — | 131 | $0.004600 | 76.9 s |
Parametri, valori consentiti e campi di queste 5 funzionalità si trovano nel catalogo per piattaforma, e non serve una chiave. Vedi il catalogo di Reddit, il catalogo di YouTube e il catalogo di Google News. Prezzi, valori massimi di limit e note sui campi in questo articolo provengono da questi cataloghi al 2026-11-02. Usa il valore price_usd del catalogo nel giorno in cui fai la chiamata.
Dopo le chiamate, trasforma righe con campi diversi in un'unica tabella in cui ogni riga sia verificabile. Mantieni almeno sei colonne. row_id unisce la piattaforma e l'id di origine, per esempio reddit:t3_1xjb3ss. source_url apre esattamente quell'elemento. Poi aggiungi platform, published_at, date_precision e fetched_at. date_precision indica secondo, giorno, settimana o sconosciuta, e fetched_at è l'ora della tua chiamata. I quattro test qui sotto mostrano perché la colonna della precisione è necessaria.
Puoi passare la tabella in due modi. Il primo è inserirla in input.
Deep Research accetta input multimodale, e il blog di Google elenca PDF, CSV, immagini, audio e video. La documentazione passa i file come {"type": "document", "uri": ..., "mime_type": "application/pdf"}. Una tabella di 131 righe vale circa 20.000 token, poco per una finestra da un milione di token. Il secondo modo è uno store di File Search: carica ogni riga o fonte come documento, con row_id, source_url e date_precision in custom_metadata. Le citazioni tornano poi come voci file_citation che riportano quei campi.
# Configuration example: turn EveryInfra responses into checkable rows for Deep Research (Gemini side not run)
import csv

def rows_from(resp, platform, fetched_at):
    for r in resp["results"]:
        url = r.get("url")
        if platform == "youtube_comments":            # comment rows have no url, so build one from the video url and comment id
            url = f'{resp["_video_url"]}&lc={r["id"]}'
        exact = isinstance(r.get("posted_at"), str) and r["posted_at"][:4].isdigit()
        yield {"row_id": f'{platform}:{r.get("id") or r.get("rank")}',
               "source_url": url, "platform": platform,
               "published_at": r.get("posted_at") or r.get("published_at") or "",
               "date_precision": "second" if exact and platform != "news" else ("day" if exact else "unknown"),
               "fetched_at": fetched_at,
               "text": (r.get("title") or r.get("text") or "")[:500]}

with open("evidence.csv", "w", newline="") as f:
    w = csv.DictWriter(f, fieldnames=["row_id", "source_url", "platform", "published_at",
                                      "date_precision", "fetched_at", "text"])
    w.writeheader()
    # for each saved response: w.writerows(rows_from(resp, "...", "2026-11-02T00:16:51+08:00"))
Su un punto le pagine di Google si contraddicono, quindi verificalo prima. Le limitazioni di File Search dicono che gli strumenti di retrieval integrati non si possono combinare: per esempio, File Search non può essere usato con Google Search o URL Context nella stessa richiesta. Ma il blog di Google dice che Deep Research può usare contemporaneamente Google Search, MCP remoto, URL Context, esecuzione del codice e File Search. L'esempio di File Search nella pagina di Deep Research confronta report interni con notizie recenti dal web, ma il suo codice attiva solo File Search.
Finché Google non lo chiarisce, esegui una piccola attività sia con file_search sia con google_search. Se fallisce, inserisci la tabella in input, non in File Search.
Test 1: le date delle notizie derivano da etichette «giorni fa»
I risultati in inglese e cinese di google_news/search riportano published_at come timestamp ISO completo, che sembra esatto. Ma tutti e 10 i risultati in inglese avevano l'orario 16:16:35 UTC, e tutti e 10 quelli in cinese 16:19:38 UTC. Avevamo inviato quelle richieste alle 16:16:32 e alle 16:19:36 UTC, cioè alle 00:16 e alle 00:19 SGT. Il campo è quindi l'ora della richiesta meno un valore «giorni fa»: la parte della data ha un significato, l'orario no.
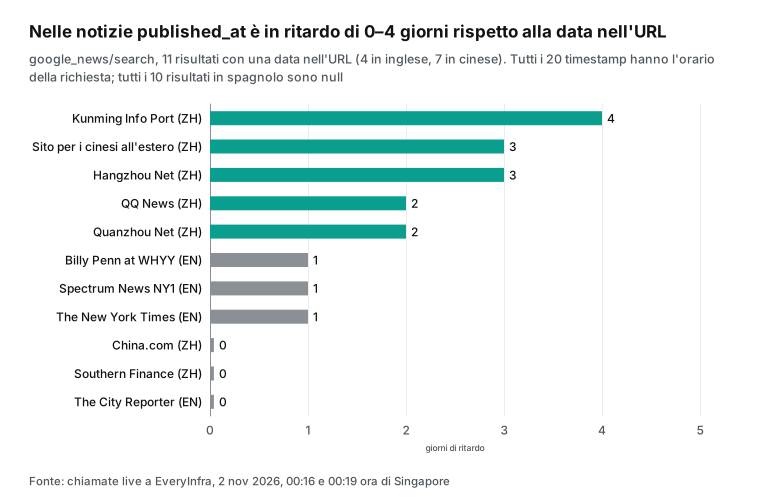
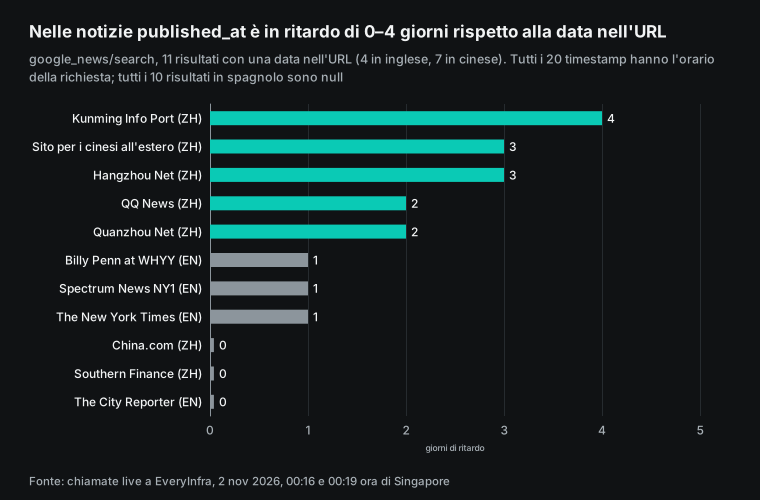
Abbiamo confrontato la parte della data con le date nel percorso dell'URL. Dei 4 risultati in inglese con un URL datato, 3 erano in ritardo di 1 giorno e 1 coincideva. L'articolo del New York Times aveva 2026/10/28 nell'URL, mentre published_at indicava 2026-10-29. L'articolo di NY1 riportava 10/30 nell'URL e 2026-10-31 nel campo. Billy Penn aveva 10/17 nell'URL e 2026-10-18 nel campo. The City Reporter coincideva.
| Testata in inglese | Data nell'URL | Data di `published_at` | Giorni di ritardo |
|---|---|---|---|
| The New York Times | 2026-10-28 | 2026-10-29 | 1 |
| Spectrum News NY1 | 2026-10-30 | 2026-10-31 | 1 |
| Billy Penn at WHYY | 2026-10-17 | 2026-10-18 | 1 |
| The City Reporter | 2026-10-30 | 2026-10-30 | 0 |
I risultati in cinese si discostavano di più, fino a 4 giorni, il che fa pensare a etichette meno precise come «1 settimana fa». I risultati in spagnolo erano peggiori in un altro modo: tutti e 10 avevano published_at impostato su null, e solo un URL spagnolo conteneva una data.
L'effetto su un report è concreto. Supponi che il report dica che le testate in inglese hanno coperto l'incendio del Bronx entro un giorno. Le date in inglese possono essere in ritardo di 1 giorno, quindi quell'affermazione richiede la data dell'URL o l'articolo stesso.
Le date in spagnolo sono vuote, quindi una cronologia in spagnolo non può basarsi affatto su questo campo. Nella tabella imposta date_precision su «giorno, possibile ritardo di 1 giorno» per l'inglese e su «sconosciuta» per lo spagnolo. Preferisci la data dell'URL quando l'URL ne contiene una. Le note sui campi sono nella pagina della funzionalità di ricerca su Google News.
Test 2: un incendio, quattro fonti, tre bilanci delle vittime
Righe verificabili non sempre concordano tra loro, e l'incendio del Bronx mostra perché. Il 2026-10-28 il New York Times ha riferito che un incendio causato dalla batteria di una e-bike in un appartamento delle Patterson Houses aveva ucciso un ragazzo di 11 anni. La commissaria dei vigili del fuoco Lillian Bonsignore ha detto che era il 401° incendio di batterie di e-bike dell'anno (The New York Times, 2026-10-28). Lo stesso giorno Gothamist ha riportato la conclusione dell'FDNY (Gothamist, 2026-10-28).
Il 2026-10-31 il New York Daily News ha riferito che altre 3 persone coinvolte nello stesso incendio erano morte, e ha indicato in 9 i decessi dell'anno per incendi di batterie al litio (New York Daily News, 2026-10-31). Spectrum Noticias, testata in spagnolo, ha citato i numeri forniti in precedenza dalla commissaria: 401 incendi, 74 feriti e 6 morti quest'anno, contro 292 incendi, 51 feriti e 1 morto l'anno scorso (Spectrum Noticias, 2026-10-31). Il 2026-10-14 Streetsblog NYC aveva riportato 5 morti fino a quel momento e un aumento del 41% degli incendi (Streetsblog NYC, 2026-10-14).
| Fonte | Pubblicato | Incendi quest'anno | Morti quest'anno | Fonte del numero |
|---|---|---|---|---|
| Streetsblog NYC | 2026-10-14 | In aumento del 41% | 5 | Dati FDNY |
| The New York Times | 2026-10-28 | 401° incendio | Nessun totale annuo | Commissario dei vigili del fuoco |
| Spectrum Noticias | 2026-10-31 | 401 | 6 | Commissario, briefing del 2026-10-28 |
| New York Daily News | 2026-10-31 | 401 (dato aggiornato alla settimana scorsa) | 9 | Funzionari dell'FDNY |
Questi numeri non sono in contraddizione. Sono istantanee dello stesso dato in momenti diversi. Il conteggio era di cinque a metà ottobre e di sei il giorno dell'incendio, per poi salire a nove dopo altri tre decessi. Ma supponi che un report dica «i media in lingua spagnola hanno riportato 6 morti quest'anno» e rimandi all'articolo del 2026-10-31. Il lettore apre il link e la citazione corrisponde, ma il dato è già superato.
Per questo la tabella ha bisogno di un'altra colonna per i numeri: quando il numero è stato dichiarato, non solo quando è uscito l'articolo. La ricerca lo conferma. Uno studio di maggio 2026 ha valutato 14 modelli su report di deep research. I link delle citazioni erano validi in oltre il 94% dei casi e pertinenti in oltre l'80%. L'accuratezza fattuale, però, si fermava tra il 39% e il 77% (arXiv 2605.06635).
Lo stesso studio ha rilevato che l'accuratezza della verifica dei fatti cala in media di circa il 42% quando le chiamate ai tool passano da 2 a 150. Un link funzionante non dimostra che la frase sia corretta. I numeri nella tabella qui sopra provengono da articoli di cronaca e mostrano come le citazioni diventano obsolete. Per i numeri esatti su incendi e vittime, usa i comunicati ufficiali dell'FDNY. L'articolo di The City Reporter sugli incendi nelle case popolari, datato 2026-10-30, è un'altra fonte che un report potrebbe citare (The City Reporter, 2026-10-30).
Test 3: un commento rimanda alla sua fonte? Reddit 35 su 35, YouTube 0 su 50
Oltre alle notizie, gran parte della ricerca sui social riguarda i commenti. Abbiamo raccolto due set. Il primo comprendeva i commenti al thread di r/nyc sugli incendi di e-bike nelle case popolari. Il secondo comprendeva i commenti più popolari a un video YouTube dell'FDNY sull'incendio di un negozio di e-bike. I due set si sono rivelati molto diversi in termini di tracciabilità.
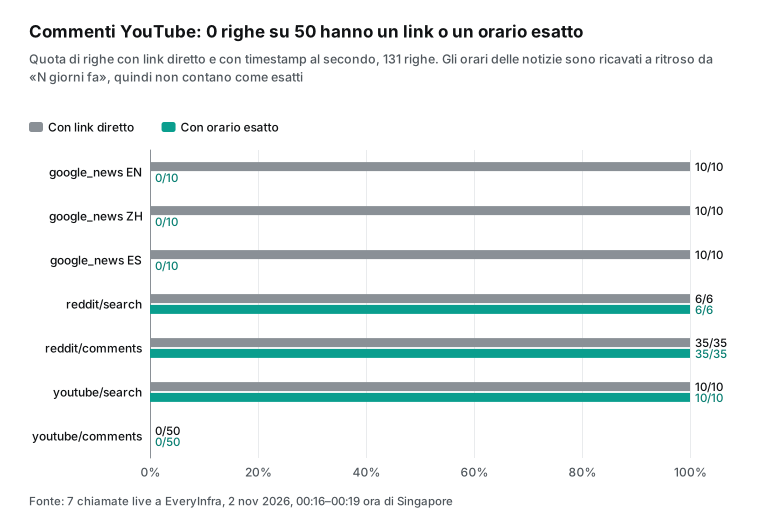
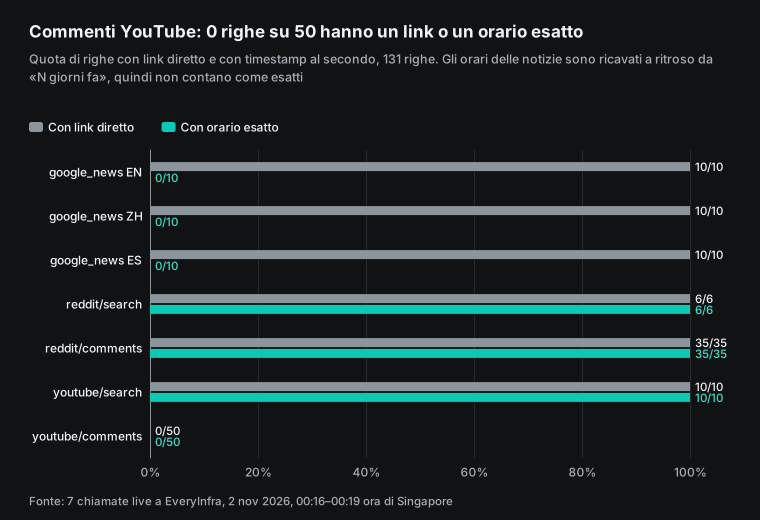
Ognuno dei 35 commenti Reddit aveva un url nella forma reddit.com/r/nyc/comments/1xjb3ss/comment/19rvuy7xzfh7n/. Aprendolo si vede quel singolo commento. Ogni posted_at era preciso al millisecondo, per esempio 2026-10-30T14:43:08.086000+00:00. Un report che dice «i commentatori di r/nyc hanno detto ...» può rimandare a quel commento esatto, e il lettore può verificarlo con un clic.
Il thread mostrava 38 commenti e ne abbiamo ottenuti 35. Quelli mancanti potrebbero essere stati eliminati o nascosti. Abbiamo analizzato perché i conteggi dei commenti Reddit non coincidono in completezza dei commenti Reddit. Il thread di r/nyc è pubblico (thread di r/nyc).
I 50 commenti YouTube non avevano il campo url. posted_at conteneva orari relativi come «1 year ago» o «7 months ago». Dei 50, 15 riportavano «year», 4 «(edited)» e 14 erano risposte.
Questo ha due conseguenze. Primo, non puoi linkare direttamente un commento. Nella nostra tabella abbiamo costruito il link combinando l'URL del video con &lc=<comment id>. È un modo comune per aprire un commento sul sito di YouTube. Tuttavia, il link non è presente tra i campi restituiti e non abbiamo trovato documentazione di Google per quel parametro, quindi lo contrassegniamo come «costruito».
| Verifica dei campi | Commenti Reddit (35 righe) | Commenti YouTube (50 righe) |
|---|---|---|
url diretto per ogni commento | 35 | 0 |
posted_at assoluto | 35, con precisione al millisecondo | 0, solo indicazioni temporali relative |
| Indicazioni temporali che contengono «year» | 0 | 15 |
| Contrassegnati «(edited)» | Non indicato | 4 |
| Risposte nel set | Visibili nel thread | 14 |
Secondo, «1 year ago» è preciso solo all'anno o al mese, e solo rispetto al momento della richiesta. Un report sulla «discussione su YouTube nell'ultimo mese» può confermare solo 4 di questi 50 commenti: «1 hour ago», «2 weeks ago» e due «3 weeks ago». Le note del catalogo per youtube/comments indicano che il parametro since filtra per data del commento, quindi puoi limitare l'intervallo già in fase di raccolta. La paginazione delle risposte è trattata in risposte ai commenti YouTube e paginazione. I dettagli dei campi sono nella pagina della funzionalità commenti YouTube.
Test 4: la ricerca per pertinenza di YouTube restituisce soprattutto video vecchi
Il problema del tempo è ancora più evidente nei risultati di ricerca di YouTube. Abbiamo usato la stessa query, e-bike battery fire, nello stesso minuto. Tutti e 10 i risultati di notizie erano degli ultimi 30 giorni. I primi 10 risultati di youtube/search per pertinenza erano 2 del 2022, 4 del 2023, 2 del 2024, 1 del 2025 e 1 del 2026. L'anno mediano era il 2023. L'unico video del 2026 era stato pubblicato il 2026-09-09, quindi anch'esso fuori dagli ultimi 30 giorni.
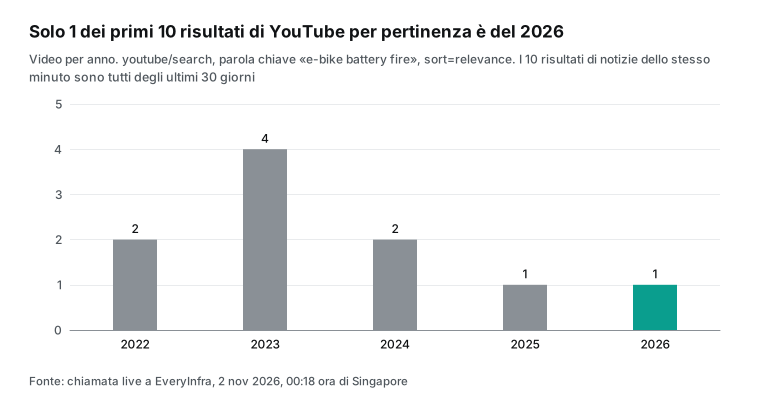
I dati non sono sbagliati. Il ranking per pertinenza di YouTube favorisce i video con molte visualizzazioni e pubblicati da molto tempo. Il più visto dei 10 aveva 510.000 visualizzazioni ed era del 2022. Ma supponi che un agente consideri i commenti a questi 10 video come l'opinione pubblica attuale. Il suo report mescolerà discussioni di tre o quattro anni fa.
La soluzione è semplice. Per le discussioni recenti, usa sort=newest oppure filtra le righe per posted_at nella tua tabella. Per le discussioni di lungo periodo, indica l'intervallo temporale nel report. Parliamo di questo tipo di distorsione del campione in integrità del campione nella ricerca sui social media. I campi della ricerca sono nella pagina della funzionalità di ricerca YouTube.
Budget di contesto: 131 righe, circa 20.000 token, l'8% di un task tipico
Il percorso B mette i dati nell'input, quindi devi conoscerne la dimensione. Il JSON grezzo delle nostre 7 chiamate pesava 79.787 byte. A circa 4 byte per token, sono 19.947 token. La pagina del modello indica una finestra di input di 1.048.576 token e un limite di output di 65.536 token. La documentazione stima circa 250.000 token di input per un task standard e circa 900.000 per un task Max. I nostri dati sono l'8% dell'input di un task tipico, quindi lasciano all'agente molto spazio per le sue ricerche e letture.
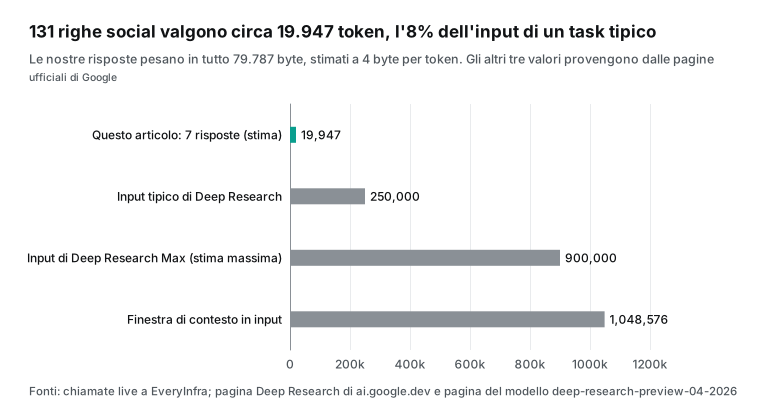
Una tabella ripulita è ancora più piccola. Le risposte grezze contengono molti campi che non servono alla ricerca, come gli URL delle miniature, le statistiche del canale e i dettagli di fatturazione. Con le nostre sei colonne e al massimo 500 caratteri di testo, 131 righe scendono a meno della metà della dimensione grezza.
C'è però anche il rischio opposto. Le best practice dicono che l'input multimodale aumenta i costi e può saturare il contesto. Il vero rischio non è rappresentato da 131 righe, ma da mille commenti provenienti da decine di thread. Con volumi simili, filtra prima per argomento e periodo oppure usa File Search per il retrieval, prima di inserire le righe in input.
Come i dati social strutturati rendono verificabili le citazioni
I quattro test portano a un metodo semplice. L'obiettivo è che il lettore possa ricondurre ogni affermazione sui social media a una singola riga. La riga deve indicare dove si trova l'elemento sulla piattaforma e quanto è preciso il suo orario.
Primo, ogni riga deve contenere un link che apra l'elemento. I thread e i commenti di Reddit, i video di YouTube e le notizie rispettano questa regola. I commenti di YouTube no: costruisci quindi il link dall'URL del video e dall'ID del commento e contrassegnalo come «costruito». Secondo, per ogni riga va indicata la precisione temporale. In questo test abbiamo osservato quattro livelli: millisecondi per i commenti Reddit, secondi per i thread Reddit e i video YouTube, giorni per le notizie in inglese. L'ultimo livello, con indicazioni temporali relative o assenti, riguardava i commenti YouTube e le notizie in spagnolo.
Terzo, registra fetched_at, il momento in cui hai effettuato la chiamata. Le indicazioni temporali relative e i numeri come «il 401° incendio di quest'anno» hanno senso solo se associati a quel momento.
Quarto, per un'affermazione che contiene un numero devi registrare «chi l'ha detto e quando». L'esempio del conteggio dei morti mostra che un link funzionante non garantisce che il numero sia aggiornato. Quinto, riporta l'ID della riga nella citazione. Con File Search, inseriscilo in custom_metadata. Con MCP o input, chiedi all'agente di scrivere row_id dopo ogni frase.
| Cosa abbiamo trovato | Rischio per il report | Cosa fare nella tabella |
|---|---|---|
Il published_at delle notizie usa l'orario della richiesta; in inglese, le date hanno un ritardo compreso tra 0 e 1 giorno | Cronologia errata | date_precision=day; preferisci la data nell'URL |
| Tutte e 10 le date delle notizie in spagnolo sono vuote | Impossibile ricostruire una cronologia | date_precision=unknown; apri l'articolo per vederne la data |
| Commenti YouTube: 0 su 50 con link, orari relativi | La citazione non porta alla fonte | Costruisci il link e segnalalo; limita il periodo con since o sort |
| Ricerca per pertinenza su YouTube: 9 su 10 precedenti al 2026 | Discussioni vecchie lette come attuali | Filtra per posted_at oppure usa sort=newest |
| Conteggi dei morti pari a 5, 6 e 9 in date diverse | Link valido, dato superato | Aggiungi una colonna «quando è stato dichiarato il numero» |
| Ricerca Reddit: 6 thread da 5 community, uno con 1.137 commenti | L'agente devia verso un argomento secondario popolare | Conserva community e filtra per argomento |
Nessuno di questi passaggi richiede una nuova funzionalità di Gemini. Bastano i tipi di citazione attuali: url_citation per le pagine web e file_citation con metadati per File Search. Mancano invece dati di input verificabili. Per questo consigliamo il percorso B quando puoi usarlo.
Nel percorso A, l'agente riceve le risposte grezze. Che si accorga o meno che gli orari dei commenti YouTube sono relativi dipende dal suo giudizio in quell'esecuzione. Nel percorso B, il tuo programma prende queste decisioni una volta sola e le registra nelle stesse colonne per ogni riga. L'agente deve solo citarle.
Controlla il catalogo: 10 funzionalità di commento su 38 restituiscono un link
Il test 3 riguardava solo Reddit e YouTube. Per capire se i commenti su altre piattaforme riportano alla fonte, non serve una chiamata dal vivo su ciascuna. Il catalogo gratuito elenca i response_fields di ogni funzionalità. Abbiamo letto GET /api/v1/social/catalog il 2026-11-02 alle 00:28 SGT. Elencava 573 funzionalità, di cui 569 disponibili. Tra quelle disponibili, 38 sono funzionalità di commento, con comment o replies nel nome dell'azione.
Tutte e 38 elencano un campo temporale (posted_at o created_at). Ma solo 10 restituiscono un url per ogni commento. Le altre 28 non hanno link. Di queste 28, 27 restituiscono almeno un id del commento. In questi casi puoi costruire un link dall'indirizzo del post e dall'id, come abbiamo fatto per YouTube. Una funzionalità non restituisce né un link né un id del commento.
| Funzionalità di commento | `url` in ogni riga | Funzionalità (nomi del catalogo) |
|---|---|---|
| Con link | 10 | reddit/comments, reddit/user_comments, twitter/comments, threads/comments, instagram/comments, linkedin/comments, github/issue_comments, netease_music/comments, gab/replies, truth_social/replies |
| Senza link, id del commento presente | 27 | Include youtube/comments, tiktok/comments, facebook/comments, weibo/comments, douyin/comments e xiaohongshu/comments |
| Né link né id del commento | 1 | naver/comments |
Quindi, nella tua tabella la colonna dei link deve prevedere due valori: «link alla fonte» e «link al post con ID del commento». Nel secondo caso, chiedi all'agente di scrivere «vedi i commenti sotto questo post». Non lasciare che il report suggerisca che il lettore possa raggiungere direttamente il commento con un clic.
Un campo nel catalogo non dimostra che il valore sia preciso. Il catalogo elenca posted_at anche per youtube/comments, ma la nostra chiamata dal vivo ha restituito orari relativi come «1 year ago». Il catalogo ti dice se un campo esiste. Una chiamata dal vivo ti dice quanto è preciso. Il catalogo è gratuito e in MCP corrisponde a everyinfra_list_capabilities, quindi il tuo prompt può chiedere all'agente di consultarlo prima di raccogliere i commenti.
Un secondo esempio per chi legge da New York: la sicurezza delle batterie oltre un singolo incendio
Lo stesso metodo funziona per argomenti correlati. Dal 2023 New York gestisce un programma sulla sicurezza delle batterie al litio. La pagina dell'ufficio del sindaco del 2024-07 riporta un dato sul 2023. Quell'anno, il 59% degli incendi di batterie al litio è partito da batterie che non erano in carica (NYC Mayor's Office, 2024-07).
Altre città affrontano lo stesso problema. Un articolo esplicativo della CBC di ottobre 2026 raccoglie i consigli dei vigili del fuoco (CBC, 2026-10). Billy Penn si è occupato della sicurezza antincendio a Filadelfia il 2026-10-17 (Billy Penn at WHYY, 2026-10-17).
Un report su come sono cambiati nel tempo i consigli pubblici mescolerebbe tre tipi di righe. Le pagine del comune forniscono dichiarazioni ufficiali con date fisse. Le notizie forniscono articoli datati, ma nel nostro test le date erano in ritardo fino a 1 giorno. I post social forniscono opinioni, con orari esatti su Reddit e relativi su YouTube. Ogni tipo ha bisogno del proprio date_precision e il prompt dovrebbe chiedere all'agente di non mescolarli in un'unica cronologia senza una nota.
Cosa non funziona e a cosa fare attenzione
Primo, non puoi chiedere un output strutturato. La limitazione è esplicita, quindi «restituisci una tabella JSON» non funzionerà. Per ottenere risultati elaborabili automaticamente, chiedi una tabella Markdown con struttura fissa e analizzala. Oppure segui la documentazione e usa previous_interaction_id con un modello standard. Nell'esempio la documentazione usa gemini-4-argon, e i modelli standard supportano l'output strutturato.
Secondo, le versioni degli agenti vengono ritirate. Entrambi i nomi attuali degli agenti contengono preview e 04-2026. L'agente di dicembre 2025, deep-research-pro-preview-12-2025, è stato deprecato il 2026-10-08 e spento il 2026-10-23, circa dieci mesi e mezzo dopo il lancio (changelog, deprecations). Tieni il nome dell'agente nella configurazione, non nel codice.
Terzo, i risultati di Google Search hanno regole d'uso. I termini aggiuntivi dell'API Gemini stabiliscono che i risultati di Grounding with Google Search vanno mostrati all'utente finale insieme ai suggerimenti di ricerca. Inoltre non devono essere memorizzati in cache, rivenduti, analizzati o usati per l'addestramento. Alcuni casi consentono la conservazione fino a due anni (termini aggiuntivi dell'API Gemini). Se archivi o riutilizzi i report, leggi prima quella sezione. Riguarda i risultati di Google Search, mentre i dati del tuo server MCP o dei tuoi file seguono i propri termini. Questo articolo non costituisce consulenza legale.
Quarto, pensa alla sicurezza. La sezione sulla sicurezza della pagina Deep Research indica tre rischi: prompt injection nei file, contenuti web pericolosi e fughe di dati quando l'agente legge insieme dati interni e web. I commenti social sono testo pubblico degli utenti e possono contenere istruzioni rivolte all'AI. Il nostro server MCP restituisce il testo degli utenti così com'è, quindi chiedi all'agente di trattare il testo dei commenti come dati, non come istruzioni.
La tua chiave EveryInfra in headers arriva al nostro server a ogni richiesta MCP. Crea una chiave separata con un limite di spesa per Deep Research. Così potrai disattivare solo quella chiave.
Quinto, leggi usage per conoscere il costo. È l'agente a decidere quanto leggere e cercare, quindi in anticipo puoi solo fare una stima. Google suggerisce di limitare l'ambito nel prompt.
Sul forum per sviluppatori di Google, il product manager della funzionalità ha risposto a un utente. L'utilizzo finale compare nel campo usage dell'oggetto Interaction, e countTokens non funziona con gli agenti (thread del forum per sviluppatori, 2025-12-21). Da parte nostra, ogni risposta mostra il costo in billing.charged_usd. Risultati vuoti ed errori sono gratuiti, come spiega la pagina dei prezzi.
Sesto, URL Context ha dei limiti. La documentazione dice che gestisce fino a 20 URL per richiesta e fino a 34 MB per URL. Non supporta i contenuti protetti da paywall né i video di YouTube (documentazione di URL Context). Deep Research non può quindi ottenere i commenti leggendo la pagina di un video di YouTube. Per questo devi prima recuperarli con youtube/comments.
| Limite | Cosa dice la documentazione | Cosa fare invece |
|---|---|---|
| Output strutturato | Non supportato | Analizza una tabella Markdown con struttura fissa o passa il risultato a un modello standard |
| Versione dell'agente | Nomi preview; l'agente di dicembre 2025 è stato spento il 2026-10-23 | Tieni il nome dell'agente nella configurazione |
| Risultati di Google Search | Da mostrare con i suggerimenti di ricerca; niente cache né analisi | Leggi i termini prima di archiviare i report |
| Prompt injection | Indicata come rischio per file e pagine web | Chiedi all'agente di trattare il testo dei commenti come dati |
| Costo | Noto solo dopo l'esecuzione, in usage | Limita l'ambito; usa una chiave EveryInfra separata con un tetto di spesa |
| URL Context | 20 URL, 34 MB ciascuno, niente video YouTube | Raccogli prima i commenti con youtube/comments |
Modifiche recenti
Il 2026-10-27 Google ha rilasciato gemini-api, uno strumento a riga di comando in beta. Chiama l'Interactions API e gli agenti ospitati da script e CI (documentazione della Gemini API CLI). Per te, un report Deep Research pianificato non richiede un programma Python. Bastano un comando e uno scheduler.
Il 2026-10-23 il vecchio agente Deep Research è stato spento e il 2026-10-13 Gemini 4 Argon ha raggiunto la disponibilità generale. Per te, il codice che usa ancora il nome dell'agente di dicembre non funziona più. Cambialo in deep-research-preview-04-2026.
FAQ
Come posso chiamare l'API Gemini Deep Research da Python?
Usa il pacchetto google-genai. L'Interactions API richiede la versione 2.3.0 o successiva (Interactions API overview), e il codice sorgente è nel repository python-genai. Chiama client.interactions.create(agent="deep-research-preview-04-2026", input=..., background=True). Richiama quindi client.interactions.get(id) in un ciclo finché lo stato non è completed o failed. Per aggiungere MCP, inserisci {"type": "mcp_server", "url": ..., "headers": ...} in tools. Questa domanda nasce dalla frase di completamento automatico di Google «gemini deep research api python».
Come funzionano i prezzi dell'API Gemini Deep Research, e c'è un piano gratuito?
Non esiste un prezzo dedicato. Paghi l'inferenza del modello più i tool, e Google stima da 1 a 3 $ per task standard e da 3 a 7 $ per task Max. Il blog di Google dice che la public preview è disponibile sui piani a pagamento, quindi la fatturazione deve essere attiva. Google Search include 5.000 ricerche gratuite al mese; poi costano 14 $ per 1.000 ricerche. Questa domanda nasce dalle frasi di completamento automatico «gemini deep research api pricing» e «deep research api free».
Posso usare l'API Gemini Deep Research su Vertex?
Sì. Google Cloud ha una propria pagina su Deep Research. Usa l'endpoint globale v1beta1 su aiplatform.googleapis.com, i token di accesso di Google Cloud e l'opzione service_tier="deferred" a metà prezzo. La pagina dei prezzi indica su Vertex una quota predefinita di Google Search di 1.000.000 al giorno. Il valore predefinito della Gemini Developer API è 1.500 al giorno (documentazione sul grounding di Vertex). Questa domanda nasce dalla frase di completamento automatico «gemini deep research api vertex».
Cosa faccio quando un task Deep Research resta in_progress?
Un utente del forum lo ha segnalato a marzo 2026 con il vecchio agente. L'interazione partiva, ma restava in_progress senza alcun utilizzo. La documentazione suggerisce lo streaming con un last_event_id salvato, così puoi riprendere dopo un'interruzione. Aggiungi anche un tuo timeout. Dopo 60 minuti, il massimo documentato, annulla il task e registralo nei log. Questa domanda nasce dal thread del forum e dalla frase di completamento automatico «gemini deep research stuck on starting research».
Deep Research può leggere da solo i commenti di Reddit o YouTube?
Può leggere pagine pubbliche con Google Search e URL Context. Ma la documentazione di URL Context dice che i video YouTube non sono supportati, e i commenti che si caricano in un secondo momento sulla pagina potrebbero non comparire. Per dati stabili sui commenti, fornisci all'agente righe strutturate tramite MCP o una tabella preparata, da reddit/comments e youtube/comments. Questa domanda nasce da thread di Reddit che chiedono se esista un vero tool di deep research per MCP (thread di r/LocalLLM).
Dove vanno la chiave API di Gemini Deep Research e la chiave EveryInfra?
Metti la chiave Gemini nell'header x-goog-api-key, oppure lascia che l'SDK legga GEMINI_API_KEY dall'ambiente. Metti la chiave EveryInfra negli headers del tool mcp_server come Authorization: Bearer <key>. Non inserire nessuna delle due chiavi nel testo del prompt. Questa domanda nasce dalla frase di completamento automatico «gemini deep research api key».
Come iniziare
Primo, registrati su EveryInfra e ottieni una chiave API. Puoi sfogliare il catalogo e provare gratis una chiamata nel marketplace dei dati, e la guida rapida è nella documentazione. Secondo, all'inizio lascia da parte Gemini. Chiama reddit/search o google_news/search con curl e verifica che url, posted_at e billing somiglino agli esempi qui. Le pagine delle piattaforme sono API per i dati di Reddit, API per i dati di YouTube e API di Google News.
Terzo, usa l'esempio del percorso A. Inserisci https://api.everyinfra.com/mcp nei tools di Deep Research e lascia solo 3 tool in allowed_tools. Esegui una ricerca su un argomento circoscritto e controlla i passaggi mcp_server_tool_call. Quarto, usa il percorso B quando ti serve un report verificabile dai lettori. Raccogli i dati, costruisci le sei colonne e passa la tabella a Deep Research. Per la raccolta di dati in parallelo con i subagenti, vedi subagenti di Claude Code per account TikTok. Per la nuova specifica MCP in produzione, vedi specifica MCP 2026 e preparazione alla produzione.
Riferimenti
- «Gemini Deep Research agent», Google AI for Developers, aggiornato il 2026-10-13, https://ai.google.dev/gemini-api/docs/deep-research
- «Deep Research preview model page», Google AI for Developers, aggiornato il 2026-10-29, https://ai.google.dev/gemini-api/docs/models/deep-research-preview-04-2026
- «Interactions API overview», Google AI for Developers, aggiornato il 2026-10-15, https://ai.google.dev/gemini-api/docs/interactions-overview
- «Interactions API reference», Google AI for Developers, aggiornato il 2026-10-28, https://ai.google.dev/api/interactions-api
- «Background execution», Google AI for Developers, https://ai.google.dev/gemini-api/docs/background-execution
- «Gemini Developer API pricing», Google AI for Developers, aggiornato il 2026-10-30, https://ai.google.dev/gemini-api/docs/pricing
- «Rate limits», Google AI for Developers, aggiornato il 2026-10-28, https://ai.google.dev/gemini-api/docs/rate-limits
- «File Search», Google AI for Developers, aggiornato il 2026-10-13, https://ai.google.dev/gemini-api/docs/file-search
- «Grounding with Google Search», Google AI for Developers, aggiornato il 2026-10-28, https://ai.google.dev/gemini-api/docs/google-search
- «URL context», Google AI for Developers, aggiornato il 2026-10-13, https://ai.google.dev/gemini-api/docs/url-context
- «Gemini API changelog», Google AI for Developers, voce del 2026-10-30, https://ai.google.dev/gemini-api/docs/changelog
- «Gemini deprecations», Google AI for Developers, aggiornato il 2026-10-22, https://ai.google.dev/gemini-api/docs/deprecations
- «Gemini API CLI», Google AI for Developers, aggiornato il 2026-10-28, https://ai.google.dev/gemini-api/docs/cli
- «Billing», Google AI for Developers, https://ai.google.dev/gemini-api/docs/billing
- «Gemini API Additional Terms of Service», Google, https://ai.google.dev/gemini-api/terms
- «Gemini Deep Research agent», documentazione di AI Studio, Google, https://aistudio.google.com/docs/deep-research
- «Use the Gemini Deep Research Agent», Google Cloud, https://docs.cloud.google.com/gemini-enterprise-agent-platform/agents/use-deep-research
- «Grounding with Google Search», Google Cloud, https://docs.cloud.google.com/vertex-ai/generative-ai/docs/grounding/grounding-with-google-search
- «Get started with Deep Research», notebook del Gemini cookbook, https://github.com/google-gemini/cookbook/blob/main/quickstarts/Get_started_Deep_Research.ipynb
- «python-genai», Google, https://github.com/googleapis/python-genai
- «Introducing Deep Research and Deep Research Max», blog di Google, 2026-04-21, https://blog.google/innovation-and-ai/models-and-research/gemini-models/next-generation-gemini-deep-research/
- «Build with Gemini Deep Research», blog di Google, 2025-12-11, https://blog.google/innovation-and-ai/technology/developers-tools/deep-research-agent-gemini-api/
- «How to use Deep Research with the Gemini API», Philipp Schmid, 2026-04-29, https://www.philschmid.de/deep-research-update
- «Deep Research API interaction stuck in_progress», forum per sviluppatori di Google, 2026-03-05, https://discuss.ai.google.dev/t/deep-research-api-interaction-stuck-in-progress-for-some-domains/129020
- «Google Gemini Deep Research costs», forum per sviluppatori di Google, 2025-12-21, https://discuss.ai.google.dev/t/google-gemini-deep-research-costs/112804
- «Deep Research agent API questions on rate limits and costs», forum per sviluppatori di Google, 2025-12-12, https://discuss.ai.google.dev/t/deep-research-agent-api-questions-for-rate-limitsand-costs/111904
- «MCP specification 2026-07-28 index», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28
- «MCP specification 2026-07-28 changelog», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/changelog
- «MCP transports», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- «MCP authorization», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- «MCP tools», Model Context Protocol, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- «Cited but not verified: source attribution in deep research agents», arXiv, 2026-05-07, https://arxiv.org/html/2605.06635v1
- «Benchmarking and error analysis of deep search and deep research agents», arXiv, 2026-10-21, https://arxiv.org/html/2610.29346v1
- «DeepResearch Bench: a benchmark for deep research agents», arXiv, https://arxiv.org/abs/2506.11763
- Catalogo delle funzionalità di dati di EveryInfra, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog
- Catalogo EveryInfra per Reddit, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=reddit
- Catalogo EveryInfra per YouTube, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=youtube
- Catalogo EveryInfra per Google News, consultato il 2026-11-02, https://api.everyinfra.com/api/v1/social/catalog?platform=google_news
- «Boy, 11, killed in e-bike battery fire in Bronx apartment», The New York Times, 2026-10-28, https://www.nytimes.com/2026/10/28/nyregion/fire-e-bike-battery-bronx.html
- «Lithium-ion battery caused Bronx fire that killed boy, FDNY says», Gothamist, 2026-10-28, https://gothamist.com/news/lithium-ion-battery-caused-bronx-fire-that-killed-11-year-old-fdny-says
- «E-bike fires have skyrocketed across NYC», New York Daily News, 2026-10-31, https://www.nydailynews.com/2026/10/31/as-bronx-family-reels-from-devastating-blaze-that-killed-4-e-bike-fires-have-skyrocketed-across-nyc/
- «E-bike battery fires on the rise at NYCHA», The City Reporter, 2026-10-30, https://www.thecityreporter.nyc/2026/10/30/e-bike-battery-fires-on-the-rise-at-nycha-leaving-death-in-their-wake/
- «Lithium-ion battery fires are up 41% as public fix stalls», Streetsblog NYC, 2026-10-14, https://nyc.streetsblog.org/2026/10/14/everyone-should-be-furious-lithium-ion-battery-fires-are-up-41-as-public-fix-stalls
- «Four dead after e-bike battery fire in the Bronx», Spectrum Noticias, 2026-10-31, https://spectrumnoticias.com/ny/nyc/noticias/2026/10/31/cuatro-muertos-tras-un-incendio-en-la-bateria-de-una-bicicleta-electrica-en-el-bronx--nypd
- «Boy, 11, dies in Bronx fire from an e-bike battery», Univision, 2026-10-29, https://www.univision.com/local/nueva-york-wxtv/muere-nino-de-11-anos-en-incendio-provocado-por-bateria-de-bicicleta-electrica-en-el-bronx
- «Mayor Adams takes new actions to prevent lithium-ion battery fires», NYC Mayor's Office, 2024-07, https://www.nyc.gov/mayors-office/news/2024/07/mayor-adams-takes-new-actions-prevent-deadly-lithium-ion-battery-fires-promote-safe-e-bike
- «What firefighters want you to know about lithium battery fires», CBC, 2026-10, https://www.cbc.ca/news/science/lithium-battery-fire-faq-9.7371004
- «How to prevent lithium-ion battery fires in Philadelphia», Billy Penn at WHYY, 2026-10-17, https://billypenn.com/2026/10/17/lithium-ion-battery-fire-safety-philadelphia/
- «E-bike battery fires on the rise at NYCHA», thread di r/nyc, Reddit, 2026-10-30, https://www.reddit.com/r/nyc/comments/1xjb3ss/ebike_battery_fires_on_the_rise_at_nycha_leaving/
- «Is there a true deep research tool for MCP», thread di r/LocalLLM, Reddit, https://www.reddit.com/r/LocalLLM/comments/1pw1ukl/is_there_a_true_deep_research_mcp_deep_research/
Riferimenti BL-66