DeepSeek Search API에 중국 소셜 앱의 플랫폼 내부 데이터를 더하는 방법
DeepSeek Search API는 호출 1,000건당 $0.75이며 좋아요와 댓글은 반환하지 않습니다. Xiaohongshu, Zhihu, Weibo 데이터를 더하면 실제 호출 8건에 $0.014가 듭니다.
DeepSeek는 2026년 10월 17일 Search와 Fetch라는 새 엔드포인트 두 개를 모든 API 사용자에게 공개했습니다. 두 엔드포인트 모두 성공한 요청 1,000건당 $0.75입니다. Search 결과에는 제목, URL, 요약 두 종류, 페이지 본문, 사이트 이름, 날짜, 점수 두 종류가 들어 있습니다. 좋아요, 댓글, 저장 수는 없습니다(DeepSeek Search and Fetch 가이드).
11월 3일 00:15~00:19 SGT에 EveryInfra xiaohongshu/search, zhihu/search, weibo/search를 “로봇청소기”라는 하나의 주제로 실행했습니다. 98개 행 모두에 좋아요 수, 댓글 수, 게시 시각이 있었습니다. Xiaohongshu에서는 33개 행 중 12개에 유료 브랜드 콘텐츠 표시도 붙어 있었습니다. “중국 구매자들은 무엇에 불만을 가질까”를 묻는 브랜드 팀에게 필요한 것이 바로 이런 필드이며, 웹 검색 결과에는 이런 필드가 없습니다.
비용을 좌우하는 요인은 분명합니다. Xiaohongshu 검색 1페이지는 $0.005556으로, DeepSeek Search 호출 1건의 7.4배입니다. 이 글에서 제시하는 호출 한도를 적용하면 질문 1,000개당 데이터 비용이 $20.89에서 $4.53으로 줄어듭니다.
이 글은 중국 밖에서 중국 시장에 판매하거나 중국 브랜드와 경쟁하는 팀을 위한 글입니다. 유럽 가전 브랜드, 미국 로봇청소기 제조사, 고객사를 위해 중국 소비자 반응을 추적하는 에이전시가 대표적인 예입니다. 이런 팀에는 제품 관련 질문에 출처와 함께 답하는 간단한 어시스턴트가 필요합니다. 이제 DeepSeek에 자체 웹 검색 엔드포인트가 생겼으므로 공개 웹 검색은 쉽게 해결할 수 있습니다. 이 글에서는 이 엔드포인트가 하는 일과 반환하지 않는 정보를 살펴보고, 중국 앱 3곳의 플랫폼 내부 데이터를 더하는 방법을 보여 줍니다. 호출별 비용도 함께 정리합니다.
이 글의 DeepSeek 관련 사실은 모두 2026년 11월 3일에 확인한 api-docs.deepseek.com에서 가져왔습니다. 저희에게는 DeepSeek API 키가 없습니다. 따라서 DeepSeek 쪽 설정은 테스트가 아니라 구성 예시입니다. EveryInfra 관련 수치는 모두 실제 호출의 원본 응답에서 가져왔습니다.
앞서 DeepSeek V4와 Claude Code로 댓글 정제하기라는 글을 썼습니다. 그 글에서는 DeepSeek를 Claude Code의 모델로 사용해 댓글 정제 비용을 측정했습니다. Search와 Fetch는 짧은 섹션 하나에서만 다뤘습니다. 이 글은 Search 엔드포인트 자체에서 출발해, 플랫폼 내부 데이터와 작업을 어떻게 나눠야 하는지 살펴봅니다.
11월 3일에 확인한 문서로 본 DeepSeek 웹 검색 API의 기능
작업을 나누기 전에 DeepSeek 쪽을 정확히 파악해야 합니다. Search and Fetch 가이드는 두 엔드포인트를 “raw JSON API”라고 부릅니다. 두 엔드포인트는 채팅 모델과 동일한 API 키를 사용하며 Authorization: Bearer 방식으로 인증합니다. Search는 쿼리 하나를 받아 DeepSeek 자체 검색 엔진의 구조화된 웹 결과를 반환합니다.
Fetch는 URL 하나를 받아 페이지 본문을 Markdown으로 반환합니다. 두 엔드포인트 모두 모델을 거치지 않으므로 토큰 단위로 과금되지 않습니다. 아래 표의 모든 행은 Search API 레퍼런스 및 Fetch API 레퍼런스와 대조해 확인했습니다.
| 항목 | 검색 | Fetch |
|---|---|---|
| 엔드포인트(호스트 api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| 요청 필드 | query(1~128자, site:, lang:, after:, before: 등 지원), count(1~50, 기본값 10), ori_question, localization(IP 주소), need_content | url(최대 8,192자, http 또는 https, 사용자 이름·비밀번호 포함 불가) |
| 대응 | results 배열이며, 각 결과에는 다음 10개 필드가 있습니다: rerank_score, title, url, snippet, summary, content, site_name, site_icon, date, authority | title, content(Markdown) |
| 요금 | 성공한 요청 1,000건당 $0.75. count는 가격에 영향 없음 | same |
| 과금 안 됨 | 실패, 빈 results 배열, 시간 초과 | 실패, 페이지 콘텐츠 없음, 시간 초과 |
| 요청 속도 제한 | 계정당 초당 100건 | 계정당 초당 25건, 대상 도메인별 제한 별도 |
개발자에게 중요한 세부 사항이 세 가지 있습니다. 첫째, summary는 모델용 긴 요약으로 보통 600~800자입니다. snippet은 사용자 인터페이스용 짧은 요약으로 100~200자입니다. 결과 10개를 전체 요약과 함께 받으면 검색 1회마다 컨텍스트에 6,000~8,000자가 추가됩니다.
둘째, date는 페이지 게시 시각(UTC)이며 알 수 없으면 null입니다. authority는 0~4 등급이고 알 수 없으면 -1입니다. rerank_score는 0~3 범위의 관련도 점수로, 가이드에서는 1.5 이상을 좋은 결과로 봅니다.
셋째, Search는 query를 그대로 검색 서비스에 전달합니다. 따라서 쿼리에 site:xiaohongshu.com을 쓸 수 있습니다. 다만 결과 수는 해당 사이트의 페이지가 DeepSeek 인덱스에 얼마나 들어 있는지에 달려 있습니다. 또한 인덱스는 각 페이지를 크롤링 시점의 상태로 보관합니다. 이것이 앱 콘텐츠에서 왜 중요한지는 아래 “스냅샷 시점과 호출 시점” 섹션에서 설명합니다.
가이드는 오류도 명확하게 설명합니다. 형식은 OpenAI 오류 형식과 같고 param 필드는 항상 null입니다. 408, 429, 5xx 오류는 잠시 기다린 뒤 재시도할 수 있습니다. 402는 잔액이 부족하다는 뜻입니다.
그 밖의 4xx 오류는 요청을 수정하지 않고 재시도하면 안 됩니다. EveryInfra도 비슷하게 동작합니다. 잘못된 값을 보내면 해당 필드를 지목하고 허용 값을 나열한 422를 반환합니다. 실제 예시는 “실제 왕복 한 번” 섹션에서 보여 줍니다.
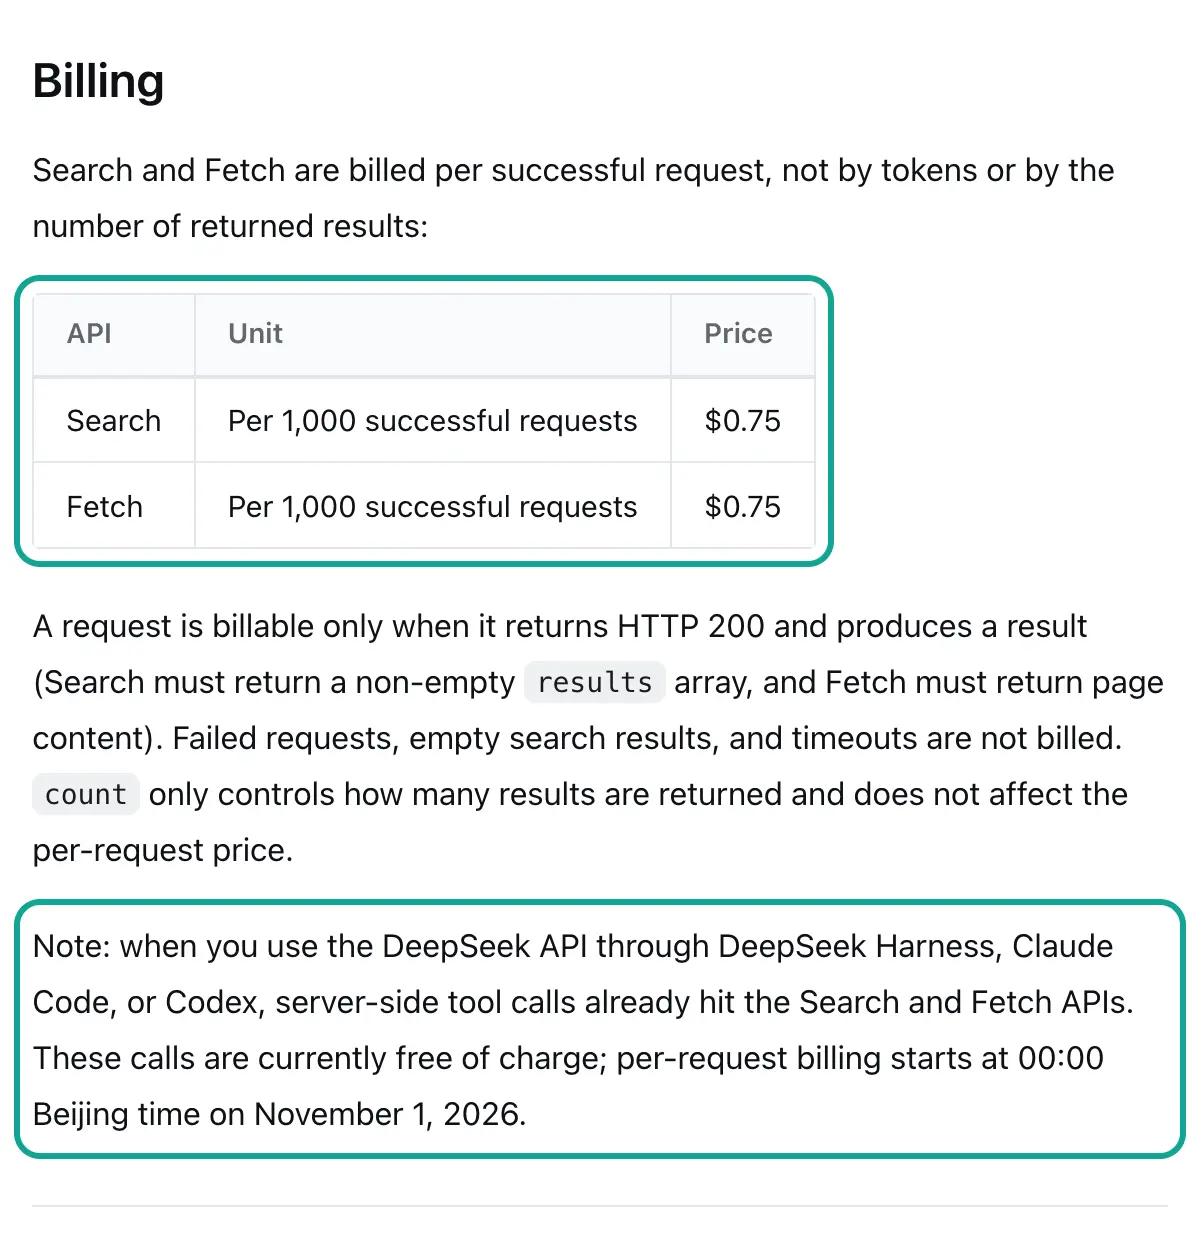
DeepSeek Search API 요금: 11월 1일부터 과금되기 시작한 항목
가격 자체는 단순합니다. 영문 요금 페이지에 따르면 Search와 Fetch는 성공한 요청 1,000건당 $0.75입니다. 중국어 페이지에는 같은 단위에 5위안으로 표시되어 있습니다. count는 결과 수만 바꿀 뿐 가격은 바꾸지 않습니다. 따라서 결과 50개를 요청하든 10개를 요청하든 요청 1건의 비용은 같습니다. 결과 1,000개 기준으로 환산하면 count=50일 때 $0.015, count=10일 때 $0.075입니다.
10월 17일 릴리스 노트에는 놓치기 쉬운 문장이 하나 있습니다. Claude Code, Codex, DeepSeek Harness는 DeepSeek API를 사용할 때 이미 서버 측 도구를 통해 Search와 Fetch를 호출하고 있습니다. 이 호출은 무료였지만, 2026년 10월 31일 16:00 UTC부터 요청당 과금이 시작됩니다. 베이징과 싱가포르 기준으로는 11월 1일 00:00입니다.
11월 3일에도 요금 페이지와 가이드에는 이 날짜 옆에 “currently free of charge(현재 무료)”라는 문구가 남아 있었습니다. 날짜가 이미 지났으므로 이 호출은 이제 과금 기간에 들어갔습니다. 팀에서 Claude Code 안에서 DeepSeek를 사용한다면(DeepSeek의 Claude Code 가이드), 이제 웹 조회 1,000건당 $0.75가 토큰 비용에 더해집니다.
검색 결과는 모델에 들어가므로 모델 가격도 확인해야 합니다. 같은 요금 페이지에서 deepseek-flash는 이제 DeepSeek-V4.1-Flash-1017을 가리킵니다. 피크 시간대에는 캐시 미스 입력이 100만 토큰당 $0.30, 출력이 $1.20입니다. 비피크 시간대 가격은 절반입니다.
피크 시간대는 평일 01:00~04:00, 06:00~10:00 UTC입니다. 런던 팀에게는 이른 아침과 늦은 오전에 해당합니다. 뉴욕 팀에게는 피크 시간대가 밤에 걸립니다. 컨텍스트 길이는 1M 토큰이며, 두 모델 모두 도구 호출과 JSON 출력을 지원합니다.
| 항목 | 단위 | USD(영문 페이지) | 기준 |
|---|---|---|---|
| Search | 성공한 요청 1,000건당 | $0.75 | 2026-11-03 |
| Fetch | 성공한 요청 1,000건당 | $0.75 | 2026-11-03 |
| deepseek-flash 입력(캐시 미스, 피크) | 1M 토큰당 | $0.30 | 2026-11-03 |
| deepseek-flash 출력(피크) | 1M 토큰당 | $1.20 | 2026-11-03 |
EveryInfra zhihu/search | 성공한 요청 1,000건당 | $0.556 | 2026-11-03 |
EveryInfra weibo/search | 성공한 요청 1,000건당 | $0.806 | 2026-11-03 |
EveryInfra xiaohongshu/search | 성공한 요청 1,000건당 | $5.556 | 2026-11-03 |
EveryInfra의 세 가격은 무료 카탈로그의 price_usd 필드에서 가져왔습니다. 규칙은 DeepSeek와 같습니다. 실패와 빈 결과는 무료입니다.
DeepSeek Search API의 웹 결과와 플랫폼 내부 데이터 비교: 필드 표
차이를 가장 잘 보려면 필드를 나란히 놓아 보면 됩니다. DeepSeek Search 결과에는 필드가 10개 있습니다. 이 필드들은 페이지를 찾고, 모델에 요약을 제공하고, 사용자에게 결과를 보여 주는 데 쓰입니다. 앱 내부 검색 결과는 이와 다른 질문, 즉 이 앱의 사람들이 이 게시물에 어떻게 반응했는가에 답하도록 만들어져 있습니다. 앱 내부 결과에도 제목, 본문, 링크, 게시 시각이 있습니다.
여기에 더해 좋아요, 댓글, 저장, 공유 수와 작성자 정보 및 콘텐츠 플래그도 있습니다. 아래 표에서 DeepSeek 열은 DeepSeek 문서를 따릅니다. 나머지 세 열은 11월 3일 실제 응답에 있던 필드입니다.
| 질문 | DeepSeek Search(문서 기준 필드) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| 어떤 내용인가? | title, summary, content | title, text(약 60자) | title, text | text |
| 어디서 열 수 있나? | url | url(액세스 토큰 포함) | url | url |
| 언제 게시되었나? | date(null일 수 있음) | posted_at, updated_at | posted_at | posted_at |
| 좋아요·저장은 몇 개인가? | none | like_count, collect_count | like_count, collect_count | like_count |
| 논의가 얼마나 활발한가? | none | comment_count, share_count | comment_count | comment_count, repost_count |
| 누가 썼나? | site_name, authority | author_name, author_id | author_name, author_follower_count, 배지 텍스트 | author_follower_count, author_verified, 인증 사유 |
| 유료 브랜드 콘텐츠인가? | none | is_cooperation_note, is_goods_note | none | 없음(인증 사유로 판단) |
이 차트에는 두 가지 한계가 있습니다. 첫째, “문서에 없음”이 DeepSeek가 이 수치를 절대 볼 수 없다는 뜻은 아닙니다. content 필드는 페이지 본문입니다. 페이지 본문에 “좋아요 12,000개”라고 적혀 있으면 모델은 그 텍스트를 읽을 수 있습니다.
하지만 이는 페이지의 텍스트일 뿐, 정렬하거나 합산할 수 있는 필드가 아닙니다. 또한 크롤링 시점의 값입니다. 둘째, 앱 열의 0%에는 두 가지 원인이 있습니다. 일부 필드는 해당 기능의 카탈로그에 없습니다. Zhihu 검색의 공유 수가 그 예입니다.
다른 필드는 카탈로그에는 있지만 이번에는 반환되지 않았습니다. 카탈로그에는 Xiaohongshu 검색의 author_is_verified가 나와 있지만, 33개 행 중 이 필드가 있는 행은 없었습니다. 따라서 코드는 카탈로그의 response_fields를 기준으로 작성하고, 어떤 행에서든 필드가 빠질 수 있다고 전제해야 합니다.
스냅샷 시점과 호출 시점: 같은 노트의 수치도 달라집니다
시간에도 차이가 있습니다. 웹 검색은 인덱스에서 페이지를 반환하므로 각 페이지는 크롤링 시점의 상태입니다. DeepSeek 문서에는 결과 필드 10개가 나와 있습니다. 그중 하나인 date는 게시 시각입니다. 크롤링 시각을 알려 주는 필드는 없으므로 스냅샷이 언제 만들어졌는지 알 수 없습니다.
앱 내부 검색은 호출 시점의 값을 돌려줍니다. 좋아요, 댓글, 저장 수는 현재 수치입니다. Xiaohongshu는 updated_at도 반환합니다. 카탈로그에서는 이를 노트의 마지막 수정 시각이라고 설명합니다.
제품 관련 주제에서는 이 차이가 큽니다. 불만 관련 Xiaohongshu 노트 20개를 좋아요순으로 정렬해 살펴봤습니다. 그중 13개는 게시 후 30일이 넘어서 마지막으로 수정되었습니다. 5개는 1년이 넘어서 수정되었습니다. 한 노트는 게시일로부터 1,154일 뒤에 수정되었습니다.
| 게시부터 마지막 수정까지의 간격 | 노트 수(20개 중) |
|---|---|
| 30일 미만 | 7 |
| 30~365일 | 8 |
| 365일 초과 | 5 |
작성자는 노트를 자주 다시 수정합니다. 본문을 고치거나, 후기를 덧붙이거나, 모델명을 바꿉니다. 웹 스냅샷이 수정 전 상태라면 모델은 이전 버전을 읽게 됩니다. 아래 스크린샷의 먼지봉투 노트는 좋아요 992개, 댓글 571개를 기록했습니다. 호출 시점에 이 노트는 게시된 지 약 일주일밖에 되지 않았습니다. 사람들이 여전히 좋아요와 댓글을 남기고 있다면, 더 오래된 스냅샷에는 더 낮은 수치가 보입니다.
Weibo는 더 최신입니다. 두 번의 검색에서 나온 게시물 25개는 모두 호출 전 4일 이내에 올라온 것이었습니다. “이번 주에 새로운 A/S 문제가 생겼나” 같은 질문의 답은 이런 게시물에 있습니다.
따라서 시간을 기준으로 작업을 나눌 수 있습니다. 브랜드 사양 페이지, 매체 리뷰, 매뉴얼, 보도자료처럼 천천히 바뀌는 콘텐츠에는 웹 검색을 사용합니다. 이런 페이지는 몇 주에 한 번 크롤링해도 충분합니다. 빠르게 바뀌는 콘텐츠에는 앱 내부 검색을 사용합니다. 지난주에 올라온 불만, 커지고 있는 A/S 문제, 수치가 계속 오르는 노트가 그 예입니다. 앱 내부 검색은 최신순, 좋아요순, 댓글순처럼 앱만 적용할 수 있는 정렬도 제공합니다.
반대도 마찬가지입니다. 앱 내부 검색은 웹 검색을 대체할 수 없습니다. 브랜드 사이트, 사양 페이지, 매체 리뷰, 이 앱들 밖의 포럼은 앱 내부 검색에 포함되지 않습니다. 서구 브랜드라면 독일 잡지의 리뷰처럼 영어권과 유럽 출처도 웹 쪽에서 다룹니다. 두 종류의 데이터는 작업을 나눠 맡습니다. 어느 한쪽이 다른 쪽을 대체하지 않습니다.
테스트 전에 정한 판단 기준
결과를 본 뒤 기준을 바꿀 수 없도록 실제 호출 전에 이 기준을 정했습니다. 아래 각 결론이 성립하는지는 이 기준으로 판단합니다.
| 기준 | 통과 기준 | 실패 |
|---|---|---|
| 플랫폼 내부 데이터가 웹 결과에 없는 필드를 더해 주는가? | 세 앱 모두에서 행의 90% 이상에 좋아요, 댓글, 게시 시각이 있음 | 한 앱이라도 90% 미만 |
| 세 앱 모두 비동기 작업으로 전환하지 않고 85초 안에 응답하는가? | 6건 모두 200 반환 | 시간 초과 또는 503 |
| 모델이 잘못된 값을 스스로 고칠 수 있는가? | 422가 필드를 지목하고 허용 값을 나열하며, 과금되지 않음 | 모호한 오류 또는 과금 발생 |
| Xiaohongshu 비용을 통제할 수 있는가? | 질문 1,000개당 데이터 비용을 $5 미만으로 낮추는 방안이 하나 있음 | 질문 수를 줄이는 것 외에는 통제 수단이 없음 |
| 행을 그대로 “구매자 목소리”로 답변에 넣을 수 있는가? | 필터가 필요한 행이 20% 이하 | 한 앱이라도 20% 초과(실패를 예상한 항목) |
결과를 미리 밝히면, 처음 네 기준은 통과합니다. 다섯 번째 기준은 세 앱 모두에서 실패하므로 뒤의 섹션에서 필터를 설명합니다.
흐름: 제품 질문 하나, 데이터 경로 두 개


흐름은 4단계이며 핵심은 2단계입니다. DeepSeek 모델은 함수를 직접 실행하지 않습니다. 모델은 “이 인수로 이 함수를 호출하라”는 내용의 tool_calls를 반환합니다. DeepSeek Search와 EveryInfra를 실제로 호출하는 것은 여러분의 코드입니다.
DeepSeek 도구 호출 가이드에도 같은 내용이 나옵니다. 함수는 사용자가 제공하며 모델은 이를 실행하지 않습니다. 이 방식의 장점은 두 API 키가 모두 서버에 남고 모델에 노출되지 않는다는 점입니다. 대신 루프를 직접 작성해야 합니다. 다음 섹션에서 전체 구성 예시를 제공합니다.
1단계에서 사용자가 질문합니다. 2단계에서 모델은 질문과 함수 설명 4개를 읽습니다. 무엇을 검색할지 정하고, 웹 검색 1건과 앱 검색 3건, 총 4건의 호출을 한 번에 보낼 수 있습니다. 3단계에서 코드는 두 엔드포인트를 호출합니다. 그리고 원본 JSON이나 축약한 버전을 해당 tool_call_id와 함께 role: tool 메시지로 돌려줍니다.
4단계에서 모델은 모든 결과를 읽고 답변을 작성합니다. 시스템 프롬프트는 각 주장 뒤에 출처 URL, 좋아요 수, 게시일을 붙이도록 지시합니다. “A 브랜드와 B 브랜드를 비교하면 사람들은 뭐라고 하나” 같은 후속 질문은 새 호출 라운드를 시작합니다. 모델이 tool_calls를 반환하지 않으면 루프가 종료됩니다.
이 흐름에서 각 데이터 경로의 역할은 분명합니다. 웹 검색은 브랜드 사이트, 사양 페이지, 매체 리뷰, 뉴스를 찾습니다. “이 모델은 어떤 기능이 있고, 브랜드는 뭐라고 말하나?”에 답합니다. 플랫폼 내부 데이터는 Xiaohongshu, Zhihu, Weibo에서 실제 사용자가 하는 말을 찾습니다. “구매자는 어떻게 평가하고, 어떤 문제가 반복해서 나오나?”에 답합니다. 두 종류의 출처가 모두 답변에 들어가면 독자는 브랜드의 주장과 구매자의 후기를 나란히 볼 수 있습니다. 둘이 어긋나는 지점에서 가장 쓸모 있는 결론이 나오는 경우가 많습니다.
도구 정의: 함수 4개를 담은 전체 JSON(구성 예시)
아래는 DeepSeek 모델에 제공하는 함수 4개입니다. 앱 함수 3개의 파라미터 이름, enum 값, 설명은 모두 EveryInfra 카탈로그의 param_meanings와 allowed_values 필드에서 가져왔습니다. 웹 검색 함수는 DeepSeek Search API 레퍼런스를 따릅니다. strict 모드를 사용합니다. DeepSeek 도구 호출 가이드에 따르면 strict 모드에는 베타 base URL(https 접두사가 붙은 api.deepseek.com/beta)이 필요합니다. 각 객체의 모든 속성이 required에 있어야 하고, additionalProperties는 false여야 합니다.
따라서 선택 파라미터라도 그냥 생략할 수는 없습니다. 이 문제는 두 가지 방법으로 처리합니다. 기본값이 있는 enum은 기본값을 enum에 넣고 모델이 그것을 고르게 합니다. sort의 relevance, date_range의 any_time이 그 예입니다. 페이지 토큰처럼 기본값이 없는 문자열에는 null을 포함한 anyOf를 사용합니다.
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword in Chinese, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]
가격을 왜 설명에 넣을까요? 모델이 description을 읽기 때문입니다. Xiaohongshu 함수에는 “one page = USD 0.005556”이라고 씁니다. 그리고 시스템 프롬프트에는 “at most one Xiaohongshu page per question, try Zhihu and Weibo first”(질문당 Xiaohongshu는 최대 1페이지, Zhihu와 Weibo를 먼저 시도)라고 씁니다.
이제 모델은 함수를 고를 때 비용 정보를 갖게 됩니다. 다만 이것은 강제 한도가 아닙니다. 강제 한도는 루프 코드에 넣어야 하며, 다음 섹션에서 보여 줍니다.
중국 밖의 팀에게는 세부 사항이 하나 더 중요합니다. 게시물이 중국어이므로 앱 함수 3개의 키워드도 중국어여야 합니다. 함수 설명에도 그렇게 적혀 있습니다. deepseek-flash 같은 모델은 영어 질문에서 좋은 중국어 키워드를 만들어 내므로, 사용자는 영어로 질문해도 됩니다. 위의 enum은 스크립트를 사용해 11월 3일자 카탈로그와 대조해 확인했습니다.
| 함수 파라미터 | 카탈로그 `allowed_values` | 도구 정의의 enum | 일치 |
|---|---|---|---|
xiaohongshu_search.sort | 5개: relevance, newest, most_liked, most_commented, most_collected | 동일한 5개 | yes |
xiaohongshu_search.date_range | 6개: any_time ~ last_1_year | 동일한 6개 | yes |
xiaohongshu_search.content_type | 3개: all, image, video | 동일한 3개 | yes |
zhihu_search.content_type | 4: all, answer, article, video | 동일한 4개 | yes |
zhihu_search.sort | 3개: general, upvote_count_descending, time_descending | 동일한 3개 | yes |
web_search.count | DeepSeek 문서: 1~50 | 최솟값 1, 최댓값 50 | yes |
이 표가 왜 중요할까요? enum이 틀리면 EveryInfra에서 422를 받고 과금되지 않습니다. 하지만 모델이 이를 고치려면 라운드가 한 번 더 필요합니다. 정의에 올바른 enum을 넣으면 왕복 한 번과 그만큼의 토큰을 아낄 수 있습니다.
카탈로그는 언제든 무료로 조회할 수 있습니다. Xiaohongshu 카탈로그 항목이 그 예입니다. 기능이 바뀌면 정의를 다시 생성하면 됩니다. Xiaohongshu 검색 기능 페이지에서도 필드를 설명합니다.
나머지 두 앱의 파라미터와 필드는 Zhihu 카탈로그 항목과 Weibo 카탈로그 항목에 나와 있습니다. Weibo 검색은 파라미터가 keyword 하나뿐이어서 함수도 가장 짧습니다. 모델이 틀리는 경우가 거의 없습니다.
루프 코드: Python으로 DeepSeek tool_calls 처리하기(구성 예시)
아래 Python 코드는 OpenAI Python SDK를 사용하며, 이 SDK는 PyPI의 openai 패키지로 제공됩니다. DeepSeek 채팅 API는 OpenAI 형식을 사용하며, OpenAI 함수 호출 가이드도 같은 tools 구조를 설명합니다. 두 데이터 엔드포인트는 모두 requests로 호출하고 타임아웃은 90초로 둡니다. EveryInfra의 동기 호출 처리 한도가 85초이기 때문입니다. 결과를 모델에 돌려주기 전에 필드 12개만 남깁니다. ensure_ascii=False는 중국어 문자를 그대로 유지합니다(Python json 문서). 이스케이프된 문자는 토큰을 몇 배 더 사용합니다.
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # at most 1 Xiaohongshu page per question

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # a 422 has param, allowed, did_you_mean: give it to the model
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "Answer in English. After each claim, give the source url, like count and post date. "
                                          "Search Zhihu and Weibo first; use Xiaohongshu only when needed. Keywords for the apps in Chinese."},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # keeps reasoning_content; required when tools are present
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
            msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})
DeepSeek 문서를 따른 사항이 두 가지 있습니다. 첫째, 사고(thinking) 모드는 기본으로 켜져 있습니다. 사고 모드 가이드에 따르면 tools가 포함된 요청은 이전 모든 턴의 reasoning_content를 다시 보내야 합니다. 그러지 않으면 API가 400을 반환합니다.
msgs.append(m) 줄이 이 역할을 합니다. 둘째, strict 모드는 베타 base URL에서만 동작합니다. 일반 URL에서는 strict 필드가 효과가 없어서 모델이 가끔 인수를 빠뜨릴 수 있습니다. 그러면 EveryInfra가 422를 반환하고, 모델은 다음 라운드에서 인수를 추가합니다.
예산 검사는 프롬프트가 아니라 루프에 둡니다. 프롬프트로는 모델에게 비용을 아끼라고 요청할 수 있을 뿐입니다. 코드는 질문 하나가 정해진 금액을 넘지 않도록 보장할 수 있습니다. 하루에 질문 수백 개를 처리하는 브랜드 팀이라면 이 차이가 월 청구서에 드러납니다.
실제 왕복 한 번: 모델이 보내는 요청과 돌아오는 응답
DeepSeek 키가 없으므로 모델 쪽은 실행하지 않았습니다. “11.11에 로봇청소기를 사려는데, 구매자들이 가장 많이 불만을 제기하는 점은?”이라는 질문을 예로 들어 보겠습니다. 도구 정의에 따라 모델은 “로봇청소기 불만”에 해당하는 중국어 키워드로 Xiaohongshu 호출을 보낼 수 있습니다. 나머지 인수는 sort가 most_liked, date_range가 any_time, content_type이 all, page_token이 null입니다. 루프는 null 값을 제거하고 아래 요청을 EveryInfra에 보냅니다. 이 호출은 실제로 실행한 것입니다.
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'
2026년 11월 3일 00:17:22 SGT에 보낸 요청은 HTTP 200으로 응답했으며 20개 행을 반환했습니다. 본문은 36,627바이트였고 billing.charged_usd는 0.005556이었습니다. 같은 분 안에 sort를 일부러 hot으로 설정해 같은 요청을 다시 보냈습니다. 그러자 code가 invalid_value, did_you_mean이 most_liked인 HTTP 422 응답이 반환되었습니다.
allowed 필드에는 유효한 값 5개가 나열되어 있었습니다. next_steps의 첫 항목은 “sort만 allowed에 있는 값으로 바꾼 뒤 다시 보내세요. 과금되지 않았습니다.”라고 안내했습니다. 이 role: tool 메시지를 받은 모델은 다음 라운드에서 sort만 바꿉니다. 사람이 개입할 필요가 없습니다.
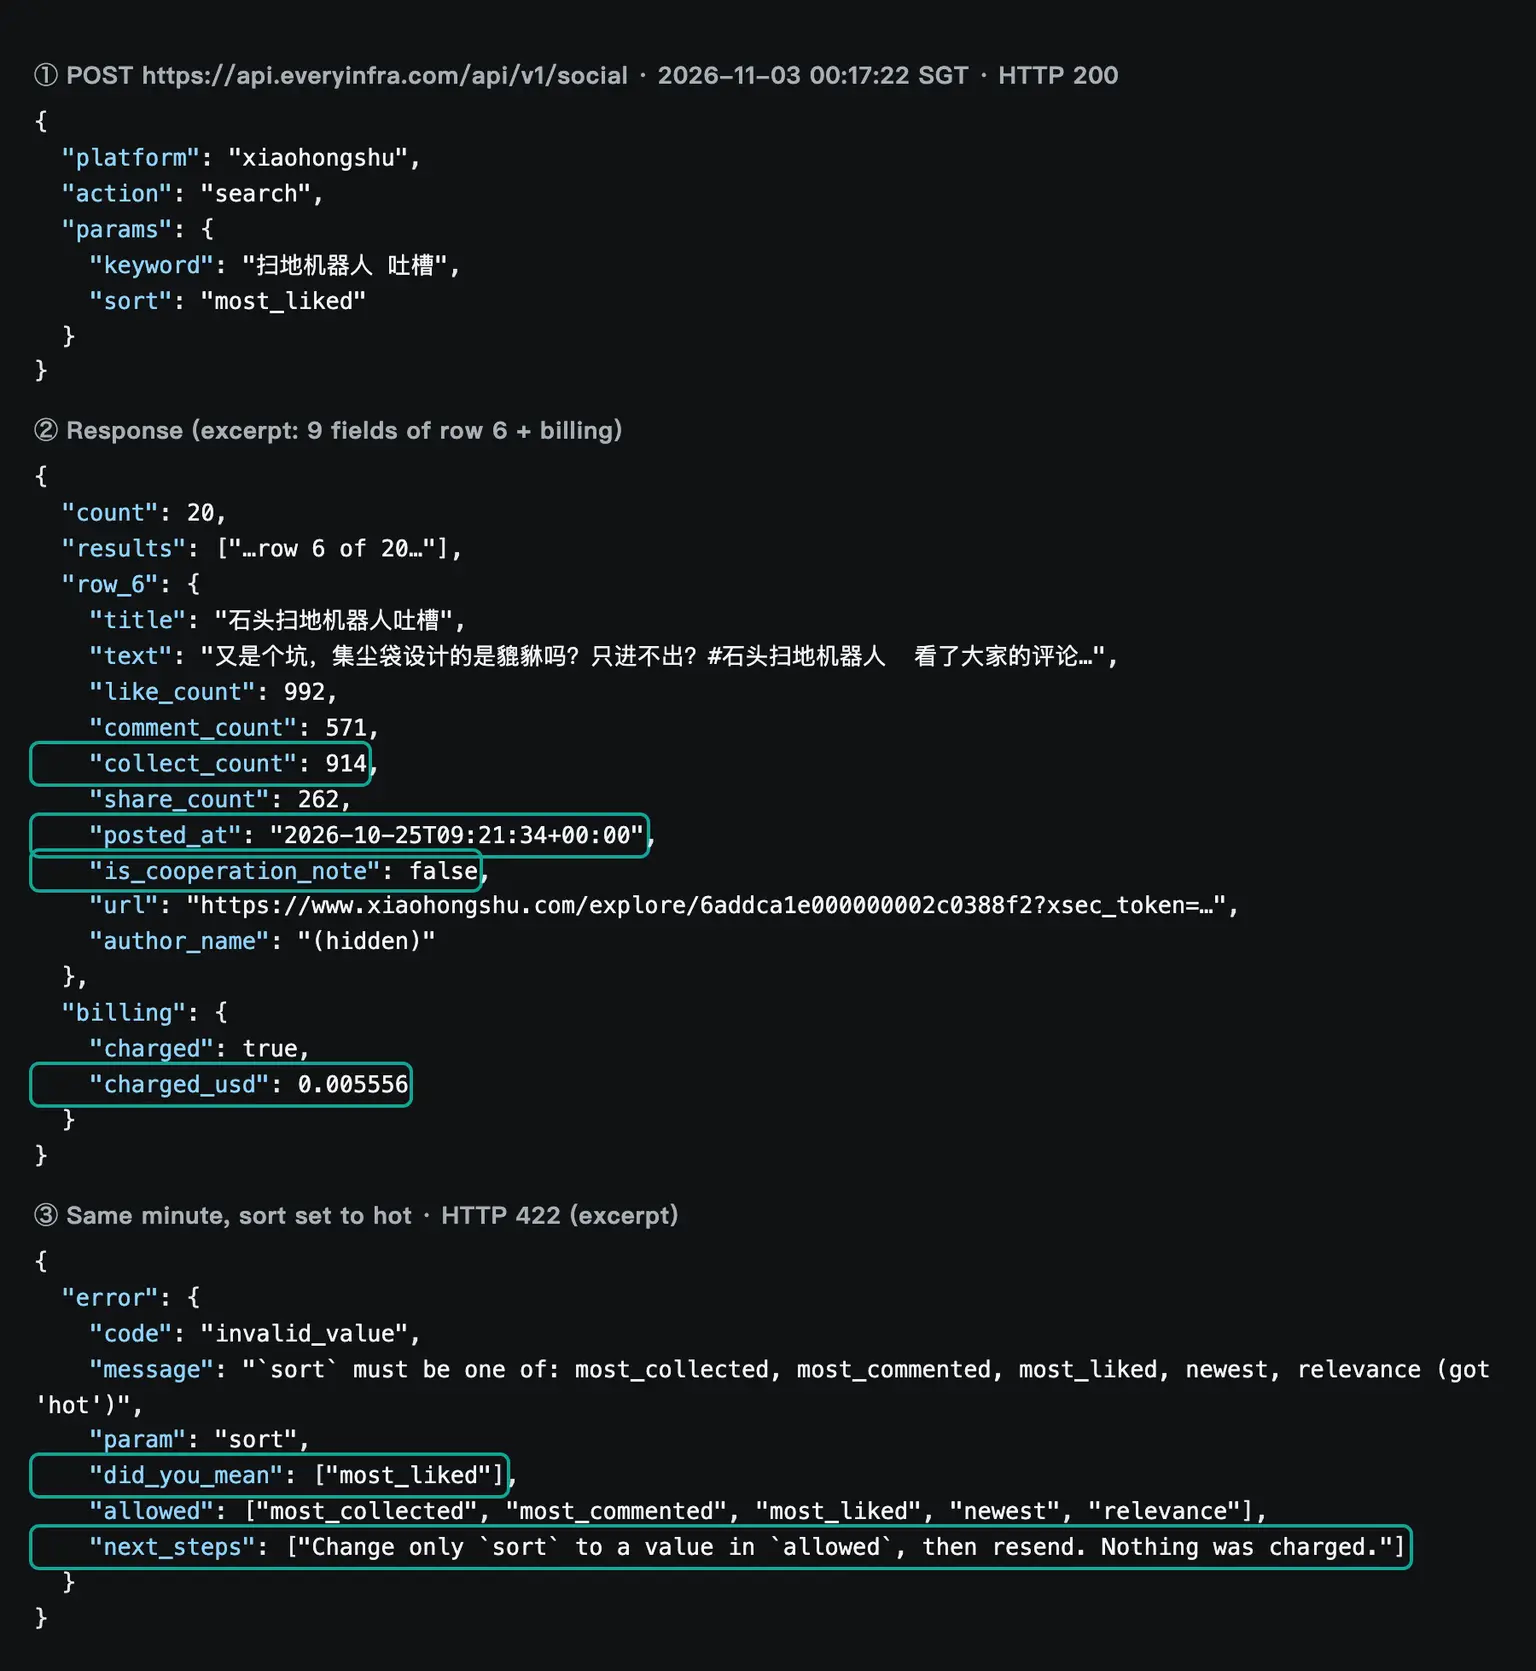
스크린샷의 6번 행은 10월 25일에 올라온 노트입니다. 제목에는 한 로봇청소기 브랜드에 대한 불만 글이라고 적혀 있습니다. 본문에는 먼지봉투 설계가 “들어가기만 하고 나오지는 않는다”고 적혀 있으며, 이는 교체용 봉투 비용 문제를 가리킵니다. 좋아요 992개, 댓글 571개, 저장 914개를 기록했습니다.
댓글 수가 좋아요 수의 절반을 넘으므로 이 노트를 계기로 실제 논의가 이어졌습니다. “가장 많은 불만”을 찾을 때 필요한 신호가 바로 이것입니다. 웹 검색 결과에서 모델이 볼 수 있는 것은 많아야 이 노트의 제목과 요약뿐입니다.
댓글에서 무엇을 두고 논쟁하는지 보려면 이 행의 url로 xiaohongshu/note를 호출해 전체 본문을 가져오면 됩니다. 댓글 호출도 가능합니다. 각 호출 역시 $0.005556이므로 같은 예산 로직이 적용됩니다.
테스트 1: 앱별 반환 결과
00:15~00:19 SGT에 “로봇청소기” 주제로 호출을 8건 실행했습니다. 그중 6건은 앱마다 2건씩이었습니다. 1건은 아래 Reddit 비교용이었고, 1건은 일부러 잘못된 값을 넣었습니다. 모든 호출이 동기 방식으로 응답했으며 비동기 작업은 필요하지 않았습니다.
| SGT | 기능 | 파라미터 | 행 | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | 로봇청소기 추천, 답변만 | 20 | $0.000556 |
| 00:16:17 | weibo/search | 로봇청소기 | 13 | $0.000806 |
| 00:16:32 | xiaohongshu/search | 로봇청소기, 댓글순, 최근 30일 | 13 | $0.005556 |
| 00:17:22 | xiaohongshu/search | sort를 hot으로 설정 | 422 | $0 |
| 00:17:22 | xiaohongshu/search | 로봇청소기 불만, 좋아요순 | 20 | $0.005556 |
| 00:18:26 | zhihu/search | 로봇청소기 단점, 추천순 | 20 | $0.000556 |
| 00:18:31 | weibo/search | 로봇청소기 A/S | 12 | $0.000806 |
| 00:18:53 | reddit/search | 로봇청소기, 인기순 | 5 | $0.000556 |
| 합계 | 103개 행 | $0.014392 |
중국 앱 3곳은 서로 매우 다른 콘텐츠를 반환했습니다. 불만 키워드로 좋아요순 정렬한 Xiaohongshu 검색은 노트 20개를 반환했습니다. 대부분의 제목은 실제 사용 경험과 피해야 할 점을 다룹니다. 먼지봉투 설계, 금지 구역 설정이 작동하지 않아 로봇이 구덩이에 빠진 일, 반려동물 감지 문제, "호구들에게 걷는 세금 같은 가전" 같은 내용입니다. 20개 중 8개에는 유료 콘텐츠 표시가 있으며, 이들은 브랜드 리뷰와 구매 가이드입니다.
서구 브랜드에게 특히 중요한 행이 하나 있습니다. 2025년 12월 16일에 올라온 노트로, 제목에서 Dyson 로봇청소기를 사지 말라고 권합니다. 좋아요 1,444개, 댓글 53개를 받았습니다. 본문에서는 제품이 나쁘지는 않지만 가성비가 너무 낮다고 말합니다. 중국에서 판매하는 서구 브랜드는 이런 노트를 앱 안에서만 찾을 수 있습니다.
아래 표는 해당 검색 결과 중 5개 행과 각 제목에 대해 저희가 작성한 영어 요약을 보여 줍니다. 참여 지표 필드가 무엇을 더해 주는지 알 수 있습니다. 어떤 불만이 가장 많은 논의를 일으켰는지 한눈에 보입니다.
| 게시일 | 제목(요약) | 좋아요 | 댓글 | 유료 표시 |
|---|---|---|---|---|
| 2026-10-16 | 반려동물 친화형 로봇인데도 걱정하던 사고가 결국 일어났다 | 3,710 | 183 | false |
| 2023-09-17 | 출입 금지 구역을 한 달 동안 무시하던 로봇이 결국 구덩이에 빠졌다 | 3,445 | 1,937 | false |
| 2025-12-16 | Dyson 로봇청소기는 사지 마세요 | 1,444 | 53 | false |
| 2026-10-25 | 한 브랜드의 먼지 봉투 디자인에 대한 불만 | 992 | 571 | false |
| 2026-07-06 | 순진한 소비자에게 물리는 세금 같은 가전 | 553 | 973 | false |
추천 관련 Zhihu 검색에서는 답변 20개가 반환되었고, 대부분 구매 가이드와 모델 목록이었습니다. Weibo 검색에서는 게시물 25개가 반환되었으며, 모두 11월 2일을 기준으로 직전 일주일 사이에 올라온 글이었습니다. Weibo 결과에는 가장 다양한 유형의 콘텐츠가 섞여 있었습니다. 조언을 구하는 사용자도 있었고, 기기가 2년 만에 고장 났는데 해당 브랜드에는 예비 부품이 없었다고 말한 사용자도 있었습니다. 브랜드 캠페인 게시물과 쇼핑 가이드 게시물도 있었습니다.
콘텐츠 종류마다 쓰임새가 다릅니다. 사람들이 반복해서 지적하는 구체적인 결함을 보려면 좋아요순이나 댓글순으로 정렬한 Xiaohongshu에서 가장 관련성 높은 결과를 얻을 수 있습니다. 무엇을 살지에 대한 전문가 분석은 Zhihu의 긴 답변에 정보가 가장 많습니다. 이번 주에 새로 나온 A/S 문제는 Weibo에서 가장 최신 정보를 얻을 수 있습니다. 웹 검색만 쓰는 어시스턴트는 이 세 가지 관점을 모두 얻기 어렵습니다. 어떤 게시물이 대표적인지 보여 주는 반응 수도 얻지 못합니다.
영어권 팀이라면 Reddit 호출 결과와 비교해 보는 것이 도움이 됩니다. "robot vacuum"의 상위 결과 5개는 10월 7일부터 10월 22일 사이에 게시되었습니다. 모두 유머 커뮤니티나 주제와 무관한 커뮤니티에서 나왔습니다. 1위는 r/TikTokCringe의 동영상 게시물(좋아요 6,551개), 2위는 r/homeassistant의 "로봇청소기 차고"(좋아요 3,076개)였습니다. 3위는 r/futurama에 올라온, 만화 캐릭터로 꾸민 로봇청소기로 좋아요 2,998개를 받았습니다. 구매자 불만은 하나도 없었습니다.
| 게시일 | 커뮤니티 | 제목 | 좋아요 | 댓글 |
|---|---|---|---|---|
| 2026-10-20 | r/TikTokCringe | 최첨단 일본 로봇청소기 | 6,551 | 107 |
| 2026-10-16 | r/homeassistant | 로봇청소기 차고 | 3,076 | 176 |
| 2026-10-14 | r/futurama | 청소부 Scruffy와 걸레 양동이로 꾸민 우리 집 로봇청소기 | 2,998 | 76 |
| 2026-10-07 | r/Perfectfit | TV 거치대 밑에 딱 들어가는 우리 집 로봇청소기 | 1,773 | 16 |
| 2026-10-22 | r/BORUpdates | AITAH, 사촌의 배우자와 나눠 갖기를 거부한 제가 잘못인가요? (주제와 무관) | 1,102 | 222 |
결국 어떤 앱이든 "top"은 유용한 것이 아니라 인기 있는 것을 보여 줍니다. 서구권 앱에서도 정렬 방식과 키워드 선택이 중요합니다. 선택할 수 있는 옵션은 Reddit 검색 기능 페이지에 정리되어 있습니다.
테스트 2: 찬성순으로 정렬하자 Zhihu 행 20개 중 최근 게시물은 0개
제품 관련 질문에서 가장 자주 문제가 되는 것은 "최신" 정보입니다. 로봇청소기는 1년에도 여러 번 바뀌므로 2년 전 구매 가이드는 더 이상 맞지 않을 수 있습니다. 저희는 posted_at을 기준으로 각 호출 결과에서 최근 30일, 즉 2026년 10월 4일 이후에 게시된 행을 셌습니다. 앱 검색 6건의 결과는 크게 달랐습니다.
극단적인 사례는 찬성 많은 순으로 정렬한 Zhihu 검색입니다. 20개 행 중 18개가 2026년 이전에 게시되었고, 가장 오래된 것은 2015년 게시물입니다. 제목은 더 눈에 띕니다. 20개 제목 중 9개가 2026년을 언급합니다.
이 9개 중 8개는 2026년 이전에 게시되었습니다. 가장 오래된 답변은 2018년 4월 12일에 게시되었지만, 제목에는 2026년 구매 가이드라고 적혀 있습니다. 이런 답변은 작성자가 해마다 본문과 연도를 업데이트하는 에버그린 콘텐츠입니다. 본문은 최신일 수 있지만, 제목만 보는 독자나 모델은 올해 게시된 글로 오해하게 됩니다.
웹 결과의 date로 이런 경우를 잡아낼 수 있을까요? 크롤링 시점에 페이지가 어떤 날짜를 표시했는지에 달려 있습니다. DeepSeek 문서는 날짜를 알 수 없을 때 date가 null이라고만 설명합니다. 플랫폼 내부 데이터는 앱 자체가 기록한 게시 시각을 제공하므로 제목과 바로 비교할 수 있습니다.
해결 방법은 간단합니다. "최근" 질문에는 Xiaohongshu에서 date_range=last_30_days와 sort=most_commented를, Zhihu에서 sort=time_descending을 사용합니다. Weibo는 기본적으로 최근 게시물을 반환합니다. "장기적인 평판" 질문에는 좋아요순으로 정렬하고, 모델에게 각 출처의 게시 연도를 함께 밝히도록 지시합니다.
비용 측면의 세부 사항도 있습니다. last_30_days를 쓴 Xiaohongshu 호출은 13개 행만 반환했습니다. 카탈로그에 따르면 이 필터를 쓰면 한 페이지에 20개보다 적은 행이 나올 수 있으며, 결과가 있는 페이지는 한 페이지로 과금됩니다. 그래서 이 호출의 결과 1,000개당 가격은 $0.427로, 꽉 찬 페이지의 $0.278보다 54% 높았습니다.
테스트 3: 먼저 걸러야 할 행
다섯 번째 기준은 실패할 것으로 예상했고, 실제로 실패했습니다. 앱마다 그대로 사용하면 "구매자 목소리"를 왜곡하는 행 유형이 하나씩 있습니다.
Xiaohongshu에서는 is_cooperation_note가 가장 직접적인 필드입니다. 33개 행 중 12개에서 이 값이 true였습니다. 최근 30일 댓글 많은 순 호출에서는 13개 중 4개, 좋아요순으로 정렬한 불만 검색 호출에서는 20개 중 8개였습니다. 유료 노트라고 해서 항상 거짓은 아닙니다.
하지만 "구매자가 무엇에 불만을 갖는가"라는 질문에 답할 때 이런 행은 브랜드가 보여 주려는 메시지를 담고 있습니다. 따라서 이런 행은 따로 묶거나 답변에서 표시해 두어야 합니다. 이 필드는 플랫폼 내부 데이터에만 있습니다. 웹 결과에는 이에 해당하는 필드가 없습니다.
최근 30일 댓글 많은 순 Xiaohongshu 검색에는 두 번째 종류의 노이즈도 있었습니다. 상위 행은 좋아요 14,963개를 받은 길 잃은 로봇 밈, 피트니스 영상, 공포 게임 클립이었습니다. 해시태그를 단 인기 게시물일 뿐 구매자 후기가 아닙니다. 따라서 구매자의 문제를 찾으려면 "불만"이나 "단점"처럼 불편 사항이 들어간 키워드를 사용하십시오.
Weibo의 문제는 노이즈입니다. 25개 행 중 10개는 좋아요도 댓글도 없었습니다. 이 중 9개는 인증 계정에서, 8개는 팔로워 100,000명 이상인 계정에서 나왔습니다. 여기에는 브랜드 캠페인 게시물과 쇼핑 가이드 게시물이 섞여 있었습니다.
한 브랜드의 라이브 방송 공지는 좋아요 2,435개, 댓글 421개를 받았습니다. 이런 게시물은 반응은 많지만 구매자 불만이 아닙니다. author_verified_reason과 본문의 상품 링크로 찾아낼 수 있습니다.
유용한 게시물은 팔로워가 수십 명이나 수백 명인 계정에서 나오는 경우가 많습니다. 이런 게시물은 브랜드와 결함을 구체적으로 짚습니다. 11월 2일 게시물에는 2024년 3월에 산 로봇청소기가 약 2년 만에 고장 났다는 내용이 있습니다. A/S 측은 해당 모델이 단종되어 부품이 없다며 200위안 상당의 보상 판매만 제안했습니다.
이 게시물은 좋아요 0개, 댓글 1개였습니다. 그래도 실제 A/S 문제를 보여 주는 사례입니다. 따라서 필터에서 반응이 적은 행을 단순히 버려서는 안 됩니다.
필터링한 뒤에는 행을 정렬합니다. 세 앱 모두 소수의 행에 반응 대부분이 몰려 있습니다.
최근 30일 댓글 많은 순 Xiaohongshu 호출은 노트 13개의 좋아요 합계가 124,557개였고, 상위 3개가 49%를 차지했습니다. 불만 검색 호출은 노트 20개, 좋아요 23,938개였고 상위 3개가 48%였습니다. Zhihu 추천 검색 호출에서는 답변 20개의 찬성 수 합계가 1,151개에 불과했습니다. 상위 3개가 75%였고 중앙값은 11이었습니다. A/S 검색 Weibo 호출은 게시물 12개, 좋아요 2,290개였습니다. 그중 한 게시물이 2,288개를 받았고, 나머지 11개는 모두 합쳐 2개였습니다.
| 호출 | 행 | 좋아요 또는 찬성 합계 | 상위 3개 행 비중 |
|---|---|---|---|
xiaohongshu/search, 댓글 많은 순, 최근 30일 | 13 | 124,557 | 49% |
xiaohongshu/search, 불만, 좋아요 많은 순 | 20 | 23,938 | 48% |
zhihu/search, 추천, 답변만 | 20 | 1,151 | 75% |
weibo/search, A/S | 12 | 2,290 | 100% |
앱이 반환한 순서 그대로 20개 행을 모델에 보내면 "다수 의견"이 인기 행 두세 개에서 나올 수 있습니다. 더 나은 방법은 루프 코드에서 행을 반응 순으로 정렬하고 author_id로 중복을 제거하는 것입니다. 그런 다음 각 행에 반응 수를 붙여 보냅니다. 그러면 모델이 독자에게 "이 노트는 좋아요가 992개입니다"나 "이 게시물은 좋아요가 0개이지만 구체적인 사실을 담고 있습니다"처럼 알려 줄 수 있습니다.
Python은 추가 라이브러리 없이 이 작업을 할 수 있습니다. like_count를 기준으로 하는 key 함수와 sorted()로 정렬합니다(Python 정렬 가이드). 이미 사용한 작성자는 set에 보관합니다. 이 단계에는 추가 호출 비용이 들지 않습니다.
답변은 어떤 모습일까: 실제 행으로 만든 형식 예시
저희는 모델을 실행하지 않았으므로 DeepSeek이 작성한 답변은 없습니다. 그래도 형식은 확인할 수 있습니다. 위의 실제 행을 바탕으로 답변 첫 부분을 직접 작성했습니다. 이것은 모델 출력이 아니라 형식 예시입니다. 모든 숫자는 원본 응답과 일치합니다. 링크에는 액세스 토큰이 포함되어 있어 "링크 생략"으로 표기했습니다.
첫 번째 불만 그룹은 먼지 봉투와 예비 부품에 관한 것입니다. 10월 25일 Xiaohongshu 노트는 한 브랜드의 먼지 봉투가 "들어가기만 하고 나오지는 않는다"고 지적하며, 좋아요 992개, 댓글 571개, 저장 914회를 기록했습니다(링크 생략, 유료 콘텐츠 아님). 두 번째 그룹은 A/S에 관한 것입니다. 11월 2일, 팔로워 124명인 Weibo 사용자는 2024년 3월에 산 기기가 2년 만에 고장 났다고 밝혔습니다. 브랜드는 해당 모델이 단종되었다며 200위안 보상 판매만 제안했습니다(링크 생략, 좋아요 0개, 댓글 1개). Zhihu에서 찬성순 상위 구매 가이드는 제목에 2026년이라고 적혀 있지만 대부분 2018년에서 2022년 사이에 게시되었습니다. 이런 가이드를 참고하기 전에 게시 연도를 확인하십시오.
예시의 각 주장에는 앱, 날짜, 반응 수, 유료 콘텐츠 표시가 붙어 있습니다. 시스템 프롬프트로 모델에 이 형식을 요구할 수 있습니다.
예시를 작성하면서 발견한 점도 있습니다. Zhihu 행 20개 중 3개씩을 차지한 작성자가 두 명 있었습니다. 한 작성자의 답변 3개는 거의 같은 문구로 시작하고, 각각 찬성 0개이며, 같은 글로 연결됩니다. 다른 작성자는 이틀 동안 답변 3개를 썼는데, 세 답변 모두 한 브랜드의 모델을 추천합니다. 이들을 서로 독립된 20개의 목소리로 세면 그 브랜드를 과대평가하게 됩니다.
따라서 행을 모델에 돌려보내기 전에 author_id로 중복을 제거하십시오. 작성자마다 반응이 가장 많은 행 하나만 남깁니다. 세 앱 모두 이 필드를 반환합니다. 코드는 몇 줄이면 되고, 모델에게 "반복 작성자에 주의하라"고 요청하는 프롬프트보다 더 신뢰할 수 있습니다.
테스트 4: 모델에 보내기 전에 토큰을 얼마나 아낄 수 있을까
이 흐름에서 가장 저렴한 단계는 결과를 모델에 돌려보내기 전에 필드를 제거하는 것입니다. 검색 3건의 토큰 수를 두 가지 형태로 추정했습니다. 하나는 원본 응답이고, 다른 하나는 필요한 13개 필드만 남긴 응답입니다. DeepSeek 토큰 사용량 가이드의 비율인 영어 문자당 약 0.3토큰, 중국어 문자당 약 0.6토큰을 적용했습니다. 이 값은 추정치이며, 실제 수치는 각 응답의 usage 필드에 있습니다.
| 검색 | 원본 문자 수 | 원본 토큰 수(추정) | 13개 필드만 남긴 문자 수 | 축소 후 토큰 수(추정) |
|---|---|---|---|---|
xiaohongshu/search 불만, 좋아요 많은 순 | 33,905 | 10,549 | 7,302 | 2,542 |
zhihu/search 단점, 찬성 많은 순 | 15,459 | 5,696 | 7,356 | 3,162 |
weibo/search A/S | 10,786 | 3,624 | 3,873 | 1,458 |
| 합계 | 60,150 | 19,869 | 18,531 | 7,162 |
축소한 형태는 64% 더 작습니다. Xiaohongshu에서 가장 많이 줄어드는데, 원본 행에 이미지 목록, 아바타, 동영상 링크, 너비와 높이가 들어 있기 때문입니다. 이 중 답변에 도움이 되는 것은 없습니다. deepseek-flash의 피크 시간 입력 가격인 백만 토큰당 $0.30을 적용하면 19,869토큰은 $0.0060, 7,162토큰은 $0.0021입니다. 호출 한 번만 보면 차이는 작습니다.
하지만 도구 호출 루프에서는 새 요청마다 이전 결과가 다시 전송됩니다. 라운드가 늘어날수록 차이도 커집니다. DeepSeek에는 컨텍스트 캐시가 있으며, 영문 요금 페이지 기준으로 캐시에 적중한 입력은 피크 시간에 백만 토큰당 $0.006입니다. 따라서 다시 보내는 부분의 실제 비용은 훨씬 낮아지지만, 캐시에 적중할 때만 그렇습니다.
DeepSeek 컨텍스트 캐싱 가이드에 따르면, 요청의 접두부가 저장된 접두부 단위와 완전히 일치할 때만 캐시에 적중합니다. 채팅 API는 상태를 유지하지 않으므로 매 라운드마다 이전 메시지를 모두 다시 보내야 합니다(멀티 라운드 대화 가이드). 여기서 루프 코드에 적용할 규칙 두 가지가 나옵니다.
첫째, 이후 라운드에서 도구 결과를 수정하거나 순서를 바꾸지 말고, 시스템 프롬프트와 도구 정의는 맨 앞에 변경 없이 둡니다. 둘째, 결과를 처음 보내기 전에 필드 제거, 정렬, 중복 제거를 마칩니다. 그러면 두 번째 라운드부터는 앞부분이 캐시 가격으로 과금되고, 새 라운드 부분만 캐시 미스 가격으로 과금됩니다.
그래도 "최근 변경 사항" 섹션의 연구가 시사하듯, 컨텍스트가 작을수록 모델이 집중하기도 쉽습니다.
비용: DeepSeek Search API는 요청 1,000건당 $0.75, Xiaohongshu는 호출당 $0.005556
가격을 나란히 놓으면 결과가 분명합니다. 웹 검색은 저렴합니다. Zhihu와 Weibo는 웹 검색과 비슷한 수준이고, Xiaohongshu는 약 10배 더 비쌉니다.
한 가지는 분명히 밝혀 둡니다. 일반 웹 검색만 놓고 보면 요청 1,000건당 $0.75인 DeepSeek Search가 요청 1,000건당 $1.389인 EveryInfra 자체 web/search보다 저렴합니다. 호출당 최대 50개 결과도 반환합니다. 따라서 이 흐름에서는 웹 검색을 DeepSeek에 맡기고, EveryInfra는 플랫폼 내부 데이터만 담당하는 것이 맞습니다. 결과 1,000개당으로 보면 격차는 더 큽니다.
결과 1,000개당 비용은 DeepSeek이 count=50일 때 $0.015, Zhihu가 $0.028, Weibo가 $0.062~$0.067, Xiaohongshu가 $0.278~$0.427입니다. 하지만 두 종류의 결과는 행 수로 비교할 수 없습니다. 웹 결과와 반응 수가 붙은 앱 게시물은 서로 다른 질문에 답합니다.
| 질문당 호출 | 단가 | 호출 수 | 소계 |
|---|---|---|---|
| DeepSeek Search | $0.00075 | 2 | $0.0015 |
xiaohongshu/search | $0.005556 | 1 | $0.005556 |
zhihu/search | $0.000556 | 1 | $0.000556 |
weibo/search | $0.000806 | 1 | $0.000806 |
| 데이터 비용(플랜 B) | 5 | $0.008418 | |
| 모델 비용(추정, 피크 시간, 입력 약 16,000토큰, 출력 약 1,500토큰) | 약 $0.0066 |
모델 비용 추정치는 오차 범위가 넓습니다. 입력에는 축소한 앱 데이터 7,162토큰과, 결과 10개씩인 검색 2건의 웹 요약 약 8,400토큰을 포함했습니다. 출력은 1,500토큰으로 계산했습니다. 이 추정에는 다시 보내는 컨텍스트와 캐시 적중이 반영되어 있지 않습니다. 데이터 비용은 카탈로그 가격에 호출 수를 곱한 값이므로 정확합니다. 질문 하나의 총비용은 약 1.5센트(미화)이며, 데이터 비용의 66%가 Xiaohongshu에서 나옵니다.
Xiaohongshu 호출을 제한하는 방법: 세 가지 플랜
페이지당 $0.005556인 Xiaohongshu가 비용 관리의 핵심입니다. 목표는 Xiaohongshu 사용량 자체를 줄이는 것이 아닙니다. 유용한 정보를 더할 때만 사용하는 것이 목표입니다. 저희는 세 가지 플랜을 정했습니다. 모든 플랜에서 질문당 DeepSeek 검색은 2회입니다.
| 요금제 | Xiaohongshu | Zhihu | 질문당 | 질문 1,000개당 | Xiaohongshu 비중 | |
|---|---|---|---|---|---|---|
| A, 전체 | 3페이지 | 2회 | 2회 | $0.0209 | $20.89 | 80% |
| B, 기본 | 1페이지 | 1회 | 1회 | $0.0084 | $8.42 | 66% |
| C, 필요 시 | 질문의 30%에 대해 1페이지 | 1회 | 1회 | $0.0045 | $4.53 | 37% |
플랜 C의 30%는 저희가 정한 값이며, 측정한 비율이 아닙니다. Xiaohongshu가 필요한 경우를 판단하는 방법은 쉬운 것부터 어려운 것까지 세 가지입니다. 첫째, 제품 카테고리를 기준으로 합니다.
뷰티, 퍼스널 케어, 유아, 홈, 소형 가전처럼 Xiaohongshu에서 이야기가 활발한 카테고리는 Xiaohongshu를 조회합니다. 부품이나 산업재는 건너뜁니다. 둘째, 저렴한 앱부터 시도합니다. Zhihu와 Weibo에서 특정 모델을 언급한 최근 행이 이미 충분히 나오면 Xiaohongshu는 건너뜁니다.
셋째, 모델이 결정하게 하되, 위 코드의 BUDGET처럼 루프에 한도를 둡니다. 모델이 두 번째 페이지를 요청하면 "budget reached"를 반환합니다. 또한 꽉 찬 페이지가 필요할 때는 last_30_days를 쓰지 마십시오. 테스트 2에서 보았듯이 13개 행만 반환하고도 한 페이지 요금이 부과될 수 있습니다. "최신" 질문에는 sort=newest를 쓰면 꽉 찬 페이지가 반환됩니다. 카탈로그의 date_range 설명에도 같은 권장 사항이 있습니다.
또 다른 방법: 원격 MCP 서버를 연결한 DeepSeek Harness(구성 예시)
루프를 직접 작성하지 않는 경우도 있을 것입니다. DeepSeek의 오픈소스 에이전트인 DeepSeek Harness(빠른 시작)를 사용한다면 도구 정의를 생략하고 대신 EveryInfra 원격 MCP 서버를 연결하면 됩니다. Harness MCP 클라이언트 README에서는 MCP 서버마다 항목 하나를 사용합니다. 원격 서버는 streamable-http 전송 방식을 사용하며 헤더를 보낼 수 있습니다. 원격 서버의 도구는 모델에 mcp__<serverName>__<tool> 형태로 표시되며, 호출당 기본 타임아웃은 60초입니다.
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
    toolCallTimeoutMs: 90000
위의 requests 타임아웃과 같은 이유로 toolCallTimeoutMs를 60초에서 90초로 늘립니다. EveryInfra MCP 서버는 MCP 2026-07-28 사양과 Streamable HTTP 전송 방식을 따릅니다. 11월 3일에 키 없이 tools/list를 호출했을 때 도구 12개가 표시되었습니다. 앱 데이터용 도구는 everyinfra_call_api이며, 플랫폼, 액션, 파라미터를 받습니다. 인증 방법은 MCP 서버 페이지에서 설명합니다.
MCP 사양의 인가 섹션은 인가를 선택 사항으로 둡니다. 서버가 HTTP 기반 전송 방식을 사용한다면 이 섹션을 따라야 합니다. EveryInfra는 요청 헤더로 API 키를 받으므로, Harness 항목에는 headers만 있으면 되고 브라우저 로그인은 필요 없습니다.
Harness에는 자체 웹 검색이 있습니다. dsh-tool-web 패키지가 web_search와 web_fetch를 추가합니다. 기본적으로 최대 8개 출처를 반환하고, 최대 4개 쿼리를 보내며, 각 요약을 800자로 자릅니다. README에 따르면 현재 모델에 자격 증명이 없으면 DeepSeek 검색 백엔드가 도구 목록에 나타나지 않습니다. 이렇게 구성하면 Harness 세션 하나에서 웹 검색은 DeepSeek이, 앱 데이터는 MCP가 담당합니다. 역할 분담은 함수 버전과 같지만, 루프는 Harness가 실행합니다.
두 방법 중 무엇을 골라야 할까요? MCP 방식은 코드가 필요 없고, 모델이 카탈로그의 새 기능을 스스로 찾아냅니다. 하지만 모델에는 범용 도구 everyinfra_call_api 하나만 보이므로, 파라미터를 알려면 먼저 카탈로그를 읽어야 합니다. 그만큼 라운드가 한두 번 늘어납니다. 함수 방식은 정의를 직접 유지 관리해야 합니다.
대신 설명, enum, 가격이 모두 고정되므로 모델이 더 잘 선택하고, 코드에서 예산을 강제할 수 있습니다. 고정된 제품 흐름 하나라면 함수를, 팀을 위한 개방형 어시스턴트라면 MCP를 사용하십시오. 데이터 API와 함께 쓰는 Claude strict tool use 글에서도 같은 트레이드오프를 비교합니다.
작동하지 않는 것과 주의할 점
첫째, 저희는 DeepSeek Search 엔드포인트를 호출하지 않았습니다. 따라서 "robot vacuum"에 대한 DeepSeek 검색이 Xiaohongshu 노트를 몇 개나 찾는지에 대한 측정값은 없습니다. 이 글에서 DeepSeek에 관한 내용은 모두 공식 문서를 근거로 합니다. DeepSeek 인덱스에 앱 콘텐츠가 얼마나 들어 있는지, 얼마나 자주 갱신되는지도 측정하지 않았습니다. "스냅숏 시점과 호출 시점" 섹션은 앱 쪽만 다룹니다.
둘째, Xiaohongshu 검색 결과의 텍스트는 약 60자 분량의 발췌문입니다. 전문을 보려면 비용이 $0.005556인 노트 상세 호출이 필요합니다. 댓글도 별도로 과금됩니다. 셋째, 세 앱 모두 공개 콘텐츠만 반환합니다. 개인 메시지, 팔로워 전용 게시물, 삭제된 게시물은 가져올 수 없습니다. Zhihu 유료 콘텐츠는 요약만 제공됩니다.
페이지네이션에는 루프 코드에서 걸리기 쉬운 세부 사항이 두 가지 있습니다. Xiaohongshu 검색 페이지는 항상 20개 행이며, limit은 효과가 없습니다. 더 많은 행이 필요하면 마지막으로 받은 페이지의 next_page_token을 사용합니다. 이 토큰은 24시간 동안만 유효합니다. 대화를 저장했다가 다음 날 이어 가면 이전 토큰은 실패합니다.
그러면 검색이 1페이지부터 다시 시작되고 요금도 다시 부과됩니다. Zhihu는 기본 20개, 최대 100개 행을 반환합니다. Weibo는 기본 20개, 최대 50개를 반환합니다. 이 두 앱은 호출당 과금이므로 페이지를 넘기는 것보다 행 수를 늘리는 편이 저렴합니다.
넷째, 컴플라이언스 측면에서 짚어야 할 점이 두 가지 있습니다. 첫째, 앱 데이터에는 개인 사용자의 이름과 프로필이 포함되어 있습니다. 콘텐츠와 링크만 인용하십시오. 개인 사용자의 신상 정보를 수집하거나 표시해서는 안 됩니다. 10월 22일에 공개된 arXiv 논문(Social-HUMINT)은 LLM으로 공개 소셜 데이터에서 개인 특성을 추론할 때의 위험을 다룹니다.
제품 관련 주제라면 주제 수준에서만 다루십시오. 둘째, 중국 본토의 일반 대중에게 서비스하는 어시스턴트는 중국의 생성형 AI 서비스 관리 잠정 방법의 적용을 받습니다. AI 생성 콘텐츠 표시 방법은 2025년 9월 1일부터 적용됩니다. 이 내용은 법률 자문이 아닙니다. 구체적인 의무는 법무팀에 확인하십시오.
다섯째, 요청 속도 제한이 서로 다릅니다. EveryInfra 계정은 기본적으로 분당 60회입니다. 저희 테스트 키에는 분당 10회라는 별도 제한이 있었습니다. DeepSeek Search는 초당 100회를 허용합니다. 트래픽이 많다면 루프에 EveryInfra 쪽 요청을 위한 큐를 추가하십시오.
최근 변경 사항
2026년 10월 17일: DeepSeek, Search와 Fetch 공개. 같은 날 모델이 DeepSeek-V4.1-Flash-1017로 바뀌었습니다. 가중치는 Hugging Face에 공개되어 있습니다. 이제 DeepSeek 키 하나로 웹 검색까지 쓸 수 있으므로 별도 검색 서비스가 필요 없습니다.
2026년 11월 1일 00:00(베이징 시간): 클라이언트의 서버 측 검색 유료화. Claude Code, Codex, Harness를 통해 DeepSeek을 사용한다면 이제 월별 청구서에 검색 요금이 표시됩니다. DeepSeek 콘솔의 사용량 페이지를 확인하십시오.
2026년 10월 13일: AI 쇼핑 에이전트 논문 버전 5 공개. 이 arXiv 논문(Does Rank Still Matter?)은 7,000개 세션을 분석했습니다. AI 에이전트는 사람보다 더 많은 결과를 살펴봤지만, 중간 순위에 있는 결과는 가장 적게 확인되었습니다.
행이 많다고 항상 좋은 것은 아니라는 뜻입니다. 모델에 보내기 전에 반응 수나 시간순으로 행을 정렬하십시오. 정렬하지 않은 50개 행보다 더 신뢰할 수 있습니다. 테스트 3의 반응 데이터도 같은 단계를 가리킵니다.
2026년 10월 25일경: DeepSeek Harness MCP 클라이언트 문서 변경. Harness는 MCP 2026-07-28 버전을 지원합니다(MCP 클라이언트 README). 원격 서버는 Streamable HTTP를 사용합니다(MCP 패키지 README). 코드 없이도 DeepSeek 에이전트에 앱 데이터를 추가할 수 있다는 뜻입니다.
FAQ
DeepSeek API는 웹 검색을 지원하나요?
채팅 API는 자체적으로 웹을 검색하지 않습니다. 방법은 두 가지입니다. 첫째, Search 엔드포인트(POST /v1/tools/search)를 직접 호출하고 그 결과를 도구 결과로 모델에 전달합니다. 둘째, DeepSeek Harness, Claude Code, Codex 같은 클라이언트를 사용합니다.
이런 클라이언트는 서버 측 도구로 Search와 Fetch를 호출하며, 2026년 11월 1일부터 요청당 과금됩니다. (질문 출처: 검색 추천어 "does deepseek api support web search". 근거: DeepSeek Search 및 Fetch 가이드.)
DeepSeek Search API 요금은 얼마이며, 무료 등급이 있나요?
성공한 요청 1,000건당 $0.75입니다. 실패, 빈 결과, 타임아웃 요청은 무료이며, count는 가격에 영향을 주지 않습니다. 요금 페이지와 가이드에서 별도의 무료 검색 할당량은 찾지 못했습니다. 지급 잔액과 충전 잔액 모두 사용료 결제에 쓰이며, 지급 잔액이 먼저 차감됩니다. (질문 출처: 검색 추천어 "deepseek search api pricing", "deepseek search api free tier". 근거: DeepSeek 요금 페이지.)
DeepSeek Search API 키는 모델 키와 같나요?
네. 가이드에 따르면 Search와 Fetch는 DeepSeek API와 동일한 Bearer 인증을 사용합니다. 키는 DeepSeek 플랫폼에서 생성합니다. 요청 속도 제한은 키가 아니라 계정 단위로 적용됩니다. (질문 출처: 검색 추천어 "deepseek search api key". 근거: DeepSeek Search 및 Fetch 가이드, 요청 속도 제한 페이지.)
DeepSeek Search와 Fetch API의 차이는 무엇이고, Fetch는 언제 써야 하나요?
Search는 쿼리 하나에 대해 여러 결과를 반환합니다. Fetch는 URL 하나에 대해 전체 페이지를 Markdown으로 반환합니다. Search도 need_content로 페이지 본문을 반환할 수 있습니다. 따라서 Fetch는 이미 링크가 있고 전문이 필요할 때 사용합니다. 앱 데이터에서 얻은 브랜드 사이트 링크가 그 예입니다.
Fetch는 대상 사이트의 접근 정책에 따라 결과가 달라집니다. 콘텐츠를 가져오지 못하면 404를 반환하며, 요금은 부과되지 않습니다. (질문 출처: 검색 추천어 "deepseek search fetch api". 근거: Fetch API 레퍼런스.)
DeepSeek Harness 검색 API: Harness에서 다른 검색 제공자를 쓸 수 있나요?
네. Harness는 웹 검색을 플러그인으로 추가합니다. web_search 도구는 dsh-tool-web 플러그인에서 제공되며, 백엔드를 다른 검색 플러그인으로 바꿀 수 있습니다. 앱 데이터는 MCP 클라이언트를 통해 원격 서버로 연결합니다. (질문 출처: 검색 추천어 "deepseek harness search provider". 근거: dsh-tool-web README, Harness 저장소.)
DeepSeek API 함수 호출은 strict 모드를 지원하나요?
네. 베타 기본 URL(https 접두사를 붙인 api.deepseek.com/beta)을 사용하고 모든 함수에 strict: true를 설정합니다. 모든 속성을 required에 나열하고 additionalProperties를 false로 설정합니다. minLength, maxLength, minItems, maxItems는 지원되지 않습니다.
strict 모드는 사고(thinking) 모드와 비사고 모드 모두에서 작동합니다. (질문 출처: 검색 추천어 "deepseek api function calling". 근거: DeepSeek 도구 호출 가이드.)
시작하는 방법
먼저 EveryInfra 빠른 시작에서 API 키를 만듭니다. 카탈로그는 무료로 조회할 수 있으니 xiaohongshu/search, zhihu/search, weibo/search의 파라미터와 가격을 확인하십시오. 플랫폼별 개요는 Xiaohongshu 데이터 API, Zhihu 데이터 API, Weibo 데이터 API에서 볼 수 있습니다. 전체 가격은 요금 페이지에 있습니다.
둘째, 이 글의 도구 정의 4개와 루프 코드를 복사합니다. 키 두 개를 넣고 질문 하나를 처음부터 끝까지 실행해 봅니다. 셋째, 비용 섹션에서 질문량에 맞는 플랜을 고르고 BUDGET에 한도를 설정합니다. 다른 도구로 같은 아이디어를 구현한 글이 두 편 있습니다. 하나는 Xiaohongshu 댓글을 위한 Claude Code 동적 워크플로이고, 다른 하나는 원격 MCP 서버를 연결한 Gemini Deep Research입니다. 댓글 데이터의 경우 Weibo 댓글도 Xiaohongshu 댓글과 같은 방식으로 작동합니다.
참고 자료
- “Search & Fetch”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/guides/search
- “Search API reference”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/api/search
- “Fetch API reference”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/api/fetch
- “Models & Pricing”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/quick_start/pricing
- “DeepSeek-V4.1-Flash-1017 release note”, DeepSeek, 2026-10-17, https://api-docs.deepseek.com/news/news261017
- “Tool Calls”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/guides/tool_calls
- “Thinking Mode”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/guides/thinking_mode
- “Rate Limit & Isolation”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/quick_start/rate_limit
- “Token & Token Usage”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/quick_start/token_usage
- “Integrate with Claude Code”, DeepSeek API Docs, 2026-11-03 열람, https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- “API keys” 페이지, DeepSeek Platform, 2026-11-03 열람, https://platform.deepseek.com/api_keys
- “DeepSeek-V4.1-Flash-1017” 모델 카드, Hugging Face, 2026-11-03 열람, https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- DeepSeek Harness 저장소, GitHub, 2026-11-03 열람, https://github.com/deepseek-ai/deepseek-harness
- “DeepSeek Harness quick start”, 2026-11-03 열람, https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- “dsh-tool-web README”, GitHub, 2026-11-03 열람, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- “dsh-mcp-client README”, GitHub, 2026-11-03 열람, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- “Harness MCP packages README”, GitHub, 2026-11-03 열람, https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python, GitHub, 2026-11-03 열람, https://github.com/openai/openai-python
- openai, PyPI, 2026-11-03 열람, https://pypi.org/project/openai/
- “Function calling”, OpenAI developer docs, 2026-11-03 열람, https://platform.openai.com/docs/guides/function-calling
- “Advanced Usage”(타임아웃), Requests docs, 2026-11-03 열람, https://requests.readthedocs.io/en/latest/user/advanced/
- “json, JSON encoder and decoder”, Python docs, 2026-11-03 열람, https://docs.python.org/3/library/json.html
- “MCP Specification 2026-07-28”, Model Context Protocol, 2026-11-03 열람, https://modelcontextprotocol.io/specification/2026-07-28
- “Transports”, MCP 2026-07-28, 2026-11-03 열람, https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- “Tools”, MCP 2026-07-28, 2026-11-03 열람, https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- “Authorization”, MCP 2026-07-28, 2026-11-03 열람, https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- “Weibo open platform API list”, 2026-11-03 열람, https://open.weibo.com/wiki/API
- “Network Data Security Management Regulations”, 중국 정부, 2024-09-30, https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- “Interim Measures for the Management of Generative AI Services”, 중국 국가인터넷정보판공실, 2023-07-13, https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- “Measures for Labeling AI-Generated Synthetic Content”, 중국 국가인터넷정보판공실 외, 2025-03-14, https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- “Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf”, arXiv:2608.22697v5, 2026-10-13, https://arxiv.org/abs/2608.22697
- “Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure”, arXiv:2610.31573, 2026-10-22, https://arxiv.org/abs/2610.31573
- EveryInfra 데이터 카탈로그, 2026-11-03 00:13(SGT) 열람, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra Xiaohongshu 카탈로그, 2026-11-03 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- EveryInfra Zhihu 카탈로그, 2026-11-03 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- EveryInfra Weibo 카탈로그, 2026-11-03 열람, https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- “Context Caching”, DeepSeek API docs, 2026-11-03 열람, https://api-docs.deepseek.com/guides/kv_cache
- “Multi-round Conversation”, DeepSeek API docs, 2026-11-03 열람, https://api-docs.deepseek.com/guides/multi_round_chat
- “Sorting Techniques”, Python docs, 2026-11-03 열람, https://docs.python.org/3/howto/sorting.html
- “Built-in Types: set”, Python docs, 2026-11-03 열람, https://docs.python.org/3/library/stdtypes.html#set-types-set-frozenset
참고 BL-73