DeepSeek Search API:平台内数据怎么补
DeepSeek Search API 每千次 $0.75,返回网页结果但不带点赞和收藏。用函数调用接小红书、知乎、微博,7 次真调花 $0.014。
DeepSeek 在 2026 年 10 月 17 日把 Search 和 Fetch 两个接口开放给所有 API 用户,每 1,000 次成功请求 5 元(英文价格页写 $0.75),返回的每条结果只有标题、链接、摘要、正文、站点、发布时间和两个评分,没有点赞、评论、收藏这类互动数(DeepSeek 网页搜索与抓取文档)。我们在 11 月 3 日 00:15–00:19(新加坡时间)用 EveryInfra 的 xiaohongshu/search、zhihu/search、weibo/search 对同一个话题「扫地机器人」各搜了两次,98 行结果里点赞数、评论数和发布时间的非空比例都是 100%,小红书 33 条里还有 12 条被标成了品牌商业合作笔记,这些是回答「大家最常吐槽什么」时最需要、网页搜索结果里又没有的字段。代价也很清楚:小红书搜一次 $0.005556,是 DeepSeek Search 一次的 7.4 倍,所以整套流程的花费主要由「小红书调几次」决定,按本文的控量方案,每 1,000 个问题的数据费可以从 $20.89 降到 $4.53。
这篇文章要回答一个具体问题:DeepSeek 有了自己的网页搜索接口以后,开发者做一个「问消费品口碑」的小助手,还缺什么、怎么补、补一次多少钱。DeepSeek 一侧的每一条事实都来自 api-docs.deepseek.com 的原文,我们没有 DeepSeek 的 API Key,所以模型和 Search 接口那一侧写成「配置示例」;EveryInfra 一侧的每个数都来自真调的原始返回。站内另一篇 DeepSeek V4 接 Claude Code 洗评论讲的是把 DeepSeek 当作 Claude Code 的模型、清洗评论的成本,只用一节概述了 Search/Fetch;本文换一个方向,从 Search 接口本身出发,讲它和平台内数据怎么分工。
deepseek api web search:DeepSeek Search API 能做什么(按 11 月 3 日读到的原文)
先把对方的能力说清楚,后面的分工才有依据。按 DeepSeek 网页搜索与抓取文档,Search 和 Fetch 是两个「原始 JSON 接口」,和对话模型共用同一把 API Key,鉴权方式是 Authorization: Bearer。Search 按一个查询词搜网页,返回结构化结果,背后是 DeepSeek 自研的搜索引擎;Fetch 抓单个网页,把正文转成 Markdown。两个接口都不经过模型,也就不按 token 计费。文档里的端点、参数和返回字段如下表,我们逐项对过 Search 接口参考和 Fetch 接口参考。
| 项 | Search | Fetch |
|---|---|---|
| 端点(域名 api.deepseek.com) | POST /v1/tools/search | POST /v1/tools/fetch |
| 请求参数 | query(1~128 字符,支持 site:、lang:、after:、before: 等语法)、count(1~50,默认 10)、ori_question、localization(IP)、need_content | url(≤8,192 字符,http/https,不能带用户名密码) |
| 返回 | results 数组,每条 10 个字段:rerank_score、title、url、snippet、summary、content、site_name、site_icon、date、authority | title、content(Markdown) |
| 价格 | 每 1,000 次成功请求 5 元 / $0.75,count 不影响单价 | 同左 |
| 不计费 | 失败、results 为空、超时 | 失败、没有正文、超时 |
| 限速 | 每账户每秒 100 次 | 每账户每秒 25 次,另有按目标域名的限速 |
这里面有三个细节值得开发者留意。第一,summary 是给模型读的长摘要,文档说通常 600~800 字符,snippet 是给界面展示的短摘要,100~200 字符;如果把 10 条结果的 summary 都塞进上下文,单次搜索就有 6,000~8,000 字符。第二,date 是网页的发布时间,统一成 UTC,「未知时为 null」;authority 是 0~4 的权威性分级,-1 表示未知,rerank_score 是 0~3 的综合排序分,文档说 1.5 分以上算优质结果。第三,Search 的 query 会原样转给搜索服务,所以 site:xiaohongshu.com 这类语法可以写,但能搜到多少,取决于这个站点有多少页面进了 DeepSeek 的索引,而且索引里存的是抓取那一刻的页面,这一点后面「快照和调用时刻」一节用真调数据说明。
错误处理也写得很清楚:错误格式和 OpenAI 兼容,param 字段恒为 null;408、429 和 5xx 可以等一会儿重试,402 是余额不足,其它 4xx 不改请求就不要重试(同一份文档的错误一节)。这和 EveryInfra 的做法接近:参数写错返回 422,并且告诉你哪个参数错了、可选值是什么,后面「一次真实往返」一节有原样返回。
deepseek search api pricing:11 月 1 日起哪些调用开始收费
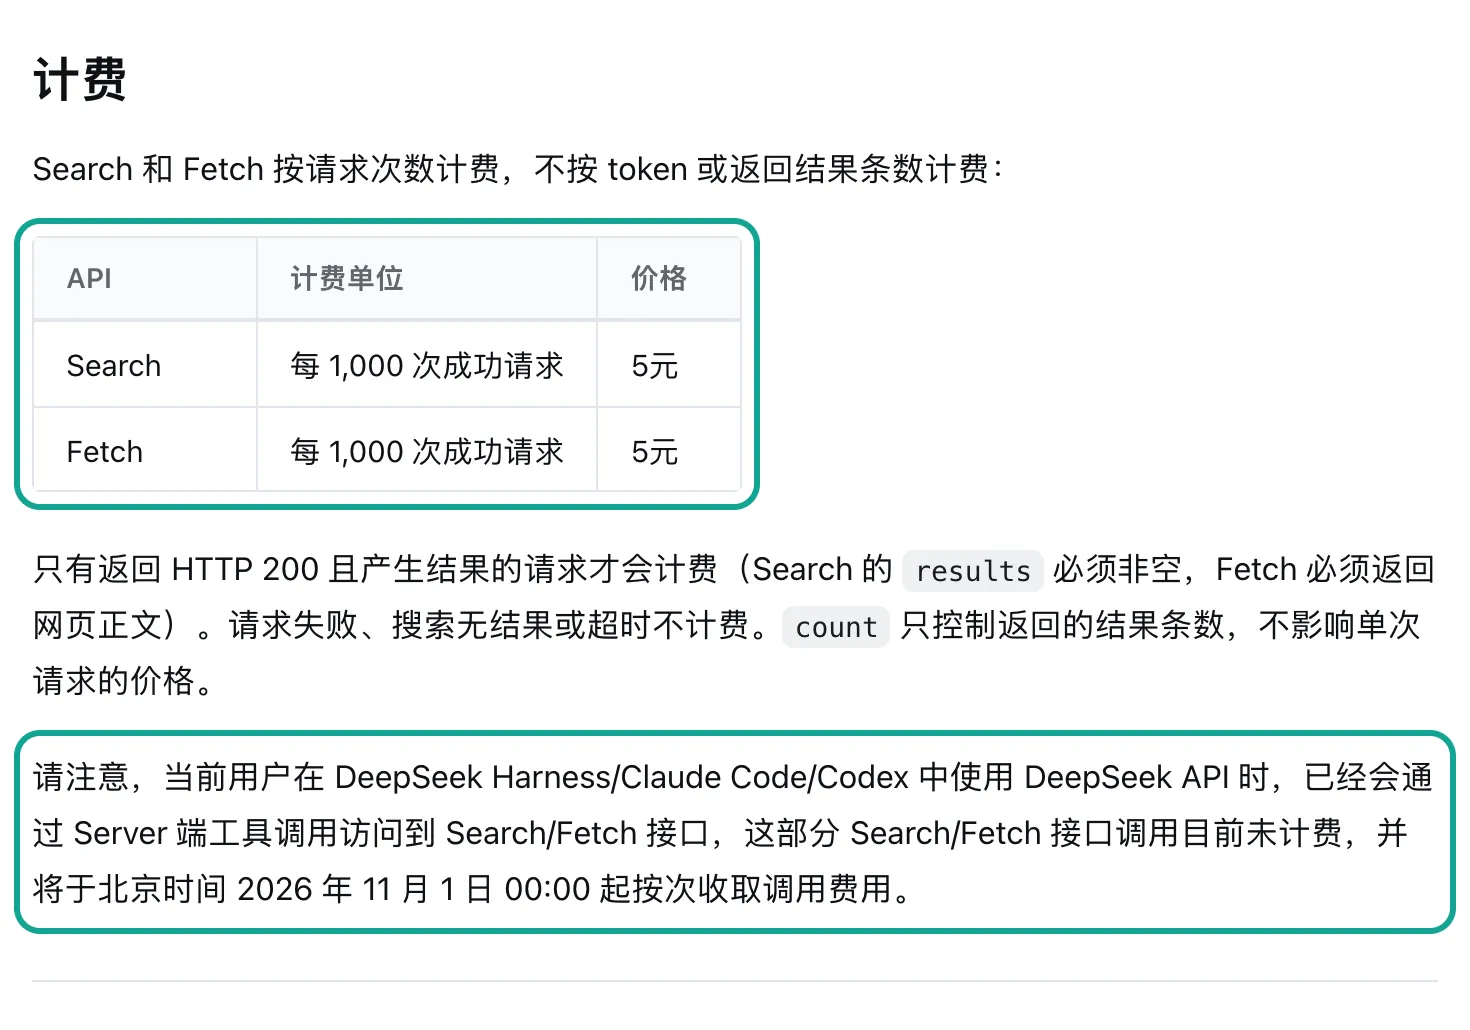
价格本身不复杂:Search 和 Fetch 都是每千次成功请求 5 元,英文价格页写 $0.75;count 只决定一次回几条,不影响单价,所以一次要 50 条和一次要 10 条是同一个价。按每千条结果算,count=50 时是 $0.015,count=10 时是 $0.075。
容易被忽略的是 10 月 17 日发布说明里的一句话:用户在 DeepSeek Harness、Claude Code、Codex 里用 DeepSeek API 时,这些客户端已经会经服务端工具调用访问 Search/Fetch,这部分「目前未计费」,从北京时间 2026 年 11 月 1 日 00:00 开始按次收费。英文版发布说明把时间写成 2026 年 10 月 31 日 16:00 UTC,两者是同一个时刻,换成新加坡时间也是 11 月 1 日 00:00。我们在 11 月 3 日读取时,中英文价格页和搜索指南里仍然是「目前未计费,并将于……起」这句原话,没有改写成「已开始计费」;按原文的日期,现在这些调用已经在计费期内。对用 Claude Code 接 DeepSeek 的开发者(DeepSeek 的 Claude Code 接入说明),这意味着让模型「上网查一下」除了 token 费,每千次还多 $0.75。
模型本身的价格也要一起看,因为搜索结果最终要喂给模型。按中文价格页,deepseek-flash(现在指向 DeepSeek-V4.1-Flash-1017)高峰时段每百万 token 输入(缓存未命中)2 元、输出 8 元,空闲时段减半;高峰是北京时间周一至周五 9:00–12:00 和 14:00–18:00。新加坡和北京同在 UTC+8,所以新加坡的开发者看自己的钟就行。英文页给的美元价是高峰输入 $0.3、输出 $1.2。上下文长度 1M,工具调用和 JSON 输出两个型号都支持。
| 计费项 | 单位 | 人民币(中文页) | 美元(英文页) | 读取日期 |
|---|---|---|---|---|
| Search | 每千次成功请求 | 5 元 | $0.75 | 2026-11-03 |
| Fetch | 每千次成功请求 | 5 元 | $0.75 | 2026-11-03 |
| deepseek-flash 输入(未命中,高峰) | 每百万 token | 2 元 | $0.30 | 2026-11-03 |
| deepseek-flash 输出(高峰) | 每百万 token | 8 元 | $1.20 | 2026-11-03 |
EveryInfra zhihu/search | 每千次成功请求 | — | $0.556 | 2026-11-03 |
EveryInfra weibo/search | 每千次成功请求 | — | $0.806 | 2026-11-03 |
EveryInfra xiaohongshu/search | 每千次成功请求 | — | $5.556 | 2026-11-03 |
EveryInfra 的三个价格取自免费目录的 price_usd 字段,规则和 DeepSeek 一样是失败和空结果不扣费。
网页结果和平台内数据的边界:一张字段表
两类数据的区别,最好的办法是把字段摆在一起看,不靠形容词。DeepSeek Search 每条结果的 10 个字段,是为「找到网页、给模型读摘要、在界面上展示」设计的:有链接、摘要、正文、站点名、发布时间和两个评分。平台内的搜索结果是为「判断一条内容在这个平台上反响如何」设计的:同样有标题、正文、链接和发布时间,另外带着点赞、评论、收藏、转发这些互动数,以及作者粉丝数、是否认证、是否商业合作这些作者和内容属性。下面这张表左列按 DeepSeek 文档,右三列按我们 11 月 3 日真调返回里实际出现的字段。
| 能回答的问题 | DeepSeek Search(文档字段) | `xiaohongshu/search` | `zhihu/search` | `weibo/search` |
|---|---|---|---|---|
| 这条内容说了什么 | title、summary、content | title、text(约 60 字摘要) | title、text | text |
| 在哪里能点开 | url | url(带访问令牌) | url | url |
| 什么时候发的 | date(可为 null) | posted_at、updated_at | posted_at | posted_at |
| 多少人赞同或收藏 | 无 | like_count、collect_count | like_count、collect_count | like_count |
| 讨论热不热 | 无 | comment_count、share_count | comment_count | comment_count、repost_count |
| 谁说的、可信度 | site_name、authority | author_name、author_id | author_name、author_follower_count、认证说明 | author_follower_count、author_verified、认证原因 |
| 是不是品牌投放 | 无 | is_cooperation_note、is_goods_note | 无 | 无(看认证原因判断) |
这张图有两点要说明边界。第一,「文档无」不等于 DeepSeek 拿不到这些数:它的 content 是网页正文,如果某个网页正文里写了「1.2 万赞」,模型也能读到,只是那是网页上的一段文字,不是一个能排序、能求和的字段,而且是抓取那一刻的数。第二,平台一列的 0% 有两种来源:一种是目录里本来就没有这个字段(比如知乎搜索没有分享数),另一种是目录里有、但这次返回里没给(比如目录写了小红书搜索有 author_is_verified,这 33 行里一行都没出现)。所以下游代码要按目录的 response_fields 写,并且允许字段缺失,不能假设每行都齐。
快照和调用时刻:同一条笔记的数字会变
字段之外还有一个时间上的差别。网页搜索返回的是索引里存的页面,也就是抓取那一刻的样子;DeepSeek 文档列出的 10 个返回字段里有发布时间 date,没有抓取时间,所以调用方看不出这条结果是哪天抓的。平台内搜索返回的是调用那一刻平台上的数:点赞、评论、收藏都是当时的值,小红书还多给一个 updated_at,目录的说明是「笔记最后编辑时间」。
这个差别在消费品话题里不小。小红书「扫地机器人 吐槽」按最多点赞排序的 20 条笔记里,13 条的最后编辑时间比发布时间晚 30 天以上,其中 5 条晚了一年以上,最长的一条发布后 1,154 天还在编辑。作者回头改正文、补「后续」、更新型号是常态,网页快照如果停在改之前,模型读到的就是旧版本。后面截图里那条 992 赞、571 评论的笔记,调用时发布才一周多;只要还有人在点赞和评论,任何一份几天前的快照记下的数都会比调用时小。微博更极端:两次搜索的 25 条全部发于调用前 4 天之内,「这几天有没有新的售后风波」这类问题,答案就在最近几天的帖子里。
所以两类来源的分工可以按时间来定。网页搜索适合找变化慢的内容:品牌官网的参数页、媒体评测、说明书和新闻稿,这些页面隔几周抓一次也不影响结论;平台内搜索适合找变化快的内容:最近一周的吐槽、正在发酵的售后问题、互动数还在涨的笔记,以及「按最新」「按点赞」「按评论」这些只有平台自己能排的顺序。两者是分工,不是谁取代谁。
动手前写下的判据
为了不在看到结果以后再改标准,我们在真调之前写下了这几条。它们决定后面每一节的结论能不能成立。
| 判据 | 通过 | 不通过 |
|---|---|---|
| 平台内数据是否带来网页结果里没有的字段 | 三个平台点赞、评论、发布时间的非空比例都 ≥90% | 任一平台低于 90% |
| 三个平台能否在 85 秒内同步返回 | 6 次调用都是 200,不需要转异步 | 出现超时或 503 |
| 参数写错时模型能否自己改 | 422 返回里有出错的参数名和可选值,且不扣费 | 只有笼统的错误信息,或者扣了费 |
| 小红书的花费能否控制住 | 有一套方案让每千个问题的数据费低于 $5 | 只能靠少问问题 |
| 结果能不能直接当「用户声音」 | 需要过滤的结果 ≤20% | 任一平台需要过滤的结果 >20%(这条我们预计会不通过) |
结果先写在这里:前四条通过,第五条三个平台都不通过,所以后面专门有一节讲怎么过滤。
流程:一个消费品问题怎样走两条路


整个流程只有四步,关键是第二步:DeepSeek 的模型自己不执行函数,它只在返回里给出 tool_calls,说「我想用这些参数调这个函数」,真正去调 DeepSeek Search 和 EveryInfra 的是你的程序(DeepSeek 工具调用文档原话:函数的功能需要用户自己提供,模型本身不执行具体函数)。这样设计的好处是两个接口的 Key 都留在你的服务器上,模型看不到;坏处是调度循环要自己写,下一节给出完整的配置示例。
第一步,用户提问。第二步,模型看了问题和 4 个函数的说明,决定先搜什么,可能一次就并行发出 4 个调用:一个网页搜索,三个平台搜索。第三步,你的程序分别调两个接口,把原始 JSON(或者删减过字段的 JSON)用 role: tool 的消息交回,tool_call_id 要对上。第四步,模型读完所有结果再写回答,系统提示里要求它每条结论后面附上来源的 url,并写明这条来源的点赞数和发布日期。问题如果需要追问(比如「石头和科沃斯分别被吐槽什么」),模型会再发一轮调用,循环直到它不再返回 tool_calls。
这个流程里,网页搜索和平台内数据各自负责一件事。网页搜索负责找到品牌官网、参数页、媒体评测和新闻,回答「这款机器有哪些功能、官方怎么说」;平台内数据负责找到真实用户在小红书、知乎、微博上的说法和反响,回答「买了的人怎么评价、哪些问题被反复提起」。把两类来源都放进回答,读者既能看到官方说法,也能看到用户声音,两者对不上的地方往往就是最值得写出来的结论。
工具定义:四个函数的 JSON 写全(配置示例)
下面是挂给 DeepSeek 模型的 4 个函数。三个平台函数的参数名、枚举值和说明逐个取自 EveryInfra 目录的 param_meanings 和 allowed_values,网页搜索函数的参数取自 DeepSeek 的 Search 接口参考。我们用的是 strict 模式的写法:按 DeepSeek 工具调用文档,strict 模式要把 base_url 换成 api.deepseek.com/beta(带 https 前缀),每个 object 的所有属性都要列进 required,并且 additionalProperties 设为 false。所以「可选参数」不能直接省略,我们用两种办法处理:有默认值的枚举,把默认值放进枚举让模型显式选(sort 选 relevance、date_range 选 any_time);没有默认值的字符串(翻页游标),用 anyOf 允许 null。
[
  {
    "type": "function",
    "function": {
      "name": "web_search",
      "strict": true,
      "description": "Search the open web with DeepSeek Search. Use for brand sites, spec pages, media reviews and news. Returns title, url, summary and date; no likes or comments.",
      "parameters": {
        "type": "object",
        "properties": {
          "query": {"type": "string", "description": "1-128 characters. Supports site:, -site:, lang:, after:, before:."},
          "count": {"type": "integer", "minimum": 1, "maximum": 50, "description": "Results to return. Price per call does not change with count."}
        },
        "required": ["query", "count"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "xiaohongshu_search",
      "strict": true,
      "description": "Search Xiaohongshu notes. One page = 20 rows = USD 0.005556. Rows include like_count, collect_count, comment_count, share_count, posted_at, is_cooperation_note. text is a ~60-char excerpt.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string", "description": "Note search keyword, e.g. a product name plus a pain point."},
          "sort": {"type": "string", "enum": ["relevance", "newest", "most_liked", "most_commented", "most_collected"]},
          "date_range": {"type": "string", "enum": ["any_time", "last_24_hours", "last_7_days", "last_30_days", "last_6_months", "last_1_year"]},
          "content_type": {"type": "string", "enum": ["all", "image", "video"]},
          "page_token": {"anyOf": [{"type": "string"}, {"type": "null"}], "description": "next_page_token from the previous page, or null for page 1."}
        },
        "required": ["keyword", "sort", "date_range", "content_type", "page_token"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "zhihu_search",
      "strict": true,
      "description": "Search Zhihu answers, articles and videos. USD 0.000556 per call, up to 20 rows by default. Rows include like_count, comment_count, posted_at, author_follower_count.",
      "parameters": {
        "type": "object",
        "properties": {
          "keyword": {"type": "string"},
          "content_type": {"type": "string", "enum": ["all", "answer", "article", "video"]},
          "sort": {"type": "string", "enum": ["general", "upvote_count_descending", "time_descending"]}
        },
        "required": ["keyword", "content_type", "sort"],
        "additionalProperties": false
      }
    }
  },
  {
    "type": "function",
    "function": {
      "name": "weibo_search",
      "strict": true,
      "description": "Search public Weibo posts. USD 0.000806 per call, up to 20 rows by default. Rows include like_count, comment_count, repost_count, posted_at, author_verified, author_verified_reason.",
      "parameters": {
        "type": "object",
        "properties": {"keyword": {"type": "string"}},
        "required": ["keyword"],
        "additionalProperties": false
      }
    }
  }
]
为什么在说明里写价格?因为模型会读 description。把「一页 $0.005556」写进小红书函数的说明,再在系统提示里写「每个问题最多查一页小红书,先查知乎和微博」,模型在选择调用哪个函数时就有了成本信息。这不是硬限制,硬限制要在你的调度代码里做(下一节)。我们用脚本把上面 JSON 里的枚举和 11 月 3 日的目录逐个比对过,结果如下:
| 函数参数 | 目录 `allowed_values` | 工具定义里的 enum | 是否一致 |
|---|---|---|---|
xiaohongshu_search.sort | 5 个:relevance、newest、most_liked、most_commented、most_collected | 同 5 个 | 一致 |
xiaohongshu_search.date_range | 6 个:any_time 到 last_1_year | 同 6 个 | 一致 |
xiaohongshu_search.content_type | 3 个:all、image、video | 同 3 个 | 一致 |
zhihu_search.content_type | 4 个:all、answer、article、video | 同 4 个 | 一致 |
zhihu_search.sort | 3 个:general、upvote_count_descending、time_descending | 同 3 个 | 一致 |
web_search.count | DeepSeek 文档:1~50 | minimum 1、maximum 50 | 一致 |
这张表的意义在于:枚举写错时,EveryInfra 会返回 422 而不扣费,但模型要多走一轮才能改对。在定义里一次写对,就少一轮往返和一轮 token。目录随时可以免费读(小红书一项的目录),能力上新或者枚举变化时,重新生成工具定义即可。小红书搜索的说明和字段解释也可以在小红书爬虫接口页看到。知乎和微博两项的参数、可选值和返回字段分别在知乎目录和微博目录里,微博搜索只有一个 keyword 参数,所以它的函数定义最短,模型几乎不会写错。
调度代码:DeepSeek 的 tool_calls 循环(配置示例)
下面这段 Python 用 OpenAI 的 Python SDK(PyPI 上的 openai 包)连 DeepSeek,因为 DeepSeek 的对话接口兼容 OpenAI 格式(OpenAI 的函数调用说明是同一套 tools 结构)。两个接口用 requests 调,超时设 90 秒,因为 EveryInfra 同步调用的预算是 85 秒。结果交回模型前只保留 13 个字段,ensure_ascii=False 让中文按原字保存而不是转义(Python json 文档),转义会让 token 数多出好几倍。
import json, os, requests
from openai import OpenAI

ds = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com/beta")
EI = "https://api.everyinfra.com/api/v1/social"
KEEP = ["url", "title", "text", "like_count", "comment_count", "collect_count", "share_count",
        "repost_count", "posted_at", "author_follower_count", "author_verified", "is_cooperation_note"]
BUDGET = {"xiaohongshu_search": 1}          # 每个问题最多 1 页小红书

def web_search(query, count):
    r = requests.post("https://api.deepseek.com/v1/tools/search", timeout=60,
                      headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
                      json={"query": query, "count": count})
    r.raise_for_status()
    hits = r.json()["results"]
    return [{k: x.get(k) for k in ("title", "url", "summary", "date", "site_name")} for x in hits]

def social(platform, params):
    params = {k: v for k, v in params.items() if v is not None}
    r = requests.post(EI, timeout=90, json={"platform": platform, "action": "search", "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"})
    body = r.json()
    if r.status_code != 200:                  # 422 带 param、allowed、did_you_mean,原样交回让模型改
        return {"error": body.get("error", body)}
    rows = body["results"]
    return [{k: x[k] for k in KEEP if x.get(k) is not None} for x in rows]

def run(question, tools):
    used = {}
    msgs = [{"role": "system", "content": "每条结论后附来源 url、点赞数和发布日期;先查知乎和微博,必要时再查小红书。"},
            {"role": "user", "content": question}]
    while True:
        m = ds.chat.completions.create(model="deepseek-flash", messages=msgs, tools=tools,
                                       extra_body={"thinking": {"type": "enabled"}}).choices[0].message
        msgs.append(m)                        # 含 reasoning_content,带 tools 时必须整条交回
        if not m.tool_calls:
            return m.content
        for c in m.tool_calls:
            a = json.loads(c.function.arguments)
            used[c.function.name] = used.get(c.function.name, 0) + 1
            if used[c.function.name] > BUDGET.get(c.function.name, 99):
                out = {"error": "budget reached for this question; answer with what you have"}
            elif c.function.name == "web_search":
                out = web_search(**a)
            else:
                out = social(c.function.name.removesuffix("_search"), a)
            msgs.append({"role": "tool", "tool_call_id": c.id, "content": json.dumps(out, ensure_ascii=False)})
有两处要按 DeepSeek 文档特别处理。第一,思考模式默认开启,按思考模式文档,只要请求里带了 tools,之前每一轮的 reasoning_content 都必须完整交回,没有交回会得到 400;代码里直接 msgs.append(m) 就是为了这个。第二,strict 模式在 beta 地址下才生效,正式地址下 strict 字段不起作用,模型偶尔会少给一个参数,这时 EveryInfra 会回 422,模型读了再补。预算检查放在调度代码里而不是提示词里,是因为提示词只能「建议」,代码才能保证一个问题最多花多少钱。
一次真实往返:模型会发出什么,接口回了什么
模型一侧我们没有跑(没有 DeepSeek Key),按工具定义,它对「双 11 买扫地机器人,大家最常吐槽什么」可能发出的小红书调用是 {"keyword": "扫地机器人 吐槽", "sort": "most_liked", "date_range": "any_time", "content_type": "all", "page_token": null}。调度代码去掉 null 以后,发给 EveryInfra 的请求就是下面这样,这一次是真调:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"xiaohongshu","action":"search","params":{"keyword":"扫地机器人 吐槽","sort":"most_liked"}}'
2026 年 11 月 3 日 00:17:22(新加坡时间)这次请求返回 200,20 行,响应体 36,627 字节,billing.charged_usd 是 0.005556。同一分钟我们故意把 sort 写成 hot 再发一次,返回 422,code 是 invalid_value,did_you_mean 是 most_liked,allowed 列出 5 个合法值,next_steps 第一条原文是「Change only sort to a value in allowed, then resend. Nothing was charged.」。模型拿到这条 role: tool 消息,下一轮只改 sort 就能成功,不用人介入。
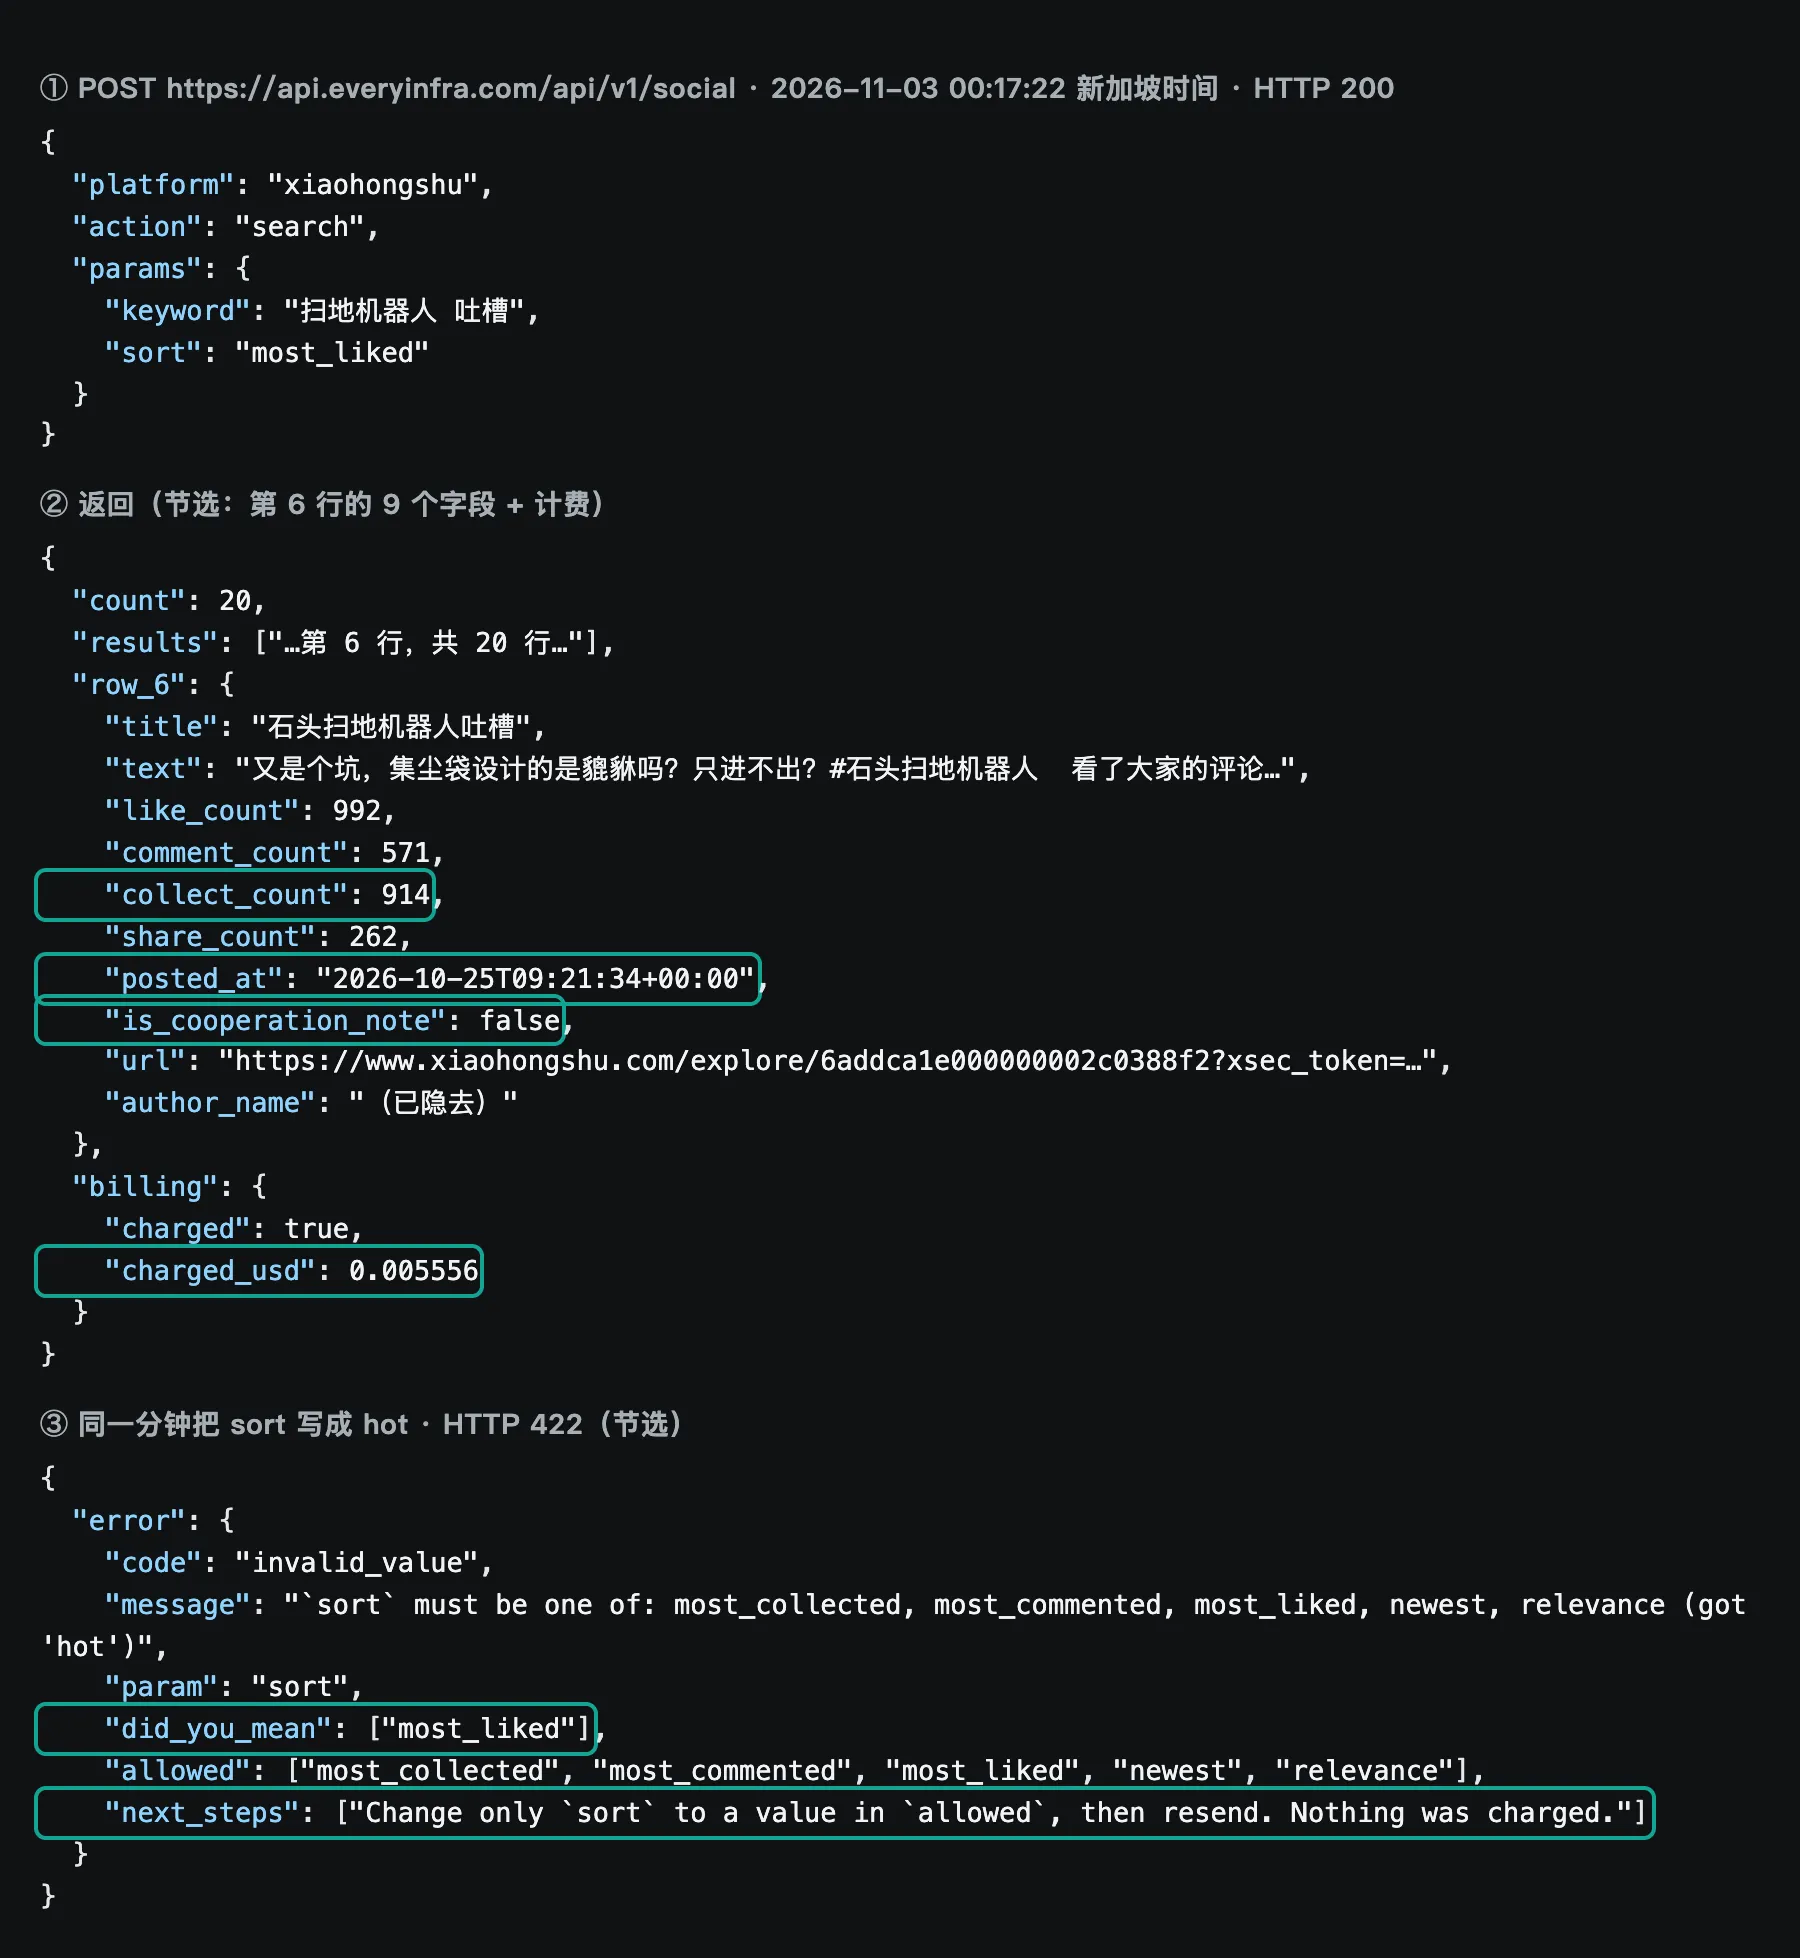
截图里第 6 行是一条 10 月 25 日发的笔记,标题「石头扫地机器人吐槽」,正文开头抱怨集尘袋「只进不出」,点赞 992、评论 571、收藏 914。这条笔记的评论数比点赞数的一半还多,说明它引发了讨论,这正是「最常吐槽什么」要找的信号;而一个网页搜索结果里,模型能看到的最多是这篇笔记的标题和一段摘要。如果要看评论里具体在吵什么,可以拿这条的 url 再调 xiaohongshu/note 拿全文,或者调评论能力,每次同样 $0.005556。
实测一:三个平台各回了什么
我们在 00:15–00:19(新加坡时间)对「扫地机器人」这个话题一共做了 7 次调用:6 次是三个平台各两次,1 次是故意写错参数。全部同步返回,没有一次需要转异步。
| 新加坡时间 | 能力 | 参数 | 返回条数 | charged_usd |
|---|---|---|---|---|
| 00:15:57 | zhihu/search | 扫地机器人 推荐,只要回答 | 20 | $0.000556 |
| 00:16:17 | weibo/search | 扫地机器人 | 13 | $0.000806 |
| 00:16:32 | xiaohongshu/search | 扫地机器人,最多评论,近 30 天 | 13 | $0.005556 |
| 00:17:22 | xiaohongshu/search | sort 写成 hot | 422 | $0 |
| 00:17:22 | xiaohongshu/search | 扫地机器人 吐槽,最多点赞 | 20 | $0.005556 |
| 00:18:26 | zhihu/search | 扫地机器人 缺点,最多赞同 | 20 | $0.000556 |
| 00:18:31 | weibo/search | 扫地机器人 售后 | 12 | $0.000806 |
| 合计 | 98 行 | $0.013836 |
三个平台给出的内容气质很不一样。小红书「吐槽」加「最多点赞」的 20 条,标题几乎都是体验和避坑:集尘袋设计、禁区设置失效后掉坑、宠物识别出问题、「智商税的电器」这类;其中 8 条带商业合作标记,是品牌投放的测评和攻略。知乎「推荐」的 20 条回答多是选购指南和型号推荐,20 条来自 14 个作者,其中两个作者各占 3 条:一个作者的 3 条回答开头文字几乎相同,都是 0 赞、引向同一篇推荐文章;另一个作者 10 月 15 日到 16 日写的 3 条,推荐的都是同一个品牌的型号。微博两次搜索共 25 条,全部是 11 月 2 日前后一周内发的,内容最杂:有用户求推荐上下水机型,有人抱怨某品牌机器停产后无配件、只能以旧换新,也有品牌官方账号的活动帖和电商导购帖。
这三种气质对应三种用途。要找「被反复提到的具体毛病」,小红书按点赞或评论排序最集中;要找「懂行的人怎么分析选购」,知乎的长回答信息量最大;要找「这几天有没有新的售后风波」,微博的时效最好。一个只用网页搜索的助手,很难同时拿到这三种视角,更拿不到每条的互动数来判断哪条更有代表性。
实测二:按点赞排序时,知乎 0/20 是近 30 天的
「新」是消费品问题里最容易出错的地方:扫地机器人一年迭代好几代,两年前的避坑指南可能已经不适用。我们按每条结果的 posted_at 算了一下,6 次平台搜索里发布于近 30 天(2026-10-04 之后)的比例差别极大。
最极端的是知乎按「最多赞同」排序的那一次:20 条里 18 条发于 2026 年之前,最早一条是 2015 年。更要细看的是标题:这 20 条里有 9 条标题写着「2026 年」,其中 8 条的 posted_at 在 2026 年之前,最早的一条发于 2018 年 4 月 12 日,标题却是「2026年扫地机器人选购」。这些多半是作者每年更新正文、改标题年份的长青回答,正文可能确实更新过,但读者和模型如果只看标题,会以为它是今年写的。网页搜索结果里的 date 能不能识别这种情况,取决于抓取时页面上标的是哪个时间,DeepSeek 文档只说未知时为 null;平台内数据给的是平台记录的发布时间,可以直接拿来和标题比。
处理办法很简单:问「最近」的问题时,小红书用 date_range=last_30_days 加 sort=most_commented,知乎用 sort=time_descending,微博默认就是近期内容;问「长期口碑」时再用点赞排序,并让模型在回答里写出每条来源的发布年份。还有一个计费上的细节:小红书 last_30_days 那次只回了 13 条,目录的说明写得很清楚,这一档一页可能不足 20 条,有结果就按一页计费,所以那一次每千条结果的单价是 $0.427,比满页的 $0.278 高 54%。
实测三:哪些结果要先过滤
判据第五条我们预计不会通过,结果也确实没通过:三个平台各有一类结果,直接当成「用户声音」会出偏差。
小红书的 is_cooperation_note 是最直接的一个字段。33 条里 12 条为 true,「最多评论 + 近 30 天」那次是 4/13,「吐槽 + 最多点赞」那次是 8/20。品牌合作笔记不等于内容不真实,但在「大家吐槽什么」这个问题里,它们代表的是品牌想让你看到的说法,应该单独归类,或者在回答里标注。这个字段只有平台内数据才有,网页搜索结果里没有对应项。
微博的问题是噪声多:25 条里 10 条既没有赞也没有评论,9 条来自认证账号,8 条来自粉丝 10 万以上的账号,其中有品牌官方的活动帖(一条品牌直播预告 2,435 赞、421 评论)和电商导购帖。这些帖子互动数高,但和「用户吐槽」无关。用 author_verified_reason(认证说明)和正文里的商品链接,可以把它们挑出来。真正有用的是那些粉丝几十到几百、带具体品牌和故障描述的帖子,比如一条 11 月 2 日的帖子说某品牌扫地机买了两年多,故障后被告知停产无配件、只能以旧换新,旧机只折 200 元。这种帖子的互动数可能是 0,但它是一条真实的售后信号,所以过滤规则不能简单地按互动数一刀切。
过滤之后还有排序。三个平台的互动数都高度集中在少数几条上:小红书「最多评论 + 近 30 天」那次 13 条共 124,557 赞,前 3 条占 49%;「吐槽 + 最多点赞」那次 20 条共 23,938 赞,前 3 条占 48%;知乎「推荐」那次 20 条只有 1,151 赞,前 3 条占 75%,中位数是 11 赞;微博「售后」那次 12 条共 2,290 赞,其中 2,288 赞落在同一条帖子上,其余 11 条加起来 2 赞。这意味着把 20 条结果按平台返回的顺序原样交给模型,模型读到的「多数意见」其实可能是两三条高赞内容的意见。更稳的做法是在调度代码里先按互动数排序、按 author_id 去重,再把每条的互动数一起交回,让模型在回答里说清楚「这是 992 赞的一条」还是「这是 0 赞但很具体的一条」。排序和去重用 Python 自带的 sorted(rows, key=lambda x: x.get("like_count") or 0, reverse=True) 加一个记录已见作者的集合就够(Python 排序指南),不需要额外的库,也不多花一次调用。
回答长什么样:按真实返回整理的格式样例
模型一侧没有跑,所以这里没有「DeepSeek 写出来的回答」。为了让读者看清系统提示要求的格式落到纸面上是什么样子,我们用前面三个平台的真实返回,手工按系统提示的规则整理了一段回答的开头。这不是模型输出,是格式样例;其中每个数都能在真实返回里对上,链接因为带访问令牌,这里写成「链接略」。
被反复提到的第一类问题是耗材和集尘设计。小红书上 10 月 25 日的一条笔记吐槽某品牌集尘袋「只进不出」,点赞 992、评论 571、收藏 914(链接略,非商业合作笔记)。第二类是售后和停产。微博上 11 月 2 日一位粉丝 124 人的用户说,2024 年 3 月买的机器两年多后故障,被告知停产无配件,只能以旧换新,旧机折价 200 元(链接略,0 赞 1 评论)。知乎上按赞同排序靠前的选购回答,多数是 2018 到 2022 年发的长青内容,标题虽然写着 2026 年,参考时请看发布年份。
样例里每条结论后面跟着平台、日期、互动数和是否商业合作,这些都可以写进系统提示,作为对模型输出格式的要求。
还有一个整理时才发现的细节:知乎的 20 条里有两个作者各占 3 条。一个作者的 3 条回答开头几乎一字不差,都是 0 赞、引向同一篇推荐文章;另一个作者两天里写的 3 条都推荐同一个品牌。把它们当成 20 个独立的声音会高估这个品牌的口碑,所以交回模型前可以按 author_id 去重,每个作者只留互动数最高的一条。这个字段三个平台都有,去重写在调度代码里只需要几行,比在提示词里要求模型「注意重复作者」可靠。
实测四:送进模型的 token 能省多少
结果交回模型之前,删掉不需要的字段,是这套流程里最省钱的一步。我们用 DeepSeek token 用量说明给的换算比例(1 个英文字符约 0.3 token,1 个中文字符约 0.6 token)估算了三次搜索原样返回和只留 13 个字段两种情况。这是估算,真实 token 数以接口返回的 usage 为准。
| 搜索 | 原样返回字符数 | 原样约合 token | 只留 13 个字段的字符数 | 精简后约合 token |
|---|---|---|---|---|
xiaohongshu/search 吐槽,最多点赞 | 33,905 | 10,549 | 7,302 | 2,542 |
zhihu/search 缺点,最多赞同 | 15,459 | 5,696 | 7,356 | 3,162 |
weibo/search 售后 | 10,786 | 3,624 | 3,873 | 1,458 |
| 合计 | 60,150 | 19,869 | 18,531 | 7,162 |
精简后少了 64%。小红书省得最多,因为它的原始行里有图片链接列表、头像、视频地址、宽高这些对回答没用的字段。按 deepseek-flash 高峰时段输入价 $0.3/百万 token,19,869 token 是 $0.0060,7,162 token 是 $0.0021,单看一次差得不多,但工具调用的循环里,之前的结果会随着每一轮请求重新发送,轮数一多就会放大。DeepSeek 有上下文缓存,命中缓存的输入只要高峰 0.04 元每百万 token,所以循环里重发的部分实际花费会低很多,但前提是能命中。按 DeepSeek 上下文缓存说明,后一次请求的前缀要和已经存下的前缀单元完全一致才算命中;而对话接口是无状态的,每一轮都要把之前全部消息拼起来重发(多轮对话说明)。落到调度代码上就是两条:交回的工具结果在后续轮次里不要改写、不要重新排序,系统提示和工具定义放在最前面且整场对话不变;精简字段、排序、去重都在第一次交回之前做完。这样第二轮以后,前面的系统提示、工具定义和第一轮结果都能按缓存价计费,只有新增的那一轮按未命中价算。
成本:DeepSeek Search 每千次 $0.75,小红书一次 $0.005556
把两边的单价放在一起,结论很直接:网页搜索很便宜,平台内数据里知乎和微博和它是一个量级,小红书贵一个量级。
需要照实说的一点:如果只要通用网页搜索,DeepSeek Search 的 $0.75 每千次比 EveryInfra 自己的 web/search($1.389 每千次)便宜,而且一次最多回 50 条。所以这套流程里网页搜索交给 DeepSeek 是合理的,EveryInfra 只负责平台内数据。按每千条结果算差距更大:DeepSeek count=50 时每千条 $0.015,知乎每千条 $0.028,微博 $0.062 到 $0.067,小红书 $0.278 到 $0.427。但这两类结果不能直接按条数比价,因为一条网页结果和一条带互动数的平台内容回答的不是同一个问题。
| 每个问题的调用 | 单价 | 次数 | 小计 |
|---|---|---|---|
| DeepSeek Search | $0.00075 | 2 | $0.0015 |
xiaohongshu/search | $0.005556 | 1 | $0.005556 |
zhihu/search | $0.000556 | 1 | $0.000556 |
weibo/search | $0.000806 | 1 | $0.000806 |
| 数据费合计(方案 B) | 5 | $0.008418 | |
| 模型费(估算,高峰,约 1.6 万 token 输入、1,500 token 输出) | 约 $0.0066 |
模型费的估算口子较大:输入按精简后的平台结果 7,162 token、两次网页搜索的摘要约 8,400 token(每次 10 条、每条约 700 个中文字符)算,输出按 1,500 token 算,循环重发和缓存都没算进去。数据费是确定的,按目录价和公开价相乘即可。一个问题的总成本大约 1.5 美分,其中小红书一项就占数据费的 66%。
小红书怎么控量:三套方案
小红书 $0.005556 一页,是派活时就点出来的问题。控量不是少用小红书,而是让它只在需要时出场。我们设了三套方案,每个问题都固定 2 次 DeepSeek Search:
| 方案 | 小红书 | 知乎 | 微博 | 每个问题 | 每 1,000 个问题 | 小红书占比 |
|---|---|---|---|---|---|---|
| A 全量 | 3 页 | 2 次 | 2 次 | $0.0209 | $20.89 | 80% |
| B 默认 | 1 页 | 1 次 | 1 次 | $0.0084 | $8.42 | 66% |
| C 按需 | 30% 的问题查 1 页 | 1 次 | 1 次 | $0.0045 | $4.53 | 37% |
方案 C 的 30% 是本文设定的,不是测出来的比例。实际怎么判断「需要」,可以有三种做法,按实现难度排列。第一种,按话题类别:美妆、个护、母婴、家居这类小红书讨论集中的品类才查,数码配件、工业品不查。第二种,先查便宜的:知乎和微博的结果里如果已经有足够多的、近 30 天的、带具体型号的内容,就不查小红书。第三种,让模型决定,但在调度代码里设上限,像上面代码里的 BUDGET,模型想调第二页时直接返回「预算已用完」。另外,要拿满页就别用 last_30_days:前面实测过它可能只回 13 条却按一页收费,「最新」类问题用 sort=newest 拿满页更划算,目录对 date_range 的说明里也这样建议。
也可以不写函数:用 DeepSeek Harness 挂远程 MCP(配置示例)
如果你用的不是自己写的调度代码,而是 DeepSeek 开源的 DeepSeek Harness(快速上手),可以跳过上面的工具定义,直接把 EveryInfra 的远程 MCP 挂上去。按 Harness 的 MCP 客户端说明,每个 MCP 服务器写一个条目,远程服务用 streamable-http 传输,可以带请求头;工具会以 mcp__<serverName>__<工具名> 的名字出现在模型的工具列表里,默认每次调用 60 秒超时。
- id: mcp-everyinfra
  name: '@deepseek-ai/dsh-mcp-client'
  config:
    serverName: everyinfra
    transport: streamable-http
    url: https://api.everyinfra.com/mcp
    headers:
      Authorization: !!js '`Bearer ${process.env.EVERYINFRA_API_KEY}`'
    toolCallTimeoutMs: 90000
toolCallTimeoutMs 从默认的 60 秒调到 90 秒,原因和前面 requests 的超时一样。EveryInfra 的 MCP 服务器按 MCP 2026-07-28 规范的 Streamable HTTP 传输提供 12 个工具(11 月 3 日不带 Key 调 tools/list 读到的数),其中查平台数据用的是 everyinfra_call_api,参数就是 platform、action、params 三项;鉴权说明见 MCP 接入页。MCP 规范的授权一节把授权定为可选,基于 HTTP 的传输按那一节的规定处理;EveryInfra 用的是在请求头里放 API Key 的方式,所以 Harness 配置里只要写 headers,不需要走浏览器登录。Harness 自带的网页搜索是 dsh-tool-web 插件,里面有 web_search 和 web_fetch 两个工具,默认一次最多 8 条来源、最多 4 个查询词、每条摘要截到 800 字符;它的说明里提到 DeepSeek 自己的搜索后端在当前模型没有凭据时不会出现在工具列表里。这样配置以后,同一个 Harness 会话里,网页搜索走 DeepSeek,平台内数据走 MCP,分工和函数调用版一样,只是调度交给了 Harness。
MCP 版和函数调用版的取舍:MCP 版不用写代码,目录有新能力时模型自己能看到,但模型看到的是一个通用的 everyinfra_call_api,需要先读目录才知道参数,多一两轮往返;函数调用版要自己维护工具定义,但每个函数的说明、枚举和价格都写死了,模型选得更准,预算也能在代码里卡住。只做一个固定流程的产品,用函数调用版;给团队做一个什么都能问的助手,用 MCP 版。站内 Claude 严格工具调用接数据接口一文比较过同样的取舍。
做不了或要注意的地方
第一,我们没有调用 DeepSeek 的 Search 接口,所以「DeepSeek 搜扫地机器人能搜到多少小红书笔记」没有实测数。本文关于它的内容全部来自文档;平台内容在 DeepSeek 索引里有多少、更新得多快,本文没有测,「快照和调用时刻」一节只说明了平台内结果这一侧的时间特征。第二,小红书搜索返回的正文是约 60 字的摘要,要全文得再调笔记详情,每次 $0.005556;评论同样单独计费。第三,三个平台都只有公开内容,私信、仅粉丝可见、已删除的内容都拿不到;知乎盐选付费内容只返回摘要。
还有两条和翻页有关的细节,写调度代码时容易踩到。小红书搜索一页固定 20 条,传 limit 不起作用,要更多结果只能用上一页返回的 next_page_token 翻页,而这个游标只在 24 小时内有效;如果你把模型的对话存下来、第二天接着问,旧游标会失效,要从第一页重新搜,也就会重新计费。知乎一次默认 20 条、最多 100 条,微博默认 20 条、最多 50 条,这两项要更多结果时调大条数比翻页划算,因为按次计费,条数不影响单价。
第四,合规上要注意两件事。一是平台数据里有个人用户的名字和主页,按网络数据安全管理条例和个人信息保护的一般要求,回答里只引用内容和链接,不要汇总、展示某个普通用户的个人信息;arXiv 上 10 月 22 日的一篇论文(Social-HUMINT)专门讨论了用大模型从公开社交数据推断个人属性的风险,做消费品话题就停在话题层面。二是如果这个助手面向中国境内公众提供服务,要看生成式人工智能服务管理暂行办法和 2025 年 9 月 1 日起施行的人工智能生成合成内容标识办法;这不是法律意见,具体义务请咨询你的法务。第五,限速:EveryInfra 账户默认每分钟 60 次,本文测试用的 Key 被单独限到每分钟 10 次;DeepSeek Search 每秒 100 次,两边差得远,并发高时要在调度代码里给 EveryInfra 一侧加排队。
最近的变化
2026-10-17,DeepSeek 开放 Search 和 Fetch。 同一天模型更新到 DeepSeek-V4.1-Flash-1017,权重在 Hugging Face 公开。对读者意味着:做网页搜索不用再自己接第三方搜索服务,同一把 Key 就够。
2026-11-01 00:00(北京时间),客户端里的服务端搜索开始收费。 用 Claude Code、Codex、Harness 接 DeepSeek 的团队,月账单会多出搜索费,可以在 DeepSeek 控制台的用量里核对。
2026-10-13,一篇关于「AI 代理替人购物」的论文更新到第 5 版。 这篇 arXiv 论文(Does Rank Still Matter?)在 7,000 次会话里发现,AI 代理浏览的结果比人多,但中间位置的结果被看到的概率最低。对读者意味着:交回模型的结果条数不是越多越好,按互动数或时间先排好序再交回,比一股脑塞 50 条更可靠;实测三的互动集中度数据也指向同一个做法。
2026-10-25 前后,DeepSeek Harness 的 MCP 客户端文档更新。 Harness 支持 MCP 2026-07-28 版协议,远程服务走 Streamable HTTP(MCP 客户端说明、MCP 分组说明)。对读者意味着:不写代码也能把平台数据挂进 DeepSeek 的代理里。
常见问题
deepseek api 联网搜索怎么做,对话接口自己会上网吗?
对话接口本身不会自己上网。联网有两种方式:一是自己调 Search 接口(POST /v1/tools/search),把结果作为工具结果交给模型;二是用 DeepSeek Harness、Claude Code、Codex 这类客户端,它们会经服务端工具调用访问 Search 和 Fetch,北京时间 2026 年 11 月 1 日起按次收费。(问题来源:联想词「deepseek api支持联网搜索吗」;依据:DeepSeek 搜索指南)
DeepSeek Search API 怎么收费,有免费额度吗?
每 1,000 次成功请求 5 元,英文页写 $0.75;失败、空结果、超时不计费,count 不影响单价。我们在价格页和搜索指南里没有看到单独的搜索免费额度;赠送余额和充值余额都能用来扣费,优先扣赠送余额。(问题来源:联想词「deepseek search api pricing」「deepseek search api free tier」;依据:DeepSeek 价格页)
DeepSeek Search API key 和模型的 key 是同一把吗?
是同一把。文档写明 Search 和 Fetch 使用与 DeepSeek API 相同的 Bearer 鉴权,Key 在 DeepSeek 开放平台创建;限速按账户算,和用哪把 Key 无关。(问题来源:联想词「deepseek search api key」;依据:DeepSeek 搜索指南、限速说明)
deepseek search fetch api 有什么区别,什么时候用 Fetch?
Search 按查询词返回多条结果,Fetch 按一个 url 返回整页 Markdown。Search 已经可以用 need_content 带回正文,所以 Fetch 主要用在你已经有链接、要读全文的时候,比如模型从平台数据里拿到一个品牌官网链接。Fetch 受目标站点访问策略影响,抓不到正文返回 404,不计费。(问题来源:联想词「deepseek search fetch api」;依据:Fetch 接口参考)
deepseek harness search api 能换成别的搜索服务吗?
能。Harness 把网页搜索做成插件,web_search 工具来自 dsh-tool-web 插件,后端可以换成其他搜索插件;平台内数据则通过 MCP 客户端挂远程服务器。(问题来源:联想词「deepseek harness search provider」;依据:dsh-tool-web 说明、Harness 仓库)
deepseek function calling 能用 strict 模式吗?
能,但要把 base_url 设成 beta 地址(api.deepseek.com/beta,带 https 前缀),所有函数都设 strict: true,每个 object 的属性全部列进 required、additionalProperties 为 false;minLength、maxLength、minItems、maxItems 不支持。思考模式和非思考模式都支持。(问题来源:联想词「deepseek api function calling」;依据:DeepSeek 工具调用文档)
上手步骤
第一步,在 EveryInfra 快速上手创建 API Key,先免费读一次目录,确认 xiaohongshu/search、zhihu/search、weibo/search 三项的参数和价格;平台总览在小红书爬虫、知乎爬虫、微博爬虫三页,单价汇总在价格页。第二步,把本文的 4 个工具定义和调度代码复制下来,换成你自己的两把 Key,先用一个问题跑通。第三步,按你的问题量选控量方案,在 BUDGET 里写上限。想先看同一类思路在别的工具里怎么做,可以读 Claude Code 动态工作流拉小红书评论和 Gemini Deep Research 接远程 MCP;要评论区的数据,微博评论和小红书评论的用法相同。
参考资料
- 网页搜索与抓取(中文),DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/zh-cn/guides/search
- Search & Fetch(英文),DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/guides/search
- Search 接口参考,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/api/search
- Fetch 接口参考,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/api/fetch
- 模型 & 价格(中文),DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/zh-cn/quick_start/pricing
- Models & Pricing(英文),DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/quick_start/pricing
- DeepSeek V4.1 Flash 新版本发布说明(中文),DeepSeek,2026-10-17,https://api-docs.deepseek.com/zh-cn/news/news261017
- DeepSeek-V4.1-Flash-1017 release note(英文),DeepSeek,2026-10-17,https://api-docs.deepseek.com/news/news261017
- Tool Calls,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/guides/tool_calls
- Thinking Mode,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/guides/thinking_mode
- Rate Limit & Isolation,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/quick_start/rate_limit
- Token & Token Usage,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/quick_start/token_usage
- Context Caching,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/guides/kv_cache
- Multi-round Conversation,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/guides/multi_round_chat
- Integrate with Claude Code,DeepSeek API 文档,2026-11-03 读取,https://api-docs.deepseek.com/quick_start/agent_integrations/claude_code
- DeepSeek API Keys 页面,DeepSeek 开放平台,2026-11-03 读取,https://platform.deepseek.com/api_keys
- DeepSeek-V4.1-Flash-1017 模型页,Hugging Face,2026-11-03 读取,https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
- DeepSeek Harness 仓库,GitHub,2026-11-03 读取,https://github.com/deepseek-ai/deepseek-harness
- DeepSeek Harness Quickstart,2026-11-03 读取,https://deepseek-harness.github.io/deepseek-harness/en/guide/quickstart
- dsh-tool-web README,GitHub,2026-11-03 读取,https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/web/tool-web/README.md
- dsh-mcp-client README,GitHub,2026-11-03 读取,https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/mcp-client/README.md
- Harness mcp 分组 README,GitHub,2026-11-03 读取,https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/mcp/README.md
- openai-python,GitHub,2026-11-03 读取,https://github.com/openai/openai-python
- openai,PyPI,2026-11-03 读取,https://pypi.org/project/openai/
- Function calling,OpenAI 开发者文档,2026-11-03 读取,https://platform.openai.com/docs/guides/function-calling
- Advanced Usage(timeout),Requests 文档,2026-11-03 读取,https://requests.readthedocs.io/en/latest/user/advanced/
- json — JSON encoder and decoder,Python 文档,2026-11-03 读取,https://docs.python.org/3/library/json.html
- MCP Specification 2026-07-28,Model Context Protocol,2026-11-03 读取,https://modelcontextprotocol.io/specification/2026-07-28
- Transports,MCP 2026-07-28,2026-11-03 读取,https://modelcontextprotocol.io/specification/2026-07-28/basic/transports
- Tools,MCP 2026-07-28,2026-11-03 读取,https://modelcontextprotocol.io/specification/2026-07-28/server/tools
- 微博开放平台 API 列表,2026-11-03 读取,https://open.weibo.com/wiki/API
- 网络数据安全管理条例,中国政府网,2024-09-30,https://www.gov.cn/zhengce/content/202409/content_6977766.htm
- 生成式人工智能服务管理暂行办法,国家互联网信息办公室,2023-07-13,https://www.cac.gov.cn/2023-07/13/c_1690898327029107.htm
- 人工智能生成合成内容标识办法,国家互联网信息办公室等,2025-03-14,https://www.cac.gov.cn/2025-03/14/c_1743654684782215.htm
- Does Rank Still Matter? Position Bias When AI Agents Shop on Our Behalf,arXiv:2608.22697v5,2026-10-13,https://arxiv.org/abs/2608.22697
- Social-HUMINT: An LLM-Augmented Unified Framework for Measuring Social Media Exposure,arXiv:2610.31573,2026-10-22,https://arxiv.org/abs/2610.31573
- EveryInfra 数据目录,2026-11-03 00:13 新加坡时间读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra 小红书目录,2026-11-03 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- EveryInfra 知乎目录,2026-11-03 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=zhihu
- EveryInfra 微博目录,2026-11-03 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=weibo
- Authorization,MCP 2026-07-28,2026-11-03 读取,https://modelcontextprotocol.io/specification/2026-07-28/basic/authorization
- Sorting Techniques,Python 文档,2026-11-03 读取,https://docs.python.org/3/howto/sorting.html
引用编号 BL-73