Strict tool use в Claude при работе с API данных: два уровня защиты от некорректных вызовов
Opus 5.5 отклоняет принудительный tool_choice. Мы сочетаем strict-инструменты с ошибками 422, которые подсказывают исправление: 29 реальных вызовов, ответ на неверные параметры за 0,17 с, без списания.
Claude Opus 5.5, Sonnet 5.5 и Fable 5.1 возвращают ошибку 400, если tool_choice равен any или tool. Код, который принудительно вызывал инструмент ради JSON заданной структуры, на этих моделях перестаёт работать. Anthropic рекомендует оставить tool_choice: auto и добавить strict: true или перенести схему в structured outputs. 1 ноября 2026 года мы создали инструменты со strict: true для получения отзывов с Trustpilot, App Store и Amazon из каталога EveryInfra. Затем отправили в наш API 29 реальных запросов. Десять из них — контрольные вызовы, которые мы добавили днём.
Вечером мы отправили ещё 12 запросов для повторной проверки.
На запросы с неверным именем параметра или значением enum за 0,11–0,23 секунды возвращалась ошибка 422. В каждом ответе 422 были указаны допустимые значения и следующий шаг; списаний не было. В ранней версии каталога у двух параметров не было списка допустимых значений. Во время дневного контрольного теста запросы с неверными значениями этих параметров не завершались ошибкой. API возвращал код 200, списывал обычную плату и незаметно подменял набор отзывов. Ничто в ответе не сообщало модели, что что-то не так.
Вечером шлюз добавил допустимые значения для этих двух параметров. Теперь на запрос с неверным значением до любого списания возвращается ошибка 422, что и подтвердила наша повторная проверка в 19:18 SGT.
Эта статья отвечает на один практический вопрос. У вас есть приложение на Claude, которое вызывает внешний API данных. Раньше вы принуждали модель вызывать ваш инструмент, чтобы каждый запрос имел одинаковую форму. На новой модели эта строка теперь падает с ошибкой. Как изменить код, чтобы модель по-прежнему надёжно вызывала API и возвращала JSON, который можно сохранить?
Каждое утверждение о Claude взято из документации Anthropic, и для каждого мы даём ссылку. На нашей тестовой машине нет API-ключа Anthropic. Поэтому код для Claude в этой статье — пример конфигурации, а не результат теста. Все цифры по EveryInfra взяты из необработанных ответов реальных вызовов 1 ноября 2026 года.
Что изменилось: три новые модели отклоняют принудительный tool_choice, поэтому strict tool use в Claude теперь используется по умолчанию
Изменение простое, и от него зависят все проектные решения дальше в статье. В примечаниях к выпуску Anthropic API от 1 сентября 2026 года сказано, что Fable 5.1 и Mythos 5.1 не поддерживают типы tool_choice any и tool. Такие запросы возвращают ошибку 400, а auto и none работают как прежде (примечания к выпуску API). Чтобы входные данные инструмента соответствовали схеме, рекомендуется strict tool use или structured outputs. В записи от 22 сентября об Opus 5.5 сказано, что та же ошибка 400 действует «как в Claude Fable 5.1». В записи от 28 сентября о Sonnet 5.5 это названо одной из пяти причин, по которым может сломаться код для Sonnet 5.
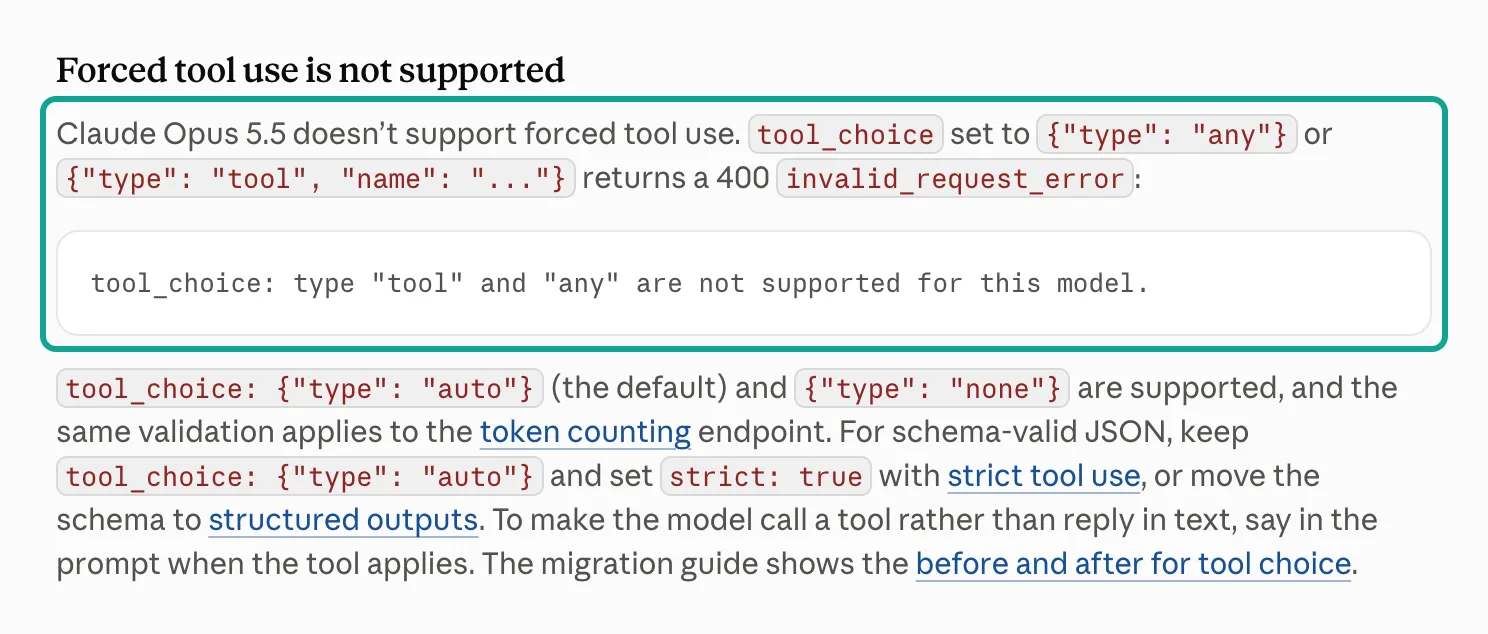
У каждой модели есть страница «What's new» с разделом «Forced tool use is not supported». На всех трёх страницах один и тот же текст ошибки, который мы приводим ниже. Его можно прочитать на страницах Opus 5.5, Sonnet 5.5 и Fable 5.1. Текст такой: tool_choice: type "tool" and "any" are not supported for this model. Та же проверка действует и для эндпоинта подсчёта токенов. Поэтому проверить принудительный вызов через подсчёт токенов до отправки не получится.
Почему Anthropic убрала принудительные вызовы? Причина указана на странице Fable 5.1. На этих моделях размышление (thinking) всегда включено, а принудительный вызов инструмента его пропускает. Тогда модель пишет свои рассуждения прямо в аргументы инструмента, и их качество падает. Это важно, если ваше приложение вызывает API данных.
В старой схеме вызов делали принудительным ради стабильной структуры. Теперь её обеспечивает strict tool use, а решение о вызове снова принимает модель. В промпте нужно указать, когда применять инструмент. На странице Fable 5.1 добавлено, что модель надёжно следует явным инструкциям по инструментам, например «Для ответа используй инструмент get_weather».
| Модель | Дата выхода | `tool_choice` any / tool | Предлагаемая Anthropic замена | Стандартная цена за 1 млн входных / выходных токенов |
|---|---|---|---|---|
| Fable 5.1 | 1 сентября 2026 г. | Ошибка 400 | auto + strict или structured outputs | $10 / $50 |
| Opus 5.5 | 22 сентября 2026 г. | Ошибка 400 | auto + strict или structured outputs | $4 / $20 |
| Sonnet 5.5 | 28 сентября 2026 г. | Ошибка 400 | auto + strict или structured outputs | $2 / $10 |
| Haiku 5.5 | 7 октября 2026 года | Не указано в примечаниях к выпуску | — | $0.10 / $0.50 |
Даты и цены взяты из примечаний к выпуску и со страницы «Тарифы» по состоянию на 1 ноября 2026 года. Эта страница также показывает, что изменение не временное. В таблице количества токенов системного промпта для использования инструментов две колонки: одна для auto, none, другая для any, tool. Для Opus 5.5 значение есть только в первой колонке — 286 токенов.
Для Opus 5 значения есть в обеих колонках — 286 и 406 токенов. В примечаниях к выпуску Haiku 5.5 перечислены другие несовместимые изменения: ручные бюджеты размышлений, параметры сэмплинга и prefill. Принудительный вызов инструментов там не упомянут, поэтому о Haiku 5.5 мы ничего не утверждаем. Но strict tool use мы применяем и для этой модели, чтобы один и тот же код работал на всех четырёх моделях.
Strict tool use — не новая функция и предназначена не только для новых моделей. На двух страницах сказано, что она доступна на всех моделях и может применяться в конфигурациях, подготовленных к соблюдению HIPAA (strict tool use, structured outputs). Изменилась её роль: раньше это была необязательная мера предосторожности, а теперь — основной путь.
Чек-лист миграции на Opus 5.5 предписывает заменить any и tool на auto плюс strict tool use или structured outputs. Там же сказано сначала проверить каждую input_schema, потому что strict поддерживает лишь подмножество JSON Schema (руководство по миграции на Opus 5.5). Основная работа по миграции — в схемах, а не в коде вызовов.
Strict tool use и structured outputs в Claude: за что отвечает каждый механизм
Названия похожи, но они контролируют разные части ответа. Strict tool use добавляет "strict": true в определение инструмента и контролирует input каждого блока tool_use. API использует сэмплинг с ограничением по грамматике, поэтому input всегда соответствует input_schema, а имя инструмента всегда допустимо.
В примере Anthropic система бронирования ожидает passengers: int. Без строгого режима модель может отправить "two" или "2". В строгом режиме она всегда отправляет 2.
Claude structured outputs — это поле output_config.format в запросе. Оно контролирует итоговый текст ответа, который становится JSON по вашей схеме. Для работы с API данных нужны оба механизма. Strict tool use обеспечивает корректность параметров, которые уходят в POST /api/v1/social. Structured outputs превращает полученные отзывы в фиксированные поля: тему, серьёзность и короткую цитату. Оба механизма используют один конвейер грамматик, поэтому ограничения у них общие.
Эти ограничения перечислены в разделе «JSON Schema limitations» на странице structured outputs. Поддерживаются: все базовые типы, enum, const, anyOf, внутренние $ref, десять строковых форматов и простые регулярные выражения. Не поддерживаются: рекурсивные схемы, числовые ограничения вроде minimum и maximum, ограничения длины строк и minItems со значением, отличным от 0 или 1. В каждом объекте должно быть additionalProperties: false. Если использовать неподдерживаемую возможность, API вернёт ошибку 400 с подробностями.
| Пункт | Strict tool use | Structured outputs (`output_config.format`) |
|---|---|---|
| Что контролирует | Аргументы инструментов в блоках tool_use | Итоговый текст ответа |
| Как включить | Добавьте "strict": true в определение инструмента | Добавьте JSON Schema в output_config.format |
| Роль в этой статье | Корректные параметры для EveryInfra | Фиксированные поля для каждого отзыва |
| Совокупные лимиты на запрос | 20 strict-инструментов, 24 необязательных параметра, 16 параметров с union-типами | Те же лимиты с общим подсчётом |
| Не поддерживается | Числовые диапазоны, длина строк, рекурсия | То же; кроме того, несовместимо с цитированием |
| Первый запрос | Дополнительная задержка на компиляцию грамматики; кеш хранится 24 часа | То же |
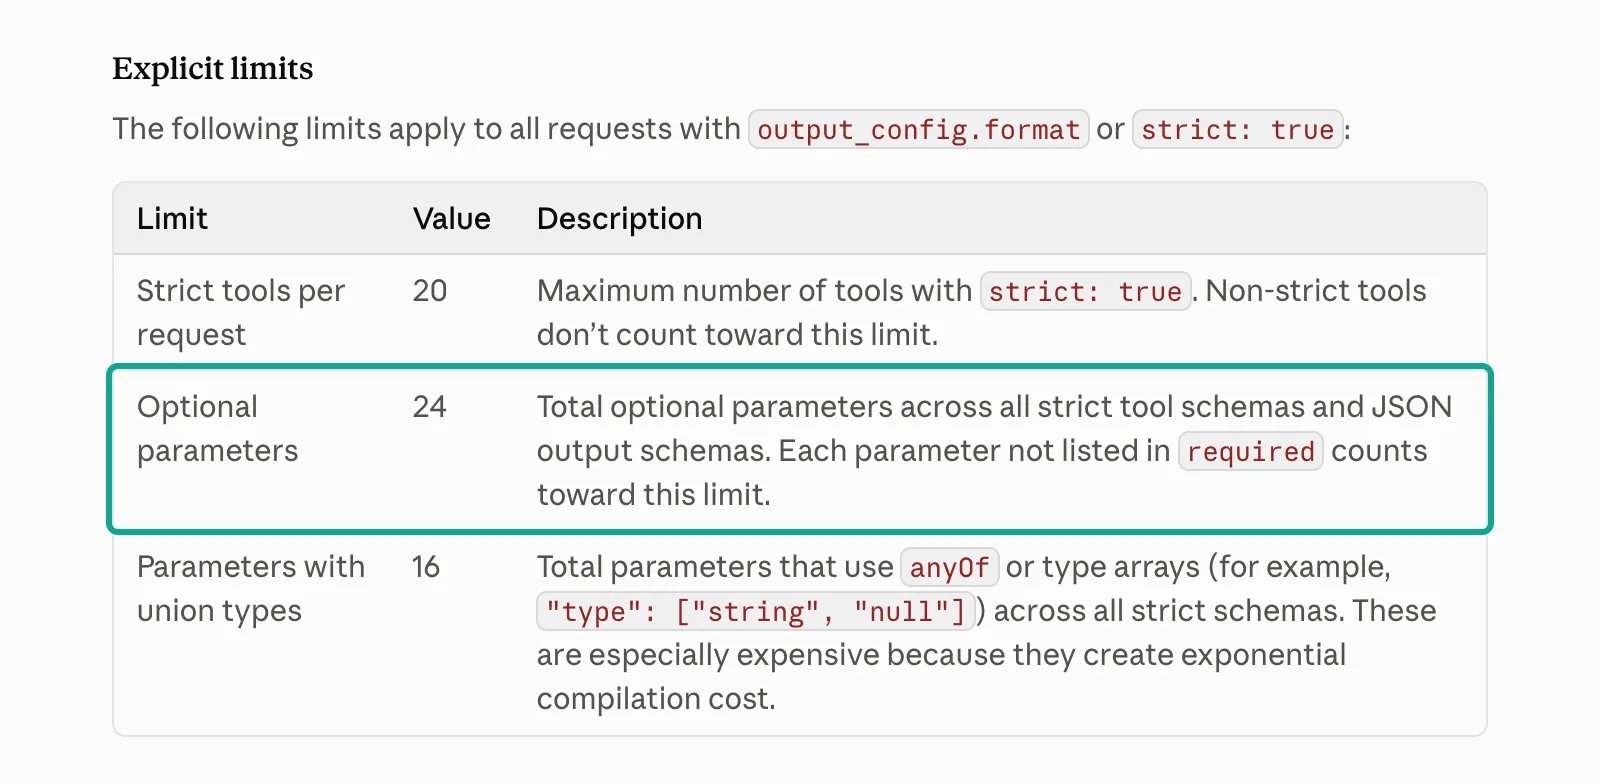
Главная ловушка — слова «на запрос». На странице structured outputs приводится пример: четыре strict-инструмента по шесть необязательных параметров уже упираются в лимит 24, даже если ни один инструмент по отдельности не выглядит сложным. Помимо явных лимитов, есть внутренние ограничения на размер скомпилированной грамматики. При их превышении API возвращает «Schema is too complex for compilation». Последний защитный лимит — тайм-аут компиляции 180 секунд.
Anthropic предлагает четыре шага в таком порядке. Помечайте как strict только критичные инструменты. Делайте параметры обязательными. Упрощайте вложенные объекты. Разделяйте работу между запросами или субагентами.


Схема показывает главную идею статьи. Первый уровень находится на стороне Claude. Режим strict гарантирует, что типы, обязательные поля и значения enum соответствуют вашей схеме. Модель не может отправить поле, например max_results, если его нет в схеме. Второй уровень находится на стороне EveryInfra.
Некоторые правила не укладываются в схему, например «ведёт ли эта ссылка на страницу товара» или «как эта платформа называет этот порядок сортировки». Наш API проверяет такие значения по каталогу. Если значение неверное, он возвращает 422 с допустимыми значениями и ближайшим совпадением. Модель меняет одно поле и отправляет запрос снова.
Уровень первый: строим strict-инструменты для POST /api/v1/social по каталогу
Эндпоинт каталога EveryInfra, GET /api/v1/social/catalog, бесплатный и не требует ключа (исходный каталог). Для каждой возможности он отдаёт обязательные и необязательные параметры, описание каждого параметра, допустимые значения (allowed_values), возвращаемые поля и цену. Мы прочитали его 1 ноября 2026 года в 00:46 SGT. В нём было 426 возможностей на 91 платформе. Из них 402 возможности на 89 платформах в тот день были доступны.
У доступных возможностей есть описания для 809 параметров. Из них у 155 указаны допустимые значения, у 143 — формат uri, у 38 — формат date. Эти три группы напрямую соответствуют enum, format: uri и format: date в схеме для режима strict. Группы не пересекаются, поэтому для 336 из 809 параметров (41,5%) можно задать ограничение, соблюдение которого гарантирует режим strict.
Лишь 155 параметров (около 19%) можно описать через enum. Остальные параметры принимают произвольный текст или числа. Для них основную работу выполняют описание и второй уровень.
Ниже — определения инструментов для трёх возможностей работы с отзывами, составленные на основе каталога. Это пример конфигурации: с Claude мы его не запускали.
[
  {
    "name": "trustpilot_reviews",
    "description": "Get recent Trustpilot reviews of one company through EveryInfra (platform trustpilot, action reviews). Call it whenever the user names a company and asks what customers say. company is the company's website domain, for example temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Website domain such as temu.com, or a trustpilot.com/review/<domain> link"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Star ratings to keep; [] keeps all"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = no date filter"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "1 to 200; use 20 unless the user asks for more"}
      },
      "required": ["company", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Get App Store reviews of one iOS app through EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Numeric App Store id, for example 6473753684"},
        "country": {"type": "string", "pattern": "^[a-z]{2}$"},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "1 to 500; use 30 unless the user asks for more"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Get the featured customer reviews shown on one Amazon product page (platform amazon, action reviews). Usually about a dozen reviews per product.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.[a-z.]{2,6}/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.com", "amazon.co.uk", "amazon.de", "amazon.fr", "amazon.it", "amazon.es", "amazon.ca", "amazon.com.au", "amazon.in", "amazon.co.jp", "amazon.sg"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]
Описанные выше лимиты потребовали четырёх проектных решений. Первое: все параметры сделаны обязательными. В каталоге для trustpilot/reviews указано шесть необязательных параметров и limit — всего семь. Если бы мы оставили все семь необязательными, они заняли бы почти треть лимита в 24 параметра.
Anthropic предлагает другой подход: если у параметра всегда есть разумное значение по умолчанию, сделайте его обязательным, и модель подставит это значение сама. Поэтому мы добавили в date значение any и разрешили пустой массив для stars. Наш код удаляет any и [] перед отправкой запроса, потому что, согласно каталогу, пустое значение означает отсутствие фильтра. Вечером мы для проверки отправили в API date: any и получили 422 за 0,11 секунды. Так что этот шаг не пропускайте.
Второе: диапазон limit указан в описании, а не в minimum или maximum, потому что числовые ограничения не поддерживаются. Значения выше максимума обрабатывает API. В каталоге для шести возможностей на этот случай указано «capped», то есть API использует максимум. Третье: простое регулярное выражение допускает только ссылки Amazon на страницы товаров. В примечании каталога к amazon/reviews сказано, что главная страница магазина не подходит.
Мы проверили ссылку на магазин по этой схеме локальным валидатором JSON Schema, и регулярное выражение её отклонило.
Четвёртое: в версии каталога, которую мы прочитали в ночь на 1 ноября, не было allowed_values для date и sort у trustpilot/reviews. Мы скопировали значения из текста каталога. Почему это было важно, показано в следующем разделе. Вечером в каталоге появились эти значения, поэтому выше мы добавили last7days. Для domain мы использовали 11 сайтов, перечисленных в каталоге в 22:14 SGT. amazon.com.mx среди них нет: для этого сайта API теперь возвращает статус 422 до списания средств. Подробности — в разделе об ограничениях.
Во всём определении используются только enum, required, additionalProperties: false, простой pattern, а также format. Их поддерживает большинство систем декодирования с ограничениями. Поддержка ограничений диапазонов чисел и длины строк различается между системами, что видно по тесту шести фреймворков в JSONSchemaBench. Поэтому эти ограничения проверяет API, возвращая при нарушении статус 422. После небольших изменений названий те же определения инструментов можно перенести к другому провайдеру моделей, а второй уровень останется без изменений.
Сколько возможностей каталога укладывается в этот бюджет? Мы подсчитали необязательные параметры у всех 402 доступных возможностей. Для возможностей, которые возвращают список, учитывали и limit. Медиана равна 1, максимум 9. Ни одна возможность не превышает 24. У 100 возможностей нет необязательных параметров, у 139 он один, то есть у 239 возможностей (59,5%) их ноль или один.
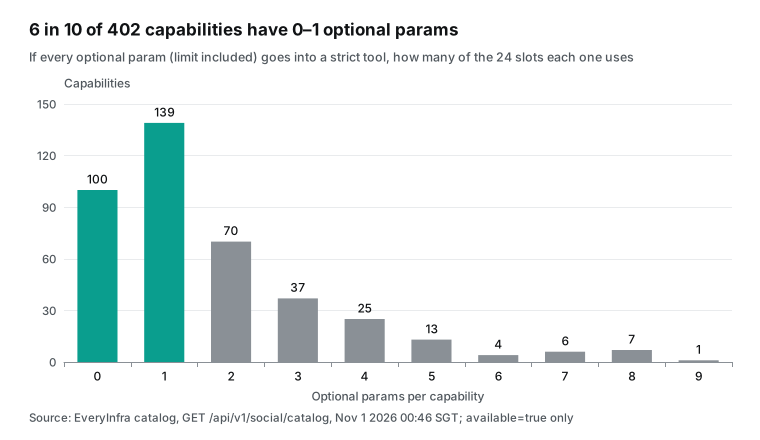
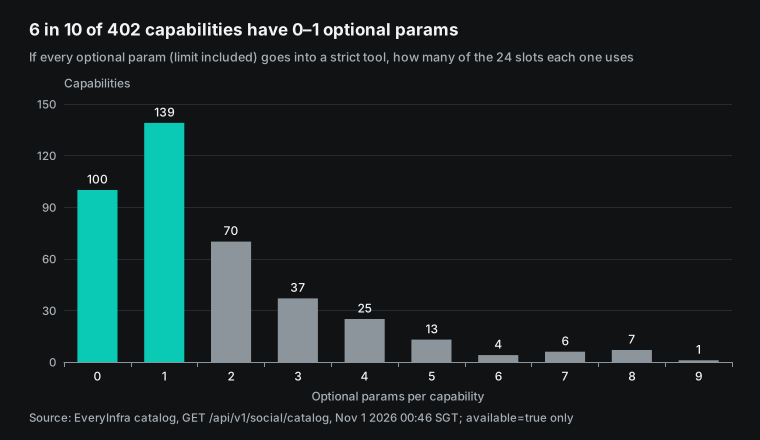
Это распределение говорит о двух вещах. Хорошая новость: если сделать все параметры обязательными, в один запрос поместятся любые 20 возможностей, и ни один слот для необязательных параметров не будет занят. Плохая новость: превратить все 402 возможности в строгие инструменты в одном месте нельзя. В сумме у них 686 необязательных параметров. При лимите 24 на запрос нужно минимум 29 групп.
Жадный алгоритм упаковки сформировал 30 групп. Один только лимит в 20 строгих инструментов на запрос требует минимум 21 группы. Поэтому правильный подход — подбирать инструменты под задачу. Для мониторинга отзывов восемь возможностей для работы с отзывами вместе занимают ровно 23 слота для необязательных параметров.
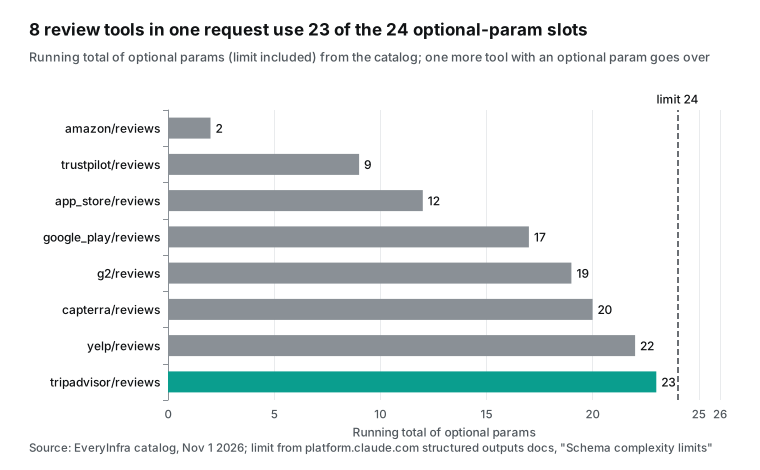
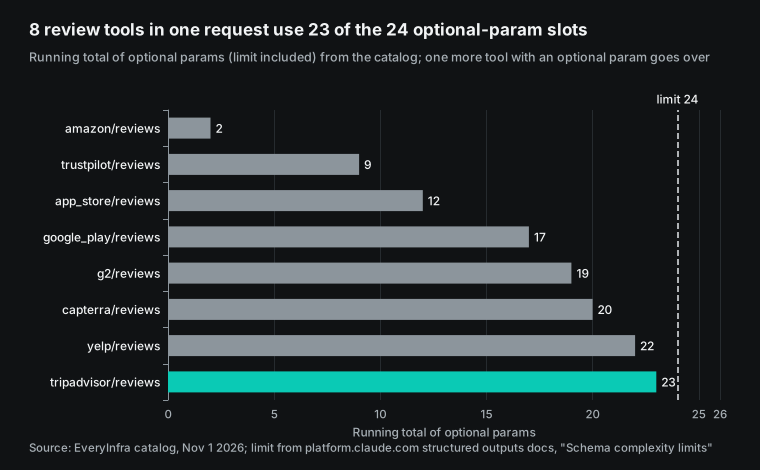
23 на один меньше лимита в 24. Добавьте схему структурированного вывода с одним необязательным полем, и запрос завершится ошибкой. Поэтому Anthropic советует делать параметры обязательными везде, где это возможно. В трёх наших инструментах-примерах все параметры обязательные, поэтому они не занимают ни одного слота для необязательных параметров. Весь бюджет остаётся для схемы вывода.
Есть и полезный контрпример. У удалённого MCP-сервера EveryInfra есть универсальный инструмент everyinfra_call_api. Его поле params представляет собой открытый объект, поскольку инструмент должен принимать параметры всех 426 возможностей. Для обычного инструмента это нормально.
Но строгий режим требует additionalProperties: false для каждого объекта, поэтому эта схема не может быть строгой. Когда мы снова прочитали список инструментов MCP 1 ноября 2026 г. в 15:41 SGT, в нём было 12 инструментов общим объёмом 16 247 байт. Поле params у everyinfra_call_api по-прежнему было открытым объектом. Если вам нужна гарантия строгого режима, пишите инструменты под конкретные задачи, как показано выше. Универсальный инструмент оставьте для исследования.
Автоматически превращайте каталог в схемы и пересобирайте их каждый день
Три инструмента можно написать вручную. С тридцатью вы ошибётесь, к тому же каталог меняется. Надёжнее небольшой скрипт. Раз в день он читает бесплатный каталог, собирает строгие инструменты по фиксированным правилам и сравнивает результат с предыдущим днём.
Мы используем шесть правил, и каждое следует из одного из описанных выше лимитов. Перед каждым вызовом наш код удаляет значения, обозначающие «не задано».
| Поле каталога | Строгая схема | Причина |
|---|---|---|
required_params | Скопировать в required | Обязательные поля не занимают слоты для необязательных параметров |
optional_params | Тоже в required, со значением «не задано», например any или [] | Бюджет в 24 слота остаётся свободным |
allowed_values | enum, точная копия с сохранением регистра | Строгий режим гарантирует, что значение будет выбрано из enum |
format: uri или date | Тот же format | Строгий режим принимает десять строковых форматов |
default_limit, max_limit | integer, диапазон указан в описании | minimum и maximum не поддерживаются |
| Каждый объект | additionalProperties: false | Обязательно в строгом режиме |
Два случая требуют участия человека. Первый: параметр, значения которого перечислены только в тексте, без allowed_values. Пример: параметры date и sort у trustpilot/reviews. Скрипт не может найти эти значения. Человек должен перенести их в enum или дождаться, пока их добавят в каталог. Для этих двух параметров значения появились в каталоге вечером 1 ноября.
Мы ведём список таких параметров и показываем его при каждой пересборке.
Второй случай: очень большой enum. В день нашего теста у 8 enum было больше 100 значений, а у самого большого 183. Большой enum увеличивает скомпилированную грамматику. По словам Anthropic, у этих внутренних лимитов нет единого числа. Для таких параметров мы не используем enum, перечисляем самые частые значения в описании и оставляем проверку ответу 422. Ответ 422 всё равно возвращает полный список allowed.
Ежедневная пересборка также показывает, когда придётся платить за новую компиляцию. На странице о структурированном выводе сказано, что скомпилированные грамматики хранятся в кеше 24 часа после последнего использования. Изменение структуры схемы сбрасывает кеш. Если структурированный вывод и инструменты используются вместе, изменение набора инструментов также сбрасывает кеш. Изменение только name или description его не сбрасывает. Поэтому скрипт должен различать два вида изменений.
Если изменился только текст, замените его без затрат. Если изменились параметры, значения или обязательные поля, следующий запрос будет медленнее. При пакетной обработке эта задержка не важна. В живом чате отправьте один прогревочный запрос в спокойное время. Пакетная обработка выигрывает и от этого правила: тысячи запросов используют один набор инструментов и одну схему вывода, поэтому грамматика компилируется один раз.
Второй уровень: ответ 422 позволяет модели самой исправить вызов
Первый уровень предотвращает ошибки структуры, но не ошибки в значениях. Модель может выбрать неверное значение, которое схема всё же допускает. Например, она может передать most_recent как порядок сортировки App Store, хотя на другой платформе этот порядок называется именно так. Или ваше приложение может вообще не использовать строгий режим и вызывать универсальный инструмент. В таких случаях второй уровень должен сразу возвращать ошибку, ничего не списывать и объяснять, как её исправить.
На странице Anthropic о вызовах инструментов есть два пункта, которые здесь применимы («handle tool calls»). Во-первых, передавайте ошибку в tool_result с is_error: true. Тогда модель повторит попытку с исправлениями, обычно 2–3 раза, прежде чем извинится перед пользователем. Во-вторых, пишите поясняющие сообщения об ошибках. Не ограничивайтесь «failed». Укажите, что пошло не так и что Claude стоит попробовать дальше.
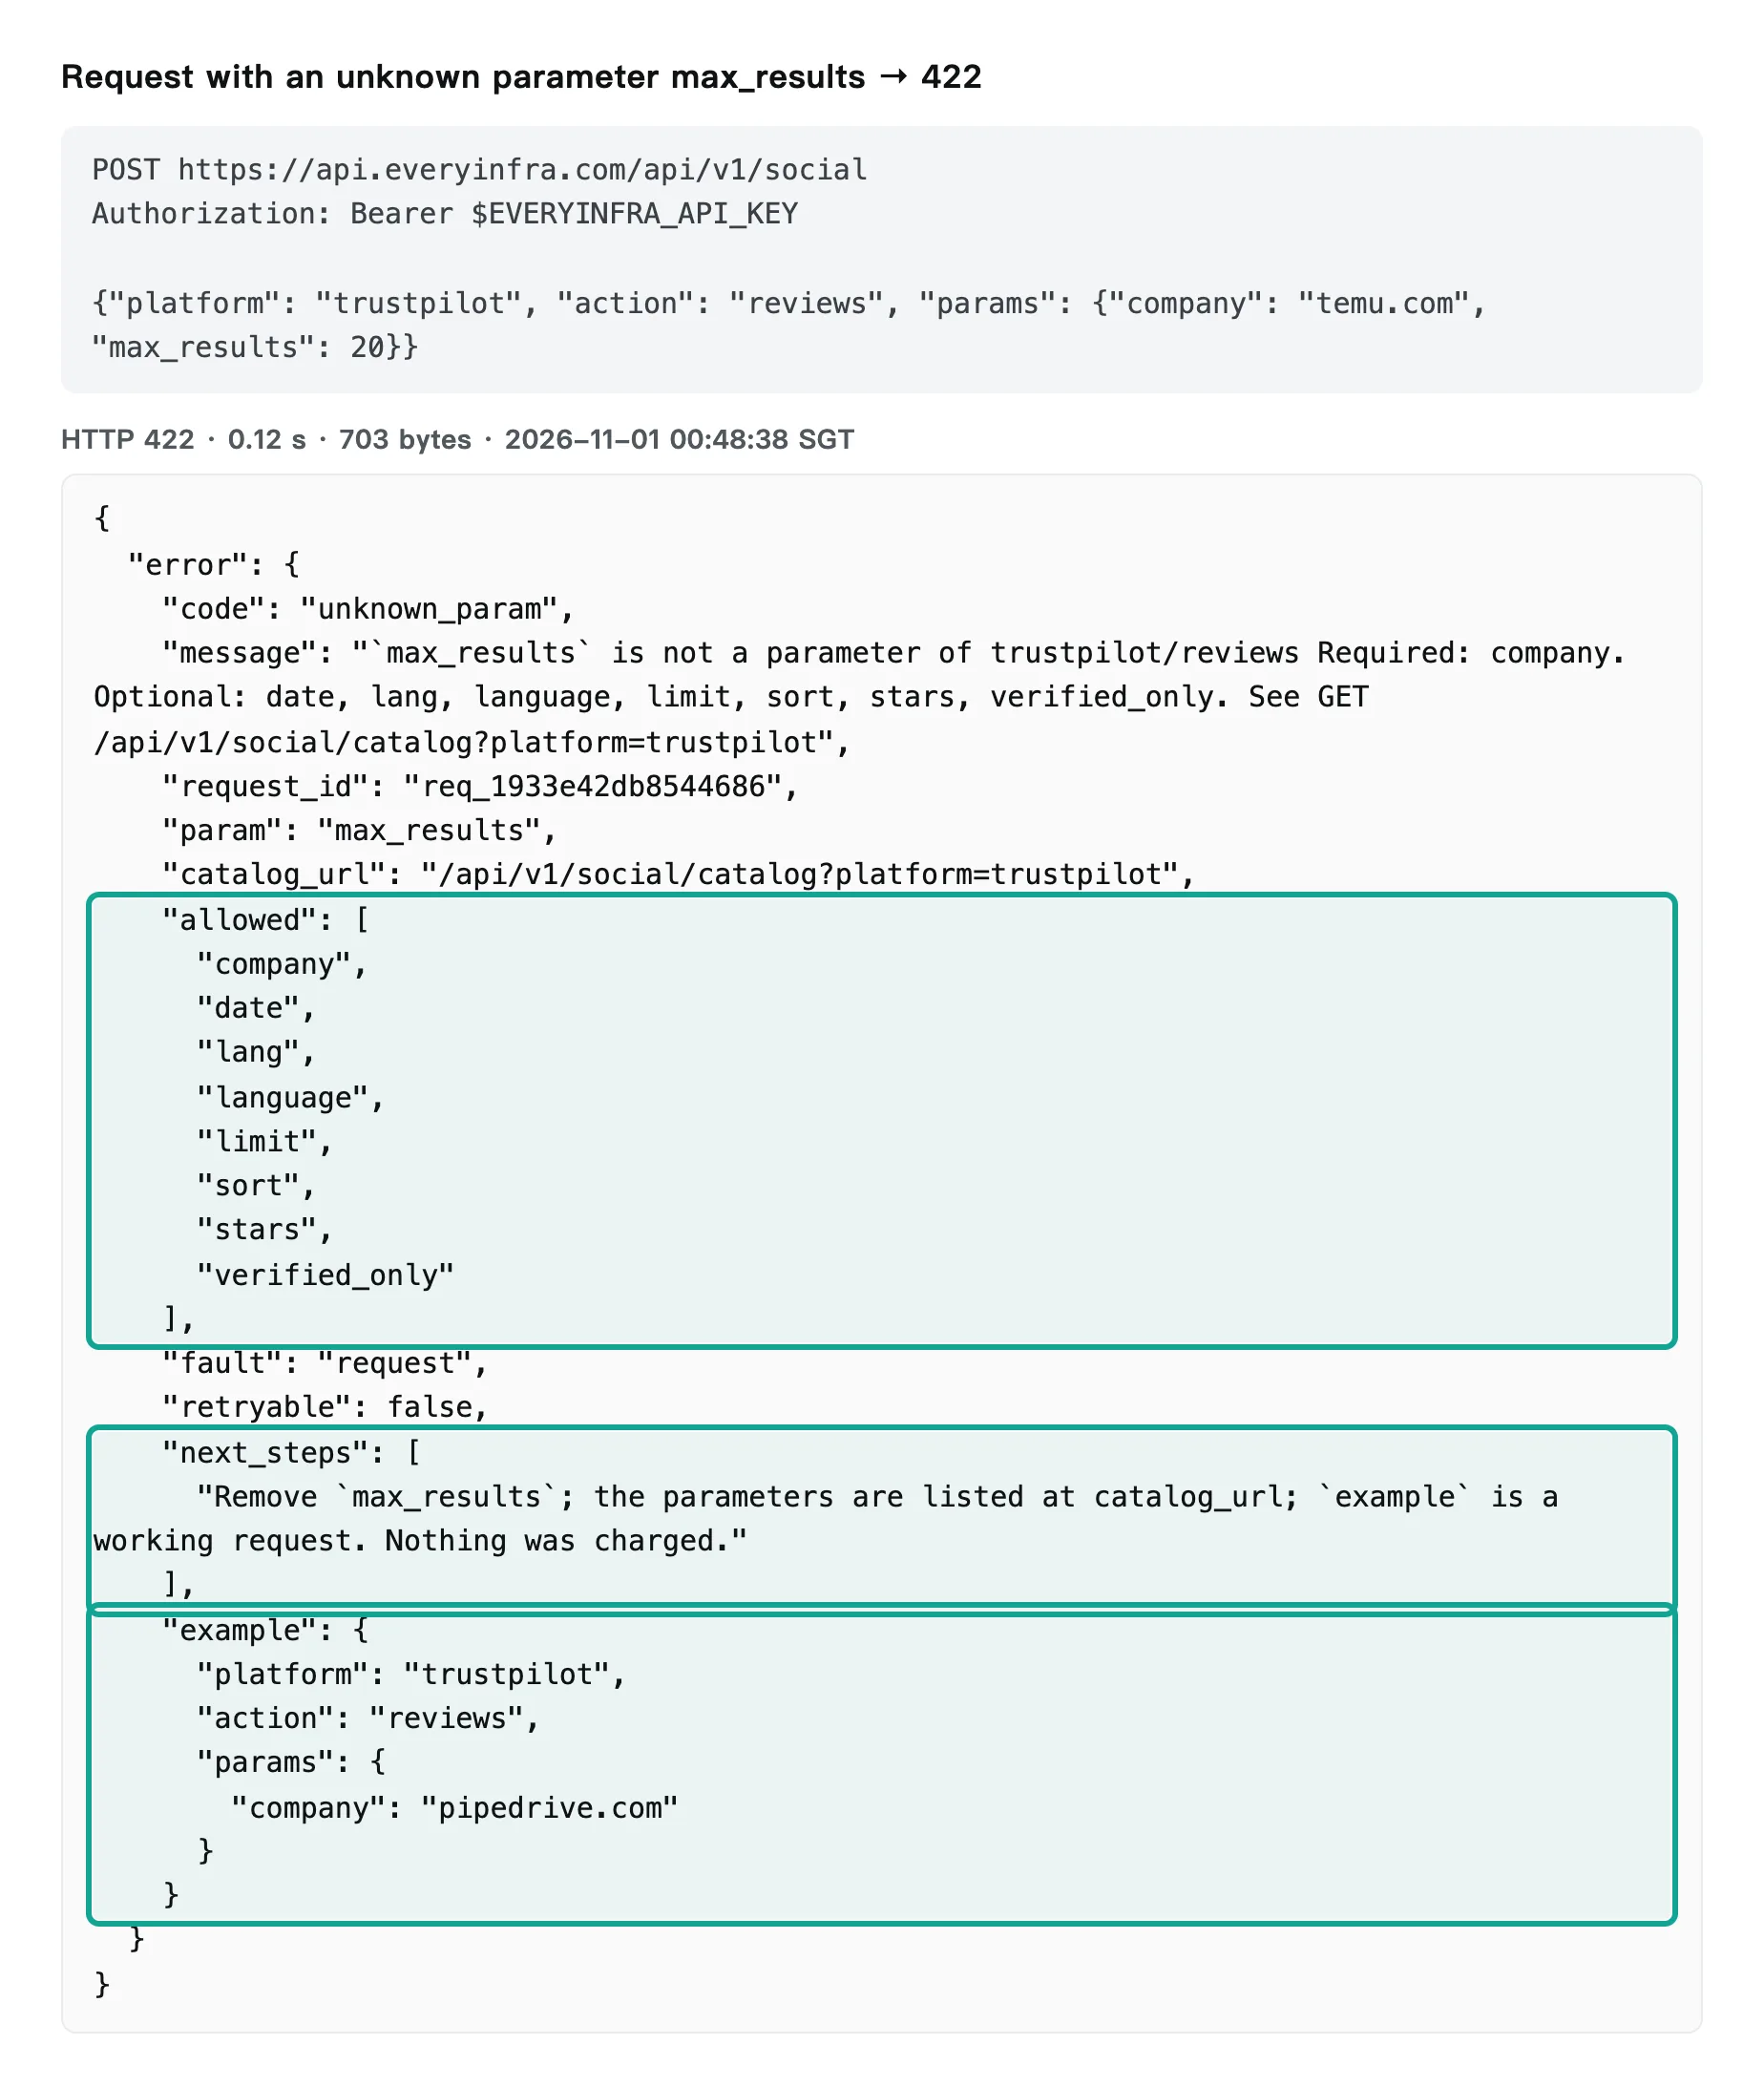
1 ноября 2026 г. с 00:48 до 00:49 SGT мы намеренно отправили семь некорректных запросов. В 00:57 SGT отправили ещё один через MCP. Ниже показан сырой ответ для неизвестного параметра. В запросе есть лишний max_results.
API вернул 422 за 0,12 с. Поле allowed перечисляет все восемь допустимых имён параметров. Поле example содержит работающий запрос. Поле next_steps предлагает удалить max_results и сообщает, что ничего не списано.
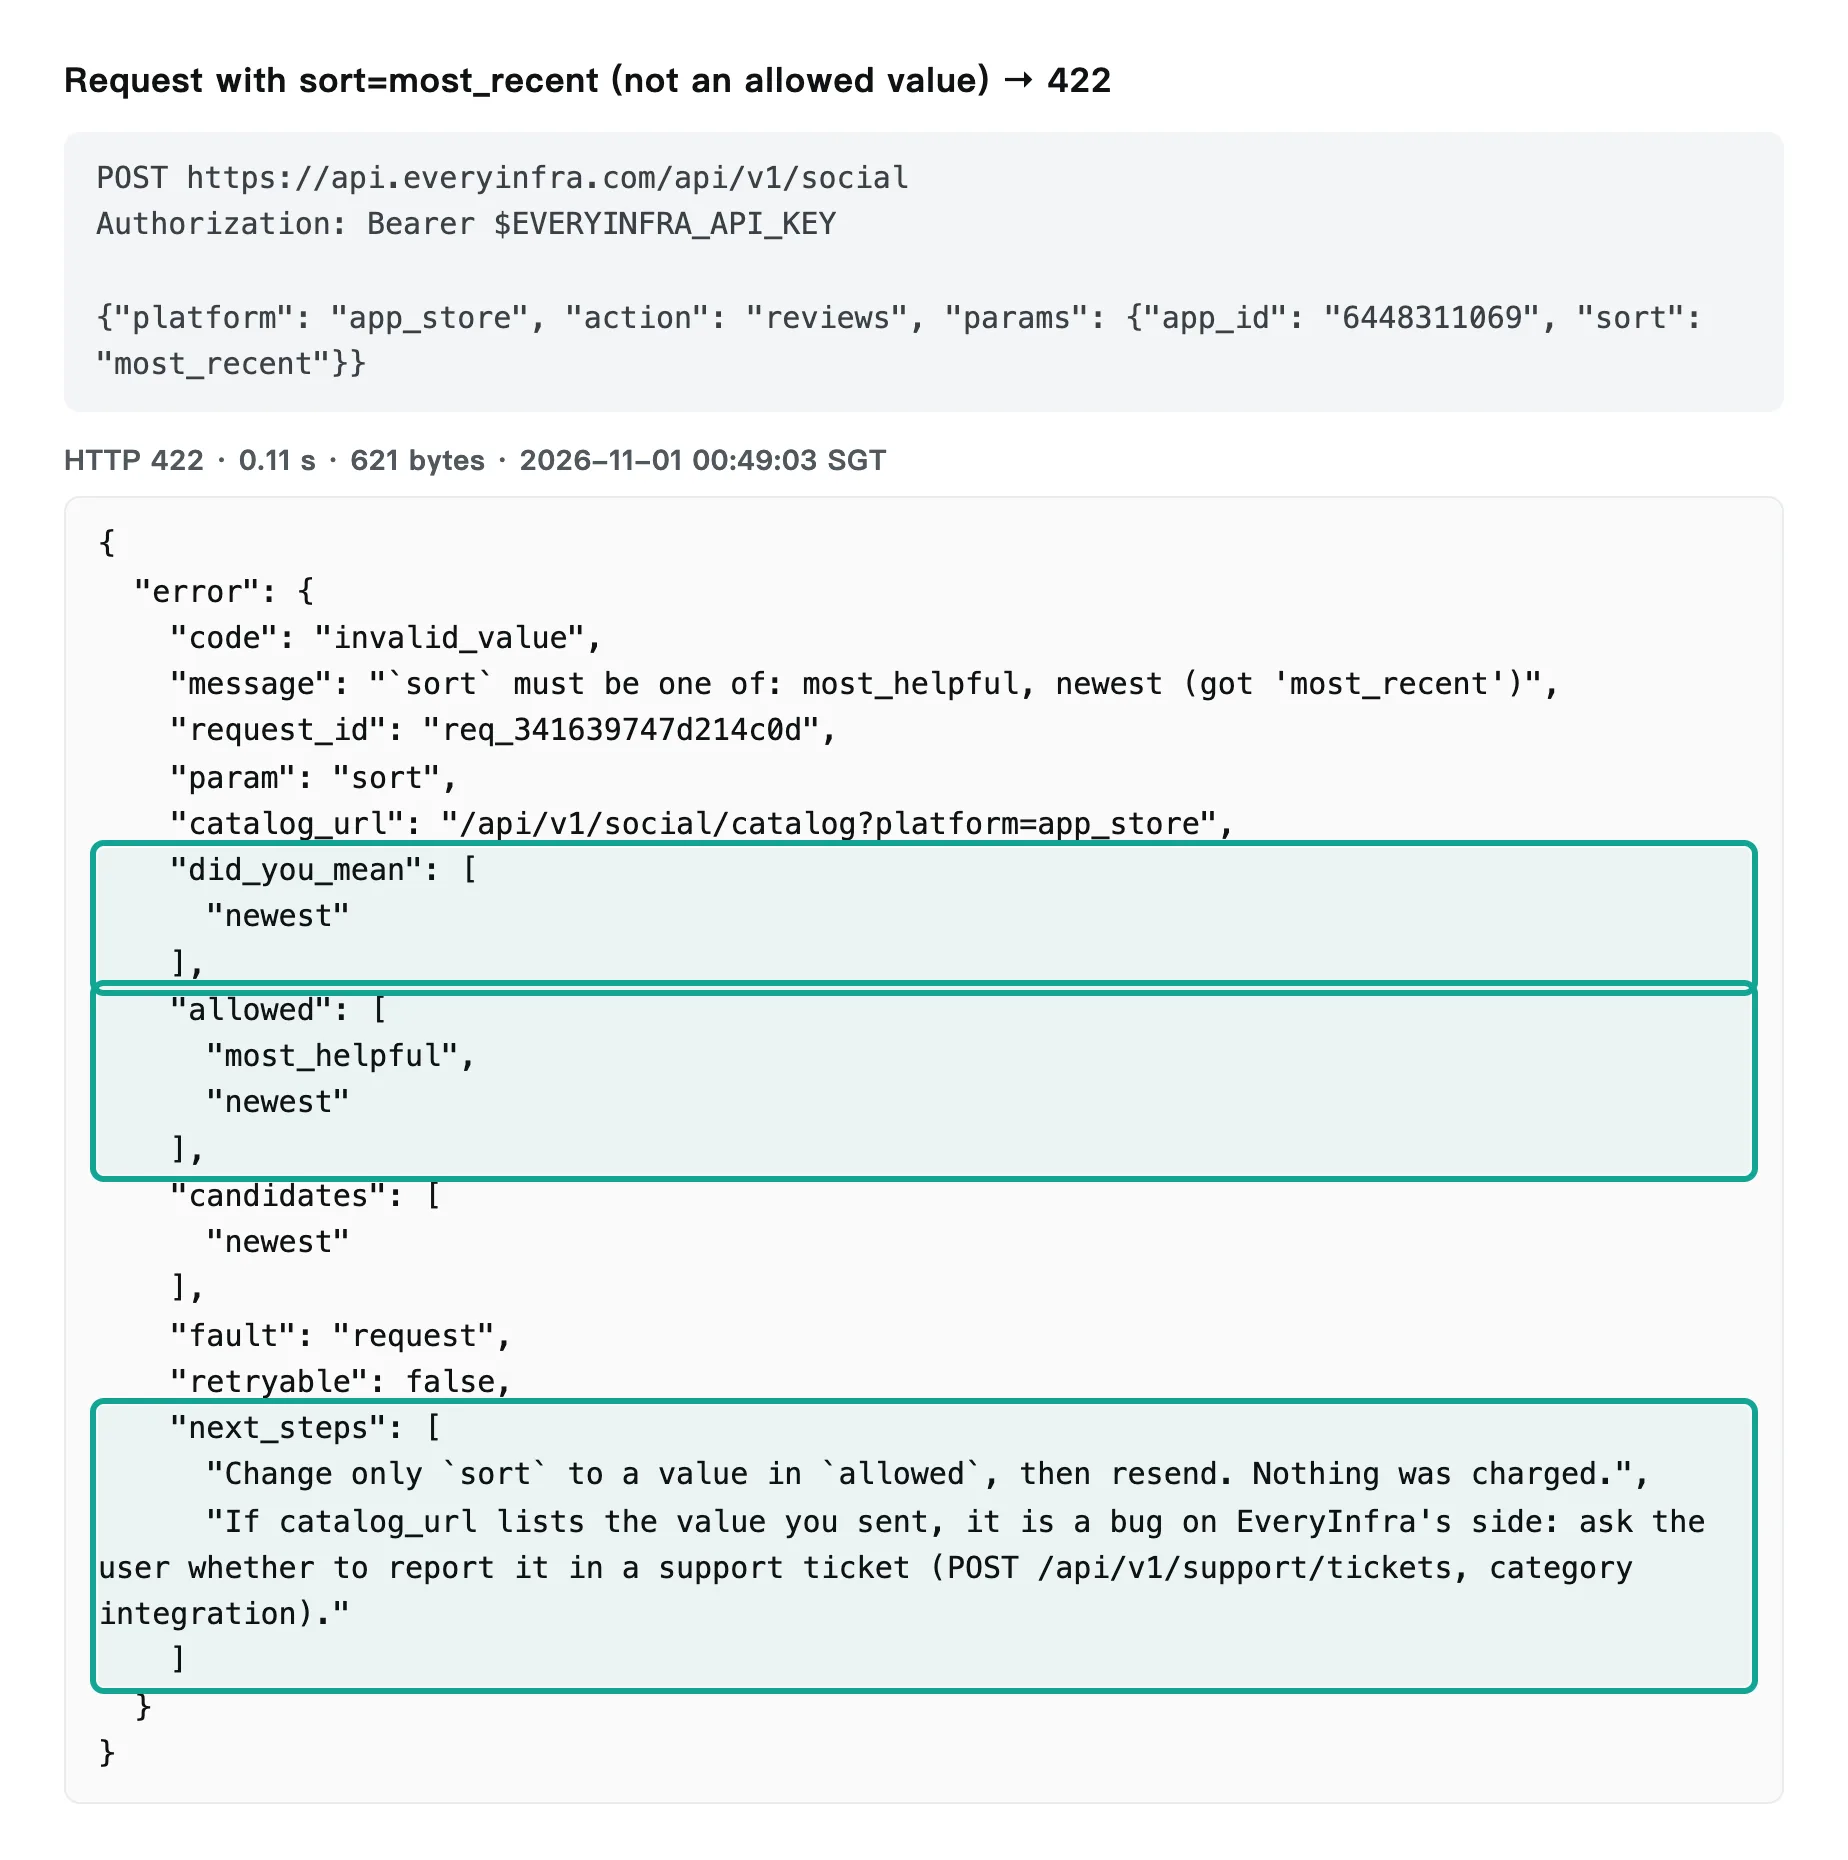
Более типичный случай: неверное значение enum. В 00:49 SGT мы отправили sort: most_recent в app_store/reviews. API вернул 422 за 0,11 с. Поле did_you_mean содержало ["newest"], а allowed содержало ["most_helpful", "newest"]. Первая строка next_steps предлагает изменить только sort на значение из allowed и отправить запрос снова, а также сообщает, что ничего не списано.
Вторая строка тоже полезна. Она объясняет, что делать, если отправленное значение есть в каталоге. Тогда ошибка на стороне EveryInfra, и модели стоит спросить пользователя, создать ли тикет в поддержку. Эта строка адресована модели. Она отделяет «я передал неверные данные» от «сервис работает неправильно». Так модель не принимает собственную ошибку за сбой и не повторяет то же значение.
В таблице ниже показаны восемь случаев с ошибками, два дневных контрольных вызова и пять вечерних повторных проверок после исправления. Последний столбец содержит результаты локальной проверки. Мы проверили все входные данные по приведённым выше определениям инструментов с помощью валидатора JSON Schema для словаря валидации «Draft 2020-12 validation vocabulary».
| Время (SGT) | Что мы сломали | Ответ | Время | Списание | Подсказки в ответе | Строгий режим блокирует раньше? |
|---|---|---|---|---|---|---|
| 00:48:37 | Нет ключа | 401 missing_key | 0.12 s | 0 | Просит передать API-ключ | Не относится |
| 00:48:38 | Лишний max_results | 422 unknown_param | 0.12 s | 0 | Список параметров, пример запроса | Да |
| 00:48:42 | company набрано как compnay | 422 missing_param | 0.23 s | 0 | Указывает опечатку, пример | Да |
| 00:48:42 | date: last7days | 503 | 1.69 s | 0 (возврат средств) | Только «повторите позже» | Тогда да; после вечернего исправления значение допустимо |
| 00:48:44 | sort: newest | 503 | 1.91 s | 0 (возврат средств) | Только «повторите позже» | Тогда да; после вечернего исправления значение допустимо |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0.11 s | 0 | did_you_mean, allowed | Да |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0.20 s | 0 | did_you_mean, allowed | Да |
| 00:57:45 | G2 sort: most_recent через MCP | isError: true | — | 0 | То же, в structuredContent | Неприменимо |
| 15:39:38 | sort: newest (контроль) | 200, 20 записей | 14.3 s | $0.001389 | Нет; другие отзывы | Тогда да; после вечернего исправления значение допустимо |
| 15:39:38 | date: last7days (контроль) | 200, 20 записей | 14.4 s | $0.001389 | Нет; другие отзывы | Тогда да; после вечернего исправления значение допустимо |
| 19:18:39 | sort: newst (после исправления) | 422 invalid_value | 0.21 s | 0 | did_you_mean (newest), allowed | Да |
| 19:18:46 | date: last_week (после исправления) | 422 invalid_value | 0.12 s | 0 | did_you_mean (last7days), allowed | Да |
| 19:18:53 | date: any (после исправления) | 422 invalid_value | 0.11 s | 0 | allowed | Нет; схема это допускает, а код удаляет значение |
| 19:19:01 | language: eng (после исправления) | 422 missing_param | 0.19 s | 0 | Просит двухбуквенный код | Нет в нашем определении |
| 19:19:23 | sort: newest (после исправления, теперь допустимо) | 200, 20 записей | 14.1 s | $0.001389 | Те же записи, что и для recency | Не нужен |
Четыре дневные строки с trustpilot/reviews требуют внимания. В раннем каталоге у параметров date и sort этой возможности было только текстовое описание, без allowed_values. Поэтому API не мог проверить их как enum на входе. В 00:48 SGT каждое неверное значение получило 503 через 1,7–1,9 с. Списания не было, а next_steps предлагал только повторить попытку через retry_after секунд.
Но списать эти две ошибки 503 на значения нельзя. В те же несколько минут в другом тесте мы вызвали trustpilot/profile без этих параметров и тоже получили 503. Значит, сама платформа в тот момент работала нестабильно.
Поэтому днём мы провели контрольный тест. В 15:39:38 SGT отправили четыре вызова в одну минуту, все для temu.com. В каждом менялся только один параметр. Мы сравнили sort: newest с допустимым sort: recency, а date: last7days с допустимым date: last30days. В 15:40 SGT добавили базовый вызов без необязательных параметров и один повтор с newest. Все шесть вызовов вернули 200 с 20 записями, каждый стоил $0,001389.
Результаты чётко разделились на две группы. Два допустимых значения и базовый вызов вернули одни и те же 20 отзывов. Все на английском, поля verification_level и source заполнены. Два значения не из списка и повтор вернули другой набор из 20 отзывов. Из них 13 на английском, 3 на французском, 2 на испанском и 2 на итальянском. Во всех 20 эти два поля были пустыми.
Итак, днём 1 ноября при неверном значении API не возвращал ни 422, ни 503. Он принимал значение, списывал обычную плату и незаметно менял результат.
Для модели это хуже, чем 503. Модель видит успешный ответ, поэтому не повторяет попытку и не предупреждает пользователя. Отзывы на разных языках попадают прямо в ваш конвейер. В тексте каталога для sort на самом деле сказано использовать recency, а не значение newest с других платформ. Но это видит только тот, кто читает текст. Проверка API этого не видела.
Таковы дневные результаты. Вечером того же дня шлюз изменил эти правила:
| Параметр | Днём 1 ноября | После вечернего исправления |
|---|---|---|
sort | Значения не перечислены; API принимал newest, списывал плату и возвращал другие отзывы | newest (то же, что recency), recency, relevance |
date | Значения не перечислены; API принимал last7days, списывал плату и возвращал другие отзывы | Пять пресетов, отсекающих отзывы по дате публикации: за последние 7, 30, 92, 183 и 366 дней |
language, lang | В тексте были только примеры | Только двухбуквенные коды; без языка возвращаются только отзывы на английском |
| Значения не из списка | API мог принять их и списать плату | 422 до любого списания, с допустимыми значениями и подсказкой did-you-mean |
Последние пять строк таблицы ошибок относятся к нашей повторной проверке с той же компанией. Неверные значения получили 422 с подсказкой и без списания. Четыре вызова вернули 200 по $0,001389 каждый: sort: newest, sort: recency, date: last7days и базовый. Все четыре вернули одни и те же 20 отзывов на английском, с verification_level и source в каждой записи. Самому старому отзыву было меньше суток, поэтому результаты с last7days и без date должны совпадать.
Это также показывает, почему нужен первый уровень. Наша строгая схема задаёт date и sort как enum, поэтому Claude не сможет отправить такие ошибочные значения. После вечернего исправления эти две ошибки останавливает и 422. Но у других параметров значения по-прежнему могут быть перечислены только в тексте, поэтому клиентская схема остаётся первой проверкой.
На стороне MCP действует то же разделение. В разделе об инструментах спецификации MCP ошибки валидации входных данных отнесены к ошибкам выполнения инструмента. Они передаются в результате с isError: true, и клиент отдаёт их модели, чтобы она могла исправить вызов. Наш вызов MCP в 00:57 SGT вернул именно это. В нашем руководстве по ошибкам API разобран каждый код ошибки, а руководство по проверке возвратов показывает, как сверять возвраты средств.
Ещё одна находка следует из небольшой заметки в документации Anthropic. Структурированный вывод не гарантирует регистр строковых значений enum. Модель может без ошибки вернуть значение, которое отличается от заданного в схеме только регистром. В заметке сказано, что это относится и к строгому использованию инструментов («structured outputs, „Invalid outputs“»). Поэтому даже в строгом режиме newest может превратиться в Newest. В 14:33 SGT мы проверили app_store/reviews с sort: Newest.
API не вернул ошибку. Он вернул 200 с 30 отзывами в порядке от новых к старым и списал $0,001389.
Одного вызова мало для вывода, поэтому с 15:39 до 15:41 SGT мы проверили ещё две платформы. На g2/reviews запросы с sort: Newest и sort: newest вернули один и тот же набор из 21 записи. На google_play/reviews запрос с sort: Top_Rated вернул 40 отзывов, все пятизвёздочные. Вызов с sort: Newest в ту же минуту вернул смесь оценок от одной до пяти звёзд, то есть значение с изменённым регистром действительно сработало. Эти четыре вызова стоили по $0,001389.
Итак, на трёх проверенных возможностях значения, различающиеся только регистром, считаются одинаковыми. Другие enum в каталоге мы не проверяли. Надёжный способ: приводить значения enum к нижнему регистру в коде перед отправкой. Одна такая строка обходится гораздо дешевле одного неверного вызова. Применим и другой совет Anthropic: не задавайте два значения enum, которые отличаются только регистром.
Параллельное использование инструментов тоже влияет на оба уровня. Оно включено по умолчанию. Поэтому модель может отправить несколько блоков tool_use за один ход, например Trustpilot и App Store вместе. На странице «parallel tool use» приведены два правила формата. Все результаты инструментов за ход передаются в одном сообщении пользователя, и перед результатами не должно быть текста. Поэтому ваш код должен обрабатывать 422 и 200 в одном ходе.
Пометьте результат 422 как is_error: true, а результат 200 верните как обычно. Тогда модель повторно отправит только неудачный вызов. Если у вашего ключа низкий лимит запросов или вам нужны простые логи, добавьте disable_parallel_tool_use: true внутрь объекта tool_choice. В режиме auto модель тогда вызывает не больше одного инструмента за ответ. Эта настройка не является параметром верхнего уровня запроса.
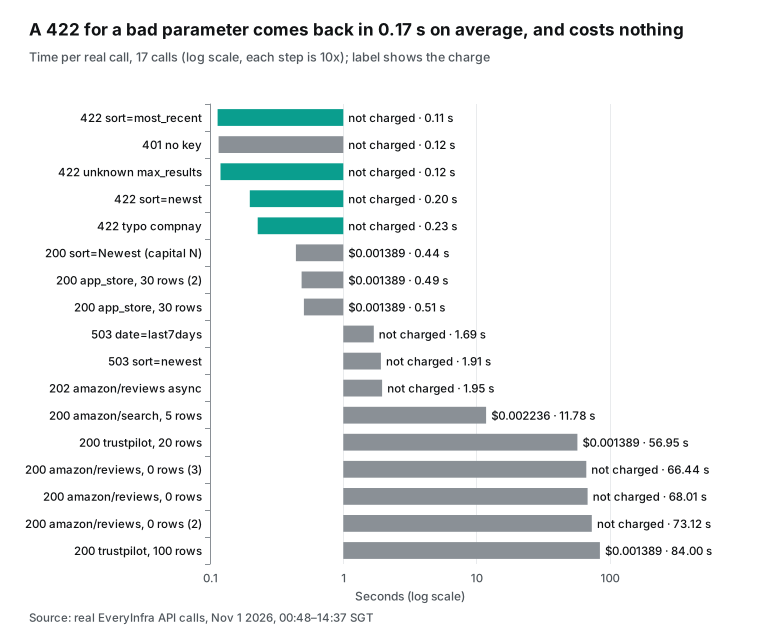
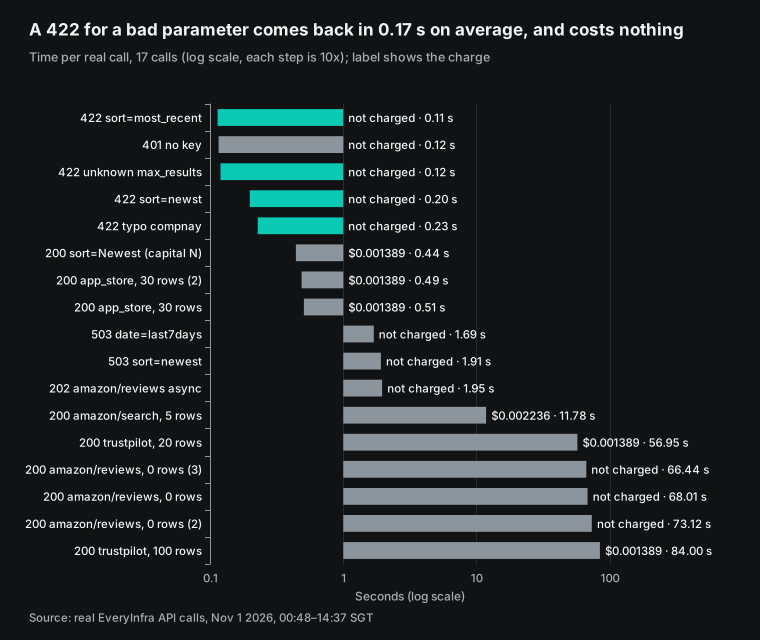
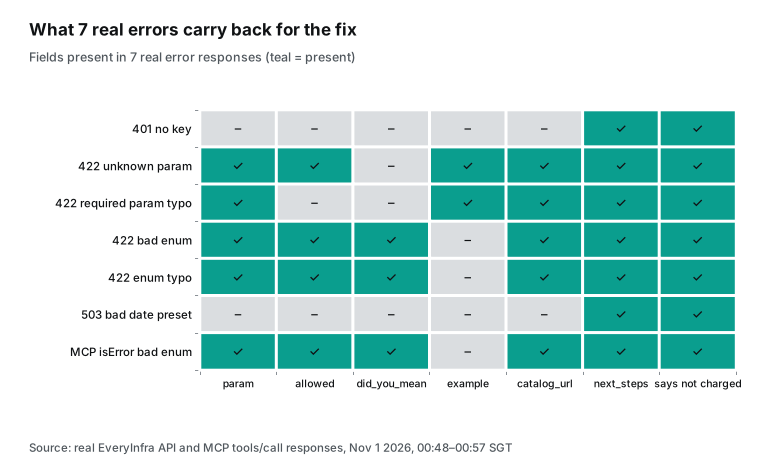
Диаграмма показывает тот же факт с другой стороны. Повторная попытка после 422 стоит $0 и около 0,17 с на стороне API: это среднее по четырём вызовам с 422. Затраты приходятся на дополнительный ход модели.
Для одного дополнительного хода используйте формулу: стоимость исправления = (токены контекста + токены ошибки) × цена входных токенов + токены исправления × цена выходных токенов. Мы берём около 240 токенов на тело ошибки и около 120 выходных токенов на исправление. Основную часть стоимости определяет длина контекста, поэтому в таблице три размера. Цены взяты со страницы с ценами по состоянию на 1 ноября 2026 г. Число в скобках показывает, скольким вызовам API для отзывов по $0,001389 каждый соответствует эта стоимость.
| Контекст | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1 000 токенов | $0.00018 (0.1) | $0.0037 (2.6) | $0.0074 (5.3) | $0.0184 (13) |
| 5 000 токенов | $0.00058 (0.4) | $0.0117 (8.4) | $0.0234 (17) | $0.0584 (42) |
| 20 000 токенов | $0.0021 (1.5) | $0.0417 (30) | $0.0834 (60) | $0.2084 (150) |
У приложения с тремя определениями инструментов и несколькими ходами контекст часто достигает 20 000 токенов. Тогда одна ошибка при работе с Opus 5.5 обходится примерно как 60 вызовов API данных. С кешированием промптов часть контекста оплачивается по цене чтения из кеша. Эта цена составляет 10% от цены входных токенов на Haiku 5.5, 5% на Opus 5.5 и Sonnet 5.5 и 2,5% на Fable 5.1. При 20 000 токенов на Opus 5.5 это снижает стоимость одного дополнительного хода с $0,0834 примерно до $0,0074.
Подставьте в формулу свою длину контекста, чтобы рассчитать соотношение для своего случая. Во всех случаях зависимость одна и та же: чем длиннее контекст, тем дороже повторная попытка. В этом экономический смысл первого уровня. Строгий режим предотвращает самую частую повторную попытку ещё до её начала.
Полный цикл: что отправляет модель и что приходит в ответ
Код ниже объединяет оба уровня в минимальном цикле. Он следует документации Anthropic. Это пример конфигурации: сторону Claude мы не запускали. Запросы и ответы EveryInfra взяты из реальных результатов от 1 ноября 2026 г.
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # reads ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # the three strict tools above
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # "any" and [] mean no filter
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=90)
    body = r.json()
    if r.status_code == 422:                    # value error: pass it to the model as is
        return json.dumps(body["error"]), True
    if r.status_code >= 400:
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}), False

messages = [{"role": "user", "content": "Use the trustpilot_reviews tool to get 20 one- and two-star reviews of temu.com from the last 30 days, then group them by topic."}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
    messages.append({"role": "user", "content": results})
Несколько деталей делают этот цикл стабильным. Код задаёт tool_choice равным auto. Это значение по умолчанию, но явное указание сообщает следующему разработчику, что принудительный вызов не используется. В сообщении пользователя указано имя инструмента.
Именно так в документации Opus 5.5 и Fable 5.1 предлагают заменять принудительный вызов. Код помещает тело ошибки 422 в tool_result как есть, с is_error: true. Не заменяйте его на «неверный параметр»: модель может воспользоваться именно allowed и did_you_mean.
При успехе код возвращает модели только пять полей: id, оценку, заголовок, текст и время публикации.
Мы измерили это на реальных ответах того дня. Поле results для 20 отзывов с Trustpilot занимало 31 046 символов. Если оставить только пять полей, оно занимало 13 040 символов, то есть на 58% меньше. Для 30 отзывов из App Store размер уменьшился с 13 012 до 7 726 символов, то есть на 41%. Чем меньше читает модель, тем дешевле каждый ход. В расчётах для пакетной обработки ниже мы используем сокращённый размер.
Вот реальный обмен запросом и ответом в этом цикле в 00:49 SGT 1 ноября 2026 года. Строгий режим заставляет модель передавать параметры вроде {"company": "temu.com", "stars": ["1", "2"], "date": "last30days", "sort": "recency", "limit": 20}. Наш код отправляет их в trustpilot/reviews. API вернул 200 через 56,9 секунды и 20 отзывов: 19 с одной звездой и 1 с двумя звёздами, опубликованные с 30 октября 2026 года по 31 октября 2026 года.
По странам: 10 из Великобритании и 3 из США; на 16 отзывов компания ответила. Списано $0,001389, столько же, сколько указано в price_usd в каталоге. Если бы модель выбрала "sort": "newest", строгий режим остановил бы этот вызов. Без строгого режима API не отклонил бы значение. Как и в контрольном тесте выше, он списал бы обычную стоимость и вернул набор отзывов на разных языках.
Что увидит структурированный вывод? Мы не запускали Claude, поэтому не приводим вывод модели. Вместо этого мы применили простые правила по ключевым словам к 100 отзывам Trustpilot из вызова в 14:37 SGT. Из 100 отзывов в 40 упоминается возврат средств, в 20 возврат товара.
35 отзывов упоминают доставку, 33 — качество или повреждения, 35 — службу поддержки, 14 — аккаунт. 16 отзывов не подходят ни под одно правило. Медианная длина текста — 432 символа, а самый длинный отзыв содержит 3 371 символ.
Эти цифры полезны в двух отношениях. Во-первых, один отзыв часто подходит сразу под несколько тем. Если схема допускает только одно значение topic, модели придётся выбирать, поэтому пропишите правило в описании, например «предпочитай тему, связанную с деньгами». Во-вторых, самый длинный отзыв занимает около 1 350 токенов.
Если вы закладываете 25 отзывов на запрос, ориентируйтесь на распределение длины, а не на среднее значение. Иначе некоторые запросы могут упереться в max_tokens. Эти отзывы опубликованы с 27 октября 2026 года по 1 ноября 2026 года, поэтому описывают только эти дни.
На втором шаге модель раскладывает каждый отзыв по фиксированным полям с помощью структурированного вывода Claude. Эта схема тоже является примером конфигурации:
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "At most 20 words copied from the review"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}
У этой схемы нет необязательных параметров, поэтому она помещается в тот же запрос, что и три строгих инструмента. Для поля quote в описании указано «не более 20 слов» вместо maxLength, потому что ограничения длины не поддерживаются. Остаются два задокументированных исключения. Если модель отказывается отвечать, в ответе будет stop_reason: "refusal", а вывод может не соответствовать схеме.
Если вывод упирается в max_tokens, в ответе будет stop_reason: "max_tokens", а вывод может быть неполным. Поэтому проверяйте stop_reason, прежде чем что-либо сохранять. Кроме того, поле, которое просит «пошаговое рассуждение», может вызвать отказ reasoning_extraction. На странице «refusals and fallback» советуют вместо этого просить краткое объяснение.
Американские команды разработчиков приложений часто начинают с отзывов в App Store. В 00:54 SGT мы прочитали 30 самых новых отзывов из США о приложении Claude (app_store/reviews, app_id 6473753684). 24 из них относятся к версии 1.261026.20, а 6 — к версии 1.261028.19. Отзывы опубликованы с 28 октября 2026 года по 30 октября 2026 года. В таблице эти выборки приведены рядом с выборками из Trustpilot.
| Выборка | Время (SGT) | Записи | 1 звезда или 2 звезды | 5 звёзд | Списание |
|---|---|---|---|---|---|
trustpilot/reviews, temu.com, stars 1–2, limit 20 | 00:49 | 20 | 20 | 0 | $0.001389 |
trustpilot/reviews, temu.com, stars 1–2, limit 100 | 14:37 | 100 | 100 | 0 | $0.001389 |
app_store/reviews, приложение Claude, США, newest | 00:54 | 30 | 10 | 16 | $0.001389 |
app_store/reviews, приложение ChatGPT, США, newest | 00:54 | 30 | 5 | 21 | $0.001389 |
У этих чисел нет статистического веса. Они показывают один практический факт. На Trustpilot одна и та же схема видит почти только плохие отзывы, потому что мы отфильтровали оценки в одну и две звезды. В App Store она видит смешанную картину.
Распределение поля вроде severity зависит от источника, поэтому задавайте уровни оповещений для каждого источника отдельно. На странице Apple для разработчиков сказано, что сводный рейтинг рассчитывается для каждой витрины и может сбрасываться с выходом новой версии. Письменные отзывы сохраняются («Apple, ratings and reviews»). Поэтому отзывы в разрезе версий полезнее общего балла.
Пакетная обработка: сколько стоит разбор 1 000 отзывов с Message Batches
Когда один цикл работает, затраты определяются объёмом. Message Batches API обрабатывает запросы асинхронно, и всё использование стоит 50% от стандартных цен. Пакет может содержать до 100 000 запросов или 256 МБ. Большинство пакетов завершается в течение часа. Запросы, не завершённые за 24 часа, истекают и не оплачиваются.
Результаты доступны 29 дней («batch processing»). На странице о структурированном выводе сказано, что функция работает с пакетами с той же скидкой 50%. Каждый запрос в пакете является полноценным запросом Messages. Поэтому строгие инструменты и output_config.format передаются как есть («create a Message Batch»).
На стороне данных первый вопрос в том, сколько записей получать за вызов. В каталоге для trustpilot/reviews указаны значение по умолчанию 20 и максимум 200, по $0,001389 за вызов. Поля с ценой за запись нет. В 14:37 SGT мы отправили limit: 100.
Мы получили 100 отзывов, а списание осталось $0,001389, столько же, сколько за 20 записей. Из этих 100 отзывов 95 были с одной звездой и 5 с двумя. 44 пришли из Великобритании, 21 из США.
Цена большого limit выражается во времени. Синхронный вызов занял 84,0 с, а по каталогу бюджет синхронного вызова составляет 85 с. Это вплотную к лимиту. Поэтому для массовой выгрузки отзывов используйте большой limit и добавляйте "mode": "async" в тело запроса. Затем опрашивайте GET /api/v1/jobs/{job_id}. Не ждите ответа синхронного вызова.
| За 1 000 отзывов | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| Стоимость модели по стандартному тарифу | $0.0577 | $1.1537 | $2.3073 | $5.7683 |
| Стоимость модели в Message Batches | $0.0288 | $0.5768 | $1.1537 | $2.8842 |
| Плата за данные, limit=100 (10 вызовов) | $0.0139 | $0.0139 | $0.0139 | $0.0139 |
| Итого, пакет + limit=100 | $0.0427 | $0.5907 | $1.1676 | $2.8981 |
Вот как мы оценили стоимость модели, чтобы вы могли подставить свои цифры. Согласно «models overview», 1 млн токенов примерно равен 2,5 млн символов Unicode, поэтому мы берём 0,4 токена на символ.
| Исходные данные для оценки | Значение | Источник |
|---|---|---|
| Отзывов на запрос | 25, то есть 40 запросов | Наш выбор |
| Символов в сокращённом отзыве | Около 440 | Реальные ответы Trustpilot и App Store |
| Инструкции и схема на запрос | Около 1 424 символов | Наш промпт и схема вывода |
| Символов на элемент вывода | Около 189 | Один пример элемента вывода |
| Всего токенов | Около 198 832 на входе, 75 600 на выходе | Символы × 0,4 |
Мы не учитывали токены рассуждений, системный промпт для использования инструментов (286 токенов на Opus 5.5) и промпт формата, который добавляют structured outputs. Поэтому эти цифры — нижняя граница. При значении по умолчанию limit=20 плата за данные для 1 000 отзывов составляет 50 вызовов и $0.0694, что в пять раз больше, чем при limit=100.
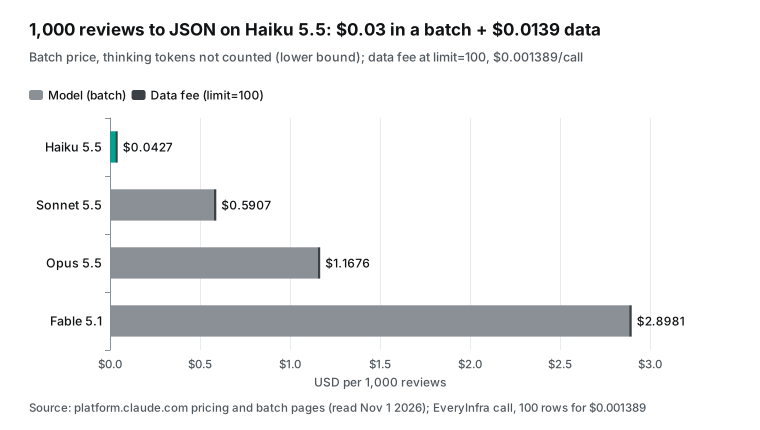
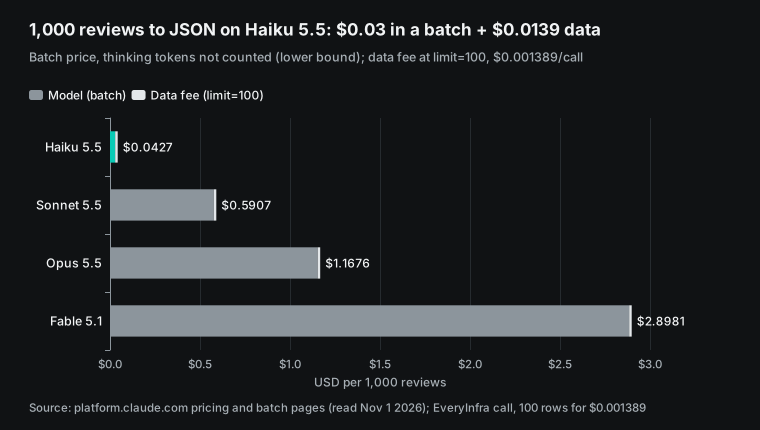
Вывод очевиден. Группировка отзывов — это много чтения и простые решения, поэтому поручите её Haiku 5.5. Тогда стоимость модели и плата за данные сопоставимы, в сумме около $0.04 за 1 000 отзывов. Opus 5.5 обходится в 27 раз дороже, а Fable 5.1 — в 68 раз. У Haiku 5.5 есть одна ценовая ступень, за которой стоит следить.
Свыше 100 000 токенов промпта цены составляют $0,50 / $2,50, а в пакете — $0,25 / $1,25. При 25 коротких отзывах на запрос вы остаётесь далеко ниже этой границы. Если нужна более тонкая оценка, например чтобы отличать «медленную доставку» от «отказа продавца принять возврат», сначала обработайте всё с помощью Haiku. Затем отправьте в Opus 5.5 только элементы с severity: high.
Теперь применим это к ежедневному мониторингу. Возьмём отзывы с одной и двумя звёздами на Trustpilot для 50 компаний, а также новые отзывы в App Store для 50 приложений. Это 100 вызовов API в день: $0.1389 в день и $4.17 за 30 дней. Мониторинг обрабатывает примерно до 2 500 отзывов в день.
За 30 дней группировка стоит около $2,16 на Haiku 5.5 в пакетах, $43,26 на Sonnet 5.5 и $86,53 на Opus 5.5. Пакеты и кеширование промптов можно сочетать, и кешированные системные промпты и определения инструментов стоят дешевле. Но доля попаданий в кеш в пакете зависит от порядка запросов. Мы это не проверяли, поэтому в цифрах это не учтено.
Что не работает и за чем следить
Сначала о пробеле в наших данных. 1 ноября 2026 г. amazon/reviews не вернул ни одного отзыва за четыре попытки. Два синхронных вызова в 00:50 и 00:51 SGT ждали около 68 и 73 с. Одна асинхронная задача в 00:53 SGT завершилась с 0 записями.
Ещё один синхронный вызов в 14:34 SGT с заданным domain ждал 66 с и тоже вернул 0 записей. Ни один из четырёх вызовов ничего не стоил. За пустые результаты средства возвращаются по правилам, а за асинхронную задачу сначала списали средства, а затем вернули.
Вечером того же дня шлюз изменил обработку двух случаев с Amazon. Мы проверили их повторно с 19:19 до 19:24 SGT:
| Запрос | Днём | Повторная проверка вечером | Списание |
|---|---|---|---|
| Сайт США, синхронно | 200, 0 записей, 66–73 с | 503 access_blocked за 24,6 с; next_steps сообщает, что быстрая повторная попытка не поможет | 0 |
| Сайт США, асинхронно | Задача завершена, 0 записей | 202 с удержанием $0,001389; задача завершилась ошибкой access_blocked | 0 (возврат средств) |
amazon.co.jp | Не тестировалось | 19:19: 422 missing_param, сообщение «missing domain». 22:14: 200 за 35,3 с, 5 отзывов, все от покупателей из других стран (3 из США, 2 из Германии) | 0 в 19:19; $0,001389 в 22:14 |
amazon.com.mx | Не тестировалось | 19:19: 422 missing_param. 22:14: 422 invalid_value за 0,09 с со списком из 11 поддерживаемых сайтов | 0 |
В 19:19 в сообщении об ошибке не говорилось, что эти два сайта не поддерживаются. В 22:14 каталог уже описывал domain как enum из 11 сайтов: amazon.com, co.uk, de, fr, it, es, ca, com.au, in, co.jp и sg. Теперь запрос к мексиканскому сайту отклоняется до списания, а в ошибке перечислены все 11 значений. В определении инструмента выше используется тот же список. Японский сайт теперь возвращает отзывы, но их авторы не всегда покупатели из Японии. Чтобы оставить только отзывы из Японии, фильтруйте по полю country.
В каталоге уже сказано, что эта возможность получает только избранные отзывы со страницы товара, обычно около десятка на товар. В тот день не удалось получить даже их. Поэтому инструмент для Amazon в этой статье служит лишь примером конфигурации. В реальных тестах мы использовали trustpilot/reviews и app_store/reviews, которые в тот день работали.
При этом amazon/search работал: в 00:51 SGT поиск по запросу «anker power bank 10000mah» вернул 5 товаров за 11,8 секунды и стоил $0,002236. Прежде чем добавлять отзывы Amazon в пакет, сверьтесь с каталогом. Затем сделайте один небольшой вызов в тот же день.
Далее — ограничения, описанные Anthropic. Strict-инструменты допускаются к использованию в сценариях, подпадающих под HIPAA, но API кэширует скомпилированные схемы отдельно от содержимого сообщений, и на них не распространяется такая же защита (strict tool use, data retention). Поэтому не помещайте список клиентов в enum. Случай с CMEK описан в руководстве по миграции на Fable 5.1 (Fable 5.1 migration guide).
| Ограничение | Что это значит для API данных | Источник |
|---|---|---|
| Никаких медицинских данных в схемах | Никаких PHI в именах свойств, enum, const и pattern | «Strict tool use, data retention» |
| Организации с CMEK | На моделях Fable нет structured outputs и strict: true; используйте только инструкцию | «Fable 5.1 migration guide» |
| Цитирование (Citations) | Не работает вместе со structured outputs: ошибка 400 | «Structured outputs, feature compatibility» |
| Смена формата | Новый output_config.format сбрасывает кэш промпта | «Structured outputs, token costs» |
К ограничению на цитирование нужно ещё одно пояснение. Для структурированных данных с источником для каждого значения используйте специальный метод из документации по citations.
Наконец, у второго уровня есть свои ограничения. Ответ 422 отсекает только ошибки, которые определены в каталоге: неизвестные параметры, отсутствующие обязательные параметры и enum с перечисленными значениями.
Он не может отсечь ошибки в правилах, которые каталог описывает только текстом. Днём 1 ноября примерами были date и sort в trustpilot/reviews. В то время неверные значения этих двух параметров даже не вызывали ошибку. За них списывалась обычная плата, а результат менялся. Вечернее исправление добавило для них допустимые значения, так что теперь такие запросы получают 422.
422 не поможет и с фактами, которые известны только во время выполнения, например «есть ли у этой компании страница на Trustpilot».
Поэтому используйте оба уровня. Всё, что можно, заложите в strict-схему. Остальные ошибки должен отсекать ответ 422. Для enum, скопированных из текста каталога, также проверяйте в коде язык и ключевые поля каждого ответа.
Диагностика: семь симптомов и как их устранить
В продакшене проблемы обычно возникают в пограничных случаях. Схема вдруг перестаёт компилироваться. Модель на каком-то ходе не вызывает инструмент. Несколько записей в пакете выбиваются из общего ряда. В таблице ниже собраны семь симптомов из документации и наших реальных вызовов.
Сначала проверьте, кто вернул код статуса. 400 приходит от Anthropic и означает, что неверен запрос или схема, поэтому исправляйте код. 422 или 503 приходят от EveryInfra и означают, что структура запроса верна, но значение не прошло проверку или выполнение завершилось с ошибкой, поэтому следуйте next_steps. Одна эта проверка экономит большую часть времени на отладку, потому что форматы ошибок различаются и их легко перепутать в логах.
| Симптом | Кто вернул | Причина | Как исправить |
|---|---|---|---|
| 400, tool_choice не поддерживается | Anthropic | any или tool на новой модели | Используйте auto и назовите инструмент в сообщении пользователя |
| 400, схема слишком сложная | Anthropic | Больше 24 необязательных параметров или большая грамматика | Сделайте параметры обязательными; большие enum замените текстом и проверкой через 422 |
| Модель отвечает текстом, без вызова инструмента | Anthropic | Нечёткая инструкция | Назовите инструмент и условие вызова; проверьте stop_reason и попросите ещё раз |
422 invalid_value | EveryInfra | Значения нет в allowed_values каталога | Исправьте одно поле по did_you_mean; без списания |
| Повторяющийся 503 | EveryInfra | Платформа работает нестабильно: наши вызовы без подозрительных значений тоже его получали. При reason: access_blocked целевая страница требует входа или доступ к ней ограничен | Подождите retry_after; после повторных сбоев передайте запрос на проверку человеку; при access_blocked смените цель |
| 200, но язык или поля выглядят неправильно | EveryInfra | Значение, которого нет в тексте каталога, было принято и изменило результат. Так было с date и sort в trustpilot/reviews до вечернего исправления | Заблокируйте его через enum на клиенте; сверьтесь с текстом каталога |
| 200, но 0 записей | EveryInfra | В тот день на целевой странице не было данных | Средства уже возвращены; смените цель или возможность |
Последние три строки взяты из наших тестов, первые четыре — из документации Anthropic. Шестую строку заложите в код, потому что у других параметров может быть та же проблема. Каждый enum, скопированный из текста каталога, пропишите в схеме. После каждого ответа сравнивайте соотношение языков и ключевые поля с эталоном. При расхождении помечайте вызов для проверки человеком. В нашем контрольном тесте 7 из 20 отзывов при неверных значениях были не на английском. Два поля были пустыми во всех 20. Простая проверка выявляет это сразу.
Последние изменения, важные для этой конфигурации
| Дата | Изменение | Что это значит для вас |
|---|---|---|
| 22 сентября 2026 г. | Запуск Opus 5.5; thinking нельзя отключить; принудительный tool_choice возвращает 400 | Уберите принудительные вызовы до перехода с Opus 5; используйте auto вместе со strict |
| 28 сентября 2026 г. | Запуск Sonnet 5.5; принудительный tool_choice тоже отклоняется | Возврат на Sonnet не позволяет обойти это изменение |
| 7 октября 2026 года | Запуск Haiku 5.5; контекстное окно на 1 млн токенов; цена в пакетном режиме $0,05 / $0,25 | Стоимость модели для массовой группировки теперь сопоставима с платой за данные |
| 15 октября 2026 г. | Models API сообщает о поддержке thinking between_tools; быстрый режим Opus 5.5 выходит из research preview | Проверяйте возможности модели в коде, а не по ID модели |
| 21 октября 2026 г. | Версия API 2026-10-21 и новые SDK (Python 2.0.0 и другие) | При обновлении SDK проверьте устаревшие поля вроде output_format |
| 22 октября 2026 г. | Claude через Google Cloud под управлением Anthropic | Ещё один вариант оплаты пакетной обработки; порядок использования strict-режима не меняется |
| 28 октября 2026 г. | Лимит размера запроса Messages увеличен с 32 МБ до 128 МБ | В один запрос помещается больше отзывов, но стоимость зависит от числа токенов |
| 29 октября 2026 г. | Usage and Cost Analytics API в бете, с группировкой по модели, рабочему пространству и ключу | Распределяйте расходы на модель по задачам и сравнивайте их с платой за данные |
| 30 октября 2026 г. | Быстрый режим для Opus 4.8 отключат 30 ноября 2026 г. | Запланируйте переход, если на этой модели у вас в продакшене работает извлечение данных |
Эти пункты взяты из API release notes, обновлённых 30 октября 2026 г., и API version migration guide. Важнее всего для этой статьи запуск Haiku 5.5 7 октября 2026 г. До него массовая группировка на Haiku 4.5 в пакетах стоила $0,50 / $2,50, в десять раз дороже, и стоимость модели намного превышала плату за данные. Теперь эти суммы сопоставимы, поэтому цена API данных становится реальным фактором.
Ещё один пункт относится к 22 сентября 2026 г.: системное сообщение посреди диалога может содержать полное определение инструмента — пока эта возможность находится в бете. Это позволяет добавить strict-инструмент посреди сессии, не сбрасывая кэш промпта. Anthropic указывает этот способ как один из вариантов замены принудительных вызовов.
Частые вопросы
Можно ли по-прежнему принудительно вызывать инструменты в Claude?
Этот вопрос взят из поисковой подсказки «claude force tool use». На Fable 5.1, Mythos 5.1, Opus 5.5 и Sonnet 5.5 нельзя. tool_choice со значением any или tool возвращает 400, и эндпоинт подсчёта токенов выполняет ту же проверку. auto и none по-прежнему работают. Оставьте auto, добавьте strict: true к инструментам и укажите в сообщении пользователя, когда использовать каждый инструмент. Если инструмент должен выполниться на текущем ходе, руководство по миграции на Fable 5.1 предлагает системное сообщение посреди диалога.
Что делать, если в claude tool_choice равен auto, а модель не вызывает инструмент?
Этот вопрос взят из подсказки «claude tool_choice». По словам Anthropic, Fable 5.1 надёжно следует явным инструкциям по инструментам. Поэтому, во-первых, сделайте инструкцию чёткой: назовите инструмент и условие вызова. Во-вторых, проверяйте stop_reason в цикле.
Если модель ответила текстом, а вам нужны данные, добавьте сообщение пользователя с просьбой выполнить вызов. В-третьих, напишите понятное description инструмента. На странице define tools подробные описания названы «безусловно, самым важным фактором качества работы инструментов».
Работают ли structured outputs в Claude на Bedrock?
Этот вопрос взят из подсказки «claude structured outputs bedrock». В таблице доступности на странице strict tool use указаны Amazon Bedrock, включая InvokeModel, и Google Cloud. На странице structured outputs сказано «на всех поддерживаемых платформах» и «для всех моделей». Моделям Fable требуется хранение данных в течение 30 дней, и на них не распространяется zero data retention. Прежде чем их использовать, ознакомьтесь со страницей о хранении данных.
Как использовать structured output в Claude с Pydantic?
Этот вопрос взят из подсказки «claude structured output pydantic». На странице structured outputs рекомендуется передавать модель Pydantic в client.messages.parse(). SDK преобразует схему и переносит неподдерживаемые ограничения, такие как minimum и maxLength, в описания. Затем он проверяет ответ по исходной схеме со всеми ограничениями.
Для EveryInfra запишите allowed_values из каталога как Literal[...], который превращается в enum. Диапазон limit задайте через Field(ge=1, le=200), и SDK проверит его локально. В каталоге для шести возможностей указано, что значения выше максимума обрезаются до него.
Стоит ли использовать structured outputs в Claude API вместе со strict-инструментами в одном запросе?
Этот вопрос взят из подсказки «claude structured outputs api». Да, можно. В разделе «Feature compatibility» страницы structured outputs сказано, что их можно использовать в одном запросе. У них общие лимиты: 20 strict-инструментов, 24 необязательных параметра и 16 параметров с union-типами, поэтому все поля схемы вывода тоже сделайте обязательными.
С чего начать
- Изучите каталог. Запрос
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilotбесплатен и не требует API-ключа. Он возвращает параметры, допустимые значения и цены. - Напишите strict-инструменты по шести правилам выше. Сделайте параметры обязательными, запишите
allowed_valuesкакenum, а диапазоны укажите в описаниях. - Получите API-ключ в разделе Быстрый старт. Отправьте один запрос с неверным значением enum и убедитесь, что получаете 422 с
did_you_mean. - Для массовой работы используйте большой
limitи"mode": "async". На стороне Claude используйте Message Batches.
Страницы платформ: API для парсинга Trustpilot, API для парсинга App Store и API для парсинга Amazon. Страницы возможностей: отзывы Trustpilot, отзывы App Store и отзывы Amazon. Другие страницы об отзывах: отзывы G2 и отзывы Google Play. Чтобы подключить удалённый MCP-сервер в Claude без кода, ознакомьтесь с настройкой удалённого MCP.
О данных отзывов как продукте читайте в статье данные отзывов как платный продукт. Также прочитайте один SKILL.md для четырёх ИИ-инструментов. О параллельной выгрузке данных с помощью субагентов читайте в статье субагенты Claude Code для брендовых аккаунтов TikTok. Сравните цены возможностей на рынке данных.
Источники
- «What's new in Claude Opus 5.5 (Forced tool use is not supported)», Anthropic, 22 сентября 2026 г., https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- «What's new in Claude Fable 5.1», Anthropic, 1 сентября 2026 г., https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- «What's new in Claude Sonnet 5.5», Anthropic, 28 сентября 2026 г., https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- «Claude Opus 5.5 migration guide», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- «Claude Fable 5.1 migration guide», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- «Claude Sonnet 5.5 migration guide», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- «API release notes», Anthropic, обновлено 30 октября 2026 г., https://platform.claude.com/docs/en/release-notes/overview
- «Strict tool use», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- «Structured outputs», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- «Define tools», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- «Handle tool calls», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- «Tool use overview», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- «How tool use works», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- «Troubleshooting tool use», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- «Parallel tool use», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- «Tool runner», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- «Tool search tool», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- «Programmatic tool calling», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- «Batch processing», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/batch-processing
- «Create a Message Batch (API reference)», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/api/messages/batches/create
- «Pricing», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/about-claude/pricing
- «Prompt caching», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- «Token counting», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/token-counting
- «Rate limits», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/api/rate-limits
- «Errors», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/api/errors
- «Models overview», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/models/overview
- «Claude Haiku 5.5 overview», Anthropic, 7 октября 2026 г., https://platform.claude.com/docs/en/models/haiku-5-5/overview
- «Claude Opus 5.5 overview», Anthropic, 22 сентября 2026 г., https://platform.claude.com/docs/en/models/opus-5-5/overview
- «Claude Mythos 5.1 overview», Anthropic, 1 сентября 2026 г., https://platform.claude.com/docs/en/models/mythos-5-1/overview
- «Effort», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/effort
- «Streaming», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/streaming
- «Refusals and fallback», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- «Citations», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/build-with-claude/citations
- «MCP connector», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- «Remote MCP servers», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- «Migrating to API version 2026-10-21», Anthropic, 21 октября 2026 г., https://platform.claude.com/docs/en/api/migration-2026-10-21
- «API and data retention», Anthropic, дата обращения: 1 ноября 2026 г., https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- «Model Context Protocol specification 2025-11-25: Tools», MCP, https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- «JSON Schema Validation», draft 2020-12, JSON Schema, https://json-schema.org/draft/2020-12/json-schema-validation
- «JSONSchemaBench», Geng et al., arXiv 2501.10868, 2025, https://arxiv.org/abs/2501.10868
- «Ratings, reviews, and responses», Apple Developer, дата обращения: 1 ноября 2026 г., https://developer.apple.com/app-store/ratings-and-reviews/
- «EveryInfra data catalog (GET /api/v1/social/catalog)», EveryInfra, дата обращения: 1 ноября 2026 г., 00:46 SGT, https://api.everyinfra.com/api/v1/social/catalog
Справка BL-60