Claudeのstrict tool useをデータAPIで使う:呼び出しを正しく保つ2つの層
Opus 5.5はtool_choiceの強制指定を受け付けません。そこでstrictツールと、修正方法を示す422エラーを組み合わせています。29回の実呼び出しでは、不正なパラメータへの応答は0.17秒で返り、課金はありませんでした。
Claude Opus 5.5、Sonnet 5.5、Fable 5.1では、tool_choiceがanyまたはtoolの場合に400エラーが返されます。ツール呼び出しを強制して固定形式のJSONを得ていたコードは、これらのモデルでは動かなくなります。Anthropicは、tool_choice: autoのままstrict: trueを追加するか、スキーマを構造化出力に移すよう推奨しています。2026年11月1日、私たちはEveryInfraのカタログからTrustpilot、App Store、Amazonのレビュー用にstrictツールを作成しました。その後、私たちのAPIに実際のリクエストを29件送信しました。そのうち10件は、午後に追加した対照用の呼び出しです。
同日夜には、再テストとしてさらに12件のリクエストを送信しました。
パラメータ名またはenum値が誤っているリクエストには、0.11〜0.23秒で422が返されました。各422レスポンスには許可値と次に取るべき対応が含まれており、いずれも料金は発生しませんでした。初期のカタログでは、2つのパラメータに許可値が定義されていませんでした。午後の対照テストでは、これらに誤った値を指定しても失敗しませんでした。APIは200を返して通常料金を課し、何の通知もなく別のレビューセットを返しました。レスポンスには、問題が起きたことをモデルに伝える情報が何もありませんでした。
同日夜、ゲートウェイにこの2つのパラメータの許可値が追加されました。現在は誤った値を指定すると課金前に422が返されます。19:18 SGTの再テストでもこれを確認しました。
この記事では、実務上の疑問を1つ取り上げます。外部のデータAPIを呼び出すClaudeアプリがあるとします。以前はモデルにツール呼び出しを強制し、すべてのリクエストを同じ形にしていました。新しいモデルでは、その行が失敗するようになりました。モデルが引き続き確実にAPIを呼び出し、保存できるJSONを返すようにするには、どう変更すればよいでしょうか。
Claudeに関する記述はすべてAnthropicのドキュメントに基づいており、それぞれにリンクを付けています。テスト環境にはAnthropicのAPIキーがありません。そのため、この記事のClaudeのコードは設定例であり、テスト結果ではありません。EveryInfraに関する数値はすべて、2026年11月1日に実際に呼び出した際の生のレスポンスから取得したものです。
変更点:3つの新モデルがtool_choiceの強制指定を拒否し、Claudeのstrictツール使用が標準に
変更自体は単純ですが、この記事で後ほど説明する設計上の判断はすべてこれに基づいています。2026年9月1日付のAnthropic APIリリースノートには、Fable 5.1とMythos 5.1がtool_choiceのタイプanyとtoolをサポートしないと記載されています。こうしたリクエストは400エラーを返し、autoとnoneの動作は変わりません(APIリリースノート)。リリースノートは、スキーマに準拠したツール入力を得る方法として、strictツール使用か構造化出力を推奨しています。9月22日のOpus 5.5の項目には、同じ400が「Claude Fable 5.1と同様に」適用されると書かれています。9月28日のSonnet 5.5の項目では、Sonnet 5のコードが動かなくなる5つの原因の1つとして挙げられています。
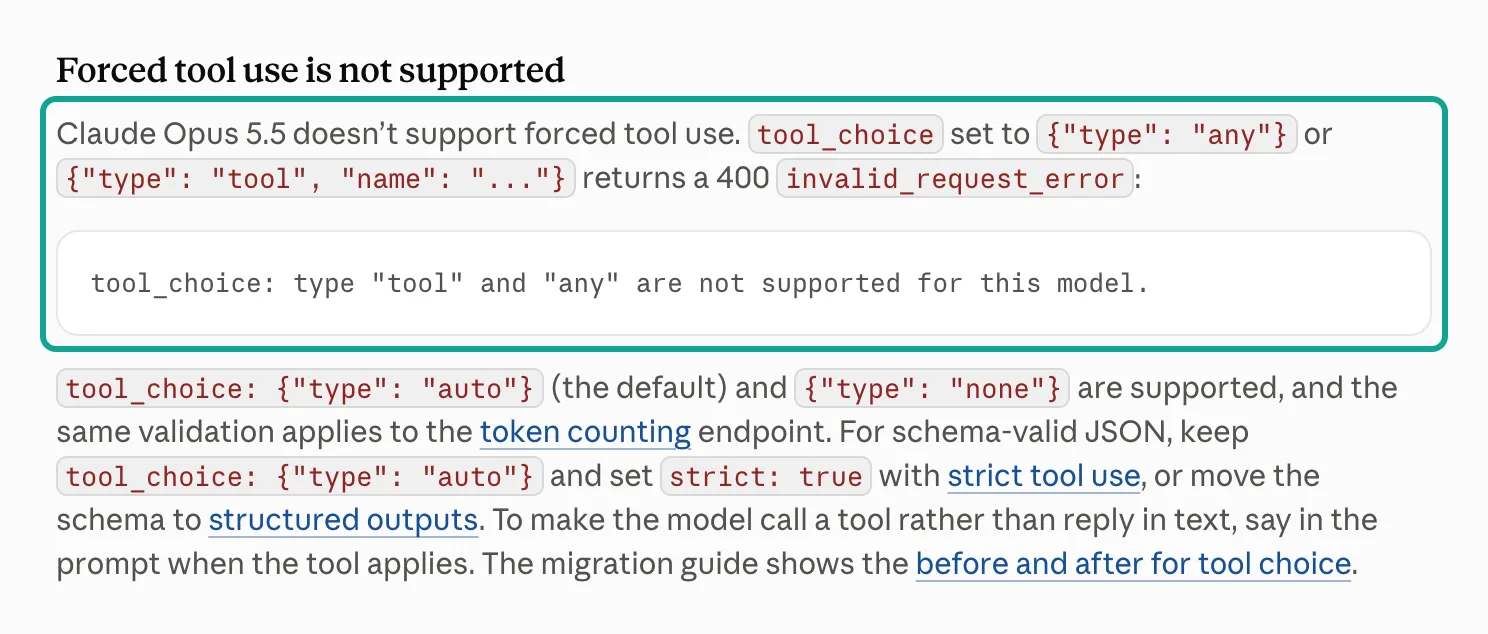
各モデルには「What's new」ページがあり、「Forced tool use is not supported」というセクションがあります。3つのページすべてに同じエラーテキストが載っており、以下に引用します。Opus 5.5、Sonnet 5.5、Fable 5.1の各ページで確認できます。テキストはtool_choice: type "tool" and "any" are not supported for this model.です。同じチェックはトークンカウントのエンドポイントにも適用されます。そのため、強制呼び出しを送信する前にトークンカウントで試すことはできません。
Anthropicはなぜ強制呼び出しを廃止したのでしょうか。理由はFable 5.1のページに書かれています。これらのモデルでは思考(thinking)が常に有効で、強制ツール呼び出しはそれをスキップします。するとモデルは推論内容をツールの引数に書き込むようになり、引数の質が下がります。データAPIを呼び出すアプリでは、これが問題になります。
以前の設計では、安定した形を得るために呼び出しを強制していました。現在はstrict文法が形を安定させ、呼び出すかどうかの判断は再びモデルに委ねられます。プロンプトでは、どのような場合にツールを使うかを明示する必要があります。Fable 5.1のページには、モデルは「get_weatherツールを使って回答してください」のような明示的なツール使用の指示に確実に従う、とも書かれています。
| モデル | リリース日 | `tool_choice` any / tool | Anthropicが示す代替手段 | 標準料金(入力/出力、MTokあたり) |
|---|---|---|---|---|
| Fable 5.1 | 2026年9月1日 | 400エラー | auto + strict、または構造化出力 | $10 / $50 |
| Opus 5.5 | 2026年9月22日 | 400エラー | auto + strict、または構造化出力 | $4 / $20 |
| Sonnet 5.5 | 2026年9月28日 | 400エラー | auto + strict、または構造化出力 | $2 / $10 |
| Haiku 5.5 | 2026年10月7日 | リリースノートに記載なし | — | $0.10 / $0.50 |
日付と料金は、2026年11月1日に確認したリリースノートと料金ページに基づいています。料金ページからは、この変更が一時的なものではないこともわかります。ツール使用のシステムプロンプトトークンの表には、auto, noneとany, toolの2列があります。Opus 5.5では、最初の列にのみ値(286トークン)があります。
Opus 5では、両方の列に値(286トークンと406トークン)があります。Haiku 5.5のリリースノートには、手動の思考バジェット、サンプリングパラメータ、プリフィルなど、その他の破壊的変更が記載されています。強制ツール使用は記載されていないため、Haiku 5.5については何も主張しません。それでもHaiku 5.5にもstrictツールを使い、4つのモデルすべてで同じコードが動くようにしています。
strictツール使用は新しい機能ではなく、新しいモデル専用でもありません。2つのページに、この機能はすべてのモデルで利用でき、HIPAA対応の対象になると書かれています(strictツール使用、構造化出力)。変わったのはその役割です。以前は任意の安全策でしたが、現在はメインの手段です。
Opus 5.5の移行チェックリストでは、anyとtoolを、autoとstrictツール使用または構造化出力の組み合わせに置き換えるよう指示しています。また、strictモードではJSON Schemaのサブセットのみがサポートされるため、先に各input_schemaを確認するよう求めています(Opus 5.5移行ガイド)。移行作業のほとんどは、呼び出しコードではなくスキーマにあります。
strictツール使用とClaudeの構造化出力:それぞれが制御するもの
2つの名前は似ていますが、制御するのはレスポンスの異なる部分です。strictツール使用では、ツール定義に"strict": trueを追加します。これは各tool_useブロックのinputを制御します。APIは文法で制約したサンプリングを使うため、入力は常にinput_schemaに一致し、ツール名も常に有効になります。
Anthropicの例は、passengers: intを必要とする予約システムです。strictモードを使わない場合、モデルは"two"や"2"を送ることがあります。strictモードでは、常に2を送ります。
Claudeの構造化出力とは、リクエストのoutput_config.formatフィールドのことです。これはレスポンスの最終テキストを制御し、スキーマに一致するJSONとして出力させます。データAPIのワークフローでは、両方が必要です。strictツールは、POST /api/v1/socialに渡すパラメータを正しく保ちます。構造化出力は、返ってきたレビューをトピック、深刻度、短い引用といった固定のフィールドに変換します。どちらの機能も同じ文法パイプラインを使うため、制限も共通です。
構造化出力のページにある「JSON Schema limitations」セクションに、これらの制限が記載されています。サポートされるものは、すべての基本型、enum、const、anyOf、内部の$ref、10種類の文字列フォーマット、単純な正規表現パターンです。サポートされないものは、再帰的なスキーマ、minimumやmaximumなどの数値制限、文字列長の制限、0または1以外のminItemsです。すべてのオブジェクトでadditionalProperties: falseを設定する必要があります。サポートされていない機能を使うと、APIは詳細を含む400エラーを返します。
| 項目 | strictツール使用 | 構造化出力(`output_config.format`) |
|---|---|---|
| 制御する対象 | tool_useブロック内のツール引数 | 最終的なレスポンステキスト |
| 有効にする方法 | ツールに"strict": trueを追加 | output_config.formatにJSON Schemaを追加 |
| この記事での役割 | EveryInfraに渡す正しいパラメータ | レビューごとの固定フィールド |
| リクエストごとの共通制限 | strictツール20個、任意パラメータ24個、ユニオン型パラメータ16個 | 同じ制限(合算してカウント) |
| 非対応 | 数値範囲、文字列長、再帰 | 同上。加えて引用(citations)と併用不可 |
| 初回リクエスト | 文法のコンパイル中に追加の遅延が発生。キャッシュは24時間有効 | 同上 |
「リクエストあたり」という表現は、よくある落とし穴です。構造化出力のページには例が示されています。任意パラメータを6個ずつ持つstrictツールが4つあるだけで、個々のツールは複雑に見えなくても上限の24個に達します。明示された上限とは別に、コンパイル済み文法のサイズにも内部上限があります。これを超えると、APIは「Schema is too complex for compilation」を返します。最後の安全策は、180秒のコンパイルタイムアウトです。
Anthropicは、次の4つのステップをこの順で推奨しています。重要なツールだけをstrictに指定する。パラメータを必須にする。ネストしたオブジェクトをフラットにする。作業を複数のリクエストやサブエージェントに分割する。


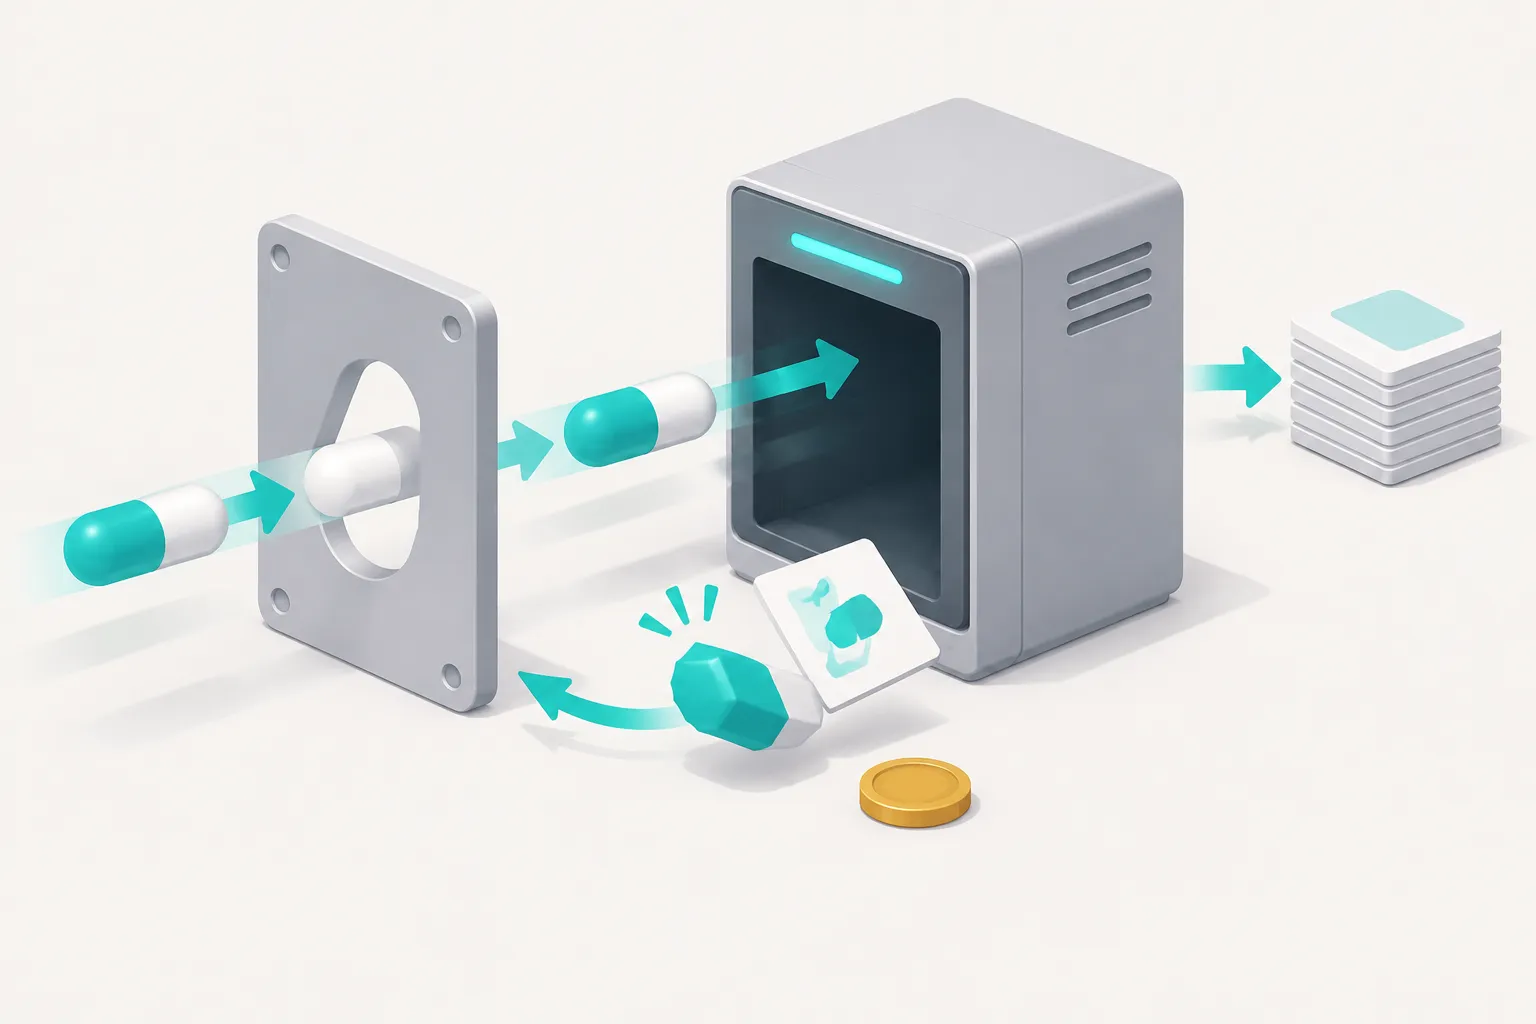
この図は、この記事の要点を示しています。第1レイヤーはClaude側にあります。strictモードにより、型、必須フィールド、enumの値がスキーマと一致することが保証されます。スキーマにmax_resultsのようなフィールドがなければ、モデルはそのフィールドを送信できません。第2レイヤーはEveryInfra側にあります。
スキーマでは表現できないルールもあります。たとえば「このリンクは商品ページか」や「このプラットフォームではこの並び順を何と呼ぶか」などです。当社のAPIは、こうした値をカタログと照合します。値が誤っている場合は、許可された値と最も近い候補を含む422を返します。モデルはフィールドを1つ修正して、リクエストを再送します。
第1レイヤー:カタログに基づくPOST /api/v1/social用strictツールの構築
EveryInfraのカタログエンドポイントGET /api/v1/social/catalogは無料で、APIキーも不要です(カタログの生データ)。各機能について、必須パラメータと任意パラメータ、各パラメータの説明、許可された値(allowed_values)、返されるフィールド、料金を確認できます。私たちは2026年11月1日00:46(SGT)にこのカタログを取得しました。カタログには91のプラットフォームにわたる426の機能が掲載されていました。このうち、その日に利用可能だったのは89のプラットフォームの402の機能です。
利用可能な機能には、809件のパラメータ説明があります。このうち155件は許可された値を列挙しており、143件はuriフォーマット、38件はdateフォーマットです。この3つのグループは、strictスキーマのenum、format: uri、format: dateにそのまま対応します。重複を除くと、809件のうち336件(41.5%)のパラメータが、strictモードで保証できる制約に変換できます。
enumにできるのは155件(約19%)だけです。残りは自由記述のテキストか数値です。これらについては、説明文と第2レイヤーで対応する必要があります。
以下は、カタログをもとに記述した3つのレビュー機能のツール定義です。これは設定例であり、Claudeに対して実行してはいません。
[
  {
    "name": "trustpilot_reviews",
    "description": "Get recent Trustpilot reviews of one company through EveryInfra (platform trustpilot, action reviews). Call it whenever the user names a company and asks what customers say. company is the company's website domain, for example temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Website domain such as temu.com, or a trustpilot.com/review/<domain> link"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Star ratings to keep; [] keeps all"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = no date filter"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "1 to 200; use 20 unless the user asks for more"}
      },
      "required": ["company", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Get App Store reviews of one iOS app through EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Numeric App Store id, for example 6473753684"},
        "country": {"type": "string", "pattern": "^[a-z]{2}$"},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "1 to 500; use 30 unless the user asks for more"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Get the featured customer reviews shown on one Amazon product page (platform amazon, action reviews). Usually about a dozen reviews per product.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.[a-z.]{2,6}/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.com", "amazon.co.uk", "amazon.de", "amazon.fr", "amazon.it", "amazon.es", "amazon.ca", "amazon.com.au", "amazon.in", "amazon.co.jp", "amazon.sg"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]上記の制限から、4つの設計判断が必要になりました。まず、すべてのパラメータを必須にしました。カタログではtrustpilot/reviewsに任意パラメータが6個あり、limitを加えると合計7個です。これらを任意のままコピーすると、24枠のほぼ3分の1を消費します。
Anthropicは別のアプローチを推奨しています。パラメータに常に妥当なデフォルト値がある場合は、そのパラメータを必須にし、モデルにデフォルト値を入力させる方法です。そこで、dateにanyという値を追加し、starsには空の配列を許可しました。カタログでは空の値はフィルターなしを意味するとされているため、私たちのコードはリクエストを送信する前にanyと[]を取り除きます。夜にテストとしてdate: anyをAPIに送ったところ、0.11秒で422が返りました。このステップは省略しないでください。
第2に、limitの範囲はminimumやmaximumではなく説明文に記載しています。数値の制約がサポートされていないためです。最大値を超える値の扱いはAPI側に任せます。カタログでは6つの機能がこのケースについて「capped」と記載しており、APIは最大値を適用します。第3に、シンプルな正規表現でAmazonのリンクを商品ページに限定しています。amazon/reviewsのカタログ注記には、ストアのトップページは使えないと書かれています。
ローカルのJSON Schemaバリデーターを使い、このスキーマでストアのリンクをテストしたところ、正規表現によって拒否されました。
4つ目に、11月1日の早い時間に取得したカタログでは、trustpilot/reviewsのdateとsortにallowed_valuesがありませんでした。そこで、カタログのテキストから値をコピーしました。それが重要だった理由は次のセクションで説明します。その日の夜にカタログにこれらの値が追加されたため、上の定義にlast7daysを追加しました。domainには、22:14(SGT)時点でカタログに掲載されていた11サイトを使いました。amazon.com.mxはこれに含まれていません。このサイトは現在、課金前に422を返すためです。詳細は制限のセクションにあります。
定義全体で使っているのは、enum、required、additionalProperties: false、単純なpatternとformatだけです。ほとんどの制約付きデコーディングシステムがこれらをサポートしています。数値範囲や長さのサポート状況はシステムによって異なります。6つのフレームワークを比較したJSONSchemaBenchのテストがそれを示しています。そのため、これらは422に任せます。こうすることで、同じツール定義を名前を少し変えるだけで別のモデルプロバイダーに移行でき、第2層は変更不要です。
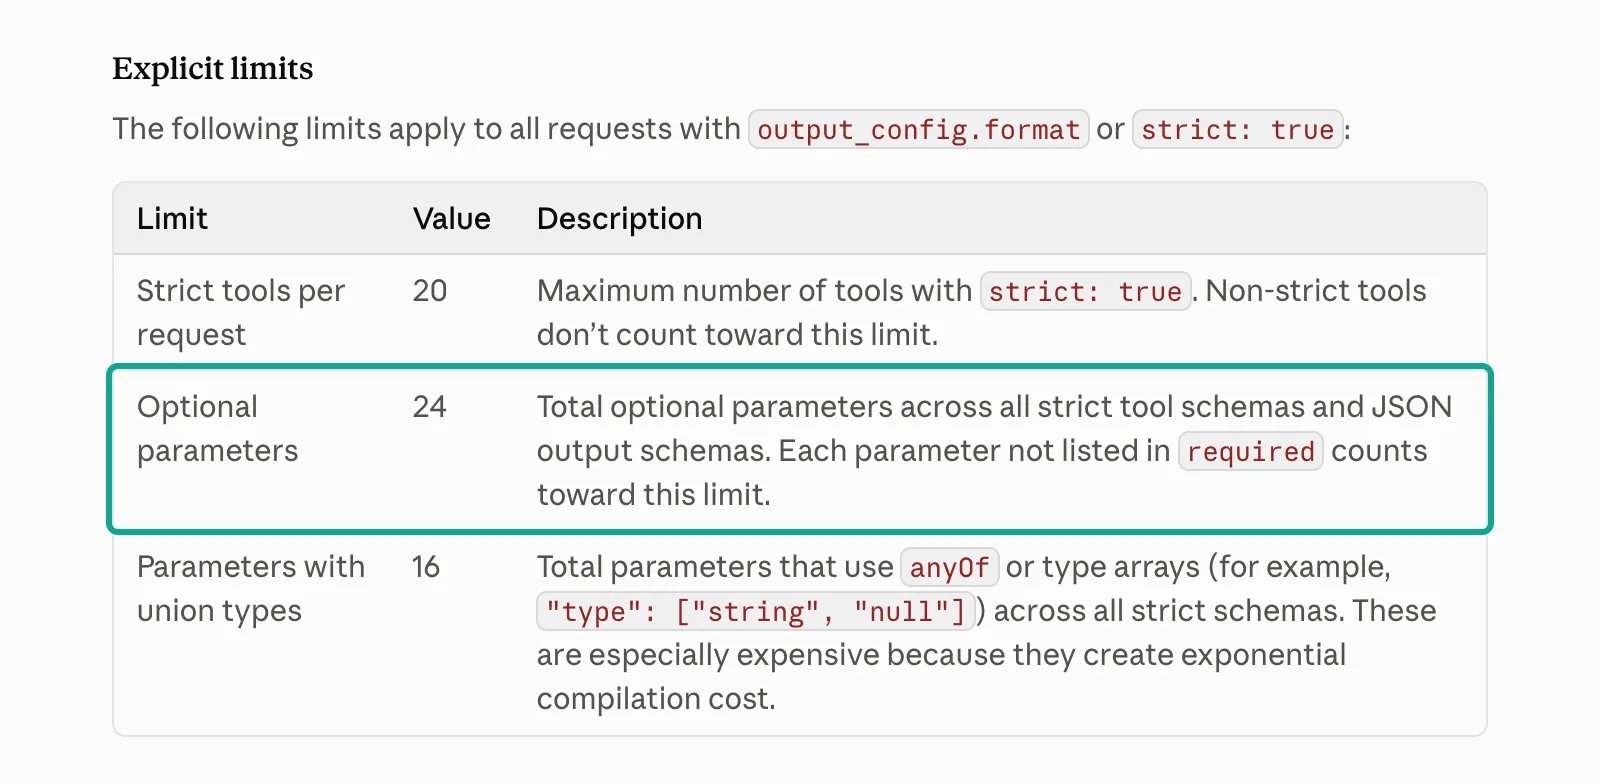
この予算にカタログの機能はいくつ収まるでしょうか。利用可能な402個の機能すべてについて、任意パラメータを数えました。リストを返す機能についてはlimitも数えました。中央値は1、最大値は9です。任意パラメータが24個を超える機能はありません。任意パラメータがない機能は100個、1個の機能は139個あり、合わせて239個の機能(59.5%)では、任意パラメータが0個または1個です。
この分布から2つのことがわかります。良い点は、すべてのパラメータを必須にすれば、どの20個の機能でも任意パラメータ枠を使わずに1つのリクエストに収められることです。悪い点は、402個の機能すべてを1つのリクエストにstrictツールとしてまとめることはできないことです。任意パラメータは合計686個です。リクエストあたり24個なので、少なくとも29グループが必要です。
貪欲法でグループ分けした結果、30グループになりました。strictツールはリクエストあたり20個までという制限だけでも、少なくとも21グループが必要です。したがって、タスクごとにツールを選ぶのが適切です。レビュー監視なら、8個のレビュー機能で任意パラメータ枠をちょうど23個使います。
23は上限の24より1少ない数です。任意フィールドを1つ持つ構造化出力スキーマを追加すると、リクエストは失敗します。Anthropicができる限りパラメータを必須にするよう勧めているのはこのためです。今回の3つのサンプルツールはすべて必須パラメータのみなので、任意枠を1つも使いません。そのため、出力スキーマ用の枠が残ります。
参考になる反例もあります。EveryInfraのリモートMCPサーバーには、汎用ツールeveryinfra_call_apiがあります。このツールは426の機能すべてを受け付ける必要があるため、paramsフィールドは自由形式のオブジェクトになっています。通常のツールであれば問題ありません。
ただし、strictモードではすべてのオブジェクトにadditionalProperties: falseが必要なため、このスキーマはstrictにできません。2026年11月1日15:41(SGT)にMCPのツール一覧を再取得したところ、ツールは12個、サイズは16,247バイトでした。everyinfra_call_apiのparamsフィールドは、引き続き自由形式のオブジェクトのままでした。strictの保証が必要な場合は、上記のようなタスク専用のツールを作成してください。汎用ツールは探索用に残しておきましょう。
カタログからスキーマを自動生成し、毎日再構築する
ツールが3つなら手作業でも書けます。30個になるとミスが出ますし、カタログ自体も変わります。より安全なのは、小さなスクリプトを使う方法です。無料のカタログを1日1回読み込み、決まったルールでstrictなツールを生成し、その結果を前日と比較します。
ルールは6つあり、それぞれ上で説明した制限に基づいています。私たちのコードでは、呼び出しのたびに事前に「未設定」の値を取り除いています。
| カタログのフィールド | strictスキーマ | 理由 |
|---|---|---|
required_params | requiredにコピー | 必須フィールドは任意枠を消費しない |
optional_params | 同じくrequiredに入れ、anyや[]などの「未設定」値を使う | 24個の任意枠を空けておける |
allowed_values | enumに大文字・小文字も含めてそのままコピー | strictモードはenumの値を保証する |
format: uriまたはdate | 同じformat | strictモードは10種類の文字列フォーマットに対応 |
default_limit、max_limit | integer、範囲は説明文に記載 | minimumとmaximumは非対応 |
| すべてのオブジェクト | additionalProperties: false | strictモードで必須 |
人の手が必要なケースが2つあります。1つ目は、allowed_valuesがなく、値がテキストでしか示されていないパラメータです。trustpilot/reviewsのdateとsortパラメータがその例です。スクリプトではこれらの値を見つけられません。人がenumにコピーするか、カタログに追加されるのを待つ必要があります。この2つは11月1日の夜にカタログに追加されました。
こうしたパラメータは一覧にして管理し、再構築のたびに表示しています。
もう1つのケースは、非常に大きなenumです。テスト当日には100を超える値を持つenumが8つあり、最大のものは183個でした。enumが大きいほど、コンパイルされる文法も大きくなります。Anthropicによると、これらの内部制限は単一の数値では決まっていません。こうしたパラメータではenumを使わず、よく使われる値を説明文に列挙し、チェックは422に任せています。いずれにせよ、422は完全なallowedリストを返します。
毎日再構築すると、新たなコンパイルコストが発生するタイミングもわかります。構造化出力のページによると、コンパイル済みの文法は最後に使われてから24時間キャッシュされます。スキーマの構造を変更すると、キャッシュはクリアされます。構造化出力とツールを併用している場合は、ツールの構成を変更してもクリアされます。nameやdescriptionだけの変更ではクリアされません。そのため、スクリプトでは2種類の変更を区別する必要があります。
テキストだけが変わった場合は、コストなしで置き換えられます。パラメータ、値、必須フィールドが変わった場合は、次のリクエストが遅くなります。バッチ処理ではこの遅延は問題になりません。ライブチャットでは、利用の少ない時間帯にウォームアップ用のリクエストを1回送ってください。バッチ処理にはこのルールによるメリットもあります。数千件のリクエストが1組のツールと1つの出力スキーマを共有するため、文法のコンパイルは1回で済みます。
第2層:422でモデル自身に呼び出しを修正させる
第1層は形式のエラーを防ぎますが、値のエラーは防げません。モデルは、スキーマ上は許容されていても誤った値を選ぶことがあります。たとえば、App Storeの並び順として、別のプラットフォームでの名前であるmost_recentを送ることがあります。また、アプリでstrictモードをまったく使わず、汎用ツールを呼び出している場合もあります。こうしたケースに備え、第2層はすぐに失敗し、課金せず、修正方法を説明する必要があります。
ツール呼び出しに関するAnthropicのページ(handle tool calls)には、ここに当てはまる点が2つあります。1つ目は、is_error: trueを設定したtool_resultにエラーを入れることです。そうすればモデルは内容を修正して再試行し、通常はユーザーに謝る前に2〜3回試みます。2つ目は、修正方法を具体的に示すエラーメッセージを書くことです。「failed」とだけ書くのではなく、何が問題で、Claudeが次に何を試すべきかを伝えてください。
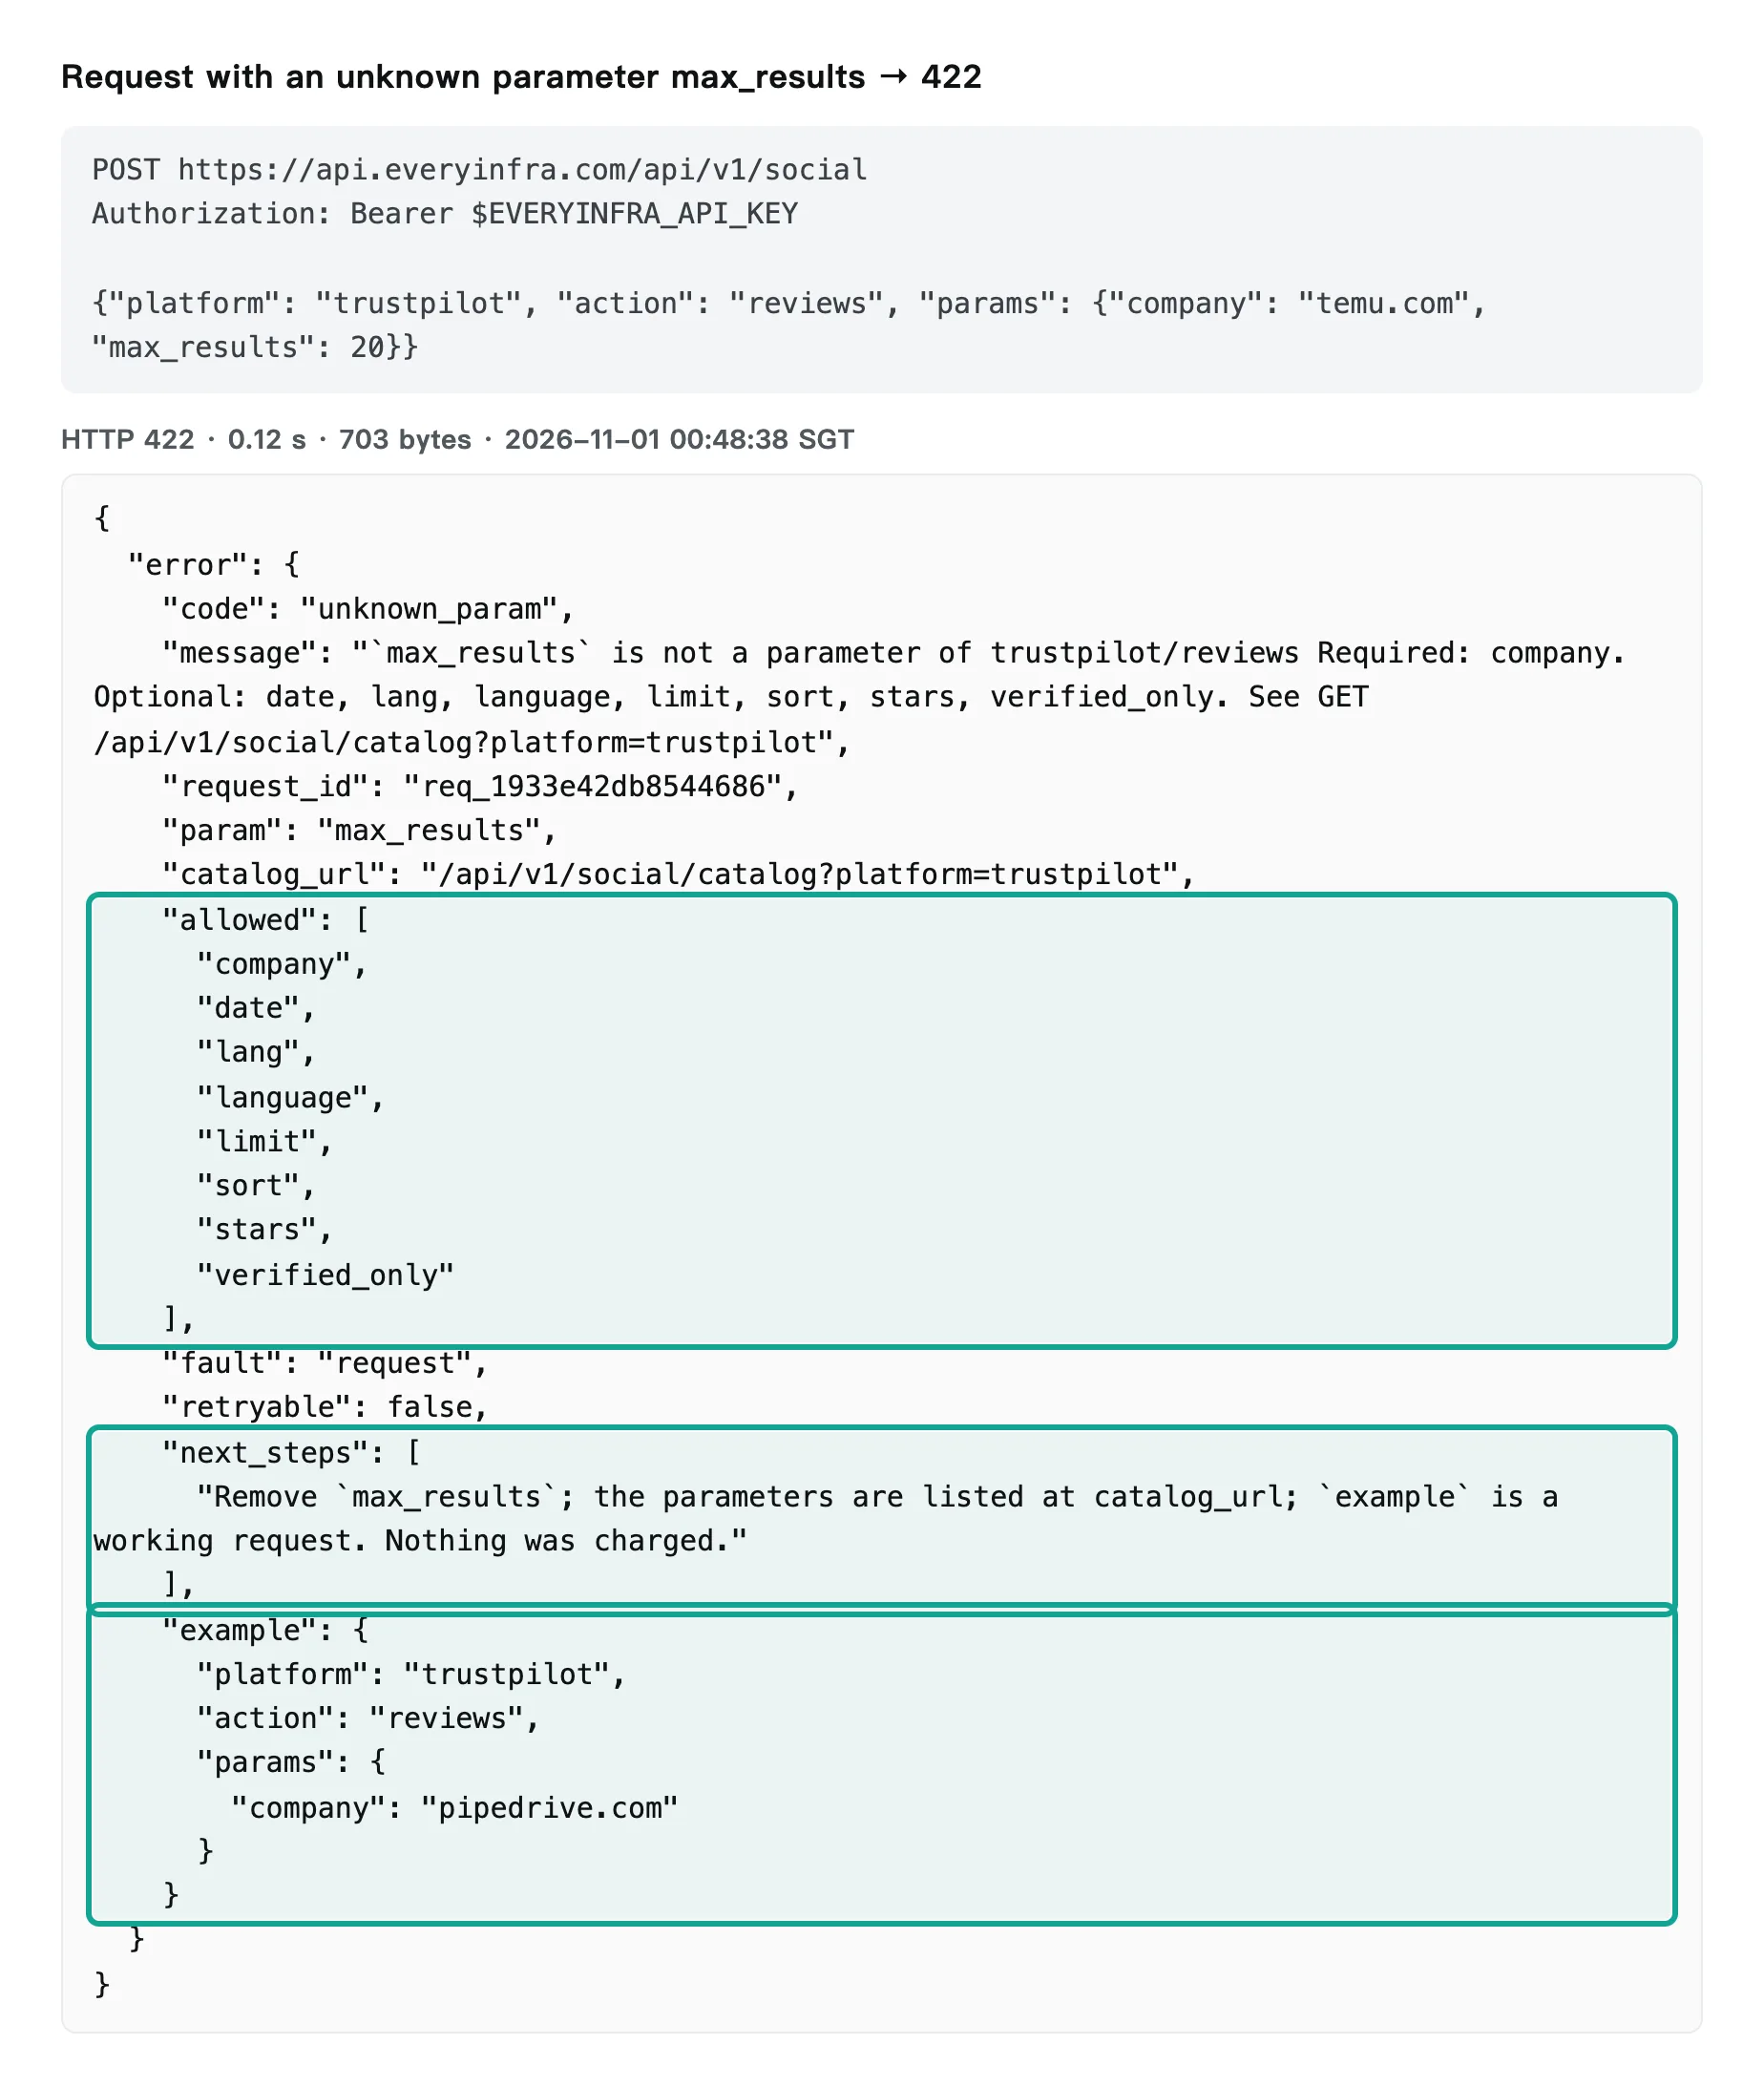
2026年11月1日00:48〜00:49(SGT)に、意図的に不正なリクエストを7件送信しました。00:57(SGT)には、MCP経由でさらに1件送信しました。以下は、不明なパラメータに対する生のレスポンスです。リクエストには余分なmax_resultsが含まれています。
APIは0.12秒で422を返しました。allowedフィールドには、有効なパラメータ名8つがすべて列挙されています。exampleフィールドには、実際に動作するリクエストが示されています。next_stepsフィールドにはmax_resultsを削除するよう記載され、課金されていないことも明記されています。
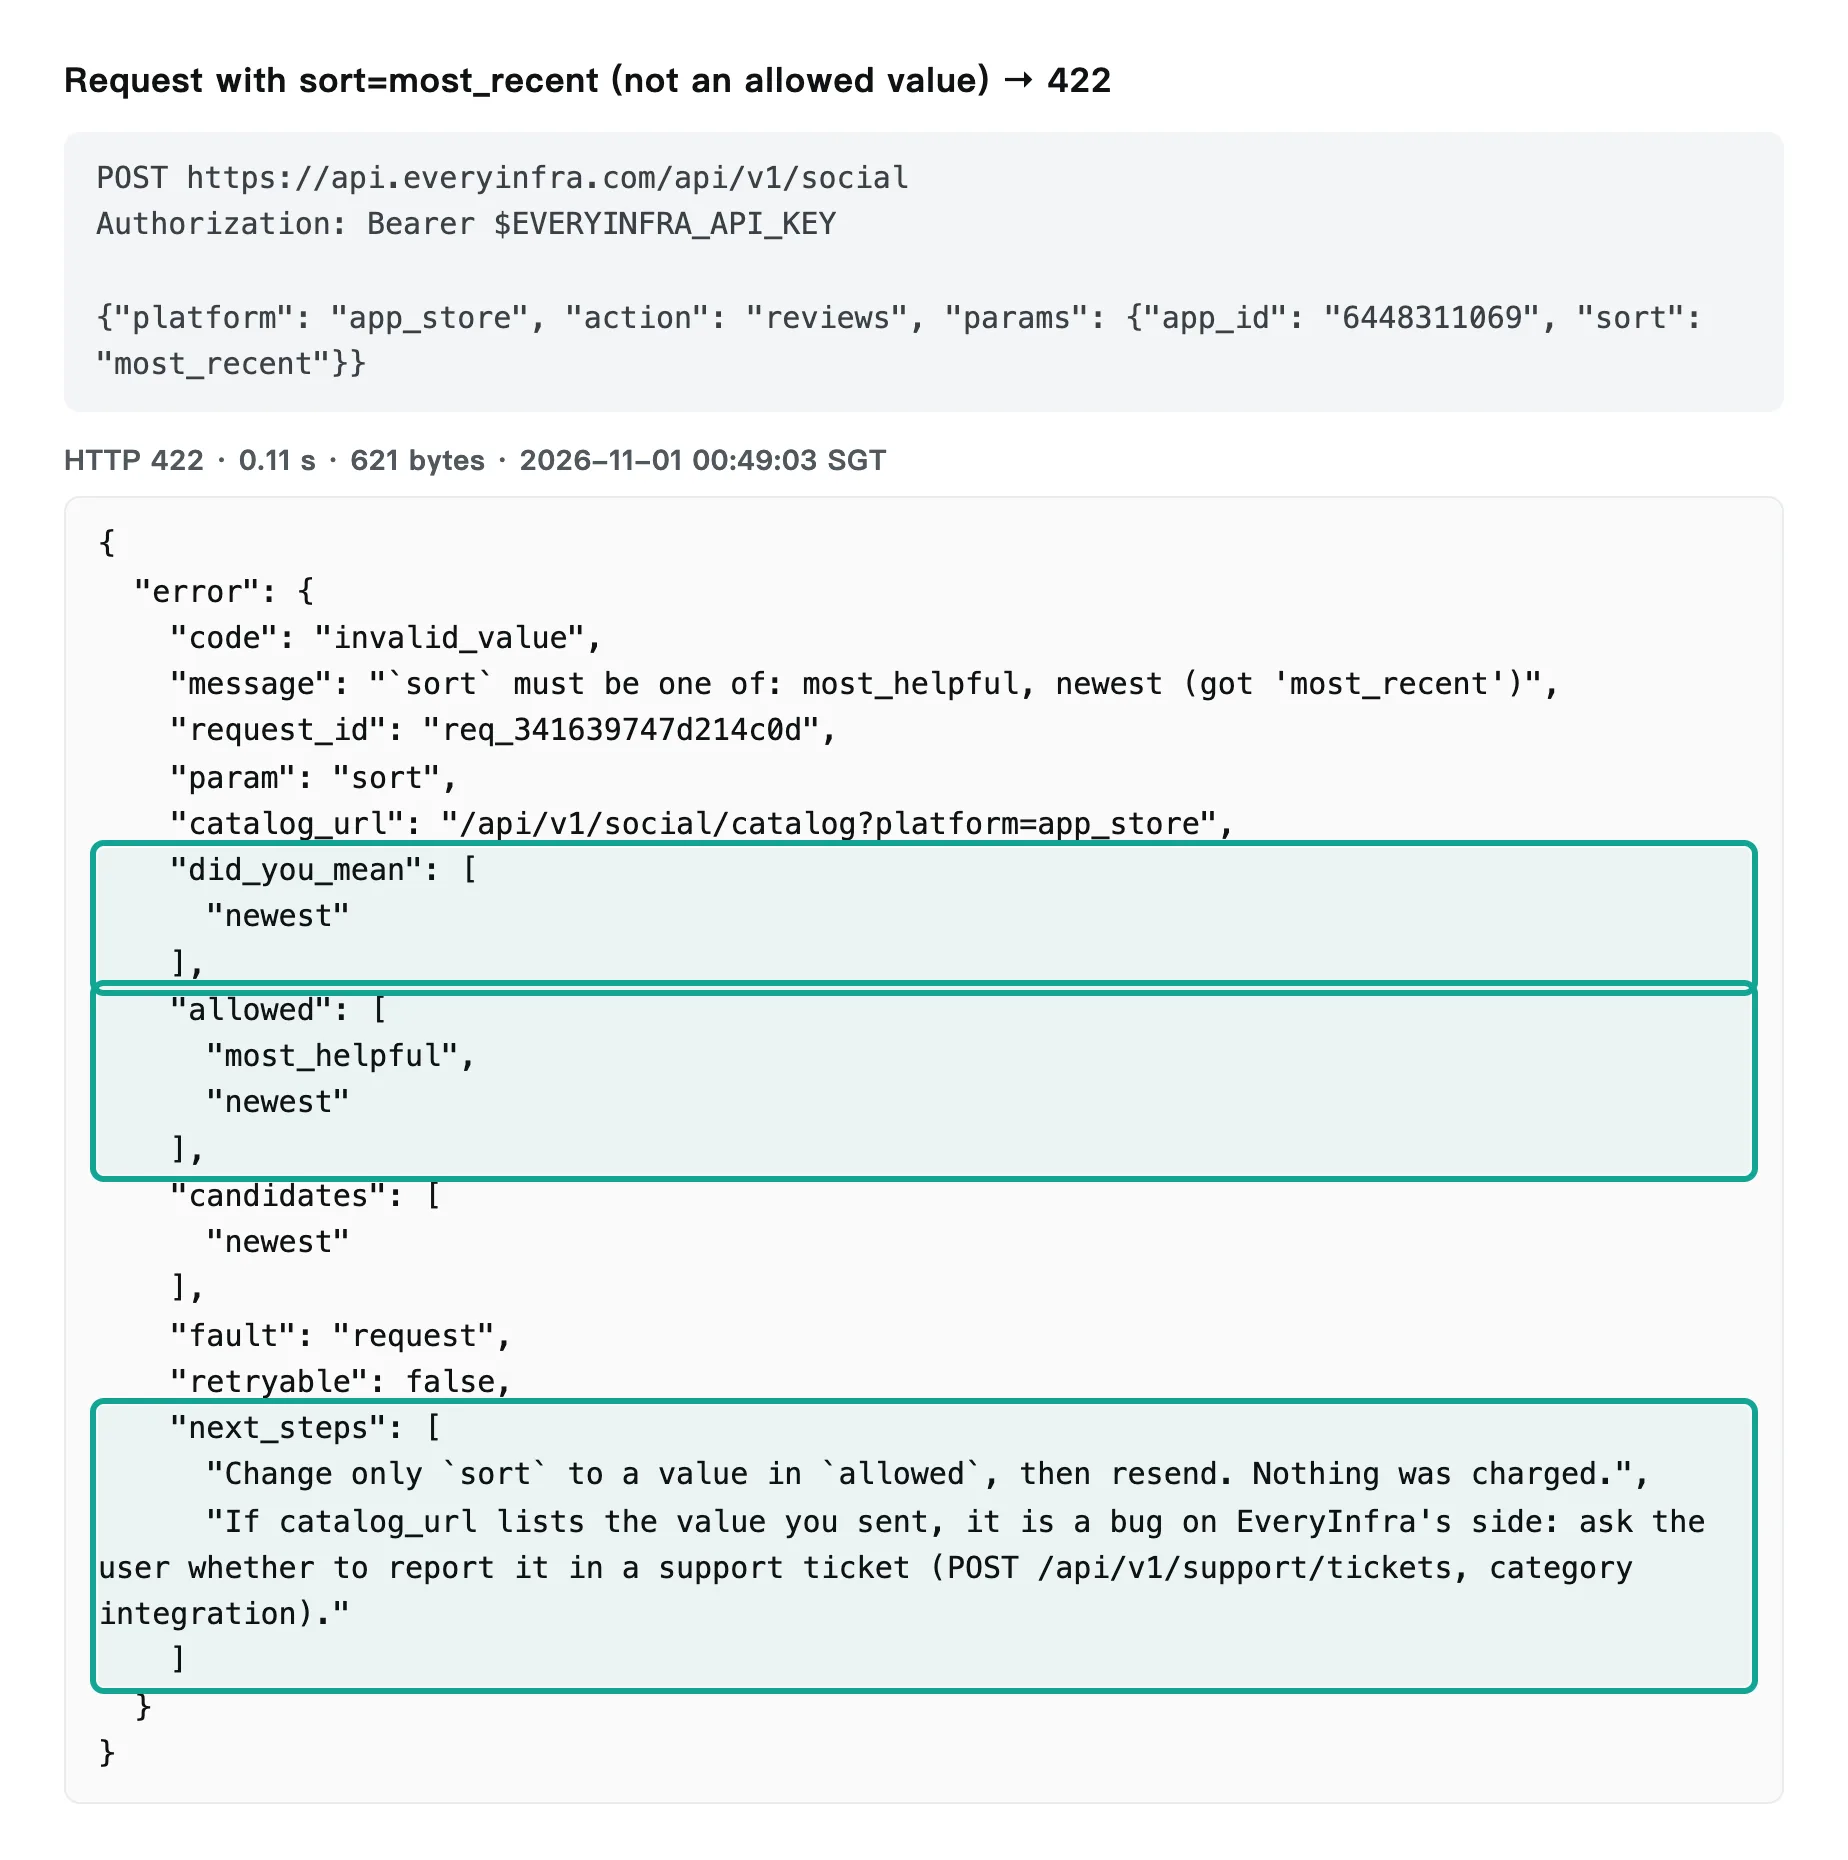
より典型的なのは、enumの値が誤っているケースです。00:49(SGT)に、app_store/reviewsにsort: most_recentを送信しました。APIは0.11秒で422を返しました。did_you_meanフィールドは["newest"]、allowedは["most_helpful", "newest"]でした。next_stepsの1行目には、sortだけをallowed内の値に変更して再送信すること、そして課金されていないことが記載されています。
2行目も役に立ちます。送信した値がカタログに記載されている場合の対処法が書かれています。その場合はEveryInfra側の不具合なので、モデルはサポートチケットを起票するかどうかをユーザーに確認すべきです。この行はモデル向けのもので、「自分の入力が間違っていた」のか「サービス側に問題がある」のかを区別します。これにより、モデルが自分のミスを障害とみなし、同じ値で再試行することを防げます。
下の表は、8つのエラーケース、午後に行った2回の対照呼び出し、修正後の夜に行った5回の再テストをまとめたものです。最後の列はローカルでのチェック結果です。各入力を上記のツール定義に照らして検証しました。検証には、Draft 2020-12 validation vocabularyに対応したJSON Schemaバリデーターを使用しました。
| 時刻(SGT) | 意図的に壊した内容 | レスポンス | 時刻 | 課金額 | レスポンス内の修正ヒント | strictで事前にブロック? |
|---|---|---|---|---|---|---|
| 00:48:37 | APIキーなし | 401 missing_key | 0.12 s | 0 | キーの送信を促す | 該当なし |
| 00:48:38 | 余分なmax_results | 422 unknown_param | 0.12 s | 0 | パラメータ一覧、リクエスト例 | 可能 |
| 00:48:42 | companyをcompnayと誤入力 | 422 missing_param | 0.23 s | 0 | 誤字の箇所と例を提示 | 可能 |
| 00:48:42 | date: last7days | 503 | 1.69 s | 0(返金済み) | 「後で再試行」のみ | 当時は「はい」。夜の修正後は有効な値 |
| 00:48:44 | sort: newest | 503 | 1.91 s | 0(返金済み) | 「後で再試行」のみ | 当時は「はい」。夜の修正後は有効な値 |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0.11 s | 0 | did_you_mean、allowed | 可能 |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0.20 s | 0 | did_you_mean、allowed | 可能 |
| 00:57:45 | MCP経由のG2 sort: most_recent | isError: true | — | 0 | 同上(structuredContent内) | 該当なし |
| 15:39:38 | sort: newest(対照) | 200、20件 | 14.3 s | $0.001389 | なし。別のレビューが返る | 当時は「はい」。夜の修正後は有効な値 |
| 15:39:38 | date: last7days(対照) | 200、20件 | 14.4 s | $0.001389 | なし。別のレビューが返る | 当時は「はい」。夜の修正後は有効な値 |
| 19:18:39 | sort: newst(修正後) | 422 invalid_value | 0.21 s | 0 | did_you_mean(newest)、allowed | 可能 |
| 19:18:46 | date: last_week(修正後) | 422 invalid_value | 0.12 s | 0 | did_you_mean(last7days)、allowed | 可能 |
| 19:18:53 | date: any(修正後) | 422 invalid_value | 0.11 s | 0 | allowed | いいえ。スキーマ上は許可され、コード側で除去 |
| 19:19:01 | language: eng(修正後) | 422 missing_param | 0.19 s | 0 | 2文字のコードを要求 | 当社の定義には含まれない |
| 19:19:23 | sort: newest(修正後、現在は有効) | 200、20件 | 14.1 s | $0.001389 | recencyと同じ行 | 不要 |
日中のtrustpilot/reviewsの4行は詳しく見る必要があります。初期のカタログでは、この機能のdateとsortパラメータにはテキストの説明しかなく、allowed_valuesがありませんでした。そのため、APIはリクエスト受信時にこれらの値をenumとして検証できません。00:48 SGTには、誤った値はいずれも1.7〜1.9秒後に503になりました。課金はされず、next_stepsにはretry_after秒後に再試行するようにとしか書かれていませんでした。
ただし、この2件の503エラーを値のせいにすることはできません。同じ数分間に、別のテストでこれらのパラメータを付けずにtrustpilot/profileを呼び出したところ、こちらも503が返りました。つまり、その時間帯はプラットフォーム自体が不安定だったのです。
そこで午後に対照テストを行いました。15:39:38 SGTに、temu.comを対象とする4回の呼び出しを同じ1分内に送りました。各呼び出しで変えたパラメータは1つだけです。sort: newestと有効なsort: recency、date: last7daysと有効なdate: last30daysをそれぞれ比較しました。15:40 SGTには、任意パラメータなしのベースライン呼び出しと、newestの再実行を1回追加しました。6回の呼び出しはすべて200で20件を返し、料金はいずれも$0.001389でした。
結果はきれいに2つのグループに分かれました。2つの有効な値とベースラインは、同じ20件のレビューを返しました。すべて英語で、verification_levelとsourceには値が入っていました。リストにない2つの値と再実行は、別の20件のレビューを返しました。そのうち13件が英語、3件がフランス語、2件がスペイン語、2件がイタリア語で、20件すべてで先の2つのフィールドは空でした。
つまり11月1日の日中は、誤った値に対して422も503も返りませんでした。APIはその値を受け付け、通常の料金を課金し、結果を黙って変えていたのです。
モデルにとって、これは503よりも悪い状況です。モデルには成功に見えるため、再試行もせず、ユーザーに警告もしません。複数言語が混ざったレビューが、そのままパイプラインに流れ込みます。実はsortのカタログテキストには、他のプラットフォームのnewestではなくrecencyを使うよう書かれています。しかし、それに気づけるのはテキストを読んだ場合だけで、APIの検証では検出されませんでした。
以上が日中の結果です。その夜、ゲートウェイでは次のルールが変更されました。
| パラメータ | 11月1日の日中 | 夜の修正後 |
|---|---|---|
sort | 値の記載なし。newestが受け付けられて課金され、異なるレビューが返された | newest(recencyと同じ)、recency、relevance |
date | 値の記載なし。last7daysが受け付けられて課金され、異なるレビューが返された | 投稿日で絞り込む5つのプリセット:過去7日、30日、92日、183日、366日 |
language、lang | 説明文に例のみ記載 | 2文字のコードのみ。言語の指定がない場合は英語のレビューのみ |
| 一覧にない値 | 受け付けられて課金される場合があった | 課金前に422を返し、許可される値とdid-you-meanのヒントを提示 |
エラー表の最後の5行は、同じ企業での再テストです。誤った値にはヒント付きの422が返り、課金はありませんでした。sort: newest、sort: recency、date: last7days、ベースラインの4回の呼び出しは200を返し、料金はそれぞれ$0.001389でした。4回とも同じ20件の英語レビューを返し、すべてのレビューにverification_levelとsourceが含まれていました。最も古いレビューも1日以内のものだったため、last7daysとdateなしの結果は一致するはずです。
この結果は、第1層が必要な理由も示しています。当社の厳格なスキーマではdateとsortをenumとして定義しているため、これらのエラーがClaudeから送られることはありません。夕方に行った修正後は、422でもこの2つのエラーを防げます。ただし、他のパラメータでは今も値が説明文にしか記載されていない場合があるため、クライアント側のスキーマが引き続き最初のチェックになります。
MCP側でも同じ区分を使っています。MCP仕様のツールのセクションでは、入力検証エラーをツール実行エラーと同じ扱いにしています。これらのエラーはisError: true付きで結果に含まれ、クライアントがモデルに渡すことで、モデルが自ら修正できます。00:57 SGTに行ったMCP呼び出しでも、まさにこの形で返されました。各エラーコードについてはAPIエラーのガイドで、返金の照合方法は返金チェックのガイドで解説しています。
Anthropicのドキュメントにある短い注記から、もう1つわかったことがあります。構造化出力では、文字列のenum値の大文字・小文字は保証されません。モデルは、スキーマと大文字・小文字だけが異なる値をエラーなしで返すことがあります。この注記によると、これはstrictモードでのツール使用にも当てはまります(構造化出力の「Invalid outputs」)。つまり、strictモードでもnewestがNewestになり得ます。14:33 SGTに、sort: Newestでapp_store/reviewsをテストしました。
APIはエラーを返しませんでした。200で新しい順に並んだ30件のレビューを返し、$0.001389を課金しました。
1回の呼び出しだけでは規則とは言えないため、15:39から15:41 SGTにかけて、さらに2つのプラットフォームでテストしました。g2/reviewsでは、sort: Newestとsort: newestが同じ21件のレコードを返しました。google_play/reviewsでは、sort: Top_Ratedが40件のレビューを返し、すべて星5つでした。同じ1分の間にsort: Newestで呼び出すと、星1つから5つまでが混在していたため、大文字を含む値でも実際に適用されていました。この4回の呼び出しの料金はそれぞれ$0.001389でした。
つまり、テストした3つの機能では、大文字・小文字が違っても同じ値として扱われます。カタログ内の他のenumはテストしていません。安全な方法は、送信前にコード側でenum値を小文字に変換することです。この1行を追加するコストは、1回の誤った呼び出しよりはるかに小さく済みます。Anthropicのもう1つのアドバイスも当てはまります。大文字・小文字だけが異なる2つのenum値を定義しないでください。
並列ツール使用も両方の層に影響します。これはデフォルトで有効です。そのため、モデルは1ターンで複数のtool_useブロックを送信できます。たとえばTrustpilotとApp Storeを同時に呼び出す場合です。並列ツール使用のページでは、2つの形式ルールが示されています。そのターンのツール結果はすべて1つのユーザーメッセージにまとめること、そして結果より前にテキストを置かないことです。そのため、コードでは同じターン内の422と200を両方処理する必要があります。
422の結果にはis_error: trueを付け、200の結果は通常どおり返します。するとモデルは、失敗した呼び出しだけを再送します。キーのレート制限が低い場合や、ログをシンプルにしたい場合は、tool_choiceオブジェクト内にdisable_parallel_tool_use: trueを追加してください。これによりautoモードでは、モデルは1回の応答につき最大1つのツールしか呼び出さなくなります。この設定はトップレベルのリクエストパラメータではありません。
このグラフは、同じ事実を別の側面から示しています。422を受けて再試行する場合、422を返したAPI呼び出しの課金額は$0で、API側の所要時間は約0.17秒です。これは4回の422呼び出しの平均です。コストがかかるのは、追加で発生するモデルのターンです。
追加の1ターンのコストは、次の式で計算します。手戻りコスト = (コンテキストトークン + エラートークン)× 入力価格 + 修正トークン × 出力価格。エラー本文には約240トークン、修正の出力には約120トークンを想定しています。コストの大部分はコンテキスト長で決まるため、表では3つのサイズを示しています。価格は、2026年11月1日に参照した料金ページに基づいています。括弧内の数値は、1回$0.001389のレビュー呼び出し何回分に相当するかを示しています。
| コンテキスト | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1,000トークン | $0.00018 (0.1) | $0.0037 (2.6) | $0.0074 (5.3) | $0.0184 (13) |
| 5,000トークン | $0.00058 (0.4) | $0.0117 (8.4) | $0.0234 (17) | $0.0584 (42) |
| 20,000トークン | $0.0021 (1.5) | $0.0417 (30) | $0.0834 (60) | $0.2084 (150) |
3つのツール定義と数ターンのやり取りがあるアプリでは、コンテキストが20,000トークンになることもよくあります。その場合、Opus 5.5での1回のミスは、データ呼び出し約60回分のコストになります。プロンプトキャッシュを使うと、コンテキスト部分にはキャッシュ読み取り価格が適用されます。この価格は入力価格に対して、Haiku 5.5で10%、Opus 5.5とSonnet 5.5で5%、Fable 5.1で2.5%です。Opus 5.5で20,000トークンの場合、追加1ターンのコストは$0.0834から約$0.0074に下がります。
お使いのコンテキスト長を式に当てはめれば、ご自身の比率がわかります。どのサイズでも傾向は同じで、コンテキストが長いほど再試行のコストは高くなります。これが第1層の経済的な理由です。strictモードは、最もよく発生する再試行を未然に防ぎます。
1回のラウンドトリップ全体:モデルが送る内容と返ってくる内容
以下のコードは、2つの層を最小限のループで組み合わせたものです。Anthropicのドキュメントに沿っています。これは設定例であり、Claude側は実行していません。EveryInfraのリクエストとレスポンスは、2026年11月1日の実際の結果です。
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # reads ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # the three strict tools above
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # "any" and [] mean no filter
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=90)
    body = r.json()
    if r.status_code == 422:                    # value error: pass it to the model as is
        return json.dumps(body["error"]), True
    if r.status_code >= 400:
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}), False

messages = [{"role": "user", "content": "Use the trustpilot_reviews tool to get 20 one- and two-star reviews of temu.com from the last 30 days, then group them by topic."}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
messages.append({"role": "user", "content": results})このループを安定させるポイントがいくつかあります。コードではtool_choiceをautoに設定しています。これはデフォルト値ですが、明示しておくことで、強制呼び出しを使っていないことが後からコードを読む開発者に伝わります。ユーザーメッセージにはツール名を明記しています。
これが、Opus 5.5とFable 5.1のドキュメントにおける強制呼び出しの代替手段です。コードでは、422のエラー本文をそのままis_error: true付きでtool_resultに入れています。「bad parameter」のような文言に置き換えないでください。モデルが活用できるのはallowedとdid_you_meanの部分だからです。
成功時は、id、rating、title、text、投稿日時の5つのフィールドだけをモデルに返します。
これはその日の実際のレスポンスで計測しました。Trustpilotのレビュー20件のresultsは31,046文字でした。5つのフィールドだけにすると13,040文字となり、58%減りました。App Storeのレビュー30件では、13,012文字から7,726文字へと41%減りました。モデルが読む量が減れば、各ターンのコストも下がります。以下のバッチ計算では、削減後のサイズを使っています。
2026年11月1日00:49 SGTに行った、このループの実際の往復を紹介します。strictモードにより、モデルは{"company": "temu.com", "stars": ["1", "2"], "date": "last30days", "sort": "recency", "limit": 20}のようなパラメータを送信します。コードはそれをtrustpilot/reviewsに送ります。APIは56.9秒後に200を返し、20件のレビューを返しました。内訳は星1つが19件、星2つが1件で、投稿日は2026年10月30日から2026年10月31日の間でした。
国別では英国が10件、米国が3件で、16件には企業からの返信がありました。課金額は$0.001389で、カタログのprice_usdと同じでした。モデルが"sort": "newest"を選んでいた場合、strictモードがその呼び出しを止めます。strictモードがなければ、APIはこの値を拒否しません。前述の対照テストと同様に、通常の料金が課金され、複数の言語が混在したレビューが返されます。
構造化出力にはどのようなデータが渡るのでしょうか。今回はClaudeを実行していないため、モデルの出力は掲載していません。代わりに、14:37 SGTの呼び出しで取得したTrustpilotのレビュー100件に、単純なキーワードルールを適用しました。100件中、返金に言及したものは40件、返品に言及したものは20件でした。
配送に言及したものは35件、品質や破損は33件、カスタマーサービスは35件、アカウントは14件でした。どのルールにも当てはまらないレビューは16件です。テキスト長の中央値は432文字で、最も長いレビューは3,371文字でした。
これらの数値は二つの点で役立ちます。まず、一つのレビューが複数のトピックに該当することはよくあります。スキーマでtopicを一つしか許可しない場合はモデルが選ぶ必要があるため、「お金に関するトピックを優先する」のようにルールを説明文に記載してください。次に、最も長いレビューは約1,350トークンです。
1リクエストあたり25件のレビューを処理する場合は、平均ではなく長さの分布を前提に計画してください。そうしないと、一部のリクエストがmax_tokensに達する可能性があります。これらのレビューは2026年10月27日から2026年11月1日までに投稿されたもので、その期間の内容しか反映していません。
第2のステップでは、Claudeの構造化出力を使って、モデルに各レビューを固定フィールドへ振り分けさせます。このスキーマは設定例でもあります。
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "At most 20 words copied from the review"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}このスキーマには任意のパラメータが1つもないため、3つのstrictツールと同じリクエストに含められます。長さの制限はサポートされていないため、quoteフィールドではmaxLengthではなく、説明文に「20語以内」と指定しています。ただし、ドキュメントに記載されている例外が2つあります。モデルが拒否した場合、レスポンスはstop_reason: "refusal"となり、出力がスキーマに一致しない可能性があります。
出力がmax_tokensに達した場合、レスポンスはstop_reason: "max_tokens"となり、出力が不完全である可能性があります。そのため、何かを保存する前にstop_reasonを確認してください。また、「ステップごとの推論」を求めるフィールドは、reasoning_extractionによる拒否を引き起こすことがあります。拒否とフォールバックのページでは、代わりに短い説明を求めることを勧めています。
米国のアプリチームは、App Storeのレビューから始めることが多いでしょう。00:54 SGTに、Claudeアプリの米国における最新レビュー30件を取得しました(app_store/reviews、app_id 6473753684)。24件はバージョン1.261026.20、6件はバージョン1.261028.19のものです。投稿日は2026年10月28日から2026年10月30日の間でした。表では、これらのサンプルをTrustpilotのサンプルと並べています。
| サンプル | 時刻(SGT) | 件数 | 星1〜2 | 星5 | 課金額 |
|---|---|---|---|---|---|
trustpilot/reviews、temu.com、starsは1–2、limitは20 | 00:49 | 20 | 20 | 0 | $0.001389 |
trustpilot/reviews、temu.com、starsは1–2、limitは100 | 14:37 | 100 | 100 | 0 | $0.001389 |
app_store/reviews、Claudeアプリ、米国、新着順 | 00:54 | 30 | 10 | 16 | $0.001389 |
app_store/reviews、ChatGPTアプリ、米国、新着順 | 00:54 | 30 | 5 | 21 | $0.001389 |
これらの件数に統計的な意味はありません。示しているのは、実務上の事実1つです。星1と星2で絞り込んだため、同じスキーマでもTrustpilotではほぼ低評価のレビューだけを扱うことになります。App Storeでは評価が混在します。
severityのようなフィールドの分布はソースによって変わるため、アラートレベルはソースごとに設定してください。Appleのデベロッパー向けページによると、総合評価はストアフロントごとに算出され、新しいバージョンでリセットされることがあります。一方、レビュー本文は残ります(Apple、評価とレビュー)。そのため、総合スコアよりもバージョンごとのレビューのほうが役立ちます。
バッチ:Message Batchesでレビュー1,000件を処理するコスト
一連の処理が1回正常に動作したら、次にコストを左右するのは処理量です。Message Batches APIはリクエストを非同期で処理し、すべての利用料金が標準料金の50%になります。1つのバッチには最大100,000リクエストまたは256 MBまで含められます。ほとんどのバッチは1時間以内に完了します。24時間以内に完了しなかったリクエストは期限切れとなり、課金されません。
結果は29日間取得できます(バッチ処理)。構造化出力のページによると、この機能はバッチでも同じ50%割引で利用できます。バッチ内の各リクエストは完全なMessagesリクエストです。そのため、strictツールとoutput_config.formatはそのまま含められます(Message Batchの作成)。
データ側で最初に決めるのは、1回の呼び出しで何件取得するかです。カタログではtrustpilot/reviewsのデフォルトは20、最大は200で、料金は1回の呼び出しあたり$0.001389です。1件あたりの料金を示すフィールドはありません。14:37 SGTにlimit: 100を送りました。
100件のレビューが返り、料金は20件のときと同じ$0.001389のままでした。100件のうち95件が星1つ、5件が星2つでした。44件が英国、21件が米国からの投稿です。
大きなlimitの代償は時間です。同期呼び出しには84.0秒かかりましたが、カタログによると同期処理の上限は85秒です。上限ぎりぎりです。そのため、レビューを一括で取得する場合は大きなlimitを指定し、リクエストボディに"mode": "async"を追加してください。そのうえでGET /api/v1/jobs/{job_id}をポーリングします。同期呼び出しの完了を待つ方式は避けてください。
| レビュー1,000件あたり | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| モデル費用(標準) | $0.0577 | $1.1537 | $2.3073 | $5.7683 |
| モデル費用(Message Batches) | $0.0288 | $0.5768 | $1.1537 | $2.8842 |
| データ料金(limit=100、10回の呼び出し) | $0.0139 | $0.0139 | $0.0139 | $0.0139 |
| 合計(バッチ+limit=100) | $0.0427 | $0.5907 | $1.1676 | $2.8981 |
ご自身の数値でも試せるよう、モデルコストの見積もり方法を説明します。モデル概要によると、1Mトークンは約2.5MのUnicode文字に相当するため、1文字あたり0.4トークンとして計算しています。
| 見積もり条件 | 値 | 出典 |
|---|---|---|
| 1リクエストあたりのレビュー数 | 25件(40リクエスト) | 今回の設定 |
| トリミング後のレビュー1件あたりの文字数 | 約440 | TrustpilotとApp Storeの実際のレスポンス |
| 1リクエストあたりの指示とスキーマ | 約1,424文字 | 当社のプロンプトと出力スキーマ |
| 出力項目1件あたりの文字数 | 約189 | 出力項目の例(1件) |
| 合計トークン数 | 入力約198,832、出力約75,600 | 文字数 × 0.4 |
思考トークン、ツール使用のシステムプロンプト(Opus 5.5で286トークン)、構造化出力が追加するフォーマットプロンプトは計算に含めていません。そのため、これらの数値は下限です。デフォルトのlimit=20では、1,000件のレビューにかかるデータ料金は50回の呼び出しで$0.0694となり、limit=100の場合の5倍です。
結果は明確です。レビューの分類は読む量が多く判断は単純なので、Haiku 5.5に任せましょう。そうすればモデル費用とデータ料金は同程度になり、合計でレビュー1,000件あたり約$0.04です。Opus 5.5は27倍、Fable 5.1は68倍のコストがかかります。Haiku 5.5には注意すべき料金のしきい値が1つあります。
プロンプトが100,000トークンを超えると、料金は$0.50 / $2.50、バッチでは$0.25 / $1.25になります。1リクエストあたり短いレビュー25件であれば、この境界を大きく下回ります。「配送が遅い」と「販売者が返品を拒否した」の区別など、より細かい判断が必要な場合は、まずすべてをHaikuで処理します。そのうえで、severity: highの項目だけをOpus 5.5に送ります。
これを日次モニターに当てはめてみます。50社分のTrustpilotの星1・星2レビューと、50アプリ分のApp Storeの新着レビューを取得します。1日あたり100回のAPI呼び出しで、1日$0.1389、30日で$4.17です。このモニターは1日あたり最大約2,500件のレビューを読み込みます。
30日間の分類にかかるコストは、バッチ処理のHaiku 5.5で約$2.16、Sonnet 5.5で$43.26、Opus 5.5で$86.53です。バッチ処理とプロンプトキャッシュは併用でき、キャッシュされたシステムプロンプトやツール定義のコストは安くなります。ただし、バッチ内のキャッシュヒット率はリクエストの順序に左右されます。これは検証していないため、上記の数値には含めていません。
うまくいかない点と注意点
第1に、当社自身の課題です。2026年11月1日、amazon/reviewsは4回試してもレビューを返しませんでした。00:50と00:51 SGTの同期呼び出し2回は、それぞれ約68秒と73秒待機しました。00:53 SGTの非同期ジョブ1回は0件で完了しました。
14:34 SGTにdomainを指定してもう1回同期呼び出しを行いましたが、66秒待機して同じく0件でした。4回の呼び出しはいずれも費用がかかっていません。空の結果はルールにより返金され、非同期ジョブは一度課金されたあと返金されました。
同日夜、ゲートウェイ側でAmazonの2つのケースが変更されました。19:19から19:24 SGTにかけて再テストした結果は以下のとおりです。
| リクエスト | 日中 | 夜の再テスト | 課金額 |
|---|---|---|---|
| 米国サイト、同期 | 200、0件、66〜73秒 | 24.6秒で503 access_blocked。next_stepsには、すぐに再試行しても解決しないと記載 | 0 |
| 米国サイト、非同期 | ジョブ完了、0件 | 202($0.001389を保留)。ジョブはaccess_blockedで失敗 | 0(返金済み) |
amazon.co.jp | 未テスト | 19:19:422 missing_param、メッセージは「missing domain」。22:14:35.3秒で200、レビュー5件。すべて他国の購入者によるもの(米国3件、ドイツ2件) | 19:19は0、22:14は$0.001389 |
amazon.com.mx | 未テスト | 19:19:422 missing_param。22:14:0.09秒で422 invalid_value。対応する11サイトの一覧つき | 0 |
19:19の時点では、この2サイトが非対応である旨はエラーメッセージに示されていませんでした。22:14の時点では、カタログでdomainが11サイトのenumとして定義されていました:amazon.com、co.uk、de、fr、it、es、ca、com.au、in、co.jp、sg。メキシコサイトへのリクエストは現在、課金前に停止され、エラーに11個の値が列挙されます。上記のツール定義も同じリストを使用しています。日本のサイトは現在レビューを返しますが、必ずしも日本の購入者によるものとは限りません。日本からのレビューだけを残すには、countryフィールドで絞り込んでください。
カタログにはもともと、この機能が取得するのは商品ページに掲載された注目レビューのみで、通常は1商品あたり12件ほどだと記載されています。その日は、それすら取得できませんでした。そのため、本記事のAmazonツールはあくまで設定例です。実際のテストには、その日正常に動作していたtrustpilot/reviewsとapp_store/reviewsを使用しました。
一方で、amazon/searchは動作していました。SGT 00:51に「anker power bank 10000mah」を検索したところ、11.8秒で5件の商品が返り、費用は$0.002236でした。Amazonのレビューをバッチに追加する前に、カタログを確認してください。そのうえで、当日に小規模な呼び出しを1回試してください。
次に、Anthropicがドキュメントに記載している制限です。strictツールはHIPAA適格ですが、APIはコンパイル済みスキーマをメッセージ内容とは別にキャッシュしており、スキーマにはメッセージ内容と同等の保護が適用されません(strictツール使用、データ保持)。そのため、顧客リストをenumに入れないでください。CMEKのケースについてはFable 5.1移行ガイドで説明されています(Fable 5.1移行ガイド)。
| 制約 | データAPIにとっての意味 | 出典 |
|---|---|---|
| スキーマに健康データを含めない | プロパティ名、enum、const、patternにPHIを含めない | strictツール使用、データ保持 |
| CMEKを利用する組織 | Fableモデルでは構造化出力もstrict: trueも使えないため、指示のみで対応する | Fable 5.1移行ガイド |
| 引用 | 構造化出力と併用不可。400エラーになる | 構造化出力、機能の互換性 |
| フォーマットの変更 | 新しいoutput_config.formatを指定するとプロンプトキャッシュがクリアされる | 構造化出力、トークンコスト |
引用の制限については、もう1点補足があります。値ごとに出典を伴う構造化データには、引用のドキュメントにある専用の方法を使ってください。
最後に、2層目にも限界があります。422で防げるのは、カタログで定義されているエラーだけです。具体的には、未定義のパラメータ、必須パラメータの欠落、列挙された許可値に含まれないenum値です。
カタログにテキストでしか記載されていないルールへの違反は防げません。11月1日の日中は、trustpilot/reviewsのdateとsortがその例でした。当時は、この2つに誤った値を指定してもエラーにすらなりませんでした。通常の料金がかかり、結果も変わりました。夕方の修正でこの2つに許可値が追加されたため、現在は422が返ります。
また、「この企業にTrustpilotのページがあるか」のように、実行時にしかわからない事実に起因するエラーも、422では防げません。
したがって、両方の層を使ってください。可能なルールはすべてstrictスキーマに入れ、残りは422に任せてください。カタログのテキストからコピーしたenumについては、各レスポンスの言語と主要フィールドもコード側で確認してください。
トラブルシューティング:7つの症状と対処法
本番環境では、問題はたいていエッジケースで発生します。スキーマが突然コンパイルに失敗したり、あるターンでモデルがツールを呼び出さなかったり、バッチ内の一部の項目が一致しなかったりします。以下の表に、ドキュメントと実際の呼び出しで確認した7つの症状をまとめます。
まず、ステータスコードを返したのがどちらかを確認します。400はAnthropicから返され、リクエストまたはスキーマが誤っていることを意味するので、コードを修正します。422または503はEveryInfraから返され、形式は正しいものの、値に問題があるか実行に失敗したことを意味するので、next_stepsに従います。2つのエラー形式は見た目が異なり、ログ上で混同しやすいため、この確認だけでデバッグ時間の大半を節約できます。
| 症状 | ステータスコードの返却元 | 原因 | 対処法 |
|---|---|---|---|
| 400、tool_choice非対応 | Anthropic | 新しいモデルでanyまたはtoolを指定 | autoを使い、ユーザーメッセージでツール名を指定する |
| 400、複雑すぎるスキーマ | Anthropic | 任意パラメータが24個を超えている、または文法が大きすぎる | パラメータを必須にし、大きなenumはテキストと422に置き換える |
| モデルがツールを呼び出さず、テキストで応答する | Anthropic | 指示が明確でない | ツール名と呼び出す条件を明示し、stop_reasonを確認して再度依頼する |
422 invalid_value | EveryInfra | 値がカタログのallowed_valuesにない | did_you_meanに従ってフィールドを1つ変更する。課金なし |
| 繰り返し発生する503 | EveryInfra | プラットフォームが不安定。疑わしい値を含まない当社の呼び出しでも発生した。reason: access_blockedの場合、対象ページはログインが必要か、アクセスが制限されている | retry_afterの時間だけ待つ。失敗が続く場合は担当者が確認する。access_blockedの場合は対象を変更する |
| 200だが、言語やフィールドがおかしい | EveryInfra | カタログのテキストに記載されていない値が受け付けられ、結果が変わった。夕方の修正前のtrustpilot/reviewsにおけるdateとsortと同様 | クライアント側のenumでブロックし、カタログのテキストを確認する |
| 200で0件 | EveryInfra | その日、対象ページにデータがなかった | 返金済み。対象または機能を変更する |
最後の3行は当社のテスト結果、最初の4行はAnthropicのドキュメントによるものです。6行目はコードに組み込んでください。他のパラメータでも同じ問題が起こり得るためです。カタログのテキストから写したenumは、すべてスキーマに記述しましょう。各レスポンスの後に、言語の内訳と主要フィールドをベースラインと照合します。差があれば、その呼び出しを人による確認対象としてマークします。対照テストでは、誤った値に対する20件のレビューのうち7件が英語以外でした。2つのフィールドは20件すべてで空でした。簡単なチェックですぐに見つけられます。
この構成に関係する最近の変更
| 日付 | 変更内容 | 利用者への影響 |
|---|---|---|
| 2026年9月22日 | Opus 5.5リリース。thinkingはオフにできず、強制tool_choiceは400を返す | Opus 5から移行する前に強制呼び出しを削除し、autoとstrictを併用する |
| 2026年9月28日 | Sonnet 5.5リリース。こちらも強制tool_choiceを拒否 | Sonnetに戻してもこの変更は回避できない |
| 2026年10月7日 | Haiku 5.5リリース。1Mコンテキスト、バッチ料金$0.05 / $0.25 | 一括グルーピングのモデルコストがデータ料金に近い水準になった |
| 2026年10月15日 | Models APIがbetween_tools thinkingへの対応状況を返すように。Opus 5.5の高速モードがリサーチプレビューを終了 | モデルの機能はモデルIDから判断せず、コードで確認する |
| 2026年10月21日 | APIバージョン2026-10-21と新しいSDK(Python 2.0.0など) | SDKを更新する際は、output_formatなどの古いフィールドがないか確認する |
| 2026年10月22日 | Google Cloud経由のClaude(Anthropic管理) | バッチ処理の課金経路が増える。strictの使い方は変わらない |
| 2026年10月28日 | Messagesのリクエストサイズ上限が32 MBから128 MBに | 1リクエストに収まるレビュー数は増えるが、コストはトークン数に応じて発生する |
| 2026年10月29日 | Usage and Cost Analytics APIがベータ版に。モデル、ワークスペース、キー別に集計 | モデルコストをタスク別に分け、データ料金と比較する |
| 2026年10月30日 | Opus 4.8の高速モードは2026年11月30日に廃止予定 | このモデルで本番の抽出処理を実行している場合は、移行を計画する |
これらの項目は、APIリリースノート(2026年10月30日更新)とAPIバージョン移行ガイドに基づいています。この記事で最も重要なのは、2026年10月7日のHaiku 5.5のリリースです。それ以前は、Haiku 4.5で一括グルーピングをバッチ実行した場合の料金は$0.50 / $2.50と現在の10倍で、モデルコストはデータ料金を大きく上回っていました。現在は両者が同程度になったため、データAPIの料金も実際に考慮すべき要素になります。
もう1つは2026年9月22日の項目で、会話途中のシステムメッセージに完全なツール定義を含められる機能です(ベータ版)。この機能により、プロンプトキャッシュを壊さずにセッション途中でstrictツールを追加できます。Anthropicは、これを強制呼び出しの代替手段の1つとして挙げています。
よくある質問
Claudeで今もツールの使用を強制できますか?
この質問は検索候補「claude force tool use」に基づいています。Fable 5.1、Mythos 5.1、Opus 5.5、Sonnet 5.5ではできません。tool_choiceにanyまたはtoolを指定すると400が返され、トークンカウントエンドポイントにも同じチェックが適用されます。autoとnoneは引き続き使えます。autoのまま、ツールにstrict: trueを追加し、各ツールをいつ使うかをユーザーメッセージで指示してください。現在のターンで必ずツールを実行する必要がある場合、Fable 5.1の移行ガイドでは会話途中のシステムメッセージを使う方法が提案されています。
claudeのtool_choiceがautoで、モデルがツールを呼び出さない場合はどうすればよいですか?
この質問は検索候補「claude tool_choice」に基づいています。Anthropicによると、Fable 5.1はツール使用に関する明示的な指示に確実に従います。そのため、まず指示を明確にし、ツール名と呼び出す条件を示してください。次に、ループ内でstop_reasonを確認してください。
モデルがテキストで応答したもののデータが必要な場合は、ツール呼び出しを求めるユーザーメッセージを追加します。3つ目に、ツールのdescriptionを明確に書きます。Define toolsページでは、詳細な説明は「ツールのパフォーマンスを左右する要因の中で、群を抜いて重要」とされています。
Claudeの構造化出力はBedrockで使えますか?
この質問は検索候補「claude structured outputs bedrock」に基づくものです。strict tool useのページにある対応表には、InvokeModelを含むAmazon BedrockとGoogle Cloudが記載されています。構造化出力のページには「サポートされているすべてのプラットフォーム」「すべてのモデル」と書かれています。Fableモデルは30日間のデータ保持が必要で、ゼロデータ保持の対象外です。使用する前にデータ保持のページを確認してください。
pydanticでClaudeの構造化出力を使うにはどうすればよいですか?
この質問は検索候補「claude structured output pydantic」に基づくものです。構造化出力のページでは、Pydanticモデルをclient.messages.parse()に渡す方法が推奨されています。SDKがスキーマを変換し、minimumやmaxLengthなどのサポートされていない制約を説明文に移します。その後、すべての制約を含む元のスキーマでレスポンスを検証します。
EveryInfraでは、カタログのallowed_valuesをLiteral[...]として書くとenumになります。limitの範囲はField(ge=1, le=200)で書けば、SDKがローカルで検証します。カタログでは、6つの機能で最大値を超える値は上限値に制限されると記載されています。
Claudeの構造化出力APIとstrictツールは同じリクエストで使うべきですか?
この質問は検索候補「claude structured outputs api」に基づくものです。はい、併用できます。構造化出力のページの「Feature compatibility」セクションには、両方を1つのリクエストで実行できると書かれています。strictツール20個、任意パラメータ24個、ユニオン型パラメータ16個という制限は両者で共有されるため、出力スキーマもすべて必須にしてください。
始め方
- カタログを確認します。
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilotは無料で、APIキーも不要です。パラメータ、指定可能な値、料金を確認できます。 - 上記の6つのルールに従ってstrictツールを書きます。パラメータは必須にし、
allowed_valuesはenumとして書き、範囲は説明文に記載します。 - クイックスタートでAPIキーを取得します。誤ったenumを指定してリクエストを1回送り、
did_you_mean付きの422が返ることを確認します。 - 大量処理には、大きな
limitと"mode": "async"を使います。Claude側ではMessage Batchesを使います。
プラットフォームページ:TrustpilotスクレイピングAPI、App StoreスクレイピングAPI、AmazonスクレイピングAPI。機能ページ:Trustpilotのレビュー、App Storeのレビュー、Amazonのレビュー。その他のレビューページ:G2のレビュー、Google Playのレビュー。ノーコードでClaudeにリモートMCPサーバーを接続するには、リモートMCPのセットアップをご覧ください。
レビューデータを商品として扱う方法は、レビューデータを有料商品にするをご覧ください。4つのAIツールで使える1つのSKILL.mdもあわせてご覧ください。サブエージェントによる並列データ取得については、TikTokブランドアカウント向けのClaude Codeサブエージェントをご覧ください。機能ごとの料金はデータマーケットで比較できます。
参考文献
- Claude Opus 5.5の新機能(ツール使用の強制は非対応)、Anthropic、2026年9月22日、https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Claude Fable 5.1の新機能、Anthropic、2026年9月1日、https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- Claude Sonnet 5.5の新機能、Anthropic、2026年9月28日、https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Opus 5.5移行ガイド、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- Claude Fable 5.1移行ガイド、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- Claude Sonnet 5.5移行ガイド、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- APIリリースノート、Anthropic、2026年10月30日更新、https://platform.claude.com/docs/en/release-notes/overview
- 厳格なツール使用、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- 構造化出力、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- ツールの定義、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- ツール呼び出しの処理、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- ツール使用の概要、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- ツール使用の仕組み、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- ツール使用のトラブルシューティング、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- 並列ツール使用、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- ツールランナー、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- ツール検索ツール、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- プログラムによるツール呼び出し、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- バッチ処理、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Message Batchの作成(APIリファレンス)、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/api/messages/batches/create
- 料金、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/about-claude/pricing
- プロンプトキャッシュ、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- トークンカウント、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/token-counting
- レート制限、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/api/rate-limits
- エラー、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/api/errors
- モデルの概要、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/models/overview
- Claude Haiku 5.5の概要、Anthropic、2026年10月7日、https://platform.claude.com/docs/en/models/haiku-5-5/overview
- Claude Opus 5.5の概要、Anthropic、2026年9月22日、https://platform.claude.com/docs/en/models/opus-5-5/overview
- Claude Mythos 5.1の概要、Anthropic、2026年9月1日、https://platform.claude.com/docs/en/models/mythos-5-1/overview
- Effort、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/effort
- ストリーミング、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/streaming
- 拒否とフォールバック、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- 引用、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/build-with-claude/citations
- MCPコネクタ、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- リモートMCPサーバー、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- APIバージョン2026-10-21への移行、Anthropic、2026年10月21日、https://platform.claude.com/docs/en/api/migration-2026-10-21
- APIとデータ保持、Anthropic、2026年11月1日閲覧、https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- Model Context Protocol仕様2025-11-25:ツール、MCP、https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- JSON Schema Validation, draft 2020-12、JSON Schema、https://json-schema.org/draft/2020-12/json-schema-validation
- JSONSchemaBench、Geng et al.、arXiv 2501.10868、2025年、https://arxiv.org/abs/2501.10868
- 評価、レビュー、返信、Apple Developer、2026年11月1日閲覧、https://developer.apple.com/app-store/ratings-and-reviews/
- EveryInfraデータカタログ(GET /api/v1/social/catalog)、EveryInfra、2026年11月1日00:46(SGT)閲覧、https://api.everyinfra.com/api/v1/social/catalog
参考資料 BL-60