Claude strict tool use con una API de datos: dos capas para llamadas válidas
Opus 5.5 ya no acepta tool_choice forzado. Unimos strict tools con errores 422 que dicen cómo corregir: 29 llamadas reales con reseñas de España y México.
Claude Opus 5.5, Sonnet 5.5 y Fable 5.1 devuelven un error 400 cuando tool_choice vale any o tool. El código que forzaba una llamada a una herramienta para obtener un JSON fijo deja de funcionar en estos modelos. Anthropic recomienda mantener tool_choice: auto y añadir strict: true, o pasar el esquema a las salidas estructuradas. El 1 nov 2026 escribimos herramientas strict para reseñas de Trustpilot, App Store y Amazon a partir del catálogo de EveryInfra, y después enviamos 29 solicitudes reales a nuestra API: dos con datos en español de España y México, y diez de control por la tarde. Esa noche repetimos 12 solicitudes más.
Las solicitudes con un nombre de parámetro o un valor de enum equivocado volvieron como 422 en un tiempo de 0,11 a 0,23 segundos. Cada 422 traía los valores permitidos y el paso siguiente, y ninguno se cobró. En el catálogo de la madrugada, dos parámetros no tenían valores permitidos. En una prueba de control por la tarde, los valores erróneos en ellos no fallaron: la API respondió 200, cobró la tarifa normal y devolvió en silencio otro conjunto de reseñas. Nada en la respuesta avisaba al modelo de que algo iba mal. Esa noche la pasarela añadió valores permitidos a esos dos parámetros, y nuestra prueba de las 19:18 SGT confirmó que un valor erróneo ya recibe un 422 sin cobro.
Este artículo responde a una pregunta práctica. Tienes una aplicación con Claude que llama a una API de datos externa. Antes forzabas al modelo a llamar a tu herramienta, así cada solicitud tenía la misma forma. En un modelo nuevo esa línea falla. ¿Cómo la cambias para que el modelo siga llamando a la API de forma fiable y devuelva un JSON que puedas guardar en tu base de datos sin limpiarlo a mano?
Todo lo que decimos sobre Claude sale de la documentación de Anthropic, y enlazamos cada afirmación. En nuestra máquina de pruebas no hay una clave de la API de Anthropic, así que el código de Claude de este artículo es un ejemplo de configuración, no un resultado de prueba. Todos los números sobre EveryInfra salen de las respuestas en bruto de llamadas reales hechas el 1 nov 2026, con la hora de Singapur (SGT) de cada una.
Qué cambió: tres modelos nuevos rechazan tool_choice forzado
El cambio es sencillo y todas las decisiones de diseño de este artículo dependen de él. Las notas de versión de la API de Anthropic del 1 sep 2026 dicen que Fable 5.1 y Mythos 5.1 no admiten los tipos any y tool de tool_choice. Esas solicitudes devuelven un error 400, mientras que auto y none siguen igual (notas de versión de la API). Las notas recomiendan strict tool use o salidas estructuradas para obtener argumentos que cumplan el esquema. El 22 sep, la entrada de Opus 5.5 dice que el mismo 400 se aplica "como en Claude Fable 5.1". El 28 sep, la entrada de Sonnet 5.5 lo lista como una de las cinco formas en que puede romperse el código escrito para Sonnet 5.
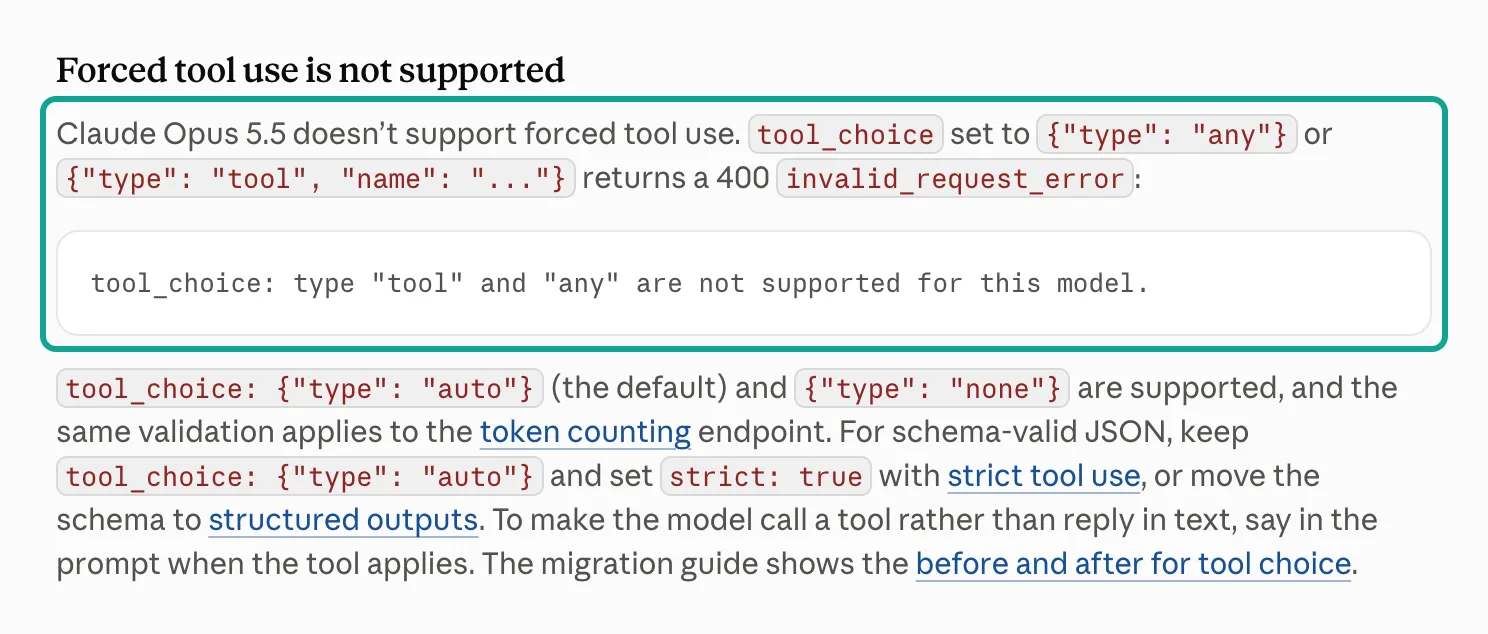
Cada modelo tiene una página "What's new" con una sección llamada "Forced tool use is not supported". Las tres páginas muestran el mismo texto de error: tool_choice: type "tool" and "any" are not supported for this model. Puedes leerlo en las páginas de Opus 5.5, Sonnet 5.5 y Fable 5.1. La misma comprobación se aplica al endpoint de conteo de tokens, de modo que tampoco sirve para probar una llamada forzada antes de enviarla.
¿Por qué Anthropic quitó las llamadas forzadas? La página de Fable 5.1 da la razón. En estos modelos el razonamiento extendido está siempre activo, y una llamada forzada lo salta. Entonces el modelo escribe su razonamiento dentro de los argumentos de la herramienta y la calidad de esos argumentos baja. Para una aplicación que llama a una API de datos esto importa mucho, porque los argumentos son justo lo que se envía al servicio y lo que después se cobra.
En el diseño antiguo forzabas la llamada para tener una forma estable. Ahora la forma estable viene de la gramática strict, y la decisión de llamar vuelve al modelo. Tu prompt debe decir cuándo se usa la herramienta. La página de Fable 5.1 añade que el modelo sigue de forma fiable instrucciones explícitas sobre herramientas, por ejemplo "Usa la herramienta get_weather para responder", así que nombrar la herramienta en el mensaje del usuario sustituye a la llamada forzada.
| Modelo | Fecha de lanzamiento | `tool_choice` any / tool | Sustituto de Anthropic | Precio estándar, entrada / salida por MTok |
|---|---|---|---|---|
| Fable 5.1 | 2026-09-01 | Error 400 | auto + strict, o salidas estructuradas | 10 USD / 50 USD |
| Opus 5.5 | 2026-09-22 | Error 400 | auto + strict, o salidas estructuradas | 4 USD / 20 USD |
| Sonnet 5.5 | 2026-09-28 | Error 400 | auto + strict, o salidas estructuradas | 2 USD / 10 USD |
| Haiku 5.5 | 2026-10-07 | No aparece en las notas de versión | — | 0,10 USD / 0,50 USD |
Las fechas y los precios vienen de las notas de versión y de la página de precios, consultadas el 1 nov 2026. La página de precios también muestra que el cambio no es temporal. Su tabla de tokens del prompt de sistema para herramientas tiene dos columnas, una para auto, none y otra para any, tool. Para Opus 5.5 solo la primera tiene valor, 286 tokens, mientras que para Opus 5 las dos columnas tienen valor, 286 y 406 tokens.
Las notas de versión de Haiku 5.5 enumeran otros cambios que rompen código, como los presupuestos manuales de razonamiento, los parámetros de muestreo y el prefill. No mencionan el uso forzado de herramientas, así que no afirmamos nada sobre Haiku 5.5. Aun así usamos herramientas strict también con él, para que el mismo código funcione en los cuatro modelos sin ramas especiales.
Strict tool use no es nuevo ni exclusivo de los modelos nuevos. Dos páginas dicen que la función está disponible en todos los modelos y es apta para entornos preparados para HIPAA (strict tool use, salidas estructuradas). Lo que cambió es su papel: antes era un paso de seguridad opcional y ahora es el camino principal. La lista de migración de Opus 5.5 pide sustituir any y tool por auto más strict o salidas estructuradas, y revisar antes cada input_schema, porque strict solo acepta un subconjunto de JSON Schema (guía de migración de Opus 5.5).
Strict tool use y claude structured outputs: qué controla cada uno
Los dos nombres se parecen, pero controlan partes distintas de la respuesta. Strict tool use añade "strict": true a la definición de una herramienta y controla el input de cada bloque tool_use. La API usa muestreo restringido por gramática, así que el input siempre coincide con el input_schema y el nombre de la herramienta siempre es válido. El ejemplo de Anthropic es un sistema de reservas que necesita passengers: int: sin strict, el modelo puede enviar "two" o "2"; con strict, siempre envía 2.
Claude structured outputs es el campo output_config.format de la solicitud. Controla el texto final de la respuesta, que pasa a ser un JSON que coincide con tu esquema. En un flujo con una API de datos necesitas las dos cosas. Las herramientas strict mantienen correctos los parámetros que van a POST /api/v1/social, y las salidas estructuradas convierten las reseñas que vuelven en campos fijos, como tema, gravedad y una cita corta. Las dos funciones usan el mismo proceso de gramática, por eso comparten los mismos límites.
La sección "JSON Schema limitations" de la página de salidas estructuradas enumera esos límites. Se admiten todos los tipos básicos, enum, const, anyOf, $ref internos, diez formatos de cadena y expresiones regulares sencillas. No se admiten los esquemas recursivos, los límites numéricos como minimum y maximum, los límites de longitud de cadena ni minItems distinto de 0 o 1. Todo objeto debe declarar additionalProperties: false, y si usas una función no admitida la API devuelve un error 400 con detalles.
| Aspecto | Strict tool use | Salidas estructuradas (`output_config.format`) |
|---|---|---|
| Qué controla | Los argumentos de los bloques tool_use | El texto final de la respuesta |
| Cómo se activa | "strict": true en una herramienta | Un JSON Schema en output_config.format |
| Papel en este artículo | Parámetros correctos para EveryInfra | Campos fijos para cada reseña |
| Límites compartidos por solicitud | 20 herramientas strict, 24 parámetros opcionales, 16 parámetros con tipos unión | Los mismos, contados en conjunto |
| No se admite | Rangos numéricos, longitud de cadena, recursión | Lo mismo, y no funciona junto con citations |
| Primera solicitud | Retraso extra mientras se compila la gramática; caché de 24 horas | Igual |
La expresión "por solicitud" es la trampa habitual. La página de salidas estructuradas da un ejemplo: cuatro herramientas strict con seis parámetros opcionales cada una ya llegan al límite de 24, aunque ninguna parezca compleja. Por encima de los límites explícitos hay límites internos sobre el tamaño de la gramática compilada; si los superas, la API responde "Schema is too complex for compilation". El último límite de seguridad es un tiempo máximo de compilación de 180 segundos. Anthropic propone cuatro pasos, en este orden: marcar como strict solo las herramientas críticas, hacer obligatorios los parámetros, aplanar los objetos anidados y repartir el trabajo entre solicitudes o subagentes.


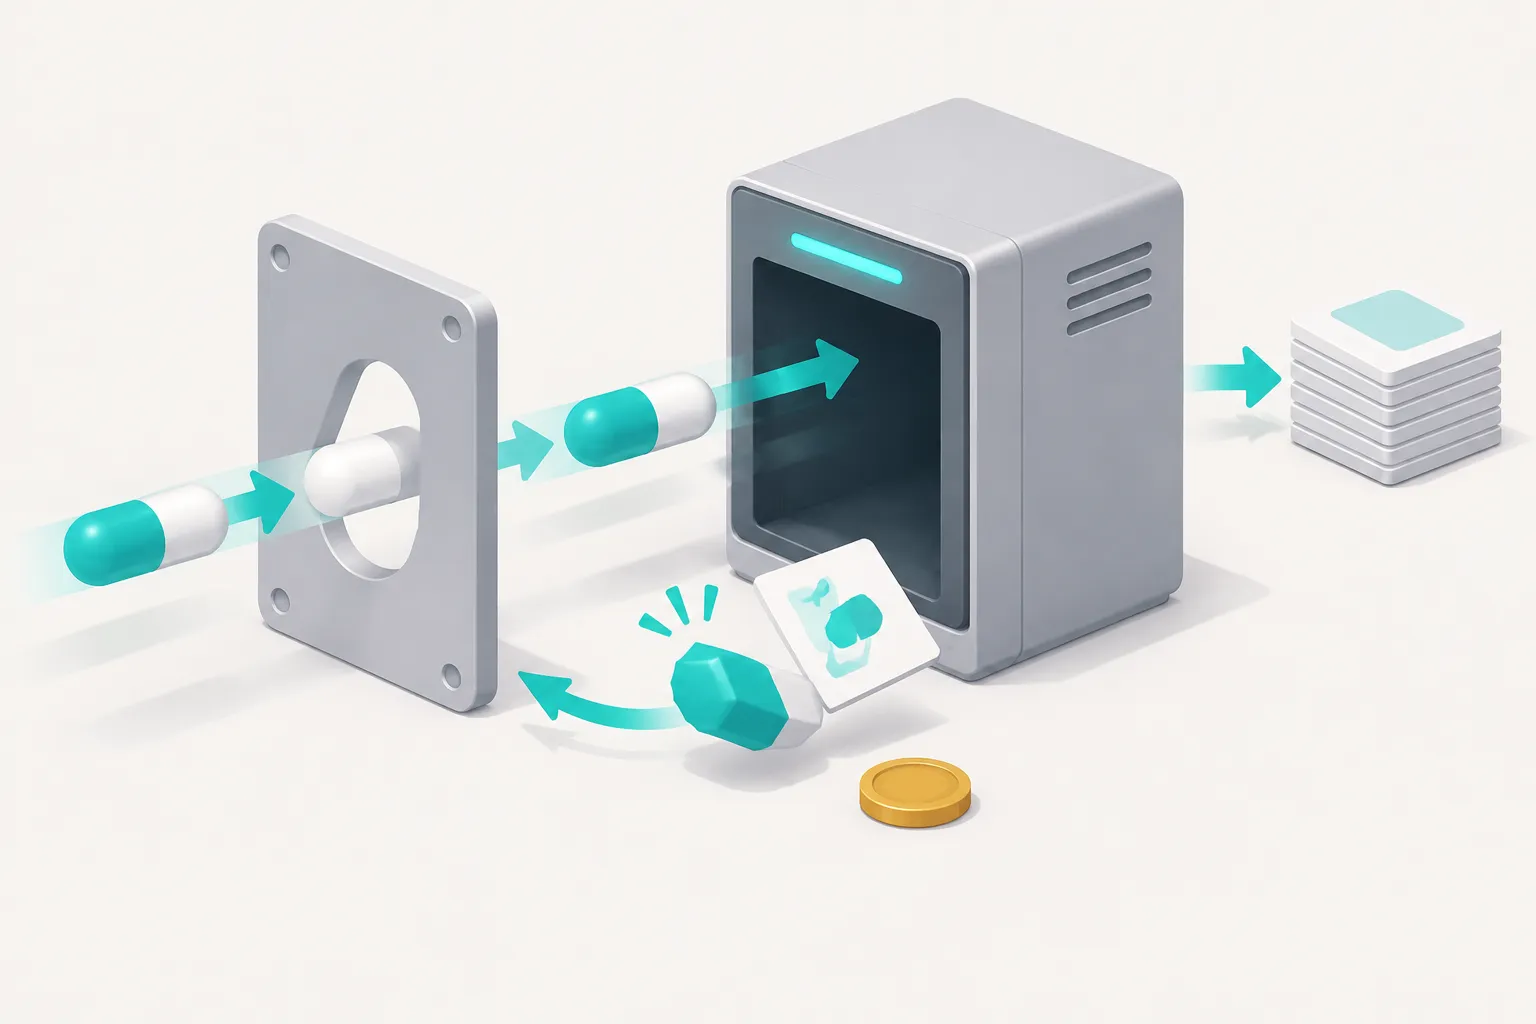
El diagrama muestra la idea central del artículo. La primera capa está del lado de Claude: el modo strict garantiza que los tipos, los campos obligatorios y los valores de enum coinciden con tu esquema, y el modelo no puede enviar un campo como max_results si tu esquema no lo tiene. La segunda capa está del lado de EveryInfra. Algunas reglas no caben en un esquema, por ejemplo "¿este enlace es una página de producto?" o "¿cómo llama esta plataforma a este orden?". Nuestra API compara esos valores con el catálogo y, cuando un valor es erróneo, devuelve un 422 con los valores permitidos y el más parecido. El modelo cambia un campo y vuelve a enviar.
Capa uno: herramientas strict para POST /api/v1/social desde el catálogo
El endpoint del catálogo de EveryInfra, GET /api/v1/social/catalog, es gratuito y no necesita clave (catálogo en bruto). Para cada capacidad indica los parámetros obligatorios y opcionales, una descripción de cada parámetro, los valores permitidos (allowed_values), los campos que devuelve y el precio. Lo leímos el 1 nov 2026 a las 00:46 SGT: listaba 426 capacidades en 91 plataformas, y 402 capacidades en 89 plataformas estaban disponibles ese día.
Las capacidades disponibles tienen 809 descripciones de parámetros. De ellas, 155 incluyen valores permitidos, 143 tienen formato uri y 38 tienen formato date. Estos tres grupos se traducen directamente a enum, format: uri y format: date en un esquema strict. Sin contar solapamientos, 336 de 809 parámetros (41,5 %) se convierten en una restricción que el modo strict puede garantizar. Solo 155 (cerca del 19 %) pueden ser un enum; el resto son texto libre o números, y ahí la descripción y la segunda capa tienen que hacer el trabajo.
Estas son las definiciones de tres herramientas de reseñas escritas a partir del catálogo y pensadas para un equipo que trabaja con España y Latinoamérica. Respecto a una versión para Estados Unidos hay tres cambios: Trustpilot recibe el idioma de las reseñas, App Store recibe el país de la tienda y Amazon limita el dominio a las tiendas en español. Es un ejemplo de configuración y no lo ejecutamos contra Claude.
[
  {
    "name": "trustpilot_reviews",
    "description": "Obtiene reseñas recientes de Trustpilot de una empresa mediante EveryInfra (platform trustpilot, action reviews). Úsala siempre que el usuario nombre una empresa y pregunte qué dicen los clientes. company es el dominio web de la empresa, por ejemplo temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Dominio como temu.com, o un enlace trustpilot.com/review/<dominio>"},
        "language": {"type": "string", "pattern": "^[a-z]{2}$", "description": "Código de idioma de dos letras, por ejemplo es; sin él, la API solo devuelve reseñas en inglés"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Estrellas que se conservan; [] conserva todas"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = sin filtro de fecha"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "De 1 a 200; usa 20 salvo que el usuario pida más"}
      },
      "required": ["company", "language", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Obtiene reseñas de App Store de una app de iOS mediante EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Id numérico de App Store, por ejemplo 6473753684"},
        "country": {"type": "string", "enum": ["mx", "es", "ar", "co", "cl", "pe", "us"]},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "De 1 a 500; usa 30 salvo que el usuario pida más"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Obtiene las reseñas destacadas que muestra una página de producto de Amazon (platform amazon, action reviews). Suelen ser una docena por producto.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.(es|com)/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.es", "amazon.com"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]
Los límites anteriores obligaron a cuatro decisiones de diseño. Primera: todos los parámetros son obligatorios. El catálogo da a trustpilot/reviews seis parámetros opcionales más limit, siete en total; si los copiáramos como opcionales, gastarían casi un tercio de los 24 huecos. Anthropic propone otra salida: cuando un parámetro siempre tiene un valor por defecto razonable, hazlo obligatorio y deja que el modelo rellene ese valor. Por eso añadimos el valor any a date y permitimos un array vacío en stars. Nuestro código quita any y [] antes de enviar la solicitud, porque el catálogo dice que un valor vacío significa "sin filtro"; esa noche date: any enviado tal cual recibió un 422, así que ese paso no se puede saltar. language, en cambio, no admite any: sin él llegan solo reseñas en inglés, así que para un mercado hispano lleva siempre es.
Segunda: el rango de limit va en la descripción y no en minimum o maximum, porque los límites numéricos no se admiten; los valores por encima del máximo son asunto de la API, y seis capacidades del catálogo indican que en ese caso se usa el máximo. Tercera: una expresión regular sencilla limita el enlace de Amazon a páginas de producto, porque la nota del catálogo para amazon/reviews dice que la portada de una tienda no funciona. Probamos un enlace de tienda contra este esquema con un validador local de JSON Schema y la expresión lo rechazó. Cuarta: el catálogo que leímos de madrugada no daba allowed_values para date y sort de trustpilot/reviews, así que copiamos los valores desde el texto. La sección siguiente muestra por qué eso importó. Esa misma noche el catálogo los añadió, así que la definición de arriba ya incluye last7days. La herramienta de Amazon no incluye amazon.com.mx: desde las 22:14 (hora de Singapur) ese sitio devuelve 422 antes de cobrar. La sección de límites explica los detalles.
Toda la definición usa solo enum, required, additionalProperties: false, pattern sencillos y format, que casi todos los sistemas de decodificación restringida admiten. Los rangos numéricos y las longitudes tienen un soporte distinto en cada sistema, como muestra la prueba de seis frameworks de JSONSchemaBench, así que los dejamos al 422. Con eso, las mismas definiciones se pueden llevar a otro proveedor de modelos cambiando pocos nombres, y la segunda capa no cambia.
El parámetro country de App Store merece una nota propia. El catálogo lo describe como texto libre de dos letras, sin lista cerrada. Nosotros lo convertimos en un enum corto con los países que nos interesan, porque así el modelo no puede inventar mex ni spain, y porque un enum pequeño casi no aumenta la gramática. Si tu equipo cubre más mercados, amplía la lista; si cubre decenas de países, vuelve a un pattern de dos letras y deja que la API rechace los códigos que no existen.
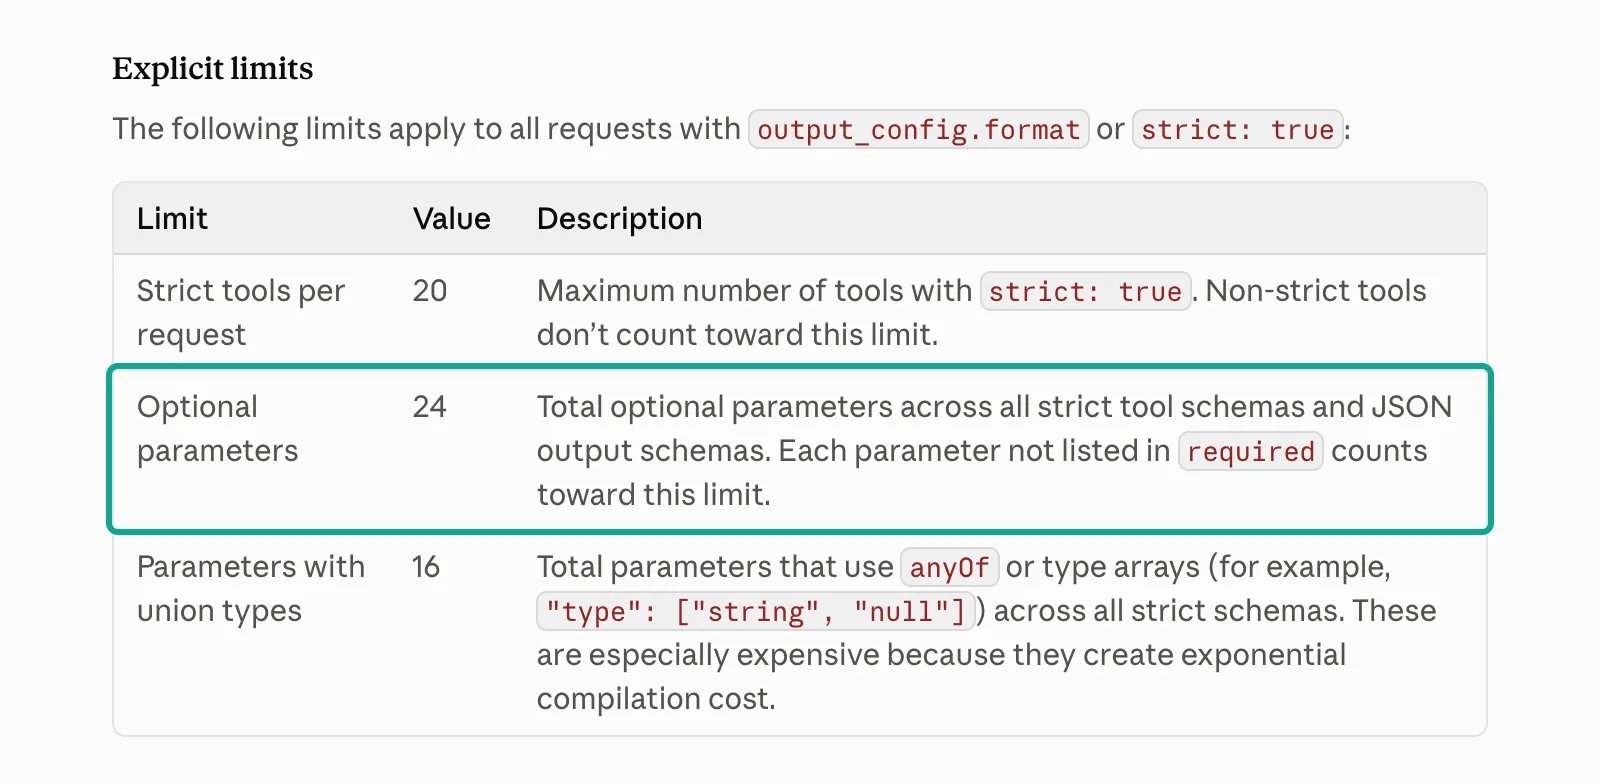
¿Cuántas capacidades del catálogo caben en este presupuesto? Contamos los parámetros opcionales de las 402 capacidades disponibles; en las que devuelven una lista contamos también limit. La mediana es 1 y el máximo es 9, así que ninguna capacidad supera por sí sola los 24. Hay 100 capacidades sin parámetros opcionales y 139 con uno, de modo que 239 capacidades (59,5 %) tienen cero o uno.
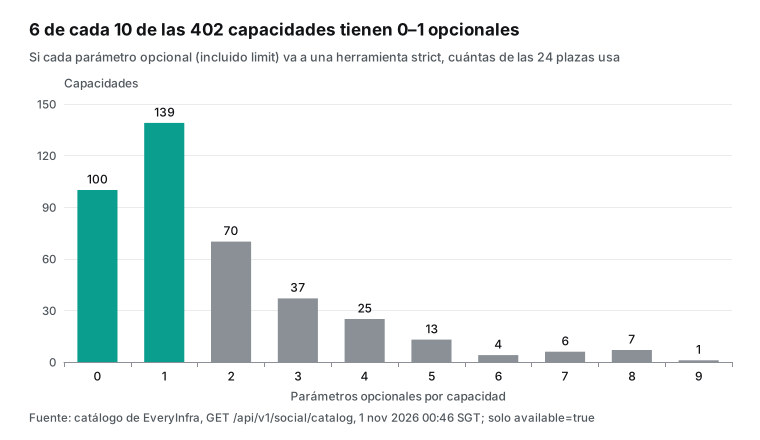
Esta distribución dice dos cosas. La buena: si haces obligatorios todos los parámetros, cualquier grupo de 20 capacidades cabe en una solicitud sin gastar huecos opcionales. La mala: no puedes convertir las 402 capacidades en herramientas strict en un solo sitio. Sus parámetros opcionales suman 686; a 24 por solicitud necesitas al menos 29 grupos, nuestro empaquetado voraz usó 30, y el límite de 20 herramientas strict por solicitud exige por sí solo al menos 21 grupos. Lo correcto es elegir herramientas por tarea. Para un monitor de reseñas, ocho capacidades de reseñas juntas usan exactamente 23 huecos opcionales.
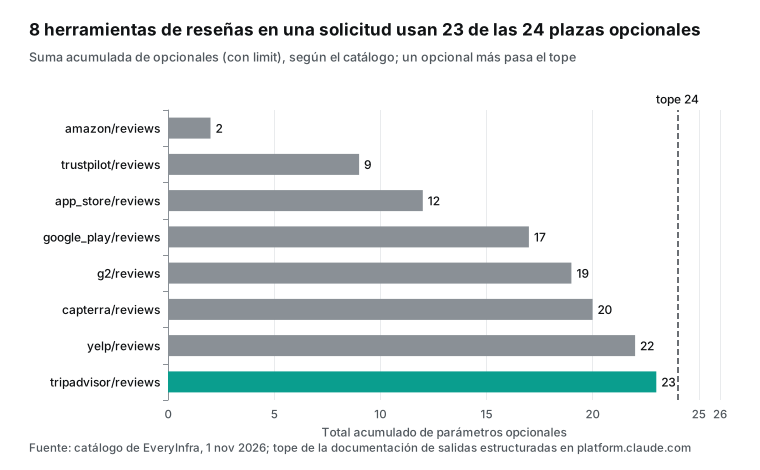
23 está uno por debajo del límite de 24. Añade un esquema de salida estructurada con un solo campo opcional y la solicitud falla. Por eso Anthropic recomienda hacer obligatorios los parámetros siempre que se pueda. Nuestras tres herramientas de ejemplo son totalmente obligatorias, así que usan cero huecos opcionales y dejan todo el presupuesto libre para el esquema de salida.
También hay un contraejemplo útil. El servidor MCP remoto de EveryInfra tiene una herramienta general, everyinfra_call_api, cuyo campo params es un objeto abierto, porque debe aceptar las 426 capacidades. Eso está bien para una herramienta normal, pero el modo strict exige additionalProperties: false en todos los objetos, así que este esquema no puede ser strict. Al volver a leer la lista de herramientas MCP el 1 nov 2026 a las 15:41 SGT, tenía 12 herramientas y ocupaba 16 247 bytes; el campo params de everyinfra_call_api seguía siendo un objeto abierto. Si quieres la garantía strict, escribe herramientas por tarea como las de arriba y deja la herramienta general para explorar.
Convertir el catálogo en esquemas cada día
Tres herramientas se escriben a mano. Con treinta cometerás errores, y además el catálogo cambia. Es más seguro un script pequeño que lea el catálogo gratuito una vez al día, construya herramientas strict con reglas fijas y compare el resultado con el del día anterior. Usamos seis reglas, cada una sale de un límite descrito arriba, y nuestro código quita los valores "sin definir" antes de cada llamada.
| Campo del catálogo | Esquema strict | Motivo |
|---|---|---|
required_params | Copiar en required | Los obligatorios no gastan huecos opcionales |
optional_params | También en required, con un valor "sin definir" como any o [] | Mantiene libre el presupuesto de 24 |
allowed_values | enum, copiado exacto, con las mismas mayúsculas | Strict garantiza los valores del enum |
format: uri o date | El mismo format | Strict acepta diez formatos de cadena |
default_limit, max_limit | integer, con el rango en la descripción | minimum y maximum no se admiten |
| Todo objeto | additionalProperties: false | Strict lo exige |
Dos casos necesitan a una persona. El primero es un parámetro que lista sus valores solo en el texto, sin allowed_values; date y sort de trustpilot/reviews son ejemplos, y también language, cuya descripción solo da ejemplos como en, fr, de y es. El script no puede encontrar esos valores: una persona tiene que copiarlos en un enum o esperar a que el catálogo los añada (los de date y sort se añadieron la noche del 1 nov). Guardamos una lista de estos parámetros y la mostramos en cada reconstrucción, para que nadie la olvide al día siguiente.
El segundo caso es un enum muy grande. El día de la prueba, 8 enums tenían más de 100 valores y el mayor tenía 183. Un enum grande agranda la gramática compilada, y Anthropic dice que esos límites internos no tienen una cifra única. Para esos parámetros omitimos el enum, ponemos los valores más comunes en la descripción y dejamos que el 422 haga la comprobación, ya que el 422 devuelve igualmente la lista allowed completa.
La reconstrucción diaria también te dice cuándo pagarás una compilación nueva. La página de salidas estructuradas dice que las gramáticas compiladas se guardan en caché durante 24 horas desde el último uso. Un cambio en la estructura del esquema borra la caché y, si usas salidas estructuradas y herramientas juntas, también la borra un cambio en el conjunto de herramientas. Un cambio solo en name o description no la borra. Así que el script debe separar dos tipos de cambio: si solo cambió el texto, se sustituye sin coste; si cambiaron parámetros, valores u obligatorios, la siguiente solicitud será más lenta. En un lote ese retraso no importa, y en un chat en directo conviene enviar una solicitud de calentamiento en un momento tranquilo.
Capa dos: el 422 deja que el modelo corrija su propia llamada
La primera capa detiene los errores de forma, pero no los de valor. Un modelo puede elegir un valor erróneo que el esquema sigue permitiendo; por ejemplo, puede enviar most_recent como orden de App Store, que es el nombre que usa otra plataforma. O tu aplicación puede no usar strict y llamar a la herramienta general. Para esos casos la segunda capa debe fallar rápido, no cobrar nada y explicar cómo corregir.
La página de Anthropic sobre la gestión de llamadas a herramientas dice dos cosas que se aplican aquí (handle tool calls). Primero, pon el error en un tool_result con is_error: true; el modelo volverá a intentarlo con correcciones, normalmente 2 o 3 veces antes de disculparse con el usuario. Segundo, escribe mensajes de error instructivos: no pongas solo "falló", di qué salió mal y qué debería intentar Claude a continuación.
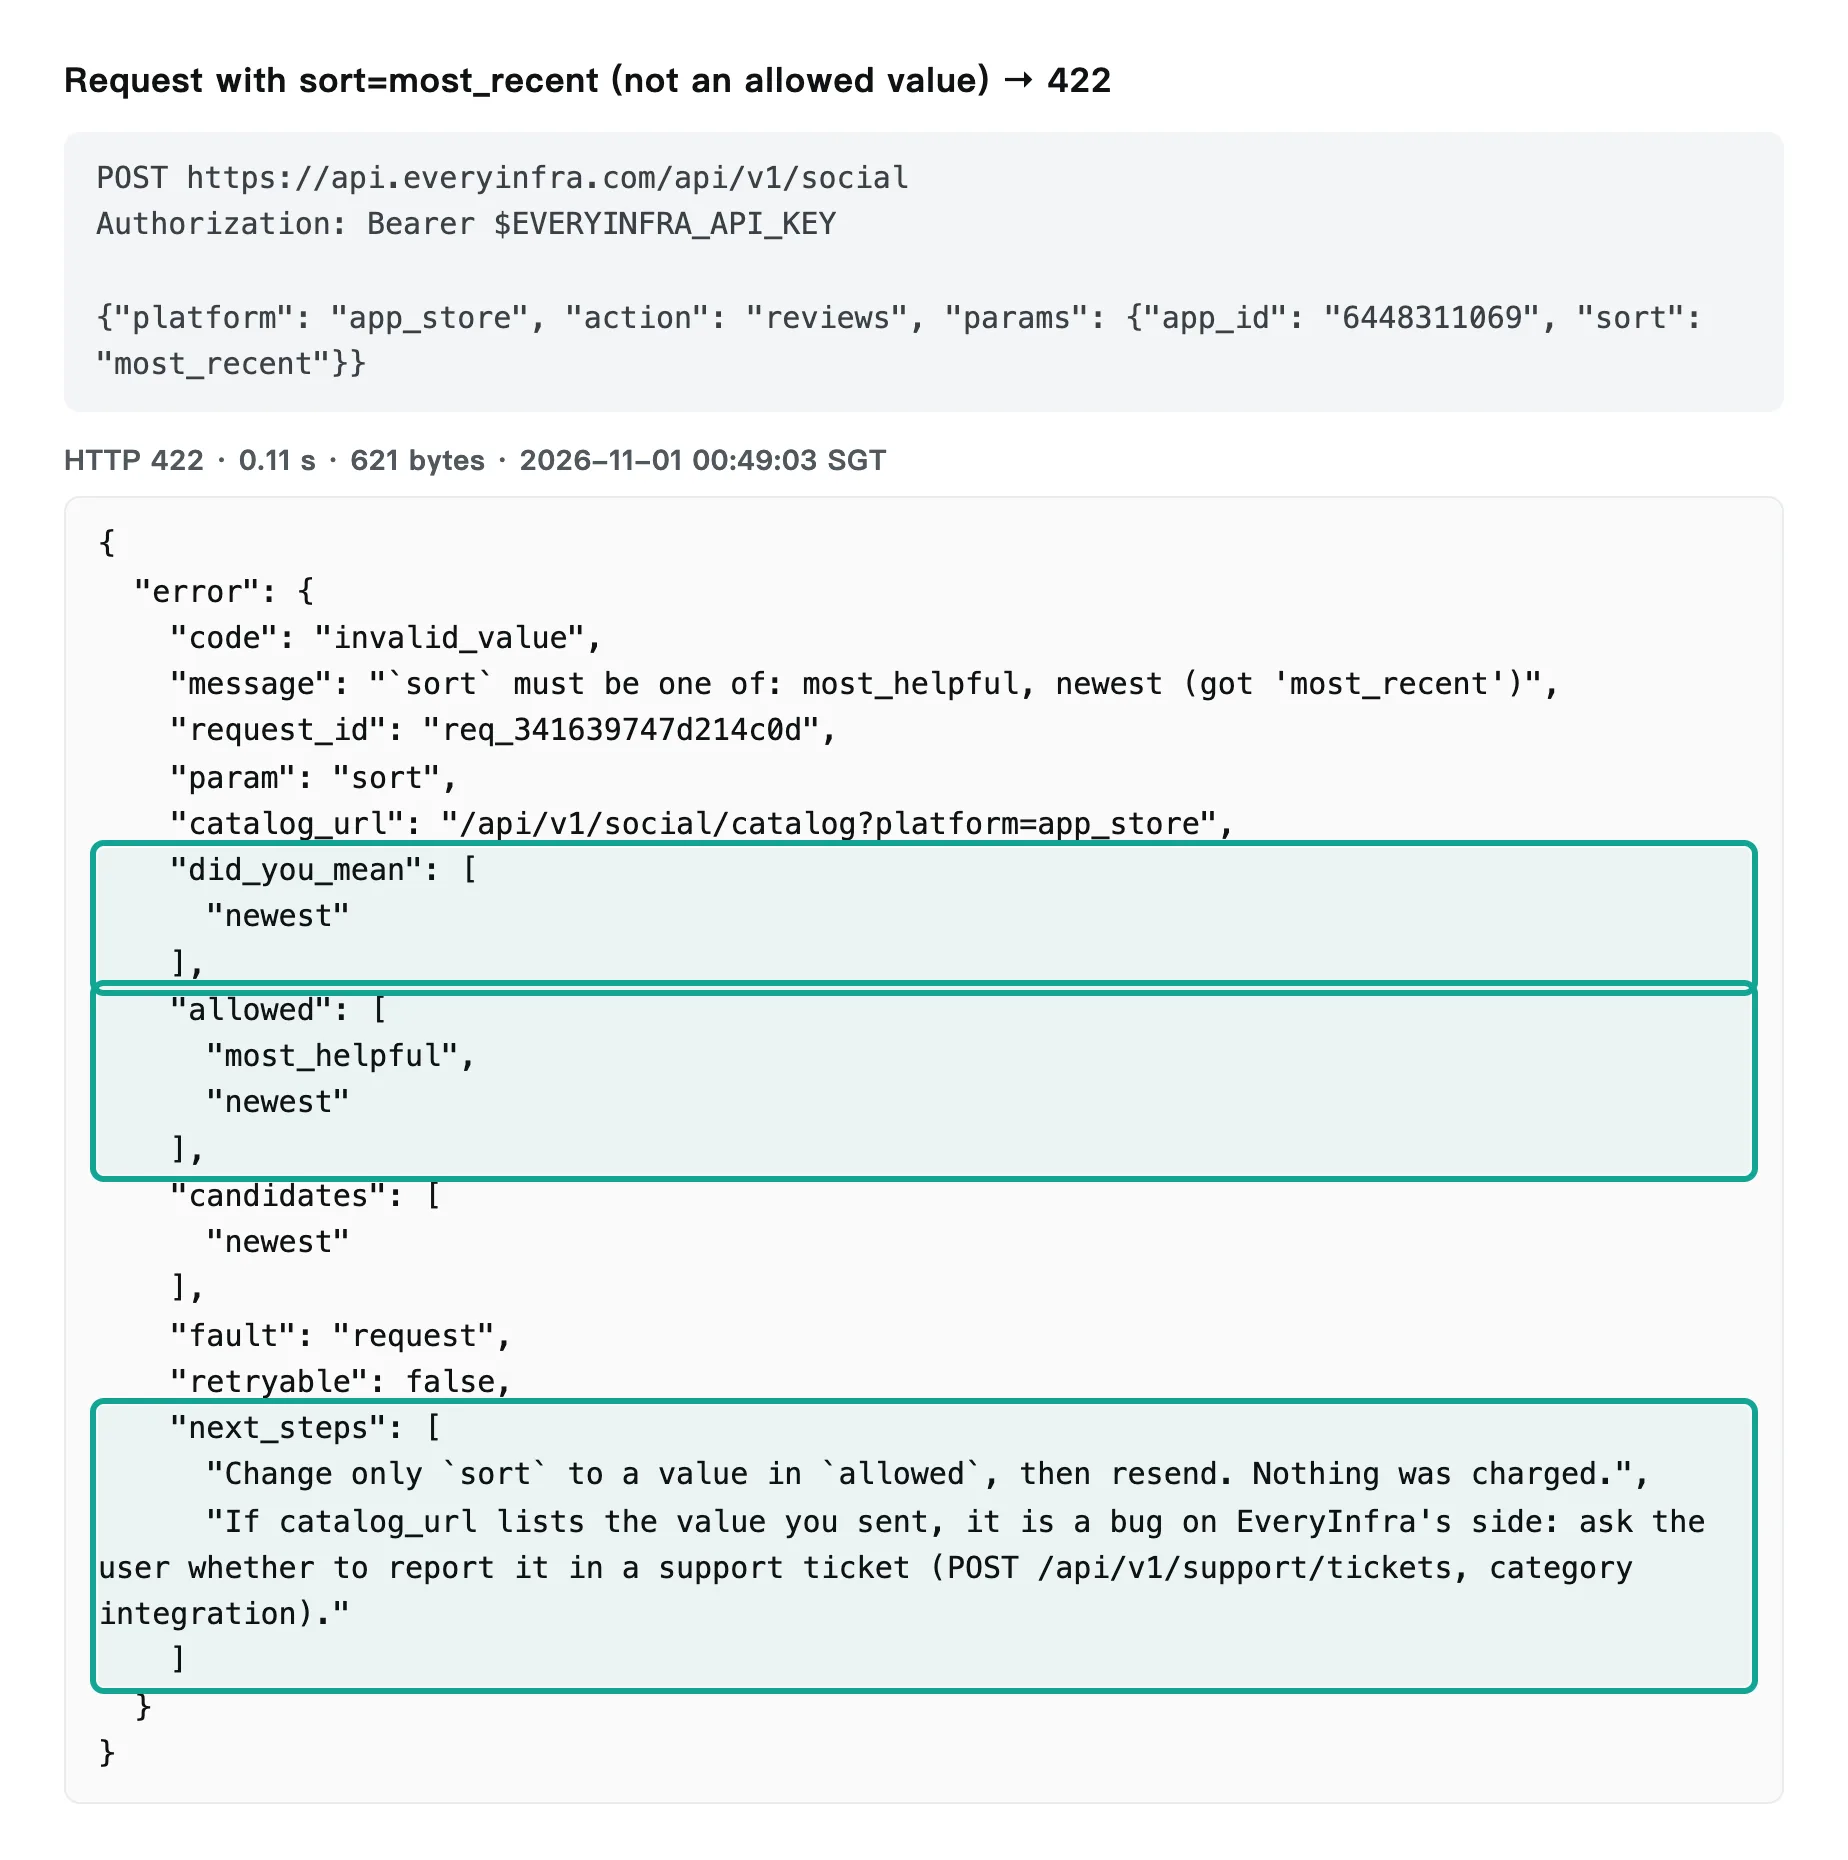
El 1 nov 2026, entre las 00:48 y las 00:49 SGT, enviamos siete solicitudes erróneas a propósito, y a las 00:57 SGT una más por MCP. Esta es la respuesta en bruto para un enum erróneo, con sort: most_recent enviado a app_store/reviews a las 00:49:03 SGT. La API respondió en 0,11 segundos:
{"error":{"code":"invalid_value","message":"`sort` must be one of: most_helpful, newest (got 'most_recent')","request_id":"req_341639747d214c0d","param":"sort","catalog_url":"/api/v1/social/catalog?platform=app_store","did_you_mean":["newest"],"allowed":["most_helpful","newest"],"candidates":["newest"],"fault":"request","retryable":false,"next_steps":["Change only `sort` to a value in `allowed`, then resend. Nothing was charged.","If catalog_url lists the value you sent, it is a bug on EveryInfra's side: ask the user whether to report it in a support ticket (POST /api/v1/support/tickets, category integration)."]}}El campo did_you_mean da la corrección directamente y retryable: false le dice al modelo que repetir lo mismo no sirve. La primera línea de next_steps pide cambiar solo sort y reenviar, y confirma que no se cobró nada. La segunda línea también es útil: dice qué hacer si el catálogo sí lista el valor enviado. En ese caso el fallo está en EveryInfra y el modelo debe preguntar al usuario si abre un ticket. Esa línea separa "mi entrada estaba mal" de "el servicio está mal", para que el modelo no confunda su propio error con una caída y no repita el mismo valor.
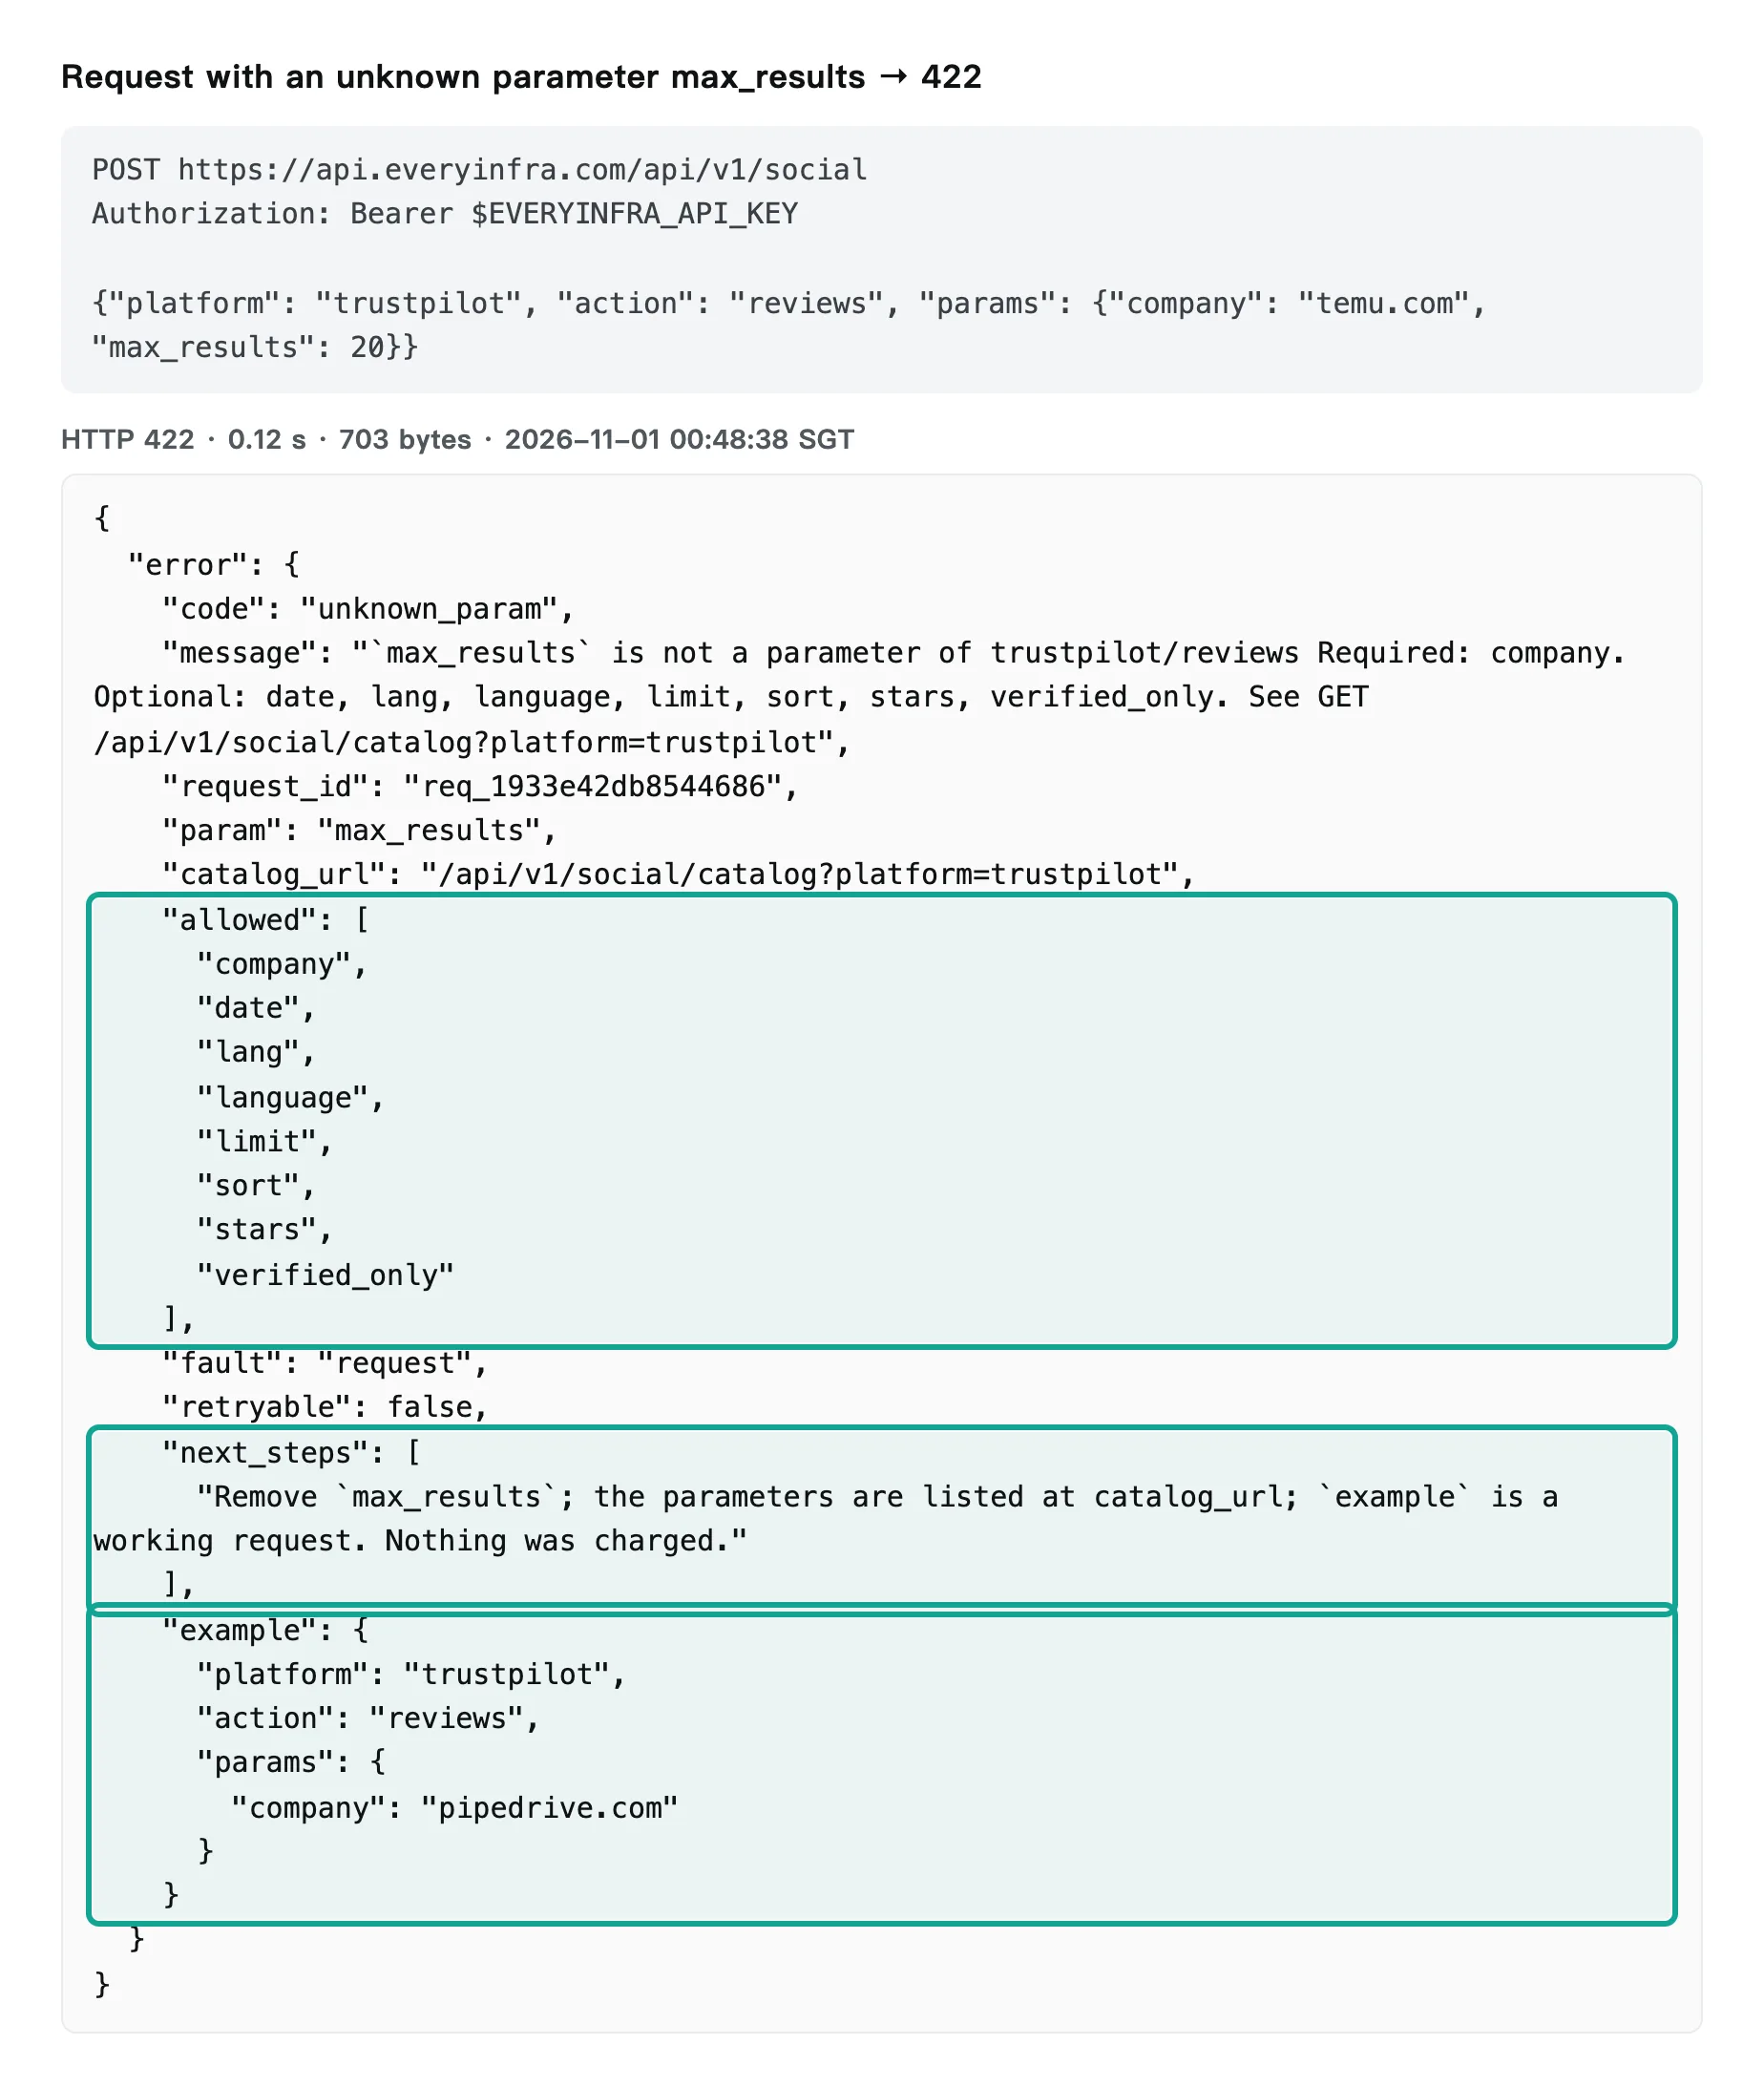
El parámetro desconocido es el otro caso típico. A las 00:48:38 SGT enviamos a trustpilot/reviews un max_results que no existe. La API devolvió un 422 en 0,12 segundos. El campo allowed lista los ocho nombres de parámetro válidos, example da una solicitud que funciona y next_steps pide quitar max_results y confirma que no se cobró nada.
La tabla reúne los ocho casos de error, las dos llamadas de control de la tarde y cinco pruebas de la noche, tras el arreglo. La última columna sale de una comprobación local: validamos cada entrada contra las definiciones de herramientas de arriba con un validador de JSON Schema (vocabulario de validación Draft 2020-12).
| Hora (SGT) | Qué rompimos | Respuesta | Tiempo | Cobro | Pistas de corrección | ¿Strict lo para antes? |
|---|---|---|---|---|---|---|
| 00:48:37 | Sin clave | 401 missing_key | 0,12 s | 0 | Pide enviar una clave | No aplica |
| 00:48:38 | max_results de más | 422 unknown_param | 0,12 s | 0 | Lista de parámetros, ejemplo | Sí |
| 00:48:42 | company escrito compnay | 422 missing_param | 0,23 s | 0 | Señala la errata, ejemplo | Sí |
| 00:48:42 | date: last7days | 503 | 1,69 s | 0 (reembolsado) | Solo "reintenta luego" | Sí entonces; valor válido tras el arreglo |
| 00:48:44 | sort: newest | 503 | 1,91 s | 0 (reembolsado) | Solo "reintenta luego" | Sí entonces; valor válido tras el arreglo |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0,11 s | 0 | did_you_mean, allowed | Sí |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0,20 s | 0 | did_you_mean, allowed | Sí |
| 00:57:45 | G2 sort: most_recent por MCP | isError: true | — | 0 | Lo mismo, en structuredContent | No aplica |
| 15:39:38 | sort: newest (control) | 200, 20 filas | 14,3 s | 0,001389 USD | Ninguna; otras reseñas | Sí entonces; valor válido tras el arreglo |
| 15:39:38 | date: last7days (control) | 200, 20 filas | 14,4 s | 0,001389 USD | Ninguna; otras reseñas | Sí entonces; valor válido tras el arreglo |
| 19:18:39 | sort: newst (tras el arreglo) | 422 invalid_value | 0,21 s | 0 | did_you_mean (newest), allowed | Sí |
| 19:18:46 | date: last_week (tras el arreglo) | 422 invalid_value | 0,12 s | 0 | did_you_mean (last7days), allowed | Sí |
| 19:18:53 | date: any (tras el arreglo) | 422 invalid_value | 0,11 s | 0 | allowed | No; el esquema lo admite y el código lo quita |
| 19:19:01 | language: eng (tras el arreglo) | 422 missing_param | 0,19 s | 0 | Pide un código de dos letras | Sí, por el pattern |
| 19:19:23 | sort: newest (tras el arreglo, ya válido) | 200, 20 filas | 14,1 s | 0,001389 USD | Las mismas filas que con recency | No hace falta |
Las cuatro filas de la tarde y la madrugada de trustpilot/reviews merecen una lectura atenta. En el catálogo de la madrugada, date y sort de esta capacidad solo tienen una descripción de texto, sin allowed_values, así que la API no puede comprobarlos como enums en la entrada. A las 00:48 SGT, cada valor erróneo recibió un 503 al cabo de 1,7 a 1,9 segundos; no se cobró y next_steps solo decía que se repitiera tras retry_after segundos. Pero esos dos 503 no se pueden achacar a los valores: en los mismos minutos, otra de nuestras pruebas llamó a trustpilot/profile sin estos parámetros y también recibió un 503. La plataforma estaba inestable en ese momento.
Por eso hicimos un control por la tarde. A las 15:39:38 SGT enviamos cuatro llamadas en el mismo minuto, todas para temu.com, cambiando un solo parámetro: sort: newest frente al válido sort: recency, y date: last7days frente al válido date: last30days. A las 15:40 SGT añadimos una llamada base sin parámetros opcionales y una repetición de newest. Las seis respondieron 200 con 20 filas y cada una costó 0,001389 USD.
Los resultados se separan en dos grupos limpios. Los dos valores válidos y la llamada base devolvieron las mismas 20 reseñas, todas en inglés, con verification_level y source rellenos. Los dos valores no listados y la repetición devolvieron otras 20: 13 en inglés, 3 en francés, 2 en español y 2 en italiano, y esos dos campos venían vacíos en las 20. Es decir, durante el día 1 nov un valor erróneo no recibía ni 422 ni 503: la API lo aceptaba, cobraba la tarifa normal y cambiaba el resultado en silencio.
Para un modelo, esto es peor que un 503. Ve un éxito, así que no reintenta ni avisa al usuario, y las reseñas con idiomas mezclados entran directamente en tu flujo de datos. El texto del catálogo para sort dice en realidad que se use recency y no el newest de otras plataformas, pero eso solo lo veía quien leía el texto, no la comprobación de la API. Aquí se ve también por qué la primera capa es necesaria: nuestro esquema strict declara date y sort como enums, así que estos errores no pueden salir de Claude.
Esa misma noche la pasarela cambió estas reglas:
| Parámetro | Durante el día 1 nov | Tras el arreglo de la noche |
|---|---|---|
sort | Sin valores listados; newest se aceptaba y cobraba, con otras reseñas | newest (igual que recency), recency, relevance |
date | Sin valores listados; last7days se aceptaba y cobraba, con otras reseñas | Cinco preajustes por fecha de publicación: 7, 30, 92, 183 y 366 días |
language, lang | El texto solo daba ejemplos | Solo dos letras; sin ellos, solo reseñas en inglés |
| Valores fuera de la lista | Podían aceptarse y cobrarse | 422 antes de cobrar, con valores permitidos y did-you-mean |
Las cinco últimas filas de la tabla de errores son nuestra prueba de la noche con la misma empresa: los valores erróneos recibieron un 422 con sugerencia y sin cobro, y sort: newest, sort: recency, date: last7days y una llamada base devolvieron las mismas 20 reseñas en inglés, con verification_level y source en todas, a 0,001389 USD cada una. La más antigua tenía menos de un día, así que last7days y la llamada sin date tenían que coincidir. Ahora el 422 también para estos dos errores, pero otros parámetros pueden seguir dando sus valores solo en el texto, así que el esquema del cliente sigue siendo el primer control.
El lado MCP sigue el mismo reparto. La especificación MCP, sección de herramientas agrupa los errores de validación de entrada con los errores de ejecución de la herramienta: van en el resultado con isError: true y el cliente se los pasa al modelo para que se corrija. Nuestra llamada MCP de las 00:57 SGT devolvió exactamente eso. Nuestra guía de errores de la API explica cada código, y la guía de comprobación de reembolsos muestra cómo cuadrar los reembolsos.
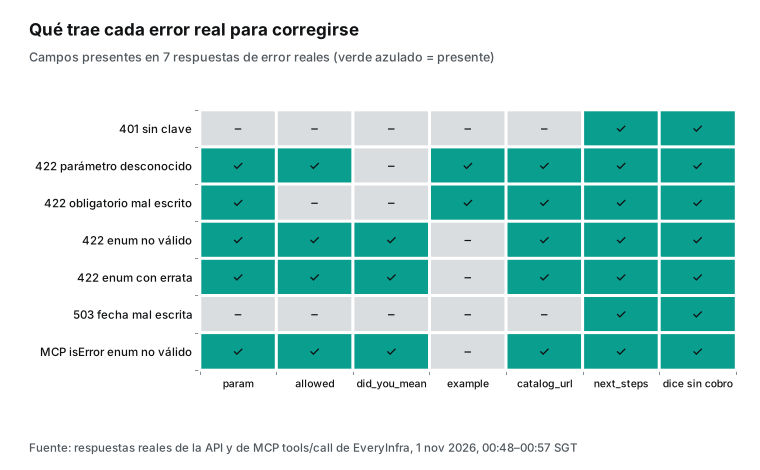
Otro hallazgo sale de una nota pequeña de la documentación de Anthropic. Las salidas estructuradas no garantizan las mayúsculas y minúsculas de los valores enum de tipo cadena: el modelo puede devolver un valor que solo difiere de tu esquema en mayúsculas, sin error, y la nota dice que esto también vale para strict tool use (salidas estructuradas, "Invalid outputs"). Así que incluso con strict, newest puede llegar como Newest. A las 14:33 SGT probamos app_store/reviews con sort: Newest. La API no devolvió error: respondió 200 con 30 reseñas en orden de más reciente a más antigua y cobró 0,001389 USD.
Una sola llamada no basta para una regla, así que entre las 15:39 y las 15:41 SGT probamos dos plataformas más. En g2/reviews, sort: Newest y sort: newest devolvieron los mismos 21 registros. En google_play/reviews, sort: Top_Rated devolvió 40 reseñas, todas de cinco estrellas, mientras que una llamada con sort: Newest en el mismo minuto trajo de una a cinco estrellas mezcladas; el valor con mayúsculas sí tuvo efecto. Esas cuatro llamadas costaron 0,001389 USD cada una. En las tres capacidades que probamos, una diferencia de mayúsculas cuenta como el mismo valor. No probamos el resto de enums del catálogo, así que lo más seguro es pasar los valores a minúsculas en tu código antes de enviarlos: una línea cuesta mucho menos que una llamada errónea. El otro consejo de Anthropic sigue en pie: no definas dos valores de enum que solo se distingan por mayúsculas.
El uso paralelo de herramientas también afecta a las dos capas. Está activado por defecto, así que el modelo puede enviar varios bloques tool_use en un turno, por ejemplo Trustpilot y App Store a la vez. La página de parallel tool use da dos reglas de formato: todos los resultados del turno van en un único mensaje de usuario y no puede haber texto antes de los resultados. Tu código debe manejar un 422 y un 200 en el mismo turno: marca el 422 con is_error: true y devuelve el 200 como siempre, y el modelo reenviará solo la llamada fallida. Si tu clave tiene un límite de ritmo bajo o quieres registros sencillos, añade disable_parallel_tool_use: true dentro del objeto tool_choice; en modo auto el modelo llamará entonces a una herramienta como mucho por respuesta. Este ajuste no es un parámetro de primer nivel de la solicitud.
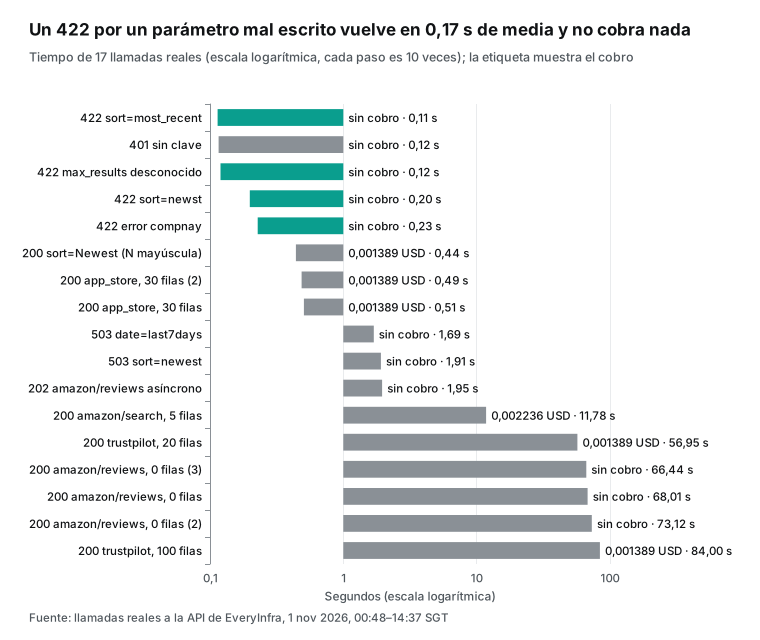
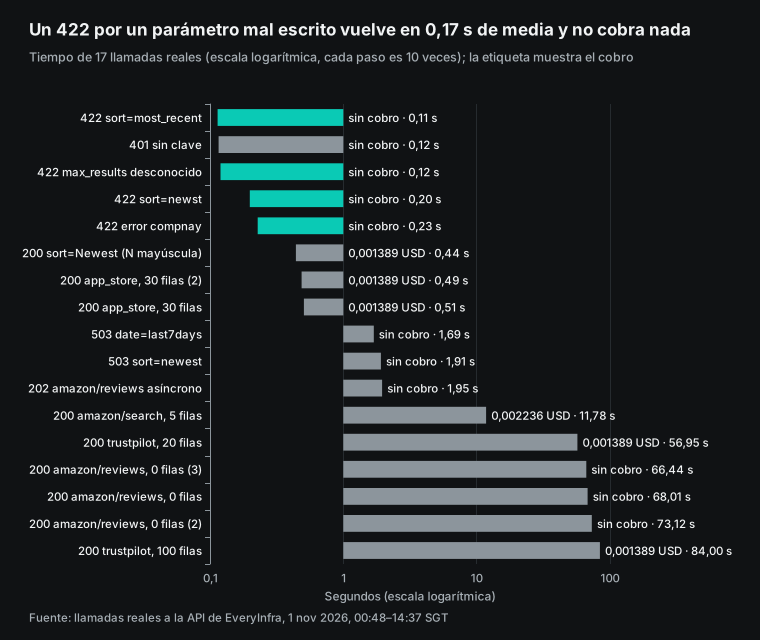
El gráfico muestra lo mismo desde otro lado. Un reintento por 422 cuesta 0 USD y unos 0,17 segundos en la API, la media de las cuatro llamadas 422. El coste está en el turno extra del modelo. El coste de un turno extra sigue una fórmula: coste del reintento ≈ (tokens de contexto + tokens del error) × precio de entrada + tokens de la corrección × precio de salida. Tomamos unos 240 tokens para el cuerpo del error y unos 120 de salida para la corrección. La longitud del contexto marca casi todo el coste, así que la tabla da tres tamaños. Los precios vienen de la página de precios, leída el 1 nov 2026; entre paréntesis, cuántas llamadas de reseñas de 0,001389 USD equivale.
| Contexto | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1000 tokens | 0,00018 USD (0,1) | 0,0037 USD (2,6) | 0,0074 USD (5,3) | 0,0184 USD (13) |
| 5000 tokens | 0,00058 USD (0,4) | 0,0117 USD (8,4) | 0,0234 USD (17) | 0,0584 USD (42) |
| 20 000 tokens | 0,0021 USD (1,5) | 0,0417 USD (30) | 0,0834 USD (60) | 0,2084 USD (150) |
Una aplicación con tres definiciones de herramientas y unos cuantos turnos llega a menudo a 20 000 tokens de contexto; entonces un error en Opus 5.5 cuesta unas 60 llamadas de datos. Con caché de prompts, la parte del contexto se cobra a precio de lectura de caché: el 10 % del precio de entrada en Haiku 5.5, el 5 % en Opus 5.5 y Sonnet 5.5 y el 2,5 % en Fable 5.1. Con 20 000 tokens en Opus 5.5, eso baja un turno extra de 0,0834 USD a unos 0,0074 USD.
Pon tu propia longitud de contexto en la fórmula y tendrás tu propia proporción. La dirección es la misma en todos los tamaños: cuanto más largo el contexto, más caro el reintento. Esa es la razón económica de la primera capa: el modo strict evita el reintento más común antes de que ocurra, y el 422 abarata los que quedan porque los resuelve en un solo turno.
Una ida y vuelta completa con reseñas en español
El código siguiente une las dos capas en un bucle mínimo. Sigue la documentación de Anthropic; es un ejemplo de configuración y no ejecutamos el lado de Claude. Las solicitudes y respuestas de EveryInfra son resultados reales del 1 nov 2026.
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # lee ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # las tres herramientas strict de arriba
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # "any" y [] = sin filtro
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=120)
    body = r.json()
    if r.status_code >= 400:                    # 422 y demás: se pasa al modelo tal cual
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at", "country")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}, ensure_ascii=False), False

messages = [{"role": "user", "content": "Usa la herramienta trustpilot_reviews para traer las reseñas en español de temu.com de los últimos 30 días y agrúpalas por tema."}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
    messages.append({"role": "user", "content": results})
Algunos detalles hacen estable este bucle. El código fija tool_choice en auto; es el valor por defecto, pero escribirlo le dice al siguiente desarrollador que aquí no hay llamada forzada. El mensaje del usuario nombra la herramienta, que es el sustituto de la llamada forzada en los documentos de Opus 5.5 y Fable 5.1. El código pone el cuerpo del error en el tool_result tal cual, con is_error: true; no lo sustituyas por "parámetro incorrecto", porque allowed y did_you_mean son lo que el modelo puede usar. Fíjate también en ensure_ascii=False: sin él, cada letra con tilde y cada eñe se convierten en una secuencia de escape de seis caracteres, como \u00f1 en lugar de ñ, y el modelo lee más tokens por la misma reseña.
Esta es la ida y vuelta real. A las 14:55 SGT del 1 nov 2026 enviamos a trustpilot/reviews los parámetros que el esquema strict produciría para esa petición: {"company": "temu.com", "language": "es", "date": "last30days", "sort": "recency", "limit": 50}. La API devolvió 200 con 27 reseñas y cobró 0,001389 USD, lo mismo que el price_usd del catálogo. Pedimos 50 y llegaron 27 porque en los últimos 30 días no había más reseñas en español: la más antigua era del 2026-10-02 y la más reciente del 2026-10-26.
El tiempo fue de 86,95 segundos medidos en nuestro cliente, red incluida. El catálogo indica un presupuesto síncrono de 85 segundos, así que esta llamada quedó en el límite. Por eso el bucle de arriba usa un timeout de 120 segundos, y por eso para trabajos grandes conviene el modo asíncrono que describimos en la sección de lotes. De las 27 reseñas, 20 venían de España, 2 de Perú, 2 de México, 1 de Argentina, 1 de Israel y 1 de Estados Unidos, y las 27 tenían respuesta de la empresa.
¿Qué vería la salida estructurada? No ejecutamos Claude, así que no damos ninguna salida del modelo. En su lugar aplicamos reglas simples de palabras clave a las 27 reseñas en español. Las reglas son toscas, por ejemplo "dinero" cuenta como reembolso y "pedido" como envío, y una reseña puede sumar en varios temas.
| Tema (regla de palabras clave) | Reseñas (de 27) | Ejemplo de palabra que coincide |
|---|---|---|
| Envío y entrega | 18 | envío, paquete, llegó, transportista |
| Reembolso | 11 | reembolso, dinero |
| Devolución | 8 | devolución, devolver |
| Calidad o daños | 7 | roto, dañado, moho |
| Atención al cliente | 5 | atención al cliente, reclamación |
| Ninguna regla | 2 | — |
Las estrellas tampoco se parecen a las de la muestra en inglés: 22 reseñas de una estrella, 1 de dos, 1 de cuatro y 3 de cinco. Aquí no filtramos por estrellas y aun así el 81 % fueron de una estrella. La mediana de longitud del texto es de 252 caracteres y la reseña más larga tiene 1421. En la muestra en inglés de 100 reseñas filtradas a una y dos estrellas, la mediana fue de 432 caracteres y la máxima de 3371. Las reseñas en español de esta muestra son más cortas, lo que abarata la lectura del modelo, pero hay muchas menos.
Estas cifras ayudan de dos maneras. Primero, una misma reseña suele encajar en más de un tema: la más larga habla de un retraso, de un producto dañado y de un reembolso que no llegaba. Si tu esquema solo admite un topic, el modelo tiene que elegir, así que pon la regla en la descripción, por ejemplo "si hay dinero de por medio, elige reembolso". Segundo, el tamaño. La respuesta completa de esta llamada ocupaba 45 512 caracteres; con seis campos (id, estrellas, título, texto, fecha y país) quedó en 14 837, un 67 % menos. Cuanto menos lee el modelo, menos cuesta cada turno.
El segundo paso pide al modelo que coloque cada reseña en campos fijos con claude structured outputs. Este esquema también es un ejemplo de configuración. Los valores del enum de topic se quedan en inglés porque son claves para tu base de datos; la cita se guarda en el idioma original de la reseña.
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "Como máximo 20 palabras copiadas de la reseña, en su idioma original"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}
Este esquema no tiene parámetros opcionales, así que cabe en la misma solicitud que las tres herramientas strict. El campo quote dice "como máximo 20 palabras" en la descripción en lugar de usar maxLength, porque los límites de longitud no se admiten. Quedan dos excepciones documentadas. Si el modelo se niega, la respuesta trae stop_reason: "refusal" y la salida puede no cumplir el esquema; si la salida llega a max_tokens, la respuesta trae stop_reason: "max_tokens" y la salida puede estar incompleta. Comprueba stop_reason antes de guardar nada. Además, un campo que pida "razonamiento paso a paso" puede provocar una negativa reasoning_extraction; la página de negativas y alternativas propone pedir una explicación breve.
App Store México frente a Estados Unidos: el mismo límite cubre semanas distintas
Los equipos de apps en Latinoamérica suelen empezar por las reseñas de App Store. A las 14:55 SGT leímos las 30 reseñas más recientes de la app de Claude en la tienda de México (app_store/reviews, app_id 6473753684, country: mx). La llamada tardó 0,67 segundos y costó 0,001389 USD. Las reseñas iban del 2026-10-05 al 2026-10-29 en hora del Pacífico y venían de 12 versiones distintas de la app. Había 19 de cinco estrellas, 2 de cuatro, 3 de dos y 6 de una.
La misma llamada en la tienda de Estados Unidos, a las 00:54 SGT, devolvió 30 reseñas escritas entre el 2026-10-28 y el 2026-10-30. Con el mismo limit, una llamada cubre unos 3 días en Estados Unidos y unos 25 días en México. Para el esquema, la consecuencia es concreta: country debe ser un enum obligatorio, no un parámetro con valor por defecto. Si el modelo lo omite, recibe la tienda de Estados Unidos sin ningún aviso, y la cobertura en días cambia varias veces. Con country obligatorio, cada llamada dice qué tienda lee y el monitor puede fijar la frecuencia por tienda. Es una sola app y un solo día de muestra, así que mide tu propia cadencia con una llamada antes de fijarla.
| Muestra | Hora (SGT) | Filas | 1 o 2 estrellas | 5 estrellas | Días cubiertos | Cobro |
|---|---|---|---|---|---|---|
trustpilot/reviews, temu.com, idioma es, 30 días | 14:55 | 27 | 23 | 3 | 25 | 0,001389 USD |
trustpilot/reviews, temu.com, 1–2 estrellas, limit 100 | 14:37 | 100 | 100 | 0 | 6 | 0,001389 USD |
app_store/reviews, app de Claude, México | 14:55 | 30 | 9 | 19 | 25 | 0,001389 USD |
app_store/reviews, app de Claude, Estados Unidos | 00:54 | 30 | 10 | 16 | 3 | 0,001389 USD |
Estos recuentos no tienen peso estadístico, pero muestran un hecho práctico. En la tienda de México, de las 9 reseñas de una o dos estrellas, 4 hablaban de la cuenta (bloqueos o verificación de edad), 3 de los límites de uso y 1 de un fallo de la app. Las reseñas mexicanas son además muy cortas, con una mediana de 83,5 caracteres. Un campo como severity se reparte de forma distinta según la fuente y el país, así que fija los umbrales de alerta por fuente y por tienda. La página para desarrolladores de Apple dice que la valoración resumida es por tienda y puede reiniciarse con una versión nueva, mientras que las reseñas escritas se conservan (Apple, valoraciones y reseñas). Por eso las reseñas por versión son más útiles que la nota total.
Lotes: el coste de 1000 reseñas con Message Batches
Cuando una ida y vuelta funciona, el coste está en el volumen. La API Message Batches procesa solicitudes de forma asíncrona y todo su uso cuesta el 50 % de los precios estándar. Un lote admite hasta 100 000 solicitudes o 256 MB, la mayoría termina en menos de una hora, y las solicitudes que no terminan en 24 horas caducan y no se facturan. Los resultados se pueden descargar durante 29 días (procesamiento por lotes). La página de salidas estructuradas dice que la función funciona con lotes con el mismo descuento del 50 %, y cada solicitud de un lote es una solicitud completa de Messages, así que las herramientas strict y output_config.format entran tal cual (crear un Message Batch).
Del lado de los datos, la primera pregunta es cuántas filas pedir por llamada. El catálogo da a trustpilot/reviews un valor por defecto de 20 y un máximo de 200, a 0,001389 USD por llamada, sin precio por fila. A las 14:37 SGT enviamos limit: 100 y recibimos 100 reseñas por el mismo 0,001389 USD que con 20 filas. El precio del limit grande es el tiempo: la llamada síncrona tardó 84,0 segundos, muy cerca del presupuesto de 85. Para descargas grandes usa un limit alto, añade "mode": "async" al cuerpo de la solicitud y consulta GET /api/v1/jobs/{job_id}; no esperes en una llamada síncrona.
| Por 1000 reseñas | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| Modelo, precio estándar | 0,0577 USD | 1,1537 USD | 2,3073 USD | 5,7683 USD |
| Modelo, Message Batches | 0,0288 USD | 0,5768 USD | 1,1537 USD | 2,8842 USD |
| Datos, limit=100 (10 llamadas) | 0,0139 USD | 0,0139 USD | 0,0139 USD | 0,0139 USD |
| Total, lote + limit=100 | 0,0427 USD | 0,5907 USD | 1,1676 USD | 2,8981 USD |
Así estimamos el coste del modelo, para que puedas poner tus propios números. La vista general de modelos dice que 1 millón de tokens equivale a unos 2,5 millones de caracteres Unicode, así que usamos 0,4 tokens por carácter. No es una cifra medida para el español, y conviene contrastarla con el endpoint de conteo de tokens sobre tus propias reseñas.
| Dato de la estimación | Valor | De dónde sale |
|---|---|---|
| Reseñas por solicitud | 25, o sea 40 solicitudes | Nuestra elección |
| Caracteres por reseña recortada | Unos 440 (muestra en inglés) o 549,5 (muestra en español) | Respuestas reales de Trustpilot y App Store |
| Instrucciones y esquema por solicitud | Unos 1424 caracteres | Nuestro prompt y esquema de salida |
| Caracteres por elemento de salida | Unos 189 | Un elemento de salida de muestra |
| Tokens totales | Unos 198 832 de entrada (242 584 con la muestra en español) y 75 600 de salida | Caracteres × 0,4 |
No contamos los tokens de razonamiento, el prompt de sistema de herramientas (286 tokens en Opus 5.5) ni el prompt de formato que añaden las salidas estructuradas, así que las cifras son un mínimo. Con la muestra en español, cada reseña recortada pesa 549,5 caracteres: la cifra de 440 mezcla Trustpilot con reseñas de App Store, mucho más cortas, y la muestra en español solo trae Trustpilot. El coste del modelo en lote sube a 0,0310 USD en Haiku 5.5, 0,6206 USD en Sonnet 5.5, 1,2412 USD en Opus 5.5 y 3,1029 USD en Fable 5.1.
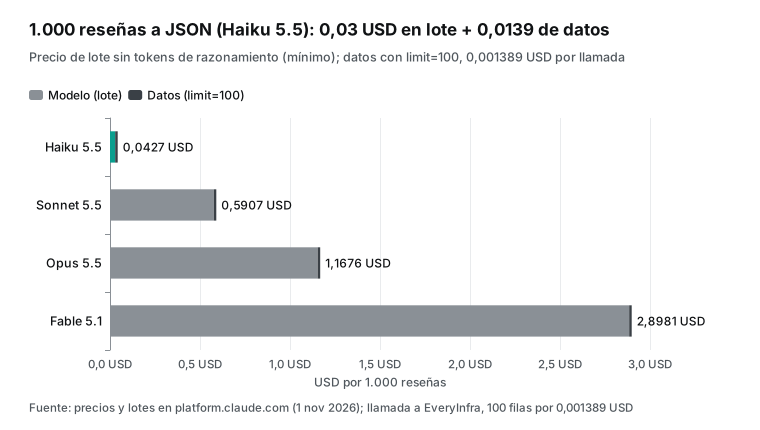
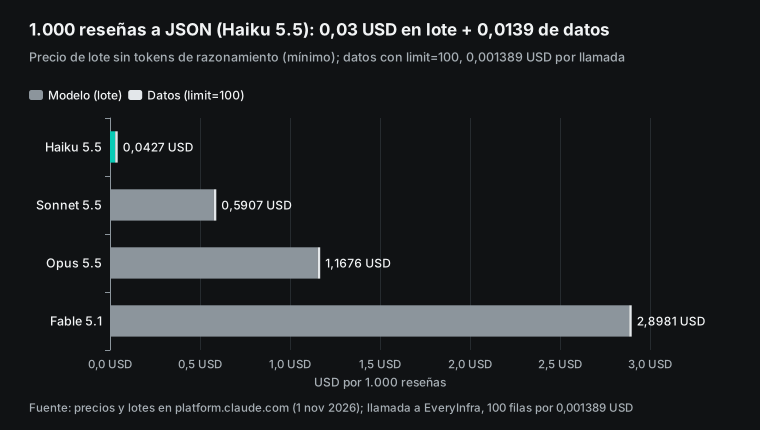
El resultado es claro. Agrupar reseñas supone mucha lectura y decisiones sencillas, así que encárgaselo a Haiku 5.5: el coste del modelo y el de los datos quedan en el mismo orden, unos 0,04 USD por 1000 reseñas en total. Opus 5.5 cuesta 27 veces más y Fable 5.1, 68 veces más. Haiku 5.5 tiene un escalón de precio que vigilar: por encima de 100 000 tokens de prompt, el precio pasa a 0,50 USD / 2,50 USD, o 0,25 USD / 1,25 USD en lote. Con 25 reseñas cortas por solicitud quedas muy por debajo. Si necesitas un juicio más fino, por ejemplo distinguir "envío lento" de "el vendedor rechazó la devolución", pasa primero Haiku por todo y envía a Opus 5.5 solo los elementos con severity: high.
En un mercado más pequeño la cuenta de datos cambia. La llamada en español de temu.com devolvió 27 filas, no 100, porque no había más. A 27 filas por llamada, el coste de datos sube a unos 0,0514 USD por 1000 reseñas, y con Haiku 5.5 en lote el coste de datos pasa a ser mayor que el del modelo: 0,0514 USD frente a 0,0310 USD. Para reseñas en español no ahorrarás subiendo limit en una sola empresa; ahorrarás ampliando la ventana de fechas con last3months y consultando con menos frecuencia.
Apliquémoslo a un monitor de mercado hispano. Supón 50 empresas con reseñas en español en Trustpilot y 50 apps en la tienda de México, todas con un ritmo de reseñas parecido al de nuestras muestras. Como una llamada cubre unos 25 días en ambos casos, una consulta semanal basta: 100 destinos por unas 4,3 semanas son unas 429 llamadas en 30 días, unos 0,60 USD de datos. El mismo monitor con una llamada diaria serían 3000 llamadas y 4,17 USD.
| Monitor de 30 días, 100 destinos | Llamadas | Datos | Reseñas leídas como máximo | Encaja con |
|---|---|---|---|---|
| Una llamada diaria | 3000 | 4,17 USD | Según el ritmo de cada destino | Tiendas con muchas reseñas, como Estados Unidos |
| Una llamada semanal | Unas 429 | Unos 0,60 USD | Unas 30 por destino y semana | Tiendas como México o reseñas en español en Trustpilot |
Lotes y caché de prompts pueden combinarse, y los prompts de sistema y las definiciones de herramientas en caché cuestan menos, pero la tasa de aciertos de caché en un lote depende del orden de las solicitudes. No lo probamos, así que no entra en estas cifras.
Lo que no funciona y lo que conviene vigilar
Primero, nuestro propio hueco. amazon/reviews no devolvió ninguna reseña en cuatro intentos el 1 nov 2026.
| Hora (SGT) | Modo | Parámetros | Tiempo | Filas | Cobro final |
|---|---|---|---|---|---|
| 00:50 | Síncrono | url de producto | 68,0 s | 0 | 0 USD |
| 00:51 | Síncrono | url de producto | 73,1 s | 0 | 0 USD |
| 00:53 | Asíncrono | url de producto, "mode": "async" | 1,95 s para crear el trabajo | 0 | 0 USD (cobrado y reembolsado) |
| 14:34 | Síncrono | url de producto y domain | 66,4 s | 0 | 0 USD |
Ninguna de las cuatro costó nada: los resultados vacíos se reembolsan por regla, y el trabajo asíncrono se cobró y luego se reembolsó. El catálogo ya dice que esta capacidad solo obtiene las reseñas destacadas de una página de producto, normalmente una docena; ese día no obtuvo ni esas. Así que la herramienta de Amazon de este artículo es solo un ejemplo de configuración, y nuestras pruebas reales usaron trustpilot/reviews y app_store/reviews. A la vez, amazon/search sí funcionó: a las 00:51 SGT, una búsqueda de "anker power bank 10000mah" devolvió 5 productos en 11,8 segundos por 0,002236 USD. Antes de añadir reseñas de Amazon a un lote, mira el catálogo y haz una llamada pequeña ese mismo día.
Esa misma noche la pasarela cambió dos casos de Amazon. Los repetimos entre las 19:19 y las 19:24, hora de Singapur:
| Solicitud | Durante el día | Prueba de la noche | Cobro |
|---|---|---|---|
| Estados Unidos, síncrona | 200, 0 filas, 66–73 s | 503 access_blocked en 24,6 s; next_steps dice que reintentar enseguida no sirve | 0 |
| Estados Unidos, asíncrona | Trabajo terminado, 0 filas | 202 con retención de 0,001389 USD; el trabajo falló con access_blocked | 0 (reembolsado) |
amazon.com.mx | Sin probar | 19:19: 422 missing_param, mensaje «falta domain». 22:14: 422 invalid_value en 0,09 s, con la lista de 11 sitios admitidos | 0 |
amazon.co.jp | Sin probar | 19:19: 422 missing_param. 22:14: 200 en 35,3 s con 5 reseñas, todas de compradores de otros países (3 de Estados Unidos y 2 de Alemania) | 0 a las 19:19; 0,001389 USD a las 22:14 |
A las 19:19, el mensaje de error no decía que esos sitios no se admitieran. A las 22:14, el catálogo ya daba domain como una lista cerrada de 11 sitios: amazon.com, co.uk, de, fr, it, es, ca, com.au, in, co.jp y sg. Amazon México queda fuera: la llamada se rechaza antes de cobrar y el error trae esos 11 valores. Hoy esta API no devuelve reseñas de Amazon México. Amazon Japón sí devuelve reseñas, pero no siempre son de compradores en Japón: filtra por el campo country si solo quieres las de ese país.
Después, los límites que documenta Anthropic. Las herramientas strict son aptas para HIPAA, pero la API guarda en caché los esquemas compilados aparte del contenido de los mensajes y sin la misma protección (strict tool use, retención de datos). No metas una lista de clientes en un enum. La guía de migración de Fable 5.1 cubre el caso de las organizaciones con CMEK (guía de migración de Fable 5.1).
| Límite | Qué significa para una API de datos | Fuente |
|---|---|---|
| Sin datos de salud en los esquemas | Nada de PHI en nombres de propiedades, enum, const o pattern | Strict tool use, retención de datos |
| Organizaciones con CMEK | Sin salidas estructuradas ni strict: true en modelos Fable; solo la instrucción | Guía de migración de Fable 5.1 |
| Citations | No funciona con salidas estructuradas; error 400 | Salidas estructuradas, compatibilidad |
| Cambio de formato | Un output_config.format nuevo borra la caché de prompts | Salidas estructuradas, costes de tokens |
Sobre las citations, una nota más: si necesitas datos estructurados con una fuente para cada valor, usa el método específico de la documentación de citations.
Por último, la segunda capa tiene límites. Un 422 solo puede detener los errores que el catálogo define: parámetros desconocidos, obligatorios que faltan y enums con valores listados. No detiene los errores en reglas que el catálogo solo da como texto, como date y sort en trustpilot/reviews durante el día 1 nov. Tampoco detiene hechos que solo se conocen al ejecutar, como "¿tiene esta empresa página en Trustpilot?" o "¿hay reseñas en español en este periodo?". Entonces esos valores erróneos ni siquiera fallaban; desde esa noche reciben un 422. Usa las dos capas: pon en el esquema strict todas las reglas que puedas, deja el resto al 422 y, para los enums copiados del texto del catálogo, comprueba en tu código el idioma y los campos clave de cada respuesta.
Solución de problemas: siete síntomas y su arreglo
En producción, los problemas suelen venir de los bordes. Un esquema deja de compilar de repente, el modelo no llama a una herramienta en un turno o unos pocos elementos de un lote no cumplen el esquema. Lo primero es ver quién devolvió el código de estado. Un 400 viene de Anthropic y significa que la solicitud o el esquema están mal, así que hay que cambiar el código. Un 422 o un 503 vienen de EveryInfra y significan que la forma es correcta pero falló un valor o la ejecución, así que hay que seguir next_steps. Esta sola comprobación ahorra casi todo el tiempo de depuración, porque los dos formatos de error se parecen y es fácil confundirlos en los registros.
| Síntoma | Quién lo devuelve | Causa | Arreglo |
|---|---|---|---|
| 400, tool_choice no admitido | Anthropic | any o tool en un modelo nuevo | Usa auto y nombra la herramienta en el mensaje del usuario |
| 400, esquema demasiado complejo | Anthropic | Más de 24 opcionales, o una gramática grande | Haz obligatorios los parámetros; cambia enums grandes por texto y 422 |
| El modelo responde en texto, sin llamar | Anthropic | Instrucción poco clara | Nombra la herramienta y el disparador; revisa stop_reason y vuelve a pedir |
422 invalid_value | EveryInfra | Valor fuera de los allowed_values del catálogo | Cambia un campo según did_you_mean; sin cobro |
| 503 que se repite | EveryInfra | La plataforma está inestable; nuestras llamadas sin valores dudosos también lo recibieron. Con reason: access_blocked, el destino pide iniciar sesión o está restringido | Espera retry_after; tras varios fallos, revisa una persona; con access_blocked, cambia el destino |
| 200, pero el idioma o los campos no cuadran | EveryInfra | Se aceptó un valor que el texto del catálogo no lista y cambió el resultado, como date y sort de trustpilot/reviews antes del arreglo de la noche | Bloquéalo con un enum en el cliente; revisa el texto del catálogo |
| 200 con 0 filas | EveryInfra | No había datos en el destino ese día | Ya reembolsado; cambia el destino o la capacidad |
Las tres últimas filas salen de nuestras pruebas y las cuatro primeras de la documentación de Anthropic. Lleva la sexta fila al código, porque otros parámetros pueden tener el mismo problema: escribe en el esquema todos los enums que copiaste del texto del catálogo y, tras cada respuesta, compara la mezcla de idiomas y los campos clave con una llamada base; si no cuadran, marca la llamada para una persona. En nuestro control, 7 de las 20 reseñas de los valores erróneos no estaban en inglés y dos campos venían vacíos en las 20; una comprobación sencilla lo detecta al momento.
Cambios recientes que afectan a esta configuración
| Fecha | Cambio | Qué significa para ti |
|---|---|---|
| 2026-09-22 | Lanzamiento de Opus 5.5; el razonamiento no se puede desactivar; tool_choice forzado devuelve 400 | Quita las llamadas forzadas antes de pasar desde Opus 5; usa auto más strict |
| 2026-09-28 | Lanzamiento de Sonnet 5.5; también rechaza tool_choice forzado | Volver a Sonnet no evita el cambio |
| 2026-10-07 | Lanzamiento de Haiku 5.5; contexto de 1M; precio en lote 0,05 USD / 0,25 USD | El coste del modelo para agrupar en volumen ya se parece al de los datos |
| 2026-10-15 | La API de modelos informa del soporte de razonamiento between_tools; el modo rápido de Opus 5.5 sale de vista previa | Comprueba las funciones del modelo en el código, no por el id |
| 2026-10-21 | Versión de API 2026-10-21 y SDK nuevos (Python 2.0.0 y otros) | Busca campos antiguos como output_format al actualizar el SDK |
| 2026-10-22 | Claude mediante Google Cloud, gestionado por Anthropic | Otra vía de facturación para lotes; el uso de strict no cambia |
| 2026-10-28 | El tamaño máximo de una solicitud de Messages pasa de 32 MB a 128 MB | Caben más reseñas en una solicitud, pero el coste sigue a los tokens |
| 2026-10-29 | API de analítica de uso y costes en beta, agrupada por modelo, espacio de trabajo y clave | Separa el coste del modelo por tarea y compáralo con el de los datos |
| 2026-10-30 | El modo rápido de Opus 4.8 se retirará el 30 nov 2026 | Planifica el cambio si haces extracción en directo con ese modelo |
Estos datos vienen de las notas de versión de la API, actualizadas el 2026-10-30, y de la guía de migración a la versión 2026-10-21. Lo más importante para este artículo es el lanzamiento de Haiku 5.5 el 2026-10-07. Antes, agrupar en lote con Haiku 4.5 costaba 0,50 USD / 2,50 USD, diez veces más, y el coste del modelo estaba muy por encima del de los datos. Ahora los dos son de tamaño parecido, y con reseñas en español, donde cada llamada trae menos filas, el precio de la API de datos pesa más que el del modelo. Otro punto del 2026-09-22: un mensaje de sistema a mitad de conversación puede llevar una definición completa de herramienta, en beta, lo que permite añadir una herramienta strict a media sesión sin romper la caché de prompts. Anthropic lo cita como uno de los sustitutos de las llamadas forzadas.
Preguntas frecuentes
Las preguntas siguientes salen de sugerencias reales del buscador. Las sugerencias en español para este tema eran pocas y repetidas, así que usamos las sugerencias en inglés, que es como se buscan estos términos técnicos también desde España y Latinoamérica.
¿Todavía se puede forzar el uso de herramientas en Claude?
Viene de la sugerencia "claude force tool use". No en Fable 5.1, Mythos 5.1, Opus 5.5 ni Sonnet 5.5: un tool_choice de any o tool devuelve un 400, y el endpoint de conteo de tokens aplica la misma comprobación. auto y none siguen funcionando. Mantén auto, añade strict: true a tus herramientas y di en el mensaje del usuario cuándo se usa cada una. Si una herramienta tiene que ejecutarse en el turno actual, la guía de migración de Fable 5.1 propone un mensaje de sistema a mitad de conversación.
¿Qué hago si tool_choice es auto y el modelo no llama a la herramienta?
Viene de la sugerencia "claude tool_choice". Anthropic dice que Fable 5.1 sigue de forma fiable las instrucciones explícitas sobre herramientas. Primero, aclara la instrucción: nombra la herramienta y el disparador. Segundo, revisa stop_reason en tu bucle y, si el modelo respondió en texto cuando necesitabas datos, añade un mensaje de usuario que pida la llamada. Tercero, escribe una buena description: la página define tools dice que las descripciones detalladas son, con diferencia, el factor más importante para el rendimiento de las herramientas.
¿Funcionan las salidas estructuradas de Claude en Bedrock?
Viene de la sugerencia "claude structured outputs bedrock". La tabla de disponibilidad de la página de strict tool use incluye Amazon Bedrock, también InvokeModel, y Google Cloud. La página de salidas estructuradas habla de "todas las plataformas compatibles" y "todos los modelos". Los modelos Fable necesitan una retención de datos de 30 días y no están cubiertos por la retención cero; revisa la página de retención de datos antes de usarlos.
¿Cómo uso las salidas estructuradas de Claude con Pydantic?
Viene de la sugerencia "claude structured output pydantic". La página de salidas estructuradas recomienda pasar un modelo de Pydantic a client.messages.parse(). El SDK transforma el esquema, mueve los límites no admitidos, como minimum y maxLength, a las descripciones y después comprueba la respuesta contra el esquema original con todos sus límites. Para EveryInfra, escribe los allowed_values del catálogo como Literal[...], que se convierte en un enum, y el rango de limit con Field(ge=1, le=200), que el SDK comprueba en local.
¿Puedo usar salidas estructuradas y herramientas strict en la misma solicitud?
Viene de la sugerencia "claude structured outputs api". Sí. La sección "Feature compatibility" de la página de salidas estructuradas dice que ambas pueden ir en una solicitud. Comparten los límites de 20 herramientas strict, 24 parámetros opcionales y 16 parámetros con tipos unión, así que haz también totalmente obligatorio el esquema de salida.
Cómo empezar
- Lee el catálogo.
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilotes gratuito, no necesita clave y da parámetros, valores permitidos y precios. - Escribe herramientas strict con las seis reglas de arriba: parámetros obligatorios,
allowed_valuescomoenumy rangos en las descripciones. Añadelanguageycountrypara tus mercados. - Consigue una clave en la guía rápida. Envía una solicitud con un enum erróneo y comprueba que recibes un 422 con
did_you_mean. - Mide con una llamada cuántos días cubre
limiten cada país, fija la frecuencia y, para volumen, usa"mode": "async"y Message Batches del lado de Claude.
Páginas de plataforma: Trustpilot Scraper API, App Store Scraper API y Amazon Scraper API. Páginas de capacidad: reseñas de Trustpilot, reseñas de App Store y reseñas de Amazon. Más páginas de reseñas: reseñas de G2 y reseñas de Google Play. Para conectar el servidor MCP remoto en Claude sin código, lee la configuración del MCP remoto.
Si quieres vender datos de reseñas como producto, lee los datos de reseñas como producto de pago. Lee también un SKILL.md para cuatro herramientas de IA, y para descargas en paralelo con subagentes, subagentes de Claude Code para cuentas de marca en TikTok. Compara los precios por capacidad en el mercado de datos.
Referencias
- What's new in Claude Opus 5.5 (Forced tool use is not supported), Anthropic, 22 sep 2026, https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- What's new in Claude Fable 5.1, Anthropic, 1 sep 2026, https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- What's new in Claude Sonnet 5.5, Anthropic, 28 sep 2026, https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Opus 5.5 migration guide, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- Claude Fable 5.1 migration guide, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- Claude Sonnet 5.5 migration guide, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- API release notes, Anthropic, actualizado el 30 oct 2026, https://platform.claude.com/docs/en/release-notes/overview
- Strict tool use, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- Structured outputs, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- Define tools, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- Handle tool calls, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- Tool use overview, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- How tool use works, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- Troubleshooting tool use, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- Parallel tool use, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- Tool runner, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- Tool search tool, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Programmatic tool calling, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- Batch processing, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Create a Message Batch (referencia de la API), Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/api/messages/batches/create
- Pricing, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/about-claude/pricing
- Prompt caching, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Token counting, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/token-counting
- Rate limits, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/api/rate-limits
- Errors, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/api/errors
- Models overview, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/models/overview
- Claude Haiku 5.5 overview, Anthropic, 7 oct 2026, https://platform.claude.com/docs/en/models/haiku-5-5/overview
- Claude Opus 5.5 overview, Anthropic, 22 sep 2026, https://platform.claude.com/docs/en/models/opus-5-5/overview
- Claude Mythos 5.1 overview, Anthropic, 1 sep 2026, https://platform.claude.com/docs/en/models/mythos-5-1/overview
- Effort, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/effort
- Streaming, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/streaming
- Refusals and fallback, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- Citations, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/build-with-claude/citations
- MCP connector, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- Remote MCP servers, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- Migrating to API version 2026-10-21, Anthropic, 21 oct 2026, https://platform.claude.com/docs/en/api/migration-2026-10-21
- API and data retention, Anthropic, consultado el 1 nov 2026, https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- Model Context Protocol specification 2025-11-25: Tools, MCP, https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- JSON Schema Validation, draft 2020-12, JSON Schema, https://json-schema.org/draft/2020-12/json-schema-validation
- JSONSchemaBench, Geng et al., arXiv 2501.10868, 2025, https://arxiv.org/abs/2501.10868
- Ratings, reviews, and responses, Apple Developer, consultado el 1 nov 2026, https://developer.apple.com/app-store/ratings-and-reviews/
- Catálogo de datos de EveryInfra (GET /api/v1/social/catalog), EveryInfra, consultado el 1 nov 2026 a las 00:46 SGT, https://api.everyinfra.com/api/v1/social/catalog
Referencia BL-60