데이터 API에 Claude strict tool use 적용하기: 유효한 호출을 보장하는 두 계층
Opus 5.5는 강제 tool_choice를 거부합니다. strict 도구와 수정 방법을 알려 주는 422 오류를 함께 사용했습니다. 실제 호출 29건에서 잘못된 파라미터 요청은 0.17초 만에 422로 반환되었고 과금되지 않았습니다.
Claude Opus 5.5, Sonnet 5.5, Fable 5.1은 tool_choice가 any 또는 tool이면 400 오류를 반환합니다. 일관된 형식의 JSON을 얻으려고 도구 호출을 강제하던 코드는 이 모델들에서 작동하지 않습니다. Anthropic은 tool_choice: auto를 유지하고 strict: true를 추가하거나, 스키마를 structured outputs로 옮기라고 권장합니다. 저희는 2026년 11월 1일 EveryInfra 카탈로그의 Trustpilot, App Store, Amazon 리뷰용 strict 도구를 작성했습니다. 그런 다음 저희 API에 실제 요청 29건을 보냈습니다. 그중 10건은 오후에 추가한 대조 호출입니다.
그날 저녁에는 재테스트로 요청 12건을 추가로 보냈습니다.
파라미터 이름이나 enum 값이 잘못된 요청은 0.11~0.23초 만에 422로 반환되었습니다. 각 422에는 허용 값과 다음 단계가 담겨 있었고, 비용은 전혀 발생하지 않았습니다. 초기 카탈로그에서는 두 파라미터에 허용 값이 없었습니다. 오후 대조 테스트에서 이 두 파라미터에 잘못된 값을 넣어도 요청은 실패하지 않았습니다. API는 200을 반환하고 정상 요금을 부과했으며, 다른 리뷰 세트를 조용히 돌려보냈습니다. 응답에는 문제가 있다는 사실을 모델에게 알려 주는 내용이 전혀 없었습니다.
그날 저녁 게이트웨이에 이 두 파라미터의 허용 값이 추가되었습니다. 이제 잘못된 값은 과금 전에 422를 받으며, 19:18 SGT에 진행한 재테스트에서도 이를 확인했습니다.
이 글은 한 가지 실무 질문에 답합니다. 외부 데이터 API를 호출하는 Claude 앱이 있다고 해 봅시다. 예전에는 모델이 도구를 호출하도록 강제해서 모든 요청의 형태가 같았습니다. 그런데 새 모델에서는 그 코드 한 줄이 실패합니다. 모델이 여전히 API를 안정적으로 호출하고 저장할 수 있는 JSON을 반환하게 하려면 어떻게 바꿔야 할까요?
Claude에 관한 모든 내용은 Anthropic 문서를 근거로 하며, 각각 링크를 달았습니다. 테스트 머신에는 Anthropic API 키가 없습니다. 따라서 이 글의 Claude 코드는 테스트 결과가 아니라 구성 예시입니다. EveryInfra에 관한 모든 수치는 2026년 11월 1일 실제 호출의 원본 응답에서 가져왔습니다.
변경 사항: 새 모델 3종이 강제 tool_choice를 거부하면서 기본 방식이 된 Claude strict tool use
변화 자체는 단순하지만, 이 글의 이후 설계 결정은 모두 이 변화에 기반합니다. 2026년 9월 1일 Anthropic API 릴리스 노트에 따르면 Fable 5.1과 Mythos 5.1은 tool_choice 유형 any와 tool을 지원하지 않습니다. 이런 요청은 400 오류를 반환하며, auto와 none은 그대로입니다(API 릴리스 노트). 릴리스 노트는 스키마에 맞는 도구 입력을 얻으려면 strict tool use나 structured outputs를 사용하라고 권장합니다. 9월 22일 Opus 5.5 항목은 같은 400이 “Claude Fable 5.1과 마찬가지로” 적용된다고 밝힙니다. 9월 28일 Sonnet 5.5 항목은 이를 Sonnet 5 코드가 깨질 수 있는 다섯 가지 경우 중 하나로 꼽습니다.
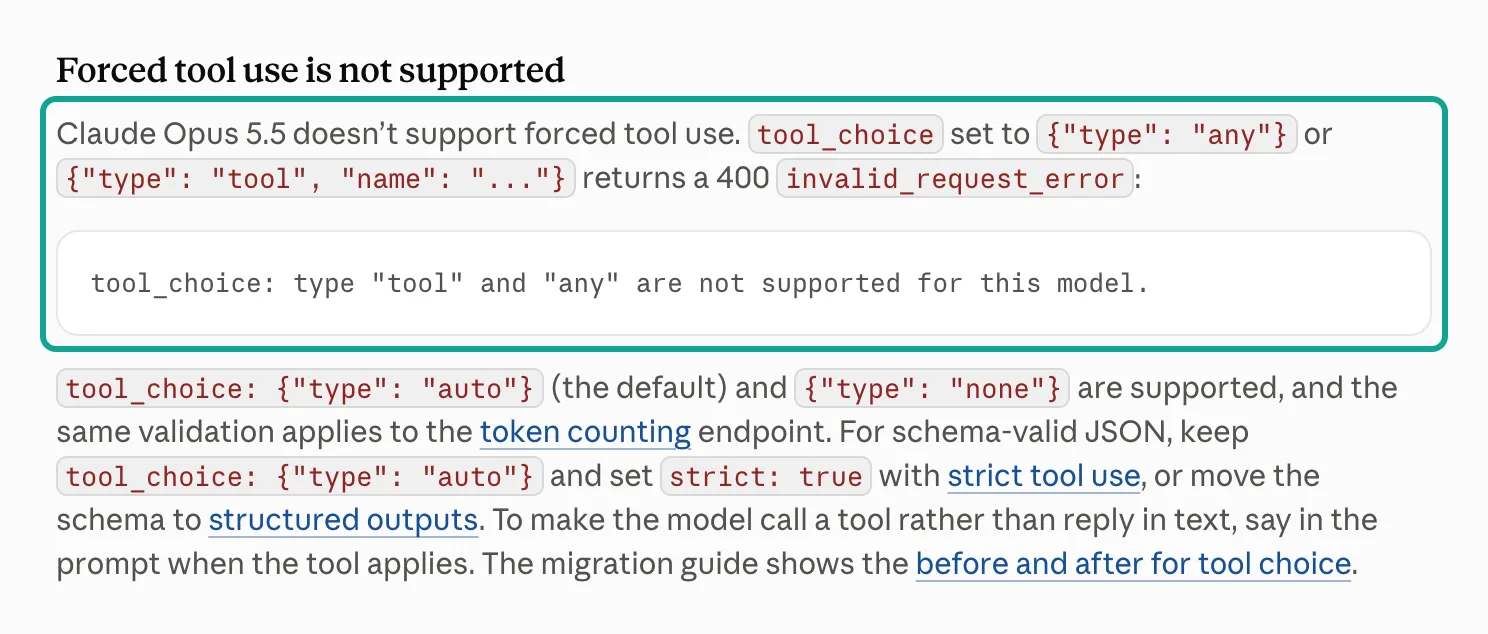
각 모델에는 “Forced tool use is not supported” 섹션이 있는 “What's new” 페이지가 있습니다. 세 페이지 모두 아래에 인용한 동일한 오류 메시지를 보여 줍니다. Opus 5.5, Sonnet 5.5, Fable 5.1 페이지에서 확인할 수 있습니다. 메시지는 tool_choice: type "tool" and "any" are not supported for this model.입니다. 같은 검사가 토큰 카운팅 엔드포인트에도 적용됩니다. 따라서 강제 호출을 보내기 전에 토큰 카운팅으로 미리 테스트할 수도 없습니다.
Anthropic은 왜 강제 호출을 없앴을까요? Fable 5.1 페이지에 이유가 나와 있습니다. 이 모델들에서는 thinking이 항상 켜져 있는데, 강제 도구 호출은 이를 건너뜁니다. 그러면 모델이 추론 내용을 도구 인수에 써 넣게 되어 인수 품질이 떨어집니다. 앱에서 데이터 API를 호출한다면 이 점이 중요합니다.
기존 설계에서는 안정적인 형태를 얻으려고 호출을 강제했습니다. 이제 안정적인 형태는 strict 문법이 보장하고, 호출 여부는 다시 모델이 결정합니다. 프롬프트에서 언제 도구를 써야 하는지 알려야 합니다. Fable 5.1 페이지는 모델이 명시적인 도구 지시를 안정적으로 따른다고 덧붙이며, 예로 "Use the get_weather tool to answer"를 듭니다.
| 모델 | 출시일 | `tool_choice` any / tool | Anthropic의 대안 | 표준 가격(MTok당 입력/출력) |
|---|---|---|---|---|
| Fable 5.1 | 2026년 9월 1일 | 400 오류 | auto + strict 또는 structured outputs | $10 / $50 |
| Opus 5.5 | 2026년 9월 22일 | 400 오류 | auto + strict 또는 structured outputs | $4 / $20 |
| Sonnet 5.5 | 2026년 9월 28일 | 400 오류 | auto + strict 또는 structured outputs | $2 / $10 |
| Haiku 5.5 | 2026년 10월 7일 | 릴리스 노트에 언급 없음 | — | $0.10 / $0.50 |
날짜와 가격은 2026년 11월 1일에 확인한 릴리스 노트와 요금 페이지를 기준으로 합니다. 요금 페이지를 보면 이 변경이 일시적이지 않다는 점도 알 수 있습니다. 도구 사용 시스템 프롬프트 토큰 표에는 auto, none 열과 any, tool 열이 있습니다. Opus 5.5는 첫 번째 열에만 286토큰이라는 값이 있습니다.
Opus 5는 두 열 모두 값이 있으며, 각각 286토큰과 406토큰입니다. Haiku 5.5 릴리스 노트에는 수동 thinking 예산, 샘플링 파라미터, prefill 등 다른 호환성 변경 사항이 나와 있습니다. 강제 도구 사용은 언급되지 않으므로 Haiku 5.5에 대해서는 판단하지 않습니다. 그래도 같은 코드가 네 모델 모두에서 실행되도록 Haiku 5.5에도 strict 도구를 사용합니다.
strict tool use는 새 기능도 아니고 새 모델 전용도 아닙니다. 두 문서 페이지에 따르면 이 기능은 모든 모델에서 사용할 수 있으며 HIPAA 준비 대상에 포함됩니다(strict tool use, structured outputs). 바뀐 것은 역할입니다. 선택적인 안전장치였던 기능이 이제는 주된 방법이 되었습니다.
Opus 5.5 마이그레이션 체크리스트는 any와 tool을 auto와 strict tool use의 조합으로 바꾸거나 structured outputs로 전환하라고 안내합니다. 또한 strict는 JSON Schema의 일부만 지원하므로 먼저 각 input_schema를 점검하라고 합니다(Opus 5.5 마이그레이션 가이드). 마이그레이션 작업의 대부분은 호출 코드가 아니라 스키마에 있습니다.
strict tool use와 Claude structured outputs: 각각 무엇을 제어하는가
두 이름은 비슷하지만 응답의 서로 다른 부분을 제어합니다. strict tool use는 도구 정의에 "strict": true를 추가하는 방식이며, 각 tool_use 블록의 input을 제어합니다. API가 문법 제약 샘플링(grammar-constrained sampling)을 사용하므로 입력은 항상 input_schema와 일치하고 도구 이름도 항상 유효합니다.
Anthropic의 예시는 passengers: int가 필요한 예약 시스템입니다. strict 모드가 없으면 모델이 "two"나 "2"를 보낼 수 있습니다. strict 모드에서는 항상 2를 보냅니다.
Claude structured outputs는 요청의 output_config.format 필드를 말합니다. 응답의 최종 텍스트를 제어하며, 이 텍스트는 스키마와 일치하는 JSON이 됩니다. 데이터 API 워크플로에는 둘 다 필요합니다. strict 도구는 POST /api/v1/social로 보내는 파라미터를 올바르게 유지합니다. structured outputs는 돌아온 리뷰를 주제, 심각도, 짧은 인용문 같은 고정 필드로 변환합니다. 두 기능은 같은 문법 파이프라인을 사용하므로 제한도 같습니다.
structured outputs 페이지의 “JSON Schema limitations” 섹션에 이 제한이 나와 있습니다. 지원: 모든 기본 타입, enum, const, anyOf, 내부 $ref, 문자열 형식 10종, 단순한 정규식 패턴. 미지원: 재귀 스키마, minimum·maximum 같은 숫자 제한, 문자열 길이 제한, 0 또는 1이 아닌 minItems. 모든 객체에는 additionalProperties: false를 지정해야 합니다. 지원하지 않는 기능을 사용하면 API가 상세 내용과 함께 400 오류를 반환합니다.
| 항목 | Strict tool use | Structured outputs(`output_config.format`) |
|---|---|---|
| 제어 대상 | tool_use 블록의 도구 인수 | 최종 응답 텍스트 |
| 활성화 방법 | 도구에 "strict": true 추가 | output_config.format에 JSON Schema 추가 |
| 이 글에서의 역할 | EveryInfra로 보낼 올바른 파라미터 | 리뷰별 고정 필드 |
| 요청당 공유 제한 | strict 도구 20개, 선택 파라미터 24개, 유니언 타입 파라미터 16개 | 같은 제한, 합산하여 계산 |
| 지원 안 함 | 숫자 범위, 문자열 길이, 재귀 | 동일하며 인용 기능과 함께 사용할 수 없음 |
| 첫 요청 | 문법 컴파일로 추가 지연 발생, 캐시는 24시간 유지 | 위와 같음 |
흔히 빠지는 함정은 “요청당”이라는 표현입니다. structured outputs 페이지에 예시가 있습니다. 선택 파라미터가 6개씩인 strict 도구 4개만으로도 24개 한도에 도달하며, 개별 도구가 복잡해 보이지 않아도 마찬가지입니다. 명시적 제한 외에도 컴파일된 문법 크기에 대한 내부 제한이 있습니다. 이를 초과하면 API가 "Schema is too complex for compilation"을 반환합니다. 마지막 안전장치는 180초의 컴파일 타임아웃입니다.
Anthropic은 다음 네 단계를 순서대로 제안합니다. 중요한 도구만 strict로 지정합니다. 파라미터를 필수로 만듭니다. 중첩 객체를 평탄화합니다. 작업을 여러 요청이나 서브에이전트로 나눕니다.


이 다이어그램이 이 글의 핵심 아이디어입니다. 첫 번째 계층은 Claude 쪽에 있습니다. strict 모드는 타입, 필수 필드, enum 값이 스키마와 일치하도록 보장합니다. 스키마에 없는 max_results 같은 필드는 모델이 보낼 수 없습니다. 두 번째 계층은 EveryInfra 쪽에 있습니다.
어떤 규칙은 스키마로 표현할 수 없습니다. 예를 들면 “이 링크가 상품 페이지인가”, “이 플랫폼에서는 이 정렬 순서를 무엇이라고 부르는가” 같은 것입니다. 저희 API는 이런 값을 카탈로그와 대조해 검사합니다. 값이 잘못되면 허용 값과 가장 가까운 값을 담은 422를 반환합니다. 모델은 필드 하나를 고쳐 요청을 다시 보냅니다.
첫 번째 계층: 카탈로그로 POST /api/v1/social용 strict 도구 만들기
EveryInfra 카탈로그 엔드포인트 GET /api/v1/social/catalog는 무료이며 키가 필요 없습니다(원본 카탈로그). 각 기능의 필수·선택 파라미터, 파라미터별 설명, 허용 값(allowed_values), 반환 필드, 가격을 제공합니다. 저희는 2026년 11월 1일 00:46 SGT에 카탈로그를 조회했습니다. 91개 플랫폼에 걸쳐 426개 기능이 등록되어 있었고, 그중 89개 플랫폼의 402개 기능을 그날 사용할 수 있었습니다.
사용 가능한 기능에는 파라미터 설명이 809개 있습니다. 이 중 155개는 허용 값을 나열하고, 143개는 uri 형식, 38개는 date 형식입니다. 이 세 그룹은 strict 스키마의 enum, format: uri, format: date에 바로 대응합니다. 중복을 제외하면 809개 중 336개(41.5%)가 strict 모드로 보장할 수 있는 제약으로 변환됩니다.
enum으로 만들 수 있는 것은 155개(약 19%)뿐입니다. 나머지는 자유 텍스트나 숫자입니다. 이런 파라미터는 설명과 두 번째 계층이 맡아야 합니다.
다음은 카탈로그를 바탕으로 작성한 리뷰 기능 3개의 도구 정의입니다. 구성 예시이며, Claude에서 실행해 보지는 않았습니다.
[
  {
    "name": "trustpilot_reviews",
    "description": "Get recent Trustpilot reviews of one company through EveryInfra (platform trustpilot, action reviews). Call it whenever the user names a company and asks what customers say. company is the company's website domain, for example temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Website domain such as temu.com, or a trustpilot.com/review/<domain> link"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Star ratings to keep; [] keeps all"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = no date filter"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "1 to 200; use 20 unless the user asks for more"}
      },
      "required": ["company", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Get App Store reviews of one iOS app through EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Numeric App Store id, for example 6473753684"},
        "country": {"type": "string", "pattern": "^[a-z]{2}$"},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "1 to 500; use 30 unless the user asks for more"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Get the featured customer reviews shown on one Amazon product page (platform amazon, action reviews). Usually about a dozen reviews per product.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.[a-z.]{2,6}/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.com", "amazon.co.uk", "amazon.de", "amazon.fr", "amazon.it", "amazon.es", "amazon.ca", "amazon.com.au", "amazon.in", "amazon.co.jp", "amazon.sg"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]
앞의 제한 때문에 네 가지 설계를 선택했습니다. 첫째, 모든 파라미터를 필수로 했습니다. 카탈로그에서 trustpilot/reviews에는 선택 파라미터가 6개 있고 limit까지 더하면 모두 7개입니다. 이를 선택 파라미터로 그대로 옮기면 24개 슬롯의 거의 3분의 1을 차지합니다.
Anthropic은 다른 접근을 제안합니다. 파라미터에 항상 합리적인 기본값이 있다면 필수로 만들고 모델이 기본값을 채우게 하라는 것입니다. 그래서 date에는 any 값을 추가하고 stars에는 빈 배열을 허용했습니다. 카탈로그에 빈 값은 필터 없음을 뜻한다고 되어 있으므로, 저희 코드는 요청을 보내기 전에 any와 []를 제거합니다. 저녁에 테스트로 date: any를 API에 보냈더니 0.11초 만에 422가 돌아왔습니다. 그러니 이 단계를 건너뛰지 마세요.
둘째, 숫자 제한이 지원되지 않으므로 limit의 범위는 minimum이나 maximum이 아닌 설명에 적었습니다. 최댓값을 넘는 값은 API가 처리합니다. 카탈로그에서 6개 기능이 이 경우를 “capped”라고 명시하므로, API는 최댓값을 적용합니다. 셋째, 단순한 정규식으로 Amazon 링크를 상품 페이지로 제한했습니다. amazon/reviews의 카탈로그 노트에 스토어 홈페이지는 작동하지 않는다고 나와 있습니다.
로컬 JSON Schema 검증기로 스토어 링크를 이 스키마에 대해 테스트했더니 정규식이 이를 거부했습니다.
넷째, 11월 1일 이른 시각에 조회한 카탈로그에는 trustpilot/reviews의 date와 sort에 대한 allowed_values가 없었습니다. 그래서 카탈로그 설명에서 값을 옮겨 왔습니다. 이것이 왜 중요했는지는 다음 섹션에서 다룹니다. 그날 저녁 카탈로그에 이 값들이 추가되어, 위 정의에 last7days를 추가했습니다. domain에는 22:14 SGT 기준 카탈로그에 나열된 사이트 11곳을 사용했습니다. amazon.com.mx는 이제 과금 전에 422를 반환하므로 포함하지 않았습니다. 자세한 내용은 제한 사항 섹션에 있습니다.
전체 정의에는 enum, required, additionalProperties: false, 단순한 pattern, format만 사용했습니다. 대부분의 제약 디코딩 시스템이 이를 지원합니다. 숫자 범위와 길이는 시스템마다 지원 수준이 다르며, 6개 프레임워크를 테스트한 JSONSchemaBench에서 이를 확인할 수 있습니다. 그래서 이런 제약은 422에 맡깁니다. 덕분에 같은 도구 정의를 이름만 조금 바꿔 다른 모델 제공업체로 옮길 수 있고, 두 번째 계층은 그대로 둘 수 있습니다.
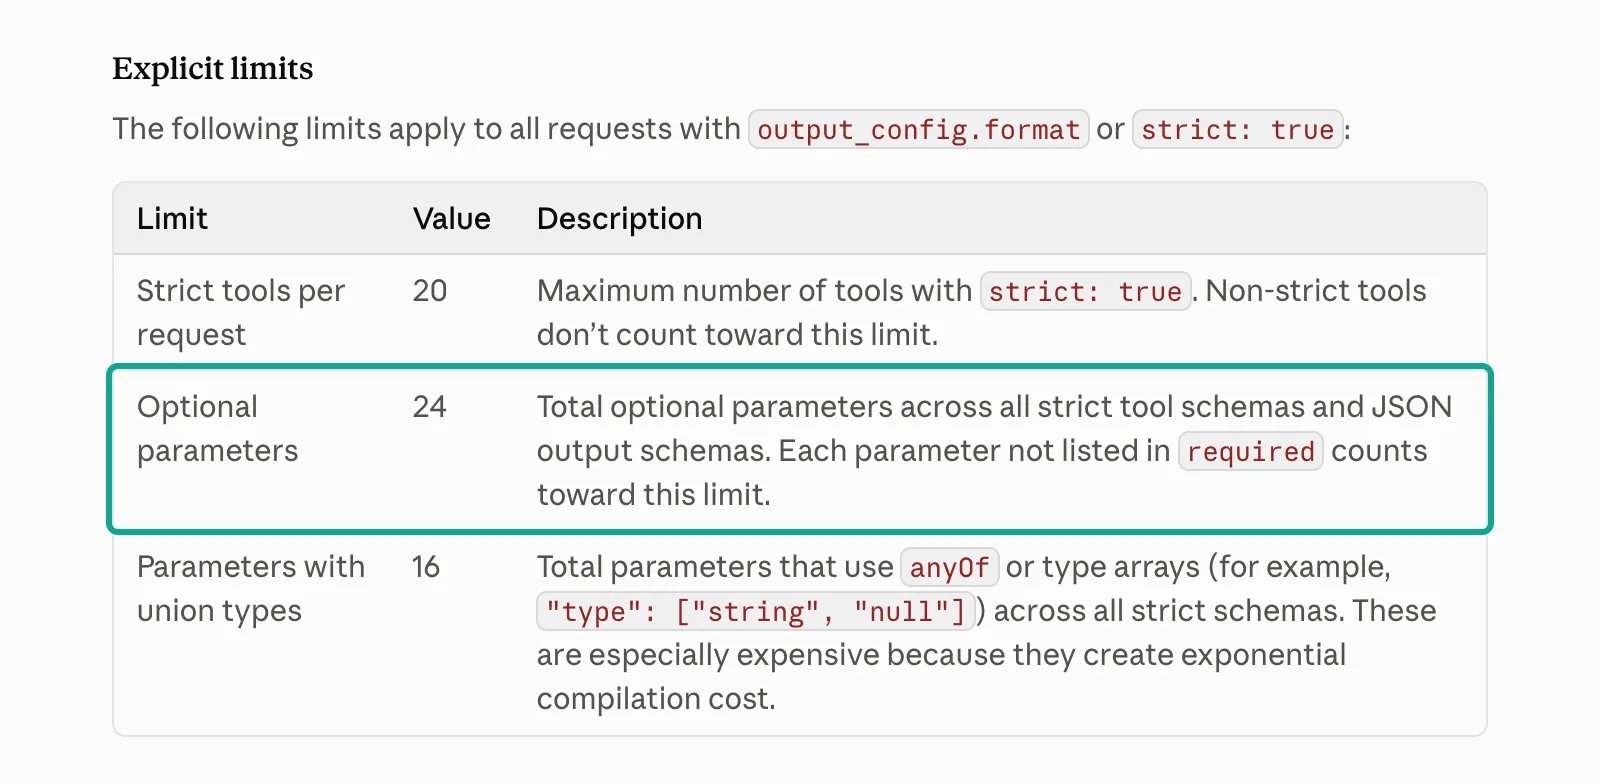
이 예산에 카탈로그 기능이 몇 개나 들어갈까요? 사용 가능한 기능 402개 전체의 선택 파라미터 수를 세었습니다. 목록을 반환하는 기능은 limit도 포함했습니다. 중앙값은 1, 최댓값은 9입니다. 24를 넘는 기능은 하나도 없습니다. 선택 파라미터가 없는 기능이 100개, 1개인 기능이 139개이므로, 239개 기능(59.5%)은 선택 파라미터가 0개 또는 1개입니다.
이 분포에서 두 가지를 알 수 있습니다. 좋은 소식은 모든 파라미터를 필수로 만들면 어떤 기능 20개든 선택 슬롯을 하나도 쓰지 않고 한 요청에 들어간다는 점입니다. 나쁜 소식은 기능 402개 전체를 한곳에서 strict 도구로 만들 수는 없다는 점입니다. 선택 파라미터를 모두 합하면 686개입니다. 요청당 24개라면 최소 29개 그룹이 필요합니다.
탐욕적(greedy) 패킹으로는 30개 그룹이 나왔습니다. 요청당 strict 도구 20개라는 제한만으로도 최소 21개 그룹이 필요합니다. 따라서 작업별로 도구를 고르는 것이 맞습니다. 리뷰 모니터라면 리뷰 기능 8개를 합쳐 선택 슬롯을 정확히 23개 사용합니다.
23은 제한값 24보다 1 작습니다. 선택 필드가 하나 있는 구조화된 출력 스키마를 추가하면 요청이 실패합니다. Anthropic이 가능하면 파라미터를 필수로 만들라고 권하는 이유가 여기에 있습니다. 예시로 든 도구 3개는 모든 파라미터가 필수이므로 선택 슬롯을 하나도 쓰지 않습니다. 남은 예산은 출력 스키마에 쓸 수 있습니다.
참고할 만한 반례도 있습니다. EveryInfra 원격 MCP 서버에는 범용 도구 everyinfra_call_api가 있습니다. 이 도구는 426개 기능을 모두 받아야 하므로 params 필드가 열린 객체입니다. 일반 도구라면 문제가 없습니다.
하지만 strict 모드는 모든 객체에 additionalProperties: false를 요구하므로 이 스키마는 strict로 만들 수 없습니다. 2026년 11월 1일 15:41 SGT에 MCP 도구 목록을 다시 읽었을 때 도구는 12개, 크기는 16,247바이트였습니다. everyinfra_call_api의 params 필드는 여전히 열린 객체였습니다. strict 보장이 필요하다면 위와 같은 작업별 도구를 작성하세요. 범용 도구는 탐색용으로 남겨 두세요.
카탈로그를 스키마로 자동 변환하고 매일 다시 빌드하기
도구 3개는 직접 작성할 수 있습니다. 하지만 도구가 30개면 실수가 생기고, 카탈로그도 바뀝니다. 더 안전한 방법은 작은 스크립트입니다. 이 스크립트는 하루에 한 번 무료 카탈로그를 읽고, 고정된 규칙으로 strict 도구를 만들고, 결과를 전날과 비교합니다.
규칙은 6개이며, 각 규칙은 앞에서 설명한 제한에서 나왔습니다. 저희 코드는 각 호출 전에 "미설정" 값을 제거합니다.
| 카탈로그 필드 | strict 스키마 | 이유 |
|---|---|---|
required_params | required에 복사 | 필수 필드는 선택 슬롯을 쓰지 않음 |
optional_params | 이것도 required에 넣고 any나 [] 같은 "미설정" 값을 둠 | 24개 슬롯 예산을 비워 둠 |
allowed_values | enum, 대소문자까지 그대로 복사 | strict 모드는 enum 값을 보장함 |
format: uri 또는 date | 같은 format | strict 모드는 문자열 형식 10가지를 허용함 |
default_limit, max_limit | integer, 범위는 설명에 기재 | minimum과 maximum은 지원되지 않음 |
| 모든 객체 | additionalProperties: false | strict 모드에서 필수 |
사람이 처리해야 하는 경우가 두 가지 있습니다. 첫째는 allowed_values 없이 값을 텍스트로만 나열한 파라미터입니다. trustpilot/reviews의 date와 sort 파라미터가 그 예입니다. 스크립트는 이런 값을 찾을 수 없습니다. 사람이 직접 enum으로 옮기거나 카탈로그에 추가될 때까지 기다려야 합니다. 이 두 파라미터의 값은 11월 1일 저녁에 카탈로그에 추가되었습니다.
이런 파라미터는 목록으로 관리하고, 다시 빌드할 때마다 표시합니다.
둘째는 매우 큰 enum입니다. 테스트 당일 값이 100개를 넘는 enum이 8개였고, 가장 큰 것은 183개였습니다. enum이 크면 컴파일된 문법도 커집니다. Anthropic은 이 내부 제한에 정해진 숫자가 없다고 설명합니다. 이런 파라미터는 enum을 생략하고, 자주 쓰는 값을 설명에 나열하고, 검증은 422에 맡깁니다. 어차피 422는 전체 allowed 목록을 돌려줍니다.
매일 다시 빌드하면 새 컴파일 비용이 언제 발생하는지도 알 수 있습니다. 구조화된 출력 문서에 따르면 컴파일된 문법은 마지막 사용 후 24시간 동안 캐시에 남습니다. 스키마 구조가 바뀌면 캐시가 지워집니다. 구조화된 출력과 도구를 함께 쓰면 도구 구성이 바뀔 때도 캐시가 지워집니다. name이나 description만 바뀌면 지워지지 않습니다. 따라서 스크립트는 두 종류의 변경을 구분해야 합니다.
텍스트만 바뀌었다면 비용 없이 교체하면 됩니다. 파라미터, 값, 필수 필드가 바뀌었다면 다음 요청이 느려집니다. 배치에서는 이 지연이 문제가 되지 않습니다. 실시간 채팅이라면 한가한 시간에 워밍업 요청을 한 번 보내세요. 배치는 이 규칙의 이점도 얻습니다. 수천 개 요청이 하나의 도구 구성과 출력 스키마를 공유하므로 문법은 한 번만 컴파일됩니다.
두 번째 레이어: 422로 모델이 스스로 호출을 고치게 하기
첫 번째 레이어는 형태 오류를 막지만 값 오류는 막지 못합니다. 모델은 스키마가 허용하는 범위 안에서 잘못된 값을 고를 수 있습니다. 예를 들어 App Store 정렬 순서로 다른 플랫폼에서 쓰는 이름인 most_recent를 보낼 수 있습니다. 또는 앱이 strict 모드를 아예 쓰지 않고 범용 도구를 호출할 수도 있습니다. 이런 경우 두 번째 레이어는 빠르게 실패하고, 과금하지 않고, 수정 방법을 알려 줘야 합니다.
Anthropic의 도구 호출 문서에는 여기에 해당하는 내용이 두 가지 있습니다(handle tool calls). 첫째, 오류는 is_error: true와 함께 tool_result에 넣으세요. 그러면 모델은 수정해서 재시도하며, 보통 2~3번 시도한 뒤에 사용자에게 사과합니다. 둘째, 해결 방법을 알려 주는 오류 메시지를 작성하세요. "failed"만 쓰지 말고, 무엇이 잘못되었는지와 Claude가 다음에 무엇을 시도해야 하는지 알려 주세요.
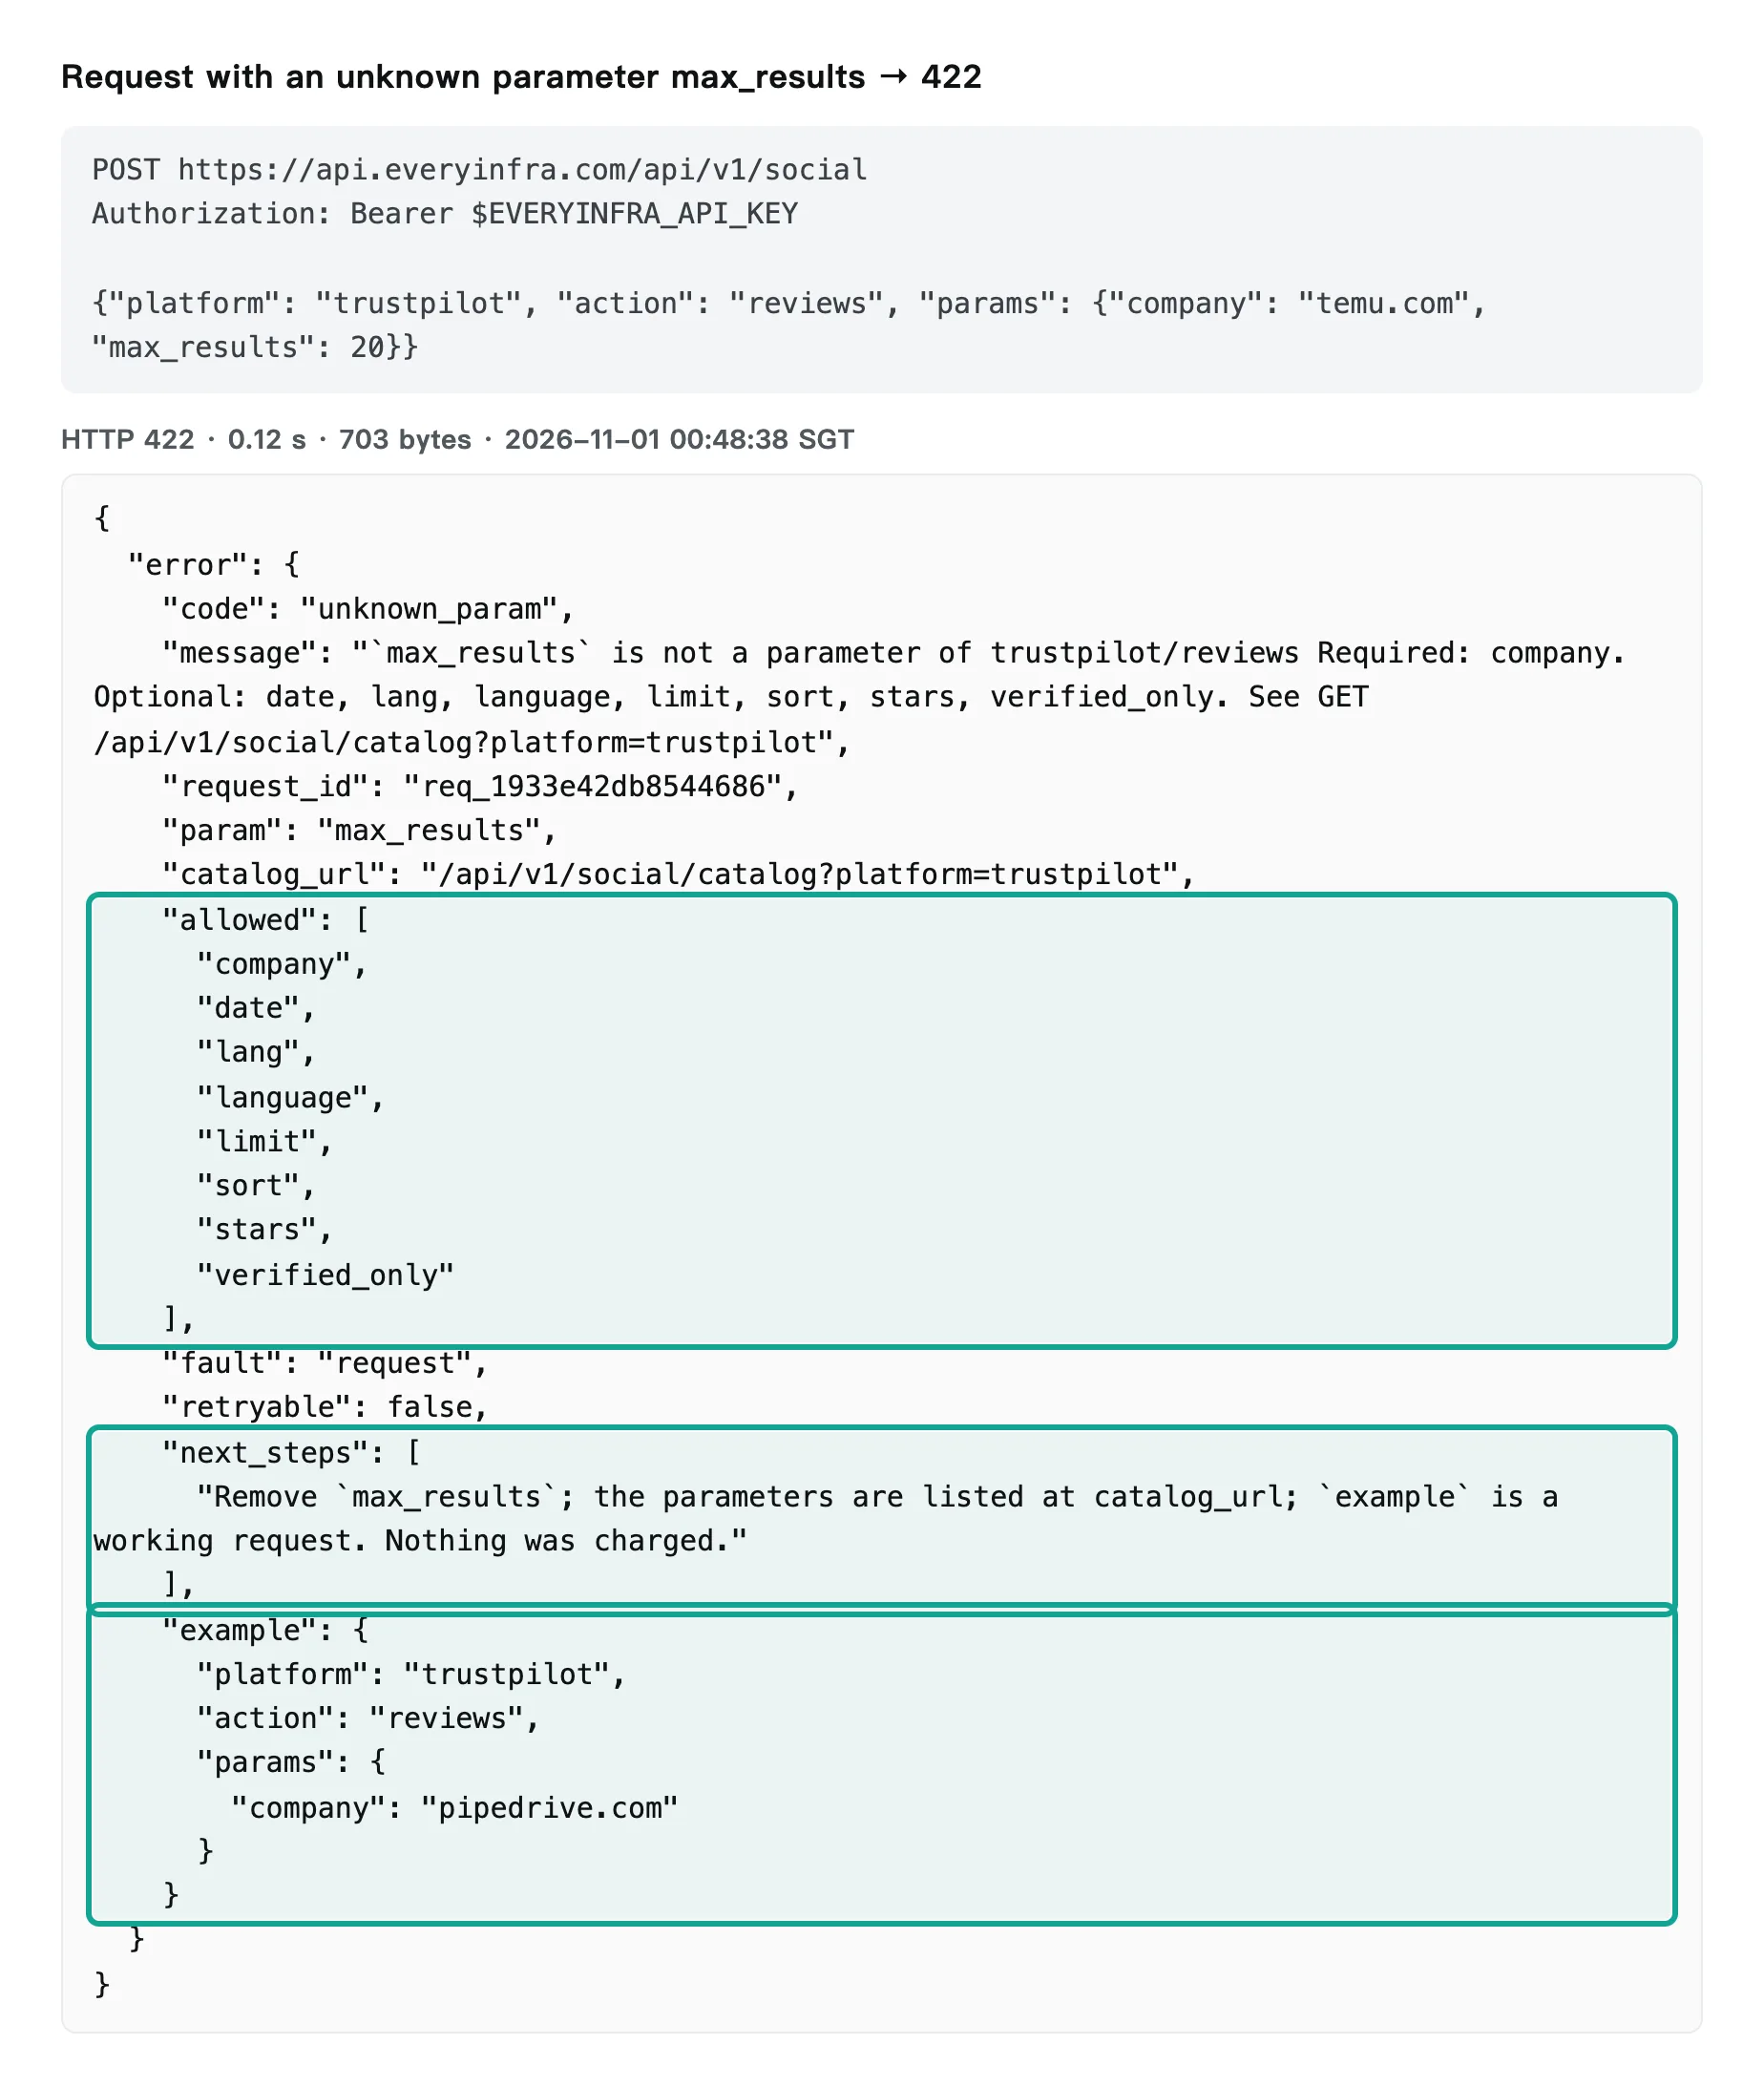
2026년 11월 1일 00:48~00:49 SGT에 일부러 잘못된 요청 7개를 보냈습니다. 00:57 SGT에는 MCP로 하나를 더 보냈습니다. 아래는 알 수 없는 파라미터에 대한 원본 응답입니다. 요청에 불필요한 max_results가 들어 있습니다.
API는 0.12초 만에 422를 반환했습니다. allowed 필드에는 유효한 파라미터 이름 8개가 모두 나열됩니다. example 필드는 정상 동작하는 요청을 보여 줍니다. next_steps 필드는 max_results를 제거하라고 안내하고, 과금되지 않았다고 알려 줍니다.
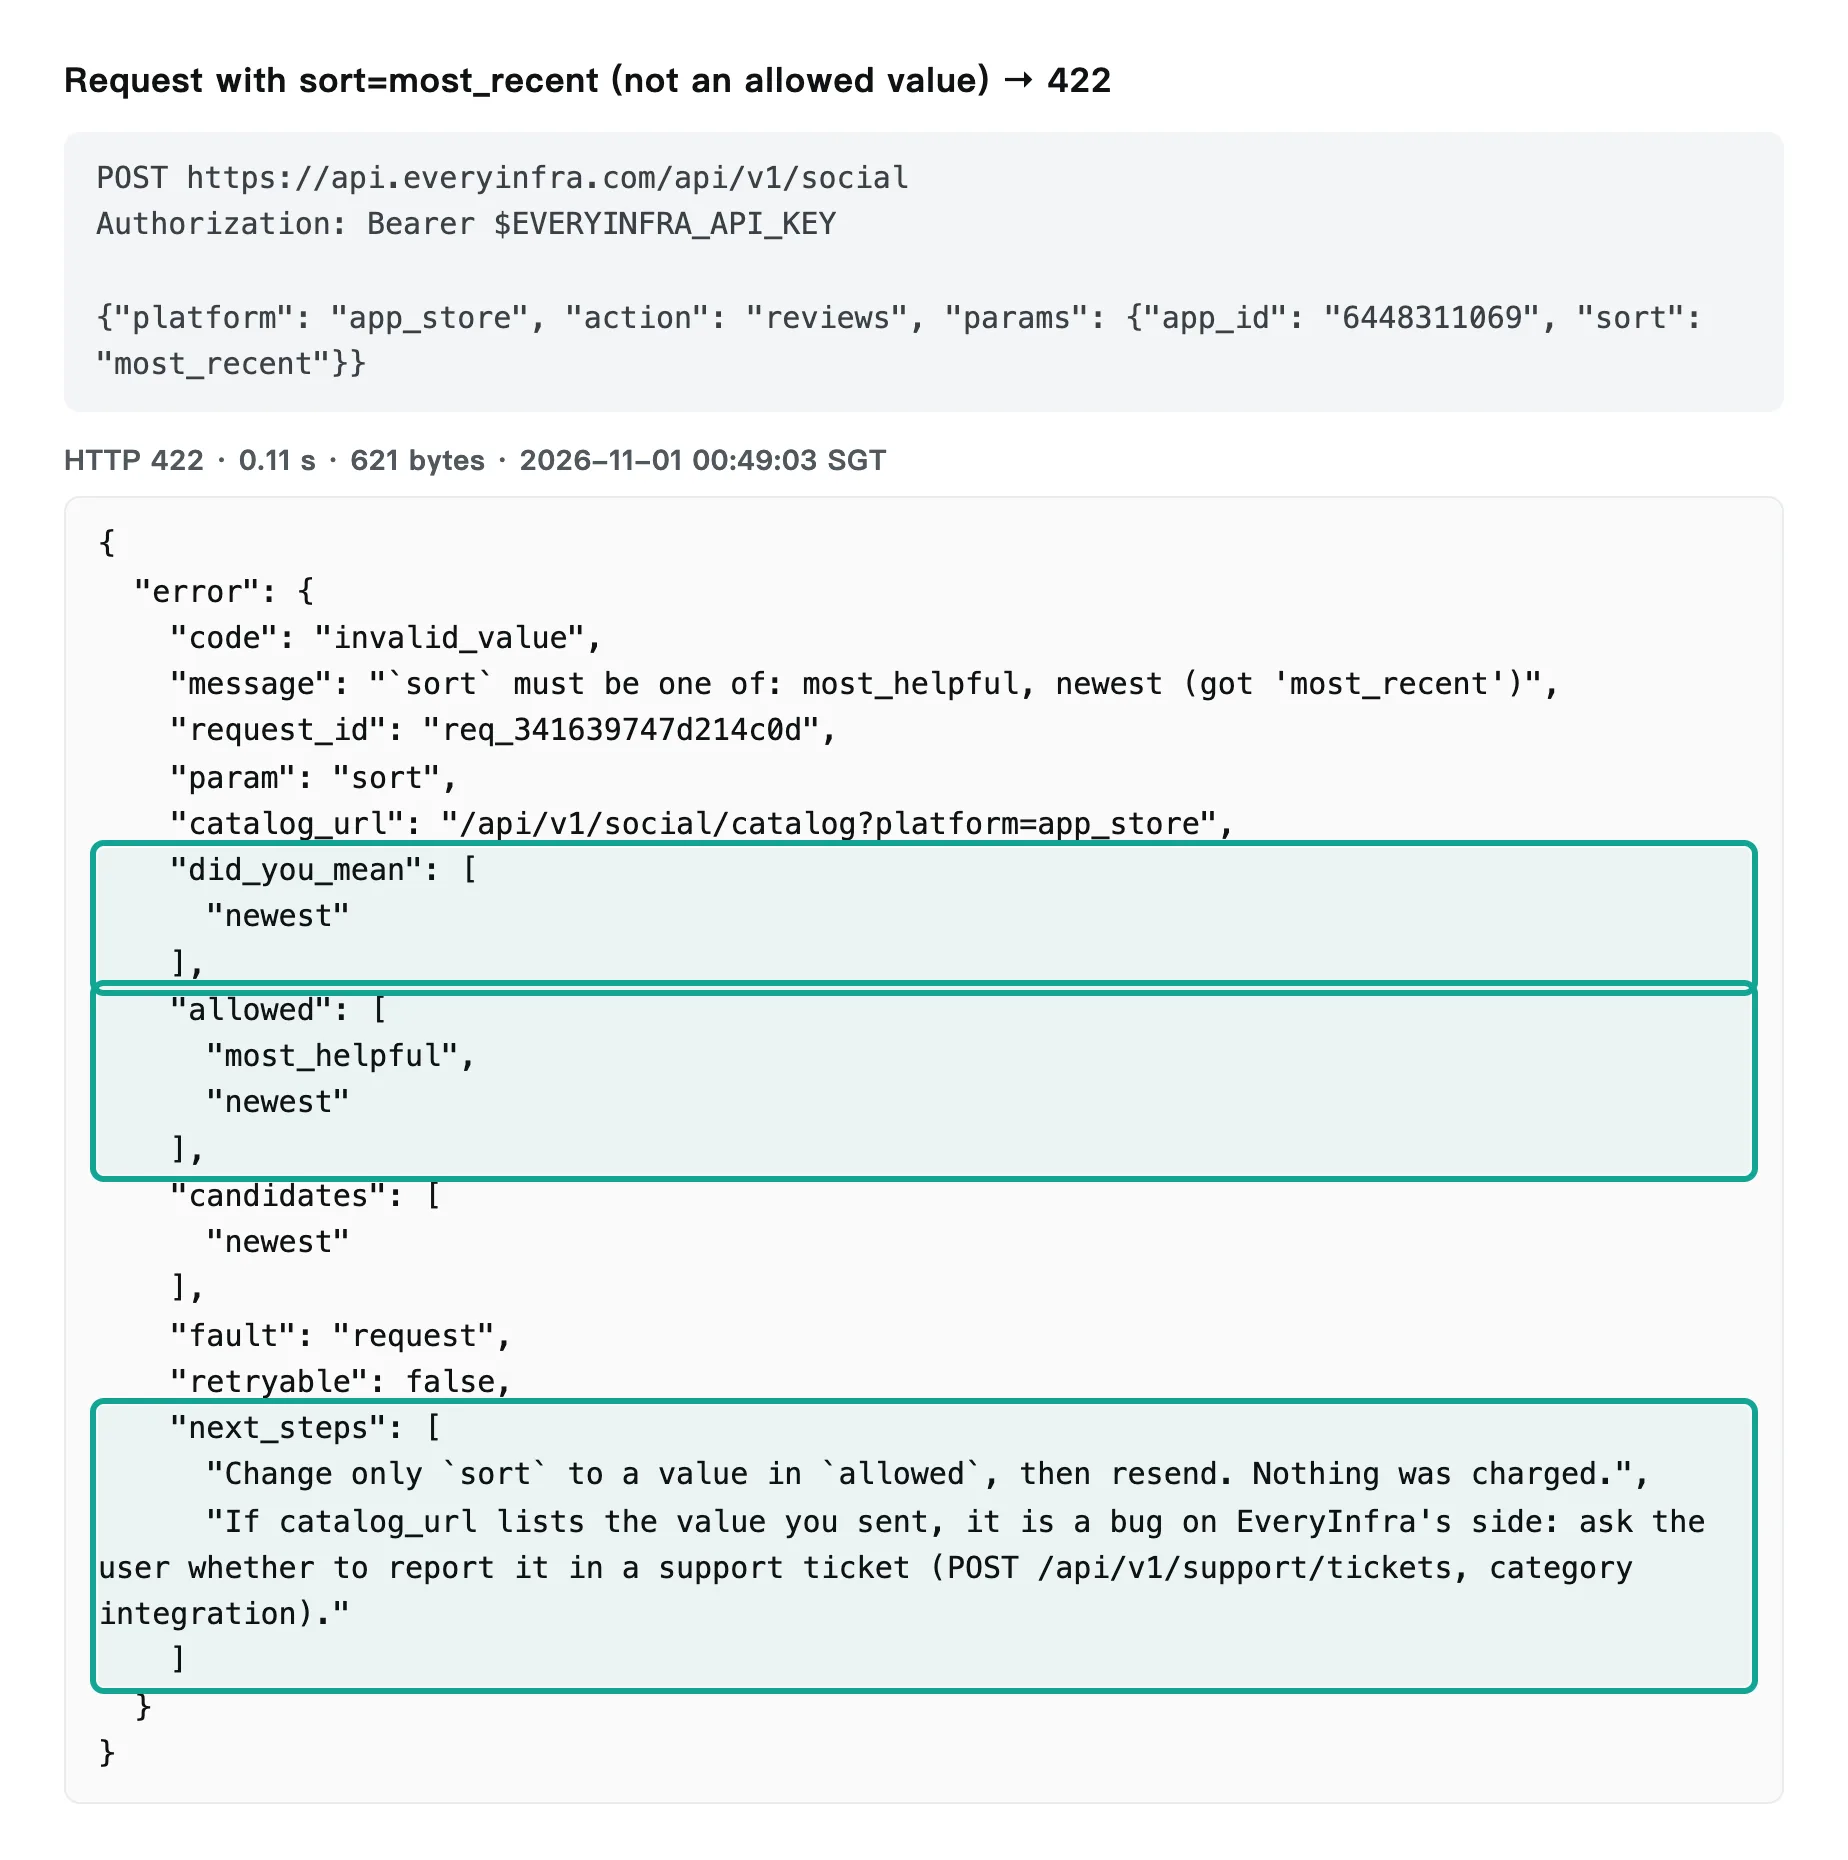
더 흔한 경우는 잘못된 enum 값입니다. 00:49 SGT에 app_store/reviews에 sort: most_recent를 보냈습니다. API는 0.11초 만에 422를 반환했습니다. did_you_mean 필드는 ["newest"], allowed는 ["most_helpful", "newest"]였습니다. next_steps의 첫 줄은 sort만 allowed에 있는 값으로 바꿔 다시 보내라고 안내하고, 과금되지 않았다고 알려 줍니다.
두 번째 줄도 유용합니다. 보낸 값이 카탈로그에 있다면 어떻게 해야 하는지 알려 줍니다. 그 경우 버그는 EveryInfra 쪽에 있으므로, 모델은 사용자에게 지원 티켓 접수 여부를 물어야 합니다. 이 줄은 모델을 위한 것입니다. "내 입력이 잘못됨"과 "서비스가 잘못됨"을 구분해 줍니다. 그래서 모델이 자신의 실수를 장애로 오인해 같은 값으로 재시도하지 않습니다.
아래 표는 오류 사례 8건, 오후 대조 호출 2건, 수정 후 저녁 재테스트 5건을 보여 줍니다. 마지막 열은 로컬 검사 결과입니다. 각 입력을 위의 도구 정의로 검증했습니다. 검증에는 Draft 2020-12 validation vocabulary를 지원하는 JSON Schema 검증기를 사용했습니다.
| 시각(SGT) | 일부러 틀린 부분 | 응답 | 시간 | 과금 | 응답의 수정 힌트 | strict가 먼저 막는가? |
|---|---|---|---|---|---|---|
| 00:48:37 | API 키 없음 | 401 missing_key | 0.12 s | 0 | 키를 보내라고 안내 | 관련 없음 |
| 00:48:38 | 불필요한 max_results | 422 unknown_param | 0.12 s | 0 | 파라미터 목록, 예시 요청 | 예 |
| 00:48:42 | company를 compnay로 잘못 입력 | 422 missing_param | 0.23 s | 0 | 오타 지적, 예시 | 예 |
| 00:48:42 | date: last7days | 503 | 1.69 s | 0(환불됨) | "나중에 재시도"만 안내 | 당시에는 예. 저녁 수정 후에는 유효한 값 |
| 00:48:44 | sort: newest | 503 | 1.91 s | 0(환불됨) | "나중에 재시도"만 안내 | 당시에는 예. 저녁 수정 후에는 유효한 값 |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0.11 s | 0 | did_you_mean, allowed | 예 |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0.20 s | 0 | did_you_mean, allowed | 예 |
| 00:57:45 | MCP로 보낸 G2 sort: most_recent | isError: true | — | 0 | structuredContent에 같은 내용 | 해당 없음 |
| 15:39:38 | sort: newest(대조) | 200, 20행 | 14.3 s | $0.001389 | 없음. 다른 리뷰 반환 | 당시에는 예. 저녁 수정 후에는 유효한 값 |
| 15:39:38 | date: last7days(대조) | 200, 20행 | 14.4 s | $0.001389 | 없음. 다른 리뷰 반환 | 당시에는 예. 저녁 수정 후에는 유효한 값 |
| 19:18:39 | sort: newst(수정 후) | 422 invalid_value | 0.21 s | 0 | did_you_mean(newest), allowed | 예 |
| 19:18:46 | date: last_week(수정 후) | 422 invalid_value | 0.12 s | 0 | did_you_mean(last7days), allowed | 예 |
| 19:18:53 | date: any(수정 후) | 422 invalid_value | 0.11 s | 0 | allowed | 아니요. 스키마가 허용하며 코드가 제거함 |
| 19:19:01 | language: eng(수정 후) | 422 missing_param | 0.19 s | 0 | 두 글자 코드를 요구 | 저희 정의에 없음 |
| 19:19:23 | sort: newest(수정 후, 이제 유효) | 200, 20행 | 14.1 s | $0.001389 | recency와 같은 행 | 필요 없음 |
낮 시간대 trustpilot/reviews 4개 행은 자세히 볼 필요가 있습니다. 초기 카탈로그에서 이 기능의 date와 sort 파라미터에는 allowed_values 없이 텍스트 설명만 있습니다. 그래서 API가 입구에서 enum으로 검사할 수 없습니다. 00:48 SGT에 잘못된 값은 각각 1.7~1.9초 뒤 503을 받았습니다. 과금되지 않았고, next_steps는 retry_after초 후에 재시도하라고만 안내했습니다.
하지만 이 두 503 오류를 값 탓으로 볼 수는 없습니다. 같은 몇 분 동안 다른 테스트에서 이 파라미터 없이 trustpilot/profile을 호출했는데, 역시 503을 받았습니다. 즉, 그 시간에는 플랫폼 자체가 불안정했습니다.
그래서 오후에 대조 테스트를 했습니다. 15:39:38 SGT에 같은 1분 안에 temu.com 대상 호출 4건을 보냈습니다. 각 호출은 파라미터 하나만 바꿨습니다. sort: newest는 유효한 sort: recency와, date: last7days는 유효한 date: last30days와 비교했습니다. 15:40 SGT에는 선택 파라미터가 없는 기준 호출 1건과 newest 반복 호출 1건을 추가했습니다. 6건 모두 200과 20행을 반환했고, 비용은 각각 $0.001389였습니다.
결과는 두 그룹으로 깔끔하게 나뉘었습니다. 유효한 값 2개와 기준 호출은 같은 리뷰 20개를 반환했습니다. 모두 영어였고, verification_level과 source에 값이 있었습니다. 목록에 없는 값 2개와 반복 호출은 다른 리뷰 20개를 반환했습니다. 그중 13개는 영어, 3개는 프랑스어, 2개는 스페인어, 2개는 이탈리아어였습니다. 20개 모두 두 필드가 비어 있었습니다.
즉, 11월 1일 낮에는 잘못된 값이 422도 503도 받지 않았습니다. API는 값을 받아들이고, 정상 요금을 과금하고, 결과를 조용히 바꿨습니다.
모델 입장에서는 503보다 나쁜 상황입니다. 모델은 성공으로 인식하므로 재시도하지도, 사용자에게 경고하지도 않습니다. 여러 언어가 섞인 리뷰가 그대로 파이프라인에 들어갑니다. 사실 카탈로그의 sort 설명에는 다른 플랫폼의 newest 값이 아니라 recency를 쓰라고 적혀 있습니다. 하지만 텍스트를 읽는 쪽만 이를 알 수 있습니다. API 검사는 이를 잡지 못했습니다.
여기까지가 낮 시간대 결과입니다. 그날 저녁 게이트웨이에서 다음 규칙이 바뀌었습니다:
| 파라미터 | 11월 1일 낮 | 저녁 수정 후 |
|---|---|---|
sort | 나열된 값 없음. newest가 받아들여져 과금되었고 다른 리뷰가 반환됨 | newest(recency와 동일), recency, relevance |
date | 나열된 값 없음. last7days가 받아들여져 과금되었고 다른 리뷰가 반환됨 | 게시일을 기준으로 최근 7일, 30일, 92일, 183일, 366일로 범위를 제한하는 프리셋 5개 |
language, lang | 텍스트에 예시만 있었음 | 두 글자 코드만 허용. 언어를 지정하지 않으면 영어 리뷰만 반환 |
| 목록에 없는 값 | 받아들여져 과금될 수 있었음 | 과금 전에 422 반환, 허용 값과 did-you-mean 힌트 포함 |
오류 표의 마지막 5개 행은 같은 회사로 진행한 재테스트입니다. 잘못된 값은 힌트가 담긴 422를 받았고 과금되지 않았습니다. sort: newest, sort: recency, date: last7days, 기준 호출의 4건은 각각 $0.001389로 200을 반환했습니다. 4건 모두 같은 영어 리뷰 20개를 반환했고, 모든 행에 verification_level과 source가 있었습니다. 가장 오래된 리뷰도 하루가 지나지 않았으므로 last7days와 date 미지정 결과는 같아야 합니다.
이 결과는 첫 번째 레이어가 필요한 이유도 보여 줍니다. 저희 strict 스키마는 date와 sort를 enum으로 나열하므로 이런 잘못된 값이 Claude 외부로 전송되지 않습니다. 저녁 수정 후에는 422도 이 두 오류를 막습니다. 하지만 다른 파라미터는 여전히 값을 텍스트로만 나열할 수 있으므로, 클라이언트 스키마가 여전히 첫 번째 검사 단계입니다.
MCP 쪽도 같은 방식으로 나눕니다. MCP 사양의 tools 섹션은 입력 검증 오류를 도구 실행 오류와 같이 다룹니다. 이 오류는 isError: true와 함께 결과에 담기고, 클라이언트가 이를 모델에 전달해 모델이 스스로 수정할 수 있게 합니다. 00:57 SGT의 MCP 호출이 정확히 이렇게 반환했습니다. 오류 코드별 설명은 API 오류 가이드에서, 환불 대조 방법은 환불 확인 가이드에서 확인할 수 있습니다.
Anthropic 문서의 작은 메모에서 나온 발견도 있습니다. 구조화된 출력은 문자열 enum 값의 대소문자를 보장하지 않습니다. 모델이 스키마와 대문자 여부만 다른 값을 오류 없이 반환할 수 있습니다. 이 메모는 strict 도구 사용에도 해당한다고 설명합니다(structured outputs, "Invalid outputs"). 따라서 strict 모드에서도 newest가 Newest가 될 수 있습니다. 14:33 SGT에 app_store/reviews를 sort: Newest로 테스트했습니다.
API는 오류를 반환하지 않았습니다. 최신순으로 정렬된 리뷰 30개와 함께 200을 반환했고, $0.001389를 과금했습니다.
호출 한 번으로 규칙을 정할 수는 없으므로, 15:39~15:41 SGT에 두 플랫폼을 더 테스트했습니다. g2/reviews에서는 sort: Newest와 sort: newest가 같은 레코드 21개를 반환했습니다. google_play/reviews에서는 sort: Top_Rated가 모두 별 5개인 리뷰 40개를 반환했습니다. 같은 1분 안에 보낸 sort: Newest 호출은 별 1~5개가 섞인 결과를 반환했으므로, 대문자가 들어간 값도 실제로 적용되었습니다. 이 4건의 호출은 각각 $0.001389였습니다.
따라서 테스트한 기능 3개에서는 대소문자만 다른 값을 같은 값으로 처리합니다. 카탈로그의 다른 enum은 테스트하지 않았습니다. 안전한 방법은 보내기 전에 코드에서 enum 값을 소문자로 바꾸는 것입니다. 이 한 줄이 잘못된 호출 한 번보다 훨씬 저렴합니다. Anthropic의 다른 권고도 적용됩니다. 대소문자만 다른 enum 값 두 개를 정의하지 마세요.
병렬 도구 사용도 두 레이어 모두에 영향을 줍니다. 병렬 도구 사용은 기본적으로 켜져 있습니다. 따라서 모델은 한 턴에 여러 tool_use 블록을 보낼 수 있습니다. 예를 들어 Trustpilot과 App Store를 함께 호출할 수 있습니다. parallel tool use 문서는 형식 규칙 두 가지를 제시합니다. 해당 턴의 모든 도구 결과는 하나의 사용자 메시지에 담아야 하고, 결과 앞에 텍스트가 오면 안 됩니다. 따라서 코드는 같은 턴의 422와 200을 함께 처리해야 합니다.
422 결과에는 is_error: true를 표시하고 200 결과는 평소대로 반환하세요. 그러면 모델은 실패한 호출만 다시 보냅니다. 키의 요청 속도 제한이 낮거나 로그를 단순하게 유지하고 싶다면 tool_choice 객체 안에 disable_parallel_tool_use: true를 추가하세요. 그러면 auto 모드에서 모델은 응답당 최대 하나의 도구만 호출합니다. 이 설정은 최상위 요청 파라미터가 아닙니다.
이 차트는 같은 사실을 다른 측면에서 보여 줍니다. 422 재시도는 비용이 $0이고 API 쪽 소요 시간은 약 0.17초입니다. 이는 422 호출 4건의 평균입니다. 비용은 추가되는 모델 턴에서 발생합니다.
추가 턴 하나의 비용은 다음 공식으로 계산합니다. 재작업 비용 = (컨텍스트 토큰 + 오류 토큰) × 입력 가격 + 수정 토큰 × 출력 가격. 오류 본문은 약 240토큰, 수정용 출력은 약 120토큰으로 잡았습니다. 비용의 대부분은 컨텍스트 길이가 좌우하므로 표에는 세 가지 크기를 실었습니다. 가격은 2026년 11월 1일에 확인한 요금 페이지 기준입니다. 괄호 안 숫자는 비용을 건당 $0.001389인 리뷰 호출 횟수로 환산한 값입니다.
| 컨텍스트 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1,000토큰 | $0.00018 (0.1) | $0.0037 (2.6) | $0.0074 (5.3) | $0.0184 (13) |
| 5,000토큰 | $0.00058 (0.4) | $0.0117 (8.4) | $0.0234 (17) | $0.0584 (42) |
| 20,000토큰 | $0.0021 (1.5) | $0.0417 (30) | $0.0834 (60) | $0.2084 (150) |
도구 정의 3개와 몇 번의 턴이 있는 앱은 컨텍스트가 20,000토큰인 경우가 많습니다. 이때 Opus 5.5에서 실수 한 번의 비용은 데이터 호출 약 60건에 해당합니다. 프롬프트 캐싱을 쓰면 컨텍스트 부분에 캐시 읽기 가격이 적용됩니다. 이 가격은 입력 가격의 10%(Haiku 5.5), 5%(Opus 5.5, Sonnet 5.5), 2.5%(Fable 5.1)입니다. Opus 5.5에서 20,000토큰 기준으로 추가 턴 하나의 비용은 $0.0834에서 약 $0.0074로 줄어듭니다.
자신의 컨텍스트 길이를 공식에 넣으면 실제 비율을 구할 수 있습니다. 크기와 관계없이 방향은 같습니다. 컨텍스트가 길수록 재시도 비용이 커집니다. 이것이 첫 번째 레이어가 필요한 경제적 이유입니다. strict 모드는 가장 흔한 재시도를 시작 전에 막습니다.
전체 왕복 한 번: 모델이 보내는 것과 돌아오는 것
아래 코드는 두 레이어를 최소한의 루프로 연결합니다. Anthropic 문서를 따랐습니다. 설정 예시이며, Claude 쪽은 실행하지 않았습니다. EveryInfra 요청과 응답은 2026년 11월 1일의 실제 결과입니다.
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # reads ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # the three strict tools above
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # "any" and [] mean no filter
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=90)
    body = r.json()
    if r.status_code == 422:                    # value error: pass it to the model as is
        return json.dumps(body["error"]), True
    if r.status_code >= 400:
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}), False

messages = [{"role": "user", "content": "Use the trustpilot_reviews tool to get 20 one- and two-star reviews of temu.com from the last 30 days, then group them by topic."}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
    messages.append({"role": "user", "content": results})
몇 가지 세부 사항이 이 루프를 안정적으로 만듭니다. 코드는 tool_choice를 auto로 설정합니다. 기본값이지만, 값을 명시하면 다음 개발자가 강제 호출을 쓰지 않는다는 점을 알 수 있습니다. 사용자 메시지에서는 도구 이름을 직접 언급합니다.
이것이 Opus 5.5와 Fable 5.1 문서에서 강제 호출 대신 권하는 방법입니다. 코드는 422 오류 본문을 그대로 is_error: true와 함께 tool_result에 넣습니다. "bad parameter"로 바꾸지 마세요. 모델이 활용할 수 있는 부분은 allowed와 did_you_mean이기 때문입니다.
성공하면 코드는 ID, 평점, 제목, 본문, 게시 시각의 5개 필드만 모델에 반환합니다.
그날의 실제 응답으로 이를 측정했습니다. Trustpilot 리뷰 20개의 results는 31,046자였습니다. 5개 필드만 남기자 13,040자로 58% 줄었습니다. App Store 리뷰 30개는 13,012자에서 7,726자로 41% 줄었습니다. 모델이 읽는 양이 줄면 턴마다 비용도 줄어듭니다. 아래 배치 계산에는 줄인 크기를 사용합니다.
다음은 2026년 11월 1일 00:49 SGT에 이 루프로 실행한 실제 왕복입니다. strict 모드에서 모델은 {"company": "temu.com", "stars": ["1", "2"], "date": "last30days", "sort": "recency", "limit": 20} 같은 파라미터를 보냅니다. 저희 코드는 이를 trustpilot/reviews로 전송합니다. API는 56.9초 후 200과 함께 리뷰 20개를 반환했습니다. 별 1개가 19개, 별 2개가 1개였고, 2026년 10월 30일부터 2026년 10월 31일 사이에 게시된 리뷰였습니다.
국가별로는 영국 10개, 미국 3개였고, 16개에는 회사 답변이 있었습니다. 과금액은 카탈로그의 price_usd와 같은 $0.001389였습니다. 모델이 "sort": "newest"를 골랐다면 strict 모드가 그 호출을 막았을 것입니다. strict 모드가 없으면 API는 이 값을 거부하지 않습니다. 위의 대조 테스트처럼 정상 요금을 과금하고 여러 언어가 섞인 리뷰를 반환했을 것입니다.
구조화된 출력에는 무엇이 들어갈까요? Claude를 실행하지 않았으므로 모델 출력은 보고하지 않습니다. 대신 14:37 SGT 호출에서 받은 Trustpilot 리뷰 100개에 간단한 키워드 규칙을 적용했습니다. 리뷰 100개 중 40개는 환불을, 20개는 반품을 언급합니다.
35개는 배송, 33개는 품질이나 파손, 35개는 고객 서비스, 14개는 계정을 언급합니다. 어떤 규칙에도 해당하지 않는 리뷰는 16개입니다. 본문 길이의 중앙값은 432자이고, 가장 긴 리뷰는 3,371자입니다.
이 숫자는 두 가지 면에서 도움이 됩니다. 첫째, 리뷰 하나가 여러 주제에 해당하는 경우가 많습니다. 스키마가 topic을 하나만 허용한다면 모델이 골라야 하므로, 설명에 "돈과 관련된 주제를 우선" 같은 규칙을 넣으세요. 둘째, 가장 긴 리뷰는 약 1,350토큰입니다.
요청당 리뷰 25개를 계획할 때는 평균이 아니라 길이 분포를 기준으로 잡으세요. 그렇지 않으면 일부 요청이 max_tokens에 도달할 수 있습니다. 이 리뷰들은 2026년 10월 27일부터 2026년 11월 1일 사이에 게시되었으므로 그 기간만 반영합니다.
두 번째 단계에서는 Claude 구조화된 출력으로 모델이 각 리뷰를 고정된 필드에 넣게 합니다. 이 스키마도 설정 예시입니다:
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "At most 20 words copied from the review"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}
이 스키마는 선택 파라미터가 0개이므로 strict 도구 3개와 같은 요청에 들어갑니다. 길이 제한은 지원되지 않으므로 quote 필드는 maxLength 대신 설명에 "최대 20단어"라고 적었습니다. 문서에 명시된 예외가 두 가지 남아 있습니다. 모델이 거부하면 응답에 stop_reason: "refusal"이 담기고, 출력이 스키마와 맞지 않을 수 있습니다.
출력이 max_tokens에 도달하면 응답에 stop_reason: "max_tokens"가 담기고, 출력이 불완전할 수 있습니다. 따라서 무엇이든 저장하기 전에 stop_reason을 확인하세요. 또한 "단계별 추론"을 요구하는 필드는 reasoning_extraction 거부를 일으킬 수 있습니다. refusals and fallback 문서는 대신 짧은 설명을 요청하라고 권합니다.
미국 앱 팀이라면 App Store 리뷰부터 시작하는 경우가 많을 것입니다. 00:54 SGT에 Claude 앱(app_store/reviews, app_id 6473753684)의 미국 최신 리뷰 30개를 읽었습니다. 24개는 버전 1.261026.20, 6개는 버전 1.261028.19에서 작성되었습니다. 리뷰는 2026년 10월 28일부터 2026년 10월 30일 사이에 게시되었습니다. 표에서 이 샘플을 Trustpilot 샘플과 나란히 비교합니다.
| 샘플 | 시각(SGT) | 행 | 별 1~2개 | 별 5개 | 과금 |
|---|---|---|---|---|---|
trustpilot/reviews, temu.com, 별 1~2개, limit 20 | 00:49 | 20 | 20 | 0 | $0.001389 |
trustpilot/reviews, temu.com, 별 1~2개, limit 100 | 14:37 | 100 | 100 | 0 | $0.001389 |
app_store/reviews, Claude 앱, 미국, newest | 00:54 | 30 | 10 | 16 | $0.001389 |
app_store/reviews, ChatGPT 앱, 미국, newest | 00:54 | 30 | 5 | 21 | $0.001389 |
이 수치에는 통계적 의미가 없습니다. 실무적인 사실 하나를 보여 줄 뿐입니다. 별 1개와 2개로 필터링했기 때문에 같은 스키마라도 Trustpilot에서는 거의 부정적인 리뷰만 보게 됩니다. App Store에서는 여러 평점의 리뷰가 섞여 있습니다.
severity 같은 필드의 분포는 출처에 따라 달라지므로 알림 기준은 출처별로 설정하세요. Apple 개발자 페이지에 따르면 요약 평점은 스토어프런트별로 집계되며 새 버전이 나오면 초기화될 수 있습니다. 작성된 리뷰는 남습니다(Apple, ratings and reviews). 따라서 전체 점수보다 버전별 리뷰가 더 유용합니다.
배치: Message Batches로 리뷰 1,000개를 처리하는 비용
왕복 한 번이 동작하면 그다음 비용은 처리량에서 발생합니다. Message Batches API는 요청을 비동기로 처리하며, 모든 사용량이 표준 가격의 50%로 과금됩니다. 배치 하나에는 최대 100,000개 요청 또는 256MB를 담을 수 있습니다. 대부분의 배치는 1시간 안에 끝납니다. 24시간 안에 끝나지 않은 요청은 만료되며 과금되지 않습니다.
결과는 29일 동안 조회할 수 있습니다(batch processing). 구조화된 출력 문서에 따르면 이 기능은 배치에서도 같은 50% 할인으로 동작합니다. 배치의 각 요청은 완전한 Messages 요청입니다. 따라서 strict 도구와 output_config.format을 그대로 넣으면 됩니다(create a Message Batch).
데이터 쪽에서 먼저 정할 것은 호출당 몇 행을 가져올지입니다. 카탈로그에서 trustpilot/reviews는 기본값 20, 최댓값 200이며 호출당 $0.001389입니다. 행당 가격 필드는 없습니다. 14:37 SGT에 limit: 100을 보냈습니다.
리뷰 100개를 받았고, 과금액은 20행일 때와 같은 $0.001389였습니다. 리뷰 100개 중 95개는 별 1개, 5개는 별 2개였습니다. 44개는 영국, 21개는 미국에서 작성되었습니다.
큰 limit의 대가는 시간입니다. 동기 호출에 84.0초가 걸렸는데, 카탈로그에 명시된 동기 처리 한도는 85초입니다. 한도에 매우 가깝습니다. 따라서 리뷰를 대량으로 가져올 때는 큰 limit을 쓰고 요청 본문에 "mode": "async"를 추가하세요. 그런 다음 GET /api/v1/jobs/{job_id}를 폴링하세요. 동기 호출로 기다리지 마세요.
| 리뷰 1,000개당 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 모델 비용(표준) | $0.0577 | $1.1537 | $2.3073 | $5.7683 |
| 모델 비용(Message Batches) | $0.0288 | $0.5768 | $1.1537 | $2.8842 |
| 데이터 요금, limit=100(호출 10건) | $0.0139 | $0.0139 | $0.0139 | $0.0139 |
| 합계, 배치 + limit=100 | $0.0427 | $0.5907 | $1.1676 | $2.8981 |
모델 비용을 어떻게 추정했는지 설명하니, 직접 수치를 넣어 계산해 보실 수 있습니다. 모델 개요 문서에 따르면 1M 토큰은 유니코드 문자 약 2.5M자에 해당하므로, 문자당 0.4토큰으로 계산했습니다.
| 추정 입력값 | 값 | 출처 |
|---|---|---|
| 요청당 리뷰 수 | 25개(요청 40건) | 저희 선택 |
| 필드를 추린 리뷰당 문자 수 | 약 440자 | 실제 Trustpilot 및 App Store 응답 |
| 요청당 지시문 및 스키마 | 약 1,424자 | 저희 프롬프트와 출력 스키마 |
| 출력 항목당 문자 수 | 약 189자 | 출력 항목 샘플 1개 |
| 총 토큰 | 입력 약 198,832, 출력 약 75,600 | 문자 수 × 0.4 |
사고(thinking) 토큰, 도구 사용 시스템 프롬프트(Opus 5.5 기준 286토큰), 구조화된 출력이 추가하는 형식 프롬프트는 계산하지 않았습니다. 따라서 이 수치는 하한값입니다. 기본값 limit=20을 쓰면 리뷰 1,000개의 데이터 요금은 호출 50건, $0.0694로 limit=100일 때의 5배입니다.
결과는 분명합니다. 리뷰 분류는 읽을 양이 많고 판단은 단순하므로 Haiku 5.5에 맡기세요. 그러면 모델 비용과 데이터 요금이 비슷해지고, 합계는 리뷰 1,000개당 약 $0.04입니다. Opus 5.5는 27배, Fable 5.1은 68배 비쌉니다. Haiku 5.5에는 주의할 가격 구간이 하나 있습니다.
프롬프트 토큰이 100,000개를 넘으면 가격이 $0.50 / $2.50, 배치에서는 $0.25 / $1.25가 됩니다. 요청당 짧은 리뷰 25개라면 이 기준에 한참 못 미칩니다. "배송 지연"과 "판매자의 반품 거부"처럼 더 세밀한 판단이 필요하다면 먼저 모든 리뷰를 Haiku로 처리하세요. 그런 다음 severity: high 항목만 Opus 5.5로 보내세요.
이제 일일 모니터에 적용해 보겠습니다. 회사 50곳의 Trustpilot 별 1~2개 리뷰와 앱 50개의 새 App Store 리뷰를 수집한다고 가정합니다. 하루 API 호출 100건으로, 하루 $0.1389, 30일 $4.17입니다. 모니터는 하루 최대 약 2,500개 리뷰를 읽습니다.
30일 기준 분류 비용은 배치 사용 시 Haiku 5.5 약 $2.16, Sonnet 5.5 $43.26, Opus 5.5 $86.53입니다. 배치와 프롬프트 캐싱은 함께 쓸 수 있으며, 캐시된 시스템 프롬프트와 도구 정의는 비용이 더 적습니다. 하지만 배치의 캐시 적중률은 요청 순서에 따라 달라집니다. 이 부분은 테스트하지 않았으므로 위 수치에 포함하지 않았습니다.
작동하지 않는 것과 주의할 점
먼저 저희 쪽의 한계입니다. amazon/reviews는 2026년 11월 1일에 네 번 시도했지만 리뷰를 하나도 반환하지 않았습니다. 00:50과 00:51 SGT의 동기 호출 2건은 각각 약 68초와 73초를 기다렸습니다. 00:53 SGT의 비동기 작업 1건은 0행으로 끝났습니다.
14:34 SGT에 domain을 지정해 보낸 동기 호출 1건도 66초를 기다린 뒤 0행을 반환했습니다. 4건 모두 비용이 들지 않았습니다. 빈 결과는 규칙에 따라 환불되며, 비동기 작업은 과금된 뒤 환불되었습니다.
그날 저녁 게이트웨이에서 Amazon 관련 두 가지 경우의 처리가 바뀌었습니다. 19:19~19:24 SGT에 다시 테스트했습니다:
| 요청 | 낮 | 저녁 재테스트 | 과금 |
|---|---|---|---|
| 미국 사이트, 동기 | 200, 0행, 66~73초 | 24.6초 만에 503 access_blocked. next_steps는 바로 재시도해도 소용없다고 안내 | 0 |
| 미국 사이트, 비동기 | 작업 완료, 0행 | 202 반환 및 $0.001389 보류. 작업은 access_blocked로 실패 | 0(환불됨) |
amazon.co.jp | 테스트하지 않음 | 19:19: 422 missing_param, 메시지 "missing domain". 22:14: 35.3초 만에 200, 리뷰 5건이 반환되었으며 모두 다른 국가의 구매자가 작성(미국 3건, 독일 2건) | 19:19에 0, 22:14에 $0.001389 |
amazon.com.mx | 테스트하지 않음 | 19:19: 422 missing_param. 22:14: 0.09초 만에 422 invalid_value, 지원 사이트 11곳 목록 포함 | 0 |
19:19에는 오류 메시지에 이 두 사이트가 지원되지 않는다는 내용이 없었습니다. 22:14에는 카탈로그가 domain을 11개 사이트의 enum으로 제시했습니다: amazon.com, co.uk, de, fr, it, es, ca, com.au, in, co.jp, sg. 이제 멕시코 사이트는 과금 전에 차단되며, 오류에 11개 값이 함께 표시됩니다. 위의 도구 정의도 같은 목록을 사용합니다. 일본 사이트는 이제 리뷰를 반환하지만, 모두 일본 구매자의 리뷰인 것은 아닙니다. 일본 리뷰만 남기려면 country 필드로 필터링하세요.
카탈로그에도 이미 명시되어 있듯이, 이 기능은 상품 페이지의 주요 리뷰만 가져오며 보통 상품당 12건 안팎입니다. 그날은 그 리뷰조차 가져오지 못했습니다. 따라서 이 글의 Amazon 도구는 설정 예시일 뿐입니다. 실제 테스트에는 그날 정상적으로 동작한 trustpilot/reviews와 app_store/reviews를 사용했습니다.
같은 시점에 amazon/search는 정상 동작했습니다. 00:51 SGT에 "anker power bank 10000mah"를 검색하자 11.8초 만에 상품 5개가 반환되었고 비용은 $0.002236이었습니다. Amazon 리뷰를 배치에 넣기 전에 카탈로그를 확인하고, 그날 소규모 호출을 한 번 해 보세요.
다음은 Anthropic이 문서화한 제약입니다. strict 도구는 HIPAA 적격이지만, API는 컴파일된 스키마를 메시지 콘텐츠와 별도로 캐시하며 메시지 콘텐츠와 동일한 보호를 적용하지 않습니다(strict tool use, data retention). 따라서 고객 목록을 enum에 넣으면 안 됩니다. CMEK 사례는 Fable 5.1 마이그레이션 가이드에서 다룹니다(Fable 5.1 migration guide).
| 한계 | 데이터 API에 미치는 영향 | 출처 |
|---|---|---|
| 스키마에 건강 데이터 금지 | 속성 이름, enum, const, pattern에 PHI 사용 금지 | “Strict tool use, data retention” |
| CMEK 조직 | Fable 모델에서는 구조화된 출력과 strict: true 사용 불가, 지시문만 사용 | “Fable 5.1 migration guide” |
| 인용(Citations) | 구조화된 출력과 함께 사용 불가, 400 오류 발생 | “Structured outputs, feature compatibility” |
| 형식 변경 | 새 output_config.format을 지정하면 프롬프트 캐시가 초기화됨 | “Structured outputs, token costs” |
인용 제약에는 한 가지 보충 설명이 필요합니다. 값마다 출처가 붙은 구조화된 데이터가 필요하다면 citations 문서에 나온 별도 방법을 사용하세요.
마지막으로, 두 번째 계층에도 한계가 있습니다. 422로 막을 수 있는 것은 카탈로그가 정의한 오류뿐입니다. 알 수 없는 파라미터, 누락된 필수 파라미터, 값이 나열된 enum이 여기에 해당합니다.
카탈로그가 텍스트로만 설명하는 규칙의 오류는 막을 수 없습니다. 11월 1일 낮 시간대 trustpilot/reviews의 date와 sort가 그 예입니다. 당시에는 이 두 파라미터에 잘못된 값을 넣어도 실패조차 하지 않았습니다. 정상 요금이 부과되었고 결과가 달라졌습니다. 저녁에 적용된 수정으로 두 파라미터에 허용 값이 추가되어, 이제는 422가 반환됩니다.
422는 "이 회사에 Trustpilot 페이지가 있는가"처럼 실행 시점에만 알 수 있는 사실도 막지 못합니다.
따라서 두 계층을 함께 사용하세요. 가능한 규칙은 모두 strict 스키마에 넣고, 나머지는 422에 맡깁니다. 카탈로그 텍스트에서 복사한 enum의 경우, 코드에서 각 응답의 언어와 핵심 필드도 함께 확인하세요.
문제 해결: 7가지 증상과 해결 방법
프로덕션에서 문제는 대개 경계 상황에서 발생합니다. 스키마가 갑자기 컴파일되지 않거나, 모델이 어떤 턴에서 도구를 호출하지 않거나, 배치의 일부 항목이 맞지 않는 경우입니다. 아래 표는 문서와 실제 호출에서 확인한 7가지 증상을 정리한 것입니다.
먼저 상태 코드를 누가 반환했는지 확인하세요. 400은 Anthropic이 반환하며 요청이나 스키마가 잘못되었다는 뜻이므로 코드를 수정해야 합니다. 422나 503은 EveryInfra가 반환하며 요청 형식은 올바르지만 값이 잘못되었거나 실행에 실패했다는 뜻이므로 next_steps를 따르세요. 두 오류는 형식이 서로 달라 로그에서 혼동하기 쉬우므로, 반환 주체만 확인해도 디버깅 시간을 대부분 줄일 수 있습니다.
| 증상 | 반환 주체 | 원인 | 해결 방법 |
|---|---|---|---|
| 400, tool_choice 미지원 | Anthropic | 신규 모델에서 any 또는 tool 사용 | auto를 사용하고 사용자 메시지에서 도구 이름을 명시 |
| 400, 스키마가 너무 복잡함 | Anthropic | 선택 파라미터 24개 초과 또는 큰 문법(grammar) | 파라미터를 필수로 지정, 큰 enum은 텍스트 설명과 422로 대체 |
| 모델이 도구 호출 없이 텍스트로 응답 | Anthropic | 지시가 불명확함 | 도구 이름과 호출 조건을 명시, stop_reason을 확인하고 다시 요청 |
422 invalid_value | EveryInfra | 카탈로그 allowed_values에 없는 값 | did_you_mean에 따라 필드 하나를 수정, 과금 없음 |
| 반복되는 503 | EveryInfra | 플랫폼이 불안정함. 의심스러운 값이 없는 호출에서도 발생했음. reason: access_blocked이면 대상 페이지에 로그인이 필요하거나 접근이 제한된 상태 | retry_after만큼 대기, 반복 실패 시 사람이 확인, access_blocked이면 대상 변경 |
| 200이지만 언어나 필드가 이상함 | EveryInfra | 카탈로그 텍스트에 없는 값이 수락되어 결과가 달라짐. 저녁 수정 전 trustpilot/reviews의 date, sort가 그 예 | 클라이언트 측 enum으로 차단, 카탈로그 텍스트 확인 |
| 200이지만 0행 | EveryInfra | 그날 대상 페이지에 데이터가 없음 | 이미 환불됨, 대상이나 기능 변경 |
마지막 세 행은 저희 테스트에서, 처음 네 행은 Anthropic 문서에서 가져온 것입니다. 여섯 번째 행은 코드에 반영하세요. 다른 파라미터에서도 같은 문제가 생길 수 있기 때문입니다. 카탈로그 텍스트에서 복사한 enum은 모두 스키마에 작성하세요. 각 응답 후에는 언어 구성과 핵심 필드를 기준값과 비교하고, 차이가 있으면 해당 호출을 사람이 확인하도록 표시하세요. 대조 테스트에서는 잘못된 값으로 받은 리뷰 20건 중 7건이 영어가 아니었고, 20건 모두에서 필드 2개가 비어 있었습니다. 간단한 검사로 바로 잡아낼 수 있습니다.
이 구성에 영향을 주는 최근 변경 사항
| 날짜 | 변경 사항 | 시사점 |
|---|---|---|
| 2026년 9월 22일 | Opus 5.5 출시, thinking 비활성화 불가, 강제 tool_choice 시 400 반환 | Opus 5에서 이전하기 전에 강제 호출을 제거하고 auto와 strict 조합 사용 |
| 2026년 9월 28일 | Sonnet 5.5 출시, 마찬가지로 강제 tool_choice 거부 | Sonnet으로 돌아가도 이 변경을 피할 수 없음 |
| 2026년 10월 7일 | Haiku 5.5 출시, 1M 컨텍스트, 배치 가격 $0.05 / $0.25 | 대량 그룹화의 모델 비용이 이제 데이터 요금과 비슷한 수준 |
| 2026년 10월 15일 | Models API가 between_tools thinking 지원 여부를 제공, Opus 5.5 fast mode의 리서치 프리뷰 종료 | 모델 ID로 판단하지 말고 코드에서 모델 기능 확인 |
| 2026년 10월 21일 | API 버전 2026-10-21 및 새 SDK(Python 2.0.0 등) | SDK 업데이트 시 output_format 같은 이전 필드가 남아 있는지 확인 |
| 2026년 10월 22일 | Google Cloud를 통한 Claude 제공(Anthropic 관리형) | 배치 작업을 위한 또 다른 과금 경로, strict 사용 방식은 동일 |
| 2026년 10월 28일 | Messages 요청 크기 제한이 32 MB에서 128 MB로 확대 | 한 요청에 더 많은 리뷰를 담을 수 있지만 비용은 토큰에 비례 |
| 2026년 10월 29일 | Usage and Cost Analytics API 베타 출시, 모델·워크스페이스·API 키별 집계 | 작업별로 모델 비용을 나누어 데이터 요금과 비교 |
| 2026년 10월 30일 | Opus 4.8의 fast mode가 2026년 11월 30일 제거 예정 | 해당 모델로 실시간 추출을 운영 중이라면 이전 계획 수립 |
이 항목들은 2026년 10월 30일에 업데이트된 API release notes와 API version migration guide에서 가져왔습니다. 이 글과 가장 관련이 큰 항목은 2026년 10월 7일 Haiku 5.5 출시입니다. 그 전에는 Haiku 4.5로 배치 대량 그룹화를 하면 $0.50 / $2.50로 10배 비쌌고, 모델 비용이 데이터 요금을 크게 웃돌았습니다. 이제는 두 비용의 규모가 비슷해져 데이터 API 가격이 실질적인 고려 요소가 됩니다.
2026년 9월 22일 항목도 있습니다. 대화 중간의 시스템 메시지에 전체 도구 정의를 담을 수 있게 되었으며, 현재 베타입니다. 이를 이용하면 프롬프트 캐시를 깨지 않고 세션 도중에 strict 도구를 추가할 수 있습니다. Anthropic은 이를 강제 호출의 대안 중 하나로 소개합니다.
자주 묻는 질문
Claude에서 아직도 도구 사용을 강제할 수 있나요?
이 질문은 검색 추천어 "claude force tool use"에서 나왔습니다. Fable 5.1, Mythos 5.1, Opus 5.5, Sonnet 5.5에서는 불가능합니다. tool_choice를 any나 tool로 지정하면 400이 반환되며, 토큰 카운팅 엔드포인트도 같은 검사를 적용합니다. auto와 none은 여전히 동작합니다. auto를 유지하고, 도구에 strict: true를 추가하고, 사용자 메시지에서 각 도구를 언제 사용할지 알려 주세요. 현재 턴에서 반드시 도구를 실행해야 한다면 Fable 5.1 마이그레이션 가이드는 대화 중간 시스템 메시지를 권장합니다.
claude tool_choice가 auto인데 모델이 도구를 호출하지 않으면 어떻게 하나요?
검색 추천어 "claude tool_choice"에서 나온 질문입니다. Anthropic에 따르면 Fable 5.1은 명시적인 도구 지시를 안정적으로 따릅니다. 따라서 첫째, 지시를 명확하게 작성하세요. 도구 이름과 호출 조건을 명시합니다. 둘째, 루프에서 stop_reason을 확인하세요.
모델이 텍스트로 응답했는데 데이터가 필요하다면, 호출을 요청하는 사용자 메시지를 추가하세요. 셋째, 도구 description을 명확하게 작성하세요. define tools 페이지는 상세한 설명을 "도구 성능에서 단연 가장 중요한 요소"라고 말합니다.
Claude의 구조화된 출력은 Bedrock에서도 동작하나요?
검색 추천어 "claude structured outputs bedrock"에서 나온 질문입니다. strict tool use 페이지의 지원 환경 표에는 InvokeModel을 포함한 Amazon Bedrock과 Google Cloud가 나와 있습니다. structured outputs 페이지에는 "all supported platforms", "all models"라고 적혀 있습니다. Fable 모델은 30일 데이터 보존이 필요하며 제로 데이터 보존 대상이 아닙니다. 사용 전에 데이터 보존 페이지를 확인하세요.
Pydantic으로 Claude의 구조화된 출력을 사용하려면 어떻게 하나요?
검색 추천어 "claude structured output pydantic"에서 나온 질문입니다. structured outputs 페이지는 Pydantic 모델을 client.messages.parse()에 전달하는 방법을 권장합니다. SDK가 스키마를 변환하고 minimum, maxLength 같은 미지원 제약을 설명으로 옮깁니다. 그런 다음 모든 제약이 포함된 원래 스키마로 응답을 검증합니다.
EveryInfra의 경우 카탈로그 allowed_values는 Literal[...]로 작성하세요. 이는 enum으로 변환됩니다. limit 범위는 Field(ge=1, le=200)로 작성하면 SDK가 로컬에서 검증합니다. 카탈로그에는 최댓값을 넘는 값이 상한으로 조정된다고 명시된 기능이 6개 있습니다.
Claude의 구조화된 출력 API와 strict 도구를 같은 요청에서 함께 사용해야 할까요?
검색 추천어 "claude structured outputs api"에서 나온 질문입니다. 네, 가능합니다. structured outputs 페이지의 "Feature compatibility" 섹션에 따르면 두 기능을 한 요청에서 함께 사용할 수 있습니다. strict 도구 20개, 선택 파라미터 24개, 유니언 타입 파라미터 16개라는 제한을 공유하므로 출력 스키마도 모든 필드를 필수로 지정하세요.
시작하는 방법
- 카탈로그를 읽으세요.
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot는 무료이며 API 키가 필요 없습니다. 파라미터, 허용 값, 가격을 확인할 수 있습니다. - 위의 6가지 규칙에 따라 strict 도구를 작성하세요. 파라미터는 필수로 지정하고,
allowed_values는enum으로 작성하고, 범위는 설명에 넣습니다. - 빠른 시작에서 API 키를 발급받으세요. 잘못된 enum으로 요청을 한 번 보내
did_you_mean이 포함된 422가 반환되는지 확인하세요. - 대량 작업에는 큰
limit와"mode": "async"를 사용하세요. Claude 측에서는 Message Batches를 사용합니다.
플랫폼 페이지: Trustpilot 스크래핑 API, App Store 스크래핑 API, Amazon 스크래핑 API. 기능 페이지: Trustpilot 리뷰, App Store 리뷰, Amazon 리뷰. 기타 리뷰 페이지: G2 리뷰, Google Play 리뷰. 코드 없이 Claude에서 원격 MCP 서버를 연결하려면 원격 MCP 설정을 참고하세요.
리뷰 데이터를 상품으로 만드는 방법은 리뷰 데이터를 유료 상품으로 만들기를 참고하세요. 하나의 SKILL.md로 4개 AI 도구 지원하기도 함께 읽어 보세요. 서브에이전트로 데이터를 병렬 수집하려면 TikTok 브랜드 계정을 위한 Claude Code 서브에이전트를 참고하세요. 기능별 가격은 데이터 마켓에서 비교할 수 있습니다.
참고 자료
- “What's new in Claude Opus 5.5 (Forced tool use is not supported)”, Anthropic, 2026년 9월 22일, https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- “What's new in Claude Fable 5.1”, Anthropic, 2026년 9월 1일, https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- “What's new in Claude Sonnet 5.5”, Anthropic, 2026년 9월 28일, https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- “Claude Opus 5.5 migration guide”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- “Claude Fable 5.1 migration guide”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- “Claude Sonnet 5.5 migration guide”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- “API release notes”, Anthropic, 2026년 10월 30일 업데이트, https://platform.claude.com/docs/en/release-notes/overview
- “Strict tool use”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- “Structured outputs”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- “Define tools”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- “Handle tool calls”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- “Tool use overview”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- “How tool use works”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- “Troubleshooting tool use”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- “Parallel tool use”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- “Tool runner”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- “Tool search tool”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- “Programmatic tool calling”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- “Batch processing”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/batch-processing
- “Create a Message Batch (API reference)”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/api/messages/batches/create
- “Pricing”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/about-claude/pricing
- “Prompt caching”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- “Token counting”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/token-counting
- “Rate limits”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/api/rate-limits
- “Errors”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/api/errors
- “Models overview”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/models/overview
- “Claude Haiku 5.5 overview”, Anthropic, 2026년 10월 7일, https://platform.claude.com/docs/en/models/haiku-5-5/overview
- “Claude Opus 5.5 overview”, Anthropic, 2026년 9월 22일, https://platform.claude.com/docs/en/models/opus-5-5/overview
- “Claude Mythos 5.1 overview”, Anthropic, 2026년 9월 1일, https://platform.claude.com/docs/en/models/mythos-5-1/overview
- “Effort”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/effort
- “Streaming”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/streaming
- “Refusals and fallback”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- “Citations”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/build-with-claude/citations
- “MCP connector”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- “Remote MCP servers”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- “Migrating to API version 2026-10-21”, Anthropic, 2026년 10월 21일, https://platform.claude.com/docs/en/api/migration-2026-10-21
- “API and data retention”, Anthropic, 2026년 11월 1일 열람, https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- “Model Context Protocol specification 2025-11-25: Tools”, MCP, https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- “JSON Schema Validation, draft 2020-12”, JSON Schema, https://json-schema.org/draft/2020-12/json-schema-validation
- “JSONSchemaBench”, Geng et al., arXiv 2501.10868, 2025, https://arxiv.org/abs/2501.10868
- “Ratings, reviews, and responses”, Apple Developer, 2026년 11월 1일 열람, https://developer.apple.com/app-store/ratings-and-reviews/
- EveryInfra 데이터 카탈로그(GET /api/v1/social/catalog), EveryInfra, 2026년 11월 1일 00:46 SGT 열람, https://api.everyinfra.com/api/v1/social/catalog
참고 BL-60