Un solo SKILL.md per quattro strumenti AI: una Skill per analizzare le recensioni dei concorrenti
Un unico SKILL.md di analisi delle recensioni dei concorrenti per Claude Code, Codex, Antigravity CLI e Gemini, verificato sulla documentazione ufficiale di ciascuno. Nove chiamate API reali hanno letto 967 recensioni per 0,0125 $.
Abbiamo scritto un unico SKILL.md di «analisi delle recensioni dei concorrenti» mantenendo il frontmatter entro la specifica Agent Skills. Secondo la documentazione ufficiale di ciascun prodotto, lo stesso file viene caricato in Claude Code, Codex e Antigravity CLI senza modifiche. Sulla nostra macchina abbiamo eseguito gli script della skill, il validatore della specifica e l'API per i dati; non abbiamo installato Codex né Antigravity. L'app Gemini può importarlo, ma i suoi script di skill non possono accedere a internet, quindi lì la skill non può recuperare i dati.
Il 26 ottobre 2026, dalle 17:25 alle 17:55 SGT, la skill ha generato un report su tre strumenti di project management. Ha usato 9 chiamate a G2, Capterra e Trustpilot, ha letto 967 recensioni e ha speso 0,012501 $ di costi API. Il rischio maggiore era nei dati, non negli strumenti. Su Trustpilot, le recensioni spontanee di cinque aziende avevano una media tra 1,29 e 2,77 stelle, mentre quelle su invito avevano una media tra 4,07 e 4,89 stelle.


In breve: uno SKILL.md, quattro cartelle, un conto da 9 chiamate
Questo articolo risponde a una domanda pratica. Oggi usi le skill di Claude Code. I tuoi colleghi usano Codex o Antigravity CLI. Tutto il team può condividere un unico SKILL.md per l'analisi delle recensioni dei concorrenti? Prima della prima chiamata API abbiamo fissato tre criteri di superamento.
Primo, il frontmatter deve rispettare la specifica Agent Skills, campo per campo. Secondo, il percorso della cartella e il modo di richiamare la skill devono provenire dalla documentazione di ciascun prodotto. Terzo, il costo API deve corrispondere al prezzo di catalogo moltiplicato per il numero di chiamate, senza alcuna differenza. Tutti e tre i criteri sono stati superati. Un prodotto li ha superati solo a metà.
La tabella mette a confronto i quattro prodotti. Ogni cella proviene dalla documentazione dei rispettivi produttori, che abbiamo consultato il 26 ottobre 2026. I link sono nelle sezioni seguenti. L'ultima colonna pone una sola domanda: lo script della skill riesce a raggiungere api.everyinfra.com? Senza questo, la skill non può svolgere il suo compito.
| Prodotto | Cartella del progetto | Cartella personale | Come richiamarla | Lo script può recuperare dati? |
|---|---|---|---|---|
| Claude Code | .claude/skills/<name>/SKILL.md | ~/.claude/skills/<name>/SKILL.md | /name, oppure Claude la sceglie in base alla descrizione | Sì nelle sessioni locali; no in Cowork o nelle sessioni cloud. |
| Codex (CLI, IDE, desktop) | .agents/skills, dalla cartella di lavoro fino alla root del repo | $HOME/.agents/skills | $name, /skills, oppure la sceglie Codex | Sì. |
| Antigravity CLI | .agents/skills/ | ~/.gemini/antigravity-cli/skills/ | /skills per elencarle, oppure la sceglie l'agente | Sì. |
| App Gemini | Non usata (caricamento dalla pagina Skills) | Non usata | / o @ seguito dal nome della skill | No: gli script che richiedono internet non sono supportati. |
La prima e la terza riga differiscono in un aspetto importante. Claude Code usa .claude/skills per i progetti. Codex, Antigravity CLI e il dismesso Gemini CLI leggono tutti .agents/skills. Quindi un repo che serve tutti questi strumenti può tenere la skill in .agents/skills/competitor-review-analysis/ e aggiungere un symlink sotto .claude/skills/. La documentazione di Claude Code dice che una cartella di skill può essere un symlink. La documentazione di Codex dice che Codex segue le cartelle di skill collegate tramite symlink (documentazione sulle skill di Claude Code; Codex Build skills).
Cosa sono le agent skill: uno SKILL.md con sei campi
Agent Skills è un formato aperto. Una skill è una cartella con almeno un file SKILL.md. Il file inizia con un frontmatter YAML, seguito dai passaggi in Markdown (specifica Agent Skills). La specifica definisce sei campi. Due sono obbligatori: name e description.
Quattro sono facoltativi: license, compatibility, metadata e allowed-tools. Il name deve avere da 1 a 64 caratteri tra lettere minuscole, cifre e trattini. Non può iniziare né finire con un trattino, non può contenere due trattini consecutivi e deve corrispondere al nome della cartella. La description deve avere da 1 a 1.024 caratteri e dire cosa fa la skill e quando usarla. La specifica indica allowed-tools come sperimentale, quindi il supporto varia da un agente all'altro.
Il formato risparmia contesto grazie alla «progressive disclosure», articolata su tre livelli. All'avvio della sessione, l'agente carica solo name e description di ogni skill, circa 100 token secondo la stima della specifica. Quando un'attività corrisponde alla descrizione, l'agente legge lo SKILL.md completo. La specifica consiglia meno di 5.000 token e meno di 500 righe. I file in scripts/ e references/ vengono caricati solo quando i passaggi ne hanno bisogno (specifica Agent Skills). Anthropic ha descritto la stessa idea il 16 ottobre 2025: dare prima all'agente un indice (Anthropic sulle Agent Skills).
name e description della nostra skill sommano 363 caratteri. A circa 4 caratteri per token, sono circa 91 token, vicini alla stima della specifica. Lo SKILL.md completo ha 51 righe e 3.426 caratteri, molto sotto il limite di 500 righe. Questi due numeri tornano più avanti, nella sezione sul contesto.
L'intero SKILL.md per le recensioni dei concorrenti
Ecco il file completo. La cartella della skill contiene anche due script e un elenco di parole chiave. scripts/fetch_reviews.py chiama l'API per i dati di EveryInfra. scripts/classify.py assegna a ogni recensione dei temi in base a regole su parole chiave. references/themes.md contiene le parole chiave.
---
name: competitor-review-analysis
description: Pull public reviews for 2-5 competing products from G2, Capterra, Trustpilot or Amazon through the EveryInfra data API, tag each review with a theme, and write a comparison report with counts, shares and quotes. Use when the user asks to compare competitor reviews, find what customers complain about, or build a review-based battlecard.
license: MIT
compatibility: Needs network access to api.everyinfra.com, Python 3.9+, and an EVERYINFRA_API_KEY environment variable. Does not run inside the Gemini app, where skill scripts cannot reach the internet.
metadata:
  version: "1.1"
  author: everyinfra-blog-example
---

# Competitor review analysis

## Inputs to confirm first
1. The products to compare (2-5). For each one, get the exact review page:
   G2 `https://www.g2.com/products/<slug>`, Capterra `https://www.capterra.com/p/<id>/<name>/`,
   Trustpilot domain such as `clickup.com`, Amazon `https://www.amazon.com/dp/<ASIN>`.
   Use the URL, not the product name. Product names change (Capterra lists monday.com as "monday AI Work Platform").
2. The theme set: `saas` or `hardware` (see references/themes.md). Ask if unclear.

## Steps
1. Fetch: run `python3 scripts/fetch_reviews.py --plan plan.json --out raw/`.
   One request per product per source. The script waits 7 s between requests,
   retries 429 with the `retry_after` value, and sends slow requests with `"mode":"async"`.
2. Check counts: read `raw/summary.json`. A source with 0 rows was not charged.
   Do not treat a short page as "no more reviews". Write the counts into the report.
3. Tag: run `python3 scripts/classify.py raw/ --themes saas > tagged.json`.
   The script tags by keyword rules, so the same input gives the same output.
4. Read 5 tagged reviews per theme and check that the tag fits. If a keyword
   matches the wrong words (v1 had `plan`, which matched "planning"), fix
   references/themes.md and run step 3 again. Note each change in the report.
5. Write `report.md` with these sections, in this order:
   - Table: product x source -> reviews read, average rating, charged USD.
   - Table: theme x product -> count and share of reviews that mention it.
   - Top 3 complaints per product, each with one short quote and its review URL.
   - Limits: what the sample cannot show (see below).

## Rules
- Report rating scales as they are: G2 and Capterra 1-5, Trustpilot 1-5 stars, Amazon 1-5 stars.
  Do not average across sources.
- Split Trustpilot by the `source` field: `Organic` (the reviewer came on their own) versus
  invitation sources (`BasicLink`, `InvitationApi`, `FileUploadInvitation`, `Shopify` and others).
  Report the average for each group. Never report one Trustpilot average for a company.
- Theme keywords are per language. For reviews that are not in English, use the matching set
  (for example `saas_es`), or report them as untagged.
- Do not print reviewer names. Quote at most 25 words per review.
- Amazon returns only the reviews shown on the product page (usually 10-15). Say so.
- Cost: every request costs the `price_usd` from `GET /api/v1/social/catalog`. Add up `billing.charged_usd` from the responses; do not estimate.

## Limits to state in every report
- The sample is the newest page of each source, not all reviews.
- Trustpilot reviews of a software company are often about billing and support, not the product. Read them as a separate signal.
Diverse righe servono solo a rendere il file portabile. Il frontmatter usa cinque dei sei campi della specifica. Non usa estensioni di Claude Code come model, context: fork o argument-hint. La riga compatibility indica i requisiti di rete e di chiave.
Chi importa il file nell'app Gemini vede subito che lì non può funzionare. I percorsi degli script sono relativi alla root della skill e i riferimenti ai file restano a un solo livello di profondità, come richiede la specifica (specifica Agent Skills). Due regole sono arrivate solo dopo aver analizzato i dati: «separa Trustpilot per fonte» e «parole chiave per lingua». Le prossime sezioni spiegano perché.
Non abbiamo controllato il file a occhio. Alle 17:56 SGT abbiamo eseguito il validatore di riferimento skills-ref 0.1.1 del repository della specifica (agentskills/skills-ref) su tre campioni. Il file originale ha restituito Valid skill. Una copia con context: fork e model: haiku ha restituito «Unexpected fields in frontmatter: context, model».
Una copia con name: Review_Skill ha restituito due errori: il nome deve essere in minuscolo e contiene caratteri non validi. Questo è coerente con la documentazione di Claude Code. In Claude Code locale funziona ogni campo della sua tabella. I caricamenti su claude.ai, la Skills API e package_skill.py accettano solo i sei campi della specifica. Lì un campo in più è un errore bloccante (documentazione sulle skill di Claude Code).
| Campione | Modifica | Risultato di skills-ref 0.1.1 | Portabile? |
|---|---|---|---|
| Originale | Nessuno | Valid skill | Sì. |
| Negativo 1 | Aggiunti context: fork e model: haiku | Errore: campi inattesi context, model | Funziona in Claude Code locale; il caricamento su claude.ai fallisce. |
| Negativo 2 | name: Review_Skill | Errore: deve essere in minuscolo; caratteri non validi | No. |
Cinque punti di accesso, cinque set di regole per il frontmatter
Prima di mettere un file in più posti, verifica cosa accetta ciascun punto di accesso. La tabella elenca solo le regole indicate nella documentazione dei produttori. Dove la documentazione non dice nulla, la cella riporta «non nella documentazione».
| Punto di accesso | `name` | `description` | Campi fuori dalla specifica | Altri limiti. |
|---|---|---|---|---|
| Specifica Agent Skills | Obbligatorio; 1–64 caratteri; minuscole, cifre, trattini; uguale alla cartella | Obbligatorio; 1–1.024 caratteri | Non fanno parte della specifica | Consigliato un corpo sotto le 500 righe. |
| Claude Code, locale | Facoltativo; per impostazione predefinita il nome della cartella | Consigliato; vengono mostrati 1.536 caratteri | model, context, hooks | I campi sconosciuti vengono ignorati. |
| Caricamento su claude.ai e Skills API | Obbligatorio; ≤64 caratteri; niente «claude» né XML | Obbligatorio; ≤1.024 caratteri | Un campo in più è un errore | Sotto i 30 MB; nessuna rete. |
| Codex | Obbligatorio | Obbligatorio | UI e dipendenze vanno in agents/openai.yaml | Il primo elenco usa il 2% del contesto o 8.000 caratteri. |
| Punto di accesso | `name` | `description` | Campi fuori dalla specifica | Altri limiti. |
|---|---|---|---|---|
| Antigravity | Facoltativo; per impostazione predefinita il nome della cartella | Obbligatorio | Non documentato | Non documentato. |
| App Gemini | Tutto in minuscolo, con le parole separate da trattini | Lunghezza non documentata | Non documentato | 100 MB in totale; gli script non possono accedere a internet. |
La tabella mostra perché ci atteniamo ai campi della specifica. La specifica è il sottoinsieme comune. Claude Code in locale è il punto di accesso più tollerante, mentre il caricamento su claude.ai è il più rigido. Scrivi per quello più rigido e ogni punto di accesso accetterà il file.
Le varie documentazioni concordano anche su come scrivere la description. Codex accorcia per prime le descrizioni quando sono installate molte skill, quindi metti all'inizio l'uso principale e le parole che la attivano (Codex Build skills). Claude Code tronca la descrizione a 1.536 caratteri, quindi metti per primo il caso d'uso principale (Claude Code skills docs). Il primo consiglio di Google è definire quando usare la skill (About the transition from Gems to skills).
La nostra prima frase dice cosa fa la skill, da quali siti e tramite quale API. La seconda dice quali richieste dell'utente devono attivarla. Il totale è di 337 caratteri, quindi nessun punto di accesso la tronca.
Skill di Claude Code: ~/.claude/skills o .claude/skills
Claude Code legge le skill da cinque posizioni: enterprise (.claude/skills/ nella cartella delle impostazioni gestite), personale (~/.claude/skills/<name>/SKILL.md), progetto (.claude/skills/<name>/SKILL.md), cartelle annidate e cartelle aggiunte con --add-dir. In caso di nomi in conflitto, le skill enterprise hanno la precedenza su quelle personali, che a loro volta hanno la precedenza su quelle di progetto (Claude Code skills docs). Una skill di progetto può essere inclusa in un commit, così ogni collega la riceve insieme al codice. Una skill personale funziona in ogni repo sul tuo computer. Le skill di progetto vengono caricate dalla cartella di avvio fino alla root del repo, quindi una sessione in packages/frontend/ vede comunque una skill nella root.
Per un report settimanale sui concorrenti contano tre limiti. Primo: le sessioni Cowork e le sessioni cloud, comprese le attività pianificate nel cloud, non leggono ~/.claude/skills/ sul tuo computer. Caricano solo le skill che attivi nel tuo account claude.ai. Se la skill si trova solo nella cartella locale, un'attività pianificata nel cloud segnala che non riesce a trovarla.
Le attività pianificate su desktop girano sul tuo computer, quindi leggono ~/.claude/skills/ (stessa documentazione, «Use skills in Cowork and cloud sessions»). Secondo: un caricamento su claude.ai accetta solo i sei campi della specifica. Terzo: l'elenco delle skill ha un budget. Ogni description più when_to_use mostra al massimo 1.536 caratteri.
L'intero elenco ha a disposizione l'1% della finestra di contesto del modello, e le skill meno usate perdono per prime la descrizione. Dopo la compattazione automatica, Claude Code ricollega le skill recenti con i loro primi 5.000 token ciascuna, entro un totale di 25.000 token (stessa documentazione). Per questo la nostra descrizione resta a 337 caratteri, con il caso d'uso principale nella prima frase.
Claude Code ha anche estensioni che funzionano solo in Claude Code. model cambia il modello per il turno. context: fork esegue la skill in un contesto di subagente separato. Alla sessione principale torna solo il risultato (skills docs; subagents docs). allowed-tools preapprova gli strumenti, e le righe di comando ! inseriscono dati in tempo reale nel corpo. Queste funzioni sono utili, ma un file che le usa non è più portabile.
Il nostro approccio mantiene il file condiviso conforme alla specifica. Per i comportamenti esclusivi di Claude Code, metti una seconda skill con lo stesso nome nella tua cartella personale. La regola «la skill personale ha la precedenza su quella di progetto» fa sì che Claude Code usi quella, mentre gli altri strumenti continuano a leggere la versione conforme alla specifica. Con context: fork, le 967 recensioni grezze restano fuori dalla sessione principale.
Puoi anche lasciare che sia il modello a chiamare gli strumenti invece di eseguire uno script. Aggiungi a Claude Code il server MCP remoto di EveryInfra. Abbiamo testato questo comando in un articolo precedente, quindi qui lo riportiamo come esempio di configurazione:
export EVERYINFRA_API_KEY="<your API key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Claude Code attiva per impostazione predefinita la ricerca degli strumenti MCP. All'avvio della sessione carica solo i nomi degli strumenti e le istruzioni del server, e recupera le definizioni degli strumenti quando servono (Claude Code MCP docs). Questo incide sui calcoli del contesto che vedremo in una sezione successiva.
Skill di Codex: .agents/skills e config.toml
Anche le skill di Codex si basano sullo standard aperto Agent Skills, e SKILL.md deve avere name e description (Codex Build skills). Codex legge quattro tipi di posizioni. Il livello repo è .agents/skills in ogni cartella, dalla cartella di lavoro fino alla root del repo. Il livello utente è $HOME/.agents/skills. Il livello admin è /etc/codex/skills.
Le skill di sistema sono incluse in Codex. Quando due skill hanno lo stesso nome, Codex non le unisce ed entrambe possono comparire nel selettore. Nella CLI o nell'estensione per IDE, digita /skills oppure menziona una skill con $. Codex può anche scegliere una skill in base alla sua descrizione. In ChatGPT si menziona una skill con @.
Due numeri nella documentazione di Codex influiscono su come scrivere la descrizione. Per impostazione predefinita, il primo elenco di skill usa al massimo il 2% della finestra di contesto del modello, oppure 8.000 caratteri se la dimensione della finestra non è nota. L'impostazione skills.max_context_tokens modifica il budget, fino a 10.000 token. Con molte skill installate, Codex prima accorcia le descrizioni, poi esclude alcune skill e mostra un avviso (Codex Build skills). Un file facoltativo agents/openai.yaml imposta il nome visualizzato, la policy allow_implicit_invocation e le dipendenze dagli strumenti MCP. Si trova nella cartella della skill e gli altri strumenti lo ignorano, quindi la skill resta portabile.
Per collegare il server MCP remoto di EveryInfra in Codex, aggiungi una tabella [mcp_servers.<name>] a ~/.codex/config.toml (Codex MCP docs). Un progetto attendibile può usare .codex/config.toml. Questo è un esempio di configurazione, che non abbiamo eseguito in un'installazione locale di Codex:
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"
enabled_tools = ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
default_tools_approval_mode = "writes"
tool_timeout_sec = 120
Due di queste righe derivano dai dati dei nostri test. enabled_tools limita la selezione a 3 strumenti. Alle 17:25 SGT la chiamata tools/list dell'MCP di EveryInfra ha restituito 25 strumenti, e alcuni creano chiavi, eliminano chiavi, modificano impostazioni o aprono ticket. A un report sulle recensioni non serve nessuno di questi. tool_timeout_sec è 120 secondi perché, per impostazione predefinita, Codex attende solo 60 secondi per ogni chiamata a uno strumento (Codex MCP docs).
Le nostre chiamate sincrone delle 17:28 e delle 17:30 SGT hanno richiesto 87,8 e 88,3 secondi. Con il valore predefinito, Codex rinuncia prima che l'API risponda. default_tools_approval_mode = "writes" chiede conferma prima di qualsiasi strumento non contrassegnato come di sola lettura. everyinfra_call_api addebita ogni chiamata, quindi il server non lo contrassegna come di sola lettura e Codex chiede conferma ogni volta. Se accetti questo costo, imposta tools.everyinfra_call_api.approval_mode solo per quello strumento.
Antigravity CLI e Gemini CLI: le cartelle sono state spostate
Il 18 giugno 2026 Google ha sostituito Gemini CLI con Antigravity CLI. Il sito della documentazione di Gemini CLI lo indica in cima alla pagina sulle skill (Gemini CLI Agent Skills docs). Il formato delle skill è lo stesso, ma le cartelle sono diverse. Gemini CLI usava ~/.gemini/skills/ per gli utenti e .gemini/skills/ per i workspace, con .agents/skills/ come alias per entrambi.
Antigravity CLI usa .agents/skills/ per i workspace e ~/.gemini/antigravity-cli/skills/ per le skill globali (Antigravity CLI migration docs). L'app desktop di Antigravity usa un'altra cartella globale ancora: ~/.gemini/config/skills/ (Antigravity skills docs). È l'unico caso in cui suggeriamo due copie, una per cartella.
Antigravity richiede solo description. Se manca name, usa il nome della cartella (stessa documentazione). La nostra skill ha entrambi i campi, quindi non ne risente. Un Codelab di Google del 25 settembre 2026 mostra i passaggi minimi.
Crea .agents/skills/<name>/SKILL.md, avvia agy, elenca le skill con /skills e fai una domanda (Google Codelabs). Su Reddit, un utente ha chiesto come configurare le skill di Antigravity e voleva la struttura delle cartelle, non un link alla documentazione (r/google_antigravity thread). Le tabelle qui sopra riportano quella struttura.
Antigravity ha spostato i server MCP da settings.json a un file mcp_config.json separato. Il file globale è ~/.gemini/config/mcp_config.json e quello di progetto è .agents/mcp_config.json. Per i server remoti, la chiave dell'indirizzo è passata da url o httpUrl a serverUrl (Antigravity CLI migration docs). Ha anche un elenco di strumenti consentiti, enabledTools.
Per impostazione predefinita attende 3 minuti per ogni chiamata a uno strumento e 5 minuti per la connessione (Antigravity MCP docs). Sono tempi più lunghi di quelli di Codex, quindi le nostre chiamate da 88 secondi non richiedono di modificare il timeout. Esempio di configurazione, non eseguito in locale:
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <your API key>" },
      "enabledTools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
Skill di Gemini: i Gem diventano di sola lettura il 17 novembre e gli script restano offline
Il 30 settembre 2026 Google ha annunciato che le skill sostituiranno i Gem. Le skill sono «interamente basate sullo standard aperto SKILL.md, nativo in Markdown», quindi puoi copiare nell'app Gemini le skill di altre piattaforme (Google Workspace Updates, 2026-09-30). Un aggiornamento del 13 ottobre ha comunicato che il rilascio delle skill nell'app Gemini è iniziato quel giorno, con completamento previsto entro metà novembre. Il lancio nelle app di Workspace è rinviato fino a nuovo avviso (Google Workspace Updates, 2026-10-13).
Due fonti Google indicano date diverse per i Gem, quindi verifica il tipo di account. Il post di Workspace del 30 settembre dice che il 17 novembre i Gem passano al pannello Impostazioni e che gli utenti «possono continuare a crearli, modificarli e usarli». Gli account business perdono i Gem non prima del 1° marzo 2027. La pagina del centro assistenza per gli account personali è più restrittiva. Per gli account Google personali di utenti dai 18 anni in su, il 17 novembre 2026 i Gem diventano skill di sola lettura. Puoi vederli, ma non puoi usarli né modificarli.
Il 17 dicembre 2026 i Gem vengono rimossi dall'app Gemini (Gemini Help: About the transition from Gems to skills). Quindi «di sola lettura dal 17 novembre» vale solo per gli account personali. Gli account business di Workspace passano a marzo 2027 e quelli education a giugno 2027. Il blog di Google concorda con il centro assistenza (Google blog: Let skills in Gemini tackle your most repetitive tasks).
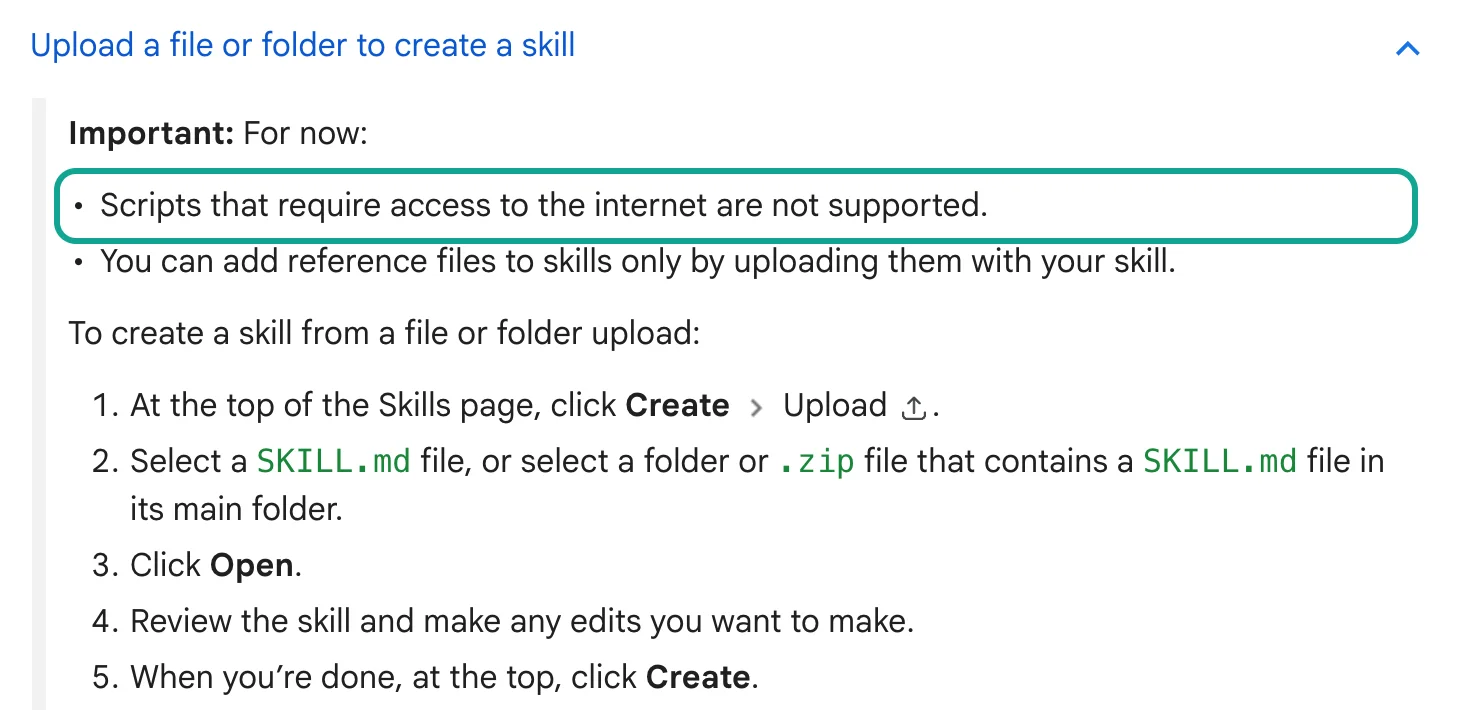
Due frasi del centro assistenza stabiliscono se questa skill può funzionare nell'app Gemini. Per ora gli script che richiedono l'accesso a internet non sono supportati. Gli script non possono eseguire azioni o richieste su siti web esterni (Gemini Help: Create & manage skills for Gemini Apps). La stessa pagina elenca le regole di caricamento.
SKILL.md deve trovarsi nella cartella principale, il nome deve essere in minuscolo con trattini e tutti i file insieme non devono superare i 100 MB. I file di testo semplice come .py, .sh, .md, .json e .csv vanno bene, mentre .docx e .xlsx no. La nostra skill rispetta tutte le regole di formato e viene importata, ma lì fetch_reviews.py non riesce a ottenere dati.
Gemini non è l'unico caso. La Claude Skills API esegue le skill in un container di esecuzione del codice «senza accesso alla rete», quindi le skill «non possono effettuare chiamate API esterne». Aggiunge anche una regola sul nome: name non può contenere le parole riservate «anthropic» o «claude», né tag XML (Claude Skills API guide). In entrambi i casi la suddivisione giusta è «skill per il processo, connettore per i dati».
Nell'app Gemini sono le app collegate a recuperare i dati. In Claude sul web e nell'API li recupera un connettore MCP. Il corpo della skill dice al modello solo quali passaggi seguire e quale report scrivere. Il centro assistenza aggiunge che le skill non funzionano ancora con Canvas o Deep Research (About the transition from Gems to skills).
Un round trip reale: la chiamata inviata dal modello e i dati che restituiamo
Uno script e una chiamata a uno strumento MCP confluiscono nella stessa richiesta sui nostri sistemi. La scheda qui sotto mostra una chiamata MCP reale a tools/call delle 17:46:24 SGT. Il modello ha chiamato everyinfra_call_api per ottenere le recensioni Trustpilot di ClickUp da una e due stelle degli ultimi 3 mesi, fino a 50 recensioni. L'API ha impiegato 27,8 secondi, ha restituito 7 recensioni e ha addebitato $0,001389.
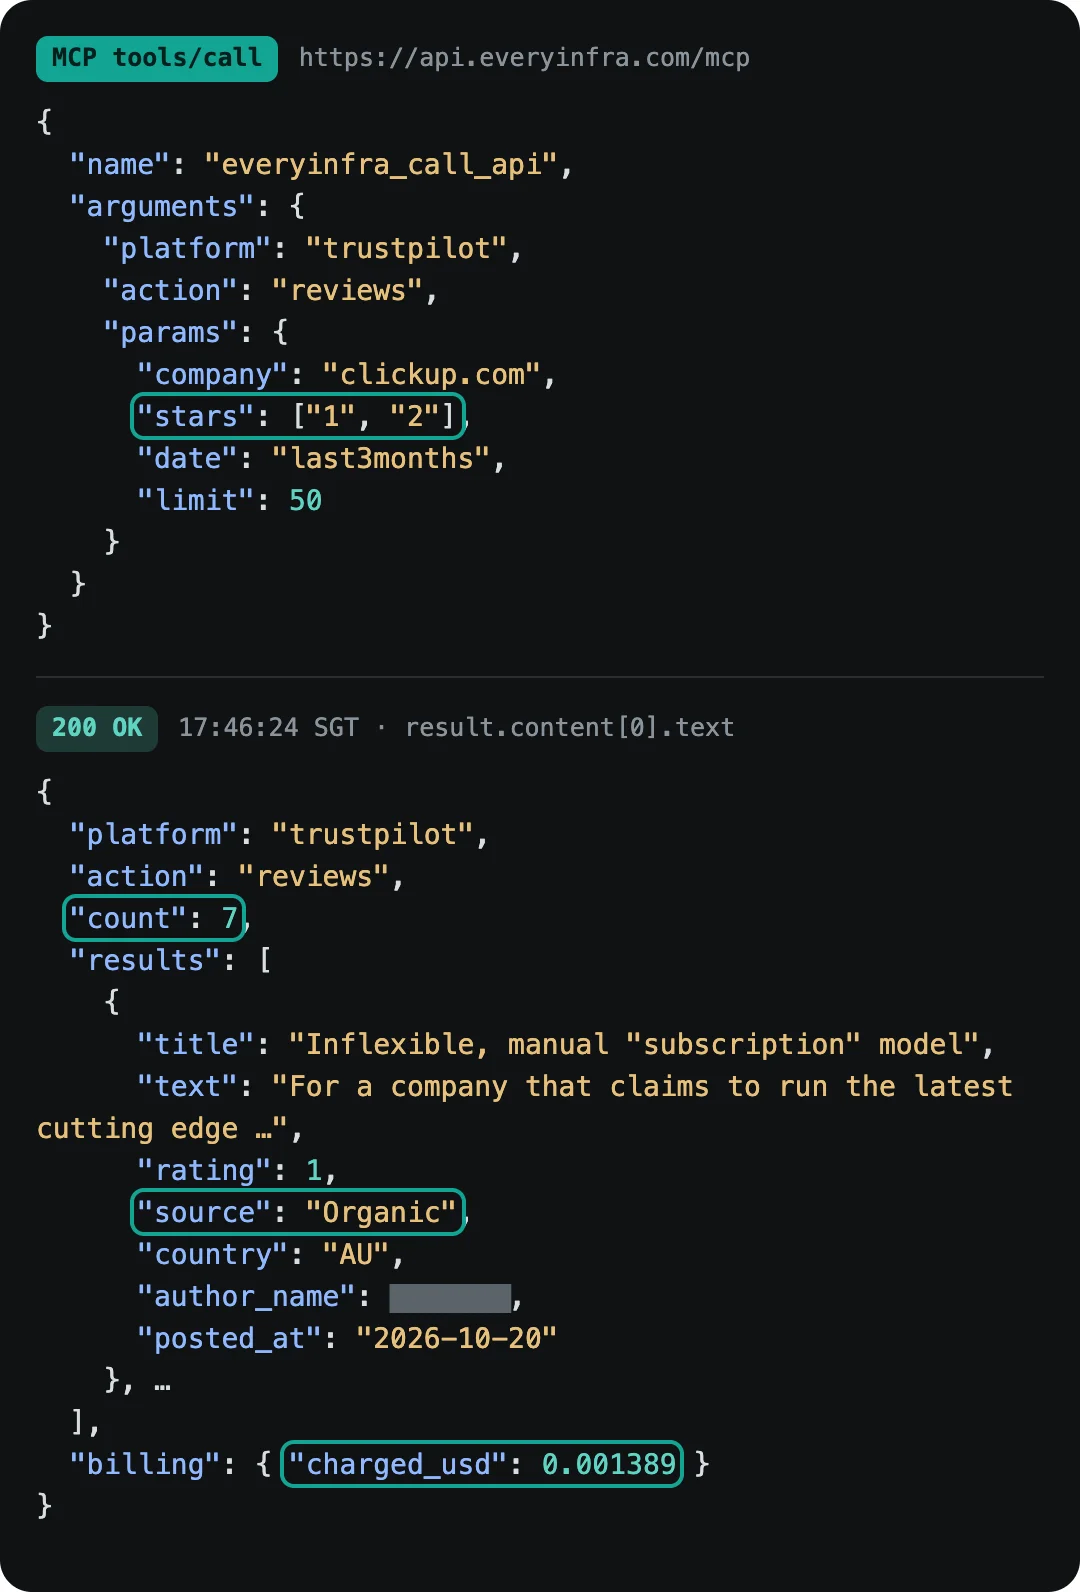
Ecco la stessa richiesta come chiamata curl diretta all'API per i dati. $EVERYINFRA_API_KEY proviene da una variabile d'ambiente e non finisce mai in un file:
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"trustpilot","action":"reviews","params":{"company":"clickup.com","stars":["1","2"],"date":"last3months","limit":50}}'
Il catalogo elenca 24 campi della risposta per trustpilot/reviews (catalogo EveryInfra). La skill usa quelli qui sotto. Abbiamo confrontato ogni nome e significato con response_fields e platform_field_meanings del catalogo.
| Campo | Significato (dal catalogo) | Come lo usa la skill. |
|---|---|---|
id, url | ID e link della recensione | Elimina i duplicati; aggiungi un link a ogni citazione. |
title, text | Titolo e corpo | Tagging per parole chiave. |
rating, rating_scale | Stelle e scala | Media per gruppo di origine. |
source | Origine della recensione | Separa le recensioni spontanee da quelle su invito. |
| Campo | Significato (dal catalogo) | Come lo usa la skill. |
|---|---|---|
verification_level | Livello di verifica (recensione su invito o organica) | Verifica incrociata con source. |
language, country | Lingua e paese | Scegli il set di parole chiave. |
experience_at, posted_at | Data dell'esperienza; data di pubblicazione | Delimita una finestra temporale. |
| Campo | Significato (dal catalogo) | Come lo usa la skill. |
|---|---|---|
reply_text | Risposta dell'azienda | Tasso di risposta. |
author_name | Nome visualizzato del recensore | Mai riportato nel report. |
I campi di G2 e Capterra sono adatti agli acquisti B2B. La prima riga di g2/reviews ha record_type summary, con la valutazione complessiva, il numero di recensioni e i pro e i contro più citati. Seguono le singole recensioni. Ogni riga di capterra/reviews ha pros, cons, valutazioni parziali per facilità d'uso e assistenza, e switching_reasons. Il catalogo segnala che switching_reasons è il campo più utile per l'analisi della concorrenza (catalogo EveryInfra).
Nove chiamate: quante recensioni restituiscono G2, Capterra, Trustpilot e Amazon
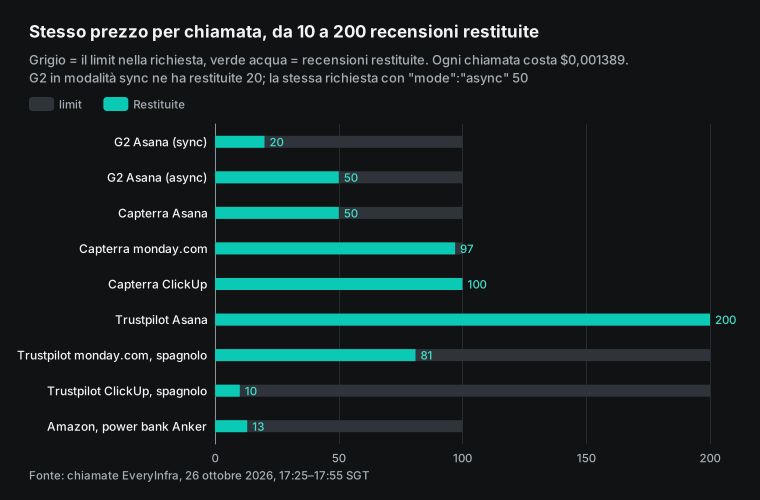
Dalle 17:25 alle 18:31 SGT abbiamo inviato 31 richieste in totale. 23 sono state addebitate e 8 no (quattro risposte 429, un timeout e tre risultati vuoti), per un totale di $0,032794. La tabella mostra le 11 richieste alla base del report sul software, comprese le due che non sono costate nulla.
| SGT | Funzionalità | Target | limit | Recensioni restituite | Tempo | Addebitato. |
|---|---|---|---|---|---|---|
| 17:25 | g2/reviews sincrono | Asana | 100 | 20, più 1 riga di riepilogo | — | $0.001389. |
| 17:27 | g2/reviews sincrono | monday.com | 100 | Timeout, 503 | 90.4 s | $0. |
| 17:28 | g2/reviews sincrono | ClickUp | 100 | 20, più 1 riga di riepilogo | 87.8 s | $0.001389. |
| 17:30 | capterra/reviews | Asana, per nome | 100 | 50 | 88.3 s | $0.001389. |
| SGT | Funzionalità | Target | limit | Recensioni restituite | Tempo | Addebitato. |
|---|---|---|---|---|---|---|
| 17:32 | capterra/reviews | «monday.com», per nome | 100 | 0, con rimborso | 67.5 s | $0. |
| 17:33 | capterra/reviews | ClickUp, per nome | 100 | 100 | 22.3 s | $0.001389. |
| 17:33 | capterra/reviews | monday.com, per URL del prodotto | 100 | 97 | 47.3 s | $0.001389. |
| 17:34 | g2/reviews asincrono | monday.com | 100 | 50, più 1 riga di riepilogo | 2,1 s per ottenere un ID del job | $0.001389. |
| SGT | Funzionalità | Target | limit | Recensioni restituite | Tempo | Addebitato. |
|---|---|---|---|---|---|---|
| 17:34 | trustpilot/reviews | asana.com | 200 | 200 | 44.5 s | $0.001389. |
| 17:35 | trustpilot/reviews | monday.com | 200 | 200 | 37.3 s | $0.001389. |
| 17:36 | trustpilot/reviews | clickup.com | 200 | 200 | 42.4 s | $0.001389. |
Tre lezioni tratte da questa tabella sono finite nel file SKILL.md. Primo: Capterra non ha trovato nulla con il nome «monday.com». Ora Capterra chiama il prodotto «monday AI Work Platform» (Capterra product page). La nostra API ha restituito 0 righe e ha rimborsato la chiamata.
Con l'URL del prodotto ha restituito 97 recensioni. Per questo il primo passaggio chiede URL, non nomi. Secondo: le chiamate G2 sincrone si avvicinano al budget di 85 secondi della modalità sincrona. La chiamata per monday.com è andata in timeout dopo 90,4 secondi, e la risposta indicava «Not charged» e suggeriva "mode":"async".
In modalità asincrona abbiamo ottenuto un ID del job in 2,1 secondi, e il job ha restituito 50 recensioni. Terzo: la stessa richiesta G2 per Asana ha restituito 20 recensioni in modalità sincrona. Alle 17:48 SGT lo script della skill l'ha inviata di nuovo in modalità asincrona e ne ha ottenute 50, tra cui tutte le 20 precedenti. Il prezzo è lo stesso, e la modalità asincrona ha restituito 2,5 volte più recensioni.
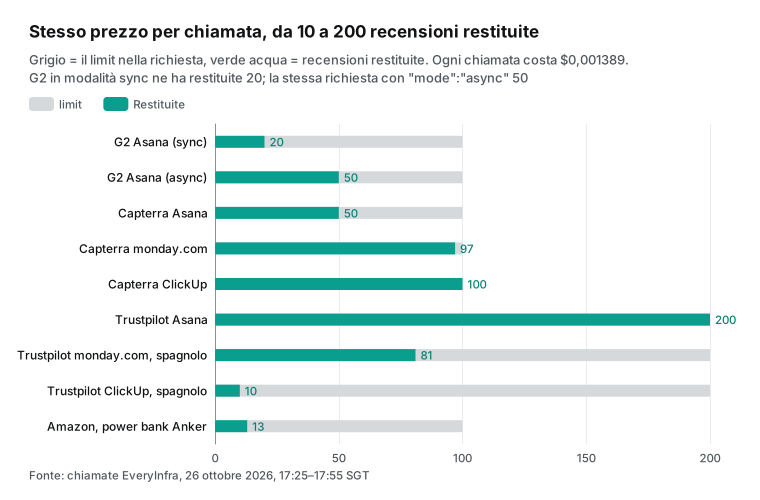
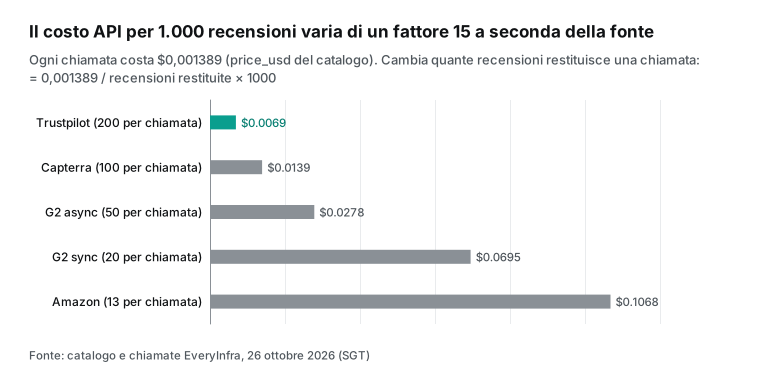
Il numero di recensioni per chiamata determina il costo per 1.000 recensioni, perché queste funzionalità addebitano per chiamata, non per recensione. Trustpilot restituisce 200 recensioni per chiamata, circa $0,0069 per 1.000. Capterra ne restituisce 100, circa $0,0139. G2 asincrono ne restituisce 50, circa $0,0278. G2 sincrono ne restituisce 20, circa $0,0695.
Amazon ne restituisce 13 per prodotto, circa $0,1068, quindi il divario è di circa 15 volte. Il numero di Amazon non è un errore. Le note del catalogo per amazon/reviews dicono che ogni sito nazionale fornisce solo le recensioni in evidenza nella pagina del prodotto (catalogo EveryInfra). Di solito sono da 10 a 15 per prodotto, non lo storico completo. Abbiamo letto lo stesso power bank UGREEN alle 17:38 e alle 17:54 SGT. Entrambe le letture hanno restituito 13 recensioni con gli stessi ID, quindi queste 13 sono un insieme stabile «in evidenza», non un campione casuale.
Ci sono state anche quattro risposte 429. Tra le 17:37:59 e le 17:38:50 SGT abbiamo inviato chiamate a 7 secondi di distanza l'una dall'altra, e quattro sono state rifiutate. Ogni risposta indicava il limite della chiave di 10 richieste al minuto, riportava retry_after pari a 1 secondo e diceva «Nothing was charged». Altre richieste avevano già usato parte di quel minuto.
Lo script ha atteso retry_after più l'intervallo normale, e ogni nuovo tentativo è andato a buon fine. Abbiamo limitato la chiave di test a 10 richieste al minuto. Il valore predefinito dell'account è 60 al minuto, condiviso da tutte le chiavi, e aumenta con il totale delle ricariche (pagina dei prezzi). Controlla il limite della tua chiave nella console.
La trappola più grande: separa le medie Trustpilot per origine
La maggior parte delle tabelle sulla concorrenza assegna a ogni azienda una sola media Trustpilot. I nostri dati dicono che quel numero significa molto poco. Dalle 17:34 alle 17:44 SGT abbiamo letto le 200 recensioni Trustpilot più recenti di sei aziende (Holded ne ha solo 48) e le abbiamo raggruppate in base al campo source. Organic significa che il recensore ha trovato la pagina da solo. BasicLink, InvitationApi, FileUploadInvitation e Shopify indicano tutti che l'azienda ha inviato un invito.
| Azienda | Recensioni organiche | Media organica | Recensioni su invito | Media su invito | Differenza | Media mista. |
|---|---|---|---|---|---|---|
| Asana | 199 | 1.90 | 1 | — | — | 1.90. |
| monday.com | 145 | 1.53 | 55 | 4.51 | 2.98 | 2.35. |
| ClickUp | 37 | 2.51 | 163 | 4.89 | 2.38 | 4.45. |
| Holded | 35 | 2.77 | 13 | 4.69 | 1.92 | 3.29. |
| Azienda | Recensioni organiche | Media organica | Recensioni su invito | Media su invito | Differenza | Media mista. |
|---|---|---|---|---|---|---|
| Anker | 132 | 2.14 | 68 | 4.62 | 2.48 | 2.98. |
| UGREEN | 21 | 1.29 | 179 | 4.07 | 2.78 | 3.77. |
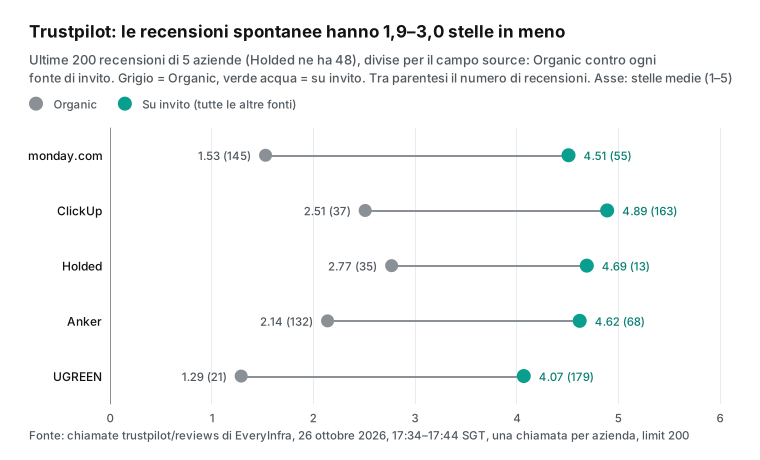
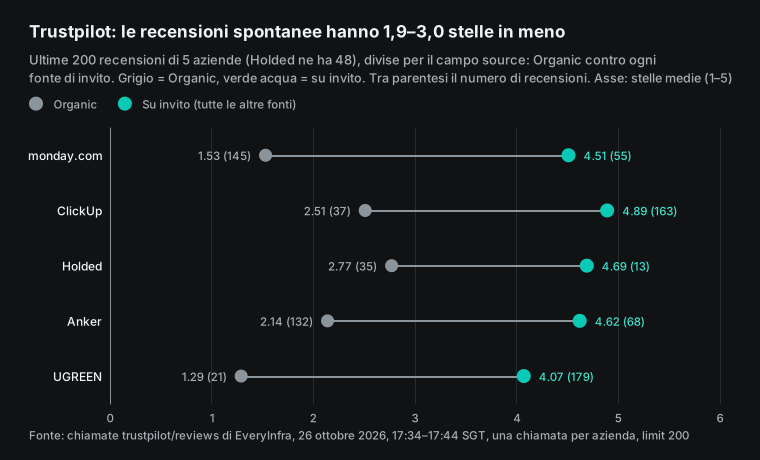
La media mista dà a ClickUp 4,45 stelle e ad Asana 1,90, quindi ClickUp sembra molto migliore. Separando i gruppi, entrambe hanno medie organiche basse: 2,51 e 1,90. La maggior parte del divario dipende dagli inviti. 163 delle 200 recensioni più recenti di ClickUp sono arrivate tramite un link di invito. monday.com mostra lo stesso schema: 145 recensioni organiche hanno una media di 1,53 stelle e 55 recensioni su invito una media di 4,51.
I brand hardware non fanno eccezione. 178 recensioni di UGREEN provengono da inviti automatici dello store Shopify, e le sue 21 recensioni organiche hanno una media di 1,29 stelle. La nostra lettura è semplice. Chi arriva di propria iniziativa spesso scrive perché qualcosa è andato storto. Chi riceve un invito spesso scrive subito dopo un acquisto.
Se si mescolano i due gruppi, la media misura quanti inviti invia un'azienda, non cosa pensano i clienti. Ci sono dei limiti. Ogni campione è composto dalle 200 recensioni più recenti, e gli intervalli di tempo variano molto. Non abbiamo valutato se le singole recensioni siano autentiche, né giudichiamo le pratiche di invito delle aziende.
Inoltre, «le 200 più recenti» coprono finestre temporali molto diverse. Le 200 di Asana vanno dal 31 gennaio 2022 al 3 ottobre 2026, quasi cinque anni. Quelle di monday.com vanno dal 15 dicembre 2024 al 24 ottobre 2026. Quelle di ClickUp vanno dal 1° aprile 2026 al 22 ottobre 2026, meno di sette mesi. Quelle di UGREEN coprono il periodo più breve: dal 30 agosto 2026 al giorno in cui le abbiamo lette, il 26 ottobre 2026.
In meno di due mesi UGREEN ha raccolto 200 recensioni, e 178 provengono da inviti dello store. Quindi un campione rappresenta due mesi di nuovi acquirenti, e un altro cinque anni di utenti di lunga data. Un report dovrebbe anche limitare tutte le fonti alla stessa finestra, per esempio con il parametro Trustpilot date: "last6months". Questa volta non abbiamo limitato la finestra, perché volevamo il quadro completo.
Il solo sito web non permette di vedere questa distinzione. Il centro assistenza di Trustpilot spiega che ogni azienda può invitare gratuitamente i clienti inviando dei link. Gli inviti automatici (email in BCC, integrazioni con gli store, API) producono recensioni etichettate «Verified». Gli inviti «Basic Link» producono recensioni etichettate «Unprompted review» (Trustpilot Help: Trustpilot invitation methods).
Abbiamo controllato la pagina di ClickUp. Una recensione a cinque stelle etichettata «Unprompted review» sul sito risulta source: BasicLink e verification_level: invited nell'API. Una recensione a una stella sulla stessa pagina, con la stessa etichetta, risulta source: Organic e verification_level: not-verified (Trustpilot: ClickUp reviews). Il sito chiama entrambe «Unprompted», mentre l'API le distingue.
Per questo la sezione Rules della skill dice «separa per origine, mai un'unica media». Le linee guida di Trustpilot per le aziende chiedono di invitare in modo imparziale (Trustpilot Guidelines for Businesses). Le linee guida regolano il modo in cui le aziende invitano, ma non cambiano il fatto che chi recensisce su invito è diverso da chi lo fa spontaneamente.
Stesso prodotto, tre siti, lamentele diverse
Anche i temi cambiano da un sito all'altro. Ecco Asana: 50 recensioni da G2 (asincrono), 50 da Capterra e 200 da Trustpilot. Le abbiamo taggate con le regole per parole chiave v1.1 della skill, e una recensione può rientrare in più temi.
| Tema | G2 (50) | Capterra (50) | Trustpilot (200). |
|---|---|---|---|
| Prezzi e fatturazione | 14% | 18% | 43%. |
| Assistenza | 12% | 14% | 46%. |
| Curva di apprendimento | 26% | 22% | 5%. |
| Facilità d'uso | 30% | 22% | 7%. |
| Tema | G2 (50) | Capterra (50) | Trustpilot (200). |
|---|---|---|---|
| Automazione | 22% | 38% | 7%. |
| Mobile | 6% | 2% | 5.5%. |
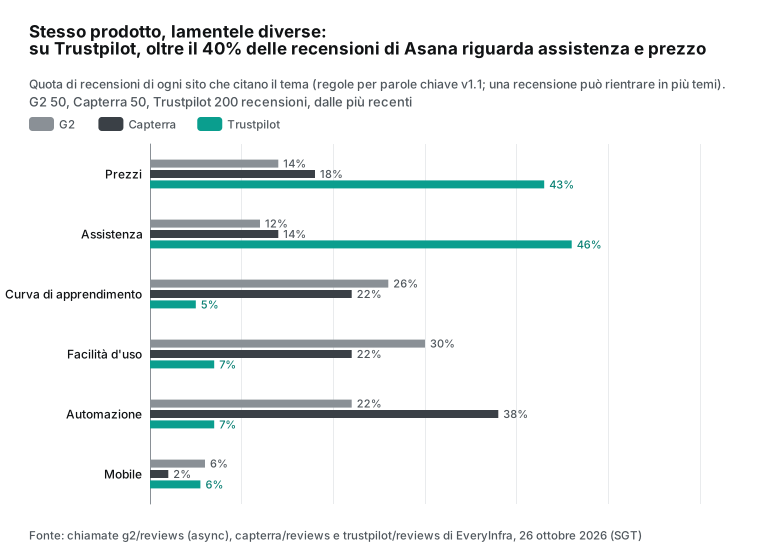
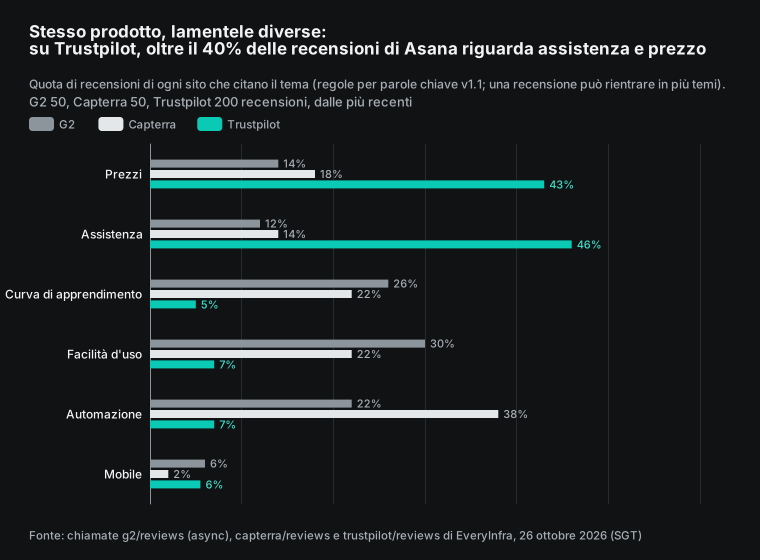
La maggior parte dei recensori su G2 e Capterra sono membri di team che usano il prodotto. Scrivono delle funzioni, come la curva di apprendimento e l'automazione. Su Trustpilot, il 46% delle recensioni di Asana cita l'assistenza e il 43% prezzi o fatturazione. Per lo più riguardano rinnovi, rimborsi e account bloccati. monday.com è simile, con il 35% sui prezzi e il 29% sull'assistenza su Trustpilot.
ClickUp è l'eccezione: in testa c'è l'automazione con il 39,5%, il che è coerente con una pagina piena di utenti attivi arrivati su invito. Le righe di riepilogo di G2 riportano i numeri di G2. Asana ha 4,4 stelle su 14.051 recensioni, e «Learning Curve» è il contro più citato (605 menzioni). monday.com ha 4,7 stelle su 17.294 recensioni e ClickUp 4,6 su 15.159 (G2: Asana reviews).
Per questo la sezione Limits della skill lo dice chiaramente. Le recensioni Trustpilot di un'azienda software riguardano soprattutto fatturazione e assistenza. Leggile come un segnale a parte e non unirle a quelle di G2 e Capterra.
Questi sono i numeri della seconda versione. Il primo elenco di parole chiave includeva plan nella categoria prezzi e usava la corrispondenza per prefisso. Il passaggio 4 della skill dice di leggere 5 recensioni taggate per tema. Quando l'abbiamo fatto, Capterra mostrava per Asana i prezzi al 58%, e molte di quelle recensioni parlavano di «project planning».
Un conteggio delle parole in quelle 50 recensioni Capterra ha trovato planning 13 volte. Anche il prefisso app nella categoria mobile corrispondeva ad appreciate 6 volte e ad approval o approvals 4 volte. Siamo passati alla corrispondenza per parola intera e abbiamo rimosso plan, app, agent e simple. La quota prezzi di Asana su Capterra è quindi scesa dal 58% al 18%, su G2 dal 30% al 14% e su Trustpilot dal 48,5% al 43%.
Ne derivano due lezioni. Le regole per parole chiave sono economiche e ripetibili, ma una persona deve verificarle a campione. Il passaggio 4 non è una formalità: alla prima esecuzione ha corretto un risultato sbagliato prima che finisse in un report.
Come si presenta il report finito
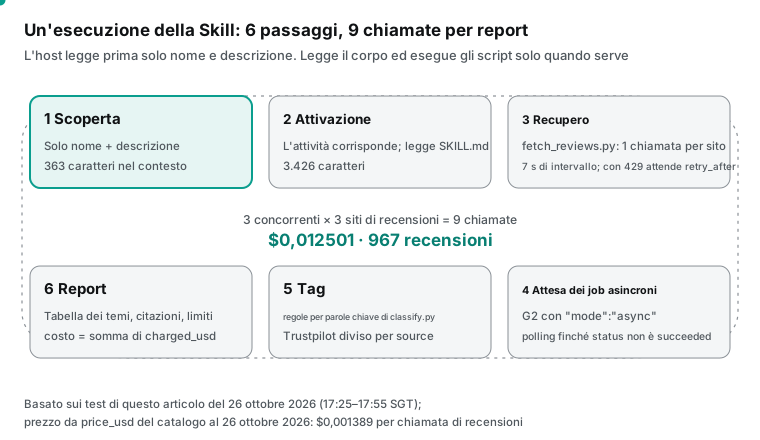
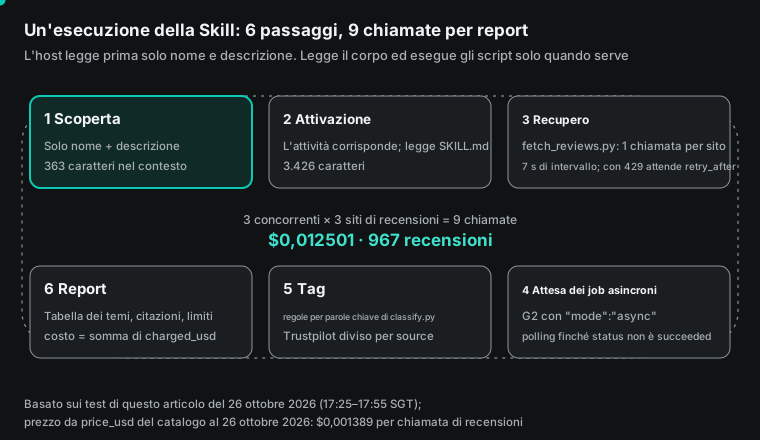
Il passaggio 5 della skill definisce il layout del report. Ecco la prima tabella, compilata con i dati di questa esecuzione: recensioni lette, stelle medie e costo per ogni prodotto su ogni sito. I tre siti restano in colonne separate, senza una media complessiva. La cella di Trustpilot mostra la media mista e i gruppi organico e su invito, come richiede la sezione Rules.
| Prodotto | G2: recensioni / media | Capterra: recensioni / media | Trustpilot: recensioni / mista (organiche / su invito) | Costo API. |
|---|---|---|---|---|
| Asana | 50 / 4.38 | 50 / 4.76 | 200 / 1,90 (1,90 / solo 1 recensione) | $0.004167. |
| monday.com | 50 / 4.64 | 97 / 4.57 | 200 / 2.35 (1.53 / 4.51) | $0.004167. |
| ClickUp | 20 / 4.22 | 100 / 4.60 | 200 / 4.45 (2.51 / 4.89) | $0.004167. |
La terza parte del report elenca le tre principali lamentele per prodotto, ognuna con una breve citazione e il relativo link. Abbiamo preso i titoli di recenti recensioni Trustpilot organiche da una e due stelle. Un titolo è una sola riga scritta dal recensore, e non compare nessun nome. Per Asana: «Ruthless company» del 3 ottobre 2026, «Forever free doesn't mean forever free» del 1° ottobre e una recensione del 28 settembre che definisce «sneaky» la policy di cancellazione.
Per monday.com: tre recensioni del 24, 22 e 21 ottobre 2026, e due dei titoli citano il «customer service». Per ClickUp: la recensione del 20 ottobre 2026 «Inflexible, manual "subscription" model», su un preavviso di 30 giorni per ridurre le postazioni. Una recensione del 5 ottobre descrive un account bloccato dopo il pagamento. Questi titoli corrispondono alla tabella dei temi. Su Trustpilot, tutte e tre le aziende ricevono più lamentele su fatturazione e assistenza che sulle funzioni.
L'ultima parte del report elenca i limiti. Il campione è il blocco più recente di ogni sito. Per Asana su Trustpilot non c'è un gruppo su invito da confrontare. L'elenco di parole chiave v1.1 è stato verificato a campione con solo 5 recensioni per tema.
Non abbiamo lasciato che fosse un modello a scrivere i numeri. Gli script hanno calcolato ogni numero della tabella a partire dalle risposte dell'API. Il modello ha svolto due compiti: ha letto campioni per trovare errori nelle parole chiave al passaggio 4 e ha impaginato tabelle e citazioni al passaggio 5. Il primo compito funziona bene solo se chiedi al modello di registrare nel report ogni modifica. Il secondo non va quasi mai storto.
Rendilo settimanale: dove eseguire le attività pianificate
Il ritmo naturale per le recensioni dei concorrenti è una volta a settimana, il lunedì. Ecco dove ogni prodotto può eseguire questa skill secondo una pianificazione e con accesso alla rete. Le attività pianificate di Claude Code su desktop girano sul tuo computer e leggono ~/.claude/skills/. Le attività pianificate nel cloud avviano ogni volta una nuova sessione cloud. Non leggono la cartella locale. Usano solo le skill attivate nel tuo account claude.ai o le skill in .claude/skills/ del repo (Claude Code skills docs).
Al DevDay del 29 settembre 2026, OpenAI ha lanciato Codex Cloud, che esegue le attività anche quando il portatile è chiuso (DevDay 2026 community recap). La documentazione di Codex non dice chiaramente se le attività cloud leggono .agents/skills dal repo. Non l'abbiamo testato, quindi non traiamo conclusioni. L'app Gemini ha pianificazioni che possono eseguire un'attività con una skill scelta (Create & manage skills for Gemini Apps). Ma, come detto sopra, lì gli script delle skill non possono accedere a internet.
Ecco i conti su base annua. Un report sul software da 9 chiamate a settimana fa 468 chiamate l'anno, cioè $0,650052 di costi API. Un report hardware settimanale da 5 chiamate aggiunge 260 chiamate e $0,36114. Nel nostro test, la chiamata sincrona più lenta ha richiesto 88 secondi. Con gli intervalli di 7 secondi e circa 5 minuti per il job asincrono G2, un report da 9 chiamate richiede meno di 10 minuti.
Una chiave con 10 richieste al minuto è sufficiente. Se la stessa chiave serve anche altri job, considera normale il 429 e riprova. Claude Code 2.1.310, rilasciato il 23 ottobre 2026, ha portato il tool Monitor su più tipi di deployment. Puoi usarlo per seguire un job asincrono lungo invece di uno script in attesa (Claude Code changelog).
Dove il tagging per parole chiave non coglie i temi: recensioni non in inglese e di prodotti hardware
Le parole chiave dipendono dalla lingua. Abbiamo chiesto le recensioni Trustpilot in spagnolo di monday.com con lang: "es". Con un limite di 200 abbiamo ottenuto 81 recensioni, e la più recente era del 28 dicembre 2023. Con le parole chiave in inglese, 80 delle 81 recensioni non hanno ricevuto nessun tema. Con l'elenco spagnolo della skill, saas_es, le recensioni senza tag sono scese a 45.
ClickUp ha solo 10 recensioni in spagnolo. Holded, uno strumento di contabilità spagnolo, ha 100 recensioni su Capterra, di cui circa 76 risultano in spagnolo. Le regole inglesi ne hanno lasciate 74 senza tag, quelle spagnole 21. Holded mostra anche una lacuna di copertura su Trustpilot.
Alle 17:44 SGT, una chiamata senza lang ha restituito 48 recensioni, tutte contrassegnate en. Alle 18:29 e alle 18:30 SGT, le chiamate con lang: "es" e con language: "es" hanno restituito entrambe 0 righe e sono state rimborsate. Il sito spagnolo di Trustpilot mostra 2.444 recensioni per Holded (Trustpilot Spain: Holded). Quindi questa esecuzione non ha ottenuto le recensioni in spagnolo di Holded, e un report deve indicare «Campione Trustpilot: solo 48 recensioni in inglese».
Le recensioni di prodotti hardware falliscono in un altro modo. Per tre power bank da 20.000 mAh (Anker, UGREEN, INIU), Amazon US ha restituito 13 recensioni in evidenza ciascuno, con medie di 4,92, 4,92 e 4,62 stelle. Sono molto al di sopra delle medie organiche su Trustpilot dei due brand, 2,14 e 1,29, perché le recensioni in evidenza di Amazon tendono a essere quelle utili e positive. Su Trustpilot, il 26% delle recensioni di Anker cita problemi di durata, come un'unità che si è rotta o ha smesso di funzionare. Niente di tutto questo compare nelle 13 di Amazon.
Anche l'elenco di parole chiave per l'hardware copre male Trustpilot: 101 delle 200 recensioni di Anker e 127 delle 200 di UGREEN non hanno ricevuto alcun tema. Per lo più riguardano spedizioni, resi e assistenza, che l'elenco hardware non copre. Non abbiamo modificato l'elenco per far sembrare migliori i numeri. Il report riporta il numero di recensioni senza tag.
I conti sul contesto: 31.581 caratteri di strumenti MCP, 363 caratteri di skill
Skill e MCP vengono spesso messi a confronto, ma usano il contesto in modi diversi. Alle 17:25 SGT abbiamo letto tools/list dell'MCP di EveryInfra. Le 25 definizioni degli strumenti totalizzano 31.581 caratteri, circa 7.895 token a 4 caratteri per token. 11 strumenti sono contrassegnati come di sola lettura e 5 come distruttivi.
I tre strumenti necessari a questa skill, everyinfra_list_capabilities, everyinfra_call_api e everyinfra_get_job, totalizzano 3.314 caratteri. All'avvio della sessione la skill aggiunge solo name e description: 363 caratteri, circa 91 token. Il SKILL.md completo ha 3.426 caratteri e viene caricato solo quando serve.
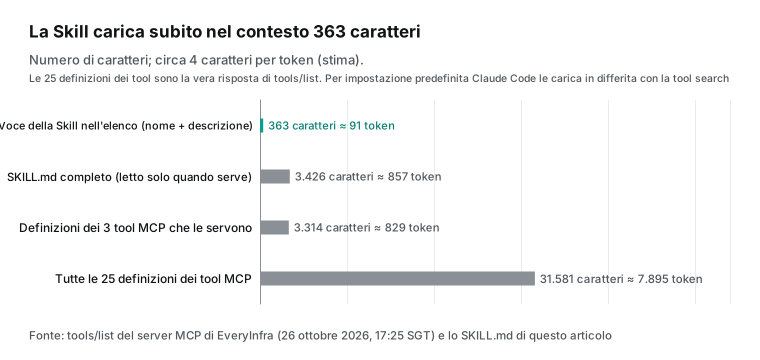
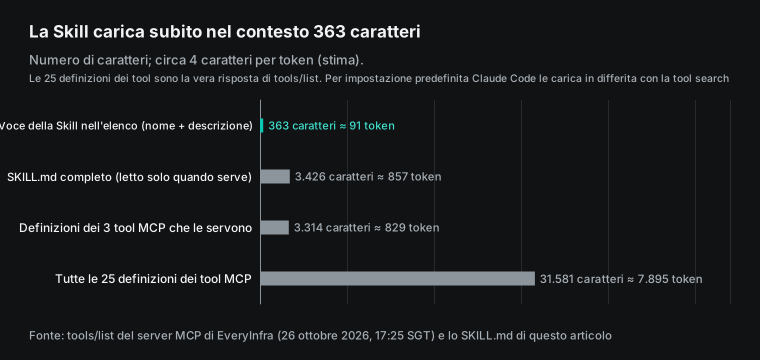
Questi numeri hanno dei limiti. Claude Code attiva per impostazione predefinita la ricerca degli strumenti MCP e all'avvio della sessione carica solo i nomi degli strumenti e le istruzioni del server. Quindi in Claude Code 25 strumenti non costano 7.895 token in anticipo (Claude Code MCP docs). Per gli altri host, consulta la loro documentazione. Codex e Antigravity hanno entrambi elenchi di strumenti consentiti (enabled_tools, enabledTools).
Riducendo gli strumenti da 25 a 3, le definizioni scendono da 31.581 a 3.314 caratteri. La specifica MCP considera readOnlyHint e destructiveHint come indicazioni per il client, non come garanzie di sicurezza (MCP specification: Tools). Un elenco di strumenti consentiti è più affidabile delle indicazioni. Il nostro consiglio: lascia alla skill il processo e il formato del report, e rendi disponibili tramite MCP solo i 3 strumenti per i dati. Quando usi entrambi, la skill deve dire «usa everyinfra_call_api, non altri strumenti».
Quanto costa un report
Abbiamo calcolato il costo lato API dal price_usd del catalogo. Nel catalogo consultato il 26 ottobre 2026, g2/reviews, capterra/reviews, trustpilot/reviews e amazon/reviews costano ciascuna $0,001389 per chiamata. Nessuna ha un'indicazione di prezzo per riga. Una chiamata restituisce fino a max_limit recensioni: 100 per G2, Capterra e Amazon, e 200 per Trustpilot (catalogo EveryInfra). Un report sul software con 3 concorrenti su 3 siti richiede 9 chiamate: 9 × $0,001389 = $0,012501.
Gli addebiti sono stati esattamente $0,012501, con una differenza pari a zero. Il report ha letto 967 recensioni, circa $0,0129 per 1.000. Un report hardware su 3 power bank richiede 3 chiamate Amazon più 2 chiamate Trustpilot: 5 × $0,001389 = $0,006945 per 439 recensioni. Timeout, risultati vuoti e risposte 429 non costano nulla, quindi i nuovi tentativi non fanno salire il conto.
| Voce | Prezzo unitario | Chiamate | Importo | Note. |
|---|---|---|---|---|
| Report sul software (G2 + Capterra + Trustpilot) | $0,001389 per chiamata | 9 | $0.012501 | 967 recensioni. |
| Report hardware (Amazon + Trustpilot) | $0,001389 per chiamata | 5 | $0.006945 | 439 recensioni. |
| Report sul software ogni settimana per un anno | $0,001389 per chiamata | 468 | $0.650052 | Le stesse 9 chiamate ogni settimana. |
| Tutte le chiamate reali per questo articolo | — | 31 richieste, 23 addebitate | $0.032794 | Include 1 chiamata amazon/search (0,002236 $). |
Sul fronte dei prodotti AI si paga un abbonamento, non una tariffa per chiamata. Abbiamo consultato questi prezzi pubblici il 26 ottobre 2026. Claude Pro costa 20 $ al mese, o 17 $ al mese con fatturazione annuale, e include Claude Code (prezzi di Claude). ChatGPT Plus costa 20 $ al mese (OpenAI Help). Con Plus, Codex funziona nella CLI, nell'estensione per IDE e sul web (prezzi di Codex). Google AI Pro costa 19,99 $ al mese e include un utilizzo base di Antigravity (piani Google AI).
Rispetto a questi piani, la tariffa dell'API è una spesa trascurabile. Il costo reale è l'utilizzo del piano che il modello consuma per leggere 967 recensioni. Nessun fornitore pubblica questo dato per singola recensione e noi non l'abbiamo misurato, quindi non diamo cifre.
Un bug nello script: «finalizing» non vuol dire completato
Lo script della skill ha mostrato un bug alla prima esecuzione reale, e la lezione merita una sezione a sé. Alle 17:48 SGT, fetch_reviews.py ha inviato la richiesta per Asana su G2 in modalità asincrona e ha iniziato a interrogare il job. Considerava conclusivo il primo stato diverso da running o queued. A 306 secondi ha letto finalizing, ha scritto 0 righe e si è fermato. Alle 17:55 SGT abbiamo controllato lo stesso job a mano.
Il suo stato era succeeded e tutte le 51 righe (50 recensioni e 1 riga di riepilogo) erano presenti. La correzione: considera finali solo succeeded, failed, canceled ed expired, e continua ad attendere con qualsiasi altro stato. Questo tipo di bug si nasconde bene dentro una skill. Quando il modello vede «0 righe», scrive «nessuna nuova recensione su G2» senza pensarci due volte. Per questo il passaggio 2 della skill dice di controllare i conteggi, scrivere 0 nel report e non interpretare mai 0 come «nessuna recensione».
Le risposte indicano con chiarezza le regole su errori e addebiti, e allo script basta leggerle:
- 429:
error.codeèrate_limited, conretry_afterin secondi e «Nothing was charged». Attendi e fai un nuovo tentativo. - Timeout 503:
error.codeètimeoutebilling.chargedè false. Passa a"mode":"async"o riducilimit. - Risultato vuoto:
countè 0 erefund.statusèsucceeded. L'addebito viene rimborsato automaticamente. - Asincrono: la risposta 202 restituisce
job_idepoll_url. L'addebito avviene all'invio. InterrogaGET /api/v1/jobs/{job_id}finché non arriva uno stato finale.
Cosa non può fare questa skill e a cosa fare attenzione
Ecco cosa la skill non può fare, o deve fare con cautela. Nell'app Gemini e nella Claude Skills API, gli script delle skill non possono accedere alla rete, quindi i dati devono arrivare da un connettore o da un server MCP. Le sessioni cloud di Claude Code e le attività pianificate nel cloud non leggono la cartella locale ~/.claude/skills/. Attiva la skill nel tuo account claude.ai oppure fai il commit nel repo. Nella Claude Skills API, name non può contenere «claude» o «anthropic».
Il nostro nome va bene, ma una skill chiamata claude-review-helper non verrebbe caricata. Nella pagina del prodotto Amazon mostra solo le recensioni in evidenza, quindi non calcolare da lì un «tasso di recensioni negative». Non confrontare aziende su Trustpilot senza separare le recensioni per fonte. Scrivi un elenco di parole chiave per ogni lingua e per ogni categoria, e indica la copertura nel report.
Su leggi e regole delle piattaforme descriviamo solo i metodi per i dati e non diamo consulenza legale. Il 14 agosto 2024 la Federal Trade Commission statunitense ha annunciato una norma definitiva. Vieta le recensioni false, quelle acquistate e i compensi subordinati a una recensione positiva (comunicato stampa della FTC; 16 CFR Part 465). La norma riguarda il modo in cui le aziende ottengono le recensioni.
Leggere recensioni pubbliche per analizzare i concorrenti è un'attività diversa. In ogni caso, non inserire i nomi dei recensori nei report e limita le citazioni a una o due righe. Le regole della skill lo prevedono già.
Novità del settore
- 29 settembre 2026, OpenAI DevDay: i plugin sono diventati il formato comune per distribuire il proprio lavoro in ChatGPT e Codex. Un plugin può contenere skill e server MCP, e il processo di invio ora permette di seguire lo stato della revisione (riepilogo della community su DevDay 2026; riepilogo di OpenAI DevDay). Cosa cambia per te: questa skill e il server MCP di EveryInfra possono essere distribuiti come un unico plugin. Il plugin si installa anche in ChatGPT sul web (ChatGPT Skills & Plugins).
- 30 settembre 2026, Google: le skill sostituiscono i Gem. Il rilascio nell'app Gemini è iniziato il 13 ottobre. I Gem degli account personali diventano di sola lettura il 17 novembre e spariscono il 17 dicembre (Workspace Updates; Gemini Help). Cosa cambia per te: se usi i Gem per i riepiloghi sui concorrenti, esporta istruzioni e file prima del 17 dicembre. Il recupero dei dati continua a non poter essere eseguito all'interno delle skill dell'app Gemini.
- Dal 19 al 23 ottobre 2026, tre release di Claude Code. La versione 2.1.304 (19 ottobre 2026) invia di nuovo l'elenco delle skill dopo la compattazione, e
/reload-skillsora invia solo le skill nuove o modificate. La versione 2.1.309 (22 ottobre 2026) ha corretto le skill con lo stesso nome nelle cartelle--add-dir, che ora vengono eseguite come<folder>:<name>. La versione 2.1.310 (23 ottobre 2026) ha portato lo strumento Monitor su più piattaforme (changelog di Claude Code). Cosa cambia per te: in una sessione lunga che genera molti report, le skill non scompaiono più dopo la compattazione. - 14 ottobre 2026, GPT-5.5 ritirato da Codex con accesso tramite ChatGPT, sostituito da GPT-6.1 Sol e altri modelli (prezzi di Codex). Cosa cambia per te: i passaggi della skill restano gli stessi, ma ripeti il controllo a campione del passaggio 4. Con le stesse regole sulle parole chiave, un nuovo modello può scegliere citazioni diverse.
- 25 settembre 2026, Google ha pubblicato un Codelab sulle skill per Antigravity CLI. Usa
.agents/skillse installa skill di terze parti connpx skills add(Google Codelabs; vercel-labs/skills). Cosa cambia per te:.agents/skillssta diventando la cartella di progetto condivisa tra i vari strumenti, quindi per le nuove skill parti da lì.
Quando questi risultati non valgono
I campioni sono piccoli, quindi partiamo dai limiti. Le quote dei temi provengono dalle 20-200 recensioni più recenti di ciascun sito, non da tutte le recensioni, e i numeri cambieranno la settimana prossima. «Le recensioni organiche hanno da 1,9 a 3,0 stelle in meno» deriva da una sola lettura su cinque aziende. Asana non ha un gruppo di recensioni su invito confrontabile, quindi non rientra in quell'intervallo. Le regole sulle parole chiave v1.1 sono state verificate a campione con 5 recensioni per tema.
Anche la parola «support» corrisponde a testi sulle funzionalità come «supports multiple views», e non abbiamo misurato questo errore. I percorsi delle cartelle e il comportamento dei quattro prodotti provengono dalla documentazione dei rispettivi produttori, consultata il 26 ottobre 2026. Le configurazioni MCP per Codex e Antigravity sono esempi che non abbiamo eseguito. Sulla nostra macchina abbiamo testato gli script della skill, il validatore della specifica e l'API di EveryInfra. Se i tuoi concorrenti non sono su G2, Capterra, Trustpilot o Amazon, usa al loro posto la funzionalità corrispondente del catalogo, ad esempio google_play/reviews, app_store/reviews o yelp/reviews.
FAQ
Cosa significa «skill.md must start with yaml frontmatter (---)»? Fonte: completamento automatico di Google «skill.md must start with yaml frontmatter (---)», consultato il 26 ottobre 2026. La prima riga di SKILL.md deve essere ---. La documentazione di Claude Code dice che il frontmatter viene letto solo quando il --- di apertura si trova sulla prima riga. Altrimenti l'intero file viene trattato come corpo. Se lo YAML non viene analizzato correttamente, la skill si carica comunque, ma senza campi (documentazione delle skill di Claude Code). Esegui agentskills validate di skills-ref per individuare subito il problema.
Dove si trovano le skill di Codex? Fonte: completamento automatico di Google «codex skills location» e «codex skills folder». In un repo, usa .agents/skills, dalla cartella di lavoro fino alla root del repo. Per un singolo utente, usa $HOME/.agents/skills. Per l'intera macchina, usa /etc/codex/skills. Codex segue i symlink (Codex Build skills).
Come riducono l'uso dei token le skill di Claude Code? Fonte: completamento automatico di Google «claude code skills to reduce token usage». All'avvio della sessione una skill aggiunge solo il nome e la descrizione, 363 caratteri nel caso di questa. Il corpo viene caricato solo quando serve. Mantieni la descrizione breve e metti per primo l'uso principale. Per le skill che usi di rado, imposta "name-only" in skillOverrides (documentazione delle skill di Claude Code). Metti i testi di riferimento lunghi in references/, non nel corpo.
Come si risolve «skill.md description cannot contain xml tags»? Fonte: completamento automatico di Google «skill.md description cannot contain xml tags». La Claude Skills API e i caricamenti su claude.ai eseguono questo controllo. Né name né description possono contenere tag XML, e name non può contenere «claude» o «anthropic» (guida alla Claude Skills API). Sostituisci qualsiasi testo <...> nella descrizione con parole semplici.
Le skill per agenti possono chiamare API esterne nell'app Gemini? Fonte: completamento automatico di Google «agent skills claude» e «gemini skills», e il testo di Gemini Help. Per ora no. Il centro assistenza dice che gli script che richiedono internet non sono supportati. Gli script non possono inviare richieste a siti esterni (Gemini Help). Usa le app collegate di Gemini per i dati e tieni nella skill solo passaggi e formati.
È sicuro installare skill di Claude Code da GitHub? Fonte: completamento automatico di Google «claude code skills github» e «claude code skills marketplace». Le skill possono contenere script, quindi leggi SKILL.md e scripts/ prima di installarle. Gemini CLI mostra un avviso di sicurezza quando installa una skill (documentazione Agent Skills di Gemini CLI). Le skill di esempio di Anthropic e OpenAI si trovano in anthropics/skills e openai/skills. OpenAI spiega anche come testare le skill con le eval («Testing Agent Skills Systematically with Evals»).
Letture consigliate
- Prova le API per le recensioni: API Trustpilot, Recensioni Trustpilot, API G2, Recensioni G2, Recensioni Capterra, Recensioni Amazon.
- Connettiti con MCP: server MCP di EveryInfra. Per la prima chiamata, consulta la guida rapida; per i costi, vedi Prezzi.
- Articolo correlato: Recensioni dei concorrenti per 30 aziende su G2 e Trustpilot.
- Articolo correlato: Come trasformare i dati delle recensioni in un prodotto a pagamento.
- Articolo correlato: Come vendere il monitoraggio delle modifiche ai siti web.
Riferimenti
- «Extend Claude with skills», Anthropic (documentazione di Claude Code), consultato il 2026-10-26, https://code.claude.com/docs/en/skills
- «Agent Skills Specification», agentskills.io, consultato il 2026-10-26, https://agentskills.io/specification
- «skills-ref reference validator», agentskills (GitHub), 0.1.1, eseguito il 2026-10-26, https://github.com/agentskills/agentskills/tree/main/skills-ref
- «Build skills», OpenAI (documentazione di Codex), consultato il 2026-10-26, https://developers.openai.com/codex/build-skills
- «Model Context Protocol», OpenAI (documentazione di Codex), consultato il 2026-10-26, https://developers.openai.com/codex/mcp
- «Agent skills», Google Antigravity Docs, consultato il 2026-10-26, https://antigravity.google/docs/skills/
- «Migration - Antigravity CLI», Google Antigravity Docs, consultato il 2026-10-26, https://antigravity.google/docs/cli/gcli-migration
- «MCP», Google Antigravity Docs, consultato il 2026-10-26, https://antigravity.google/docs/mcp
- «Agent Skills», documentazione di Gemini CLI, consultato il 2026-10-26, https://geminicli.com/docs/cli/skills/
- «Introducing skills in the Gemini app and Workspace, plus what's next for Gems», Google Workspace Updates, 2026-09-30, https://workspaceupdates.googleblog.com/2026/09/skills-gemini-app-workspace.html
- «An update on the launch of skills in the Gemini app and Workspace», Google Workspace Updates, 2026-10-13, https://workspaceupdates.googleblog.com/2026/10/an-update-on-launch-of-skills-in-gemini-app-and-workspace.html
- «Let skills in Gemini tackle your most repetitive tasks», blog di Google, 2026-09-30, https://blog.google/products-and-platforms/products/gemini/automate-tasks-with-skills/
- «Create & manage skills for Gemini Apps», Gemini Help, consultato il 2026-10-27, https://support.google.com/gemini/answer/17094296
- «About the transition from Gems to skills», Gemini Help, consultato il 2026-10-27, https://support.google.com/gemini?p=gems_to_skills
- «Using Agent Skills with the API», Anthropic (documentazione di Claude), consultato il 2026-10-26, https://docs.claude.com/en/api/skills-guide
- «Connect Claude Code to tools via MCP», Anthropic (documentazione di Claude Code), consultato il 2026-10-26, https://code.claude.com/docs/en/mcp
- «Claude Code changelog», Anthropic, versioni da 2.1.304 a 2.1.310 (dal 2026-10-19 al 2026-10-23), https://code.claude.com/docs/en/changelog
- «Equipping agents for the real world with Agent Skills», Anthropic, 2025-10-16, https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
- Catalogo dati di EveryInfra GET /api/v1/social/catalog, EveryInfra, consultato il 2026-10-26 alle 17:25 SGT, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra MCP (tools/list, tools/call), EveryInfra, chiamato il 2026-10-26 alle 17:25 e alle 17:46 SGT, https://api.everyinfra.com/mcp
- «monday AI Work Platform product page», Capterra, consultato il 2026-10-26 (l'accesso tramite script restituisce 403; letto con un motore di browser), https://www.capterra.com/p/147657/monday-com/
- «Trustpilot invitation methods», Trustpilot Help Center, consultato il 2026-10-26, https://help.trustpilot.com/s/article/Trustpilot-invitation-methods?language=en_US
- «ClickUp Reviews», Trustpilot, consultato il 2026-10-26 (l'accesso tramite script restituisce 403; letto con un motore di browser), https://www.trustpilot.com/review/clickup.com
- «Guidelines for Businesses», Trustpilot, consultato il 2026-10-26, https://corporate.trustpilot.com/legal/for-businesses/guidelines-for-businesses
- «Asana Reviews», G2, consultato il 2026-10-26 (l'accesso tramite script restituisce 403; letto con un motore di browser), https://www.g2.com/products/asana/reviews
- «Tools», specifica Model Context Protocol 2025-06-18, consultato il 2026-10-26, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- «Plans & pricing», Claude, consultato il 2026-10-26, https://claude.com/pricing
- «What is ChatGPT Plus?», OpenAI Help Center, consultato il 2026-10-26, https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus
- «Pricing», OpenAI (documentazione di Codex), consultato il 2026-10-26, https://developers.openai.com/codex/pricing
- «Google AI Pro & Ultra», Google, consultato il 2026-10-26, https://gemini.google/subscriptions/
- «How to use AI Agent Skills (with Antigravity CLI)», Google Codelabs, 2026-09-25, https://codelabs.developers.google.com/antigravity/how-to-create-agent-skills-for-antigravity-cli
- «How do you actually set up Antigravity agent skills?», Reddit r/google_antigravity, consultato il 2026-10-26, https://www.reddit.com/r/google_antigravity/comments/1qvrxxx/how_do_you_actually_set_up_antigravity_agent/
- «Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials», FTC, 2024-08-14, https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- «16 CFR Part 465, Rule on the Use of Consumer Reviews and Testimonials», eCFR, consultato il 2026-10-26, https://www.ecfr.gov/current/title-16/chapter-I/subchapter-D/part-465
- «Create custom subagents», Anthropic (documentazione di Claude Code), consultato il 2026-10-26, https://code.claude.com/docs/en/sub-agents
- «DevDay 2026 announcements and developer resources», OpenAI Developer Community, 2026-09-29, https://community.openai.com/t/devday-2026-announcements-and-developer-resources/1402006
- «DevDay 2026 Recap», OpenAI, 2026-09-29, https://openai.com/index/devday-2026-recap/
- «Skills & Plugins», ChatGPT Learn, consultato il 2026-10-26, https://learn.chatgpt.com/docs/skills-and-plugins
- vercel-labs/skills, GitHub, consultato il 2026-10-26, https://github.com/vercel-labs/skills
- anthropics/skills, GitHub, consultato il 2026-10-26, https://github.com/anthropics/skills
- openai/skills, GitHub, consultato il 2026-10-26, https://github.com/openai/skills
- «Testing Agent Skills Systematically with Evals», blog OpenAI Developers, 2026-01-22, https://developers.openai.com/blog/eval-skills
- Recensioni di Holded (sito spagnolo), Trustpilot, consultato il 2026-10-26, https://es.trustpilot.com/review/holded.com
Riferimenti BL-54