Claude strict tool use 调数据接口实测
Opus 5.5 拒绝强制 tool_choice,用 strict 工具加 422 自愈调评论接口:写错参数 0.17 秒退回不扣费,千条约 $0.04。
Claude Opus 5.5、Sonnet 5.5 和 Fable 5.1 收到 tool_choice 为 any 或 tool 的请求会直接返回 400,过去靠强制调用拿固定 JSON 的写法在这三个模型上不能用了;官方给的替代是 tool_choice: auto 加 strict: true,或者把 schema 移到结构化输出。我们在 2026 年 11 月 1 日按 EveryInfra 当天的数据目录给 Trustpilot、App Store、Amazon 评论写了 strict 工具,真调接口 29 次(其中 10 次是下午补的对照),当晚又复测 12 次:故意写错的参数名和枚举值在 0.11–0.23 秒内被 422 退回,每条都带合法取值和下一步怎么改,一分钱没扣。白天实测时,目录里没有列出合法取值的两个参数写错后不会被退回,下午的对照里照常返回 200、照常扣费,拿回来的评论却悄悄换了一批;当晚网关已经给这两个参数列出合法取值,写错的值在扣费前回 422,我们 19:18 复测确认了。按这套做法批量把 1,000 条评论抽成固定 JSON,用 Haiku 5.5 走 Message Batches 估算约 $0.03,加上接口费 $0.0139,合计约 $0.04。
这篇文章回答一个具体问题:手上有一个要调外部数据接口的 Claude 应用,过去用 tool_choice: {"type": "tool"} 逼模型每次都按固定格式发请求,换到新模型后这行代码报错了,怎么改才能让模型继续稳定地调接口、拿到能直接入库的 JSON。Claude 一侧的每条行为都来自 Anthropic 官方文档的原文,我们本机没有 Anthropic API Key,所以 Claude 一侧的代码都写成「配置示例」,没有冒充实测;EveryInfra 一侧的每个数字都来自当天真调的原始返回。
发生了什么:三个新模型拒绝强制 tool_choice,claude strict tool use 成了默认写法
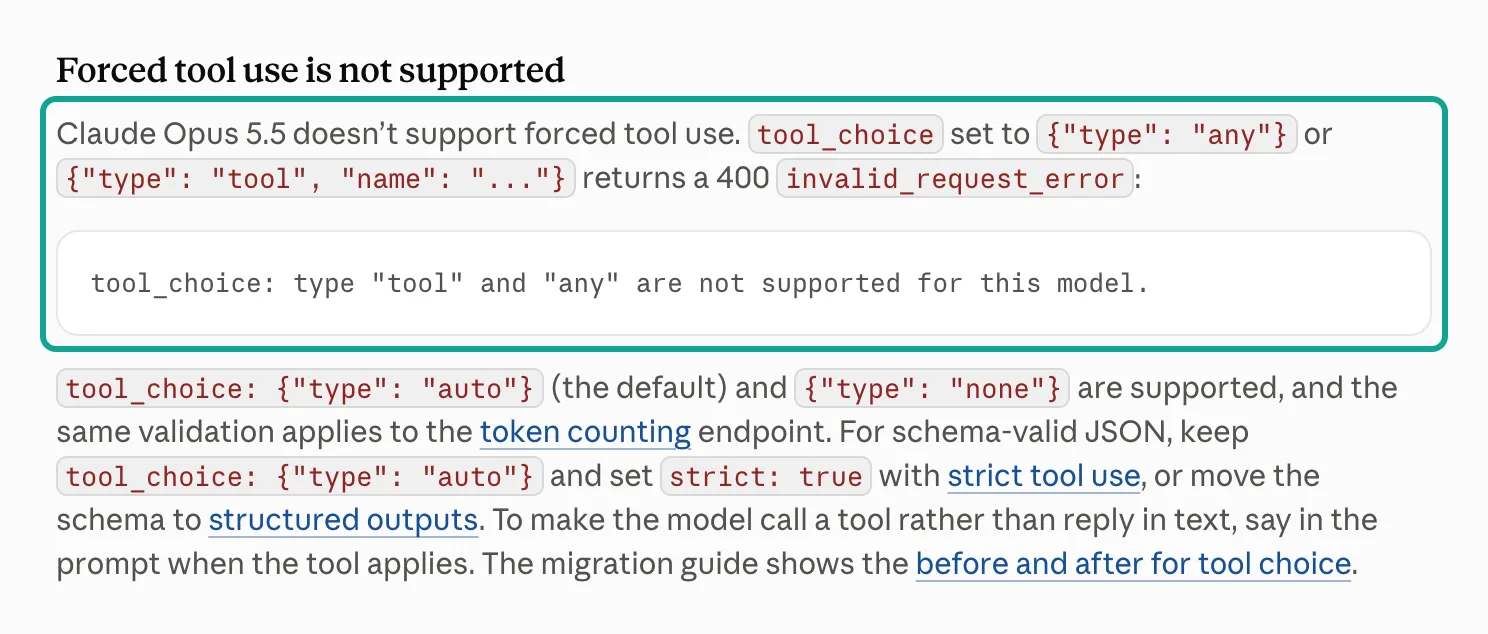
先把事实钉死,因为后面的设计全部建立在这个变化上。Anthropic 的 API 更新日志在 2026 年 9 月 1 日写明,Fable 5.1 和 Mythos 5.1 上 tool_choice 的 any 和 tool 两种类型不再支持、返回 400,auto 和 none 不变,并建议用 strict tool use 或结构化输出保证工具输入符合 schema(API 更新日志)。9 月 22 日发布 Opus 5.5 时,同一份日志写的是「和 Fable 5.1 一样」也返回 400;9 月 28 日的 Sonnet 5.5 把它列为从 Sonnet 5 升级时会断的五处之一。三个模型的「新功能」页各有一节原文,标题都叫「Forced tool use is not supported」,返回的错误文本是同一句:tool_choice: type "tool" and "any" are not supported for this model.(Opus 5.5 新功能、Sonnet 5.5 新功能、Fable 5.1 新功能)。
为什么要拿掉强制调用?Fable 5.1 的页面给了理由:这几个模型的思考一直开着,强制工具调用会跳过思考,模型只好把推理过程写进工具参数里,参数质量反而下降(Fable 5.1 新功能)。这句话对调数据接口的人很关键:以前我们逼模型「必须调这个工具」,换来的是格式稳定;现在官方认为这样会让参数变差,于是把「格式稳定」交给 strict 的语法约束,把「要不要调」交回给模型,由提示词说明什么时候该调。Fable 5.1 页面还补了一句,它会可靠地遵守明确的工具指令,例如在用户消息里写「用某某工具回答」。对我们这种「每条消息都必须查数据」的场景,替代写法就是把指令放进 user 消息,或者按 Fable 5.1 迁移指南的建议用会话中途的 system 消息临时加工具(Fable 5.1 迁移指南)。
| 模型 | 发布日期 | `tool_choice` any / tool | 官方替代 | 标准价(输入 / 输出,每百万 token) |
|---|---|---|---|---|
| Fable 5.1 | 2026-09-01 | 400 | auto + strict,或结构化输出 | $10 / $50 |
| Opus 5.5 | 2026-09-22 | 400 | auto + strict,或结构化输出 | $4 / $20 |
| Sonnet 5.5 | 2026-09-28 | 400 | auto + strict,或结构化输出 | $2 / $10 |
| Haiku 5.5 | 2026-10-07 | 发布说明未列此项 | — | $0.10 / $0.50 |
表里的日期和价格取自更新日志与定价页,2026 年 11 月 1 日读取。定价页另有一个细节可以佐证这个变化是长期的:工具调用系统提示词的 token 数表里,Opus 5.5 只填了 auto, none 一栏(286 token),any, tool 一栏是空的,而它的前代 Opus 5 两栏都有(286 和 406 token)。Haiku 5.5 的发布说明列了几类从 Haiku 4.5 升级会断的写法(手动思考预算、采样参数、预填充等),没有强制工具调用这一条,所以本文不推断它的行为;做批量分类时我们仍然按 strict 写,代码对四个模型通用。
还要排除一个常见误解:strict 不是新功能,也不是只给新模型用。strict tool use 和结构化输出两页的「可用性」一节都写着在每个模型上可用、可以用于 HIPAA 场景(strict tool use、结构化输出)。这次变化只是让它从「可选的加固」变成「唯一的正路」。Opus 5.5 迁移指南的检查清单里,这一条写成「把 tool_choice 的 any 和 tool 换成 auto 加 strict tool use 或结构化输出」,并提醒加 strict: true 之前先逐个检查工具的 input_schema,因为 strict 只接受 JSON Schema 的一个子集,每个对象都必须设 additionalProperties: false(Opus 5.5 迁移指南)。换句话说,迁移的工作量主要在 schema,而不在调用代码。
strict tool use 和 claude structured outputs 各管什么
两样东西名字相近,管的地方不同,混用之前要分清。strict tool use 在工具定义上加 "strict": true,约束的是模型发出的 tool_use 块里的 input:用语法约束采样,让参数必定符合 input_schema,工具名也必定有效。官方举的例子是订票系统要 passengers: int,不开 strict 时模型可能给 "two" 或 "2",开了以后一定是 2(strict tool use)。claude structured outputs 指的是请求里的 output_config.format,约束的是模型最后那段回复本身,让它成为符合你给的 JSON Schema 的一段 JSON(结构化输出)。
调数据接口的完整流程里两样都用得上:发请求时用 strict 工具,保证发给 POST /api/v1/social 的参数形状正确;拿到评论后,让模型按 output_config.format 把每条评论归成主题、严重程度和一句原文,交给下游入库。两者共用同一套语法编译流程,所以限制也是同一套。结构化输出页的「JSON Schema 限制」一节写明:支持基本类型、enum、const、anyOf、$ref、常见字符串格式和简单正则;不支持递归、minimum/maximum 这类数值约束、minLength/maxLength,数组的 minItems 只支持 0 和 1,每个对象都必须写 additionalProperties: false。
| 项 | strict tool use | 结构化输出 `output_config.format` |
|---|---|---|
| 约束对象 | tool_use 块里的工具参数 | 模型的最终回复 |
| 开启方式 | 工具定义加 "strict": true | 请求加 output_config.format(JSON Schema) |
| 在本文的用途 | 让模型发给 EveryInfra 的参数形状正确 | 把评论归成固定字段,直接入库 |
| 共同上限(一次请求合计) | strict 工具最多 20 个;可选参数合计 24 个;联合类型参数 16 个 | 同左(两者合并计算) |
| 不能用 | 数值范围、字符串长度、递归 | 同左;另外不能和引用(citations)同时开 |
| 首次延迟 | schema 首次编译有额外延迟,编译结果缓存 24 小时 | 同左 |
这张表里最容易踩的是「一次请求合计」。结构化输出页「Schema complexity limits」一节的说明原文举了例子:4 个 strict 工具每个 6 个可选参数,就已经顶到 24 的上限,哪怕单看每个工具都不复杂。超过这些显式上限之外,还有编译后语法大小的内部上限,超了返回「Schema is too complex for compilation」;最后兜底的是 180 秒的编译超时。官方给的降复杂度顺序是:只给关键工具开 strict,把能必填的参数改成必填,拍平嵌套,最后才是拆成多次请求或交给子代理。


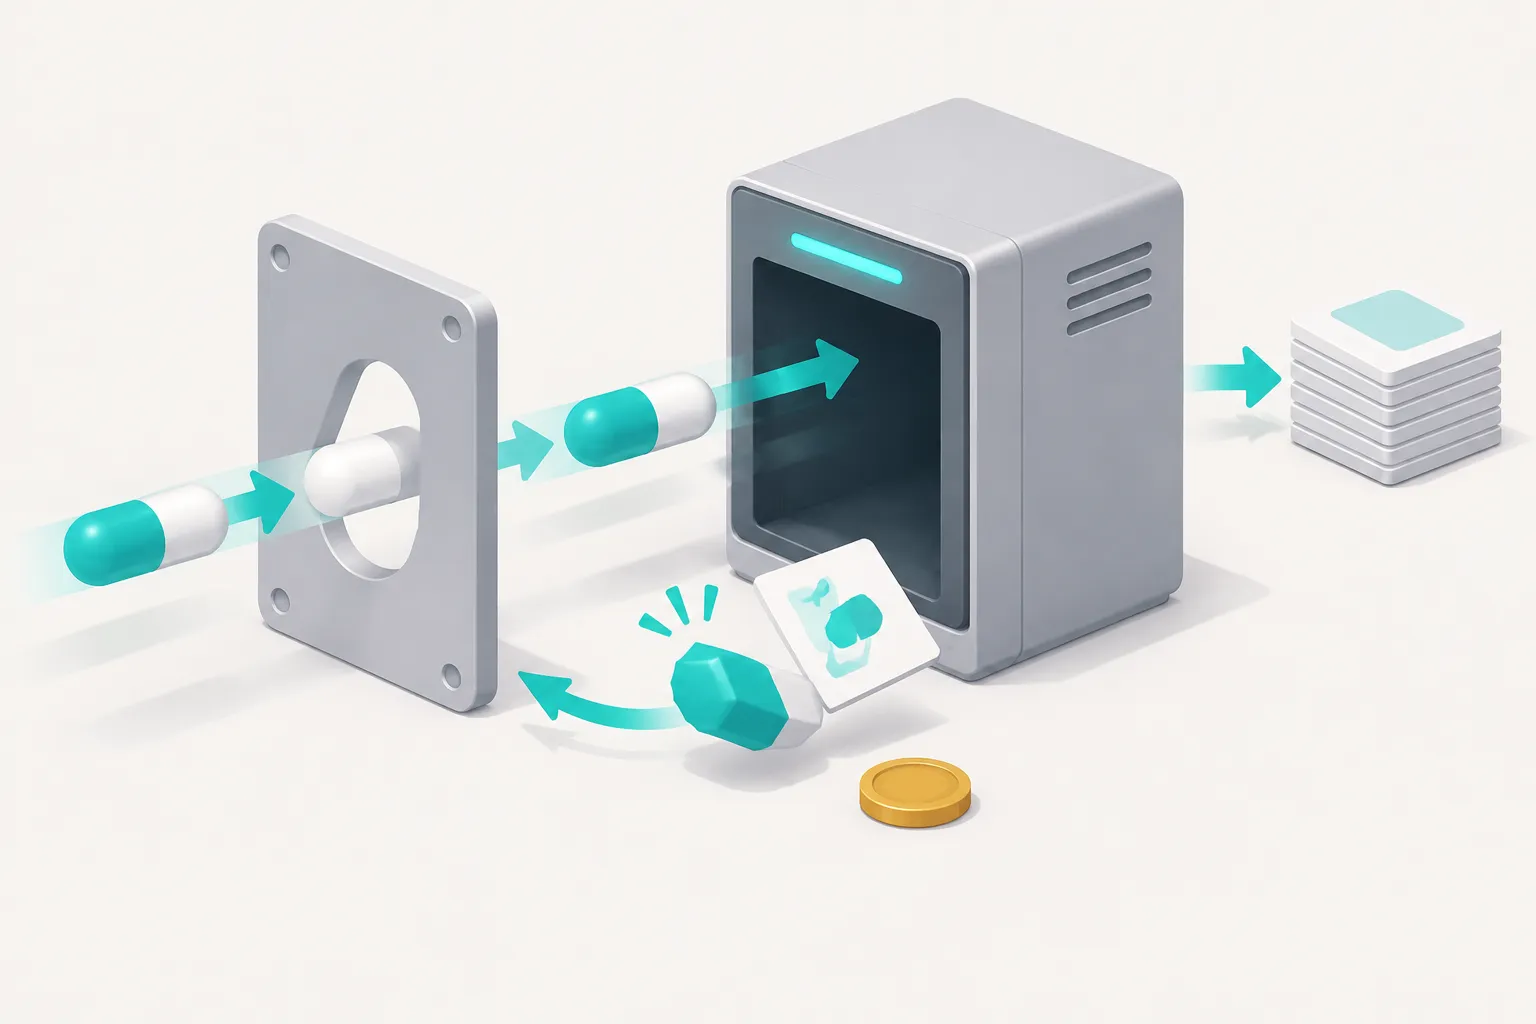
上面这张图是本文的主线。第一层在 Anthropic 一侧:strict 保证参数的类型、必填项和枚举值都在 schema 里,模型不可能发出 max_results 这种 schema 里没有的字段。第二层在 EveryInfra 一侧:schema 写不进去的东西,例如「这个 ASIN 是否真的是商品页」「这个值在当前平台叫什么」,由接口按目录校验,错了返回 422,并把合法取值和最接近的候选一起交回,模型改一处再发。两层各管一半,缺一层都会漏。
第一层:从目录生成 POST /api/v1/social 的 strict 工具
EveryInfra 的目录接口 GET /api/v1/social/catalog 免费、无需 Key,返回每项能力的必填参数、可选参数、每个参数的说明、合法取值(allowed_values)、返回字段和价格(目录原始返回)。我们在 2026 年 11 月 1 日 00:46(新加坡时间)读的版本有 426 项能力、91 个平台,其中 402 项、89 个平台当天可用;可用能力的参数说明一共 809 条,155 条列了合法取值,143 条标了 uri 格式,38 条标了 date 格式。这三类正好对应 strict 支持的三种约束:enum、format: uri 和 format: date。去掉重叠后,809 条里有 336 条(41.5%)可以原样翻译成 strict 能保证的约束,其中能写成 enum 的 155 条约占 19%;其余是自由文本或数字,只能靠描述和第二层兜底。
下面是我们按目录给三项评论能力写的工具定义,这是配置示例,Claude 一侧没有实跑;每个字段的来源在后面逐条交代。
[
  {
    "name": "trustpilot_reviews",
    "description": "Get recent Trustpilot reviews of one company through EveryInfra (platform trustpilot, action reviews). Call it whenever the user names a company and asks what customers say. company is the company's website domain, for example temu.com.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "company": {"type": "string", "description": "Website domain such as temu.com, or a trustpilot.com/review/<domain> link"},
        "stars": {"type": "array", "items": {"type": "string", "enum": ["1", "2", "3", "4", "5"]}, "description": "Star ratings to keep; [] keeps all"},
        "date": {"type": "string", "enum": ["any", "last7days", "last30days", "last3months", "last6months", "last12months"], "description": "any = no date filter"},
        "sort": {"type": "string", "enum": ["recency", "relevance"]},
        "limit": {"type": "integer", "description": "1 to 200; use 20 unless the user asks for more"}
      },
      "required": ["company", "stars", "date", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "app_store_reviews",
    "description": "Get App Store reviews of one iOS app through EveryInfra (platform app_store, action reviews).",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "app_id": {"type": "string", "pattern": "^[0-9]{6,12}$", "description": "Numeric App Store id, for example 6473753684"},
        "country": {"type": "string", "pattern": "^[a-z]{2}$"},
        "sort": {"type": "string", "enum": ["newest", "most_helpful"]},
        "limit": {"type": "integer", "description": "1 to 500; use 30 unless the user asks for more"}
      },
      "required": ["app_id", "country", "sort", "limit"],
      "additionalProperties": false
    }
  },
  {
    "name": "amazon_reviews",
    "description": "Get the featured customer reviews shown on one Amazon product page (platform amazon, action reviews). Usually about a dozen reviews per product.",
    "strict": true,
    "input_schema": {
      "type": "object",
      "properties": {
        "url": {"type": "string", "pattern": "^https://www\\.amazon\\.[a-z.]{2,6}/(dp|gp/product|product-reviews)/[A-Z0-9]{10}"},
        "domain": {"type": "string", "enum": ["amazon.com", "amazon.co.uk", "amazon.de", "amazon.fr", "amazon.it", "amazon.es", "amazon.ca", "amazon.com.au", "amazon.in", "amazon.co.jp", "amazon.sg"]}
      },
      "required": ["url", "domain"],
      "additionalProperties": false
    }
  }
]
这份定义有四处取舍,都是被上面的限制逼出来的。第一,所有参数都写成必填。目录里 trustpilot/reviews 有 6 个可选参数,加上 limit 是 7 个,原样照搬会占掉 24 个可选名额的近三成;官方建议「如果一个参数总有合理默认值,就改成必填,让模型显式填默认值」,所以我们给 date 加了一个 any 值、给 stars 允许空数组,由自己的代码在转发前把 any 和 [] 去掉,因为接口的说明写的是「留空不限」;当晚我们把 date: any 原样发给接口试了一次,0.11 秒回 422,所以这一步不能省。第二,limit 的上下限写进描述而不是 minimum/maximum,因为数值约束不受支持;超出上限的值由接口处理,目录里有 6 项能力把这种情况写明为「capped」(截到上限)。第三,Amazon 链接用一条简单正则限定成商品页,目录对 amazon/reviews 的 url 说明原文是「不能用店铺首页代替」,我们用本机的 JSON Schema 校验器跑过一条店铺链接,确认会被这条正则拒绝。第四,11 月 1 日凌晨读的目录没有给 trustpilot/reviews 的 date 和 sort 列 allowed_values,取值是我们从中文说明里抄出来的,这一点在下一节会变成一个真实的问题;当晚目录已经补上,date 五个预设、sort 三个值(newest、recency、relevance)都能直接从 allowed_values 生成,上面的定义也照着加了 last7days。Amazon 的 domain 照目录在 22:14(新加坡时间)列出的 11 个站点写成枚举,没有 amazon.com.mx:这个站在扣费前就回 422,经过见「边界」一节。整份定义只用了 enum、required、additionalProperties: false、简单 pattern 和 format 这几样各家受约束解码实现都普遍支持的写法,数值范围、长度这类支持程度不一的约束一律留给接口的 422(各实现覆盖差异见 JSONSchemaBench 对六个框架的评测),这样同一份工具定义稍改字段名就能搬到别家模型,第二层完全不用改。
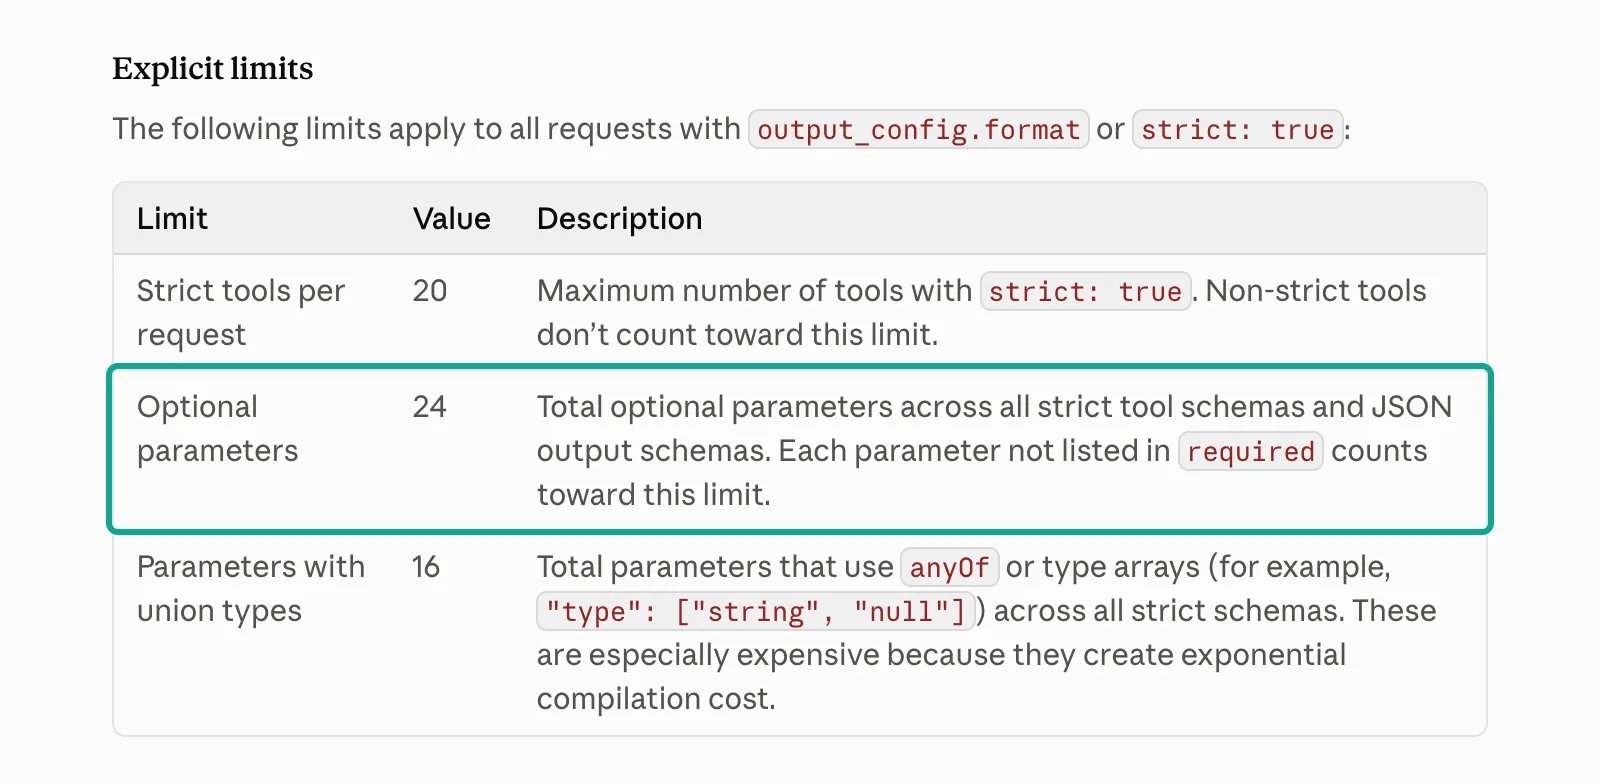
那么目录里的能力有多少能塞进 strict 的预算?我们把 402 项可用能力的可选参数逐个数了一遍,带列表返回的能力把 limit 也算作可选。结果是中位数 1 个,最多 9 个,没有一项能力单独超过 24;100 项没有可选参数,139 项只有 1 个,两者合计 239 项,占 59.5%。
这个分布说明两件事。好的一面是,按「全部改必填」的写法,目录里任何 20 项能力都能放进一次请求,可选名额一个都不用;按原样保留可选参数的写法,挑可选参数最少的 20 项也正好用 0 个名额。坏的一面是,想把全部 402 项都做成 strict 工具不现实:所有能力的可选参数合计 686 个,按每次 24 个算,理论上至少要分 29 组,我们用贪心装箱实际分了 30 组,而每次请求最多 20 个 strict 工具也意味着至少 21 组。所以正确的做法不是给每项能力一个工具,而是按任务挑。拿评论监测这个任务来说,8 个评论类能力合起来正好用掉 23 个可选名额。
23 离 24 只差 1,再加一个结构化输出 schema 只要有一个可选字段就会超。这正是官方建议「能必填就必填」的原因:我们示例里的三个工具全部必填,可选名额用了 0 个,把预算留给后面的结构化输出。还有一个现成的反例值得一提:EveryInfra 远程 MCP 的通用工具 everyinfra_call_api 把 params 定义成一个不限字段的对象,因为它要通吃 426 项能力;这在普通工具里没问题,但 strict 要求每个对象都写 additionalProperties: false,这样的 schema 开不了 strict。我们在 2026 年 11 月 1 日 15:41(新加坡时间)改稿时重读的 MCP 工具列表一共 12 个工具、16,247 字节,everyinfra_call_api 的 params 仍是不限字段的对象;想要 strict 的保证,就得像上面这样按任务另写专用工具,通用工具留给探索。
把目录自动翻译成 schema:规则和每天重生成
手写三个工具没问题,手写三十个就会出错,而且目录会变。更稳的做法是写一个小脚本,每天读一次免费目录,按固定规则生成 strict 工具,再和昨天的版本比对。我们用的规则只有六条,每一条都对应前面讲过的一个限制。第一,required_params 原样进 required。第二,optional_params 也进 required,但每个可选参数要有一个表示「不设置」的值:字符串枚举加一个 any,数组允许空,布尔值由描述写明默认值;转发前由代码把这些值去掉。第三,参数说明里有 allowed_values 的写成 enum,原样照抄,不改大小写,不合并近义词。第四,format 为 uri 或 date 的写成同名 format,其余格式不写,因为 strict 只认文档列出的十种字符串格式。第五,limit 写成 integer,把目录的 default_limit 和 max_limit 写进描述,不写 minimum、maximum。第六,每个对象都加 additionalProperties: false,工具描述的第一句写清 平台/能力,第二句写触发条件。
这套规则有两处需要人工补。一是像 trustpilot/reviews 的 date、sort 这样只在文字说明里列了取值、没有 allowed_values 的参数,脚本识别不出来,只能人工从说明里抄成枚举,或者等目录补上(这两个参数当晚已经补上);我们把这类参数记成清单,每次重生成时提醒一次。二是目录里取值超过一百个的枚举,当天有 8 个,最多的一个有 183 个取值,原样写进 schema 会让编译后的语法变大,官方文档说这类内部上限没有单一的数字,超了会返回「Schema is too complex for compilation」。对这种参数,我们的做法是不写 enum,在描述里给出最常用的几个值,把校验交给接口的 422,反正 422 会带回完整的 allowed 列表。
每天重生成还有一个好处:知道什么时候会多付一次编译时间。结构化输出页写明,编译好的语法缓存 24 小时;改了 schema 的结构,或者在同时用结构化输出和工具时改了工具集合,缓存就失效,下一次请求要重新编译;只改 name 和 description 不会失效(结构化输出)。所以脚本比对时要区分两种变化:描述文字变了,直接替换,没有代价;参数、取值或必填项变了,意味着下一批请求的第一个会慢,批处理里这点延迟可以忽略,实时对话里就值得在低峰时先发一个预热请求。批处理本身也受益于这一点:一个批次里成千上万个请求共用同一份工具和输出 schema,只编译一次。
第二层:422 让模型自愈,我们真调了哪些错
第一层挡住的是形状错误,挡不住取值错误:模型完全可能在 schema 允许的范围内填错,例如 App Store 排序写成 most_recent(这是别的平台的叫法),或者干脆没有用 strict、直接走通用工具。这时候第二层要做的是:快速失败、不扣费、把怎么改说清楚。Anthropic 处理工具结果的文档写了两条和这里直接相关的话:把错误放进 tool_result 并设 is_error: true,模型会带着修正重试,通常 2–3 次后才会向用户道歉;以及错误文本要写清楚哪里错了、下一步该怎么做,而不是只写「failed」(处理工具调用)。
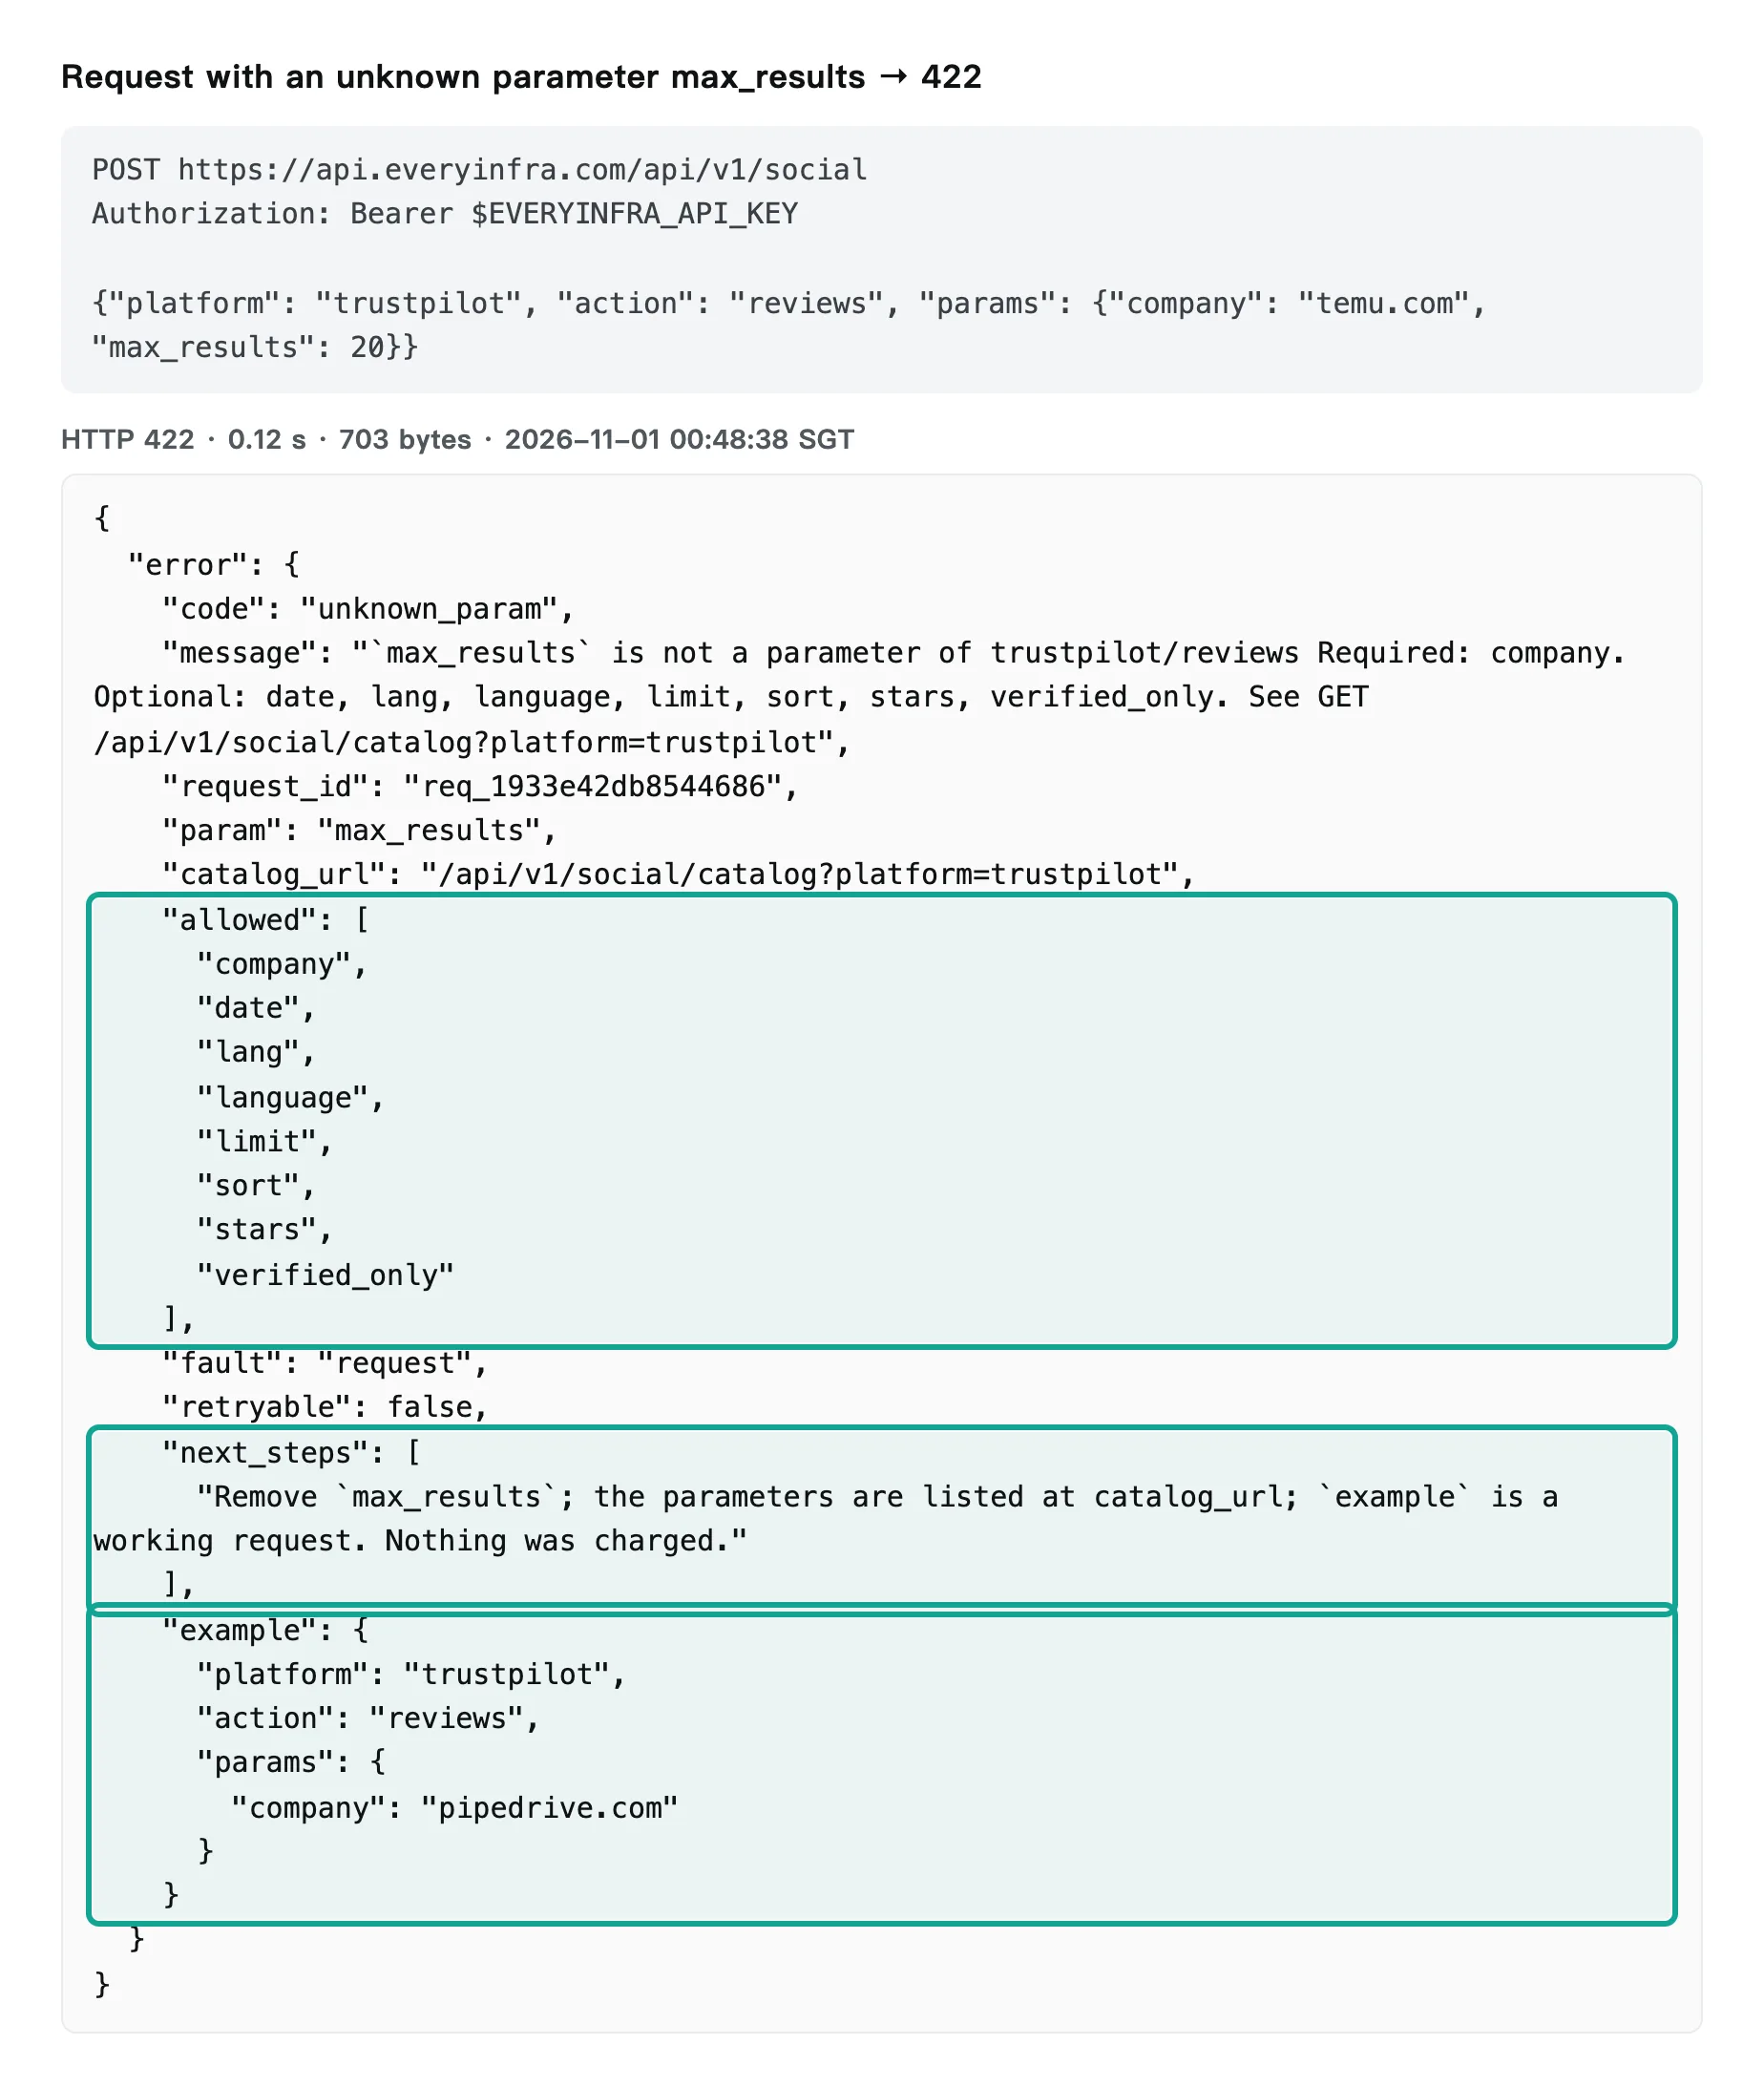
我们在新加坡时间 2026 年 11 月 1 日 00:48 到 00:49 之间故意发了 7 个错误请求,又在 00:57 通过 MCP 发了 1 个。下面是未知参数那一次的原样返回:请求里多了一个 max_results,接口在 0.12 秒内返回 422,allowed 列出全部 8 个合法参数名,example 给了一条能直接用的请求,next_steps 写明「去掉 max_results」和「未扣费」。
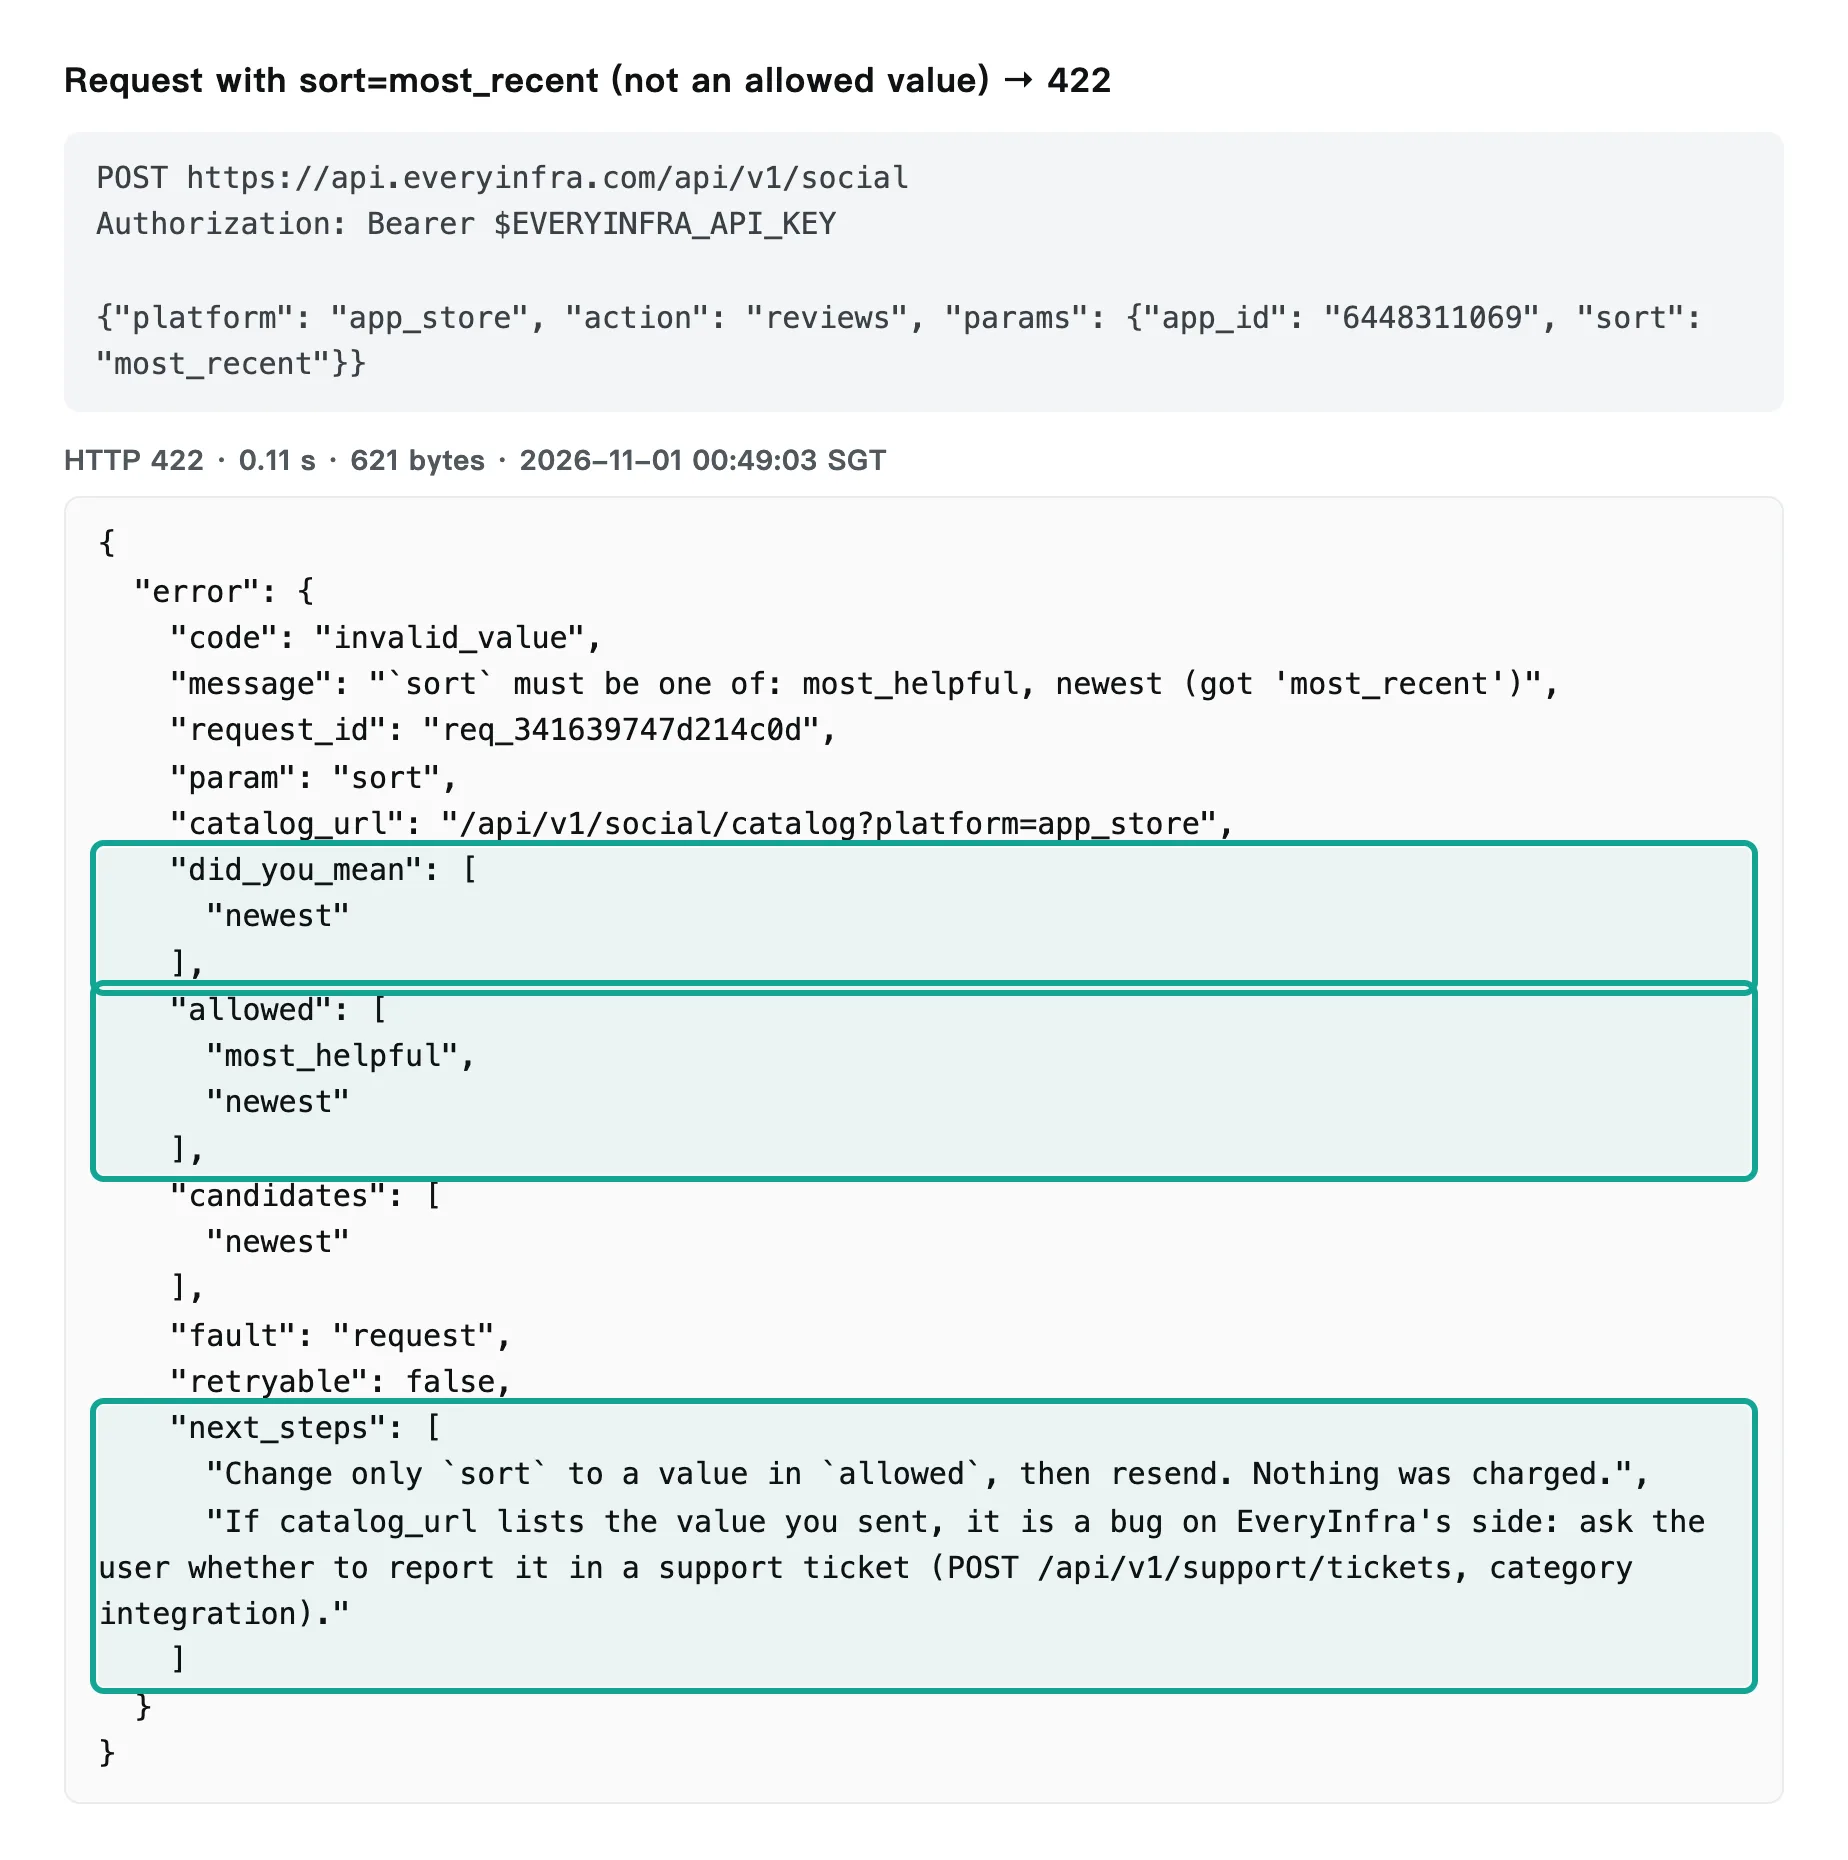
枚举写错的情况更典型。00:49 我们给 app_store/reviews 发了 sort: most_recent,接口 0.11 秒返回 422,did_you_mean 是 ["newest"],allowed 是 ["most_helpful", "newest"],next_steps 第一句是「只把 sort 改成 allowed 里的值再发,未扣费」。第二句也值得注意:如果目录里明明列了你发的值,那是 EveryInfra 这边的问题,请先问用户要不要提工单。这句话是写给模型看的,它把「我错了」和「接口错了」分开,避免模型把自己的错误当成服务故障反复重试。
7 个错误请求、1 个 MCP 调用、下午补的两次对照和当晚修复后的 5 次复测放在一张表里看更清楚。表里「strict 能否提前拦住」一列,是我们用本机 JSON Schema 校验器(Draft 2020-12 校验词汇表)拿上面那份工具定义逐条校验的结果。
| 时间(新加坡时间) | 故意写错的地方 | 接口返回 | 耗时 | 扣费 | 带回的修复线索 | strict 能否提前拦住 |
|---|---|---|---|---|---|---|
| 00:48:37 | 不带 Key | 401 missing_key | 0.12 s | 0 | 只说要带 Key | 不相关 |
| 00:48:38 | 多一个 max_results | 422 unknown_param | 0.12 s | 0 | 合法参数表、示例请求 | 能 |
| 00:48:42 | company 拼成 compnay | 422 missing_param | 0.23 s | 0 | 指出拼错、示例请求 | 能 |
| 00:48:42 | date: last7days | 503 | 1.69 s | 0(已退) | 只说稍后重试 | 当时能;当晚起是合法值 |
| 00:48:44 | sort: newest | 503 | 1.91 s | 0(已退) | 只说稍后重试 | 当时能;当晚起是合法值 |
| 00:49:03 | sort: most_recent | 422 invalid_value | 0.11 s | 0 | did_you_mean、allowed | 能 |
| 00:49:03 | G2 sort: newst | 422 invalid_value | 0.20 s | 0 | did_you_mean、allowed | 能 |
| 00:57:45 | MCP 里 G2 sort: most_recent | isError: true | — | 0 | 同上,放在 structuredContent | 不适用 |
| 15:39:38 | sort: newest(对照) | 200,20 条 | 14.3 s | $0.001389 | 无,评论换了一批 | 当时能;当晚起是合法值 |
| 15:39:38 | date: last7days(对照) | 200,20 条 | 14.4 s | $0.001389 | 无,评论换了一批 | 当时能;当晚起是合法值 |
| 19:18:39 | sort: newst(修复后) | 422 invalid_value | 0.21 s | 0 | did_you_mean(newest)、allowed | 能 |
| 19:18:46 | date: last_week(修复后) | 422 invalid_value | 0.12 s | 0 | did_you_mean(last7days)、allowed | 能 |
| 19:18:53 | date: any(修复后) | 422 invalid_value | 0.11 s | 0 | allowed | 不能(schema 允许,靠代码去掉) |
| 19:19:01 | language: eng(修复后) | 422 missing_param | 0.19 s | 0 | 写明要两位语言码 | 定义里没有这个参数 |
| 19:19:23 | sort: newest(修复后,已合法) | 200,20 条 | 14.1 s | $0.001389 | 和 recency 逐条相同 | 不需要 |
这张表里最值得细看的是 trustpilot/reviews 的白天四行。凌晨时它的 date 和 sort 在目录里只有中文说明,没有 allowed_values,所以接口没法在入口按枚举校验。凌晨 00:48 这两个写错的值各回了一次 503,1.7–1.9 秒,已退款,next_steps 只说隔 retry_after 秒后重试。但这两次 503 不能直接算到取值头上:同一时段我们另一组测试里,不带这两个参数的 trustpilot/profile 也回过 503,说明那几分钟这个平台本身就不稳。
所以下午我们补了一组对照。15:39:38(新加坡时间)同一分钟并发四次,公司都是 temu.com,只改一个参数:sort: newest 和合法的 sort: recency,date: last7days 和合法的 date: last30days;15:40 又补了一次什么都不传的基准和一次 newest 的重复。六次全部返回 200、各 20 条、各扣 $0.001389。结果分成干净的两组:两个合法值和基准拿回的是同一批 20 条,全是英文评价,verification_level、source 都有值;两个没列出的值和那次重复拿回的是另一批 20 条,13 条英文、3 条法语、2 条西语、2 条意大利语,这两个字段在 20 条里全是空的。也就是说,11 月 1 日白天写错的取值既不报 422 也不报 503,而是被接受、照常扣费,并悄悄改掉了返回的内容。对模型来说这比 503 更糟:它拿到的是一次「成功」,不会重试,也不会提醒用户,混了语言的评论直接进了下游。目录里 sort 的说明原文其实写了「这里应传 recency,不套用其他平台的 newest」,可惜只有读说明的人能看到,接口的校验看不到。
以上是 11 月 1 日白天的实测。当晚网关改了下面几处:
| 参数 | 11 月 1 日白天 | 当晚修复后 |
|---|---|---|
sort | 目录没列取值;newest 照收、照扣费,评论换了一批 | 收 newest(等于 recency)、recency、relevance |
date | 目录没列取值;last7days 照收、照扣费,评论换了一批 | 五个预设按发布日期截止,往前推 7、30、92、183、366 天 |
language、lang | 说明只举了例子 | 只收两位语言码;不传时只给英语评论 |
| 不在列表里的值 | 可能被照收并扣费 | 扣费前回 422,带允许值和 did-you-mean |
我们 19:18–19:21(新加坡时间)用同一家公司复测:sort: newst、date: last_week 在 0.12–0.21 秒内回 422,分别建议 newest 和 last7days,未扣费;sort: newest、sort: recency、date: last7days 和什么都不传的基准四次都回 200、各扣 $0.001389,拿回的是同一批 20 条,全是英文,verification_level 和 source 20 条都有值。这批评论最早一条也是不到一天前发的,所以 last7days 和不传 date 结果相同是正常的。
这组对照也说明了第一层为什么不能省:我们的 strict schema 把 date 和 sort 写成了枚举,这两个错误在 Claude 发出请求之前就不可能出现。这两个参数当晚已经能被 422 拦住,但目录里还会有别的参数只在说明里写了取值,客户端 schema 仍然是最早能拦住错误的地方,而 422 能保证写错的值不会被悄悄接受。MCP 一侧的分工也是按这个思路设计的:MCP 规范的工具一节把输入校验失败归为工具执行错误,放进结果并设 isError: true,要求客户端交给模型自我修正,我们 00:57 那次 MCP 调用正是这样返回的。站内的 API 报错处理指南按错误码逐个讲了该怎么分流,失败退款对账讲了怎么核对退款。
另一个值得写的观察来自 Anthropic 文档里一条不太起眼的说明:结构化输出不保证字符串 enum 值的大小写,模型可能返回只在大小写上和 schema 不同的值,而且不会报错,这一条同样适用于 strict tool use(结构化输出「Invalid outputs」一节)。也就是说,即使开了 strict,newest 也可能变成 Newest。我们在 14:33(新加坡时间)先试了一次 app_store/reviews 的 sort: Newest:接口没有报错,返回 200、30 条评论,按发布时间从新到旧排好,扣费 $0.001389。一次不够下结论,15:39 到 15:41 又在另外两个平台各试了一次:g2/reviews 的 sort: Newest 和小写 newest 拿回的 21 条记录完全相同;google_play/reviews 的 sort: Top_Rated 返回 40 条、全是五星,和同一时段 sort: Newest 那次一星到五星混着的 40 条明显不同,说明大写的取值确实生效了。这四次各扣 $0.001389。所以在我们测过的三项能力上,大小写偏差会被当作同一个值;目录里其他带枚举的能力没有逐个测,稳妥的写法仍是在转发前把枚举值统一成小写,这一行代码的成本远低于一次走错的调用。官方给的另一条建议也要照做:不要定义只差大小写的两个枚举值。
还有一个和两层都有关的设置是并行工具调用。它默认开着,模型可能在同一轮里一口气发出好几个 tool_use,例如同时查 Trustpilot 和 App Store;并行工具调用页写明两条格式规则:这一轮所有工具结果要放进同一条 user 消息,而且结果前面不能有文字。对调数据接口的人来说,这意味着你的代码要能同时处理一个 422 和一个 200:把 422 的那条设 is_error: true,200 的那条照常返回,模型下一轮只会重发错的那个。如果你的 Key 每分钟次数有限,或者想让日志一目了然,可以在 tool_choice 里加 disable_parallel_tool_use: true,这样 auto 模式下模型每轮最多调一个工具,仍然可以只回文字。注意这个开关写在 tool_choice 对象里,不是请求的顶层参数,写错位置不会生效。
这张图换了一个角度看同一件事:一次 422 返工的接口成本是 0 美元、0.17 秒左右(四次 422 的平均),真正花钱的是模型多跑的那一轮。一轮返工的模型费可以用一个公式算:返工成本 ≈(上下文 token + 错误体 token)× 输入单价 + 修正 token × 输出单价。错误体按约 240 token、修正按约 120 token 算,上下文的长短决定了大头,所以下表按 1k、5k、20k 三档给出(单价取自定价页,2026 年 11 月 1 日读取,括号里是相当于几次 $0.001389 的评论调用)。
| 上下文 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 1,000 token | $0.00018(0.1 次) | $0.0037(2.6 次) | $0.0074(5.3 次) | $0.0184(13 次) |
| 5,000 token | $0.00058(0.4 次) | $0.0117(8.4 次) | $0.0234(17 次) | $0.0584(42 次) |
| 20,000 token | $0.0021(1.5 次) | $0.0417(30 次) | $0.0834(60 次) | $0.2084(150 次) |
带三个工具定义和几轮对话的应用,上下文到 2 万 token 很常见,这时在 Opus 5.5 上错一次的代价约是 60 次数据调用;如果前面的上下文命中提示缓存,上下文那一项按缓存读价算(Haiku 5.5 是标准输入价的 10%,Opus 5.5 和 Sonnet 5.5 是 5%,Fable 5.1 是 2.5%),20k 那一档在 Opus 5.5 上会从 $0.0834 降到约 $0.0074。把你自己的上下文长度代进公式就能得到自己的倍数。不论落在哪一档,结论的方向都一样:上下文越长,返工越贵,这是第一层值得做的经济理由,strict 让最常见的那类返工根本不发生。
一次完整往返:模型发出什么,我们回了什么
下面把两层接起来,写成一个最小的循环。代码是配置示例,按 Anthropic 文档的写法组织,Claude 一侧没有实跑;EveryInfra 一侧的请求和返回都是当天的真实结果。
import json, os, requests, anthropic

client = anthropic.Anthropic()                 # 读 ANTHROPIC_API_KEY
EI = "https://api.everyinfra.com/api/v1/social"
TOOLS = json.load(open("tools.json"))           # 上一节的三个 strict 工具
ROUTE = {"trustpilot_reviews": ("trustpilot", "reviews"),
         "app_store_reviews": ("app_store", "reviews"),
         "amazon_reviews": ("amazon", "reviews")}

def call_everyinfra(name, args):
    platform, action = ROUTE[name]
    params = {k: v for k, v in args.items() if v not in ("any", [], None)}   # any / [] 表示不筛选
    r = requests.post(EI, json={"platform": platform, "action": action, "params": params},
                      headers={"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}, timeout=90)
    body = r.json()
    if r.status_code == 422:                    # 取值错误:原样交给模型,让它按 allowed / did_you_mean 改
        return json.dumps(body["error"]), True
    if r.status_code >= 400:
        return json.dumps(body.get("error", body)), True
    rows = [{k: x.get(k) for k in ("id", "rating", "title", "text", "posted_at")} for x in body["results"]]
    return json.dumps({"count": body["count"], "charged_usd": body["billing"]["charged_usd"], "reviews": rows}), False

messages = [{"role": "user", "content": "用 trustpilot_reviews 工具查 temu.com 最近 30 天的一星和二星评价,取 20 条,然后按主题归类。"}]
while True:
    resp = client.messages.create(model="claude-opus-5-5", max_tokens=4000, tools=TOOLS,
                                  tool_choice={"type": "auto"}, messages=messages)
    messages.append({"role": "assistant", "content": resp.content})
    if resp.stop_reason != "tool_use":
        break
    results = []
    for block in resp.content:
        if block.type == "tool_use":
            text, is_err = call_everyinfra(block.name, block.input)
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": text, "is_error": is_err})
messages.append({"role": "user", "content": results})几个细节决定了这个循环稳不稳。tool_choice 显式写 auto,其实不写也是默认值,写出来是为了让后来的人一眼看出这里没有强制调用。用户消息里点名「用 trustpilot_reviews 工具」,这是 Opus 5.5 和 Fable 5.1 文档给出的替代强制调用的写法。422 的错误体原样放进 tool_result 并设 is_error: true,不要自己改写成一句「参数错误」,因为 allowed 和 did_you_mean 才是模型能用的东西。成功时只把五个字段交回模型:代码里留的是 id、星级、标题、正文和发布时间。我们拿当天的真实返回算过,20 条 Trustpilot 评论的 results 有 31,046 个字符,只留这五个字段后是 13,040 个字符,少了 58%;30 条 App Store 评论从 13,012 个字符降到 7,726 个,少了 41%。模型读得越少,每一轮越便宜,后面算批量账时也按裁剪后的大小算。
这个循环在 2026 年 11 月 1 日 00:49(新加坡时间)对应的真实一次往返是这样的。strict 保证模型发出的参数形如 {"company": "temu.com", "stars": ["1", "2"], "date": "last30days", "sort": "recency", "limit": 20},我们的代码原样转给 trustpilot/reviews,接口 56.9 秒后返回 200,20 条评论里 19 条一星、1 条二星,发布时间在 10 月 30 日到 10 月 31 日之间,按国家看英国 10 条、美国 3 条,16 条带商家回复,扣费 $0.001389,和目录 price_usd 一致。如果模型这一步填了 "sort": "newest",strict 会让它根本发不出去;如果没开 strict、走了通用工具,接口不会退回这个值,而是像上一节的对照那样照常扣费,返回一批混了语言的评论。
结构化输出会看到什么样的评论?我们没有在本机跑 Claude,所以不报模型的归类结果,只用一组简单的关键词规则给 14:37 取到的那 100 条 Trustpilot 一二星评价做了一个粗略的底数,规则原文和结果都留了档。100 条里 40 条提到退款,20 条提到退货,35 条提到物流或配送,33 条提到质量或破损,35 条提到客服,14 条提到账号;16 条一条规则都没命中。正文长度的中位数是 432 个字符,最长的一条 3,371 个字符。这组数有两个用处。第一,它告诉你 topic 枚举该怎么设:一条评论平均命中不止一个主题,如果 schema 只允许一个 topic,模型就得取舍,取舍的规则要写进描述,例如「优先选和钱有关的主题」。第二,最长的评论有 3,371 个字符,约 1,350 个 token,按每个请求 25 条评论估算批量成本时,要按长度的分布估而不是按平均值,否则个别请求会超出你给的 max_tokens,触发前面说的截断。这 100 条评论的发布时间从 2026 年 10 月 27 日到 2026 年 11 月 1 日,App Store 那 30 条 Claude 应用评论则在 2026 年 10 月 28 日到 2026 年 10 月 30 日之间,两者都只代表这几天。
拿到评论以后,第二步让模型按固定字段归类,这里用的是 claude structured outputs。下面的 schema 也是配置示例:
{
  "type": "json_schema",
  "schema": {
    "type": "object",
    "properties": {
      "source": {"type": "string", "enum": ["trustpilot", "amazon", "app_store"]},
      "items": {
        "type": "array",
        "items": {
          "type": "object",
          "properties": {
            "review_id": {"type": "string"},
            "rating": {"type": "integer"},
            "topic": {"type": "string", "enum": ["delivery", "refund", "quality", "price", "support", "app_bug", "account", "other"]},
            "severity": {"type": "string", "enum": ["low", "medium", "high"]},
            "quote": {"type": "string", "description": "At most 20 words copied from the review"}
          },
          "required": ["review_id", "rating", "topic", "severity", "quote"],
          "additionalProperties": false
        }
      }
    },
    "required": ["source", "items"],
    "additionalProperties": false
  }
}
这份 schema 的可选参数是 0 个,和三个 strict 工具放在同一次请求里也不会顶到上限。quote 只要求「最多 20 个词」而不是 maxLength,因为长度约束不受支持。还要留意两个官方写明的例外:模型拒答时返回 stop_reason: "refusal",输出可能不符合 schema;被 max_tokens 截断时返回 stop_reason: "max_tokens",输出可能不完整(结构化输出)。所以入库之前仍然要检查 stop_reason,不能因为开了结构化输出就跳过校验。另外,要求模型在某个字段里写「推理过程」可能触发 reasoning_extraction 拒答,拒答与回退页建议改成要一句简短解释。
如果评论来自 App Store,同样的流程拿到的是另一种分布。我们 00:54 读的 Claude 应用(app_store/reviews,app_id 6473753684)最新 30 条评论里,一星 8 条、二星 2 条、三星 3 条、四星 1 条、五星 16 条,24 条来自版本 1.261026.20、6 条来自 1.261028.19;同一时刻 ChatGPT 应用的 30 条里一星 5 条、五星 21 条。这些数没有统计意义,只说明一个实际情况:同一套 schema 在 Trustpilot 上几乎全是差评(因为我们筛了一二星),在 App Store 上好坏都有,severity 这种字段的分布会随来源变化,下游的告警阈值要按来源分开定。Apple 自己的开发者页面也提醒,摘要评分按地区计算、可以在发新版时重置,但书面评论不会因此清空(App Store 评分与评论),所以按版本号看评论比按总分看更有用。
这组数还给工具定义提了两条具体要求。第一,country 应当写成必填枚举,不要留给默认值。14:55 我们读了 Claude 应用墨西哥区(country: mx)最新 30 条评论:0.67 秒返回,扣 $0.001389,时间从 2026-10-05 排到 2026-10-29(太平洋时间),跨 12 个版本;美国区同样 30 条只覆盖 10-28 到 10-30。同一个 limit 在两个店面覆盖的时间差了好几倍,如果 country 是可选的,模型漏填时拿到的就是美国区,而且返回里看不出来。写成必填以后,模型每次都得说清读的是哪个店面,下游按店面定读取频率。
第二,limit 的描述里应当写明小语种市场的取法。同一时刻我们按西语读 temu.com 的 Trustpilot 评论(language: es、最近 30 天、limit: 50),只回来 27 条,因为这 30 天里西语评论就这么多;这次调用量到 86.95 秒,已经碰到目录写的 85 秒同步预算。所以 limit 的描述里可以加一句「小语种市场选较长的 date 时间窗,不要靠加大 limit 凑条数」,同时由你的代码在这类请求的请求体里加 "mode": "async",不让同步请求贴着超时线跑。这两条都只来自一个应用、一家公司、一天的样本,定频率前先用一次调用测一下自己的目标。
批量:用 Message Batches 算 1,000 条评论的账
一次往返跑通以后,真正花钱的是批量。Message Batches 把请求异步处理,所有用量按标准价的 50% 收费;一个批次最多 100,000 个请求或 256 MB,多数一小时内完成,24 小时没处理完的请求过期且不收费,结果保留 29 天(批处理)。结构化输出页的「功能兼容」一节写明它可以和批处理一起用、同样享受五折。批次里每个请求都是完整的 Messages 请求,所以上面的 strict 工具和 output_config.format 原样放进去即可(创建批次的接口说明)。
批量场景下,数据这一侧先要回答一个问题:一次取多少条。目录里 trustpilot/reviews 默认 20 条、最多 200 条,价格是每次 $0.001389,没有按行计费的字段。我们 14:37(新加坡时间)发了一次 limit: 100,返回 100 条,扣费仍是 $0.001389,和取 20 条一样;这 100 条里 95 条一星、5 条二星,发布时间从 10 月 27 日到 11 月 1 日,英国 44 条、美国 21 条。代价是时间:同步请求用了 84.0 秒,而目录写明同步调用的预算是 85 秒,已经贴着上限。所以批量拉评论的正确姿势是 limit 取大、请求体加 "mode": "async",拿 job_id 去轮询 GET /api/v1/jobs/{job_id},而不是同步硬等。
| 每 1,000 条评论 | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| 模型费,标准价 | $0.0577 | $1.1537 | $2.3073 | $5.7683 |
| 模型费,Message Batches | $0.0288 | $0.5768 | $1.1537 | $2.8842 |
| 接口费,limit=100(10 次) | $0.0139 | $0.0139 | $0.0139 | $0.0139 |
| 合计(批处理 + limit=100) | $0.0427 | $0.5907 | $1.1676 | $2.8981 |
模型费的估算方法写在这里,便于你替换成自己的数:每个请求放 25 条评论,1,000 条共 40 个请求;每条评论裁剪后约 440 个字符,每个请求的指令和 schema 约 1,424 个字符;每条输出约 189 个字符;按 Anthropic 模型总览「100 万 token 约合 250 万个 Unicode 字符」的比例,每字符折 0.4 个 token(模型总览)。合计约 198,832 个输入 token、75,600 个输出 token。没有计入思考 token、工具系统提示词(Opus 5.5 为 286 token)和结构化输出自动注入的格式说明,所以这是下限。接口费如果用默认 limit=20,1,000 条要 50 次、$0.0694,是 limit=100 的 5 倍。
这张图的结论很直接:评论归类这种「读得多、判断简单」的活交给 Haiku 5.5,模型费和接口费在同一个量级,合计每千条约 $0.04;换成 Opus 5.5 贵 27 倍,Fable 5.1 贵 68 倍。Haiku 5.5 有一个要注意的价格台阶:提示词超过 100,000 token 时单价变成 $0.50 / $2.50,批处理是 $0.25 / $1.25,所以每个请求塞 25 条、每条几百字符,远离这条线是对的。如果你的归类需要更强的判断,例如区分「物流慢」和「商家拒退」这种细分主题,可以先用 Haiku 全量过一遍,再把 severity: high 的那一小部分交给 Opus 5.5 复核。
按这个账算一个每天跑的监测:50 家公司的 Trustpilot 差评加 50 个应用的 App Store 新评论,每天 100 次接口调用,接口费每天 $0.1389,30 天 $4.17;每天最多约 2,500 条评论,30 天用 Haiku 5.5 批处理归类约 $2.16,用 Sonnet 5.5 约 $43.26,用 Opus 5.5 约 $86.53。批处理和提示缓存可以叠加,固定的系统提示和工具定义命中缓存后还会更便宜,但缓存在批次里的命中率要看请求的到达顺序,我们没有实测,这里不算进去。
做不了或要注意的地方
先说我们自己的。amazon/reviews 当天 4 次都没有拿到评论:00:50、00:51 两次同步各等了约 68 和 73 秒,00:53 一次异步任务状态是成功但 0 条,14:34 带上 domain 再试一次,等了 66 秒还是 0 条。这 4 次都没有扣费,空结果按规则退回,异步那次先扣后退,任务记录里写着已退款。目录对这项能力的说明本来就写了「只能取到商品页展示的精选评论,每个商品通常十几条」,而当天连这十几条也没取到。所以本文的 Amazon 工具定义只能算配置示例,示例里换成了 trustpilot/reviews 和 app_store/reviews 这两项当天实测可用的能力;同一时段 amazon/search 是正常的,00:51 搜「anker power bank 10000mah」返回 5 个商品、11.8 秒、扣 $0.002236。想做 Amazon 评论监测的,先用目录和一次小额调用确认当天可用,再接进批量。
当晚网关改了 Amazon 评论的两种情况,我们 19:19–19:24(新加坡时间)复测如下:
| 请求 | 白天 | 当晚复测 | 扣费 |
|---|---|---|---|
| 美国站,同步 | 200,0 条,66–73 秒 | 24.6 秒回 503 access_blocked,next_steps 写明商品要登录或受限、马上重试没用 | 0 |
| 美国站,异步 | 任务成功但 0 条 | 202,预扣 $0.001389;任务以 access_blocked 失败 | 0(已退款) |
amazon.co.jp | 未测 | 19:19 回 422 missing_param,说明只写「缺少 domain」;22:14 再测,35.3 秒回 200、5 条,5 条都是其他国家买家写的(美国 3 条、德国 2 条) | 19:19 为 0;22:14 扣 $0.001389 |
amazon.com.mx | 未测 | 19:19 回 422 missing_param;22:14 再测,0.09 秒回 422 invalid_value,列出 11 个支持的站点 | 0 |
19:19 那两次的错误说明没有直说不支持这两个站。22:14 再测时,目录已经把 domain 改成 11 个站点的枚举:amazon.com、co.uk、de、fr、it、es、ca、com.au、in、co.jp、sg。墨西哥站在扣费前就被挡下,错误里带着这 11 个值,上面的工具定义也照这份写。日本站能取到评论,但返回的不一定是日本买家写的,要看日本本地评论就按 country 字段筛。
再说 Anthropic 一侧写明的边界。第一,HIPAA:strict 工具可以用于 HIPAA 场景,但受保护的健康信息不能出现在 schema 里,包括属性名、enum 值、const 值和 pattern,因为编译后的 schema 和消息内容分开缓存,不享有同样的保护(strict tool use 数据保留一节)。把客户名单做成 enum 这种写法要避免。第二,启用了客户自管密钥(CMEK)的组织在 Fable 模型上用不了结构化输出和 strict: true,Fable 5.1 迁移指南说这种情况只能靠指令本身。第三,引用功能和结构化输出不能同时开,同时开返回 400;需要「结构化数据加逐项出处」的,要改用引用文档里专门的写法(引用)。第四,改了 schema 结构或工具集合会让编译缓存失效,首个请求会慢一些;只改 name 和 description 不会。
最后,第二层不是万能的。422 只能挡住目录里写明了规则的错误:未知参数、缺必填、列了合法取值的枚举。目录里只用文字描述的规则,例如 11 月 1 日白天的 trustpilot/reviews 的 date 和 sort,以及「这个公司域名在 Trustpilot 上有没有主页」这种只有执行时才知道的事,422 都管不到;前一类当时甚至不会失败,而是照常扣费、悄悄改掉结果,当晚这两个参数补上合法取值后才改成回 422。所以本文的建议是两层都要:能写进 schema 的规则写进 strict 工具,写不进的交给 422;对从说明文字抄来的枚举,再在代码里抽查一下返回的语言和字段是否和平时一致。
排查:七种症状和对应的改法
把这套写法接进生产以后,问题通常不出在主路径上,而是出在边角:某个 schema 突然编译不过,某个模型这一轮不调工具,某次批量里有几条结果对不上。下面这张表把我们在文档和真调里遇到的七种症状放在一起,每一行的「原因」都能在前文找到出处。排查时先看 HTTP 状态码是谁返回的:400 来自 Anthropic,说明请求或 schema 本身有问题,改代码;422 和 503 来自 EveryInfra,说明请求形状没问题、取值或执行出了问题,按错误体里的 next_steps 处理。这一个区分就能省掉大部分排查时间,因为两边的错误体格式不同,日志里很容易混在一起。
| 症状 | 谁返回的 | 原因 | 改法 |
|---|---|---|---|
| 400,提示 tool_choice 不支持 | Anthropic | 在新模型上用了 any 或 tool | 改成 auto,在 user 消息里点名工具 |
| 400,提示 schema 太复杂 | Anthropic | 可选参数合计超过 24,或语法过大 | 可选改必填;大枚举改成描述加 422 |
| 模型回了文字、没调工具 | Anthropic | 指令不够明确 | 点名工具和触发条件,检查 stop_reason 后追问 |
422 invalid_value | EveryInfra | 取值不在目录的 allowed_values 里 | 按 did_you_mean 改一处再发,未扣费 |
| 503 且反复失败 | EveryInfra | 平台当时不稳;凌晨我们不带可疑参数的请求也遇到过。reason 是 access_blocked 时是目标页要登录或受限 | 按 retry_after 退避,连续失败交给人看,不让模型无限重试;access_blocked 换目标 |
| 200,但语言或字段和平时不一样 | EveryInfra | 传了目录说明里没列的取值,被接受并改变了结果(11 月 1 日白天 trustpilot/reviews 的 date、sort 就是这样,当晚起回 422) | 客户端写成 enum 拦住;对照目录说明改 |
| 200 但 0 条 | EveryInfra | 目标页当天没有可取的数据 | 空结果已退款;换目标或换能力,不要重试同一个 |
表里后三行是本文实测得出的,前四行来自 Anthropic 文档。其中第六行最值得做成代码,因为别的参数也可能出同样的问题:凡是从说明文字抄来、目录没有列 allowed_values 的枚举,都在 schema 里写死;返回后再抽查一下语言分布和关键字段是否为空,和基准不一致就把这次调用标为「需要人看」。我们下午的对照里,写错的值拿回的 20 条有 7 条不是英文、两个验证字段全空,这样的抽查一眼就能发现。
行业动向:最近 60 天和这件事有关的变化
| 日期 | 变化 | 对读者意味着什么 |
|---|---|---|
| 2026-09-22 | Opus 5.5 发布,思考不能关闭,强制 tool_choice 返回 400 | 从 Opus 5 升级要先改掉强制调用,改成 auto 加 strict |
| 2026-09-28 | Sonnet 5.5 发布,同样拒绝强制 tool_choice | 中档模型也要改,不能靠「换回 Sonnet」绕过去 |
| 2026-10-07 | Haiku 5.5 发布,100 万上下文,批处理价 $0.05 / $0.25 | 评论归类这类批量活的模型费降到和接口费同一量级 |
| 2026-10-15 | Models API 开始报告每个模型是否接受 between_tools 思考类型;Opus 5.5 快速模式结束研究预览 | 上线前可以程序化检查模型能力,不用靠模型 ID 猜 |
| 2026-10-21 | API 版本 2026-10-21 和新一代 SDK(Python 2.0.0 等)发布 | 升级 SDK 时一并检查 output_format 等旧写法是否还在 |
| 2026-10-22 | Claude 可经 Google Cloud 项目以 Anthropic 托管方式调用 | 在 Google Cloud 上跑批量的团队多了一个付费渠道,strict 用法不变 |
| 2026-10-28 | Messages API 单个请求上限从 32 MB 提到 128 MB | 一次塞进更多评论成为可能,但成本按 token 算,不按请求算 |
| 2026-10-29 | 用量与成本分析 API 进入 beta,可按模型、工作区、Key 分组 | 批量归类的模型费可以按任务拆账,和接口费放在一起看 |
| 2026-10-30 | Opus 4.8 的快速模式宣布 11 月 30 日下线 | 还在用老模型跑实时抽取的,要排迁移时间 |
这几条都来自 2026 年 10 月 30 日更新的 API 更新日志和对应的API 版本迁移说明。其中和本文关系最大的是 10 月 7 日 Haiku 5.5 的发布:在它之前,用 Haiku 4.5 做批量归类的批处理价是 $0.50 / $2.50,是现在的 10 倍,模型费远大于接口费;之后两者在同一个量级,选数据源时接口价格开始成为一个真正的变量。另一条值得一提的是 9 月 22 日一起上线的「会话中途 system 消息可以携带完整工具定义」(beta),它让你在会话中途加一个 strict 工具而不破坏提示缓存,是官方推荐的替代强制调用的方式之一。
常见问题
claude force tool use 还能用吗?
这个问题来自搜索联想词「claude force tool use」。在 Fable 5.1、Mythos 5.1、Opus 5.5 和 Sonnet 5.5 上不能用:tool_choice 为 any 或 tool 都返回 400,auto 和 none 照常可用,token 计数接口也做同样的检查。替代方法是保留 auto、给工具加 strict: true,并在 user 消息里写明什么时候用哪个工具;必须在当前这一轮调用某个工具的,Fable 5.1 迁移指南建议用会话中途的 system 消息。
claude tool_choice 设成 auto,模型不调工具怎么办?
来自联想词「claude tool_choice」。官方的说法是 Fable 5.1 能可靠地遵守明确的工具指令,所以第一步是把指令写明确:点名工具、说明触发条件。第二步是在你的循环里检查 stop_reason,如果模型直接回了文字而你确实需要数据,就追加一条 user 消息要求它调用。第三,工具的 description 要写清楚「什么时候该用」,定义工具页说详尽的描述是影响工具表现「最重要的因素」。
claude structured outputs bedrock 上能用吗?
来自联想词「claude structured outputs bedrock」。strict tool use 页的可用性表把 Amazon Bedrock(含 InvokeModel)和 Google Cloud 等平台都列为可用,结构化输出页写的是「所有支持的平台、所有模型」。要注意的是 Fable 系列要求 30 天数据保留,不在零数据保留范围内,用之前按数据保留说明确认你的组织是否符合。
claude structured output pydantic 怎么写?
来自联想词「claude structured output pydantic」。结构化输出页推荐把 Pydantic 模型传给 client.messages.parse():SDK 会转换 schema、把不受支持的约束(例如 minimum、maxLength)移到字段描述里,再按原 schema 和全部约束校验返回值。对接 EveryInfra 时,推荐把目录里的 allowed_values 写成 Literal[...],它会被翻译成 enum;limit 的范围用 Field(ge=1, le=200) 写,SDK 会在本地校验;接口端目录里有 6 项能力写明超过上限按上限截断。
claude structured outputs api 和 strict 工具要不要同时开?
来自联想词「claude structured outputs api」。可以同时开,结构化输出页「功能兼容」一节专门写了两者能在同一个请求里一起用。要记住它们共用 20 个 strict 工具、24 个可选参数、16 个联合类型参数这组上限,所以输出 schema 也要尽量全部必填。
上手步骤
- 读目录:
GET https://api.everyinfra.com/api/v1/social/catalog?platform=trustpilot免费、不用 Key,拿到参数、合法取值和价格。 - 按本文的四条取舍写 strict 工具:能必填的必填,
allowed_values写成enum,范围写进描述,链接用简单正则。 - 在快速上手领 Key,先用一个故意写错的枚举发一次请求,确认能拿到 422 和
did_you_mean,再接进循环。 - 批量时
limit取大并加"mode": "async",Claude 一侧用 Message Batches。
各平台和能力的说明页:Trustpilot 爬虫接口、Trustpilot 评价、App Store 爬虫接口、App Store 评价、Amazon 爬虫接口、Amazon 评价、G2 评价、Google Play 评价;想不写代码、直接在 Claude 里接远程 MCP,看远程 MCP 配置;同一类评论数据怎么做成产品,看评论数据如何做成付费产品和一份 SKILL.md 通用四个 AI 工具的竞品评论实测;用子代理并行拉数据的做法,看 Claude Code subagents 并行拉 TikTok 品牌号。各项能力的价格可以在数据市场对照。
参考资料
- Claude Opus 5.5 新功能(Forced tool use is not supported),Anthropic,2026-09-22,https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- Claude Fable 5.1 新功能,Anthropic,2026-09-01,https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- Claude Sonnet 5.5 新功能,Anthropic,2026-09-28,https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- Claude Opus 5.5 迁移指南,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/models/opus-5-5/migration-guide
- Claude Fable 5.1 迁移指南,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- Claude Sonnet 5.5 迁移指南,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/models/sonnet-5-5/migration-guide
- API 更新日志,Anthropic,2026-10-30 更新,https://platform.claude.com/docs/en/release-notes/overview
- Strict tool use,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/strict-tool-use
- Structured outputs,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- Define tools,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/define-tools
- Handle tool calls,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/handle-tool-calls
- Tool use overview,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- How tool use works,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/how-tool-use-works
- Troubleshooting tool use,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/troubleshooting-tool-use
- Parallel tool use,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/parallel-tool-use
- Tool runner,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-runner
- Tool search tool,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Programmatic tool calling,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/tool-use/programmatic-tool-calling
- Batch processing,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Create a Message Batch(API 参考),Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/api/messages/batches/create
- Pricing,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/about-claude/pricing
- Prompt caching,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/prompt-caching
- Token counting,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/token-counting
- Rate limits,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/api/rate-limits
- Errors,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/api/errors
- Models overview,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/models/overview
- Claude Haiku 5.5 概览,Anthropic,2026-10-07,https://platform.claude.com/docs/en/models/haiku-5-5/overview
- Claude Opus 5.5 概览,Anthropic,2026-09-22,https://platform.claude.com/docs/en/models/opus-5-5/overview
- Claude Mythos 5.1 概览,Anthropic,2026-09-01,https://platform.claude.com/docs/en/models/mythos-5-1/overview
- Effort,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/effort
- Streaming,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/streaming
- Refusals and fallback,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/refusals-and-fallback
- Citations,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/build-with-claude/citations
- MCP connector,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/mcp-connector
- Remote MCP servers,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/agents-and-tools/remote-mcp-servers
- Migrating to API version 2026-10-21,Anthropic,2026-10-21,https://platform.claude.com/docs/en/api/migration-2026-10-21
- API and data retention,Anthropic,2026-11-01 读取,https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- MCP 规范 2025-11-25:Tools,Model Context Protocol,2025-11-25,https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- JSON Schema Validation 2020-12,JSON Schema,2022-06,https://json-schema.org/draft/2020-12/json-schema-validation
- JSONSchemaBench,Geng 等,arXiv 2501.10868,2025,https://arxiv.org/abs/2501.10868
- Ratings, reviews, and responses,Apple Developer,2026-11-01 读取,https://developer.apple.com/app-store/ratings-and-reviews/
- EveryInfra 数据目录(GET /api/v1/social/catalog),EveryInfra,2026-11-01 00:46 读取,https://api.everyinfra.com/api/v1/social/catalog
引用编号 BL-60