Un SKILL.md en cuatro IA: reseñas de la competencia
Un mismo SKILL.md de análisis de reseñas para Claude Code, Codex, Antigravity CLI y Gemini, contrastado con la documentación oficial. Nueve llamadas reales leyeron 967 reseñas por 0,0125 USD.
Escribimos un único SKILL.md de «análisis de reseñas de la competencia» y dejamos su frontmatter dentro de la especificación de Agent Skills. Según la documentación oficial de cada producto, el mismo archivo se carga sin cambios en Claude Code, Codex y Antigravity CLI; en nuestra máquina ejecutamos los scripts de la skill, el validador de la especificación y la API de datos, sin instalar Codex ni Antigravity. La app de Gemini lo importa, pero sus scripts no pueden salir a internet, así que allí no obtiene datos.
El 26 de octubre de 2026, entre las 17:25 y las 17:55 (hora de Singapur), la skill preparó un informe sobre tres herramientas de gestión de proyectos. Fueron 9 llamadas a G2, Capterra y Trustpilot, con 967 reseñas y 0,012501 USD de coste de API. El mayor riesgo no estaba en las herramientas, sino en los datos. En Trustpilot, las reseñas espontáneas de cinco empresas tenían una media de 1,29 a 2,77 estrellas, y las invitadas, de 4,07 a 4,89. Para el lector hispanohablante hay otro hallazgo: con reglas de palabras en inglés, 80 de 81 reseñas en español de monday.com quedaron sin tema.


La respuesta corta: un SKILL.md, cuatro carpetas y una factura de 9 llamadas
Este artículo responde a una pregunta práctica. Usas Claude Code skills y tu equipo usa Codex o Antigravity CLI. ¿Podéis compartir un solo SKILL.md para analizar reseñas de la competencia? Antes de la primera llamada fijamos tres criterios. El frontmatter debía pasar la especificación de Agent Skills campo por campo. Cada carpeta y cada forma de invocar la skill debían salir de la documentación oficial de cada producto. Y el coste de la API debía coincidir con el precio del catálogo multiplicado por el número de llamadas, con diferencia cero. Los tres criterios se cumplieron, pero un producto solo lo cumplió a medias.
La tabla compara los cuatro productos. Cada celda sale de documentación oficial leída el 26 de octubre de 2026, con los enlaces en las secciones siguientes. La última columna responde a una pregunta clave: ¿puede el script de la skill llegar a api.everyinfra.com? Sin eso, esta skill no puede hacer su trabajo.
| Producto | Carpeta del proyecto | Carpeta personal | Cómo se invoca | ¿El script obtiene datos? |
|---|---|---|---|---|
| Claude Code | .claude/skills/<nombre>/SKILL.md | ~/.claude/skills/<nombre>/SKILL.md | /nombre, o Claude la elige por la descripción | Sí en sesiones locales; no en Cowork ni en la nube. |
| Codex (CLI, IDE, escritorio) | .agents/skills, desde la carpeta de trabajo hasta la raíz del repo | $HOME/.agents/skills | $nombre, /skills, o Codex la elige | Sí. |
| Producto | Carpeta del proyecto | Carpeta personal | Cómo se invoca | ¿El script obtiene datos? |
|---|---|---|---|---|
| Antigravity CLI | .agents/skills/ | ~/.gemini/antigravity-cli/skills/ | /skills para listarlas, o el agente la elige | Sí. |
| App de Gemini | No aplica (se sube en la página Skills) | No aplica | / o @ y el nombre | No: los scripts que necesitan internet no se admiten. |
Claude Code usa .claude/skills para los proyectos, mientras que Codex, Antigravity CLI y el ya retirado Gemini CLI leen .agents/skills. Por eso, un repositorio que sirva a todas estas herramientas puede guardar la skill en .agents/skills/competitor-review-analysis/ y poner un enlace simbólico en .claude/skills/. La documentación de Claude Code dice que una carpeta de skill puede ser un enlace simbólico, y la de Codex dice que Codex sigue los enlaces simbólicos (documentación de skills de Claude Code; Codex Build skills). Así hay una sola copia que mantener.
Qué son las agent skills: un SKILL.md con seis campos
Agent Skills es un formato abierto. Una skill es una carpeta con al menos un archivo SKILL.md, que empieza con un frontmatter YAML seguido de pasos en Markdown (especificación de Agent Skills). La especificación define seis campos: dos obligatorios, name y description, y cuatro opcionales, license, compatibility, metadata y allowed-tools. El name debe tener de 1 a 64 caracteres en minúsculas, dígitos y guiones, sin guion al principio ni al final, sin dos guiones seguidos y con el mismo nombre que la carpeta. La description debe tener de 1 a 1024 caracteres y decir qué hace la skill y cuándo usarla. El campo allowed-tools figura como experimental.
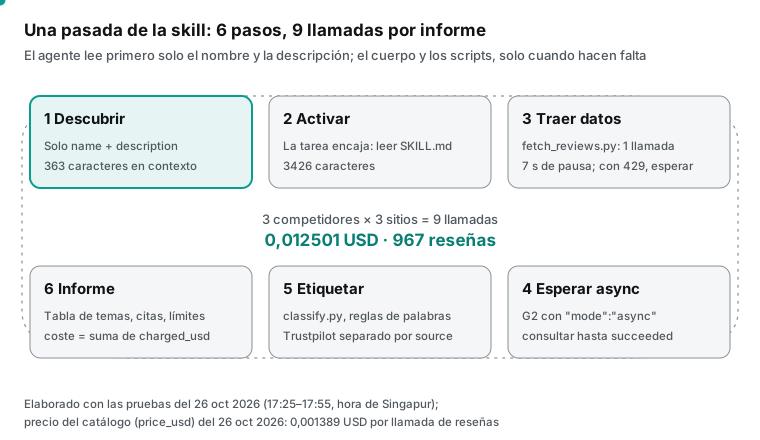
El formato ahorra contexto con lo que la especificación llama «divulgación progresiva», en tres niveles. Al empezar la sesión, el agente carga solo el name y la description de cada skill, unos 100 tokens según la estimación de la especificación. Cuando una tarea encaja con la descripción, lee el SKILL.md completo, que debería tener menos de 5000 tokens y menos de 500 líneas. Los archivos de scripts/ y references/ se cargan solo cuando los pasos los necesitan (especificación de Agent Skills). Anthropic explicó la misma idea el 16 de octubre de 2025: primero un índice, y el libro solo cuando hace falta (Anthropic sobre Agent Skills).
En nuestra skill, name y description suman 363 caracteres. Con unos 4 caracteres por token, son unos 91 tokens, cerca de la estimación de la especificación. El SKILL.md completo tiene 51 líneas y 3426 caracteres, muy por debajo del límite de 500 líneas. Estas dos cifras vuelven a salir en la sección sobre el contexto.
El SKILL.md de análisis de reseñas, completo
Este es el archivo completo. La carpeta de la skill incluye además dos scripts y una lista de palabras clave: scripts/fetch_reviews.py llama a la API de datos de EveryInfra, scripts/classify.py etiqueta cada reseña con temas mediante reglas de palabras, y references/themes.md guarda esas palabras. El cuerpo está en inglés porque así lo entienden por defecto Codex, Antigravity y Gemini, pero la especificación no pone límites de formato al cuerpo, de modo que puedes traducir los pasos al español.
---
name: competitor-review-analysis
description: Pull public reviews for 2-5 competing products from G2, Capterra, Trustpilot or Amazon through the EveryInfra data API, tag each review with a theme, and write a comparison report with counts, shares and quotes. Use when the user asks to compare competitor reviews, find what customers complain about, or build a review-based battlecard.
license: MIT
compatibility: Needs network access to api.everyinfra.com, Python 3.9+, and an EVERYINFRA_API_KEY environment variable. Does not run inside the Gemini app, where skill scripts cannot reach the internet.
metadata:
  version: "1.1"
  author: everyinfra-blog-example
---

# Competitor review analysis

## Inputs to confirm first
1. The products to compare (2-5). For each one, get the exact review page:
   G2 `https://www.g2.com/products/<slug>`, Capterra `https://www.capterra.com/p/<id>/<name>/`,
   Trustpilot domain such as `clickup.com`, Amazon `https://www.amazon.com/dp/<ASIN>`.
   Use the URL, not the product name. Product names change (Capterra lists monday.com as "monday AI Work Platform").
2. The theme set: `saas` or `hardware` (see references/themes.md). Ask if unclear.

## Steps
1. Fetch: run `python3 scripts/fetch_reviews.py --plan plan.json --out raw/`.
   One request per product per source. The script waits 7 s between requests,
   retries 429 with the `retry_after` value, and sends slow requests with `"mode":"async"`.
2. Check counts: read `raw/summary.json`. A source with 0 rows was not charged.
   Do not treat a short page as "no more reviews". Write the counts into the report.
3. Tag: run `python3 scripts/classify.py raw/ --themes saas > tagged.json`.
   The script tags by keyword rules, so the same input gives the same output.
4. Read 5 tagged reviews per theme and check that the tag fits. If a keyword
   matches the wrong words (v1 had `plan`, which matched "planning"), fix
   references/themes.md and run step 3 again. Note each change in the report.
5. Write `report.md` with these sections, in this order:
   - Table: product x source -> reviews read, average rating, charged USD.
   - Table: theme x product -> count and share of reviews that mention it.
   - Top 3 complaints per product, each with one short quote and its review URL.
   - Limits: what the sample cannot show (see below).

## Rules
- Report rating scales as they are: G2 and Capterra 1-5, Trustpilot 1-5 stars, Amazon 1-5 stars.
  Do not average across sources.
- Split Trustpilot by the `source` field: `Organic` (the reviewer came on their own) versus
  invitation sources (`BasicLink`, `InvitationApi`, `FileUploadInvitation`, `Shopify` and others).
  Report the average for each group. Never report one Trustpilot average for a company.
- Theme keywords are per language. For reviews that are not in English, use the matching set
  (for example `saas_es`), or report them as untagged.
- Do not print reviewer names. Quote at most 25 words per review.
- Amazon returns only the reviews shown on the product page (usually 10-15). Say so.
- Cost: every request costs the `price_usd` from `GET /api/v1/social/catalog`. Add up `billing.charged_usd` from the responses; do not estimate.

## Limits to state in every report
- The sample is the newest page of each source, not all reviews.
- Trustpilot reviews of a software company are often about billing and support, not the product. Read them as a separate signal.
Varias líneas existen solo para que el archivo sea portable. El frontmatter usa cinco de los seis campos de la especificación y no usa extensiones de Claude Code como model, context: fork o argument-hint. La línea compatibility deja claro que hacen falta red y una clave, así que quien importe el archivo en la app de Gemini verá enseguida que allí no funcionará. Las rutas de los scripts son relativas a la raíz de la skill y las referencias a archivos tienen un solo nivel, como pide la especificación (especificación de Agent Skills). Dos reglas llegaron solo después de ver los datos: «separar Trustpilot por origen» y «palabras clave por idioma». Las secciones siguientes explican por qué.
No validamos el archivo a ojo. A las 17:56 (hora de Singapur) pasamos el validador de referencia skills-ref 0.1.1 del repositorio de la especificación (agentskills/skills-ref) sobre tres muestras. El archivo original dio Valid skill. Una copia con context: fork y model: haiku dio «Unexpected fields in frontmatter: context, model». Otra copia con name: Review_Skill dio dos errores: el nombre debe ir en minúsculas y contiene caracteres no válidos. Esto coincide con la documentación de Claude Code: en local se aceptan todos sus campos, pero las subidas a claude.ai, la Skills API y package_skill.py solo aceptan los seis de la especificación, y un campo de más es un error (documentación de skills de Claude Code).
| Muestra | Cambio | Resultado de skills-ref 0.1.1 | ¿Portable? |
|---|---|---|---|
| Original | Ninguno | Valid skill | Sí. |
| Negativa 1 | Se añaden context: fork y model: haiku | Error: campos context y model inesperados | En Claude Code local sí; la subida a claude.ai falla. |
| Negativa 2 | name: Review_Skill | Error: debe ir en minúsculas; caracteres no válidos | No. |
Cinco puntos de entrada, cinco reglas para el frontmatter
Antes de copiar el mismo archivo en varios sitios, conviene saber qué acepta cada uno. La tabla recoge solo reglas que la documentación oficial escribe; donde no dice nada, la celda pone «no consta».
| Punto de entrada | `name` | `description` | Campos fuera de la especificación | Otros límites |
|---|---|---|---|---|
| Especificación Agent Skills | Obligatorio; 1–64 caracteres; igual que la carpeta | Obligatorio; 1–1024 caracteres | No forman parte | Menos de 500 líneas. |
| Claude Code local | Opcional; por defecto, el nombre de la carpeta | Recomendado; se muestran 1536 caracteres | model, context, hooks | Los campos desconocidos se ignoran. |
| Subida a claude.ai y Skills API | Obligatorio; ≤64; sin «claude» ni XML | Obligatorio; ≤1024 | Un campo de más es un error | Menos de 30 MB; sin red. |
| Punto de entrada | `name` | `description` | Campos fuera de la especificación | Otros límites |
|---|---|---|---|---|
| Codex | Obligatorio | Obligatorio | Interfaz y dependencias en agents/openai.yaml | Lista inicial: 2 % del contexto u 8000 caracteres. |
| Antigravity | Opcional; por defecto, la carpeta | Obligatorio | No consta | No consta. |
| App de Gemini | Minúsculas y guiones | Longitud no consta | No consta | 100 MB en total; scripts sin internet. |
Por eso nos limitamos a los campos de la especificación. La especificación es el mínimo común: Claude Code local es el punto de entrada más tolerante y la subida a claude.ai es el más estricto, así que si escribes para el más estricto, todos aceptan el archivo. Las tres documentaciones coinciden también en cómo escribir la description. Codex acorta primero las descripciones cuando hay muchas skills, así que conviene poner delante el uso principal (Codex Build skills). Claude Code corta a los 1536 caracteres (documentación de skills de Claude Code). El primer consejo de Google es definir cuándo usar la skill (ayuda de Gemini). Nuestra descripción tiene 337 caracteres, así que no la recorta ningún punto de entrada.
Claude Code skills: ~/.claude/skills o .claude/skills
Claude Code lee skills de cinco sitios: empresa (.claude/skills/ en la carpeta de configuración gestionada), personal (~/.claude/skills/<nombre>/SKILL.md), proyecto (.claude/skills/<nombre>/SKILL.md), carpetas anidadas y carpetas añadidas con --add-dir. Si dos tienen el mismo nombre, la de empresa gana a la personal y la personal gana a la de proyecto (documentación de skills de Claude Code). Una skill de proyecto se puede subir al repositorio, de modo que todo el equipo la recibe con el código. Una skill personal sirve en todos los repositorios de tu máquina. Las skills de proyecto se buscan desde la carpeta de inicio hasta la raíz del repositorio.
Tres límites afectan a un informe semanal. Primero, las sesiones de Cowork y las sesiones en la nube, incluidas las tareas programadas en la nube, no leen ~/.claude/skills/ de tu ordenador: solo cargan las skills activadas en tu cuenta de claude.ai. Las tareas programadas de escritorio sí se ejecutan en tu máquina y sí leen esa carpeta (misma documentación). Segundo, una subida a claude.ai solo acepta los seis campos de la especificación. Tercero, la lista de skills tiene un presupuesto: cada description más when_to_use muestra como máximo 1536 caracteres, la lista entera recibe el 1 % de la ventana de contexto y, tras la compactación automática, Claude Code vuelve a adjuntar las skills recientes con sus primeros 5000 tokens, hasta 25 000 tokens en total.
Claude Code tiene además extensiones propias. model cambia el modelo durante el turno, allowed-tools aprueba herramientas por adelantado y context: fork ejecuta la skill en un subagente aparte, de forma que solo el resultado vuelve a la sesión principal (documentación de skills; subagentes). Son útiles, pero un archivo que las usa deja de ser portable. Nuestra solución es mantener el archivo compartido dentro de la especificación y poner una segunda skill con el mismo nombre en la carpeta personal cuando quieras un comportamiento exclusivo de Claude Code. Como la personal gana a la de proyecto, Claude Code usa esa copia y las demás herramientas siguen leyendo la versión estándar.
También puedes dejar que el modelo llame a herramientas en vez de ejecutar un script. Basta con añadir el servidor MCP remoto de EveryInfra a Claude Code. Probamos este comando en un artículo anterior, así que aquí lo damos como ejemplo de configuración:
export EVERYINFRA_API_KEY="<tu clave de API>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Claude Code activa por defecto la búsqueda de herramientas MCP: al empezar solo carga los nombres de las herramientas y las instrucciones del servidor, y busca las definiciones cuando hacen falta (documentación MCP de Claude Code). Esto cambia las cuentas de la sección sobre el contexto.
Codex skills: .agents/skills y config.toml
Las skills de Codex también se basan en el estándar abierto de Agent Skills, y el SKILL.md debe tener name y description (Codex Build skills). Codex lee cuatro tipos de ubicación: .agents/skills en cada carpeta desde la de trabajo hasta la raíz del repositorio, $HOME/.agents/skills para el usuario, /etc/codex/skills para el administrador y las skills de sistema que trae Codex. Si dos skills se llaman igual, Codex no las fusiona y ambas aparecen en el selector. En la CLI o la extensión del IDE se escribe /skills o se menciona la skill con $; en ChatGPT se usa @.
La documentación de Codex da dos cifras que afectan a la descripción. Por defecto, la lista inicial de skills ocupa como máximo el 2 % de la ventana de contexto, u 8000 caracteres si no se conoce su tamaño. El ajuste skills.max_context_tokens permite subir ese presupuesto hasta 10 000 tokens. Con muchas skills instaladas, Codex acorta primero las descripciones y después omite algunas skills con un aviso. Un archivo opcional, agents/openai.yaml, define el nombre visible, la política allow_implicit_invocation y las dependencias MCP; vive en la carpeta de la skill y las demás herramientas lo ignoran.
Para conectar el servidor MCP remoto de EveryInfra en Codex se añade una tabla [mcp_servers.<nombre>] a ~/.codex/config.toml, o a .codex/config.toml en un proyecto de confianza (documentación MCP de Codex). Esto es un ejemplo de configuración; no lo ejecutamos en un Codex local:
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"
enabled_tools = ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
default_tools_approval_mode = "writes"
tool_timeout_sec = 120
Dos líneas salen de nuestras pruebas. enabled_tools deja solo 3 herramientas porque, a las 17:25 (hora de Singapur), la llamada tools/list del MCP de EveryInfra devolvió 25, y algunas crean o borran claves, cambian ajustes o abren tickets. tool_timeout_sec sube a 120 segundos porque Codex espera por defecto 60 segundos por llamada (documentación MCP de Codex), y nuestras llamadas síncronas de las 17:28 y las 17:30 tardaron 87,8 y 88,3 segundos. Con el valor por defecto, Codex se rendiría antes de recibir la respuesta. Por último, default_tools_approval_mode = "writes" pide confirmación para toda herramienta no marcada como de solo lectura, y everyinfra_call_api cobra por llamada, así que Codex preguntará cada vez; si aceptas ese coste, puedes aprobar solo esa herramienta.
Antigravity CLI y Gemini CLI: las carpetas cambiaron
Google sustituyó Gemini CLI por Antigravity CLI el 18 de junio de 2026, y la propia web de documentación de Gemini CLI lo dice en su página de skills (documentación de Gemini CLI). El formato de las skills es el mismo, pero las carpetas cambian. Gemini CLI usaba ~/.gemini/skills/ para el usuario y .gemini/skills/ para el espacio de trabajo, con .agents/skills/ como alias. Antigravity CLI usa .agents/skills/ para el espacio de trabajo y ~/.gemini/antigravity-cli/skills/ para las skills globales (guía de migración de Antigravity CLI). La app de escritorio de Antigravity usa otra carpeta global, ~/.gemini/config/skills/ (skills de Antigravity), y es el único caso en que recomendamos dos copias.
Antigravity solo exige description y, si falta name, usa el nombre de la carpeta. Un Codelab de Google del 25 de septiembre de 2026 muestra los pasos mínimos: crear .agents/skills/<nombre>/SKILL.md, arrancar agy, listar con /skills y hacer una pregunta (Google Codelabs). En Reddit, un usuario pedía la estructura de carpetas en lugar de enlaces a la documentación (hilo de r/google_antigravity). Las tablas de arriba responden a esa pregunta.
Antigravity sacó los servidores MCP de settings.json a un archivo propio, mcp_config.json: el global está en ~/.gemini/config/mcp_config.json y el del proyecto en .agents/mcp_config.json. Para servidores remotos, la clave de la dirección pasó de url o httpUrl a serverUrl (guía de migración). También tiene lista blanca de herramientas, enabledTools, y por defecto espera 3 minutos por llamada y 5 minutos para conectar (documentación MCP de Antigravity). Es más holgado que Codex, así que nuestras llamadas de 88 segundos no necesitan cambios. Ejemplo de configuración, no ejecutado en local:
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <tu clave de API>" },
      "enabledTools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
Skills de Gemini: los Gems pasan a solo lectura el 17 de noviembre y los scripts siguen sin red
El 30 de septiembre de 2026, Google anunció que las skills sustituirán a los Gems y que están construidas sobre el estándar abierto SKILL.md, de modo que se pueden copiar skills hechas en otras plataformas (Google Workspace Updates, 30-09-2026). La actualización del 13 de octubre dijo que las skills empezaban a llegar ese día a la app de Gemini, con el despliegue completo previsto para mediados de noviembre, y que el lanzamiento en las apps de Workspace se retrasa sin fecha (Google Workspace Updates, 13-10-2026).
Dos fuentes oficiales dan fechas distintas para los Gems, así que hay que mirar el tipo de cuenta. La entrada de Workspace del 30 de septiembre dice que el 17 de noviembre los Gems pasan al panel de Ajustes y que se pueden seguir creando, editando y usando; las cuentas de empresa no los pierden antes del 1 de marzo de 2027. La página de ayuda para cuentas personales es más estricta. Para cuentas personales de mayores de 18 años, el 17 de noviembre de 2026 los Gems se convierten en skills de solo lectura: se pueden ver, pero no usar ni editar. El 17 de diciembre de 2026 desaparecen de la app (ayuda de Gemini: transición de Gems a skills). El blog de Google coincide con la ayuda (blog de Google). Las cuentas de empresa de Workspace cambian en marzo de 2027 y las educativas en junio de 2027.
| Tipo de cuenta | Gems | Fecha | Fuente |
|---|---|---|---|
| Personal, mayores de 18 años | Pasan a skills de solo lectura | 17-11-2026 | Ayuda de Gemini. |
| Personal, mayores de 18 años | Se eliminan de la app | 17-12-2026 | Ayuda de Gemini. |
| Workspace empresa y sin ánimo de lucro | Dejan de funcionar | No antes del 01-03-2027 | Workspace Updates. |
| Workspace educación | Dejan de funcionar | No antes del 01-06-2027 | Workspace Updates. |
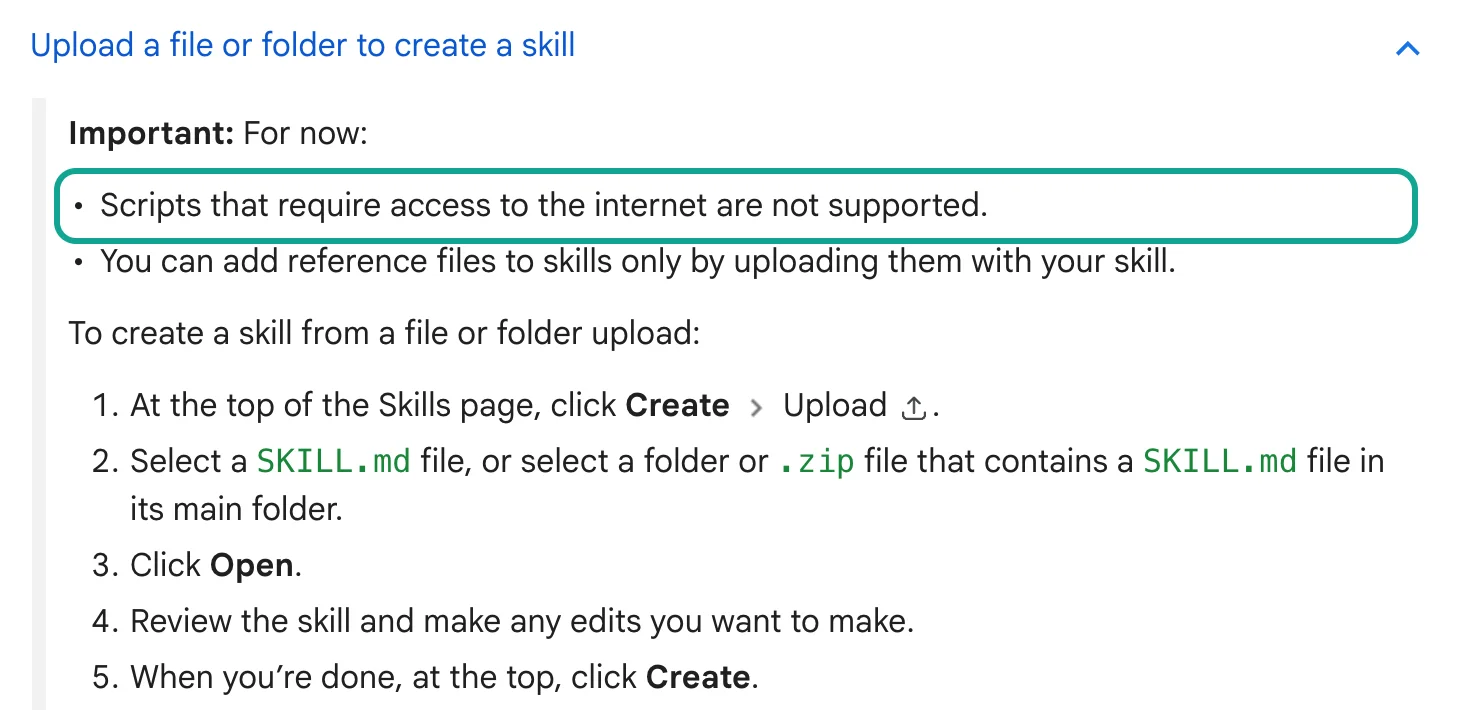
Dos frases de la ayuda deciden si esta skill sirve en la app de Gemini. Por ahora no se admiten scripts que necesiten acceso a internet, y los scripts no pueden hacer acciones ni peticiones en sitios externos (ayuda de Gemini: crear y gestionar skills). La misma página fija las reglas de subida: el SKILL.md en la carpeta raíz, nombre en minúsculas con guiones y 100 MB como máximo entre todos los archivos. Se admiten archivos de texto como .py, .sh, .md, .json o .csv, pero no .docx ni .xlsx. Nuestra skill cumple el formato y se puede importar, pero fetch_reviews.py no obtendrá datos allí.
Gemini no es el único caso. La Skills API de Claude ejecuta las skills en un contenedor de ejecución de código «sin acceso a la red», que no puede llamar a APIs externas. Además, el name no puede contener las palabras reservadas «anthropic» ni «claude», ni etiquetas XML (guía de la Skills API de Claude). En ambos entornos, el reparto correcto es «la skill para el proceso, el conector para los datos». En la app de Gemini, los datos llegan por las apps conectadas, y en Claude web o en la API, por un conector MCP. La ayuda de Gemini añade que las skills todavía no funcionan con Canvas ni con Deep Research.
Una llamada real: lo que envía el modelo y lo que devolvemos
Un script y una llamada MCP acaban en la misma petición en nuestro lado. La tarjeta muestra una llamada MCP tools/call real a las 17:46:24 (hora de Singapur). El modelo llamó a everyinfra_call_api para pedir las reseñas de una y dos estrellas de ClickUp en Trustpilot de los últimos 3 meses, hasta 50. La API tardó 27,8 segundos, devolvió 7 reseñas y cobró 0,001389 USD.
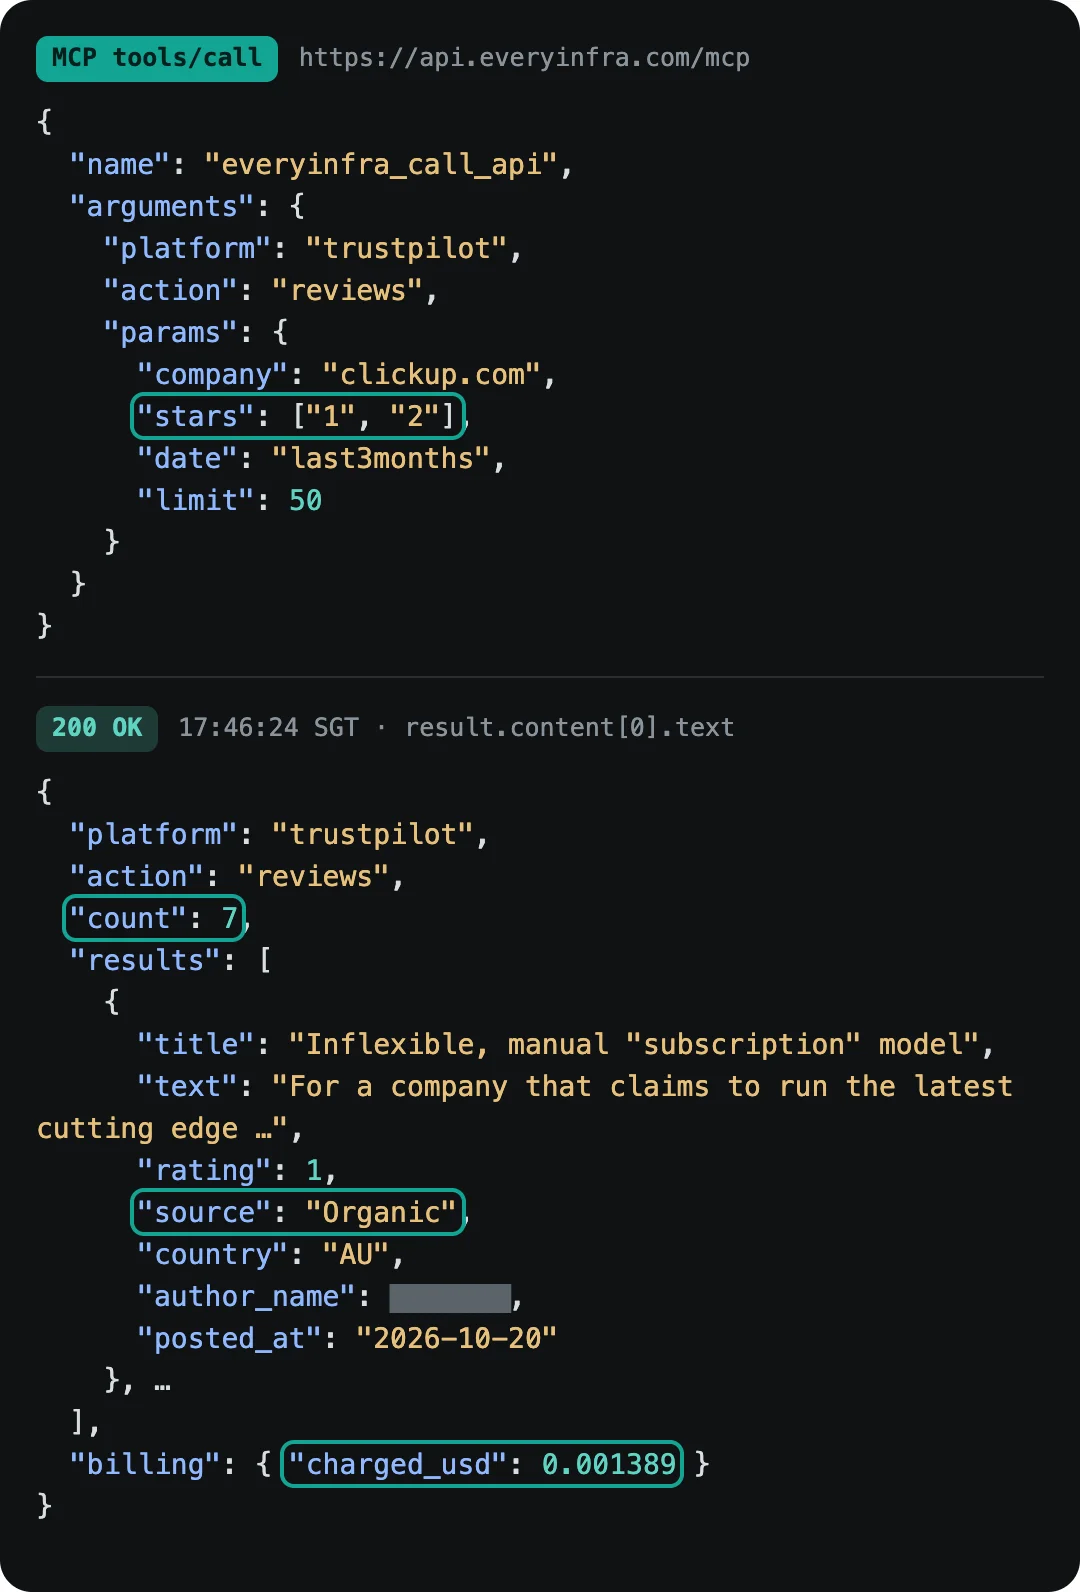
La misma petición con curl directamente a la API de datos queda así. La variable $EVERYINFRA_API_KEY se lee del entorno y nunca se escribe en un archivo:
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"trustpilot","action":"reviews","params":{"company":"clickup.com","stars":["1","2"],"date":"last3months","limit":50}}'
El catálogo lista 24 campos de respuesta para trustpilot/reviews (catálogo de EveryInfra). La skill usa los de la tabla, y comprobamos cada nombre y cada significado con response_fields y platform_field_meanings del catálogo.
| Campo | Significado (del catálogo) | Uso en la skill |
|---|---|---|
id, url | ID y enlace de la reseña | Quitar duplicados y enlazar citas. |
title, text | Título y texto | Etiquetar por palabras. |
rating, rating_scale | Estrellas y escala | Media por grupo de origen. |
source | Origen de la reseña | Separar espontáneas e invitadas. |
| Campo | Significado (del catálogo) | Uso en la skill |
|---|---|---|
verification_level | Nivel de verificación (invitada u orgánica) | Contrastar con source. |
language, country | Idioma y país | Elegir la lista de palabras. |
experience_at, posted_at | Fecha de la experiencia y de publicación | Recortar la ventana de tiempo. |
reply_text, author_name | Respuesta de la empresa; nombre visible del autor | Tasa de respuesta; el nombre nunca sale en el informe. |
Los campos de G2 y Capterra encajan con la compra B2B. La primera fila de g2/reviews tiene record_type igual a summary, con la nota global, el número de reseñas y los pros y contras más citados. Cada fila de capterra/reviews trae pros, cons, notas parciales de facilidad de uso y soporte, y switching_reasons, que el catálogo señala como el campo más útil para analizar a la competencia (catálogo de EveryInfra).
Nueve llamadas: cuántas reseñas devuelven G2, Capterra, Trustpilot y Amazon
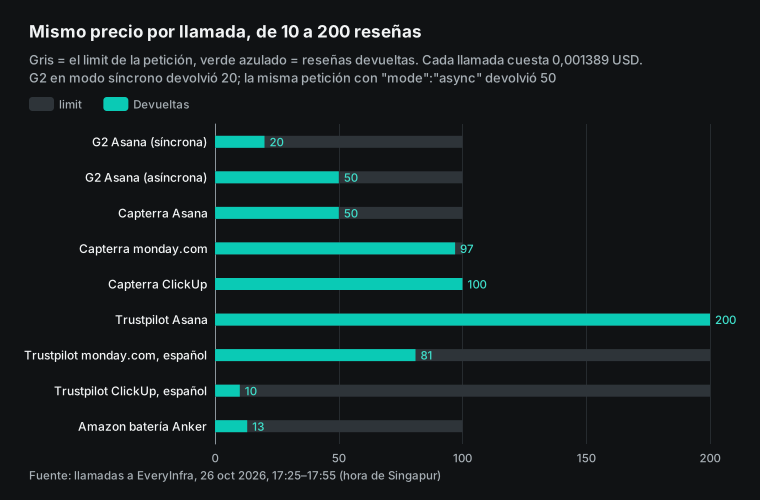
Entre las 17:25 y las 18:31 (hora de Singapur) enviamos 31 peticiones: 23 con cobro y 8 sin cobro (cuatro 429, un tiempo de espera agotado y tres resultados vacíos), con un total de 0,032794 USD. La tabla recoge las 11 peticiones del informe de software, incluidas las dos que no costaron nada.
| Hora de Singapur | Capacidad | Objetivo | limit | Reseñas | Tiempo | Cobro |
|---|---|---|---|---|---|---|
| 17:25 | g2/reviews síncrona | Asana | 100 | 20 y 1 fila de resumen | — | 0,001389 USD. |
| 17:27 | g2/reviews síncrona | monday.com | 100 | Tiempo agotado, 503 | 90,4 s | 0 USD. |
| 17:28 | g2/reviews síncrona | ClickUp | 100 | 20 y 1 fila de resumen | 87,8 s | 0,001389 USD. |
| 17:30 | capterra/reviews | Asana, por nombre | 100 | 50 | 88,3 s | 0,001389 USD. |
| Hora de Singapur | Capacidad | Objetivo | limit | Reseñas | Tiempo | Cobro |
|---|---|---|---|---|---|---|
| 17:32 | capterra/reviews | «monday.com», por nombre | 100 | 0, reembolsada | 67,5 s | 0 USD. |
| 17:33 | capterra/reviews | ClickUp, por nombre | 100 | 100 | 22,3 s | 0,001389 USD. |
| 17:33 | capterra/reviews | monday.com, por URL del producto | 100 | 97 | 47,3 s | 0,001389 USD. |
| 17:34 | g2/reviews asíncrona | monday.com | 100 | 50 y 1 fila de resumen | 2,1 s hasta el ID de tarea | 0,001389 USD. |
| Hora de Singapur | Capacidad | Objetivo | limit | Reseñas | Tiempo | Cobro |
|---|---|---|---|---|---|---|
| 17:34 | trustpilot/reviews | asana.com | 200 | 200 | 44,5 s | 0,001389 USD. |
| 17:35 | trustpilot/reviews | monday.com | 200 | 200 | 37,3 s | 0,001389 USD. |
| 17:36 | trustpilot/reviews | clickup.com | 200 | 200 | 42,4 s | 0,001389 USD. |
Tres lecciones de estas tablas entraron en el SKILL.md. La primera: Capterra no encontró nada con el nombre «monday.com», porque ahora llama al producto «monday AI Work Platform» (ficha de Capterra); nuestra API devolvió 0 filas y reembolsó la llamada, y con la URL del producto devolvió 97 reseñas. Por eso el primer paso pide URL y no nombres. La segunda: las llamadas síncronas a G2 rozan el presupuesto síncrono de 85 segundos. La de monday.com agotó el tiempo a los 90,4 segundos, la respuesta indicó «Not charged» y sugirió "mode":"async", y con el modo asíncrono tuvimos el ID de tarea en 2,1 segundos y 50 reseñas al terminar.
La tercera lección es la más rentable. La misma petición de Asana en G2 devolvió 20 reseñas en modo síncrono y, a las 17:48, el script de la skill la repitió en modo asíncrono y obtuvo 50, entre ellas las 20 anteriores. Al mismo precio, el modo asíncrono devolvió 2,5 veces más reseñas.
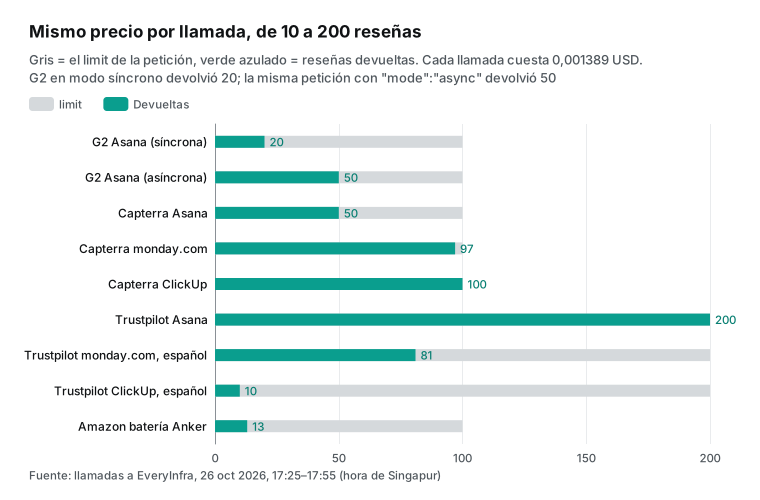
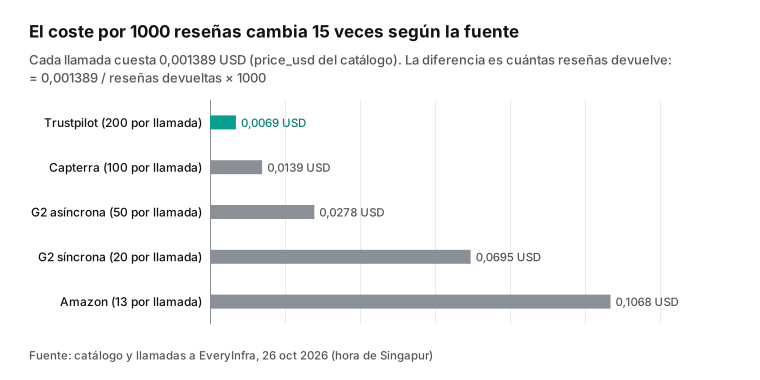
El número de reseñas por llamada fija el coste por cada 1000 reseñas, porque estas capacidades cobran por llamada y no por reseña. Trustpilot devuelve 200 por llamada, unos 0,0069 USD por 1000. Capterra devuelve 100, unos 0,0139 USD. G2 en modo asíncrono devuelve 50, unos 0,0278 USD, y en síncrono 20, unos 0,0695 USD. Amazon devuelve 13 por producto, unos 0,1068 USD, así que la diferencia es de unas 15 veces.
Lo de Amazon no es un fallo. Las notas del catálogo para amazon/reviews dicen que cada tienda nacional solo muestra las reseñas destacadas de la ficha del producto, normalmente entre 10 y 15, y no el historial completo (catálogo de EveryInfra). Leímos la misma batería UGREEN a las 17:38 y a las 17:54 (hora de Singapur), y las dos lecturas devolvieron las mismas 13 reseñas con los mismos ID. Es un conjunto estable de «destacadas», no una muestra aleatoria.
Hubo además cuatro respuestas 429. Entre las 17:37:59 y las 17:38:50 (hora de Singapur) enviamos llamadas cada 7 segundos y cuatro fueron rechazadas. Cada respuesta indicaba el límite de la clave, 10 peticiones por minuto, un retry_after de 1 segundo y «Nothing was charged». Otras peticiones ya habían usado parte de ese minuto. El script esperó retry_after más la pausa normal y todos los reintentos funcionaron. A la clave de prueba le pusimos un tope de 10 peticiones por minuto; la cuenta trae 60 por minuto por defecto, compartidas entre todas las claves, y sube con lo recargado en total (página de precios). El límite de la tuya aparece en la consola.
La mayor trampa: separar las medias de Trustpilot por origen
La mayoría de las tablas de competencia dan una sola media de Trustpilot por empresa, y nuestros datos dicen que esa cifra significa muy poco. Entre las 17:34 y las 17:44 (hora de Singapur) leímos las 200 reseñas más recientes de Trustpilot de seis empresas (Holded solo tenía 48 en esa lectura) y las agrupamos por el campo source. Organic significa que la persona encontró la página por su cuenta. BasicLink, InvitationApi, FileUploadInvitation y Shopify significan que la empresa envió una invitación.
| Empresa | Espontáneas (Organic) | Media espontáneas | Invitadas | Media invitadas | Diferencia | Media mezclada |
|---|---|---|---|---|---|---|
| Asana | 199 | 1,90 | 1 | — | — | 1,90. |
| monday.com | 145 | 1,53 | 55 | 4,51 | 2,98 | 2,35. |
| ClickUp | 37 | 2,51 | 163 | 4,89 | 2,38 | 4,45. |
| Empresa | Espontáneas (Organic) | Media espontáneas | Invitadas | Media invitadas | Diferencia | Media mezclada |
|---|---|---|---|---|---|---|
| Holded | 35 | 2,77 | 13 | 4,69 | 1,92 | 3,29. |
| Anker | 132 | 2,14 | 68 | 4,62 | 2,48 | 2,98. |
| UGREEN | 21 | 1,29 | 179 | 4,07 | 2,78 | 3,77. |
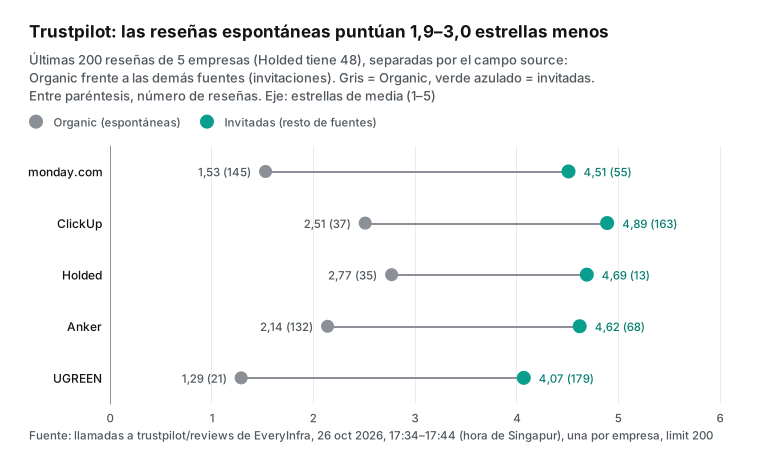
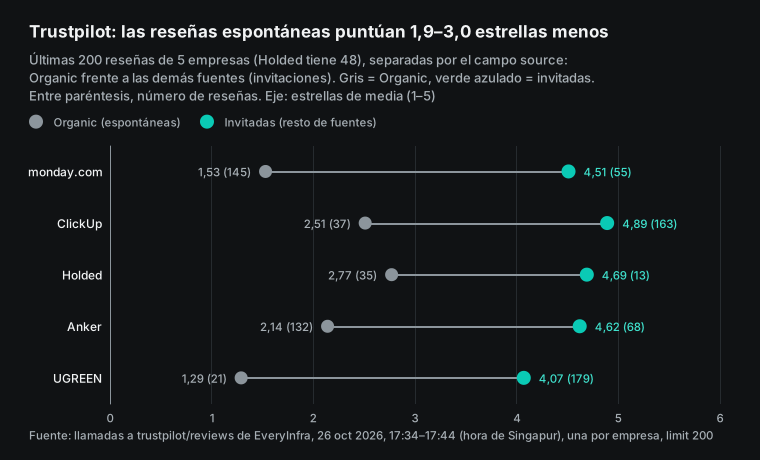
Con la media mezclada, ClickUp tiene 4,45 estrellas y Asana 1,90, y ClickUp parece mucho mejor. Al separar los grupos, las dos tienen medias espontáneas bajas, 2,51 y 1,90. Casi toda la diferencia viene de las invitaciones: 163 de las 200 reseñas recientes de ClickUp llegaron por un enlace de invitación. monday.com sigue el mismo patrón, con 145 reseñas espontáneas a 1,53 estrellas y 55 invitadas a 4,51. Con el hardware pasa lo mismo: 178 reseñas de UGREEN llegaron por invitaciones automáticas de su tienda Shopify, y sus 21 espontáneas tienen una media de 1,29.
Nuestra lectura es sencilla. Quien llega por su cuenta suele escribir porque algo fue mal, y quien recibe una invitación suele escribir justo después de comprar. Si se mezclan los dos grupos, la media mide cuántas invitaciones envía una empresa y no lo que piensan sus clientes. Hay límites. Cada muestra son las 200 reseñas más recientes y los periodos cubiertos son muy distintos. No juzgamos si una reseña es real ni valoramos las prácticas de invitación de ninguna empresa.
«Las 200 más recientes» abarcan además periodos muy diferentes. Las de Asana van del 31-01-2022 al 03-10-2026, casi cinco años. Las de monday.com van del 15-12-2024 al 24-10-2026, y las de ClickUp del 01-04-2026 al 22-10-2026, menos de siete meses. UGREEN tiene el periodo más corto, del 30-08-2026 al día de la lectura, el 26-10-2026, y en menos de dos meses reunió 200 reseñas, 178 de ellas por invitaciones de su tienda. Un informe debería recortar todas las fuentes a la misma ventana, por ejemplo con el parámetro date: "last6months" de Trustpilot.
La web por sí sola no deja ver la separación. La ayuda de Trustpilot explica que cualquier empresa puede invitar gratis a sus clientes con enlaces. Las invitaciones automáticas (correo en copia oculta, integraciones de tiendas, API) generan reseñas marcadas como «Verified», y las invitaciones por «Basic Link» generan reseñas marcadas como «Unprompted review» (ayuda de Trustpilot: métodos de invitación). Lo comprobamos en la página de ClickUp. Una reseña de cinco estrellas marcada en la web como «Unprompted review» aparece en la API como source: BasicLink y verification_level: invited. Una de una estrella con la misma etiqueta aparece como source: Organic y verification_level: not-verified (Trustpilot: reseñas de ClickUp).
La web llama «Unprompted» a las dos, y la API las separa. Por eso las reglas de la skill dicen «separar por origen y no dar nunca una sola media». Las directrices de Trustpilot para empresas piden invitar sin sesgos (Guidelines for Businesses de Trustpilot). Esas directrices regulan cómo se invita, pero no cambian el hecho de que quien llega invitado es distinto de quien llega solo.
Mismo producto, tres sitios, quejas distintas
Los temas también cambian de un sitio a otro. Para Asana tomamos 50 reseñas de G2 (modo asíncrono), 50 de Capterra y 200 de Trustpilot, y las etiquetamos con las reglas de palabras v1.1 de la skill; una reseña puede tener varios temas.
| Tema | G2 (50) | Capterra (50) | Trustpilot (200) |
|---|---|---|---|
| Precio y facturación | 14 % | 18 % | 43 %. |
| Soporte | 12 % | 14 % | 46 %. |
| Curva de aprendizaje | 26 % | 22 % | 5 %. |
| Tema | G2 (50) | Capterra (50) | Trustpilot (200) |
|---|---|---|---|
| Facilidad de uso | 30 % | 22 % | 7 %. |
| Automatización | 22 % | 38 % | 7 %. |
| Móvil | 6 % | 2 % | 5,5 %. |
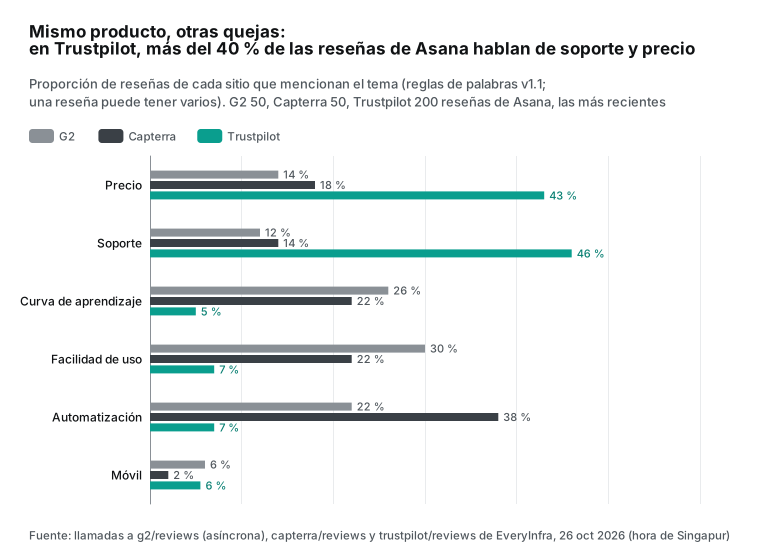
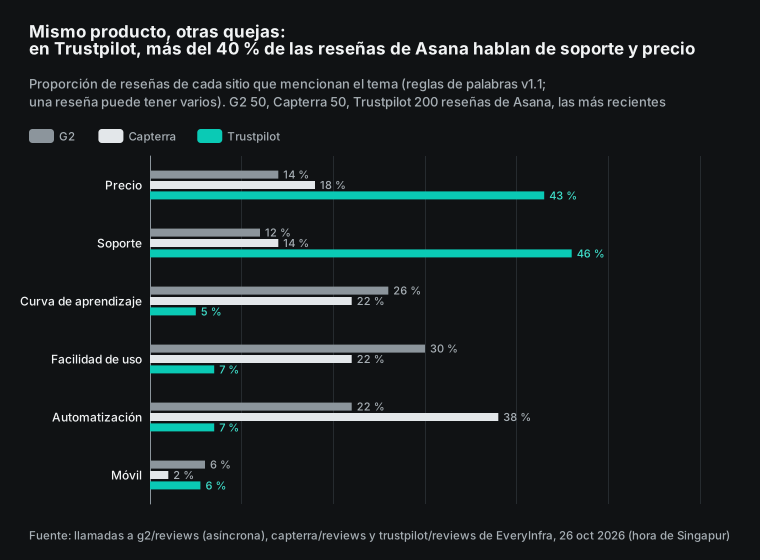
En G2 y Capterra opinan sobre todo miembros de equipos que usan el producto, así que hablan de funciones, como la curva de aprendizaje o la automatización. En Trustpilot, el 46 % de las reseñas de Asana menciona el soporte y el 43 % el precio o la facturación, casi siempre por renovaciones, reembolsos o cuentas bloqueadas. monday.com se parece, con un 35 % de precio y un 29 % de soporte en Trustpilot. ClickUp es la excepción: la automatización encabeza con un 39,5 %, lo que encaja con una página llena de usuarios activos invitados. Las filas de resumen de G2 dan las cifras de la propia plataforma: Asana tiene 4,4 estrellas con 14 051 reseñas, y su contra más citado es «Learning Curve», con 605 menciones (G2: reseñas de Asana).
Estas cifras son de la segunda versión. La primera lista de palabras tenía plan dentro de precio, con coincidencia por prefijo. El paso 4 de la skill pide leer 5 reseñas etiquetadas por tema, y al hacerlo vimos que Capterra daba un 58 % de precio para Asana, cuando muchas de esas reseñas hablaban de «project planning». El recuento de esas 50 reseñas encontró planning 13 veces, y el prefijo app de móvil coincidía también con appreciate 6 veces. Pasamos a coincidencia de palabra completa y quitamos plan, app, agent y simple. El precio de Asana en Capterra bajó del 58 % al 18 %, en G2 del 30 % al 14 % y en Trustpilot del 48,5 % al 43 %. Las reglas de palabras son baratas y repetibles, pero alguien tiene que revisarlas.
Reseñas en español: la lista de palabras también tiene idioma
Esta es la sección que más importa a un equipo hispanohablante. Pedimos las reseñas en español de monday.com en Trustpilot con lang: "es". Un limit de 200 devolvió 81 reseñas, la más reciente del 28-12-2023, y 69 llegaron por invitaciones de carga de archivos; la media global es de 4,72 estrellas. Con las palabras clave en inglés, 80 de las 81 reseñas quedaron sin tema. Con la lista en español saas_es de la skill, quedaron 45 sin tema, y los temas más citados fueron facilidad de uso (27,2 %) y soporte (13,6 %). ClickUp solo tiene 10 reseñas en español, y con la lista saas_es quedaron 2 sin tema.
| Muestra | Reseñas | Sin tema con reglas en inglés | Sin tema con `saas_es` | Fecha más reciente |
|---|---|---|---|---|
Trustpilot monday.com, lang: "es" | 81 | 80 | 45 | 28-12-2023. |
Trustpilot ClickUp, lang: "es" | 10 | No medido | 2 | 28-08-2026. |
| Capterra Holded | 100 | 74 | 21 | 19-09-2026. |
Holded, el programa de gestión y contabilidad con sede en España, es el ejemplo más claro. En Capterra tiene 100 reseñas en la muestra, de las que unas 76 se leen en español; con reglas en inglés quedaron 74 sin tema y con saas_es, 21. Con la lista en español, el 39 % menciona la facilidad de uso, otro 39 % el precio y el 28 % el soporte. Una de las reseñas de Capterra, de mayo de 2022, se queja de que Holded no gestionaba el SII en Canarias para empresas de más de 6 millones de euros de facturación. Es justo el tipo de detalle local que una lista de palabras en inglés no detecta.
Holded también mostró un hueco de cobertura en Trustpilot. A las 17:44 (hora de Singapur), una llamada sin lang devolvió 48 reseñas, todas marcadas como en, con una media mezclada de 3,29. A las 18:29 y a las 18:30 (hora de Singapur) repetimos con lang: "es" y con language: "es", y las dos llamadas devolvieron 0 filas y se reembolsaron. Sin embargo, la web de Trustpilot en español muestra 2444 opiniones de Holded con un TrustScore de 4,2 (Trustpilot España: Holded). Esta vez no obtuvimos las reseñas en español de Holded, y un informe honesto debe decir «muestra de Trustpilot: solo 48 reseñas en inglés».
El hardware falla de otra manera. Para tres baterías externas de 20 000 mAh (Anker, UGREEN e INIU), Amazon Estados Unidos devolvió 13 reseñas destacadas de cada una, con medias de 4,92, 4,92 y 4,62 estrellas. Son muy superiores a las medias espontáneas de Trustpilot de esas marcas, 2,14 y 1,29, porque las destacadas de Amazon tienden a ser útiles y positivas. En Trustpilot, el 26 % de las reseñas de Anker habla de durabilidad, como una batería que se rompió o dejó de funcionar, y nada de eso aparece en las 13 de Amazon. La lista de hardware además cubre mal Trustpilot: 101 de las 200 de Anker y 127 de las 200 de UGREEN quedaron sin tema, porque hablan de envíos, devoluciones y soporte. No cambiamos la lista para que las cifras quedaran mejor; el informe indica cuántas reseñas quedan sin tema.
Cómo queda el informe terminado
El paso 5 de la skill fija la estructura del informe. Esta es la primera tabla con los datos de esta ejecución: reseñas leídas, media de estrellas y coste por producto y sitio. Cada sitio va en su columna y no hay media global. La celda de Trustpilot da la media mezclada y los grupos espontáneo e invitado, como exigen las reglas.
| Producto | G2: reseñas / media | Capterra: reseñas / media | Trustpilot: reseñas / mezclada (espontáneas / invitadas) | Coste de API |
|---|---|---|---|---|
| Asana | 50 / 4,38 | 50 / 4,76 | 200 / 1,90 (1,90 / solo 1) | 0,004167 USD. |
| monday.com | 50 / 4,64 | 97 / 4,57 | 200 / 2,35 (1,53 / 4,51) | 0,004167 USD. |
| ClickUp | 20 / 4,22 | 100 / 4,60 | 200 / 4,45 (2,51 / 4,89) | 0,004167 USD. |
La tercera parte del informe recoge las tres quejas principales por producto, con una cita breve y su enlace. Tomamos títulos de reseñas espontáneas recientes de una y dos estrellas en Trustpilot, sin nombres de autores. En Asana aparecen «Ruthless company» del 03-10-2026 y «Forever free doesn't mean forever free» del 01-10-2026. En monday.com hay tres seguidas del 24-10-2026, el 22-10-2026 y el 21-10-2026, y dos títulos nombran el servicio al cliente. En ClickUp destaca la del 20-10-2026, «Inflexible, manual "subscription" model», sobre el preaviso de 30 días para reducir licencias, y una del 05-10-2026 sobre una cuenta bloqueada tras pagar. Estos títulos encajan con la tabla de temas: en Trustpilot, las tres empresas reciben más quejas por facturación y soporte que por funciones.
No dejamos que un modelo escribiera las cifras. Los scripts calcularon cada número de la tabla a partir de las respuestas de la API. El modelo hizo dos trabajos: leer muestras para encontrar errores de palabras en el paso 4 y maquetar tablas y citas en el paso 5. El primero solo sale bien si le pides que anote cada cambio en el informe, y el segundo casi nunca falla.
Hacerlo semanal: dónde pueden vivir las tareas programadas
Lo natural es un informe de competencia cada lunes. Las tareas programadas de escritorio de Claude Code se ejecutan en tu máquina y leen ~/.claude/skills/. Las tareas programadas en la nube empiezan cada vez una sesión nueva, no leen la carpeta local y solo usan las skills activadas en claude.ai o las que están en .claude/skills/ del repositorio (documentación de skills de Claude Code). En el DevDay del 29 de septiembre de 2026, OpenAI presentó Codex Cloud, que ejecuta tareas con el portátil cerrado (resumen del DevDay 2026). La documentación de Codex no dice con claridad si las tareas en la nube leen .agents/skills del repositorio, y no lo probamos. La app de Gemini permite programar tareas con una skill elegida, pero sus scripts siguen sin red.
Las cuentas anuales son pequeñas. Un informe de software de 9 llamadas cada semana son 468 llamadas al año, 0,650052 USD de API. Un informe semanal de hardware de 5 llamadas añade 260 llamadas y 0,36114 USD. En nuestra prueba, la llamada síncrona más lenta tardó 88 segundos; con las pausas de 7 segundos y unos 5 minutos para la tarea asíncrona de G2, un informe de 9 llamadas termina en menos de 10 minutos. Una clave con 10 peticiones por minuto basta, pero si la misma clave atiende otros trabajos, hay que tratar el 429 como algo normal. Claude Code 2.1.310, publicado el 23 de octubre de 2026, llevó la herramienta Monitor a más plataformas, útil para seguir una tarea asíncrona larga (registro de cambios de Claude Code).
Las cuentas del contexto: 31 581 caracteres de herramientas MCP frente a 363 de la skill
Skills y MCP se comparan a menudo, pero usan el contexto de forma distinta. A las 17:25 (hora de Singapur) leímos tools/list del MCP de EveryInfra: las 25 definiciones de herramientas suman 31 581 caracteres, unos 7895 tokens a 4 caracteres por token, con 11 herramientas marcadas como de solo lectura y 5 como destructivas. Las tres que necesita esta skill, everyinfra_list_capabilities, everyinfra_call_api y everyinfra_get_job, suman 3314 caracteres. Al empezar la sesión, la skill solo añade su name y su description, 363 caracteres o unos 91 tokens, y el SKILL.md completo, de 3426 caracteres, se carga solo cuando se usa.
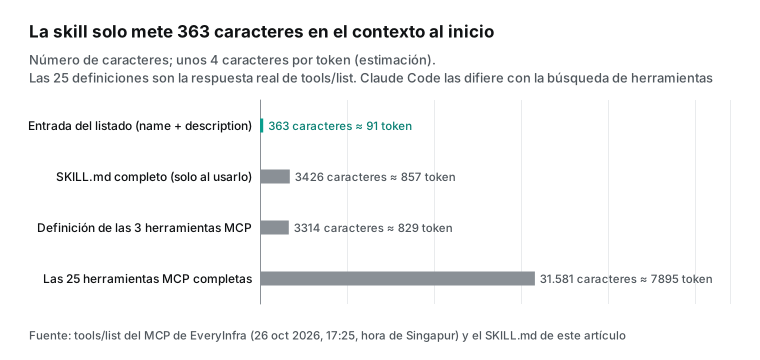
Estas cifras tienen límites. Claude Code activa por defecto la búsqueda de herramientas MCP y al empezar solo carga nombres e instrucciones del servidor, así que en Claude Code las 25 herramientas no cuestan 7895 tokens desde el principio (documentación MCP de Claude Code). Para otros entornos hay que mirar su documentación. Codex y Antigravity tienen listas blancas (enabled_tools, enabledTools), y al pasar de 25 herramientas a 3 las definiciones bajan de 31 581 a 3314 caracteres. La especificación MCP trata readOnlyHint y destructiveHint como pistas para el cliente, no como garantías de seguridad (especificación MCP: Tools), así que una lista blanca es más fiable que las pistas.
Cuánto cuesta un informe
El coste de API sale del price_usd del catálogo. En el catálogo leído el 26-10-2026, g2/reviews, capterra/reviews, trustpilot/reviews y amazon/reviews cuestan 0,001389 USD por llamada y ninguna lleva marca de cobro por filas. Una llamada devuelve hasta max_limit reseñas: 100 en G2, Capterra y Amazon, y 200 en Trustpilot (catálogo de EveryInfra). Un informe de software con 3 competidores en 3 sitios son 9 llamadas, es decir, 9 × 0,001389 USD = 0,012501 USD. Los cobros reales sumaron exactamente 0,012501 USD, con diferencia cero, por 967 reseñas, unos 0,0129 USD por cada 1000. Un informe de hardware con 3 baterías son 3 llamadas a Amazon y 2 a Trustpilot, 0,006945 USD por 439 reseñas. Los tiempos agotados, los resultados vacíos y los 429 no cuestan nada.
| Concepto | Precio unitario | Llamadas | Importe | Notas |
|---|---|---|---|---|
| Informe de software (G2 + Capterra + Trustpilot) | 0,001389 USD por llamada | 9 | 0,012501 USD | 967 reseñas. |
| Informe de hardware (Amazon + Trustpilot) | 0,001389 USD por llamada | 5 | 0,006945 USD | 439 reseñas. |
| Informe de software semanal durante un año | 0,001389 USD por llamada | 468 | 0,650052 USD | Mismas 9 llamadas cada semana. |
| Todas las llamadas reales del artículo | — | 31 peticiones, 23 cobradas | 0,032794 USD | Incluye 1 amazon/search (0,002236 USD). |
El lado de la herramienta de IA es una suscripción, no un pago por llamada. Precios públicos leídos el 26-10-2026: Claude Pro cuesta 20 USD al mes, o 17 USD al mes con pago anual, e incluye Claude Code (precios de Claude). ChatGPT Plus cuesta 20 USD al mes (ayuda de OpenAI), y con Plus, Codex funciona en la CLI, la extensión del IDE y la web (precios de Codex). Google AI Pro cuesta 19,99 USD al mes e incluye un uso básico de Antigravity (planes de Google AI). Al lado de estas cuotas, el coste de API es calderilla. El coste real es el uso del plan que gasta el modelo al leer 967 reseñas, y como ningún proveedor lo publica por reseña y no lo medimos, no damos cifra.
Un error en el script: «finalizing» no es el final
El script de la skill mostró un error en su primera ejecución real, y la lección merece su propia sección. A las 17:48 (hora de Singapur), fetch_reviews.py envió la petición asíncrona de Asana a G2 y consultó el estado de la tarea. El script trataba como final el primer estado distinto de running o queued, así que a los 306 segundos leyó finalizing, escribió 0 filas y se detuvo. A las 17:55 consultamos la misma tarea a mano: su estado era succeeded y las 51 filas (50 reseñas y 1 de resumen) estaban ahí. La corrección es tratar como finales solo succeeded, failed, canceled y expired, y seguir esperando en cualquier otro estado.
Este tipo de error se esconde bien dentro de una skill, porque cuando el modelo ve «0 filas» escribe «no hay reseñas nuevas en G2» sin dudar. Por eso el paso 2 de la skill pide comprobar los recuentos, anotar el 0 en el informe y no leerlo nunca como «no hay reseñas». Las respuestas de la API indican con claridad las reglas de errores y cobros, y el script solo tiene que leerlas:
| Situación | Lo que devuelve la API | Cobro | Qué hace el script |
|---|---|---|---|
| 429 | error.code = rate_limited, con retry_after | No («Nothing was charged») | Espera y reintenta. |
| Tiempo agotado (503) | error.code = timeout, billing.charged = false | No | Pasa a "mode":"async" o baja limit. |
| Resultado vacío | count = 0, refund.status = succeeded | Se reembolsa | Anota 0 en el informe. |
| Asíncrona (202) | job_id y poll_url | Al enviar | Consulta GET /api/v1/jobs/{job_id} hasta un estado final. |
Lo que esta skill no puede hacer y lo que hay que vigilar
En la app de Gemini y en la Skills API de Claude, los scripts de una skill no llegan a la red, así que los datos tienen que venir de un conector o de MCP. Las sesiones en la nube y las tareas programadas en la nube de Claude Code no leen ~/.claude/skills/ local, de modo que hay que activar la skill en claude.ai o subirla al repositorio. En la Skills API, el name no puede contener «claude» ni «anthropic»; el nuestro cumple, pero una skill llamada claude-review-helper fallaría al subirla. Amazon solo da las reseñas destacadas de la ficha, así que no sirve para calcular una «tasa de reseñas negativas». Trustpilot no permite comparar empresas sin separar por origen, y conviene tener una lista de palabras por idioma y por categoría, con la cobertura indicada en el informe.
Sobre normas, describimos métodos de datos y no damos asesoramiento jurídico. En la Unión Europea, la Directiva (UE) 2019/2161, conocida como directiva «Ómnibus», reforzó las reglas de protección de los consumidores, también para las reseñas en línea (Directiva (UE) 2019/2161). España la incorporó con el Real Decreto-ley 24/2021, de 2 de noviembre, que añadió a la ley de consumidores la obligación de informar sobre si las reseñas se verifican y cómo (BOE-A-2021-17910). Estas normas regulan cómo publican reseñas las empresas. Leer reseñas públicas para analizar a la competencia es otra actividad, pero aun así conviene dejar fuera de los informes los nombres de los autores y limitar las citas a una o dos frases, como ya dicen las reglas de la skill.
Novedades del sector
- 29-09-2026, DevDay de OpenAI: los plugins pasaron a ser la forma común de distribuir trabajo en ChatGPT y Codex, con skills y servidores MCP en un mismo paquete (resumen del DevDay 2026; recapitulación de OpenAI). Qué significa para ti: esta skill y el MCP de EveryInfra pueden publicarse como un solo plugin, que también se instala en ChatGPT web (Skills & Plugins).
- 30-09-2026, Google: las skills sustituyen a los Gems. El despliegue en la app de Gemini empezó el 13-10-2026, y en cuentas personales los Gems pasan a solo lectura el 17-11-2026 y desaparecen el 17-12-2026 (Workspace Updates; ayuda de Gemini). Qué significa para ti: si usas Gems para resúmenes de competencia, exporta instrucciones y archivos antes del 17 de diciembre.
- Del 19-10-2026 al 23-10-2026, tres versiones de Claude Code. La 2.1.304 (19-10-2026) reenvía la lista de skills tras compactar, la 2.1.309 (22-10-2026) corrigió las skills con el mismo nombre en carpetas
--add-dir, que ahora se invocan como<carpeta>:<nombre>, y la 2.1.310 (23-10-2026) llevó la herramienta Monitor a más plataformas (registro de cambios). Qué significa para ti: en una sesión larga con muchos informes, las skills ya no se pierden tras la compactación. - 14-10-2026, GPT-5.5 deja Codex con inicio de sesión de ChatGPT, sustituido por GPT-6.1 Sol y otros modelos (precios de Codex). Qué significa para ti: los pasos de la skill no cambian, pero conviene repetir la revisión del paso 4, porque otro modelo puede elegir otras citas.
- 25-09-2026, Google publicó un Codelab de skills para Antigravity CLI, con
.agents/skillsy la instalación de skills de terceros mediantenpx skills add(Google Codelabs; vercel-labs/skills). Qué significa para ti:.agents/skillsse está convirtiendo en la carpeta común entre herramientas.
Cuándo no se sostienen estas conclusiones
Las muestras son pequeñas, así que los límites van primero. Las proporciones de temas salen de las 20 a 200 reseñas más recientes de cada sitio, no de todas, y cambiarán la semana que viene. «Las espontáneas puntúan de 1,9 a 3,0 estrellas menos» sale de una sola lectura de cinco empresas, y Asana queda fuera porque no tiene grupo invitado comparable. Las reglas de palabras v1.1 se revisaron con solo 5 reseñas por tema, y la palabra «support» también coincide con textos como «supports multiple views», un error que no medimos. Las carpetas y el comportamiento de los cuatro productos salen de documentación oficial leída el 26-10-2026, y las configuraciones MCP de Codex y Antigravity son ejemplos que no ejecutamos. En nuestra máquina probamos los scripts de la skill, el validador de la especificación y la API de EveryInfra. Si tus competidores no están en G2, Capterra, Trustpilot ni Amazon, cambia a la capacidad equivalente del catálogo, como google_play/reviews, app_store/reviews o yelp/reviews.
Preguntas frecuentes
¿Qué significa el error «skill.md must start with yaml frontmatter (---)»?
Fuente: autocompletado de Google «skill.md must start with yaml frontmatter (---)», leído el 26-10-2026. La primera línea de SKILL.md debe ser ---. La documentación de Claude Code dice que solo lee el frontmatter cuando el --- inicial está en la primera línea; si no, todo el archivo se trata como cuerpo, y si el YAML no se puede leer, la skill se carga sin campos (documentación de skills de Claude Code). Con agentskills validate de skills-ref se detecta antes.
¿Dónde está la carpeta de codex skills?
Fuente: autocompletado de Google «codex skills location» y «codex skills folder». En un repositorio, .agents/skills, desde la carpeta de trabajo hasta la raíz. Para un usuario, $HOME/.agents/skills, y para la máquina, /etc/codex/skills. Codex sigue los enlaces simbólicos (Codex Build skills).
¿Cómo reducen las claude code skills el uso de tokens?
Fuente: autocompletado de Google «claude code skills to reduce token usage». Al empezar la sesión, una skill solo añade su nombre y su descripción, 363 caracteres en esta. El cuerpo se carga solo cuando se usa. Mantén la descripción corta con el uso principal delante, y para las skills que casi no usas pon "name-only" en skillOverrides (documentación de skills de Claude Code).
¿Hay skills de Claude Code en español y gratis?
Fuente: autocompletado de Google «skills claude code español gratis». Una skill es solo una carpeta con texto y scripts, así que se puede escribir en español sin coste; la especificación no limita el idioma del cuerpo (especificación de Agent Skills). Lo que sí depende del idioma es cualquier regla de palabras clave, como mostramos con saas_es. Hay ejemplos públicos en anthropics/skills y openai/skills.
¿Pueden las agent skills llamar a APIs externas en la app de Gemini?
Fuente: autocompletado de Google «agent skills claude» y «gemini skills», y el texto de la ayuda de Gemini. Hoy no: la ayuda dice que no se admiten scripts que necesiten internet y que los scripts no pueden enviar peticiones a sitios externos (ayuda de Gemini). Usa las apps conectadas de Gemini para los datos y deja en la skill solo los pasos y el formato.
¿Es seguro instalar skills desde GitHub?
Fuente: autocompletado de Google «claude code skills github». Las skills pueden llevar scripts, así que lee SKILL.md y scripts/ antes de instalar. Gemini CLI muestra un aviso de seguridad al instalar una skill (documentación de Gemini CLI). OpenAI explica además cómo probar skills con evaluaciones (Testing Agent Skills Systematically with Evals).
Para seguir leyendo
- Prueba las APIs de reseñas: API de Trustpilot, reseñas de Trustpilot, API de G2, reseñas de G2, reseñas de Capterra, reseñas de Amazon.
- Conecta por MCP: servidor MCP de EveryInfra. Para tu primera llamada, la guía rápida; para precios, la página de precios.
- Artículo relacionado: Reseñas de la competencia de 30 empresas en G2 y Trustpilot.
- Artículo relacionado: Cómo convertir datos de reseñas en un producto de pago.
- Artículo relacionado: Cómo vender la monitorización de cambios web.
Referencias
- Extend Claude with skills, Anthropic (documentación de Claude Code), leído 26-10-2026, https://code.claude.com/docs/en/skills
- Agent Skills Specification, agentskills.io, leído 26-10-2026, https://agentskills.io/specification
- Validador de referencia skills-ref, agentskills (GitHub), 0.1.1, ejecutado 26-10-2026, https://github.com/agentskills/agentskills/tree/main/skills-ref
- Build skills, OpenAI (documentación de Codex), leído 26-10-2026, https://developers.openai.com/codex/build-skills
- Model Context Protocol, OpenAI (documentación de Codex), leído 26-10-2026, https://developers.openai.com/codex/mcp
- Agent skills, Google Antigravity Docs, leído 26-10-2026, https://antigravity.google/docs/skills/
- Migration - Antigravity CLI, Google Antigravity Docs, leído 26-10-2026, https://antigravity.google/docs/cli/gcli-migration
- MCP, Google Antigravity Docs, leído 26-10-2026, https://antigravity.google/docs/mcp
- Agent Skills, documentación de Gemini CLI, leído 26-10-2026, https://geminicli.com/docs/cli/skills/
- Introducing skills in the Gemini app and Workspace, Google Workspace Updates, 30-09-2026, https://workspaceupdates.googleblog.com/2026/09/skills-gemini-app-workspace.html
- An update on the launch of skills in the Gemini app and Workspace, Google Workspace Updates, 13-10-2026, https://workspaceupdates.googleblog.com/2026/10/an-update-on-launch-of-skills-in-gemini-app-and-workspace.html
- Let skills in Gemini tackle your most repetitive tasks, blog de Google, 30-09-2026, https://blog.google/products-and-platforms/products/gemini/automate-tasks-with-skills/
- Create & manage skills for Gemini Apps, ayuda de Gemini, leído 27-10-2026, https://support.google.com/gemini/answer/17094296
- About the transition from Gems to skills, ayuda de Gemini, leído 27-10-2026, https://support.google.com/gemini?p=gems_to_skills
- Using Agent Skills with the API, Anthropic (documentación de Claude), leído 26-10-2026, https://docs.claude.com/en/api/skills-guide
- Connect Claude Code to tools via MCP, Anthropic, leído 26-10-2026, https://code.claude.com/docs/en/mcp
- Claude Code changelog, Anthropic, versiones 2.1.304 a 2.1.310 (19-10-2026 a 23-10-2026), https://code.claude.com/docs/en/changelog
- Equipping agents for the real world with Agent Skills, Anthropic, 16-10-2025, https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
- Catálogo de datos de EveryInfra, GET /api/v1/social/catalog, leído 26-10-2026 17:25 (hora de Singapur), https://api.everyinfra.com/api/v1/social/catalog
- MCP de EveryInfra (tools/list, tools/call), llamado 26-10-2026 17:25 y 17:46 (hora de Singapur), https://api.everyinfra.com/mcp
- Ficha de monday AI Work Platform, Capterra, leído 26-10-2026 (con script devuelve 403; leído con motor de navegador), https://www.capterra.com/p/147657/monday-com/
- Trustpilot invitation methods, ayuda de Trustpilot, leído 26-10-2026, https://help.trustpilot.com/s/article/Trustpilot-invitation-methods?language=en_US
- ClickUp Reviews, Trustpilot, leído 26-10-2026 (con script devuelve 403; leído con motor de navegador), https://www.trustpilot.com/review/clickup.com
- Guidelines for Businesses, Trustpilot, leído 26-10-2026, https://corporate.trustpilot.com/legal/for-businesses/guidelines-for-businesses
- Asana Reviews, G2, leído 26-10-2026 (con script devuelve 403; leído con motor de navegador), https://www.g2.com/products/asana/reviews
- Tools, especificación de Model Context Protocol 2025-06-18, leído 26-10-2026, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Plans & pricing, Claude, leído 26-10-2026, https://claude.com/pricing
- What is ChatGPT Plus?, ayuda de OpenAI, leído 26-10-2026, https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus
- Pricing, OpenAI (documentación de Codex), leído 26-10-2026, https://developers.openai.com/codex/pricing
- Google AI Pro & Ultra, Google, leído 26-10-2026, https://gemini.google/subscriptions/
- How to use AI Agent Skills (with Antigravity CLI), Google Codelabs, 25-09-2026, https://codelabs.developers.google.com/antigravity/how-to-create-agent-skills-for-antigravity-cli
- How do you actually set up Antigravity agent skills?, Reddit r/google_antigravity, leído 26-10-2026, https://www.reddit.com/r/google_antigravity/comments/1qvrxxx/how_do_you_actually_set_up_antigravity_agent/
- Directiva (UE) 2019/2161 («Ómnibus»), EUR-Lex, 27-11-2019, https://eur-lex.europa.eu/eli/dir/2019/2161/oj
- Real Decreto-ley 24/2021, de 2 de noviembre, BOE-A-2021-17910, BOE, 03-11-2021, https://www.boe.es/diario_boe/txt.php?id=BOE-A-2021-17910
- Create custom subagents, Anthropic (documentación de Claude Code), leído 26-10-2026, https://code.claude.com/docs/en/sub-agents
- DevDay 2026 announcements and developer resources, comunidad de desarrolladores de OpenAI, 29-09-2026, https://community.openai.com/t/devday-2026-announcements-and-developer-resources/1402006
- DevDay 2026 Recap, OpenAI, 29-09-2026, https://openai.com/index/devday-2026-recap/
- Skills & Plugins, ChatGPT Learn, leído 26-10-2026, https://learn.chatgpt.com/docs/skills-and-plugins
- vercel-labs/skills, GitHub, leído 26-10-2026, https://github.com/vercel-labs/skills
- anthropics/skills, GitHub, leído 26-10-2026, https://github.com/anthropics/skills
- openai/skills, GitHub, leído 26-10-2026, https://github.com/openai/skills
- Testing Agent Skills Systematically with Evals, blog de desarrolladores de OpenAI, 22-01-2026, https://developers.openai.com/blog/eval-skills
- Opiniones sobre Holded, Trustpilot España, leído 26-10-2026, https://es.trustpilot.com/review/holded.com
Referencia BL-54