1つのSKILL.mdを4つのAIツールで使う:競合レビュー分析スキルを作る
Claude Code、Codex、Antigravity CLI、Gemini向けの競合レビュー用SKILL.mdを1つ作成し、各公式ドキュメントと照合しました。実際のAPI呼び出し9回で967件のレビューを読み込み、費用は$0.0125でした。
「競合レビュー分析」のSKILL.mdを1つ作成し、フロントマターはAgent Skills仕様の範囲内に収めました。各製品の公式ドキュメントによれば、同じファイルを変更なしでClaude Code、Codex、Antigravity CLIに読み込めます。手元の環境ではスキルのスクリプト、仕様バリデーター、データAPIを実行しましたが、CodexとAntigravityはインストールしていません。Geminiアプリはこのファイルをインポートできますが、スキルのスクリプトがインターネットにアクセスできないため、Geminiアプリではデータを取得できません。
2026年10月26日17:25〜17:55(SGT)に、このスキルでプロジェクト管理ツール3製品のレポートを1件作成しました。G2、Capterra、Trustpilotへの呼び出しは9回、読み込んだレビューは967件、API料金は$0.012501でした。最大のリスクはツールではなくデータにありました。Trustpilotでは、5社について、自発的に投稿されたレビューの平均が星1.29〜2.77だったのに対し、招待経由のレビューの平均は星4.07〜4.89でした。


結論:SKILL.mdは1つ、フォルダは4つ、請求は9回の呼び出し分
この記事では、実務上の疑問に1つ答えます。あなたは今Claude Codeのスキルを使っていて、チームメイトはCodexやAntigravity CLIを使っています。競合レビュー分析用のSKILL.mdを1つ、チーム全体で共有できるでしょうか。最初のAPI呼び出しの前に、合格基準を3つ書き出しました。
第一に、フロントマターがAgent Skillsの仕様をフィールドごとに満たしていること。第二に、フォルダパスとスキルの呼び出し方が各製品の公式ドキュメントに基づいていること。第三に、APIの利用料がカタログ価格×呼び出し回数とぴったり一致し、差がゼロであること。3つの条件はすべて満たしました。ただし、半分しか満たさなかった製品が1つありました。
下の表で4製品を並べて比較します。各セルの内容は、2026年10月26日に確認した各社の公式ドキュメントに基づいています。リンクは以下の各セクションにあります。最後の列は「スキル自身のスクリプトがapi.everyinfra.comにアクセスできるか」の1点です。これができなければ、このスキルは役目を果たせません。
| 商品 | プロジェクトフォルダ | 個人用フォルダ | 呼び出し方 | スクリプトでデータを取得できるか |
|---|---|---|---|---|
| Claude Code | .claude/skills/<name>/SKILL.md | ~/.claude/skills/<name>/SKILL.md | /name、または説明文をもとにClaudeが選択 | ローカルセッションでは可。Coworkやクラウドセッションでは不可。 |
| Codex(CLI、IDE、デスクトップ) | .agents/skills(作業フォルダからリポジトリのルートまで) | $HOME/.agents/skills | $name、/skills、またはCodexが選択 | はい。 |
| Antigravity CLI | .agents/skills/ | ~/.gemini/antigravity-cli/skills/ | /skillsで一覧表示、またはエージェントが選択 | はい。 |
| Geminiアプリ | 使用しない(「スキル」ページでアップロード) | 未使用 | /または@とスキル名 | 不可:インターネットが必要なスクリプトはサポートされていません。 |
1行目と3行目には重要な違いが1つあります。Claude Codeは、プロジェクト用に.claude/skillsを使います。Codex、Antigravity CLI、提供終了したGemini CLIは、いずれも.agents/skillsを読み込みます。そのため、これらすべてのツールで使うリポジトリでは、スキルを.agents/skills/competitor-review-analysis/に置き、.claude/skills/の下にそのシンボリックリンクを追加できます。Claude Codeのドキュメントにはスキルフォルダーをシンボリックリンクにできると書かれており、Codexのドキュメントにはシンボリックリンクされたスキルフォルダーをたどると書かれています(Claude Code skills docs、Codex Build skills)。
エージェントスキルとは:6つのフィールドを持つSKILL.md
Agent Skillsはオープンなフォーマットです。スキルは、少なくとも1つのSKILL.mdファイルを含むフォルダです。このファイルはYAMLフロントマターで始まり、その後にMarkdownで手順が続きます(Agent Skills仕様)。仕様では6つのフィールドが定義されており、そのうちnameとdescriptionの2つが必須です。
残りの4つ、license、compatibility、metadata、allowed-toolsは任意です。nameは小文字の英字、数字、ハイフンからなる1〜64文字で、ハイフンで始めたり終えたりすることはできず、ハイフンを2つ続けることもできません。また、フォルダ名と一致している必要があります。descriptionは1〜1,024文字で、スキルが何をするのか、いつ使うのかを記述します。仕様ではallowed-toolsが実験的とされているため、エージェントによってサポート状況が異なります。
このフォーマットは「段階的開示(progressive disclosure)」によってコンテキストを節約します。段階は3つあります。セッション開始時、エージェントは各スキルのnameとdescriptionだけを読み込みます。仕様の見積もりでは約100トークンです。タスクが説明文に合致すると、エージェントはSKILL.md全体を読み込みます。仕様では5,000トークン未満、500行未満が推奨されています。scripts/とreferences/内のファイルは、手順で必要になったときにだけ読み込まれます(Agent Skills仕様)。Anthropicも2025年10月16日に同じ考え方を説明しており、まずエージェントに目次を渡すというものです(AnthropicによるAgent Skillsの解説)。
このスキルのnameとdescriptionは合計363文字です。1トークンあたり約4文字とすると約91トークンで、仕様の見積もりに近い値です。SKILL.md全体は51行・3,426文字で、500行の上限を大きく下回ります。この2つの数値は、後述のコンテキストのセクションで再び取り上げます。
競合レビュー用SKILL.mdの全文
以下がファイルの全文です。スキルのフォルダには、このほかにスクリプト2つとキーワードリスト1つが含まれています。scripts/fetch_reviews.pyはEveryInfraのデータAPIを呼び出します。scripts/classify.pyはキーワードルールに基づいて、各レビューにテーマのタグを付けます。references/themes.mdにはキーワードを格納しています。
---
name: competitor-review-analysis
description: Pull public reviews for 2-5 competing products from G2, Capterra, Trustpilot or Amazon through the EveryInfra data API, tag each review with a theme, and write a comparison report with counts, shares and quotes. Use when the user asks to compare competitor reviews, find what customers complain about, or build a review-based battlecard.
license: MIT
compatibility: Needs network access to api.everyinfra.com, Python 3.9+, and an EVERYINFRA_API_KEY environment variable. Does not run inside the Gemini app, where skill scripts cannot reach the internet.
metadata:
  version: "1.1"
  author: everyinfra-blog-example
---

# Competitor review analysis

## Inputs to confirm first
1. The products to compare (2-5). For each one, get the exact review page:
   G2 `https://www.g2.com/products/<slug>`, Capterra `https://www.capterra.com/p/<id>/<name>/`,
   Trustpilot domain such as `clickup.com`, Amazon `https://www.amazon.com/dp/<ASIN>`.
   Use the URL, not the product name. Product names change (Capterra lists monday.com as "monday AI Work Platform").
2. The theme set: `saas` or `hardware` (see references/themes.md). Ask if unclear.

## Steps
1. Fetch: run `python3 scripts/fetch_reviews.py --plan plan.json --out raw/`.
   One request per product per source. The script waits 7 s between requests,
   retries 429 with the `retry_after` value, and sends slow requests with `"mode":"async"`.
2. Check counts: read `raw/summary.json`. A source with 0 rows was not charged.
   Do not treat a short page as "no more reviews". Write the counts into the report.
3. Tag: run `python3 scripts/classify.py raw/ --themes saas > tagged.json`.
   The script tags by keyword rules, so the same input gives the same output.
4. Read 5 tagged reviews per theme and check that the tag fits. If a keyword
   matches the wrong words (v1 had `plan`, which matched "planning"), fix
   references/themes.md and run step 3 again. Note each change in the report.
5. Write `report.md` with these sections, in this order:
   - Table: product x source -> reviews read, average rating, charged USD.
   - Table: theme x product -> count and share of reviews that mention it.
   - Top 3 complaints per product, each with one short quote and its review URL.
   - Limits: what the sample cannot show (see below).

## Rules
- Report rating scales as they are: G2 and Capterra 1-5, Trustpilot 1-5 stars, Amazon 1-5 stars.
  Do not average across sources.
- Split Trustpilot by the `source` field: `Organic` (the reviewer came on their own) versus
  invitation sources (`BasicLink`, `InvitationApi`, `FileUploadInvitation`, `Shopify` and others).
  Report the average for each group. Never report one Trustpilot average for a company.
- Theme keywords are per language. For reviews that are not in English, use the matching set
  (for example `saas_es`), or report them as untagged.
- Do not print reviewer names. Quote at most 25 words per review.
- Amazon returns only the reviews shown on the product page (usually 10-15). Say so.
- Cost: every request costs the `price_usd` from `GET /api/v1/social/catalog`. Add up `billing.charged_usd` from the responses; do not estimate.

## Limits to state in every report
- The sample is the newest page of each source, not all reviews.
- Trustpilot reviews of a software company are often about billing and support, not the product. Read them as a separate signal.一部の行は、ファイルの移植性を確保するためだけに設けています。フロントマターでは、仕様で定められた6つのフィールドのうち5つを使用しています。model、context: fork、argument-hintといったClaude Codeの拡張は使用していません。compatibilityの行には、ネットワーク接続とAPIキーの要件を記載しています。
ファイルをGeminiアプリにインポートした人は、そこでは実行できないことがすぐにわかります。スクリプトのパスはスキルのルートからの相対パスとし、ファイル参照は仕様の求めるとおり1階層までにとどめています(Agent Skills仕様)。「Trustpilotはソースごとに分割する」と「キーワードは言語ごとに用意する」の2つのルールは、実際にデータを処理してから追加したものです。その理由は次のセクション以降で説明します。
ファイルは目視で確認したわけではありません。17:56 SGTに、仕様リポジトリにあるリファレンスバリデーターskills-ref 0.1.1(agentskills/skills-ref)を3つのサンプルに対して実行しました。元のファイルはValid skillを返しました。context: forkとmodel: haikuを加えたコピーは「Unexpected fields in frontmatter: context, model」を返しました。
name: Review_Skillとしたコピーでは、名前は小文字でなければならないこと、無効な文字が含まれていることの2つのエラーが返りました。これはClaude Codeのドキュメントの記述と一致します。ローカルのClaude Codeでは、ドキュメントの表にあるすべてのフィールドを使用できます。一方、claude.aiへのアップロード、Skills API、package_skill.pyが受け付けるのは仕様の6つのフィールドのみで、余分なフィールドがあると検証エラーになります(Claude Codeのスキルに関するドキュメント)。
| サンプル | 変更内容 | skills-ref 0.1.1の結果 | 移植可能か |
|---|---|---|---|
| 元のファイル | なし | Valid skill | はい。 |
| 不正例1 | context: forkとmodel: haikuを追加 | エラー:想定外のフィールド context、model | ローカルのClaude Codeでは動作、claude.aiへのアップロードは失敗。 |
| 不正例2 | name: Review_Skill | エラー:小文字である必要あり、無効な文字を含む | いいえ。 |
5つのエントリーポイント、5通りのフロントマタールール
1つのファイルを複数の場所に置く前に、各エントリーポイントが何を受け付けるかを確認してください。表には、各社の公式ドキュメントに明記されているルールのみを記載しています。ドキュメントに記載がない項目は「ドキュメントに記載なし」としています。
| 入口 | `name` | `description` | 仕様外のフィールド | その他の制限 |
|---|---|---|---|---|
| Agent Skillsの仕様 | 必須、1〜64文字、小文字・数字・ハイフン、フォルダ名と同一 | 必須、1〜1,024文字 | 仕様の対象外 | 本文は500行未満を推奨。 |
| Claude Code(ローカル) | 任意、デフォルトはフォルダ名 | 推奨、表示は1,536文字まで | model、context、hooks | 未知のフィールドは無視。 |
| claude.aiへのアップロードとSkills API | 必須、64文字以下、「claude」やXMLは不可 | 必須、1,024文字以下 | 余分なフィールドはエラー | 30MB未満、ネットワーク不可。 |
| Codex | 必須 | 必須 | UIと依存関係はagents/openai.yamlに記述 | 初回のリストはコンテキストの2%または8,000文字を使用。 |
| 入口 | `name` | `description` | 仕様外のフィールド | その他の制限 |
|---|---|---|---|---|
| Antigravity | 任意、デフォルトはフォルダ名 | 必須 | ドキュメントに記載なし | ドキュメントに記載なし。 |
| Geminiアプリ | すべて小文字、単語はハイフンで区切る | 長さはドキュメントに記載なし | ドキュメントに記載なし | 合計100 MB。スクリプトはインターネットにアクセスできません。 |
この表を見ると、私たちが仕様のフィールドだけを使う理由がわかります。仕様はすべてに共通するサブセットです。最も制約が緩いエントリポイントはローカルのClaude Codeで、最も厳しいのはclaude.aiへのアップロードです。最も厳しいものに合わせて書けば、どのエントリポイントでもファイルが受け付けられます。
descriptionの書き方についても、各ドキュメントの内容は一致しています。Codexはスキルが多数インストールされているとまず説明を短縮するため、主な用途とトリガーとなる語を先頭に置きます(Codex Build skills)。Claude Codeは説明を1,536文字で切り詰めるため、主なユースケースを先頭に置きます(Claude Codeスキルのドキュメント)。Googleが最初に挙げるヒントは、スキルを使うタイミングを定義することです(About the transition from Gems to skills)。
1文目では、スキルが何をするのか、どのサイトから、どのAPIを通じて行うのかを述べています。2文目では、どのようなユーザーのリクエストでスキルを起動すべきかを述べています。合計337文字なので、どのエントリポイントでも切り詰められません。
Claude Codeのスキル:~/.claude/skillsまたは.claude/skills
Claude Codeは5か所からスキルを読み込みます。エンタープライズ(管理設定フォルダ内の.claude/skills/)、個人(~/.claude/skills/<name>/SKILL.md)、プロジェクト(.claude/skills/<name>/SKILL.md)、ネストされたフォルダ、--add-dirで追加したフォルダです。名前が重複した場合は、エンタープライズが個人より優先され、個人がプロジェクトより優先されます(Claude Codeスキルのドキュメント)。プロジェクトスキルはコミットできるため、チームメンバー全員がコードと一緒に受け取れます。個人スキルは手元のマシン上のすべてのリポジトリで使えます。プロジェクトスキルは起動したフォルダからリポジトリのルートまでさかのぼって読み込まれるため、packages/frontend/で開始したセッションでもルートのスキルが見えます。
週次の競合レポートでは、3つの制限が重要になります。1つ目に、Coworkセッションとクラウドセッション(クラウドのスケジュールタスクを含む)は、手元のマシンの~/.claude/skills/を読み込みません。読み込むのは、claude.aiアカウントで有効にしたスキルだけです。スキルがローカルフォルダにしかない場合、クラウドのスケジュールタスクはスキルが見つからないと報告します。
デスクトップのスケジュールタスクは自分のマシン上で実行されるため、~/.claude/skills/を読み込みます(同じドキュメントの「Use skills in Cowork and cloud sessions」)。第2に、claude.aiへのアップロードでは、仕様にある6つのフィールドしか受け付けません。第3に、スキル一覧には文字数の上限があります。各descriptionとwhen_to_useを合わせて、表示されるのは最大1,536文字です。
一覧全体に割り当てられるのはモデルのコンテキストウィンドウの1%で、使用頻度の低いスキルから説明が省かれます。自動コンパクションの後、Claude Codeは最近使ったスキルを、それぞれ先頭の5,000トークンずつ、合計25,000トークン以内で再添付します(同ドキュメント)。そのため、私たちの説明は337文字に収め、主なユースケースを1文目に置いています。
Claude Codeには、Claude Codeでしか動作しない拡張もあります。modelはそのターンのモデルを切り替えます。context: forkはスキルをフォークしたサブエージェントのコンテキストで実行します。メインセッションに戻るのは結果だけです(スキルのドキュメント、サブエージェントのドキュメント)。allowed-toolsはツールを事前に承認し、!コマンド行は本文にライブデータを挿入します。これらの機能は便利ですが、使用したファイルは移植性を失います。
私たちの方針では、共有ファイルを仕様の範囲内に収めます。Claude Code専用の動作が必要な場合は、同じ名前の2つ目のスキルを個人フォルダに置きます。「個人がプロジェクトより優先される」ルールによりClaude Codeはそちらを使い、他のツールは引き続き仕様準拠版を読み込みます。context: forkを使えば、未加工のレビュー967件はメインセッションに入りません。
スクリプトを実行する代わりに、モデルにツールを呼び出させることもできます。Claude CodeにEveryInfraのリモートMCPサーバーを追加します。このコマンドは以前の記事でテスト済みなので、ここでは設定例として示します。
export EVERYINFRA_API_KEY="<your API key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Claude CodeはデフォルトでMCPツール検索を有効にしています。セッション開始時に読み込むのはツール名とサーバーの指示だけです。ツール定義は必要に応じて参照します(Claude CodeのMCPドキュメント)。これにより、後のセクションで扱うコンテキストの計算が変わります。
Codexのスキル:.agents/skillsとconfig.toml
CodexのスキルもオープンなAgent Skills標準に基づいており、SKILL.mdにはnameとdescriptionが必須です(Codex Build skills)。Codexは4種類の場所を読み込みます。リポジトリレベルは、作業フォルダからリポジトリのルートまでの各フォルダにある.agents/skillsです。ユーザーレベルは$HOME/.agents/skillsです。管理者レベルは/etc/codex/skillsです。
システムスキルはCodexに同梱されています。2つのスキルの名前が同じ場合、Codexはそれらを統合せず、両方がピッカーに表示されることがあります。CLIまたはIDE拡張機能では、/skillsと入力するか、$でスキルをメンションします。Codexは説明からスキルを選ぶこともできます。ChatGPTでは、@でスキルをメンションします。
Codexのドキュメントには、説明の書き方に影響する数値が2つあります。デフォルトでは、最初のスキル一覧に使われるのはモデルのコンテキストウィンドウの最大2%で、ウィンドウサイズが不明な場合は8,000文字です。skills.max_context_tokens設定でこの予算を変更でき、上限は10,000トークンです。多数のスキルをインストールしている場合、Codexはまず説明を短縮し、次に一部のスキルを除外して警告を表示します(Codex Build skills)。任意のagents/openai.yamlファイルでは、表示名、allow_implicit_invocationポリシー、MCPツールの依存関係を設定します。このファイルはスキルのフォルダに置かれ、他のツールからは無視されるため、スキルの移植性は保たれます。
CodexでEveryInfraのリモートMCPサーバーに接続するには、~/.codex/config.tomlに[mcp_servers.<name>]テーブルを追加します(Codex MCP docs)。信頼済みのプロジェクトでは.codex/config.tomlも使えます。以下は設定例で、ローカルのCodex環境では実行していません。
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"
enabled_tools = ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
default_tools_approval_mode = "writes"
tool_timeout_sec = 120テストデータでは、このうち2行を設定しました。enabled_toolsでは3つのツールだけを残しています。17:25 SGTの時点で、EveryInfra MCPのtools/list呼び出しは25個のツールを返し、その中にはキーの作成、キーの削除、設定の変更、チケットの起票を行うものも含まれていました。レビューレポートにはどれも不要です。tool_timeout_secを120秒にしているのは、Codexがデフォルトではツール呼び出しごとに60秒しか待たないためです(CodexのMCPドキュメント)。
17:28と17:30 SGTに実行した同期呼び出しには、それぞれ87.8秒と88.3秒かかりました。デフォルトのままでは、APIが応答する前にCodexが待機を打ち切ります。default_tools_approval_mode = "writes"は、読み取り専用とマークされていないツールの実行前に確認を求めます。everyinfra_call_apiは呼び出しごとに課金されるため、サーバーは読み取り専用とマークしておらず、Codexは毎回確認を求めます。そのコストを許容できる場合は、このツールに対してだけtools.everyinfra_call_api.approval_modeを設定してください。
Antigravity CLIとGemini CLI:フォルダの場所が変更
Googleは2026年6月18日にGemini CLIをAntigravity CLIに置き換えました。Gemini CLIのドキュメントサイトでも、スキルのページ冒頭にその旨が記載されています(Gemini CLIのAgent Skillsドキュメント)。スキルの形式は同じですが、フォルダが異なります。Gemini CLIでは、ユーザー用に~/.gemini/skills/、ワークスペース用に.gemini/skills/を使い、.agents/skills/はその両方のエイリアスでした。
Antigravity CLIでは、ワークスペース用に.agents/skills/、グローバルスキル用に~/.gemini/antigravity-cli/skills/を使います(Antigravity CLIの移行ドキュメント)。Antigravityのデスクトップアプリは、さらに別のグローバルフォルダ~/.gemini/config/skills/を使います(Antigravityのスキルドキュメント)。フォルダごとに1つずつ、2つのコピーを置くことをおすすめするのはこのケースだけです。
Antigravityで必須なのはdescriptionだけです。nameがない場合はフォルダ名が使われます(同ドキュメント)。私たちのスキルには両方のフィールドがあるため、影響はありません。2026年9月25日公開のGoogle Codelabでは、最小限の手順が紹介されています。
.agents/skills/<name>/SKILL.mdを作成し、agyを起動して、/skillsでスキルを一覧表示し、質問します(Google Codelabs)。Redditでは、あるユーザーがAntigravityのスキルの設定方法を尋ね、ドキュメントへのリンクではなくフォルダ構成を知りたいと書いていました(r/google_antigravityのスレッド)。上の表がその構成です。
AntigravityはMCPサーバーの設定をsettings.jsonから独立したmcp_config.jsonに移しました。グローバルファイルは~/.gemini/config/mcp_config.json、プロジェクトファイルは.agents/mcp_config.jsonです。リモートサーバーでは、アドレスのキーがurlまたはhttpUrlからserverUrlに変わりました(Antigravity CLIの移行ドキュメント)。ツールの許可リストenabledToolsもあります。
デフォルトでは、ツール呼び出し1回につき3分、接続に5分待機します(Antigravity MCP docs)。Codexより長いため、当社の88秒かかる呼び出しでもタイムアウトを変更する必要はありません。以下は設定例で、ローカルでは実行していません。
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <your API key>" },
      "enabledTools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
Geminiのスキル:Gemは11月17日に読み取り専用になり、スクリプトは引き続きオフライン
2026年9月30日、GoogleはスキルがGemに代わると発表しました。スキルは「オープンでMarkdownネイティブなSKILL.md標準のみに基づいて構築」されているため、他のプラットフォームのスキルをGeminiアプリにコピーできます(Google Workspace Updates, 2026-09-30)。10月13日の更新によると、同日からGeminiアプリでスキルの提供が始まり、11月中旬までに完了する見込みです。Workspaceアプリでの提供開始は、追って通知があるまで延期されています(Google Workspace Updates, 2026-10-13)。
Gemの移行日はGoogleの情報源によって異なるため、ご自身のアカウントの種類を確認してください。9月30日のWorkspaceの投稿によると、11月17日にGemは設定パネルに移動し、ユーザーは「引き続き作成、編集、使用できる」とされています。ビジネスアカウントでGemが使えなくなるのは、早くても2027年3月1日です。一方、個人アカウント向けのヘルプセンターのページには、より厳しい内容が書かれています。18歳以上のユーザーが利用する個人用Googleアカウントでは、2026年11月17日にGemが読み取り専用のスキルになります。表示はできますが、使用や編集はできません。
2026年12月17日、GemはGeminiアプリから削除されます(Gemini Help: About the transition from Gems to skills)。つまり「11月17日に読み取り専用になる」のは個人アカウントだけです。Workspaceのビジネスアカウントは2027年3月、教育機関向けアカウントは2027年6月に移行します。Googleブログの内容もヘルプセンターと一致しています(Google blog: Let skills in Gemini tackle your most repetitive tasks)。
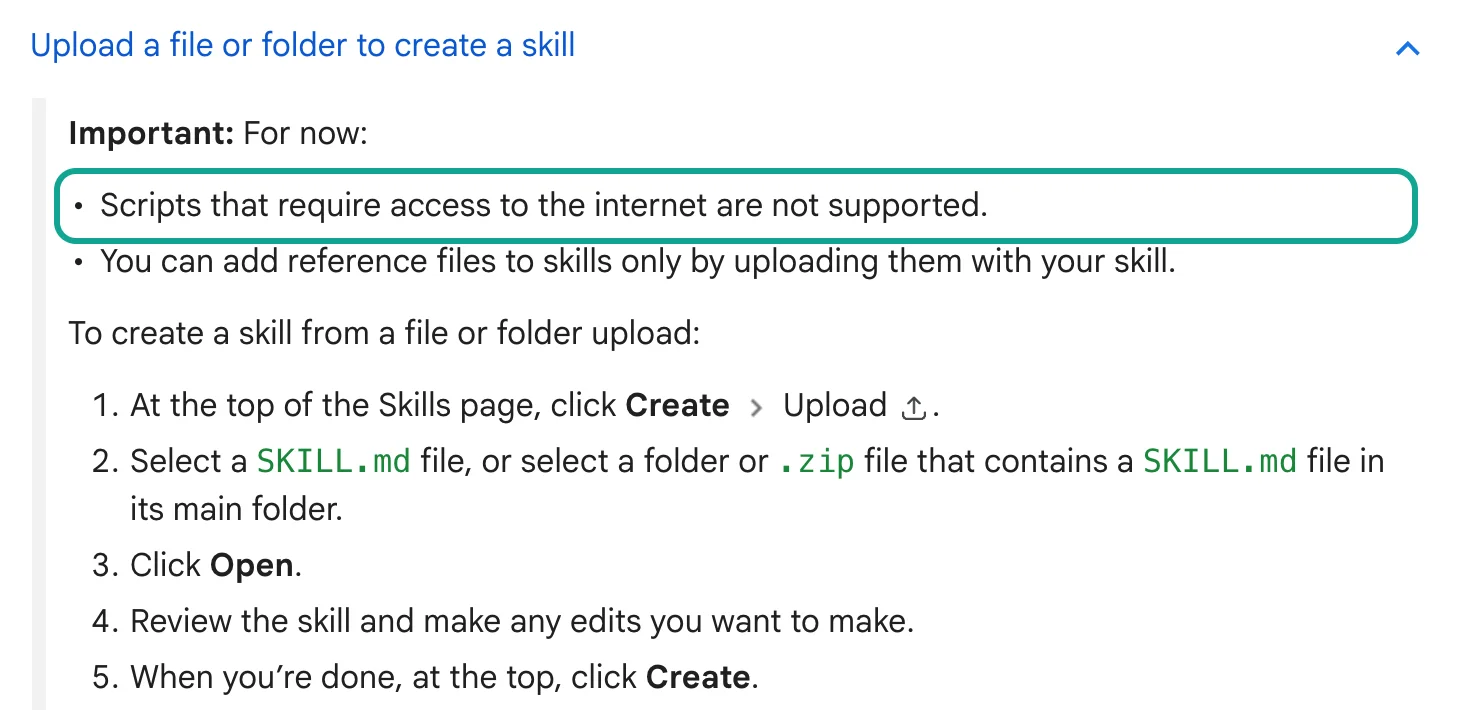
このスキルがGeminiアプリで動くかどうかは、ヘルプセンターの2つの文で決まります。現時点では、インターネットへのアクセスが必要なスクリプトはサポートされていません。また、スクリプトは外部のウェブサイトでアクションやリクエストを実行できません(Gemini Help: Create & manage skills for Gemini Apps)。同じページにはアップロードのルールも記載されています。
SKILL.mdはルートフォルダに置き、名前は小文字とハイフンで構成し、全ファイルの合計を100 MB以下にする必要があります。.py、.sh、.md、.json、.csvなどのプレーンテキストファイルは使えますが、.docxと.xlsxは使えません。今回のスキルは形式のルールをすべて満たしておりインポートもできますが、Gemini上ではfetch_reviews.pyでデータを取得できません。
これはGeminiに限った話ではありません。Claude Skills APIはスキルを「ネットワークアクセスなし」のコード実行コンテナで実行するため、スキルは「外部APIを呼び出せません」。さらに名前のルールもあり、nameには予約語の「anthropic」や「claude」、XMLタグを含められません(Claude Skills API guide)。どちらの環境でも、「プロセスはスキル、データはコネクタ」と役割を分けるのが正解です。
Geminiアプリでは、連携アプリがデータを取得します。ウェブ版のClaudeとAPIでは、MCPコネクタがデータを取得します。スキル本体は、どの手順に従い、どのレポートを書くかをモデルに伝えるだけです。ヘルプセンターには、スキルがまだCanvasやDeep Researchでは使えないことも書かれています(About the transition from Gems to skills)。
実際の1往復:モデルが送る呼び出しと当社が返すデータ
スクリプトでもMCPツール呼び出しでも、当社側では同じリクエストになります。下のカードは、SGT 17:46:24に実行した実際のMCP tools/callです。モデルはeveryinfra_call_apiを呼び出し、ClickUpに関する過去3か月の星1つと星2つのTrustpilotレビューを最大50件リクエストしました。APIの処理時間は27.8秒で、7件のレビューを返し、課金額は$0.001389でした。
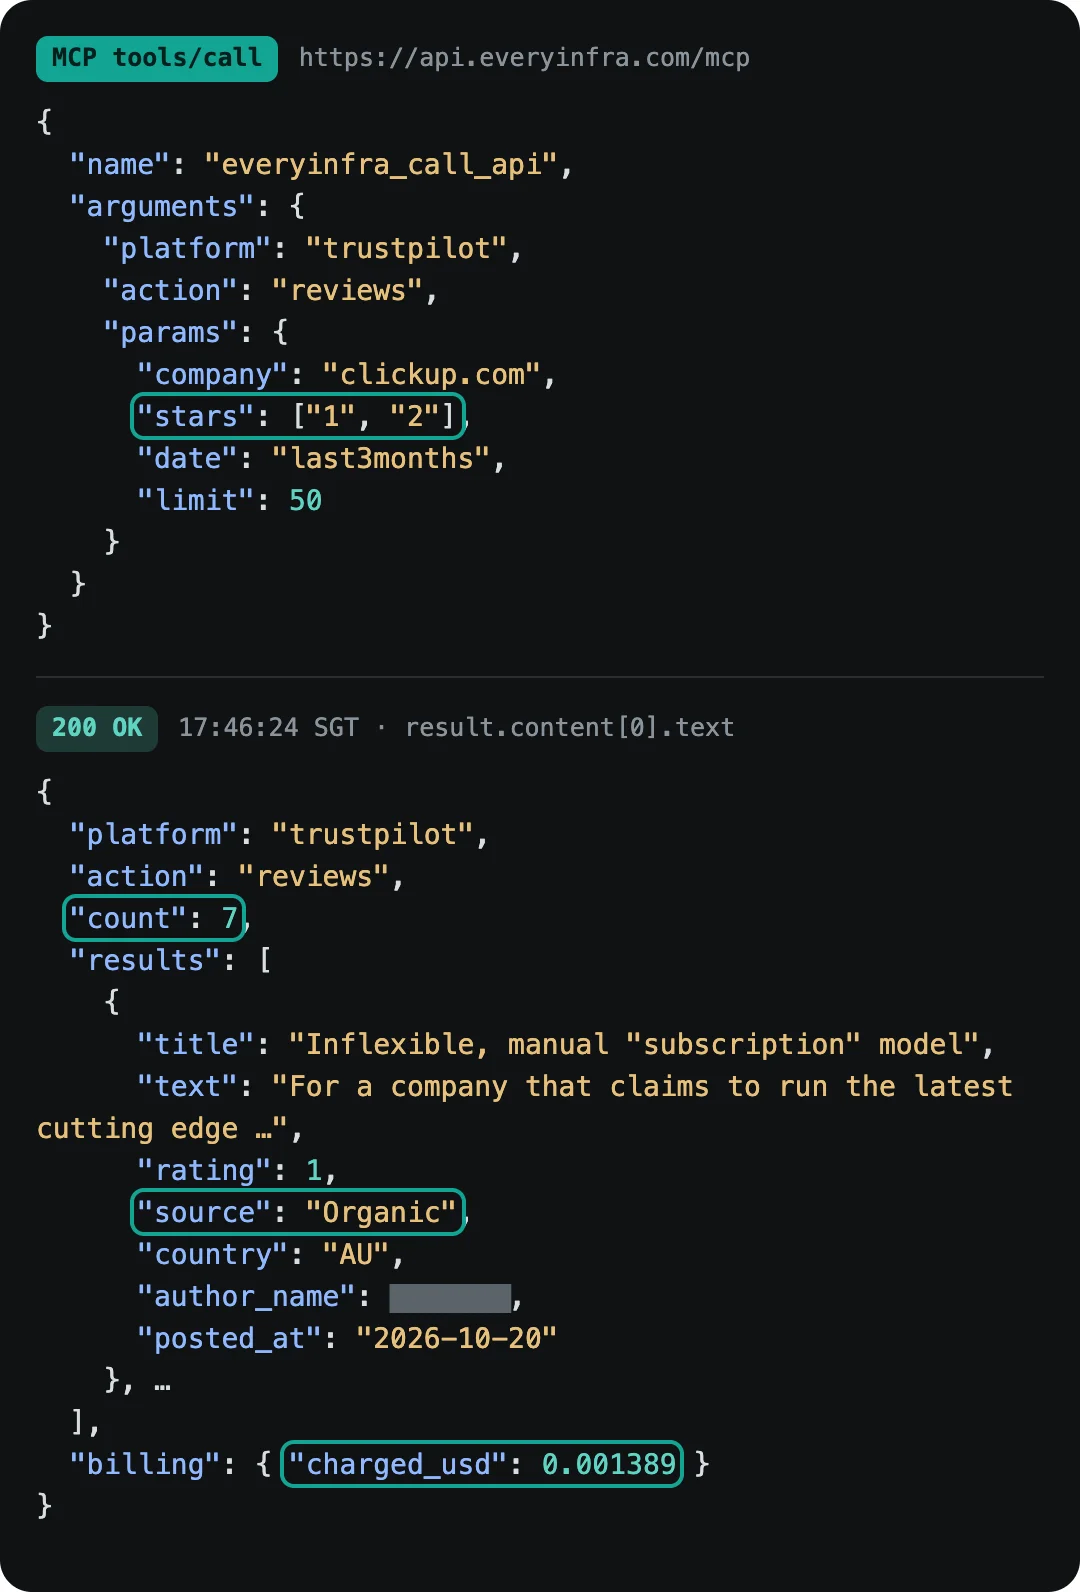
同じリクエストをcurlでデータAPIに直接送ると、次のようになります。$EVERYINFRA_API_KEYは環境変数から読み込み、ファイルには書き込みません。
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"platform":"trustpilot","action":"reviews","params":{"company":"clickup.com","stars":["1","2"],"date":"last3months","limit":50}}'カタログにはtrustpilot/reviewsのレスポンスフィールドが24個掲載されています(EveryInfraカタログ)。スキルが使うのは以下のフィールドです。各フィールドの名前と意味は、カタログのresponse_fieldsとplatform_field_meaningsに照らして確認しました。
| フィールド | 意味(カタログより) | スキルでの使い方 |
|---|---|---|
id、url | レビューIDとリンク | 重複を除外し、各引用にリンクを付ける。 |
title、text | タイトルと本文 | キーワードのタグ付け。 |
rating、rating_scale | 星の数と評価尺度 | ソースごとに平均を算出。 |
source | レビューのソース | 自発的なレビューと招待によるレビューに分ける。 |
| フィールド | 意味(カタログより) | スキルでの使い方 |
|---|---|---|
verification_level | 認証レベル(招待またはオーガニック) | sourceと照合する。 |
language、country | 言語と国 | キーワードセットを選ぶ。 |
experience_at、posted_at | 体験日、投稿日 | 期間で絞り込む。 |
| フィールド | 意味(カタログより) | スキルでの使い方 |
|---|---|---|
reply_text | 企業からの返信 | 返信率。 |
author_name | レビュー投稿者の表示名 | レポートには一切出力しません。 |
G2とCapterraのフィールドは、B2Bの購買検討に向いています。g2/reviewsの最初の行はrecord_typeがsummaryで、総合評価、レビュー数、最も多く言及された長所と短所が入っています。その後に個別のレビューが続きます。capterra/reviewsの各行には、pros、cons、使いやすさとサポートのサブ評価、switching_reasonsが含まれます。カタログでは、switching_reasonsが競合分析に最も役立つフィールドだと説明されています(EveryInfraカタログ)。
9回の呼び出し:G2、Capterra、Trustpilot、Amazonが返すレビュー数
SGT 17:25から18:31までに、合計31件のリクエストを送りました。課金されたのは23件で、8件は課金されませんでした(429レスポンス4件、タイムアウト1件、空の結果3件)。合計額は$0.032794です。表には、ソフトウェアのレポートに使った11件のリクエストを、費用がかからなかった2件も含めて示しています。
| SGT | 機能 | 対象 | limit | 取得レビュー数 | 時刻 | 課金 |
|---|---|---|---|---|---|---|
| 17:25 | g2/reviews同期 | Asana | 100 | 20件+サマリー行1件 | — | $0.001389. |
| 17:27 | g2/reviews同期 | monday.com | 100 | タイムアウト、503 | 90.4 s | $0. |
| 17:28 | g2/reviews同期 | ClickUp | 100 | 20件+サマリー行1件 | 87.8 s | $0.001389. |
| 17:30 | capterra/reviews | Asana(名前で指定) | 100 | 50 | 88.3 s | $0.001389. |
| SGT | 機能 | 対象 | limit | 取得レビュー数 | 時刻 | 課金 |
|---|---|---|---|---|---|---|
| 17:32 | capterra/reviews | 「monday.com」(名前で指定) | 100 | 0件、返金済み | 67.5 s | $0. |
| 17:33 | capterra/reviews | ClickUp(名前で指定) | 100 | 100 | 22.3 s | $0.001389. |
| 17:33 | capterra/reviews | monday.com(製品URLで指定) | 100 | 97 | 47.3 s | $0.001389. |
| 17:34 | g2/reviews非同期 | monday.com | 100 | 50件+サマリー行1件 | ジョブID取得まで2.1秒 | $0.001389. |
| SGT | 機能 | 対象 | limit | 取得レビュー数 | 時刻 | 課金 |
|---|---|---|---|---|---|---|
| 17:34 | trustpilot/reviews | asana.com | 200 | 200 | 44.5 s | $0.001389. |
| 17:35 | trustpilot/reviews | monday.com | 200 | 200 | 37.3 s | $0.001389. |
| 17:36 | trustpilot/reviews | clickup.com | 200 | 200 | 42.4 s | $0.001389. |
この表から得た3つの教訓をSKILL.mdに反映しました。第1に、Capterraでは「monday.com」という名前では何も見つかりませんでした。Capterraでの現在の製品名は「monday AI Work Platform」です(Capterra product page)。当社のAPIは0件を返し、その呼び出しは返金されました。
製品URLを指定すると、97件のレビューが返りました。そのため、手順1では名前ではなくURLを求めます。第2に、G2の同期呼び出しは85秒の同期上限ぎりぎりで動きます。monday.comの呼び出しは90.4秒でタイムアウトし、レスポンスには「Not charged」と表示され、"mode":"async"が提案されていました。
非同期モードでは2.1秒でジョブIDを取得でき、ジョブは50件のレビューを返しました。第3に、同じAsanaのG2リクエストを同期モードで実行すると、20件のレビューが返されました。17:48 SGTにスキルのスクリプトから非同期モードで再送信したところ50件が返され、先の20件はすべてその中に含まれていました。料金は同じで、非同期モードでは2.5倍のレビューが返されました。
これらのレビュー機能はレビュー単位ではなく呼び出しごとに課金されるため、呼び出しごとのレビュー数によって1,000件あたりのコストが決まります。Trustpilotは呼び出しごとに200件を返し、1,000件あたり約$0.0069です。Capterraは100件で約$0.0139、G2の非同期は50件で約$0.0278、G2の同期は20件で約$0.0695です。
Amazonは製品あたり13件で約$0.1068となり、差は約15倍です。Amazonの件数が少ないのは不具合ではありません。amazon/reviewsのカタログの注記には、どの国のサイトでも製品ページに掲載された注目のレビューしか取得できないと記載されています(EveryInfraカタログ)。通常は製品あたり10〜15件で、全履歴ではありません。同じUGREENのモバイルバッテリーを17:38と17:54 SGTに取得したところ、どちらも同じIDの13件のレビューが返されました。つまり、この13件はランダムなサンプルではなく、固定された「注目」のセットです。
429レスポンスも4回ありました。17:37:59から17:38:50 SGTの間にリクエストを7秒間隔で送信したところ、4回が拒否されました。各レスポンスには、キーのレート制限(毎分10リクエスト)、1秒のretry_after、「Nothing was charged」というメッセージが含まれていました。その1分間の枠は、他のリクエストですでに一部使われていました。
スクリプトはretry_afterに通常の間隔を加えた時間だけ待機し、再試行はすべて成功しました。テスト用キーのレート制限は毎分10リクエストに設定していました。アカウントのデフォルトは毎分60リクエストで、すべてのキーで共有され、チャージの累計額に応じて引き上げられます(料金ページ)。ご自身のキーのレート制限はコンソールで確認してください。
最大の落とし穴:Trustpilotの平均はソース別に分ける
多くの競合比較表では、各社にTrustpilotの平均評価を1つだけ割り当てています。私たちのデータでは、この数値にはほとんど意味がありません。17:34から17:44 SGTにかけて、6社(Holdedは48件のみ)の最新200件のTrustpilotレビューを読み込み、sourceフィールドでグループ化しました。Organicは、レビュアーが自分でページを見つけたことを意味します。BasicLink、InvitationApi、FileUploadInvitation、Shopifyはいずれも、企業が招待を送ったことを意味します。
| 企業 | オーガニックレビュー数 | オーガニック平均評価 | 招待レビュー数 | 招待平均評価 | 価格差 | 混合平均評価 |
|---|---|---|---|---|---|---|
| Asana | 199 | 1.90 | 1 | — | — | 1.90. |
| monday.com | 145 | 1.53 | 55 | 4.51 | 2.98 | 2.35. |
| ClickUp | 37 | 2.51 | 163 | 4.89 | 2.38 | 4.45. |
| Holded | 35 | 2.77 | 13 | 4.69 | 1.92 | 3.29. |
| 企業 | オーガニックレビュー数 | オーガニック平均評価 | 招待レビュー数 | 招待平均評価 | 価格差 | 混合平均評価 |
|---|---|---|---|---|---|---|
| Anker | 132 | 2.14 | 68 | 4.62 | 2.48 | 2.98. |
| UGREEN | 21 | 1.29 | 179 | 4.07 | 2.78 | 3.77. |
混合平均ではClickUpが星4.45、Asanaが星1.90で、ClickUpのほうがはるかに良く見えます。グループを分けると、オーガニックの平均はどちらも低く、2.51と1.90です。差の大部分は招待によるものです。ClickUpの最新200件のレビューのうち163件は招待リンク経由でした。monday.comも同じ傾向で、オーガニックレビュー145件の平均は星1.53、招待レビュー55件の平均は星4.51です。
ハードウェアブランドも同様です。UGREENのレビューのうち178件はShopifyストアからの自動招待によるもので、オーガニックレビュー21件の平均は星1.29です。私たちの解釈はシンプルです。自分から訪れる人は、何か問題が起きたときに書くことが多いです。招待を受けた人は、購入直後に書くことが多いです。
2つを混ぜると、平均値が示すのは顧客の評価ではなく、企業が送る招待の数になります。制約もあります。各サンプルは最新200件のレビューで、対象期間は大きく異なります。個々のレビューが本物かどうかは判断しておらず、各社の招待の運用についても評価しません。
「最新200件」がカバーする期間もまったく異なります。Asanaの200件は2022年1月31日から2026年10月3日までで、ほぼ5年に及びます。monday.comは2024年12月15日から2026年10月24日までです。ClickUpは2026年4月1日から2026年10月22日までで、7か月未満です。最も短いのはUGREENで、2026年8月30日から、私たちが読んだ当日の2026年10月26日までです。
UGREENは2か月足らずで200件のレビューを集め、そのうち178件はストアの招待経由でした。つまり、あるサンプルは2か月分の新規購入者、別のサンプルは5年分の長期ユーザーです。レポートでは、たとえばTrustpilotのパラメータdate: "last6months"を使って、すべてのソースを同じ期間にそろえることも必要です。今回は全体像を見たかったため、期間をそろえていません。
Webサイトだけでは、この内訳はわかりません。Trustpilotのヘルプセンターによると、どの企業もリンクを送って無料で顧客を招待できます。自動招待(BCCメール、ストア連携、API)によるレビューには「Verified」というラベルが付きます。「Basic Link」による招待では「Unprompted review」というラベルが付きます(Trustpilot Help: Trustpilot invitation methods)。
ClickUpのページを確認しました。Webサイトで「Unprompted review」と表示された星5のレビューは、APIではsource: BasicLink、verification_level: invitedです。同じページで同じラベルが付いた星1のレビューはsource: Organic、verification_level: not-verifiedです(Trustpilot: ClickUp reviews)。Webサイトではどちらも「Unprompted」ですが、APIでは区別されています。
そのため、スキルのRulesには「ソース別に分け、1つの平均にしない」と書かれています。Trustpilot自身の企業向けガイドラインも、偏りのない招待を求めています(Trustpilot Guidelines for Businesses)。ガイドラインが定めるのは企業の招待方法です。招待されたレビュアーが自発的なレビュアーと異なるという事実は変わりません。
同じ製品でも、3つのサイトで不満は異なる
テーマもサイトによって変わります。以下はAsanaの例で、G2から50件(非同期)、Capterraから50件、Trustpilotから200件を取得しました。スキルのキーワードルールv1.1でタグ付けしており、1件のレビューが複数のテーマに該当することもあります。
| テーマ | G2 (50) | Capterra(50件) | Trustpilot(200件) |
|---|---|---|---|
| 料金と請求 | 14% | 18% | 43%. |
| サポート | 12% | 14% | 46%. |
| 学習コスト | 26% | 22% | 5%. |
| 使いやすさ | 30% | 22% | 7%. |
| テーマ | G2 (50) | Capterra(50件) | Trustpilot(200件) |
|---|---|---|---|
| 自動化 | 22% | 38% | 7%. |
| モバイル | 6% | 2% | 5.5%. |
G2とCapterraのレビュアーの多くは、製品を使っているチームメンバーです。学習コストや自動化など、機能について書いています。Trustpilotでは、Asanaのレビューの46%がサポートに、43%が料金や請求に言及しています。その多くは契約更新、返金、アカウントのロックに関するものです。monday.comも同様で、Trustpilotでは料金が35%、サポートが29%です。
例外はClickUpです。自動化が39.5%で首位となっており、招待されたアクティブユーザーのレビューが多いページであることと整合します。G2のサマリー行にはG2自身の数値を載せています。Asanaは14,051件のレビューで星4.4、最も多く挙げられた短所は「Learning Curve」(605件)です。monday.comは17,294件で星4.7、ClickUpは15,159件で星4.6です(G2:Asanaのレビュー)。
そのため、スキルのLimitsセクションでは次のように明記しています。ソフトウェア企業のTrustpilotレビューは、大半が請求とサポートに関するものです。別のシグナルとして読み、G2やCapterraと統合しないでください。
これは改訂版の数値です。最初のキーワードリストでは、料金のテーマにplanという語を前方一致で含めていました。スキルのステップ4では、テーマごとにタグ付けされたレビューを5件読むよう指示しています。実際に読んでみると、CapterraではAsanaの料金が58%となっており、その多くは「project planning(プロジェクト計画)」に関するレビューでした。
Capterraのその50件のレビューで単語を数えると、planningが13回出現しました。モバイルのappの前方一致も、appreciateに6回、approvalまたはapprovalsに4回一致していました。そこで単語単位の一致に切り替え、plan、app、agent、simpleを削除しました。その結果、AsanaのCapterraでの料金の割合は58%から18%に、G2は30%から14%に、Trustpilotは48.5%から43%に下がりました。
ここから2つの教訓が得られます。キーワードルールは安価で再現性がありますが、人によるスポットチェックが必要です。ステップ4は形だけの手順ではありません。初回の実行で、誤った結果がレポートに入る前に修正できました。
完成したレポートの例
スキルのステップ5でレポートのレイアウトを定めています。以下は今回の実行データを入れた最初の表で、各サイトにおける製品ごとの読み込んだレビュー数、平均星数、コストを示しています。3つのサイトは別々の列のままにし、全体平均は出していません。Rulesの要件どおり、Trustpilotのセルには混合平均と、オーガニック・招待の各グループを示しています。
| 商品 | G2:レビュー数 / 平均 | Capterra:レビュー数 / 平均 | Trustpilot:レビュー数 / 混合平均(オーガニック / 招待) | API料金 |
|---|---|---|---|---|
| Asana | 50 / 4.38 | 50 / 4.76 | 200 / 1.90(1.90 / 1件のみ) | $0.004167. |
| monday.com | 50 / 4.64 | 97 / 4.57 | 200 / 2.35 (1.53 / 4.51) | $0.004167. |
| ClickUp | 20 / 4.22 | 100 / 4.60 | 200 / 4.45 (2.51 / 4.89) | $0.004167. |
レポートの3つ目のパートでは、製品ごとに上位3つの不満を、短い引用とリンク付きで挙げます。Trustpilotの最近のオーガニックな星1・星2レビューのタイトルを使いました。タイトルはレビュアーが書いた1行で、レビュアー名は掲載していません。Asanaの場合は、2026年10月3日の「Ruthless company」、10月1日の「Forever free doesn't mean forever free」、そして解約ポリシーを「sneaky」と表現した9月28日のレビューです。
monday.comの場合は、2026年10月24日、10月22日、10月21日の3件のレビューで、そのうち2件のタイトルが「customer service」に触れています。ClickUpの場合は、シート数を減らすのに30日前の通知が必要なことを扱った、2026年10月20日のレビュー「Inflexible, manual "subscription" model」です。10月5日のレビューは、支払い後にアカウントがロックされたことを書いています。これらのタイトルはテーマの表と一致しています。Trustpilotでは、3社とも機能ではなく請求とサポートへの不満が最も多く寄せられています。
レポートの最後のパートでは制約を挙げます。サンプルは各サイトの最新分です。Trustpilotには、比較できるAsanaの招待グループがありません。キーワードリストv1.1のスポットチェックは、テーマごとに5件のレビューでしか行っていません。
数値はモデルに書かせていません。表の数値はすべて、スクリプトがAPIレスポンスから算出しました。モデルが担当したのは二つの作業です。ひとつはステップ4でサンプルを読んでキーワードの誤りを見つけること、もうひとつはステップ5で表と引用をレイアウトすることです。前者は、変更点をそれぞれレポートに記録するようモデルに指示した場合にのみうまく機能します。後者はほとんど失敗しません。
週次で回す:定期実行の置き場所
競合レビューの確認は、週1回、月曜日に行うのが自然なリズムです。各製品でこのスキルをネットワークアクセス付きでスケジュール実行できる場所は次のとおりです。Claude Codeデスクトップのスケジュールタスクはお使いのマシン上で実行され、~/.claude/skills/を読み込みます。クラウドのスケジュールタスクは、毎回新しいクラウドセッションを開始します。ローカルフォルダは読み込みません。使用するのは、claude.aiアカウントで有効にしたスキルか、リポジトリの.claude/skills/にあるスキルのみです(Claude Codeのスキルに関するドキュメント)。
2026年9月29日のDevDayで、OpenAIはノートPCを閉じている間もタスクを実行するCodex Cloudを発表しました(DevDay 2026コミュニティまとめ)。Codexのドキュメントには、クラウドタスクがリポジトリの.agents/skillsを読み込むかどうかが明記されていません。私たちは検証していないため、結論は出しません。Geminiアプリには、選択したスキルでタスクを実行できるスケジュール機能があります(Create & manage skills for Gemini Apps)。ただし前述のとおり、Geminiアプリではスキルのスクリプトがインターネットにアクセスできません。
年間の計算は次のとおりです。9回の呼び出しで作るソフトウェアレポートを週1回作成すると、年間468回の呼び出しとなり、API料金は$0.650052です。5回の呼び出しで作るハードウェアレポートを毎週追加すると、260回の呼び出しと$0.36114が加わります。テストでは、最も遅い同期呼び出しに88秒かかりました。7秒の間隔とG2の非同期ジョブにかかる約5分を含めても、9回の呼び出しで作るレポート1件は10分未満で終わります。
1分あたり10リクエストのAPIキーで十分です。同じAPIキーを他のジョブでも使う場合は、429を通常の応答として扱い、リトライしてください。2026年10月23日にリリースされたClaude Code 2.1.310では、Monitorツールがより多くのデプロイ形態で使えるようになりました。スリープするスクリプトの代わりに、Monitorツールで長時間の非同期ジョブを監視できます(Claude Codeの変更履歴)。
キーワードによるタグ付けが漏れるケース:英語以外のレビューとハードウェアのレビュー
キーワードは言語に依存します。monday.comのスペイン語のTrustpilotレビューをlang: "es"で取得しました。limitを200にすると81件のレビューが返り、最新のものは2023年12月28日付でした。英語のキーワードでは、81件中80件にテーマが付きませんでした。スキルのスペイン語リストsaas_esを使うと、タグなしの件数は45件に減りました。
ClickUpのスペイン語レビューは10件しかありません。スペインの会計ツールHoldedにはCapterraで100件のレビューがあり、そのうち約76件がスペイン語と判断できます。英語のルールでは74件、スペイン語のルールでは21件がタグなしのまま残りました。Holdedでも、Trustpilotのカバレッジ不足が見られます。
17:44(SGT)にlangを指定せずに呼び出すと48件のレビューが返り、すべてenでした。18:29と18:30(SGT)にlang: "es"とlanguage: "es"で呼び出すと、どちらも0件で返金されました。スペイン版TrustpilotにはHoldedのレビューが2,444件表示されています(Trustpilot Spain: Holded)。つまり、この実行ではHoldedのスペイン語のレビューを取得できておらず、レポートには「Trustpilotのサンプル:英語のレビュー48件のみ」と記載する必要があります。
ハードウェアレビューでは、別の問題が生じます。20,000mAhのモバイルバッテリー3製品(Anker、UGREEN、INIU)について、Amazon USはそれぞれ注目のレビューを13件返し、平均評価は星4.92、星4.92、星4.62でした。これは2ブランドのTrustpilotでのオーガニックレビューの平均評価(星2.14と星1.29)を大きく上回ります。Amazonの注目のレビューは、参考になる肯定的なレビューに偏るためです。Trustpilotでは、Ankerのレビューの26%が、壊れた、動かなくなったといった耐久性の問題に触れています。Amazonの13件には、そうした内容のレビューが1件もありません。
ハードウェア向けのキーワードリストは、Trustpilotのカバー率も低く、Ankerは200件中101件、UGREENは200件中127件がどのテーマにも該当しませんでした。その大半は配送、返品、サポートに関する内容で、ハードウェア向けリストの対象外です。数値を良く見せるためにリストを変更することはしていません。タグなしの件数はレポートに記載しています。
コンテキストの計算:MCPツールは31,581文字、スキルは363文字
スキルとMCPはよく比較されますが、コンテキストの使い方が異なります。17:25 SGTに、EveryInfra MCPのtools/listを読み取りました。25個のツール定義は合計31,581文字で、1トークンを4文字とすると約7,895トークンです。11個のツールが読み取り専用、5個のツールが破壊的としてマークされています。
このスキルが必要とする3つのツール、everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_jobは合計3,314文字です。セッション開始時にスキルが追加するのはnameとdescriptionだけで、363文字、約91トークンです。SKILL.md全体は3,426文字で、使用時にのみ読み込まれます。
これらの数値には注意点があります。Claude CodeはMCPツール検索をデフォルトで有効にしており、セッション開始時に読み込むのはツール名とサーバーの指示だけです。そのため、Claude Codeでは25個のツールで開始時点から7,895トークンを消費するわけではありません(Claude Code MCPドキュメント)。他のホストについては、それぞれのドキュメントを確認してください。CodexとAntigravityには、どちらもツールの許可リスト(enabled_tools、enabledTools)があります。
25個のツールを3個に絞ると、定義は31,581文字から3,314文字に減ります。MCPの仕様では、readOnlyHintとdestructiveHintはクライアントへのヒントとして扱われ、セキュリティを保証するものではありません(MCP specification: Tools)。ヒントよりも許可リストのほうが確実です。おすすめの構成は、プロセスとレポート形式をスキルに任せ、MCPでは3つのデータツールだけを開放することです。両方を使う場合は、スキルに「他のツールではなくeveryinfra_call_apiを使う」と書いておきます。
レポート1件あたりのコスト
API側の料金は、カタログのprice_usdから算出しました。2026年10月26日に読み取ったカタログでは、g2/reviews、capterra/reviews、trustpilot/reviews、amazon/reviewsはいずれも1回の呼び出しあたり$0.001389です。どのエンドポイントにも行単位の課金を示すマークは付いていません。1回の呼び出しで返るレビューは最大max_limit件で、G2、Capterra、Amazonは100件、Trustpilotは200件です(EveryInfraカタログ)。競合3社を3サイトで調べるソフトウェアレポートは9回の呼び出しで、9 × $0.001389 = $0.012501です。
請求額はちょうど$0.012501で、差額はゼロでした。このレポートでは967件のレビューを読み込んでおり、1,000件あたり約$0.0129です。モバイルバッテリー3製品のハードウェアレポートは、Amazonへの呼び出し3回とTrustpilotへの呼び出し2回で、439件のレビューに対して5 × $0.001389 = $0.006945です。タイムアウト、空の結果、429レスポンスは課金されないため、リトライしても請求額は増えません。
| 項目 | 単価 | 呼び出し回数 | 金額 | 備考 |
|---|---|---|---|---|
| ソフトウェアレポート(G2 + Capterra + Trustpilot) | 1回の呼び出しあたり$0.001389 | 9 | $0.012501 | レビュー967件。 |
| ハードウェアレポート(Amazon + Trustpilot) | 1回の呼び出しあたり$0.001389 | 5 | $0.006945 | レビュー439件。 |
| ソフトウェアレポートを1年間毎週作成 | 1回の呼び出しあたり$0.001389 | 468 | $0.650052 | 毎週同じ9回の呼び出し。 |
| この記事のために実際に行ったすべての呼び出し | — | 31リクエスト、うち23件が課金 | $0.032794 | 1回のamazon/search呼び出し($0.002236)を含みます。 |
AI製品側は、呼び出しごとの料金ではなくサブスクリプションです。以下の公開価格は2026年10月26日に確認したものです。Claude Proは月額$20、年払いなら月額$17で、Claude Codeが含まれます(Claudeの料金)。ChatGPT Plusは月額$20です(OpenAI Help)。Plusでは、CodexをCLI、IDE拡張機能、Webで使えます(Codexの料金)。Google AI Proは月額$19.99で、Antigravityのエントリーレベルの利用枠が含まれます(Google AIプラン)。
これらのプランと比べれば、APIの費用はわずかです。実質的なコストは、モデルが967件のレビューを読むために消費するプランの利用枠です。レビュー1件あたりの消費量を公開しているベンダーはなく、私たちも計測していないため、数値は示しません。
スクリプトのバグ:「finalizing」は完了ではない
スキルのスクリプトは最初の本番実行でバグが見つかり、その教訓は独立したセクションにする価値があります。17:48(SGT)に、fetch_reviews.pyはAsanaのG2リクエストを非同期モードで送信し、ジョブをポーリングしました。スクリプトは、runningやqueued以外の最初のステータスを終了とみなしていました。306秒の時点でfinalizingを読み取り、0件と書き込んで停止しました。17:55(SGT)に、同じジョブを手動で確認しました。
ステータスはsucceededで、51件(レビュー50件とサマリー行1件)がすべてそろっていました。修正方法は、succeeded、failed、canceled、expiredだけを最終状態とみなし、それ以外のステータスでは待機を続けることです。この種のバグはスキルの中に潜みやすいものです。モデルは「0件」を見ると、ためらわずに「G2に新しいレビューなし」と書いてしまいます。そのため、スキルの手順2では、件数を確認してレポートに0と書くこと、そして0を「レビューなし」と解釈しないことを指示しています。
レスポンスにはエラーと課金のルールが明記されているので、スクリプトはそれを読むだけで済みます。
- 429:
error.codeはrate_limitedで、retry_after(秒)と「Nothing was charged」が返ります。待ってからリトライします。 - 503タイムアウト:
error.codeはtimeoutで、billing.chargedはfalseです。"mode":"async"に切り替えるか、limitを下げます。 - 空の結果:
countは0で、refund.statusはsucceededです。課金分は自動的に返金されます。 - 非同期:202で
job_idとpoll_urlが返ります。課金は送信時に発生します。最終ステータスになるまでGET /api/v1/jobs/{job_id}をポーリングします。
このスキルにできないことと注意点
スキルにできないこと、または注意が必要なことは次のとおりです。GeminiアプリとClaude Skills APIでは、スキルのスクリプトがネットワークにアクセスできないため、データはコネクタかMCPで取得する必要があります。Claude Codeのクラウドセッションとクラウドのスケジュールタスクは、ローカルの~/.claude/skills/を読み込みません。claude.aiアカウントでスキルを有効にするか、リポジトリにコミットしてください。Claude Skills APIでは、nameに「claude」や「anthropic」を含めることはできません。
このスキルの名前は問題ありませんが、claude-review-helperという名前のスキルはアップロードに失敗します。Amazonから取得できるのは商品ページに表示される注目のレビューだけなので、そこから「低評価レビューの割合」を算出しないでください。Trustpilotでは、ソース別に分けずに企業を比較しないでください。キーワードリストは言語ごと・カテゴリごとに1つずつ作成し、カバー率をレポートに記載してください。
法律やプラットフォームの規約については、データの手法のみを説明し、法的助言は行いません。米国連邦取引委員会(FTC)は2024年8月14日に最終規則を発表しました。この規則は、偽のレビュー、購入したレビュー、好意的なレビューを条件とする報酬を禁止しています(FTCプレスリリース、16 CFR Part 465)。この規則は、企業がレビューをどのように集めるかに関するものです。
競合分析のために公開レビューを読むのは、これとは別の行為です。それでも、レポートにはレビュー投稿者の名前を載せず、引用は1〜2行にとどめてください。スキルのRulesにもそう書かれています。
業界の動向
- 2026年9月29日、OpenAI DevDay:ChatGPTとCodexに機能を提供する共通の方法がプラグインになりました。1つのプラグインにスキルとMCPサーバーをまとめて含めることができ、申請プロセスでは審査状況も追跡できるようになりました(DevDay 2026 community recap、OpenAI DevDay recap)。影響:このスキルとEveryInfraのMCPサーバーを1つのプラグインとして配布できます。Web版のChatGPTにもインストールできます(ChatGPT Skills & Plugins)。
- 2026年9月30日、Google:Gemsがスキルに置き換わる。Geminiアプリへの展開は10月13日に始まりました。個人アカウントのGemsは11月17日に読み取り専用になり、12月17日には利用できなくなります(Workspace Updates、Gemini Help)。影響:競合のまとめにGemsを使っている場合は、12月17日までに指示とファイルをエクスポートしてください。Geminiアプリのスキル内では、引き続きデータ取得を実行できません。
- 2026年10月19日〜10月23日、Claude Codeの3件のリリース。バージョン2.1.304(2026年10月19日)では、コンパクション後にスキル一覧を再送信するようになり、
/reload-skillsは新規または変更されたスキルだけを送信するようになりました。バージョン2.1.309(2026年10月22日)では、--add-dirで指定したフォルダ内にある同名スキルの問題が修正され、各スキルは<folder>:<name>として実行されるようになりました。バージョン2.1.310(2026年10月23日)では、Monitorツールの対応プラットフォームが拡大しました(Claude Code changelog)。影響:多数のレポートを実行する長時間のセッションでも、コンパクション後にスキルが認識されなくなることはなくなりました。 - 2026年10月14日、ChatGPTアカウントでログインしたCodexでGPT-5.5が提供終了となり、代わりにGPT-6.1 Solなどのモデルが使えるようになりました(Codex pricing)。影響:スキルの手順は変わりませんが、ステップ4のスポットチェックはやり直してください。同じキーワードルールでも、新しいモデルでは別の引用が選ばれることがあります。
- 2026年9月25日、GoogleがAntigravity CLIのスキルに関するCodelabを公開。
.agents/skillsを使い、npx skills addでサードパーティのスキルをインストールします(Google Codelabs、vercel-labs/skills)。影響:.agents/skillsはツール間で共通のプロジェクトフォルダになりつつあるため、新しいスキルはまずそこに置いてください。
これらの結果が当てはまらない場合
サンプル数が少ないため、まず調査上の制約を示します。各テーマの割合は、各サイトの全レビューではなく最新の20〜200件から算出しており、来週には数値が変わります。「自発的に投稿されたレビューの星評価は1.9〜3.0低い」という結果は、5社を対象にした1回の分析に基づいています。Asanaには比較対象となる招待レビュー群がないため、この範囲には含めていません。キーワードルールv1.1は、テーマごとに5件のレビューで抜き取り確認を行いました。
「support」という単語は「supports multiple views」のような機能の説明文にも一致しますが、この誤差は測定していません。4つの製品のフォルダパスと動作は、各ベンダーの公式ドキュメント(2026年10月26日に確認)に基づいています。CodexとAntigravityのMCP設定は設定例であり、実際には実行していません。手元の環境では、スキルのスクリプト、仕様バリデーター、EveryInfra APIをテストしました。競合がG2、Capterra、Trustpilot、Amazonに掲載されていない場合は、google_play/reviews、app_store/reviews、yelp/reviewsなど、対応するカタログの機能に置き換えてください。
FAQ
「skill.md must start with yaml frontmatter (---)」とはどういう意味ですか? 出典:Googleオートコンプリート「skill.md must start with yaml frontmatter (---)」、2026年10月26日に確認。SKILL.mdの1行目は---でなければなりません。Claude Codeのドキュメントによると、フロントマターが読み込まれるのは、開始の---が1行目にある場合だけです。それ以外の場合は、ファイル全体が本文として扱われます。YAMLを解析できない場合でもスキルは読み込まれますが、フィールドは一切読み込まれません(Claude Code skills docs)。skills-refのagentskills validateを実行すれば、早い段階で検出できます。
Codexのスキルの配置場所はどこですか? 出典:Googleオートコンプリート「codex skills location」「codex skills folder」。リポジトリでは、作業フォルダからリポジトリのルートまでにある.agents/skillsを使います。ユーザー単位では$HOME/.agents/skills、マシン全体では/etc/codex/skillsを使います。Codexはシンボリックリンクをたどります(Codex Build skills)。
Claude Codeのスキルでトークン使用量を減らすには? 出典:Googleオートコンプリート「claude code skills to reduce token usage」。セッション開始時にスキルが追加するのは名前と説明文だけで、このスキルの場合は363文字です。本文は使用時にのみ読み込まれます。説明文は短くし、主な用途を最初に書いてください。あまり使わないスキルには、skillOverridesで"name-only"を設定してください(Claude Code skills docs)。長い参考資料は本文ではなくreferences/に置いてください。
「skill.md description cannot contain xml tags」というエラーはどう直せばよいですか? 出典:Googleのオートコンプリート「skill.md description cannot contain xml tags」。このチェックはClaude Skills APIとclaude.aiへのアップロード時に行われます。nameとdescriptionのどちらにもXMLタグは使えず、nameには「claude」や「anthropic」も含められません(Claude Skills APIガイド)。説明文中の<...>は普通の言葉に置き換えてください。
Geminiアプリのエージェントスキルから外部APIを呼び出せますか? 出典:Googleオートコンプリート「agent skills claude」「gemini skills」、およびGeminiヘルプの記載。現時点ではできません。ヘルプセンターには、インターネット接続が必要なスクリプトはサポートされていないと記載されています。スクリプトから外部のWebサイトにリクエストを送ることはできません(Gemini Help)。データの取得にはGeminiの連携アプリを使い、スキルには手順とフォーマットだけを記述してください。
GitHubからClaude Codeのスキルをインストールしても安全ですか? 出典:Googleのオートコンプリート「claude code skills github」と「claude code skills marketplace」。スキルにはスクリプトを含められるため、インストール前にSKILL.mdとscripts/を読んでください。Gemini CLIはスキルのインストール時にセキュリティの確認を表示します(Gemini CLIのエージェントスキルに関するドキュメント)。AnthropicとOpenAIによるスキルの例は、anthropics/skills と openai/skills にあります。OpenAIは評価(evals)を使ったスキルのテスト方法も解説しています(Testing Agent Skills Systematically with Evals)。
関連記事
- レビュー関連のAPIを試す:Trustpilot API、Trustpilotのレビュー、G2 API、G2のレビュー、Capterraのレビュー、Amazonのレビュー。
- MCPで接続:EveryInfra MCPサーバー。最初のリクエストはクイックスタート、価格は料金をご覧ください。
- 関連記事:G2とTrustpilotで見る競合30社のレビュー。
- 関連記事:レビューデータを有料プロダクトにする方法。
- 関連記事:Webの変更監視を販売する方法。
参考文献
- Extend Claude with skills、Anthropic(Claude Codeのドキュメント)、2026-10-26閲覧、https://code.claude.com/docs/en/skills
- Agent Skills Specification、agentskills.io、2026-10-26閲覧、https://agentskills.io/specification
- skills-refリファレンスバリデーター、agentskills(GitHub)、0.1.1、2026-10-26実行、https://github.com/agentskills/agentskills/tree/main/skills-ref
- Build skills、OpenAI(Codexドキュメント)、2026-10-26閲覧、https://developers.openai.com/codex/build-skills
- Model Context Protocol、OpenAI(Codexドキュメント)、2026-10-26閲覧、https://developers.openai.com/codex/mcp
- Agent skills、Google Antigravityドキュメント、2026-10-26閲覧、https://antigravity.google/docs/skills/
- Migration - Antigravity CLI、Google Antigravityドキュメント、2026-10-26閲覧、https://antigravity.google/docs/cli/gcli-migration
- MCP、Google Antigravityドキュメント、2026-10-26閲覧、https://antigravity.google/docs/mcp
- Agent Skills、Gemini CLIドキュメント、2026-10-26閲覧、https://geminicli.com/docs/cli/skills/
- Introducing skills in the Gemini app and Workspace, plus what's next for Gems、Google Workspace Updates、2026-09-30公開、https://workspaceupdates.googleblog.com/2026/09/skills-gemini-app-workspace.html
- GeminiアプリとWorkspaceにおけるスキル提供開始に関する最新情報、Google Workspace Updates、2026-10-13、https://workspaceupdates.googleblog.com/2026/10/an-update-on-launch-of-skills-in-gemini-app-and-workspace.html
- 特に繰り返しの多い作業はGeminiのスキルに任せましょう、Googleブログ、2026-09-30、https://blog.google/products-and-platforms/products/gemini/automate-tasks-with-skills/
- Create & manage skills for Gemini Apps、Geminiヘルプ、2026-10-27閲覧、https://support.google.com/gemini/answer/17094296
- About the transition from Gems to skills、Geminiヘルプ、2026-10-27閲覧、https://support.google.com/gemini?p=gems_to_skills
- Using Agent Skills with the API、Anthropic(Claudeドキュメント)、2026-10-26閲覧、https://docs.claude.com/en/api/skills-guide
- Connect Claude Code to tools via MCP、Anthropic(Claude Codeドキュメント)、2026-10-26閲覧、https://code.claude.com/docs/en/mcp
- Claude Code変更履歴、Anthropic、バージョン2.1.304〜2.1.310(2026-10-19〜2026-10-23)、https://code.claude.com/docs/en/changelog
- Agent Skillsでエージェントを現実世界の業務に対応させる、Anthropic、2025-10-16、https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
- EveryInfraデータカタログ(GET /api/v1/social/catalog)、EveryInfra、2026-10-26 17:25 SGT閲覧、https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra MCP(tools/list、tools/call)、EveryInfra、2026-10-26 17:25および17:46(SGT)に呼び出し、https://api.everyinfra.com/mcp
- monday AI Work Platform製品ページ、Capterra、2026-10-26閲覧(スクリプトからのアクセスは403を返すため、ブラウザエンジンで閲覧)、https://www.capterra.com/p/147657/monday-com/
- Trustpilotの招待方法、Trustpilotヘルプセンター、2026-10-26閲覧、https://help.trustpilot.com/s/article/Trustpilot-invitation-methods?language=en_US
- ClickUp Reviews、Trustpilot、2026-10-26閲覧(スクリプトからのアクセスは403を返すため、ブラウザエンジンで閲覧)、https://www.trustpilot.com/review/clickup.com
- Guidelines for Businesses、Trustpilot、2026-10-26閲覧、https://corporate.trustpilot.com/legal/for-businesses/guidelines-for-businesses
- Asana Reviews、G2、2026-10-26閲覧(スクリプトからのアクセスは403を返すため、ブラウザエンジンで閲覧)、https://www.g2.com/products/asana/reviews
- ツール、Model Context Protocol仕様(2025-06-18版)、2026-10-26閲覧、https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- プランと料金、Claude、2026-10-26閲覧、https://claude.com/pricing
- What is ChatGPT Plus?、OpenAIヘルプセンター、2026-10-26閲覧、https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus
- Pricing、OpenAI(Codexドキュメント)、2026-10-26閲覧、https://developers.openai.com/codex/pricing
- Google AI Pro & Ultra、Google、2026-10-26閲覧、https://gemini.google/subscriptions/
- AIエージェントスキルの使い方(Antigravity CLI編)、Google Codelabs、2026-09-25、https://codelabs.developers.google.com/antigravity/how-to-create-agent-skills-for-antigravity-cli
- Antigravityのエージェントスキルは実際どう設定するのか?、Reddit r/google_antigravity、2026-10-26閲覧、https://www.reddit.com/r/google_antigravity/comments/1qvrxxx/how_do_you_actually_set_up_antigravity_agent/
- Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials、FTC、2024-08-14、https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- 16 CFR Part 465(消費者レビューおよび推薦文の使用に関する規則)、eCFR、2026-10-26閲覧、https://www.ecfr.gov/current/title-16/chapter-I/subchapter-D/part-465
- カスタムサブエージェントの作成、Anthropic(Claude Codeドキュメント)、2026-10-26閲覧、https://code.claude.com/docs/en/sub-agents
- DevDay 2026の発表と開発者向けリソース、OpenAI Developer Community、2026-09-29、https://community.openai.com/t/devday-2026-announcements-and-developer-resources/1402006
- DevDay 2026 Recap、OpenAI、2026-09-29、https://openai.com/index/devday-2026-recap/
- Skills & Plugins、ChatGPT Learn、2026-10-26閲覧、https://learn.chatgpt.com/docs/skills-and-plugins
- vercel-labs/skills、GitHub、2026-10-26閲覧、https://github.com/vercel-labs/skills
- anthropics/skills、GitHub、2026-10-26閲覧、https://github.com/anthropics/skills
- openai/skills、GitHub、2026-10-26閲覧、https://github.com/openai/skills
- Evalsによるエージェントスキルの体系的なテスト、OpenAIデベロッパーブログ、2026-01-22、https://developers.openai.com/blog/eval-skills
- Holded reviews(スペイン語版サイト)、Trustpilot、2026-10-26閲覧、https://es.trustpilot.com/review/holded.com
参考資料 BL-54