SKILL.md 하나로 AI 도구 4개에서 쓰는 경쟁사 리뷰 스킬 만들기
Claude Code, Codex, Antigravity CLI, Gemini에서 쓰는 경쟁사 리뷰 SKILL.md 하나를 각 공식 문서와 대조해 확인했습니다. 실제 API 호출 9회로 리뷰 967개를 $0.0125에 읽었습니다.
"경쟁사 리뷰 분석" SKILL.md를 하나 작성하고, frontmatter는 Agent Skills 사양 범위 안에서만 구성했습니다. 각 제품의 공식 문서에 따르면 이 파일은 수정 없이 Claude Code, Codex, Antigravity CLI에서 그대로 로드됩니다. 저희 머신에서는 스킬 스크립트, 사양 검증 도구, 데이터 API를 실행했고, Codex와 Antigravity는 설치하지 않았습니다. Gemini 앱은 이 파일을 가져올 수는 있지만 스킬 스크립트가 인터넷에 접속할 수 없어서 데이터를 가져오지 못합니다.
2026년 10월 26일 17:25~17:55(SGT)에 이 스킬로 프로젝트 관리 도구 3개에 대한 보고서 하나를 만들었습니다. G2, Capterra, Trustpilot에 9회 호출해 리뷰 967개를 읽었고, API 요금은 $0.012501이었습니다. 가장 큰 위험은 도구가 아니라 데이터에 있었습니다. Trustpilot에서 5개 회사의 자발적 리뷰는 평균 별점이 1.29~2.77점이었고, 초대 리뷰는 4.07~4.89점이었습니다.


결론부터: SKILL.md 하나, 폴더 4곳, 호출 9회분 비용
이 글은 실무적인 질문 하나에 답합니다. 여러분은 지금 Claude Code 스킬을 쓰고 있고, 팀원들은 Codex나 Antigravity CLI를 씁니다. 팀 전체가 경쟁사 리뷰 분석용 SKILL.md 하나를 공유할 수 있을까요? 첫 API 호출 전에 통과 기준 세 가지를 정해 두었습니다.
첫째, frontmatter가 필드 하나하나까지 Agent Skills 사양을 통과해야 합니다. 둘째, 폴더 경로와 스킬 호출 방법은 각 제품의 공식 문서에 근거해야 합니다. 셋째, API 요금이 카탈로그 가격 × 호출 수와 오차 없이 일치해야 합니다. 세 가지 모두 통과했습니다. 다만 한 제품은 절반만 통과했습니다.
아래 표에서 네 제품을 나란히 비교합니다. 모든 칸은 2026년 10월 26일에 확인한 각 업체의 공식 문서에서 가져왔습니다. 링크는 아래 각 섹션에 있습니다. 마지막 열은 스킬 자체 스크립트가 api.everyinfra.com에 접속할 수 있는지 한 가지만 확인합니다. 접속할 수 없으면 이 스킬은 제 역할을 할 수 없습니다.
| 제품 | 프로젝트 폴더 | 개인 폴더 | 호출 방법 | 스크립트의 데이터 가져오기 가능 여부 |
|---|---|---|---|---|
| Claude Code | .claude/skills/<name>/SKILL.md | ~/.claude/skills/<name>/SKILL.md | /name 또는 Claude가 설명을 보고 선택 | 로컬 세션에서는 가능, Cowork나 클라우드 세션에서는 불가. |
| Codex(CLI, IDE, 데스크톱) | .agents/skills, 작업 폴더부터 저장소 루트까지 | $HOME/.agents/skills | $name, /skills 또는 Codex가 선택 | 가능. |
| Antigravity CLI | .agents/skills/ | ~/.gemini/antigravity-cli/skills/ | /skills로 목록 보기 또는 에이전트가 선택 | 가능. |
| Gemini 앱 | 사용 안 함(스킬 페이지에서 업로드) | 사용 안 함 | / 또는 @와 스킬 이름 | 불가: 인터넷이 필요한 스크립트는 지원되지 않음. |
첫 번째 행과 세 번째 행에는 중요한 차이가 하나 있습니다. Claude Code는 프로젝트용으로 .claude/skills를 씁니다. Codex, Antigravity CLI, 지원이 종료된 Gemini CLI는 모두 .agents/skills를 읽습니다. 따라서 이 도구들을 모두 지원하는 저장소라면 스킬을 .agents/skills/competitor-review-analysis/에 두고 .claude/skills/ 아래에 이를 가리키는 심볼릭 링크를 추가하면 됩니다. Claude Code 문서에 따르면 스킬 폴더는 심볼릭 링크여도 되고, Codex 문서에 따르면 Codex는 심볼릭 링크로 연결된 스킬 폴더를 따라갑니다(Claude Code 스킬 문서; Codex Build skills).
에이전트 스킬이란 무엇인가: 필드 6개로 이루어진 SKILL.md
Agent Skills는 개방형 형식입니다. 스킬은 최소 하나의 SKILL.md 파일을 담은 폴더입니다. 파일은 YAML frontmatter로 시작하고, 그 뒤에 Markdown으로 작성한 단계가 이어집니다(Agent Skills 사양). 사양에는 필드 6개가 정의되어 있으며, 그중 name과 description 2개가 필수입니다.
나머지 4개인 license, compatibility, metadata, allowed-tools는 선택입니다. name은 소문자, 숫자, 하이픈으로 된 1~64자여야 합니다. 하이픈으로 시작하거나 끝날 수 없고, 하이픈을 연속으로 두 개 쓸 수 없으며, 폴더 이름과 같아야 합니다. description은 1~1,024자이며 스킬이 하는 일과 사용할 시점을 설명해야 합니다. 사양은 allowed-tools를 실험적 기능으로 표시하므로 에이전트마다 지원 여부가 다릅니다.
이 형식은 3단계로 된 "점진적 공개(progressive disclosure)"로 컨텍스트를 절약합니다. 세션이 시작되면 에이전트는 각 스킬의 name과 description만 로드하며, 사양의 추정치로는 약 100토큰입니다. 작업이 설명과 일치하면 에이전트가 전체 SKILL.md를 읽습니다. 사양은 5,000토큰 미만, 500줄 미만을 권장합니다. scripts/와 references/의 파일은 단계에서 필요할 때만 로드됩니다(Agent Skills 사양). Anthropic도 2025년 10월 16일에 같은 개념을 설명했습니다. 에이전트에게 목차를 먼저 주라는 것입니다(Agent Skills에 대한 Anthropic 글).
저희 스킬의 name과 description은 합쳐서 363자입니다. 토큰당 약 4자로 계산하면 약 91토큰으로, 사양의 추정치와 비슷합니다. 전체 SKILL.md는 51줄, 3,426자로 500줄 한도보다 훨씬 짧습니다. 이 두 숫자는 아래 컨텍스트 섹션에서 다시 다룹니다.
경쟁사 리뷰 SKILL.md 전문 공개
전체 파일은 다음과 같습니다. 스킬 폴더에는 스크립트 2개와 키워드 목록 1개도 들어 있습니다. scripts/fetch_reviews.py는 EveryInfra 데이터 API를 호출합니다. scripts/classify.py는 키워드 규칙으로 각 리뷰에 주제 태그를 붙입니다. references/themes.md에는 키워드가 들어 있습니다.
---
name: competitor-review-analysis
description: Pull public reviews for 2-5 competing products from G2, Capterra, Trustpilot or Amazon through the EveryInfra data API, tag each review with a theme, and write a comparison report with counts, shares and quotes. Use when the user asks to compare competitor reviews, find what customers complain about, or build a review-based battlecard.
license: MIT
compatibility: Needs network access to api.everyinfra.com, Python 3.9+, and an EVERYINFRA_API_KEY environment variable. Does not run inside the Gemini app, where skill scripts cannot reach the internet.
metadata:
  version: "1.1"
  author: everyinfra-blog-example
---

# Competitor review analysis

## Inputs to confirm first
1. The products to compare (2-5). For each one, get the exact review page:
   G2 `https://www.g2.com/products/<slug>`, Capterra `https://www.capterra.com/p/<id>/<name>/`,
   Trustpilot domain such as `clickup.com`, Amazon `https://www.amazon.com/dp/<ASIN>`.
   Use the URL, not the product name. Product names change (Capterra lists monday.com as "monday AI Work Platform").
2. The theme set: `saas` or `hardware` (see references/themes.md). Ask if unclear.

## Steps
1. Fetch: run `python3 scripts/fetch_reviews.py --plan plan.json --out raw/`.
   One request per product per source. The script waits 7 s between requests,
   retries 429 with the `retry_after` value, and sends slow requests with `"mode":"async"`.
2. Check counts: read `raw/summary.json`. A source with 0 rows was not charged.
   Do not treat a short page as "no more reviews". Write the counts into the report.
3. Tag: run `python3 scripts/classify.py raw/ --themes saas > tagged.json`.
   The script tags by keyword rules, so the same input gives the same output.
4. Read 5 tagged reviews per theme and check that the tag fits. If a keyword
   matches the wrong words (v1 had `plan`, which matched "planning"), fix
   references/themes.md and run step 3 again. Note each change in the report.
5. Write `report.md` with these sections, in this order:
   - Table: product x source -> reviews read, average rating, charged USD.
   - Table: theme x product -> count and share of reviews that mention it.
   - Top 3 complaints per product, each with one short quote and its review URL.
   - Limits: what the sample cannot show (see below).

## Rules
- Report rating scales as they are: G2 and Capterra 1-5, Trustpilot 1-5 stars, Amazon 1-5 stars.
  Do not average across sources.
- Split Trustpilot by the `source` field: `Organic` (the reviewer came on their own) versus
  invitation sources (`BasicLink`, `InvitationApi`, `FileUploadInvitation`, `Shopify` and others).
  Report the average for each group. Never report one Trustpilot average for a company.
- Theme keywords are per language. For reviews that are not in English, use the matching set
  (for example `saas_es`), or report them as untagged.
- Do not print reviewer names. Quote at most 25 words per review.
- Amazon returns only the reviews shown on the product page (usually 10-15). Say so.
- Cost: every request costs the `price_usd` from `GET /api/v1/social/catalog`. Add up `billing.charged_usd` from the responses; do not estimate.

## Limits to state in every report
- The sample is the newest page of each source, not all reviews.
- Trustpilot reviews of a software company are often about billing and support, not the product. Read them as a separate signal.
몇몇 줄은 오로지 파일 이식성을 위해 들어 있습니다. frontmatter는 사양의 6개 필드 중 5개를 사용합니다. model, context: fork, argument-hint 같은 Claude Code 확장 필드는 쓰지 않습니다. compatibility 줄에는 네트워크 연결과 API 키 요구 사항을 적었습니다.
Gemini 앱에 이 파일을 가져온 사람은 Gemini 앱에서는 실행할 수 없다는 것을 바로 알 수 있습니다. 스크립트 경로는 스킬 루트 기준 상대 경로이고, 파일 참조는 사양의 권고대로 한 단계 깊이까지만 둡니다(Agent Skills 사양). "Trustpilot은 출처별로 나누기"와 "언어별 키워드" 두 규칙은 실제 데이터를 가져온 뒤에야 추가했습니다. 이유는 다음 섹션에서 설명합니다.
파일을 눈으로만 확인하지 않았습니다. 17:56(SGT)에 사양 저장소의 참조 검증 도구 skills-ref 0.1.1(agentskills/skills-ref)로 샘플 3개를 검사했습니다. 원본 파일은 Valid skill을 반환했습니다. context: fork와 model: haiku를 추가한 사본은 "Unexpected fields in frontmatter: context, model"을 반환했습니다.
name: Review_Skill로 바꾼 사본은 이름은 소문자여야 하며 잘못된 문자가 포함되어 있다는 오류 2개를 반환했습니다. 이 결과는 Claude Code 문서와 일치합니다. 로컬 Claude Code에서는 문서 표에 있는 모든 필드가 동작합니다. 하지만 claude.ai 업로드, Skills API, package_skill.py는 사양의 6개 필드만 허용하며, 필드가 하나라도 더 있으면 바로 오류가 납니다(Claude Code 스킬 문서).
| 샘플 | 변경 사항 | skills-ref 0.1.1 결과 | 이식 가능 여부 |
|---|---|---|---|
| 원본 | 없음 | Valid skill | 가능. |
| 실패 사례 1 | context: fork 및 model: haiku 추가 | 오류: 예상치 못한 필드 context, model | 로컬 Claude Code에서는 동작, claude.ai 업로드는 실패. |
| 실패 사례 2 | name: Review_Skill | 오류: 소문자여야 함, 잘못된 문자 포함 | 불가. |
진입점 5곳, frontmatter 규칙도 5가지
파일 하나를 여러 곳에 두기 전에 각 진입점이 무엇을 허용하는지 확인하세요. 표에는 각 업체의 공식 문서에 명시된 규칙만 넣었습니다. 문서에 언급이 없는 경우에는 "문서에 없음"으로 표시했습니다.
| 진입점 | `name` | `description` | 스펙 외 필드 | 기타 제한 |
|---|---|---|---|---|
| Agent Skills 사양 | 필수; 1–64자; 소문자, 숫자, 하이픈; 폴더 이름과 동일 | 필수; 1–1,024자 | 사양에 포함되지 않음 | 본문 500줄 미만 권장. |
| Claude Code, 로컬 | 선택, 기본값은 폴더 이름 | 권장; 1,536자까지 표시 | model, context, hooks | 알 수 없는 필드는 무시. |
| claude.ai 업로드 및 Skills API | 필수; 64자 이하; "claude" 또는 XML 사용 불가 | 필수; 1,024자 이하 | 추가 필드는 오류 | 30 MB 미만; 네트워크 사용 불가. |
| Codex | 필수 | 필수 | UI와 의존성은 agents/openai.yaml에서 설정 | 첫 목록은 컨텍스트의 2% 또는 8,000자 사용 |
| 진입점 | `name` | `description` | 스펙 외 필드 | 기타 제한 |
|---|---|---|---|---|
| Antigravity | 선택, 기본값은 폴더 이름 | 필수 | 문서에 없음 | 문서에 없음 |
| Gemini 앱 | 모두 소문자, 단어는 하이픈으로 구분 | 길이는 문서에 없음 | 문서에 없음 | 총 100 MB, 스크립트는 인터넷 접속 불가 |
이 표를 보면 스펙 필드만 사용하는 이유를 알 수 있습니다. 스펙은 모든 진입점의 공통 부분집합입니다. 로컬 Claude Code는 가장 관대한 진입점이고, claude.ai 업로드는 가장 엄격합니다. 가장 엄격한 쪽에 맞춰 작성하면 모든 진입점이 파일을 받아들입니다.
description 작성법에 대해서도 각 문서의 의견이 일치합니다. Codex는 스킬이 많이 설치되면 설명부터 줄이므로 핵심 용도와 트리거 단어를 앞에 둡니다(Codex Build skills). Claude Code는 설명을 1,536자에서 자르므로 핵심 사용 사례를 앞에 둡니다(Claude Code skills docs). Google의 첫 번째 팁은 스킬을 언제 사용할지 정의하라는 것입니다(About the transition from Gems to skills).
저희 설명의 첫 문장은 스킬이 무엇을 하는지, 어떤 사이트에서 어떤 API로 데이터를 가져오는지를 말합니다. 두 번째 문장은 어떤 사용자 요청에서 스킬이 실행되어야 하는지를 말합니다. 전체 337자이므로 어느 진입점에서도 잘리지 않습니다.
Claude Code 스킬: ~/.claude/skills 또는 .claude/skills
Claude Code는 다섯 곳에서 스킬을 읽습니다. 엔터프라이즈(관리형 설정 폴더의 .claude/skills/), 개인(~/.claude/skills/<name>/SKILL.md), 프로젝트(.claude/skills/<name>/SKILL.md), 중첩 폴더, 그리고 --add-dir로 추가한 폴더입니다. 이름이 겹치면 엔터프라이즈가 개인보다, 개인이 프로젝트보다 우선합니다(Claude Code skills docs). 프로젝트 스킬은 커밋할 수 있으므로 모든 팀원이 코드와 함께 받습니다. 개인 스킬은 내 컴퓨터의 모든 저장소에서 작동합니다. 프로젝트 스킬은 시작 폴더부터 저장소 루트까지 거슬러 올라가며 로드되므로, packages/frontend/에서 시작한 세션에서도 루트의 스킬을 볼 수 있습니다.
주간 경쟁사 리포트에서는 세 가지 제한이 중요합니다. 첫째, Cowork 세션과 클라우드 세션(클라우드 예약 작업 포함)은 내 컴퓨터의 ~/.claude/skills/를 읽지 않습니다. 이 세션들은 claude.ai 계정에서 켠 스킬만 로드합니다. 스킬이 로컬 폴더에만 있으면 클라우드 예약 작업은 스킬을 찾을 수 없다고 보고합니다.
데스크톱 예약 작업은 내 컴퓨터에서 실행되므로 ~/.claude/skills/를 읽습니다(같은 문서의 "Use skills in Cowork and cloud sessions"). 둘째, claude.ai 업로드는 스펙의 6개 필드만 허용합니다. 셋째, 스킬 목록에는 예산이 있습니다. 각 스킬의 description과 when_to_use는 합쳐서 최대 1,536자까지만 표시됩니다.
전체 목록에는 모델 컨텍스트 윈도우의 1%가 할당되며, 가장 적게 쓰인 스킬부터 설명이 빠집니다. 자동 압축(auto-compaction) 후에는 Claude Code가 최근 스킬을 각각 처음 5,000토큰씩, 총 25,000토큰 이내로 다시 붙입니다(같은 문서). 그래서 저희 설명은 337자로 유지하고 핵심 사용 사례를 첫 문장에 둡니다.
Claude Code에는 Claude Code에서만 작동하는 확장 기능도 있습니다. model은 해당 턴의 모델을 바꿉니다. context: fork는 스킬을 분기된 서브에이전트 컨텍스트에서 실행하며, 메인 세션에는 결과만 돌아옵니다(skills docs; subagents docs). allowed-tools는 도구를 미리 승인하고, ! 명령줄은 실시간 데이터를 본문에 주입합니다. 유용한 기능이지만, 이를 사용한 파일은 더 이상 이식성이 없습니다.
저희는 공유 파일을 스펙 범위 안에 둡니다. Claude Code 전용 동작이 필요하면 같은 이름의 두 번째 스킬을 개인 폴더에 둡니다. "개인이 프로젝트보다 우선" 규칙에 따라 Claude Code는 이 스킬을 사용하고, 다른 도구는 계속 스펙 버전을 읽습니다. context: fork를 쓰면 원본 리뷰 967건이 메인 세션에 들어오지 않습니다.
스크립트를 실행하는 대신 모델이 도구를 호출하게 할 수도 있습니다. Claude Code에 EveryInfra 원격 MCP 서버를 추가합니다. 이 명령은 이전 글에서 테스트했으므로 여기서는 설정 예시로 제시합니다:
export EVERYINFRA_API_KEY="<your API key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Claude Code는 MCP 도구 검색을 기본으로 켭니다. 세션 시작 시에는 도구 이름과 서버 지침만 로드하고, 필요할 때 도구 정의를 조회합니다(Claude Code MCP docs). 이 점은 뒤쪽 섹션의 컨텍스트 계산에 영향을 줍니다.
Codex 스킬: .agents/skills와 config.toml
Codex 스킬도 개방형 Agent Skills 표준을 기반으로 하며, SKILL.md에는 name과 description이 있어야 합니다(Codex Build skills). Codex는 네 종류의 위치를 읽습니다. 저장소 수준은 작업 폴더부터 저장소 루트까지 모든 폴더의 .agents/skills입니다. 사용자 수준은 $HOME/.agents/skills, 관리자 수준은 /etc/codex/skills입니다.
시스템 스킬은 Codex에 기본으로 포함되어 있습니다. 두 스킬의 이름이 같아도 Codex는 병합하지 않으며, 둘 다 선택 목록에 나타날 수 있습니다. CLI나 IDE 확장에서는 /skills를 입력하거나 $로 스킬을 멘션합니다. Codex가 설명을 보고 스킬을 직접 고를 수도 있습니다. ChatGPT에서는 @로 스킬을 멘션합니다.
Codex 문서의 두 숫자가 설명 작성 방식에 영향을 줍니다. 기본적으로 첫 스킬 목록은 모델 컨텍스트 윈도우의 최대 2%를 사용하며, 윈도우 크기를 알 수 없으면 8,000자를 사용합니다. skills.max_context_tokens 설정으로 이 예산을 최대 10,000토큰까지 바꿀 수 있습니다. 스킬이 많이 설치되어 있으면 Codex는 먼저 설명을 줄이고, 그다음 일부 스킬을 제외한 뒤 경고를 표시합니다(Codex Build skills). 선택 사항인 agents/openai.yaml 파일로 표시 이름, allow_implicit_invocation 정책, MCP 도구 의존성을 설정합니다. 이 파일은 스킬 폴더에 있고 다른 도구는 이를 무시하므로 스킬의 이식성이 유지됩니다.
Codex에서 EveryInfra 원격 MCP 서버를 연결하려면 ~/.codex/config.toml에 [mcp_servers.<name>] 테이블을 추가합니다(Codex MCP docs). 신뢰할 수 있는 프로젝트에서는 .codex/config.toml을 사용할 수 있습니다. 아래는 설정 예시이며, 로컬 Codex 설치에서 실행해 보지는 않았습니다:
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"
enabled_tools = ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
default_tools_approval_mode = "writes"
tool_timeout_sec = 120
이 중 두 줄은 테스트 데이터를 바탕으로 정했습니다. enabled_tools는 도구를 3개만 남깁니다. 17:25 SGT에 EveryInfra MCP tools/list 호출은 도구 25개를 반환했고, 그중 일부는 키 생성, 키 삭제, 설정 변경, 티켓 생성을 수행합니다. 리뷰 리포트에는 이런 도구가 하나도 필요하지 않습니다. tool_timeout_sec를 120초로 둔 이유는 Codex가 기본적으로 도구 호출당 60초만 기다리기 때문입니다(Codex MCP docs).
17:28과 17:30 SGT의 동기 호출은 각각 87.8초와 88.3초가 걸렸습니다. 기본값이라면 Codex는 API가 응답하기 전에 포기합니다. default_tools_approval_mode = "writes"는 읽기 전용으로 표시되지 않은 도구를 실행하기 전에 확인을 요청합니다. everyinfra_call_api는 호출마다 과금되므로 서버가 읽기 전용으로 표시하지 않으며, Codex는 매번 확인을 요청합니다. 이 비용을 감수한다면 해당 도구 하나에 대해 tools.everyinfra_call_api.approval_mode를 설정합니다.
Antigravity CLI와 Gemini CLI: 폴더 위치가 바뀌었다
Google은 2026년 6월 18일 Gemini CLI를 Antigravity CLI로 대체했습니다. Gemini CLI 문서 사이트의 스킬 페이지 상단에도 이 내용이 나와 있습니다(Gemini CLI Agent Skills docs). 스킬 형식은 같지만 폴더가 다릅니다. Gemini CLI는 사용자용으로 ~/.gemini/skills/, 워크스페이스용으로 .gemini/skills/를 사용했고, .agents/skills/는 두 곳 모두의 별칭이었습니다.
Antigravity CLI는 워크스페이스용으로 .agents/skills/, 전역 스킬용으로 ~/.gemini/antigravity-cli/skills/를 사용합니다(Antigravity CLI migration docs). Antigravity 데스크톱 앱은 또 다른 전역 폴더인 ~/.gemini/config/skills/를 사용합니다(Antigravity skills docs). 폴더별로 사본 하나씩, 총 두 개를 두도록 권장하는 경우는 여기뿐입니다.
Antigravity는 description만 필수입니다. name이 없으면 폴더 이름을 사용합니다(같은 문서). 저희 스킬에는 두 필드가 모두 있으므로 영향이 없습니다. 2026년 9월 25일자 Google Codelab에 최소 단계가 나와 있습니다.
.agents/skills/<name>/SKILL.md를 만들고, agy를 실행하고, /skills로 스킬 목록을 확인한 뒤 질문합니다(Google Codelabs). Reddit에서 한 사용자는 Antigravity 스킬 설정 방법을 물으며 문서 링크가 아니라 폴더 구조를 알고 싶다고 했습니다(r/google_antigravity thread). 위의 표가 바로 그 구조입니다.
Antigravity는 MCP 서버 설정을 settings.json에서 별도의 mcp_config.json으로 옮겼습니다. 전역 파일은 ~/.gemini/config/mcp_config.json, 프로젝트 파일은 .agents/mcp_config.json입니다. 원격 서버의 주소 키는 url 또는 httpUrl에서 serverUrl로 바뀌었습니다(Antigravity CLI migration docs). 도구 허용 목록인 enabledTools도 있습니다.
기본적으로 도구 호출당 3분, 연결에 5분을 기다립니다(Antigravity MCP docs). Codex보다 길기 때문에 88초가 걸리는 저희 호출에서도 타임아웃을 바꿀 필요가 없습니다. 로컬에서 실행하지 않은 설정 예시입니다:
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <your API key>" },
      "enabledTools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
Gemini 스킬: Gems는 11월 17일 읽기 전용으로 바뀌고, 스크립트는 인터넷에 접속할 수 없다
2026년 9월 30일 Google은 스킬이 Gems를 대체한다고 발표했습니다. 스킬은 "개방형 Markdown 네이티브 SKILL.md 표준 위에 전적으로 구축"되었으므로 다른 플랫폼의 스킬을 Gemini 앱으로 복사할 수 있습니다(Google Workspace Updates, 2026-09-30). 10월 13일 업데이트에 따르면 스킬은 그날부터 Gemini 앱에 배포되기 시작했고 11월 중순까지 완료될 예정입니다. Workspace 앱 출시는 추후 공지가 있을 때까지 연기되었습니다(Google Workspace Updates, 2026-10-13).
Google의 두 출처가 Gems 일정을 다르게 안내하므로 계정 유형을 확인해야 합니다. 9월 30일 Workspace 게시물에 따르면 11월 17일 Gems는 설정 패널로 옮겨지며, 사용자는 "계속해서 만들고, 편집하고, 사용할 수 있습니다". 비즈니스 계정에서 Gems가 사라지는 시점은 빨라도 2027년 3월 1일입니다. 개인 계정용 고객센터 페이지는 더 엄격하게 안내합니다. 만 18세 이상의 개인 Google 계정에서는 2026년 11월 17일 Gems가 읽기 전용 스킬로 바뀝니다. 볼 수는 있지만 사용하거나 편집할 수는 없습니다.
2026년 12월 17일에는 Gemini 앱에서 Gems가 제거됩니다(Gemini Help: About the transition from Gems to skills). 따라서 "11월 17일부터 읽기 전용"은 개인 계정에만 해당합니다. Workspace 비즈니스 계정은 2027년 3월, 교육용 계정은 2027년 6월에 전환됩니다. Google 블로그도 고객센터와 같은 내용입니다(Google blog: Let skills in Gemini tackle your most repetitive tasks).
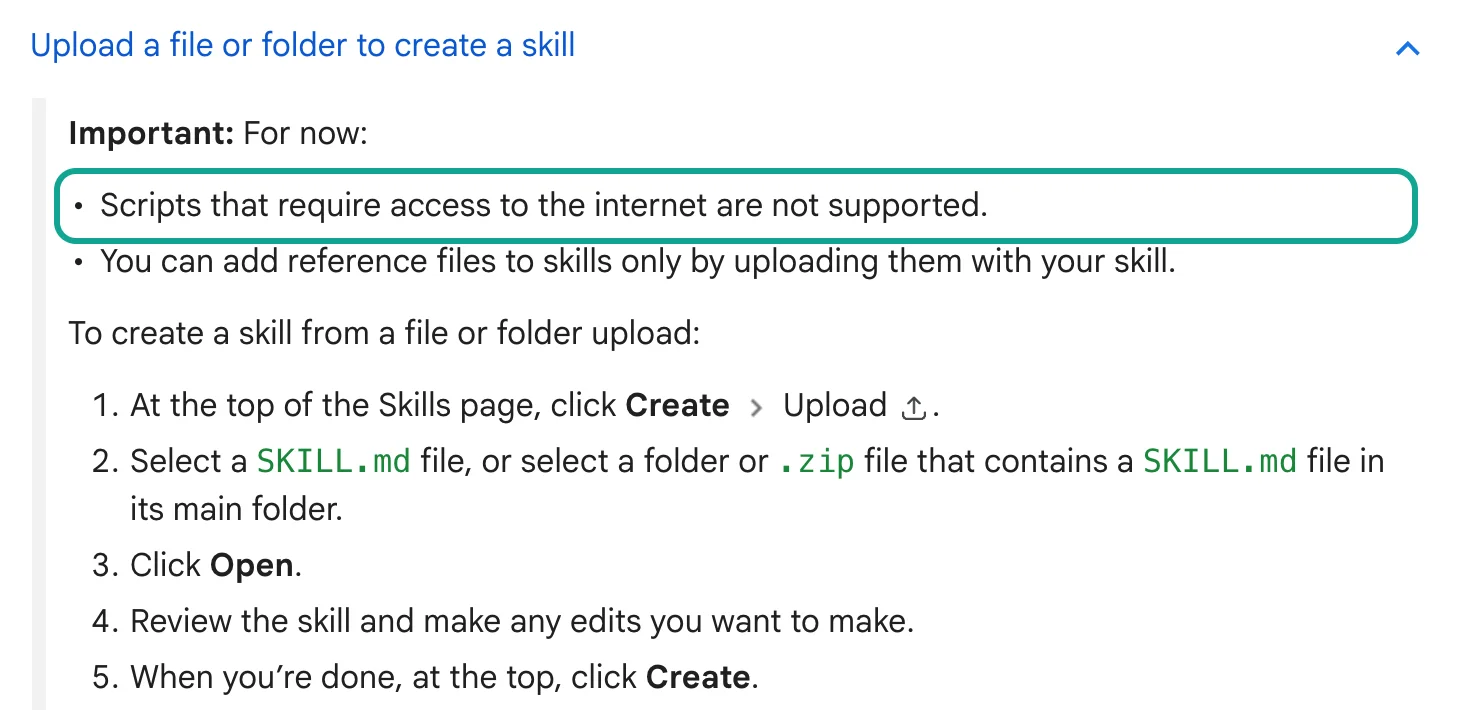
이 스킬이 Gemini 앱에서 작동할 수 있는지는 고객센터의 두 문장으로 결정됩니다. 현재 인터넷 접속이 필요한 스크립트는 지원되지 않습니다. 스크립트는 외부 웹사이트에서 액션이나 요청을 수행할 수 없습니다(Gemini Help: Create & manage skills for Gemini Apps). 같은 페이지에 업로드 규칙도 나와 있습니다.
SKILL.md는 루트 폴더에 있어야 하고, 이름은 소문자와 하이픈으로만 구성해야 하며, 전체 파일 크기는 100 MB 이하여야 합니다. .py, .sh, .md, .json, .csv 같은 일반 텍스트 파일은 허용되지만 .docx와 .xlsx는 허용되지 않습니다. 저희 스킬은 모든 형식 규칙을 충족해 가져오기에 성공하지만, fetch_reviews.py는 그곳에서 데이터를 가져올 수 없습니다.
Gemini만 그런 것은 아닙니다. Claude Skills API는 "네트워크 접근이 없는" 코드 실행 컨테이너에서 스킬을 실행하므로, 스킬은 "외부 API 호출을 할 수 없습니다". 이름 규칙도 하나 더 있습니다. name에는 예약어 "anthropic"이나 "claude", 또는 XML 태그를 넣을 수 없습니다(Claude Skills API guide). 두 곳 모두 "프로세스는 스킬로, 데이터는 커넥터로" 나누는 것이 올바른 방식입니다.
Gemini 앱에서는 연결된 앱이 데이터를 가져옵니다. 웹의 Claude와 API에서는 MCP 커넥터가 데이터를 가져옵니다. 스킬 본문은 모델에게 어떤 단계를 따르고 어떤 리포트를 작성할지만 알려 줍니다. 고객센터에 따르면 스킬은 아직 Canvas나 Deep Research와 함께 작동하지 않습니다(About the transition from Gems to skills).
실제 왕복 한 번: 모델이 보내는 호출과 EveryInfra가 반환하는 데이터
스크립트와 MCP 도구 호출은 EveryInfra 쪽에서 결국 같은 요청이 됩니다. 아래 카드는 17:46:24 SGT의 실제 MCP tools/call입니다. 모델은 everyinfra_call_api를 호출해 최근 3개월간 ClickUp의 별 1개·2개 Trustpilot 리뷰를 최대 50건 요청했습니다. API는 27.8초 만에 리뷰 7건을 반환했고 $0.001389를 과금했습니다.
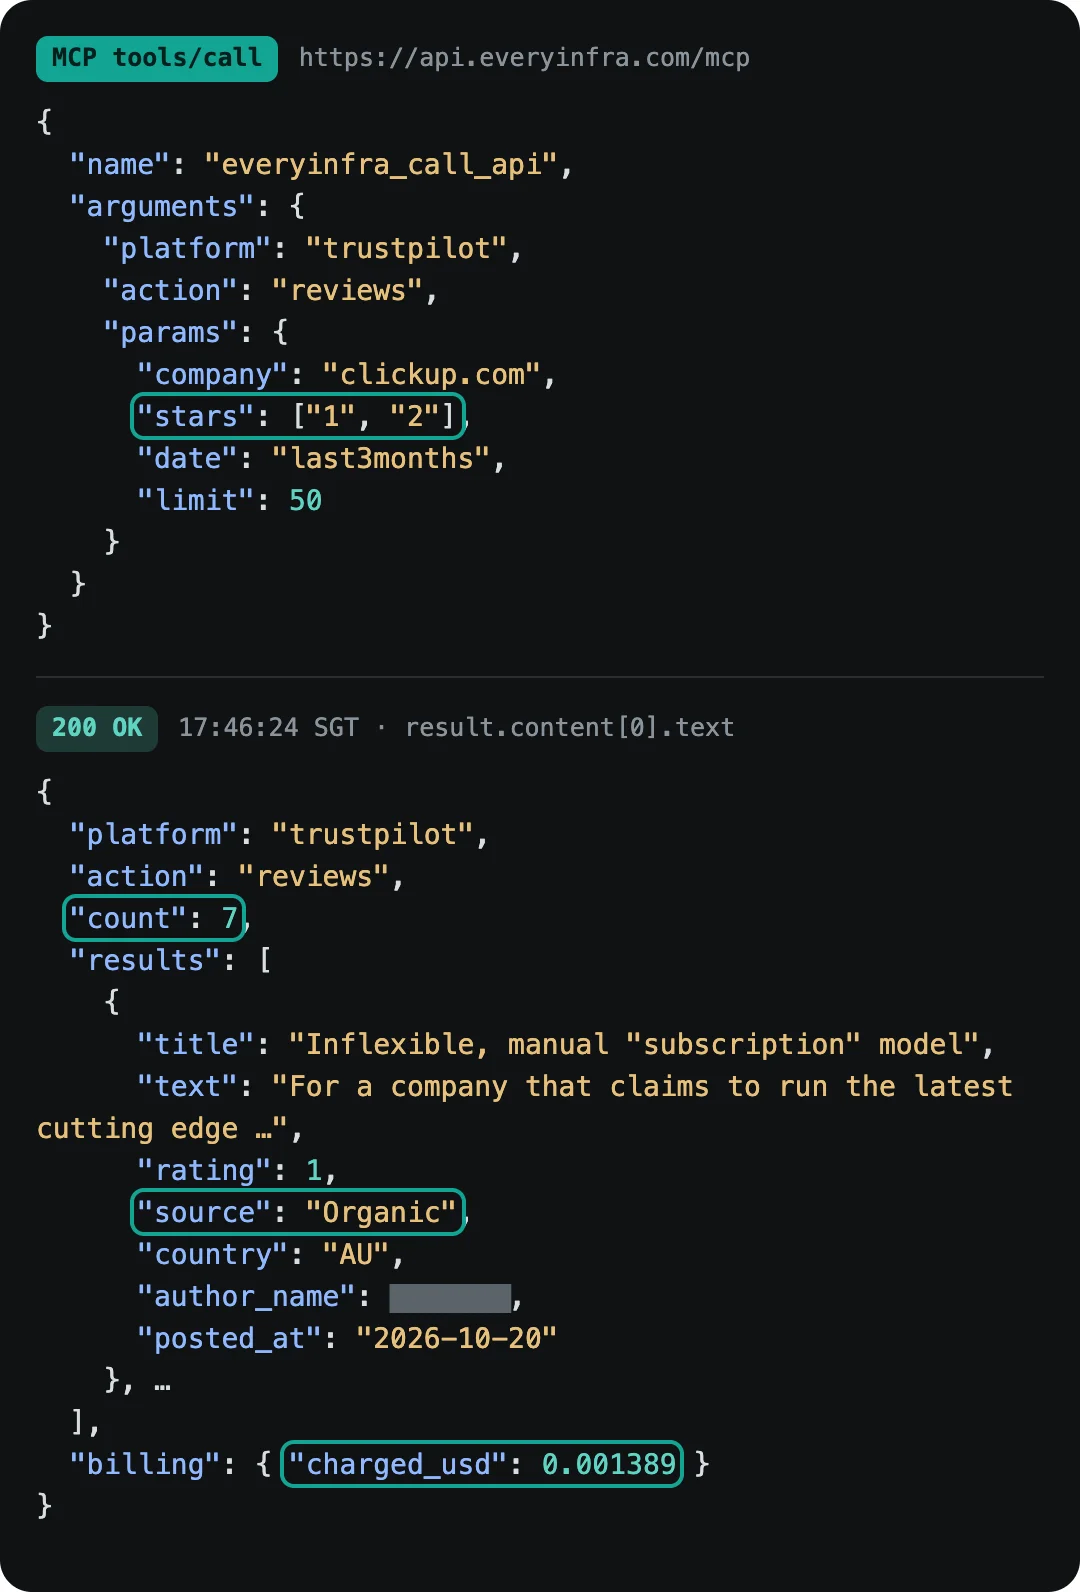
같은 요청을 데이터 API에 curl로 직접 보내면 다음과 같습니다. $EVERYINFRA_API_KEY는 환경 변수에서 가져오며 파일에는 절대 넣지 않습니다:
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"trustpilot","action":"reviews","params":{"company":"clickup.com","stars":["1","2"],"date":"last3months","limit":50}}'
카탈로그에는 trustpilot/reviews의 응답 필드가 24개 있습니다(EveryInfra 카탈로그). 스킬은 아래 필드를 사용합니다. 각 이름과 의미는 카탈로그의 response_fields와 platform_field_meanings에 대조해 확인했습니다.
| 필드 | 의미(카탈로그 기준) | 스킬에서의 용도 |
|---|---|---|
id, url | 리뷰 ID와 링크 | 중복 제거, 인용마다 링크 |
title, text | 제목과 본문 | 키워드 태깅 |
rating, rating_scale | 별점과 척도 | 출처 그룹별 평균 |
source | 리뷰 출처 | 자발적 리뷰와 초대 리뷰 구분 |
| 필드 | 의미(카탈로그 기준) | 스킬에서의 용도 |
|---|---|---|
verification_level | 인증 수준(초대 또는 자발적) | source와 교차 확인 |
language, country | 언어와 국가 | 키워드 세트 선택 |
experience_at, posted_at | 경험 날짜, 게시 날짜 | 기간 필터링 |
| 필드 | 의미(카탈로그 기준) | 스킬에서의 용도 |
|---|---|---|
reply_text | 기업 답변 | 답변율 |
author_name | 리뷰어 표시 이름 | 리포트에 출력하지 않음 |
G2와 Capterra 필드는 B2B 구매 검토에 적합합니다. g2/reviews의 첫 행은 record_type이 summary이며 전체 평점, 리뷰 수, 가장 많이 언급된 장단점을 담고 있습니다. 그 뒤에 개별 리뷰가 이어집니다. capterra/reviews의 각 행에는 pros, cons, 사용 편의성과 지원에 대한 세부 평점, switching_reasons가 있습니다. 카탈로그에는 switching_reasons가 경쟁사 분석에 가장 유용한 필드라고 적혀 있습니다(EveryInfra 카탈로그).
호출 9번: G2, Capterra, Trustpilot, Amazon은 리뷰를 몇 건씩 반환하나
17:25부터 18:31 SGT까지 총 31건의 요청을 보냈습니다. 23건이 과금되었고 8건은 과금되지 않았으며(429 응답 4건, 타임아웃 1건, 빈 결과 3건), 총액은 $0.032794였습니다. 표에는 소프트웨어 리포트에 사용된 요청 11건이 있으며, 비용이 들지 않은 2건도 포함되어 있습니다.
| SGT | 기능 | 대상 | limit | 반환된 리뷰 | 시간 | 과금 |
|---|---|---|---|---|---|---|
| 17:25 | g2/reviews 동기 | Asana | 100 | 20건 + 요약 행 1개 | — | $0.001389. |
| 17:27 | g2/reviews 동기 | monday.com | 100 | 타임아웃, 503 | 90.4 s | $0. |
| 17:28 | g2/reviews 동기 | ClickUp | 100 | 20건 + 요약 행 1개 | 87.8 s | $0.001389. |
| 17:30 | capterra/reviews | Asana, 이름으로 검색 | 100 | 50 | 88.3 s | $0.001389. |
| SGT | 기능 | 대상 | limit | 반환된 리뷰 | 시간 | 과금 |
|---|---|---|---|---|---|---|
| 17:32 | capterra/reviews | "monday.com", 이름으로 검색 | 100 | 0건, 환불됨 | 67.5 s | $0. |
| 17:33 | capterra/reviews | ClickUp, 이름으로 검색 | 100 | 100 | 22.3 s | $0.001389. |
| 17:33 | capterra/reviews | monday.com, 제품 URL로 검색 | 100 | 97 | 47.3 s | $0.001389. |
| 17:34 | g2/reviews 비동기 | monday.com | 100 | 50건 + 요약 행 1개 | 작업 ID 발급까지 2.1초 | $0.001389. |
| SGT | 기능 | 대상 | limit | 반환된 리뷰 | 시간 | 과금 |
|---|---|---|---|---|---|---|
| 17:34 | trustpilot/reviews | asana.com | 200 | 200 | 44.5 s | $0.001389. |
| 17:35 | trustpilot/reviews | monday.com | 200 | 200 | 37.3 s | $0.001389. |
| 17:36 | trustpilot/reviews | clickup.com | 200 | 200 | 42.4 s | $0.001389. |
이 표에서 얻은 세 가지 교훈을 SKILL.md에 반영했습니다. 첫째, Capterra는 "monday.com"이라는 이름으로는 아무것도 찾지 못했습니다. Capterra에서는 현재 이 제품을 "monday AI Work Platform"이라고 부릅니다(Capterra product page). EveryInfra API는 0행을 반환하고 호출 비용을 환불했습니다.
제품 URL로 요청하자 리뷰 97건이 반환되었습니다. 그래서 1단계에서는 이름이 아니라 URL을 요청합니다. 둘째, G2 동기 호출은 85초의 동기 처리 한도에 근접합니다. monday.com 호출은 90.4초에 타임아웃되었고, 응답에는 "Not charged"라는 문구와 함께 "mode":"async"를 쓰라는 제안이 있었습니다.
비동기 모드에서는 2.1초 만에 작업 ID를 받았고, 작업은 리뷰 50건을 반환했습니다. 셋째, 같은 Asana G2 요청이 동기 모드에서는 리뷰 20건을 반환했습니다. 17:48 SGT에 스킬 스크립트가 같은 요청을 비동기 모드로 다시 보내자 50건을 받았고, 앞서 받은 20건이 모두 포함되어 있었습니다. 가격은 같고, 비동기 모드는 2.5배 많은 리뷰를 반환했습니다.
이 리뷰 기능들은 리뷰 단위가 아니라 호출 단위로 과금하므로, 호출당 리뷰 수가 리뷰 1,000건당 비용을 결정합니다. Trustpilot은 호출당 200건을 반환해 1,000건당 약 $0.0069입니다. Capterra는 100건으로 약 $0.0139, G2 비동기는 50건으로 약 $0.0278, G2 동기는 20건으로 약 $0.0695입니다.
Amazon은 제품당 13건으로 약 $0.1068이므로 차이는 약 15배입니다. Amazon의 건수가 적은 것은 결함이 아닙니다. 카탈로그의 amazon/reviews 설명에 따르면 모든 국가 사이트가 제품 페이지의 추천 리뷰만 제공합니다(EveryInfra 카탈로그). 보통 제품당 10~15건이며 전체 이력은 아닙니다. 같은 UGREEN 보조배터리를 17:38과 17:54 SGT에 읽었습니다. 두 번 모두 같은 ID의 리뷰 13건이 반환되었으므로, 이 13건은 무작위 샘플이 아니라 고정된 "추천" 세트입니다.
429 응답도 4건 있었습니다. 17:37:59부터 17:38:50 SGT 사이에 7초 간격으로 호출을 보냈는데, 4건이 거부되었습니다. 각 응답에는 키의 한도인 분당 10건이 명시되어 있었고, retry_after는 1초였으며, "Nothing was charged"라고 적혀 있었습니다. 그 1분 안에 다른 요청이 이미 한도의 일부를 사용한 상태였습니다.
스크립트는 retry_after에 평소 간격을 더한 만큼 기다렸고, 재시도는 모두 성공했습니다. 테스트 키는 분당 10건으로 제한해 두었습니다. 계정 기본 한도는 모든 키에 걸쳐 공유되는 분당 60건이며, 누적 충전액이 늘면 한도도 올라갑니다(요금 페이지). 자신의 키 한도는 콘솔에서 확인할 수 있습니다.
가장 큰 함정: Trustpilot 평균은 출처별로 나눠야 한다
대부분의 경쟁사 비교표는 회사마다 Trustpilot 평균 하나를 제시합니다. 저희 데이터에 따르면 이 숫자는 거의 의미가 없습니다. 17:34부터 17:44 SGT까지 6개 회사의 최신 Trustpilot 리뷰를 200건씩 읽고(Holded는 48건뿐) source 필드로 묶었습니다. Organic은 리뷰어가 스스로 페이지를 찾아왔다는 뜻입니다. BasicLink, InvitationApi, FileUploadInvitation, Shopify는 모두 회사가 초대를 보냈다는 뜻입니다.
| 회사 | 자발적 리뷰 | 자발적 리뷰 평균 | 초대 리뷰 | 초대 리뷰 평균 | 차이 | 혼합 평균 |
|---|---|---|---|---|---|---|
| Asana | 199 | 1.90 | 1 | — | — | 1.90. |
| monday.com | 145 | 1.53 | 55 | 4.51 | 2.98 | 2.35. |
| ClickUp | 37 | 2.51 | 163 | 4.89 | 2.38 | 4.45. |
| Holded | 35 | 2.77 | 13 | 4.69 | 1.92 | 3.29. |
| 회사 | 자발적 리뷰 | 자발적 리뷰 평균 | 초대 리뷰 | 초대 리뷰 평균 | 차이 | 혼합 평균 |
|---|---|---|---|---|---|---|
| Anker | 132 | 2.14 | 68 | 4.62 | 2.48 | 2.98. |
| UGREEN | 21 | 1.29 | 179 | 4.07 | 2.78 | 3.77. |
혼합 평균으로 보면 ClickUp은 별 4.45개, Asana는 1.90개로 ClickUp이 훨씬 나아 보입니다. 그룹을 나누면 두 회사 모두 자발적 리뷰 평균이 각각 2.51과 1.90으로 낮습니다. 차이의 대부분은 초대에서 나옵니다. ClickUp의 최신 리뷰 200건 중 163건이 초대 링크를 통해 들어왔습니다. monday.com도 같은 패턴입니다. 자발적 리뷰 145건의 평균은 별 1.53개, 초대 리뷰 55건의 평균은 4.51개입니다.
하드웨어 브랜드도 다르지 않습니다. UGREEN 리뷰 중 178건은 Shopify 스토어의 자동 초대에서 나왔고, 자발적 리뷰 21건의 평균은 별 1.29개입니다. 저희 해석은 간단합니다. 스스로 찾아오는 사람은 대개 문제가 생겨서 리뷰를 씁니다. 초대를 받은 사람은 대개 구매 직후에 씁니다.
둘을 섞으면 평균은 고객의 생각이 아니라 회사가 초대를 얼마나 많이 보내는지를 측정하게 됩니다. 한계도 있습니다. 각 샘플은 최신 리뷰 200건이며, 포괄하는 기간이 크게 다릅니다. 개별 리뷰의 진위는 판단하지 않았고, 어떤 회사의 초대 관행도 평가하지 않습니다.
"최신 200건"이 포괄하는 기간도 크게 다릅니다. Asana의 200건은 2022년 1월 31일부터 2026년 10월 3일까지로 거의 5년입니다. monday.com은 2024년 12월 15일부터 2026년 10월 24일까지입니다. ClickUp은 2026년 4월 1일부터 2026년 10월 22일까지로 7개월이 채 안 됩니다. UGREEN이 가장 짧아서 2026년 8월 30일부터 데이터를 읽은 당일인 2026년 10월 26일까지입니다.
UGREEN은 두 달이 안 되는 기간에 리뷰 200건을 모았고, 그중 178건이 스토어 초대에서 나왔습니다. 즉 한 샘플은 두 달간의 신규 구매자이고, 다른 샘플은 5년간의 장기 사용자입니다. 리포트에서는 모든 출처를 같은 기간으로 맞추는 것도 필요합니다. 예를 들어 Trustpilot 파라미터 date: "last6months"를 사용할 수 있습니다. 이번에는 전체 그림을 보고 싶었기 때문에 기간을 자르지 않았습니다.
웹사이트만 봐서는 이 구분을 알 수 없습니다. Trustpilot 고객센터에 따르면 모든 회사는 링크를 보내 고객을 무료로 초대할 수 있습니다. 자동 초대(BCC 이메일, 스토어 연동, API)로 작성된 리뷰에는 "Verified" 라벨이 붙습니다. "Basic Link" 초대로 작성된 리뷰에는 "Unprompted review" 라벨이 붙습니다(Trustpilot Help: Trustpilot invitation methods).
ClickUp 페이지를 확인했습니다. 웹사이트에서 "Unprompted review" 라벨이 붙은 별 5개 리뷰가 API에서는 source: BasicLink, verification_level: invited입니다. 같은 페이지에서 같은 라벨이 붙은 별 1개 리뷰는 source: Organic, verification_level: not-verified입니다(Trustpilot: ClickUp reviews). 웹사이트는 둘 다 "Unprompted"로 표시하지만 API는 둘을 구분합니다.
그래서 스킬의 Rules에는 "출처별로 나누고, 평균 하나로 합치지 않는다"라고 적혀 있습니다. Trustpilot의 기업용 가이드라인은 편향 없이 초대할 것을 요구합니다(Trustpilot Guidelines for Businesses). 가이드라인은 회사가 초대하는 방식을 규제할 뿐, 초대받은 리뷰어가 자발적 리뷰어와 다르다는 사실을 바꾸지는 않습니다.
같은 제품, 세 사이트, 서로 다른 불만
주제도 사이트마다 달라집니다. 아래는 Asana의 G2 리뷰 50건(비동기), Capterra 리뷰 50건, Trustpilot 리뷰 200건입니다. 스킬의 키워드 규칙 v1.1로 태깅했으며, 리뷰 하나가 여러 주제에 해당할 수 있습니다.
| 주제 | G2 (50) | Capterra(50건) | Trustpilot(200건) |
|---|---|---|---|
| 요금 및 결제 | 14% | 18% | 43%. |
| 지원 | 12% | 14% | 46%. |
| 학습 곡선 | 26% | 22% | 5%. |
| 사용 편의성 | 30% | 22% | 7%. |
| 주제 | G2 (50) | Capterra(50건) | Trustpilot(200건) |
|---|---|---|---|
| 자동화 | 22% | 38% | 7%. |
| 모바일 | 6% | 2% | 5.5%. |
G2와 Capterra 리뷰어는 대부분 제품을 사용하는 팀원입니다. 이들은 학습 곡선이나 자동화 같은 기능에 대해 씁니다. Trustpilot에서는 Asana 리뷰의 46%가 지원을, 43%가 요금이나 결제를 언급합니다. 대부분 갱신, 환불, 계정 잠금에 관한 내용입니다. monday.com도 비슷해서 Trustpilot에서 요금 35%, 지원 29%입니다.
ClickUp은 예외로, 자동화가 39.5%로 가장 많습니다. 초대받은 활성 사용자로 가득한 페이지와 맞아떨어지는 결과입니다. G2 요약 행에는 G2 자체 수치가 나옵니다. Asana는 리뷰 14,051건에서 별 4.4개이고, "Learning Curve"가 가장 많이 언급된 단점입니다(605회). monday.com은 리뷰 17,294건에서 별 4.7개, ClickUp은 15,159건에서 4.6개입니다(G2: Asana reviews).
그래서 스킬의 Limits 섹션에 이를 분명히 적어 둡니다. 소프트웨어 회사에 대한 Trustpilot 리뷰는 대부분 결제와 지원에 관한 것입니다. 별도의 신호로 읽어야 하며, G2나 Capterra와 합치지 않아야 합니다.
이 수치는 두 번째 버전입니다. 첫 키워드 목록에는 요금 항목에 plan이라는 단어가 있었고 접두사 일치 방식을 사용했습니다. 스킬의 4단계는 주제별로 태깅된 리뷰 5건을 읽으라고 지시합니다. 그렇게 해 보니 Capterra에서 Asana의 요금 비율이 58%로 나왔고, 그중 상당수가 "project planning"에 관한 리뷰였습니다.
Capterra 리뷰 50건의 단어를 세어 보니 planning이 13번 나왔습니다. 모바일 항목의 app 접두사도 appreciate에 6번, approval 또는 approvals에 4번 일치했습니다. 전체 단어 일치 방식으로 바꾸고 plan, app, agent, simple을 뺐습니다. 그러자 Asana의 요금 비율이 Capterra에서 58%에서 18%로, G2에서 30%에서 14%로, Trustpilot에서 48.5%에서 43%로 떨어졌습니다.
여기서 두 가지 교훈을 얻었습니다. 키워드 규칙은 저렴하고 반복 가능하지만, 사람이 표본 검사를 해야 합니다. 4단계는 형식적인 절차가 아닙니다. 첫 실행에서 잘못된 결과가 리포트에 들어가기 전에 바로잡았습니다.
완성된 리포트는 어떤 모습인가
스킬의 5단계가 리포트 레이아웃을 정합니다. 아래는 이번 실행 데이터로 채운 첫 번째 표로, 사이트별·제품별로 읽은 리뷰 수, 평균 별점, 비용을 보여 줍니다. 세 사이트는 별도 열로 유지하며 전체 평균은 두지 않습니다. Trustpilot 칸에는 Rules에 따라 혼합 평균과 자발적·초대 그룹을 함께 표시합니다.
| 제품 | G2: 리뷰 수 / 평균 | Capterra: 리뷰 수 / 평균 | Trustpilot: 리뷰 수 / 혼합(자발적 / 초대) | API 비용 |
|---|---|---|---|---|
| Asana | 50 / 4.38 | 50 / 4.76 | 200 / 1.90 (1.90 / 리뷰 1건뿐) | $0.004167. |
| monday.com | 50 / 4.64 | 97 / 4.57 | 200 / 2.35 (1.53 / 4.51) | $0.004167. |
| ClickUp | 20 / 4.22 | 100 / 4.60 | 200 / 4.45 (2.51 / 4.89) | $0.004167. |
리포트의 세 번째 부분에는 제품별 상위 불만 3가지를 짧은 인용과 링크와 함께 나열합니다. 최근 자발적 별 1개·2개 Trustpilot 리뷰의 제목을 가져왔습니다. 제목은 리뷰어가 쓴 한 줄이며, 리뷰어 이름은 나오지 않습니다. Asana의 경우 2026년 10월 3일의 "Ruthless company", 10월 1일의 "Forever free doesn't mean forever free", 그리고 해지 정책을 "sneaky"라고 표현한 9월 28일 리뷰입니다.
monday.com은 2026년 10월 24일, 10월 22일, 10월 21일의 리뷰 3건이며, 그중 두 제목에 "customer service"가 들어 있습니다. ClickUp은 사용자 시트를 줄이려면 30일 전에 통보해야 한다는 내용의 2026년 10월 20일 리뷰 "Inflexible, manual 'subscription' model"입니다. 10월 5일 리뷰는 결제 후 계정이 잠긴 일을 설명합니다. 이 제목들은 주제 표와 일치합니다. Trustpilot에서 세 회사 모두 기능이 아니라 결제와 지원에 대한 불만이 가장 많습니다.
리포트의 마지막 부분에는 한계를 나열합니다. 샘플은 각 사이트의 최신 리뷰 묶음입니다. Asana는 Trustpilot에 비교할 초대 그룹이 없습니다. 키워드 목록 v1.1은 주제당 리뷰 5건으로만 표본 검사했습니다.
숫자는 모델에게 맡기지 않았습니다. 표의 모든 숫자는 스크립트가 API 응답에서 계산했습니다. 모델은 두 가지 일을 했습니다. 4단계에서 샘플을 읽어 키워드 오류를 찾았고, 5단계에서 표와 인용을 배치했습니다. 첫 번째 일은 모델에게 변경 사항을 하나하나 리포트에 기록하게 해야만 제대로 작동합니다. 두 번째 일은 거의 틀리지 않습니다.
매주 실행하기: 예약 실행을 어디에 둘 수 있나
경쟁사 리뷰는 매주 월요일 한 번이 자연스러운 주기입니다. 각 제품에서 네트워크 접근이 가능한 상태로 이 스킬을 예약 실행할 수 있는 곳은 다음과 같습니다. Claude Code 데스크톱 예약 작업은 내 컴퓨터에서 실행되며 ~/.claude/skills/를 읽습니다. 클라우드 예약 작업은 매번 새 클라우드 세션을 시작하며, 로컬 폴더는 읽지 않습니다. claude.ai 계정에서 활성화한 스킬이나 저장소의 .claude/skills/에 있는 스킬만 사용합니다(Claude Code skills docs).
2026년 9월 29일 DevDay에서 OpenAI는 노트북을 닫아도 작업을 실행하는 Codex Cloud를 출시했습니다(DevDay 2026 community recap). Codex 문서에는 클라우드 작업이 저장소의 .agents/skills를 읽는지 명확히 나와 있지 않습니다. 직접 테스트하지 않았으므로 결론은 내리지 않습니다. Gemini 앱에는 선택한 스킬로 작업을 실행할 수 있는 예약 기능이 있습니다(Create & manage skills for Gemini Apps). 하지만 앞서 설명했듯이 그곳의 스킬 스크립트는 인터넷에 접속할 수 없습니다.
연간 비용을 계산하면 다음과 같습니다. 호출 9번짜리 소프트웨어 리포트를 매주 한 번 만들면 연간 468번 호출, API 비용 $0.650052입니다. 호출 5번짜리 하드웨어 리포트를 매주 추가하면 호출 260번과 $0.36114가 더해집니다. 테스트에서 가장 느린 동기 호출은 88초가 걸렸습니다. 7초 간격과 G2 비동기 작업에 걸리는 약 5분을 합쳐도 호출 9번짜리 리포트 하나는 10분 안에 끝납니다.
분당 10건 한도의 키로 충분합니다. 같은 키를 다른 작업에도 쓴다면 429가 발생하는 것을 정상적인 상황으로 보고 재시도하면 됩니다. 2026년 10월 23일 출시된 Claude Code 2.1.310은 Monitor 도구를 더 많은 배포 유형으로 확대했습니다. 대기하는 스크립트 대신 이 도구로 오래 걸리는 비동기 작업을 지켜볼 수 있습니다(Claude Code changelog).
키워드 태깅이 놓치는 곳: 영어 외 리뷰와 하드웨어 리뷰
키워드는 언어에 좌우됩니다. lang: "es"로 monday.com의 스페인어 Trustpilot 리뷰를 요청했습니다. 요청 한도를 200으로 설정하자 리뷰 81건이 반환되었고, 가장 최신 리뷰는 2023년 12월 28일 것이었습니다. 영어 키워드로는 81건 중 80건에 주제가 붙지 않았습니다. 스킬의 스페인어 목록 saas_es를 쓰자 태그 없는 리뷰가 45건으로 줄었습니다.
ClickUp은 스페인어 리뷰가 10건뿐입니다. 스페인 회계 도구인 Holded는 Capterra에 리뷰가 100건 있고, 그중 약 76건이 스페인어로 보입니다. 영어 규칙으로는 74건이, 스페인어 규칙으로는 21건이 태그 없이 남았습니다. Holded는 Trustpilot에서도 수집 범위의 공백을 보여 줍니다.
17:44 SGT에 lang 없이 보낸 호출은 리뷰 48건을 반환했고 모두 en으로 표시되었습니다. 18:29와 18:30 SGT에 lang: "es"와 language: "es"로 보낸 호출은 둘 다 0행을 반환하고 환불되었습니다. 스페인 Trustpilot 사이트에는 Holded 리뷰가 2,444건 있습니다(Trustpilot Spain: Holded). 따라서 이번 실행에서는 Holded의 스페인어 리뷰를 가져오지 못했고, 리포트에 "Trustpilot 샘플: 영어 리뷰 48건만 포함"이라고 명시해야 합니다.
하드웨어 리뷰는 다른 방식으로 실패합니다. 20,000 mAh 보조배터리 3종(Anker, UGREEN, INIU)에 대해 Amazon US는 각각 추천 리뷰 13건을 반환했고, 평균은 별 4.92, 4.92, 4.62개였습니다. 두 브랜드의 Trustpilot 자발적 리뷰 평균인 2.14와 1.29보다 훨씬 높은데, Amazon의 추천 리뷰가 도움이 되는 긍정적인 리뷰 쪽으로 기울기 때문입니다. Trustpilot에서는 Anker 리뷰의 26%가 기기가 고장 나거나 작동을 멈추는 등의 내구성 문제를 언급합니다. Amazon의 13건에는 이런 내용이 전혀 없습니다.
하드웨어 키워드 목록은 Trustpilot 리뷰도 제대로 다루지 못합니다. Anker 200건 중 101건, UGREEN 200건 중 127건에 주제가 붙지 않았습니다. 대부분 배송, 반품, 지원에 관한 내용인데, 하드웨어 목록에는 이런 항목이 없습니다. 숫자를 좋아 보이게 하려고 목록을 고치지는 않았습니다. 리포트에는 태그 없는 리뷰 수를 명시합니다.
컨텍스트 계산: MCP 도구는 31,581자, 스킬은 363자
스킬과 MCP를 자주 비교하지만, 둘은 컨텍스트를 서로 다르게 사용합니다. 17:25 SGT에 EveryInfra MCP tools/list를 읽었습니다. 도구 정의 25개는 총 31,581자로, 토큰당 4자 기준 약 7,895토큰입니다. 11개 도구는 읽기 전용, 5개는 파괴적(destructive) 도구로 표시되어 있습니다.
이 스킬에 필요한 도구 3개인 everyinfra_list_capabilities, everyinfra_call_api, everyinfra_get_job은 합계 3,314자입니다. 세션 시작 시 스킬이 추가하는 것은 name과 description뿐으로 363자, 약 91토큰입니다. 전체 SKILL.md는 3,426자이며 사용할 때만 로드됩니다.
이 수치에는 한계가 있습니다. Claude Code는 MCP 도구 검색을 기본으로 켜고, 세션 시작 시 도구 이름과 서버 지침만 로드합니다. 따라서 Claude Code에서는 도구 25개가 처음부터 7,895토큰을 차지하지 않습니다(Claude Code MCP docs). 다른 호스트는 해당 문서를 확인해야 합니다. Codex와 Antigravity에는 둘 다 도구 허용 목록(enabled_tools, enabledTools)이 있습니다.
도구를 25개에서 3개로 줄이면 정의는 31,581자에서 3,314자로 줄어듭니다. MCP 스펙은 readOnlyHint와 destructiveHint를 보안 보장이 아니라 클라이언트에 대한 힌트로 취급합니다(MCP specification: Tools). 힌트보다 허용 목록이 더 믿을 만합니다. 저희는 프로세스와 리포트 형식은 스킬이 맡고, MCP에서는 데이터 도구 3개만 여는 방식을 권장합니다. 둘을 함께 쓸 때는 스킬에 "다른 도구가 아니라 everyinfra_call_api를 사용한다"라고 적어야 합니다.
리포트 한 번에 드는 비용
API 비용은 카탈로그의 price_usd로 계산했습니다. 2026년 10월 26일에 읽은 카탈로그에서 g2/reviews, capterra/reviews, trustpilot/reviews, amazon/reviews는 각각 호출당 $0.001389입니다. 행 단위 과금 표시가 있는 기능은 없습니다. 호출 한 번은 최대 max_limit건의 리뷰를 반환하며, G2, Capterra, Amazon은 100건, Trustpilot은 200건입니다(EveryInfra 카탈로그). 경쟁사 3곳을 3개 사이트에서 분석하는 소프트웨어 리포트는 호출 9번입니다: 9 × $0.001389 = $0.012501.
실제 과금액은 정확히 $0.012501로 차이가 없었습니다. 리포트는 리뷰 967건을 읽었으며, 1,000건당 약 $0.0129입니다. 보조배터리 3종에 대한 하드웨어 리포트는 Amazon 호출 3번과 Trustpilot 호출 2번으로 5 × $0.001389 = $0.006945이며, 리뷰 439건을 얻습니다. 타임아웃, 빈 결과, 429 응답은 비용이 들지 않으므로 재시도해도 청구액이 늘지 않습니다.
| 항목 | 단가 | 호출 수 | 금액 | 비고 |
|---|---|---|---|---|
| 소프트웨어 리포트(G2 + Capterra + Trustpilot) | 호출당 $0.001389 | 9 | $0.012501 | 리뷰 967건 |
| 하드웨어 리포트(Amazon + Trustpilot) | 호출당 $0.001389 | 5 | $0.006945 | 리뷰 439건 |
| 1년간 매주 소프트웨어 리포트 | 호출당 $0.001389 | 468 | $0.650052 | 매주 동일한 9건의 호출. |
| 이 글에서 실행한 실제 호출 전체 | — | 요청 31건, 과금 23건 | $0.032794 | amazon/search 호출 1건($0.002236) 포함. |
AI 제품은 호출당 요금이 아니라 구독제입니다. 아래 공개 가격은 2026년 10월 26일에 확인했습니다. Claude Pro는 월 $20, 연간 결제 시 월 $17이며 Claude Code가 포함됩니다(Claude pricing). ChatGPT Plus는 월 $20입니다(OpenAI Help). Plus에서는 Codex를 CLI, IDE 확장 프로그램, 웹에서 사용할 수 있습니다(Codex pricing). Google AI Pro는 월 $19.99이며 기본 수준의 Antigravity 이용이 포함됩니다(Google AI plans).
이런 요금제에 비하면 API 요금은 미미한 수준입니다. 실제 비용은 모델이 리뷰 967건을 읽는 데 쓰는 요금제 사용량입니다. 이 사용량을 리뷰당 수치로 공개하는 업체는 없고 저희도 측정하지 않았으므로, 수치는 제시하지 않습니다.
스크립트 버그: "finalizing"은 완료 상태가 아니다
스킬 스크립트는 첫 실제 실행에서 버그를 드러냈고, 여기서 얻은 교훈은 별도 섹션으로 다룰 만합니다. 17:48 SGT에 fetch_reviews.py는 Asana G2 요청을 비동기 모드로 보내고 작업을 폴링했습니다. 스크립트는 running이나 queued가 아닌 상태가 처음 나타나자 작업이 끝난 것으로 처리했습니다. 306초 시점에 finalizing을 읽고 0행을 기록한 뒤 멈췄습니다. 17:55 SGT에 같은 작업을 직접 확인했습니다.
상태는 succeeded였고, 51행(리뷰 50건과 요약 행 1개)이 모두 들어 있었습니다. 해결 방법은 succeeded, failed, canceled, expired만 최종 상태로 보고, 그 밖의 상태에서는 계속 기다리는 것입니다. 이런 버그는 스킬 안에 숨어 있기 쉽습니다. 모델은 "0행"을 보면 별다른 의심 없이 "G2에 새 리뷰 없음"이라고 씁니다. 그래서 스킬의 2단계에서는 건수를 확인하고, 보고서에 0을 기록하되, 0을 "리뷰 없음"으로 해석하지 말라고 지시합니다.
응답에 오류와 과금 규칙이 명확히 표시되므로, 스크립트는 이를 읽기만 하면 됩니다:
- 429:
error.code는rate_limited이며,retry_after(초 단위)와 "Nothing was charged"가 함께 반환됩니다. 기다린 뒤 재시도합니다. - 503 타임아웃:
error.code는timeout이고billing.charged는 false입니다."mode":"async"로 전환하거나limit을 낮춥니다. - 빈 결과:
count가 0이고refund.status가succeeded입니다. 과금액은 자동으로 환불됩니다. - 비동기: 202 응답으로
job_id와poll_url이 반환됩니다. 과금은 제출 시점에 이루어집니다. 최종 상태가 될 때까지GET /api/v1/jobs/{job_id}를 폴링합니다.
이 스킬이 할 수 없는 것과 주의할 점
이 스킬이 할 수 없거나 주의해서 해야 하는 일은 다음과 같습니다. Gemini 앱과 Claude Skills API에서는 스킬 스크립트가 네트워크에 접근할 수 없으므로, 커넥터나 MCP 서버가 데이터를 가져와야 합니다. Claude Code 클라우드 세션과 클라우드 예약 작업은 로컬 ~/.claude/skills/를 읽지 않습니다. claude.ai 계정에서 스킬을 활성화하거나 저장소에 커밋하세요. Claude Skills API에서는 name에 "claude"나 "anthropic"을 넣을 수 없습니다.
저희 스킬 이름은 문제없지만, claude-review-helper라는 이름의 스킬은 업로드에 실패합니다. Amazon은 상품 페이지에서 추천 리뷰만 제공하므로, 이를 근거로 "부정 리뷰 비율"을 계산하지 마세요. 리뷰 출처를 구분하지 않은 채 Trustpilot에서 기업을 비교하지 마세요. 키워드 목록은 언어별, 카테고리별로 하나씩 작성하고, 보고서에 커버리지를 기록하세요.
법률과 플랫폼 규칙에 관해서는 데이터 처리 방법만 설명하며, 법률 자문은 제공하지 않습니다. 미국 연방거래위원회(FTC)는 2024년 8월 14일 최종 규칙을 발표했습니다. 이 규칙은 가짜 리뷰, 구매한 리뷰, 긍정적인 리뷰를 조건으로 한 보상을 금지합니다(FTC press release; 16 CFR Part 465). 이 규칙은 기업이 리뷰를 확보하는 방식에 관한 것입니다.
경쟁사 분석을 위해 공개 리뷰를 읽는 것은 이와 다른 활동입니다. 그래도 보고서에는 리뷰 작성자 이름을 넣지 말고, 인용은 한두 줄로 제한하세요. 스킬의 Rules에 이미 그렇게 명시되어 있습니다.
업계 소식
- 2026년 9월 29일, OpenAI DevDay: 플러그인이 ChatGPT와 Codex에 작업을 배포하는 공통 방식이 되었습니다. 플러그인 하나에 스킬과 MCP 서버를 함께 담을 수 있고, 제출 절차에 심사 진행 상황 추적 기능이 추가되었습니다(DevDay 2026 community recap; OpenAI DevDay recap). 시사점: 이 스킬과 EveryInfra MCP 서버를 하나의 플러그인으로 배포할 수 있습니다. 웹 버전 ChatGPT에도 설치됩니다(ChatGPT Skills & Plugins).
- 2026년 9월 30일, Google: 스킬이 Gems를 대체. Gemini 앱 출시는 10월 13일에 시작되었습니다. 개인 계정의 Gems는 11월 17일에 읽기 전용으로 바뀌고 12월 17일에 사라집니다(Workspace Updates; Gemini Help). 시사점: 경쟁사 요약에 Gems를 사용하고 있다면 12월 17일 전에 지침과 파일을 내보내세요. Gemini 앱 스킬 안에서는 여전히 데이터를 가져올 수 없습니다.
- 2026년 10월 19일~10월 23일, Claude Code 릴리스 3건. 버전 2.1.304(2026년 10월 19일)는 컴팩션 후 스킬 목록을 다시 전송하며,
/reload-skills는 이제 새로 추가되거나 변경된 스킬만 전송합니다. 버전 2.1.309(2026년 10월 22일)는--add-dir폴더에 있는 같은 이름의 스킬 문제를 수정했으며, 이제 해당 스킬은<folder>:<name>형식으로 실행됩니다. 버전 2.1.310(2026년 10월 23일)은 Monitor 도구를 더 많은 플랫폼으로 확대했습니다(Claude Code changelog). 시사점: 많은 보고서를 실행하는 긴 세션에서도 컴팩션 후 스킬이 더 이상 누락되지 않습니다. - 2026년 10월 14일, ChatGPT로 로그인한 Codex에서 GPT-5.5 지원 종료. 대신 GPT-6.1 Sol 등의 모델이 제공됩니다(Codex pricing). 시사점: 스킬 단계는 그대로지만, 4단계의 표본 점검은 다시 수행하세요. 키워드 규칙이 같아도 새 모델은 다른 인용문을 고를 수 있습니다.
- 2026년 9월 25일, Google이 Antigravity CLI 스킬 Codelab 공개. 이 Codelab은
.agents/skills를 사용하며npx skills add로 서드파티 스킬을 설치합니다(Google Codelabs; vercel-labs/skills). 시사점:.agents/skills가 도구 간 공통 프로젝트 폴더로 자리 잡고 있으니, 새 스킬은 먼저 이곳에 두세요.
이 결과가 성립하지 않는 경우
표본이 작으므로 한계부터 밝힙니다. 테마별 비중은 전체 리뷰가 아니라 사이트별 최신 리뷰 20~200건에서 산출했으며, 다음 주에는 수치가 달라질 것입니다. "자발적 리뷰의 별점이 1.9~3.0점 낮다"는 결과는 5개 기업을 한 번 확인한 결과입니다. Asana에는 비교할 만한 초대 리뷰 그룹이 없어 이 범위에 포함하지 않았습니다. 키워드 규칙 v1.1은 테마당 리뷰 5건으로 표본 점검했습니다.
"support"라는 단어는 "supports multiple views" 같은 기능 설명에도 매칭되며, 이 오차는 측정하지 않았습니다. 네 제품의 폴더 경로와 동작은 2026년 10월 26일에 확인한 각 업체의 공식 문서를 따릅니다. Codex와 Antigravity의 MCP 설정은 직접 실행해 보지 않은 설정 예시입니다. 저희 환경에서는 스킬 스크립트, 사양 검증기, EveryInfra API를 테스트했습니다. 경쟁사가 G2, Capterra, Trustpilot, Amazon에 없다면 google_play/reviews, app_store/reviews, yelp/reviews처럼 해당하는 카탈로그 기능으로 바꾸세요.
FAQ
"skill.md must start with yaml frontmatter (---)"는 무슨 뜻인가요? 출처: Google 자동완성 "skill.md must start with yaml frontmatter (---)", 2026년 10월 26일 확인. SKILL.md의 첫 줄은 반드시 ---여야 합니다. Claude Code 문서에 따르면 여는 ---가 첫 줄에 있을 때만 프런트매터를 읽습니다. 그렇지 않으면 파일 전체가 본문으로 처리됩니다. YAML 파싱에 실패해도 스킬은 로드되지만 필드는 하나도 없습니다(Claude Code skills docs). skills-ref의 agentskills validate를 실행하면 이 문제를 미리 잡을 수 있습니다.
Codex 스킬 위치는 어디인가요? 출처: Google 자동완성 "codex skills location", "codex skills folder". 저장소에서는 작업 폴더부터 저장소 루트까지의 .agents/skills를 사용합니다. 사용자 단위로는 $HOME/.agents/skills, 머신 전체에는 /etc/codex/skills를 사용합니다. Codex는 심볼릭 링크를 따라갑니다(Codex Build skills).
Claude Code 스킬은 어떻게 토큰 사용량을 줄이나요? 출처: Google 자동완성 "claude code skills to reduce token usage". 세션 시작 시 스킬은 이름과 설명만 추가하며, 이 스킬의 경우 363자입니다. 본문은 사용할 때만 로드됩니다. 설명은 짧게 쓰고 핵심 용도를 맨 앞에 두세요. 자주 쓰지 않는 스킬은 skillOverrides에 "name-only"를 설정하세요(Claude Code skills docs). 긴 참고 자료는 본문이 아니라 references/에 두세요.
"skill.md description cannot contain xml tags" 오류는 어떻게 해결하나요? 출처: Google 자동완성 "skill.md description cannot contain xml tags". Claude Skills API와 claude.ai 업로드에서 이 항목을 검사합니다. name과 description 모두 XML 태그를 포함할 수 없으며, name에는 "claude"나 "anthropic"을 넣을 수 없습니다(Claude Skills API guide). 설명에 있는 <...> 텍스트를 일반 단어로 바꾸세요.
Gemini 앱에서 에이전트 스킬이 외부 API를 호출할 수 있나요? 출처: Google 자동완성 "agent skills claude", "gemini skills" 및 Gemini 고객센터 문서. 현재는 불가능합니다. 고객센터에 따르면 인터넷이 필요한 스크립트는 지원되지 않습니다. 스크립트는 외부 웹사이트로 요청을 보낼 수 없습니다(Gemini Help). 데이터는 Gemini의 연결된 앱으로 가져오고, 스킬에는 단계와 형식만 두세요.
GitHub에서 Claude Code 스킬을 설치해도 안전한가요? 출처: Google 자동완성 "claude code skills github", "claude code skills marketplace". 스킬에는 스크립트가 포함될 수 있으므로 설치 전에 SKILL.md와 scripts/를 읽어 보세요. Gemini CLI는 스킬을 설치할 때 보안 확인 메시지를 표시합니다(Gemini CLI Agent Skills docs). Anthropic과 OpenAI의 예제 스킬은 anthropics/skills와 openai/skills에 있습니다. OpenAI는 eval로 스킬을 테스트하는 방법도 설명합니다(Testing Agent Skills Systematically with Evals).
더 읽어보기
- 리뷰 API 사용해 보기: Trustpilot API, Trustpilot 리뷰, G2 API, G2 리뷰, Capterra 리뷰, Amazon 리뷰.
- MCP로 연결: EveryInfra MCP 서버. 첫 호출은 빠른 시작을, 가격은 요금을 참고하세요.
- 관련 글: G2와 Trustpilot에서 본 경쟁사 30곳의 리뷰.
- 관련 글: 리뷰 데이터를 유료 상품으로 만드는 방법.
- 관련 글: 웹 변경 모니터링을 판매하는 방법.
참고 자료
- “Extend Claude with skills”, Anthropic(Claude Code 문서), 2026-10-26 열람, https://code.claude.com/docs/en/skills
- “Agent Skills Specification”, agentskills.io, 2026-10-26 열람, https://agentskills.io/specification
- “skills-ref reference validator”, agentskills(GitHub), 0.1.1, 2026-10-26 실행, https://github.com/agentskills/agentskills/tree/main/skills-ref
- “Build skills”, OpenAI(Codex 문서), 2026-10-26 열람, https://developers.openai.com/codex/build-skills
- “Model Context Protocol”, OpenAI(Codex 문서), 2026-10-26 열람, https://developers.openai.com/codex/mcp
- “Agent skills”, Google Antigravity Docs, 2026-10-26 열람, https://antigravity.google/docs/skills/
- “Migration - Antigravity CLI”, Google Antigravity Docs, 2026-10-26 열람, https://antigravity.google/docs/cli/gcli-migration
- “MCP”, Google Antigravity Docs, 2026-10-26 열람, https://antigravity.google/docs/mcp
- “Agent Skills”, Gemini CLI 문서, 2026-10-26 열람, https://geminicli.com/docs/cli/skills/
- “Introducing skills in the Gemini app and Workspace, plus what's next for Gems”, Google Workspace Updates, 2026-09-30, https://workspaceupdates.googleblog.com/2026/09/skills-gemini-app-workspace.html
- “An update on the launch of skills in the Gemini app and Workspace”, Google Workspace Updates, 2026-10-13, https://workspaceupdates.googleblog.com/2026/10/an-update-on-launch-of-skills-in-gemini-app-and-workspace.html
- “Let skills in Gemini tackle your most repetitive tasks”, Google 블로그, 2026-09-30, https://blog.google/products-and-platforms/products/gemini/automate-tasks-with-skills/
- “Create & manage skills for Gemini Apps”, Gemini 고객센터, 2026-10-27 열람, https://support.google.com/gemini/answer/17094296
- “About the transition from Gems to skills”, Gemini 고객센터, 2026-10-27 열람, https://support.google.com/gemini?p=gems_to_skills
- “Using Agent Skills with the API”, Anthropic(Claude 문서), 2026-10-26 열람, https://docs.claude.com/en/api/skills-guide
- “Connect Claude Code to tools via MCP”, Anthropic(Claude Code 문서), 2026-10-26 열람, https://code.claude.com/docs/en/mcp
- “Claude Code changelog”, Anthropic, 버전 2.1.304~2.1.310(2026-10-19~2026-10-23), https://code.claude.com/docs/en/changelog
- “Equipping agents for the real world with Agent Skills”, Anthropic, 2025-10-16, https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
- EveryInfra 데이터 카탈로그 GET /api/v1/social/catalog, EveryInfra, 2026-10-26 17:25 SGT 열람, https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra MCP(tools/list, tools/call), EveryInfra, 2026-10-26 17:25 및 17:46 SGT 호출, https://api.everyinfra.com/mcp
- “monday AI Work Platform” 제품 페이지, Capterra, 2026-10-26 열람(스크립트 접근 시 403 반환, 브라우저 엔진으로 열람), https://www.capterra.com/p/147657/monday-com/
- “Trustpilot invitation methods”, Trustpilot 고객센터, 2026-10-26 열람, https://help.trustpilot.com/s/article/Trustpilot-invitation-methods?language=en_US
- “ClickUp Reviews”, Trustpilot, 2026-10-26 열람(스크립트 접근 시 403 반환, 브라우저 엔진으로 열람), https://www.trustpilot.com/review/clickup.com
- “Guidelines for Businesses”, Trustpilot, 2026-10-26 열람, https://corporate.trustpilot.com/legal/for-businesses/guidelines-for-businesses
- “Asana Reviews”, G2, 2026-10-26 열람(스크립트 접근 시 403 반환, 브라우저 엔진으로 열람), https://www.g2.com/products/asana/reviews
- “Tools”, Model Context Protocol 사양 2025-06-18, 2026-10-26 열람, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- “Plans & pricing”, Claude, 2026-10-26 열람, https://claude.com/pricing
- “What is ChatGPT Plus?”, OpenAI 고객센터, 2026-10-26 열람, https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus
- “Pricing”, OpenAI(Codex 문서), 2026-10-26 열람, https://developers.openai.com/codex/pricing
- “Google AI Pro & Ultra”, Google, 2026-10-26 열람, https://gemini.google/subscriptions/
- “How to use AI Agent Skills (with Antigravity CLI)”, Google Codelabs, 2026-09-25, https://codelabs.developers.google.com/antigravity/how-to-create-agent-skills-for-antigravity-cli
- “How do you actually set up Antigravity agent skills?”, Reddit r/google_antigravity, 2026-10-26 열람, https://www.reddit.com/r/google_antigravity/comments/1qvrxxx/how_do_you_actually_set_up_antigravity_agent/
- “Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials”, FTC, 2024-08-14, https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- “16 CFR Part 465, Rule on the Use of Consumer Reviews and Testimonials”, eCFR, 2026-10-26 열람, https://www.ecfr.gov/current/title-16/chapter-I/subchapter-D/part-465
- “Create custom subagents”, Anthropic(Claude Code 문서), 2026-10-26 열람, https://code.claude.com/docs/en/sub-agents
- “DevDay 2026 announcements and developer resources”, OpenAI Developer Community, 2026-09-29, https://community.openai.com/t/devday-2026-announcements-and-developer-resources/1402006
- “DevDay 2026 Recap”, OpenAI, 2026-09-29, https://openai.com/index/devday-2026-recap/
- “Skills & Plugins”, ChatGPT Learn, 2026-10-26 열람, https://learn.chatgpt.com/docs/skills-and-plugins
- vercel-labs/skills, GitHub, 2026-10-26 열람, https://github.com/vercel-labs/skills
- anthropics/skills, GitHub, 2026-10-26 열람, https://github.com/anthropics/skills
- openai/skills, GitHub, 2026-10-26 열람, https://github.com/openai/skills
- “Testing Agent Skills Systematically with Evals”, OpenAI Developers 블로그, 2026-01-22, https://developers.openai.com/blog/eval-skills
- Holded 리뷰(스페인어 사이트), Trustpilot, 2026-10-26 열람, https://es.trustpilot.com/review/holded.com
참고 BL-54