一份SKILL.md通用四个AI工具:竞品评论实测
同一份SKILL.md放进Claude Code、Codex都能用;9次调用读967条评论花$0.0125,Trustpilot星级要按来源拆开。
同一份「竞品评论分析」SKILL.md,按 Agent Skills 规范校验通过后,按各家官方文档,原样放进 Claude Code、Codex、Antigravity CLI 的技能目录就能被发现(我们本机实跑的是技能脚本、规范校验器和数据接口,没有安装 Codex 和 Antigravity);Gemini 应用能导入它,但技能里的脚本不能联网,取不到数据。2026 年 10 月 26 日 17:25–17:55(新加坡时间)我们用这份技能做了一份 3 家项目管理软件的竞品报告:G2、Capterra、Trustpilot 各 3 次调用,共 9 次,读到 967 条评论,接口费 $0.012501。真正会让结论翻过来的不是工具差异,而是数据本身:Trustpilot 上 5 家公司「自己找上门」的评价平均只有 1.29–2.77 星,经邀请来的是 4.07–4.89 星,不按来源拆开,同一家公司的口碑能差出 3 颗星。


先说结论:一份 SKILL.md、四个目录、一张 9 次调用的账单
这篇文章想回答一个很具体的问题:如果你已经在用 Claude Code,又想让同事在 Codex 或 Antigravity CLI 里跑同一套「竞品评论分析」流程,能不能只写一份 SKILL.md?我们的判据是在任何真调之前写下的:frontmatter 必须通过 Agent Skills 规范的逐条校验;每个产品的目录和调用方式都要在官方文档里找到原文;接口费必须等于目录单价乘以调用次数,差额为 0 才算对上。三条都过了,但有一个产品只过了一半。
下表把四个产品放在一起。表里每一格都来自 2026 年 10 月 26 日读取的官方文档,链接在后面各节逐条给出;「能不能取数」一列指技能自带的脚本能否访问 api.everyinfra.com,这是这份技能能不能干活的关键。
| 产品 | 项目级目录 | 个人级目录 | 怎么调用 | 技能脚本能否联网取数 |
|---|---|---|---|---|
| Claude Code | .claude/skills/<名字>/SKILL.md | ~/.claude/skills/<名字>/SKILL.md | /名字,或模型按描述自动选 | 能(本机会话);Cowork 和云端会话不读本机目录 |
| Codex(CLI、IDE、桌面) | .agents/skills(从当前目录一路找到仓库根) | $HOME/.agents/skills | $名字、/skills,或自动选 | 能 |
| Antigravity CLI | .agents/skills/ | ~/.gemini/antigravity-cli/skills/ | /skills 查看,或自动选 | 能 |
| Gemini 应用 | 不适用(在 Skills 页面上传) | 不适用 | / 或 @ 加技能名 | 不能:帮助中心写明需要联网的脚本不支持 |
第一行和第三行的差别值得多说一句。Claude Code 的项目目录是 .claude/skills,而 Codex、Antigravity CLI 和已经停止服务的 Gemini CLI 都认 .agents/skills。所以一个仓库里要同时服务这几个工具,最省事的做法是把技能放在 .agents/skills/competitor-review-analysis/,再在 .claude/skills/ 下放一个指向它的符号链接;Claude Code 的文档明确写了技能目录可以是符号链接,Codex 的文档也写了会跟随符号链接扫描(Claude Code 技能文档;Codex Build skills)。
Agent Skills 是什么:SKILL.md 只有 6 个字段
Agent Skills 是一个开放格式:一个技能就是一个文件夹,里面至少有一个 SKILL.md,开头是 YAML frontmatter,后面是 Markdown 写的步骤(Agent Skills 规范)。规范只定义了 6 个字段:必填的 name 和 description,可选的 license、compatibility、metadata、allowed-tools。name 必须是 1–64 个字符,只能有小写字母、数字和连字符,不能以连字符开头或结尾,不能出现两个连续的连字符,还必须和所在文件夹同名;description 是 1–1,024 个字符,要同时写「做什么」和「什么时候用」;compatibility 不超过 500 个字符;allowed-tools 被标为实验性,各家支持程度不同。
这个格式之所以能省上下文,靠的是规范里叫「渐进披露」的三层加载:会话开始时只把每个技能的 name 和 description 放进上下文,规范估计约 100 个 token;任务和描述对上了,才读整份 SKILL.md,规范建议正文少于 5,000 个 token、少于 500 行;scripts/、references/ 里的文件要用到时才读(Agent Skills 规范)。Anthropic 在 2025 年 10 月 16 日介绍这套设计时,用的也是同一个思路:先给目录,再按需翻书(Anthropic:Equipping agents for the real world with Agent Skills)。
我们这份技能的 name 加 description 一共 363 个字符,按约 4 个字符合 1 个 token 估算约 91 个 token,和规范的估计在同一量级;整份 SKILL.md 是 51 行、3,426 个字符,远低于 500 行的建议上限。这两个数是后面「上下文账」一节的基础。
竞品评论分析这份 SKILL.md 长什么样
下面是完整的 SKILL.md。它附带两个脚本和一份关键词表:scripts/fetch_reviews.py 调 EveryInfra 数据接口取评论,scripts/classify.py 按关键词给每条评论打主题,references/themes.md 是关键词表。正文用英文写,因为 Codex、Antigravity 和 Gemini 的界面默认都是英文,中文读者用的时候可以把步骤翻成中文,规范对正文没有格式限制。
---
name: competitor-review-analysis
description: Pull public reviews for 2-5 competing products from G2, Capterra, Trustpilot or Amazon through the EveryInfra data API, tag each review with a theme, and write a comparison report with counts, shares and quotes. Use when the user asks to compare competitor reviews, find what customers complain about, or build a review-based battlecard.
license: MIT
compatibility: Needs network access to api.everyinfra.com, Python 3.9+, and an EVERYINFRA_API_KEY environment variable. Does not run inside the Gemini app, where skill scripts cannot reach the internet.
metadata:
  version: "1.1"
  author: everyinfra-blog-example
---

# Competitor review analysis

## Inputs to confirm first
1. The products to compare (2-5). For each one, get the exact review page:
   G2 `https://www.g2.com/products/<slug>`, Capterra `https://www.capterra.com/p/<id>/<name>/`,
   Trustpilot domain such as `clickup.com`, Amazon `https://www.amazon.com/dp/<ASIN>`.
   Use the URL, not the product name. Product names change (Capterra lists monday.com as "monday AI Work Platform").
2. The theme set: `saas` or `hardware` (see references/themes.md). Ask if unclear.

## Steps
1. Fetch: run `python3 scripts/fetch_reviews.py --plan plan.json --out raw/`.
   One request per product per source. The script waits 7 s between requests,
   retries 429 with the `retry_after` value, and sends slow requests with `"mode":"async"`.
2. Check counts: read `raw/summary.json`. A source with 0 rows was not charged.
   Do not treat a short page as "no more reviews". Write the counts into the report.
3. Tag: run `python3 scripts/classify.py raw/ --themes saas > tagged.json`.
   The script tags by keyword rules, so the same input gives the same output.
4. Read 5 tagged reviews per theme and check that the tag fits. If a keyword
   matches the wrong words (v1 had `plan`, which matched "planning"), fix
   references/themes.md and run step 3 again. Note each change in the report.
5. Write `report.md` with these sections, in this order:
   - Table: product x source -> reviews read, average rating, charged USD.
   - Table: theme x product -> count and share of reviews that mention it.
   - Top 3 complaints per product, each with one short quote and its review URL.
   - Limits: what the sample cannot show (see below).

## Rules
- Report rating scales as they are: G2 and Capterra 1-5, Trustpilot 1-5 stars, Amazon 1-5 stars.
  Do not average across sources.
- Split Trustpilot by the `source` field: `Organic` (the reviewer came on their own) versus
  invitation sources (`BasicLink`, `InvitationApi`, `FileUploadInvitation`, `Shopify` and others).
  Report the average for each group. Never report one Trustpilot average for a company.
- Theme keywords are per language. For reviews that are not in English, use the matching set
  (for example `saas_es`), or report them as untagged.
- Do not print reviewer names. Quote at most 25 words per review.
- Amazon returns only the reviews shown on the product page (usually 10-15). Say so.
- Cost: every request costs the `price_usd` from `GET /api/v1/social/catalog`. Add up `billing.charged_usd` from the responses; do not estimate.

## Limits to state in every report
- The sample is the newest page of each source, not all reviews.
- Trustpilot reviews of a software company are often about billing and support, not the product. Read them as a separate signal.
这份文件里有几处是专门为「跨工具」写的。frontmatter 只用了规范的 6 个字段里的 5 个,没有用 Claude Code 才认的 model、context: fork、argument-hint 等扩展字段;compatibility 一行把「需要联网、需要 Key」写死,这样 Gemini 应用导入时,读的人一眼能看到它在那里跑不起来;脚本路径都写成相对技能根目录的路径,规范要求文件引用从技能根算起、只嵌一层(Agent Skills 规范)。Rules 一节里「按 source 拆 Trustpilot」和「关键词按语言分」两条,是我们跑完数据之后才加的,后面两节会讲为什么。
校验不是凭眼睛。17:56(新加坡时间)我们用规范仓库里的参考校验器 skills-ref 0.1.1(agentskills/skills-ref)跑了三组:这份技能原样输出 Valid skill;复制一份加上 context: fork 和 model: haiku,校验器报「Unexpected fields in frontmatter: context, model」;再复制一份把 name 改成 Review_Skill,校验器同时报「must be lowercase」和「contains invalid characters」。这和 Claude Code 文档的说法一致:在 Claude Code 本机,表里的所有字段都能用,但上传到 claude.ai、走 Skills API 或用 package_skill.py 打包时,只允许规范的 6 个字段,多一个就是硬错误(Claude Code 技能文档:Using skill frontmatter outside Claude Code)。
| 校验样本 | 改了什么 | skills-ref 0.1.1 结果 | 能不能跨工具用 |
|---|---|---|---|
| 原样 | 无 | Valid skill | 能 |
| 反样本 1 | 加 context: fork、model: haiku | 报错:多出 context、model 两个字段 | Claude Code 本机能用,上传 claude.ai 会失败 |
| 反样本 2 | name: Review_Skill | 报错:必须小写、含非法字符 | 不能 |
五个入口对 frontmatter 的要求不一样
把同一份文件放进不同入口之前,最好先看清每个入口对字段的要求。下表只列官方文档里写明的规则,文档没写的格子写「文档未写」,不按经验补。
| 入口 | `name` | `description` | 规范以外的字段 | 其他限制 |
|---|---|---|---|---|
| Agent Skills 规范 | 必填,1–64 字符,小写、数字、连字符,与目录同名 | 必填,1–1,024 字符 | 不在规范内 | 正文建议少于 500 行 |
| Claude Code 本机 | 可选,缺省用目录名 | 建议填;与 when_to_use 合计显示 1,536 字符 | 支持 model、context、hooks 等扩展 | 不认识的字段静默忽略 |
| claude.ai 上传 / Skills API | 必填,≤64 字符,不含「claude」「anthropic」和 XML 标签 | 必填,≤1,024 字符,不含 XML 标签 | 多一个字段就报错 | 上传不超过 30 MB,容器无网络 |
| Codex | 必填 | 必填 | 另用 agents/openai.yaml 放界面和依赖 | 初始列表默认占上下文 2% 或 8,000 字符 |
| Antigravity | 可选,缺省用目录名 | 必填 | 文档未写 | 文档未写 |
| Gemini 应用 | 全小写、连字符分词 | 文档未写长度 | 文档未写 | 合计 ≤100 MB,脚本不能联网 |
这张表说明了为什么我们坚持只用规范字段:规范是几个入口要求的交集,Claude Code 本机最宽松,claude.ai 上传最严格,只要按最严格的写,所有入口都能接受。对 description 的写法,几家文档给的建议几乎一样:Codex 说描述会在技能多时被先缩短,要把关键用途和触发词放在最前面(Codex Build skills);Claude Code 说描述加 when_to_use 超过 1,536 个字符会被截断,关键用途放第一句(Claude Code 技能文档);Gemini 帮助中心的三条建议第一条是「写清楚什么时候用」(About the transition from Gems to skills)。所以我们的描述第一句写「做什么、从哪些站、用什么接口」,第二句写「用户说什么话时触发」,一共 337 个字符,在每个入口都不会被截断。
Claude Code skills:放在 ~/.claude/skills 还是 .claude/skills
Claude Code 的技能分五层:企业级(放在托管设置目录的 .claude/skills/)、个人级 ~/.claude/skills/<名字>/SKILL.md、项目级 .claude/skills/<名字>/SKILL.md、子目录里的嵌套技能,以及 --add-dir 加进来的目录;同名时企业级优先于个人级,个人级优先于项目级(Claude Code 技能文档)。对这份技能来说,放项目级的好处是能提交进仓库,团队里每个人拉下代码就有;放个人级的好处是所有仓库都能用。项目级技能会从启动目录一路往上找到仓库根,所以在 packages/frontend/ 里启动也能用到根目录的技能。
有三条限制和「定时跑竞品报告」直接相关。第一,Cowork 会话和云端会话(包括云端定时任务)不读你电脑上的 ~/.claude/skills/,只加载你 claude.ai 账号里启用的技能;如果技能只在本机目录里,云端定时任务调用时会报「找不到这个技能」;而桌面端的定时任务在本机跑,会读 ~/.claude/skills/(Claude Code 技能文档:Use skills in Cowork and cloud sessions)。第二,把技能上传到 claude.ai 时,frontmatter 只能有规范的 6 个字段。第三,技能目录在上下文里有预算:每条 description 加 when_to_use 最多显示 1,536 个字符,整个目录的预算是模型上下文窗口的 1%,技能多了之后,用得最少的那些会先被去掉描述;会话被自动压缩后,Claude Code 会重新附上最近调用过的技能,每个保留前 5,000 个 token,合计不超过 25,000 个 token(同一文档)。所以我们把描述写在 337 个字符以内,并把最关键的用途放在第一句。
Claude Code 还有几项只在它自己那里生效的扩展:model 可以让技能临时换模型,context: fork 可以把技能放进子代理里跑,allowed-tools 可以预先批准工具,! 开头的命令行可以把实时数据注入技能正文(Claude Code 技能文档:Frontmatter reference)。这些都好用,但用了就不能原样带去 Codex 或 Gemini。我们的做法是保持主文件只用规范字段,需要 Claude Code 专用行为时,另放一份同名技能到个人目录,利用「个人级优先于项目级」的规则覆盖。
技能也可以放进子代理里跑:context: fork 让技能在一个分出去的子代理上下文里执行,主会话只拿回结果(Claude Code 技能文档;Claude Code 子代理文档)。对竞品评论分析来说,这样做的好处是 967 条评论的原文不会进主会话,坏处是这个字段不在规范里,加了就不能原样上传 claude.ai。我们的折中办法前面说过:仓库里的主文件不加,个人目录里放一份加了 context: fork 的同名版本,Claude Code 按「个人级优先」用后者,其他工具读到的仍是规范版本。
如果你更想让模型直接调工具,而不是跑脚本,也可以把 EveryInfra 的远程 MCP 加进 Claude Code。下面这条命令我们在之前的文章里实测过,这里作为配置示例给出:
export EVERYINFRA_API_KEY="<你的 API Key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --scope user --header 'Authorization: Bearer ${EVERYINFRA_API_KEY}'
claude mcp get everyinfra
Claude Code 默认开着 MCP 工具搜索:会话开始时只加载工具名和服务器说明,工具定义等用到时再查(Claude Code MCP 文档:Scale with MCP tool search)。这一点会影响后面「上下文账」的结论。
Codex skills:.agents/skills 与 config.toml
Codex 的技能格式同样建立在 Agent Skills 开放标准上,SKILL.md 必须有 name 和 description(Codex Build skills)。Codex 读四类位置:仓库级从当前目录到仓库根每一层的 .agents/skills,用户级 $HOME/.agents/skills,管理员级 /etc/codex/skills,以及 OpenAI 随 Codex 附带的系统技能。两个技能同名时 Codex 不合并,两个都会出现在选择器里。调用方式是在 CLI 或 IDE 扩展里输入 /skills 或用 $ 点名,也可以让 Codex 按描述自动选;ChatGPT 里用 @ 点名。
Codex 文档里有两个和描述长度直接相关的数字:初始技能列表默认最多占模型上下文窗口的 2%,上下文窗口大小未知时最多 8,000 个字符;可以用 skills.max_context_tokens 调整,上限 10,000 个 token。技能装多了,Codex 先缩短描述,再省略部分技能并给出警告(Codex Build skills)。所以 Claude Code 和 Codex 的经验是一样的:描述的第一句要写清楚用途和触发词。Codex 还支持一个可选的 agents/openai.yaml,用来设置界面名称、是否允许隐式调用(allow_implicit_invocation),以及声明依赖的 MCP 服务器;这个文件放在技能文件夹里,其他工具会忽略它,不影响可移植性。
在 Codex 里接 EveryInfra 远程 MCP,用 ~/.codex/config.toml(或受信任项目里的 .codex/config.toml)的 [mcp_servers.<名字>] 表(Codex MCP 文档)。下面是配置示例,没有在本机 Codex 里跑过:
[mcp_servers.everyinfra]
url = "https://api.everyinfra.com/mcp"
bearer_token_env_var = "EVERYINFRA_API_KEY"
enabled_tools = ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
default_tools_approval_mode = "writes"
tool_timeout_sec = 120这几行里有两处是按我们的实测数据定的。enabled_tools 只留 3 个工具,因为 EveryInfra 的 MCP 在 17:25(新加坡时间)的 tools/list 返回了 25 个工具,其中有建 Key、删 Key、改设置、建工单这类写操作,评论分析用不上。tool_timeout_sec 改成 120 秒,是因为 Codex 默认每次工具调用只等 60 秒(Codex MCP 文档),而我们 17:28 和 17:30 的两次同步调用分别用了 87.8 秒和 88.3 秒,G2 那次还在 90.4 秒时被我们自己的接口以超时结束;不改超时,Codex 会在接口回来之前先放弃。default_tools_approval_mode = "writes" 会对没有标只读的工具弹确认,而 everyinfra_call_api 因为每次都扣费,被标成了非只读,所以每次取数都会问你一次;如果你接受这笔花费,可以用 tools.everyinfra_call_api.approval_mode 单独放行。
Antigravity CLI 与 Gemini CLI:目录换了一次
Google 在 2026 年 6 月 18 日用 Antigravity CLI 替换了 Gemini CLI,Gemini CLI 文档站首页现在就写着这句话(Gemini CLI Agent Skills 文档)。两者的技能格式相同,目录不同:Gemini CLI 的用户级是 ~/.gemini/skills/(或别名 ~/.agents/skills/),项目级是 .gemini/skills/(或别名 .agents/skills/);Antigravity CLI 的项目级统一成 .agents/skills/,全局共享目录改成 ~/.gemini/antigravity-cli/skills/(Antigravity CLI 迁移文档)。要注意的是,Antigravity 桌面应用的全局目录又是另一个:~/.gemini/config/skills/(Antigravity 技能文档)。同一家公司的两个产品,全局目录不一样,这是本文唯一一处我们建议「两边各放一份」的地方。
Antigravity 的 frontmatter 只要求 description,name 缺省时取文件夹名(同一文档);我们这份技能两个字段都有,不受影响。Google 在 2026 年 9 月 25 日发布的 Codelab 演示了最小流程:在项目里建 .agents/skills/<名字>/SKILL.md,启动 agy,用 /skills 看到技能列表,然后直接提问(Google Codelabs:How to use AI Agent Skills with Antigravity CLI)。Reddit 上有用户问「Antigravity 技能到底怎么装」,要的是文件夹结构而不是文档链接(r/google_antigravity 讨论帖);上面这张表就是答案。
Antigravity 把 MCP 配置从 settings.json 拆到独立的 mcp_config.json:全局 ~/.gemini/config/mcp_config.json,项目 .agents/mcp_config.json,远程服务器的地址键从 url/httpUrl 改成了 serverUrl(Antigravity CLI 迁移文档)。它也有工具白名单 enabledTools,默认每次工具调用等 3 分钟、连接等 5 分钟(Antigravity MCP 文档),比 Codex 宽松,我们的 88 秒调用不用改超时。配置示例如下(未在本机运行):
{
  "mcpServers": {
    "everyinfra": {
      "serverUrl": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer <你的 API Key>" },
      "enabledTools": ["everyinfra_list_capabilities", "everyinfra_call_api", "everyinfra_get_job"]
    }
  }
}
Gemini 应用的 skills:Gems 11 月 17 日变只读,但技能脚本不能联网
Google 在 2026 年 9 月 30 日宣布用 skills 取代 Gems,说技能「完全建立在开放的 SKILL.md 标准上」,可以把别的平台上做的技能复制进 Gemini 应用(Google Workspace Updates,2026-09-30)。10 月 13 日的更新说,Gemini 应用里的技能当天开始推送,预计 11 月中旬推完;Workspace 应用里的技能推迟,时间待定(Google Workspace Updates,2026-10-13)。
关于 Gems 的日期,两份官方材料写法不同,读的时候要分清账号类型。9 月 30 日那篇 Workspace 公告写的是:11 月 17 日 Gems 挪进设置面板,「用户仍然可以创建、编辑和使用」,商业版最早 2027 年 3 月 1 日才停用。而面向个人账号的帮助中心写的是:18 岁以上的个人 Google 账号,2026 年 11 月 17 日 Gems 转成技能并变为只读,能看但不能用、不能改、不能新建;12 月 17 日从 Gemini 应用移除(Gemini 帮助中心:About the transition from Gems to skills)。也就是说,「11 月 17 日变只读」只对个人账号成立,Workspace 商业版要到 2027 年 3 月,教育版到 2027 年 6 月。Google 博客的说法和帮助中心一致:个人账号从 11 月开始移除 Gems(Google 博客:Let skills in Gemini tackle your most repetitive tasks)。
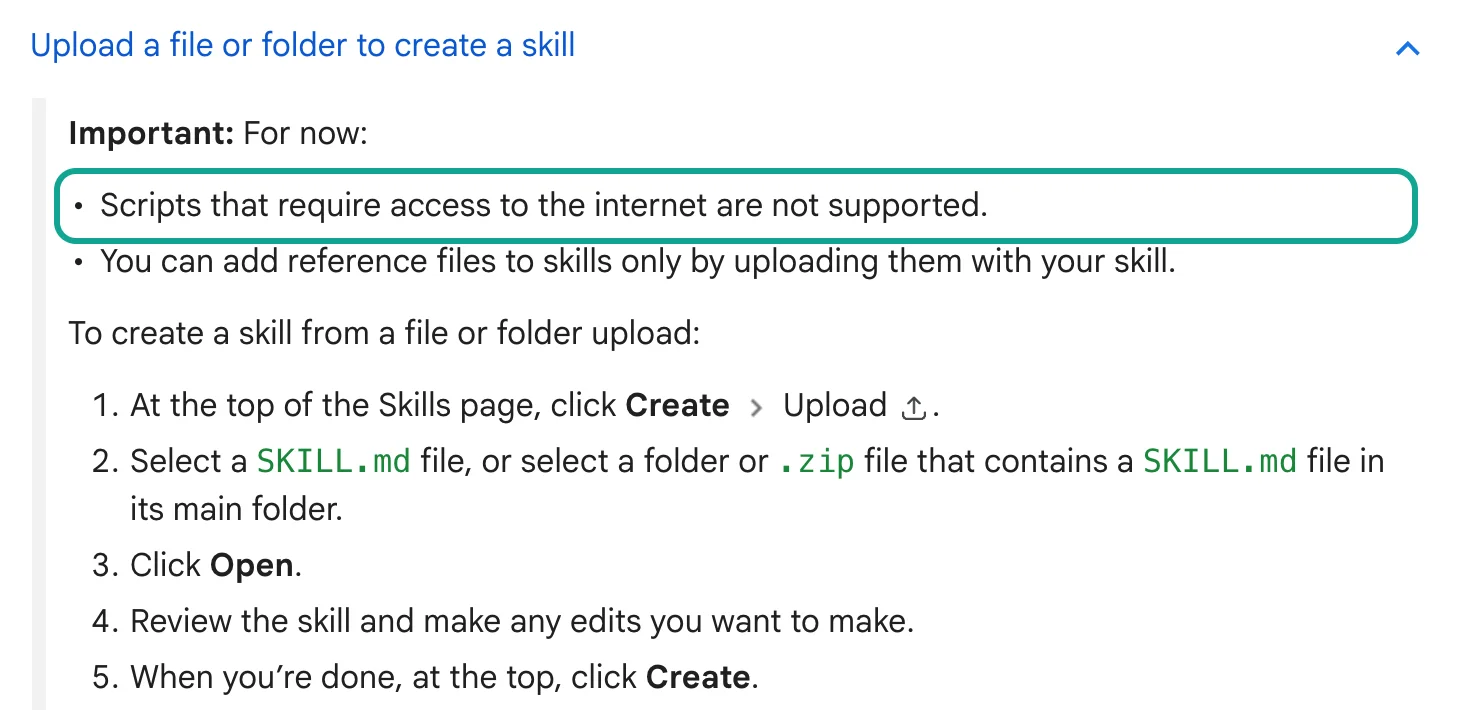
真正决定这份技能能不能在 Gemini 应用里干活的,是帮助中心「上传文件或文件夹创建技能」一节的两句话:需要访问互联网的脚本目前不支持;脚本不能对外部网站发起操作或请求(Gemini 帮助中心:Create & manage skills for Gemini Apps)。同一页还写了上传要求:SKILL.md 必须在根目录,名字全小写、用连字符分词,所有文件合计不超过 100 MB,.py、.sh、.md、.json、.csv 这些纯文本文件可以传,.docx、.xlsx 不行。我们这份技能完全符合格式要求,能导入,但 fetch_reviews.py 在那里取不到数据。
这不是 Gemini 一家的限制。Claude 的 Skills API 也写着技能在代码执行容器里运行,「没有网络访问,不能调用外部 API」;它还多一条名字规则:name 不能含保留词「anthropic」和「claude」,也不能含 XML 标签(Claude Skills API 指南)。所以在这两种环境里,正确的组合是「技能管流程,连接器管数据」:Gemini 应用里通过已连接的应用取数,Claude 网页版和 API 里通过 MCP 连接器取数,技能正文只负责告诉模型按什么步骤、出什么格式的报告。帮助中心还说,技能暂时不能和 Canvas、Deep Research 一起用(About the transition from Gems to skills),想让 Deep Research 读评论数据的读者要等后续更新。
一次真实往返:模型发出的调用和我们回的数据
不管技能是跑脚本还是让模型调 MCP,最后落到我们这边的都是同一个请求。下面这张卡片是 17:46:24(新加坡时间)一次真实的 MCP tools/call:模型调用 everyinfra_call_api,要 ClickUp 在 Trustpilot 上最近 3 个月的一星、二星评价,最多 50 条;接口用时 27.8 秒,回了 7 条,扣费 $0.001389。
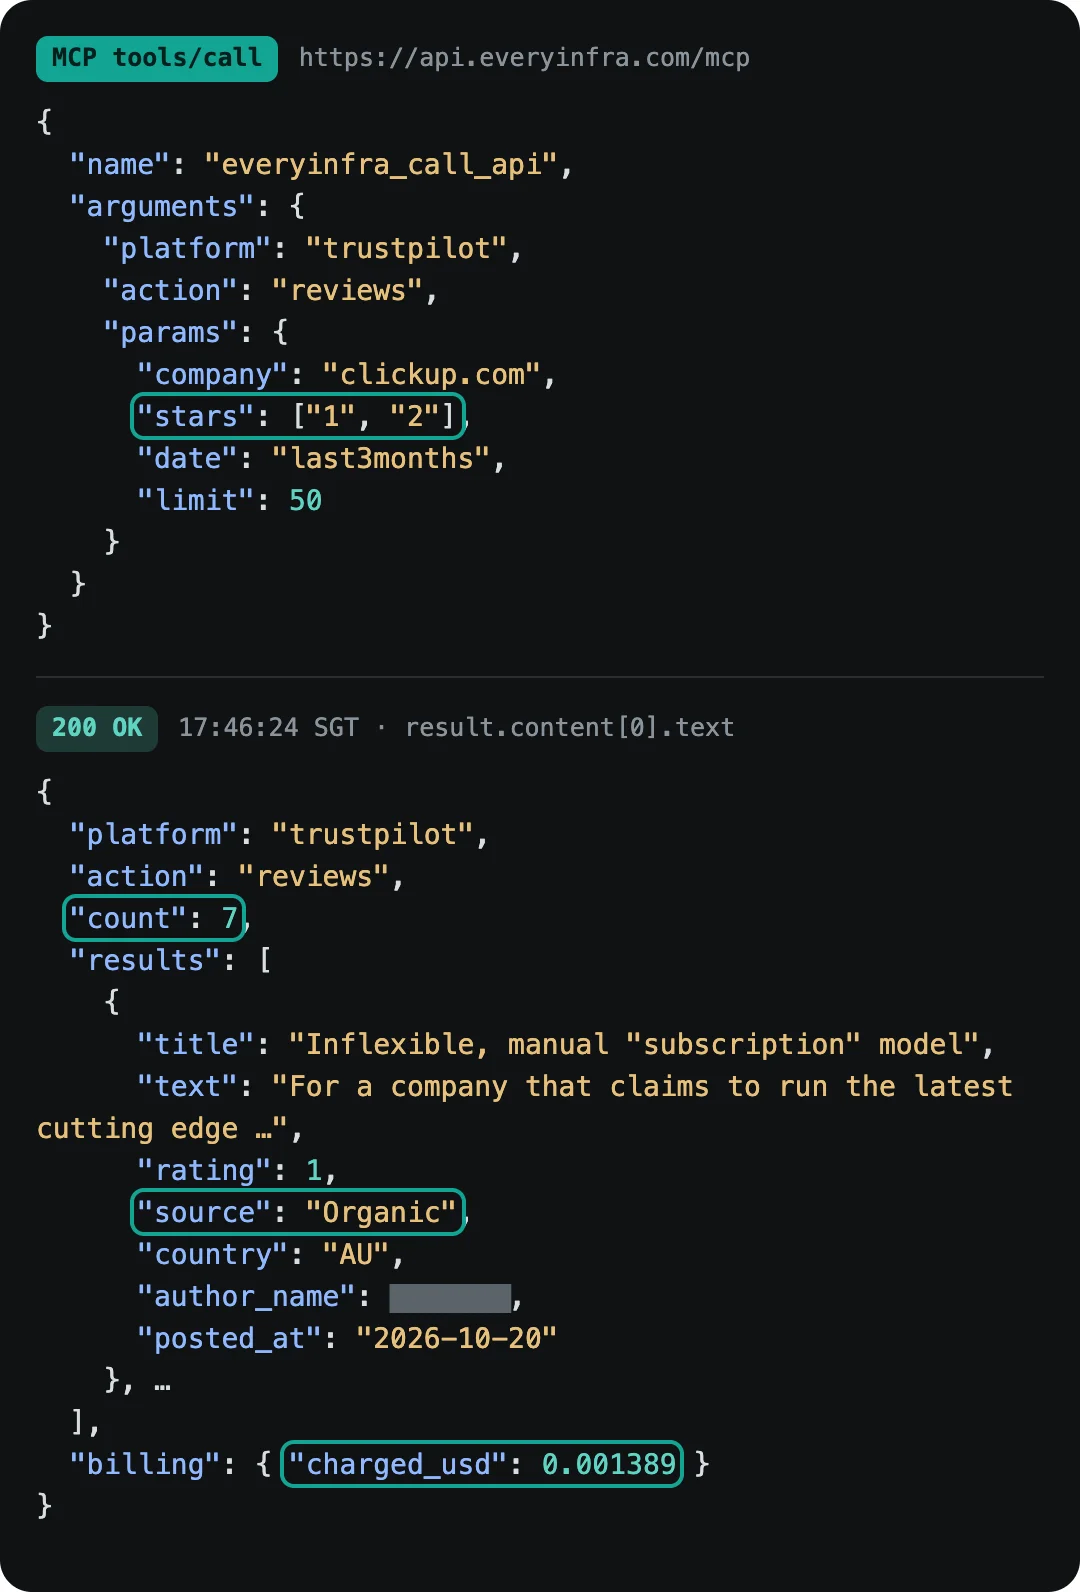
同样的请求用 curl 直接发到数据接口是这样($EVERYINFRA_API_KEY 只从环境变量读,不写进文件):
curl -s -X POST https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"trustpilot","action":"reviews","params":{"company":"clickup.com","stars":["1","2"],"date":"last3months","limit":50}}'
trustpilot/reviews 在目录里的返回字段有 24 个(EveryInfra 目录),这份技能用到的是下面几个。字段名和含义都和目录 response_fields、platform_field_meanings 逐个对过;source 和 verification_level 是下一节的主角。
| 字段 | 含义(取自目录) | 这份技能怎么用 |
|---|---|---|
id、url | 评价 ID 和链接 | 去重;报告里的引文附链接 |
title、text | 标题和正文 | 关键词归类 |
rating、rating_scale | 星级和满分 | 按来源分组求平均 |
source | 评价来源 | 拆「自发」和「经邀请」 |
verification_level | 验证等级(邀请评价 / 自发评价) | 和 source 交叉核对 |
language、country | 语言和国家 | 选关键词表 |
experience_at、posted_at | 消费发生时间、发布时间 | 截时间窗 |
reply_text | 商家回复 | 统计回复率 |
author_name | 评论人昵称 | 报告里不出现 |
G2 和 Capterra 的字段更适合 B2B 选型:g2/reviews 第一行是一条 record_type 为 summary 的汇总,带综合评分、评价总数和被提到最多的优缺点,后面才是逐条评价;capterra/reviews 每条都有 pros、cons、易用性和客服等分项评分,还有 switching_reasons(从别家迁来的原因),目录特意注明这是做竞品分析时最有价值的字段(EveryInfra 目录)。
9 次调用读到多少条:G2、Capterra、Trustpilot、Amazon 实测
我们在 17:25–18:31(新加坡时间)一共发了 31 次请求:23 次扣费,8 次没扣(4 次 429、1 次超时、3 次空结果),合计 $0.032794。下表是项目管理软件那份报告用到的 11 次请求,包括两次没扣费的。
| 新加坡时间 | 能力 | 目标 | limit | 返回评论 | 用时 | 扣费 |
|---|---|---|---|---|---|---|
| 17:25 | g2/reviews 同步 | Asana | 100 | 20(另有 1 行汇总) | — | $0.001389 |
| 17:27 | g2/reviews 同步 | monday.com | 100 | 超时,503 | 90.4 秒 | $0 |
| 17:28 | g2/reviews 同步 | ClickUp | 100 | 20(另有 1 行汇总) | 87.8 秒 | $0.001389 |
| 17:30 | capterra/reviews | Asana(按名字) | 100 | 50 | 88.3 秒 | $0.001389 |
| 17:32 | capterra/reviews | 「monday.com」(按名字) | 100 | 0,自动退款 | 67.5 秒 | $0 |
| 17:33 | capterra/reviews | ClickUp(按名字) | 100 | 100 | 22.3 秒 | $0.001389 |
| 17:33 | capterra/reviews | monday.com(按产品链接) | 100 | 97 | 47.3 秒 | $0.001389 |
| 17:34 | g2/reviews 异步 | monday.com | 100 | 50(另有 1 行汇总) | 2.1 秒拿到任务号 | $0.001389 |
| 17:34 | trustpilot/reviews | asana.com | 200 | 200 | 44.5 秒 | $0.001389 |
| 17:35 | trustpilot/reviews | monday.com | 200 | 200 | 37.3 秒 | $0.001389 |
| 17:36 | trustpilot/reviews | clickup.com | 200 | 200 | 42.4 秒 | $0.001389 |
这张表里有三件事,都写进了 SKILL.md。第一,Capterra 按名字「monday.com」查不到:Capterra 现在把这个产品叫「monday AI Work Platform」(Capterra 产品页),我们的接口返回 0 条并自动退款;改用产品链接后回了 97 条。所以技能第一步要求用链接,不用名字。第二,G2 同步调用接近 85 秒的同步预算,monday.com 那次在 90.4 秒时超时,响应里写明「Not charged」,并建议加 "mode":"async";我们照做后 2.1 秒拿到任务号,任务结束时回了 50 条。第三,同样一个 Asana 的 G2 请求,同步只回 20 条,17:48 用技能脚本异步再跑一次回了 50 条,前一次的 20 条全部包含在后一次里。单价相同,异步多拿 1.5 倍。
一次调用能拿回几条,直接决定了每千条评论的成本,因为这些评论能力都是按次计费,不按条数。Trustpilot 一次回 200 条,每 1,000 条约 $0.0069;Capterra 一次 100 条,约 $0.0139;G2 异步 50 条,约 $0.0278;G2 同步 20 条,约 $0.0695;Amazon 每个商品只回 13 条,约 $0.1068,最贵和最便宜差约 15 倍。Amazon 只有十几条不是故障:目录在 amazon/reviews 的参数说明里写明,各国站点都只能取到商品页展示的精选评论,每个商品通常十几条,取不到全部历史评论(EveryInfra 目录)。我们 17:38 和 17:54 对同一个 UGREEN 充电宝各取一次,两次都是 13 条,ID 完全相同,说明这 13 条是稳定的「首页精选」,不是随机抽样。
还有 4 次 429。17:37:59 到 17:38:50 之间,我们按 7 秒间隔连发,4 次被拒,响应写着这把 Key 每分钟 10 次的上限、retry_after 1 秒,「Nothing was charged」。原因是前一分钟里已经有别的请求;脚本按 retry_after 加上间隔重试后全部成功。我们这次用的测试 Key 被单独限到每分钟 10 次;账户默认是每分钟 60 次、所有 Key 共用,按充值累计升档(价格页),你自己 Key 的上限以控制台为准。
最大的坑:Trustpilot 的平均分要按来源拆开
做竞品表时最常见的写法,是给每家公司写一个 Trustpilot 平均分。我们的数据说明这个数几乎没有意义。17:34–17:44(新加坡时间)我们读了 6 家公司在 Trustpilot 上最新的 200 条评价(Holded 一共 48 条),按 source 字段分组:Organic 是评价人自己找到页面写的,其余的 BasicLink、InvitationApi、FileUploadInvitation、Shopify 都是公司发出的邀请。
| 公司 | 自发(Organic)条数 | 自发平均星级 | 经邀请条数 | 经邀请平均星级 | 差 | 混在一起的平均 |
|---|---|---|---|---|---|---|
| Asana | 199 | 1.90 | 1 | — | — | 1.90 |
| monday.com | 145 | 1.53 | 55 | 4.51 | 2.98 | 2.35 |
| ClickUp | 37 | 2.51 | 163 | 4.89 | 2.38 | 4.45 |
| Holded | 35 | 2.77 | 13 | 4.69 | 1.92 | 3.29 |
| Anker | 132 | 2.14 | 68 | 4.62 | 2.48 | 2.98 |
| UGREEN | 21 | 1.29 | 179 | 4.07 | 2.78 | 3.77 |
只看「混在一起的平均」,ClickUp 4.45 星、Asana 1.90 星,好像 ClickUp 的口碑好得多。拆开以后,两家的自发评价都很低(2.51 和 1.90),差别主要来自 ClickUp 发了大量邀请:最新 200 条里 163 条走的是邀请链接。monday.com 也一样,145 条自发评价平均 1.53 星,55 条经邀请的平均 4.51 星。硬件品牌同样如此:UGREEN 的 178 条来自 Shopify 店铺的自动邀请,自发的 21 条平均只有 1.29 星。我们的推理是:自发评价天然偏向「出了问题才来写」,邀请评价天然偏向「刚买完、心情还好」,两者混在一起,平均分就成了「这家公司发了多少邀请」的函数,而不是口碑的函数。这个结论的边界是:样本是每家最新的 200 条,时间跨度差别很大(Asana 的 200 条横跨 2022 年 1 月到 2026 年 10 月,ClickUp 的 200 条只有 2026 年 4 月到 10 月);我们没有判断任何一条评价的真假,也不评价任何公司的邀请做法是否合规。
「最新 200 条」覆盖的时间也差得很远,这会让上面的比较再打一个折扣。Asana 的 200 条从 2022 年 1 月 31 日写到 2026 年 10 月 3 日,将近四年九个月;monday.com 从 2024 年 12 月 15 日到 2026 年 10 月 24 日;ClickUp 从 2026 年 4 月 1 日到 2026 年 10 月 22 日,不到七个月;Anker 从 2026 年 3 月 21 日开始;UGREEN 最短,从 2026 年 8 月 30 日到读取当天 2026 年 10 月 26 日,不到两个月就攒了 200 条,其中 178 条来自店铺自动邀请。同样叫「最新 200 条」,有的是近两个月的新客反馈,有的是近五年的老用户积怨。所以报告里除了按来源拆,还应该把时间窗截齐,例如都用 Trustpilot 的 date: "last6months" 参数;这次为了看全貌我们没有截,读者照做时可以加上。
更麻烦的是,只看网页分不出来。Trustpilot 的帮助中心说,所有公司都可以免费发链接邀请顾客写评价;自动邀请(BCC 邮箱、电商插件、API)写出的评价会标「Verified」,而「Basic Link」邀请写出的评价在网页上标的是「Unprompted review」(Trustpilot 帮助中心:Trustpilot invitation methods)。我们核对了 ClickUp 页面:网页上标「Unprompted review」的那条五星评价,在接口里是 source: BasicLink、verification_level: invited;同一页那条标「Unprompted review」的一星差评,在接口里是 source: Organic、verification_level: not-verified(Trustpilot:ClickUp 评价页)。网页把这两种都叫「Unprompted」,接口分得开。这就是这份技能 Rules 一节要求「按 source 拆、不报一个总平均」的原因。Trustpilot 自己的商家准则也要求邀请不能有偏向(Trustpilot Guidelines for Businesses),但准则管的是「怎么邀请」,不改变「邀请来的人和自己来的人不一样」这个事实。
同一家公司,三个评论站在抱怨不同的事
把同一个产品放到三个评论站上看主题,差别同样大。下面是 Asana:G2 异步取到的 50 条、Capterra 的 50 条、Trustpilot 的 200 条,用技能里的关键词规则 v1.1 归类,每条评论可以命中多个主题。
| 主题 | G2(50 条) | Capterra(50 条) | Trustpilot(200 条) |
|---|---|---|---|
| 价格与计费 | 14% | 18% | 43% |
| 客服 | 12% | 14% | 46% |
| 上手难 | 26% | 22% | 5% |
| 好用 | 30% | 22% | 7% |
| 自动化 | 22% | 38% | 7% |
| 手机端 | 6% | 2% | 5.5% |
G2 和 Capterra 上写评价的多是在用产品的团队成员,所以话题围绕功能:好不好上手、自动化够不够。Trustpilot 上的 Asana 评价有 46% 提到客服、43% 提到价格和计费,读下来多数是续费、退款、账号被锁这类账务问题。monday.com 也类似,Trustpilot 上价格 35%、客服 29%;ClickUp 的 Trustpilot 是例外,自动化 39.5% 排第一,这和它大量邀请评价、邀请对象是活跃用户的情况一致。G2 的汇总行给了平台自己统计的口碑:Asana 综合 4.4 分、14,051 条评价,被提到最多的缺点是「Learning Curve」(605 次);monday.com 4.7 分、17,294 条;ClickUp 4.6 分、15,159 条(G2:Asana 评价页)。所以技能的 Limits 一节写了一句:软件公司的 Trustpilot 评价多半在说账务和客服,应当作单独的信号读,不和 G2、Capterra 混算。
这一节的数字是第二版。第一版关键词表里,「价格」主题有一个词 plan,按前缀匹配;跑完后我们按技能第 4 步,每个主题读 5 条抽检,发现 Capterra 上 Asana「价格」占 58%,读下来很多评论在说「project planning」。逐词统计:Capterra 那 50 条里 planning 出现 13 次,mobile 主题的 app 前缀还命中了 appreciate 6 次、approval 和 approvals 各 2 次。改成整词匹配、去掉 plan、app、agent、simple 四个词之后,Capterra 上 Asana 的「价格」从 58% 降到 18%,G2 从 30% 降到 14%,Trustpilot 从 48.5% 降到 43%。这件事说明两点:关键词规则便宜、可复算,但必须有人抽检;第 4 步不是客套话,它在第一次运行就改掉了一个会写进报告的错误结论。
技能跑完交出来的报告长什么样
技能第 5 步规定了报告的结构。下面是用这次真调数据按那个结构填出来的第一张表:每家产品在每个评论站读到多少条、平均几星、花了多少钱。三个站的星级分别列,不求总平均;Trustpilot 一格同时写混合平均和「自发 / 经邀请」两个分组,这是 Rules 里的要求。
| 产品 | G2:条数 / 平均 | Capterra:条数 / 平均 | Trustpilot:条数 / 混合平均(自发 / 经邀请) | 接口费 |
|---|---|---|---|---|
| Asana | 50 / 4.38 | 50 / 4.76 | 200 / 1.90(1.90 / 仅 1 条) | $0.004167 |
| monday.com | 50 / 4.64 | 97 / 4.57 | 200 / 2.35(1.53 / 4.51) | $0.004167 |
| ClickUp | 20 / 4.22 | 100 / 4.60 | 200 / 4.45(2.51 / 4.89) | $0.004167 |
报告的第三部分是「每家的前三条抱怨,各配一句短引文和评价链接」。我们从 Trustpilot 的自发一星、二星评价里按时间倒序挑了标题,标题本身就是评价人写的一句话,评论人昵称不出现。Asana 最近的几条是 2026 年 10 月 3 日的「Ruthless company」、10 月 1 日的「Forever free doesn't mean forever free」、9 月 28 日说取消政策「sneaky」的一条;monday.com 是 2026 年 10 月 24 日、10 月 22 日、10 月 21 日连续三条,其中两条标题直接写「customer service」;ClickUp 是 2026 年 10 月 20 日那条讲年付合同减少席位要提前 30 天通知的「Inflexible, manual "subscription" model」,以及 10 月 5 日一条说付了钱账号还被锁住的评价。这些标题和上一节的主题表是对得上的:Trustpilot 上三家被骂得最多的都是账务和客服,不是功能。报告的最后一部分写局限:样本只是各站最新的一批;Trustpilot 的 Asana 没有邀请组可比;关键词表 v1.1 只抽检了每个主题 5 条。
我们没有让模型替我们写这份报告的结论,表里每个数都由脚本从接口响应里现算。真正交给模型的是两件事:按第 4 步读样本、找关键词误判;按第 5 步把表和引文排成一份可读的文档。前一件事模型做得好不好,取决于你有没有要求它把每次改动写进报告;后一件事几乎不会出错。
把它变成每周一份:定时任务放在哪
竞品评论分析最自然的用法是每周一跑一次。四个产品里,能让这份技能定时、并且能联网取数的位置是这样的。Claude Code 的桌面端定时任务在本机运行,会读 ~/.claude/skills/;云端定时任务每次都从一个新的云端会话开始,不读本机目录,只能用你在 claude.ai 账号里启用的技能,或者提交进仓库 .claude/skills/ 的技能(Claude Code 技能文档)。OpenAI 在 2026 年 9 月 29 日的 DevDay 上推出了 Codex Cloud,任务在笔记本合上时也能跑(DevDay 2026 社区汇总);云端任务是否读取仓库里的 .agents/skills,我们在 Codex 文档里没有找到明确写法,也没有验证,这里不下结论。Gemini 应用有「schedule」可以按时间触发任务并指定技能(Create & manage skills for Gemini Apps),但如前所述,技能脚本在那里不能联网。
算一笔年账:每周一份 9 次调用的软件报告,一年 52 份是 468 次,接口费 $0.650052;如果每周再加一份 5 次调用的硬件报告,一年多 260 次、$0.36114。按我们的实测,一份 9 次调用的报告,同步模式下单次最慢 88 秒,加上每次 7 秒的间隔和 G2 异步任务约 5 分钟的等待,整份报告 10 分钟内能跑完;限速每分钟 10 次的 Key 足够,但如果同一把 Key 同时跑别的任务,就要把 429 当成常态来处理。2026 年 10 月 23 日的 Claude Code 2.1.310 把 Monitor 工具带到了更多部署方式上,长时间等异步任务时可以用它看进度,而不是让脚本空等(Claude Code 更新日志)。
关键词归类会漏什么:西语评论和硬件评论
关键词是按语言写的。我们用 lang: "es" 取了 monday.com 在 Trustpilot 上的西语评价,limit 200 只回了 81 条,最新一条是 2023 年 12 月 28 日,69 条来自文件上传邀请;用英文关键词归类,81 条里 80 条打不上任何主题,换成技能里的西语关键词表 saas_es 后,没打上的降到 45 条。ClickUp 的西语评价只有 10 条。西班牙的财务软件 Holded 在 Capterra 上的 100 条评价里,约 76 条读起来是西语,英文规则下 74 条打不上主题,西语规则下降到 21 条。Holded 在 Trustpilot 上还暴露了一个覆盖缺口:17:44 不传 lang 时回来 48 条,全部标 en;18:29 和 18:30(新加坡时间)分别用 lang: "es" 和 language: "es" 再取两次,都返回 0 条并自动退款,而 Trustpilot 西语站页面显示 Holded 有 2,444 条评价(Trustpilot 西语站:Holded)。也就是说,这家西班牙公司的西语评价我们这次没有取到,报告里只能写「Trustpilot 样本仅英文 48 条」。
硬件评论的问题不一样。Anker、UGREEN、INIU 三款 20,000 mAh 充电宝,在 Amazon 上各取到 13 条精选评论,平均星级 4.92、4.92、4.62,高于 Trustpilot 上这两个品牌的自发评价(2.14 和 1.29),因为 Amazon 首页精选本身就偏向高赞好评。Trustpilot 上 Anker 有 26% 的评价提到耐用性问题(坏了、不工作了),这在 Amazon 的 13 条里看不到。反过来,硬件关键词表在 Trustpilot 上的覆盖率很低:Anker 200 条里 101 条、UGREEN 200 条里 127 条打不上主题,读下来多是物流、退换货和客服,硬件表里没有这些主题。我们没有为了好看去改表,而是在报告里如实写「未归类」的条数。
上下文账:25 个 MCP 工具定义 31,581 个字符,技能目录 363 个字符
技能和 MCP 常被拿来比较,其实它们占上下文的方式不同。17:25(新加坡时间)我们读了 EveryInfra MCP 的 tools/list:25 个工具的定义合计 31,581 个字符,按 4 个字符合 1 个 token 估算约 7,895 个 token;其中 11 个标了只读,5 个标了破坏性。这份技能真正需要的 everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_job 三个工具,定义合计 3,314 个字符。而技能本身在会话开始时只放 name 和 description,363 个字符,约 91 个 token;整份 SKILL.md 3,426 个字符,用到时才读。
这组数的边界要说清楚。Claude Code 默认开着 MCP 工具搜索,会话开始只加载工具名和服务器说明,所以在 Claude Code 里,挂上 25 个工具也不会一上来就占 7,895 个 token(Claude Code MCP 文档)。别的宿主是否延后加载,要看各自文档;Codex 和 Antigravity 都提供了工具白名单(enabled_tools、enabledTools),把 25 个减到 3 个,定义量就从 31,581 个字符降到 3,314 个字符。MCP 规范把 readOnlyHint、destructiveHint 定义为给客户端的提示,不是安全保证(MCP 规范:Tools),所以白名单比依赖提示更可靠。我们的建议是:技能负责流程和报告格式,MCP 只开取数要用的 3 个工具;两者一起用时,技能里写清楚「用 everyinfra_call_api,不要用别的工具」。
每份报告多少钱
接口费按目录 price_usd 算。2026 年 10 月 26 日读取的目录里,g2/reviews、capterra/reviews、trustpilot/reviews、amazon/reviews 都是每次 $0.001389,没有按条数分档的标记,一次调用最多回 max_limit 条(G2、Capterra、Amazon 100,Trustpilot 200)(EveryInfra 目录)。一份 3 家竞品 × 3 个评论站的软件报告是 9 次调用:9 × $0.001389 = $0.012501,我们实际扣费也是 $0.012501,差额为 0;读到 967 条评论,折合每 1,000 条约 $0.0129。一份 3 款充电宝的硬件报告是 3 次 Amazon 加 2 次 Trustpilot,5 × $0.001389 = $0.006945,读到 439 条。超时和空结果不扣费,429 也不扣费,所以失败重试不会让这笔账变大。
| 项目 | 单价 | 次数 | 金额 | 说明 |
|---|---|---|---|---|
| 软件竞品报告(G2 + Capterra + Trustpilot) | $0.001389 / 次 | 9 | $0.012501 | 967 条评论 |
| 硬件竞品报告(Amazon + Trustpilot) | $0.001389 / 次 | 5 | $0.006945 | 439 条评论 |
| 每周跑一次软件报告,一年 52 次 | $0.001389 / 次 | 468 | $0.650052 | 按同样 9 次调用估算 |
| 本文全部真调 | — | 31 次请求,23 次扣费 | $0.032794 | 含 1 次 amazon/search($0.002236) |
对方产品这一侧的费用是订阅价,不按调用算。2026 年 10 月 26 日读取的公开价:Claude Pro 按月付 $20、按年付每月 $17,Pro 及以上才包含 Claude Code(Claude 定价页);ChatGPT Plus 每月 $20,Codex 在 Plus 档可以用 CLI、IDE 扩展和网页版,用量和 ChatGPT Work 共享(OpenAI 帮助中心:What is ChatGPT Plus;Codex 定价);Google AI Pro 每月 $19.99,包含 Antigravity 的入门用量(Google AI 订阅页)。和这些订阅比,接口费是零头;真正要算的是模型读 967 条评论花掉的订阅用量,这部分各家都不按条公布,我们没有测,不写数字。
脚本里踩到的坑:finalizing 不是终态
技能脚本第一次实跑就暴露了一个 bug,值得单独写。17:48(新加坡时间)我们用 fetch_reviews.py 跑 Asana 的 G2 异步请求,脚本轮询任务状态,遇到第一个不是 running、queued 的状态就当作结束;那次它在 306 秒时读到 finalizing,写下 0 条结果,收工。17:55 我们手动查同一个任务,状态已经是 succeeded,51 行(50 条评价加 1 行汇总)都在。修法是只把 succeeded、failed、canceled、expired 当终态,其余一律继续等。这类 bug 在技能里特别隐蔽:模型看到「0 条」,会很自然地写成「G2 上没有新评价」。所以技能第 2 步要求核对条数,0 条要写进报告,不当成「没有评价」。
错误和扣费的规则,在响应里都写得很明白,技能脚本只需要照着读:
- 429:
error.code为rate_limited,带retry_after秒数和「Nothing was charged」,按秒数等待后重试。 - 503 超时:
error.code为timeout,billing.charged为 false,建议改"mode":"async"或减小limit。 - 空结果:
count为 0,refund.status为succeeded,扣的那一次自动退回。 - 异步:202 返回
job_id和poll_url,扣费在提交时发生,轮询GET /api/v1/jobs/{job_id}到终态。
做不了或要注意的地方
下面这些是这份技能明确做不到、或者用的时候要小心的地方。Gemini 应用和 Claude Skills API 里,技能脚本不能联网,取数要交给连接器或 MCP;Claude Code 的云端会话和云端定时任务不读本机 ~/.claude/skills/,要把技能启用到 claude.ai 账号或提交进仓库;name 在 Claude Skills API 里不能含「claude」「anthropic」,我们的名字不受影响,但如果你给技能起名叫 claude-review-helper,上传会失败。Amazon 只给商品页精选评论,不能拿来算「差评率」;Trustpilot 不按来源拆就不能比较公司;关键词表要按语言、按品类各写一份,覆盖率要写进报告。
法律和平台规则方面,我们只写数据方法,不给法律意见。美国联邦贸易委员会 2024 年 8 月 14 日公布的规则禁止制造、购买虚假评价和有条件的好评激励(FTC 新闻稿;16 CFR Part 465);中国的《网络反不正当竞争暂行规定》自 2024 年 9 月 1 日起施行,把虚假评价列为网络不正当竞争行为(国家市场监督管理总局令第 91 号)。做竞品分析时读公开评价没有问题,但报告里不要出现评论人昵称,引文控制在一两句,这份技能的 Rules 已经写了。
行业动向
- 2026 年 9 月 29 日,OpenAI DevDay:插件成为 ChatGPT 和 Codex 共用的分发形式,一个插件可以同时带技能和 MCP 服务器,提交和审核流程也更新了(DevDay 2026 社区汇总;OpenAI DevDay 回顾)。对读者意味着:这份技能加上 EveryInfra 的 MCP 可以打成一个插件,在 ChatGPT 网页版里也能装(ChatGPT Skills & Plugins)。
- 2026 年 9 月 30 日,Google 宣布 skills 取代 Gems,10 月 13 日开始在 Gemini 应用推送,个人账号的 Gems 11 月 17 日只读、12 月 17 日移除(Workspace Updates;帮助中心)。对读者意味着:用 Gems 做竞品摘要的人,要在 12 月 17 日前把说明和文件导出来;需要联网取数的部分在 Gemini 应用的技能里跑不了。
- 2026 年 10 月 19 日到 23 日,Claude Code 连发三个版本:2.1.304(10 月 19 日)在压缩上下文后重新发送技能列表,
/reload-skills只发新的或改过的技能;2.1.309(2026 年 10 月 22 日)修复了--add-dir目录里同名技能用不了的问题,改用<目录名>:<技能名>调用;2.1.310(10 月 23 日)加入 Monitor 工具(Claude Code 更新日志)。对读者意味着:在长会话里反复跑竞品报告,压缩之后技能不会再「丢」。 - 2026 年 10 月 14 日,GPT-5.5 从用 ChatGPT 登录的 Codex 下线,换成 GPT-6.1 Sol 等新模型(Codex 定价页)。对读者意味着:模型换了,技能里的步骤不用改,但第 4 步的人工抽检要重新做一遍,同样的关键词规则下,模型挑的引文可能不同。
- 2026 年 9 月 25 日,Google 发布 Antigravity CLI 的技能 Codelab,用
.agents/skills和npx skills add安装第三方技能(Google Codelabs;vercel-labs/skills)。对读者意味着:.agents/skills正在成为几家工具共用的项目目录,新技能优先放这里。
结论在什么情况下不成立
这篇文章的样本很小,结论的边界要写在前面。主题占比来自每个站点最新的 20–200 条评价,不是全部评价,换一周再跑数字会变;Trustpilot 的「自发比邀请低 1.9–3.0 颗星」来自 5 家公司各一次读取,Asana 没有可比的邀请组,不在其中;关键词规则 v1.1 只抽检了每个主题 5 条,「客服」这个词也会命中「supports multiple views」这类功能描述,误差没有量化。四个产品的目录和行为来自 2026 年 10 月 26 日读取的官方文档,Codex 和 Antigravity 的 MCP 配置是配置示例,没有在本机运行;我们本机只实测了技能脚本、规范校验器和 EveryInfra 接口。如果你的竞品不在 G2、Capterra、Trustpilot、Amazon 上,这份技能要换成目录里对应平台的评论能力,例如 google_play/reviews、app_store/reviews、yelp/reviews。
常见问题
skill.md must start with yaml frontmatter (---) 是什么错误? 出处:Google 联想词「skill.md must start with yaml frontmatter (---)」,2026-10-26 读取。意思是 SKILL.md 的第一行必须是 ---。Claude Code 文档写明,只有当开头的 --- 在文件第一行时才读 frontmatter,否则整个文件都当正文;YAML 解析不了时技能仍会加载,但所有字段为空(Claude Code 技能文档)。用 skills-ref 的 agentskills validate 能提前发现这类问题。
codex skills location 在哪? 出处:Google 联想词「codex skills location」「codex skills folder」。仓库里是 .agents/skills(从当前目录一路到仓库根),个人是 $HOME/.agents/skills,机器级是 /etc/codex/skills;Codex 会跟随符号链接(Codex Build skills)。
claude code skills 怎么减少 token 用量? 出处:Google 联想词「claude code skills to reduce token usage」。技能在会话开始只放名字和描述,本文这份是 363 个字符;正文用到时才读。把描述写短、关键用途放第一句,不常用的技能在 skillOverrides 里设成只显示名字(Claude Code 技能文档)。需要大量参考资料时放进 references/,不要塞进正文。
skill.md description cannot contain xml tags 怎么办? 出处:Google 联想词「skill.md description cannot contain xml tags」。这是 Claude Skills API 和 claude.ai 上传时的检查:name 和 description 都不能含 XML 标签,name 还不能含「claude」「anthropic」(Claude Skills API 指南)。把描述里的 <...> 改成普通文字即可。
agent skills 能在 Gemini 应用里调用外部接口吗? 出处:Google 联想词「agent skills claude」「gemini skills」与 Gemini 帮助中心原文。目前不能:帮助中心写明需要访问互联网的脚本不支持,脚本不能对外部网站发请求(Create & manage skills for Gemini Apps)。取数要交给 Gemini 的已连接应用,技能只写步骤和格式。
claude skills 安装教程:从 GitHub 装别人的技能安全吗? 出处:Google 联想词「claude skills 安装 教程」「claude code skills github」。技能可以带脚本,装之前要读一遍 SKILL.md 和 scripts/。Gemini CLI 安装技能时会弹出安全确认(Gemini CLI Agent Skills 文档);Anthropic 和 OpenAI 的官方示例仓库分别在 anthropics/skills 和 openai/skills,OpenAI 还写过怎么用评测集系统地测技能(Testing Agent Skills Systematically with Evals)。
延伸阅读
- 想直接试评论接口:Trustpilot 数据接口、Trustpilot 评价能力、G2 数据接口、G2 评价能力、Capterra 评价能力、Amazon 评价能力。
- 用 MCP 接入:EveryInfra MCP 服务器;第一次调用看快速上手,价格看定价页。
- 相关文章:30 家公司的竞品口碑实测:G2 和 Trustpilot;评论数据如何做成付费产品;网页变更监控怎么商业化。
参考资料
- Extend Claude with skills,Anthropic(Claude Code 文档),2026-10-26 读取,https://code.claude.com/docs/en/skills
- Agent Skills Specification,agentskills.io,2026-10-26 读取,https://agentskills.io/specification
- skills-ref 参考校验器,agentskills(GitHub),0.1.1,2026-10-26 运行,https://github.com/agentskills/agentskills/tree/main/skills-ref
- Build skills,OpenAI(Codex 文档),2026-10-26 读取,https://developers.openai.com/codex/build-skills
- Model Context Protocol,OpenAI(Codex 文档),2026-10-26 读取,https://developers.openai.com/codex/mcp
- Agent skills,Google Antigravity Docs,2026-10-26 读取,https://antigravity.google/docs/skills/
- Migration - Antigravity CLI,Google Antigravity Docs,2026-10-26 读取,https://antigravity.google/docs/cli/gcli-migration
- MCP,Google Antigravity Docs,2026-10-26 读取,https://antigravity.google/docs/mcp
- Agent Skills,Gemini CLI 文档,2026-10-26 读取,https://geminicli.com/docs/cli/skills/
- Introducing skills in the Gemini app and Workspace, plus what's next for Gems,Google Workspace Updates,2026-09-30,https://workspaceupdates.googleblog.com/2026/09/skills-gemini-app-workspace.html
- An update on the launch of skills in the Gemini app and Workspace,Google Workspace Updates,2026-10-13,https://workspaceupdates.googleblog.com/2026/10/an-update-on-launch-of-skills-in-gemini-app-and-workspace.html
- Let skills in Gemini tackle your most repetitive tasks,Google 博客,2026-09-30,https://blog.google/products-and-platforms/products/gemini/automate-tasks-with-skills/
- Create & manage skills for Gemini Apps,Gemini 帮助中心,2026-10-26 读取,https://support.google.com/gemini/answer/17094296
- About the transition from Gems to skills,Gemini 帮助中心,2026-10-27 读取,https://support.google.com/gemini?p=gems_to_skills
- Using Agent Skills with the API,Anthropic(Claude 文档),2026-10-26 读取,https://docs.claude.com/en/api/skills-guide
- Connect Claude Code to tools via MCP,Anthropic(Claude Code 文档),2026-10-26 读取,https://code.claude.com/docs/en/mcp
- Claude Code changelog,Anthropic,2.1.304–2.1.310(2026-10-19 至 2026-10-23),https://code.claude.com/docs/en/changelog
- Equipping agents for the real world with Agent Skills,Anthropic,2025-10-16,https://www.anthropic.com/research/equipping-agents-for-the-real-world-with-agent-skills
- EveryInfra 数据目录 GET /api/v1/social/catalog,EveryInfra,2026-10-26 17:25 读取,https://api.everyinfra.com/api/v1/social/catalog
- EveryInfra MCP(tools/list、tools/call),EveryInfra,2026-10-26 17:25、17:46 调用,https://api.everyinfra.com/mcp
- monday AI Work Platform 产品页,Capterra,2026-10-26 读取(脚本访问返回 403,用浏览器引擎读取),https://www.capterra.com/p/147657/monday-com/
- Trustpilot invitation methods,Trustpilot 帮助中心,2026-10-26 读取,https://help.trustpilot.com/s/article/Trustpilot-invitation-methods?language=en_US
- ClickUp Reviews,Trustpilot,2026-10-26 读取(脚本访问返回 403,用浏览器引擎读取),https://www.trustpilot.com/review/clickup.com
- Guidelines for Businesses,Trustpilot,2026-10-26 读取,https://corporate.trustpilot.com/legal/for-businesses/guidelines-for-businesses
- Asana Reviews,G2,2026-10-26 读取(脚本访问返回 403,用浏览器引擎读取),https://www.g2.com/products/asana/reviews
- Tools,Model Context Protocol 规范 2025-06-18,2026-10-26 读取,https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Plans & pricing,Claude,2026-10-26 读取,https://claude.com/pricing
- What is ChatGPT Plus?,OpenAI 帮助中心,2026-10-26 读取,https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus
- Pricing,OpenAI(Codex 文档),2026-10-26 读取,https://developers.openai.com/codex/pricing
- Google AI Pro & Ultra,Google,2026-10-26 读取,https://gemini.google/subscriptions/
- How to use AI Agent Skills (with Antigravity CLI),Google Codelabs,2026-09-25,https://codelabs.developers.google.com/antigravity/how-to-create-agent-skills-for-antigravity-cli
- How do you actually set up Antigravity agent skills?,Reddit r/google_antigravity,2026-10-26 读取,https://www.reddit.com/r/google_antigravity/comments/1qvrxxx/how_do_you_actually_set_up_antigravity_agent/
- Federal Trade Commission Announces Final Rule Banning Fake Reviews and Testimonials,FTC,2024-08-14,https://www.ftc.gov/news-events/news/press-releases/2024/08/federal-trade-commission-announces-final-rule-banning-fake-reviews-testimonials
- 16 CFR Part 465 Rule on the Use of Consumer Reviews and Testimonials,eCFR,2026-10-26 读取,https://www.ecfr.gov/current/title-16/chapter-I/subchapter-D/part-465
- 网络反不正当竞争暂行规定(国家市场监督管理总局令第 91 号),中国证监会北京监管局转载,2024-09-11,https://www.csrc.gov.cn/beijing/c105536/c7505996/content.shtml
- DevDay 2026 announcements and developer resources,OpenAI 开发者社区,2026-09-29,https://community.openai.com/t/devday-2026-announcements-and-developer-resources/1402006
- DevDay 2026 Recap,OpenAI,2026-09-29,https://openai.com/index/devday-2026-recap/
- Skills & Plugins,ChatGPT Learn,2026-10-26 读取,https://learn.chatgpt.com/docs/skills-and-plugins
- vercel-labs/skills,GitHub,2026-10-26 读取,https://github.com/vercel-labs/skills
- anthropics/skills,GitHub,2026-10-26 读取,https://github.com/anthropics/skills
- openai/skills,GitHub,2026-10-26 读取,https://github.com/openai/skills
- Testing Agent Skills Systematically with Evals,OpenAI 开发者博客,2026-01-22,https://developers.openai.com/blog/eval-skills
- Create custom subagents,Anthropic(Claude Code 文档),2026-10-26 读取,https://code.claude.com/docs/en/sub-agents
- Holded 评价页(西语站),Trustpilot,2026-10-26 读取,https://es.trustpilot.com/review/holded.com
引用编号 BL-54