Tencent Hy4 y llamadas a herramientas con datos en vivo de Weibo, Bilibili y Douyin: esquemas, tipos y tokens
Los pesos de Hy4 aún no salen; para alojarlo tú usas Hy4 preview. Con su plantilla: 3 herramientas suman 506 tokens y 10 filas de Douyin, 12.902.
Tencent lanzó Hy4 el 4-11-2026. Sin embargo, cuando revisamos Hugging Face en la madrugada del 11-11-2026 (hora de Singapur), los únicos pesos descargables seguían siendo los de Hy4 preview, subidos el 27 de agosto. Por lo tanto, si hoy quieres ejecutar Hy4 en tus propias GPU y darle datos sociales en vivo, usas la versión preview; el modelo final solo está disponible mediante API alojadas. No ejecutamos el modelo, así que el lado del modelo es un ejemplo de configuración. Lo que probamos en vivo es nuestra API de datos: 18 llamadas en tres momentos del 11 de noviembre. Con la plantilla de chat y el tokenizador que trae Hy4 preview contamos los tokens de una ida y vuelta completa con herramientas: tres definiciones de herramientas suman 506 tokens al prompt, diez resultados de búsqueda de Douyin cuestan 12.902 tokens como JSON sin recortar y solo 1110 tokens (8,6 %) cuando dejamos los campos que el modelo necesita. El fallo que más equipos van a encontrar es de tipos: el analizador de vLLM para Hy4 convierte cada argumento según el tipo que declara tu esquema, así que un limit sin "type": "integer" llega a tu código como el texto "10", y nuestra API responde con un 422 sin cobrar nada.
Este artículo responde una pregunta práctica. Ejecutas un modelo de pesos abiertos por tu cuenta, o planeas hacerlo, porque los datos deben quedarse en tu red, porque quieres controlar el coste o porque quieres ajustarlo. Ahora quieres que responda preguntas como "¿qué es tendencia hoy en las redes chinas y cómo se ven los vídeos sobre eso?". El modelo no sabe lo que pasó hoy. Así que le das un conjunto de herramientas. Pide datos cuando los necesita, tu código los trae y el resultado vuelve al chat. En cada paso decimos qué medimos o llamamos en vivo y qué es un ejemplo de configuración basado en documentación pública.
Primero, las versiones: tencent hy4, Hy4 preview y "código abierto"
Antes de escribir revisamos las versiones, porque en internet se mezclan. El comunicado de Tencent del 4 de noviembre anuncia el Hy4 final con nuevas funciones de visión y uso del ordenador. Dice que Tencent "planea publicar los pesos y las fichas del sistema en los próximos días". La página de investigación de Hy del mismo día dice lo mismo. El 11 de noviembre, hacia las 00:20 hora de Singapur, consultamos la API pública de Hugging Face buscando modelos de Tencent con "Hy4" en el nombre. Devolvió dos: tencent/Hy4-preview y tencent/Hy4-preview-FP8. Ambos se crearon el 27 de agosto y cambiaron por última vez el 28 de agosto. La página tencent/Hy4 devolvió 404. Volvimos a comprobarlo el 12-11-2026 a las 01:10 hora de Singapur, antes de publicar, con el mismo resultado: solo los dos repositorios de la preview. La API de modelos devolvió 401 para tencent/Hy4, que es su respuesta cuando un repositorio no existe o no es público. Hoy, "pesos abiertos" solo es cierto para la versión preview.
Los datos de la preview vienen de la ficha del modelo y del repositorio de GitHub. Es un modelo de mezcla de expertos con 770B parámetros en total y 49B activos por token. Tiene 78 capas; cada capa MoE tiene 256 expertos enrutados, de los que cada token usa 8, más un experto compartido. Una capa aparte de 10B para predicción de varios tokens ayuda a la decodificación especulativa. La ventana de contexto es de 1M tokens y la licencia es Apache 2.0. Sumamos los tamaños de la lista de archivos de Hugging Face: los pesos BF16 son 131 fragmentos y 1560,0 GB, y los FP8 son 130 fragmentos y 813,8 GB. Todos los comandos de despliegue de las guías de Tencent usan paralelismo de tensores en 8 GPU. Ese número determina el coste de alojarlo tú, que vemos más adelante.
Para el modelo final, hoy se entra por una API alojada. Leímos la API de modelos de OpenRouter el 11 de noviembre a las 00:16 hora de Singapur. La entrada tencent/hy4 se creó el 4 de noviembre. Indica un contexto de 1.048.576 tokens, Tencent como único proveedor, cuantización fp4, un máximo de 65.536 tokens de salida y tools entre los parámetros admitidos. Los precios allí eran 0,417 USD por millón de tokens de entrada y 1,2505 USD por millón de tokens de salida. El comunicado de Tencent da un precio de lista de unos 0,90 y 2,70 USD, y dice que Tencent Cloud TokenHub cobra Hy4 a mitad de precio hasta el 31 de diciembre de 2026.
| Versión | Fecha | Pesos | Cómo llamarlo | Llamadas a herramientas |
|---|---|---|---|---|
| Hy4 preview | Subido el 27 ago 2026; actualizado el 28 ago | Públicos, Apache 2.0; BF16 1560,0 GB, FP8 813,8 GB | Alojarlo con vLLM o SGLang; hay copias alojadas | Sí; plantilla y analizador públicos |
| Hy4 (final) | 4 nov 2026 | "En los próximos días"; no encontrados el 11 nov | Tencent Cloud TokenHub, OpenRouter, WorkBuddy | Las API alojadas aceptan tools |
| Hy4 Flash | Comunicado: "se lanzará pronto" | Desconocido | No disponible | Desconocido |
Esta tabla fija las reglas del resto del artículo. Los detalles del protocolo, la plantilla, el tokenizador y el analizador vienen de archivos públicos de la preview, así que podemos revisarlos línea por línea en nuestra máquina. Del modelo final solo podemos citar lo que publican los proveedores alojados. Cuando Tencent publique los pesos finales, hay que medir otra vez los tokens si cambia la plantilla. Lo anotamos en la sección de límites.
Por qué un modelo de pesos abiertos necesita datos sociales en vivo
Un modelo de pesos abiertos no sabe nada después de su fecha de corte. La página de investigación de Hy4 dice que Tencent mejoró la "recuperación sensible al tiempo, la síntesis de varias fuentes y la verificación de consistencia factual", y reporta una tasa de alucinación menor. Pero esas mejoras suponen que alguien le da material reciente al modelo. Dentro de los productos de Tencent, la búsqueda y los conectores de WorkBuddy y Yuanbao hacen ese trabajo. Tu copia alojada no tiene ninguno. Pregúntale qué es tendencia ahora en Weibo y solo puede adivinar o decir que no lo sabe.
Las cifras de alucinación de Tencent no coinciden entre el comunicado y la página de investigación. Ambas son pruebas internas. No las reprodujimos, así que cita la fuente si las usas.
Las llamadas a herramientas resuelven la parte del "material reciente". El modelo no se conecta a internet. Escribe una petición estructurada como "llama a weibo_trending con limit 20". Tu código lee esa petición, llama a la API de datos real y devuelve el resultado al chat como un mensaje tool. Luego el modelo sigue. Esta división deja el lado de los datos en tus manos: qué endpoint llamar, qué clave enviar, qué campos quitar y cuántas llamadas por minuto permitir. El modelo solo decide cuándo necesita datos y qué pedir.
Elegimos tres fuentes porque muestran tres formas de datos comunes. Las tendencias de Weibo son una tabla corta: cada fila tiene un puesto, un título y una cifra de popularidad. La búsqueda de vídeos de Bilibili devuelve una lista de vídeos con muchos campos, pero cada fila es corta. La búsqueda de vídeos de Douyin devuelve filas con perfiles de autor, etiquetas, música y URL de vídeo en varias tasas de bits, así que cada fila es larga. Para quien no conozca estas redes: Weibo es el principal microblog público de China, Bilibili es un sitio de vídeo con público joven y comentarios sobre la pantalla, y Douyin es la versión china de la app de vídeo corto que muchos conocen como TikTok. Las páginas generales son Weibo, Bilibili y Douyin. Las tres formas cargan el contexto del modelo de forma muy distinta, como muestran las mediciones.
Cómo se ve hy4 function calling en el texto del modelo
La mayoría de los desarrolladores conoce hy4 function calling a través de una API compatible con OpenAI. Envías un arreglo tools y recibes tool_calls, como en la guía de function calling de OpenAI. Pero ese JSON no es lo que escribe el modelo. Descargamos el archivo chat_template.jinja de la preview, que define el texto que el modelo lee y escribe. La lista de herramientas va al principio del mensaje de sistema dentro de <tools></tools>, un objeto JSON por línea. Para hacer llamadas, el modelo escribe primero <tool_calls:opensource>. Cada llamada es <tool_call:opensource> más el nombre de la función, luego pares de etiquetas <arg_key> y <arg_value>, y después las etiquetas de cierre. Este es un fragmento que renderizamos con esa plantilla en nuestra máquina. La respuesta de la herramienta es el resultado real y recortado de Weibo de la ronda 1:
<tool_calls:opensource><tool_call:opensource>weibo_trending<arg_key:opensource>limit</arg_key:opensource><arg_value:opensource>20</arg_value:opensource></tool_call:opensource></tool_calls:opensource><|hy_end:opensource|><|hy_start:opensource|>tool<|hy_middle:opensource|><tool_response:opensource>[{"rank":1,"title":"金鸡奖获奖名单","hot_value":1323824,"category":"电影"},{"rank":2,"title":"拼多多送货上门新规11月13日生效","hot_value":856784, ...(Los dos primeros títulos son "Lista de ganadores de los premios Gallo de Oro", en la categoría de cine, y "La norma de entrega a domicilio de Pinduoduo entra en vigor el 13 de noviembre").
Este formato tiene tres efectos directos. Primero, a nivel del modelo cada valor de argumento es texto: 20 y "20" se ven igual. El analizador del servidor tiene que convertir los valores en números leyendo tu esquema, así que los tipos del esquema importan. Segundo, cuando la plantilla escribe tus definiciones de herramientas en el prompt, elimina dos claves, strict y defer_loading. Lo comprobamos: la palabra "strict" no aparece en nuestro prompt renderizado, así que el modelo nunca ve si pediste modo estricto. La clave additionalProperties sí se mantiene. Tercero, cuando hay herramientas, preserved_thinking vale true por defecto, así que el razonamiento anterior se queda en los prompts siguientes. El modo de razonamiento por defecto es high; puedes desactivarlo con reasoning_effort: "no_think". Ambos ajustes cambian tu factura de tokens.
El framework de inferencia convierte el texto de etiquetas de nuevo en tool_calls. La receta de vLLM para Hy4 usa --tool-call-parser hy_v4 --reasoning-parser hy_v4 --enable-auto-tool-choice. El recetario de SGLang usa --tool-call-parser auto. Leímos hy_v4_tool_parser.py en la rama principal de vLLM. Su función _parse_value busca el tipo de cada argumento en tu esquema. Prueba booleano, luego entero, luego número, luego JSON, y solo al final se queda con texto. La última corrección funcional de este archivo fue el PR #61542, fusionado el 31-10-2026. Evita que el analizador quite los espacios de los nombres de argumentos. Si tu versión de vLLM es anterior, las herramientas con espacios en los nombres de argumentos fallan.
# Ejemplo de configuración (de la receta de vLLM para Hy4; no lo ejecutamos): 8 GPU, FP8, herramientas activas
vllm serve tencent/Hy4-preview-FP8 \
  --tensor-parallel-size 8 \
  --speculative-config '{"num_speculative_tokens":3,"method":"mtp"}' \
  --attention-backend FLASHMLA_SPARSE \
  --tool-call-parser hy_v4 --reasoning-parser hy_v4 \
  --enable-auto-tool-choice \
  --tool-strict-level function \
  --served-model-name hy4-preview --port 8000
La última opción, --tool-strict-level function, no está en la guía de Tencent. vLLM la añadió el 18 de septiembre de 2026 en el PR #56268. La descripción del PR da un dato útil. En 9500 peticiones a un despliegue en producción, ninguna fijó tool_choice, y las 17.476 definiciones de herramientas tenían strict en false, porque los SDK y frameworks de agentes comunes lo envían así por defecto. Así que el servidor no podía restringir el formato de la llamada, y cuando el modelo escribía etiquetas rotas, ningún analizador podía recuperarlas. La opción tiene tres niveles. auto mantiene el comportamiento anterior: solo se restringen las herramientas marcadas como estrictas. function restringe la envoltura de la llamada y el nombre de la función. parameter además ajusta cada argumento a su esquema. Si alojas el modelo, este interruptor es tuyo. En una API alojada, decide el proveedor.
Las puntuaciones de uso de herramientas que publica Tencent
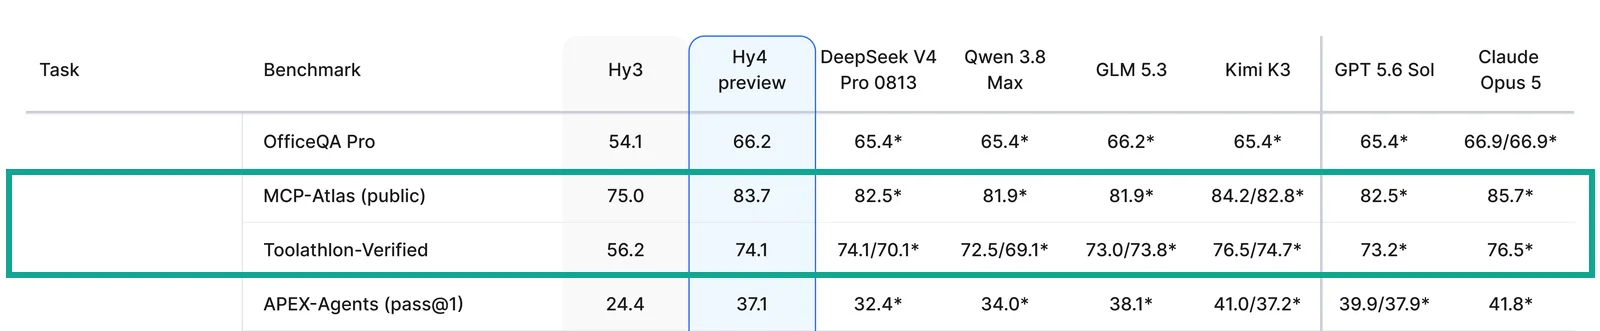
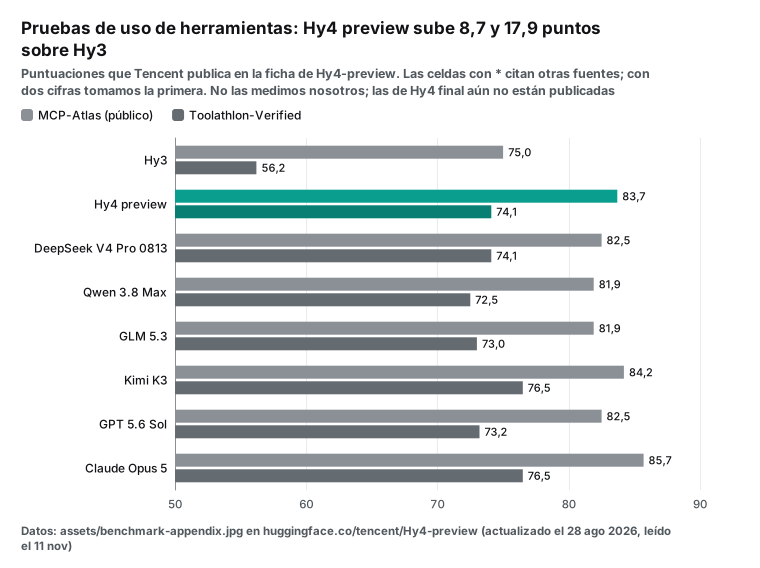
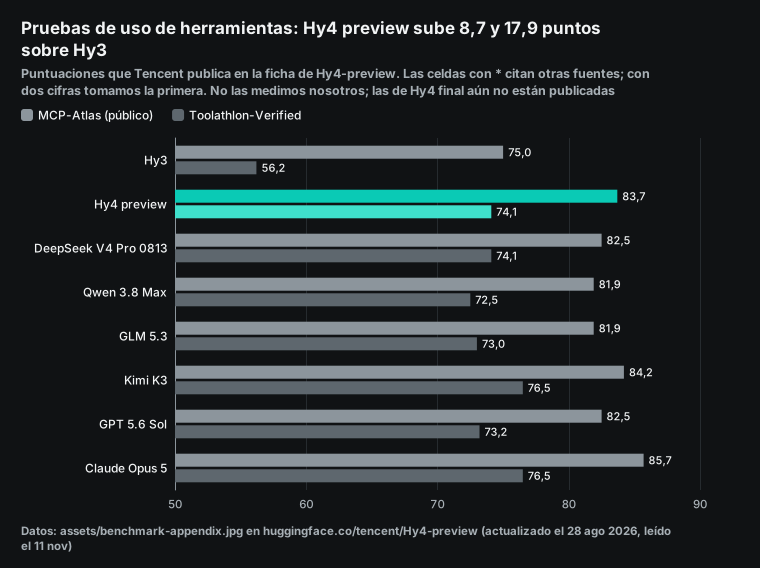
No podemos probar en nuestra máquina si el modelo llama a una herramienta en el momento correcto o si rellena bien los argumentos. Lo que sí podemos citar es el apéndice de la ficha de la preview. Dos filas tienen relación directa con el uso de herramientas: MCP-Atlas (público) y Toolathlon-Verified. Hy4 preview obtiene 83,7 y 74,1. La generación anterior, Hy3, obtiene 75,0 y 56,2. En la misma tabla, GLM 5.3 tiene 81,9 y 73,0, Kimi K3 tiene 84,2 y 76,5, y Claude Opus 5 tiene 85,7 y 76,5. La tabla marca con un asterisco las cifras de otros fabricantes, lo que significa que Tencent las cita de otra fuente. Las tareas y la puntuación de Toolathlon están en su repositorio de GitHub, y Hugging Face explica cómo se publican estas cifras en su guía de resultados de evaluación.
Estas cifras dicen dos cosas, con dos límites. De Hy3 a Hy4 preview, las puntuaciones de herramientas subieron mucho; Toolathlon subió 17,9 puntos. Entre los modelos abiertos de la misma generación, Hy4 preview está en la parte media alta, no en lo más alto. Primer límite: son cifras de la preview. No encontramos estas dos filas para el modelo final en la página de investigación; la ficha del sistema debería aclararlo. Segundo límite: las herramientas de estas pruebas son sobre todo de archivos, web y código. Una llamada concreta como "buscar en Bilibili por palabra clave" no es la misma tarea. Por eso no adivinamos con qué frecuencia el modelo se equivoca al llamar. Medimos qué pasa cuando lo hace.
Diseño de herramientas: una herramienta genérica o una por capacidad
Cuando una API de datos ofrece cientos de capacidades, la primera idea suele ser una sola herramienta genérica. Sus argumentos son una plataforma, una acción y un objeto params, y el modelo los rellena. Escribimos ese diseño y la alternativa, una herramienta por capacidad, y medimos cuántos tokens añade cada uno al prompt. Renderizamos cada uno con la plantilla de la preview y contamos los tokens con su tokenizador. La base es el mismo mensaje de sistema y la misma pregunta sin herramientas: 71 tokens.
[
  {"type": "function", "function": {
    "name": "weibo_trending",
    "description": "Weibo hot search list right now: rank, title, hot_value, category, label.",
    "parameters": {"type": "object", "additionalProperties": false, "required": [],
      "properties": {"limit": {"type": "integer", "minimum": 1, "maximum": 200}}},
    "strict": true}},
  {"type": "function", "function": {
    "name": "bilibili_search",
    "description": "Search Bilibili videos by keyword. Returns title, url, posted_at, view/like/comment/danmaku counts.",
    "parameters": {"type": "object", "additionalProperties": false, "required": ["keyword"],
      "properties": {"keyword": {"type": "string"},
        "sort": {"type": "string", "enum": ["most_commented", "most_liked", "most_viewed", "newest", "relevance"]},
        "limit": {"type": "integer", "minimum": 1, "maximum": 50}}},
    "strict": true}},
  {"type": "function", "function": {
    "name": "douyin_search",
    "description": "Search Douyin videos by keyword. Returns text, url, posted_at, like/comment/share counts, author.",
    "parameters": {"type": "object", "additionalProperties": false, "required": ["keyword"],
      "properties": {"keyword": {"type": "string"},
        "publish_time": {"type": "string", "enum": ["half_year", "one_day", "one_week", "unlimited"]},
        "sort": {"type": "string", "enum": ["most_liked", "newest", "relevance"]},
        "limit": {"type": "integer", "minimum": 1, "maximum": 50}}},
    "strict": true}}
]
Copiamos los valores de los enums de estas tres herramientas de nuestro catálogo público. El catálogo también da una descripción de cada parámetro (en chino), el número de filas por defecto y el máximo. Estos son los cuatro diseños.
| Diseño | Herramientas | Bytes del JSON | Tokens añadidos al prompt |
|---|---|---|---|
1 herramienta genérica, params como objeto anidado | 1 | 525 | 256 |
| 3 herramientas dedicadas, argumentos planos, texto corto en inglés | 3 | 1415 | 506 |
| 3 herramientas dedicadas, descripciones del catálogo pegadas | 3 | 3237 | 939 |
| 10 herramientas dedicadas, argumentos planos, texto corto en inglés | 10 | 3675 | 1090 |
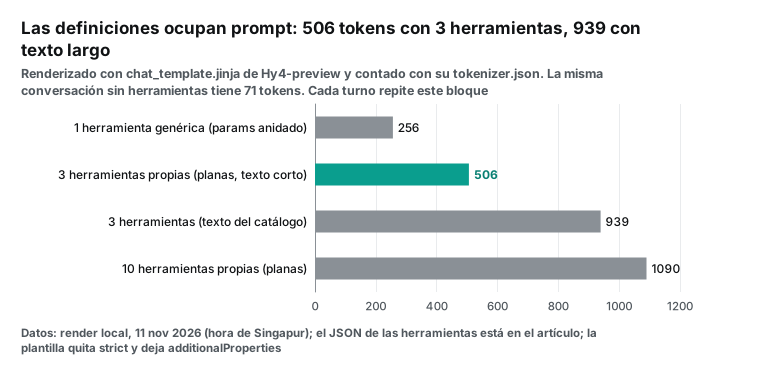
La herramienta genérica usa menos tokens, pero pasa lo difícil al modelo. El modelo tiene que recordar cientos de nombres de plataformas y acciones, y los nombres de argumentos y valores permitidos de cada una. Cuando se equivoca, solo lo sabe por nuestra respuesta 422. El problema de tipos de la sección anterior también pesa más aquí. params es un objeto, y en el formato de etiquetas el modelo lo escribe como texto JSON. El analizador de vLLM lo convierte de nuevo en objeto solo si tu esquema dice "type": "object". Las herramientas dedicadas cuestan entre 250 y 300 tokens más, y a cambio cada argumento tiene tipo, enum y límites, así que tanto el analizador como las restricciones del servidor pueden hacer su trabajo. Pegar las descripciones largas del catálogo casi duplica el coste, y la mayor parte del texto extra es detalle para personas, como cuánto tiempo vale un token de página. El modelo no lo necesita para decidir. Recomendamos una frase corta por herramienta y dejar los detalles en tu ejecutor.
Recuerda que este coste se paga en cada turno. La lista de herramientas vive en el mensaje de sistema, así que el modelo la vuelve a leer cada vez que lo llamas. Una tarea como "mira tendencias y luego busca en dos plataformas" necesita al menos tres turnos, así que las definiciones se cobran tres veces. Con 10 herramientas, son 1090 tokens por turno. Al precio de entrada de OpenRouter, 0,417 USD por millón de tokens, tres turnos cuestan unos 0,0014 USD. Es poco para una tarea. Si tu agente ejecuta miles de tareas al día, ya no es poco.
Tipos de argumentos: sin "integer", 10 se vuelve "10"
Este es el hallazgo más práctico del artículo, y puedes comprobarlo entero sin ejecutar el modelo. Copiamos sin cambios las funciones de conversión de valores del analizador de vLLM y las ejecutamos en nuestra máquina. Les dimos el mismo texto, 10, y solo cambiamos cómo el esquema declara limit. Luego enviamos los resultados a nuestra API real.
| Cómo declara el esquema limit | Valor que devuelve el analizador | Resultado en EveryInfra |
|---|---|---|
{"type": "integer"} | 10 (entero) | Respuesta normal |
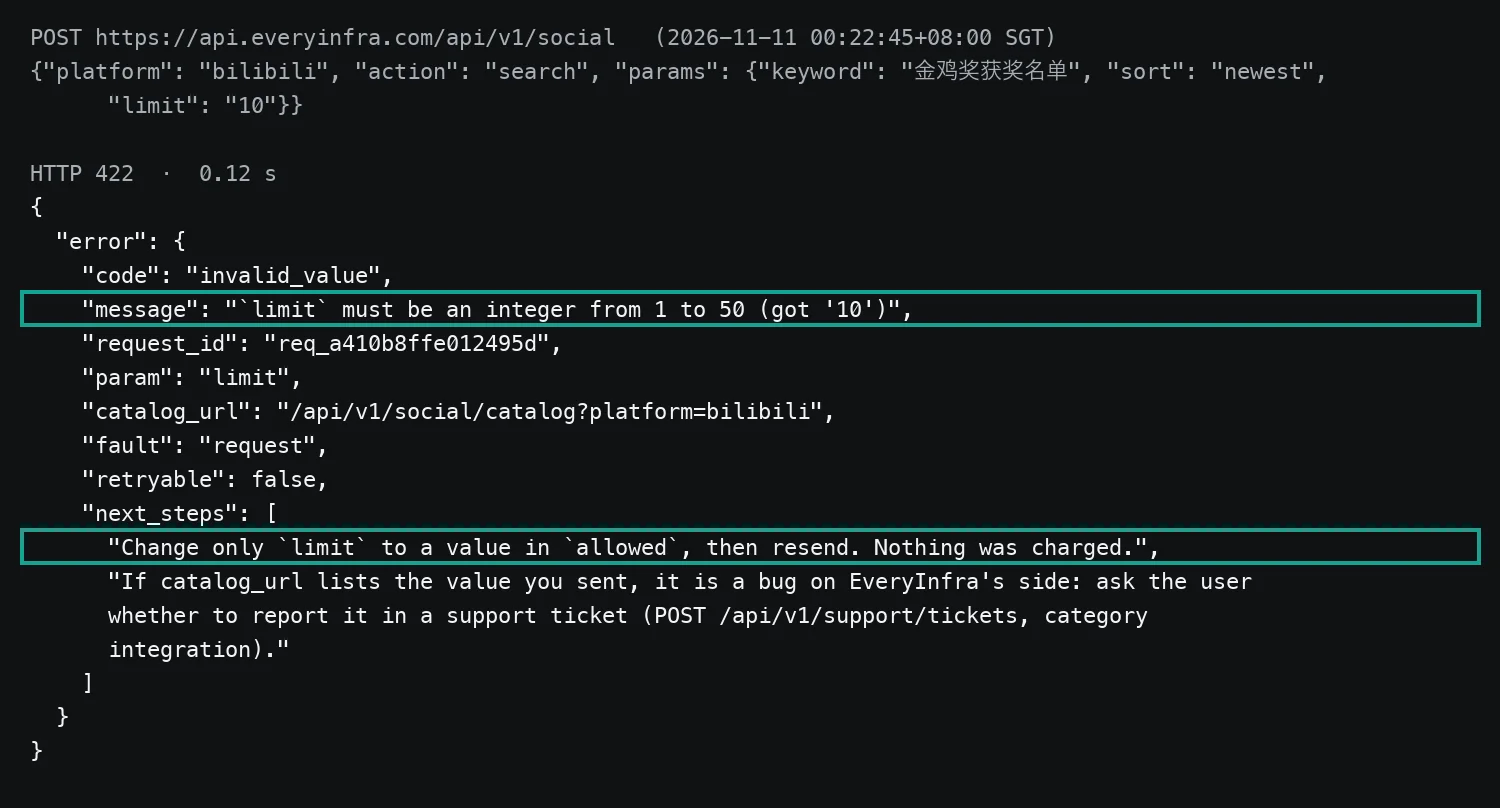
{"type": "string"} | "10" (texto) | 422: limit must be an integer from 1 to 50 (got '10'); sin cobro |
| Sin tipo | "10" (texto) | El mismo 422 |
| Argumento ausente del esquema | "10" (texto) | El mismo 422 |
Herramienta genérica, params declarado como object | Objeto | Respuesta normal |
Herramienta genérica, params sin tipo | Un texto largo | 422: params: Input should be a valid dictionary; sin cobro |
Las dos respuestas 422 de la tabla son llamadas en vivo del 11-11-2026 a las 00:22 hora de Singapur. La captura de abajo muestra la primera. Cuando un argumento está mal, nuestra API nombra el argumento, dice qué espera y qué enviaste, y añade "Nothing was charged" en next_steps. Ese texto está escrito para que lo lea un modelo. Devuélvelo sin cambios como mensaje tool y la mayoría de los modelos corrige el argumento y vuelve a llamar. Pero eso cuesta un turno más de razonamiento y un prompt más, y Hy4 tiene el razonamiento profundo activo por defecto. La solución más barata es declarar todos los tipos en el esquema y convertir tipos una vez en tu ejecutor: si un valor es un texto de dígitos y el esquema dice integer, conviértelo antes de enviarlo. Para escribir los tipos, sigue la referencia de type de JSON Schema; la guía de structured outputs de OpenAI detalla qué formas admite el modo estricto, por ejemplo que todas las propiedades vayan en required y que additionalProperties sea false.
En la misma sesión enviamos también una búsqueda de Bilibili con sort igual a hot, que no existe (00:20 hora de Singapur). La respuesta fue otra vez un 422. Listaba todos los valores permitidos y los dos más cercanos, most_liked y most_viewed, y de nuevo sin cobro. Para un agente, un error que dice cómo arreglarlo es mucho más útil que un simple "Bad Request". Para tu factura, una petición fallida no cuesta nada en el lado de los datos, así que dejar que el modelo reintente solo cuesta tokens del modelo.
El lado del ejecutor en una ida y vuelta completa: llamadas escritas a mano, respuestas reales
Esta es una ida y vuelta completa, vista desde el ejecutor. El usuario pregunta: "¿Qué está en el número uno de las tendencias de Weibo ahora? Busca 10 vídeos relacionados en Bilibili y 10 en Douyin, y dime dónde la conversación es más reciente". El lado del modelo es un ejemplo de configuración: no ejecutamos Hy4, y escribimos a mano las llamadas del modelo para esta pregunta. Las tres llamadas a nuestra API son llamadas en vivo de la madrugada del 11 de noviembre, y cada respuesta y cobro sale de las respuestas originales.


En el primer turno, el modelo lee la pregunta y la lista de herramientas y llama a weibo_trending(limit=20). Nuestro ejecutor lo convierte en una petición a EveryInfra. La enviamos a las 00:19:46 hora de Singapur. Devolvió 20 tendencias en 0,81 segundos y cobró 0,000556 USD. El número uno era "Lista de ganadores de los premios Gallo de Oro", con una popularidad de 1.323.824, en la categoría de cine. Los Gallo de Oro son los principales premios del cine chino, y la ceremonia fue la noche del 10 de noviembre. El número dos era una nueva norma de entrega a domicilio de Pinduoduo. En el segundo turno, el modelo usa la tendencia principal como frase de búsqueda y hace dos llamadas a la vez: bilibili_search y douyin_search, con publish_time=one_day en Douyin. Bilibili devolvió 10 filas a las 00:21:05 en 1,7 segundos por 0,000556 USD. Douyin devolvió 10 filas a las 00:21:20 en 5,97 segundos por 0,008333 USD. Nuestra clave de prueba permite 10 peticiones por minuto; al enviar llamadas seguidas chocamos dos veces con ese límite y recibimos dos respuestas 429. Cada 429 decía que se reintentara tras 6 segundos y que no se había cobrado nada. La sección de errores tiene los detalles.
# Ejecutor: convierte los tool_calls del modelo en peticiones a EveryInfra, recorta y devuelve al modelo.
# El lado del modelo es un ejemplo de configuración (cliente compatible con OpenAI hacia tu vLLM);
# el lado de EveryInfra coincide con las llamadas en vivo de este artículo.
import json, os, requests
from openai import OpenAI

llm = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
EI = "https://api.everyinfra.com/api/v1/social"
HEAD = {"Authorization": f"Bearer {os.environ['EVERYINFRA_API_KEY']}"}
ROUTE = {"weibo_trending": ("weibo", "trending"),
         "bilibili_search": ("bilibili", "search"),
         "douyin_search": ("douyin", "search")}
KEEP = {"weibo_trending": ["rank", "title", "hot_value", "category"],
        "bilibili_search": ["title", "url", "posted_at", "view_count", "comment_count", "danmaku_count"],
        "douyin_search": ["text", "url", "posted_at", "like_count", "comment_count", "author_name"]}

def run_tool(name, args, schema):
    if name not in ROUTE:                       # lista blanca: nunca enviar nombres inventados
        return {"error": f"unknown tool {name}"}
    for k, v in list(args.items()):             # reparar tipos según el esquema: "10" -> 10
        if schema.get(k, {}).get("type") == "integer" and isinstance(v, str) and v.isdigit():
            args[k] = int(v)
    platform, action = ROUTE[name]
    r = requests.post(EI, headers=HEAD, timeout=90,
                      json={"platform": platform, "action": action, "params": args})
    body = r.json()
    if r.status_code != 200:                    # devolver el 422; el modelo puede leer next_steps
        return body.get("error", body)
    rows = [{k: row.get(k) for k in KEEP[name] if row.get(k) is not None}
            for row in body.get("results", [])]
    for row in rows:
        if "text" in row:
            row["text"] = row["text"][:80]
    return {"count": len(rows), "results": rows, "charged_usd": body["billing"]["charged_usd"]}
No escribimos la respuesta final del modelo por él. Lo que sabemos es lo que vería. Las 10 filas de Bilibili venían por relevancia. La mayoría se publicó el 9 y el 10 de noviembre, la más antigua el 19-10-2026 (un vídeo sobre las nominaciones), y solo 1 de 10 tenía menos de 24 horas; casi todas eran predicciones hechas antes de la ceremonia. Las 10 filas de Douyin, filtradas a las últimas 24 horas, se publicaron todas después de la ceremonia de la noche del 10 de noviembre. La mayoría de los autores eran cuentas de medios como Sohu Entertainment, la radio y televisión de Xiamen, 1905 Movie Network y CCTV Arts, y la publicación más nueva tenía 0,6 horas. Así que la respuesta correcta a "dónde es más reciente la conversación" depende del orden que pases a Bilibili. Por eso el enum de sort tiene que estar en el esquema de la herramienta.
Cómo contamos tokens sin ejecutar el modelo
Todas las cifras de tokens de este artículo son medidas, no estimadas. Usamos los archivos de Hy4 preview en nuestra máquina, y tú puedes hacer lo mismo. Paso uno: descarga chat_template.jinja (14.674 bytes) y tokenizer.json (unos 9,4 MB) de Hugging Face. No necesitas pesos. Paso dos: carga la plantilla en un entorno aislado de Jinja y añade las dos funciones que Transformers ofrece al renderizar plantillas, raise_exception y un filtro tojson que acepte ensure_ascii. La guía de plantillas de chat de Transformers describe estas convenciones. Paso tres: pasa el mensaje de sistema, la pregunta, las herramientas, las llamadas del modelo y las respuestas de herramientas en formato de mensajes de OpenAI. La plantilla devuelve el texto exacto que lee el modelo. Después cuéntalo con la biblioteca tokenizers.
| Paso | Archivo o herramienta | Tamaño o versión | Qué obtienes |
|---|---|---|---|
| 1 | chat_template.jinja | 14.674 bytes | El texto exacto de herramientas, llamadas y respuestas |
| 2 | tokenizer.json | Unos 9,4 MB | Recuentos de tokens que coinciden con el modelo |
| 3 | Entorno Jinja + tojson + raise_exception | jinja2 y tokenizers con uv | El mismo render que hace Transformers |
| 4 | Mensajes en formato OpenAI | Respuestas reales de la ronda 1 | Tamaño del prompt por turno, sin recortar y recortado |
Este método tiene dos ventajas. El recuento coincide con el prompt que envía el framework, porque vLLM y SGLang usan la misma plantilla. Y puedes hacer pruebas controladas: cambia un campo o añade una herramienta y ves el cambio al instante, sin GPU. Los límites también están claros. El tokenizador solo cuenta la entrada. Cuánto razonamiento escribe el modelo y lo largas que son sus llamadas solo lo sabes ejecutándolo. Y si una API alojada usa una plantilla distinta del archivo público, tu factura será distinta. En nuestra medición del 11-11-2026, el chat base sin herramientas ocupó 71 tokens. Usa ese número para comprobar que tu render coincide con el nuestro.
Aunque no medimos la salida, su estructura se puede prever. Con --reasoning-parser hy_v4, vLLM separa el razonamiento del texto de la respuesta y lo pone en un campo aparte; la documentación de salidas de razonamiento de vLLM explica cómo leerlo. Las llamadas van a tool_calls. Ambos pasan por el servidor compatible con OpenAI de vLLM, así que tu ejecutor solo lee campos estándar. Ten en cuenta preserved_thinking: con herramientas, el razonamiento se queda en el prompt siguiente, así que los tres turnos tendrán más tokens de entrada que los que medimos. Para bajar esa parte, usa no_think en los turnos que solo traen datos y activa el razonamiento en el turno final.
Recorta los resultados antes de que el modelo los vea
Pasar la respuesta original de la API al modelo es el camino más fácil y el más caro. Contamos las tres respuestas de la ronda 1 con el tokenizador de Hy4 y luego dejamos solo los campos que el modelo necesita para esta pregunta.
| Capacidad | Filas | Bytes sin recortar | Tokens sin recortar | Tokens recortados | Parte que queda |
|---|---|---|---|---|---|
weibo/trending | 20 | 7276 | 3287 | 545 | 16,6 % |
bilibili/search | 10 | 8949 | 3227 | 842 | 26,1 % |
douyin/search | 10 | 29.001 | 12.902 | 1110 | 8,6 % |
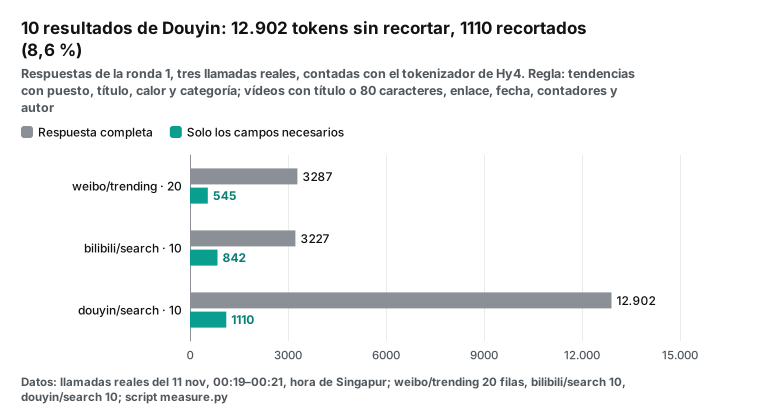
Douyin es la grande por sus campos. En el catálogo, douyin/search lista 55 response_fields. Además del texto, los contadores y el autor, incluyen URL de vídeo en varias tasas de bits, enlaces de descarga, una portada y una portada animada, datos de música, identificadores de etiquetas, el avatar del autor y su número de seguidores. Estos campos sirven para análisis. No ayudan al modelo a decidir qué plataforma es más reciente, y entierran el título y la fecha útiles entre URL largas. La respuesta de Weibo es corta, pero cada fila lleva un enlace de búsqueda codificado en porcentaje. Cada carácter chino se convierte en nueve caracteres como %E9%87%91, y el tokenizador solo puede cortarlos en trozos pequeños. Por eso 20 filas sin recortar ya cuestan 3287 tokens.
Cuando renderizamos el chat completo de tres turnos, la diferencia es más clara. Con los resultados sin recortar, el prompt del tercer turno ocupa 20.096 tokens; recortado, 3177. Sumando los tres turnos, los totales son 24.565 y 4904. Hy4 tiene un contexto de 1M, así que la versión sin recortar cabe. Pero un prompt más largo significa razonamiento más lento, un primer token más tardío y una factura mayor en cualquier API que cobre por token. Fija la regla de recorte por tarea. Para un resumen de tendencias, deja títulos, fechas y contadores. Si el modelo tiene que citar publicaciones, deja los enlaces. Si quieres el tono de los comentarios, usa un endpoint de comentarios y deja el texto. Nuestra regla está en el código del ejecutor y puedes cambiarla.
Tres momentos: las tendencias cambian; ¿Bilibili y Douyin siguen el ritmo?
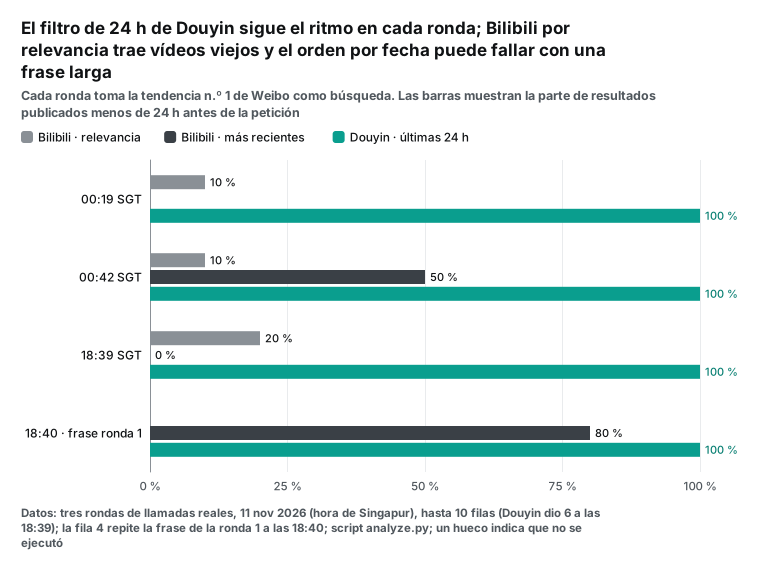
Repetimos el flujo en tres momentos del 11 de noviembre de 2026 (hora de Singapur: 00:19, 00:42 y 18:39). Cada ronda toma la tendencia n.º 1 de Weibo y la busca en Bilibili y Douyin. Regla fijada antes de empezar: un resultado es reciente si se publicó menos de 24 horas antes de la petición. A las 18:40 repetimos la frase de la ronda 1 ("ganadores de los premios Gallo de Oro") para separar un tema nuevo de un fallo de búsqueda.
| Hora (SGT) | Tendencia n.º 1 (popularidad) | Top 20 igual a ronda 1 | Bilibili relevancia | Bilibili por fecha | Douyin 24 h | Cobrado |
|---|---|---|---|---|---|---|
| 00:19 | Ganadores del Gallo de Oro (1.323.824) | 20 / 20 | 1 / 10 | no se ejecutó | 10 / 10 | 0,009445 USD |
| 00:42 | Ganadores del Gallo de Oro (1.035.614) | 17 / 20 | 1 / 10 | 5 / 10 | 10 / 10 | 0,010001 USD |
| 18:39 | Plumífero 1000 yuanes más barato en línea (1.105.701) | 0 / 20 | 2 / 10 | 0 / 10 | 6 / 6 | 0,010001 USD |
| 18:40, frase de la ronda 1 | — | — | no se ejecutó | 8 / 10 | 10 / 10 | 0,008889 USD |
En 23 minutos, 17 de las 20 tendencias siguieron en la lista; a las 18:39 no quedaba ninguna y la n.º 1 era un tema de compras. Tu ejecutor puede guardar la lista de 10 a 30 minutos, pero medio día después debe leerla de nuevo.
Bilibili por relevancia dio sobre todo vídeos viejos: a las 18:39 el más antiguo tenía casi cinco años. El orden por fecha funcionó con una frase corta (8 de 10 a las 18:40), pero falló con la frase larga de las 18:39: su resultado más nuevo tenía 16 días y los dos vídeos de menos de una hora no aparecieron. No sabemos por qué Bilibili ordena así; solo contamos lo que vimos.
Douyin con publish_time=one_day acertó las cuatro veces. A las 18:39 devolvió solo 6 filas y costó igual 0,008333 USD, porque el catálogo cobra por petición; solo las llamadas fallidas o vacías son gratis. Douyin tardó hasta 8,3 segundos y Bilibili hasta 8,1.
En la ronda 2, dos publicaciones de Douyin daban ganadores distintos del premio al mejor intérprete masculino. Una cuenta de medios verificada nombró a Tony Leung Ka-fai a las 21:43 (hora de Pekín); una cuenta personal sin verificar dio otro nombre a las 18:07. Sin autor ni hora, el modelo lee dos textos con el mismo peso. Por eso el recorte conserva author_name y posted_at; para verificar hechos, añade author_is_verified.
| Lo que vimos | Qué hacer en el ejecutor |
|---|---|
| La lista cambia por completo en 18 horas | Guárdala de 10 a 30 minutos |
| Las tendencias son frases largas | Reduce a 2–4 palabras clave o combina ambos órdenes por posted_at |
| Relevancia trae vídeos viejos | Usa sort=newest para noticias |
| Douyin da menos filas y cobra por petición | No repitas para llenar la lista |
| Publicaciones contradictorias | Conserva autor, hora y verificación |
| Hasta 8,3 s por búsqueda | Tiempo de espera de 30 s o más |
En total, 13 llamadas correctas costaron 0,038336 USD; las 429 y 422 fueron gratis. Un monitor cada 30 minutos gasta unos 0,48 USD al día en datos.
Cinco tareas más para tu ejecutor
El ejecutor de arriba tiene unas treinta líneas. En producción necesita cinco cosas más, y cada una corresponde a algo que vimos en las pruebas. Primero, una lista blanca. A veces los modelos inventan un nombre de herramienta o escriben mal un argumento. El ejecutor solo acepta los nombres que conoce y devuelve un error para todo lo demás. Nunca construyas una petición con un nombre de plataforma y acción escrito por el modelo. Es otro motivo para evitar la herramienta genérica: deja la lista blanca en manos del modelo.
Segundo, reparar tipos. Aunque el esquema tenga todos los tipos, un servidor puede funcionar sin modo estricto y un modelo puede poner un número entre comillas. El ejecutor convierte los textos de dígitos en enteros y los textos con forma de JSON en objetos, según el esquema, y se ahorra un 422 y un turno. Para leer el JSON del modelo basta el módulo json de Python. El archivo tool_strict_level.py de vLLM define los tres niveles de restricción; en el servidor usan etiquetas estructurales de XGrammar. Con el nivel parameter activo, los argumentos siguen el esquema y tu reparación pasa a ser una red de seguridad.
Tercero, límites de ritmo y reintentos. Ante un 429, nuestra API devuelve retry_after y el ejecutor espera ese tiempo. No muestres el 429 al modelo, porque puede probar otros argumentos y empeorar el problema. La clave de prueba de este artículo permite 10 llamadas por minuto. Cuarto, recortar, como ya vimos. Quinto, controlar el coste. Cada respuesta incluye charged_usd. Súmalo a los metadatos del turno, junto al uso de tokens del modelo, y sabrás el coste real de cada respuesta. Sirven Requests o el cliente de Python de OpenAI; nuestra API solo necesita un cuerpo JSON y una cabecera Bearer.
| Tarea | Lo que vimos | Dónde va |
|---|---|---|
| Lista blanca de nombres | La herramienta genérica deja que el modelo elija cualquier plataforma | Diccionario ROUTE |
| Reparar tipos | limit como "10" recibe un 422 sin cobro | Bucle sobre el esquema antes de la petición |
| Esperar ante un 429 | Dos 429 con retry_after de 6 s en la clave de prueba | Esperar y reenviar el mismo cuerpo |
| Recortar campos | 10 filas de Douyin: 12.902 tokens sin recortar, 1110 recortadas | Diccionario KEEP |
| Controlar el coste | Cada respuesta 200 trae charged_usd | Valor de retorno de run_tool |
Antes de lanzar: repite las llamadas del modelo en tu propio despliegue
No ejecutamos Hy4, así que tienes que comprobar en tu propio despliegue si el modelo llama bien a las herramientas. El método es sencillo. Elige entre 20 y 30 preguntas reales de tu producto que cubran tres casos: preguntas que necesitan una herramienta, charla o preguntas generales que no necesitan ninguna, y tareas que necesitan dos herramientas seguidas. Incluye también algunas preguntas con erratas, tono coloquial o mezcla de chino e inglés, porque así preguntan los usuarios reales; cuando la descripción de una herramienta es demasiado estrecha, son estas preguntas las que más acaban sin llamada o con la llamada equivocada. Ejecuta cada pregunta 3 veces con los mismos ajustes de muestreo, guarda los tool_calls del modelo tal cual y juzga cada uno con las mismas reglas que tu ejecutor. Escribe los criterios de aprobado y suspenso antes de la prueba y no los cambies después de ver los resultados.
| Comprobación | Cuándo pasa | Si falla, revisa |
|---|---|---|
| Nombre de herramienta válido | El nombre está en el ROUTE del ejecutor | Descripciones de herramientas demasiado parecidas o largas |
| Argumentos válidos | jsonschema valida arguments contra los parameters de la herramienta | Tipos que faltan; --tool-strict-level parameter en el servidor |
| Sin llamada cuando no hace falta | Las preguntas de charla dan tool_calls vacío | Un tool_choice fijado en required |
| Los dos pasos encajan | La palabra clave del segundo turno sale del resultado del primero | Falta el mensaje tool anterior en el turno siguiente |
| Se corrige tras un error | Tras devolver nuestro 422, los argumentos siguientes pasan la validación | El ejecutor recortó next_steps |
La mayor parte del coste de estas repeticiones es tiempo de tu propia GPU. No necesitas llamadas de datos en vivo en cada pasada: guarda respuestas reales como las de este artículo como muestras fijas y dáselas al modelo a partir del segundo turno. Así cada pasada recibe la misma entrada y puedes comparar versiones con justicia. Para una prueba de extremo a extremo, haz unas pocas llamadas en vivo; una ronda de tres llamadas cuesta unos 0,0094 USD a los precios de catálogo de este artículo. También puedes repetir las mismas preguntas con el modelo final alojado y compararlo con la preview en tus propias herramientas. Mientras los pesos finales no sean públicos, es la forma más directa de decidir si cambiar de modelo.
Anota cuatro tasas en cada pasada: nombres de herramienta válidos, argumentos que pasan la validación, llamadas hechas cuando no hacía falta y errores corregidos en un turno después de un 422. Compara esas cuatro cifras entre la preview y el modelo final, y antes y después de cada cambio en una descripción de herramienta. Una o dos conversaciones no muestran si un cambio ayudó de verdad.
La factura: entrada del modelo, llamadas de datos y alojamiento propio
Empecemos por una ida y vuelta. El lado de los datos usa los precios del catálogo: weibo/trending 0,000556 USD, bilibili/search 0,000556 USD y douyin/search 0,008333 USD. Juntos son 0,009445 USD, que también es la suma de charged_usd en nuestras respuestas en vivo. En el lado del modelo solo podemos poner precio a la entrada. Los prompts de los tres turnos suman 24.565 tokens sin recortar y 4904 recortados. Al precio de entrada de Hy4 que OpenRouter mostraba el 11 de noviembre a las 00:16 hora de Singapur, 0,417 USD por millón de tokens, son unos 0,0102 USD y 0,0020 USD. Al precio del comunicado de Tencent, unos 0,90 USD por millón, son unos 0,0221 USD y 0,0044 USD. No medimos la salida del modelo, incluido el razonamiento activo por defecto, así que no está en estas cifras. Añádela desde tus propios registros.
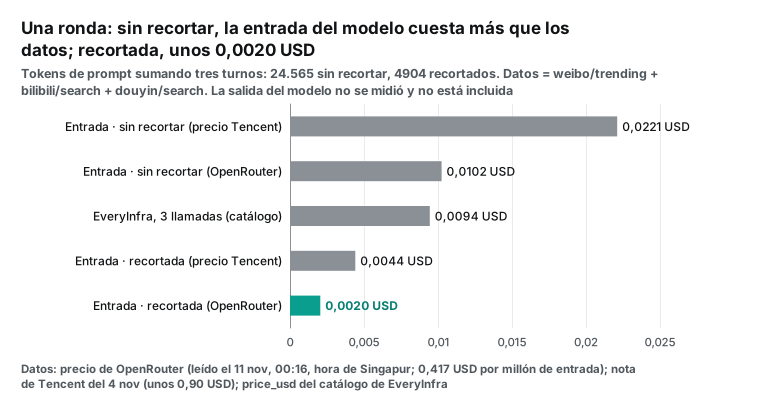
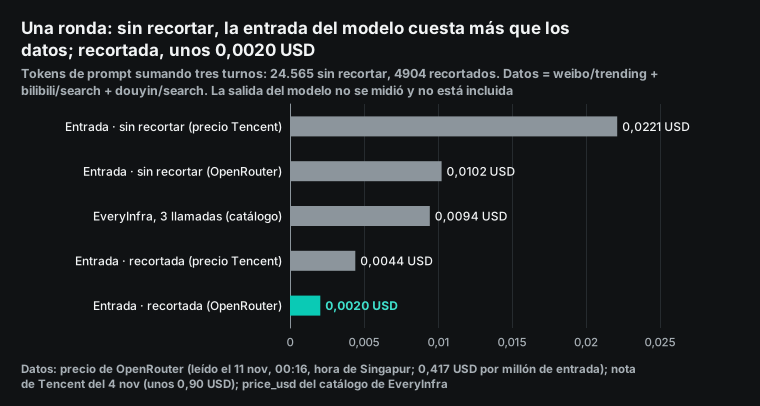
Fíjate en la barra del medio. Con los resultados sin recortar, lo que cuesta que el modelo lea los datos es más que lo que cuestan los datos. Con los resultados recortados, la entrada del modelo baja a una quinta parte del coste de los datos. Así que en este tipo de tarea el ahorro principal no es una fuente de datos más barata; son las doce líneas de recorte de tu ejecutor. Ahora escala la tarea a una vez por hora durante 30 días. Los datos cuestan unos 6,80 USD. La entrada del modelo al precio de OpenRouter cuesta unos 1,47 USD recortada y unos 7,38 USD sin recortar.
| Concepto | Precio unitario (al leerlo) | Una ronda | Cada hora, 30 días |
|---|---|---|---|
| Datos de EveryInfra (3 llamadas) | price_usd del catálogo (leído el 11 nov, 00:16 SGT; sin cambios el 12 nov) | 0,009445 USD | 6,80 USD |
| Entrada de Hy4 recortada (OpenRouter) | 0,417 USD por millón de tokens (11 nov, 00:16 SGT) | 0,0020 USD | 1,47 USD |
| Entrada de Hy4 sin recortar (OpenRouter) | Igual | 0,0102 USD | 7,38 USD |
| Entrada de Hy4 recortada (lista de Tencent) | Unos 0,90 USD por millón (comunicado del 4 nov) | 0,0044 USD | 3,18 USD |
| Alojamiento propio en 8 GPU H200 (bajo demanda) | Runpod, 5,29 USD por GPU y hora (leído el 11 nov) | — | 30.470 USD |
El precio de Tencent de la tabla es el de lista. Tencent Cloud actualizó su página de precios de modelos el 10-11-2026 para indicar que la inferencia de Hy4 se cobra al 50 % del precio de lista hasta el 31 de diciembre. Cuando termine la oferta, el precio alojado se duplica; tenlo en cuenta al comparar el coste alojado con el propio.
La fila del alojamiento propio necesita su propia explicación. Los pesos FP8 de Hy4 preview ocupan 813,8 GB, y las guías usan paralelismo de tensores en 8 GPU. Una NVIDIA H200 tiene 141 GB de memoria, así que 8 suman 1128 GB; lo que queda tras los pesos es para la caché KV. Al precio bajo demanda de 5,29 USD por H200 y hora de la página de precios de Runpod, 8 GPU cuestan 42,32 USD por hora, unos 30.470 USD en 30 días. El mismo dinero compra unos 73.000 millones de tokens de entrada en OpenRouter. Para revisar tendencias cada hora, alojarlo tú no tiene sentido por coste. Su valor está en otra parte: los datos se quedan en tu centro de datos, puedes ajustar el modelo, controlas las restricciones de salida con opciones del servidor como --tool-strict-level y ningún proveedor te limita el ritmo. Si ya tienes una máquina de 8 GPU libre, las llamadas de datos pasan a ser el principal gasto en efectivo de este trabajo: unos pocos dólares al mes.
Errores, límites de ritmo y cobros
En un ciclo de llamadas a herramientas, los errores son normales. Por eso necesitas saber qué errores cuestan dinero y cuáles puede resolver el modelo. Esta tabla lista todos los errores que vimos. Todas las horas son del 11-11-2026, hora de Singapur.
| Hora | Qué pasó | HTTP | Qué decía la respuesta | Cobro |
|---|---|---|---|---|
| 00:19:54, 00:19:57 | Clave de prueba por encima de 10 peticiones por minuto | 429 | rate_limited, retry_after 6 s, Nothing was charged | 0 USD |
| 00:20:01 | sort con el valor hot, que no existe | 422 | Todos los valores permitidos; did_you_mean most_liked, most_viewed | 0 USD |
| 00:22:45 | limit enviado como el texto "10" | 422 | must be an integer from 1 to 50 (got '10') | 0 USD |
| 00:22:52 | params enviado como un texto | 422 | params: Input should be a valid dictionary | 0 USD |
Gestiona el 429 en el ejecutor, no en el modelo: espera retry_after y reenvía la misma petición. El modelo no necesita saberlo. Devuelve el 422 al modelo, porque solo el modelo sabe qué quería preguntar. Nuestras respuestas de error incluyen fault: request significa que la petición está mal y hay que cambiarla; account indica un límite de la cuenta. También incluyen retryable, que dice si tiene sentido reintentar sin cambios. Para capacidades más lentas como la búsqueda de Douyin, el catálogo dice que las peticiones síncronas tienen un margen de 85 segundos; si necesitas más, añade "mode": "async" al cuerpo, obtén un identificador de tarea y consúltalo. Los pasos de configuración y las claves están en la guía de inicio rápido, y los precios en la página de precios.
Límites y puntos a vigilar
Primero, no probamos el comportamiento del modelo. No ejecutamos Hy4, así que todo lo que decimos sobre qué llamadas hace el modelo es un ejemplo de configuración. Si llama a las herramientas en el momento justo y si inventa argumentos, tienes que juzgarlo con las cifras publicadas por Tencent y tus propias repeticiones. Segundo, nuestros recuentos de tokens usan la plantilla y el tokenizador de la preview. Si los pesos finales llegan con una plantilla distinta, por ejemplo con otro formato de lista de herramientas o nuevas reglas para conservar el razonamiento, mide otra vez. No vemos la plantilla de las API alojadas. Tercero, no damos latencia del modelo, porque no lo ejecutamos; los segundos de este artículo son solo tiempos de respuesta de nuestra API.
Cuarto, el alcance de los datos. Las listas de tendencias y los resultados de búsqueda de vídeo son contenido que las plataformas muestran en público. Nuestra API no inicia sesión y no toca contenido privado. Weibo, Bilibili y Douyin tienen sus propias plataformas para desarrolladores (Weibo, Bilibili, Douyin), adecuadas para datos autorizados de tus propias cuentas; leer contenido público de varias cuentas es el caso de este artículo. Quinto, la búsqueda de Douyin cuesta unas 15 veces más por llamada que las otras dos; es el 88 % del coste de datos de una ronda. Con un presupuesto ajustado, revisa primero Weibo y Bilibili y llama a Douyin solo cuando el tema lo merezca.
Lecturas relacionadas
Artículos relacionados: GLM 5.3 escribe scripts para Zhihu y Weibo en Claude Code; Qwen-Agent recibe sus herramientas por MCP remoto; DeepSeek V4.1 Flash limpia y etiqueta diez mil reseñas; tutorial de la API de Douyin con Python. Si tu modelo ya tiene un cliente con MCP, conéctalo a nuestro servidor MCP remoto.
Preguntas frecuentes
¿Dónde encuentro un hy4 function calling example?
La ficha del modelo y el repositorio de Tencent solo muestran ejemplos de chat simple; no hay un ejemplo completo de llamadas a herramientas. Para el formato, lee el archivo chat_template.jinja y la documentación de tool calling de vLLM. El JSON de herramientas y el código del ejecutor de este artículo sirven de ejemplo, y el formato de la petición es el mismo que en function calling de OpenAI.
¿Qué suele causar un hy4 function calling error?
Por el código fuente y nuestras llamadas en vivo, hay tres causas comunes. Una: el servidor funciona sin --enable-auto-tool-choice y --tool-call-parser hy_v4, así que las etiquetas originales aparecen en el texto de la respuesta. Dos: el esquema omite los tipos de argumentos, así que enteros y objetos salen como texto y la API de datos devuelve 422. Tres: la versión de vLLM es anterior al 31-10-2026, así que los nombres de argumentos con espacios cambian. Compara la tercera con el PR #61542.
¿Cómo llamo a la tencent hy4 api y en qué se diferencia de alojarlo yo?
Las opciones alojadas son Tencent Cloud TokenHub, compatible con OpenAI, y OpenRouter, cuyos pasos de alta están en su guía de inicio rápido. Ambas aceptan tools y sirven el Hy4 final. Alojarlo tú hoy significa usar los pesos de la preview. Controlas la plantilla, el analizador y el modo estricto, y necesitas 8 GPU para empezar.
¿Puedo ejecutar un modelo tan grande en local?
En la discusión #10 de la página de Hy4-preview en Hugging Face, un usuario señala que Qwen y GLM ya tienen versiones de menos de 300B que caben en una máquina, y que Hy4 es mucho más grande. Según nuestro recuento, los pesos FP8 ocupan 813,8 GB, lo que exige al menos 8 GPU de 141 GB. Miembros de la comunidad publicaron versiones GGUF de pocos bits en la misma zona de discusión (hilos #8 y #9; consulta la documentación del formato GGUF), pero no hay datos publicados sobre su calidad ni sobre la estabilidad de sus llamadas a herramientas. Si solo necesitas que el modelo revise tendencias, una API alojada más nuestra API de datos es un comienzo más realista.
Referencias
- Tencent Launches Hy4, Joining the Ranks of the World's Leading Open-Source AI Models, Tencent, 2026-11-04, https://www.tencent.com/tencent-launches-hy4-joining-the-ranks-of-the-worlds-leading-open-source-ai-models/
- Introducing Hy4, Tencent Hy, 2026-11-04, https://hy.tencent.ai/research/hy4
- Ficha del modelo tencent/Hy4-preview, Hugging Face, actualizada 2026-08-28, https://huggingface.co/tencent/Hy4-preview
- tencent/Hy4-preview-FP8, Hugging Face, actualizada 2026-08-28, https://huggingface.co/tencent/Hy4-preview-FP8
- Tencent-Hunyuan/Hy4-preview, GitHub, https://github.com/Tencent-Hunyuan/Hy4-preview
- chat_template.jinja de Hy4-preview, Hugging Face, https://huggingface.co/tencent/Hy4-preview/blob/main/chat_template.jinja
- Guía de uso de tencent/Hy4-preview, vLLM Recipes, https://recipes.vllm.ai/tencent/Hy4-preview
- Recetario de Hy4-Preview, SGLang, https://lmsysorg.mintlify.app/cookbook/autoregressive/Tencent/Hy4-Preview
- hy_v4_tool_parser.py, vLLM, último commit 2026-11-08, https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/hy_v4_tool_parser.py
- Preserve whitespace in HYV4 argument names (#61542), vLLM, 2026-10-31, https://github.com/vllm-project/vllm/pull/61542
- Add --tool-strict-level (#56268), vLLM, 2026-09-18, https://github.com/vllm-project/vllm/pull/56268
- tool_strict_level.py, vLLM, https://github.com/vllm-project/vllm/blob/main/vllm/tool_parsers/tool_strict_level.py
- Tool Calling, documentación de vLLM, https://docs.vllm.ai/en/latest/features/tool_calling.html
- Structured Outputs, documentación de vLLM, https://docs.vllm.ai/en/latest/features/structured_outputs.html
- Reasoning Outputs, documentación de vLLM, https://docs.vllm.ai/en/latest/features/reasoning_outputs.html
- OpenAI-Compatible Server, documentación de vLLM, https://docs.vllm.ai/en/latest/serving/openai_compatible_server.html
- Tool Parser, documentación de SGLang, https://docs.sglang.io/advanced_features/tool_parser.html
- Function calling, documentación de OpenAI, https://platform.openai.com/docs/guides/function-calling
- Structured outputs, documentación de OpenAI, https://platform.openai.com/docs/guides/structured-outputs
- Tool & Function Calling, documentación de OpenRouter, https://openrouter.ai/docs/guides/features/tool-calling
- Quickstart, documentación de OpenRouter, https://openrouter.ai/docs/quickstart
- API de modelos (precio y parámetros de tencent/hy4), OpenRouter, leída 2026-11-11 00:16 SGT, https://openrouter.ai/api/v1/models
- Artículo de lanzamiento de Hy4, Tencent Cloud Developer Community, 2026-11-04, https://developer.cloud.tencent.com/article/2776227
- Model pricing, Tencent Cloud, actualizada 2026-11-10, https://www.tencentcloud.com/document/product/1300/78937
- Chat templates, documentación de Hugging Face Transformers, https://huggingface.co/docs/transformers/main/en/chat_templating
- Documentación de Tokenizers, Hugging Face, https://huggingface.co/docs/tokenizers/index
- Evaluation results, documentación de Hugging Face Hub, https://huggingface.co/docs/hub/eval-results
- GGUF, documentación de Hugging Face Hub, https://huggingface.co/docs/hub/gguf
- Toolathlon, HKUST NLP, GitHub, https://github.com/hkust-nlp/Toolathlon
- DeepSeek Sparse Attention, arXiv 2512.02556, https://arxiv.org/abs/2512.02556
- IndexCache, arXiv 2603.12201, https://arxiv.org/abs/2603.12201
- Apache License 2.0, Apache Software Foundation, https://www.apache.org/licenses/LICENSE-2.0
- Jinja, Pallets, GitHub, https://github.com/pallets/jinja
- Documentación de XGrammar, https://xgrammar.mlc.ai/docs/
- Documentación de Requests, https://requests.readthedocs.io/en/latest/
- openai-python, OpenAI, GitHub, https://github.com/openai/openai-python
- json, documentación de Python, https://docs.python.org/3/library/json.html
- Type, referencia de JSON Schema, https://json-schema.org/understanding-json-schema/reference/type
- NVIDIA H200 Tensor Core GPU, NVIDIA, https://www.nvidia.com/en-us/data-center/h200/
- GPU Cloud Pricing, Runpod, leída 2026-11-11, https://www.runpod.io/pricing
- Discusión #10 en tencent/Hy4-preview, Hugging Face, 2026-08-29, https://huggingface.co/tencent/Hy4-preview/discussions/10
- Tencent says its Hy4 joins 'top-tier' of open-source AI models, Nikkei Asia, 2026-11-04, https://asia.nikkei.com/business/technology/artificial-intelligence/tencent-says-its-hy4-joins-top-tier-of-open-source-ai-models
- Tools (especificación MCP), Model Context Protocol, https://modelcontextprotocol.io/specification/2025-06-18/server/tools
- Documentación de la API de Weibo Open Platform, Sina Weibo, https://open.weibo.com/wiki/API
- Bilibili Open Platform, Bilibili, https://openhome.bilibili.com/
- Douyin Open Platform, Douyin, https://developer.open-douyin.com/
- Catálogo de datos sociales de EveryInfra, EveryInfra, leído 2026-11-11 00:16 SGT, https://api.everyinfra.com/api/v1/social/catalog
- Tencent Hy4 Is INSANE: Is THIS the BEST Open Model Yet?, YouTube, 2026-11-06, https://www.youtube.com/watch?v=GBjDU9Ct0VQ
- Documentación de jsonschema, Python, https://python-jsonschema.readthedocs.io/en/stable/
Referencia BL-130