douyin api python:取抖音数据三条路实测
用 Python 取抖音数据有三条路:官方开放平台要企业资质和用户授权,开源脚本要登录和签名,按次 API 一条搜索到回复的完整链实测 $0.0106。
我们在 2026 年 11 月 10 日 00:14–00:34(新加坡时间)用 Python 的 requests 跑了 4 次「搜索 → 作品详情 → 评论 → 评论回复 → 视频文稿」完整链,每次 5 个请求全部成功,每条链扣费 $0.010557,其中 79% 花在搜索那一步。按真实返回条数算,搜索结果每千条约 $0.76,评论每千条约 $0.032,回复每千条约 $0.029,差 23–27 倍;所以用 Python 做抖音数据,省钱的关键不是少调评论,而是少翻搜索页。另外两条路我们按一手材料逐条核对:抖音开放平台的数据能力要用户授权,部分只对企业、党政和事业单位开放,关键词视频搜索只回最近 1 天的视频,官方服务端 SDK 没有 Python 版;GitHub 上最常见的开源抓取项目,自己在 README 里写明要登录态或签名参数,近 30 天的 issue 里还在报新验证和请求被拒。
官方接口和开源脚本两部分只引用官方文档、项目 README 和公开 issue 的原文;按次付费接口这部分,每个数字都来自我们自己的真实调用。
先说结论:三条路分别适合谁
三条路不是谁替代谁,而是适用人群几乎不重叠。下面这张表把每条路要准备的东西、能拿到的范围和主要风险放在一起,表里每一项在后文都有出处和实测。
| 维度 | 抖音开放平台官方接口 | GitHub 开源脚本 | 按次付费数据接口(本文实测 EveryInfra) |
|---|---|---|---|
| 主体要求 | 部分数据能力仅限企业、党政和事业单位 | 无 | 无,注册拿 API Key |
| 能读谁的数据 | 授权给你的抖音用户自己的作品和数据;关键词搜索要特殊权限 | 公开页面能看到的,取决于登录态 | 公开作品、评论、回复、文稿 |
| 关键词搜索 | 「关键词视频搜索」只回最近 1 天;「抖音视频搜索」要申请内测 | README 写游客身份拿不到抖音搜索 | douyin/search,可选最近 1 天到不限时间 |
| 上手前置 | 建应用、申请能力、审核 2–7 个工作日、用户授权 | 装依赖、导入 Cookie 或开浏览器登录 | 一个环境变量 |
| Python 支持 | 服务端 SDK 只有 Java、NodeJS、Go | 多数项目本身就是 Python | 任何能发 HTTP 的语言 |
| 主要风险 | 能力可被收回;不得做对外售卖的数据服务 | 签名和验证随时变,账号有风险,部分许可证禁止商用 | 按次付费;失败和空结果不扣费 |
| 费用 | 接口本身不收费,成本在资质和审核 | 代码免费,成本在维护时间和代理 | 本文一条完整链 $0.010557 |
我们的判断是:如果你做的是自家抖音号的运营后台、要回复评论、要在应用里展示授权用户自己的数据,官方接口是唯一正当的选择,它给的数据最全,也带写权限。如果你只是偶尔下载几个视频做研究,开源下载器足够,但要接受它随时失效。如果你要按话题持续采集别人的公开视频和评论、做舆情或研究,又不想自己维护登录和签名,按次付费接口是投入最少的一条路。后面每一节分别给出依据。
第一条路:抖音开放平台官方接口能拿什么、要什么资质
很多教程把「抖音开放平台」写成一个能随便查抖音数据的 API,这和官方文档不符。开放平台的数据能力几乎都建立在「用户授权」上:你的应用先让某个抖音用户登录授权,拿到 access_token,然后只能读这个用户自己的作品、粉丝和互动数据。官方的登录与授权文档写得很清楚:需要用户授权的接口用 access_token,有效期 15 天;不需要用户授权的接口用 client_token,有效期 2 小时;refresh_token 有效期 30 天,最多续 5 次,最长续期 195 天。文档还写了「数据经营能力,用户必须在 PC 端完成授权」。
数据能力的准入条件
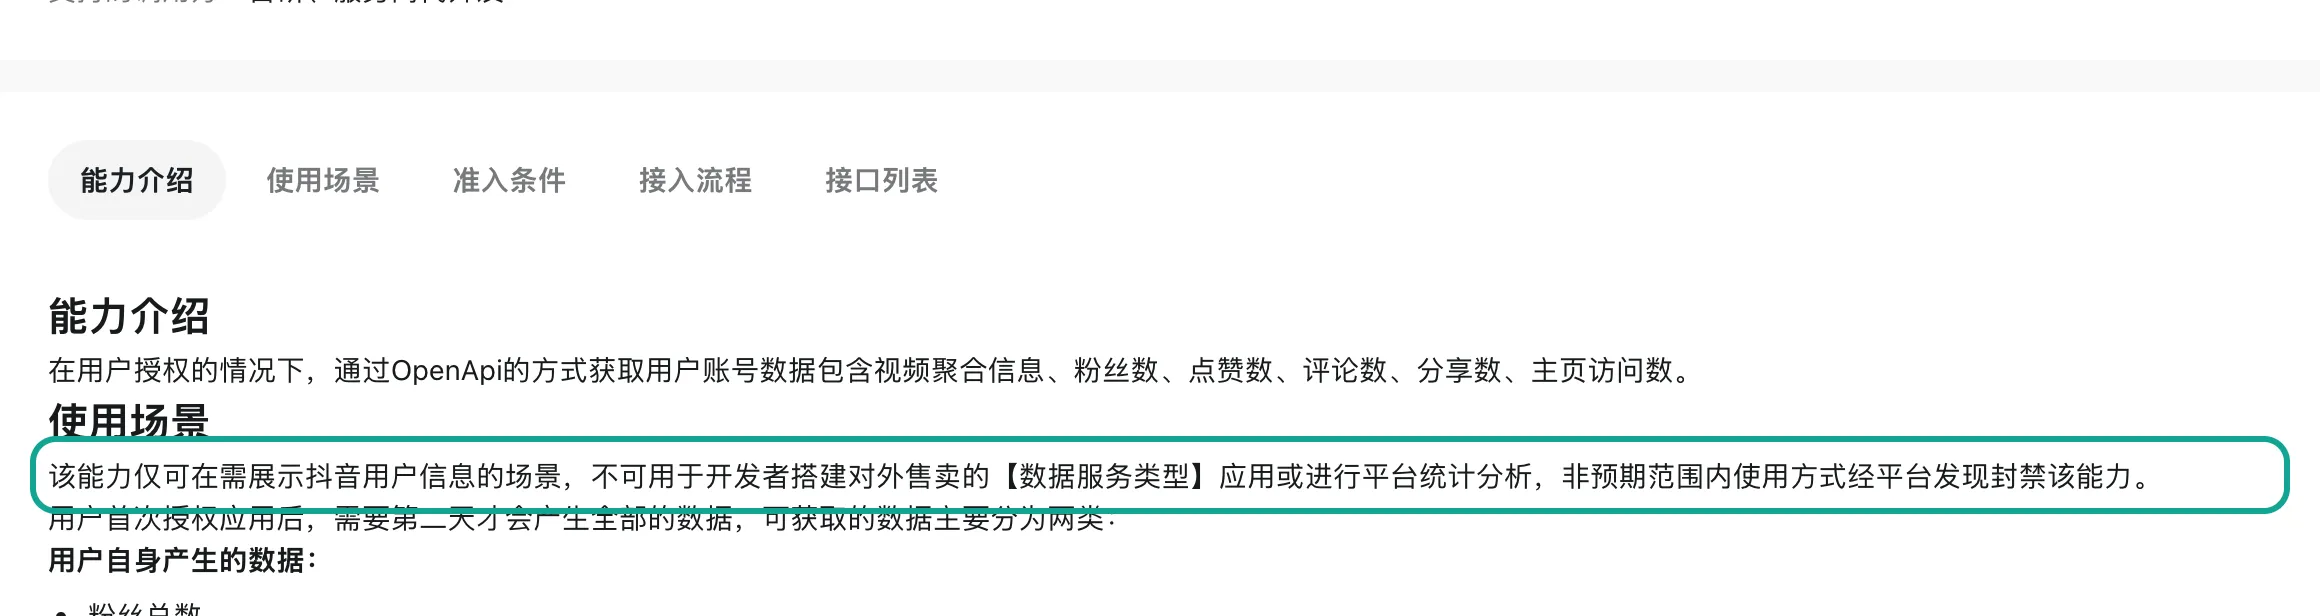
我们逐个打开了数据相关的能力页。「用户互动数据」能力的准入条件原文是「仅限企业、党政和事业单位类型开发者申请」,使用场景一栏写的是:该能力仅可在需展示抖音用户信息的场景,不可用于开发者搭建对外售卖的数据服务类型应用或进行平台统计分析,超出预期范围使用会被封禁。这句话决定了官方接口不适合拿来做舆情监测或行业研究:你能拿到的是授权用户自己的粉丝数、点赞数、评论数和主页访问数,而且用户首次授权后要第二天才会产生全部数据。
「视频数据」能力同样以用户授权为前提:在经过用户授权的情况下,可以查询视频的标题、封面、是否置顶、创建时间,以及点赞、播放、分享、评论等官方数据。移动或网站应用要同时申请「内容运营-视频信息数据」和「内容运营-视频互动数据」两个能力,平台审核 2–3 个工作日,滥用会被收回。读视频列表用的「查询授权账号视频列表」接口要求 access-token 来自用户授权,文档还写着「目前暂不支持时间过滤」。
评论这一块,「视频评论管理接入方案」列出了评论列表、评论回复列表、回复评论和置顶评论四个接口,前提是申请「互动管理」权限,Scope 是 video.comment。它的适用场景是后台管理系统接入「抖音账号」的实时评论,也就是你自己或授权给你的账号下的评论,不是任意视频的评论。
关键词搜索:只回最近 1 天,或者要申请内测
对做话题研究的人来说,最关键的是搜索。开放平台有两套搜索相关的接口,我们都核对了原文。第一套是「关键词视频搜索」,Scope 是 video.search,需要申请权限、需要用户授权,使用前要先在管理中心创建关键词,并且「该接口只返回最近 1 天的视频」。服务商平台上对同一能力的说明是:开发者申请「与我相关」的关键词后,可以搜索视频标题中含有这些关键词的公开视频并回复评论,搜索结果只返回最近 1 天发布的公开视频(视频搜索管理)。在用户类型及权限说明的权限表里,这项「关键词视频管理」被标为特殊权限、默认关闭。
第二套是「搜索能力」分类下的「抖音视频搜索」和「抖音图文搜索」,在 OpenAPI 列表里描述为「用户输入搜索词后,获取抖音视频相关内容的搜索结果信息」,在 OpenAPI SDK 总览里对应的 Scope 是 aweme.dy.video_search_v2。它的产品页「抖音搜索能力对外开放了」写的是为第三方应用提供内容搜索服务,提升用户的搜索和问答体验,接入方式是「申请内测,填写内测申请工单,审批通过后即可接入」。也就是说,它面向的是要把抖音内容展示给自己用户的应用,不是批量采集;而开放平台的小程序运营规范第 10.4.2 条写明,使用内测 API 的小程序,开放平台团队有权回收接口能力。
| 官方能力 | Scope | 是否要用户授权 | 准入或限制(原文要点) | 审核时间 |
|---|---|---|---|---|
| 用户互动数据 | data.external.user | 是 | 仅限企业、党政、事业单位;不可做对外售卖的数据服务 | 2–3 个工作日 |
| 视频数据 | video.data.bind 等 | 是 | 需同时申请视频信息、视频互动两个能力 | 2–3 个工作日 |
| 视频评论管理 | video.comment | 是 | 申请互动管理权限 | 未写明 |
| 关键词视频搜索 | video.search | 是 | 特殊权限,只回最近 1 天 | 未写明 |
| 抖音视频搜索 | aweme.dy.video_search_v2 | 否(client_token) | 内测申请,审批通过后接入 | 未写明 |
| 一般能力申请 | 各能力 | — | 填写预期使用场景 | 5–7 个工作日 |
最后一行来自能力概览:能力或功能申请提交后审核时效 5–7 个工作日,申请提额同样 5–7 个工作日。再加上创建应用这一步:新建的应用是测试应用,相关操作对线上环境不生效,上线后的应用才可商用。顺带一提,开放平台对发布能力的门槛更高,抖音发布能力使用规范要求企业主体注册资本不少于 50 万、注册时间不少于 1 年,并且不再向个体工商户开放。
官方接口和 Python
对搜索「douyin api python」的人,还有一个容易被忽略的事实:开放平台的服务端 OpenAPI SDK 目前只支持 Java、NodeJS、Go 三种语言,没有 Python。这不妨碍你用 Python 调官方接口,因为它们本质上是普通的 HTTPS 接口,requests 发 GET、POST 就行,只是 token 换取、刷新和续期要自己写。真正的门槛不在语言,而在资质和授权:没有企业主体、没有愿意授权给你的抖音用户,绝大部分数据接口根本调不通。
第二条路:GitHub 上的开源脚本
搜「douyin scraper github」和「抖音评论爬虫github」,前排几乎都是同一批开源项目。我们在 2026 年 11 月 10 日 00:22(新加坡时间)用 GitHub 的公开接口读了 6 个常见项目的星标数、最后推送时间和许可证,又逐个读了 README 和近 30 天的 issue。下面只写这些公开材料里的事实,不评价项目好坏。
| 项目 | 星标 | 最后推送 | 许可证 | README 写明的前置条件 |
|---|---|---|---|---|
| MediaCrawler | 70,735 | 2026-11-09 | 自定义(README 写禁止商业用途) | Playwright 登录保存登录态,扫码登录 |
| Douyin_TikTok_Download_API | 21,313 | 2026-11-09 | Apache-2.0 | v5 用无头浏览器生成游客身份;纯 Python 实现多种签名 |
| douyin-downloader | 12,576 | 2026-11-09 | MIT | Python 3.9+;浏览器登录后保存 Cookie |
| TikTokDownload | 8,892 | 2024-06-28 | MIT | 已一年多没有推送 |
| f2 | 2,729 | 2026-10-19 | Apache-2.0 | 配置 Cookie;部分内容需要登录 |
| Crawler | 1,478 | 2026-10-19 | 非商业使用许可 | 在测试文件里加自己的 Cookie;建议加代理池 |
登录态和签名是绕不开的维护成本
MediaCrawler 的 README 把自己的做法写得很直白:基于 Playwright 浏览器自动化框架登录保存登录态,利用保留登录态的浏览器上下文,通过 JS 表达式获取签名参数;默认用 CDP 模式连接用户已有的 Chrome,复用已有的登录状态和 Cookie,以「大幅降低平台风控检测风险」。它的免责声明写着本仓库所有内容仅供学习和参考,禁止用于商业用途。这意味着它首先是一个学习项目,拿去做付费服务的数据源,和它自己的声明冲突。
Douyin_TikTok_Download_API 在 v5 的说明里写了 v4 最大的问题:接口会悄无声息地失效,Cookie 过期、签名算法改变、接口被限流,直到有人提 issue 才知道。v5 因此改成用无头浏览器生成游客身份、身份池自动补充,签名部分用纯 Python 实现多个签名参数,部署要 PostgreSQL(带 TimescaleDB 扩展)、Redis 8 和 Python 3.12。对本文最关键的一句在它的能力表下面:抖音对游客不提供搜索和话题下的作品,作者也还没测过登录身份能否拿到,所以这两项在抖音上「都没有提供」。换句话说,按关键词搜抖音视频这件事,这个两万多星的项目目前不做。它近期的 issue 也能看出维护量:11 月 5 日合并的 #821 专门把 A-Bogus 签名里的 SM3 计算提速了 9.5%,11 月 9 日的 #825 报告内容请求长时间积压。
douyin-downloader 的 README 直接写了限制:抖音的请求校验目前会挡住命令行下载单个视频、合集、音乐、喜欢和收藏,作者主页作品可以尝试用 Playwright 浏览器兜底,但不保证成功;刷新 Cookie 或重试都不能解决这类校验拦截。它的 issue 区在过去两周有三条和本文直接相关:10 月 25 日的 #257 说下载评论时偶尔得到空文件,连续 50 次以上下载时很多都是空的;10 月 26 日的 #258 贴出的报错是作品列表第 1 页被抖音拒绝,提示安全校验只放行网页内发起的请求,重试或重新登录都无效;11 月 9 日的 #263 说重新登录获取了 Cookie 仍然不返回作品详情,前几周还能用。
验证码同样在变。10 月 28 日 MediaCrawler 的 #996 记录了一种新的验证:在抖音网页搜索「AI国风」时,结果页被弹窗遮挡,不再是滑块对齐缺口,而是按文字描述从九宫格里选图片、拖到下方区域再提交。提问者明确写了没有尝试自动识别或提交验证码。11 月 2 日的 #998 则是在修抖音图文作品 /note/ 链接里的作品 ID 解析。我们不教、也不建议绕过这些校验;列出来是为了说明,自建脚本的成本主要不在写第一版代码,而在每周追平台变化。
robots.txt 和许可证
我们在 00:35(新加坡时间)读了抖音网页版的 robots.txt:文件里点名列出了 26 个搜索引擎和 AI 抓取器的 User-agent,统一不允许抓 /follow、带 general_search 参数的搜索页等路径,对其中一个分组还写了 /video/、/search/ 等路径不允许,文件里没有 User-agent: * 的通配分组。robots 文件只是网站对抓取器的声明,不是法律文本;它说明的是平台对搜索页的态度。许可证方面,上表 6 个项目里有 2 个明确写了非商业用途,商用前要先读清楚。
第三条路:按次付费接口,用 Python 跑完整链
第三条路是把登录、签名、验证和页面变化交给接口提供方,自己只发 HTTP 请求、按次付费。本文实测的是 EveryInfra 的数据接口,用到五项能力:douyin/search 关键词搜索、douyin/video 作品详情、douyin/comments 评论、douyin/comment_replies 评论回复、douyin/transcript 视频文稿。能力名、参数、价格和返回字段都来自免费目录 /api/v1/social/catalog,我们在 00:13 读取:douyin/search 每页 $0.008333,其余四项每次 $0.000556,其中评论和回复按每 20 条一档计费,一条都没返回的档不扣费。平台总览见 抖音数据接口页。


下面是我们实际跑的脚本(去掉了注释以外的空行)。它只依赖 requests,Key 从环境变量读,搜索结果里挑评论数最多的视频,评论里挑回复最多的那条再取回复,每一步的请求和完整响应都存成 JSON 文件,方便事后复算。碰到 429(这把测试 Key 每分钟 10 次)就等 60 秒重试。
"""Douyin chain: search -> video -> comments -> comment_replies -> transcript."""
import json, os, sys, time
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]          # never hard-code the key
SESSION = requests.Session()
SESSION.headers.update({"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})

def call(action, params, tag, name):
    body = {"platform": "douyin", "action": action, "params": params}
    for attempt in range(3):
        t0 = time.time()
        r = SESSION.post(API, json=body, timeout=120)
        dt = round(time.time() - t0, 2)
        if r.status_code == 429:                  # rate limited: wait, then retry
            time.sleep(60)
            continue
        break
    data = r.json()
    Path(tag).mkdir(exist_ok=True)
    Path(tag, f"{name}.json").write_text(json.dumps(
        {"elapsed_s": dt, "http_status": r.status_code, "request": body, "response": data},
        ensure_ascii=False, indent=1))
    print(name, r.status_code, dt, (data.get("billing") or {}).get("charged_usd"))
    return data

def rows_of(data):
    rows = data.get("results") or []
    return rows if isinstance(rows, list) else [rows]

def main(keyword, tag):
    s = call("search", {"keyword": keyword, "sort": "most_liked",
                        "publish_time": "half_year", "page_token": ""}, tag, "1_search")
    url = max(rows_of(s), key=lambda v: v.get("comment_count") or 0)["url"]
    call("video", {"url": url}, tag, "2_video")
    c = call("comments", {"url": url, "page_token": ""}, tag, "3_comments")
    top = max([x for x in rows_of(c) if not x.get("is_reply")], key=lambda x: x.get("reply_count") or 0)
    call("comment_replies", {"url": url, "comment_id": str(top["id"]), "page_token": ""}, tag, "4_replies")
    call("transcript", {"url": url}, tag, "5_transcript")

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
运行方式是 export EVERYINFRA_API_KEY=... 之后 python douyin_chain.py "赣南脐橙" run1。代码里有三处值得解释。第一,requests.Session 会复用连接,requests 文档写明同一主机的多次请求复用底层 TCP 连接能明显提速;我们的一条链 5 个请求都发往同一个地址。第二,timeout=120 不能省,同步接口的单次预算是 85 秒,客户端超时要比它长。第三,page_token 传空字符串而不是不传:目录里写明,传空字符串表示从第一页开始翻,响应里会给 next_page_token;不传则是单次调用,没有下一页。我们用的是 requests 2.34.2(PyPI 显示要求 Python 3.10 以上),本机 Python 环境由 uv 临时创建;10 月 25 日发布的 Python 3.15.2 是一个加急的安全版本,修了 ssl 证书信任和 tarfile 的问题,跑数据脚本的机器值得顺手升级。
如果不想写代码,也可以把同一套能力接进 AI 工具。下面是远程 MCP 的配置示例(客户端不同,字段名略有差别;Key 同样从环境变量读),接上以后,AI 会用 everyinfra_call_api 这个工具按同样的 platform、action、params 调用。抖音这一组能力的 MCP 说明见 抖音 MCP 页。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
实测:三个关键词、四次跑链
抖音的内容面极广:据第 57 次《中国互联网络发展状况统计报告》,截至 2025 年 12 月我国网民规模达 11.25 亿人,网上外卖、短视频和网络游戏的用户规模增长显著(江苏网信网转述,2026-04-22)。所以同一段代码要能应付完全不同的话题。我们选了三个跨领域的关键词,让同一段代码面对不同类型的内容:「赣南脐橙」是农产品,2026 产季在 11 月 6 日正式开采(新华网,11 月 6 日),采收季的视频和评论量都在上升;「流感疫苗」是公共卫生话题,中国疾控中心 11 月 5 日的第 44 周流感监测周报写明北方省份流感病毒检测阳性率上升、甲型流感占 65.4%;「智利车厘子」是进口水果,正好在南半球车厘子上市前。三条链分别在 00:14、00:24、00:28(新加坡时间)跑,00:16–00:17 另跑了一轮翻页,00:34 跑了一次并行版。
| 实测 | 时间(新加坡时间) | 关键词 | 搜索条数 | 评论条数 | 回复条数 | 文稿字数 | 串行总耗时 | 扣费 |
|---|---|---|---|---|---|---|---|---|
| 一 | 00:14 | 赣南脐橙 | 10 | 18 | 20 | 1,502 | 48.18 秒 | $0.010557 |
| 二 | 00:24 | 流感疫苗 | 11 | 20 | 20 | 13 | 35.85 秒 | $0.010557 |
| 三 | 00:28 | 智利车厘子 | 10 | 19 | 18 | 526 | 38.84 秒 | $0.010557 |
| 四(并行) | 00:34 | 赣南脐橙 | 11 | 20 | 20 | — | 墙钟 33.49 秒 | $0.010557 |
20 个请求最终全部返回 HTTP 200,每条链的扣费完全一样:搜索 $0.008333 加四个 $0.000556。要说明一点:表里的串行总耗时是 5 步各自耗时之和,不含限速等待。三次串行实测各至少有一步先收到 429(这把测试 Key 每分钟 10 次),脚本等 60 秒后重试成功;所以从发出搜索到拿到文稿,三条链的墙钟分别约 108、97、99 秒。限速那一次不扣费,扣费明细里看不到它。三次串行链的总耗时是 35.85、38.84、48.18 秒,中位 38.84 秒,没有达到我们动笔前定的「中位不超过 30 秒」的目标;拖慢它的是视频文稿一步,三次分别 22.35、21.8、22.35 秒,占串行总耗时的 46.4%、60.8%、57.5%。文稿要先下载音轨再转写,它的耗时和视频长短关系不大:实测二的视频只有 5 秒,文稿只有 13 个字,转写仍用了 21.8 秒。实测一的作品详情用了 18.36 秒,另外三次在 5.17–10.06 秒之间,单次波动比较大。
实测二还暴露了一个选片问题。脚本按评论数从搜索结果里挑视频,挑中的是评论 12,442 条、时长却只有 5 秒的一条,文稿那 13 个字读起来像背景音乐里的一句歌词,和疫苗没有关系。这不是接口出错,而是挑选规则的问题:评论多的短视频,讨论往往发生在评论区,画面和声音里没有可分析的内容。做话题研究时,建议先按 duration_sec 过滤,比如只留 60 秒以上的视频,再按评论数排序;这次流感疫苗的 11 条搜索结果里,有 8 条满足这个条件。
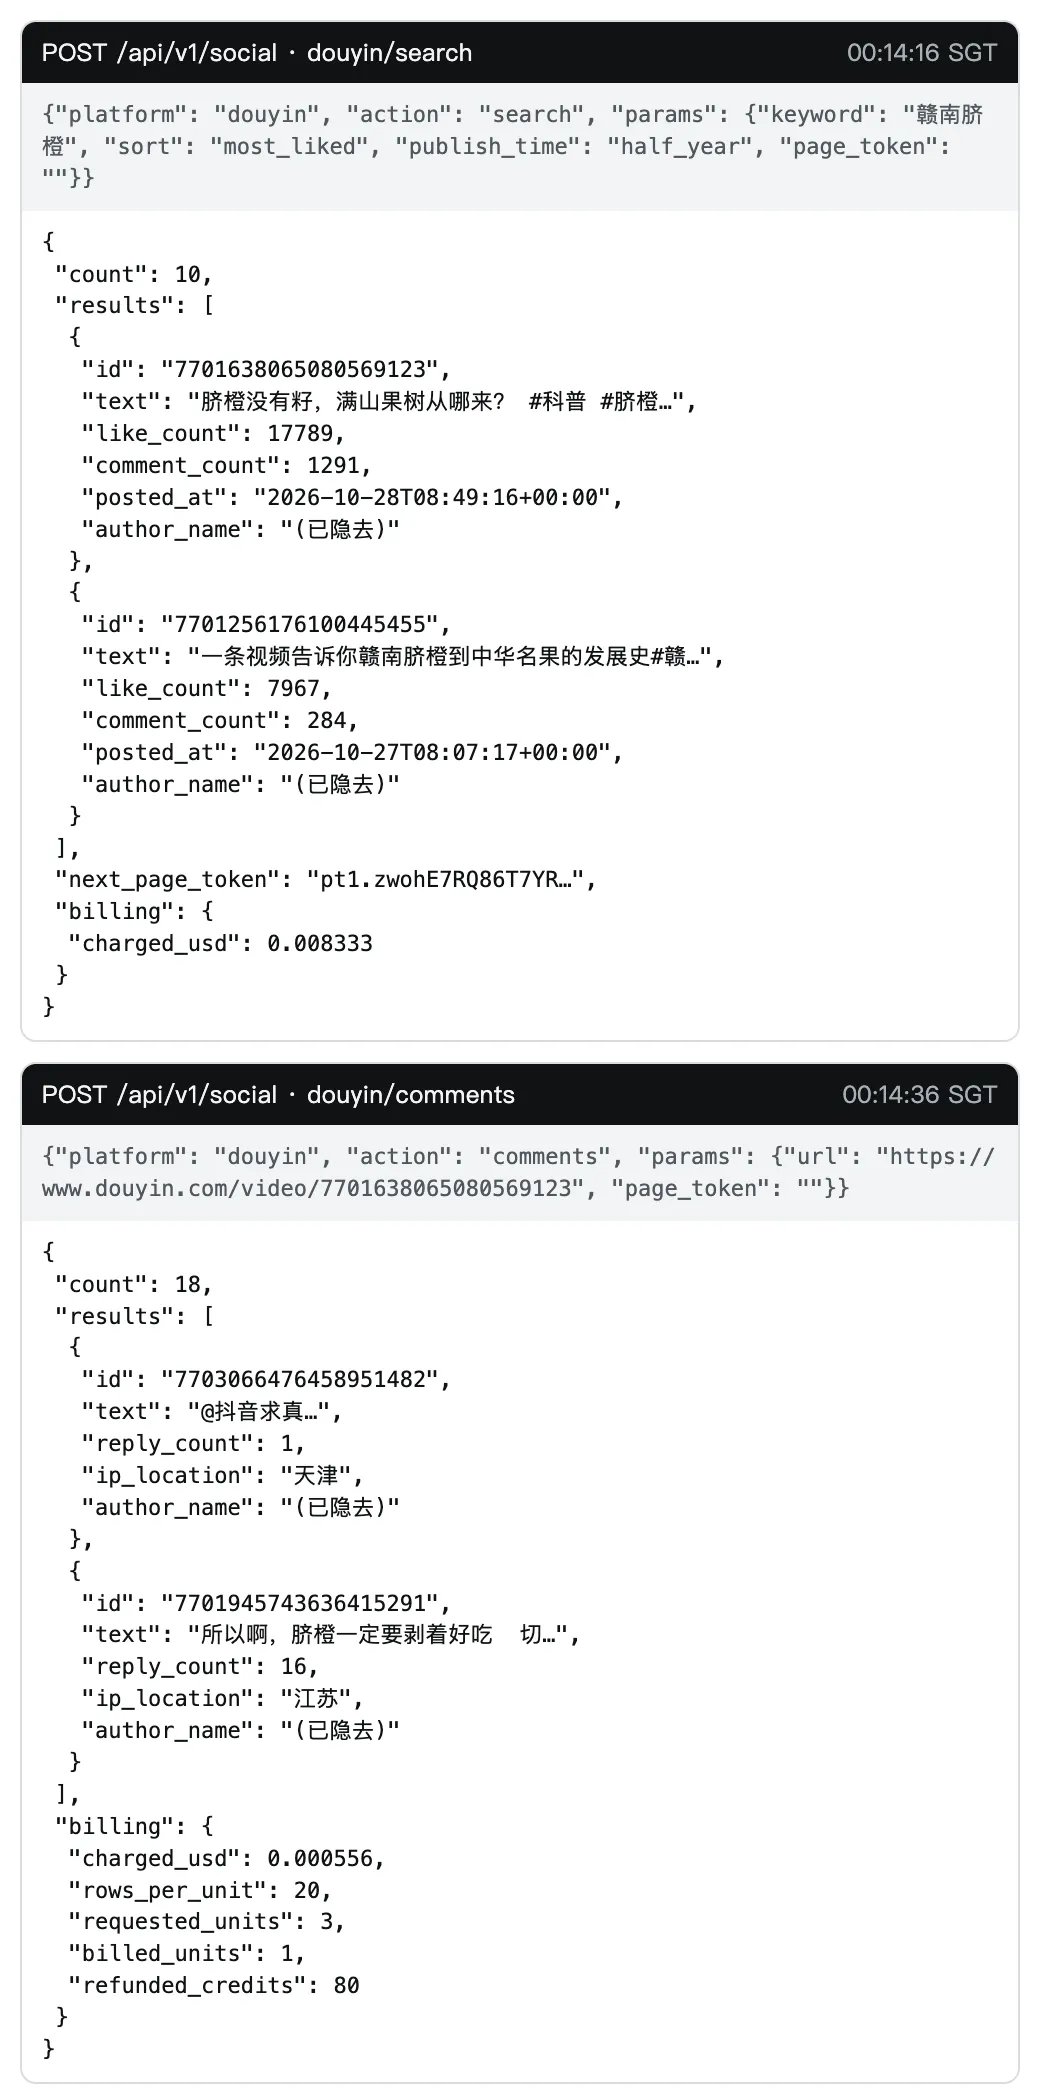
接口返回的样子见下图:上半是实测一的搜索请求和前两条结果,下半是评论请求和计费明细。作者昵称我们在截图里隐去了;评论自带的 ip_location 是平台强制展示的 IP 属地,18 条里 18 条都有。
几条从原始返回里读出来的观察,后面算成本时会用到。第一,搜索按「点赞最多」排序时,第一页 10 条的点赞数从 17,789 递减到 946,第二页 13 条从 473 递减到 3,两页之间没有重复,顺序在页与页之间是连续的。第二,搜索结果每行 29–30 个字段,三次都没有 view_count;目录对这个字段的说明是抖音不对外公开播放量,多数结果没有这个字段,有时为 0,都不代表真实播放,判断热度要用点赞、评论和分享数。实测一的作品详情里 view_count 就是 0,而点赞是 17,789、分享 10,584。第三,评论回复里很多是「楼中楼」:三次各 20、20、18 条回复中,分别有 15、11、16 条带 reply_to_reply_id,说明它们回复的是楼里另一条回复,而不是顶层评论。做情绪分析时,如果只看顶层评论,会漏掉讨论最集中的那部分。
分页怎么翻:next_page_token 实测
抖音的评论和搜索结果都很长,分页是 Python 脚本里最容易写错的地方。我们在 00:16–00:17(新加坡时间)用实测一的令牌接着翻:搜索翻到第 2 页、评论翻到第 3 页、回复翻到第 2 页。
tok = first_page["next_page_token"]          # from the response of page 1
while tok:
    d = call("comments", {"url": url, "page_token": tok}, "pages", f"comments_{n}")
    tok = d.get("next_page_token")            # missing key = last page
    n += 1
结果和目录的说明对得上,也有一个和直觉不同的地方。搜索第 2 页回了 13 条,比默认的 10 条多,与第 1 页 0 重复;目录写的是「按抖音的整页取、不截断,常常多出几条,相邻两页重复给的视频不再给」。评论三页分别回了 18、9、20 条,共 47 条、0 重复,而这条视频的评论数是 1,291(含回复)。目录写每页最多 50 条顶层评论,实际每页只有 9–20 条,所以计费只扣了 1 档:响应里 requested_units 是 3、billed_units 是 1、refunded_credits 是 80,也就是预扣的 3 档按实际条数退回了 2 档。回复两页各 20 条,共 40 条、0 重复,那条顶层评论的 reply_count 是 66,两页覆盖了 61%。
这个观察对写脚本有两个直接影响。一是不要用「每页 50 条」去估算要翻多少页,按实测每页约 16 条(三页平均 15.7 条)估更接近;1,291 条评论里顶层评论约占多少,要看 reply_count 的合计,实测一首页 18 条顶层评论的回复数合计是 177。二是不用担心「请求 50 条只回 9 条却按 50 条扣钱」,计费按实际返回条数分档,少回就少扣。令牌 24 小时内有效,参数一变就失效,脚本中途停了要从第一页重来。
字段:每一步回什么
下表是三次实测里每一步实际返回的主要字段,和目录 response_fields 逐个对过;只列做分析时最常用的,完整列表看目录。
| 能力 | 每行字段数(实测) | 常用字段 | 要注意的 |
|---|---|---|---|
douyin/search | 29–30 | id、url、text、like_count、comment_count、share_count、collect_count、posted_at、author_follower_count、hashtags | 没有 view_count;next_page_token 在顶层和每行都有 |
douyin/video | 30 或 46 | 同上,加 duration_sec、music、video_tags、city、location | 实测一回了 46 个字段,二、三回了 30 个,按视频本身的信息多少变化 |
douyin/comments | 16 | id、text、like_count、reply_count、ip_location、liked_by_author、posted_at | 18/18、20/20、19/19 条带 IP 属地 |
douyin/comment_replies | 14–16 | id、text、like_count、reply_to_id、reply_to_reply_id、posted_at | 回复楼中楼时才有 reply_to_reply_id;实测 58 条回复都没有 ip_location |
douyin/transcript | 21 | text、segments(start、end、text)、duration_sec、audio_url | 实测一 170 句、二 2 句、三 57 句 |
时间字段 posted_at 是带时区的 ISO 8601,例如实测一的视频是 2026-10-28T08:49:16+00:00,换成新加坡时间是 10 月 28 日 16:49,直接能被 pandas 或数据库解析。video_url 和 audio_url 带签名、会过期,要留存视频或音频得及时下载。评论者的昵称和头像属于个人信息,我们在文章和截图里都隐去了,做研究时建议同样处理。
把五步结果合成一张表:三条视频的评论长什么样
拿到数据只是第一步。我们用 pandas 把每条链的五个 JSON 合成一张以评论为行的表:视频的点赞、发布时间并到每条评论上,再算评论距视频发布过了多少小时、IP 属地分布、点赞集中度。读文件的写法很短:
import json, pandas as pd
v = json.load(open("run1/2_video.json"))["response"]["results"]
c = pd.DataFrame(json.load(open("run1/3_comments.json"))["response"]["results"])
c["posted_at"] = pd.to_datetime(c["posted_at"])
c["hours_after_video"] = (c["posted_at"] - pd.to_datetime(v["posted_at"])).dt.total_seconds() / 3600
summary = {"ip_top": c["ip_location"].value_counts().head(4).to_dict(),
           "lag_median_h": c["hours_after_video"].median(),
           "top3_like_share": c["like_count"].nlargest(3).sum() / c["like_count"].sum()}
三条视频的首页评论差别很大,这些差别正是做话题研究时要注意的。赣南脐橙那条科普视频,首页 18 条评论来自 7 个 IP 属地,江西 8 条、广东 5 条,产地自己的讨论占了将近一半;评论距视频发布的中位时间是 21.4 小时,最早的也在 12.8 小时之后;点赞高度集中,前 3 条评论拿走了 18 条评论全部点赞的 84.6%。流感疫苗那条视频发布于 9 月 30 日,首页 20 条评论来自 14 个 IP 属地,分布散得多,评论距发布的中位时间是 402.9 小时,也就是半个多月后仍有人在讨论,前 3 条的点赞占比只有 45.9%。智利车厘子那条是 11 月 3 日发的带货类视频,19 条评论来自 8 个属地,广东 5 条、云南 4 条,点赞中位数是 0,基本没有形成讨论。
这几组数说明两件事。第一,抖音返回的首页评论不是时间顺序,而是平台排序后的「头部评论」,所以首页能反映讨论的重心,但不能拿来算评论的时间分布或地域占比,要算占比得把评论翻完。第二,IP 属地字段只在评论行上有:三次实测的 57 条顶层评论全部带 ip_location,58 条回复则 0 条带,虽然目录的回复字段列表里写了它。做地域分析时只能用顶层评论,回复要按所属的顶层评论去归类。另外,评论的点赞集中度差异很大(45.9% 到 84.6%),做情绪统计时按点赞加权和不加权会得出很不一样的结论,建议两种都报。
每千条成本:搜索贵、评论便宜
「douyin api alternative」这类搜索背后,大多数人想知道的是一千条数据到底花多少钱。我们不用目录单价除以 limit 去推,而是用真实返回条数和真实扣费现算。样本是实测一至三的 3 条串行链,加上 00:16–00:17 用实测一的令牌翻的 4 页(搜索第 2 页、评论第 2 和第 3 页、回复第 2 页),共 19 次请求;实测四是和实测一同一关键词的并行重跑,没有计入,免得同一话题算两遍。所以下表搜索是 3 + 1 次、评论 3 + 2 次、回复 3 + 1 次。
| 能力 | 计费方式(目录) | 实测调用 | 实测返回条数 | 实测扣费 | 每千条成本 |
|---|---|---|---|---|---|
douyin/search | 每页 $0.008333 | 4 | 44 | $0.033332 | 约 $0.76 |
douyin/comments | 每 20 条一档,每档 $0.000556 | 5 | 86 | $0.002780 | 约 $0.032 |
douyin/comment_replies | 每 20 条一档,每档 $0.000556 | 4 | 78 | $0.002224 | 约 $0.029 |
douyin/video | 每次 $0.000556 | 3 | 3 个视频 | $0.001668 | 每千个视频 $0.556 |
douyin/transcript | 每次 $0.000556 | 3 | 3 个视频 | $0.001668 | 每千个视频 $0.556 |
搜索每千条约 $0.76,是评论的 23 倍、回复的 27 倍。原因很简单:一页搜索只回 10–13 条却按页收 $0.008333,而一档评论最多 20 条只收 $0.000556。这意味着设计采集方案时,「多搜几个词、每个词只翻一页、然后在命中的视频下面深挖评论」比「少搜几个词、每个词翻很多页」便宜得多。我们站内另一篇抖音接口逐项比价按 37 项能力做了横向对比,本文不重复,只补这次用 Python 跑出来的条数和每千条价。
换一种取样也不改变结论。如果把实测四也算进去、用全部 24 次请求:搜索 5 次共 55 条,扣 $0.041665,每千条约 $0.76;评论 6 次共 106 条,扣 $0.003336,每千条约 $0.031;回复 5 次共 98 条,扣 $0.00278,每千条约 $0.028。搜索仍然是评论的 24 倍、回复的 27 倍。
并行能省多少时间
既然一条链里文稿一步最慢,而作品详情、文稿和评论之间互不依赖,自然的想法是拿到搜索结果后三件事同时做。我们用 Python 标准库的 concurrent.futures 改了一版,在 00:34(新加坡时间)跑了一次。
from concurrent.futures import ThreadPoolExecutor

def comments_then_replies():
    c = call("comments", {"url": url, "page_token": ""}, tag, "3_comments")
    top = max(rows_of(c), key=lambda x: x.get("reply_count") or 0)
    call("comment_replies", {"url": url, "comment_id": str(top["id"]), "page_token": ""}, tag, "4_replies")

with ThreadPoolExecutor(max_workers=3) as pool:
    jobs = [pool.submit(call, "video", {"url": url}, tag, "2_video"),
            pool.submit(call, "transcript", {"url": url}, tag, "5_transcript"),
            pool.submit(comments_then_replies)]
    for j in jobs:
        j.result()
并行版的墙钟时间是 33.49 秒,五步各自的耗时加起来是 47.52 秒。和串行的中位 38.84 秒比,只快了约 14%,因为这一次的文稿用了 27.44 秒,整条链的时间几乎就是「搜索 6.05 秒 + 文稿 27.44 秒」。结论是:并行能把评论、回复和详情的时间藏进文稿的等待里,但单条链的下限由文稿决定。要真正提高吞吐,应该在多个视频之间并行,同时注意 Key 的每分钟请求上限;这把测试 Key 每分钟 10 次,一条链 5 个请求,每分钟最多跑 2 条。文稿特别慢的场景,可以在请求体里加 "mode": "async",拿到 job_id 后去轮询,不占着连接等。
三个场景的月账单
只看单价不够直观,我们按三个真实场景算了账,单价取目录,每页条数取上一节同一批样本的平均(搜索每页 11.0 条、评论 17.2 条、回复 19.5 条)。
| 场景 | 每次跑的内容 | 每次请求数 | 每次费用 | 每次约得条数 | 频率 | 合计 |
|---|---|---|---|---|---|---|
| 赣南脐橙产区舆情日报 | 10 个词各搜 1 页;每词取前 3 个视频,取详情、文稿、评论 3 页;每视频 2 条热评取回复 | 220 | $0.2001 | 2,888 | 每天,30 天 | $6.00 |
| 流感疫苗话题周报 | 5 个词各搜 2 页;每词 5 个视频,同上 | 185 | $0.1806 | 2,425 | 每周,4 周 | $0.72 |
| 智利车厘子进口商周报 | 6 个词各搜 2 页;每词 4 个视频,同上 | 180 | $0.1934 | 2,354 | 每周,4 周 | $0.77 |
第一个场景每天约 2,888 条数据,折合每千条约 $0.069,比单看搜索的 $0.76 低一个数量级,因为大部分条数来自便宜的评论和回复。三个场景里搜索费用分别占 41.6%、46.1%、51.7%。如果预算紧,最先砍的应该是搜索页数,而不是评论深度。这些数只算接口费,不含你自己的服务器和存储。
错误和扣费:哪些情况不花钱
自建脚本出错时最难的是判断「这次失败有没有花钱、要不要重试」。我们在 00:30(新加坡时间)故意做了三次错误调用,加上前面的实测,整理成下表。
| 情况 | HTTP 状态 | 返回要点 | 扣费 |
|---|---|---|---|
| 不带 Key | 401 | missing_key,next_steps 写明 Nothing was charged | 0 |
| sort 写成 hottest | 422 | invalid_value,列出允许值 most_liked、newest、relevance,did_you_mean 给出 most_liked | 0 |
| 评论能力传了用户主页链接 | 200 | count 0,reason 为 empty_result_refunded,refund 成功 | 0 |
| 评论一页只回 9–20 条 | 200 | requested_units 3、billed_units 1、退 80 credits | 只扣 1 档 |
| 超过每分钟请求上限 | 429 | 三次串行实测各碰到至少 1 次,脚本等 60 秒重试后成功 | 0 |
第二行值得多说一句:422 的错误信息不只告诉你错了,还给出允许值和最接近的候选,这对把脚本交给 AI 编写和修改特别有用,模型读到错误就能自己改对。第三行说明参数类型错了但格式合法时,接口返回空结果并原路退费,而不是报错;所以脚本里要检查 count,不能只看状态码。重试时如何避免重复扣费,可以看站内的幂等键与重试和失败退款对账两篇。
什么时候另外两条路更合适
按次付费接口不是所有场景的答案,下面照实写另外两条路的优势。
官方接口在三类场景里明显更好。第一是要写操作:回复评论、置顶评论、发布视频,只有开放平台能做,按次付费的数据接口只读。第二是要读授权账号自己的私有数据:粉丝画像、主页访问数、每日新增播放,这些数据本来就只对账号主人开放,开放平台通过用户授权把它们交给你的应用,其他路线拿不到也不该拿。第三是你本身就是企业,要在自己的产品里长期展示抖音内容,而且能接受审核周期,那么官方的搜索能力内测虽然门槛高,换来的是平台认可的稳定性。
开源脚本也有它的位置。如果你只是偶尔下载自己能看到的几个视频、做一次性的课堂作业或个人备份,装一个下载器比注册任何服务都快,代码可以读、可以改,数据只在你自己的电脑上。如果你的团队有专人维护抓取,愿意承担登录、签名、代理和验证的持续投入,自建可以做到完全的控制,例如保存原始页面、按自己的节奏重试。只是要把维护时间算进成本:本文第二节列出的 issue 都发生在最近 30 天,一个人每周花半天追平台变化,按任何工程师的时薪算,都比本文场景一每月 $6.00 的接口费高。
按次付费接口最适合的是中间这一大块:要持续采集别人的公开视频和评论,不需要写操作,没有专人维护抓取,希望出错时不花钱、结果能直接进表格或数据库。它的短板也要说清楚:拿不到授权账号的私有数据;视频文稿单次要 20 多秒;搜索按页计费,翻很多页的方案会很快变贵。
不写代码、想在 AI 工具里直接查,可以看魔搭 MCP 广场接小红书、抖音数据、飞书多维表格字段捷径和 WorkBuddy 连接器;小红书一侧的同类问题看小红书 API 官方与第三方对比;同一套 Python 写法换 platform 和 action,就能用于 TikTok 数据接口和小红书数据接口。
合规与边界
这一节只写数据方法和边界,不构成法律意见。三条路面对的是同一组法律文本。《个人信息保护法》第十三条和第二十七条写明,可以在合理的范围内处理个人自行公开或者其他已经合法公开的个人信息,个人明确拒绝的除外;对个人权益有重大影响的,应当取得个人同意。评论者的昵称、头像、IP 属地都属于个人信息,所以我们建议研究和舆情场景只保留文本和统计字段,昵称和头像不入库。
2025 年 10 月 15 日起施行的修订版《反不正当竞争法》第十三条新增了一款:经营者不得以欺诈、胁迫、避开或者破坏技术管理措施等不正当方式,获取、使用其他经营者合法持有的数据。开源脚本里讨论的签名参数、验证码、请求校验,正是平台的技术管理措施,这也是我们在第二节只陈述、不教绕过的原因。2025 年 1 月 1 日起施行的《网络数据安全管理条例》对网络数据处理活动提出了一般要求,数据量大、要长期留存的项目应当一并对照。
高校和研究机构做这类项目,伦理审查常会问三件事:公开帖子怎么存、存多久、怎么去掉身份信息。本文的字段事实可以直接拿来回答:顶层评论带 IP 属地、回复不带,视频和音频地址会过期,昵称和头像可以在入库前丢掉。建议在第一次调用前就定好只入库哪几列,例如文本、点赞数、发布时间和属地,原始 JSON 的留存期限写进项目说明,到期删除,而不是导出几千条之后再回头清理。
数据本身也有边界,下面这些是实测能确认的:抖音不公开播放量,任何字段里的播放数都不要当真;视频和音频地址会过期;评论翻页每页只有 9–20 条,几千条评论的视频要翻很多页;搜索结果按抖音自己的排序和去重给出,不是全量,不能用来估算某个话题的视频总数。
行业动向
- 2026 年 11 月 9 日:douyin-downloader 的 #263 报告重新登录后仍拿不到作品详情。对读者意味着:基于 Cookie 的脚本,失效往往不在你这一侧,重新登录也未必能恢复。
- 2026 年 11 月 5 日:中国疾控中心第 44 周流感监测周报显示北方省份阳性率上升(中国疾控中心)。对读者意味着:公共卫生话题的讨论量会跟着流行季变化,同一套脚本在 12 月可能要多翻几页。
- 2026 年 11 月 5 日:Douyin_TikTok_Download_API 合并 #821,把签名计算提速 9.5%。对读者意味着:开源项目的维护精力很大一部分花在签名上。
- 2026 年 10 月 28 日:MediaCrawler #996 记录抖音搜索页出现九宫格选图拖拽验证。对读者意味着:网页端搜索是验证最密集的地方,自建脚本要预留人工处理的时间。
常见问题
douyin api python 有没有官方的 Python SDK?
没有,开放平台服务端 SDK 只有 Java、NodeJS、Go,用 Python 调官方接口要自己写 token 的换取和刷新,详见上文「官方接口和 Python」。(问题来自 Google 联想词「douyin api python」「douyin python」。)
douyin scraper github 上的项目现在还能用吗?
下载自己能看到的单个视频多数还能用;按关键词搜索和批量取评论,要靠登录态和签名,近 30 天的 issue 里还在报请求被拒和新验证,详见上文「第二条路」。(问题来自联想词「douyin scraper github」「抖音评论爬虫github」。)
有没有免费的 douyin api alternative?
开源脚本代码免费,但要自己提供登录态、处理签名和验证,部分项目许可证禁止商用。官方开放平台接口不收调用费,但要企业资质、用户授权和审核,而且不能用于对外售卖的数据服务。按次付费接口要花钱,本文一条五步完整链 $0.010557。(问题来自联想词「douyin api alternative free」「douyin api alternatives」。)
抖音评论爬虫怎么拿到二级回复?
先用评论接口拿顶层评论,每条带 reply_count;对 reply_count 大于 0 的评论,用 douyin/comment_replies 传视频链接和评论 id 取回复,每页最多 20 条,用 next_page_token 翻页。本文实测三次各取到 20、20、18 条回复,其中 15、11、16 条是楼中楼。(问题来自联想词「douyin comment scraper」「抖 音 爬 取 评论」。)
抖音开放平台接口调用要什么条件?
建应用、申请能力(审核 2–7 个工作日)、拿到抖音用户授权;部分数据能力仅限企业、党政和事业单位,详见上文「数据能力的准入条件」。(问题来自联想词「抖音开放平台 接口调用」。)
抖音视频里说的话能直接转成文字吗?
可以,douyin/transcript 返回整段文字和逐句时间轴。本文实测 338 秒的视频得到 1,502 字、170 句,单次约 22 秒,每次 $0.000556。(问题来自联想词「douyin transcripts scraper」。)
上手步骤
- 在控制台创建 API Key,写进环境变量
EVERYINFRA_API_KEY,步骤见快速上手。 - 免费读一次目录
GET /api/v1/social/catalog?platform=douyin,确认参数、价格和available;价格汇总也可以看价格页和数据市场。 pip install requests,复制第三节的脚本,python douyin_chain.py "你的关键词" run1。- 打开 run1 目录里的五个 JSON,核对每一步的
billing.charged_usd;要翻页就把next_page_token原样传回。
参考资料
- 抖音开放平台,《用户互动数据》能力页,读取于 2026-11-10,https://developer.open-douyin.com/capacity-center-page/capacity-detail/7180284622729658424
- 抖音开放平台,《视频数据》能力页,读取于 2026-11-10,https://developer.open-douyin.com/capacity-center-page/capacity-detail/7180522194714230845
- 抖音开放平台,《登录与授权》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/sdk/mobile-app/permission/overall-permission
- 抖音开放平台,《查询授权账号视频列表》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/video-management/douyin/search-video/account-video-list
- 抖音开放平台,《视频评论管理接入方案》,读取于 2026-11-10,https://open.douyin.com/platform/resource/docs/ability/interaction-management/video-comment-management-solution
- 抖音开放平台,《关键词视频搜索》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/search-management/keywords-video-list/keywords-video
- 抖音服务商平台,《视频搜索管理》,读取于 2026-11-10,https://partner.open-douyin.com/docs/resource/zh-CN/dop/ability/search-management/video
- 抖音开放平台,《用户类型及权限说明》,读取于 2026-11-10,https://open.douyin.com/platform/resource/docs/accession-guide/type-and-permission
- 抖音开放平台,《OpenAPI 列表》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/list
- 抖音开放平台,《移动/网站应用 OpenAPI SDK 总览》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/openapi/sdk-overview
- 抖音开放平台,《抖音搜索能力对外开放了》,读取于 2026-11-10,https://developer.open-douyin.com/product/search
- 抖音开放平台,《小程序运营规范》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/mini-app/operation/management/specification/standard
- 抖音开放平台,《能力概览》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/ability/common-solution
- 抖音开放平台,《创建移动应用和网站应用》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/develop/app-mgmt/create-mobile-and-web-app
- 抖音开放平台,《抖音发布能力使用规范》,读取于 2026-11-10,https://developer.open-douyin.com/docs/resource/zh-CN/dop/operation-standard/platform-capabilities/useclue
- GitHub,NanmiCoder/MediaCrawler README,读取于 2026-11-10,https://github.com/NanmiCoder/MediaCrawler
- GitHub,Evil0ctal/Douyin_TikTok_Download_API README,读取于 2026-11-10,https://github.com/Evil0ctal/Douyin_TikTok_Download_API
- GitHub,jiji262/douyin-downloader README,读取于 2026-11-10,https://github.com/jiji262/douyin-downloader
- GitHub,Johnserf-Seed/TikTokDownload,读取于 2026-11-10,https://github.com/Johnserf-Seed/TikTokDownload
- GitHub,Johnserf-Seed/f2 README,读取于 2026-11-10,https://github.com/Johnserf-Seed/f2
- GitHub,ShilongLee/Crawler README,读取于 2026-11-10,https://github.com/ShilongLee/Crawler
- GitHub,Douyin_TikTok_Download_API #821,2026-11-05,https://github.com/Evil0ctal/Douyin_TikTok_Download_API/pull/821
- GitHub,Douyin_TikTok_Download_API #825,2026-11-09,https://github.com/Evil0ctal/Douyin_TikTok_Download_API/issues/825
- GitHub,douyin-downloader #257,2026-10-25,https://github.com/jiji262/douyin-downloader/issues/257
- GitHub,douyin-downloader #258,2026-10-26,https://github.com/jiji262/douyin-downloader/issues/258
- GitHub,douyin-downloader #263,2026-11-09,https://github.com/jiji262/douyin-downloader/issues/263
- GitHub,MediaCrawler #996,2026-10-28,https://github.com/NanmiCoder/MediaCrawler/issues/996
- GitHub,MediaCrawler #998,2026-11-02,https://github.com/NanmiCoder/MediaCrawler/pull/998
- 抖音,robots.txt,读取于 2026-11-10,https://www.douyin.com/robots.txt
- EveryInfra,数据接口目录,读取于 2026-11-10 00:13 新加坡时间,https://api.everyinfra.com/api/v1/social/catalog
- requests 文档,Advanced Usage:Session Objects,读取于 2026-11-10,https://requests.readthedocs.io/en/latest/user/advanced/#session-objects
- PyPI,requests 2.34.2,2026-05-14,https://pypi.org/project/requests/
- Python Software Foundation,Python 3.15.2,2026-10-25,https://www.python.org/downloads/release/python-3152/
- Python 文档,concurrent.futures,读取于 2026-11-10,https://docs.python.org/3/library/concurrent.futures.html
- 新华网,《开采啦!寻乌赣南脐橙开启甜蜜上市季》,2026-11-06,http://jx.news.cn/20261106/5ef2412547124be8abd31025cce39206/c.html
- 中国疾病预防控制中心,《2026年第44周第933期中国流感监测周报》,2026-11-05,https://www.chinacdc.cn/jksj/jksj04_14249/202611/t20261105_1842732.html
- 国家互联网信息办公室,《中华人民共和国个人信息保护法》,2021-08-20,https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- 国家知识产权局,《中华人民共和国反不正当竞争法(2025年修订)》,2026-05-20 收录,https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- 生态环境部转载国务院令第790号,《网络数据安全管理条例》,2024-10-03,https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- 江苏网信网,《第57次中国互联网络发展状况统计情况》,2026-04-22,https://www.jswx.gov.cn/shuju/zixun/202604/t20260422_1324983.shtml
引用编号 BL-127