用 Python 拿 B 站数据的三条路:bilibili api python 实测
用 Python 取 B站数据三条路:开放平台只收境内法人,两个常用开源项目今年收律师函停更,按次 API 五步链实测每条 $0.00278。
我们在 2026 年 11 月 11 日 00:14–00:24(新加坡时间)用 Python 的 requests 跑了 3 次「搜索 → 视频详情 → 评论 → 弹幕 → 字幕」完整链,15 个请求全部返回 HTTP 200,每条链扣费 $0.00278。最值得写下来的发现是弹幕不是全量:同一条有 36,824 条弹幕的科普视频,我们调了 6 次,合起来只有 190 条不重复,占 0.52%;做受众分析时,它适合当「哪一段让观众起反应」的抽样,不适合当总量。另外两条路我们逐条核对了一手材料:哔哩哔哩开放平台的准入要求写着「在中国境内合法成立并存续的法人」,数据接口只读授权 UP 主自己的稿件;GitHub 上星标 2 万多的接口文档整理项目和星标 4 千多的 Python 库,分别在 2026 年 1 月 28 日和 7 月 6 日收到 B 站委托的律师函后停止维护。
官方接口和开源项目两部分只引用开放平台原文、项目 README 和公开 issue;按次付费接口这部分,每个数字都来自我们自己的真实调用,原始响应和复算脚本都留了存档。
先说结论:三条路分别适合谁
三条路的适用人群几乎不重叠。下面这张表把每条路要准备的东西、能拿到的范围和主要风险放在一起,表里每一项在后文都有出处或实测。
| 维度 | 哔哩哔哩开放平台 | 开源库与接口文档整理项目 | 按次付费数据接口(本文实测 EveryInfra) |
|---|---|---|---|
| 主体要求 | 在中国境内合法成立并存续的法人,交营业执照和盖章承诺函 | 无 | 无,注册拿 API Key |
| 能读谁的数据 | 授权给你的 UP 主自己的稿件和账号数据 | 公开页面能看到的,部分要登录 Cookie | 公开视频、热门评论、弹幕、字幕、热门榜 |
| 关键词搜索 | 文档目录里没有站内搜索接口 | 有,但签名和风控随时变 | bilibili/search,5 种排序 |
| 弹幕 | 只有直播间的实时弹幕长连接 | 有,项目里写着要处理签名 | bilibili/danmaku,带视频内时间点 |
| Python 支持 | 签名示例只有 Go、C# | 多数项目就是 Python | 任何能发 HTTP 的语言 |
| 2026 年的状态 | 正常运营 | 两个常用项目收到律师函后停更 | 本文实测 15 个请求全部 200 |
| 费用 | 接口不收费,成本在资质和授权 | 代码免费,成本在维护和风险 | 本文一条完整链 $0.00278 |
我们的判断是:如果你是机构、MCN 或品牌服务商,要替自己签约的 UP 主发稿、看后台数据,开放平台是唯一正当的选择,它能写、能读私有数据,其他路线都做不到。如果你只想在自己电脑上下载几个公开视频做课堂素材,命令行下载器足够,但要接受它随时失效、维护者随时停更。如果你要按话题持续拿别人的公开视频、评论和弹幕做研究或舆情,又不是境内法人,也不想自己维护签名,按次付费接口是投入最少的一条路。后面每一节分别给出依据。
第一条路:哔哩哔哩开放平台官方接口能拿什么、要什么资质
很多教程把「B 站 API」写成一个人人都能申请的公开接口,这和开放平台自己的文档不符。开放平台的平台简介写的是,它面向「媒体机构、有开发能力的 up 主、垂直行业企业、品牌服务商等」,提供基础的服务能力和行业解决方案。文档中心首页把开放能力分成账号授权、用户管理、视频管理、数据开放、专栏管理、直播能力六类,其中「数据开放」的原文是「包括用户授权后的用户数据、稿件数据等能力」。关键词在「用户授权后」:你拿到的是授权给你的那个 UP 主自己的数据,不是全站任意视频的数据。
准入:境内法人、营业执照和盖章承诺函
我们在 2026 年 11 月 11 日 00:31(新加坡时间)截取了开放平台管理规范的「准入要求」一节。原文写开发者入驻应满足四个条件:在中国境内合法成立并存续的法人;信誉良好,未在经营异常名录、未在失信名单中;已注册哔哩哔哩开发者账号;以及其他入驻条件。手续上要提交营业执照有效期在一个月以上的《企业法人营业执照》副本,以及加盖公章的《入驻承诺函》,两者的信息要和填写的一致,否则申请会被驳回。这一条直接把个人开发者、海外公司和高校里的个人研究者挡在了门外。
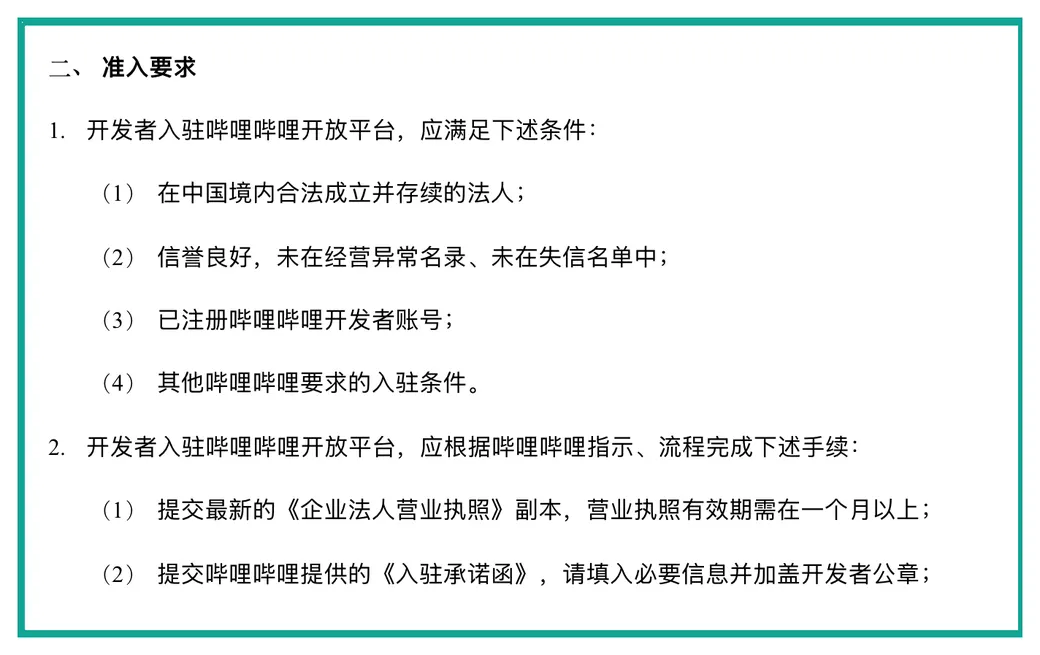
管理规范同一页还写了几条对数据用途的限制:不得泄露关联 UP 主的账号信息、稿件数据(原文列举了「稿件源文件、稿件发布数量、弹幕、转评赞情况等」);关联 UP 主要求删除数据的,不得拒绝,也不得保留匿名化或去标识化后的信息;开发者退出或被清退时,要删除或返还通过开放平台获取的用户数据和运营数据。开发者服务协议对「关联 UP 主」的定义是开发者在开放平台中关联并接入本服务的哔哩哔哩账号,开发者应拥有其完整使用权或已获得合法的运营授权。换句话说,开放平台的数据是给「替 UP 主干活的人」用的,不是给研究别人视频的人用的。
数据开放:只能读授权 UP 主自己的稿件
我们逐个打开了数据相关的接口文档。「获取单个稿件数据」的 Scope 是 ARC_DATA,标注「需要申请权限、需要用户授权」,说明里写着授权用户包括该稿件的作者、联合投稿人,返回标题、发布时间、播放、弹幕数、评论数、收藏、投币、分享、点赞这九个数。「获取整体稿件增量数据」返回用户整体稿件维度近 30 天的增量。「查询单一视频稿件详情」的 Scope 是 ARC_BASE,同样只能查授权用户自己的稿件。「获取已授权用户基础公开信息」只回昵称、头像和 openid,文档专门解释 openid 只在开发者和应用维度唯一,是为了防止用户轨迹被跨应用追踪。开放平台的隐私政策对用户也是这样说明的:使用稿件数据管理服务时,平台向关联开发者披露的是用户自己的稿件数据,用户可以随时在授权管理里取消。
| 官方接口 | Scope | 要用户授权 | 能读什么(原文要点) |
|---|---|---|---|
| 获取单个稿件数据 | ARC_DATA | 是 | 授权用户自己稿件的播放、弹幕数、评论数、收藏、投币、分享、点赞 |
| 获取整体稿件增量数据 | ARC_DATA | 是 | 授权用户全部稿件近 30 天的增量 |
| 查询单一视频稿件详情 | ARC_BASE | 是 | 授权用户自己稿件的标题、分区、时长、审核状态 |
| 获取已授权用户基础公开信息 | USER_INFO | 是 | 昵称、头像、openid |
| 直播间消息长连接 | 直播开放平台 | 主播授权 | 授权直播间的实时弹幕、礼物等消息 |
| 关键词搜索、任意视频评论、点播弹幕 | — | — | 文档目录中没有找到 |
最后一行要解释一下。我们按文档中心左侧目录逐项看过账号授权、用户管理、视频稿件管理、专栏管理、数据开放服务、直播能力、活动接入、经营号客服、交易电商、充电业务、课堂业务等分类,没有找到「按关键词搜索全站视频」「读取任意视频的评论」「读取点播视频弹幕」这几类接口。这是我们在 11 月 11 日读到的目录,开放平台以后可能增加;做选型前请以当时的文档为准。
签名和授权:官方接口在 Python 里怎么调
就算有了资质,调用方式也和一般的 REST 接口不同。OAuth 2.0 文档写明,先在开放平台完成入驻和应用申请拿到 client_id 和 secret,再让用户授权换 access_token;应用申请了新的 scope,已授权用户要重新授权才能调新接口;每个 refresh_token 只能用一次。接口签名说明要求每个请求带一组 x-bili- 开头的请求头,把它们按字典序拼成待签名字符串,用 app_secret 做 HMAC-SHA256,结果放进 Authorization;时间戳不能超过当前时间 10 分钟,否则请求会被丢弃。文档给的参考实现是 Go 代码和一个 C# 示例仓库,没有 Python。下面是我们按这份文档改写的 Python 版本,只用标准库的 hmac;我们没有开放平台账号,这段没有对真实接口跑过,属于配置示例。
"""Bilibili Open Platform v2.0 request signature, rewritten from the official doc (not run against a live app)."""
import hashlib, hmac, json, time, uuid

def bili_headers(client_id: str, app_secret: str, access_token: str, body: dict | None) -> dict:
    raw = json.dumps(body, separators=(",", ":")) if body else ""
    signed = {
        "x-bili-accesskeyid": client_id,
        "x-bili-content-md5": hashlib.md5(raw.encode()).hexdigest(),   # md5 of "" for GET
        "x-bili-signature-method": "HMAC-SHA256",
        "x-bili-signature-nonce": str(uuid.uuid4()),
        "x-bili-signature-version": "2.0",
        "x-bili-timestamp": str(int(time.time())),                     # must be within 10 minutes
    }
    to_sign = "\n".join(f"{k}:{signed[k]}" for k in sorted(signed))
    sig = hmac.new(app_secret.encode(), to_sign.encode(), hashlib.sha256).hexdigest()
    return {**signed, "Accept": "application/json", "Content-Type": "application/json",
            "access-token": access_token, "Authorization": sig}
签名本身不难,真正的门槛在前面:没有境内法人主体、没有愿意授权给你的 UP 主,这段代码签出来的请求一个都调不通。文档的状态码表里,4002 是签名异常,4003 是请求过期,4004 是重复请求,碰到时先查时间戳和 nonce。
直播弹幕是例外:开放平台的长连接
开放平台唯一和「弹幕」直接相关的公开能力在直播一侧。直播开放平台的长链数据协议写的是:通过应用接口拿到弹幕服务器地址后,客户端用 WebSocket 发鉴权包,之后每 20 秒发一次心跳,服务器推送 LIVE_OPEN_PLATFORM_DM 这类消息,消息里的用户标识是 open_id,原 uid 字段标注为「即将废弃」。开源的 blivedm 是一个获取直播弹幕的 Python 库,README 写它同时支持网页端和直播开放平台两种接口,最后推送在 2026 年 8 月 15 日。这条路适合做自己直播间的互动玩法,和本文要做的点播视频弹幕分析不是一回事:点播视频的弹幕是观众在视频某一秒发的,带视频内时间点,开放平台文档里没有读取它的接口。
第二条路:开源库和接口文档整理项目
搜「bilibili api python github」「bilibili api collect」,前排几乎都是同一批开源项目。我们在 2026 年 11 月 11 日 00:21(新加坡时间)用 GitHub 的公开接口读了 7 个常见项目的星标数、最后推送时间、许可证和归档状态,又逐个读了 README。下面只写这些公开材料里的事实,不评价项目好坏。
| 项目 | 星标 | 最后推送 | 归档 | README 首屏写的状态 |
|---|---|---|---|---|
| SocialSisterYi/bilibili-API-collect | 20,123 | 2026-01-30 | 是 | 停止维护并永久关停;2026 年 1 月 28 日收到律师函警告邮件 |
| Nemo2011/bilibili-api | 4,155 | 2026-07-06 | 是 | 已停止维护并将永久关停;附 2026 年 7 月 6 日的侵权告知函 |
| nilaoda/BBDown | 13,824 | 2026-05-14 | 是 | 已归档,不再维护 |
| pskdje/bilibili-API-collect | 312 | 2026-01-28 | 是 | 贡献者复刻,基础内容同步到 2026 年 1 月 25 日 |
| Vespa314/bilibili-api | 1,356 | 2022-06-19 | 否 | 描述写「不再维护」 |
| yt-dlp/yt-dlp | 206,667 | 2026-11-04 | 否 | 通用下载器,B 站是其中一个站点 |
| NanmiCoder/MediaCrawler | 70,803 | 2026-11-09 | 否 | 多平台采集,README 的能力表里 B 站各项都打勾 |
2026 年的两封律师函
这张表最重要的信息在第二、三行。接口文档整理项目 bilibili-API-collect 的 README 现在只剩一段说明:2026 年 1 月 28 日,维护者收到 B 站委托的律师事务所发来的律师函警告邮件,指控项目「通过技术手段对哔哩哔哩平台非公开的 API 接口及其调用逻辑、参数结构、访问控制及安全认证机制进行系统性收集、整理」,并以技术文档、代码示例等形式向不特定公众传播;维护者即日起停止维护并删除相关文档和源代码。贡献者在被删除前做了一个复刻,描述写基础内容同步在 2026 年 1 月 25 日,也已归档。
Python 库 bilibili-api 的 README 首屏是一份声明加一封侵权告知函,落款是上海一家律师事务所,日期 2026 年 7 月 6 日。告知函列举的行为包括「突破登录态与访问控制、绕过反爬风控与签名鉴权、抓取 OGV 番剧与付费课程内容、采集弹幕并反查用户真实身份等」,要求停止开发、维护、更新和传播,删除或回滚相关代码,并发布公开声明。仓库的声明写明「即日起将停止对仓库的维护,并永久关停仓库」。它在 PyPI 上的包 bilibili-api-python 最后一个版本是 17.4.2,发布于 2026 年 6 月 19 日,要求 Python 3.10 以上;包还能装,但不会再有修复。也就是说,搜「bilibili api python」「bilibili api pypi」排在前面的那个库,今年 7 月以后已经是一个不再更新的历史版本。
对读者的直接影响有两点。第一,基于这两个项目写的脚本,接口一变就没人修了,你得自己追。第二,律师函里点名的行为(绕过签名鉴权、绕过风控、反查弹幕发送者身份)正是很多教程里教的东西;继续沿用这些写法之前,先读完本文「合规与边界」一节。
WBI 签名、风控和登录 Cookie:还在维护的项目在修什么
还在维护的通用项目,过去 30 天也在频繁修 B 站。yt-dlp 的 B 站提取器在每次请求视频页时会先「Downloading wbi sign」,也就是去拿网页端的 WBI 签名参数,这一行能在 issue 贴出的日志里直接看到。10 月 17 日的 #17847 报告下载时视频文件地址返回 HTTP 567,维护者在自己的网络里复现不了,提问者在多个波兰 IP 上都能复现。10 月 21 日的 #17879 报告只能识别出一个 html 格式,评论里有人写,不带 /en/ 的视频地址当天在浏览器里跳到了 404 页。10 月 22 日的 #17894 和 #17890 报告「Unable to extract initial state」,参与者判断像是某种机器人检测,页面源码里缺了初始状态数据。同一天提交的修复 #17898 到我们 11 月 11 日查看时仍未合并,B 站提取器文件的最后一次提交停在 7 月 3 日。
MediaCrawler 这边,11 月 4 日提交、11 月 5 日合并的 #1000 修的是 B 站的 WBI 密钥读取:原来的代码从浏览器的 localStorage 读 WBI 密钥,页面或上下文被关掉时会抛异常,整批采集崩溃、还没落盘的数据全部丢失;兜底请求又没带登录 Cookie,接口返回 412 或未登录,拿不到有效密钥。这一个 PR 同时说明了三件事:网页端接口要 WBI 签名,签名密钥要从页面里取,取的时候最好带着登录态。我们不教、也不建议绕过这些校验;列出来是为了说明,自建脚本的成本主要不在写第一版,而在每周追平台变化。
用户协议和 robots.txt
我们在 00:23(新加坡时间)读了 B 站主站的 robots.txt:对所有抓取器统一不允许 /medialist/detail/、/index.html,以及 /en/、/ja/、/es/ 等 8 个语言路径;另有一组分享预览机器人单列。语言路径出现在 robots.txt 里,和 yt-dlp issue 里「/en/video/ 能打开、/video/ 跳 404」的现象对得上,说明主站最近在调整多语言地址。robots.txt 只是网站对抓取器的声明,不是法律文本。更直接的是《哔哩哔哩弹幕网用户使用协议》(2025 年 5 月 7 日生效)第 5.6 条第 3 项:未经事先明确书面许可,禁止以机器人软件、蜘蛛软件、爬虫软件等任何自动程序、脚本、软件和任何理由自行或委托他人、协助他人获取平台的服务、内容、数据。第 1.2 条还写了服务仅供用户非商业性使用。这两条是任何一条路都要面对的平台规则,我们把它原样写在这里,供你自己判断。
第三条路:按次付费接口,用 Python 跑完整链
第三条路是自己只发 HTTP 请求、按次付费,不用自己维护签名、风控校验和页面解析。本文实测的是 EveryInfra 的数据接口,B 站一共 8 项能力,本文的完整链用到其中五项:bilibili/search 关键词搜索、bilibili/video 视频详情、bilibili/comments 热门评论、bilibili/danmaku 弹幕、bilibili/subtitles 字幕;另外还测了 bilibili/user_posts、bilibili/profile 和 bilibili/popular。能力名、参数、价格和返回字段都来自免费目录 /api/v1/social/catalog,我们在 00:13(新加坡时间)读取:8 项全部 available=true,热门榜每页 $0.000806,其余 7 项每次 $0.000556;搜索默认 20 条、最多 50 条。2026 年 11 月 12 日(新加坡时间)我们重读了一次目录:字幕一项调到每次 $0.000792,其余 7 项不变,按新价一条完整链是 $0.003016;本文的实测扣费都是 11 月 11 日当时的价格。平台总览见 B 站数据接口页。
下面是我们实际跑的脚本。它只依赖 requests,Key 从环境变量读;搜索按播放量排序,先只留 5 到 60 分钟的视频(太长的往往是几十小时的合集),再挑弹幕数最多的一条,依次取详情、评论、弹幕、字幕,每一步的请求和完整响应都存成 JSON 文件,方便事后复算。碰到 429(这把测试 Key 每分钟 10 次)就等 60 秒重试。
"""Bilibili chain: search -> video -> comments -> danmaku -> subtitles."""
import json, os, sys, time
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]          # never hard-code the key
SESSION = requests.Session()
SESSION.headers.update({"Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})

def call(action, params, tag, name):
    body = {"platform": "bilibili", "action": action, "params": params}
    for attempt in range(4):
        t0 = time.time()
        r = SESSION.post(API, json=body, timeout=120)
        dt = round(time.time() - t0, 2)
        if r.status_code == 429:                  # rate limited: wait, then retry
            time.sleep(60)
            continue
        break
    data = r.json()
    Path(tag).mkdir(exist_ok=True)
    Path(tag, f"{name}.json").write_text(json.dumps(
        {"elapsed_s": dt, "http_status": r.status_code, "request": body, "response": data},
        ensure_ascii=False, indent=1))
    print(name, r.status_code, dt, data.get("count"), (data.get("billing") or {}).get("charged_usd"))
    return data

def rows_of(data):
    rows = data.get("results") or []
    return rows if isinstance(rows, list) else [rows]

def main(keyword, tag):
    s = call("search", {"keyword": keyword, "sort": "most_viewed", "limit": 20}, tag, "1_search")
    pool = [v for v in rows_of(s) if 300 <= (v.get("duration_sec") or 0) <= 3600] or rows_of(s)
    url = max(pool, key=lambda v: v.get("danmaku_count") or 0)["url"]
    call("video", {"url": url}, tag, "2_video")
    call("comments", {"url": url, "limit": 10}, tag, "3_comments")
    call("danmaku", {"url": url, "limit": 200}, tag, "4_danmaku")
    call("subtitles", {"url": url}, tag, "5_subtitles")

if __name__ == "__main__":
    main(sys.argv[1], sys.argv[2])
运行方式是 export EVERYINFRA_API_KEY=... 之后 python bili_chain.py "黑洞 科普" run2。代码里有三处值得解释。第一,requests.Session 会复用连接,requests 文档写明对同一主机的多次请求会复用底层 TCP 连接;我们用的是 requests 2.34.2,PyPI 显示它要求 Python 3.10 以上。第二,timeout=120 不能省:本文实测视频详情一步最长用了 64.95 秒,客户端超时要留够。第三,挑视频前先按时长过滤:实测一的搜索结果里,播放量最高的前三条分别长 117,379 秒、100,509 秒和 100,483 秒,都是三十个小时左右的课程合集,弹幕和字幕都很难对应到具体的一节课。
如果不想写代码,也可以把同一套能力接进 AI 工具。下面是远程 MCP 的配置示例(客户端不同,字段名略有差别;Key 同样从环境变量读),接上以后,AI 会用 everyinfra_call_api 这个工具按同样的 platform、action、params 调用。各客户端的接法见 MCP 接入页。
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
实测:三个跨领域关键词、三条完整链
我们选了三个跨领域的关键词,让同一段代码面对不同类型的内容:「线性代数 公开课」是教育,「黑洞 科普」是科学传播,「柑橘 种植技术」是农业。三条链分别在 00:14、00:16、00:22(新加坡时间)开始,下表的「完成」是字幕一步返回的时刻。
| 实测 | 开始—完成(新加坡时间) | 关键词 | 选中的视频 | 时长 | 搜索 | 弹幕 | 字幕 | 串行总耗时 | 扣费 |
|---|---|---|---|---|---|---|---|---|---|
| 一 | 00:14:39—00:15:28 | 线性代数 公开课 | 考研数学习题课(行列式) | 54:49 | 20 行 | 100 行 | 983 句 | 51.43 秒 | $0.00278 |
| 二 | 00:16:10—00:17:39 | 黑洞 科普 | 「一毫米黑洞威力多大」 | 12:57 | 20 行 | 100 行 | 367 句 | 91.54 秒 | $0.00278 |
| 三 | 00:22:41—00:24:20 | 柑橘 种植技术 | 「桔子的一生」农业纪录片 | 6:15 | 20 行 | 19 行 | 1 句 | 100.26 秒 | $0.00278 |
15 个请求全部返回 HTTP 200,每次扣 $0.000556,每条链 $0.00278,三条链合计 $0.00834。我们动笔前定的目标是「5 步串行中位总耗时不超过 20 秒」,实际中位是 91.54 秒,差得很远。拖慢它的是视频详情一步,三次分别用了 23.96、64.95、37.45 秒,占串行总耗时的 46.6%、71.0%、37.4%;搜索和评论都在 2 秒以内,弹幕 9.63–13.02 秒。实测三的字幕一步用了 48.88 秒,是唯一一次字幕比详情还慢的情况。详情慢和是否带流地址没有对应关系:回了音视频流地址的实测一(6 路视频流、3 路音频流,最高 480P,有效期到 11 月 11 日 02:15 新加坡时间,约 2 小时后过期)反而最快,最慢的实测二只有 22 个字段、没有流地址;慢的原因我们不知道。只要统计数时,搜索结果里已经有播放、点赞、评论数、弹幕数和收藏数,可以不调详情。
接口返回的样子见下图:上半是实测一的弹幕请求和其中两条结果,下半是字幕请求和前两句。截图只保留两行,作者名隐去,账户余额字段删掉了。
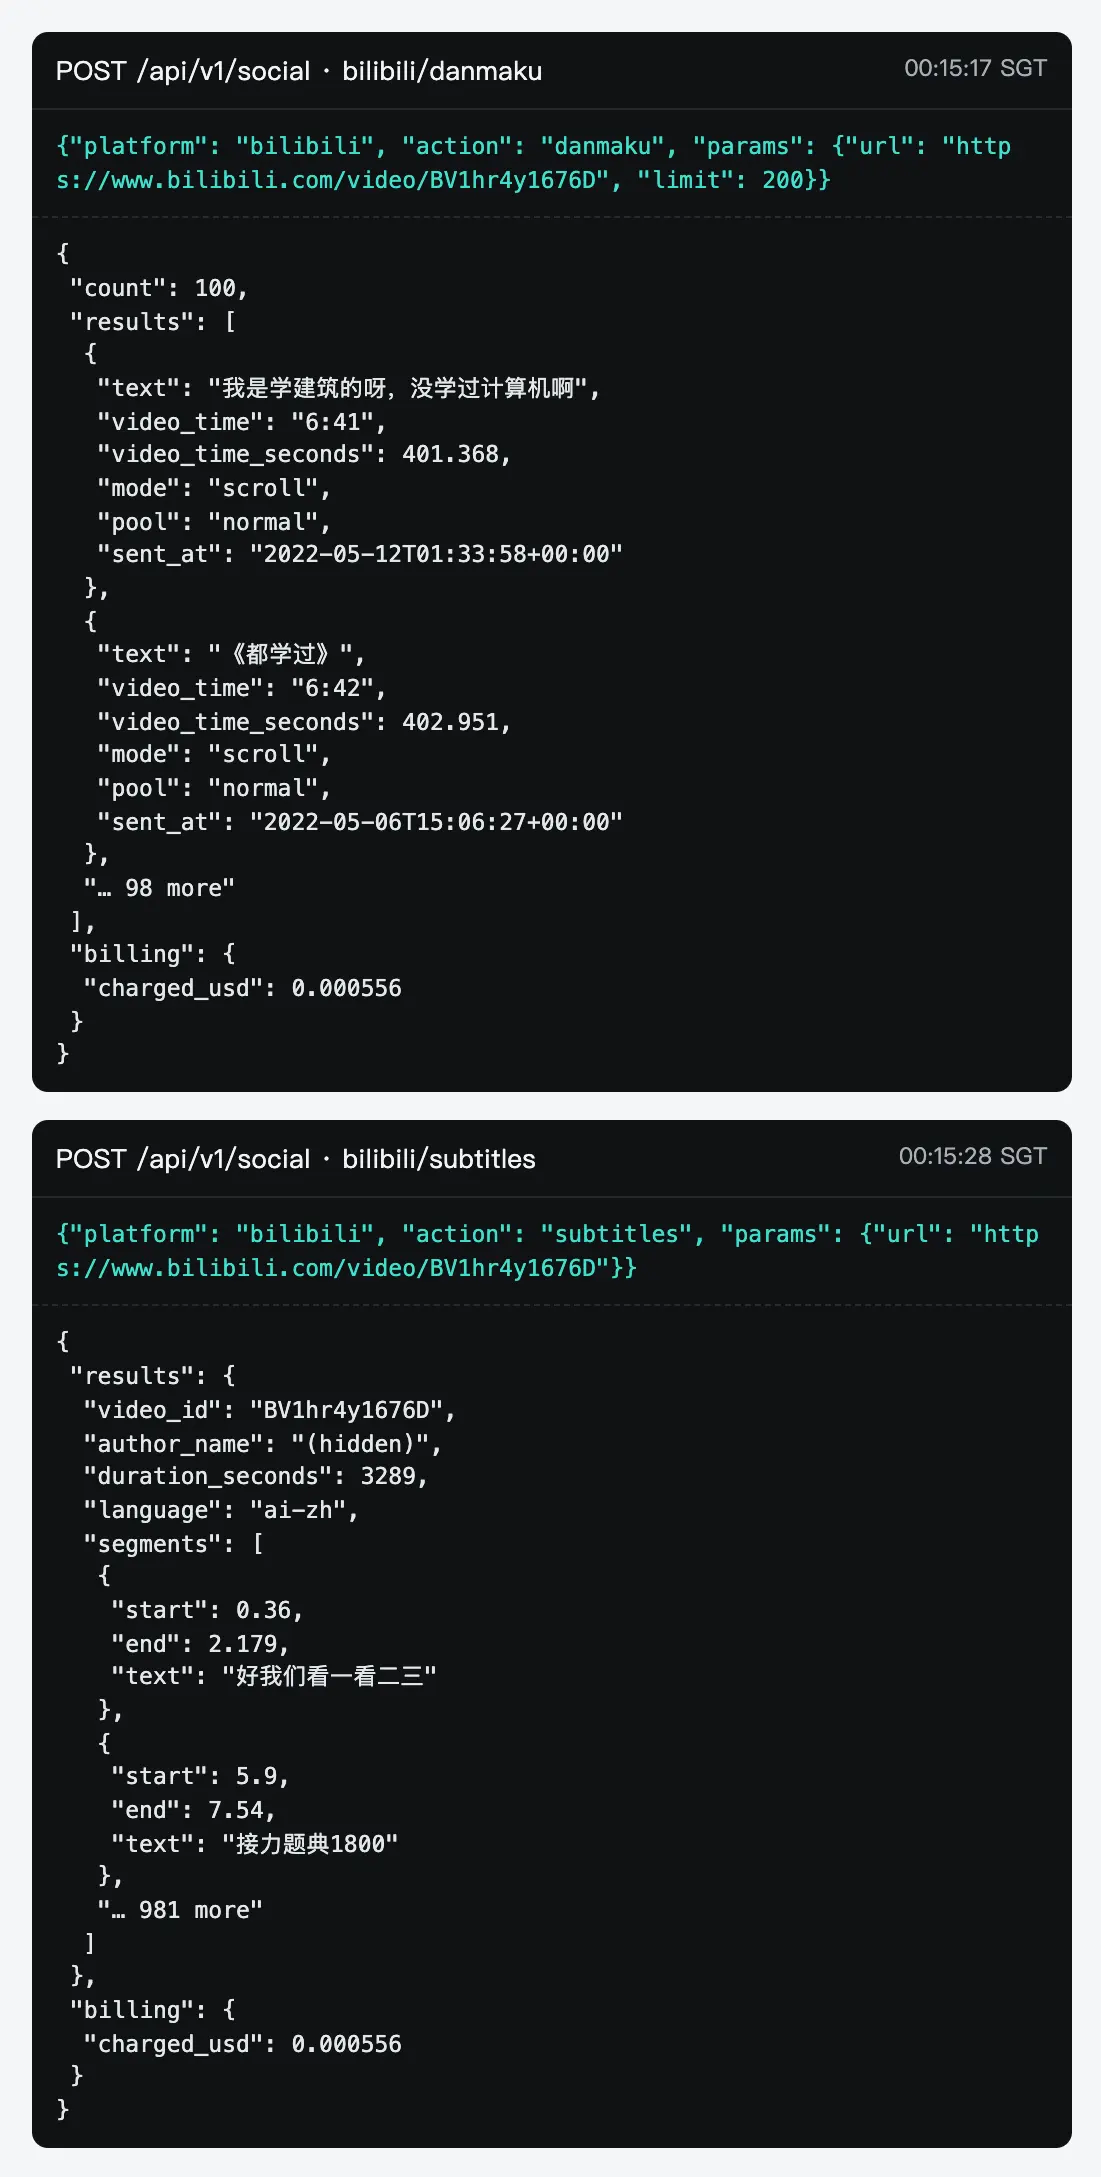
三条链的原始返回里还有几条和直觉不同的观察。第一,评论接口回的是按热度排序的热门评论:实测二排在最前的几条点赞分别是 7,825、5,544、2,812,回复数 204、504、46;实测一的第一条来自视频作者本人,内容和视频简介相同。第二,搜索结果每行 19–20 个字段,60 行里没有一行带 coin_count 和 share_count,这和目录的 field_note 一致;投币数要从视频详情拿。第三,实测三那条农业视频的字幕返回 language 为 English、全文只有一个词,时间也换成了「00:00:01.560」这样的字符串,而实测一、二的时间是秒数;这条视频以画面和音乐为主,没有人声,接口照常扣了 $0.000556。用字幕做分析的脚本,要先判断 segments 的条数和时间格式。
字段:每一步回什么
下表是三次实测里每一步实际返回的主要字段,和目录 response_fields 逐个对过;只列做分析时最常用的,完整列表看目录。
| 能力 | 每行字段数(实测) | 常用字段 | 要注意的 |
|---|---|---|---|
bilibili/search | 19–20 | id、url、title、view_count、like_count、comment_count、danmaku_count、favorite_count、duration_sec、posted_at、tags | 实测 60 行都没有 coin_count、share_count |
bilibili/video | 22 或 26 | 同上,加 coin_count、share_count、video_streams、audio_streams、streams_expire_at | 流地址约 2 小时过期;实测二、三没有回流地址,只有 22 个字段 |
bilibili/comments | 10 | id、text、like_count、reply_count、posted_at | 按热度排序的热门评论,带作者名和主页链接 |
bilibili/danmaku | 10 | text、video_time、video_time_seconds、mode、color、pool、sent_at | 没有发送者字段;弹幕多的视频只回一部分 |
bilibili/subtitles | 9 | language、text、segments(start、end、text)、duration_seconds | 实测一、二是 ai-zh;无人声视频只回一句 |
bilibili/popular | 24 | 同搜索,加 aid、recommend_reason、ip_location | 每页 20 条,带 next_page_token;实测 20 条都有 ip_location |
弹幕行里没有发送者字段,这一点值得单独说。前面提到的律师函把「采集弹幕并反查用户真实身份」列为侵权行为之一;我们实测的弹幕只有文本、视频内时间点、显示方式、颜色、弹幕池和发送时间,从字段上就拿不到发送者。做研究时这反而省事:不需要再做一道去标识化。时间字段 posted_at、sent_at 是带时区的 ISO 8601,例如实测二的视频是 2025-10-05T02:30:00+00:00,换成新加坡时间是 10 月 5 日 10:30,能直接被 pandas 或数据库解析。
弹幕不是全量:重复调用也补不齐
实测三那条视频的 danmaku_count 是 19,弹幕请求回了 19 条,也就是全拿到了;实测一、二的视频弹幕多,各回了 100 条。所以对弹幕少的视频,一次调用就是全量;对弹幕多的视频,一次只拿到一部分。实测一的视频有 3,731 条弹幕,回来的 100 条占 2.7%;实测二的视频有 36,824 条,100 条只占 0.27%。
我们想知道多调几次能不能补齐,于是对实测二的视频又调了 5 次弹幕:00:25 一次,00:27–00:28(新加坡时间)连续 4 次。结果是:00:17 那次和 00:25 那次只重叠 10 条,00:25 那次带来了 90 条新弹幕;之后 4 次和 00:25 那次完全相同,一条新的都没有。6 次合起来只有 190 条不重复,占 36,824 条的 0.52%,花了 6 × $0.000556 = $0.003336。两次不同的样本差别也很大:00:17 那次的发送时间从 2025 年 10 月 5 日一直到 2026 年 11 月 8 日,00:25 那次全部落在 2025 年 10 月 5 日到 10 月 28 日之间,也就是视频发布后的头三周。
这组数说明两件事。第一,弹幕接口给的是样本,不是全量;样本在几分钟的尺度上会变,但短时间内重复调用拿到的是同一批,靠「多调几次」凑不出全量。第二,样本的分布偏向视频开头:实测二的 100 条里有 89 条落在视频前 15 秒,其中 66 条是同一个网络梗「彳亍」;实测一的 100 条只覆盖到第 606 秒,而视频长 3,289 秒,覆盖率 18.4%。动笔前我们定的判据是「覆盖视频时长 80% 以上才说能画整条时间轴」,实测一不到,实测二虽然时间上覆盖了 92.9%,但 89% 的条数挤在前 15 秒,后面每分钟只有 1 条。结论:一次弹幕请求可以回答「观众在开头和前几分钟对什么起反应」,不能回答「整条视频哪一分钟弹幕最多」。要画整条时间轴,字幕才是全量的:实测一的字幕 983 句,最后一句结束在 3,287.3 秒,覆盖了整条视频。
跨领域例子:用弹幕和字幕看一堂课哪里让学生起反应
教育和科普团队最常问的是「观众在哪一段卡住、在哪一段兴奋」。这类问题以前要靠问卷或平台后台,而后台只对 UP 主自己开放。弹幕的特殊之处在于它带视频内时间点,可以和字幕按时间对齐:观众在第几秒说了什么,老师在那一秒正在讲什么。我们用 Python 标准库的 bisect 做对齐,用 Counter 按分钟计数,不需要额外安装任何包:
import bisect, json, re
from collections import Counter

dm = json.load(open("run1/4_danmaku.json"))["response"]["results"]
seg = json.load(open("run1/5_subtitles.json"))["response"]["results"]["segments"]
starts = [float(s["start"]) for s in seg]

def said_at(t):                                   # subtitle line playing at second t
    i = max(0, bisect.bisect_right(starts, t) - 1)
    return seg[i]["text"]

per_minute = Counter(int(d["video_time_seconds"] // 60) for d in dm)
questions = [(d["video_time"], d["text"], said_at(d["video_time_seconds"]))
             for d in dm if re.search(r"[??]|为什么|怎么|吗", d["text"])]
print(per_minute.most_common(4), len(questions))
实测一是一堂 55 分钟的考研数学习题课,讲行列式。100 条弹幕里有 25 条落在第 0 分钟、17 条在第 2 分钟,最集中的是第 6–7 分钟,两分钟共 37 条。对齐字幕后看得很清楚:这两分钟老师在讲如何交换行列式的行,用了「第一个泡泡上去」的比喻,弹幕立刻刷起「冒泡法」「计算机汤家凤」「考研 408 指导」,37 条里有 19 条提到计算机、数据结构、编程或自己的专业,比如「我是学建筑的呀,没学过计算机啊」「我一个经管人上哪里学计算机编程冒泡法」。对授课老师来说,这是一个很具体的信号:一个跨学科的比喻能抓住注意力,但对没学过编程的学生是一道新门槛,下一次可以在比喻后面补一句解释。
问题型弹幕是另一类信号。我们用一个简单的规则(带问号,或带「为什么」「怎么」「吗」等字)筛出 15 条,其中 5 条是同一个问题的变体:「老师,一个三行四列的行列式怎么算啊?」。行列式只对方阵有定义,这个问题本身说明有一部分观众还没建立「行列式是方阵的属性」这个前提,而它反复出现在视频开头的几秒里,适合在下一版课的片头加一张提示卡。第 5 分钟还有一条「行列式里为什么会有矩阵」,对应的字幕正好在讲代数余子式的性质。这些判断都只基于 100 条样本,它能告诉你「有」,不能告诉你「有多少比例的观众」。
科普视频的情况不同。实测二的黑洞科普视频,100 条弹幕里 89 条在前 15 秒,绝大多数是梗;问题型只有 4 条,比如「那一微米呢?」「那一纳米的黑洞呢?」,而热门评论第一条「下次能不能放一个一纳米的黑洞?」有 7,825 个赞,第二条「被黑洞吸进去的东西都去哪了」有 504 条回复。也就是说,同一个好奇心在弹幕和评论里各出现了一次:弹幕是即时的一句话,评论区是有人接着讨论的地方。做科普选题时,评论里回复最多的那个问题,往往就是下一期视频的题目。
农业视频是第三种样子。实测三那条「桔子的一生」只有 19 条弹幕,一次全拿到了,其中 4 条是问题:「这里把刺夹在里面起什么用啊」「怎么做到一起成熟的」「没放怎么采收的」。热门评论里有人写广西的沃柑、砂糖橘、金桔,有人写去湖北秭归带着蜜蜂采脐橙蜜。对做农业科普或产地推广的团队,这 19 条弹幕已经是一份小型的「观众想知道什么」清单。弹幕作为「某一秒的集体反应」,在教育、科普和农业题材里都有分析价值。
每千条成本:弹幕最便宜
「bilibili api」这类搜索背后,很多人想知道一千条数据到底花多少钱。我们不用目录单价除以 limit 去推,而是用三条完整链的真实返回行数和真实扣费现算,每项能力 3 次调用。
| 能力 | 计费方式(目录) | 实测调用 | 实测返回 | 实测扣费 | 每千行成本 |
|---|---|---|---|---|---|
bilibili/danmaku | 每次 $0.000556 | 3 | 219 行 | $0.001668 | 约 $0.0076 |
bilibili/search | 每次 $0.000556 | 3 | 60 行 | $0.001668 | 约 $0.0278 |
bilibili/video | 每次 $0.000556 | 3 | 3 个视频 | $0.001668 | 每千个视频 $0.556 |
bilibili/subtitles | 每次 $0.000556(11 月 12 日起 $0.000792) | 3 | 3 个视频,共 1,351 句 | $0.001668 | 每千个视频 $0.556 |
单价一样,每千行成本取决于每次返回多少行:弹幕一次回得最多,所以最便宜,比搜索便宜约 3.7 倍。这和我们前一篇抖音 Python 实测的结论正好相反:抖音那边搜索按页收费、最贵,评论按 20 条一档、最便宜;B 站这边所有能力按次收费,谁一次回得多谁就便宜。设计采集方案时,B 站的思路因此是「多拿弹幕和搜索」。字幕按视频计,实测时一个视频 $0.000556(11 月 12 日起 $0.000792)拿到整条视频的逐句文本和时间轴,实测一 983 句、8,697 字,是三项文本数据里信息量最大的。
上表字幕一行的条数写法要说明:三条视频的字幕分别是 983 句、367 句和 1 句,合计 1,351 句;表里写「3 个视频」是因为字幕按视频计费。把弹幕重复调用的 6 次也算进来,弹幕一共 8 次调用(三条链 3 次,加上对实测二视频的 5 次重复),共返回 719 行、扣 $0.004448,每千行约 $0.0062,但其中只有 309 行互不重复;按不重复行数算,每千行约 $0.0144。重复调用不划算,这一点前面已经说过。
三个场景的月账单
只看单价不够直观,我们按三个真实场景算了账,单价取 2026 年 11 月 12 日读取的目录(字幕每次 $0.000792,其余每次 $0.000556,热门榜每页 $0.000806),调用次数按场景写明。
| 场景 | 每次跑的内容 | 频率 | 每月调用次数 | 每月接口费 |
|---|---|---|---|---|
| 一门 20 节的公开课,每周看反馈 | 每节课取视频详情、热门评论、弹幕;字幕只在开始时取一次 | 每周,4 周 | 260 | $0.1493 |
| 科普 UP 主选题观察 | 每天搜 10 个词(最新排序);每个词每周深挖 5 个视频的详情、评论、弹幕 | 每天搜索,每周深挖 | 900 | $0.5004 |
| 热门榜快照 | 每天存热门榜前 5 页共 100 个视频 | 每天,30 天 | 150 | $0.1209 |
第一个场景每月不到 15 美分,对一门课的教学团队来说接近零成本;它真正的成本在后面的人工阅读和归类。第二个场景里搜索每天 10 次、每月 $0.1668,占 33%,其余是深挖。第三个场景用到的 bilibili/popular 是 8 项能力里单价最高的,每页 $0.000806,我们 00:26(新加坡时间)实测一页回 20 条,20 条都带 IP 属地和分区,那一页里「日常」3 条、「电子竞技」2 条,其余分区各 1 条。这些数只算接口费,不含你自己的服务器和存储。价格汇总也可以看价格页和数据市场。
错误和扣费:哪些情况不花钱
自建脚本出错时最难的是判断「这次失败有没有花钱、要不要重试」。我们在 00:26–00:27(新加坡时间)故意做了几次错误调用和一次异步调用,加上前面的实测,整理成下表。
| 情况 | HTTP 状态 | 返回要点 | 扣费 |
|---|---|---|---|
| 不带 Key | 401 | missing_key,next_steps 写明 Nothing was charged | 0 |
| sort 写成 hottest | 422 | invalid_value,列出 5 个允许值,did_you_mean 给出 most_liked、most_viewed | 0 |
视频详情加 "mode": "async" | 202 | 3.0 秒拿到 job_id 和 poll_url;每 5 秒轮询,00:27:12 为 finalizing,00:27:25 为 succeeded | $0.000556 |
| 无人声视频取字幕 | 200 | 只回一句,language 为 English | $0.000556 |
| 超过每分钟请求上限 | 429 | 碰到 1 次:实测 3 的第一次搜索(00:22:41 前约 1 分钟),这把测试 Key 每分钟 10 次;脚本等 60 秒重试后 200 | 0:这次响应没存,同一天 00:15 我们读到的另一次 429 响应写明 Nothing was charged;实测 3 只扣 5 次,合计 $0.00278 |
第二行值得多说一句:422 的错误信息不只告诉你错了,还给出允许值和最接近的候选,这对把脚本交给 AI 写和改特别有用,模型读到错误就能自己改对。对弹幕来说,链接里要能提取出 BV 号,目录的参数说明写了这一点。第三行的异步模式适合视频详情这种慢步骤:不占着连接等 30 到 60 秒,先拿 job_id,再去轮询。第四行是唯一「成功但没用」的情况,字幕接口照常扣费,所以批量取字幕前,可以先用搜索结果里的分区和时长做一道筛选。重试时如何避免重复扣费,可以看站内的幂等键与重试和失败退款对账两篇。
什么时候另外两条路更合适
按次付费接口不是所有场景的答案,下面照实写另外两条路的优势。
开放平台在三类场景里明显更好。第一是要写操作:投稿、编辑、删除稿件,开专栏,开直播,只有开放平台能做,按次付费的数据接口只读。第二是要读授权账号自己的私有数据:近 30 天增量、充电数、后台统计,这些数据本来就只对账号主人开放,开放平台通过授权把它们交给你的应用,其他路线拿不到也不该拿。第三是做直播互动:直播开放平台的长连接是实时推送,延迟和完整性都比任何轮询方案好,而且平台认可。如果你本身就是境内企业、手上有签约 UP 主,开放平台的资质门槛对你不是门槛。
开源项目也有它的位置。如果你只是偶尔下载自己能看到的几个视频做课堂素材或个人备份,装一个下载器比注册任何服务都快,代码可以读、可以改,数据只在你自己的电脑上。还在维护的通用下载器(例如 yt-dlp)更新很快,坏了往往几天内就有人提修复。只是要把两件事算进去:一是维护时间,本文第二节列出的 issue 都发生在最近 30 天,B 站提取器的修复到现在还没合并;二是风险,今年两个项目收到律师函后停更,基于它们的脚本已经没人修了。
按次付费接口最适合的是中间这一大块:要持续拿别人的公开视频、热门评论、弹幕和字幕,不需要写操作,不是境内法人或不想走资质流程,没有专人维护签名,希望出错时不花钱、结果能直接进表格或数据库。它的短板也要说清楚:拿不到授权账号的私有数据;评论回的是热门评论,不是完整评论区;弹幕多的视频只拿到样本,不是全量;视频详情单次要 24 到 65 秒。同一套 Python 写法换 platform 和 action,也能用于 抖音数据接口和 YouTube 数据接口;小红书一侧的同类问题看小红书 API 官方与第三方对比,Instagram 一侧看 Python 取 Instagram 帖子和评论。
合规与边界
这一节只写数据方法和边界,不构成法律意见。三条路面对的是同一组法律文本和同一份平台协议。《个人信息保护法》第十三条和第二十七条写明,可以在合理的范围内处理个人自行公开或者其他已经合法公开的个人信息,个人明确拒绝的除外;对个人权益有重大影响的,应当取得个人同意。评论者的昵称、头像、主页链接都属于个人信息,我们建议研究和教学反馈场景只保留文本、点赞数、回复数和时间,昵称和主页链接不入库。弹幕行本身不带发送者字段,这一侧天然更干净。本文实测的返回都是公开页面上展示的内容:视频信息、热门评论、弹幕文本和字幕,没有任何账号的私有数据,也没有弹幕发送者的身份。
2025 年修订的《反不正当竞争法》第十三条写明,经营者不得以欺诈、胁迫、避开或者破坏技术管理措施等不正当方式,获取、使用其他经营者合法持有的数据。开源项目里讨论的 WBI 签名、风控校验、登录态,正是平台的技术管理措施,这也是我们在第二节只陈述、不教绕过的原因;B 站今年两封律师函引用的也正是这部法律和《民法典》《网络安全法》。《网络安全法》经 2025 年 10 月 28 日的修改决定修订,新文本自 2026 年 1 月 1 日起施行;2025 年 1 月 1 日起施行的《网络数据安全管理条例》对网络数据处理活动提出了一般要求。数据量大、要长期留存的项目应当一并对照,必要时请教你自己的法律顾问。
高校和研究机构做这类项目,伦理审查常会问三件事:公开内容怎么存、存多久、怎么去掉身份信息。本文的字段事实可以直接拿来回答:弹幕没有发送者字段,评论带作者名和主页链接,视频流地址约 2 小时过期,字幕是平台生成的 AI 转写(language 为 ai-zh)。建议在第一次调用前就定好只入库哪几列,原始 JSON 的留存期限写进项目说明,到期删除。
数据本身也有边界,下面这些是实测能确认的:评论只是热门评论,不能用来算评论区的情绪比例;弹幕是样本且偏向开头,不能用来估计全片弹幕分布;字幕对无人声视频几乎为空;搜索结果按 B 站自己的排序给出,不是全量,不能用来估算某个话题的视频总数。
常见问题
bilibili api python 有没有官方的 Python SDK?
没有。开放平台的签名示例是 Go 代码和一个 C# 示例仓库;用 Python 调官方接口要自己按签名文档实现 HMAC-SHA256,本文第一节给了一个按文档改写的配置示例。前提是你是境内法人并获得 UP 主授权。
「bilibili api request was banned」是什么原因?
网页端接口要 WBI 签名,部分请求还要登录态;缺签名、密钥过期、请求太频繁,都会被拒(常见 412)。MediaCrawler 11 月 5 日合并的 #1000 就是在修 WBI 密钥读取和兜底请求不带登录 Cookie 的问题。按次付费接口这一侧,本文 28 个数据请求没有碰到 412,只在实测 3 开头被每分钟上限挡了 1 次 429,等 60 秒重试就过了;我们故意构造的错误里,不带 Key 返回 401、排序值写错返回 422,都没有扣费。
b站 api 接口能拿到弹幕吗?
开放平台只有直播间的实时弹幕长连接,要主播授权;点播视频的弹幕,文档目录里没有找到读取接口。按次付费接口的 bilibili/danmaku 带视频内时间点,没有发送者字段,本文实测每千行约 $0.0076。
bilibili api key 怎么申请?
开放平台的 client_id 和 app_secret 要先以境内法人入驻、创建应用后才能拿到;按次付费接口在控制台创建 API Key 即可,步骤见下面「上手步骤」。
上手步骤
- 在控制台创建 API Key,写进环境变量
EVERYINFRA_API_KEY,步骤见快速上手。 - 免费读一次目录
GET /api/v1/social/catalog?platform=bilibili,确认参数、价格和available。 pip install requests,复制第三节的脚本,python bili_chain.py "你的关键词" run1。- 打开 run1 目录里的五个 JSON,核对每一步的
billing.charged_usd;字幕先看segments条数,弹幕记住它是样本。
参考资料
- 哔哩哔哩开放平台,文档中心首页,读取于 2026-11-11,https://open.bilibili.com/doc
- 哔哩哔哩开放平台,《平台简介》,读取于 2026-11-11,https://open.bilibili.com/doc/4
- 哔哩哔哩开放平台,《哔哩哔哩开放平台管理规范》(2022-07-29 生效),读取于 2026-11-11,https://open.bilibili.com/agreement/management-protocol
- 哔哩哔哩开放平台,《开发者服务协议》,读取于 2026-11-11,https://open.bilibili.com/agreement/developer-service
- 哔哩哔哩开放平台,《隐私政策》,读取于 2026-11-11,https://open.bilibili.com/agreement/privacy-policy
- 哔哩哔哩开放平台,《查询单一视频稿件详情》,读取于 2026-11-11,https://open.bilibili.com/doc/4/d9554788-dcef-f139-6217-b487d41c3826
- 哔哩哔哩开放平台,《获取整体稿件增量数据》,读取于 2026-11-11,https://open.bilibili.com/doc/4/708a4ce5-5a6e-d8ce-b2e8-ff8a26a83b05
- 哔哩哔哩开放平台,《获取单个稿件数据》,读取于 2026-11-11,https://open.bilibili.com/doc/4/3f46ac2e-1318-3aa0-5548-0d9fd624d520
- 哔哩哔哩开放平台,《OAuth 2.0 接入》,读取于 2026-11-11,https://open.bilibili.com/doc/4/eaf0e2b5-bde9-b9a0-9be1-019bb455701c
- 哔哩哔哩开放平台,《接口签名实现标准和状态码》,读取于 2026-11-11,https://open.bilibili.com/doc/4/8673959e-f7bb-56e6-6e68-d225f971b81b
- 哔哩哔哩开放平台,《获取已授权用户基础公开信息》,读取于 2026-11-11,https://open.bilibili.com/doc/4/feb66f99-7d87-c206-00e7-d84164cd701c
- GitHub,bilibili-openplatform/SignatureAlgorithm_DotnetDemo,读取于 2026-11-11,https://github.com/bilibili-openplatform/SignatureAlgorithm_DotnetDemo
- 哔哩哔哩直播开放平台,《长链数据协议说明》,读取于 2026-11-11,https://open-live.bilibili.com/document/657d8e34-f926-a133-16c0-300c1afc6e6b
- 哔哩哔哩,《哔哩哔哩弹幕网用户使用协议》(2025-05-07 生效),读取于 2026-11-11,https://www.bilibili.com/protocal/licence.html
- 哔哩哔哩,robots.txt,读取于 2026-11-11 00:23 新加坡时间,https://www.bilibili.com/robots.txt
- GitHub,Nemo2011/bilibili-api README(含 2026-07-06 侵权告知函),读取于 2026-11-11,https://github.com/Nemo2011/bilibili-api
- PyPI,bilibili-api-python 17.4.2,2026-06-19,https://pypi.org/project/bilibili-api-python/
- GitHub,SocialSisterYi/bilibili-API-collect README(2026-01-28 律师函说明),读取于 2026-11-11,https://github.com/SocialSisterYi/bilibili-API-collect
- GitHub,pskdje/bilibili-API-collect,读取于 2026-11-11,https://github.com/pskdje/bilibili-API-collect
- GitHub,nilaoda/BBDown README,读取于 2026-11-11,https://github.com/nilaoda/BBDown
- GitHub,Vespa314/bilibili-api,读取于 2026-11-11,https://github.com/Vespa314/bilibili-api
- GitHub,xfgryujk/blivedm README,读取于 2026-11-11,https://github.com/xfgryujk/blivedm
- GitHub,yt-dlp/yt-dlp,读取于 2026-11-11,https://github.com/yt-dlp/yt-dlp
- GitHub,yt-dlp #17847,2026-10-17,https://github.com/yt-dlp/yt-dlp/issues/17847
- GitHub,yt-dlp #17879,2026-10-21,https://github.com/yt-dlp/yt-dlp/issues/17879
- GitHub,yt-dlp #17890,2026-10-22,https://github.com/yt-dlp/yt-dlp/issues/17890
- GitHub,yt-dlp #17894,2026-10-22,https://github.com/yt-dlp/yt-dlp/issues/17894
- GitHub,yt-dlp #17898,2026-10-22,https://github.com/yt-dlp/yt-dlp/pull/17898
- GitHub,NanmiCoder/MediaCrawler README,读取于 2026-11-11,https://github.com/NanmiCoder/MediaCrawler
- GitHub,MediaCrawler #1000,2026-11-04 提交、2026-11-05 合并,https://github.com/NanmiCoder/MediaCrawler/pull/1000
- EveryInfra,数据接口目录,读取于 2026-11-11 00:13 新加坡时间,https://api.everyinfra.com/api/v1/social/catalog
- requests 文档,Advanced Usage:Session Objects,读取于 2026-11-11,https://requests.readthedocs.io/en/latest/user/advanced/#session-objects
- PyPI,requests 2.34.2,2026-05-14,https://pypi.org/project/requests/
- Python 文档,bisect,读取于 2026-11-11,https://docs.python.org/3/library/bisect.html
- Python 文档,collections.Counter,读取于 2026-11-11,https://docs.python.org/3/library/collections.html#collections.Counter
- Python 文档,hmac,读取于 2026-11-11,https://docs.python.org/3/library/hmac.html
- 国家互联网信息办公室,《中华人民共和国个人信息保护法》,2021-08-20,https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- 国家知识产权局,《中华人民共和国反不正当竞争法(2025年修订)》,2026-05-20 收录,https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- 生态环境部转载国务院令第790号,《网络数据安全管理条例》,2024-10-03,https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- 国家互联网信息办公室,《中华人民共和国网络安全法》(2026-01-01 施行文本),2025-12-29,https://www.cac.gov.cn/2025-12/29/c_1768735112911946.htm
- 国家互联网信息办公室,《全国人大常委会关于修改〈中华人民共和国网络安全法〉的决定》,2025-10-29,https://www.cac.gov.cn/2025-10/29/c_1763461514768457.htm
引用编号 BL-133