weibo api python:取微博数据三条路实测
用 Python 取微博数据三条路:开放平台每授权用户每天 100 次,开源脚本靠 Cookie,按次付费 API 跑完 7 步链一条 $0.0051。
我们在 2026 年 11 月 11 日 00:14–00:37(新加坡时间)用 Python 的 requests 跑了 4 次「热搜 → 话题搜索 → 帖子搜索 → 帖子详情 → 评论 → 评论回复 → 转发」7 步完整链,每次的请求最终都拿到了结果或者被如实退费,一条完整链扣费 $0.005142,耗时 19.37–33.94 秒。最值得写下来的发现不是价格,而是样本:四次实测里,按「评论最多」挑出来的那条帖子,正文里都没有我们搜的关键词;同一个词「流感」在 00:14 只回 12 条、跨度 7 天,到 00:46 回满 50 条、全部是最近 20 分钟发的。另外两条路我们按一手材料逐条核对:微博开放平台写明一个应用内单个授权用户每天只能请求 100 次,评论接口只返回授权用户自己的评论,并且禁止第三方在服务器端存储用户数据;GitHub 上常见的 weibo scraper 项目,自己在 README 里写明关键词搜索和转发要 Cookie,近 60 天的 issue 里还在报返回非 JSON 和结果不超过 500 条。
官方接口和开源脚本两部分只引用 open.weibo.com 原文、项目 README 和公开 issue;按次付费接口这部分,每个数字都来自我们自己的真实调用,脚本和原始返回都保存着,可以逐条复算。
先说结论:三条路分别适合谁
三条路的适用人群几乎不重叠。下面这张表把每条路要准备的东西、能拿到的范围和主要风险放在一起,表里每一项在后文都有出处或实测记录。
| 维度 | 微博开放平台官方接口 | GitHub 开源脚本 | 按次付费数据接口(本文实测 EveryInfra) |
|---|---|---|---|
| 主体要求 | 建应用、审核;weibo-cli 要在微博 App 里刷脸做开发者认证 | 无 | 无,注册拿 API Key |
| 能读谁的数据 | 以授权用户为中心:评论接口只返回授权用户的评论,用户时间线只能查当前授权用户 | 公开页面能看到的,取决于有没有 Cookie | 公开的热搜、话题、帖子、评论、回复、转发、用户主页 |
| 关键词搜索 | 话题搜索是高级接口,只回最新 200 条;按条计费的商业数据 API 要联系商务 | README 写明关键词搜索要 Cookie,网页最多显示 50 页 | weibo/search、weibo/topic_search |
| 频次 | 单授权用户每天 100 次,单 IP 每小时 15,000 次 | 自己控制间隔,项目默认 8–15 秒一次 | 接口限速,429 不扣费 |
| 存储 | 禁止第三方服务器端存储用户数据 | 自己决定,后果自负 | 按你的用途和适用法律处理 |
| 费用 | 普通接口不收费;weibo-cli 积分包 ¥69 起;商业数据 API 无公开价 | 代码免费,成本在维护时间和账号 | 本文一条 7 步完整链 $0.005142 |
我们的判断是:如果你做的是自家微博账号的运营工具,要发帖、回评论、在应用里展示授权用户自己的数据,开放平台是唯一正当的选择,它带写权限,也最稳定。如果你是学生,要给一篇论文抓一个公开账号几百条微博,开源脚本足够,但要接受 Cookie 三个月左右就过期、随时可能被限制访问。如果你要按话题和热搜持续采集别人的公开内容,做新闻、舆情或者公共服务研究,又不想维护 Cookie,按次付费接口是投入最少的一条路。后面每一节分别给出依据。
第一条路:微博开放平台官方接口
很多教程把「微博 API」写成一个输入关键词就能查全站微博的接口,这和 open.weibo.com 上的文档不符。开放平台的大多数读接口都以 OAuth2 授权用户为中心:你的应用先让一个微博用户登录授权,拿到 access_token,然后读的是这个用户能看到、或者这个用户自己产生的数据。官方的授权接口文档在示例里给出的 access_token 有效期是 7200 秒,也就是两小时,过期要重新授权。
现在还能申请什么
我们逐页打开了几个最常被问到的接口。评论列表接口 2/comments/show 的说明里写着只返回授权用户的评论,每页默认 50 条;也就是说,你拿不到一条热门微博下面所有陌生人的评论。用户时间线接口 2/statuses/user_timeline 要求 uid 必须是当前授权用户,最多只返回 5 条,使用官方 SDK 时是 10 条。话题搜索接口 2/search/topics 属于高级接口,只搜带话题的微博,只返回最新的 200 条结果,每页最多 50 条。还在开放的普通接口里,公共时间线 2/statuses/public_timeline 返回的是平台挑出的最新公开微博,不能按关键词筛选。
高级接口要单独申请。高级接口申请页写明,应用要先通过审核,提交申请后 3 个工作日内处理,而且页面上注明部分旧接口已经不再受理。我们没有替真实应用提交申请,所以审核能不能过、要多久,这里只引原文,不下结论。
频次和存储:每天 100 次,不能存到服务器
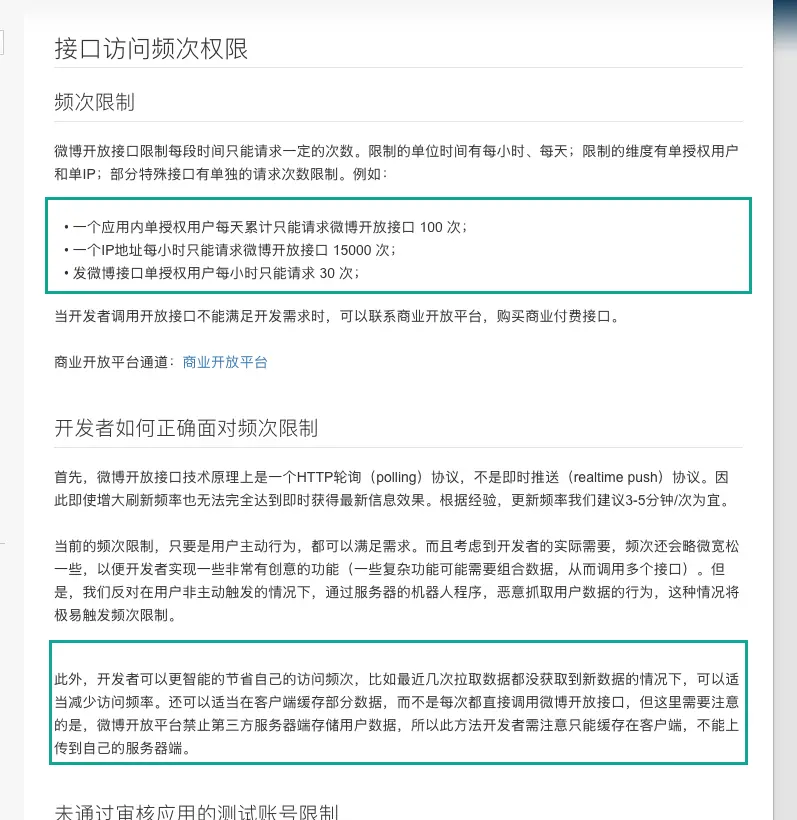
开放平台的接口访问频次权限页面最后更新于 2025 年 5 月 15 日,给出三个例子:一个应用内单个授权用户每天累计只能请求开放接口 100 次,一个 IP 每小时只能请求 15,000 次,发微博接口单授权用户每小时只能请求 30 次。同一页还写了两句对数据研究影响更大的话:平台反对在用户非主动触发的情况下,用服务器上的机器人程序抓取用户数据;开放平台禁止第三方在服务器端存储用户数据,缓存只能放在客户端。页面建议的刷新频率是 3–5 分钟一次。如果开放接口不够用,这一页让开发者去联系商业开放平台。
开发者协议把这些限制写得更细。第 2.7.7 条要求通过开放平台取得的数据只能用于接入的应用本身;第 2.7.8 条写明,以为第三方收集、分析数据为业务的开发者,只能使用微博商业数据 API,并要签《商业数据服务合作协议》;第 2.5.15 条要求停止服务时删除全部数据;还有一条要求不得以政府舆情监测为由索取数据,除非能提供委托函原件。对一个做舆情或者行业研究的团队来说,这几条意味着:用普通开放接口做研究,从协议上就站不住。
商业数据 API:按条计费,没有公开价
微博商业数据 API 的首页列出三种计费方式:按条计费的数据额度(关键词、用户、签到等内容,包括原创、转发和评论),按查询次数计费,以及按权限计费;页面给的联系方式是一个商务邮箱。我们没有找到公开的价目表,也没有以客户身份去询价,所以本文不比较它和其他路的价格。能确定的是,它面向的是签了协议的企业客户,门槛在合同而不在技术。
weibo-cli:2026 年的新入口
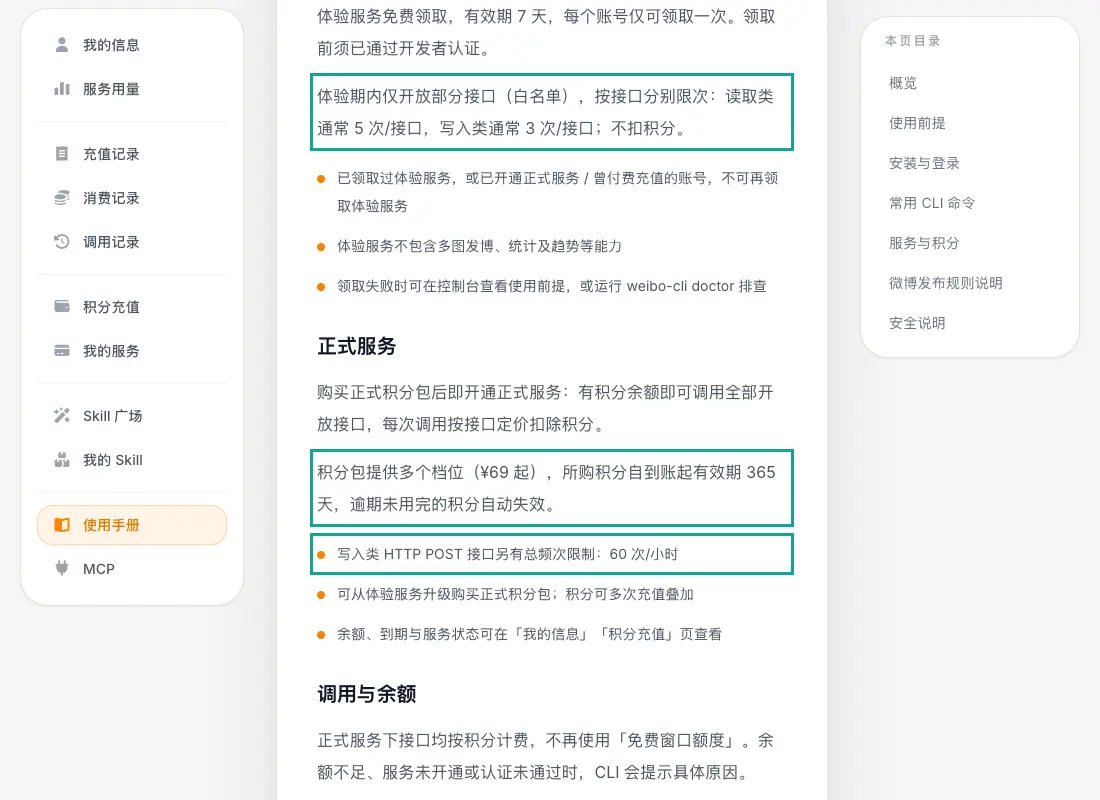
2026 年开放平台多了一个命令行工具。weibo-cli 使用手册写明:安装要 Node 18 以上,用 OAuth 登录;开发者认证要在微博 App 里刷脸;每个账号可以领一次 7 天免费体验,体验期只对白名单开放,读取类接口通常每个 5 次、写入类 3 次;正式使用买积分包,¥69 起,有效期 365 天;写入类 POST 接口每小时 60 次;用 AI 生成的内容发布时要声明。npm 上的 @weibo-ai/weibo-cli 包创建于 2026 年 5 月 25 日,最新版本 0.9.8 发布于 2026 年 9 月 22 日。新浪财经转载的 IT之家报道说它在 6 月 22 日上线,有 70 多个接口、支持 MCP。
weibo-cli 解决的是「授权用户自己用 AI 助手操作自己的微博」这件事,体验额度每个接口 5 次,显然不是给批量采集设计的。对 Python 用户来说,它也不是一个 Python 包:你可以在 Python 里用 subprocess 调它,但鉴权、刷脸认证和积分都绕不开。
| 你想做的事 | 开放平台对应接口 | 原文写的限制 |
|---|---|---|
| 读一条热门微博下的全部评论 | 2/comments/show | 只返回授权用户的评论;每页默认 50 条 |
| 读某个公开账号的历史微博 | 2/statuses/user_timeline | uid 必须是当前授权用户;最多 5 条(SDK 10 条) |
| 按关键词搜微博 | 2/search/topics(高级) | 只搜话题,只回最新 200 条;要申请 |
| 大批量按关键词取数据 | 商业数据 API | 签协议,按条或按次计费,无公开价 |
| 用 AI 助手操作自己的账号 | weibo-cli | 刷脸认证;体验每接口 5 次;积分包 ¥69 起 |
第二条路:GitHub 上的开源脚本(weibo scraper)
搜「weibo scraper github」或者「微博评论爬虫」,排在前面的是几个维护多年的 Python 项目。我们在 2026 年 11 月 11 日 00:23(新加坡时间)用 GitHub 接口现读了它们的星标、最后推送时间和许可证,又逐个读了 README。下表只写 README 和接口返回里有的东西。
| 项目 | 星标 | 最后推送 | 许可证 | README 里关于登录的原文要点 |
|---|---|---|---|---|
| dataabc/weibo-crawler | 4,694 | 2026-11-06 | 未声明 | Cookie 可选;不加 Cookie 能拿到大部分微博,关键词搜索和转发必须加 |
| dataabc/weiboSpider | 9,750 | 2026-02-04 | 未声明 | 必须 Cookie,Cookie 大约三个月过期 |
| dataabc/weibo-search | 2,339 | 2026-06-05 | 未声明 | 要 Cookie;一个搜索条件最多显示 50 页 |
| nghuyong/WeiboSpider | 4,127 | 2026-06-30 | MIT | 替换 weibo.com 的 Cookie 后运行 |
| NanmiCoder/MediaCrawler | 70,803 | 2026-11-09 | 自定义,禁止商用 | 多平台,用浏览器登录 |
| stay-leave/weibo-public-opinion-analysis | 1,057 | 2026-10-24 | 未声明 | 舆情分析全流程,README 说一天大概能取十万条 |
Cookie:可选、必须,还是三个月一换
dataabc/weibo-crawler 的 README 把加不加 Cookie 的区别写得很具体:微博数在 2,000 条以下的用户,不加 Cookie 能拿到用户信息和大部分微博;2,000 条以上的用户,不加 Cookie 只能拿到最近 2,000 条里的大部分。它举的例子是一个当时有 1,085 条微博的用户,不加 Cookie 拿到 1,026 条,约 94.56%。同一份 README 写明「关键词搜索必须设定 cookie」,抓转发也要加 Cookie。它的姊妹项目 weiboSpider 则在常见问题里提醒,Cookie 有期限,大约三个月,过期要重新复制。换句话说,凡是涉及搜索和转发这两步,开源路线都要一个登录过的账号。
我们读的六个 README 都没有单独介绍微博的访客系统,只讲 Cookie 怎么从浏览器开发者工具里复制。关于限速,weibo-crawler 的配置说明写着微博抓取的延迟默认 8–15 秒,评论请求间隔默认 1–2 秒;它还提示大批量抓取中途被限制时,可以按已抓条数算出中断页数,从那一页重新开始。
近 60 天的 issue:返回非 JSON、结果不超过 500 条
开源项目的真实状态要看 issue。weibo-crawler 的 #653 在 2026 年 9 月 26 日提出:用户说之前 5 个月都能正常运行,从 8 月中旬开始,抓完第一页若干条后就报「Expecting value」,也就是服务器返回的已经不是 JSON;按 10、20、40、80、160 秒退避重试都没用,换了新复制的 Cookie 也一样。weibo-search 的 #590 在 2026 年 10 月 13 日提出:所有关键词的结果都不超过 500 条,提问者怀疑是网页只显示 50 页。这和 weibo-search 自己 README 里的说法一致:结果多于 50 页不显示,所以它让你把时间切细,用 FURTHER_THRESHOLD 参数决定什么时候再细分。
另一方面,这些项目也在积极维护。weibo-crawler 在 2026 年 11 月 4 日提交、11 月 5 日合并了 #658,重构存档流程、补齐评论和状态核验;11 月 6 日又合并了 #659。MediaCrawler 在 11 月 4 日合并了一个修复(#1000)。维护活跃说明它们还能用,也说明平台那一侧一直在变,脚本要跟着改。
robots.txt、许可证和两起判例
weibo.com/robots.txt 对所有未点名的爬虫写的是 Disallow /,只对点名的搜索引擎放行,点名的几家 AI 抓取程序只能访问站点地图和少数几个路径;文件头还声明了 ai-train=no。移动版 m.weibo.cn/robots.txt 同样对所有爬虫 Disallow /。robots 规则本身不是法律,但在国内已经被法院当成经营者自主决定的一部分:上海交通大学竞争法律与政策研究中心整理的字节跳动诉微博案中,北京市高级人民法院二审驳回了字节跳动的全部诉讼请求,认为微博通过 robots 协议限制特定爬虫属于经营自主权。更早的新浪微博诉脉脉案((2016)京73民终588号)确立了取用开放平台数据要同时取得用户授权和平台授权的「三重授权」规则,脉脉赔偿 200 万元。
许可证也要看。上表四个项目没有声明许可证,在 GitHub 的默认规则下,你没有复制和再分发它们代码的授权;MediaCrawler 的 README 写明仅供学习和参考,禁止商业用途。用开源脚本做公司业务之前,这一项和 Cookie 一样要先处理。
第三条路:按次付费接口,用 Python 跑完整链
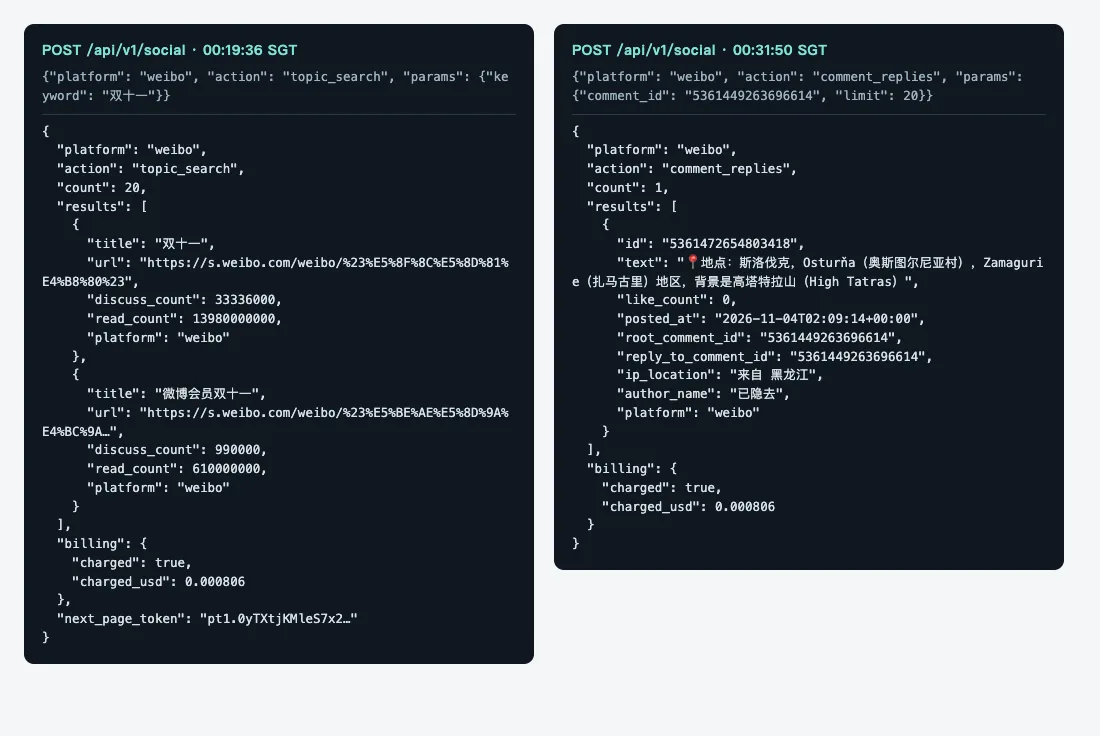
第三条路不用你自己维护 Cookie、签名和页面解析,你的 Python 代码只发 HTTP 请求、收 JSON。我们用 EveryInfra 的 POST /api/v1/social,平台填 weibo,换 action 就能调不同能力。开工前先免费读一次目录 GET /api/v1/social/catalog?platform=weibo,确认每个能力的参数、单价和 available:2026 年 11 月 11 日 00:13(新加坡时间)读到的单价是 weibo/trending、weibo/comments 每次 $0.000556,weibo/search、weibo/topic_search、weibo/post_detail、weibo/comment_replies、weibo/reposts、weibo/user_posts 每次 $0.000806;weibo/user_post_search(在某个用户的微博里搜关键词)当天在目录里是 available=false,本文不用。11 月 12 日复读目录,以上单价没有变化。


下面这段脚本就是我们最后一版实测用的代码,只依赖 requests。Key 只从环境变量读,脚本把每一步的请求、耗时和完整返回存成 JSON,方便事后核对扣费。和第一版相比,它多了两处改动,原因都来自实测:一是 503 且标着可重试时按 retry_after 等待后重发,二是先按正文过滤帖子再按评论数排序,后面两节会解释为什么。
"""Weibo chain: trending -> topic_search -> search -> post_detail -> comments -> comment_replies -> reposts.
pip install requests==2.32.3 ; export EVERYINFRA_API_KEY=... ; python weibo_chain.py 流感 run6"""
import json, os, sys, time
from pathlib import Path
import requests

API = "https://api.everyinfra.com/api/v1/social"
SESSION = requests.Session()
SESSION.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]  # key stays in the environment


def call(action, params, out_dir, name):
    body = {"platform": "weibo", "action": action, "params": params}
    for _ in range(4):
        t0 = time.time()
        r = SESSION.post(API, json=body, timeout=120)
        data = r.json()
        err = data.get("error") or {}
        # 429 (rate limit) and retryable 503 are not charged: wait as told, then send the same request again
        if r.status_code == 429 or (r.status_code == 503 and err.get("retryable")):
            time.sleep(int(err.get("retry_after") or 60))
            continue
        break
    rec = {"started_sgt": time.strftime("%H:%M:%S", time.localtime(t0)), "elapsed_s": round(time.time() - t0, 2),
           "http_status": r.status_code, "request": body, "response": data}
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{name}.json").write_text(json.dumps(rec, ensure_ascii=False, indent=1))
    rows = data.get("results") or []
    print(name, r.status_code, rec["elapsed_s"], len(rows), (data.get("billing") or {}).get("charged_usd"), flush=True)
    return data, rows


def main(keyword, tag):
    out = Path(os.environ.get("OUT_DIR", ".")) / tag
    call("trending", {"limit": 50}, out, "1_trending")
    call("topic_search", {"keyword": keyword}, out, "2_topic_search")
    _, posts = call("search", {"keyword": keyword, "limit": 50}, out, "3_search")
    # keep only rows whose text really contains the keyword, then take the most-commented one
    on_topic = [p for p in posts if keyword in (p.get("text") or "")] or posts
    post = max(on_topic, key=lambda p: (int(p.get("comment_count") or 0), int(p.get("repost_count") or 0)))
    pid = str(post["id"])
    call("post_detail", {"url": pid}, out, "4_post_detail")
    _, comments = call("comments", {"url": pid, "limit": 50}, out, "5_comments")
    if comments:
        top = max(comments, key=lambda c: int(c.get("like_count") or 0))
        call("comment_replies", {"comment_id": str(top["id"]), "limit": 20}, out, "6_comment_replies")
    call("reposts", {"url": pid, "limit": 20}, out, "7_reposts")


if __name__ == "__main__":
main(sys.argv[1], sys.argv[2])七步各做一件事。weibo/trending 取热搜榜,每行有排名、标题、分类、热度值和「热」「新」「沸」标签;weibo/topic_search 按关键词找话题,每个话题带阅读量和讨论量;weibo/search 按关键词搜帖子;weibo/post_detail 补全一条帖子的计数和作者信息;weibo/comments 取一级评论;weibo/comment_replies 取某条评论下的回复;weibo/reposts 取转发列表。要追某个作者的历史微博,再加一步 weibo/user_posts,它支持 page_token 翻页,我们在前四次实测里每次都翻了两页。
实测:四个关键词、七次跑链
我们选了四个关键词:「流感」和「流感疫苗」对应公共卫生场景,「双十一」是当天全站最热的消费话题,「智利车厘子」是一个冷门的进口生鲜词,用来看冷热词的差别。前四次用第一版脚本(按评论数直接挑帖子,碰到 429 等 60 秒),后三次用上面的最终版。下表是每次的结果,时间是新加坡时间,除实测七在 11 月 12 日外都是 2026 年 11 月 11 日。
| 实测 | 时间 | 关键词 | 搜索回条数(limit 50) | 选中帖子的评论计数 | 评论 / 回复 / 转发实际返回 | 7 步耗时 | 7 步扣费 |
|---|---|---|---|---|---|---|---|
| 一 | 00:14–00:19 | 流感 | 12 | 4 | 2 / 0(空,退费)/ 3 | 25.19 秒 | $0.004336 |
| 二 | 00:19–00:21 | 双十一 | 17 | 36 | 24 / 1 / 14 | 33.94 秒 | $0.005142 |
| 三 | 00:31–00:33 | 流感疫苗 | 11 | 6 | 5 / 1 / 20 | 19.37 秒 | $0.005142 |
| 四 | 00:33–00:37 | 智利车厘子 | 50 | 25 | 12 / 0(空,退费)/ 503 两次,不扣费 | 32.87 秒 | $0.003530 |
| 五 | 00:46–00:47 | 流感 | 50 | 未取到(503) | 2 / 1 / 503,不扣费 | — | $0.002724 |
| 六 | 00:47–00:55 | 流感 | 38 | 0 | 0(空,退费)/ 未调 / 503,不扣费 | —(含重试等待约 8 分钟) | $0.002168 |
| 七(11 月 12 日) | 00:15–00:20 | 流感 | 15 | 2 | 1 / 503(容量满,退费)/ 503,不扣费 | —(含重试等待约 5 分钟) | $0.003530 |
表里「7 步扣费」只算链上 7 个请求,不含另外调用的 weibo/user_posts(每页 $0.000806,后面分页一节单独算)。每一次扣费都和目录单价一致:热搜和评论 $0.000556,其他 $0.000806;评论回复返回 0 条时 billing.reason 是 empty_result_refunded,扣 $0;503 失败时是 request_failed_refunded,同样扣 $0。前四次三条完整链(实测一到三)的总耗时中位是 25.19 秒,没有达到我们动笔前定的 20 秒目标;拖慢的是帖子搜索(3.95–13.95 秒)和评论回复(5.91–7.23 秒)两步,热搜一步始终不到 1 秒。限速等待不算在耗时里:前四次一共碰到 6 次 429,每次等 60 秒后重发成功,429 不扣费。
实测五是一次意外,也是一个有用的样本。00:46 我们换上新脚本再跑「流感」,话题搜索、帖子详情和转发三步在 0.13–0.23 秒内直接返回 503,错误体里写着 service temporarily unavailable、retryable 为 true、retry_after 为 60 秒,并注明这是第 1 次(或第 2 次)失败、不扣费,第 3 次失败会说明该检查什么。三步都没扣钱,那次实际花费只有成功的四步。我们因此在脚本里加上了对可重试 503 的等待重发,实测六就是加上之后的结果。
实测六(00:47–00:55)和第二天的实测七(11 月 12 日 00:15–00:20)用的是加了重试的最终版。实测六里话题搜索连续三次 503,第三次的错误体写着「10 分钟内 5 次失败、都没扣费」,并建议先发一次它给出的示例请求,判断是这个目标的问题还是服务的问题;实测七里评论回复返回 503,原因写的是 capacity_exhausted,也就是这项能力当时在服务一侧满员,同样退费,并明确说明这不是你的限速。七次跑链里,热搜、帖子搜索、评论和用户主页每一次都成功,话题搜索 7 次成功 5 次,帖子详情 7 次成功 6 次。
还有一个省请求的小改动:调评论之前先看帖子的 comment_count,为 0 就跳过;评论回复只对点赞最多的一两条评论去取,因为评论行没有回复数,我们 6 次回复调用一共只回了 3 条。空结果虽然退费,但每多一次请求,整条链就多等一两秒到七秒,跑几十个关键词时,这些等待会比钱更先成为瓶颈。
最容易踩的坑:评论最多的帖子,往往不是你要找的帖子
第一版脚本的挑帖规则很自然:搜索结果里评论最多的那条,评论数超过 20 的优先。四次实测下来,这个规则挑出的帖子 4 次都不含关键词。搜「流感」挑到的是一条动漫同人微博,它出现在结果里,是因为正文以外的话题或长文部分命中了;搜「流感疫苗」挑到的是一个 594 万粉丝的摄影账号发的风景照;搜「双十一」挑到的是一条讲「人只能在吃穿上省钱」的帖子,和购物节沾边但没提「双十一」;搜「智利车厘子」挑到的是一张电商预售卡片。
我们回头统计了四次搜索的每一行:limit 都是 50,热词「流感」「双十一」「流感疫苗」只回了 12、17、11 条,其中正文真正出现关键词的是 8、12、6 条,合计 26/40,也就是 65%;冷门词「智利车厘子」一次回满 50 条,正文含关键词的只有 24 条(48%),剩下大多是同一批电商卡片和带话题标签的转发。正文不含关键词的行偏偏评论更多,因为大号的帖子更容易通过话题、长文或者转发原文被搜到,它们的评论数又天然更高。
修复只要一行:先过滤 keyword in text,再按评论数排序。实测六和实测七用了这一行,结果正好说明它为什么必要,也说明它不够:实测七的 15 行里评论最多的一行有 312 条评论,是 2025 年 1 月 17 日发的一条线上中文课广告,正文里没有「流感」,按老规则就会挑中它;过滤后挑中的是一条 2 条评论、担心自己得了流感的普通帖子。实测六的 38 行里 37 行正文含「流感」,可全部是 00:36–00:51 这 15 分钟里刚发的帖子,评论最多的只有 1 条;过滤后挑中的是一条从答题小游戏里一键分享出来的帖子(来源设备字段写的就是那个小游戏),评论数 0,评论接口回空列表并退费。过滤能避免挑错帖子,但变不出互动;要评论样本,就得等帖子积累一段时间再去取,或者先用话题搜索找讨论量大的话题。如果你做的是研究抽样,这一行还不够,下面这段代码把搜索结果先分成「正文命中」和「只在话题或转发里命中」两组,分别统计,再决定要不要把第二组纳入样本。我们的建议是两组都保存,但在报告里分开写数字,不然一条大号的风景照就会把你的「流感疫苗讨论」样本拉偏。
import json, sys
from collections import Counter

def split_rows(path, keyword):
    rows = json.load(open(path))["response"]["results"]
    hit = [r for r in rows if keyword in (r.get("text") or "")]
    other = [r for r in rows if keyword not in (r.get("text") or "")]
    def summary(group):
        return {"rows": len(group),
                "comments": sum(int(r.get("comment_count") or 0) for r in group),
                "verified": sum(1 for r in group if r.get("author_verified")),
                "newest": max((r["posted_at"] for r in group), default=None)}
    return {"keyword_in_text": summary(hit), "keyword_elsewhere": summary(other)}

print(json.dumps(split_rows(sys.argv[1], sys.argv[2]), ensure_ascii=False, indent=1))
第二个发现和时间有关。同一个词「流感」,00:14 的搜索回 12 条,发布时间从 11 月 3 日跨到 11 月 10 日;00:46 再搜,回满 50 条,49 条正文含「流感」,全部发布于最近 20 分钟(新加坡时间 00:27–00:46)。也就是说,weibo/search 返回的是一个随时刻变化的窗口,热词在某些时刻偏向最新发布,某些时刻混入更早的高互动帖子。做研究时,固定每天的采样时刻,比追求「一次取够 50 条」更重要。
分页:哪些能力能翻页
微博这几个能力的分页方式并不统一,写循环之前要先看目录里的 page_token 字段。下表是 2026 年 11 月 11 日目录里的参数和我们实测到的每页条数。
| 能力 | 每次上限 | 翻页方式 | 实测每次条数 |
|---|---|---|---|
weibo/trending | limit 最大 200 | 无,一次取完榜单 | 50(我们取 50) |
weibo/search | limit 默认 20、最大 50 | 无 page_token | 11、12、15、15、17、19、38、50、50 |
weibo/topic_search | 每页 20 | page_token,24 小时有效 | 18、20、19、19;第 2 页 10 |
weibo/comments | limit 最大 50 | 无 page_token | 2、24、5、12、21、2、0、1 |
weibo/comment_replies | limit 最大 20 | 无 | 0、1、1、0、1 |
weibo/reposts | limit 最大 20 | 无 | 3、14、20 |
weibo/user_posts | 每页 20 | page_token,24 小时有效;post_type 可选 all、image、original、video | 每页 10,翻 2 页都是 10 |
weibo/user_posts 目录写每页最多 20 条,我们 8 次调用每次都回 10 条,计费按次,所以每千条成本按 10 条算。topic_search 的 next_page_token 原样传回就能取下一页,第二页回了 10 个话题,之后 token 为空表示到头。weibo/search 没有翻页参数,同一个词用 limit 20 回了 15 条、limit 50 隔 8 秒再搜回了 19 条,想要更多样本就要换关键词组合或者换采样时刻。
字段:每一步回什么,哪些常缺
帖子类的行(search、post_detail、user_posts、reposts)有 15–19 个字段:id、url、text、posted_at、like_count、comment_count、repost_count、image_urls、作者的 id、粉丝数、关注数、是否认证、认证说明、来源设备,以及 is_repost。post_detail 多一个 is_long_text,告诉你正文是不是长文;转发行多一个 original_post_id。目录里写着 post_detail 可能返回 view_count(阅读数),我们 4 次详情调用都没有拿到。实测四「智利车厘子」的 50 行搜索结果里没有作者粉丝数这一列,详情里才有,所以按粉丝数筛选之前要先补一次详情。
评论行只有 10 个字段:id、text、like_count、posted_at、作者 id 和名字、头像、post_id、post_url、platform。它没有 ip_location,也没有回复数,所以你无法从评论列表判断哪条评论下面有回复,只能按点赞挑。回复行多了 root_comment_id、reply_to_comment_id 和 ip_location;我们拿到的回复里,ip_location 写的是「来自 黑龙江」这样的属地,但也出现过「来自 AI罗伯特贱萌版」——发回复的是一个名叫「评论罗伯特」的账号,它在实测二那条帖子的 24 条评论里占了 2 条,点赞最多的那条评论下唯一的回复也是它发的。做情绪或观点分析时,建议先按作者把这类自动评论账号单独标出来。
计数也会变。实测二的帖子在搜索结果里显示 41 条评论、447 次转发,10 秒后详情显示 36 条评论、397 次转发;15 分钟后对同一条帖子再取一次评论,回 21 条,第一次是 24 条。我们没有办法判断是删评、折叠还是统计延迟,只能把它当作数据边界写清楚:同一条帖子的计数和评论列表,在分钟级别上就会不一样,报告里要写采集时刻。
每千条成本:热搜最便宜,用户主页最贵
只看单价会误判成本,因为每次返回的条数差很多。我们把全部真实调用的扣费加起来,除以真实返回的条数,得到每千条成本;空结果已经退费,不计入。计算只用原始 JSON,脚本如下。
import glob, json
from collections import defaultdict

agg = defaultdict(lambda: {"calls": 0, "rows": 0, "usd": 0.0})
for f in glob.glob("raw/run*/[1-9]_*.json"):
    d = json.load(open(f))
    resp, action = d["response"], d["request"]["action"]
    a = agg[action]
    a["calls"] += 1
    a["rows"] += len(resp.get("results") or [])
    a["usd"] += (resp.get("billing") or {}).get("charged_usd", 0.0)
for action, a in sorted(agg.items()):
    per_1000 = a["usd"] / a["rows"] * 1000 if a["rows"] else None
    print(f"{action:16} calls={a['calls']:2} rows={a['rows']:4} usd={a['usd']:.6f} per_1000={per_1000}")
结果是:热搜榜每千条约 $0.0111(一次 50 条只要 $0.000556);帖子搜索约 $0.039;评论约 $0.043;话题搜索约 $0.047;转发约 $0.065;用户主页约 $0.081,因为每页只回 10 条。帖子详情按每千个帖子 $0.806。评论回复在 6 次调用里只回了 3 条,样本太少,不算每千条。换一种说法:同样花 1 美元,可以拍 1,798 次热搜快照,或者取大约 23,000 条评论,或者补全 1,240 条帖子详情。
跨领域例子:用热搜做公共卫生和公共事件时间线
流感季正好是检验「热搜能不能当公共卫生信号」的时候。中国疾控中心的流感监测周报(数据截至 2026 年 11 月 1 日)写着南方省份流感病毒检测阳性率略有下降、北方省份上升,全国报告 106 起流感样病例暴发疫情;北京、上海等地政府网站在 11 月初都发了流感疫苗接种的通知。我们想看的是:同一个时间段,微博热搜榜上能看到多少和流感有关的条目。
做法:每 20 分钟拍一次榜
我们用 weibo/trending(limit 50)从 2026 年 11 月 11 日 00:14 拍到 03:22(新加坡时间,和北京时间相同),实测链里顺带拍了 6 次,后台脚本每 20 分钟再拍一次,共 16 次快照、800 行,花费 16 × $0.000556 = $0.0089。每一行都存原始 JSON,然后用下面这段代码把它们拼成一张「条目 × 时刻」的名次表,再按关键词和分类挑出公共卫生、公共事件两类条目。
import glob, json, re
from collections import defaultdict

HEALTH = re.compile(r"流感|疫苗|疾控|病毒|感染|呼吸道|支原体|发热|医院|医保|卫健|健康|疫情|肺炎|诺如")
snaps = []
for f in glob.glob("raw/run*/1_trending.json") + glob.glob("raw/trending/*.json"):
    d = json.load(open(f))
    if d.get("http_status") == 200:
        t = (d.get("started_sgt") or f[-11:-5]).replace(":", "")[:4]
        snaps.append((t[:2] + ":" + t[2:], d["response"]["results"]))
snaps.sort()
ranks = defaultdict(dict)                      # title -> {time: rank}
for t, rows in snaps:
    for r in rows:
        ranks[r["title"]][t] = r["rank"]
health = {k: v for k, v in ranks.items() if HEALTH.search(k)}
print(len(snaps), "snapshots,", len(ranks), "distinct titles,", len(health), "health titles")
for k, v in health.items():
    print(k, [v.get(t) for t, _ in snaps])     # None = not on the list at that moment
看到了什么
第一,三个多小时、800 行里,没有一条和流感或疫苗有关。用上面的关键词规则只命中 1 条,是 03:02 上榜的「13岁女孩腹痛1年家长忽视确诊胃癌」;按平台自己的分类,「健康医疗」类一共 2 条,另一条是 01:42 上榜的「原来真正的阿尔兹海默是这样的」,名次都在第 36 名以后。可同一时段 weibo/topic_search 查「流感」,#流感# 这个话题显示阅读 5.4 亿、讨论 49 万,#流感季全家防护指南# 阅读 7,843 万。话题的累计量很大,热搜榜上却看不到,说明热搜反映的是「此刻在冲榜的东西」,不是一个话题持续有多少人在讨论。做流感季研究,话题搜索的阅读量和讨论量,加上固定时刻的帖子搜索,比热搜榜更适合当主指标。
第二,热度值在夜里大幅下降,不能跨时刻直接比。第 1 名「金鸡奖获奖名单」16 次都在榜首,热度从 142.1 万降到 15.8 万;前 50 名热度之和从 3,297 万降到 294 万,降了 91%。如果你把不同时刻的热度值画在一条线上,看到的主要是作息曲线,而不是话题本身的冷热。Cui 和 Kertész 2022 年对热搜的研究(arXiv:2208.10176)也专门讨论了昼夜节律对条目热度的影响。我们的做法是:跨时刻比名次,或者比同一张快照里的相对热度(某条热度除以当次第 1 名),并且每天在相同时刻采样。
第三,名次不完全由热度值决定。第 1、3、4 名在 16 次快照里都是同一个条目;第 3 名「进博会到APEC见证中国开放纵深」的热度在 112.7 万到 9.7 万之间变化,和第 1 名的比值从 0.43 变到 0.95,名次却一次没动。三个小时的数据不足以判断原因,我们不下结论;对研究者来说,能确定的是:名次是榜单规则的结果,不能当成热度的单调函数来用。
第四,20 分钟的间隔会漏掉短命条目。16 次快照里一共出现 85 个不同条目,其中 7 个只出现过一次,23 个每次都在。如果你要研究「一条公共卫生消息在榜上停留多久」,间隔要缩到 5 分钟以内,成本按上一节的单价线性增加。
数据边界
热搜榜数据说明写明,热度按「实时热度 × 领域关注度 × 大众度 × 质量度」计算,每分钟更新,榜单是前 50 名,还有「商业广告」标识;我们 800 行里的标签只有「新」「热」「沸」和空白,没有遇到广告位,但长期采集时要把它单独标出来。热搜榜应该被当作「平台在某一时刻展示了什么」的记录,用来研究议程和曝光;它不能代表人群,也不能拿来估计发病情况。2023 年发表在 JMIR 上的一项研究(e49300)研究甲流期间的公众情绪时,用的是 2022 年 11 月到 2023 年 3 月的全部相关微博帖子,而不是热搜榜,这也是更稳妥的做法。本文不对任何疾病的流行程度、疫苗效果或政策下结论。
三个场景的月账单
把单价和实测每页条数放进三个真实场景,算出来的接口费都不高。第一个是公共卫生研究组做流感季热搜时间线:每 10 分钟拍一次热搜(一个月 4,320 次),每天对 5 个关键词各翻 2 页话题、各搜一次帖子,每天补 3 条帖子的详情、评论和转发。第二个是新闻编辑部追一个 72 小时的突发事件:每 5 分钟拍一次热搜,10 个关键词每小时搜一次,挑 60 条帖子取详情、评论、回复和转发。第三个是一家关注中国市场的智利车厘子出口商,4 周里每天搜 6 个词。
| 场景 | 请求数 | 热搜快照 | 搜索和话题搜索 | 帖子、评论、转发、主页 | 合计 |
|---|---|---|---|---|---|
| 流感季热搜时间线(30 天) | 5,040 | $2.40 | $0.36 | $0.20 | $2.96 |
| 突发事件编辑部(72 小时) | 1,854 | $0.48 | $0.60 | $0.18 | $1.26 |
| 智利车厘子出口商(4 周) | 624 | $0.06 | $0.15 | $0.22 | $0.44 |
时间线场景里 81% 的钱花在热搜快照上,所以拍照频率是最该先想清楚的参数。开放平台建议的刷新频率是 3–5 分钟一次,热搜官方说明写的是每分钟更新;我们的经验是,做研究 10 分钟一次已经能看清一个条目的上榜、爬升和下榜,频率翻倍,成本也跟着翻倍。这里只算接口费,不算存储、分析和人工。
第三个场景的钱最少,但能看到的东西不少。我们回头读了实测四「智利车厘子」那 50 行搜索结果:29 行写了果径规格(J 到 4J,最多的是 J 和 4J),20 行提到礼盒,8 行是预售,31 行来自认证账号,50 行里只有 39 段不同的正文,其余是同一张电商卡片的重复。对出口商来说,这说明两件事:一是中国电商在 11 月就开始用规格和礼盒卖预售,规格是销售里的通用语言;二是搜索结果里重复的卡片很多,统计「讨论量」之前要先按正文去重,否则同一张卡片会被算好几次。这些统计只用一次搜索的原始 JSON,没有多花一分钱。
错误和扣费:哪些情况不花钱
我们在 00:30 前后专门做了几次错误测试,都没有花钱。不带 Key 请求返回 401,先鉴权再校验参数,未鉴权的请求探测不到参数结构;weibo/user_posts 的 post_type 传 originals 返回 422,错误信息里列出允许值 all、image、original、video,并提示你想要的可能是 original;调用当天暂停的 weibo/user_post_search 返回 503 unavailable,不扣费。正式实测里,429 限速、503 可重试失败和空结果,全部都是 $0。
这对写自动化脚本的人很重要:重试本身不花钱,所以脚本可以放心地按 retry_after 重发;但同一条请求成功两次就会扣两次,所以重试只针对明确的失败状态,不要对超时以外的成功结果重发。按次计费、失败退款怎么在你自己的账本里对上,可以看我们写过的失败退款对账和AI 代理重试与幂等键两篇。
什么时候另外两条路更合适
按次付费接口不是所有人的最优解。如果你要替用户发微博、回评论、置顶,或者在自己的应用里展示授权用户自己的粉丝和互动数据,只有开放平台能做,任何第三方接口都不该替你做这件事。如果你所在的机构要长期、大批量采集并对外提供分析服务,开发者协议第 2.7.8 条已经说明要走商业数据 API 并签协议,那条路的合同和数据范围是按次接口给不了的。
开源脚本更合适的情况也存在:你只需要一次性下载某个公开账号的全部历史微博做论文,量在几千条,愿意花一个下午复制 Cookie、调延迟;或者你需要的字段是某个项目已经解析好的,比如 weibo-crawler 的 Live Photo 视频和存档核对报告。这时自己跑脚本的边际成本接近零。反过来,如果你要每 10 分钟采一次热搜、每天跑几十个关键词,又不想让一个账号的 Cookie 成为整条流程的单点,按次接口更省心。
延伸阅读
样本偏差看社媒研究的样本完整性,让 AI 写采集脚本看GLM-5.3 和 Claude Code 写知乎、微博脚本,抖音同类问题看douyin api python 三条路实测,公共卫生信号监测看健康谣言的社媒信号监测。
合规与边界
不管走哪条路,有几条法律底线是一样的。《个人信息保护法》第 13 条列出了处理个人信息的合法性基础,第 27 条允许在合理范围内处理已经合法公开的个人信息,但个人明确拒绝或者对个人权益有重大影响的除外;评论里的昵称、属地和发言内容都属于个人信息。2025 年修订的《反不正当竞争法》第 13 条写明,不得以违反诚实信用原则的方式,通过破坏或者规避技术管理措施等手段获取他人合法持有的数据。2025 年 1 月 1 日起施行的《网络数据安全管理条例》对网络数据处理者的安全义务做了细化。
具体到本文的做法:我们只取公开内容,不登录任何账号,不碰私信和仅粉丝可见的内容;文章里出现的评论作者一律隐去昵称;研究报告里引用评论时,建议只引汇总数字或者改写后的观点,不放可以反查到个人的原文。本文不教任何绕过平台限制的方法,前面引用开源项目的 Cookie 和限速说明,是为了让你知道那条路的维护成本,不是推荐你那样做。
常见问题
weibo api python 有没有现成的示例代码?
有。本文第三节的脚本可以直接运行:装 requests,把 Key 放进环境变量 EVERYINFRA_API_KEY,执行 python weibo_chain.py 流感 run1,就会依次调 7 个能力,并把每一步的原始返回存成 JSON。如果你要的是开放平台的官方 Python 示例,open.weibo.com 的文档以 HTTP 接口说明为主,需要先完成 OAuth 授权拿到 access_token,读取范围受授权用户限制。
微博 api 申请要什么条件?
开放平台的普通接口建应用即可调用,但受「单授权用户每天 100 次」等频次限制;高级接口要应用先通过审核,申请后 3 个工作日内处理,部分旧接口已不受理。weibo-cli 要在微博 App 里刷脸完成开发者认证,体验期只对白名单开放。以收集和分析数据为业务的,开发者协议要求使用商业数据 API 并签合作协议。
微博评论爬虫怎么拿到二级回复?
先用 weibo/comments 取一级评论,再把某条评论的 id 传给 weibo/comment_replies。注意评论行没有回复数字段,你不知道哪条评论下有回复,我们 6 次调用里有 2 次回了空列表(已退费)。经验做法是先挑点赞最多的几条评论去取回复,回复行里会带 root_comment_id、reply_to_comment_id 和 ip_location。
上手步骤
- 在控制台创建 API Key,写进环境变量
EVERYINFRA_API_KEY,步骤见快速上手。 - 免费读一次目录
GET /api/v1/social/catalog?platform=weibo,确认参数、价格和available;价格汇总也可以看价格页和数据市场,微博各能力的说明在微博数据接口页。 pip install requests,复制第三节的脚本,执行python weibo_chain.py "你的关键词" run1。- 打开 run1 目录里的 JSON,核对每一步的
billing.charged_usd;要追作者历史,用weibo/user_posts并把next_page_token原样传回。 - 想让 AI 助手直接调这些能力,可以接MCP 服务,工具和价格与 HTTP 接口相同。
各能力的参数页:weibo/search、weibo/trending、weibo/topic_search、weibo/post_detail、weibo/comments、weibo/comment_replies、weibo/reposts、weibo/user_posts。同类平台可以对照抖音数据接口、B 站数据接口和小红书数据接口。
参考资料
- 微博开放平台,《接口访问频次权限》,2025-05-15 更新,读取于 2026-11-11,https://open.weibo.com/wiki/%E6%8E%A5%E5%8F%A3%E8%AE%BF%E9%97%AE%E9%A2%91%E6%AC%A1%E6%9D%83%E9%99%90
- 微博开放平台,《开发者协议》,读取于 2026-11-11,https://open.weibo.com/wiki/%E5%BC%80%E5%8F%91%E8%80%85%E5%8D%8F%E8%AE%AE
- 微博开放平台,《高级接口申请》,读取于 2026-11-11,https://open.weibo.com/wiki/%E9%AB%98%E7%BA%A7%E6%8E%A5%E5%8F%A3%E7%94%B3%E8%AF%B7
- 微博开放平台,《2/comments/show》,读取于 2026-11-11,https://open.weibo.com/wiki/2/comments/show
- 微博开放平台,《2/statuses/user_timeline》,读取于 2026-11-11,https://open.weibo.com/wiki/2/statuses/user_timeline
- 微博开放平台,《2/search/topics》,读取于 2026-11-11,https://open.weibo.com/wiki/2/search/topics
- 微博开放平台,《2/statuses/public_timeline》,读取于 2026-11-11,https://open.weibo.com/wiki/2/statuses/public_timeline
- 微博开放平台,《Oauth2/access_token》,读取于 2026-11-11,https://open.weibo.com/wiki/Oauth2/access_token
- 微博开放平台,《授权机制说明》,读取于 2026-11-11,https://open.weibo.com/wiki/%E6%8E%88%E6%9D%83%E6%9C%BA%E5%88%B6%E8%AF%B4%E6%98%8E
- 微博开放平台,《微博API》接口列表,读取于 2026-11-11,https://open.weibo.com/wiki/%E5%BE%AE%E5%8D%9AAPI
- 微博开放平台,《Scope》,读取于 2026-11-11,https://open.weibo.com/wiki/Scope
- 微博开放平台,《错误代码说明》,读取于 2026-11-11,https://open.weibo.com/wiki/Error_code
- 微博开放平台,weibo-cli 使用手册,读取于 2026-11-11 00:2x 新加坡时间,https://open.weibo.com/cli/quickstart
- 微博开放平台,weibo-cli 命令列表,读取于 2026-11-11,https://open.weibo.com/cli/api/cli/commands
- 微博商业数据 API 首页,读取于 2026-11-11,https://openapi.sc.weibo.com/
- npm,@weibo-ai/weibo-cli,0.9.8,2026-09-22,https://www.npmjs.com/package/@weibo-ai/weibo-cli
- 新浪财经转载 IT之家,《微博推出 weibo-cli》,2026-06-26,https://finance.sina.com.cn/tech/digi/2026-06-26/doc-inietsps5205508.shtml
- 微博热搜,《热搜榜数据说明》,读取于 2026-11-11,https://m.s.weibo.com/vtopic/datadescription?tab=rank
- 微博热搜,《热搜榜说明》(旧版公式),读取于 2026-11-11,https://m.s.weibo.com/hot/description
- 微博,robots.txt,读取于 2026-11-11,https://weibo.com/robots.txt
- 微博移动版,robots.txt,读取于 2026-11-11,https://m.weibo.cn/robots.txt
- GitHub,dataabc/weibo-crawler README,读取于 2026-11-11,https://github.com/dataabc/weibo-crawler
- GitHub,dataabc/weiboSpider README,读取于 2026-11-11,https://github.com/dataabc/weiboSpider
- GitHub,dataabc/weibo-search README,读取于 2026-11-11,https://github.com/dataabc/weibo-search
- GitHub,nghuyong/WeiboSpider README,读取于 2026-11-11,https://github.com/nghuyong/WeiboSpider
- GitHub,NanmiCoder/MediaCrawler README,读取于 2026-11-11,https://github.com/NanmiCoder/MediaCrawler
- GitHub,stay-leave/weibo-public-opinion-analysis README,读取于 2026-11-11,https://github.com/stay-leave/weibo-public-opinion-analysis
- GitHub,weibo-crawler #653,2026-09-26,https://github.com/dataabc/weibo-crawler/issues/653
- GitHub,weibo-crawler #652,2026-09-17,https://github.com/dataabc/weibo-crawler/issues/652
- GitHub,weibo-crawler #658,2026-11-05 合并,https://github.com/dataabc/weibo-crawler/pull/658
- GitHub,weibo-crawler #659,2026-11-06 合并,https://github.com/dataabc/weibo-crawler/pull/659
- GitHub,weibo-search #590,2026-10-13,https://github.com/dataabc/weibo-search/issues/590
- GitHub,MediaCrawler #1000,2026-11-04,https://github.com/NanmiCoder/MediaCrawler/pull/1000
- EveryInfra,数据接口目录,读取于 2026-11-11 00:13 新加坡时间,https://api.everyinfra.com/api/v1/social/catalog
- requests 文档,Advanced Usage:Session Objects,读取于 2026-11-11,https://requests.readthedocs.io/en/latest/user/advanced/#session-objects
- PyPI,requests,读取于 2026-11-11,https://pypi.org/project/requests/
- 国家互联网信息办公室,《中华人民共和国个人信息保护法》,2021-08-20,https://www.cac.gov.cn/2021-08/20/c_1631050028355286.htm
- 国家知识产权局,《中华人民共和国反不正当竞争法(2025年修订)》,2026-05-20 收录,https://www.cnipa.gov.cn/art/2026/5/20/art_104_206437.html
- 生态环境部转载国务院令第790号,《网络数据安全管理条例》,2024-10-03,https://www.mee.gov.cn/zcwj/gwywj/202410/t20241003_1087417.shtml
- 上海交通大学竞争法律与政策研究中心,字节跳动诉微博 robots 协议案二审,2021-10-21,https://cclp.sjtu.edu.cn/Show.aspx?info_lb=672&info_id=5120&flag=648
- 广东外语外贸大学知识产权研究院,新浪微博诉脉脉不正当竞争案((2016)京73民终588号),读取于 2026-11-11,https://sciiip.gdufs.edu.cn/info/1028/1083.htm
- 中国疾病预防控制中心,《2026年第44周中国流感监测周报》,2026-11-05,https://www.chinacdc.cn/jksj/jksj04_14249/202611/t20261105_1842732.html
- 北京市人民政府,《流感疫苗去年打过,今年为什么还要打?》,2026-11-04,https://www.beijing.gov.cn/fuwu/bmfw/sy/jrts/202611/t20261104_4931879.html
- 上海市人民政府,《@普陀新就业群体工会会员:免费流感疫苗开约!》,2026-11-06,https://www.shanghai.gov.cn/nw17239/20261106/de579962c67d46c6888397fc74bb9b0d.html
- 湖滨区人民政府,《不用花钱,湖滨农村的老人、中小学生可以打流感疫苗啦!》,2026-10,https://www.hubin.gov.cn/25114/2026/10/2320886.html
- 中共广东省委老干部局转载南方网,《流感季提前,今年秋冬警惕「先甲流后乙流」》,2026-11-05,https://www.gdlgb.gov.cn/xwdt/slzx6/content/post_123219.html
- Cui, H. & Kertész, J.,Attention dynamics on the Chinese social media Sina Weibo during the COVID-19 pandemic,EPJ Data Science,2021,https://doi.org/10.1140/epjds/s13688-021-00263-0
- Cui, H. & Kertész, J.,Competition for popularity and interventions on a Chinese microblogging site,arXiv:2208.10176,https://arxiv.org/abs/2208.10176
- PubMed,Cui & Kertész 2021 摘要,https://pubmed.ncbi.nlm.nih.gov/33552838/
- JMIR,Public sentiment toward influenza A on Weibo(e49300),2023,https://doi.org/10.2196/49300
引用编号 BL-134