GLM-5.3接入Claude Code:知乎微博舆情脚本
GLM-5.3 接入 Claude Code 的配置、Coding Plan 档位与自带 MCP,加知乎微博舆情脚本真调:一次运行数据费 $0.0058。
想知道一个话题在中文互联网上怎么被讨论,最常见的两处是知乎和微博:知乎上是几百字的长回答,答主会算账、讲理由;微博上是十几个字的短评论,情绪来得快,转得也快。两边放在一起看,才知道「大家在吵什么」和「大家为什么这么想」。本文用一个具体的组合来做这件事:在 Claude Code 里把模型换成智谱的 GLM-5.3 或 GLM-5.3-Flash,让它写一个叫 topic_pulse.py 的舆情脚本,脚本用 EveryInfra 的 zhihu/search、zhihu/content_comments、weibo/search、weibo/comments 四项能力拉同一话题的知乎回答、知乎评论和微博评论,最后由 GLM 读结果写出对比摘要。话题选的是这几个月开发者圈子里讨论最多的「Coding Plan 涨价」。
先交代哪些是真跑的、哪些是配置示例。本机没有智谱账号,所以「Claude Code 接 GLM-5.3」这一侧的全部步骤,都按 docs.bigmodel.cn 和 docs.z.ai 在 2026-11-04 读取的原文写成配置示例,本文没有用 GLM-5.3 跑过 Claude Code。脚本和数据一侧是真跑的:2026-11-04 00:16 到 02:08(新加坡时间)之间,我们对 EveryInfra 接口一共发了 52 次请求,其中 34 次返回数据并扣费,合计 $0.020404,其余 18 次是失败或空结果,都没扣费;这 52 次里有 1 次是通过 MCP 的 tools/call 发的。脚本完整跑了三遍:第二遍带读回答全文,12 次请求、扣费 $0.00581;第三遍是最终版,只用上面四项能力,7 次请求全部成功、扣费 $0.004142。
一、glm 5.3 claude code 能做什么:本文的任务
分工一句话:接口取数,GLM 读数。取数这一半要的是每条回答、每条评论一行的结构化记录,带点赞数、发布时间和所属问题,脚本拿到就能统计,这一步不需要模型。读数这一半要判断几十条评论里哪些是表情、哪些是复读、哪些在谈价格、哪些在算额度,这一步需要模型。Claude Code 把两半串起来:你用一句中文描述要什么,它写脚本、跑脚本、读脚本的输出,再把结论写给你。选 GLM-5.3,是因为智谱专门为 Claude Code 写了接入文档,套餐和按量价都按人民币标价,下面第二到第四节逐条给出处。
下表是本文真跑部分的概览。「条数」是这次实际返回的条数,「花费」是 EveryInfra 按目录价逐次扣费的实际金额,失败和空结果都不扣费。
| 能力 | 本次真调 | 单次目录价 | 结果 |
|---|---|---|---|
weibo/search | 6 次(含 1 次走 MCP) | $0.000806 | 每次 20 条,「Coding Plan 涨价」20 条里只有 7 条正文提到 coding plan |
weibo/comments | 9 次有数据,1 次空结果 | $0.000556 | 最多一次 43 条;字母短链接返回 0 条,自动退款 |
zhihu/search | 5 次 | $0.000556 | 每次 20 条回答,摘要 51 到 86 字 |
zhihu/content_comments | 7 次 | $0.000556 | 一次 3 到 26 条一级评论 |
zhihu/content_detail(可选) | 7 次成功,1 次 429 | $0.000556 | 单条回答全文,最长 756 字 |
最终版脚本只用前四行的能力:知乎一侧从 zhihu/search 出发,搜索结果已经带问题标题、回答链接、摘要和点赞数,再用 zhihu/content_comments 读高赞回答下的评论;要读某条回答的全文,再加一次 zhihu/content_detail。表里没有列 GLM 的调用,因为那一侧没有跑过。
二、智谱一侧:GLM-5.3 和 GLM-5.3-Flash 是什么
GLM-5.3 是智谱 2026-08-19 上线的旗舰文本模型。智谱开放平台的模型页写明:它只处理文本,上下文窗口 1M token,最大输出 128K token;思考功能始终开启,只能在 low、high、max 三档之间选,默认 max,不再支持关闭思考(GLM-5.3 模型页)。同一页还有一句容易被忽略的提示:订阅了 Coding Plan 的用户(包括已过期的),调用模型 API 时目前只能用 OpenAI Chat Completion 协议。这句话说的是直接调模型 API,不影响 Claude Code 走 Anthropic 兼容端点,但它提醒我们,套餐用户和按量用户在智谱那里是两套规则。
GLM-5.3-Flash 晚一周,2026-08-26 上线,是原生多模态模型,采用线性注意力和稀疏注意力的混合架构,总参数 320B、激活 18B,计算量和 KV 缓存都比 GLM-5.3 小很多(新品发布记录)。它的模型页推荐 temperature 为 1、top_p 为 0.95、reasoning_effort 为 max,思考同样只能开启(GLM-5.3-Flash 模型页)。对写脚本这件事来说,两者的差别主要在价格和速度:第十一节会算到,同样一段会话,Flash 的费用大约是 GLM-5.3 的九分之一。
| 项目 | GLM-5.3 | GLM-5.3-Flash | 依据(2026-11-04 读取) |
|---|---|---|---|
| 上线日期 | 2026-08-19 | 2026-08-26 | 智谱新品发布记录 |
| 输入类型 | 只有文本 | 文本和图像(多模态) | 两个模型页 |
| 上下文 / 最大输出 | 1M / 128K | 1M(文档写可配 1M 窗口) | 模型页、切换模型页 |
| 思考 | 始终开启,low / high / max | 始终开启,推荐 max | 模型页 |
| 按量价(每百万 token,人民币) | 输入 ¥8,缓存命中 ¥2,输出 ¥28 | 输入 ¥0.8,缓存命中 ¥0.23,输出 ¥2.8 | 智谱价格页 |
| 国际站按量价(每百万 token,美元) | 输入 $1.4,缓存 $0.26,输出 $4.4 | 输入 $0.15,缓存 $0.03,输出 $0.50 | Z.ai 价格页 |
| Coding Plan 积分系数(输入 / 缓存 / 输出) | 6.9 / 1.7 / 24 | 2.3 / 0.56 / 8 | Coding Plan 套餐概览 |
价格页另有两条和成本有关的说明:缓存存储目前限时免费;1 个 token 大约对应 1.6 个汉字(智谱价格页)。后面估算 token 数时,我们就用这个比例。国际站 Z.ai 的价格来自 Z.ai 价格页,同一天读取。
智谱给 Claude Code 用的地址是 Anthropic 兼容端点 https://open.bigmodel.cn/api/anthropic;给 Codex 用的是 https://open.bigmodel.cn/api/v1;其他 OpenAI 兼容的编程工具用 https://open.bigmodel.cn/api/coding/paas/v4;普通按量调用用 https://open.bigmodel.cn/api/paas/v4。这四个地址不能混用:编程工具走 coding 路径才吃套餐额度。国际站的 Claude Code 地址是 https://api.z.ai/api/anthropic(Z.ai Claude Code 接入页)。
两份智谱文档之间有一个不一致,值得单独说。智谱的 Claude Code 接入页 在 2026-11-04 读取时,手动配置的示例还是 ANTHROPIC_DEFAULT_SONNET_MODEL 写 glm-5.2[1m]、ANTHROPIC_DEFAULT_HAIKU_MODEL 写 glm-4.7;而 Coding Plan 文档里的 如何切换模型 页已经把三个模型变量都写成 glm-5.3-flash[1m],并写明「Claude Code 2.1.140 等版本验证 OK」。套餐概览又说,调用 GLM-5.2、GLM-5.1 会自动切到 GLM-5.3,调用 GLM-5-Turbo、GLM-4.7 会自动切到 GLM-5.3-Flash(套餐概览)。所以照旧页面配置也能用,只是你以为在用 GLM-5.2,实际跑的是 GLM-5.3。我们的建议是按「如何切换模型」页写新名字,再在 Claude Code 里输入 /status 看 Model 一行到底是哪个。
两份文档对思考强度的映射写法也不一样,按新页面理解就够了:默认是 max,在 Claude Code 里用 /effort 切到 high,会话就从 max 降到 high,费用和耗时都会少一些。
三、Coding Plan 档位、价格和积分怎么算
Coding Plan 是智谱面向编程工具卖的包月套餐,2026-07-30 起改为积分制。2026-11-04 在 GLM Coding Plan 订阅页 读到的个人版连续包月价格是 Lite ¥118、Pro ¥538、Max ¥1078;连续包季打 8 折,连续包年打 7 折。按国家外汇管理局公布的 2026-11-03 人民币对美元中间价 6.7150 折算,三档包月约合 $17.57、$80.12、$160.54(外汇局人民币汇率中间价)。国际站 Z.ai 的套餐页没有在我们的无头浏览器里渲染出来,只能引用它文档里的一句「Starting at just 18 USD per month」(Z.ai Coding Plan 概览),具体档位以订阅页为准。
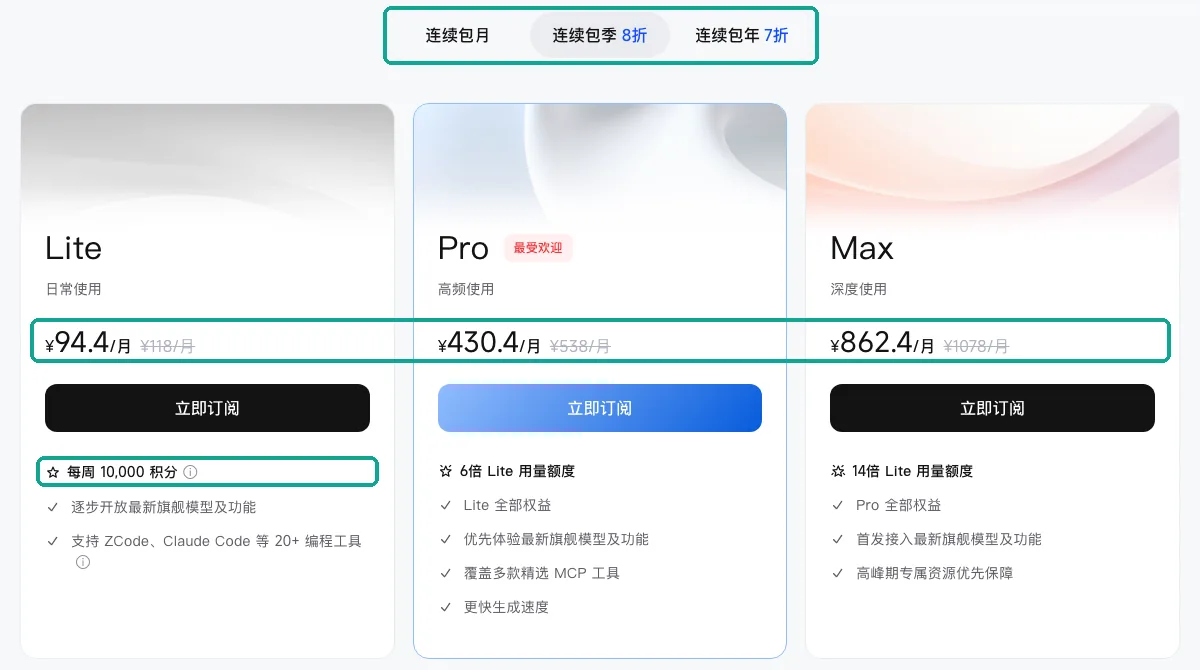
积分额度按 5 小时和每周两个窗口限制。套餐概览给的数字是:Lite 每 5 小时 2,000 积分、每周 10,000 积分;Pro 每 5 小时 12,000、每周 60,000;Max 每 5 小时 28,000、每周 140,000。5 小时积分在消耗 5 小时后动态刷新,周积分从下单时起每 7 天一个周期;额度用完后要等下一个周期,系统不会去扣你的余额或资源包。积分的算法写得很清楚:模型消耗的积分等于「输入 token × 输入系数 + 缓存命中 token × 缓存系数 + 输出 token × 输出系数」再除以 10,000;MCP 工具(联网搜索、网页读取、开源仓库)每次调用按 1.2 积分算。非高峰时段模型调用按 50% 扣,高峰时段是每周一到周五 14:00 到 18:00(UTC+8);Z.ai 文档把同一个时段写成新加坡时间 14:00 到 18:00,两者其实是同一个时区(Z.ai Coding Plan 概览)。
| 档位 | 包月价(人民币) | 约合美元 | 5 小时积分 | 每周积分 | 按本文会话示例,GLM-5.3 高峰期每周可跑几次 |
|---|---|---|---|---|---|
| Lite | ¥118 | $17.57 | 2,000 | 10,000 | 约 48 次 |
| Pro | ¥538 | $80.12 | 12,000 | 60,000 | 约 288 次 |
| Max | ¥1078 | $160.54 | 28,000 | 140,000 | 约 673 次 |
最后一列是我们按第十一节的会话示例换算的:一段写脚本的会话在 GLM-5.3 上约 207.8 积分,Flash 上约 68.7 积分;非高峰时段次数翻倍。这只是数量级参考,真实会话的 token 构成差别很大。
套餐有几条使用限制,写脚本时都会碰到。第一,套餐只能在指定的工具和产品环境里用,在规定工具之外调用 API 不享受套餐额度(套餐概览);FAQ 写得更直白:自建应用、网站、机器人、SaaS 要用标准 API(Coding Plan 常见问题)。Z.ai 的使用政策也写了同样的意思「Use limited to supported tools」(Z.ai 使用政策)。第二,从 2026-10-16 起,标准 API 的 Key 和 Coding Plan 的 Key 分开管理,两者不能互换;把标准 Key 填进编程工具,不会走套餐额度(API Key 分类管理公告)。第三,套餐不退款、账号不能共享,并发上限按 Max、Pro、Lite 从高到低(套餐使用说明)。
第一条对本文的脚本设计影响最大。很多人会想让 topic_pulse.py 自己调 GLM 做分类,再把分类结果交回 Claude Code,这样脚本可以单独定时跑。按智谱的规则,这样做脚本里的 GLM 调用不算在套餐里,要另开标准 API 按量付费。所以本文的分工是:脚本只取数、只做不需要模型的统计(条数、长度、噪声规则);需要读懂内容的部分,留给 Claude Code 里的 GLM 在会话里做。这样套餐额度用在它该用的地方,脚本也能在没有任何模型的机器上跑。
四、how to use glm 5.3 in claude code:配置示例
下面是一份 ~/.claude/settings.json 的配置示例,按智谱「如何切换模型」页和 Claude Code 官方环境变量文档整理。本文没有智谱账号,这份配置没有在本机跑过,Key 用占位符。
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "你的 Coding Plan API Key",
    "ANTHROPIC_BASE_URL": "https://open.bigmodel.cn/api/anthropic",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": "1",
    "EVERYINFRA_API_KEY": "你的 EveryInfra Key"
  }
}逐项说一下。ANTHROPIC_AUTH_TOKEN 的值会被 Claude Code 加上 Bearer 前缀放进 Authorization 请求头(Claude Code 环境变量),这里要填 Coding Plan 的 Key,不是标准 API 的 Key。三个 ANTHROPIC_DEFAULT_*_MODEL 决定 Claude Code 内部的 opus、sonnet、haiku 三个别名实际调哪个模型:智谱新页面的示例三个都写 glm-5.3-flash[1m],Z.ai 的示例是 opus 和 sonnet 写 glm-5.3[1m]、haiku 写 glm-5.3-flash[1m]。本文按后者写,因为写脚本这类活用主模型,后台的小任务用 Flash 省积分。如果你的套餐紧张,三个都写 Flash 也可以。
[1m] 后缀不能省。Claude Code 的模型配置文档写明:遇到不认识的模型 ID,它会假定上下文是 200K 并在启动时给出警告;给 ID 加 [1m],它就按 1M 窗口处理(Claude Code 模型配置)。GLM-5.3 的真实窗口是 1M,不加后缀会过早压缩上下文,读长结果时尤其明显。CLAUDE_CODE_AUTO_COMPACT_WINDOW 控制压缩前允许用到多少 token,取值 100,000 到 1,000,000,智谱的示例写满 1,000,000。API_TIMEOUT_MS 写 3,000,000 毫秒是智谱的建议,GLM 在 max 思考档下单次响应可能很长。CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC 关掉遥测之类的非必要请求。最后一行 EVERYINFRA_API_KEY 是给脚本用的:写在 env 里,Claude Code 启动的子进程都能读到,脚本里用 os.environ 取,不写进代码。
还有一句必须照实写的话。Claude Code 的 LLM 网关文档说,任何实现了受支持 API 格式的网关都能用,但 Anthropic「doesn't support routing Claude Code to non-Claude models through any gateway」(Claude Code LLM 网关)。也就是说,Claude Code 接 GLM 能跑,是智谱一侧做了兼容;出了问题,找的是智谱的文档和客服,而不是 Claude Code 的。2026-11-04 读取时 Claude Code 的最新版本是 2026-11-03 发布的 2.1.317(Claude Code 更新日志),智谱新页面写的验证版本是 2.1.140,中间差了很多个版本,遇到奇怪的报错先看两边的更新记录。
| 环境变量 | 本文的值 | 作用 | 出处 |
|---|---|---|---|
ANTHROPIC_BASE_URL | https://open.bigmodel.cn/api/anthropic | 把请求发到智谱的 Anthropic 兼容端点 | 智谱切换模型页 |
ANTHROPIC_AUTH_TOKEN | Coding Plan Key | 作为 Bearer 令牌发送 | Claude Code 环境变量文档 |
ANTHROPIC_DEFAULT_OPUS_MODEL / SONNET | glm-5.3[1m] | 主模型 | Z.ai Claude Code 接入页 |
ANTHROPIC_DEFAULT_HAIKU_MODEL | glm-5.3-flash[1m] | 后台小任务 | Z.ai Claude Code 接入页 |
CLAUDE_CODE_AUTO_COMPACT_WINDOW | 1000000 | 压缩前可用的 token 数 | Claude Code 环境变量文档 |
API_TIMEOUT_MS | 3000000 | 单次请求超时 | 智谱 Claude Code 接入页 |
CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC | 1 | 关掉非必要请求 | Claude Code 环境变量文档 |
不想手改文件的话,智谱提供了一个安装脚本 claude_code_env.sh(从 https://cdn.bigmodel.cn/install/claude_code_env.sh 下载),以及一个交互式工具 npx @z_ai/coding-helper(智谱 Claude Code 接入页)。配完后开一个新终端运行 claude,输入 /status:Settings source 应该指向你的 ~/.claude/settings.json,Model 应该显示 glm-5.3 或 glm-5.3[1m]。
五、两套 MCP 并存:自带搜索做什么,我们的接口做什么
Coding Plan 自带了一组 MCP 工具(MCP 是 Model Context Protocol 的缩写,一种让模型调用外部工具的公开协议)。2026-11-04 读取的套餐文档列了五样:联网搜索 webSearchPrime、网页读取 webReader、开源仓库 zread(三个工具:search_doc、get_repo_structure、read_file),以及图像视频理解(本地运行的 @z_ai/mcp-server,npm 最新 0.1.6,2026-10-29 发布)。前两样的文档里都有同一句话:在 Claude Code 中使用 GLM Coding Plan 时,模型服务端已内置联网搜索 MCP / 网页读取 MCP,无需安装(联网搜索 MCP、网页读取 MCP)。只有你用别的模型、又想用这两个工具时,才需要按文档里的 claude mcp add 命令手动装。
自带工具能做的事,文档写得很具体:webSearchPrime 返回网页标题、URL、摘要、网站名称和图标;webReader 抓取指定 URL 的网页,返回标题、正文、元数据和链接列表。这对写代码很够用:查一个库的最新用法、读一篇报错讨论、看 GitHub 上的 README。舆情脚本要的是另一种形状的数据:每条回答、每条评论一行,带点赞数、回复数、发布时间和它属于哪个问题或哪条帖子,脚本拿到就能排序、去噪、算中位数。下表按两边文档写的返回字段,加上我们 2026-11-04 真调时实际拿到的字段,说明两类工具各自适合什么。我们没有智谱账号,表中自带工具一列只引文档,没有实测。
| 要拿的东西 | 自带搜索 / 网页读取(按智谱文档) | EveryInfra 能力(2026-11-04 真调返回的字段) |
|---|---|---|
| 知乎上谈某个话题的回答 | 网页标题、URL、摘要、网站名称 | zhihu/search:问题标题、回答链接、摘要、点赞数、评论数、收藏数、发布时间,一次 20 条 |
| 某条知乎回答的全文 | 网页标题、正文、元数据、链接列表 | zhihu/content_detail:单条回答全文和点赞、评论、收藏数 |
| 知乎回答下的评论 | 同上,一整页正文 | zhihu/content_comments:每条评论一行,带 text、like_count、reply_count,一次 3 到 26 条 |
| 微博关键词搜索 | 网页标题、URL、摘要 | weibo/search:id、url、text、posted_at、评论数、转发数、点赞数,一次 20 条 |
| 微博评论 | 同上 | weibo/comments:每条评论一行,一次 2 到 43 条 |
| 新闻、文档、GitHub | 适合 | 不是这类能力的用途 |
两家平台也有自己的开放平台,适合你只需要自己账号的数据、或者要走平台授权接入的场景。知乎数据开放平台的 zhihu_search 用 Bearer 令牌加时间戳鉴权,Count 最大 10,ContentText 是摘要,HasMore 固定为 false,结果附精选评论列表(知乎数据开放平台:搜索);它的热榜技能 limit 取 1 到 30(知乎数据开放平台:热榜技能)。微博开放平台的 comments/show 文档写明只返回授权用户的评论(微博 API:comments/show),search/topics 属于高级接口、只返回最新 200 条(微博 API:search/topics);新出的 weibo-cli 要做人脸核验的开发者认证,试用白名单期 7 天,每个读接口大约 5 次,额度包从 ¥69 起、有效期 365 天(微博开放平台 CLI)。
所以两套 MCP 的分工是这样的:Coding Plan 自带的搜索和网页读取,用来查文档、查新闻、读公开网页,它们按每次 1.2 积分从套餐里扣;EveryInfra 的 MCP 或接口,用来拿平台内的结构化数据,按次付美元。两者在 Claude Code 里可以同时挂着,模型会按工具描述自己选。挂 EveryInfra 远程 MCP 的命令示例如下(这一步我们在本机真做过 initialize 和 tools/list,返回 12 个工具):
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer $EVERYINFRA_API_KEY"

# 确认挂上了:应列出 everyinfra 和它的工具数
claude mcp list
这 12 个工具里,舆情脚本只用得上两个:everyinfra_list_capabilities 查有哪些平台和能力、要什么参数,everyinfra_call_api 真正调能力。2026-11-04 00:23(新加坡时间)我们通过 MCP 的 tools/call 调了一次 weibo/search,搜「智谱 Coding Plan」,返回 20 条、扣费 $0.000806,和直接调接口一样。返回的文本有 15,103 个字符。这个长度要留意:Claude Code 对单个 MCP 工具结果超过 10,000 token 会给警告、默认上限 25,000 token(可以用 MAX_MCP_OUTPUT_TOKENS 调),文本结果超过 50,000 个字符会存成文件再给模型(Claude Code MCP 文档)。20 条微博离上限还远,但如果让模型直接通过 MCP 一次拉 50 条评论、再拉 20 个回答,上下文很快就满了。这也是本文让 GLM 写脚本、而不是让 GLM 直接一条条调 MCP 的原因:脚本把几十次调用的结果压成一个统计好的 JSON,模型只读压缩后的那一份。
另一个和网关有关的细节:Claude Code 默认开启工具搜索,MCP 工具先延迟加载,请求里会带 defer_loading 字段和 tool_reference 块;走 ANTHROPIC_BASE_URL 网关时,Claude Code 期望网关转发这些字段。2.1.305 及以后的版本,如果网关因此返回 400 或 422,Claude Code 会自动不带工具搜索重试一次,MCP 工具改为一开始就全部加载(Claude Code MCP 文档)。我们没法验证智谱端点是否接受这些字段;如果你挂了很多 MCP 服务,发现上下文一开头就占得很满,原因可能在这里。
六、流程:一次舆情对比怎么走


整件事只有一条主线。第一步,你在 Claude Code 里说一句话,例如「写一个脚本,对比知乎和微博最近怎么看 Coding Plan 涨价,先拉数据,再告诉我两边的差别」。第二步,GLM-5.3 读你的要求,先调 everyinfra_list_capabilities 或读接口文档,弄清楚四项能力要什么参数,然后写出 topic_pulse.py。第三步,Claude Code 运行脚本,脚本依次调微博搜索、微博评论、知乎搜索、知乎评论,把结果和每次调用的花费写进一个 JSON。第四步,GLM 读这个 JSON,按你要的格式写对比摘要。
这条主线里有两个数字值得记住。第一个是压缩比:第二遍运行时,接口返回的原始 JSON 一共 50,859 个字符,按智谱的比例和英文约 4 个字符一个 token 估算,大约 14,543 个 token;脚本去掉字段、只留文本后剩 4,315 个字符,约 2,207 个 token,压掉了 85%。GLM 每一轮都要重读上下文,这 12,000 多个 token 的差别会在一段会话里被乘上很多次。第二个是耗时:第二遍从 00:33:55 跑到 00:37:01(新加坡时间),3 分多钟,其中大部分是脚本为了不超过每分钟 10 次的请求上限主动等待的时间,以及一次 429 之后的退避。
七、脚本:GLM 要写出什么样的 topic_pulse.py
下面是我们给 Claude Code 的提示词,你可以原样用。
写一个 Python 脚本 topic_pulse.py,只用标准库。输入一个话题关键词,用 EveryInfra 接口(POST https://api.everyinfra.com/api/v1/social,Key 从环境变量 EVERYINFRA_API_KEY 读)做四件事:用 weibo/search 搜 20 条微博,挑评论数不少于 3、正文含指定词的帖子,用 weibo/comments 各拉 50 条评论;用 zhihu/search 搜 20 条回答,按问题归组,只留标题匹配指定正则的问题,挑总点赞最高的 3 个,用 zhihu/content_comments 各拉点赞最高那条回答下的 50 条评论。每次请求间隔 6.5 秒。遇到 429 或 503 按返回的 retry_after 等待后重试;返回体里 recent_failures 达到 3 就别再试这项能力。去掉表情、复读、4 个字以内的评论和平台机器人的回复。输出一个 JSON:每边的条数、去噪后条数、中位长度、点赞最高的 5 条、每次调用的能力、HTTP 状态、条数和 charged_usd。
这段提示词里每一条都有来由。「只用标准库」是为了让脚本在任何机器上都能跑,不用装依赖。「间隔 6.5 秒」来自 EveryInfra 默认的每分钟 10 次请求上限,6.5 秒一档能留出余量。「按 retry_after 等待」和「recent_failures 达到 3 就别再试」是我们第一遍跑完才加上的,第九节会讲第一遍为什么跑了 7 分多钟。「只留标题匹配的问题」是第二遍看完结果才加的,原因也在第九节。「去掉平台机器人的回复」是因为微博评论里有一种「@微博智搜」的自动回复,混在里面会让统计失真。
下面是 GLM 应该写出的核心部分,本文的版本是我们按这个提示词写好并真跑过的第三版(完整文件约 120 行),这里只节选调用和容错的部分。
API = "https://api.everyinfra.com/api/v1/social"
KEY = os.environ["EVERYINFRA_API_KEY"]
GAP = 6.5            # 两次请求间隔,保持在每分钟 10 次以内
DOWN = set()         # 10 分钟内失败 3 次的能力,本次运行不再调

def call(platform, action, params, tries=3):
    if f"{platform}/{action}" in DOWN:
        return None
    body = json.dumps({"platform": platform, "action": action, "params": params}).encode()
    for attempt in range(tries):
        req = urllib.request.Request(API, data=body, method="POST", headers={
            "Authorization": f"Bearer {KEY}", "Content-Type": "application/json"})
        try:
            with urllib.request.urlopen(req, timeout=120) as r:
                code, d = r.status, json.load(r)
        except urllib.error.HTTPError as e:
            code, d = e.code, json.loads(e.read() or b"{}")
        log(platform, action, code, d)       # 记下条数和 billing.charged_usd
        time.sleep(GAP)
        err = d.get("error") or {}
        if code == 200:
            return d
        if (err.get("recent_failures") or 0) >= 3:   # 返回体说别再重试了
            DOWN.add(f"{platform}/{action}")
            return None
        if code in (429, 503) and err.get("retryable") and attempt < tries - 1:
            time.sleep(min(err.get("retry_after", 30), 60))
            continue
        return None

# 知乎:先搜回答,按问题归组,只留标题匹配的问题;再读每个问题下点赞最高那条回答的评论
for q in top_questions:
    answers += by_q[q]                   # 搜索结果自带问题标题、链接、摘要和点赞数
    best = max(by_q[q], key=lambda x: x.get("like_count") or 0)
    zcomments += rows(call("zhihu", "content_comments", {"url": best["url"], "limit": 50}))
这段代码里最关键的是对错误返回体的处理。EveryInfra 的错误不是一句「出错了」,而是一个带字段的 JSON:fault 说明是谁的问题,retryable 和 retry_after 说明能不能重试、等多久,recent_failures 说明这项能力最近失败了几次,next_steps 用自然语言告诉调用方下一步该做什么,example 给一个已知能成功的请求。脚本读这些字段做判断,比按 HTTP 状态码硬写重试次数可靠得多;GLM 在 Claude Code 里读到同样的字段,也能自己决定换一种取法,而不是反复重试。第二遍运行时 00:35:34(新加坡时间)碰到一次 429,脚本按返回的等待时间退避,33 秒后重试成功,这一次没有扣费。
去噪的规则也值得看一眼:评论去掉「回复@某人:」前缀后,4 个字以内的算短评论;整条只由表情标签(形如方括号里的几个字)、空白、数字、「是」「是啊」「是的」「哈哈」「666」组成的算表情或复读;作者名里有「智搜」的算平台机器人。这些规则是我们看了第一批真实评论后写的,不是凭想象。它们不完美,比如「确实」两个字会被当成短评论去掉,但对「统计有多少人在认真说话」这个目的足够了。
八、一次真实往返:知乎、微博各真调了什么
正式跑脚本之前,我们先手工把要用的能力各调了一遍,确认参数和返回格式。下面按时间顺序记录,时刻都是 2026-11-04 新加坡时间。
| 时刻(SGT) | 能力 | 参数 | HTTP | 条数 | 扣费 |
|---|---|---|---|---|---|
| 00:16:49 | weibo/search | 关键词「Coding Plan 涨价」 | 200 | 20 | $0.000806 |
| 00:17:03 | zhihu/search | 关键词「Coding Plan 涨价」 | 200 | 20 | $0.000556 |
| 00:18:41 | weibo/comments | 一条谈本地部署的帖子 | 200 | 13 | $0.000556 |
| 00:21:42 | zhihu/content_detail | 积分制改版问题下 47 赞的回答 | 200 | 1 | $0.000556 |
| 00:21:56 | zhihu/content_comments | 同一回答 | 200 | 7 | $0.000556 |
| 00:22:37 | weibo/comments | 一条谈 DeepSeek 涨价的帖子 | 200 | 43 | $0.000556 |
| 00:22:57 | weibo/comments | 用字母短链接代替数字 ID | 200 | 0 | $0(空结果退款) |
微博这一侧很顺。weibo/search 返回的每条微博带 id、url、text、posted_at、评论数、转发数和点赞数,搜「Coding Plan 涨价」的 20 条发布时间在 2026-08-17 到 2026-10-26 之间。weibo/comments 接受数字 ID 或带数字 ID 的链接,一条谈 DeepSeek 涨价的帖子一次给了 43 条评论,时间是 2026-08-18 到 08-19。唯一的坑是链接格式:我们故意用一个字母形式的短链接去调,返回 200、0 条,reason 写着 empty_result_refunded,没有扣费。脚本里直接用搜索结果的 id 字段就不会碰到这个问题。
知乎这一侧,zhihu/search 返回 20 条回答,每条带问题标题、回答链接、摘要、点赞数、评论数、收藏数和发布时间,摘要长度 51 到 86 字。这已经够脚本做两件事:按回答链接里的问题 ID 把回答归组,再按点赞挑出每组最值得读的那一条。zhihu/content_comments 接受回答链接,返回这条回答下的一级评论,每条带正文、点赞数和回复数。00:21:42 用 zhihu/content_detail 读的那条回答是一位用户抱怨续费价格从每月 422 元涨到八九百元,47 赞、28 条评论,全文 88 字;00:21:56 再读它下面的评论,拿到 7 条。摘要不够、要读回答全文时才需要 zhihu/content_detail,每条一次请求。
九、脚本跑三遍:关键词漂移、限流和标题过滤
第一遍关键词是「智谱 Coding Plan」,从 00:24:58 跑到 00:32:37(新加坡时间),7 分 39 秒,一共 15 次请求、扣费 6 次,合计 $0.003586,其余 9 次失败都没扣费。时间长,是因为这一版对失败的请求一律等 60 秒再试,还没有读返回体里的 recent_failures。更大的问题是关键词漂移:「智谱 Coding Plan」搜出来的微博里,评论最多的一条是某主播的带货帖,和话题无关,脚本挑了它去拉评论。
第二遍改了三处:加上 recent_failures 达到 3 就停的判断,加上 --must "coding plan" 要求微博正文必须含这个词,关键词换成更具体的「Coding Plan 涨价」。这一版还会用 zhihu/content_detail 读每个问题下搜索已找到的回答全文。从 00:33:55 跑到 00:37:01(新加坡时间),3 分 6 秒,12 次请求,扣费 10 次,合计 $0.00581;没扣费的两次里,一次是 00:35:34 的 429,33 秒后重试成功。下面第十节的对比数字,用的就是这一遍和手工阶段拉到的数据。
第二遍的结果比第一遍干净,但它也暴露了按点赞挑问题的毛病。知乎搜「Coding Plan 涨价」的 20 条回答里,标题提到智谱或 GLM 的有 8 条,比如「如何看待智谱coding plan 这次涨价?」「为什么智谱的Coding Plan国内的比国外的还贵?」;但按总点赞挑出来的 3 个问题是「为什么 GPT 要暂停$200 pro 订阅?」(523 赞)、「现在还能买到性价比高的coding plan吗?」(378 赞)和「如何评价阿里云百炼Coding Plan Lite停止续费和升级」(235 赞)。它们都在谈 Coding Plan 的定价逻辑,和话题相关,但不是专门谈智谱。如果你要的是「大家怎么看智谱涨价」,就要在挑问题时再加一个标题过滤,例如要求标题含「智谱」「GLM」或「某谱」。这正是 Claude Code 适合做的事:你看完第一份摘要说一句「只要谈智谱的」,GLM 改一行过滤条件再跑一遍,多花不到一美分。
微博一侧更明显。「Coding Plan 涨价」搜到的 20 条微博里,正文提到 coding plan 的只有 7 条,其中评论数不少于 3 的只有 2 条:一条是用户退订讯飞套餐后试各家替代方案,一条是说 GLM-5.3 提升很大但涨价太多。两条帖子一共只拉到 5 条评论。另外 13 条里有新闻转载、行业日报、游戏资讯,评论数最多的一条(50 条)是 DeepSeek 涨价的话题帖。这说明一个现实:小众的技术话题在微博上讨论量很薄,大部分声音在知乎。为了让对比有足够样本,我们把手工阶段拉到的 4 组微博评论(共 73 条,主题分别是本地部署、DeepSeek 涨价、各家定价思路和一条评论全是表情的帖子)和第二遍的 5 条合在一起,得到 78 条微博评论;知乎一侧是第二遍的 71 条评论加手工阶段的 7 条,也是 78 条。两边条数相同,比例才好比。
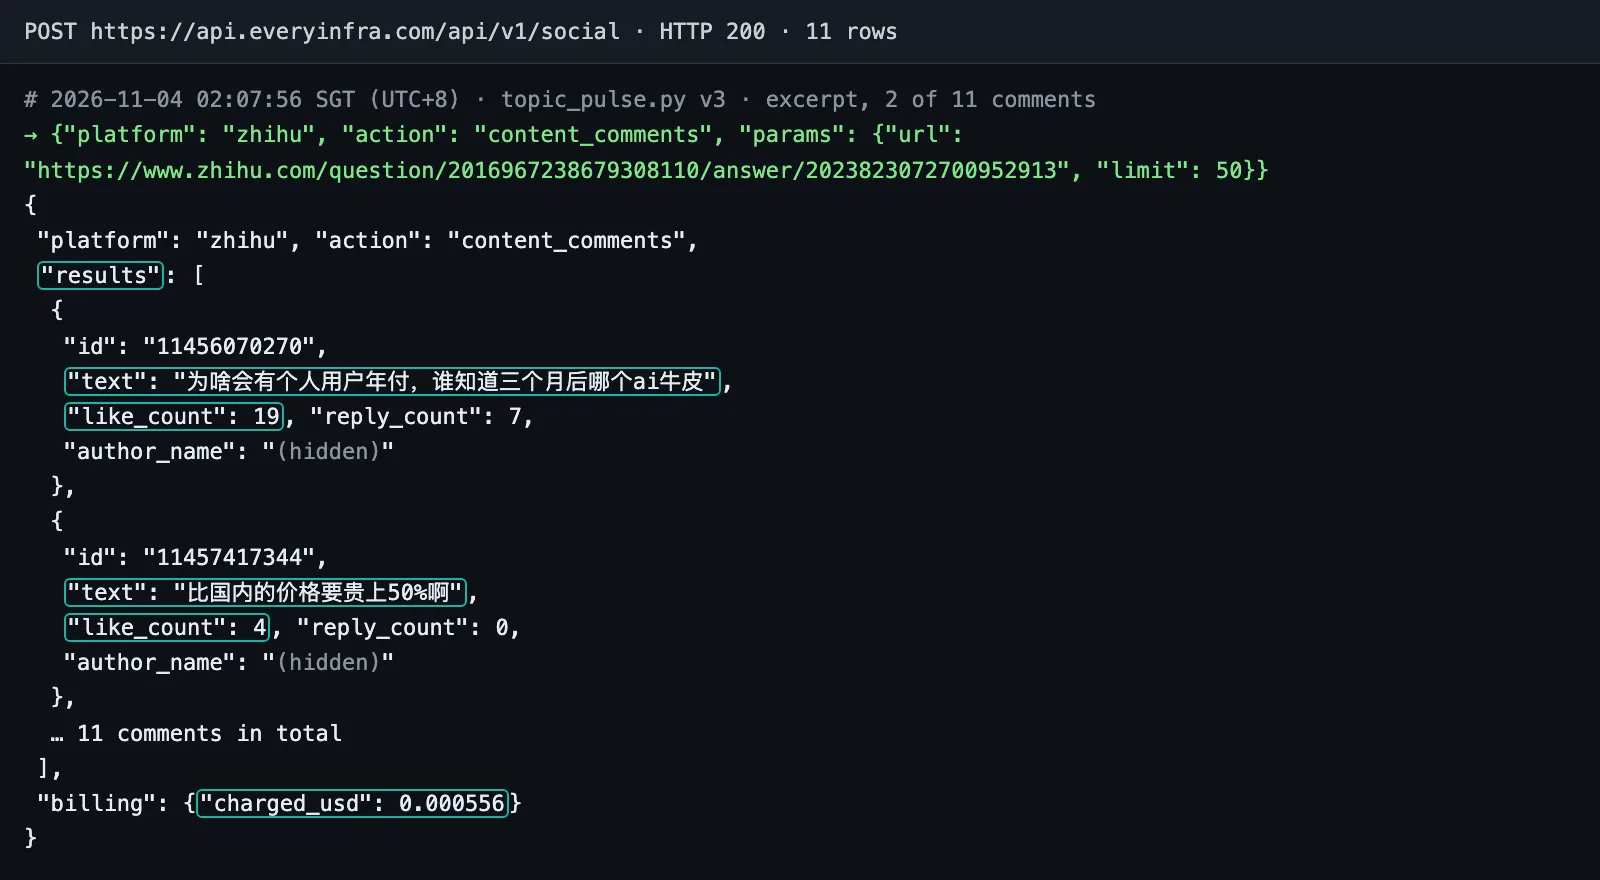
第三遍按上面说的加了知乎标题过滤,这也是本文的最终版脚本。我们去掉了读全文这一步,只留四项能力,加上 --zhihu-title "智谱|GLM|某谱",2026-11-04 02:06:32 到 02:08:22(新加坡时间)跑完,1 分 50 秒,7 次请求全部返回 200,扣费 7 次,合计 $0.004142。微博一侧和第二遍一样,读到同样 2 条帖子的 5 条评论。知乎一侧,加了标题过滤后挑出的 3 个问题都在谈智谱:「如何看待智谱 GLM Coding Plan 7.30 改版为积分制?」(最高赞回答 47 赞、28 条评论)、「现在哪里能订阅到 GLM-5 coding plan 呢,为什么这个模型这么火爆?」(36 赞)和「如何评价某谱的Coding Plan这么贵?」(7 赞)。三条回答下分别读到 7、11、3 条评论,共 21 条,按第七节的去噪规则一条都没去掉,中位长度 26 字。点赞最高的一条评论(19 赞)问的是为什么会有人选年付,「谁知道三个月后哪个ai牛皮」;另一条(4 赞)说国际站「比国内的价格要贵上50%啊」。
十、知乎和微博怎么说:对比摘要
这一节是 GLM 读完结果后应该写出来的东西。为了不让模型给自己打分,下面的数字都由 analysis.py 从原始返回现算,不经过任何模型;文字部分是我们按这些数字写的示范。
先看长度。去噪后,微博评论的中位长度是 14 个字,90% 的评论不超过 36 字,最长一条 158 字;知乎评论的中位长度是 28 个字,90% 不超过 70 字,最长 229 字;知乎回答(4 条)的中位长度是 310.5 字,最长 756 字。同样是「评论」,知乎的比微博长一倍;而知乎回答又比知乎评论长十倍。这意味着如果你只看微博,得到的是情绪;要看理由,得去知乎读回答。
再看噪声。微博 78 条评论里去掉了 15 条:6 条 4 个字以内(「是」「是啊」这类),4 条纯表情,3 条是「@微博智搜」的自动回复,1 条重复,1 条只有链接。知乎 78 条评论里只去掉了 8 条:3 条太短,2 条只有链接,2 条重复,1 条纯表情。微博的噪声比例是 19%,知乎是 10%。微博的机器人回复值得单独提:有用户在评论里 @ 平台的智能搜索问「deepseek涨价多少」,机器人回一段长答案,这些回复在点赞排序里还排得很靠前,不去掉就会把「机器人怎么说」当成「网友怎么说」。
然后是主题。我们给六个主题各写了一组关键词:价格(涨价、贵、多少钱、元、刀)、额度(额度、用量、用满、5 小时、周、积分、重置)、质量(降智、变笨、量化)、对比(DeepSeek、Kimi、Codex、Claude、千问、MiniMax)、本地部署(本地、显存、部署)、封号与风控(封号、风控、限流)。一条评论可以属于多个主题。微博保留的 63 条里,谈价格的 22.2%,谈对比的 15.9%,谈质量和本地部署的各 4.8%,谈额度的只有 3.2%。知乎保留的 70 条里,谈额度的 25.7%,谈价格和对比的各 20%,谈质量和风控的各 5.7%,本地部署为 0。
| 维度 | 微博(78 条评论) | 知乎(78 条评论 + 4 条回答) | 怎么读 |
|---|---|---|---|
| 去噪后条数 | 63 | 70 | 微博噪声多一倍 |
| 中位长度 | 14 字 | 评论 28 字,回答 310.5 字 | 知乎能看到理由 |
| 去噪后总点赞 | 112 | 评论 349,回答 1,183 | 知乎的高赞回答集中 |
| 最多的主题 | 价格 22.2% | 额度 25.7% | 微博谈「贵不贵」,知乎谈「够不够用」 |
| 有、另一边没有的主题 | 本地部署 4.8% | 封号风控 5.7% | 样本小,只作线索 |
按这些数字,GLM 写出的对比摘要大致是这样(示范文字,不是模型生成):
两边都在谈价格,但谈法不同。微博上是一句话的态度,「价格也是越来越离谱」「那我肯定选DeepSeek啊」,很少给理由,五条里有一条在拿别家比。知乎上的人在算账:点赞最高的回答认为,API 折扣超过 15 倍的套餐只要被用满,毛利就是负的;高赞评论在说额度,「最近尤其是送重置卡那次之后,只有以前一半左右了」(74 赞)。知乎有 5.7% 的评论谈风控和封号,微博没有;微博有人在谈本地部署能不能替代套餐,知乎这批评论里没有。样本很小(每边 78 条),而且知乎回答是按点赞挑的,偏向最有争议的说法。
这段摘要里引用的原话,我们只取了公开评论的内容,不带昵称。点赞数来自返回里的 like_count。需要再强调一次局限:这是一个话题、一个晚上、每边 78 条的样本,主题词是人写的规则,GLM 做分类时可能会归得更准,也可能会归错。它能回答的是「这两个平台上的讨论有什么不一样」,不能回答「多少人支持涨价」。
十一、成本:数据费、GLM token 费和套餐积分
先算数据费。第二遍运行的 12 次请求里,weibo/search 1 次 $0.000806,其余 9 次成功的请求各 $0.000556,503 和 429 不扣费,合计 $0.00581。这批数据去噪前一共 79 行文本(5 条微博评论、3 条知乎回答、71 条知乎评论),另有 40 条搜索结果,折合每千行文本 $0.0735。最终版去掉读全文,一次运行 7 次请求、$0.004142,读回 5 条微博评论和 21 条知乎评论,另有 40 条搜索结果。每天跑一次第二遍这样的规模,一个月是 $0.1743;跑最终版,一个月是 $0.12426。
再算模型费。没有智谱账号,我们无法测一段真实会话用了多少 token,所以借 Claude Code 成本文档里的一条会话示例来估:1.2k 输入、5.3k 输出、940k 缓存读取、50k 缓存写入(Claude Code 成本文档)。这条示例的构成和「写一个百行脚本、跑两次、改一次」差不多:缓存读取占了绝大部分,因为每一轮都要重读之前的上下文。智谱没有单独的缓存写入价,我们把缓存写入按普通输入算。
| 模型与站点 | 会话示例费用 | 约合美元 | 读结果写摘要一次 | 套餐积分(高峰期) |
|---|---|---|---|---|
| GLM-5.3,智谱开放平台 | ¥2.438 | $0.3631 | $0.008884 | 207.8 |
| GLM-5.3,Z.ai | $0.3394 | $0.3394 | $0.00969 | 同上 |
| GLM-5.3-Flash,智谱开放平台 | ¥0.272 | $0.0405 | $0.000888 | 68.7 |
| GLM-5.3-Flash,Z.ai | $0.0385 | $0.0385 | $0.001081 | 同上 |
| 一次脚本运行的数据费(EveryInfra) | $0.00581 |
「读结果写摘要一次」一列按 2,207 个输入 token(第二遍去字段后的文本)加 1,500 个输出 token 算,这是脚本写好以后、每天让 GLM 读一次新数据的边际成本。人民币按 2026-11-03 中间价 6.7150 折算。
这张图想说明的是:在这类任务里,钱主要花在「让模型写和改」上,而不是「拿数据」上。写一次脚本,GLM-5.3 的费用是数据费的 63 倍,Flash 是 7 倍。脚本写好以后,每天的边际成本就变成了数据费加一次读摘要:用 Flash 读,一次合计不到 $0.007。如果你用的是 Coding Plan,模型费就变成积分:Lite 套餐每周 10,000 积分,高峰期能跑大约 48 段这样的 GLM-5.3 会话、145 段 Flash 会话;非高峰时段翻倍。Coding Plan 自带的联网搜索每次 1.2 积分,查几次文档几乎不占额度。
还有一笔容易漏掉的钱:把整份原始返回丢给模型。第二遍的原始 JSON 约 14,543 个 token,按 GLM-5.3 智谱价每百万输入 ¥8,读一次约 ¥0.116,约合 $0.017,约是数据费本身的 3 倍;而且每多一轮对话就要再读一次。让脚本先压缩,模型只读压缩后的 2,207 个 token,是这个组合里最省钱的一个决定。
十二、做不到的地方
第一,按问题拉全部回答的 zhihu/question_answers 在本文测试时不可用,失败的请求都没扣费;所以脚本从 zhihu/search 出发,每个问题只读搜索找到的回答和它下面的评论,不是问题下的全部回答。
第二,智谱一侧完全没有实测。配置示例按 2026-11-04 读取的文档写,文档自己有两处不一致(默认模型、思考强度映射)。GLM-5.3 在 Claude Code 里实际写出的脚本是什么样、要改几轮、真实用了多少 token,本文都没有数据。模型费是借用 Claude Code 文档里一条会话示例的 token 构成估算的,不是测量值。
第三,样本小。每边 78 条评论,微博侧有 73 条来自手工挑选的几条帖子,不是脚本自动选的;知乎回答只有 4 条。主题分类用的是关键词规则,「刀」「周」这类字可能误命中。结论只能当线索,不能当比例。
第四,Coding Plan 的额度只在指定工具里有效,所以「让脚本每天定时跑、自己调 GLM 写摘要」这种用法不在套餐范围内,要另付标准 API 的钱。本文的设计是让定时任务只跑脚本,摘要留给你下次打开 Claude Code 时让 GLM 读。
第五,微博评论里没有 IP 属地字段。目录显示 weibo/comments 不返回属地,楼中楼回复要用 weibo/comment_replies(每次 $0.000806,带属地)。如果你的分析要按地区看,得多调这一项。
十三、行业动向:近 30 天和 GLM-5.3、Coding Plan 有关的变化
模型一侧,2026-10-12 量子位报道,智谱在 ZCode 3.15.1 里放出了 GLM-5.3-Highspeed,网友实测约 490 tokens/s(量子位);这个型号目前只在 ZCode 里,Coding Plan 文档没有把它列进 Claude Code 可用的模型。npm 上的图像视频理解 MCP @z_ai/mcp-server 在 2026-10-29 更新到 0.1.6(npm)。
安全一侧,Anthropic 在 2026-09-29 发表研究,认为 GLM-5.3 能自主完成端到端的漏洞利用,且发布时没有足够的防护(Anthropic 研究)。2026-10-30 Help Net Security 报道了 Irregular 的评估:13 个场景里 GLM-5.3 没有拒绝任何一个,评估方建议在给它更多自主权限前先测试限制措施(Help Net Security)。对本文的意义是:在 Claude Code 里给 GLM 开文件和命令权限时,按最小权限来,脚本只需要读写一个目录、访问一个接口。
价格一侧,2026-10-16 起智谱把标准 API 和 Coding Plan 的 Key 分开管理(见第三节)。2026-10-23 的 36 氪报道,双 11 期间智谱是少数真打折的,Lite 月卡从 ¥118 降到 ¥115(36 氪)。10 月下旬智源社区转述,部分 Coding Plan 用户因模型「降智」问题收到了额度重置卡补偿(智源社区),这和知乎评论里「送重置卡那次之后,只有以前一半左右了」对得上,但重置卡的具体规则我们没有在智谱文档里查到。
十四、上手步骤
按下面的顺序做,大约半小时能跑通。第 1 到 3 步是配置示例,第 4 到 6 步本文真跑过。
- 在智谱开放平台订阅 Coding Plan,在「个人编程套餐」入口新建一个套餐 Key(2026-10-16 后标准 Key 不能用于套餐)。
- 按第四节的示例编辑
~/.claude/settings.json,开新终端运行claude,输入/status确认 Model 是glm-5.3。 - 在 Claude Code 里问一句「现在用的是什么模型」,再输入
/effort看当前思考档,需要省积分就切到 high。 - 在 EveryInfra 快速开始 拿到 Key,写进
settings.json的EVERYINFRA_API_KEY;可选:按第五节挂上远程 MCP。 - 把第七节的提示词交给 Claude Code,让它写出
topic_pulse.py并跑一遍,先用--weibo-posts 2 --zhihu-questions 2小规模试,知乎问题加--zhihu-title过滤。 - 让 GLM 读输出的 JSON 写对比摘要;看完后加过滤条件(例如标题必须含「智谱」)再跑一遍。
四项能力的参数和返回字段,分别见 知乎数据接口 下的 知乎搜索、知乎评论、可选的 知乎内容详情,以及 微博数据接口 下的 微博搜索、微博评论。远程 MCP 的工具清单见 MCP 服务,各能力的目录价见 价格页。
相关阅读:想看模型在清洗评论这一步的表现和费用,读 DeepSeek V4 接 Claude Code 清洗评论,本篇 topic_pulse.py 输出的 JSON 可以直接作为它的输入;更多用 Claude Code 跑平台数据的写法见 Claude Code 动态工作流拉小红书评论;「按点赞挑」带来的偏差见 社交媒体研究的样本完整性;失败不扣费、按 charge_id 退款的细节见 失败退款对账。
常见问题
glm-5.3 接入claude code 要改哪些配置,模型名为什么加 [1m]?
只改 ~/.claude/settings.json 的 env,完整写法见第四节。容易漏的是 [1m] 后缀:Claude Code 不认识 glm-5.3 这个 ID 时按 200K 上下文提前压缩,加上后缀才按 1M 处理;改完开新终端,用 /status 核对 Model 一行。问题来源:搜索引擎联想词「glm-5.3 接入claude code」「how to use glm 5.3 in claude code」(2026-11-04 查询);依据:智谱如何切换模型、Claude Code 模型配置。
Coding Plan 的额度能在自己的脚本里调 GLM 吗?
不能。套餐只在官方列出的工具和产品环境里有效,在规定工具以外调用 API 不享受套餐额度;自建应用、网站、机器人、SaaS 要用标准 API 按量付费。2026-10-16 起两类 Key 也分开管理。所以本文的脚本只取数,摘要交给 Claude Code 里的 GLM 写。问题来源:搜索引擎联想词「智谱 coding plan 额度」「glm coding plan limits」(2026-11-04 查询);依据:Coding Plan 套餐概览、Coding Plan 常见问题。
Coding Plan 自带的联网搜索能拿到知乎回答和微博评论吗?
按智谱文档,联网搜索返回网页标题、URL、摘要、网站名称和图标,网页读取返回标题、正文、元数据和链接列表,适合查文档、读新闻。舆情脚本要的是每条回答、每条评论一行、带点赞和时间的记录,这一部分用 zhihu/search、zhihu/content_comments、weibo/search、weibo/comments 拿。我们没有智谱账号,自带工具没有实测。问题来源:搜索引擎联想词「glm coding plan 联网搜索」「glm coding plan 联网搜索不到」(2026-11-04 查询);依据:联网搜索 MCP、网页读取 MCP。
知乎有 api 吗?
有。知乎数据开放平台提供搜索和热榜等接口,搜索每次最多 10 条、返回摘要、附精选评论,用 Bearer 令牌加时间戳鉴权,适合要走平台授权的场景。本文的脚本用 EveryInfra 的 zhihu/search 一次取 20 条回答,再用 zhihu/content_comments 读回答下的评论,2026-11-04 最终版一次运行读到 21 条知乎评论,知乎部分扣费 $0.002224。问题来源:搜索引擎联想词「知乎有api吗」「知乎官方api」(2026-11-04 查询);依据:知乎数据开放平台:搜索、知乎搜索能力页。
GLM-5.3-Flash 和 GLM-5.3 写脚本该选哪个?
按智谱价格页,Flash 的输入、输出单价都是 GLM-5.3 的十分之一,缓存命中约九分之一;按本文的会话示例估算,Flash 写一次脚本约 $0.04,GLM-5.3 约 $0.36。百行左右的取数脚本,先用 Flash 写,遇到改不对的地方再切到 GLM-5.3。问题来源:搜索引擎联想词「glm 5.3 flash vs glm 5.3」「glm 5.3 flash cost」(2026-11-04 查询);依据:智谱价格页、Z.ai 价格页。
Coding Plan 现在多少钱,什么时候扣得少?
2026-11-04 读取的个人版连续包月价是 Lite ¥118、Pro ¥538、Max ¥1078,包季 8 折、包年 7 折。非高峰时段模型调用按 50% 扣积分,高峰是周一到周五 14:00 到 18:00(UTC+8)。套餐不退款。问题来源:搜索引擎联想词「智谱 coding plan 价格」「glm coding plan pricing」「智谱 coding plan 退款」(2026-11-04 查询);依据:GLM Coding Plan 订阅页、套餐使用说明。
参考资料
- 智谱:如何切换模型(Coding Plan,2026-11-04 读取)
- 智谱:Claude Code 接入指南
- 智谱:Claude Code 介绍
- 智谱:GLM Coding Plan 套餐概览
- 智谱:Coding Plan 快速开始
- 智谱:Coding Plan 使用说明
- 智谱:Coding Plan 常见问题
- 智谱:套餐用量调整公告(2026-07-30 新版)
- 智谱:API Key 分类管理公告(2026-10-16)
- 智谱:联网搜索 MCP
- 智谱:网页读取 MCP
- 智谱:开源仓库 MCP(zread)
- 智谱:视觉理解 MCP
- 智谱:其他工具接入与适用工具清单
- 智谱:GLM-5.3 模型页
- 智谱:GLM-5.3-Flash 模型页
- 智谱:价格页
- 智谱:新品发布记录
- 智谱:费用问题
- 智谱:API 问题
- 智谱:GLM Coding Plan 订阅页(2026-11-04 读取价格)
- Z.ai:Coding Plan 概览
- Z.ai:Claude Code 接入
- Z.ai:切换到最新模型
- Z.ai:使用政策
- Z.ai:快速开始
- Z.ai:价格页
- Z.ai 博客:GLM-5.3
- Claude Code:LLM 网关
- Claude Code:模型配置
- Claude Code:环境变量
- Claude Code:MCP
- Claude Code:设置
- Claude Code:成本
- Claude Code:更新日志(2.1.317,2026-11-03)
- Claude Code 仓库 CHANGELOG
- MCP 规范 2026-07-28 版
- 智谱 glm-cookbook:Claude Code 接入示例
- npm:@z_ai/mcp-server
- npm:@z_ai/coding-helper
- 知乎数据开放平台
- 知乎数据开放平台:搜索接口
- 知乎数据开放平台:热榜技能
- 微博开放平台 CLI
- 微博开放平台 CLI 快速开始
- 微博 API:comments/show
- 微博 API:search/topics
- 微博 API:频次限制
- EveryInfra 能力目录(2026-11-04 读取)
- 国家外汇管理局:人民币汇率中间价
- Anthropic:GLM-5.3 and the spread of advanced cyber capabilities(2026-09-29)
- Help Net Security:Irregular 对 GLM-5.3 的评估(2026-10-30)
- 量子位:智谱新模型 490 tokens/s(2026-10-12)
- 36 氪:Token 扎堆上架电商双 11(2026-10-23)
- 智源社区:降智补偿与重置卡
引用编号 BL-81