ChatGPT scheduled tasks做每周需求雷达
ChatGPT 定时任务接 EveryInfra MCP,每周一拉 Reddit、Quora 的抱怨和提问;接口费每周 $0.007226,取数要先点确认。
能做,而且很便宜:一份每周一出的「需求雷达」按 EveryInfra 目录价算,接口费是 $0.007226,一年 52 份约 $0.38。要提前知道的不是钱,而是「确认」:2026 年 10 月 26 日 17:23(新加坡时间)我们读了 EveryInfra 远程 MCP 的工具清单,25 个工具里取数用的 everyinfra_call_api 和 everyinfra_search 都标着 readOnlyHint=false、destructiveHint=true(因为每次调用都扣钱)。OpenAI 开发者文档《Add custom MCP server》写明 ChatGPT 支持读、写两类工具,没标只读的按写操作处理,写操作默认要确认:每个对话第一次调用会弹确认,点允许即可,也可以选「本对话记住」。人在电脑前时这只是多点一下;可定时任务的说明写明需要确认的动作会让任务暂停。所以想让它无人值守地跑,要么在 Business、Enterprise 工作区里给这个应用放开确认,要么把「取数」和「ChatGPT 读数写报告」拆开。
本文说的「需求雷达」,是每周一早上自动跑一次的一份短报告:按你写死的几个关键词和社区,去 Reddit、Quora 上看这一周用户在抱怨什么、在问什么,挑出各 5 条最值得看的原帖,附链接和一句话归纳。它适合产品经理、出海品牌的运营和做内容选题的人,回答的是「本周用户在说什么」,不预测销量,也不替你判断谁对谁错。


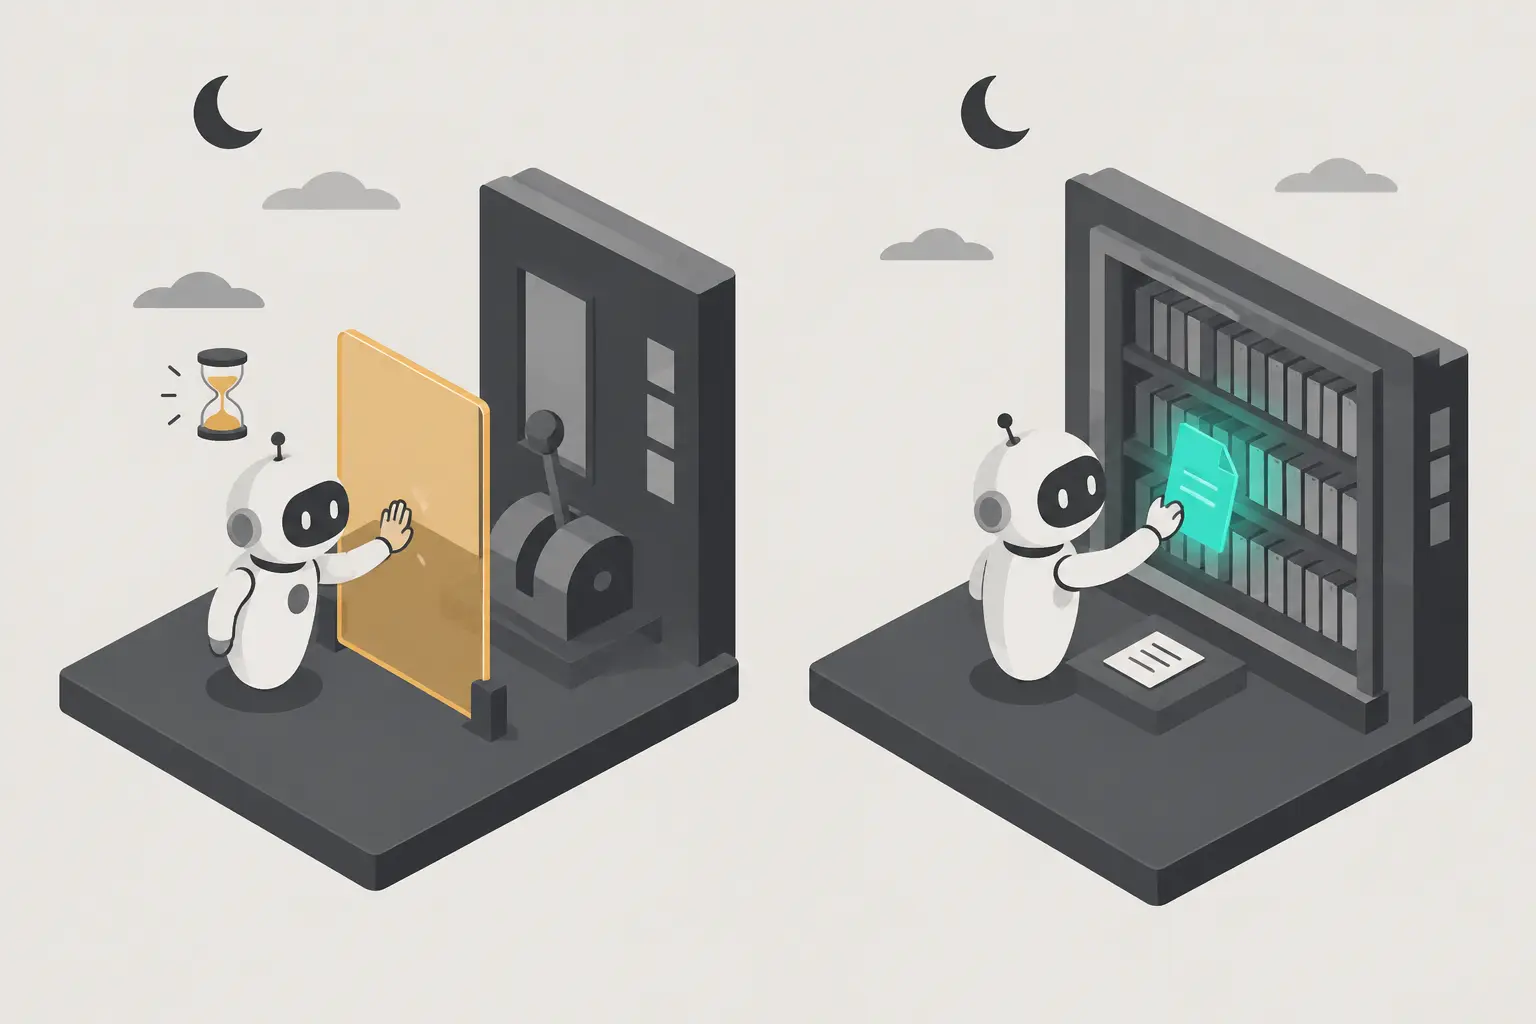
这张图里最容易被忽略的是那道「权限闸」。ChatGPT 的定时任务不是一段固定脚本,而是到点后让模型按你写的说明自己去调工具;每一次调工具之前,ChatGPT 都会按工具的标注和你的权限设置决定「直接调」还是「先问你」;按 OpenAI 开发者文档,没标只读的工具属于后者,每个对话第一次调用弹确认,点允许就过。人坐在电脑前时,「先问你」只是多点一下;定时任务在凌晨或周一早上跑,「先问你」就等于任务停在那里。下面每一节都在回答一个问题:这道闸在什么套餐、什么设置下要人来点,怎么让它不挡住定时任务。
先看结论:chatgpt scheduled tasks 在各套餐下能跑到哪一步
我们先把官方文档里和这件活有关的限制放进一张表,再在后面逐条讲依据。表里每一格都来自 2026 年 10 月 26 日读到的 OpenAI 帮助中心原文;ChatGPT 一侧我们没有账号实测,所以这张表是「按文档应当如此」,不是「我们跑过」。
| 套餐 | 同时启用的定时任务 | 最快多久一次 | 自定义 MCP | 取数工具(非只读)在定时任务里 |
|---|---|---|---|---|
| Free、Go | 3 个 | 每天最多 1 次,时间是「早上、下午、晚上」这类窗口 | 帮助中心没有列出 Free;社区有用户报告要先开开发者模式 | 文档没写;不建议依赖 |
| Plus | 5 个 | 每小时 1 次,可设准点 | 帮助中心只写了 Pro 和 Business、Enterprise、Edu | 文档没写;不建议依赖 |
| Pro($100 / $200 / $500) | 15 个 | 每小时 1 次,可设准点 | 可以接;帮助中心 FAQ 写只有读取类权限 | 开发者文档写读写工具都支持、写操作要确认;待确认时任务暂停 |
| Business | 10 个 | 每小时 1 次,可设准点 | 只有管理员和所有者能创建 | 可用;按权限设置可能要确认,需要确认时任务暂停 |
| Enterprise、Edu | Enterprise 15 个、Edu 10 个 | 每小时 1 次,可设准点 | 管理员可按角色授权「Create plugins with MCPs」 | 同上,另可在「Action control」里逐个放行动作 |
定时任务上限、频率和 Free 的时间窗口出自《Scheduled tasks in ChatGPT》的「Review scheduled task limits」一节;自定义 MCP 的套餐范围出自《Connecting custom MCP servers in ChatGPT》的 FAQ;Pro 三档的月费出自《About ChatGPT Pro tiers》,Plus 的 $20/月出自《What is ChatGPT Plus?》。Free 能不能接自定义 MCP,官方帮助中心没有写;官方社区 10 月 7 日的一条回复说 Free 账号仍要先在「Security and login」里打开开发者模式,这只是用户报告,我们按「未确认」处理。
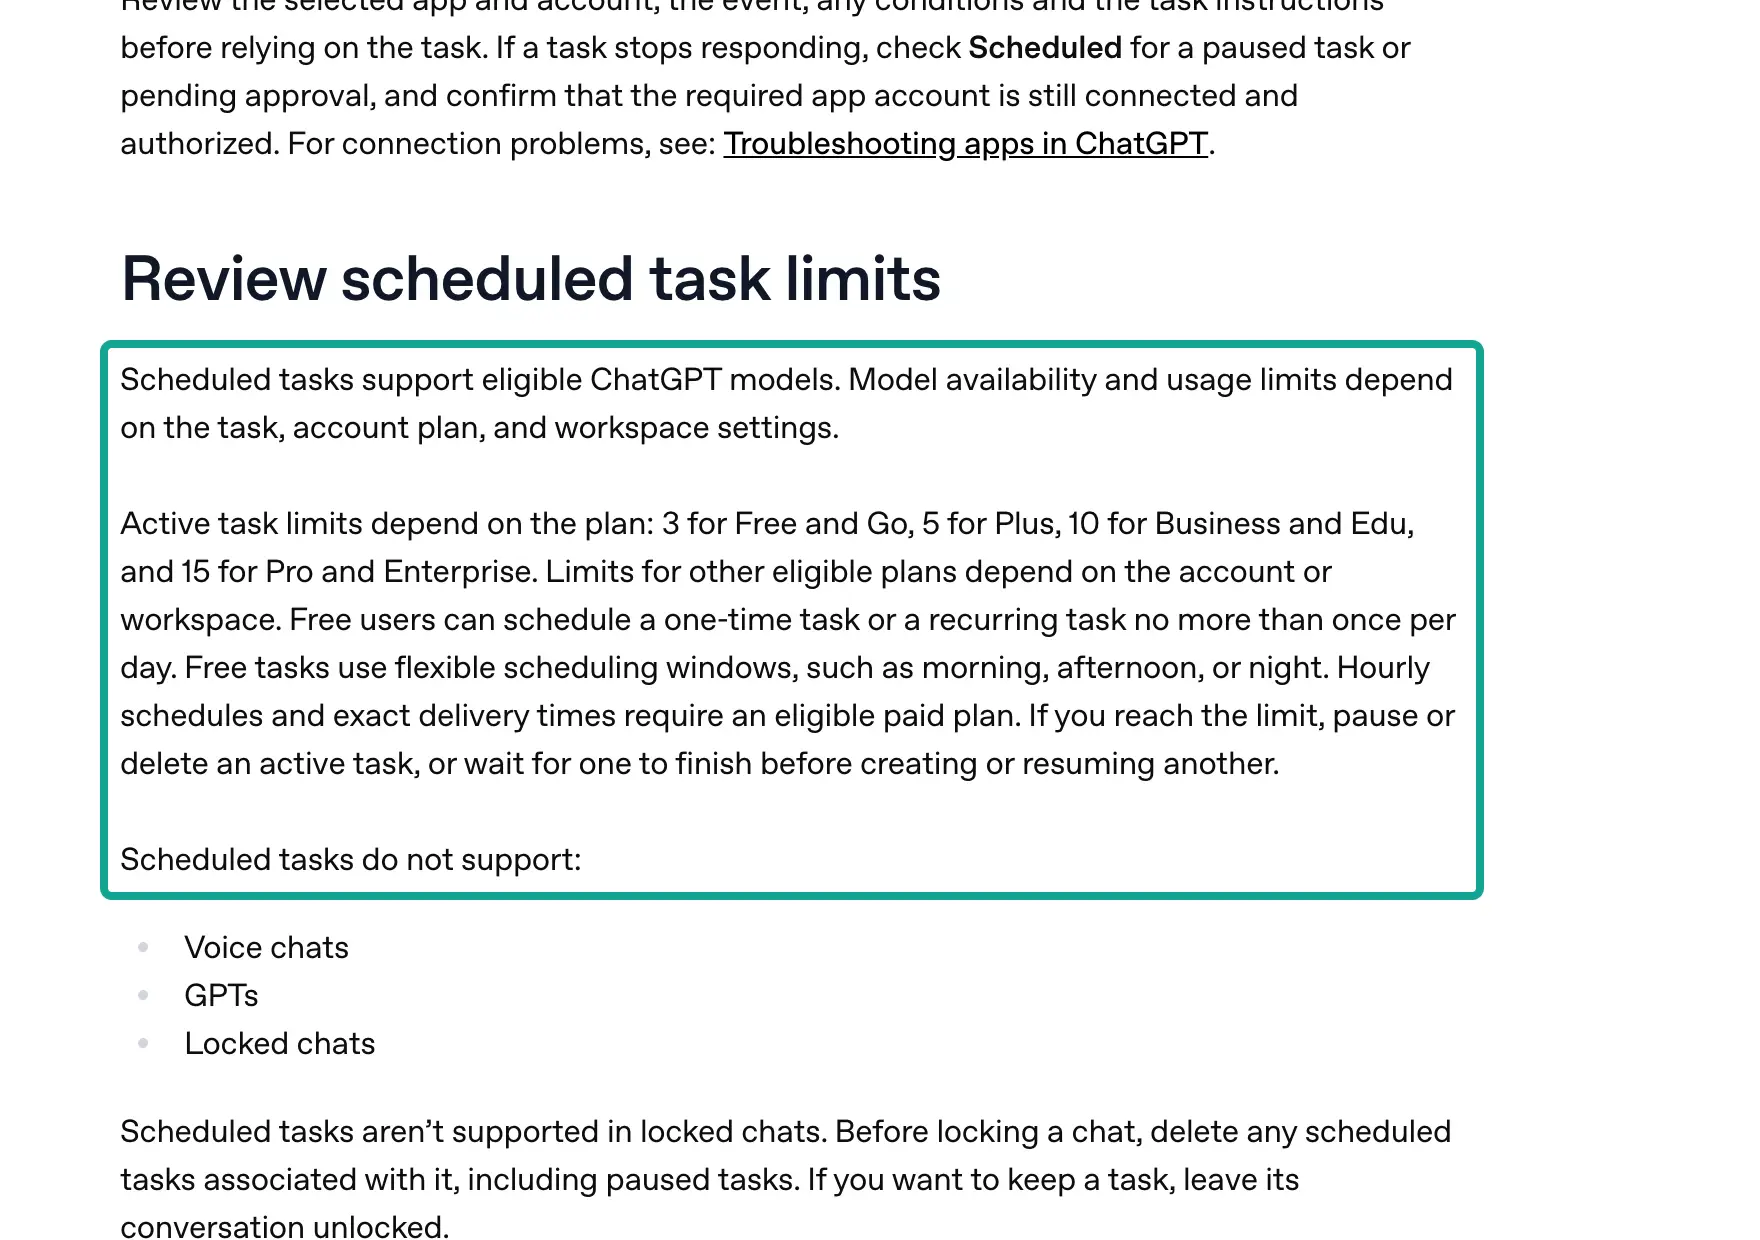
这张表推出的第一个判断是:如果你只有 Plus 或 Pro,最省心的方案不是让定时任务直接调我们的取数工具(每个新对话第一次调用都要你点确认),而是第七节写的「拆开」做法;如果你在 Business 或 Enterprise 工作区,并且管理员愿意给这个应用放开动作,直接接 MCP 是最短的一条路。第二个判断是:每周一次的雷达在所有付费套餐上都不会碰到频率上限,真正要算的是「同时启用的任务个数」——Plus 只有 5 个名额,一个品类一个任务的话,5 个品类就占满了。
一次运行走的 6 站
第 1 站和第 6 站是 ChatGPT 的事,第 3 站和第 5 站是我们的事,中间的第 2 站和第 4 站决定这件活能不能稳定地跑。第 2 站的「写死」很重要:定时任务每次都是让模型重新读一遍你的说明,说明里留给模型自己发挥的地方越多,它每周选的关键词、排序、条数就越可能不一样,花的钱和拿回来的东西也跟着变。OpenAI 的定时任务开发者文档给了同样的建议:在任务说明里点名要用的技能或工具,不要依赖模型自动选;排进计划之前先在普通对话里手动跑一遍,确认提示的范围、模型和工具都符合预期。第 4 站下面单独用一节讲。
第一步:加一个 chatgpt custom mcp connector(不用再开开发者模式)
2026 年 10 月 1 日,OpenAI 负责插件开发者平台的员工在官方社区回复:连接自定义 MCP 服务器已经不需要先进入「开发者模式」,所有符合条件的用户都可以在 Plugins 页面点「+」,再点「Add custom MCP server」;工作区里原来叫「Developer mode」的权限改名为「Create custom MCP servers」,帮助中心现在的写法是「Create plugins with MCPs」。开发者文档《Connect and test your plugin》列出的步骤是:填名称和说明,在 Connection 里填带 /mcp 路径的公网 HTTPS 地址,配置认证,勾选风险提示,选「Create as a plugin」,再检查发现到的工具和元数据。
认证这一步要先想清楚。开发者文档的认证一章要求需要账号的 MCP 服务器实现 OAuth 2.1,并在 /.well-known/oauth-protected-resource 发布元数据;第三方教程(AnythingMCP 的 ChatGPT 指南)记录的界面选项是「OAuth」「No authentication」「OAuth or no authentication」三种,没有「填一个 API Key 请求头」的选项。我们在 17:42(新加坡时间)对 api.everyinfra.com 的三个发现地址各发了一次 GET,结果都是 404:
| 发现地址 | 状态 | 对 ChatGPT 的意思 |
|---|---|---|
/.well-known/oauth-protected-resource | 404 | 选 OAuth 会找不到元数据 |
/.well-known/oauth-protected-resource/mcp | 404 | 同上 |
/.well-known/oauth-authorization-server | 404 | 同上 |
POST /mcp,User-Agent 为 curl/8.5.0 | 200,0.119 秒 | ChatGPT 的校验请求不会被我们挡掉 |
所以在 ChatGPT 里只能选「No authentication」,Key 放进地址:https://api.everyinfra.com/mcp?key=你的Key。这一点我们没有在 ChatGPT 里点过,依据有两个:一是我们不带 Key 调 MCP 时服务器自己的报错写着「header Authorization: Bearer or ?key= query param」(17:30 SGT 的真实返回),二是 EveryInfra 网关的鉴权代码对 MCP 同时接受这两种写法。最后一行是专门测的:一位开发者 9 月 3 日在官方社区报告,ChatGPT 校验自定义 MCP 时发出的请求 User-Agent 是 curl/8.5.0,他的防火墙把它当成脚本拦了,ChatGPT 只报「does not implement OAuth」;我们用同一个 User-Agent 调初始化,200 返回。
把 Key 放进地址有代价,要事先知道。RFC 6750 第 2.3 节写得很直接:带令牌的地址很可能被记进日志,除非无法放进请求头,否则不应使用这种方式;第 5.3 节也建议不要把令牌放进页面地址。ChatGPT 会保存你填的地址,团队里有权限看这个应用配置的人也能看到。我们的建议是给 ChatGPT 单独开一把 Key,并用上三个限制:只放行 reddit/* 和 quora/* 能力(Key 的 scope_mode=selected),设一个美元总限额(spend_limit_usd,10 月 26 日上线,到了限额返回 403 key_spend_limit_reached 且不扣费),再设一个过期时间。这三个字段都写在我们的 OpenAPI 说明里。按本文的配方,一年的接口费不到 $0.40,限额设成 $2 就足够覆盖一年还留出余量,即使地址泄露,损失也被锁死在这个数以内。
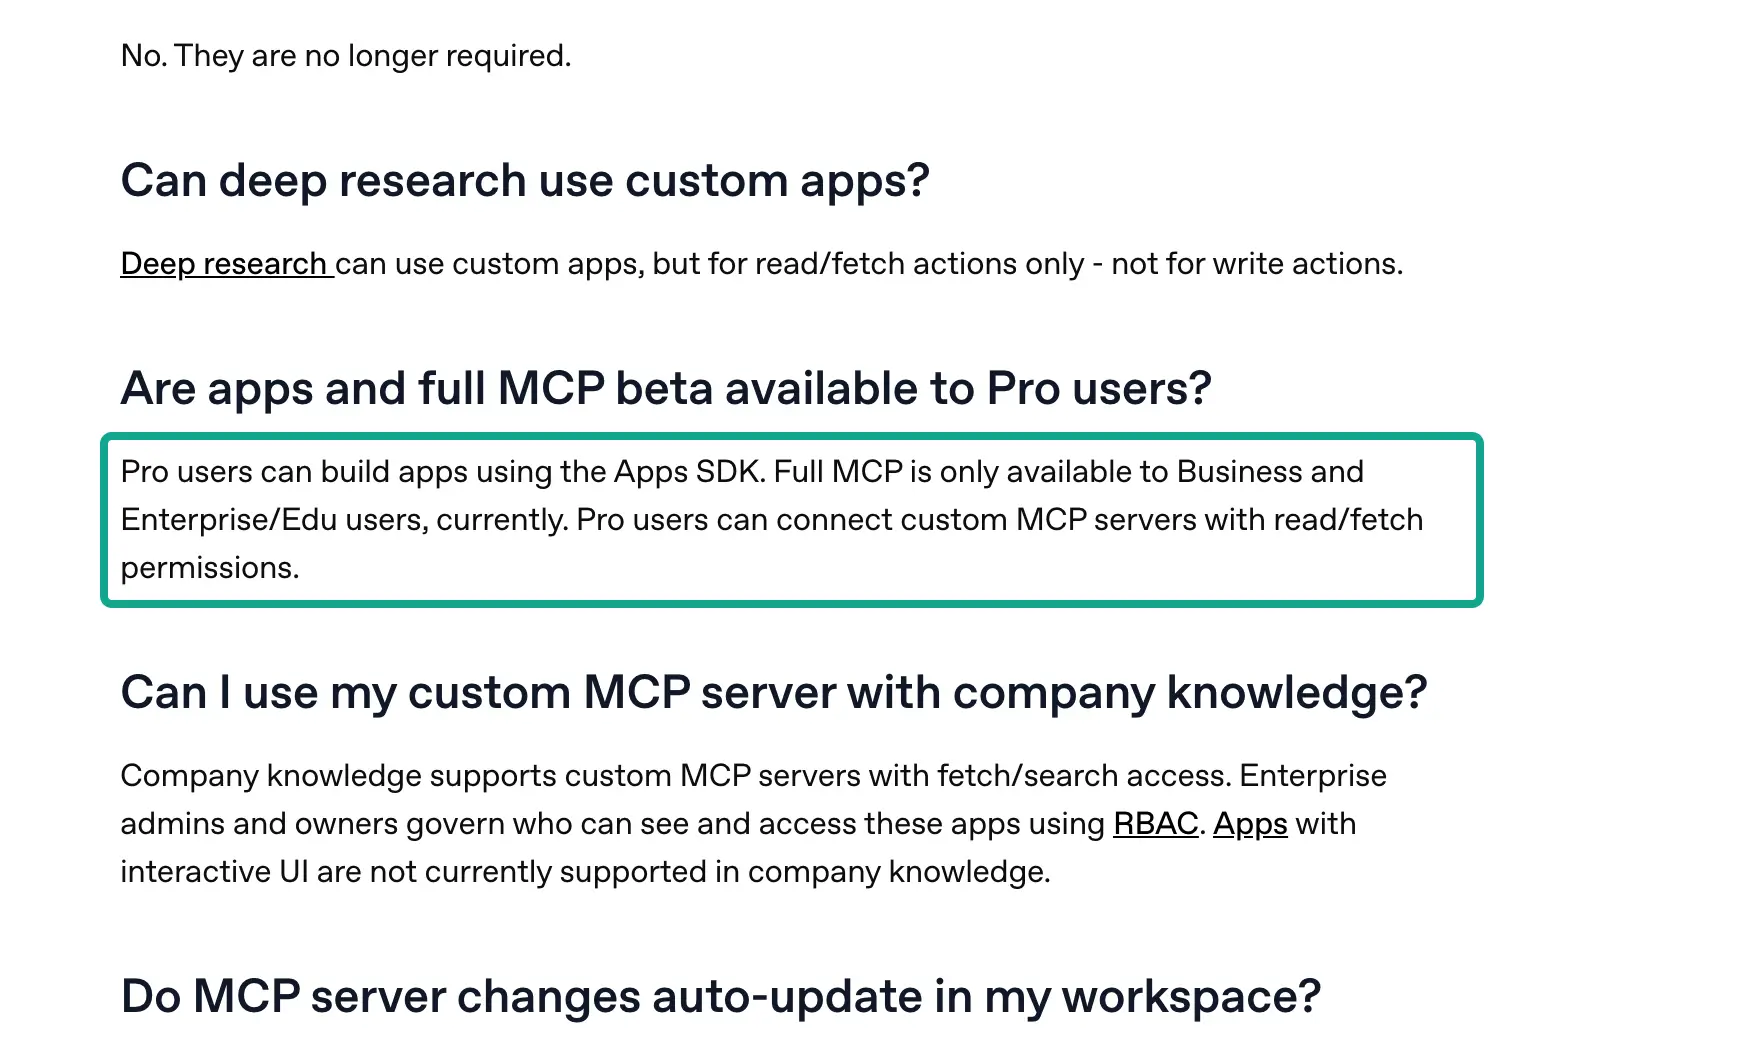
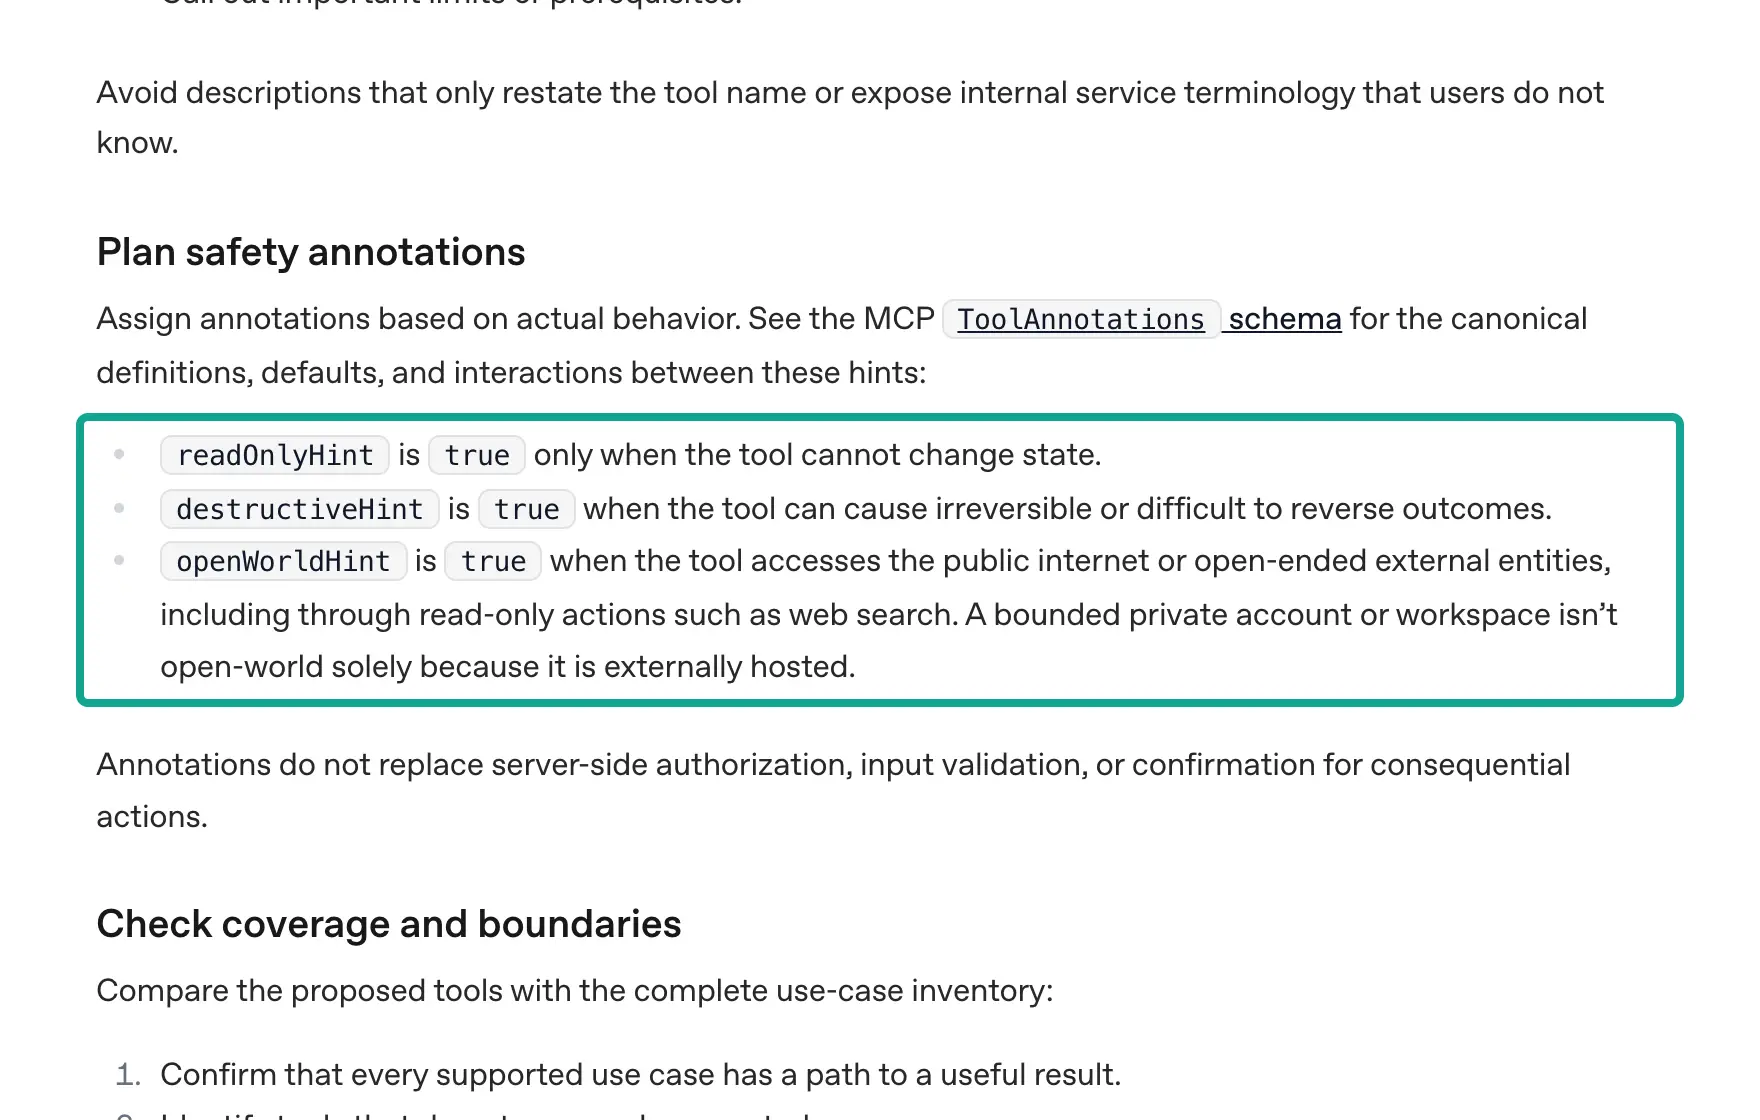
截图里这句话和 OpenAI 开发者文档的写法对不上。《Add custom MCP server》开头就写 ChatGPT 支持服务器上的读、写两类工具;「Reviewing and confirming tool calls」一节写明:ChatGPT 按 readOnlyHint 判断只读,没有这个标注的工具按写操作处理;写操作默认要确认;你可以对某个工具选择在本对话里记住允许,新对话或刷新后会重新问。按这个说法,我们的取数工具在 ChatGPT 里能用:每个对话第一次调用会弹确认,点允许即可,不是用不了。我们没有 Pro 账号实测;如果你在 Pro 上看到的和这里不同,以你看到的为准。
一次真实往返:ChatGPT 发什么,我们回什么
ChatGPT 连上自定义 MCP 以后,每次调工具发出的都是一条 JSON-RPC 的 tools/call 请求。我们在 17:34:47(新加坡时间)用 curl 发了一条一模一样的请求,只是把 Key 放在 Authorization 请求头里:
curl -s https://api.everyinfra.com/mcp \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Accept: application/json, text/event-stream" \
  -d '{"jsonrpc":"2.0","id":4,"method":"tools/call",
       "params":{"name":"everyinfra_call_api",
                 "arguments":{"platform":"reddit","action":"search",
                              "params":{"keyword":"robot vacuum keeps getting stuck","sort":"top","limit":10}}}}'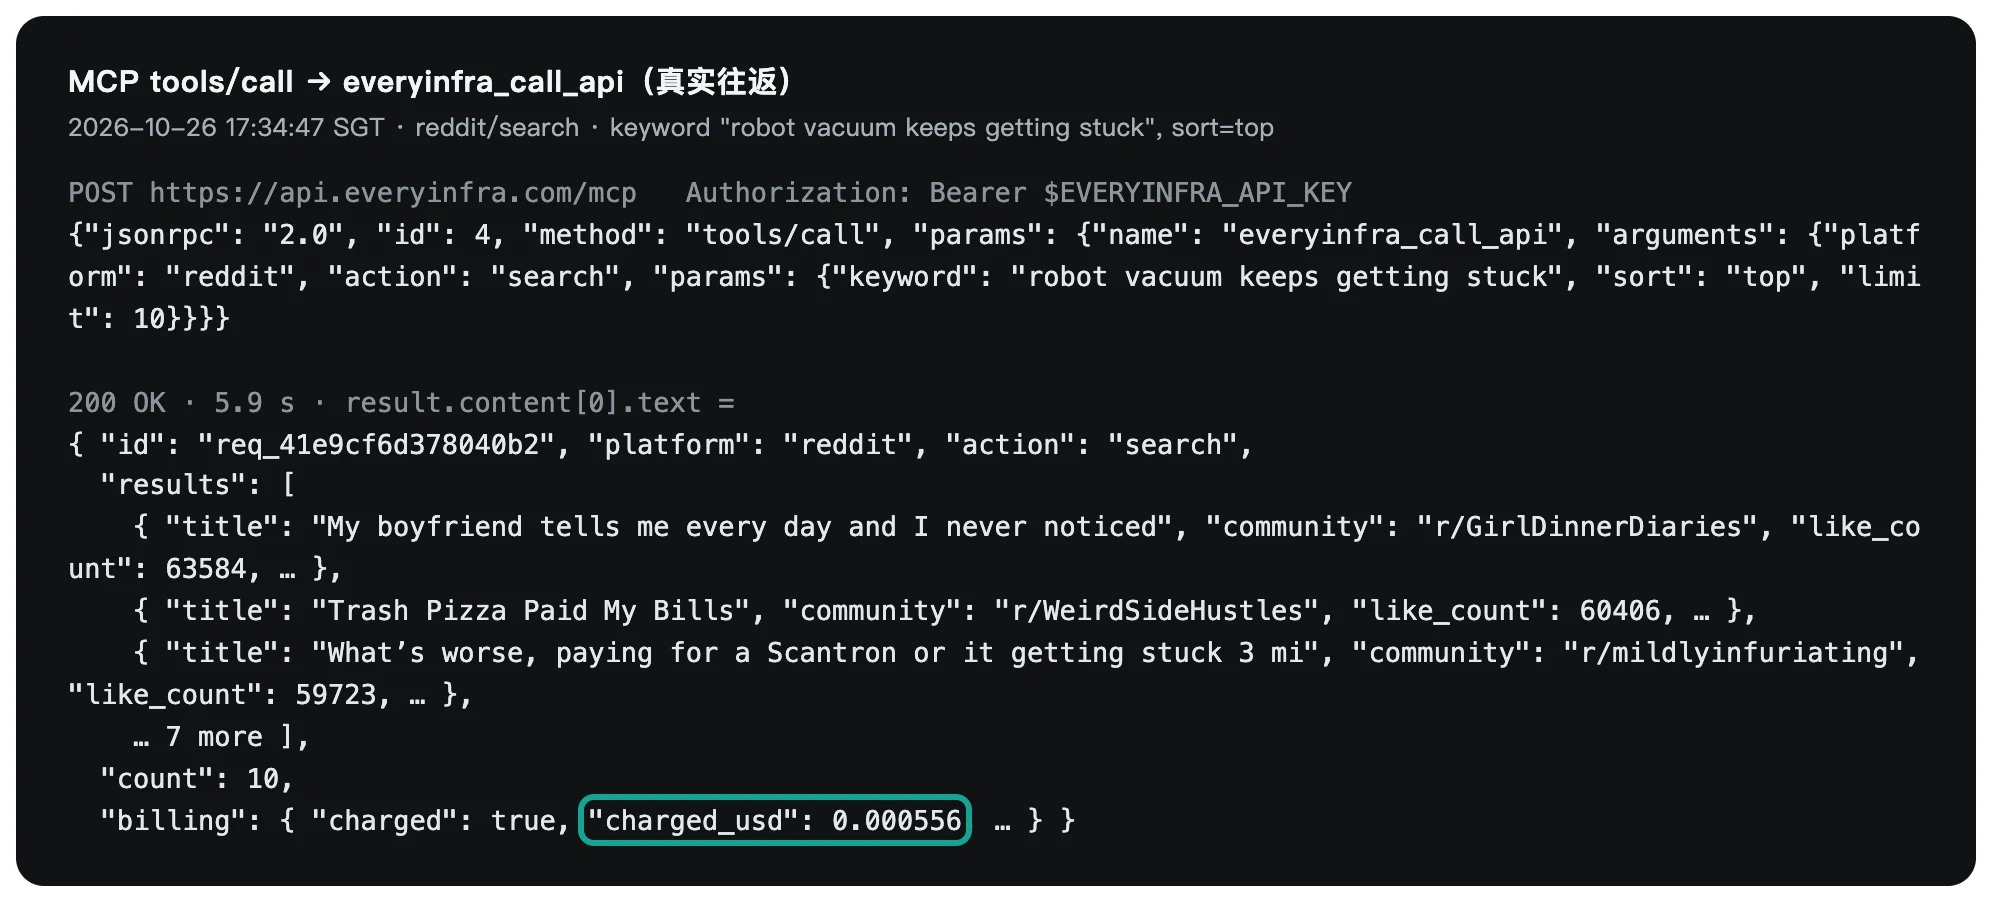
返回用了 5.9 秒,10 行,扣费 $0.000556,等于目录里 reddit/search 的 price_usd;返回里出现的 10 个字段(id、url、title、text、author_username、community、like_count、comment_count、posted_at、platform)全部在目录的 response_fields 里,没有目录外的字段。可这 10 条结果没有一条提到 vacuum:排第一的是一篇点赞 63,584 的恋爱帖,第二是一篇副业帖。原因在目录写的参数说明里:reddit/search 的时间窗固定为最近一个月,sort=top 是按分数排,一句 5 个词的长句里只要有一个词命中就会被召回,再按全站分数排序,结果就是一个月里全 Reddit 分数最高、碰巧带了 stuck 或 getting 的帖子。
我们在 17:35:11 换成 sort=relevance 再跑一次同一句话:10 条全部提到 vacuum,其中 2 条五个词都出现。这说明问题不在接口,在模型替你选的参数。人在对话里看到结果不对会马上改;定时任务里没人看,模型可能每周都这样花钱拿回一堆无关的帖子。所以第二站的任务说明要把 sort 写死,关键词用 2–3 个词的短语,并且要求模型在报告末尾列出「本次每个调用返回几条、几条相关」,你扫一眼就知道这一周的数据有没有跑偏。
图里另一根青绿柱是 Dreame。我们在 17:31:36 搜这个扫地机器人品牌,25 条里只有 3 条真的和 Dreame 有关,其余是 r/Dreams 的梦境帖和网文推广帖——搜索把 Dreame 当成了 dream。Roborock 这种不会和常用词撞车的品牌就好得多(18/25)。对出海品牌来说,这条很实用:品牌名像普通英文单词的,关键词搜索会被噪声淹没,应该改用品牌自己的社区(Dreame 有 r/Dreame_Tech)走 reddit/subreddit_posts,或者在关键词里加上品类词。
取数工具为什么要确认:25 个工具的标注
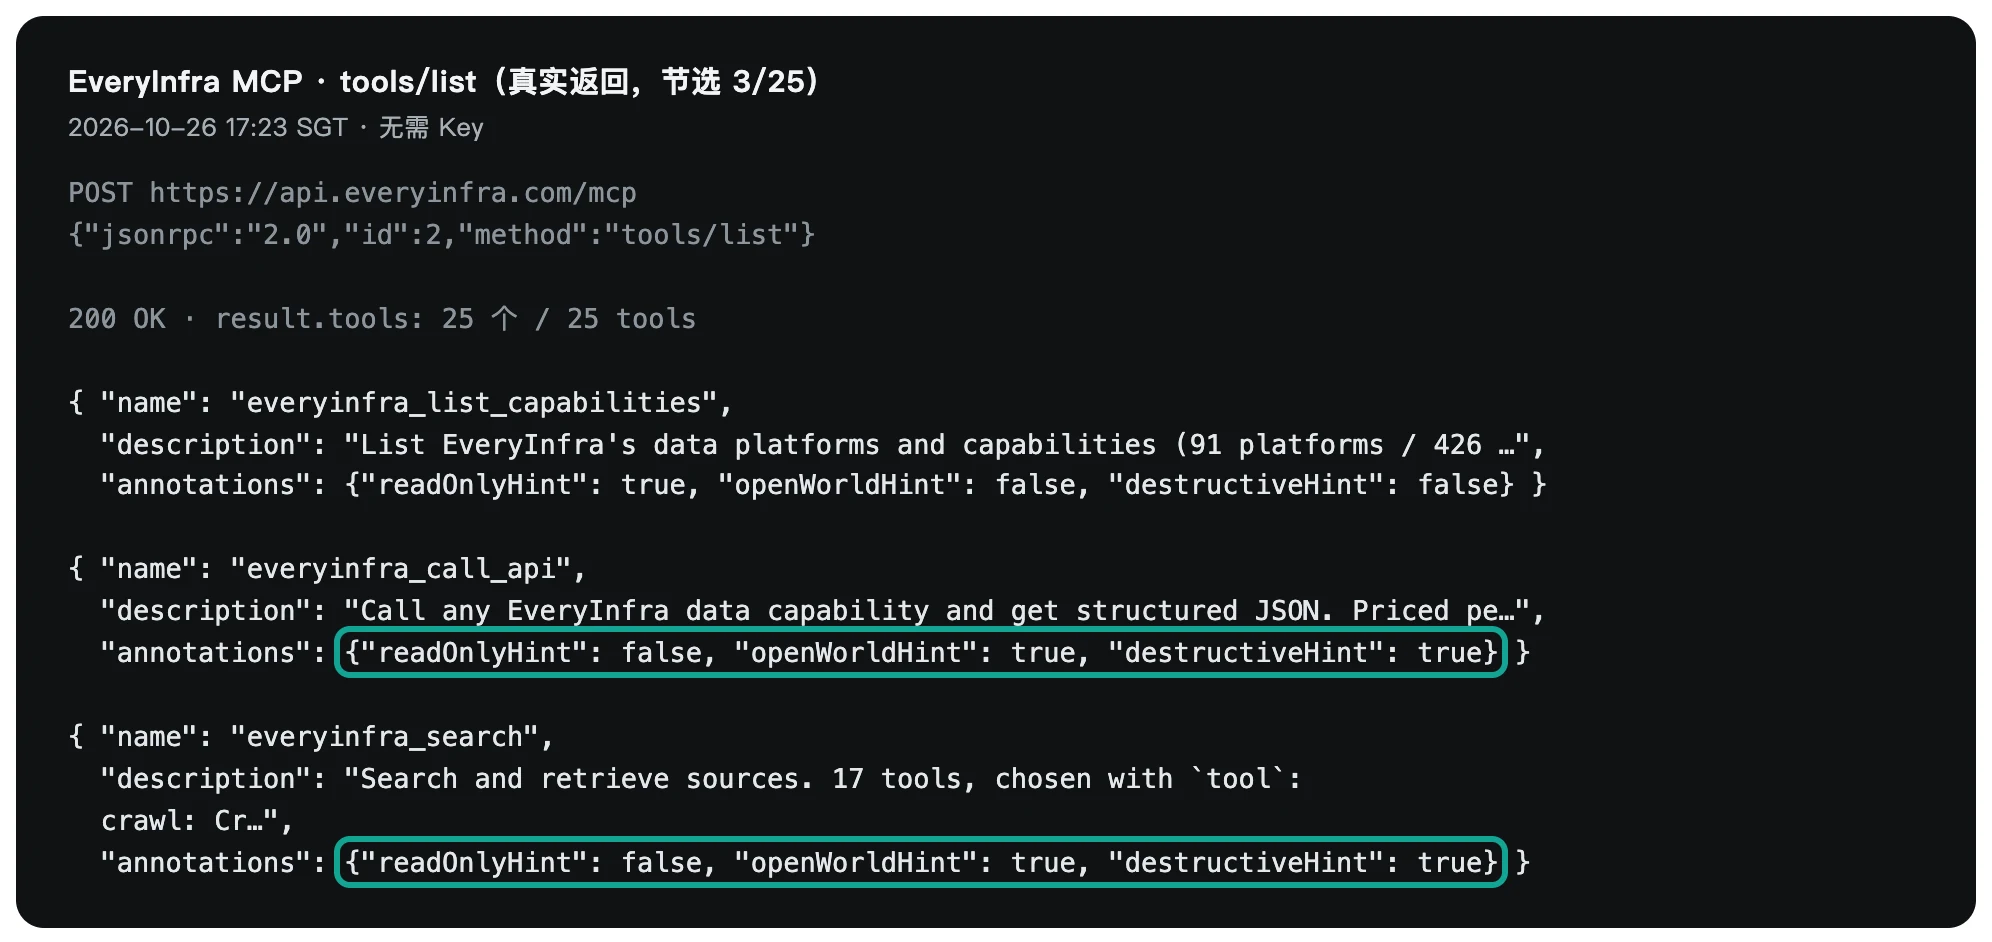
MCP 规范给每个工具准备了几个标注。2025-11-25 版规范的 ToolAnnotations 定义写着:readOnlyHint 为 true 表示工具不改变它所处的环境,默认 false;destructiveHint 只在非只读时有意义,默认 true;openWorldHint 表示工具会和外部开放世界打交道,默认 true。OpenAI 的插件开发文档要求「只有在工具不能改变状态时」才把 readOnlyHint 设成 true,并说明这些标注帮助 ChatGPT 和 Codex 选择确认和安全行为。也就是说,标注本身不执行任何事,但宿主会照着它决定要不要问人:Codex 的 MCP 配置里有一个 default_tools_approval_mode,取值 writes 时「对没有标成只读的工具弹出确认」,这是 OpenAI 文档里写明的规则。ChatGPT 也一样:《Add custom MCP server》写明它按 readOnlyHint 判断只读,没有这个标注的工具按写操作处理,写操作默认要确认。
我们的 25 个工具里,11 个只读:列能力、查任务、查验证码类型、查账户、查用量、查调用记录、查账单、列 Key、列工单、取充值链接、读单个工单。剩下 14 个非只读,其中 5 个标了可能不可逆:两个取数工具 everyinfra_call_api、everyinfra_search,另外 3 个和本文的取数无关(其中之一是删 Key)。取数工具为什么不标只读?它确实不改 Reddit 上的任何东西,可它会从你的钱包里扣钱,这是「改变环境」;所以我们的规则是:访问外部网站的标 openWorldHint=true,付费调用一律标 destructiveHint=true。我们认为这样标是对的:如果把一个会花钱的工具标成只读,宿主就会不问一声地放行,模型在循环里出错时你连拦的机会都没有。
标注之外,ChatGPT 还有一层用户自己的权限设置。《Managing app permissions in ChatGPT》列了四档:「Always ask」读和改都先问;「Allow read actions」读不问、改要问;「Allow low-risk actions」自动放行低风险动作,高风险的可能要确认或被拒;「Allow all actions」所有支持的动作都不再弹确认,但这一档只能对单个应用或账号设,账号级、工作区级的默认选择器里没有它。同一页还写明,「Always allow」这个记住选择的按钮不对工作区成员开放,也不对需要额外安全审查的动作开放。插件文档的变更记录显示,这套「什么时候问」的设置是 2026 年 6 月 12 日上线的。
| 你的设置 | 我们的取数工具(非只读、标了不可逆)会怎样 | 定时任务里的结果 |
|---|---|---|
| Always ask | 每次都弹确认,点允许即可 | 任务停在待确认,直到你点 |
| Allow read actions | 不算读,弹确认 | 同上 |
| Allow low-risk actions(默认) | 标了不可逆,大概率不算低风险,弹确认 | 同上 |
| Allow all actions(只能对单个应用设) | 支持的动作不再弹确认 | 可以无人值守;社区有人报告定时运行时仍被安全检查拦下 |
表里第二、三列是按文档推断的,ChatGPT 没有公开「低风险」的判定规则。在普通对话里,不管哪一档,最多就是第一次调用弹一次确认,点允许、选本对话记住,同一对话里后面就不再问。定时任务另有一件事要知道,下面这几份社区报告说的就是它。
2026 年 10 月 4 日,一位用户在 OpenAI 官方社区发了一份回归报告:这位用户的定时任务每周读 Gmail、做调研、决定要发哪封邮件,Gmail 设成了「Allow all actions」,任务说明里也写了长期授权,可到发邮件和写 Google Sheets 那一步,调用被拦下,提示是「This tool call was blocked by OpenAI's safety checks」。帖子里列出 9 月 30 日到 10 月 3 日的多次失败;10 月 5 日另一位用户把同一份任务说明原样粘进普通对话,8 次 Trello 写入全部成功,而定时运行时被拦。到 10 月 8 日,回帖里还有人报告 GitHub 写入时好时坏、任务读取和整理邮件的动作一直正常。另一份 10 月 6–8 日的报告更麻烦:写 GitHub 被拦之后,每小时运行的任务在约 64–65 秒后被系统改成停用,下一次就不跑了。这些都是用户报告,OpenAI 在帖子里还没有给出结论。官方文档的写法是:写操作要确认,确认了就能调,没有说定时任务里不能写。这几份报告说明的是,在定时运行这个场景里,确认之后仍被安全检查拦下的情况确实有人遇到。我们的取数工具在 ChatGPT 眼里属于写操作,所以想让雷达稳定地无人值守,最好别把取数押在定时任务里。
三种做法怎么选
取数工具在 ChatGPT 里要确认,定时任务里又没人点,对策就有三种:在允许的工作区里把这道闸打开;把取数挪到 ChatGPT 外面,让 ChatGPT 只读;或者干脆不用 ChatGPT 的定时任务。
| 做法 | 适合谁 | 怎么做 | 代价和风险 |
|---|---|---|---|
| A. 直接接 MCP | Business、Enterprise 工作区 | 管理员创建应用、发布;对这个应用设「Allow all actions」;首跑在普通对话里手动点一次 | 社区报告定时运行时仍可能被安全检查拦;Key 在地址里,要用受限 Key |
| B. 拆开:外部取数,ChatGPT 只读 | Plus、Pro、个人账号 | 每周一 08:00 用 cron、n8n 或 GitHub Actions 调我们的 REST,把结果写进 Google Drive 或 GitHub 里的一个文件;09:00 的 ChatGPT 定时任务用 Drive 或 GitHub 连接器读这个文件、写报告 | 多一个调度器;ChatGPT 只做读,最稳 |
| C. 不用 ChatGPT 的定时任务 | 想全自动、能写一点代码的人 | 用 OpenAI Responses API 的远程 MCP 工具(require_approval: "never"、allowed_tools)由自己的 cron 调;或者用 Claude Code 的云端定时任务 | 按 token 计费;不在 ChatGPT 界面里 |
做法 B 是官方社区里一位做企业流程自动化的回帖人给的思路:让 AI 只负责判断和写一份结构化记录,由你能控制的确定性程序去执行(同一帖 10 月 7 日的回复)。放在需求雷达上,「执行」就是取数:调度器调 EveryInfra 不需要任何人确认,ChatGPT 那一步只剩读文件,正好落在文档说稳定的那一类。我们之前写过一篇用 n8n 每天定时调 EveryInfra 出日报的实测,那篇里的工作流改一下关键词、把输出写进 Google Drive,就是做法 B 的前半段。做法 C 里,Responses API 的 MCP 文档写明可以用 require_approval 跳过确认、用 allowed_tools 只导入需要的工具;Claude Code 的云端定时任务在 Pro、Max、Team、Enterprise 上可用,关电脑也会跑。这两条我们都没有在本文里实测,只列出可选的路。
雷达要取哪些数:三组真调
一份雷达能不能用,取决于取回来的东西是不是「这一周」「这个品类」的。我们在 2026 年 10 月 26 日 17:31–17:41(新加坡时间)用同一把测试 Key 跑了三组:中文读者关心的扫地机器人出海(关键词 robot vacuum、Roborock、Dreame、robot vacuum mop,社区 r/RobotVacuums),英文 SaaS 读者常见的密码管理器(password manager,社区 r/PasswordManagers),以及西语关键词(aspiradora robot、robot aspirador)。一共 32 次请求,其中 22 次计费,合计 $0.016397;另外 10 次是故意的错误请求、被限速的请求和空结果,都没有扣钱。下面只讲扫地机器人这一组的细节,另两组的数在后面的表和图里。
第一件事是时间跨度。目录写明 reddit/search 的时间窗固定为最近一个月,max_limit 是 25;按 sort=newest 取满 25 条,最新到最老只差几个小时:robot vacuum 15.6 小时、Roborock 24.4 小时、robot vacuum mop 6.5 小时,Dreame 只有 0.2 小时(因为它把所有带 dream 的新帖都算进来了)。如果周一早上只取「最新 25 条」,你看到的是周日下午到周一早上的帖子,周二到周六说了什么全漏掉。按社区取就完全不同:reddit/subreddit_posts 对 r/RobotVacuums 用 sort=top、date_range=past_week、limit=100,一次拿回 100 帖,最早一帖在 10 月 19 日、最晚在 10 月 26 日,跨度 166.3 小时,几乎正好一周。
所以这件活的主力应该是 reddit/subreddit_posts,关键词搜索只当补充,用来发现你还不知道的社区。这一条在我们的判据里本来是按「25 条里有几条落在 7 天内」来判的,结果 25 条全在 7 天内,按原来的线应判「每周一次够」;但这条线量错了东西——25 条全在 7 天内,恰恰是因为它们全挤在最近十几个小时里。我们在检查记录里把这一条记为「判据设计有误」,结论按跨度改写,原判据保留不动。
第二件事是这一周的帖子里有什么。r/RobotVacuums 一周热门 100 帖里,按我们写在分析脚本开头的规则粗筛:标题以问号结尾或以 how、what、which、best、anyone 这类词开头的算「提问」,有 49 帖;标题或正文前 400 字里出现 stuck、broken、issue、avoid、return 这类词的算「带抱怨词」,有 35 帖。分数最高的一帖标题就是一句劝退某个品牌的话(32 分、16 条评论);评论最多的是「帮我说服另一半买扫地机」(53 条评论)、「用了一年还满意的人吗」(31 条)、「有了扫地机还得自己打扫哪里」(30 条)、「好的避障真的存在吗」(23 条)。这几条恰好是一份雷达要抓的东西:购买阻力、长期可靠性、清洁死角、避障信任。
规则粗筛只是为了挑出要细读的帖子,不能当结论:一句「Lol avoid Eureka」没有抱怨词表里的词,却是最明确的抱怨;反过来,「How are the lesser-known robot vacuum brands holding up?」是提问,背后其实是对小品牌可靠性的担心。真正的归类留给 ChatGPT 在任务里做,它擅长把一句口语读成「对什么不满」。我们的规则只承担一件事:告诉你这一周提问多还是抱怨多,跟上周比有没有明显变化。
第三件事是评论。我们对评论最多的三帖调了 reddit/comments,每次 limit=50,实际返回 30、29、22 条——接口只返回顶层评论,没有展开楼中楼,这和我们之前写的 Reddit 评论为什么不完整是同一个现象。三帖里「带抱怨词」的评论分别是 10、3、5 条。读下来,「用了一年还满意吗」那帖里有人说近期买的几台新旗舰机一周内都出了电气故障;「好的避障真的存在吗」那帖里点赞最多的评论是「我不在家时绝不让它跑」,好几条评论都在说出门前要先把地上的东西捡干净。这类话在商品评价里很少出现,却正是「扫地机为什么没帮我省时间」的答案——巧的是,Quora 这一周新出现的 2 个问题之一正是「为什么很多用户觉得扫地机根本没帮他们省时间」。
第四件事是 Quora 的量。quora/questions 用 date_range=past_week_last_7_days、limit=30:robot vacuum 一周只有 2 个新问题,换成过去 30 天是 30 个(碰到了 limit,实际更多);Roborock 一周是 0 个,这次没有扣钱,返回里写着 "reason": "empty_result_refunded";password manager 一周 4 个、一个月 11 个。Quora 在这份雷达里的作用是补「还没买的人在想什么」,量小,适合每月看一次,不必每周都调。
西语这一组提醒了语言的坑。reddit/search 搜 aspiradora robot(按相关性)返回 8 条,7 条相关,来自 r/AskChile、r/Colombia 等拉美社区,其中一帖在问「市面上最好的扫地机是哪台」,另一帖是智利用户抱怨某品牌没有为智利市场做规划;可换成 robot aspirador(按最新)返回的 11 条几乎全是葡萄牙语社区(r/TudoCasa、r/CasualPT),因为葡语里扫地机就叫 aspirador robot。Quora 更明显:aspiradora robot 一个月 0 条(退款);robot aspirador 放宽到一年返回 5 条,全是英文的「aspire / robotics」问题,跟扫地机无关,而且因为不是空结果,照常扣了 $0.001389。做多语言雷达时,每个语言要单独验一遍关键词,不能把中文或英文的关键词直接翻译过去。
| 组 | 能力和参数 | 返回 | 相关 | 跨度 | 扣费 |
|---|---|---|---|---|---|
| 扫地机 | reddit/subreddit_posts r/RobotVacuums,top,past_week,100 | 100 | 全部来自该社区 | 166.3 小时 | $0.000556 |
| 扫地机 | reddit/search robot vacuum,newest,25 | 25 | 22 | 15.6 小时 | $0.000556 |
| 扫地机 | reddit/search Dreame,newest,25 | 25 | 3 | 0.2 小时 | $0.000556 |
| 扫地机 | quora/questions robot vacuum,past_week,30 | 2 | 2 | — | $0.001389 |
| 扫地机 | quora/questions Roborock,past_week,30 | 0 | — | — | $0(退款) |
| 密码管理器 | reddit/subreddit_posts r/PasswordManagers,top,past_week,100 | 20 | 全部来自该社区 | 160.1 小时 | $0.000556 |
| 密码管理器 | reddit/search password manager,newest,25 | 25 | 12 | 7.1 小时 | $0.000556 |
| 西语 | reddit/search aspiradora robot,relevance,25 | 8 | 7 | 602.5 小时 | $0.000556 |
| 西语 | quora/questions robot aspirador,past_year,30 | 5 | 0 | — | $0.001389 |
任务说明怎么写
有了上面这些数,任务说明就可以写得很死。下面是我们给 ChatGPT 定时任务准备的一份配置示例(没有在 ChatGPT 里跑过),关键是三处:每个调用的平台、动作和参数都写清楚,不让模型自己挑;要求先查后写,报告末尾附上调用清单和花费;遇到调用被拦或失败时,不要重试成别的参数,而是把「本来要调什么」原样列出来,方便你手动补跑。
每周一 09:00(Asia/Singapore)运行。只用 @EveryInfra 插件里的 everyinfra_call_api,按下面的清单逐个调用,不要改参数,不要增加调用:
1. platform=reddit, action=subreddit_posts, params={subreddit: "RobotVacuums", sort: "top", date_range: "past_week", limit: 100}
2. platform=reddit, action=subreddit_posts, params={subreddit: "Dreame_Tech", sort: "top", date_range: "past_week", limit: 50}
3. platform=reddit, action=search, params={keyword: "robot vacuum", sort: "relevance", limit: 25}
4. platform=quora, action=questions, params={keyword: "robot vacuum", date_range: "past_week_last_7_days", limit: 30}
5. 从第 1 步结果里按 comment_count 取前 5 帖,对每帖调 platform=reddit, action=comments, params={url: <帖子 url>, limit: 100}
输出:
- 「本周抱怨」前 5:每条一句话归纳 + 原帖链接 + 评论数;只写现象,不点名普通用户。
- 「本周提问」前 5:同上。
- 和上周的报告比:按帖子 url 去重,标出新出现的主题。
- 附录:每个调用返回几条、其中几条和关键词有关、billing.charged_usd,最后给出合计。
如果某个调用失败或被拦:不要换参数重试,把它的 platform、action、params 原样列在附录里,然后继续做后面的步骤。
这份说明里第 5 步的 5 次评论调用是整份雷达里最花时间的部分:17:33–17:41 的 6 次 reddit/comments 中位数 22.2 秒,最慢一次 43.4 秒。ChatGPT 侧没有公开单个工具调用的超时时间,Codex 的 MCP 配置默认 tool_timeout_sec 是 60 秒,可以当参考;我们目录写的同步预算是 85 秒,超过就该在请求体里加 "mode": "async",再用 everyinfra_get_job 取结果。
用这周的真数据走一遍:一份样例报告
为了让「报告长什么样」有个参照,我们按上面的任务说明,用 17:31–17:41(新加坡时间)这一轮真调拿回来的 r/RobotVacuums 一周热门 100 帖和 3 帖评论,手工归纳了一份样例。它不是 ChatGPT 生成的,只说明一份合格的周报要包含哪些东西、每条结论能不能落回原帖。
| 栏目 | 条目(括号里是评论数) | 依据 |
|---|---|---|
| 本周抱怨 1 | 用了一年后维护像「兼职工作」,拖布有异味(31) | 帖子正文和 30 条顶层评论,其中 10 条带抱怨词 |
| 本周抱怨 2 | 滚筒拖布贴墙留一条没拖到的缝,在纠结换回旋转拖布(20) | 帖子标题和正文 |
| 本周抱怨 3 | 某品牌对故障机给出按折旧计价的退款方案(16,本周分数最高的一帖) | 帖子正文 |
| 本周抱怨 4 | 买便宜机器想省时间省钱,结果花了更多(13) | 帖子正文 |
| 本周抱怨 5 | 欧盟保修送修 18 天后仍未解决(3) | 帖子标题 |
| 本周提问 1 | 怎么说服另一半买扫地机(53) | 标题 |
| 本周提问 2 | 有了扫地机还得自己打扫哪里(30):沙发顶、门后、斜腿椅子底下 | 29 条顶层评论 |
| 本周提问 3 | 好的避障真的存在吗(23):点赞最多的回复是「我不在家时绝不让它跑」 | 22 条顶层评论 |
| 本周提问 4 | 1,300–1,500 美元预算在四款旗舰里怎么选(13) | 帖子正文 |
| 本周提问 5 | 自动集尘站长期看到底省不省维护(10) | 标题 |
这份样例里有两件事值得拿出来说。一是「抱怨」和「提问」高度重叠:评论最多的几帖表面上是提问,评论里装的全是抱怨,所以报告不能只看标题分类,第 5 步读评论那 $0.00278 是整份雷达里最值的钱。二是报告的价值在「跟上周比」,单看一周,只能说出「维护负担、清洁死角、避障信任」这几个老话题;连跑几周后,哪个话题突然多了、哪个品牌名突然高频出现,才是产品和运营要的信号。所以后面一节我们专门测了「隔一段时间再跑,变了多少」。
一周多少钱
接口费按能力目录在 17:22(新加坡时间)读到的 price_usd 算。每周配方是 10 次调用:1 次 reddit/subreddit_posts、2 次 reddit/search、2 次 quora/questions、5 次 reddit/comments。
| 能力 | 单价 | 每周次数 | 小计 |
|---|---|---|---|
reddit/subreddit_posts | $0.000556 | 1 | $0.000556 |
reddit/search | $0.000556 | 2 | $0.001112 |
quora/questions | $0.001389 | 2 | $0.002778 |
reddit/comments | $0.000556 | 5 | $0.002780 |
| 合计 | 10 | $0.007226 |
一年 52 周是 $0.375752,三个品类各跑一份是一年约 $1.13。空结果会自动退款,所以实际只会更少;如果你想要现成的痛点汇总,目录里还有 reddit/painpoint($0.072/次,按关键词找帖子并读评论,给出负面评论计数和高频词),一次的钱够跑 10 周配方。它适合偶尔对一个新品类做一次摸底,不适合每周跑。
ChatGPT 自己的费用要另外算,而且没法换算成每周多少钱。帮助中心写明 Work 与 Codex 共用同一套用量规则;ChatGPT 的计价说明给的是 Plus 每 5 小时能发多少条消息的区间(GPT-6.1 Sol 15–160 条),并提醒看起来相似的任务消耗也可能差很多。一位 Plus 用户在 r/codex 上 10 月 5 日的帖子里说,他每天 7 点的定时任务跑了 13 分钟,5 小时用量显示用掉 29%;OpenAI 客服回复他定时任务走 Work,和 Codex 共用额度。按这个量级,一份需求雷达占 ChatGPT 订阅的那部分,远比 $0.007226 的接口费显眼。
限速、空结果和失败怎么计费
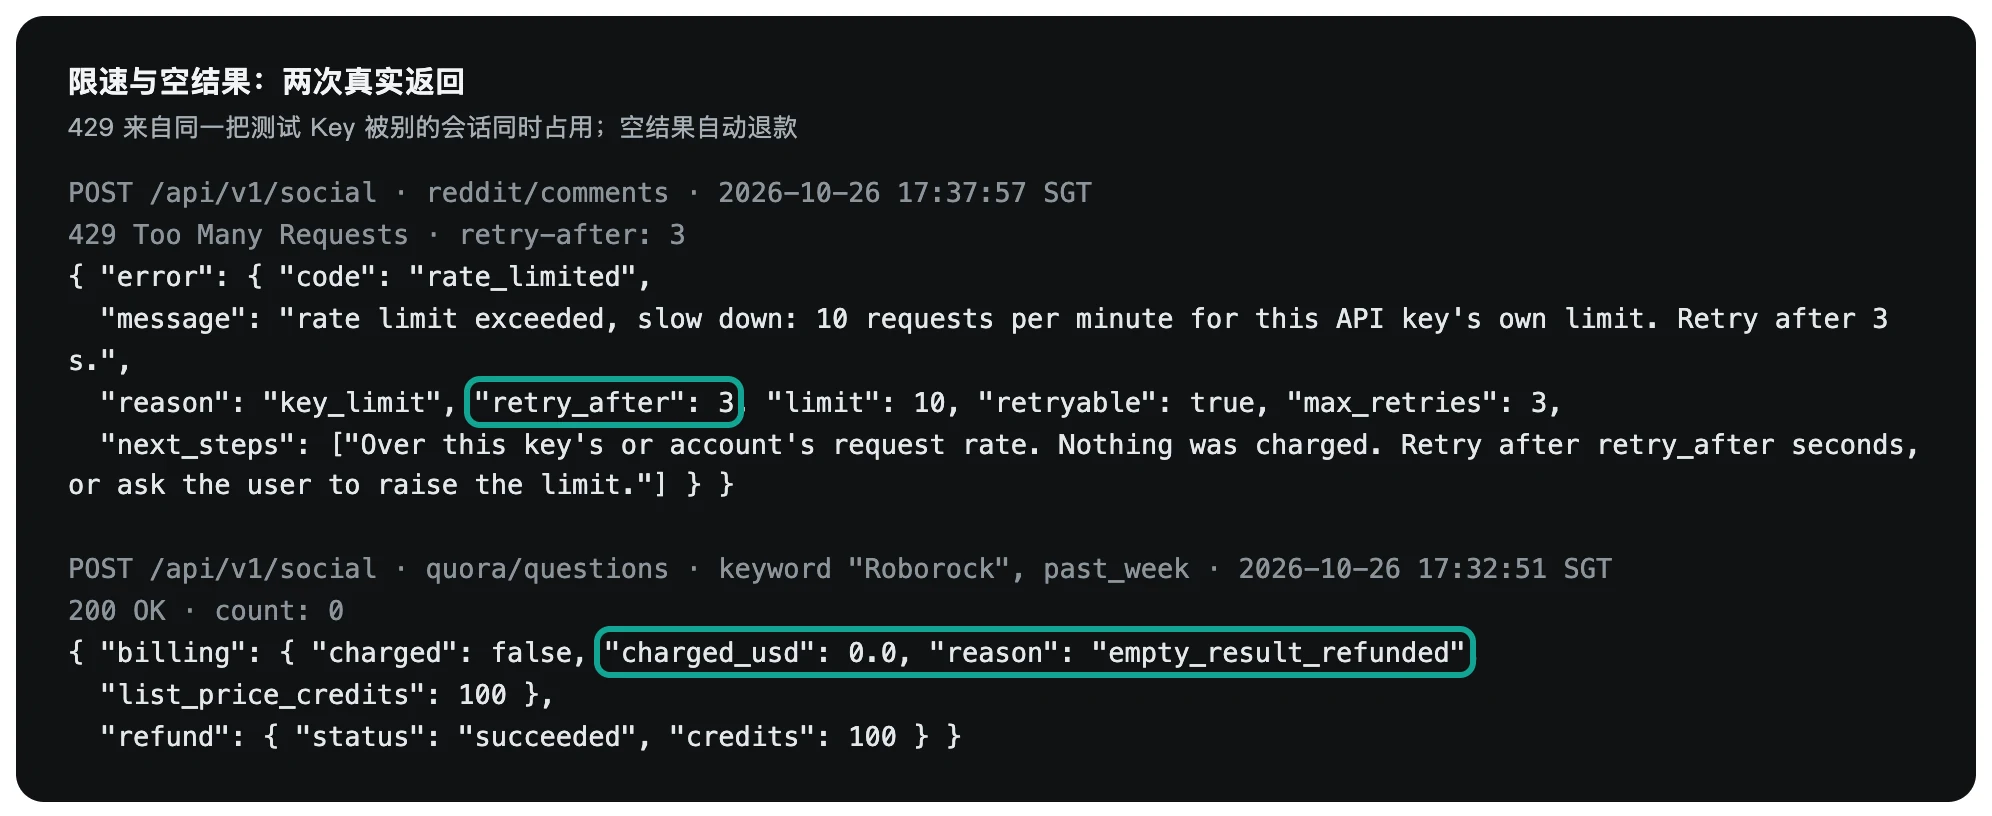
我们这次真调里碰到的四种「没拿到数据」的情况,扣费都是 0,但对定时任务的影响不一样。
| 情况 | 我们这次的真实返回 | 扣费 | 对定时任务意味着什么 |
|---|---|---|---|
| 不带 Key | REST 401 missing_key;MCP 返回 isError: true,提示两种传 Key 的写法 | $0 | 地址里漏了 ?key= 时,模型会读到可读的错误,不会悄悄失败 |
| 参数写错 | sort: "latest" 返回 422,带 allowed 列表;sort: "newst" 返回 422,带 did_you_mean: ["newest"] | $0 | 模型能照着改;但说明里写死参数,根本不会走到这里 |
| 被限速 | 17:37:57 起 4 次 429,retry_after 3 秒,limit 10 次/分钟 | $0 | 测试 Key 同时被别的会话占用;正式 Key 的限额见控制台。说明里要允许模型等几秒再试 |
| 空结果 | quora/questions Roborock 一周 0 条,empty_result_refunded | $0 | 报告里写「本周无新问题」,不要当成失败 |
这里要说清楚一点:我们这次 4 次被限速,原因是这把测试 Key 同时还在被别的会话使用,每分钟 10 次的上限是这把 Key 自己的设置,不代表正式 Key 的限额;OpenAPI 说明写的账户级上限是每分钟 60 次。一份雷达一次只调 10 次,正常不会碰到;但如果你在同一把 Key 上同时跑好几个品类的任务,又刚好都设在周一 09:00,就可能撞上。错开几分钟最简单。
chatgpt scheduled tasks not working:常见原因和对策
「not working」在搜索联想里排在「chatgpt scheduled tasks」后面第一位。把官方文档写明的限制和社区报告合起来,和这件活有关的原因有 9 类;前 5 类有官方原文,后 4 类是用户报告,按报告处理。
| 现象 | 原因 | 出处 | 对策 |
|---|---|---|---|
| 任务没跑,显示暂停 | 需要确认的动作让任务暂停;长期没人看的任务可能自动暂停;关联的对话被删或归档也会暂停 | 帮助中心《Scheduled tasks》 | 去 Scheduled 页面看有没有待确认;每隔几周打开一次报告 |
| 建不了新任务 | 同时启用的任务到了上限(3/5/10/15) | 同上 | 暂停或删掉不用的任务 |
| Free 账号任务不准点 | Free 用早上、下午、晚上这样的弹性窗口,每天最多一次 | 同上 | 需要准点就用付费档 |
| 任务读不到项目里的文件 | 在项目里建的任务不能访问项目里上传的文件 | 同上 | 把参考资料写进任务说明,或放进连接器能读的地方 |
| 在 GPTs、语音、加锁对话里建不了 | 定时任务不支持这三处 | 同上 | 在普通对话或 Work 里建 |
| 写操作被拦(用户报告) | 「blocked by OpenAI's safety checks」,同样的提示在普通对话里能成功;官方文档只说写操作要确认 | 官方社区 10 月 4 日起的报告 | 把取数挪到外部调度器,ChatGPT 只读(做法 B) |
| 任务跑完自己停用 | 写入失败后约一分钟被改成停用 | 官方社区 10 月 6–8 日的报告 | 同上;每周检查一次任务状态 |
| 加自定义 MCP 时报「does not implement OAuth」 | 校验请求被对方防火墙拦,或者服务器本来就没有 OAuth | 官方社区 9 月 3 日的报告 | 对 EveryInfra 选「No authentication」 |
| 任务吃掉大量 Work 用量 | 定时任务走 Work,和 Codex 共用额度 | r/codex 10 月 5 日的帖子、计价说明 | 任务说明写短、写死;报告只要摘要 |
r/ChatGPT 上一个 30 多条回复的求助帖把几类问题混在了一起:有人每小时的任务写 GitHub 失败后被自动关掉,有人每周一的任务连续三周没出现在任务列表里,还有人问它为什么没跑时,模型回答「我做了,只是你看不到」。最后这一种最值得警惕:模型对「自己做了什么」的描述不能当证据。这也是我们要求报告末尾附调用清单和 charged_usd 的原因——有没有调过、调了几次、花了多少,以我们这边的调用记录为准,控制台里每一次调用都有 request_id 可查。另一个帖子把自动暂停说成「悖论」:任务做得越好越不需要打开它,可长时间不打开它就会被当成没人用而暂停(r/ChatGPT)。每周一的雷达至少要让它推送到你会看的地方,这本身就是对策。
一小时内再跑一次:每周对比要按什么去重
每周雷达的核心动作是「这周和上周比」。要知道两次运行之间会变什么、该按哪个字段去重,我们把第一组里的三次调用原样重跑了一遍。动手前我们写下的线是「间隔不少于 45 分钟」。第一次重跑在新加坡时间 18:13:31 到 18:14:28,离原始调用只有 38.7 到 42.4 分钟,没达到这条线,测试记录里照实记了一笔。于是我们在新加坡时间 18:21:02 到 18:21:52 又跑了一次,离原始调用 46.1 到 50.0 分钟,这次满足条件。多出来的 6 次调用花了 $0.003336;算上它们,整场测试一共 38 次请求,28 次计费,合计 $0.019733。
| 调用 | 原始调用(新加坡时间) | 行数:原始 → 第一次重跑 → 第二次重跑 | 第二次新出现 | 第二次消失 |
|---|---|---|---|---|
reddit/search robot vacuum,newest,25 | 17:31:05 | 25 → 25 → 25 | 1(一条促销帖) | 1(最旧的一条) |
reddit/subreddit_posts r/RobotVacuums,top,past_week,100 | 17:32:11 | 100 → 24 → 100 | 1(新问「3.8 厘米门槛能不能过」) | 1(本周最高分那帖) |
reddit/subreddit_posts r/PasswordManagers,top,past_week,100 | 17:35:46 | 20 → 19 → 19 | 0 | 1 |
这张表说明三件事。第一,past_week 是一个以调用时刻为终点、往回数 168 小时的滑动窗口,不是自然周。r/RobotVacuums 本周得分最高的「Lol avoid Eureka」(32 分)发于 2026-10-19 10:09(UTC);我们 18:13(新加坡时间)重跑时,正好是 UTC 10 月 26 日 10:13,它刚满 7 天,就掉出了窗口。r/PasswordManagers 掉出去的那一帖发于 10 月 19 日 10:06(UTC),原因相同。所以任务每周固定同一时刻跑,每个帖子恰好落在一周里;如果某个周一任务因为暂停后补跑而晚了几个小时,窗口边缘的帖子就会两头都没看到;反过来早跑了,就会有几帖连续两周出现。
第二,去重用 id 或 url,不要用标题。帖子在两次运行之间分数、评论数都会变,但 id 和 url 不变。把上周的 id 列表留在报告里(或者方案 B 写出去的那个文件里),本周不在列表里的才标「新」。标题只适合做第二道筛:西语那组里,同一个账号在 r/AskChile 和 r/RepublicadeChile 隔两分半发了同一个问题,这是两个 id 不同的帖子,只有按规范化后的标题才能并成一条。
第三,也是最出乎意料的:返回行数不稳定。同样的参数,r/RobotVacuums 在 50 分钟内先后返回 100 行、24 行、又是 100 行。那 24 行恰好是 5 分以上的全部帖子,缺的是 76 条 0 分帖(它们加起来只有 16 条评论)。这次 24 行的返回状态是 200,照常计费。对雷达的结论影响不大,因为进报告的帖子一条没少;但如果你拿「本周帖子数」衡量社区热度,这种波动就会造成假的「骤降」。所以报告附录要逐次列出返回行数:社区拉取的行数不到上周一半时,先把这一次调用重跑一遍,再下「这周冷清了」的结论。
还有一个所有按票数排序都有的效应:周日晚上发的帖子到周一运行时只积累了几个小时的票,下一周它已经在窗口外了,所以一周最后一两天的帖子天然排得靠后。如果你在意这一点,可以在报告里加一小段「最近 24 小时评论最多的帖子」,不需要多调一次接口,直接在同一次社区拉取的结果里按 posted_at 筛出来就行。
字段说明:报告用到的每个字段
下面三张能力的字段都和目录里的 response_fields 逐个对过;只列雷达用得上的,其余字段(如图片地址、外链域名)见目录。平台和能力页:Reddit 数据接口、Quora 数据接口,能力页分别是 reddit/search、reddit/subreddit_posts、reddit/comments、quora/questions。
| 能力 | 字段 | 含义 | 雷达里怎么用 |
|---|---|---|---|
reddit/search、reddit/subreddit_posts | id、url | 帖子 ID 和链接 | 按它去重、和上周比 |
| 同上 | title、text | 标题和正文 | 归类的原料 |
| 同上 | community | 所属社区,不含 r/ 前缀 | 看讨论集中在哪些社区 |
| 同上 | like_count、comment_count | 分数和评论数 | 排序,挑出要读评论的帖子 |
| 同上 | posted_at | 发帖时间 | 判断是不是这一周的 |
| 同上 | flair | 帖子的分类标签原文 | 有的社区用它区分「求推荐」「求助」 |
reddit/comments | text、like_count、posted_at | 评论正文、分数、时间 | 读抱怨的细节 |
quora/questions | title、url、posted_at | 问题标题、链接、时间 | 「本周提问」 |
| 同上 | answer_count、follower_count | 回答数、关注数 | 判断问题有没有人答 |
author_username 两个 Reddit 能力都会返回,但雷达里不需要它;Reddit 的《Responsible Builder Policy》禁止从数据推断用户的健康、政治倾向等敏感特征,也禁止重新识别用户身份。任务说明里那句「只写现象,不点名普通用户」就是为这个写的。
不经过 ChatGPT,同一份数据怎么取
做法 B 的调度器、或者你想先手动看一眼数据时,直接调 REST 就行。参数和 MCP 里一模一样,只是外面少了一层 JSON-RPC:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"reddit","action":"subreddit_posts",
       "params":{"subreddit":"RobotVacuums","sort":"top","date_range":"past_week","limit":100}}'
17:32:11(新加坡时间)这条请求返回 100 帖,用了 17.3 秒,扣费 $0.000556。目录对每个能力都写了 max_limit:reddit/search 是 25(超过会被截到 25),reddit/subreddit_posts 和 reddit/comments 是 100,quora/questions 是 200。按次计费、不按行计费,所以在上限以内把 limit 取满最划算。完整的入门步骤在文档快速上手,MCP 的通用接法见远程 MCP 接入验收和 MCP 服务说明页。
这套做法的边界
第一,ChatGPT 侧的所有行为我们都没有实测,只能按 2026 年 10 月 26 日读到的文档写;OpenAI 的套餐和权限规则改得很勤(本文引用的帮助中心页面多数标着「几小时前更新」),发布前要再核一遍。第二,Pro 账号能不能调取数工具,两份官方文档写法不一:帮助中心 FAQ 写 Pro 的自定义 MCP 只有 read/fetch 权限,开发者文档写读写工具都支持、写操作要确认。本文按开发者文档写,Pro 上的实际表现我们没有测。第三,我们的提问、抱怨规则是粗筛,100 帖的样本只够说明「有很多」,不够说明比例;要做比例,至少要连续跑几周、每周人工抽查。第四,Reddit 的数据从 2026 年 11 月 13 日起不再提供 RSS,公共 API 计划在 2027 年 3 月关闭(TechCrunch 2026-09-30 报道,原文见 r/modnews 公告),靠 RSS 做的雷达要换路;我们写过一篇停 RSS 之后监测怎么换。第五,雷达只说「用户在说什么」,不说「市场有多大」:Reddit 和 Quora 的用户群不代表全部买家,结论要和销量、客服记录对照着看。
最近的变化
- 2026-08-25,定时任务能被应用事件触发、能分享(ChatGPT 发布说明):Plus、Pro 可以让 Work 在新 Gmail、Slack 消息、GitHub PR 变化时跑任务;Free 可以同时开 3 个任务。对读者意味着:需求雷达这种「按时间」的任务不受影响,但你可以把做好的雷达分享给同事,各自接自己的连接器。
- 2026-09-29,支持的插件可以用 MCP 事件触发自动化(同一份发布说明,开发者文档见 MCP Events):要求 MCP 2.0(协议版本 2026-07-28),服务端用 webhook 推送事件。对读者意味着:EveryInfra 是按次拉取的接口,不主动推事件;要「有新帖就提醒」,仍然是定时去拉。
- 2026-10-01,接自定义 MCP 不再需要开发者模式(官方社区员工回复):从 Plugins 页面直接加,工作区权限改名。对读者意味着:按旧教程找「Developer mode」开关会找不到,直接去 Plugins 页面。
- 2026-10-04 起,定时任务里的写操作被安全检查拦下的用户报告(官方社区,OpenAI 尚未回应):读取类动作不受影响。对读者意味着:官方文档的说法是写操作要确认、确认后能调;但要在定时任务里无人值守地「花钱、改东西」,把它挪出 ChatGPT 最稳。
- 2026-09-30,Reddit 宣布 11 月 13 日停 RSS、2027 年 1 月 12 日前要登记应用(r/modnews):对读者意味着:靠 RSS 订阅社区新帖的雷达要在 11 月 13 日前换掉。
- 2026-10-26,EveryInfra 的 Key 可以设美元总限额(OpenAPI 说明里的
spend_limit_usd和key_spend_limit_reached):对读者意味着:把 Key 放进 ChatGPT 的地址里之前,可以先给它封一个顶。
常见问题
chatgpt tasks 和 chatgpt scheduled tasks 是一回事吗? 是同一个功能的不同叫法。早期界面叫「Tasks」,现在帮助中心的标题是「Scheduled tasks in ChatGPT」,入口是侧栏的 Scheduled 页面,能建一次性、重复和监测变化的任务。出处:搜索联想「chatgpt tasks」与「chatgpt scheduled tasks」并列出现(2026-10-26 读取);帮助中心。
chatgpt scheduled tasks not working,最先查什么? 先去 Scheduled 页面看任务是不是「暂停」或者「待确认」:帮助中心写明需要确认的动作会让任务暂停,长期没人看的任务也可能自动暂停。再看任务是不是在项目、GPTs、语音或加锁对话里建的。如果任务里有写入动作,看报告里有没有「blocked by OpenAI's safety checks」(社区报告过的情况)。出处:联想词「chatgpt scheduled tasks not working」「chatgpt scheduled tasks not showing」;帮助中心;官方社区报告。
chatgpt custom mcp connector 一定要开开发者模式吗? 不用了。2026 年 10 月 1 日起在 Plugins 页面点「+」→「Add custom MCP server」即可;Business 工作区只有管理员和所有者能建,Enterprise、Edu 由管理员按角色授权。出处:联想词「chatgpt custom mcp connectors」;官方社区员工回复;帮助中心。
chatgpt scheduled tasks limit 是多少? 同时启用的任务 Free 和 Go 3 个、Plus 5 个、Business 和 Edu 10 个、Pro 和 Enterprise 15 个;付费档最快每小时一次,Free 每天最多一次。事件触发的任务所有任务合计每小时 30 次、每天 720 次。出处:联想词「chatgpt scheduled tasks limit」;帮助中心。
ChatGPT 能调 EveryInfra 的取数工具吗?它没标只读,会不会被拦? 能。OpenAI 开发者文档写明 ChatGPT 支持读、写两类工具,没标 readOnlyHint 的按写操作处理,写操作默认要确认:每个对话第一次调用会弹确认,点允许即可,也可以选本对话记住,新对话会再问一次。定时任务里没人点确认,任务会暂停,所以排进计划前先在普通对话里手动跑一遍。出处:《Add custom MCP server》;本文 2026-10-26 17:23 和 20:04(新加坡时间)读取的 tools/list。
EveryInfra 的 MCP 在 ChatGPT 里要选哪种认证? 选「No authentication」,把 Key 写进地址的 ?key=。我们这边没有发布 OAuth 元数据,三个发现地址都是 404;选 OAuth 会报找不到。Key 要单独开一把,限定能力、设美元总限额。出处:本文 2026-10-26 17:42(新加坡时间)的探针;开发者文档《Authentication》。
一份每周需求雷达要多少钱? 接口费按 10 次调用算是 $0.007226,一年约 $0.38;空结果自动退款。ChatGPT 的订阅和 Work 用量另算。出处:本文按能力目录 2026-10-26 的 price_usd 计算,真调扣费与目录价一致。
相关阅读
- 用 n8n 每天定时调 EveryInfra 出日报:2.45 新调度器实测
- 远程 MCP 接入验收:能发现工具,离真正可用还差什么
- Reddit 11 月 13 日停 RSS:监测怎么换
- Reddit 评论为什么不完整
- 多平台口碑监测怎么搭
- Reddit 痛点调研:reddit/painpoint
- 价格
参考资料
- Scheduled tasks in ChatGPT,OpenAI Help Center,2026-10-26 读取,<https://help.openai.com/en/articles/10291617-scheduled-tasks-in-chatgpt>
- ChatGPT Work and Codex,OpenAI Help Center,2026-10-26 读取,<https://help.openai.com/en/articles/20001275>
- ChatGPT release notes(2026-08-25、2026-09-29、2026-10-20 等条目),OpenAI Help Center,<https://help.openai.com/en/articles/6825453-chatgpt-release-notes>
- Connecting custom MCP servers in ChatGPT,OpenAI Help Center,2026-10-26 读取,<https://help.openai.com/en/articles/12584461-connecting-custom-mcp-servers-in-chatgpt>
- Managing app permissions in ChatGPT,OpenAI Help Center,<https://help.openai.com/articles/20001495>
- Connected apps in ChatGPT,OpenAI Help Center,<https://help.openai.com/en/articles/11487775-apps-in-chatgpt>
- About ChatGPT Pro tiers,OpenAI Help Center,<https://help.openai.com/articles/9793128>
- What is ChatGPT Plus?,OpenAI Help Center,<https://help.openai.com/en/articles/6950777-what-is-chatgpt-plus>
- What is ChatGPT Go?,OpenAI Help Center,<https://help.openai.com/en/articles/11989085-what-is-chatgpt-go>
- ChatGPT Business release notes(2026-09-29 Team tasks),OpenAI Help Center,<https://help.openai.com/en/articles/11391654-chatgpt-business-release-notes>
- ChatGPT Enterprise and Edu release notes,OpenAI Help Center,<https://help.openai.com/en/articles/10128477-chatgpt-enterprise-and-edu-release-notes>
- Regression: Scheduled Tasks safety checks block authorized Gmail sends and Google Sheets writes,OpenAI Developer Community,2026-10-04(用户报告),<https://community.openai.com/t/1403242>
- Developer Mode missing from Security & Login on ChatGPT Pro(2026-10-01 OpenAI 员工回复),OpenAI Developer Community,<https://community.openai.com/t/1402157>
- Feature Request: Use an Identifiable User-Agent for Custom MCP Server Validation,OpenAI Developer Community,2026-09-03(用户报告),<https://community.openai.com/t/feature-request-use-an-identifiable-user-agent-for-custom-mcp-server-validation/1394731>
- ChatGPT Scheduled Tasks fail to write to GitHub and automatically disable themselves,OpenAI Developer Community,2026-10-08(用户报告),<https://community.openai.com/t/chatgpt-scheduled-tasks-fail-to-write-to-github-and-automatically-disable-themselves-after-failed-executions-without-user-authorization/1404882>
- Connect and test your plugin,OpenAI Developers,<https://developers.openai.com/plugins/deploy/connect-chatgpt>
- Authentication,OpenAI Developers,<https://developers.openai.com/plugins/build/auth>
- Define tools(Plan safety annotations),OpenAI Developers,<https://developers.openai.com/plugins/plan/tools>
- Build an MCP server,OpenAI Developers,<https://developers.openai.com/plugins/build/mcp-server>
- Plugin UI changelog(2026-06-12 App permission controls),OpenAI Developers,<https://developers.openai.com/plugins/changelog>
- MCP Events,OpenAI Developers,<https://developers.openai.com/plugins/build/mcp-events>
- Scheduled tasks(Codex),OpenAI Developers,<https://developers.openai.com/codex/app/automations>
- MCP and Connectors(Responses API),OpenAI Developers,<https://developers.openai.com/api/docs/guides/tools-connectors-mcp>
- Model Context Protocol,ChatGPT Learn,<https://learn.chatgpt.com/docs/extend/mcp>
- Pricing(ChatGPT Work and Codex),ChatGPT Learn,<https://learn.chatgpt.com/docs/pricing>
- Schema Reference:ToolAnnotations,Model Context Protocol 2025-11-25,<https://modelcontextprotocol.io/specification/2025-11-25/schema#toolannotations>
- Authorization,Model Context Protocol 2025-11-25,<https://modelcontextprotocol.io/specification/2025-11-25/basic/authorization>
- RFC 6750:The OAuth 2.0 Authorization Framework: Bearer Token Usage,IETF,2012-10,<https://www.rfc-editor.org/rfc/rfc6750>
- RFC 9728:OAuth 2.0 Protected Resource Metadata,IETF,<https://datatracker.ietf.org/doc/html/rfc9728>
- MCP Inspector,Model Context Protocol,<https://modelcontextprotocol.io/docs/tools/inspector>
- Continuing our infrastructure updates: What's changing in the coming months,r/modnews,2026-09-30,<https://www.reddit.com/r/modnews/comments/1wubgvt/continuing_our_infrastructure_updates_whats/>
- Reddit is killing RSS feeds and ending public API access because of AI bots,TechCrunch,2026-09-30(二手,原文见 31),<https://techcrunch.com/2026/09/30/reddit-is-killing-rss-feeds-ending-public-api-access-because-of-ai-bots/>
- Responsible Builder Policy,Reddit Help,<https://support.reddithelp.com/hc/en-us/articles/42728983564564-Responsible-Builder-Policy>
- Scheduled tasks failing,r/ChatGPT(用户讨论),<https://www.reddit.com/r/ChatGPT/comments/1x049yo/scheduled_tasks_failing/>
- Isn't this kind of a paradox for scheduled tasks?,r/ChatGPT(用户讨论),<https://www.reddit.com/r/ChatGPT/comments/1wvnhp8/isnt_this_kind_of_a_paradox_for_scheduled_tasks/>
- Did ChatGPT Scheduled Tasks recently start consuming your Codex/Work usage allowance?,r/codex,2026-10-05(用户报告),<https://www.reddit.com/r/codex/comments/1wxxqwh/did_chatgpt_scheduled_tasks_recently_start/>
- Automate work with scheduled tasks,Claude Code Docs,<https://code.claude.com/docs/en/routines>
- ChatGPT Scheduled Tasks: What They Are and How to Use Them,Zapier,2026-09-02(二手),<https://zapier.com/blog/chatgpt-scheduled-tasks/>
- ChatGPT MCP: Connect MCP Servers to ChatGPT,AnythingMCP,2026-09-25(二手),<https://anythingmcp.com/guides/clients/chatgpt>
- EveryInfra 能力目录,2026-10-26 17:22 读取,<https://api.everyinfra.com/api/v1/social/catalog>
- EveryInfra OpenAPI 说明,2026-10-26 17:42 读取,<https://api.everyinfra.com/openapi.json>
- r/RobotVacuums 社区首页,<https://www.reddit.com/r/RobotVacuums/>
- Add custom MCP server(Reviewing and confirming tool calls 一节),OpenAI Developers,2026-10-26 20:05 读取,<https://developers.openai.com/api/docs/guides/custom-mcp-server>
引用编号 BL-55