Claude Code dynamic workflows 分类小红书评论:接口实测加脚本示例
Claude Code 动态工作流并行拉小红书评论分类:4/8 页只回 10 条,一篇 24/25 是进团,同页重取换 7 条,500 条约 $0.22。
我们在 2026 年 11 月 2 日 00:14–00:22(新加坡时间)用 EveryInfra 的接口真调了 10 次、拉回 6 篇小红书笔记下的 100 条一级评论,接口费合计 $0.066671;其中一篇笔记的 25 条评论里有 24 条只写了「进团」「参团」或一个「进」字,而目录写着每页 15 条的 xiaohongshu/comments,8 页里有 4 页只回了 10 条。按目录价,500 条评论要 34 次调用、$0.189;按实测的每页 12.5 条算是 40 次、$0.222;如果先扔掉这 25% 的噪声、还要凑满 500 条有用评论,就是 54 次、$0.300。另一个容易被忽略的结论来自同一个请求发三次:同一篇笔记默认排序的第一页,6 分钟后有 7 条换成了别的评论,三次都按一次计费,所以 Claude Code 动态工作流的「续跑」和「重跑」在这件活里不只是省 token 的问题,还决定你拿到的是不是同一批数据、要不要再付一次钱。
这篇文章要回答的问题很具体:给一个商品关键词,想让 Claude Code 自己写一段并行程序,把小红书上相关笔记的评论拉回来,分成需求、投诉、比价、种草四类,最后出一张汇总表。它该用动态工作流还是普通子代理,脚本骨架长什么样,接数据走远程 MCP 还是 POST /api/v1/social,500 条评论要调几次、花多少,并行时限速和失败重试要注意什么。Claude Code 一侧的每一条功能事实都来自 官方文档 workflows 页 和 更新日志,我们没有在本机运行工作流,所以那部分写成「配置示例」;EveryInfra 一侧的每个数字都来自真调的原始返回。
这件活是什么:500 条小红书评论,分成四类出一张表
先把任务定死,因为后面所有的数都按它算。输入是一个关键词,本文用「扫地机器人」:双十一前后,这个品类在小红书上有大量「买哪款」「踩坑」「多少钱」的讨论,评论区天然混着四种声音。输出是一张表:四类各多少条、各占多少、每类挑几条点赞最多的原文,外加接口费和抽查一致率。中间要做的事是三段:用 xiaohongshu/search 找笔记,用 xiaohongshu/comments 和 xiaohongshu/sub_comments 拉评论和回复,再让模型逐条分类。四个类别的定义写在脚本里:需求是在问买哪款、要推荐或链接;投诉是产品或服务出了问题;比价是提到价格、平替、购买渠道;种草是自己用过并推荐。分不进去的归「其他」。
为什么这件活值得用并行程序做,而不是在一个对话里一页一页拉?因为它同时满足三个条件。第一,笔记之间互不依赖,拉 A 篇不需要知道 B 篇的结果。第二,读进来的远多于最后要留下的:我们实测一条评论原样返回平均约 1,445 字节,评论文本本身只有约 95 字节,500 条原样就是 70 多万字节。第三,分类这一步规则固定,小模型就够。Anthropic 在 2026 年 10 月 22 日发的文章《Building agents: When to fold subagents into your main agent loop》主张多数智能体应该少拆子代理,但也写明在「多项任务要用各自的新上下文并行处理、用完即弃」时保留它们(Anthropic 原文)。这件活正好是这一种。
我们实际拉的是 6 篇笔记,挑法是先用 xiaohongshu/search 按「评论最多」排序拿第一页 20 篇,再挑出 6 篇标题各不相同的:一篇双十一评测提醒(2,069 条评论)、一篇对石头扫地机的吐槽(570 条)、一篇 2026 年购买指南(377 条)、一篇健身短剧式的扫地机内容(3,278 条)、一篇说扫地机是「智商税」的(973 条),还有一篇新手小白求推荐的(487 条)。这 20 篇里有 10 篇的 is_cooperation_note 是 true,也就是带合作标识的商业笔记;小红书的合作笔记走蒲公英平台的先审后发流程,品牌方要在 72 小时内确认或驳回(蒲公英帮助中心「内容审核规范」,页面显示更新于 2026-10-22)。我们挑的 6 篇恰好都不是合作笔记,这一点在解读「种草」这一类时要记住。
| 笔记(本文代号) | 标题 | 搜索时显示的评论数 | 本文拉到的一级评论 |
|---|---|---|---|
| A | 千万先别买扫地机器人❗️先看双十一评测结果 | 2,069 | 25(2 页) |
| B | 石头扫地机器人吐槽 | 570 | 30(2 页) |
| C | 2026年扫地机器人购买指南! | 377 | 10 |
| D | 有力量的扫地机器人 | 3,278 | 10 |
| E | 智商税的电器|鸡肋的扫地机 | 973 | 15 |
| F | 大数据把我推给第一次买扫地机的新手小白 | 487 | 10 |
Claude Code dynamic workflows 是什么:官方文档原文怎么定义
Claude Code 官方文档对动态工作流的定义是:一段编排许多子代理的 JavaScript 脚本,由 Claude 针对你描述的任务来写,由一个运行时在后台执行,你的会话在这期间仍能响应(workflows 页)。这个功能在 2026 年 5 月 28 日的 v2.1.154 里首次出现,更新日志的原话是「让 Claude 创建一个工作流,它会在后台把工作分给几十到几百个代理」,用 /workflows 看运行情况(更新日志 2.1.154)。发布时 Anthropic 的介绍文章说它先以研究预览开放,现在文章顶部已经改成「已全面开放」,适用于 CLI、桌面应用、VS Code 扩展,以及 Pro、Max、Ultra、Team、Enterprise 套餐和 Claude API、Amazon Bedrock、Vertex AI、Microsoft Foundry(Anthropic 介绍文章)。
脚本本身的样子,文档给了一个保存后的示例:开头是 export const meta = { name, description },后面是带顶层 await 的普通 JavaScript。agent() 启动一个子代理,pipeline() 对列表里每一项各跑一条流水,parallel() 同时跑一组任务并等它们全部结束;phase() 把后面的代理归到进度视图的一个分组里,log() 在分组上方显示一行消息,args 是调用时传进来的参数(workflows 页「What the saved script looks like」「Edit a saved script」两节)。给 agent() 传 schema 时,这个子代理返回符合该 JSON Schema 的对象而不是一段话;输出校验连续五次不过,调用就失败,次数可以用 MAX_STRUCTURED_OUTPUT_RETRIES 改(同页)。这正是分类这一步要用的:让每个分类代理只交回 {id, label} 的数组,脚本直接拿去计数。
启动方式有三种。第一种是在你自己输入的提示里写 ultracode 这个词,或者直接说「用一个工作流」;第二种是 /effort ultracode,让 Claude 对这个会话里每个够分量的任务都自己决定要不要写工作流;第三种是运行已经保存的工作流命令,比如自带的 /deep-research;命令参考里把它归为「自带的动态工作流」一类(命令文档)(workflows 页「Have Claude write a workflow」)。关键词只在人亲手输入的提示里生效:用 -p 传进去的提示(非交互模式,见 headless 文档)、定时任务的提示、webhook 或 PR 评论转进来的文字都不会触发(同页「Where the keyword works」)。这一条对「每周自动跑一次评论分类」的想法有直接影响:定时任务里写 ultracode 没用,要先把一次满意的运行保存成命令,再在定时任务里调用这个命令。
| 子代理 | 技能 | 智能体团队 | 动态工作流 | |
|---|---|---|---|---|
| 是什么 | Claude 启动的一个工人 | Claude 照着做的说明 | 一个主代理带几个对等会话 | 运行时执行的一段脚本 |
| 下一步由谁决定 | Claude,逐轮决定 | Claude,照提示走 | 主代理,逐轮决定 | 脚本 |
| 中间结果放在哪 | Claude 的上下文 | Claude 的上下文 | 共享任务列表 | 脚本变量 |
| 可重复的是什么 | 工人定义 | 说明本身 | 团队定义 | 编排本身 |
| 规模 | 每轮几个任务 | 同子代理 | 几个长时间运行的同伴 | 每次几十到几百个代理 |
| 被打断时 | 这一轮重来 | 这一轮重来 | 队友继续跑 | 同一会话内可续跑 |
上表逐格译自 workflows 页「When to use a workflow」一节的对照表(原文)。对评论分类这件活,最重要的是第三行:用普通子代理时,6 篇笔记各自交回的摘要都要落进主对话;用工作流时,100 条评论的原文、每条的标签、抽查结果都待在脚本变量里,主对话只收到最后那张表。智能体团队目前还是实验功能,要设 CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 才能用(agent teams 页),这里不考虑。
动态工作流和普通子代理的区别:计划放在代码里,还是放在对话里
同一件活,用子代理做和用工作流做,差别不在「能不能并行」,而在谁拿着计划。用子代理时,Claude 每一轮决定再派谁、派几个,每个子代理的结果都要回到它的上下文里,它才能决定下一步;子代理文档写明,会话里同时运行的子代理到 20 个时,再用 Agent 工具启动就会失败并提示不要重试,这个数可以用 CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS 改(子代理文档「Concurrent subagent limit」)。用工作流时,循环、分支、重试次数都写死在脚本里,Claude 不用每一轮重新想「下一篇笔记派给谁」,也就不会因为看了前面几篇的结果而改变后面的做法。对分类任务来说,这种「不会中途变卦」反而是优点:每一篇笔记用的是同一套提示、同一个 schema,结果可以横向比。
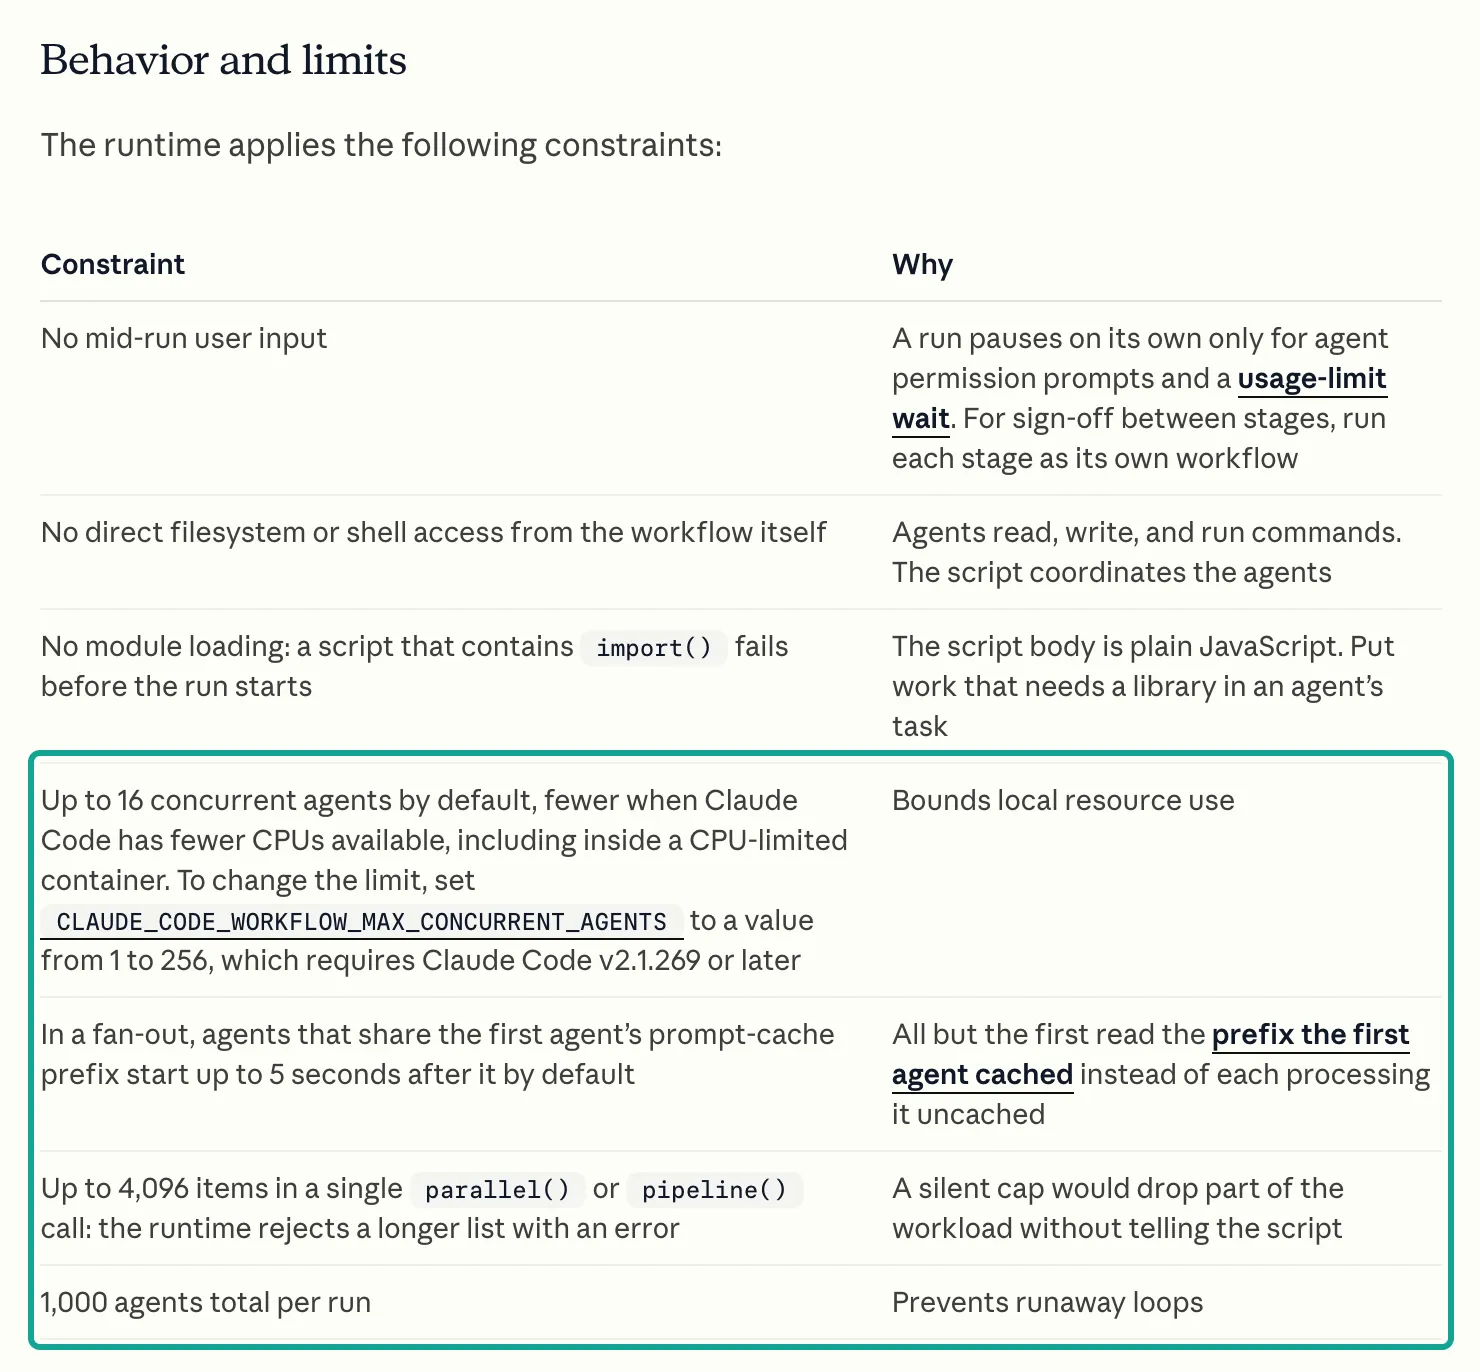
运行时对脚本有几条硬限制,下面这张截图来自官方文档原文,青绿框里是和本文最相关的三条:默认最多 16 个代理同时跑,CPU 少时更少,可以用 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS 设成 1 到 256(要 v2.1.269 以上);一次 parallel() 或 pipeline() 最多 4,096 项,超过就报错而不是悄悄截断;一次运行最多 1,000 个代理。另外三条同样要记住:运行中不能再向你要输入,脚本本身不能直接读写文件或运行命令,脚本里写 import() 会在开跑前失败。
「脚本不能直接访问文件和命令」这一条决定了数据怎么进来。脚本里不能写 fetch,也不能 curl,所以调 EveryInfra 必须交给代理:代理能用会话里接好的 MCP 工具,也能在权限允许时运行 Bash。工作流写作参考里还写了一条:工作流代理通过工具搜索可以用到会话里连接的全部 MCP 工具,但交互式登录的 MCP 服务器在无头或定时运行里可能不在(这份参考是 Claude Code 自带的 /workflow-authoring 技能,要 v2.1.248 以上,见 workflows 页「Edit a saved script」;自带技能的概念见 技能文档)。EveryInfra 的远程 MCP 用请求头里的 Key 认证,不走交互式登录,所以无头运行也能用。
还有一条和时间有关:脚本里调用 Date.now()、Math.random() 和不带参数的 new Date() 会直接抛错,因为续跑时要重放同样的 agent() 调用,时间戳和随机数会让重放对不上;需要时间就通过 args 传进去(workflows 页)。所以「只拉最近 24 小时的评论」这种条件,要么交给接口参数(xiaohongshu/search 有 date_range=last_24_hours),要么在启动时把日期写进 args,不能在脚本里现取当前时间。
版本和开关:哪些行为从哪个版本开始
动态工作流从 5 月底到现在一直在改,很多网上的教程写的是旧行为。下面这张表只列和本文这件活有关的条目,版本号和日期都取自 Claude Code 更新日志(同一份内容在 GitHub 上的 CHANGELOG.md),文档里写了版本要求的另注出处。
| 版本 | 日期 | 变化 | 对评论分类的影响 |
|---|---|---|---|
| 2.1.154 | 2026-05-28 | 首次推出动态工作流和 /workflows | 起点 |
| 2.1.157 | 2026-05-29 | 加了关闭关键词触发的设置 | 提示里写「workflow」不再误触发 |
| 2.1.269 | 文档注明 | 可用 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS 改并发 | 用它把同时调接口的代理压到 2~3 个 |
| 2.1.271 | 文档注明 | 碰到订阅用量上限时暂停等重置,而不是让代理失败;Pro 默认规模改为 small | 长时间运行不会因为额度中途全挂 |
| 2.1.296 | 2026-10-09 | 新增 CLAUDE_CODE_WORKFLOW_SUBAGENT_MODEL,让全部工作流代理用同一个模型 | 想全用 Haiku 时一个变量就够 |
| 2.1.299 | 2026-10-14 | /usage 加了针对工作流、max 努力程度和大工具结果的提醒 | 跑完能看这次花在哪 |
| 2.1.301 | 2026-10-15 | 修了工作流代理有时跳过自己的步骤、运行仍报成功的问题 | 分类代理漏做不再被当成功 |
| 2.1.305 | 2026-10-20 | 修了续跑时把已完成的 pipeline()/parallel() 代理又跑一遍的问题 | 续跑不再重复拉评论、重复扣费 |
| 2.1.311 | 2026-10-26 | 修了子代理用不了「在它启动后才连上」的 MCP 服务器的工具 | 远程 MCP 连得慢时代理不再找不到工具 |
| 2.1.316 | 2026-10-31 | 新增 CLAUDE_CODE_SUBAGENT_EFFORT,统一设子代理的努力程度 | 分类代理可以统一设成 low |
2.1.269 和 2.1.271 两行的出处分别是 workflows 页「Behavior and limits」与「When a run hits your usage limit」,以及同页「Set a size guideline」。规模建议(size guideline)有四档:unrestricted 不限,small 少于 5 个代理,medium 少于 10 个,large 少于 50 个;它只是给 Claude 的建议,不是硬上限,硬上限仍是上面那 1,000 个(同页)。也可以在任何设置文件里写 workflowSizeGuideline(设置参考)。对 500 条评论这件活,medium 就够:1 个搜索代理、6~40 个拉取代理(取决于笔记数,下文会讲怎么用批量接口把它压到 2 个)、同样数量的分类代理、1 个抽查、1 个汇总。
ultracode 有两种开法,效果不一样,而且有版本差异。在会话里输入 /effort ultracode:从 2.1.284 起只打开 ultracode、不改努力程度,用 /effort ultracode off 关掉;2.1.284 之前它会把会话设成 xhigh,off 的写法会报 Invalid argument。启动时用 claude --effort ultracode(要 2.1.203 以上):打开 ultracode 的同时把努力程度设成 xhigh(模型配置文档「Adjust effort level」;workflows 页「Let Claude decide with ultracode」)。打开 ultracode 时,「大型工作流」提醒不再出现,子代理的并发上限也不再执行(workflows 页「Let Claude decide with ultracode」)。对要调外部付费接口的任务,我们的建议是不开 ultracode,而是在单个提示里明确要求写工作流,这样第一次启动前能看到计划、选择要不要跑。
接上数据:远程 MCP 还是 POST /api/v1/social
数据接口有两种接法,工作流都能用,差别在代理怎么调。第一种是把 EveryInfra 接成远程 MCP 服务器,代理直接调用工具;第二种是让代理用 Bash 跑 curl,请求 POST https://api.everyinfra.com/api/v1/social。Claude Code 的 MCP 文档给的远程 HTTP 服务器写法是 claude mcp add --transport http <名字> <网址>,带 Bearer 认证时加 --header(MCP 文档)。我们的远程 MCP 走 MCP 规范里的 Streamable HTTP 传输(MCP 规范 2025-11-25 传输一节),工具调用按规范是 tools/call 请求、结果放在 content 数组里(MCP 规范 2025-11-25 工具一节)。tools/list 实测返回 12 个工具,其中和本文有关的是 everyinfra_list_capabilities、everyinfra_call_api、everyinfra_get_job 三个。
# 配置示例:Key 只放在环境变量里,不写进任何文件
export EVERYINFRA_API_KEY="<你的 Key>"
claude mcp add --transport http everyinfra https://api.everyinfra.com/mcp \
  --header "Authorization: Bearer ${EVERYINFRA_API_KEY}"

# 让工作流和它的代理少弹确认:.claude/settings.json 的 permissions.allow 里加
#   "Workflow", "mcp__everyinfra__everyinfra_call_api", "mcp__everyinfra__everyinfra_get_job"
# 并发压到 3 个,避免一把每分钟 10 次的 Key 被打满
export CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS=3
权限这一段有两个出处。在 claude -p 和 Agent SDK 里,Claude Code 从不弹工作流的确认框,要让它启动,可以在允许规则里加 Workflow(全部工作流)或 Workflow(<名字>)(某个保存过的工作流)(workflows 页「Approve the plan before it runs」)。官方介绍文章建议配合自动权限模式使用工作流(权限模式文档里叫 auto mode,由分类器审查每次调用);也可以用 PreToolUse 钩子对这次调用返回 allow(钩子文档)。MCP 工具的允许规则要写成 mcp__<服务器名>__<工具名>,通配符只能放在服务器名后面,例如 mcp__everyinfra__*(权限文档)。工作流启动的子代理沿用你的权限规则,文档的建议是:长时间运行前,先把代理要用的工具加进允许规则,免得跑到一半停下来等确认(workflows 页)。
选哪种接法,我们的判断是:分类这种只读、调用次数可控的活,用 MCP。理由有三。一是代理不需要 Bash 权限,少一类风险;Claude Code 的沙箱默认网络出口为空,curl 要另外放行域名(沙箱文档)。二是 MCP 工具的说明里已经写了计费规则和翻页方法,代理读了就会用 next_page_token。三是错误返回本身带 retry_after、allowed、did_you_mean,代理不用猜。curl 的好处是能把原样 JSON 直接写进文件,适合要留存原始数据的场景;如果你要保存每次返回做审计,就在拉取代理里用 curl 写文件、只把 {id, text, like_count} 交回脚本。
有一个尺寸上的坑要先知道。Claude Code 在 MCP 工具输出超过 1 万 token 时提醒,默认上限 2.5 万 token,可以用 MAX_MCP_OUTPUT_TOKENS 调;成功的文本结果超过 5 万字符会存成文件(MCP 文档「MCP output limits and warnings」)。我们实测一页 15 条评论的 MCP 返回是 16,892 字节,xiaohongshu/search 一页 20 篇笔记是 34,991 字节,都在线内;但 comments_batch 一次拉 3 篇的返回已经是 42,991 字节,按这个比例一次 20 篇约 28 万字节,肯定会被存成文件,代理要再读一次文件才能往下做。这不影响结果,只是多一步;想让返回直接留在代理的上下文里,就一次拉 3~4 篇。
一次真实往返:代理发出什么,接口回了什么
下面这次是 2026 年 11 月 2 日 00:17:55(新加坡时间)我们按 MCP 协议发出的 tools/call,和 Claude Code 里的代理调用 mcp__everyinfra__everyinfra_call_api 时发出的是同一种 JSON-RPC 请求。目标是笔记 F(新手小白求推荐),按点赞排序。返回包在 result.content[0].text 里,是一段 JSON 文本;下面只留前两条评论和计费字段;笔记链接后面的查询参数已省略,作者昵称、ID 已隐去。
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"everyinfra_call_api",
 "arguments":{"platform":"xiaohongshu","action":"comments",
  "params":{"url":"https://www.xiaohongshu.com/explore/692b0d81000000001d03ea4c","sort":"most_liked"}}}}

{"id":"req_b7efc0a2e4784211","platform":"xiaohongshu","action":"comments","count":10,
 "pagination":{"page":1,"has_more":true,"stop_reason":null},
 "results":[
  {"id":"693ab483000000001702fef1","text":"想问问大疆的怎么样呢?听说避障挺强的","like_count":3,
   "author_name":"已隐去","author_id":"已隐去","sub_comment_count":0,"note_id":"692b0d81000000001d03ea4c"},
  {"text":"您好,请帮忙推荐,预算3000-4000元,养宠家庭,需要拖地功能强一些的,感谢[哇R]","like_count":3, "…":"…"}],
 "billing":{"charged":true,"charged_usd":0.005556}}
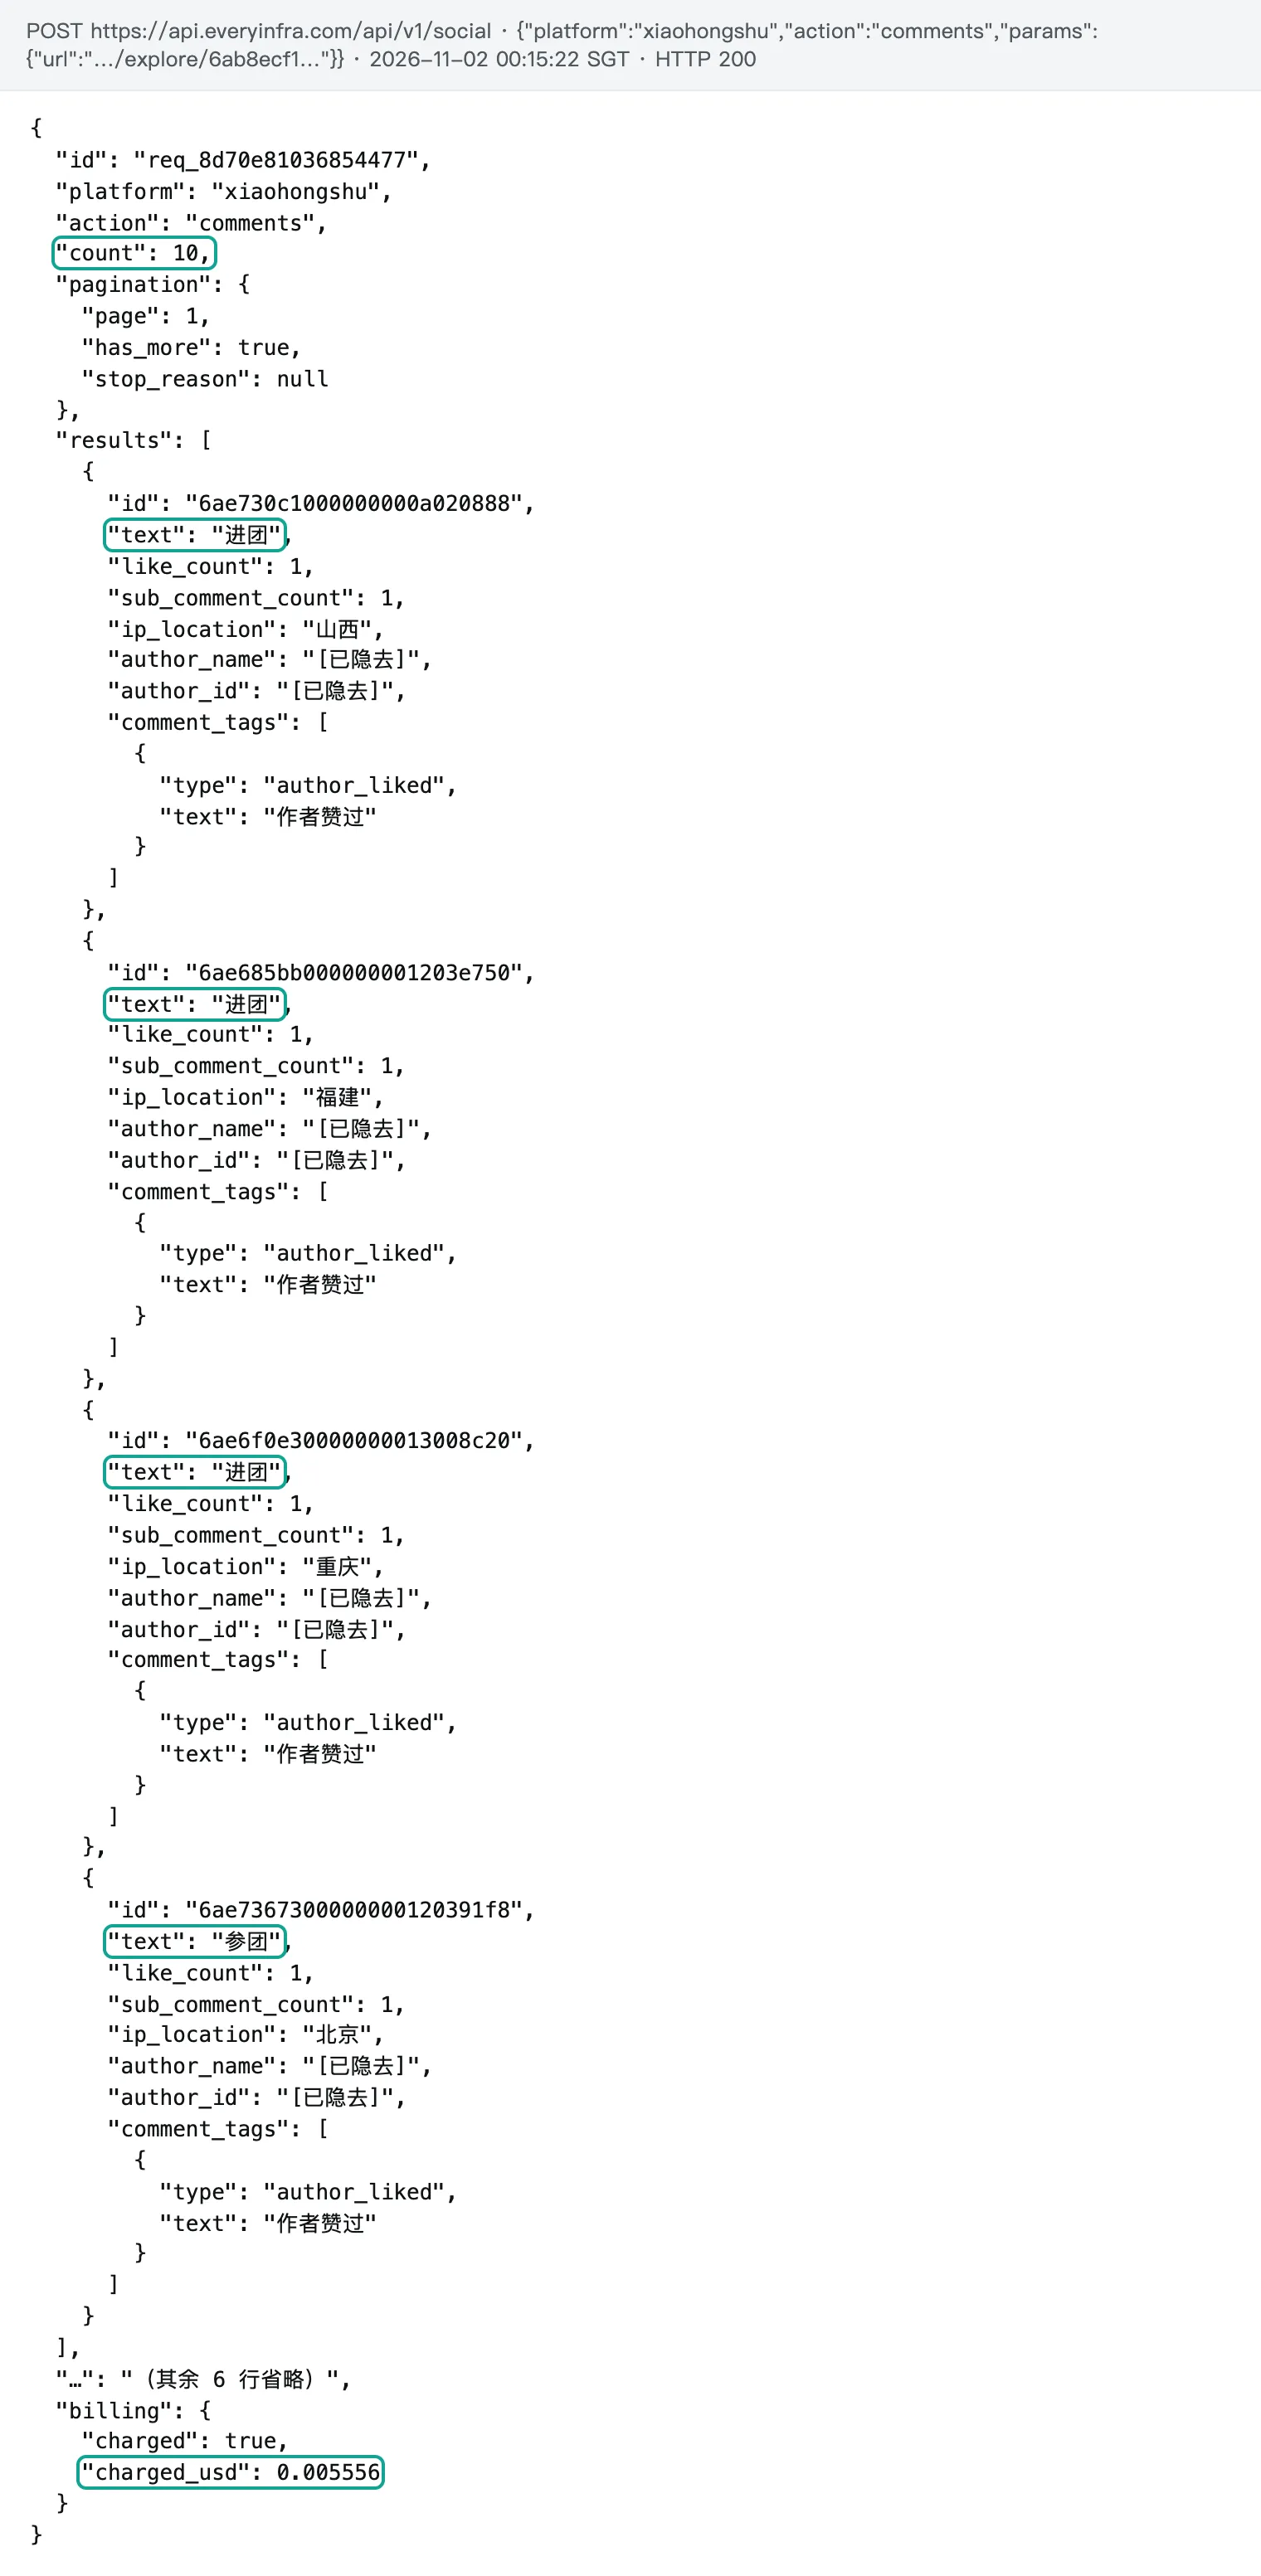
这 10 条有 8 条是标准的「需求」:几乎每条都带面积、预算、有没有宠物、地面材质,例如「140平,有地毯,没有宠物,全屋地砖,掉头发,预算3000,推荐哪个」。这类评论对选品和客服都有用,而且结构很整齐,适合让模型顺手抽出「预算」「面积」「宠物」三个字段。返回字段和 目录 里 xiaohongshu/comments 的 response_fields 一一对得上:id、text、like_count、posted_at、ip_location、sub_comment_count、note_id、note_url、next_page_token、comment_tags、sub_comments 等 20 个;其中 comment_tags 会标出「作者赞过」「置顶评论」「选择了某个投票选项」,sub_comments 会带上第一条回复。
脚本骨架:发现、拉取、预筛、分类、抽查、汇总(配置示例)
下面是我们按官方文档的接口写的脚本骨架,没有在本机运行,所以只能当配置示例。它分五个 phase(),但实际是六站:预筛不是一个代理,而是脚本里的一行正则,不花 token。设计上的几个取舍都对应前面的实测:拉取代理只交回 id、text、like_count,不交作者信息和 30 多个其他字段;分类代理用 schema 约束成固定的五个标签;抽查用另一个模型独立重标 10%,不给它看第一遍的结果。


export const meta = {
  name: 'xhs-comment-triage',
  description: '按关键词拉小红书评论,去噪后分成需求、投诉、比价、种草,出汇总表',
  whenToUse: '给一个商品关键词,想知道小红书评论区在问什么、抱怨什么',
  phases: [
    { title: 'Discover', detail: '1 个代理搜笔记' },
    { title: 'Fetch', detail: '每篇笔记 1 个代理拉 2 页评论' },
    { title: 'Classify', detail: '每篇笔记 1 个代理分类' },
    { title: 'Verify', detail: '另一个模型重标 10%' },
    { title: 'Report', detail: '1 个代理出表' },
  ],
}

const KEYWORD = (args && args.keyword) || '扫地机器人'
const NOTE_COUNT = (args && args.notes) || 20
const TOOL = 'mcp__everyinfra__everyinfra_call_api'
const LABELS = ['需求', '投诉', '比价', '种草', '其他']
const NOISE = /^(进团|参团|进|\s*)$|^(\[[^\]]+R\]|\s)*$/

const NOTES = { type: 'object', required: ['notes'], properties: { notes: { type: 'array', items: {
  type: 'object', required: ['url', 'title'],
  properties: { url: { type: 'string' }, title: { type: 'string' }, comment_count: { type: 'integer' } } } } } }
const COMMENTS = { type: 'object', required: ['comments', 'calls', 'charged_usd'], properties: {
  calls: { type: 'integer' }, charged_usd: { type: 'number' },
  comments: { type: 'array', items: { type: 'object', required: ['id', 'text'],
    properties: { id: { type: 'string' }, text: { type: 'string' }, like_count: { type: 'integer' } } } } } }
const LABELED = { type: 'object', required: ['items'], properties: { items: { type: 'array', items: {
  type: 'object', required: ['id', 'label'],
  properties: { id: { type: 'string' }, label: { type: 'string', enum: LABELS } } } } } }

phase('Discover')
const found = await agent(
  `用 ${TOOL} 调 platform=xiaohongshu, action=search, params={keyword:"${KEYWORD}", sort:"most_commented"}。` +
  `用返回的 next_page_token 翻页,凑够 ${NOTE_COUNT} 篇。url 原样保留,不要删掉 xsec_token。`,
  { schema: NOTES, model: 'haiku', effort: 'low', label: 'search' })

const results = await pipeline(found.notes.slice(0, NOTE_COUNT),
  (note) => agent(
    `用 ${TOOL} 调 xiaohongshu/comments,params={url:"${note.url}"},再用 next_page_token 拉第 2 页。` +
    `返回 429 就按 error.retry_after 秒等待后重试,最多 3 次;422 不重试,照原文报告。` +
    `每条只留 id、text、like_count;把每次的 billing.charged_usd 加总填进 charged_usd。`,
    { schema: COMMENTS, model: 'haiku', effort: 'low', phase: 'Fetch', label: note.title.slice(0, 12) }),
  (r) => ({ ...r, kept: r.comments.filter((c) => !NOISE.test(c.text.trim())),
            dropped: r.comments.filter((c) => NOISE.test(c.text.trim())).length }),
  (r) => agent(
    `把每条小红书评论分到 ${LABELS.join('、')} 之一。需求=问买哪款、要推荐或链接;投诉=产品或服务出了问题;` +
    `比价=提到价格、平替、渠道;种草=自己用过并推荐;其他=玩梗或与产品无关。\n` +
    JSON.stringify(r.kept.map((c) => ({ id: c.id, text: c.text }))),
    { schema: LABELED, model: 'haiku', effort: 'low', phase: 'Classify', label: 'classify' })
    .then((l) => ({ ...r, labels: l ? l.items : [] })),
)

const ok = results.filter(Boolean)
const all = ok.flatMap((r) => r.labels.map((x) => ({ ...x, text: (r.kept.find((c) => c.id === x.id) || {}).text })))
const sample = all.filter((_, i) => i % 10 === 0)
log(`拉到 ${ok.length}/${found.notes.length} 篇;预筛去掉 ${ok.reduce((s, r) => s + r.dropped, 0)} 条`)

phase('Verify')
const second = await agent(
  `独立给下面的评论打标签,类别:${LABELS.join('、')}。\n` + JSON.stringify(sample.map(({ id, text }) => ({ id, text }))),
  { schema: LABELED, model: 'sonnet', effort: 'medium', label: 'relabel-10pct' })
const agree = sample.filter((s) => ((second && second.items.find((y) => y.id === s.id)) || {}).label === s.label).length

phase('Report')
const counts = {}
for (const x of all) counts[x.label] = (counts[x.label] || 0) + 1
return await agent(
  `写一张 Markdown 表:每类条数和占比,每类挑 3 条原文;末尾写接口费 $${ok.reduce((s, r) => s + r.charged_usd, 0).toFixed(4)}、` +
  `抽查一致 ${agree}/${sample.length}。\n` + JSON.stringify({ counts, examples: all.slice(0, 150) }),
{ model: 'sonnet', effort: 'low', label: 'report' })这段骨架里有几处是官方文档明确支持、但容易写错的地方。meta 必须是脚本的第一条语句,而且只能是字面量对象;里面用了变量、函数调用或展开运算,/<名字> 就会从命令补全里消失(workflows 页「Edit a saved script」)。phases 里的标题要和 phase() 的参数一字不差,否则会多出一个进度分组(同页)。pipeline() 里某一项的代理失败时,这一项的位置会是 null,所以要 filter(Boolean);直接 await 的代理失败,则整个运行结束(同页「When an agent stalls and restarts」)。抽查这一步用的是 sonnet、汇总也用 sonnet,拉取和分类用 haiku:Claude Code 给工作流代理选模型的顺序和子代理一样,脚本里写的模型算「这一次调用指定的模型」,什么都没写就用会话的模型(workflows 页「Cost」;子代理文档列出的别名是 sonnet、opus、haiku、fable,见 子代理文档「Choose a model」)。
为什么预筛放在脚本里而不是交给模型?因为脚本是普通 JavaScript,正则、过滤、计数都不花 token;而这一步要拿掉的是「进团」「参团」、空文本和纯表情这类不需要理解的东西。下一节会看到,这类评论在我们的 100 条里占了 25 条。官方的写作参考也提醒,工作流如果按前 N 条、抽样或不重试来限制覆盖范围,要用 log() 写出丢掉了什么,否则读者会以为全覆盖了;骨架里那行 log() 就是干这个的。
实测一:目录写每页 15 条,实际 8 页里 4 页只有 10 条
目录对 xiaohongshu/comments 写的是 page_size 15、limit_ignored true,也就是每页条数固定、传 limit 没用;xiaohongshu/sub_comments 是 10,xiaohongshu/search 是 20,comments_batch 每篇 15。动手前我们写下的假设是「每页都是 15 条」,实测否定了它:00:15:22(新加坡时间)拉的笔记 A 第一页只有 10 条,00:15:49 的第二页是 15 条;00:17:38 的 comments_batch 一次拉 3 篇,C 和 D 各 10 条、E 15 条;00:17:55 走 MCP 拉的笔记 F 是 10 条。8 页平均 12.5 条。
短页不代表后面没有了。A 和 F 两个短页的 pagination.has_more 都是 true,批量返回的 C、D 两篇每一行也都带 next_page_token,A 篇第二页就回到了 15 条。我们的推测是平台对第一页做了不同的处理(比如把置顶或投票相关的评论单独放),但我们没有更多证据,这里只写现象:按页计费时,每页条数不固定,就不能用「目标条数 ÷ 15」来算要调几次。脚本里正确的停止条件是「已经拿到的条数够了」或「has_more 是 false」,而不是「调够了 N 页」。
回复也一样。笔记 B 里有一条评论的 sub_comment_count 是 52,我们 00:17:17 用 xiaohongshu/sub_comments 拉它的回复,第一页只回了 5 条(目录写 10),其中 2 条 text 是空的,应该是只发了图片或表情。也就是说,拉回复要比拉一级评论更费次数:同样 $0.005556 一次,一级评论平均 12.5 条,回复这一次只有 3 条有文字。对分类任务,我们的建议是默认不拉回复,只在某条一级评论被判成「投诉」且回复数多时,再单独拉它的回复看商家或其他用户怎么接话。
| 能力 | 目录 page_size | 本文实测每页条数 | 每次价格 | 每条有效文本的成本 |
|---|---|---|---|---|
xiaohongshu/search | 20 | 20(1 页) | $0.005556 | 每篇笔记约 $0.00028 |
xiaohongshu/comments | 15 | 10~15,平均 12.5(8 页) | $0.005556 | 每条约 $0.00044 |
xiaohongshu/comments_batch | 每篇 15 | 每篇 10~15(3 篇) | 每篇 $0.005556 | 和单篇相同 |
xiaohongshu/sub_comments | 10 | 5,其中 2 条无文字(1 页) | $0.005556 | 每条约 $0.0019 |
实测二:规则预筛能拿掉什么,拿不掉什么
动手前的第三个假设是「评论可以直接进模型分类」,通过标准是每篇笔记的噪声都低于 30%。实测在笔记 A 上失败得很彻底:A 篇两页 25 条,有 24 条的全文就是「进团」「参团」或一个「进」字(17 条进团、6 条参团、1 条进)。截图里能看到,这些评论多半带「作者赞过」的标签,有的带「选择了某个投票选项」的标签,sub_comment_count 都是 1。我们的理解是这篇笔记在评论区组织拼团,用户回一句「进团」等作者拉群;这些评论对「用户想要什么」毫无信息量,却占满了按页计费的名额。其他 5 篇里只有 D 篇有 1 条噪声(一条空文本)。
为了知道「一行正则」能做到什么程度,我们写了一个纯关键词的规则分类器当基线,规则如下:先判噪声(全文只有进团、参团、进,或只有表情,或为空),再依次判投诉(臭、退、智商税、缠绕、烧心等)、需求(推荐、哪款、请问、问号等)、比价(价、钱、元、平替、预算、1688 等)、种草(好用、干净、解放、香等),都不中就是「未判定」。这不是模型的结果,它只是告诉我们哪些事规则能做、哪些事一定要交给模型。100 条的结果是:噪声 25、需求 24、投诉 13、比价 8、种草 5、未判定 25。
| 规则做得对的 | 规则做错或做不了的 |
|---|---|
| 「进团」「参团」整句匹配,25 条噪声全部拿掉 | 「所以你的意思是这个鬼在我们家潜伏了四天…?」是玩梗,规则因为问号判成需求 |
| 「3块钱一个 能用一个月」判成比价 | 「我一千多买的小米性价比款都不会缠绕头发」其实在推荐,规则因为「缠绕」判成投诉 |
| 「140平…预算3000,推荐哪个」判成需求 | 「看评论区才知道集尘袋是一次性的…」是新知识,规则判不出,归未判定 |
| 「集尘站出风臭的很,能怎么弄一下吗?」判成投诉 | 「洗衣机在那转半小时的时候,你是不是也站边上等着」是反问,规则判成需求 |
这张对照表说明了脚本为什么分两段:规则只负责去噪,因为噪声的样子非常固定,判错的代价几乎为零;四类意图交给模型,因为同一个问号可以是求推荐、可以是反问、也可以是玩梗。C 篇和 D 篇的标题分别是「购买指南」和「扫地机器人」,评论区却几乎都在聊博主本人的剧情和身材,7 条以上是规则和模型都应该放进「其他」的玩笑。只看标题挑笔记会高估有效评论的比例,这也是我们建议把 is_cooperation_note、评论数和标题一起交给发现代理、让它先排除明显的短剧和段子笔记的原因。
抽查的强度可以参考文本标注研究:有实验发现模型零样本标注在多数任务上胜过众包标注员(arXiv 2303.15056),也有研究发现模型和任务之间差异很大(arXiv 2311.05769),方法论文章把严格验证列为必做项(Sociologica 2024)。落到这件活上就是:抽查不能省,而且要用另一个模型、不给它看第一遍的标签;如果抽查一致率低于你事先定的线(比如 80%),就先改类别定义,再整批重跑分类,不要只改那几条。
实测三:同一页取三次,评论换了 7 条,每次都扣钱
这一节回答一个工作流特有的问题:代理失败、你重跑时,会发生什么?我们把 00:15:33(新加坡时间)拉过的笔记 B 第一页,在 00:21:35 和 00:21:55 用一字不差的请求体又拉了两次。结果是:第二次的 15 条里只有 8 条和第一次相同,7 条是新面孔;第三次和第一次有 13 条相同,和第二次有 10 条相同,三次合起来是 22 条不同的评论。三次都扣了 $0.005556,没有因为请求相同而免费。
这意味着「默认排序」不是一个稳定的顺序,它会随时间和平台的推荐变化。在工作流里,这会和续跑规则叠在一起。官方文档写得很清楚:续跑时,已完成的代理返回保存的结果;但第一个提示变了的代理会重跑,它之后的所有代理也重跑;失败的代理会重跑,它之后启动的所有代理也重跑,哪怕它们已经完成了。文档举的例子是脚本依次启动 A、B、C、D,B 失败,续跑时 A 取缓存,B、C、D 全部再跑(workflows 页「Which agents run again」)。2026 年 10 月 20 日的 v2.1.305 还修了一个问题:在那之前,未改动的脚本续跑时,pipeline() 和 parallel() 里已完成的代理也可能被再跑一遍(更新日志 2.1.305)。
把两件事放在一起:拉取代理一旦重跑,就会再调一次接口、再付一次钱,而且拿回来的评论可能和上次不一样,后面已经分好类的那批结果就对不上了。所以我们在骨架之外有三条建议。第一,把拉取和分类拆成两个工作流:先跑一个只拉数据的工作流,让代理把结果写进文件;确认数据满意后,再跑分类工作流读这些文件。这样分类阶段失败重跑时,不会碰接口。第二,拉取时用 sort=newest 或 sort=most_liked,比默认排序稳定得多,翻页时不要换排序,目录说换了排序上一页的 next_page_token 就不再适用。第三,分类结果按评论 id 去重再计数,因为同一条评论可能在两次拉取里各出现一次。
还有一种「重跑」是代理卡住后的自动重启。文档写明,一个代理长时间没有输出,就会用同样的提示从头开始,最多重启五次;重启时它之前已经改过的文件保持改过的样子,已经花的 token 也算在这次运行里(workflows 页「When an agent stalls and restarts」)。等待自己工具调用返回的时间不算进卡住的时间窗口,所以一次 2.5 秒左右的接口调用不会触发它(另一种失败是响应流长时间无声,由流式空闲看门狗结束,超时用 CLAUDE_STREAM_IDLE_TIMEOUT_MS 设,见 网络配置文档);但如果代理在 429 后按 retry_after 等了很久、又没有任何输出,就可能被判成卡住重来,重来就会重复已经付过钱的调用。实测的 429 只要求等 1 秒,这个风险不大;但在共享 Key 被多个代理同时打满时,等待会变长,可以给拉取代理单独设 stallMs,例如 agent(prompt, { stallMs: 600000 })。
并行的限速:16 个代理对一把每分钟 10 次的 Key
工作流默认同时跑 16 个代理,而我们用的这把 Key 被单独限到每分钟 10 次请求,同一时间还被其他程序共用。我们的调用节奏是约每 10 秒一次,按说远低于上限,但响应头 x-ratelimit-remaining-requests 记录下来的剩余次数依次是 5、5、2、0,00:15:59(新加坡时间)那次直接回了 429,之后才恢复到 8、3、6、5、1。这就是共享 Key 的真实样子:你看不到别人什么时候在调,只能看响应头和 429。如果一把 Key 只有你一个程序在用,剩余次数应该随你的调用单调减少、过一分钟再回升;本文这种忽高忽低的跳动来自共享,你独占 Key 时复现不出来。
429 的返回体是可以直接交给代理读的。这次的原文是:"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",同时给了 retry_after: 1、retryable: true、max_retries: 3,以及一句「Nothing was charged」。我们没有只等 1 秒,而是保守地等了 60 秒以上再重发,00:17:17 拿到 200。这次 429 没有扣钱,charged_usd 合计里没有它。骨架里拉取代理的提示写的就是这条规则:429 按 error.retry_after 等待后重试,最多 3 次。Anthropic 自己的 API 遇到超速也回 429 并带 retry-after 头(Anthropic 限速文档),两边的处理方式可以写成同一段提示。
{"error":{"code":"rate_limited",
  "message":"rate limit exceeded, slow down: 10 requests per minute for this API key's own limit. Retry after 1s.",
  "reason":"key_limit","retry_after":1,"limit":10,"fault":"account","retryable":true,"max_retries":3,
  "next_steps":["Over this key's or account's request rate. Nothing was charged. Retry after retry_after seconds, or ask the user to raise the limit."]}}
靠重试扛限速是被动的,主动的办法有两个。第一个是压并发:把 CLAUDE_CODE_WORKFLOW_MAX_CONCURRENT_AGENTS 设成 2 或 3。一个拉取代理连拉两页大约要 5 秒接口时间加上模型自己思考的时间,3 个代理同时跑,每分钟的请求数大致落在 10 次上下,配合重试就够了。注意这个变量管的是整个运行的并发,分类阶段的代理也会被一起压慢;如果你在意总时长,就按上一节的建议把拉取和分类拆成两个工作流,分类那个不设限。第二个是用批量接口:xiaohongshu/comments_batch 一次请求最多 20 篇笔记,按笔记数计费。00:17:38 我们用它一次拉了 3 篇,回了 35 条评论,扣 $0.016667,也就是每篇 $0.005556,和单篇 xiaohongshu/comments 一样;一次请求用了 3.28 秒,单篇大约 2.4 秒。
| 拉 40 篇笔记的第一页 | 请求次数 | 每分钟 10 次时最少要几分钟 | 接口费 |
|---|---|---|---|
逐篇 xiaohongshu/comments | 40 | 4 | $0.22224 |
xiaohongshu/comments_batch,每次 20 篇 | 2 | 1 | $0.22224 |
批量接口改变的是请求次数,不是钱。对共享 Key 和工作流来说,请求次数才是瓶颈:40 次请求在每分钟 10 次的 Key 上至少要 4 分钟,2 次请求几秒钟就完。所以更好的骨架是:发现代理之后,用 1~2 个代理调 comments_batch 拉所有笔记的第一页,再按 next_page_token 对评论多的笔记单独拉第二页。批量返回的每一行都带 next_page_token,可以直接接 xiaohongshu/comments 往下翻。目录特别提醒,部分笔记失败时要看返回里的 partial 和 missed,不要把没返回的笔记当成没有评论;拉取代理的提示里要把这句写进去。
还有一个可选项是异步模式。目录说任何能力都可以在请求体里加 "mode":"async",立刻拿到 202 和 job_id,再去轮询 GET /api/v1/jobs/{job_id}。00:18:21 我们对笔记 B 第二页用了异步模式,202 返回时状态已经是 succeeded,00:18:30 轮询拿到 15 条;轮询本身免费,也不占每分钟的次数(MCP 工具说明里写明了 everyinfra_get_job 不计入每分钟限额)。评论这种 2~3 秒就回的能力用不着异步,但如果你的工作流同时还要拉别的慢能力,异步加轮询可以让代理不用一直挂着等。
失败、重试和扣费:哪些会重复付钱
把这次遇到的情况和工作流的行为对在一起,就能看出哪些事要在脚本里防。下表的「工作流会怎样」一列全部来自 workflows 页,「接口扣不扣钱」一列来自本文的真调返回。
| 情况 | 工作流会怎样 | 接口扣不扣钱 | 脚本里怎么防 |
|---|---|---|---|
| 429 限速 | 代理自己处理,工作流不感知 | 不扣(返回写明 Nothing was charged) | 提示里写按 retry_after 重试,最多 3 次 |
422 参数错,例如 sort=hottest | 代理自己处理 | 不扣 | 提示里写不重试、原样报告 |
| 代理卡住 | 同一提示从头重来,最多 5 次 | 已经成功的调用会再调、再扣 | 给拉取代理设 stallMs |
| 某个代理失败后续跑 | 它和它之后启动的代理全部重跑 | 重跑的拉取再扣一次 | 拉取和分类拆成两个工作流 |
| 同一请求 6 分钟内重发 | — | 每次都扣,内容也会变 | 结果按评论 id 去重 |
| 分类输出不合 schema | 自动重试,五次不过则失败 | 不涉及接口 | schema 只留必要字段 |
| 碰到订阅用量上限 | 暂停等重置(v2.1.271 起,满足条件时;会话本身的等待见 交互模式文档) | 不涉及接口 | 先在小范围试跑 |
422 那次是 00:16:07(新加坡时间)故意把 sort 写成 hottest。返回的原文是 `"sort must be one of: default, most_liked, newest (got 'hottest')",同时给了 allowed 列表和 did_you_mean: ["most_liked"],并写明没有扣费。这种错误对工作流特别友好:分类代理和拉取代理都能看懂,改一个参数就能继续,不用回到主对话问你。我们在 [Claude strict tool use 那篇](/blog/claude-strict-tool-use-data-api)里测过,把工具定义设成严格模式能在模型这一侧就挡住非法枚举;在工作流里,更简单的做法是在拉取代理的提示里直接写死 sort` 的值。
算一笔账:500 条评论要调几次、花多少
接口费只有一个单价。2026 年 11 月 2 日 00:14 读到的 目录 上,xiaohongshu/search、xiaohongshu/comments、xiaohongshu/sub_comments、xiaohongshu/comments_batch 都是每次(批量是每篇)$0.005556,失败和空结果不扣。按页计费的能力,次数等于「要多少条 ÷ 每页条数」向上取整。三档算法如下,都只算评论页,不含搜索;搜索一页 20 篇笔记,500 条评论通常需要 20~40 篇笔记,也就是再加 1~2 次、$0.0056~$0.0111。
| 算法 | 每页条数 | 调用次数 | 接口费 |
|---|---|---|---|
| 按目录 | 15 | 34 | $0.188904 |
| 按本文实测 | 12.5 | 40 | $0.22224 |
| 要 500 条去噪后的评论(噪声按实测 25%) | 12.5 | 54(要先拉 667 条) | $0.300024 |
| 本文实际花费:10 次计费请求、12 个计费单位 | — | 10 | $0.066671 |
第三档值得多说一句。25% 的噪声比例来自我们的 6 篇笔记,而且几乎全部出自 A 篇;换一个关键词,这个比例可能是 0,也可能更高。我们的建议是:先用工作流在 3~5 篇笔记上试跑一次,看 log() 里报的预筛条数,再决定要拉多少篇。官方文档对成本给的建议也是一样的:大任务之前先在一个小切片上跑,用 /workflows 看每个代理用了多少 token,随时可以停(workflows 页「Cost」)。
Claude 一侧的费用我们没有实测,只能给出能核对的部分。按 2026 年 11 月 2 日读取的 Anthropic 定价页,Haiku 5.5 在 10 万 token 以内的提示是输入每百万 token $0.10、输出 $0.50,Sonnet 5.5 是 $2 和 $10,Opus 5.5 是 $4 和 $20。500 条评论只留文本时,按定价页「10 kB 约 2,500 token」的比例粗估约 1.2 万 token,用 Haiku 分类的输入费不到 $0.002;真正的大头是每个代理自带的系统提示、工具定义和来回的推理,这部分取决于 Claude Code 版本和你接了多少 MCP 工具,我们没有测,只能请你看 /workflows 里的数。订阅用户的工作流用量算进套餐的用量和速率限制,成本文档写明每个子代理和每个工作流代理都会在主对话之外单独发请求。Reddit 上发布帖下有用户说一次提示用掉了 70 万 token、占了 Max 套餐 36% 的用量,也有人说第一次试就用了 120 万 token(Reddit 发布帖),这些是用户自述,没法核,但足以说明先试小切片的必要。
上下文和 token:为什么要在拉取那一站就瘦身
一条评论原样返回平均约 1,445 字节,只留文本平均约 95 字节,差约 15 倍。原样的 JSON 里有作者昵称、头像地址、IP 属地、标签、内嵌回复、带 xsec_token 的笔记链接等 20 个字段,对分类几乎都没用。按定价页那个粗略比例,原样一条约 361 token,只留文本约 24 token;中文的实际比例会不同,要精确就用 token 计数接口按你用的模型算。
在工作流里,这个差别体现在两处。第一处是分类代理的输入:如果拉取代理把原样 JSON 交回脚本,分类代理每篇就要读 1~3 万 token 的 JSON;只交文本,就只有几百 token。第二处是提示缓存:文档写明,同一次运行里模型、努力程度、代理类型、工具、输出 schema 和工作目录都相同的代理,会共享同一段工具和系统提示的前缀,后启动的代理能读前一个的缓存;工作流代理的缓存默认保留 5 分钟,用 subagentPromptCacheTtl 可以改成 1 小时,但 1 小时缓存的写入单价更高(workflows 页「Prompt caching in a fan-out」;提示缓存文档)。骨架里所有拉取代理都用同样的 model: 'haiku'、effort: 'low' 和同一个 COMMENTS schema,就是为了让它们共享这段前缀;如果你给不同笔记用不同模型,这个缓存就用不上了。
分类这一站怎么写:schema、类别定义和一致率
分类代理的 schema 只有两个字段:id 和 label,label 用枚举限定成五个值。字段越少,模型越不容易出错,五次校验重试也越不容易用完。如果你还想要「预算」「面积」「有没有宠物」这种结构化信息,最好单独开一个抽取阶段,只对判成「需求」的评论跑,而不是在分类的 schema 里加一堆可选字段。Anthropic API 的结构化输出功能用 output_config.format 里的 json_schema 约束返回(结构化输出文档),工作流的 schema 选项在 Claude Code 里起的是同样的作用:返回值直接是对象,脚本不用解析文本。
类别定义要写到让人能判。我们在规则基线里看到的四种错误,都来自定义不清:反问句和玩梗被当成需求,「性价比款不缠头发」这种对比被当成投诉。所以骨架里的定义都是「是什么」而不是关键词:需求是「问买哪款、要推荐或链接」,投诉是「产品或服务出了问题」,比价是「提到价格、平替、渠道」,种草是「自己用过并推荐」,玩梗归其他。一条评论同时是需求和比价(「预算 3000,推荐哪个」)时怎么办?我们的做法是按「这条评论想要什么」判主类别,所以这条是需求;如果你的业务更关心价格带,就把比价排在需求前面,在提示里写清优先级。
抽查的设计借的是工作流文档里说的「对抗式复核」:让独立的代理去挑别人的结论,结论经得住才报告(workflows 页「When to use a workflow」)。分类不是找 bug,所以我们没有让抽查代理去「驳倒」第一遍的标签,而是让它在看不到第一遍结果的情况下重新打一遍,再算一致率。用不同的模型(骨架里是 Sonnet)可以减少两个代理犯同样错误的概率。一致率本身也只是一个下限的参考:两个模型都把玩梗判成需求时,一致率高也没用。所以第一次跑一个新关键词时,最好再从抽查样本里挑 20 条自己看一遍,把不一致的和你觉得错的都写进类别定义里,然后再整批跑。
做不了或要注意的地方
第一,脚本不能直接联网,所有接口调用都在代理里发生,代理就是模型,所以「调几次」「等多久」最终是模型在执行你写的提示,可能偶尔多调一次。用 schema 让拉取代理交回 calls 和 charged_usd,在汇总里核一遍总花费,是我们能想到的最直接的防线。第二,工作流运行中不能向你要输入;如果你希望「拉完先给我看一眼再分类」,官方的建议就是把每个阶段拆成单独的工作流(workflows 页「Behavior and limits」)。第三,你把会话放到后台或退出 Claude Code 时,运行不会自己继续,要让 Claude 重新启动它,从保存的结果续跑;仍在运行中的代理会从头开始、重新花 token(agent view 文档)。
第四,小红书的评论链接需要 xsec_token。目录要求优先用近期搜索结果里的完整网址、保留查询参数;拉取代理的提示里一定要写「url 原样保留」,否则模型很可能顺手把它「清理」成干净的网址。翻页游标的有效期是 24 小时,跨天续跑时要从头取。第五,我们只能拿到公开可见的评论;作者设成不可见或被折叠的评论不会出现在返回里,这在投诉分析里可能低估负面声音。第六,本文所有分类数字都是规则基线,不是模型结果;500 条是按单价和实测页大小推算的,不是我们真的拉了 500 条。第七,Claude Code 一侧的版本差异很大,本文以 2026 年 11 月 2 日读到的文档和 2.1.316 的更新日志为准,你本地的版本用 claude --version 看。
还有一条和平台规则有关的提醒。评论数据里有用户的 IP 属地和昵称,汇总报告里只放类别、条数和去掉昵称的原文摘录。如果要把带评论原文的报告发给客户或公开,先确认你的用途符合当地法规和平台条款;本文只讲数据方法,不提供法律意见。
常见问题
claude code workflow vs subagent,评论分类该选哪个?
只有几篇笔记、你想边看边改时,用子代理:每个子代理交回一段摘要,你在对话里就能决定下一步(我们在 Claude Code 子代理拉 TikTok 品牌号那篇里就是这么做的)。笔记多、规则已经想清楚、只要最后一张表时,用工作流:计划写在脚本里,中间结果不进对话,失败可以在同一会话里续跑。官方文档的对照表把差别概括成「谁拿着计划」(workflows 页)。(问题出处:搜索联想词「claude code workflow vs subagent」)
Claude Code dynamic workflows 一次要用掉多少 token?
官方没有给固定数字,只说一次运行可能比在对话里做同样的事多用不少 token,建议先在小切片上试、用 /workflows 看每个代理的用量(workflows 页「Cost」)。Reddit 发布帖里有用户自述一次提示用掉 70 万到 120 万 token(Reddit)。本文这件活的接口费是另一笔,500 条评论约 $0.222。(问题出处:搜索联想词「claude code workflows cost」,其下有「cost per token」「cost reddit」等十个变体)
ultracode 是什么,要不要打开?
ultracode 是 Claude Code 的一个开关,打开后 Claude 会对每个够分量的任务自己决定写工作流,不再等你开口。它和努力程度是两回事:会话里用 /effort ultracode(2.1.284 起)只开开关、不改努力程度;只有启动参数 claude --effort ultracode 会顺带把努力程度设成 xhigh(模型配置文档)。打开后「大型工作流」提醒不再出现,子代理并发上限也不执行。对要调付费接口的任务,我们建议不开,改成在单个提示里要求写工作流。(问题出处:搜索联想词「ultracode claude」「ultracode claude effort」)
工作流跑到一半出了错,怎么让它停下来让人看?
官方的答案是运行中不能要输入,需要人签字的地方就拆成两个工作流(workflows 页「Behavior and limits」)。你也可以随时在 /workflows 里选中运行按 x 停下,已完成的代理结果会保留。Hacker News 上的讨论里也有人提出同样的顾虑:瓶颈不是跑得快,而是能不能在长时间运行中插进人的判断(HN 讨论,2026-05-28)。(问题出处:Reddit 发布帖下的一条评论,提问者想知道工作流在什么信号下停下来交给人审)
小红书评论采集要不要自己写爬虫?
自己写爬虫要处理 xsec_token、登录状态、风控和翻页,工作流的代理也没法替你维持登录。用按次计费的接口,代理只需要一个 Key 和一个网址;本文的 小红书数据接口按次 $0.005556,失败和空结果不扣,评论、回复、批量评论分别见 评论、评论回复、多链接评论批量采集。(问题出处:搜索联想词「小红书评论采集」「小红书评论抓取」「小红书评论爬虫」)
怎么开始
- 在 EveryInfra 控制台拿一个 Key,先用免费的目录接口看清
xiaohongshu/search和xiaohongshu/comments的参数。 - 按上文的命令把远程 MCP 接进 Claude Code,详细步骤见 远程 MCP 接入验收 和 MCP 服务说明。
- 在 Claude Code 里输入「用一个工作流,按上面的骨架拉 5 篇扫地机器人笔记的评论并分类」,先看计划再选「Yes, run it」。
- 跑完用
/workflows看每个代理的 token,用汇总表末尾的接口费核对 价格页;满意后在/workflows里按s保存成命令。
同样的骨架换个平台只要改能力名:抖音评论见 抖音数据接口,微博见 微博数据接口;要先清洗再分类,可以参考 用 DeepSeek V4 在 Claude Code 里洗评论。
参考资料
- Orchestrate subagents at scale with dynamic workflows,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/workflows
- Claude Code changelog,Anthropic,读取时最新为 2.1.316(2026-10-31),https://code.claude.com/docs/en/changelog
- CHANGELOG.md,anthropics/claude-code(GitHub),2026-11-02 读取,https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
- Introducing dynamic workflows,Anthropic,2026-05-28 发布,页面已注明全面开放,https://claude.com/resources/articles/introducing-dynamic-workflows-in-claude-code
- Claude Code Adds Dynamic Workflows for Parallel Agent Coordination,InfoQ,2026-06,https://www.infoq.com/news/2026/06/dynamic-workflows-claude-code/
- Building agents: When to fold subagents into your main agent loop,Anthropic,2026-10-22,https://claude.com/resources/articles/building-agents-when-to-fold-subagents-into-your-main-agent-loop
- Create custom subagents,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/sub-agents
- Run agents in parallel,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/agents
- Orchestrate teams of Claude Code sessions,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/agent-teams
- Extend Claude with skills,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/skills
- Settings reference,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/settings-reference
- Model configuration,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/model-config
- Environment variables,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/env-vars
- Agent SDK reference - TypeScript(Workflow 工具),Anthropic,2026-11-02 读取,https://code.claude.com/docs/en/agent-sdk/typescript
- Connect Claude Code to tools via MCP,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/mcp
- Manage costs effectively,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/costs
- Configure permissions,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/permissions
- Permission modes,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/permission-modes
- Prompt caching in Claude Code,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/prompt-caching
- Run Claude Code programmatically,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/headless
- Hooks reference,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/hooks
- Sandboxing,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/sandboxing
- Plugin manifest reference(workflows 字段),Anthropic,2026-11-02 读取,https://code.claude.com/docs/en/plugins/manifest-reference
- Agent view,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/agent-view
- Claude Code on the web,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/claude-code-on-the-web
- Remote Control,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/remote-control
- Interactive mode,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/interactive-mode
- Network configuration(流式空闲看门狗),Anthropic,2026-11-02 读取,https://code.claude.com/docs/en/network-config
- Scheduled tasks,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/scheduled-tasks
- Commands,Anthropic(Claude Code 文档),2026-11-02 读取,https://code.claude.com/docs/en/commands
- Pricing,Anthropic(Claude 平台文档),2026-11-02 读取,https://platform.claude.com/docs/en/about-claude/pricing
- Structured outputs,Anthropic(Claude 平台文档),2026-11-02 读取,https://platform.claude.com/docs/en/build-with-claude/structured-outputs
- Rate limits,Anthropic(Claude 平台文档),2026-11-02 读取,https://platform.claude.com/docs/en/api/rate-limits
- Token counting,Anthropic(Claude 平台文档),2026-11-02 读取,https://platform.claude.com/docs/en/build-with-claude/token-counting
- Transports(Specification 2025-11-25),Model Context Protocol,2026-11-02 读取,https://modelcontextprotocol.io/specification/2025-11-25/basic/transports
- Tools(Specification 2025-11-25),Model Context Protocol,2026-11-02 读取,https://modelcontextprotocol.io/specification/2025-11-25/server/tools
- 小红书能力目录(xiaohongshu),EveryInfra,2026-11-02 00:14 读取,https://api.everyinfra.com/api/v1/social/catalog?platform=xiaohongshu
- 内容审核规范,小红书蒲公英帮助中心,页面显示 2026-10-22 更新,https://pgy.xiaohongshu.com/help/detail?id=6495c527d1eedeeb48fb18b1f875650e&userType=4
- 蒲公英(小红书内容合作平台)首页,小红书,2026-11-02 读取,https://pgy.xiaohongshu.com/
- ChatGPT Outperforms Crowd-Workers for Text-Annotation Tasks,Gilardi、Alizadeh、Kubli,arXiv 2303.15056(v2 2023-07-19),https://arxiv.org/abs/2303.15056
- Are Chatbots Reliable Text Annotators? Sometimes,Kristensen-McLachlan 等,arXiv 2311.05769(v2 2025-02-25),https://arxiv.org/abs/2311.05769
- Best Practices for Text Annotation with Large Language Models,Petter Törnberg,Sociologica,2024,https://sociologica.unibo.it/article/view/19461
- Introducing dynamic workflows in Claude Code(讨论帖),r/ClaudeAI,2026-05,https://www.reddit.com/r/ClaudeAI/comments/1tq9ofy/introducing_dynamic_workflows_in_claude_code/
- Dynamic Workflows in Claude Code(讨论),Hacker News,2026-05-28,https://news.ycombinator.com/item?id=48311705
引用编号 BL-64