How to scrape TikTok comments:三种方法
1 万条 TikTok 评论:Apify 公开价 $5 到 $12.5,我们实测约 $0.03,但单条视频最多 200 条;附导出 CSV 的脚本。
同样拿 1 万条 TikTok 评论,Apify Store 里用的人最多的 TikTok Comments Scraper 公开价是 $5.00(Business 档)到 $12.50(Free 档),Store 里最便宜的第三方 scraper 是 $2.50;我们在 2026 年 11 月 7 日用 EveryInfra 真调,tiktok/comments 一次 $0.000556 拿回 200 条,50 条视频各取 200 条只要 $0.028,连回复一起展开、去重后写成 CSV,实跑单价是每千条 $0.0114,1 万条约 $0.11。这个价格有一条硬边界:我们一条视频最多给 200 条顶层评论,想从一条爆款视频里拿满 1 万条,我们做不到,那种活应该用 Apify 或 TikTok 官方的研究接口。实跑里还有三个别处没写过的发现:同一条视频隔 75 秒取两次,200 条里只有 183 条相同;评论里附带的回复只占这些评论自报回复数的 47%,要用回复翻页补,补完 9 个线程拿到 107 条里的 106 条;一条护肤视频的评论里 14% 没有文字,是图片或贴纸评论。
这篇是教程:先讲三条路(无代码工具、Python 自己抓、调接口)各自怎么做、卡在哪,再给一份完整的 Python 脚本,把评论和回复翻页、去重、写成 Excel 能直接打开的 CSV,最后用同一个场景「拿 1 万条评论」把三条路的钱和时间算清楚。各类 TikTok 数据和 Apify 的逐项比价,我们在 Apify TikTok Scraper 替代 里已经写过,本文不重复那张总表。
本文的「每千条价」都按同一个算法:一次请求实际扣掉的钱,除以这次实际返回的条数,再乘 1,000。分母用实际条数,不用请求里写的 limit;回得少的那几次,我们这一侧的单价只会被算高。第三方工具一侧只用公开材料:Store 页面、价格页、文档,以及不用账号就能读的公开接口。我们没有注册 Apify 或任何浏览器插件的账号,没有买它们的服务,所以表里对方的数字都是「公开单价」,不是「实测账单」;EveryInfra 一侧的每个数字都能回到我们保存的原始响应。
一条 TikTok 评论里有什么:顶层评论、回复和回复的回复
动手之前先把要抓的东西说清楚。TikTok 的评论区是一棵两层半的树:视频下面是顶层评论;每条顶层评论下面是回复;回复里还可以 @ 另一条回复,形成「回复的回复」,但在页面上它们仍然平铺在同一条顶层评论下面,并不会再缩进一层。TikTok 自己给研究人员的接口把这件事写得很直白:传 video_id 返回这条视频的评论,传 comment_id 返回这条评论的回复,两种查询不能同时用(Query Video Comments)。所以无论用哪种工具,「抓评论」其实是两件事:先拿顶层评论,再对有回复的那些评论逐条展开。很多工具只做第一件,或者第二件只做一半,这是后面比价时最容易看漏的地方。
评论区也越来越不只是文字。TikTok 在 2026 年 9 月 3 日宣布上线语音评论(最长 60 秒)、评论区投票、一条评论最多 9 张图的图片轮播和实况照片评论,同一篇公告里给出的数字是每天超过 17 亿条评论(TikTok 新闻室,2026-09-03)。对抓数据的人,这意味着「文本为空」的评论会越来越多:一条只有贴纸或语音的评论,在大多数导出工具里就是一行空文本。开源库 TikTokApi 的问题列表里,2026 年 5 月 25 日就有人报告贴纸评论只回一个 [Sticker] 占位符、拿不到图片地址(issue #1303)。我们在实测里也数了空文本的条数,见下文。
一条评论值得保存的字段大致是这几类:评论 ID、文本、点赞数、回复数、发表时间、作者标识,以及它在树里的位置(是不是回复、回复的是谁)。下表把 EveryInfra 两个评论能力在目录里登记的返回字段列出来,和 TikTok 研究接口的字段对照。目录是公开的,不用 Key 就能读(能力目录,2026-11-07 00:13 新加坡时间读取)。
| 字段 | `tiktok/comments` | `tiktok/comment_replies` | TikTok 研究接口 | 说明 |
|---|---|---|---|---|
| 评论 ID | id | id | id | 去重和拼树都靠它 |
| 文本 | text | text | text | 贴纸、语音评论可能为空 |
| 点赞数 | like_count | like_count | like_count | |
| 回复数 | reply_count(顶层评论) | 无 | reply_count | 顶层评论自报的回复总数 |
| 是否回复 | is_reply | is_reply | 用 parent_comment_id 判断 | |
| 回复给哪条评论 | reply_to_id | reply_to_id | parent_comment_id | |
| 回复给哪条回复 | 无 | reply_to_reply_id | 无 | 只在回复的回复上出现 |
| 作者 | author_username、author_id | 另有 author_name、author_url、author_avatar_url | display_name(只在查回复时) | 公开字段,导出时建议打码 |
| 作者点赞、置顶 | liked_by_author、pinned_by_author | liked_by_author | 无 | |
| 语言 | 无 | language | 无 | |
| 发表时间 | posted_at(ISO 8601) | posted_at | create_time(Unix 秒) | |
| 翻页 | 无,单次最多 200 条 | next_page_token,每页最多 20 条 | cursor、has_more,每次最多 100 条 |
三条路总览:无代码工具、Python 自己抓、调接口
搜「how to scrape tiktok comments」,排在前面的基本是三类结果:Apify Store 里的评论 scraper 页面、Reddit 和 GitHub 上的讨论、教你写 Python 的视频。它们分别对应三条路:不写代码,用别人做好的工具点几下;自己写 Python,直接对着 TikTok 网页抓;或者调一个已经把结果整理好的接口。三条路的差别不只是价钱,还有一条视频最多能拿多少条、回复拿不拿得全、要不要登录 TikTok、出了错由谁处理。下表先把六个具体工具放在一起,后面三节逐条展开,再用同一个场景「拿 1 万条评论」算账。
| 路线 | 代表 | 上手步数 | 一条视频最多拿多少 | 回复 | 要不要账号或登录 | 每千条(公开价或实测) |
|---|---|---|---|---|---|---|
| 浏览器插件 | Chrome 应用店里的评论导出插件 | 装插件、注册、粘链接、导出 | 免费 200 条,更多要付费版 | 有 | 要插件账号,用你自己的浏览器 | 付费版价格在插件内,未公开 |
| 网页导出服务 | 按档位收费的评论导出网站 | 粘链接、导出 | 免费 100 条;付费档每条 5,000 到 250,000 条 | 有 | 免费档不用注册 | 价格表由页面脚本加载,未读到 |
| 云端 scraper | Apify TikTok Comments Scraper | 注册、填链接和条数、运行、导出 | 按 commentsPerPost 设定 | 按 maxRepliesPerComment 设定 | 要 Apify 账号 | $1.25(Free 档)到 $0.50(Business 档) |
| Python 开源库 | TikTokApi 7.3.3 | 装库、装 Playwright、取 ms_token、写脚本 | 理论上可翻页,实际常被拦 | 有方法,未实测 | 要从浏览器复制 ms_token | 软件免费,代理和时间另算,未实测 |
| 官方研究接口 | TikTok Research API | 申请、审核约 4 周、取 token | 每次 100 条,用 cursor 翻页 | 有 | 只给获批的学术和非营利研究 | 免费,每天 1,000 次请求 |
| 数据接口 | EveryInfra tiktok/comments + tiktok/comment_replies | 拿 Key、发一个 POST | 顶层评论一次最多 200 条,不能再翻 | 每页 20 条,可翻到底 | 只要 API Key | 实测 每千条 $0.0028(评论)、每千条 $0.0278(回复页) |
这张表里最该看的一列是「一条视频最多拿多少」。如果你的活是「一条爆款视频下面几万条评论全要」,那么免费插件和我们的接口都不够:插件免费档停在 100 或 200 条,我们的 tiktok/comments 一次最多 200 条顶层评论、没有翻页参数,这一点在 Apify TikTok Scraper 替代的对比文 里我们已经测过,加 cursor 参数会直接回 422。这时 Apify 这类按条计费、能自己翻到底的云端 scraper,或者获批的官方研究接口,才是对的工具。反过来,如果你的活是「几十上百条视频,每条看前面几百条热评」,比如每周看一遍竞品新视频的口碑,那么按次计费的接口每千条只要零点几美分,便宜两到三个数量级。先想清楚是哪一种,再往下看。
第一条路:无代码工具,浏览器插件和 Apify TikTok Comments Scraper
无代码的工具分两种。一种装在你自己的浏览器里,读的是你眼前这个页面;另一种在别人的服务器上跑,你只交一个链接。
浏览器插件以 Chrome 应用店里一款专门导出 TikTok 评论的插件为例。它的商店页写着:装好插件、注册账号、粘贴视频链接、点导出,可以导出 CSV 或 XLSX,字段包括评论 ID、回复的是哪条评论、用户 ID、用户名、昵称、评论文本、时间、点赞数、作者是否点赞、回复数、是否置顶和用户主页;免费最多导出 200 条,再多要升级付费版,价格只在插件的订阅页里显示;页面还写明导出的数据在你本机处理,不经过它的服务器。我们读到的版本是 2.3.1,更新日期 2026 年 11 月 4 日(Chrome 应用店商店页,2026-11-07 读取)。这类插件的好处是不用写代码,坏处也很直接:它在你的浏览器里模拟滚动,评论多的视频要一直开着页面等它滚完,几百条视频就得手动粘几百次链接,而且它用的是你自己的 TikTok 会话。
网页导出服务以一家按档位收费的评论导出网站为例。它的 TikTok 评论页写着:免费档不用注册,每条视频最多 100 条;Personal 档每条视频 5,000 条,Premium 50,000 条,Business 250,000 条;免费档只能导 Excel,CSV 从 Personal 档起,JSON 只有 Business 档;回复会导出,并用 reply_to 列标出回复的是谁。它的 API 只开给 Premium 和 Business:Premium 每天最多建 100 个导出、同时只能跑 1 个,Business 不限每天次数、同时 5 个(该网站的 API 档位文档,2026-11-07 读取)。它的价格表由页面脚本加载,我们 2026-11-07 用不执行脚本的方式读取时拿不到具体金额,所以本文不写它的价格,只写各档的条数上限。它在同一页还写了一句很实在的话:TikTok 对匿名读取限流很严,几千条评论的视频几分钟导完,几十万条的要等更久。
云端 scraper 的代表是 Apify Store 里的 TikTok Comments Scraper,作者是 Clockworks,页面标为 Apify 维护。它的用法是:注册 Apify 账号,打开这个 actor(Apify 对云端抓取程序的叫法),填视频链接或用户名、每条视频要几条评论(commentsPerPost)、每条评论要几条回复(maxRepliesPerComment),点运行,结束后把数据集导出成 JSON、CSV、Excel、XML 或 HTML。Store 页面给的输入示例是每条视频 100 条评论、每条评论 2 条回复;视频被删或设为私密时,它不会静默跳过,而是往结果里写一条带 errorCode 的错误记录,比如 POST_NOT_FOUND_OR_PRIVATE。用接口调用时,Apify 的「同步运行并取数据集」端点可以直接用 format=csv 拿回 CSV,CSV 默认带 UTF-8 BOM,还可以用 maxItems 和 maxTotalChargeUsd 给这一次运行设费用上限(Run Actor synchronously and get dataset items)。
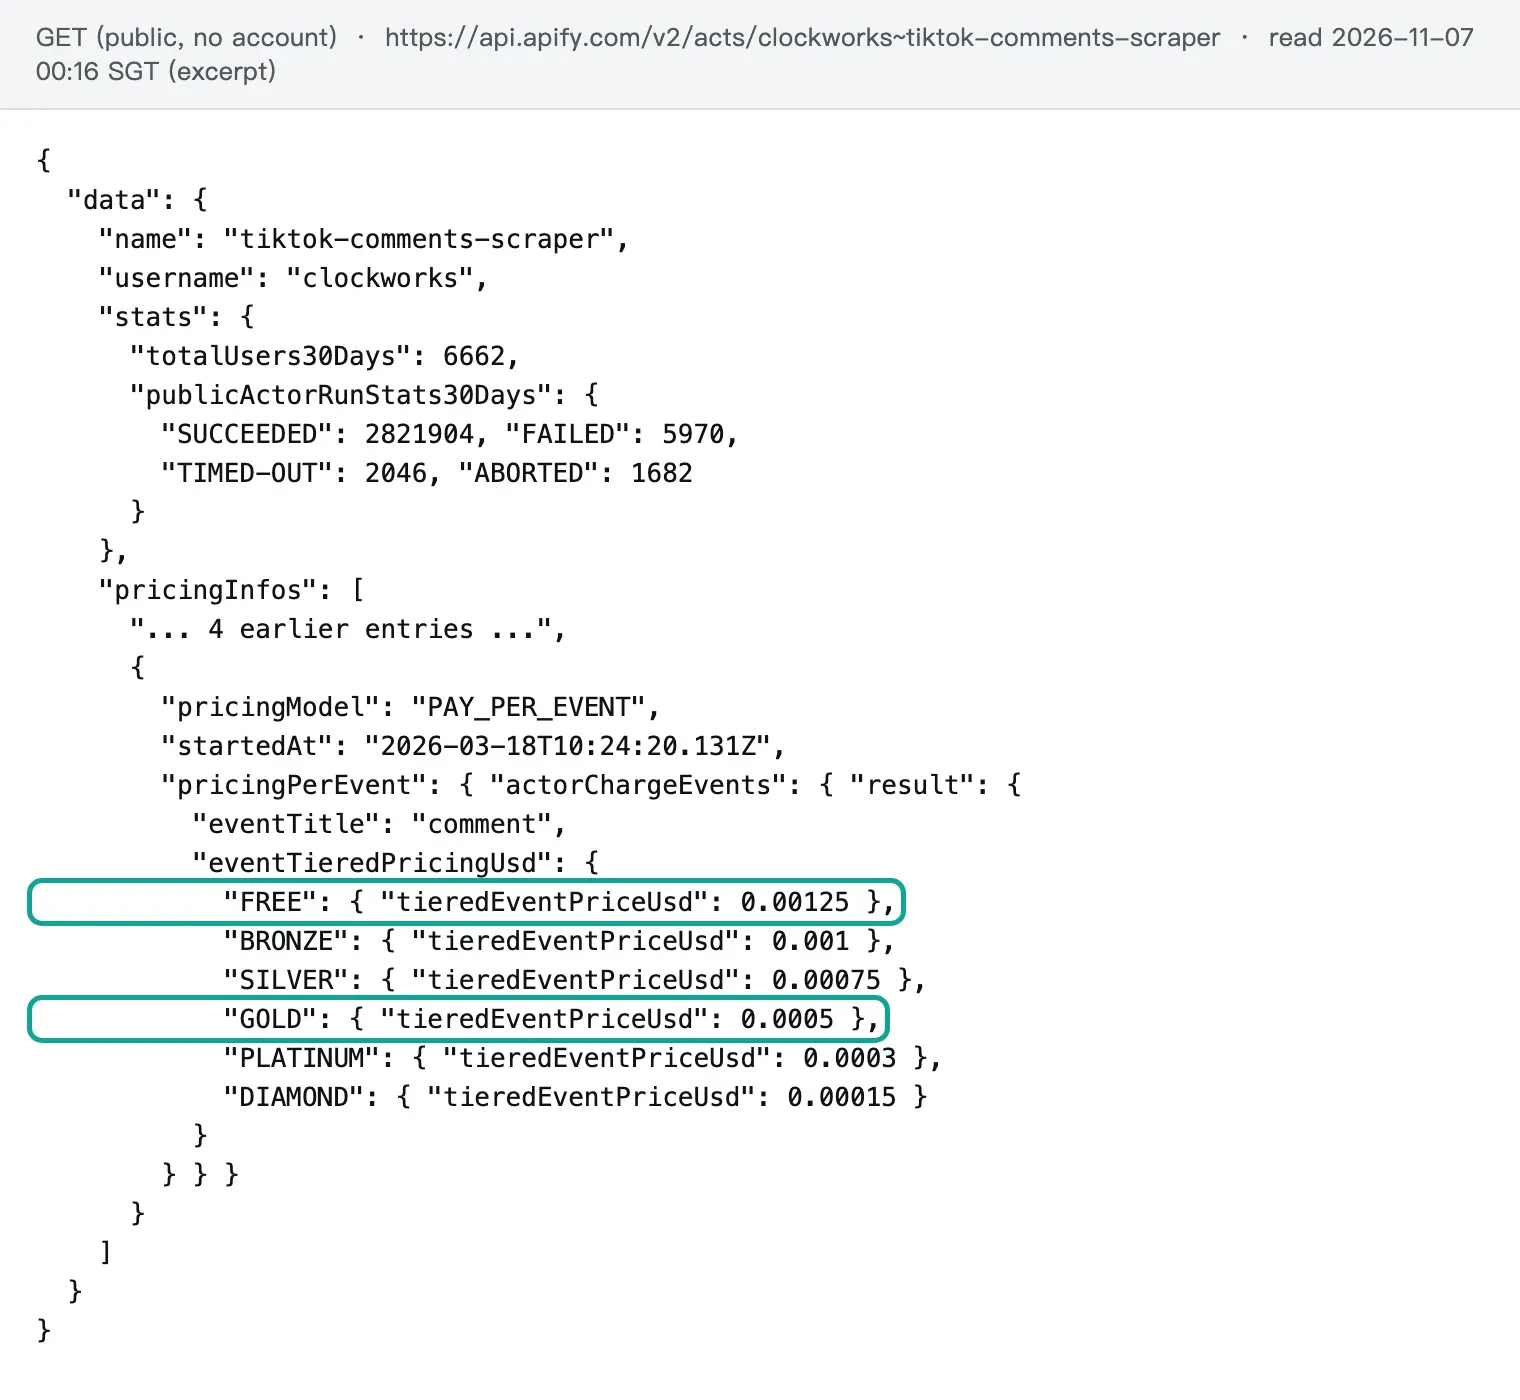
它怎么收费,要以公开接口为准。我们在 2026-11-07 00:16 新加坡时间读了它不需要账号的公开元数据(Apify 公开接口):定价模型是按事件计费(pay per event),从 2026 年 3 月 18 日起生效,唯一的计费事件叫 comment,也就是「数据集里的一条评论」。每条评论的价格按套餐分六档:FREE $0.00125、BRONZE $0.001、SILVER $0.00075、GOLD $0.0005、PLATINUM $0.0003、DIAMOND $0.00015,换成每千条就是 $1.25、$1.00、$0.75、$0.50、$0.30、$0.15。BRONZE、SILVER、GOLD 分别对应 Starter、Scale、Business 套餐;PLATINUM 和 DIAMOND 只给企业客户(Apify 定价页、Actor 定价与成本)。套餐本身的月费是 Free $0、Starter $19、Scale $199、Business $999,每个套餐带同额的预付用量,Free 档每月 $5;预付额度当月不用就作废,Free 档用超了要等下个计费周期才能再用。
这里有一处要提醒:同一个 Store 页面的常见问题一节还写着「抓 1,000 条结果要 $5」「推荐每月 $29 的 Starter 套餐,每月能拿 5,800 多条」,和公开接口里的现价(Free 档每千条 $1.25)、价格页上的 Starter 月费($19)都对不上(Store 页面,2026-11-07 读取)。我们在 2026-10-27 的对比文里已经报告过这类不一致,到今天还在。以账单为准的话,应该看 Store 页「Pricing」标签和公开接口里的 pricingInfos,不要看 FAQ 里的那段文字。
这个 actor 用的人很多。公开元数据里的统计是:累计 52,805 个用户,近 30 天 6,662 个;近 30 天跑了 2,831,602 次,成功 2,821,904 次、失败 5,970 次、超时 2,046 次、中止 1,682 次,成功率 99.66%;97 条评价,平均 4.73 分;最后一次修改是 2026 年 11 月 6 日 15:43(协调世界时)。用的人多、成功率高,是它在「tiktok comments scraper」这个词上排第一的原因,也是我们比价时拿它当基准的原因。
Clockworks 这个不是 Store 里唯一的选择。我们用 Apify 公开的 Store 搜索接口搜「tiktok comments」,一共 1,498 个结果;按相关度看前 30 个,去掉商品评价、视频加评论这类不是专做评论的,剩下 20 个 TikTok 评论 scraper(Store 搜索接口,2026-11-07 00:23 新加坡时间读取)。按 Free 档每千条评论的价格排,最便宜的三个是 $0.25,中位数 $0.45,最贵的 $5.00;Clockworks 的 $1.25 在中间偏上。有几个还另收「启动一次」的费用,从 $0.00005 到 $0.01 不等。还有一个标题里写着「$0.25/1000 results」,公开接口里 Free 档每条却是 $0.005,也就是每千条 $5,标题和计费对不上。每千条 $0.30 及以下的 8 个,近 30 天用户在 7 到 810 个之间,Clockworks 在同一份搜索结果里是 6,669 个,用量差了一个量级以上。下图把这 20 个的 Free 档价格排出来,第三方作者按价格从低到高记作 A 到 S。
第二条路:scraping TikTok comments with Python,开源库还能不能用
「scraping tiktok comments python」是这个词簇里联想最多的说法之一,背后的需求很朴素:不想按条付钱,想自己写几十行代码搞定。我们看了三个最常被推荐的开源项目今天的状态,结论是:能用,但要付出的代价不在钱上,在维护上。
第一个是 TikTokApi,GitHub 上 6,733 颗星,是「TikTok 非官方 Python 封装」里最出名的一个。PyPI 上的最新版本是 7.3.3,2026 年 4 月 1 日发布,要求 Python 3.9 以上(PyPI 页面);仓库最后一次推送是 2026 年 8 月 24 日,还有 150 个未关闭的问题(GitHub 仓库,2026-11-07 读取)。它的视频对象有一个 comments(count, cursor) 方法,内部对 TikTok 网页用的 /api/comment/list/ 每次请求 20 条、用 cursor 往后翻。用它之前要做三件事:pip install TikTokApi,再 python -m playwright install 装一个无头浏览器(Playwright 安装文档),然后从你自己浏览器的 tiktok.com Cookie 里复制一个 ms_token 填进去。README 的排错一节写得很坦白:如果报 EmptyResponseException,意思是 TikTok 在拦这个请求、认出你是机器人,你可能需要代理。问题列表里也能看到这一点:2025 年 8 月 28 日有人报告「评论抓取不工作」(issue #1255),2026 年 7 月 18 日又有人报告用户级查询返回 200 但正文为空(issue #1311),两个都还开着。
第二个是很多人以为能抓评论的 yt-dlp。它的 --write-comments 参数确实存在,但能不能拿到评论取决于每个网站的提取器。我们读了 yt-dlp 主分支上的 TikTok 提取器源码(tiktok.py,2026-11-07 读取,共 1,749 行),里面只把评论数映射成 comment_count,没有抓评论正文的函数;2022 年那条「TikTok 评论提取」的需求已经关闭(issue #5037)。yt-dlp 本身更新很勤,最新版是 2026 年 10 月 26 日的 2026.10.26(发布页),但用它下 TikTok 视频可以,抓评论不行。
第三类是 GitHub 上名字就叫「TikTok comment scraper」的小项目。按星数排前几个:cubernetes/TikTokCommentScraper 212 颗星,最后推送 2023 年 8 月 5 日;xtekky/TikTok-Comment-Scraper 56 颗星,最后推送 2023 年 12 月 2 日;RomySaputraSihananda/tiktok-comment-scrapper 63 颗星,最后推送 2025 年 12 月 8 日(cubernetes、xtekky、RomySaputraSihananda,GitHub 接口 2026-11-07 读取)。第一个的作者在 Reddit 上自己说过,他的办法是在浏览器里自动滚动、把评论全部加载出来再导出,「几千条可以,几万条不行」,而且「很取巧」(r/webscraping 讨论)。这几个项目停更一两年,在 TikTok 改过几轮网页之后还能不能跑,要你自己试。
为什么自己抓这么难维护?TikTok 网页取评论的请求要带一组由页面脚本算出来的签名参数和 Cookie,脚本一改,参数就失效;匿名访问又有限流。这是平台有意设的门槛。我们不教怎么绕过这些参数:TikTok 美国服务条款第 3.4 节禁止未经书面批准用自动化系统抓取平台数据(TikTok 美国服务条款,2026 年 7 月 15 日更新),而美国法院 2026 年 10 月有两起「绕过反抓取措施」的案子没被驳回(MediaPost 报道,相关评论见参考资料)。这不是法律意见,只说明:自己写脚本绕签名,技术上要不停追,法律上也多一层不确定;导出的评论带用户名,要按个人信息处理,见下文「合规与隐私」一节。
所以 Python 这条路的真实成本是:软件免费,但你要维护一个无头浏览器、一份会过期的 Cookie、可能还有一组代理,每次 TikTok 改网页都要等库作者修或者自己修。我们没有在本机实测 TikTokApi 抓评论,原因是它要用一个真实 TikTok 会话的 Cookie,这一节的结论都来自它的文档、源码和问题列表。下文的 Python 脚本走的是第三条路:Python 只负责调接口、翻页、去重和写 CSV,不碰 TikTok 的网页。
第三条路:tiktok comments scraper API,两个能力怎么配合
第三条路是调一个已经把评论整理成结构化行的接口。EveryInfra 的 TikTok 评论分两个能力,都走同一个端点 POST https://api.everyinfra.com/api/v1/social,按次计费,每次 $0.000556(能力目录,2026-11-07 00:13 新加坡时间读取;也可以看 TikTok 评论能力页 和 评论回复能力页)。
tiktok/comments 按视频取评论。必填参数只有 url(具体的 TikTok 视频链接),可选 limit,默认 20、最多 200;目录里写着每条顶层评论最多附带两条回复,不保证完整对话树。它一次请求就把这一批全部拿回来,不提供翻页参数,所以同一条视频最多拿到 200 行。
tiktok/comment_replies 按评论取回复。必填 url 和 comment_id(上一步顶层评论的 id),可选 page_token:把上一页响应里的 next_page_token 原样传回,拿下一页;不传从第一页开始。目录写明每页最多 20 条回复、每页算一次调用、令牌 24 小时有效,limit 对它不起作用。这正好补上前一个能力「每条最多两条回复」的缺口:先用 tiktok/comments 找到回复多的评论,再对这些评论逐条翻 tiktok/comment_replies。
一次最简单的请求长这样:
curl -s https://api.everyinfra.com/api/v1/social \
  -H "Authorization: Bearer $EVERYINFRA_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"platform":"tiktok","action":"comments","params":{"url":"https://www.tiktok.com/@<作者>/video/<视频ID>","limit":200}}'
返回体里 results 是评论数组,billing.charged_usd 是这次实际扣的钱。失败、空结果不扣费:没拿到数据时,响应里 billing.charged 是 false、charged_usd 是 0,原因写在 billing.reason。另外有两个跟限速有关的点,脚本里都要处理:第一,按 Key 限速,超了回 429,错误体里带 retry_after(秒);第二,服务端临时不可用时回 503 或 429,错误体里 retryable 为 true,同样给 retry_after。下文实测三专门记了我们这次碰到的情况。慢的请求可以在请求体里加 "mode":"async",立刻拿到 202 和 job_id,再去 GET /api/v1/jobs/{job_id} 取结果,同步请求的等待上限是 85 秒。
实测一:一条 120 万播放的视频,200 条评论里有什么
测试视频是一条护肤类视频,2026 年 9 月 25 日发布,我们在 11 月 7 日 00:15(新加坡时间)用 tiktok/search 搜「skincare routine」时它排在评论数第一:播放 1,238,029 次,搜索结果自报 1,116 条评论(作者是个人创作者,下文只写视频 ID 7689447084436573472)。选它是因为评论数在一千出头,正好超过一次请求的 200 条上限,能看出「拿到的是哪 200 条」。
评论请求在 00:15 到 00:28 之间连续失败,00:32:41(新加坡时间)那一次成功了,耗时 36.71 秒,回 200 行,扣 $0.000556,每千条 $0.0028。200 行里 154 条是顶层评论,46 条是附带的回复(is_reply 为 true)。154 条顶层评论里有 34 条有回复,它们自报的回复数(reply_count)加起来是 97,我们随评论拿到了 46 条,覆盖 47%;回复数超过 2 条、需要翻页才能补全的线程有 8 个。这和目录里那句「每条顶层评论最多附带两条回复」一致:附带的回复只是每个线程的前两条,完整的对话要靠下一节的 tiktok/comment_replies。
其余几个字段的分布也值得记下来,写分析时用得上。4 条评论文本为空,TikTok 支持只发图片或贴纸的评论,这类评论没有文字,分析前要单独处理;19 条评论被作者点过赞(liked_by_author);没有置顶评论。评论的发表时间从 9 月 25 日一直到 11 月 6 日,跨了 6 周,说明这 200 条既不是「最新 200 条」,也不是严格按点赞排序:顶层评论的第 1 条有 1,667 个赞,第 2 条是 0 个赞、11 月 6 日刚发的,第 7 条又是 1,316 个赞。这和 TikTok App 里默认的评论顺序一样,是把高赞评论和新评论混在一起排。154 条顶层评论的点赞中位数只有 1。如果你要做的是「本周新增评论」,就不能只看这一次返回,要按 posted_at 自己筛。
还有一个细节,是我们在跑 CSV 脚本时顺手测出来的。脚本在 00:33:56(新加坡时间)又取了一次同一条视频,距第一次 75 秒,也回 200 行,但两次的评论 ID 只有 183 个相同,17 条换了。热度排序是活的:新评论进来、点赞数变化,前 200 名就会变。实际影响是:同一条视频多次抓取的结果合并时,必须按评论 id 去重,不能按「第几条」对齐;为了看清这种变化有多大,我们在 01:06(新加坡时间)又取了一次,距第一次 33 分钟,89.56 秒回 200 行,扣 $0.000556。这一次和 00:32 那次只有 169 条相同,和 00:33 那次 167 条相同;三次合起来一共 243 条不同的评论。三次里最新的一条评论都是 11 月 6 日 14:42(协调世界时)发的,也就是说这半小时里没有新评论进入前 200 名,换掉的 31 条完全是排序变动。想拿到更多不同的评论,隔一段时间重抓、合并去重是一个办法:三次共花 $0.001668,比一次多拿 43 条。
下图是 CSV 脚本实跑时三条视频各拿到的行数,按来源分成三段:评论请求里的顶层评论、评论请求里附带的回复、翻回复页补回来的回复。视频 B 是另一条护肤视频,页面显示 311 条评论,评论请求回了 197 行,耗时 89.42 秒;视频 C 页面 297 条,回 200 行,64.01 秒。三条视频合计 685 行。
实测二:回复怎么翻到底,一个 24 条回复的线程
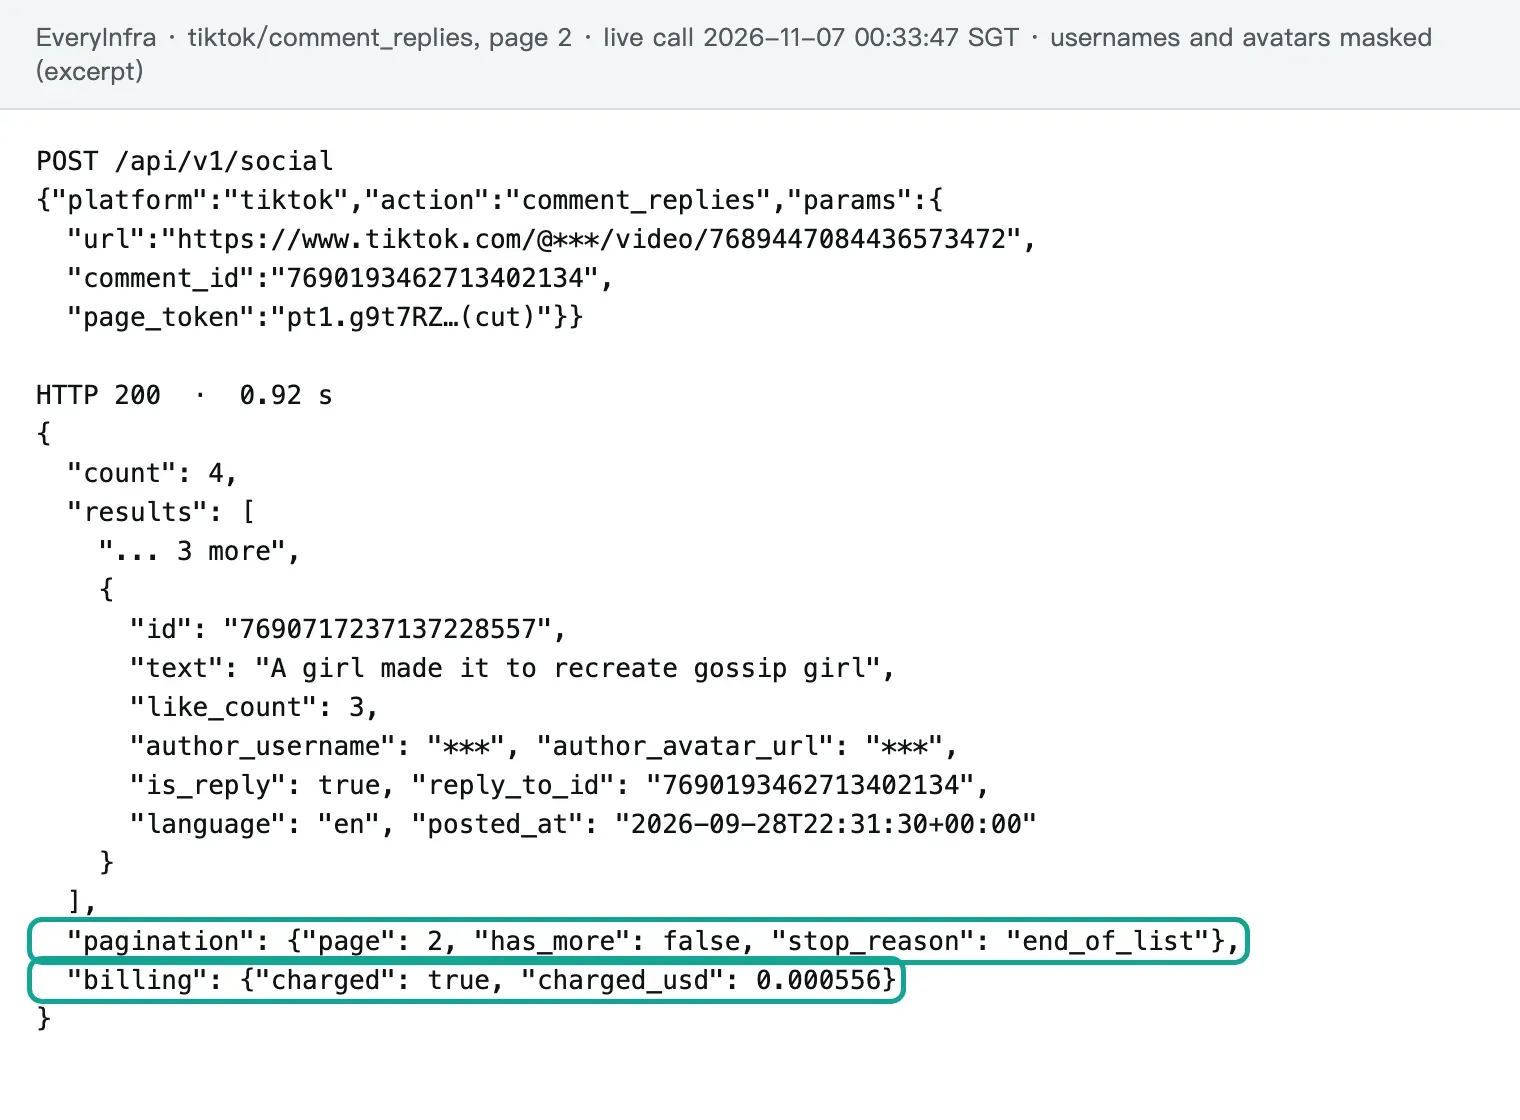
接着展开回复最多的那条评论(ID 7690193462713402134,自报 24 条回复)。00:33:41(新加坡时间)发第一页,不带 page_token,0.99 秒回 20 条,响应里 pagination.has_more 为 true,next_page_token 是一串以 pt1. 开头的令牌;00:33:47 把令牌原样传回去拿第二页,0.92 秒回 4 条,has_more 为 false,stop_reason 是 end_of_list。两页一共 24 条,和自报数一致,没有重复 ID;评论请求里附带的那 2 条回复也在这 24 条里,所以合并时会重复,要去重。
| 页 | 新加坡时间 | 请求里的 `page_token` | 返回条数 | 耗时 | `has_more` | `stop_reason` | 扣费 |
|---|---|---|---|---|---|---|---|
| 1 | 00:33:41 | 不传 | 20 | 0.99 秒 | true | 空 | $0.000556 |
| 2 | 00:33:47 | 第 1 页的 next_page_token | 4 | 0.92 秒 | false | end_of_list | $0.000556 |
两页各扣 $0.000556,按回复条数算每千条 $0.0463;满页 20 条时是 $0.0278,是评论请求的 10 倍,因为一页只装 20 条。
回复页的字段比评论请求多。24 条里有 17 条带 reply_to_reply_id,也就是「回复的回复」,占 71%:这个线程里大部分人不是在回原评论,而是在回别人的回复。只看评论请求附带的两条回复,这种来回争论的结构是看不出来的。每条回复还带 language,这 24 条里 23 条识别为英语、1 条法语;时间从 2026-09-27 到 2026-10-18,原评论发出三周后还有人在回。
CSV 脚本实跑时一共展开了 9 个线程(每条视频回复最多的 3 个),自报回复数合计 107 条,回复页一共拿回 106 条,覆盖 99.1%;唯一差 1 条的是视频 B 一个自报 31 条回复的线程,两页拿回 30 条,差的那条可能已被删除或折叠。11 次回复请求最快 0.74 秒、最慢 1.65 秒,比评论请求快两个数量级,所以展开回复几乎不增加等待时间,只增加次数。
实测三:半小时里 11 次失败,扣了多少钱
写教程不能只写顺利的那几次。本文一共真调 30 次(下图是 00:39 之前的 29 次,01:06 那次重抓见实测一,成功),11 次失败,下表把失败按类型列出来。11 次都没扣钱:9 次服务端失败的 billing.charged_usd 是 0、billing.reason 是 request_failed_refunded;Key 超速和参数错这 2 次在计费之前就被挡下,响应里没有 billing,错误说明里写明「Nothing was charged」。
| 类型 | 次数 | 新加坡时间 | 每次耗时 | 错误码与 `fault` | 扣费 |
|---|---|---|---|---|---|
| 服务暂时不可用 | 7 | 00:14:54–00:20:02 | 10.4–20.5 秒 | 503 unavailable,service,retry_after 60 秒 | $0 |
| 服务端限流 | 2 | 00:24:20、00:28:30 | 10.4–10.7 秒 | 429 rate_limited(限流),service,retry_after 60 秒 | $0 |
| 本 Key 每分钟次数超限 | 1 | 00:19:44 | 0.17 秒 | 429 rate_limited(限流),account,retry_after 16 秒 | $0 |
参数错(comment_id 不是合法 ID) | 1 | 00:39:08 | 0.20 秒 | 422 missing_param,request,不该重试 | $0 |
几个观察。第一,00:15 到 00:28 之间评论能力是真的不可用,换视频、换成异步模式都一样,00:32 恢复后再没失败过;同一时段别的 TikTok 能力也回过 503(00:14:54 的 tiktok/user_videos),只有 00:15:22 那次 tiktok/search 成功,说明是接口当时大面积不可用,不只评论一项;这些失败都没扣费。第二,错误体是写给程序和 AI 看的:每次都带 retryable、retry_after(服务端失败是 60 秒,Key 超速是 16 秒)、max_retries 和「未扣费」的说明;第 1 次失败时错误体写「Failure 1 of 3」,同一能力 10 分钟内失败到第 3 次时,错误体会附一个 example 请求,建议先拿它试一次:示例能返回数据,说明是目标视频的问题(删了、设了私密或 ID 写错);示例也失败,就是服务这边的问题,这时错误体给出开工单的接口,但写明要先问用户同意再开。我们这次示例也失败了,因为是写稿测试,没有开工单。第三,fault 字段区分了是谁的问题:service 是我们这边,account 是你的 Key 超了速,request 是请求本身写错,前两种可以等一等重试,最后一种重试没用,要改参数。下文的脚本就是按这个规则写的重试逻辑。
这段经历对选工具也有意义:任何一条路都会遇到 TikTok 侧的限流和失败,区别在于失败的成本由谁承担。按次计费、失败不扣,失败的代价只是时间;按条计费的 scraper 失败时一般不产生结果、也就不产生结果费,但 Apify 文档提醒,部分按事件计费的 actor 会另收平台用量费,运行本身的计算资源可能照样计费(Actors in Store);自己写脚本,失败的代价是你的时间加代理流量。
Scrape TikTok comments to CSV:完整 Python 脚本
下面这份脚本就是我们 11 月 7 日实跑用的那一份,没有删减。它只依赖 requests(Requests 文档)和标准库,做五件事:按 Key 的每分钟 10 次限速主动排队;遇到 429 或 retryable 的错误就按 retry_after 等待后重试,参数错(4xx)不重试;对每条视频取最多 200 条评论;挑出回复数超过 2 条、回复最多的 N 个线程,用 page_token 翻回复页;按评论 id 去重后写成带 BOM 的 UTF-8 CSV,再把每次请求的状态、行数、扣费和耗时另存一份 .calls.json,方便对账。
"""Export TikTok comments (and optional reply threads) to CSV with the EveryInfra API.

Usage:
    export EVERYINFRA_API_KEY=...            # never hard-code the key
    python tiktok_comments_to_csv.py urls.txt comments.csv --replies 3 --hash-authors

urls.txt has one public TikTok video URL per line.
"""
import argparse
import csv
import hashlib
import json
import os
import sys
import time

import requests

API = "https://api.everyinfra.com/api/v1/social"
MIN_INTERVAL = 6.5          # seconds between calls: stays under 10 requests per minute
FIELDS = ["video_url", "id", "is_reply", "reply_to_id", "reply_to_reply_id", "text",
          "like_count", "reply_count", "author", "posted_at", "liked_by_author",
          "pinned_by_author", "source"]

session = requests.Session()
session.headers["Authorization"] = "Bearer " + os.environ["EVERYINFRA_API_KEY"]
last_call = 0.0
spent_usd = 0.0
calls = []


def call(action, params, tries=3):
    """One POST with client-side pacing; retries 429 and retryable 5xx, never retries 4xx."""
    global last_call, spent_usd
    for attempt in range(tries):
        wait = MIN_INTERVAL - (time.time() - last_call)
        if wait > 0:
            time.sleep(wait)
        last_call = time.time()
        t0 = time.time()
        r = session.post(API, json={"platform": "tiktok", "action": action, "params": params}, timeout=120)
        body = r.json()
        billing = body.get("billing") or {}
        spent_usd += billing.get("charged_usd") or 0.0
        rows = body.get("results") if isinstance(body.get("results"), list) else []
        calls.append({"action": action, "params": params, "status": r.status_code, "rows": len(rows),
                      "charged_usd": billing.get("charged_usd"), "seconds": round(time.time() - t0, 2),
                      "at_utc": time.strftime("%Y-%m-%dT%H:%M:%SZ", time.gmtime(t0))})
        if r.status_code == 200:
            return body
        err = body.get("error") or {}
        if r.status_code == 429 or err.get("retryable"):
            time.sleep(err.get("retry_after") or 60)
            continue
        print(f"{action} failed: {r.status_code} {err.get('code')} {err.get('message')}", file=sys.stderr)
        return None
    return None


def author_of(row, hash_authors):
    name = row.get("author_username") or ""
    return hashlib.sha256(name.encode()).hexdigest()[:10] if hash_authors and name else name


def to_row(video_url, row, source, hash_authors):
    out = {k: row.get(k) for k in FIELDS if k in row}
    out.update(video_url=video_url, author=author_of(row, hash_authors), source=source)
    return out


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("urls")
    ap.add_argument("out")
    ap.add_argument("--limit", type=int, default=200, help="comments per video, 1-200")
    ap.add_argument("--replies", type=int, default=0, help="pull full reply threads for the N most-replied comments")
    ap.add_argument("--reply-pages", type=int, default=3, help="max reply pages per thread (20 replies per page)")
    ap.add_argument("--hash-authors", action="store_true")
    a = ap.parse_args()

    seen, rows = set(), []
    videos = [u.strip() for u in open(a.urls) if u.strip()]
    for url in videos:
        body = call("comments", {"url": url, "limit": a.limit})
        if not body:
            continue
        top = []
        for c in body["results"]:
            if c["id"] in seen:
                continue
            seen.add(c["id"])
            rows.append(to_row(url, c, "comments", a.hash_authors))
            if not c.get("is_reply"):
                top.append(c)
        # replies: only the threads with more replies than the two that come inline
        threads = sorted((c for c in top if (c.get("reply_count") or 0) > 2),
                         key=lambda c: c["reply_count"], reverse=True)[: a.replies]
        for c in threads:
            token = None
            for _ in range(a.reply_pages):
                params = {"url": url, "comment_id": c["id"]}
                if token:
                    params["page_token"] = token
                page = call("comment_replies", params)
                if not page:
                    break
                for rep in page["results"]:
                    if rep["id"] in seen:
                        continue
                    seen.add(rep["id"])
                    rows.append(to_row(url, rep, "comment_replies", a.hash_authors))
                token = next((x.get("next_page_token") for x in page["results"] if x.get("next_page_token")), None) \
                    or page.get("next_page_token")
                if not token:
                    break

    with open(a.out, "w", newline="", encoding="utf-8-sig") as f:   # BOM so Excel reads UTF-8 and emoji
        w = csv.DictWriter(f, fieldnames=FIELDS, extrasaction="ignore")
        w.writeheader()
        w.writerows(rows)
    print(json.dumps({"videos": len(videos), "rows": len(rows), "calls": len(calls),
                      "spent_usd": round(spent_usd, 6)}, ensure_ascii=False))
    json.dump(calls, open(a.out + ".calls.json", "w"), indent=1)


if __name__ == "__main__":
    main()
几个写法上的选择,解释一下原因。限速放在客户端做,而不是等 429 再退:每次请求前算好距上一次的间隔,不足 6.5 秒就先睡,这样一分钟最多 9 次多一点,不会撞上 10 次的线;撞上了也只是多等 16 秒,不扣钱。去重用一个全局的 seen 集合,因为同一条回复会出现两次:评论请求附带一次,回复页里又一次,我们实跑时 703 行里有 18 行是这样重复的。写文件用 utf-8-sig 编码,也就是在文件开头加一个 BOM 标记(Python codecs 文档),Excel 看到它才会按 UTF-8 读,评论里的中文、表情才不会变成乱码(Microsoft 支持文档);如果下一步是用 pandas 读,encoding="utf-8-sig" 同样能正确处理(pandas.read_csv)。CSV 的转义交给标准库 csv.DictWriter(Python csv 模块),评论里的换行、逗号、双引号都会按 RFC 4180 的规则加引号(RFC 4180),不要自己用逗号拼字符串。
--hash-authors 是给研究和内部分析用的:把用户名换成 SHA-256 的前 10 位(Python hashlib 文档),同一个人在不同评论里仍然是同一个值,可以统计「谁评论最多」,但表里不直接出现用户名。这不等于匿名化,用户名的哈希可以被枚举反推,只是减少表格在内部传来传去时的暴露面,下文「合规与隐私」一节再细说。没有装 requests 的话,用 uv 可以不建虚拟环境直接跑:uv run --with requests python3 tiktok_comments_to_csv.py urls.txt comments.csv --replies 3 --hash-authors(uv 运行脚本)。
导出的 CSV 有 13 列,含义如下。除 video_url、author、source 三列是脚本加的,其余都是接口原样返回的字段名。
| 列名 | 来自 | 含义 | 实跑样例 |
|---|---|---|---|
video_url | 脚本 | 这一行属于哪条视频 | https://www.tiktok.com/@…/video/7689447084436573472 |
id | 接口 | 评论或回复的唯一 ID,去重用它 | 7690193462713402134 |
is_reply | 接口 | false 是顶层评论,true 是回复 | False |
reply_to_id | 回复页 | 这条回复属于哪条顶层评论 | 7690193462713402134 |
reply_to_reply_id | 回复页 | 回的是哪一条回复;为空表示直接回原评论 | 24 条里 17 条有值 |
text | 接口 | 评论正文,图片或贴纸评论为空 | 685 行里 39 行为空 |
like_count | 接口 | 点赞数 | 最高 1,667 |
reply_count | 评论请求 | 这条评论自报的回复数 | 最高 31 |
author | 脚本 | 用户名,加 --hash-authors 后是 10 位哈希 | 3f9c…(示意) |
posted_at | 接口 | 发表时间,UTC,ISO 8601 | 2026-09-27T12:55:18+00:00 |
liked_by_author | 接口 | 视频作者是否点过赞 | 视频 A 有 19 条 |
pinned_by_author | 接口 | 是否被作者置顶 | 视频 A 没有 |
source | 脚本 | 这一行来自 comments 还是 comment_replies | 597 / 88 |
需要更多列,比如回复的 language、作者的显示名,就把字段名加进 FIELDS:回复页的每一行还有 language、author_name、author_url、video_id 等字段,完整列表见目录(字段目录)。评论请求本身不返回语言字段,要语言就得自己用语言识别库判断,或者只对回复用接口给的 language。


我们在 11 月 7 日 00:33:55 到 00:38:26(新加坡时间)用这份脚本跑了 3 条视频,参数是 --replies 3 --hash-authors,即每条视频展开回复最多的 3 个线程。结果:一共 14 次请求,全部成功,用时 271 秒,花了 $0.007784;拿回 703 行,按 id 去重后 685 行,删掉的 18 行全是评论请求附带、又在回复页出现的回复。按去重后的行数算,每千条 $0.0114。
| 视频 | 搜索自报评论数 | 评论请求行数 | 评论请求耗时 | 展开线程 | 回复页请求 | 去重后行数 | 空文本 |
|---|---|---|---|---|---|---|---|
| A(护肤,124 万播放) | 1,116 | 200 | 51.2 秒 | 3 | 4 | 241 | 4 |
| B(护肤,82 万播放) | 311 | 197 | 89.42 秒 | 3 | 4 | 237 | 33 |
| C(护肤,34 万播放) | 297 | 200 | 64.01 秒 | 3 | 3 | 207 | 2 |
| 合计 | 1,724 | 597 | 204.6 秒 | 9 | 11 | 685 | 39 |
这张表能看出三件事。第一,时间几乎都花在评论请求上:3 次评论请求合计 204.6 秒,11 次回复请求合计约 10 秒,剩下的是脚本主动排队的间隔。评论请求一次 37 到 90 秒,这个速度决定了批量导出的节奏,下一节算 1 万条时会用到。第二,评论数在 300 条上下的视频,200 条顶层评论加上展开的回复,已经能覆盖页面上大部分评论:视频 B 去重后 237 行,占自报 311 条的 76%;视频 C 207 行,占 70%。评论数上千的视频 A 只覆盖 22%,这时候要么接受只拿热门的 200 条,要么改用能整条翻完的工具。第三,视频 B 的 237 行里 33 行没有文字,占 14%;这条视频的评论区里有很多人只发图片或贴纸。做情绪分析前要先把这些行过滤掉,否则空文本会被模型当成「中性」,拉低负面比例。
去重之后的 CSV 直接用 Excel 打开就能看,中文和表情没有乱码。source 列 597 行是 comments、88 行是 comment_replies;is_reply 为 true 的行一共 214 行,其中 26 行是「回复的回复」。按 posted_at 看,视频 B 的 237 行发表在 2026-11-02 到 2026-11-06 之间,视频 C 的 207 行在 2026-10-12 到 2026-11-05 之间,视频 A 是 9 月 25 日发的老视频,最新一条评论是 2026-11-06 14:42(协调世界时):新视频的评论区一周内就基本成形,适合按天增量导出。
同样 10,000 条评论,三条路各要多少钱、多少时间
把场景定死:要 1 万条 TikTok 评论,写成一个 CSV。分两种情况:一是 50 条视频、每条 200 条热门评论,二是一条视频下面的 1 万条。价格全部按 2026 年 11 月 7 日读到的公开价和我们当天的实测扣费算,只算用量,不含套餐月费;时间一栏只写测过的,没测的写「未实测」。
| 路线 | 50 条视频 × 200 条 | 一条视频 1 万条 | 时间 | 算法与出处 |
|---|---|---|---|---|
| 浏览器评论导出插件 | 免费档到 200 条为止,再多要付费版 | 要付费版 | 每条视频手动粘链接、等页面滚完;未实测 | Chrome 应用店页面,价格在插件订阅页 |
| 按档位收费的评论导出网站 | 免费档每条 100 条,不够;付费档起每条 5,000 条 | 中间档起(每条 50,000 条) | 未实测 | 价格表由脚本加载,未读到金额 |
| Apify Clockworks,Free 档 | $12.50 | $12.50 | 未实测 | $0.00125 × 10,000;超过 Free 档每月 $5 的额度,实际要开 Starter |
| Apify Clockworks,Starter(BRONZE) | $10.00 | $10.00 | 未实测 | $0.001 × 10,000;Starter 月费 $19,含 $19 用量 |
| Apify Clockworks,Business(GOLD) | $5.00 | $5.00 | 未实测 | $0.0005 × 10,000;月费 $999 |
| Apify Store 最便宜的第三方 | $2.50 起 | $2.50 起 | 未实测 | Free 档 $0.00025 × 10,000,部分另收启动费 |
| Python 自己写 | 软件 $0,另付代理和维护时间 | 同左 | 未实测 | 见上文「第二条路」 |
| EveryInfra,只取评论 | $0.028 | 做不到 | 实测每次 37–90 秒,50 次顺序跑约 55 分钟 | 50 次 × $0.000556 |
| EveryInfra,评论加回复展开 | 约 $0.11 | 做不到 | 实测 3 条视频 271 秒,按此推 50 条约 75 分钟 | 实跑每千条 $0.0114 × 10 |
这张表的读法是先看第三列。一条视频要 1 万条,我们这一行是「做不到」,不是贵,是接口不给翻页,200 条是硬上限;这种需求选 Apify 或 Store 里的第三方,钱在 $2.50 到 $12.50 之间,或者走 TikTok 研究接口的申请流程(每天 10 万条,但只给非商业研究者,研究接口常见问题)。如果是 50 条视频各取热门评论,三条路的差距就是两个数量级:同样 1 万条,我们是 2.8 美分,Apify Clockworks 的 Business 档是 5 美元、Free 档 12.5 美元,Store 里最便宜的第三方 2.5 美元。
时间上,我们这一行是实测推出来的:评论请求 5 次成功(00:32:41 那次 36.71 秒、CSV 实跑 3 次 51.20、89.42、64.01 秒、01:06 重抓 89.56 秒)的平均耗时是 66.2 秒,50 条视频顺序跑大约 55 分钟。加了 "mode":"async" 可以一次提交、稍后取结果,在每分钟 10 次的限速下 5 分钟内能把 50 个任务都交上去,但这种并行方式我们这次没有跑,所以表里不写。Apify 和插件的耗时我们都没测,这一栏空着比编一个数更有用。钱以外还有一个隐性成本:Apify 的 Free 档用量超了 $5 就得等下个月或升级,我们的接口按次从余额里扣,失败不扣;两边的计费方式不同,写预算时要分开算。
每千条价格的图:为什么差两个数量级
上一节的差距,换成「每千条评论多少钱」看得更清楚。下图用对数坐标,把我们的三种实测单价和 Apify 那边的价格排在一起,从下到上每格差 10 倍。
我们三种单价的来源都是同一个数:每次调用 $0.000556。差别只在一次调用装了多少行。tiktok/comments 一次装满 200 行,每千条 $0.0028;tiktok/comment_replies 一页最多 20 行,每千条 $0.0278,贵 10 倍;CSV 实跑把两者混在一起,再扣掉重复行,是 $0.0114。
| 一次调用装了多少行 | 实测出处 | 每千条 |
|---|---|---|
200 行(tiktok/comments,limit: 200) | 00:32:41 视频 A | $0.0028 |
197 行(tiktok/comments) | 00:35:13 视频 B | $0.0028 |
20 行(tiktok/comment_replies 满页) | 00:33:41 第 1 页 | $0.0278 |
4 行(tiktok/comment_replies 最后一页) | 00:33:47 第 2 页 | $0.139 |
| 685 行 / 14 次(CSV 实跑合计) | 00:33:55–00:38:26 | $0.0114 |
所以用我们的接口时,省钱的关键是让每次调用装满:评论请求永远传 limit: 200,回复只展开真正需要的线程,回复数不到 3 条的线程不要翻,因为前两条已经随评论附带回来了。
Apify 那边的价格是按条计费的,一次运行装多少条不影响单价,影响单价的是你的套餐档位,从 Free 档每千条 $1.25 到 DIAMOND 档 $0.15,差 8 倍多。Store 里第三方的 Free 档价格中位数是 $0.45,最低 $0.25。我们最贵的回复页单价 $0.0278,也比 Store 里最便宜的 $0.25 低一个数量级。
接进 AI 工具:远程 MCP 配置示例
很多人抓评论的下一步是把它丢给大模型做情绪分类、归纳槽点。如果你本来就在 Claude、Cursor 这类支持 MCP(Model Context Protocol,一个让 AI 客户端调用外部工具的开放协议,规范)的客户端里工作,可以不写脚本,让模型直接调评论接口。EveryInfra 的远程 MCP 地址是 https://api.everyinfra.com/mcp,取数据用的工具叫 everyinfra_call_api,参数就是上面的 platform、action、params(MCP 接入说明)。下面是一份配置示例,Key 用环境变量传,不写死在文件里:
{
  "mcpServers": {
    "everyinfra": {
      "type": "http",
      "url": "https://api.everyinfra.com/mcp",
      "headers": { "Authorization": "Bearer ${EVERYINFRA_API_KEY}" }
    }
  }
}
这份是配置示例,写法按 Claude Code 的 MCP 文档(.mcp.json 支持 ${VAR} 环境变量展开,Claude Code MCP 文档)。本文的数字都来自直接调 HTTP 接口,没有经 MCP 跑一遍。用 MCP 时要注意两件事。一是返回体积:200 条评论原样返回有几万字符,会占掉模型不少上下文,我们在 Claude Code 子代理那篇 里量过,200 条评论的 MCP 返回有 54,819 个字符;做法是让一个子代理去取、只交回摘要,或者让模型只取 limit 50。二是确认弹窗:everyinfra_call_api 会扣费,客户端会要求你确认,批量跑之前在权限设置里只放行这一个工具。Apify 也有自己的 MCP 服务器(Apify MCP server),可以让模型搜索和运行 Store 里的 actor,按 actor 自己的价格扣费。
什么时候 Apify 或插件更合适
按我们今天的实测和对方的公开文档,下面几种情况用 Apify 或插件更合适,照实写出来。
第一,一条视频要全部评论。我们的 tiktok/comments 一次最多 200 条顶层评论,没有翻页;tiktok/comment_replies 能把某一条评论下的回复翻到底,但拿不到第 201 条顶层评论。一条几万评论的爆款视频,要做完整的评论区分析(比如抽奖要统计所有参与者),Clockworks 的 scraper 能用 commentsPerPost 一直翻,按档位收费的评论导出网站最高档单条视频给到 250,000 条,TikTok 研究接口能用 cursor 翻。这件事它们能做,我们做不到。
第二,偶尔导一两条视频、不想写任何代码。插件免费档 200 条、评论导出网站免费档 100 条,对「看一眼这条视频大家在说什么」已经够了,还不用注册接口。我们的接口要拿 Key、写一个请求或用试用台,第一次上手的步数多一两步。
第三,已经在 Apify 平台上搭了流程。Apify 的定时任务、Webhook、和 Make、Zapier、Google Drive 等的集成都现成(Store 页面列了这些集成),同一个账号里还有别的平台的 scraper;如果你每月的量不大、已经付了 Starter 月费、预付额度用不完,再换一家省下的钱可能不值得迁移的工夫。
第四,学术研究。如果你是获批的学术或非营利研究人员,TikTok 研究接口免费、每天 10 万条、数据来自平台本身,评论里的电话、邮箱会被打码,研究伦理审查也更好过(研究接口常见问题)。它的代价是审核约 4 周、只给研究用途,而且视频统计数据是存档值,可能比线上低。
反过来,几十上百条视频、每条看前几百条热评、要定时跑、要接进 AI 工具,按次计费的接口每千条便宜两到三个数量级,失败不扣费,这是我们这一侧的长处。两边各有边界,选之前先按上一节算一下自己的量。
合规与隐私:公开评论也是个人信息
评论是用户公开发的,但这不等于可以随便用。三件事要分开看:平台条款、个人信息、你拿数据去做什么。以下只写数据方法和边界,不是法律意见。
平台条款:TikTok 美国服务条款(2026 年 7 月 15 日更新)第 3.4 节写明,不得使用任何自动化系统或软件(包括「机器人」)从平台抓取、爬取、导出或以其他方式提取任何数据,除非得到 TikTok USDS 合资公司的书面批准(TikTok 美国服务条款)。研究接口另有一份条款,规定获批数据只能用于获批的研究项目(研究工具服务条款)。美国联邦第九巡回上诉法院在 hiQ 诉 LinkedIn 案里认为,抓取公开页面不太可能构成《计算机欺诈与滥用法》里的「未经授权访问」(第九巡回法院 2022 年判决),但违反服务条款的合同责任、以及上一节提到的「绕过技术措施」类诉讼,是另外的问题。
个人信息:评论带用户名、用户 ID、头像链接,在欧盟《通用数据保护条例》下都算个人数据,处理要有合法依据,并且只收必要的部分(GDPR 第 5、6 条)。TikTok 研究接口自己的做法可以参考:它返回的评论文本会把电话号码、邮箱打码,文档里给了改前改后的例子(Query Video Comments)。我们的脚本默认提供 --hash-authors,把用户名换成 SHA-256 前 10 位,同一个人在同一份表里仍然能对上,但表里不出现原名;做情绪分析、话题归纳,用不到作者是谁。
拿去做什么:看竞品口碑、做选题、写内部报告,和把评论原文连同作者转载到公开网站、拿去训练模型对外卖,风险完全不同。欧盟《数字服务法》第 40 条给研究人员开了一条申请平台数据的正式渠道(DSA 第 40 条),如果你的用途是公共利益研究,可以先走这条路。EveryInfra 只返回公开可见的评论,不提供私密账号、私信或登录后才能看的内容,这是我们这一侧的边界。
最近的变化(2026 年 9–11 月)
| 日期 | 变化 | 对抓评论的人意味着什么 |
|---|---|---|
| 2026-09-03 | TikTok 上线语音评论、评论投票、图片轮播评论,公告说每天超过 17 亿条评论(新闻室) | 文本为空的评论会变多,导出后要单独标记,别当成删掉的评论 |
| 2026-10-09 | 美国联邦法官驳回 Apple 在 YouTube 抓取案中的撤案动议,同月稍早字节跳动在同类案中的撤案请求也被驳回(MediaPost) | 「绕过反抓取措施」正在成为诉讼理由,自己写脚本破解签名的风险变高 |
| 2026-10-26 | yt-dlp 发布 2026.10.26 版,TikTok 提取器仍只取评论数,不抓评论正文(发布页) | 别指望 --write-comments 能导 TikTok 评论 |
| 2026-11-04 | 上文那款 Chrome 评论导出插件更新到 2.3.1,免费档仍是 200 条(Chrome 应用店商店页,2026-11-07 读取) | 插件在跟着 TikTok 网页改版持续修,免费额度没变 |
| 2026-11-06 | Apify 的 TikTok Comments Scraper 最后一次修改,价格仍是 2026-03-18 起的六档(公开接口) | 本文用的对方价格是 11 月 7 日的现价 |
上手:从试用台到每天自动导出
第一步,在 数据市场 里找到 TikTok 评论,用试用台填一条视频链接跑一次,看返回的字段是不是你要的;试用台的请求和直接调接口一样按次计费,失败不扣费。第二步,在控制台拿一个 API Key,照 快速上手 用 curl 发一次上面的请求。第三步,把本文的脚本存成 tiktok_comments_to_csv.py,把视频链接一行一个写进 urls.txt,跑一次,打开 CSV 核对行数。第四步,想每天自动跑,就把脚本交给 cron、GitHub Actions 或你自己的定时任务,每次只传当天新发的视频;一天 50 条视频、每条再展开 3 个回复线程,按本文 CSV 实跑折算:3 条视频 685 行,每条约 228 行,50 条约 11,400 行,乘每千条 $0.0114,每天约 $0.13,一个月(30 天)约 $3.9。价格以 定价页 和目录里的 price_usd 为准。
如果你还要别的平台的评论,同一个 Key、同一个端点,换 platform 就行,比如 YouTube 评论 和 Instagram 评论;平台总览见 TikTok 接口 和 YouTube 接口。想看 TikTok 各类数据和 Apify 的逐项价格对比,读 Apify TikTok Scraper 替代;想了解 Apify 的计费方式本身,读 Apify 价格怎么算;想看所有平台的替代方案,读 Apify 替代方案。
常见问题
下面的问题来自搜索联想词和论坛原帖,每问写了出处。
Can you scrape TikTok comments?可以抓 TikTok 评论吗?
技术上可以,三条路都能拿到公开评论;条款上,TikTok 美国服务条款禁止未经书面批准用自动化方式提取平台数据(服务条款第 3.4 节),获批的学术研究可以走官方研究接口。我们的接口只返回公开可见的评论。问题出处:Google 联想词「can you scrape tiktok comments」(2026-11-07 查询)。
有没有免费的 TikTok comments scraper?
有,但都有上限:评论导出网站免费档每条视频 100 条,Chrome 评论导出插件免费 200 条,Apify Free 套餐每月 $5 预付额度按 Clockworks 的 Free 档价格能换约 4,000 条评论,TikTok 研究接口免费但只给获批研究人员。开源库 TikTokApi 免费,但要自己处理拦截和 Cookie。问题出处:联想词「free tiktok comments scraper」「scrape tiktok comments free」,以及 r/DataHoarder 的帖子「Scraping TikTok comments without paying for those…」(Reddit)。
TikTok 评论怎么导出到 Excel?
用插件或评论导出网站可以直接导 Excel;用本文的脚本会得到一个带 BOM 的 UTF-8 CSV,Excel 双击打开时中文和表情不会乱码。如果你拿到的是不带 BOM 的 CSV,在 Excel 里用「数据 → 从文本/CSV」导入并选 UTF-8(Microsoft 支持文档)。问题出处:联想词「export tiktok comments to excel」;r/DataHoarder 一位用户写论文时花钱买了导出服务,结果「一直出现随机字母」,就是编码问题(Reddit)。
有没有 TikTok comments API?
TikTok 面向开发者的 Display API 只有 /v2/user/info/、/v2/video/list/、/v2/video/query/ 三个接口,读的是授权用户自己的资料和视频,没有评论接口(Display API 概览);官方的评论接口只在研究接口里,要申请审核(研究接口产品页)。第三方接口有,本文的 tiktok/comments 和 tiktok/comment_replies 就是一种。问题出处:联想词「tiktok comments api」「get tiktok comments api」;r/webscraping 的帖子「Does an API exist to scrape TikTok comment text on videos」(Reddit)。
Apify 抓 TikTok 评论为什么要我填 Cookie?
Stack Overflow 上有人问,用 Apify 抓 TikTok 评论时设置里要求提供登录 Cookie(Stack Overflow 标签页)。这通常出现在 Store 里某些第三方 scraper 上,不同作者做法不同;Clockworks 的 Store 页输入示例里只有链接和条数。给第三方工具交自己的 TikTok Cookie,等于把账号登录态交出去,能不交就不交。我们的接口不需要你提供任何 TikTok 账号或 Cookie。
一条视频能拿到全部评论吗?
用我们的接口不能:tiktok/comments 一次最多 200 条,没有翻页;回复可以用 tiktok/comment_replies 翻到底。要一条视频的全部评论,用 Apify 的 commentsPerPost、评论导出网站的付费档或研究接口的 cursor。问题出处:联想词「export all tiktok comments」「export tiktok comments free no limit」。
参考资料
- TikTok for Developers:Research API: Query Video Comments,接口说明,2026-11-07 读取
- TikTok Newsroom:Say more in the comments,2026-09-03
- GitHub:TikTok-Api issue #1303:贴纸评论只返回占位符,2026-05-25
- EveryInfra:Social API 能力目录(TikTok),2026-11-07 00:13 新加坡时间读取
- Apify Store:TikTok Comments Scraper(Clockworks),2026-11-07 读取
- Apify Docs:Run Actor synchronously and get dataset items,2026-11-07 读取
- Apify API:clockworks~tiktok-comments-scraper 公开元数据,2026-11-07 00:16 新加坡时间读取
- Apify:Pricing,2026-11-07 读取
- Apify Docs:Pricing and costs,2026-11-07 读取
- Apify API:Store 搜索「tiktok comments」,2026-11-07 00:23 新加坡时间读取
- PyPI:TikTokApi 7.3.3,2026-04-01 发布
- GitHub:davidteather/TikTok-Api,最后推送 2026-08-24,2026-11-07 读取
- Playwright:Installation(Python),2026-11-07 读取
- GitHub:TikTok-Api issue #1255:评论抓取不工作,2025-08-28
- GitHub:TikTok-Api issue #1311:返回 200 但正文为空,2026-07-18
- GitHub:yt-dlp TikTok 提取器源码,2026-11-07 读取
- GitHub:yt-dlp issue #5037:TikTok 评论提取,2022-10-31 关闭
- GitHub:yt-dlp 2026.10.26 发布页,2026-10-26
- GitHub:cubernetes/TikTokCommentScraper,最后推送 2023-08-05
- GitHub:xtekky/TikTok-Comment-Scraper,最后推送 2023-12-02
- GitHub:RomySaputraSihananda/tiktok-comment-scrapper,最后推送 2025-12-08
- Reddit r/webscraping:Does an API exist to scrape TikTok comment text on videos,2026-11-07 读取
- TikTok:Terms of Service(US)第 3.4 节,2026-07-15 更新
- MediaPost:Apple Must Face Suit Over YouTube Scraping,2026-10-09
- Communications of the ACM:Web Scraping as Illegal Circumvention?,2026 年 10 月
- Apify Docs:Actors in Store,2026-11-07 读取
- Requests:Advanced Usage,2026-11-07 读取
- Python 文档:codecs:utf-8-sig,2026-11-07 读取
- Microsoft Support:Opening CSV UTF-8 files correctly in Excel,2026-11-07 读取
- pandas:pandas.read_csv,2026-11-07 读取
- Python 文档:csv:CSV File Reading and Writing,2026-11-07 读取
- RFC Editor:RFC 4180:CSV 格式,2005-10
- Python 文档:hashlib,2026-11-07 读取
- uv 文档:Running scripts,2026-11-07 读取
- TikTok for Developers:Research API FAQ,2026-11-07 读取
- Model Context Protocol:Specification,2026-11-07 读取
- Claude Code Docs:Connect Claude Code to tools via MCP,2026-11-07 读取
- Apify Docs:Apify MCP server,2026-11-07 读取
- TikTok:Research API Terms of Service,2026-11-07 读取
- 美国第九巡回上诉法院:hiQ Labs v. LinkedIn 判决书(17-16783),2022-04-18
- EUR-Lex:Regulation (EU) 2016/679(GDPR),2016-04-27
- EUR-Lex:Regulation (EU) 2022/2065(DSA),2022-10-19
- Reddit r/DataHoarder:Scraping TikTok comments without paying,2026-11-07 读取
- Reddit r/DataHoarder:How do I extract comments from TikTok for my research,2026-11-07 读取
- TikTok for Developers:Display API Overview,2026-11-07 读取
- TikTok for Developers:Research API 产品页,2026-11-07 读取
- Stack Overflow:tiktok 标签下的活跃问题,2026-11-07 读取
引用编号 BL-104